
L’analyse de régression linéaire constitue l’un des piliers méthodologiques les plus universellement déployés au sein des sciences quantitatives contemporaines. Qu’il s’agisse de modéliser l’impact d’un traitement pharmacologique, d’analyser des trajectoires d’apprentissage en psychologie cognitive ou d’évaluer des fonctions de coût en économétrie, l’estimation des relations fonctionnelles entre variables requiert une rigueur qui dépasse largement le simple calcul mécanique d’une droite d’ajustement. Dans les cursus universitaires tout comme dans la pratique professionnelle de terrain, la calculatrice graphique Texas Instruments TI-84 Plus demeure un instrument privilégié pour l’exploration rapide, autonome et robuste de ces modèles bivariés et multivariés.
Cependant, une pratique empirique trop répandue consiste à s’en remettre exclusivement au coefficient de détermination et à la valeur de la pente pour conclure à la validité d’une régression. Cette approche purement réductionniste occulte une exigence épistémologique fondamentale : la confrontation du modèle théorique aux écarts individuels qu’il génère inévitablement face aux observations empiriques. La droite des moindres carrés ne représente en effet qu’une synthèse géométrique globale, incapable à elle seule de révéler des violations structurelles locales qui peuvent invalider totalement les inférences statistiques produites.
C’est précisément ici qu’intervient l’analyse des résidus, véritable examen anatomique de la pertinence d’un ajustement linéaire. En projetant graphiquement les déviations verticales entre valeurs observées et valeurs prédites, le chercheur ou l’analyste accède à une lecture diagnostique de premier ordre, permettant de vérifier la linéarité, la constance de la variance et l’absence de biais systématique. Ce guide exhaustif a pour vocation d’exposer de manière magistrale et opératoire l’intégralité du protocole permettant de concevoir, paramétrer, tracer et interpréter avec une précision clinique un graphique des résidus sur une calculatrice de la gamme TI-84.
1. Introduction aux graphiques des résidus et pertinence méthodologique
1.1 Définition et rôle fondamental du graphique des résidus
Sur le plan mathématique formel, un résidu se définit avec une simplicité déconcertante comme la différence arithmétique constatée entre la valeur empirique mesurée d’une variable réponse dépendante et la valeur théorique projetée par l’équation de régression pour une même valeur de la variable explicative. Cette soustraction élémentaire matérialise la portion de variance que le modèle déterministe s’avère incapable d’expliquer au moyen de la covariation linéaire entre les dimensions observées. Loin d’être un simple sous-produit arithmétique négligeable, ce terme d’écart incarne la composante stochastique résiduelle indispensable à la modélisation statistique.
Dans l’architecture de la validation statistique, le graphique des résidus remplit une fonction diagnostique indispensable pour évaluer la validité interne d’un modèle linéaire. Alors que la projection conjointe des points expérimentaux et de la droite de régression sur un repère classique tend visuellement à masquer les légères inflexions sous l’effet de l’échelle globale des grandeurs, l’isolement des résidus sur un axe d’ordonnée centré autour de la valeur zéro agit comme une véritable loupe méthodologique. Cette représentation amplifie les anomalies spatiales, mettant immédiatement en évidence d’éventuels déséquilibres de distribution que l’œil humain ne saurait déceler sur le diagramme de dispersion primitif.
Il existe une croyance particulièrement pernicieuse selon laquelle un coefficient de détermination élevé, s’approchant par exemple de 0,95 ou 0,99, garantirait infailliblement la stricte linéarité de la relation empirique sous-jacente. L’histoire de la statistique a maintes fois réfuté ce postulat trompeur, notamment à travers le célèbre quartet d’Anscombe, où des ensembles de données fondamentalement non linéaires, paraboliques ou pollués par des points d’influence majeurs produisent des coefficients de Pearson rigoureusement identiques. Seul l’examen graphique minutieux des résidus offre le garde-fou nécessaire pour ne pas confondre une convergence globale avec une adéquation fonctionnelle locale.
Ainsi, la pratique de l’analyse statistique s’affranchit du cadre purement descriptif et exploratoire pour s’élever au rang de processus confirmatoire rigoureux. En soumettant le modèle à l’épreuve de ses propres erreurs, le chercheur ne cherche plus simplement à optimiser des indicateurs synthétiques de performance, mais vérifie activement si les postulats mathématiques autorisant l’inférence, le test d’hypothèse et l’extrapolation sont scrupuleusement respectés par les données recueillies.
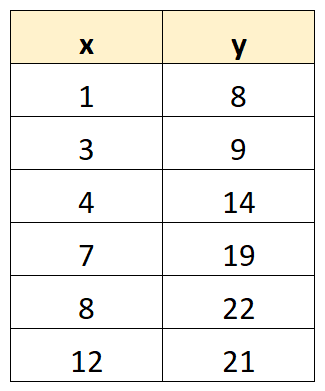
1.2 Importance de l’évaluation des résidus dans la recherche quantitative
Dans le domaine des sciences expérimentales, du génie biomédical et de la psychométrie, la construction et la validation d’instruments de mesure reposent sur la calibration précise de relations prédictives. Lorsqu’un chercheur tente de modéliser un comportement cognitif à l’aide d’un temps de latence ou de quantifier une concentration biochimique via un signal de fluorescence, l’omission du diagnostic résiduel expose le protocole à des risques considérables. Une régression mal spécifiée engendre une cascade de distorsions pouvant fausser l’évaluation de seuils critiques d’intervention ou masquer l’effet subtil mais déterminant d’un facteur secondaire.
Les conséquences d’une méconnaissance de ces diagnostics sont particulièrement sévères au regard des erreurs d’inférence de Type I (faux positifs) et de Type II (faux négatifs). Lorsque les hypothèses sous-jacentes à la régression des moindres carrés sont violées, les erreurs types affectant le calcul de la pente et de l’ordonnée à l’origine se trouvent erronées, le plus souvent sévèrement sous-estimées. Il en résulte des intervalles de confiance artificiellement resserrés et des valeurs de probabilité p-value artificiellement significatives, conduisant la communauté scientifique à accepter pour vraies des associations fallacieuses ou à rejeter prématurément des hypothèses de recherche fondées.
La reproductibilité expérimentale, qui constitue la pierre angulaire de la science moderne, impose une standardisation méthodique de ces protocoles d’investigation. L’enregistrement systématique des distributions d’erreurs et l’évaluation de leur structure garantissent que les modèles publiés ne reflètent pas des artéfacts d’échantillonnage ou des surajustements opportunistes. La vérification visuelle des résidus constitue donc un critère de transparence déontologique dans toute publication scientifique reposant sur l’analyse de données d’observation.
Sous l’angle didactique, la calculatrice graphique TI-84 Plus occupe une place d’excellence dans les cursus d’initiation aux méthodes quantitatives et d’apprentissage universitaire de la statistique. En éliminant les barrières syntaxiques des environnements de programmation plus complexes tout en conservant une rigueur algorithmique absolue, elle permet à l’apprenant de manipuler directement les matrices de données, de visualiser immédiatement les conséquences d’un ajustement et de développer une intuition géométrique profonde des concepts abstraits que sont la résidualité, l’indépendance et la dispersion.
1.3 Objectifs pédagogiques et structure du protocole pas à pas
L’objectif fondamental de ce guide est de conférer à l’utilisateur une totale autonomie opérationnelle dans l’orchestration des menus statistiques et graphiques de la calculatrice Texas Instruments. Trop souvent, les utilisateurs se heurtent à des blocages techniques élémentaires, tels que des conflits de dimensions de listes, des superpositions indésirables de courbes analytiques ou des réglages défaillants de fenêtres de visualisation, qui entravent l’analyse réflexive. Ce manuel dissèque minutieusement chaque interaction matérielle, de la frappe des touches à la configuration des sous-menus spécialisés.
Un accent théorique et fonctionnel particulier est placé sur la genèse automatisée de la liste système réservée, intitulée RESID. Loin d’être un simple conteneur passif, cette entité dynamique est pilotée par le processeur arithmétique de la machine, qui recalcule et réactualise l’intégralité des écarts observés dès lors qu’un modèle de régression est instancié. Comprendre la relation intime entre l’exécution de la commande de modélisation et le rafraîchissement de cette mémoire tampon constitue la clé de voûte de la maîtrise de l’appareil.
Au-delà de la manipulation mécanique, l’apprenant sera guidé vers le développement d’un regard critique averti. Tracer un graphique des résidus ne représente que la moitié du cheminement ; l’étape décisive réside dans l’art sémiologique de décoder ce que le nuage de points révèle du monde empirique. Par une étude comparative de patrons typiques (idéaux, hétérogènes, curvilignes ou influencés par des données atypiques), ce document dote l’analyste des réflexes méthodologiques lui permettant de porter un diagnostic irréfutable sur la solidité de ses modèles.
2. Fondements théoriques des résidus dans l’analyse de régression linéaire
2.1 Formulation mathématique de l’erreur résiduelle
Dans le paradigme de l’ajustement linéaire univarié, un modèle statistique postule que la variable dépendante observée y pour un individu ou une unité expérimentale i peut s’exprimer sous la forme d’une fonction linéaire de la variable explicative x, augmentée d’un terme résiduel d’erreur. Dès lors, l’expression formelle du résidu d’échantillon, universellement désigné par la lettre e (ou epsilon indicé pour la population théorique), se formalise par la relation fondamentale suivante :
Pour chaque observation indicée i allant de 1 à n, l’équation s’établit ainsi : ei = yi – ŷi, où yi représente la mesure empirique réelle issue du protocole expérimental et ŷi symbolise l’estimation issue de l’évaluation numérique de la droite de régression ŷi = a · xi + b. Cette différence reflète sans ambiguïté l’amplitude géométrique de l’écart vertical séparant chaque point expérimental de la droite calculée.
La méthode universellement adoptée par la TI-84 pour déterminer les coefficients scalaires de la droite d’ajustement est celle des moindres carrés ordinaires (MCO), conceptualisée de façon conjointe par Carl Friedrich Gauss et Adrien-Marie Legendre. Cette procédure d’optimisation différentielle consiste à minimiser la somme quadratique des résidus individuels. L’une des conséquences algébriques inhérentes à la dérivation des équations normales du premier degré stipule que la somme brute des résidus est rigoureusement nulle : la somme arithmétique des ei pour i variant de 1 à n est égale à 0, impliquant corolairement que la moyenne arithmétique de ces mêmes résidus s’annule toujours sur l’échantillon d’estimation dès lors qu’une constante scalaire b est incluse dans l’ajustement.
Il est impératif d’opérer une distinction théorique nette entre le résidu d’échantillon ei, qui est une grandeur calculée observable et dépendante des données recueillies, et l’erreur stochastique de population εi, qui demeure une variable latente inobservable propre au processus sous-jacent de génération des données. De surcroît, l’amplitude absolue des résidus bruts dépend directement des unités de mesure attribuées à la variable réponse Y, ce qui influence leur dispersion apparente et exige de l’analyste une mise en perspective constante par rapport à la variance totale du phénomène étudié.
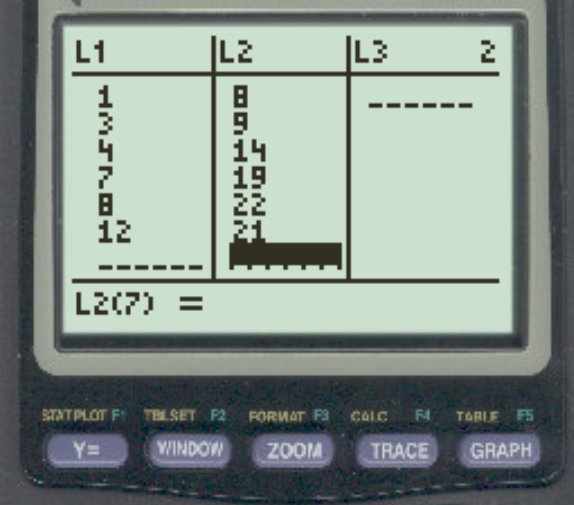
2.2 Le théorème de Gauss-Markov et l’optimalité des estimateurs
L’édifice mathématique de la régression linéaire repose sur le célébrissime théorème de Gauss-Markov. Ce dernier postule que, sous un ensemble précis de conditions restrictives appliquées aux termes d’erreur, les estimateurs des coefficients de régression obtenus via la méthode des moindres carrés constituent les meilleurs estimateurs linéaires sans biais existants, désignés en terminologie académique par l’acronyme anglais BLUE (Best Linear Unbiased Estimators). Cette propriété d’optimalité stipule qu’aucune autre combinaison linéaire sans biais des observations ne saurait produire une variance d’échantillonnage inférieure à celle calculée par les MCO.
Pour que cette optimalité soit garantie, quatre conditions fondamentales portant sur l’espérance conditionnelle et la matrice de variance-covariance des erreurs doivent être rigoureusement satisfaites :
- L’espérance mathématique conditionnelle des erreurs par rapport aux valeurs de la variable prédictive doit être strictement nulle : E(εi | X) = 0, ce qui formalise l’absence de biais systématique d’ajustement.
- La variance des perturbations stochastiques doit demeurer constante pour toutes les valeurs de la variable explicative, une propriété désignée sous le terme d’homoscédasticité : Var(εi | X) = σ².
- L’absence totale de covariance entre les termes d’erreur pris deux à deux pour des unités distinctes, garantissant l’absence d’autocorrélation : Cov(εi, εj) = 0 pour tout i différent de j.
- L’indépendance stricte entre la variable prédictive exogène X et les perturbations stochastiques résiduelles ε.
Lorsque l’une ou plusieurs de ces conditions structurales se trouvent compromises au sein de l’échantillon analysé, les propriétés de convergence et d’efficacité statistique des estimateurs s’effondrent. Bien que les coefficients calculés puissent demeurer asymptotiquement sans biais dans certains cas de figures spécifiques, la variance calculée pour ces coefficients devient biaisée, ce qui fausse intégralement le calcul du test t de Student et de la statistique F de Fisher. La vérification visuelle des résidus constitue précisément le premier filtre diagnostique permettant de garantir la non-violation de ces postulats théoriques.
2.3 Types de résidus : bruts, standardisés et studentisés
Dans l’environnement computationnel d’une calculatrice graphique telle que la TI-84 Plus, les résidus générés nativement et stockés dans la liste réservée RESID sont des résidus dits bruts. Ils s’expriment rigoureusement dans l’unité physique de la variable dépendante Y. Si cette caractéristique offre une lisibilité directe quant à l’amplitude tangible des déviations du modèle (en mètres, en secondes ou en unités de concentration sanguine), elle pose une limite méthodologique intrinsèque : la comparaison immédiate de la dispersion résiduelle entre plusieurs études ou variables d’échelles dissemblables s’avère impossible.
Pour surmonter cette contrainte d’échelle et faciliter la détection systématique des observations atypiques, la théorie statistique préconise la standardisation des résidus. Les résidus standardisés s’obtiennent en divisant chaque résidu brut ei par l’écart-type résiduel de l’échantillon, noté se, calculé à partir des degrés de liberté de l’ajustement linéaire. Cette mise à l’échelle adimensionnelle confère aux résidus une distribution de moyenne nulle et d’écart-type unitaire, autorisant l’analyste à appliquer des règles heuristiques éprouvées : toute valeur résiduelle standardisée excédant le seuil absolu de 2 ou 3 dénote une observation inhabituelle requérant une investigation approfondie.
Une sophistication métrologique supplémentaire est apportée par les résidus studentisés, souvent désignés sous le terme de résidus standardisés de façon interne ou externe. Ce raffinement computationnel prend en compte le fait mathématique fondamental que la variance des résidus n’est pas strictement uniforme sur l’ensemble du domaine d’observation : elle est intrinsèquement plus faible pour les points situés aux extrémités de la distribution de X en raison de l’effet d’attraction de la droite des moindres carrés. En pondérant chaque résidu par un terme correctif dépendant du bras de levier matriciel individuel (l’élément diagonal hii de la matrice de projection), la studentisation confère aux résidus une variance rigoureusement unitaire, offrant le baromètre le plus fiable pour isoler les points d’influence majeurs.
3. Hypothèses statistiques fondamentales vérifiables via le graphique des résidus
3.1 L’hypothèse de linéarité de la relation sous-jacente
L’hypothèse primordiale conditionnant la pertinence de l’analyse repose sur la véracité de la linéarité fonctionnelle liant la variable explicative à la variable réponse. Cette hypothèse pose que le taux moyen de variation de Y consécutif à une incrémentation d’une unité de X est invariant sur l’ensemble du spectre d’observation. Dans les faits, de nombreux phénomènes naturels ou psychosociaux répondent à des lois de rendements décroissants, de saturation enzymatique ou de cinétiques exponentielles qui ne peuvent être capturées fidèlement par une droite continue.
Le graphique des résidus met en lumière cette distorsion fonctionnelle avec une acuité remarquable. Alors qu’une relation réellement linéaire produit un semis de points dépourvu de toute morphologie discernable le long de l’axe neutre, une relation curvilinéaire sous-jacente engendre une structuration géométrique explicite des résidus. On observe classiquement une courbure systématique en parabole (forme de U ou de U inversé), où les résidus sont majoritairement concentrés d’un côté de l’axe pour les valeurs médianes de X, et regroupés de l’autre côté pour les valeurs faibles et élevées.
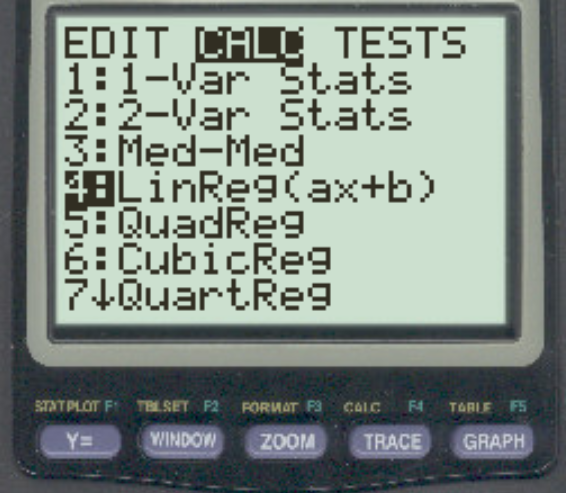
Le risque inhérent à l’ignorance d’une telle non-linéarité se traduit par des erreurs d’interpolation dramatiques et une incapacité structurelle à prédire les comportements marginaux. Le modèle sous-estime systématiquement la variable dépendante sur certains tronçons de l’échelle d’observation pour ensuite la surestimer lourdement sur d’autres intervalles. Dès lors que cette signature visuelle en arc se manifeste sur l’écran de la TI-84, le statisticien est immédiatement averti de la nécessité de réviser sa spécification analytique en envisageant des transformations algébriques ou des régressions polynomiales d’ordre supérieur.
3.2 L’homoscédasticité : constance de la variance des erreurs
L’homoscédasticité, issue des racines grecques homo (semblable) et skedasis (dispersion), formalise la condition selon laquelle le bruit stochastique entourant le modèle de régression présente une variabilité uniforme d’un bout à l’autre de la variable prédictive. L’hypothèse nulle d’homoscédasticité garantit que la précision prédictive du modèle demeure qualitativement identique, que l’on effectue une estimation au bas de l’échelle de mesure ou à son sommet.
Le phénomène antagoniste, universellement redouté des méthodologistes, porte le nom d’hétéroscédasticité. Sur le graphique des résidus de la TI-84, l’hétéroscédasticité se dévoile sous la forme hautement caractéristique d’un entonnoir, d’un porte-voix ou d’un mégaphone (cone shape). Le faisceau de points résiduels, initialement très dense et resserré autour de l’ordonnée zéro pour les faibles valeurs d’abscisse, s’évase progressivement vers une dispersion verticale considérable à mesure que l’on progresse vers les valeurs élevées de X, ou inversement selon la dynamique du système étudié.
Les conséquences théoriques de l’hétéroscédasticité ne se traduisent pas par un déplacement biaisé de la droite d’ajustement, mais par une instabilité critique de l’erreur type des estimateurs. Les calculs usuels de variances s’avèrent dès lors faussés, ce qui invalide directement l’intégralité des tests d’hypothèse t et des intervalles de confiance calculés par la TI-84. Le chercheur risque ainsi de conclure triomphalement à la significativité statistique d’une variable qui ne résisterait pas à une correction de White ou à l’application d’une procédure d’estimation par les moindres carrés pondérés.
3.3 Normalité et indépendance des observations
Pour que les tests de significativité associés aux coefficients de la droite conservent leur validité exacte pour des échantillons de taille modeste (typiquement n inférieur à 30 ou 50 observations), la théorie statistique requiert que les perturbations résiduelles suivent asymptotiquement une loi normale de moyenne nulle et d’écart-type constant. L’examen du graphique de dispersion des résidus permet d’effectuer un contrôle visuel direct de cette tendance de distribution centrale.
Une configuration de points reflétant la normalité empirique manifeste une plus forte densité d’occurrences aux abords immédiats de la droite horizontale d’ordonnée zéro, accompagnée d’un effilement progressif et symétrique de la fréquence des points à mesure que l’on s’éloigne vers les ordonnées positives et négatives. À l’inverse, une asymétrie résiduelle prononcée ou la présence d’un agrégat compact de résidus décalé d’un côté de l’axe trahit une non-normalité flagrante de la distribution sous-jacente, souvent imputable à des effets de plancher, de plafond ou à des biais de sélection de l’échantillon expérimental.
Enfin, l’hypothèse d’indépendance mutuelle des observations requiert qu’aucune corrélation ne lie les perturbations résiduelles successives. Bien que la TI-84 ne dispose pas nativement d’un test automatisé de Durbin-Watson dans son menu standard, l’affichage des résidus ordonnés selon la séquence chronologique de collecte permet d’identifier l’autocorrélation temporelle ou sérielle. Si les points résiduels successifs oscillent de manière continue au-dessus puis en dessous de l’axe zéro en dessinant des vagues sinusoidales régulières, l’indépendance stochastique est irrémédiablement rompue, signalant une inertie temporelle ou l’omission d’une variable explicative périodique.
4. Présentation de la calculatrice TI-84 et préparation de l’environnement de travail
4.1 Spécificités des modèles de la gamme TI-84 Plus
La famille des calculatrices Texas Instruments TI-84 Plus s’est enrichie de multiples déclinaisons technologiques au fil des décennies, chacune présentant des spécificités matérielles et logicielles qu’il convient de distinguer pour optimiser le travail graphique. Le modèle de base TI-84 Plus, doté d’un écran à cristaux liquides monochrome monochrome de 96 par 64 pixels, offre les fonctionnalités statistiques complètes tout en imposant une granularité visuelle relativement basse lors de la projection des nuages de résidus complexes.
La variante TI-84 Plus Silver Edition a introduit une mémoire d’archive flash substantiellement accrue et une cadence de calcul supérieure, mais c’est véritablement l’émergence des modèles TI-84 Plus CE (Colour Edition) et TI-84 Plus CE-T qui a révolutionné l’ergonomie visuelle du diagnostic résiduel. Avec un écran couleur haute résolution rétroéclairé de 320 par 240 pixels, ces versions permettent de distinguer nettement les listes par des codes couleur contrastés, de tracer la droite neutre en une teinte distincte de celle des points résiduels, et d’afficher des libellés statistiques avec une typographie nettement plus lisible.
Quelle que soit la génération matérielle utilisée, il est fortement recommandé de s’assurer de l’actualisation du système d’exploitation interne (l’OS de la machine). Les versions d’OS récentes (version 2.55 MP sur les modèles monochromes et versions 5.x sur les modèles CE) intègrent le moteur de rendu mathématique MathPrint. Cette mise à jour garantit la stabilité des listes matricielles résiduelles, évite les gels intempestifs de la mémoire RAM lors de régressions répétées et standardise l’interface des menus de calcul sous forme de formulaires clairs avec arguments guidés.
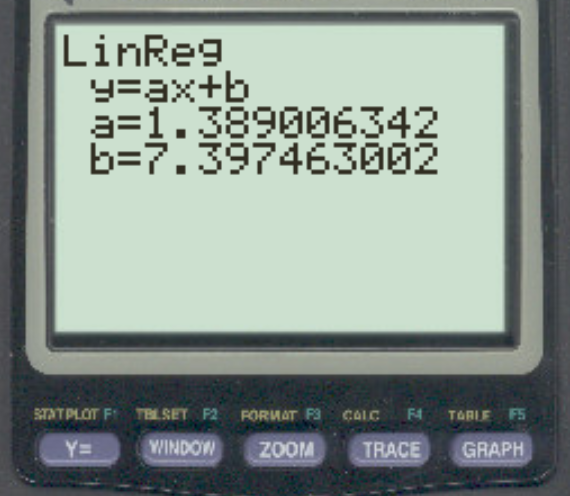
4.2 Réinitialisation et configuration optimale des paramètres d’affichage
Avant d’engager la moindre procédure de calcul statistique, il est méthodologiquement impératif de purger l’environnement logiciel de la machine afin de prévenir les interférences d’affichage. La présence d’anciennes fonctions mathématiques mémorisées dans le gestionnaire d’équations constitue la cause la plus récurrente de graphiques illisibles ou tronqués. Pour y remédier, il convient de presser la touche [Y=] située à l’extrême supérieur gauche du clavier de commande, d’examiner attentivement les lignes de Y1 jusqu’à Y0, et d’effacer chaque expression parasite à l’aide de la touche [CLEAR].
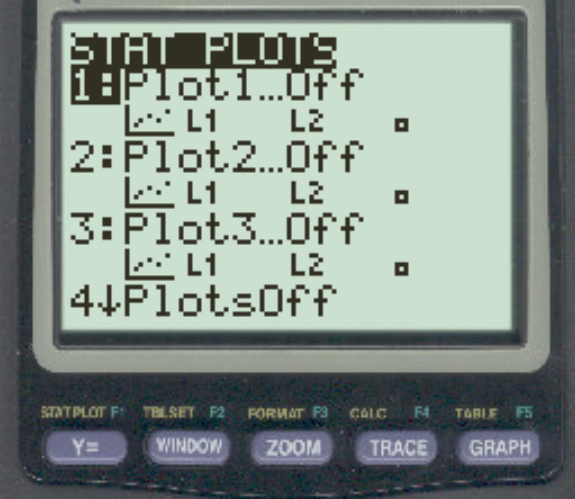
L’étape subséquente consiste à s’assurer de la neutralisation des diagrammes statistiques antérieurs. Au sein de ce même écran d’équations [Y=], le sommet de la fenêtre présente les mentions Plot1, Plot2 et Plot3. Si l’un de ces intitulés apparaît surligné en fond noir inversé, cela signifie qu’un tracé statistique résiduel ou un histogramme d’une session de travail antérieure est actif, risquant de provoquer un conflit dimensionnel lors de la tentative de traçage. Pour désactiver un Plot, il suffit d’utiliser les flèches directionnelles pour placer le curseur clignotant directement sur son nom et de presser la touche [ENTER] pour le faire basculer vers son état inactif non surligné.
Il est par ailleurs fondamental d’inspecter les paramètres globaux de la calculatrice en pressant la touche [MODE]. Bien que la plupart des options n’altèrent pas l’analyse statistique directe, il est conseillé de vérifier que les notations numériques sont positionnées sur Normal (et non Sci ou Eng) et que l’affichage des fractions est paramétré de manière conventionnelle. Enfin, l’extinction des fonctions de traçage superflues, telles que les coordonnées polaires ou les représentations paramétriques, préserve la fluidité du processeur lors du rendu visuel de nuages comportant des dizaines de coordonnées empiriques.
4.3 Gestion de la mémoire et organisation des listes statistiques
La TI-84 Plus architecture le stockage de ses données tabulaires au sein de conteneurs discrets dénommés listes, étiquetées par défaut de L1 jusqu’à L6. Lors de l’amorce d’un nouveau protocole expérimental, ces conteneurs abritent fréquemment les scories numériques de séances précédentes. Conserver ces résidus de calcul altérerait inévitablement les nouvelles séries, soit par écrasement partiel, soit par allongement involontaire du nombre d’enregistrements pris en compte dans le modèle.
Pour assainir la mémoire statistique, la méthode la plus directe consiste à solliciter le menu d’administration de la mémoire en pressant la combinaison de touches [2nd] puis [+ ] (accès à la fonction supérieure MEM). Au sein du menu déroulant qui s’affiche, l’utilisateur sélectionne l’option 2:Mem Management/Delete, puis l’élément 4:List…. À partir de cette nomenclature détaillée, il devient possible de purger les données obsolètes tout en visualisant l’occupation de la mémoire RAM en octets. Une alternative plus rapide pour un effacement standard consiste à employer la commande ClrList directement depuis l’écran principal de calcul, suivie des noms des listes cibles.
Un avertissement capital s’impose quant au statut de la liste système réservée dénommée RESID. Cette liste ne doit sous aucun prétexte être effacée manuellement ou supprimée de la structure d’indexation du système d’exploitation par le menu MEM. Même si sa présence est temporairement masquée ou si son contenu est obsolète, elle constitue le réceptacle prédéfini par le microprocesseur de Texas Instruments pour y déverser le flux continu des déviations verticales dès l’instant où un algorithme de régression linéaire est sollicité. Préserver l’intégrité de cette mémoire tampon est le prérequis absolu à la réussite du protocole graphique détaillé ci-après.
5. Étape 1 : Saisie rigoureuse des données empiriques dans l’éditeur statistique
5.1 Accès à l’éditeur de listes (STAT Edit)
Le traitement empirique débute invariablement par l’encodage méthodique des séries d’observations quantitatives au sein du tableur matriciel de la calculatrice. Pour pénétrer dans cet environnement de travail, il convient d’appuyer sur la touche physique [STAT], idéalement positionnée au centre du bloc de navigation principal. Cette action déclenche l’apparition immédiate d’un menu horizontal scindé en trois volets conceptuels : EDIT, CALC et TESTS.
Le curseur étant positionné par défaut sur le premier onglet EDIT, il suffit de valider l’option sélectionnée 1:Edit… soit en pressant directement la touche numérique [1], soit en appuyant sur la touche de confirmation [ENTER]. L’écran de la calculatrice se métamorphose alors pour afficher un tableau à colonnes multiples, couronné par les en-têtes formels L1, L2, L3, représentant les différentes listes de travail disponibles dans la mémoire dynamique.
Si des données antérieures encombrent l’une des colonnes de l’éditeur, la procédure d’effacement doit être scrupuleusement observée pour éviter une désorganisation du tableau. L’utilisateur doit utiliser la flèche multidirectionnelle vers le haut pour faire remonter le curseur au sein même de l’en-tête de la colonne (par exemple sur l’intitulé textuel L1, qui apparaît alors surligné). Il convient ensuite de presser impérativement la touche [CLEAR], puis de valider par [ENTER]. La colonne se vide instantanément. Attention : presser la touche [DEL] alors que l’en-tête est sélectionné ne vide pas la colonne, mais supprime purement et simplement la liste L1 de l’affichage, contraignant l’utilisateur à réinitialiser son éditeur via la commande SetUpEditor.
5.2 Insertion des variables indépendantes (X) et dépendantes (Y)
L’attribution rigoureuse des colonnes constitue une convention méthodologique fondamentale garantissant l’exactitude des calculs automatisés ultérieurs. Par consensus opératoire, la liste L1 est réservée à la variable explicative indépendante, usuellement symbolisée par l’axe des abscisses X, tandis que la liste L2 est affectée à la variable réponse dépendante, projetée sur l’axe des ordonnées Y. Le non-respect de cette polarité inverserait le sens de l’ajustement mathématique et produirait une droite sans pertinence causale.
L’encodage des valeurs de la variable explicative s’effectue dans la colonne L1. À l’aide du pavé numérique, l’opérateur saisit la première valeur numérique, puis valide son enregistrement en pressant la touche [ENTER]. Le curseur descend alors automatiquement sur la cellule indicée L1(2), prêt à recevoir l’observation suivante. Il convient d’accorder une vigilance absolue à la saisie des décimales en employant la touche point [.] et non la virgule typographique de séparation des arguments, ainsi qu’au codage des grandeurs négatives qui requiert l’usage du symbole négatif unaire [(-)] situé au bas du pavé numérique, et non de l’opérateur arithmétique de soustraction [-].
Une fois l’intégralité du vecteur X encodée dans la liste L1, l’utilisateur oriente le curseur vers la colonne adjacente L2 au moyen de la flèche directionnelle droite. Le même protocole d’insertion pas à pas est appliqué pour les mesures correspondantes de la variable dépendante Y. Il est absolument crucial de vérifier l’appariement terme à terme : la valeur saisie sur la ligne indicée k de la liste L2 doit correspondre rigoureusement à l’observation expérimentale conjointe associée à la ligne k de la liste L1. Toute permutation involontaire ruinerait la cohérence stochastique du modèle de régression.
5.3 Validation pré-analytique de l’échantillon saisi
Avant d’engager le moteur de calcul mathématique de la TI-84, une phase de contrôle qualité des données encodées est indispensable. La première vérification porte sur l’égalité dimensionnelle stricte des deux listes matricielles. L’utilisateur doit s’assurer que le bas des colonnes L1 et L2 coïncide parfaitement : la cellule active vide de la liste L1 doit porter le même numéro d’indice que celle de la liste L2, attestant que chaque observation X possède son corollaire exact en Y.
La seconde précaution relève de la relecture croisée de la série d’observations. Une erreur typographique courante consiste à omettre une décimale ou à insérer involontairement un zéro surnuméraire, transformant instantanément une mesure anodine en un point aberrant artificiel qui gauchirait l’intégralité du calcul de la pente des moindres carrés. Un balayage vertical des colonnes au moyen des flèches haut et bas permet de valider la plausibilité des ordres de grandeur au regard du protocole de mesure appliqué.
Une fois la conformité du tableau empirique définitivement établie, il convient de s’extraire de l’éditeur statistique dans des conditions de sécurité assurées. L’opérateur ne doit pas appuyer sur la touche [CLEAR], qui risque d’effacer la cellule en cours de survol, mais doit impérativement composer la séquence d’échappement universelle [2nd] puis [MODE] (accès à la commande supérieure QUIT). Cette manipulation valide la clôture du tableur et réoriente l’affichage vers l’écran principal d’exécution des commandes.
6. Étape 2 : Exécution de la régression linéaire et génération automatique de la variable RESID
6.1 Sélection et paramétrage du modèle LinReg(ax+b)
L’estimation des paramètres de la droite de régression requiert la mobilisation du module d’algèbre statistique de la calculatrice. À partir de l’écran d’accueil neutre, l’utilisateur actionne à nouveau la touche [STAT], puis déplace le focus vers la droite à l’aide de la flèche de navigation pour atteindre le sous-menu supérieur CALC. Cette section compile l’ensemble des algorithmes d’ajustement mathématique, allant des modèles linéaires aux régressions logistiques et sinusoïdales complexes.
Au sein de cette nomenclature analytique, il convient de sélectionner scrupuleusement l’option 4:LinReg(ax+b) en pressant le chiffre [4] sur le clavier numérique. Remarque méthodologique : l’option 8:LinReg(a+bx) calcule rigoureusement le même ajustement mathématique mais permute les notations algébriques de la pente et de l’ordonnée à l’origine selon les standards de la statistique anglo-saxonne ; le modèle 4:LinReg(ax+b) demeure la convention académique francophone privilégiée.
L’interface de saisie des paramètres dépend de la version logicielle de votre calculatrice TI-84 :
- Sur les systèmes récents dotés de l’assistant MathPrint : Un formulaire interactif apparaît à l’écran. Il convient de renseigner le champ Xlist en tapant [2nd] puis [1] pour afficher le symbole de la liste L1, puis de renseigner le champ Ylist en tapant [2nd] puis [2] pour L2. Le champ FreqList doit être impérativement laissé vierge en l’absence de pondération par les fréquences.
- Sur les versions logicielles classiques monochromes : La commande apparaît directement sur l’écran d’accueil sous la syntaxe textuelle
LinReg(ax+b). L’opérateur doit alors spécifier manuellement les arguments successifs séparés par des virgules de séparation typographique (touche [,] située au-dessus de la touche 7) selon la nomenclature :LinReg(ax+b) L1, L2.
Une étape d’une importance stratégique capitale consiste à ordonner à la calculatrice de stocker l’équation de régression résultante au sein d’une mémoire de fonction graphique. Pour ce faire, dans le formulaire MathPrint, placez le curseur sur la ligne intitulée Store RegEQ:. Appuyez sur la touche [VARS], naviguez avec la flèche droite vers le sous-menu supérieur Y-VARS, sélectionnez l’option 1:Function…, puis validez le choix 1:Y1 en pressant la touche [ENTER]. L’étiquette textuelle Y1 s’inscrit alors dans le formulaire. Cette étape garantit que le modèle déterministe complet sera disponible pour les projections graphiques et les calculs analytiques croisés.
6.2 Calcul de la droite d’ajustement et des indicateurs de corrélation
Pour finaliser l’estimation du modèle, il suffit d’abaisser le curseur clignotant sur l’option Calculate au bas du formulaire et d’appuyer avec fermeté sur la touche [ENTER] (ou simplement de valider la ligne de commande sur les anciens modèles). Le microprocesseur de la calculatrice traite alors instantanément les listes de données par l’algorithme des moindres carrés et renvoie un écran récapitulatif structuré détaillant les résultats paramétriques majeurs.
L’affichage présente en premier lieu l’équation générale sous la forme y=ax+b, suivie de la valeur numérique de la pente a (coefficient directeur indiquant le taux de variation marginale de Y par unité de X) et de la valeur de la constante b (ordonnée à l’origine représentant la prédiction mathématique lorsque X s’annule formellement). L’analyste est immédiatement en mesure de consigner l’expression formelle de sa fonction prédictive empirique.
Si la configuration de la machine a été préalablement optimisée, l’écran affiche également deux indicateurs stochastiques d’une importance cruciale : le coefficient de détermination r² (ou R-carré) et le coefficient de corrélation linéaire de Pearson r. Important : si ces deux paramètres statistiques fondamentaux n’apparaissent pas à l’écran, cela dénote la désactivation du moteur d’évaluation diagnostique de la TI-84. Pour y remédier définitivement, composez la séquence [2nd] puis [0] pour accéder au CATALOG général, faites défiler l’alphabet vers le bas jusqu’à localiser l’instruction textuelle DiagnosticOn, validez deux fois consécutivement par [ENTER] jusqu’à obtenir la mention Done, puis réexécutez l’estimation LinReg(ax+b).
Bien que la consultation de ces métriques soit indispensable, l’obtention d’un coefficient de corrélation r proche de +1 ou -1 ne doit jamais inciter le praticien à interrompre son analyse. C’est précisément à ce stade du protocole que l’investigation méthodologique bascule vers le diagnostic critique de la validité de l’ajustement.
6.3 Mécanisme de génération de la liste système RESID
Le déclenchement du calcul de la régression linéaire via l’instruction LinReg(ax+b) produit un événement logiciel interne fondamental : la création et l’actualisation dynamique immédiate d’une liste système réservée baptisée de manière univoque RESID. Le microprocesseur ne se contente pas d’extraire les paramètres scalaires a et b ; il applique instantanément la soustraction d’ajustement pour chaque observation individuelle enregistrée dans les listes actives.
Le mécanisme interne exécuté par l’unité arithmétique de la calculatrice opère selon une séquence matricielle rigoureusement définie :
- Extraction séquentielle de chaque valeur xi de la liste source L1 ;
- Évaluation de la prédiction théorique associée via l’équation du modèle : ŷi = a · xi + b ;
- Calcul arithmétique de l’écart vertical individuel : ei = yi – ŷi, où yi est la valeur correspondante de la liste L2 ;
- Stockage ordonné du résultat ei dans le vecteur mémoire système RESID au même indice positionnel i.
Il est fondamental de concevoir la liste RESID comme une variable volatile et dynamique. À chaque nouvelle instanciation d’un modèle d’ajustement (qu’il s’agisse d’une régression quadratique, logarithmique ou d’une autre régression linéaire exécutée sur des jeux de données dissemblables), le contenu de la liste RESID est purement et simplement écrasé par les nouveaux résidus générés. Cette caractéristique implique qu’un graphique de résidus tracé ultérieurement reflétera toujours rigoureusement le tout dernier calcul d’ajustement exécuté sur la machine.
L’utilisateur désireux d’examiner la valeur brute de ces écarts peut inspecter visuellement la liste RESID en réouvrant l’éditeur statistique ([STAT] puis 1:Edit). En faisant défiler les colonnes vers la droite au-delà de la liste L6, ou en configurant l’en-tête d’une colonne libre pour y appeler le nom RESID (via le catalogue des listes), il est possible de parcourir pas à pas la distribution quantitative des écarts numériques d’échantillonnage.
7. Étape 3 : Configuration pas à pas du graphique statistique (Stat Plot) pour les résidus
7.1 Accès au gestionnaire de graphiques (STAT PLOT)
L’exploitation visuelle des résidus requiert la mobilisation du sous-système de traçage de diagrammes statistiques spécialisés de la TI-84, totalement distinct du moteur conventionnel de tracé des fonctions analytiques. Pour y accéder, l’opérateur doit composer la séquence de touches [2nd] puis [Y=] (accès à la commande sérigraphiée supérieure STAT PLOT). Cette commande ouvre une interface dédiée à la gestion des trois tracés statistiques indépendants supportés par la calculatrice, identifiés sous les étiquettes Plot1, Plot2 et Plot3.
À partir de cette fenêtre d’administration, il est méthodologiquement recommandé d’activer exclusivement le premier tracé tout en neutralisant les deux autres, de manière à prévenir tout enchevêtrement illisible de données statistiques. Si l’un des blocs Plot2 ou Plot3 affiche la mention On, il convient de descendre sur la ligne correspondante, d’appuyer sur [ENTER], de sélectionner l’état Off et de valider. Une fois cette précaution prise, l’utilisateur revient sur la première ligne et appuie sur [ENTER] pour configurer le tracé 1:Plot1….
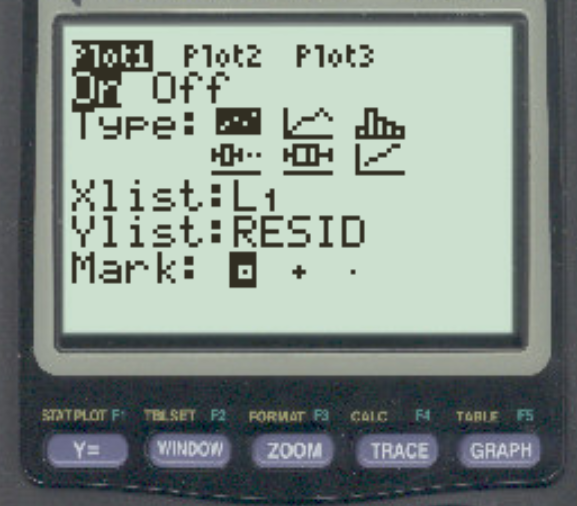
Au sein de l’écran de configuration du Plot1, la toute première option horizontale régit l’état d’activation du graphique statistique. Le curseur clignotant est initialement positionné sur l’une des deux bascules textuelles On ou Off. Si le statut n’est pas déjà actif, déplacez le curseur sur le terme On et pressez la touche de confirmation [ENTER]. L’intitulé On apparaît dorénavant surligné en fond noir opaque, certifiant que les instructions graphiques configurées ci-dessous seront pleinement exécutées lors de la sollicitation de l’affichage.
7.2 Sélection du type de représentation graphique
La seconde ligne du menu de configuration, précédée du libellé Type:, propose un ruban horizontal affichant six icônes stylisées figurant les formats de modélisation graphique statistique nativement supportés par le micrologiciel de Texas Instruments. Ces icônes symbolisent successivement : le diagramme de dispersion (scatter plot), la ligne brisée reliant les points chronologiques (connected scatter plot), l’histogramme de distribution en barres, la boîte à moustaches modifiée identifiant les données aberrantes, la boîte à moustaches classique continue, et enfin la droite d’estimation de probabilité normale.
L’évaluation rigoureuse d’un graphique des résidus impose impérativement le recours au premier pictogramme : le diagramme de dispersion (nuage de points décorrélés sans segmentation de liaison). L’utilisateur doit s’assurer que le curseur clignote sur la toute première icône figurant un semis de points isolés à l’extrême gauche du ruban, puis presser la touche [ENTER] pour sceller ce choix méthodologique. Toute sélection d’un tracé relié induirait des artefacts visuels trompeurs en reliant artificiellement des résidus adjacents sans justification chronologique.
La ligne suivante, intitulée Mark:, autorise le paramétrage typographique du symbole géométrique utilisé par la calculatrice pour matérialiser chaque observation à l’écran. Trois options sont offertes : le carré évidé de taille moyenne, la croix fine stylisée en forme de plus, et le point minuscule d’un seul pixel. Recommandation technique : optez pour le carré évidé ou la croix. Le point miniature, bien que plus précis mathématiquement, s’avère particulièrement difficile à repérer sur les écrans à cristaux liquides non rétroéclairés des modèles monochromes TI-84 Plus. Sur les déclinaisons TI-84 Plus CE, une ligne additionnelle intitulée Color: permet de sélectionner la nuance chromatique du tracé au moyen des flèches gauche et droite (le bleu marine ou le magenta offrant un excellent contraste).
7.3 Attribution rigoureuse des listes d’axes (Xlist et Ylist)
Cette étape constitue le cœur opératoire du paramétrage méthodologique : c’est ici que s’opère la substitution entre les données empiriques initiales de la variable dépendante et les erreurs de modélisation générées par l’algorithme des moindres carrés. Descendez à l’aide de la flèche de navigation verticale sur la ligne identifiée par le label Xlist:.
Sur l’axe horizontal des abscisses, il convient de maintenir la projection des valeurs de la variable explicative indépendante d’origine. Si le champ n’affiche pas spontanément la référence L1, composez la séquence [2nd] puis [1] pour insérer la désignation de la première liste statistique. Cette attribution permettra d’analyser le comportement de la dispersion résiduelle en fonction de la progression des grandeurs de mesure du facteur prédictif empirique.
Descendez ensuite d’un cran pour positionner le curseur actif sur la ligne critique Ylist:. Par défaut, ce champ affiche fréquemment la liste L2, qui correspondrait au tracé du simple nuage de points originel. Il est impératif de remplacer cette variable par la liste système contenant les résidus de modélisation. Pour affecter le vecteur d’erreurs, suivez scrupuleusement la séquence de navigation suivante :
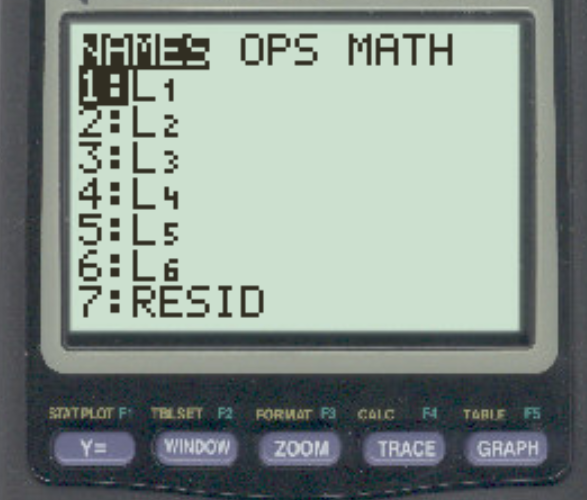
- Appuyez sur la touche [2nd] puis sur la touche [STAT] (accès à la commande supérieure sérigraphiée LIST) ;
- L’écran bascule vers le gestionnaire global des listes de variables, positionné par défaut sur l’onglet horizontal NAMES ;
- Faites défiler le curseur vers le bas à l’aide de la flèche directionnelle jusqu’à localiser l’entrée nominative identifiée sous l’acronyme explicite RESID (généralement située au-delà de la ligne 6 ou 7 selon la configuration mémoire de l’appareil) ;
- Appuyez sur la touche de confirmation [ENTER].
Le champ Ylist: affiche dorénavant fièrement la chaîne de caractères textuelle RESID. Le tracé Plot1 est désormais paramétré pour croiser sur un repère orthogonal les valeurs de la variable explicative en abscisse et les amplitudes de déviations verticales du modèle en ordonnée. Le piège méthodologique absolu consisterait à saisir manuellement les lettres R, E, S, I, D à l’aide des touches alphabétiques de la calculatrice : la TI-84 interpréterait cette frappe comme un produit implicite de variables scalaires non initialisées et générerait une erreur syntaxique bloquante.
8. Étape 4 : Ajustement de l’affichage avec ZoomStat et optimisation visuelle
8.1 Utilisation de la fonction automatisée ZoomStat
Une erreur fréquente commise par les utilisateurs novices consiste à presser immédiatement la touche de rendu [GRAPH] après avoir paramétré le Plot1. Cette précipitation se solde presque invariablement par un affichage déconcertant : soit l’écran demeure désespérément vierge, soit les points apparaissent agglutinés ou rejetés hors du champ de vision visible. Ce dysfonctionnement résulte du fait que les bornes géométriques de la fenêtre graphique active correspondent usuellement aux dimensions conventionnelles du repère trigonométrique standardisé (allant de -10 à +10 sur les deux axes), ce qui ne correspond aucunement à l’échelle spécifique de dispersion de vos résidus.
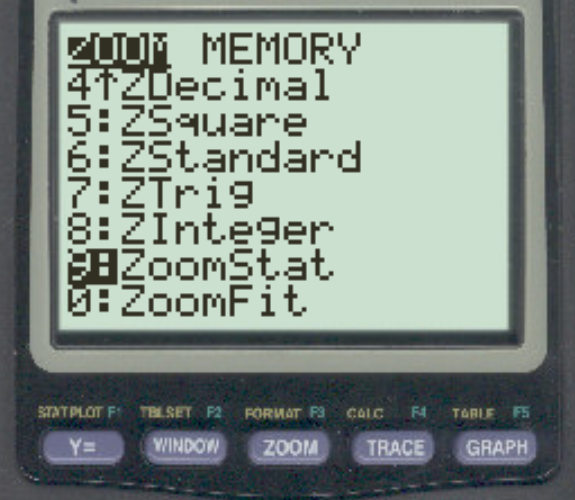
Pour contourner cette limitation sans contraindre l’opérateur à des calculs d’échelle fastidieux, le système de Texas Instruments intègre un algorithme d’optimisation dimensionnelle dédié spécifiquement aux données statistiques. Appuyez sur la touche [ZOOM] localisée sur la rangée supérieure centrale du clavier. Le menu déroulant des méthodes de recadrage géométrique s’affiche à l’écran.
Parcourez la liste vers le bas jusqu’à atteindre l’instruction numéro neuf, libellée 9:ZoomStat, ou appuyez directement sur la touche numérique [9]. L’instruction ZoomStat scanne instantanément les listes actives assignées dans le gestionnaire de tracés (ici Xlist: L1 et Ylist: RESID). L’algorithme calcule les extrema absolus (Xmin, Xmax, Ymin et Ymax) et recalibre de manière dynamique les limites physiques de l’affichage pour garantir que la totalité des points d’observation résiduels soit intégrée dans le cadre de visualisation sans la moindre troncature marginale. Le nuage des résidus se matérialise alors sous vos yeux avec une netteté géométrique parfaite.
8.2 Ajout manuel de la ligne de référence horizontale y = 0
Bien que le nuage de points soit parfaitement calibré à l’écran grâce à ZoomStat, l’évaluation clinique de la dispersion souffre d’un déficit d’ancrage fondamental : l’absence d’une ligne d’équilibre marquant visuellement l’écart nul. En effet, l’axe physique des abscisses tracé par la calculatrice est fréquemment repoussé en bas ou en haut de l’écran en fonction des limites asymétriques calculées par l’algorithme statistique, privant l’analyste du repère central indispensable pour scinder les écarts positifs des déviations négatives.
Pour superposer une droite de référence absolue au graphique de dispersion, il convient d’adjoindre une fonction mathématique nulle au moteur de tracé analytique de l’appareil. Procédez de la façon suivante :
- Appuyez sur la touche [Y=] pour accéder à l’éditeur des fonctions mathématiques ;
- Déplacez le curseur jusqu’à une ligne de fonction vierge, typiquement le champ Y2= (si l’équation de régression a été préalablement sauvegardée dans Y1) ;
- Saisissez simplement le chiffre arithmétique 0 sur le pavé numérique ;
- Astuce pour les possesseurs de TI-84 Plus CE : Déplacez le curseur vers l’extrême gauche de la ligne pour modifier le style de trait et la couleur. Attribuez par exemple la couleur rouge ou noire et optez pour un tracé en pointillé pour marquer clairement qu’il s’agit d’un axe de repère et non d’une courbe de tendance ;
- Appuyez sur la touche [GRAPH] située tout en haut à droite.
La calculatrice redessine alors le diagramme statistique tout en traçant une ligne droite horizontale rigoureuse traversant l’écran de part en part au niveau de l’ordonnée zéro. Cet artifice visuel d’une puissance redoutable matérialise la frontière théorique de l’ajustement parfait : tout point résiduel situé exactement sur cette ligne correspond à une observation empirique rigoureusement prédite par le modèle des moindres carrés. Tout point culminant au-dessus reflète une sous-estimation du modèle (le phénomène réel est supérieur à la prédiction), tandis que tout point stagnant en dessous signale une surestimation mathématique.
8.3 Personnalisation avancée de la fenêtre graphique (Menu WINDOW)
Bien que la commande ZoomStat constitue une aide automatisée précieuse, l’œil de l’expert exige fréquemment des ajustements métriques manuels pour éliminer les illusions d’optique provoquées par des étirements verticaux disproportionnés. Lorsque l’amplitude des résidus est infime par rapport à l’étendue de la variable explicative, ZoomStat a tendance à dilater l’axe Y de manière disproportionnée, donnant à des fluctuations mineures l’apparence faussement alarmante d’une instabilité critique.
Pour affiner le cadrage, pressez la touche [WINDOW]. Vous accédez ainsi à l’ensemble des paramètres scalaires délimitant le volume de projection cartographique :
- Xmin et Xmax : Définissent les bornes extrêmes gauche et droite du graphique. Il est méthodologiquement pertinent de fixer Xmin légèrement en deçà de la plus petite valeur observée de L1 et Xmax légèrement au-delà de la plus grande valeur empirique, afin d’éviter que des points marginaux ne s’écrasent contre le bord physique de l’écran.
- Xscl (X-scale) : Détermine l’espacement entre deux graduations successives sur l’axe horizontal. Ajustez cette valeur pour éviter un noircissement continu de l’axe par une accumulation excessive de traits de graduation.
- Ymin et Ymax : Déterminent l’amplitude verticale des résidus visualisés. Pour garantir une appréciation impartiale de l’homoscédasticité, la bonne pratique méthodologique consiste à symétriser manuellement ces deux bornes autour de l’axe neutre. Si l’écart maximal positif est de +4,2 et l’écart maximal négatif de -3,1, paramétrez manuellement Ymin sur -5 et Ymax sur +5. Cette symétrie spatiale élimine toute distorsion perceptive quant à la répartition de la variance.
- Yscl : Fixe le pas d’échelonnement vertical de l’axe résiduel (par exemple une graduation toutes les 1 ou 2 unités d’écart-type résiduel).
Une fois ces valeurs recalibrées avec discernement, appuyez à nouveau sur la touche [GRAPH] sans réitérer de commande Zoom (ce qui écraserait vos réglages manuels). L’espace graphique obtenu offre désormais des conditions métrologiques irréprochables pour l’examen sémiologique et diagnostique des résidus.
9. Guide d’interprétation clinique et méthodologique des graphiques de résidus
9.1 Le patron idéal : dispersion aléatoire et homoscédastique
L’objectif visé lors de la modélisation par régression linéaire est d’extraire la totalité du signal déterministe reliant les deux variables pour ne laisser subsister au titre des résidus qu’un pur bruit blanc stochastique, c’est-à-dire une entropie informationnelle totalement dénuée de structure intelligible. Sur l’écran de votre TI-84, la signature graphique d’un modèle linéaire parfaitement adapté et respectueux de l’ensemble des postulats des moindres carrés répond à une morphologie visuelle universellement documentée sous l’appellation de « patron aléatoire en bande horizontale ».
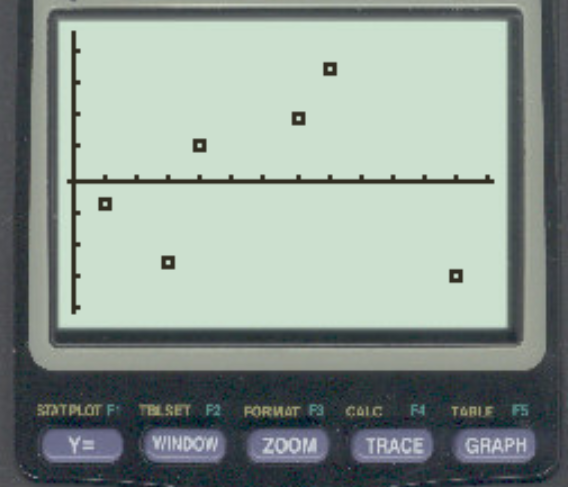
Ce patron idéal se caractérise par trois propriétés géométriques fondamentales observables simultanément :
- Une distribution spatiale uniforme : Les points résiduels forment une bande rectangulaire d’épaisseur visuellement constante s’étendant horizontalement d’un bout à l’autre de l’axe des abscisses, sans aucun resserrement ni évasement identifiable en fonction des valeurs de X.
- Une absence totale de structuration géométrique : Le semis de points semble avoir été projeté sur l’écran de manière totalement chaotique, ne laissant deviner aucune courbure, aucune inflexion parabolique, aucune ondulation périodique ni aucune ligne de fuite oblique.
- Un équilibre barycentrique autour de zéro : La densité des observations réparties au-dessus de la droite horizontale neutre équilibre symétriquement la densité des points positionnés en dessous, attestant que l’espérance mathématique des erreurs demeure nulle sur l’ensemble du domaine empirique analysé.
L’observation d’une telle configuration sur votre calculatrice atteste que le modèle de régression linéaire extrait toute la cohérence fonctionnelle présente au sein du jeu de données. Vous pouvez dès lors conclure en toute sérénité méthodologique que la droite calculée représente une approximation optimale du phénomène étudié, autorisant l’usage des coefficients pour l’explication scientifique, le calcul d’intervalles de prédiction fiables et la prise de décision empirique.
9.2 Utilisation de la fonction TRACE pour l’analyse individuelle des observations
L’interprétation d’un graphique de résidus ne se limite pas à un jugement synthétique global ; elle requiert fréquemment l’investigation détaillée des cas particuliers. La TI-84 dispose d’un outil d’auscultation point par point particulièrement performant : la fonction [TRACE], accessible par la touche dédiée située sur la rangée supérieure du clavier, juste à gauche de la touche Graph.
Dès l’activation de la commande TRACE, un curseur clignotant en croix vient se positionner directement sur l’un des points résiduels du diagramme statistique. Au bas de l’écran à cristaux liquides apparaissent simultanément les coordonnées numériques précises du point inspecté : la valeur X de la variable explicative pour l’individu sous observation, et la coordonnée Y, qui représente très exactement l’amplitude numérique du résidu brut ei généré par la formule d’estimation.
À l’aide des touches directionnelles gauche et droite, l’analyste fait transiter le curseur le long du vecteur des données selon l’ordre séquentiel d’enregistrement dans les listes matricielles L1 et L2. Ce balayage pas à pas permet d’identifier sans ambiguïté les observations responsables des perturbations marginales :
- Repérer l’identifiant individuel ou le numéro de ligne de l’observation présentant le résidu le plus élevé en valeur absolue (l’écart extrême maximal ou minimal) ;
- Noter la valeur précise de l’écart afin de la comparer au seuil empirique de deux ou trois fois l’erreur type résiduelle ;
- Vérifier sur la table de données originelle si cette déviation prononcée ne s’explique pas par un biais de mesure expérimental, une distraction lors de la transcription manuelle ou une particularité physiologique du sujet testé.
9.3 Distinction entre résidus bruts et ajustement aux valeurs prédites
Dans l’approche conventionnelle de la régression linéaire simple telle que développée jusqu’à présent, nous avons fait le choix méthodologique de projeter les résidus ei en ordonnée contre la variable indépendante originelle xi en abscisse. Cette configuration est hautement intuitive et parfaitement adaptée tant que le modèle ne comporte qu’un unique prédicteur continu. Cependant, l’épistémologie de l’analyse multivariée et de l’économétrie préconise une représentation alternative encore plus générale : le graphique des résidus croisés non pas contre X, mais contre les valeurs théoriques prédites ŷ (y-chapeau).
Dans le cadre d’un modèle bivarié simple (une seule variable X prédisant Y), le graphique des résidus en fonction de X et le graphique des résidus en fonction de ŷ sont rigoureusement homothétiques d’un point de vue topologique : les nuages de points présentent une morphologie absolument identique, seul l’échelonnement métrique de l’axe des abscisses subissant une transformation affine dépendant du signe et de la magnitude de la pente calculée a. Dès lors, projeter les résidus contre X fournit un diagnostic visuel équivalent tout en demeurant directement intelligible dans l’unité de mesure du facteur explicatif initial.
Toutefois, pour familiariser l’apprenant aux standards avancés des logiciels statistiques de type R, SAS ou SPSS, il est pédagogiquement enrichissant de savoir générer le graphique en fonction de ŷ sur la TI-84. La manipulation implique de peupler une liste tierce (par exemple la liste L3) avec les estimations du modèle. Pour ce faire, ouvrez l’éditeur de listes ([STAT], 1:Edit), placez le curseur d’en-tête sur l’intitulé L3, et formulez l’expression algébrique d’évaluation en tapant Y1(L1) (en faisant appel au nom de fonction Y1 via le menu VARS et en renseignant L1 comme argument matriciel). Validez par [ENTER] : la liste L3 se remplit instantanément de l’intégralité des prédictions théoriques ŷ. Il suffit ensuite de reconfigurer le Plot1 pour désigner Xlist: L3 et Ylist: RESID.
10. Détection et traitement des anomalies : Hétéroscédasticité, non-linéarité et valeurs aberrantes
10.1 Identification et conséquences visuelles de la non-linéarité
La première pathologie structurelle décelable sur un graphique des résidus est l’inadéquation de la forme fonctionnelle linéaire, qui survient lorsque le chercheur a postulé à tort une trajectoire rectiligne pour décrire un phénomène intrinsèquement curviligne. À l’écran, cette distorsion se manifeste par une rupture spectaculaire de l’hypothèse de stationnarité moyenne des erreurs. Au lieu de fluctuer de façon aléatoire autour de l’axe zéro, les points résiduels dessinent une courbe continue nettement individualisée.
L’archétype le plus récurrent est la configuration parabolique en arche ou en cuvette (forme de U régulier ou de U renversé). Dans cette situation, les résidus adoptent des valeurs fortement positives aux extrémités du domaine d’observation de X, plongent massivement sous la ligne zéro pour les valeurs centrales du facteur explicatif, puis remontent au-dessus de l’axe à l’autre extrémité. Une telle signature visuelle constitue la preuve indubitable que la dérivée seconde du phénomène empirique n’est pas nulle et que la relation sous-jacente relève d’un polynôme de second degré de type quadratique.
Face à une telle anomalie diagnostique, l’obstination à utiliser le modèle linéaire standard engendre des erreurs d’interprétation critiques. Les solutions correctives à implémenter sur la calculatrice consistent à renoncer à l’instruction LinReg pour explorer des modélisations polynomiales supérieures disponibles dans le menu STAT CALC, telles que 6:QuadReg (régression quadratique du second degré) ou 7:CubicReg. Alternativement, le chercheur peut opérer une transformation mathématique de la variable explicative directement dans le tableur de listes (en appliquant par exemple le logarithme népérien ln(L1) ou la racine carrée √(L1) dans une liste L3) avant de recalculer une régression linéaire sur ces données linéarisées.
10.2 Diagnostic visuel de l’hétéroscédasticité
La seconde aberration majeure révélée par l’analyse résiduelle concerne la violation de l’hypothèse d’homogénéité de la variance stochastique, désignée sous le vocable d’hétéroscédasticité. Lorsque vous contemplez le graphique des résidus sur l’écran de la TI-84, cette rupture se manifeste par une modification flagrante de l’épaisseur verticale de la bande de dispersion à mesure que l’on balaie l’axe horizontal de gauche à droite.
Le profil le plus classique est le motif en pavillon de trompette ou en entonnoir évasé (cone shape). Pour les faibles scores de la variable explicative X, les points résiduels apparaissent extrêmement compacts, presque soudés à la ligne d’ordonnée zéro, témoignant d’une incertitude de mesure très faible. Puis, au fur et à mesure que les valeurs de X progressent vers des ordres de grandeur élevés, le semis de points éclate dans l’espace vertical, oscillant entre des sommets positifs considérables et des abîmes négatifs prononcés. Le comportement inverse (dispersion initiale large se resserrant vers un goulet étroit) constitue également une variante hétéroscédastique documentée.
Les répercussions méthodologiques d’un tel état sont pernicieuses : si les estimations ponctuelles de la pente conservent leur propriété d’absence de biais, leur incertitude d’échantillonnage n’est plus maîtrisée, gonflant le risque d’accepter une corrélation illusoire. Pour remédier à l’hétéroscédasticité directement depuis l’environnement TI-84, la démarche la plus couramment mobilisée consiste à appliquer une transformation stabilisatrice de variance sur la variable dépendante Y. L’application d’une fonction logarithmique (en calculant ln(L2) au sein de la colonne L3) ou la mise en œuvre de transformations de Box-Cox permet fréquemment de restaurer l’homoscédasticité et de reconduire un ajustement valide sur l’échelle transformée.
10.3 Repérage des points de levier et observations aberrantes (outliers)
La robustesse des ajustements par les moindres carrés ordinaires est notoire pour son extrême vulnérabilité à l’effet polluant des points marginaux atypiques. Un unique enregistrement expérimental erroné suffit à faire basculer la droite d’ajustement à la manière d’une balançoire à bascule, masquant des tendances profondes ou créant une corrélation artificielle ex nihilo. Le graphique des résidus constitue l’arme d’investigation la plus efficace pour isoler ces cas perturbateurs.
Il convient de distinguer conceptuellement deux natures d’anomalies périphériques qui se manifestent de manière dissemblable sur l’écran de visualisation :
- L’observation aberrante (outlier) sur la variable réponse : Il s’agit d’un point dont la valeur X se situe parfaitement au cœur de la distribution standard de l’échantillon, mais dont la valeur observée Y s’avère totalement incongrue au regard du reste de la population. Sur le graphique des résidus, ce point se matérialise sous la forme d’un satellite isolé culminant à des altitudes verticales disproportionnées au-dessus ou en dessous de la ligne neutre, loin de la bande de dispersion générale de ses pairs.
- Le point à fort bras de levier (high leverage point) : Il s’agit d’une observation dont la coordonnée X présente une valeur totalement excentrique ou extrême par rapport à la masse des autres données. Si ce point s’aligne fidèlement avec la trajectoire prédictive du modèle, il affichera paradoxalement un résidu proche de zéro, mais exercera une attraction disproportionnée sur l’orientation de la pente globale. Sur le graphique de la TI-84, ce point se repère par son isolement spatial prononcé à l’extrême droite ou à l’extrême gauche de l’axe des abscisses, séparé du nuage principal par un vide horizontal conséquent.
Lorsqu’une telle anomalie se trouve mise en lumière via l’outil [TRACE], un protocole décisionnel rigoureux s’impose. L’analyste ne doit jamais effacer opportunément une observation atypique dans le seul but d’améliorer son coefficient R². Il convient en premier lieu de contrôler l’absence d’erreur typographique matérielle dans le tableur L1/L2. Si la mesure est authentique, il est préconisé de mener une analyse de sensibilité scindée : calculer et reporter la régression en intégrant le point marginal, puis recalculer le modèle après exclusion motivée de ce dernier, en discutant ouvertement dans le rapport de recherche de l’impact structural exercé par cette observation singulière.
11. Résolution des erreurs courantes et dépannage technique sur la TI-84
11.1 L’erreur « ERR:DIM MISMATCH » : causes et correction
Parmi les incidents techniques susceptibles de paralyser un étudiant ou un chercheur lors de la manipulation d’une calculatrice Texas Instruments, le message d’erreur syntaxique système intitulé ERR:DIM MISMATCH (erreur de discordance dimensionnelle) figure au premier rang de la fréquence des signalements. Cet écran d’interruption abrupte survient presque instantanément lors de la pression sur la touche Graph ou lors du lancement de l’instruction LinReg.
La cause fondamentale de cette panne informatique réside dans l’incapacité mathématique du processeur à apparier deux vecteurs d’arguments ne comportant pas un nombre strictement identique d’éléments scalaires. Dans le contexte spécifique de la création d’un graphique des résidus, cette dissymétrie survient typiquement selon le mécanisme opératoire suivant :
- L’utilisateur a initialement encodé dix observations dans L1 et L2, puis exécuté LinReg, peuplant la liste RESID de dix grandeurs résiduelles ;
- Ultérieurement, l’opérateur retourne dans l’éditeur de listes ([STAT], 1:Edit) et adjoint deux nouvelles données expérimentales dans L1 et L2 (qui comptent dorénavant douze lignes), ou en supprime une ;
- L’utilisateur tente alors de visualiser directement le graphique des résidus via [GRAPH] sans avoir pris la précaution de relancer l’algorithme d’ajustement. Le gestionnaire de graphiques (Plot1) tente alors de croiser une liste horizontale L1 comportant douze valeurs avec une liste résiduelle verticale RESID qui n’en contient toujours que dix, provoquant le blocage immédiat du processeur.
La résolution de cette panne requiert l’application d’un protocole d’alignement méthodique en deux temps :
- Sélectionnez l’option 1:Quit sur l’écran d’erreur pour revenir à la ligne de commande ;
- Ouvrez l’éditeur de listes ([STAT], 1:Edit) et vérifiez rigoureusement que les colonnes L1 et L2 présentent une égale longueur de remplissage en éliminant toute cellule orpheline ;
- Étape obligatoire de recalcul : Exécutez impérativement à nouveau la commande de régression linéaire LinReg(ax+b) L1, L2 via le menu [STAT] [CALC]. Cette exécution réactualise instantanément la liste système RESID en lui injectant le nombre exact de résidus correspondant à la nouvelle dimension matricielle de l’échantillon. Le tracé graphique via [GRAPH] redevient alors immédiatement fonctionnel et exempt de toute erreur système.
11.2 L’erreur « ERR:INVALID DIM » et disparition de la liste RESID
Une autre anomalie logicielle déstabilisante se manifeste sous la dénomination textuelle ERR:INVALID DIM (dimension invalide). Contrairement à la discordance de longueurs examinée précédemment, ce blocage technique survient lorsque la calculatrice tente d’accéder à une liste matricielle référencée dans les paramètres graphiques mais que celle-ci s’avère totalement vide (contenant zéro élément, dimension nulle) ou que son pointeur d’indexation a été corrompu dans la mémoire vive suite à une mauvaise manipulation du menu d’effacement.
Cette situation se produit fréquemment lorsqu’un utilisateur a exécuté la commande de purge générale de mémoire ou a tenté de tracer le graphique Plot1 configuré avec Ylist: RESID avant d’avoir exécuté la moindre régression linéaire depuis la mise sous tension de l’appareil. La liste RESID n’ayant pas encore été instanciée par l’algorithme de moindres carrés, le système bute sur un conteneur inexistant et suspend le rendu graphique.
Pour rétablir l’environnement opérationnel dans son intégrité d’usine, mettez en œuvre la séquence de restauration suivante :
- Pressez 1:Quit pour vous dégager de l’écran d’interruption ;
- Assurez-vous de la présence effective de données non nulles dans vos listes de travail L1 et L2 ;
- Si les en-têtes standard de vos colonnes ont été supprimés par accident, réparez l’architecture de l’éditeur en appuyant sur [STAT], en sélectionnant l’option 5:SetUpEditor, puis en validant par [ENTER]. Cette commande réaffecte les listes par défaut L1 à L6 aux colonnes de l’éditeur ;
- Relancez l’exécution d’une régression linéaire via [STAT] [CALC] 4:LinReg(ax+b). Cette action force le système à réallouer l’espace mémoire requis pour la liste RESID et à la peupler des valeurs courantes, dissipant instantanément l’erreur de dimension invalide.
11.3 Superposition indésirable de courbes et conflits d’affichage
L’une des déconvenues visuelles les plus déroutantes lors de la restitution d’un graphique des résidus consiste à voir apparaître, en travers du nuage de points d’erreurs, une droite oblique épaisse traversant l’écran de manière totalement incongrue. Ce tracé parasite n’est autre que la droite de régression linéaire globale stockée lors de l’étape précédente dans le gestionnaire de fonctions Y1, qui se trouve superposée par inadvertance sur le repère des résidus.
Cette superposition constitue une aberration méthodologique et géométrique sévère : l’échelle verticale du graphique des résidus étant calibrée sur l’amplitude restreinte des erreurs ei (souvent de l’ordre de quelques dixièmes ou centièmes d’unités), tracer au travers de ce micromonde la fonction originelle calculée sur l’échelle globale de Y crée une pollution visuelle totale, masquant des points résiduels et écrasant la lisibilité de la variance.
Pour assainir immédiatement l’écran sans pour autant effacer la formule analytique mémorisée dans Y1 (dont vous pourriez avoir besoin ultérieurement pour des interpolations numériques), procédez à la neutralisation sélective du tracé analytique :
- Appuyez sur la touche [Y=] pour visualiser l’éditeur d’équations ;
- Positionnez le curseur clignotant directement sur le symbole de l’égalité arithmétique = situé immédiatement après l’intitulé Y1 ;
- Appuyez sur la touche de confirmation [ENTER]. L’ombrage noir entourant le symbole d’égalité disparaît pour laisser place à un signe égal simple non surligné. Cet état visuel indique que l’équation demeure en mémoire mais que son traçage graphique est temporairement désactivé ;
- Vérifiez parallèlement que la fonction Y2=0 (votre droite de repère horizontal) conserve en revanche son signe égal solidement surligné en fond noir ;
- Pressez la touche [GRAPH] : l’écran s’affiche désormais dans une limpidité parfaite, libéré de toute droite parasite et présentant exclusivement vos résidus structurés par rapport à la droite d’équilibre nulle.
12. Étude de cas appliquée et exercices méthodologiques pas à pas
12.1 Cas pratique 1 : Évaluation de l’anxiété cognitive face au score de performance
Afin de consolider les acquis méthodologiques par l’expérimentation concrète, nous proposons une étude de cas appliquée issue de la psychologie différentielle cognitive. Une équipe de chercheurs souhaite évaluer l’impact d’un niveau d’anxiété pré-compétitive (mesuré par une échelle psychométrique standardisée variant de 10 à 60 points) sur les scores d’attention soutenue obtenus lors d’une tâche d’inhibition psychomotrice complexe (notée de 0 à 100 points). Un échantillon pilote de dix participants (n = 10) a fourni les mesures expérimentales ordonnées suivantes :
Les données appariées se déclinent ainsi sous la syntaxe [Anxiété X ; Performance Y] : [12 ; 88], [16 ; 82], [20 ; 79], [25 ; 71], [30 ; 65], [36 ; 58], [42 ; 49], [48 ; 41], [54 ; 31], [60 ; 20]. L’expérimentateur encode scrupuleusement la série d’anxiété au sein de la liste L1 et les scores de performance attentionnelle dans la liste L2 de sa TI-84.
L’exécution de la commande de modélisation LinReg(ax+b) L1, L2 délivre les indicateurs numériques suivants : une pente négative a ≈ -1,406, une ordonnée à l’origine b ≈ 105,74, et un coefficient de détermination saisissant de R² ≈ 0,996 assorti d’un coefficient de corrélation r ≈ -0,998. Un analyste superficiel interromprait prématurément son examen à ce stade, proclamant la découverte d’une loi linéaire décroissante quasi-parfaite liant l’anxiété à la détérioration de la performance motrice.
Engageons à présent l’auscultation critique des résidus :
- Configuration de Plot1 : Type nuage de points, Xlist sur L1, Ylist sur RESID, marqueur carré ;
- Définition de Y2 = 0 dans l’écran [Y=] et désactivation du tracé de Y1 ;
- Exécution du recadrage dimensionnel par [ZOOM] [9:ZoomStat].
Le verdict visuel est saisissant : le graphique des résidus ne dévoile aucunement un nuage aléatoire homogène, mais exhibe une courbure concave spectaculaire en forme de cuvette régulière. Les résidus des scores extrêmes (aux alentours de X=12 et X=60) culminent positivement bien au-dessus de la ligne zéro, tandis que les résidus des scores médians (entre X=30 et X=42) s’enfoncent tous dans des valeurs négatives prononcées. Malgré un R² frôlant la perfection statistique, le phénomène empirique sous-jacent est curviligne, répondant possiblement à la loi bien connue de Yerkes-Dodson. L’ajustement linéaire classique doit être formellement récusé au profit d’un ajustement polynomial quadratique, démontrant magistralement l’indispensable utilité méthodologique du diagnostic résiduel.
12.2 Cas pratique 2 : Modélisation du temps de réaction selon l’âge des participants
Pour illustrer la détection d’une perturbation stochastique hétérogène, examinons une seconde recherche expérimentale consacrée à l’évolution de la vitesse de traitement de l’information selon l’âge chronologique des individus. Une batterie de tests de temps de réaction simple (mesuré en millisecondes, variable dépendante Y) est administrée à une cohorte de dix sujets stratifiés par tranches d’âge s’échelonnant de 20 à 65 ans (variable explicative X).
Les observations recueillies se résument comme suit : [20 ans ; 210 ms], [25 ans ; 215 ms], [30 ans ; 222 ms], [35 ans ; 235 ms], [40 ans ; 240 ms], [45 ans ; 270 ms], [50 ans ; 255 ms], [55 ans ; 310 ms], [60 ans ; 280 ms], [65 ans ; 360 ms]. Saisissez les âges chronologiques dans la liste L1 et les latences motrices correspondantes dans la colonne L2.
La commande LinReg renvoie une droite d’estimation formulée par y ≈ 2,98x + 133,9 avec un R² tout à fait honorable de 0,84, suggérant que l’âge explique environ 84% de la variance de l’allongement du temps de réaction. Le diagnostic résiduel est alors déployé selon le protocole rigoureusement identique via Plot1 et ZoomStat.
L’observation du graphique des résidus met en lumière un patron morphologique d’école : le profil d’hétéroscédasticité en porte-voix ou en entonnoir évasé. Entre 20 et 35 ans, l’amplitude des déviations résiduelles oscille de façon extrêmement resserrée dans un corridor ne dépassant pas ±5 millisecondes autour de la ligne horizontale neutre. En revanche, dès que l’âge franchit le cap des 50 ans, la variabilité interindividuelle explose, générant des résidus verticaux massifs s’écartant de plus de 40 millisecondes au-dessus et en dessous de la ligne théorique.
L’analyse clinique de cette dispersion révèle un principe fondamental de neurogérontologie : le vieillissement n’altère pas les facultés motrices de manière uniforme au sein de la population. Si le temps de réaction moyen s’allonge indiscutablement, la variabilité interindividuelle croît de façon exponentielle avec l’âge, certains aînés conservant des performances proches de celles des jeunes adultes tandis que d’autres décrochent lourdement. L’usage d’une simple régression linéaire ordinaire se heurte ici à une violation caractérisée de l’hypothèse d’homoscédasticité, imposant à l’expérimentateur de consigner explicitement cette hétérogénéité de variance et d’envisager une pondération de son modèle pour les estimations individuelles ultérieures.
12.3 Protocole de synthèse et bonnes pratiques pour la rédaction académique
L’aboutissement d’une recherche empirique quantitative culmine dans la restitution rigoureuse des résultats au sein d’une publication, d’un mémoire ou d’un rapport technique respectant les normes de la communauté scientifique internationale, à l’instar des directives édictées par l’American Psychological Association (APA). Les standards méthodologiques contemporains exigent formellement que l’analyse des postulats sous-jacents de la régression fasse l’objet d’un compte-rendu explicite préalablement à toute interprétation des seuils de significativité p.
Dans la section « Résultats » de votre manuscrit, l’évaluation des résidus doit faire l’objet d’un paragraphe dédié, articulé selon des formulations académiques standardisées, par exemple : « Préalablement à l’évaluation des coefficients d’ajustement, l’intégrité des postulats de la régression des moindres carrés a été examinée par inspection graphique de la distribution des résidus. La projection des résidus d’échantillon face aux valeurs de la variable explicative a mis en évidence une dispersion aléatoire homogène dénuée de tendance curvilinéaire apparente, confirmant la validité de l’hypothèse de linéarité tout comme celle de l’homoscédasticité des variances d’erreur. » Si des violations ont été diagnostiquées, elles doivent être documentées avec la même transparence, en justifiant le recours à des transformations stabilisatrices ou à des approches non paramétriques.
Pour conclure cette étude magistrale, nous condensons l’ensemble des manipulations matérielles requises sur la calculatrice graphique sous la forme d’une check-list opératoire chronologique synthétisée en cinq étapes fondamentales :
- Encodage et purge : Nettoyez l’éditeur [STAT] [1], insérez X dans L1 et Y dans L2 en vérifiant scrupuleusement l’égalité des dimensions et l’absence d’erreurs de saisie ;
- Régression et genèse : Exécutez [STAT] [CALC] [4] en assignant Xlist: L1, Ylist: L2 et Store RegEQ: Y1. Cette opération génère et actualise dynamiquement la liste système réservée RESID ;
- Paramétrage du Stat Plot : Accédez à [2nd] [Y=], activez le Plot1 (On), sélectionnez l’icône de diagramme de dispersion, configurez Xlist: L1 et remplacez impérativement Ylist par RESID (obtenu via la combinaison [2nd] [STAT]) ;
- Balancement visuel : Ouvrez [Y=], désactivez le surlignage de la fonction Y1 pour supprimer les droites parasites obliques, et programmez la droite de référence d’équilibre Y2 = 0 ;
- Affichage et analyse clinique : Déclenchez l’optimisation d’échelle via [ZOOM] [9:ZoomStat], inspectez les points atypiques avec l’outil [TRACE], et posez un diagnostic méthodologique éclairé sur la linéarité et l’homoscédasticité de vos données empiriques.
Par l’application rigoureuse de ce protocole, la calculatrice TI-84 Plus transcende son statut d’outil de calcul élémentaire pour devenir un instrument de diagnostic méthodologique puissant. Elle permet au chercheur, à l’ingénieur et à l’étudiant d’aborder l’analyse des données quantitatives avec une indépendance conceptuelle totale et un esprit critique aiguisé face aux simplifications réductrices des indicateurs purement synthétiques.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Belsley, D. A., Kuh, E., & Welsch, R. E. (2005). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Chatterjee, S., & Hadi, A. S. (2012). Regression analysis by example (5th ed.). John Wiley & Sons.
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman & Hall.
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
- Texas Instruments. (2020). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.