
Dans le champ contemporain de la visualisation de données et de l’analyse décisionnelle, la restitution intelligible d’ensembles d’informations multidimensionnels constitue un enjeu méthodologique de premier ordre. À mesure que les organisations et les chercheurs traitent des matrices empiriques de plus en plus complexes, les formes élémentaires de représentation graphique — telles que l’histogramme isolé ou la simple courbe univariée — révèlent rapidement leurs limites intrinsèques. L’incapacité d’un format visuel unique à encapsuler simultanément des variables de natures hétérogènes, mesurées selon des ordres de grandeur disparates ou régies par des dynamiques temporelles asynchrones, engendre une déperdition d’information préjudiciable à la prise de décision stratégique.
Le graphique combiné, communément désigné sous le vocable anglophone de combo chart, émerge comme une réponse rigoureuse à cette contrainte d’interopérabilité visuelle. En associant au sein d’un repère orthogonal partagé la morphologie discrète de l’histogramme en colonnes et la trajectoire continue du tracé linéaire, cet artefact sémiotique offre une capacité de synthèse exceptionnelle. Au sein de l’écosystème infonuagique de Google Sheets, la production de tels graphiques ne relève pas d’un simple exercice de mise en forme esthétique, mais d’une véritable démarche d’ingénierie visuelle, articulant rigueur mathématique, respect des lois de la psychophysique et structuration matricielle soignée.
Le présent traité propose une analyse exhaustive et pragmatique de la conception d’un graphique combiné dans Google Sheets. À travers un itinéraire séquentiel rigoureux en sept étapes opérationnelles, enrichi d’un solide ancrage épistémologique et de protocoles de résolution des anomalies métrologiques, ce guide offre aux analystes de données, chercheurs et praticiens les moyens d’optimiser l’efficience de leurs communications visuelles tout en garantissant une fidélité analytique absolue.
1. Fondements conceptuels et épistémologiques du graphique combiné
1.1 Définition et nature hybride du graphique combiné
Le graphique combiné se définit sur le plan structural comme une représentation visuelle composite intégrant au moins deux registres géométriques distincts pour coder des variables dépendantes associées à une variable indépendante commune. Dans sa configuration prototypique, il adjoint des barres verticales à une ou plusieurs lignes brisées ou courbes. D’un point de vue sémiotique, cette hybridation mobilise ce que Jacques Bertin a théorisé sous le concept de variables visuelles fondamentales : l’histogramme exploite la variation de longueur et de surface dans une disposition discrète, tandis que la ligne s’appuie sur la position relative de points nodaux connectés par des vecteurs de pente. Cette dualité permet une ségrégation perceptive immédiate des séries de données superposées.
Sur le plan théorique, la modélisation graphique conjointe de séries hétérogènes résout l’antinomie entre visualisations univariées — limitées à la description d’une seule distribution — et visualisations multivariées complexes qui exigent souvent une transposition dans des espaces multidimensionnels peu intuitifs pour le récepteur. La typologie bivariée du graphique combiné permet de juxtaposer des phénomènes de nature physique ou économique radicalement différente, tels qu’une grandeur volumétrique mesurée en devises et une variation indiciaire formulée en ratio. La pertinence fonctionnelle de ce dispositif repose ainsi sur la mise en dialogue immédiate des grandeurs de flux, naturellement traduites par l’ancrage massif des barres, et des dynamiques tendancielles, idéalement soutenues par la fluidité visuelle de la ligne.
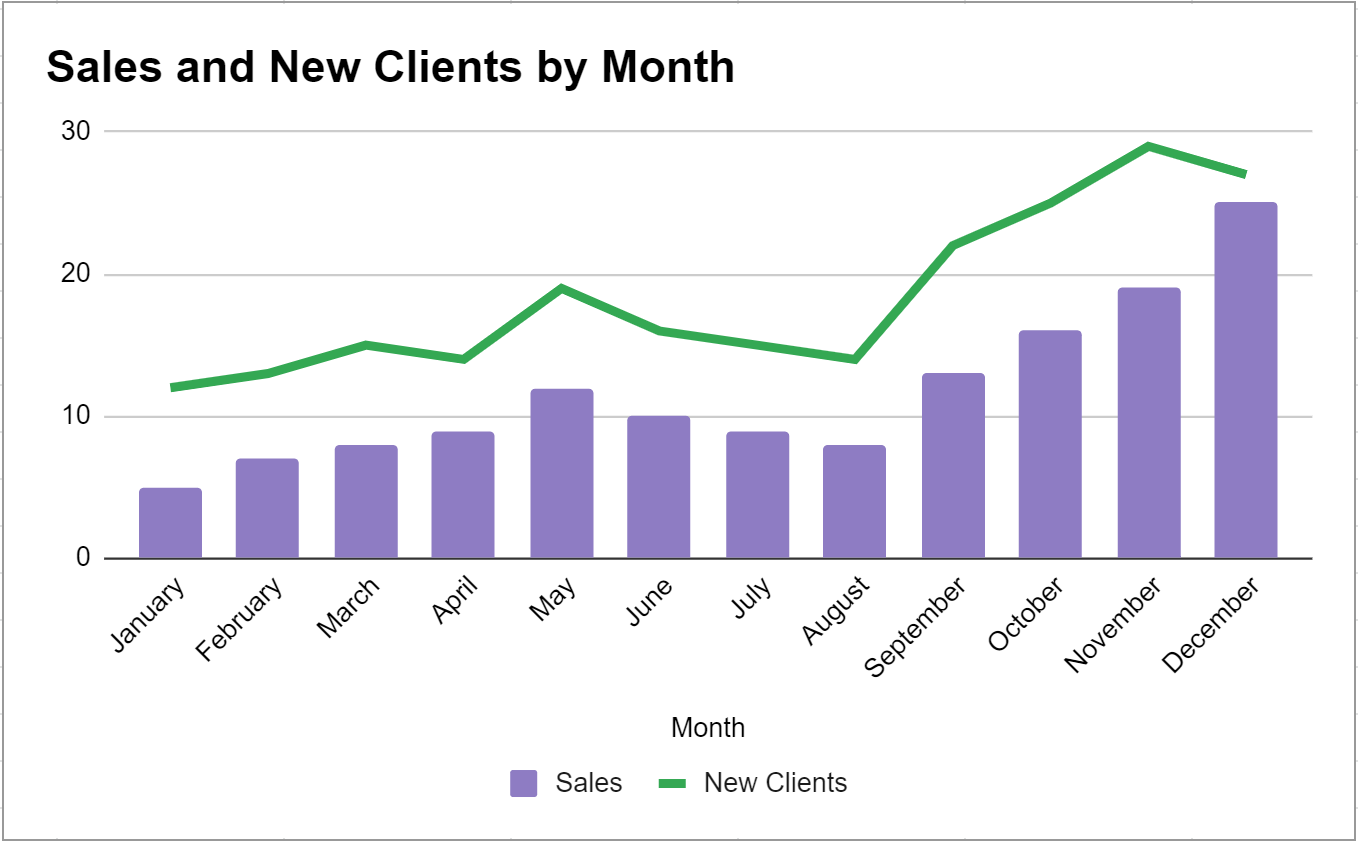
L’hybridation morphologique ne constitue pas une simple cohabitation esthétique ; elle établit un schéma relationnel dans lequel l’œil de l’observateur opère une décomposition hiérarchique instantanée. Les barres établissent le substrat quantitatif, définissant l’ampleur macroscopique de l’échantillon observé à chaque intervalle discrétisé, tandis que la trajectoire linéaire transcende la segmentation temporelle pour imprimer la direction, l’accélération ou l’inflexion du second indicateur. Il en résulte un gain substantiel d’efficience communicationnelle par rapport à la consultation disjointe de deux figures graphiques parallèles.
1.2 Cadre cognitif et psychophysique de la perception des données
La perception des représentations de données est soumise aux contraintes neurobiologiques du système visuel humain, formalisées notamment par la théorie de la charge cognitive développée par John Sweller. Lors de l’analyse d’un graphique combiné, le cortex visuel doit traiter simultanément des stimuli spatiaux, des contrastes chromatiques et des repères scalaires. Si l’agencement structural est défaillant, l’effort imposé à la mémoire de travail — qualifié de charge cognitive extrinsèque — compromet la compréhension des relations mathématiques sous-jacentes. La théorie postule qu’une surcharge survient lorsque l’observateur est contraint d’effectuer des allers-retours oculaires constants entre des éléments graphiques disjoints pour opérer une synthèse conceptuelle.
Dans ce contexte, les principes de la psychologie de la Gestalt fournissent une grille de lecture déterminante pour configurer adéquatement l’espace graphique dans Google Sheets. Le principe de ségrégation figure-fond régit la clarté avec laquelle les barres et la ligne se détachent du quadrillage sous-jacent et de l’arrière-plan du canevas. De surcroît, le principe de continuité favorise l’interprétation de la série linéaire en tant que trajectoire cohérente et ininterrompue, même lorsqu’elle croise ou chevauche l’arête sommitale d’une colonne. Le principe de similitude intervient quant à lui dans la discrimination des catégories, imposant une différenciation chromatique et texturale sans équivoque entre les primitives géométriques.
Enfin, la minimisation des biais heuristiques lors de la lecture d’axes simultanés constitue l’un des défis majeurs de la psychophysique appliquée aux graphiques combinés. Comme l’ont démontré William S. Cleveland et Robert McGill dans leurs travaux fondateurs sur la perception graphique, l’œil humain évalue avec une grande précision les positions relatives le long d’une échelle commune, mais commet des erreurs systématiques d’appréciation lorsqu’il s’agit de comparer des pentes ou des surfaces relatives sur des échelles dissociées. L’introduction d’un double axe vertical exige par conséquent une vigilance extrême afin d’éviter les illusions de corrélation induites par des superpositions graphiques artificielles résultant d’un paramétrage arbitraire des étendues scalaires.
1.3 Cas d’usage méthodologiques en analyse statistique
L’application du graphique combiné s’impose avec une acuité particulière dans la modélisation économétrique et l’analyse de gestion opérationnelle. L’une des confrontations les plus paradigmatiques réside dans l’examen conjoint de métriques de flux et de métriques de stock. Considérons par exemple le suivi financier d’une entreprise : les revenus mensuels bruts constituent une variable de flux, caractérisée par une accumulation périodique qui s’arrête et se réinitialise à chaque fin de cycle comptable, trouvant ainsi une résonance conceptuelle parfaite dans la verticalité close des barres. À l’opposé, le volume de trésorerie disponible ou le nombre cumulé d’abonnés actifs représente une variable d’état ou de stock, dont l’évolution continue dans la durée est rigoureusement traduite par un tracé linéaire reliant les points de contrôle.
Un deuxième cas d’usage fondamental concerne la juxtaposition de grandeurs macroscopiques absolues et de valeurs relatives ou proportionnelles. Les analystes confrontent fréquemment un volume total de transactions, exprimé en dizaines de milliers d’unités monétaires, à un taux de marge brute ou un taux de conversion formulé en pourcentage. La disparité des unités de mesure — la valeur absolue s’étendant sur une échelle cardinale large tandis que le taux évolue généralement dans un intervalle borné entre zéro et un — interdit l’emploi d’un axe vertical unique sans provoquer l’effondrement visuel de la série proportionnelle sur la ligne de base. Le graphique combiné, articulé autour d’un axe secondaire, permet de préserver l’amplitude sémiotique des deux indicateurs sans tronquer la variance de la variable relative.
Un troisième champ d’application méthodologique réside dans la détection empirique des corrélations au sein de séries chronologiques. L’analyste cherche souvent à déterminer si les fluctuations périodiques d’une variable déterminée, telle qu’une dépense d’investissement promotionnel, induisent des modifications consécutives ou immédiates sur un indicateur de rendement, comme le coût d’acquisition client. L’alignement temporel des colonnes d’investissement et de la courbe des coûts permet d’identifier visuellement des phénomènes de résonance, de retard de phase ou de découplage structurel, fournissant des hypothèses préliminaires solides avant le calcul formel des coefficients de corrélation croisée de Pearson ou de Spearman.
2. Architecture et préparation rigoureuse des jeux de données
2.1 Normalisation matricielle dans la feuille de calcul
L’efficacité du moteur graphique de Google Sheets est intimement subordonnée à la structure géométrique et logique du tableau matriciel sous-jacent. Une feuille de calcul destinée à alimenter un graphique combiné doit respecter les canons de la normalisation relationnelle, où chaque ligne correspond rigoureusement à une observation discrète et chaque colonne à un descripteur typé de variable. La première colonne de la matrice doit être impérativement allouée à la variable explicative ou indépendante, généralement une variable temporelle ordonnée de façon continue. Les colonnes subséquentes doivent héberger les séries de données quantitatives dépendantes qui feront l’objet de la double représentation.
Le typage des données représente une étape critique souvent négligée. Google Sheets met en œuvre des algorithmes d’inférence de type qui analysent la syntaxe des cellules ; si des séparateurs décimaux hétérogènes (virgules versus points selon les paramètres linguistiques régionaux) ou des formats temporels non standardisés sont injectés, le système peut requalifier une observation numérique en chaîne de caractères typographique. Une telle altération corrompt la linéarité de l’axe des ordonnées ou empêche le tracé des segments de ligne. Il est donc indispensable d’uniformiser l’ensemble des cellules numériques selon les conventions régionales de la feuille de calcul, accessible via le menu Fichier > Paramètres.
De surcroît, l’hygiène matricielle exige une élimination systématique des espaces parasites, des caractères non imprimables et des entêtes fusionnés. Les cellules fusionnées, fréquemment utilisées pour des considérations de mise en page manuelle, constituent l’une des causes majeures d’échec lors de l’attribution des séries dans l’éditeur de graphiques. Chaque cellule de l’entête doit demeurer atomique et isolée, garantissant que l’indexation de la plage matricielle (par exemple, A1:C13) ne subisse aucun décalage d’adresse relative lors de son interprétation par le processeur d’interface.
2.2 Gestion des discontinuités et des valeurs manquantes
La complétude de la série statistique conditionne la régularité topologique du graphique combiné. En situation d’échantillonnage réel, il n’est pas rare de constater des omissions de mesure ou des valeurs manquantes (valeurs null ou cellules vides). L’analyste doit trancher entre deux approches mathématiques distinctes : l’omission pure et simple de l’observation, qui génère une discontinuité ou un saut spatial dans la série linéaire, ou l’interpolation, qui consiste à déduire une valeur approximative à partir des nœuds adjacents. Si l’omission reflète fidèlement l’absence d’information empirique, elle fragilise le principe gestaltiste de bonne continuité et perturbe la lecture de la trajectoire tendancielle.
Google Sheets propose des mécanismes de gestion des cellules vides dans les paramètres avancés du graphique, permettant d’interpoler linéairement le tracé de la courbe ou, à l’inverse, de matérialiser une brèche dans le tracé. Toutefois, la standardisation préalable au sein du jeu de données offre un contrôle analytique nettement supérieur. Le remplacement d’une valeur manquante par un zéro doit être proscrit s’il ne correspond pas à un état réel du phénomène étudié, sous peine de fausser dramatiquement l’échelle de l’axe vertical et d’induire des chutes vertigineuses de la courbe qui ne traduisent aucune réalité économique ou physique.
Enfin, la cohérence dimensionnelle des plages d’échantillonnage s’impose comme une exigence absolue. Toutes les séries représentées doivent partager une couverture temporelle ou catégorielle rigoureusement congruente. Si la série dédiée aux colonnes couvre douze mois tandis que la série allouée à la ligne ne dispose que de huit mois d’historique, les cellules restantes doivent être traitées avec méthode pour éviter une asymétrie perceptive qui conduirait l’observateur à supposer erronément un arrêt prématuré de l’une des dynamiques.
2.3 Modélisation de l’échantillon empirique de référence
Pour soutenir la démonstration technique détaillée dans ce document, nous concevons un échantillon empirique normé, simulant l’activité commerciale d’une entreprise de services logiciels sur un cycle calendaire complet de douze mois consécutifs. Ce jeu de données synthétise parfaitement l’exigence d’hétérogénéité métrologique propre aux graphiques combinés, articulant une grandeur monétaire macroscopique et un volume unitaire de dénombrement démographique.
L’axe temporel est circonscrit aux douze mois de l’année civile, de janvier à décembre, positionnés séquentiellement. La variable quantitative primaire correspond au Volume des ventes, exprimé en euros courants (EUR). Cette grandeur financière constitue une métrique de flux, cumulée à l’échelle mensuelle, dont les variations saisonnières et la masse financière justifient amplement une visualisation sous forme de colonnes verticales ancrées sur l’axe zéro. L’échelle de cette variable s’étend typiquement de 15 000 à 45 000 euros.
La variable quantitative secondaire correspond au Nombre de nouveaux clients acquis au cours de la même fenêtre temporelle. Cette variable discrète, quantifiée en unités entières, évolue dans un ordre de grandeur radicalement différent, oscillant entre 20 et 90 acquisitions mensuelles. La conjonction de ces deux séries au sein d’un même espace de coordonnées constitue l’archétype du défi de visualisation que le graphique combiné avec double axe vertical permet de surmonter avec élégance et précision.
3. Étape 1 : Saisie méthodique des données sources
3.1 Agencement géométrique des colonnes dans Google Sheets
L’organisation spatiale des données dans la feuille de calcul conditionne la capacité du logiciel à déduire automatiquement la structure du graphique sans exiger une reconfiguration manuelle fastidieuse. Dans l’interface de Google Sheets, l’utilisateur doit disposer les séries selon un agencement vertical canonique. La colonne A doit être réservée exclusivement à l’axe des abscisses (la variable indépendante temporelle), tandis que les colonnes adjacentes B et C doivent accueillir respectivement la variable quantitative primaire et la variable quantitative secondaire.
Le respect absolu de la contrainte d’adjacence matricielle est capital. Aucune colonne vide ne doit être intercalée entre les données temporelles et les données numériques, car le moteur d’interprétation contextuelle de Google Sheets interpréterait cette vacuité comme une rupture de continuité, segmentant artificiellement la plage sélectionnée en blocs indépendants. De même, aucune ligne vide ne doit scinder les observations chronologiques. La matrice doit former un pavé rectangulaire compact et hermétique de dimensions $13 \times 3$, s’étendant exactement de la cellule A1 à la cellule C13.
Cet agencement géométrique rigoureux permet de maximiser l’interopérabilité avec les fonctionnalités automatisées du tableur. Lorsque les colonnes sont convenablement ordonnées de gauche à droite selon leur niveau de hiérarchie relationnelle (Abscisse, Ordonnée 1, Ordonnée 2), Google Sheets procède par défaut à une assignation intuitive des rôles fonctionnels des séries dès l’initialisation de l’objet graphique, épargnant à l’analyste de nombreuses manipulations de redéfinition de plages.
3.2 Formulation des entêtes et sémantique des descripteurs
La première ligne du tableau matriciel joue un rôle prépondérant dans la métadonnée graphique. Les cellules A1, B1 et C1 doivent comporter des intitulés concis, dénués de toute ambiguïté sémantique, mais suffisamment explicites pour guider l’interprétation du lecteur. Les termes génériques tels que « Données 1 » ou « Métrique » doivent être rigoureusement bannis au profit de descripteurs normalisés explicitant l’unité de mesure associée au phénomène quantifié.
Pour la cellule A1, l’intitulé Mois définit sans équivoque la granularité temporelle. Pour la cellule B1, la formulation Ventes (EUR) renseigne immédiatement sur la nature de la transaction et la devise de référence, évitant ainsi d’avoir à encombrer le corps du graphique d’explications terminologiques annexes. Pour la cellule C1, l’étiquette Nouveaux Clients stipule la nature du dénombrement d’entités sans confusion possible avec un effectif total cumulé. Ces descripteurs textuels sont automatiquement capturés par Google Sheets pour générer la légende du graphique et préfigurer les étiquettes d’axes verticaux.
La propreté syntaxique de ces entêtes est également impérative. Les retours à la ligne forcés à l’intérieur de la cellule d’entête doivent être évités, car ils induisent parfois des anomalies de rendu dans l’affichage des légendes vectorielles ou provoquent un écourtement inesthétique du texte (troncature par points de suspension). L’intégrité textuelle de la ligne 1 constitue le garant de la lisibilité sémiotique globale de la composition visuelle.
3.3 Validation de la complétude du tableau matriciel (A1:C13)
Avant toute tentative d’instanciation de l’objet graphique, l’analyste doit conduire un audit métrologique de la plage A1:C13. Les valeurs empiriques doivent être scrupuleusement renseignées pour chaque mois de l’année. À titre indicatif, la matrice de référence est constituée des observations suivantes : Janvier (21 000 EUR ; 32 clients), Février (24 500 EUR ; 38 clients), Mars (29 000 EUR ; 45 clients), Avril (27 500 EUR ; 41 clients), Mai (33 000 EUR ; 52 clients), Juin (38 500 EUR ; 60 clients), Juillet (42 000 EUR ; 75 clients), Août (36 000 EUR ; 58 clients), Septembre (39 500 EUR ; 68 clients), Octobre (44 000 EUR ; 82 clients), Novembre (41 500 EUR ; 79 clients), et Décembre (46 000 EUR ; 88 clients).
Il convient de s’assurer de l’absence totale de dépendances fonctionnelles défaillantes à l’intérieur de ces cellules. Si les données proviennent de formules dynamiques telles que des fonctions de sommation conditionnelle (SOMME.SI.ENS) ou des requêtes tabulaires (QUERY), il importe de vérifier qu’aucun code d’erreur (tel que #REF!, #VALEUR! ou #N/A) ne subsiste dans la plage. Une seule cellule en état d’erreur invalide la restitution graphique de l’intégralité de la série concernée.
Enfin, une vérification du formatage conditionnel et de l’alignement typographique s’avère salutaire. Par défaut, Google Sheets aligne systématiquement les valeurs numériques à droite et les chaînes de texte à gauche. Un nombre qui s’aligne spontanément à gauche dans sa cellule indique une anomalie d’encodage (par exemple, l’usage d’un espace insécable ou d’un point décimal inadapté à la configuration régionale), signalant que le processeur graphique ne pourra le traiter comme une coordonnée quantitative continue.
4. Étape 2 : Sélection des plages et insertion de l’objet graphique
4.1 Techniques de sélection active de la matrice de données
L’ancrage du futur graphique repose sur la définition d’un intervalle de référence rigoureux. Pour opérer la sélection active de la matrice A1:C13, plusieurs procédures coexistent au sein de l’environnement Google Sheets. La méthode la plus intuitive consiste à cliquer sur la cellule supérieure gauche A1, puis, en maintenant le bouton gauche de la souris enfoncé, à glisser le curseur diagonalement jusqu’à la cellule inférieure droite C13, provoquant la mise en surbrillance bleutée de l’ensemble des données et de leurs métadonnées associées.
Toutefois, pour les ensembles de données plus volumineux ou afin d’éviter tout dérapage manuel susceptible de tronquer l’échantillon, l’usage des raccourcis clavier offre une précision chirurgicale supérieure. Il est recommandé de positionner le focus sur la cellule A1, puis d’exécuter la combinaison de touches Ctrl + Shift + Flèche Bas (sur Windows) ou Cmd + Shift + Flèche Bas (sur macOS) pour atteindre la limite inférieure de la matrice, suivie de Ctrl + Shift + Flèche Droite pour englober l’ensemble des colonnes adjacentes. L’utilisateur prévient ainsi tout risque de sélection partielle préjudiciable.
Il est fondamental de réitérer l’impératif d’inclure la première ligne des entêtes au sein de cette sélection active. Si l’utilisateur restreint sa sélection à l’intervalle A2:C13, le système perd le repère sémantique des descripteurs de variables, ce qui force l’algorithme à attribuer des désignations arbitraires aux séries (telles que « Série 1 » et « Série 2 ») et complique inutilement les opérations de configuration ultérieures.
4.2 Exécution de la commande d’insertion native
Une fois la matrice A1:C13 activement sélectionnée, l’instanciation du composant graphique s’effectue via les commandes natives de l’interface logicielle. L’analyste peut accéder à cette fonction en parcourant l’arborescence des menus supérieurs : un clic sur l’onglet Insérer déploie un menu contextuel au sein duquel figure l’option Graphique. L’activation de cette commande déclenche immédiatement l’analyse heuristique du tableau par le moteur de rendu et l’ancrage d’un objet vectoriel flottant sur la feuille active.
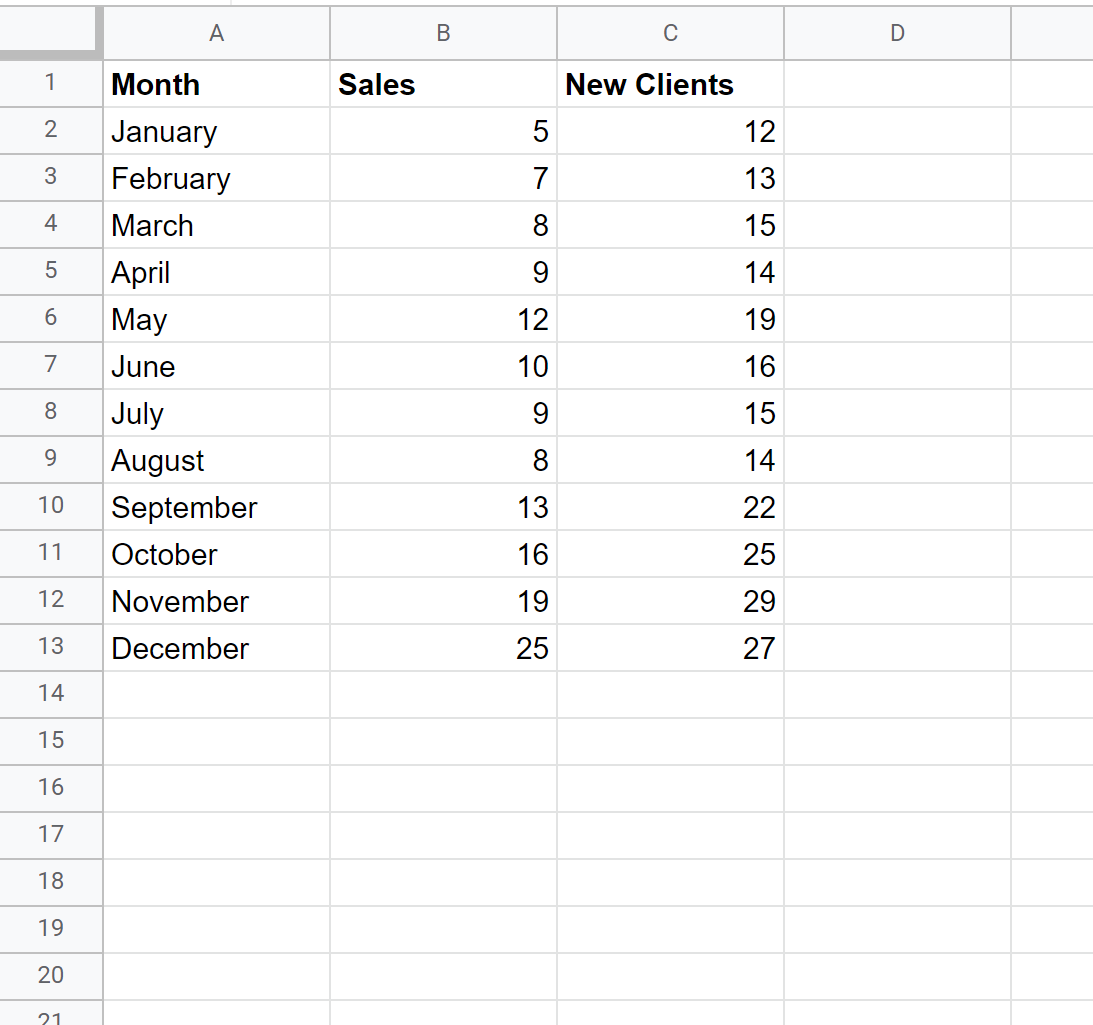
Alternativement, la barre d’outils standard propose une icône contextuelle dédiée figurant un histogramme stylisé. L’appui sur cette icône produit un effet strictement équivalent à l’arborescence textuelle, optimisant le flux de travail de l’utilisateur habitué aux raccourcis d’interface. Dès l’exécution de la commande, deux phénomènes surviennent en simultané : l’apparition du canevas graphique au premier plan de l’écran et le déploiement automatique d’un volet latéral interactif intitulé Éditeur de graphiques sur la bordure droite de l’espace de travail.
L’objet graphique ainsi créé possède des propriétés de positionnement dynamique. Il ne modifie en rien le contenu des cellules qu’il recouvre superficiellement et peut être translaté à tout moment par une opération de glisser-déposer. Il est recommandé de repositionner l’objet inséré à droite de la colonne D ou en dessous de la ligne 15, afin de conserver une visibilité permanente et intégrale sur les données sources pendant toute la phase de paramétrage configurationnel.
4.3 Analyse du comportement graphique par défaut du moteur
Le moteur d’intelligence visuelle de Google Sheets procède à une analyse statistique préalable de la géométrie matricielle sélectionnée afin de déterminer le format graphique le plus probable. Dans la majorité des cas impliquant une première colonne temporelle suivie de deux séries numériques continues, le tableur génère par défaut un Graphique linéaire standard (ou parfois un histogramme à colonnes groupées), représentant les deux métriques sous une forme morphologique identique.
L’examen critique de cette restitution initiale révèle immédiatement l’inadéquation de la réponse par défaut face à un problème métrologique bivarié hétérogène. Les deux variables étant projetées sur un axe vertical unique partagé (situé à gauche), la série du volume des ventes (oscillant entre 20 000 et 46 000) dicte entièrement la graduation de l’axe, qui s’échelonne typiquement de 0 à 50 000 unités. Par voie de conséquence, la série du nombre de clients, dont les grandeurs sont comprises entre 30 et 90, se trouve écrasée de façon infinitésimale contre la ligne d’abscisse horizontale.
Ce diagnostic visuel confirme l’insuffisance analytique de la configuration par défaut. La courbe des clients apparaît sous la forme d’un segment rigoureusement plat, masquant l’intégralité de sa variance, de ses points d’inflexion et de sa dynamique intrinsèque. Ce constat met en lumière la nécessité absolue d’engager une reconfiguration structurelle méthodique, en mutant la typologie de base vers un graphique combiné doté d’une distribution morphologique différenciée et d’un double système d’axes ordonnés.
5. Étape 3 : Conversion structurelle vers le graphique combiné
5.1 Accès opératoire à l’éditeur de graphiques
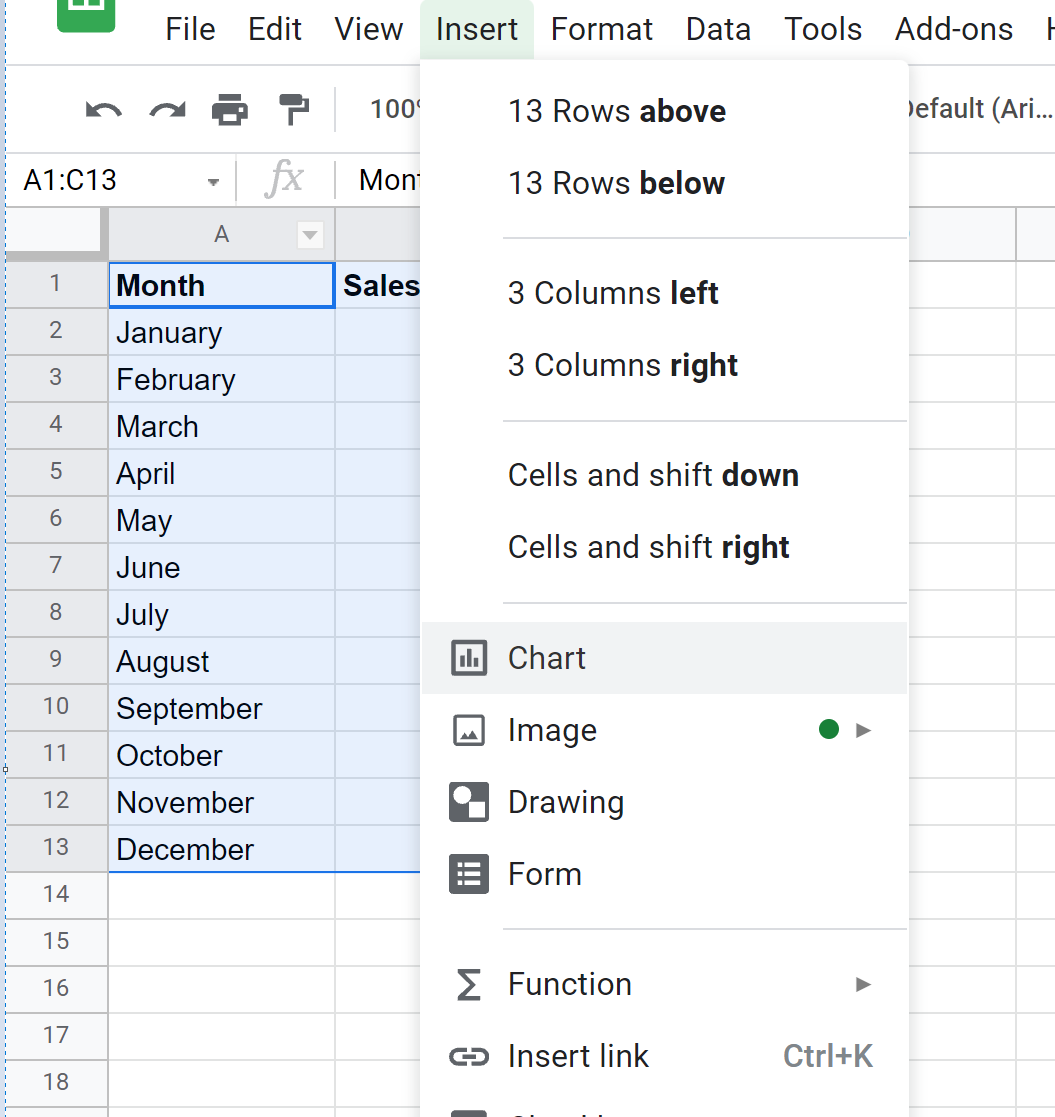
L’orchestration des propriétés structurelles du graphique requiert l’activation continue du panneau d’édition latéral. Si ce dernier a été malencontreusement fermé lors des manipulations spatiales de repositionnement du canevas, l’utilisateur peut le révoquer instantanément en sélectionnant l’objet graphique d’un simple clic gauche, puis en activant le menu contextuel symbolisé par trois points verticaux superposés dans le coin supérieur droit du cadre de visualisation. La sélection de l’option Modifier le graphique rétablit le volet latéral dédié.
Une méthode encore plus expéditive consiste à effectuer un double-clic directement sur le corps du canevas graphique. Cette action invoque immédiatement l’Éditeur de graphiques. L’interface se compose structurellement de deux onglets majeurs aux finalités distinctes : l’onglet Configurer, dévolu à la définition des plages sources, à l’assignation des axes et au choix du type de représentation, et l’onglet Personnaliser, réservé aux finitions stylistiques, chromatiques et typographiques.
Pour cette troisième étape, l’attention opérationnelle doit se porter impérativement sur l’onglet Configurer. L’analyste doit vérifier avec rigueur que le champ « Plage de données » indique précisément la matrice A1:C13 et que les options intitulées « Utiliser la ligne 1 comme en-têtes » ainsi que « Utiliser la colonne A comme étiquettes » sont formellement cochées. Cette vérification garantit la robustesse du substrat sur lequel s’appliquera la mutation typologique.
5.2 Sélection du modèle de graphique combiné
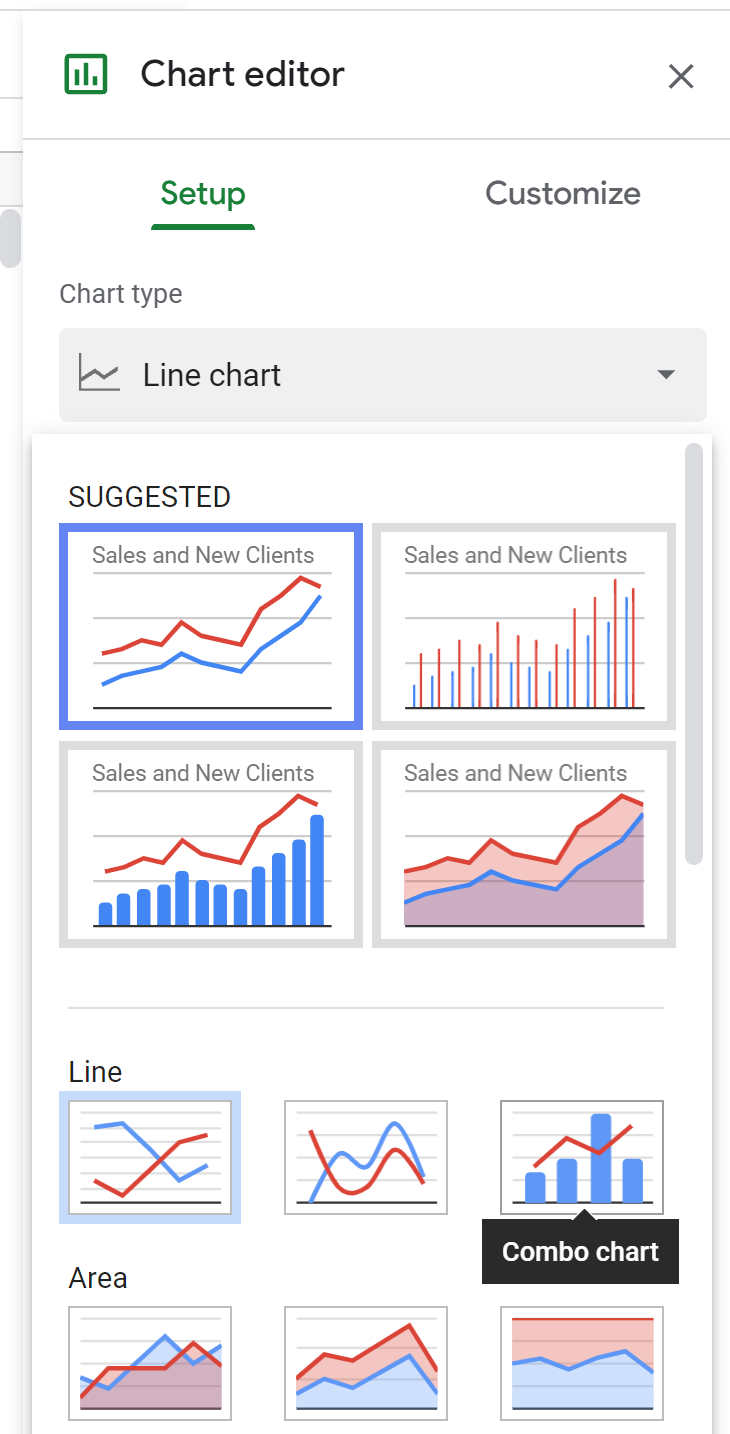
Le changement de paradigme visuel s’opère au sein du menu déroulant Type de graphique, positionné au sommet de l’onglet de configuration. Par défaut, ce menu affiche la sélection prédictive du logiciel (généralement Graphique en courbes). En déployant cette liste déroulante hiérarchisée, l’utilisateur accède à la taxonomie exhaustive des représentations graphiques supportées par Google Sheets, regroupées par catégories morphologiques (Lignes, Surfaces, Colonnes, Barres, Secteurs, Dispersion et Autres).
L’opérateur doit descendre au sein de cette nomenclature jusqu’à la section des graphiques linéaires ou composites pour localiser le pictogramme officiel du Graphique combiné. Ce pictogramme est identifiable par l’association explicite d’une barre verticale bleue stylisée surmontée d’une ligne brisée rouge. Un clic sur cet archétype commande la transformation immédiate du modèle géométrique du canevas.
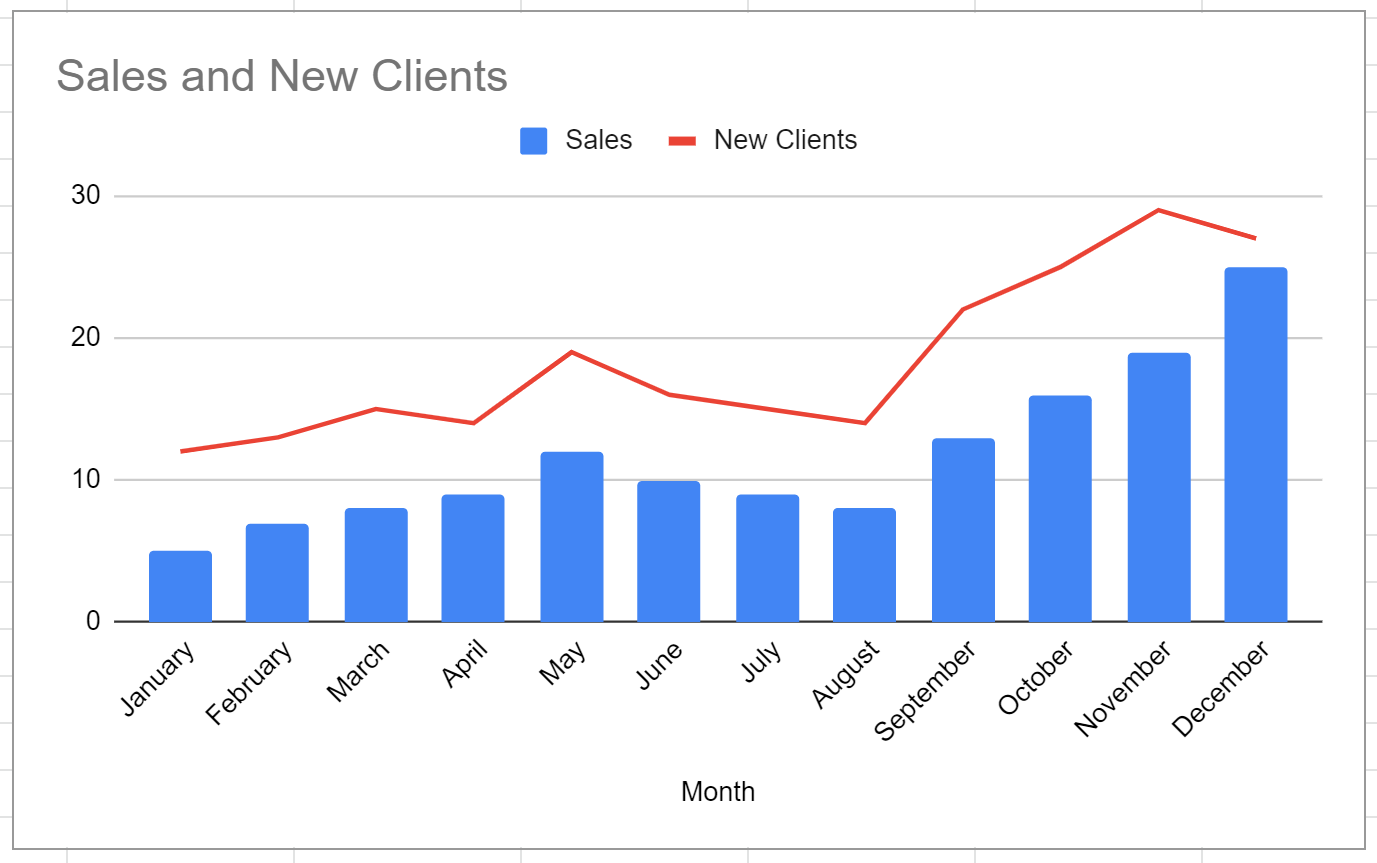
Dès la sélection effectuée, le processeur algorithmique de Google Sheets reconfigure en temps réel le rendu vectoriel de la figure. Les séries ne sont plus contraintes par un type géométrique unilatéral : le logiciel redistribue formellement les métriques, assignant conventionnellement le premier jeu de données numériques (Ventes) sous la forme d’un histogramme en colonnes, et la série consécutive (Nouveaux Clients) sous la forme d’une courbe continue traversant le plan de projection.
5.3 Validation de la morphologie initiale post-conversion
La validation de cette métamorphose structurelle exige un examen critique attentif. À ce stade du processus, la colonne A relative aux mois calendaires doit s’inscrire fidèlement le long de l’axe horizontal inférieur (l’axe des abscisses, ou axe $X$). Chaque mois doit correspondre à une coordonnée discrète équidistante le long du plan. Si les étiquettes de mois se trouvent inversées ou agrégées de manière erronée, l’utilisateur doit contrôler dans l’onglet de configuration que l’option « Inverser les lignes et les colonnes » est bien désactivée.
Sur le plan des variables dépendantes, la métrique Ventes (EUR) doit dorénavant occuper l’espace sous la forme de barres verticales s’élevant depuis la ligne d’ordonnée zéro. Simultanément, la métrique Nouveaux Clients doit se dessiner comme un fil d’Ariane continu. Toutefois, un problème visuel subsiste : bien que la typologie soit devenue combinée, les deux séries sont toujours ancrées sur une échelle verticale unifiée à gauche du cadre.
Il en résulte que le problème métrologique initial d’écrasement visuel n’est que partiellement résolu. La courbe des clients, bien que morphologiquement différenciée de l’histogramme des ventes, demeure collée au plancher du graphique en raison de l’incommensurabilité des ordres de grandeur. Cette étape transitoire confirme néanmoins la validité de la mutation structurelle et prépare le terrain pour l’assignation sérielle granulaire et la mise en œuvre de l’axe secondaire.
6. Étape 4 : Configuration sérielle et assignation morphologique
6.1 Paramétrage granulaire de la série en colonnes (Ventes)
Pour dépasser l’agencement générique proposé par le système et adapter le graphique aux exigences de rigueur de l’analyse empirique, il convient de basculer vers l’onglet Personnaliser de l’éditeur latéral. Cet onglet renferme la sous-section capitale intitulée Séries, au sein de laquelle s’exécute le calibrage micrométrique de chaque variable dépendante prise isolément. Par défaut, le sélecteur d’application affiche l’option « Appliquer à toutes les séries », un état global qu’il faut abandonner pour travailler de manière granulaire.
L’analyste doit déployer ce menu et cibler formellement la série Ventes (EUR). Dès lors, les panneaux de configuration se restreignent aux propriétés spécifiques de cette métrique. Il importe de s’assurer que le paramètre Type est explicitement verrouillé sur la valeur Colonnes (ou Histogramme). Ce choix formel est motivé par la nature économique de la donnée : une recette financière mensuelle constitue une grandeur agrégée sur une période discrète, dont l’impact matériel est fidèlement restitué par le volume surfacique d’une barre ancrée au sol cognitif du graphique.
Les propriétés de mise en forme des colonnes méritent une attention rigoureuse. L’utilisateur peut y définir la couleur de remplissage principale et, le cas échéant, une couleur de bordure pour accentuer la démarcation physique des rectangles. La régulation de l’opacité du remplissage (généralement fixée à 80 % ou 90 %) permet d’adoucir la présence visuelle de ces blocs imposants, facilitant ainsi le croisement ultérieur de la série linéaire sans générer d’occlusion visuelle préjudiciable aux points de données d’arrière-plan.
6.2 Paramétrage granulaire de la série linéaire (Clients)
L’étape consécutive requiert une manipulation analogue orientée vers la seconde variable empirique. En réactivant le sélecteur contextuel de la sous-section Séries, l’utilisateur isole cette fois la série Nouveaux Clients. L’architecture de cette variable exige de vérifier ou de forcer le paramètre Type sur l’option Ligne. La linéarité du tracé est ici le vecteur indispensable à la traduction de la cinématique d’acquisition : elle souligne le rythme, la vélocité et les fluctuations d’un flux d’adhésions humaines d’un mois sur l’autre.
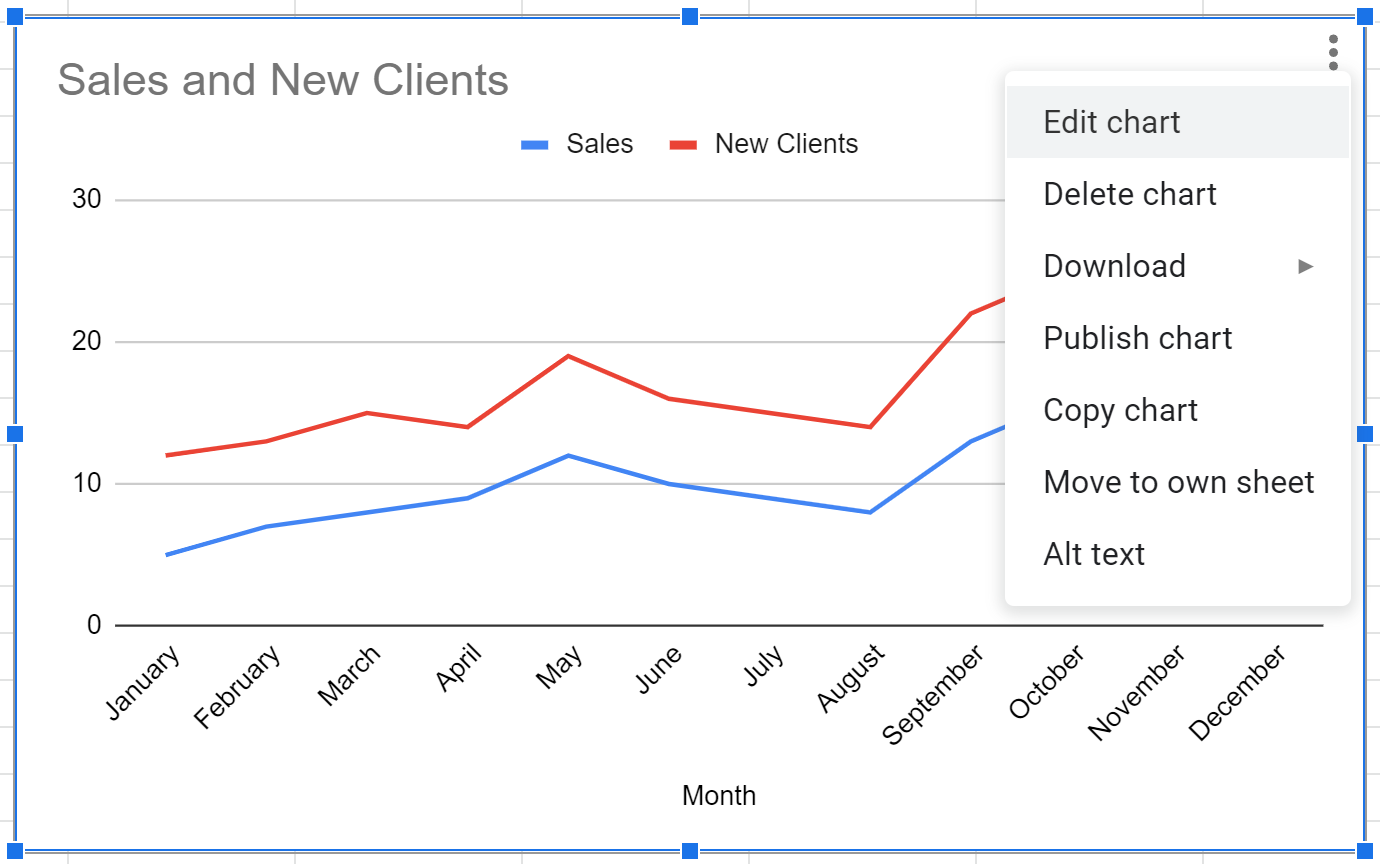
Le paramétrage de l’épaisseur du trait (épaisseur de ligne) joue un rôle perceptif déterminant. Un tracé excessivement fin (1 pixel) perd son identité visuelle face à la masse imposante des colonnes financières, incitant le cerveau de l’observateur à le reléguer au rang d’artefact secondaire ou d’erreur de quadrillage. Inversement, un trait trop épais (8 pixels) dégrade la précision de localisation des sommets d’inflexion et occulte une partie substantielle des histogrammes adjacents. Un compromis méthodologique réside dans l’adoption d’une épaisseur normalisée de 2 à 4 pixels, assurant une présence graphique affirmée sans perte de netteté géométrique.
Par ailleurs, le format de la ligne peut être ajusté pour refléter le statut ontologique de la donnée. Bien que le trait continu demeure le standard conventionnel pour des données historiques certaines, Google Sheets autorise l’usage de lignes tiretées ou pointillées. Ce type de tracé alternatif doit toutefois être strictement réservé à la représentation de séries prédictives, de bornes d’intervalles de confiance ou d’objectifs théoriques budgétés, afin de ne pas semer le trouble quant à l’empirisme des observations réelles.
6.3 Interpolation et jonction des segments de ligne
L’affichage de la série linéaire confronte l’analyste à un dilemme mathématique fondamental : l’alternative entre une interpolation linéaire classique et un lissage continu par courbe spline. Dans l’onglet de personnalisation de la série linéaire, Google Sheets offre une case à cocher intitulée « Lissage ». L’activation de cette option substitue aux segments brisés polygonaux une fonction mathématique polynomiale d’interpolation qui arrondit les transitions entre chaque nœud de mesure.
D’un point de vue esthétique, le lissage par spline produit une composition visuellement fluide et harmonieuse. Cependant, d’un point de vue épistémologique et statistique, son emploi est hautement controversé lors du traitement de données discrètes mensuelles. La courbe spline invente littéralement des trajectoires et des points intermédiaires virtuels qui n’ont jamais fait l’objet d’un recueil d’observations. Elle peut artificiellement déplacer les extremums locaux au-dessus de leur valeur empirique réelle pour maintenir sa courbure tangente, altérant ainsi la fidélité de restitution des ruptures brutales de tendance. Par conséquent, pour un rapport analytique ou une publication scientifique, il est fortement préconisé de conserver l’interpolation linéaire polygonale stricte.
Pour contrebalancer l’austérité géométrique de la ligne brisée et ancrer sans équivoque chaque observation mensuelle, il convient de matérialiser les points nodaux réels. Dans les options de série, le paramètre Taille du point doit être extrait de sa valeur par défaut (zéro ou invisible) pour être calibré sur une dimension perceptible, idéalement 5 ou 7 pixels. L’attribution d’une Forme de point géométrique simple (tel qu’un cercle plein ou un losange) confère au lecteur un repère spatial infaillible pour identifier la coordonnée cartésienne exacte $(x, y)$ de chaque mois, indépendamment du segment vectoriel qui les relie.
7. Étape 5 : Implémentation stratégique de l’axe vertical secondaire
7.1 Fondements métrologiques de la dissociation des échelles
La dissociation des échelles au moyen d’un axe vertical secondaire constitue le cœur opérationnel de la résolution graphique entreprise. Sur le plan de la théorie métrologique, superposer au sein d’un même repère deux variables dépendantes non directement commensurables (ici, des euros et un effectif d’individus) pose un défi de calibration. Si l’on force leur cohabitation sur une échelle commune, la variable dont les grandeurs sont les plus faibles subit un nivellement mécanique destructeur d’information, annihilant l’utilité même de la visualisation de données.
L’implémentation d’un axe vertical de droite, opérant en parfaite symétrie spatiale avec l’axe vertical de gauche, restaure la dynamique d’exploration visuelle. Elle permet à chacune des séries de déployer son amplitude propre sur l’intégralité de la hauteur verticale utile du graphique. L’observateur n’est plus contraint d’extrapoler les variations de la courbe basse par un effort de déchiffrement mental ; les deux trajectoires se développent dans un espace perceptible optimal, permettant l’analyse comparative synchrone des accélérations, décélérations et paliers structurels des deux indicateurs d’intérêt.
Cependant, cette opportunité sémiotique s’accompagne d’une responsabilité cognitive accrue. La dissociation des échelles brise l’unicité de lecture géométrique : l’altitude physique d’un point sur le graphique n’indique plus une valeur absolue univoque, mais dépend strictement du bord vertical (gauche ou droite) auquel la série correspondante est indexée. L’analyste doit impérativement maîtriser cette dualité afin de prévenir toute lecture erronée ou tout soupçon de manipulation visuelle de la part des destinataires de l’analyse.
7.2 Affectation de la série linéaire à l’axe de droite
La procédure technique permettant d’affecter la variable secondaire à l’axe vertical droit est d’une grande simplicité dans Google Sheets, mais nécessite d’accéder au champ adéquat au sein de l’arborescence des réglages. Dans le volet latéral, sous l’onglet Personnaliser, l’utilisateur doit rouvrir la section Séries et s’assurer que la variable Nouveaux Clients est bel et bien sélectionnée dans le menu d’attribution sérielle.
Au sein des paramètres spécifiques de cette série, sous les choix d’épaisseur et de couleur, se trouve un menu déroulant déterminant intitulé Axe. Par défaut, ce champ affiche l’état « Axe de gauche ». En cliquant sur ce menu, l’opérateur doit commuter la valeur active vers Axe de droite. L’effet sur le canevas est immédiat et saisissant : une nouvelle colonne graduée d’ordonnées se matérialise sur la bordure droite du graphique, spécifiquement calibrée pour absorber l’intervalle d’échantillonnage de la métrique démographique (approximativement de 0 à 100 unités).
Instantanément, la courbe des clients se détache du plancher de l’axe des abscisses pour se hisser à travers le corps central du graphique. Sa trajectoire révèle désormais toute sa richesse morphologique : le pic d’acquisition du mois de juillet et la consolidation d’automne apparaissent avec une netteté remarquable, survolant l’histogramme des ventes sans subir la moindre compression scalaire. La structure fondamentale du graphique combiné à double axe est à ce stade pleinement opérationnelle.
7.3 Équilibrage et synchronisation proportionnelle des axes
Bien que l’axe secondaire soit établi, l’agencement graphique peut souffrir d’un manque d’harmonisation métrologique si les gradients des échelles ne sont pas calibrés de manière réfléchie. Par défaut, Google Sheets calcule les bornes minimales et maximales de façon automatique et dynamique. Cette automatisation conduit fréquemment à des incohérences : par exemple, l’axe de gauche peut débuter à zéro tandis que l’axe de droite commence à un plancher arbitraire (comme 20 clients), amplifiant de façon démesurée les variations relatives de la courbe par rapport aux barres.
Pour corriger cette distorsion, l’analyste doit descendre dans l’onglet Personnaliser et examiner successivement les sections Axe vertical (qui régit l’axe de gauche) et Axe vertical de droite. Dans chacune de ces sections, il est impératif de renseigner explicitement la valeur 0 dans le champ Valeur minimale. L’ancrage rigoureux du zéro sur les deux axes constitue une obligation méthodologique majeure : il empêche toute illusion d’optique consistant à exagérer artificiellement un taux d’évolution modeste et garantit l’honnêteté intellectuelle de la représentation.
Ensuite, l’équilibrage des Valeurs maximales doit être ajusté de manière à harmoniser les lignes de quadrillage horizontales. Si l’axe des ventes s’élève jusqu’à 50 000 avec 5 intervalles majeurs (pas de 10 000), il est judicieux de fixer le plafond de l’axe des clients à 100 avec 5 intervalles majeurs (pas de 20). Cette concordance arithmétique permet aux repères horizontaux de coïncider parfaitement à travers toute l’étendue du canevas, supprimant le désagréable effet de « grilles croisées discordantes » qui encombre et pollue la lecture visuelle.
8. Étape 6 : Personnalisation chromatique et harmonisation esthétique
8.1 Théorie des couleurs appliquée à la différenciation catégorielle
Le choix de la palette chromatique ne répond pas à une quête de séduction ornementale, mais obéit à des lois rigoureuses de ségrégation visuelle et d’ergonomie cognitive. Deux séries coexistant dans un espace dense doivent présenter un contraste colorimétrique suffisant pour être discriminées instantanément, y compris par des personnes présentant des déficits de la perception des couleurs (daltonisme ou dyschromatopsies diverses, touchant environ 8 % de la population masculine). Les recommandations d’accessibilité telles que les Web Content Accessibility Guidelines (WCAG) préconisent un ratio de contraste supérieur à 3:1 entre les composantes visuelles graphiques adjacentes.
L’utilisation simultanée de teintes rouge et verte pour différencier les colonnes de la courbe doit être catégoriquement proscrite en raison des confusions majeures qu’elle engendre chez les individus deutéranopes et protanopes. Une combinaison chromatique hautement efficiente et éprouvée consiste à associer une tonalité froide et sombre pour les éléments de volume (par exemple, un bleu ardoise ou un bleu marine profond) à une teinte chaude et lumineuse pour la dynamique vectorielle (un orange ambré ou un corail saturé). Ce schéma chromatique exploite un contraste à la fois de teinte et de luminance, garantissant une lisibilité optimale sur écran comme à l’impression monochrome.
Dans Google Sheets, cette harmonisation s’opère dans la section Séries du panneau Personnaliser. La couleur de remplissage de la série Ventes (EUR) sera calibrée sur un bleu sobre (code hexadécimal indicatif : #2A5C8A), tandis que la ligne de Nouveaux Clients sera habillée d’un orange distinctif (code hexadécimal indicatif : #E66C37). Cette dissociation franche évite toute hésitation cognitive lors de la consultation rapide d’un tableau de bord ou d’une note de synthèse stratégique.
8.2 Ajustement dimensionnel des barres et espacement
La morphologie des colonnes de l’histogramme influe profondément sur l’équilibre des masses visuelles au sein de la composition. Des barres trop effilées confèrent au graphique un aspect squelettique et réduisent l’impact sémiotique de la métrique de flux financier ; à l’opposé, des barres hypertrophiées se touchant presque bouchent le plancher visuel et étouffent le tracé linéaire qui les traverse, engendrant une sensation de saturation graphique inconfortable.
Google Sheets ne dispose pas toujours d’un curseur dédié à l’espacement inter-barres dans le cas spécifique des graphiques combinés (contrairement aux diagrammes à colonnes pures), mais régule cette largeur par le ratio global de dimensionnement de l’objet et la présence d’autres séries en colonnes. Néanmoins, l’analyste peut influencer cet agencement par le redimensionnement physique du cadre graphique global. En étirant modérément l’objet vectoriel en largeur, on augmente naturellement la respiration spatiale entre les différentes travées mensuelles.
Il convient également de vérifier que les contours des colonnes ne sont pas surchargés d’effets superflus. L’attribution d’un contour noir épais autour de chaque barre crée une vibration optique parasitaire (effet de moiré ou bruit visuel dénoncé par le statisticien Edward Tufte). Il est préférable de configurer la bordure sur « Aucune » ou de sélectionner une teinte strictement identique à la couleur de remplissage, afin de préserver la netteté et la pureté des arêtes géométriques.
8.3 Mise en valeur sélective des points focaux
L’une des techniques avancées pour maximiser la portée analytique d’un graphique combiné réside dans la mise en relief délibérée des singularités statistiques, telles que les performances record, les points d’inflexion critiques ou les ruptures d’approvisionnement. Google Sheets propose une fonctionnalité d’une grande valeur à cet égard : le Formatage de point de données individuel.
Dans la sous-section Séries de l’onglet Personnaliser, l’utilisateur peut cliquer sur le bouton Ajouter juxtaposé au libellé « Mettre en forme le point de données ». Une fenêtre modale s’ouvre, invitant à sélectionner une coordonnée temporelle précise au sein de la série choisie. Par exemple, il est possible d’isoler la colonne du mois de Décembre (qui enregistre le pic annuel de ventes à 46 000 EUR) et de lui attribuer une couleur de remplissage différenciée ou une saturation accrue, marquant immédiatement son statut de résultat exceptionnel.
Cette mise en valeur sélective doit néanmoins être maniée avec une grande retenue méthodologique. Si chaque point ou barre fait l’objet d’un codage chromatique personnalisé, le graphique bascule dans une cacophonie visuelle qui anéantit le bénéfice de la structure catégorielle d’ensemble. La mise en exergue ne conserve sa force de signal sémiotique que si elle demeure rare, ciblée et formellement justifiée par les impératifs de la démonstration analytique.
9. Étape 7 : Typographie, étiquetage et ancrage sémantique
9.1 Formulation académique du titre principal et sous-titres
L’ancrage sémantique transforme un assemblage géométrique en un document statistique autonome et exploitable. Le premier vecteur de cette explicitation est le titre principal du graphique. Il convient de bannir impitoyablement les formulations laconiques ou tautologiques telles que « Graphique 1 » ou « Ventes et Clients ». Un titre rigoureux sur le plan académique doit expliciter avec précision la nature des variables dépendantes, le champ d’observation et l’étendue temporelle du recueil d’informations.
Une formulation exemplaire pour notre échantillon de référence s’énonce ainsi : « Analyse comparative des volumes de ventes brutes et de l’acquisition de nouveaux clients — Exercice calendaire 2024 ». Ce libellé informe instantanément le lecteur sur le périmètre de l’enquête. L’analyste peut également mobiliser l’espace de Sous-titre du graphique offert par Google Sheets pour préciser des mentions méthodologiques complémentaires, telles que l’unité monétaire retenue (ex. : « Valeurs exprimées en euros courants hors taxes (EUR HT) ») ou la source administrative des données.
Sur le plan typographique, l’harmonie stylistique commande de sélectionner une police neutre sans empattement (sans-serif) telle que Roboto, Arial ou Open Sans, qui assure une lisibilité irréprochable sur les écrans numériques de résolutions variables. Le titre principal doit recevoir un traitement hiérarchique dominant (taille de police fixée à 14 ou 16 points, corps gras), tandis que le sous-titre adoptera un gabarit plus effacé (taille de 10 ou 11 points, teinte gris foncé neutre), évitant d’entrer en collision perceptive avec les légendes fonctionnelles du canevas.
9.2 Labellisation exhaustive des axes verticaux et horizontaux
L’absence de labellisation explicite sur les axes d’ordonnées constitue l’une des erreurs les plus dévastatrices en visualisation bivariée. En présence de deux axes verticaux disposés de part et d’autre de la figure, l’observateur est confronté à un risque immédiat d’inversion des repères. Il est par conséquent impératif de nommer sans ambiguïté chaque composante scalaire du repère cartésien.
Dans la section Titres des graphiques et des axes du menu de personnalisation, l’utilisateur doit successivement sélectionner les différents axes dans le menu déroulant :
- Pour le Titre de l’axe vertical (gauche), il convient de renseigner la mention formelle de la métrique primaire :
Volume des ventes (EUR). Cette inscription verticale rappelle immédiatement que la graduation de gauche concerne l’histogramme monétaire. - Pour le Titre de l’axe vertical de droite, la mention doit être tout aussi univoque :
Nouveaux clients (unités). Ce texte confirme sans contestation possible que la graduation de droite gouverne l’altitude de la ligne brisée. - Pour le Titre de l’axe horizontal, si la mention textuelle des mois (Janvier, Février…) est évidente, l’ajout de la mention synthétique
Période temporelle (Mois)élimine toute conjecture résiduelle.
L’orientation angulaire des étiquettes de l’axe horizontal (la graduation des mois) doit être surveillée avec rigueur. Lorsque l’espace horizontal est restreint, Google Sheets a tendance à faire pivoter les étiquettes de texte à 45 ou 90 degrés, ou à n’afficher qu’une étiquette sur deux pour éviter le chevauchement. Ce phénomène de rotation dégrade la vitesse de lecture. Il est préférable d’élargir le cadre global du graphique ou d’adopter des abréviations mensuelles canoniques sur trois lettres (Jan, Fév, Mar…) afin de préserver une horizontalité parfaite (inclinaison à 0 degré) du texte d’abscisse.
9.3 Positionnement et architecture de la légende
La légende assure la médiation finale entre le code chromatique et le descripteur lexical des variables. Dans l’onglet Personnaliser, la section Légende permet de piloter avec précision son emplacement physique et sa typographie. Si Google Sheets installe souvent la légende sur la bordure droite ou au pied du graphique par défaut, ces localisations présentent des inconvénients ergonomiques majeurs : la position basse grignote la hauteur utile dévolue aux axes verticaux, tandis que la position latérale droite comprime la largeur du canevas et entre en concurrence visuelle avec l’axe secondaire.
La recommandation standard en ergonomie des données consiste à positionner la légende au Sommet du graphique, immédiatement sous le titre et le sous-titre. Cette disposition aligne la lecture de la légende sur le sens naturel de parcours oculaire occidental (de haut en bas et de gauche à droite). L’observateur enregistre la clé de décodage des formes et des couleurs avant même de plonger dans l’analyse détaillée des coordonnées cartésiennes.
Une alternative de conception avancée réside dans l’activation d’Étiquettes de données directes apposées directement sur les points nodaux ou au sommet des barres. En affichant la valeur numérique exacte à côté de certains repères majeurs, l’analyste supprime totalement l’effort de consultation de l’axe vertical. Toutefois, cette technique doit être employée avec parcimonie : si les douze mois reçoivent à la fois des étiquettes de barres et des étiquettes de courbe, le graphique subit une saturation d’informations textuelles qui détruit la lisibilité des tendances globales.
10. Résolution des anomalies fréquentes et cas limites
10.1 Gestion des écarts d’échelle disproportionnés
Un défi métrologique complexe survient lorsque les séries de données subissent des variations internes exponentielles ou comportent des ordres de grandeur d’une dispersion phénoménale au sein d’une même métrique (par exemple, un mois d’activité exceptionnelle générant une valeur décuplée par rapport à la moyenne). Dans une telle conjecture, la colonne hors-norme compresse toutes les autres barres vers le bas, faisant disparaître la granularité d’observation des fluctuations locales de la période d’activité standard.
Une première tentation consiste à recourir à une échelle logarithmique sur l’axe vertical primaire, option directement commutable dans Google Sheets. Si la transformation logarithmique résout l’aplatissement géométrique en comprimant les grands écarts, elle induit un danger perceptif massif dans un graphique combiné : la hauteur physique des barres cesse d’être proportionnelle à la quantité quantitative réelle, ce qui viole le principe de proportionnalité surfacique cher à la sémiologie graphique. Les observateurs non formés aux mathématiques interprètent quasi systématiquement les barres sur une base linéaire intuitive, ce qui fausse radicalement leur jugement sur la réalité des volumes financiers.
La parade méthodologique recommandée face à des écarts disproportionnés insolubles consiste à renoncer à l’intégration au sein d’un graphique unique. Il est infiniment plus rigoureux de segmenter la visualisation en deux graphiques distincts verticalement alignés (small multiples), partageant une abscisse temporelle rigoureusement identique, mais disposant chacun d’un axe d’ordonnée linéaire optimisé pour son propre intervalle dynamique. Cette séparation supprime le risque d’illusion perceptive tout en maintenant la synchronisation temporelle de l’analyse comparative.
10.2 Inversion de l’attribution des séries et redressement
Une anomalie d’usage récurrente dans Google Sheets se manifeste par l’attribution inversée des morphologies géométriques lors de la conversion initiale : la variable des clients se retrouve matérialisée sous forme de colonnes massives tandis que les flux financiers sont tracés par la ligne continue. Cette inversion contrarie la logique sémiotique, les grandeurs financières massives s’accommodant bien mieux de l’ancrage volumétrique des barres que les dénombrements unitaires de conversion.
Pour redresser cette situation sans effacer le graphique ni réécrire la matrice de données, l’opérateur doit procéder à une permutation raisonnée au sein de l’éditeur latéral :
- Se rendre dans l’onglet Personnaliser, sous-section Séries.
- Sélectionner la série des
Ventes (EUR)et basculer son Type vers Colonnes, puis assigner son Axe sur l’Axe de gauche. - Sélectionner consécutivement la série
Nouveaux Clients, modifier son Type vers Ligne, et réassigner son ancrage sur l’Axe de droite.
Si l’inversion provient d’une mauvaise interprétation initiale des colonnes sources dans l’onglet Configurer, l’utilisateur peut également intervenir au niveau de la section Séries de cet onglet pour réordonner physiquement les champs. En cliquant sur le menu vertical à trois points juxtaposé à l’une des métriques, il est possible de supprimer la série mal assignée, puis de cliquer sur Ajouter une série pour sélectionner explicitement la plage de cellules adéquate (par exemple, forcer la sélection manuelle de la plage B1:B13). Cette souplesse opératoire permet de réaligner le moteur graphique sans jamais altérer l’intégrité du tableau source.
10.3 Correction des chevauchements et de la saturation informative
L’accumulation d’éléments graphiques dans un espace restreint engendre fréquemment ce que les cognitivistes qualifient d’encombrement visuel (visual clutter). Ce phénomène se traduit par l’enchevêtrement des lignes de quadrillage, des étiquettes de données numériques, des segments de courbe et des têtes de colonnes, contraignant le cerveau à un filtrage attentionnel épuisant.
Pour assainir la composition, l’analyste doit appliquer une politique drastique d’épuration visuelle. La première action corrective consiste à alléger le quadrillage. Dans la section Quadrillage et graduations de l’onglet Personnaliser, il est vivement conseillé de désactiver les lignes de quadrillage secondaires pour ne conserver que les repères majeurs. Il est même possible d’atténuer la présence des repères majeurs en modifiant leur teinte du noir vers un gris très pâle (ex. : #E0E0E0), réduisant considérablement la compétition visuelle avec les séries de données.
Une seconde mesure concerne le filtrage sélectif des étiquettes textuelles. Si des étiquettes de données ont été apposées sur les colonnes et la courbe, il convient de supprimer celles qui n’apportent aucune plus-value interprétative majeure. Enfin, une attention scrupuleuse doit être portée à la résolution d’affichage. Un graphique combiné conçu sur un moniteur de bureau haute définition (4K) peut devenir parfaitement illisible une fois projeté sur un écran de conférence de résolution standard ou compressé dans un rapport au format PDF mobile. Il est indispensable de tester la lisibilité du graphique à différentes échelles de zoom pour garantir l’indépendance et la robustesse de sa restitution perceptive.
11. Dynamisation, interactivité et automatisation du graphique
11.1 Liaison à des plages de données expansibles
Dans un contexte d’exploitation opérationnelle continue, les jeux de données ne demeurent pas statiques ; ils s’enrichissent périodiquement de nouvelles observations mensuelles ou hebdomadaires. Si la plage du graphique combiné est figée sur un intervalle absolu borné (comme A1:C13), l’adjonction des données du mois de janvier de l’année subséquente en ligne 14 sera purement et simplement ignorée par le processeur graphique, exigeant une modification manuelle récurrente des paramètres de configuration.
Pour automatiser l’intégration continue des données sans intervention humaine permanente, l’analyste doit employer la syntaxe des plages ouvertes dans l’onglet Configurer. En substituant à l’adresse fixe A1:C13 la notation dynamique A1:C, le champ de scrutation s’étend virtuellement jusqu’à l’infinie limite inférieure de la feuille de calcul. Chaque nouvelle rangée complétée dans les colonnes A, B et C sera instantanément vectorisée et incorporée au graphique combiné, l’axe horizontal recalculant automatiquement sa subdivision pour accueillir le nouvel intervalle temporel.
Pour prévenir l’apparition de barres fantômes ou de zones vides béantes provoquées par la capture de cellules vierges au sein d’une plage ouverte, il est particulièrement élégant d’intercaler une formule de filtrage matriciel en amont. L’utilisation d’une formule telle que =FILTER(A1:C; A1:A"") ou d’une instruction QUERY dans un onglet dédié permet de consolider un jeu de données propre et hermétique qui alimentera le graphique combiné avec une fiabilité mathématique absolue, isolant ainsi la visualisation des aléas de saisie dans le tableau brut de collecte.
11.2 Configuration des fonctionnalités d’interactivité native
L’un des atouts distinctifs de Google Sheets par rapport aux outils traditionnels de publication statique réside dans son moteur d’interactivité native, pleinement fonctionnel en environnement web. Lors de la consultation dynamique d’un graphique combiné par des collaborateurs ou des décideurs, le survol des primitives géométriques par le pointeur de la souris déclenche l’apparition d’infobulles contextuelles enrichies (tooltips).
Ces infobulles indiquent avec une précision chirurgicale la valeur exacte de l’observation sélectionnée, supprimant ainsi la nécessité d’estimer mentalement la coordonnée cartésienne le long de l’axe vertical correspondant. Dans les réglages avancés, l’utilisateur peut calibrer le comportement de ces infobulles, optant pour un affichage isolé de la série survolée ou pour un affichage agrégé consolidant l’ensemble des valeurs temporelles de l’abscisse au sein d’un même cadre flottant, ce qui facilite grandement la comparaison locale immédiate.
De surcroît, Google Sheets autorise l’interfaçage des graphiques avec des Segments de filtrage (Slicers), accessibles via le menu Données > Ajouter un segment. Cet outil d’exploration dynamique permet à l’utilisateur final de filtrer interactivement les données du graphique selon des critères catégoriels (par exemple, isoler un trimestre spécifique ou une typologie particulière de clientèle) sans jamais toucher aux formules ni à la matrice source. Le graphique combiné se transforme ainsi en un véritable micro-tableau de bord analytique et réactif.
11.3 Exportation vectorielle et intégration académique
La finalité d’une démarche d’analyse de données réside fréquemment dans l’exportation des résultats vers des supports de communication formels : mémoires académiques, articles de recherche scientifique, rapports annuels de gouvernance ou présentations exécutives. Google Sheets offre des protocoles d’exportation préservant scrupuleusement l’intégrité graphique du travail accompli.
En activant le menu contextuel à trois points du graphique, la commande Télécharger déploie trois formats d’encapsulation technique :
- Le format Image PNG (.png) : adapté aux usages rapides sur le web ou dans des environnements bureautiques informels, mais souffrant d’une pixellisation destructrice lors des opérations de mise à l’échelle ou d’impression papier haute densité.
- Le format Document PDF (.pdf) : idéal pour la conservation de la mise en page et la transmission de rapports immuables.
- Le format Graphisme vectoriel évolutif (.svg) : le standard d’excellence pour l’édition scientifique et professionnelle. Le format SVG code chaque barre, point, ligne et caractère textuel sous la forme de primitives géométriques vectorielles pures. Il garantit une netteté absolue, exempte de tout flou de pixellisation, quelle que soit la taille de reproduction finale dans un logiciel de publication assistée par ordinateur ou d’édition typographique (tel que LaTeX).
Par ailleurs, pour les utilisateurs œuvrant au sein de l’environnement Google Workspace, l’intégration du graphique dans un document Google Docs ou une présentation Google Slides s’effectue par simple copier-coller avec maintien du lien dynamique. Cette fonctionnalité remarquable permet de mettre à jour instantanément la figure au sein du rapport textuel dès que de nouvelles valeurs sont saisies dans la feuille de calcul source, supprimant les manipulations redondantes de réexportation et garantissant la concordance permanente entre les données numériques et leur restitution visuelle.
12. Synthèse évaluative et grille de conformité scientifique
12.1 Check-list méthodologique avant publication
Avant d’autoriser la diffusion institutionnelle ou la soumission académique d’un graphique combiné réalisé dans Google Sheets, l’analyste se doit de conduire une revue critique d’intégrité métrologique. Cette démarche d’audit final s’articule autour d’une grille de contrôle séquentielle et systématique :
- Audit d’exactitude matricielle : La plage de données sélectionnée couvre-t-elle l’intégralité exacte des observations sans omission accidentelle ni inclusion de lignes d’agrégation globale (les totaux généraux ne doivent jamais être injectés comme un point chronologique supplémentaire au risque de briser l’échelle) ?
- Vérification de l’ancrage du zéro : Les deux axes verticaux (primaire et secondaire) prennent-ils formellement naissance à la coordonnée zéro ? Si un axe est tronqué, cette distorsion est-elle explicitement documentée, motivée et justifiée sur le plan statistique ?
- Ségrégation morphologique : La distribution géométrique (colonnes pour les volumes ou flux agrégés, ligne polygonale pour les dynamiques ou les ratios continus) est-elle rigoureusement respectée et cohérente avec la nature des variables ?
- Accessibilité et contraste : Les teintes sélectionnées garantissent-elles une lisibilité parfaite pour des personnes atteintes de déficits chromatiques, et résistent-elles à une reproduction en niveaux de gris ?
- Indépendance sémantique : Les titres des axes précisent-ils sans ambiguïté la nature de la variable et l’unité de mesure exacte (devises, taux, effectifs) pour chaque côté de la figure ?
- Sobriété graphique : Tous les éléments superflus générateurs de bruit visuel (contours massifs, quadrillages secondaires envahissants, étiquettes numériques redondantes) ont-ils été neutralisés ?
12.2 Critères d’intégrité déontologique de la visualisation
La puissance d’impact d’un graphique combiné confère à son auteur une lourde responsabilité éthique. L’histoire de la statistique foisonne d’exemples où des représentations bivariées à axes multiples ont été délibérément manipulées pour tromper le jugement du public ou des instances de décision, phénomène abondamment dénoncé dans les ouvrages critiques de référence en sémiologie statistique.
L’une des manipulations les plus insidieuses consiste à modifier arbitrairement l’amplitude de l’axe secondaire pour aligner artificiellement deux courbes et suggérer une relation de cause à effet ou une synchronisation parfaite là où il n’existe qu’une coïncidence stochastique ou des fluctuations d’amplitudes disproportionnées. En étirant ou en comprimant l’axe de droite par rapport à l’axe de gauche, l’opérateur malveillant peut faire coïncider les pentes de deux séries totalement déconnectées, abusant de l’heuristique naturelle de l’observateur qui assimile le parallélisme visuel à une corrélation mathématique directe.
Le respect des standards déontologiques impose par conséquent une stricte transparence dans la documentation de la provenance des données brutes, l’explicitation des formules de calcul sous-jacentes et le refus catégorique de toute troncature d’axe destinée à amplifier artificiellement des variations infinitésimales. La visualisation scientifique ne doit pas chercher à imposer une narration prédéterminée aux dépens de la réalité empirique, mais doit s’ériger en un instrument d’élucidation sobre, loyal et fidèle des données réelles.
12.3 Bilan comparatif du graphique combiné face aux alternatives
En ultime analyse, l’opportunité de recourir au graphique combiné doit être mise en balance avec les architectures visuelles alternatives. S’il demeure un dispositif d’une remarquable puissance synthétique pour rapprocher des métriques interdépendantes sur un cycle chronologique, il ne constitue pas une panacée universelle adaptée à tous les auditoires ni à toutes les configurations de données.
Face à un public profane ou peu accoutumé aux abstractions quantitatives, la présence de deux axes verticaux distincts génère une charge cognitive non négligeable et induit un taux d’erreur de lecture significatif. Dans cette situation, la stratégie consistant à déployer deux graphiques disjoints superposés verticalement — partageant rigoureusement la même trame temporelle en abscisse mais disposant chacun d’un axe vertical unique à gauche — s’avère souvent plus pédagogique, bien qu’elle exige une surface de composition deux fois plus étendue.
De même, si l’objectif méthodologique premier réside dans la quantification formelle de la corrélation statistique entre deux variables quantitatives continues plutôt que dans l’étude de leur évolution temporelle conjointe, le diagramme de dispersion (scatter plot) constitue un choix théoriquement supérieur. En projetant la variable primaire sur l’axe des abscisses et la variable secondaire sur l’axe des ordonnées, le diagramme de dispersion met directement en scène la distribution bivariée et autorise le tracé d’une droite de régression linéaire, évacuant l’intermédiaire du temps pour se concentrer sur l’intensité du lien stochastique.
Le tableau suivant synthétise les critères d’arbitrage méthodologique gouvernant le choix du format visuel en fonction des objectifs analytiques poursuivis :
- Graphique combiné (barres et ligne, double axe) : Idéal pour l’analyse synchronisée d’un flux volumique et d’un taux tendanciel au fil du temps dans des rapports d’activité denses, à destination de décideurs avertis maîtrisant la lecture bivariée.
- Graphiques disjoints alignés (small multiples) : Préférables lorsque les échelles sont hautement divergentes ou lorsque le rapport s’adresse à un public large requérant une clarté immédiate exempte de tout risque de confusion d’axes.
- Diagramme de dispersion (scatter plot) : Indispensable pour la modélisation statistique formelle de relations de dépendance, d’hypothèses causales et la recherche de corrélations non temporelles.
- Graphique linéaire à axe unifié : Strictement réservé aux séries de même nature métrologique et partageant des étendues de grandeurs rigoureusement comparables.
Parvenu au terme de cette trajectoire de modélisation, l’analyste dispose désormais de l’ensemble des compétences conceptuelles, techniques et ergonomiques indispensables pour concevoir, personnaliser et déployer des graphiques combinés d’une rigueur scientifique irréprochable au sein de Google Sheets. Maîtriser l’architecture matricielle, dompter les subtilités du moteur graphique et respecter les fondements sémiotiques de la communication visuelle permet de transformer des données brutes hétérogènes en des instruments de conviction clairs, élégants et méthodologiquement inattaquables.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
Few, S. (2009). Now you see it: Simple visualization techniques for quantitative analysis. Analytics Press.
Google Workspace. (2024). Types de graphiques disponibles dans Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/190718
Knaflic, C. N. (2015). Storytelling with data: A data visualization guide for business professionals. John Wiley & Sons.
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
Ware, C. (2020). Information visualization: Perception for design (4e éd.). Morgan Kaufmann.
World Wide Web Consortium. (2018). Web content accessibility guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/