
Dans le champ contemporain de l’analyse quantitative et de la recherche expérimentale, la sémiotique graphique constitue une composante déterminante de la démarche scientifique. L’exploration et la restitution rigoureuse de relations multivariées requièrent des protocoles visuels précis, capables de traduire sans ambiguïté les structures factorielles sous-jacentes. L’omniprésence des plans expérimentaux factoriels dans les sciences du comportement, la psychométrie clinique, l’épidémiologie et la sociologie computationnelle confronte régulièrement les chercheurs à la nécessité d’examiner les interactions entre variables catégorielles prédictives et indicateurs quantitatifs d’intérêt. Le diagramme en bâtons multivariable, ou diagramme en barres groupées, s’impose alors comme un vecteur analytique incontournable, permettant une décomposition visuelle immédiate des effets principaux et des interactions de second ordre.
Toutefois, la génération de telles visualisations au sein de l’environnement statistique R ne relève pas d’une simple exécution d’instructions procédurales. Elle exige une compréhension profonde de la formalisation théorique sous-jacente articulée par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics, transcrite et perfectionnée par Hadley Wickham au sein de l’écosystème ggplot2. Cette grammaire impose une dissociation conceptuelle stricte entre les données sources brutes, les assignations esthétiques fonctionnelles, les transformations statistiques intermédiaires et le déploiement des primitives géométriques sur le plan cartésien. Déployer un barplot multivariable implique de maîtriser simultanément l’ingénierie des données tabulaires et la grammaire graphique afin d’éviter les écueils de distorsion cognitive qui menacent fréquemment la validité des inférences visuelles.
Ce guide exhaustif a pour vocation d’analyser méthodologiquement et techniquement la modélisation des diagrammes en bâtons multivariables dans ggplot2. Du formatage strict des matrices relationnelles au traitement algorithmique des barres d’erreur, en passant par l’optimisation chromatique conforme aux exigences d’accessibilité universelle et l’intégration de sous-facettes tridimensionnelles, chaque section aborde les défis computationnels et sémiologiques avec le degré d’exigence requis par la publication scientifique à fort impact. À travers un parcours alliant théorie mathématique, principes d’ergonomie cognitive et implémentations reproductibles, cet ouvrage offre une référence complète pour transformer des jeux de données complexes en représentations graphiques irréprochables.
1. Fondements théoriques et pertinence du barplot multivariable en sciences comportementales
1.1 Visualisation des variables catégorielles et sous-groupes expérimentaux
Le diagramme en bâtons appliqué à la statistique descriptive répond à une finalité sémiotique explicite : représenter l’amplitude d’une grandeur quantitative ou l’effectif discret d’un ensemble en associant chaque catégorie discrète à un segment rectangulaire dont la dimension axiale, généralement la hauteur, est strictement proportionnelle à la valeur observée. Dans les paradigmes expérimentaux modernes, l’observation d’un facteur unique isolé s’avère fréquemment insuffisante pour rendre compte de la variabilité des phénomènes étudiés. Les modèles contemporains exigent l’introduction simultanée de facteurs primaires, tels que le traitement expérimental administré, et de facteurs secondaires ou modérateurs, tels que la cohorte démographique, le profil génétique ou la stratification sociologique. Dès lors, le barplot multivariable doit dédoubler son encodage spatial pour restituer fidèlement la structure multidimensionnelle du plan d’expérience.
La distinction épistémologique entre variables discrètes nominales, dépourvues de relation d’ordre naturelle, et variables ordinales, caractérisées par un ordonnancement intrinsèque, conditionne directement la validité sémiologique de la représentation. Une erreur de catégorisation compromet la lisibilité des distributions et peut induire une illusion de continuité là où ne subsistent que des séparations discrètes. Dans l’analyse comportementale, où les variations interindividuelles sont intrinsèquement bruitées, la manipulation d’agrégats statistiques tels que la moyenne arithmétique ou la médiane impose une vigilance extrême. Un mauvais agencement graphique risque de dissimuler des asymétries de distribution fondamentales ou d’amener le lecteur à postuler une équidistance fallacieuse entre des niveaux d’échelles de mesure subjectives, de type Likert, rompant ainsi le contrat de neutralité de l’observation scientifique.
L’évitement des biais d’interprétation visuelle constitue un prérequis incontournable de la recherche empirique. La perception humaine des surfaces et des longueurs est soumise à des illusions cognitives documentées par la psychologie de la Gestalt. Lorsqu’un diagramme juxtapose des barres de sous-groupes sans respecter une ségrégation spatiale sans ambiguïté, l’œil de l’analyste tend à agréger involontairement les rectangles adjacents en blocs informes, perdant la capacité d’isoler la contribution spécifique de chaque sous-groupe expérimental. La rigueur impose donc de concevoir une architecture visuelle discriminant clairement l’effet intra-sujet de l’effet inter-sujets par une segmentation catégorielle disciplinée, interdisant toute ambiguïté sur la nature absolue ou relative des grandeurs reportées.
1.2 La grammaire des graphiques selon Leland Wilkinson appliquée à ggplot2
L’implémentation des diagrammes au sein du package ggplot2 repose sur la transposition algorithmique des principes axiomatiques formulés par le statisticien et informaticien Leland Wilkinson. Dans son œuvre matricielle, Wilkinson soutient qu’un graphique statistique ne doit point être appréhendé comme une image statique figée, mais comme une composition sémantique modulaire résultant de l’assemblage de couches indépendantes et interconnectées. Cette approche systématique distingue formellement la source de données tabulaires, les correspondances esthétiques qui établissent un pont analytique entre variables statistiques et propriétés visuelles perceptibles, et les objets géométriques qui matérialisent ces relations sous forme de primitives tangibles dans un repère spatial déterminé.
Au sein de ce modèle conceptuel, l’assignation esthétique, désignée par l’opérateur fonctionnel aes(), constitue le pivot computationnel de la visualisation. Elle instancie une fonction mathématique projective reliant les colonnes d’un tableau d’observations à des dimensions graphiques précises : l’abscisse cartésienne, l’ordonnée quantitative, la tonalité de remplissage chromatique, la couleur de délimitation périphérique ou l’opacité sélective. Ainsi, pour générer un barplot multivariable, le facteur expérimental principal est typiquement couplé à la coordonnée horizontale, tandis que le facteur de stratification secondaire se voit assigner le canal du remplissage chromatique. La primitive géométrique interprète ensuite cette cartographie pour projeter une pluralité de bâtons distincts au lieu d’un unique agrégat indifférencié.
L’atout méthodologique majeur de cette modularité réside dans la traçabilité intégrale et la reproductibilité computationnelle du pipeline d’analyse. En séparant les transformations statistiques brutes de l’interprétation esthétique finale, la grammaire graphique immunise le chercheur contre les modifications subjectives ad hoc. Chaque étape du traitement visuel devient inspectable, vérifiable et recalculable de manière algorithmique. Cette isolation structurelle des couches graphiques permet de modifier l’échelle sous-jacente ou d’ajouter des indicateurs de dispersion sans altérer l’intégrité des relations esthétiques primaires préalablement définies, garantissant une cohérence documentaire absolue au sein des publications savantes.
1.3 Typologie des configurations multivariables pour diagrammes en bâtons
Lorsqu’il s’agit de croiser deux ou plusieurs variables catégorielles en conjonction avec une métrique quantitative continue, trois configurations structurales fondamentales se détachent au sein de la sémiologie graphique. La première configuration, qualifiée de structure juxtaposée ou en esquive, sépare physiquement les modalités du second facteur le long de l’axe des abscisses, créant ainsi des grappes de barres distinctes pour chaque niveau du facteur principal. Cette disposition offre l’avantage cognitif suprême de préserver une ligne de base d’origine commune, située à la valeur zéro, pour l’intégralité des bâtons. Elle autorise donc une évaluation directe, précise et sans distorsion de la variance absolue existant entre les différents niveaux des traitements comparés.
La deuxième configuration repose sur la structure empilée, au sein de laquelle les segments correspondant aux sous-groupes du facteur secondaire sont superposés verticalement les uns au-dessus des autres pour former une barre composite unique. Ce format graphique s’avère particulièrement efficace lorsque la métrique globale résultant de l’addition des composantes possède une signification scientifique tangible, telle qu’une population totale, un coût budgétaire agrégé ou une charge énergétique globale. En revanche, l’empilement dégrade sévèrement la capacité du lecteur à évaluer l’évolution des strates intermédiaires, privées de ligne de base commune et soumises aux fluctuations géométriques imposées par les segments inférieurs.
La troisième modalité structurelle est constituée par le diagramme normalisé à cent pour cent, qui transforme automatiquement les valeurs métriques absolues en fréquences relatives normalisées sur l’intervalle unitaire. Toutes les barres agrégées adoptent dès lors une dimension verticale identique, visualisant exclusivement la distribution proportionnelle interne de chaque groupe. Cette solution analytique est indispensable pour neutraliser les disparités statistiques causées par des effectifs d’échantillonnage inégaux, permettant d’isoler la structure de composition d’une population sans subir l’interférence de son volume total. Le choix entre ces configurations dépend impérativement de l’hypothèse de recherche posée par le protocole expérimental : évaluation des grandeurs absolues inter-groupes, appréciation du volume global cumulatif, ou comparaison fine des profils de répartition proportionnelle relative.
2. Préparation de l’environnement de programmation et principes fondamentaux
2.1 Installation et chargement des packages statistiques requis
L’initialisation d’un flux de travail rigoureux dans le système R requiert le déploiement d’un écosystème logiciel standardisé, pérenne et interopérable. La construction de visualisations sophistiquées repose prioritairement sur le méta-package tidyverse, conçu sous la direction d’Hadley Wickham. Ce recueil fédère des bibliothèques hautement spécialisées partageant une philosophie syntaxique et structurelle commune. L’incorporation globale du tidyverse garantit l’accessibilité immédiate de ggplot2 pour le rendu graphique vectoriel, tout en fournissant conjointement les fonctionnalités d’ingénierie de données contenues dans le package dplyr. Il demeure également possible, dans les environnements de calcul restreints ou les serveurs de production automatisés, de restreindre le chargement aux stricts composants minimaux requis via l’appel ciblé aux bibliothèques isolées.
La manipulation des données préalablement à leur passage dans le moteur géométrique nécessite une mobilisation constante des verbes de transformation de dplyr. Des opérations telles que le filtrage d’observations aberrantes, le regroupement factoriel par classes expérimentales, et l’agrégation statistique pour l’obtention des moyennes et des indices de dispersion s’exécutent de manière optimale dans cet environnement déclaratif unifié. Cette interconnexion logique entre manipulation tabulaire et sémiotique visuelle simplifie le passage des objets de données au sein des pipelines analytiques en limitant les copies mémoire inutiles et les conversions de types hasardeuses qui corrompent fréquemment les structures vectorielles sous R de base.
Une vigilance particulière doit être accordée au contrôle strict des versions logicielles et à la compatibilité des dépendances binaires sous-jacentes. L’évolution de ggplot2 à travers ses versions majeures successives a introduit des modifications substantielles dans la gestion des thèmes graphiques par défaut, le traitement formel des échelles chromatiques et les protocoles d’alignement des textes vectoriels. L’adoption d’outils d’isolation d’environnement tels que renv s’avère hautement recommandée dans le cadre de recherches académiques publiables. Ce dispositif fige l’arbre exact des versions des packages invoqués, assurant qu’un script générant un diagramme en bâtons multivariable produise un résultat visuel et numérique rigoureusement identique lors d’une réplication ultérieure sur une architecture informatique tierce.
2.2 Anatomie d’une instruction de base avec la fonction ggplot
La genèse d’une figure statistique sous ggplot2 débute invariablement par l’invocation de la fonction d’instanciation primordiale nommée ggplot(). Cette routine computationnelle procède à la création d’un conteneur graphique abstrait et initialise les métadonnées de base associées à la visualisation. Lorsqu’elle est appelée sans paramètre géométrique subséquent, la fonction génère un espace cartésien neutre, dépourvu de tout élément figuratif, mais configuré selon les spécifications intrinsèques de l’échantillon d’observations transmis via son argument source. Cette séparation délibérée entre l’instanciation du conteneur et le tracé physique des marques visuelles illustre parfaitement l’essence modulaire de la grammaire wilkinsonienne.
La transmission des correspondances esthétiques globales s’opère par l’intermédiaire de l’auxiliaire syntaxique aes() imbriqué dans l’instruction d’initialisation. Les arguments positionnels horizontaux et verticaux y reçoivent formellement les noms symboliques des vecteurs composant la structure tabulaire d’entrée. Dans le cadre précis d’une figure multivariable, une troisième dimension perceptive doit être corrélée à un vecteur de stratification pour permettre la ségrégation des sous-groupes. Cette attribution s’effectue usuellement par l’affectation du second facteur prédictif au canal désigné par l’argument fill, lequel détermine la teinte de remplissage surfacique des polygones de chaque bâton, se distinguant théoriquement de l’argument color qui gouverne exclusivement le contour linéaire périphérique.
L’héritage hiérarchique des esthétiques constitue l’un des mécanismes les plus puissants du moteur ggplot2. Toute assignation d’une variable au sein de l’instruction aes() déclarée à la racine de l’appel ggplot() est automatiquement propagée à l’ensemble des couches géométriques additionnelles ultérieurement raccordées au moyen de l’opérateur d’addition binaire. Cela assure la consistance globale du graphique tout en permettant, si le protocole sémiotique l’exige, de surcharger localement ces esthétiques au sein d’une géométrie spécifique, offrant une flexibilité totale lors de l’adjonction ultérieure d’indicateurs paramétriques ou de textures complémentaires sans redéfinition globale fastidieuse.
2.3 Distinction technique entre geom_bar et geom_col
L’un des écueils les plus récurrents rencontrés lors de l’apprentissage de la grammaire de ggplot2 réside dans la confusion opérationnelle entre les deux primitives géométriques dédiées aux bâtons : geom_bar() et geom_col(). Bien qu’elles produisent des rendus graphiques morphologiquement similaires constitués de parallélépipèdes verticaux ou horizontaux, leurs mécanismes computationnels internes divergent radicalement dans la transformation sous-jacente des données transmises. Cette dichotomie structurelle découle de la spécification de la transformation statistique implicite associée à chaque fonction géométrique.
Par défaut, la fonction geom_bar() applique un algorithme de transformation statistique nommé stat_count(). Cela signifie que le logiciel ne requiert aucune variable quantitative explicite pour l’ordonnée cartésienne : il balaie le vecteur discret assigné à l’abscisse, dénombre de manière automatisée la fréquence d’apparition de chaque niveau factoriel, et attribue ces sommes d’occurrences comme hauteur des barres finales. Si un utilisateur tente d’alimenter directement geom_bar() avec un tableau récapitulatif contenant déjà des moyennes pré-calculées ou des indices monétaires tout en omettant de redéfinir l’argument statistique sur l’identité formelle, le compilateur graphique intercepte l’instruction comme une erreur de cardinalité dimensionnelle ou produit une sommation redondante aberrante.
À l’inverse, l’instruction geom_col() intègre nativement la spécification statistique stat_identity(). Elle postule obligatoirement que l’utilisateur fournit de façon conjointe une variable catégorielle sur l’un des axes et une variable numérique scalaire pré-calculée sur l’axe opposé. Pour la conception d’un barplot multivariable en milieu académique — où l’on reporte quasi systématiquement des grandeurs estimées issues de modèles statistiques, des pourcentages contrôlés ou des scores moyens pondérés accompagnés de leur dispersion —, l’utilisation méthodique et directe de geom_col() s’impose comme une recommandation méthodologique prépondérante. Elle favorise une transparence computationnelle totale en séparant distinctement le pipeline de calcul analytique d’une part, et la routine d’encodage graphique pur d’autre part.
3. Structuration et mise en forme des données tabulaires
3.1 Le paradigme du format long versus format large
La condition sine qua non d’une utilisation fluide et robuste de ggplot2 réside dans la mise en conformité stricte des données d’entrée avec les principes méthodologiques formalisés sous l’appellation de format ordonné, ou tidy data. Cette convention théorique impose une équivalence univoque entre la morphologie tabulaire et la sémantique de l’expérience : chaque variable étudiée doit constituer une et une seule colonne distincte, chaque observation ou unité d’échantillonnage doit occuper une ligne spécifique, et chaque valeur scalaire élémentaire doit être assignée à une cellule individuelle. Les données collectées dans les protocoles comportementaux ou biologiques se présentent hélas fréquemment sous un format dit large, au sein duquel les modalités successives d’un facteur répété ou d’un sous-groupe sont disséminées dans de multiples colonnes juxtaposées.
La présence d’un format large empêche l’exploitation des canaux esthétiques fondamentaux de ggplot2. Le moteur graphique ne peut pas lier la couleur de remplissage à une variable si les niveaux de cette dernière constituent les intitulés de colonnes indépendantes dans la matrice de données. L’analyste se trouve alors contraint d’appliquer une opération mathématique de réorganisation structurelle visant à pivoter le tableau matriciel le long de son axe d’observation. Cette opération transforme la collection de colonnes de mesures en un couple unifié constitué d’une colonne de clés factorielles capturant les anciens noms de champs, et d’une colonne de valeurs numériques regroupant les grandeurs associées, comprimant ainsi la largeur de la table tout en étendant verticalement sa longueur d’échantillonnage.
L’implémentation algorithmique de cette transformation s’effectue élégamment dans l’écosystème moderne de R au moyen de la fonction pivot_longer() issue du package tidyr. En spécifiant explicitement les colonnes matrices cibles à résorber, ainsi que les désignations lexicales des deux nouvelles variables générées, le chercheur reconfigure l’espace tabulaire en une structure parfaitement intelligible pour l’analyse factorielle. Ce passage systématique et maîtrisé du format étendu vers le format long constitue le fondement invariable autorisant l’assignation simultanée d’un facteur primaire sur l’axe cartésien et d’un facteur secondaire sur le canal d’ordonnancement ou de remplissage chromatique au sein de la grammaire de visualisation.
3.2 Création d’un ensemble de données empiriques structuré
Afin d’illustrer la construction d’un diagramme multivariable à haute fidélité sans dépendre de sources externes instables, il est méthodologiquement pertinent de synthétiser un jeu de données expérimental contrôlé simulant un plan factoriel croisé à mesures répétées ou sous-groupes indépendants. Considérons un protocole évaluant l’efficacité de trois modalités thérapeutiques distinctes administrées à des cohortes de participants stratifiées selon leur profil clinique, caractérisé par deux groupes diagnostiques homogènes. Pour conférer un réalisme substantiel à cet échantillon théorique, il convient de générer un nombre répliqué d’observations au sein de chaque sous-cellule expérimentale afin de capturer l’hétérogénéité stochastique naturelle inhérente aux mesures quantitatives réelles.
La génération computationnelle d’un tel agencement factoriel s’appuie fréquemment sur des fonctions de répétition combinatoire couplées à des tirages pseudo-aléatoires au sein de distributions normales paramétrées. Chaque combinaison de facteurs doit être peuplée d’indices scalaires représentatifs, par exemple un score moyen de récupération psychophysiologique ou un temps de latence cognitive mesuré en millisecondes. Il est alors essentiel d’instancier un tableau de données, de type tibble, intégrant formellement les colonnes désignant l’identifiant du sujet, l’affectation au traitement expérimental, la strate clinique d’appartenance, et le score métrique quantitatif résultant de l’évaluation standardisée.
Préalablement à toute tentative de cartographie géométrique, une phase d’audit qualité s’impose pour valider l’intégrité de la structure tabulaire ainsi générée. Cet audit implique la vérification des types primitifs de données, l’absence absolue de valeurs manquantes non documentées ou tronquées sur les identifiants d’interaction, et la balance de l’échantillon si le protocole théorique prévoyait un plan expérimental orthogonale équilibré. L’application préventive de ces diagnostics descriptifs élémentaires immunise le chercheur contre les anomalies spatiales ultérieures, telles que l’apparition de barres fantômes de dimensions nulles ou le rejet silencieux de lignes d’observations par le moteur de rendu de ggplot2.
3.3 Gestion et typage des facteurs pour l’ordonnancement catégoriel
L’une des causes fondamentales de dysfonctionnement esthétique dans les figures produites sous R provient de la confusion pernicieuse entre les vecteurs de chaînes de caractères brutes et les vecteurs typés sous forme de facteurs stochastiques formels. Par défaut, lorsqu’un ensemble de chaînes textuelles est transmis aux esthétiques cartésiennes de ggplot2, la fonction convertit implicitement les données sous-jacentes selon un ordonnancement alphanumérique strictement standardisé. Dans la majorité des protocoles de recherche, cette organisation alphabétique passive s’avère méthodologiquement absurde : elle sépare les groupes témoins des conditions actives ou détruit la séquence temporelle logique d’un plan d’exposition séquentiel.
La neutralisation de cette contrainte nécessite une conversion explicite et rigoureuse de chaque variable catégorielle en facteur catégorisé au moyen de la fonction factor(), ou des primitives spécialisées du package forcats. Cette procédure permet à l’expérimentateur d’assigner manuellement l’agencement immuable des niveaux factoriels sous-jacents. L’ordre séquentiel défini au sein du vecteur des niveaux dicte impérativement au compilateur de ggplot2 l’emplacement exact occupé par chaque barre sur l’axe des abscisses, ainsi que l’ordre séquentiel d’apparition des étiquettes et des symboles au sein de la légende explicative associée.
L’exploitation fine du package forcats enrichit considérablement cette discipline de typage. Des fonctions canoniques telles que fct_reorder() permettent de réorganiser les modalités d’un facteur selon la valeur médiane ou moyenne d’une variable métrique concomitante, tandis que fct_rev() inverse instantanément l’ordonnancement des niveaux pour adapter le graphique aux exigences sélectives de lecture descendante ou ascendante. La manipulation délibérée des facteurs confère au concepteur de la figure un contrôle absolu sur la trajectoire visuelle du lecteur, transformant une juxtaposition arbitraire de bâtons en une progression narrative fluide, hiérarchisée et conforme aux hypothèses théoriques sous-jacentes.
4. Construction pas à pas d’un barplot groupé avec position esquivée
4.1 Mise en œuvre du positionnement esquivé via position_dodge
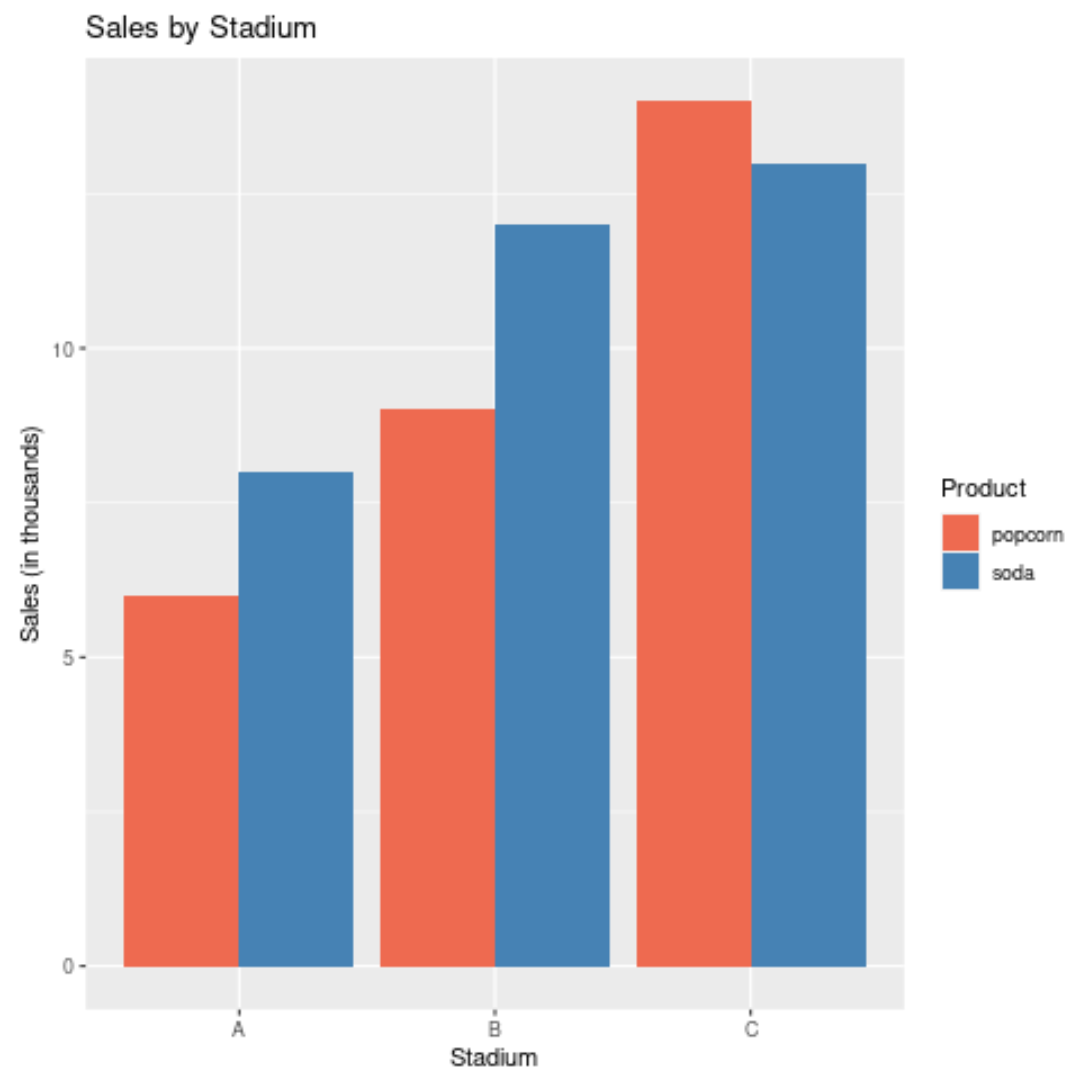
Le diagramme en bâtons multivariable par excellence repose sur le principe de l’esquive spatiale, une opération sémiotique désignée sous le vocable anglo-saxon de position dodging. Cette mécanique consiste à fragmenter le groupe de barres associé à une catégorie primaire de l’axe cartésien horizontal en autant de segments individualisés qu’il existe de modalités dans le facteur secondaire assigné au remplissage, puis à les décaler latéralement sans chevauchement. Ce déploiement côte à côte assure que chaque sous-groupe dispose d’une surface propre et distincte émergeant rigoureusement depuis le niveau zéro du système de coordonnées, maximisant ainsi l’acuité des jugements comparatifs inter-sujets.
Dans la syntaxe de ggplot2, ce comportement peut être sollicité de manière sommaire en fournissant la chaîne littérale standardisée position = "dodge" au sein de l’instruction géométrique choisie. Néanmoins, cette notation abréviée applique des paramètres de décalage rigides et automatisés qui se révèlent rapidement insuffisants dès lors que l’on cherche à paramétrer des ajustements dimensionnels fins, ou que l’on envisage de surimposer des couches graphiques secondaires telles que des barres d’erreur statistique. L’approche rigoureuse en milieu scientifique consiste donc à instancier formellement la fonction d’ajustement géométrique position_dodge() en tant qu’objet fonctionnel complet.
L’utilisation explicite de l’objet position_dodge() confère au statisticien le contrôle paramétrique direct sur l’amplitude numérique de la translation latérale appliquée aux primitives géométriques. En synchronisant cet objet entre les multiples couches visuelles d’un même graphique, on élimine de façon définitive les risques fréquents de collision spatiale, de superposition chaotique ou de déphasage géométrique entre les barres de moyennes et leurs indicateurs de dispersion correspondants. Cette instanciation formelle constitue l’étape fondatrice assurant l’intégrité architecturale de la scène visuelle générée.
4.2 Contrôle géométrique de la largeur et de l’espacement des barres
La lisibilité d’un diagramme en barres groupées est hautement conditionnée par l’équilibre géométrique existant entre l’épaisseur matérielle des bâtons et l’espace négatif, ou blanc typographique, qui sépare les grappes catégorielles successives le long de l’abscisse. Par défaut, ggplot2 configure une largeur de barre standardisée unitaire qui peut saturer visuellement l’espace cartésien, générant une sensation d’encombrement graphique pénalisant la discrimination rapide des contrastes expérimentaux. Pour moduler cette densité, le concepteur dispose du paramètre width directement intégré à la primitive géométrique, définissant la fraction de l’intervalle catégoriel horizontal allouée à la matérialisation physique des polygones rectangulaires.
Une interaction technique subtile lie le paramètre d’épaisseur width de la fonction géométrique et l’argument d’esquive spatiale width paramétré au sein de position_dodge(). Pour préserver une juxtaposition contiguë des barres d’un même sous-groupe sans laisser d’interstices anarchiques ni provoquer de chevauchements partiels, la valeur d’esquive doit être strictement calibrée en phase avec la largeur globale assignée aux barres. Lorsque ces deux grandeurs numériques sont rigoureusement alignées, par exemple sur une valeur d’amplitude normalisée à zéro virgule neuf, les rectangles constitutifs de chaque modalité secondaire s’emboîtent avec une régularité géométrique parfaite.
L’ajustement réfléchi de cette métrique dimensionnelle poursuit un objectif d’ergonomie cognitive précis. Il permet d’établir une hiérarchie perceptive instantanée : l’intervalle spatial intra-groupe séparant les barres contiguës d’une même modalité primaire doit demeurer nettement inférieur à l’intervalle spatial inter-groupes isolant les grappes catégorielles entre elles. Cette différenciation des vides structurels exploite directement la loi de proximité gestaltiste, guidant l’œil du chercheur vers la reconnaissance spontanée de la partition expérimentale et facilitant la lecture comparative immédiate des effets du traitement à travers les sous-cohortes examinées.
4.3 Syntaxe minimale reproductible pour barplot multivariable groupé
L’assemblage concret d’un script fonctionnel illustre la mise en cohérence de l’ensemble de ces préceptes méthodologiques. Dans une démarche canonique, la table de données consolidée en amont est passée au constructeur graphique, au sein duquel l’abscisse reçoit la variable catégorielle indépendante primaire, l’ordonnée accueille la métrique scalaire issue de l’agrégation statistique, et l’argument de remplissage capture le facteur de segmentation secondaire. La couche de projection physique est immédiatement jointe par l’intermédiaire de geom_col(), au sein de laquelle la largeur géométrique et le décalage par esquive sont fixés conjointement pour garantir un agencement spatial irréprochable.
L’exécution de cette syntaxe minimale robuste génère une structure graphique fondamentale exempte d’artefacts techniques. Les barres sont réparties équitablement, regroupées en clusters méthodologiques homogènes, et adoptent par défaut une palette chromatique contrastée distribuée le long de la roue chromatique unitaire de R. Néanmoins, l’observation critique de cette sortie brute met instantanément en lumière les lacunes inhérentes à un rendu natif : absence totale d’indicateurs de variance probabiliste, échelles cartésiennes définies sans respiration marginale, typographie générique non optimisée et conventions graphiques éloignées des standards éditoriaux contemporains.
Cette étape minimale ne doit donc en aucun cas être perçue comme un produit d’analyse finalisé, mais plutôt comme le squelette fonctionnel sur lequel l’analyste va greffer des couches d’enrichissement sémiologique. Elle confirme la validité formelle de l’association entre les données ordonnées et les primitives spatiales, confirmant que le moteur computationnel traite de manière idoine la cardinalité des facteurs croisés. C’est à partir de cette fondation stabilisée que s’articulent la diversification des modes de projection, l’ajustement colorimétrique rigoureux et la quantification explicite des incertitudes statistiques.
5. Représentations alternatives : diagrammes empilés et normalisés
5.1 Implémentation du barplot empilé avec position_stack
Bien que la disposition esquivée demeure la norme préférentielle pour l’estimation analytique des moyennes expérimentales, l’architecture du diagramme empilé, implémentée sous ggplot2 au moyen de la directive position_stack(), remplit une fonction sémiotique fondamentale lorsque l’objet d’étude porte sur la décomposition analytique d’un tout cumulé. Dans cette configuration géométrique, les rectangles symbolisant les modalités du facteur secondaire ne sont plus déplacés latéralement, mais s’empilent verticalement les uns sur les autres le long de l’axe des ordonnées. La cote sommitale du rectangle le plus élevé coïncide dès lors rigoureusement avec la sommation arithmétique globale de l’ensemble des strates constitutives.
Sur le plan de la validité méthodologique, l’emploi de cette structure requiert impérativement que la métrique tracée soit de nature strictement additive et non-négative. Elle s’applique de manière idéale à la décomposition d’un temps total d’observation comportementale fractionné en divers sous-types d’activités motrices, ou à la répartition des charges financières globales allouées à divers départements d’un centre de recherche clinique. Tenter d’empiler des métriques d’intensités relatives, des moyennes standardisées ou des indices pouvant adopter des valeurs négatives constitue un contresens statistique majeur aboutissant à une distorsion visuelle inacceptable de la réalité sous-jacente.
Il importe toutefois de souligner les sévères limites cognitives inhérentes à la lecture du barplot empilé. Si le segment positionné à la base du tracé bénéficie d’une ligne de référence commune calée sur l’abscisse zéro — autorisant une évaluation comparative aussi précise que dans une configuration esquivée —, les segments situés aux étages supérieurs reposent sur des lignes de flottaison instables, dépendantes de la variabilité cumulative des strates sous-jacentes. L’appareil visuel humain se montrant notoirement défaillant pour juger des longueurs de segments dépourvus d’origine commune, la comparaison de la magnitude des couches intermédiaires d’une barre à l’autre s’avère particulièrement imprécise et sujette à de fortes distorsions perceptuelles.
5.2 Standardisation relative via le positionnement normalisé
Pour s’émanciper des distorsions induites par les disparités d’échelles absolues tout en préservant le principe d’empilement vertical, la grammaire graphique intègre le positionnement normalisé, opéré via l’instruction position_fill(). Cet ajustement algorithmique recalcule à la volée la contribution absolue de chaque strate pour la convertir en une fraction décimale de la somme locale de la barre, bornant uniformément l’ensemble des colonnes composites entre une base nulle et une limite maximale stricte de un, équivalant à cent pour cent de la composition sectorielle.
Cette approche apporte une solution méthodologique de premier ordre dans les protocoles d’observation où les tailles d’échantillons ou les volumes de population varient substantiellement d’une condition d’observation à l’autre. Par exemple, si l’on examine la distribution phénotypique ou la proportion d’adhésion à un protocole clinique au sein de cohortes dont les effectifs bruts divergent fortement pour des raisons de recrutement démographique, l’examen des grandeurs absolues masque fréquemment les variations de profils relatives. Le recours à position_fill() neutralise mathématiquement le biais de volume pour focaliser l’évaluation visuelle sur l’anatomie proportionnelle interne de chaque groupe.
L’interprétation de ces diagrammes normalisés exige néanmoins une explicitation rigoureuse dans l’appareil d’accompagnement de la figure. L’ordonnée cartésienne ne reflétant plus des grandeurs physiques directes mais des ratios de décomposition, il convient de reformater systématiquement les graduations de l’axe vertical sous forme de pourcentages explicites. Cette standardisation graphique garantit que le lecteur n’attribue pas à un groupe numériquement marginal une importance démographique équivalente à celle d’un groupe massif, préservant ainsi l’exactitude de l’inférence contextuelle sans sacrifier la précision du détail compositionnel.
5.3 Critères méthodologiques de sélection entre esquive et empilement
L’arbitrage formel entre les architectures esquivées, empilées absolues et normalisées à cent pour cent ne saurait résulter d’une simple préférence esthétique subjective ; il engage directement la responsabilité épistémologique du chercheur quant à la transmission fidèle de ses résultats. Le choix doit découler d’un alignement méthodologique strict avec la nature des variables mesurées et la hiérarchie des hypothèses scientifiques formulées. Le schéma esquivé doit systématiquement prévaloir lorsque la question centrale porte sur l’interaction factorielle et la détection d’écarts de moyennes indépendants, où chaque sous-groupe expérimental doit être jaugé à l’aune de sa propre performance absolue.
À l’inverse, l’empilement absolu ne se justifie que lorsque la métrique totale résultante possède une signification première prépondérante dans le modèle explicatif par rapport à l’importance relative de ses composants isolés. Si la curiosité de l’analyste se porte en premier lieu sur la préservation du total et secondairement sur une estimation visuelle grossière du partage des charges, le tracé de position_stack() demeure admissible. Dès lors que l’analyste s’intéresse exclusivement aux variations de distribution structurelle au détriment des volumes globaux, la géométrie de position_fill() s’impose naturellement comme l’unique format épistémologiquement fondé.
Tout manquement à ces critères de sélection expose la communication scientifique à des risques manifestes d’erreurs d’interprétation chez le lecteur académique. Présenter des proportions cumulées sous forme esquivée tend à dissimuler la complétude du tout, obligeant l’esprit à une recomposition mentale arithmétique laborieuse. Inversement, empiler des grandeurs d’intensité non additives relève d’une faute méthodologique qui fausse le jugement en érigeant une hauteur cumulée totalement dépourvue de réalité empirique dans le monde observable.
6. Gestion avancée de la palette chromatique et de l’accessibilité visuelle
6.1 Personnalisation manuelle des teintes via scale_fill_manual
L’utilisation non maîtrisée des palettes chromatiques générées automatiquement par les logiciels d’analyse de données constitue l’une des faiblesses récurrentes de la production graphique scientifique. L’attribution arbitraire de teintes par défaut compromet souvent la hiérarchie informative, introduit des associations culturelles ou sémantiques inappropriées et dégrade la clarté visuelle globale. L’environnement ggplot2 répond à cette problématique par l’intermédiaire de fonctions d’échelle modulaires, au premier rang desquelles figure la routine scale_fill_manual(), conférant à l’utilisateur une autorité totale sur le mappage chromatique appliqué aux variables de remplissage catégorielles.
Le paramétrage rigoureux de scale_fill_manual() repose sur l’injection d’un vecteur de valeurs scalaires encodées sous la forme de codes hexadécimaux standardisés à six caractères ou de désignations chromatiques formellement répertoriées. Il est méthodologiquement impératif de construire un vecteur nommé associant expressément chaque code couleur à la modalité textuelle correspondante de la variable factorielle représentée. Cette liaison explicite élimine tout risque de permutation aléatoire des couleurs lors de réordonnancements ultérieurs du tableau de données ou en présence de filtrages sélectifs masquant temporairement certaines conditions expérimentales.
Cette maîtrise manuelle des nuances autorise l’intégration de principes de mise en relief sélective hautement fonctionnels dans les publications à fort volume de données. L’analyste peut assigner délibérément des teintes neutres, telles que des gris froids ou des ocres désaturés, aux conditions de contrôle standard ou aux sous-groupes de référence, tout en réservant une teinte saturée et vibrante à la cohorte ayant reçu l’intervention novatrice d’intérêt. Ce guidage attentionnel fondé sur le contraste chromatique structurel accroît l’efficacité de la transmission scientifique en attirant immédiatement le regard du lecteur sur le cœur de la découverte empirique rapportée.
6.2 Adoption de palettes perceptuellement uniformes
Au-delà de la personnalisation manuelle ponctuelle, la pratique scientifique contemporaine privilégie de plus en plus l’adoption de systèmes d’échelles chromatiques conçus selon les règles rigoureuses de l’uniformité perceptuelle. Dans un système de ce type, une variation numérique équivalente entre deux valeurs dans l’espace théorique correspond à une distance perceptuelle rigoureusement constante pour l’œil humain à travers l’ensemble du spectre utilisé. À ce titre, la suite d’échelles viridis, intégrée nativement dans ggplot2 via la fonction scale_fill_viridis_d() pour les variables discrètes, constitue le standard de référence par excellence.
Les échelles viridis présentent la particularité mathématique de progresser de façon monotone le long de l’axe de luminance globale tout en modulant harmonieusement les saturations spectrales. Cette caractéristique préserve la transmission intégrale de l’information sous-jacente même en cas d’impression sur support papier monochrome en nuances de gris — une contrainte logistique encore largement répandue dans la distribution physique des revues savantes. Aucune bande spectrale ne semble artificiellement dilatée ou rétrécie, immunisant le barplot multivariable contre les artefacts optiques qui caractérisent notoirement les palettes arc-en-ciel conventionnelles de type jet ou rainbow.
Une alternative tout aussi robuste pour la stratification des facteurs discrets réside dans les échelles ColorBrewer, développées initialement par la cartographe Cynthia Brewer et mobilisables au moyen de scale_fill_brewer(). Ces palettes reposent sur une typologie fonctionnelle divisant les besoins chromatiques en séquences ordonnées, échelles divergentes articulées autour d’un pivot médian neutre, et palettes qualitatives pures destinées aux variables nominales exemptes de hiérarchie. La sélection méthodique d’une palette qualitative issue de ColorBrewer garantit une séparabilité perceptive maximale des sous-groupes sans privilégier visuellement une catégorie par un excès immérité de brillance lumineuse.
6.3 Accessibilité universelle et conformité pour daltonisme
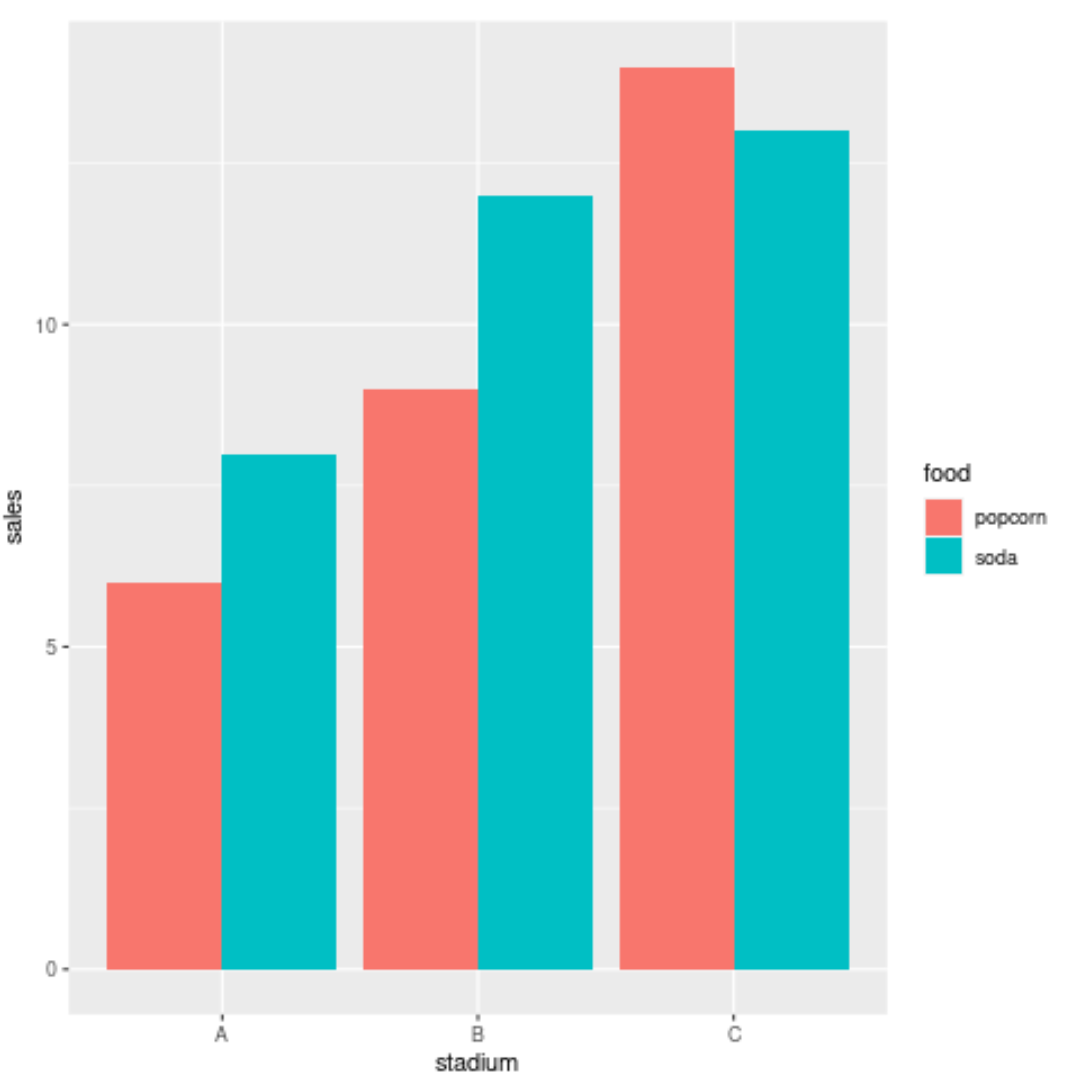
L’impératif de démocratisation et de rigueur éthique de la recherche scientifique impose de garantir l’accessibilité universelle des visualisations produites à l’ensemble de la communauté académique, y compris aux personnes présentant des anomalies de la perception des couleurs. Les dyschromatopsies congénitales, au premier rang desquelles la deutéranopie et la protanopie affectant la différenciation des longueurs d’ondes rouges et vertes, touchent une fraction substantielle de la population humaine masculine. Concevoir un barplot multivariable discriminant deux cohortes thérapeutiques critiques uniquement par une opposition binaire de rouge et de vert constitue un manquement flagrant aux normes d’accessibilité éditoriales.
Pour assurer une conformité indiscutable aux standards d’accessibilité numérique, il est recommandé de soumettre systématiquement les ébauches graphiques à des algorithmes de simulation de daltonisme, facilement accessibles dans R via des extensions spécialisées telles que colorblindr ou l’instruction dichromat(). Ces outils transforment la matrice de l’image pour restituer fidèlement la perception visuelle des sujets deutéranopes, tritanopes ou achromates, permettant d’identifier immédiatement les fusions chromatiques invalidantes et de corriger l’assignation des teintes en amont de toute diffusion publique.
En outre, la meilleure pratique de conception graphique préconise l’instauration d’un système de redondance sémiotique. La couleur ne doit jamais constituer l’unique canal d’encodage distinctif des barres. En associant la modulation chromatique à des variations de motifs de hachures discrètes — rendues possibles grâce à des extensions comme ggpattern —, à des étiquetages directs judicieusement disposés, ou à une différenciation marquée de la luminance des bordures périphériques, le concepteur s’assure que son message analytique demeure parfaitement décodable indépendamment de la vision chromatique du récepteur ou de la fidélité colorimétrique du terminal d’affichage employé.
7. Calcul et intégration rigoureuse des barres d’erreur
7.1 Estimation statistique de la variabilité expérimentale
Dans la littérature scientifique internationale, un diagramme en bâtons illustrant des grandeurs empiriques sans intégrer formellement d’indicateurs de variabilité stochastique est désormais considéré comme irrecevable et non publiable. La hauteur d’une barre matérialise une tendance centrale ponctuelle, généralement la moyenne arithmétique de l’échantillon, mais demeure silencieuse quant à la densité, à la dispersion et à l’incertitude fondamentale des mesures observées. Il incombe dès lors au chercheur d’estimer avec une exactitude mathématique scrupuleuse les paramètres statistiques d’incertitude préalablement à toute entreprise de modélisation visuelle.
Le choix de la métrique d’incertitude engage des fondements épistémologiques distincts qu’il convient de ne jamais confondre. L’écart-type d’échantillonnage, abrégé en SD pour standard deviation, renseigne exhaustivement sur la dispersion intrinsèque des observations individuelles autour de la moyenne au sein de la population examinée ; il conserve une amplitude stable quelle que soit la taille de l’échantillon dès lors que la distribution est stabilisée. L’erreur-type de la moyenne, quant à elle abrégée en SEM pour standard error of the mean, estime la précision avec laquelle la moyenne d’un échantillon donné approxime la véritable moyenne paramétrique inconnue de la population parente ; elle décroît mathématiquement de façon inversement proportionnelle à la racine carrée du nombre de réplications collectées.
Une alternative inférentielle largement plébiscitée réside dans le calcul des intervalles de confiance paramétriques, fondés sur la loi de distribution théorique de Student ajustée aux degrés de liberté de l’expérience, ou générés de façon non paramétrique par le biais de rééchantillonnages algorithmiques successifs dits par bootstrap. Les intervalles de confiance à 95 % fournissent une lecture probabiliste directe : sous l’hypothèse de répétition du protocole d’échantillonnage dans des conditions strictement analogues, la fourchette métrique bornée délimitera la véritable moyenne inconnue dans quatre-vingt-quinze pour cent des itérations réalisées. L’intégration de ces métriques nécessite une dérivation computationnelle rigoureuse opérée au sein du pipeline dplyr par l’association séquentielle des fonctions group_by() et summarise().
7.2 Superposition de geom_errorbar sur des barres esquivées
L’adjonction visuelle d’indicateurs de variabilité sur un barplot multivariable esquivé représente l’un des défis techniques les plus délicats de ggplot2, fréquemment source de désalignements spatiaux majeurs. La fonction géométrique dédiée, nommée geom_errorbar(), requiert l’assignation de deux coordonnées verticales obligatoires au sein de ses correspondances esthétiques : ymin, définissant la borne inférieure calculée de l’intervalle, et ymax, matérialisant sa borne supérieure. Lorsque ces coordonnées sont injectées sur une structure catégorielle croisée, la géométrie doit être expressément avertie de la répartition spatiale latérale appliquée aux barres sous-jacentes.
La résolution absolue de tout conflit d’alignement impose de synchroniser formellement le paramètre position_dodge() de la géométrie des barres d’erreur avec celui assigné à la primitive geom_col(). L’argument numérique d’amplitude d’esquive doit être strictement identique dans les deux déclarations, sans quoi le moteur graphique procède à des calculs de décalage asynchrones qui aboutissent au positionnement aberrant des barres d’erreur à mi-chemin entre deux colonnes ou en plein cœur des interstices vides. Ce parallélisme programmatique rigoureux garantit que chaque segment d’incertitude vient se jucher avec une précision millimétrique au centre parfait de la tête du parallélépipède rectangulaire auquel il se rattache.
Sur le plan de l’esthétique et de la pureté du dessin, il est d’usage d’ajuster l’amplitude transversale des moustaches horizontales délimitant les bornes de la barre d’erreur. Par défaut, geom_errorbar() adopte une envergure équivalente à l’épaisseur intégrale de la barre sous-jacente, alourdissant considérablement le rendu et créant une pollution visuelle parasite à proximité des zones de contact. En réduisant drastiquement le paramètre local width de la barre d’erreur à une fraction modérée, comprise couramment entre zéro virgule un et zéro virgule trois, l’analyste confère à son tracé une élégance typographique conforme aux critères de lisibilité des meilleures maisons d’édition académiques internationales.
7.3 Bonnes pratiques académiques relatives à la transparence des données
La présentation d’un diagramme en bâtons surmonté d’une barre d’erreur standard ne satisfait plus pleinement les exigences actuelles de la science ouverte et de la reproductibilité empirique. De nombreux collectifs scientifiques dénoncent l’effet d’occultation produit par les barplots, souvent désignés sous l’appellation péjorative de graphiques dynamite. En comprimant l’ensemble d’un nuage distributionnel complexe en deux grandeurs scalaires uniques — une moyenne et un écart —, le chercheur dissimule involontairement d’éventuelles distributions multimodales, des dissymétries prononcées ou la présence d’observations aberrantes influentes qui invalident pourtant l’usage même de la moyenne arithmétique.
Pour restaurer la transparence des données tout en maintenant l’utilité synthétique du barplot multivariable, les normes de publication encouragent la superposition directe des observations individuelles brutes sous forme de points semi-transparents. Cette prouesse géométrique est opérée sous ggplot2 au moyen de l’extension de positionnement position_jitterdodge() associée à la primitive geom_point(). Cet agencement déplace les observations individuelles de manière contrôlée le long d’un axe d’esquive couplé à une dispersion stochastique modérée, distribuant un nuage de points directement au-dessus ou à l’intérieur de chaque bâton sans saturer l’espace par un empilement artificiel rigide.
Enfin, toute communication de résultats expérimentaux impose l’inclusion systématique d’une note de légende exhaustive stipulant avec clarté la métrique d’incertitude retenue. L’omission de cette précision constitue un vice méthodologique lourd : le lecteur ne peut deviner si les bornes délimitent un écart-type purement descriptif, une erreur-type reflétant la puissance d’échantillonnage ou un intervalle de confiance probabiliste. L’énoncé explicite de la taille réelle de l’échantillon par sous-groupe et de la nature formelle de l’indicateur assure une traçabilité totale et permet aux spécialistes du domaine de conduire des méta-analyses précises à partir des figures publiées.
8. Personnalisation typographique et stylistique des axes et légendes
8.1 Modification des intitulés avec la fonction labs
La lisibilité sémantique d’une figure scientifique repose fondamentalement sur la précision et l’exhaustivité de ses éléments textuels contextuels. Les conventions de nommage employées au sein des structures de données informatiques privilégient des identifiants concis, fréquemment rédigés en syntaxe camelCase, serpentée ou agrémentée d’abréviations cryptiques adaptées au codage mais totalement inaptes à la communication éditoriale. Laisser de telles désignations techniques brutes sur les axes ou la légende d’un graphique publié témoigne d’un manque de rigueur préjudiciable. La fonction unifiée labs() fournit l’interface dédiée pour convertir ces identifiants logiciels en libellés textuels irréprochables.
L’utilisation de la fonction labs() centralise en une déclaration unique l’ensemble des titres fonctionnels de la composition visuelle. Elle permet d’assigner un titre principal clair et synthétique, un éventuel sous-titre contextualisant le protocole ou la cohorte observée, ainsi qu’une légende de bas de page formelle documentant la taille globale de l’échantillon et les niveaux de significativité des tests statistiques mis en œuvre. De surcroît, elle gère de manière ciblée les intitulés des coordonnées cartésiennes horizontales et verticales, imposant d’inclure obligatoirement entre parenthèses ou crochets les unités physiques ou métriques dans lesquelles sont exprimées les mesures quantitatives reportées.
Un aspect critique souvent négligé concerne le traitement de la légende générée par l’assignation du facteur de remplissage chromatique. Par défaut, ggplot2 attribue au bandeau de légende le nom brut de la variable mappée dans aes(fill = ...). Au sein de l’environnement labs(), il est indispensable de surcharger cette assignation en stipulant expressément l’argument correspondant pour fournir un intitulé descriptif complet et soigné. Si la composition du graphique et la distribution spatiale des catégories rendent la signification des sous-groupes chromatiques immédiatement auto-évidente, l’assignation d’une valeur nulle à ce titre de légende permet d’épurer la composition textuelle tout en maximisant la place allouée à l’espace cartésien pur.
8.2 Configuration des échelles discrètes et continues
Le contrôle chirurgical de la géométrie spatiale s’exécute par l’intermédiaire des fonctions régissant le comportement des échelles de coordonnées, identifiées par les préfixes scale_x_ et scale_y_. Sur l’axe continu des ordonnées, gouverné typiquement par scale_y_continuous(), le chercheur dispose d’une série de paramètres pour stabiliser le cadre d’affichage. L’argument breaks autorise la spécification manuelle des graduations maîtresses, éliminant les pas d’incrémentation bizarres ou asymétriques générés de manière algorithmique par le moteur par défaut, et garantissant que les repères numériques reflètent des seuils théoriquement pertinents pour la discipline concernée.
Une idiosyncrasie graphique notable de ggplot2 réside dans l’adjonction automatique d’une marge d’expansion de cinq pour cent le long des limites cartésiennes, destinée à empêcher que les points de données n’entrent en collision directe avec les axes structurels. Si cette disposition s’avère bénéfique pour un nuage de points, elle produit sur un barplot un effet particulièrement disgracieux en créant un espace de flottaison vide sous la base des barres, qui semblent alors flotter au-dessus de la ligne zéro d’abscisse. L’utilisation avertie de l’argument expand = expansion(mult = c(0, 0.05)) neutralise intégralement ce vide inférieur en forçant l’ancrage direct et net de la base des bâtons sur l’axe cartésien, tout en maintenant une marge d’aération protectrice à l’extrémité supérieure pour éviter que les barres d’erreur ne percutent le bord externe du cadre.
Sur l’axe catégoriel des abscisses, régulé par scale_x_discrete(), l’expérimentateur dispose d’outils puissants pour intervenir sur le flux séquentiel des données sans avoir à restructurer la matrice de données sous-jacente. L’argument limits permet de réordonner instantanément l’agencement horizontal des modalités factorielles ou d’exclure arbitrairement un sous-groupe d’analyse sans perturber le reste de la scène. Conjointement, l’argument labels permet d’associer des chaînes de caractères enrichies et correctement typographiées à chaque niveau factoriel, autorisant l’insertion d’espaces typographiques insécables, de caractères grecs ou de retours à la ligne contrôlés indispensables pour prévenir les chevauchements textuels sur des figures denses.
8.3 Application de thèmes préétablis et personnalisation via theme
Le rendu visuel global d’une composition dans ggplot2 est orchestré par le moteur de thématisation, qui encapsule l’intégralité des attributs stylistiques non directement liés aux données : fonds d’arrière-plan, lignes de quadrillage maîtresses et secondaires, épaisseurs des traits de repères et caractéristiques typographiques. Le thème par défaut, identifiable à son arrière-plan grisâtre quadrillé de blanc, a fait l’objet de critiques répétées au sein de la communauté scientifique en raison de sa consommation inutile d’encre lors de l’impression et de son interférence avec la perception des contrastes délicats. L’adoption d’alternatives épurées constitue la première étape d’une standardisation professionnelle.
L’application d’un thème préconfiguré minimaliste, tel que theme_classic() ou theme_minimal(), confère immédiatement au barplot multivariable une élégance conforme aux exigences des périodiques scientifiques majeurs. Le thème classique, en particulier, supprime tout arrière-plan superflu et élimine intégralement le quadrillage interne pour ne conserver que deux axes orthogonaux nets d’encre noire, rappelant les standards séculaires de la publication académique. Pour stabiliser l’esthétique globale de manière pérenne au sein d’un manuscrit complet, l’exécution préliminaire de la commande générale theme_set() assure l’uniformisation instantanée de toutes les figures ultérieurement compilées.
Pour peaufiner le rendu au-delà des thèmes prédéfinis, la fonction modulaire theme() offre une granularité de contrôle totale grâce à ses arguments paramétrés par des constructeurs d’éléments dédiés. La fonction element_text() régule la famille de police, la graisse, la taille en points typographiques et l’angle d’orientation des étiquettes des axes. Lorsqu’un plan expérimental croise de multiples modalités factorielles dont les dénominations s’avèrent étendues, une rotation angulaire à quarante-cinq degrés des textes de l’abscisse, associée à un calage spatial latéral via les arguments hjust et vjust, prévient toute collision textuelle disgracieuse tout en maintenant une lisibilité biomécanique confortable pour l’observateur.
9. Décomposition avancée par facettage pour variables multiples
9.1 Introduction d’un troisième facteur avec facet_wrap
Lorsque la structure factorielle d’un plan expérimental s’accroît en complexité en intégrant un troisième facteur explicatif orthogonal — tel qu’un stade chronologique d’observation longitudinale, un protocole d’induction pharmacologique complémentaire ou une ségrégation par site d’expérimentation multicentrique —, l’agrégation de l’ensemble des barres au sein d’une unique scène cartésienne conduit irrémédiablement à une saturation cognitive critique. La multiplication des bâtons esquivés génère une surcharge d’informations empêchant la lecture des interactions globales. La réponse méthodologique à cette difficulté conceptuelle repose sur le paradigme des petits multiples formalisé par Edward Tufte, incarné dans ggplot2 par les techniques de facettage.
L’adjonction de la fonction facet_wrap() scinde algorithmiquement l’échantillon de données globales en une série de sous-ensembles homogènes gouvernés par les niveaux factoriels de la troisième variable, puis projette pour chaque strate un sous-graphique miniature distinct et complet agencé selon une trame séquentielle en lignes et colonnes. Cette décomposition permet de conserver un barplot multivariable bivarié classique au sein de chaque panneau individuel — combinant le premier facteur en abscisse et le second facteur en remplissage —, tout en autorisant une navigation comparative immédiate entre les panneaux distribués dans l’espace éditorial.
Le contrôle de l’architecture matricielle dans facet_wrap() s’opère par la configuration des arguments de dimensionnement nrow et ncol, qui contraignent le nombre de rangées et de colonnes de la planche finale. Par défaut, le moteur garantit une stricte égalité d’échelle cartésienne sur l’intégralité des sous-graphiques générés. Cette contrainte d’invariance dimensionnelle constitue une garantie méthodologique fondamentale : elle interdit les variations arbitraires d’amplitudes verticales d’une facette à l’autre, assurant que des hauteurs physiques identiques de bâtons reflètent rigoureusement des valeurs statistiques d’ampleur parfaitement équivalente dans toute la figure composite.
9.2 Structuration en matrice croisée avec facet_grid
Pour les protocoles expérimentaux d’ordre supérieur caractérisés par l’interaction croisée de quatre dimensions de variables catégorielles distinctes, l’organisation séquentielle simple offerte par facet_wrap() s’avère insuffisante pour cartographier l’orthogonalité du protocole. L’environnement ggplot2 déploie alors sa primitive structurelle la plus aboutie : la fonction facet_grid(). Cette instruction projette les données selon une véritable matrice bidimensionnelle explicite, reliant les niveaux d’un facteur modérateur spécifique aux rangées horizontales du tableau visuel, tandis que les modalités d’un autre facteur régulent l’ordonnancement des colonnes verticales.
Cette disposition spatiale rigoureusement quadrillée permet d’examiner visuellement les interactions de second et de troisième ordre avec une clarté analytique sans équivalent. Chaque cellule de la grille abrite un diagramme en bâtons multivariable autonome, positionné à l’intersection exacte des conditions de stratification croisées. Le chercheur peut ainsi balayer visuellement les lignes d’un coup d’œil horizontal pour évaluer la stabilité des effets à travers le premier facteur d’agencement, puis parcourir verticalement les colonnes pour identifier de façon instantanée d’éventuelles ruptures de monotonie ou des inversions d’effets imputables à l’intervention du second facteur d’agencement matriciel.
L’utilisation de facet_grid() soulève néanmoins la question délicate de l’élasticité dimensionnelle, gérée par le paramètre scales. Si le logiciel autorise la libération des échelles via les valeurs "free_x", "free_y" ou "free", cette flexibilité doit être maniée avec une prudence épistémologique extrême lors de la composition d’un barplot. Déverrouiller l’axe des ordonnées au sein d’une matrice de facettes détruit toute base comparative immédiate : un bâton de faible magnitude physique dans un panneau donné peut être surdimensionné en raison d’un axe d’ordonnée localement dilaté, induisant gravement en erreur le lecteur qui comparerait visuellement les panneaux sans scruter obsessionnellement les étiquettes numériques de chaque axe périphérique.
9.3 Homogénéisation esthétique des bandeaux de facettes
L’intégration de multiples panneaux facettés complexifie substantiellement la charge informative globale d’un document graphique, imposant un travail minutieux d’homogénéisation stylistique pour prévenir l’encombrement perceptif. Les éléments textuels et structurels situés au sommet ou sur les flancs latéraux de chaque sous-graphique, désignés sous le terme de bandeaux de facettes, constituent l’interface sémiotique guidant l’orientation du lecteur. Une mauvaise configuration de ces en-têtes alourdit la structure et détourne l’attention des données empiriques sous-jacentes.
La personnalisation de ces bandeaux s’opère au sein de l’environnement theme() par l’intermédiaire des arguments strip.background et strip.text. En associant à strip.background une primitive element_rect() dépourvue de bordure opaque et peinte d’une nuance neutre extrêmement claire, l’analyste allège immédiatement la structure visuelle globale. L’élimination des fonds de bandeaux agressifs ou saturés au profit de séparations subtiles confère une respiration graphique indispensable, évitant l’écueil classique de la grille carcérale où les données semblent confinées au second plan derrière une armature graphique proéminente.
Parallèlement, la mise en forme de strip.text via element_text() doit assurer une lisibilité sans faille des intitulés de facettes. Il convient de calibrer avec rigueur le corps typographique en points pour éviter les césures de mots hasardeuses, tout en sélectionnant une graisse typographique semi-audacieuse pour discriminer clairement les en-têtes contextuels des valeurs scalaires des axes. L’emploi harmonieux de marges intérieures équilibrées au sein des bandeaux garantit que les labels textuels respirent sans comprimer l’espace vertical disponible pour le déploiement des primitives géométriques, aboutissant à un équilibre sémiotique global remarquable.
10. Annotation directe des barres et lisibilité numérique
10.1 Positionnement précis des étiquettes numériques avec geom_text
Bien que la force sémiotique première d’un barplot réside dans sa capacité à fournir une appréciation géométrique immédiate des grandeurs relatives, la précision quantitative fine demeure souvent requise au sein des contextes éditoriaux académiques ou décisionnels. Forcer un lecteur à projeter mentalement le sommet d’une barre sur l’axe des ordonnées au moyen d’une translation oculaire laborieuse peut générer des erreurs de parallaxe et ralentir l’assimilation cognitive des valeurs clés. L’adjonction d’étiquettes numériques directes, positionnées à proximité immédiate de chaque bâton via geom_text(), constitue une réponse ergonomique élégante.
L’implémentation de cette annotation directe sur un diagramme en bâtons multivariable impose la même rigueur algorithmique que celle régissant l’ancrage des barres d’erreur statistique. L’esthétique spécifique label doit recevoir la variable numérique scalaire cible préalablement formatée. Simultanément, la fonction geom_text() doit impérativement se voir assigner l’objet position_dodge(width = ...) calibré sur la même valeur numérique que celle régissant la primitive géométrique des barres, faute de quoi toutes les étiquettes textuelles se concentreraient au centre géométrique du groupe factoriel principal dans un télescopage chaotique illisible.
Le réglage fin de l’altitude verticale des étiquettes fait intervenir les arguments d’ancrage textuel vjust, ou de déplacement continu via nudge_y. Si l’on opte pour une disposition sommitale externe, plaçant le texte au-dessus de la crête de chaque barre, une valeur négative de vjust ou un léger incrément positif de nudge_y surélève le label pour ménager un espacement aéré avec la surface du rectangle. Si la figure incorpore simultanément des barres d’erreur statistique, le texte doit impérativement être déplacé au-delà de la borne supérieure ymax du segment d’incertitude pour prévenir tout chevauchement direct entre le tracé vectoriel de la moustache et les caractères d’imprimerie du chiffre annoté.
10.2 Utilisation de geom_label pour accroître la lisibilité textuelle
Lorsque la complexité dimensionnelle ou la saturation spatiale d’une figure interdit le placement externe des annotations au-dessus des barres, l’analyste se trouve contraint d’insérer les valeurs chiffrées à l’intérieur même du corps géométrique des rectangles de données. Dans cette configuration interne, l’application simple de caractères textuels bruts via geom_text() s’expose à de sévères problèmes de lisibilité, particulièrement lorsque la teinte de remplissage de la barre présente une luminance proche de la couleur d’encre typographique sélectionnée. La primitive spécialisée geom_label() apporte une parade technique efficace à cette dégradation du contraste.
La commande geom_label() se distingue par la génération automatisée d’un cartouche d’arrière-plan, constitué d’un polygone rectangulaire miniature enchâssant directement la chaîne typographique. Cet encadrement protecteur isole optiquement les caractères de l’arrière-plan coloré sous-jacent. En modulant le paramètre de transparence alpha et le rayon d’arrondi des coins via label.r, il est possible de concevoir des cartouches discrets semi-transparents qui maintiennent une lisibilité numérique sans masquer brutalement la continuité chromatique de la surface de la barre hôte.
Il convient toutefois de souligner qu’une utilisation immodérée de geom_label() peut alourdir visuellement la scène graphique en ajoutant une multiplicité de micro-bordures périphériques concurrentes. Le paramètre label.size, qui régule l’épaisseur du filet délimitant le cartouche, doit fréquemment être neutralisé à la valeur zéro pour éliminer tout trait de contour agressif. De même, les marges internes de rembourrage, gouvernées par l’argument label.padding, doivent être configurées avec parcimonie pour éviter que des cartouches textuels surdimensionnés n’entrent en collision mutuelle au sein de sous-groupes expérimentaux contigus particulièrement rapprochés.
10.3 Formatage algorithmique des nombres affichés
L’affichage direct de grandeurs quantitatives issues d’agrégations computationnelles sans retraitement éditorial constitue un manquement sévère aux bonnes pratiques de la publication. Des nombres scalaires projetés avec six ou sept décimales flottantes issues d’un calcul de division arithmétique saturent l’espace graphique d’informations parasites dépourvues de validité métrologique réelle. L’analyste doit impérativement conditionner algorithmiquement les chaînes numériques préalablement à leur transmission à l’argument d’encodage textuel.
L’utilisation de la bibliothèque scales simplifie considérablement cette discipline de standardisation numérique au sein du pipeline d’analyse. Des fonctions hautement spécialisées telles que label_percent(), label_number() ou label_comma() permettent de convertir à la volée des fractions continues en chaînes de pourcentages parfaitement calibrées, d’ajuster le nombre de décimales significatives autorisées, ou d’introduire des séparateurs de milliers conformes aux conventions typographiques internationales. La composition modulaire d’une expression de formatage garantit qu’une grandeur décimale brute soit traduite de manière uniforme et élégante sur l’ensemble des panneaux.
Par ailleurs, dans le cas particulier des barplots normalisés ou empilés accueillant une multitude de sous-segments secondaires, certaines strates expérimentales peuvent afficher des valeurs métriques nulles ou infinitésimales. L’impression systématique d’étiquettes affichant la valeur zéro sur des segments d’épaisseur quasi invisible génère une pollution visuelle inacceptable. Il s’avère alors méthodique d’intégrer une clause conditionnelle de filtrage, au moyen d’une syntaxe fonctionnelle type if_else() au sein de dplyr, pour substituer les valeurs inférieures à un seuil critique d’affichage par des chaînes de caractères vides. Cette précaution algorithmique garantit que seules les strates dotées d’une matérialité géométrique suffisante reçoivent une annotation textuelle explicite.
11. Diagnostic des anomalies techniques et écueils méthodologiques
11.1 Résolution des problèmes d’alignement et de décalage spatial
L’une des anomalies les plus déconcertantes survenant lors de la programmation d’un barplot multivariable réside dans le phénomène de déformation dissymétrique de la largeur des barres. Ce comportement aberrant se manifeste typiquement lorsqu’une sous-catégorie expérimentale ne contient aucune observation empirique enregistrée pour l’un des niveaux du facteur principal. Le moteur computationnel de ggplot2 traite l’absence d’observation comme un vide factoriel local ; lors de l’exécution de l’ajustement d’esquive spatiale, l’algorithme ne détecte qu’une unique modalité présente au sein de la grappe considérée et lui alloue unilatéralement l’intégralité de la largeur spatiale du cluster, produisant une barre gigantesque et difforme juxtaposée à des barres minces régulières.
La résolution de ce désordre spatial n’exige aucun bricolage graphique superficiel, mais impose une régularisation structurelle de la matrice de données d’entrée. La solution conceptuelle consiste à expliciter formellement la vacuité de la cellule manquante au sein du tableau tabulaire. Cette opération s’accomplit par l’application de la fonction complete() issue du package tidyr, qui procède à l’expansion combinatoire intégrale de l’ensemble des croisements factoriels théoriquement possibles, et attribue automatiquement une valeur scalaire égale à zéro ou à une valeur manquante standardisée explicite aux sous-cellules non échantillonnées dans la réalité empirique.
Une fois la table structurellement équilibrée par cette complétion combinatoire, l’algorithme position_dodge() identifie la présence formelle du niveau factoriel même si sa magnitude quantitative est nulle. Il réserve ainsi un intervalle spatial rigoureusement proportionné et identique à celui alloué aux autres sous-groupes, maintenant une épaisseur de bâton strictement constante à travers l’ensemble des coordonnées cartésiennes horizontales. La discipline du statisticien consiste donc à traiter la source d’incohérence matricielle en amont pour restaurer la symétrie géométrique pure de l’espace de projection en aval.
11.2 Erreurs liées à la redondance non voulue des calculs de fréquence
Un autre écueil technique omniprésent réside dans la sommation redondante et silencieuse d’indicateurs scalaires causée par une méconnaissance de la transformation statistique implicite de la fonction geom_bar(). Lorsqu’un analyste transmet à geom_bar() un jeu de données contenant de multiples réplications expérimentales par cellule sans procéder à une agrégation préalable sous dplyr, le moteur applique par défaut l’algorithme stat_count(). Si le chercheur force l’argument stat = "identity" pour contourner le blocage du compilateur sans comprendre la mécanique sous-jacente, le logiciel additionne aveuglément l’ensemble des scores individuels des sujets de la cellule au lieu d’en calculer la moyenne, érigeant une barre dont la hauteur totale reflète la taille de l’échantillon multipliée par l’intensité du phénomène.
Cette sommation non désirée aboutit à des représentations visuelles faussées, générant des hauteurs monumentales totalement décorrélées des véritables moyennes de la population observée, sans qu’aucun message d’erreur ou d’avertissement logiciel n’alerte le programmeur sur la caducité de sa figure. Ce symptôme se manifeste fréquemment lorsque l’utilisateur constate que l’axe des ordonnées affiche des ordres de grandeur démesurés par rapport aux échelles de mesure initialement administrées sur le terrain expérimental.
La prévention absolue de cet artefact méthodologique repose sur une doctrine de codage intransigeante : l’analyste ne doit jamais déléguer au moteur de rendu graphique le calcul des agrégations quantitatives complexes. La trajectoire vertueuse impose de calculer formellement les métriques descriptives — moyennes pondérées, médianes, écarts-types et bornes d’intervalles — au sein d’une étape tabulaire dédiée et auditable sous dplyr, puis de mobiliser exclusivement la primitive déclarative directe geom_col(). Cette séparation formelle entre calcul statistique analytique et encodage géométrique passif neutralise définitivement toute tentative d’agrégation sauvage et opaque par le compilateur graphique.
11.3 Mauvaises pratiques sémiotiques à proscrire formellement
La conception d’un barplot multivariable est régie par des impératifs d’intégrité sémiotique dont la transgression altère profondément la crédibilité de l’argumentation scientifique. La faute déontologique la plus sévère réside dans la troncature délibérée ou accidentelle de la ligne de base zéro sur l’axe continu d’amplitude quantitative. Contrairement au nuage de points ou au tracé linéaire de séries chronologiques qui encodent l’information par la position relative de coordonnées spatiales ponctuelles, le diagramme en bâtons fonde l’intégralité de son message sur la surface matérielle totale et la longueur intégrale du rectangle déployé. L’œil humain compare des ratios de volumes ; tronquer l’origine cartésienne en débutant l’axe à une valeur non nulle amplifie artificiellement des écarts infinitésimaux, tombant sous le coup de la manipulation visuelle caractérisée.
Un deuxième travers stylistique majeur concerne la tentation de surcharger la composition visuelle au moyen d’effets tridimensionnels non fonctionnels, d’ombres portées artificielles ou de dégradés chromatiques décoratifs superflus, désignés collectivement par Edward Tufte sous le vocable de chartjunk. La projection d’un barplot sous une perspective pseudo-isométrique tridimensionnelle introduit des distorsions géométriques insurmontables : les surfaces planes deviennent des parallélépipèdes déformés par la perspective, rendant l’estimation optique des grandeurs relatives rigoureusement impossible et privant le document de sa neutralité scientifique fondamentale.
Enfin, la confiance exclusive accordée au seul canal de remplissage chromatique sans vérification scrupuleuse des contrastes d’accessibilité constitue une pratique sémiotique répréhensible. L’utilisation conjointe de barres non texturées, de palettes spectrales non calibrées pour les daltonismes, ou le refus délibéré de reporter les incertitudes d’échantillonnage transforme une figure potentiellement informative en un obstacle à la dissémination ouverte du savoir. L’éthique de la visualisation savante impose un dépouillement décoratif total, une traçabilité intégrale des axes cartésiens et une lisibilité universelle garantissant l’accès impartial de l’ensemble de la communauté scientifique aux données fondamentales publiées.
12. Exportation haute fidélité et conformité aux standards éditoriaux
12.1 Utilisation avancée de la fonction ggsave pour la publication
L’aboutissement du processus d’ingénierie graphique réside dans la sérialisation physique de la figure sous forme de fichier numérique prêt pour l’intégration typographique au sein d’un manuscrit soumis pour publication. Bien que les environnements de développement intégrés tels que RStudio offrent des interfaces graphiques interactives permettant l’exportation manuelle par clics de souris, cette procédure empirique doit être proscrite en raison de son absence totale de reproductibilité. La manipulation de la commande unifiée ggsave() s’impose comme l’unique standard opérationnel fiable pour garantir la constance géométrique absolue des figures exportées.
Le paramétrage rigoureux de ggsave() exige la spécification impérative des dimensions physiques métriques réelles au moyen des arguments width et height, couplés à l’unité de mesure explicite via l’argument units, paramétré de préférence en centimètres ou en pouces. Omettre ces arguments dimensionnels revient à laisser le compilateur déduire la taille du graphique à partir de la surface courante de la fenêtre d’affichage à l’écran, générant des variations imprévisibles du ratio de la police de caractères par rapport à la taille des barres géométriques à chaque réexécution du code sur des moniteurs distincts.
L’arbitrage entre formats vectoriels et matriciels constitue un choix technique décisif pour la pérennité typographique du document. Pour l’impression académique haut de gamme, les formats vectoriels purs tels que le PDF ou l’EPS doivent systématiquement être privilégiés. Ces formats encodent les éléments sous forme de primitives mathématiques polygonales pures, garantissant une infinité de grossissement sans pixellisation ni perte de netteté des polices de caractères et des lignes de moustaches. Lorsqu’un format matriciel raster s’avère contractuellement exigé par l’éditeur pour des contraintes d’archivage d’images composites, le format TIFF ou PNG non compressé doit être sélectionné, en fixant expressément le paramètre de résolution spatiale minimale dpi à une valeur stricte de 300 points par pouce pour les figures en demi-teinte, ou 600 à 1200 points par pouce pour les schémas linéaires en noir et blanc.
12.2 Mise en conformité avec les directives stylistiques de l’APA
La publication d’un barplot multivariable au sein des revues affiliées aux sciences psychologiques, éducatives et comportementales impose une standardisation formelle alignée sur les prescriptions du manuel de style de l’American Psychological Association, actuellement régi par sa 7e édition. Cette normalisation éditoriale ne relève pas d’une coquetterie de présentation ; elle poursuit un objectif d’homogénéisation cognitive destiné à permettre aux relecteurs et aux lecteurs de localiser instantanément les éléments clés du protocole sans être distraits par des idiosyncrasies stylistiques individuelles.
Les directives stylistiques de l’APA proscrivent formellement l’utilisation d’arrière-plans colorés ou grisés, ainsi que la présence de tout quadrillage intérieur, qu’il soit majeur ou mineur. Les bordures d’encadrement supérieur et droit de la scène graphique doivent également être éradiquées pour ne laisser subsister que les axes structurels horizontaux et verticaux, noirs et fins. Les typographies doivent adopter des familles de polices standardisées hautement lisibles — telles que Arial, Calibri ou Times New Roman —, appliquées avec une constance absolue de corps typographique au sein d’une hiérarchie stricte comprise entre huit et douze points.
L’organisation typographique externe suit également un agencement rigide en trois zones fonctionnelles disjointes. La figure ne doit comporter aucun titre directement imprimé à l’intérieur de la surface cartésienne. Elle débute invariablement au-dessus de l’image par la mention formelle du numéro d’ordre de la figure en caractères gras, immédiatement suivie sur une ligne distincte par le titre descriptif du graphique composé en italique standardisé. Sous la figure, une section désignée sous le terme de note de bas de figure débute par la mention Note. en italique, accueillant l’explicitation exhaustive de la métrique d’incertitude représentée par les barres d’erreur, la définition de chaque abréviation cryptique et les éventuels seuils d’inférence statistique et de probabilité critique associés.
12.3 Automatisation des flux de travail pour manuscrits scientifiques
Le parachèvement de la démarche de reproductibilité computationnelle s’incarne dans l’intégration transparente des scripts graphiques ggplot2 au sein d’environnements d’édition dynamique de documents reproductibles, tels que Quarto ou R Markdown. Ce paradigme d’écriture computationnelle intègre étroitement le code d’ingénierie des données tabulaires, les routines de visualisation et le corps textuel du manuscrit au sein d’un document source unifié en texte brut, éliminant les transferts manuels de fichiers d’images qui constituent le goulot d’étranglement de l’erreur humaine dans la recherche traditionnelle.
Au sein d’un document computationnel moderne, les blocs de code exécutables régissant la création du barplot multivariable sont gouvernés par des balises d’options spécialisées insérées en en-tête de segment. Des paramètres normalisés tels que fig-width, fig-height, fig-cap et fig-align permettent de contraindre la géométrie physique de l’image vectorielle directement lors de la phase de compilation du document maître vers le format de sortie finalisé, qu’il s’agisse de formats PDF compilés sous LaTeX ou de publications web sous standard HTML5.
Cette automatisation garantit une pérennité absolue de la recherche scientifique face aux inévitables évolutions du corpus de données empiriques. Si des mesures expérimentales additionnelles sont collectées ou si un protocole de nettoyage statistique impose l’exclusion motivée d’une série d’observations défectueuses, une simple réévaluation séquentielle du document source régénère l’intégralité des barplots multivariables, recalcule à la volée les barres d’erreur statistique et réaligne impeccablement les annotations sans exiger la moindre retouche graphique manuelle. Cette symbiose parfaite entre rigueur sémiotique, précision mathématique et automatisation computationnelle concrétise l’idéal méthodologique de la science ouverte et pleinement reproductible.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Brewer, C. A. (2015). Designing Better Maps: A Guide for GIS Users (2nd ed.). Esri Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0