
Dans le champ contemporain de la science des données et de l’analyse statistique avancée, la représentation visuelle ne constitue pas un simple artifice d’illustration, mais s’impose comme un instrument fondamental d’inférence, de validation d’hypothèses et de communication scientifique. Face à l’accroissement exponentiel de la dimensionnalité des jeux de données modernes — qu’ils soient issus de cohortes épidémiologiques, d’expérimentations psychométriques, de capteurs industriels ou de simulations bio-informatiques —, les praticiens se heurtent continuellement aux limites physiques et perceptuelles de la projection sur un plan bidimensionnel unique. L’entassement d’informations hétérogènes au sein d’un repère orthogonal partagé engendre invariablement une saturation graphique, altérant la lisibilité des motifs sous-jacents et augmentant de manière critique la charge cognitive imposée au lecteur.
Pour surmonter cet écueil méthodologique, l’ingénierie de visualisation sous l’écosystème Python a formalisé une approche rigoureuse reposant sur le partitionnement de l’espace géométrique en sous-graphiques coordonnés, souvent désignés sous l’appellation de micro-tracés ou de multiples graphiques. Au cœur de cette dynamique, la bibliothèque Seaborn, conçue par Michael Waskom, opère une synthèse remarquable entre la puissance programmatique de bas niveau offerte par le moteur graphique fondamental Matplotlib et l’expressivité descriptive exigée par les modèles statistiques modernes. En conférant une abstraction déclarative de haut niveau sans renoncer à la granularité de l’architecture orientée objet sous-jacente, ce couplage logiciel permet d’élaborer des architectures visuelles modulaires d’une grande sophistication.
Le présent traité propose une exploration exhaustive, systématique et rigoureusement documentée de la création, du calibrage et de la perfection formelle des sous-graphiques à l’aide conjointe de Seaborn et de Matplotlib. En articulant les principes théoriques de la perception visuelle avec une manipulation pointue des structures de données scalaires, vectorielles et matricielles, nous détaillerons l’ensemble des mécanismes opératoires nécessaires à la production de figures composites prêtes pour la soumission dans des revues académiques de premier rang. De l’anatomie intime des objets graphiques en mémoire jusqu’aux stratégies avancées de gestion des flux d’exécution et de déduplication des composants textuels, ce guide constitue le manuel de référence définitif pour transformer des jeux de données complexes en démonstrations empiriques irréprochables.
1. Introduction à la visualisation multidimensionnelle avec Seaborn et Matplotlib
1.1 Le rôle des sous-graphiques dans l’analyse exploratoire des données
L’analyse exploratoire des données, telle que formalisée originellement par John Tukey dans ses travaux séminaux, repose sur le principe cardinal selon lequel les structures sous-jacentes d’un phénomène doivent émerger de l’examen visuel direct des distributions et des covariations avant toute modélisation probabiliste rigide. Dans le cadre de l’étude de variables psychométriques, comportementales ou biomédicales, les chercheurs sont fréquemment confrontés à des ensembles de données où plusieurs variables dépendantes interagissent sous l’effet de multiples facteurs modérateurs ou médiateurs. Tenter d’appréhender ces relations multivariées par la simple superposition de couches de données au sein d’un unique système de coordonnées cartésiennes conduit inévitablement à un phénomène sévère d’occlusion visuelle. Le chevauchement anarchique des marqueurs ponctuels, la confusion des densités de probabilité continues et l’entrelacement inextricable des lignes de régression détruisent la saillance des contrastes statistiques essentiels.
La décomposition de la surface visuelle en une pluralité de sous-graphiques géométriquement alignés constitue la réponse computationnelle et cognitive à cette contrainte d’encombrement. En segmentant l’information selon des dimensions taxonomiques cohérentes, le concepteur du tracé réduit drastiquement l’effort d’encodage et de décodage imposé au système visuel humain. Cette technique, conceptualisée par Edward Tufte sous le vocable de « petites figures multiples » (small multiples), repose sur la répétition d’une même métaphore graphique à travers différentes sous-populations ou variables d’intérêt, en maintenant une rigoureuse stabilité de l’échelle et de la forme. Cette disposition permet à l’œil de procéder à des comparaisons transversales instantanées sans devoir réinterpréter continuellement la sémantique des axes.
Enfin, dans le contexte spécifique de la publication scientifique à comité de lecture, l’intégration de sous-graphiques ordonnés répond à une exigence non négociable de compacité et d’honnêteté intellectuelle. Les directives éditoriales imposent de restreindre le nombre total de planches tout en maximisant la transparence empirique. Présenter simultanément la variabilité interindividuelle, la tendance centrale, la précision de l’estimation par intervalles de confiance et la distribution marginale au sein d’un même panneau structuré permet d’exposer la totalité du signal analytique tout en neutralisant les biais d’interprétation induits par un cadrage réducteur.
1.2 Complémentarité architecturale entre Matplotlib et Seaborn
Pour maîtriser pleinement la génération programmatique de figures composites en Python, il est impératif de dissiper l’illusion selon laquelle Seaborn constituerait une entité logicielle autonome, totalement substituée à Matplotlib. En réalité, l’architecture logicielle de la visualisation scientifique sous Python est intrinsèquement hiérarchique et modulaire. Matplotlib, conçu à l’origine par John Hunter, agit comme le moteur graphique vectoriel de bas niveau, un équivalent computationnel d’un environnement de dessin technique complet doté de moteurs de rendu capables de projeter des entités géométriques fondamentales — telles que des polygones, des lignes, des collections de marqueurs et des chemins de Bézier — sur un canevas numérique arbitraire.
Seaborn opère comme une surcouche d’abstraction statistique de haut niveau, directement greffée sur ce moteur de dessin élémentaire. La bibliothèque prend en charge les opérations statistiques répétitives et fastidieuses qui nécessiteraient autrement des dizaines de lignes de code matriciel avec NumPy et Matplotlib : calcul automatique des estimateurs de densité par noyau gaussien (KDE), bootstrapping robuste pour l’estimation empirique des intervalles de confiance à 95 %, partitionnement conditionnel des séries temporelles ou catégorielles, et application de palettes de couleurs optimisées selon les principes de l’ergonomie visuelle moderne. Néanmoins, dès lors qu’il s’agit de structurer l’espace topologique global, Seaborn délègue intégralement la gestion du canevas physique et du découpage spatial aux structures de données de Matplotlib.
Cette symbiose s’articule autour d’un principe fondamental de la programmation orientée objet : l’injection de dépendances. Plutôt que de contraindre l’utilisateur à adopter un conteneur spatial rigide et opaque, l’API de Seaborn est conçue pour accepter explicitement des instances d’axes préexistantes, générées au préalable par le moteur de Matplotlib. Par conséquent, le flux de travail optimal en science computationnelle consiste à mobiliser Matplotlib pour la scénarisation spatiale, l’allocation géométrique matricielle et le micro-positionnement typographique, tout en exploitant la puissance sémantique de Seaborn pour projeter les données statistiques à l’intérieur de ces réceptacles géométriques préparés avec une exactitude chirurgicale.
1.3 Distinction fondamentale entre fonctions au niveau de la figure et au niveau des axes
L’une des sources de confusion les plus tenaces pour les analystes de données réside dans l’incapacité à discriminer rigoureusement les deux paradigmes d’appel coexistant au sein de la bibliothèque Seaborn : les fonctions dites « au niveau des axes » (Axes-level) et les fonctions dites « au niveau de la figure » (Figure-level). Cette dichotomie conceptuelle structure l’ensemble de l’interface de programmation et dicte le degré de liberté dont dispose l’utilisateur pour orchestrer des compositions multi-panneaux personnalisées.
Les fonctions opérant au niveau des axes — telles que sns.scatterplot, sns.boxplot, sns.histplot ou sns.lineplot — sont des transformateurs d’espaces locaux. Elles admettent de manière systématique un argument formel universel nommé ax. Lorsqu’un utilisateur invoque l’une de ces fonctions en lui transmettant une référence explicite vers un objet de type axe préalablement instancié, la fonction procède exclusivement au tracé à l’intérieur des délimitations de ce conteneur spécifique, sans altérer les autres compartiments de l’espace graphique ni tenter de s’approprier la gestion du canevas global. Cette granularité fine fait des fonctions Axes-level les briques de base indispensables pour composer des tableaux de bord asymétriques, des visualisations en mosaïque ou des architectures graphiques hétérogènes combinant différents types de diagrammes.
À l’opposé, les fonctions opérant au niveau de la figure — incarnées par des fonctions génériques comme sns.relplot, sns.catplot, sns.displot ou sns.pairplot — constituent des fabriques autonomes de haut niveau. Elles encapsulent la totalité de la chaîne de création graphique, instanciant en interne un objet conteneur complexe tel qu’un FacetGrid, dimensionnant automatiquement la figure et gérant le placement unilatéral des marges et des légendes. Si ces fonctions de haut niveau offrent une commodité remarquable pour déployer des treillis réguliers en une seule instruction déclarative, elles introduisent un verrou architectural majeur : elles n’acceptent en aucun cas l’argument ax et ne peuvent être intégrées directement au sein d’une grille de sous-graphiques préconfigurée par Matplotlib. Comprendre cette frontière opérationnelle est le prérequis absolu à toute tentative de mise en page avancée.
2. L’architecture objet sous-jacente : Figure et Axes
2.1 Démystification de l’objet Figure
L’architecture interne de Matplotlib, sur laquelle repose l’ensemble de l’écosystème graphique scientifique de Python, s’articule autour d’une hiérarchie d’arborescence d’objets fortement typée. Au sommet de cette organisation pyramidale trône l’objet Figure, matérialisé par la classe matplotlib.figure.Figure. D’un point de vue conceptuel et physique, la Figure doit être appréhendée non pas comme un tracé ou une courbe, mais comme le canevas matériel global — l’équivalent de la feuille de papier à dessin ou de la toile vierge de l’artiste — sur lequel viendront s’ancrer, selon des coordonnées spatiales relatives rigoureusement calculées, l’ensemble des éléments graphiques constitutifs de la planche.
La Figure encapsule les propriétés spatiales fondamentales qui dictent le rendu terminal du document. Parmi celles-ci, le paramètre géométrique figsize joue un rôle déterminant. Exprimé de manière standard sous la forme d’un tuple de réels représentant la largeur et la hauteur en pouces (inches), ce paramètre fixe le ratio d’aspect initial du document. La résolution spatiale absolue est quant à elle régie par l’attribut dpi (dots per inch), qui définit la densité de pixels par unité de longueur lors de la rastérisation. Une compréhension intime de ces deux dimensions scalaires est indispensable pour garantir que la taille relative des glyphes typographiques et l’épaisseur des traits conservent une harmonie absolue, indépendamment de la taille de l’écran ou des exigences de composition typographique des éditeurs scientifiques.
Sur le plan structurel, l’objet Figure constitue le parent direct de tous les éléments d’annotation d’ordre supérieur. Il héberge le titre suprême ou titre global de l’œuvre scientifique (implémenté par la méthode suptitle), les légendes globales consolidées traversant les frontières des compartiments individuels, les fonds de couleur du canevas général, ainsi que les bordures géométriques externes. La Figure n’a cependant aucune notion directe des données mathématiques brutes : elle ignore la sémantique statistique des vecteurs ou des matrices, se bornant à fournir le cadre topologique et le moteur de rendu requis pour coordonner ses objets enfants.
2.2 Compréhension approfondie de l’objet Axes
Si la Figure incarne la totalité du support physique, l’objet Axes (représenté par la classe matplotlib.axes.Axes) constitue le cœur battant de la modélisation statistique. Il importe d’emblée d’opérer une clarification lexicale impérative : dans la nomenclature de Matplotlib, le terme pluriel « Axes » désigne une entité singulière, à savoir un sous-système de coordonnées cartésiennes (ou polaires) complet, et ne doit sous aucun prétexte être confondu avec le terme « Axis » (au singulier en anglais), qui fait référence aux lignes scalaires individuelles de projection (l’axe des abscisses ou l’axe des ordonnées).
Un objet Axes matérialise l’espace mathématique borné à l’intérieur duquel les valeurs numériques sont traduites en formes géométriques perceptibles. Chaque instance d’un axe dispose de sa propre matrice de transformation projective, convertissant les coordonnées du plan des données en coordonnées physiques relatives à l’écran. Cette instance agrège une constellation de composants structurels spécialisés : les bordures du tracé (désignées sous le vocable de spines), les lignes d’axes horizontales et verticales (xaxis et yaxis), les repères visuels discrets (ticks), ainsi que les étiquettes textuelles qui leur sont associées (ticklabels). Chaque composant possède son propre état interne, modifiable de manière chirurgicale sans impacter les éléments voisins.
Une caractéristique fondamentale de cette architecture objet réside dans la totale indépendance fonctionnelle dont jouit chaque instance d’Axes au sein d’une même Figure parente. Deux compartiments adjacents peuvent afficher des dynamiques statistiques totalement hétérogènes, mobiliser des échelles asymétriques — l’un pouvant être soumis à une transformation logarithmique décimale tandis que l’autre conserve une métrique linéaire — ou être régis par des limites de données diamétralement opposées. Simultanément, un même objet Axes possède une capacité d’hébergement composite remarquable : il est parfaitement apte à recevoir en superposition séquentielle une infinité de couches de rendu, permettant par exemple d’inscrire sur une surface géométrique identique une matrice d’estimation de densité, un nuage de points semi-transparent et une courbe d’ajustement polynomial.
2.3 Cycle de vie d’un objet graphique dans l’environnement Python
La création et la manipulation d’objets graphiques sous Python s’inscrivent dans un cycle de vie précis au sein de la mémoire vive de l’interpréteur, particulièrement influencé par la présence ou l’absence d’environnements interactifs tels que les carnets Jupyter (Jupyter Notebooks) ou les terminaux IPython. L’initialisation d’un environnement de tracé via le module procédural matplotlib.pyplot instancie de manière implicite ou explicite des structures de données complexes gérées par un composant d’orchestration global nommé Gcf (Graphics Context Framework). Lorsque la commande de création d’une figure est émise, une allocation mémoire substantielle est réservée pour maintenir la représentation sous forme d’arborescence d’objets, englobant l’ensemble des artistes visuels (Artists) qui composeront la scène.
Au fil de l’exécution séquentielle du script, chaque fonction de tracé invoquée qu’elle appartienne à l’API de Matplotlib ou à celle de Seaborn, altère incrémentiellement l’état interne des objets visés. Les collections géométriques s’accumulent, les boîtes de délimitation (bounding boxes) sont recalculées dynamiquement et les tampons de rendu se préparent à la phase de dessin vectoriel ou matriciel. Cependant, cette allocation présente une persistance marquée : dans l’interface de pyplot, les figures demeurent référencées par le gestionnaire d’état jusqu’à ce qu’un ordre de destruction explicite intervienne. Dans les contextes de traitement par lots ou de boucles itératives massives traitant des milliers de séries chronologiques, cette accumulation peut conduire rapidement à un épuisement des ressources mémoires de la machine hôte.
Pour régir de manière hygiénique cette consommation de ressources, l’ingénieur logiciel doit maîtriser les routines de destruction et de libération. L’invocation impérative de plt.close(fig) ou de plt.close('all') ordonne la rupture des références circulaires, autorisant le ramasse-miettes (Garbage Collector) de Python à recycler la mémoire occupée par les instances d’arbres graphiques. De surcroît, au sein des carnets Jupyter, le moteur d’affichage en ligne (inline backend) intercepte la fin de cellule d’exécution pour déclencher le rendu visuel automatique, tout en conservant potentiellement en cache les figures rendues, rendant la dissociation des états computationnels indispensable à la reproductibilité des visualisations itératives complexes.
3. Syntaxe fondamentale : Initialisation d’une grille avec plt.subplots()
3.1 Déclaration géométrique matricielle des lignes et colonnes
L’interface paradigmatique contemporaine pour orchestrer une disposition multi-panneaux ordonnée repose sur l’appel à la fonction déclarative matplotlib.pyplot.subplots(). Cette fonction de manufacture spatiale agit comme un constructeur unifié permettant d’instancier, en une seule transaction programmatique cohérente, l’objet canevas conteneur Figure et l’ensemble de la constellation d’objets Axes correspondants, disposés selon un quadrillage cartésien rigoureux.
La géométrie fondamentale de ce quadrillage est dictée par les deux premiers paramètres positionnels de la fonction, à savoir nrows et ncols, qui spécifient respectivement le nombre de rangées horizontales et de colonnes verticales de sous-graphiques souhaités. L’adjonction simultanée du paramètre d’échelle spatiale figsize=(largeur, hauteur) s’avère alors cruciale : elle permet d’allouer une superficie totale proportionnée au volume de tracés anticipé. L’omission d’un recalibrage explicite de figsize lors de l’accroissement des dimensions de la grille contraint Matplotlib à comprimer l’ensemble des panneaux dans les dimensions par défaut du canevas, écrasant les rapports d’aspect individuels et générant des collisions visuelles dévastatrices entre les annotations typographiques des cellules voisines.
Le comportement de retour de la fonction plt.subplots() est régi par une logique adaptative liée à la topologie dimensionnelle demandée. Dans le cas trivial où les paramètres sont laissés à leurs valeurs implicites unitaires (nrows=1, ncols=1), la fonction renvoie un scalaire unique représentant l’axe solitaire. Lorsque la dimension déclarée équivaut à un vecteur unidimensionnel — c’est-à-dire une rangée unique comportant plusieurs colonnes ou une colonne unique s’étirant sur plusieurs rangées —, le second élément retourné adopte la structure d’un tableau unidimensionnel (1D) issu de la bibliothèque NumPy. Dès lors que l’agencement franchit le cap de la bidimensionnalité stricte (avec nrows > 1 et ncols > 1), Matplotlib instancie une matrice NumPy bidimensionnelle (2D) de références d’axes, structurée de manière isomorphe à la configuration spatiale des lignes et des colonnes sur le canevas.
3.2 Le mécanisme de transmission du paramètre ax dans Seaborn
Dès l’instant où l’espace d’affichage a été mathématiquement fractionné par l’appel à plt.subplots(), la responsabilité du tracé effectif des données statistiques est transférée à la bibliothèque Seaborn. C’est à cet embranchement précis que se matérialise l’interaction symbiotique entre les deux couches logicielles. L’ensemble des méthodes graphiques opérant au niveau des axes au sein de l’API de Seaborn expose de façon universelle un argument nommé explicitement ax.
Ce paramètre ax fonctionne comme un aiguillage topologique strict. En lui affectant une référence spécifique extraite du tableau d’axes généré par Matplotlib, l’analyste contraint l’algorithme de Seaborn à canaliser la totalité de sa machinerie de rendu statistique exclusivement dans le périmètre spatial délimité par cette instance précise. Si, par exemple, un utilisateur désire inscrire une boîte à moustaches au sein de la cellule supérieure droite d’une grille 2×2, il lui suffira de passer l’argument formel ax=axes[0, 1] lors de l’appel à sns.boxplot(). Seaborn interroge alors les méthodes internes de cet objet d’axe pour configurer la géométrie des données, sans solliciter aucune commande globale de pyplot.
Les conséquences d’une omission de ce paramètre formel ax sont délétères pour la rigueur du script. En l’absence d’une cible expressément qualifiée, Seaborn recourt à un comportement historique hérité du modèle procédural de MATLAB : il interroge l’état global du sous-système pyplot et exécute son tracé sur l’axe considéré comme « actif » ou « courant » via la routine interne plt.gca() (Get Current Axes). Dans des scripts complexes comportant des flux conditionnels ou des boucles non linéaires, cette dépendance implicite à l’axe actif engendre immanquablement des écrasements involontaires, les nouvelles données venant s’inscrire en surimpression anarchique sur le dernier sous-graphique manipulé, laissant les cellules cibles préalablement réservées dans un état de vacuité stérile.
3.3 Décompression des structures de retour de subplots
L’exploitation efficiente et idiomatique du constructeur plt.subplots() implique une maîtrise rigoureuse du déballage de tuples (tuple unpacking), un idiome syntaxique élégant propre au langage Python. La signature de retour de la fonction se présente invariablement sous la forme d’une paire d’éléments ordonnés : (fig, axes). Le premier membre référence l’instance globale de la Figure, tandis que le second agrège la collection d’axes. Selon l’envergure dimensionnelle définie lors de l’instanciation, la syntaxe de déballage doit s’adapter pour garantir une manipulation fluide et sans ambiguïté des conteneurs.
Dans les scénarios requérant des architectures linéaires simples, l’affectation directe d’une variable par cellule de tracé est permise par la syntaxe de décompression multiple. Pour un alignement de deux graphiques sur une rangée unique, l’expression fig, (ax1, ax2) = plt.subplots(1, 2) permet d’associer immédiatement des identifiants nominatifs explicites à chaque sous-espace cartésien, éliminant tout besoin d’indexation numérique subséquente. Cette approche procure une excellente clarté de lecture pour les scripts de prototypage rapide où le nombre d’éléments demeure strictement invariable.
À l’inverse, lorsque l’architecture géométrique s’étend à des grilles bidimensionnelles complexes — par exemple un treillis de trois lignes sur quatre colonnes —, le déballage scalaire immédiat devient irréaliste et sous-optimal. L’objet axes doit être conservé sous sa forme matricielle originelle de tableau NumPy bidimensionnel : fig, axes = plt.subplots(3, 4). Dès lors, la sélection spatiale s’opère par le biais de l’opérateur d’indexation matricielle standard axes[ligne, colonne], les indices débutant impérativement à zéro conformément aux conventions de programmation sous Python. La cellule située à l’intersection de la deuxième ligne et de la troisième colonne sera ainsi adressée sans la moindre ambiguïté spatiale par l’identifiant axes[1, 2].
4. Cas pratique pas à pas : Création d’une grille 2×2 de boîtes à moustaches
4.1 Configuration de l’environnement expérimental et création du DataFrame
Afin de concrétiser de manière empirique les concepts architecturaux exposés précédemment, développons une étude de cas intégralement réplicable, centrée sur l’analyse comparative de métriques comportementales et cognitives issues d’une cohorte clinique simulée. L’objectif méthodologique consiste à juxtaposer, au sein d’une même matrice visuelle équilibrée de deux lignes sur deux colonnes, la distribution différentielle de quatre variables psychométriques dépendantes en fonction d’un facteur inter-sujets binaire représentant l’appartenance à un groupe contrôle ou à un groupe soumis à une intervention expérimentale.
L’initialisation de l’environnement d’analyse commande l’importation conjointe des fondations logicielles scientifiques : le module de manipulation tabulaire Pandas, l’interface graphique procédurale pyplot de Matplotlib, ainsi que la bibliothèque Seaborn. Pour garantir la totale reproductibilité des observations statistiques générées, une graine pseudo-aléatoire fixe est injectée dans le générateur de nombres aléatoires de NumPy. Le jeu de données synthétisé modélise un échantillon robuste de deux cents participants, pour lesquels sont mesurés un temps de réaction en millisecondes, un score d’attention sélective, un indice de mémoire de travail et un taux d’erreur comportemental, variables caractérisées par des échelles métriques intrinsèquement hétérogènes.
La structuration de ce DataFrame obéit rigoureusement aux principes des « données ordonnées » (Tidy Data) théorisés par Hadley Wickham : chaque ligne correspond à une observation unitaire représentant un sujet unique, tandis que chaque colonne encode une variable d’identification ou une mesure expérimentale continue. Un diagnostic préliminaire des types de données permet de vérifier l’absence d’aberrations numériques ou de valeurs manquantes, assurant que les algorithmes d’estimation de Seaborn pourront calculer les médianes et les dispersions interquartiles sans distorsion structurelle.
4.2 Instanciation de la disposition 2×2 et distribution des variables
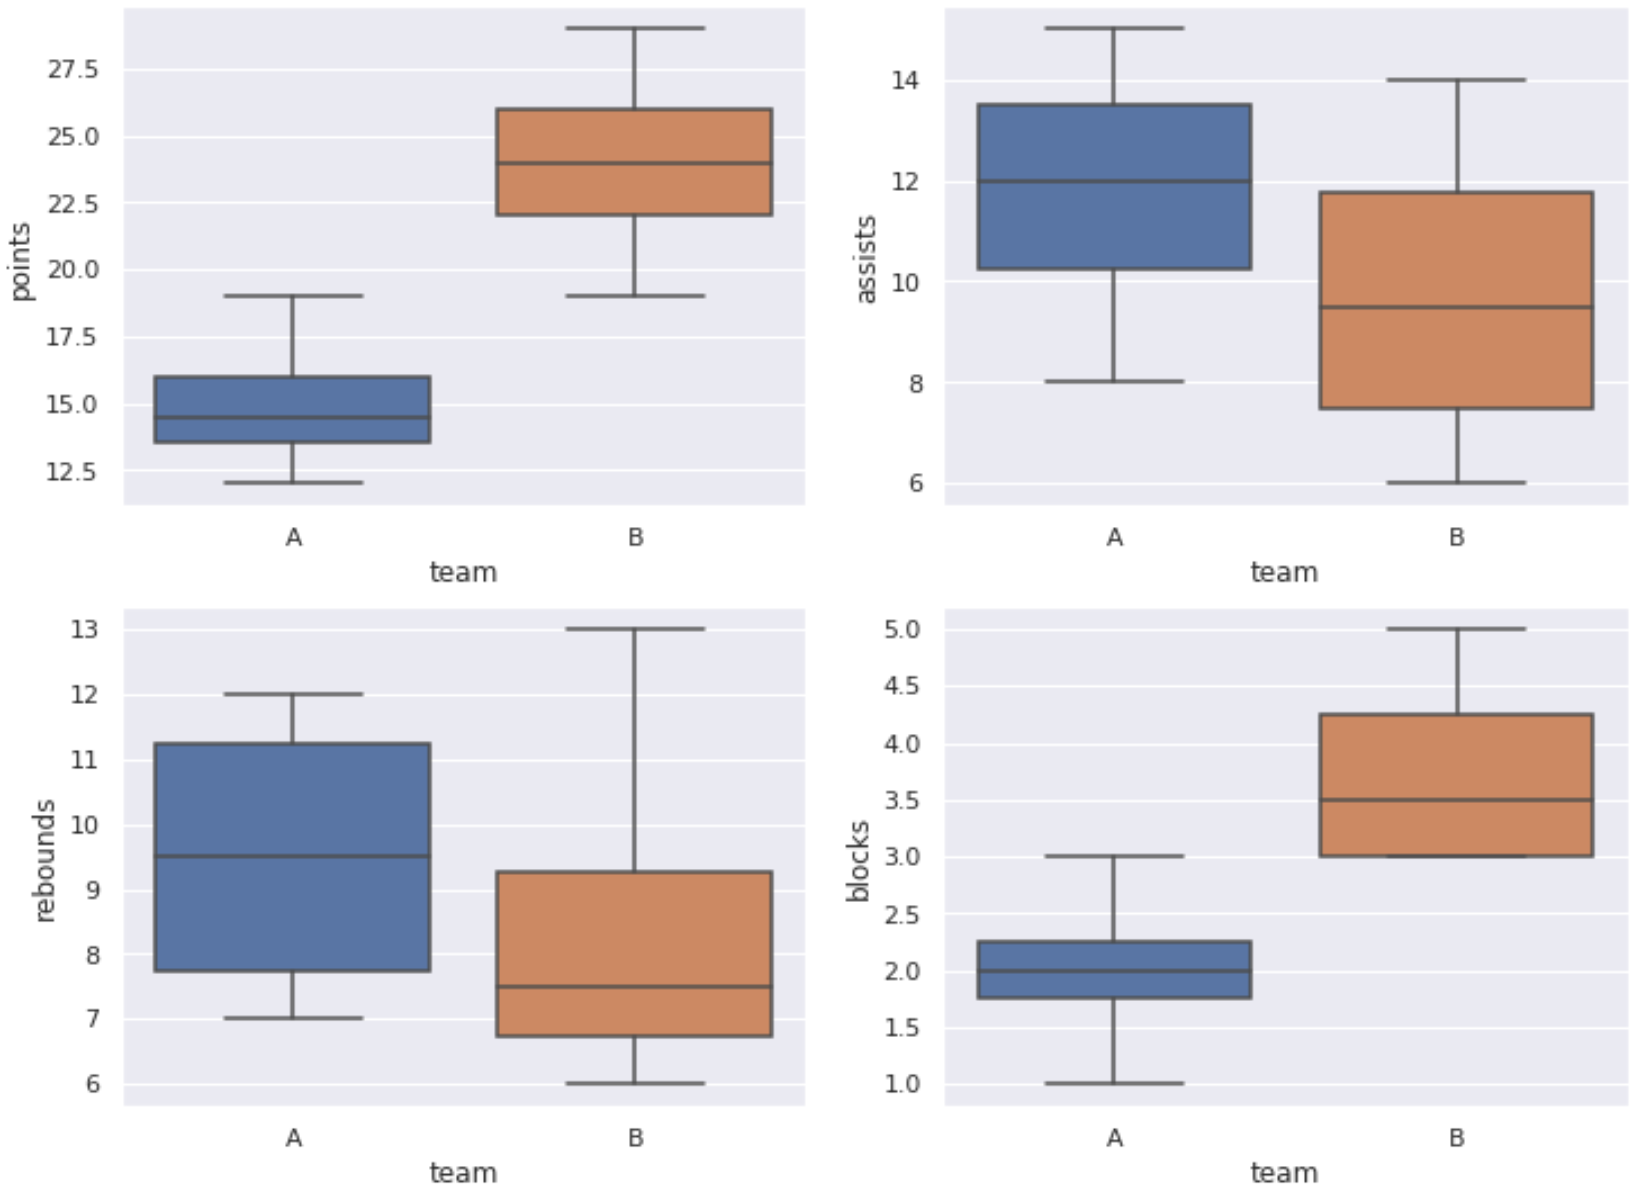
L’agencement spatial de la figure est formellement ouvert par la déclaration d’une grille matricielle symétrique via l’appel fig, axes = plt.subplots(2, 2, figsize=(12, 10)). Ce calibrage géométrique offre une largeur totale de douze pouces pour une hauteur de dix pouces, octroyant un espace généreux à chaque compartiment pour déployer son annotation sans générer de promiscuité visuelle indésirable entre les axes contigus. Le récepteur matriciel axes est désormais instancié sous la forme d’un conteneur NumPy de dimensions (2, 2).
L’injection des tracés statistiques de Seaborn s’opère par une série d’affectations séquentielles rigoureuses, chaque appel routant spécifiquement un couple de variables vers son compartiment spatial désigné :
- Compartiment nord-ouest
axes[0, 0]: La fonctionsns.boxplot(data=df, x='Groupe', y='Temps_Reaction', ax=axes[0, 0])vient ancrer la représentation de la distribution de la vitesse de traitement de l’information. - Compartiment nord-est
axes[0, 1]: L’instructionsns.boxplot(data=df, x='Groupe', y='Score_Attention', ax=axes[0, 1])cartographie l’efficacité de la focalisation attentionnelle sur la cellule adjacente. - Compartiment sud-ouest
axes[1, 0]: L’appelsns.boxplot(data=df, x='Groupe', y='Memoire_Travail', ax=axes[1, 0])instancie les boîtes à moustaches décrivant la capacité mnésique en partie inférieure gauche. - Compartiment sud-est
axes[1, 1]: Enfin, l’expressionsns.boxplot(data=df, x='Groupe', y='Taux_Erreur', ax=axes[1, 1])finalise le remplissage structurel par la matérialisation des métriques d’exactitude comportementale.
Chacun de ces appels agit de manière étanche et délimitée. Seaborn interroge le sous-ensemble de données désigné, calcule les percentiles 25, 50 et 75 régissant la morphologie de la boîte, évalue la distance interquartile pour implémenter les moustaches de Tukey selon un facteur de 1,5, et projette les observations atypiques au-delà de ces bornes sous la forme de points isolés sur l’axe individuel mandaté, sans interférer avec les calculs en cours sur les axes périphériques.
4.3 Interprétation analytique des représentations obtenues
L’intérêt épistémologique d’une telle configuration en panneau composite réside dans l’immédiateté de la lecture synthétique qu’elle autorise. En examinant simultanément les quatre quadrants géométriques, l’expérimentateur n’observe pas des variables isolées au sein de graphiques épars, mais évalue le profil clinique holistique de la cohorte soumise à l’intervention. La comparaison des lignes transversales de médianes conditionnelles révèle d’un seul coup d’œil si l’intervention expérimentale induit une réduction conjointe du temps de réaction et du taux d’erreur, tout en favorisant une progression substantielle des facultés mnésiques et attentionnelles.
De surcroît, la visualisation de la hauteur relative des boîtes — matérialisant l’écart interquartile (IQR) — apporte un éclairage crucial sur l’homogénéité ou l’hétérogénéité des réponses thérapeutiques entre les groupes. Une dispersion accrue des scores dans le groupe expérimental sur le cadran axes[0, 1] trahirait immédiatement une variabilité de susceptibilité individuelle à l’intervention, une information qu’un simple tableau de moyennes arithmétiques masquerait totalement sous l’effet du lissage mathématique.
Enfin, la présence éventuelle de points extrêmes au-delà des moustaches fournit un diagnostic instantané quant à la présence d’asymétries distributionnelles ou de sujets aberrants au sein de la cohorte. Cette synoptique multi-paramétrique condensée s’aligne rigoureusement sur les standards de soumission académique les plus stricts, fournissant au réviseur et au lecteur une synthèse exhaustive de l’effet d’expérimentation sans diluer la rigueur de la preuve empirique à travers des dizaines de figures segmentées.
5. Gestion de l’indexation matricielle des sous-graphiques
5.1 Navigation dans un tableau d’axes bidimensionnel
L’adressage des cellules de tracé au sein d’une architecture multi-panneaux exige une compréhension rigoureuse des correspondances géométriques sous-tendant l’indexation matricielle. Pour une grille générée par plt.subplots(nrows, ncols) où les deux dimensions sont strictement supérieures à un, le tableau NumPy sous-jacent applique rigoureusement la convention mathématique standard d’indexation matricielle [i, j], où i représente l’indice de ligne (ordonnée vers le bas) et j représente l’indice de colonne (abscisse vers la droite).
Il survient fréquemment chez les scientifiques habitués à l’analyse géométrique cartésienne un contresens cognitif consistant à confondre les coordonnées spatiales (x, y) d’un plan mathématique avec les coordonnées scalaires d’une matrice. Dans un système cartésien, l’abscisse x précède l’ordonnée y. À l’opposé absolu, dans l’indexation matricielle d’un tableau NumPy d’axes graphiques, l’axe vertical (la sélection de la rangée de haut en bas) constitue le premier indice, tandis que l’axe horizontal (la sélection de la colonne de gauche à droite) n’intervient qu’au second rang. Une méprise à cet égard aboutit immanquablement à une interversion des tracés ou à des erreurs d’accès hors limites dès lors que le nombre de lignes diffère du nombre de colonnes.
La gestion devient d’autant plus subtile lorsque le nombre total de variables d’intérêt à représenter ne correspond pas à un multiple parfait des dimensions de la matrice. Par exemple, si une étude exige d’exposer sept variables cliniques au sein d’une grille dimensionnée à 2×4 (offrant ainsi huit emplacements potentiels), la dernière cellule spatiale située aux coordonnées matricielles axes[1, 3] demeure résiduelle. L’analyste doit impérativement concevoir son architecture logicielle de manière à adresser de façon programmatique ces sous-graphiques surnuméraires pour en piloter le devenir, sous peine d’afficher une boîte d’axes vide et disgracieuse dégradant le professionnalisme de la présentation finale.
5.2 Aplatissement méthodique des axes avec flatten() et ravel()
Lorsque le déploiement des tracés graphiques doit s’opérer de manière programmatique à travers une liste séquentielle de métriques continues, la structure bidimensionnelle de la matrice d’axes se révèle paradoxalement contre-productive. L’obligation d’imbriquer deux boucles de contrôle — l’une itérant sur les lignes i et l’autre sur les colonnes j — complexifie inutilement la logique algorithmique, accroît le risque d’erreurs d’indexation et réduit la maintenabilité du code source face à des variations dynamiques du volume de données.
Pour éliminer cette complexité géométrique, l’ingénierie logicielle sous Python préconise l’aplatissement méthodique du conteneur d’axes, transformant le tenseur bidimensionnel en un vecteur séquentiel linéaire à une seule dimension. Les deux méthodes fondamentales offertes par la bibliothèque NumPy pour accomplir cette métamorphose sont flatten() et ravel(). Bien qu’elles conduisent en apparence à un résultat fonctionnel analogue permettant d’indexer le tableau aplati via un unique entier scalaire axes_flat[k], leurs comportements internes en mémoire présentent une distinction théorique notable :
- La méthode
axes.flatten()alloue systématiquement un nouveau bloc de mémoire et retourne une copie physique indépendante du tableau d’axes originel. - La méthode
axes.ravel()tente d’extraire une simple vue mémoire (view) contiguë des références d’objets sans duplication superflue, optimisant l’usage des pointeurs internes lorsque l’agencement sous-jacent en mémoire le permet.
Dans le contexte spécifique de la manipulation d’axes graphiques Matplotlib — où la taille du tableau n’excède généralement pas quelques dizaines d’éléments —, l’écart de performance brute entre ces deux routines s’avère négligeable. Néanmoins, l’emploi systématique de axes.ravel() ou axes.flatten() permet de linéariser l’espace topologique avec une remarquable économie de moyens conceptuels, ouvrant la voie à des schémas d’itération élégants et parfaitement résilients face aux modifications structurelles ultérieures de la grille.
5.3 Automatisation du tracé à travers des boucles itératives
L’intégration conjointe d’un tableau d’axes aplati et des fonctions d’itération natives du langage Python, tout particulièrement la fonction enumerate(), permet d’ériger des architectures de visualisation entièrement automatisées et dynamiques. Cette approche industrielle découple totalement la spécification des variables de données de l’ingénierie de rendu graphique.
Considérons un scénario analytique dans lequel un praticien doit projeter les densités statistiques de six biomarqueurs distincts. Plutôt que de dupliquer six blocs d’instructions quasiment identiques en assignant manuellement les indices, le script déclare une liste exhaustive contenant les identifiants textuels des colonnes cibles. En parcourant simultanément cette liste et le vecteur d’axes aplati à l’aide de enumerate(colonnes), chaque variable est projetée de manière univoque sur l’axe d’indice correspondant via l’argument ax=axes_flat[i]. Le code devient compact, exempt de redondance et auto-documenté.
Cette logique d’automatisation résout avec une égale élégance le traitement des sous-graphiques vacants évoqué précédemment. Si la taille du vecteur d’axes linéarisé surpasse le nombre effectif de variables à inspecter, une boucle résiduelle conditionnelle peut être instantanément déclenchée à partir de l’indice terminal jusqu’à la borne finale de la grille. L’application ciblée de la méthode d’invisibilité ax.set_visible(False) sur chacun de ces conteneurs superflus permet de neutraliser totalement leur affichage : le moteur graphique cesse de restituer les bordures, les fonds et les graduations associées, préservant la pureté de la mise en page sans contraindre l’analyste à recalculer des topologies de grilles asymétriques complexes.
6. Harmonisation des échelles et contrôle des limites d’axes
6.1 Partage automatique des échelles avec sharex et sharey
L’un des biais d’interprétation les plus pernicieux en visualisation de données réside dans l’hétérogénéité non contrôlée des échelles d’axes entre plusieurs représentations juxtaposées. Lorsque l’œil humain procède à l’évaluation comparative de deux distributions ou de deux pentes d’effet présentées côte à côte, le postulat perceptuel implicite repose sur l’équivalence des repères métriques. Si un sous-graphique module ses ordonnées entre 0 et 10 tandis que son voisin direct s’étend de 0 à 1000, l’observateur sera spontanément enclin à surévaluer l’amplitude des variations du premier tracé, attribuant une importance clinique majeure à ce qui ne constitue en réalité qu’une fluctuation marginale. Pour neutraliser ce biais cognitif fondamental, la normalisation stricte des échelles s’avère indispensable.
Le constructeur plt.subplots() intègre un mécanisme architectural natif d’une redoutable efficacité pour verrouiller cette cohérence métrique : les paramètres booléens ou catégoriels sharex et sharey. En assignant la valeur True à sharey (ou en restreignant ce partage aux éléments d’une même ligne spatiale via la valeur de chaîne 'row'), Matplotlib établit une liaison dynamique bidirectionnelle entre l’ensemble des instances d’axes concernées. Les bornes d’ordonnées sont instantanément unifiées pour englober le minimum absolu et le maximum absolu calculés sur l’agrégat de toutes les séries de données injectées.
Au-delà de cette indispensable harmonisation statistique, l’activation du partage des échelles induit une épuration graphique automatique hautement bénéfique. Constatant que les échelles sont devenues strictement isomorphes, Matplotlib supprime intelligemment les graduations et les étiquettes numériques redondantes sur l’ensemble des axes intérieurs de la grille. Seules les bordures externes — généralement la colonne de gauche pour l’ordonnée et la rangée inférieure pour l’abscisse — conservent leurs annotations chiffrées, ce qui élimine radicalement le bruit visuel inutile et libère un espace substantiel pour la projection pure des données.
6.2 Calibrage individuel des intervalles de données
Bien que l’automatisation offerte par sharex et sharey réponde à une majorité de situations cliniques standardisées, certains contextes exploratoires exigent une intervention manuelle chirurgicale pour ajuster individuellement les intervalles d’affichage. Les fonctions de haut niveau de Seaborn délèguent cette responsabilité aux méthodes d’instance de la classe Axes de Matplotlib, principalement ax.set_xlim(left, right) pour le domaine horizontal et ax.set_ylim(bottom, top) pour l’intervalle vertical.
Ce calibrage individuel s’avère impératif lors de l’investigation de signaux comportant des seuils théoriques ou régulateurs intangibles. Par exemple, si une mesure psychométrique est circonscrite par construction entre les scores absolus de 0 et 100, laisser le moteur graphique ajuster automatiquement les limites autour du minimum observé (par exemple 42) et du maximum observé (par exemple 78) altère la perception globale de la performance du groupe. L’invocation explicite de ax.set_ylim(0, 100) restaure la pleine vérité de l’ancrage psychologique de la mesure. De même, ce bornage manuel permet d’éviter l’écueil classique de la troncature involontaire de barres d’erreur asymétriques ou de points extrêmes atypiques situés en marge des distributions principales.
Par ailleurs, l’ajustement des intervalles n’est pas confiné à la simple translation arithmétique linéaire. Face à des données caractérisées par une asymétrie distributionnelle extrême ou s’étendant sur plusieurs ordres de grandeur — comme les concentrations sanguines de substances pharmacologiques ou des variables de richesse économique —, l’application d’une métrique non linéaire devient incontournable. L’analyste mobilisera alors avec profit la méthode ax.set_yscale('log') ou ax.set_yscale('symlog'). Cette transformation topologique interne de l’axe reconfigure l’intégralité du calcul des graduations sans altérer les structures de données sous-jacentes du DataFrame Pandas.
6.3 Configuration chirurgicale des graduations (Ticks)
La précision d’une figure scientifique se mesure également à la qualité de son système de graduation (ticks), qui constitue le pont d’interprétation métrique unissant le tracé à l’esprit du chercheur. Un espacement trop dense des graduations sature l’espace, générant des collisions typographiques illisibles ; un espacement trop clairsemé prive le lecteur de la capacité d’évaluer quantitativement les grandeurs observées. La maîtrise fine des méthodes de bas niveau de l’objet Axes permet de naviguer avec une exactitude absolue entre ces deux écueils.
Le contrôle de l’emplacement spatial des repères s’opère formellement via la méthode ax.set_xticks(locations), où locations est une liste ordonnée ou un tableau NumPy définissant les positions mathématiques exactes des graduations majeures. Dans la foulée, le formalisme d’affichage textuel associé à ces repères peut être totalement réécrit à l’aide de ax.set_xticklabels(labels). C’est à ce niveau qu’interviennent des options ergonomiques essentielles, telles que le pivotement angulaire des étiquettes à l’aide du paramètre de rotation rotation=45 et la spécification de l’ancrage d’alignement horizontal ha='right', permettant d’éviter tout télescopage lorsque les descripteurs de variables textuelles s’avèrent étendus.
Pour des exigences de publication encore plus raffinées, Matplotlib met à disposition des classes spécialisées issues du sous-module matplotlib.ticker, notamment MultipleLocator pour imposer un pas de graduation fixe et rigide, ou PercentFormatter et ScalarFormatter pour uniformiser la notation scientifique et décimale. En combinant la beauté descriptive des palettes Seaborn avec la discipline métrologique imposée par la configuration des graduations d’axes, l’analyste confère à son travail un degré de rigueur et d’autorité visuelle indiscutable.
7. Titrage, étiquetage et gestion unifiée des légendes
7.1 Hiérarchie des titres entre figure globale et axes individuels
L’ordonnancement sémantique d’un document visuel composite repose sur une architecture textuelle pyramidale rigoureusement hiérarchisée. Le lecteur doit être en mesure d’appréhender d’abord l’objectif expérimental global de la planche graphique, puis d’identifier instantanément la spécificité méthodologique de chaque sous-système de coordonnées, avant de plonger dans le décryptage des valeurs numériques détaillées.
Au sommet de cette hiérarchie trône le super-titre, matérialisé sous l’API Matplotlib par l’invocation de fig.suptitle("Intitulé descriptif global", fontsize=16, fontweight='bold'). Cette instruction insère une chaîne typographique au sommet absolu du canevas, au-dessus de l’intégralité du treillis de sous-graphiques. L’ajustement paramétrique de la position verticale via l’argument y (par exemple y=0.98) permet de contrôler millimétriquement la respiration spatiale entre cet intitulé souverain et les bordures supérieures de la première rangée d’axes, prévenant ainsi les collisions typographiques particulièrement disgracieuses.
À l’échelon immédiatement inférieur, chaque compartiment d’axe individuel doit impérativement recevoir un sous-titre ciblé délimitant son périmètre expérimental, implémenté au moyen de ax.set_title("Condition A vs Condition B", fontsize=12, pad=10). L’argument de marge interne pad assure un décollement vertical suffisant au-dessus du cadre de tracé. En milieu académique, la convention éditoriale préconise l’adjonction de préfixes alphabétiques normalisés en majuscules grasses ou entre parenthèses — tels que (A), (B), (C), (D) —, intégrés soit dans l’intitulé de l’axe, soit positionnés dans le coin supérieur gauche du cadre via des coordonnées relatives à l’axe (transform=ax.transAxes). Cette nomenclature unifiée fluidifie le renvoi textuel depuis le corps de l’article scientifique vers les différents sous-panneaux de la figure.
7.2 Étiquetage explicite des axes de coordonnées
Un défaut récurrent constaté lors de l’emploi candide de Seaborn réside dans la propagation aveugle des étiquettes d’axes par défaut. Seaborn extrait automatiquement le nom des colonnes du DataFrame Pandas pour baptiser les axes d’abscisses et d’ordonnées. Si cette automatisation se révèle commode durant la phase de codage exploratoire, elle devient inacceptable dans une production destinée à la dissémination publique dès lors que les intitulés bruts de la base de données contiennent des underscores, des abréviations cryptiques ou manquent de mentionner les unités physiques de mesure.
L’assainissement de cette couche informative s’effectue par l’appel explicite aux méthodes d’instance ax.set_xlabel() et ax.set_ylabel(). Chaque grandeur représentée doit être formulée dans une langue académique châtiée, systématiquement accompagnée de son unité de mesure normalisée placée entre crochets ou entre parenthèses (par exemple : « Temps d’immersion [s] » ou « Concentration sérique [µmol/L] »). Cette rigueur descriptive prémunit l’analyse contre toute ambiguïté dimensionnelle.
Dans les configurations d’alignement matriciel dense où les échelles sont harmonisées, il est impératif d’éradiquer systématiquement les étiquettes redondantes sur les axes intérieurs afin de maximiser ce qu’Edward Tufte nomme le « ratio données-encre » (data-ink ratio). Si une même variable de groupe est déclinée sur trois colonnes adjacentes, l’affichage de la mention « Groupe expérimental » sous chaque colonne constitue une pollution textuelle inutile. En assignant la chaîne vide ax.set_xlabel("") sur les compartiments supérieurs et intermédiaires, l’analyste décharge l’espace visuel sans sacrifier la moindre fraction de compréhension conceptuelle.
7.3 Consolidation et déduplication des légendes
L’articulation entre l’automatisation esthétique de Seaborn et la rigidité structurelle d’une grille Matplotlib génère fréquemment une aberration de composition majeure : la multiplication pléthorique des légendes. Dès lors qu’une variable de catégorisation secondaire est assignée au paramètre sémantique hue au sein d’une fonction Seaborn (telle que sns.scatterplot ou sns.lineplot), la bibliothèque greffe automatiquement un cartouche de légende à l’intérieur de l’objet Axes ciblé. Dans une grille 2×2, ce comportement mécanique engendre quatre légendes rigoureusement identiques, flottant au sein de chaque sous-graphique et venant souvent masquer une partie critique du nuage de points.
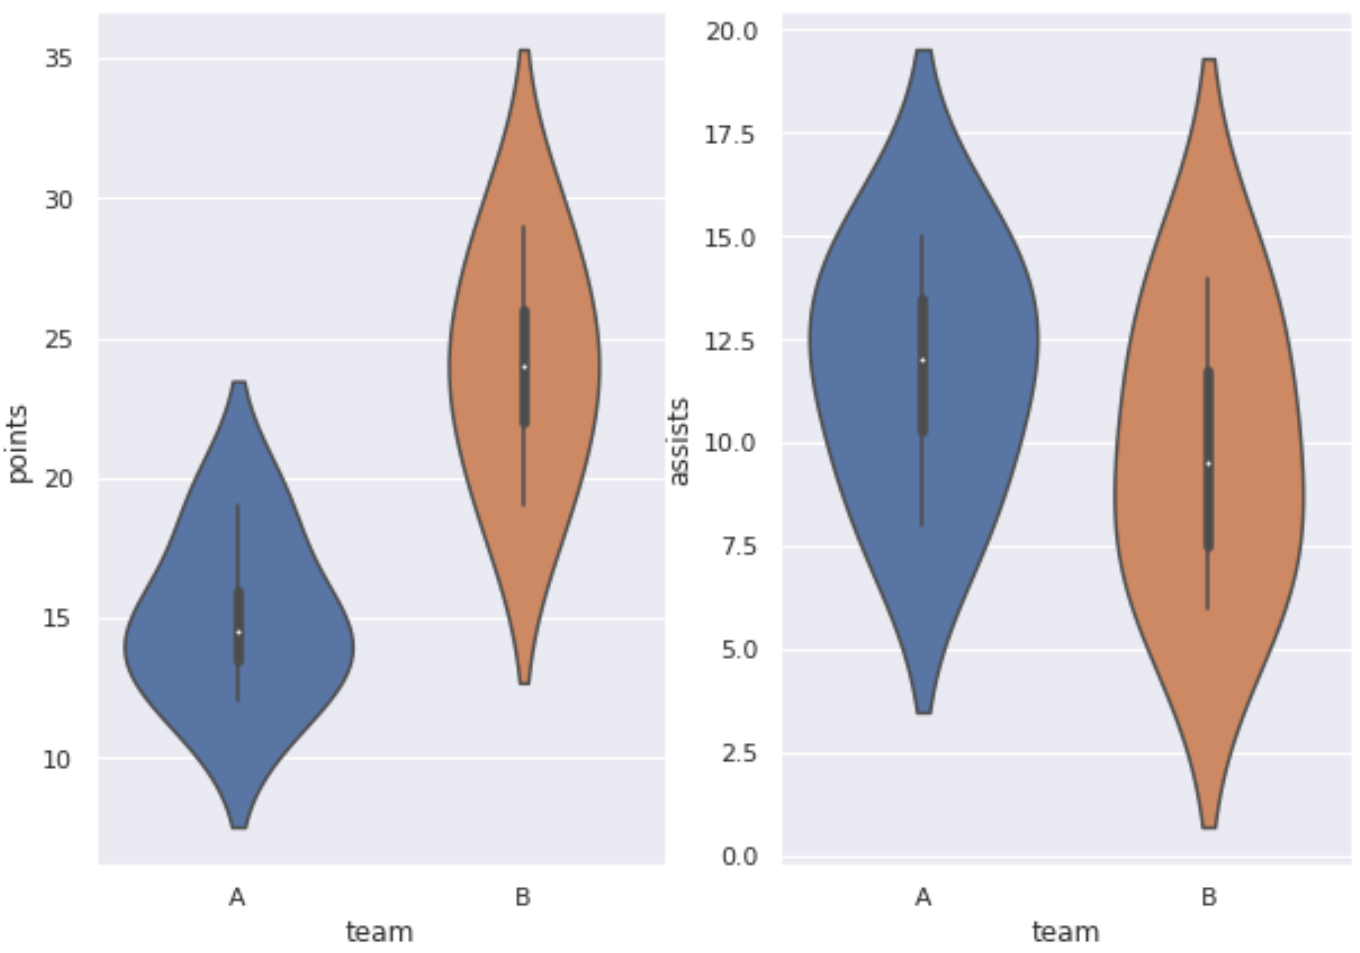
Pour rétablir une élégance éditoriale irréprochable, l’analyste doit procéder à une déduplication méthodique suivie d’une consolidation au niveau de la Figure parente. Le protocole programmatique s’articule en trois temps :
- Interdiction ou suppression des légendes locales créées par Seaborn, soit en passant le paramètre
legend=Falselors des appels de tracé, soit en purgeant explicitement les conteneurs existants via l’instructionax.legend_.remove()sur les axes secondaires. - Extraction chirurgicale des descripteurs visuels originels — les poignées géométriques (handles) et leurs libellés sémantiques (labels) — à partir du premier axe porteur à l’aide de la méthode
handles, labels = ax.get_legend_handles_labels(). - Instanciation d’une légende globale unique rattachée non plus à un axe local, mais à la totalité du canevas via l’appel
fig.legend(handles, labels, loc='upper center', bbox_to_anchor=(0.5, 1.05), ncol=3).
Cette approche unifiée permet de déporter le cartouche explicatif en dehors de la surface active de projection statistique — par exemple dans un bandeau horizontal centré au-dessus des sous-graphiques ou ancré sur la marge latérale droite —, libérant l’intégralité de l’espace interne des cellules pour la visualisation optimale des données empiriques.
8. Optimisation de l’espacement et mise en page géométrique
8.1 Résolution des chevauchements avec tight_layout
L’un des désagréments visuels les plus immédiats constatés lors de la génération initiale d’un treillis de sous-graphiques avec Matplotlib réside dans le chevauchement intempestif des éléments d’annotation périphérique. Par défaut, le moteur de positionnement historique alloue des espacements constants et conservateurs entre les centres des axes cartésiens. Lorsque l’utilisateur enrichit ses tracés de sous-titres volumineux, d’étiquettes d’ordonnées substantielles ou pivote les libellés de graduations horizontales, ces composantes textuelles entrent régulièrement en collision avec les bordures ou les titres des cellules immédiatement adjacentes.
Le remède algorithmique standard à cette pathologie spatiale consiste à invoquer la routine automatique plt.tight_layout() (ou fig.tight_layout()). Cet algorithme sophistiqué procède à une analyse dynamique de la totalité des boîtes de délimitation englobantes (bounding boxes) occupées par l’ensemble des artistes textuels et géométriques de la scène. Il recalcule ensuite itérativement les marges externes ainsi que les espacements inter-axes afin d’assurer qu’aucun glyphe typographique ne vienne empiéter sur le territoire de son voisin, préservant ainsi une lisibilité parfaite.
Toutefois, l’application aveugle de tight_layout() induit un écueil structurel bien connu lorsque la figure intègre un super-titre global généré par fig.suptitle(). L’algorithme standard de tight_layout calcule son périmètre d’ajustement sans toujours tenir compte de la présence de ce super-titre supérieur, aboutissant paradoxalement à comprimer la première rangée de sous-graphiques directement sur le texte du titre global. Pour contourner ce conflit géométrique, l’ingénieur doit contraindre l’espace de calcul de l’algorithme via le paramètre formel rect=[gauche, bas, droite, haut], par exemple en spécifiant fig.tight_layout(rect=[0, 0.03, 1, 0.95]), réservant ainsi explicitement les 5 % supérieurs du canevas pour l’expression sereine du super-titre.
8.2 Ajustement millimétré des marges via subplots_adjust
Bien que les mécanismes d’ajustement automatique répondent favorablement à un large éventail d’architectures symétriques standard, ils s’avèrent parfois impuissants à résoudre les défis d’équilibrage imposés par des mises en page non conventionnelles — par exemple lorsqu’une légende latérale volumineuse est déportée hors du cadre ou lorsque différentes typologies d’axes requièrent des espacements asymétriques. Dans de telles circonstances de haute précision éditoriale, la prise de contrôle manuelle par la méthode fig.subplots_adjust() s’impose comme la solution de référence.
Cette fonction offre un contrôle métrique absolu sur six dimensions topologiques cardinales, toutes calibrées en fractions décimales relatives normalisées de la dimension totale de la Figure (variant de 0.0 à 1.0) :
leftetright: fixent respectivement la position des bordures d’ancrage les plus à gauche et les plus à droite de la totalité du treillis graphique.bottomettop: gouvernent l’altitude des limites inférieures et supérieures du complexe d’axes.wspace(width space) : quantifie l’espacement horizontal brut séparant deux colonnes adjacentes, exprimé en fraction de la largeur moyenne des axes.hspace(height space) : régit l’espacement vertical brut interposé entre deux rangées consécutives, exprimé en fraction de la hauteur moyenne des axes.
Une calibration méthodique de ces paramètres permet de sculpter l’espace visuel avec une rigueur absolue. Si l’analyste constate qu’une légende générale consolidée de deux pouces de large a été positionnée sur le flanc droit de la figure, il lui suffira de borner le paramètre right=0.82 au sein de subplots_adjust. Ce réglage intime au moteur graphique de compresser l’ensemble de la grille sur les 82 % initiaux de la largeur du canevas, garantissant que la légende extérieure disposera des 18 % restants pour s’épanouir sans jamais subir de compression ni écraser les tracés scientifiques adjacents.
8.3 L’option layout=’constrained’ de Matplotlib moderne
Face aux limites historiques et aux réglages empiriques parfois laborieux imposés par tight_layout() et subplots_adjust(), les concepteurs des versions modernes de Matplotlib ont développé une infrastructure entièrement repensée d’ordonnancement géométrique dynamique : le moteur d’agencement contraint (Constrained Layout). Activé dès la phase d’instanciation initiale de la grille par la directive déclarative plt.subplots(nrows, ncols, layout='constrained'), ce système supplante avantageusement les anciennes routines de post-traitement spatial.
À la différence de tight_layout() qui procède à une réévaluation géométrique ponctuelle statique au moment de son invocation — rendant l’agencement vulnérable à toute modification textuelle subséquente —, le moteur layout='constrained' instancie un solveur de contraintes mathématiques réactif qui s’exécute continuellement en tâche de fond. Durant l’intégralité du cycle d’assemblage du graphique, le solveur calcule et ajuste dynamiquement les marges nécessaires pour accommoder les boîtes englobantes de tous les éléments annexes, incluant de manière parfaitement native et transparente le super-titre fig.suptitle(), les titres d’axes individuels, les étiquettes de graduation et les légendes externes consolidées.
Outre sa remarquable simplicité syntaxique, qui élimine le recours aux ajustements manuels empiriques de marges, le mode contraint brille par sa capacité à préserver scrupuleusement l’alignement géométrique strict des conteneurs d’axes au sein de rangées ou de colonnes partagées, même si l’un des graphiques présente des étiquettes numériques considérablement plus larges que son homologue supérieur. Il convient toutefois de souligner une règle d’incompatibilité absolue : l’activation de layout='constrained' interdit formellement l’usage concurrent de plt.tight_layout() ou de fig.subplots_adjust(), sous peine de lever des exceptions logicielles au sein de la boucle de rendu de Matplotlib.
9. Dispositions complexes et asymétriques : GridSpec et subplot_mosaic
9.1 Conception de grilles hétérogènes avec GridSpec
Si la disposition matricielle régulière en sous-graphiques symétriques couvre la grande majorité des besoins analytiques standards, certaines problématiques de recherche exigent une hiérarchie spatiale plus complexe, où différentes représentations occupent des superficies inégales au sein de la même planche. L’archétype méthodologique de cette exigence réside dans la figure combinant un tracé bivarié principal central (comme un nuage de points ou une carte de densité 2D) encadré sur ses marges par deux histogrammes univariés projetant les distributions marginales respectives de l’abscisse et de l’ordonnée.
Pour matérialiser de telles architectures topologiques hétérogènes, Matplotlib fournit un gestionnaire de découpage géométrique de bas niveau d’une flexibilité totale : la classe matplotlib.gridspec.GridSpec. Plutôt que de créer immédiatement des instances d’axes figées, GridSpec structure le canevas sous la forme d’un canevas virtuel segmenté en une maille virtuelle arbitraire de lignes et de colonnes. C’est ensuite à l’analyste qu’incombe la liberté de définir comment chaque objet Axes viendra occuper ou fusionner ces micro-cellules virtuelles en utilisant la syntaxe universelle de découpage (slicing) de Python.
L’implémentation opérationnelle suit une séquence logique rigoureuse : instanciation d’un canevas vierge fig = plt.figure(figsize=(10, 10)), création d’une grille de référence par exemple gs = GridSpec(4, 4, figure=fig), puis assignation des sous-graphiques par extraction de tranches d’indices. L’histogramme marginal horizontal sera ainsi logé sur la première rangée couvrant les trois premières colonnes via ax_top = fig.add_subplot(gs[0, :3]), le nuage de points occupera le corps central majeur via ax_main = fig.add_subplot(gs[1:, :3]), et la densité marginale verticale sera projetée sur la colonne résiduelle via ax_right = fig.add_subplot(gs[1:, 3]). Les fonctions spécialisées de Seaborn peuvent alors être injectées de façon sélective dans ces réceptacles sur mesure via l’éternel argument ax, ouvrant la voie à des créations graphiques de haute virtuosité académique.
9.2 La syntaxe déclarative moderne de subplot_mosaic
Bien que la classe GridSpec confère une puissance géométrique sans limites, sa syntaxe reposant sur des tranches d’indexation numérique matricielle peut rapidement devenir rébarbative, propice aux erreurs de calcul d’indices et difficilement lisible lors des revues de code en équipe de recherche. Consciente de ce verrou cognitif, l’équipe de développement de Matplotlib a introduit une abstraction déclarative moderne d’une élégance absolue : la fonction plt.subplot_mosaic().
Cette approche révolutionne la mise en page en permettant de modéliser l’agencement spatial des sous-graphiques directement sous la forme d’une chaîne de caractères multi-lignes ou d’une liste imbriquée de symboles textuels expressifs, formant une véritable maquette visuelle (ASCII art conceptuel) de la figure désirée. Par exemple, une mise en page associant un large panneau supérieur s’étendant sur toute la largeur de la figure, surmontant deux panneaux inférieurs de taille égale, se déclare intuitivement de la manière suivante :
layout = [["haut", "haut"], ["gauche", "droite"]]
fig, ax_dict = plt.subplot_mosaic(layout, figsize=(10, 8))
Dans cette architecture, la fonction renvoie non plus une matrice d’indices abstraits, mais un dictionnaire ordonné Python (ax_dict) dont les clés correspondent précisément aux identifiants nominatifs spécifiés dans la maquette déclarative. L’injection des fonctions statistiques de Seaborn atteint alors une fluidité et une lisibilité d’ingénierie inégalées : il suffit d’adresser les cibles de tracé via leurs clés textuelles explicites, telles que sns.lineplot(..., ax=ax_dict['haut']) ou sns.barplot(..., ax=ax_dict['gauche']). Si la structure spatiale de la publication doit être réordonnée ultérieurement, la modification de la maquette textuelle réorganise l’intégralité de la planche sans exiger la réécriture de la moindre ligne de manipulation d’indices.
9.3 Gestion des proportions différentielles d’axes
La structuration d’une figure scientifique asymétrique ne dépend pas uniquement du regroupement ou de la fusion de cellules, mais repose également sur la capacité à allouer des proportions différentielles fines entre les rangées ou entre les colonnes. Dans une démarche de démonstration statistique, il est fréquent qu’un panneau principal — hébergeant l’analyse de régression centrale de l’étude — requière une surface visuelle nettement prépondérante, tandis que des panneaux secondaires dédiés à des vérifications méthodologiques ou à des contrôles statistiques doivent occuper une présence discrète et resserrée.
Tant plt.subplots() que GridSpec et subplot_mosaic() incorporent nativement deux arguments déterminants pour moduler ces dynamiques d’échelle : width_ratios et height_ratios. Transmis sous la forme de séquences de valeurs numériques réelles ou entières, ces vecteurs dictent au moteur de placement la distribution proportionnelle de l’espace géométrique total disponible. Par exemple, la spécification d’un ratio de largeur width_ratios=[3, 1] ordonne à Matplotlib d’allouer 75 % de l’envergure horizontale du canevas à la première colonne de tracés, cantonnant la seconde colonne aux 25 % résiduels.
Cette pondération asymétrique s’avère particulièrement précieuse pour intégrer directement des bandes thermiques d’annotations génomiques, des panneaux de distribution de résidus d’ajustement ou des contrôles de qualité analytiques en marge des résultats expérimentaux principaux. En équilibrant chirurgicalement ces ratios de hauteur et de largeur, le concepteur du tracé confère à la planche finale une harmonie esthétique et une clarté structurelle qui renforcent directement l’impact persuasif de l’argumentation scientifique.
10. Les approches alternatives axées sur les figures : FacetGrid, catplot et pairplot
10.1 Le paradigme du conditionnement graphique avec FacetGrid
Au-delà de l’approche orientée objet descendante reposant sur l’injection explicite d’instances d’axes dans les fonctions de bas niveau, Seaborn propose un paradigme alternatif puissant fondé sur le principe du conditionnement graphique systématique, théorisé en statistique informatique sous le concept de treillis (trellis display). Cette méthodologie trouve son incarnation centrale dans la classe FacetGrid.
Un FacetGrid matérialise le concept des « petites figures multiples » en instanciant un tableau de sous-graphiques dont chaque cellule correspond à un sous-ensemble des données brutes, partitionné selon les modalités d’une ou plusieurs variables catégorielles de conditionnement. Plutôt que de contraindre l’analyste à itérer manuellement sur des segments de DataFrame, le FacetGrid prend en charge l’intégralité du fractionnement statistique. L’utilisateur instancie la grille en déclarant les variables responsables du partitionnement horizontal (col) et vertical (row), puis applique une fonction graphique unifiée à l’ensemble du treillis par l’intermédiaire de la méthode vectorielle FacetGrid.map() ou FacetGrid.map_dataframe().
Cette approche se distingue par son degré élevé d’automatisation interne. L’objet FacetGrid calcule et standardise automatiquement l’étendue des axes, propage une nomenclature de sous-titres rigoureuse indiquant la modalité factorielle propre à chaque cadran, et centralise la génération des légendes sans requérir la moindre intervention de bas niveau. Elle constitue la solution d’ingénierie idéale pour explorer de vastes espaces de données multidimensionnelles où l’on souhaite observer la déformation systématique d’une relation bivariée à travers les différents niveaux d’un facteur expérimental.
10.2 Utilisation pragmatique de relplot, catplot et displot
Dans les versions contemporaines de Seaborn, l’instanciation manuelle directe d’un objet FacetGrid combinée à des appels à map() a été progressivement éclipsée au profit d’interfaces déclaratives de très haut niveau, qualifiées de fonctions génériques de figure (Figure-level functions). Il s’agit principalement de sns.relplot() pour les données relationnelles continues (nuages de points et séries temporelles), sns.catplot() pour l’exploration de catégories discrètes (boîtes, violons, bandes, barres), et sns.displot() pour l’évaluation des distributions et des densités statistiques.
Ces fonctions agissent comme de puissantes fabriques logicielles intégrant intrinsèquement le partitionnement multidimensionnel. En exploitant simplement leurs arguments formels col, row, et col_wrap (ce dernier permettant d’enrouler une séquence factorielle linéaire sur plusieurs rangées lorsque le nombre de niveaux dépasse la largeur tolérable d’une page), l’analyste peut générer des visualisations composites d’une immense complexité en une seule instruction compacte. Le dimensionnement s’opère alors non plus via un figsize global rigide, mais par la spécification de la hauteur unitaire d’un sous-graphique (height) et de son ratio d’aspect (aspect), Seaborn déduisant mathématiquement les dimensions optimales de la Figure globale résultante.
Toutefois, cette extraordinaire commodité procédurale s’accompagne d’un tribut architectural non négociable qu’il convient de garder à l’esprit. Dès lors qu’une figure est générée par relplot, catplot ou displot, elle est captive de son conteneur interne et ne peut sous aucun prétexte être encapsulée au sein d’une cellule spécifique d’une grille Matplotlib externe créée par plt.subplots(). En outre, ces fonctions de haut niveau imposent une stricte homogénéité de tracé : il est conceptuellement impossible de mélanger, au sein du même treillis généré par catplot, un graphique en violon sur le premier cadran et une analyse de régression linéaire bivariée sur le second. Le choix entre la flexibilité totale de plt.subplots() et l’automatisation expressive des fonctions de figure constitue l’arbitrage fondamental de l’ingénieur de visualisation.
10.3 Exploration multidimensionnelle globale avec pairplot et jointplot
Pour conclure le panorama des architectures visuelles intégrées de Seaborn, il est incontournable de traiter de deux outils emblématiques de la phase exploratoire initiale : sns.pairplot() et sns.jointplot(). Ces procédures statistiques spécialisées automatisent le déploiement de topologies graphiques complexes qui exigeraient autrement des dizaines de lignes de code procédural avec Matplotlib.
La fonction sns.pairplot() matérialise le concept mathématique classique de matrice de nuages de points (Scatterplot Matrix ou SPLOM). En lui fournissant un DataFrame multidimensionnel, elle instancie instantanément un tableau carré symétrique de dimensions N x N, où N représente le nombre de métriques continues sélectionnées. La fonction cartographie alors sur chaque cellule hors-diagonale le nuage de points bivarié croisant la variable de ligne avec celle de colonne, tandis que la diagonale principale est automatiquement dédiée à la représentation univariée de la distribution de la variable sous la forme d’un histogramme ou d’un profil de densité lissé par noyau gaussien. Cet outil permet d’identifier d’un seul regard les colinéarités suspectes, les hétéroscédasticités et les séparations structurelles de sous-populations.
De son côté, sns.jointplot() encapsule une architecture composite de dimensions 2×2 articulée autour d’un panneau central majeur focalisé sur la distribution conjointe de deux variables (nuage de points, hexbins de densité hexagonale ou contours d’isodensité de noyau), coiffé de deux sous-graphiques marginaux étroits projetant les densités univariées de chaque axe. Bien que ces fonctions retournent des objets conteneurs spécialisés (respectivement PairGrid et JointGrid), leurs architectures internes restent accessibles pour des opérations de chirurgie esthétique personnalisées : les attributs g.fig et g.axes (ou g.ax_joint, g.ax_marg_x) permettent d’extraire les références d’objets sous-jacentes pour appliquer toutes les méthodes de raffinement typographique et métrique propres à Matplotlib.
11. Esthétique, stylisation et préparation pour la publication académique
11.1 Application de thèmes et de styles typographiques avec sns.set_theme()
La transformation d’une ébauche graphique exploratoire en une figure répondant aux standards esthétiques et typographiques des revues internationales de référence (telles que Nature, Science ou les périodiques de l’IEEE) requiert une discipline formelle rigoureuse. L’une des forces majeures de Seaborn réside dans son gestionnaire de thèmes unifié, accessible à travers l’instruction paradigmatique sns.set_theme(), qui permet de configurer globalement les paramètres d’affichage du moteur Matplotlib (le dictionnaire interne rcParam).
La configuration du contexte graphique via le paramètre formel context constitue la première étape d’alignement éditorial. En assignant la valeur context='paper', Seaborn recalibre l’ensemble des éléments typographiques, l’épaisseur des lignes et la taille des marqueurs pour les adapter aux contraintes de résolution et de lisibilité propres à une impression papier sur deux colonnes de texte. Par opposition, les contextes 'notebook', 'talk' ou 'poster' augmentent proportionnellement l’échelle des annotations pour garantir leur visibilité sur des écrans d’ordinateurs ou des projections en amphithéâtre.
Sur le plan stylistique pur, le choix du paramètre style='ticks' ou style='white' est généralement préconisé par les chartes graphiques académiques, rompant avec le fond gris quadrillé par défaut hérité de la bibliothèque ggplot de R. Pour épurer définitivement la scène et maximiser le ratio données-encre, l’application finale de la fonction sns.despine() est impérative. Cette commande procède à l’ablation immédiate des bordures supérieures et droites (spines) de l’ensemble des sous-graphiques de la figure, éliminant les lignes de cadre superflues qui n’apportent aucun support d’information métrique tout en allégeant considérablement la composition générale.
11.2 Choix de palettes chromatiques rigoureuses et accessibles
L’utilisation de la couleur en visualisation scientifique ne saurait être guidée par des considérations purement décoratives ou subjectives. Une palette chromatique mal calibrée peut induire des distorsions d’interprétation catastrophiques, masquer des discontinuités statistiques ou exclure d’emblée une fraction significative de la communauté scientifique atteinte de déficiences de la vision des couleurs (daltonisme, deutéranopie, protanopie).
Seaborn intègre un support exhaustif pour les palettes de couleurs dites « perceptuellement uniformes », développées à l’origine par la communauté scientifique de Matplotlib, au premier rang desquelles figurent Viridis, Cividis, Plasma et Inferno. Ces palettes se distinguent par une progression strictement linéaire de leur luminance perçue : si la figure est imprimée sur une rotative en niveaux de gris purs, la structure topologique et la gradation du gradient demeurent parfaitement préservées, sans créer de faux paliers ou de gradients fantômes.
Dans le cadre de tracés partitionnés en sous-graphiques, l’analyste veillera scrupuleusement à appliquer une sémantique chromatique cohérente et invariante :
- Palettes séquentielles : Destinées à modéliser des grandeurs quantitatives ordonnées possédant une directionnalité naturelle, allant de valeurs faibles à des valeurs élevées (par exemple,
palette='Blues'oupalette='viridis'). - Palettes divergentes : Requises dès lors que les données s’articulent autour d’un point zéro critique ou d’une valeur médiane d’équilibre (par exemple, variations positives et négatives autour d’une moyenne via
palette='vlag'oupalette='coolwarm'). - Palettes qualitatives désaturées : Mobilisées pour discriminer des catégories discrètes indépendantes (groupes cliniques, espèces), en exploitant des collections optimisées pour l’accessibilité comme la palette
colorblindnative de Seaborn (palette='colorblind').
11.3 Exportation haute définition aux formats vectoriels et matriciels
L’ultime étape du flux de production graphique réside dans la sérialisation physique du canevas sur le support de stockage via la commande impérative plt.savefig(). Une figure de sous-graphiques élaborée avec la plus grande virtuosité computationnelle perdra la totalité de sa portée si son exportation s’avère floue, tronquée ou dégradée par des algorithmes de compression destructeurs.
Les maisons d’édition académiques réclament universellement deux voies de soumission distinctes. Pour les rendus matriciels rastérisés (utilisés lors des phases d’évaluation préliminaires ou pour des figures intégrant des millions de marqueurs de nuages de points qui alourdiraient dramatiquement un fichier vectoriel), le format PNG s’impose comme le standard de référence. La commande doit impérativement spécifier une densité de points minimale de 300 à 600 DPI afin de garantir la netteté cristalline du texte sous fort grossissement : plt.savefig('figure_1.png', dpi=300, bbox_inches='tight').
Cependant, pour l’impression finale et l’insertion dans des systèmes de composition typographique de haute tenue comme LaTeX via Overleaf, les formats vectoriels purs tels que le PDF (Portable Document Format), l’EPS (Encapsulated PostScript) ou le SVG (Scalable Vector Graphics) demeurent les maîtres absolus : plt.savefig('figure_1.pdf', format='pdf', bbox_inches='tight'). Dans ces fichiers vectoriels, chaque caractère textuel, chaque bordure de boîte à moustaches et chaque graduation sont encodés sous la forme d’équations géométriques scalables. La résolution devient théoriquement infinie, permettant à l’imprimeur d’agrandir la planche composite à l’échelle d’un panneau d’exposition scientifique sans déplorer la moindre pixelisation ni perte de netteté des détails les plus ténus.
12. Erreurs récurrentes, écueils techniques et bonnes pratiques
12.1 Résolution des erreurs d’indexation et d’incompatibilité de dimensions
Dans l’exercice quotidien de la programmation graphique avec Matplotlib et Seaborn, les développeurs se heurtent fréquemment à des exceptions d’exécution brutales, au premier rang desquelles trône la redoutée : IndexError: too many indices for array. Ce message d’erreur trahit systématiquement une inadéquation entre le modèle conceptuel que l’analyste se fait de sa grille et la structure tensorielle réelle de l’objet renvoyé par plt.subplots().
Cet incident survient typiquement lorsqu’un script configuré initialement pour une grille 2×2 (qui renvoie une matrice 2D autorisant l’accès axes[0, 1]) est modifié pour n’afficher qu’une seule rangée de deux colonnes (plt.subplots(1, 2)). Face à cette dimension unitaire, Matplotlib applique un comportement d’aplatissement automatique (squeezing) par défaut, renvoyant un tableau NumPy unidimensionnel (1D) de taille 2. Dès lors, toute tentative d’accéder aux axes en fournissant deux indices matriciels (par exemple axes[0, 1]) déclenche instantanément une erreur de dépassement d’indice, le tableau 1D n’admettant qu’un seul scalaire.
Pour immuniser définitivement ses pipelines de traitement contre cette instabilité structurelle, l’ingénieur rigoureux doit mobiliser l’argument préventif squeeze=False au sein de plt.subplots(). Cette directive explicite contraint Matplotlib à maintenir invariablement un tableau NumPy bidimensionnel strict, quelles que soient les dimensions scalaires déclarées pour nrows et ncols. Ainsi, même pour une configuration à ligne unique plt.subplots(1, 2, squeeze=False), la cellule de droite demeurera adressable en toute sécurité par axes[0, 1], garantissant l’invariance structurelle du code d’injection graphique aval face à des modifications dimensionnelles amont.
12.2 Débogage des conflits d’écrasement et d’axes actifs non ciblés
Un autre désordre algorithmique récurrent se matérialise par le phénomène dit « d’écrasement de tracé » ou de « ciblage fantôme ». L’utilisateur découvre avec stupeur que l’un de ses sous-graphiques agrège de multiples visualisations entremêlées et illisibles, tandis qu’un compartiment voisin demeure totalement vierge de toute donnée, affichant des axes dénués de la moindre courbe.
Ce dysfonctionnement s’enracine presque exclusivement dans un mélange méthodologique hybride hautement toxique : la contamination d’un flux de programmation orienté objet par des appels procéduraux globaux issus de l’état mutable de matplotlib.pyplot. Lorsqu’un analyste utilise par exemple plt.plot(), plt.xlabel() ou plt.title() au milieu d’un script structuré autour de références explicites d’axes ax, ces fonctions procédurales ne ciblent pas nécessairement l’objet qu’il suppose être en cours d’édition, mais frappent aveuglément l’axe désigné comme « courant » par le gestionnaire d’état de Matplotlib.
La règle d’or pour éliminer définitivement ces anomalies de superposition réside dans l’adoption d’un paradigme orienté objet pur et strict :
- Bannir formellement toute instruction globale
plt.quelque_chose()dès lors que la phase d’initialisation du canevasplt.subplots()a été franchie (à l’exception des directives de fermeture ou de rendu final telles queplt.show()etplt.savefig()). - Vérifier scrupuleusement que chaque fonction de haut niveau de Seaborn reçoit expressément son argument de ciblage géométrique formel (
ax=mon_axe_cible). - Exécuter l’intégralité des personnalisations typographiques et métriques en s’adressant exclusivement aux méthodes d’instance de cet objet spécifique (
ax.set_title(),ax.set_xlabel(),ax.set_ylim()).
12.3 Bonnes pratiques d’ingénierie logicielle pour des scripts de tracé maintenables
Pour élever la production de figures scientifiques au rang d’un processus industriel fiable, auditable et pérenne, il est capital d’appliquer aux scripts de visualisation les mêmes standards d’ingénierie logicielle que ceux exigés pour les pipelines de modélisation mathématique ou de bio-informatique. La pratique consistant à rédiger des scripts monolithiques non structurés de plusieurs centaines de lignes mêlant extraction SQL, nettoyage de données avec Pandas et instructions de dessin Matplotlib doit être proscrite.
La première bonne pratique repose sur l’encapsulation modulaire : la logique de restitution de chaque typologie de sous-graphique doit être isolée au sein de fonctions Python dédiées, admettant en entrée un sous-ensemble de données épuré et une référence d’axe ax typée statiquement (grâce au module typing de Python : def tracer_profil_clinique(df: pd.DataFrame, ax: matplotlib.axes.Axes) -> None:). Cette séparation hermétique autorise la réutilisation immédiate des routines graphiques au sein de multiples projets, facilite l’écriture de tests unitaires visuels et simplifie considérablement le débogage collaboratif.
Enfin, la totale séparation entre la phase de transformation des données (ETL) et la phase de rendu graphique s’avère non négociable pour garantir la reproductibilité computationnelle. Les jeux de données doivent être totalement consolidés, agrégés et typés avant d’être présentés aux fonctions de dessin de Seaborn. L’analyste doit proscrire l’insertion de filtrages ou de calculs d’imputation complexes à l’intérieur même des arguments d’appel des fonctions graphiques. En sanctuarisant ces frontières architecturales, le chercheur s’assure que son flux de travail scientifique demeure robuste, évolutif et conforme aux exigences d’intégrité et de transparence qui régissent la recherche scientifique contemporaine.
Références
Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56).
Rougier, N. P. (2021). Scientific Visualization: Python + Matplotlib. Nicolas P. Rougier. https://github.com/rougier/scientific-visualization-book
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10