
La visualisation des données quantitatives constitue l’un des piliers fondamentaux de l’analyse exploratoire et de l’inférence statistique contemporaine. Face à des distributions empiriques complexes, le chercheur doit disposer d’instruments graphiques capables de retranscrire fidèlement la réalité sous-jacente des phénomènes observés, sans masquer les discontinuités locales ni saturer l’espace de perception visuelle. Si l’histogramme demeure traditionnellement l’outil de premier recours pour représenter la distribution d’une variable continue discrétisée, ses contraintes intrinsèques, notamment la juxtaposition de rectangles contigus, imposent des limites sévères dès lors qu’il s’agit de comparer simultanément plusieurs sous-populations ou de discerner avec finesse la dynamique d’une densité empirique.
C’est précisément dans cette brèche méthodologique que s’insère le polygone de fréquence. En reliant par des segments linéaires ordonnés les centres de classe associés à leurs effectifs respectifs, cette géométrie graphique offre une alternative d’une élégance et d’une clarté remarquables. Loin d’être une simple variation esthétique de l’histogramme, le polygone de fréquence modifie profondément la lecture de la dispersion statistique en introduisant une continuité perceptive qui guide l’œil le long des gradients d’accroissement et de décroissance des effectifs. Cette continuité visuelle se révèle particulièrement précieuse au sein des sciences comportementales, de la biométrie et de la psychométrie, où les chercheurs manipulent fréquemment des échelles composites et doivent juxtaposer les trajectoires distributionnelles de cohortes distinctes sans induire d’occlusion graphique.
Au sein de l’environnement de calcul statistique R, et tout particulièrement au travers de l’écosystème graphique unifié incarné par la bibliothèque ggplot2, la construction d’un polygone de fréquence bénéficie d’une rigueur formelle issue de la grammaire des graphiques théorisée par Leland Wilkinson. Ce guide exhaustif a pour ambition d’explorer de manière approfondie les dimensions théoriques, mathématiques, algorithmiques et appliquées du polygone de fréquence dans R. À travers l’analyse méticuleuse des fonctions dédiées, le contrôle strict des paramètres de discrétisation, la transition vers les représentations surfaciques et la mise en œuvre de protocoles de publication académique, cet article propose un parcours complet destiné aux chercheurs et analystes soucieux d’élever la précision de leurs restitutions graphiques.
1. Introduction aux polygones de fréquence et fondements statistiques
1.1 Définition et rôle du polygone de fréquence
Le polygone de fréquence est une représentation graphique univariée qui traduit la distribution d’une variable quantitative continue ou discrète à large étendue. Sur le plan de sa construction géométrique élémentaire, cette figure repose sur le partitionnement préalable du continuum de la variable en un ensemble d’intervalles mutuellement exclusifs et exhaustivement couvrants, couramment désignés sous le terme de classes ou de tranches. À l’intérieur de chaque classe, l’effectif observé est quantifié, puis rattaché à une coordonnée spatiale bidimensionnelle dont l’abscisse correspond rigoureusement au point milieu mathématique de l’intervalle et l’ordonnée au dénombrement absolu ou relatif des observations. Le tracé final s’obtient par l’interconnexion linéaire séquentielle de ces coordonnées nodales, formant une ligne brisée continue.
L’un des avantages majeurs de cette géométrie réside dans sa capacité à offrir une visualisation fluide d’une distribution discrétisée. Contrairement aux structures en blocs massifs, le polygone privilégie la perception des gradients de fréquence, permettant à l’observateur d’appréhender intuitivement la pente avec laquelle une distribution s’élève vers son mode ou décroît vers ses queues. Cette vectorisation affine la transition cognitive entre la réalité discrète de l’échantillonnage et le modèle théorique sous-jacent.
Il est toutefois crucial d’établir une différenciation fondamentale entre cette courbe empirique polygonale et une courbe de densité théorique. Alors que la courbe théorique, à l’instar de la fonction de densité gaussienne, dérive d’une formulation analytique continue intégrant à l’unité, le polygone de fréquence demeure un estimateur non paramétrique brut, strictement dépendant de la discrétisation par classes. Il constitue une étape intermédiaire entre l’histogramme classique et l’estimation de densité par noyau, permettant d’approcher la forme de la distribution sous-jacente tout en conservant une traçabilité directe avec les effectifs dénombrés.
1.2 Comparaison conceptuelle : polygone de fréquence versus histogramme
La comparaison entre l’histogramme et le polygone de fréquence dépasse la simple préférence esthétique ; elle relève d’un arbitrage sémiologique et méthodologique rigoureux. L’histogramme matérialise l’effectif par l’aire d’un rectangle érigé sur chaque classe. Cette matérialité volumique est idéale pour appréhender la masse de données contenue dans un intervalle précis. En contrepartie, la présence des bordures verticales crée une série de discontinuités visuelles qui hachent la perception globale de la distribution. Ces frontières artificielles peuvent induire l’observateur en erreur en suggérant des ruptures nettes dans des phénomènes psychologiques ou biologiques qui varient en réalité de façon continue.
Le polygone de fréquence supprime ces discontinuités grâce à sa trajectoire linéaire ininterrompue. Cette propriété le rend incomparablement supérieur lorsqu’il s’agit de superposer plusieurs distributions au sein d’un même repère cartésien. La superposition de trois ou quatre histogrammes aboutit inévitablement à un encombrement visuel inextricable, où les barres s’occultent mutuellement, même en ayant recours à des transparences chromatiques complexes. En revanche, plusieurs polygones de fréquence peuvent cohabiter harmonieusement sur un unique graphique, leurs intersections linéaires révélant immédiatement les zones de divergence ou de convergence entre différents groupes expérimentaux.
Le choix méthodologique entre ces deux approches doit donc être guidé par la complexité du dessein d’analyse. Si l’objectif exclusif consiste à décrire un échantillon univarié isolé en insistant sur le volume absolu de chaque tranche, l’histogramme demeure parfaitement recevable. Dès lors que l’analyste cherche à mettre en évidence des allures de distribution, à traquer des déplacements modaux entre conditions expérimentales ou à limiter la fatigue cognitive du lecteur face à des données multigroupes, le polygone de fréquence s’impose comme le paradigme visuel optimal.
1.3 Pertinence méthodologique dans la recherche en psychologie
Dans le champ de la recherche en psychologie et en sciences cognitives, la nature des mesures recueillies confère au polygone de fréquence une pertinence méthodologique singulière. Les protocoles psychométriques s’appuient fréquemment sur des inventaires cliniques ou des échelles de type Likert dont les scores globaux, obtenus par sommation d’items, génèrent des variables quantitatives discrètes à large étendue. Visualiser de telles distributions à l’aide de polygones permet aux cliniciens et aux chercheurs d’identifier instantanément le profil distributionnel d’une cohorte, en repérant d’éventuels effets de plafond ou de plancher qui compromettraient la validité d’une échelle de mesure.
L’examen minutieux des formes empiriques constitue un préalable obligatoire à l’inférence statistique. Le polygone de fréquence permet une inspection visuelle fine des asymétries positives ou négatives, ainsi que de l’aplatissement de la distribution. Une asymétrie marquée sur une échelle d’évaluation de la dépression, par exemple, signale immédiatement une concentration d’individus asymptomatiques dans les valeurs basses et une longue traîne vers les scores sévères. Cette configuration alerte immédiatement le méthodologue sur la violation potentielle du postulat de normalité univariée requis par les modèles linéaires classiques, orientant ainsi la stratégie analytique vers des transformations de variables ou des tests non paramétriques.
Enfin, la clarté sémiotique des polygones de fréquence répond aux exigences rigoureuses de transmission de l’information dans les revues académiques internationales. Dans les publications affiliées aux standards de l’American Psychological Association, l’économie visuelle est primordiale. Présenter l’évolution des scores d’anxiété entre un groupe témoin et plusieurs groupes thérapeutiques sous la forme de tracés polygonaux superposés confère aux figures une lisibilité immédiate, valorisant les dynamiques d’efficacité différentielle sans saturer les planches éditoriales.
2. Configuration de l’environnement de programmation dans R
2.1 Installation et chargement de la bibliothèque ggplot2
Pour mettre en œuvre des représentations graphiques répondant aux exigences scientifiques modernes, l’utilisation du moteur graphique natif de R, bien qu’opérationnelle, s’avère rapidement limitée face à la complexité des personnalisations requises. L’adoption de la bibliothèque logicielle ggplot2, fer de lance de l’écosystème Tidyverse, constitue le standard méthodologique contemporain. Cette bibliothèque implémente formellement la grammaire des graphiques, un paradigme formel qui décompose chaque figure en couches structurelles indépendantes : les données sources, les correspondances esthétiques, les transformations statistiques, les objets géométriques et le système de coordonnées cartésiennes.
L’accès à cet environnement nécessite l’installation préalable du paquetage sur la machine de l’utilisateur, une opération exécutée dans la console de programmation au moyen de la commande dédiée aux dépôts officiels du Comprehensive R Archive Network. Une fois cette étape franchie, le chargement de la bibliothèque au début de chaque script de travail mobilise l’environnement de fonctions indispensables à la génération des tracés. Il est hautement recommandé de maintenir l’interpréteur R et ses dépendances logicielles à jour, afin de prévenir d’éventuelles régressions ou incompatibilités entre les fonctions de transformation statistique interne et le moteur de rendu graphique vectoriel.
Au-delà du simple chargement de la bibliothèque, l’analyste gagne à configurer les options globales de son environnement d’affichage graphique au sein de sa session RStudio ou de son interpréteur de commandes. L’ajustement préventif de paramètres tels que la résolution d’affichage par défaut en points par pouce ou la gestion du périphérique graphique vectoriel assure une restitution visuelle nette, exempte d’artéfacts de pixellisation lors de la phase itérative de développement du polygone de fréquence.
2.2 Préparation et structuration rigoureuse du jeu de données
L’intégration fluide de données au sein du paradigme de ggplot2 est conditionnée par l’adhésion stricte au principe du format ordonné, internationalement formalisé sous le vocable de données bien rangées ou données ordonnées. Dans cette architecture tabulaire canonique, chaque colonne doit correspondre de manière univoque à une variable conceptuelle distincte, chaque ligne doit représenter une unité d’observation individuelle unique, et chaque cellule doit consigner une mesure atomique isolée. Les représentations dites larges, où plusieurs colonnes matérialisent en réalité des occurrences temporelles répétées d’une même métrique, doivent impérativement faire l’objet d’un pivotage préalable pour être exploitées de façon optimale.
La typologie interne des vecteurs composant le tableau de données constitue un second point d’attention fondamental. La variable destinée à alimenter le polygone de fréquence doit impérativement être instanciée sous la forme d’un vecteur numérique à virgule flottante ou d’un vecteur d’entiers. Si la variable a été malencontreusement importée sous forme de chaîne de caractères ou de facteur non ordonné, l’algorithme sous-jacent de discrétisation de ggplot2 échouera systématiquement à calculer les intervalles de classe continus, générant des erreurs d’exécution bloquantes. De même, les variables de regroupement catégorielles destinées aux comparaisons inter-groupes doivent être formellement typées en tant que facteurs factoriels explicites.
La préparation rigoureuse des données implique également une inspection préliminaire approfondie des étendues de valeurs et des valeurs aberrantes potentielles. L’existence d’une seule valeur aberrante extrême, résultant par exemple d’une erreur de saisie manuelle dans un protocole clinique, distend dramatiquement l’abscisse cartésienne, contraignant l’algorithme à créer une multitude de classes vides et écrasant le polygone central en une ligne méconnaissable. Un examen descriptif sommaire permet de garantir l’intégrité métrologique du jeu de données avant toute tentative de modélisation visuelle.
2.3 Garantie de reproductibilité avec set.seed()
La reproductibilité computationnelle constitue l’un des fondements inaliénables de la démarche scientifique moderne. Dès lors qu’un tutoriel, une démonstration méthodologique ou une simulation expérimentale implique la génération de nombres pseudo-aléatoires pour émuler des populations de scores psychométriques, l’aléa doit pouvoir être rigoureusement répliqué par n’importe quel chercheur exécutant le script sur une machine distincte. Dans l’écosystème R, cette fixité de l’aléa algorithmique est gouvernée par la fonction d’initialisation du générateur de nombres pseudo-aléatoires.
L’invocation d’une graine aléatoire explicite via la commande dédiée permet de caler le générateur sous-jacent de Mersenne-Twister sur un état déterministe invariable. En attribuant un entier fixe en argument de cette fonction avant toute opération de tirage aléatoire, l’utilisateur s’assure que les fonctions de simulation statistique généreront très exactement la même séquence numérique lors de chaque exécution intégrale du code. Cette précaution méthodologique élimine toute divergence de tracé liée à la variabilité d’échantillonnage lors des phases d’apprentissage et de validation des figures.
À titre démonstratif pour les développements qui suivent, la simulation d’un échantillon continu étalon s’effectue avantageusement par le biais de tirages au sein d’une distribution gaussienne théorique d’effectif contrôlé, dotée d’une moyenne et d’un écart-type représentatifs des échelles d’évaluation standardisées. La structuration de ce vecteur simulé à l’intérieur d’un tableau de données formel offre une base de travail saine, robuste et universellement reproductible pour l’ensemble des manipulations graphiques ultérieures.
3. Construction du polygone de fréquence fondamental avec geom_freqpoly()
3.1 Initialisation du canevas graphique avec ggplot()
L’édification d’un polygone de fréquence dans ggplot2 débute invariablement par l’initialisation du canevas cartésien au moyen de la fonction maîtresse du système. Cet appel liminaire a pour vocation première de lier formellement la structure tabulaire contenant les observations au moteur graphique, créant ainsi un environnement graphique vierge mais spatialement calibré. À cette étape, l’environnement alloue les coordonnées en mémoire sans imprimer de marqueur physique sur le plan de travail, établissant l’échafaudage abstrait sur lequel les géométries ultérieures viendront se déposer.
Le paramétrage central de cette initialisation réside dans la déclaration des correspondances esthétiques fondamentales au travers de la fonction d’association visuelle. Pour un polygone de fréquence univarié standard, seule la coordonnée horizontale de l’abscisse requiert une assignation explicite en lui fournissant le nom de la colonne numérique cible. L’absence de spécification pour l’ordonnée est délibérée et parfaitement normale : la dimension verticale ne provient pas d’une colonne préexistante dans les données brutes, mais d’une opération mathématique de dénombrement qui sera déléguée à la couche géométrique.
Cette distinction met en lumière la logique modulaire des calques successifs propre à la philosophie de Hadley Wickham. Le canevas initial ne fait que stipuler que la variable d’intérêt est distribuée le long de l’axe horizontal. L’instruction graphique demeure dans l’attente d’une géométrie opérationnelle capable d’interpréter cette variable continue, de la discrétiser et de décider du mode d’incarnation graphique des effectifs résultants sur l’axe vertical.
3.2 Application et mécanique interne de geom_freqpoly()
L’adjonction de la couche géométrique spécifique s’opère par l’adjonction de la fonction dédiée au tracé polygonale de fréquence à l’aide de l’opérateur de composition propre à la grammaire de ggplot2. Dès que cette géométrie est ajoutée à la chaîne d’instructions, le moteur graphique déclenche en coulisses un mécanisme algorithmique sophistiqué articulé autour d’une transformation statistique de partitionnement continu. Cette routine interne segmente le continuum de la variable en segments adjacents, compte rigoureusement le nombre d’observations chutant à l’intérieur de chaque intervalle, et calcule les coordonnées médianes exactes de chaque classe.
Une fois les coordonnées cartésiennes temporaires établies par l’algorithme statistique, la géométrie du polygone entreprend le raccordement linéaire des points. Chaque sommet de la ligne brisée possède pour abscisse le point médian de sa classe respective, et pour ordonnée l’effectif d’observations correspondant. Les segments linéaires rectilignes relient alors séquentiellement les sommets contigus, matérialisant visuellement la dynamique de variation sans rupture volumique.
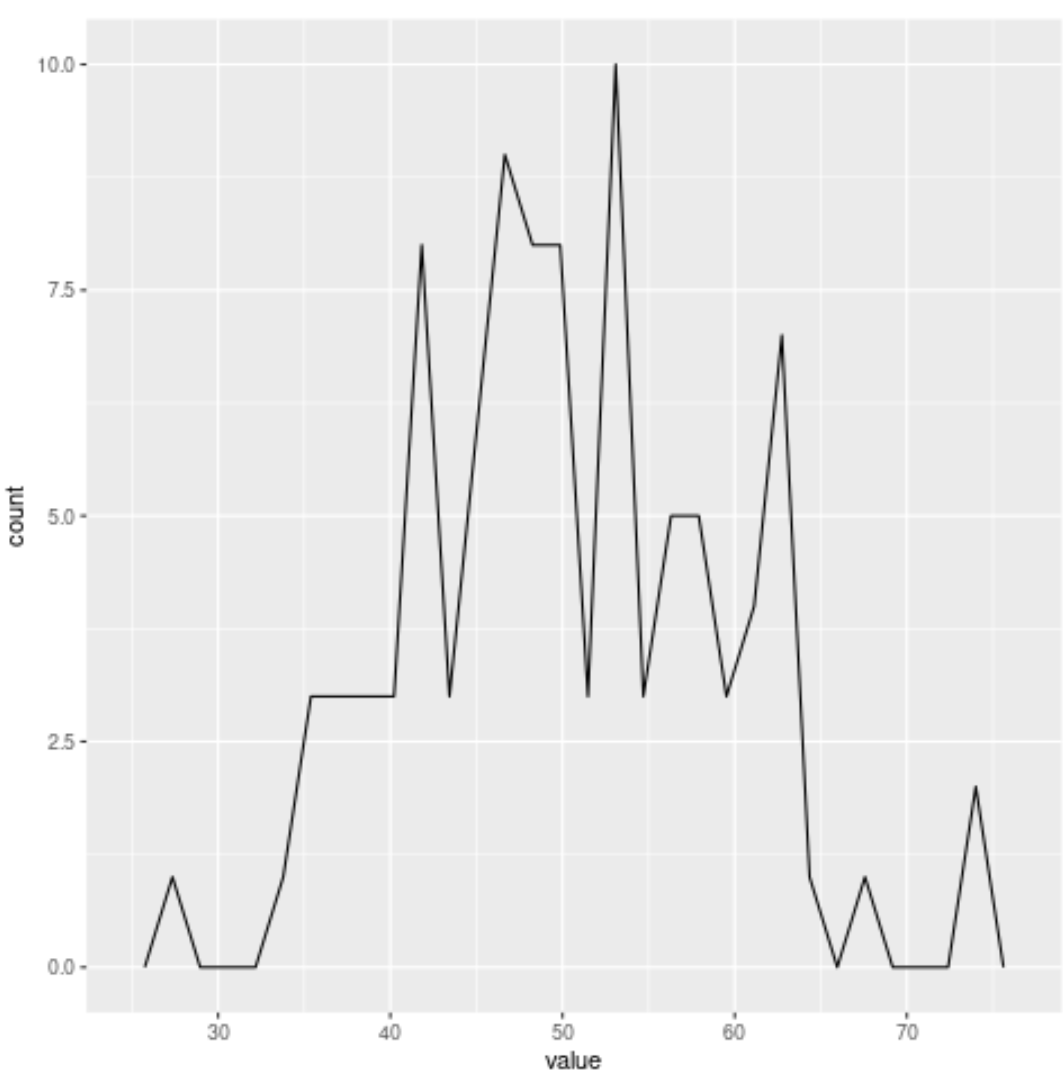
L’exécution de cette commande produit instantanément le tracé univarié brut sur la surface d’affichage. À ce stade primaire, le polygone apparaît sous la forme d’un trait sombre continu reposant sur un fond graphique neutre quadrillé. Bien que d’une sobriété dépouillée, ce premier tracé offre déjà une lecture instantanée de l’allure distributionnelle de l’échantillon, permettant d’identifier sans délai la localisation du mode dominant et l’étalement général de la dispersion empirique.
3.3 Interprétation des coordonnées et des axes par défaut
La lecture analytique des axes générés automatiquement par ggplot2 fournit des indications précieuses sur le fonctionnement de la fonction. L’axe vertical est spontanément labellisé du terme anglo-saxon matérialisant les effectifs dénombrés par tranche. La graduation de cet axe est automatiquement ajustée pour inclure le sommet le plus élevé de la distribution, offrant une marge d’affichage suffisante afin que la crête du polygone n’entre pas en collision visuelle avec la bordure supérieure du système de coordonnées.
Un phénomène géométrique capital caractérise le polygone de fréquence par rapport à d’autres représentations linéaires : la présence de segments d’ancrage aux bornes extrêmes. Pour que le polygone ne flotte pas de manière arbitraire au-dessus de l’axe des abscisses, l’algorithme interne insère automatiquement deux classes virtuelles additionnelles, dotées chacune d’un effectif rigoureusement nul, situées immédiatement avant la première classe observée et immédiatement après la dernière classe garnie. Cette astuce de calcul force les deux extrémités de la ligne brisée à descendre se fixer sur la ligne de base d’ordonnée zéro, fermant ainsi conceptuellement la distribution.
L’observateur avisé doit néanmoins prêter attention aux artéfacts graphiques potentiels créés par des classes d’effectif nul intercalées au sein même de la distribution. Si un intervalle ne contient aucune donnée entre deux modes distincts, le polygone s’effondrera jusqu’à l’ordonnée zéro avant de remonter vers le second mode, formant une dépression spectaculaire. Il convient de vérifier méthodologiquement que cette morphologie reflète fidèlement une discontinuité dans la réalité empirique du phénomène mesuré, et non une discrétisation excessivement fragmentée.
4. Paramétrage du nombre de classes (bins) et de leur largeur (binwidth)
4.1 Impact statistique du paramètre par défaut à 30 intervalles
Lors de l’appel élémentaire à la fonction de tracé sans paramétrage explicite de discrétisation, le système graphique applique de manière immuable une valeur heuristique par défaut fixée à trente intervalles. Ce comportement s’accompagne systématiquement d’un message d’avertissement affiché dans la console R, signalant à l’utilisateur que le partitionnement par défaut a été utilisé et l’enjoignant vivement à choisir une largeur de classe mieux adaptée aux spécificités de son jeu de données. Ce message ne constitue en aucun cas une erreur d’exécution, mais un garde-fou épistémologique fondamental.
Le chiffre arbitraire de trente classes représente un compromis statistique générique conçu pour fournir un aperçu immédiat sur des jeux de données d’envergure moyenne, mais il s’avère fréquemment inapproprié dans des contextes de recherche spécialisés. Lorsque l’échantillon comporte un faible nombre d’observations, par exemple cinquante ou cent individus, le contraindre dans trente classes dilue dramatiquement les effectifs unitaires. De nombreuses classes se retrouvent réduites à un ou deux points, voire totalement vides, générant un tracé chaotique marqué par un bruit visuel excessif qui masque totalement la tendance centrale sous-jacente.
À l’inverse, face à des volumétries massives comprenant plusieurs centaines de milliers d’enregistrements, trente classes imposent un niveau d’agrégation beaucoup trop lâche. Les spécificités morphologiques locales, telles que des bi-modalités rapprochées ou des asymétries subtiles au sommet de la courbe, sont alors complètement effacées et amalgamées au sein de classes géantes. Ce phénomène de sous-ajustement empêche toute appréhension fine de la réalité empirique. L’analyste se trouve donc dans l’obligation méthodologique de reprendre le contrôle direct de cette discrétisation.
4.2 Ajustement explicite du nombre de classes via l’argument bins
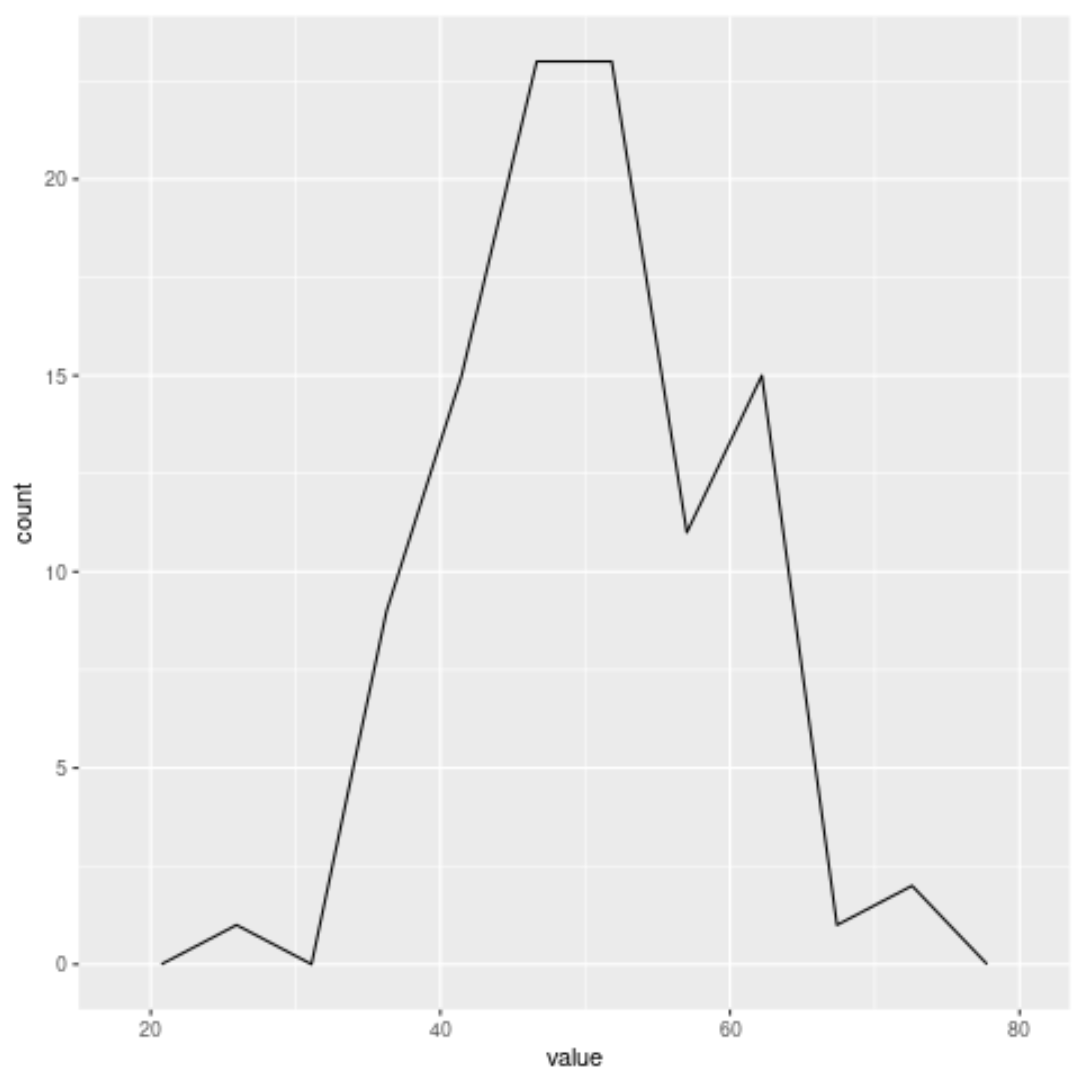
Le premier levier d’action pour moduler la discrétisation consiste à spécifier explicitement le nombre absolu d’intervalles souhaité au moyen de l’argument formel dédié au sein de la fonction géométrique. En modifiant cette valeur numérique entière, le chercheur ordonne à l’algorithme interne de diviser l’étendue totale de la variable d’intérêt en un nombre exact de segments de largeurs égales. Cette approche directe permet de corriger rapidement des visualisations manifestement dégradées par le réglage standard.
La réduction concertée du partitionnement à une valeur modérée, telle que dix ou quinze classes sur des effectifs limités, produit un effet de lissage mécanique immédiat. Les sommets parasites s’estompent au profit d’une trajectoire globale cohérente qui met en évidence l’allure générale de la distribution empirique. À l’inverse, l’élévation graduelle du paramètre permet d’explorer la granularité interne des données lorsque la taille de la cohorte offre une puissance statistique suffisante pour garnir des intervalles resserrés sans créer de discontinuités artificielles.
Il est pédagogiquement formateur de procéder à des comparaisons systématiques en faisant varier cette valeur de cinq à cinquante classes par paliers successifs. Cette inspection exploratoire révèle comment la perception des modes d’une distribution peut être dramatiquement altérée par un choix arbitraire. Un pic unique observé avec huit classes peut soudainement se scinder en deux sommets distincts lorsqu’on bascule à vingt classes, révélant une hétérogénéité sous-jacente au sein de l’échantillon que l’agrégation primitive dissimulait.
4.3 Contrôle précis de l’intervalle avec le paramètre binwidth
Bien que l’ajustement du nombre total de classes via l’argument précédent soit commode, la pratique la plus rigoureuse sur le plan métrologique consiste à définir la largeur absolue des intervalles à l’aide de l’argument dédié à la largeur de classe. Ce mode opératoire s’ancre directement dans les unités concrètes de la mesure psychologique ou biométrique analysée, conférant une signification tangible immédiate à la géométrie du graphique. Si l’on évalue un score psychométrique échelonné sur cent points, fixer la largeur de classe à cinq unités signifie que chaque sommet du polygone synthétisera l’effectif exact d’individus situés dans une fourchette de cinq points.
Le contrôle de la largeur de classe s’avère particulièrement crucial pour aligner la discrétisation sur la granularité naturelle des instruments de recueil de données. Pour une échelle d’anxiété standardisée dont le pas de mesure est unitaire, une largeur de deux ou trois points permet de respecter la discrétisation native du test sans introduire de distorsion arithmétique. L’interprétation clinique ou théorique des données gagne ainsi en précision, chaque point nodal du polygone correspondant à une fraction parfaitement identifiable de l’instrument d’évaluation.
L’utilisation de cet argument soulève cependant la question de l’origine spatiale du découpage le long de l’axe réel. ggplot2 offre la possibilité de stabiliser l’emplacement des intervalles en recourant aux arguments de calage de centre ou de frontière. En définissant explicitement une limite de classe sur un entier rond pertinent pour le domaine d’étude, l’analyste prévient tout glissement arbitraire du maillage causé par les valeurs minimales de l’échantillon, garantissant une stabilité parfaite des tracés entre différentes vagues de collecte de données.
4.4 Application des règles heuristiques statistiques de discrétisation
Pour s’émanciper du tâtonnement empirique et asseoir le choix de la largeur de classe sur des bases mathématiques formelles, le chercheur gagne à mobiliser les grandes règles heuristiques de discrétisation issues de la théorie statistique. La plus ancienne et la plus célèbre demeure la règle de Herbert Sturges, formulée en 1926. Conçue sous l’hypothèse sous-jacente d’une distribution normale, elle calcule le nombre optimal de classes en appliquant une fonction logarithmique en base deux à la taille globale de l’échantillon, incrémentée d’une unité. La largeur de classe dérive ensuite de la division de l’étendue observée par ce nombre d’intervalles théorique.
Bien qu’historiquement omniprésente dans les manuels, la formulation de Sturges tend à sous-estimer sévèrement le nombre de classes nécessaire dès lors que la taille de l’échantillon dépasse quelques centaines d’observations, induisant un lissage excessif. Pour pallier cette faiblesse, David Scott a introduit en 1979 une règle asymptotique optimale basée sur la minimisation de l’erreur quadratique intégrée de l’estimateur par histogramme. Sa formule définit directement la largeur de classe idéale en fonction de l’écart-type empirique de la variable et de la racine cubique du nombre d’observations, offrant une excellente sensibilité pour les distributions régulières unimodales.
Dans les contextes appliqués où les distributions présentent de l’asymétrie ou des queues épaisses chargées de valeurs extrêmes, la formulation robuste établie par David Freedman et Persi Diaconis en 1981 constitue le standard méthodologique absolu. Cette formulation substitue l’écart-type par l’écart interquartile, le rendant totalement insensible aux dérives causées par des valeurs isolées aux extrémités. Dans R, le chercheur peut traduire immédiatement cette équation mathématique en divisant le double de l’intervalle interquartile de son vecteur de données par la racine cubique de l’effectif total, puis injecter directement le résultat scalaire obtenu dans le paramètre de largeur de classe de son polygone graphique.
5. Remplissage et gestion des surfaces : transition vers geom_area()
5.1 Contraintes structurelles du remplissage dans geom_freqpoly()
Dès lors que l’analyste cherche à accroître l’impact esthétique ou la lisibilité de sa figure, l’envie émerge spontanément de colorer l’espace délimité sous le tracé du polygone de fréquence. Or, l’application naïve de l’argument de remplissage chromatique au sein de la fonction spécifique du polygone s’avère systématiquement inopérante. Les utilisateurs découvrent avec frustration que si la couleur de bordure réagit fidèlement à leurs directives, l’intérieur de la courbe demeure désespérément transparent et vierge de toute teinte.
Cette contrainte n’est nullement un bogue logiciel, mais la traduction scrupuleuse de la philosophie géométrique de ggplot2. Sur le plan structural, l’objet géométrique associé au polygone de fréquence est une entité purement unidimensionnelle : il s’agit d’un ensemble ordonné de segments linéaires possédant une longueur, une épaisseur et une texture de ligne, mais aucune surface propre. N’ayant pas de dimension spatiale bidimensionnelle fermée, cet objet géométrique est intrinsèquement incapable de supporter un attribut de remplissage surfacique.
La distinction mathématique entre un contour linéaire ouvert et une surface polygonale fermée impose donc une adaptation méthodologique. Pour matérialiser un aplat coloré sous les sommets du tracé, l’utilisateur doit impérativement faire appel à une famille géométrique distincte, expressément conçue pour tracer des aires continues fermées reposant sur un socle d’ordonnée défini, déplaçant ainsi la modélisation vers des outils complémentaires.
5.2 Implémentation de geom_area() couplé à stat=’bin’
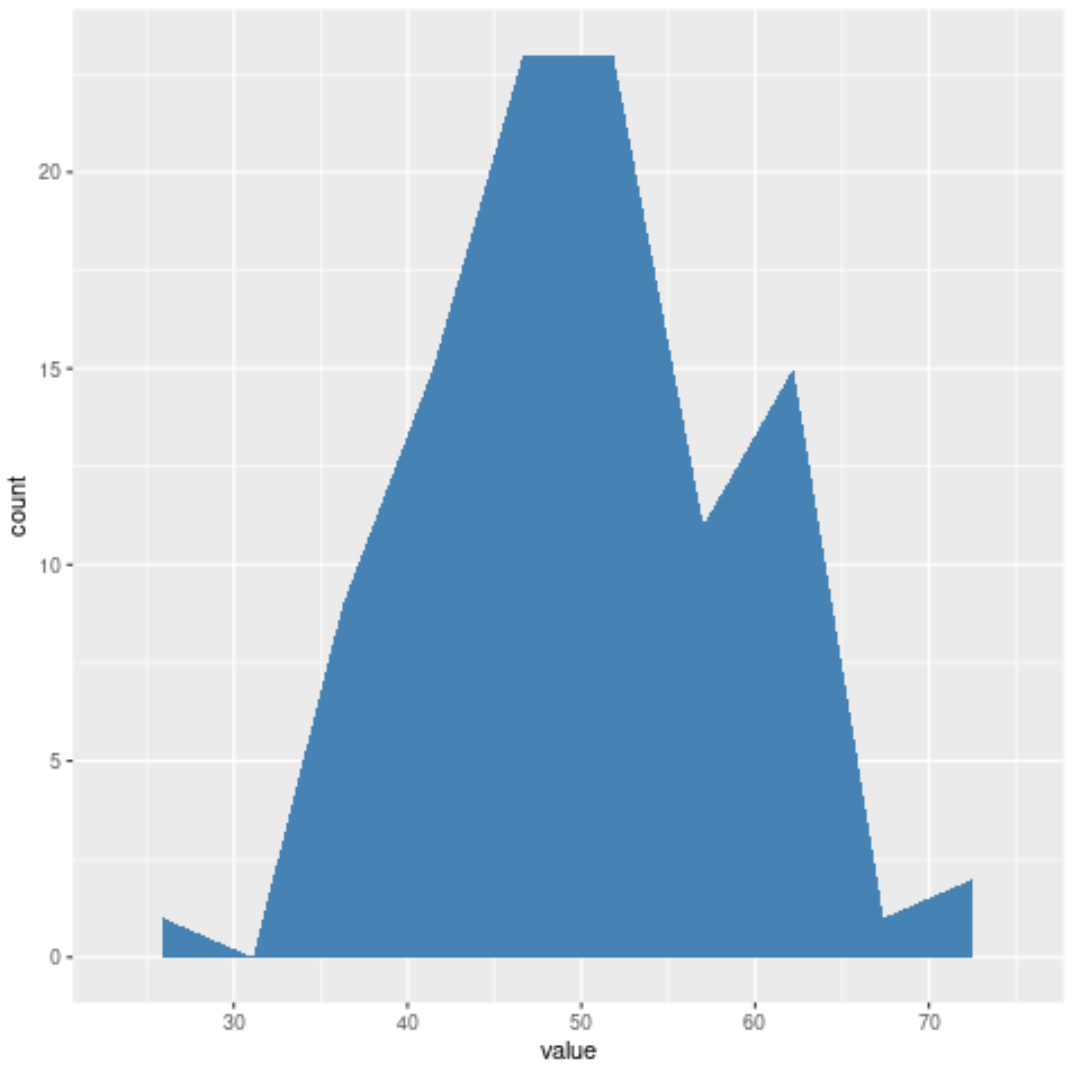
La solution pour obtenir un polygone de fréquence plein réside dans l’utilisation conjointe de la géométrie de surface continue disponible dans la bibliothèque. Par conception, cette fonction relie des coordonnées successives et comble l’espace résiduel situé entre la trajectoire supérieure et la ligne horizontale d’ordonnée zéro. Néanmoins, appelée dans sa configuration standard, cette géométrie attend des couples de coordonnées déjà agrégées et ne procède à aucun calcul de dénombrement par classe.
Pour lui conférer le comportement exact d’un polygone de fréquence, il est indispensable de détourner sa transformation statistique interne par défaut en lui assignant explicitement la transformation statistique de partitionnement continu. En stipulant cette transformation au sein des paramètres de la fonction de surface, le moteur graphique applique le découpage par intervalles, calcule les effectifs correspondants au centre des tranches, et plaque la surface pleine sur cette structure discrétisée. L’illusion d’un polygone de fréquence magnifiquement rempli est alors parfaite.
Cette approche combinée impose une exigence absolue de synchronisation paramétrique. Si l’analyste superpose un tracé linéaire de contour par-dessus la surface pleine pour accentuer la netteté du profil, il doit veiller avec une rigueur absolue à transmettre exactement la même largeur de classe ou le même nombre d’intervalles aux deux fonctions géométriques. La moindre divergence de paramétrage statistique entre la surface et le contour linéaire briserait l’alignement visuel, créant une disparité disharmonieuse où les arêtes de la surface déborderaient du trait de contour.
5.3 Contrôle de la transparence et du contraste visuel
L’introduction d’aplats de couleur massifs sous une courbe de distribution comporte des risques majeurs d’altération de la lisibilité graphique si elle n’est pas tempérée par une gestion fine de l’opacité. L’application d’une couleur opaque dense obstrue intégralement les lignes de grille secondaires du canevas cartésien, empêchant l’œil d’évaluer avec précision l’atterrissage des effectifs sur les axes gradués. Pire encore, lors de la superposition ultérieure de plusieurs distributions, une surface opaque efface impitoyablement toute information située au second plan.
Le paramètre d’atténuation d’opacité constitue la clé de voûte de cette harmonisation perceptuelle. En abaissant cette valeur à une fraction décimale comprise généralement entre vingt et quarante pour cent de la saturation maximale, l’analyste confère à la surface une translucidité délicate. Les repères cartésiens demeurent parfaitement perceptibles en filigrane à travers la teinte, tandis que la masse distributionnelle gagne une présence visuelle immédiate qui guide l’interprétation sans surcharger l’espace d’affichage.
Dans un contexte de diffusion scientifique au sein de revues à comité de lecture, la sobriété chromatique doit guider le choix des teintes. L’emploi de couleurs primaires excessivement saturées est à proscrire au profit de palettes feutrées ou de gris typographiques rigoureusement contrastés. Le meilleur rendu visuel s’obtient fréquemment en couplant une surface très légèrement teintée à un trait de crête linéaire d’une nuance chromatique identique mais pleinement opaque et légèrement renforcé en épaisseur, garantissant ainsi une délimitation spatiale sans équivoque.
6. Comparaison de groupes et variables catégorielles
6.1 Mappage esthétique par la couleur de contour aes(color = groupe)
La véritable supériorité opérationnelle du polygone de fréquence sur l’histogramme traditionnel se déploie pleinement lors de l’investigation comparative de sous-populations expérimentales ou cliniques. Pour mettre en œuvre cette différenciation graphique, la grammaire des graphiques propose un mécanisme élégant : l’assignation d’une variable catégorielle de regroupement au sein de la correspondance esthétique de couleur du trait. Dès lors que cette liaison est établie, l’interpréteur graphique fragmente automatiquement le jeu de données sous-jacent selon les modalités du facteur spécifié.
Cette fragmentation statistique s’exécute de manière autonome au sein de la boucle de calcul interne. L’algorithme applique la discrétisation par classes à chaque sous-échantillon de manière indépendante, calcule les effectifs propres à chaque modalité factorielle, puis génère autant de lignes brisées indépendantes qu’il existe de niveaux dans la variable de groupe. Chaque ligne se voit attribuer une déclinaison chromatique distincte issue de la palette active, tandis qu’une légende descriptive standardisée est immédiatement positionnée sur le flanc droit du canevas graphique sans qu’aucune ligne de code supplémentaire ne soit requise.
L’analyste dispose ainsi d’un outil diagnostique d’une puissance redoutable pour évaluer instantanément la séparation des tendances centrales et l’homogénéité des dispersions entre conditions. Si une intervention thérapeutique engendre une diminution sensible des symptômes dépressifs, le tracé polygonale du groupe traité apparaîtra nettement décalé vers la gauche par rapport à celui du groupe contrôle, tandis que d’éventuelles différences d’aplatissement entre les deux courbes témoigneront d’une variabilité de réponse différentielle au traitement.
6.2 Mappage du remplissage surfacique par groupe via geom_area()
L’extension de la comparaison inter-groupes à des représentations surfaciques pleines au moyen de la géométrie de surface soulève un défi géométrique fondamental : l’arbitrage de la position spatiale des couches. Par défaut, la plupart des géométries de surface appliquent un positionnement d’empilement cumulatif, où chaque modalité vient se hisser directement sur la crête de la modalité précédente. Si ce positionnement est adapté à l’analyse de la décomposition de volumes macroéconomiques totaux, il s’avère catastrophique pour la comparaison de distributions statistiques.
L’empilement altère dramatiquement la lecture des distributions secondaires : les courbes supérieures ne reposent plus sur le niveau zéro de l’axe des ordonnées, mais sur une ligne de base ondulante dictée par la distribution du groupe inférieur. Dès lors, il devient rigoureusement impossible d’évaluer visuellement la forme, l’asymétrie ou le mode intrinsèque des groupes surélevés. Dans toute analyse distributionnelle comparative, l’utilisateur doit impérativement forcer l’argument de positionnement à sa valeur d’identité, obligeant chaque surface à débuter rigoureusement son ascension depuis la base d’ordonnée zéro.
La neutralisation de l’empilement implique une gestion intransigeante du degré de transparence chromatique. Les surfaces se recouvrant mutuellement le long de l’axe des abscisses, une opacité trop prononcée entraînerait l’annihilation visuelle des groupes situés en arrière-plan. En calibrant minutieusement le coefficient d’atténuation sur des valeurs très diaphanes et en renforçant impérativement la démarcation par des tracés linéaires de contour nets, l’analyste préserve la visibilité intégrale de l’ensemble des surfaces en compétition.
6.3 Optimisation des palettes de couleurs pour publication scientifique
Le choix des harmonies de couleurs dans une publication scientifique ne relève pas de considérations cosmétiques secondaires ; il engage la rigueur déontologique de la transmission des résultats et l’accessibilité universelle de l’information. Les palettes de couleurs par défaut, bien que fonctionnelles pour l’exploration rapide, présentent des variations de luminance non linéaires qui peuvent fausser la perception de l’importance relative des groupes. De surcroît, elles s’avèrent fréquemment illisibles pour la fraction significative de la population masculine atteinte de déficiences de la vision chromatique, comme le daltonisme.
Pour se conformer aux normes des comités d’éthique et des éditeurs scientifiques internationaux, il est vivement recommandé d’intégrer des palettes conçues pour préserver une perception équitable et robuste. La famille de palettes perceptuellement uniformes intégrée nativement dans ggplot2 via les échelles de couleur de type Viridis constitue l’une des solutions techniques les plus abouties. Conçues mathématiquement pour que les gradients correspondent à une échelle de luminance strictement monotone, ces teintes demeurent parfaitement différentiables pour les individus souffrant de deutéranopie ou de protanopie.
Un autre atout inestimable de ces palettes validées scientifiquement réside dans leur résilience absolue lors du passage à l’impression monochrome. Même converties en un dégradé continu de niveaux de gris au sein d’une publication imprimée sur papier, les différentes courbes conservent des contrastes de luminosité distincts, évitant que les tracés ne se fondent en une nappe de gris informe. L’utilisation des fonctions dédiées aux palettes Viridis ou ColorBrewer permet d’assurer cette compatibilité éditoriale de manière fluide et reproductible.
7. Polygones de densités relatives et fréquences cumulées
7.1 Conversion des effectifs bruts en densités ou proportions
L’affichage d’effectifs bruts sur l’axe des ordonnées trouve une limite méthodologique absolue dès lors que l’on cherche à comparer des groupes dont les tailles d’échantillon sont substantiellement inégales. Si une cohorte clinique comprend cinq cents patients tandis que le groupe témoin n’en rassemble qu’une cinquantaine, le tracé du groupe majoritaire écrasera inévitablement celui du groupe minoritaire au bas du repère cartésien. Cette disproportion de masse masque totalement la réalité de la forme de la distribution du petit groupe, empêchant toute comparaison visuelle équitable de leurs dispersions relatives.
Pour lever ce biais d’échelle sans dénaturer la métrique horizontale, il est indispensable de normaliser les comptages par tranche en les convertissant en densités empiriques. Au sein du système ggplot2, cette opération s’effectue sans restructurer le tableau source grâce à l’utilisation des fonctions d’évaluation différée de statistique. En stipulant explicitement sur l’axe vertical l’assignation de la variable interne de densité générée par l’algorithme de partitionnement, le moteur recalcule l’ordonnée de manière à ce que l’aire totale délimitée sous chaque polygone soit rigoureusement égale à l’unité.
Grâce à cette normalisation mathématique unitaire, les tracés polygonaux des deux cohortes se hissent à des altitudes comparables, indépendamment de leurs effectifs absolus d’origine. Les formes géométriques deviennent instantanément superposables et directement évaluables : le clinicien peut enfin juger si la proportion relative de sujets présentant des scores déviants est plus marquée dans une condition que dans l’autre, restituant à l’analyse comparative toute sa validité méthodologique.
7.2 Construction d’un polygone de fréquences relatives
Si la notion de densité continue mathématique est rigoureuse, elle présente l’inconvénient d’engendrer des ordonnées parfois difficiles à interpréter pour des publics non statisticiens, les valeurs décimales de densité ne reflétant pas intuitivement des pourcentages concrets d’observations. Une alternative pédagogique particulièrement séduisante consiste à construire un polygone de fréquences relatives, exprimant directement le pourcentage d’individus de l’échantillon présent dans chaque intervalle de mesure.
La concrétisation de cette approche repose sur une manipulation arithmétique élémentaire au sein de la correspondance esthétique verticale. En divisant le dénombrement de chaque classe par la somme cumulative globale des effectifs dénombrés, l’utilisateur obtient une proportion comprise entre zéro et un. Le couplage de cette formulation statistique avec les utilitaires de formatage typographique disponibles dans l’extension d’échelles de R permet de convertir automatiquement ces fractions décimales en pourcentages explicites sur l’axe vertical.
Cette représentation confère aux graphiques une lisibilité clinique incomparable dans les rapports d’évaluation psychologique. L’analyste peut ainsi déclarer sans ambiguïté devant une assemblée de praticiens que le pic modal de la courbe traduit le fait que vingt-cinq pour cent de la cohorte évaluée se situe dans l’intervalle de score considéré. La transmission des seuils épidémiologiques ou psychométriques s’en trouve grandement simplifiée et dénuée d’artéfacts mathématiques abstrus.
7.3 Élaboration d’une ogive de Galton (fréquences cumulées)
Le spectre des représentations polygonales s’enrichit considérablement avec la mise en œuvre du polygone de fréquences cumulées ascendantes, historiquement désigné sous le nom d’ogive de Galton en hommage aux travaux pionniers de Sir Francis Galton sur l’hérédité et la biométrie. Alors que le polygone standard illustre la masse locale propre à chaque classe, l’ogive de fréquences cumulées modélise l’accumulation progressive des probabilités au fur et à mesure que l’on progresse de la valeur minimale vers la valeur maximale de la variable.
La génération de cette trajectoire sigmoïdale s’obtient dans ggplot2 en composant les fonctions d’évaluation statistique différée pour appliquer une somme cumulative séquentielle sur les effectifs dénombrés par la routine de partitionnement. La courbe résultante s’élève de manière strictement monotone, partant d’une ordonnée nulle à l’extrémité gauche de l’axe des abscisses pour atteindre cent pour cent des effectifs ou la proportion unitaire à son point culminant droit.
En psychométrie et en docimologie, l’ogive de Galton constitue l’instrument étalon pour la standardisation des instruments de mesure, l’étalonnage des barèmes et le calcul visuel instantané des rangs centiles. Un simple balayage horizontal sur le seuil de cinquante pour cent permet d’abaisser une perpendiculaire vers l’abscisse afin d’estimer graphiquement la médiane exacte de la distribution. De même, la pente d’accroissement maximale au sein de l’ogive identifie sans calcul algébrique la région où se concentre la densité modale de la population évaluée.
8. Personnalisation esthétique et typographique avancée
8.1 Modification des attributs graphiques des lignes
Pour conférer à un polygone de fréquence une stature adaptée aux standards des publications savantes, il est impératif d’abandonner les réglages de rendu linéaires par défaut pour orchestrer manuellement la hiérarchie visuelle des tracés. Le premier paramètre d’ajustement concerne l’épaisseur du trait continu. Un filet excessivement mince tend à s’effacer sur les écrans à haute résolution ou lors de la réduction photographique pour l’impression, tandis qu’un trait trop épais empâte les sommets et dégrade la précision de repérage des coordonnées. Un calibrage équilibré assure une présence graphique ferme sans sacrifier la délicatesse des inflexions modales.
Lorsque la figure intègre simultanément plusieurs sous-groupes, l’analyste avisé ne saurait s’en remettre exclusivement à la différenciation par la couleur. L’adjonction d’une modulation formelle sur la texture même de la ligne via l’assignation de motifs distincts (traits pleins, tiretés réguliers, pointillés fins ou séquences alternées) offre une sécurité métrologique absolue. Cette redondance sémiotique garantit que même si l’article est reproduit par un procédé d’impression dégradé ou photocopié en noir et blanc par un étudiant, la distinction structurelle entre les cohortes demeurera parfaitement identifiable.
Enfin, la gestion des jonctions de segments au niveau des sommets mérite une attention typographique particulière. Par défaut, les raccordements peuvent présenter des arêtes vives quelque peu agressives lorsque la pente change brutalement de signe. L’ajustement des paramètres d’extrémité de ligne et de jointure de sommet permet d’adoucir perceptuellement ces transitions anguleuses, apportant au tracé géométrique un fini visuel d’une grande distinction académique.
8.2 Gestion fine des axes avec scale_x_continuous et scale_y_continuous
Le contrôle exhaustif de la spatialisation cartésienne s’opère par la mobilisation des fonctions d’échelle continue dédiées aux axes orthogonalement conjugués. L’une des interventions les plus salutaires sur l’axe des ordonnées consiste à neutraliser l’expansion spatiale par défaut imposée par le moteur graphique. Spontanément, ggplot2 ajoute une marge de cinq pour cent en dessous de la valeur minimale de l’axe, créant un espace résiduel disgracieux entre le tracé du polygone et l’arête inférieure du graphique. L’annulation explicite de cette marge au moyen des arguments d’expansion permet d’ancrer fermement la ligne de base du polygone sur l’axe horizontal d’origine zéro.
Sur l’axe des abscisses, la synchronisation rigoureuse des graduations numériques affichées avec les intervalles de discrétisation statistique constitue une règle de bonne pratique essentielle. En configurant explicitement le vecteur des repères de graduation via les arguments d’échelle, l’analyste peut faire coïncider les étiquettes textuelles avec les frontières réelles des classes de mesure. Cette concordance mathématique immédiate épargne au lecteur l’effort cognitif d’avoir à extrapoler mentalement la correspondance entre les graduations arbitraires du canevas et les limites d’intervalles du polygone.
Il importe également de manipuler avec une extrême circonspection le réglage des étendues cartésiennes extrêmes. L’amputation imprudente des bornes spatiales au moyen de fonctions d’échelle mal paramétrées risque d’éliminer physiquement les observations marginales en amont de la transformation statistique, modifiant ainsi le calcul des effectifs totaux. L’utilisateur doit impérativement privilégier le zoom spatial via le système de coordonnées cartésiennes, lequel restreint la vue affichée sans jamais altérer le calcul arithmétique de la distribution sous-jacente.
8.3 Application et adaptation de thèmes académiques complets
L’esthétique standard de base proposée par le moteur graphique de Hadley Wickham, bien que reconnaissable entre mille avec son fond gris ardoise strié de lignes blanches, fait rarement l’unanimité auprès des comités de rédaction des revues de psychologie et de sciences humaines. L’adoption d’un thème épuré constitue la première étape d’une professionnalisation du rendu. Les thèmes minimalistes ou classiques intégrés au logiciel permettent de substituer immédiatement le panneau grisâtre par une surface d’une clarté absolue, encadrée par des axes linéaires noirs discrets.
Pour se conformer scrupuleusement aux recommandations édictées dans le manuel de publication de l’American Psychological Association, l’analyste personnalisera finement les sous-éléments du canevas grâce à la fonction de modification globale de thématique. Cette fonction permet de supprimer intégralement les quadrillages internes superflus, d’épaissir légèrement les axes principaux, d’orienter convenablement les étiquettes et de décaler subtilement les titres d’axes pour ménager un espace de respiration visuelle garantissant un confort de lecture optimal.
Le traitement des éléments typographiques parachève cette quête d’élégance éditoriale. L’harmonisation des familles de polices de caractères entre le corps de l’article scientifique et le texte intégré aux figures évite les ruptures graphiques heurtées. Le calibrage hiérarchique des corps de police, attribuant une taille affirmée au titre descriptif, un corps moyen aux intitulés des axes et un calibrage plus modeste aux annotations de bas de page, guide méthodiquement le regard du relecteur à travers les différents niveaux de lecture de la figure.
9. Combinaison du polygone de fréquence avec d’autres représentations
9.1 Superposition conjointe d’un histogramme et d’un polygone
La coexistence d’un histogramme traditionnel et d’un polygone de fréquence au sein d’une seule et même composition graphique constitue une démarche d’une richesse pédagogique et heuristique remarquable. Cette double matérialisation permet d’illustrer de manière éclatante la dialectique entre la décomposition volumique par blocs et la dynamique continue d’interconnexion linéaire. Le lecteur perçoit alors instantanément comment le sommet du polygone vient épouser avec précision le bord supérieur médian de chaque colonne rectangulaire.
Pour réussir cette superposition sans susciter de confusion perceptive, une hiérarchisation visuelle stricte doit être instituée. L’histogramme doit impérativement être relégué en arrière-plan graphique en lui assignant une tonalité neutre, telle qu’un gris très doux, assortie d’un indice de transparence significatif. Le polygone de fréquence viendra alors se déposer au premier plan, matérialisé par une ligne sombre et saturée qui tranche vigoureusement sur les barres estompées, capturant l’attention sur la trajectoire sans occulter la structure de partitionnement sous-jacente.
Une exigence de rigueur statistique absolue conditionne toutefois la validité d’une telle composition : la concordance parfaite des paramètres de discrétisation. L’utilisateur doit obligatoirement injecter des valeurs rigoureusement identiques pour le paramètre de largeur de classe ou de nombre de classes au sein des deux fonctions géométriques successives. La moindre disparité arithmétique romprait l’isomorphisme entre le sommet des rectangles et les nœuds du polygone, détruisant instantanément la cohérence scientifique du graphique.
9.2 Intégration d’indicateurs de tendance centrale et de dispersion
Si la forme générale d’une distribution constitue une information précieuse, la mise en relation immédiate de ce profil avec les indices canoniques de la statistique paramétrique ou non paramétrique décuple la valeur analytique de la représentation visuelle. L’incorporation d’indicateurs de tendance centrale s’opère commodément dans l’environnement R par l’adjonction de couches de délimitation orthogonale positionnées le long de l’axe horizontal, marquant l’emplacement exact de la moyenne ou de la médiane empirique.
La distinction formelle entre ces indices fondamentaux renseigne instantanément sur l’asymétrie de la distribution. En traçant par exemple une ligne verticale discontinue pour identifier la moyenne arithmétique et une seconde ligne pointillée d’une autre teinte pour désigner la médiane, l’analyste matérialise l’écartement physique entre ces deux métriques. Un décalage substantiel entre la médiane et la moyenne alerte immédiatement le clinicien sur l’attraction exercée par des valeurs extrêmes situées dans la queue de distribution.
Cette armature statistique gagne à être enrichie par l’intégration d’annotations textuelles directes implantées judicieusement au sein du canevas grâce aux fonctions d’étiquetage contextuel. Inscrire en toutes lettres la valeur numérique exacte de l’indice ou baliser l’intervalle correspondant à l’emprise de l’écart-type ou de l’intervalle de confiance épargne au lecteur de pénibles allers-retours entre le texte de l’article et les axes de la figure, instaurant une communication scientifique directe et fluide.
9.3 Ajout d’un tapis de données univarié (geom_rug)
Quelle que soit la sophistication d’un polygone de fréquence, il demeure par définition un condensé agrégé qui dissimule la granularité des unités observationnelles primaires ayant servi à sa confection. Pour combler cette perte d’information sans altérer la pureté du tracé supérieur, l’adjonction d’un tapis de données univarié constitue une solution méthodologique de premier ordre, plébiscitée par les spécialistes de l’analyse exploratoire.
Ce tapis de données matérialise chaque observation élémentaire de l’échantillon sous la forme d’un petit tiret vertical gravé directement le long de la marge inférieure du repère cartésien, au ras de l’abscisse. La concentration spatiale de ces marques individuelles reflète physiquement la densité locale : là où les tirets se serrent jusqu’à former un bloc dense et continu, le sommet du polygone s’élève majestueusement ; là où les tirets s’espacent de manière erratique, la courbe retombe vers la base zéro.
L’utilisation judicieuse de la transparence sur ces tirets individuels se révèle d’une efficacité diagnostique redoutable pour détecter des phénomènes de sur-traçage liés à des scores identiques partagés par de nombreux participants. De surcroît, cette géométrie périphérique permet de repérer instantanément des données aberrantes ou des profils cliniques totalement isolés aux confins de l’axe, qui disparaîtraient autrement dans le lissage de la classe terminale du polygone.
10. Décomposition graphique par facettage (Facetting)
10.1 Structuration en panneaux multiples avec facet_wrap()
Bien que la superposition de multiples polygones colorés sur un même graphique demeure opérationnelle pour comparer deux ou trois conditions, cette stratégie atteint un seuil de saturation visuelle critique dès lors que la variable de croisement comporte un nombre élevé de modalités. La multiplication des lignes entremêlées, la prolifération des croisements de segments et le foisonnement chromatique génèrent une surcharge cognitive majeure qui compromet la transmission de l’information. Dans ce contexte, la méthode du facettage s’impose comme l’alternative architecturale par excellence.
L’instruction de découpage en panneaux enveloppants offre la possibilité d’éclater instantanément la distribution globale en une matrice de sous-graphiques autonomes, allouant un panneau distinct à chaque modalité d’un facteur catégoriel. L’analyste contrôle l’organisation matricielle en stipulant explicitement le nombre désiré de colonnes ou de rangées, orchestrant ainsi une disposition spatiale harmonieuse adaptée au format de mise en page de la publication cible.
Cette décomposition systématique isole parfaitement les profils distributionnels des cohortes tout en autorisant une comparaison oculaire quasi instantanée, chaque sous-graphique partageant scrupuleusement la même orientation cartésienne. Cette approche s’avère particulièrement irremplaçable pour documenter la variabilité des scores psychométriques à travers de multiples strates sociodémographiques, des tranches d’âge successives ou des groupes cliniques catégorisés selon la sévérité de leurs troubles diagnostiques.
10.2 Matrices croisées complexes avec facet_grid()
Lorsque le plan de recherche mobilise un protocole factoriel croisant simultanément deux variables indépendantes distinctes, la décomposition simple doit être élevée à un niveau de complexité supérieur par l’emploi de la fonction de facettage en grille matricielle. Cette commande permet de croiser de manière rigoureuse un facteur positionné en ligne et un second facteur distribué en colonne, générant une table graphique bidimensionnelle d’une puissance expressive exceptionnelle.
Dans le cadre d’un essai randomisé contrôlé en neuropsychologie, une telle grille permet par exemple de ventiler la distribution des scores cognitifs selon la condition d’assignation thérapeutique en rangées (groupe placebo versus molécule active) et selon le profil génétique ou le genre des participants en colonnes. Les interactions factorielles sautent alors littéralement aux yeux : si l’action du traitement est modulée par le sous-groupe biologique, le polygone présentera une translation spectaculaire dans une cellule spécifique de la matrice, alors qu’il demeurera immobile dans les autres conditions.
La typographie des bandeaux d’en-tête de cette matrice graphique requiert une attention méticuleuse. Il convient d’assurer une labellisation limpide des facettes pour éviter que les acronymes ou abréviations de variables codées dans le tableau brut ne viennent perturber la clarté de la lecture. La configuration soignée des étiquettes de facettes garantit une restitution formelle immédiatement compréhensible pour l’évaluateur scientifique.
10.3 Gestion stratégique des échelles libres ou contraintes
Le facettage soulève une question épistémologique et méthodologique centrale : convient-il de verrouiller strictement les échelles de mesure à travers l’ensemble des panneaux ou est-il légitime d’autoriser les axes à flotter librement ? Par défaut, le moteur de ggplot2 applique une contrainte d’invariance totale : tous les panneaux partagent rigoureusement les mêmes bornes d’abscisse et d’ordonnée. Ce choix délibéré assure une comparabilité métrologique absolue, empêchant toute surinterprétation illusoire de variations mineures.
Il existe néanmoins des configurations expérimentales où la libération de l’axe vertical se justifie pleinement, notamment lorsque les effectifs d’échantillon varient drastiquement entre les strates explorées. Dans une telle hypothèse, contraindre l’axe des ordonnées sur la valeur maximale du groupe le plus abondant condamnerait le polygone du plus petit échantillon à végéter sous la forme d’un trait aplati au ras du sol cartésien. La libération concertée de l’axe des effectifs permet de réajuster l’amplitude verticale pour chaque panneau, restituant la lisibilité de la forme interne de chaque sous-groupe.
Cette flexibilité impose toutefois une mise en garde déontologique sévère. En libérant l’axe des ordonnées, une hauteur identique sur deux panneaux distincts cessera de représenter un effectif équivalent. L’analyste se trouve alors dans l’obligation formelle de signaler ostensiblement cette asymétrie d’échelle au sein de la légende explicative de la figure ou du texte méthodologique, sous peine d’induire le lecteur en erreur en lui suggérant une parité d’effectif contredite par la réalité des données brutes.
11. Diagnostic des anomalies, erreurs courantes et optimisation
11.1 Résolution des erreurs de types de données et valeurs non numériques
L’une des causes les plus récurrentes d’échec ou d’aberration visuelle lors de l’instanciation d’un polygone de fréquence réside dans l’inadéquation du type de données alimentant l’axe des abscisses. Il arrive fréquemment, à la suite d’un processus d’importation mal configuré depuis un tableur ou une base relationnelle, qu’une variable quantitative soit silencieusement interprétée par R comme un vecteur de chaînes de caractères textuelles ou comme un facteur qualitatif non ordonné. Les symptômes graphiques d’un tel incident sont immédiats : le polygone refuse de se tracer ou dégénère en une série de lignes verticales absconses.
Pour prévenir cette défaillance technique, l’analyste doit instaurer un diagnostic systématique de la structure de ses données avant toute incantation graphique, en inspectant minutieusement le typage interne de ses colonnes au moyen des fonctions d’aperçu structurel intégrées. Si la variable cible apparaît étiquetée sous une nature textuelle, une conversion explicite vers le type numérique flottant doit être opérée de manière rigoureuse dans la chaîne de traitement.
Ce processus de conversion nécessite une vigilance accrue quant à la gestion des séparateurs décimaux. Dans les contextes francophones, les données numériques importées contiennent couramment des virgules en lieu et place des points décimaux anglo-saxons. L’application directe et naïve d’une commande de coercition numérique sur une colonne contenant des virgules aura pour effet dramatique de transformer silencieusement toutes les valeurs concernées en valeurs manquantes non attribuées. Une substitution préalable des virgules par des points s’impose donc comme une précaution incontournable.
11.2 Gestion des données manquantes et avertissements de suppression
L’apparition d’un message d’avertissement standard signalant la suppression d’un nombre déterminé de lignes contenant des valeurs non finies constitue un grand classique de l’exécution graphique dans ggplot2. Cet avertissement survient dès lors que la colonne d’intérêt héberge des observations non renseignées, codées conventionnellement sous la forme de constantes manquantes. Face à ces lacunes, le moteur de partitionnement statistique se trouve dans l’incapacité logique d’affecter ces sujets à une classe d’abscisse déterminée, et prend l’initiative de les exclure du tracé.
Bien que cet avertissement ne paralyse pas la génération de la figure, son traitement ne saurait être ignoré par le chercheur rigoureux. La suppression implicite d’individus modifie mécaniquement la représentativité de la distribution affichée. La meilleure pratique consiste à procéder à un filtrage explicite préalable des données au sein d’un pipeline de transformation en amont de l’appel graphique, purifiant ainsi le flux transmis au traceur et évitant la prolifération de messages parasites dans la console d’exécution.
Sur le plan de la communication scientifique, l’amputation de données manquantes doit impérativement faire l’objet d’une déclaration transparente dans l’appareil de notes accompagnant la figure académique. Le chercheur indiquera avec précision le nombre exact d’observations omises en raison de valeurs manquantes, assurant ainsi une auditabilité totale du graphique par rapport aux tables de statistiques descriptives consignées dans le corps de la publication.
11.3 Évitement des pièges d’interprétation visuelle
L’usage du polygone de fréquence requiert une vigilance méthodologique permanente pour déjouer certains pièges perceptuels inhérents à sa géométrie linéaire continue. Le premier écueil concerne la création illusoire de valeurs continues inexistantes dans les données réelles. Lorsque l’on relie par une ligne brisée le point d’une classe d’entiers discrets à une autre classe, l’œil est naturellement incité à interpoler l’existence de valeurs fractionnaires intermédiaires qui n’ont aucun sens dans la réalité de l’instrument de recueil.
Un second piège d’interprétation réside dans la confusion intellectuelle récurrente entre un polygone de fréquence et une estimation de densité par noyau. Si ces deux représentations partagent une morphologie globale similaire, leurs fondements mathématiques divergent radicalement. Le polygone demeure strictement assujetti aux frontières arbitraires de son partitionnement par classes, tandis que l’estimateur à noyau lisse la distribution par le glissement continu d’une fonction de pondération gaussienne ou épanechnikovienne. L’analyste ne doit jamais attribuer à un polygone la douceur asymptotique d’un estimateur à noyau sans en assumer les limites de variance empirique.
Enfin, l’observateur doit veiller aux effets de bordure et aux artefacts de lissage qui pourraient suggérer l’existence de scores théoriquement impossibles. Un ancrage mal négocié à la base zéro ou un intervalle de classe trop large peut étendre artificiellement la traîne du polygone dans des zones de valeurs négatives, alors même que le score psychométrique sous-jacent est strictement borné à zéro. L’adéquation entre les limites mathématiques du tracé et les contraintes de l’échelle d’évaluation clinique doit être validée de manière impérative.
12. Étude de cas pratique intégrée : analyse de scores psychométriques
12.1 Contexte de l’étude et génération des données expérimentales
Pour parachever ce traité exhaustif, nous proposons une étude de cas empirique contextualisée simulant un protocole de recherche translationnelle en psychologie clinique et cognitive. Imaginons un essai clinique visant à éprouver l’efficacité d’une nouvelle thérapie cognitive et comportementale digitalisée destinée à atténuer les symptômes d’anxiété généralisée. Deux cohortes indépendantes de patients ont été recrutées : un groupe témoin inscrit sur une liste d’attente avec prise en charge standard, et un groupe expérimental bénéficiant du programme thérapeutique informatisé intensif durant huit semaines consécutives.
À l’issue de l’intervention, l’ensemble des participants a complété une échelle d’inventaire psychométrique standardisée de l’anxiété dont les scores varient sur un continuum borné allant de zéro à soixante points. Les questions de recherche guidant l’investigation statistique sont limpides : l’intervention novatrice induit-elle un déplacement modal tangible vers les scores de faible anxiété ? Modifie-t-elle l’asymétrie de la distribution clinique comparativement au profil usuel observé dans la condition témoin ?
La simulation d’un tel jeu de données dans l’environnement R se réalise en générant deux vecteurs distribués suivant des paramètres de moyenne et d’écart-type représentatifs de ces populations cliniques. Les données sont ensuite agrégées au sein d’une structure tabulaire bien ordonnée, associant de manière univoque l’identifiant individuel, l’étiquette factorielle du groupe thérapeutique et la mesure numérique du score psychométrique obtenu. Une inspection préliminaire avec des outils d’exploration tabulaire permet de s’assurer que les valeurs simulées respectent scrupuleusement les contraintes de l’échelle d’évaluation.
12.2 Script complet pas à pas pour un polygone prêt pour publication
L’implémentation opérationnelle de cette figure scientifique mobilise l’ensemble des concepts théoriques développés au fil des chapitres précédents au sein d’un pipeline d’instructions rigoureusement structuré. Le script démarre par l’initialisation du canevas cartésien en liant le jeu de données issu de l’étude clinique et en assignant la variable de score d’anxiété à l’abscisse horizontale, tandis que l’assignation factorielle du groupe thérapeutique gouverne simultanément la teinte de contour et le remplissage surfacique.
La seconde couche logicielle introduit la géométrie surfacique asservie à la transformation statistique de discrétisation continue. Pour satisfaire aux exigences méthodologiques de comparaison de formes, le positionnement spatial est expressément verrouillé sur sa modalité d’identité, garantissant que les surfaces débutent à l’altitude zéro. L’opacité est minutieusement bridée à une fraction translucide subtile, évitant toute occlusion du groupe sous-jacent. Par-dessus ce lit surfacique, la géométrie du polygone linéaire vient apposer un trait de contour net et affirmé, dont la largeur de classe est rigoureusement harmonisée sur celle de la surface sous-jacente.
L’achèvement du script intègre l’adjonction de lignes de repère verticales matérialisant l’emplacement exact des médianes de chaque cohorte, ainsi que la configuration d’une échelle chromatique scientifiquement optimisée pour les daltoniens. L’habillage typographique se conclut par l’application d’un thème classique épuré conforme aux normes APA, enrichi de titres d’axes explicites intégrant les unités de mesure et d’une légende soigneusement positionnée à l’intérieur de l’espace vacant du graphique pour maximiser l’emprise visuelle des données.
12.3 Exportation vectorielle haute définition pour revues académiques
L’ultime maillon de la chaîne de production scientifique réside dans l’exportation de la figure graphique sous une forme garantissant une fidélité de restitution absolue lors des opérations de composition éditoriale. L’utilisation naïve de copies d’écran matricielles ou d’enregistrements graphiques sommaires dégrade dramatiquement la résolution des tracés, introduisant des artéfacts de compression inacceptables pour les comités de lecture des revues internationales de premier rang.
La commande d’exportation native de ggplot2 constitue l’instrument étalon pour cette tâche critique. Elle permet de débrayer le rendu de la résolution locale de l’écran pour générer un fichier autonome dont l’utilisateur gouverne les dimensions physiques exactes au millimètre ou au pouce près. Cette précision dimensionnelle garantit que les corps de police de caractères et les épaisseurs de traits conçus dans l’environnement R conserveront scrupuleusement leurs proportions idéales une fois insérés sur une colonne ou une pleine page de texte.
Sur le plan du format de fichier, le recours aux formats graphiques vectoriels, tels que le PDF haute fidélité, le format SVG ou l’Encapsulated PostScript, doit être systématiquement privilégié. Contrairement aux images matricielles, les fichiers vectoriels ne stockent pas des pixels mais des équations géométriques de tracés : la figure peut ainsi être agrandie à l’infini lors de la mise en page sans subir la moindre altération de netteté. Pour les revues exigeant impérativement des fichiers matriciels, un format sans perte comme le TIFF calibré à un minimum de trois cents voire six cents points par pouce assurera une qualité visuelle irréprochable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Galton, F. (1875). Statistics by intercomparison, with remarks on the law of frequency of error. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 49(322), 33–46. https://doi.org/10.1080/14786447508641179
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0