
L’analyse visuelle des données quantitatives constitue l’un des piliers méthodologiques fondamentaux de la démarche scientifique contemporaine, en particulier dans les disciplines empiriques telles que les sciences du comportement, la psychométrie, la biométrie et les neurosciences cognitives. Face à la multiplication de signaux physiologiques continus, de trajectoires longitudinales d’apprentissage ou de temps de réaction soumis à une forte variabilité stochastique, le simple tracé d’un nuage de points s’avère souvent insuffisant pour appréhender l’architecture sous-jacente des relations fonctionnelles. C’est dans cet interstice épistémologique — entre le recueillement scrupuleux de l’observation brute et l’abstraction formalisée d’un modèle inférentiel — que s’impose le lissage statistique appliqué à la visualisation de données.
Au sein de l’écosystème de programmation statistique R, le package ggplot2, conçu par Hadley Wickham sur les préceptes de la Grammar of Graphics formalisée par Leland Wilkinson, a profondément bouleversé la façon dont les chercheurs construisent, décomposent et articulent leurs représentations graphiques. Loin de se réduire à un artifice purement esthétique destiné à adoucir les aspérités d’un tracé, la ligne de lissage incarne une véritable estimation non paramétrique ou semi-paramétrique de la distribution conditionnelle de la variable dépendante en fonction d’un prédicteur continu. Maîtriser les rouages algorithmiques, les paramètres de régulation et les conventions syntaxiques de la fonction geom_smooth() représente ainsi une compétence indispensable pour tout analyste désireux de communiquer ses résultats avec rigueur, clarté et reproductibilité.
Ce guide exhaustif a pour ambition d’explorer de manière approfondie les mécanismes théoriques, méthodologiques et appliqués entourant la création de courbes de lissage avec ggplot2. À travers une progression didactique allant des fondements conceptuels de l’ajustement local jusqu’aux architectures multi-groupes les plus sophistiquées, nous détaillerons l’usage des régressions locales (LOESS), des modèles linéaires et polynomiaux, des modèles additifs généralisés (GAM), ainsi que le traitement rigoureux des bandes d’incertitude et la prévention des artefacts d’interprétation. Chaque notion sera mise en perspective à l’aide d’exemples issus de la psychologie expérimentale et des sciences sociales quantitatives, permettant d’ériger des visualisations graphiques à la hauteur des exigences de publication académique les plus strictes.
1. Introduction aux courbes de lissage dans ggplot2 : Principes et fondements théoriques
1.1 Le rôle du lissage dans l’analyse exploratoire des données
Dans la pratique de l’analyse exploratoire de données, théorisée initialement par John Tukey, l’investigateur se trouve continuellement confronté à la tension dialectique opposant la fidélité empirique au bruit expérimental et la lisibilité cognitive du signal sous-jacent. Lorsqu’un nuage de points regroupe plusieurs centaines ou milliers d’observations individuelles, la superposition dense des coordonnées cartésiennes engendre fréquemment un phénomène de saturation visuelle (couramment désigné sous le terme d’overplotting). Cette densité empêche l’œil humain d’isoler la trajectoire tendancielle moyenne, masquant d’éventuelles non-linéarités, des points d’inflexion subtils ou des effets de seuil critiques. Le lissage graphique intervient précisément comme un filtre statistique destiné à réduire la variance haute fréquence inhérente aux fluctuations d’échantillonnage, tout en préservant la structure basse fréquence qui traduit la relation fonctionnelle d’intérêt.
Il est impératif d’établir une distinction épistémologique fondamentale entre l’interpolation géométrique et l’ajustement statistique. L’interpolation mathématique pure cherche à faire passer impérativement une ligne par l’intégralité des points observés, créant ainsi une trajectoire erratique hautement sensible au moindre artefact de mesure. À l’inverse, le lissage statistique procède par régression : il postule que chaque point observé reflète une composante déterministe altérée par une erreur aléatoire distribuée selon une loi stochastique. En estimant l’espérance conditionnelle $E(Y|X=x)$, le tracé lissé extrait une synthèse probabiliste des données, fournissant à l’expérimentateur un modèle visuel intuitif de la dynamique étudiée, qu’il s’agisse de la dégradation progressive du temps de réaction face à la fatigue ou des cinétiques d’habituation émotionnelle.
1.2 L’architecture graphique de ggplot2 et l’opérateur geom_smooth()
L’implémentation du lissage dans l’environnement R via ggplot2 repose sur une dissociation conceptuelle stricte entre la géométrie visuelle (la couche geom) et la transformation statistique sous-jacente (la couche stat). Contrairement aux fonctions graphiques de base de R telles que lines() ou lowess() qui requièrent le calcul préalable des coordonnées projetées au sein de structures matricielles séparées, geom_smooth() encapsule de manière native l’appel à la fonction statistique stat_smooth(). Cette dernière prend en charge l’évaluation computationnelle du modèle spécifié directement à partir du tableau de données d’entrée, sans nécessiter d’étapes manuelles de manipulation matricielle intermédiaire.
Lors de son exécution, la couche de calcul génère un ensemble standardisé de variables internes temporaires accessibles à l’environnement graphique. Parmi celles-ci figurent la prédiction ponctuelle (after_stat(y)), les bornes inférieure et supérieure de l’intervalle d’estimation (after_stat(ymin) et after_stat(ymax)), ainsi que l’erreur type locale de la prédiction (after_stat(se)). Cette architecture modulaire garantit une intégration harmonieuse avec les autres couches sémiotiques de ggplot2 : un utilisateur peut superposer en toute transparence un nuage de points élémentaire via geom_point(), des tracés de densité conditionnelle ou des représentations d’intervalles marginaux, tout en préservant une cohérence absolue d’échelles, de repères cartésiens et de groupements esthétiques.
1.3 Typologie des données psychométriques propices au lissage
Les investigations psychométriques et neurocognitives constituent un terrain d’application particulièrement propice à l’usage des courbes de lissage en raison de la nature souvent bruitée et non linéaire des variables recueillies. Dans les protocoles longitudinaux ou à mesures répétées, tels que le suivi de l’acquisition d’une habileté motrice au fil de micro-sessions successives, les courbes individuelles manifestent d’importantes oscillations dues aux fluctuations attentionnelles momentanées. Le lissage permet de dégager l’archétype développemental moyen sans masquer la dynamique globale par une contrainte de linéarité stricte arbitraire.
De surcroît, les problématiques d’interaction non linéaire et de modération en psychopathologie expérimentale — par exemple, la relation complexe reliant les niveaux d’anxiété pré-compétitive aux scores de performance mnésique — échappent fréquemment aux postulats de la régression linéaire classique. L’utilisation de tracés lissés offre une approche non paramétrique directe pour diagnostiquer d’éventuelles formes en cloche ou en U inversé. Enfin, bien que les échelles psychométriques de type Likert soient ordinales, leur agrégation sous forme de scores composites continus ou leur analyse conjointe avec des mesures de latence informatisées (exprimées en millisecondes) génère un continuum empirique idéal pour l’application d’ajustements statistiques continus.
2. Configuration de l’environnement R et structure des jeux de données d’illustration
2.1 Préparation du corpus logiciel et des bibliothèques associées
Afin de garantir une exécution reproductible et conforme aux standards de la science ouverte, le déploiement d’une infrastructure analytique robuste s’avère indispensable. L’écosystème tidyverse constitue le socle fondamental de notre démarche, intégrant le moteur graphique ggplot2 ainsi que les utilitaires de manipulation de données dplyr, tidyr et tibble. Parallèlement, l’évaluation de modèles statistiques complexes requiert l’activation de bibliothèques spécialisées dans le lissage semi-paramétrique et la modélisation mathématique robuste, notamment mgcv pour les modèles additifs généralisés, splines pour les fonctions de base polynomiales par morceaux, et MASS pour les algorithmes de régression robuste fondés sur les estimateurs M.
La reproductibilité computationnelle de nos simulations nécessite l’ancrage déterministe du générateur de nombres pseudo-aléatoires de R par l’instruction set.seed(42). De surcroît, afin d’assurer une lisibilité optimale compatible avec les directives éditoriales des revues scientifiques internationales, nous définissons en préambule un thème graphique minimaliste et épuré. Ce réglage global neutralise les fonds gris quadrillés par défaut au profit d’un contraste élevé, supprime les fioritures visuelles superflues et harmonise la typographie des axes et des légendes.
2.2 Création d’un jeu de données synthétique pour les analyses comportementales
Pour illustrer de manière concrète et didactique l’ensemble des fonctionnalités de lissage statistique, nous générons un tableau de données empiriques simulées (df_cognitif) modélisant une cohorte de 500 participants soumis à une épreuve d’évaluation de la mémoire de travail sous diverses conditions d’induction de stress. Le scénario modélise une variable prédictive continue représentant l’anxiété d’évaluation (mesurée sur un continuum standardisé de 0 à 100 unités arbitraires) et une variable dépendante capturant l’efficacité mnésique (exprimée par un score de rappel pondéré).
Afin de confronter les algorithmes de lissage aux défis méthodologiques réels, nous injectons de manière délibérée une hétéroscédasticité contrôlée : la variance résiduelle s’accroît à mesure que les scores d’anxiété s’élèvent, traduisant le fait que les individus hautement anxieux manifestent une désorganisation cognitive plus erratique. La relation sous-jacente suit délibérément une trajectoire curviligne non linéaire, débutant par un plateau de résistance, suivi d’une détérioration progressive, puis d’un effondrement prononcé aux valeurs extrêmes. Une variable factorielle stratifie également la cohorte en deux groupes méthodologiques : condition contrôle sans tâche concurrente et condition d’interférence phonologique.
2.3 Nettoyage et validation des formats de données pour ggplot2
L’intégrité du rendu visuel dans ggplot2 dépend directement de la rigueur de structuration de la table de données d’entrée. La conformité au paradigme tidy data impose que chaque colonne corresponde sans équivoque à une variable unique et que chaque ligne représente une unité d’observation expérimentale individualisée. Les variables qualitatives doivent impérativement être instanciées sous forme de facteurs stricts (factor), dotés d’étiquettes de niveaux explicites, évitant ainsi que les identifiants numériques d’intervention ne soient interprétés par inadvertance comme des métriques continues par le moteur géométrique.
De plus, la prise en charge des données manquantes (NA) constitue un enjeu méthodologique prépondérant lors du recours au lissage. Alors que les fonctions graphiques de base peuvent interrompre brutalement leur tracé ou renvoyer des messages d’erreur opaques face aux valeurs absentes, geom_smooth() procède à une élimination univariée ou bivariée par observation (listwise deletion) restreinte aux axes sollicités, avertissant l’utilisateur par une notification console du nombre d’entrées écartées. La standardisation minutieuse des vecteurs numériques et la vérification des bornes de distribution via la commande summary() préviennent l’apparition d’artefacts aux frontières du repère cartésien.
3. Syntaxe fondamentale de geom_smooth() : Du nuage de points au tracé continu
3.1 Superposition classique : geom_point() et geom_smooth()
L’initialisation d’un graphique bivarié associant un nuage de points et une courbe d’ajustement repose sur une combinatoire syntaxique d’une remarquable concision. L’appel premier à la fonction ggplot() délimite le jeu de données sous-jacent et établit le système de projection cartésienne à travers l’instruction aes(x = anxiete, y = rappel). Ce mappage esthétique global se transmet ensuite par héritage aux couches subordonnées ajoutées via l’opérateur d’addition binaire +. L’invocation consécutive de geom_point() et de geom_smooth() produit alors l’affichage simultané des observations élémentaires et de la trajectoire estimée.
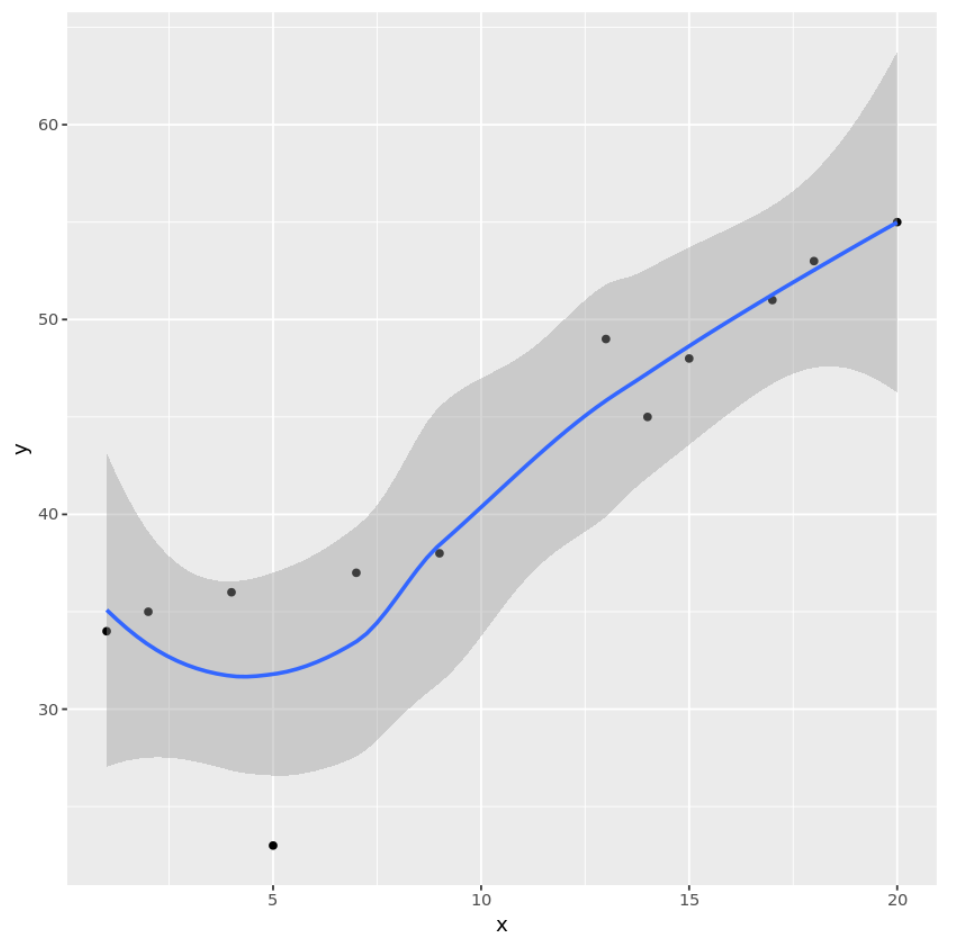
L’ordre de déclaration de ces couches au sein du script revêt une importance capitale pour la hiérarchie perceptive finale. En vertu du modèle de superposition en couches de ggplot2, les éléments déclarés en premier sont gravés au plan le plus profond du canevas, tandis que les instructions ultérieures viennent se superposer au premier plan. Par conséquent, il est méthodologiquement recommandé d’appeler geom_point() avant geom_smooth() lorsque l’on souhaite que la ligne continue et son ruban d’incertitude demeurent pleinement visibles au-dessus des observations denses, ou d’inverser cet ordre si la visibilité intacte de chaque point individuel constitue l’impératif prioritaire de communication.
3.2 Comportement par défaut selon le volume d’échantillonnage
L’une des spécificités les plus remarquables de geom_smooth() réside dans son comportement heuristique adaptatif en matière de sélection algorithmique. Lorsqu’aucun argument de modélisation n’est formellement fourni par l’opérateur (via le paramètre method), le moteur statistique interne évalue la taille de l’échantillon conditionnel $n$ associé à chaque niveau de croisement graphique. Si le nombre d’observations est strictement inférieur au seuil critique de 1000 points ($n < 1000$), ggplot2 déclenche automatiquement une régression pondérée locale (LOESS, issue de la fonction native stats::loess). Cette heuristique privilégie une grande souplesse d’ajustement adaptée aux jeux de données de dimensions modestes à moyennes.
À l’inverse, dès lors que l’échantillon atteint ou excède 1000 observations ($n ge 1000$), le coût computationnel quadratique de l’algorithme LOESS devient prohibitif pour les performances de la machine hôte. Le système bascule alors de manière autonome vers un modèle additif généralisé (GAM) propulsé par la bibliothèque externe mgcv, en appliquant une formule d’ajustement par défaut spécifiée selon $y sim s(x, bs = « cs »)$. Dans les deux cas, le terminal R affiche un message didactique informant l’analyste de l’algorithme retenu et de la formule mathématique implicite, incitant ainsi le chercheur à formaliser explicitement ses choix méthodologiques pour les publications formelles.
3.3 Personnalisation élémentaire de la formule d’ajustement
L’interaction entre l’argument d’algorithme method et l’argument d’ajustement formula constitue le cœur opérationnel de la personnalisation du lissage. Par défaut, la formule d’expression statistique est déclarée sous la forme canonique formula = y ~ x. Il convient de souligner avec rigueur une convention syntaxique propre à ggplot2 qui déstabilise fréquemment les praticiens habitués aux modèles de base de R : au sein de geom_smooth(), les lettres y et x ne renvoient pas aux dénominations réelles des colonnes contenues dans le tableau de données, mais font strictement référence aux coordonnées structurelles définies dans le bloc d’assignation esthétique aes().
Toute tentative de formuler l’ajustement en utilisant les noms des variables d’origine (par exemple formula = rappel ~ anxiete) se soldera irrémédiablement par une erreur d’exécution indiquant l’absence des objets spécifiés dans l’environnement de calcul interne de la statistique. En respectant scrupuleusement la notation relative y ~ x, l’utilisateur s’assure que les transformations algébriques requises — qu’il s’agisse d’une formulation quadratique y ~ poly(x, 2), d’un terme logarithmique y ~ log(x) ou d’une décomposition par splines — opéreront correctement sur les grandeurs géométriques associées aux axes d’affichage.
4. Maîtrise du lissage non paramétrique local : La méthode LOESS
4.1 Fondements mathématiques de la régression pondérée locale (LOESS)
La régression locale pondérée, formalisée sous l’acronyme LOESS (Locally Estimated Scatterplot Smoothing) par William S. Cleveland, représente l’un des archétypes les plus raffinés de l’estimation non paramétrique de courbes. Le postulat directeur de cette approche repose sur l’hypothèse qu’au voisinage immédiat de tout point cible $x_0$, la relation complexe reliant $Y$ à $X$ peut être valablement approchée par une fonction polynomiale de degré modeste (le plus souvent de degré 1 pour une approximation linéaire locale, ou de degré 2 pour une approximation quadratique locale). L’ajustement n’est donc pas global mais s’effectue de manière segmentée et glissante sur l’ensemble du domaine empirique.
Pour estimer la valeur prédite en $x_0$, l’algorithme attribue un poids statistique décroissant à chaque point d’observation $(x_i, y_i)$ de l’échantillon en fonction de sa distance euclidienne relative au point pivot $|x_i – x_0|$. Ce calcul mobilise traditionnellement une fonction de pondération à support compact, telle que la fonction tricubique :
$$W(u) = (1 – |u|^3)^3 \quad \text{pour } |u| < 1, \quad W(u) = 0 \quad \text{pour } |u| ge 1$$
Les paramètres polynomiaux locaux sont alors estimés par la minimisation de la somme des moindres carrés pondérés, conférant à la courbe finale une grande continuité différentiable exempte de discontinuités anguleuses.
4.2 Régulation de la souplesse de la courbe via l’argument ‘span’
L’opérateur fondamental permettant d’arbitrer le degré de souplesse ou de rigidité de l’ajustement LOESS au sein de geom_smooth() est le paramètre span (souvent documenté sous la notation $\alpha$). Ce coefficient scalaire, compris théoriquement dans un intervalle ouvert de 0 à l’infini (bien qu’empiriquement confiné entre 0.1 et 1.5 dans la majorité des applications), quantifie la proportion effective des points de données totaux qui sont incorporés à l’intérieur de la fenêtre de pondération locale entourant chaque point d’évaluation.
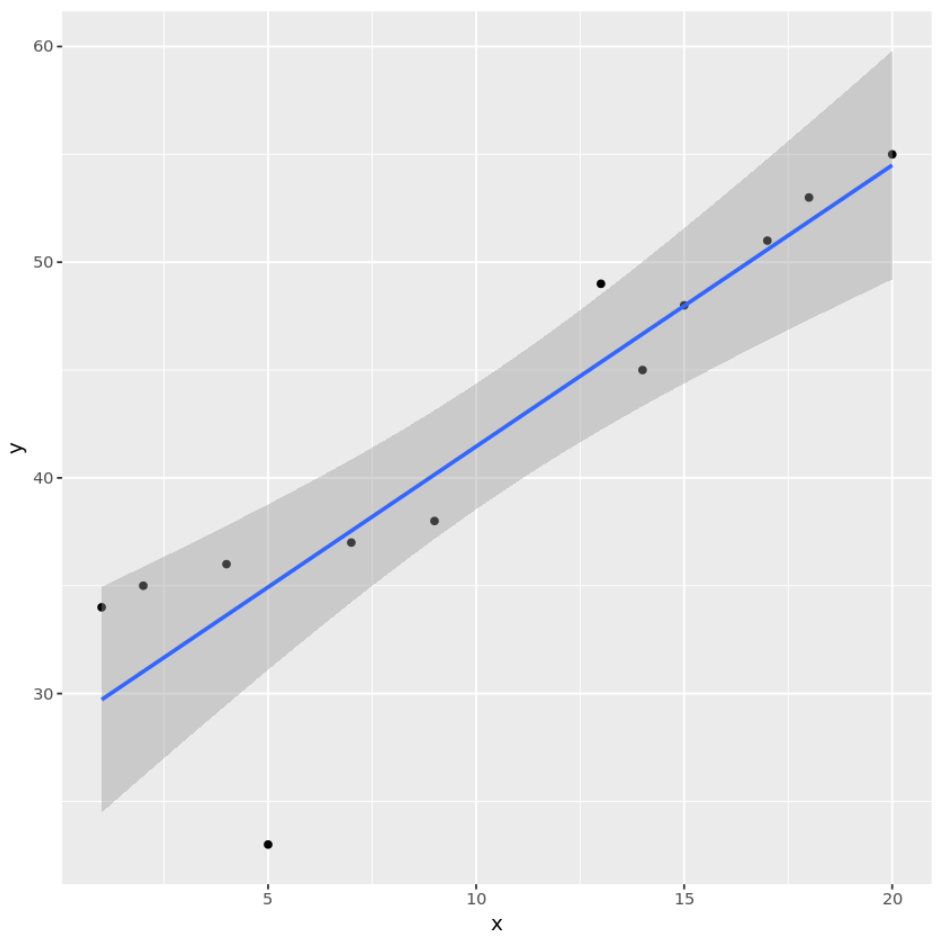
Un paramètre span particulièrement réduit (par exemple $\alpha = 0.2$) force l’algorithme à n’agréger que les observations spatialement les plus contiguës, conférant à la courbe une réactivité exacerbée capable d’épouser des micro-oscillations rapides. Toutefois, cette sensibilité extrême expose l’analyste au risque majeur de surajustement (overfitting), où le tracé finit par refléter le bruit expérimental singulier de l’échantillon plutôt que la fonction génératrice sous-jacente. Inversement, l’assignation d’une valeur élevée (par exemple $\alpha = 0.9$) génère un sous-lissage (underfitting), dilatant la fenêtre d’ajustement jusqu’à lisser excessivement les véritables inflexions fonctionnelles, transformant la trajectoire en une ligne quasi-asymptotique dépourvue de nuances comportementales.
4.3 Limites et hypothèses d’utilisation de LOESS en recherche expérimentale
En dépit de son élégance mathématique et de son immédiateté visuelle dans l’exploration préliminaire de cohortes psychométriques, la méthode LOESS présente d’importantes contraintes méthodologiques qu’il incombe à tout chercheur d’appréhender avec lucidité. D’un point de vue computationnel, sa complexité temporelle s’élève à $\mathcal{O}(n^2)$, impliquant une croissance exponentielle des durées de calcul dès que le corpus dépasse quelques milliers d’enregistrements. C’est précisément cette barrière d’échelle qui motive la désactivation par défaut de LOESS au profit des GAM dans les routines d’automatisation de ggplot2.
Sur le plan inférentiel, LOESS demeure une approche essentiellement descriptive : elle ne livre aucune équation paramétrique concise résumant la dynamique globale par un jeu restreint de coefficients aisément publiables dans les tables d’un manuscrit scientifique. De surcroît, cette méthode manifeste une instabilité structurelle prononcée aux limites extrêmes des axes cartésiens (phénomène de bordure), où l’asymétrie unilatérale de la fenêtre de pondération induit des biais d’estimation accrus. Enfin, toute projection extrapolative hors des bornes de l’échantillon observé est formellement prohibée en raison de la nature strictement locale du noyau d’ajustement.
5. Ajustement de modèles linéaires paramétriques avec method = ‘lm’
5.1 Remplacement du lissage local par une régression linéaire globale
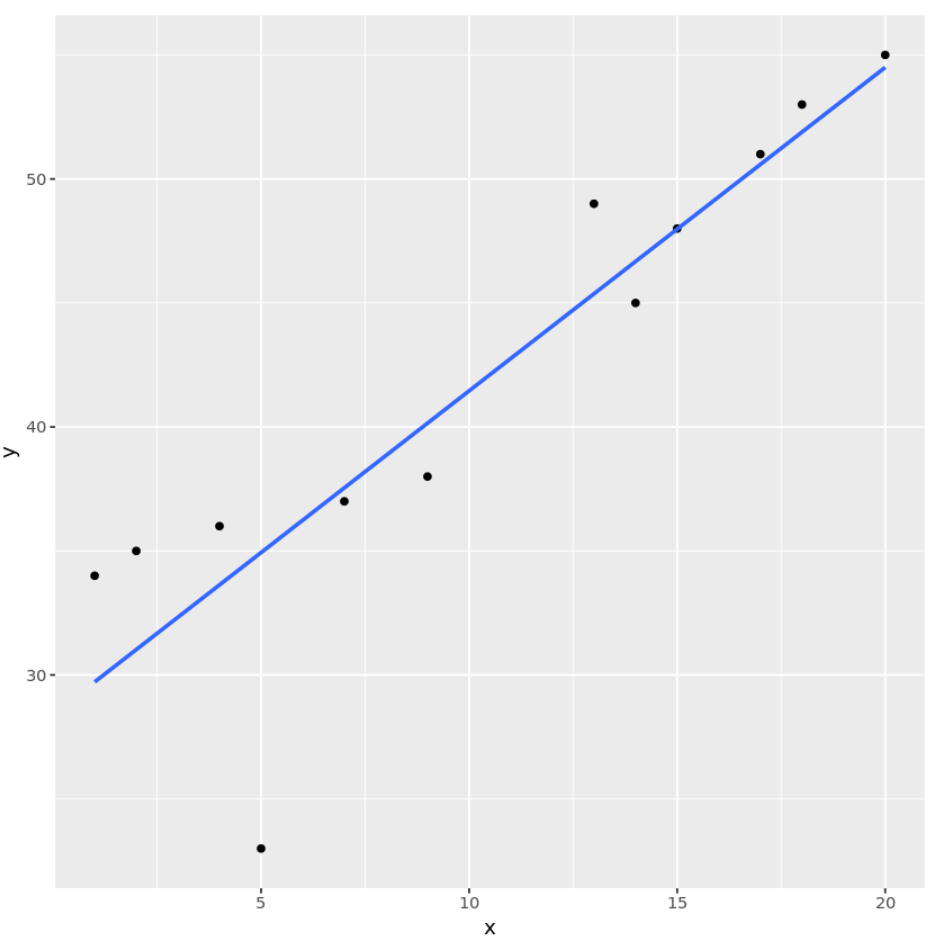
Lorsque le cadre épistémologique de l’étude repose sur des hypothèses confirmatoires a priori postulant une relation de proportionnalité directe entre deux grandeurs, l’abandon du lissage local non paramétrique au profit d’une régression linéaire ordinaire s’impose comme une évidence méthodologique. L’implémentation graphique de cette modélisation sous ggplot2 s’effectue par l’adjonction explicite de l’argument method = "lm" (pour Linear Model) au sein de la fonction geom_smooth(), couplée à la spécification canonique formula = y ~ x.
Ce paramétrage substitue l’estimation glissante par le calcul global des coefficients de pente ($\beta_1$) et d’ordonnée à l’origine ($\beta_0$) selon la méthode des moindres carrés ordinaires (OLS). La trajectoire résultante adopte la géométrie d’une droite vectorielle rigide s’étendant d’une extrémité à l’autre des données. La correspondance visuelle avec les résultats inférentiels produits par la commande statistique usuelle summary(lm(rappel ~ anxiete, data = df_cognitif)) est absolue : l’angle d’inclinaison de la ligne transcrit exactement la constante de pente, tandis que le ruban d’erreur reflète fidèlement la variance d’échantillonnage standard associée aux estimateurs gaussiens.
5.2 Extension aux relations polynomiales : Détection d’effets curvilinéaires
La recherche en sciences psychologiques et ergonomiques est fréquemment guidée par des modèles théoriques postulant des relations non linéaires paramétriques. L’exemple historique le plus emblématique demeure sans conteste la loi de Yerkes-Dodson, qui théorise que l’éveil attentionnel ou le stress optimise l’efficience motrice et mnésique jusqu’à un seuil médian optimal, au-delà duquel toute élévation supplémentaire de l’anxiété engendre une dégradation rapide des performances. Ce phénomène adopte visuellement l’allure caractéristique d’une parabole ou courbe en U inversé.
Pour matérialiser visuellement un tel modèle paramétrique sous ggplot2 sans déroger à la rigueur de la méthode lm, il suffit d’enrichir l’argument formel par une décomposition polynomiale orthogonale via formula = y ~ poly(x, 2). L’opérateur polynomial calcule en arrière-plan des vecteurs de covariables décorrélés évitant les problèmes de multicolinéarité computationnelle inhérents aux simples termes d’élévation à la puissance brute (bien que l’usage de poly(x, 2, raw = TRUE) soit également possible si l’on désire ajuster strictement la formulation brute $y = \beta_0 + \beta_1 x + \beta_2 x^2$). L’extension vers des degrés supérieurs (degrés 3 ou cubiques pour observer une stabilisation intermédiaire, degrés 4 pour des cinétiques bi-phasiques) s’avère immédiate, tout en exigeant une vigilance accrue face aux oscillations aberrantes de Runge pouvant surgir aux extrémités du domaine.
5.3 Transformations de variables intégrées dans la formule
L’analyse des temps de réaction, de la latence de traitement perceptif ou des intensités de stimuli psychophysiques impose presque systématiquement l’application de transformations mathématiques non linéaires en raison de l’asymétrie positive prononcée des lois de distribution temporelles. Au lieu de contraindre l’analyste à créer des variables transformées préalables au sein de sa table de données (comme une colonne de log-temps ou de racines carrées), geom_smooth() permet d’incorporer ces opérateurs fonctionnels directement au sein de sa spécification formelle.
Ainsi, l’inclusion de l’expression formula = y ~ log(x) permet d’ajuster une régression logarithmique respectant les préceptes de la loi psychophysique de Weber-Fechner, modélisant un rendement perceptif marginal décroissant à mesure que l’intensité de la stimulation s’accroît. Il importe de souligner que cette approche conserve l’échelle arithmétique originale sur l’axe cartésien des abscisses, rendant l’interprétation clinique ou ergonomique directement accessible aux praticiens. Cette méthode se distingue conceptuellement de l’instruction scale_x_log10() qui, elle, compresse la trame graphique globale en projetant l’espace euclidien sur une échelle logarithmique où la ligne ajustée redevient visuellement droite.
6. Modèles additifs généralisés (GAM) et splines de régression pour trajectoires complexes
6.1 L’utilisation de method = ‘gam’ pour un compromis souplesse-rigueur
Lorsque la structure des données empiriques manifeste des courbures sinueuses complexes qui ne peuvent être capturées fidèlement par des modèles polynomiaux de bas degré, sans pour autant que l’on veuille subir les limites computationnelles de LOESS sur les cohortes de grande taille, les modèles additifs généralisés (GAM) constituent le standard méthodologique absolu. Théorisés par Trevor Hastie et Robert Tibshirani, puis magnifiquement implémentés dans l’environnement R par Simon Wood au travers du package mgcv, les GAM appréhendent la relation fonctionnelle continue via des fonctions de lissage non paramétriques pénalisées.
L’implémentation opérationnelle au sein de ggplot2 s’articule autour de l’instruction geom_smooth(method = "gam", formula = y ~ s(x, bs = "cs")). Le symbole fonctionnel s(x) désigne une fonction de spline de lissage, tandis que l’argument bs = "cs" sélectionne des splines de régression cubiques avec pénalisation de retrait (shrinkage cubic splines). Ce cadre mathématique permet au modèle de déterminer de manière endogène le degré optimal de courbure en appliquant une pénalité rigoureuse sur la dérivée seconde de la fonction, garantissant que le tracé demeure aussi lisse que possible tout en épousant scrupuleusement la trajectoire sous-jacente des observations psychométriques.
6.2 Intégration de splines naturelles et splines cubiques avec le package splines
Une alternative élégante et hautement paramétrable aux splines de lissage entièrement automatiques réside dans l’utilisation conjointe de la méthode linéaire method = "lm" avec les constructeurs de bases de splines issus de la bibliothèque native splines. Deux opérateurs majeurs sont couramment mobilisés par les biostatisticiens et analystes du comportement : bs() pour les splines de base cubiques polynomiales par morceaux (B-splines) et ns() pour les splines cubiques naturelles (Natural Cubic Splines), ces dernières imposant une contrainte de linéarité stricte au-delà des nœuds frontières de l’échantillon.
La syntaxe geom_smooth(method = "lm", formula = y ~ splines::ns(x, df = 4)) permet de spécifier un ajustement souple délimité précisément par quatre degrés de liberté (df). Cette approche offre un contrôle déterministe absolu sur la complexité structurelle de la courbe. De surcroît, l’expérimentateur peut assigner manuellement l’emplacement spatial des nœuds internes d’articulation (via l’argument knots = c(valeur1, valeur2)) afin de contraindre la flexibilité du lissage à des moments expérimentaux critiques, tels que l’administration d’un traitement pharmacologique de renforcement cognitif ou l’amorce d’une phase de repos au cours d’une session de testing prolongée.
6.3 Contrôle du surajustement par validation croisée généralisée (GCV)
Le principal écueil guettant le chercheur engagé dans la modélisation de trajectoires empiriques réside dans le surapprentissage, situation délétère où l’algorithme se méprend en interprétant le bruit stochastique généré par les participants atypiques comme une véritable inflexion de la fonction génératrice. Dans les GAM exécutés nativement par geom_smooth(), ce péril est jugulé de façon algorithmique par la minimisation automatique d’un critère d’optimisation mathématique : la validation croisée généralisée (Generalized Cross-Validation, ou GCV).
Le critère GCV quantifie mathématiquement l’erreur quadratique moyenne de prédiction prévisible en simulant de manière récursive l’omission d’observations individuelles. La valeur optimale du paramètre de lissage $lambda$ correspond au point d’équilibre minimisant ce critère de perte global. Lors de la rédaction d’un compte-rendu méthodologique, il est vivement recommandé d’extraire et de consigner les degrés de liberté effectifs estimés (effective degrees of freedom, ou $edf$) issus du modèle GAM sous-jacent. Un indicateur $edf \approx 1$ traduit une stricte linéarité fonctionnelle, tandis qu’un indicateur $edf ge 3$ atteste formellement de la présence d’une non-linéarité prononcée au sein des observations analysées.
7. Modélisation des distributions non gaussiennes : Régression robuste et GLM
7.1 Application des modèles linéaires généralisés (method = ‘glm’)
L’hypothèse classique d’homoscédasticité et de normalité des résidus inhérente à la régression linéaire ordinaire se heurte fréquemment à la nature discrète, asymétrique ou bornée des mesures recueillies lors de tâches informatisées. En particulier, les variables indicatrices de succès ou d’échec à un item psychométrique (codées 0 ou 1) ou les taux de précision proportionnels violent fondamentalement les postulats de l’estimation des moindres carrés, produisant des extrapolations aberrantes en deçà de 0 ou au-delà de 1 lorsqu’on utilise un lissage linéaire standard.
Pour remédier à cette incongruité méthodologique, geom_smooth() permet l’intégration directe de la structure des modèles linéaires généralisés via l’instruction method = "glm", enrichie du paramètre method.args = list(family = "binomial"). Cette configuration déploie une fonction de lien logistique (logit) reliant l’espérance mathématique conditionnelle à la combinaison linéaire du prédicteur. Le tracé généré adopte l’allure d’une sigmoïde asymptotique confinée avec rigueur à l’intervalle de probabilité $[0, 1]$, matérialisant parfaitement la cinétique de passage d’un état d’échec récurrent à un état de maîtrise cognitive sous l’effet de l’apprentissage.
7.2 Gestion des données aberrantes avec la régression robuste (method = MASS::rlm)
Les protocoles chronométriques et les expérimentations conduites à large échelle sur des cohortes d’étudiants ou d’usagers en ligne sont constamment pollués par des données aberrantes (outliers). Qu’il s’agisse de pressions involontaires de touches induisant des temps de réaction minuscules ou d’épisodes de distraction sévère générant des latences anormalement longues, ces observations parasites exercent un effet de levier disproportionné sur les estimateurs OLS, infléchissant la droite de régression linéaire dans une direction méthodologiquement faussée.
La substitution de la fonction de perte quadratique usuelle par un estimateur M robuste permet d’annihiler l’influence délétère de ces points excentrés. En spécifiant method = MASS::rlm au sein de geom_smooth(), l’ajustement est recalculé au travers d’un processus de moindres carrés itérativement repondérés mobilisant des fonctions de perte pondérée (telles que la fonction d’influence de Huber ou la fonction bicarée de Tukey). La ligne de régression résultante traverse le cœur dense de la distribution empirique sans dévier de sa trajectoire sous l’effet des scores erratiques, offrant une restitution fidèle de la tendance centrale robuste de la population étudiée.
7.3 Régression quantile non paramétrique avec quantreg (method = ‘rq’)
Les approches fondées sur la régression moyenne classique masquent par construction l’éventuelle hétérogénéité structurelle existant le long de la distribution conditionnelle de la variable dépendante. En neurosciences comportementales, il est fréquent que l’impact d’une élévation du niveau de stress ne modifie que marginalement la moyenne arithmétique globale des temps de réponse, tout en étirant dramatiquement les quantiles les plus lents en raison d’un effondrement ponctuel du contrôle attentionnel exécutif.
L’intégration de la bibliothèque quantreg au sein de geom_smooth() via l’argument method = "rq" permet d’estimer et de visualiser des fonctions quantiles conditionnelles continues. En exploitant le paramètre de transmission method.args = list(tau = c(0.1, 0.5, 0.9)), le graphique s’enrichit d’un faisceau de courbes visualisant conjointement la trajectoire du 10e percentile (les réponses les plus rapides et automatisées), de la médiane conditionnelle ($tau = 0.5$, imperméable aux asymétries) et du 90e percentile (les latences d’échappement attentionnel). Cette approche quantile offre une cartographie d’une exhaustivité incomparable pour documenter l’élargissement de la variabilité intra-individuelle.
8. Gestion, calcul et interprétation des bandes de confiance (se = TRUE / FALSE)
8.1 Signification statistique de la zone grisée par défaut
Par défaut, toute instanciation de geom_smooth() dans ggplot2 s’accompagne d’une bande semi-transparente de couleur grise entourant la courbe d’estimation centrale. Cette zone graphique traduit l’évaluation ponctuelle continue de l’intervalle de confiance à 95% associé à la valeur attendue conditionnelle de la fonction $E(Y|X=x)$. Il est capital de rappeler une distinction épistémologique essentielle trop souvent bafouée dans les publications : cet intervalle reflète l’incertitude d’échantillonnage inhérente à l’estimation de la moyenne de la population, et ne saurait en aucun cas être confondu avec un intervalle de prédiction individuel, lequel engloberait la dispersion propre des observations singulières futures.
La morphologie géométrique de ce ruban présente de manière caractéristique un rétrécissement prononcé au voisinage du centre de gravité des données ($\bar{X}$), et un élargissement graduel à mesure que l’on s’éloigne vers les limites périphériques du domaine d’observation. Cette configuration hyperbolique découle directement de la formule théorique de la variance de la valeur estimée $\hat{Y}$ dans les modèles de régression, où l’incertitude liée à l’estimation de la pente s’amplifie proportionnellement à la distance au carré par rapport au barycentre empirique :
$$\text{Var}(\hat{Y}|X = x_0) = \sigma^2 \left( \frac{1}{n} + \frac{(x_0 – \bar{x})^2}{\sum (x_i – \bar{x})^2} \right)$$
Lorsque la densité de points est faible aux frontières, la marge d’erreur s’accroît considérablement, avertissant le lecteur de la précarité inférentielle des extrapolations périphériques.
8.2 Modification du niveau de confiance avec l’argument ‘level’
Bien que le seuil de significativité bilatéral à $\alpha = 0.05$ (correspondant à une couverture de confiance de 95%) soit conventionnellement ancré dans les pratiques scientifiques, les contextes exploratoires ou les protocoles préenregistrés aux critères de réplication drastiques peuvent justifier l’ajustement formel de cette amplitude stochastique. L’argument level au sein de geom_smooth() permet de moduler précisément la probabilité de couverture nominale de l’intervalle.
L’attribution de la valeur level = 0.99 étire l’enveloppe du ruban d’incertitude afin de garantir une certitude paramétrique accrue, ce qui s’avère particulièrement pertinent lors de l’exploration d’échantillons restreints où les fluctuations aléatoires sont amplifiées. Réciproquement, la fixation de level = 0.90 rétrécit la bande d’erreur, permettant de focaliser l’attention sur le noyau dense de certitude statistique. Il est méthodologiquement primordial que le niveau de confiance retenu pour le tracé corresponde sans équivoque aux seuils de décision formulés dans le corps textuel et les tables d’analyse inférentielle de l’article scientifique associé.
8.3 Personnalisation esthétique de la bande d’erreur
L’intégration visuelle de la bande de confiance requiert une harmonisation fine avec la densité sous-jacente des points pour prévenir tout effet d’occlusion sémiotique indésirable. Le paramètre alpha régit le degré d’opacité de la zone d’incertitude : abaisser cette valeur à alpha = 0.15 permet de préserver la parfaite netteté des observations individuelles disséminées sous le ruban, tout en délimitant distinctement la zone d’erreur.
Parallèlement, la couleur de remplissage du ruban peut être dissociée de la teinte du trait d’estimation grâce à l’articulation conjointe des arguments color (assigné à la ligne centrale) et fill (assigné au polygone de l’intervalle). Enfin, dans les représentations graphiques denses comportant une multiplicité de sous-groupes expérimentaux superposés, le chevauchement chaotique des rubans d’incertitude peut générer une confusion visuelle insurmontable. Dans une telle situation, la désactivation pure et simple de la bande d’erreur par l’instruction se = FALSE devient un impératif d’hygiène graphique, la variance pouvant être consignée séparément au sein d’un panneau d’intervalles marginaux ou de tableaux récapitulatifs.
9. Personnalisation esthétique avancée : Couleur, épaisseur, typographie et styles de trait
9.1 Modification des attributs graphiques statiques de la courbe
La sémiotique graphique d’une figure destinée à une publication scientifique répond à des exigences de clarté, de sobriété et de contraste rigoureusement encadrées par les guides de style internationaux, à l’image des normes édictées par l’American Psychological Association (APA). Le tracé par défaut de ggplot2, caractérisé par une fine ligne bleue continue, doit être adapté pour satisfaire aux contraintes d’accessibilité visuelle (notamment pour les lecteurs présentant des déficiences de la vision chromatique) ainsi qu’aux exigences d’impression en niveaux de gris.
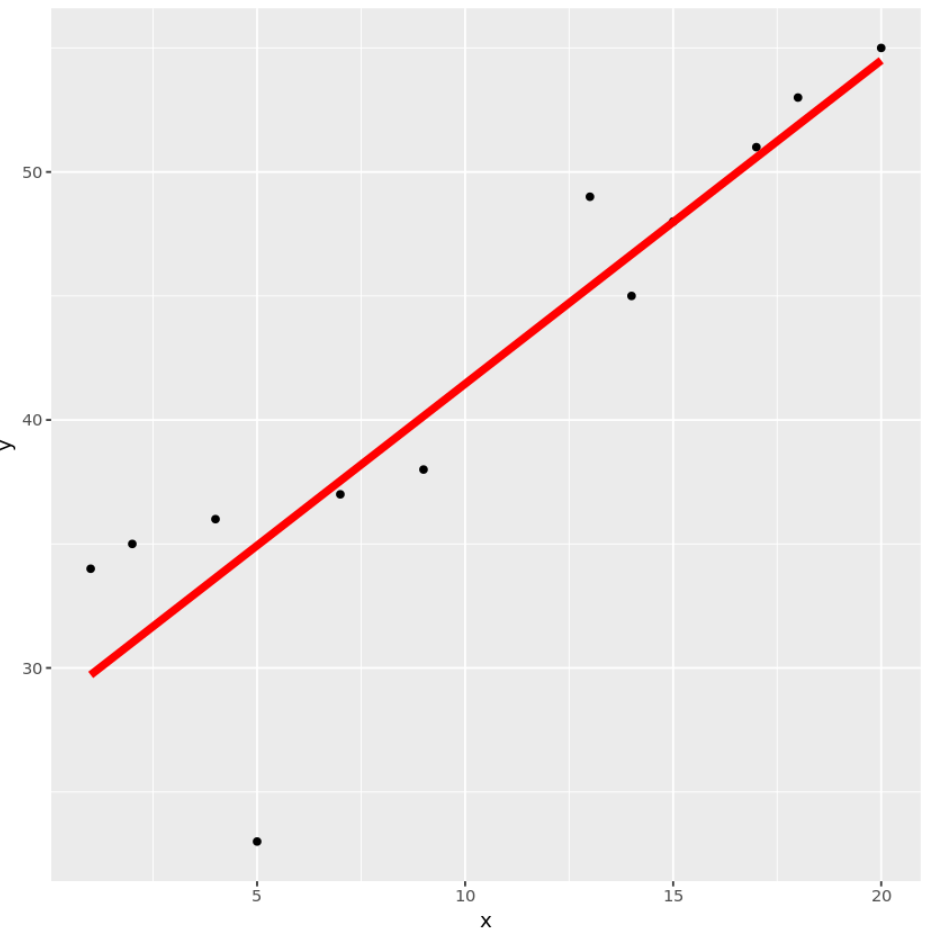
Le contrôle de l’épaisseur du trait s’opère via l’argument linewidth = 1.2 (qui a formellement supplanté le paramètre historique size pour les objets géométriques linéaires dans les versions récentes de ggplot2). La sélection d’un calibre suffisant garantit que la courbe d’estimation émerge sans ambiguïté au-dessus du nuage de points sans pour autant saturer l’espace pictural. La modification du type de ligne au moyen du paramètre linetype permet d’introduire une hiérarchisation perceptive immédiate : l’usage d’une ligne continue (linetype = "solid") est traditionnellement réservé aux modèles validés ou principaux, tandis qu’un tracé tireté (linetype = "dashed") ou pointillé (linetype = "dotted") signale visuellement une tendance hypothétique, une extrapolation théorique ou un ajustement concurrent de comparaison.
9.2 Séparation rigoureuse entre esthétiques globales et paramètres locaux
L’un des pièges récurrents rencontrés lors de l’apprentissage de la syntaxe de ggplot2 réside dans la confusion entre l’attribution d’une valeur constante à un paramètre visuel et le mappage esthétique dynamique indexé sur les variables de données. Lorsqu’un chercheur souhaite colorer une courbe de lissage en rouge bordeaux uniforme, l’instruction color = "firebrick" doit impérativement être déclarée à l’extérieur de l’environnement aes(), directement dans les arguments génériques de geom_smooth().
L’inclusion par inadvertance de cette instruction au sein de l’environnement fonctionnel — par exemple sous la forme erronée geom_smooth(aes(color = "firebrick")) — produit un résultat inattendu : le moteur interprète la chaîne de caractères "firebrick" comme un facteur catégoriel unitaire, crée une légende graphique artificielle superflue et attribue au tracé la première nuance par défaut de la palette chromatique active. La maîtrise rigoureuse de cette distinction garantit une génération propre des figures, exempte d’artefacts d’affichage ou de redondances textuelles déconcertantes.
9.3 Superposition de multiples modèles sur un même graphique
L’une des stratégies les plus fécondes dans l’analyse exploratoire avancée consiste à confronter visuellement plusieurs hypothèses concurrentes de modélisation sur un corpus empirique unique. L’architecture de ggplot2 autorise la déclaration séquentielle de multiples couches geom_smooth() au sein du même canevas, chacune exploitant une méthode d’ajustement distincte afin de mettre en exergue les divergences locales d’ajustement.
Il est ainsi particulièrement instructif de superposer une droite de régression linéaire classique (method = "lm", linetype = "dashed", color = "black") et un lissage non paramétrique local de type GAM ou LOESS (method = "gam", color = "darkblue"). Cette confrontation graphique permet d’évaluer d’un seul coup d’œil si l’hypothèse de linéarité postule une simplification acceptable du phénomène comportemental ou si elle mutile gravement une dynamique curvilinéaire sous-jacente. L’intégration d’une légende comparative explicite peut être harmonieusement structurée en assignant manuellement une chaîne descriptive à l’esthétique color au sein de chaque couche et en contrôlant les concordances chromatiques au moyen de la fonction d’échelle manuelle scale_color_manual().
10. Stratification et analyse multi-groupes : Groupes, couleurs et facettage
10.1 Lissage conditionnel par sous-populations expérimentales
L’investigation psychologique moderne s’intéresse rarement à des trajectoires univariées isolées : la quasi-totalité des plans factoriels interroge l’existence d’effets d’interaction statistique, postulant que la relation entre deux variables quantitatives se module différentiellement selon les modalités d’un facteur expérimental ou sociodémographique (groupe clinique vs témoin, condition d’induction de stress vs relaxation). La grammaire de ggplot2 répond à ce défi avec une virtuosité technique inégalée.
En assignant une variable factorielle à l’esthétique chromatique générale dans le bloc d’initialisation — via ggplot(df_cognitif, aes(x = anxiete, y = rappel, color = condition)) —, le moteur statistique applique automatiquement une décomposition factorielle en sous-échantillons étanches. L’appel subséquent à geom_smooth() ne trace plus une courbe globale unique mais calcule et projette autant de courbes de lissage indépendantes qu’il existe de niveaux au sein du facteur désigné, chacune parée de sa signature chromatique distincte et de son propre ruban d’incertitude. Le croisement direct des pentes ou la divergence des courbures fournit un indicateur visuel saisissant d’une modération statistique significative.
10.2 Contrôle fin de l’esthétique group sans altération des couleurs
Il est des contextes méthodologiques où l’expérimentateur souhaite calculer des courbes d’ajustement stratifiées par strate sans pour autant fragmenter son graphique en une multitude de couleurs bariolées qui surchargeraient la perception du lecteur. Ce cas de figure se rencontre notamment lors de la visualisation de trajectoires individuelles au sein de données longitudinales de type panel (communément désignées sous le nom de spaghetti plots).
L’utilisation explicite de l’esthétique de groupement aes(group = identifiant_participant) permet de scinder les calculs de lissage de manière totalement invisible sur le plan chromatique. Il devient alors aisé de tracer en arrière-plan cinquante courbes individuelles très fines et semi-transparentes de couleur grise uniforme (linewidth = 0.3, alpha = 0.3, se = FALSE) illustrant la variabilité idiosyncrasique de chaque participant, tout en superposant au premier plan une courbe de lissage agrégée globale rouge et épaisse représentant l’espérance mathématique de la cohorte. Cette hiérarchisation visuelle résout élégamment le dilemme opposant l’idiographie individuelle à la synthèse nomothétique du signal expérimental.
10.3 Décomposition en sous-graphiques via facet_wrap() et facet_grid()
Lorsque le plan de recherche factoriel se complexifie par l’adjonction de variables modératrices multiples (par exemple la condition expérimentale croisée avec le sexe biologique et la tranche d’âge), la superposition exhaustive de l’ensemble des courbes de lissage et de leurs rubans d’incertitude respectifs sur un canevas unique engendre un enchevêtrement illisible. La technique du facettage (small multiples) offre alors une alternative analytique d’une exceptionnelle puissance sémiotique.
L’adjonction de la commande facet_wrap(~ condition) ou de la matrice bidirectionnelle facet_grid(sexe ~ condition) distribue instantanément les sous-populations au sein d’une grille ordonnée de vignettes graphiques autonomes. Au sein de chaque panneau, geom_smooth() recalcule l’ajustement statistique restreint à la cellule expérimentale correspondante, tout en garantissant une identité d’échelle cartésienne sur les axes d’abscisses et d’ordonnées. Cette synchronisation dimensionnelle standardisée permet au chercheur de comparer instantanément les profils de courbure, les amplitudes d’incertitude et les translations d’ordonnée à l’origine à travers l’ensemble des strates du protocole.
11. Diagnostics, pièges statistiques et prévention des artefacts d’interprétation
11.1 Le danger de la sur-interprétation des oscillations locales
La flexibilité des algorithmes non paramétriques constitue simultanément leur force exploratoire majeure et leur principal écueil épistémologique. Face à une courbe d’ajustement issue d’un lissage LOESS excessivement réactif ou d’un GAM insuffisamment pénalisé, l’analyste court en permanence le danger cognitif d’attribuer une signification théorique profonde à ce qui ne relève en vérité que d’une fluctuation d’échantillonnage aléatoire. La présence d’une ondulation locale ou d’un léger creux temporaire au sein d’une trajectoire comportementale ne saurait être assimilée à une découverte empirique sans un contrôle diagnostique impitoyable.
Une bonne pratique de visualisation diagnostique consiste à superposer systématiquement un tapis d’observations marginales le long de l’axe des abscisses à l’aide de l’instruction geom_rug(alpha = 0.3). Cet artifice graphique matérialise la densité locale exacte des données empiriques sous la forme de fines graduations verticales. L’inspection conjointe du tapis de données et du ruban d’incertitude permet d’identifier instantanément les illusions d’inflexion : si une ondulation spectaculaire de la courbe se produit précisément au-dessus d’une zone aride où le tapis de données ne dénombre aucun point et où le ruban d’erreur s’évase considérablement, le chercheur conclura prudemment à un artefact algorithmique dépourvu de toute validité psychologique.
11.2 Conflits de domaine et troncature des limites d’extrapolation
Un écueil statistique classique lors de l’application de régressions linéaires ou polynomiales au moyen de geom_smooth() réside dans le comportement d’extrapolation cartésienne régit par l’argument fullrange. Par défaut, la valeur de cet argument est initialisée à fullrange = FALSE, ce qui contraint strictement le tracé de la courbe et de son ruban aux bornes empiriques réelles observées au sein de l’échantillon ($[min(X), max(X)]$). Le basculement délibéré à fullrange = TRUE force le modèle à étendre son estimation prédictive jusqu’aux limites absolues définies par la fenêtre d’affichage cartésienne.
Cette démarche d’extension doit être maniée avec une prudence méthodologique extrême. D’une part, l’extrapolation polynomiale tend à diverger vers l’infini avec une vélocité exponentielle dès que l’on quitte le support empirique des données. D’autre part, dans de nombreux contextes psychométriques, les variables d’évaluation sont contraintes par des planchers ou des plafonds physiques infranchissables (un score d’efficience mnésique ne saurait descendre sous le seuil de zéro ni excéder 100% de rappel). La projection aveugle d’un modèle non borné engendre alors des prédictions mathématiquement aberrantes. Il est dans ce cas impératif d’utiliser une transformation logistique préalable ou d’ajuster une régression binomiale tronquant naturellement la fonction dans l’espace de définition valide.
11.3 Performances computationnelles et alternatives sur très grands volumes de données
L’essor des technologies contemporaines d’enregistrement continu — telles que l’oculométrie à haute fréquence (eye-tracking), l’analyse cinématique du mouvement ou le suivi d’interactions sur des plateformes web regroupant des centaines de milliers de transactions — confronte les routines standards de ggplot2 à de sévères engorgements computationnels. L’exécution d’un modèle LOESS standard sur un corpus de 100 000 points est vouée à saturer irrémédiablement la mémoire vive ou à monopoliser le processeur durant de longues minutes de calcul infructueux.
Face au phénomène du Big Data comportemental, plusieurs stratégies d’ingénierie statistique doivent être mobilisées. La première consiste à exploiter la configuration optimisée du package mgcv en spécifiant explicitement dans geom_smooth() l’option method = "gam", method.args = list(discrete = TRUE). Cette instruction enclenche une discrétisation matricielle préalable des covariables continues, réduisant de plusieurs ordres de grandeur le temps d’évaluation des splines sans altérer la fidélité perceptible de la trajectoire finale. Une seconde alternative consiste à opérer un lissage sur des sous-échantillons représentatifs aléatoires, ou à procéder préalablement à un partitionnement par casiers hexagonaux (hexagonal binning via geom_hex()) sur lequel est ensuite adossé le modèle de synthèse.
12. Bonnes pratiques de communication scientifique et reproductibilité en psychologie
12.1 Exportation haute résolution pour manuscrits soumis aux revues à comité de lecture
La finalisation d’une figure intégrant des lignes de lissage pour une soumission auprès d’une revue académique exige une rigueur technique sans faille lors de l’exportation des fichiers sources. L’utilisation du visualiseur intégré de l’environnement RStudio produit des rendus matriciels compressés dépendants de la résolution arbitraire de l’écran hôte, totalement inaptes à l’évaluation par les comités éditoriaux. L’unique protocole d’exportation valide repose sur l’appel rigoureux à la fonction programmée ggsave().
Les standards internationaux d’édition scientifique privilégient les formats vectoriels purs tels que le format PDF ou SVG pour les manuscrits finaux. Les instructions vectorielles encodent les courbes de lissage sous la forme de formules mathématiques de Bézier indépendantes de tout maillage de pixels, garantissant une netteté infinitésimale lors des opérations de grossissement ou d’impression typographique. Si un format matriciel s’avère impérativement requis par la revue, l’exportation au format TIFF ou PNG non compressé doit afficher une résolution minimale impérative de 300 points par pouce (dots per inch, DPI) pour les graphiques monochromes et 600 DPI pour les représentations combinant points denses et rubans d’incertitude, tout en fixant explicitement les dimensions métriques en centimètres :
ggsave("figure1_trajectoire_anxiete.pdf", plot = graphique_final, width = 16, height = 10, units = "cm", device = cairo_pdf)
12.2 Normes de rédaction et description des graphiques de lissage
L’éthique de la communication scientifique impose une transparence absolue dans la description méthodologique des représentations visuelles. Une figure scientifique ne saurait se suffire à elle-même sans une légende textuelle autonome détaillée conforme aux préconisations du manuel de l’APA (7ème édition). Pour chaque tracé continu présenté dans un manuscrit, l’auteur a l’obligation morale d’expliciter sans ambiguïté les paramètres computationnels sous-jacents qui ont forgé la trajectoire observée.
La légende doit obligatoirement stipuler la méthode exacte de modélisation mise en œuvre (par exemple : « La ligne continue bleue illustre un modèle additif généralisé [GAM] ajusté par des splines de régression cubiques pénalisées »), la formulation mathématique du terme de relation, ainsi que la signification statistique précise du ruban d’accompagnement (par exemple : « La zone d’ombrage grise délimite l’intervalle de confiance ponctuel à 95% calculé autour de la moyenne conditionnelle »). Dans le cas d’un lissage LOESS, la valeur précise du coefficient de régulation de fenêtre (span) doit être explicitement consignée. Enfin, l’analyste doit formellement rappeler dans le texte narratif que les bandes d’incertitude locales ne se substituent pas à un test d’hypothèse formel d’adéquation globale du modèle.
12.3 Partage de code et pérennité des flux de travail (Open Science)
Dans le contexte actuel de la crise de reproductibilité touchant les sciences empiriques, l’élaboration de figures graphiques ne peut plus être dissociée de la mise à disposition intégrale du pipeline analytique qui les a générées. La préservation de la pérennité computationnelle d’un graphique ggplot2 requiert l’encapsulation scrupuleuse des scripts au sein d’un environnement de projet RStudio adossé à un document de programmation lettrée de type Quarto (.qmd) ou R Markdown (.Rmd). Cette architecture garantit l’entrelacement direct du code de génération graphique, des commentaires méthodologiques et des données sources nettoyées.
De surcroît, les versions des packages statistiques spécialisés (tels que ggplot2, mgcv ou splines) connaissant des évolutions algorithmiques au fil du temps, il est vivement préconisé de figer l’état exact de l’environnement logiciel au moyen du gestionnaire d’infrastructure renv. Ce dispositif enregistre de façon déterministe les numéros de version de chaque bibliothèque dans un fichier de verrouillage textuel (renv.lock), permettant à tout examinateur ou chercheur tiers de reconstituer à l’identique, sur n’importe quel système d’exploitation, l’environnement informatique exact ayant présidé à l’ajustement des courbes de lissage publiées.
Pour synthétiser les commandes et architectures de modélisation abordées tout au long de ce manuel de référence, le tableau méthodologique suivant récapitule les configurations canoniques de geom_smooth() en regard de leurs fondements statistiques et de leurs indications privilégiées en recherche empirique :
Méthode (method) |
Formule type (formula) |
Nature de l’ajustement | Cas d’usage privilégiés |
|---|---|---|---|
"loess" |
y ~ x (avec span) |
Régression polynomiale locale pondérée | Exploration non paramétrique fluide ($n < 1000$). |
"lm" |
y ~ x |
Moindres carrés ordinaires (OLS) | Validation d’hypothèses de linéarité stricte. |
"lm" |
y ~ poly(x, 2) |
Régression polynomiale globale | Dynamiques curvilignes (ex. lois en U inversé). |
"gam" |
y ~ s(x, bs = "cs") |
Splines pénalisées par régularisation | Trajectoires complexes sur larges cohortes ($n ge 1000$). |
"glm" |
y ~ x (family = "binomial") |
Modèle linéaire généralisé logistique | Taux de réussite binaires, probabilités bornées. |
MASS::rlm |
y ~ x |
Estimateurs M robustes pondérés | Présence marquée de valeurs extrêmes ou aberrantes. |
En mobilisant avec discernement cette diversité méthodologique, l’analyste dépasse la simple restitution figurative pour ériger le graphique statistique en un véritable outil de découverte, de modélisation rigoureuse et de communication scientifique irréprochable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman & Hall/CRC.
- Koenker, R. (2005). Quantile regression. Cambridge University Press. https://doi.org/10.1017/CBO9780511754097
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781315370279