
Dans le paysage contemporain de l’analyse exploratoire et de la communication scientifique, la restitution visuelle des distributions statistiques constitue un jalon méthodologique déterminant. Si la sémiologie graphique s’est considérablement enrichie au cours des dernières décennies grâce aux apports conjoints des sciences cognitives et des technologies computationnelles, le diagramme circulaire — communément désigné sous le vocable vernaculaire de « camembert » — demeure l’une des figures les plus omniprésentes, mais également les plus âprement débattues de la statistique descriptive. Utilisé dès l’aube du dix-neuvième siècle par William Playfair pour illustrer la répartition des territoires de l’Empire ottoman, cet artefact géométrique possède une force intuitive singulière : il matérialise immédiatement la notion de partition d’un tout fini en composantes discrètes mutuellement exclusives.
Cependant, l’implémentation de cette forme graphique au sein de l’environnement de programmation statistique R, et plus particulièrement au travers de l’écosystème ggplot2 développé par Hadley Wickham, confronte immédiatement l’analyste à un paradoxe programmatique et conceptuel. En effet, contrairement aux bibliothèques logicielles traditionnelles qui proposent une fonction unitaire et fermée pour engendrer de tels visuels, ggplot2 ne comporte délibérément aucune géométrie native de type dédié. Cette absence apparente n’est nullement une omission technique, mais l’affirmation rigoureuse d’une philosophie : celle de la grammaire des graphiques théorisée par Leland Wilkinson. Dans ce paradigme formel, un diagramme circulaire ne représente pas une classe géométrique fondamentale indépendante, mais l’aboutissement projectif d’un diagramme en barres unidimensionnel superposé dans un espace de coordonnées cartésiennes, auquel on applique une transformation polaire continue.
Le présent article propose une exploration intégrale, technique et méthodologique de la construction, de l’optimisation esthétique et de l’interprétation critique des diagrammes circulaires au sein de ggplot2. Conçu selon les exigences de la recherche quantitative et de l’édition scientifique, ce guide détaillera chaque étape opérationnelle, depuis la préparation analytique des structures de données avec dplyr jusqu’au déploiement de visualisations sophistiquées conformes aux standards éditoriaux les plus rigoureux, notamment ceux de l’American Psychological Association. À travers une démarche pédagogique et réflexive, nous aborderons également les questions de perception sensorielle, les contraintes d’accessibilité chromatique pour les personnes présentant des déficiences visuelles, ainsi que les alternatives géométriques préférables lorsque la complexité de l’information excède les capacités cognitives de lecture angulaire.
1. Introduction aux diagrammes circulaires et fondements théoriques dans ggplot2
1.1 Définition sémiotique et principes de la représentation proportionnelle
D’un point de vue sémiotique, le diagramme circulaire se définit comme une partition fermée d’un espace géométrique bidimensionnel régulier, circonscrit par une trajectoire orbitale plane dont la somme angulaire totale équivaut strictement à trois cent soixante degrés géométriques ou deux pi radians. La fonction sémiotique primaire de cette représentation repose sur le principe de proportionalité intégrale : l’aire totale du disque incarne l’intégralité d’un ensemble de référence, tandis que chaque secteur angulaire matérialise une sous-population spécifique. Sur le plan mathématique, cette correspondance s’exprime par une relation d’isomorphisme linéaire direct liant l’angle central sous-tendu au sommet du secteur, la superficie sectorielle délimitée par les deux rayons et l’arc de cercle, et la fréquence relative ou proportion de la modalité statistique observée au sein de l’échantillon empirique.
Cette forme de représentation trouve sa légitimité analytique exclusive au sein des variables qualitatives discrètes nominales ou catégorielles, dont les modalités s’avèrent strictement exhaustives et mutuellement disjointes. Lorsqu’une unité statistique individuelle est susceptible d’appartenir simultanément à plusieurs catégories, ou lorsque l’agrégation des proportions partielles ne restitue pas exactement l’unité absolue (cent pour cent de l’effectif total), l’emploi d’un diagramme circulaire engendre une distorsion cognitive sévère, invalidant la métaphore spatiale du tout et de ses parties.
Néanmoins, l’évaluation psychophysique de cette sémiologie graphique révèle des vulnérabilités perceptives majeures. Les travaux expérimentaux fondateurs conduits par William S. Cleveland et Robert McGill dans les années 1980 sur la perception visuelle des données graphiques ont hiérarchisé les tâches d’extraction cognitive élémentaires mobilisées par le cortex visuel humain. Leurs conclusions démontrent sans ambiguïté que les jugements perceptifs fondés sur la position relative le long d’une échelle commune (comme c’est le cas dans un diagramme en barres horizontales ou verticales alignées) présentent une précision de décodage infiniment supérieure aux jugements fondés sur l’angle au centre ou sur la superficie surfacique. Le système perceptif humain tend en effet à sous-estimer systématiquement les angles aigus et à surestimer les angles obtus, un biais cognitif explicité notamment par la loi de puissance de Stevens et les constantes de Weber-Fechner, ce qui complique l’ordonnancement mental précis de segments d’amplitudes comparables.
1.2 Philosophie de la grammaire des graphiques appliquée aux camemberts
L’architecture de ggplot2 dérive de la formalisation théorique élaborée par Leland Wilkinson dans son ouvrage canonique The Grammar of Graphics. Cette approche postule qu’un graphique statistique ne doit pas être appréhendé comme une entité statique et monolithique, mais plutôt comme la composition algébrique rigoureuse de couches indépendantes et permutables : des données brutes, un système d’associations esthétiques reliant les variables aux propriétés visuelles (position, couleur, forme, taille), des représentations géométriques (points, lignes, polygones), des transformations statistiques implicites ou explicites, des échelles dimensionnelles et un système de coordonnées spatiales au sein duquel ces éléments sont projetés.
C’est précisément cette rigueur conceptuelle qui justifie l’absence volontaire d’une fonction primitive telle qu’un marqueur géométrique direct pour les camemberts dans l’infrastructure de base développée par Hadley Wickham. Intégrer une commande directe romprait la pureté formelle de la grammaire en créant un cas particulier injustifié. Dans le système formel de ggplot2, une tranche de diagramme circulaire n’est rien d’autre qu’une barre cartésienne ordinaire dont l’abscisse est comprimée et dont l’axe vertical d’empilement subit une transformation non linéaire pour être replié sur lui-même le long d’un cercle trigonométrique.
Cette approche décompositionnelle confère au statisticien et au développeur une plasticité technique inégalée. En dissociant la structure tabulaire des effectifs, leur empilement unidimensionnel et leur géométrisation orbitale, le moteur graphique offre la latitude d’intervenir à chaque étape du pipeline de rendu visuel. Il devient ainsi envisageable de manipuler séparément l’épaisseur des tranches, les rayons d’exclusion centrale pour concevoir des diagrammes en anneau, ou encore la cinématique d’orientation de l’angle initial, garantissant une flexibilité algorithmique inaccessible aux logiciels fonctionnant par modèles fermés.
1.3 Rôle des diagrammes de proportion dans l’analyse de données en sciences humaines
Dans le champ empirique des sciences humaines, et tout particulièrement en psychologie cognitive, sociale et différentielle, la quantification des profils typologiques représente une tâche analytique récurrente. Qu’il s’agisse de documenter la prévalence de certains styles d’attachement interpersonnel au sein d’une cohorte clinique, d’analyser la répartition des grands traits de personnalité issus du modèle à cinq facteurs (Big Five), ou d’examiner la distribution des profils comportementaux face à des protocoles expérimentaux d’apprentissage, le chercheur manipule continuellement des classifications qualitatives exhaustives. La communication de ces structures de données auprès de comités scientifiques ou d’audiences professionnelles requiert des représentations synthétiques capables de transmettre l’architecture globale d’un échantillon en un coup d’œil.
L’utilisation d’un diagramme de proportion peut s’avérer pertinente dans ce contexte spécifique lorsqu’il existe une asymétrie structurale majeure au sein de la distribution — par exemple pour mettre en évidence la domination écrasante d’un statut clinique face à des modalités secondaires marginales — ou lorsque l’objectif de communication consiste non pas à permettre des comparaisons numériques de haute précision décimale, mais à véhiculer la prépondérance intuitive d’un bloc par rapport à la collectivité des répondants.
Toutefois, cette utilisation impose une déontologie méthodologique sans faille. En psychologie appliquée et en psychiatrie, les biais de lecture induits par des choix graphiques contestables peuvent altérer la perception du risque épidémiologique ou déformer l’évaluation d’un pronostic thérapeutique. Le praticien et le chercheur doivent donc appréhender les diagrammes circulaires non comme un ornement esthétique superficiel, mais comme un instrument de transmission de données dont chaque pixel et chaque degré doivent être gouvernés par le souci scrupuleux de l’exactitude scientifique et de la neutralité sémiologique.
2. Configuration de l’environnement de travail et préparation des données
2.1 Installation et chargement des bibliothèques nécessaires
L’opérationnalisation technique sous R nécessite l’initialisation d’un espace de travail intégrant des extensions dédiées à l’ingénierie des données et à leur transcription graphique. Bien que l’installation autonome du paquet ggplot2 soit techniquement viable, il demeure méthodologiquement préférable d’importer l’intégralité du métapaquet tidyverse. Cette suite logicielle coordonnée assure une fluidité opérationnelle idéale entre l’étape d’importation des fichiers plats, le nettoyage vectoriel, la restructuration matricielle et l’assemblage graphique finalisé.
Parallèlement à ggplot2, l’exploitation systématique des verbes de transformation de dplyr constitue le socle algorithmique indispensable pour dériver les indicateurs de sommation et d’alignement spatial nécessaires au paramétrage des étiquettes. Dans le cadre de protocoles impliquant des restitutions complexes, l’intégration conjointe de modules complémentaires spécialisés, tels que scales pour le formatage standardisé des pourcentages ou ggrepel pour la résolution dynamique des collisions textuelles, s’impose avec force. Pour garantir une reproductibilité computationnelle absolue à travers différents systèmes d’exploitation, l’analyste veillera également à fixer les paramètres d’encodage textuel en UTF-8 et à contrôler la graine aléatoire globale lorsque des mécanismes de dispersion stochastique sont mobilisés.
L’exécution des commandes d’importation en tête de script s’effectue usuellement via l’instruction library(tidyverse) complétée par library(scales). Cette démarche unifiée charge en mémoire les fonctions essentielles de manipulation tabulaire et prépare le moteur graphique R aux routines d’affichage haute performance, neutralisant par la même occasion les conflits potentiels de masquage de fonctions entre paquets hétérogènes.
2.2 Structuration formelle du jeu de données (Data Frame)
La grammaire des graphiques impose une contrainte structurale inaliénable : les données soumises au moteur de rendu doivent impérativement adopter un format rectangulaire normalisé, désigné dans la terminologie statistique contemporaine sous le concept de « données ordonnées » ou tidy data. Au sein d’une telle structure tabulaire, chaque colonne correspond obligatoirement à une variable scientifique unique et distincte, tandis que chaque ligne matérialise une observation ou une unité d’agrégation empirique spécifique.
Lors de la manipulation d’effectifs catégoriels, deux conformations initiales peuvent se présenter à l’analyste : un tableau individuel où chaque ligne enregistre les réponses qualitatives d’un sujet expérimental déterminé, ou une matrice pré-agrégée associant directement à chaque modalité textuelle son effectif numérique absolu. Dans les deux cas, le typage strict des vecteurs représente un prérequis technique capital. Les variables textuelles décrivant les catégories qualitatives doivent être formellement converties en facteurs au sens du langage R. Cette conversion ne constitue pas un simple raffinement syntaxique : elle permet de verrouiller l’ordre hiérarchique intrinsèque des modalités grâce au vecteur ordonné des niveaux associés, empêchant ainsi le moteur graphique d’appliquer par défaut un tri alphabétique lexicographique dénué de pertinence substantive.
Une attention méticuleuse doit également être accordée au diagnostic et au traitement des valeurs manquantes. La présence de valeurs nulles ou indéterminées au sein du vecteur de comptage compromet les calculs trigonométriques d’angles cumulés. De surcroît, l’omission non contrôlée d’une modalité absente dans un sous-groupe lors d’analyses comparatives peut induire une rupture géométrique indésirable lors du tracé sectoriel.
2.3 Calcul préalable des fréquences relatives et cumuls d’angles
Bien que ggplot2 soit doté de moteurs statistiques internes capables d’effectuer des calculs d’agrégation automatique lors de l’exécution graphique, il est hautement recommandé, selon les meilleures pratiques d’ingénierie de données, de procéder à l’explicitation mathématique préalable des fréquences et des positions angulaires au sein d’une chaîne séquentielle dplyr. Cette démarche assure une traçabilité totale des étapes de calcul et prévient les comportements imprévisibles lors de la superposition d’éléments textuels ou de repères cartésiens.
L’algorithme de dérivation implique la sommation brute des effectifs, suivie de la division scalaire de chaque effectif partiel par le volume total de la cohorte afin d’obtenir la fréquence relative proportionnelle comprise rigoureusement dans l’intervalle réel fermé zéro-un. Dès lors que cette proportion est établie, le calcul des bornes cumulatives s’opère au moyen de la fonction cumsum(). Cette étape est cruciale : elle détermine les points de rupture géométrique le long de l’axe linéaire virtuel qui sera ultérieurement enroulé autour du pôle central.
Pour garantir que l’ancrage typographique des futures étiquettes textuelles coïncide rigoureusement avec le centre gravitationnel de chaque secteur de disque, il convient de dériver analytiquement le centroïde angulaire. Ce point milieu s’obtient classiquement en soustrayant à la borne cumulative supérieure de la modalité la moitié exacte de sa propre proportion relative. Ce calcul vectoriel préalable évite les approximations manuelles fastidieuses et confère au code une résilience absolue face à toute modification ultérieure du jeu de données sous-jacent.
3. Construction pas à pas d’un diagramme circulaire fondamental
3.1 Création du diagramme en barres empilées sous-jacent
L’échafaudage architectural d’un diagramme circulaire dans ggplot2 s’amorce paradoxalement par l’édification d’un diagramme en barres empilées parfaitement rectiligne au sein d’un repère bidimensionnel orthogonal conventionnel. Cette étape fondamentale repose sur la mobilisation de la fonction geom_bar() ou, plus explicitement lorsque les fréquences ont été dérivées en amont, de la fonction geom_col(), laquelle équivaut à geom_bar(stat = "identity"). La subtilité structurelle de cette phase préliminaire réside dans l’attribution d’une constante arbitraire invariable à l’esthétique d’abscisse.
En assignant une chaîne de caractères vide, une constante numérique scalaire ou une étiquette générique à l’axe des x au sein de la fonction d’association aes(x = ""), l’analyste force le système graphique à agréger l’ensemble des segments catégoriels sur une unique colonne spatiale verticale, neutralisant de fait toute dispersion latérale. Dans le même temps, la variable quantitative représentant la fréquence relative ou l’effectif brut est affectée à l’axe des ordonnées y, tandis que la variable qualitative catégorielle est assignée à l’attribut esthétique de remplissage colorimétrique fill.
Le résultat intermédiaire ainsi produit prend la forme d’un ruban segmenté unitaire, érigé le long de l’axe des ordonnées, dont la hauteur cumulée correspond à l’intégralité de l’échantillon ou à cent pour cent dans le cas de données normalisées. Cette barre empilée constitue la matrice topologique matricielle dont la déformation projective spatiale ultérieure donnera naissance à la géométrie circulaire recherchée.
3.2 Application de la transformation polaire via coord_polar
Le passage décisif du paradigme cartésien traditionnel au paradigme sectoriel s’effectue par l’adjonction de la couche de transformation non affine coord_polar(). Cette fonction altère la métrique fondamentale de projection de l’espace graphique en substituant au réseau orthonormé habituel un système orthogonal de coordonnées polaires, au sein duquel chaque point spatial est défini par un rayon de translation radiale et un angle d’azimut polaire.
L’argument opératoire fondamental de cette routine réside dans la spécification du paramètre directionnel theta = "y". Par cette instruction explicite, l’utilisateur enjoint le moteur mathématique de ggplot2 de courber l’axe linéaire vertical des ordonnées y pour le refermer sur lui-même selon une trajectoire circulaire complète fermée, tandis que l’axe des abscisses x, préalablement comprimé en une dimension d’épaisseur constante, est projeté le long de l’axe radial d’expansion vers l’extérieur. Si l’analyste omettait cet argument ou spécifiait par inadvertance theta = "x", le moteur tenterait d’enrouler l’axe transversal des catégories, produisant une série d’arcs concentriques informes de type diagramme en rayon de soleil inversé, impropre à la restitution sectorielle.
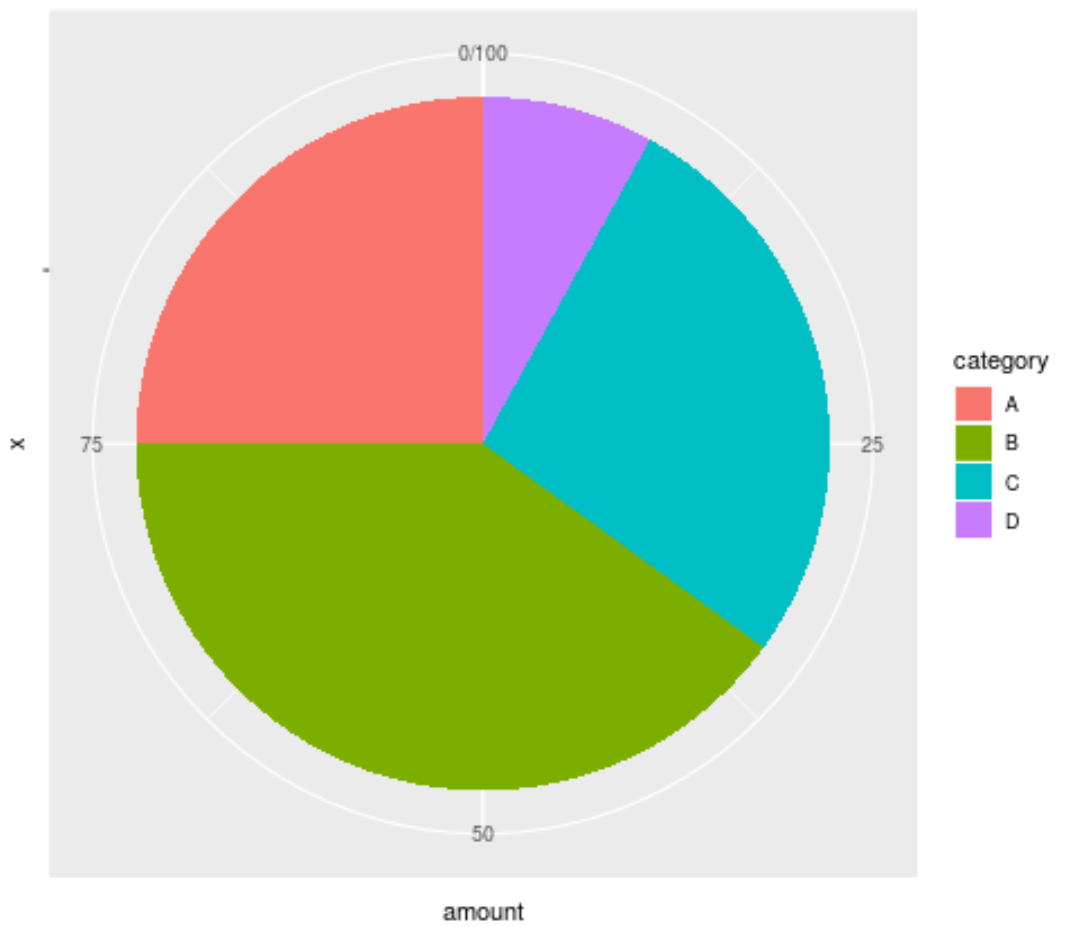
Un autre paramètre géométrique déterminant de la fonction réside dans la clause start = 0. Cette variable d’initialisation accepte une valeur scalaire exprimée en unités de radians et régit l’angle de rotation d’attaque à partir duquel le premier secteur catégoriel commence à se déployer le long du périmètre circulaire. Par défaut, la valeur zéro correspond à une orientation verticale zénithale dirigée vers le sommet du graphique, le déploiement s’opérant dans le sens trigonométrique ou horaire en fonction du paramètre de direction vectorielle interne direction = 1.
3.3 Anatomie de l’objet graphique généré
L’objet graphique résultant de cette double opération structurale présente une anatomie visuelle singulière qui trahit immédiatement sa genèse computationnelle cartésienne. À ce stade primitif du développement du script, la figure affiche un enchevêtrement composite d’éléments d’habillage graphique qui parasitent lourdement l’intelligibilité globale de l’œuvre. Le moteur graphique reproduit scrupuleusement la grille de fond grisâtre caractéristique du thème par défaut de ggplot2, superposant un réseau de cercles concentriques gris et de rayons sécants matérialisant les anciennes lignes de fuite des ordonnées et des abscisses.
De surcroît, le périmètre extérieur du disque se trouve flanqué d’étiquettes scalaires numériques indiquant les valeurs cumulatives de l’axe enroulé, créant une graduation circonférentielle d’une redondance visuelle criante. Le pourtour du graphique conserve également les titres textuels assignés par défaut aux axes géométriques, exposant une étiquette d’abscisse vide ou absurde et un intitulé d’ordonnée vertical plaqué maladroitement le long du bord gauche de la toile de projection.
Sur le flanc droit de la composition émerge la légende automatique générée par l’association esthétique de couleur. Bien que cette légende assure pour l’instant la seule clé de décodage des modalités représentées, elle impose une gymnastique oculaire permanente au récepteur, contraint de naviguer incessamment entre les tranches colorées du disque et la table de correspondance latérale. Cette configuration initiale illustre parfaitement la nécessité d’une phase de post-traitement sémiologique profond destinée à éliminer le bruit visuel inhérent à la transcription mécanique d’un système de coordonnées vers un autre.
4. Raffinement esthétique et suppression du bruit visuel
4.1 Élimination des artefacts cartésiens avec theme_void
L’élévation d’un tracé primitif au rang de figure publiable exige l’éradication totale des reliques structurales issues du repère cartésien d’origine. Dans l’arsenal stylistique de ggplot2, l’approche la plus efficace pour accomplir cette opération de décontamination graphique consiste à invoquer la fonction de thématisation globale theme_void(). Contrairement aux thèmes classiques tels que theme_minimal(), theme_light() ou theme_classic() qui conservent des éléments de démarcation linéaire ou des grilles subtiles, le thème vide applique une politique de tabula rasa absolue.
Dès son activation en fin de chaîne d’instructions, theme_void() désactive intégralement les bordures du panneau, supprime les lignes de grille primaires et secondaires, annule l’affichage des coches scalaires le long des axes et efface les textes numériques de graduation. Le disque géométrique se retrouve ainsi isolé dans sa pureté spatiale, libéré de tout carcan technique superflu.
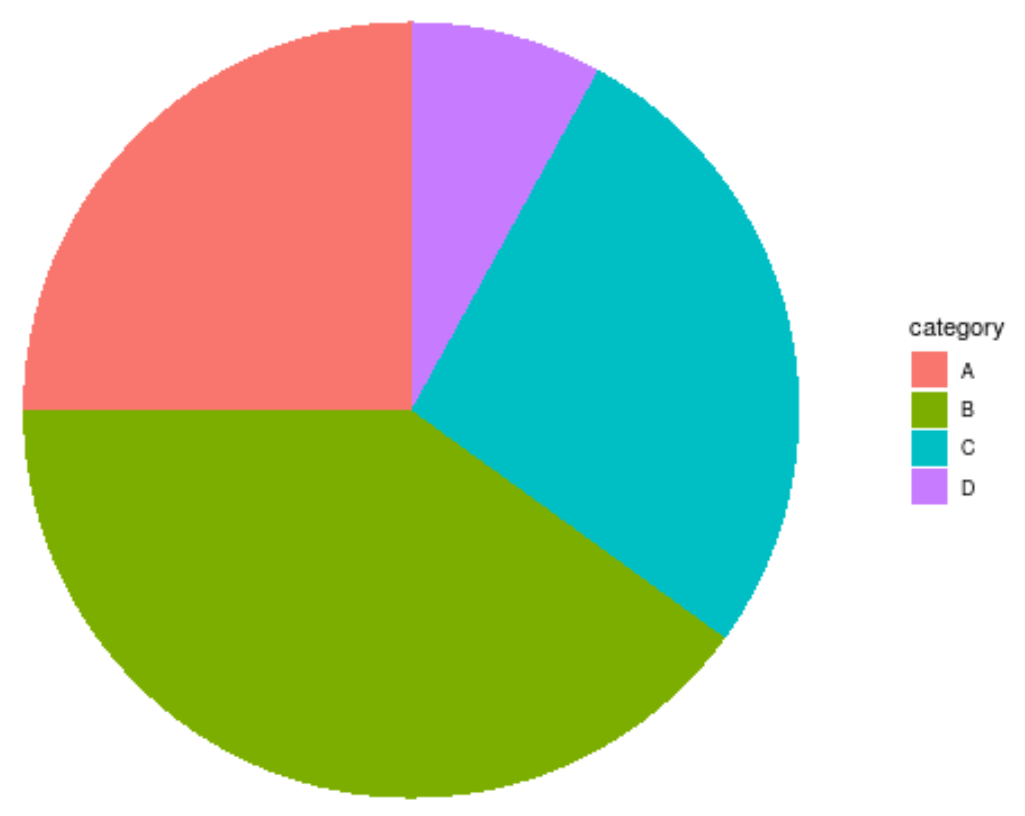
Toutefois, l’application brutale de cette commande nécessite parfois une compensation de calibrage géométrique. Dans certaines configurations d’affichage vectoriel, la suppression des contraintes d’axes peut induire des altérations du ratio d’aspect dimensionnel, conduisant à une déformation de l’ellipse spatiale si la fenêtre graphique d’exportation n’est pas rigoureusement carrée. Pour prémunir le visuel contre toute distorsion anamorphique involontaire, l’analyste averti prendra soin d’adjoindre la clause coord_polar(theta = "y") d’une spécification stricte du ratio d’aspect au sein du bloc d’ajustement du thème, ou d’encadrer l’environnement de sortie au moyen de dimensions d’exportation symétriques.
4.2 Nettoyage contextuel des libellés avec la fonction labs
Bien que la thématique vide masque l’apparence physique des axes, la gestion explicite de la métadonnée textuelle via la fonction unifiée labs() demeure un impératif de bonne pratique algorithmique. Cette étape assure une maîtrise déclarative totale sur l’ensemble des ancrages textuels susceptibles de subsister ou d’être injectés dans la structure graphique globale.
L’élimination définitive de tout vestige d’intitulé d’axe se formalise par l’assignation explicite de valeurs nulles aux attributs directionnels au moyen des clauses x = NULL et y = NULL. Par cette déclaration sans équivoque, l’analyste garantit qu’aucun espace de marge résiduel ne sera alloué inutilement à des conteneurs textuels fantômes, maximisant ainsi la surface géométrique effective dévolue au déploiement du disque de données.
Simultanément, la fonction labs() permet de structurer la hiérarchie informative de la figure en introduisant un titre principal concis mais informatif via l’argument title, un sous-titre contextualisant les paramètres de l’étude par l’argument subtitle, ainsi qu’une note méthodologique d’étayage grâce au paramètre caption. Cet espace de bas de page est particulièrement précieux en milieu académique : il permet de documenter instantanément la taille totale de l’échantillon observé, la nature des filtres de sélection appliqués ou le test d’homogénéité d’ajustement rattaché à la distribution des effectifs.
4.3 Ajustement des bordures de secteurs pour une meilleure lisibilité
L’une des limites physiologiques les plus pénalisantes du diagramme circulaire réside dans la difficulté cognitive à identifier les lignes de démarcation lorsque deux secteurs chromatiquement adjacents présentent des valeurs de luminance ou de saturation excessivement voisines. Pour résoudre ce problème d’acuité visuelle et restaurer une séparation optique nette entre les catégories, l’introduction d’un liséré périphérique de contraste s’avère indispensable.
Cette démarcation structurelle s’opère directement au niveau de la couche d’instanciation géométrique en paramétrant les attributs vectoriels color et linewidth (ou size dans les versions antérieures de ggplot2) au sein de la fonction geom_col(). L’assignation d’une teinte neutre pure — typiquement le blanc "white" pour des arrière-plans d’impression clairs, ou un gris anthracite profond dans le cadre de présentations sur fond sombre — matérialise une césure optique franche entre les différentes portions du disque.
Ce partitionnement linéaire joue un rôle perceptif déterminant dans la discrimination des secteurs d’amplitude marginale. En détourant rigoureusement chaque polygone curviligne, il permet au cortex visuel de délimiter l’angle d’attaque de chaque sommet sans que les pigments de couleur ne fusionnent optiquement par phénomène d’assimilation chromatique spatiale. L’épaisseur du tracé doit néanmoins être calibrée avec une grande sobriété : un liséré disproportionné amputerait la superficie surfacique des petits secteurs, faussant la proportion géométrique relative réellement perçue par l’observateur.
5. Intégration et positionnement précis des étiquettes de données
5.1 Calcul précis des centroïdes angulaires
L’implantation d’étiquettes alphanumériques directement au cœur des secteurs géométriques constitue l’antidote le plus efficace contre la fatigue cognitive engendrée par les légendes déportées. Cependant, l’ancrage spatial de ces descripteurs textuels exige une rigueur trigonométrique absolue afin d’éviter que le texte n’empiète sur les frontières inter-secteurs ou ne dérive de manière asymétrique vers la périphérie orbitale.
Pour déterminer le centroïde angulaire optimal de chaque modalité catégorielle, il convient d’exécuter une opération de cinématique inverse sur le vecteur ordonné des fréquences relatives. Au sein d’un pipeline d’ingénierie analytique piloté par dplyr, l’analyste procède à l’évaluation de la médiane cumulative de tranche. L’équation de dérivation s’énonce formellement comme suit : la coordonnée axiale y de placement de l’étiquette correspond à la somme cumulative des proportions des modalités précédentes, à laquelle s’additionne la stricte moitié de la proportion relative de la modalité courante.
Une complexité additionnelle survient fréquemment en raison du sens de lecture conventionnel du moteur graphique. Alors que les coordonnées linéaires cartésiennes croissent naturellement de bas en haut (de zéro vers le plafond d’accumulation), la projection polaire standard ordonne souvent les stranches dans le sens horaire à partir du zénith. Cette inversion directionnelle apparente impose de vérifier avec une minutie scrupuleuse la concordance spatiale entre le vecteur cumulé décroissant et le sens d’enroulement des polygones, sous peine d’assigner l’étiquette descriptive d’une catégorie majoritaire sur le secteur dévolu à une catégorie marginale.
5.2 Implémentation technique avec geom_text et position_stack
Une alternative élégante à la dérivation purement manuelle des coordonnées médianes repose sur l’exploitation des capacités de calcul spatial intégrées à ggplot2, orchestrées au moyen de la directive de positionnement position_stack(vjust = 0.5). Lorsqu’elle est transmise en argument au marqueur d’affichage typographique geom_text(), cette instruction ordonne au système de déterminer automatiquement la position médiane de chaque strate empilée, simplifiant considérablement l’architecture syntaxique du code source.
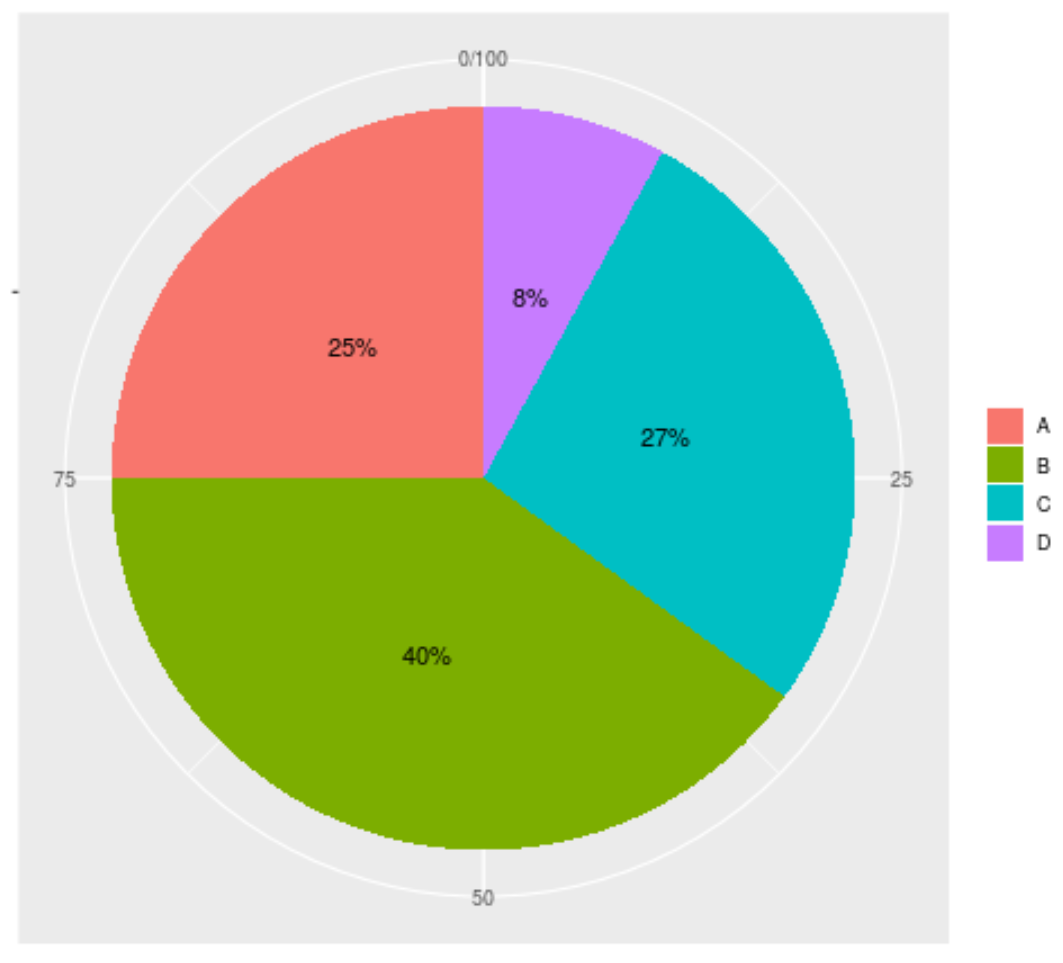
Le contenu textuel de l’étiquette doit combiner de façon synthétique la désignation catégorielle et sa valeur quantitative associée, généralement exprimée sous forme de pourcentage normalisé. La concaténation de ces informations s’effectue dynamiquement au moyen de la fonction paste0() combinée aux utilitaires de conversion du paquet scales, notamment scales::percent() qui garantit un contrôle parfait du nombre de décimales affichées et de la ponctuation typographique.
Le raffinement de cette couche typographique implique également l’ajustement méticuleux des paramètres morphologiques de la fonte de caractères. La variable size règle l’échelle du corps typographique, la commande fontface = "bold" assure une lisibilité robuste par le renforcement de la graisse des caractères, tandis que la couleur d’encrage color doit faire l’objet d’une sélection rigoureuse pour maximiser le contraste spectrophotométrique sur le fond sectoriel qui lui sert d’assise.
5.3 Résolution des chevauchements d’étiquettes dans les petits secteurs
L’écueil récurrent de l’étiquetage sectoriel réside dans le phénomène d’occlusion typographique, qui survient inéluctablement lorsque deux ou plusieurs modalités adjacentes affichent des proportions extrêmement faibles. La surface physique de ces secteurs étroits se révèle alors incapable de contenir le libellé textuel, provoquant des superpositions illisibles de glyphes qui dégradent l’intégrité sémiologique de la publication.
Pour contourner cet obstacle, deux stratégies techniques complémentaires peuvent être déployées. La première consiste à instaurer une barrière conditionnelle stricte au niveau de la génération textuelle : les étiquettes ne sont matérialisées que pour les secteurs dont la fréquence relative excède un seuil critique d’intelligibilité spatiale, arbitrairement fixé par exemple à cinq pour cent de la masse totale. Les modalités situées en deçà de ce seuil voient leur libellé masqué sur la figure principale et renvoyé systématiquement vers la note méthodologique de bas de page ou vers une table numérique annexe.
La seconde approche, d’une grande sophistication graphique, mobilise les mécanismes de répulsion algorithmique du paquet spécialisé ggrepel. Bien que ce paquet ait été originellement conçu pour des espaces cartésiens stricts, il est possible, moyennant une configuration rigoureuse des forces d’attraction et de déportation externe le long d’un rayon virtuel élargi, d’expulser les étiquettes problématiques en dehors de l’enveloppe circulaire du disque, en reliant chaque texte à son secteur d’origine par un segment vectoriel de guidage discret.
6. Gestion experte des palettes chromatiques et accessibilité
6.1 Attribution manuelle de nuances hexadécimales personnalisées
L’assignation des couleurs ne saurait être abandonnée aux routines chromatiques automatisées du logiciel, qui procèdent généralement par interpolation équidistante le long d’une roue de couleurs HSL par défaut. Ces teintes standards, outre leur banalité stylistique, présentent souvent des contrastes de luminance inadéquats pour l’édition professionnelle. L’analyste rigoureux prendra le contrôle direct de l’échelle d’encrage via l’instruction scale_fill_manual().
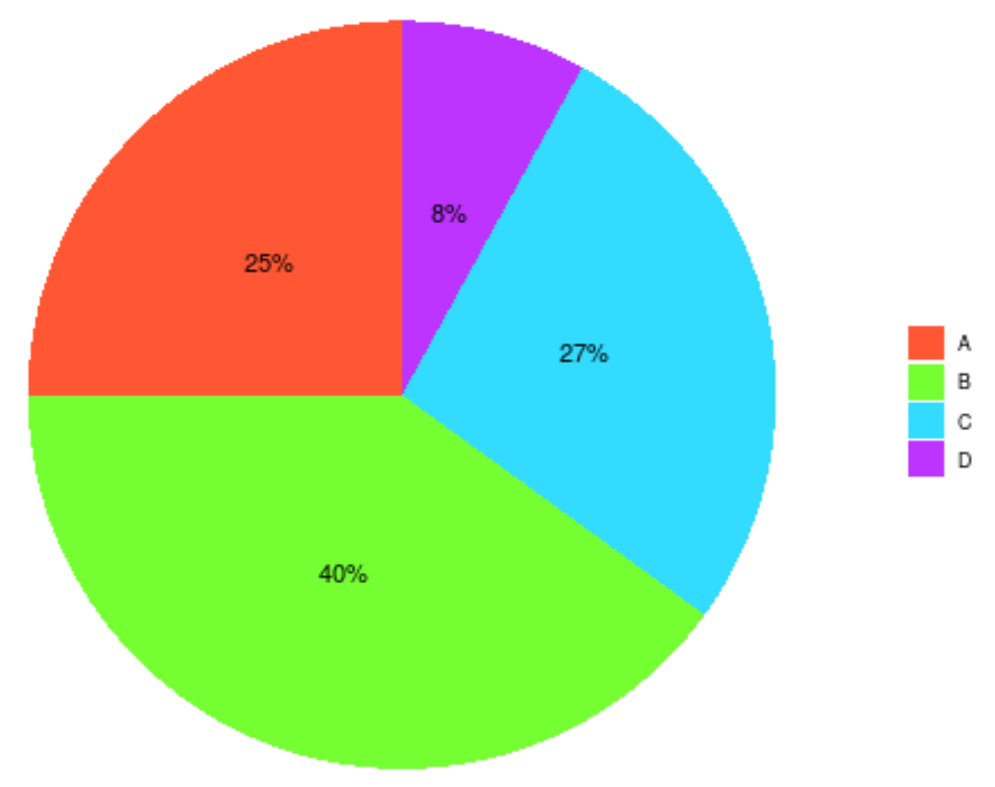
Cette fonction accepte un vecteur ordonné ou nommé de codes hexadécimaux précis garantissant une fidélité chromatique absolue. Cette démarche permet d’aligner rigoureusement la figure sur les chartes graphiques des revues académiques, des institutions universitaires ou des commanditaires institutionnels. De surcroît, l’encodage manuel de nuances spécifiques offre la possibilité de manipuler délibérément la hiérarchie visuelle : en attribuant une teinte saturée et vibrante à une modalité clinique d’intérêt majeur tout en enveloppant les catégories comparatives dans des gris colorés ou des nuances pastel désaturées, l’analyste guide instantanément la focalisation cognitive du lecteur vers le message probant de la recherche.
Il convient néanmoins de respecter une discipline compositionnelle stricte : la multiplication désordonnée de teintes primaires disparates engendre une saturation sensorielle préjudiciable à la sérénité analytique. L’harmonie générale doit reposer sur un ensemble cohérent de valeurs de luminance calibrées assurant un confort de lecture optimal sur supports imprimés comme sur écrans numériques rétroéclairés.
6.2 Adoption de palettes perceptuellement uniformes et adaptées au daltonisme
L’universalité de la diffusion scientifique impose la prise en considération impérative des déficiences de la vision des couleurs (dyschromatopsies), lesquelles affectent approximativement huit pour cent de la population masculine et près d’un demi-pour cent de la population féminine au niveau mondial, principalement sous les formes de deutéranopie et de protanopie.
Pour prévenir toute perte d’intelligibilité auprès de ces lecteurs, l’intégration des échelles établies par Cynthia Brewer via la fonction scale_fill_brewer() s’avère hautement recommandée. Les palettes qualitatives spécifiquement éprouvées pour la distinction catégorielle, telles que Set2 ou Dark2, ont été construites pour maximiser la séparabilité géométrique des couleurs au sein de l’espace tridimensionnel de la vision humaine.
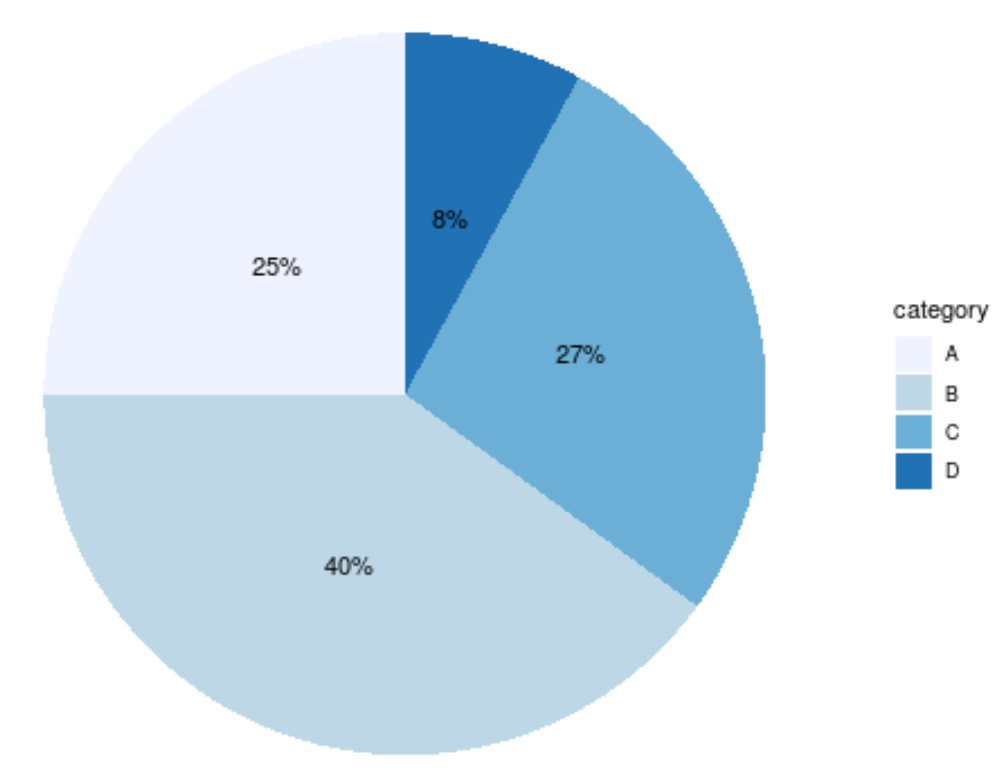
Dans cette même perspective d’accessibilité universelle, les échelles développées sous l’égide de la bibliothèque Viridis (accessibles via scale_fill_viridis_d() pour les variables discrètes) représentent une référence contemporaine absolue. Ces palettes présentent la particularité mathématique d’être rigoureusement perceptuellement uniformes : la progression de la clarté relative le long de la série de couleurs demeure strictement monotone et linéaire, y compris lorsqu’elle est convertie intégralement en niveaux de gris purs lors d’impressions monochromes économiques ou appréhendée par des observateurs présentant une insensibilité totale aux longueurs d’onde moyennes.
6.3 Équilibre sémiotique et neutralité affective des couleurs
En psychologie et en sciences du comportement, la couleur ne constitue pas un simple support de différenciation optique ; elle véhicule une charge sémiotique et émotionnelle implicite susceptible de biaiser l’interprétation des données. L’attribution inconsciente ou maladroite de teintes à forte connotation affective peut induire des jugements de valeur prématurés chez le lecteur.
Ainsi, colorer systématiquement une modalité associée à une psychopathologie en rouge vif tout en affichant un profil adaptatif en vert tendre introduit une polarisation axiologique (« mauvais » contre « bon ») qui excède la stricte neutralité de la description scientifique. De telles pratiques sont à proscrire formellement dans le cadre de comptes rendus de recherche objectifs. Il convient de privilégier des palettes douces, composées d’ocres, de bleus ardoisés, de vert sauge ou de pourpres atténués, qui préservent la dignité du sujet d’étude et invitent à une analyse dépassionnée des effectifs empiriques.
En outre, lorsque plusieurs figures comparatives se succèdent au fil d’un même article scientifique, la persistance rigoureuse des assignations de couleurs s’impose comme une obligation méthodologique absolue. Une modalité conceptuelle identique apparaissant dans trois figures distinctes doit impérativement conserver le même code hexadécimal à travers l’ensemble du manuscrit, sous peine de plonger le lecteur dans une confusion cognitive permanente.
7. Transformation en diagramme en anneau (Donut Chart)
7.1 Théorie géométrique du diagramme en anneau
Le diagramme en anneau, fréquemment désigné dans la littérature anglophone sous l’appellation de donut chart, constitue une variation topologique du diagramme circulaire standard, obtenue par l’évidement substantiel de sa zone centrale. D’un point de vue morphologique, cette transformation substitue au disque plein un tore plan délimité par deux circonférences concentriques de rayons inégaux.
Sur le plan de la psychophysique de la perception visuelle, cette altération structurelle engendre une modification profonde de la tâche de décodage imposée à l’observateur. En éliminant le sommet angulaire central où convergent l’ensemble des pointes sectorielles, l’anneau supprime délibérément l’indice de lecture fondé sur l’angle au centre. L’attention perceptive du lecteur se trouve ainsi réorientée exclusivement vers deux dimensions géométriques alternatives : la longueur de l’arc périphérique externe et la superficie relative de chaque segment torique.
Bien que certains théoriciens de la visualisation minimale critiquent cette forme pour sa double courbure, de nombreuses études ergonomiques suggèrent que les jugements de proportions basés sur la longueur relative d’arcs circulaires périphériques présentent une précision statistique parfaitement comparable, voire légèrement supérieure dans certaines conditions d’affichage, à l’estimation intuitive d’angles au centre fermés. L’anneau offre en outre l’avantage sémiologique d’atténuer la focalisation excessive sur le point focal central, souvent perçu comme oppressant dans les disques denses.
7.2 Mise en œuvre algorithmique dans ggplot2
La transcription informatique d’un diagramme en anneau dans le cadre déclaratif de ggplot2 constitue une démonstration éclatante de la modularité de la grammaire des graphiques. Ne disposant d’aucune primitive géométrique dédiée, le moteur permet néanmoins d’atteindre cette forme par une manipulation élémentaire de l’axe radial d’abscisse avant l’enroulement polaire.
La procédure technique se déploie en calibrant l’argument dimensionnel width au sein de geom_col() et en définissant explicitement les bornes limites de l’axe des abscisses au moyen de l’instruction xlim(). En attribuant à la barre empilée cartésienne une position numérique décalée par rapport à l’origine (par exemple en assignant x = 2) et en élargissant le domaine scalaire de l’axe au travers de la clause xlim(0.5, 2.5), l’analyste crée un vide artificiel entre l’origine cartésienne zéro et la base intérieure de la barre empilée.
Lorsque la fonction coord_polar(theta = "y") est superposée à cette structure décalée, l’intervalle spatial vide situé entre l’abscisse zéro et la base de la barre se trouve déployé radialement autour du pôle, engendrant un espace d’exclusion circulaire parfait au centre de la figure. L’épaisseur relative du tore graphique se régule ensuite avec une précision chirurgicale en ajustant simplement le ratio numérique entre la largeur de barre et l’intervalle défini dans xlim().
7.3 Exploitation de l’espace central vide
Le principal atout ergonomique du diagramme en anneau réside dans la libération d’une surface graphique centrale hautement stratégique. Dans un diagramme circulaire conventionnel, le point central est surchargé de sommets géométriques concourants interdisant toute inscription typographique. À l’inverse, l’évidement central de l’anneau offre un sanctuaire textuel idéal pour accueillir des descripteurs synthétiques de haut niveau.
L’exploitation de cette niche spatiale s’opère couramment au moyen de la fonction d’annotation textuelle directe annotate(). Cette commande permet d’implanter au barycentre absolu de la figure (aux coordonnées x = 0 au sein du système polaire interne) des métriques globales capitales, telles que l’effectif global total de l’échantillon empirique (N = …), la valeur d’une proportion cible emblématique, ou un indicateur de tendance globale.
Cette disposition compositionnelle enrichit considérablement la portée analytique du document : le lecteur accède simultanément, dans un même champ visuel unifié, à la distribution proportionnelle fine des composantes qualitatives périphériques et à la masse globale de l’échantillon étudié. La mise en page typographique centrale doit toutefois préserver une zone d’aération suffisante par rapport au périmètre interne de l’anneau afin de ne pas reconstituer une congestion graphique au sein de la figure.
8. Contrôle de l’ordre d’affichage, tri et gestion des catégories résiduelles
8.1 Ordonnancement logique et hiérarchique des modalités
La lisibilité d’un graphique sectoriel dépend de façon critique de la séquence séquentielle selon laquelle les tranches se succèdent sur la circonférence. L’affichage d’une distribution catégorielle selon un ordre alphabétique fortuit constitue l’une des erreurs méthodologiques les plus destructrices en matière de restitution statistique. Le lecteur se trouve alors contraint d’effectuer des comparaisons spatiales désordonnées pour repérer les catégories dominantes.
L’optimisation de cette disposition exige une restructuration préalable rigoureuse des niveaux du facteur représentant la variable qualitative. L’écosystème forcats fournit des outils algorithmiques particulièrement puissants pour automatiser cette réorganisation. La fonction fct_reorder() permet d’ordonner les niveaux de la variable catégorielle en fonction directe de sa fréquence d’apparition empirique, assurant un alignement strictement décroissant des proportions.
En couplant ce tri hiérarchique avec le paramétrage judicieux de l’angle initial start = 0 dans la routine coord_polar(), l’analyste contraint la modalité quantitativement la plus importante à s’ancrer précisément au zénith du tracé (position « midi » sur un cadran horaire conventionnel). Les segments subséquents se déploient ensuite de manière fluide par ordre d’importance décroissante, offrant au regard une trajectoire d’exploration logique et sans heurt cognitif.
8.2 Agrégation des catégories marginales sous une modalité commune
L’un des pièges récurrents dans le traitement de variables qualitatives à large spectre réside dans l’émiettement excessif du disque en une multitude de micro-secteurs. Dès lors qu’une distribution comporte plus de six ou sept modalités distinctes, le diagramme circulaire perd toute efficacité communicative : les tranches marginales deviennent indiscernables et leurs étiquettes respectives entrent en collision inéluctable.
Pour remédier à cette dispersion, la solution technique consiste à procéder à une réduction dimensionnelle sélective au moyen de la fonction fct_lump_n() ou fct_lump_prop() issue du paquet forcats. Cette procédure agrège automatiquement l’ensemble des catégories les moins fréquentes au sein d’une méta-modalité synthétique désignée par convention sous le terme générique « Autres » ou « Catégories résiduelles ».
Sur le plan sémiologique, cette tranche composite doit impérativement faire l’objet d’un traitement chromatique spécifique. Ne représentant pas une entité ontologique homogène mais un agrégat de sous-ensembles hétéroclites, elle doit être systématiquement reléguée à la fin de la séquence ordonnée et revêtue d’une nuance chromatiquement neutre, typiquement un gris moyen désaturé. Cette convention graphique avertit visuellement l’observateur du caractère résiduel de la catégorie, évitant que son volume d’ensemble ne soit confondu avec une classe comportementale unifiée.
8.3 Gestion des typologies dichotomiques et ordonnées
Les données collectées en sciences humaines ne relèvent pas toutes de classifications nominales pures. Une proportion considérable de protocoles expérimentaux génère des distributions dichotomiques binaires (présence/absence d’un symptôme, réussite/échec à une tâche) ou des variables polytomiques ordonnées issues d’instruments d’évaluation psychométrique tels que les échelles de Likert.
Dans le cas spécifique des structures dichotomiques pures, le recours au diagramme circulaire s’avère particulièrement intuitif : la bipartition spatiale du disque traduit parfaitement la dualité de l’espace d’échantillonnage. L’attention graphique doit alors se concentrer sur l’établissement d’un contraste franc entre les deux segments, par exemple en opposant une nuance pleine et saturée à un fond neutre ou légèrement tramé.
Pour les variables qualitatives ordinales, la hiérarchie naturelle des modalités doit impérativement supplanter le tri par fréquence d’apparition. Si l’on représente une échelle d’évaluation comportant les échelons « Faible », « Modéré », « Élevé » et « Sévère », il serait méthodologiquement absurde de réorganiser ces paliers par volume quantitatif décroissant. La séquence spatiale circonférentielle doit impérativement respecter la continuité progressive de l’échelle d’intensité sous-jacente. Cette progression sera avantageusement soulignée par un gradient chromatique séquentiel monotone, où l’amplification de la saturation colorimétrique traduit l’élévation graduelle du niveau de la variable mesurée.
9. Comparaisons multi-groupes et facettage avec facet_wrap
9.1 Génération de sous-graphiques sériels proportionnels
L’analyse des distributions catégorielles gagne considérablement en profondeur lorsqu’elle est contextualisée à travers plusieurs sous-populations expérimentales. Qu’il s’agisse de comparer les structures typologiques entre genres, entre tranches d’âge ou entre bras d’intervention clinique au sein d’un essai randomisé, la mise en vis-à-vis de graphiques circulaires permet d’apprécier les distorsions distributionnelles intergroupes.
Au sein de l’environnement ggplot2, cette multiplication modulaire s’exécute de manière élégante via la fonction de facettage sériel facet_wrap() ou facet_grid(). En introduisant une directive telle que facet_wrap(~ groupe_traitement), le moteur décline la figure de base en une série ordonnée de petits sous-graphiques homogènes (couramment désignés dans la théorie graphique sous le concept de small multiples de Tufte).
Cette architecture en série présente l’immense avantage de mutualiser l’ensemble des attributs esthétiques, évitant ainsi les fastidieuses répétitions de légendes. Une clé colorimétrique unique et coordonnée régit l’intégralité des panneaux, libérant l’espace visuel au profit de la comparaison immédiate des proportions sectorielles entre les différents horizons expérimentaux.
9.2 Défis géométriques liés au facettage en coordonnées polaires
L’hybridation des coordonnées polaires avec les algorithmes de facettage matriciel soulève néanmoins des défis de calibrage géométrique spécifiques. Contrairement aux graphiques cartésiens où les échelles d’axes peuvent être libérées et ajustées dynamiquement pour chaque panneau, l’application de coord_polar() impose des contraintes structurales rigides qui ne tolèrent pas de libération dimensionnelle asymétrique.
Un soin tout particulier doit être accordé à la régulation des espacements inter-panneaux au sein des directives de thématisation, spécifiquement via le paramètre panel.spacing = unit(..., "lines"). En l’absence de marges de dégagement suffisantes, les cercles adjacents peuvent sembler s’écraser mutuellement, générant une impression de congestion graphique désagréable pour le regard.
De surcroît, le formatage des bandeaux d’identification textuelle surmontant chaque facette (gouverné par l’élément stylistique strip.text) doit faire l’objet d’une personnalisation minutieuse. Le corps typographique de ces en-têtes doit être suffisamment affirmé pour distinguer sans ambiguïté les sous-populations étudiées, tout en évitant d’empiéter verticalement sur le périmètre sommital des disques sectoriels sous-jacents.
9.3 Optimisation de la densité d’information par page
La prolifération non régulée de diagrammes circulaires au sein d’une grille de facettage expose l’analyste à un risque majeur de surcharge cognitive. L’estimation comparée de superficies et d’angles à travers plusieurs disques concurrents représente une charge mentale particulièrement lourde pour le cerveau humain, qui peine à mémoriser les écarts d’inclinaison d’un panneau à l’autre.
Il est donc méthodologiquement impératif de circonscrire l’usage du facettage polaire à un volume restreint de sous-groupes, idéalement compris entre deux et quatre panneaux distincts. Au-delà de ce seuil empirique, la résolution spatiale de chaque disque individuel se trouve excessivement compressée par les contraintes d’affichage dimensionnel de la page, rendant la discrimination des tranches marginales quasiment impossible.
Lorsque le protocole de recherche exige impérativement la comparaison simultanée d’un grand nombre de cohortes (par exemple dix ou quinze centres hospitaliers distincts), il convient de renoncer formellement à la multiplication des disques circulaires au profit d’un diagramme en barres empilées normalisées à cent pour cent ou, mieux encore, d’un tableau d’effectifs synthétique intégrant des indicateurs visuels intégrés de type micro-barres.
10. Exemples pratiques appliqués aux données psychologiques
10.1 Exemple 1 : Répartition des profils d’attachement chez de jeunes adultes
Pour illustrer concrètement la mise en œuvre de ces préceptes méthodologiques au sein de la discipline psychologique, considérons une première investigation empirique portant sur la distribution des styles d’attachement interpersonnel chez une cohorte de trois cent cinquante étudiants universitaires, mesurés à l’aide d’un questionnaire standardisé selon la typologie quadripartite classique : Sécure, Anxieux-préoccupé, Évitant-dégagé et Désorganisé-craintif.
L’implémentation débute par la construction d’un tableau synthétique sous dplyr, dans lequel les effectifs bruts sont convertis en fréquences relatives normalisées. Le typage strict de la variable qualitative est garanti par la commande factor(), dont les niveaux sont ordonnés de manière descendante selon le poids démographique de chaque profil : le style sécure, largement prépondérant au sein de la cohorte avec près de cinquante-cinq pour cent des effectifs, est positionné en tête de liste, suivi des profils évitant, anxieux et enfin désorganisé.
Le script ggplot2 mobilise une chaîne associant geom_col(width = 1, color = "white", linewidth = 0.8) et coord_polar(theta = "y", start = 0). L’application d’une palette manuelle sélectionne quatre nuances de bleu et de gris-vert issues d’un nuancier académique sobre. L’intégration des pourcentages s’effectue via geom_text() avec une directive position_stack(vjust = 0.5), assurant une incrustation des étiquettes au centre gravitationnel de chaque part. L’extinction du bruit cartésien par theme_void() et l’adjonction d’un titre formel conforme aux exigences de diffusion complètent le graphique, produisant une figure limpide qui communique instantanément la prédominance structurelle du profil d’attachement sécurisé.
10.2 Exemple 2 : Typologie des stratégies d’adaptation face au stress (Coping)
Une seconde application expérimentale s’intéresse aux modalités d’ajustement comportemental face à un stresseur aigu au sein d’une unité de soins intensifs hospitalière. Les stratégies de coping déployées par un échantillon de cent vingt soignants ont été colligées selon cinq taxonomies distinctes : Résolution active de problèmes, Recherche de soutien social, Réévaluation cognitive positive, Évitement comportemental et Distraction cognitive.
Dans ce contexte où l’effectif total présente une valeur clinique fondamentale, la conversion de la représentation vers un diagramme en anneau s’avère particulièrement pertinente. Le pipeline R initialise la construction en assignant la coordonnée x = 2 au sein de aes() et en verrouillant les limites dimensionnelles de l’abscisse via la commande xlim(0.5, 2.5), ce qui engendre un évidement central parfaitement calibré lors de la projection par coord_polar(theta = "y").
La zone d’exclusion centrale accueille deux lignes de texte typographique superposées, injectées au moyen d’instructions annotate() jumelées : la mention textuelle « Échantillon » surmontant l’inscription numérique « N = 120 ». Les secteurs de l’anneau sont revêtus d’une palette séquentielle Viridis pour garantir une différenciation accessible aux praticiens dyschromates. Les pourcentages calculés en amont sont positionnés à l’intérieur de l’anneau, tandis que les libellés textuels complets sont ordonnés dans une légende latérale soigneusement épurée, offrant une synthèse clinique d’une grande valeur pédagogique lors des réunions d’évaluation institutionnelle.
10.3 Exemple 3 : Distribution des scores de satisfaction thérapeutique post-intervention
Le troisième scénario empirique explore les résultats d’une évaluation standardisée de l’efficacité d’un protocole de remédiation cognitive pour patients cérébro-lésés. L’investigation repose sur un plan quasi-expérimental comparant un groupe soumis au programme innovant à un groupe témoin ayant bénéficié d’une prise en charge conventionnelle, la mesure de satisfaction post-thérapeutique s’exprimant sur une échelle polytomique à trois niveaux : « Insatisfait », « Modérément satisfait » et « Pleinement satisfait ».
Le traitement des données implique ici la génération sérielle de deux sous-graphiques à l’aide de la directive facet_wrap(~ Condition). La variable ordinale de satisfaction conserve rigoureusement son ordonnancement sous-jacent, proscrivant tout reclassement par volume quantitatif. Une palette divergente douce est appliquée à l’aide de scale_fill_manual(), attribuant une teinte ocre pâle à l’insatisfaction, un gris clair à la satisfaction modérée et un vert d’eau profond à la pleine satisfaction thérapeutique.
Cette mise en scène facettée met en lumière un contraste saisissant : alors que le disque du groupe témoin expose un morcellement presque égalitaire de ses tranches, le cercle du groupe expérimental présente une écrasante majorité visuelle dévolue à la pleine satisfaction. L’alignement standardisé des deux figures au sein de la même grille bidimensionnelle offre aux cliniciens et aux évaluateurs de santé publique une perception immédiate du bénéfice relationnel et clinique induit par le nouveau protocole d’intervention.
11. Exportation haute résolution et intégration dans des rapports scientifiques
11.1 Utilisation experte de ggsave pour les formats vectoriels et matriciels
L’aboutissement du processus graphique réside dans la phase d’encodage et d’exportation vers des formats de fichiers physiques exploitables par les logiciels de traitement de texte et les presses universitaires. L’utilitaire standardisé de l’écosystème ggplot2 pour accomplir cette tâche est la fonction ggsave(), dont la maîtrise technique conditionne la qualité visuelle finale des manuscrits scientifiques.
Pour les publications académiques de premier ordre, l’exportation vectorielle doit être systématiquement privilégiée. En ciblant des formats tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics), l’analyste préserve la nature mathématique des primitives graphiques : les arcs de cercle, les tracés de texte et les séparations linéaires demeurent des équations paramétriques indépendantes de la résolution d’affichage. Cette approche garantit une netteté absolue et une absence totale de pixellisation, quelle que soit la puissance de grossissement appliquée par le comité de lecture ou le système d’impression lithographique.
Lorsque des contraintes éditoriales spécifiques imposent la restitution d’images matricielles ou bitmap (typiquement sous format PNG ou TIFF), le paramétrage explicite de la résolution spatiale via l’argument dpi (points par pouce) devient impératif. Les normes de l’édition scientifique exigent invariablement une résolution minimale de trois cents points par pouce pour les figures en tons continus, et de six cents, voire douze cents points par pouce pour les tracés au trait comprenant des libellés textuels fins, assurant une reproduction fidèle exempte de flou chromatique sur papier glacé.
11.2 Intégration dans des environnements R Markdown et Quarto
L’essor contemporain des paradigmes de recherche reproductible a largement généralisé la rédaction directe des articles scientifiques au sein d’environnements computationnels intégrés tels que R Markdown et Quarto. Ces technologies abolissent la frontière ancestrale entre le code d’analyse statistique, la production graphique et la rédaction narrative en compilant dynamiquement l’intégralité du document à partir du script source originel.
Au sein d’un bloc de code (ou chunk) Quarto ou R Markdown, la restitution d’un diagramme circulaire requiert une configuration rigoureuse des métadonnées d’en-tête de bloc. Les paramètres dimensionnels fig.width et fig.height doivent être impérativement déclarés avec des valeurs rigoureusement identiques (par exemple six pouces par six pouces) afin de préserver le ratio d’aspect strictement unitaire imposé par la symétrie circulaire de la figure. Tout écart dimensionnel entre la largeur et la hauteur allouées induirait un étirement non contrôlé du canvas lors de la compilation finale vers des formats de sortie tels que LaTeX ou HTML5.
En outre, l’optimisation de l’alignement spatial s’opère au moyen de la directive fig.align = 'center', tandis que la prise en charge des polices vectorielles compatibles avec l’environnement typographique de l’ouvrage s’assure par l’activation de pilotes graphiques avancés tels que cairo_pdf ou ragg_png. Cette rigueur dans la chaîne de compilation garantit que les glyphes typographiques du graphique adoptent exactement la même métrique morphologique que le corps de texte du manuscrit global.
11.3 Conformité avec les normes éditoriales académiques (style APA)
Les publications en sciences psychologiques et comportementales sont presque universellement soumises au respect scrupuleux des normes édictées dans le manuel de publication de l’American Psychological Association (septième édition). Le style APA encadre de manière extrêmement détaillée la typographie, l’ancrage et la formulation des figures scientifiques.
Selon ces prescriptions réglementaires, aucun titre graphique ne doit être incorporé directement à l’intérieur du canvas visuel généré par R. La figure doit être restituée dans sa nudité structurale, le numéro de la figure (par exemple Figure 1, imprimé en caractères gras) figurant au-dessus du graphique, aligné à gauche. Il est immédiatement suivi, à la ligne suivante, par un titre descriptif synthétique composé en italique (par exemple Répartition proportionnelle des styles d’attachement au sein de la cohorte étudiée).
Sous la figure s’insère obligatoirement une légende explicative formelle précédée de la mention Note. en italique. Cet espace méthodologique doit définir de manière exhaustive l’ensemble des abréviations mobilisées, expliciter la signification des liserés ou des nuances chromatiques, et préciser formellement l’effectif global observé (ex. : N = 350). Les appels de figure au sein du texte courant doivent être parfaitement intégrés d’un point de vue discursif, le chercheur devant proscrire les formules passives isolées au profit de phrases analytiques explicites orientant le lecteur vers la réalité statistique matérialisée par le graphique.
12. Évaluation critique du diagramme circulaire et alternatives recommandées
12.1 Limites perceptuelles et cognitives inhérentes au camembert
Au terme de cette exploration technique détaillée, une réflexion épistémologique et ergonomique approfondie s’impose quant à l’opportunité méthodologique de mobiliser le diagramme circulaire dans le cadre de la recherche scientifique rigoureuse. Malgré sa popularité indéfectible auprès des médias de vulgarisation et du monde de l’entreprise, cette forme graphique fait l’objet de réserves sévères, quasi unanimes, de la part des théoriciens de la visualisation de données de réputation internationale, à commencer par Edward Tufte ou Stephen Few.
La critique centrale repose sur l’incapacité physiologique notoire du cortex visuel des primates à estimer avec précision les grandeurs physiques angulaires et les aires bidimensionnelles irrégulières. Lorsque deux secteurs sectoriels adjacents présentent des pourcentages proches — par exemple vingt-sept pour cent et vingt-trois pour cent —, l’œil humain est intrinsèquement incapable de discerner avec certitude lequel des deux secteurs est prépondérant sans devoir s’en remettre à la lecture du chiffre imprimé sur l’étiquette textuelle. Le support graphique échoue ainsi dans sa mission première, qui consiste à transmettre une information quantitative instantanée par la seule voie visuelle pré-attentive.
De surcroît, le diagramme circulaire présente un ratio données/encre particulièrement médiocre. Une immense quantité de pigments ou de pixels est mobilisée pour représenter un nombre infime de valeurs scalaires discrètes. Dès que la distribution dépasse cinq catégories, l’encombrement spatial devient insoutenable et la géométrie des tranches s’altère au détriment de l’analyse, justifiant que l’on envisage systématiquement des géométries alternatives plus efficaces.
12.2 Alternatives méthodologiques supérieures : diagrammes en barres et points
Dans l’écrasante majorité des configurations empiriques, le recours à un diagramme en barres horizontales ordonnées, programmé au moyen de la fonction geom_col(), constitue une alternative méthodologiquement et cognitivement immensément supérieure au diagramme circulaire. Dans un tel agencement, l’ensemble des modalités catégoriel s’aligne le long d’un axe vertical de référence commun, tandis que les grandeurs quantitatives s’expriment par la longueur linéaire des barres projetées sur une échelle horizontale partagée.
Ce format sollicite la tâche cognitive élémentaire classée au sommet absolu de la hiérarchie perceptive de Cleveland et McGill : le jugement de position le long d’une échelle alignée identique. L’observateur est capable d’identifier un écart de deux pour cent entre deux modalités en une fraction de seconde, avec un taux d’erreur presque nul. De plus, l’orientation horizontale des barres offre un espace typographique latéral infini pour insérer des libellés textuels descriptifs longs sans aucune contrainte de chevauchement, éliminant de facto le recours aux légendes déportées.
Une variante encore plus sobre et élégante réside dans le tracé de Cleveland ou lollipop chart, qui remplace le rectangle plein de la barre par une tige linéaire fine terminée par un point focal d’ancrage quantitatif généré via geom_point(). Cette géométrie allège drastiquement la charge graphique de la figure tout en maximisant la précision de lecture au niveau de la coordonnée terminale. Enfin, pour les restitutions tabulaires denses impliquant des analyses multicritères croisées, la conception de tableaux numériques structurés intégrant des micro-barres graphiques directes (sparklines) surpasse incomparablement la prolifération de camemberts miniatures dispersés.
12.3 Arbre de décision empirique pour le chercheur en sciences sociales
Afin de guider rationnellement le chercheur en sciences sociales et humaines face à ce choix de représentation sémiologique, nous proposons un arbre de décision méthodologique fondé sur les caractéristiques intrinsèques des variables à restituer. Cet algorithme décisionnel repose sur des critères d’admissibilité stricts destinés à préserver l’intégrité cognitive du message scientifique.
La première condition d’arbitrage concerne l’exhaustivité de la somme proportionnelle : la somme arithmétique de l’ensemble des fréquences relatives équivaut-elle de manière inaliénable à exactement cent pour cent de l’échantillon observé ? Si la réponse est négative — notamment dans les cas de questions à choix multiples ou d’indicateurs de prévalence cumulatifs non mutuellement exclusifs —, le diagramme circulaire doit être formellement rejeté d’emblée au profit de barres disjointes indépendantes.
La seconde condition concerne la cardinalité du répertoire des modalités : la variable qualitative comporte-t-elle strictement entre deux et au grand maximum quatre catégories divergentes ? Si la distribution excède quatre composantes, l’emploi du camembert est formellement déconseillé en raison de l’émiettement inévitable des secteurs et des risques d’occlusion typographique. Dans cette situation, le diagramme en barres ordonnées s’impose comme l’unique standard acceptable.
La troisième condition interroge la finalité substantive de la restitution : l’objectif prioritaire réside-t-il dans la mise en exergue spectaculaire d’une asymétrie monumentale au sein d’un tout unitaire (par exemple la marginalisation extrême d’un sous-groupe unique représentant quatre-vingt-quinze pour cent de la masse empirique) ? Si et seulement si l’ensemble de ces trois conditions cumulatives est validé, l’analyste peut légitimement mobiliser un diagramme circulaire ou un diagramme en anneau dans ggplot2, en veillant scrupuleusement à appliquer l’ensemble des raffinements esthétiques, typographiques et chromatiques détaillés tout au long de cet ouvrage afin de servir au mieux la vérité et la clarté de la démonstration scientifique.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars. https://monoskop.org/File:Bertin_Jacques_Semiologie_Graphique.pdf
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Few, S. (2007). Save the pies for dessert. Visual Business Intelligence Newsletter, 2007(8), 1–14. http://www.perceptualedge.com/articles/visual_business_intelligence/save_the_pies_for_dessert.pdf
- Harrower, M., & Brewer, C. A. (2003). ColorBrewer.org: An online tool for selecting colour schemes for maps. The Cartographic Journal, 40(1), 27–37. https://doi.org/10.1179/000870403235002042
- Playfair, W. (1801). The statistical breviary; shewing, on a principle entirely new, the resources of every state and kingdom in Europe. T. Bensley.
- Spence, I. (2005). No humble pie: The origins and usage of a statistical chart. Journal of Educational and Behavioral Statistics, 30(4), 353–368. https://doi.org/10.3102/10769986030004353
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2e éd.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0