
Dans le champ contemporain de l’ingénierie logicielle et de la science des données, l’interopérabilité des systèmes repose fondamentalement sur la sérialisation et la désérialisation textuelle des structures informationnelles. Parmi les protocoles de fait régissant les architectures distribuées, les interfaces de programmation applicative et le stockage de données hétérogènes, la notation d’objets JavaScript s’impose comme une norme prépondérante. Cependant, la transition entre une représentation textuelle brute et une structure de données en mémoire vive expose régulièrement les praticiens à des ruptures d’exécution abruptes. Parmi ces écueils, l’exception formellement désignée sous le libellé ValueError: Trailing data constitue une anomalie particulièrement révélatrice des tensions existant entre la spécification formelle d’un format et l’interprétation pragmatique des flux de données continus.
Cette exception se manifeste avec une acuité singulière au sein des écosystèmes analytiques fondés sur le langage Python, et plus spécifiquement lors de la manipulation de corpus volumineux à l’aide de la bibliothèque Pandas ou du module natif d’analyse syntaxique. Loin de représenter une simple coquille syntaxique élémentaire, ce dysfonctionnement signale un désaccord profond entre le modèle conceptuel du parseur — qui postule l’existence d’une entité sémantique close et unique — et la réalité topologique du document source, lequel agrège fréquemment des entités multiples juxtaposées. L’incompréhension de cette dichotomie conduit fréquemment à des diagnostics erronés, orientant le développeur vers des tentatives infructueuses de correction de son code algorithmique alors même que la défaillance réside dans le protocole d’ingestion sous-jacent.
L’ambition de ce traité exhaustif est d’élucider avec une rigueur académique et méthodologique les fondements épistémologiques, mécanistiques et syntaxiques de l’erreur Trailing data. En décomposant les couches d’abstraction successives qui séparent l’octet brut stocké sur disque de la matrice bidimensionnelle de calcul, nous établirons une taxonomie complète des causes déclenchantes, des dérives de spécification du protocole RFC 8259 jusqu’aux subtilités du format JSON Lines. À travers un parcours analytique jalonné de solutions canoniques, d’architectures résilientes et de protocoles de validation formelle, cet article fournit aux ingénieurs et chercheurs les outils cognitifs et techniques nécessaires pour maîtriser l’intégrité de leurs flux d’ingestion de données.
1. Introduction épistémologique et anatomie de l’erreur ValueError: Trailing data
1.1 Définition formelle et taxonomie de l’exception
Au sein de la taxonomie des exceptions intégrées au langage Python, l’exception ValueError occupe une position sémantique intermédiaire fondamentale. Héritant directement de la classe fondamentale Exception, elle est formellement invoquée lorsqu’une fonction ou un opérateur reçoit un argument possédant le type attendu mais caractérisé par une valeur inappropriée ou incohérente avec le domaine de définition de l’opération. Dans le cadre précis de la désérialisation textuelle, la survenue du qualificatif contextuel Trailing data — traduisible par données résiduelles ou données traînantes — précise que l’algorithme d’analyse lexicale a consommé avec succès un fragment syntaxiquement valide, mais a constaté la présence de jetons ou d’octets supplémentaires non sollicités au-delà de la frontière théorique de clôture.
Cette distinction s’avère cruciale dans la modélisation de l’erreur. Contrairement à une simple exception de syntaxe, qui signalerait une malformation interne telle qu’une virgule superflue, une chaîne non délimitée ou une accolade orpheline, l’erreur de données traînantes atteste que le début du flux est parfaitement régulier et s’est clos de manière autonome. La rupture intervient lorsque le curseur d’analyse, censé attester de la fin absolue du document, rencontre des éléments signifiants là où le silence syntaxique ou de simples caractères d’espacement étaient impérativement exigés. Il s’agit par conséquent d’une violation du flux de données global plutôt que d’une invalidité structurelle intrinsèque du bloc initialement parsé.
L’impact de cette exception sur les pipelines de traitement de données scientifiques et psychométriques s’avère considérable. Dans les protocoles expérimentaux où des séries temporelles, des temps de réaction ou des comptes rendus textuels qualitatifs sont colligés en temps réel, l’échec de désérialisation stoppe net les chaînes de calcul automatisées. Lorsqu’un processus d’ingestion automatisé s’interrompt brutalement devant des données résiduelles, l’intégrité des cohortes statistiques peut être compromise, entraînant des pertes d’échantillons ou des biais d’attrition computationnelle susceptibles d’altérer la validité interne des conclusions empiriques.
1.2 Le contrat de spécification RFC 8259 et ses contraintes
L’origine normative de cette divergence réside dans le standard formel régissant la sérialisation, codifié de manière incontournable par le document normatif RFC 8259 publié par l’Internet Engineering Task Force (IETF). Selon les termes explicites de cette spécification, un texte valide est défini comme une séquence de jetons structurée autour d’une entité racine unique. Cette racine universelle peut se manifester sous la forme d’un conteneur composite — qu’il s’agisse d’un objet délimité par des accolades ou d’un tableau séquentiel délimité par des crochets — ou d’une valeur primitive isolée, telle qu’une chaîne de caractères, un nombre, un booléen ou la valeur nulle.
La contrainte nodale imposée par la norme stipule qu’un flux d’information conforme doit se terminer immédiatement après la résolution complète de cette entité racine unique, les seuls caractères autorisés post-terminaison étant strictement limités aux séparateurs d’espacement conventionnels, à savoir l’espace horizontal, la tabulation, le saut de ligne et le retour chariot. Dès lors qu’un parseur respectueux des spécifications officielles rencontre un octet textuel non blanc après la fermeture de l’élément racine, il se trouve dans l’obligation protocolaire de rejeter l’intégralité du document en soulevant une alerte formelle d’irrégularité.
Dans les échanges inter-systèmes contemporains, ces déviations syntaxiques provoquent des ruptures de communication asymétriques. Lorsqu’un sous-système producteur concatène plusieurs structures sans les encapsuler préalablement dans un conteneur global unificateur, il produit un flux composite déviant. Si le système consommateur adhère rigoureusement à la norme RFC 8259, la transaction échoue irrémédiablement, illustrant l’adage classique de robustesse logicielle selon lequel un système doit être conservateur dans ce qu’il émet et libéral dans ce qu’il accepte, un équilibre précisément mis à l’épreuve par la survenue de données traînantes.
1.3 Manifestation symptomatique dans l’écosystème Pandas
Dans le contexte opérationnel des bibliothèques d’analyse de données, l’exception se manifeste de manière spectaculaire lors de l’usage de la fonction d’ingestion standard read_json offerte par Pandas. L’appel canonique et naïf consistant à soumettre le chemin d’un fichier à cette fonction sans spécification paramétrique avancée repose sur le postulat implicite que la cible matérielle contient un document monolithique conforme au standard strict. Dès que le fichier déroge à cette convention — situation récurrente lors de l’importation de journaux d’événements ou d’enregistrements comportementaux séquentiels —, la fonction capitule immédiatement.
L’évaluation du contenu textuel par Pandas s’effectue généralement selon une approche stricte, visant à construire d’emblée une représentation tabulaire complète en mémoire vive. Dès les premiers octets succédant au premier enregistrement clos, le moteur sous-jacent détecte la rupture de continuité. La trace d’appel générée par l’interpréteur Python dévoile alors une cascade d’invocations révélatrice : le wrapper Python de haut niveau délègue le traitement aux mécanismes de désérialisation rapide écrits en langage C ou Cython, lesquels renvoient l’anomalie fondamentale vers l’espace applicatif supérieur sous l’intitulé caractéristique :
ValueError: Trailing data
L’examen minutieux de la pile d’exécution permet d’observer que l’erreur remonte à travers les modules de parsing internes, attestant que le moteur a finalisé la construction d’un premier nœud sémantique valide mais se heurte à l’impossibilité de rattacher les octets subséquents à la racine active. Cette trace ne doit donc pas être interprétée comme le signe d’une corruption de bas niveau du disque ou d’une défaillance de la mémoire de l’interpréteur, mais comme l’attestation formelle d’un malentendu architectural entre la structure topologique réelle du corpus et le protocole d’ingestion sélectionné par l’analyste.
2. Mécanismes sous-jacents de la désérialisation JSON en Python
2.1 Fonctionnement interne du parseur json.loads
Pour appréhender la genèse de l’exception, il est indispensable de disséquer la cinématique d’exécution du module standard de Python, et plus singulièrement de la fonction json.loads. Cette fonction opère par l’intermédiaire d’un analyseur lexical combiné à un automate à états finis. Lors de la transmission d’une chaîne de caractères en mémoire, le parseur initialise un pointeur de lecture à l’indice zéro et progresse séquentiellement dans le flux pour identifier les frontières structurelles des jetons linguistiques.
Lorsqu’une accolade ouvrante est identifiée, l’automate engage un état d’empilement récursif destiné à capturer l’ensemble des paires de clés et de valeurs associées, en gérant scrupuleusement les niveaux d’imbrication éventuels. À l’instant précis où l’accolade fermante correspondant au niveau hiérarchique racine est rencontrée, l’automate dépile sa structure et considère que l’entité sémantique principale est définitivement close. À cette étape, l’algorithme enregistre la position courante du pointeur d’analyse et effectue un balayage prospectif terminal sur le reliquat de la chaîne.
Ce contrôle d’intégrité final vise à vérifier que les caractères restants ne sont constitués que de séparateurs triviaux non signifiants. Si le pointeur de lecture rencontre un quelconque caractère non conforme à cette vacuité syntaxique — par exemple une nouvelle accolade ouvrante marquant le départ d’un second objet non relié —, l’interpréteur interrompt immédiatement le traitement et lève l’exception. Il convient de noter que des moteurs alternatifs optimisés tels que ujson ou orjson appliquent des vérifications similaires au niveau du code C sous-jacent, bien que leurs libellés d’erreurs respectifs puissent varier légèrement dans leur phraséologie tout en sanctionnant rigoureusement la même violation de terminaison de flux.
2.2 L’architecture d’ingestion de la bibliothèque Pandas
La bibliothèque Pandas, conçue pour manipuler des structures de données tabulaires à hautes performances, n’opère pas comme un simple lecteur de fichiers textuels passif. Sa fonction read_json constitue une couche d’abstraction sophistiquée dont le mandat est de transmuter un flux sérialisé arbitraire en une matrice de colonnes typées, dénommée DataFrame. Cette transformation exige une déduction typologique immédiate des valeurs scalaires, une harmonisation des structures de colonnes et une allocation mémoire vectorielle continue.
Pour accomplir cette tâche de manière optimale, Pandas encapsule des moteurs d’analyse écrits en C, principalement dérivés des bibliothèques ujson et d’extensions internes spécifiques. Par défaut, le moteur assume que le flux d’entrée se conforme rigoureusement à l’une des orientations tabulaires conventionnelles : un tableau d’enregistrements, une table d’index ou un dictionnaire de colonnes. Le flux textuel est ainsi ingéré sous l’hypothèse d’une unité holistique unique qui doit être transformée d’un seul bloc en méta-structures exploitables.
Lorsque le moteur de bas niveau de Pandas engage son parcours de lecture, il applique une rigueur absolue à la délimitation du périmètre des données. Dès lors qu’un premier bloc logique est résolu, la moindre présence d’octets supplémentaires déclenche une rétroaction d’échec vers la couche Python de haut niveau. L’absence d’instructions complémentaires quant à la manière d’interpréter ces fragments additionnels interdit à Pandas d’improviser une stratégie d’agrégation, ce qui contraint l’interpréteur à clore la tentative d’importation par l’émission de la fameuse exception de données traînantes.
2.3 Le décalage entre structure de fichier et attente de l’interpréteur
Le point de friction fondamental qui engendre l’erreur ValueError: Trailing data réside dans un écart herméneutique entre le modèle mental de l’opérateur et la grammaire stricte de l’interpréteur logiciel. L’analyste de données, confronté à un fichier contenant une succession chronologique d’enregistrements, perçoit intuitivement ce corpus comme un réceptacle unique et cohérent de données tabulaires. Il conçoit son document comme une base de faits unifiée, indépendamment de la ponctuation spécifique séparant chaque enregistrement individuel.
À l’inverse, l’interpréteur informatique applique une logique booléenne implacable dénuée de toute capacité d’extrapolation contextuelle. Si le fichier est configuré sous la forme de documents successifs juxtaposés sans matrice englobante, chaque enregistrement forme une unité linguistique indépendante et autosuffisante. Dès la clôture du premier enregistrement, le parseur décrète la fermeture logique de la transaction textuelle. Dès lors, la juxtaposition d’un second objet équivaut, du point de vue formel de l’automate d’analyse syntaxique, à l’injection d’un parasitage syntaxique imprévu.
Ce conflit de paradigme s’illustre nettement dans la confrontation entre un tableau d’objets conventionnel et une série d’objets adjacents. Le tableau requiert des crochets périphériques et une séparation méticuleuse par des virgules intercalaires. Lorsque ces éléments de liaison structurelle sont absents, la structure est perçue par le système non pas comme une collection ordonnée, mais comme un agrégat désordonné d’éléments fragmentaires concurrents, violant le contrat axiomatique d’unicité documentaire posé par les algorithmes de chargement conventionnels.
3. Reproduction méthodique de l’exception dans l’environnement Pandas
3.1 Construction d’un jeu de données expérimental minimal
Afin de disséquer le phénomène avec une précision chirurgicale, construisons un scénario expérimental représentatif des conditions réelles rencontrées dans les laboratoires de sciences comportementales ou d’analyse psychométrique. Considérons une étude empirique mesurant la charge cognitive et l’indice d’anxiété de sujets soumis à une tâche informatisée. Chaque passation génère un enregistrement constitué d’un identifiant unique de participant, d’un score numérique standardisé et d’un compte rendu introspectif recueilli à l’issue de l’épreuve.
Dans un contexte d’enregistrement en temps réel, l’application expérimentale a consigné chaque événement de fin de test en écrivant successivement un objet autonome dans un même fichier nommé donnees_experimentales.json, sans instancier de conteneur global englobant. Le fichier résultant présente sur le disque la structure textuelle suivante, où chaque ligne matérielle héberge un objet complet :
{« participant_id »: « P001 », « score_cognitif »: 84.5, « anxiete »: « faible », « verbatim »: « Tâche fluide. »}
{« participant_id »: « P002 », « score_cognitif »: 62.1, « anxiete »: « elevee », « verbatim »: « Difficultés de concentration. »}
{« participant_id »: « P003 », « score_cognitif »: 77.8, « anxiete »: « moderee », « verbatim »: « Rythme soutenu mais gérable. »}
D’un point de vue visuel et logique, cette disposition apparaît remarquablement ordonnée et immédiatement compréhensible pour l’esprit humain. Chaque entité dispose de ses attributs qualitatifs et quantitatifs délimités par des accolades régulières. Néanmoins, sur le plan strictement topologique, nous sommes en présence d’une pluralité de structures lexicales indépendantes réparties sur plusieurs lignes, sans aucune balise de tête ou de clôture générale assurant la cohésion globale du fichier sous l’angle du format standardisé.
3.2 Exécution du script déclencheur et analyse de la trace
Lorsque le chercheur tente d’ingérer ce jeu de données dans son environnement de traitement analytique via un script Python naïf, il fait traditionnellement appel à l’instruction fondamentale de haut niveau :
import pandas as pd
df = pd.read_json(‘donnees_experimentales.json’)
L’exécution de cette commande provoque l’interruption immédiate du processus d’interprétation et l’affichage d’une trace d’erreur détaillée au sein de la console d’exécution. L’examen attentif de cette pile d’appels permet de reconstituer avec exactitude la chronologie de l’échec d’ingestion logicielle :
Traceback (most recent call last):
File « analyse.py », line 2, in <module>
df = pd.read_json(‘donnees_experimentales.json’)
File « pandas/io/json/_json.py », line 746, in read_json
return json_reader.read()
File « pandas/io/json/_json.py », line 931, in read
obj = self._get_object_parser(self.data)
File « pandas/io/json/_json.py », line 959, in _get_object_parser
obj = FrameParser(decode, self.orient, …)
File « pandas/io/json/_json.py », line 1077, in parse
self._parse()
File « pandas/io/json/_json.py », line 1205, in _parse
loads(json, …)
ValueError: Trailing data
L’inspection de la pile démontre que le parseur interne a procédé à la lecture du premier objet débutant par l’accolade ouvrante de l’enregistrement de l’individu P001, a parcouru les champs successifs, et s’est clos avec succès à l’accolade fermante située en fin de première ligne. Dès la reprise de son analyse lexicale, le pointeur a traversé le saut de ligne pour heurter l’accolade ouvrante de l’individu P002. N’ayant pas été instruit de la possibilité de rencontrer des entités consécutives, le moteur interprète ce caractère inattendu comme une impureté textuelle intolérable et soulève immédiatement l’anomalie de données résiduelles.
3.3 Rôle des retours à la ligne dissimulés dans le corpus textuel
La situation diagnostique se complexifie considérablement lorsque le corpus textuel investigué intègre des retours à la ligne disséminés au sein même des valeurs textuelles des champs, par exemple dans les transcriptions d’entretiens qualitatifs ou les réponses ouvertes issues de questionnaires psychologiques. Si un répondant insère un retour chariot au cœur de sa déposition subjective, la représentation de ce saut de ligne peut s’effectuer selon deux modalités techniques aux conséquences diamétralement opposées.
Dans l’hypothèse optimale, le saut de ligne est rigoureusement sérialisé sous la forme d’une séquence d’échappement explicite composée des deux caractères typographiques barre oblique inversée et n (n). Dans cette configuration, le saut de ligne est purement logique et ne rompt pas la continuité matérielle de la chaîne de caractères sous-jacente. L’analyseur lexical identifie la séquence échappée comme un simple caractère de contrôle textuel appartenant à la chaîne sans altérer son statut de champ de données unitaire.
En revanche, si l’exportation des données a été réalisée de manière imparfaite, le retour à la ligne peut être matérialisé par un octet de saut de ligne physique (0x0A) inséré directement au milieu de la chaîne sans échappement préalable. Cette situation engendre une fragmentation matérielle anarchique de la structure de l’enregistrement. Lorsque le parseur traite un tel document, il subit une rupture de flux inattendue, générant des faux positifs de fin de ligne ou invalidant totalement la reconnaissance des délimiteurs sémantiques. Cette distinction subtile entre saut de ligne matériel et saut de ligne logique échappé constitue l’une des sources majeures d’obscurcissement du diagnostic lors de l’investigation de fichiers volumineux corrompus.
4. La nature spécifique du format JSON Lines (NDJSON)
4.1 Fondements et architecture de la norme JSONL / NDJSON
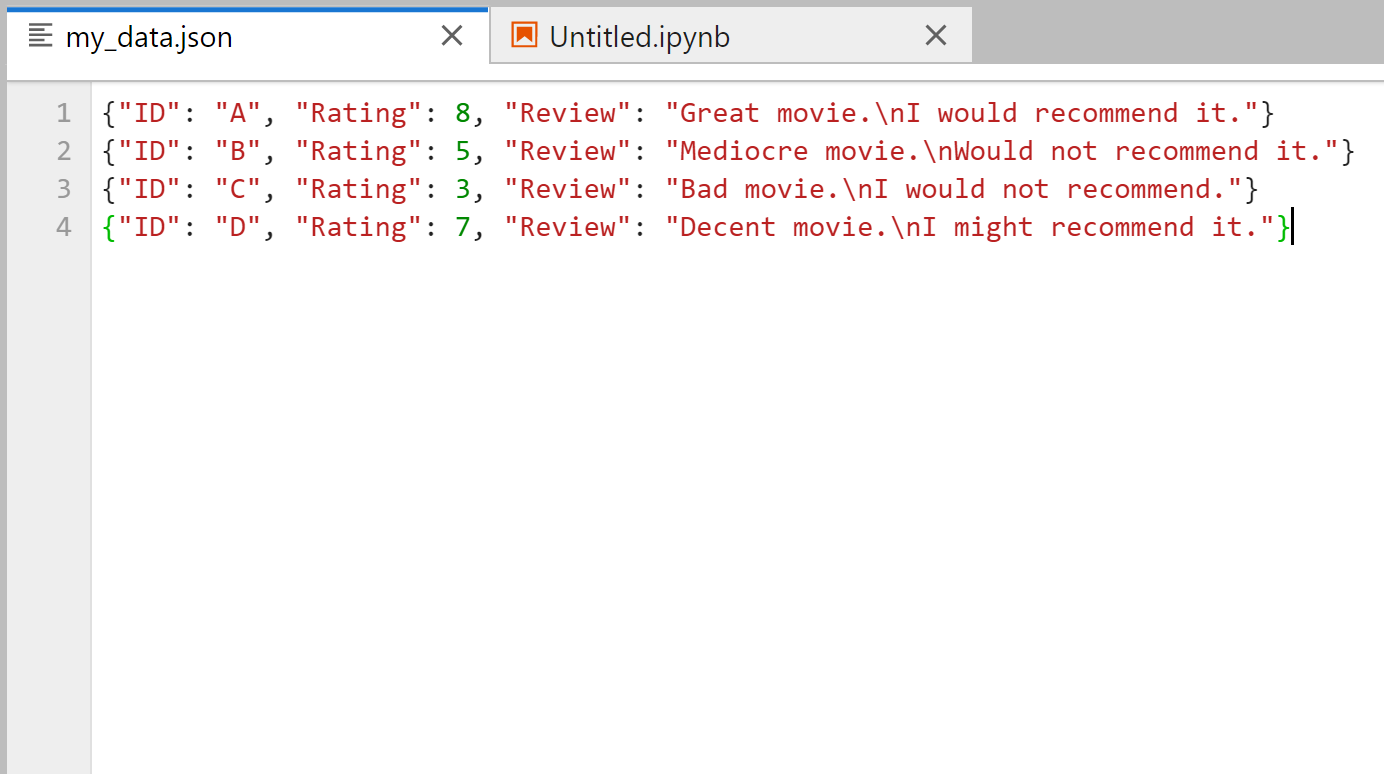
Face aux limitations inhérentes à la manipulation de gigantissimes fichiers monolithiques, la communauté du génie logiciel a formalisé un standard de persistance textuelle particulièrement élégant : le format JSON Lines, également désigné sous le vocable technique de NDJSON (Newline Delimited JSON). La prémisse architecturale de cette norme repose sur un principe d’indépendance structurelle intégrale : chaque ligne matérielle du fichier constitue, à elle seule, un objet sérialisé complet, autosuffisant et rigoureusement valide au sens de la norme RFC 8259.
Cette approche découple radicalement l’intégrité de chaque enregistrement individuel de celle de l’ensemble du conteneur de stockage. Le délimiteur unificateur universel cesse d’être une structure arborescente globale fermée par des crochets périphériques pour devenir le caractère matériel de fin de ligne, traditionnellement codé par le saut de ligne UNIX (0x0A). Chaque entité commence au premier caractère de sa ligne respective et se termine rigoureusement avant l’amorce de la ligne suivante, instaurant une topologie hautement granulaire et ordonnée.
Les gains computationnels dérivés de cette topologie sont considérables pour l’ingénierie des systèmes à haute disponibilité. Le format JSON Lines s’avère nativement adapté au traitement de flux continus (data streaming), dans la mesure où un producteur d’événements peut écrire un nouvel enregistrement sur disque sans avoir à désérialiser au préalable l’ensemble du corpus préexistant pour insérer un nœud dans un tableau. De surcroît, cette architecture autorise une scalabilité horizontale majeure, permettant à des sous-systèmes distribués de traiter des segments arbitraires du corpus par simple partitionnement linéaire sans recourir à des analyses syntaxiques croisées complexes.
4.2 Comparaison structurelle : JSON monolithique versus JSON Lines
L’analyse comparative des profils de consommation de ressources et de tolérance aux défaillances entre un document classique monolithique et un document structuré en lignes indépendantes permet de mieux appréhender les fondements computationnels de ces formats de stockage. Le tableau analytique suivant synthétise les propriétés intrinsèques régissant chacun de ces deux paradigmes de sérialisation :
- Empreinte mémoire d’ingestion : Le format classique requiert impérativement un chargement glouton de l’intégralité du document en mémoire vive afin de reconstituer l’arborescence racine, générant des pics de consommation substantiels. Le format JSON Lines autorise une lecture séquentielle streaming et un traitement incrémental ligne par ligne sans saturation de la mémoire vive.
- Résilience aux corruptions matérielles : Dans un document monolithique, la présence d’un seul caractère défaillant invalide l’ensemble de l’arbre syntaxique, rendant la totalité du corpus illisible. Avec le standard JSON Lines, une altération accidentelle se trouve confinée à la ligne spécifique affectée, autorisant le parseur à isoler l’erreur et à poursuivre l’ingestion des autres enregistrements intacts.
- Complexité de modification incrémentale : L’ajout d’une observation dans un fichier monolithique impose la réécriture de la fin du flux pour déplacer le délimiteur de clôture global. En JSON Lines, l’opération correspond à une simple opération d’adjonction linéaire en fin de fichier (append), opération élémentaire optimisée au niveau du système de fichiers sous-jacent.
- Parallélisation algorithmique : Un flux monolithique ne peut être découpé arbitrairement sans rompre la hiérarchie contextuelle des balises. Le format JSON Lines permet un partitionnement direct du fichier en blocs d’octets distincts confiés simultanément à plusieurs cœurs d’exécution processeur, sous réserve d’aligner les découpages sur les sauts de ligne matériels.
Ces divergences fondamentales expliquent pourquoi un fichier contenant plusieurs lignes indépendantes d’objets, bien qu’extrêmement robuste et polyvalent, déstabilise systématiquement les fonctions de lecture conçues exclusivement pour l’évaluation de blocs monolithiques. L’exception de données résiduelles est la conséquence mécanique directe de cette collision entre un mode de stockage orienté flux et un algorithme d’évaluation orienté conteneur global.
4.3 Origine des fichiers JSON Lines dans les études empiriques
Dans la recherche académique contemporaine et l’analyse de métriques de production, la prolifération spontanée de fichiers structurés selon la convention JSON Lines résulte directement de la modernisation des architectures de collecte. Les interfaces de programmation applicative contemporaines délaissent progressivement la transmission de réponses globales volumineuses au profit de mécanismes de transmission paginés ou continus. Lorsqu’un script Python consomme une API de journalisation comportementale ou de veille numérique, il réceptionne une succession de micro-charges utiles qu’il consigne chronologiquement au fil de l’eau sur le disque local.
Ce paradigme s’avère omniprésent dans la conception des protocoles expérimentaux en sciences cognitives. Lors de l’administration d’épreuves de longue durée mesurant l’attention soutenue ou la prise de décision stochastique, la sécurité méthodologique commande d’enregistrer chaque épreuve immédiatement après sa résolution par le sujet. En cas de dysfonctionnement électrique imprévu de la station de travail, les essais antérieurs sont d’ores et déjà matérialisés sur le support permanent sous forme de lignes autonomes closes. Le recours au formatage incrémental sans encapsulation prévient toute perte de données expérimentales précieuses.
Par ailleurs, les plateformes d’apprentissage en ligne, les systèmes d’interaction homme-machine et les dispositifs connectés de suivi biométrique génèrent structurellement des journaux d’événements continus. Les fichiers résultants, fréquemment affublés d’une simple extension textuelle générique ou identifiés trompeusement sous l’extension .json conventionnelle, dissimulent en réalité une nature séquentielle stricte. Le chercheur non averti, induit en erreur par l’extension du fichier, applique alors les protocoles de chargement traditionnels et déclenche inévitablement la levée de l’exception liée aux données subséquentes non gérées.
5. Résolution canonique : Paramétrage rigoureux de pd.read_json
5.1 Application explicite du paramètre lines=True
La résolution canonique et la plus immédiate de l’exception au sein de l’environnement Pandas réside dans la désignation explicite du mode de traitement par lignes. En informant le moteur de l’organisation séquentielle du corpus, l’analyste réaligne l’algorithme d’ingestion sur la topologie matérielle effective du fichier source. Cette opération s’effectue au moyen de l’injection explicite de l’argument booléen lines=True lors de l’appel de la méthode de lecture :
import pandas as pd
df = pd.read_json(‘donnees_experimentales.json’, lines=True)
L’activation de ce paramètre modifie en profondeur la dynamique interne de la fonction. Au lieu d’invoquer le parseur monolithique sur l’ensemble de la chaîne textuelle, le sous-système de Pandas commute vers un itérateur de flux. Ce mécanisme segmente préalablement le fichier physique en fonction des sauts de ligne réels et soumet chaque segment unitaire à l’analyseur lexical de manière isolée. L’anomalie de données traînantes est ainsi neutralisée à sa source même, puisque la présence d’enregistrements subséquents est désormais explicitement attendue et orchestrée par le gestionnaire d’ingestion tabulaire.
La matrice résultante reconstitue fidèlement la structure relationnelle projetée par le concepteur des données. Chaque ligne matérielle se traduit par un enregistrement horizontal au sein de la table de données, tandis que les clés communes à chaque objet se voient allouées aux colonnes correspondantes. Les types de variables sous-jacents, qu’ils soient de nature numérique à virgule flottante ou textuelle, bénéficient dès lors du moteur d’inférence vectoriel de Pandas sans générer le moindre conflit syntaxique résiduel.
5.2 Ajustement concordant de l’argument typologique orient
Bien que l’assignation de la valeur vraie au paramètre lines suffise dans la majorité des scénarios courants, une compréhension approfondie exige d’examiner son interaction synergique avec le paramètre d’orientation textuelle, formalisé sous l’attribut orient. Par construction conceptuelle et spécification interne, l’argument lines=True n’est rigoureusement compatible qu’avec l’orientation dite records, qui désigne une suite séquentielle de représentations d’enregistrements individuels sous forme de dictionnaires structurés.
Dans certaines circonstances complexes, des systèmes tiers génèrent des fichiers JSON Lines selon des orientations divergentes, par exemple sous forme de valeurs scalaires brutes (orient=’values’) ou de segments découpés associant index et structures (orient=’split’). Tenter de forcer la lecture de tels formats non conventionnels sans harmoniser explicitement l’argument d’orientation produit des désalignements dimensionnels sévères, voire la résurgence d’exceptions d’incompatibilité structurelle :
df = pd.read_json(‘donnees_complexes.json’, lines=True, orient=’records’)
La formulation explicite de cette conjonction de paramètres garantit une sécurité préventive maximale dans les pipelines automatisés de production. Elle prémunit l’environnement d’exécution contre toute modification éventuelle des valeurs par défaut des futures versions de la bibliothèque Pandas et documente de manière transparente les postulats structurels adoptés par l’ingénieur lors de l’implémentation de la phase d’acquisition des données.
5.3 Validation de l’intégrité de la structure DataFrame générée
L’ingestion réussie sans déclenchement d’erreurs ne saurait constituer à elle seule une preuve suffisante de l’intégrité analytique du jeu de données constitué. Un protocole méthodologique d’ingestion rigoureux impose l’exécution systématique d’une série de vérifications dimensionnelles et structurelles immédiatement après l’opération de lecture. Cette phase d’assurance qualité post-ingestion permet de dépister d’éventuelles corruptions silencieuses qui n’auraient pas suffi à interrompre le parseur mais altéreraient néanmoins la distribution statistique des variables.
Le contrôle initial réside dans l’évaluation dimensionnelle de la matrice via l’attribut shape, couplée à la vérification des types de stockage machine représentés par l’attribut dtypes. Cette inspection permet de vérifier que le volume total d’enregistrements concorde avec le nombre théorique d’événements attendus et qu’aucune colonne numérique n’a été convertie de façon régressive en type générique objet à cause de la présence d’irrégularités textuelles :
assert df.shape[0] == 3, « Déficit d’observations identifié au sein du corpus. »
assert df[‘score_cognitif’].dtype == ‘float64’, « Erreur d’inférence du type numérique. »
assert not df.empty, « La structure de données instanciée est anormalement vide. »
Il convient également d’accorder une vigilance spécifique à la gestion des lignes vides accidentellement insérées en fin de document par des éditeurs de texte ou des processus d’exportation défaillants. Lors de l’usage de lines=True, une succession de sauts de ligne terminaux non imprimables peut occasionner l’adjonction d’enregistrements fantômes peuplés de valeurs manquantes (NaN). L’application immédiate d’un filtre d’élagage conditionnel permet de restaurer la conformité de l’échantillon sans altérer les propriétés de représentativité des données expérimentales sous-jacentes.
6. Gestion des caractères d’échappement et retours à la ligne complexes
6.1 Différenciation entre saut de ligne structurel et littéral textuel
L’un des défis les plus redoutables rencontrés dans l’assainissement de flux sérialisés réside dans la collision sémantique entre le saut de ligne structurel — qui délimite la frontière matérielle entre deux enregistrements JSON Lines distincts — et le saut de ligne littéral textuel présent au sein d’un compte rendu discursif. Au regard de l’architecture binaire d’un fichier texte, l’octet représentant le saut de ligne conventionnel correspond uniformément à la valeur hexadécimale 0x0A (caractère typographique de nouvelle ligne LF). Sans une convention d’échappement absolue, le parseur se trouve dans l’incapacité logique de déterminer si cet octet signale une fin de bloc documentaire ou un retour chariot interne à une phrase.
Pour qu’un document NDJSON demeure structurellement intègre, tout retour à la ligne inséré par un utilisateur au sein d’une zone textuelle libre doit être rigoureusement transmuté par l’encodeur source en une chaîne d’échappement explicite constituée d’une barre oblique inversée suivie du caractère alphabétique n (n). Cette séquence est constituée de deux octets distincts (0x5C puis 0x6E), éliminant formellement l’octet matériel 0x0A de l’intérieur de la charge utile de l’enregistrement. L’enregistrement complet demeure ainsi confiné sur une ligne matérielle unique.
Lorsqu’une interface de saisie ou un protocole de transmission corrompt ce contrat de sérialisation en laissant fuiter des octets 0x0A bruts au milieu des chaînes de valeurs, la topologie du format JSON Lines est instantanément annihilée. Le paramètre lines=True devient alors inopérant : l’analyseur scinde artificiellement l’enregistrement corrompu en deux fragments textuels orphelins. Le premier fragment souffre d’une troncature brutale sans fermeture de guillemet ni d’accolade, tandis que le second fragment apparaît comme une séquence de données résiduelles dénuée d’amorce structurelle, reproduisant l’erreur sous une forme structurellement insoluble pour les parseurs standards.
6.2 Nettoyage préliminaire des chaînes textuelles en Python
Face à un corpus textuel dégradé présentant des retours de ligne non échappés au sein de structures pourtant sérialisées, une phase de remédiation prétraitée s’avère indispensable avant toute tentative de soumission au moteur d’ingestion de Pandas. Cette opération de normalisation syntaxique requiert la mise en œuvre de filtres d’expressions régulières ou de générateurs à flux tendu programmés à l’aide de la bibliothèque standard de Python.
L’algorithme de remédiation consiste à parcourir le flux d’octets ou de caractères textuels pour détecter l’état contextuel du parseur lexical. En traquant l’ouverture et la fermeture des guillemets délimitant les chaînes de valeurs, il devient possible d’identifier si un caractère matériel de saut de ligne se manifeste à l’intérieur ou à l’extérieur des bornes délimitant un champ textuel :
import re
def assainir_flux_jsonl(flux_brut):
lignes_corrigees = []
tampon = « »
en_chaine = False
echappement = False
for caractere in flux_brut:
if caractere == » and not echappement:
echappement = True
tampon += caractere
continue
if caractere == ‘ »‘ and not echappement:
en_chaine = not en_chaine
if caractere == ‘n’ and en_chaine:
tampon += ‘n’
else:
tampon += caractere
echappement = False
return tampon
Ce traitement régénère un flux parfaitement intègre dans lequel l’ensemble des sauts de ligne internes a été rigoureusement transformé en séquences d’échappement textuelles conventionnelles. La structure globale recouvre sa stricte linéarité matérielle, restaurant ainsi la compatibilité totale du document avec les mécanismes d’ingestion vectorielle de haut niveau.
6.3 Préservation sémantique des retours à la ligne dans l’analyse de corpus
Dans les champs disciplinaires du traitement automatique du langage naturel (TALN) et des humanités numériques, l’éradication aveugle des retours à la ligne ne saurait être considérée comme une solution méthodologique acceptable. Les sauts de ligne, les structurations en strophes ou les séparations de paragraphes constituent des marqueurs sémantiques et stylistiques fondamentaux pour l’évaluation psycholinguistique des textes ou la modélisation de discours complexes.
L’ingénieur logiciel se trouve ainsi confronté à un arbitrage méthodologique fondamental entre la standardisation syntaxique destructive — qui substituerait de simples espaces blancs aux sauts de ligne — et la conservation sémantique fidèle du verbatim brut recueilli lors des passations expérimentales. L’implémentation de processus d’échappement rigoureux garantit la conciliation parfaite de ces exigences contradictoires : le formalisme de stockage en ligne unique demeure inattaquable pour les parseurs, tandis que l’application d’un décodage de restitution textuelle restitue l’architecture discursive originale au moment opportun de l’analyse linguistique.
Cette distinction conceptuelle protège l’aval des pipelines de recherche computationnelle. Lors de l’application ultérieure de modèles de segmentation lexicale, d’analyse de sentiments ou d’extraction d’entités nommées basés sur des architectures de réseaux de neurones profonds, la présence des délimitations de paragraphes sous leur forme échappée préserve la fidélité des contextes phrastiques. La rigueur apportée à la gestion des caractères d’échappement conditionne ainsi directement la reproductibilité et la finesse des conclusions scientifiques dérivées de corpus discursifs denses.
7. Alternatives analytiques via la bibliothèque standard json
7.1 Traitement par itération explicite ligne par ligne
Lorsque la rigidité des abstractions de haut niveau de Pandas se heurte à des fichiers volumineux présentant des anomalies sporadiques, le recours délibéré aux mécanismes fondamentaux offerts par la bibliothèque standard json de Python constitue une stratégie de contournement d’une robustesse exceptionnelle. En reprenant le contrôle programmatique direct de la boucle d’ingestion, le chercheur s’affranchit des hypothèses restrictives imposées par les wrappers automatisés.
L’implémentation canonique de cette approche exploite un gestionnaire de contexte sécurisé (with open) associé à une boucle d’itération native sur les lignes du fichier. Chaque enregistrement textuel est soumis individuellement à la fonction json.loads, permettant de collecter les dictionnaires résultants dans une structure matricielle pythonique intermédiaire avant l’instanciation finale de la table de données :
import json
import pandas as pd
enregistrements_valides = []
with open(‘donnees_experimentales.json’, ‘r’, encoding=’utf-8′) as fichier:
for index_ligne, ligne in enumerate(fichier, start=1):
ligne_nettoyee = ligne.strip()
if not ligne_nettoyee:
continue
try:
entite = json.loads(ligne_nettoyee)
enregistrements_valides.append(entite)
except ValueError as erreur:
print(f »Anomalie structurelle détectée à la ligne {index_ligne}: {erreur} »)
df = pd.DataFrame(enregistrements_valides)
Ce protocole présente des vertus diagnostiques et opérationnelles incomparables. D’une part, il élimine tout risque d’échec global induit par une survenue locale de données traînantes au niveau du document entier. D’autre part, en isolant le parsing de chaque ligne au sein d’un bloc de gestion d’exception explicite (try…except), il offre une visibilité granulaire absolue sur les coordonnées topologiques précises des éventuelles lignes défaillantes, autorisant une journalisation fine des anomalies sans interrompre le traitement des données valides adjacentes.
7.2 Utilisation de json.JSONDecoder et méthode raw_decode
Dans des configurations hautement dégradées où un fichier ne comporte aucun saut de ligne séparateur et juxtapose directement des objets JSON contigus — par exemple sous la forme anarchique {« id »: 1}{« id »: 2} —, tant l’appel par défaut de Pandas que le mode lines=True s’avèrent structurellement impuissants. Dans un tel contexte, la méthode spécialisée raw_decode de la classe json.JSONDecoder constitue l’instrument ultime de dissection syntaxique.
La méthode raw_decode possède la propriété architecturale unique d’analyser un flux textuel à partir d’un index donné, de désérialiser la première entité valide rencontrée, et de retourner un tuple comprenant non seulement l’objet Python reconstruit, mais également l’indice positionnel exact marquant la fin de cette entité dans la chaîne globale. Contrairement à json.loads, elle ne lève aucune exception face aux données résiduelles subséquentes :
import json
def decoder_flux_accolades_multiples(chaine_brute):
decodeur = json.JSONDecoder()
longueur_flux = len(chaine_brute)
indice_courant = 0
resultats = []
while indice_courant < longueur_flux:
while indice_courant < longueur_flux and chaine_brute[indice_courant].isspace():
indice_courant += 1
if indice_courant >= longueur_flux:
break
objet, index_prochain = decodeur.raw_decode(chaine_brute, idx=indice_courant)
resultats.append(objet)
indice_courant = index_prochain
return resultats
Cette mécanique algorithmique permet d’extraire séquentiellement l’intégralité des structures imbriquées d’un flux continu sans jamais achopper sur l’existence de caractères traînants. Elle convertit l’inconvénient des données résiduelles en une propriété dynamique d’avancement linéaire, fournissant un mécanisme de sauvetage absolu pour les jeux de données altérés par des processus d’exportation défectueux.
7.3 Comparatif de performance computationnelle et algorithmique
Bien que l’itération ligne par ligne en Python pur et l’usage de raw_decode offrent une résilience et une flexibilité maximales, elles introduisent une charge computationnelle intermédiaire qu’il convient de quantifier méthodiquement. L’instanciation de multiples dictionnaires individuels dans l’espace mémoire managé de Python génère un surcoût d’allocation dynamique et de ramasse-miettes significativement supérieur aux routines vectorielles écrites en C de la méthode pd.read_json(lines=True).
Sur un corpus expérimental modeste de dix mille enregistrements, l’écart d’exécution demeure marginal, oscillant généralement entre quelques dizaines de millisecondes et une seconde complète. En revanche, lorsque le volume de données atteint des échelles industrielles de plusieurs millions d’observations, l’exécution d’une boucle Python standard peut s’avérer jusqu’à dix fois plus lente que le moteur d’ingestion natif de Pandas, principalement en raison des barrières d’interprétation du bytecode et du surcoût mémoire induit par la représentation des types de haut niveau.
La recommandation technique fondamentale s’établit donc selon un principe de subsidiarité rationnelle : il convient de privilégier systématiquement l’instruction hautement optimisée pd.read_json(chemin, lines=True) pour l’ensemble des fichiers conformes aux spécifications du standard NDJSON. Les alternatives manuelles reposant sur json.loads ou raw_decode doivent être rigoureusement réservées aux contextes d’assainissement préliminaire, aux jeux de données non standardisés nécessitant une quarantaine sélective ou aux scénarios d’investigation médico-légale de fichiers partiellement corrompus.
8. Traitement de corpus massifs et contraintes de mémoire vive
8.1 Lecture par blocs de données (chunking)
L’analyse de données massives (Big Data) issues d’expérimentations cognitives à grande échelle ou d’environnements d’apprentissage connectés confronte régulièrement l’ingénieur à une saturation brutale de la mémoire vive, formalisée sous l’acronyme redouté d’erreur OOM (Out Of Memory). Lorsqu’un document JSON Lines atteint un volume de plusieurs gigaoctets, tenter de l’ingérer en une seule instruction vectorielle monopolise l’espace mémoire physique disponible, provoquant le blocage de la machine hôte.
Pour contourner ce goulet d’étranglement physique sans renoncer à la puissance analytique de Pandas, la configuration combinée des arguments lines=True et chunksize constitue l’architecture opérationnelle de référence. En stipulant un entier positif pour le paramètre chunksize, la fonction read_json ne retourne plus un DataFrame statique unique mais instancie un itérateur de blocs hautement performant :
import pandas as pd
taille_bloc = 50000
accumulateur_statistique = 0.0
total_observations = 0
lecteur = pd.read_json(‘corpus_massif.jsonl’, lines=True, chunksize=taille_bloc)
for segment_df in lecteur:
accumulateur_statistique += segment_df[‘score_cognitif’].sum()
total_observations += len(segment_df)
moyenne_globale = accumulateur_statistique / total_observations
Cette approche permet d’exécuter des calculs d’agrégation, des normalisations ou des réductions dimensionnelles continues en maintenant une empreinte mémoire vive constante et prévisible, indépendamment de la taille absolue du corpus stocké sur disque. Chaque bloc est alloué, transformé, puis libéré au profit du bloc suivant, garantissant la viabilité computationnelle des chaînes de traitement les plus denses.
8.2 Intégration d’outils de calcul distribué (Dask et Polars)
Dans les contextes contemporains exigeant des performances d’ingestion ultra-rapides sur des architectures modernes multicœurs, les bibliothèques d’ingénierie de données de nouvelle génération apportent des gains de productivité considérables. Parmi ces écosystèmes, Polars, entièrement développé en langage de programmation Rust, se distingue par son moteur d’exécution multithread hautement optimisé au niveau matériel.
La fonction polars.read_ndjson propose une alternative radicale pour l’ingestion de fichiers JSON Lines volumineux. En exploitant la vectorisation SIMD et une gestion de mémoire de bas niveau exempte de verrous d’interpréteur (GIL), Polars permet d’analyser des flux NDJSON à des débits approchant les limites physiques de lecture des supports de stockage SSD. De manière analogue, la bibliothèque de calcul distribué Dask propose via dask.dataframe.read_json(…, lines=True) un partitionnement paresseux (lazy evaluation) autorisant le traitement coordonné de collections distribuées de fichiers sans saturer les nœuds de calcul individuels :
import polars as pl
df_pl = pl.read_ndjson(‘corpus_massif.jsonl’)
Il est remarquable d’observer que l’exigence d’alignement structurel demeure strictement identique au sein de ces frameworks d’avant-garde. L’oubli de la spécification de la nature séquentielle du format se solde invariablement par la levée d’exceptions analogues relatives à la découverte d’octets résiduels, attestant de l’universalité de la contrainte syntaxique formalisée par la norme RFC 8259 à travers l’ensemble des moteurs d’ingénierie logicielle contemporains.
8.3 Bonnes pratiques de stockage pour les mégadonnées textuelles
Bien que le format JSON Lines offre une souplesse remarquable pour les opérations d’enregistrement au fil de l’eau et le diagnostic syntaxique immédiat, il s’avère intrinsèquement inefficace pour l’archivage analytique à long terme. La redondance systématique des libellés de clés textuelles à chaque ligne matérielle induit une inflation exponentielle du volume d’octets physiques stockés sur disque, dégradant la bande passante lors des relectures fréquentes.
Dès lors qu’un corpus expérimental a été assaini et que l’intégrité de ses structures a été définitivement certifiée, la bonne pratique architecturale commande d’opérer une transition technologique vers des formats de stockage binaires et colonnaires hautement optimisés, tels que le format Apache Parquet ou le format Feather (Arrow). La conversion d’un flux JSON Lines assaini vers le format Parquet s’exécute de manière triviale via Pandas :
df = pd.read_json(‘donnees_assainies.jsonl’, lines=True)
df.to_parquet(‘donnees_consolidees.parquet’, compression=’snappy’, index=False)
Cette transition technologique confère des avantages déterminants : la taille du fichier physique se trouve typiquement compressée d’un facteur cinq à dix, les types de colonnes stricts sont figés de manière inaltérable dans les métadonnées binaires, et le temps de relecture analytique est divisé par plusieurs ordres de grandeur. Cette démarche prévient définitivement toute résurgence ultérieure de l’erreur Trailing data en éliminant totalement l’étape fragile de désérialisation textuelle lors des phases d’analyse statistique finale.
9. Cas limites : Encodages, BOM et caractères invisibles résiduels
9.1 L’influence corruptrice de l’indicateur d’ordre des octets (BOM UTF-8)
Dans l’univers complexe du traitement de documents textuels hétérogènes, la présence de métadonnées invisibles injectées par les systèmes d’exploitation constitue une cause insidieuse de déclenchement d’exceptions de désérialisation. L’indicateur d’ordre des octets, universellement désigné sous son acronyme anglophone BOM (Byte Order Mark), correspond à la séquence d’octets hexadécimale 0xEF, 0xBB, 0xBF insérée en tête de fichier par certains éditeurs de texte opérant sous l’environnement Microsoft Windows pour signaler un encodage UTF-8.
Lorsque cette signature est présente au début d’un flux d’ingestion soumis à un décodeur textuel conventionnel, elle est interprétée sous la forme du caractère invisible zéro-largeur insécable représenté par la séquence Unicode ufeff. Si un fichier JSON est décodé à l’aide d’un codec standard tel que utf-8 au lieu du codec spécialisé utf-8-sig, ce métacaractère demeure actif dans la chaîne textuelle transmise au parseur lexical. Placée en préambule, cette signature peut bloquer l’identification de l’accolade ouvrante initiale.
Plus grave encore, lorsque plusieurs fichiers possédant chacun un en-tête BOM sont concaténés de manière automatisée par un script shell naïf afin de former un vaste corpus d’expérimentation, les signatures BOM des fichiers subséquents se retrouvent projetées au milieu ou à la fin du flux global. Lors du parsing de la dernière accolade d’un document, la découverte immédiate de la séquence résiduelle d’un BOM intercalaire déclenche instantanément la notification d’une exception de données traînantes. Pour immuniser le pipeline contre ce désagrément, la spécification systématique de l’encodage ‘utf-8-sig’ est impérative :
df = pd.read_json(‘donnees_concatenees.jsonl’, lines=True, encoding=’utf-8-sig’)
9.2 Gestion des espaces insécables et métacaractères invisibles
Outre les problématiques d’en-têtes binaires, les flux textuels peuvent être altérés par l’introduction fortuite de caractères de contrôle non imprimables et de séparateurs d’espacement exotiques. L’espace insécable (Unicode 0x00A0), l’espace typographique fine, ou les octets nuls accidentellement injectés lors de transferts réseau corrompus constituent des éléments susceptibles de déstabiliser les moteurs d’analyse syntaxique.
Selon les spécifications strictes du document RFC 8259, les seuls caractères blancs officiellement autorisés pour entourer les structures lexicales sont strictement limités aux points de code ASCII classiques : l’espace conventionnel (0x20), la tabulation horizontale (0x09), le saut de ligne (0x0A) et le retour chariot (0x0D). Tout autre caractère d’espacement d’origine typographique internationale est perçu par le parseur comme un caractère graphique autonome non autorisé dans les zones structurelles délimitantes.
Lorsqu’un tel métacaractère invisible subsiste à la fin d’un document immédiatement après la fermeture de l’accolade finale, le balayage de vacuité terminale échoue irrémédiablement, soulevant l’exception d’octets traînants alors même que le document semble visuellement clos et vierge de toute anomalie dans un visualiseur textuel standard. Une inspection minutieuse à l’aide d’un éditeur hexadécimal ou le nettoyage programmatique systématique des résidus non ASCII en fin de chaîne permet d’éliminer définitivement ces impuretés structurelles fantômes.
9.3 Multi-documents JSON concaténés sans saut de ligne
Un cas pathologique particulièrement complexe survient lorsqu’un protocole d’exportation défaillant a concaténé plusieurs objets sémantiquement valides sans intercaler le moindre saut de ligne matériel, résultant en une collision séquentielle de jetons structurels formalisée par la juxtaposition brutale }{. Dans ce scénario critique, le mode standard de Pandas échoue avec l’erreur ValueError: Trailing data dès le second objet, et le mode lines=True capitule tout aussi brutalement car la totalité du fichier se trouve condensée sur une ligne unique continue.
Pour restaurer la lisibilité d’un tel corpus sans recourir à des parseurs tiers lourds, il est nécessaire d’implémenter un algorithme de rééquilibrage de syntaxe fondé sur le décompte explicite du niveau d’imbrication des accolades (brace counting). Cet automate parcourt chaque caractère textuel et incrémente un compteur lors de la rencontre d’une accolade ouvrante, tout en le décrémentant lors de chaque accolade fermante, en veillant à ignorer scrupuleusement les accolades littérales incluses à l’intérieur des chaînes de caractères :
def segmenter_accolades_accolées(flux_brut):
enregistrements = []
tampon = []
niveau = 0
en_chaine = False
echappement = False
for c in flux_brut:
tampon.append(c)
if c == » and not echappement:
echappement = True
continue
if c == ‘ »‘ and not echappement:
en_chaine = not en_chaine
if not en_chaine:
if c == ‘{‘:
niveau += 1
elif c == ‘}’:
niveau -= 1
if niveau == 0:
enregistrements.append(« ».join(tampon).strip())
tampon = []
echappement = False
return enregistrements
Cette procédure reconstruit de manière déterministe les frontières individuelles de chaque enregistrement originel. Les blocs ainsi isolés peuvent ensuite être convertis en une véritable structure JSON Lines conforme par l’adjonction de sauts de ligne réguliers, permettant une réimportation fluide et immédiate au sein des environnements d’analyse statistique habituels.
10. Validation de schémas et assainissement méthodologique pré-ingestion
10.1 Application des contrats de données avec JSON Schema
L’assainissement syntaxique d’un fichier ne constitue qu’une première étape vers la fiabilité scientifique totale de l’ingestion ; la conformité sémantique des données ingérées s’avère tout aussi déterminante. Pour garantir qu’aucun enregistrement corrompu ou incomplet ne s’infiltre dans l’espace d’analyse empirique, la mise en œuvre de contrats de données stricts formalisés via la norme JSON Schema constitue la pratique académique par excellence.
Un schéma formel permet de définir avec une précision mathématique la nature attendue de chaque champ : typage scalaire des scores, bornes minimales et maximales autorisées pour les variables psychométriques, listes d’énumérations fermées pour les attributs qualitatifs et présence obligatoire des identifiants uniques. L’application de ce contrat pré-ingestion est rendue triviale grâce à la bibliothèque jsonschema :
import jsonschema
from jsonschema import validate
schema_experience = {
« type »: « object »,
« properties »: {
« participant_id »: {« type »: « string »},
« score_cognitif »: {« type »: « number », « minimum »: 0, « maximum »: 100},
« anxiete »: {« type »: « string », « enum »: [« faible », « moderee », « elevee »]},
« verbatim »: {« type »: « string »}
},
« required »: [« participant_id », « score_cognitif », « anxiete »]
}
En soumettant chaque ligne du corpus JSON Lines à la méthode validate en amont de son injection dans la table globale de calcul, le chercheur s’assure qu’aucune déviation structurelle silencieuse n’altère la distribution des scores. Cette rigueur contractuelle transforme le pipeline d’ingestion en une véritable barrière de contrôle qualité prémunissant l’ensemble de l’étude empirique contre les artéfacts de mesure.
10.2 Validation déclarative robuste avec Pydantic
Dans les architectures applicatives contemporaines orientées vers la performance et la concision syntaxique, la bibliothèque Pydantic s’est imposée comme le standard d’excellence pour la validation et le typage statique des flux textuels en Python. En s’appuyant sur les annotations de types natives du langage, Pydantic permet de définir des modèles déclaratifs d’une puissance expressive remarquable.
Un modèle de validation Pydantic prend en charge automatiquement les opérations complexes de coercition de types, la validation conditionnelle inter-champs, et la conversion de représentations temporelles ou textuelles non standardisées vers des objets Python hautement spécialisés :
from pydantic import BaseModel, Field, ValidationError
from typing import Literal
class EnregistrementSujet(BaseModel):
participant_id: str
score_cognitif: float = Field(ge=0.0, le=100.0)
anxiete: Literal[‘faible’, ‘moderee’, ‘elevee’]
verbatim: str = « »
Lors du parcours séquentiel du fichier d’entrée, chaque enregistrement textuel est instancié via l’opérateur déclaratif EnregistrementSujet.model_validate_json(ligne). En cas de non-conformité structurelle ou de défaillance typologique, l’interpréteur génère un rapport d’erreur structuré d’une précision exemplaire sans compromettre l’exécution générale du système, élevant la robustesse globale du pipeline d’analyse à un standard industriel irréprochable.
10.3 Filtrage et assainissement avant chargement tabulaire
L’interception des enregistrements non conformes soulève une problématique méthodologique cardinale dans la recherche empirique : le traitement réservé aux données rejetées. Une démarche scientifique intègre interdit l’élimination discrète et non documentée d’observations divergentes, sous peine d’induire des biais de sélection expérimentale majeurs. Pour résoudre cette contrainte éthique et technique, l’implémentation du patron d’architecture logicielle dit de quarantaine (quarantine pipeline) est hautement recommandée.
Ce patron consiste à diviser le flux d’ingestion en deux canaux distincts à la sortie du module de validation : les enregistrements strictement conformes sont immédiatement acheminés vers le DataFrame opérationnel destiné aux analyses inférentielles, tandis que les lignes défaillantes — qu’elles présentent une anomalie d’octets traînants, une clé manquante ou une valeur hors limites — sont détournées vers un journal d’audit de quarantaine permanent :
import json
import pandas as pd
conforme_registre = []
quarantaine_audit = []
with open(‘flux_entree.jsonl’, ‘r’, encoding=’utf-8′) as src:
for no, ligne in enumerate(src, 1):
try:
obj = json.loads(ligne.strip())
# Validation contractuelle…
conforme_registre.append(obj)
except Exception as err:
quarantaine_audit.append({« ligne »: no, « contenu »: ligne, « erreur »: str(err)})
df_final = pd.DataFrame(conforme_registre)
pd.DataFrame(quarantaine_audit).to_csv(‘audit_quarantaine.csv’, index=False)
Ce protocole garantit une traçabilité expérimentale absolue (audit trail). Le chercheur conserve la capacité de quantifier précisément le taux de rétention de son corpus, d’expliciter le devenir de chaque observation exclue dans les sections méthodologiques de ses publications scientifiques et de recalculer a posteriori la sensibilité statistique de ses résultats finaux face à l’attrition des données d’échantillon.
11. Considérations ergonomiques et cognitives dans la résolution de bugs
11.1 Clarté sémantique des messages d’erreur et charge cognitive
La résolution efficiente des anomalies informatiques ne dépend pas exclusivement de compétences purement algorithmiques ; elle est également conditionnée par des facteurs d’ergonomie cognitive logicielle. L’intitulé laconique ValueError: Trailing data illustre de façon frappante les limites de l’expressivité sémantique de certains messages d’erreur ancestraux conçus initialement pour des ingénieurs système plutôt que pour des scientifiques des données explorant des corpus complexes.
Au prisme de la théorie de la charge cognitive formalisée par John Sweller, ce message d’erreur impose une charge extrinsèque substantielle à l’opérateur. L’expression de données traînantes ne désigne pas intuitivement l’origine architecturale du conflit — à savoir l’absence du drapeau de lecture par lignes face à un fichier séquentiel —, mais décrit uniquement l’état de panique terminale de l’automate lexical au moment précis de sa collision avec le second objet textuel.
Cette ambiguïté terminologique induit fréquemment un biais de confirmation pernicieux chez le programmeur. Persuadé que l’erreur provient de la syntaxe interne de ses fonctions d’analyse ou d’un bug d’allocation mémoire au sein de l’interpréteur, le praticien consacre des heures précieuses à auditer son code algorithmique, alors même que l’anomalie découle exclusivement d’une discordance typologique entre la forme physique du document et le paramétrage de son outil d’ingestion. La prise de conscience de cette friction ergonomique constitue le premier pas vers une pratique réflexive et mature du génie logiciel appliqué aux sciences empiriques.
11.2 Développement de heuristiques diagnostiques pour le data scientist
Afin de minimiser le temps de latence cognitive séparant la survenue de l’exception de sa résolution déterministe, le chercheur en sciences de données doit internaliser une heuristique de diagnostic rationnelle structurée sous la forme d’un arbre de décision standardisé. Face à toute levée de l’erreur Trailing data, la première règle réflexive consiste à s’interdire toute modification prématurée du script applicatif avant d’avoir formellement inspecté les premiers octets matériels du fichier cible.
L’utilisation concertée des utilitaires standards en ligne de commande disponibles dans les environnements POSIX constitue la démarche d’investigation la plus véloce et la plus rigoureuse. L’exécution de quelques commandes élémentaires permet de trancher instantanément la topologie du corpus sans mobiliser la machinerie lourde de l’interpréteur Python :
- head -n 2 donnees.json : Visualise immédiatement si les deux premiers enregistrements sont configurés sous forme d’objets indépendants sur des lignes distinctes ou englobés dans un crochet matriciel général.
- tail -n 2 donnees.json : Vérifie la présence de résidus textuels, de lignes blanches ou de marqueurs de concaténation anormaux en extrême fin de flux.
- wc -l donnees.json : Dénombre le nombre effectif de lignes matérielles, validant instantanément l’adéquation au format JSON Lines.
- jq . donnees.json : L’outil jq analyse immédiatement la validité du flux et signale avec une précision chirurgicale la ligne et la colonne exactes de toute rupture de spécification.
Cette approche heuristique ramène la résolution du problème d’un exercice d’improvisation chronophage à un protocole scientifique de vérification d’hypothèses séquentiel, limitant l’usure cognitive de l’analyste et assurant un diagnostic infaillible en quelques secondes d’investigation instrumentée.
11.3 Documentation de code et reproductibilité scientifique
Dans la perspective de la crise de la reproductibilité qui traverse les sciences empiriques contemporaines, la clarification des hypothèses d’ingestion de données revêt une importance méthodologique de premier ordre. Un script d’analyse statistique ne peut être considéré comme scientifiquement valide si les postulats régissant la conversion des données brutes en matrices de calcul demeurent occultés dans des formulations implicites non documentées.
L’ingénieur a le devoir déontologique de documenter explicitement dans ses cahiers de laboratoire électroniques et au sein de ses scripts d’analyse la nature exacte des formats exploités. L’usage délibéré d’annotations de types, d’assertions dimensionnelles préventives et de docstrings descriptives clarifiant la justification du paramètre lines=True assure la pérennité du protocole de traitement à travers le temps et l’espace :
def ingérer_donnees_psychometriques(chemin_acces: str) -> pd.DataFrame:
« » »
Désérialise un corpus comportemental structuré au format JSON Lines (NDJSON).
L’argument lines=True est formellement requis pour prévenir l’exception ValueError: Trailing data
induite par la succession d’enregistrements d’essais individuels sans encapsulation globale.
« » »
return pd.read_json(chemin_acces, lines=True, orient=’records’, encoding=’utf-8′)
Cette transparence scripturale garantit que tout confrère ou évaluateur scientifique sera en mesure de réexécuter l’intégralité de la chaîne d’analyse empirique sans heurter d’obstacles d’ingestion artificiels, concourant directement à l’idéal de transparence, de vérifiabilité et d’intégrité qui fonde la démarche de la science ouverte.
12. Protocoles de tests unitaires, intégration continue et industrialisation
12.1 Conception de suites de tests unitaires avec Pytest
L’industrialisation pérenne des chaînes d’ingestion de données exige la sanctuarisation du code applicatif à travers l’implémentation de batteries de tests automatisés exhaustives. L’écosystème de tests Pytest s’affirme comme le framework de prédilection en environnement Python pour modéliser et éprouver la robustesse des fonctions de désérialisation face à l’ensemble des scénarios de corruption textuelle envisageables.
Une stratégie de test unitaire rigoureuse doit articuler la validation du comportement nominal — ingestion fluide d’un fichier NDJSON régulier — avec la vérification de la résilience face aux cas limites de données résiduelles. L’utilisation experte des fixtures de Pytest permet de générer à la volée des environnements de fichiers temporaires reproduisant fidèlement les anomalies de structure sans polluer le référentiel de code source :
import pytest
import pandas as pd
@pytest.fixture
def fichier_ndjson_valide(tmp_path):
fichier = tmp_path / « valide.jsonl »
fichier.write_text(‘{« id »: 1, « val »: 10.5}n{« id »: 2, « val »: 20.2}n’, encoding= »utf-8″)
return str(fichier)
@pytest.fixture
def fichier_donnees_traînantes(tmp_path):
fichier = tmp_path / « corrompu.json »
fichier.write_text(‘{« id »: 1}{« id »: 2}’, encoding= »utf-8″)
return str(fichier)
def test_ingestion_lignes_succes(fichier_ndjson_valide):
df = pd.read_json(fichier_ndjson_valide, lines=True)
assert len(df) == 2
assert « val » in df.columns
def test_interception_erreur_donnees_traînantes(fichier_donnees_traînantes):
with pytest.raises(ValueError, match= »Trailing data »):
pd.read_json(fichier_donnees_traînantes, lines=False)
La mise en place de ces assertions formelles assure que toute altération accidentelle des arguments par défaut ou toute régression syntaxique introduite lors des cycles de maintenance logicielle sera immédiatement interceptée par la suite de tests, garantissant une étanchéité opérationnelle absolue du système d’ingestion.
12.2 Intégration de vérifications automatiques dans les pipelines CI/CD
L’assurance qualité logicielle contemporaine délocalise l’exécution des batteries de vérification vers des serveurs d’intégration continue (Continuous Integration / Continuous Deployment), orchestrés via des plateformes telles que GitHub Actions, GitLab CI ou Jenkins. Dans ces infrastructures automatisées, chaque commit ou fusion de branche déclenche l’exécution des tests de conformité avant toute mise en production des modèles d’analyse.
Au-delà des simples tests unitaires applicatifs, l’intégration continue permet d’automatiser des audits préventifs de qualité des données (Data Quality Checks) sur les jeux d’échantillons versionnés au sein du projet. L’intégration d’outils d’évaluation contractuelle tels que Great Expectations permet de bloquer automatiquement toute tentative d’intégration de fichiers sources dont le schéma ne correspondrait pas scrupuleusement aux conventions de nommage et d’encodage attendues.
Ce verrouillage automatisé empêche formellement la publication de scripts de traitement défaillants au sein des environnements d’analyse scientifique partagés. Si un collaborateur tente d’introduire un module d’ingestion omettant la gestion explicite des flux de lignes sur un corpus NDJSON, le pipeline CI/CD rejette impitoyablement la proposition de modification de code, protégeant ainsi l’ensemble de la communauté de recherche contre les déconvenues d’interruption de service et les incohérences d’ingestion de données expérimentales.
12.3 Synthèse des recommandations et charte d’ingestion standardisée
Au terme de cette exploration exhaustive des fondements et des résolutions de l’exception ValueError: Trailing data, il apparaît opportun de formaliser une charte synthétique d’ingestion standardisée guidant le praticien dans l’ordonnancement de ses choix technologiques. Face à tout fichier de données textuelles, le data scientist doit appliquer la matrice décisionnelle suivante :
- Document JSON monolithique unique : Adopter l’appel standard pd.read_json(chemin) avec vérification impérative de l’encodage encoding=’utf-8-sig’ pour neutraliser les éventuels marqueurs d’ordre des octets.
- Flux séquentiel au format JSON Lines (NDJSON) : Spécifier systématiquement la combinaison canonique indissociable lines=True, orient=’records’, en veillant à traiter le corpus par blocs via chunksize dès lors que le fichier dépasse le gigaoctet de données brutes.
- Fichiers massifs orientés haute performance : Migrer l’ingestion initiale vers polars.read_ndjson pour exploiter le parallélisme matériel multithread, puis figer immédiatement le corpus assaini au format binaire colonnaire Parquet.
- Corpus altérés avec retours à la ligne internes ou accolades orphelines : Mettre en œuvre une phase de remédiation en amont reposant sur le module standard json et la méthode raw_decode combinée à un canal de quarantaine documenté assurant la totale traçabilité méthodologique des rejets.
En observant scrupuleusement ces principes directeurs, l’analyste transforme une contrainte de syntaxe ardue en une opportunité d’accroître la rigueur, l’élégance et la résilience computationnelle de l’ensemble de ses architectures logicielles et de ses protocoles de recherche empirique.
Références
Bray, T. (Éd.). (2017). The JavaScript Object Notation (JSON) Data Interchange Format (RFC No. 8259). Internet Engineering Task Force (IETF). https://datatracker.ietf.org/doc/html/rfc8259
Collette, A. (2013). Python and HDF5: Fast storage for large data. O’Reilly Media.
McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 445, 56-61. https://doi.org/10.25080/Majora-92bf1921-003
McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3e éd.). O’Reilly Media.
Newline Delimited JSON Consortium. (s. d.). NDJSON: Newline delimited JSON. http://ndjson.org/
Pandas Development Team. (2024). pandas.read_json documentation. PyData. https://pandas.pydata.org/docs/reference/api/pandas.read_json.html
Python Software Foundation. (2024). json — JSON encoder and decoder. Python standard library documentation. https://docs.python.org/3/library/json.html
Ritchie, C. (2024). Polars: Blazingly fast DataFrames in Rust, Python, and Node.js. https://pola.rs/
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
Unicode Consortium. (2023). The Unicode Standard: FAQ – UTF-8, UTF-16, UTF-32 & BOM. https://unicode.org/faq/utf_bom.html
Van Rossum, G., & Drake, F. L. (2009). Python 3 reference manual. CreateSpace.
Ward, H., & JSON Schema Team. (2020). JSON Schema: A media type for describing JSON data. Internet Engineering Task Force. https://json-schema.org/