
Dans l’écosystème du langage de programmation statistique R, la visualisation des données occupe une place prépondérante, servant de passerelle indispensable entre la modélisation mathématique abstraite et l’interprétation empirique. Héritier direct du langage S développé dans les laboratoires Bell, R intègre un sous-système graphique natif d’une grande puissance mais fondé sur un paradigme impératif strict. L’un des écueils les plus récurrents auxquels se heurtent tant les chercheurs chevronnés que les praticiens de la science des données réside dans l’apparition subite et apparemment cryptique de l’alerte d’exécution stipulant que l’instruction d’initialisation n’a pas encore été invoquée. Cette notification technique, formellement libellée sous l’expression plot.new has not been called yet, interrompt brutalement le flux d’affichage et signale une rupture fondamentale dans la séquence d’opérations attendue par le périphérique de traçage.
L’occurrence de cette anomalie ne relève pas d’une défaillance aléatoire de l’interpréteur ou d’un bogue sous-jacent du noyau de calcul, mais constitue au contraire la manifestation rigoureuse d’une violation du modèle d’état fini qui gouverne le moteur graphique standard de R. Contrairement aux approches modernes et déclaratives popularisées par la grammaire des graphiques, le moteur graphique de base repose sur une machine à états séquentielle. Chaque tracé est tributaire de l’établissement préalable d’un cadre spatial muni d’un système de coordonnées géométriques, de marges cartésiennes et d’une allocation de mémoire dédiée. Lorsqu’une commande d’ornementation visuelle ou de bas niveau est soumise sans que l’espace d’accueil n’ait été formellement instancié, le moteur d’exécution constate la vacuité du canevas et refuse de projeter des points dans le néant géométrique.
Comprendre, diagnostiquer et résoudre de manière pérenne cette erreur exige une immersion approfondie dans les fondements architecturaux du sous-système graphique de R. Cet article propose une dissection exhaustive de ce mécanisme, depuis les structures de mémoire bas niveau du moteur graphique jusqu’aux stratégies d’orchestration dans des contextes complexes d’analyses psychométriques, de visualisations multifenêtres et de scripts hautement automatisés. À travers l’examen détaillé des fonctions de haut et de bas niveau, l’étude d’exemples empiriques minutieusement commentés et la mise en lumière des interactions contradictoires entre systèmes graphiques concurrents, nous établirons un cadre méthodologique solide permettant d’éradiquer définitivement cette entrave à la productivité analytique et d’assurer une parfaite reproductibilité computationnelle de vos représentations visuelles.
1. Déconstruction épistémologique et technique de l’erreur plot.new has not been called yet
1.1 Anatomie interne du moteur graphique standard de R
L’architecture graphique historique de R, encapsulée au sein des paquetages fondamentaux dénommés graphics et grDevices, procède directement de la philosophie computationnelle formalisée par John Chambers dans les années 1970 et 1980 pour le langage S. Ce sous-système repose sur une métaphore picturale traditionnelle : celle du peintre appliquant méthodiquement des couches successives de pigments sur une toile préalablement tendue et apprêtée. Dans ce modèle impératif, le moteur graphique agit en tant que machine à états globale. Cette machine conserve en permanence un ensemble de registres internes décrivant l’état courant de l’affichage, notamment la géométrie de la fenêtre, la matrice de transformation affinant les coordonnées utilisateur en coordonnées physiques de l’écran, ainsi que les propriétés stylistiques immédiates telles que les épaisseurs de trait, les polices de caractères et les palettes chromatiques.
La gestion de la mémoire d’affichage dans ce paradigme s’articule autour d’un tampon graphique dépendant d’un périphérique actif. Lorsqu’un périphérique d’affichage est sollicité, qu’il s’agisse d’une fenêtre interactive à l’écran ou d’un fichier matriciel ou vectoriel sérialisé sur disque, le moteur réserve des structures de données en langage C sous-jacentes qui décrivent les zones de traçage. Ces structures englobent la zone totale du périphérique, la région extérieure des marges, et enfin la zone de traçage proprement dite, désignée sous le terme de région de traçage de la figure. L’existence de ces structures est conditionnée à une cinétique stricte : tant qu’une opération explicite de structuration spatiale n’a pas eu lieu, le système de transformation des coordonnées demeure inerte et indéfini.
Par conséquent, la séquentialité des instructions dans l’espace de rendu n’est pas une simple recommandation ergonomique, mais une contrainte algorithmique absolue. Le moteur graphique ne conserve pas d’arbre syntaxique abstrait des objets géométriques sous forme d’entités vectorielles indépendantes en mémoire vive prêtes à être recalculées dynamiquement. Chaque instruction envoyée au périphérique modifie irréversiblement les pixels ou les commandes vectorielles dans le tampon d’affichage en s’appuyant strictement sur les coordonnées calculées lors de l’instruction précédente. Si la première opération soumise au moteur ne remplit pas le rôle de configurateur de l’espace, la chaîne de transmission des coordonnées s’interrompt immédiatement, provoquant l’interruption formelle du processus de rendu.
1.2 Mécanisme de déclenchement de plot.new() et initialisation du canevas
Au cœur de cette machine à états réside une primitive interne essentielle : la fonction plot.new(), parfois accessible ou invoquée sous l’alias de plus bas niveau issu du langage C. Le rôle fondamental de cette commande consiste à opérer la transition d’un état non initialisé ou d’un état clos vers un nouvel état d’affichage prêt à recevoir des inscriptions géométriques. Lors de son exécution, la fonction procède à plusieurs vérifications critiques : elle s’assure de l’existence d’un périphérique graphique ouvert, fait avancer le compteur de pages si le périphérique supporte des documents multipages, purge le tampon visuel précédent de la zone de dessin active et configure les dimensions physiques initiales de la future figure.
L’exécution de cette primitive est indissociable de la fonction connexe plot.window(). Si la première crée la toile matérielle et alloue les marges du graphique en fonction des paramètres de configuration du système, la seconde établit la concordance mathématique entre les coordonnées absolues du périphérique, généralement exprimées en millimètres, en pouces ou en pixels, et les coordonnées relatives de l’utilisateur, exprimées dans les unités des variables statistiques analysées. C’est précisément cette articulation qui convertit une échelle de variance, un temps de réaction en millisecondes ou une mesure d’intelligence psychométrique en coordonnées physiques situées entre les bords gauche et droit, inférieur et supérieur de la fenêtre d’affichage.
Dès lors que cette séquence fondatrice est omise, le sous-système de calcul cartésien est frappé d’une incapacité structurelle à interpréter les instructions subséquentes. Si un utilisateur tente d’injecter une commande exigeant de tracer une entité à une coordonnée arbitraire sans que l’espace n’ait été préalablement calibré, le système refuse de projeter aveuglément ces points. La fonction interne d’aiguillage constate que le drapeau d’état indiquant qu’un nouveau tracé a été validé est toujours positionné sur la valeur négative. L’interpréteur interrompt immédiatement l’évaluation du script pour préserver l’intégrité de la pile d’exécution et renvoie le message sans équivoque indiquant que la commande d’initialisation du canevas n’a pas encore été appelée.
1.3 Distinction fondamentale entre fonctions graphiques de haut niveau et de bas niveau
Pour appréhender l’étiologie de cette erreur, il convient d’établir une dichotomie catégorielle rigoureuse au sein des fonctions proposées par le paquetage standard. Les concepteurs du système graphique de R ont scindé les outils visuels en deux familles étanches : les fonctions graphiques de haut niveau d’une part, et les primitives d’ornementation de bas niveau d’autre part. Cette distinction ne repose pas sur la complexité mathématique des données traitées, mais sur leur autonomie procédurale face au cycle de vie du canevas d’affichage.
Les fonctions de haut niveau, dont les archétypes les plus illustres sont plot(), hist(), boxplot(), barplot() ou encore curve(), assument la responsabilité intégrale de la création de la figure. Dès leur invocation, elles encapsulent de manière transparente l’appel à la primitive d’ouverture du tracé, calculent automatiquement les étendues minimales et maximales des données transmises, sollicitent l’ajustement de la fenêtre mathématique, dessinent les axes de graduation, inscrivent les libellés descriptifs et projettent la géométrie primaire des observations. Ces fonctions sont des instanciateurs complets d’univers graphiques : elles suffisent à elles-mêmes pour générer une représentation visuelle achevée à partir de structures de données brutes.
À l’opposé, les fonctions de bas niveau, représentées par des commandes telles que lines(), points(), text(), mtext(), segments() ou abline(), sont structurellement des parasites fonctionnels. Dépourvues de la faculté d’instancier un nouvel espace ou de configurer le référentiel cartésien, elles ont pour mandat exclusif d’enrichir, de superposer ou de modifier un tracé déjà matérialisé à l’écran. L’appel prématuré d’une fonction de bas niveau en début de script ou immédiatement après la fermeture d’un périphérique antérieur tente d’exécuter une tâche de second ordre dans un univers géométrique inexistant. C’est cette confusion procédurale, consistant à demander l’adjonction d’ornements sur une structure porteuse absente, qui constitue la cause fondamentale de l’interruption du processus de tracé.
2. Analyse des fonctions graphiques de bas niveau à l’origine de l’interruption
2.1 Le cas canonique des fonctions lines() et segments()
Parmi les déclencheurs les plus fréquents de l’anomalie figure l’usage isolé de la commande permettant le tracé de courbes continues. La fonction lines() attend impérativement en entrée des vecteurs d’abscisses et d’ordonnées destinés à être reliés de proche en proche par des segments linéaires successifs. Toutefois, cette opération d’interpolation linéaire requiert la connaissance préalable des facteurs d’échelle mathématiques régissant la transformation des unités de mesure en pixels du périphérique. Sans la définition préalable de ces paramètres par le biais d’un repère préalablement posé, la fonction se trouve dans l’incapacité absolue de situer le premier point de départ de la trajectoire polygonale.
De façon strictement analogue, la fonction segments(), qui permet de tracer une collection disjointe de traits droits reliant des paires de coordonnées spécifiées par des quadruplets de valeurs spatiales, ne dispose d’aucun mécanisme autonome de secours pour déterminer la taille de la fenêtre de traçage. Si un analyste tente de modéliser visuellement des flux, des transitions d’états d’un réseau ou des lignes de régression par morceaux en appelant directement cette commande au démarrage de sa session d’analyse, l’instruction se heurte à un registre d’état vierge. Le gestionnaire de bas niveau n’effectue aucune déduction implicite des étendues spatiales à partir des arguments fournis, car son contrat logiciel stipule qu’il doit uniquement dessiner à l’intérieur de marges déjà allouées par un cadre parent.
L’exception levée lors de l’interpolation sans fenêtre d’observation souligne la rigueur de l’architecture graphique. L’absence d’une heuristique par défaut capable de deviner automatiquement les bornes d’un graphique lors de l’exécution de lines() est délibérée : elle prévient la survenue d’aberrations dimensionnelles silencieuses qui surviendraient si des tracés successifs tentaient unilatéralement de redéfinir la grille de projection cartésienne. Cette rigueur conceptuelle garantit la cohérence des échelles superposées mais sanctionne immédiatement tout écart de séquence par un arrêt péremptoire du calcul visuel.
2.2 L’usage prématuré de points(), text() et mtext()
L’adjonction de marqueurs discrets et d’annotations textuelles relève d’une problématique conceptuelle identique. La fonction points(), conçue pour imprimer des symboles géométriques variés à des coordonnées ponctuelles précises, suppose que la surface réceptrice est déjà segmentée et orientée. Tenter d’utiliser cette primitive pour afficher la distribution d’une variable quantitative sans avoir préalablement établi la grille de fondation produit instantanément le message d’alerte étudié. L’interpréteur ne peut déterminer si la coordonnée soumise correspond au centre de la zone de visualisation, à un coin périphérique ou à une zone excédant les limites physiques de l’affichage.
La labellisation graphique via les commandes text() et mtext() illustre avec encore plus d’acuité la dépendance structurelle envers les zones géométriques déclarées. La commande text() est programmée pour situer des chaînes de caractères à l’intérieur de la zone de traçage interne définie par les coordonnées utilisateur. En revanche, la commande mtext() est dévolue à l’inscription de texte typographique dans les marges entourant cette même zone. Si aucun tracé primaire n’a orchestré la division entre la zone centrale et les quatre marges cardinales via les paramètres d’environnement graphique, l’ancrage spatial devient une impossibilité topologique.
Cette rupture de la pile d’exécution graphique lors de la tentative de labellisation isolée intervient fréquemment dans les scripts où la manipulation des données et leur mise en forme esthétique sont imbriquées de façon désordonnée. Par exemple, vouloir inscrire une légende analytique, marquer un seuil critique par une valeur textuelle ou numéroter des observations empiriques avant d’avoir formellement initialisé le repère orthonormé provoque invariablement la cessation des opérations d’affichage, obligeant le développeur à restructurer la chronologie de ses appels procéduraux.
2.3 Les fonctions d’enrichissement géométrique : polygon(), rect() et abline()
Le sous-système graphique met à disposition des chercheurs des primitives d’enrichissement surfacique d’une grande flexibilité technique, au premier rang desquelles figurent polygon() et rect(). La commande polygon() autorise la construction de figures géométriques fermées aux sommets arbitraires, facilitant notamment la visualisation d’intervalles de confiance continus, de distributions de probabilités sous une courbe ou d’enveloppes convexes d’échantillons. Néanmoins, le remplissage de ces surfaces par des motifs de hachures ou des aplats de couleurs semi-transparents implique une projection bidimensionnelle qui ne tolère aucune ambiguïté quant à l’origine et à la directionalité des axes cartésiens.
Il en va de même pour la fonction rect(), fréquemment exploitée pour matérialiser des zones de validité clinique, des fenêtres temporelles d’intérêt ou des seuils de significativité statistique sous forme de rectangles colorés en arrière-plan d’une distribution. Si le script commence par vouloir projeter ce rectangle de fondation avant de tracer les observations elles-mêmes, l’intuition de l’analyste, qui conçoit le rectangle comme une couche inférieure devant être dessinée chronologiquement en premier, se heurte de plein fouet aux impératifs du moteur de R. Le moteur refuse de peindre un fond géométrique tant que la scène globale n’a pas été déclarée au moyen d’un canevas primaire récepteur.
La célèbre fonction abline(), prisée pour son extrême concision lors de l’adjonction de droites horizontales, verticales ou issues d’un modèle d’analyse linéaire, manifeste un comportement tout aussi intransigeant. En acceptant directement en argument des valeurs de pente et d’intersection ou un objet issu d’une modélisation statistique, cette primitive promet d’étendre la droite d’un bout à l’autre de la fenêtre active. Cependant, calculer l’intersection entre une droite mathématiquement infinie et les bordures finies d’un dessin requiert la connaissance formelle des quatre coins de la boîte englobante. En l’absence de cette géométrie délimitée, le calcul vectoriel s’effondre et R renvoie l’erreur de non-initialisation.
2.4 Gestion des éléments d’habillage : legend() et axis()
L’habillage typographique et sémiotique d’une figure statistique s’appuie principalement sur la génération de légendes explicatives au moyen de legend() et sur la construction sur mesure des axes de coordonnées via l’instruction axis(). Ces deux composants logiciels constituent des couches fonctionnelles hautement spécialisées dont la vocation exclusive est de calibrer l’intelligibilité d’un tracé existant. L’utilisation d’une légende implique un calcul géométrique complexe de positionnement relatif, que ce dernier soit exprimé par des mots-clés topologiques tels que la partie supérieure droite ou par des coordonnées numériques absolues.
Lorsque la fonction legend() est appelée isolément, la machinerie interne tente de récupérer les dimensions métriques de la boîte englobante active pour y calculer l’espacement entre les symboles, les lignes de texte et la bordure décorative de la légende. Faute de trouver une zone de tracé allouée, l’évaluation déclenche instantanément l’exception d’interruption. Ce scénario se produit fréquemment lorsqu’un programmeur tente de générer une boîte de légende orpheline dans le dessein théorique de la sauvegarder en tant que ressource visuelle autonome ou pour composer manuellement une planche composite sans avoir instancié de sous-fenêtre graphique réceptrice.
De son côté, la commande axis() illustre le paroxysme de la dépendance structurelle. Conçue pour permettre un contrôle millimétré de l’orientation des graduations, de l’espacement des étiquettes et de la densité des marques d’intervalles sur l’un des quatre côtés de la figure, elle suppose l’existence préalable d’un domaine mathématique rigoureusement circonscrit. R ne peut implémenter de graduations sur une dimension dont l’origine, la terminaison et la dynamique de transformation n’ont pas fait l’objet d’une déclaration formelle, ce qui conduit inéluctablement au blocage de la séquence de commande si un appel à axis() n’est pas précédé d’un canevas configuré pour masquer ses axes automatiques initiaux.
3. Cas pratique 1 : Résolution de l’erreur lors de l’application de lines() sur une régression
3.1 Reproduction contrôlée de l’erreur avec un modèle polynomial
Afin d’examiner avec une rigueur empirique le déploiement de cette erreur et d’en disséquer les mécanismes correctifs, considérons un protocole expérimental typique en sciences comportementales. Imaginons une étude modélisant la dégradation de la performance cognitive en fonction de la durée de privation de sommeil, mesurée sur un échantillon d’individus suivis de manière contrôlée. La relation sous-jacente présente une cinétique non linéaire que l’on choisit d’ajuster à l’aide d’un modèle polynomial d’ordre deux via la fonction de modélisation statistique linéaire standardisée lm().
Le chercheur extrait les estimations de son modèle en générant une grille continue de prédictions sur l’ensemble de l’amplitude temporelle de l’étude. Désireux d’observer directement la trajectoire de la courbe prédite, il commet l’erreur courante de solliciter immédiatement la fonction lines() en lui transmettant le vecteur temporel ordonné et les valeurs ajustées issues de son modèle. L’environnement d’exécution R réagit instantanément par la levée de l’erreur fatale plot.new has not been called yet. L’analyste se trouve bloqué, non pas en raison d’une incohérence mathématique au sein de sa matrice de covariance ou de ses prédictions vectorielles, mais par le simple fait que la commande de tracé de courbe n’a trouvé aucun référentiel pour situer les points de flexion du polynôme.
L’analyse détaillée du message généré dans la console d’interprétation révèle que l’interpréteur a interrompu son travail dès les premières lignes du code assembleur compilé du moteur graphique. L’évaluation de l’ordonnée polynomiale n’a même pas pu être comparée aux pixels du moniteur, car la table des variables d’environnement graphique interne indique une valeur d’état non initialisée pour la figure en cours d’élaboration.
3.2 Implémentation de la solution séquentielle via plot() préalable
La résolution canonique de cette impasse impose de rétablir la chronologie impérative requise par la machine graphique de base. Avant de pouvoir projeter la moindre courbe lissée, il est impératif d’initialiser l’espace cartésien en faisant appel à la fonction de haut niveau plot(). Ce premier appel fondateur assume la charge de lire les valeurs extrêmes des variables prédictives et des observations empiriques, d’ajuster les marges canoniques de la fenêtre et d’imprimer la grille de lecture globale sur le périphérique graphique.
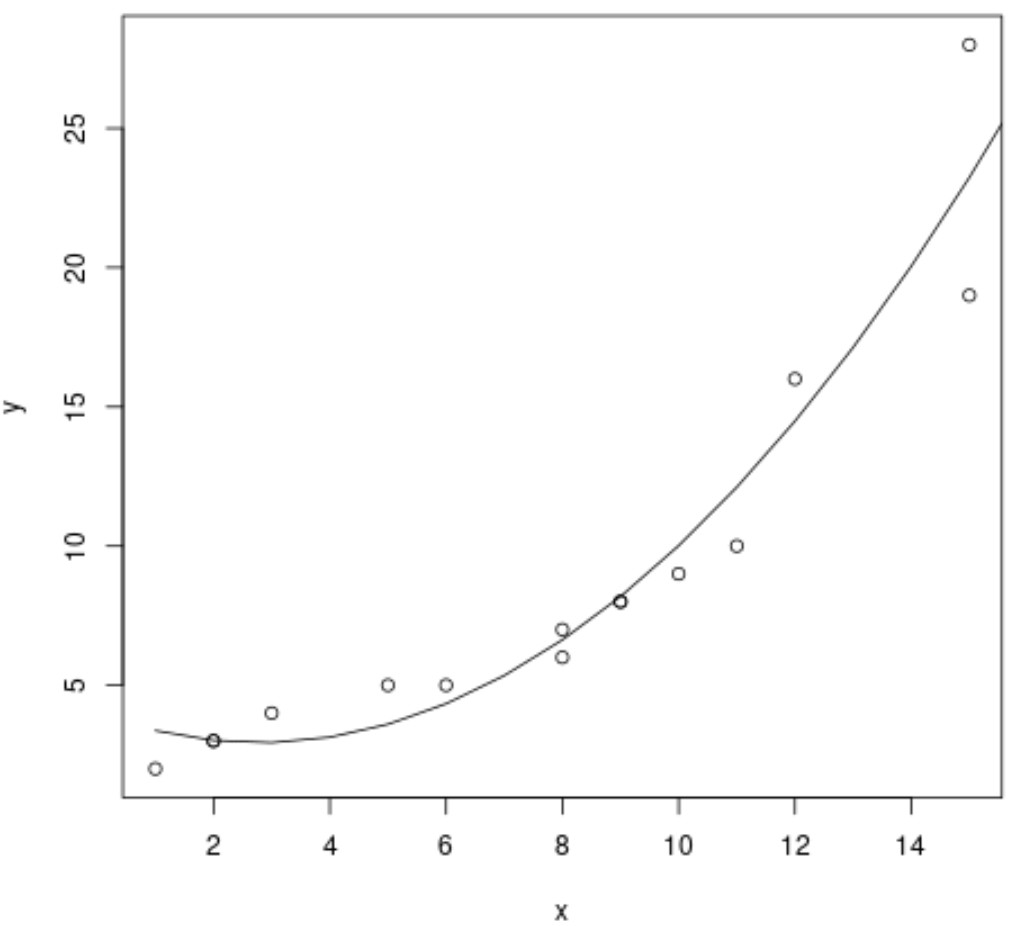
Dans ce cadre restauré, la démarche consiste à utiliser la fonction plot() pour représenter le nuage de points de dispersion des observations individuelles des participants. Cet appel positionne de manière invisible mais rigoureuse les repères cartésiens internes et configure les transformations d’échelles nécessaires. Dès lors que cette scène de base est stabilisée sur l’écran ou dans le tampon mémoire, l’appel subséquent à la commande lines() s’exécute sans la moindre anicroche. La fonction de bas niveau hérite docilement des caractéristiques géométriques établies par l’instruction précédente et vient inscrire la trajectoire polynomiale par-dessus les données empiriques.
Cette approche séquentielle garantit une adéquation géométrique absolue. Les valeurs ajustées du modèle polynomial s’alignent avec exactitude sur les coordonnées des observations qui ont présidé à leur estimation. Le tracé de la régression polynomiale enrichit le diagramme de dispersion sans détruire le contexte spatial, réalisant ainsi l’objectif analytique initial tout en respectant scrupuleusement le cycle de vie des primitives de rendu de R.
3.3 Ajustement préventif des paramètres d’échelle xlim et ylim
Une difficulté connexe survient fréquemment lors de l’application de cette solution séquentielle : la troncature de la courbe ajustée. Lorsque la fonction initiale de haut niveau plot() est invoquée sur le seul jeu de données empiriques brutes, elle calibre ses paramètres d’échelle sur les valeurs minimales et maximales des points effectivement observés. Or, un modèle de régression, en particulier s’il implique des termes polynomiaux d’ordre supérieur ou des extrapolations asymptotiques, peut projeter des prédictions qui s’écartent sensiblement des limites de la dispersion échantillonnale.
Si la ligne de régression tracée par la commande lines() excède l’amplitude originellement enregistrée par la fonction plot(), les portions périphériques de la courbe seront purement et simplement tronquées par le moteur de rendu, sans déclencher d’erreur explicite mais en dégradant la fidélité de l’affichage scientifique. Pour parer à cette déficience visuelle, l’analyste doit effectuer un calcul préventif des limites dimensionnelles extrêmes en combinant de façon dynamique l’étendue des données d’observation et celle des valeurs prédites par la modélisation.
L’attribution explicite des arguments xlim et ylim au sein de la commande initiale plot() permet de réserver un espace géométrique suffisant pour contenir à la fois le nuage de points et l’intégralité du profil fonctionnel de la courbe estimée. Cette anticipation vectorielle protège le tracé contre tout phénomène d’écrêtage, assurant une concordance visuelle sans faille et préservant l’intégrité de l’interprétation statistique du phénomène modélisé.
4. Cas pratique 2 : Résolution de l’erreur avec points() et superpositions empiriques
4.1 Scénario d’échec classique lors du tracé d’échantillons stratifiés
Un autre cas d’usage emblématique où surgit immanquablement l’erreur d’absence d’initialisation de plot.new concerne la représentation d’échantillons stratifiés ou subdivisés en multiples sous-groupes expérimentaux. Considérons un protocole de recherche comparant les performances attentionnelles d’individus issus de trois cohortes distinctes : un groupe témoin, un groupe soumis à un stresseur aigu et un groupe ayant bénéficié d’une intervention de remédiation cognitive. Le chercheur dispose d’un tableau de données unique qu’il souhaite représenter visuellement en appliquant des attributs stylistiques individualisés à chaque sous-ensemble.
Guidé par une logique algorithmique procédurale, l’analyste scinde ses données par groupe et tente d’itérer sur chaque sous-cohorte en utilisant directement la fonction points() pour injecter successivement les éléments de chaque classe avec leur couleur respective. Dès le premier passage de la séquence d’exécution, l’interpréteur R s’arrête net, levant l’exception d’absence d’initialisation. L’analyste est déconcerté, estimant avoir fourni des matrices de données valides à une fonction précisément dédiée à l’impression de points.
L’erreur découle du fait qu’aucun réceptacle global n’a été formalisé pour accueillir la superposition cumulative des différentes strates de l’échantillon. En sollicitant points() d’emblée, le script demande au système d’afficher la première strate dans le vide spatial. Même si le chercheur comptait ajouter les strates les unes après les autres, le moteur exige qu’une coquille vide mais rigoureusement calibrée soit positionnée en premier lieu pour définir les frontières de l’espace de dispersion commun.
4.2 Déclaration d’un canevas vide avec plot(…, type = ‘n’)
Pour dénouer cette impasse avec une élégance idiomatique conforme aux standards de R, la stratégie de référence réside dans l’utilisation méthodique de l’argument de neutralisation du type de tracé au sein de la fonction principale de haut niveau. L’affectation du paramètre type = ‘n’ dans un appel préliminaire à la fonction plot() ordonne explicitement au moteur de générer l’ensemble de l’armature cartésienne sans imprimer le moindre pixel de données dans l’espace intérieur.
Cette technique présente des vertus méthodologiques remarquables. L’instruction configure l’ensemble des métadonnées du dessin : la surface globale de la figure est allouée, les marges extérieures sont réservées conformément aux canons typographiques, les axes d’abscisses et d’ordonnées sont dessinés avec leurs graduations chiffrées, et les titres ainsi que les libellés dimensionnels sont gravés sur le support. Cependant, la zone centrale de traçage demeure vierge de toute marque, fonctionnant comme un canevas blanc prêt à recevoir les couches graphiques subséquentes.
En recourant à ce canevas passif, le praticien s’assure que le domaine mathématique de l’espace correspond à la variabilité globale de l’échantillon tout entier. Il suffit d’alimenter cette commande inaugurale avec les bornes globales de l’étude pour que le repère spatial soit scellé de manière définitive, immunisant la suite de la routine graphique contre tout risque de blocage ou d’écrasement dimensionnel.
4.3 Stratification visuelle et ajout progressif des cohortes d’observations
Une fois le canevas neutre institué, la machine à états de R se trouve dans une disposition optimale pour accepter une succession ininterrompue d’appels de bas niveau. L’injection méthodique de chaque cohorte empirique peut désormais s’effectuer sans encombre au moyen de la fonction points(). Chaque appel successif spécifie les sous-vecteurs de données adéquats, tout en exploitant librement les modificateurs de symboles typographiques et les palettes de couleurs.
L’attribution individualisée du paramètre de forme de point, désigné par l’acronyme historique pch pour le contrôle des symboles de traçage, combinée à la sélection fine des teintes chromatiques par l’argument col, permet d’élaborer une visualisation multidimensionnelle d’une parfaite lisibilité analytique. Les cohortes cliniques se superposent harmonieusement dans le même référentiel, sans générer de décalage d’échelle ou d’artefact spatial.
Pour couronner cette construction par stratification successive, l’adjonction finale d’une boîte de légende par la commande legend() s’exécute avec une fluidité absolue. Puisque l’espace graphique de base est toujours actif et correctement indexé dans le sous-système de R, la légende vient s’ancrer précisément aux coordonnées spécifiées, clôturant la modélisation visuelle par une synthèse sémiotique rigoureuse et exempte de toute instabilité d’exécution.
5. Cas pratique 3 : Résolution de l’erreur avec abline() et indicateurs statistiques
5.1 Tentative d’insertion directe de droites de régression ou de seuils théoriques
L’un des automatismes les plus tenaces chez les modélisateurs formés à l’analyse de données consiste à vouloir matérialiser instantanément un résultat statistique synthétique sitôt son estimation achevée. Dans de nombreux protocoles d’évaluation psychologique, il est d’usage de comparer les données observées à des normes théoriques standardisées, telles qu’un seuil critique de significativité clinique ou un niveau moyen de référence populationnelle. Face à ce besoin, la commande abline() s’impose spontanément à l’esprit en raison de son apparente simplicité opératoire.
Cependant, l’invocation de abline() de façon déconnectée, par exemple immédiatement après avoir ajusté un modèle par moindres carrés ordinaires ou après avoir calculé un score seuil, conduit immédiatement à la levée de l’erreur d’état non initialisé. Le programmeur omet le fait que abline() ne possède aucune capacité intrinsèque à matérialiser un espace métrique. La fonction tente de calculer des intersections vectorielles avec les parois d’une enceinte qui n’a pas été déclarée au niveau du périphérique d’affichage.
Cette incompréhension découle du fait que, conceptuellement, une droite géométrique pure est un objet d’étendue infinie défini par une équation affine. Sur un écran d’ordinateur ou sur une feuille d’impression, une telle infinité ne peut être représentée que par le biais d’un recadrage strict aux bordures d’un rectangle d’observation. En l’absence d’une fenêtre préalable spécifiant les frontières du monde physique, R est incapable d’inférer les bornes de troncature du tracé et refuse logiquement d’exécuter l’ordre graphique orphelin.
5.2 Synchronisation de abline() avec une figure initiale active
Pour restaurer la conformité procédurale de la modélisation visuelle, l’insertion des droites de repère doit impérativement être synchronisée avec une figure initiale préalablement rendue active. La chronologie logicielle doit impérativement démarrer par la création du conteneur visuel, qu’il s’agisse d’un histogramme de distribution des scores via hist(), d’un tracé de densité ou d’un nuage d’observations transversales généré par plot().
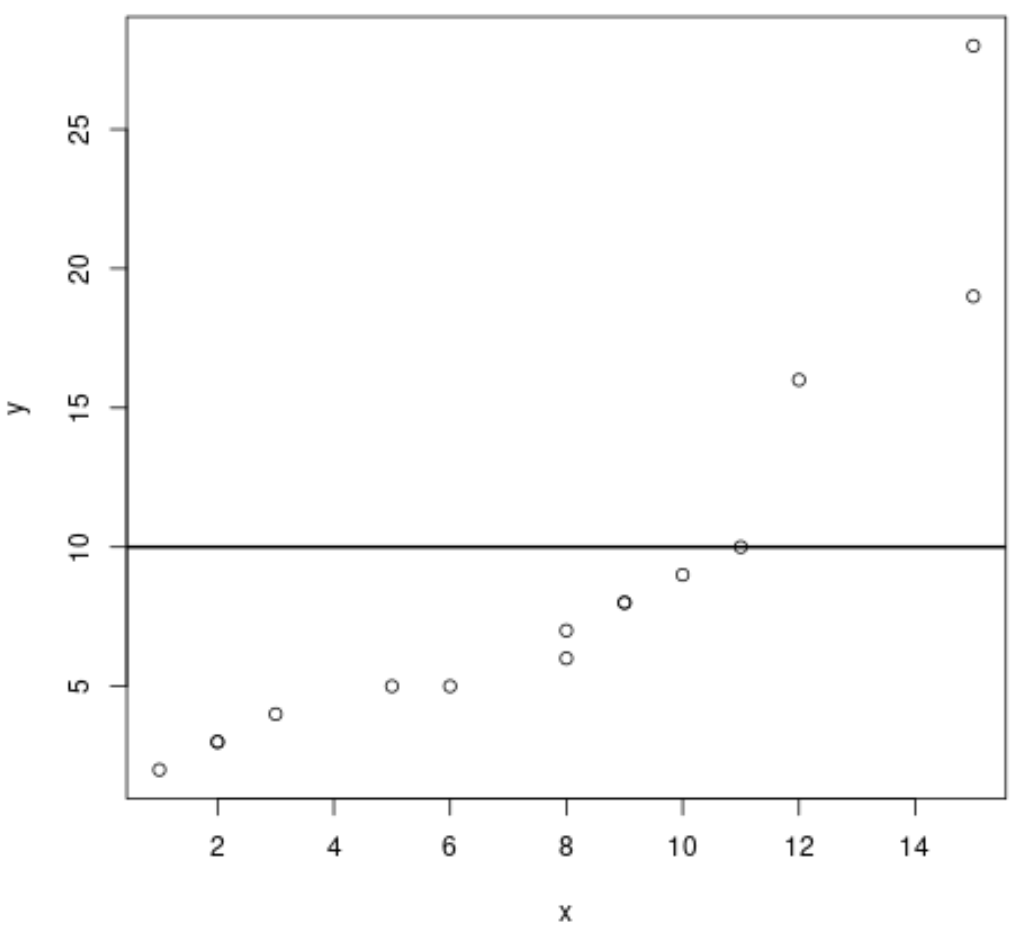
Dès que le conteneur principal a projeté les données dans la fenêtre du périphérique, la fonction abline() peut être appelée pour ajouter des repères analytiques ciblés. Par exemple, l’affectation de l’argument vertical v = seuil permet de tracer une ligne de démarcation orthogonale à l’abscisse pour signaler une coupure diagnostique, tandis que l’argument horizontal h = seuil projette une référence parallèle à l’axe des ordonnées pour marquer une moyenne normative.
Cette synchronisation séquentielle garantit que les coordonnées de la droite s’inscrivent parfaitement à l’intérieur des marges de la figure active. La droite traverse l’espace géométrique sans en perturber les proportions relatives ni corrompre les métriques établies par l’histogramme ou le nuage de points fondateur. Le flux computationnel retrouve sa rectitude, aboutissant à une représentation visuelle conforme aux exigences académiques les plus strictes.
5.3 Affichage conjoint d’intervalles de confiance et de normes statistiques
Dans le prolongement des analyses psychométriques avancées, l’affichage de simples repères linéaires s’avère souvent insuffisant pour caractériser l’incertitude inhérente aux mesures comportementales. L’analyste se trouve régulièrement dans l’obligation de superposer à la fois une valeur centrale de tendance et un faisceau d’intervalles de confiance ou de déviations standard autour de cette moyenne théorique. Ce défi graphique met en lumière l’importance d’une orchestration sans faille des fonctions de bas niveau.
La méthodologie adéquate consiste à articuler méthodiquement la commande abline() pour la modélisation de la valeur centrale et la fonction lines() pour le tracé des bordures supérieure et inférieure de l’intervalle de confiance. L’ensemble de cette composition doit reposer sur un unique canevas hôte créé en amont. En gérant judicieusement les paramètres de style de trait, tels que la commande lty pour appliquer des tiretés aux bornes d’incertitude statistique, l’analyste enrichit le graphe sans jamais réinitialiser l’environnement d’affichage sous-jacent.
Cette approche évite tout conflit d’état au sein du périphérique graphique. La succession ordonnée des appels d’ornementation visuelle tire pleinement parti de la persistance de l’état du canevas, produisant une figure scientifique d’une haute densité informationnelle où la distribution observée, les normes théoriques et les marges d’erreur s’intègrent sans la moindre interférence technique.
6. Le cas particulier des visualisations multifenêtres et paramètres graphiques par()
6.1 Conflits générés par l’utilisation de mfrow, mfcol et layout()
L’un des environnements les plus fertiles pour l’apparition impromptue de l’erreur de non-initialisation réside dans la configuration de matrices d’affichage destinées à juxtaposer plusieurs visualisations au sein d’une même planche scientifique. Pour diviser l’espace du périphérique en une grille ordonnée de sous-figures, les praticiens recourent classiquement à la modification des variables d’état globales via la fonction par(), en lui passant des vecteurs de dimensionnement matriciel désignés par mfrow ou mfcol, ou en faisant appel au gestionnaire plus sophistiqué layout().
La modification de ces variables partitionne virtuellement la zone graphique en une matrice de sous-régions indépendantes. Cependant, cette partition ne procède pas automatiquement à l’initialisation du canevas au sein de chaque alvéole de la grille. Chaque cellule élémentaire doit traverser son propre cycle d’initialisation par le truchement d’un appel spécifique à une fonction de haut niveau. Si, au cours du parcours séquentiel de la matrice d’affichage, le code tente d’injecter une commande de bas niveau telle que lines() ou text() dans une sous-région qui n’a pas encore accueilli de tracé initialisateur de haut niveau, le système bloque immédiatement l’exécution.
Cette situation se matérialise fréquemment lors de l’exécution de boucles de tracé mal alignées avec les dimensions de la grille. Par exemple, si une boucle itère sur un nombre d’indices inférieur à la taille de la grille matricielle et qu’une fonction d’ornementation externe est déclenchée après l’interruption de la boucle, cette dernière tente de s’ancrer dans la cellule suivante restée totalement inerte. L’absence de synchronisation entre l’indexation de la grille et l’état d’activation des sous-canevas débouche immanquablement sur la résurgence du message d’erreur d’absence de tracé actif.
6.2 Corruption de l’environnement graphique lors d’altérations des marges (mar, oma)
L’optimisation typographique des publications universitaires requiert fréquemment un ajustement millimétré des marges intérieures et extérieures séparant les différentes représentations d’une planche visuelle. Le paramètre mar gouverne la taille des marges intérieures associées à chaque figure unitaire, tandis que le paramètre oma régule l’amplitude des marges globales ceinturant l’ensemble du périphérique multifenêtre. Néanmoins, une manipulation imprudente de ces dimensions peut induire une corruption fonctionnelle sévère de l’environnement de tracé.
Lorsque des marges disproportionnées sont assignées à un périphérique dont les dimensions physiques absolues sont réduites, la surface allouée à la région de traçage intérieure peut se trouver réduite à une valeur nulle, voire à une quantité négative sur le plan computationnel. Dans de telles circonstances, l’interpréteur R commence par émettre une alerte d’invalidité dimensionnelle indiquant que les marges de la figure sont excessives. Si le script tente néanmoins de poursuivre son exécution sans corriger cette incompatibilité géométrique, l’appel subséquent à une primitive graphique avorte, générant en chaîne l’impossibilité d’exécuter l’initialisation fondamentale du tracé.
Ce phénomène d’erreur en cascade obscurcit souvent le diagnostic pour le chercheur non averti. Focalisé sur le message final de non-initialisation du canevas, il peut omettre d’examiner les paramètres d’espacement définis dans les lignes antérieures de son code source. Il est donc fondamental de comprendre que toute anomalie géométrique réduisant à néant l’espace effectif de dessin empêche physiquement l’instanciation de plot.new(), bloquant l’ensemble du flux de production visuelle.
6.3 Rétablissement de la matrice d’affichage et clôture propre des contextes
La règle cardinale gouvernant la gestion saine des paramètres graphiques globaux réside dans la préservation systématique de l’état initial de l’environnement avant toute modification locale. Dès lors qu’une fonction ou un script scientifique altère la configuration du périphérique au moyen de par(), les valeurs préexistantes doivent être sauvegardées dans une variable dédiée. Le mécanisme standard préconise la capture intégrale des paramètres modifiables par une affectation préventive ciblant l’argument de filtrage des paramètres en lecture seule.
Cette approche permet d’assurer une réinitialisation absolue de l’environnement graphique dès que la séquence de tracé multifenêtre touche à sa fin. En restaurant la variable sauvegardée à l’issue de la procédure, le script garantit que les futures routines graphiques démarreront sur une configuration saine, évitant que des réglages résiduels de partition matricielle ou de réduction marginale ne viennent contaminer les tracés ultérieurs exécutés au sein de la même session R.
L’absence de ce réflexe de clôture contextuelle est la source d’innombrables dysfonctionnements sporadiques dans les laboratoires de recherche. Un script exécuté isolément peut fonctionner à la perfection lors d’une première phase de test, puis échouer inexplicablement lors de sa deuxième exécution simplement parce que la session R a conservé en mémoire un état matriciel fragmenté où les sous-zones n’ont pas été purgées. La rigueur de la réinitialisation constitue ainsi l’un des piliers garants d’une programmation scientifique reproductible et robuste.
7. Dysfonctionnements liés aux périphériques graphiques (Devices) et environnements de développement
7.1 Interruption et réinitialisation des périphériques avec dev.off(), dev.new() et dev.cur()
Toute instruction graphique exécutée dans l’environnement R est adressée à un récepteur matériel ou logiciel dénommé périphérique de traçage, ou graphic device dans la terminologie anglo-saxonne native. Ces périphériques peuvent être interactifs, à l’image des fenêtres de rendu intégrées aux systèmes d’exploitation sous Windows, macOS ou Linux, ou non interactifs, dans le cas des convertisseurs matriciels ou vectoriels produisant des fichiers sérialisés sur le disque dur. Le suivi de ces instances d’affichage est assuré par un registre numérique interne que l’analyste peut interroger à tout moment à l’aide de commandes dédiées telles que dev.cur() et dev.list().
Une anomalie fréquente à l’origine du blocage de l’initialisation du canevas survient lorsqu’un périphérique d’affichage se retrouve dans un état dit fantôme ou corrompu. Cet état se manifeste lorsqu’une routine d’exportation graphique a été prématurément interrompue par une erreur de syntaxe ou par une intervention manuelle de l’utilisateur avant que le périphérique n’ait été formellement scellé. Dans ce cas de figure, l’instance du périphérique demeure ouverte en mémoire vive mais son tampon d’écriture est verrouillé ou corrompu, interdisant toute nouvelle instanciation spatiale par le moteur d’exécution.
La thérapeutique face à cet engorgement opérationnel réside dans l’utilisation méthodique de la commande de clôture dev.off(). Exécutée dans la console de commande, cette instruction referme le périphérique courant et transfère le contrôle au périphérique antérieur dans la pile du système. En situation de blocage sévère, il est fréquemment salutaire de répéter cet appel au sein d’une boucle conditionnelle tant que le périphérique actif ne revient pas au périphérique standard de référence, désigné sous le label de périphérique nul. Une fois le système assaini, l’instanciation propre d’une nouvelle surface de rendu par la commande dev.new() permet de restaurer l’intégrité fonctionnelle complète du pipeline graphique.
7.2 Incohérences spécifiques à RStudio et aux notebooks R Markdown / Quarto
L’hégémonie contemporaine de l’environnement de développement intégré RStudio et des documents computationnels tels que R Markdown et Quarto introduit des couches d’abstraction supplémentaires entre l’interpréteur R de base et l’utilisateur final. RStudio intercepte les appels graphiques standards pour les rediriger vers un composant propriétaire interne chargé d’alimenter le panneau d’affichage visuel, identifié sous l’onglet Plots. Ce dispositif d’interception gère une pile historique des figures générées et redimensionne dynamiquement les tracés en fonction des ajustements de l’interface graphique utilisateur.
Ce mécanisme sophistiqué peut toutefois se désynchroniser du moteur graphique standard de R. Lors de sessions d’analyse intensives comportant des dizaines de figures successives, le tampon de communication entre la session R sous-jacente et l’interface Web ou Qt de RStudio peut se retrouver saturé. Dans ces circonstances, une primitive de haut niveau peut être correctement transmise par le code mais ignorée par le visualiseur graphique, laissant la session dans l’illusion qu’aucun nouveau tracé n’a été matérialisé. L’appel de bas niveau qui suit immédiatement heurte alors un état graphique non reconnu, déclenchant l’exception de non-initialisation.
Dans le contexte des blocs de code exécutés de façon fragmentée au sein des carnets interactifs de type Quarto ou R Markdown, la problématique est exacerbée par la nature isolée de chaque cellule computationnelle. Si un analyste place la commande fondatrice de haut niveau dans un bloc de code et tente d’exécuter la commande d’ornementation de bas niveau dans un bloc adjacent sans réinitialiser le contexte, le moteur de rendu du notebook, qui traite chaque bloc comme un environnement d’évaluation hermétique scellé par son propre périphérique temporaire, refuse catégoriquement l’opération. L’exécution d’une primitive de bas niveau dans une cellule indépendante échoue systématiquement, car le canevas créé dans la cellule précédente a été irrémédiablement clos dès la fin de l’évaluation de cette dernière.
7.3 Gestion des exportations graphiques automatisées (png, pdf, svg)
L’automatisation de la production visuelle au sein de pipelines de traitement massif des données impose fréquemment l’exportation directe de graphiques vers des formats de stockage sur disque tels que le format matriciel png ou les formats vectoriels pdf et svg. Le protocole standard gouvernant ces opérations en langage R exige le déploiement d’un triptyque procédural scrupuleux : ouverture explicite du périphérique de fichier ciblé, génération méthodique du contenu graphique, et enfin scellement hermétique du conteneur sur le disque dur via l’appel à dev.off().
Le piège récurrent menant à la corruption du périphérique et à la levée de l’erreur d’initialisation manquante réside dans l’omission ou la mauvaise organisation des commandes intermédiaires. Si un script batch ouvre un fichier de destination à l’aide de l’instruction png(« figure.png ») et procède immédiatement à l’appel d’une fonction d’ornementation telle que lines() sans avoir convoqué de fonction de haut niveau, le fichier cible demeure une enveloppe binaire vide dépourvue de tout repère d’échelle. Non seulement l’interpréteur interrompt le script avec l’erreur canonique, mais le fichier ouvert sur le disque dur reste verrouillé par le système d’exploitation, empêchant toute lecture ou écriture ultérieure.
Pour prévenir cette défaillance, toute chaîne d’exportation scriptée doit être structurée avec une rigueur défensive absolue. Il est impératif d’intégrer des mécanismes assurant que chaque ouverture de fichier d’enregistrement est inconditionnellement suivie d’une fonction de haut niveau validée, et que l’instruction de clôture finale est garantie d’être évaluée, y compris en cas de défaillance algorithmique survenue au cœur de la séquence de tracé.
8. Interférences entre paradigmes : Le piège de la cohabitation Base R et ggplot2
8.1 Divergences architecturales entre Grid Graphics et Base Graphics
L’une des causes majeures de confusion chez les programmeurs contemporains découle de la cohabitation, au sein de l’écosystème R, de deux paradigmes graphiques radicalement antinomiques : le moteur graphique traditionnel désigné sous le vocable de Base Graphics et le moteur structurel moderne dénommé Grid Graphics. Alors que le système de base opère selon le paradigme impératif de la machine à états picturale explicité précédemment, le moteur Grid, conçu par Paul Murrell, propose une modélisation déclarative orientée objet fondée sur des arbres de structures géométriques et des fenêtres relatives appelées viewports.
L’écosystème ultra-populaire ggplot2, conçu par Hadley Wickham pour transposer la grammaire formelle des graphiques de Leland Wilkinson dans le langage R, est entièrement édifié sur le socle technique de Grid. Dans cette approche, l’invocation de fonctions graphiques ne produit aucun tracé direct immédiat dans le tampon mémoire des pixels. Elle assemble au contraire un objet complexe en mémoire vive, porteur d’une structure arborescente complète encapsulant les données statistiques, les relations esthétiques de mise en correspondance, les systèmes de coordonnées et les facettes d’affichage.
Ce n’est qu’au moment précis où cet objet composite est formellement évalué par l’interpréteur, généralement via la méthode d’affichage print() ou lors de son rendu explicite dans la console, que le moteur Grid instancie ses fenêtres de dessin spécifiques et matérialise la géométrie visuelle. De ce fait, le tampon d’affichage géré par Grid est totalement découplé et étanche par rapport à l’état interne de la machine à états de Base Graphics. Les deux univers coexistent au sein du même exécutable R mais ne partagent aucun registre de coordonnées, aucune matrice de projection affine et aucun registre d’étalonnage de canevas.
8.2 Erreurs courantes lors de la tentative de greffer lines() sur un tracé ggplot
L’erreur matérialisée par la formule plot.new has not been called yet frappe de plein fouet l’analyste qui tente de mélanger naïvement ces deux philosophies logicielles au sein d’une même unité de script. Un cas d’école consiste à générer un tracé d’une grande sophistication esthétique au moyen d’un pipeline d’instructions ggplot2, à le faire s’afficher à l’écran, puis à vouloir y greffer immédiatement une annotation de bas niveau issue de la boîte à outils traditionnelle, telle que l’adjonction d’une droite de référence via abline() ou d’une courbe de tendance via lines().
Bien que le graphique généré par ggplot2 brille ostensiblement sous les yeux de l’utilisateur dans le panneau d’affichage, le sous-système Base Graphics n’a, pour sa part, absolument pas été sollicité. Son compteur d’état est vierge, aucune zone de traçage n’a été allouée dans son registre historique et le drapeau signalant l’exécution de plot.new() est resté à l’état négatif. Lorsque l’instruction de bas niveau est évaluée, elle interroge le sous-système de base, constate l’absence totale de canevas déclaré dans son propre référentiel et interrompt le programme net en levant l’alerte d’absence d’initialisation préalable.
Cette barrière architecturale engendre une grande perplexité, car la présence visible d’une figure sur le périphérique donne l’illusion trompeuse qu’un espace cartésien est disponible pour de futures inscriptions. Le moteur de rendu de R sanctionne l’incompatibilité sous-jacente des contextes d’affichage : une primitive de base ne peut en aucun cas s’arrimer de manière implicite aux structures vectorielles d’un objet géré par la bibliothèque Grid.
8.3 Stratégies d’intégration et équivalences idiomatiques
Face à cette dualité de moteurs, la première règle de bonne pratique d’ingénierie logicielle consiste à préserver une stricte étanchéité de paradigme au sein de chaque projet de recherche. Si le choix méthodologique initial s’est porté sur ggplot2, l’ensemble des enrichissements, annotations, droites de tendance et labels textuels doit impérativement être déployé par le truchement des couches géométriques déclaratives de cette même bibliothèque, à savoir les fonctions canoniques geom_line(), geom_point(), geom_smooth(), geom_segment() ou annotate().
Dans les situations complexes où la réutilisation de routines graphiques héritées développées sous le modèle historique de base s’avère incontournable au sein d’un pipeline moderne, il est nécessaire de recourir à des passerelles d’interfaçage dédiées. Le paquetage gridGraphics propose par exemple des convertisseurs algorithmiques capables d’émuler la machine à états de base au-dessus d’un canevas Grid, traduisant chaque instruction procédurale en un arbre de primitives vectorielles recalculables.
De même, des solutions d’orchestration avancées fournies par des bibliothèques telles que cowplot ou ggplotify autorisent la transformation d’enregistrements graphiques natifs en objets manipulables au sein de la grammaire moderne. Ces mécanismes permettent d’encapsuler proprement des visualisations disparates au sein d’un même canevas composite sans risquer d’altérer l’état interne des périphériques d’exécution respectifs.
9. Automatisation, boucles itératives et fonctions personnalisées sans canevas
9.1 Pièges récurrents au sein des boucles for() et fonctions vectorielles
L’industrialisation des analyses statistiques modernes conduit inévitablement les chercheurs à formaliser la génération de représentations visuelles au travers de structures algorithmiques itératives, telles que les boucles traditionnelles for() ou les opérateurs de programmation fonctionnelle vectorisée issus de la famille apply() ou du paquetage purrr. C’est précisément au cœur de ces architectures sérielles que l’absence d’un contrôle rigoureux de l’état du canevas déploie ses conséquences les plus délétères.
Considérons un protocole d’analyse de données chronobiologiques ou de suivi longitudinal de signaux physiologiques enregistrés chez des centaines de sujets expérimentaux. L’analyste se propose de concevoir un script automatisé générant une trajectoire temporelle continue pour chaque participant. L’erreur méthodologique typique consiste à insérer l’instruction de haut niveau plot() au sein de la première itération conditionnelle, puis à reléguer l’injection des observations de l’ensemble des participants suivants à l’usage exclusif de la primitive lines().
Si la première itération échoue de manière inattendue en raison d’une valeur manquante ou si l’indexation de la collection de données commence sur un indice inattendu, la commande d’instanciation de base est purement et simplement sautée par le flux de contrôle conditionnel. Dès lors, la seconde itération tente d’exécuter la fonction d’ornementation lines() sans que le canevas récepteur n’ait été matérialisé lors de l’étape précédente. Le pipeline complet s’effondre en cours de traitement de nuit, invalidant des heures d’exécution automatisée à cause d’une rupture dans la cinétique d’initialisation de l’affichage.
9.2 Encapsulation sécurisée dans des fonctions génératrices personnalisées
Pour immuniser les scripts industriels contre cette vulnérabilité structurelle, il est impératif d’encapsuler la production graphique au sein de fonctions logicielles autonomes, défensives et hautement paramétrées. Une fonction graphique scientifiquement robuste ne doit jamais postuler aveuglément l’existence d’un canevas préexistant dans l’environnement global d’exécution sans en vérifier la présence ou sans offrir une alternative explicite.
La convention de programmation idiomatique en langage R impose de concevoir ces fonctions personnalisées en leur adjoignant un argument booléen de contrôle, universellement désigné sous l’étiquette add = FALSE. Lorsque ce paramètre conserve sa valeur négative par défaut, la fonction assume l’obligation de créer son propre univers graphique au moyen d’un appel inaugurale à une fonction de haut niveau calibrée sur les bornes du jeu de données fourni. À l’inverse, si l’analyste positionne délibérément cet argument sur la valeur logique vraie, la fonction renonce à initialiser le repère et procède directement à la superposition de ses motifs via des primitives de bas niveau.
Cette conception modulaire garantit une flexibilité d’usage maximale. La fonction peut être mobilisée de manière totalement isolée pour produire une planche autonome, ou au contraire être incorporée sans heurts au sein d’une boucle cumulative visant à empiler des profils empiriques multiples sur une même structure porteuse, éradiquant dès lors tout risque d’incohérence quant à l’état de la machine d’affichage.
9.3 Vérification programmatique de l’état du périphérique avant le tracé
Au-delà de la paramétrisation des arguments, une ingénierie logicielle défensive de haut niveau nécessite une interrogation dynamique et programmatique de l’environnement graphique avant l’exécution de toute commande géométrique sensible. Le langage R offre des primitives d’introspection système capables de révéler instantanément l’état opérationnel du sous-système de tracé.
L’analyste peut notamment sonder la variable d’environnement .Device ou inspecter la valeur renvoyée par dev.cur() pour déterminer si un périphérique est non seulement ouvert en mémoire vive, mais s’il dispose d’une page active. Des mécanismes d’inspection plus intimes permettent de conditionner l’appel formel à plot.new() en testant si l’état interne de la figure correspond à une phase de traçage vierge. Si l’évaluation révèle l’absence d’initialisation, le wrapper logiciel procède de manière totalement transparente à l’instanciation requise avant de dérouler les couches d’ornementation.
Le déploiement de ces mécanismes de garde programmatique s’avère particulièrement pertinent dans la rédaction de paquetages R distribués sur le réseau CRAN. En intégrant ces barrières de sécurité au cœur des bibliothèques de calcul partagées, les concepteurs d’outils statistiques épargnent aux utilisateurs finaux la confrontation avec des alertes d’exécution cryptiques dont l’origine relève de l’infrastructure logicielle plutôt que de la modélisation des données.
10. Applications avancées en modélisation psychologique et analyse comportementale
10.1 Visualisation de trajectoires longitudinales de participants
L’analyse des trajectoires de développement cognitif, des processus d’apprentissage séquentiel et de l’évolution des marqueurs affectifs s’appuie largement sur des protocoles de recueil de données longitudinaux. La visualisation rigoureuse de ces dynamiques intra-individuelles impose de tracer les profils d’évolution temporelle d’une multitude de participants sur un graphique partagé, afin de contraster visuellement la variance intra-sujet avec l’hétérogénéité inter-individuelle globale.
La mise en œuvre réussie de cette modélisation visuelle nécessite l’établissement d’une matrice dimensionnelle englobant l’intégralité des horizons temporels de l’étude en abscisse, et les extremums absolus de la variable psychologique d’intérêt en ordonnée. En initialisant ce cadre fondateur au moyen d’un canevas neutre calculé sur l’ensemble de la population de l’échantillon, le chercheur s’assure qu’aucun profil marginal ne viendra excéder les frontières du système de coordonnées.
Une fois cette fondation consolidée, une boucle itérative peut parcourir l’index des participants pour y appliquer successivement la fonction lines(). Chaque trajectoire individuelle vient s’inscrire avec sa transparence et sa nuance chromatique propre au-dessus du repère commun, sans générer la moindre interruption d’état graphique. Cette stratification visuelle maîtrisée permet d’observer l’émergence d’attracteurs comportementaux ou de profils de divergence développementale avec une clarté analytique irréprochable.
10.2 Tracé des courbes caractéristiques des items (Théorie de la Réponse à l’Item)
Dans le domaine de la psychométrie contemporaine, la Théorie de la Réponse à l’Item (TRI) constitue le cadre de référence pour l’étalonnage et la validation des échelles d’évaluation de traits latents, qu’il s’agisse de compétences cognitives, d’attitudes psychosociales ou de dimensions de la personnalité. Au cœur de cette modélisation mathématique se trouvent les Courbes Caractéristiques des Items (CCI), qui traduisent la probabilité non linéaire de réussite ou d’adhésion à un énoncé en fonction du niveau d’aptitude latent, traditionnellement dénoté par la lettre grecque thêta.
La restitution visuelle comparative des propriétés d’une batterie d’items exige de superposer sur une même figure les fonctions logistiques à un, deux ou trois paramètres associées à chaque question. L’analyste doit impérativement commencer par concevoir l’arène géométrique de l’espace latent en invoquant la commande de haut niveau plot() ou curve() avec le premier item de l’instrument psychométrique, ou au moyen d’un canevas vierge couvrant le spectre canonique du continuum latent, s’étendant conventionnellement de moins quatre à plus quatre écarts-types.
C’est uniquement après la matérialisation de cette scène réceptrice que les équations des items subséquents peuvent être projetées de façon cumulative en sollicitant la commande curve(…, add = TRUE) ou la primitive lines(). L’agencement scrupuleux de cette superposition offre aux psychométriciens une lecture directe des indices de discrimination, représentés par la pente de chaque sigmoïde au point d’inflexion, ainsi que des paramètres de difficulté associés à chaque niveau du continuum psychologique sans jamais risquer l’effondrement de l’environnement d’affichage.
10.3 Représentation de distributions latentes et de temps de réaction
L’investigation des architectures cognitives élémentaires mobilise de manière intensive l’analyse de la latence des réponses comportementales. Les distributions empiriques de temps de réaction se caractérisent universellement par une dissymétrie positive marquée, caractérisée par une queue de distribution étirée vers les latences élevées, que l’on modélise préférentiellement au travers de lois ex-Gaussiennes, de Weibull ou de Wald.
L’analyse approfondie de ces données requiert fréquemment la superposition simultanée d’un histogramme de fréquences empiriques normalisées et d’une estimation de densité par noyau lissée via la commande density(), complétée par la projection analytique de la courbe de densité théorique ajustée par estimation du maximum de vraisemblance. Dans ce pipeline graphique hautement dense, la moindre erreur de séquentialité conduit inexorablement à la levée de l’erreur d’initialisation manquante.
Le protocole opératoire méthodique exige de convoquer la fonction hist() en activant le paramètre de normalisation probabiliste, assurant que l’aire totale de l’histogramme est unitaire, tout en calibrant l’ordonnée maximale pour anticiper le sommet de la courbe de densité. Dès que l’histogramme de fréquences a scellé l’espace des coordonnées, les appels coordonnés à lines() viennent déposer avec une parfaite fluidité les estimations non paramétriques et les courbes théoriques continues, réalisant un diagnostic visuel de l’adéquation de la modélisation mathématique aux distributions observées.
11. Débogage méthodique et gestion des exceptions graphiques dans les scripts R
11.1 Stratégie systématique d’inspection de la pile d’appels (Call Stack)
Lorsque l’alerte d’exécution plot.new has not been called yet survient au sein d’une base de code complexe comprenant des milliers de lignes et de multiples modules imbriqués, la localisation manuelle de l’instruction fautive peut rapidement s’apparenter à une quête fastidieuse. Pour remédier à cette difficulté avec la rigueur requise par l’ingénierie logicielle moderne, l’analyste doit exploiter les outils d’introspection et d’analyse post-mortem mis à disposition par l’environnement d’exécution de R.
L’invocation immédiate de la commande traceback() dès la survenue de l’incident permet de déployer l’intégralité de la pile d’appels ayant conduit à l’interruption du processus d’affichage. Cette arborescence d’exécution dévoile la séquence exacte des fonctions mères ayant encapsulé la primitive de bas niveau jusqu’au point de rupture fatal. L’examen des différents niveaux de la pile permet d’identifier sans ambiguïté la fonction utilisateur qui a prématurément ordonné une injection géométrique dans un espace resté vierge.
Pour les investigations de débogage encore plus complexes, la configuration globale du gestionnaire d’erreurs via l’instruction options(error = recover) transforme l’environnement d’exécution en un débogueur interactif complet dès la levée de l’exception. Cette configuration suspend l’évaluation du script au moment précis du dysfonctionnement et autorise l’analyste à pénétrer dans l’environnement lexical de chaque niveau de la pile d’appels. Il devient dès lors possible d’inspecter l’état des variables, de vérifier l’état du périphérique graphique actif et d’isoler la raison pour laquelle l’étape fondatrice d’initialisation a été contournée.
11.2 Utilisation de tryCatch() pour intercepter l’absence d’initialisation
Dans le cadre du déploiement de chaînes de traitement automatisées fonctionnant en continu sur des serveurs distants ou au sein de pipelines d’intégration continue, une interruption inopinée d’un script en raison d’une anomalie graphique est formellement inadmissible. Le système doit être doté d’une résilience algorithmique suffisante pour intercepter les défaillances potentielles, consigner l’incident dans un journal d’audit et rétablir de manière autonome un état fonctionnel stable.
L’outil privilégié pour assurer cette étanchéité opérationnelle est la structure de contrôle des exceptions matérialisée par la fonction tryCatch(). En encapsulant les blocs d’instructions graphiques sensibles au sein de cette commande, le développeur peut intercepter de manière chirurgicale les alertes et erreurs levées par l’interpréteur R. Si le bloc d’évaluation constate une défaillance indiquant que le tracé n’a pas été initialisé, le gestionnaire de capture d’erreur prend la main sans faire avorter le programme principal.
Ce gestionnaire d’exception peut alors exécuter une stratégie de contournement ou de repli hautement méthodique : il consigne un message de diagnostic explicite au sein des journaux du système, purge les périphériques graphiques corrompus au moyen de dev.off(), initialise un nouveau canevas sécurisé par l’intermédiaire d’un appel direct à plot.new() et réexécute l’instruction de bas niveau qui avait initialement échoué. Cette programmation défensive confère aux pipelines analytiques une robustesse industrielle indispensable au traitement fiable de jeux de données massifs.
11.3 Audit des scripts et refactorisation pour une reproductibilité computationnelle
L’éradication pérenne des anomalies graphiques passe nécessairement par un audit structurel des scripts de recherche hérités, trop souvent élaborés sous forme de suites linéaires d’instructions impératives sans séparation stricte des responsabilités logicielles. Pour hisser la qualité computationnelle d’un code source aux standards d’une science rigoureuse et reproductible, une phase de refactorisation architecturale s’impose.
Cette standardisation organisationnelle doit instaurer une hiérarchie séquentielle inaltérable dans la structuration interne des fichiers de traitement. Chaque routine de visualisation doit être divisée en cinq segments hermétiques :
- Préparation et validation des structures de données : assainissement des tables, vérification des types, filtrage des valeurs manquantes et calcul préalable des statistiques descriptives ou des coefficients de modélisation.
- Sauvegarde et configuration de l’environnement graphique : capture de l’état initial des variables système via opar <- par(no.readonly = TRUE), configuration des marges, des palettes chromatiques et des divisions matricielles requises.
- Instanciation formelle du canevas géométrique : exécution de la fonction fondatrice de haut niveau, nue ou enrichie de ses premières observations, scellant de façon pérenne les échelles mathématiques et les bornes dimensionnelles.
- Enrichissement géométrique par strates ordonnées : appel rigoureusement cadencé des primitives d’ornementation de bas niveau telles que lines(), points(), polygon() et abline().
- Habillage sémiotique et clôture environnementale : impression des annotations marginales, ajout des légendes typographiques, scellement du périphérique de fichier si nécessaire et restauration systématique des paramètres initiaux via par(opar).
L’application rigoureuse de cette nomenclature de développement assainit intégralement la base de code, garantissant une exécution déterministe lors de chaque déploiement sur de nouvelles machines virtuelles ou au fil des montées en version de l’écosystème R.
12. Synthèse, arbre de décision opérationnel et standards de code pérennes
12.1 Protocole décisionnel pas à pas pour corriger plot.new has not been called yet
Afin de synthétiser les directives opérationnelles dégagées tout au long de cette étude, un protocole décisionnel séquentiel permet d’identifier et de résoudre instantanément toute occurrence de l’erreur dans un script R :
- Étape 1 : Diagnostic du périphérique actif. Vérifier si un périphérique graphique récepteur est formellement ouvert à l’aide de la commande dev.cur(). Si la valeur retournée est égale à un, aucun périphérique n’est disponible ; ouvrir immédiatement un environnement d’affichage via dev.new() ou une fonction d’exportation sur disque. Si le périphérique semble verrouillé ou instable, forcer la clôture de tous les récepteurs fantômes en répétant l’appel à dev.off() jusqu’au retour à l’état nul, puis réinstancier.
- Étape 2 : Vérification du paradigme graphique mobilisé. Examiner la commande ayant déclenché l’interruption d’exécution. Si la primitive appartient au sous-système standard de base mais que la figure précédente a été tracée à l’aide de l’écosystème ggplot2, éliminer immédiatement la primitive de base et la remplacer par son équivalent déclaratif au sein de la grammaire des graphiques.
- Étape 3 : Identification de la hiérarchie fonctionnelle. Constater la nature de la fonction d’affichage appelée en tête de séquence. S’il s’agit d’une fonction d’ornementation de bas niveau, insérer impérativement en amont une fonction d’initialisation de haut niveau, telle qu’un appel fondateur à plot() ou hist().
- Étape 4 : Choix du mode d’instanciation de l’espace. Si le tracé final doit combiner des strates disparates ne pouvant être affichées simultanément dès la première commande, instancier un canevas vierge en mobilisant le paramètre type = ‘n’ au sein de la commande initiale plot(), en prenant soin de lui fournir l’amplitude globale calculée sur l’ensemble des données.
- Étape 5 : Validation de l’amplitude géométrique. Examiner si les arguments d’échelle spatiale xlim et ylim encadrent avec une marge de sécurité suffisante l’intégralité des annotations, courbes et régressions qui viendront enrichir la scène lors des étapes subséquentes du pipeline.
12.2 Tableau comparatif des solutions selon le cas d’usage
Le choix de la stratégie de remédiation technique dépend intimement de l’objectif d’ingénierie visuelle poursuivi. Le comparatif détaillé ci-après consigne les arbitrages méthodologiques recommandés en fonction des scénarios d’usage les plus caractéristiques rencontrés en science des données et en modélisation empirique :
- Scénario d’ajustement d’une courbe sur un nuage de points continu : Le problème réside dans l’appel direct de la fonction lines() sur des prédictions mathématiques. L’action corrective immédiate consiste à précéder cette instruction d’un appel à plot(x, y) pour imprimer les observations empiriques réelles. L’avantage principal réside dans la clarté immédiate de la lecture visuelle et la simplicité de mise en œuvre, pour un coût computationnel quasi nul.
- Scénario de stratification de cohortes ou sous-groupes discrets : Le dysfonctionnement procède de l’usage prématuré de points() dans des séquences itératives segmentées. La solution de référence impose la création préalable d’un canevas neutre au moyen de plot(…, type = ‘n’). Cette démarche garantit un contrôle architectural total sur les bornes métriques globales et évite tout décalage géométrique entre sous-groupes.
- Scénario d’ornementation statistique par seuils ou moyennes : La rupture provient de l’invocation déconnectée de abline(). La remédiation consiste à séquencer strictement le code en plaçant l’instruction primaire de haut niveau représentant la distribution avant l’adjonction de la droite repère. L’approche assure une contextualisation spatiale immédiate et empêche les erreurs d’intersection vectorielle aux bordures de la boîte englobante.
- Scénario de planches d’affichage multifenêtres matricielles : L’écueil découle de l’injection d’ornements dans une cellule de la grille de partition n’ayant pas encore reçu d’instanciation autonome. La résolution requiert la synchronisation absolue de l’indexation de la matrice mfrow avec les fonctions fondatrices, combinée à la sauvegarde et à la réinitialisation rigoureuse des variables d’environnement via par(no.readonly = TRUE).
- Scénario de cohabitation conflictuelle avec l’écosystème ggplot2 : Le conflit émerge de la tentative d’annexer une primitive procédurale sur un objet déclaratif Grid. La correction pérenne repose sur la refactorisation de la primitive vers une couche géométrique native telle que geom_line() ou le recours temporaire à des modules de conversion spécialisés. La maintenabilité du code à long terme s’en trouve décuplée.
12.3 Règles d’or pour un pipeline graphique robuste et maintenable en R
Pour parachever cette immersion méthodologique, trois préceptes intangibles doivent guider la conception de toute infrastructure computationnelle dédiée à la production de graphiques scientifiques en langage R :
Premièrement, sanctuarisez le principe de séparation stricte entre calcul analytique et rendu esthétique. Aucune fonction de visualisation ne devrait assumer la charge d’ajuster des modèles statistiques complexes ou de nettoyer des données brutes en cours de tracé. En isolant hermétiquement les routines de calcul en amont, vous vous garantissez que l’ensemble des métadonnées dimensionnelles indispensables à la calibration du canevas spatial est parfaitement disponible au moment précis où s’ouvre la fenêtre graphique.
Deuxièmement, traitez les périphériques d’affichage comme des ressources système critiques sujettes à des contraintes d’allocation et de libération. De la même manière qu’une connexion à une base de données relationnelle ou qu’un descripteur de fichier sur disque doit impérativement être refermé après usage, un périphérique graphique R doit être scellé de manière déterministe au sein d’un bloc de clôture inconditionnelle. La purge systématique des tampons d’écriture résiduels constitue le remède le plus sûr contre la contamination sournoise de vos environnements d’analyse.
Troisièmement, documentez et testez explicitement les dépendances graphiques au sein de vos scripts de recherche. L’illusion que le comportement d’un moteur graphique procédural sera identique d’une version de R à une autre, indépendamment du système d’exploitation hôte et des interfaces de développement utilisées, est la source première de l’effondrement de la reproductibilité scientifique. En codifiant explicitement les ordres de tracé, en vérifiant l’état des périphériques de manière programmatique et en refactorisant impitoyablement les séquences orphelines, vous érigez des pipelines de données pérennes, élégants et résistants à l’épreuve du temps computationnel.
Références
Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer. https://doi.org/10.1007/978-0-387-75936-4
Chambers, J. M., & Hastie, T. J. (Eds.). (1992). Statistical models in S. Wadsworth & Brooks/Cole Advanced Books & Software.
Murrell, P. (2018). R graphics (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429464010
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0