
Dans le domaine de l’ingénierie des données tabulaires et de la recherche empirique, la gestion structurée des informations textuelles constitue une compétence méthodologique fondamentale. Qu’il s’agisse de préparer des cohortes expérimentales pour des analyses statistiques avancées, d’harmoniser des nomenclatures administratives disparates ou d’optimiser l’interopérabilité des jeux de données destinés à des environnements de programmation tels que R ou Python, l’artisanat du tableur exige une rigueur conceptuelle sans faille. L’application Google Sheets s’est imposée comme une plateforme collaborative omniprésente au sein des laboratoires universitaires, des départements de bio-statistique et des organisations d’analyse décisionnelle. Cependant, la manipulation de chaînes de caractères au sein de cette interface infonuagique dissimule des complexités logiques et architecturales qui dépassent de loin la simple juxtaposition visuelle de fragments textuels.
Le traitement des données tabulaires repose historiquement sur les principes de la normalisation relationnelle, où chaque cellule est censée représenter une valeur atomique indivisible. Néanmoins, les impératifs pratiques de l’analyse multivariée, de la communication visuelle et de l’interfaçage de bases de données nécessitent fréquemment des opérations inverses : la dénormalisation sélective et l’assemblage de plusieurs variables distribuées dans des colonnes adjacentes en une entité sémantique unique. Qu’il s’agisse de fabriquer des identifiants pérennes, de combiner des dimensions géographiques ou de synthétiser des réponses à des batteries de questionnaires psychométriques, la combinaison de colonnes requiert une maîtrise approfondie des paradigmes scalaires et matriciels offerts par le moteur de calcul de Google Sheets.
Ce guide encyclopédique se propose d’explorer de manière exhaustive l’ensemble des mécanismes algorithmiques, des fonctions natives et des architectures computationnelles dédiés à la fusion et à la concaténation de colonnes. En examinant successivement les opérateurs élémentaires, les fonctions d’agrégation conditionnelle, les routines vectorielles et les impératifs d’hygiène logicielle, cet ouvrage offre aux chercheurs, analystes et gestionnaires de données les fondations théoriques et pratiques nécessaires pour concevoir des flux de travail automatisés, reproductibles et hautement performants.
1. Introduction méthodologique à la combinaison de données textuelles dans Google Sheets
1.1 Définition conceptuelle de la fusion et de la concaténation de colonnes
Il convient d’établir d’emblée une distinction théorique et technique capitale entre deux opérations souvent confondues par les utilisateurs profanes des feuilles de calcul : la fusion physique de cellules et la concaténation de valeurs textuelles. La fusion physique d’éléments de grille relève exclusivement de la mise en page et de l’ergonomie visuelle. Lorsqu’un analyste sélectionne plusieurs cellules adjacentes et applique la commande de fusion d’interface, le logiciel unifie les coordonnées géométriques des cellules sélectionnées en une seule boîte graphique, tout en détruisant ou en occultant les valeurs sous-jacentes situées hors de la cellule supérieure gauche. Cette altération topologique brise l’indexation cartésienne du tableau, compromet gravement la navigabilité algorithmique et empêche l’exécution de requêtes relationnelles automatisées.
À l’opposé, la concaténation de données représente une opération de calcul symbolique qui préserve scrupuleusement l’intégrité structurelle de la base de données. L’opération consiste à lire les chaînes de caractères hébergées dans des cellules distinctes et à générer dynamiquement, au sein d’une nouvelle cellule réceptrice, une chaîne résultante issue de leur agrégation séquentielle. Dans ce cadre, aucune donnée source n’est altérée ni détruite ; l’intégrité référentielle du modèle demeure intacte. L’opération n’a pas pour objet de modifier l’organisation spatiale des données primitives, mais de produire une variable dérivée enrichie.
Dans l’optique des théories de normalisation de bases de données formalisées par Edgar F. Codd, chaque colonne doit initialement héberger une variable atomique respectant la première forme normale. La combinaison programmatique de colonnes permet d’engendrer des identifiants composites ou des descripteurs synthétiques sans sacrifier l’atomicité des sources sous-jacentes. Les variables initiales restent disponibles pour des segmentations ultérieures, tandis que la variable agrégée répond aux exigences d’un palier d’analyse spécifique.
1.2 Enjeux analytiques de l’unification des variables textuelles
L’unification de variables textuelles s’inscrit au cœur des protocoles de modélisation quantitative, notamment en psychométrie, en épidémiologie et en sociologie computationnelle. L’une des applications les plus critiques réside dans la génération de clés primaires composites. Dans de nombreux protocoles d’échantillonnage longitudinaux, un participant ne peut être identifié de façon unique par son simple numéro d’ordre ; son unicité dépend de la combinaison synergique de son centre d’inclusion, de sa cohorte d’appartenance et de son millésime de recrutement. La fusion déterministe de ces dimensions génère un index infalsifiable facilitant les appariements relationnels ultérieurs.
Par ailleurs, l’harmonisation de variables démographiques discontinues représente une tâche quotidienne incontournable. Les données collectées via des formulaires numériques scindent presque systématiquement les patronymes, les prénoms, les titres de civilité ou les segments d’adresses géographiques. Pour reconstituer des étiquettes d’identification complètes ou normaliser des répertoires institutionnels, l’analyste doit réagencer ces fragments selon des conventions syntaxiques strictes adaptées aux normes postales ou typographiques en vigueur.
Enfin, sur le plan de la chaîne de traitement scientifique, la préparation des jeux de données dans Google Sheets précède fréquemment leur exportation vers des environnements spécialisés tels que The R Project for Statistical Computing, SAS ou SPSS. La consolidation préalable de colonnes descriptives simplifie l’architecture des tables d’entrée, évite la multiplication d’arguments complexes dans les scripts d’importation et réduit drastiquement la charge cognitive des évaluateurs lors de la lecture de tableaux de bord de synthèse.
1.3 Panorama des approches algorithmiques disponibles
Le moteur de calcul de Google Sheets déploie un écosystème diversifié de solutions algorithmiques pour répondre aux multiples exigences de la transformation textuelle. La méthode la plus élémentaire repose sur l’utilisation de l’opérateur syntaxique d’esperluette (&), hérité des standards de programmation de première génération. Cet opérateur binaire permet une juxtaposition directe et agile de fragments hétérogènes, idéale pour des opérations ponctuelles à faible volumétrie de variables.
Parallèlement, la plateforme maintient des fonctions d’assemblage traditionnelles issues de la norme internationale des tableurs, à l’instar de CONCAT et CONCATENATE. Bien que fonctionnelles, ces instructions présentent des architectures rigides qui ont progressivement montré leurs limites face à l’émergence de jeux de données massifs et multidimensionnels nécessitant des règles fines de délimitation ou de gestion des valeurs manquantes.
Pour surmonter ces contraintes, l’ingénierie logicielle contemporaine a introduit des fonctions d’ordre supérieur hautement expressives telles que TEXTJOIN, capable d’itérer sur des plages continues tout en ignorant de façon conditionnelle les cellules vides. Couplées aux paradigmes matriciels offerts par ARRAYFORMULA ou aux fonctions lambda itératives, ces approches modernes permettent de vectoriser entièrement les processus de concaténation, transformant des tâches autrefois répétitives en pipelines de données automatisés, dynamiques et computationnellement efficients.
2. La méthode fondamentale : Utilisation de l’opérateur perluète (&)
2.1 Mécanique syntaxique et logique d’évaluation de l’opérateur &
L’opérateur perluète, universellement désigné sous le terme d’esperluette ou de symbole commercial &, constitue le primitif computationnel de base pour l’assemblage de chaînes de caractères. D’un point de vue algébrique, il s’agit d’un opérateur binaire infixé : il prend deux opérandes situées de part et d’autre de son point d’insertion et retourne une chaîne scalaire unique résultant de leur fusion séquentielle. L’instruction canonique s’articule sous la forme générale =A1&B1, où le contenu de la cellule A1 est directement adossé à celui de la cellule B1.
Le moteur d’évaluation de Google Sheets procède à une analyse strictement séquentielle de gauche à droite lorsqu’une expression comporte plusieurs opérateurs de ce type. Un trait fondamental de cet opérateur réside dans son mécanisme de transtypage implicite non destructif. Si une cellule source contient une valeur numérique entière, une décimale ou une valeur logique booléenne, le moteur convertit automatiquement cet opérande en sa représentation textuelle équivalente sans altérer le typage natif de la cellule d’origine.
La simplicité structurelle de cette syntaxe confère à la formule une grande vélocité de calcul lors de l’exécution sur des architectures légères. L’esperluette ne requiert aucune allocation de mémoire dédiée à la gestion de piles d’arguments complexes, ce qui en fait un outil de prédilection pour les manipulations algorithmiques élémentaires ne nécessitant pas de structures conditionnelles élaborées.
2.2 Exemple pratique 1 : Fusion brute de deux variables textuelles
Considérons un protocole de recherche médicale au sein duquel les chercheurs doivent consigner, pour chaque observation, deux variables indépendantes réparties dans deux colonnes distinctes : la colonne A abrite l’identifiant numérique du sujet expérimental (par exemple « 1042 »), tandis que la colonne B contient le code d’attribution de la condition d’exposition pharmacologique (par exemple « PLA » pour le placebo ou « TRA » pour le groupe de traitement actif).
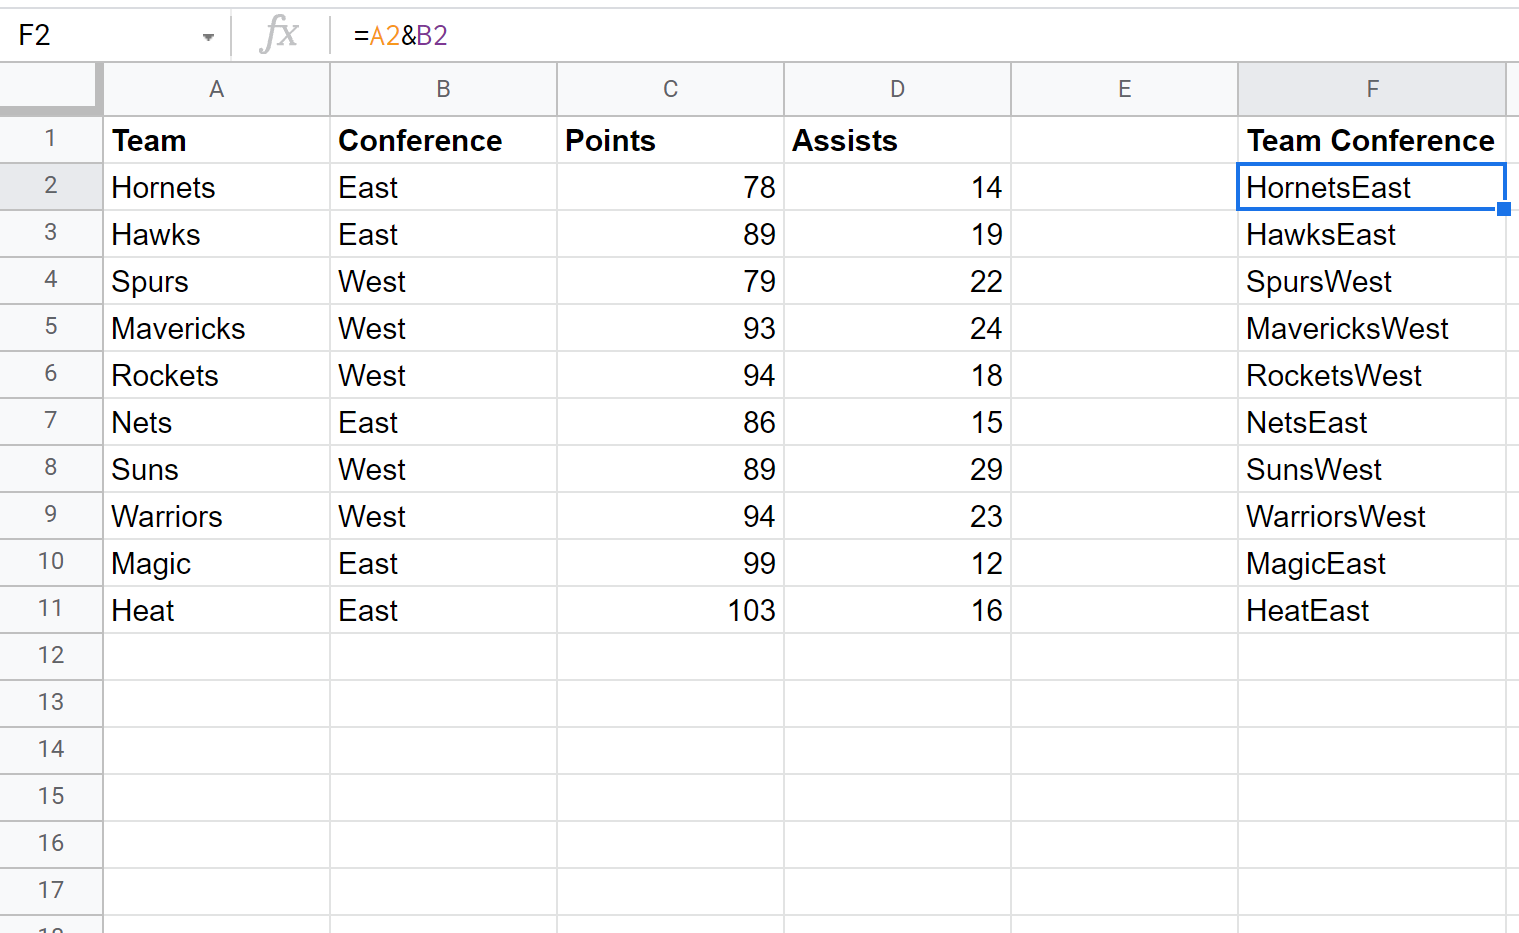
Pour assembler ces deux composantes en une étiquette brute au sein de la colonne C, l’analyste se positionne sur la cellule C2 et consigne l’expression : =A2&B2. Dès validation de l’instruction, le processeur de calcul évalue les références, procède à l’extraction des contenus respectifs et affiche instantanément le résultat unifié : « 1042PLA ». Cette juxtaposition s’effectue sans insertion d’aucun espace ou séparateur intermédiaire, liant intimement les deux chaînes d’origine.
Il est capital d’observer le comportement de cette formule face à la présence d’une valeur manquante ou d’une cellule vide dans l’une des colonnes sources. Si le sujet expérimental n’a pas encore reçu son code d’attribution en B2, la cellule est évaluée comme une chaîne vide de longueur nulle (« »). Par conséquent, la formule =A2&B2 produira simplement « 1042 », garantissant une continuité fonctionnelle sans lever d’erreur bloquante d’exécution, bien que le résultat puisse induire une ambiguïté sémantique si le chercheur ne prend pas garde à l’absence de la seconde variable.
2.3 Extension multi-colonnes : Concaténation de trois variables ou plus
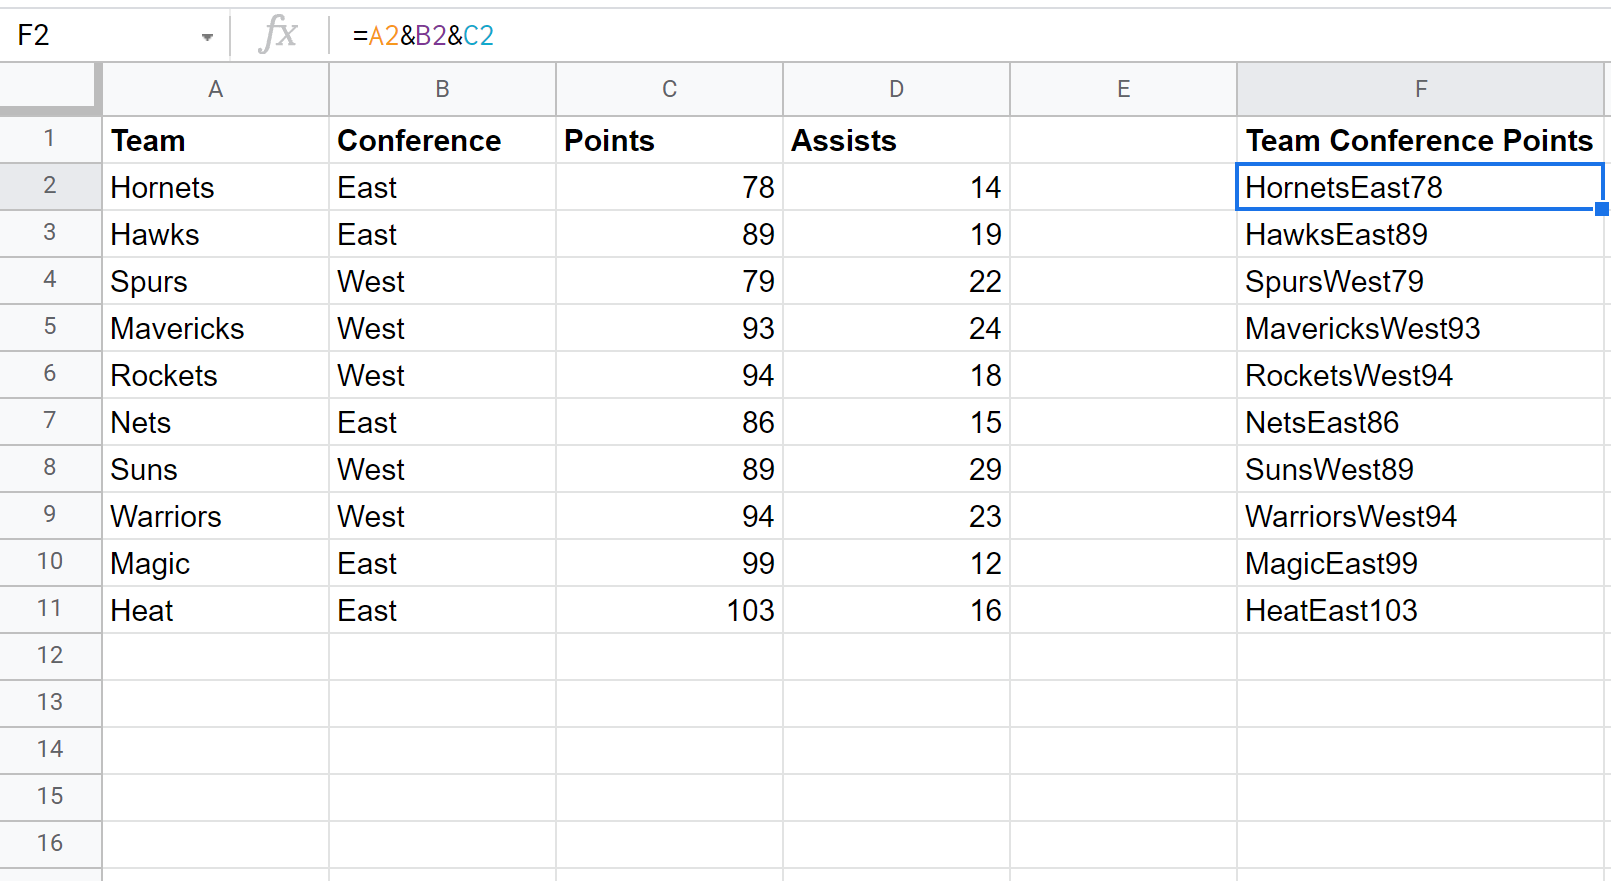
L’opérateur perluète possède une nature associative qui autorise l’enchaînement successif de multiples opérandes au sein d’une même ligne d’instruction. La structure syntaxique s’étend alors naturellement selon le schéma canonique : =A2&B2&C2&D2. Cette linéarité permet de fusionner un nombre arbitraire de colonnes au fur et à mesure que la complexité descriptive de l’échantillon l’exige.
Illustrons cette généralisation par une étude multicentrique en sciences de l’exercice impliquant trois variables réparties dans les colonnes A, B et C : l’équipe d’appartenance de l’athlète (« OLY »), la conférence de rattachement géographique (« EST ») et le rang de performance séquentiel (« 01 »). En déployant la formule =A2&B2&C2 dans la colonne D, l’environnement de calcul génère sans discontinuité la chaîne composite « OLYEST01 ». Chaque variable vient s’insérer exactement au point de terminaison de la précédente.
Néanmoins, cette approche montre de sévères limites ergonomiques et méthodologiques lorsque le volume des variables à combiner croît significativement. Rédiger une formule impliquant une quinzaine de colonnes via des perluètes consécutives devient une source majeure de fautes d’inattention et de fautes de frappe. L’illisibilité du code source complique les opérations de relecture par les pairs, tandis que la moindre modification structurelle de l’ordre des colonnes impose une reconfiguration manuelle fastidieuse et propice à l’introduction d’erreurs d’adressage.
3. L’intégration de délimiteurs personnalisés via l’opérateur &
3.1 Insertion de constantes littérales et règles d’échappement
Dans la quasi-totalité des contextes de traitement de données réels, la juxtaposition brute de données textuelles sans élément séparateur engendre une bouillie sémantique difficilement exploitable. Pour garantir la lisibilité humaine et l’intelligibilité des analyseurs lexicaux automatisés, il est impératif d’intercaler des délimiteurs visuels ou structurels entre les variables assemblées. L’intégration de telles constantes littérales au sein de l’instruction d’assemblage requiert l’application de règles syntaxiques rigoureuses régies par l’usage des guillemets droits doubles.
Tout caractère textuel statique, qu’il s’agisse d’une ponctuation usuelle, d’un caractère typographique spécifique ou d’un simple espacement, doit être obligatoirement délimité par des guillemets droits doubles pour que le compilateur de Google Sheets le traite comme une chaîne littérale et non comme un nom de fonction ou une référence matricielle indéterminée. Les délimiteurs les plus communément admis dans les architectures tabulaires comprennent l’espace blanc standard ( » « ), le trait d’union ou tiret du six (« -« ), la barre oblique (« / ») et le tiret de soulignement ou tiret bas (« _ »).
L’incorporation délibérée de ces délimiteurs répond à des critères d’ergonomie cognitive éprouvés. Un identifiant structuré sous la forme d’un code segmenté facilite la vérification visuelle immédiate, diminue le taux d’erreur de saisie manuelle lors des audits sur documents papier et permet aux algorithmes de segmentation textuelle de scinder ultérieurement les entités à l’aide de masques de recherche déterministes.
3.2 Exemple pratique 2 : Création de chaînes avec espaces et séparateurs simples
L’un des archétypes de la préparation de données réside dans la réconciliation des états civils élémentaires distribués au sein de listes de contacts ou de répertoires d’échantillons. Supposons que la colonne A consigne le prénom d’un répondant (« Alexandre ») et la colonne B son nom patronymique (« Dumas »). Une fusion brute produirait l’aberration lexicale « AlexandreDumas ».
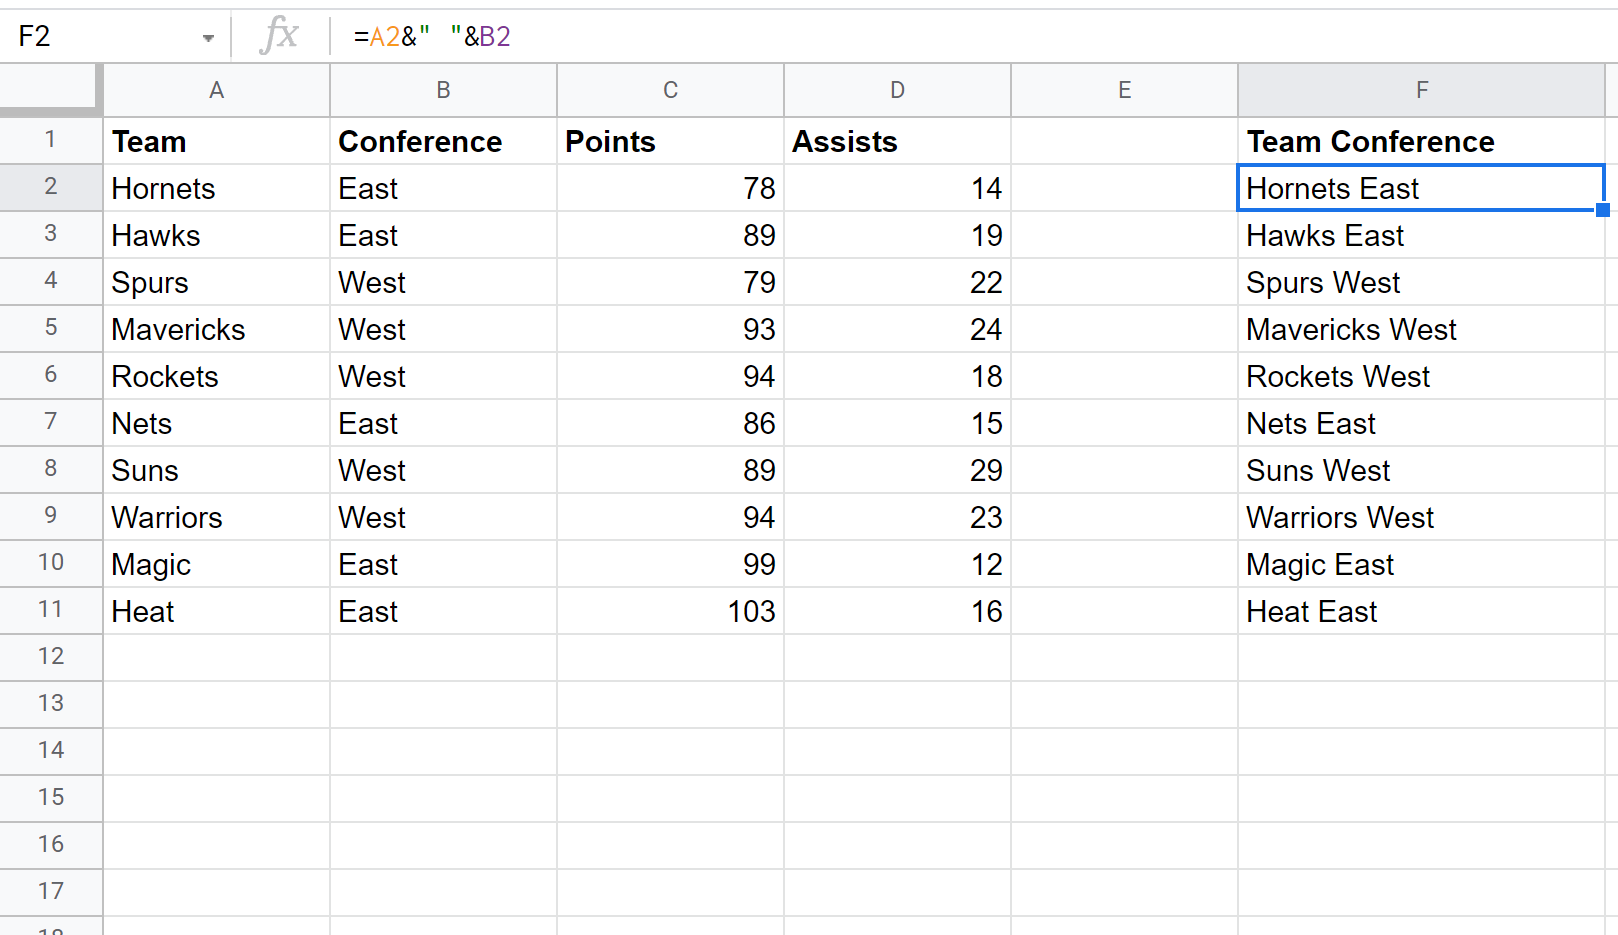
Pour insérer un espace intercalaire régulateur, l’opérateur perluète doit être instancié deux fois : la première pour lier le prénom à la constante textuelle représentant l’espace, la seconde pour relier cet espace au nom patronymique. La formule prend alors la structure suivante : =A2& » « &B2. Le moteur lit la valeur de A2, lui adjoint le caractère d’espacement délimité par les guillemets, puis accole le contenu de B2, renvoyant l’expression irréprochable « Alexandre Dumas ».
Cette logique d’assemblage s’adapte sans effort à des architectures de codage plus denses. Si une nomenclature d’inventaire hospitalier requiert la formulation d’un identifiant combinant le numéro d’étage (« ET03 ») et le code du lit médicalisé (« L12 »), l’insertion d’un séparateur de type trait d’union s’effectue via l’instruction =A2& »-« &B2, matérialisant la chaîne « ET03-L12 ». De manière analogue, la structuration de données destinées à des formats de balisage ou à des bases de données orientées colonnes peut mobiliser des barres verticales ou des points-virgules, instanciés avec rigueur selon la syntaxe =A2& » | « &B2.
3.3 Combinaison complexe associant texte statique explicatif et données variables
Au-delà de la simple articulation de variables disjointes, l’opérateur & permet de générer des sorties textuelles hautement descriptives en hybridant du texte statique narratif et des valeurs cellulaires dynamiques. Cette technique s’avère particulièrement précieuse lors de la rédaction automatisée de synthèses cliniques, de notifications destinées à des correspondants ou d’étiquettes de traçabilité pour des tubes d’échantillons biologiques.
L’analyste peut ainsi intercaler des segments de texte servant de préfixes, de suffixes ou d’incises explicatives afin de conférer une valeur sémantique immédiate au résultat agrégé. Considérons l’expression complexe suivante : = »Sujet d’étude : « &A2& » | Groupe assigné : « &B2& » (Protocole révisé) ». Dans ce modèle, les chaînes fixes encadrées de guillemets fournissent le cadre conceptuel, tandis que les coordonnées A2 et B2 injectent dynamiquement les attributs spécifiques de chaque ligne.
Cette flexibilité impose toutefois une vigilance scrupuleuse quant à la cohérence typographique. Les espaces séparateurs doivent impérativement être insérés à l’intérieur des guillemets délimitant le texte statique (par exemple, en veillant à insérer un espace avant ou après les deux-points). L’oubli de ces espacements infra-littéraux représente le piège le plus fréquent lors de la production de libellés automatisés, aboutissant à des télescopages disgracieux qui discréditent la qualité professionnelle du livrable.
4. L’approche par les fonctions natives : CONCATENATE et CONCAT
4.1 Analyse critique de la fonction CONCATENATE
La fonction CONCATENATE représente le dispositif historique implémenté au sein des logiciels tableurs pour effectuer l’agrégation ordonnée de composantes textuelles. Sa syntaxe formelle repose sur une nomenclature d’arguments séparés par des points-virgules : CONCATENATE(chaîne1; [chaîne2; …]). Elle accepte une liste ouverte d’arguments pouvant être des références directes à des cellules, des valeurs scalaires brutes ou des chaînes littérales expressément bornées par des guillemets.
Sur le plan des performances algorithmiques et de la consommation de ressources, il n’existe aucune divergence mesurable entre l’emploi de CONCATENATE et l’usage direct de l’opérateur perluète (&). Les deux entités partagent le même sous-système de calcul dans l’environnement Google Sheets. L’arbitrage entre ces deux approches relève avant tout de considérations de lisibilité et de politique de développement au sein des équipes. Certains analystes privilégient la forme fonctionnelle pour formaliser visuellement l’opération d’agrégation au sein d’une formule imbriquée complexe, estimant qu’elle réduit l’ambiguïté visuelle inhérente à la prolifération des symboles d’esperluette.
À titre d’illustration méthodologique, la reconstitution d’un intitulé expérimental mobilisant un code d’essai, une modalité temporelle et un identifiant de réplicat peut s’écrire : =CONCATENATE(A2; » – T »; B2; » – R »; C2). La séquence des arguments reproduit fidèlement la chaîne chronologique d’assemblage, offrant une architecture modulaire facile à auditer lors des procédures de contrôle qualité des scripts de recherche.
4.2 La fonction CONCAT : Spécificités et restrictions bivariées
Il est impératif de ne point confondre la fonction classique précédente avec son avatar minimaliste, la fonction CONCAT. Alors que l’usage populaire a tendance à utiliser les deux termes de manière interchangeable, l’API de Google Sheets impose à la fonction CONCAT une restriction structurelle absolue : elle n’accepte strictement que deux et uniquement deux arguments, selon la signature canonique CONCAT(valeur1; valeur2).
Cette brièveté paramétrique destine principalement CONCAT à des micro-opérations automatisées, souvent imbriquées au sein de fonctions d’ordre supérieur ou d’arborescences conditionnelles où l’analyste cherche à minimiser la charge syntaxique. Tenter d’exécuter une formule comportant trois arguments telle que =CONCAT(A2; B2; C2) déclenchera inévitablement une erreur d’analyse de formule, le compilateur refusant d’évaluer une arité excédant le seuil bivarié autorisé.
Cette contrainte structurelle rend la fonction CONCAT totalement inadaptée à la génération de chaînes formatées impliquant des délimiteurs textuels. L’adjonction d’un simple espace entre deux variables nécessiterait d’imbriquer deux instances de la fonction : =CONCAT(A2; CONCAT( » « ; B2)). Une telle gymnastique intellectuelle nuit dramatiquement à la lisibilité du modèle et doit être formellement proscrite au profit de l’opérateur & ou de la fonction CONCATENATE.
4.3 Imbrication des fonctions CONCATENATE pour hiérarchiser les flux
L’un des atouts du paradigme fonctionnel réside dans son aptitude à s’interfacer avec d’autres structures algorithmiques au moyen de l’imbrication syntaxique. Il est ainsi envisageable d’incorporer des fonctions logiques de branchement conditionnel, telles que la fonction IF, directement au sein de la liste des arguments de CONCATENATE. Cette hiérarchisation permet de moduler dynamiquement la structure de la chaîne générée selon les attributs intrinsèques des observations.
Envisageons un scénario clinique où la présence d’une mention spécifique dans la chaîne finale dépend du statut de validation d’un contrôle de qualité consigné dans la colonne C. L’analyste peut structurer l’appel suivant : =CONCATENATE(A2; » – « ; B2; IF(C2= »Valide »; » [Homologué] »; » [En suspens] »)). Le moteur de calcul résout en premier lieu l’évaluation logique contenue dans la fonction IF, puis injecte le résultat scalaire retourné dans le flux d’agrégation globale de la fonction CONCATENATE.
Cependant, une telle densité architecturale soulève la question critique de la maintenabilité des formules sur le long terme. Dans un contexte de recherche collaborative où plusieurs gestionnaires de bases de données se succèdent, l’empilement excessif de fonctions conditionnelles au sein d’arguments textuels peut transformer une simple tâche de transformation en une énigme difficile à débugger. La documentation rigoureuse de ces flux et l’isolation des calculs intermédiaires dans des colonnes de transit constituent des précautions managériales indispensables.
5. La fonction TEXTJOIN : Révolution de la gestion des délimiteurs et des valeurs manquantes
5.1 Architecture et paramètres de la fonction TEXTJOIN
L’introduction de la fonction TEXTJOIN a constitué une évolution paradigmatique majeure dans la manipulation de données textuelles au sein de Google Sheets. Conçue spécifiquement pour pallier les déficiences structurelles des fonctions traditionnelles, TEXTJOIN propose une signature algorithmique à la fois puissante et condensée, articulée autour de trois paramètres cardinaux obligatoires : TEXTJOIN(délimiteur; ignorer_vide; texte1; [texte2; …]).
Le premier argument, délimiteur, définit la chaîne de caractères qui sera automatiquement intercalée entre chaque entité textuelle. Le second argument, ignorer_vide, requiert une valeur booléenne (TRUE ou FALSE) stipulant si le moteur de calcul doit écarter ou retenir les cellules dépourvues de contenu. Enfin, le paramètre texte1 et ses extensions subséquentes reçoivent les références cellulaires, des chaînes indépendantes ou, avantage décisif, des plages bidimensionnelles ou vectorielles continues telles que A2:D2.
La capacité native de TEXTJOIN à ingérer des plages continues sans obliger l’utilisateur à déclarer explicitement chaque cellule représente un gain de productivité inestimable. Alors qu’une concaténation de dix colonnes via l’opérateur & exige une déclaration minutieuse de dix références et de neuf séparateurs, TEXTJOIN résout l’opération en une seule déclaration d’intervalle compacte, réduisant drastiquement le nombre de caractères de la formule et éliminant tout risque d’omission ponctuelle.
5.2 Traitement rigoureux des cellules vides et des données manquantes
L’un des défis méthodologiques les plus ardus lors de l’assemblage de bases de données volumineuses réside dans la gestion des données manquantes ou des cellules nulles. Dans les approches primitives reposant sur l’esperluette ou CONCATENATE, l’intercalation d’un délimiteur entre deux cellules dont l’une est vide engendre irrémédiablement l’apparition d’un délimiteur « orphelin ». Par exemple, la formule =A2& » – « &B2& » – « &C2 produira « ValeurA – – ValeurC » si la colonne B n’est pas renseignée, souillant la qualité de la présentation et faussant les traitements ultérieurs.
La fonction TEXTJOIN résout élégamment cette anomalie structurelle grâce à son deuxième paramètre, ignorer_vide. Lorsque cet argument est valorisé à TRUE, l’algorithme procède à un balayage préalable des éléments de la plage : toute cellule ne contenant aucun caractère ou n’abritant qu’une chaîne de longueur zéro est immédiatement purgée de la file d’attente d’agrégation. Le délimiteur n’est injecté qu’entre les valeurs effectivement peuplées, garantissant une jointure parfaite sans résidu typographique.
Inversement, le positionnement de cet argument à FALSE force le moteur à préserver la matérialité spatiale des vides en insérant consécutivement les séparateurs. Cette configuration se révèle analytiquement précieuse dans le cadre de protocoles d’exportation vers des architectures de type CSV positionnel, où la persistance d’un séparateur vide signale formellement à l’analyseur lexical externe l’absence d’une mesure sans corrompre le décompte des colonnes attendues.
5.3 Exemple pratique 3 : Combinaison de plages multidimensionnelles
Pour apprécier la puissance expressive de cette fonction, considérons l’analyse de passation d’un questionnaire d’évaluation psychologique comprenant cinq épreuves cognitives consécutives consignées dans les colonnes A, B, C, D et E d’une feuille de travail. L’objectif consiste à générer un profil linéaire synthétique pour chaque individu, en séparant chaque score par une flèche directionnelle (« -> »), tout en neutralisant les épreuves non administrées ou neutralisées par le protocole.
La mise en œuvre est d’une remarquable simplicité conceptuelle. Il suffit d’inscrire dans la cellule réceptrice la formule suivante : =TEXTJOIN( » -> « ; TRUE; A2:E2). Si un participant a passé avec succès les épreuves 1, 2 et 5, mais a été exempté des épreuves 3 et 4 (les cellules C2 et D2 étant rigoureusement vides), la formule générera spontanément l’étiquette fluide « Score1 -> Score2 -> Score5 ».
La comparaison de la charge cognitive de développement entre cette solution et les techniques désuètes est sans appel. Réaliser la même tâche de neutralisation conditionnelle des vides via des opérateurs d’esperluette aurait nécessité une arborescence invraisemblable de conditions IF imbriquées pour tester la vacuité de chaque cellule avant de décider d’adjoindre ou non le séparateur. TEXTJOIN condense cette intelligence algorithmique en une instruction lisible, robuste et immédiatement transposable à des centaines de colonnes contiguës.
6. La fonction JOIN : Spécificités pour les tableaux unidimensionnels
6.1 Différences fondamentales entre JOIN et TEXTJOIN
Au sein de la bibliothèque de manipulation de chaînes de Google Sheets, la fonction JOIN est fréquemment perçue comme un doublon fonctionnel de TEXTJOIN. Il existe pourtant des divergences structurales fondamentales dans leurs signatures respectives et leurs logiques sous-jacentes. La fonction JOIN présente une syntaxe simplifiée à l’extrême, formulée sous la séquence : JOIN(délimiteur; tableau_ou_plage).
La césure technique essentielle réside dans l’incapacité de la fonction JOIN à filtrer intrinsèquement les valeurs manquantes. JOIN ne possède aucun paramètre booléen dédié à l’exclusion des cellules nulles. Si la plage vectorielle soumise à l’évaluation contient des cellules vides, JOIN procède mécaniquement à l’insertion des délimiteurs aux intersections correspondantes, générant des duplications consécutives du caractère de séparation au même titre qu’un opérateur perluète naïf.
Par ailleurs, la fonction JOIN est strictement optimisée pour l’évaluation de vecteurs unidimensionnels (une ligne unique ou une colonne unique). Bien qu’elle puisse techniquement traiter des plages rectangulaires, son comportement de parcours peut s’avérer moins transparent que celui de TEXTJOIN. Dès lors, elle s’adresse en priorité à des cas d’usage où le jeu de données d’entrée est préalablement certifié complet, sans risque d’interférences liées à des valeurs lacunaires.
6.2 Scénarios d’usage optimaux pour la fonction JOIN
L’utilisation de la fonction JOIN s’avère particulièrement pertinente lors de la génération à la volée de listes d’attributs sérialisés au format CSV ou de vecteurs destinés à peupler des requêtes SQL de type IN (‘valeur1’, ‘valeur2’, …). Lorsque l’analyste travaille sur une colonne d’identifiants strictement peuplée et souhaite compacter l’ensemble des éléments dans une cellule unique pour un archivage compact, la concision de JOIN offre une élégance computationnelle appréciable.
Considérons une situation d’expérimentation où trois scores intermédiaires, obligatoirement obtenus par l’ensemble des cohortes, occupent les colonnes A, B et C d’une feuille de travail. Pour compiler ces scores sous la forme d’un tuple ordonné conventionnel, la syntaxe se résume à l’expression : =JOIN(« , « ; A2:C2). La formule itère horizontalement sur les trois cellules contiguës et renvoie la séquence « ScoreA, ScoreB, ScoreC » sans la moindre surcharge paramétrique.
Le tableau comparatif suivant permet de synthétiser les caractéristiques opératoires et de guider l’analyste dans le choix de la méthode idoine selon la typologie structurelle des données à agréger :
- Opérateur & : Arborescence libre ; arguments multiples non contigus ; aucune gestion native des cellules vides ; concision modérée.
- Fonction CONCATENATE : Liste d’arguments explicites ; non compatible avec les plages continues simples ; gestion manuelle des cellules vides requise.
- Fonction CONCAT : Strictement limitée à deux arguments scalaires ; inadaptée aux séparateurs complexes.
- Fonction JOIN : Plages vectorielles unidimensionnelles denses ; ne filtre pas les cellules vides ; formule très compacte.
- Fonction TEXTJOIN : Plages continues ou discontinues multidimensionnelles ; neutralisation automatisée des vides (optionnelle) ; délimiteur unique global.
7. Automatisation matricielle : Déploiement dynamique avec ARRAYFORMULA
7.1 Théorie du calcul matriciel dans Google Sheets
L’un des écueils majeurs des environnements de feuilles de calcul conventionnels réside dans la nécessité opérationnelle de recopier incrémentalement une formule le long d’une colonne de données. Cette pratique manuelle, qu’elle soit exécutée par glisser-déposer de la poignée de recopie ou par double-clic contextuel, contrevient aux principes les plus élémentaires de la gouvernance de données moderne. Elle favorise l’apparition de désynchronisations lorsqu’un opérateur omet d’étendre la formule aux nouvelles lignes saisies, et fragilise la reproductibilité scientifique en exposant la feuille à des écrasements accidentels de cellules isolées.
Pour immuniser les flux d’analyse contre ces fragilités, Google Sheets intègre un paradigme computationnel d’une puissance exceptionnelle hérité de l’algèbre vectorielle : le calcul matriciel unifié par l’entremise de la fonction structurelle ARRAYFORMULA. Ce méta-opérateur transforme une fonction scalaire standard en une directive vectorielle capable d’ingérer des colonnes entières en lieu et place de cellules singulières, et de déverser automatiquement les résultats sur l’ensemble de la dimension verticale sous-jacente.
En inscrivant une unique formule matricielle dans la cellule d’en-tête ou sur la première ligne d’un tableau, l’analyste verrouille la logique computationnelle au sommet de la hiérarchie. L’ensemble des lignes existantes, ainsi que toute observation additionnelle insérée ultérieurement dans la base, se trouvent automatiquement évaluées sans nécessiter la moindre intervention humaine de maintenance.
7.2 Exemple pratique 4 : Vectorisation de l’opérateur & avec ARRAYFORMULA
La vectorisation d’une opération de combinaison textuelle élémentaire illustre parfaitement l’efficience de cette architecture. Supposons une base de données démographique hébergeant plusieurs dizaines de milliers de lignes, où la colonne A accueille les prénoms et la colonne B les patronymes. Au lieu d’inscrire =A2& » « &B2 en cellule C2 et de dupliquer l’instruction jusqu’aux tréfonds de la grille, l’analyste consigne une directive matricielle globale.
La syntaxe de base s’articule comme suit : =ARRAYFORMULA(A2:A& » « &B2:B). Dès la validation, le processeur de calcul instancie simultanément la concaténation sur chaque paire de coordonnées (An, Bn) et projette instantanément les résultats dans la colonne réceptrice C. Toutefois, cette formulation brute présente l’inconvénient d’évaluer également les lignes vierges du bas de la feuille, générant des milliers d’espaces inutiles qui alourdissent inutilement le classeur.
Pour parfaire l’ingénierie de cette routine, il convient d’associer la matrice à un filtre conditionnel de vacuité, garantissant que le calcul s’interrompt rigoureusement dès que la source s’épuise. La formulation professionnelle devient alors : =ARRAYFORMULA(IF(ISBLANK(A2:A); « »; A2:A& » « &B2:B)), ou de manière équivalente : =ARRAYFORMULA(IF(A2:A= » »; « »; A2:A& » « &B2:B)). Cette clause de garde examine la colonne de référence A : si la cellule est dépourvue de contenu, la fonction renvoie une chaîne vide sans exécuter l’assemblage, optimisant substantiellement l’empreinte mémoire et la réactivité de l’interface graphique sur les jeux de données dépassant les 10 000 enregistrements.
7.3 Interactions entre ARRAYFORMULA, TEXTJOIN et les limitations matricielles
L’expansion de la programmation matricielle se heurte fréquemment à un écueil technique universel au sein de Google Sheets : l’incompatibilité native entre les fonctions d’agrégation globale et le constructeur ARRAYFORMULA. La fonction TEXTJOIN, de par sa conception intrinsèque, est une fonction réductrice qui compresse l’ensemble des éléments qui lui sont soumis en un unique scalaire textuel. Par conséquent, encapsuler une expression telle que ARRAYFORMULA(TEXTJOIN( » – « ; TRUE; A2:C)) ne produira pas une ligne combinée par observation, mais fusionnera l’intégralité absolue du tableau en une monstrueuse cellule unique.
Pour contourner ce verrouillage structurel tout en bénéficiant de l’automatisation vectorielle, l’environnement Google Sheets a été enrichi d’un ensemble de fonctions fonctionnelles d’ordre supérieur basées sur le calcul lambda, au premier rang desquelles trône la fonction BYROW couplée à LAMBDA. Cette association d’avant-garde permet d’itérer ligne par ligne sur une matrice bidimensionnelle tout en préservant l’autonomie d’agrégation de TEXTJOIN au sein de chaque enregistrement.
Le déploiement d’une telle routine moderne se structure selon l’expression canonique suivante : =BYROW(A2:C; LAMBDA(ligne; IF(COUNTA(ligne)=0; « »; TEXTJOIN( » – « ; TRUE; ligne)))). Dans cette architecture de pointe, la fonction BYROW isole séquentiellement chaque sous-vecteur horizontal ligne de la plage A2:C, transmet cette référence à la fonction personnalisée LAMBDA, qui exécute localement l’assemblage conditionnel via TEXTJOIN. Cette approche conjugue l’extrême compacité de TEXTJOIN à l’évolutivité dynamique de la propagation matricielle, représentant l’état de l’art absolu de l’ingénierie tabulaire sur Google Sheets.
8. Gestion des formats numériques, dates et valeurs spéciales lors de la fusion
8.1 Le problème de la conversion implicite des données typées
L’un des pièges les plus déconcertants pour les analystes réside dans l’altération visuelle dramatique que subissent les variables numériques formatées, les horodatages et les devises monétaires lorsqu’ils sont soumis à une opération d’assemblage textuel. Dans Google Sheets, il existe une dichotomie profonde entre la valeur brute stockée au cœur du moteur de calcul et le masque d’affichage superficiel appliqué par la couche de présentation de l’interface utilisateur.
Cette divergence se manifeste avec une acuité particulière lors de la manipulation des dates. Dans l’architecture logicielle des tableurs, une date n’est pas un texte, mais un nombre de série séquentiel représentant le nombre de jours écoulés depuis une date pivot conventionnelle (le 30 décembre 1899). Si la cellule A2 abrite la date du 15 octobre 2023, celle-ci est visualisée sous une forme temporelle familière grâce à un masque de formatage, mais sa valeur computationnelle réelle est un entier équivalent à 45214. Si un analyste tente une concaténation directe via l’expression = »Session du « &A2, le logiciel procédera au transtypage de la valeur sous-jacente brute, générant l’aberration textuelle : « Session du 45214 ».
Ce phénomène d’oblitération du formatage affecte pareillement les valeurs pourcentages et les variables monétaires. Une valeur décimale de 0,15 affichée « 15 % » redeviendra inéluctablement « 0.15 » au sein de la chaîne assemblée, tandis qu’un montant calibré à deux décimales perdra ses zéros terminaux, corrompant la rigueur formelle des rapports générés de manière automatisée.
8.2 Application de la fonction TEXT pour standardiser les variables
Pour neutraliser cette perte de formatage et contraindre le moteur d’évaluation à respecter les conventions de présentation requises, il est indispensable de mobiliser la fonction de formatage explicite TEXT. Cette instruction permet d’intercepter la valeur brute avant son injection dans la chaîne et de lui appliquer un gabarit de chaîne de substitution rigoureusement défini. Sa signature s’articule sous la forme : TEXT(nombre; format).
Le second argument, format, reçoit un motif de structuration textuel délimité par des guillemets doubles, empruntant la syntaxe standard des masques d’affichage. Pour restaurer l’intégrité de l’exemple chronologique précédent, la formulation doit être remaniée selon l’expression : =A2& » (Session du « &TEXT(B2; « jj/mm/aaaa »)& ») ». Le composant TEXT(B2; « jj/mm/aaaa ») force le moteur à convertir le numéro de série sous-jacent en une séquence calendaire explicite respectant fidèlement le découpage jour, mois et année.
Cette méthodologie s’applique avec une rigueur égale à la normalisation des scores continus issus d’instruments de mesure psychométriques ou de capteurs de laboratoire. Si une variable numérique doit obligatoirement présenter deux décimales, y compris lorsque celles-ci se composent de zéros non significatifs, l’analyste recourra à la fonction de calibrage : TEXT(C2; « 0,00 »). L’intégration au sein d’une chaîne composite globale prendra ainsi la forme : = »Score Z : « &TEXT(C2; « 0,00 »)& » | Cohorte : « &D2, garantissant une uniformité visuelle et typographique impeccable sur l’ensemble des lignes de la cohorte.
8.3 Gestion des valeurs booléennes et des valeurs d’erreur
La présence de valeurs booléennes issues de tests logiques préliminaires (VRAI ou FAUX) au sein des colonnes à combiner requiert également une analyse attentive. Lorsque ces valeurs sont agrégées via des opérateurs de concaténation, Google Sheets convertit implicitement ces entités en leurs équivalents textuels littéraux « VRAI » ou « FAUX » (ou « TRUE » / « FALSE » selon la localisation linguistique paramétrée sur le compte Google Workspace). Si l’analyste désire transcrire ces états sous la forme de bits binaires normalisés (1 ou 0) ou d’étiquettes qualitatives (« Positif » / « Négatif »), l’utilisation préalable d’une fonction conditionnelle IF s’avère indispensable pour intercepter la valeur avant l’assemblage textuel.
Plus redoutable encore est la propagation des valeurs d’erreur au sein des pipelines de concaténation. Si l’une quelconque des cellules sources héberge un code d’anomalie d’exécution tel que #N/A, #VALUE! ou #DIV/0!, ce statut d’erreur contamine instantanément l’intégralité de la formule de fusion, annihilant la production textuelle de la ligne concernée. Ce comportement toxique peut déstabiliser des tableaux de bord entiers lors de l’intégration de données imparfaites.
Pour immuniser les chaînes contre cette vulnérabilité structurelle, il est impératif d’encapsuler les segments sensibles au sein de la fonction de sécurisation IFERROR ou IFNA. La formulation technique prend alors la forme d’un blindage syntaxique : =IFERROR(A2& » – « &B2; « Donnée non disponible »), ou plus subtilement au niveau de la variable vulnérable : =A2& » – « &IFERROR(B2; « N/A »). Cette précaution garantit la continuité opérationnelle du flux de calcul tout en documentant explicitement la nature de la déficience d’échantillonnage.
9. Hygiène et préparation des données avant la combinaison
9.1 Élimination des espaces parasites : La fonction TRIM
L’un des axiomes fondamentaux de la science des données stipule que la qualité d’une chaîne de traitement analytique dépend exclusivement de l’hygiène des données injectées en amont, un principe universellement formalisé par l’adage « Garbage In, Garbage Out ». Lors de la collecte d’informations textuelles via des formulaires d’évaluation ou des processus d’importation depuis des bases relationnelles legacy, les cellules d’entrée sont fréquemment polluées par des espaces résiduels invisibles, logés sournoisement en début de mot, en queue de chaîne ou sous la forme de doubles espacements internes.
Ces espaces parasites, indiscernables à l’œil nu sur une feuille dense, altèrent gravement les opérations de concaténation ultérieures. Si la cellule A2 contient la chaîne « Paris » suivie de trois espaces fantômes, l’application naïve d’une formule d’assemblage avec un délimiteur espace =A2& » « &B2 engendrera une distorsion typographique inacceptable comprenant quatre espaces consécutifs entre les deux variables. Pire encore, ces micro-espacements compromettent l’utilisation ultérieure des chaînes produites dans le cadre de fonctions de recherche matricielle telles que VLOOKUP ou XLOOKUP.
L’application systématique de la fonction TRIM représente le remède méthodologique canonique à cette pathologie. Cette instruction procède à l’élimination automatique de tous les espaces situés en préfixe et en suffixe d’une chaîne, tout en réduisant les espaces consécutifs internes à un unique intervalle régulier. L’analyste rigoureux veillera donc à intégrer un assainissement préalable au sein même de la formule d’assemblage : =TRIM(A2)& » « &TRIM(B2). Cette précaution neutralise d’emblée toute dérive typographique issue des colonnes sources.
9.2 Uniformisation de la casse : Fonctions PROPER, UPPER et LOWER
L’hétérogénéité de la saisie manuelle constitue une autre source majeure de dissonance au sein des jeux de données textuelles. Dans une colonne recueillant des patronymes ou des toponymes géographiques, il est fréquent de constater la coexistence anarchique de saisies intégrales en lettres minuscules (« dupont »), de saisies en capitales bloquées (« DUPONT ») et de graphies irrégulières issues d’erreurs de dactylographie (« duPont »). Une fusion aveugle de ces données avec d’autres variables dégrade considérablement la qualité formelle des analyses de synthèse.
Google Sheets met à la disposition des chercheurs une triade de fonctions de normalisation de la casse linguistique destinées à standardiser les variables avant leur intégration séquentielle :
- UPPER(texte) : Convertit l’intégralité des caractères alphabétiques d’une chaîne en capitales d’imprimerie. Cette fonction est typiquement mobilisée pour uniformiser les codes de protocoles, les acronymes institutionnels ou les patronymes selon les standards administratifs francophones.
- LOWER(texte) : Transmute tous les caractères en minuscules standard. Elle trouve son utilité dans l’homogénéisation des adresses de courrier électronique ou des identifiants de métadonnées pour le Web.
- PROPER(texte) : Applique la règle de la casse titre, convertissant la lettre initiale de chaque segment lexical en majuscule tout en basculant impérativement toutes les lettres subséquentes en minuscules. C’est l’outil par excellence de la normalisation des prénoms et des appellations géographiques.
L’orchestration synergique de ces fonctions au sein d’une même formule de combinaison textuelle permet d’atteindre un niveau d’uniformité exemplaire. L’expression =UPPER(TRIM(A2))& » « &PROPER(TRIM(B2)) garantit que, quelle que soit l’anarchie initiale de la saisie dans les colonnes A et B, la variable résultante adoptera rigoureusement la syntaxe institutionnelle conventionnelle (« DUPONT Alexandre »), renforçant instantanément la solidité esthétique et computationnelle de la base de données.
9.3 Suppression des caractères non imprimables : La fonction CLEAN
L’intégration de données brutes issues de transferts par copier-coller depuis des plateformes Web, des fichiers PDF non structurés ou des terminaux industriels introduit fréquemment des éléments perturbateurs bien plus insidieux que de simples espaces : les caractères de contrôle non imprimables. Ces résidus techniques, issus des premiers indices de la table ASCII (codes 0 à 31), englobent des retours chariots inopinés, des sauts de ligne intempestifs ou des signaux de tabulation invisibles.
Ces caractères corrompent insidieusement la topologie des feuilles de calcul. Un saut de ligne dissimulé dans une cellule source provoquera l’étirement vertical asymétrique de la ligne d’affichage lors de la concaténation, ou causera l’éclatement arbitraire des lignes de commande lors de l’exportation finale du fichier sous la forme d’un tableau délimité par des virgules ou des tabulations.
Pour immuniser les chaînes contre cette nuisance structurelle, la fonction CLEAN doit être adjointe aux routines d’assainissement. Cette instruction élimine sans compromis l’intégralité des caractères de contrôle invisibles hébergés dans la cible. Dans les architectures de données les plus exigeantes, les analystes bâtissent une forteresse syntaxique combinant les deux prérequis d’hygiène, formulée selon le modèle : =CLEAN(TRIM(A2))& » – « &CLEAN(TRIM(B2)). Ce double filtrage garantit une pureté textuelle optimale, préalable indispensable à toute opération d’agrégation d’envergure.
10. Applications pratiques : Cas d’études empiriques et psychométriques
10.1 Étude de cas A : Création d’identifiants uniques anonymisés de participants
Dans le cadre des protocoles de recherche en psychologie cognitive et en imagerie cérébrale, la protection de la vie privée des participants et le respect des directives d’éthique de la recherche imposent une anonymisation rigoureuse des données dès la phase de saisie primaire. L’objectif méthodologique consiste à forger un code d’identification alphanumérique unique (Subject ID) encapsulant plusieurs dimensions contextuelles tout en interdisant toute rétro-ingénierie permettant l’identification directe de la personne.
Considérons une étude multicentrique internationale impliquant trois colonnes de métadonnées : la colonne A répertorie le code mnémonique du laboratoire d’acquisition (« NEURO »), la colonne B contient le millésime calendaire de l’évaluation (« 2023 »), et la colonne C consigne le numéro séquentiel d’inclusion du participant au sein du centre d’étude (« 47 »). L’impératif protocolaire exige la génération d’un identifiant normalisé répondant au schéma syntaxique strict : LABO-ANNEE-SEQ3D, où le numéro séquentiel doit obligatoirement être ajusté sur trois positions par l’adjonction de zéros de tête non significatifs.
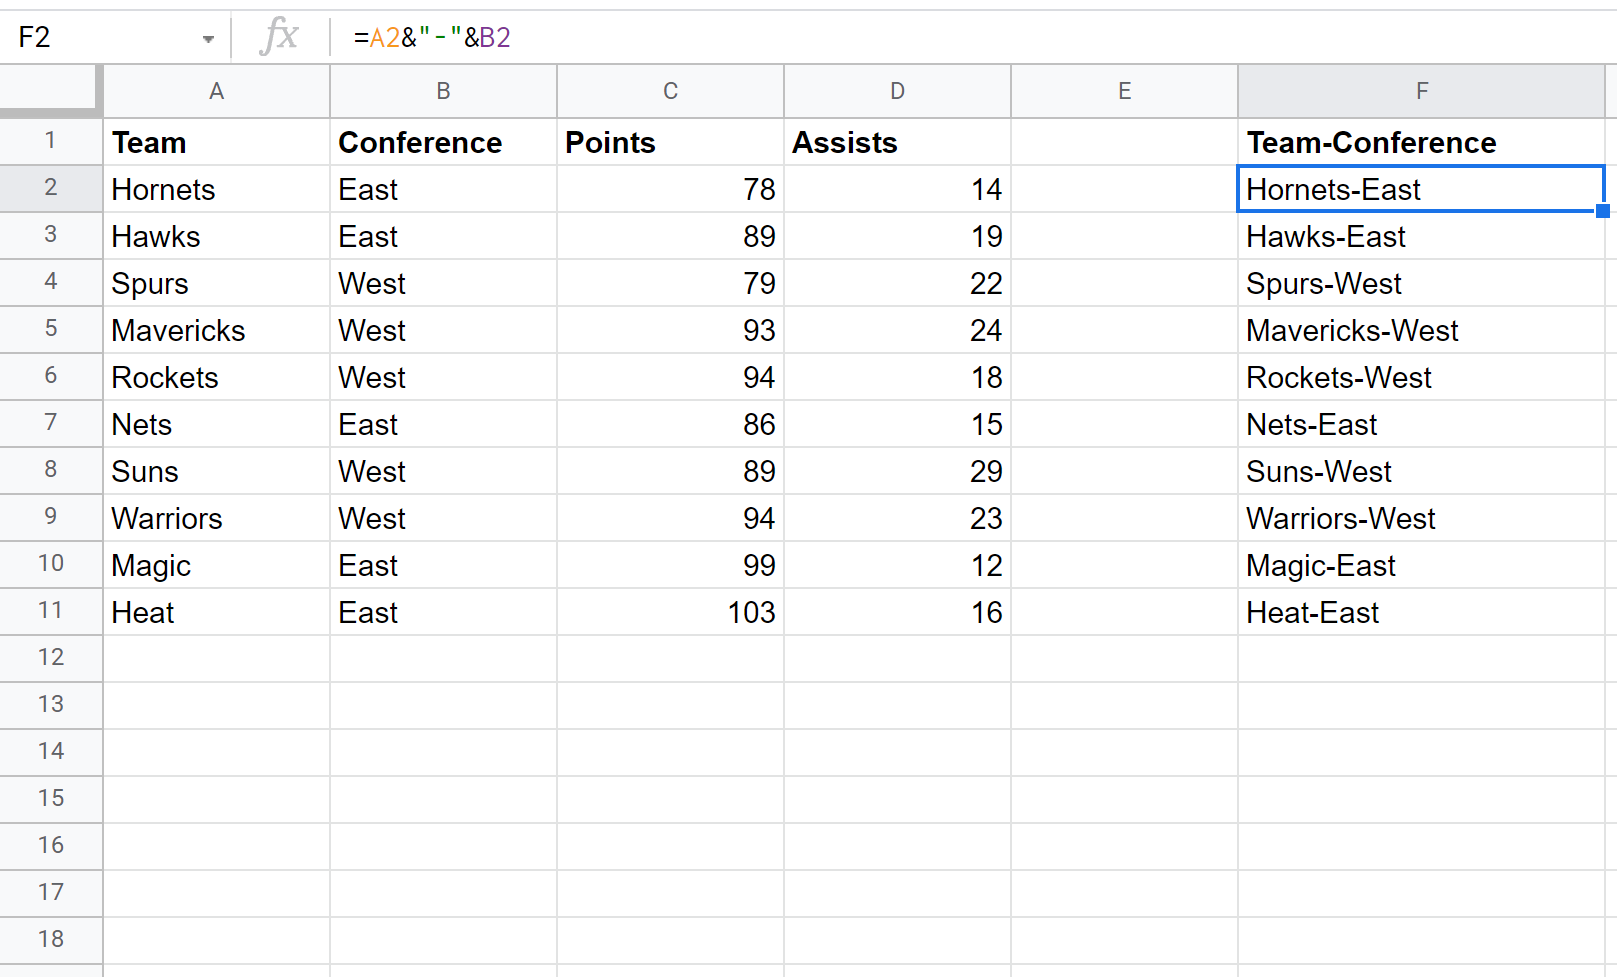
Pour matérialiser cette contrainte d’ingénierie, la formule fait appel à l’association synergique de l’opérateur perluète et de la fonction de calibrage numérique TEXT : =A2& »-« &B2& »-« &TEXT(C2; « 000 »). L’évaluation de cette expression pour le participant numéro 47 produit la chaîne pérenne « NEURO-2023-047 ». L’identifiant ainsi produit respecte les contraintes d’unicité, garantit une traçabilité sans faille à travers les différentes étapes du protocole expérimental et offre une lisibilité optimale lors de l’injection des matrices dans des scripts de modélisation statistique avancée.
10.2 Étude de cas B : Compilation d’adresses postales et de localisations de centres
La gestion administrative de cohortes épidémiologiques distribuées sur de multiples territoires requiert la génération automatisée d’étiquettes de localisation postale destinées à l’expédition d’auto-questionnaires ou de matériels de recueil biologique. Dans les systèmes d’information hospitaliers, les composantes territoriales sont systématiquement segmentées afin de préserver la flexibilité relationnelle : la colonne A accueille le numéro et l’intitulé de la voie (« 12 rue de la Paix »), la colonne B héberge un complément d’adresse facultatif (« Bâtiment B, Escalier 3 »), la colonne C consigne le code postal (« 75002 ») et la colonne D documente la commune de résidence (« PARIS »).
L’écueil récurrent de cette tâche réside dans le caractère optionnel de la colonne B. L’usage d’une formule d’assemblage rudimentaire basée sur des séparateurs fixes produirait une redondance disgracieuse de virgules lorsque l’appartement ou le bâtiment n’est pas renseigné. La mise en œuvre de la fonction TEXTJOIN associée à un assainissement typographique permet de résoudre l’intégralité du problème en une opération unique : =TEXTJOIN(« , « ; TRUE; TRIM(A2); TRIM(B2); TRIM(C2)& » « &UPPER(TRIM(D2))).
Dans ce modèle d’ingénierie, le code postal et la localité sont préalablement condensés avec un espace séparateur et une mise en capitales conforme aux préconisations postales, tandis que TEXTJOIN traite l’enchaînement global. Si la colonne B est rigoureusement vide, le paramètre ignorer_vide=TRUE court-circuite son existence, délivrant la séquence fluide « 12 rue de la Paix, 75002 PARIS ». Si le complément existe, il s’insère naturellement avec la ponctuation appropriée, illustrant la supériorité de cette approche pour la production documentaire automatisée.
10.3 Étude de cas C : Synthèse textuelle de résultats d’échelles de Likert
L’administration d’inventaires de personnalité psychométriques génère de vastes matrices de données où chaque ligne correspond à un participant et chaque colonne à un item spécifique noté sur une échelle ordinale de type Likert en 5 ou 7 points. Dans le cadre de protocoles d’audit préliminaire de la qualité des réponses, les psychométriciens ont fréquemment besoin d’inspecter visuellement et rapidement le patron de réponse individuel (Response Pattern) d’un sujet afin de détecter d’éventuels biais d’acquiescement systématique ou de désengagement attentionnel (par exemple, un participant répondant uniformément « 1 » à toutes les questions).
Supposons une batterie de test condensée comprenant dix items distribués de la colonne A à la colonne J d’une feuille de travail. Pour compiler cette séquence en une signature textuelle compacte sans séparateur visuel superflu, l’analyste utilise la formulation condensée suivante : =TEXTJOIN(« »; FALSE; A2:J2). En neutralisant le délimiteur au moyen d’une chaîne vide et en forçant l’agrégation ordonnée, la formule génère un profil séquentiel direct sous la forme d’une chaîne telle que « 1542315542 ».
Cette signature scalaire condense une information multidimensionnelle complexe dans une unité visuelle immédiatement déchiffrable. L’analyste peut alors adjoindre des règles de mise en forme conditionnelle ou des requêtes par expressions régulières pour isoler instantanément les profils aberrants présentant une invariance suspecte (tels que « 3333333333 ») ou des alternances stéréotypées. Cette méthodologie accélère considérablement l’étape de nettoyage des données avant le calcul des coefficients de cohérence interne (alpha de Cronbach) ou la modélisation en équations structurelles.
11. Diagnostic des anomalies, erreurs courantes et optimisation des performances
11.1 Diagnostic et résolution des messages d’erreur fréquents
Le déploiement de formules d’assemblage textuel au sein de structures tabulaires complexes expose inévitablement l’analyste à des manifestations d’erreurs d’exécution. L’une des plus emblématiques lors de l’usage de routines matricielles vectorisées est la redoutée erreur #REF!, accompagnée de l’infobulle contextuelle : « La formule matricielle n’a pas pu être étendue car elle écraserait les données de la cellule… ». Cette collision spatiale survient dès qu’une cellule située dans la zone de projection descendante de la fonction ARRAYFORMULA contient un caractère résiduel, une formule orpheline ou même un espace vide saisi manuellement. La résolution impose de localiser la cellule incriminée et de la purger de tout contenu pour permettre à la matrice de se déployer sans entrave.
Une autre anomalie courante est matérialisée par l’erreur #VALUE!. Dans le contexte de la manipulation textuelle, cette rupture de calcul survient presque systématiquement lors de l’imbrication de fonctions attendant des arguments typés numériques au sein d’un pipeline textuel dépourvu de transtypage adéquat, ou lors de l’usage d’opérateurs arithmétiques (+, *) en lieu et place de l’opérateur logique de concaténation (&). Il convient de rappeler que dans Google Sheets, l’opérateur plus (+) tente une addition arithmétique : l’expression = »Code » + 10 soulèvera instantanément une erreur de valeur, là où = »Code » & 10 produira pacifiquement « Code10 ».
Enfin, les erreurs de référence circulaire surviennent lorsqu’un analyste imprudent englobe la cellule réceptrice elle-même à l’intérieur de la plage d’agrégation. Si vous inscrivez en D2 une formule tentant de consolider la plage TEXTJOIN( » « ; TRUE; A2:D2), le moteur de calcul entre dans une boucle d’auto-évaluation infinie qu’il interrompt aussitôt en levant une alerte de boucle de calcul. Le dimensionnement des bornes matricielles doit donc être inspecté avec une minutie constante.
11.2 Impact computationnel sur les feuilles de calcul volumineuses
L’évolutivité d’un écosystème de données sous Google Sheets est conditionnée par les limites d’allocation de ressources processeur et mémoire attribuées à chaque classeur par l’infrastructure cloud. Les opérations de concaténation textuelle, bien qu’apparemment triviales, engendrent un coût computationnel cumulatif colossal lorsqu’elles sont instanciées de manière itérative sur des centaines de milliers de lignes de calcul. Chaque concaténation nécessite l’allocation de nouveaux blocs mémoire pour héberger la chaîne résultante, ainsi que l’exécution de cycles d’horloge pour l’analyse lexicale.
Dans ce contexte, le recours à des milliers de formules scalaires indépendantes dupliquées verticalement dégrade dramatiquement les performances d’ouverture, de défilement et de recalcul du classeur. La vectorisation via ARRAYFORMULA ou BYROW rationalise significativement cette empreinte en regroupant l’arbre d’exécution au sein d’un thread computationnel unifié, réduisant la latence globale.
Néanmoins, lorsque le modèle arrive à maturité et que les données consolidées n’ont plus vocation à être recalculées dynamiquement, la stratégie d’ingénierie la plus saine consiste à opérer un figeage définitif des valeurs. Cette manœuvre s’accomplit en sélectionnant la colonne combinée, en exécutant un copier standard, suivi immédiatement d’un Collage spécial en tant que valeurs seules (accessible via le raccourci Ctrl+Maj+V sur Windows ou Cmd+Maj+V sur macOS). Cette action détruit la dépendance algorithmique et pérennise le résultat sous la forme de chaînes statiques, allégeant instantanément la charge de calcul du tableur pour les utilisateurs collaboratifs.
11.3 Contrôle de conformité a posteriori par expressions régulières
Une fois les opérations de combinaison menées à bien, la gouvernance des données scientifiques exige l’implémentation d’une phase de contrôle qualité destinée à vérifier la conformité syntaxique des chaînes synthétisées. Même au sein de pipelines rigoureusement paramétrés, une anomalie dans une cellule source peut corrompre l’architecture de l’identifiant composite généré. La mobilisation des expressions régulières (Regex) intégrées nativement dans Google Sheets offre une modalité d’audit automatisée d’une précision chirurgicale.
La fonction REGEXMATCH permet d’évaluer la structure lexicale d’une chaîne au regard d’un motif abstrait (pattern) prédéterminé. Supposons que l’analyste ait généré une colonne d’identifiants composites devant obligatoirement répondre au schéma de trois lettres majuscules, suivies d’un tiret, puis de quatre chiffres (par exemple « LAB-2024 »). Pour auditer la validité de la colonne combinée C, une colonne de vérification logique peut être adjointe, hébergeant l’instruction matricielle : =ARRAYFORMULA(IF(C2:C= » »; « »; REGEXMATCH(C2:C; « ^[A-Z]{3}-[0-9]{4}$ »))).
Cette directive scanne l’intégralité de la production textuelle et renvoie le booléen VRAI si la chaîne respecte scrupuleusement la grammaire formelle, ou FAUX à la moindre déviation (telle qu’un espace résiduel, une lettre minuscule orpheline ou un chiffre manquant). L’analyste peut alors adosser un filtre d’affichage sur les occurrences négatives pour circonscrire instantanément les anomalies de fusion et corriger les sources avant le verrouillage et l’exportation des données de recherche.
12. Arbre décisionnel comparatif et recommandations méthodologiques
12.1 Matrice décisionnelle pour le choix de la méthode idéale
Face à la pluralité des mécanismes algorithmiques décrits au fil de ce traité, le praticien doit être en mesure d’arbitrer rationnellement entre les solutions en fonction des contraintes intrinsèques de son jeu de données. Le schéma d’arbitrage méthodologique suivant permet de formaliser cette sélection de manière reproductible :
- Cas 1 : Concaténation binaire ou tertiaire simple sans cellules manquantes.
Solution optimale : L’opérateur perluète (&). Sa vélocité de frappe et son absence de surcharge fonctionnelle en font l’outil le plus direct pour des tâches ponctuelles à faible complexité d’agencement. - Cas 2 : Assemblage de plages continues larges (plus de trois colonnes) avec présence potentielle de cellules vides.
Solution optimale : La fonction TEXTJOIN. Sa capacité à encapsuler des intervalles de type A2:K2 et son argument de purge ignorer_vide=TRUE garantissent une chaîne fluide sans délimiteurs consécutifs parasites. - Cas 3 : Déploiement automatisé sur des bases de données volumineuses dynamiques sans décalage de formules.
Solution optimale : ARRAYFORMULA combiné à l’opérateur perluète et filtré par IF(ISBLANK()) pour les assemblages simples ; ou l’architecture moderne BYROW / LAMBDA / TEXTJOIN pour les fusions horizontales complexes sur plages multidimensionnelles. - Cas 4 : Concaténation impliquant des dates, pourcentages ou monnaies.
Solution impérative : L’encapsulation systématique des variables numériques au sein de la fonction de masquage TEXT afin de neutraliser l’évaluation brute des numéros de série informatiques.
12.2 Guide des bonnes pratiques en gouvernance des données de recherche
L’exécution de transformations textuelles ne doit jamais s’affranchir d’un cadre rigoureux de gouvernance de l’information. En premier lieu, il est méthodologiquement impératif d’instituer la règle de l’immutabilité des données sources. Les colonnes d’origine ayant servi à forger des variables combinées ne doivent en aucun cas être effacées ou remplacées au sein de la même feuille. Elles doivent être sanctuarisées dans des onglets de données primaires verrouillés en écriture, les colonnes assemblées n’étant déployées que dans des vues dérivées ou des tables de calcul dédiées.
Deuxièmement, toute manipulation algorithmique combinant des variables doit faire l’objet d’une documentation exhaustive au sein d’un dictionnaire de données (Codebook). Ce livrable méthodologique consigne la formule exacte mobilisée, la liste des arguments sources, la description du délimiteur utilisé et la signification sémantique de l’entité composite résultante. Cette transparence est la condition sine qua non de la reproductibilité scientifique lors des audits par des comités de lecture ou des agences de régulation.
Enfin, une discipline exemplaire s’impose dans la normalisation des conventions de nommage des en-têtes de colonnes (Header Names). Une colonne résultant de la fusion d’un prénom et d’un nom ne devrait jamais être intitulée de façon laconique « Nom », mais arborer une désignation non ambiguë telle que nom_complet, ou subject_composite_id pour un identifiant protocolé, facilitant l’adressage lors des traitements automatisés avals.
12.3 Synthèse procédurale pour les praticiens et chercheurs
En synthèse de cette exploration approfondie, la mise en œuvre réussie d’une routine de combinaison de colonnes dans Google Sheets s’articule autour d’un pipeline séquentiel rigoureux en cinq étapes incontournables :
- 1. Nettoyer (Hygiène) : Assainir préalablement les cellules sources par l’application conjointe des fonctions TRIM et CLEAN pour neutraliser les espaces fantômes et les caractères non imprimables.
- 2. Typer (Formatage) : Convertir explicitement les dates, devises et décimales via la fonction TEXT pour figer leur représentation typographique humaine au sein de la chaîne.
- 3. Concaténer (Assemblage) : Déployer la formule appropriée (opérateur & pour la simplicité, TEXTJOIN pour l’intelligence des vides, BYROW/LAMBDA pour la puissance matricielle).
- 4. Valider (Audit) : Soumettre la variable agrégée à une batterie de vérifications formelles par le biais de la fonction REGEXMATCH pour certifier l’intégrité de la syntaxe générée.
- 5. Figer (Optimisation) : Si les flux de données sont stabilisés, substituer les formules par leurs valeurs statiques via un collage spécial afin de libérer les ressources de calcul de l’infrastructure collaborative.
En intégrant ces préceptes algorithmiques, ces blindages syntaxiques et ces exigences méthodologiques, les gestionnaires de données et chercheurs s’assurent d’exploiter tout le potentiel de Google Sheets, transformant un simple tableur bureautique en un environnement robuste, performant et digne des plus hauts standards de la science des données contemporaine.
Références
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Google Workspace. (2023). Documentation de l’assistance Google Sheets : Fonctions de texte. Centre d’aide Google. https://support.google.com/docs/table/25273
- Google Workspace. (2023). ARRAYFORMULA : Développer des formules matricielles sur plusieurs lignes et colonnes. Centre d’aide Google. https://support.google.com/docs/answer/3093275
- Google Workspace. (2023). TEXTJOIN : Combiner du texte provenant de plusieurs plages et/ou chaînes. Centre d’aide Google. https://support.google.com/docs/answer/7013470
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer. https://doi.org/10.1007/0-387-28695-0