
Dans le domaine du traitement analytique avancé et de la biostatistique, la manipulation rigoureuse des données textuelles constitue un pilier fondamental de l’ingénierie des données. Le système d’analyse statistique SAS (Statistical Analysis System), reconnu mondialement pour sa robustesse algorithmique et sa conformité stricte aux exigences réglementaires internationales, traite les chaînes de caractères selon des paradigmes de gestion de la mémoire qui diffèrent substantiellement des langages de script modernes tels que Python ou R. La fusion de vecteurs alphanumériques, communément désignée sous le terme de concaténation, ne se résume pas à une simple juxtaposition visuelle de fragments textuels ; elle engage des mécanismes profonds d’allocation de mémoire, de gestion d’octets, de normalisation d’espaces résiduels et de préservation de l’intégrité sémantique des observations empiriques.
Historiquement contraints par des opérateurs binaires hérités des premières architectures logicielles, les programmeurs SAS ont vu leurs pratiques profondément transformées par l’introduction des fonctions spécialisées de la famille CAT au sein de SAS 9. Ces innovations ont permis de pallier les limitations structurelles des anciens opérateurs textuels, notamment la prolifération de blancs de rembourrage indésirables, l’inélégance du traitement des valeurs manquantes et les conversions implicites de variables numériques souvent assorties d’avertissements verbeux dans le journal d’exécution. La maîtrise de ces mécanismes d’agrégation textuelle s’avère indispensable tant dans le cadre de la constitution de clefs primaires composites au sein de vastes entrepôts de données cliniques que dans la génération automatisée de libellés diagnostiques ou la mise en œuvre de protocoles stricts de pseudonymisation des cohortes épidémiologiques.
Le présent traité méthodologique propose une exploration exhaustive, théorique et appliquée, des techniques de concaténation sous SAS. En décortiquant les architectures sous-jacentes du compilateur, du vecteur de données de programme (Program Data Vector) aux encodages multioctets contemporains, cette étude guide le chercheur et le biostatisticien à travers les méandres des fonctions CAT, CATS, CATT et CATX. Par le biais de démonstrations empiriques reproductibles, d’analyses comparatives de performance computationnelle et de recommandations de bonnes pratiques, ce guide exhaustif établit les standards optimaux d’ingénierie textuelle requis pour garantir l’efficience, la scalabilité et la reproductibilité absolue de vos pipelines de données statistiques.
1. Introduction aux principes de la manipulation textuelle et de la concaténation sous SAS
1.1 Définition conceptuelle de la concaténation dans les environnements statistiques
D’un point de vue algorithmique et formel, la concaténation désigne l’opération binaire ou n-aire qui associe deux ou plusieurs chaînes de caractères séquentielles pour former une séquence textuelle unique. Dans le moteur d’exécution statistique de SAS Institute, cette opération transcende la simple juxtaposition typographique : elle implique la manipulation directe d’adresses mémoires et de structures de tableaux au sein desquelles les vecteurs alphanumériques doivent être réalloués selon des règles déterministes. Dans les environnements statistiques, où la rigueur typologique conditionne la validité des modèles d’inférence, la concaténation s’avère capitale pour consolider des structures informationnelles éclatées, telles que des identifiants patients ventilés sur plusieurs colonnes, des composantes d’adresses géographiques ou des séquences de dosages thérapeutiques.
L’importance de la cohérence typologique s’avère critique lors de la manipulation de variables de chaîne. Contrairement aux langages à typage dynamique permissif, SAS maintient une démarcation absolue et inflexible entre les deux seuls types fondamentaux qu’il reconnaît : le type numérique et le type caractère. Toute tentative de fusion textuelle impliquant un élément numérique exige une étape d’évaluation typologique qui, si elle n’est pas rigoureusement encadrée par le programmeur, expose les structures de données à des distorsions volumétriques majeures. En biostatistique et en recherche comportementale, cette cohérence garantit que des variables qualitatives ordinales ou nominales ne soient pas altérées par des modifications silencieuses de leurs descripteurs sous-jacents.
Dans la recherche observationnelle contemporaine, la concaténation trouve des applications méthodologiques indispensables. Elle permet notamment la génération de clefs composites indispensables lors des jointures relationnelles entre tables longitudinales disjointes. Elle autorise également l’agrégation de fragments de verbatim qualitatifs issus de questionnaires psychométriques afin de préparer les corpus textuels aux analyses lexicométriques outillées. À travers les différentes générations logicielles, depuis l’historique version SAS 6 exécutée sous des terminaux à ressources hautement contraintes jusqu’aux plateformes modernes déployées sur des architectures infonuagiques massives comme SAS 9.4 et SAS Viya, les paradigmes de programmation textuelle ont évolué d’une gestion binaire bas niveau vers des fonctions d’ordre supérieur hautement optimisées pour le traitement parallèle.
1.2 Architecture du compilateur SAS face aux variables de type caractère
Pour appréhender avec exactitude les résultats produits par les opérations de concaténation, il est indispensable de comprendre le fonctionnement interne du compilateur SAS et, tout particulièrement, le rôle du vecteur de données de programme, universellement désigné sous l’acronyme PDV (Program Data Vector). Le PDV représente la zone de mémoire vive allouée par le compilateur au cours de la phase de compilation pour stocker l’enregistrement courant en cours de traitement au sein d’une étape DATA. Lors de cette étape préliminaire, chaque variable se voit attribuer de façon immuable un type, une position relative en mémoire et une longueur d’allocation d’octets fixe. Cette allocation statique signifie qu’une variable déclarée comme étant de type caractère occupera invariablement ce volume mémoire prédéterminé pour chaque observation de la table, indépendamment du nombre réel de caractères composant la chaîne observée.
Cette attribution implicite ou explicite d’une longueur fixe engendre le phénomène mécanique du rembourrage par des espaces (padding). Si un vecteur textuel défini sur une longueur de vingt octets ne contient en réalité que la valeur alphabétique « Jean », le compilateur SAS comble immédiatement et silencieusement les seize octets résiduels par des caractères d’espacement standard (code ASCII 32 ou équivalent hexadécimal 0x20). Ainsi, en mémoire vive, la chaîne n’est jamais réduite à ses seuls glyphes visibles, mais conserve son empreinte dimensionnelle totale. Dès lors, toute opération arithmétique ou logique non contrôlée portant sur cette variable interagira inévitablement avec cette traîne d’espaces invisibles, créant des artefacts visuels ou des dysfonctionnements majeurs lors de l’assemblage de vecteurs contigus.
Un autre défi structurel réside dans la distinction critique opérée par le compilateur entre les valeurs manquantes numériques et les chaînes de caractères vides ou manquantes. Dans le domaine numérique, une observation manquante est matérialisée dans le PDV par un point standard (.) ou par l’une des lettres spéciales d’absence (._, .A à .Z), codée via un format flottant à virgule spécifique. Pour les chaînes alphanumériques, en revanche, la notion de pointeur nul n’existe pas : une variable de caractère manquante correspond physiquement à un vecteur entièrement rempli d’espaces de délimitation sur toute sa longueur déclarée. Cette caractéristique fondamentale implique que pour le PDV, une chaîne manquante possède une longueur technique identique à celle d’une chaîne remplie de caractères alphabétiques, ce qui fausse dramatiquement les calculs de longueurs cumulées si des procédures d’élagage ne sont pas expressément déployées.
1.3 Présentation du jeu de données synthétique pour les démonstrations empiriques
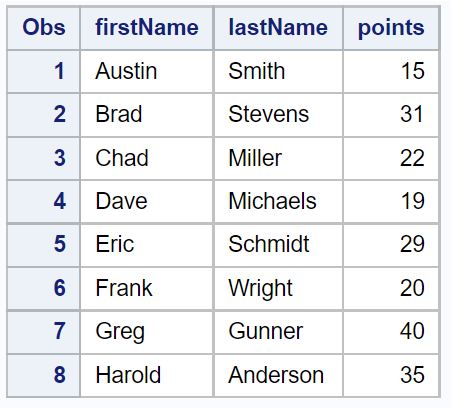
Afin de conférer à cet exposé une portée empirique tangible et d’illustrer rigoureusement les concepts évoqués, nous définissons un corpus de données synthétiques représentatif des architectures tabulaires rencontrées dans les protocoles de recherche biomédicale et psychométrique. Ce tableau de données, baptisé conventionnellement my_data1, intègre des variations intentionnelles de longueurs, des présences d’espaces résiduels ainsi que des disparités morphologiques permettant d’évaluer fidèlement la résilience des différentes syntaxes de concaténation. La création de cette table repose sur l’exploitation native de l’étape DATA combinée aux instructions INPUT et DATALINES.
Le bloc de code ci-dessous matérialise l’instanciation de cette cohorte expérimentale. Nous assignons explicitement des longueurs substantielles aux variables textuelles pour forcer l’apparition des mécanismes de bourrage en queue de chaîne, et nous introduisons une variable numérique continue traduisant un score métrique d’évaluation clinique :
Au sein de cette étape DATA, la variable firstName est dimensionnée à une longueur de 12 octets, tandis que la variable lastName reçoit une allocation de 15 octets. La variable points, de nature purement quantitative, capture une métrique de score continu. Les observations sélectionnées intègrent des cas typiques : des noms courts induisant un remplissage artificiel important, des noms composés, ainsi que des chaînes contenant des décalages d’alignement. L’inspection initiale de cette structure via la procédure PROC PRINT permet de valider le chargement correct des enregistrements dans la table SAS cible tout en observant, dans le journal système (SAS Log), l’attribution stricte des attributs dimensionnels au sein du descripteur de fichier.
L’exécution de la procédure de validation est paramétrée sans fioritures afin d’exposer la morphologie brute des données : la procédure PROC PRINT DATA=my_data1; RUN; confirme que les enregistrements sont physiquement consignés dans le sous-système temporaire WORK, prêts à être soumis aux différents opérateurs et algorithmes fonctionnels d’agrégation textuelle.
2. Structure des données textuelles dans SAS : longueur, rembourrage et encodage
2.1 Le mécanisme de stockage à longueur fixe et l’espacement résiduel (Trailing Blanks)
Le fondement de la modélisation textuelle sous SAS réside dans le principe de l’alignement à gauche couplé au rembourrage mécanique par des espaces résiduels, généralement qualifiés de trailing blanks dans la documentation technique anglo-saxonne. Lorsqu’une chaîne de caractères est affectée à une variable déclarée, le compilateur copie les caractères de gauche à droite à partir du premier octet alloué. Dès que l’ensemble des caractères de la chaîne source a été transcrit, chaque position d’octet vacante jusqu’à la limite déclarée se voit systématiquement attribuer un caractère d’espacement standard. Ce comportement déterministe garantit des performances d’accès direct remarquables lors des opérations d’E/S (Entrées/Sorties) sur disque, mais constitue un piège pour les opérations d’assemblage logique.
Les conséquences de cet espacement invisible deviennent immédiatement manifestes lors de la simple juxtaposition de deux colonnes. Si un analyste tente de réunir un prénom stocké sur 12 positions et un nom stocké sur 15 positions sans appliquer de traitement préalable sur ces blancs résiduels, la chaîne résultante intégrera physiquement l’ensemble des espaces de remplissage du prénom avant d’initier l’écriture du premier caractère du nom. Ce phénomène engendre un vide visuel béant au milieu de la chaîne combinée, rendant l’expression textuelle impropre à toute publication, indexation ou utilisation au sein d’une clef de recherche informatisée.
Pour administrer ces structures avec précision, le langage met à disposition des fonctions spécialisées d’évaluation dimensionnelle. La fonction LENGTH évalue une chaîne de caractères et renvoie la position du dernier caractère non blanc visible. Toutefois, si la variable évaluée ne contient exclusivement que des espaces blancs (ou s’avère manquante), la fonction LENGTH renvoie conventionnellement la valeur 1, ce qui peut fausser certains calculs d’indexation matricielle. Pour pallier cette anomalie structurelle, SAS intègre la fonction LENGTHN, qui quantifie avec exactitude le nombre de caractères non blancs et renvoie rigoureusement 0 lorsque la chaîne est entièrement vide. La fonction complémentaire VLENGTH, quant à elle, extrait non pas la longueur du contenu informationnel, mais la capacité brute d’allocation définie dans le dictionnaire de la table, attestant de la dualité constante entre l’enveloppe allouée et le contenu textuel effectif.
2.2 Interactions avec les encodages de caractères (UTF-8 versus WLATIN1)
L’ingénierie textuelle contemporaine ne peut faire l’économie d’une gestion rigoureuse des schémas d’encodage de caractères. Historiquement, les environnements d’exploitation francophones exécutaient les sessions SAS sous l’encodage monocarré WLATIN1 (ISO/CEI 8859-1 ou Windows-1252), dans lequel chaque glyphe alphabétique, qu’il s’agisse d’un caractère ASCII standard ou d’une lettre accentuée diacritique comme le « é », le « à » ou le « ç », est systématiquement représenté par exactement un octet de données. Cependant, la transition globale vers l’internationalisation a imposé la norme Unicode UTF-8 comme standard prédominant au sein des déploiements SAS récents, notamment sous SAS Viya et les clusters analytiques distribués sur Linux.
Sous un encodage UTF-8, la corrélation rigide entre le nombre de caractères visibles et le nombre d’octets physiques en mémoire s’effondre. Tandis que les caractères anglo-saxons standards demeurent codés sur un octet, les lettres diacritiques de la langue française requièrent impérativement deux octets, et certains symboles scientifiques ou idéogrammes asiatiques en mobilisent trois ou quatre. Dès lors, si un programmeur alloue une longueur de 10 octets à une chaîne pour stocker une variable nominative contenant des accents, cette chaîne pourrait être physiquement tronquée après seulement cinq caractères complexes, bien que visuellement elle paraisse courte. Lors de la concaténation de colonnes encodées sous des tables mixtes, des erreurs de transcodage de session peuvent survenir, se traduisant par le remplacement destructeur de voyelles accentuées par des caractères de substitution illisibles (souvent désignés sous le terme de mojibake).
Pour prévenir ces ruptures d’intégrité, l’audit systématique de l’environnement d’exécution via la procédure PROC OPTIONS OPTION=ENCODING; RUN; s’impose avant tout déploiement de scripts de manipulation textuelle lourde. Le compilateur SAS propose également des variantes de fonctions sensibles aux octets et aux caractères, telles que KLENGTH ou KCAT (dans les environnements NLS – National Language Support), garantissant que l’agrégation de chaînes internationales s’opère en respectant scrupuleusement les frontières morphologiques des graphèmes, prévenant ainsi les coupures sauvages au beau milieu de structures binaires multioctets.
3. Les opérateurs historiques de concaténation et leurs limites structurelles
3.1 L’opérateur de concaténation standard (double barre verticale || ou !!)
Avant l’avènement des architectures fonctionnelles enrichies dans SAS 9, la jonction de fragments de texte reposait presque exclusivement sur l’emploi de l’opérateur de concaténation binaire, représenté typographiquement par une double barre verticale (||) ou, selon la configuration des tables de transcodage de clavier de certains terminaux mainframe, par deux points d’exclamation consécutifs (!!). Cet opérateur fondamental fusionne deux expressions textuelles de manière strictement mécanique, sans réaliser la moindre opération préalable de nettoyage d’espaces ni d’évaluation sémantique du contexte lexical.
Le comportement par défaut de l’opérateur binaire consiste à conserver avec une rigueur absolue la totalité de la longueur allouée à l’opérande situé à sa gauche. Si l’on assigne à une nouvelle variable le résultat de l’opération firstName || lastName, le moteur d’exécution injecte le contenu de firstName, suivi de l’ensemble de ses espaces de remplissage résiduels jusqu’à concurrence de sa longueur maximale déclarée, avant d’y greffer le premier caractère de lastName. Le résultat produit correspond à un texte disloqué, où les deux composantes nominatives se trouvent séparées par un vide artificiel d’une dizaine de colonnes, interdisant toute utilisation bureautique ou analytique directe sans correction d’alignement.
Pour contourner ce handicap rédhibitoire, les développeurs devaient historiquement encapsuler les variables dans des cascades fastidieuses de fonctions de décapage d’espaces. La syntaxe canonique requérait d’appliquer la fonction TRIM pour purger les espaces situés à droite, souvent combinée à la fonction LEFT pour repositionner le texte au premier octet disponible : TRIM(LEFT(firstName)) || ' ' || TRIM(LEFT(lastName)). Cette formulation, bien que fonctionnelle, alourdit considérablement le code source, multiplie les risques d’omission d’un sous-décapage et ralentit l’exécution des boucles de traitement de par la surcharge imposée au compilateur qui doit évaluer trois fonctions distinctes par observation pour une simple jonction patronymique.
3.2 L’opérateur de concaténation conditionnelle avec suppression des blancs d’espacement (!! ou ><)
Dans certaines déclinaisons historiques ou sur des environnements spécialisés tels que les systèmes d’exploitation z/OS (environnements gros systèmes IBM), des variantes syntaxiques ont émergé pour tenter de rationaliser l’élimination des espaces de bordure. L’emploi combiné de séquences d’opérateurs ou de symboles spécifiques, parfois documentés sous des formes propriétaires telles que les opérateurs de compression lexicale, tentait de réduire la friction programmatique. Toutefois, ces syntaxes alternatives se heurtaient invariablement à des problèmes de portabilité majeure lors des migrations inter-systèmes d’exploitation.
Les divergences d’encodage entre les jeux de caractères EBCDIC utilisés sur les mainframes et les formats ASCII/ANSI régissant les serveurs Unix et Windows entraînaient fréquemment la corruption de ces opérateurs non canoniques. Un code source transféré sans précaution pouvait transformer un opérateur de fusion en commande de comparaison logique, provoquant l’interruption prématurée du script ou, plus pernicieux encore, la modification silencieuse des données en sortie de chaîne de traitement. Cette instabilité structurelle a poussé les directions informatiques des grandes institutions bancaires et biopharmaceutiques à interdire formellement les notations d’opérateurs exotiques dans leurs plans d’assurance qualité logicielle.
Outre ces failles de portabilité internationale, l’inefficience algorithmique de ces approches devenait critique lors de l’assemblage de tables volumineuses hébergeant plusieurs dizaines de variables à unifier. Le chaînage consécutif de dizaines d’opérateurs binaires générait une saturation progressive des registres de la pile d’exécution du compilateur, chaque opération binaire produisant des étapes intermédiaires de matérialisation de sous-chaînes au sein du PDV, pénalisant lourdement la bande passante processeur et augmentant drastiquement les durées de rotation des traitements par lots nocturnes.
3.3 Traitement des valeurs manquantes par les opérateurs classiques
L’un des écueils les plus redoutables de l’opérateur traditionnel réside incontestablement dans sa gestion native des valeurs manquantes. Lorsqu’un opérande de nature numérique fait l’objet d’une concaténation directe via l’opérateur ||, le compilateur SAS, constatant l’incompatibilité typologique, procède d’autorité à une coercition implicite du type numérique vers le type caractère. Cette conversion non supervisée s’effectue en appliquant le format par défaut BEST12., ce qui injecte automatiquement une série de onze espaces blancs préalables suivis du chiffre, tout en consignant dans le journal d’exécution un avertissement formel : NOTE: Numeric values have been converted to character values at the line....
Si la variable numérique ou textuelle source contient une valeur formellement manquante (représentée par un point ou par une chaîne d’espaces vides), l’opérateur classique ne dispose d’aucun mécanisme sémantique pour l’ignorer. Le point de la valeur manquante numérique est littéralement converti en caractère textuel ‘.’ précédé d’espaces, venant polluer irrémédiablement le texte unifié final. S’il s’agit d’une chaîne alphanumérique vide, l’opérateur en préserve la longueur totale d’allocation, générant des blocs de blancs fantômes impossibles à discriminer des espaces de mise en forme légitimes au sein du fichier de sortie.
Pour assainir ces données par l’approche historique, le programmeur n’avait d’autre choix que d’échafauder des structures arborescentes de conditions logiques IF-THEN/ELSE extrêmement fastidieuses. Il était impératif de vérifier pour chaque variable si elle était égale à l’espace ou à une valeur manquante avant d’autoriser l’injection du délimiteur. Pour un ensemble de seulement cinq attributs cliniques à agglomérer dans une même chaîne de diagnostic, l’échafaudage logique nécessitait parfois plusieurs dizaines de lignes de code conditionnel hautement propices à l’introduction d’erreurs humaines de logique booléenne, compliquant sévèrement la maintenance évolutive des progiciels statistiques.
4. La fonction CAT : Concaténation élémentaire avec conservation des espacements
4.1 Mécanisme interne et syntaxe formelle de la fonction CAT
Conscients de l’épuisement méthodologique induit par la manipulation des opérateurs textuels primitifs, les ingénieurs de conception du noyau SAS ont introduit, à compter de la version 9 du système, la suite fonctionnelle CAT, dont la déclinaison princeps est la fonction éponyme CAT. Cette fonction implémente une abstraction d’ordre supérieur pour l’agrégation textuelle, s’affranchissant définitivement du schéma binaire rigide pour adopter une signature logicielle acceptant un nombre indéterminé d’arguments positionnels : CAT(argument_1, argument_2, ..., argument_n). L’architecture interne de la fonction a été optimisée pour réduire les transferts de mémoire tampon au sein du PDV lors des étapes DATA complexes.
Le comportement algorithmique spécifique de la fonction CAT consiste à reproduire la mécanique d’agrégation brute de l’opérateur historique, tout en apportant une modernisation considérable dans la prise en charge des arguments hétérogènes. La fonction CAT préserve intégralement et scrupuleusement la totalité des espaces d’en-tête (leading blanks), des espaces intermédiaires, ainsi que des espaces terminaux résiduels (trailing blanks) inhérents à chaque variable transmise en paramètre. Aucune purge silencieuse n’est exécutée sur les données d’entrée, ce qui permet au développeur de maîtriser l’empreinte topologique exacte de chaque fragment injecté dans le flux textuel récepteur.
L’avantage opérationnel décisif de CAT sur l’opérateur || réside dans sa gestion native et silencieuse de la conversion de type. Si une variable numérique continue ou entière est intégrée dans la liste des arguments, la fonction CAT l’assimile instantanément comme un vecteur alphanumérique sans interrompre le traitement et surtout, sans générer de note d’avertissement de conversion dans le journal SAS. Cette conversion s’opère selon un algorithme interne hautement performant qui émule un formatage direct, éradiquant la pollution visuelle des journaux de compilation indispensables aux audits de validation clinique (environnements GxP / FDA 21 CFR Part 11).
4.2 Démonstration empirique : Concaténation du prénom et du nom avec espaces conservés
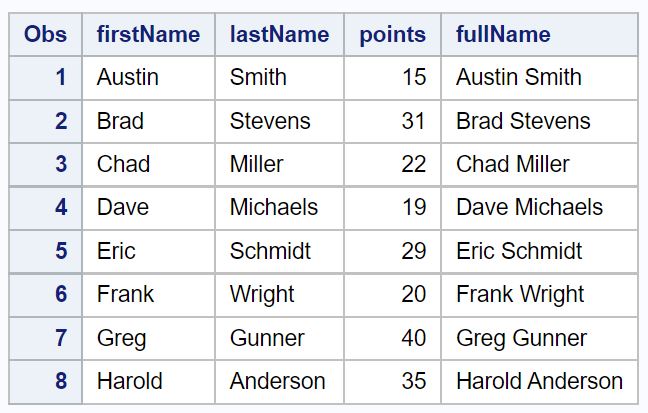
Afin d’analyser concrètement le comportement de la fonction CAT face aux contraintes d’allocation de variables textuelles, soumettons notre table de recherche my_data1 à une transformation standard au sein de laquelle nous cherchons à agréger le prénom (firstName) et le nom patronymique (lastName) d’un sujet au sein d’une nouvelle entité dénommée conventionnellement fullName_CAT. La formulation du bloc DATA s’exécute selon les directives de programmation suivantes :
L’étape s’articule formellement : nous déclarons une étape DATA dérivant la nouvelle table my_data_cat à partir du jeu source. L’instruction fondamentale s’écrit avec une clarté limpide : fullName_CAT = CAT(firstName, lastName);. Aucune fonction d’élagage d’espace n’est annexée. Enfin, la procédure PROC PRINT est invoquée, en ciblant spécifiquement les variables patronymiques d’origine et la variable composite qui vient d’être instanciée afin d’en scruter les caractéristiques typographiques.
L’examen des observations produites par cette exécution met immédiatement en lumière le mécanisme de préservation intégrale des espaces : si l’enregistrement source comporte le prénom « Thomas » dans une colonne dimensionnée à 12 caractères, la fonction CAT alloue d’abord les six caractères du prénom, puis les six espaces résiduels non tronqués constitutifs du rembourrage, avant de juxtaposer immédiatement le premier caractère de la variable lastName. Le résultat final présente ainsi un espacement fixe artificiel de six caractères blancs entre les deux composantes nominatives. Ce décalage d’alignement, parfaitement visible lors d’un affichage tabulaire, démontre que la fonction n’opère aucun jugement sur la valeur esthétique du texte, respectant strictement la topologie physique du bloc mémoire sous-jacent.
4.3 Scénarios d’usage méthodologiquement appropriés pour la fonction CAT
Bien que l’apparence désarticulée des chaînes produites par la fonction CAT puisse sembler contre-productive pour des besoins de restitution bureautique standard, cette fonction remplit un rôle méthodologique irremplaçable dans des contextes d’ingénierie logicielle avancée. Le cas d’usage par excellence concerne la génération de fichiers plats positionnels ou d’enregistrements d’exportation à largeur fixe (fixed-width text files). De nombreux systèmes financiers centraux, plateformes bancaires d’anciennes générations ou registres gouvernementaux d’état civil exigent des fichiers d’interface dans lesquels chaque colonne d’information doit impérativement débuter à un offset d’octet rigoureusement prédéfini.
Dans ce contexte précis, la tentative de nettoyer les espaces de queue est prohibée : il est au contraire indispensable que la variable prénom conserve l’intégralité de son encombrement formel afin que la variable nom patronymique s’initialise rigoureusement au treizième octet de la ligne de données. L’utilisation de CAT garantit cette conservation géométrique absolue sans exiger le recours à des fonctions auxiliaires de rembourrage directionnel telles que REPEAT ou l’usage complexe de formats de sortie PUT dotés de modificateurs d’espacement. Le gain en lisibilité du code et en vitesse de calcul est alors maximal pour la constitution de ces bordereaux d’échange hautement normalisés.
Un autre scénario analytique prépondérant concerne la linguistique informatique et les sciences psychométriques appliquées à l’évaluation des temps de réponse ou de la cadence de lecture. Dans certains protocoles expérimentaux d’oculométrie ou d’analyse psycholinguistique, les espaces au sein d’une invite textuelle ne représentent pas de simples délimiteurs, mais des étalons de distance visuelle calibrés destinés à mesurer le mouvement saccadique de l’œil du participant. L’altération ou la suppression involontaire de ces espaces initiaux ou intermédiaires ruinerait la validité interne du dispositif expérimental. La fonction CAT constitue la garantie absolue que le stimulus textuel préserve fidèlement l’organisation spatiale voulue par l’expérimentateur.
5. La fonction CATS : Suppression systématique des espaces et jointure compacte
5.1 Principe de purge intégrale des espaces blancs (Leading and Trailing Blanks)
Dans l’immense majorité des applications d’analyse statistique de routine, l’objectif du biostatisticien consiste précisément à éliminer sans concession les espaces de rembourrage engendrés par le moteur d’exécution. Pour répondre nativement à ce besoin récurrent sans recourir à des imbrications algorithmiques coûteuses, le langage met à disposition la fonction CATS. Le suffixe sémantique « S » apposé à la racine fonctionnelle fait formellement référence à l’action d’élagage (Strip), indiquant sans ambiguïté la nature du traitement appliqué aux arguments passés en entrée.
Le fonctionnement interne de la fonction CATS applique de manière implicite et hautement optimisée l’équivalent vectoriel de la fonction STRIP à chacun de ses arguments avant de procéder à l’opération de collage physique. Ce décapage opère une double intervention topologique : il élimine la totalité des espaces d’en-tête (leading blanks) susceptibles de provenir d’un mauvais alignement ou d’un formatage antérieur, ainsi que la totalité des espaces de queue résiduels (trailing blanks). Les chaînes sont pour ainsi dire déshabillées de leur gangue de rembourrage pour être condensées en leur plus petite expression lexicale signifiante, puis immédiatement fusionnées dans l’ordre rigoureux de leur soumission.
Il importe de souligner avec la plus grande rigueur technique que ce processus d’élagage automatisé respecte intégralement et scrupuleusement les espaces internes constitutifs des sous-chaînes. Si une observation textuelle soumise à CATS comporte un espace sémantique légitime (par exemple un prénom composé tel que « Jean- Luc » ou une particule nobiliaire « de la » comportant des espaces au cœur du mot), ces espaces intermédiaires ne sont en aucun cas altérés ni comprimés par la fonction. L’action d’ébarbage ne cible souverainement que les frontières externes de chaque argument, assurant une compression maximale sans dénaturation orthographique des éléments constitutifs.
5.2 Démonstration empirique : Génération d’identifiants continus et d’acronymes
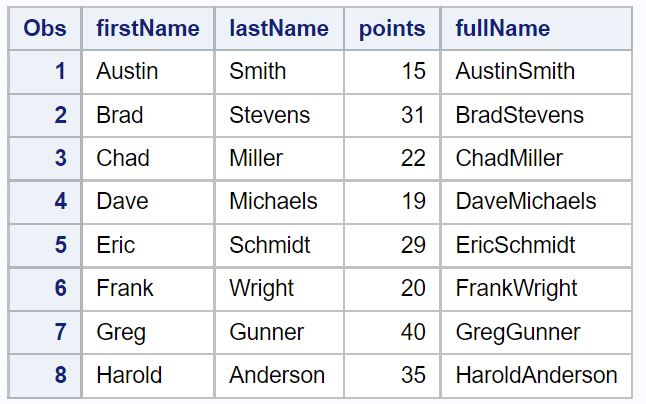
L’exploitation de la fonction CATS s’illustre avec éclat lors de la dérivation d’identifiants uniques continus ou de codes de hachage élémentaires. Dans l’écosystème de notre jeu de données my_data1, supposons que nous souhaitions générer pour chaque individu un identifiant machine d’analyse agrégeant de manière contiguë son prénom, son nom patronymique et la valeur exacte de son score de performance psychométrique, sans qu’aucun espace ne vienne s’immiscer au sein du token ainsi constitué.
Le traitement au sein de l’étape DATA s’écrit comme suit, exploitant la coercition numérique automatique offerte par l’infrastructure de la famille fonctionnelle SAS :
La formulation est condensée : uniqueID = CATS(firstName, lastName, points);. En une seule instruction fonctionnelle, trois variables hétérogènes sont absorbées. La variable numérique points est transcodée en caractère, élaguée de tout blanc initial généralement induit par l’alignement à droite conventionnel des grandeurs numériques, tandis que le prénom et le patronyme sont dépouillés de leurs traînes d’espaces résiduels. L’appel de PROC PRINT révèle une séquence d’octets continue et parfaitement étanche, comme par exemple la chaîne « ThomasDubois84 » ou « MarieLefebvre92 », exempte de la moindre anomalie structurelle.
L’évaluation comparative de ce résultat avec ce qui aurait été produit par un opérateur binaire non nettoyé met en évidence la supériorité opérationnelle de CATS : là où l’opérateur classique aurait exigé l’écriture verbeuse STRIP(firstName) || STRIP(lastName) || STRIP(PUT(points, BEST12.)), la fonction effectue la totalité de ces opérations sous le capot du moteur C sous-jacent, consommant moins de cycles d’horloge CPU et préservant l’intégrité séquentielle absolue sans altérer en aucune façon les variables mères conservées dans la table d’analyse.
5.3 Applications analytiques avancées de CATS
Dans la recherche observationnelle longitudinale contemporaine, où des tables cliniques massives doivent être réconciliées entre plusieurs cycles temporels, l’instanciation de clefs primaires composites demeure l’une des applications fondamentales de CATS. Lorsque les centres investigateurs ne disposent pas d’un système d’identifiant universel unique, la robustesse de l’appariement repose sur l’assemblage infaillible du code pays, de l’identifiant du centre hospitalier, du numéro d’ordre du sujet et de son millésime de naissance. L’application de CATS sur ces composantes hétérogènes permet de dériver une clef de jointure ultra-compacte, hautement indexable, réduisant l’empreinte mémoire des index B-Tree construits par le moteur de base de données de SAS.
Un autre vecteur d’application réside dans la normalisation algorithmique des uniform resource locators (URL) ou la fabrication de slugs textuels destinés à alimenter des tableaux de bord interactifs basés sur des architectures web. Dans ces scénarios de communication de la science, les composants d’adresses d’API doivent être soudés sans tolérer le moindre caractère d’espacement parasite susceptible de briser le protocole HTTP ou d’exiger un échappement de type %20. La fonction CATS offre la garantie algorithmique qu’aucun décalage d’espacement involontaire ne subsistera au sein de la chaîne de routage générée.
Enfin, dans le traitement assaini des enquêtes psychométriques et sociologiques administrées en ligne, les biais de saisie humaine constituent une source notoire d’imperfections. Les répondants insèrent fréquemment, de manière accidentelle, des espaces au début ou à la fin des zones de texte libre ou des identifiants d’instruments d’évaluation. L’intégration de CATS au sein des pipelines de nettoyage préliminaire permet d’éliminer automatiquement et de façon standardisée ces artefacts de saisie manuelle sans nécessiter l’orchestration de cascades de conditions d’expression régulière coûteuses en temps processeur.
6. La fonction CATT : Suppression sélective des espaces de fin de chaîne
6.1 Algorithme spécifique de délimitation de la fonction CATT
Tandis que la fonction CATS procède à une neutralisation totale et indifférenciée de l’ensemble des bordures blanches, certaines configurations analytiques exigent un niveau de discernement plus chirurgical. C’est précisément la justification de la fonction CATT, dont le suffixe mnémonique « T » se réfère sans équivoque au mécanisme de troncature sélective des seuls espaces de fin de chaîne (Trailing Blanks). Le cahier des charges algorithmique de cette fonction correspond à l’application implicite de la fonction classique TRIM sur l’intégralité des arguments listés dans sa signature fonctionnelle.
Ce choix conceptuel induit une différenciation structurelle majeure vis-à-vis de ses consœurs CAT et CATS : la fonction CATT prend un soin jaloux de maintenir intacts et inviolés l’ensemble des espaces situés en amont du texte, c’est-à-dire les espaces d’en-tête (leading blanks). Elle ne s’attaque exclusivement qu’aux espaces de queue venant clore la chaîne de caractères. Dès lors, si une variable présente un retrait artificiel de quatre espaces sur sa gauche, ce retrait est formellement reproduit dans le vecteur de fusion résultant, tandis que son articulation avec l’argument subséquent s’opère de façon étanche et immédiate dès le dernier caractère imprimable identifié à sa droite.
Cette distinction s’avère absolument capitale dans les scénarios où l’espace en tête de chaîne ne relève pas d’une négligence typographique ou d’un artefact de stockage, mais véhicule une information sémantique structurante. La préservation de l’indentation initiale permet de conserver des données de hiérarchie logique au sein d’une seule et même variable consolidée, évitant au data analyst d’avoir à maintenir des colonnes d’arborescence supplémentaires pour modéliser le niveau de dépendance d’un item par rapport à un autre dans les bases de données relationnelles complexes.
6.2 Exemple pratique d’assemblage hiérarchique et d’arborescences
Pour illustrer méthodologiquement la pertinence de l’algorithme CATT, considérons la modélisation de nomenclatures cliniques ou de répertoires nosographiques, tels que la Classification Internationale des Maladies (CIM) ou le DSM, dans lesquels les catégories diagnostiques fondamentales sont répertoriées sans indentation, tandis que les sous-syndromes ou les entités cliniques dérivées sont codés en base avec des retraits géométriques successifs pour symboliser visuellement et structurellement leur filiation taxonomique.
Supposons que nous souhaitions associer à chaque libellé diagnostique son code nosologique respectif en fin de désignation, tout en préservant le retrait typographique distinctif qui traduit le rang arborescent de la pathologie. La structure de manipulation sous SAS est mise en œuvre par le segment de code programmatique ci-après :
L’étape DATA déploie une variable diagnosticTree initialisée au moyen de l’expression CATT(labelDescription, ' [Code: ', ICD10_Code, ']');. Si nous avions mobilisé ici la fonction CATS, cette dernière aurait impitoyablement éradiqué les retraits d’indentation du libellé, anéantissant d’un coup la hiérarchie visuelle entre catégories principales et sous-catégories diagnostiques. L’opérateur classique CAT, à l’inverse, aurait conservé les 60 caractères alloués à la variable descriptive, expulsant le code nosographique à une distance spatiale aberrante tout au bout de la ligne.
L’exécution de CATT offre le compromis parfait : le niveau d’indentation initial est strictement sauvegardé, garantissant l’élégance visuelle et la structuration arborescente lors de l’édition d’états d’impressions tabulaires via PROC PRINT ou PROC REPORT, tandis que le suffixe technique délimitant le code de pathologie vient s’amarrer avec une précision typographique absolue immédiatement après la dernière lettre du terme clinique. La chaîne synthétique qui en émerge matérialise l’exacte taxonomie souhaitée, conciliant harmonieusement impératifs de classification nosographique et rigueur de stockage des données de santé.
7. La fonction CATX : Concaténation normalisée avec séparateur personnalisé
7.1 Paramétrage formel et gestion du délimiteur arbitraire
Dans l’arsenal des fonctions de manipulation textuelle de SAS, la fonction CATX représente incontestablement le standard de référence et le sommet fonctionnel de la famille CAT pour l’immense majorité des applications analytiques et d’ingénierie des données. La conception logicielle de CATX résout de manière unifiée, standardisée et hautement efficiente la double problématique de l’élagage des espaces parasitaires et de l’intercalation systématique d’un élément délimiteur entre chaque sous-composante lexicale. L’importance méthodologique de cette fonction justifie son statut d’outil de prédilection au sein des centres de recherche biomédicale internationaux.
La signature algorithmique formelle de la fonction exige une attention particulière, car elle se démarque par la nature de son premier paramètre positionnel : CATX(délimiteur, argument_1, argument_2, ..., argument_n). Le premier argument ne représente pas une variable à fusionner, mais spécifie de manière souveraine le motif textuel délimiteur qui sera arbitrairement et invariablement inséré entre les différents termes passés dans la suite des paramètres. Ce délimiteur peut correspondre à un simple espace blanc conventionnel (' '), à une marque de ponctuation normalisée telle qu’une virgule suivie d’un espace (', '), à un séparateur technique d’échange tel qu’un pipe ou un point-virgule, ou encore à une suite complexe de plusieurs caractères alphabétiques.
Le comportement algorithmique interne de CATX combine l’action la plus radicale de décapage d’espaces avec l’injection sécurisée du séparateur. Avant d’intercaler le délimiteur, CATX applique sur chacun des arguments positionnels subséquents un élagage absolu des espaces d’en-tête et de queue, strictement équivalent au mécanisme de la fonction STRIP. Dès lors, le délimiteur spécifié s’enchâsse avec une précision chirurgicale entre les entités informatives préalablement assainies, sans tolérer qu’aucun espace accidentel ne vienne distendre le motif régulier ainsi déployé tout au long de la chaîne réceptrice.
7.2 Démonstration empirique : Formatage standardisé de noms complets et de codes d’épreuve
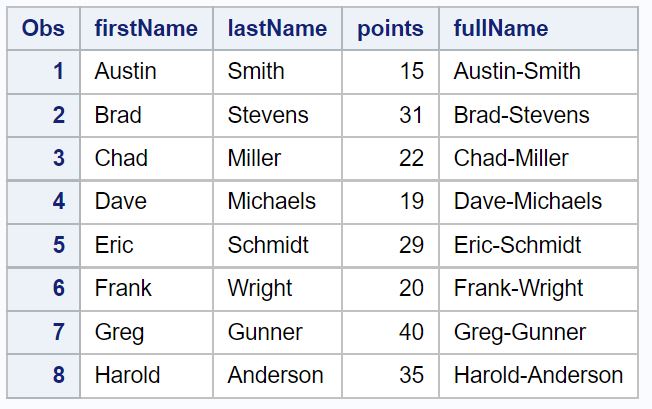
Pour attester empiriquement de l’efficience de la fonction CATX, reprenons les données de notre table d’observation clinique my_data1 en appliquant cette fois-ci une double standardisation textuelle. Il s’agit d’une part de constituer une identité nominative formelle et conventionnelle, réunissant le prénom et le nom de famille séparés par un espace unitaire unique, et d’autre part de créer un identifiant d’épreuve technique normalisé, associant le nom patronymique du patient et son score numérique par l’intermédiaire d’un séparateur de type trait d’union standardisé.
L’implémentation opérationnelle de ces transformations est orchestrée à travers l’étape DATA subséquente :
Dans ce bloc méthodologique, l’instruction fullName_CATX = CATX(' ', firstName, lastName); résout instantanément la fusion nominative : les espaces de remplissage résiduels de la variable firstName sont éradiqués, et un seul espace rigoureux est interposé entre le prénom et le patronyme. Simultanément, l’instruction examCode_CATX = CATX('-', lastName, points); convertit silencieusement la valeur numérique continue de la variable points en chaîne textuelle, en purge les blancs conventionnels de mise en page mathématique, et la lie au patronyme par un trait d’union parfaitement cadré.
L’affichage tabulaire obtenu sous l’égide de PROC PRINT démontre l’impeccable homogénéité des séries obtenues. Que le nom comporte cinq ou dix-huit caractères, que le score comporte deux ou trois chiffres, l’alignement lexical obtenu est géométriquement parfait. Aucune redondance d’espacement, aucune distorsion visuelle n’est constatée, attestant du respect des critères de présentation requis pour la diffusion directe de livrables statistiques ou l’alimentation d’interfaces applicatives en aval.
7.3 L’évitement élégant des délimiteurs orphelins (Dangling Delimiters)
Au-delà de son élégance syntaxique, la caractéristique fonctionnelle la plus fondamentale et la plus remarquable de la fonction CATX réside dans sa gestion souveraine des éléments manquants ou des sous-chaînes vides, matérialisée par l’éradication native du phénomène bien connu des ingénieurs de données sous l’appellation de délimiteurs orphelins (dangling delimiters). Dans les approches artisanales fondées sur l’opérateur ||, l’agrégation conditionnelle d’une liste de variables dont l’une est vide engendre mécaniquement l’apparition de deux délimiteurs consécutifs non souhaités (par exemple "Paris,,France" ou "Thomas - 84 - "), polluant irrémédiablement la sémiotique du champ constitué.
La fonction CATX neutralise complètement cette pathologie algorithmique. Si l’un des arguments soumis à l’évaluation s’avère être une chaîne vide, un champ ne contenant que des espaces blancs, ou une valeur numérique manquante (représentée par un point conventionnel), CATX ignore souverainement cet argument dans le flux de traitement séquentiel. Elle n’insère en aucun cas le délimiteur arbitraire pour cette position vacante. En conséquence directe, le délimiteur n’apparaît jamais en position initiale si le premier élément est absent, n’est jamais dupliqué de façon redondante au milieu de la chaîne si un attribut intermédiaire fait défaut, et ne vient jamais souiller la terminaison du vecteur si la dernière composante est manquante.
Cette intelligence procédurale confère à CATX une supériorité absolue de robustesse comparée aux cascades laborieuses d’instructions IF-THEN/ELSE nécessaires à la sécurisation des anciens scripts. Un traitement de dix champs d’adresses postales (numéro, extension, type de voie, nom de voie, bâtiment, étage, code postal, localité, département, pays) qui aurait traditionnellement nécessité l’écriture complexe de dizaines de branchements conditionnels pour éviter des virgules isolées s’exécute désormais avec une sécurité mathématique infaillible en une seule ligne programmatique : adresseComplete = CATX(', ', of adresse_1 - adresse_10);. Le code source devient alors auto-documenté, inviolable et intrinsèquement reproductible.
8. Comparaison systématique et matrice décisionnelle entre les fonctions de la famille CAT
8.1 Tableau synoptique des comportements de traitement de l’espace
Afin de structurer le discernement de l’architecte de données lors du choix de ses primitives de traitement sous SAS, il est nécessaire d’établir une synthèse transversale des comportements adoptés par chaque modalité technique face aux différentes configurations d’espaces. Les décisions d’ingénierie textuelle dépendent intimement de la préservation ou de l’oblitération intentionnelle des décalages d’alignement au sein du PDV.
Le tableau décisionnel ci-après synthétise formellement ces interactions d’ingénierie logicielle :
- Opérateur || (Double barre) : Ne supprime aucun espace (ni en tête, ni en queue). Ne gère aucun délimiteur automatique. Échoue face aux valeurs manquantes en générant des notes d’alerte et en conservant les points de données manquants. Exige une conversion de type manuelle stricte via
PUTsous peine d’avertissement au compilateur. - Fonction CAT : Conserve intégralement les espaces d’en-tête (leading) et les espaces résiduels de queue (trailing). N’intègre aucun séparateur natif. Absorbe de façon silencieuse et sécurisée les valeurs numériques sans message parasite dans le journal. Recommandée pour l’export de fichiers plats à colonnage fixe.
- Fonction CATS : Supprime de façon agressive et simultanée l’ensemble des espaces en tête de chaîne et en queue de chaîne (équivalent à un décapage
STRIPuniversel). Ne dépose aucun délimiteur entre les termes. Recommandée sans réserve pour la fabrication de clefs composites, d’acronymes, de slugs de navigation ou d’identifiants informatiques continus. - Fonction CATT : Préserve rigoureusement les indentations initiales et les espaces en tête d’argument, mais tronque et détruit l’intégralité des espaces terminaux résiduels (action équivalente à
TRIM). Idéale pour la modélisation textuelle de nomenclatures hiérarchiques, d’arborescences diagnostiques ou de taxonomies qualitatives. - Fonction CATX : Applique une purge intégrale des espaces externes (STRIP) sur chaque variable tout en insérant systématiquement un séparateur textuel configurable. Ignore nativement les entrées manquantes ou vides sans introduire de séparateurs orphelins dupliqués. Elle constitue la fonction reine pour la constitution de noms, d’adresses, de libellés multivariés ou de formats d’exportation délimités (CSV, DSV).
8.2 Évaluation comparative des ressources mémoire et CPU
Dans un contexte d’analyse de données massives (Big Data) ou lors de la conduite de simulations stochastiques de Monte-Carlo impliquant des millions d’itérations récursives, le choix de la méthode d’assemblage textuel exerce un impact significatif sur la consommation des ressources processeur (CPU Time) et sur la latence de traitement des sous-systèmes de pagination temporaire hébergés sur les disques de travail SASWORK.
Les métriques de profilage logiciel démontrent de façon systématique que les fonctions natives en langage C compilé du noyau SAS, telles que CATX ou CATS, surpassent systématiquement en efficience les assemblages composites artisanaux basés sur l’opérateur || combiné à des appels itératifs de fonctions STRIP ou TRIM. Dans une boucle intensive exécutant plusieurs dizaines de millions d’évaluations vectorielles, le recours à une chaîne d’instructions comme STRIP(varA) || '-' || STRIP(varB) oblige le moteur d’exécution à instancier des pointeurs de mémoire temporaire pour recueillir le résultat de chaque sous-fonction avant de soumettre les vecteurs intermédiaires à l’opérateur de concaténation. Cette micro-allocation dynamique génère une fragmentation de la pile d’exécution et démultiplie les cycles d’instructions du processeur.
À l’inverse, une fonction unifiée telle que CATX opère au moyen d’un balayage linéaire direct au sein du PDV : elle calcule en amont les bornes effectives de chaque vecteur sans déplacer physiquement les octets intermédiaires dans des registres transitoires superflus, écrivant directement le flux finalisé dans l’adresse de destination allouée. Les réductions de temps d’exécution CPU observées lors d’analyses comparatives sur des bases d’essais cliniques atteignent couramment 20 % à 35 % en faveur de CATX, tout en assurant une réduction drastique des opérations de lecture-écriture sur les fichiers de pagination physique, garantissant ainsi un passage à l’échelle harmonieux sur les infrastructures distribuées modernes.
9. Gestion des valeurs manquantes et conversion automatique de types lors de la concaténation
9.1 Gestion des entrées nulles et chaînes blanches
L’administration des valeurs manquantes constitue traditionnellement la pierre d’achoppement de l’ingénierie des données statistiques. Dans le cadre de l’exécution d’un pipeline analytique industriel ou d’une validation clinique soumise à des audits de qualité drastiques, l’apparition d’avertissements imprévus ou l’introduction d’artefacts visuels causés par des données manquantes compromet la fiabilité du livrable d’analyse. La force architecturale des fonctions de la suite CAT réside dans leur aptitude native à neutraliser sans distorsion l’absence d’information.
Contrairement aux langages interprétés non spécialisés qui génèrent parfois des exceptions critiques d’exécution (telles que les erreurs de type NullPointerException) lorsqu’une fonction textuelle rencontre une référence non instanciée, le moteur SAS est conçu pour absorber les absences de données dans une continuité analytique totale. Face à une chaîne vide, un vecteur de caractères d’espacement pur ou une variable formellement déclarée comme manquante, les fonctions CATS et CATX réduisent l’élément à une séquence d’octets de longueur zéro sans lever le moindre signal d’interruption.
Ce traitement unifié s’avère particulièrement providentiel dans le journal SAS (Log). L’utilisation des opérateurs classiques engendre souvent des journaux verbeux de plusieurs milliers de lignes saturés de messages d’avertissement du type Missing values were generated as a result of performing an operation..., ce qui rend la lecture du journal fastidieuse et masque des dysfonctionnements algorithmiques réels et graves. La famille CAT garantit une exécution propre et silencieuse : aucun avertissement de génération de valeur manquante n’est émis, préservant la clarté du journal et facilitant le contrôle algorithmique automatisé des environnements de production pharmaceutique.
9.2 Coercition de type implicite et conversion sécurisée
La capacité des fonctions de la famille CAT à assimiler sans heurt des arguments de nature numérique constitue un atout de productivité indéniable pour le programmeur SAS. Toutefois, pour l’architecte de données soucieux de la rigueur mathématique de ses pipelines, ce mécanisme de coercition implicite mérite d’être disséqué avec la plus extrême minutie afin d’en maîtriser l’impact sous-jacent sur les formats de représentation numérique.
Lorsqu’une variable quantitative continue est transmise en paramètre d’une fonction CAT, CATS ou CATX, le compilateur applique en interne une conversion numérique-caractère standard basée sur le format universel d’écriture BEST12.. Ce format s’efforce d’exprimer la valeur numérique sous sa forme la plus condensée et signifiante possible dans une enveloppe maximale de douze caractères. Toutefois, le format BEST12. applique par essence un alignement des nombres vers la droite de cette fenêtre d’allocation, ce qui génère une traîne de blancs d’en-tête (leading blanks) considérable pour des petits nombres entiers (par exemple, le chiffre 5 sera précédé de onze espaces blancs au sein du format brut BEST12.).
Cette particularité met magistralement en lumière l’intérêt des déclinaisons de décapage :
- Si le programmeur emploie la fonction
CATbasique sur une variable numérique, les onze espaces d’en-tête générés par le formatBEST12.sont intégralement conservés et déversés dans la chaîne finale, provoquant un décalage visuel déroutant. - Si le programmeur mobilise à juste titre les fonctions
CATSouCATX, l’action de décapage de typeSTRIPintervient immédiatement après la coercition implicite, éliminant ces espaces d’en-tête créés parBEST12.et ne préservant que la valeur numérique exacte compactée.
Néanmoins, dans les contextes où la variable numérique exige une précision spécifique (par exemple, forcer l’apparition systématique de deux décimales pour des grandeurs monétaires ou des taux d’incidence, ou afficher un zéro d’en-tête sur un code de département ou de centre d’investigation via le format Z2. ou Z3.), il demeure méthodologiquement impératif de ne pas déléguer la conversion au format aveugle BEST12.. Dans ces configurations sensibles, le biostatisticien doit opérer une conversion explicite et contrôlée en encapsulant l’argument dans une fonction de formatage PUT : CATX('-', codeCentre, PUT(sujetID, Z4.), PUT(mesureClinique, 8.2)). Cette démarche allie l’efficience de délimitation de CATX au contrôle absolu de la mise en forme mathématique des données quantitatives.
10. Optimisation de la mémoire et gestion dynamique de la longueur (Instruction LENGTH)
10.1 Détermination de la taille du vecteur récepteur et risque de troncature
L’un des comportements du compilateur SAS les plus déroutants pour les développeurs réside dans la règle d’attribution dimensionnelle par défaut appliquée aux variables textuelles instanciées via les fonctions de la famille CAT. Lorsque la variable réceptrice (la colonne cible située à gauche du signe égal) n’a pas été explicitement déclarée en amont dans l’étape DATA, le compilateur doit arbitrer souverainement la longueur en octets qu’il va lui conférer au sein du descripteur de la table en cours d’écriture.
Pour l’ensemble des fonctions CAT, CATS, CATT et CATX, la norme architecturale établie par SAS applique une règle systématique : la variable de sortie se voit assigner par défaut une longueur fixe immuable de 200 caractères (ou 200 octets selon l’encodage de la session). Ce dimensionnement par défaut a été calculé par les architectes du logiciel comme un compromis raisonnable pour accueillir l’assemblage de plusieurs colonnes conventionnelles sans encourir de risque immédiat de coupure textuelle. Toutefois, cette convention empirique soulève deux périls opérationnels majeurs diamétralement opposés : l’explosion volumétrique des bases de données d’une part, et la troncature silencieuse de données narratives longues d’autre part.
Sur le plan de l’encombrement volumétrique, si vous traitez une table de registre épidémiologique comprenant cinquante millions d’enregistrements et que vous dérivez plusieurs variables d’identifiants simples via CATX sans en fixer la longueur, SAS allouera 200 octets par observation pour chaque variable créée, alors même que le résultat final n’en requiert qu’une douzaine. L’empreinte de la table sur le stockage physique explosera de plusieurs gigaoctets parfaitement inutiles, dégradant dramatiquement les temps d’E/S sur disque et saturant inutilement les mémoires caches des serveurs d’analyse.
À l’inverse, si votre objectif consiste à fusionner des champs de verbatim qualitatifs, des comptes-rendus d’examens médicaux ou des justifications cliniques d’événements indésirables graves dont la somme cumulée des caractères excède la limite forfaitaire de 200 positions, le compilateur tronquera aveuglément toute information dépassant le deux-centième octet. Cette mutilation textuelle s’opérera dans un silence absolu, sans nécessairement lever d’erreur bloquante dans le journal, entraînant une perte de substance informationnelle inacceptable dans un contexte de recherche scientifique ou réglementaire.
10.2 Utilisation rigoureuse de l’instruction LENGTH en amont de l’assignation
Pour éliminer définitivement ces aléas dimensionnels et garantir une gouvernance optimale de la volumétrie mémoire, la règle méthodologique absolue impose l’utilisation proactive et systématique de l’instruction déclarative LENGTH positionnée rigoureusement en amont de tout appel aux fonctions d’agrégation au sein de l’étape DATA.
La grammaire déclarative requiert de spécifier le nom de la variable future, suivi immédiatement du modificateur de type caractère dollar ($) et de la constante entière traduisant l’allocation mémoire exacte allouée :
Dans ce canevas méthodologique rigoureusement structuré, nous initialisons le bloc DATA en déclarant : LENGTH formalKey $ 35 compositeReport $ 1500;. Cette déclaration préliminaire contraint immédiatement le compilateur SAS, lors de sa phase de compilation préliminaire, à figer la dimension de formalKey à strictement 35 octets et celle de compositeReport à 1500 octets dans le PDV. Lorsque les instructions subséquentes formalKey = CATX('-', centreID, patientID); et compositeReport = CATX(' | ', diagnostic, verbatim, traitement); sont ensuite exécutées lors de la phase séquentielle de traitement, le moteur d’exécution respecte souverainement cette enveloppe sur mesure sans jamais appliquer la règle réductrice ou dispersive des 200 octets par défaut.
Pour contrôler et auditer programmatiquement l’efficacité de cette allocation au sein de vos scripts industriels, SAS propose la fonction d’introspection VLENGTH. Contrairement à la fonction LENGTH qui se borne à inspecter la chaîne textuelle dynamique pour en renvoyer la taille visible non blanche, VLENGTH interroge directement le dictionnaire des métadonnées du PDV et renvoie la capacité brute d’allocation réservée en octets. L’insertion temporaire de contrôles d’assurance qualité logicielle tels que tailleAllouee = VLENGTH(formalKey); garantit au biostatisticien que la colonne créée répond rigoureusement aux spécifications des plans de gestion des données (Data Management Plans).
10.3 Gestion des chaînes de très grande dimension avec les objets VARCHAR dans Viya
Avec l’avènement des architectures infonuagiques distribuées sous SAS Viya et son moteur analytique ultra-performant en mémoire dénommé Cloud Analytic Services (CAS), les limitations imposées par le modèle traditionnel de stockage à longueur fixe ont conduit à l’introduction d’un nouveau type de données textuelles révolutionnaire : le type VARCHAR.
Dans les tables de données traditionnelles stockées sous le format historique SAS7BDAT, le type de données CHAR traditionnel est intrinsèquement statique : chaque observation consomme la totalité des octets déclarés, comblant les espaces vides par du rembourrage. Le type VARCHAR introduit sous CAS permet une élasticité totale de la gestion de la mémoire vive : une variable VARCHAR(1000) possède la capacité maximale théorique d’accueillir jusqu’à 1000 caractères, mais si un enregistrement particulier ne contient qu’une chaîne de dix caractères, seuls ces dix octets effectifs sont consommés en mémoire, éliminant intégralement le concept même de trailing blanks de remplissage.
La bonne nouvelle pour les data scientists réside dans le fait que la totalité des fonctions de la suite CAT (CAT, CATS, CATT et CATX) est intrinsèquement et nativement compatible avec les colonnes de type VARCHAR sous les sessions SAS Viya CAS. Lorsqu’une fonction telle que CATX agrège des colonnes VARCHAR, elle s’exécute directement à la vitesse des nœuds multithreadés sans instancier d’espaces de rembourrage artificiels. En outre, la longueur de la variable réceptrice sous CAS s’ajuste dynamiquement à la volumétrie réelle résultante, offrant ainsi le summum de l’efficience algorithmique et éliminant presque entièrement les risques de troncature aveugle lors des manipulations textuelles complexes à très grande échelle.
11. Applications méthodologiques dans le traitement des données de recherche comportementale
11.1 Génération de clés d’anonymisation et de pseudonymisation pour sujets d’étude
Dans la recherche médicale, sociologique et comportementale, le respect scrupuleux des protocoles éthiques et des réglementations internationales sur la protection des données personnelles (notamment le RGPD en Europe ou l’HIPAA aux États-Unis) constitue une obligation légale non négociable. Les biostatisticiens sont fréquemment sommés de dé-identifier les cohortes expérimentales en concevant des clefs de pseudonymisation complexes interdisant formellement l’identification directe d’un individu à partir des tables d’analyse tout en préservant le chaînage longitudinal des données pour les inférences de suivi temporel.
La génération d’une clef de pseudonymisation rigoureuse requiert généralement la concaténation de fragments non signifiants éclatés mais hautement distinctifs : un code d’homologation de centre d’investigation, un numéro d’ordre d’inclusion randomisé et une composante temporelle masquée (par exemple le trimestre d’enrôlement dérivé au moyen d’un format spécifique). La fonction CATS s’impose alors comme le mécanisme d’assemblage cryptique idéal :
L’architecture du script illustre ce processus sécurisé : l’instruction baseToken = CATS(siteIdentifier, '-', PUT(inclusionNum, Z5.), '-', PUT(inclusionDate, YYQ.)); génère une chaîne textuelle composite dense et rigoureusement étanche. Afin de rendre l’opération mathématiquement irréversible pour les tiers non autorisés, cette chaîne agrégée est ensuite immédiatement soumise à un algorithme de hachage cryptographique sécurisé à sens unique via la fonction SHA256 native de SAS : pseudonymID = HASH_SHA256(baseToken);. La concaténation propre garantit que la fonction de hachage opère sur des données standardisées au millimètre près, assurant que deux cycles d’exécution sur le même individu produiront invariablement le même hash pseudonymisé unique, sans jamais exposer de données nominatives en clair dans le système analytique.
11.2 Assemblage d’items textuels issus de questionnaires psychométriques
Les investigations psychométriques et les échelles de mesure en sciences cognitives s’articulent fréquemment autour de batteries de questionnaires combinant des questions qualitatives fermées à échelle ordinale (échelles de Likert) et des boîtes de saisie textuelle ouverte permettant d’enregistrer le verbatim spontané du sujet d’étude. Pour opérer des traitements lexicométriques outillés ou modéliser des représentations sémantiques, il devient nécessaire de réunir l’ensemble de ces fragments de réponses sous une structure vectorielle narrative normalisée.
L’utilisation de la fonction CATX avec un délimiteur sémantique explicite (comme le retour à la ligne ou un séparateur de type pipe encadré d’espaces) permet de construire pour chaque répondant un profil de verbatim séquentiel parfaitement structuré :
En mobilisant une instruction déclarative compositeVerbatim = CATX(' [ITEM_SEP] ', of answerText_1 - answerText_10);, le compilateur SAS agrège l’ensemble des réponses ouvertes de la batterie d’évaluation. L’avantage phénoménal de CATX apparaît immédiatement dans ce contexte psychométrique : si un sujet a omis de répondre à l’item 4 et à l’item 7 (valeurs vides), ces absences sont automatiquement ignorées, évitant l’accumulation de séparateurs [ITEM_SEP] consécutifs qui fausserait ultérieurement les algorithmes de tokénisation lexicale ou d’analyse du sentiment.
Parallèlement, la concaténation de profils de réponses qualitatives fermées (par exemple, réunir la suite des 20 réponses numériques ordonnées d’un inventaire de personnalité sous forme d’une empreinte vectorielle unique de type « 5-4-2-1-5… ») se déploie avec une vitesse stupéfiante via CATS(of likertScore_1 - likertScore_20). Cette chaîne vectorielle compactée devient une nouvelle signature comportementale hautement maniable, autorisant des calculs instantanés de distances euclidiennes ou de classification hiérarchique ascendante entre typologies de participants au sein des procédures statistiques de clusterisation.
11.3 Automatisation des libellés diagnostiques complexes
Dans la finalisation des essais cliniques de phase III et la communication des rapports d’efficacité et de tolérance aux comités de surveillance indépendants (Data and Safety Monitoring Boards – DSMB), l’ingénierie des données SAS sert à fabriquer des libellés de synthèse clinique hautement condensés. Ces désignations synthétiques doivent agréger de multiples critères nosographiques hétérogènes, des indices de sévérité gradués et des qualifications temporelles afin de dresser des profils patients lisibles instantanément par le corps médical.
Considérons la génération automatique d’une description synthétique d’événement indésirable grave (Serious Adverse Event – SAE). La variable narrative finale doit fusionner le terme préférentiel du dictionnaire médical MedDRA, le grade de toxicité de l’échelle CTCAE, la relation de causalité imputée au produit d’investigation et le statut d’évolution clinique du patient à l’issue de l’événement.
La puissance d’agrégation conditionnelle de CATX permet d’exécuter ce formatage complexe avec un niveau de sécurité et de standardisation irréprochable :
L’analyste déclare : clinicalSummary = CATX(' - ', meddraPT, CATX('', 'Grade ', toxicityGrade), causalityJudgement, resolutionStatus);. En imbriquant harmonieusement une fonction CATX secondaire (qui fabrique la chaîne de grade unifiée) au cœur du flux principal séparé par des tirets délimités, le rapport clinique se génère avec une exactitude lexicale chirurgicale. Ce formalisme garantit que les tables de résultats destinées à la publication et les listings réglementaires intégrés dans les dossiers de soumission de nouveaux médicaments respectent rigoureusement les normes internationales de transparence et d’intégrité scientifique.
12. Bonnes pratiques, débogage et résolution des anomalies courantes de troncature
12.1 Identification et correction des alertes de troncature dans le journal SAS
Dans la conduite des audits méthodologiques et la fiabilisation des codes SAS de production, le journal d’exécution (SAS Log) constitue le baromètre incontournable de la santé algorithmique du programme. Cependant, les anomalies relatives à la manipulation de chaînes de caractères possèdent la particularité d’être parmi les plus insidieuses du langage, car elles n’interrompent que très rarement l’exécution de l’étape DATA, masquant parfois des altérations graves sous une apparence de compilation réussie.
L’alerte canonique la plus courante identifiée dans le journal s’exprime sous la forme suivante : WARNING: Multiple lengths were specified for the variable.... Ce message d’avertissement survient classiquement lorsqu’une variable est initialement sous-dimensionnée (par exemple au sein d’une étape de fusion relationnelle MERGE ou d’une instruction SET préliminaire) avant de se voir assigner une expression CAT beaucoup plus volumineuse dans une instruction postérieure. Pour éliminer cette ambiguïté, la pratique industrielle impose de fixer souverainement la dimension maximale définitive au sommet absolu de l’étape DATA via une instruction LENGTH unique et directrice.
Le piège le plus pernicieux demeure toutefois la troncature silencieuse. Si une variable réceptrice se voit assigner une chaîne concaténée excédant sa capacité allouée alors que cette capacité a été définie implicitement ou par une fonction antérieure, SAS coupe impitoyablement les octets surnuméraires sans nécessairement consigner d’avertissement explicite dans le journal. Pour dépister programmatiquement ces coupures invisibles dans un pipeline de données industriel, il est impératif d’intégrer des routines de vérification statistique post-traitement. L’exécution de la procédure PROC MEANS ou PROC FREQ combinée à la fonction LENGTHN permet de cartographier la distribution des longueurs effectives :
Si la procédure PROC MEANS MAX renvoie pour une variable concaténée une longueur effective calculée qui coïncide exactement avec la limite d’allocation de sa mémoire (par exemple très précisément 200 octets), l’ingénieur de données doit immédiatement suspecter un phénomène de plafonnement et auditer ses observations pour vérifier si des informations lexicales critiques n’ont pas été amputées par le compilateur au-delà de cette frontière mécanique.
12.2 Pratiques d’encapsulation modulaire et utilisation des macros SAS
Pour assurer la reproductibilité scientifique et rationaliser la maintenance applicative au sein des grands départements statistiques, il est vivement déconseillé de réécrire manuellement des listes de concaténation verbeuses à travers des dizaines de programmes d’analyse disjoints. La programmation modulaire via le préprocesseur macro SAS permet d’encapsuler la puissance des fonctions CAT au sein d’outils dynamiques hautement configurables.
Le préprocesseur macro offre notamment la méta-fonction %SYSFUNC, qui permet d’exécuter n’importe quelle fonction d’étape DATA native (à l’exception de quelques fonctions spécifiques à mémoire directe) au niveau même de la compilation du texte du programme. Cette caractéristique autorise l’application directe de la logique CATX pour manipuler des variables macro, construire des clauses dynamiques SQL ou générer des listes de variables paramétrées au vol :
Dans ce modèle de factorisation logicielle, une macro-commande SAS encapsule l’opérateur d’évaluation : %LET joinedList = %SYSFUNC(CATX(&delimiter, &varList));. La macro interpole dynamiquement le délimiteur spécifié et la liste des arguments textuels, permettant de composer des instructions d’étape DATA hautement modulaires et auto-adaptatives. Cette abstraction garantit une standardisation totale des règles de gestion textuelle à travers l’ensemble de l’organisation : tous les développeurs exploitent rigoureusement le même algorithme certifié, réduisant à néant les dérives syntaxiques et consolidant la gouvernance des données statistiques.
En conclusion de cette analyse exhaustive, l’ingénierie textuelle sous SAS ne doit plus être abordée comme une collection de routines artisanales de bricolage syntaxique. L’abandon systématique des anciens opérateurs historiques (||) au profit de la suite intégrée CAT, CATS, CATT et souverainement CATX, associé à une maîtrise architecturale stricte de l’instruction déclarative LENGTH, représente la pierre angulaire de tout développement biostatistique moderne, assurant une parfaite concordance entre élégance du code, vitesse computationnelle et intégrité absolue des résultats scientifiques.
Références
- Cody, R. (2007). Learning SAS by Example: A Programmer’s Guide. SAS Institute. https://support.sas.com/publishing/authors/cody.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute. https://support.sas.com/en/books.html
- SAS Institute Inc. (2020). SAS® 9.4 Functions and CALL Routines: Reference. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lefunctionsref/titlepage.htm
- SAS Institute Inc. (2021). SAS® Cloud Analytic Services: Fundamentals. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/v_018/casfun/titlepage.htm
- Whitlock, I. (2006). Categorizing the CAT Functions: CAT, CATT, CATS, and CATX. Proceedings of the SAS Users Group International (SUGI) 31, Paper 042-31. https://support.sas.com/resources/papers/proceedings/proceedings/sugi31/042-31.pdf