
Dans le domaine des sciences comportementales, de la psychologie cognitive et des neurosciences cliniques, la quantification des phénomènes psychologiques repose fondamentalement sur l’inférence statistique. Les chercheurs ne peuvent que rarement accéder à l’exhaustivité d’une population cible ; ils doivent plutôt recueillir des observations auprès d’échantillons restreints et déterminer si les régularités observées reflètent de véritables dynamiques psychologiques ou de simples fluctuations d’échantillonnage aléatoires. C’est dans ce cadre rigoureux que s’inscrit la notion de valeur critique, frontière mathématique indispensable départageant l’acceptation provisoire d’un modèle stochastique neutre de son rejet au profit d’un effet empirique tangible. La maîtrise des distributions d’échantillonnage théoriques constitue ainsi le socle de toute démarche quantitative intègre.
Pendant plusieurs décennies, le calcul et la consultation de ces seuils critiques dépendaient exclusivement d’épaisses tables statistiques annexées aux manuels de biométrie ou de modules informatiques spécialisés et coûteux. Aujourd’hui, la démocratisation des outils de calcul en nuage transforme en profondeur la méthodologie de recherche. L’application Google Sheets s’est imposée comme un environnement de travail polyvalent, collaboratif et d’une remarquable précision algorithmique pour l’analyse de données expérimentales. Loin d’être un simple tableur bureautique, cet outil intègre des bibliothèques de calcul numérique avancées capables d’évaluer instantanément les fonctions quantiles des lois de probabilité usuelles, qu’il s’agisse de la loi normale, de la loi de Student, du Khi-deux ou de la distribution de Fisher-Snedecor.
Ce guide exhaustif a pour vocation de fournir aux chercheurs, cliniciens, enseignants et étudiants une méthodologie pas-à-pas pour modéliser, dériver et automatiser le calcul des valeurs critiques au sein de Google Sheets. À travers une analyse poussée des fondements épistémologiques du paradigme de Neyman-Pearson, des spécificités syntaxiques des fonctions inverses et des exigences métrologiques contemporaines, ce manuel détaille l’ensemble des procédures analytiques nécessaires à la construction d’environnements d’analyse transparents, auditables et reproductibles, en stricte conformité avec les standards internationaux de la recherche scientifique.
1. Fondements théoriques des valeurs critiques dans la recherche en psychologie
1.1 Rôle de l’inférence statistique et des tests d’hypothèses
L’édifice de la psychologie scientifique contemporaine s’appuie largement sur le modèle hypothético-déductif formalisé par l’école de pensée de Jerzy Neyman et Egon Pearson. Dans ce cadre épistémologique, toute investigation empirique débute par la formulation explicite de deux propositions mutuellement exclusives et exhaustives : l’hypothèse nulle, traditionnellement désignée par la notation standardisée H0, et l’hypothèse alternative, notée H1. L’hypothèse nulle postule invariablement l’absence d’effet, l’équivalence stricte entre des conditions expérimentales ou l’indépendance totale entre deux dimensions psychologiques mesurées. À l’inverse, l’hypothèse alternative traduit l’intuition théorique du chercheur, affirmant l’existence d’une divergence systématique, d’une corrélation mesurable ou d’une modulation cognitive induite par une manipulation expérimentale.
La nécessité d’établir des critères de décision numériques s’impose d’elle-même dès lors que l’on observe la variabilité interindividuelle inhérente à toute population biologique ou humaine. Deux individus soumis à un protocole strictement identique présenteront des temps de réaction, des scores d’anxiété ou des performances mnésiques dissemblables en raison du bruit de mesure, de l’état neurophysiologique transitoire ou de traits de personnalité sous-jacents. L’inférence statistique a pour mandat d’évaluer la probabilité qu’une différence observée entre des moyennes d’échantillons découle uniquement de cette gigue aléatoire d’échantillonnage. En fixant a priori une règle de décision probabiliste, le chercheur s’assure que le passage de la simple description de l’échantillon à l’extrapolation populationnelle ne relève pas d’une appréciation subjective ou biaisée par des attentes de confirmation.
Dans ce processus décisionnel binaire, le risque d’erreur de première espèce, universellement symbolisé par la lettre grecque alpha, représente la probabilité d’affirmer à tort l’existence d’un effet psychologique réel alors que l’hypothèse nulle est mathématiquement vraie dans la population générale. Dans les protocoles expérimentaux contrôlés, une mauvaise gestion de ce risque entraîne la prolifération de faux positifs dans la littérature savante, conduisant des équipes de recherche entières dans des impasses théoriques ou validant prématurément des interventions thérapeutiques inefficaces. La délimitation d’un seuil décisionnel rigide constitue donc le premier rempart méthodologique contre les biais cognitifs propres à l’observateur scientifique.
1.2 Distinction entre statistique de test observée et valeur critique
Pour statuer de manière univoque sur le sort de l’hypothèse nulle, le statisticien évalue deux grandeurs mathématiques fondamentalement distinctes mais intrinsèquement liées : la statistique de test empirique (calculée à partir des données recueillies) et la valeur critique (dérivée de la théorie des probabilités). La valeur critique se définit formellement comme l’abscisse sur l’axe d’une distribution d’échantillonnage théorique qui délimite la frontière exacte entre la région d’acceptation (ou de non-rejet) de H0 et la zone de rejet critique. Cette frontière est calculée indépendamment des résultats concrets de l’expérience ; elle dépend exclusivement du modèle de distribution postulé, du niveau de risque alpha toléré par le chercheur et, le cas échéant, des degrés de liberté conditionnés par la taille de l’échantillon.
La règle de décision formelle repose sur une comparaison géométrique et algébrique directe : la statistique de test calculée (telle qu’un score t de Student, une valeur standardisée z, un écart de Khi-deux ou un ratio F de Fisher) est confrontée à la valeur critique. Dans le cadre d’un test bilatéral symétrique, si la valeur absolue de la statistique calculée est strictement supérieure à la valeur critique absolue, l’observateur conclut que les données recueillies sont trop incompatibles avec l’hypothèse nulle pour être attribuées au simple hasard de l’échantillonnage. L’hypothèse nulle est alors rejetée avec le niveau de confiance fixé. Si, à l’inverse, la statistique empirique demeure en deçà du seuil critique, le non-rejet de l’hypothèse nulle s’impose mathématiquement, ce qui n’équivaut nullement à prouver que H0 est vraie, mais signale simplement l’absence de preuves statistiques suffisantes.
Il convient de distinguer conceptuellement cette démarche par seuil critique, héritée de l’approche décisionnelle de Neyman-Pearson, de l’approche par la probabilité critique ou p-valeur préconisée par Ronald Fisher. Alors que la p-valeur quantifie la probabilité exacte d’obtenir, sous l’hypothèse nulle, un résultat au moins aussi extrême que celui effectivement observé dans l’échantillon, la valeur critique préétablit l’amplitude minimale que devra franchir la statistique d’échantillonnage pour justifier un basculement de l’état de croyance rationnelle. L’utilisation conjointe des deux indicateurs enrichit l’analyse, mais la détermination de la valeur critique demeure la pierre angulaire de la planification expérimentale, notamment lors du calcul préalable de la taille d’échantillon requise.
1.3 Fixation du seuil de signification alpha et puissance statistique
La standardisation du seuil de signification alpha s’est historiquement cristallisée autour de conventions probabilistes strictes au sein de la société savante de psychologie et des comités éditoriaux internationaux. Les seuils de 0,05 (tolérance d’un risque d’erreur de 5 %), 0,01 (risque de 1 %) et 0,001 (risque de 0,1 %) sont quasi universellement employés pour graduer la force de la réfutation empirique. Le choix du seuil alpha de 0,05, initialement popularisé par Fisher comme un jalon commode pour la recherche agronomique, fait aujourd’hui l’objet d’un examen critique rigoureux en psychologie quantitative, incitant parfois les méthodologistes à abaisser ce seuil à 0,005 pour limiter la crise de la reproductibilité des résultats expérimentaux.
La fixation délibérée du seuil de signification exerce un impact direct et immédiat sur la topologie de la distribution théorique et sur l’étendue spatiale de la région critique de rejet. Plus le chercheur restreint le niveau alpha (par exemple en glissant de 0,05 à 0,01), plus la valeur critique s’éloigne du centre de la distribution vers ses extrémités distales. Ce déplacement repousse mécaniquement la frontière d’exigence, requérant des tailles d’effet nettement plus massives ou des variances résiduelles considérablement réduites pour que la statistique d’échantillonnage parvienne à franchir le seuil d’admissibilité au rejet de H0.
Cette rigueur accrue entraîne toutefois une contrepartie méthodologique majeure : l’élévation mécanique du risque d’erreur de deuxième espèce, universellement désigné par la lettre bêta. L’erreur de type II consiste à échouer dans le rejet d’une hypothèse nulle qui est pourtant fondamentalement fausse dans le monde réel, masquant ainsi un effet psychologique authentique. La puissance statistique d’une étude, définie par le complément unitaire (1 – bêta), représente la probabilité mathématique de détecter un effet d’une amplitude donnée lorsqu’il existe réellement. Le chercheur se trouve donc perpétuellement contraint à un arbitrage épistémologique délicat : minimiser le risque alpha pour ne pas encombrer le champ scientifique d’artéfacts illusoires, tout en maintenant une puissance statistique adéquate (généralement ciblée à 0,80 ou 0,90) afin de ne pas stériliser l’effort de découverte expérimentale.
2. Principes généraux du calcul des valeurs critiques dans Google Sheets
2.1 Utilité de Google Sheets pour la modélisation statistique
Dans l’écosystème contemporain des technologies de l’information appliquées à la psychologie, l’utilisation d’une feuille de calcul hébergée sur le nuage telle que Google Sheets présente des atouts stratégiques indéniables. Contrairement aux environnements statistiques monolithiques et propriétaires fermés, le tableur en ligne autorise une co-construction synchrone des matrices de données entre des équipes de recherche géographiquement dispersées. La traçabilité algorithmique y est absolue : chaque calcul intermédiaire, de l’imputation des données brutes à l’évaluation finale du seuil de décision, demeure exposé dans la grille de calcul, supprimant le fonctionnement en boîte noire souvent reproché aux logiciels statistiques traditionnels.
L’accessibilité financière et technique constitue un autre levier d’émancipation méthodologique. De nombreux laboratoires, étudiants en master ou praticiens cliniciens ne disposent pas des licences logicielles requises pour exécuter des scripts sous des plateformes spécialisées onéreuses. Google Sheets permet d’implémenter des architectures d’analyse inférentielle complètes sans aucun coût d’infrastructure, tout en garantissant une portabilité intégrale sur les systèmes d’exploitation Windows, macOS, Linux et les terminaux mobiles. Cette démocratisation s’aligne parfaitement avec les principes directeurs du mouvement de la science ouverte (Center for Open Science), qui préconise la mise à disposition publique et auditable de l’ensemble des matrices de traitement des données empiriques.
Par ailleurs, la flexibilité architecturale du tableur permet de concevoir des protocoles psychométriques dynamiques sur mesure. L’injection directe des formules mathématiques inverses au sein de feuilles intégrant des chronométrages de passation de tests, des calculs de scores composites d’échelles de Likert ou des coefficients d’accord inter-juges permet d’obtenir un traitement en flux continu. Dès qu’un sujet d’expérience achève sa session et que ses données s’inscrivent dans la matrice, les degrés de liberté sont recalculés en temps réel, réajustant immédiatement les frontières critiques sans nécessiter de recompilation manuelle.
2.2 Structure syntaxique générale des fonctions inverses de distribution
Le calcul d’une valeur critique au sein de l’interpréteur de formules de Google Sheets repose sur l’exploitation des fonctions dites inverses de distribution, souvent identifiées par le suffixe .INV. D’un point de vue analytique, alors qu’une fonction de répartition classique (associée au suffixe .DIST) ingère une abscisse numérique pour renvoyer la probabilité cumulative intégrée depuis l’infini négatif jusqu’à cette coordonnée, la fonction inverse opère la transformation réciproque exacte. Elle requiert en entrée une valeur de probabilité comprise dans l’intervalle ouvert ]0; 1[ et restitue en sortie l’abscisse précise, c’est-à-dire le quantile ou la valeur critique correspondant rigoureusement à cette surface sous la courbe.
La configuration syntaxique de ces fonctions obéit à un ordonnancement régulier d’arguments qu’il convient de maîtriser scrupuleusement. En règle générale, le premier paramètre obligatoire est la probabilité cumulative (souvent directement liée au risque alpha). Pour les distributions dont la morphologie géométrique varie en fonction de la taille d’échantillonnage, des arguments structurels complémentaires doivent être injectés, au premier rang desquels figurent les degrés de liberté. Pour les familles de lois à plusieurs paramètres de dispersion ou de forme, tels que la distribution de Fisher-Snedecor, l’utilisateur doit spécifier distinctement les degrés de liberté associés au numérateur puis au dénominateur du ratio de variance.
Un aspect fondamental réside dans la gestion de la nomenclature bilingue et des conventions de nommage au sein de l’écosystème de Google. Bien que Google Sheets reconnaisse nativement les désignations standardisées issues de la norme internationale de standardisation des formules de tableur (largement alignée sur le standard Microsoft Excel OpenXML), les dénominations francophones coexistent fréquemment avec la nomenclature anglophone. Il est ainsi possible de rencontrer des appellations telles que LOI.STUDENT.INVERSE aux côtés des formes canoniques standardisées T.INV ou T.INV.2T. L’utilisation systématique des dénominations abrégées modernes avec séparateurs par points est hautement recommandée en raison de leur stabilité algorithmique lors des échanges de fichiers entre chercheurs utilisant des configurations régionales divergentes.
2.3 Précision numérique et configuration des paramètres régionaux
L’exactitude des calculs statistiques dans un tableur dépend étroitement des paramètres régionaux configurés dans les paramètres du document (accessibles via le menu Fichier > Paramètres). En effet, le monde académique francophone recourt traditionnellement à la virgule comme séparateur décimal, tandis que la norme anglo-saxonne impose l’usage exclusif du point typographique. Dans une feuille de calcul configurée en environnement français, l’insertion d’une formule telle que =T.INV(0.05, 15) générera inévitablement une erreur d’analyse de formule (#ERROR!), car l’interpréteur interprète le point comme un caractère textuel invalide et la virgule comme le délimiteur d’arguments. En configuration française standard, la syntaxe rigoureuse exige l’utilisation du point-virgule pour partitionner les arguments et de la virgule pour spécifier les fractions décimales : =T.INV(0,05; 15).
Au-delà de cette barrière syntaxique, la précision numérique sous-jacente du moteur de calcul de Google Sheets doit être appréhendée avec clairvoyance. Le logiciel effectue ses calculs internes selon la norme de représentation en virgule flottante à double précision IEEE 754. Cela garantit une précision théorique d’environ 15 à 17 chiffres décimaux significatifs. Toutefois, les options d’affichage de l’interface utilisateur tronquent souvent les nombres à deux ou trois décimales par défaut pour des motifs de lisibilité graphique. Le chercheur doit veiller à étendre l’affichage numérique des cellules contenant les valeurs critiques à un minimum de quatre à cinq décimales significatives lors des phases d’évaluation préliminaires.
L’omission de cette précaution élémentaire peut engendrer des erreurs d’interprétation critiques, en particulier lorsque la statistique observée se situe dans le voisinage immédiat du seuil de décision. Si une statistique calculée atteint 2,0451 et que la valeur critique affichée est arrondie grossièrement à 2,05 par l’interface alors que sa valeur exacte non tronquée s’établit à 2,0452, une appréciation hâtive pourrait amener le chercheur à conclure faussement au non-rejet de l’hypothèse nulle. La vérification métrologique des frontières computationnelles constitue un prérequis incontournable à la validation de tout protocole inférentiel informatisé.
3. Calcul de la valeur critique t pour un test unilatéral avec T.INV
3.1 Spécificités mathématiques du test de Student unilatéral à gauche
Le test t de Student, originellement théorisé par William Sealy Gosset sous le pseudonyme historique de Student, s’applique à l’analyse de moyennes lorsque la variance de la population parente demeure inconnue et doit être estimée à partir de l’échantillon lui-même. Dans de multiples paradigmes expérimentaux en psychologie cognitive ou clinique, la théorie sous-jacente permet de postuler a priori le sens directionnel précis de l’effet anticipé. Lorsqu’un protocole vise explicitement à vérifier si une intervention psychologique produit une diminution statistiquement significative d’un symptôme délétère — comme le niveau de cortisol salivaire après un entraînement à la cohérence cardiaque ou le nombre d’erreurs commises lors d’une tâche de mémoire de travail —, le chercheur formalise un test unilatéral à gauche (ou inférieur).
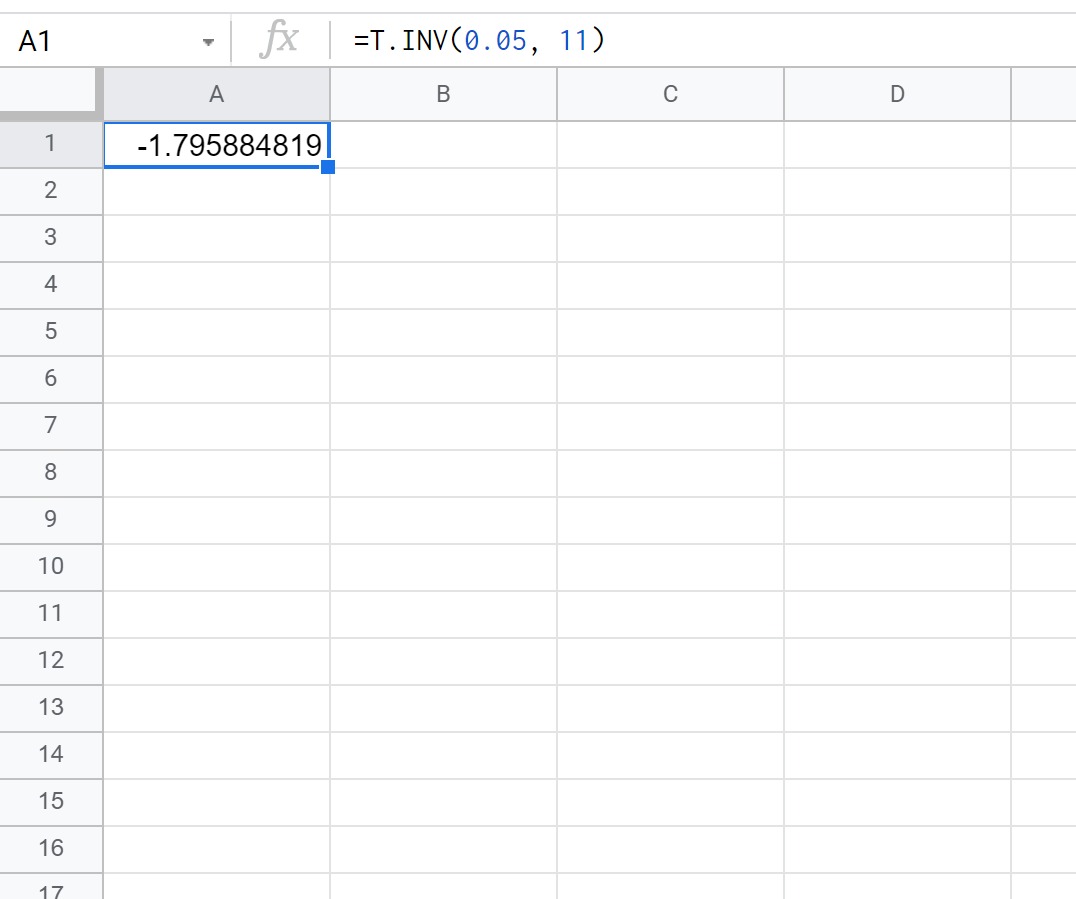
Dans cette configuration unilatérale gauche, l’intégralité de la région de rejet de l’hypothèse nulle, correspondant à la proportion totale du risque alpha (par exemple 0,05), est massée exclusivement dans la queue inférieure de la distribution d’échantillonnage de Student. La fonction de référence implémentée dans Google Sheets pour dériver ce quantile spécifique est la fonction T.INV. La structure formelle de la formule s’énonce comme suit : =T.INV(probabilité; degrés_liberté). L’argument de probabilité attendu correspond directement à la surface d’intégration cumulée depuis l’extrême gauche de la courbe jusqu’à l’abscisse critique recherchée.
Une particularité analytique immédiate de cette formulation réside dans le signe algébrique de la valeur critique retournée par l’algorithme : celle-ci est invariablement négative. Cette polarité négative découle rigoureusement de la symétrie de la distribution de Student autour de son espérance mathématique qui est égale à zéro. Étant donné que la probabilité injectée (alpha = 0,05) est strictement inférieure à 0,50, l’abscisse associée se situe impérativement sur le segment négatif de l’axe des réels. Le chercheur ne doit en aucun cas s’alarmer de cette négativité : elle traduit fidèlement le fait que pour rejeter l’hypothèse nulle au profit de l’hypothèse de diminution, la statistique t empirique calculée devra être encore plus négative (c’est-à-dire inférieure en valeur relative) que la valeur critique issue de la formule.
3.2 Calcul de la valeur critique pour un test unilatéral à droite
À l’opposé du schéma précédent, de nombreuses hypothèses en neurosciences computationnelles et en psychologie de l’apprentissage postulent une augmentation univoque d’une performance, se traduisant par un test unilatéral à droite (ou supérieur). On cherchera par exemple à démontrer qu’un entraînement cognitif informatisé intensif majore le score standardisé de flexibilité mentale ou que l’administration d’un inducteur émotionnel accroît la conductance cutanée des participants. Dans ce cas de figure, l’ensemble de la région critique d’admissibilité au rejet de H0 se trouve relégué dans l’extrémité positive de la loi de distribution.
L’utilisation de la fonction T.INV dans Google Sheets pour un test unilatéral droit requiert un ajustement arithmétique élémentaire mais crucial de l’argument de probabilité. Dans la mesure où les fonctions de répartition cumulatives standards calculent l’intégrale de probabilité de moins l’infini jusqu’au point cible, spécifier directement le paramètre alpha dans la formule reviendrait à calculer la borne de la queue inférieure. Pour capturer la frontière de la queue supérieure renfermant une proportion alpha de l’aire totale, il est nécessaire d’introduire le complément unitaire de cette valeur, soit l’expression mathématique (1 - alpha). La syntaxe canonique devient ainsi : =T.INV(1 - alpha; degrés_liberté).
Par l’application des propriétés fondamentales de la symétrie axiale propre aux densités de probabilité de Student, la valeur numérique obtenue par cette manipulation est strictement identique en magnitude absolue à celle dérivée pour le test unilatéral gauche, mais affectée d’un signe positif. Alternativement, certains utilisateurs recourent à la composition de fonctions en inversant simplement le signe de la formule unilatérale gauche via l’expression =-T.INV(alpha; degrés_liberté). Bien que fonctionnellement équivalente, l’écriture exploitant le complément unitaire 1 - alpha est hautement préférable sur le plan de la rigueur conceptuelle, car elle formalise explicitement que 95 % de l’aire sous la courbe se situent à gauche de la coordonnée critique recherchée.
3.3 Exemple pratique : analyse d’un protocole cognitif directionnel
Afin d’ancrer ces notions dans une démarche de modélisation empirique concrète au sein de Google Sheets, considérons une étude expérimentale portant sur la vitesse d’accès au lexique mental chez des patients atteints d’aphasie motrice légère à la suite d’un accident vasculaire cérébral. L’équipe de neuropsychologie développe une nouvelle technique de réhabilitation par amorçage mélodique et prédit de manière unilatérale que cette approche réduira le temps moyen de dénomination d’images par rapport à la valeur de référence établie par la norme clinique. Le protocole implique un échantillon préliminaire de N = 12 patients, ce qui confère au modèle exactement 11 degrés de liberté (ddl = N – 1 = 11). Le risque d’erreur alpha est fixé à la valeur classique de 0,05.
Dans la feuille de calcul dédiée à l’analyse, le chercheur sélectionne une cellule libre, par exemple la cellule B4, et procède à la saisie de l’équation suivante : =T.INV(0,05; 11). Dès la validation de la formule, l’interpréteur de Google Sheets exécute l’algorithme d’approximation polynomiale de la distribution cumulative inverse et restitue avec une haute fidélité le nombre réel -1,79588. Ce résultat constitue la borne numérique infrangible du domaine d’acceptation de H0 pour ce devis de recherche.
La règle d’interprétation clinique s’articule alors de manière transparente : lors du calcul de la statistique de test t observée sur les données empiriques de l’échantillon, le chercheur devra vérifier si la valeur calculée pénètre plus profondément dans la queue gauche de la distribution. Si le protocole débouche par exemple sur une statistique observée de t = -2,14, l’inégalité formelle t_obs (-2,14) < t_crit (-1,79588) est satisfaite. Le chercheur rejette formellement l’hypothèse nulle au seuil unilatéral de 5 % et conclut avec une sécurité statistique adéquate à l’efficacité du protocole d’amorçage mélodique pour réduire les temps de latence lexicale.
4. Calcul de la valeur critique t pour un test bilatéral avec T.INV.2T
4.1 Fondements de l’approche bilatérale sans a priori directionnel
Bien que les hypothèses directionnelles soient courantes, la majorité des recherches exploratoires en psychologie requièrent l’application d’un test bilatéral (ou test à deux queues). Ce positionnement méthodologique s’impose dès lors que le chercheur ne dispose pas de fondements théoriques suffisamment robustes pour postuler le sens précis de l’effet, ou lorsqu’une modification dans n’importe quelle direction présenterait un intérêt clinique ou heuristique majeur. Par exemple, l’évaluation de l’impact d’un nouveau psychotrope sur le sommeil paradoxal doit envisager aussi bien une augmentation qu’une réduction de cette phase neurobiologique, ces deux déviations pouvant signaler des réorganisations fonctionnelles antagonistes.
Sur le plan géométrique, l’approche bilatérale exige une distribution rigoureusement équitable du risque d’erreur alpha entre les deux extrémités extrêmes de la loi théorique de Student. Si un seuil global alpha de 0,05 est retenu, cette probabilité est fragmentée en deux surfaces distinctes de probabilité alpha / 2 = 0,025, positionnées symétriquement dans la queue inférieure gauche et dans la queue supérieure droite. La région de rétention de l’hypothèse nulle occupe ainsi les 95 % centraux de l’aire sous la courbe de densité de probabilité, enserrés entre deux bornes critiques parfaitement symétriques : -t_crit et +t_crit.
Une caractéristique primordiale des fonctions bilatérales spécialisées dans les tableurs récents est leur tendance à renvoyer systématiquement une valeur critique scalaire positive. L’utilisateur doit impérativement avoir conscience que cette coordonnée positive n’est que la moitié de la frontière décisionnelle. La règle de rejet bilatérale stipule formellement que l’hypothèse nulle doit être abandonnée si la statistique empirique calculée est soit strictement supérieure au seuil positif retourné par la fonction, soit strictement inférieure à son opposé arithmétique négatif.
4.2 Syntaxe et particularités de la fonction T.INV.2T
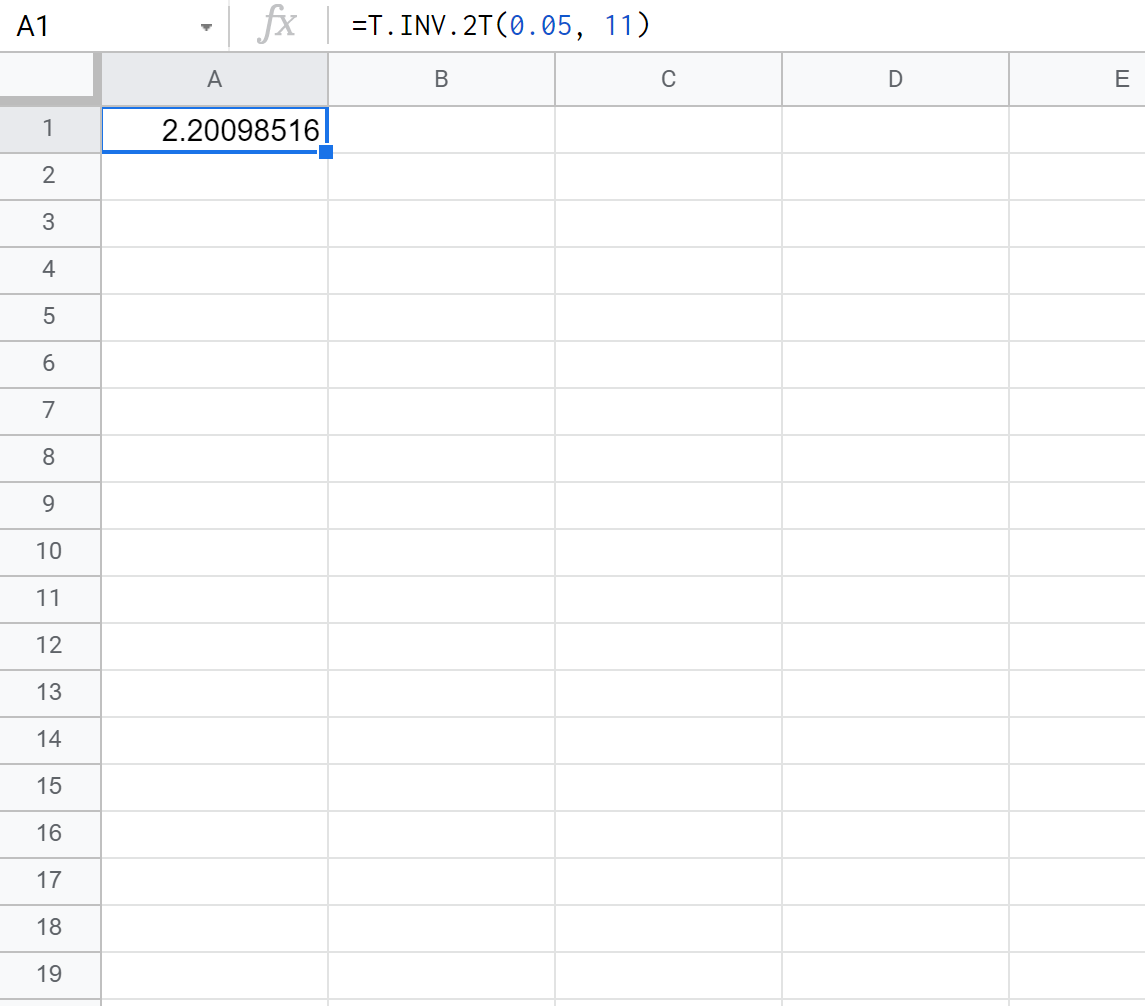
Pour simplifier l’écriture et prémunir les chercheurs contre des erreurs manuelles de fractionnement probabiliste, les développeurs de Google Sheets ont intégré une fonction native dédiée aux analyses bidirectionnelles : T.INV.2T. La syntaxe générale de cet outil d’ingénierie statistique se structure comme suit : =T.INV.2T(probabilité; degrés_liberté). L’avantage ergonomique majeur de cette formulation réside dans le fait que l’argument de probabilité attendu correspond directement au risque alpha total alloué à l’ensemble du test bilatéral, sans que l’analyste n’ait à procéder lui-même à une division par deux préalable.
En coulisses, le moteur de calcul de Google Sheets traite cet appel en divisant de manière automatisée l’argument de probabilité par deux et en calculant l’abscisse positive associée à la queue supérieure droite. Pour valider l’intégrité de ce mécanisme et appréhender l’interchangeabilité des fonctions du tableur, il est particulièrement instructif de comparer les résultats produits par deux expressions distinctes. Dans une matrice comportant 11 degrés de liberté avec un risque global fixé à 0,05, l’instruction unilatérale exploitant le complément unitaire de la demi-surface =T.INV(1 - (0,05 / 2); 11) renvoie exactement la même magnitude numérique que l’instruction directe =T.INV.2T(0,05; 11).
Cette convergence computationnelle souligne la cohérence mathématique interne de Google Sheets. Toutefois, il convient d’attirer l’attention sur un écueil d’inversion classique : si un praticien injectait par mégarde l’expression alpha / 2 au sein de la fonction T.INV.2T, par exemple en écrivant =T.INV.2T(0,025; 11), le tableur fractionnerait de nouveau cette probabilité en deux dans son algorithme interne, calculant alors une valeur critique correspondant en réalité à un risque global alpha de 0,025 (soit 0,0125 par queue). Cette confusion induirait une sévérité excessive de la frontière décisionnelle et réduirait considérablement la puissance statistique de l’étude à l’insu de l’expérimentateur.
4.3 Exemple empirique : évaluation d’une intervention psychothérapeutique
Examinons l’application de cette procédure à un essai clinique contrôlé en psychologie de la santé évaluant les effets d’un programme d’intervention basé sur la pleine conscience chez des soignants présentant un syndrome d’épuisement professionnel. Les scores d’anxiété situationnelle sont recueillis via l’inventaire standardisé STAI avant et après le protocole de huit semaines. Dans la mesure où les praticiens souhaitent détecter tout mouvement significatif des scores, qu’il s’agisse d’un apaisement clinique ou au contraire d’une exacerbation paradoxale de l’anxiété liée à la confrontation aux stresseurs professionnels, un devis bilatéral s’impose de facto. Le collectif d’étude comprend 12 participants suivis longitudinalement, ce qui assigne au modèle un total de 11 degrés de liberté dans le cadre d’un test t pour échantillons appariés, pour un risque nominal alpha de 0,05.
Dans la feuille Google Sheets centralisant les calculs d’efficacité thérapeutique, la cellule réservée à la borne critique bilatérale reçoit la formule : =T.INV.2T(0,05; 11). L’interpréteur de commandes exécute le calcul et affiche immédiatement la valeur numérique de 2,20098. Le chercheur sait dès lors que la frontière d’indifférence statistique s’étend précisément sur le segment réel délimité par l’intervalle [-2,20098 ; +2,20098].
Supposons à présent que le calcul différentiel des moyennes appariées de cette cohorte aboutisse à une statistique observée de t = -2,45. Lors de la confrontation décisionnelle, le chercheur observe que bien que la statistique empirique soit négative, sa valeur absolue (2,45) excède le seuil critique unitaire (2,20098), ce qui place sans équivoque le score observé dans la zone de rejet inférieure (puisque -2,45 < -2,20098). L’hypothèse nulle d’équivalence pré-post intervention est formellement réfutée au seuil bilatéral de 5 %, permettant de documenter de manière probante l’impact du programme d’intervention sur la symptomatologie anxieuse des participants.
5. Calcul de la valeur critique z pour les tests unilatéraux avec NORM.S.INV
5.1 Propriétés de la loi normale standard dans l’évaluation psychométrique
La distribution normale standardisée, universellement désignée sous le vocable de loi normale centrée réduite ou loi de Laplace-Gauss, constitue le socle historique et opérationnel de la psychométrie contemporaine. Caractérisée par une fonction de densité symétrique en cloche dont l’espérance mathématique est nulle (mu = 0) et l’écart-type unitaire (sigma = 1), cette modélisation s’applique lorsque la variance de la population générale est rigoureusement connue par étalonnage standardisé, ou lorsque la taille de l’échantillon expérimental devient suffisamment massive pour que le théorème central limite s’applique avec toute sa puissance asymptotique.
Le recours au test standardisé z s’avère particulièrement légitime dans l’étalonnage des épreuves standardisées d’intelligence (telles que les échelles de Wechsler), où les populations de normalisation regroupent plusieurs milliers d’individus, fournissant une estimation quasi parfaite de la variance populationnelle. Lorsque les effectifs d’échantillons expérimentaux dépassent plusieurs centaines de sujets, la distribution de Student converge d’ailleurs mathématiquement vers la distribution normale standard, les degrés de liberté tendant vers l’infini. Dans ce contexte asymptotique, l’estimation de l’erreur-type ne souffre plus d’incertitude substantielle liée à l’échantillonnage de la variance, rendant superflue la modulation des valeurs critiques par les degrés de liberté.
Pour dériver les quantiles précis de cette distribution continue de référence, Google Sheets implémente la fonction NORM.S.INV (ou sa dénomination francophone correspondante LOI.NORMALE.STANDARD.INVERSE). Le symbole « S » intercalé dans la nomenclature rappelle qu’il s’agit de la version « Standard » de la loi normale, évitant ainsi à l’utilisateur d’avoir à déclarer manuellement les paramètres de moyenne et d’écart-type dans les arguments de calcul. Cette fonction prend en charge un argument d’entrée unique représentant la probabilité cumulative cumulée depuis la queue gauche.
5.2 Implémentation technique pour les tests unilatéraux inférieurs et supérieurs
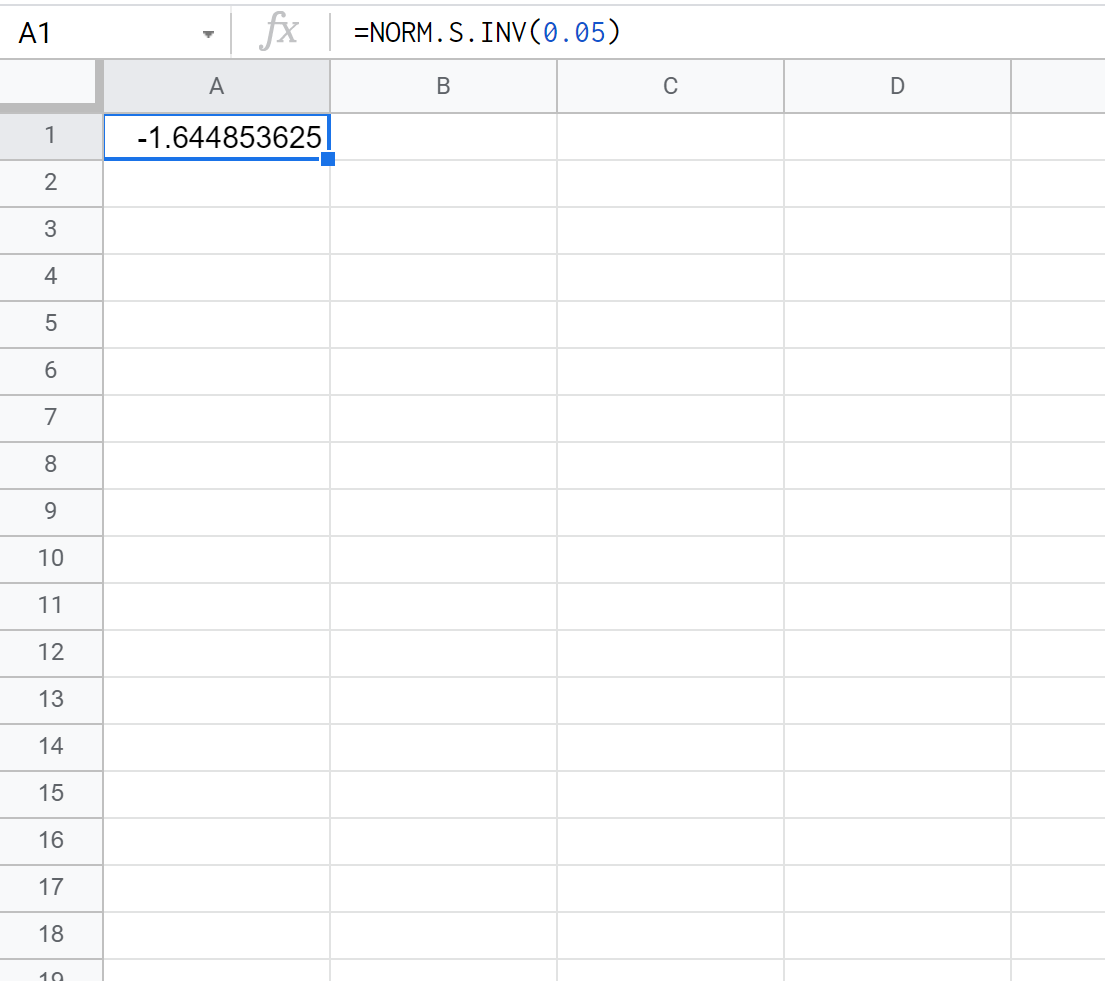
L’implémentation opérationnelle de la valeur critique standardisée z pour un test unilatéral dans l’environnement Google Sheets obéit à la même rigueur géométrique que celle décrite pour la loi de Student, mais s’affranchit de tout paramètre de degré de liberté. Pour paramétrer un test unilatéral inférieur (visant par exemple à déceler un effondrement psychopathologique ou un déficit fonctionnel sous un seuil théorique), le chercheur injecte directement le niveau de risque alpha dans la formule suivante : =NORM.S.INV(alpha).
Lorsque le risque consenti est configuré à alpha = 0,05, la formule =NORM.S.INV(0,05) génère instantanément la valeur critique emblématique de -1,64485. La zone de rejet correspond alors à tous les scores standardisés z observés strictement inférieurs à cette constante négative. À l’inverse, dès lors que l’hypothèse sous-jacente postule une supériorité ou un gain psychologique unilatéral, l’intégration du risque doit être ciblée sur l’extrémité droite de l’enveloppe gaussienne. La formule nécessite alors l’introduction du complément unitaire sous la forme : =NORM.S.INV(1 - alpha).
En exécutant cette dernière avec une tolérance au risque de 5 % (=NORM.S.INV(1 - 0,05) soit =NORM.S.INV(0,95)), le tableur retourne rigoureusement la valeur positive correspondante de +1,64485. Il est d’une grande valeur pédagogique de mémoriser ces coordonnées canoniques associées aux différents seuils de significativité conventionnels. Ainsi, pour un niveau d’exigence statistique renforcé à alpha = 0,01, les fonctions =NORM.S.INV(0,01) et =NORM.S.INV(0,99) restituent respectivement les coordonnées critiques universelles de -2,32635 et +2,32635, établissant des contraintes empiriques considérablement plus sévères pour le chercheur.
5.3 Cas d’application clinique : dépistage standardisé d’un déficit cognitif
Illustrons cette méthodologie dans le cadre d’un dépistage clinique standardisé en neuropsychologie clinique de l’adulte vieillissant. Un service hospitalier utilise une batterie de tests d’évaluation des capacités d’inhibition cognitive dont les propriétés psychométriques dans la population générale sont parfaitement caractérisées, avec une distribution gaussienne de moyenne mu = 100 et d’écart-type sigma = 15. Un neuropsychologue cherche à identifier si un patient consultant pour des plaintes mnésiques débutantes présente un déficit d’inhibition pathologique statistiquement exceptionnel par rapport à sa classe d’âge. Le clinicien adopte une démarche de test unilatéral gauche hautement conservatrice en calibrant le seuil alpha à un risque strict de 1 % (0,01).
Dans la feuille de calcul clinique informatisée configurée sous Google Sheets, la cellule dédiée au seuil décisionnel accueille la syntaxe suivante : =NORM.S.INV(0,01). Le système calcule immédiatement le quantile critique de -2,32635. Le clinicien formalise ensuite le calcul de la statistique standardisée z propre au patient évalué. Supposons que le sujet obtienne un score brut de 62 à l’épreuve. La transformation standardisée élémentaire s’établit selon la formule psychométrique classique : z_obs = (X - mu) / sigma = (62 - 100) / 15 = -38 / 15 = -2,5333.
L’étape de confrontation inférentielle s’opère de façon binaire et indiscutable : la statistique calculée z de -2,5333 est strictement inférieure à la valeur critique calculée par Google Sheets (-2,32635). Le score du patient se situe donc profondément au sein de la région critique unilatérale de rejet de l’hypothèse de normalité cognitive. Le clinicien peut conclure de manière objective, avec moins de 1 % de risque d’erreur de première espèce, à la présence d’une altération significative des mécanismes d’inhibition cognitive excédant largement les fluctuations normales attendues dans la population de référence.
6. Calcul de la valeur critique z pour les tests bilatéraux
6.1 Fragmentation de la zone de rejet dans la distribution normale
La mise en œuvre d’un test bilatéral sous l’hypothèse d’une loi normale standardisée représente le cadre analytique par excellence de nombreuses études épidémiologiques et d’essais cliniques à large échelle où l’expérimentateur n’émet aucun a priori sur le sens de la modulation. Dans ce paradigme de non-directionnalité absolue, la structure de la région d’infirmation de l’hypothèse nulle subit une scission spatiale stricte : la moitié de la marge d’erreur globale consentie (alpha / 2) est reléguée dans la queue distale gauche sous l’ordonnée -z_crit, tandis que la fraction complémentaire (alpha / 2) est projetée dans la queue distale droite au-delà de l’ordonnée +z_crit.
Cette géométrie bifide engendre une modélisation mentale claire de l’espace des possibles. L’intégrale de la fonction de densité gaussienne sur le segment délimité par [-z_crit ; +z_crit] équivaut rigoureusement au niveau de confiance bilatéral, couramment quantifié par l’expression (1 - alpha). Pour un seuil d’erreur standard de 5 %, cette région d’inertie décisionnelle englobe exactement 95 % des observations potentielles générées par le processus stochastique sous H0. Toute émergence d’une statistique d’échantillonnage en dehors de ce couloir de sécurité traduit un désaccord flagrant avec le modèle d’absence d’effet.
Contrairement aux fonctions relatives à la distribution de Student qui disposent d’une déclinaison bilatérale explicite par le truchement de T.INV.2T, l’environnement logiciel de Google Sheets ne comporte pas de fonction autonome désignée par un équivalent NORM.S.INV.2T. Le chercheur est donc invité à structurer lui-même les arguments probabilistes au sein de la fonction univariée fondamentale NORM.S.INV, ce qui exige une compréhension limpide des symétries d’intégration pour prévenir toute dérive de paramétrage.
6.2 Formulations adaptées dans Google Sheets
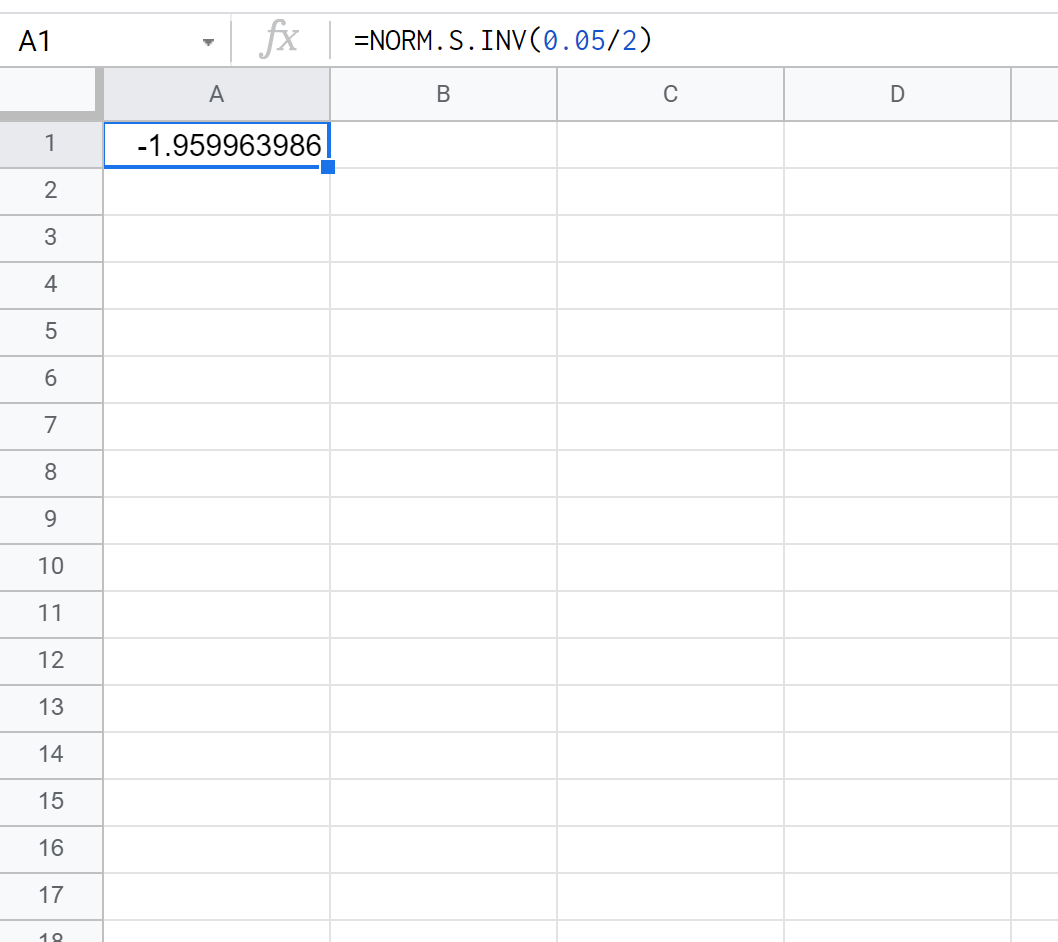
Pour déterminer les bornes critiques symétriques bilatérales d’un test z dans Google Sheets, deux formulations algorithmiques canoniques s’offrent au praticien. La première consiste à interroger directement la borne inférieure en transmettant à la fonction le quantile correspondant à la demi-surface alpha. Pour un seuil global traditionnellement calibré à alpha = 0,05, le chercheur injecte l’expression : =NORM.S.INV(0,05 / 2), ce qui équivaut à =NORM.S.INV(0,025). L’exécution de cette syntaxe restitue immédiatement la constante universelle -1,95996 (communément arrondie par convention éditoriale à -1,96).
La seconde formulation vise à cibler d’emblée la coordonnée positive marquant la limite de la queue supérieure. Cette opération s’effectue en retranchant la demi-surface alpha de l’unité, traduisant le fait que 97,5 % de l’aire sous la courbe se situent sous ce seuil critique droit : =NORM.S.INV(1 - (0,05 / 2)), ou de façon condensée =NORM.S.INV(0,975). Le tableur renvoie sans surprise la valeur absolue conjuguée +1,95996. Une méthode de programmation robuste consiste également à encapsuler la fonction de queue inférieure dans la fonction de valeur absolue universelle : =ABS(NORM.S.INV(alpha / 2)), fournissant un étalon positif directement exploitable pour les tests de comparaison logique.
La reproduction de cette architecture computationnelle sur les autres paliers conventionnels d’exigence scientifique consolide les repères du statisticien. Pour une investigation à haut niveau de sécurité épistémique régie par un risque global alpha = 0,01, le fractionnement bilatéral implique une probabilité par queue de 0,005. La syntaxe =NORM.S.INV(1 - (0,01 / 2)) génère alors avec une précision décimale irréprochable le quantile +2,57583 (généralement contracté à +2,576). Pour un seuil ultra-conservateur à alpha = 0,001, la formule =NORM.S.INV(1 - (0,001 / 2)) établit la frontière à +3,29053, illustrant la vertigineuse progression des exigences requises pour rejeter l’hypothèse nulle.
6.3 Application aux études épidémiologiques en santé mentale
La mise en œuvre de ces calculs prend tout son sens dans les grands dispositifs d’observation épidémiologique en psychologie publique. Considérons une vaste cohorte nationale analysant l’impact du déploiement généralisé du télétravail sur un indicateur validé de bien-être subjectif et de vitalité psychologique mesuré sur une échelle continue standardisée (moyenne populationnelle historique mu = 50, écart-type sigma = 10). L’échantillon d’observation regroupe un effectif massif de N = 2 500 cadres d’entreprise. Les chercheurs n’ayant pas d’hypothèse unilatérale stricte quant aux bénéfices ou méfaits globaux de cette modalité de travail retiennent un test bilatéral à un seuil d’exigence alpha = 0,05.
Dans la feuille Google Sheets orchestrant les indicateurs clés du projet, la cellule réservée au seuil critique bilatéral est paramétrée par la formule : =NORM.S.INV(1 - (0,05 / 2)), confirmant le repère théorique de 1,95996. Les analyses descriptives menées sur la cohorte révèlent une moyenne observée d’échantillon de 50,45 points. Pour tester la significativité de cette fluctuation, le statisticien évalue l’erreur-type de la moyenne par la formule sigma_moy = sigma / RACINE(N) = 10 / RACINE(2500) = 10 / 50 = 0,20.
La statistique standardisée observée z se calcule dès lors instantanément par le rapport z_obs = (Moyenne_obs - mu) / sigma_moy = (50,45 - 50) / 0,20 = 0,45 / 0,20 = 2,25. En soumettant cette statistique empirique à la règle de décision bilatérale, l’analyste constate que |z_obs| = 2,25 > z_crit = 1,95996. La valeur observée se situe hors de l’intervalle de rétention [-1,96 ; +1,96]. L’hypothèse nulle est rejetée au seuil de 5 %. Bien que l’écart brut en points de bien-être apparaisse modeste dans l’absolu, l’extrême puissance conférée par la taille massive de l’échantillon permet d’établir avec certitude que la modulation observée n’est pas le fruit d’une simple variation aléatoire d’échantillonnage.
7. Détermination et calcul des degrés de liberté selon les devis expérimentaux
7.1 Calcul des degrés de liberté pour échantillons indépendants
L’exactitude du calcul d’une valeur critique dans la famille des lois de Student et de Fisher dépend impérativement de la rigueur avec laquelle les degrés de liberté (notés usuellement ddl en français ou df pour degrees of freedom) sont spécifiés dans les formules mathématiques de Google Sheets. Dans le cadre d’un protocole expérimental à deux groupes indépendants — où un groupe de participants soumis à une condition expérimentale est confronté à un groupe témoin distinct —, le calcul des degrés de liberté sous l’hypothèse classique d’homoscédasticité (égalité des variances de population) répond à la formulation algébrique standardisée : ddl = n1 + n2 - 2, où n1 et n2 représentent les effectifs respectifs de chaque échantillon.
Pour assurer la pérennité et l’évolutivité d’une feuille d’analyse dans Google Sheets, il est fortement déconseillé d’injecter manuellement une valeur numérique statique pour ce paramètre. Les matrices de recherche étant fréquemment sujettes à des ajouts d’observations tardives ou à des invalidations de passations expérimentales, la détermination des effectifs doit être systématiquement automatisée au moyen des fonctions de comptage du tableur. En supposant que les scores du groupe témoin soient consignés dans la plage de cellules A2:A35 et ceux du groupe expérimental dans la plage B2:B40, l’analyste calculera dynamiquement les degrés de liberté dans une cellule dédiée via la formule : =NB(A2:A35) + NB(B2:B40) - 2.
Cette approche dynamique déploie toute son efficacité lorsque la cellule contenant les degrés de liberté est directement liée en tant que paramètre d’entrée dans la fonction inverse de valeur critique. Ainsi, une cellule calculant la valeur critique bilatérale s’écrira : =T.INV.2T(0,05; C2), où C2 héberge l’équation de sommation dynamique des effectifs. Toute suppression ultérieure d’un participant non conforme au protocole entraînera un recalcul instantané de la taille d’échantillon, une mise à jour immédiate des degrés de liberté et, consécutivement, un réajustement automatique de la valeur critique théorique sans aucune intervention humaine requise.
7.2 Degrés de liberté pour mesures répétées et échantillons appariés
La topologie des degrés de liberté change fondamentalement de paradigme statistique lorsque le protocole expérimental s’appuie sur des mesures répétées ou des échantillons appariés. Dans ces devis intra-sujets, chaque participant agit comme son propre témoin en étant évalué sous l’ensemble des conditions expérimentales, ou se trouve apparié de manière bijective avec un pair sur la base de critères psychométriques étroitement corrélés (tels que le niveau intellectuel général ou l’âge chronologique). Dans cette configuration, l’unité fondamentale d’analyse statistique n’est plus le score isolé d’un sujet, mais le vecteur des différences intra-individuelles calculées pour chaque paire d’observations.
Conséquemment, la quantification des degrés de liberté ne se calcule plus à partir de la somme totale des observations divisées, mais repose exclusivement sur le dénombrement des paires complètes diminué d’une seule unité de liberté : ddl = N_paires - 1. Cette spécificité impose une vigilance redoublée quant au traitement des données manquantes dans les tableurs. Si un sujet a complété le pré-test mais n’a pas pu honorer la passation du post-test en raison d’une défection expérimentale (attrition), la ligne d’observation correspondante devient incomplète et doit impérativement être exclue du calcul des degrés de liberté sous peine de fausser les estimateurs de variance différentielle.
Dans l’environnement Google Sheets, pour éviter qu’une cellule textuelle vide ne vienne altérer un calcul automatique basé sur la fonction NB, il est judicieux de recourir à des formules conditionnelles matricielles robustes. Par exemple, si la condition initiale réside dans la colonne A et la condition consécutive dans la colonne B sur une plage s’étendant de la ligne 2 à 50, le dénombrement strict des paires synchrones exploitables s’effectuera via la syntaxe : =NB.SI.ENS(A2:A50; "<>"; B2:B50; "<>") - 1. Cette formule s’assure qu’une ligne n’est comptabilisée dans les degrés de liberté que si les deux cellules associées renferment des valeurs numériques effectives. Cette précaution garantit que la valeur critique issue de T.INV.2T reflète parfaitement le degré de restriction probabiliste imposé par l’échantillon apparié réel.
7.3 Prise en compte de la correction de Welch pour variances inégales
L’un des postulats cardinaux du test t de Student pour échantillons indépendants réside dans l’hypothèse d’homoscédasticité, qui assume que les variances des populations dont sont extraits les échantillons sont sensiblement équivalentes. Or, dans les investigations de psychologie clinique, de psychopathologie ou de neurosciences comportementales, ce postulat est extrêmement souvent violé : la variance d’un groupe clinique pathologique est quasi systématiquement supérieure à celle d’un groupe contrôle indemne de troubles. Lorsque l’hétéroscédasticité est avérée et que les effectifs des groupes sont inégaux, l’application aveugle de la formule standard des degrés de liberté (n1 + n2 - 2) biaise lourdement le taux d’erreur de première espèce.
La réponse méthodologique standardisée à cette fragilité réside dans la mise en œuvre de la correction d’approximation de Welch-Satterthwaite. Cette modélisation substitue aux degrés de liberté entiers traditionnels une quantité mathématique continue hautement sophistiquée, calculée comme une fonction composite pondérée des variances empiriques d’échantillons (s1^2 et s2^2) et de leurs tailles respectives : ddl_Welch = [ (s1^2/n1 + s2^2/n2)^2 ] / [ (s1^2/n1)^2 / (n1 - 1) + (s2^2/n2)^2 / (n2 - 1) ]. L’application de ce modèle engendre presque systématiquement des degrés de liberté fractionnaires comportant des décimales, par exemple ddl = 23,417.
L’un des atouts computationnels majeurs de Google Sheets réside dans son aptitude algorithmique à évaluer sans discontinuité les fonctions T.INV et T.INV.2T sur des degrés de liberté réels non entiers. Alors que les tables statistiques imprimées imposent d’arrondir arbitrairement les degrés de liberté à l’entier inférieur le plus proche, l’algorithme sous-jacent de Google Sheets calcule la fonction Gamma d’Euler pour évaluer précisément l’intégrale de probabilité sur n’importe quelle valeur fractionnaire. Le chercheur peut donc connecter directement la cellule abritant la formule complexe de Welch aux arguments de degrés de liberté de sa fonction de seuil critique, préservant ainsi une exactitude analytique sans compromis face aux violations de l’homoscédasticité.
8. Calcul des valeurs critiques pour la distribution du Khi-deux
8.1 Rôle des tests du Khi-deux dans l’analyse de variables qualitatives
En psychologie sociale, en psychologie différentielle et en épidémiologie psychiatrique, une proportion substantielle des données collectées ne se déploie pas sous forme de variables quantitatives continues, mais se manifeste sous forme de catégories nominales ou ordinales discontinues. Qu’il s’agisse d’évaluer le choix préférentiel d’une stratégie de coping face à une situation anxiogène, l’adhésion à une typologie de croyances ou la prévalence croisée de troubles comorbides au sein d’une population, le chercheur doit recourir à la modélisation non paramétrique du Khi-deux formalisée par Karl Pearson.
Les tests du Khi-deux se divisent principalement en deux architectures logiques : le test de conformité (ou d’adéquation), qui évalue si la distribution observée d’un échantillon univarié s’écarte d’une distribution théorique préétablie, et le test d’indépendance (ou d’homogénéité), qui examine au moyen d’un tableau de contingence croisé si deux dimensions catégorielles sont statistiquement dépendantes l’une de l’autre. Contrairement à la distribution normale ou à celle de Student, la loi du Khi-deux n’est pas symétrique : elle est définie exclusivement sur l’axe des réels positifs [0 ; +infini[ et présente une asymétrie positive très prononcée qui s’atténue progressivement lorsque les degrés de liberté augmentent.
Dans un tableau de contingence structuré comportant r lignes et c colonnes de modalités, la morphologie exacte de la loi du Khi-deux sous-jacente est régie par un nombre de degrés de liberté universellement obtenu par le produit cartésien marginal : ddl = (r - 1) * (c - 1). Dans le cadre d’un test de conformité univarié comportant k catégories mutuellement exclusives, les degrés de liberté se résument simplement à l’expression ddl = k - 1. Toute déviation empirique majeure par rapport aux effectifs théoriques attendus sous l’hypothèse d’indépendance déplace la statistique calculée vers des grandeurs positives élevées, justifiant le caractère structurellement unilatéral de l’évaluation du rejet.
8.2 Syntaxe des fonctions CHISQ.INV et CHISQ.INV.RT
Pour dériver les coordonnées critiques associées à la loi du Khi-deux, Google Sheets met à la disposition des utilisateurs deux fonctions principales : CHISQ.INV et CHISQ.INV.RT (ou leurs équivalents historiques francophones respectifs LOI.KHIDEUX.INVERSE et LOI.KHIDEUX.INVERSE.DROITE). La compréhension de la distinction entre ces deux outils est capitale pour éviter toute erreur de paramétrage directionnel de la probabilité.
La fonction CHISQ.INV.RT (le suffixe RT renvoyant au terme anglo-saxon Right Tail, signalant la queue droite de la distribution) constitue la fonction naturelle et préférentielle pour l’immense majorité des tests d’hypothèses en psychologie. Sa syntaxe s’exprime sous la forme épurée : =CHISQ.INV.RT(alpha; degrés_liberté). Dans cette formulation, l’utilisateur injecte directement le risque de première espèce consenti (par exemple 0,05). La fonction calcule instantanément l’abscisse au-delà de laquelle subsiste précisément une surface résiduelle équivalente à ce risque alpha dans la queue supérieure de la courbe.
À l’opposé, la fonction standard CHISQ.INV repose sur le principe de la distribution cumulative inverse classique depuis l’origine gauche de l’axe. Sa syntaxe générale est : =CHISQ.INV(probabilité; degrés_liberté). Dès lors, si un chercheur souhaite obtenir la même valeur critique de rejet avec cette fonction univariée gauche, il doit impérativement lui transmettre le complément unitaire de la zone de rejet, c’est-à-dire l’expression mathématique : =CHISQ.INV(1 - alpha; degrés_liberté). La méconnaissance de ce mécanisme conduit fréquemment des utilisateurs novices à saisir =CHISQ.INV(0,05; ddl), ce qui renvoie une abscisse aberrante correspondant à la borne séparant les 5 % d’écarts les plus faibles observés sous le modèle nul, annihilant totalement le sens de la démonstration statistique.
8.3 Exemple concret : analyse de choix comportementaux sous stress
Illustrons la mise en application de ces concepts au travers d’un paradigme de psychologie sociale expérimentale. Des chercheurs analysent l’influence d’un inducteur de stress aigu (la passation du test de stress social de Trier) sur l’adoption de stratégies comportementales réactives classifiées en trois modalités discrètes : la négociation collaborative, l’évitement passif ou l’affrontement assertif. Le protocole confronte deux groupes d’individus : un groupe expérimental préalablement soumis au protocole d’induction de stress et un groupe témoin placé dans une condition neutre de repos. Les données sont agrégées sous la forme d’un tableau de contingence de dimensions 2 lignes (conditions : stress versus contrôle) par 3 colonnes (comportements : négociation, évitement, affrontement).
Le paramétrage des degrés de liberté s’établit mécaniquement par le calcul ddl = (2 – 1) * (3 – 1) = 1 * 2 = 2 degrés de liberté. L’équipe de recherche calibre le seuil alpha à la valeur conventionnelle de 0,05. Dans la matrice de calcul hébergée sur Google Sheets, l’analyste détermine la valeur critique d’indépendance comportementale en insérant dans la cellule de référence la syntaxe optimisée suivante : =CHISQ.INV.RT(0,05; 2).
Le moteur d’évaluation numérique de Google Sheets exécute instantanément l’intégration inverse et produit la valeur critique rigoureuse de 5,99146. Ce nombre réel fixe la borne d’homogénéité : si la statistique du Khi-deux empirique déduite des observations croisées — calculée selon la formule de sommation standardisée des écarts quadratiques entre effectifs observés et théoriques Somme[(O - E)^2 / E] — s’élève par exemple à Khi2_obs = 7,42, la condition logique Khi2_obs (7,42) > Khi2_crit (5,99146) est formellement vérifiée. L’hypothèse nulle d’indépendance des conduites comportementales à l’égard de l’état de stress est résolument rejetée, validant empiriquement l’impact de l’activation neuroendocrinienne sur les choix d’adaptation psychosociale.
9. Calcul des valeurs critiques pour la distribution de Fisher-Snedecor (F)
9.1 Fondements de la statistique F dans l’analyse de variance (ANOVA)
Lorsque les protocoles de recherche en psychologie étendent leur devis expérimental au-delà de la confrontation binaire de deux moyennes pour analyser l’action conjointe de multiples variables indépendantes ou de facteurs comportant plusieurs modalités (trois groupes ou davantage), le test t de Student s’avère méthodologiquement inopérant. La multiplication des tests t par paires engendrerait en effet une inflation dramatique et incontrôlée du risque global d’erreur de type I par le mécanisme d’accumulation probabiliste. La réponse universelle à cette contrainte réside dans l’analyse de variance (ANOVA), conçue par Ronald Fisher et formalisée mathématiquement avec George Snedecor au travers de la distribution de la statistique F.
Le ratio F repose structurellement sur le quotient de deux estimateurs de variance indépendants : la variance inter-groupes (qui capture la dispersion des moyennes des conditions autour de la moyenne générale, intégrant les effets du traitement expérimental additionnés au bruit de mesure) rapportée à la variance intra-groupe ou résiduelle (qui quantifie la fluctuation purement aléatoire des sujets à l’intérieur de chaque groupe). Si l’hypothèse nulle d’égalité stricte des moyennes des populations est vraie, ce rapport de variances fluctue stochastiquement autour d’une espérance centrale proche de 1. Dès lors qu’un effet expérimental tangible opère, le numérateur croît sous l’effet du différentiel induit, projetant le ratio F vers des valeurs substantielles.
La distribution théorique de cette statistique se définit continûment sur le demi-axe positif [0 ; +infini[ et présente la particularité fondamentale d’être paramétrée non pas par un, mais par deux indicateurs de degrés de liberté distincts. Le premier paramètre, noté ddl1, correspond aux degrés de liberté associés à la source de variation située au numérateur (égal au nombre de groupes ou de conditions moins 1). Le second paramètre, noté ddl2, formalise les degrés de liberté propres à la variance d’erreur située au dénominateur (correspondant à l’effectif total cumulé diminué du nombre total de groupes). Pour les tests omnibus classiques de l’ANOVA, la zone de rejet se concentre exclusivement dans la queue unilatérale supérieure droite de la loi de distribution.
9.2 Implémentation de F.INV et F.INV.RT dans Google Sheets
La dérivation computationnelle de la valeur critique F au sein de Google Sheets mobilise deux fonctions dédiées : F.INV.RT et F.INV (dont les correspondances historiques françaises sont respectivement LOI.F.INVERSE.DROITE et LOI.F.INVERSE). À l’instar de ce qui a été développé pour la loi du Khi-deux, la fonction F.INV.RT est intrinsèquement configurée pour isoler la surface de rejet située dans l’extrémité supérieure de la loi de Fisher, ce qui en fait l’outil d’élection pour le chercheur menant une analyse de variance factorielle.
La syntaxe opératoire de la fonction pour la queue supérieure s’agence selon la séquence ordonnée suivante : =F.INV.RT(alpha; ddl1; ddl2). L’utilisateur fournit successivement le seuil de signification désiré, puis les degrés de liberté du numérateur, et enfin les degrés de liberté du dénominateur. Par exemple, pour un modèle factoriel confrontant 3 conditions expérimentales auprès d’un échantillon global de 60 participants, ddl1 = 3 - 1 = 2 et ddl2 = 60 - 3 = 57. L’insertion de la formule =F.INV.RT(0,05; 2; 57) délivrera directement le seuil d’admissibilité au rejet.
La fonction complémentaire F.INV évalue quant à elle l’intégrale cumulative depuis la gauche de la distribution. Pour extraire la même valeur critique que celle délivrée par la version unilatérale droite, le chercheur devra lui adresser le complément unitaire du risque d’erreur en écrivant rigoureusement : =F.INV(1 - alpha; ddl1; ddl2). Il importe de souligner la très grande sensibilité de la distribution de Fisher aux variations d’effectifs : l’accroissement des degrés de liberté du dénominateur abaisse progressivement la valeur critique nécessaire pour documenter un effet statistiquement significatif, reflétant l’affinement asymptotique de l’estimation de la variance d’erreur résiduelle de l’appareil de mesure.
9.3 Application à un protocole factoriel en psychologie du développement
Pour illustrer la mise en pratique de cette distribution multivariée, examinons une étude transversale en psychologie du développement comparant les capacités de métacognition et de régulation attentionnelle chez des enfants scolarisés répartis en trois tranches d’âge successives : Groupe 1 (6-7 ans), Groupe 2 (8-9 ans) et Groupe 3 (10-11 ans). Le protocole mobilise un échantillon homogène de 15 enfants dans chaque cohorte, soit un effectif global agrégé de N = 45 participants. Le chercheur formalise une analyse de variance univariée à un facteur pour déterminer si l’âge chronologique module globalement l’efficience métacognitive, en calibrant le niveau alpha conventionnel à 0,05.
La définition des paramètres de distribution impose de déterminer rigoureusement les deux instances de degrés de liberté requises par le modèle de Snedecor. Le premier degré de liberté, associé au facteur inter-sujets (l’âge), s’établit à ddl1 = k - 1 = 3 - 1 = 2. Le second paramètre, caractérisant la variance résiduelle intra-groupe, s’évalue par la relation ddl2 = N - k = 45 - 3 = 42. L’analyste se positionne sur la cellule dédiée au contrôle des frontières critiques dans sa feuille Google Sheets et renseigne l’instruction suivante : =F.INV.RT(0,05; 2; 42).
Le système calcule et restitue avec une haute fidélité le quantile critique de 3,21994. Dès lors, le critère d’évaluation statistique du modèle omnibus s’établit sans équivoque : si la décomposition de la somme des carrés des écarts conduit à une statistique empirique F observée supérieure ou égale à 3,22, l’hypothèse nulle d’équivalence absolue du développement métacognitif entre les trois classes d’âge sera réfutée. Si l’ANOVA logicielle produit par exemple une statistique de F(2, 42) = 4,87, la comparaison formelle F_obs (4,87) > F_crit (3,22) scellera le rejet de l’hypothèse nulle, autorisant le chercheur à planifier des analyses de contrastes post-hoc ou des comparaisons par paires pour isoler les ruptures développementales spécifiques entre les sous-groupes.
10. Automatisation et création d’outils décisionnels dynamiques
10.1 Automatisation de la règle de rejet par instructions conditionnelles
L’un des avantages les plus décisifs de l’exploitation de Google Sheets dans les laboratoires de recherche réside dans l’opportunité d’automatiser intégralement le verdict statistique d’inférence en couplant les cellules de valeurs critiques aux fonctions de test logique conditionnel. Au lieu de contraindre l’analyste à comparer visuellement et manuellement les grandeurs empiriques observées aux seuils théoriques — une démarche fastidieuse qui constitue une source avérée d’erreurs d’inattention dans les études à large bande passante —, il est aisé d’écrire des formules algorithmiques qui formulent immédiatement la sentence inférentielle.
Pour un test bilatéral symétrique (par exemple un test t ou un test z), la structure de la formule logique imbriquera la fonction de comparaison SI et l’opérateur de magnitude absolue ABS. Supposons que la statistique t calculée sur l’échantillon soit située en cellule D10 et que la valeur critique bilatérale positive issue de T.INV.2T soit hébergée en cellule E10. La cellule d’arbitrage automatisé recevra la syntaxe décisionnelle suivante : =SI(ABS(D10) > E10; "Rejet de H0 (Effet significatif)"; "Non-rejet de H0 (Effet non significatif)"). Dès la confirmation de cette formule, le tableur évalue la condition relationnelle et affiche de façon dynamique le statut d’admissibilité du modèle.
Dans le cas des devis unilatéraux où l’orientation vectorielle du résultat prime, la logique décisionnelle doit incorporer des contraintes directionnelles strictes au moyen de connecteurs logiques ET. Pour un test unilatéral prédisant une diminution où la statistique observée réside en D10 et la valeur critique négative calculée par T.INV en E10, l’instruction conditionnelle s’écrira : =SI(D10 < E10; "Rejet H0 : Diminution significative confirmée"; "Non-rejet H0 : Diminution non prouvée"). La sécurisation des protocoles d’analyse par de tels gardes-fous computationnels standardise l’évaluation des données et élimine toute ambiguïté lors des revues de dépouillement collégiales.
10.2 Conception d’un tableau de bord paramétrable pour le chercheur
Pour démultiplier l’efficience analytique d’un laboratoire, il est hautement avantageux d’aménager une feuille de calcul dédiée sous la forme d’un tableau de bord décisionnel interactif et entièrement paramétrable. Ce dispositif permet à tout investigateur d’ajuster instantanément les paramètres généraux de l’étude (seuil alpha consenti, directionalité du test, taille des groupes) et de voir l’ensemble de la batterie des valeurs critiques se recalculer et s’adapter en temps réel sans devoir jamais réécrire la moindre ligne de code statistique.
La première composante de cette architecture repose sur l’intégration d’un menu de validation des données pour la sélection des seuils de signification. En sélectionnant la cellule réservée au risque alpha (par exemple B2), le chercheur configure une liste déroulante restreinte aux standards académiques usuels : 0,05; 0,01; 0,001; 0,005. Une seconde cellule paramétrique (B3) peut recevoir une autre liste déroulante proposant l’alternative directionnelle : "Bilatéral", "Unilatéral supérieur", "Unilatéral inférieur". La liaison de ces paramètres aux fonctions critiques s’opère ensuite par des branchements conditionnels élaborés.
L’implémentation de formules imbriquées dynamiques permet alors d’aiguiller le calcul vers la fonction adéquate. Par exemple, la dérivation d’un seuil critique de Student peut être formulée de la façon suivante : =SI(B3="Bilatéral"; T.INV.2T(B2; C2); SI(B3="Unilatéral inférieur"; T.INV(B2; C2); T.INV(1-B2; C2))), où C2 héberge le comptage automatique des degrés de liberté. Grâce à cette conception modulaire, l’importation de nouvelles matrices de données empiriques brutes recalcule de manière transparente l’intégralité des horizons critiques, conférant aux équipes de recherche un gain de productivité et une traçabilité expérimentale sans précédent.
10.3 Mise en valeur visuelle par la mise en forme conditionnelle
L’optimisation des flux de travail dans Google Sheets franchit une étape supplémentaire par l’exploitation des règles de mise en forme conditionnelle basées sur les résultats inférentiels calculés. Lors de l’exploration préliminaire de volumineuses bases de données psychométriques — comportant des dizaines de dimensions de personnalité, d’indices neuropsychologiques ou d’items de questionnaires —, la lecture textuelle pure de tableaux de chiffres s’avère cognitivement saturante. La mise en couleur automatisée des indicateurs statistiques permet un criblage visuel instantané des patterns de significativité émergents.
Pour configurer cette signalétique sémiotique, l’utilisateur sélectionne l’ensemble de la plage de cellules hébergeant les résultats décisionnels, puis accède au menu Format > Mise en forme conditionnelle. Il est particulièrement judicieux d’instaurer une règle basée sur une formule personnalisée. Si l’on souhaite colorer de façon ostensible en vert émeraude doux toute cellule témoignant d’un rejet de l’hypothèse nulle, la règle s’appuiera sur la concordance textuelle : =D10="Rejet de H0 (Effet significatif)", en appliquant un style typographique gras et un fond de cellule contrasté.
De surcroît, une modélisation visuelle encore plus fine consiste à mettre en exergue l’ampleur de la distance séparant la statistique observée de sa valeur critique de référence. En programmant un formatage basé sur une échelle de nuances colorimétriques graduées corrélée à l’écart standardisé (Stat_obs - Valeur_critique), l’analyste fait instantanément émerger les effets hautement robustes qui surpassent de très loin les contraintes de rejet, les distinguant d’un simple coup d’œil des effets limites qui flirtent dangereusement avec la frontière d’indécision. Cette spatialisation chromatique accélère substantiellement le repérage exploratoire sans jamais sacrifier la rigueur mathématique du dispositif.
11. Erreurs fréquentes et pièges d’interprétation dans Google Sheets
11.1 Confusion entre fonctions unilatérales et bilatérales
L’une des bévues computationnelles les plus pernicieuses et les plus fréquemment documentées lors des audits méthodologiques de feuilles de calcul en recherche réside dans l’utilisation interchangeable et inappropriée des fonctions unilatérales et bilatérales. L’erreur la plus classique consiste à faire appel à la fonction univariée standard T.INV tout en lui assignant le niveau alpha nominal global (par exemple 0,05) au sein d’un devis expérimental conceptuellement bilatéral. Ce faisant, l’analyste calibre en réalité la région critique sur une seule queue de probabilité équivalente à l’ensemble du risque alpha, doublant involontairement le taux d’erreur de première espèce effectif de son protocole, qui glisse subrepticement de 0,05 à 0,10.
Cette distorsion computationnelle confère une permissivité illégitime à l’appareil de preuve : des statistiques de test empiriques modestes, qui auraient dû être déclarées non significatives dans un cadre bilatéral rigoureusement contrôlé, franchissent indûment le seuil artificiellement assoupli produit par la formule erronée. Ce phénomène génère des déclarations de significativité frauduleuses bien qu’involontaires, qui polluent les synthèses méta-analytiques ultérieures et compromettent l’intégrité de la littérature en sciences du comportement.
Pour prévenir cette dérive systémique, tout protocole d’analyse sur tableur doit impérativement intégrer une procédure de vérification croisée formalisée. Avant de statuer définitivement sur les données, l’analyste doit effectuer un contrôle de congruence théorique : si le test postule l’absence d’a priori de direction, la fonction exploitée doit être sans équivoque T.INV.2T. Si pour des motifs spécifiques la fonction T.INV est conservée dans un cadre bilatéral, le chercheur a l’obligation métrologique de vérifier que le premier argument intègre formellement la demi-probabilité cumulative, matérialisée par l’écriture explicite alpha / 2 ou 1 - (alpha / 2).
11.2 Incompréhension des queues de distribution et des signes algébriques
Un autre écueil méthodologique récurrent concerne la mauvaise interprétation des signes algébriques négatifs retournés par les fonctions évaluant l’intégrale depuis la queue inférieure d’une distribution symétrique. De nombreux utilisateurs, déconcertés par l’apparition d’un nombre négatif lors de l’exécution d’une commande telle que =T.INV(0,05; 15) produisant -1,75305, appliquent de manière réflexe la fonction de valeur absolue ABS pour forcer le résultat à devenir positif, sans appréhender les répercussions logiques de cette manipulation sur le sens du test.
Si le protocole expérimental initial postule une diminution directionnelle (test unilatéral gauche où les scores expérimentaux doivent être inférieurs à ceux du contrôle), la valeur critique doit impérativement demeurer négative. La zone de rejet est exclusivement située sur le segment réel inférieur à cette coordonnée négative. En transformant arbitrairement ce seuil en une valeur positive +1,75305 et en appliquant un opérateur de supériorité, l’expérimentateur inverse complètement la directionnalité de son épreuve d’hypothèse : il évalue désormais par mégarde si le groupe a augmenté au lieu de diminuer, commettant un contresens expérimental absolu.
L’alignement rigoureux entre la formulation conceptuelle de l’hypothèse alternative H1 et la polarisation algébrique de la valeur critique constitue une obligation scientifique inaliénable. Les analystes doivent systématiquement documenter dans une note attenante à la formule le sens géométrique de la région critique : les valeurs de rejet doivent être inférieures au seuil négatif pour une prédiction d’amoindrissement, et supérieures au seuil positif pour une prédiction d’accroissement. L’utilisation aveugle de transformations mathématiques sans maîtrise de la topologie de la distribution théorique constitue l’un des vecteurs majeurs de biais dans l’analyse de données non supervisée.
11.3 Amalgame entre valeur critique et p-valeur
La confusion conceptuelle entre la valeur critique et la probabilité empirique ou p-valeur (p-value) représente une aberration épistémologique qui subsiste de manière surprenante jusque dans des manuscrits soumis à évaluation académique. Il n’est pas rare de constater qu’un investigateur traite la valeur critique retournée par une fonction inverse (par exemple le seuil 1,96 issu de NORM.S.INV) comme si elle représentait une probabilité, affirmant maladroitement que le test a fourni « une probabilité de significativité de 1,96 », ce qui constitue un non-sens mathématique élémentaire, toute probabilité étant axiomatiquement bornée dans l’intervalle fermé [0 ; 1].
Il est impératif de rappeler avec insistance la césure fondamentale séparant ces deux grandeurs dans le tableur. Les fonctions arborant le suffixe .INV (telles que T.INV, NORM.S.INV, CHISQ.INV.RT, F.INV.RT) sont des convertisseurs de quantiles : elles partent d’une probabilité théorique fixée arbitrairement par le chercheur pour délivrer une coordonnée d’abscisse critique exprimée dans l’unité de mesure de la statistique de test. À l’opposé diamétral, les fonctions assorties du suffixe .DIST (telles que T.DIST, NORM.S.DIST, CHISQ.DIST.RT, F.DIST.RT) accomplissent l’opération inverse : elles ingèrent la statistique empirique calculée sur les données pour délivrer la p-valeur exacte associée, c’est-à-dire une surface de probabilité sous la courbe.
Cette distinction n’est pas seulement terminologique ; elle structure la validité même de l’argumentation scientifique lors de la rédaction du rapport de recherche. Le chercheur compare la statistique empirique à la valeur critique pour valider la règle de décision d’acceptation ou de rejet selon Neyman-Pearson, et rapporte parallèlement la p-valeur continue pour quantifier le degré d’incompatibilité des données observées avec l’hypothèse nulle sous l’angle fisherien. La confusion de ces deux paradigmes méthodologiques au sein des cellules de Google Sheets témoigne d’un déficit de formation quantitative qu’il convient d’éradiquer par une standardisation stricte des pratiques de laboratoire.
12. Bonnes pratiques, reproductibilité et communication scientifique
12.1 Documentation rigoureuse des formules statistiques dans le tableur
Dans la perspective contemporaine de la crise de la reproductibilité affectant la psychologie expérimentale et les neurosciences, l’élaboration de feuilles de calcul analytiques ne peut plus être envisagée comme une activité privée et informelle. Une matrice de données hébergée sur Google Sheets doit répondre aux exigences de clarté, d’auditabilité et d’intégrité logicielle qui prévalent dans le développement informatique rigoureux. Toute cellule abritant une fonction inverse de dérivation critique doit être documentée de manière à ce qu’un réviseur externe, un auditeur académique ou un nouveau membre de l’équipe de recherche puisse en décoder instantanément l’architecture.
Google Sheets intègre pour ce faire des fonctionnalités d’annotation contextuelle remarquablement efficientes. L’insertion systématique de commentaires explicatifs (via le raccourci Maj+F2 ou le menu contextuel Insérer un commentaire) permet d’expliciter sans alourdir la grille visuelle les choix théoriques sous-jacents : mention explicite de la directionnalité du test (unilatéral ou bilatéral), justification méthodologique du seuil alpha retenu (par exemple, ajustement conservateur de Bonferroni à la suite de comparaisons multiples) et rappel des hypothèses distributionnelles assumées. De surcroît, la standardisation du nommage des plages de cellules (accessibilité via Données > Plages nommées) permet de remplacer des syntaxes opaques telles que =T.INV.2T(B1; C1) par des expressions limpides et signifiantes : =T.INV.2T(Alpha_Global; Degres_Liberte_Total).
Enfin, la préservation de l’intégrité algorithmique du document exige le verrouillage préventif des structures de calcul. Les erreurs matérielles de manipulation — telles que l’écrasement involontaire d’une formule par la saisie d’un chiffre brut ou la suppression accidentelle d’une référence cellulaire lors d’un tri de colonne — représentent les vecteurs d’altération les plus courants des données de recherche. En activant la protection des plages (Données > Protéger les feuilles et les plages), l’investigateur principal peut verrouiller l’ensemble des cellules contenant les équations statistiques et les seuils critiques, n’autorisant la saisie libre que sur les zones strictement dédiées aux données brutes empiriques.
12.2 Conformité avec les normes de publication académique (APA)
La finalité ultime de l’analyse inférentielle réside dans la communication transparente et normalisée des résultats au sein des revues scientifiques internationales à comité de lecture. La quasi-totalité des périodiques en psychologie quantitative, neurosciences cognitives et sciences du comportement adhère aux standards typographiques et éditoriaux prescrits par le manuel de publication de l’American Psychological Association (actuellement dans sa 7e édition). La transcription des calculs dérivés de Google Sheets dans le corps d’un article savant doit respecter scrupuleusement ces règles formelles.
Selon les normes APA, il n’est pas d’usage d’inclure explicitement la valeur critique numérique dans la phrase de synthèse inférentielle principale ; le rapport met traditionnellement en avant la statistique observée, les degrés de liberté entre parenthèses, la p-valeur exacte et la taille d’effet mesurée (comme le d de Cohen ou l’êta-carré partiel). Néanmoins, la valeur critique constitue l’élément justificatif indispensable qui a guidé la décision binaire rapportée. Ainsi, une formulation conforme s’énoncera sous la forme suivante : « Les performances mnésiques du groupe expérimental se sont révélées significativement supérieures à celles du groupe témoin, t(48) = 2,45, p = ,018, d = 0,71 (valeur critique bilatérale t_crit = 2,01 au seuil alpha de ,05) ».
Les conventions typographiques imposent par ailleurs des règles d’arrondi décimal strictes. Les statistiques inférentielles (t, F, z) et les valeurs critiques associées doivent être systématiquement rapportées avec exactement deux décimales significatives (par exemple, t_crit = 1,96 et non pas 1,95996). De plus, lorsque la grandeur numérique rapportée est par nature strictement bornée entre 0 et 1 (ce qui est le cas des probabilités alpha et des p-valeurs), le style APA impose de supprimer le zéro initial précédant le séparateur décimal (écrire p < ,05 ou p = ,012 au lieu de 0,05 ou 0,012). Enfin, la transparence méthodologique contemporaine encourage vivement les chercheurs à mentionner explicitement dans la section « Méthode et analyses statistiques » la plateforme computationnelle mobilisée, en déclarant l’utilisation de Google Sheets pour la détermination dynamique des seuils d’inférence.
12.3 Pérennité, archivage ouvert et sécurité des données de recherche
L’utilisation de services infonuagiques pour le traitement de données empiriques soulève des enjeux majeurs en matière de pérennité archivistique, de gouvernance éthique et de sécurité des informations nominatives des sujets expérimentaux. Si la flexibilité collaborative de Google Sheets s’avère remarquable au quotidien, un laboratoire de recherche ne peut s’affranchir d’une politique rigoureuse de sauvegarde et d’interopérabilité des formats. Les architectures logicielles propriétaires en ligne demeurent dépendantes de la connectivité réseau et de modifications potentielles d’API ou de politiques commerciales d’hébergement.
Pour assurer la reproductibilité à long terme des analyses au-delà de la durée de vie commerciale d’un service spécifique, l’investigateur doit procéder à des exportations régulières de ses matrices d’analyse dans des formats ouverts, standardisés et pérennes. L’exportation au format OpenDocument Spreadsheet (ODS) ou sous la forme de fichiers de données délimités par des virgules (CSV) — accompagnés d’un dictionnaire de variables exhaustif et de scripts de formules décrits en texte brut — garantit que des équipes indépendantes pourront auditer et reproduire les calculs plusieurs décennies après la publication initiale de l’étude, conformément aux directives internationales de la science ouverte (principes FAIR : Facile à trouver, Accessible, Interopérable, Réutilisable).
Parallèlement, la protection des données sensibles des participants constitue un impératif éthique et légal absolu, régi en Europe par le Règlement Général sur la Protection des Données (RGPD) et à l’international par les déclarations de bioéthique d’Helsinki. Les feuilles Google Sheets hébergeant des données de recherche clinique ou comportementale ne doivent sous aucun prétexte renfermer d’informations directement identifiantes (noms, prénoms, coordonnées, adresses IP). L’attribution d’un identifiant numérique pseudonymisé opaque pour chaque participant doit être scrupuleusement opérée en amont de toute saisie dans le tableur. Enfin, la gestion fine des autorisations de partage du document en nuage doit faire l’objet d’une surveillance continue : l’accès doit être strictement restreint aux membres accrédités du protocole expérimental au moyen d’adresses institutionnelles authentifiées, proscrivant formellement l’usage de liens de partage publics non sécurisés.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Google. (2023). Google Sheets function list and syntax guide. Google Support Documentation. https://support.google.com/docs/table/25273
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
Nosek, B. A., Alter, G., Banks, G. C., Borsboom, D., Bowman, S. D., Breckler, S. J., Buck, S., Chambers, C. D., Chin, G., Christensen, G., Contestabile, M., Dafoe, A., Eich, E., Freese, J., Glennerster, R., Goroff, D., Green, D. P., Hesse, B., Humphreys, M., … Yarkoni, T. (2015). Promoting an open research culture. Science, 348(6242), 1422-1425. https://doi.org/10.1126/science.aab2374
Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110-114. https://doi.org/10.2307/3002019
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129-133. https://doi.org/10.1080/00031305.2016.1154108
Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28-35. https://doi.org/10.2307/2332510