
Dans le paysage contemporain de la recherche en psychologie et en sciences du comportement, l’analyse des données quantitatives est devenue un pilier fondamental de la validation empirique des modèles théoriques. L’avènement des logiciels d’analyse statistique automatisés tels que SPSS, R, Jamovi ou Prism a considérablement fluidifié le flux de travail des chercheurs et des cliniciens, transformant des calculs d’intégrales matricielles complexes en quelques clics ou lignes de code. Néanmoins, cette automatisation poussée a souvent engendré un effet secondaire délétère au sein de la communauté scientifique : la perte de compréhension conceptuelle et mécanique des opérations sous-jacentes. L’inférence statistique se réduit trop fréquemment à une lecture machinale d’indices algorithmiques, où le praticien scrute la mention standardisée d’une valeur sans mesurer la géométrie distributionnelle qui lui a donné naissance.
Le calcul manuel d’une valeur p (ou p-value) à partir d’un score standardisé, communément désigné sous le terme de score Z, constitue l’un des exercices les plus émancipateurs et éclairants pour quiconque s’intéresse à la rigueur méthodologique. Cette démarche ne relève nullement d’un passéisme désuet ou d’une nostalgie des tables papier jaunies par le temps ; elle incarne au contraire la quintessence du raisonnement probabiliste. En apprenant à convertir à la main une déviation empirique standardisée en une probabilité d’erreur sous l’hypothèse nulle, le chercheur réinvestit l’espace géométrique défini par Carl Friedrich Gauss et Pierre-Simon de Laplace, transcendant l’opacité des boîtes noires logicielles.
Le présent article offre un guide magistral et exhaustif destiné aux étudiants avancés, aux doctorants, aux chercheurs académiques et aux praticiens de la psychologie clinique désireux de maîtriser l’intégralité du cheminement reliant un score Z à sa valeur p. À travers une décomposition systématique des fondements théoriques, des propriétés mathématiques de la loi normale, des conventions de lecture des différentes tables statistiques, de la gestion minutieuse des hypothèses unilatérales et bilatérales, et des techniques d’interpolation fine, ce manuel vous dotera d’une compétence analytique pérenne, garante d’une interprétation critique et inaltérable des résultats expérimentaux.
1. Fondements théoriques du score Z et de la valeur p en psychologie
1.1 Définition et rôle du score Z dans la standardisation des données
Dans l’arsenal psychométrique contemporain, la diversité des outils d’évaluation engendre une profusion de systèmes de mesure hétérogènes. Qu’il s’agisse des unités arbitraires d’un inventaire de dépression comme l’échelle de Beck, des temps de réaction milliseconde par milliseconde enregistrés lors d’une tâche d’inhibition motrice, ou encore des scores composites issus d’une batterie d’efficience intellectuelle de type WAIS (Wechsler Adult Intelligence Scale), le chercheur se trouve confronté à une incommensurabilité fondamentale des scores bruts. Un résultat brut de 34 à un questionnaire d’anxiété n’entretient aucune comparabilité spontanée avec un score de 115 obtenu à un sous-test de mémoire de travail. Pour transcender cette limitation intrinsèque, l’application d’une métrique universelle devient impérative.
La transformation d’un score brut psychométrique en un score standardisé Z s’opère au moyen de la formule canonique de normalisation centrée réduite, définie pour une variable aléatoire continue $X$ de moyenne théorique $\mu$ et d’écart-type théorique $\sigma$ (ou de leurs équivalents empiriques $\bar{x}$ et $s$) :
$$Z = \frac{X – \mu}{\sigma}$$
Cette opération mathématique linéaire décompose le traitement du score brut en deux phases successives : un centrage (soustraction de la moyenne), qui translate l’origine du référentiel afin d’attribuer la coordonnée zéro au centre de gravité de la distribution, suivi d’une réduction (division par l’écart-type), qui comprime ou dilate l’échelle de dispersion afin d’instaurer une variance unitaire.
L’élimination définitive des unités physiques ou psychométriques primitives octroie au score Z une propriété remarquable d’invariance d’échelle au sein des distributions gaussiennes. Le score standardisé ne mesure plus une grandeur idiosyncratique, mais exprime avec une rigueur absolue la distance signée séparant une observation donnée du barycentre de son groupe d’appartenance, exprimée en fractions ou en multiples d’écart-type. Ainsi, un sujet affichant un score $Z = +1,5$ se situe formellement à un écart-type et demi au-dessus de la moyenne de sa population de référence, quelle que soit la nature de l’épreuve administrée, garantissant une comparabilité universelle des profils psychologiques tant sur le plan interindividuel qu’intra-individuel.
1.2 Signification statistique et interprétation épistémologique de la valeur p
Si le score Z fournit une métrique spatiale de l’éloignement d’une observation, la valeur p constitue la traduction probabiliste de cette déviation au sein du cadre inférentiel standardisé de la psychologie scientifique. D’un point de vue strictement formel, la valeur p représente la probabilité conditionnelle, calculée sous l’hypothèse théorique que l’hypothèse nulle ($H_0$) est rigoureusement exacte, d’obtenir une statistique de test (ici le score Z) au moins aussi extrême ou divergente que la valeur empiriquement observée dans l’échantillon. Elle se note de façon condensée $P(D mid H_0)$, où $D$ correspond à la configuration des données recueillies.
Une distinction conceptuelle majeure, fréquemment obscurcie dans la formation universitaire introductive, doit être opérée entre le seuil de signification préétabli, désigné par la lettre grecque $\alpha$ (erreur de première espèce), et la valeur p observée a posteriori. Le seuil $\alpha$, conventionnellement fixé à 0,05 ou 0,01 dans les sciences humaines selon les préceptes historiques posés par Ronald Aylmer Fisher, constitue une règle décisionnelle normative fixée avant l’amorce de toute collecte de données. En revanche, la valeur p est une variable aléatoire continue qui découle directement de l’échantillon prélevé. Dans le paradigme d’aide à la décision théorisé par Jerzy Neyman et Egon Pearson, la valeur p sert de critère de tranchage mécanique : si $p le \alpha$, l’hypothèse nulle est rejetée en faveur de l’hypothèse alternative ; si $p > \alpha$, l’hypothèse nulle est maintenue, faute d’éléments probants suffisants.
Sur le plan épistémologique, il est crucial de réaffirmer avec force ce que la valeur p n’est pas : elle n’indique en aucune manière la probabilité que l’hypothèse nulle soit vraie, pas plus qu’elle ne mesure la probabilité que l’hypothèse alternative soit fausse, ce qui constituerait l’erreur logique désignée sous le nom de sophisme de la transposition de la conditionnelle ($P(H_0 mid D) \neq P(D mid H_0)$). La valeur p évalue exclusivement le degré de compatibilité ou de tension entre le modèle théorique sous-jacent (l’absence de tout effet ou différence systématique) et la matérialité des observations psychologiques collectées, fournissant une estimation du poids de l’évidence empirique accumulée contre $H_0$.
1.3 Nécessité de la maîtrise du calcul manuel en recherche et formation clinique
L’hégémonie technologique des suites logicielles a incontestablement démocratisé l’usage des statistiques inférentielles, mais elle a parallèlement induit une forme d’analphabétisme structural chez de nombreux praticiens et étudiants en psychologie. La relégation des opérations analytiques aux processeurs informatiques occulte la dynamique géométrique sous-jacente qui structure la distribution d’échantillonnage. La maîtrise du calcul manuel d’une valeur p à partir d’un score Z restaure chez le clinicien et l’expérimentateur une perception spatiale et tangible de l’inférence statistique. Elle permet de visualiser l’espace sous la courbe, d’appréhender viscéralement le concept de surface critique, et de relier intuitivement l’amplitude d’une déviation standardisée à sa rareté stochastique.
Sur le terrain professionnel, l’autonomie méthodologique conférée par cette compétence manuelle s’avère irremplaçable. Que ce soit lors d’une expertise psychologique en milieu judiciaire, lors de passations cliniques au chevet d’un patient en contexte hospitalier ou lors de missions humanitaires isolées où l’accès à un environnement logiciel dédié est compromis, être capable d’estimer et d’isoler une probabilité d’erreur à l’aide d’une simple table imprimée et d’un calepin garantit la continuité de l’évaluation diagnostique rigoureuse.
En outre, la compétence manuelle agit comme un puissant bouclier critique contre les dysfonctionnements logiciels, les anomalies d’arrondi ou les erreurs d’encodage de variables binaires. L’expérimentateur rompu au calcul manuel détecte immédiatement une incohérence flagrante — par exemple, une valeur p rapportée à 0,02 pour un score Z dérisoire de 0,54 —, là où un utilisateur passif accepterait sans ciller le produit défectueux d’une saisie erronée. Enfin, sur le plan pédagogique, la validation de cette démarche opératoire constitue le rite de passage indispensable certifiant qu’un étudiant en sciences du comportement ne se contente pas d’appliquer des recettes algorithmiques superficielles, mais domine les axiomes fondamentaux de l’induction probabiliste.
2. Propriétés mathématiques de la distribution normale centrée réduite
2.1 Caractéristiques intrinsèques de la courbe en cloche de Gauss
L’édifice du score Z repose entièrement sur le cadre formel fourni par la distribution normale standardisée, également qualifiée de loi normale centrée réduite ou de loi de Gauss-Laplace. Cette fonction mathématique continue, désignée couramment par la notation universelle $\mathcal{N}(0, 1)$, se singularise par deux paramètres déterministes invariables : une espérance mathématique théorique rigoureusement nulle ($\mu = 0$) et une variance strictement unitaire ($\sigma^2 = 1$, induisant par voie de conséquence un écart-type $\sigma = 1$).
La morphologie de cette courbe en cloche présente un ensemble de propriétés géométriques fondamentales qui conditionnent toute la logique du calcul manuel des probabilités. La première d’entre elles réside dans sa symétrie axiale bilatérale parfaite autour de son ordonnée centrale d’abscisse zéro ($Z = 0$). Cette symétrie implique que la médiane, le mode et la moyenne arithmétique de la distribution sont parfaitement superposés en ce point médian central, divisant l’espace probabiliste total en deux moitiés rigoureusement isométriques représentant chacune une probabilité exacte de 0,5 (ou 50 % de la masse de probabilité).
Sur le plan différentiel, la dérivée seconde de la fonction de densité de la loi normale s’annule en deux points singuliers d’abscisses $Z = -1$ et $Z = +1$, marquant les points d’inflexion exacts où la concavité de la courbe passe d’un profil tourné vers le bas à un profil tourné vers le haut. Enfin, la courbe fait preuve d’un comportement strictement asymptotique à mesure que les valeurs de Z croissent vers l’infini positif ($+\infty$) ou décroissent vers l’infini négatif ($-\infty$). En des termes mathématiques formels, la courbe s’approche indéfiniment de l’axe horizontal des abscisses sans jamais entrer en contact physique avec lui :
$$\lim_{z to +\infty} f(z) = 0 \quad \text{et} \quad \lim_{z to -\infty} f(z) = 0$$
Cette propriété asymptotique garantit que, quel que soit l’éloignement d’une déviation observée, la probabilité théorique résiduelle dans les queues de distribution n’est jamais rigoureusement égale à zéro absolu, postulats mathématiques cruciaux pour le traitement ultérieur des scores extrêmes.
2.2 La fonction de répartition cumulative et l’intégrale de probabilité
Pour convertir une abscisse déterminée (le score Z) en une grandeur probabiliste opérationnelle (la valeur p), il est indispensable de manipuler la fonction de densité de probabilité normale standard, conventionnellement dénotée $phi(z)$ (phi minuscule), dont l’expression analytique s’écrit formellement :
$$\phi(z) = \frac{1}{\sqrt{2\pi}} e^{-\frac{z^2}{2}}$$
Dans ce modèle continu, la probabilité ponctuelle d’observer une valeur unique isolée est rigoureusement nulle ($P(Z = z) = 0$), car un point géométrique ne possède aucune largeur sous une courbe continue. Par conséquent, les probabilités ne peuvent s’exprimer que sous la forme d’intervalles délimités, matérialisés graphiquement par l’aire sous la courbe délimitée par la fonction de densité.
La probabilité cumulée depuis l’extrémité négative infinie jusqu’à une valeur seuil spécifique $z$ est définie par la fonction de répartition cumulative, universellement désignée par la lettre grecque majuscule $Phi(z)$ (Phi majuscule) :
$$\Phi(z) = P(Z le z) = \int_{-\infty}^{z} \phi(t) , dt = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-\frac{t^2}{2}} , dt$$
C’est précisément ici que surgit l’obstacle mathématique historique qui justifie l’existence des tables statistiques : l’intégrande $e^{-t^2/2}$ ne possède aucune primitive analytique susceptible de s’exprimer sous la forme d’une combinaison finie de fonctions élémentaires standard (algébriques, trigonométriques ou exponentielles). Pour résoudre cette intégrale définie et évaluer l’aire sous la courbe, les mathématiciens ont dû recourir à des méthodes d’intégration numérique par développements en séries de Taylor-Maclaurin, intégrales de quadrature gaussienne ou fractions continues de Laplace. Ces résolutions algorithmiques hautement fastidieuses ont été condensées et immortalisées au sein des fameuses tables de probabilité normale, permettant aux chercheurs d’accéder instantanément, par simple consultation manuelle, au résultat précalculé d’une intégrale hautement sophistiquée.
2.3 La règle empirique 68-95-99.7 appliquée aux scores Z
Avant même de plonger dans l’examen minutieux d’une table statistique imprimée, tout chercheur en psychologie se doit d’avoir intégré mentalement les proportions fondamentales régissant la dispersion de la loi normale, formalisées au travers du théorème de Bienaymé-Tchebychev restreint ou, plus couramment, de la règle empirique 68-95-99.7. Cette règle mnémotechnique découle directement des intégrales calculées pour les intervalles symétriques centrés sur l’origine.
Pour un score Z compris dans l’intervalle strict $[-1; +1]$, c’est-à-dire une dispersion n’excédant pas un écart-type de part et d’autre de la moyenne arithmétique, l’aire cumulée sous la courbe équivaut approximativement à 68,27 % de la surface totale :
$$P(-1 le Z le +1) = \Phi(1) – \Phi(-1) \approx 0,6827$$
Lorsque l’on étend l’intervalle à deux écarts-types, soit pour $Z in [-2; +2]$, l’aire circonscrite englobe 95,45 % de la masse de probabilité totale de la population :
$$P(-2 le Z le +2) = \Phi(2) – \Phi(-2) \approx 0,9545$$
Enfin, l’élargissement à trois écarts-types, matérialisé par l’intervalle $[-3; +3]$, emprisonne la quasi-totalité des observations empiriques, avec un confinement atteignant 99,73 % de la distribution :
$$P(-3 le Z le +3) = \Phi(3) – \Phi(-3) \approx 0,9973$$
En pratique clinique et expérimentale, ces seuils empiriques constituent d’irremplaçables points de repère heuristiques. Si un calcul manuel préliminaire aboutit à un score $Z = +1,98$ et que l’analyste déduit intuitivement une valeur p bilatérale supérieure à 10 %, la discordance manifeste avec la règle empirique — qui stipule que moins de 5 % des observations dépassent deux écarts-types en valeur absolue — signalera immédiatement l’existence d’une bévue arithmétique. Cette cartographie mentale élémentaire constitue le premier garde-fou contre les erreurs de manipulation tabulaire.
3. Anatomie et lecture méthodique de la table de distribution Z
3.1 Typologie des tables statistiques de probabilité normale
L’une des sources majeures de confusion chez les néophytes réside dans l’hétérogénéité structurelle des tables de la loi normale publiées dans les manuels universitaires et les annexes d’ouvrages statistiques de référence. Il n’existe pas une présentation unique et universellement adoptée, mais trois grandes familles de tables statistiques dont le maniement requiert des opérations arithmétiques préalables distinctes.
La première famille, incontestablement la plus répandue dans la littérature internationale contemporaine, est la table cumulative intégrale (souvent désignée sous le terme de cumulative from $-\infty$). Cette table fournit directement la valeur de la fonction de répartition $Phi(z)$, c’est-à-dire l’aire totale balayée depuis la queue infinie gauche jusqu’à l’abscisse Z ciblée. Elle se reconnaît infailliblement à sa valeur d’ordonnée médiane : pour un score $Z = 0,00$, la table affiche exactement $0,5000$.
La deuxième famille correspond aux tables demi-courbe (ou tables centristes $0 to Z$). Ces documents, fréquemment rencontrés dans les manuels francophones traditionnels, ne cartographient que la surface comprise strictement entre le centre de gravité de la distribution ($Z = 0$) et le score Z positif étudié. Dans une telle table, pour $Z = 0,00$, la probabilité inscrite est de $0,0000$, et pour $Z = 1,96$, la valeur affichée est d’environ $0,4750$. Son utilisation requiert l’addition ou la soustraction d’une constante de 0,5 selon la nature de la queue étudiée.
La troisième famille regroupe les tables des queues supérieures (ou right-tail tables), qui fournissent directement la surface résiduelle située à droite du score Z, c’est-à-dire $P(Z > z) = 1 – Phi(z)$. Elles se caractérisent par des probabilités décroissantes à mesure que Z augmente, débutant à $0,5000$ pour $Z = 0$ et tendant rapidement vers zéro. Pour identifier immédiatement et sans équivoque la typologie de la table mise à votre disposition, le réflexe méthodologique fondamental consiste à consulter le schéma graphique surmontant généralement la matrice ou à vérifier l’entrée correspondant à $Z = 0,00$.
3.2 Structure matricielle de repérage des décimales
L’architecture d’une table Z standard adopte une structure matricielle bidimensionnelle particulièrement ingénieuse, permettant de consigner une résolution numérique à deux décimales au sein d’un espace typographique restreint. Pour extraire avec précision l’aire sous la courbe associée à un score standardisé, l’opérateur doit décomposer mentalement le score Z en deux composantes scalaires disjointes : le préfixe décimal et le suffixe centésimal.
L’axe vertical des ordonnées, situé sur la bordure gauche de la table sous l’intitulé générique Z, indexe les valeurs entières accompagnées de leur première décimale (le chiffre des dixièmes). Les rangées s’échelonnent généralement de manière incrémentielle de dixième en dixième, par exemple de $0,0$ jusqu’à $3,4$ ou $4,0$. C’est le long de cette colonne directrice que l’on isole la première partie de la coordonnée.
L’axe horizontal supérieur des abscisses, matérialisé par la rangée de tête de la matrice, indexe la seconde décimale du score (le chiffre des centièmes), distribuée sur dix colonnes normées : $0,00$, $0,01$, $0,02$, $0,03$, $0,04$, $0,05$, $0,06$, $0,07$, $0,08$ et $0,09$. L’intersection exacte entre la rangée horizontale sélectionnée et la colonne verticale visée révèle la valeur de probabilité recherchée. Une vigilance rigoureuse est requise dans la manipulation des zéros non significatifs : une confusion courante consiste à repérer la rangée $1,4$ et à consulter distraitement la colonne $0,05$ pour un score de $1,405$ au lieu d’une valeur rigoureusement arrondie à deux décimales ($1,41$ ou $1,45$).
3.3 Tables des scores positifs versus tables des scores négatifs
Dans les manuels de référence édités sous l’égide de l’American Psychological Association ou au sein des traités classiques d’économétrie, les tables de la loi normale cumulative se présentent idéalement sous la forme d’un diptyque exhaustif à deux volets : une première page dévolue aux scores Z strictement négatifs (affichant des probabilités comprises entre $0,0001$ et $0,5000$) et une seconde page dédiée aux scores Z positifs (présentant des probabilités réparties entre $0,5000$ et $0,9999$).
Toutefois, par souci d’économie d’impression ou de concision éditoriale, de nombreux formulaires d’examens et manuels appliqués ne fournissent qu’une table unilatérale restreinte aux seules valeurs positives de Z ($Z ge 0$). Face à cette restriction matérielle, l’opérateur est tenu d’exploiter la règle fondamentale de symétrie axiale de la loi gaussienne pour déterminer les probabilités associées aux scores négatifs. Cette propriété s’énonce mathématiquement sous la forme de l’identité du complément symétrique :
$$\Phi(-z) = 1 – \Phi(z)$$
Ainsi, si vous devez évaluer la probabilité cumulée associée à un score négatif $Z = -1,64$ à l’aide d’une table exclusivement positive, la procédure consiste à indexer la valeur positive équivalente $|Z| = +1,64$, à extraire sa probabilité cumulative gauche (soit $Phi(1,64) = 0,9495$), puis à retrancher manuellement ce résultat de l’unité fondamentale :
$$\Phi(-1,64) = 1 – 0,9495 = 0,0505$$
Cette maîtrise de la permutation des signes et de la soustraction unitaire prévient toute paralysie technique face à des supports de consultation tronqués.
4. Formulation des hypothèses et sélection de l’orientation du test
4.1 Formulation formelle de l’hypothèse nulle et de l’hypothèse alternative
Le calcul d’une valeur p ne saurait être réduit à une simple manipulation arithmétique décontextualisée ; il tire toute sa validité scientifique de son articulation logique avec le système d’hypothèses statistiques préalablement énoncé. Avant d’approcher la moindre table numérique, le chercheur doit obligatoirement avoir formalisé deux propositions mutuellement exclusives et collectivement exhaustives : l’hypothèse nulle ($H_0$) et l’hypothèse alternative ($H_1$).
L’hypothèse nulle ($H_0$) postule de manière invariable l’absence de divergence systématique, l’inexistence d’un traitement thérapeutique, ou la conformité absolue de l’échantillon empirique avec une population de référence prédéterminée de paramètre moyen $\mu_0$. Elle s’exprime conventionnellement sous la forme d’une stricte égalité mathématique :
$$H_0 : \mu = \mu_0$$
L’hypothèse alternative ($H_1$), quant à elle, traduit la conjecture théorique substantive que l’expérimentateur cherche à étayer au moyen de l’évidence empirique. C’est la formulation de $H_1$ qui détermine l’emplacement de la zone critique de rejet de $H_0$ et qui dicte de façon univoque l’algorithme arithmétique qu’il conviendra d’appliquer à l’aire extraite de la table statistique. Selon les exigences éthiques et déontologiques de la recherche en psychologie, le choix de $H_1$ doit être scellé de manière inaltérable avant le recueil des données (idéalement via un protocole de pré-enregistrement, ou preregistration), afin d’éradiquer toute tentation de remaniement opportuniste post-hoc (souvent désigné sous l’étiquette de HARKing : Hypothesizing After the Results are Known).
4.2 Justification méthodologique des tests unilatéraux en psychologie
Un test statistique est formellement qualifié d’unilatéral (ou one-tailed test) lorsque l’hypothèse alternative $H_1$ postule une direction a priori exclusive et non équivoque quant à l’effet recherché. Cette orientation directionnelle peut prendre la forme d’une détérioration ou réduction symptomatique :
$$H_1 : \mu < \mu_0 \quad (\text{test unilatéral à gauche})$$
ou inversement, celle d’une supériorité, d’un gain mnésique ou d’une augmentation de score :
$$H_1 : \mu > \mu_0 \quad (\text{test unilatéral à droite})$$
L’intérêt méthodologique majeur du design unilatéral réside dans son gain immédiat de puissance statistique ($1 – \beta$). En massant l’intégralité du risque d’erreur de première espèce $\alpha$ (par exemple 0,05) sur une seule et unique queue de la distribution plutôt qu’en le fractionnant en deux parts égales, le seuil critique d’admission du score Z s’abaisse en valeur absolue. Pour un seuil $\alpha = 0,05$, le seuil critique passe de $|Z| ge 1,96$ (en bilatéral) à $Z ge +1,645$ ou $Z le -1,645$ (en unilatéral), facilitant le rejet de l’hypothèse nulle.
Néanmoins, la contrepartie épistémologique de ce choix est d’une sévérité implacable. En optant pour un test unilatéral, l’expérimentateur s’interdit formellement de détecter ou de considérer comme statistiquement significatif un effet qui surviendrait dans la direction diamétralement opposée à son intuition théorique, quelle que soit son amplitude phénoménale. Si une nouvelle psychothérapie expérimentale conçue pour réduire l’anxiété venait en réalité à aggraver dramatiquement la souffrance des patients avec un score $Z = +4,50$, un cadre unilatéral gauche formel conclurait simplement à un « non-rejet de l’hypothèse nulle », occultant une découverte clinique fondamentale. C’est pourquoi la communauté méthodologique enjoint à une prudence draconienne quant à l’usage des tests unilatéraux, les réservant aux contextes où un effet en sens inverse est théoriquement absurde ou biologiquement impossible.
4.3 Légitimité et prédominance des tests bilatéraux dans l’expérimentation
Face aux risques de biais inhérents à la focalisation unilatérale, le test bilatéral (ou two-tailed test) s’impose comme le standard méthodologique dominant au sein des revues savantes à comité de lecture en psychologie, psychiatrie et neurosciences. Dans ce schéma, l’hypothèse alternative $H_1$ adopte une posture non directionnelle, se bornant à affirmer l’existence d’une différence quantitative entre la moyenne observée et la moyenne théorique sans préjuger de son signe :
$$H_1 : \mu \neq \mu_0$$
Ce protocole garantit une impartialité totale du dispositif d’évaluation : toute déviation substantielle de la variable aléatoire, qu’elle traduise une facilitation ou une inhibition, une progression ou une régression, sera identifiée et soumise au verdict inférentiel. La zone de rejet critique de $H_0$ se trouve par conséquent scindée de façon rigoureusement équitable entre les deux extrémités extrêmes de la courbe de Gauss.
Pour un seuil nominal d’erreur $\alpha = 0,05$, une surface de probabilité égale à $\alpha / 2 = 0,025$ est allouée à la queue inférieure gauche, tandis qu’une portion symétrique de $\alpha / 2 = 0,025$ est attribuée à la queue supérieure droite. Cette partition impose une sévérité accrue au dispositif de preuve empirique : pour atteindre le statut de significativité statistique, le score Z empirique devra franchir des seuils plus exigeants ($Z le -1,96$ ou $Z ge +1,96$). En psychologie clinique, où les effets secondaires paradoxaux des interventions sont monnaie courante, le recours au test bilatéral constitue une norme déontologique élémentaire protégeant la recherche contre les conclusions téméraires.
5. Calcul pas à pas pour un test unilatéral à gauche (Left-Tailed Test)
5.1 Identification de la zone de rejet inférieure
Le test unilatéral à gauche s’applique aux contextes de recherche où la déviation empirique d’intérêt réside exclusivement dans les valeurs inférieures au centre de référence de la distribution. En psychopathologie expérimentale, cette configuration est ubiquitaire lors des essais cliniques randomisés consacrés à la réduction de symptômes morbides : évaluation de la diminution de l’échelle de dépression de Beck (BDI-II), chute des scores de réactivité traumatique sur le PCL-5, ou réduction du nombre d’erreurs commises lors d’une tâche de mémoire épisodique.
Sur le plan géométrique, l’aire critique de probabilité se situe intégralement concentrée à l’extrême gauche de la courbe normale centrée réduite, dans la zone d’asymptote négative. Le chercheur s’intéresse exclusivement à la probabilité d’observer un score inférieur ou égal au score empirique recueilli. Par définition, un score Z congruent avec cette hypothèse directionnelle affichera un signe négatif ($Z < 0$). La valeur p unilatérale gauche correspond très précisément à l’expression de la fonction de répartition cumulative :
$$p = P(Z le z) = \Phi(z)$$
Aucune manipulation soustractive n’est requise lorsque l’on manipule une table cumulative standard à partir de $-\infty$ : la valeur extraite correspond directement et sans altération à la valeur p du test unilatéral.
5.2 Procédure d’extraction manuelle sur la table cumulative
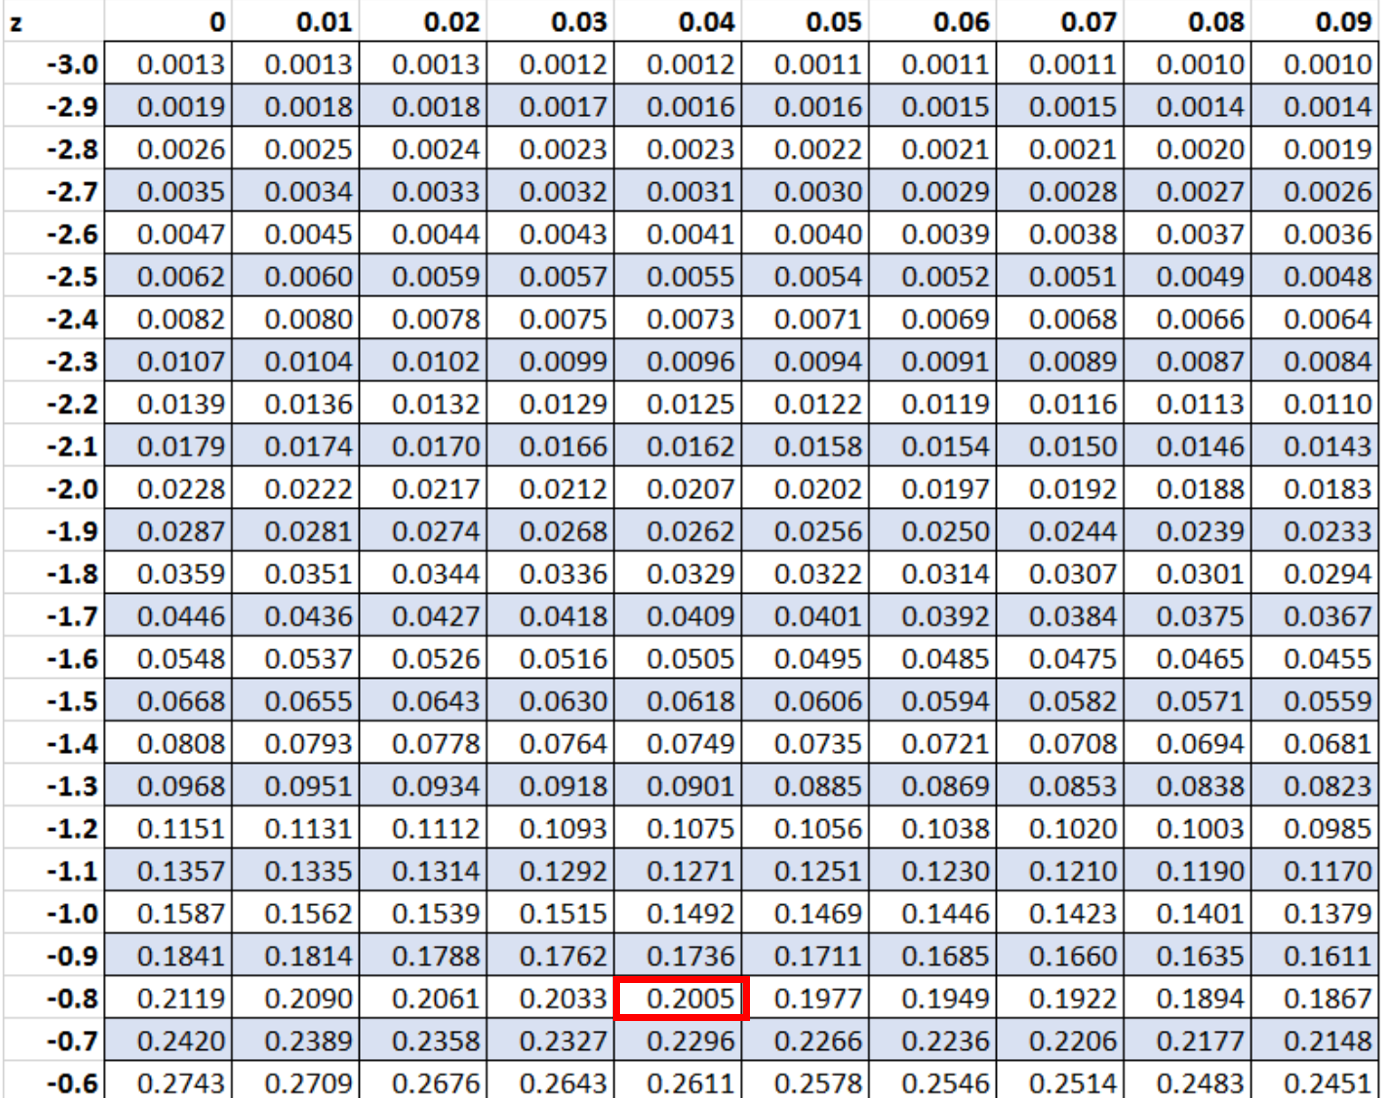
Pour extraire manuellement la valeur p associée à un score Z négatif dans le cadre d’un test unilatéral à gauche, la démarche opératoire suit une chronologie rigoureuse en quatre temps sur une table cumulative :
- Étape 1 : Identifiez le score standardisé empirique obtenu, par exemple $Z_{\text{obs}}$, et arrondissez-le avec rigueur à deux décimales selon les conventions mathématiques en vigueur (la troisième décimale supérieure ou égale à 5 provoquant l’incrémentation de la seconde).
- Étape 2 : Rendez-vous sur la section de la table normale dédiée aux valeurs négatives. Scannez la première colonne d’ordonnée descendante (colonne de gauche) pour repérer la ligne qui affiche le préfixe du score (entier négatif et premier chiffre décimal).
- Étape 3 : Projetez votre regard horizontalement le long de cette ligne jusqu’à la colonne verticale d’abscisse qui coïncide exactement avec la deuxième décimale (chiffre des centièmes) de votre score standardisé.
- Étape 4 : Relevez la valeur numérique décimale située à l’intersection matricielle. Dans une table cumulative standard allant de $-\infty$ à $Z$, ce nombre décimal représente immédiatement la probabilité cumulée recherchée, sans qu’aucun calcul additionnel ne soit exigé.
Dans l’éventualité où vous ne disposeriez que d’une table restreinte aux valeurs positives, vous prendrez la valeur absolue de votre score $|Z|$, vous chercherez sa probabilité cumulée $Phi(|Z|)$, puis vous effectuerez la soustraction manuelle $p = 1 – Phi(|Z|)$, en vertu du principe de symétrie gaussienne explicité précédemment.
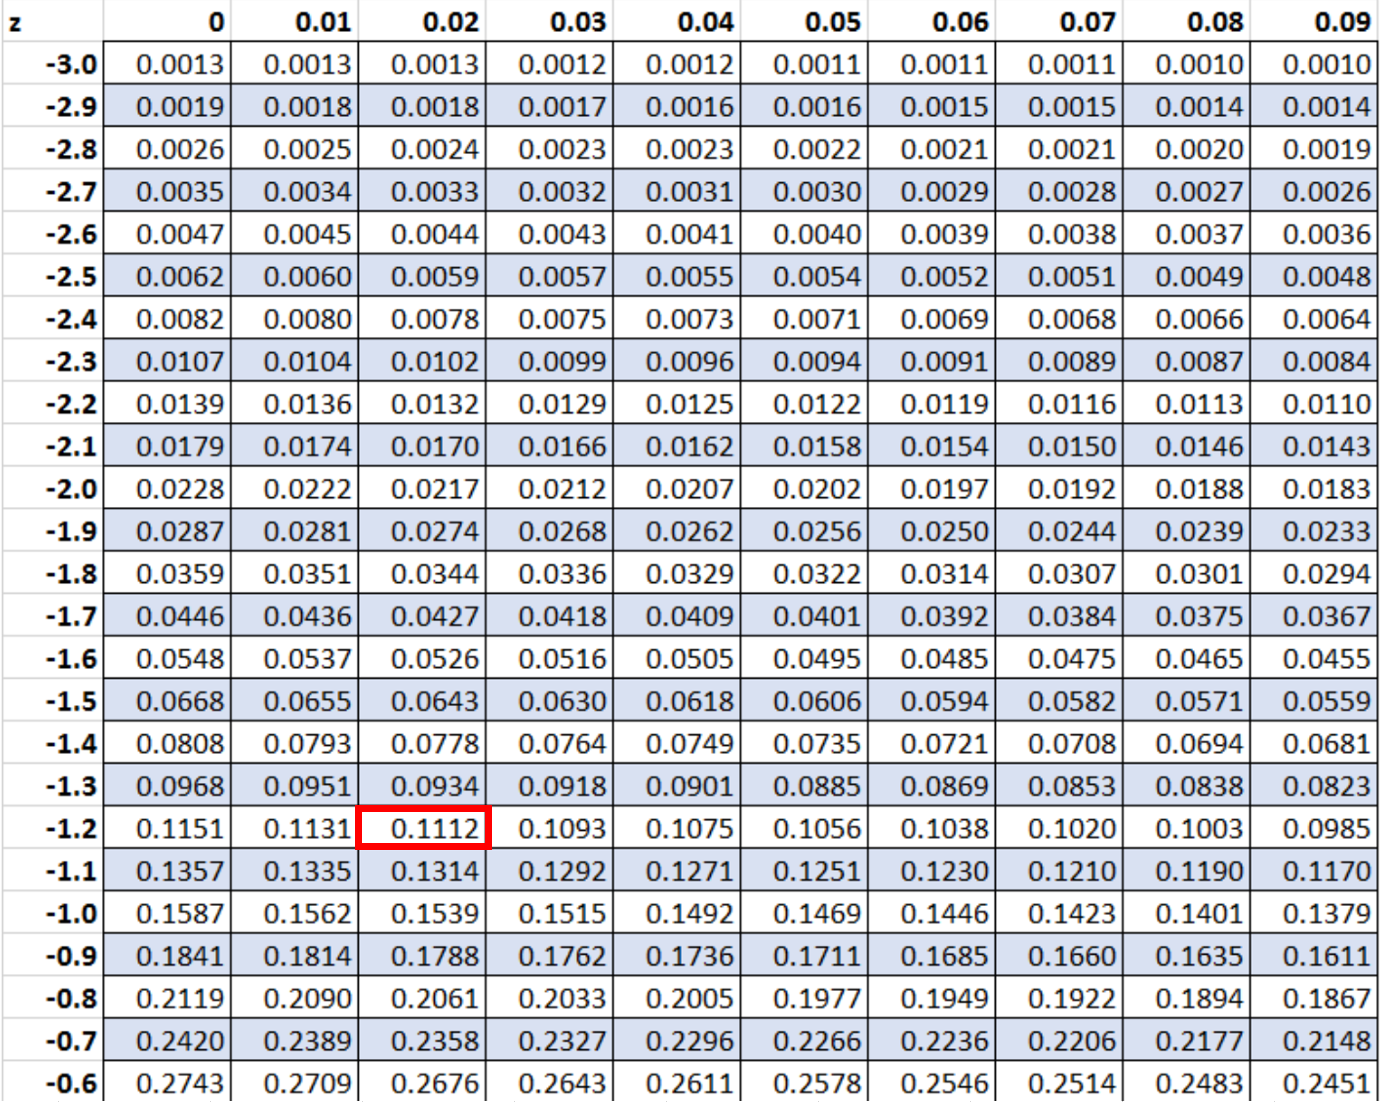
5.3 Exemple numérique contextualisé : Score Z = -1,22
Considérons une étude clinique menée auprès d’une cohorte d’adolescents présentant un trouble oppositionnel avec provocation, au sein de laquelle on évalue l’impact d’un entraînement cognitif à la régulation de la colère. L’hypothèse de recherche stipule de manière unilatérale que les participants manifesteront une réduction significative de leurs passages à l’acte impulsifs après intervention. À l’issue du protocole expérimental, le traitement statistique des données débouche sur une statistique de test standardisée de $Z = -1,22$.
L’orientation de l’hypothèse étant strictement dirigée vers une baisse des occurrences morbides, nous exécutons un test unilatéral à gauche. Le calcul de la valeur p s’établit comme suit :
- Nous isolons le composant structural du score : le préfixe $-1,2$ et le centième $0,02$.
- Sur le volet des valeurs négatives de notre table cumulative, nous parcourons la colonne d’indexation verticale jusqu’à localiser précisément la rangée étiquetée -1,2.
- Nous nous déplaçons horizontalement le long de cette rangée vers la droite jusqu’à croiser la colonne étiquetée 0,02.
- À la cellule d’intersection des coordonnées $(-1,2 ,;, 0,02)$, la table affiche le nombre décimal 0,1112.
L’aire cumulée sous la courbe normale à gauche de $-1,22$ est donc rigoureusement égale à 0,1112. Puisqu’il s’agit d’un test unilatéral à gauche, la valeur p équivaut sans réserve à cette probabilité :
$$p = P(Z le -1,22) = 0,1112$$
En confrontant ce résultat au seuil alpha conventionnel de 0,05, nous constatons que $p = 0,1112 > 0,05$. En application stricte de la règle de décision inférentielle, l’analyste se trouve dans l’incapacité de rejeter l’hypothèse nulle : l’évidence empirique accumulée est insuffisante pour affirmer que la thérapie cognitive a produit une diminution statistiquement significative des conduites agressives au sein de cet échantillon.
6. Calcul pas à pas pour un test unilatéral à droite (Right-Tailed Test)
6.1 Compréhension de la queue supérieure de la distribution
À l’inverse symétrique du cas précédent, le test unilatéral à droite intervient lorsque le cadre conceptuel postule formellement que l’effet expérimental doit se traduire par une augmentation ou une supériorité quantitative de la variable mesurée par rapport au point d’ancrage historique ou théorique. Dans les sciences psychologiques, cette approche trouve son application naturelle dans les études d’optimisation neuropsychologique, les entraînements à l’empan mnésique, ou les programmes éducatifs axés sur le développement de la résilience émotionnelle, où toute modification favorable induit des scores plus élevés.
Sous cette configuration directionnelle ($H_1 : \mu > \mu_0$), la région critique de rejet de $H_0$ est déportée à l’extrémité droite de la distribution normale standardisée, sous l’asymptote positive supérieure. Dès lors, le chercheur n’est plus intéressé par la masse des observations antérieures au score Z, mais cherche au contraire à quantifier la probabilité stochastique résiduelle d’observer une valeur supérieure ou égale à son observation empirique, soit l’événement probabiliste :
$$P(Z ge z)$$
Une erreur méthodologique dévastatrice consiste à lire directement la table cumulative standard et à considérer la valeur extraite comme la valeur p finale. Dans une table cumulative standard à partir de $-\infty$, la valeur extraite correspond à $Phi(z)$, soit la probabilité que Z soit inférieur au score. Puisque pour tout score Z positif substantiel, cette probabilité cumulative dépasse largement 0,5 (atteignant souvent des grandeurs comme 0,90 ou 0,98), assimiler naïvement cette surface à la valeur p conduirait à l’absurdité scientifique de conclure qu’un résultat situé à trois écarts-types de la moyenne génère une probabilité d’erreur de 99 % !
6.2 La règle du complément mathématique
Pour contourner l’orientation univoque des tables cumulatives de gauche et isoler avec une justesse irréprochable l’aire de la queue supérieure droite, le statisticien fait appel à l’un des théorèmes cardinaux de la théorie des probabilités de Kolmogorov : le théorème de la probabilité totale appliqué à un événement complémentaire.
L’espace d’échantillonnage total de la loi normale centrée réduite étant continûment défini sur $\mathbb{R}$ de $-\infty$ à $+\infty$, l’intégrale complète de sa fonction de densité est rigoureusement égale à la certitude absolue, soit 1 :
$$\int_{-\infty}^{+\infty} \phi(t) , dt = 1$$
En vertu de ce postulat fondamental, la probabilité d’observer un score strictement supérieur à $z$ et la probabilité d’observer un score inférieur ou égal à $z$ constituent deux événements parfaitement complémentaires dont la somme algébrique vaut exactement 1 :
$$P(Z le z) + P(Z > z) = 1$$
En réarrangeant cette équation élémentaire pour isoler l’inconnue recherchée, nous obtenons l’équation universelle du complément de queue supérieure :
$$p = P(Z > z) = 1 – P(Z le z) = 1 – \Phi(z)$$
Le calcul manuel d’une valeur p unilatérale droite exige donc indéfectiblement l’exécution d’une soustraction arithmétique : extraire la valeur cumulative de la table, puis retrancher cette grandeur décimale du chiffre unitaire 1,0000.
6.3 Exemple numérique contextualisé : Score Z = 1,43
Illustrons cette procédure à travers un protocole de recherche en psychologie ergonomique. Une équipe de chercheurs évalue l’impact d’une nouvelle interface visuelle épurée sur la vitesse de traitement de l’information chez des contrôleurs aériens. La conjecture théorique stipule explicitement que l’interface allégée doit accroître le nombre de cibles discriminées par minute. L’analyse des données recueillies sur un échantillon standardisé génère une statistique de test de $Z = +1,43$.
L’hypothèse alternative étant orientée unilatéralement vers une amélioration ($H_1 : \mu > \mu_0$), nous devons déterminer manuellement l’aire résiduelle droite associée à ce score Z positif. Voici le déroulement de la séquence de calcul :
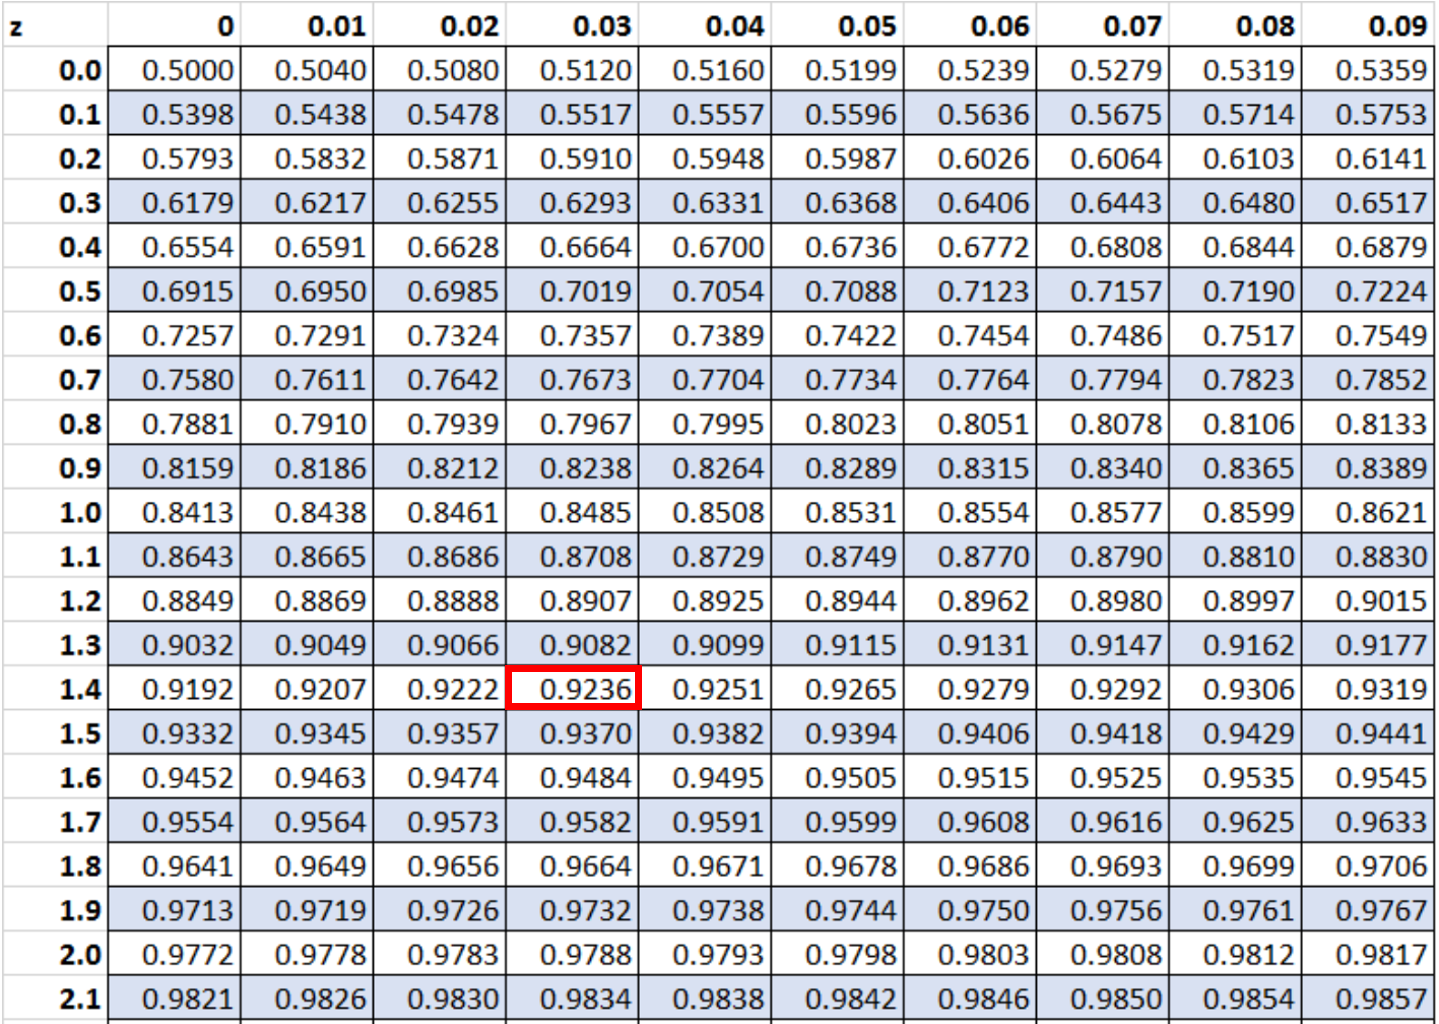
- Décomposition du score standardisé : partie entière et dixième = $1,4$ ; centième = $0,03$.
- Consultation de la table de probabilité cumulative : repérage de la ligne $1,4$ sur l’axe vertical gauche, puis progression horizontale jusqu’à la colonne $0,03$.
- Lecture de la probabilité cumulée : à l’intersection exacte de la rangée $1,4$ et de la colonne $0,03$, nous identifions la valeur $Phi(1,43) = 0,9236$.
- Cette valeur indique que 92,36 % de la distribution théorique se situe en dessous du score observé. Or, nous cherchons la masse de probabilité située au-dessus.
- Application de la règle du complément unitaire :
$$p = 1 – \Phi(1,43) = 1,0000 – 0,9236 = 0,0764$$
La valeur p unilatérale droite obtenue à la main s’élève donc très précisément à 0,0764 (ou 7,64 %). En confrontant ce chiffre au seuil conventionnel $\alpha = 0,05$, nous constatons que $p = 0,0764 > 0,05$. Bien que la tendance empirique s’exprime dans la direction théoriquement postulée, l’écart ne satisfait pas aux critères de significativité statistique requis pour rejeter l’hypothèse nulle au seuil de confiance de 95 %.
7. Calcul pas à pas pour un test bilatéral (Two-Tailed Test)
7.1 Fondement théorique du doublement de l’aire de queue
Le test bilatéral constitue le dispositif inférentiel le plus impartial et le plus exigeant de la statistique expérimentale. Dans cette configuration, l’hypothèse de recherche ne préjuge pas de la polarité de la déviation : elle postule que la manipulation expérimentale induira un changement notable, mais demeure neutre quant à savoir si ce changement prendra la forme d’une augmentation ou d’une diminution ($H_1 : \mu \neq \mu_0$).
Sous cette perspective non directionnelle, un résultat empirique s’écartant du centre de référence présente un caractère « extrême » en fonction de son éloignement absolu par rapport à zéro, et non de son signe algébrique. Une déviation standardisée de $+2$ écarts-types est conceptuellement tout aussi déstabilisante pour l’hypothèse nulle qu’une déviation de $-2$ écarts-types. Pour refléter fidèlement cette équivalence probabiliste, la valeur p bilatérale doit quantifier la probabilité cumulative globale d’obtenir un score dont la valeur absolue est au moins aussi élevée que la valeur absolue du score effectivement observé :
$$p = P(|Z| ge |z_{\text{obs}}|)$$
Sur le plan topologique sous la courbe de Gauss, cette région ne correspond plus à un intervalle continu unique, mais à la disjonction de deux aires géométriques disjointes situées aux antipodes de la distribution : la surface située sous la queue extrême gauche au-delà de $-|z_{\text{obs}}|$ et la surface située sous la queue extrême droite au-delà de $+|z_{\text{obs}}|$ :
$$p = P(Z le -|z_{\text{obs}}|) + P(Z ge +|z_{\text{obs}}|)$$
Puisque la courbe normale présente une symétrie axiale bilatérale parfaite, ces deux aires de queues polaires sont rigoureusement identiques en termes de volume de probabilité. Il en découle la règle fondamentale du calcul bilatéral : la valeur p s’obtient en isolant la probabilité de la queue unilatérale extrême associée au score, puis en multipliant systématiquement cette surface résiduelle par un facteur scalaire de deux :
$$p = 2 \times P(Z ge |z_{\text{obs}}|) = 2 \times [1 – \Phi(|z_{\text{obs}}|)]$$
7.2 Algorithme de calcul pour un score Z positif bilatéral
Lorsqu’une recherche clinique fait appel à un cadre bilatéral et que le score Z standardisé calculé sur l’échantillon s’avère positif ($Z > 0$), la procédure séquentielle manuelle se structure selon les étapes arithmétiques suivantes :
- Étape 1 : Extraction de la probabilité cumulée gauche. Consultez la table cumulative pour repérer la cellule correspondant au score $Z$. Vous obtenez la valeur $Phi(Z)$, qui est systématiquement supérieure à 0,5000.
- Étape 2 : Isolement de la queue supérieure unilatérale droite. Appliquez la soustraction unitaire pour extraire la surface résiduelle de la queue droite :
$$p_{\text{unilatérale}} = 1 – \Phi(Z)$$ - Étape 3 : Duplication bilatérale symétrique. Multipliez la probabilité unilatérale résiduelle ainsi obtenue par deux afin d’intégrer son alter ego symétrique virtuel situé dans la queue inférieure opposée :
$$p_{\text{bilatérale}} = 2 \times [1 – \Phi(Z)]$$ - Étape 4 : Contrôle de cohérence statistique. Assurez-vous impérativement que la probabilité bilatérale finale obtenue demeure strictement comprise entre 0 et 1. Si le score Z initial était nul ($Z = 0$), $p = 2 \times (1 – 0,5) = 1,0000$.
7.3 Algorithme de calcul pour un score Z négatif bilatéral
À l’inverse, si l’expérimentation produit une statistique de test standardisée présentant une coordonnée négative ($Z < 0$) au sein d'un protocole bilatéral, le recours à la soustraction unitaire devient superflu si l'on dispose d'une table cumulative intégrale incluant les valeurs négatives :
- Étape 1 : Lecture directe de l’aire de queue inférieure. Localisez directement les coordonnées du score négatif $Z$ dans la section négative de la table cumulative. La valeur extraite représente directement l’aire résiduelle de la queue gauche :
$$p_{\text{unilatérale}} = \Phi(Z)$$
(cette valeur est structurellement inférieure à 0,5000). - Étape 2 : Doublement direct de la surface. Multipliez immédiatement cette probabilité par deux pour tenir compte de la déviation symétrique virtuelle correspondante dans la queue supérieure droite :
$$p_{\text{bilatérale}} = 2 \times \Phi(Z)$$ - Étape 3 : Variante pour table unilatérale positive. Si votre table ne possède que des valeurs positives, convertissez le score en valeur absolue $|Z|$, extrayez $Phi(|Z|)$, soustrayez-la de 1 pour trouver l’aire unilatérale résiduelle, puis multipliez par deux :
$$p_{\text{bilatérale}} = 2 \times [1 – \Phi(|Z|)]$$
Cette symétrie opératoire confirme que, dans un test bilatéral, un score négatif et son équivalent positif exact produisent rigoureusement la même valeur p finale.
7.4 Démonstration appliquée : Comparaison de Z = -1,75 et Z = +1,75
Pour ancrer définitivement cette mécanique algorithmique, réalisons une démonstration mathématique croisée en comparant deux scores Z jumeaux opposés, $-1,75$ et $+1,75$, dans le cadre d’un test bilatéral non directionnel ($H_1 : \mu \neq \mu_0$).
Cas A : Score négatif $Z = -1,75$
- Dans la table normale cumulative (section des valeurs négatives), nous ciblons la rangée -1,7 et nous intersectons avec la colonne 0,05.
- La cellule d’intersection nous fournit l’aire sous la courbe située à gauche de $-1,75$ :
$$\Phi(-1,75) = 0,0401$$ - Puisque le test est bilatéral, nous appliquons le facteur multiplicatif deux :
$$p = 2 \times 0,0401 = 0,0802$$
Cas B : Score positif $Z = +1,75$
- Dans la table normale cumulative (section des valeurs positives), nous ciblons la rangée 1,7 et nous intersectons avec la colonne 0,05.
- La cellule d’intersection nous fournit l’aire cumulative située sous la courbe à gauche de $+1,75$ :
$$\Phi(+1,75) = 0,9599$$ - Nous isolons la surface de la queue supérieure droite par le complément unitaire :
$$p_{\text{queue droite}} = 1 – 0,9599 = 0,0401$$ - Nous multiplions cette aire unilatérale par deux pour intégrer la queue opposée :
$$p = 2 \times 0,0401 = 0,0802$$
La congruence est absolue : les deux voies opératoires convergent vers une valeur p bilatérale rigoureusement identique de 0,0802 (ou 8,02 %). Si nous confrontons ce résultat au seuil alpha canonique $\alpha = 0,05$, nous observons que $p = 0,0802 > 0,05$. En conséquence, bien que la probabilité unilatérale isolée ($0,0401$) semblait franchir le cap des 5 %, la rigueur du cadrage bilatéral rétablit la réalité probabiliste globale : l’effet n’est pas statistiquement significatif au seuil de 5 %, et l’hypothèse nulle doit être conservée.
8. Techniques d’interpolation linéaire pour les scores Z non tabulés
8.1 Gestion des valeurs à trois décimales ou plus
Dans la pratique courante de l’analyse psychométrique et expérimentale, les scores Z bruts issus des équations de standardisation ne tombent que très rarement sur des valeurs décimales rondes à deux chiffres après la virgule. Une standardisation d’échantillon impliquant des moyennes et des écarts-types réels débouche quasi systématiquement sur des nombres réels continus dotés d’une infinité de décimales (par exemple $Z = 1,645$, $Z = 1,95996$ ou $Z = 2,326$).
Or, la granularité typographique des tables de probabilités imprimées standard s’arrête strictement à la deuxième décimale (le centième). Face à cette contrainte matérielle, de nombreux praticiens commettent l’erreur d’arrondir sommairement leur score à la décimale la plus proche. Si cette approximation est sans conséquence au cœur du ventre de la distribution, elle devient périlleuse aux frontières critiques de significativité statistique ($p \approx 0,05$ ou $p \approx 0,01$). Un arrondi opportuniste peut faire basculer artificiellement un résultat du statut de non-significatif à significatif, compromettant l’intégrité de la recherche.
Pour résoudre cette imprécision sans recourir à un ordinateur, le chercheur fait appel à l’interpolation linéaire locale. Cette méthode mathématique repose sur l’hypothèse d’approximation selon laquelle, sur un micro-segment d’abscisse extrêmement resserré (une amplitude d’exactement $0,01$ écart-type entre deux entrées consécutives de la table), la fonction de répartition gaussienne se comporte de manière quasi-rectiligne. La courbure infinitésimale de la courbe en cloche peut ainsi être assimilée localement à une droite affine sans distorsion probabiliste dommageable.
8.2 Formule mathématique de l’interpolation linéaire
Soit un score Z empirique non tabulé, noté $x$, positionné de façon intermédiaire entre deux bornes d’abscisses consécutives tabulées $x_1$ et $x_2$ (avec $x_1 < x < x_2$ et $x_2 – x_1 = 0,01$). Soient $y_1 = \Phi(x_1)$ et $y_2 = \Phi(x_2)$ les probabilités cumulées respectives extraites directement de la matrice statistique.
L’équation d’interpolation linéaire, dérivée du théorème de proportionnalité des accroissements finis (ou théorème de Thalès appliqué aux coordonnées cartésiennes), s’énonce formellement sous la forme :
$$y = y_1 + \frac{x – x_1}{x_2 – x_1} \times (y_2 – y_1)$$
Où :
- $x$ représente le score Z précis dont on recherche la probabilité cumulée inconnue $y = Phi(x)$.
- $x_1$ est la borne tabulée immédiatement inférieure (au centième inférieur).
- $x_2$ est la borne tabulée immédiatement supérieure (au centième supérieur).
- $y_1$ et $y_2$ représentent les entrées de probabilités respectives lues dans la table.
- Le terme $(x_2 – x_1)$ valant invariablement $0,01$ dans une table classique à deux décimales, la fraction se simplifie en un facteur de pondération centésimal : $\frac{x – x_1}{0,01} = 100 \times (x – x_1)$.
En résolvant cette équation arithmétique simple à l’aide d’un crayon, l’analyste détermine la coordonnée probabiliste intermédiaire avec une précision qui s’accorde remarquablement avec les sorties des algorithmes d’intégration numérique des logiciels les plus pointus.
8.3 Cas d’application clinique : Interpolation d’un score Z de 1,645
Le score $Z = 1,645$ représente sans doute le seuil le plus célèbre de la statistique inférentielle, matérialisant la frontière critique théorique du seuil unilatéral à $\alpha = 0,05$. Effectuons manuellement son interpolation pour en dériver les valeurs p exactes.
- Identification des bornes d’encadrement :
Le score $1,645$ se situe exactement à mi-chemin entre $x_1 = 1,64$ et $x_2 = 1,65$. - Extraction tabulaire des probabilités d’encadrement :
Dans la table cumulative normale :- Pour $x_1 = 1,64$, l’intersection $(1,6 ,;, 0,04)$ donne $y_1 = \Phi(1,64) = 0,9495$.
- Pour $x_2 = 1,65$, l’intersection $(1,6 ,;, 0,05)$ donne $y_2 = \Phi(1,65) = 0,9505$.
- Calcul du taux de variation locale :
$$\Delta y = y_2 – y_1 = 0,9505 – 0,9495 = 0,0010$$
$$\Delta x = x – x_1 = 1,645 – 1,640 = 0,005$$
Le ratio d’avancement au sein de l’intervalle est de :
$$\frac{x – x_1}{x_2 – x_1} = \frac{0,005}{0,01} = 0,5$$ - Application de la formule d’interpolation :
$$y = \Phi(1,645) = 0,9495 + [0,5 \times 0,0010] = 0,9495 + 0,0005 = 0,9500$$
L’aire cumulée gauche sous la courbe à $Z = 1,645$ est donc exactement égale à 0,9500. Dès lors, les valeurs p se déduisent immédiatement selon l’orientation adoptée :
- Pour un test unilatéral à droite :
$$p = 1 – \Phi(1,645) = 1,0000 – 0,9500 = 0,0500$$
Nous retrouvons la stricte égalité théorique du seuil critique à 5 %. - Pour un test bilatéral :
$$p = 2 \times [1 – \Phi(1,645)] = 2 \times 0,0500 = 0,1000$$
Ce résultat démontre sans appel qu’un score Z de 1,645, bien qu’extrêmement significatif sous un prisme unilatéral ($p = 0,05$), n’atteint aucunement le seuil de significativité requis sous une perspective bilatérale standard ($p = 0,10 > 0,05$).
9. Traitement des valeurs extrêmes de Z et gestion des asymptotes
9.1 Limites de sensibilité des tables usuelles face aux grands scores Z
L’un des défis les plus déconcertants pour l’analyste travaillant manuellement survient lorsque l’échantillon expérimental génère un score Z d’une magnitude considérable, excédant largement les bornes imprimées des tables statistiques courantes. La quasi-totalité des manuels de psychométrie et de méthodologie quantitative interrompt leur grille d’indexation à des valeurs de $|Z|$ oscillant entre $3,09$, $3,49$ ou plus rarement $3,99$.
Au-delà de ces frontières, la table affiche invariablement une probabilité cumulative arrondie à $0,9999$ (pour les scores positifs) ou à $0,0001$ (pour les scores négatifs), voire cesse purement et simplement toute tabulation. Face à un score atypique de $Z = +4,20$ ou $Z = -5,15$ — configurations fréquemment observées lors de recherches en neurosciences cognitives employant la magnétoencéphalographie (MEG) ou dans les études épidémiologiques portant sur de très vastes cohortes —, l’étudiant inexpérimenté se trouve désarmé, ne sachant si la valeur p doit être décrétée égale à zéro ou si le calcul est frappé de caducité.
Sur le plan fondamental, il est impératif de comprendre que la loi normale possède un support théorique infini sur la totalité de l’axe des réels ($\mathbb{R}$). Sa fonction de densité $\phi(z) = \frac{1}{\sqrt{2\pi}} e^{-z^2/2}$ étant strictement positive pour tout $z in ]-\infty; +\infty[$, l’aire sous la courbe d’une queue extrême, aussi ténue soit-elle, n’est jamais strictement nulle. La troncature des tables physiques ne traduit aucunement l’extinction mathématique de la probabilité, mais reflète simplement une contrainte de mise en page matérielle et une limite de résolution typographique.
9.2 Formules d’approximation asymptotique pour scores Z majeurs
Lorsqu’un chercheur est tenu de produire une estimation rigoureuse de la valeur p sans recourir à un environnement de programmation, il est mathématiquement inadmissible de poser arbitrairement $p = 0$. Il convient alors de mobiliser les outils de l’analyse asymptotique, en premier lieu desquels se distingue le développement en fraction rationnelle de Laplace et le célèbre rapport de Mills (Mills’ ratio).
Pour des valeurs de Z positives et particulièrement élevées ($Z > 3$), l’aire de la queue supérieure résiduelle $P(Z > z) = 1 – Phi(z)$ peut être approximée avec une remarquable fidélité par le premier terme du développement asymptotique de Gordon :
$$P(Z > z) \approx \frac{\phi(z)}{z} = \frac{1}{z \sqrt{2\pi}} e^{-\frac{z^2}{2}}$$
Sachant que la constante $\frac{1}{\sqrt{2\pi}} \approx 0,398942$, la formule opérationnelle se simplifie sous une forme facilement manipulable à l’aide d’une calculatrice scientifique élémentaire :
$$P(Z > z) \approx \frac{0,398942}{z} \times e^{-\frac{z^2}{2}}$$
Appliquons cette formule d’approximation asymptotique à un score hautement déviant de $Z = 4,00$ :
- Calcul du carré du score divisé par deux : $\frac{z^2}{2} = \frac{4^2}{2} = \frac{16}{2} = 8$.
- Évaluation de la composante exponentielle : $e^{-8} \approx 0,00033546$.
- Calcul du terme multiplicatif préfactoriel : $\frac{0,398942}{4} \approx 0,0997355$.
- Produit final :
$$P(Z > 4) \approx 0,0997355 \times 0,00033546 \approx 0,00003346 \quad (3,35 \times 10^{-5})$$
La valeur analytique exacte calculée par intégration numérique sur supercalculateur étant de $0,00003167$, l’approximation asymptotique manuelle fournit l’ordre de grandeur scientifique exact avec une marge d’erreur relative dérisoire, permettant de quantifier précisément la rareté statistique du phénomène sans capituler devant les limites de la table imprimée.
9.3 Normes de notation académique pour les valeurs p infinitésimales
L’interaction entre les limites tabulaires et la rédaction scientifique impose une discipline de notation formelle extrêmement stricte. L’American Psychological Association (APA), à travers les directives révisées de son manuel de publication (7e édition), proscrit formellement et sous toutes ses formes la notation erronée :
$$\text{À proscrire absolument : } p = 0,000 \quad \text{ou} \quad p = 0,0000$$
Une telle déclaration est mathématiquement aberrante dans un modèle continu infini, car elle stipulerait que l’événement observé est rigoureusement impossible sous $H_0$, ce qui violerait le principe asymptotique de la distribution normale. Déclarer $p = 0$ équivaudrait à revendiquer une certitude absolue, notion antinomique avec les fondements du raisonnement stochastique.
Lorsque le calcul manuel ou la lecture d’une table tronquée indique une probabilité inférieure à la sensibilité de l’instrument de mesure (généralement le millième), la norme déontologique exige de basculer vers une formulation d’inégalité stricte utilisant des seuils de troncature conventionnels :
- Si la table s’arrête à $Z = 3,09$ (correspondant à une queue unilatérale de $0,001$), tout score supérieur sera rapporté sous la forme : $p < 0,001$.
- Si l’on manipule une table à quatre décimales et que le score dépasse $Z = 3,75$, la valeur sera conventionnellement consignée sous la forme : $p < 0,0001$.
Ce formalisme préserve la rigueur épistémique du chercheur en rappelant que la statistique inférentielle évalue une tension d’échantillonnage probabiliste, et non une vérité logique déterministe.
10. Erreurs méthodologiques fréquentes et pièges d’interprétation
10.1 Erreurs géométriques et confusions de directions de queue
La pratique pédagogique et l’expertise éditoriale d’articles scientifiques révèlent une récurrence systématique de bévues méthodologiques directement liées à une mauvaise appréhension spatiale de la courbe de Gauss lors du calcul manuel de la valeur p. Ces failles ne relèvent pas d’une incompétence arithmétique globale, mais d’une rupture dans la chaîne logique reliant l’orientation de l’hypothèse au calcul de l’aire sous la courbe.
Le piège le plus omniprésent réside dans l’omission de la soustraction unitaire lors d’un test unilatéral à droite avec une table cumulative. L’opérateur extrait docilement la probabilité associée à un score positif (par exemple $Phi(2,10) = 0,9821$) et conclut sans recul critique que $p = 0,9821$. Cette méprise transforme une déviation expérimentale spectaculaire en un échec statistique retentissant, simplement parce que l’analyste a confondu la masse des observations antérieures avec la queue critique d’intérêt ($1 – 0,9821 = 0,0179$).
Une seconde faille classique consiste en l’omission pure et simple du doublement de l’aire lors d’un test bilatéral. L’analyste identifie correctement la surface résiduelle d’une queue extrême (par exemple $0,035$), mais omet de la multiplier par deux, rapportant un résultat fallacieux de $p = 0,035$ au lieu de $p = 0,070$. Cette défaillance introduit des erreurs de première espèce (faux positifs) massives au sein de la littérature scientifique, conduisant à la publication de prétendues « découvertes » qui ne sont en réalité que des fluctuations stochastiques non significatives au seuil conventionnel de 5 %.
10.2 Biais d’arrondi et transcriptions défectueuses
La précision de la valeur p calculée manuellement est hautement tributaire de la rigueur arithmétique appliquée aux étapes préliminaires de standardisation. Une source majeure d’imprécision provient de l’arrondi prématuré du score Z. Lors du calcul de la statistique de test :
$$Z = \frac{\bar{X} – \mu}{\frac{\sigma}{\sqrt{n}}}$$
si l’expérimentateur arrondit grossièrement l’erreur-type au centième dès le dénominateur, l’erreur de propagation décimale peut dévier artificiellement le score Z final d’un ou deux dixièmes. Par exemple, faire passer un score Z de $1,97$ à $1,93$ modifie substantiellement l’aire de queue bilatérale ($p = 0,0488$ contre $p = 0,0536$), faisant franchir indûment au résultat la barrière fatidique de la significativité statistique.
Par ailleurs, la consultation visuelle d’une table imprimée est propice aux erreurs de glissement matriciel. La structure compacte de ces matrices numériques favorise des confusions fréquentes d’indexation, la plus redoutable étant l’inversion entre la colonne de tête étiquetée $0,00$ et les colonnes adjacentes, ou la confusion entre les lignes de signes opposés. Pour prémunir son calcul contre ces glissements perceptifs, le praticien méthodique emploie une règle physique opaque pour masquer les lignes inférieures et pointe du stylet l’intersection ciblée, vérifiant systématiquement le préfixe décimal avant de consigner définitivement sa valeur de probabilité.
10.3 Confusion pernicieuse entre probabilité p et taille d’effet
Parmi toutes les dérives interprétatives qui polluent les sciences comportementales, l’assimilation fallacieuse d’une faible valeur p à une forte amplitude clinique ou théorique demeure la plus tenace et la plus préjudiciable. De nombreux chercheurs succombent au sophisme consistant à affirmer qu’une intervention psychologique générant une valeur $p = 0,0001$ possède un impact thérapeutique intrinsèquement supérieur à une méthode produisant une valeur $p = 0,042$.
Il est épistémologiquement indispensable de rappeler que la valeur p ne mesure absolument pas l’amplitude d’un effet ; elle mesure exclusivement le degré de certitude statistique quant au rejet de l’absence d’effet. La magnitude du score Z (et par voie de conséquence la petitesse de la valeur p) est le produit conjoint de deux facteurs indépendants : l’effet réel dans la population et la taille de l’échantillon ($N$), comme l’illustre la formulation asymptotique élémentaire :
$$\text{Statistique de test} \approx \text{Taille de l’effet} \times \sqrt{N}$$
Dans un protocole portant sur une cohorte gigantesque ($N = 100,000$ sujets), une différence clinique totalement dérisoire et insignifiante sur le plan pratique (par exemple un gain d’un demi-point sur une échelle d’anxiété graduée de 0 à 100) engendrera un score standardisé titanesque ($Z > 5$) et une valeur p infinitésimale ($p < 0,00001$). À l'inverse, dans une étude pilote clinique portant sur $N = 12$ patients cérébrolésés, un progrès thérapeutique phénoménal peut déboucher sur un score $Z = 1,85$ et une valeur p bilatérale non significative ($p = 0,064$), simplement par manque de puissance statistique.
C’est pourquoi le calcul manuel d’une valeur p ne doit jamais s’envisager de manière isolée. Il constitue une formalité probabiliste de décision qui doit obligatoirement être complétée par l’évaluation standardisée de la taille d’effet (notamment le d de Cohen ou le coefficient $\eta^2$) et par la construction d’un intervalle de confiance à 95 % autour de la différence observée, conformément aux directives méthodologiques de l’APA.
11. Études de cas appliquées aux protocoles de recherche en psychologie
11.1 Cas clinique 1 : Évaluation de l’efficacité d’une thérapie cognitive (Test unilatéral gauche)
Afin d’éprouver la robustesse de notre protocole dans un cadre écologique concret, considérons une recherche clinique conduite au sein d’une unité hospitalière universitaire de psychiatrie. Un groupe de $N = 49$ patients souffrant de trouble anxiété généralisée (TAG) est soumis à un protocole standardisé de restructuration cognitive de huit semaines. L’évaluation de l’anxiété s’opère au moyen de l’échelle d’anxiété de Hamilton (HAM-A), dont l’évolution différentielle moyenne standardisée dans la population clinique non traitée correspond à une distribution normale de moyenne $\mu_0 = 0$ et d’écart-type connu $\sigma = 14$ points.
À l’issue de l’intervention thérapeutique, l’échantillon expérimental affiche une réduction symptomatique moyenne de $\bar{X} = -4,28$ points. La question de recherche stipule explicitement que la thérapie doit produire une réduction de l’anxiété, justifiant la formulation formelle d’un test unilatéral à gauche :
$$H_0 : \mu ge 0 \quad \text{versus} \quad H_1 : \mu < 0$$
Le calcul de l’erreur-type de la moyenne donne :
$$\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{N}} = \frac{14}{\sqrt{49}} = \frac{14}{7} = 2,00$$
Le score Z empirique standardisé s’obtient alors immédiatement :
$$Z_{\text{obs}} = \frac{\bar{X} – \mu_0}{\sigma_{\bar{X}}} = \frac{-4,28 – 0}{2,00} = -2,14$$
Passons à l’extraction manuelle de la valeur p :
- Nous consultons la table normale cumulative pour les valeurs négatives.
- Nous repérons la rangée correspondant à la valeur -2,1 sur l’axe vertical gauche.
- Nous suivons cette ligne jusqu’à la colonne correspondant à 0,04.
- L’intersection matricielle exacte $(-2,1 ,;, 0,04)$ révèle la probabilité cumulée :
$$\Phi(-2,14) = 0,0162$$ - Puisqu’il s’agit d’un test unilatéral à gauche, la valeur p équivaut directement à cette aire :
$$p = 0,0162$$
Conclusion statistique et clinique : Au seuil de signification standard $\alpha = 0,05$, la valeur p observée ($0,0162$) est strictement inférieure à $\alpha$. Nous rejetons l’hypothèse nulle au profit de l’hypothèse alternative. Le clinicien affirme avec un niveau de confiance supérieur à 98 % que le programme de restructuration cognitive entraîne une réduction significative des manifestations cliniques de l’anxiété chez ces patients.
11.2 Cas clinique 2 : Amélioration de la mémoire de travail par neurofeedback (Test unilatéral droit)
Dans le domaine des neurosciences appliquées, un laboratoire examine les potentialités d’un entraînement cérébral assisté par électroencéphalographie (neurofeedback ciblant le rythme thêta frontal) sur les capacités de mémoire de travail. L’épreuve de validation repose sur l’empan mnésique envers de chiffres de la WAIS-IV. La distribution normative de cette sous-épreuve auprès d’une population adulte saine affiche un score standardisé moyen de référence de $\mu_0 = 10$ avec un écart-type de $\sigma = 3$.
Une cohorte de $N = 36$ jeunes adultes complète un entraînement intensif de vingt séances. Lors du bilan post-intervention, la performance moyenne du groupe atteint $\bar{X} = 10,94$ points. Les chercheurs postulent une amélioration univoque des capacités cognitives consécutivement au renforcement neurophysiologique, imposant un test unilatéral à droite :
$$H_0 : \mu le 10 \quad \text{versus} \quad H_1 : \mu > 10$$
Calculons l’erreur-type de l’échantillon :
$$\sigma_{\bar{X}} = \frac{3}{\sqrt{36}} = \frac{3}{6} = 0,50$$
Calcul de la statistique de test Z :
$$Z_{\text{obs}} = \frac{10,94 – 10,00}{0,50} = \frac{0,94}{0,50} = +1,88$$
Détermination séquentielle de la valeur p manuelle :
- Dans la table cumulative positive, nous localisons la rangée 1,8 et la colonne 0,08.
- La cellule d’intersection nous fournit l’aire sous la courbe située à gauche de $1,88$ :
$$\Phi(1,88) = 0,9699$$ - Puisque l’hypothèse alternative postule une supériorité ($H_1 : \mu > 10$), nous cherchons l’aire résiduelle droite au-dessus de $1,88$. Nous appliquons la règle du complément unitaire :
$$p = 1 – \Phi(1,88) = 1,0000 – 0,9699 = 0,0301$$
Conclusion statistique et clinique : La valeur p obtenue manuellement est de $p = 0,0301$. Confrontée au seuil nominal prédéterminé $\alpha = 0,05$, nous constatons que $p < \alpha$. L'hypothèse nulle est rejetée. L'expérimentateur conclut que l'entraînement par neurofeedback induit une élévation statistiquement significative des performances de mémoire de travail au sein de cet échantillon.
11.3 Cas clinique 3 : Effet du niveau de cortisol salivaire sur l’empathie (Test bilatéral)
Enfonçons-nous dans une étude exploratoire de psychobiologie de la personnalité. Un groupe de chercheurs explore l’existence d’une corrélation endocrine complexe en évaluant l’impact d’une exposition aiguë au stress physiologique (induite par le Trier Social Stress Test) sur les capacités d’empathie cognitive, mesurées par le test des yeux de Baron-Cohen (Reading the Mind in the Eyes Test – RMET). Dans les conditions normatives basales, la performance moyenne à ce test de décodage des états mentaux d’autrui est de $\mu_0 = 28$ points sur 36, avec un écart-type historique de $\sigma = 4$.
Un échantillon de $N = 64$ volontaires sains subit le protocole d’induction de stress et enregistre des niveaux élevés de cortisol salivaire. Lors de la passation ultérieure du RMET, le score moyen s’élève à $\bar{X} = 27,01$ points. La littérature neurobiologique présentant des résultats contradictoires quant à savoir si le stress favorise l’affiliation prosociale ou rétrécit la théorie de l’esprit, l’équipe adopte une stricte neutralité directionnelle, imposant un test bilatéral :
$$H_0 : \mu = 28 \quad \text{versus} \quad H_1 : \mu \neq 28$$
Calculons l’erreur-type de la distribution d’échantillonnage :
$$\sigma_{\bar{X}} = \frac{4}{\sqrt{64}} = \frac{4}{8} = 0,50$$
Standardisation de la déviation empirique :
$$Z_{\text{obs}} = \frac{27,01 – 28,00}{0,50} = \frac{-0,99}{0,50} = -1,98$$
Déroulement de la procédure bilatérale manuelle :
- Le score étant négatif ($Z = -1,98$), nous consultons la section négative de la table cumulative.
- Nous indexons la rangée -1,9 et la colonne 0,08.
- La lecture matricielle fournit l’aire sous la queue inférieure gauche :
$$\Phi(-1,98) = 0,0239$$ - Le protocole étant non directionnel et impartial (bilatéral), nous devons obligatoirement doubler cette aire unilatérale pour intégrer son pendant symétrique supérieur :
$$p = 2 \times \Phi(-1,98) = 2 \times 0,0239 = 0,0478$$
Conclusion statistique et clinique : La valeur p bilatérale finale atteint très exactement $p = 0,0478$. Confrontée au seuil décisionnel canonique $\alpha = 0,05$, nous observons que $0,0478 le 0,05$. L’effet est déclaré statistiquement significatif au seuil de 5 %. Les chercheurs peuvent conclure que le stress aigu altère significativement la précision de l’empathie cognitive, tout en soulignant dans leur rapport que la significativité demeure marginale, appelant à une réplication sur un échantillon élargi.
12. Intégration décisionnelle et rédaction des résultats selon les normes APA
12.1 Mécanisme formel de décision statistique face au seuil de signification
Le calcul manuel rigoureux d’une valeur p ne constitue que la première phase de l’inférence quantitative ; il doit impérativement s’intégrer au sein d’un algorithme de décision logique rigoureusement articulé autour du risque d’erreur consenti. Dans le modèle classique d’épreuve d’hypothèse de Fisher, Neyman et Pearson, le chercheur applique une règle de tranchage univoque et impersonnelle qui soustrait l’analyste au biais de confirmation :
| Condition Inférentielle | Verdict Statistique | Interprétation Théorique |
|---|---|---|
| $p le \alpha$ (ex. $p le 0,05$) | Rejet de l’hypothèse nulle ($H_0$) | L’évidence empirique est incompatible avec l’aléa seul. Démonstration de l’existence probable de l’effet. |
| $p > \alpha$ (ex. $p > 0,05$) | Maintien de l’hypothèse nulle ($H_0$) | Absence d’éléments empiriques suffisants pour rejeter l’aléa. Conclusion suspensive (non-affirmative). |
Une rigueur stylistique et conceptuelle inflexible s’impose lors de la rédaction du verdict lorsque $p > \alpha$. Un chercheur consciencieux n’écrit jamais que « l’hypothèse nulle est prouvée » ou que « l’intervention n’a aucun effet ». L’absence de preuve ne constitue pas la preuve de l’absence. La seule conclusion scientifiquement recevable consiste à affirmer que les données recueillies ne fournissent pas d’évidence suffisante pour délaisser le modèle d’absence d’effet au seuil de confiance sélectionné.
12.2 Formalisme rédactionnel et standardisation APA (7e édition)
La transmission des données quantitatives au sein de la communauté scientifique obéit aux normes typographiques ultra-précises dictées par le manuel de style de l’APA (Publication Manual of the American Psychological Association, 7e éd.). La transcription d’une analyse standardisée Z et de sa valeur p manuelle doit se conformer aux impératifs suivants :
- Règles typographiques : Les symboles statistiques représentant des variables continues s’écrivent strictement en italique ($z$, $p$, $d$, $\bar{X}$). En revanche, les abréviations d’indices ou de tests en toutes lettres demeurent en romain normal (ex. ANOVA, TAG).
- Gestion du zéro initial : En langue anglaise (et par imitation internationale dans de nombreux périodiques scientifiques francophones), lorsqu’une grandeur statistique est bornée par construction entre 0 et 1 (ce qui est intrinsèquement le cas des probabilités $p$, des coefficients de corrélation $r$ et des proportions $R^2$), la valeur ne doit pas comporter de zéro avant la virgule ou le point décimal (ex. $p = .048$ et non $p = 0.048$). Dans une publication rédigée strictement en français académique traditionnel respectant les normes de l’Imprimerie Nationale, le zéro initial et la virgule décimale peuvent être tolérés, mais l’usage APA direct prime dès que l’article s’adresse à un lectorat international ($p = ,048$).
- Précision décimale : Les scores statistiques ($z$) se rapportent avec deux décimales exactes. Les valeurs p se rapportent avec deux ou trois décimales exactes (ex. $p = .016$ ou $p = .030$). Si la valeur manuelle dérive d’une intégration infinitésimale inférieure au millième, elle se formule sous la condition $p < .001$.
Voici les canevas rédactionnels canoniques adaptés à nos trois cas cliniques d’illustration :
Exemple unilatéral gauche : « Les résultats indiquent une réduction significative des symptômes d’anxiété au terme des huit semaines de thérapie cognitive, $z = -2,14$, $p = ,016$ (unilatéral), $d = -0,61$. »
Exemple unilatéral droit : « L’entraînement par neurofeedback s’accompagne d’une amélioration significative des performances à l’empan mnésique, $z = 1,88$, $p = ,030$ (unilatéral), $d = 0,31$. »
Exemple bilatéral : « L’induction aiguë de stress modifie significativement les capacités d’empathie cognitive sur le RMET, $z = -1,98$, $p = ,048$ (bilatéral), IC à 95 % $[-1,97 ; -0,01]$, $d = -0,25$. »
12.3 Synthèse procédurale et arbre de décision pour le calcul manuel autonome
Pour parachever ce manuel de référence, nous synthétisons l’ensemble de la démarche méthodologique au travers d’un protocole procédural séquentiel invariable. Ce canevas en quatre phases garantit une exécution sans faille du calcul manuel d’une valeur p à partir de n’importe quel score standardisé :
- Phase 1 : Standardisation empirique
$$\text{Calculer } Z = \frac{X – \mu}{\sigma} \quad \text{ou} \quad Z = \frac{\bar{X} – \mu_0}{\frac{\sigma}{\sqrt{n}}}$$
Arrondir le score obtenu rigoureusement à deux décimales exactes. - Phase 2 : Analyse de l’orientation théorique du design expérimental
Vérifier la formulation de l’hypothèse alternative de recherche ($H_1$) scellée a priori :- Si $H_1 : \mu < \mu_0 implies$ Test unilatéral à gauche.
- Si $H_1 : \mu > \mu_0 implies$ Test unilatéral à droite.
- Si $H_1 : \mu \neq \mu_0 implies$ Test bilatéral non directionnel.
- Phase 3 : Extraction tabulaire sur la table cumulative
Projeter le score Z sur la table pour extraire $Phi(Z)$ :- Repérer la rangée d’entier et de premier dixième sur la colonne verticale gauche.
- Repérer la colonne de second centième sur la rangée horizontale haute.
- Isoler l’intersection matricielle correspondant à l’aire cumulative gauche.
- Phase 4 : Ajustement arithmétique de la valeur p finale
Appliquer l’opérateur géométrique correspondant à la décision de la Phase 2 :- Unilatéral gauche : $p = Phi(Z)$ (lecture directe sur Z négatif).
- Unilatéral droit : $p = 1 – Phi(Z)$ (application du complément unitaire).
- Bilatéral : $p = 2 \times [1 – \Phi(|Z|)]$ ou $p = 2 \times \Phi(-|Z|)$ (multiplication systématique de l’aire de queue résiduelle par deux).
En vous appropriant cette méthodologie pas à pas, vous vous affranchissez définitivement de la dépendance aveugle aux interfaces informatiques. Vous acquérez la maîtrise intellectuelle des fondements de la statistique inférentielle, conférant à vos analyses psychométriques et expérimentales une profondeur, une clarté conceptuelle et une intégrité scientifique irréprochables.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.