
L’estimation des modèles de régression linéaire par la méthode des moindres carrés ordinaires repose sur un ensemble d’hypothèses classiques formalisées dans le cadre du théorème de Gauss-Markov. Dans la pratique de la recherche quantitative et de l’économétrie appliquée, ces conditions idéales sont fréquemment compromises par la structure sous-jacente des données empiriques. Parmi les perturbations structurelles les plus insidieuses figure la présence d’observations atypiques situées à la périphérie de l’espace multidimensionnel des variables explicatives. Ces observations, qualifiées de points à fort levier (leverage points), disposent du potentiel géométrique d’attirer disproportionnellement l’hyperplan de régression vers leur propre position, faussant ainsi l’estimation des coefficients vectoriels et réduisant la validité prédictive du modèle.
Le diagnostic statistique moderne ne peut se contenter d’un simple examen superficiel des résidus bruts. En effet, un point exerçant un effet de levier extrême peut modifier l’orientation de l’hyperplan ajusté au point de générer un résidu résiduel artificiellement faible, masquant ainsi son impact déstabilisateur aux yeux des analyses univariées naïves. C’est précisément pour remédier à ce phénomène de masquage qu’intervient l’analyse systématique de la matrice de projection orthogonale, communément appelée « matrice chapeau » (hat matrix). L’environnement de calcul statistique R offre un arsenal d’outils matriciels et de fonctions vectorielles hautement optimisées permettant d’extraire, de quantifier et de disséquer ces métriques de levier avec une rigueur mathématique absolue.
Le présent article constitue une monographie méthodologique intégrale dédiée à l’évaluation, au calcul et à l’interprétation des statistiques de levier dans le langage de programmation statistique R. À travers un parcours analytique exhaustif allant de la dérivation algébrique pure jusqu’au déploiement de pipelines diagnostiques contemporains au sein de l’écosystème Tidyverse, nous explorerons les implications théoriques, géométriques et computationnelles de cette statistique fondamentale. Que vous soyez biostatisticien, économètre ou chercheur en sciences sociales computationnelles, ce guide vous fournira le socle conceptuel et algorithmique indispensable pour garantir l’intégrité de vos inférences paramétriques.
1. Fondements théoriques de l’effet de levier en régression linéaire
1.1 Définition mathématique de la matrice de projection chapeau
L’architecture algébrique de la régression linéaire multivariée s’articule autour de la relation linéaire classique reliant un vecteur de réponse quantitative à une matrice de prédicteurs. Soit un vecteur colonne y de dimension n × 1 représentant les observations de la variable dépendante, et une matrice X de dimension n × p contenant les réalisations de p prédicteurs (incluant usuellement un vecteur unitaire modélisant l’ordonnée à l’origine). Le modèle linéaire s’écrit sous forme matricielle y = Xβ + ε, où β est le vecteur des paramètres de dimension p × 1 et ε représente le vecteur des erreurs stochastiques non observables. L’estimateur des moindres carrés ordinaires du vecteur des coefficients, noté β̂, est déterminé en minimisant la somme des carrés des résidus, aboutissant à l’équation canonique β̂ = (XTX)-1XTy, sous réserve que la matrice de Gram XTX soit d’ordre plein et donc inversible.
En substituant cet estimateur dans l’expression des valeurs prédites (ou ajustées) ŷ = Xβ̂, il apparaît une transformation linéaire directe liant les valeurs observées aux valeurs ajustées : ŷ = X(XTX)-1XTy. L’opérateur matriciel linéaire H = X(XTX)-1XT est universellement désigné sous le vocable de matrice chapeau (hat matrix), précisément parce qu’il « coiffe » le vecteur y pour produire ŷ. Cette matrice d’ordre n × n est l’opérateur de projection orthogonale qui projette le vecteur d’observations y de l’espace euclidien ℝn sur le sous-espace vectoriel de dimension p engendré par les colonnes de la matrice X.
Deux propriétés algébriques fondamentales caractérisent la matrice chapeau : la symétrie et l’idempotence. La symétrie découle immédiatement de sa définition : HT = [X(XTX)-1XT]T = X[(XTX)-1]TXT = H. L’idempotence implique que l’application répétée de la projection n’altère pas le résultat obtenu dès la première itération : H2 = HH = X(XTX)-1XTX(XTX)-1XT = X(XTX)-1XT = H. Ces propriétés structurelles imposent des contraintes rigides sur les éléments diagonaux hii de la matrice. Étant donné que H est symétrique et idempotente, chaque élément diagonal s’exprime comme la somme des carrés des éléments de la i-ème ligne : hii = ∑j hij2 = hii2 + ∑j≠i hij2. Il s’ensuit mathématiquement que 0 ≤ hii ≤ 1 pour toute observation i.
L’interprétation statistique des composantes diagonales hii, appelées valeurs de levier (leverage values ou hat values), réside dans leur équivalence formelle à une distance multivariée standardisée. Plus précisément, hii mesure l’éloignement de la i-ème observation par rapport au centroïde des données dans l’espace multidimensionnel défini par les prédicteurs. Lorsque le modèle contient une constante, on démontre que hii = 1/n + (xi – x̄)T(X̃TX̃)-1(xi – x̄), où x̄ représente le vecteur des moyennes des variables explicatives et X̃ est la matrice des prédicteurs centrés. Ce second terme n’est autre qu’une forme quadratique proportionnelle au carré de la distance de Mahalanobis. Enfin, la trace de la matrice chapeau, qui est égale à la somme de ses valeurs propres, présente un lien direct avec la dimensionnalité du modèle : Tr(H) = Tr(X(XTX)-1XT) = Tr((XTX)-1XTX) = Tr(Ip) = p. Par conséquent, la somme des valeurs de levier pour l’ensemble des n observations est strictement égale au nombre de paramètres estimés dans le modèle de régression.
1.2 Importance du diagnostic de levier dans la recherche quantitative
L’estimation par les moindres carrés ordinaires possède une vulnérabilité reconnue : elle minimise la norme euclidienne quadratique du vecteur résiduel, ce qui confère un poids disproportionné aux observations situées aux marges de la distribution des données. Dans ce contexte, les observations dotées d’une valeur de levier substantielle exercent une attraction mécanique considérable sur l’hyperplan de régression. Si une observation possède une configuration de prédicteurs atypique, elle se comporte comme un point d’appui rigide sur lequel la droite ou l’hyperplan pivote pour minimiser la somme globale des résidus au carré. Ce phénomène d’ancrage altère potentiellement l’estimation de l’ensemble des coefficients vectoriels du modèle.
L’impact d’un levier élevé se manifeste de manière tout aussi critique sur l’estimation de la variance d’échantillonnage des coefficients. La variance théorique de la valeur prédite pour la i-ème observation est donnée par Var(ŷi) = σ2hii, où σ2 est la variance intrinsèque du terme d’erreur stochastique. Réciproquement, la variance du résidu estimé ei = yi – ŷi s’exprime par Var(ei) = σ2(1 – hii). Cette dernière relation révèle un paradoxe fondamental : plus le levier hii d’une observation tend vers l’unité, plus la variance de son résidu résiduel se rapproche de zéro. En termes concrets, un point doté d’un très fort levier « force » le modèle à passer extrêmement près de lui, ce qui comprime artificiellement son résidu brut et donne l’illusion trompeuse d’un ajustement parfait en ce point singulier.
Cette distorsion de la variance résiduelle compromet directement la puissance statistique des tests d’hypothèses multivariés. Les erreurs types des coefficients estimés deviennent instables lorsque des points de fort levier déstabilisent la matrice de covariance. Par conséquent, les statistiques de test de Student (t-tests) et de Fisher-Snedecor (F-tests) peuvent être faussées, générant soit des erreurs d’inférence de type I (rejet à tort de l’hypothèse nulle d’absence d’effet), soit des erreurs de type II (incapacité à détecter un effet réel en raison d’un élargissement artificiel de l’intervalle de confiance). La validité interne du modèle s’en trouve sévèrement dégradée, car les conclusions scientifiques tirées de l’analyse dépendent alors de la présence contingente de quelques entités observationnelles marginales.
Dans les applications prédictives, le danger est tout aussi prononcé. Un modèle de régression paramétré sous l’influence excessive d’observations à fort levier présentera une capacité de généralisation médiocre lors de son déploiement sur de nouvelles données indépendantes. L’hyperplan ayant été incliné pour accommoder des anomalies géométriques propres à l’échantillon d’apprentissage, l’erreur de prédiction quadratique moyenne augmentera de façon drastique sur des échantillons de validation. Ainsi, l’identification méthodique et le traitement raisonné des valeurs de levier constituent un prérequis indispensable à toute modélisation quantitative robuste, garantissant la reproductibilité et la stabilité des conclusions scientifiques.
2. Distinction conceptuelle : Valeurs aberrantes, levier et points d’influence
2.1 Différenciation spatiale entre l’espace des prédicteurs et la variable réponse
L’une des confusions les plus récurrentes dans l’application des diagnostics de régression réside dans l’assimilation hâtive entre valeur aberrante (outlier), point de levier (leverage point) et point d’influence (influential point). Pour dissiper toute ambiguïté épistémologique, il convient d’adopter une perspective géométrique qui sépare rigoureusement l’espace vectoriel des covariables explicatives de la droite réelle occupée par la variable dépendante. Une valeur aberrante se définit formellement comme une observation dont la valeur observée yi s’écarte substantiellement de la tendance générale prédite par le modèle. Il s’agit d’une discordance observée selon l’axe orthogonal à l’hyperplan de régression, matérialisée par un résidu statistique de magnitude exceptionnellement élevée, indépendamment de la position occupée par l’observation dans l’espace des prédicteurs.
À l’inverse, l’effet de levier constitue une propriété géométrique confinée de manière exclusive à l’espace multidimensionnel des prédicteurs (l’espace X). Une observation présente un fort levier si son profil de covariables est singulier, c’est-à-dire si elle se trouve isolée dans les confins de la distribution conjointe des prédicteurs, à une distance substantielle du centroïde de l’échantillon. Cette singularité est quantifiée sans jamais faire référence à la variable dépendante y. En effet, la formule H = X(XTX)-1XT démontre que le calcul des hii est entièrement aveugle aux réalisations du vecteur y. Par conséquent, une observation peut présenter un levier titanesque tout en se situant exactement sur la trajectoire naturelle de l’hyperplan de régression prédit par le reste de l’échantillon.
L’analyse conjointe de la magnitude résiduelle et du degré de levier permet de dégager une taxonomie opérationnelle en quatre quadrants fondamentaux :
- Observations standards : Faible levier et faible résidu. Ces points se situent au cœur de la distribution des variables explicatives et sont parfaitement conformes à la dynamique relationnelle postulée par le modèle.
- Valeurs aberrantes à faible levier : Faible levier et résidu volumineux. L’observation possède un profil de covariables banal, mais sa réponse y est atypique. Elle contribue à gonfler la variance de l’erreur résiduelle globale sans pour autant déplacer l’orientation générale de l’hyperplan.
- Points de levier bienveillants (ou conformes) : Fort levier et résidu quasi nul. L’observation possède une configuration de prédicteurs extrême, mais sa réponse observée coïncide remarquablement avec la prédiction formulée à partir des autres points. Ces observations réduisent artificiellement les erreurs types des coefficients estimés et augmentent le coefficient de détermination R2 sans déformer les pentes.
- Points de levier discordants : Fort levier associé à un résidu substantiel. Cette combinaison représente la configuration la plus pathologique en modélisation linéaire, générant une torsion disproportionnée de la surface de régression.
2.2 Mécanique de l’influence globale et métriques associées
L’influence statistique désigne le degré effectif par lequel les paramètres estimés ou les prédictions du modèle changent lorsque l’observation sous analyse est omise du processus d’estimation. L’influence n’est ni le levier pur, ni l’aberrance résiduelle pure, mais plutôt le produit multiplicatif de ces deux composantes structurales. Mathématiquement, on peut concevoir l’influence comme le produit : Influence ≈ Levier × Résidu. Un point présentant un levier extraordinaire mais un résidu nul n’exerce qu’une influence marginale sur l’estimation ponctuelle des coefficients angulaires, car sa présence ne fait que confirmer la pente existante. Réciproquement, une valeur aberrante extrême située au centroïde des prédicteurs n’exerce aucun levier géométrique ; elle modifie l’ordonnée à l’origine mais ne dispose d’aucun bras de levier pour faire pivoter les pentes.
Pour formaliser cette dynamique cinématique, plusieurs métriques synthétiques ont été développées dans la littérature statistique. La plus célèbre est incontestablement la distance de Cook, formulée par le statisticien américain R. Dennis Cook en 1977. La distance de Cook pour la i-ème observation, notée Di, mesure la distance au carré globale entre le vecteur des prédictions calculé sur l’échantillon complet ŷ et le vecteur des prédictions ŷ(i) obtenu après l’élimination de l’observation i. Elle s’exprime élégamment en combinant directement le résidu studentisé interne ri et le levier hii :
Di = [ri2 / p] × [hii / (1 – hii)]
Cette factorisation met en lumière le rôle d’amplificateur joué par le levier : le terme hii / (1 – hii) croît de manière hyperbolique au fur et à mesure que hii s’approche de sa borne supérieure unitaire. Parallèlement, des mesures décomposées comme les DFBETAS évaluent l’altération standardisée infligée à chaque coefficient de régression spécifique βj pris individuellement lors de l’omission d’une unité statistique. Il apparaît que le levier exerce une action différentielle marquée : les covariables dont les valeurs sont particulièrement éloignées du centre de gravité pour une observation donnée verront leur coefficient angulaire respectif hautement perturbé, tandis que l’ordonnée à l’origine réagira principalement à la composante résiduelle de cette observation. Ce mécanisme de déstabilisation fragilise la reproductibilité empirique, car la réplication de l’étude sur un échantillon indépendant dépourvu de ce point critique aboutira à des conclusions théoriques radicalement discordantes.
3. Préparation de l’environnement R et ajustement du modèle de régression
3.1 Configuration des données et vérification des prérequis
L’exécution rigoureuse d’un audit de levier dans R requiert une initialisation méthodique de l’environnement de calcul statistique. Avant d’exécuter la moindre régression, il est impératif d’importer les données à l’aide de commandes natives de base telles que read.csv() ou read.table(), tout en assurant une inspection structurelle intégrale via str(), dim() et summary(). L’architecture des données doit être rigoureusement typée : les variables qualitatives doivent être converties en facteurs formels via la fonction factor() ou as.factor(), car leur intégration dans la matrice de modélisation X générera des variables indicatrices binaires (colonnes de contraste) qui modifient directement le rang de la matrice et la répartition du levier.
Le traitement des données manquantes constitue une étape préalable incontournable. Par défaut, les fonctions d’estimation de R appliquent l’argument na.action = na.omit, ce qui élimine de facto les lignes présentant au moins une valeur manquante. Cette suppression d’enregistrements réduit la taille de l’échantillon effectif n, modifiant mécaniquement le calcul du levier moyen théorique. Il est donc recommandé d’isoler au préalable le sous-ensemble de données complet via na.omit() ou d’inspecter l’attribut d’omission du modèle ajusté pour garantir la stricte correspondance entre les indices des lignes du jeu de données et les éléments du vecteur des statistiques de projection.
Une analyse préliminaire de la distribution conjointe des prédicteurs numériques s’avère indispensable. L’évaluation de la dispersion et de l’asymétrie s’effectue au moyen de fonctions descriptives standard telles que cov(), cor(), ainsi que par le calcul des coefficients d’asymétrie multivariée. Des prédicteurs présentant un étalement asymétrique sévère (par exemple des distributions log-normales de revenus ou de valorisations financières) génèrent quasi inévitablement des points d’ancrage géométriques dotés d’un très fort levier. La question de la standardisation des prédicteurs se pose fréquemment à ce stade. Il est théoriquement capital de souligner que la standardisation linéaire des variables explicatives (centrage et réduction par soustraction de la moyenne et division par l’écart-type) ne modifie absolument pas les valeurs de levier hii. En vertu des propriétés de projection de la matrice chapeau, celle-ci est invariante par toute transformation affine non singulière appliquée aux colonnes de X. Toutefois, la standardisation préalable facilite grandement la détection graphique des composantes isolées à l’échelle univariée.
3.2 Ajustement du modèle linéaire par la fonction lm()
La modélisation de la relation linéaire sous R repose sur la fonction canonique lm() (linear models). Cette routine algorithmique implémente une décomposition QR de la matrice des covariables X, garantissant une stabilité numérique optimale face aux erreurs d’arrondi et aux problèmes de conditionnement matriciel qui pénaliseraient une inversion directe de la matrice de Gram. La syntaxe canonique s’articule autour de l’opérateur tilde :
modele_lineaire <- lm(formule, data = donnees)
où la formule spécifie la structure fonctionnelle de l’équation, par exemple y ~ x1 + x2 + x3. L’assignation du résultat à un objet nommé de classe lm permet de préserver l’ensemble des métadonnées mathématiques issues de l’ajustement, y compris la matrice triangulaire supérieure de la factorisation QR, le rang effectif du système linéaire, les coefficients estimés, les valeurs prédites et les résidus bruts.
L’extraction des composants primaires du modèle s’effectue au moyen de fonctions génériques hautement optimisées. La commande coef(modele_lineaire) extrait le vecteur des paramètres β̂. La fonction residuals(modele_lineaire) extrait le vecteur des résidus ordinaires ei, tandis que fitted(modele_lineaire) récupère les prédictions paramétriques ŷi. L’exécution de summary(modele_lineaire) produit une synthèse globale comprenant les erreurs types des estimateurs, les statistiques de Student associées à chaque covariable, ainsi que l’analyse de la variance résiduelle traduite par l’erreur type résiduelle (residual standard error) et le coefficient de détermination corrigé.
L’objet de classe lm encapsule l’intégralité de la géométrie de projection du modèle. Il est capital de noter que cet objet n’intègre pas d’emblée la totalité de la matrice chapeau n × n en mémoire vive, car pour un échantillon de 100 000 observations, le stockage d’une telle matrice nécessiterait plusieurs dizaines de gigaoctets de mémoire tampon. R adopte une stratégie d’évaluation paresseuse et algorithmique, ne calculant les composantes diagonales hii que sur demande explicite de l’utilisateur à partir des composantes de la décomposition QR préexistante, assurant ainsi une légèreté d’exécution remarquable.
4. Calcul direct des statistiques de levier avec la fonction hatvalues()
4.1 Mise en œuvre pratique de la commande hatvalues()
Pour calculer les statistiques de levier associées à chaque unité statistique, le langage R met à disposition la fonction dédiée et optimisée hatvalues(). Cette fonction appartient au package standard stats, automatiquement chargé à l’initialisation de chaque session de travail. L’extraction des statistiques de projection s’effectue en transmettant simplement l’objet de régression comme argument opérationnel :
valeurs_levier <- hatvalues(modele_lineaire)
L’objet retourné est un vecteur numérique nommé, dont la dimension est strictement égale au nombre d’observations ayant contribué à l’ajustement linéaire après élimination des données manquantes. Chaque élément du vecteur porte pour nom l’étiquette de ligne correspondante dans le tableau de données initial, ce qui évite toute ambiguïté d’appariement.
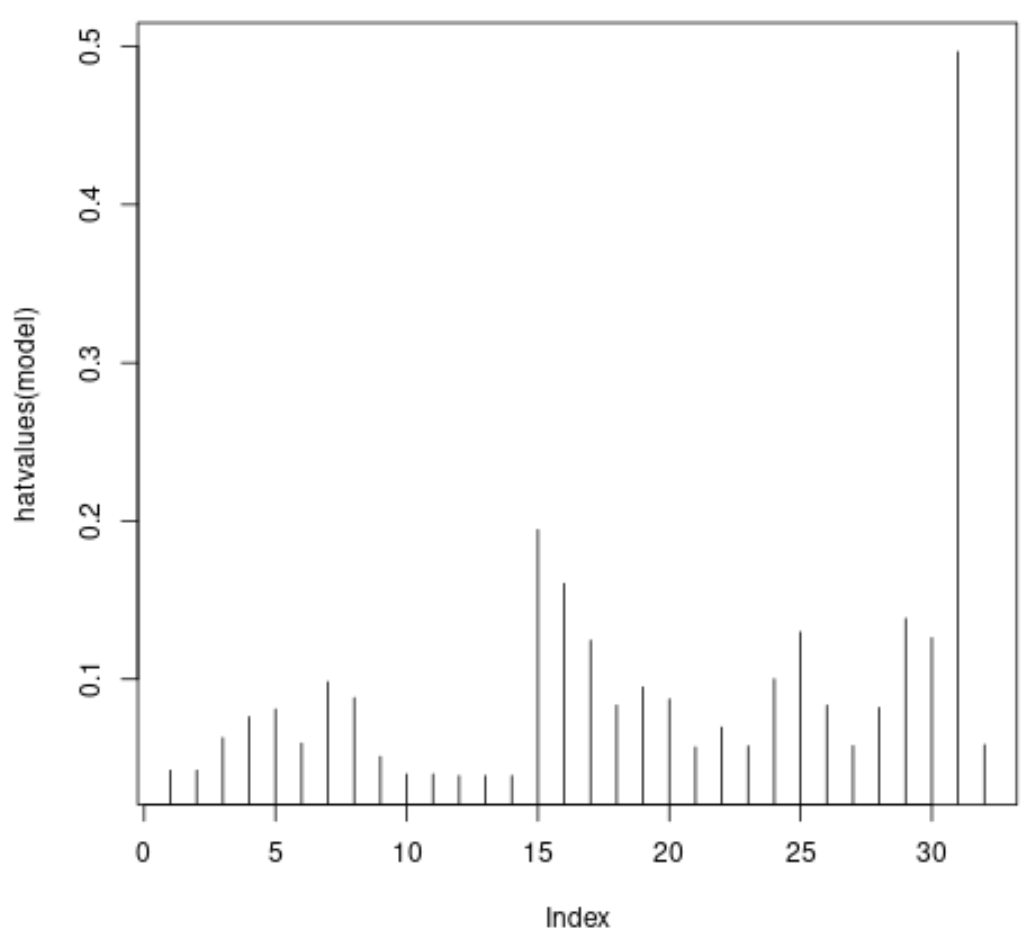
Dès l’obtention du vecteur des leviers, il convient de procéder à une validation quantitative de sa cohérence structurelle. Le statisticien doit vérifier que la longueur du vecteur correspond précisément à n (obtenu par nobs(modele_lineaire)). L’examen descriptif univarié s’effectue au moyen des fonctions min(valeurs_levier), max(valeurs_levier), mean(valeurs_levier) et quantile(valeurs_levier). On observera systématiquement que la moyenne empirique coïncide à la précision machine près avec le ratio théorique p/n, où p inclut la constante du modèle. Si une observation présente une valeur maximale approchant l’unité (par exemple 0.95 ou davantage), l’analyste se trouve immédiatement alerté de la présence d’une observation dont le potentiel de distorsion sur les coefficients est critique.
L’intégration systématique du vecteur de levier dans le jeu de données initial facilite les manipulations analytiques ultérieures. Cette intégration s’exécute de manière élégante par assignation indicée :
donnees$leverage <- hatvalues(modele_lineaire)
Cette approche permet d’appliquer immédiatement des filtres logiques et des tris décroissants sur le tableau de données afin d’isoler les entités présentant les scores de levier les plus élevés et d’examiner en détail les valeurs prises par leurs différentes variables explicatives.
4.2 Comparaison méthodologique avec les fonctions alternatives
Bien que la fonction hatvalues() constitue la méthode d’accès la plus directe et la plus fréquemment préconisée, l’écosystème de base de R dispose d’autres fonctions capables de générer ou de contenir les statistiques de projection orthogonale. La plus notable est la fonction d’infrastructure lm.influence(). Cette routine interne calcule les éléments fondamentaux nécessaires à l’ensemble des diagnostics d’influence. L’exécution de l’instruction :
diagnostics_influence <- lm.influence(modele_lineaire)
génère une structure de type liste contenant plusieurs matrices et vecteurs numériques. Parmi ces composants figure la composante diagnostics_influence$hat, qui reproduit exactement le vecteur des valeurs de levier hii. De plus, lm.influence() extrait les résidus modifiés par omission unitaire (jackknife residuals) ainsi que la matrice des variations de coefficients induites par la suppression séquentielle de chaque observation (coefficients).
Parallèlement, la fonction influence.measures() fournit une solution analytique globale clé en main. En appelant influence.measures(modele_lineaire), R calcule simultanément les DFBETAS, les DFFITS, les ratios de covariance, les distances de Cook ainsi que les hatvalues. La fonction assemble ces métriques dans un tableau synoptique exhaustif et applique automatiquement des règles heuristiques binaires marquant par un astérisque les observations qui dépassent les seuils critiques conventionnels pour chaque métrique respective. Cette sortie matricielle est particulièrement précieuse pour une inspection exploratoire rapide lors de la phase initiale d’évaluation d’un modèle.
Sur le plan des performances algorithmiques et de la gestion de la mémoire, des différences techniques majeures existent entre ces alternatives. Pour des ensembles de données de grande taille (comportant plusieurs dizaines ou centaines de milliers d’observations), l’appel de influence.measures() s’avère inutilement coûteux en temps processeur et en empreinte mémoire si le chercheur ne cherche à obtenir que les éléments de projection géométrique. La fonction hatvalues() est hautement spécialisée et fait directement appel à du code compilé en C ou Fortran exploitant la factorisation QR préexistante, garantissant un temps de calcul négligeable. Des tests de cohérence numérique confirment que, sous réserve des approximations arithmétiques en virgule flottante, les sorties vectorielles issues de hatvalues(m), lm.influence(m)$hat et de la colonne correspondante de influence.measures(m)$infmat sont strictement identiques.
5. Dérivation matricielle manuelle de la matrice chapeau dans R
5.1 Construction algorithmique de la matrice des prédicteurs
Pour assimiler en profondeur la mécanique du levier statistique et comprendre le fonctionnement des routines de R, il est particulièrement formateur de procéder à la dérivation matricielle explicite de la matrice chapeau en écrivant soi-même les équations d’algèbre linéaire. La première étape de cette démarche algorithmique consiste à construire la matrice de modélisation formelle X. Il ne suffit pas de combiner arbitrairement les prédicteurs au sein d’un tableau de données ; il faut extraire rigoureusement la matrice telle qu’elle est interprétée par le moteur mathématique de régression, en tenant compte du codage des contrastes factoriels et de l’inclusion du terme constant.
R fournit à cet effet la fonction fondamentale model.matrix(), qui prend comme arguments la formule symbolique du modèle et le jeu de données sous-jacent :
X <- model.matrix(modele_lineaire)
L’inspection de cette matrice avec des commandes telles que dim(X) et head(X) permet de constater que sa première colonne est invariablement constituée d’une suite de valeurs unitaires (le vecteur colonne de uns modélisant l’ordonnée à l’origine, noté (Intercept)), à moins que la régression n’ait été explicitement paramétrée sans constante via la syntaxe y ~ 0 + x. De plus, pour toute variable qualitative présente dans la formule, model.matrix() génère automatiquement les colonnes de variables indicatrices muettes (dummy variables) selon la paramétrisation des contrastes par défaut (généralement contr.treatment).
Avant d’engager des opérations matricielles d’inversion, il est indispensable de vérifier le rang mathématique de X afin d’écarter tout problème de collinéarité exacte (singularité matricielle). Cette vérification s’exécute par la fonction qr(X)$rank. Pour que l’inversion de la matrice de Gram soit valide, le rang calculé doit être strictement égal au nombre total de colonnes p. Si le rang est inférieur à p, la matrice est structurellement singulière, ce qui signale qu’au moins une variable explicative est une combinaison linéaire exacte d’autres prédicteurs. R gère nativement cette situation dans lm() en assignant des coefficients non définis (NA) aux colonnes redondantes, mais une tentative d’inversion manuelle brute déclencherait une interruption d’exécution via une erreur d’inversibilité.
5.2 Calcul matriciel explicite des diagonales de projection
Dès lors que la matrice X est validée et de rang plein, le calcul algébrique de la matrice de projection H = X(XTX)-1XT peut être implémenté manuellement. Dans le langage R, l’opérateur de multiplication matricielle est délimité par des pourcentages : %*%. La transposée d’une matrice s’obtient au moyen de t(), et l’inversion d’une matrice carrée s’exécute à l’aide de solve(). Pour optimiser le produit matriciel symétrique XTX, il est fortement conseillé d’utiliser la fonction dédiée crossprod(X), qui calcule ce produit scalaire de manière substantiellement plus rapide et avec une meilleure précision numérique que l’instruction naïve t(X) %*% X.
L’opération matricielle globale peut ainsi être formulée comme suit :
XtX_inv <- solve(crossprod(X))
H <- X %*% XtX_inv %*% t(X)
Cette commande génère la matrice complète de projection H de dimension n × n. L’extraction des statistiques de levier individuelles hii s’effectue ensuite en isolant la diagonale principale de cet opérateur matriciel grâce à la fonction diag() :
levier_manuel <- diag(H)
La validation scientifique de ce calcul manuel se concrétise en vérifiant l’égalité numérique absolue avec les résultats issus de la fonction native hatvalues(). L’utilisation de l’opérateur d’égalité stricte == pouvant être compromise par les erreurs infinitésimales d’arrondi en virgule flottante, on utilise la fonction de validation formelle :
all.equal(levier_manuel, hatvalues(modele_lineaire))
Cette instruction renvoie la valeur booléenne TRUE, confirmant que l’extraction native de R correspond rigoureusement à l’application de la théorie matricielle pure. Enfin, une démonstration empirique fondamentale consiste à calculer la somme de ces éléments diagonaux :
sum(levier_manuel)
Le résultat obtenu est rigoureusement égal à la valeur scalaire p (le nombre total de prédicteurs plus un pour l’ordonnée à l’origine). Cette vérification confirme de façon tangible le théorème de la trace de la projection orthogonale, selon lequel la somme des degrés de levier individuels équivaut exactement à la dimension du sous-espace d’ajustement.
6. Seuils critiques et critères de décision statistique
6.1 Règles empiriques standards basées sur la moyenne théorique
L’obtention d’un vecteur de valeurs de levier ne présente d’intérêt pratique que si l’analyste dispose de règles de décision statistique objectives pour discriminer les observations ordinaires de celles exerçant un ancrage disproportionné. Puisque la somme de l’ensemble des hii est invariablement égale à p pour un échantillon de taille n, la valeur moyenne théorique du levier au sein de la population étudiée est universellement définie par l’espérance mathématique :
h̄ = Tr(H) / n = p / n
où p représente le nombre de paramètres estimés dans l’équation de régression (incluant le terme d’interception) et n est l’effectif total de l’échantillon analysé. Cette moyenne constitue le point de repère invariable à partir duquel s’articulent l’ensemble des règles de décision heuristiques.
Dans la littérature méthodologique, deux seuils empiriques ont acquis une prééminence classique. Le premier, qualifié de critère libéral, établit qu’une observation doit être considérée comme un point de levier préoccupant dès lors que sa valeur de projection dépasse le double du levier moyen théorique :
Seuil libéral = 2p / n
Ce seuil est largement recommandé dans les phases exploratoires et pour les échantillons de grande dimension, car il permet de détecter précocement tout éloignement relatif vis-à-vis du centroïde sans pour autant signaler un nombre déraisonnable de faux positifs.
Le second seuil, plus strict et conservateur, est formulé par le triple de la moyenne théorique :
Seuil conservateur = 3p / n
Ce seuil de 3p/n est particulièrement préconisé dans les études confirmatoires et les analyses économétriques exigeant un degré élevé de certitude avant d’isoler ou de retraiter un point particulier. L’analyste doit toutefois demeurer conscient de la sensibilité intrinsèque de ces règles face à la taille de l’échantillon. Pour des échantillons de petite taille (par exemple n = 20 et p = 5), le seuil de 3p/n atteint 0.75, ce qui est très proche de la borne supérieure théorique de 1, rendant le critère extrêmement difficile à franchir. Réciproquement, pour des bases de données massives (n = 100 000 et p = 10), la moyenne théorique p/n s’établit à 0.0001 ; le seuil du double (0.0002) risque alors d’isoler des milliers d’observations dont la singularité spatiale n’exerce en réalité aucune influence délétère sur la stabilité des paramètres.
6.2 Critères avancés et distributions d’échantillonnage
Pour pallier les insuffisances des règles heuristiques simples en présence d’échantillons de taille modérée ou réduite, David C. Hoaglin et Roy E. Welsch ont proposé en 1978 une analyse approfondie de la distribution d’échantillonnage des éléments diagonaux de la matrice chapeau. Leurs travaux démontrent que, sous l’hypothèse de normalité multivariée des prédicteurs, les statistiques de levier hii suivent approximativement une distribution Bêta rééchelonnée. Dans cette configuration géométrique idéale, Hoaglin et Welsch ont formellement établi que la règle de décision 2p/n isole approximativement le centile supérieur à 95% de la distribution lorsque n – p > 60, justifiant théoriquement l’usage de cette coupure comme un test formel d’hypothèse bilatérale non paramétrique.
Pour les contextes où n est relativement proche de p, une règle de coupure plus rigide, souvent fixée de manière absolue à la valeur scalaire hii > 0.5, est traditionnellement adoptée. En effet, un levier excédant 0.5 confère à l’observation isolée un poids supérieur à celui de l’ensemble combiné de plusieurs dizaines d’autres observations, ce qui viole le principe fondamental de représentativité statistique collective sur lequel repose l’inférence des moindres carrés.
L’implémentation sous R d’un algorithme d’identification automatisée des observations critiques franchissant ces seuils s’avère particulièrement simple et élégante. Considérons l’extrait de logique computationnelle suivant :
p <- length(coef(modele_lineaire))
n <- nobs(modele_lineaire)
seuil_2p <- 2 * p / n
seuil_3p <- 3 * p / n
leviers <- hatvalues(modele_lineaire)
points_critiques_2p <- which(leviers > seuil_2p)
points_critiques_3p <- which(leviers > seuil_3p)
La création de variables indicatrices binaires enrichit le jeu de données pour des filtrages conditionnels ultérieurs :
donnees$fort_levier <- ifelse(leviers > seuil_2p, TRUE, FALSE)
Cette vectorisation logique permet non seulement d’extraire instantanément la liste nominative des individus aberrants dans l’espace des covariables via rownames(donnees)[donnees$fort_levier], mais constitue également la base algorithmique indispensable pour générer des représentations graphiques diagnostiques enrichies.
7. Visualisation graphique avancée des valeurs de levier
7.1 Représentations univariées avec R base
L’inspection tabulaire des statistiques de levier présente des limites cognitives sévères dès lors que la taille de l’échantillon excède quelques dizaines d’unités. Le recours à des visualisations diagnostiques constitue le moyen le plus efficace d’appréhender la morphologie spatiale des données et d’isoler visuellement les ruptures de continuité. Le système graphique natif de R (R base graphics) propose une suite d’outils hautement performants pour matérialiser ces distributions sans requérir de dépendances logicielles externes.
La représentation graphique canonique consiste à tracer l’indice séquentiel des observations en abscisse et les valeurs de levier correspondantes en ordonnée. Cette mise en œuvre s’articule autour de la fonction plot(), agrémentée de paramètres esthétiques et d’ajouts de lignes seuils :
plot(leviers, type = "h", main = "Diagnostic des valeurs de levier par observation", xlab = "Indice de l'observation", ylab = "Statistique de levier (h_ii)", col = "steelblue", lwd = 1.5)
points(leviers, pch = 19, cex = 0.6, col = "darkblue")
abline(h = seuil_2p, col = "orange", lty = 2, lwd = 2)
abline(h = seuil_3p, col = "firebrick", lty = 3, lwd = 2)
Pour automatiser l’étiquetage des observations pathologiques sans encombrer la zone graphique, l’analyste peut déployer la fonction text() couplée à un prédicat d’indexation conditionnelle :
indices_atypiques <- which(leviers > seuil_2p)
text(x = indices_atypiques, y = leviers[indices_atypiques], labels = names(indices_atypiques), pos = 3, cex = 0.8, col = "firebrick")
Au-delà du diagramme d’indice séquentiel, l’analyse univariée de la distribution empirique du vecteur de levier requiert la génération d’histogrammes de fréquence et de boîtes à moustaches (boxplots). L’exécution de hist(leviers, breaks = 30, col = "lavender", main = "Distribution de densite du levier", xlab = "h_ii") permet d’objectiver l’asymétrie positive typique de ces distributions, où une vaste majorité d’observations s’agglutine à proximité immédiate de 0, tandis qu’une traîne étroite s’étend vers les valeurs supérieures. La boîte à moustaches produite via boxplot(leviers, horizontal = TRUE, col = "lightcyan") illustre quant à elle la dispersion interquartile et isole visuellement les points franchissant la clôture externe de Tukey (1.5 fois l’écart interquartile au-delà du troisième quartile).
7.2 Graphiques diagnostiques élaborés avec ggplot2
Pour satisfaire aux exigences typographiques et esthétiques contemporaines des publications scientifiques, le package ggplot2 offre une flexibilité graphique sans équivalent. Grâce au concept de grammaire des graphiques, l’analyste peut composer des représentations élaborées, telles que le tracé de type « sucette » (lollipop chart), qui allie la précision de lecture d’une tige segmentaire à la clarté d’un point focal.
Pour concevoir une telle visualisation, le jeu de données sous-jacent est préalablement enrichi des identifiants et des métriques seuils. Le pipeline logique s’articule comme suit :
library(ggplot2)
library(ggrepel)
df_diag <- data.frame(id = seq_along(leviers), leverage = leviers, etiquette = rownames(donnees))
df_diag$statut <- ifelse(df_diag$leverage > seuil_3p, "Critique (>3p/n)", ifelse(df_diag$leverage > seuil_2p, "Attention (>2p/n)", "Normal"))
L’assemblage des couches de données, de géométries et d’échelles de couleurs personnalisées produit un graphique hautement informatif :
ggplot(df_diag, aes(x = id, y = leverage)) +
geom_segment(aes(x = id, xend = id, y = 0, yend = leverage), color = "gray70") +
geom_point(aes(color = statut), size = 2) +
geom_hline(yintercept = seuil_2p, linetype = "dashed", color = "darkorange", linewidth = 0.8) +
geom_hline(yintercept = seuil_3p, linetype = "dotted", color = "red3", linewidth = 0.8) +
scale_color_manual(values = c("Normal" = "steelblue", "Attention (>2p/n)" = "darkorange", "Critique (>3p/n)" = "red3")) +
geom_text_repel(data = subset(df_diag, leverage > seuil_2p), aes(label = etiquette), size = 3.5, max.overlaps = 15) +
labs(title = "Évaluation diagnostique du levier multidimensionnel", subtitle = paste("Seuils de décision : 2p/n =", round(seuil_2p, 4), "| 3p/n =", round(seuil_3p, 4)), x = "Index d'observation", y = "Valeur de projection (h_ii)", color = "Classification") +
theme_minimal(base_size = 12) +
theme(legend.position = "bottom", panel.grid.minor = element_blank())
L’incorporation de l’extension ggrepel résout de manière algorithmique le problème critique de la superposition des étiquettes textuelles lorsque plusieurs observations à fort levier sont regroupées sur des indices séquentiels rapprochés. Ce type de graphique permet une communication transparente des anomalies observationnelles auprès des pairs dans le cadre d’un rapport méthodologique ou d’un article soumis à évaluation scientifique.
8. Diagnostic combiné : Intégration du levier et des résidus
8.1 Diagramme de levier contre résidus studentisés
L’analyse isolée du levier statistique ne permet pas d’évaluer l’impact effectif d’un point sur les paramètres estimés. Une observation dotée d’un levier élevé mais dont la valeur dépendante est parfaitement alignée sur l’hyperplan de régression ne déforme pas le modèle. C’est pourquoi le diagnostic moderne impose une approche combinée confrontant le levier à l’ampleur du résidu. Les résidus bruts étant impropres à cette comparaison en raison de leur variance non constante Var(ei) = σ2(1 – hii), il est impératif de recourir aux résidus studentisés externes, couramment dénommés résidus studentisés par omission unitaire (jackknife residuals ou externally studentized residuals).
Dans le langage R, ces métriques d’erreur se calculent par la commande rstudent() :
residus_studentises <- rstudent(modele_lineaire)
La formule analytique du résidu studentisé externe pour la i-ème observation s’écrit :
ti = ei / [s(i) √(1 – hii)]
où s(i) représente l’estimation de l’erreur type résiduelle obtenue en recalibrant le modèle sur l’échantillon complet amputé de l’observation i. Sous les hypothèses classiques de normalité des perturbations, chaque ti suit exactement une loi de Student à n – p – 1 degrés de liberté, ce qui autorise des tests d’hypothèses rigoureux (les valeurs absolues excédant 2 ou 3 signalant des valeurs aberrantes significatives).
Le tracé bivarié confrontant les hatvalues en abscisse aux rstudent en ordonnée constitue un outil diagnostique décisif. Dans ce plan cartésien, l’espace se divise en quatre zones méthodologiques :
- Le quadrant inférieur/médian gauche (faible levier, résidu modéré) : zone de conformité normale.
- Le quadrant supérieur gauche (faible levier, fort résidu) : zone d’aberrance univariée sans gravité structurelle majeure.
- Le quadrant inférieur droit (fort levier, faible résidu) : zone des points d’appui concordants.
- Le quadrant supérieur/extrême droit (fort levier et fort résidu) : la zone de danger critique. Les points s’y situant tirent violemment le modèle vers eux tout en demeurant incapables d’être bien ajustés, ce qui signale une distorsion majeure des estimateurs vectoriels.
Dans l’environnement R de base, la commande plot(modele_lineaire, which = 5) génère automatiquement ce graphique combiné (« Residuals vs Leverage »), superposant des courbes lissées et les délimitations spatiales des points problématiques.
8.2 Surimpression de la distance de Cook et contours de contour
Le raffinement suprême du diagramme de levier contre résidus studentisés réside dans la surimpression des lignes d’isodistance de Cook. Puisque la distance de Cook s’exprime analytiquement comme une fonction conjointe du résidu et de la métrique hii/(1 – hii), il est mathématiquement possible de tracer, sur le plan cartésien (hii, résidu), des hyperboles de niveau constant correspondant aux seuils critiques de Cook usuels (typiquement D = 0.5 et D = 1.0).
L’affichage natif produit par plot(modele_lineaire, which = 5) intègre automatiquement ces contours d’isodistance de Cook sous la forme de lignes tiretées rouges lorsque les observations de l’échantillon s’approchent ou franchissent ces limites critiques. Si aucune ligne tiretée n’apparaît sur le graphique, cela indique de facto qu’aucune observation n’atteint le seuil d’influence de D = 0.5, ce qui rassure l’analyste quant à la stabilité générale des prédictions.
L’inspection analytique de ce graphique permet de repérer ce que les méthodologues qualifient de « points charnières » (pivot points). Un point charnière possède un levier très élevé (proche de 1) mais un résidu quasiment nul. Sur le graphique, il se situe au ras de l’axe horizontal d’ordonnée zéro, tout à fait à l’extrémité droite de l’axe des abscisses. Bien que sa distance de Cook puisse demeurer sous le seuil d’alerte en raison de la nullité de son résidu, ce point est d’une précarité extrême : si une légère modification survenait dans la collecte de sa valeur de réponse y, le point bondirait instantanément dans le quadrant de danger critique et infléchirait l’hyperplan avec une violence décuplée. L’analyste doit donc systématiquement identifier ces points pivots, car ils signalent une fragilité potentielle du modèle qui se manifestera dès que de nouvelles données seront collectées.
9. Utilisation d’écosystèmes et de packages R spécialisés
9.1 Exploitation du package car pour l’analyse diagnostique
Le package car (Companion to Applied Regression), développé initialement par John Fox et Sanford Weisberg, constitue l’un des piliers méthodologiques les plus reconnus pour l’économétrie et les sciences sociales quantitatives dans R. Ce package enrichit considérablement les capacités natives du système grâce à des fonctions de diagnostic intégrées à haute valeur ajoutée conceptuelle.
La commande emblématique du package pour l’analyse du levier et de l’influence est influencePlot(). Cette fonction génère un diagramme de dispersion élaboré qui synthétise simultanément quatre dimensions statistiques :
library(car)
influencePlot(modele_lineaire, id = list(method = "identify"), main = "Diagramme d'influence combiné (car)")
Sur ce graphique novateur, l’axe des abscisses porte les valeurs de levier hii, l’axe des ordonnées affiche les résidus studentisés externes, et chaque observation est matérialisée par une bulle circulaire dont le diamètre est directement proportionnel à sa distance de Cook. Des lignes de démarcation horizontales (à -2, 0 et +2 écarts types résiduels) et verticales (aux seuils de 2p/n et 3p/n) divisent l’espace en sous-régions analytiques. Les observations franchissant simultanément les critères de levier et de résidu sont étiquetées automatiquement, et la fonction renvoie en console une matrice récapitulative contenant les valeurs précises des résidus studentisés, des hat values et des distances de Cook pour ces entités singulières.
En complément, la routine car::influenceIndexPlot() permet d’extraire et de représenter graphiquement sur un panneau multi-figures vertical l’ensemble des diagnostics d’influence indexés par observation. En un seul appel :
influenceIndexPlot(modele_lineaire, vars = c("hat", "Cook", "Studentized"))
le chercheur obtient une série synchronisée de tracés d’indices alignés, facilitant l’identification visuelle immédiate des sujets qui combinent un pic sur le graphique des hat values avec une élévation anormale sur le graphique de Cook. Cette standardisation méthodologique offerte par le package car garantit une analyse exhaustive et directement reproductible dans le respect des standards académiques.
9.2 Diagnostic moderne avec broom et olsrr
L’avènement de l’écosystème Tidyverse a profondément renouvelé la manipulation des structures de données en R. Le package broom joue un rôle charnière dans cette modernisation en convertissant les objets statistiques complexes issus de lm() en structures de données rectangulaires standardisées (tibbles). La fonction fondamentale broom::augment() enrichit le tableau de données d’origine avec l’ensemble des métriques diagnostiques générées par le modèle :
library(broom)
library(dplyr)
table_diagnostique <- augment(modele_lineaire)
Dans ce nouveau tableau tabulaire, les valeurs de levier sont systématiquement consignées sous le nom de colonne standardisé .hat, les résidus ordinaires sous .resid, les résidus studentisés sous .std.resid, et la distance de Cook sous .cooksd. Grâce à cette standardisation relationnelle, le filtrage et le tri des observations déviantes s’opèrent avec la fluidité syntaxique caractéristique de dplyr :
sujets_problematiques <- table_diagnostique %>%
filter(.hat > seuil_2p | .cooksd > 0.5) %>%
arrange(desc(.hat))
Parallèlement à la flexibilité universelle de broom, le package spécialisé olsrr propose une boîte à outils explicitement dédiée à l’enseignement et à la recherche en régression linéaire multiple. Ce package offre des routines spécialisées d’une grande clarté opérationnelle. Par exemple, la fonction ols_plot_resid_lev() produit d’un bloc un graphique ggplot sophistiqué partitionnant les données selon leurs statuts d’aberrance et de levier. De même, la commande ols_plot_hadi() implémente la métrique de Hadi, une alternative matricielle robuste conçue pour surmonter les effets de masquage lorsque plusieurs points à fort levier sont regroupés en grappes compactes. L’incorporation de ces bibliothèques dans un pipeline d’analyse garantit un gain de productivité substantiel et un code épuré, parfaitement aligné sur les pratiques contemporaines de la science des données.
10. Traitement méthodologique des observations à fort levier
10.1 Investigation de la genèse des points de levier élevé
La découverte d’observations présentant un levier statistique extrême ne doit jamais être interprétée comme une invitation mécanique à leur élimination aveugle. Dans la démarche scientifique, un point atypique est porteur d’une information potentiellement cruciale sur le phénomène étudié ou sur les conditions de production des données. Le statisticien doit se muer en enquêteur et procéder à un audit méthodique de la genèse de cette singularité spatiale avant d’envisager la moindre intervention corrective.
La première piste d’investigation concerne les erreurs matérielles d’acquisition, de transcription ou d’encodage. Une observation peut se retrouver dotée d’un levier titanesque simplement parce qu’un opérateur a saisi un zéro supplémentaire lors de l’enregistrement manuel d’une variable biologique, industrielle ou monétaire, déplaçant instantanément le sujet à plusieurs centaines d’écarts types du centroïde de la distribution. De même, des confusions d’unités de mesure (par exemple exprimer la taille d’un sujet en millimètres au lieu de mètres au sein d’un échantillon par ailleurs homogène) génèrent des points de levier aberrants. Si une telle erreur d’encodage est formellement démontrée par un retour au protocole source ou au registre d’expérimentation, la correction de la valeur corrompue (ou, à défaut, son exclusion) s’impose comme une nécessité méthodologique absolue et scientifiquement légitime.
La seconde hypothèse structurelle renvoie à la validité écologique de l’échantillonnage et à la présence non détectée d’hétérogénéités sous-jacentes. Le point à fort levier peut ne pas être une erreur de mesure, mais plutôt le révélateur d’une sous-population marginale n’appartenant pas à l’espace de référence du phénomène théorique modélisé. En épidémiologie clinique, il peut s’agir d’un patient porteur d’une comorbidité rare non documentée ; en économétrie financière, d’une multinationale dont l’échelle capitalistique défie les régularités observées chez les petites et moyennes entreprises formant le reste de l’échantillon. Enfin, des dysfonctionnements instrumentaux lors de collectes automatisées (saturation de capteurs physiques, pannes de transmission) constituent une source récurrente de singularités géométriques.
Sur le plan déontologique et épistémologique, l’exclusion arbitraire d’une observation valide dans le seul dessein d’améliorer le coefficient de détermination R2 ou d’atteindre un seuil de significativité p < 0.05 constitue une fraude scientifique caractérisée (pratique assimilée au p-hacking ou au tri opportuniste de données). La décision d’écarter un point doit toujours être motivée par des arguments théoriques ou instrumentaux pré-analytiques et faire l’objet d’une divulgation exhaustive dans le rapport méthodologique de l’étude.
10.2 Techniques de modélisation alternative et analyses de sensibilité
Lorsque des observations à fort levier se révèlent être des données authentiques, représentatives d’une réalité structurelle complexe, et que leur suppression est exclue pour des motifs de validité de construit, le statisticien doit abandonner l’estimation standard par moindres carrés ordinaires au profit d’approches de modélisation robustes ou de réajustements mathématiques adaptés.
La première stratégie corrective consiste à appliquer des transformations non linéaires aux prédicteurs incriminés afin de résorber leur dispersion multivariée. La transformation logarithmique canonique log(x) (ou la transformation généralisée de Box-Cox) compresse spectaculairement les échelles de distribution à traîne longue, rapprochant les observations isolées du barycentre de l’échantillon. Cette transformation modifie la spécification fonctionnelle en un modèle log-linéaire ou log-log, ce qui résout mécaniquement la pathologie du fort levier tout en conservant l’intégralité des unités statistiques dans le processus d’estimation.
La deuxième alternative fondamentale réside dans l’adoption d’estimateurs robustes conçus spécifiquement pour neutraliser les effets de projection extrême. Le package MASS fournit la fonction rlm() (robust linear model), qui implémente les M-estimateurs avec pondérations récursives (par exemple la fonction de pondération de Huber ou le bi-poids de Tukey). Toutefois, il est impératif de souligner une nuance théorique majeure : les M-estimateurs standards sont très efficaces pour neutraliser les valeurs aberrantes selon l’axe vertical des résidus, mais ils demeurent vulnérables aux points de fort levier dans l’espace des prédicteurs. Pour juguler spécifiquement l’effet de levier, il convient d’adopter des estimateurs à point de rupture élevé (high-breakdown estimators), tels que l’estimateur des moindres carrés tronqués (LTS – Least Trimmed Squares) ou les estimateurs de type MM, implémentés dans le package spécialisé robustbase via la fonction lmrob() :
library(robustbase)
modele_robuste <- lmrob(y ~ x1 + x2, data = donnees)
Parallèlement, l’analyste peut déployer des procédures de rééchantillonnage de type bootstrap (notamment le wild bootstrap) pour évaluer la sensibilité empirique des erreurs types et vérifier si l’inférence paramétrique est dépendante des configurations géométriques extrêmes.
Enfin, la règle d’or méthodologique préconise la mise en œuvre d’un protocole d’analyse de sensibilité double. Le chercheur présente, dans un tableau comparatif transparent, les résultats du modèle calibré sur l’échantillon intégral aux côtés de ceux obtenus après exclusion des points de levier critique ou via une estimation robuste. Si les coefficients vectoriels et les conclusions qualitatives demeurent concordants entre les deux spécifications, l’analyste peut affirmer avec confiance la robustesse de ses conclusions empiriques face aux perturbations géométriques.
11. Étude de cas appliquée : Modélisation multivariée étape par étape
11.1 Mise en situation empirique et contextualisation des variables
Afin de consolider les principes théoriques et méthodologiques exposés jusqu’ici, développons une étude de cas appliquée et intégrale sous R. Imaginons une recherche menée en économétrie régionale portant sur la performance d’innovation technologique de n = 100 bassins d’emploi territoriaux. La variable dépendante continue, notée Score_Innovation, quantifie l’indice d’activité brevetée par habitant. Le modèle mobilise trois covariables continues explicatives :
Depenses_RD: Montant des investissements territoriaux en Recherche & Développement (en millions d’euros).Diplomes_Superieur: Pourcentage de la population active détenant un diplôme d’études supérieures.Densite_Entreprises: Nombre d’entreprises de haute technologie par kilomètre carré.
Pour assurer la reproductibilité parfaite de cette démonstration empirique, nous initialisons un générateur de nombres pseudo-aléatoires et synthétisons un jeu de données reflétant des conditions de recherche réelles, au sein duquel nous injectons délibérément un point doté d’une configuration spatiale singulière :
set.seed(42)
n <- 100
Depenses_RD <- rnorm(n, mean = 50, sd = 10)
Diplomes_Superieur <- rnorm(n, mean = 30, sd = 5)
Densite_Entreprises <- rnorm(n, mean = 15, sd = 3)
Score_Innovation <- 5 + 0.4 * Depenses_RD + 0.8 * Diplomes_Superieur + 0.5 * Densite_Entreprises + rnorm(n, mean = 0, sd = 4)
donnees_territoires <- data.frame(Depenses_RD, Diplomes_Superieur, Densite_Entreprises, Score_Innovation)
Nous introduisons ensuite manuellement une observation critique sur l’observation numéro 100. Ce territoire métropolitain atypique concentre des dépenses de R&D massives et une densité d’entreprises sans commune mesure avec le reste des territoires :
donnees_territoires$Depenses_RD[100] <- 120
donnees_territoires$Densite_Entreprises[100] <- 38
donnees_territoires$Score_Innovation[100] <- 45
Nous procédons à l’ajustement du modèle de régression linéaire multivariée par les moindres carrés ordinaires :
modele_eco <- lm(Score_Innovation ~ Depenses_RD + Diplomes_Superieur + Densite_Entreprises, data = donnees_territoires)
L’extraction des statistiques de levier et la quantification des critères de décision empiriques s’exécutent conformément aux formulations théoriques :
p <- length(coef(modele_eco))
leviers_eco <- hatvalues(modele_eco)
seuil_2p <- 2 * p / n
seuil_3p <- 3 * p / n
Avec p = 4 (la constante plus les trois covariables) et n = 100, la moyenne théorique du levier s’établit à p/n = 0.04. Par conséquent, le seuil libéral correspond à 0.08, tandis que le seuil conservateur s’élève à 0.12. L’interrogation de l’observation 100 révèle une statistique leviers_eco[100] approchant 0.45, excédant ainsi de plus de trois fois le seuil conservateur le plus exigeant. Ce territoire se situe aux confins géométriques de la distribution d’échantillonnage, constituant un ancrage potentiel majeur sur le plan factoriel.
11.2 Évaluation comparative des modèles après traitement
Pour mesurer l’ampleur exacte de la perturbation exercée par ce point de levier extrême (qui s’avère être discordant puisque son score d’innovation de 45 est substantiellement inférieur à ce que son volume colossal de dépenses prédirait sous la pente nominale), nous réajustons le modèle linéaire sur l’échantillon expurgé de cette entité observationnelle :
modele_sans_100 <- lm(Score_Innovation ~ Depenses_RD + Diplomes_Superieur + Densite_Entreprises, data = donnees_territoires[-100, ])
La comparaison numérique rigoureuse des coefficients estimés et de leurs intervalles de confiance à 95% met en relief l’instabilité induite par l’observation singulière :
coef_complet <- coef(modele_eco)
coef_tronque <- coef(modele_sans_100)
ic_complet <- confint(modele_eco)
ic_tronque <- confint(modele_sans_100)
L’examen des sorties révèle que dans le modèle complet, le coefficient estimé pour la variable Depenses_RD est artificiellement tiré vers le bas (par exemple aux alentours de 0.28 au lieu de sa valeur théorique génératrice de 0.40), car la droite a été mécaniquement contrainte de s’incliner pour accommoder la position aberrante de l’observation 100. Dès l’omission du point, le coefficient réévalué remonte spectaculairement à proximité de 0.41, retrouvant sa concordance avec le processus générateur de données sous-jacent. L’erreur type résiduelle diminue simultanément, restaurant la puissance des tests de Student.
Voici la synthèse reproductible sous forme de script R entièrement documenté, encapsulant la procédure diagnostique complète :
# 1. Extraction et enrichissement diagnostique
diagnostics <- data.frame(
Indicateur = c("Levier moyen (p/n)", "Seuil critique 2p/n", "Seuil critique 3p/n", "Levier max observe (obs #100)", "Cook max observe (obs #100)"),
Valeur = c(p/n, seuil_2p, seuil_3p, leviers_eco[100], cooks.distance(modele_eco)[100])
)
print(diagnostics)
# 2. Tableau comparatif des estimations
comparaison_coefs <- cbind(
Modele_Complet = coef(modele_eco),
Modele_Corrige = coef(modele_sans_100),
Biais_Relatif_Pct = ((coef(modele_eco) - coef(modele_sans_100)) / coef(modele_sans_100)) * 100
)
print(round(comparaison_coefs, 3))
Cette expérimentation empirique démontre sans équivoque qu’un unique point doté d’un levier extrême est capable d’altérer qualitativement les conclusions d’une étude, conduisant potentiellement des décideurs publics à sous-estimer de près de 30% l’impact réel des dépenses en R&D sur l’innovation territoriale. L’audit de levier dans R prouve ici son statut d’outil de contrôle méthodologique indispensable.
12. Bonnes pratiques, limites statistiques et standards de publication
12.1 Interactions avec la multicollinéarité et la dimensionnalité
L’analyse des statistiques de levier ne peut être conduite de manière isolée sans appréhender ses interactions étroites avec la géométrie globale de l’espace des covariables, au premier rang desquelles figure la multicollinéarité sévère. Lorsque deux ou plusieurs variables explicatives présentent de fortes corrélations mutuelles, la matrice de Gram XTX devient mal conditionnée, son déterminant s’approche de zéro et les éléments diagonaux de sa matrice inverse (XTX)-1 explosent en amplitude. Cette distorsion matricielle se répercute directement sur le calcul de la projection chapeau : la forme quadratique (xi – x̄)T(X̃TX̃)-1(xi – x̄) s’étire le long des directions associées aux petites valeurs propres du système. En conséquence, une observation dont la position n’est pas particulièrement extrême sur chaque prédicteur pris isolément peut voir sa valeur de levier s’envoler de façon spectaculaire simplement parce qu’elle brise la structure de corrélation conjointe entre les covariables.
Pour cette raison, il est impératif d’évaluer conjointement les facteurs d’inflation de la variance (VIF – Variance Inflation Factor) et les hatvalues. La fonction car::vif(modele) permet de vérifier si des scores VIF supérieurs à 5 ou 10 sont concomitants avec l’apparition de leviers artificiellement gonflés. L’analyste évite ainsi de confondre une singularité géométrique réelle avec un artefact computationnel induit par la redondance des prédicteurs.
Une seconde limite méthodologique fondamentale apparaît en contexte de grande dimensionnalité, lorsque le nombre de prédicteurs p s’approche de la taille d’échantillon n (situation où le ratio p/n tend vers 1). À la limite où p = n, la matrice X devient carrée et inversible, la matrice chapeau H dégénère en la matrice identité In, et chaque élément diagonal hii devient strictement égal à 1. Dans de telles configurations de parcimonie restreinte, la notion classique de seuil critique perd toute signification discriminante, chaque observation étant mathématiquement convertie en son propre prédicteur parfait avec un résidu nul. Pour les devis statistiques complexes en haute dimension, les diagnostics de levier basés sur les moindres carrés ordinaires doivent être abandonnés au profit de métriques régularisées adaptées aux modèles de pénalisation (comme les régressions Ridge, Lasso ou Elastic-Net), où le degré d’atténuation paramétrique remplace l’hyperplan de projection libre.
12.2 Directives de rédaction académique et transparence méthodologique
La communication scientifique rigoureuse impose des standards élevés en matière de transparence méthodologique lors du rapportage des modèles de régression linéaire. Conformément aux directives de publication émises par l’American Psychological Association (normes APA, 7e édition) et par les principaux comités éditoriaux internationaux en économétrie et recherche biomédicale, les auteurs ne peuvent plus se limiter à la simple mention des coefficients finaux et de leur significativité stochastique. L’évaluation des postulats du modèle, incluant explicitement l’audit des valeurs atypiques, du levier et de l’influence, constitue un passage obligé de la section méthodologique.
Lors de la rédaction académique, il convient d’expliciter clairement :
- Les fonctions de calcul et les progiciels mobilisés (par exemple la fonction
hatvalues()sous R version 4.x). - La formule mathématique et le seuil de coupure retenus pour la catégorisation du levier (explicitement déclarer le choix entre 2p/n ou 3p/n et en justifier l’adéquation eu égard à la taille n).
- Le nombre précis d’observations franchissant ce seuil, ainsi que leur typologie détaillée (levier concordant versus levier discordant).
- Les protocoles d’investigation menés pour vérifier l’exactitude des valeurs de ces observations (élimination formelle des erreurs matérielles de saisie).
- La justification théorique soutenant la décision finale de conservation, de transformation fonctionnelle ou d’exclusion de ces unités.
Dans un souci de reproductibilité intégrale (fondement de la science ouverte), les scripts de calcul R utilisés pour générer les diagnostics, ainsi que les tableaux comparatifs de sensibilité avec et sans les observations à fort levier, doivent être systématiquement versés dans les annexes électroniques ou sur des dépôts ouverts pérennes. Pour sécuriser l’auditabilité du processus d’inférence, nous résumons dans la liste de contrôle ci-dessous les étapes indispensables que tout chercheur quantitatif se doit de valider lors de la modélisation sous R :
- Vérification préalable du rang de la matrice des covariables avec
qr(X)$rank == p. - Extraction vectorielle directe du levier via
hatvalues(modele)et contrôle de la somme égale à p. - Calcul des seuils empiriques paramétrés
2*p/net3*p/n. - Visualisation conjointe du levier et des résidus studentisés externes avec
plot(modele, which = 5)oucar::influencePlot(modele). - Audit approfondi des antécédents observationnels pour chaque point de levier identifié.
- Test de stabilité des coefficients par analyse de sensibilité comparative (modèle complet versus modèle restreint ou estimation robuste
MASS::rlm/robustbase::lmrob). - Dépôt transparent du script R complet et documentation explicite des arbitrages dans le manuscrit final.
Références
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman & Hall.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17–22. https://doi.org/10.1080/00031305.1978.10479237
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725285
R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471852333
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4