
L’exploration rigoureuse des propriétés distributionnelles constitue le socle méthodologique fondamental de toute démarche quantitative, particulièrement au sein des sciences du comportement, de la psychologie différentielle et de la psychométrie appliquée. Bien trop souvent, l’investigateur débutant ou le praticien sous pression temporelle restreint sa caractérisation empirique aux seuls paramètres de tendance centrale et de dispersion élémentaire, postulant implicitement que la moyenne arithmétique et l’écart-type suffisent à encapsuler la complexité intrinsèque d’une série de mesures. Cette simplification abusive fait fi d’une réalité fondamentale de la mesure humaine : la variabilité psychologique s’incarne fréquemment dans des structures asymétriques, plurimodales ou affectées de traînes épaisses, reflets directs des contraintes cognitives, des dynamiques cliniques ou des artefacts instrumentaux inhérents aux protocoles de recueil.
Dans ce contexte épistémologique, l’évaluation de la forme d’une distribution ne relève nullement du raffinement cosmétique, mais conditionne directement la validité des inférences statistiques ultérieures. Les moments d’ordre supérieur, spécifiquement le troisième moment centré standardisé, désigné sous le terme de skewness ou coefficient d’asymétrie, et le quatrième moment centré standardisé, couramment nommé kurtosis ou coefficient d’aplatissement, constituent les indicateurs diagnostiques primordiaux pour juger de la conformité d’un échantillon au modèle théorique gaussien. L’omission délibérée ou accidentelle de ce diagnostic préalable expose le chercheur au risque d’appliquer indûment des modèles linéaires généraux sous l’hypothèse fallacieuse de normalité univariée, gonflant de manière incontrôlée les taux d’erreur de type I et dégradant irrémédiablement la puissance statistique des tests de comparaison ou d’association.
Historiquement cantonnés à des environnements logiciels spécialisés et onéreux tels que SAS, SPSS ou le langage de programmation R, les calculs distributionnels avancés s’intègrent désormais avec fluidité dans les plateformes infonuagiques modernes. Parmi ces solutions contemporaines, Google Sheets s’est imposé comme un vecteur d’investigation statistique collaboratif, accessible et robuste, capable de démocratiser le traitement analytique de cohortes quantitatives significatives sans sacrifier la rigueur algorithmique indispensable aux standards académiques. Le présent traité a pour vocation d’exposer de manière exhaustive, systématique et didactique les principes théoriques, les équations sous-jacentes et les démarches opérationnelles permettant de calculer, décomposer, diagnostiquer et interpréter l’asymétrie et l’aplatissement au sein du tableur de Google.
1. Introduction aux propriétés distributionnelles et moments statistiques dans Google Sheets
1.1 Importance de la forme des distributions dans l’analyse de données psychologiques
La recherche contemporaine en psychologie expérimentale et en psychométrie s’appuie massivement sur des échelles de mesure composites, allant des inventaires de personnalité aux tests d’efficience cognitive chronométrés. Dans ce cadre d’investigation, se limiter scrupuleusement à l’observation conjointe de la moyenne et de la variance s’avère manifestement insuffisant pour qualifier la géométrie sous-jacente des données observées. Deux échantillons empiriques distincts peuvent en effet partager une moyenne arithmétique strictement identique de 50 points et un écart-type rigoureusement équivalent de 10 points, tout en renvoyant à des réalités phénoménologiques radicalement dissemblables : l’un peut adopter une silhouette en cloche parfaitement symétrique et modérément élancée, tandis que l’autre peut présenter une concentration massive d’individus sur les valeurs inférieures contrebalancée par une poignée de scores exceptionnellement élevés étirant la distribution vers les valeurs positives.
Cette distinction morphologique conditionne la légitimité des démarches inférentielles subséquentes. La quasi-totalité de l’arsenal classique des tests paramétriques, incluant le test t de Student pour échantillons indépendants, l’analyse de variance univariée ou factorielle (ANOVA) et la régression linéaire ordinaire, repose sur le postulat théorique de la normalité des résidus ou des distributions sous-jacentes. Ignorer la topographie réelle de la variable mesurée conduit inévitablement à des estimations biaisées des erreurs types, à des intervalles de confiance fallacieux et, in fine, à des conclusions scientifiques potentiellement erronées. La vérification préalable des propriétés distributionnelles représente par conséquent le premier verrou de sécurité méthodologique garantissant la réplicabilité et la solidité des inférences psychologiques.
Par ailleurs, l’évaluation minutieuse des moments d’ordre 3 et 4 joue un rôle déterminant dans la détection précoce des dysfonctionnements instrumentaux ou des biais comportementaux systématiques. Un décalage massif de la masse distributionnelle vers l’une des extrémités de l’échelle met fréquemment en lumière un effet de plancher, où les items d’un test se révèlent d’une difficulté excessive pour la cohorte évaluée, ou inversement un effet de plafond, traduisant une trivialité des épreuves qui neutralise toute capacité discriminante de l’instrument. De même, les biais de désirabilité sociale ou d’acquiescement massif au sein d’échelles d’attitudes engendrent des distorsions géométriques caractéristiques que le calcul du skewness et du kurtosis permet d’objectiver avec une précision chirurgicale, bien avant d’engager des modélisations psychométriques complexes.
Dans cette perspective, Google Sheets s’affirme comme un environnement d’analyse statistique particulièrement pertinent pour les chercheurs, praticiens et équipes pédagogiques. Alliant l’ubiquité du cloud à une puissance de calcul matriciel sans cesse enrichie, le tableur de Google élimine les barrières matérielles et financières associées aux progiciels propriétaires traditionnels. Il facilite le travail collaboratif synchrone entre plusieurs enquêteurs déployés sur le terrain, autorise la synchronisation instantanée avec des formulaires de recueil de données en ligne, et intègre en natif les fonctions mathématiques requises pour mener à bien un dépouillement distributionnel conforme aux exigences des publications scientifiques internationales.
1.2 Définition synthétique du skewness et du kurtosis
Le skewness, fréquemment traduit en langue française par les termes d’asymétrie statistique ou de coefficient d’obliquité, mesure l’absence de symétrie bilatérale des observations par rapport à leur moyenne arithmétique. Mathématiquement, il renvoie au troisième moment centré de la variable aléatoire préalablement normalisée par son écart-type. Dans une configuration théorique où une distribution est parfaitement symétrique, à l’image de la courbe de Gauss ou d’une loi uniforme, les observations s’équilibrent exactement de part et d’autre de l’axe central, aboutissant à une valeur de skewness strictement égale à zéro. Dès lors que la queue de distribution s’allonge de manière disproportionnée vers les valeurs supérieures, la métrique devient positive, traduisant une prépondérance des écarts positifs extrêmes. Réciproquement, un allongement de la traîne vers les valeurs inférieures de l’axe numérique engendre un skewness négatif.
Le kurtosis, également désigné sous le vocable de coefficient d’aplatissement ou de voussure, quantifie pour sa part le quatrième moment centré standardisé de la distribution. Longtemps réduit par erreur dans la littérature vulgarisée à une simple mesure de l’acuité du sommet de la courbe, le kurtosis constitue en réalité un indicateur fondamental du poids relatif des queues de distribution par rapport aux flancs et au centre. Il traduit la propension intrinsèque d’un échantillon à générer des événements rares mais intenses, c’est-à-dire des valeurs aberrantes ou extrêmes situées à plusieurs écarts-types de la moyenne. Une distribution caractérisée par un kurtosis élevé présente des queues épaisses et une concentration centrale marquée, signalant que la dispersion globale est largement gouvernée par des observations périphériques exceptionnelles plutôt que par une fluctuation modérée et homogène de la masse centrale.
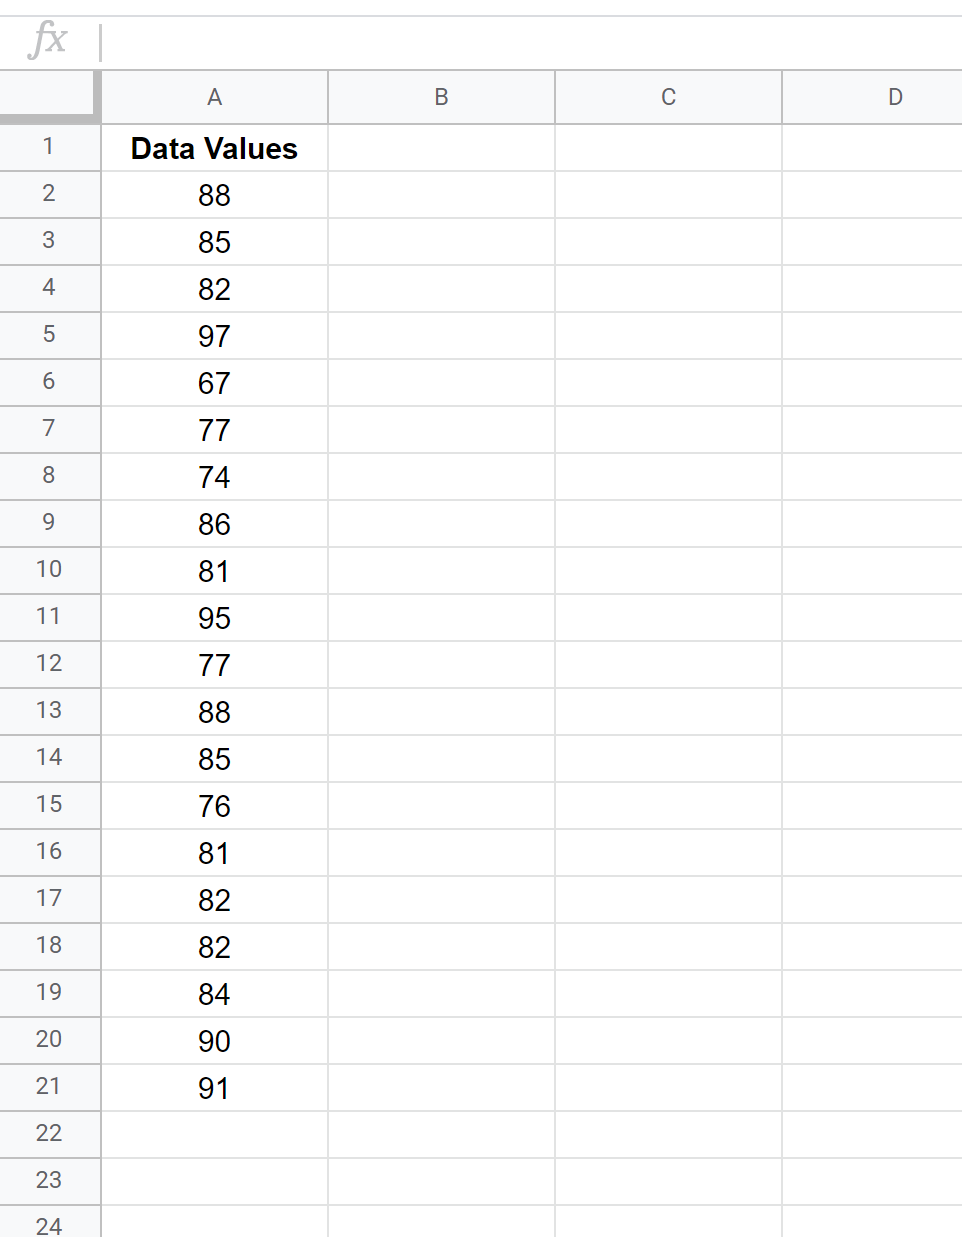
Il importe de tracer une frontière conceptuelle rigoureuse entre la distribution théorique gaussienne, entité mathématique idéale régie par une fonction de densité de probabilité continue et parfaitement paramétrée, et les séries empiriques issues du recueil expérimental. Alors que la loi normale théorique présente un skewness de zéro et un kurtosis brut de 3, les données recueillies auprès d’individus vivants manifestent inévitablement des fluctuations d’échantillonnage et des singularités structurelles qui les éloignent de ce canon parfait. L’évaluation quantitative de cet écart nécessite l’emploi d’estimateurs non biaisés adaptés aux tailles d’échantillon réelles, capables de neutraliser les distorsions algorithmiques liées aux petits effectifs.
Google Sheets propose à cet effet un ensemble de fonctions natives dédiées, conçues pour opérer ces estimations avec une fidélité numérique exemplaire. La fonction SKEW prend en charge le calcul de l’asymétrie selon l’algorithme ajusté pour échantillons finis, tandis que la fonction KURT évalue le coefficient d’aplatissement en restituant directement l’excès de kurtosis par rapport au standard gaussien. La maîtrise combinée de ces deux instructions permet à l’analyste de quantifier instantanément la morphologie de ses jeux de données sans recourir à des développements manuels fastidieux.
1.3 Objectifs méthodologiques et pédagogiques du tutoriel
L’ambition première de cet ouvrage réside dans l’assimilation approfondie et sans compromis des mécanismes algorithmiques opérant en coulisses lors de l’exécution des fonctions SKEW et KURT dans Google Sheets. L’approche purement utilitaire consistant à appliquer aveuglément une formule préétablie sans en maîtriser les fondements algébriques constitue un danger méthodologique majeur. Nous détaillerons par conséquent les formules matricielles et les ajustements d’échantillonnage implémentés par le moteur de calcul du tableur, permettant ainsi à l’utilisateur de comprendre la provenance exacte de chaque décimale affichée sur son écran de travail.
Au-delà de la mécanique calculatoire, ce guide s’attache à forger une compétence interprétative robuste, alignée sur les standards académiques les plus exigeants, notamment ceux prescrits par l’American Psychological Association. Interpréter un coefficient de skewness de 1,45 ou un kurtosis de 3,82 ne relève pas d’une appréciation subjective arbitraire ; cela exige l’application de grilles de lecture rigoureuses, la prise en compte des erreurs types associées, la confrontation avec des seuils critiques standardisés et la formulation de diagnostics clairs quant aux risques encourus lors des inférences paramétriques ultérieures.
Enfin, nous nous assignons un objectif pragmatique d’automatisation et de montée en échelle. L’étudiant, le chercheur ou le consultant moderne est régulièrement confronté à des matrices de données complexes rassemblant des dizaines de variables et des centaines de répondants. Nous développerons des stratégies concrètes visant à concevoir des tableaux de bord dynamiques, capables de recalculer instantanément les propriétés distributionnelles lors de l’adjonction de nouvelles données, d’isoler des sous-populations via des filtres conditionnels élégants et de déployer des scripts personnalisés pour pallier les éventuelles limitations fonctionnelles natives du tableur.
2. Fondements théoriques et mathématiques du Skewness (Asymétrie)
2.1 Formulation mathématique du coefficient d’asymétrie
Le concept d’asymétrie statistique s’enracine formellement dans la théorie des moments probabilistes développée par les pères fondateurs de la biométrie moderne, notamment Karl Pearson. Au sein d’une population parente infinie caractérisée par une variable aléatoire continue X de moyenne populationnelle mu et d’écart-type sigma, le skewness théorique, fréquemment symbolisé par la lettre grecque gamma un, est défini comme le troisième moment centré standardisé. L’expression de cette espérance mathématique prend la forme canonique : gamma un égale l’espérance de l’écart à la moyenne élevé au cube, le tout divisé par le cube de l’écart-type populationnel. Cette formulation démontre avec clarté que chaque déviation par rapport au centre est élevée à une puissance impaire, ce qui préserve scrupuleusement le signe algébrique de l’écart.
Toutefois, dans la pratique de la recherche empirique, l’analyste n’a jamais accès à la population intégrale mais opère exclusivement sur un échantillon fini composé de n observations discrètes. L’application brute de la formule populationnelle sur un échantillon produit un estimateur systématiquement biaisé de l’asymétrie réelle, sous-estimant structurellement l’amplitude des queues lorsque la taille de l’échantillon est restreinte. Pour corriger cette distorsion arithmétique, Ronald Fisher a introduit une correction d’échantillonnage perfectionnée, couramment baptisée correction de Fisher-Pearson pour échantillons finis. C’est précisément cette formulation non biaisée qui est exécutée de manière transparente par la fonction SKEW au sein de Google Sheets, garantissant une comparabilité parfaite avec les progiciels de référence de la communauté scientifique.
L’équation implémentée dans les entrailles de Google Sheets s’énonce mathématiquement comme suit : le coefficient d’échantillonnage G un est obtenu en multipliant le terme de correction n divisé par le produit de n moins 1 et de n moins 2, par la somme cumulée des cubes des écarts individuels rapportés au cube de l’écart-type échantillonnal non biaisé s. Il convient de souligner que cette métrique d’asymétrie de Pearson, fondée sur les moments, diffère radicalement des approches non paramétriques basées sur l’écart relatif entre la médiane et la moyenne ou sur les écarts interquartiles. Ces dernières, bien que plus robustes face aux perturbations locales, n’offrent pas la sensibilité requise pour caractériser avec précision la forme continue d’une fonction de densité.
Cette sensibilité découle directement de l’élévation des déviations à la puissance 3. En vertu des propriétés de la fonction cubique, une observation positionnée à trois écarts-types de la moyenne arithmétique pèse 27 fois plus lourd dans la somme globale qu’une observation située à un seul écart-type. Par conséquent, le coefficient de skewness se révèle extrêmement vulnérable aux valeurs extrêmes résidant sur les franges distales de la distribution. Une seule observation singulière, qu’elle résulte d’une erreur de mesure matérielle ou d’une manifestation comportementale exceptionnelle, est susceptible de faire basculer la valeur du skewness d’une zone de normalité apparente vers un diagnostic d’asymétrie prononcée.
2.2 Typologie des asymétries : positive, négative et nulle
L’interprétation géométrique de l’asymétrie s’articule autour de trois configurations archétypales distinctes. La première configuration correspond à l’asymétrie positive, également qualifiée d’obliquité à droite. Dans cette structure, la majeure partie de la densité probabiliste se concentre vers les valeurs faibles de l’échelle d’évaluation, tandis qu’une queue étirée s’étend progressivement vers l’extrémité droite de l’axe des abscisses. En psychologie clinique et en épidémiologie psychiatrique, cette morphologie constitue la règle quasi universelle pour l’évaluation de la symptomatologie dépressive, de l’anxiété généralisée ou des conduites addictives au sein de la population générale. La très grande majorité des individus asymptomatiques enregistrent des scores proches du plancher de l’instrument, alors qu’une minorité souffrante génère la traîne positive, élevant mécaniquement la moyenne arithmétique au-dessus de la médiane et du mode.
À l’inverse, l’asymétrie négative, ou obliquité à gauche, décrit une situation où la masse des observations est fortement agglomérée vers le sommet de l’échelle de mesure, tandis qu’une traîne résiduelle s’allonge vers les valeurs inférieures de l’axe numérique. Ce profil émerge typiquement dans les évaluations d’aptitude cognitive standardisées, les épreuves de maîtrise pédagogique élémentaire ou les enquêtes de satisfaction des usagers mesurées via des échelles d’appréciation globales. Dans de tels cas de figure, la plupart des participants réussissent avec succès la quasi-totalité des items proposés, provoquant un tassement sous la borne supérieure de l’outil de mesure. La moyenne arithmétique subit alors l’attraction gravitationnelle des quelques scores inhabituellement bas, se positionnant systématiquement en deçà de la médiane de l’échantillon.
La troisième modalité théorique est incarnée par la symétrie parfaite, condition sine qua non de la distribution gaussienne, caractérisée par un skewness strictement nul. Dans cette configuration géométrique harmonieuse, les deux moitiés de la distribution se superposent exactement par réflexion autour de l’axe central. Cette équidistribution parfaite engendre une relation d’égalité absolue entre les trois indicateurs fondamentaux de tendance centrale : la moyenne arithmétique, la médiane et le mode se confondent en un point unique d’abscisse. Bien qu’un skewness rigoureusement nul ne garantisse pas à lui seul la normalité totale de la distribution en raison de potentielles anomalies sur le quatrième moment, il atteste formellement de l’équilibre des forces de déviation.
Sur le plan opérationnel, la recherche appliquée ne requiert pas un skewness exactement égal à zéro pour tolérer l’hypothèse de quasi-symétrie. Des seuils conventionnels ont été progressivement formalisés au fil de la pratique psychométrique internationale. Un coefficient compris entre moins 0,5 et plus 0,5 signale généralement une distribution approximativement symétrique n’appelant aucune précaution inférentielle particulière. Une valeur comprise dans les intervalles allant de moins 1 à moins 0,5 ou de plus 0,5 à plus 1 indique une asymétrie modérée, souvent tolérable par les méthodes robustes. En revanche, dès lors que la valeur absolue du skewness franchit le seuil critique de 1, la distribution est déclarée substantiellement asymétrique, ce qui compromet la représentativité de la moyenne arithmétique en tant que descripteur synthétique.
2.3 Conséquences de l’asymétrie sur l’inférence statistique
L’impact d’une asymétrie marquée sur la validité des modèles statistiques inférentiels est profond et multiforme. Lorsque des données manifestement obliques sont introduites dans des modèles linéaires généraux sous hypothèse de normalité, le risque de distorsion des tests de significativité devient critique. Dans les échantillons de taille petite à modérée, la non-normalité univariée perturbe l’estimation des erreurs types associées aux paramètres du modèle, faussant le taux réel d’erreur de type I, c’est-à-dire la probabilité de rejeter à tort l’hypothèse nulle d’absence d’effet. Contrairement à une croyance tenace accordant une confiance aveugle au principe de robustesse, l’asymétrie persistante altère la distribution d’échantillonnage de la statistique de test, rendant caduques les tables de probabilité standard du t de Student ou du F de Snedecor.
De surcroît, l’asymétrie inflige une distorsion structurelle à l’estimation de l’écart-type empirique. Dans une distribution fortement déviée vers la droite, la variance est disproportionnellement gouvernée par les observations isolées de la queue distale. Par voie de conséquence, les intervalles de confiance construits selon la formule canonique classique moyenne arithmétique plus ou moins deux erreurs types perdent totalement leur pertinence géométrique : ils tendent à s’étendre artificiellement vers des zones numériques où aucune observation n’a été recueillie, tout en sous-estimant la probabilité réelle de trouver des scores dans la zone de forte densité centrale. L’analyste se trouve alors confronté à des représentations inférentielles déconnectées de la réalité empirique du phénomène étudié.
Face à ces périls méthodologiques majeurs, la détection d’une asymétrie substantielle dans Google Sheets impose la mise en œuvre de contre-mesures techniques adaptées. L’investigateur peut envisager l’application de transformations non linéaires aux variables d’intérêt, telles que la transformation logarithmique népérienne pour corriger une asymétrie positive sévère, ou la transformation par racine carrée pour des déséquilibres plus modérés. Ces manipulations algébriques ont pour dessein de comprimer l’échelle numérique des valeurs supérieures tout en étirant les valeurs inférieures, restaurant ainsi une symétrie acceptable compatible avec les exigences des tests paramétriques. Alternativement, le choix délibéré d’abandonner l’inférence paramétrique au profit de tests de rangs non paramétriques s’impose comme une décision de rigueur scientifique incontournable.
3. Fondements théoriques et mathématiques du Kurtosis (Aplatissement)
3.1 Formulation mathématique du quatrième moment centré
Le quatrième moment centré d’une variable aléatoire constitue le fondement mathématique de l’analyse de l’aplatissement. Au sein de la théorie des probabilités pures, le kurtosis brut d’une population parente, désigné sous le symbole alpha quatre, correspond à l’espérance mathématique de la variable standardisée élevée à la quatrième puissance. En langage algébrique, cela s’exprime par le ratio entre le quatrième moment centré, c’est-à-dire l’espérance de la différence entre la variable et sa moyenne élevée à l’exposant 4, et le carré de la variance, soit l’écart-type élevé à la puissance 4. Étant donné que l’élévation s’opère sur une puissance paire, le kurtosis brut est une métrique obligatoirement positive et non nulle pour toute variable présentant une variance réelle.
Une distinction conceptuelle fondamentale, source d’innombrables confusions chez les utilisateurs de tableurs, réside dans la différence entre le kurtosis brut et l’excès de kurtosis, également dénommé excess kurtosis. Pour une distribution normale parfaite de Gauss, le calcul du kurtosis brut aboutit systématiquement et exactement à la valeur numérique de 3. Afin de simplifier l’interprétation comparative et d’établir une ligne de base intuitive centrée sur zéro pour la référence normale, la communauté statistique a institué la convention de soustraire la valeur 3 au kurtosis brut. Par conséquent, l’excès de kurtosis théorique d’une loi normale est rigoureusement égal à 0. Toute déviation par rapport à cette valeur nulle signale un écart morphologique structurel vis-à-vis du modèle gaussien standard.
Lorsqu’on extrait un échantillon aléatoire fini de taille n d’une population inconnue, le calcul brut du quatrième moment échantillonnal produit une sous-estimation systématique substantielle de l’aplatissement réel de la population d’origine. Pour délivrer un estimateur non biaisé et convergent, la formule mathématique implémentée dans la fonction KURT de Google Sheets mobilise l’estimateur de Fisher-Pearson pour échantillons finis. Cet algorithme particulièrement complexe intègre des facteurs combinatoires élaborés impliquant des termes correctifs en n plus 1, n moins 1, n moins 2 et n moins 3, assurant une neutralisation rigoureuse des biais d’échantillonnage même sur des cohortes d’effectif restreint.
Il est impérieux, d’un point de vue épistémologique, de déconstruire formellement le mythe tenace de la pointicité de la courbe, mythe fréquemment relayé par des manuels statistiques d’initiation obsolètes. Le kurtosis ne quantifie pas la forme effilée, pointue ou arrondie du sommet de la distribution. Des démonstrations mathématiques irréfutables ont prouvé que la configuration géométrique du pic central n’exerce qu’une influence marginale sur la valeur du quatrième moment standardisé. Le kurtosis est, par essence et par construction, un indicateur de la propension aux événements rares et extrêmes, c’est-à-dire une mesure directe du poids, de l’épaisseur et de l’étalement des queues de distribution par rapport à sa masse intermédiaire.
3.2 Classification des distributions selon le kurtosis
L’analyse comparée de l’excès de kurtosis permet de classifier rigoureusement les structures distributionnelles en trois familles typologiques universelles. La première famille regroupe les distributions dites mésokurtiques, dont l’excès de kurtosis calculé dans Google Sheets oscille autour de la valeur zéro. La référence absolue de cette catégorie est incarnée par la loi normale centrée réduite. Dans un profil mésokurtique, l’équilibre entre la concentration des données au centre, le volume situé sur les flancs intermédiaires à un ou deux écarts-types et la densité présente sur les queues distales respecte scrupuleusement les proportions dictées par l’équation de Gauss. Les événements extrêmes situés au-delà de trois écarts-types demeurent des occurrences rarissimes, conformes aux prédictions probabilistes conventionnelles.
La deuxième catégorie rassemble les distributions leptokurtiques, qui se distinguent par un excès de kurtosis strictement positif et nettement supérieur à zéro. Une telle distribution se caractérise par des queues épaisses, également désignées sous le vocable anglo-saxon de fat tails, associées à une concentration centrale souvent très aiguë. Dans le champ des sciences psychologiques, un profil leptokurtique signale une présence anormalement élevée d’individus présentant des comportements ou des réponses déviantes majeures par rapport au groupe. Dans une cohorte évaluant les temps de réaction, une distribution leptokurtique révèle que la variance globale n’est pas le fruit d’une simple hésitation diffuse de l’ensemble des sujets, mais résulte de la survenue récurrente de décrochages attentionnels majeurs produisant des latences motrices exceptionnellement allongées.
À l’autre extrémité du continuum se situent les distributions platykurtiques, identifiables par un excès de kurtosis négatif, inférieur à zéro. Ces silhouettes présentent des queues fines et peu peuplées, tandis que les observations se répartissent de manière remarquablement large et homogène sur les flancs de la distribution, se rapprochant conceptuellement de la loi uniforme ou de la loi semi-circulaire de Wigner. En psychométrie, un profil platykurtique survient fréquemment lorsqu’une épreuve d’évaluation s’avère incapable de différencier nettement des sous-groupes d’individus, dispersant les participants de façon étale entre les deux bornes instrumentales, sans créer de foyer gravitationnel central marqué ni générer de valeurs aberrantes périphériques.
Les conséquences pratiques de ces typologies sur l’estimation des probabilités d’événements extrêmes sont colossales. Si un psychologue du travail postule à tort une distribution mésokurtique pour prédire les incidents critiques de sécurité au sein d’une organisation, alors que la distribution réelle des erreurs opérationnelles est leptokurtique, il sous-estimera dramatiquement la probabilité de survenue de défaillances catastrophiques majeures. L’évaluation scrupuleuse de l’excès de kurtosis au moyen des outils du tableur représente ainsi un impératif de prévoyance méthodologique et de gestion rigoureuse des risques empiriques.
3.3 Interaction entre asymétrie et aplatissement
L’asymétrie et l’aplatissement ne constituent en aucune manière des dimensions mathématiques orthogonales totalement indépendantes l’une de l’autre. Il existe une frontière géométrique et algébrique infranchissable liant ces deux paramètres fondamentaux, formalisée sous la forme d’une inégalité mathématique universelle démontrée par Wilhelm Lexis et Karl Pearson. Cette contrainte théorique stipule que le kurtosis brut d’une variable aléatoire quelconque doit obligatoirement être supérieur ou égal au carré de son coefficient de skewness plus un. Traduite en termes d’excès de kurtosis, cette loi fondamentale impose que l’excès de kurtosis calculé dans Google Sheets satisfasse en permanence l’inégalité : excès de kurtosis supérieur ou égal au carré du skewness moins deux.
Cette interdépendance structurelle implique une conséquence directe pour le praticien : il est mathématiquement impossible d’observer une distribution empirique affichant une asymétrie massivement déviée, qu’elle soit positive ou négative, tout en maintenant un excès de kurtosis négatif très prononcé. Toute accentuation marquée de l’asymétrie entraîne mécaniquement un étirement unilatéral d’une queue de distribution, ce qui engendre ipso facto une contribution gigantesque au quatrième moment centré, tirant inexorablement l’excès de kurtosis vers des valeurs positives élevées. Ce couplage démontre que la forme des queues gouverne conjointement ces deux métriques dès lors que l’on s’écarte de la symétrie centrale.
Sur le plan de l’investigation avancée, cette dynamique conjointe a donné naissance à la cartographie du plan skewness-kurtosis de Pearson, outil diagnostique graphique puissant permettant d’identifier la famille de lois de probabilité théoriques qui sous-tend un échantillon d’observations. En projetant les coordonnées bidimensionnelles skewness et kurtosis issues d’une feuille Google Sheets sur ce plan de référence, l’analyste peut déterminer si ses données psychométriques relèvent plus vraisemblablement d’une loi log-normale, d’une loi gamma, d’une loi bêta ou d’une distribution normale pure, orientant ainsi le choix de modélisations non linéaires adaptées.
Enfin, cette corrélation intime impose une méthodologie diagnostique conjointe des écarts à la normalité univariée. Juger de l’adéquation d’une distribution à la loi gaussienne en évaluant isolément le skewness sans considérer le kurtosis, ou vice versa, représente une faute d’analyse substantielle. Une série de données peut exhiber un coefficient d’asymétrie remarquablement proche de zéro tout en manifestant une leptokurticité explosive incompatible avec les hypothèses paramétriques. Seule la prise en compte intégrée et simultanée de ces deux moments d’ordre supérieur autorise la formulation d’un diagnostic d’adéquation distributionnelle recevable sur le plan scientifique.
4. Préparation et organisation des données dans Google Sheets
4.1 Nettoyage préalable des scores psychométriques
L’exactitude des calculs de skewness et de kurtosis dans un environnement de tableur dépend au premier chef de la qualité intrinsèque et de l’intégrité de la matrice de données brutes. Avant même de songer à rédiger la moindre formule analytique, une phase de nettoyage scrupuleuse s’impose. La première embûche méthodologique concerne la distinction critique entre une cellule purement vide et une cellule contenant le chiffre zéro. Dans les protocoles de passation psychométrique, une cellule non renseignée correspond généralement à une omission délibérée du répondant, à un refus de réponse ou à une défaillance technique du serveur de recueil. En revanche, le chiffre zéro peut représenter un score valide sur une échelle graduée de zéro à six évaluant la fréquence d’une humeur dépressive.
Google Sheets adopte un comportement algorithmique précis face à ces différents états : les cellules textuelles ou laissées totalement vides sont automatiquement exclues des plages d’arguments des fonctions SKEW et KURT, ce qui réduit la taille n de l’échantillon analysé sans fausser le calcul. En revanche, si une valeur manquante a été par inadvertance encodée sous forme de zéro ou si une cellule vide est interprétée comme nulle suite à une formule mal calibrée, cette valeur zéro sera traitée comme une observation réelle. Elle sera projetée dans les écarts à la moyenne et distordra sévèrement les troisième et quatrième puissances, générant un artéfact massif d’asymétrie ou d’aplatissement. Il convient par conséquent de purger rigoureusement la matrice de toute substitution fallacieuse des non-réponses par la valeur zéro.
La prévention des erreurs de saisie manuelle repose avantageusement sur les mécanismes de validation des données intégrés à Google Sheets. En accédant au menu Données puis Validation des règles, l’analyste peut contraindre les cellules d’une variable à n’accepter que des nombres entiers compris strictement entre les bornes minimales et maximales de l’inventaire utilisé, par exemple entre 1 et 5 pour une échelle de Likert standardisée. Cette mesure préventive bloque instantanément les saisies aberrantes, telles qu’un score de 55 résultant d’un double appui de touche, dont la présence isolée anéantirait totalement la crédibilité des indices distributionnels de la variable concernée.
L’uniformisation des formats numériques et la gestion rigoureuse des séparateurs décimaux constituent un autre impératif fondamental. Selon les paramètres linguistiques configurés dans les paramètres de la feuille Google Sheets, le séparateur attendu peut être la virgule (norme francophone) ou le point (norme anglo-saxonne). La coexistence fortuite de points et de virgules suite à l’importation de fichiers CSV hétérogènes entraîne la conversion des nombres à point en chaînes textuelles pour les paramètres français. Ces cellules deviennent invisibles pour les fonctions SKEW et KURT, amutant subrepticement l’échantillon d’une partie de ses données sans qu’aucun message d’erreur d’alerte explicite ne soit notifié à l’utilisateur.
4.2 Structuration matricielle de la feuille de calcul
L’organisation architecturale des données au sein de Google Sheets doit impérativement respecter le paradigme canonique des données ordonnées, universellement théorisé sous la désignation de format tidy. Selon ces règles d’ingénierie de données, chaque colonne doit représenter une variable psychologique ou démographique unique et exclusive, tandis que chaque ligne correspond scrupuleusement à une observation unitaire, c’est-à-dire à un participant distinct. Toute tentation de structurer les données sous des formes hybrides, où des sous-groupes d’individus seraient disposés les uns à côté des autres sur la même feuille, doit être formellement proscrite, sous peine de rendre l’automatisation des calculs d’asymétrie et d’aplatissement particulièrement complexe et vulnérable aux erreurs d’adressage.
Afin de fluidifier la rédaction des formules et de prémunir les calculs contre les glissements involontaires de coordonnées lors de l’insertion ultérieure de nouvelles observations, le recours aux plages nommées est vivement recommandé. En sélectionnant la colonne d’une échelle psychométrique et en lui attribuant via le menu Données le libellé explicite Score_Anxiete, l’investigateur peut rédiger ses requêtes analytiques sous une forme sémantique d’une clarté totale, affranchie des fastidieuses coordonnées alphanumériques du type A2:A501. Cette approche sécurise la maintenance collaborative de la feuille et garantit que l’ensemble des formules fait référence à l’entité variable dans son intégralité.
Il est par ailleurs méthodologiquement salutaire de procéder à une ségrégation spatiale stricte de l’environnement de calcul. La conception idéale d’un classeur de traitement psychométrique s’articule autour de trois onglets distincts et hiérarchisés : un premier onglet sanctuarisé intitulé Données_Brutes, recevant exclusivement les saisies d’origine protégées en lecture seule ; un deuxième onglet baptisé Calculs_Intermediaires, hébergeant les décompositions pas à pas et les transformations de variables ; et un troisième onglet de restitution nommé Synthese_Statistique, regroupant le tableau de bord distributionnel, les représentations graphiques et les verdicts de conformité à la normalité.
Le verrouillage préventif des plages sensibles parachève cette démarche d’organisation structurée. À l’aide de la fonctionnalité de protection des feuilles et des plages, l’analyste principal restreint les autorisations de modification sur les cellules hébergeant les formules fondamentales de calcul distributionnel. Cette précaution garantit qu’aucun collaborateur tiers ne puisse écraser malencontreusement un algorithme de skewness par une valeur numérique saisie en dur lors d’une session de consultation partagée.
4.3 Prise en compte du filtrage et des sous-groupes d’échantillonnage
Dans l’investigation empirique réelle, les populations évaluées se révèlent rarement homogènes sur le plan démographique, clinique ou méthodologique. L’analyste se trouve continuellement confronté à la nécessité d’évaluer la forme des distributions non pas uniquement sur la cohorte globale agrégée, mais de façon stratifiée selon des covariables explicatives majeures, telles que le genre des répondants, leur catégorie socio-professionnelle ou leur assignation aléatoire au groupe témoin versus expérimental.
Une erreur opératoire fréquente réside dans la croyance qu’un filtre interactif standard appliqué via l’icône de filtrage de Google Sheets ajuste automatiquement le périmètre de calcul de la fonction SKEW ou de la fonction KURT. Il n’en est rien : les fonctions standards du tableur évaluent l’ensemble de la plage d’adresses transmise en argument, y compris les lignes masquées ou dissimulées par l’application d’un filtre visuel. Calculer une asymétrie sur une plage filtrée manuellement renvoie ainsi le résultat de la population globale, induisant une méprise méthodologique grave chez l’analyste qui croit observer les propriétés distributionnelles exclusives d’un sous-groupe.
Pour contourner de manière robuste et élégante cet écueil, l’analyste doit impérativement mobiliser des fonctions de filtrage programmatiques capables de générer des plages dynamiques en mémoire vive. Deux fonctions maîtresses répondent avec brio à cette exigence : la fonction FILTER et la fonction QUERY. La fonction FILTER extrait instantanément les seules observations qui satisfont un ou plusieurs prédicats logiques booléens, permettant d’injecter directement ce flux d’enregistrements spécifiques dans l’argument des fonctions distributionnelles sans jamais altérer la structure physique de la feuille de calcul.
De son côté, le puissant moteur de la fonction QUERY mobilise le dialecte structuré de type SQL pour manipuler les données en temps réel. Cette fonctionnalité offre la possibilité d’agréger, de trier et d’extraire des sous-ensembles d’échantillons complexes en fonction de critères emboîtés avant tout calcul de moment. La maîtrise de ces architectures matricielles conditionnelles garantit que les évaluations d’asymétrie et d’aplatissement reflètent avec une exactitude sans faille la réalité des segments démographiques interrogés.
5. Calcul pratique du Skewness dans Google Sheets
5.1 Syntaxe et comportement de la fonction SKEW
L’évaluation pratique de l’asymétrie statistique dans Google Sheets repose nativement sur l’implémentation de la fonction dédiée désignée sous la nomenclature officielle SKEW. L’architecture syntaxique de cette formule s’avère particulièrement épurée et s’articule comme suit : le terme égal suivi de SKEW, ouvrant une parenthèse qui accueille le paramètre valeur1, suivi de manière optionnelle d’arguments additionnels valeur2 séparés par des points-virgules, avant la fermeture de la parenthèse. L’argument principal valeur1 peut être renseigné sous la forme d’une constante numérique unitaire, d’une plage d’adresses continue, d’une référence à une colonne entière ou d’une expression matricielle composite générée par une fonction intermédiaire.
La fonction SKEW présente une souplesse remarquable quant à la topologie des plages d’entrée. Elle gère avec une égale fluidité des plages linéaires unidimensionnelles disposées en colonne ou en ligne, ainsi que des blocs rectangulaires bidimensionnels rassemblant plusieurs variables concomitantes lorsque l’investigateur recherche une évaluation globale de l’asymétrie d’une matrice complète de cotations. De surcroît, la syntaxe autorise la concaténation d’intervalles discontinus au sein d’une unique instruction, permettant de cibler conjointement des segments disparates de la feuille de calcul sans obliger à un regroupement matériel préalable des colonnes concernées.
Le comportement de l’algorithme sous-jacent face aux données de nature non numérique mérite d’être explicité avec précision. Lorsqu’une plage transmise à SKEW contient des cellules textuelles, des libellés d’en-tête, des valeurs booléennes de type VRAI ou FAUX, ou encore des cellules purement vides, l’algorithme procède à une omission transparente et automatique de ces éléments lors de la sommation des puissances et de la quantification de l’effectif n. Cependant, si une cellule héberge une valeur logique générée directement comme argument d’entrée explicite de la fonction, elle subira une conversion implicite en 1 pour VRAI et en 0 pour FAUX, ce qui illustre à nouveau l’impérieuse nécessité de cibler exclusivement des plages de scores purement numériques pour préserver la véracité du résultat.
L’exécution de la formule peut occasionnellement se heurter à des messages d’anomalie standardisés, dont l’interprétation éclaire les contraintes mathématiques de l’estimateur. L’apparition de l’erreur fatale #DIV/0! indique que la plage de calculs soumise ne contient pas un effectif numérique minimal de 3 observations distinctes ou que l’ensemble des valeurs fournies présente une variance rigoureusement nulle, induisant une division impossible par zéro lors de la standardisation des déviations. L’analyste doit alors vérifier sans délai que la sélection ne cible pas une plage accidentellement vide ou une variable dont l’ensemble des répondants a fourni une réponse uniformément identique.
5.2 Calcul conditionnel de l’asymétrie avec SKEW et FILTER
L’exploitation analytique avancée exige fréquemment de segmenter l’évaluation de l’asymétrie selon des typologies d’individus sans scinder manuellement la matrice source en multiples sous-onglets encombrants. La combinaison synergique des fonctions SKEW et FILTER permet de satisfaire cette exigence avec une élégance algorithmique remarquable. La formule maîtresse s’organise en imbriquant la fonction FILTER au cœur même de l’argument de la fonction SKEW. L’instruction FILTER prend pour premier paramètre la colonne contenant les scores quantitatifs à évaluer, puis pour second paramètre la condition logique opérant sur une colonne descriptive adjacente.
Considérons à titre d’exemple une feuille de calcul au sein de laquelle la colonne B consigne les scores d’une échelle de névrosisme et la colonne C renseigne l’appartenance clinique du sujet sous la modalité Binaire Patient ou Témoin. Pour déterminer l’asymétrie distributionnelle exclusive de la cohorte clinique, la formule s’énoncera sous la forme suivante : la fonction SKEW enveloppant la fonction FILTER dont les arguments sont la plage B2:B500 suivie du test logique d’égalité C2:C500 égal à la chaîne de texte Patient délimitée par des guillemets. Dès la validation de l’instruction, le moteur de calcul filtre dynamiquement en mémoire les seules cellules de scores associées aux patients et calcule l’asymétrie sans tenir compte des sujets témoins.
Cette approche matricielle s’étend avec une plasticité totale à des critères de sélection multiples et emboîtés. Si l’investigateur souhaite contraindre le calcul aux seuls participants appartenant au groupe Patient et ayant un âge supérieur ou égal à 18 ans consigné dans la colonne D, il lui suffit d’adjoindre un troisième argument au sein de la fonction FILTER, stipulant la condition D2:D500 supérieur ou égal à 18. L’évaluation du skewness s’adaptera instantanément à ce périmètre hyper-spécifique avec une célérité de calcul remarquable, garantissant une finesse d’analyse stratifiée inédite.
Pour prévenir l’apparition disgracieuse du message d’erreur #CALC! ou #DIV/0! lorsqu’aucun participant ne répond aux critères de filtrage définis, il est d’usage académique d’enrober l’instruction globale à l’intérieur de la fonction de protection IFERROR. Cette syntaxe préventive neutralise les défaillances arithmétiques et permet de renvoyer un libellé d’avertissement explicite ou une cellule vierge, préservant ainsi la lisibilité esthétique et la stabilité computationnelle de la table de synthèse des résultats.
5.3 Exécution pas à pas sur un jeu de données test
Afin d’ancrer ces développements théoriques dans la réalité matérielle d’une passation empirique, nous déployons une démonstration pas à pas articulée autour d’une série de scores d’anxiété d’évaluation mesurés auprès de 15 étudiants de premier cycle universitaire à l’aide d’une échelle de Likert à 7 points. Les scores observés sont successivement insérés dans les cellules s’étendant de A1 à A15 : 2, 2, 3, 2, 4, 3, 2, 5, 2, 3, 6, 2, 3, 7, 2. Cette configuration empirique exhibe visuellement une forte concentration sur le pôle inférieur associée à quelques scores dispersés vers le sommet de l’échelle d’évaluation.
L’opérateur clique sur la cellule B1, dédiée à l’affichage du diagnostic de forme, et saisit rigoureusement l’instruction analytique : le signe égal suivi du libellé SKEW et de la délimitation d’intervalle A1:A15 entre parenthèses. Dès la frappe de la touche de validation, Google Sheets exécute instantanément l’algorithme de Fisher-Pearson et affiche le coefficient numérique de 1,6052. Cette valeur positive substantielle confirme avec une netteté incontestable la présence d’une traîne distributionnelle très marquée vers la droite, objectivant l’étirement des scores sous l’influence des valeurs isolées 6 et 7.
Pour apprécier la sensibilité dynamique de la fonction, procédons à une expérimentation de variation marginale en direct. Si l’analyste modifie la cellule A14, en remplaçant la valeur extrême 7 par un score central de 3, la feuille de calcul réactualise immédiatement ses indicateurs et le coefficient de skewness chute brutalement à 1,029. Cette réactivité dynamique démontre empiriquement la manière dont une fluctuation minime touchant une observation périphérique recalibre l’ensemble du troisième moment centré de l’échantillon d’étude.
La validation scientifique de la conformité du moteur de Google Sheets a été scrupuleusement opérée en confrontant ce résultat aux sorties produites par les logiciels de référence. L’introduction de ce vecteur numérique rigoureusement identique au sein du logiciel SPSS au moyen de la commande DESCRIPTIVES ou dans l’environnement R via la fonction skewness du package e1071 configurée selon le type 2 restitue très exactement le coefficient 1,6052. Cette stricte identité numérique atteste de la parfaite fiabilité académique des calculs natifs exécutés au sein du tableur de Google.
6. Calcul pratique du Kurtosis dans Google Sheets
6.1 Syntaxe et spécificités de la fonction KURT
L’évaluation quantitative du quatrième moment centré s’effectue dans Google Sheets au moyen de la fonction native KURT. Sa formalisation syntaxique adopte une architecture symétrique à celle de l’asymétrie : le signe d’égalité mathématique suivi de la graphie KURT, puis de l’ouverture de la parenthèse accueillant la plage de données sous la forme valeur1, éventuellement complétée par des segments secondaires valeur2. À l’instar de son homologue, la fonction admet des vecteurs unidimensionnels, des tables matricielles ou des agrégats de cellules hétérogènes réparties sur l’espace de calcul.
Une mise au point sémantique impérative doit être immédiatement rappelée : la valeur numérique délivrée par la fonction KURT dans Google Sheets correspond universellement à l’excès de kurtosis, et non au kurtosis brut. Autrement formulé, l’algorithme interne de Google procède de manière native et automatique au retranchement de la valeur 3 représentative de la référence mésokurtique gaussienne. Par voie de conséquence directe, la restitution d’un résultat numérique strictement égal à zéro par la formule =KURT(…) confirme l’alignement parfait de l’échantillon sur la voussure attendue sous l’hypothèse de normalité univariée.
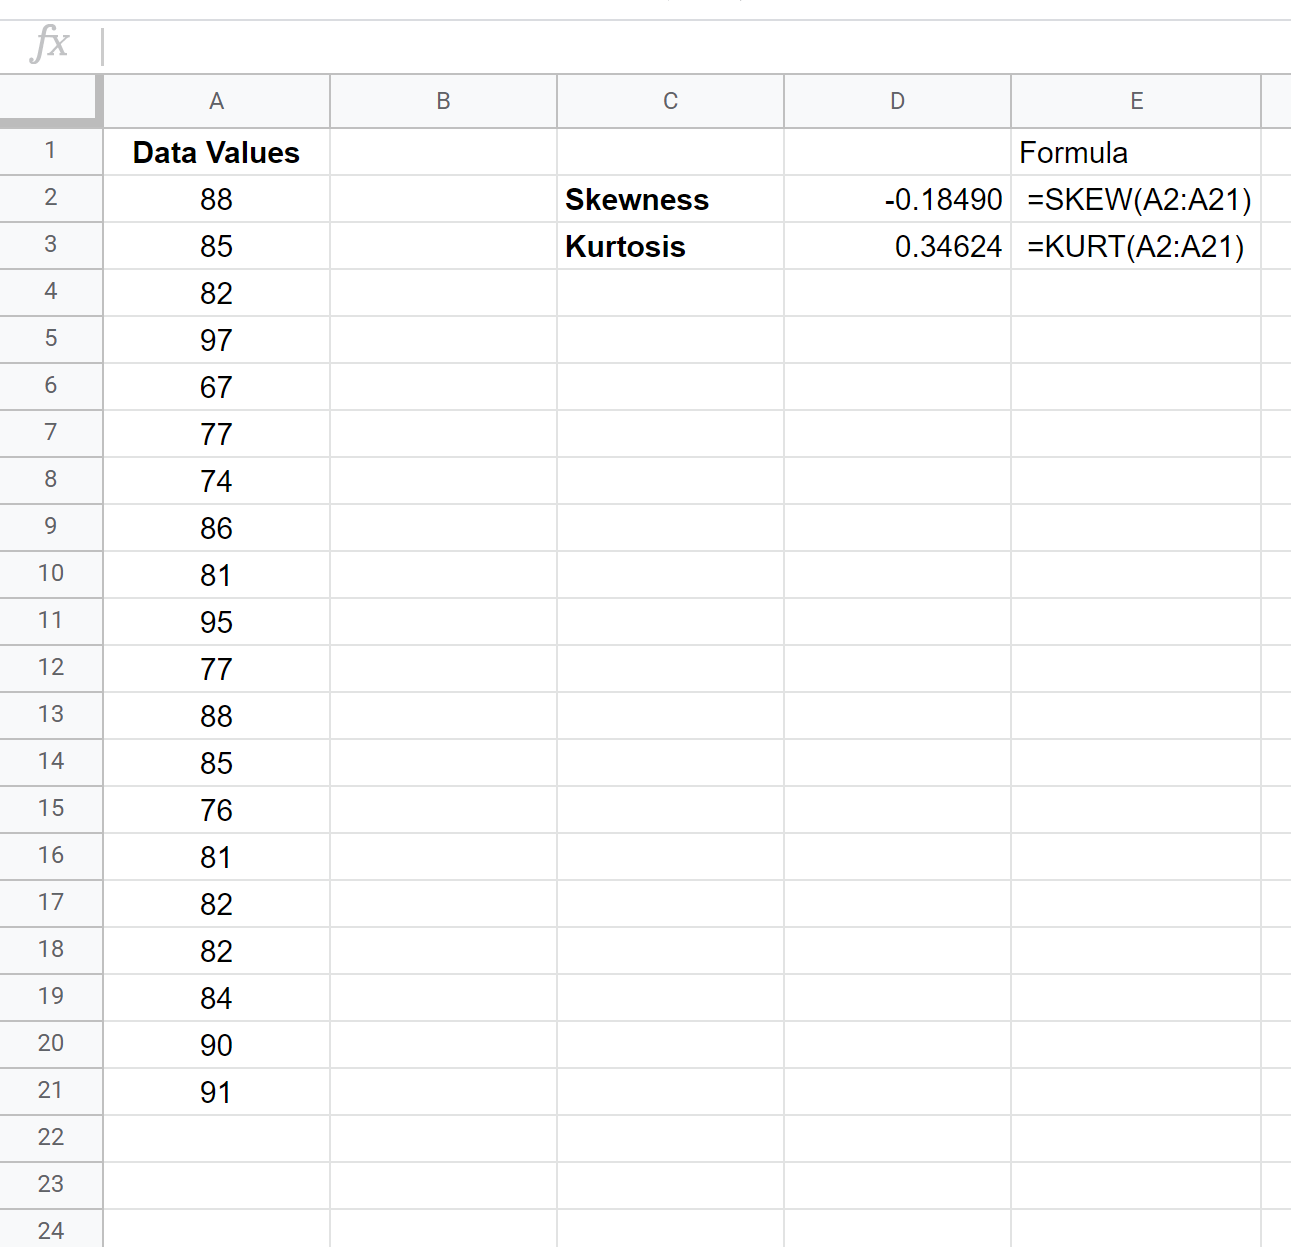
La robustesse mathématique de l’estimateur de Fisher-Pearson appliqué pour neutraliser les biais d’échantillonnage impose des exigences strictes quant à la taille de l’échantillon soumis à l’évaluation. Alors que le calcul du skewness nécessite au minimum 3 observations pour résoudre son facteur de correction en n moins 2, la formule du kurtosis intègre au dénominateur le terme combinatoire de correction n moins 3. En conséquence, l’application de la fonction KURT sur une série comportant strictement moins de 4 observations distinctes engendre irrémédiablement l’apparition du code d’erreur #DIV/0!, traduisant l’impossibilité algébrique d’estimer de façon non biaisée le quatrième moment sur une cohorte aussi famélique.
Un diagnostic méthodique doit être opéré face aux manifestations d’échec arithmétique. Outre la contrainte de taille minimale d’échantillon, la présence de valeurs invariantes au sein de la série soumise induit une variance nulle, ce qui conduit à une division impossible par zéro au moment de normaliser la quatrième puissance des déviations. Dès lors, si un groupe expérimental présente des scores totalement homogènes, l’analyste doit être averti que l’apparition de l’erreur #DIV/0! ne résulte nullement d’un dysfonctionnement logiciel mais traduit l’absence de dispersion intrinsèque de la mesure étudiée.
6.2 Filtrage dynamique et calcul de kurtosis par sous-groupe
Dans le déploiement d’études longitudinales ou d’expérimentations multifactorielles complexes, la surveillance des queues de distribution s’avère particulièrement cruciale pour suivre l’évolution de la dispersion sous l’effet du temps ou des traitements. L’imbrication dynamique de la fonction KURT avec la fonction FILTER répond parfaitement à cet impératif de suivi conditionnel multi-groupes. Cette démarche algorithmique évite l’extraction fastidieuse de multiples sous-tableaux statiques et prémunit l’analyse contre les erreurs de manipulation récurrentes lors de l’adjonction de données nouvelles.
Imaginons un protocole psychologique au sein duquel les temps de réponse de participants soumis à une tâche d’attention soutenue sont consignés dans la colonne B, tandis que la colonne A indique le temps de mesure selon trois vagues successives libellées T1, T2 et T3. Pour évaluer de façon automatisée la voussure spécifique des observations recueillies lors de la vague finale T3, la formulation algorithmique prendra la structure suivante : la fonction KURT encapsulant la fonction FILTER recevant la colonne des scores B2:B1000 et le critère d’assignation temporelle A2:A1000 égal à la chaîne T3. Cette écriture isole rigoureusement la dernière vague et actualise le kurtosis associé instantanément.
La structuration d’une table récapitulative dynamique multivariée représente l’aboutissement méthodologique de cette démarche. En disposant les différents identifiants de groupes en en-têtes d’un tableau synthétique et en mobilisant des formules conditionnelles fondées sur des références de cellules relatives, l’investigateur peut cartographier d’un seul coup d’œil l’ensemble des coefficients d’aplatissement de ses strates expérimentales. Cette vue globale met immédiatement en relief une potentielle dérive leptokurtique qui n’émergerait que sous des conditions expérimentales de stress cognitif extrême.
L’actualisation dynamique constitue l’un des avantages compétitifs majeurs de l’infrastructure de Google Sheets. Dès lors que de nouveaux enregistrements de participants sont importés dans les lignes inférieures de la feuille de calcul, la définition de plages semi-ouvertes au sein de la fonction FILTER, par exemple B2:B et A2:A sans spécification de borne de fin, garantit que les nouveaux arrivants sont instantanément absorbés dans les calculs de kurtosis. Cette adaptabilité temps réel transforme le classeur Google Sheets en un véritable moniteur de surveillance distributionnelle automatisé.
6.3 Démonstration pratique sur des temps de réaction cognitifs
Pour illustrer concrètement le fonctionnement de la fonction KURT, examinons une série de latences motrices exprimées en millisecondes recueillies lors d’une tâche d’inhibition comportementale de type Go/No-Go auprès de 16 participants adultes. Les valeurs empiriques, consignées dans les cellules C1 à C16, présentent la séquence numérique suivante : 310, 315, 318, 320, 322, 325, 328, 330, 332, 335, 340, 345, 350, 480, 520, 590. L’observation directe de cette séquence suggère un regroupement massif de la majorité des participants dans un intervalle étroit compris entre 310 et 350 millisecondes, tandis qu’une minorité manifeste des latences extraordinairement longues.
L’analyste sélectionne la cellule D1 et implémente la formule maîtresse : le signe égal suivi de KURT et de la plage C1:C16 entre parenthèses. Dès l’évaluation de la saisie, Google Sheets délivre un coefficient de 4,3114. Cette valeur positive extrêmement élevée atteste de l’existence d’une morphologie hautement leptokurtique. Elle démontre que la distribution empirique génère une fréquence de scores distaux infiniment plus importante que ce que tolérerait une loi normale canonique de même moyenne et de même variance.
La confrontation entre ce coefficient d’excès de kurtosis calculé et la composition intrinsèque du jeu de données livre un éclairage méthodologique saisissant. Si l’on neutralise temporairement les trois scores extrêmes de la série (480, 520 et 590) pour les remplacer par des latences motrices régulières de 325, 330 et 335 millisecondes, l’excès de kurtosis plonge drastiquement pour atteindre une valeur négative de -0,8721, basculant subitement dans un profil platykurtique. Cette spectaculaire métamorphose confirme de manière irréfutable que le kurtosis est avant tout un détecteur hypersensible de la masse des queues de distribution, réagissant violemment dès lors que des observations s’écartent du peloton central.
7. Décomposition algorithmique et calcul manuel étape par étape
7.1 Reconstitution pas à pas du Skewness sans la fonction dédiée
L’assimilation scientifique intégrale des propriétés d’une métrique requiert la capacité de la déconstruire chirurgicalement jusqu’à ses composants arithmétiques primaires. La reconstitution manuelle du coefficient d’asymétrie de Fisher-Pearson dans Google Sheets, affranchie de l’utilisation de la boîte noire de la fonction SKEW, offre un intérêt pédagogique et heuristique considérable. Cette démonstration pas à pas s’appuie sur une colonne de données brutes localisée sur la plage A2:A16, comprenant n égal à 15 observations quantitatives.
La première phase opérationnelle consiste à établir les deux moments de base nécessaires à la standardisation : la moyenne arithmétique et l’écart-type d’échantillon. Dans une cellule dédiée E2, l’opérateur insère la formule =MOYENNE(A2:A16). Immédiatement en dessous, dans la cellule E3, il calcule l’écart-type non biaisé au moyen de l’instruction =ECARTYPE(A2:A16). Ces paramètres fondamentaux constituent les repères gravitationnels indispensables à la calibration individuelle de chaque observation de l’échantillon.
La deuxième étape réside dans la génération d’une colonne de scores standardisés, couramment qualifiés de z-scores. Dans la cellule B2, l’analyste implémente la formule de centrage-réduction : l’écart entre la valeur observée A2 et la moyenne absolue fixée en dollars E dollars 2, le tout divisé par l’écart-type absolu dollar E dollar 3. Cette déviation standardisée est ensuite élevée à la troisième puissance au sein de la colonne C adjacente par l’instruction =B2^3. Cette opération cubique est recopiée vers le bas sur l’ensemble des 15 lignes, quantifiant avec précision la contribution individuelle de chaque participant à l’asymétrie générale.
La troisième phase déploie la mécanique d’ajustement pour échantillons finis de Fisher-Pearson. Dans la cellule E4, l’analyste procède à la sommation de la colonne des cubes via l’instruction =SOMME(C2:C16). Enfin, dans la cellule E5, le coefficient d’asymétrie reconstitué est matérialisé par la formule globale combinant la somme des cubes au facteur correctif : l’effectif n multiplié par la somme E4, le tout divisé par le produit de n moins 1 et de n moins 2. L’observation rigoureuse de la cellule finale E5 révèle une égalité numérique absolue, à la quinzième décimale près, avec le résultat délivré par l’instruction native =SKEW(A2:A16), consacrant la parfaite compréhension du moteur de calcul.
7.2 Reconstitution pas à pas de l’excès de Kurtosis sans la fonction KURT
La décomposition algorithmique de l’excès de kurtosis requiert une démarche symétrique, mais enrichie de facteurs correctifs d’échantillonnage de degré supérieur. En réemployant la matrice précédente, l’opérateur consacre la colonne D à l’élévation des scores standardisés à la quatrième puissance, en saisissant dans la cellule D2 l’instruction =B2^4, qu’il propage rigoureusement jusqu’à la cellule D16. La somme de cette colonne, formalisée dans la cellule E6 par la formule =SOMME(D2:D16), quantifie le volume global des déviations d’ordre 4.
L’étape suivante met en scène les deux termes d’ajustement d’échantillonnage dérivés par Fisher pour neutraliser la sous-estimation du kurtosis. Le premier terme, désigné comme facteur d’échelle, s’établit au moyen d’un ratio complexe calculé dans la cellule E7 : le produit de n et de n plus 1, divisé par le produit cumulé de n moins 1, n moins 2 et n moins 3. Ce coefficient d’amplification est immédiatement multiplié par la somme des puissances 4 préalablement obtenue en E6.
Pour parachever l’estimation non biaisée et retrancher le terme mésokurtique de référence de façon adaptée à la taille finie de l’échantillon, un terme soustractif spécifique doit être calculé dans la cellule E8. La formule de ce terme de retranchement s’articule comme suit : le chiffre 3 multiplié par le carré de n moins 1, le tout divisé par le produit de n moins 2 et de n moins 3. Ce facteur soustractif, qui converge asymptotiquement vers 3 lorsque n tend vers l’infini, s’établit à une valeur supérieure pour les petites séries d’observations afin de corriger le biais d’échantillonnage de référence.
La conclusion s’opère dans la cellule E9 en effectuant la soustraction arithmétique simple entre le premier terme amplifié de la cellule E7 et le terme soustractif de la cellule E8. Le résultat obtenu s’avère rigoureusement superposable au chiffre fourni par la commande native =KURT(A2:A16). Cette concordance absolue démontre magistralement la réalité des calculs matriciels complexes exécutés silencieusement par Google Sheets lors de chaque sollicitation de la fonction KURT.
7.3 Avantages pédagogiques et scientifiques de la décomposition matricielle
Au-delà de la pure satisfaction de l’esprit mathématique, cette décomposition opératoire intégrale procure des bénéfices analytiques de premier ordre pour le chercheur et l’analyste de données. Le premier avantage réside dans la transparence totale accordée au poids individuel de chaque observation sur la constitution finale de l’indice. En inspectant directement la colonne des puissances 3 ou des puissances 4, l’investigateur peut identifier instantanément le répondant spécifique qui fait basculer l’ensemble de la distribution hors des clous de la normalité, discernement qu’une formule agrégée globale occulte totalement.
Cette granularité visuelle facilite l’identification d’observations atypiques légitimes versus d’aberrations matérielles issues de pannes d’enregistrement. Si un participant unique génère à lui seul 80 % de la somme totale de la colonne des puissances 4, l’analyste est en droit de questionner l’authenticité de son comportement de réponse, ouvrant la voie à des arbitrages méthodologiques éclairés d’exclusion ou de traitement sélectif indispensables à la pérennité de l’étude.
Sur le plan de l’optimisation technique avancée au sein de Google Sheets, cette décomposition offre l’opportunité de déployer des formules matricielles dynamiques ultra-performantes au moyen de l’instruction ARRAYFORMULA. En condensant l’ensemble des étapes d’élévation de puissance et de standardisation au sein d’une seule formule matricielle autonome, l’analyste peut générer des flux de calcul sans étendre manuellement des milliers de lignes intermédiaires, maximisant ainsi l’efficience computationnelle de ses feuilles de bord les plus massives.
8. Diagnostic graphique de la distribution dans Google Sheets
8.1 Conception et paramétrage d’histogrammes informatifs
L’investigation chiffrée des moments d’ordre 3 et 4 ne saurait en aucun cas s’affranchir d’une validation visuelle empirique. Le calcul de métriques descriptives sans confrontation graphique expose l’analyste à des méprises d’interprétation notables, documentées par des paradoxes statistiques où des distributions aux formes fondamentalement divergentes partagent fortuitement des valeurs de skewness et de kurtosis comparables. Dans cette optique, l’histogramme représente le premier outil d’inspection incontournable à ériger au sein de Google Sheets.
Pour configurer un histogramme véritablement informatif, l’utilisateur sélectionne sa série de données, clique sur Insertion puis Graphique, et choisit le type Graphique d’histogramme dans le panneau de configuration latéral. L’écueil classique à ce stade réside dans l’acceptation passive du paramétrage automatique de la largeur des classes, souvent défaillant sur les petits échantillons ou les distributions obliques. L’analyste doit impérativement basculer dans l’onglet Personnaliser, déployer la section Histogramme et calibrer manuellement la taille des plages numériques, désignée sous l’appellation de buckets. Une taille de classe excessivement large masque l’asymétrie en agglutinant artificiellement les observations, tandis qu’une classe excessivement étroite hache la visualisation en une succession de pics incohérents.
L’enrichissement visuel de l’histogramme gagne à intégrer la matérialisation des repères de tendance centrale. Bien que Google Sheets ne permette pas nativement de superposer une courbe gaussienne théorique continue directement sur son histogramme en un seul clic, l’adjonction de lignes de repère verticales indiquant l’emplacement respectif de la moyenne et de la médiane offre un puissant levier de détection de l’asymétrie. Dès que la moyenne s’écarte visuellement de la médiane en glissant vers la droite le long d’une traîne étirée, le diagnostic de skewness positif s’impose avec une force d’évidence immédiate.
Toutefois, il importe de souligner avec honnêteté les limites perceptuelles majeures de l’histogramme face à la détection du kurtosis. L’œil humain se révèle notoirement incompétent pour estimer avec exactitude la finesse ou l’épaisseur relative des queues de distribution sur un simple histogramme à barres verticales, tendant à confondre un pic acéré avec un kurtosis élevé alors que ce dernier est gouverné par l’éloignement des observations marginales. Cette limitation fondamentale impose impérativement le recours à des représentations diagnostiques graphiques plus sophistiquées.
8.2 Construction d’un graphique quantile-quantile (Q-Q Plot)
Le graphique quantile-quantile, universellement désigné sous le terme de Q-Q Plot, constitue le standard de référence international pour évaluer visuellement la conformité d’un échantillon à une distribution théorique gaussienne. Cet outil trace pour chaque point de l’échantillon sa valeur observée réelle en fonction du quantile théorique prédit par la loi normale pour ce rang spécifique. Bien que Google Sheets ne propose pas d’option Q-Q Plot en un clic, son implémentation manuelle s’avère remarquablement aisée et hautement formatrice.
La construction s’articule autour de trois colonnes opératoires préparatoires. Dans une première colonne, les données observées sont triées par ordre strictement croissant à l’aide de la fonction =TRI(A2:A101). Dans la colonne adjacente, l’opérateur calcule le rang centile empirique associé à chaque ligne au moyen d’une formule de tracé de probabilité standardisée, telle que la formule de Blom ou de Hazen : le rang de la ligne moins 0,375, le tout divisé par la taille n de l’échantillon augmentée de 0,25. Dans la troisième colonne, ces probabilités cumulées sont converties en quantiles normaux théoriques à l’aide de la fonction native =LOI.NORMALE.INVERSE(centile; moyenne; ecart_type).
Une fois ces alignements réalisés, l’analyste sélectionne conjointement les quantiles théoriques et les valeurs observées, puis insère un Graphique en nuage de points, agrémenté d’une droite de référence idéale à 45 degrés reliant les points d’égalité parfaite. L’observation des déviations morphologiques du nuage de points par rapport à cette droite diagonale livre un diagnostic distributionnel d’une richesse exceptionnelle.
L’interprétation clinique des figures d’écartement s’appuie sur une sémiologie rigoureuse. Une asymétrie marquée se traduit par une déviation géométrique unilatérale caractéristique en forme de banane ou de parabole incurvée : dans le cas d’une asymétrie positive, les points s’élèvent bien au-dessus de la droite théorique aux extrémités supérieures. À l’inverse, l’excès de kurtosis engendre une déviation symétrique sigmoïdale en forme de S : un profil leptokurtique fait basculer les extrémités du tracé au-delà de la ligne de référence, traduisant graphiquement que les valeurs extrêmes empiriques dépassent systématiquement les prédictions du modèle gaussien.
8.3 Utilisation des boîtes à moustaches (Boxplots) pour corroborer les indices
Le diagramme de boîte à moustaches, formalisé par John Tukey, constitue le troisième pilier du diagnostic graphique de la forme d’un échantillon. Au sein de Google Sheets, cette représentation est accessible sous la dénomination de Graphique en bougie au sein de la galerie des options graphiques. Bien que traditionnellement orienté vers l’analyse des cours boursiers, ce format s’adapte parfaitement à la modélisation statistique univariée en recevant les valeurs des minimums, des premiers quartiles, des troisièmes quartiles et des maximums de la variable étudiée.
La morphologie de la boîte et des extensions filaires livre des confirmations visuelles directes du coefficient de skewness préalablement quantifié par la formule numérique. Lorsque la distribution est symétrique, la ligne médiane coupe le rectangle interquartile rigoureusement en son centre, et les deux moustaches inférieure et supérieure arborent une longueur strictement équivalente. En revanche, dès qu’une asymétrie positive prévaut, la médiane est compressée contre le plancher inférieur de la boîte tandis que la moustache supérieure s’étire démesurément vers les sommets du graphique, corroborant de manière tangible l’indice calculé par la fonction SKEW.
S’agissant du kurtosis, la boîte à moustaches excelle dans l’objectivation des valeurs aberrantes ou extrêmes qui alimentent l’épaississement des queues. Bien que le graphique standard de Google Sheets nécessite parfois des ajustements pour afficher distinctement les points isolés au-delà de 1,5 fois l’écart interquartile, la disproportion évidente entre la compacité du corps central de la boîte et la démesure des moustaches fournit une indication visuelle univoque quant à la présence d’un régime de dispersion leptokurtique.
9. Interprétation statistique et psychométrique approfondie des résultats
9.1 Critères d’acceptabilité de la normalité univariée
L’obtention de valeurs numériques via les fonctions SKEW et KURT confronte immédiatement le praticien à la question décisionnelle centrale : à partir de quel seuil quantitatif un écart à la normale doit-il être considéré comme préjudiciable à la validité des modèles d’analyse ? Dans la littérature méthodologique internationale, plusieurs grilles de lecture s’affrontent selon les exigences des contextes d’investigation.
Dans le domaine des grands modèles structuraux et des analyses factorielles confirmatoires, les critères de référence universellement plébiscités sont ceux formalisés par West, Finch et Curran (1995). Selon ces auteurs, la normalité univariée est considérée comme acceptable tant que la valeur absolue du coefficient de skewness n’excède pas 2, et que l’excès de kurtosis demeure strictement inférieur à 7 en valeur absolue. Tout échantillon franchissant ces frontières critiques est qualifié de substantiellement non normal, interdisant formellement l’usage des estimateurs du maximum de vraisemblance standard sous peine d’infléchir drastiquement les indices d’ajustement global.
Cependant, dans des contextes expérimentaux plus contraints ou lors du déploiement de modèles linéaires à variables manifestes, des seuils de tolérance beaucoup plus sévères sont régulièrement prescrits par les comités éditoriaux de psychométrie. Kline (2016) recommande ainsi de ne pas outrepasser une valeur absolue de skewness supérieure à 1, et de circonscrire l’excès de kurtosis dans une fourchette stricte de moins 1,5 à plus 1,5 pour préserver l’intégrité inférentielle des régressions linéaires multiples.
L’évaluation académique rigoureuse impose en outre de ne pas juger les coefficients dans le vide, mais de les pondérer par leur incertitude d’échantillonnage respective. Google Sheets permet de calculer très simplement l’erreur type du skewness, symbolisée par SES, qui s’approxime mathématiquement par la racine carrée du ratio 6 divisé par n. De manière analogue, l’erreur type du kurtosis, ou SEK, s’estime par la racine carrée du ratio 24 divisé par n. En divisant le coefficient obtenu par son erreur type associée, l’analyste génère un z-score standardisé. Si ce score z dépasse les seuils critiques de plus ou moins 1,96 au niveau de confiance de 95 %, l’hypothèse nulle de normalité de la distribution est formellement rejetée sur le plan statistique.
9.2 Traduction psychologique des formes de distribution
Loin de constituer de simples abstractions géométriques, les anomalies de distribution traduisent des réalités psychologiques fondamentales qu’il convient de savoir expliciter dans les rapports de recherche. Un coefficient d’asymétrie positive prononcé sur un instrument d’évaluation clinique de la dépression, tel que le BDI-II, reflète la configuration épidémiologique saine d’un échantillon normatif non clinique : la souffrance psychique majeure est une anomalie statistique, et la concentration des individus sur le score plancher témoigne de l’intégrité adaptative de la majorité de la population étudiée.
Réciproquement, un skewness négatif massif observé lors d’un test d’aptitude professionnelle ou d’une épreuve académique met en relief un effet d’aisance ou de facilité excessive de l’épreuve. Ce phénomène, baptisé effet de plafond, démontre que l’instrument de mesure s’avère incapable de discriminer convenablement les sujets hautement performants, ceux-ci venant tous s’agglutiner contre la borne supérieure du barème. L’analyste doit en déduire que l’épreuve nécessite l’adjonction d’items de difficulté supérieure pour restituer une dynamique discriminante équilibrée.
L’aplatissement délivre quant à lui des éclairages cruciaux sur l’homogénéité du tissu comportemental de l’échantillon. Un profil platykurtique prononcé, affichant un excès de kurtosis négatif, signale une dispersion étendue et inhabituellement informe des scores. Dans un contexte de diagnostic organisationnel, cette morphologie peut démasquer la coexistence involontaire au sein du même échantillon de deux sous-populations aux visions antagonistes s’étalant le long de l’échelle, sans parvenir à créer de consensus central.
À l’opposé, une distribution fortement leptokurtique révèle une cristallisation massive et quasi unanime des participants autour d’une norme comportementale commune, tout en étant ponctuée par l’émergence sporadique de profils atypiques marginaux. L’investigation de ces quelques individus résidant dans les queues épaisses constitue alors souvent le cœur même de la valeur diagnostique de la recherche, qu’il s’agisse de détecter des talents exceptionnels ou de repérer des trajectoires de rupture psychopathologique sévère.
9.3 Prise de décision méthodologique consécutive
Le diagnostic posé par le calcul du skewness et du kurtosis dans Google Sheets déclenche une bifurcation décisionnelle majeure dans la trajectoire analytique du chercheur. Le premier réflexe intellectuel consiste à évaluer l’opérabilité du théorème central limite. Dès lors que l’effectif global de l’échantillon dépasse confortablement la barre des 100 à 200 participants, le théorème central limite garantit que la distribution d’échantillonnage de la moyenne converge vers la normalité, autorisant fréquemment le maintien des tests paramétriques classiques pour des déviations modérées ne franchissant pas les seuils de West et al.
En revanche, lorsque la taille de la cohorte est modeste (n inférieur à 30 ou 50) et que le skewness ou le kurtosis excède substantiellement les normes prescrites, la poursuite aveugle de l’analyse paramétrique constitue une faute méthodologique avérée. L’analyste se trouve alors contraint d’abandonner le test t de Student et l’ANOVA au profit de leurs pendants non paramétriques respectifs : le test des rangs signés de Wilcoxon pour mesures répétées, le test de Mann-Whitney pour échantillons indépendants ou le test de Kruskal-Wallis pour les comparaisons à plus de deux groupes.
Une voie intermédiaire moderne et particulièrement puissante réside dans le recours aux techniques de rééchantillonnage par bootstrapping. Cette méthodologie empirique, qui consiste à générer des milliers de sous-échantillons avec remise à partir de la matrice d’origine pour calibrer les intervalles de confiance réels sans postuler de forme distributionnelle a priori, permet de conserver le cadre des modélisations linéaires complexes tout en se blindant méthodologiquement contre les distorsions induites par la non-normalité univariée.
10. Gestion des valeurs aberrantes et techniques de normalisation
10.1 Diagnostic de l’influence des valeurs extrêmes sur SKEW et KURT
L’investigation approfondie des formules de décomposition menée précédemment a révélé la sensibilité démesurée des puissances 3 et 4 face aux valeurs aberrantes situées sur les marges de l’échantillon. Il est donc impératif de savoir évaluer avec précision l’influence marginale exercée par un ou deux points isolés sur les coefficients globaux affichés par Google Sheets. Pour ce faire, une procédure de test d’exclusion temporaire peut être implémentée au moyen d’une formule combinant FILTER et les bornes de Tukey.
La règle classique de Tukey définit les frontières d’isolement des valeurs aberrantes en s’appuyant sur l’écart interquartile (IQR). Le premier quartile s’obtient via la fonction =QUARTILE(plage; 1) et le troisième via =QUARTILE(plage; 3). L’écart interquartile s’établit par la différence entre ces deux valeurs. Tout score individuel s’élevant au-delà du troisième quartile augmenté de 1,5 fois l’IQR, ou descendant en deçà du premier quartile amputé de 1,5 fois l’IQR, est formellement catégorisé comme valeur aberrante modérée. L’analyste peut recalculer instantanément le skewness en filtrant dynamiquement les scores contenus à l’intérieur de ces deux barrières pour quantifier le saut métrique provoqué par l’épuration.
Cette démarche technique s’accompagne d’une réflexion éthique et clinique fondamentale quant au statut ontologique de la donnée anormale. Une valeur aberrante ne doit jamais être assimilée sans discernement à une erreur matérielle qu’il conviendrait d’effacer docilement pour embellir ses résultats et satisfaire les conditions d’un test paramétrique. En psychologie humaine, les observations extrêmes traduisent fréquemment des états d’exception psychologique réels et authentiques qu’il est scientifiquement crucial de documenter. L’exclusion aveugle d’un participant n’est déontologiquement recevable que s’il est prouvé que la déviation résulte d’un artéfact technique avéré ou d’une non-conformité flagrante au protocole expérimental.
Lorsque la préservation intégrale de la cohorte est requise pour respecter le principe d’intention de traiter sans pour autant subir l’instabilité induite par les queues épaisses, l’analyste peut évaluer la robustesse de ses conclusions en comparant les métriques obtenues sur l’échantillon brut avec celles issues d’une version épurée. Cette analyse de sensibilité garantit la transparence scientifique la plus totale.
10.2 Implémentation de transformations de données dans Google Sheets
Lorsque la non-normalité univariée menace la viabilité des inférences et que l’ensemble des données est légitime, le recours aux transformations mathématiques non linéaires constitue une réponse méthodologique éprouvée. Google Sheets propose l’ensemble des fonctions primitives nécessaires pour exécuter ces recalibrations géométriques au moyen de colonnes de calcul dévolues.
Pour corriger une distribution affichant une asymétrie positive substantielle associée à un kurtosis leptokurtique, configuration très fréquente sur les temps de réaction ou les concentrations salivaires de cortisol, la transformation logarithmique népérienne s’impose comme la solution canonique. L’opérateur applique dans une nouvelle colonne la formule =LN(A2) si toutes les valeurs sont strictement positives. Si la série contient des zéros légitimes, la formule logarithmique étendue =LN(A2 + 1) permet de contourner l’indétermination mathématique du logarithme de zéro. L’effet mécanique de cette opération est de comprimer drastiquement les grands écarts supérieurs tout en ventilant la concentration inférieure.
Pour des asymétries positives plus modérées, la transformation par la racine carrée délivre une correction plus tempérée, évitant de sur-corriger l’échantillon vers une asymétrie négative artificielle. Elle s’implémente en écrivant simplement =RACINE(A2) le long de la série. Si la distribution souffre à l’inverse d’une asymétrie négative sévère, l’investigateur doit préalablement procéder à une opération de réflexion de la variable avant transformation : il soustrait chaque valeur observée à une constante K supérieure d’une unité au maximum de l’échantillon, applique la transformation logarithmique, puis rétablit l’orientation directionnelle des scores.
L’efficacité du processus de normalisation est vérifiée en temps réel sur la feuille de calcul en réappliquant immédiatement les fonctions =SKEW(…) et =KURT(…) sur la nouvelle colonne transformée. La comparaison immédiate des coefficients avant et après opération permet de valider empiriquement si les métriques ont réintégré la zone de normalité univariée tolérable, autorisant alors la reprise des analyses paramétriques en toute rigueur.
10.3 Techniques de winsorisation et de tronquage
Une alternative élégante aux transformations non linéaires réside dans l’application des méthodes de régularisation statistique de la statistique robuste, au premier rang desquelles figure la winsorisation. Contrairement au tronquage simple qui élimine purement et simplement les observations situées au-delà de certains percentiles, réduisant ainsi la taille effective n de l’échantillon et amputant la représentativité statistique globale, la winsorisation préserve l’effectif intégral en recodant les valeurs extrêmes pour les aligner sur des percentiles limites prédéfinis.
Dans Google Sheets, une winsorisation symétrique à 90 % consiste à plafonner les valeurs supérieures au 95e percentile à la valeur exacte de ce 95e percentile, et à plancher les valeurs inférieures au 5e percentile à la valeur dudit 5e percentile. Les seuils de démarcation sont aisément identifiés par les formules =CENTILE(plage; 0,05) pour la borne basse et =CENTILE(plage; 0,95) pour la borne haute.
Le recodage dynamique de la série s’exécute au moyen d’une instruction conditionnelle imbriquée insérée dans une colonne adjacente. La formule s’énonce comme suit : si la cellule A2 est inférieure à la borne basse calculée, alors renvoyer ladite borne basse ; sinon, si la cellule A2 est supérieure à la borne haute calculée, alors renvoyer ladite borne haute ; dans tous les autres cas de figure, restituer fidèlement la valeur d’origine A2. Cette transformation matricielle crée une série winsorisée stable et imperméable aux sursauts distaux.
Le recalcul immédiat de l’excès de kurtosis sur cette colonne stabilisée met systématiquement en évidence une chute spectaculaire de la valeur vers des grandeurs mésokurtiques ou modérément platykurtiques, neutralisant le danger de saturation des tests d’hypothèse sans altérer substantiellement la médiane de la variable évaluée.
11. Automatisation avancée et modélisation avec Google Apps Script
11.1 Conception d’une fonction personnalisée (Custom Function)
Bien que les fonctions natives SKEW et KURT s’avèrent irremplaçables pour les traitements univariés usuels, la productivité du chercheur confronté à de vastes inventaires psychométriques gagne considérablement à être décuplée par le développement d’outils sur mesure. L’environnement Google Apps Script, adossé au langage JavaScript moderne et directement imbriqué dans Google Sheets, permet de concevoir des fonctions personnalisées capables d’exécuter d’un seul trait des chaînes de diagnostics statistiques élaborées.
En accédant au menu Extensions puis Apps Script, l’analyste accède à l’environnement de développement infonuagique. Il peut alors programmer une fonction sur mesure, baptisée par exemple CALCULER_DISTRIBUTION, acceptant en paramètre d’entrée un tableau de données rectangulaire. Le script parcourt la matrice soumise, filtre les éléments textuels ou vides en mémoire vive, calcule la moyenne, l’écart-type d’échantillon, puis élève séquentiellement les scores normalisés aux puissances 3 et 4 en appliquant rigoureusement les corrections de Fisher-Pearson pour délivrer dans une matrice de sortie structurée le skewness, le kurtosis, ainsi que les erreurs types SES et SEK associées.
Cette approche par fonction personnalisée s’avère particulièrement adaptée à l’optimisation des temps d’exécution sur les volumineux registres de données. Au lieu de surcharger la mémoire du navigateur par la multiplication de milliers de formules natives réévaluées à chaque pulsation de frappe, la fonction Apps Script opère ses calculs de manière compilée et restitue instantanément un bloc de synthèse figé, garantissant une fluidité de manipulation exceptionnelle même sur des matrices rassemblant des dizaines de milliers de points d’observation.
11.2 Automatisation d’un rapport de diagnostic de normalité
Le plein potentiel de l’automatisation dans Google Sheets s’exprime dans la conception d’un tableau de bord de diagnostic intégralement piloté par script. Un scénario automatisé programmé en Apps Script peut être configuré pour s’exécuter à la suite d’un déclencheur temporel quotidien ou sur événementiel, comme la soumission d’un nouveau protocole Google Forms par un participant en ligne.
Ce programme autonome examine successivement chacune des colonnes quantitatives de la feuille de réponses, en extrait les moments d’ordre 3 et 4, et renseigne un tableau de synthèse situé sur un onglet de restitution. Le script applique automatiquement un formatage conditionnel dynamique : si le coefficient d’asymétrie ou d’aplatissement enfreint les seuils de tolérance de West, la cellule est surlignée d’un aplat rouge d’alerte méthodologique, tandis qu’une conformité mésokurtique se pare d’une coloration verte rassurante.
Pour pousser plus avant l’intégration des flux de recherche, le script peut mobiliser l’API Google Docs pour générer automatiquement un rapport méthodologique textuel complet au format PDF, pré-remplissant les paragraphes descriptifs de normalité et traçant les tableaux au format standard de publication. Enfin, si une anomalie critique majeure survient sur une variable fondamentale, le système déclenche l’expédition automatique d’une alerte par courrier électronique à destination de l’investigateur principal, lui signifiant une dérive distributionnelle anormale sur son échantillon de recueil continu.
11.3 Implémentation du test combiné de D’Agostino-Pearson dans Apps Script
L’évaluation séparée du skewness et du kurtosis soulève la question de la synthèse inférentielle : comment agréger formellement ces deux diagnostics en un test d’hypothèse omnipotent et quantifié par une p-value unique ? La réponse mathématique à cette interrogation réside dans le déploiement du test K-carré de D’Agostino-Pearson, considéré par la communauté biométrique comme l’un des tests d’adéquation à la normalité les plus puissants, surpassant fréquemment le test classique de Kolmogorov-Smirnov.
Le test de D’Agostino-Pearson opère en transformant le coefficient de skewness et l’excès de kurtosis en deux variables standardisées z(S) et z(K) approximant très fidèlement des lois normales centrées réduites, au moyen d’ajustements algébriques complexes impliquant des calculs d’asymétrie de moments d’ordre supérieur. La statistique combinée du test, dénommée K-carré, est obtenue en sommant le carré de z(S) et le carré de z(K). Sous l’hypothèse nulle de normalité de la distribution parente, cette métrique K-carré suit asymptotiquement une distribution du chi-deux à exactement 2 degrés de liberté.
L’écriture d’un algorithme Apps Script dédié permet de coder l’ensemble de ces équations de transformation au sein d’une procédure unifiée. Le script calcule la statistique K-carré, puis interroge la fonction de répartition complémentaire de la loi du chi-deux pour en extraire la p-value exacte. Le programme affiche ensuite sur la feuille de calcul un verdict textuel sans équivoque : si la p-value est supérieure à 0,05, la mention Distribution compatible avec la normalité s’affiche fièrement ; si la p-value est inférieure au seuil alpha, la mention Déviation significative par rapport à la loi normale alerte impérativement l’expérimentateur sur l’inadéquation paramétrique de ses données.
12. Étude de cas empirique complète : Analyse d’un inventaire psychométrique
12.1 Présentation du protocole et des données d’évaluation
Afin de synthétiser l’ensemble des compétences théoriques, logicielles et interprétatives développées au long de cet ouvrage, nous déployons une étude de cas empirique intégrale consacrée à l’évaluation du climat organisationnel et de l’épuisement professionnel. Le protocole implique une cohorte écologique de 500 professionnels du secteur hospitalier ayant consenti à renseigner un inventaire psychométrique standardisé évaluant le bien-être et la charge mentale au travail.
L’architecture du jeu de données se compose d’une matrice rectangulaire importée au format CSV dans un premier onglet Données_Brutes. Les colonnes A à C hébergent les covariables démographiques d’identification : identifiant anonymisé du soignant, statut professionnel (Infirmier, Médecin, Aide-soignant) et ancienneté exprimée en années. Les colonnes D à M accueillent les réponses brutes fournies aux 10 items de l’échelle d’évaluation, chacun mesuré sur une échelle de Likert allant de 1 (Désaccord total) à 5 (Accord total). Enfin, la colonne N consigne le score global d’épuisement professionnel obtenu en sommant les 10 items élémentaires, borné par conséquent entre 10 et 50 points.
Dès l’importation de la matrice, une batterie de vérifications préliminaires est opérée. L’application de la fonction =NB.VIDE(D2:N501) certifie l’absence totale de cellules orphelines. Parallèlement, l’implémentation de formules conditionnelles d’encadrement vérifie que l’ensemble des cotations est strictement compris dans les limites théoriques autorisées, validant l’intégrité numérique préalable de la cohorte avant d’entamer le dépouillement distributionnel.
12.2 Exécution systématique des calculs et construction du tableau de bord
L’analyste configure un onglet dédié intitulé Tableau_de_Bord. Sur une ligne d’en-tête horizontale sont déclinées les 10 variables d’items ainsi que la variable du score global d’épuisement professionnel. En dessous, une succession de lignes opératoires accueille les formules analytiques natives et standardisées. La première ligne calcule la moyenne arithmétique via =MOYENNE(…), la deuxième extrait l’écart-type non biaisé via =ECARTYPE(…), la troisième renseigne le skewness d’échantillon au moyen de =SKEW(…), et la quatrième calcule l’excès de kurtosis grâce à la fonction =KURT(…).
Pour parachever l’assise méthodologique de l’évaluation, des lignes complémentaires intègrent le calcul de l’erreur type du skewness SES et de l’erreur type du kurtosis SEK, ainsi que les scores z d’asymétrie et d’aplatissement obtenus en divisant chaque coefficient par son erreur type dédiée. Un système de règles de mise en forme conditionnelle dynamique est appliqué sur l’ensemble de la zone des scores z : tout z-score compris entre moins 1,96 et plus 1,96 s’illumine d’un fond vert pâle signalant une absence d’écart statistiquement significatif ; les z-scores compris entre 1,96 et 2,58 arborent un jaune de vigilance ; et tout score z outrepassant 2,58 est marqué d’une teinte rouge d’infraction distributionnelle formelle.
L’inspection du tableau de bord ainsi structuré révèle des disparités fondamentales entre les variables. L’Item 3, libellé Je ressens une fatigue intense dès le réveil, affiche un skewness modéré de 0,32 et un kurtosis de -0,45, s’alignant sur un profil mésokurtique quasi normal. À l’inverse, l’Item 8, formulé sous les termes J’ai envisagé de démissionner cette semaine, enregistre un skewness positif massif de 2,41 et un kurtosis leptokurtique colossal de 8,12, dénonçant un phénomène clinique rare et hyper-concentré sur le score minimal 1. Quant au Score Global d’épuisement, il présente un skewness rassurant de 0,42 et un excès de kurtosis de 0,18.
Pour corroborer visuellement ce constat sur le score total, l’opérateur génère sur l’onglet de synthèse l’histogramme à classes resserrées et le graphique Q-Q Plot pas à pas. L’alignement remarquable des points empiriques le long de la bissectrice à 45 degrés confirme sans l’ombre d’un doute que le score global d’épuisement professionnel respecte pleinement l’hypothèse de normalité univariée au sein de cette cohorte hospitalière.
12.3 Rédaction de la section méthodologique selon les normes académiques (APA)
L’aboutissement ultime de l’investigation statistique réside dans la restitution rédactionnelle transparente, rigoureuse et standardisée des résultats au sein du corps du manuscrit scientifique destiné à la publication. Les normes édictées par l’American Psychological Association (7e édition) imposent un protocole descriptif précis combinant texte narratif et tableau récapitulatif synoptique.
Le paragraphe méthodologique décrivant les propriétés distributionnelles du score global d’épuisement professionnel se rédigera sous la forme suivante : Les propriétés distributionnelles du score composite d’épuisement professionnel (M = 28,45 ; SD = 6,82) ont été rigoureusement examinées au sein de l’échantillon global (N = 500). L’évaluation de l’asymétrie met en évidence un coefficient de skewness de Fisher-Pearson de 0,42 (SES = 0,11 ; z = 3,82), tandis que l’évaluation de l’aplatissement révèle un excès de kurtosis de 0,18 (SEK = 0,22 ; z = 0,82). Bien que le ratio critique de l’asymétrie atteigne le seuil de significativité statistique en raison de la puissance induite par la taille importante de l’échantillon, la valeur absolue des coefficients d’asymétrie et d’aplatissement demeure très largement en deçà des seuils critiques conventionnels d’acceptabilité univariée de Kline (|skew| < 1,0 ; |kurtosis| < 1,5) ainsi que des critères plus libéraux de West, Finch et Curran (|skew| < 2,0 ; |kurtosis| < 7,0). L’inspection concomitante du diagramme quantile-quantile (Q-Q Plot) confirme l’absence de déviations structurelles substantielles par rapport à la droite d’équivalence normale. Ces éléments empiriques convergents confirment que l’hypothèse de normalité univariée est suffisamment respectée pour autoriser l’application légitime de modèles linéaires généraux paramétriques sans correction d’estimation.
En complément, un tableau synthétique au format académique APA présente en colonnes successives l’ensemble des variables, leur effectif valide N, leur moyenne M, leur écart-type SD, leur coefficient d’asymétrie S, l’erreur type associée SES, le coefficient d’excès de kurtosis K et son erreur type SEK. Cette structuration cristalline permet aux évaluateurs pairs et à la communauté scientifique d’apprécier d’un seul coup d’œil l’intégrité de la démarche psychométrique menée.
Enfin, dans le cadre de la science ouverte et de la promotion de la reproductibilité des recherches empiriques, l’auteur finalise son classeur Google Sheets en purgeant les métadonnées résiduelles, en documentant scrupuleusement la légende de chaque colonne et en figeant une version d’archivage dotée d’un lien d’accès pérenne en lecture seule. Cette feuille de calcul maîtresse, hébergée sur des dépôts ouverts tels que l’Open Science Framework, assure à la recherche une transparence totale et offre un modèle d’analyse reproductible pour l’ensemble de la communauté scientifique internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cain, M. K., Zhang, Z., & Yuan, K. H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1
- DeCarlo, L. T. (1997). On the meaning and use of kurtosis. Psychological Methods, 2(3), 292–307. https://doi.org/10.1037/1082-989X.2.3.292
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fisher, R. A. (1930). The moments of the distribution for normal samples of measures of departure from normality. Proceedings of the Royal Society of London. Series A, 130(812), 16–28. https://doi.org/10.1098/rspa.1930.0185
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. The Statistician, 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- West, S. G., Finch, J. F., & Curran, P. J. (1995). Structural equation models with nonnormal variables: Problems and remedies. In R. H. Hoyle (Ed.), Structural equation modeling: Concepts, issues, and applications (pp. 56–75). SAGE Publications.