
L’évaluation rigoureuse de la validité prédictive des modèles quantitatifs constitue l’un des piliers méthodologiques fondamentaux de la recherche empirique contemporaine, tout particulièrement au sein des sciences comportementales, de la psychométrie et de la modélisation statistique appliquée. Face à la prolifération d’algorithmes d’apprentissage automatique et de techniques de régression linéaire ou non linéaire, le chercheur et le praticien se trouvent confrontés à la nécessité impérieuse de quantifier avec une précision chirurgicale l’écart résiduel séparant les observations concrètes du monde réel des prédictions théoriques issues de leurs formalisations mathématiques. Parmi l’éventail des métriques d’erreur disponibles, l’erreur quadratique moyenne, universellement désignée sous l’acronyme anglophone RMSE (Root Mean Square Error), s’impose comme l’étalon d’or pour juger de la précision absolue d’un modèle d’estimation continu.
Le calcul du RMSE ne se résume pas à une simple manipulation arithmétique dénuée de sens théorique ; il incarne une philosophie spécifique de la pénalisation de l’erreur où les écarts de grande amplitude se voient sanctionnés de manière géométrique. Cette sensibilité accrue aux déviations substantielles confère au RMSE une importance singulière lors de l’étalonnage d’instruments psychométriques ou de protocoles expérimentaux dans lesquels une prédiction fortement erronée entraîne des conséquences cliniques ou diagnostiques critiques. Cependant, bien que des environnements de programmation statistique sophistiqués tels que R ou Python soient fréquemment mobilisés dans les laboratoires de pointe, le tableur Microsoft Excel demeure le vecteur d’analyse préliminaire, d’audit rapide et de diffusion collaborative le plus omniprésent dans le monde universitaire et institutionnel.
Comprendre, décomposer et maîtriser le calcul de l’erreur quadratique moyenne au sein de l’architecture matricielle et fonctionnelle d’Excel permet de démystifier les mécanismes internes de l’inférence prédictive tout en garantissant un contrôle qualité irréprochable des données empiriques. Ce traité exhaustif a pour vocation d’exposer avec une minutie académique les fondements théoriques, la décomposition algébrique, les procédures de mise en œuvre manuelle et automatisée, ainsi que les subtilités d’interprétation du RMSE dans Microsoft Excel, en prêtant une attention toute particulière aux applications issues de la psychologie quantitative et des sciences humaines.
1. Introduction aux fondements théoriques de l’erreur quadratique moyenne (RMSE)
1.1 Définition conceptuelle et origine mathématique
L’erreur quadratique moyenne prend racine au cœur de la théorie classique de l’estimation statistique et trouve son origine historique dans les travaux séminaux d’Adrien-Marie Legendre et de Carl Friedrich Gauss sur la méthode des moindres carrés développée au tournant du XIXe siècle. Conçue initialement pour concilier les divergences observationnelles en astronomie géodésique, cette approche postulait que la configuration optimale d’un système de paramètres est celle qui minimise la somme des carrés des écarts entre les observations empiriques et les valeurs déduites du modèle théorique. Sur le plan conceptuel, le RMSE représente l’écart-type de la distribution des résidus, c’est-à-dire la mesure absolue de la dispersion des données autour de la surface d’ajustement ou de l’hyperplan de régression.
D’un point de vue physique et métrologique, le RMSE exprime la distance euclidienne moyenne, renormalisée par le nombre d’observations, séparant le vecteur des valeurs prédites du vecteur des valeurs effectivement mesurées dans un espace vectoriel de dimension n. Cette métrique jouit d’une propriété mathématique remarquable : l’invariance d’échelle par translation, couplée à une homogénéité linéaire par rapport à l’unité de mesure de la variable réponse. Si la variable dépendante est exprimée en millisecondes, en points d’un inventaire d’évaluation clinique ou en microvolts d’activité électrophysiologique, le RMSE conserve strictement cette même unité physique, conférant ainsi une signification tangible directe à la quantité d’imprécision inhérente au modèle.
Dans l’évaluation de la validité interne d’un modèle explicatif, le RMSE joue un rôle d’arbitre sans compromis. Alors que des indicateurs adimensionnels comme le coefficient de détermination peuvent masquer d’importantes distorsions d’étalonnage lorsque la variance totale de l’échantillon est massive, le RMSE quantifie sans fard l’erreur résiduelle brute. Il permet de répondre sans ambiguïté à la question cardinale : quelle est l’ampleur moyenne de l’erreur de mesure commise lorsque le modèle postule un comportement ou un résultat individuel ?
1.2 Pertinence de la métrique en modélisation psychologique et comportementale
L’adoption du RMSE dans les sciences du comportement répond à des exigences épistémologiques rigoureuses dictées par la nature même de la mesure psychologique. Dans le cadre de la théorie classique des tests formalisée par Gulliksen et Lord, tout score observé est conceptualisé comme l’addition d’un score vrai inobservable et d’une composante d’erreur aléatoire. Lorsque les psychométriciens conçoivent des modèles d’équations structurelles ou des régressions hiérarchiques pour prédire des traits latents, l’estimation de la fidélité de ces instruments dépend intrinsèquement de la minimisation de la variance d’erreur. Le RMSE devient ici l’outil privilégié pour évaluer la précision avec laquelle un ensemble d’items ou de biomarqueurs opérationnalise une dimension cognitive ou affective.
Dans les champs appliqués de la psychologie différentielle et de la neuropsychologie, l’objectivation des écarts individuels revêt une portée diagnostique majeure. Qu’il s’agisse d’anticiper le déclin cognitif à partir d’épreuves de mémoire épisodique ou de modéliser la propension à l’épuisement professionnel sous l’effet de stresseurs organisationnels, une sous-estimation systématique ou des écarts erratiques majeurs peuvent fausser l’orientation clinique d’un patient. L’utilisation du RMSE permet de garantir que l’algorithme prédictif ne génère pas d’aberrations locales non contrôlées, préservant ainsi la justice distributive et la sécurité éthique des décisions diagnostiques automatisées.
Enfin, en psychophysique et dans l’étude des fonctions sensorielles, le RMSE s’avère indispensable pour ajuster les courbes psychométriques de réponse sigmoïde, telles que celles dérivées de la loi de Weber-Fechner ou de la fonction de puissance de Stevens. Lors de l’ajustement non linéaire des seuils de discrimination sensorielle auditive ou visuelle, le calcul du RMSE entre les probabilités de détection empiriques et la modélisation logistique offre un critère sans équivoque pour déterminer le degré d’adéquation morphologique de la fonction de réponse théorique au système perceptif humain.
1.3 Distinction épistémologique entre prédiction et observation
Toute entreprise de quantification de l’erreur résiduelle repose sur une délimitation conceptuelle stricte entre le statut des scores empiriques observés, traditionnellement notés Oi ou yi, et celui des estimations théoriques générées par le modèle, notées Pi ou ŷi. Les scores empiriques constituent des reflets phénoménologiques captés par le biais d’un dispositif expérimental ou d’un questionnaire standardisé ; ils sont tributaires d’aléas contextuels, de fluctuations attentionnelles, d’erreurs d’arrondi ou de biais de désirabilité sociale. Ces valeurs observées incarnent la matérialité de l’échantillon, avec toute l’imperfection intrinsèque inhérente à la mesure du vivant.
À l’inverse, les scores prédits représentent des abstractions mathématiques déterministes, dérivées d’une fonction analytique paramétrée sur la base d’hypothèses théoriques préalables. L’écart (Pi – Oi) ne saurait par conséquent être interprété de manière simpliste comme un simple déchet algorithmique. Cet écart résiduel délimite la frontière exacte entre la composante du phénomène psychologique que notre formalisation parvient à capturer de façon nomothétique et la part stochastique ou idiographique qui échappe irréductiblement à la structure du modèle.
Cette distinction soulève une question épistémologique profonde quant aux limites de l’inférence statistique face à la variabilité humaine. Une valeur résiduelle non nulle ne disqualifie pas nécessairement la pertinence d’une théorie psychologique. Elle rappelle au chercheur que la modélisation du comportement n’est pas un système déterministe laplacien fermé, mais une approximation asymptotique de processus probabilistes complexes traversés par un bruit biologique et environnemental irréductible.
2. Décomposition analytique de la formule mathématique du RMSE
2.1 Analyse des composantes individuelles de l’équation
L’expression mathématique formelle de l’erreur quadratique moyenne s’énonce selon la relation fondamentale suivante :
RMSE = √ [ (1 / n) * ∑i=1n (Pi – Oi)2 ]
Pour appréhender la portée de cet opérateur, une dissection séquentielle de chaque élément de l’équation s’impose. Le terme (Pi – Oi), souvent désigné sous le terme de résidu individuel ei, symbolise la déviation unitaire entre la valeur estimée par la fonction de modélisation pour le sujet ou l’essai i et la valeur véritablement relevée lors de la phase de recueil de données. L’alignement indiciel rigoureux de ces paires observationnelles constitue une condition absolue de validité : chaque projection théorique doit correspondre de manière bijective et homothétique au participant ou à l’instant temporel qui lui a donné naissance.
L’opérateur de sommation Sigma prescrit l’accumulation itérative de ces déviations sur l’ensemble du domaine d’échantillonnage, parcourant chaque indice de 1 jusqu’au seuil cardinal n. Ce paramètre n reflète la taille effective de l’échantillon d’analyse. Dans la théorie pure des moindres carrés appliqués à des modèles de régression multiple, la normalisation statistique substitue parfois au dénominateur strict n la quantité (n – p), où p caractérise le nombre de paramètres libres estimés dans l’équation. Cette modification introduit les degrés de liberté résiduels pour corriger le biais d’estimation sur de petites cohortes, transformant le RMSE en estimateur non biaisé de l’écart-type de la population cible.
2.2 L’impact de la mise au carré des résidus
L’opération d’élévation à la puissance deux (Pi – Oi)2 remplit une double fonction mathématique déterminante dans la métrologie des modèles statistiques. Sur le plan purement arithmétique élémentaire, cette transformation garantit la stricte positivité de tous les résidus individuels. Dans le cas où l’on omettrait cette étape, les déviations positives (surestimations du modèle) et les déviations négatives (sous-estimations) s’annuleraient mutuellement au cours de l’itération sommative, aboutissant à une résultante globale proche de zéro susceptible de faire miroiter une adéquation parfaite là où le modèle échoue dramatiquement à prédire la réalité.
Sur le plan géométrique et probabiliste, la mise au carré engendre un effet de pénalisation non linéaire et progressif. Alors qu’une déviation d’une unité produit une pénalité égale à 1, un écart de deux unités génère une pénalisation de 4, un écart de cinq unités culmine à 25, et un écart de dix unités propulse la contribution au terme sommatif à 100. Cette croissance exponentielle octroie un poids démesuré aux erreurs de forte amplitude.
Ce mécanisme confère au RMSE une sensibilité exacerbée aux points extrêmes ou aux singularités statistiques. Dans un jeu de données psychométriques, si un répondant présente un pattern de réponses aberrant en raison d’un manque d’engagement attentionnel ou d’un profil clinique atypique non pris en compte par la structure du test, la déviation induite va dominer outrageusement la somme des carrés, gonflant artificiellement l’indice global du RMSE. Cette hyperréactivité impose une vigilance constante quant à la structure distributionnelle des résidus.
2.3 Rôle de la normalisation par la taille de l’échantillon
L’agrégation des erreurs quadratiques sans facteur de division produirait la somme des carrés des erreurs résiduelles (notée conventionnellement SSE pour Sum of Squared Errors). Cette dernière souffre d’un défaut rédhibitoire : sa valeur dépend strictement et linéairement du volume volumétrique de l’échantillon agrégé. L’analyse d’un groupe de mille participants afficherait mécaniquement une SSE largement supérieure à celle d’une cohorte de cinquante individus, quand bien même la fidélité unitaire du modèle serait rigoureusement identique.
L’insertion de la fraction 1 / n opère le passage décisif de l’accumulation brute à une espérance mathématique de la variance de l’erreur. Cette normalisation transforme l’indicateur en une moyenne arithmétique d’écarts quadratiques, neutralisant ainsi l’effet de taille de l’échantillon et stabilisant la mesure asymptotique de la performance. Grâce à cette opération de pondération, il devient méthodologiquement recevable de comparer la validité d’un modèle ajusté sur deux sous-échantillons expérimentaux de dimensions divergentes, comme une cohorte de contrôle comprenant trois cents sujets sains et un groupe clinique restreint à quarante patients atteints d’un syndrome rare.
2.4 L’étape finale de l’extraction de la racine carrée
La moyenne des carrés des résidus, désignée sous le vocable d’erreur quadratique moyenne non extraite ou MSE (Mean Squared Error), résout l’essentiel des contraintes d’optimisation mathématique. Elle constitue d’ailleurs la fonction de coût différentiable standard mobilisée par les algorithmes de descente de gradient. Cependant, la MSE présente une faiblesse sémantique paralysante pour le chercheur : son unité physique équivaut au carré de l’unité de la variable analysée. Calculer une MSE sur des scores d’anxiété mesurés sur une échelle de 0 à 100 produit un indice exprimé en « points au carré », entité conceptuelle dénuée de sens clinique intuitif.
L’application finale de l’opérateur racine carrée rétablit la dimensionnalité originelle du système de mesure. En réalignant l’échelle du résidu standardisé sur l’échelle de départ de l’inventaire psychométrique ou de la tâche expérimentale, le RMSE restitue une métrique instantanément appréhendable. Un RMSE de 4,2 points sur une échelle d’évaluation de la dépression indique textuellement que, en moyenne pondérée par la norme quadratique, les prédictions générées par l’algorithme s’écartent d’environ quatre points du score effectif rapporté par le sujet.
3. Structuration et préparation des données psychométriques dans Microsoft Excel
3.1 Organisation rigoureuse des colonnes de données
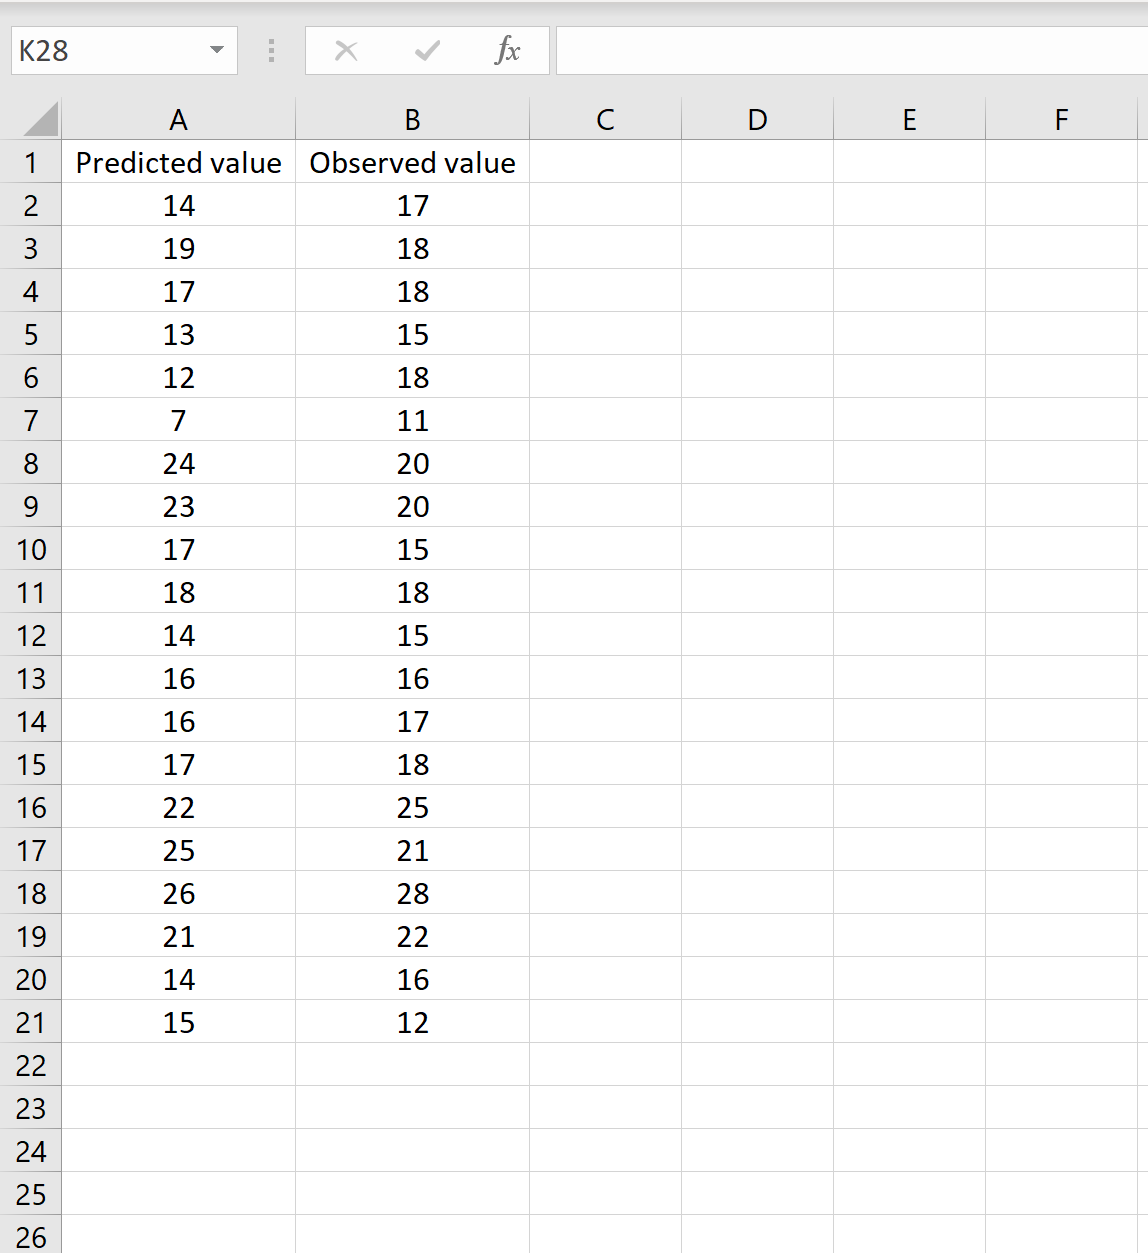
La réussite et la reproductibilité du calcul statistique dans l’écosystème Excel reposent avant tout sur l’application stricte des règles de formalisation des bases de données tabulaires relationnelles (principes du tidy data). Pour traiter des données psychométriques destinées à l’évaluation d’un modèle prédictif, l’agencement spatial au sein de la feuille de calcul doit obéir à une géométrie colonnaire rigide et continue, exempte de cellules fusionnées ou de ruptures de lignes intercalaires.
Il est impératif de réserver la colonne A pour l’identifiant univoque de l’observation (numéro d’anonymat du participant, identifiant de session ou code d’essai chronométré). La colonne B accueille systématiquement le vecteur des valeurs empiriques réelles, étiquetée conventionnellement Score_Observe_O ou Y_Reel. La colonne C reçoit le vecteur homothétique des projections théoriques modélisées, labellisée Score_Predit_P ou Y_Chapeau.
Les en-têtes doivent être confinés à la première rangée (ligne 1) sans fioritures syntaxiques ni caractères spéciaux susceptibles d’engendrer des erreurs de syntaxe lors de l’interrogation par macros ou plages nommées. Dès la mise en place de cette architecture, il convient d’adopter des techniques d’adressage absolu à l’aide du symbole dollar (par exemple $B$2:$B$150) lors de l’écriture ultérieure des fonctions analytiques, empêchant ainsi tout ripage pernicieux des plages de référence lors de manipulations cellulaires ultérieures.
3.2 Nettoyage préalable et gestion des valeurs manquantes
L’intégrité du dénominateur n conditionne la validité probabiliste globale du RMSE. Les investigations en sciences humaines sont particulièrement tributaires des données incomplètes générées par l’abandon de participants en cours d’étude, l’omission involontaire d’items ou l’élimination de données physiologiques altérées par des artefacts de mouvement. Si une cellule demeure vide ou contient une chaîne de caractères non numérique au sein de la colonne des observations ou des prédictions, le tableur est susceptible d’altérer silencieusement la cardinalité de l’échantillon ou de lever une exception d’exécution arithmétique bloquante.
La stratégie la plus rigoureuse dans le contexte d’une validation de modèle repose sur l’exclusion par liste complète (connue en méthodologie sous le terme de listwise deletion). Seuls les couples d’observations (Oi, Pi) disposant simultanément de leurs deux coordonnées numériques validées doivent être conservés pour le calcul. Pour implémenter cette purge au sein d’Excel, l’activation des filtres automatiques via l’onglet Données > Filtrer permet d’isoler en quelques clics les rangées comportant des cellules vides au niveau des colonnes B et C, autorisant leur suppression propre sans déstructurer le reste du classeur.
Pour des jeux de données plus conséquents, il est judicieux de recourir à une colonne auxiliaire de contrôle d’intégrité exploitant la logique booléenne :
=ET(ESTNUM(B2); ESTNUM(C2))
Cette expression renvoie la valeur logique VRAI si et seulement si les deux entrées adjacentes sont rigoureusement quantifiables, offrant une variable de tri infaillible pour préserver l’orthodoxie mathématique de l’analyse.
3.3 Standardisation des formats numériques
Une source fréquente d’aberrations de calcul dans Microsoft Excel réside dans l’hétérogénéité des formats d’encodage des cellules, particulièrement lors de l’importation de fichiers textuels bruts au format CSV issus de plateformes expérimentales telles que PsychoPy, Qualtrics ou Gorilla Experiment Builder. Si les chiffres ont été enregistrés avec un point comme séparateur décimal alors que les paramètres régionaux du système d’exploitation français attendent une virgule, Excel interprète silencieusement ces nombres comme des chaînes de texte typographiques banales, les excluant ainsi de toute fonction d’agrégation arithmétique sans émettre d’avertissement explicite.
Pour remédier à cette anomalie, l’ensemble des colonnes de mesure doit être sélectionné puis typé de façon contraignante au format « Nombre » avec un paramétrage uniforme de deux à quatre décimales via la boîte de dialogue Format de cellule (Ctrl + 1). En présence de résidus textuels récalcitrants, l’application de la fonction =CNUM(B2) ou la mobilisation de la commande Texte vers colonnes permet de forcer la conversion logicielle de la typologie des données en valeurs flottantes opérationnelles.
Il est en outre essentiel de neutraliser l’insertion accidentelle d’espaces insécables (codes ASCII 160) souvent exportés par les bases de données SQL. L’utilisation imbriquée de la formule =SUPPRESPACE(EPURAGE(cellule)) assainit radicalement les données avant toute tentative de calcul de l’écart quadratique.
4. Méthode pas à pas : Calcul manuel décomposé du RMSE dans Excel
4.1 Étape 1 : Calcul des erreurs résiduelles simples
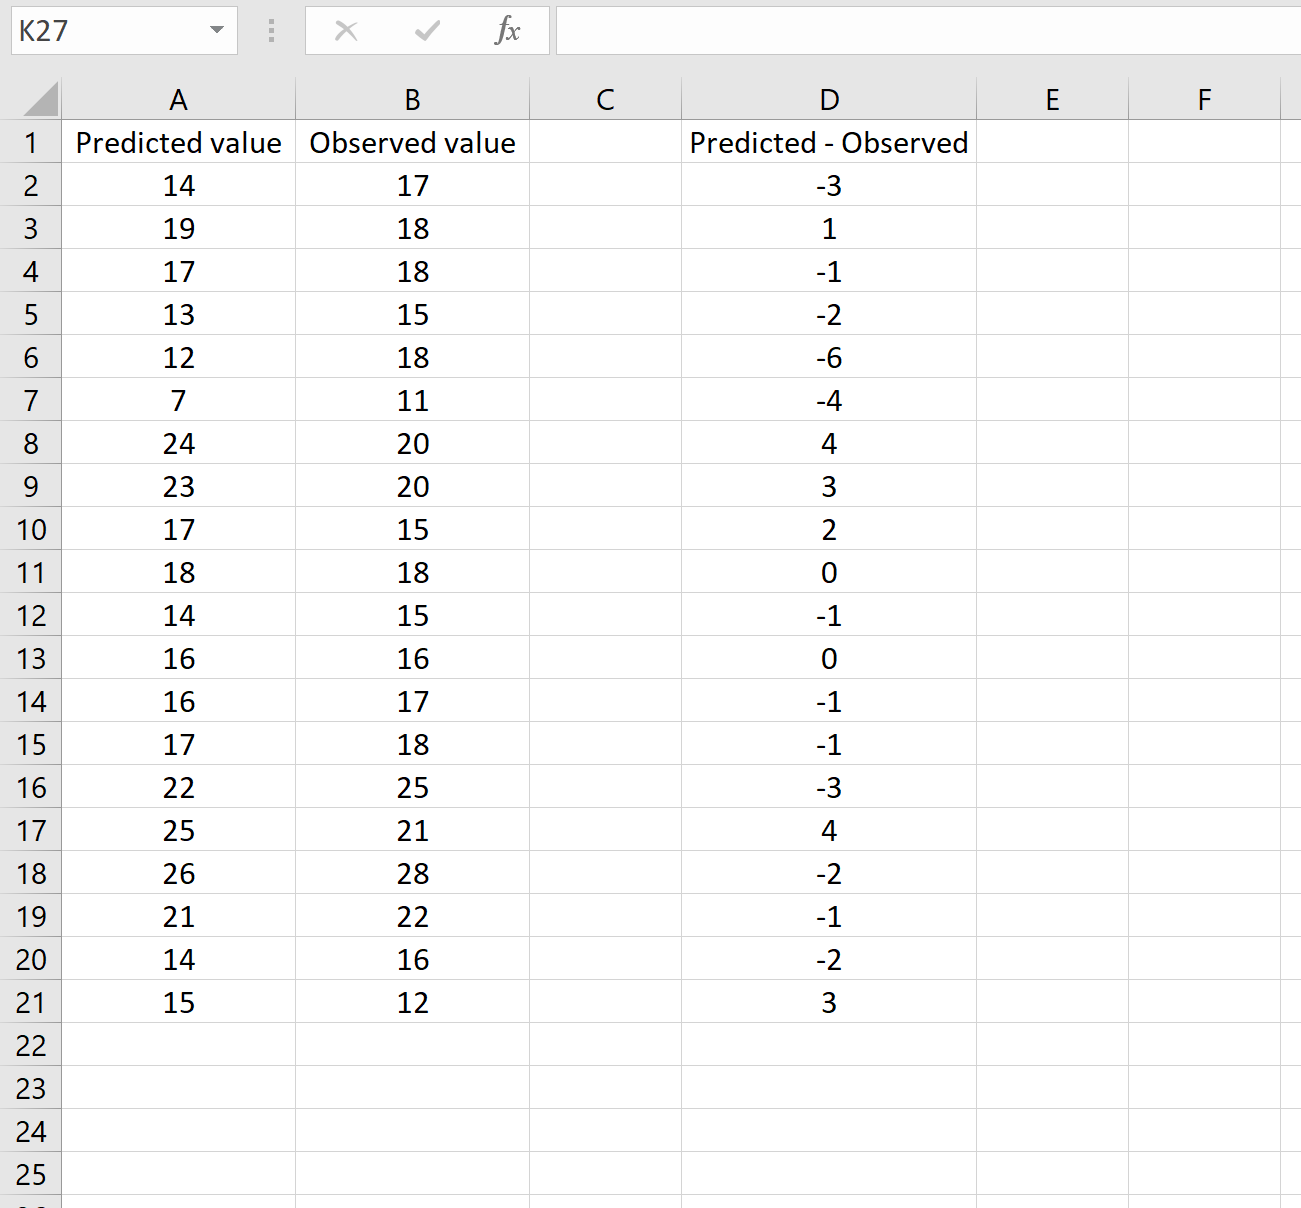
La décomposition pédagogique du calcul offre l’inestimable avantage de rendre transparente chaque phase du traitement statistique, favorisant ainsi le contrôle visuel des erreurs locales et facilitant les audits méthodologiques. La première opération concrète consiste à dériver le vecteur des écarts arithmétiques bruts au sein d’une quatrième colonne dédiée (colonne D), que l’on nommera explicitement Residu_e.
Positionnez-vous sur la cellule D2 et insérez la formule arithmétique élémentaire calculant la déviation directionnelle :
=(C2-B2)
Cette formulation soustrait systématiquement la valeur observée réelle de la valeur théorique estimée par le modèle. Par l’action d’un double-clic sur la poignée de recopie incrémentale située à l’angle inférieur droit de la cellule D2, cette formule se propage instantanément jusqu’au bas du jeu de données, générant l’intégralité du profil des erreurs de prédiction.
Dans l’hypothèse où le vecteur théorique P a été ajusté par un modèle de régression linéaire par moindres carrés ordinaires centré (avec présence d’une constante d’ordonnée à l’origine), le chercheur méticuleux procédera immédiatement à une vérification fondamentale : la somme des éléments de cette colonne d’écarts simples, calculée via =SOMME(D2:Dn), doit converger rigoureusement vers zéro (aux micro-erreurs d’arrondi binaire près). Cette confirmation atteste que le modèle est globalement non biaisé sur son échantillon de calibrage.
4.2 Étape 2 : Élévation au carré des écarts individuels
L’étape subséquente consiste à neutraliser la composante directionnelle du signe et à appliquer le facteur d’amplification non linéaire aux déviations observées. Dans une cinquième colonne (colonne E), étiquetée Residu_Carre_e2, l’implémentation algorithmique se focalise sur l’élévation exponentielle de la colonne adjacente.
Au niveau de la cellule E2, deux options d’encodage fonctionnel équivalentes s’offrent au praticien : l’usage de l’opérateur arithmétique d’exponentiation chapeau =D2^2 ou le recours à la fonction mathématique native =PUISSANCE(D2; 2). La première formulation est généralement privilégiée pour sa concision d’écriture et sa rapidité d’exécution par le moteur d’évaluation d’Excel.
La propagation de cette formule sur l’axe vertical permet de générer la distribution des résidus quadratiques. Cette visualisation met en lumière l’asymétrie positive typique de ces grandeurs : l’écrasante majorité des observations bien ajustées par le modèle affichent des valeurs minuscules comprimées vers le zéro, tandis que les observations atypiques ou mal appréhendées par les prédicteurs émergent immédiatement sous forme de valeurs particulièrement massives. Ce repérage constitue une première alerte heuristique quant à la présence éventuelle de violations des postulats de normalité des résidus.
4.3 Étape 3 : Calcul de la moyenne des carrés des résidus (MSE)
Ayant obtenu l’ensemble des termes quadratiques unitaires, l’objectif analytique se déplace vers l’extraction de la tendance centrale de ces déviations amplifiées, opération qui correspond techniquement à l’évaluation de la MSE. Pour concrétiser cette synthèse dans le tableur, on sélectionne une cellule isolée d’agrégation, par exemple la cellule G2, que l’on libellera dans la rangée adjacente MSE_Calculée.
La syntaxe canonique à déployer fait appel à la fonction de centralité statistique native :
=MOYENNE(E2:En)
où la variable textuelle n matérialise l’index de la dernière ligne occupée par les données du protocole expérimental.
Une alternative de calcul arithmétique direct, particulièrement rassurante sur le plan méthodologique pour s’assurer qu’aucune cellule vide n’a été illicitement assimilée à la valeur numérique zéro, consiste à scinder l’opération sous la forme composite suivante :
=SOMME(E2:En) / NB(E2:En)
La fonction NB possède l’avantage critique d’énumérer strictement les cellules contenant des entités numériques effectives, ignorant délibérément les chaînes textuelles ou les annotations qualitatives marginales. Cette précaution garantit que le dénominateur de normalisation correspond sans aucune ambiguïté au volume véritable d’observations validées au sein du protocole.
4.4 Étape 4 : Application de la fonction RACINE
L’aboutissement de la démarche analytique requiert le rapatriement de la mesure de dispersion dans l’espace géométrique originel de la variable dépendante par le truchement de l’opération de radication. Dans une cellule finale proéminente, positionnée par exemple en G3 et surmontée de la mention RMSE_Final, l’utilisateur sollicite la fonction d’extraction de la racine carrée positive d’un nombre réel :
=RACINE(G2)
ou, en reliant directement cette phase à l’étape computationnelle précédente sans transiter par une cellule d’attente :
=RACINE(MOYENNE(E2:En))
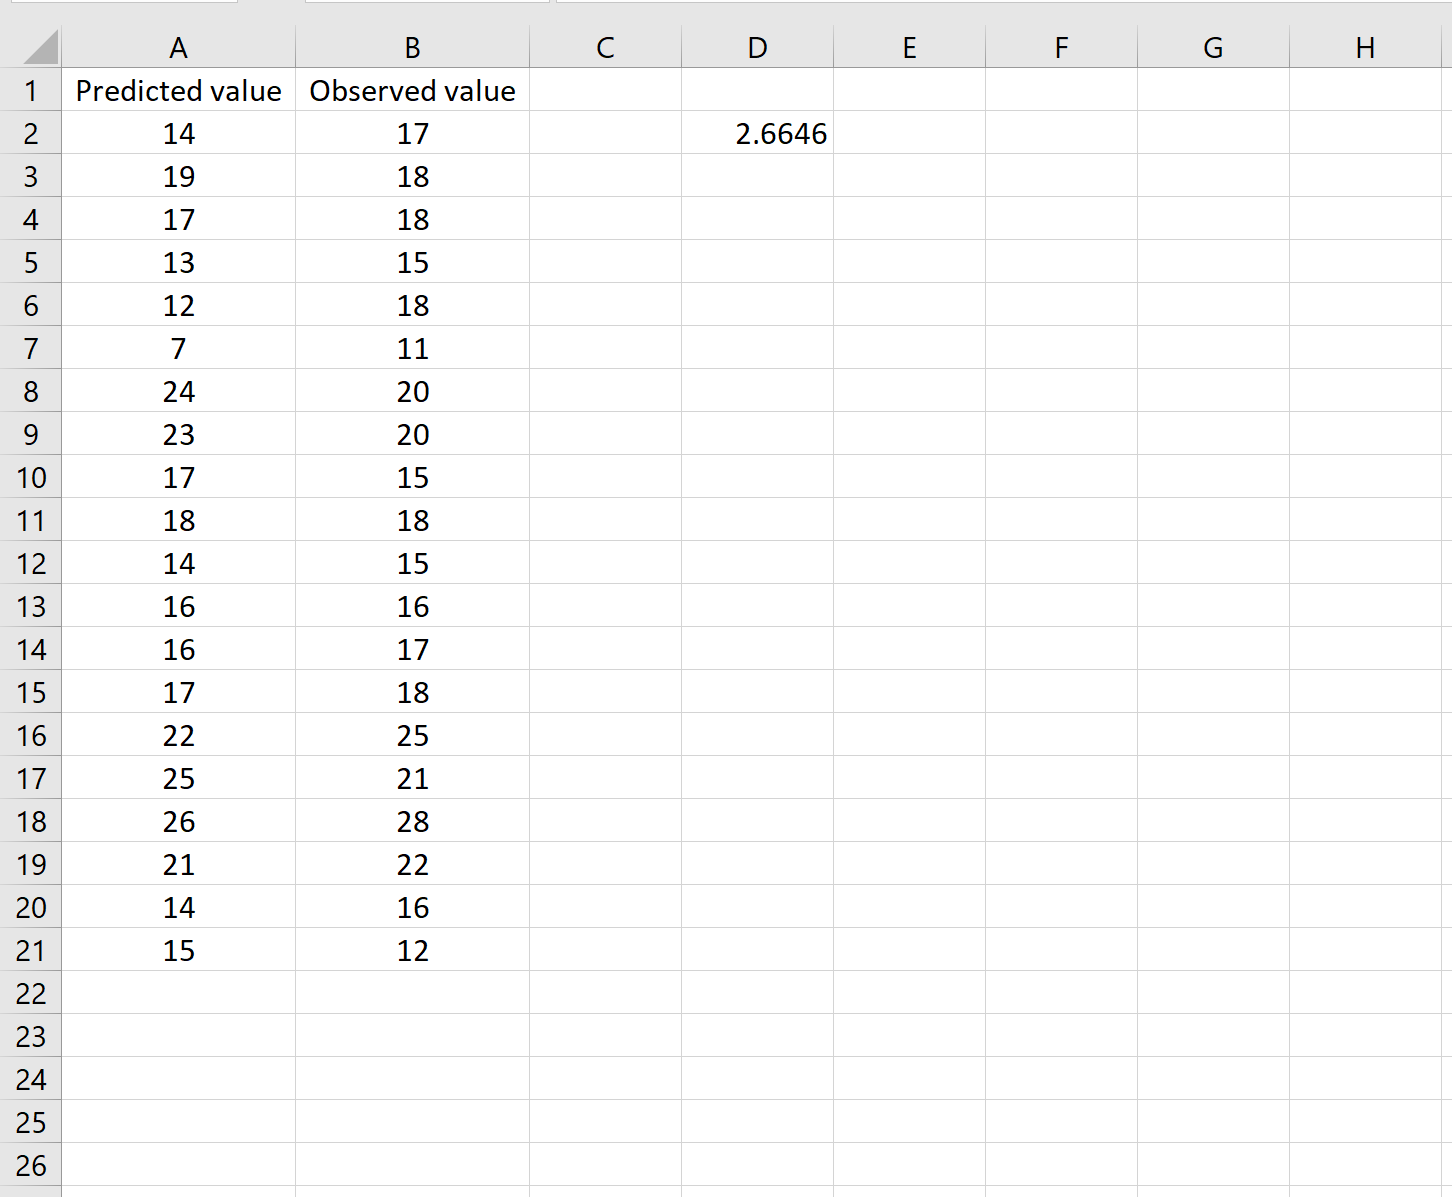
La valeur numérique qui se matérialise instantanément au sein de cette cellule clôture la séquence opérationnelle. Elle représente avec exactitude la marge d’erreur quadratique moyenne de votre architecture prédictive, formulée dans la même métrique scalaire que l’instrument psychométrique ou la variable biologique investiguée.
Pour parachever l’élaboration de ce tableau de bord, il est hautement recommandé d’appliquer une mise en forme visuelle ciblée sur cette cellule terminale : encadrement renforcé, coloration d’accentuation douce, et calibrage de la précision d’affichage à deux décimales significatives selon les standards des comités de lecture scientifique internationaux.
5. Méthode avancée : Formules compactes et calculs directs en une seule cellule
5.1 Utilisation combinée des fonctions RACINE et MOYENNE
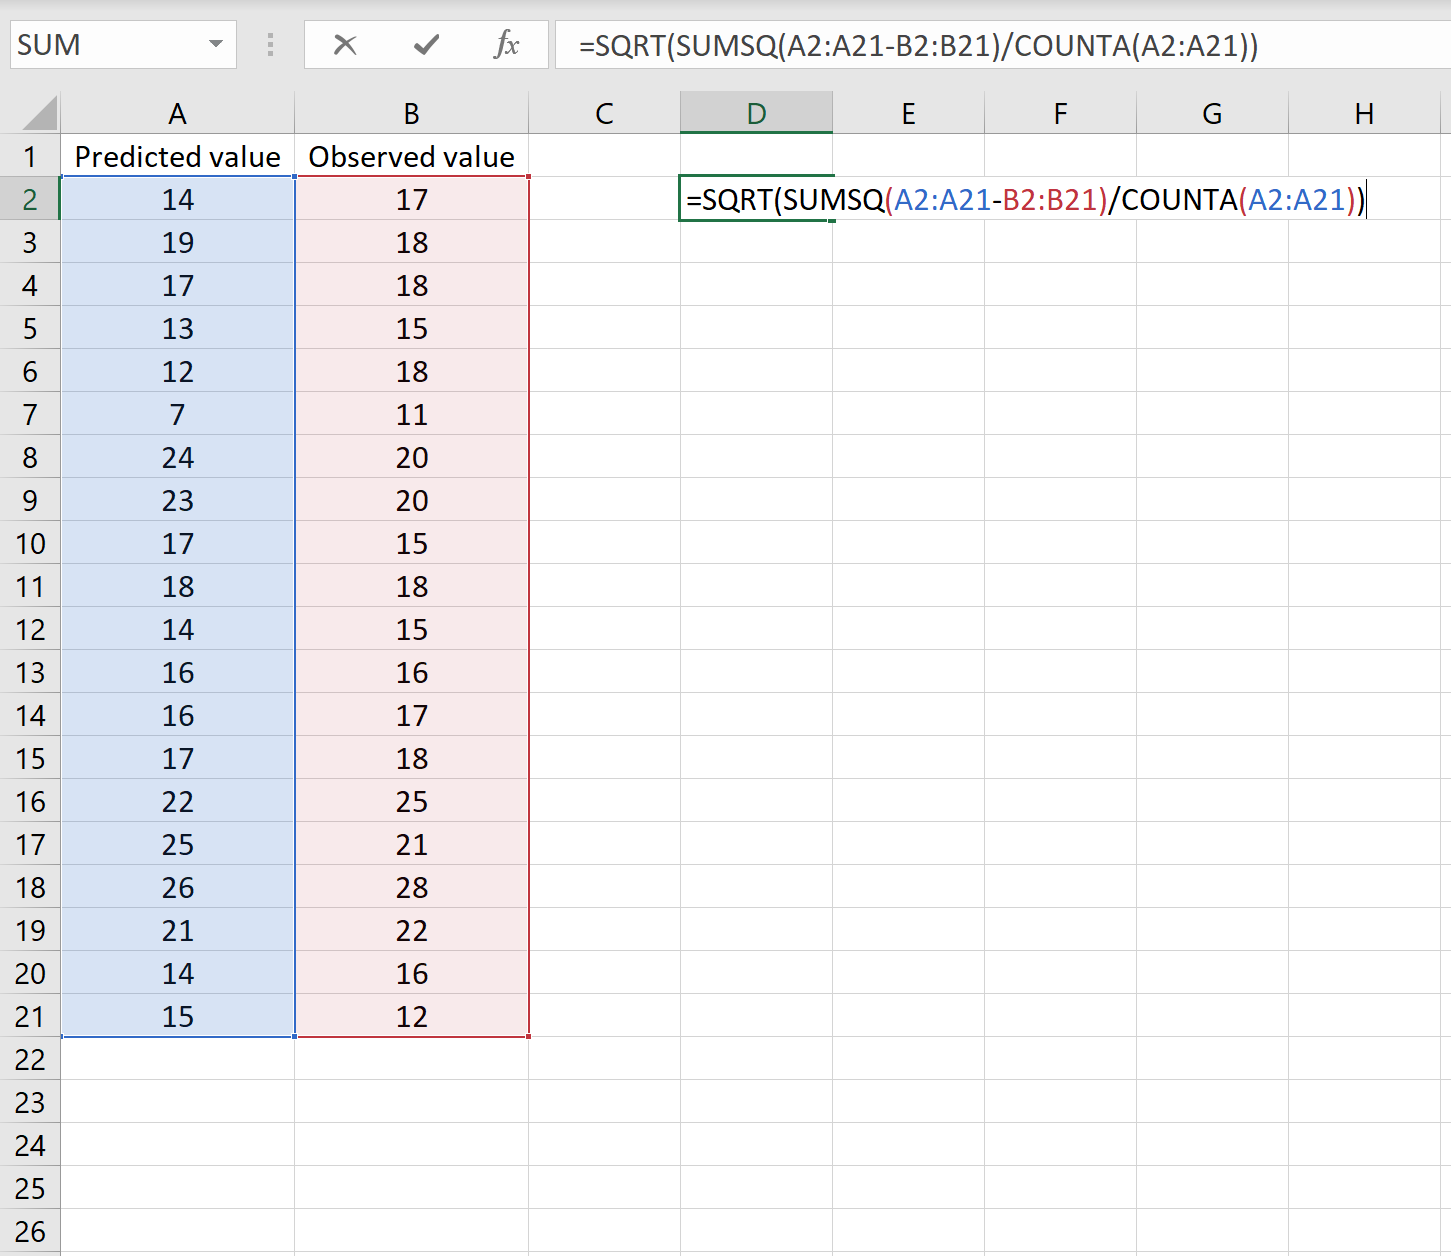
Bien que la décomposition colonnaire pas à pas possède des vertus pédagogiques incontestables, elle présente l’inconvénient logistique d’alourdir considérablement la structure spatiale de la feuille de calcul, notamment lorsque le chercheur manipule des banques de données psychométriques massives composées de dizaines de milliers de lignes ou souhaite comparer simultanément la performance prédictive d’une vingtaine de modèles concurrents. Excel permet heureusement de condenser l’intégralité de la chaîne d’opérations algébriques au sein d’une seule formule matricielle compacte et élégante.
En exploitant le paradigme matriciel d’évaluation vectorielle, la syntaxe synthétique s’articule comme suit :
=RACINE(MOYENNE((B2:Bn – C2:Cn)^2))
Dans cette formulation, l’expression (B2:Bn – C2:Cn) instancie en mémoire vive un vecteur temporaire contenant les déviations résiduelles un à un. L’opérateur d’élévation à la puissance ^2 transforme ensuite ce vecteur virtuel en un tableau de carrés résiduels, dont la fonction MOYENNE calcule sans délai la valeur centrale avant que la fonction RACINE n’en délivre la métrique finale consolidée.
Sur les versions patrimoniales de Microsoft Excel (éditions 2019, 2016, 2013 et antérieures), cette formule constitue une équation matricielle classique. Elle requiert impérativement, pour son exécution valide, d’être confirmée non point par une simple frappe de la touche Entrée, mais par la combinaison de touches dédiée Ctrl + Maj + Entrée (générant automatiquement les accolades englobantes {…} autour de la formule). L’omission de cette validation matricielle spécifique produit inexorablement un code d’erreur de typage ou une évaluation mathématiquement erronée cantonnée à la première ligne du tableau.
5.2 Exploitation de la fonction SOMMEPROD pour optimiser la robustesse
Pour pallier les contraintes de manipulation et les risques opérationnels inhérents à l’oubli de la validation matricielle Ctrl + Maj + Entrée par des tiers utilisateurs du classeur, la fonction SOMMEPROD s’impose comme une alternative d’une robustesse exceptionnelle. Conçue nativement pour traiter des matrices de données sans exiger de combinaison de touches particulière, elle force l’évaluation vectorielle de ses arguments arithmétiques.
L’adaptation de la syntaxe du RMSE par le canal de SOMMEPROD s’écrit de la façon suivante :
=RACINE(SOMMEPROD((B2:Bn – C2:Cn)^2) / NB(B2:Bn))
Dans cette architecture, SOMMEPROD opère la quadrature vectorielle des écarts puis additionne instantanément l’intégralité des termes matriciels résultants. Cette sommation brute est ensuite divisée par le dénombrement rigoureux des observations quantifiables assuré par la fonction NB, garantissant un dénominateur mathématique absolument fiable. L’ensemble est encapsulé dans la fonction de radication RACINE.
Cette approche présente une valeur ajoutée substantielle au sein des environnements professionnels partagés et des équipes de recherche multicentriques. Elle évite l’altération accidentelle du résultat lors de modifications de la formule par des collaborateurs non avertis de la syntaxe matricielle classique, tout en conservant une vitesse de calcul optimale sur des cohortes psychométriques denses.
5.3 Comportement dynamique sous Excel 365 et Excel 2021
L’introduction du moteur de calcul à tableaux dynamiques au sein de Microsoft 365 et d’Excel 2021 a profondément redéfini l’algèbre computationnelle du logiciel. Dans ces versions modernes, toute formule manipulant des plages vectorielles étendues est interprétée nativement comme une opération matricielle sans nécessiter la moindre gymnastique de raccourcis clavier.
La formule matricielle fondamentale =RACINE(MOYENNE((B2:Bn – C2:Cn)^2)) s’exécute désormais par une validation standard via la touche Entrée. Le moteur d’évaluation gère de façon transparente la vectorisation en mémoire cache L2/L3 du microprocesseur, accélérant considérablement le temps de cycle lors du recalcul itératif de modèles complexes comportant des centaines de milliers de lignes d’enregistrement expérimental.
Cette réactivité dynamique se manifeste également avec une efficacité redoutable lorsque les données sont formalisées sous forme de Tableaux Structurés (activables via le raccourci Ctrl + L ou l’onglet Accueil > Mettre sous forme de tableau). Dans ce contexte, la syntaxe se mue en une expression sémantique auto-documentée :
=RACINE(MOYENNE((Tableau1[Score_Observe] – Tableau1[Score_Predit])^2))
Toute adjonction ultérieure de nouvelles observations de participants au bas du tableau déclenche une expansion automatique de la plage de calcul sans exiger la révision manuelle des indices numériques de rangées dans la formule.
6. Génération préalable des valeurs prédites via les outils d’analyse d’Excel
6.1 Utilisation des fonctions PENTE et ORDONNEE.ORIGINE
Dans de nombreuses configurations de recherche empirique, le chercheur dispose d’une série de mesures comportementales prédictives (notées X) et de réponses observées (notées Y), mais n’a pas encore calculé les valeurs ajustées Pi requises pour confronter son modèle théorique à la réalité. Microsoft Excel met à disposition des fonctions statistiques analytiques permettant de déterminer instantanément les coefficients de la droite de régression linéaire univariée optimale répondant aux critères des moindres carrés ordinaires.
La pente de la trajectoire d’ajustement, traditionnellement désignée par le coefficient de régression standardisé ou non standardisé bêta (β), s’obtient au moyen de la formule mathématique suivante :
=PENTE(B2:Bn; A2:An)
où la plage B2:Bn encapsule le vecteur des variables à expliquer (les scores Y observés) et la plage A2:An héberge le vecteur des prédicteurs empiriques (les mesures X). Il est impératif de veiller à respecter cet ordre séquentiel des arguments, sous peine d’inverser involontairement les axes de dépendance fonctionnelle.
Concomitamment, le terme d’interception à l’origine, symbolisant la constante alpha (α) qui positionne la hauteur de la droite lorsque le prédicteur est nul, se dérive via l’instruction :
=ORDONNEE.ORIGINE(B2:Bn; A2:An)
Dès lors que ces deux paramètres scalaires sont consignés dans des cellules fixes dédiées, par exemple en F1 et F2, le vecteur complet des valeurs prédites Pi peut être généré dans la colonne réservée aux prédictions en déployant sur la ligne 2 l’équation linéaire fondamentale :
=($F$1 * A2) + $F$2
L’étirement de cette expression fournit le vecteur indispensable pour initier ensuite le protocole de dérivation du RMSE.
6.2 Application directe de la fonction PREVISION.LINEAIRE
Lorsque l’objectif méthodologique réside exclusivement dans l’obtention des scores prédits sans qu’il soit impératif d’isoler explicitement les coefficients de régression dans le tableau de bord, Excel offre une passerelle fonctionnelle directe à travers la fonction PREVISION.LINEAIRE (anciennement labellisée PREVISION dans les versions patrimoniales du tableur).
Cette fonction encapsule la résolution matricielle interne des moindres carrés pour projeter instantanément la valeur théorique ŷ associée à un point de mesure déterminé. Sa syntaxe opératoire canonique s’articule comme suit :
=PREVISION.LINEAIRE(A2; $B$2:$B$n; $A$2:$A$n)
Le premier argument désigne la valeur spécifique du prédicteur X pour l’observation courante (cellule A2 en adressage relatif). Les deuxième et troisième arguments désignent respectivement l’ensemble de référence immuable des réponses observées Y et des prédicteurs X (verrouillés de manière absolue via l’opérateur dollar pour prémunir le calcul contre tout glissement longitudinal lors du déploiement vertical).
Si cette approche se distingue par sa grande rapidité pour des modélisations bivariées, elle présente toutefois des restrictions fonctionnelles sévères : la fonction PREVISION.LINEAIRE ne peut accommoder nativement des structures d’analyse multivariées incluant des régresseurs multiples, ni intégrer des termes d’interaction non linéaires complexes fréquemment requis dans l’analyse factorielle comportementale.
6.3 Exploitation du complément Utilitaire d’analyse de données
Pour les analyses statistiques exhaustives exigeant une décomposition détaillée de la variance, Microsoft Excel embarque un composant logiciel hautement spécialisé : l’Utilitaire d’analyse (Analysis ToolPak). Ce module d’extension statistique doit être initialement activé via le menu Fichier > Options > Compléments > Gérer : Compléments Excel > Atteindre, en cochant la case relative à l’Utilitaire d’analyse.
Une fois cette passerelle configurée, le ruban Données s’enrichit d’une icône intitulée Utilitaire d’analyse. L’activation de cette commande permet de sélectionner le module Régression, ouvrant un panneau de paramétrage statistique complet. L’utilisateur y configure la plage d’entrée Y (scores observés), la plage d’entrée X (pouvant inclure plusieurs colonnes contiguës de régresseurs), et veille impérativement à cocher les options d’exportation Résidus et Résidus standardisés.
Le rapport synthétique généré automatiquement sur une nouvelle feuille de calcul délivre une mine d’informations descriptives, incluant la table d’ANOVA et l’inventaire complet des résidus unitaires. Il convient de porter une attention méticuleuse à la métrique désignée sous le nom d’Erreur-type au sein du tableau des statistiques de la régression : cette valeur n’est autre que l’estimation corrigée du RMSE, calculée en divisant la somme des carrés résiduels par les degrés de liberté (n – k – 1) plutôt que par n pur. La confrontation de cette erreur-type avec le RMSE calculé manuellement permet de mesurer avec exactitude l’impact de la correction d’échantillonnage sur le diagnostic de votre modèle empirique.
7. Analyse comparative : RMSE face aux métriques alternatives d’évaluation
7.1 RMSE contre Erreur Absolue Moyenne (MAE)
Dans l’arsenal métrologique de la modélisation quantitative, l’arbitrage théorique opposant l’erreur quadratique moyenne à l’erreur absolue moyenne (MAE – Mean Absolute Error) constitue un débat épistémologique fondamental. La divergence structurelle entre ces deux indicateurs découle directement de la topologie géométrique des espaces métriques sous-jacents : là où la MAE mobilise la norme L1 (fondée sur la distance de Manhattan), le RMSE opérationnalise la norme L2 (enracinée dans la distance euclidienne).
La formule de la MAE se déploie dans Excel au moyen de la syntaxe matricielle suivante :
=MOYENNE(ABS(B2:Bn – C2:Cn))
Sur le plan de l’herméneutique statistique, la MAE attribue un poids strictement proportionnel à chaque écart individuel : une déviation de 10 points pèse exactement dix fois plus qu’un écart de 1 point. Elle décrit l’erreur typique au sens de la médiane de la distribution conditionnelle. À l’opposé, en élevant les déviations au carré avant d’en extraire la moyenne, le RMSE privilégie la pénalisation des extrêmes. Par définition mathématique universelle, l’inégalité de Cauchy-Schwarz impose que :
RMSE ≥ MAE
La stricte égalité entre ces deux mesures n’apparaît que dans la configuration hautement théorique où l’intégralité des résidus présente une amplitude absolument identique en valeur absolue. Dès lors qu’une hétérogénéité d’ajustement émerge, le ratio RMSE / MAE progresse au-delà de l’unité. Un différentiel massif entre un RMSE élevé et une MAE modérée constitue un signal clinique clair : le modèle fonctionne de manière très satisfaisante pour l’écrasante majorité de la cohorte, mais commet des erreurs de prédiction substantielles sur un sous-ensemble marginal d’individus atypiques.
7.2 RMSE et Coefficient de Détermination (R²)
Une confusion méthodologique tenace en recherche psychométrique consiste à évaluer l’adéquation d’un modèle d’ajustement uniquement à travers le prisme du coefficient de détermination (R²), calculable dans Excel par la fonction =COEFFICIENT.DETERMINATION(B2:Bn; A2:An). Bien que le R² exprime avec élégance la proportion de variance de la variable observée captée par le modèle mathématique, cet indicateur adimensionnel peut masquer de profondes carences diagnostiques.
En effet, le R² est une métrique relative dépendante de la dispersion totale (variance) de l’échantillon initial. Si une étude porte sur une population clinique présentant une variabilité interindividuelle considérable (par exemple, des scores d’anxiété s’étendant d’une extrémité pathologique à l’autre de l’échelle), le R² tendra mécaniquement à afficher des valeurs flatteuses (proches de 0,85 ou 0,90), quand bien même le RMSE mettrait en évidence des erreurs prédictives locales de 10 ou 15 points, rendant l’outil totalement impropre à une prise de décision clinique personnalisée.
Réciproquement, sur un échantillon excessivement homogène où la variance globale est très restreinte, le R² peut s’effondrer vers des valeurs dérisoires (0,15) alors même que le modèle réalise des prédictions d’une fidélité chirurgicale caractérisées par un RMSE infinitésimal. Le RMSE offre une mesure absolue d’exactitude préservée des artefacts de sélection d’échantillon, s’affirmant comme l’antidote requis face aux illusions interprétatives occasionnées par la seule lecture du coefficient de détermination.
7.3 Sensibilité comparée aux valeurs aberrantes (outliers)
La sensibilité aiguë du RMSE aux valeurs extrêmes conditionne de manière déterminante son utilisation en psychologie quantitative. Dans les protocoles informatisés de recueil de données, la présence d’observations aberrantes causées par des erreurs de saisie, des réflexes moteurs involuntarily déclenchés ou des décrochages cognitifs n’est jamais exclue. Sous l’égide de la métrique quadratique, un résidu isolé de magnitude 50 produit une contribution locale de 2500 unités à la somme des erreurs, exerçant une force d’attraction sur la valeur finale capable de tripler ou quadrupler le RMSE d’un échantillon moyen.
Si la finalité du protocole scientifique consiste à modéliser un système à tolérance d’erreur zéro — par exemple le monitorage de la vigilance d’aiguilleurs du ciel ou l’évaluation du risque de passage à l’acte suicidaire — cette vulnérabilité intrinsèque du RMSE se mue en un atout déterminant : l’analyste recherche délibérément un indicateur qui surpénalise sans clémence la moindre déviation massive. En revanche, si la recherche ambitionne d’isoler la tendance centrale d’un phénomène comportemental au sein d’une population intrinsèquement hétérogène (telle que des enfants présentant des troubles du spectre autistique), l’emploi sans nuance du RMSE peut gravement biaiser les conclusions comparatives.
Dans ce dernier scénario, l’arbitrage méthodologique invite le statisticien à compléter systématiquement l’analyse du RMSE par l’évaluation conjointe de la MAE ou d’estimateurs robustes dérivés de la régression de Huber, garantissant que les inférences scientifiques ne sont pas l’artéfact d’une poignée de données périphériques isolées.
8. Interprétation quantitative et psychométrique de la valeur du RMSE
8.1 Évaluation contextualisée selon l’amplitude de l’échelle
Contrairement aux coefficients de corrélation de Pearson bornés conventionnellement par l’intervalle [-1 ; +1], le RMSE est une statistique non standardisée dont l’amplitude numérique ne possède aucun plafond absolu. Une valeur de RMSE s’élevant à 0,45 peut témoigner d’une imprécision désastreuse si l’échelle de mesure varie entre 0 et 1 (comme dans les probabilités de réussite à une épreuve cognitive), tout en représentant une performance de prédiction extraordinaire si l’investigation mesure des potentiels évoqués sensoriels échelonnés sur des milliers d’unités arbitraires.
Pour conférer une intelligibilité psychométrique au RMSE, il est indispensable de le contextualiser en le rapportant aux caractéristiques distributionnelles de la variable dépendante empirique O. L’étalon de comparaison de premier ordre réside dans l’écart-type de l’échantillon observé, calculable via =ECART-TYPE.STANDARD(B2:Bn). Ce dernier chiffre représente l’erreur commise par un modèle naïf qui se bornerait à prédire indifféremment pour chaque participant la moyenne générale du groupe.
Une heuristique de conformité largement adoptée en modélisation structurelle stipule que pour qu’un modèle prédictif justifie son utilité explicative face à un modèle nul basique, son RMSE doit impérativement se situer en deçà de la moitié de l’écart-type de la variable réponse :
RMSE < 0,5 * σy
Un ratio supérieur à ce seuil indique que la sophistication des variables indépendantes mobilisées n’apporte qu’un gain prédictif négligeable comparé à la simple imputation de la tendance centrale d’une cohorte standard.
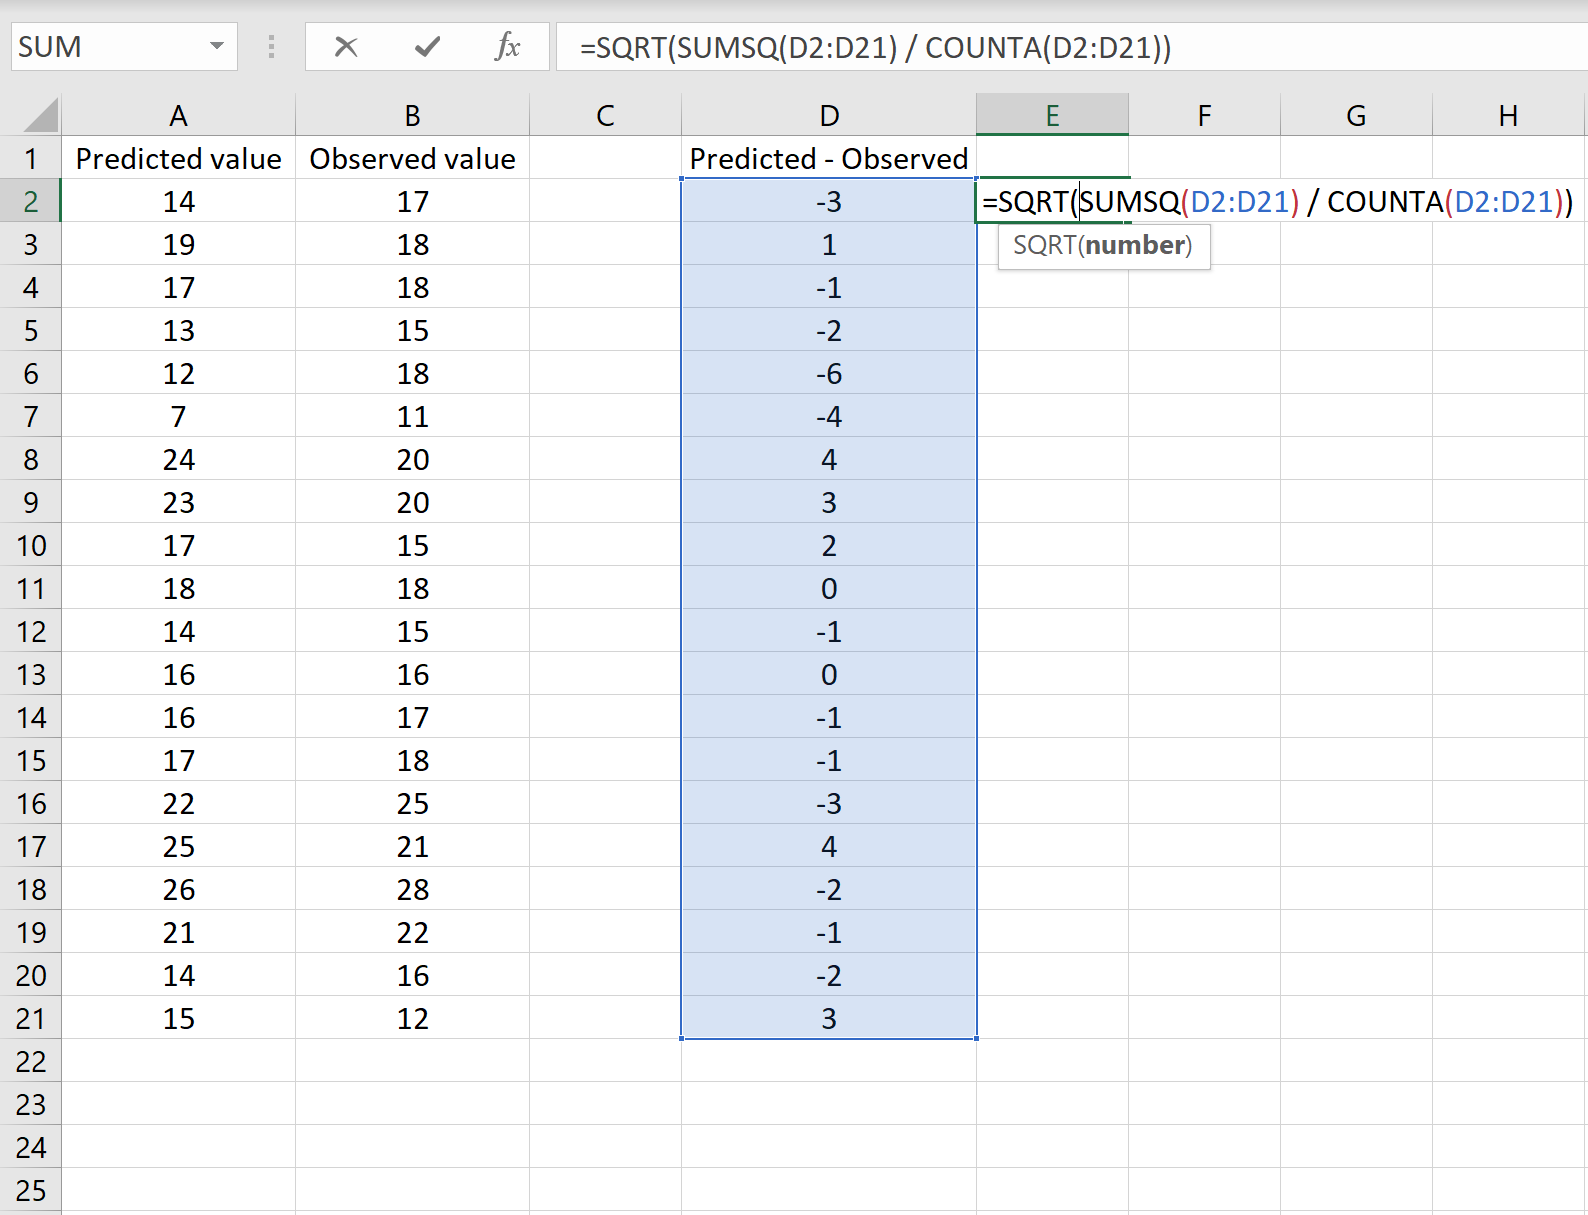
8.2 Calcul et intérêt du RMSE Normalisé (NRMSE)
Pour autoriser des comparaisons inter-échelles rigoureuses — par exemple confronter l’aptitude d’un modèle algorithmique à anticiper simultanément les scores d’un inventaire d’extraversion échelonné de 10 à 50 et ceux d’un test d’efficience intellectuelle calibré de 40 à 160 — les statisticiens recourent à la standardisation de l’indice sous la forme du RMSE Normalisé (NRMSE).
Deux protocoles de normalisation dominent la littérature empirique contemporaine. Le premier consiste à rapporter le RMSE à l’étendue globale (l’intervalle interquartile ou le range maximal observé) de l’instrument de mesure :
NRMSERange = RMSE / (Max(O) – Min(O))
qui s’implémente dans la cellule de synthèse d’Excel par la composition fonctionnelle suivante :
=G3 / (MAX(B2:Bn) – MIN(B2:Bn))
Ce ratio s’exprime typiquement sous forme de pourcentage d’erreur rapporté à la capacité d’excursion dynamique complète du test psychométrique.
La seconde alternative opère la division du RMSE par l’espérance arithmétique de la cohorte d’évaluation :
NRMSEMoyenne = RMSE / MOYENNE(B2:Bn)
Cette forme s’apparente au coefficient de variation de la dispersion des erreurs. Son usage exige cependant une réserve méthodologique formelle : la variable sous-jacente doit impérativement relever d’une échelle de rapport possédant un zéro absolu naturel et non conventionnel (tel qu’un temps de réponse ou une conductance cutanée). Son application à des scores d’échelles de Likert d’intervalles arbitraires induit un biais d’échelle susceptible de dénaturer les inférences intergroupes.
8.3 Diagnostic du surapprentissage et de la validité croisée
L’évaluation isolée du RMSE au sein de l’unique échantillon d’ajustement initial expose le chercheur au risque majeur du surapprentissage (overfitting). Ce phénomène préjudiciable intervient lorsqu’un modèle statistique trop paramétré ou une modélisation polynomiale d’ordre élevé épouse fidèlement les singularités stochastiques et le bruit d’échantillonnage de la cohorte de calibrage, au détriment dramatique de sa capacité de généralisation nomothétique à de nouvelles cohortes de sujets.
Pour prémunir l’analyse contre cet écueil méthodologique, l’architecture Excel peut accueillir un protocole de scission d’échantillon (split-sample validation). À l’aide de la fonction d’aléa =ALEA(), la population générale est ventilée selon un ratio conventionnel de 70% alloué à la cohorte d’apprentissage (training set) et 30% dévolu à la cohorte de validation indépendante (test set). Le modèle est rigoureusement calibré sur les données d’apprentissage afin de dériver les coefficients prédictifs, puis ces mêmes paramètres figés sont appliqués pour générer les valeurs prédites sur les données d’évaluation neutres.
Le diagnostic comparatif repose sur l’évaluation simultanée de deux métriques : le RMSETrain et le RMSETest. Une concordance étroite entre ces deux indicateurs certifie la robustesse transcendantale de l’architecture prédictive. À l’opposé, la survenue d’une divergence marquée — matérialisée par un RMSE d’évaluation excédant de plus de 20% à 30% le RMSE d’apprentissage — constitue la signature empirique irréfutable d’un modèle artificiellement contraint par le surajustement, dictant une réduction impérative du nombre de régresseurs libres.
9. Automatisation du calcul du RMSE à l’aide de macros VBA dans Excel
9.1 Conception d’une fonction personnalisée (UDF)
L’automatisation procédurale représente l’étape ultime de rationalisation pour les praticiens confrontés à des routines récurrentes de traitement de données psychométriques. Bien que les formules natives d’Excel couvrent la majorité des besoins opérationnels, elles obligent l’utilisateur à réécrire des combinatoires syntaxiques parfois lourdes et vulnérables aux coquilles de typographie. L’environnement Visual Basic for Applications (VBA) permet de concevoir une fonction personnalisée (User Defined Function ou UDF) sur mesure, instanciant un mot-clé unique tel que =CalculerRMSE(Plage_Reelle; Plage_Predite).
Cette approche logicielle offre plusieurs avantages décisifs : elle simplifie radicalement la lecture des formules complexes au sein des cellules de synthèse, standardise la méthodologie computationnelle au sein d’un laboratoire ou d’un service d’évaluation clinique, et permet d’encapsuler des contrôles d’intégrité matricielle impossibles à exécuter par une formule de cellule conventionnelle sans alourdir la grille visuelle du classeur.
L’intégration d’une telle routine nécessite l’ouverture de l’éditeur de code intégré par le biais du raccourci universel Alt + F11, suivie de l’insertion d’un module standard via la commande Insertion > Module, au sein duquel le script algorithmique sera déployé.
9.2 Code source commenté et structure algorithmique
L’implémentation de la fonction personnalisée requiert une rigueur algorithmique absolue garantissant la gestion des exceptions, le typage strict des structures de mémoire et le rejet préventif des matrices dimensionnellement asymétriques. Le listing fonctionnel structuré se déploie selon le modèle architectural suivant :
Function CalculerRMSE(ByVal PlageObservee As Range, ByVal PlagePredit As Range) As Variant
‘ Déclaration des variables scalaires et vectorielles en typage strict
Dim nObservations As Long
Dim i As Long
Dim SommeCarres As Double
Dim Ecart As Double
Dim VecteurObs As Variant
Dim VecteurPred As Variant
‘ Contrôle de parité dimensionnelle des sélections
If PlageObservee.Cells.CountLarge <> PlagePredit.Cells.CountLarge Then
CalculerRMSE = CVErr(xlErrRef)
Exit Function
End If
‘ Récupération matricielle directe en mémoire vive pour optimiser les performances
VecteurObs = PlageObservee.Value
VecteurPred = PlagePredit.Value
SommeCarres = 0#
nObservations = 0
‘ Boucle de calcul itérative ignorant les valeurs textuelles ou manquantes
For i = 1 To UBound(VecteurObs, 1)
If IsNumeric(VecteurObs(i, 1)) And IsNumeric(VecteurPred(i, 1)) And Not IsEmpty(VecteurObs(i, 1)) And Not IsEmpty(VecteurPred(i, 1)) Then
Ecart = CDbl(VecteurObs(i, 1)) – CDbl(VecteurPred(i, 1))
SommeCarres = SommeCarres + (Ecart * Ecart)
nObservations = nObservations + 1
End If
Next i
‘ Évaluation finale de l’expression mathématique
If nObservations > 0 Then
CalculerRMSE = Sqr(SommeCarres / nObservations)
Else
CalculerRMSE = CVErr(xlErrDiv0)
End If
End Function
Ce script extrait les sélections sous la forme de tableaux de variantes en mémoire vive, contournant les lenteurs critiques associées à l’interrogation récurrente cellule par cellule du classeur hôte. L’algorithme valide la nature numérique de chaque entrée individuelle, écartant sans ambiguïté les anomalies textuelles sans interrompre brutalement le fil d’exécution.
9.3 Déploiement et pérennité dans un classeur macro-activé (.xlsm)
L’incorporation de scripts VBA modifie la structure de conservation physique du document. Il est impératif de substituer au format conventionnel de stockage (.xlsx) le format d’enregistrement spécifique compatible avec les macros, identifié par l’extension .xlsm. Si cette sauvegarde spécifique est ignorée lors de la fermeture du tableur, l’ensemble du code source élaboré au sein du module VBA sera irrémédiablement purgé par le mécanisme de sécurité interne de Microsoft Excel.
Dans l’optique d’un déploiement institutionnel élargi au sein d’une équipe de recherche ou d’un réseau hospitalier, il devient contre-productif de dupliquer manuellement ce module dans chaque fichier d’expérimentation unitaire. La gouvernance méthodologique préconise la compilation du code sous la forme d’un Complément Excel (.xlam).
Cette procédure d’exportation permet de greffer la fonction =CalculerRMSE() au moteur général de l’application cliente sur les postes informatiques cibles. Elle garantit son accessibilité permanente au sein de n’importe quel classeur vierge, tout en protégeant l’intégrité du code source sous-jacent contre les manipulations accidentelles grâce à la mise en place d’un mot de passe de verrouillage du projet Visual Basic.
10. Diagnostic des anomalies et résolution des erreurs de calcul dans Excel
10.1 Résolution des codes d’erreur classiques (#VALEUR!, #DIV/0!, #N/A)
L’implémentation de protocoles computationnels matriciels dans Microsoft Excel confronte inévitablement l’analyste à des codes d’interruption sémantique que le chercheur rigoureux doit savoir diagnostiquer et désamorcer sans délai.
Le code d’erreur #VALEUR! signale typiquement la présence insidieuse d’une variable typographique incompatible au sein du canal de sommation arithmétique. Cette situation émerge fréquemment lorsqu’une cellule contient une chaîne textuelle masquer (telle que l’annotation clinique « ND » pour Non Déterminé ou un espace typographique insécable). La fonction standard MOYENNE ou l’opérateur d’élévation à la puissance ^2 ne pouvant contraindre un texte en scalaire numérique, l’arbre de calcul s’interrompt instantanément. Le recours aux filtres de données ou à la formule de contrôle =ESTNUM() identifie immédiatement les cellules fautives.
Le message #DIV/0! traduit une impossibilité mathématique d’exécution résultant d’un dénominateur nul au sein de la fraction de normalisation. Cette anomalie apparaît lorsque la plage sélectionnée ne comprend aucune valeur numérique effective ou que l’intégralité des rangées a été filtrée ou vidée. La vérification de la plage désignée au sein de la fonction NB() constitue la modalité de correction de premier plan.
Enfin, le code #N/A (Non Applicable) signale une asymétrie dimensionnelle irrémédiable entre les matrices confrontées. Si la plage des observations réelles s’étend sur cent lignes (B2:B101) alors que la plage des estimations théoriques n’en couvre que quatre-vingt-dix-neuf (C2:C100), le moteur vectoriel se trouve en incapacité structurelle d’apparier la centième coordonnée, provoquant la levée immédiate de l’exception d’incompatibilité.
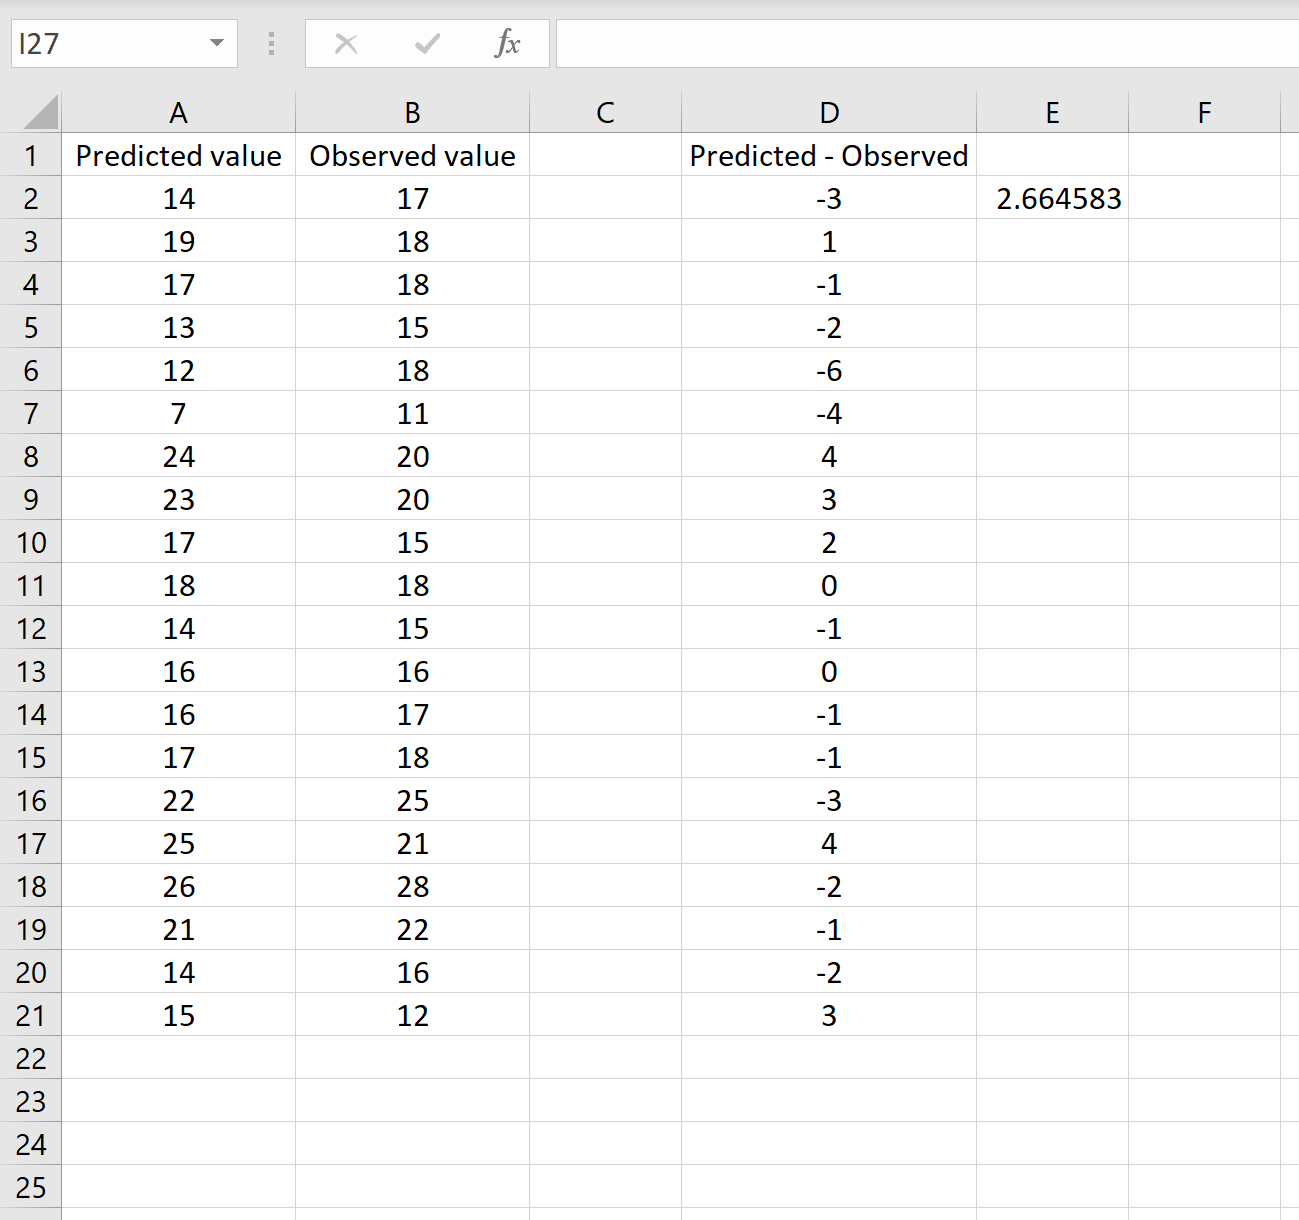
10.2 Pièges liés aux références relatives et au glissement de cellules
L’un des écueils opérationnels les plus insidieux réside dans la gestion laxiste du mode de référencement spatial au sein des formules du tableur. Lors du recours aux formules combinées complexes ou lors de l’application de fonctions décomposées de normalisation, l’omission des indicateurs de verrouillage absolu (symbolisés par le caractère dollar $) engendre un phénomène pernicieux de décalage spatial progressif au fur et à mesure que l’utilisateur déploie la formule par glissement vertical ou horizontal.
Par exemple, si le terme d’interception d’un modèle de régression est consigné en cellule F1 et que la formule d’estimation est encodée de manière relative sous la forme =(A2*F$2)+F1, la duplication vers le bas convertira automatiquement cette référence en F2, puis en F3, associant à l’évaluation des coefficients totalement dénués de rapport avec les constantes initiales. L’observation statistique en aval produit alors un résultat numérique formellement validé par le tableur, mais dont la valeur est substantiellement faussée.
Pour auditer avec lucidité ces dérives architecturales, l’utilisation de l’outil d’audit Évaluer la formule (accessible via l’onglet Formules > Audit de formule) offre une projection pas à pas du graphe de dépendance logique. De même, l’activation du mode d’affichage des formules intégrales via le raccourci clavier Ctrl + " permet de balayer d’un coup d’œil l’orthodoxie des adressages absolus sur l’ensemble de la grille de calcul.
10.3 Gestion de la précision numérique en virgule flottante
Bien que Microsoft Excel demeure un instrument d’analyse accessible et performant, les chercheurs manipulant des protocoles de précision chronométrique fine ou des données neurophysiologiques à haute fréquence d’échantillonnage doivent rester conscients des limites physiques imposées par son moteur arithmétique interne. Excel est assujetti aux spécifications normatives standardisées de la norme IEEE 754 relatives à l’arithmétique en virgule flottante à double précision, plafonnant la précision computationnelle à 15 chiffres significatifs.
Dans les configurations d’expérimentation où les déviations différentielles (Pi – Oi) atteignent des grandeurs infinitésimales (de l’ordre de 10-8 ou inférieures), la quadrature de ces micro-termes génère des valeurs si ténues qu’elles franchissent le seuil de sous-dépassement arithmétique (underflow) de la machine. Ce phénomène conduit le tableur à tronquer purement et simplement les résidus infimes en zéros absolus, minorant artificiellement la sommation d’erreur finale.
Réciproquement, lors de soustractions opposant de très grands nombres presque équivalents, des artefacts de précision binaire peuvent produire des résidus artificiels résiduels non nuls. Pour stabiliser l’assise du calcul sans altérer l’essence de l’information statistique, il est fortement conseillé d’encapsuler les dérivations résiduelles sensibles dans la fonction d’arrondi formel =ARRONDI(écart; 8), harmonisant la valeur numérique inscrite en mémoire vive avec l’exactitude substantielle des instruments de captation expérimentale.
11. Applications pratiques : Études de cas en psychologie quantitative
11.1 Cas 1 : Modélisation des scores d’anxiété préopératoire (STAI)
Pour ancrer ces développements théoriques dans la réalité empirique du laboratoire, examinons un premier cas d’étude clinique dédié à la prédiction du niveau d’anxiété ressenti par une cohorte de 120 patients devant subir une intervention chirurgicale programmée. L’anxiété préopératoire est mesurée à l’aide de l’inventaire standardisé STAI (State-Trait Anxiety Inventory de Spielberger), produisant un score continu calibré entre 20 (calme absolu) et 80 (détresse émotionnelle aiguë). Le modèle d’ajustement intègre l’âge des participants, le score d’anxiété-trait sous-jacent et une mesure psychométrique de soutien social perçu.
Les scores STAI observés sont répertoriés dans la colonne B (Score_Observe) et les projections établies par l’équation de régression multivariée sont importées dans la colonne C (Score_Predit). Le déploiement de la syntaxe condensée =RACINE(MOYENNE((B2:B121 – C2:C121)^2)) délivre une valeur de RMSE s’élevant à 6,42 points. L’écart-type empirique de la variable réponse STAI affichant par ailleurs une valeur σy = 14,80, le critère d’adéquation heuristique (RMSE < 0,5 * σ) est pleinement satisfait (6,42 étant substantiellement inférieur au seuil critique de 7,40).
Sur le plan de l’interprétation clinique appliquée, ce résultat signifie concrètement que les prédictions algorithmiques formulées par le modèle s’écartent en moyenne pondérée d’environ six points du ressenti d’anxiété authentiquement verbalisé par le patient. Pour le corps médical, cette marge d’erreur représente une fourchette diagnostique acceptable, les transitions entre paliers de gravité clinique sur l’inventaire STAI s’opérant par sauts de dix points, validant ainsi l’intégration de ce modèle dans le dispositif d’accueil hospitalier.
11.2 Cas 2 : Prédiction des temps de réaction dans une tâche d’attention soutenue
La chronométrie mentale explore une typologie de signaux comportementaux présentant des singularités distributionnelles prononcées : les temps de réaction (TR). Dans une tâche de vigilance attentionnelle de type Stroop ou Go/No-Go mesurée auprès de 250 sujets, les scores chronométriques bruts s’échelonnent typiquement de 250 à 1800 millisecondes, arborant une asymétrie distributionnelle positive marquée avec une longue traîne de réponses tardives induisant une forte hétéroscédasticité des résidus.
Dans ce contexte, le calcul brut d’un RMSE sur les millisecondes directes produirait un indicateur démesurément distordu par les temps de réponse extrêmes générés par les décrochages attentionnels sporadiques. Le protocole méthodologique impose une linéarisation préalable par le truchement de la transformation logarithmique népérienne appliquée aux observations :
Y_Log = LN(Temps_Reaction_Brut)
Le calcul du RMSE s’effectue subséquemment sur le différentiel des échelles logarithmiques, générant une valeur unitaire adimensionnelle compacte, par exemple RMSELog = 0,145. Bien que rigoureusement conforme aux présupposés de normalité de l’analyse, cette valeur pose un défi d’interprétation intuitive pour le neuroscientifique non mathématicien. Le re-transfert d’échelle par l’exponentiation directe du RMSE n’étant pas formellement recevable sur le plan purement statistique en raison de l’inégalité de Jensen, ce RMSE transformé doit être interprété comme une marge d’erreur relative géométrique approximant un écart prédictif unitaire d’environ 15,6% autour de la cinétique attentionnelle médiane.
11.3 Cas 3 : Suivi longitudinal de l’efficacité d’une psychothérapie
La troisième illustration clinique aborde le monitoring longitudinal de trajectoires de rétablissement psychothérapeutique chez 80 patients présentant un épisode dépressif caractérisé, suivis de manière hebdomadaire durant seize semaines. L’évaluation de la sévérité symptomatique est confiée à l’inventaire BDI-II (Beck Depression Inventory), dont la cotation s’étend de 0 à 63 points. L’enjeu fondamental consiste à arbitrer entre deux modélisations prédictives concurrentes : un modèle de décroissance strictement linéaire postulant une rémission à vitesse constante face à un modèle curvilinéaire quadratique postulant un effet d’atténuation progressive de l’efficacité thérapeutique au fil du temps.
Les deux modèles sont ajustés séparément au sein du classeur Excel. Le modèle linéaire univarié délivre un RMSELin = 7,85 points. Le modèle curvilinéaire complexe, générant des projections ajustées via l’adjonction d’un terme polynomial Semaine2, abaisse la valeur d’erreur à RMSEQuad = 3,12 points. La contraction massive du RMSE de plus de 60% démontre de manière irréfutable la supériorité structurelle de la fonction curvilinéaire pour capturer la dynamique non linéaire du processus de guérison.
Cette application concrète sous Excel illustre parfaitement la vocation d’arbitrage objectif dévolue au RMSE : au-delà de la confirmation visuelle intuitive sur un graphique de dispersion, la métrique quadratique apporte une quantification d’une rigueur absolue justifiant mathématiquement le rejet de l’hypothèse de décroissance linéaire au profit du modèle asymptotique.
12. Bonnes pratiques académiques, reporting APA et limites méthodologiques
12.1 Formalisation et inclusion du RMSE dans un manuscrit aux normes APA
La publication de résultats issus de modélisations prédictives dans des périodiques scientifiques affiliés à l’American Psychological Association (APA) exige une stricte conformité stylistique et statistique encadrée par la 7e édition du manuel des normes APA. Les statistiques descriptives et inférentielles d’ajustement ne s’improvisent pas et répondent à des conventions typographiques standardisées destinées à garantir l’universalité de la communication savante.
L’acronyme RMSE doit être rédigé en capitales romaines, tandis que les paramètres distributionnels associés s’inscrivent en italique lorsqu’il s’agit de symboles mathématiques (par exemple, N majuscule pour la population totale ou n minuscule pour un sous-groupe d’échantillonnage, R2 pour le coefficient de détermination). Au sein des tableaux récapitulatifs de régression, le RMSE figure typiquement sur une rangée de synthèse positionnée immédiatement au bas du tableau, aux côtés du critère d’information d’Akaike (AIC) et du R2 ajusté, étiqueté sobrement sous la mention RMSE avec une précision normalisée à deux décimales significatives (voire trois en présence d’échelles très resserrées).
Dans le corps du texte narratif, la formalisation intégrée prend la forme d’un paragraphe descriptif articulant la pertinence statistique et la portée sémantique, comme le démontre la formulation canonique suivante :
« L’adéquation globale du modèle de régression multivariée a révélé une capacité prédictive robuste, rendant compte d’une part substantielle de la variance des scores cliniques (R² = .64, F(3, 116) = 68,72, p < .001). L’erreur quadratique moyenne associée à ce paramétrage s’est élevée à RMSE = 4,12 points sur l’inventaire BDI-II, demeurant largement sous le seuil d’adéquation empirique fixé à la moitié de l’écart-type de la population (σ = 9,45), attestant ainsi d’une fidélité d’estimation clinique remarquable pour le suivi individuel des patients. »
12.2 Archivage et reproductibilité des classeurs Excel de recherche
L’essor contemporain du mouvement pour la science ouverte (Open Science) impose des standards drastiques de reproductibilité computationnelle aux chercheurs soumettant leurs protocoles à l’examen de comités de pairs. Déposer un classeur Excel opaque, encombré de références circulaires non résolues, de valeurs en dur superposées aux formules ou dépourvu d’indications méthodologiques détaillées contrevient frontalement aux principes directeurs FAIR (Faciles à trouver, Accessibles, Interopérables et Réutilisables).
Pour hisser un classeur Excel de recherche aux standards de reproductibilité académique, une première feuille de calcul doit obligatoirement être consacrée au Dictionnaire de données (Codebook). Ce répertoire documente avec minutie chaque variable du protocole : désignation abrégée, dénomination développée, instrument psychométrique d’origine, unité physique ou bornage d’échelle de mesure, statut logique (variable observée, prédicteur théorique ou résidu intermédiaire) et traitement appliqué aux données absentes.
Par ailleurs, les cellules contenant des formules clés de calcul du RMSE doivent impérativement être documentées au moyen de Notes de cellule explicatives détaillant la syntaxe arithmétique mobilisée et justifiant le choix des plages vectorielles ciblées. Enfin, avant tout versement sur un entrepôt de données pérenne (tel que l’Open Science Framework – OSF ou Zenodo), le classeur doit être converti en mode de protection en lecture seule via l’onglet Révision > Protéger la feuille, figeant les formules algorithmiques contre toute altération accidentelle lors de la manipulation par des auditeurs tiers.
12.3 Frontières fonctionnelles d’Excel et transition vers R ou Python
En dépit de son accessibilité universelle et de son indiscutable polyvalence fonctionnelle pour les diagnostics exploratoires préliminaires, le tableur Microsoft Excel rencontre d’inexorables limites structurelles lorsqu’il est confronté aux exigences de la modélisation statistique avancée contemporaine. Les architectures de données psychométriques complexes requièrent fréquemment l’estimation de modèles linéaires mixtes à effets aléatoires (pour appréhender la hiérarchisation des données emboîtées dans des contextes scolaires ou hospitaliers), l’implémentation de régressions pénalisées (Lasso, Ridge, Elastic Net) ou la conduite d’arbres de régression non linéaires que le moteur d’Excel ne peut exécuter nativement sans extensions spécialisées.
Dès lors que la taille du jeu de données excède les dizaines de milliers d’enregistrements chronométriques continus, ou lorsque l’analyste souhaite systématiser une validation croisée à dix plis (10-fold cross-validation), l’écriture répétitive de formules ou l’exécution de macros VBA devient excessivement chronophage et instable comparée à l’efficacité d’environnements programmatiques modernes. Le passage vers des écosystèmes d’analyse tels que R ou Python s’impose alors naturellement comme une transition épistémologique indispensable.
Cette transition ne rend pas caduque l’expertise acquise sur le tableur ; au contraire, elle la sublime. Tout chercheur menant des modélisations dans R à l’aide de packages dédiés à l’évaluation tels que yardstick (au sein de l’univers tidymodels) ou Metrics, ou sous Python avec la bibliothèque scikit-learn (via la fonction root_mean_squared_error), tirera un immense bénéfice de pouvoir auditer, vérifier et calibrer ses algorithmes de machine learning en les confrontant aux calculs décomposés pas à pas dans Microsoft Excel. Cette double compétence méthodologique garantit une maîtrise absolue de la mécanique de l’erreur, depuis l’intimité de la cellule arithmétique unitaire jusqu’aux pipelines d’intelligence artificielle les plus élaborés.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://doi.org/10.1037/t00742-000
- Chai, T., & Draxler, R. R. (2014). Root mean square error (RMSE) or mean absolute error (MAE)? – Arguments against avoiding RMSE in the literature. Geoscientific Model Development, 7(3), 1247–1250. https://doi.org/10.5194/gmd-7-1247-2014
- Gulliksen, H. (1950). Theory of mental tests. John Wiley & Sons. https://doi.org/10.1037/13240-000
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Legendre, A. M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. F. Didot.
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Microsoft Corporation. (2024). Documentation sur les fonctions de feuille de calcul Excel. Microsoft Support. https://support.microsoft.com/fr-fr/excel
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Willmott, C. J., & Matsuura, K. (2005). Advantages of the mean absolute error (MAE) over the root mean square error (RMSE) in assessing average model performance. Climate Research, 30(1), 79–82. https://doi.org/10.3354/cr030079