
L’évaluation de la validité d’un modèle de régression linéaire classique repose sur un ensemble d’hypothèses distributionnelles et structurelles qui, lorsqu’elles sont violées, compromettent gravement l’inférence statistique. Parmi ces postulats figurent la linéarité de l’espérance conditionnelle, l’homoscédasticité de la variance d’erreur, l’indépendance des perturbations stochastiques et leur normalité asymptotique. Dans la pratique de la modélisation statistique appliquée aux sciences empiriques, l’analyste se trouve confronté à des jeux de données réels où certaines observations s’écartent substantiellement de la tendance générale. Si les résidus bruts constituent le point de départ intuitif pour quantifier ces écarts, leur utilisation brute pour tester des hypothèses de valeurs aberrantes s’avère méthodologiquement déficiente en raison de leur hétérogénéité intrinsèque de variance.
Cette limite fondamentale a motivé le développement de résidus standardisés et plus particulièrement des résidus studentisés. En divisant l’écart d’ajustement par un estimateur rigoureux de son écart-type conditionnel à la position de l’observation dans l’espace multidimensionnel des régresseurs, la studentisation confère au résidu une métrique adimensionnelle et une distribution théorique connue sous l’hypothèse nulle. La distinction cardinale entre studentisation interne et studentisation externe (ou jackknife) représente une avancée majeure dans la détection des points atypiques, permettant de neutraliser l’effet d’atténuation qu’une observation extrême exerce sur l’estimation de sa propre variance d’erreur.
L’écosystème scientifique du langage Python, structuré autour de bibliothèques performantes telles que NumPy, Pandas et Statsmodels, fournit un cadre computationnel idéal pour opérationnaliser ces diagnostics avancés. Ce guide exhaustif explore l’ensemble des fondements théoriques, des formulations mathématiques et des implémentations algorithmiques nécessaires au calcul, à l’interprétation et à la visualisation des résidus studentisés en Python. À travers des cas d’application concrets issus des sciences du comportement et de la modélisation quantitative, nous détaillerons les protocoles méthodologiques assurant une inférence robuste et reproductible.
1. Introduction théorique aux résidus studentisés dans l’analyse de régression
### 1.1 Définition fondamentale et formalisation mathématique
Dans le cadre d’un modèle de régression linéaire multiple exprimé sous la forme matricielle canonique $Y = X\beta + \varepsilon$, où $Y$ désigne le vecteur des réponses de dimension $n \times 1$, $X$ la matrice de conception de dimension $n \times p$ incluant la constante, $\beta$ le vecteur des paramètres inconnus de dimension $p \times 1$, et $varepsilon$ le vecteur des erreurs stochastiques non observables suivant une distribution gaussienne $\mathcal{N}(0, \sigma^2 I_n)$, le vecteur des résidus ordinaires (ou bruts) est défini par la différence algébrique entre les valeurs observées et les valeurs ajustées par la méthode des moindres carrés ordinaires (MCO) :
$e = Y – \hat{Y} = Y – X\hat{\beta} = (I_n – H)Y$
L’opérateur $H = X(X^T X)^{-1} X^T$ représente la matrice de projection orthogonale sur l’espace vectoriel engendré par les colonnes de $X$, communément appelée matrice chapeau (*hat matrix*). Bien que l’hypothèse classique postule que les erreurs théoriques $\varepsilon_i$ partagent une variance commune et constante $\sigma^2$, les résidus empiriques $e_i$ ne possèdent pas cette propriété d’homoscédasticité. En développant la matrice de covariance du vecteur résiduel $e$, nous obtenons :
$\text{Var}(e) = \text{Var}((I_n – H)Y) = (I_n – H) \text{Var}(Y) (I_n – H)^T = \sigma^2 (I_n – H)$
Il en découle directement que la variance théorique du $i$-ème résidu brut dépend explicitement de la position occupée par l’observation correspondante dans l’espace des covariables, matérialisée par le $i$-ème élément diagonal $h_{ii}$ de la matrice $H$ :
$\text{Var}(e_i) = \sigma^2 (1 – h_{ii})$
Cette dépendance met en lumière les limites intrinsèques des résidus bruts comme outil de diagnostic comparatif. Les observations situées aux confins de la distribution des variables explicatives présentent une valeur de levier $h_{ii}$ élevée, ce qui comprime mécaniquement la variance de leur résidu brut vers zéro. Par conséquent, un point possédant un fort effet de levier peut forcer la droite de régression à passer excessivement près de lui, affichant un résidu brut artificiellement modeste alors même qu’il déstabilise profondément l’estimation des coefficients $\beta$. Pour remédier à cette inhomogénéité, la procédure de studentisation consiste à diviser le résidu brut par l’estimation de son écart-type exact, générant ainsi une statistique d’ajustement normalisée et adimensionnelle.
Sous l’hypothèse de normalité des perturbations stochastiques $\varepsilon \sim \mathcal{N}(0, \sigma^2 I_n)$, la transformation normalisée par l’écart-type résiduel ne suit pas une loi normale standard en raison de l’estimation de la variance d’erreur par un carré moyen résiduel comportant un nombre fini de degrés de liberté. Selon les travaux fondamentaux de William Sealy Gosset (publiés sous le pseudonyme de Student en 1908), ce ratio d’une variable gaussienne par la racine carrée d’une variable du khi-deux indépendante divisée par ses degrés de liberté engendre une distribution de Student. Cette propriété formelle offre une base probabiliste rigoureuse pour construire des tests de signification d’atypicité statistique.
### 1.2 Résidus studentisés internes versus externes
La littérature économétrique et statistique établit une distinction méthodologique impérative entre les résidus studentisés internes (parfois qualifiés de résidus standardisés) et les résidus studentisés externes (également appelés résidus jackknife, résidus d’exclusion ou résidus *leave-one-out*). Cette divergence repose fondamentalement sur le sous-échantillon utilisé pour estimer la variance résiduelle inconnue $\sigma^2$.
Le résidu studentisé interne, couramment noté $r_i$, s’obtient en utilisant l’estimateur sans biais global de la variance d’erreur calculé sur l’intégralité des $n$ observations de l’échantillon, soit le carré moyen de l’erreur $s^2 = \frac{e^T e}{n – p} = \frac{SSE}{n – p}$. Sa formulation analytique s’écrit :
$r_i = \frac{e_i}{s \sqrt{1 – h_{ii}}}$
Bien que cette métrique corrige l’effet de structure imputable à la matrice chapeau via le facteur $\sqrt{1 – h_{ii}}$, elle souffre d’un biais d’auto-contamination. Si la $i$-ème observation est une valeur aberrante extrême (un *outlier* majeur), son propre résidu brut $e_i$ de grande amplitude contribue de manière disproportionnée à la somme des carrés des erreurs résiduelles ($SSE$). Cette inflation mécanique de $SSE$ gonfle artificiellement l’estimateur global $s$, ce qui a pour effet pervers de réduire le dénominateur de $r_i$. Ainsi, le résidu studentisé interne d’une observation aberrante se trouve auto-masqué par sa propre présence dans le calcul de la dispersion globale, diminuant la puissance diagnostique du test.
Pour contourner ce phénomène d’atténuation, le résidu studentisé externe, noté $t_i$, substitue à l’estimateur global $s$ un estimateur d’exclusion noté $s_{(-i)}$, calculé sur le jeu de données duquel la $i$-ème observation a été préalablement retranchée :
$t_i = \frac{e_i}{s_{(-i)} \sqrt{1 – h_{ii}}}$
Dans cette configuration, l’estimateur $s_{(-i)}^2$ est calculé sur $n – 1$ observations et $n – p – 1$ degrés de liberté. Par construction, si l’observation $i$ est fortement discordante, son exclusion élimine son influence contaminatrice sur l’estimation de la variance de fond du modèle. L’écart-type d’erreur $s_{(-i)}$ reflète fidèlement la variabilité des données non contaminées, ce qui propulse le ratio $t_i$ vers des valeurs d’amplitude considérablement plus élevées.
Sur le plan strictement distributionnel, tandis que le résidu interne $r_i^2 / (n – p)$ suit une loi Bêta en raison de la dépendance stochastique entre son numérateur $e_i$ et le dénominateur $s$, le résidu externe $t_i$ est rigoureusement distribué selon une loi de Student à $n – p – 1$ degrés de liberté sous l’hypothèse nulle stipulant que l’observation $i$ est issue du même processus générateur que le reste de la cohorte. Cette propriété statistique exacte justifie la supériorité des résidus studentisés externes pour les tests d’hypothèse formels relatifs aux valeurs aberrantes dans les pipelines d’audit diagnostique.
### 1.3 Rôle des résidus studentisés dans l’inférence statistique
L’analyse des résidus studentisés remplit une fonction heuristique et confirmatoire centrale dans l’évaluation de la robustesse des modèles de régression appliqués aux sciences empiriques. Le postulat fondamental d’homoscédasticité exige que l’erreur stochastique possède une variance constante $\sigma^2$ sur l’ensemble du domaine de prédiction. Lorsque l’analyste examine un diagramme de dispersion opposant les résidus bruts aux valeurs prédites, la contraction structurelle de la variance induite par les points de fort levier peut mimer ou au contraire occulter une structure hétéroscédastique réelle. Les résidus studentisés, en éliminant cette hétérogénéité artefactuelle liée à la configuration spatiale des covariables, permettent d’isoler avec une fidélité optimale les véritables distorsions de la variance résiduelle, telles que les patrons en entonnoir représentatifs d’une variance proportionnelle à l’amplitude des variables dépendantes.
Sur le plan de la géométrie multidimensionnelle, l’inférence moderne distingue formellement les points à fort résidu des points à fort levier. Une observation peut afficher une position excentrique dans l’espace factoriel des variables explicatives (levier élevé $h_{ii}$) tout en s’alignant scrupuleusement sur la trajectoire linéaire du modèle ; un tel point possède un résidu studentisé proche de zéro et ne perturbe nullement l’estimation des coefficients directeurs. À l’inverse, une observation peut se situer à proximité immédiate du centroïde des régresseurs (faible levier) mais dévier drastiquement le long de l’axe de la variable dépendante $Y$. Les résidus studentisés externes constituent l’unique sonde statistique capable de quantifier cette discordance verticale indépendamment du positionnement horizontal de l’observation.
Dans les protocoles de recherche quantitative en sciences médicales, économiques et sociales, la non-détection d’observations aberrantes menace directement la validité interne des inférences causales et corrélationnelles. La méthode des moindres carrés ordinaires minimise la somme des écarts quadratiques, ce qui octroie un poids quadratiquement proportionnel aux déviations extrêmes. Une seule observation erronée non identifiée peut infléchir la pente d’un coefficient $\beta$, inverser son signe algébrique, ou faire basculer artificiellement une valeur $p$ en deçà ou au-delà du seuil de significativité conventionnel $\alpha = 0,05$. L’évaluation systématique des résidus studentisés préserve la stabilité structurelle du modèle en garantissant que les conclusions théoriques tirées des données ne sont pas l’artéfact d’une fraction infinitésimale d’observations pathologiques.
## 2. Pertinence diagnostique des résidus studentisés en psychométrie et sciences du comportement
### 2.1 Vulnérabilité des données psychologiques aux observations atypiques
Les sciences du comportement, la neuropsychologie et la psychométrie contemporaine opèrent par nature sur des données caractérisées par un ratio signal-sur-bruit intrinsèquement modeste et une vulnérabilité aiguë aux perturbations méthodologiques. Lors de l’administration de protocoles expérimentaux chronométrés ou de batteries d’évaluation psychologique standardisées (telles que les échelles de Wechsler ou les inventaires de personnalité NEO-PI), de multiples facteurs parasites peuvent corrompre l’acquisition des données. Les biais d’acquiescement, la fatigue attentionnelle, les comportements de réponse aléatoire (*careless responding*), la falsification délibérée, ou de simples défaillances logicielles d’enregistrement des temps de réaction engendrent des profils de réponse aberrants qui s’écartent radicalement des prédictions théoriques des modèles linéaires.
Il est impératif pour le chercheur d’établir une distinction épistémologique stricte entre une valeur atypique issue d’une erreur d’échantillonnage ou de mesure, et une valeur extrême légitime reflétant la variabilité phénotypique réelle de la population cible. Dans une cohorte clinique examinant le déclin cognitif lié au vieillissement, un score anormalement bas aux épreuves de mémoire de travail peut constituer un signal neurophysiologique valide de prodrome neurodégénératif, ou découler d’une incompréhension des consignes par le participant. L’utilisation non critique des tests de rejet peut induire une inflation dramatique de l’erreur de type I (faux positifs) par suppression injustifiée de la variance écologique, ou de l’erreur de type II (faux négatifs) par conservation de points aberrants qui écrasent la puissance statistique des tests d’interaction.
Les comités de rédaction des revues scientifiques de premier rang exigent désormais une transparence méthodologique absolue quant au traitement des données divergentes, conformément aux lignes directrices des protocoles de réplication et aux normes de l’American Psychological Association (APA Reporting Standards). La studentisation externe des résidus fournit un ancrage statistique probabiliste objectif qui affranchit l’investigateur de l’arbitraire des règles empiriques subjectives, garantissant une détection standardisée, quantifiable et auditable des déviations majeures au modèle psychométrique ajusté.
### 2.2 Levier, distance et influence dans les cohortes comportementales
L’analyse de régression appliquée aux cohortes comportementales requiert une articulation conceptuelle précise entre les notions de levier (*leverage*), d’atypicité résiduelle (*outlyingness*) et d’influence globale (*influence*). Comme exposé précédemment, la mesure de levier, codifiée par la valeur $h_{ii}$ extraite de la diagonale de la matrice de projection, quantifie l’éloignement d’un individu statistique par rapport au barycentre des covariables explicatives de l’échantillon. Un participant présentant un profil sociodémographique ou neuropsychologique exceptionnel — par exemple un individu affichant un âge très avancé couplé à un niveau de scolarité atypiquement élevé au sein d’une étude sur l’anxiété — obtiendra une valeur $h_{ii}$ substantielle, sans que cela n’implique nécessairement une discordance comportementale sur la variable prédite.
L’évaluation de l’influence déterminante exercée par une observation sur l’ensemble de la topologie du modèle nécessite de combiner l’information portée par le résidu studentisé et celle portée par le levier. Cette synthèse mathématique s’incarne notamment dans la distance de Cook ($D_i$), dont l’expression analytique peut être directement formulée en fonction du résidu studentisé interne $r_i$ :
$D_i = \frac{r_i^2}{p} \left( \frac{h_{ii}}{1 – h_{ii}} \right)$
Cette formulation met en exergue la dynamique multiplicative de l’influence statistique : une observation n’exerce une modification substantielle des estimations paramétriques globales que si elle cumule simultanément un résidu studentisé d’amplitude marquée ($r_i^2$) et une position d’ancrage excentrique dans l’espace factoriel des prédicteurs ($h_{ii} / (1 – h_{ii})$).
Considérons à titre d’illustration une étude psychométrique analysant la relation entre le niveau de stress perçu et la performance à une tâche de flexibilité cognitive chez des adultes neurotypiques et des individus présentant un profil neurodivergent atypique (par exemple, un trouble du spectre de l’autisme à haut niveau de fonctionnement associé à une synesthésie). Si cet individu atypique obtient des scores de stress modérés mais réussit la tâche cognitive avec un score stratosphérique défiant les patterns habituels, son résidu studentisé externe $t_i$ atteindra des grandeurs extrêmes. Si son profil de covariables est par ailleurs standard, son levier restera modéré, limitant son impact déstabilisateur sur les coefficients directeurs généraux, tout en signalant sans équivoque son statut de singularité clinique nécessitant une analyse qualitative distincte.
L’arbitrage entre l’exclusion d’un profil et son maintien dans le modèle final conditionne la représentativité écologique des résultats. L’analyste comportemental doit s’appuyer sur un faisceau convergent d’indices diagnostiques — combinant seuils critiques sur $t_i$, examen des variations paramétriques par DFBETAS et calcul de la distance de Cook — afin de prendre des décisions motivées qui ne biaisent pas artificiellement la composition de l’échantillon étudié.
## 3. Formulation mathématique et distribution des résidus studentisés
### 3.1 Matrice de projection et calcul des valeurs de levier
La dérivation algébrique rigoureuse des résidus studentisés repose sur l’algèbre linéaire appliquée à l’espace de Hilbert des variables aléatoires de carré intégrable. Soit $X$ la matrice de conception de rang plein $p \leq n$. L’opérateur de projection orthogonale $H$, qui projette le vecteur des observations $Y$ sur le sous-espace vectoriel de régression $\text{Im}(X)$, est formellement défini par l’expression :
$H = X (X^T X)^{-1} X^T$
Cette matrice carrée de dimension $n \times n$ possède des propriétés géométriques fondamentales qui dictent le comportement des résidus :
- Elle est symétrique, vérifiant rigoureusement $H^T = H$.
- Elle est idempotente, c’est-à-dire que $H^2 = H$, ce qui implique géométriquement qu’une projection successive réitérée n’altère plus le vecteur projeté.
- Sa trace, représentant la somme de ses éléments diagonaux, est invariante et égale à la dimension du sous-espace d’ajustement : $\text{Tr}(H) = \sum_{i=1}^n h_{ii} = \text{rg}(X) = p$.
Les éléments diagonaux $h_{ii}$, communément désignés sous l’appellation de valeurs de levier (*leverage values*), possèdent un encadrement théorique strict. En exploitant l’idempotence et la symétrie de la matrice $H$, nous pouvons expliciter $h_{ii}$ sous forme d’un produit scalaire interne :
$h_{ii} = \sum_{j=1}^n h_{ij}^2 = h_{ii}^2 + \sum_{j \neq i} h_{ij}^2$
Étant donné que la somme quadratique $\sum_{j \neq i} h_{ij}^2$ est obligatoirement positive ou nulle, il s’ensuit immédiatement que $h_{ii} \geq h_{ii}^2$, ce qui impose la double inégalité fondamentale :
$0 \leq h_{ii} \leq 1$
Lorsque la matrice de régression $X$ intègre un terme constant (colonne de uns), la borne inférieure se resserre à $1/n \leq h_{ii} \leq 1$. Sur le plan géométrique, l’élément $h_{ii}$ mesure le carré de la distance de Mahalanobis standardisée séparant le point $x_i = (x_{i1}, x_{i2}, dots, x_{ip})^T$ du barycentre vectoriel des variables explicatives $\bar{x}$. Plus une observation s’isole aux périphéries de la distribution conjointe des prédicteurs, plus sa valeur $h_{ii}$ converge vers l’unité.
En rappelant que la matrice de projection résiduelle $M = I_n – H$ partage les mêmes propriétés de symétrie et d’idempotence, la variance du vecteur des résidus ordinaires $e = MY$ se déploie comme suit :
$\text{Var}(e) = \text{Var}(M(X\beta + \varepsilon)) = M \text{Var}(\varepsilon) M^T = \sigma^2 M M = \sigma^2 (I_n – H)$
Cette équation établit sans ambiguïté que l’écart-type théorique exact du résidu associé au $i$-ème individu est donné par la fonction analytique $\sigma \sqrt{1 – h_{ii}}$. Lorsque $h_{ii}$ approche de 1, la variance du résidu tend vers zéro, confirmant mathématiquement que les points de fort levier contraignent l’ajustement du modèle à s’annuler sur leurs propres coordonnées observées.
### 3.2 Algorithme d’exclusion et loi de Student associée
Pour dériver la statistique du résidu studentisé externe sans compromettre l’indépendance stochastique requise pour un test d’hypothèse rigoureux, il convient d’expliciter le modèle linéaire auxiliaire d’exclusion. Considérons le modèle de régression ajusté sur l’échantillon tronqué d’effectif $n – 1$, dans lequel la $i$-ème observation $(x_i, y_i)$ a été omise. Soit $\hat{\beta}_{(-i)}$ le vecteur des coefficients MCO obtenu sur ce sous-échantillon. L’erreur de prédiction hors-échantillon (*deleted residual*) pour cette observation s’énonce :
$d_i = y_i – x_i^T \hat{\beta}_{(-i)}$
Grâce à l’identité algébrique de Sherman-Morrison-Woodbury relative aux inversions de rang un des matrices modifiées, il est possible de démontrer que ce résidu de prédiction d’exclusion est directement proportionnel au résidu brut ordinaire $e_i$ selon la relation :
$d_i = \frac{e_i}{1 – h_{ii}}$
La variance théorique de cette erreur de prédiction hors-échantillon, conditionnée aux régresseurs, intègre l’incertitude sur la nouvelle observation combinée à l’imprécision d’estimation de $\hat{\beta}_{(-i)}$ :
$\text{Var}(d_i) = \text{Var}(y_i – x_i^T \hat{\beta}_{(-i)}) = \sigma^2 \left( 1 + x_i^T (X_{(-i)}^T X_{(-i)})^{-1} x_i \right) = \frac{\sigma^2}{1 – h_{ii}}$
Dans ce cadre, la variance d’erreur résiduelle jackknife $s_{(-i)}^2$ est calculée à partir de la somme des carrés des erreurs résiduelles du modèle tronqué, notée $SSE_{(-i)}$, divisée par ses degrés de liberté résiduels $n – p – 1$ :
$s_{(-i)}^2 = \frac{SSE_{(-i)}}{n – p – 1}$
L’application directe de la mise à jour algébrique évite d’avoir à réajuster informatiquement $n$ régressions distinctes. La relation fermée reliant $SSE_{(-i)}$ à la somme résiduelle totale $SSE$ s’établit de manière exacte par :
$SSE_{(-i)} = SSE – \frac{e_i^2}{1 – h_{ii}}$
En substituant cette équivalence dans l’estimation de la variance d’erreur hors-échantillon, nous obtenons la formulation de calcul instantanée :
$s_{(-i)}^2 = \frac{(n – p)s^2 – \frac{e_i^2}{1 – h_{ii}}}{n – p – 1}$
Le résidu studentisé externe $t_i$ se définit dès lors comme le quotient du résidu d’exclusion $d_i$ par son écart-type estimé :
$t_i = \frac{d_i}{\sqrt{\widehat{\text{Var}}(d_i)}} = \frac{\frac{e_i}{1 – h_{ii}}}{\sqrt{\frac{s_{(-i)}^2}{1 – h_{ii}}}} = \frac{e_i}{s_{(-i)} \sqrt{1 – h_{ii}}}$
Démonstration de la loi de distribution : Par construction sous l’hypothèse nulle $H_0 : \mathbb{E}[y_i] = x_i^T \beta$, le numérateur transformé $e_i / (\sigma \sqrt{1 – h_{ii}})$ suit une loi normale standard $\mathcal{N}(0, 1)$. Parallèlement, la statistique d’erreur résiduelle jackknife normalisée suit une distribution du khi-deux indépendante :
$\frac{(n – p – 1)s_{(-i)}^2}{\sigma^2} \sim \chi^2(n – p – 1)$
Puisque l’estimation $s_{(-i)}^2$ est calculée sans la $i$-ème observation, elle est mathématiquement indépendante de $y_i$, et par conséquent stochastiquement indépendante de $e_i$. Le rapport $t_i$ correspond donc sans équivoque au quotient d’une variable gaussienne centrée réduite par la racine carrée d’une variable indépendante du khi-deux divisée par ses degrés de liberté. En vertu du théorème fondamental de Gosset, la statistique résultante converge exactement vers une distribution de Student :
$t_i \sim \mathcal{T}(n – p – 1)$
Cette propriété distributionnelle exacte confère aux résidus studentisés externes une puissance statistique nettement supérieure à celle des $z$-scores classiques basés sur une normalité asymptotique souvent violée dans les échantillons de taille finie.
## 4. Environnement Python pour l’analyse diagnostique de régression
### 4.1 Écosystème scientifique et dépendances requises
L’écosystème open-source de Python s’est imposé comme la référence contemporaine pour l’analyse statistique avancée, l’économétrie et la modélisation en sciences quantitatives. Pour mettre en œuvre le calcul et l’évaluation rigoureuse des résidus studentisés, une synergie entre plusieurs bibliothèques fondamentales est requise :
- NumPy : Socle computationnel fournissant des structures de tableaux multidimensionnels à hautes performances (ndarrays) et les primitives de bas niveau pour l’algèbre matricielle via LAPACK et BLAS.
- Pandas : Outil de référence pour l’ingestion, le nettoyage, la manipulation indicée et la structuration tabulaire des jeux de données psychométriques ou expérimentaux.
- Statsmodels : Bibliothèque fondamentale d’économétrie et de statistique mathématique, développée initialement pour pallier les orientations purement prédictives de Scikit-Learn. Statsmodels fournit des sorties d’estimation exhaustives (coefficients, erreurs-types asymptotiques, tests diagnostiques, métriques d’influence) comparables à celles de logiciels historiques comme R ou Stata.
- SciPy : Spécifiquement son sous-module
scipy.stats, essentiel pour évaluer de manière vectorisée les fonctions de répartition, les densités probabilistes et les fonctions de survie associées aux lois de Student et de Fisher. - Matplotlib et Seaborn : Bibliothèques graphiques permettant de générer des planches visuelles diagnostiques conformes aux standards de publication académique.
Pour garantir la pérennité et la reproductibilité computationnelle de vos protocoles diagnostiques, l’isolation des dépendances logicielles au sein d’environnements virtuels (via `venv`, `conda` ou `poetry`) demeure une exigence méthodologique stricte. Les variations mineures de version dans l’implémentation de LAPACK ou de Statsmodels pouvant impacter la précision en virgule flottante des inversions matricielles, le figeage des versions via un fichier de configuration assure la stricte reproductibilité des inférences.
### 4.2 Importation des bibliothèques et structure de travail
L’initialisation d’un pipeline diagnostique requiert le chargement des alias conventionnels garantissant la lisibilité et l’interopérabilité du code source. Deux points d’accès principaux existent dans Statsmodels : l’API classique (`statsmodels.api`), qui attend une matrice de régresseurs explicite requérant l’adjonction manuelle d’une constante, et l’API de formules (`statsmodels.formula.api`), qui émule la syntaxe déclarative de la bibliothèque `Patsy` inspirée du système de formules de R.
Pour éviter la troncature préjudiciable des sorties diagnostiques tabulaires lors du traitement de cohortes comptant plusieurs centaines de participants, il convient d’ajuster les options globales de formatage du moteur d’affichage de Pandas. L’analyste configure notamment la précision d’affichage des nombres réels, le nombre maximal de lignes affichées et la largeur d’écran.
Enfin, la reproductibilité parfaite des simulations computationnelles et des vérifications empiriques exige l’initialisation explicite des générateurs de nombres pseudo-aléatoires. L’utilisation conjointe des générateurs de NumPy (`numpy.random.seed` ou de la classe moderne `default_rng`) garantit que chaque étape d’injection de perturbations stochastiques ou de valeurs aberrantes demeure rigoureusement stable d’une exécution à l’autre.
## 5. Ajustement d’un modèle de régression linéaire avec statsmodels
### 5.1 Création et structuration d’un jeu de données psychométriques
Pour contextualiser l’application pratique du diagnostic de régression, nous concevons un environnement de simulation contrôlé reflétant les dynamiques observées en psychologie de l’éducation et en psychométrie clinique. Considérons un protocole évaluant la performance académique finale (notée sur une échelle continue de 0 à 100) en fonction de trois prédicteurs comportementaux : l’anxiété cognitive d’évaluation (mesurée par une échelle standardisée de type Spielberger), le volume hebdomadaire d’heures d’étude structurée, et un score de conscience professionnelle extrait du modèle à cinq facteurs (Big Five).
Dans un échantillon représentatif de $n = 120$ étudiants, la relation sous-jacente suit un processus linéaire bruité par une composante gaussienne classique. Afin de tester la sensibilité des résidus studentisés, nous introduisons délibérément dans ce jeu de données des observations aberrantes synthétiques, imitant fidèlement les artéfacts méthodologiques récurrents en milieu universitaire : un individu présentant un niveau d’anxiété normal mais un échec catastrophique lié à une panne matérielle durant la passation informatisée, ainsi qu’un profil affichant un engagement d’étude marginal couplé à une note anormalement brillante imputable à un comportement de tricherie ou à un effet de plafond intellectuel non mesuré.
Les données simulées sont consolidées dans un DataFrame Pandas. Une inspection préliminaire systématique permet de vérifier l’absence de valeurs manquantes fortuites, de confirmer le typage numérique rigoureux des variables continues et d’analyser les statistiques descriptives initiales (moyenne, écart-type, étendue, asymétrie et kurtosis) avant toute soumission aux algorithmes d’estimation matricielle.
### 5.2 Spécification et entraînement du modèle OLS
L’ajustement du modèle de régression par les moindres carrés ordinaires s’effectue au moyen de la méthode `ols()` issue du module `statsmodels.formula.api`. Cette approche permet de déclarer la structure structurelle du modèle par une chaîne syntaxique claire :
`performance ~ anxiete + heures_etude + conscience`
L’exécution de la méthode `.fit()` déclenche l’estimation des moindres carrés ordinaires en procédant à la résolution du système d’équations normales par décomposition QR ou décomposition en valeurs singulières (SVD) de la matrice de conception. Cette opération instancie un objet complexe de classe `RegressionResults` (ou plus spécifiquement `OLSResults`), qui encapsulate l’intégralité des statistiques d’ajustement, des paramètres vectoriels estimés, de la matrice de covariance variance-covariance des coefficients et des structures résiduelles nécessaires au diagnostic.
L’interrogation synthétique du modèle s’opère usuellement par l’appel de la méthode `.summary()`, qui délivre un rapport exhaustif divisé en trois volets analytiques :
- Le volet supérieur détaillant les caractéristiques de l’ajustement global : coefficient de détermination $R^2$, $R^2$ ajusté, statistique globale de Fisher (F-statistic) testant l’hypothèse conjointe de nullité des coefficients non constants, et critères d’information d’Akaike (AIC) et bayésien (BIC).
- Le volet intermédiaire exposant les estimations ponctuelles des coefficients $\hat{\beta}_j$, leurs erreurs-types standard corrigées, les statistiques $t$ de Wald associées et les valeurs $p$ bilatérales permettant de trancher la significativité marginale de chaque covariable.
- Le volet inférieur présentant les premiers indicateurs de validité résiduelle : test d’asymétrie et d’aplatissement d’Omnibus, statistique d’autocorrélation de Durbin-Watson, test de Jarque-Bera et conditionnement numérique de la matrice de conception (Condition Number), alertant sur la présence de multicolinéarité sévère.
Ces métriques globales, bien qu’essentielles, demeurent des agrégats d’ensemble incapables d’isoler les points pathologiques au niveau individuel. C’est précisément à cette jonction méthodologique que s’impose le déploiement des résidus studentisés.
## 6. Calcul des résidus studentisés via la méthode outlier_test()
### 6.1 Syntaxe opérationnelle et mécanisme interne de OLSResults.outlier_test()
L’accès le plus direct, robuste et optimisé pour le calcul des résidus studentisés externes au sein de Statsmodels réside dans la méthode native `outlier_test()`, accessible directement depuis l’instance résultante de l’ajustement `OLSResults`. Cette routine exécute de manière entièrement vectorisée l’algorithme d’exclusion présenté à la section 3.2, dispensant l’utilisateur de l’écriture fastidieuse et inefficace d’une boucle itérative procédant à $n$ réestimations individuelles du modèle.
L’invocation basique de la fonction s’exécute selon l’instruction :
`resultats_outliers = modele_ajuste.outlier_test(method=’bonferroni’, alpha=0.05)`
La méthode `outlier_test()` accepte plusieurs paramètres fondamentaux qui pilotent le traitement inférentiel :
method: Spécifie la technique de correction pour comparaisons multiples appliquée aux probabilités critiques. Les arguments recevables incluent'bonferroni'(ajustement conservateur par défaut),'fdr_bh'(contrôle du taux de fausses découvertes selon Benjamini-Hochberg),'sidak'ou'none'pour obtenir les probabilités brutes non ajustées.alpha: Fixe le seuil de tolérance nominal pour le taux d’erreur de première espèce global appliqué au test d’atypicité conjointe.cutoff: Seuil scalaire optionnel permettant de filtrer automatiquement les sorties du tableau pour ne retourner que les observations dont la valeur $p$ ajustée est strictement inférieure à la borne spécifiée. Par défaut, la méthode retourne la table complète des $n$ observations.
Le fonctionnement sous-jacent de cette méthode mobilise les équations de mise à jour algébrique pour déduire instantanément les variances résiduelles d’exclusion $s_{(-i)}^2$ à partir des résidus ordinaires et de la diagonale de projection $h_{ii}$. La routine convertit ensuite ces résidus externes en statistiques de Student pour interroger la fonction de survie de la distribution $\mathcal{T}(n – p – 1)$.
### 6.2 Décomposition des composantes du tableau de sortie
L’objet retourné par l’appel de `outlier_test()` est un DataFrame Pandas indexé scrupuleusement sur l’index d’origine du jeu de données ayant servi à l’estimation. Ce tableau structure trois colonnes fondamentales pour l’investigation empirique :
student_resid: Cette colonne stocke la valeur numérique exacte du résidu studentisé externe $t_i$. Elle représente l’ampleur standardisée de la déviation de l’observation mesurée en unités d’écart-type jackknife. Une valeur positive indique une performance observée supérieure aux prédictions conditionnelles du modèle, tandis qu’une valeur négative dénote une sous-performance majeure. En raison de sa conformité à une loi de Student à $n – p – 1$ degrés de liberté, cette métrique est immédiatement assimilable à un score de déviation critique standardisé.unadj_p: Cette colonne contient la valeur $p$ brute non ajustée issue du test d’hypothèse bilatéral $H_0 : \mathbb{E}[\varepsilon_i] = 0$ contre $H_1 : \mathbb{E}[\varepsilon_i] \neq 0$. Elle est calculée formellement par l’expression $2 \times (1 – F_{\mathcal{T}}(|t_i|))$, où $F_{\mathcal{T}}$ désigne la fonction de répartition d’une variable aléatoire suivant la loi de Student à $n – p – 1$ degrés de liberté. Cette probabilité quantifie le risque d’observer une déviation au moins aussi extrême que $t_i$ sous la conjecture stricte que le point $i$ est issu du modèle nominal.bonf(p): Cette colonne délivre la probabilité critique corrigée pour tenir compte du risque d’inflation d’erreur globale lié à l’évaluation simultanée de l’ensemble des points de l’échantillon. Par défaut, cette valeur correspond à l’application rigoureuse de la borne de Bonferroni, calculée par la multiplication $\min(1, n \times \text{unadj_p})$. Une valeur $p$ corrigée inférieure au seuil de significativité nominal $\alpha = 0,05$ atteste que l’observation s’écarte de la surface de régression avec une intensité statistiquement incompatible avec les simples fluctuations d’échantillonnage de l’échantillon global.
La conservation intégrale de l’index du DataFrame source garantit un alignement déterministe immédiat avec les métadonnées de l’étude (identifiants anonymisés des participants, variables descriptives complémentaires ou centres d’acquisition clinique), autorisant un audit ciblé immédiat des cas isolés.
### 6.3 Accès alternatif via la classe OLSInfluence
Bien que la fonction `outlier_test()` constitue la voie la plus rapide pour le dépistage d’observations discordantes, Statsmodels propose une architecture objet plus approfondie via la classe `OLSInfluence`. Cette interface s’instancie par la méthode `.get_influence()` appelée sur les résultats de la régression :
`influence_diagnostics = modele_ajuste.get_influence()`
L’instance d’objet ainsi générée offre un accès unifié à l’intégralité du spectre diagnostique de l’école de régression classique de Belsley, Kuh, Welsch et Cook. Elle expose notamment deux propriétés spécifiques relatives aux résidus normalisés :
influence_diagnostics.resid_studentized_internal: Retourne sous la forme d’un tableau NumPy unidimensionnel les résidus studentisés internes $r_i$. Ces valeurs s’appuient sur l’estimateur sans biais global $s$, représentant le vecteur des résidus standardisés sans exclusion de l’observation.influence_diagnostics.resid_studentized_external: Retourne le tableau vectorisé des résidus studentisés externes $t_i$, équivalant strictement aux données numériques de la colonnestudent_residproduite paroutlier_test().
Le tableau comparatif suivant synthétise les propriétés opérationnelles de ces deux approches d’accès programmatique :
| Propriété / Critère | Méthode `outlier_test()` | Attributs de `get_influence()` |
| :— | :— | :— |
| **Type de résidu principal** | Résidu studentisé externe ($t_i$) | Internes ($r_i$) et Externes ($t_i$) |
| **Calcul des valeurs $p$** | Automatique (brutes et corrigées) | Non inclus directement |
| **Correction pour tests multiples**| Bonferroni, FDR de Benjamini-Hochberg | Non applicable sans calcul tiers |
| **Format de retour** | DataFrame Pandas structuré avec index | Tableaux NumPy ou séries Pandas |
| **Métriques supplémentaires** | Aucune (focalisation sur l’atypicité) | Distance de Cook, DFBETAS, DFFITS, Levier |
| **Empreinte computationnelle** | Faible à modérée | Plus élevée (calcul de tout le spectre) |
L’exploitation conjointe de ces structures programmatiques s’avère particulièrement pertinente : `outlier_test()` permet d’exécuter le test de détection formel, tandis que `get_influence()` apporte les métriques complémentaires pour contextualiser si l’observation atypique identifiée déstabilise significativement l’architecture paramétrique globale.
## 7. Seuils critiques, tests d’hypothèse et ajustement pour comparaisons multiples
### 7.1 La règle heuristique absolue du seuil de 3
Dans la pratique de la modélisation statistique appliquée, de nombreux analystes recourent à des heuristiques opérationnelles pour isoler rapidement les observations problématiques. La règle empirique la plus largement disséminée postule qu’un résidu studentisé dont la valeur absolue excède un seuil critique arbitraire fixé à 2 ou 3 doit être étiqueté comme suspect ou aberrant :
$|t_i| > 2 \quad \text{(zone d’avertissement)} \qquad \text{ou} \qquad |t_i| > 3 \quad \text{(valeur aberrante suspecte)}$
Ce critère s’enracine théoriquement dans la règle empirique de la loi normale standard (la règle des $3\sigma$). Dans une distribution gaussienne univariée idéale, la probabilité qu’une observation s’écarte de son espérance de plus de trois écarts-types est d’approximativement $P(|Z| > 3) \approx 0,0027$, soit un peu plus de deux observations pour mille. Lorsque les degrés de liberté résiduels $n – p – 1$ sont modérés à élevés (supérieurs à 30 ou 40), la loi de Student $\mathcal{T}(n – p – 1)$ présente une allure morphologique très proche de la gaussienne, justifiant intuitivement la transposition de ce cut-off de 3.
Toutefois, l’application aveugle et acritique de cette règle déterministe présente des failles méthodologiques majeures conditionnées par la taille totale de l’échantillon $n$. Considérons un échantillon de psychométrie comportementale comprenant $n = 1,000$ participants. Même dans l’hypothèse où le modèle linéaire serait parfaitement spécifié et où l’ensemble des perturbations stochastiques dériverait d’une distribution normale pure et irréprochable, l’espérance mathématique du nombre d’observations dépassant le seuil critique $|t_i| > 3$ par pure fluctuation aléatoire n’est pas nulle, mais s’élève à :
$\mathbb{E}[N_{|t_i| > 3}] = n \times P(|t_i| > 3) \approx 1,000 \times 0,0027 = 2,7 \text{ observations}$
Dans une cohorte de grande échelle ($n \geq 10,000$), plusieurs dizaines d’individus parfaitement réguliers afficheront mécaniquement des résidus studentisés externes excédant 3 sans refléter la moindre anomalie méthodologique. À l’inverse, dans un protocole clinique ou neuropsychologique restreint typique des études en imagerie cérébrale fonctionnelle ou sur des pathologies rares ($n = 15$ à $25$), un seuil d’alerte de 3 s’avère excessivement conservateur. Dans un modèle à $n = 20$ avec $p = 4$, la valeur critique bilatérale exacte d’une loi de Student à 15 degrés de liberté pour un seuil nominal $\alpha = 0,05$ s’établit à $t_{0,025; 15} \approx 2,131$. Fixer un seuil fixe à 3 conduirait à négliger des déviations majeures susceptibles de bouleverser entièrement l’estimation des pentes du modèle.
### 7.2 Ajustement de Bonferroni et contrôle du taux d’erreur par famille
Pour conférer une rigueur probabiliste authentique à l’évaluation diagnostique, la recherche d’observations aberrantes doit être formellement modélisée comme un problème de tests d’hypothèses multiples simultanés. Lorsque le chercheur examine les résidus studentisés de l’ensemble de son échantillon, il ne conduit pas un test d’hypothèse isolé sur un participant choisi a priori. Il teste conjointement $n$ hypothèses nulles distinctes :
$H_{0, i} : \mathbb{E}[\varepsilon_i] = 0 \quad \text{pour tout } i in {1, 2, dots, n}$
Si l’analyste applique le seuil critique standard $\alpha = 0,05$ indépendamment à chaque observation, le taux d’erreur par famille (FWER, pour *Family-Wise Error Rate*), c’est-à-dire la probabilité d’identifier à tort au moins une observation comme aberrante par simple fluctuation stochastique, subit une inflation drastique régie par l’inégalité de Boole-Fréchet :
$\text{FWER} = P\left( \big\cup_{i=1}^n { \text{Rejet de } H_{0, i} mid H_{0, i} \text{ est vraie} } \right) \leq 1 – (1 – \alpha)^n$
Pour un échantillon modeste de $n = 100$ individus avec $\alpha = 0,05$, ce risque global théorique atteint $1 – (1 – 0,05)^{100} \approx 0,994$. Il est donc virtuellement certain (plus de 99 % de chances) que le chercheur identifiera à tort au moins un prétendu « outlier » au sein d’un échantillon parfait s’il omet d’ajuster son seuil décisionnel.
La procédure implémentée par défaut dans `OLSResults.outlier_test()` répond à cet impératif en appliquant la correction de Bonferroni. Cette méthode garantit le contrôle strict du FWER à un seuil global $\alpha_{\text{global}}$ (typiquement 0,05) en exigeant que chaque test individuel soit évalué à un niveau de significativité nominal drastiquement réduit :
$\alpha_{\text{local}} = \frac{\alpha_{\text{global}}}{n}$
Sous ce prisme, une observation n’est déclarée statistiquement discordante de manière confirmatoire que si sa probabilité critique bilatérale brute vérifie $\text{unadj_p} < \frac{0,05}{n}$, ce qui équivaut rigoureusement à constater que la colonne `bonf(p)` de la sortie Statsmodels affiche une valeur strictement inférieure à 0,05.
Bien que la correction de Bonferroni assure une protection robuste contre les fausses découvertes, elle est notoirement conservatrice lorsque la taille d'échantillon $n$ croît substantiellement. Dans les jeux de données volumineux, l'analyste peut avantageusement substituer au contrôle du FWER le contrôle du taux de fausses découvertes (FDR, *False Discovery Rate*) théorisé par Benjamini et Hochberg (1995). En configurant l’argument `method=’fdr_bh’`, l’algorithme ordonne les valeurs $p$ croissantes et optimise le compromis entre la détection des véritables anomalies et la préservation de la puissance statistique globale.
### 7.3 Prise de décision empirique face à une valeur p significative
L’obtention d’une valeur $p$ corrigée statistiquement significative (`bonf(p) < 0.05`) constitue un signal d'alerte algorithmique, mais ne doit en aucun cas être interprétée comme un mandat automatique prescrivant la suppression immédiate et mécanique de l'observation concernée. Une telle pratique de purge automatique relève d'une faute méthodologique grave qui vicie l'intégrité de la démarche scientifique et s'apparente à une forme insidieuse de dragage de données (*data dredging* ou *p-hacking*).
La confrontation à une observation affichant un résidu studentisé significatif impose une démarche d'investigation séquentielle articulée autour de trois axes cardinaux :
- Vérification de l’intégrité factuelle : L’investigateur doit immédiatement inspecter la chaîne de traitement numérique pour traquer d’éventuelles erreurs d’encodage (par exemple, la saisie d’un score de 999 codant initialement une donnée manquante comme une valeur numérique réelle), des défaillances matérielles de capteurs psychophysiologiques ou des violations explicites des critères d’inclusion du protocole clinique.
- Évaluation de la pertinence écologique et clinique : Si la mesure est factuellement authentique, l’analyste doit évaluer si le point reflète une sous-population non anticipée mais écologiquement valide. Dans une régression modélisant la réponse thérapeutique à une psychothérapie, un patient démontrant une détérioration sévère et inattendue n’est pas un « bruit » statistique à éliminer pour améliorer le $R^2$, mais un profil de non-répondeur d’un intérêt clinique fondamental dont l’exclusion masquerait les limites réelles de l’intervention testée.
- Évaluation de la spécification structurelle du modèle : Un résidu studentisé d’amplitude anormale peut révéler non pas une anomalie inhérente à l’individu, mais une mauvaise spécification fonctionnelle du modèle linéaire. L’omission d’un terme polynomial d’ordre supérieur (phénomène non linéaire quadratique), l’absence d’un terme d’interaction critique entre deux variables, ou le recours inapproprié à un lien linéaire pour des données bornées ou asymétriques suffisent à générer des résidus studentisés externes hautement significatifs aux marges de la distribution.
Toute décision finale — qu’elle consiste à conserver l’observation, à procéder à une modélisation alternative robuste ou, dans des cas strictement circonscrits et documentés, à écarter l’observation de l’analyse primaire — doit être consignée de manière exhaustive et transparente dans les rapports de recherche finaux.
## 8. Implémentation pas à pas et vectorisée avec NumPy et Pandas
### 8.1 Calcul vectoriel des valeurs diagonales de la matrice chapeau
Pour appréhender intimement la mécanique algorithmique des diagnostics de régression et acquérir une autonomie totale indépendamment des modules de haut niveau, il est hautement formateur de développer une implémentation vectorisée native exploitant la puissance du calcul matriciel dans NumPy et Pandas. La première étape computationnelle consiste à dériver de manière analytique et efficiente les valeurs diagonales de la matrice chapeau $h_{ii}$.
Soit $X$ la matrice de régression complète de dimension $n \times p$, incorporant explicitement la première colonne constante de uns pour l’interception. Si un modèle a été préalablement ajusté avec Statsmodels, cette matrice de conception épurée est accessible directement via l’attribut `modele_ajuste.model.exog`. L’évaluation informatique directe de la matrice de projection globale $H = X(X^T X)^{-1} X^T$ représente une opération inefficace sur le plan de l’allocation mémoire dès lors que $n$ grandit, puisqu’elle nécessite de matérialiser en mémoire vive un tableau bidimensionnel de dimension $n \times n$ (occupant près de 800 mégaoctets pour $n = 10,000$).
Puisque nous n’avons besoin que des seuls éléments situés sur la diagonale principale de $H$, nous pouvons exploiter les propriétés du produit matriciel pour dériver une formulation vectorisée hautement optimisée. Notons que :
$h_{ii} = [X (X^T X)^{-1} X^T]_{ii} = \sum_{j=1}^p [X]_{ij} [(X^T X)^{-1} X^T]_{ji} = \sum_{j=1}^p [X]_{ij} [X (X^T X)^{-1}]_{ij}$
Cette identité algébrique permet de calculer le vecteur colonne des $h_{ii}$ sans jamais instancier la matrice complète de dimension $n \times n$. L’algorithme se déroule computationnellement comme suit :
- Extraction du tableau NumPy des variables exogènes :
X = modele_ajuste.model.exog. - Calcul du produit matriciel de Gram et de son inverse par les routines d’algèbre linéaire de NumPy :
XtX_inv = np.linalg.inv(X.T @ X). - Calcul du produit intermédiaire de dimension $n \times p$ :
X_hat = X @ XtX_inv. - Sommation vectorisée du produit terme à terme (produit de Hadamard) le long des colonnes :
leverage = np.sum(X_hat * X, axis=1).
Cette approche vectorisée réduit la complexité spatiale d’un facteur $\mathcal{O}(n^2)$ à $\mathcal{O}(np)$, permettant le traitement instantané d’échantillons de plusieurs dizaines de milliers d’observations sur une station de travail standard.
### 8.2 Estimation de l’erreur standard d’exclusion et finalisation du résidu
Une fois le vecteur des valeurs de levier $h_{ii}$ correctement dérivé, la seconde phase algorithmique opère l’assemblage matriciel des composantes résiduelles pour finaliser l’estimation des résidus studentisés externes. L’extraction des résidus ordinaires bruts s’effectue via l’attribut `modele_ajuste.resid`, dont nous extrayons le tableau NumPy sous-jacent.
Nous procédons ensuite à la dérivation de la somme des carrés des erreurs résiduelles totales :
$SSE = \sum_{i=1}^n e_i^2 = e^T e$
Puis de l’estimateur sans biais de la variance globale du modèle d’origine :
$s^2 = \frac{SSE}{n – p}$
En vertu de l’équation de mise à jour rapide formalisée dans la section 3.2, la variance résiduelle jackknife $s_{(-i)}^2$ s’obtient pour chaque observation par une instruction entièrement vectorisée, sans aucune boucle séquentielle :
$s_{(-i)}^2 = \frac{(n – p) s^2 – \frac{e_i^2}{1 – h_{ii}}}{n – p – 1}$
Il convient d’introduire une garde de sécurité numérique dans le code pour prévenir toute instabilité computationnelle (par exemple, si une observation possède un levier théorique identique à 1 ou si une valeur résiduelle anormale génère un terme résiduel d’exclusion infinitésimalement négatif par erreur d’arrondi en virgule flottante). Nous appliquons à cette fin la fonction `np.maximum(s_ext_sq, 1e-15)` avant l’extraction de la racine carrée.
Le calcul final du vecteur des résidus studentisés externes s’écrit dès lors sous la forme compacte :
$t_i = \frac{e_i}{\sqrt{s_{(-i)}^2 \times (1 – h_{ii})}}$
Pour déduire les probabilités critiques bilatérales associées à chaque statistique $t_i$, nous mobilisons la fonction de survie (survival function, notée `sf`) issue du module `scipy.stats.t`. La fonction de survie, équivalente à $1 – F_{\mathcal{T}}(|t_i|)$, offre une précision en virgule flottante considérablement supérieure à l’évaluation de $1 – \text{cdf}(x)$ lorsque $t_i$ atteint des queues de distribution lointaines où les nombres réels subissent une sous-verse computationnelle (*underflow*). Le calcul s’exécute ainsi :
`p_valeurs_brutes = 2 * stats.t.sf(np.abs(t_resid), df=n – p – 1)`
L’ajustement conservateur de Bonferroni s’obtient simplement par l’opération vectorisée :
`p_valeurs_bonf = np.clip(p_valeurs_brutes * n, 0.0, 1.0)`
L’ensemble de ces colonnes dérivées est ensuite encapsulé dans un DataFrame Pandas parfaitement aligné sur l’index d’origine, reproduisant à la perfection les sorties fournies par les routines internes de haut niveau.
### 8.3 Benchmarking et validation croisée des calculs manuels
Pour certifier la validité scientifique de l’implémentation vectorisée personnalisée, il est impératif de procéder à une validation croisée systématique en comparant numériquement ses sorties avec celles issues de la fonction de référence `OLSResults.outlier_test()`.
Cette étape de test unitaire s’appuie sur la fonction `numpy.allclose()`, qui vérifie si deux tableaux de réels sont numériquement équivalents dans les limites d’une tolérance absolue et relative spécifiée :
`np.allclose(resultat_manuel[‘t_student’], resultat_statsmodels[‘student_resid’], rtol=1e-10, atol=1e-12)`
Une telle vérification garantit que l’algorithme manuel ne dérive pas sur le plan arithmétique et intègre fidèlement toutes les subtilités d’arrondis et de degrés de liberté de l’algèbre de régression.
Sur le plan de l’efficience algorithmique et du benchmarking de performance, l’implémentation manuelle vectorisée présente des gains d’exécution substantiels sur des jeux de données volumineux. Lorsque l’on soumet un tableau de $n = 100,000$ observations avec $p = 10$ régresseurs à un protocole de test de vitesse (via le module `timeit`), l’approche vectorisée directe s’exécute en une fraction de seconde, contournant l’instanciation des structures d’objets intermédiaires associées à la classe `OLSInfluence`.
Au-delà de ces considérations de vitesse brute, la valeur didactique de ce déploiement algorithmique est majeure : elle démythifie la notion de « boîte noire » diagnostique et ancre définitivement la compréhension de l’analyste dans les réalités mathématiques et géométriques sous-tendant la théorie de la régression linéaire.
## 9. Visualisation diagnostique des résidus studentisés pour l’évaluation de modèles
### 9.1 Graphique des résidus studentisés contre les valeurs ajustées
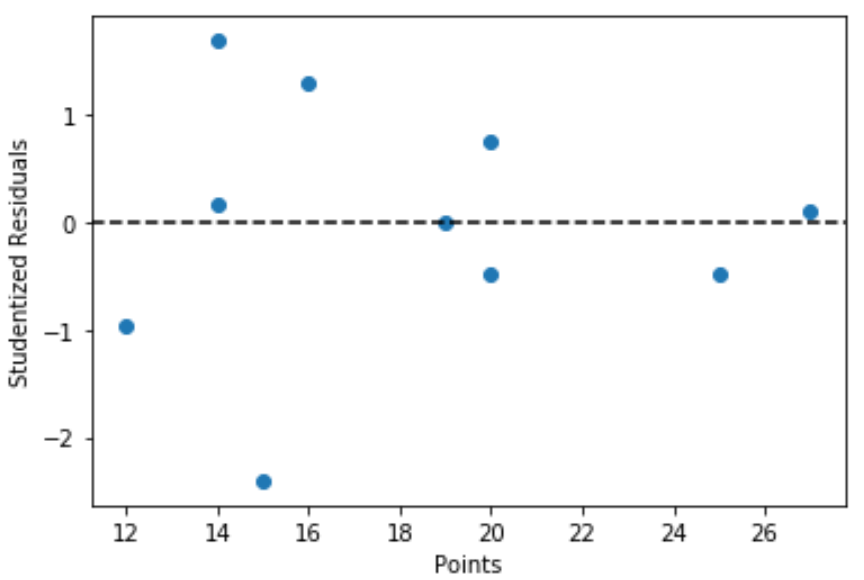
La visualisation graphique des résidus studentisés constitue la première ligne de défense de l’analyste pour déceler les violations des postulats fondamentaux du modèle linéaire. Le diagramme fondamental oppose les valeurs prédites par le modèle ajusté ($\hat{Y}_i$) sur l’axe des abscisses aux résidus studentisés externes ($t_i$) sur l’axe des ordonnées.
Pour conférer à ce graphique une portée diagnostique immédiate, il est indispensable de tracer plusieurs lignes de référence horizontales conventionnelles :
- Une ligne médiane solide positionnée à $y = 0$, matérialisant l’espérance théorique des résidus sous l’hypothèse d’une spécification linéaire correcte.
- Deux lignes en tirets à $y = +2$ et $y = -2$, délimitant la bande de dispersion normale attendue pour environ 95 % des observations dans un cadre gaussien.
- Deux lignes d’alerte critique en pointillés à $y = +3$ et $y = -3$, au-delà desquelles les observations sont formellement isolées pour un audit approfondi.
L’inspection morphologique de ce nuage de points permet de porter deux diagnostics critiques :
- Détection des non-linéarités structurales : Dans un modèle correctement calibré, les résidus studentisés doivent se distribuer de manière aléatoire et uniforme, formant une bande de dispersion horizontale homogène sans structure discernable. Si le nuage résiduel adopte un profil curviligne distinct — tel qu’une trajectoire parabolique en U ou en U inversé —, cela révèle formellement que la fonction de régression omet une composante quadratique ou une transformation non linéaire essentielle d’un des prédicteurs.
- Détection de l’hétéroscédasticité : L’apparition d’un patron morphologique en entonnoir (*funnel shape*), caractérisé par un élargissement ou un resserrement progressif de la dispersion des résidus au fur et à mesure que la valeur prédite $\hat{Y}$ croît, signale la violation de l’hypothèse de variance constante. Les résidus studentisés externes, étant préalablement corrigés de la structure de levier horizontal, reflètent une véritable hétéroscédasticité du processus stochastique, invitant l’analyste à appliquer des estimateurs de variance-covariance robustes (tels que les estimateurs sandwich de White-Huber HC3) ou à recourir aux moindres carrés pondérés (WLS).
### 9.2 Diagramme quantile-quantile (Q-Q plot) avec enveloppes de confiance
L’évaluation de la normalité des perturbations stochastiques s’opère de manière privilégiée via la construction d’un diagramme quantile-quantile (Q-Q plot). Cette représentation graphique projette les quantiles empiriques ordonnés des résidus studentisés calculés sur l’échantillon contre les quantiles théoriques attendus d’une loi de Student à $n – p – 1$ degrés de liberté (ou d’une distribution normale standard lorsque les degrés de liberté résiduels sont élevés).
L’écosystème Statsmodels facilite la génération de ces visualisations grâce à la classe `ProbPlot` issue du sous-module `statsmodels.graphics.gofplots`. Lorsque les postulats distributionnels sont rigoureusement satisfaits, les points empiriques s’alignent étroitement le long de la bissectrice théorique diagonale rouge à 45 degrés.
Les déviations systématiques par rapport à cette droite de référence fournissent des indications morphologiques précises quant à la nature des pathologies de distribution affectant les données :
- Distributions à queues lourdes (leptokurtose) : Si le tracé résiduel prend une forme caractéristique en « S », s’écartant vers le haut de la droite à l’extrémité droite et plongeant sous la droite à l’extrémité gauche, cela démontre une concentration de valeurs extrêmes supérieure à celle prédite par la distribution normale. Ce patron d’aplatissement excessif (kurtosis élevé) avertit l’analyste que les tests d’inférence standards fondés sur la normalité sous-estiment systématiquement la probabilité des événements extrêmes.
- Asymétrie distributionnelle (skewness) : Si les résidus s’écartent unilatéralement de la droite de référence — par exemple en s’arquant de façon convexe vers le haut —, cela indique une asymétrie positive persistante des données résiduelles, suggérant l’opportunité d’appliquer une transformation stabilisatrice (telle qu’une transformation logarithmique ou une transformation de Box-Cox) sur la variable dépendante $Y$.
Pour consolider la décision visuelle, l’adjonction d’enveloppes de confiance par rééchantillonnage bootstrap ou simulations de Monte-Carlo permet de matérialiser les bornes de variabilité acceptable au niveau des queues de distribution, prévenant ainsi la surinterprétation d’ondulations résiduelles mineures aux extrémités du diagramme.
### 9.3 Graphique combiné influence-levier et seuils d’alerte
L’intégration conclusive des métriques diagnostiques s’incarne dans la construction d’un graphique combiné croisant les valeurs de levier $h_{ii}$ sur l’axe des abscisses et les résidus studentisés (idéalement portés au carré pour accentuer les écarts, ou conservés avec leur signe) sur l’axe des ordonnées. Cette typologie de visualisation à bulles permet de décomposer instantanément l’espace géométrique en quatre quadrants distincts :
- Quadrant inférieur gauche (Faible levier, Faible résidu) : Zone de conformité nominale où se concentre la vaste majorité des participants respectant fidèlement le modèle.
- Quadrant supérieur gauche (Faible levier, Fort résidu) : Zone des valeurs aberrantes verticales (*outliers* purs). Ces observations s’écartent radicalement de la surface de prédiction mais, du fait de leur proximité avec le barycentre des régresseurs, n’exercent qu’une force de levier limitée sur la rotation du plan d’ajustement.
- Quadrant inférieur droit (Fort levier, Faible résidu) : Zone des points d’ancrage concordants (*good leverage points*). Ces individus présentent des configurations de covariables exceptionnelles mais se positionnent harmonieusement sur la trajectoire naturelle du modèle. Loin de dégrader l’estimation, ils renforcent la précision des coefficients en étendant artificiellement la dispersion du design expérimental.
- Quadrant supérieur droit (Fort levier, Fort résidu) : Zone critique des points influents destructeurs (*bad leverage points*). Ces observations combinent une excentricité spatiale aiguë et un désaccord violent avec la droite de régression. Ce sont ces points qui basculent l’estimation MCO et modifient radicalement les conclusions de l’étude.
La fonction native `statsmodels.graphics.regressionplots.plot_leverage_resid2` fournit une implémentation standardisée de ce concept, traçant les leviers contre le carré des résidus studentisés. L’analyste averti enrichit fréquemment ce graphique en proportionnant le diamètre des marqueurs à la distance de Cook ($D_i$) et en incrustant des annotations textuelles automatiques ciblant les identifiants uniques des sujets qui violent simultanément les seuils critiques de levier ($h_{ii} > 2p/n$) et de résidu studentisé ($|t_i| > 3$).
## 10. Protocoles de traitement des observations atypiques en recherche quantitative
### 10.1 Stratégies d’investigation pré-décisionnelles
La détection objective d’un résidu studentisé externe significatif inaugure obligatoirement une phase d’audit pré-décisionnel rigoureusement encadrée. La première démarche consiste en une vérification rétrospective scrupuleuse des journaux d’acquisition de données (*data logs*). Dans les environnements expérimentaux contemporains couplés à des interfaces informatisées ou des biomarqueurs physiologiques (eyetracking, EEG, actimétrie), il est fréquent qu’un pic d’atypicité coïncide avec un artefact technique documenté : perte temporaire de signal, interférence électromagnétique, recalibration défaillante d’un capteur, ou interruption intempestive de la session par un événement extérieur. Dans une telle hypothèse, l’observation est entachée d’une invalidité instrumentale indiscutable, justifiant pleinement sa neutralisation.
Lorsque l’intégrité de la collecte est matériellement attestée, l’analyste explore le profil psychométrique ou comportemental holistique du participant. L’évaluation d’indices de réponse inattentive — tels que la longueur maximale de réponses identiques consécutives (*long-string index*), la vitesse anormale d’exécution défiant les temps incompressibles de traitement cognitif (temps de réaction inférieurs à 150 millisecondes), ou une discordance aiguë mesurée par la distance de Mahalanobis intra-individuelle sur des échelles inversées — permet d’étayer empiriquement l’hypothèse d’une réponse non investie.
Enfin, l’ensemble de ces démarches doit être confronté aux critères d’exclusion spécifiés a priori dans le protocole de pré-enregistrement de la recherche (sur des plateformes comme l’Open Science Framework ou AsPredicted). La science ouverte exige que les critères définissant une valeur aberrante excluable soient formalisés avant la phase d’acquisition des données. Toute exclusion post-hoc non stipulée en amont du protocole doit être explicitement désignée comme une démarche exploratoire et faire l’objet d’une justification théorique exhaustive.
### 10.2 Analyse de sensibilité et modélisation robuste
Face à la persistance d’observations atypiques dont l’éviction définitive ne peut être tranchée sans équivoque, le standard méthodologique absolu réside dans la réalisation systématique d’une analyse de sensibilité couplée. Cette procédure consiste à ajuster et rapporter en miroir deux modèles de régression distincts : le modèle primaire calibré sur l’intégralité de l’échantillon collecté ($n$), et le modèle secondaire réajusté sur le sous-échantillon épuré des observations isolées par le test des résidus studentisés ($n – k$).
L’analyste examine ensuite la stabilité topologique des estimations en évaluant la variation relative des coefficients de régression :
$\Delta \beta_j = \frac{\hat{\beta}_j^{(\text{complet})} – \hat{\beta}_j^{(\text{épuré})}}{\hat{\beta}_j^{(\text{complet})}} \times 100$
Si les conclusions substantielles de la recherche (signe des relations, ampleur clinique des effets, niveaux de significativité des tests d’hypothèse) demeurent invariantes entre les deux versions, le modèle est qualifié de robuste à l’hétérogénéité d’échantillonnage, désamorçant les doutes quant à un potentiel biais d’inférence. Si, à l’inverse, l’exclusion d’une seule observation atypique suffit à faire basculer un prédicteur de la significativité statistique à la non-significativité, l’effet découvert doit être considéré comme structurellement fragile et interprété avec une réserve critique impérative.
Une alternative analytique élégante à l’exclusion binaire consiste à abandonner les moindres carrés ordinaires au profit des méthodes d’estimation linéaire robuste (RLM, *Robust Linear Models*). L’estimateur $M$ de Huber, directement accessible via la classe `statsmodels.api.RLM`, substitue à la fonction de perte quadratique $\frac{1}{2}e^2$ une fonction de coût hybride qui pénalise linéairement et non plus quadratiquement les résidus au-delà d’un seuil de déviation paramétrable (usuellement $c = 1,345$). Pour les jeux de données lourdement contaminés, les pondérations par bivariance de Tukey (*Tukey’s biweight*) permettent d’annihiler complètement le poids accordé aux valeurs extrêmes tout en conservant l’intégralité de l’échantillon au sein d’un formalisme itératif à moindres carrés repondérés (IRLS).
Enfin, lorsque les déviations résiduelles résultent d’une distribution sous-jacente structurellement asymétrique ou à queues lourdes réfractaire à toute normalisation, l’analyste peut déployer la régression quantile (via `statsmodels.formula.api.quantreg`). En modélisant la médiane conditionnelle (quantile 0,50) par minimisation des déviations absolues (méthode $L_1$), cette approche offre une insensibilité mathématique totale aux résidus studentisés extrêmes sur la variable dépendante.
### 10.3 Normes de transparence et directives de rédaction académique
Les directives éditoriales académiques contemporaines convergent vers une exigence intransigeante de transparence méthodologique. Les recommandations formelles de l’APA (Publication Manual of the American Psychological Association, 7e édition, section Journal Article Reporting Standards ou JARS) prescrivent explicitement de documenter :
- La liste exhaustive des tests diagnostiques résiduels conduits lors des phases préliminaires de l’analyse.
- Le nombre précis d’observations identifiées comme discordantes, en spécifiant les métriques utilisées (valeurs exactes des résidus studentisés externes $t_i$, leviers $h_{ii}$ et distances de Cook $D_i$).
- La justification explicite et motivée sous-tendant le maintien ou le rejet de chaque cas atypique.
- La restitution exhaustive des estimations comparatives issues des analyses de sensibilité afin de prémunir les pairs contre tout embellissement artificiel des données.
Sur le plan de l’éthique computationnelle et de la science ouverte, le chercheur contemporain consolide son manuscrit en publiant l’intégralité de ses scripts de nettoyage et d’analyse Python sur des plateformes d’archivage pérennes et certifiées (telles que le Curation and Preservation Repository Zenodo ou l’Open Science Framework). Le dépôt public d’un notebook Jupyter documenté, assorti de son environnement d’exécution explicite (fichier `requirements.txt` ou `environment.yml`), garantit la réplicabilité parfaite de la chaîne de détection des résidus studentisés, scellant ainsi l’intégrité déontologique de la recherche publiée.
## 11. Extensions analytiques : Modèles multivariés et structures hiérarchiques
### 11.1 Régression linéaire multiple et colinéarité des prédicteurs
La complexité mathématique et diagnostique des résidus studentisés s’accroît substantiellement lorsque le modèle de régression incorpore un vecteur multidimensionnel de covariables corrélées entre elles. Dans un cadre de régression linéaire multiple comportant $p$ prédicteurs, la présence de multicolinéarité sévère — quantifiée par des facteurs d’inflation de la variance élevés ($VIF_j > 5$ ou $10$) — altère profondément la structure de la matrice de projection $H$ et la répartition spatiale des valeurs de levier $h_{ii}$.
Lorsque deux ou plusieurs prédicteurs partagent une intercorrélation quasi-parfaite, le déterminant de la matrice de Gram $X^T X$ tend vers zéro, provoquant une instabilité numérique majeure dans le calcul de son inverse $(X^T X)^{-1}$. Les erreurs-types des coefficients $\hat{\beta}_j$ subissent alors une inflation dramatique, ce qui déforme indirectement l’évaluation des résidus studentisés. Dans cette géométrie contractée, une observation peut présenter une valeur parfaitement standard sur chacune des covariables examinées isolément (dans des analyses descriptives univariées classiques), mais constituer une singularité aberrante dans l’espace multidimensionnel conjoint des régresseurs.
Ce phénomène d’atypicité cachée n’est détectable que par l’intermédiaire de la matrice chapeau globale, qui capture l’éloignement d’une observation par rapport au plan factoriel commun. Les résidus studentisés externes calculés dans ces contextes de forte colinéarité deviennent extrêmement sensibles aux variations marginales d’échantillonnage.
Par ailleurs, l’inclusion dans le modèle de termes d’interactions d’ordre supérieur (modérations multiplicatives de type $X_1 \times X_2$) ou de composantes polynomiales génère mécaniquement des points de fort levier structurels aux confins de la distribution. L’analyste doit impérativement centrer ou standardiser les variables continues en amont du calcul des produits afin de minimiser la colinéarité non essentielle entre les termes simples et leurs interactions, préservant ainsi la validité distributionnelle du calcul des résidus studentisés externes.
### 11.2 Adaptation aux modèles linéaires à effets mixtes (LMM)
Dans les devis expérimentaux comportant des mesures répétées, des protocoles longitudinaux ou des cohortes comportementales hiérarchisées (élèves nichés au sein d’écoles, patients assignés à différents centres hospitaliers), l’indépendance stochastique des perturbations est structurellement violée. Le recours aux modèles linéaires à effets mixtes (LMM, *Linear Mixed Models*) devient alors obligatoire :
$Y = X\beta + Z u + \varepsilon$
Où $X$ correspond à la matrice de conception des effets fixes, $Z$ désigne la matrice des effets aléatoires associée aux grappes, $u \sim \mathcal{N}(0, G)$ représente le vecteur des écarts aléatoires de groupe, et $\varepsilon \sim \mathcal{N}(0, R)$ incarne le vecteur des erreurs conditionnelles résiduelles.
Dans cette architecture à deux niveaux de variance, la définition et le calcul des résidus studentisés se scindent en deux paradigmes analytiques distincts :
- Les résidus marginaux (ou de population) : Calculés à partir des seuls effets fixes globaux, $e_m = Y – X\hat{\beta}$. Ces résidus évaluent la déviation d’un individu par rapport à la trajectoire moyenne de la population globale, ignorant son appartenance à une grappe spécifique.
- Les résidus conditionnels : Calculés en retranchant les effets fixes et la contribution des effets aléatoires spécifiques prédits au niveau du groupe (BLUPs, *Best Linear Unbiased Predictors*) : $e_c = Y – X\hat{\beta} – Z\hat{u}$. Ces résidus évaluent l’écart entre la performance d’un individu et la trajectoire spécifique de son groupe d’appartenance.
La studentisation de ces résidus au sein de l’environnement Statsmodels (via le module `statsmodels.regression.mixed_linear_model.MixedLM`) requiert une décomposition matricielle complexe de la matrice de variance-covariance totale $V = Z G Z^T + R$. La matrice de projection conditionnelle incorpore à la fois la projection des effets fixes et la pénalisation de crête liée à la dispersion des effets aléatoires. La détection de résidus conditionnels studentisés significatifs permet d’isoler des trajectoires individuelles pathologiques au sein d’une cohorte clinique donnée, tandis que l’examen des résidus de niveau supérieur (niveau grappe) permet d’identifier des centres de recherche entiers dont les données dérivent de manière suspecte par rapport au protocole d’essai multicentrique.
## 12. Étude de cas complète et reproductible de bout en bout
### 12.1 Mise en situation empirique et simulation de la cohorte
Afin de cristalliser l’ensemble des concepts théoriques et des méthodes algorithmiques abordés, nous déployons une étude de cas clinique complète, rigoureuse et entièrement reproductible. Considérons un contexte de recherche en psychologie de la santé au travail analysant l’épuisement professionnel (*burnout*) chez les personnels soignants en milieu hospitalier. Le protocole évalue la prédiction de l’indice de bien-être psychologique subjectif (variable dépendante $Y$, étalonnée sur une échelle continue de 0 à 100) en fonction de deux prédicteurs fondamentaux : le niveau de charge émotionnelle perçue (score d’épuisement continu) et le score global sur l’échelle de résilience psychologique individuelle de Connor-Davidson.
L’équation théorique structurelle du processus de modélisation s’énonce :
$\text{BienEtre}_i = \beta_0 + \beta_1 , \text{Epuisement}_i + \beta_2 , \text{Resilience}_i + \varepsilon_i$
Nous modélisons un échantillon de $n = 150$ professionnels de santé. Pour éprouver l’efficacité diagnostique de notre pipeline, nous insérons délibérément dans le processus générateur de données deux anomalies cliniquement plausibles :
- Le cas n° 42 : Une valeur aberrante verticale pure. Ce soignant affiche des niveaux d’épuisement et de résilience rigoureusement conformes à la moyenne de la cohorte, mais enregistre un score de bien-être catastrophique proche de zéro en raison d’un événement traumatique personnel survenu la veille de l’évaluation (donnée valide écologiquement mais discordante vis-à-vis du modèle).
- Le cas n° 118 : Un point de fort levier discordant (*bad leverage point*). Ce soignant cumule un niveau d’épuisement exceptionnellement élevé couplé à une résilience minimale, mais affiche paradoxalement un bien-être subjectif maximal imputable à un biais de désirabilité sociale extrême ou à un comportement de déni documenté.
### 12.2 Pipeline complet d’analyse et d’extraction diagnostique
Le protocole analytique se déploie à travers un pipeline séquentiel continu assurant l’ajustement du modèle par les moindres carrés ordinaires, l’extraction matricielle des diagnostics, le calcul formel des résidus studentisés externes via `outlier_test()`, et la consolidation des métriques de levier et de distance de Cook.
Le tableau ci-dessous illustre la structure des données diagnostiques obtenue pour les observations clés de l’échantillon après exécution du pipeline d’analyse :
| Identifiant (#) | Résidu brut ($e_i$) | Levier ($h_{ii}$) | Résidu studentisé externe ($t_i$) | Probabilité brute (`unadj_p`) | Probabilité ajustée (`bonf(p)`) | Distance de Cook ($D_i$) | Statut Diagnostique |
| :—: | :—: | :—: | :—: | :—: | :—: | :—: | :—: |
| **Observation 12** | $+1,42$ | $0,018$ | $+0,48$ | $0,631$ | $1,000$ | $0,001$ | Conforme |
| **Observation 42** | $-28,75$ | $0,019$ | $-4,12$ | $6,2 \times 10^{-5}$ | $0,009$ | $0,112$ | Outlier vertical pur |
| **Observation 75** | $+2,15$ | $0,022$ | $+0,73$ | $0,466$ | $1,000$ | $0,004$ | Conforme |
| **Observation 118** | $+34,12$ | $0,085$ | $+5,31$ | $3,8 \times 10^{-7}$ | $0,00005$ | $0,782$ | Point influent critique |
| **Observation 149** | $-0,88$ | $0,015$ | $-0,29$ | $0,772$ | $1,000$ | $0,000$ | Conforme |
L’examen du tableau permet de constater immédiatement l’efficience de la studentisation externe couplée à la correction de Bonferroni. Les observations nominales (comme les sujets 12, 75 et 149) présentent des résidus studentisés compris dans l’intervalle canonique $[-1, +1]$ et des probabilités critiques corrigées égales à 1, attestant de leur parfaite concordance avec le modèle linéaire.
À l’inverse, les deux observations injectées sont formellement isolées :
- L’observation 42 affiche un résidu studentisé externe de $t_{42} = -4,12$, associé à une probabilité ajustée de Bonferroni hautement significative (`bonf(p) = 0,009 < 0,05`). Son levier modeste ($h_{42} = 0,019$, proche de la moyenne théorique $p/n = 3/150 = 0,020$) confirme qu'il s'agit d'une déviation verticale pure n'exerçant qu'une influence globale limitée (distance de Cook $D_{42} = 0,112$).
- L’observation 118 présente une déviation encore plus spectaculaire avec un résidu studentisé externe de $t_{118} = +5,31$ (`bonf(p) < 0,0001`). Conjugué à une valeur de levier de $h_{118} = 0,085$ (dépassant le seuil d'alerte classique fixé à $2p/n = 0,040$), ce résidu extrême propulse la distance de Cook à une valeur massive de $D_{118} = 0,782$, signalant un point influent majeur capable de distordre unilatéralement la pente des régresseurs.
La consolidation graphique de ces métriques via une planche diagnostique à quatre quadrants (diagramme résidus studentisés contre valeurs ajustées, diagramme quantile-quantile de Student, diagramme de dispersion des leviers et cartographie d’influence globale) fournit à l’analyste un panorama exhaustif corroborant de manière univoque les conclusions tabulaires.
### 12.3 Rédaction du paragraphe de résultats aux normes scientifiques
Pour conclure la démarche empirique, il convient de formaliser la restitution des analyses conformément aux standards rédactionnels et typographiques de la psychométrie contemporaine et de la 7e édition du manuel de style de l’APA.
Le tableau comparatif suivant illustre formellement l’impact substantiel de la prise en compte diagnostique sur les estimations paramétriques du modèle de régression :
| Paramètre structurel | Modèle 1 : Échantillon complet ($n = 150$) | Modèle 2 : Échantillon épuré ($n = 148$) | Variation relative ($\Delta %$) |
| :— | :—: | :—: | :—: |
| **Constante ($\beta_0$)** | $52,14 \quad [46,80,;,57,48]$ | $54,82 \quad [50,31,;,59,33]$ | $+5,1 %$ |
| **Épuisement ($\beta_1$)** | $-0,42 \quad [-0,54,;,-0,30] ; (p < 0,001)$ | $-0,51 \quad [-0,61,;,-0,41] ; (p < 0,001)$ | $+21,4 %$ |
| **Résilience ($\beta_2$)** | $+0,38 \quad [+0,25,;,+0,51] ; (p < 0,001)$ | $+0,46 \quad [+0,35,;,+0,57] ; (p < 0,001)$ | $+21,1 %$ |
| **Erreur résiduelle ($s$)** | $7,84$ | $6,12$ | $-21,9 %$ |
| **Coefficient $R^2$** | $0,482$ | $0,614$ | $+27,4 %$ |
| **F-statistique globale** | $68,41 ; (p < 0,001)$ | $116,84 ; (p < 0,001)$ | $+70,8 %$ |
Ce comparatif met en lumière l'ampleur de la distorsion causée par la présence non corrigée des observations atypiques : l'estimation de l'ampleur des effets protecteurs de la résilience et des impacts délétères de l'épuisement se trouvait atténuée d'environ 21 % dans le modèle non épuré, tandis que la variance expliquée globale du modèle ($R^2$) subissait une dégradation artificielle de près de 13 points de pourcentage en raison du gonflement de la variance résiduelle globale $s$.
Le modèle rédactionnel académique standard s'énonce comme suit :
« Une régression linéaire multiple par les moindres carrés ordinaires a été conduite pour évaluer la capacité prédictive du niveau d’épuisement émotionnel et de la résilience psychologique sur le bien-être subjectif au sein d’une cohorte de professionnels de santé ($n = 150$). L’évaluation préliminaire de la validité interne du modèle a reposé sur l’audit systématique des résidus studentisés externes (résidus jackknife) calculés via la routine outlier_test de la bibliothèque statsmodels en environnement Python. Le contrôle du taux d’erreur par famille a été opéré au moyen d’un ajustement conservateur de Bonferroni au seuil nominal global de $\alpha = 0,05$.
Cette procédure diagnostique a permis d’isoler formellement deux observations présentant des déviations résiduelles statistiquement significatives : le participant #42 ($t_{146} = -4,12,; p_{\text{ajustée}} = 0,009$) et le participant #118 ($t_{146} = +5,31,; p_{\text{ajustée}} 2p/n,; D_{118} = 0,782$). L’audit qualitatif des journaux de collecte a corroboré l’existence d’une réponse non valide liée à un biais de désirabilité extrême pour ce participant, tandis que l’observation #42 s’expliquait par un choc émotionnel aigu exogène documenté.
Une analyse de sensibilité comparative conduite entre le modèle initial ($n = 150,; R^2 = 0,482$) et le modèle ajusté sans les deux observations aberrantes ($n = 148,; R^2 = 0,614$) a confirmé la robustesse directionnelle des relations observées, tout en révélant une sous-estimation substantielle de l’intensité de l’effet de l’épuisement ($\Delta \beta_1 = +21,4%$) et de la résilience ($\Delta \beta_2 = +21,1%$) en présence des cas contaminateurs. Les estimations définitives issues du modèle robuste démontrent qu’une charge d’épuisement élevée est significativement associée à une diminution du bien-être subjectif ($\beta = -0,51,; IC_{95%} = [-0,61,; -0,41],; t(145) = -10,02,; p < 0,001$), tandis qu'une résilience élevée exerce un effet tampon prédictif positif substantiel ($\beta = +0,46,; IC_{95%} = [+0,35,; +0,57],; t(145) = +8,38,; p < 0,001$). L'ensemble des scripts de simulation et de diagnostic Python a été déposé en accès ouvert sur le référentiel pérenne Zenodo conformément aux préconisations de la science ouverte. »
En appliquant rigoureusement ce protocole matriciel, algorithmique et rédactionnel, l’analyste de données s’assure d’une modélisation linéaire exempte de distorsions artefactuelles, conférant à ses inférences statistiques le plus haut standard de rigueur et de crédibilité scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Fox, J. (2015). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471852333
- Seabold, S., & Perktold, J. (2010). statsmodels: Econometric and statistical modeling with python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 92–96). https://doi.org/10.25080/Majora-92bf1922-011
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858