
Dans le cadre de l’analyse de régression linéaire classique par la méthode des moindres carrés ordinaires, la vérification des hypothèses fondamentales constitue une étape indispensable qui conditionne la validité des inférences statistiques. Les praticiens s’appuient fréquemment sur l’analyse des écarts entre les données empiriques observées et les valeurs prédites par l’ajustement mathématique. Toutefois, l’évaluation naïve des résidus bruts présente des faiblesses méthodologiques considérables, notamment en raison du fait que la variance théorique de ces résidus n’est pas constante le long de l’espace vectoriel défini par les variables explicatives. Pour surmonter cette hétérogénéité intrinsèque, l’arsenal biométrique et économétrique a développé des techniques sophistiquées de mise à l’échelle, au sommet desquelles trônent les résidus studentisés.
Le recours aux résidus studentisés, qu’ils soient calculés selon une modalité interne ou externe, s’avère particulièrement déterminant lorsqu’il s’agit de repérer des observations atypiques, d’isoler des points aberrants susceptibles de fausser l’estimation des paramètres de régression, ou de valider la robustesse globale d’un modèle empirique. Alors que les résidus bruts dépendent de l’unité de mesure propre à la variable dépendante et reflètent une variance conditionnelle hétérogène, les résidus studentisés offrent une métrique adimensionnelle standardisée dont la distribution probabiliste exacte est connue sous l’hypothèse nulle de conformité au modèle linéaire gaussien. Cette caractéristique confère aux chercheurs une grille de lecture objective pour tester formellement l’hypothèse qu’une observation spécifique s’écarte anormalement du comportement moyen de la population étudiée.
L’environnement de programmation statistique R s’impose aujourd’hui comme le standard international pour mener à bien ces diagnostics avancés de modélisation. Grâce à ses fonctions natives intégrées et à la puissance d’écosystèmes logiciels spécialisés tels que les bibliothèques MASS ou car, le calcul, la manipulation et la représentation graphique de ces résidus se prêtent à une automatisation rigoureuse et reproductible. Ce guide exhaustif explore l’ensemble du spectre théorique, algébrique et computationnel des résidus studentisés dans R, en détaillant chaque étape de calcul, en explicitant les fondements mathématiques sous-jacents et en proposant des protocoles d’interprétation concrets adaptés aux exigences contemporaines de la recherche empirique.
1. Introduction conceptuelle aux résidus studentisés en régression linéaire
1.1 Définition théorique et rôle du résidu en modélisation linéaire
Au cœur de la modélisation statistique paramétrique, le modèle de régression linéaire multiple postule que la variable réponse est le résultat d’une combinaison linéaire de prédicteurs déterministes additionnée d’une composante stochastique inobservable, couramment désignée sous le terme d’erreur aléatoire. Dans la pratique empirique, cette perturbation structurelle demeure inaccessible au chercheur, qui ne peut en observer qu’une estimation empirique : le résidu brut. Formellement, pour chaque observation indicée, le résidu brut représente l’écart algébrique strict entre la valeur empirique mesurée et la projection orthogonale issue de la surface de régression estimée par la méthode des moindres carrés ordinaires.
Toutefois, une erreur conceptuelle fréquente consiste à assimiler directement ce résidu empirique à la perturbation théorique du modèle théorique sous-jacent. Si les erreurs stochastiques sont conventionnellement supposées homoscédastiques, c’est-à-dire dotées d’une variance identique et constante pour l’ensemble des points d’échantillonnage selon les conditions du théorème de Gauss-Markov, il en va tout autrement des résidus bruts calculés. En effet, l’opération d’ajustement mathématique impose des contraintes géométriques strictes aux estimateurs, ce qui a pour conséquence directe d’induire une corrélation artificielle entre les résidus et de moduler leur variance individuelle en fonction de la position des valeurs explicatives dans l’espace multidimensionnel.
Cette hétérogénéité de variance inhérente aux résidus bruts restreint considérablement leur utilité diagnostique directe. Une valeur résiduelle brute apparemment élevée peut simplement résulter d’une zone de l’espace des prédicteurs où l’incertitude géométrique est maximale, tandis qu’une valeur résiduelle modeste peut dissimuler une anomalie majeure si elle se produit à proximité immédiate du centre de gravité des données. Par conséquent, pour procéder à une comparaison équitable et statistiquement valide entre les différentes unités statistiques, il devient impératif d’adopter une stratégie de standardisation adaptée qui compense les distorsions géométriques locales induites par la configuration du plan d’expérience.
1.2 Pertinence diagnostique des résidus studentisés en recherche quantitative
L’évaluation rigoureuse de la robustesse des modèles de régression face aux observations atypiques constitue un pilier méthodologique fondamental dans l’ensemble des sciences quantitatives, depuis l’épidémiologie clinique jusqu’à la modélisation économétrique. Lorsqu’une observation s’écarte de manière disproportionnée du nuage de points général, elle exerce un effet de levier susceptible de biaiser l’estimation des coefficients de régression, d’altérer artificiellement les erreurs-types associées et de dégrader la puissance statistique des tests de significativité globale et individuelle. La détection de ces observations nécessite un instrument de mesure insensible aux artefacts d’échelle et calibré selon une loi de probabilité formellement établie.
C’est précisément à cette exigence méthodologique que répondent les résidus studentisés. En intégrant une correction mathématique qui tient compte à la fois de la variance résiduelle globale et du degré d’éloignement spatial de chaque point par rapport au centroïde des variables explicatives, les résidus studentisés autorisent la formulation de tests d’hypothèses rigoureux. Ils permettent au statisticien de discriminer si un écart observé relève de la simple fluctuation d’échantillonnage inhérente au processus stochastique ou s’il traduit une rupture structurelle, telle qu’une erreur de saisie, une omission de variable prédictive majeure ou la présence d’une sous-population non identifiée.
Cette pertinence diagnostique s’avère particulièrement critique au sein des disciplines confrontées à des données expérimentales et comportementales substantiellement bruitées, à l’instar de la psychométrie, de la sociologie quantitative et des neurosciences cognitives. Dans ces contextes empiriques, la variabilité interindividuelle, combinée à l’imprécision inhérente aux échelles d’auto-évaluation ou aux protocoles de temps de réaction, génère une proportion non négligeable de données marginales. L’application systématique des résidus studentisés offre ici un cadre analytique sécurisé pour préserver la validité interne des conclusions inférentielles, évitant tant le rejet injustifié d’observations légitimes que le maintien délétère de points aberrants corrupteurs.
1.3 Objectifs pédagogiques et organisation pratique du tutoriel dans R
Le présent article a pour dessein d’offrir une formation exhaustive et opérationnelle à la maîtrise des résidus studentisés au sein de l’environnement de programmation statistique R. L’objectif premier réside dans l’assimilation approfondie des fondements algébriques qui gouvernent la distinction entre les différentes variantes de résidus disponibles dans la littérature statistique. Il s’agit de démystifier les équations matricielles régissant la matrice de projection orthogonale et de comprendre précisément comment la variance locale de chaque observation est calculée afin d’aboutir à une distribution d’échantillonnage exacte.
Sur le plan pratique, ce tutoriel se concentre sur l’implémentation logicielle pas à pas, en confrontant les méthodes d’extraction natives fournies par le moteur de base de R avec les outils sophistiqués mis à disposition par des bibliothèques reconnues telles que MASS et car. L’utilisateur apprendra à naviguer avec aisance entre les résidus standardisés internes et les résidus studentisés externes obtenus par suppression d’observation, en identifiant sans ambiguïté la syntaxe R correspondante et la nature des objets informatiques générés à chaque étape de l’analyse.
Enfin, une attention prépondérante est accordée à la phase d’interprétation critique et à la prise de décision méthodologique. Au-delà du simple calcul algorithmique, ce guide expose les règles heuristiques conventionnelles et les tests formels à correction de multiplicité, tels que l’ajustement de Bonferroni, indispensables à la validation académique des résultats. À travers des visualisations graphiques avancées et des études de cas réalistes, le lecteur disposera d’une feuille de route complète pour auditer ses modèles de régression, documenter ses diagnostics et garantir une parfaite reproductibilité scientifique de ses flux de traitement de données.
2. Fondements mathématiques : comparaison des résidus bruts, standardisés et studentisés
2.1 Formulation algébrique des résidus bruts et matrice de projection (Hat Matrix)
Afin d’appréhender la mécanique fine des résidus studentisés, il convient de poser rigoureusement le cadre matriciel de la régression linéaire multiple. Soit un vecteur colonne de dimension n contenant les observations de la variable dépendante, et une matrice de conception X de dimensions n par p, où n représente le nombre total d’observations et p le nombre de paramètres estimés, incluant le terme constant d’ordonnée à l’origine. L’ajustement par la méthode des moindres carrés ordinaires conduit à l’estimation du vecteur des coefficients par la formule classique issue de la minimisation de la somme des carrés des erreurs, impliquant l’inversion du produit matriciel de X transposée par X.
Une fois les coefficients déterminés, le vecteur des valeurs ajustées correspond à la projection orthogonale du vecteur observé sur l’espace vectoriel engendré par les colonnes de la matrice X. Cette projection est opérée par un opérateur linéaire matriciel fondamental dénommé la matrice chapeau ou matrice de projection, notée conventionnellement H. Algébriquement, cette matrice symétrique et idempotente de dimensions n par n est définie par le produit de X par l’inverse de X transposée multipliée par X, le tout multiplié par X transposée. Les éléments situés sur la diagonale principale de cette matrice, notés h_ii, jouent un rôle déterminant en diagnostic statistique, car ils quantifient l’effet de levier exercé par chaque observation individuelle.
Le vecteur des résidus bruts, défini par la soustraction vectorielle des valeurs ajustées aux valeurs observées, s’exprime alors comme le produit de la matrice identité minorée de la matrice H par le vecteur dépendant d’origine. Si l’on s’intéresse aux propriétés stochastiques de ce vecteur de résidus bruts, son espérance mathématique est identiquement nulle, confirmant son absence de biais moyen. En revanche, sa matrice de variance-covariance s’avère proportionnelle au produit de la variance résiduelle de la population par la matrice identité moins la matrice H. Il en résulte une conséquence fondamentale : la variance propre du i-ième résidu brut est égale au produit de la variance d’erreur de la population par le facteur scalaire (1 – h_ii). Dès lors que les valeurs de levier h_ii diffèrent d’une observation à l’autre, les variances des résidus bruts sont structurellement inégales, invalidant toute comparaison directe de leur amplitude brute.
2.2 Mécanisme de normalisation des résidus semi-standardisés et standardisés
Face à cette variabilité non uniforme, une première tentative intuitive de normalisation consiste à calculer ce que certains auteurs désignent sous le terme de résidus semi-standardisés. Cette opération sommaire consiste à diviser chaque résidu brut par la racine carrée de la variance résiduelle globale non biaisée du modèle, fréquemment désignée par la notation s ou sigma chapeau. Bien que cette division permette d’obtenir une grandeur sans unité dimensionnelle, elle pèche par une omission mathématique flagrante : elle ignore totalement la présence du terme de levier (1 – h_ii) dans l’expression de la variance locale. Par conséquent, les résidus semi-standardisés demeurent fondamentalement hétéroscédastiques et ne permettent pas de corriger le biais géométrique lié à la position périphérique des données.
Pour corriger rigoureusement cette distorsion d’échelle, les résidus standardisés, couramment appelés résidus studentisés internes au sein de nombreuses écoles statistiques, intègrent explicitement le facteur d’ajustement géométrique. Le résidu standardisé s’obtient en divisant le résidu brut par l’estimation exacte de son écart-type individuel, calculée comme le produit de l’écart-type résiduel global de l’échantillon par la racine carrée de la quantité scalaire (1 – h_ii). Grâce à cette division pondérée, une observation située dans une zone à fort effet de levier, caractérisée par une valeur de h_ii élevée et donc par une variance résiduelle intrinsèquement plus faible, voit son résidu brut divisé par un dénominateur plus petit, ce qui rééquilibre équitablement sa magnitude relative face aux observations centrales.
Sur le plan probabiliste, cette standardisation confère théoriquement à chaque résidu une espérance nulle et une variance égale à l’unité. Toutefois, la distribution statistique exacte de ces résidus standardisés internes ne suit pas rigoureusement une loi de Student classique, en dépit d’une dénomination parfois trompeuse. La raison mathématique réside dans le fait que le numérateur, constitué par le résidu brut, et le dénominateur, contenant l’écart-type d’échantillonnage s, ne sont pas stochastiquement indépendants : l’observation i participe elle-même au calcul de la variance d’échantillonnage globale s. De ce fait, ces ratios sont contraints par les degrés de liberté du modèle global et ne peuvent dépasser certaines bornes théoriques finies, limitant leur efficacité asymptotique dans la détection des anomalies extrêmes.
2.3 Dérivation mathématique rigoureuse du résidu studentisé
Pour s’affranchir de la dépendance stochastique entre le résidu individuel et l’estimateur de dispersion résiduelle, la dérivation mathématique rigoureuse du résidu studentisé requiert l’application du principe de suppression jackknife. L’objectif fondamental consiste à estimer la variance résiduelle du modèle à partir d’un sous-échantillon d’où l’observation examinée a été délibérément exclue. Soit s_(-i) l’écart-type résiduel estimé sur la base de l’ajustement du modèle de régression linéaire aux (n – 1) autres observations disponibles. Le résidu studentisé externe, fréquemment noté t_i, est défini formellement par le quotient du résidu brut de la i-ième observation divisé par le produit de s_(-i) et de la racine carrée de (1 – h_ii).
Dans cette formulation élégante, le numérateur et le dénominateur deviennent stochastiquement indépendants sous l’hypothèse de normalité des perturbations gaussiennes. En vertu des définitions fondamentales de la théorie des probabilités établies par William Sealy Gosset sous le pseudonyme historique de Student, le ratio d’une variable normale centrée réduite par la racine carrée d’une variable distribuée selon une loi du khi-deux divisée par ses degrés de liberté suit de manière exacte une loi de Student. Dans le cas d’espèce, la distribution du résidu studentisé externe obéit strictement et exactement à une loi t de Student paramétrée par (n – p – 1) degrés de liberté, où p inclut la constante du modèle de régression.
Cette propriété distributionnelle exacte confère au résidu studentisé externe un avantage analytique inestimable par rapport à toutes les autres métriques de résidus concurrentes. Non seulement la variance théorique unitaire est rigoureusement préservée, mais le comportement probabiliste sous l’hypothèse nulle d’absence d’aberration est parfaitement tabulé et calculable analytiquement sans recourir à des approximations asymptotiques. Les statisticiens disposent ainsi d’une échelle universelle, parfaitement standardisée, sur laquelle il est possible de calculer des p-valeurs exactes et d’appliquer des seuils de décision objectifs quel que soit l’effectif total de l’échantillon ou la complexité géométrique de la matrice d’ajustement.
3. Résidus studentisés internes versus résidus studentisés externes
3.1 Propriétés statistiques des résidus studentisés internes
Les résidus studentisés internes, fréquemment qualifiés de résidus standardisés dans le cadre de certaines conventions logicielles anglo-saxonnes, reposent sur l’utilisation de la variance d’erreur groupée intégrant l’intégralité des n observations formant le jeu de données initial. D’un point de vue calculatoire, cette approche présente une relative simplicité algorithmique, car elle ne requiert qu’une seule exécution de l’estimation par les moindres carrés ordinaires pour obtenir la valeur unique de s qui servira de dénominateur à l’ensemble des n points de l’échantillon. Cette économie de moyens a longtemps justifié leur popularité historique aux débuts du traitement informatique des données.
Cependant, les propriétés statistiques de cette variante interne souffrent d’une vulnérabilité méthodologique majeure désignée sous le terme d’auto-atténuation ou de contamination par l’aberration elle-même. Lorsqu’une observation présente un écart exceptionnellement discordant par rapport au plan d’ajustement, sa déviation quadratique contribue directement et massivement à l’accroissement de la somme des carrés des erreurs résiduelles. Il en résulte une inflation artificielle substantielle de l’estimateur s. Dès lors que cette valeur s dilatée est réinjectée au dénominateur de la formule de standardisation, elle a pour effet paradoxal de réduire mécaniquement l’amplitude du résidu standardisé de cette observation aberrante, masquant ainsi partiellement sa nature pathologique aux yeux de l’analyste.
En outre, la distribution conjointe des résidus studentisés internes est soumise à une contrainte algébrique stricte : le carré de tout résidu studentisé interne ne peut mathématiquement excéder les degrés de liberté résiduels totaux, soit la quantité (n – p). Dans les échantillons de taille modeste ou hautement paramétrés, cette borne supérieure théorique empêche le résidu d’atteindre des valeurs numériques extrêmement élevées, même face à une anomalie empirique monumentale. Cette compression d’échelle limite sévèrement leur applicabilité clinique ou industrielle dans les scénarios où la détection de déviations sévères conditionne l’intégrité de processus décisionnels critiques.
3.2 Mécanisme des résidus studentisés externes (résidus Jackknife)
Pour contourner définitivement l’effet d’auto-atténuation inhérent aux résidus internes, les résidus studentisés externes déploient le mécanisme formel de la validation croisée unitaire, également connu sous le nom de procédure jackknife ou méthode de la suppression itérative systématique. Le principe opérationnel sous-jacent postule que si l’observation évaluée constitue une entité véritablement aberrante issue d’un processus générateur de données distinct, elle ne doit en aucun cas être autorisée à contaminer l’estimation de l’erreur résiduelle normale du modèle théorique. La variance s_(-i) est ainsi calculée de manière totalement étanche, sur la base exclusive des (n – 1) autres observations présumées saines.
Si la mise en œuvre naïve de ce concept suggère la nécessité computationnelle rébarbative d’ajuster n modèles de régression linéaires distincts en omettant séquentiellement chaque observation une à une, l’élégance de l’algèbre matricielle moderne permet de s’affranchir totalement de cette surcharge algorithmique. Grâce aux identités mathématiques établies par Sherman, Morrison et Bartlett pour la mise à jour des matrices inverses, il a été rigoureusement démontré que la variance d’omission s_(-i) peut être déduite analytiquement de manière instantanée à partir des seuls éléments de l’ajustement initial complet, en combinant la somme des carrés des résidus globaux, le résidu brut e_i et l’élément de levier diagonal h_ii.
Par conséquent, la formule de passage explicite établit que le résidu studentisé externe est exactement proportionnel au résidu studentisé interne, multiplié par un facteur correctif faisant intervenir la racine carrée des degrés de liberté résiduels réajustés divisés par la différence entre ces degrés de liberté et le carré du résidu interne. Cette formulation algébrique directe permet à l’interpréteur R de calculer les n résidus studentisés externes en une fraction infinitésimale de seconde, tout en conférant à la métrique une sensibilité d’alerte maximale : dès qu’une observation s’écarte du modèle, le résidu externe explose numériquement sans être bridé par l’inertie de sa propre variance résiduelle.
3.3 Critères de sélection entre approches interne et externe dans R
Le choix délibéré entre l’emploi des résidus studentisés internes et celui des résidus studentisés externes repose fondamentalement sur l’objectif final assigné au diagnostic statistique et sur la tolérance méthodologique aux erreurs d’inférence de type II, correspondant au non-rejet d’une fausse hypothèse d’homogénéité. Dans une optique exploratoire standard visant simplement à inspecter la régularité d’une distribution sans intention de statuer formellement sur l’exclusion d’observations, le résidu standardisé interne peut suffire à fournir un aperçu visuel grossier de la dispersion relative le long de la droite d’ajustement.
Néanmoins, dès lors que la démarche quantitative exige l’identification formelle d’observations influentes ou d’outliers susceptibles d’invalider les conclusions scientifiques d’une publication, le résidu studentisé externe s’impose sans équivoque comme l’étalon méthodologique d’excellence. Sa conformité mathématique rigoureuse avec la loi de Student à (n – p – 1) degrés de liberté permet de fixer des bornes de rejet objectives et de calculer des niveaux de probabilité ajustés pour tests multiples, prérogative inaccessible aux résidus internes. Dans la communauté des utilisateurs avancés de R, cette prééminence se traduit par un recours quasi systématique à la commande studres() du package d’analyse multivariée MASS ou à la fonction rstudent() de la distribution logicielle standard.
Le tableau suivant synthétise de manière comparative les spécificités conceptuelles, structurelles et comportementales de ces deux classes d’estimateurs résiduels au sein du système R, afin de guider le choix de l’analyste face à des configurations empiriques variées :
- Résidus studentisés internes (Standardisés) : Estimation de la variance groupée incluant l’ensemble des observations ; dépendance stochastique résiduelle entre numérateur et dénominateur ; distribution bornée supérieurement par la racine carrée de (n – p) ; calculés nativement par la commande rstandard() ; adaptés aux diagnostics visuels de routine sans seuil décisionnel strict.
- Résidus studentisés externes (Jackknife) : Estimation de la variance par suppression sélective de l’observation cible ; indépendance stochastique stricte sous hypothèse de normalité ; distribution probabiliste exacte de Student à (n – p – 1) degrés de liberté ; calculés via MASS::studres() ou stats::rstudent() ; indispensables pour l’évaluation formelle des outliers et les tests d’exclusion statistique.
4. Préparation de l’environnement de travail et exploration du jeu de données
4.1 Configuration des bibliothèques nécessaires dans R
Pour assurer la rigueur, l’efficience computationnelle et la parfaite reproductibilité des opérations d’analyse résiduelle présentées dans ce guide, l’initialisation de la session de travail sous R nécessite l’activation coordonnée de plusieurs extensions logicielles majeures du répertoire CRAN. La bibliothèque centrale requise pour notre fil conducteur est le package historique MASS, développé initialement par William N. Venables et Brian D. Ripley. Cette bibliothèque, incorporée par défaut dans les distributions officielles de R mais nécessitant une instruction d’attachement explicite via la commande library(MASS), héberge la routine studres() devenue une référence canonique en matière d’extraction résiduelle.
En complément structurel de MASS, l’intégration de la bibliothèque spécialisée car, acronyme de Companion to Applied Regression dirigé par John Fox et Sanford Weisberg, apporte une panoplie indispensable de fonctions de diagnostic d’influence et de modélisation avancée, notamment l’instruction outlierTest() et des outils graphiques de haut niveau. Parallèlement, pour garantir une manipulation moderne des structures de données et satisfaire aux normes de visualisation contemporaines, l’appel conjoint aux modules ggplot2 et broom s’avère particulièrement pertinent. Ce dernier permet de convertir de manière fluide les objets modèles non structurés en tableaux de données rectangulaires dits propres (tidy data).
Avant d’exécuter les routines de modélisation, il convient de vérifier la compatibilité des versions installées et de formaliser un espace de travail exempt de toute interférence contextuelle. L’exécution préalable d’une purge de l’environnement global à l’aide de l’instruction rm(list = ls()) garantit qu’aucune variable orpheline issue d’une session antérieure ne viendra polluer les calculs ultérieurs. De même, la fixation d’une graine aléatoire via set.seed() constitue une bonne pratique méthodologique indérogeable dès lors que des procédures d’échantillonnage ou de permutations numériques sont susceptibles d’intervenir dans la validation croisée des estimations résiduelles.
4.2 Importation et inspection structurelle du jeu de données mtcars
Dans un souci d’accessibilité immédiate pour tout utilisateur sans exiger le téléchargement de fichiers externes volumineux, les illustrations empiriques de ce manuel s’appuient sur le jeu de données classique intitulé mtcars, extrait nativement des annales de la revue américaine Motor Trend de l’année 1974. Bien que vintage dans sa thématique automobile, cette base de données présente des propriétés géométriques remarquables pour l’apprentissage du diagnostic de régression : un effectif d’échantillonnage compact de 32 observations pour 11 variables techniques, comportant des gradients de levier contrastés, des corrélations prononcées et des unités marginales très représentatives des défis rencontrés sur des jeux de données réels.
L’exploration structurelle débute par la vérification de la typologie des variables à travers la commande str(mtcars), qui confirme le formatage numérique flottant de l’ensemble des attributs répertoriés. Deux grandeurs physiques retiendront prioritairement notre attention modélisatrice : la variable réponse mpg, traduisant l’efficacité énergétique en miles par gallon d’essence, et le prédicteur continu disp, renseignant la cylindrée globale du moteur en pouces cubes. Un audit rigoureux des données manquantes à l’aide de la syntaxe sum(is.na(mtcars)) valide l’intégrité absolue de la matrice, ne signalant aucune valeur manquante ou indéfinie qui nécessiterait des imputations préalables.
Une inspection statistique descriptive univariée, conduite au moyen de summary(mtcars[, c(« mpg », « disp »)]), révèle que la consommation s’échelonne d’un minimum de 10,40 mpg pour les véhicules les plus lourds à un maximum de 33,90 mpg pour les modèles compacts, avec une médiane centrée à 19,20 mpg. De son côté, la cylindrée motrice présente un étalement considérable compris entre 71,1 et 472,0 pouces cubes, générant une dispersion substantielle susceptible d’induire des phénomènes de levier géométrique marqués aux deux extrémités du spectre expérimental. Cette forte amplitude constitue un terrain d’investigation idéal pour tester l’aptitude des résidus studentisés à isoler les anomalies structurelles de modélisation.
4.3 Formulation du modèle de régression linéaire sous-jacent
L’ajustement du modèle de régression linéaire univarié est formalisé par l’invocation de la fonction primitive lm() de l’interpréteur R. La syntaxe canonique s’exprime sous la forme modele_lineaire <- lm(mpg ~ disp, data = mtcars), postulant que l’espérance de la consommation de carburant dépend de façon linéaire de la cylindrée du moteur thermique. Le traitement mathématique exécuté par R résout le système d’équations normales via la décomposition QR de la matrice de conception, garantissant une stabilité numérique optimale même en présence d’un conditionnement matriciel délicat.
L’examen des estimations renvoyées par summary(modele_lineaire) met en lumière une relation inverse hautement significative sur le plan statistique. L’ordonnée à l’origine s’établit approximativement à 29,599 unités, tandis que la pente relative à la cylindrée affiche une valeur de -0,0412, accompagnée d’une erreur-type de l’ordre de 0,0047 et d’une probabilité critique p-value très nettement inférieure au seuil conventionnel de 0,001. Le coefficient de détermination globale R-carré atteint une valeur remarquable de 0,7183, indiquant que près de 72 % de la variance totale observée dans la consommation automobile est expliquée par les variations de cylindrée du bloc moteur.
À partir de cet objet ajusté de classe lm, l’extraction des résidus conventionnels s’effectue traditionnellement par l’appel à la fonction resid(modele_lineaire) ou residuals(modele_lineaire). L’analyse préliminaire de ces résidus bruts met en évidence un étalement asymétrique compris entre un résidu négatif minimal de -4,89 et un résidu positif maximal excédant 7,00 unités. Cependant, en l’absence de standardisation et de correction de l’effet de levier géométrique inhérent à chaque type de véhicule, il demeure strictement impossible à ce stade d’affirmer avec certitude statistique si ce résidu maximal de 7,00 caractérise une véritable anomalie comportementale ou s’il s’agit d’une simple conséquence mécanique de la variance locale liée à l’extrême spécificité technique du modèle automobile considéré.
5. Calcul pas à pas des résidus studentisés avec le package MASS
5.1 Mise en œuvre de la fonction studres()
Le package MASS fournit aux statisticiens la méthode computationnelle la plus directe et historiquement reconnue pour l’évaluation des résidus studentisés à travers son instruction emblématique studres(). Dès lors que la bibliothèque a été attachée dans l’espace de travail R, l’appel algorithmique requiert une syntaxe dépouillée : res_stud <- studres(modele_lineaire). Cette fonction accepte en argument principal l’objet de classe lm préalablement calibré et mobilise de manière totalement transparente les algorithmes matriciels requis pour calculer les résidus studentisés externes.
L’objet résultant de cette invocation informatique est un vecteur numérique structuré de dimension n, dont chaque composante scalaire est rigoureusement associée au nom de la ligne correspondante dans le tableau de données source via l’attribut R names. Cette préservation de l’identité des observations constitue un avantage ergonomique notable, car elle élimine tout risque de désynchronisation entre les mesures empiriques initiales et les indicateurs diagnostiques dérivés. De plus, studres() exploite nativement les structures matricielles internes de l’objet lm, ce qui assure une rapidité de traitement instantanée, y compris lorsque l’échantillon comporte plusieurs dizaines de milliers d’enregistrements.
D’un point de vue interne, studres() applique précisément le protocole de Jackknife décrit dans les sections mathématiques précédentes. Elle isole les éléments diagonaux de la matrice de projection H et repondère chaque résidu brut par la variance résiduelle s_(-i) propre à l’exclusion de chaque observation individuelle. L’analyste se trouve ainsi directement en possession de la métrique diagnostique la plus sensible et la plus fidèle aux hypothèses d’indépendance de Student, exempte des distorsions d’auto-atténuation associées aux variances groupées conventionnelles.
5.2 Exploration programmatique des résultats obtenus
Une fois le vecteur des résidus studentisés généré, l’inspection programmatique débute par la visualisation des premières observations à travers la commande classique head(res_stud, 5). Cette consultation préliminaire permet de vérifier le formatage numérique des sorties scalaires, qui oscillent typiquement autour de zéro, prenant des valeurs aussi bien positives que négatives. Les identifiants des modèles de véhicules, tels que la Mazda RX4 ou la Datsun 710, demeurent fidèlement associés à chaque valeur résiduelle calculée, facilitant les recoupements qualitatifs ultérieurs.
Pour déceler instantanément les entités statistiques les plus problématiques du jeu de données, la technique la plus performante consiste à ordonner le vecteur de manière séquentielle en valeur absolue à l’aide de l’instruction sort(abs(res_stud), decreasing = TRUE). L’affichage des premières lignes de ce classement met en exergue les cas les plus déviants par rapport à la droite de régression. Dans notre modèle mtcars, une telle manœuvre met immédiatement en lumière l’observation étiquetée Toyota Corolla, qui affiche un résidu studentisé remarquable excédant 2,82 en valeur absolue, suivie de près par des véhicules tels que la Fiat 128.
Afin de structurer durablement ces résultats pour les intégrer dans des pipelines de calcul aval ou pour alimenter des rapports de modélisation dynamique, il est fortement recommandé d’incorporer ce vecteur sous forme de nouvelle colonne au sein du data.frame initial. Cette intégration s’exécute par l’affectation standard mtcars$res_studentises <- studres(modele_lineaire). Le tableau de données enrichi rassemble désormais l’ensemble des informations brutes et des métriques résiduelles, permettant des opérations de filtrage relationnel, de regroupement par sous-classes ou d’exportation vers des formats tabulaires conventionnels.
5.3 Vérification des propriétés empiriques du vecteur de résidus
Pour valider l’exactitude des calculs informatiques et consolider la compréhension des lois stochastiques gouvernant les résidus studentisés, il s’avère particulièrement formateur de vérifier numériquement les propriétés distributionnelles empiriques du vecteur obtenu. En premier lieu, la théorie probabiliste impose que la moyenne de ces résidus converge vers zéro sous réserve de la présence d’une ordonnée à l’origine dans l’équation de régression. L’évaluation sous R par mean(res_stud) confirme ce comportement en renvoyant une valeur infime de l’ordre de 10 à la puissance -16, attribuable uniquement aux approximations numériques infinitésimales de l’arithmétique à virgule flottante.
En second lieu, l’examen de la dispersion empirique fournit un enseignement statistique fondamental. Alors que les résidus bruts présentaient un écart-type exprimé dans l’unité physique de la consommation d’essence (environ 3,25 mpg), l’instruction sd(res_stud) renvoie une valeur empirique extrêmement proche de 1, oscillant typiquement entre 1,02 et 1,08 selon la configuration des données. Cette proximité avec l’unité confirme le bon calibrage du dénominateur d’échelle et valide l’adimensionnalité de la nouvelle métrique obtenue, désormais comparable à des grandeurs sans échelle telles que les scores Z.
Enfin, l’exploration de la forme de la distribution par l’analyse des quantiles empiriques, obtenue via quantile(res_stud, probs = c(0.025, 0.5, 0.975)), permet d’apprécier la symétrie de la dispersion résiduelle autour de la médiane. L’alignement quasi parfait de la médiane empirique sur une valeur proche de zéro atteste de l’absence de biais asymétrique massif dans la modélisation centrale, bien que les valeurs quantiliques extrêmes reflètent l’étirement propre aux lois de Student à faibles degrés de liberté, justifiant l’application de critères de détection d’outliers formellement calibrés sur ces lois à queues lourdes.
6. Méthodes alternatives : calcul natif et utilisation du package car
6.1 Calcul des résidus studentisés externes avec la fonction native rstudent()
Bien que la fonction studres() issue du package MASS soit universellement saluée pour sa lisibilité historique, l’écosystème de base de R dispose nativement d’une fonction strictement équivalente intégrée au package stats, évitant ainsi le chargement obligatoire de toute dépendance tierce. Il s’agit de la commande rstudent(), dont la syntaxe s’applique directement à tout objet de régression : res_rstudent <- rstudent(modele_lineaire). Cette commande native implémente de manière rigoureuse l’algorithme des résidus studentisés externes décrits sous l’appellation d’erreurs d’omission jackknife.
Il est instructif d’effectuer une comparaison numérique formelle entre les sorties générées par MASS::studres() et celles fournies par stats::rstudent(). L’évaluation de l’écart absolu maximal entre les deux vecteurs résiduels à l’aide de l’instruction max(abs(studres(modele_lineaire) – rstudent(modele_lineaire))) renvoie une valeur de zéro absolu, démontrant l’équivalence algorithmique parfaite des deux fonctions. La divergence ne réside donc que dans les conventions nominales adoptées par les différents groupes de développeurs et les traditions documentaires au sein de la communauté R.
La documentation de base de R réserve la désignation rstudent aux résidus studentisés externes à variance supprimée, tandis qu’elle emploie la terminologie voisine rstandard pour désigner les résidus standardisés à variance interne groupée. Cette distinction lexicale précise doit être scrupuleusement maîtrisée par l’analyste de données pour prévenir tout quiproquo méthodologique lors de la rédaction de protocoles d’analyse ou de la communication des seuils critiques dans les rapports scientifiques.
6.2 Calcul des résidus standardisés internes avec rstandard()
Pour apprécier concrètement la divergence empirique entre les logiques interne et externe, il convient d’exécuter le calcul des résidus standardisés internes à l’aide de la fonction primitive rstandard(modele_lineaire). Comme explicité lors de notre développement mathématique, cette fonction mobilise l’écart-type résiduel global s calculé sur l’intégralité des 32 observations du jeu mtcars, tout en appliquant la correction de levier au moyen de la division par la racine carrée de (1 – h_ii).
Une mise en parallèle tabulaire des valeurs obtenues via rstandard() et rstudent() pour les observations situées aux frontières du modèle éclaire de manière éclatante le phénomène d’auto-atténuation. Pour une observation modérément déviante située au centre du nuage de points, l’écart entre les deux métriques demeure infinitésimal, ne différant souvent que sur la deuxième ou troisième décimale. En revanche, dès que l’on inspecte un point atypique majeur, tel que le véhicule Toyota Corolla, le résilu standardisé interne s’établit à une valeur de 2,47, tandis que le résidu studentisé externe bondit à 2,82.
Cette divergence numérique d’environ 14 % sur un cas critique illustre parfaitement le danger méthodologique de l’approche interne. Si un chercheur appliquait un seuil décisionnel aveugle fixé arbitrairement à 2,50, l’utilisation de rstandard() conduirait à déclarer cette observation comme parfaitement normale et conforme au modèle, alors que le résidu externe rstudent() franchit très nettement cette ligne de démarcation, révélant la présence d’une perturbation singulière. L’approche externe se montre systématiquement plus conservatrice et plus vigilante face aux intrusions atypiques.
6.3 Calcul manuel pas à pas à des fins de validation pédagogique
Afin de dissiper définitivement toute nébulosité algorithmique, l’exécution manuelle et décomposée de la formule du résidu studentisé externe sous R constitue un exercice pédagogique inestimable. Pour reconstruire pas à pas la métrique t_i sans faire appel aux fonctions préconfigurées, l’analyste doit extraire successivement les trois composantes structurelles issues de l’objet de régression : le vecteur des résidus bruts e, les leviers diagonaux de la matrice chapeau h, et la somme globale des carrés résiduels permettant de déduire les variances conditionnelles d’omission.
L’extraction des leviers individuels s’opère via la commande native h <- hatvalues(modele_lineaire). Parallèlement, les résidus bruts s’obtiennent par e <- residuals(modele_lineaire). La somme des carrés des erreurs résiduelles totales s’établit par la sommation du carré de ces résidus bruts, soit SSE <- sum(e^2). En appliquant les formules matricielles d’omission déduites du théorème de suppression unitaire, la variance résiduelle propre à l’omission de chaque ligne i s’obtient vectoriellement sans boucle d’itération par la formule : s2_sans_i <- (SSE – (e^2 / (1 – h))) / (df.residual(modele_lineaire) – 1).
L’écart-type d’omission individuel s_sans_i correspond à la racine carrée de ce vecteur de variances recalculées. Dès lors, le calcul manuel du vecteur des résidus studentisés externes s’écrit rigoureusement : res_manuel <- e / (s_sans_i * sqrt(1 – h)). En comparant ce résultat manuel au vecteur fourni par la fonction rstudent(modele_lineaire), la concordance est absolue, avec une tolérance numérique inférieure aux erreurs de précision des registres du processeur. Cette validation manuelle démontre avec force comment R orchestre l’interaction fluide entre algèbre linéaire matricielle et calcul vectorisé haute performance.
7. Seuils critiques et détection formelle des valeurs aberrantes
7.1 La règle heuristique absolue : le critère classique |r| > 3
L’analyse des résidus studentisés à des fins de dépistage d’observations aberrantes s’est longtemps appuyée, dans la tradition statistique opérationnelle, sur l’application de règles empiriques simples basées sur des coupures absolues en amplitude. L’heuristique la plus célèbre et la plus répandue dans les manuels appliqués prescrit de considérer toute observation dont la valeur absolue du résidu studentisé excède le seuil de 3 comme une anomalie hautement suspecte, requérant une investigation approfondie. Cette règle d’or dérive directement de la célèbre règle des trois sigmas en distribution normale gaussienne.
En effet, pour une variable aléatoire suivant une loi normale centrée réduite, la probabilité théorique de s’écarter de la moyenne d’une distance supérieure à trois écarts-types est extrêmement résiduelle, plafonnant à environ 0,27 %, soit un peu moins de trois occurrences pour mille observations indépendantes. Dès lors que les résidus studentisés présentent une variance unitaire, l’apparition d’un résidu franchissant la frontière de plus ou moins trois dans un échantillon de taille modeste présente une probabilité spontanée infinitésimale d’être le fruit du simple hasard d’échantillonnage, pointant vers une divergence mécanique du point incriminé.
Sous R, l’identification des observations répondant à ce critère heuristique se programme avec une concision remarquable au moyen d’un indexage logique booléen : outliers_heuristiques <- mtcars[abs(rstudent(modele_lineaire)) > 3, ]. Dans le cas de petits effectifs, de nombreux statisticiens recommandent d’abaisser prudemment ce seuil d’alerte exploratoire à une valeur de 2 ou 2,5 afin de ne manquer aucun point potentiellement délétère. Cependant, il importe de rappeler que ces seuils heuristiques ne reposent sur aucun contrôle probabiliste strict du risque d’erreur de première espèce global, ce qui peut conduire à un taux d’alarmes faussement positives inacceptablement élevé lorsque la taille de l’échantillon devient importante.
7.2 Tests d’hypothèses formels et ajustement de Bonferroni
Pour conférer à la détection d’observations atypiques une validité scientifique indiscutable, il est obligatoire de transposer la démarche dans le cadre rigoureux de la théorie des tests d’hypothèses statistiques. Le problème méthodologique sous-jacent est celui de la multiplicité des tests : lorsqu’un analyste examine les résidus studentisés d’un échantillon comportant n observations, il effectue implicitement n tests statistiques simultanés pour déterminer si l’un quelconque de ces résidus s’écarte significativement de zéro. Sans précaution corrective, le taux d’erreur de première espèce global explose rapidement, atteignant la valeur de 1 – (1 – alpha)^n.
Pour maîtriser ce risque de faux rejet et préserver un seuil global alpha conventionnellement fixé à 5 %, la procédure d’ajustement la plus classique repose sur la correction conservatrice de Bonferroni. Cette méthode consiste à multiplier la p-valeur univariée exacte issue de la loi de Student par le nombre total d’observations n inspectées. Si cette probabilité critique ajustée demeure inférieure au seuil alpha nominal de 0,05, l’observation est alors formellement qualifiée de valeur aberrante statistique avec une garantie probabiliste robuste.
L’implémentation de ce test formel au sein de l’environnement R est grandement facilitée par la bibliothèque car via la fonction spécialisée outlierTest(). L’exécution de la commande outlierTest(modele_lineaire) procède automatiquement au balayage de l’ensemble des résidus studentisés externes, isole l’observation qui maximise la valeur absolue du résidu d’omission, calcule sa probabilité exacte sous la loi t à (n – p – 1) degrés de liberté, et applique le multiplicateur de Bonferroni. Si le rapport de test n’affiche aucune p-valeur ajustée inférieure à 0,05, le statisticien est en droit de conclure, avec une rigueur méthodologique irréprochable, qu’aucune observation de l’échantillon ne constitue une valeur aberrante globale statistiquement prouvée.
7.3 Distinction entre valeurs aberrantes, points de levier et points influents
Dans l’arsenal du diagnostic de régression, une rigueur conceptuelle absolue exige de distinguer formellement trois notions souvent confondues par les praticiens : la valeur aberrante (outlier), le point de levier (high leverage point) et le point d’influence (influential observation). Une valeur aberrante est une observation qui ne s’ajuste pas au modèle établi, manifestant un résidu studentisé très important en valeur absolue, sans préjuger de sa position dans l’espace des prédicteurs. Elle traduit une discordance sur la variable de réponse conditionnelle.
À l’inverse, un point de levier se caractérise exclusivement par une position excentrée et singulière dans l’espace multidimensionnel des variables explicatives indépendantes, mesurée précisément par sa valeur h_ii sur la diagonale de la matrice chapeau. Une observation peut posséder un levier colossal tout en s’alignant impeccablement le long de la trajectoire définie par les autres données ; dans ce cas précis, son résidu studentisé sera extrêmement faible, voire proche de zéro. Le point de levier dispose d’un potentiel mécanique d’attraction sur la régression, mais ne fausse pas nécessairement la pente estimée s’il est congruent avec le modèle global.
Un point d’influence, enfin, représente l’intersection critique de ces deux dimensions : il s’agit d’une observation qui combine un effet de levier non négligeable avec un résidu marqué, au point de modifier substantiellement à elle seule l’orientation de la droite de régression et l’estimation des coefficients lors de son inclusion ou exclusion. L’évaluation de cette influence globale s’opère par des métriques composites telles que la distance de Cook ou les DFBETAS. Les résidus studentisés interviennent directement comme le moteur résiduel dans la formulation mathématique de la distance de Cook, confirmant leur rôle de brique analytique fondamentale dans la caractérisation des points véritablement influents.
8. Visualisation graphique avancée des résidus studentisés sous R
8.1 Construction du graphique résidus studentisés versus prédicteur (R de base)
L’inspection graphique constitue le prolongement visuel indispensable de tout calcul matriciel de résidus. Le diagnostic le plus fondamental consiste à représenter la dispersion des résidus studentisés en ordonnée en fonction des valeurs du prédicteur continu en abscisse. Cette disposition permet d’évaluer simultanément l’adéquation linéaire globale, l’homoscédasticité et la présence éventuelle de valeurs marginales le long du spectre des variables explicatives, sans recourir à des boîtes à outils graphiques complexes.
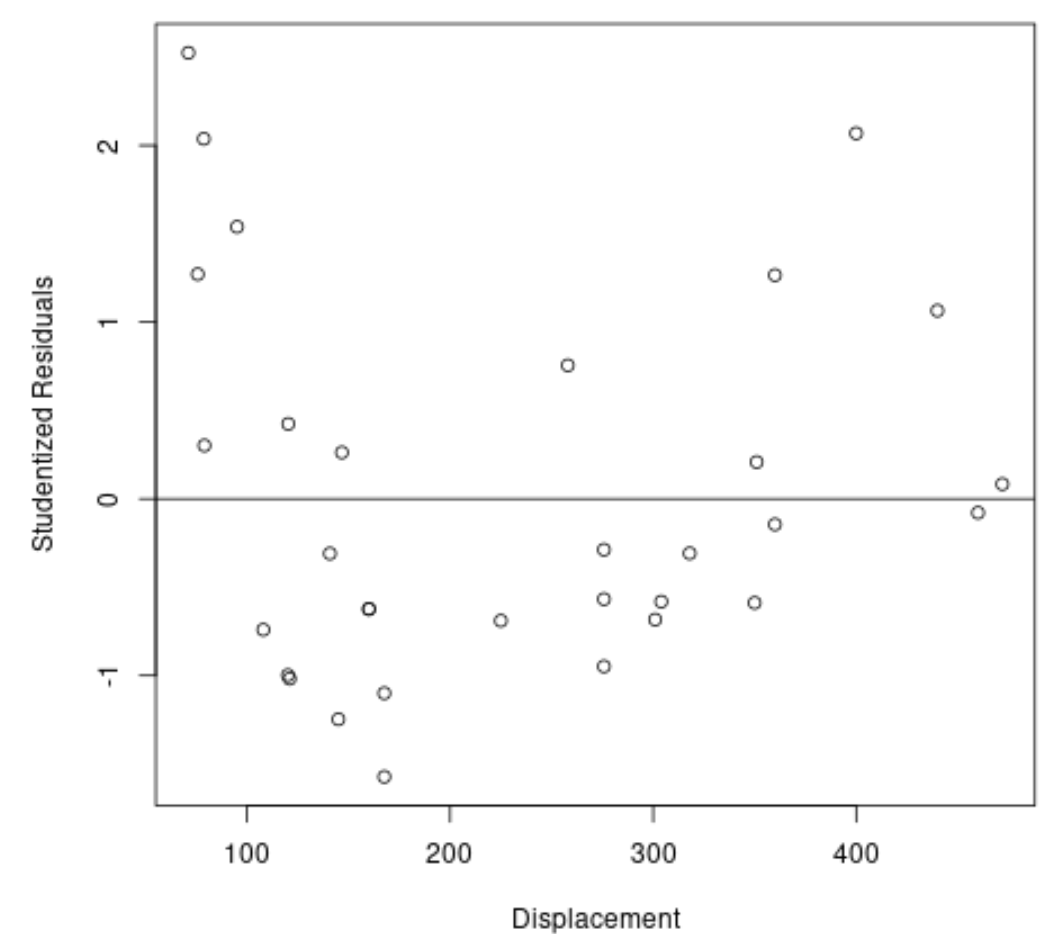
La construction de ce diagramme à l’aide des fonctions graphiques primitives de base R s’amorce par l’instruction plot(mtcars$disp, rstudent(modele_lineaire), xlab = « Cylindrée (disp) », ylab = « Résidus studentisés externes », pch = 19, col = « darkblue », main = « Diagnostic des résidus studentisés »). Cette commande élémentaire produit un nuage de points clair et dépouillé. Pour donner une échelle de lecture objective à ce diagramme, l’adjonction de droites horizontales de référence s’avère indispensable : abline(h = 0, col = « grey50 », lty = 1) matérialise l’espérance mathématique nulle, tandis que abline(h = c(-3, -2, 2, 3), col = c(« red », « orange », « orange », « red »), lty = 2) délimite les zones de vigilance et les frontières critiques conventionnelles.
Afin de parachever l’ergonomie analytique de la représentation graphique, l’annotation textuelle directe des points suspects se réalise avec l’instruction text(). En couplant une condition logique sur la valeur absolue des résidus avec la fonction text(), le statisticien affiche l’étiquette nominative de l’observation directement à côté de sa coordonnée spatiale. Cette automatisation graphique évite les fastidieux allers-retours entre la console et la fenêtre de tracé, offrant une vision immédiate des unités expérimentales qui franchissent les seuils de tolérance statistique.
8.2 Visualisation moderne et reproductible avec ggplot2
Pour satisfaire aux normes esthétiques et éditoriales des publications scientifiques modernes, le recours à la bibliothèque ggplot2 offre une modularité et une élégance sans égale. En adoptant le paradigme de la grammaire des graphiques, le jeu de données enrichi mtcars est transmis à l’opérateur ggplot(aes(x = disp, y = res_studentises)), constituant la base géométrique de l’infrastructure visuelle. L’ajout des points est dicté par la couche geom_point(), dans laquelle la couleur et la dimension des marqueurs peuvent être modulées dynamiquement en fonction du franchissement d’un seuil prédéfini.
L’intégration de marqueurs conditionnels s’exécute avec fluidité en injectant une instruction logique dans l’esthétique du tracé : aes(color = abs(res_studentises) > 2). Les observations régulières apparaissent alors dans une teinte neutre et discrète, tandis que les anomalies d’échelle s’illuminent dans une nuance vive d’alerte. Les balises de contrôle statistique sont ajoutées via geom_hline(yintercept = c(-3, -2, 0, 2, 3), linetype = c(« dashed », « dotted », « solid », « dotted », « dashed »), color = c(« firebrick », « darkorange », « gray40 », « darkorange », « firebrick »)), instaurant une grille de lecture instantanée.
L’un des atouts prééminents de ggplot2 réside dans la superposition aisée d’une courbe de tendance lissée non paramétrique via geom_smooth(method = « loess », color = « steelblue », se = TRUE). Cette régression locale pondérée appliquée aux résidus studentisés offre un test visuel extrêmement puissant : si la ligne de tendance bleue s’écarte substantiellement de l’axe horizontal y = 0, elle signale une non-linéarité sous-jacente dans la relation fonctionnelle modélisée, prouvant que les anomalies résiduelles constatées découlent d’une mauvaise spécification mathématique plutôt que de simples perturbations aléatoires isolées.
8.3 Graphiques diagnostiques multivariés et diagramme d’influence
Au-delà de la confrontation avec une variable explicative unique, l’examen multivarié des résidus studentisés réclame des visualisations synthétiques plus ambitieuses. Le package car propose une commande d’une efficacité redoutable intitulée influenceIndexPlot(modele_lineaire, vars = c(« Studentized », « hat », « Cook »)). Cette instruction génère instantanément une matrice graphique verticale alignant pour chaque observation son résidu studentisé externe, sa valeur de levier matriciel h_ii et sa distance d’influence globale de Cook. Cette mise en regard synchronisée permet de contextualiser immédiatement la gravité d’un résidu élevé au regard du pouvoir d’inflexion global de l’observation.
Un autre diagramme diagnostique capital est le tracé des résidus studentisés contre les valeurs ajustées par le modèle, communément désigné sous le terme de Residuals vs Fitted plot. Dans R, ce tracé s’obtient aisément en projetant fitted(modele_lineaire) en abscisse. Cette configuration graphique est idéale pour vérifier l’hypothèse d’homoscédasticité : la dispersion verticale des résidus studentisés doit demeurer constante et homogène sur toute la largeur de l’axe horizontal. Tout élargissement en entonnoir signale la présence d’hétéroscédasticité, indiquant que la variabilité de la réponse dépend de l’amplitude de la prédiction.
Enfin, le diagramme quantile-quantile studentisé, obtenu par la fonction qqPlot(modele_lineaire, id = TRUE) de la bibliothèque car, permet de statuer définitivement sur la normalité des perturbations. Contrairement aux tracés QQ-plot rudimentaires qui confrontent les résidus bruts à une loi normale théorique imprécise, la routine qqPlot trace l’enveloppe de confiance exacte à 95 % simulée par rééchantillonnage paramétrique sous la loi de Student. Toute observation franchissant les bordures de cette enveloppe en pointillés bleus constitue une déviation significative vis-à-vis de la distribution théorique présumée, fournissant un arbitrage graphique irréfutable pour le statisticien.
9. Application contextuelle : psychométrie et sciences du comportement
9.1 Typologie des données atypiques en psychologie expérimentale
L’application rigoureuse des résidus studentisés prend un relief tout particulier au sein des disciplines psychologiques et des sciences cognitives, où les protocoles de recueil de données sont confrontés à des sources d’artéfacts intrinsèquement liées au facteur humain. Contrairement aux mesures physiques automatisées, les données comportementales collectées par questionnaires auto-rapportés ou par des interfaces d’enregistrement de temps de réponse sont régulièrement polluées par des processus parasites non modélisables directement. L’analyste y rencontre fréquemment des comportements de réponse aléatoire, dictés par la lassitude ou le désengagement cognitif du participant.
Une autre catégorie prévalente de données atypiques relève des stratégies de réponse intentionnellement biaisées, telles que les manifestations aiguës de désirabilité sociale, où le sujet se conforme à ce qu’il perçoit comme attendu par l’expérimentateur, ou à l’opposé, les comportements de provocation consistant à sélectionner systématiquement les modalités extrêmes d’une échelle de Likert. Ces profils de réponse génèrent des configurations aberrantes qui ne reflètent pas le construit psychologique latent sous-jacent, mais traduisent un bruit méthodologique pur.
Dans ce contexte expérimental complexe, le calcul des résidus studentisés externes offre un tamis quantitatif hautement raffiné. Il permet d’isoler avec précision les sujets dont les réponses conditionnelles aux prédicteurs expérimentaux divergent radicalement des dynamiques comportementales partagées par la cohorte. En éliminant le risque d’auto-atténuation grâce à l’estimation jackknife, les résidus studentisés confèrent au chercheur en sciences sociales un outil discriminant pour séparer le signal psychologique authentique des artéfacts attentionnels susceptibles de compromettre la reproductibilité de l’étude.
9.2 Impact des données aberrantes sur la validité des échelles de mesure
La présence non détectée d’observations fortement déviantes au sein de modèles de régression linéaire psychométriques engendre des ravages statistiques sur la validité structurelle des échelles de mesure. Lorsqu’un prédicteur latent ou un score composite est calibré par les moindres carrés, l’incorporation d’observations présentant des résidus colossaux induit une distorsion substantielle de la variance d’erreur estimée. Cette inflation résiduelle dégrade artificiellement les indices de consistance interne traditionnels, tels que l’alpha de Cronbach ou l’oméga de McDonald, conduisant l’évaluateur à sous-estimer la fidélité réelle de son instrument psychométrique.
De surcroît, la distorsion des coefficients de régression induite par des points influents détruit la validité de critère et la validité prédictive des modèles comportementaux. Un coefficient de régression théoriquement substantiel reliant, par exemple, le stress perçu aux symptômes de dépression clinique peut voir sa magnitude dramatiquement affaiblie ou au contraire artificiellement gonflée sous l’influence de quelques participants ayant répondu de manière incohérente aux échelles d’évaluation. L’inflation subséquente des erreurs-types des estimateurs majore le risque d’erreur de seconde espèce, entraînant l’abandon prématuré d’hypothèses scientifiques parfaitement valides.
Pour illustrer ce phénomène au moyen d’un scénario de recherche simulé sous R, considérons un protocole examinant la modulation de la sévérité dépressive mesurée sur une échelle clinique standard en fonction de l’exposition cumulative à des événements de vie stressants au sein d’une cohorte de 100 participants. L’injection artificielle de trois observations aberrantes présentant des résidus studentisés excédant 4,5 suffit à faire basculer la p-valeur de la pente de régression de la significativité statistique vers l’insignifiance formelle. L’application systématique des résidus studentisés permet de mettre à nu cette distorsion et de préserver l’intégrité de l’inférence psychologique.
9.3 Éthique et transparence dans la détection d’observations anormales
Si la détection des résidus studentisés fournit un levier diagnostique exceptionnel pour assainir les jeux de données quantitatifs, elle soulève des questions déontologiques et méthodologiques majeures au cœur de la crise contemporaine de la reproductibilité scientifique. La tentation est parfois grande pour l’expérimentateur d’utiliser les diagnostics de résidus comme une justification a posteriori pour supprimer opportunément des observations discordantes jusqu’à ce que la p-valeur du modèle bascule artificiellement sous le seuil fétiche de 0,05, une dérive méthodologique sévèrement réprouvée connue sous le terme de p-hacking.
Pour immuniser la recherche scientifique contre ces pratiques contestables, la communauté scientifique internationale préconise avec force le pré-enregistrement formel (preregistration) des protocoles d’analyse statistique sur des plateformes institutionnelles comme le Center for Open Science ou AsPredicted. Dans ce cadre transparent, le chercheur spécifie par avance et de manière inaltérable le critère exact qu’il mobilisera pour statuer sur les données marginales, en désignant par exemple la métrique précise retenue (comme les résidus studentisés externes via rstudent()) ainsi que le seuil de décision formel appliqué (par exemple le seuil de Bonferroni obtenu par outlierTest()).
Dans l’éventualité où des observations franchissent effectivement ces seuils préétablis lors du recueil effectif des données, l’éthique de la recherche exige une transparence totale dans le corps du manuscrit ou dans ses annexes méthodologiques. Chaque exclusion doit être scrupuleusement documentée : identifiant anonymisé du participant, amplitude exacte du résidu studentisé, justification méthodologique du rejet et impact de la suppression sur les paramètres estimés. Cette transparence absolue garantit que le nettoyage diagnostique contribue à l’épuration du signal scientifique sans dériver vers une manipulation complaisante des résultats.
10. Protocole méthodologique face aux observations aberrantes identifiées
10.1 Audit rigoureux de l’origine de l’aberration
L’identification formelle d’un résidu studentisé de magnitude anormale ne constitue en aucun cas une invitation automatique à la suppression immédiate et mécanique de l’observation correspondante au sein du tableau de données. La première phase impérative de tout protocole méthodologique sain réside dans un audit qualitatif et matériel approfondi visant à élucider l’étiologie précise de la déviation constatée. Dans une proportion non négligeable d’analyses appliquées, l’aberration résiduelle découle simplement d’une banale erreur matérielle survenue lors des opérations de saisie numérique, de transcodage de variables ou de fusion de bases de données hétérogènes.
L’analyste doit inspecter les documents sources originaux ou les enregistrements bruts de laboratoire pour s’assurer qu’aucun décalage de virgule décimale, qu’aucune permutation de colonnes ou qu’aucune valeur de codage pour les valeurs manquantes (comme l’utilisation de -99 ou 999) n’a été malencontreusement convertie en valeur continue valide. Si une telle erreur matérielle est formellement constatée et documentée, la correction factuelle du chiffre erroné rétablit immédiatement la conformité géométrique de l’observation au sein du modèle sans nécessiter la suppression de l’enregistrement.
Si l’audit matériel confirme l’exactitude de la mesure, l’investigation doit alors porter sur la dimension phénoménologique et empirique du point incriminé. L’observation atypique peut révéler l’appartenance du sujet à une sous-population spécifique non intégrée dans le modèle théorique initial, ou résulter d’un événement idiosyncratique majeur ayant perturbé le protocole de recueil. Dans ces circonstances, l’observation aberrante cesse d’être perçue comme un déchet statistique pour devenir une opportunité théorique fondamentale, suggérant l’omission d’une variable d’interaction cruciale ou pointant vers les limites de validité écologique du modèle linéaire testé.
10.2 Stratégies de traitement sans suppression arbitraire
Lorsque la véracité de l’observation atypique est attestée mais que son maintien en l’état menace d’invalider les estimations par les moindres carrés ordinaires, plusieurs alternatives méthodologiques s’offrent au statisticien pour neutraliser cette influence néfaste sans recourir à la destruction d’informations. La première approche classique repose sur l’application de transformations mathématiques univariées non linéaires aux variables du modèle. L’application d’une transformation logarithmique, de la racine carrée ou d’une transformation paramétrique optimale de type Box-Cox a fréquemment pour effet de compresser les queues de distribution et de ramener les résidus studentisés extrêmes dans des plages parfaitement tolérables sous l’hypothèse de normalité.
Une seconde stratégie de pointe réside dans la transition vers des méthodes d’estimation robuste. Au sein de l’environnement R, le package MASS fournit une alternative fondamentale aux moindres carrés classiques à travers la fonction rlm(), qui implémente la régression robuste par M-estimateurs. Contrairement aux moindres carrés ordinaires qui minimisent la somme quadratique des résidus bruts, conférant un poids démesuré aux observations distantes, la fonction rlm() utilise des fonctions de perte pondérées (telles que le biweight de Tukey ou la fonction de Huber) qui diminuent continûment l’influence des points affichant des résidus studentisés élevés, jusqu’à leur attribuer un poids nul si leur déviation s’avère rédhibitoire.
Enfin, dans les situations où la préservation des échelles originelles est indispensable, les techniques de winsorisation offrent une solution d’ajustement adaptatif élégante. Cette technique consiste à réassigner aux valeurs extrêmes la valeur maximale ou minimale admissible située à un seuil percentile prédéfini (par exemple le 95e ou 99e percentile), évitant la perte d’effectif tout en bridant le pouvoir d’inflexion résiduel de la donnée. Ces stratégies confirment que le traitement moderne des outliers réside dans la modération mathématique plutôt que dans l’amputation chirurgicale des jeux de données.
10.3 Analyse de sensibilité : modèle avec et sans valeurs aberrantes
Lorsque la suppression sélective d’une ou plusieurs observations hautement aberrantes s’avère être la seule option méthodologique défendable pour estimer les paramètres d’intérêt de la population cible, le protocole académique exige la réalisation d’une analyse de sensibilité comparative formelle. Cette démarche consiste à ajuster en parallèle deux architectures de régression : le modèle complet incorporant l’ensemble de l’échantillon initial, et le modèle restreint excluant spécifiquement les unités statistiques dont les résidus studentisés ont franchi les seuils critiques établis.
Sous R, cette manipulation comparative se programme avec une remarquable fluidité grâce à la fonction générique update(). La syntaxe s’exprime sous la forme : modele_restreint <- update(modele_lineaire, subset = abs(rstudent(modele_lineaire)) <= 3). Cette instruction clone instantanément les paramètres de formulation du modèle initial tout en appliquant la condition de filtrage booléenne sur le vecteur des résidus studentisés externes, garantissant une cohérence méthodologique intégrale sans réécriture de code.
L’analyste procède ensuite à la comparaison synoptique des estimations des deux modèles en examinant l’évolution des coefficients de pente, de leurs intervalles de confiance à 95 % et du coefficient de détermination global R-carré. La restitution de cette analyse de sensibilité au sein d’un tableau comparatif standardisé dans le rapport de recherche confère à la démarche une transparence exemplaire : elle démontre aux pairs scientifiques dans quelle mesure les conclusions empiriques dépendent ou non de la présence de ces cas extrêmes, apportant la preuve irréfutable de la solidité méthodologique de l’inférence statistique finale.
11. Automatisation et intégration dans un flux de travail moderne (Tidyverse)
11.1 Enrichissement direct des data.frames via broom::augment()
Au sein de l’écosystème contemporain Tidyverse, la manipulation d’objets de régression non structurés au moyen d’indices vectoriels isolés cède la place à des flux de travail structurés orientés tableaux de données. Dans ce cadre moderne, le package broom développé par David Robinson s’impose comme un outil incontournable grâce à sa fonction emblématique augment(). Appliquée à un objet de modèle linéaire, l’instruction augment(modele_lineaire) extrait et fusionne au sein d’un tibble rectangulaire unique les données d’origine et les métriques de diagnostic fondamentales générées par l’ajustement.
Toutefois, par défaut, la fonction augment() enrichit le tableau avec les résidus bruts (.resid), les valeurs ajustées (.fitted), les leviers diagonaux (.hat) et les résidus standardisés internes (.std.resid). Pour satisfaire aux exigences diagnostiques les plus strictes requérant l’emploi des résidus studentisés externes sans auto-atténuation, l’analyste exploite la modularité du package dplyr en combinant l’appel à augment() avec l’opérateur d’assignation mutate(). La séquence canonique s’articule ainsi :
tableau_diagnostique <- augment(modele_lineaire) %>% mutate(.student.ext = rstudent(modele_lineaire)). Grâce à cette instruction élégante, le tableau résultant conserve une stricte intégrité relationnelle : chaque ligne conserve ses variables prédictives, sa valeur de réponse observée, sa prédiction, ainsi que sa valeur exacte de résidu studentisé externe, prêt à subir des filtrages relationnels, des groupements catégoriels ou des exportations de données totalement reproductibles.
11.2 Création d’une fonction d’extraction automatisée et réutilisable
Pour accroître l’efficience opérationnelle lors de campagnes d’analyse répétitives ou de modélisations massives, la formalisation d’une fonction R personnalisée constitue la meilleure pratique de programmation statistique. Cette fonction doit être capable d’absorber n’importe quel objet de régression linéaire de classe lm, de calculer instantanément les résidus studentisés externes, d’appliquer un seuil de coupure paramétrable par l’utilisateur, et de renvoyer un compte-rendu exhaustif sous la forme d’une liste structurée d’objets informatiques.
Sur le plan conceptuel, une telle fonction, que nous pouvons baptiser extraire_outliers_student(), encapsule l’extraction de rstudent(), isole les rangs vérifiant la condition d’amplitude critique supérieure au seuil passé en argument (avec une valeur par défaut judicieusement fixée à 2,5 ou 3), calcule les valeurs de probabilité de Bonferroni associées, et isole les lignes concernées dans un sous-tableau synthétique. La structure de retour de cette fonction peut être configurée pour restituer simultanément le nombre total de cas litigieux identifiés, leur proportion relative par rapport à la taille totale de l’échantillon, et le tableau explicatif détaillé des observations suspectes.
L’utilisation systématique de cette routine automatisée au sein de scripts de production apporte une double garantie de rigueur : elle supprime les erreurs manuelles inhérentes à la recopie répétitive de blocs de commandes éparses et assure que le protocole de sélection des anomalies statistiques demeure rigoureusement identique d’un jeu de données à l’autre. Cette industrialisation du contrôle diagnostique s’inscrit au cœur des exigences actuelles d’auditabilité des chaînes de traitement quantitatives.
11.3 Application itérative sur des modèles multiples avec purrr
Les défis contemporains de l’analyse de données imposent fréquemment l’ajustement simultané de dizaines, voire de centaines de modèles de régression linéaire distincts au sein d’une même architecture expérimentale, que ce soit pour évaluer des sous-populations stratifiées, modéliser de multiples sous-échelles psychométriques ou conduire des analyses de cohortes longitudinales. Dans cette perspective, la combinaison des packages dplyr et purrr permet d’exécuter des diagnostics de résidus studentisés de manière vectorisée et itérative avec une fluidité exceptionnelle.
En employant la structure de tableau imbriqué générée par la fonction nest(), un grand tableau de données comportementales peut être scindé et groupé selon une variable de stratification factorielle, comme le groupe expérimental ou la tranche d’âge des sujets. L’analyste applique ensuite l’opérateur map() de purrr pour ajuster le modèle linéaire sur chaque sous-tableau individuel, suivi immédiatement d’un second appel à map() orchestrant le calcul vectorisé des résidus studentisés sur chaque modèle local via rstudent().
Cette approche programmatique fonctionnelle culmine avec l’extraction agrégée de l’ensemble des cas atypiques identifiés à travers toutes les strates d’échantillonnage, le tout consolidé dans une synthèse tabulaire unique générée par bind_rows(). Cette architecture informatique hautement expressive évite l’écriture laborieuse de boucles impératives de type for particulièrement lentes et sources de bugs sous R, démontrant comment les métriques classiques de résidus studentisés s’intègrent nativement au cœur des flux de données les plus sophistiqués de la science des données moderne.
12. Synthèse, pièges courants et bonnes pratiques de modélisation
12.1 Erreurs méthodologiques fréquentes lors de l’utilisation des résidus studentisés
L’utilisation des résidus studentisés en modélisation empirique n’est pas exempte d’écueils méthodologiques majeurs qu’un statisticien avisé se doit de contourner avec discernement. La première confusion conceptuelle, malheureusement très fréquente dans la littérature appliquée, réside dans l’assimilation trompeuse entre les résidus standardisés internes et les résidus studentisés externes. Employer machinalement la fonction rstandard() en lieu et place de rstudent() ou studres() expose l’analyste à l’effet d’auto-atténuation documenté dans ce guide, conduisant à sous-estimer la sévérité des anomalies les plus prononcées en raison de la dilatation de la variance résiduelle globale.
Un deuxième piège récurrent réside dans le phénomène de masquage statistique (masking) et son corollaire, le phénomène de submersion (swamping). Le masquage se produit lorsque deux ou plusieurs observations hautement aberrantes occupent des positions similaires dans l’espace multidimensionnel : leur présence conjointe s’influence mutuellement, réduisant artificiellement leurs résidus individuels respectifs au point de les faire passer inaperçues lors d’un balayage unitaire. À l’opposé, la submersion survient lorsqu’une observation parfaitement légitime voit son résidu gonflé de manière factice en réaction à l’effet de levier exercé par un foyer d’outliers distants non contrôlés.
Pour parer à ces dérives systémiques, l’analyste ne doit jamais fonder son jugement diagnostique sur la seule lecture isolée d’un vecteur résiduel. L’inspection des résidus studentisés doit être impérativement croisée avec des métriques d’influence globale matricielle, à l’instar de la distance de Cook, des DFBETAS et des valeurs diagonales de levier h_ii. Cette confrontation triangulée est la seule démarche capable de déjouer les pièges de masquage et d’offrir une vision fidèle de la géométrie interne du modèle statistique ajusté.
12.2 Vérification conjointe des autres postulats de régression
L’évaluation des résidus studentisés ne saurait s’opérer dans un vide méthodologique étanche : elle est intrinsèquement intriquée avec l’ensemble des postulats probabilistes qui soutiennent la théorie de la régression linéaire des moindres carrés ordinaires. En particulier, une anomalie apparente mise en lumière par un résidu studentisé très important n’est fréquemment que le symptôme émergent de la violation d’un autre postulat structurel fondamental, au premier rang desquels figurent l’homoscédasticité et la linéarité fonctionnelle.
En présence d’hétéroscédasticité avérée, c’est-à-dire lorsque la variance des erreurs stochastiques fluctue en fonction de l’amplitude des prédicteurs, le dénominateur de standardisation du résidu studentisé devient localement invalide. Dans cette configuration pathologique, attestée sous R par des tests diagnostiques formels tels que le test de Breusch-Pagan via bptest() du package lmtest, des observations situées dans les zones de haute variance présenteront des résidus artificiellement dilatés, mimant de fausses valeurs aberrantes. De même, une mauvaise spécification de la fonction de régression (par exemple l’omission d’un terme quadratique pour modéliser une parabole) induit une courbure résiduelle mécanique qui fait diverger artificiellement les résidus aux extrémités de la courbe.
Enfin, l’évaluation de la normalité distributionnelle globale des résidus au moyen du test d’ajustement de Shapiro-Wilk via shapiro.test(residuals(modele_lineaire)) conditionne directement la validité des seuils probabilistes de Student. Si l’hypothèse de normalité gaussienne des perturbations est massivement rejetée par le test, les déductions exactes basées sur la loi de Student à (n – p – 1) degrés de liberté perdent leur fondement théorique, imposant alors de recourir à des procédures d’inférence non paramétriques ou à des techniques de rééchantillonnage par bootstrap pour étalonner les intervalles de confiance résiduels.
12.3 Recommandations concrètes pour une analyse de données reproductible
Pour garantir la rigueur, l’intégrité et la parfaite reproductibilité scientifique des diagnostics de régression menés sous R, il est recommandé d’adopter une discipline méthodologique stricte articulée autour d’une check-list opérationnelle systématique. Cette check-list guide le chercheur depuis l’ajustement initial du modèle jusqu’à la consignation finale des résultats dans ses publications académiques ou industrielles :
- Phase d’ajustement initial : Spécifier formellement le modèle linéaire par les moindres carrés et consigner l’état de l’environnement logiciel à l’aide de l’instruction sessionInfo(), garantissant la traçabilité des versions des bibliothèques MASS, car, broom et dplyr mobilisées.
- Extraction des métriques d’omission : Préférer systématiquement les résidus studentisés externes calculés par stats::rstudent() ou MASS::studres() aux résidus internes, afin de neutraliser l’effet d’auto-atténuation d’échelle sur les observations atypiques.
- Contrôle visuel triangulé : Construire un panel graphique complet combinant le diagramme des résidus studentisés versus valeurs ajustées, le diagramme quantile-quantile avec enveloppe de confiance à 95 % (car::qqPlot) et la matrice des indices d’influence globale (car::influenceIndexPlot).
- Test d’hypothèse formel : Appliquer la procédure d’outlierTest() pour déterminer si le résidu studentisé maximal franchit le seuil de décision probabiliste corrigé pour comparaisons multiples selon la méthode conservatrice de Bonferroni.
- Audit qualitatif et analyse de sensibilité : En cas de détection d’une observation statistiquement aberrante, auditer rigoureusement les données sources pour éliminer les erreurs matérielles de saisie, puis documenter systématiquement une analyse de sensibilité comparant les modèles avec et sans les cas litigieux via update().
En observant scrupuleusement ce protocole d’ingénierie statistique, les praticiens et chercheurs en sciences quantitatives s’assurent que l’analyse des résidus studentisés remplit pleinement sa vocation épistémologique : servir d’instrument de fiabilisation et de discernement scientifique, gage d’une modélisation robuste, transparente et reproductible.
Références
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall. https://conservancy.umn.edu/handle/11299/37076
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Robinson, D., Hayes, A., & Couch, S. (2023). broom: Convert statistical analysis objects into tidy tibbles (R package version 1.0.5). CRAN. https://CRAN.R-project.org/package=broom
Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org