
L’analyse quantitative des données comportementales, cliniques et psychométriques repose de manière cruciale sur la capacité des chercheurs et des praticiens à synthétiser des distributions complexes sans en dénaturer la structure sous-jacente. Si les indices de tendance centrale tels que la moyenne arithmétique et la médiane fournissent un premier ancrage synthétique, ils s’avèrent fréquemment insuffisants pour caractériser l’hétérogénéité d’une cohorte ou pour établir des échelles normatives fiables. Dans ce contexte, la segmentation par quantiles, et plus spécifiquement le découpage en quintiles, constitue une approche non paramétrique d’une efficacité remarquable. Elle permet de structurer une population en cinq sous-groupes d’effectifs théoriquement équivalents, facilitant ainsi l’identification des profils extrêmes, l’évaluation de la sévérité symptomatique et la standardisation des instruments de mesure.
Le logiciel Microsoft Excel s’est imposé comme un vecteur omniprésent de traitement et d’analyse des données au sein des laboratoires universitaires, des institutions hospitalières et des cabinets de consultation. Néanmoins, l’apparente simplicité de ses fonctions statistiques masque des subtilités algorithmiques considérables, notamment en ce qui concerne l’interpolation linéaire et la gestion des bornes d’intervalles. Calculer des quintiles dans un tableur ne se résume pas à l’application aveugle d’une formule prédéfinie ; cette opération exige une compréhension rigoureuse des modèles sous-jacents, une vigilance méthodique quant à la structure des données empiriques et une maîtrise technique des environnements de calcul modernes versus historiques.
Ce guide exhaustif a pour vocation d’articuler les fondements mathématiques rigoureux de la partition en quintiles avec leur mise en œuvre pratique et optimisée dans Microsoft Excel. À travers l’examen détaillé des fonctions patrimoniales et contemporaines, la déconstruction d’un cas clinique réel portant sur l’attention sélective, et l’exploration des techniques d’automatisation par formules matricielles dynamiques, cet article offre un protocole méthodologique complet. Les praticiens et chercheurs y trouveront les clés indispensables pour convertir des données brutes en indicateurs standardisés exploitables, tout en prévenant les artéfacts de mesure et les biais d’interprétation inhérents à l’analyse distributionnelle.
1. Introduction théorique et statistique aux quintiles
1.1 Définition mathématique des quantiles et division en cinq segments
Dans le cadre formel de la théorie de la statistique descriptive univariée, un quantile représente une valeur charnière qui divise la distribution ordonnée d’une variable aléatoire ou empirique en intervalles contigus contenant des fractions prédéterminées et égales de l’effectif total. Formellement, soit une série statistique ordonnée d’observations réelles notée (X = (x_{(1)}, x_{(2)}, dots, x_{(N)})) où (x_{(1)} le x_{(2)} le dots le x_{(N)}). Pour une probabilité cumulée (p in ]0, 1[), le quantile d’ordre (p) correspond à la valeur (Q(p)) telle qu’une proportion théorique (p) des données observées se situe en deçà ou à égalité de cette valeur, tandis qu’une proportion complémentaire (1 – p) se situe au-delà.
La partition spécifique d’une série ordonnée en cinq sous-ensembles d’effectifs rigoureusement équivalents définit la famille des quintiles. Contrairement à une partition binaire opérée par la médiane (second quantile d’ordre 0,5) ou à une division quaternaire opérée par les quartiles, les quintiles scindent l’espace distributionnel en cinq segments représentant chacun exactement 20 % (soit une proportion de 0,20) de la masse des observations. Cette subdivision nécessite l’identification formelle de quatre valeurs frontières ou seuils critiques d’accumulation, traditionnellement indexés par la notation (Q_1, Q_2, Q_3) et (Q_4).
Ces quatre seuils correspondent respectivement au 20e centile ((P_{20})), au 40e centile ((P_{40})), au 60e centile ((P_{60})) et au 80e centile ((P_{80})) de la fonction de répartition empirique. Il est primordial d’établir une distinction épistémologique et technique stricte entre les valeurs limites de coupure (qui sont des grandeurs scalaires précises issues de l’espace des données) et les intervalles de quintiles résultants. Les intervalles constituent des classes ordinales mutuellement exclusives délimitées par ces seuils : le premier quintile regroupe les observations inférieures ou égales à (Q_1) ; le deuxième quintile s’étend de (Q_1) exclu à (Q_2) inclus ; le troisième de (Q_2) exclu à (Q_3) inclus ; le quatrième de (Q_3) exclu à (Q_4) inclus ; et le cinquième quintile rassemble l’ensemble des scores strictement supérieurs à (Q_4).
1.2 Pertinence des quintiles dans l’évaluation psychologique et comportementale
L’application des quintiles dans le champ de la psychométrie et des sciences comportementales répond à des impératifs méthodologiques cruciaux liés à l’étalonnage et à la normalisation des batteries d’évaluation standardisées. Les instruments de mesure psychologique, qu’il s’agisse de questionnaires de personnalité, de tests d’efficience intellectuelle ou d’échelles d’évaluation neuropsychologique, génèrent des scores bruts qui ne possèdent pas d’échelle de mesure absolue. La standardisation par quintiles confère un sens normatif immédiat aux performances individuelles en les situant de manière graduée et pragmatique au sein de la population de référence, selon une métrique en cinq classes facilement appréhendable tant par les chercheurs que par les praticiens cliniciens.
Cette approche s’avère particulièrement pertinente pour la stratification des cohortes cliniques selon des niveaux de sévérité symptomatique gradués, par exemple dans l’évaluation des troubles anxieux ou des épisodes dépressifs majeurs. Le découpage en cinq sous-ensembles permet de distinguer avec une finesse accrue les états infracliniques, modérés ou sévères, en évitant le carcan trop restrictif d’un découpage en terciles ou la granularité parfois excessive des déciles qui exige des puissances d’échantillonnage difficilement atteignables en contexte clinique spécialisé.
De surcroît, la conversion des scores bruts en rangs de quintiles constitue un puissant outil méthodologique pour atténuer le bruit statistique et les biais d’asymétrie inhérents aux échelles ordinales de type Likert. Ces échelles présentent souvent une saturation des réponses vers les extrêmes, qu’il s’agisse du biais d’acquiescement ou de la désirabilité sociale. La conversion non linéaire induite par l’ordonnancement en quintiles redresse la distribution empirique en écrasant les distances arbitraires entre échelons de réponse pour rétablir une équipartition des sujets. Dans la recherche épidémiologique et les protocoles de diagnostics différentiels, ces seuils permettent d’isoler avec précision les 20 % d’individus présentant les profils les plus à risque, servant ainsi de critère d’inclusion ou de filtre prédictif robuste pour des investigations neurophysiologiques ou pharmacologiques ultérieures.
1.3 Propriétés distributionnelles et hypothèses sous-jacentes
L’un des atouts épistémologiques majeurs de la partition par quintiles réside dans sa robustesse éprouvée face aux violations flagrantes de la normalité univariée. Alors que les métriques paramétriques classiques — telles que la moyenne arithmétique et l’écart-type — reposent sur le postulat restrictif d’une distribution gaussienne des scores d’erreur, les quantiles constituent des mesures d’ordre strictement non paramétriques. Ils ne requièrent aucune hypothèse préalable relative à la forme géométrique sous-jacente de la densité de probabilité, ce qui les rend parfaitement adaptés aux variables psychologiques fréquemment marquées par des effets de plancher ou de plafond.
Cette robustesse se manifeste de façon éclatante dans leur résistance comparée aux valeurs aberrantes (outliers) et aux données extrêmes. Dans un échantillon donné, une observation atypique issue d’une erreur de saisie ou d’un comportement non coopératif d’un participant va modifier substantiellement la moyenne et amplifier artificiellement la variance ; en revanche, elle n’aura qu’un impact marginal, voire nul, sur la position des seuils de quintiles, dans la mesure où seule sa position relative dans la hiérarchie des rangs est prise en compte par l’algorithme de calcul.
Toutefois, les propriétés distributionnelles de la série conservent une influence déterminante sur la configuration spatiale des intervalles de quintiles. L’asymétrie empirique (skewness) induit une compression asymétrique des seuils : une distribution fortement étalée vers la droite verra ses trois premiers seuils resserrés dans une plage réduite de scores faibles, tandis que le quatrième seuil sera nettement plus distant, reflétant l’élongation de la queue de distribution. De même, l’aplatissement (kurtosis) affecte l’écartement des seuils médians par rapport aux seuils périphériques. D’un point de vue asymptotique, la stabilité de l’estimation des quantiles dépend intimement de la taille minimale de l’échantillon ((N)). Bien qu’un calcul formel soit mathématiquement réalisable dès (N = 5), l’erreur type d’échantillonnage d’un quantile est inversement proportionnelle à la densité de la distribution au point considéré et croît à mesure que l’on s’approche des extrémités. Une estimation asymptotiquement stable des quintiles requiert, selon les standards psychométriques établis par l’American Psychological Association, un effectif minimal de plusieurs dizaines de sujets pour garantir que les seuils calculés ne constituent pas de simples fluctuations aléatoires de l’échantillonnage.
2. Les fondements du calcul des quintiles dans Microsoft Excel
2.1 Historique et évolution des fonctions de centiles dans Excel
L’architecture computationnelle de Microsoft Excel a connu d’importantes mutations au fil des décennies, reflétant l’effort de standardisation entrepris par l’éditeur pour aligner ses algorithmes sur les canons statistiques internationaux. Jusqu’à la version 2007 du tableur, l’estimation des quantiles reposait exclusivement sur une fonction patrimoniale unique, libellée CENTILE dans la version francophone et PERCENTILE dans la mouture anglo-saxonne d’origine. Bien que largement employée dans le monde académique et professionnel, cette fonction historique souffrait d’un déficit d’explicitation quant à sa gestion probabiliste des bornes extrêmes de la distribution, conduisant parfois à des incohérences lors du traitement de jeux de données aux effectifs restreints.
À partir de la version 2010, Microsoft a procédé à une refonte structurelle de sa bibliothèque statistique afin de satisfaire aux normes de précision algorithmique édictées par les organismes internationaux comme l’Organisation internationale de normalisation (ISO) et la Commission électrotechnique internationale (CEI). Cette mise à niveau a entraîné la bifurcation de la commande originelle en deux fonctions spécialisées : CENTILE.INCLURE (correspondant à PERCENTILE.INC en anglais) et CENTILE.EXCLURE (correspondant à PERCENTILE.EXC). Tandis que la fonction historique CENTILE a été maintenue au sein de la catégorie des fonctions de compatibilité descendante afin d’assurer la pérennité des classeurs conçus sous des versions antérieures, l’usage des nouvelles syntaxes est devenu la norme méthodologique recommandée.
Pour les chercheurs et analystes évoluant dans des contextes multilingues ou collaboratifs internationaux, la maîtrise des équivalences terminologiques est indispensable. Le moteur d’analyse d’Excel assure une traduction bidirectionnelle transparente lors de l’ouverture d’un classeur : une formule enregistrée sous la dénomination francophone =CENTILE.INCLURE(matrice; k) se transformera automatiquement en =PERCENTILE.INC(array, k) dans un environnement configuré en langue anglaise. Cette translittération logicielle ne modifie en rien la structure binaire sous-jacente des arguments, garantissant l’intégrité computationnelle des classeurs lors d’échanges scientifiques transfrontaliers.
2.2 Syntaxe fondamentale et arguments des fonctions de partition
L’exécution d’une partition par centiles dans Excel exige le respect rigoureux des spécifications syntaxiques propres à chaque fonction. Les instructions CENTILE.INCLURE et CENTILE.EXCLURE partagent une signature algorithmique binaire articulée autour de deux arguments obligatoires : matrice et k. L’argument matrice (ou array) définit la plage continue ou discontinue de cellules contenant les observations empiriques quantitatives. Cette plage peut être spécifiée sous forme de coordonnées directes (par exemple A2:A101), de références de tableaux structurés (par exemple TableauScores[Attention]) ou encore de vecteurs dynamiques générés par d’autres formules matricielles en amont.
L’argument scalaire k représente la valeur de probabilité cumulée associée au seuil quantile ciblé. Contrairement à une erreur fréquemment observée chez les utilisateurs néophytes qui consiste à renseigner un entier relatif compris entre 1 et 100, le paramètre k doit impérativement être exprimé sous la forme d’un nombre décimal standardisé appartenant à l’intervalle réel des probabilités. Dès lors, la segmentation en quintiles implique la saisie séquentielle des valeurs suivantes pour k :
- Premier quintile ((Q_1), 20e centile) :
k = 0,2(ou20%) - Deuxième quintile ((Q_2), 40e centile) :
k = 0,4(ou40%) - Troisième quintile ((Q_3), 60e centile) :
k = 0,6(ou60%) - Quatrième quintile ((Q_4), 80e centile) :
k = 0,8(ou80%)
Le non-respect de ces contraintes de typage déclenche l’interruption du processus d’évaluation et l’affichage d’erreurs formelles. Si l’argument k contient un caractère alphabétique ou un délimiteur incompatible avec les paramètres régionaux du système d’exploitation, Excel renvoie le code d’erreur #VALEUR!. En revanche, si k franchit les frontières de validité autorisées par la fonction — par exemple si l’utilisateur saisit par inadvertance un entier tel que 20 au lieu de 0,2, ou si la plage désignée dans matrice ne contient aucune observation numérique valide —, le moteur de calcul déclenche l’affichage du code d’erreur #NOMBRE!.
2.3 Principes d’interpolation linéaire appliqués par le moteur de calcul
L’évaluation des quantiles sur un échantillon discret pose un défi mathématique fondamental dès lors que le produit de l’effectif (N) par la proportion ciblée ne correspond pas à un indice de rang entier au sein du vecteur ordonné. Dans cette situation, le tableur est contraint de recourir à un algorithme interne d’estimation par interpolation linéaire afin de déterminer une valeur plausible comprise entre deux observations adjacentes. L’utilisateur doit impérativement distinguer le rang théorique continu (exprimé sous forme de nombre réel) de l’indexation discrète des observations empiriques au sein de la matrice triée.
Lorsque le rang calculé possède une composante fractionnaire non nulle, le moteur de calcul d’Excel procède à une pondération linéaire des deux valeurs d’observation entourant ce rang théorique. Soit (R) le rang positionnel théorique calculé par le logiciel, que l’on peut décomposer en sa partie entière (I = lfloor R rfloor) et sa partie fractionnaire (D = R – I), avec (0 le D < 1). La valeur extrapolée du quantile correspond à l'application de la relation linéaire suivante :
[text{Quantile} = x_{(I)} + D cdot (x_{(I+1)} – x_{(I)})]
Cette méthode computationnelle garantit la continuité mathématique de la fonction quantile empirique, mais elle exerce des répercussions directes sur les données selon leur nature discrète ou continue. Appliquée à des variables psychologiques discrètes — telles que le nombre de réponses correctes à une tâche cognitive ou le score sommatique d’une échelle ordinale —, l’interpolation produit des valeurs seuils fractionnaires (par exemple 14,35 réponses) qui ne correspondent à aucune réalisation concrète dans le protocole expérimental. La parité du nombre total d’observations (N) influence également la position exacte de ces coupures : un échantillon de taille paire n’engendre pas les mêmes fractions résiduelles qu’un échantillon impair, rendant la compréhension intime de l’équation de rang absolument essentielle pour interpréter les résultats avec rigueur scientifique.
3. Analyse comparative des fonctions : CENTILE, CENTILE.EXCLURE et CENTILE.INCLURE
3.1 Examen approfondi de la fonction CENTILE.INCLURE (PERCENTILE.INC)
La fonction CENTILE.INCLURE incarne l’approche classique de l’estimation des quantiles sur un domaine probabiliste fermé. Du point de vue de la modélisation mathématique, elle postule que les observations minimale et maximale de l’échantillon collecté représentent respectivement la probabilité cumulée 0 et la probabilité cumulée 1. En conséquence, l’argument scalaire (k) est formellement autorisé à couvrir l’ensemble du segment continu fermé ([0, 1]). Cette caractéristique en fait l’outil d’élection lorsque l’on souhaite contraindre l’estimation statistique à demeurer rigoureusement ancrée à l’intérieur des limites empiriques observables.
L’équation fondamentale gouvernant le calcul du rang positionnel continu (R_{inc}) dans CENTILE.INCLURE est définie par l’expression mathématique :
[R_{inc} = 1 + k cdot (N – 1)]
Dans cette formule, (N) représente le nombre cardinal d’observations numériques valides présentes dans la matrice source, et (k) le niveau de quantile spécifié. Si (k = 0), le rang obtenu est égal à 1, ce qui retourne sans ambiguïté la valeur minimale absolue (x_{(1)}). Réciproquement, si (k = 1), le rang théorique équivaut à (1 + 1 cdot (N – 1) = N), pointant directement vers la valeur maximale (x_{(N)}). Il convient de souligner que cette formule produit des résultats d’une stricte parité numérique avec l’ancienne fonction universelle CENTILE, assurant ainsi une continuité analytique sans faille avec les travaux scientifiques historiques.
Dans le domaine de la psychométrie appliquée et de l’étalonnage des tests psychologiques, la fonction CENTILE.INCLURE est très majoritairement privilégiée par les praticiens. En effet, lorsqu’un échantillon d’étalonnage est supposé saturer l’ensemble du spectre fonctionnel observable chez une population cible donnée, l’intégration stricte des bornes empiriques inférieure et supérieure permet d’assigner une partition exhaustive à l’intégralité des participants sans créer de zones d’indétermination mathématique aux marges extrêmes de l’échantillon.
3.2 Examen approfondi de la fonction CENTILE.EXCLURE (PERCENTILE.EXC)
À l’opposé de cette approche ancrée aux extrêmes empiriques, la fonction CENTILE.EXCLURE procède d’une philosophie statistique résolument inférentielle. Elle part du postulat probabiliste selon lequel un échantillon de taille finie (N), extrait d’une population sous-jacente infinie ou continue, ne saurait englober la totalité des valeurs extrêmes possibles de cette population. En vertu de ce principe, l’observation minimale observée (x_{(1)}) ne saurait correspondre à un centile de 0 %, pas plus que l’observation maximale (x_{(N)}) ne saurait saturer le centile de 100 %. La fonction opère donc sur un intervalle strictement ouvert : (k in ]0, 1[).
L’algorithme de positionnement de CENTILE.EXCLURE calibre le rang théorique ajusté (R_{exc}) selon la formulation classique de Hazen :
[R_{exc} = k cdot (N + 1)]
Cette modification de la constante d’ajustement entraîne des conséquences algorithmiques majeures sur la plage de validité du paramètre (k). Pour qu’un rang puisse être valablement évalué entre le premier et le dernier élément ordonné, il est impératif que (R_{exc} ge 1) et (R_{exc} le N). Par conséquent, la fonction rejette mathématiquement toute valeur de (k) vérifiant l’inégalité :
[k frac{N}{N + 1}]
Dès lors que la valeur scalaire de (k) franchit ces seuils de tolérance, Excel interrompt le processus et génère immédiatement l’erreur #NOMBRE!. Cette particularité restreint drastiquement l’emploi de CENTILE.EXCLURE sur des échantillons de faibles dimensions. Par exemple, si l’on tente d’extraire le premier quintile ((k = 0,2)) au moyen de cette fonction sur un groupe de seulement trois sujets ((N = 3)), le seuil minimal admissible pour (k) est de (1 / (3 + 1) = 0,25) ; la formule échoue donc irrémédiablement. En revanche, pour des cohortes épidémiologiques massives, cette fonction offre une estimation non biaisée des paramètres d’une loi continue sous-jacente en projetant les seuils au-delà des artéfacts d’échantillonnage immédiats.
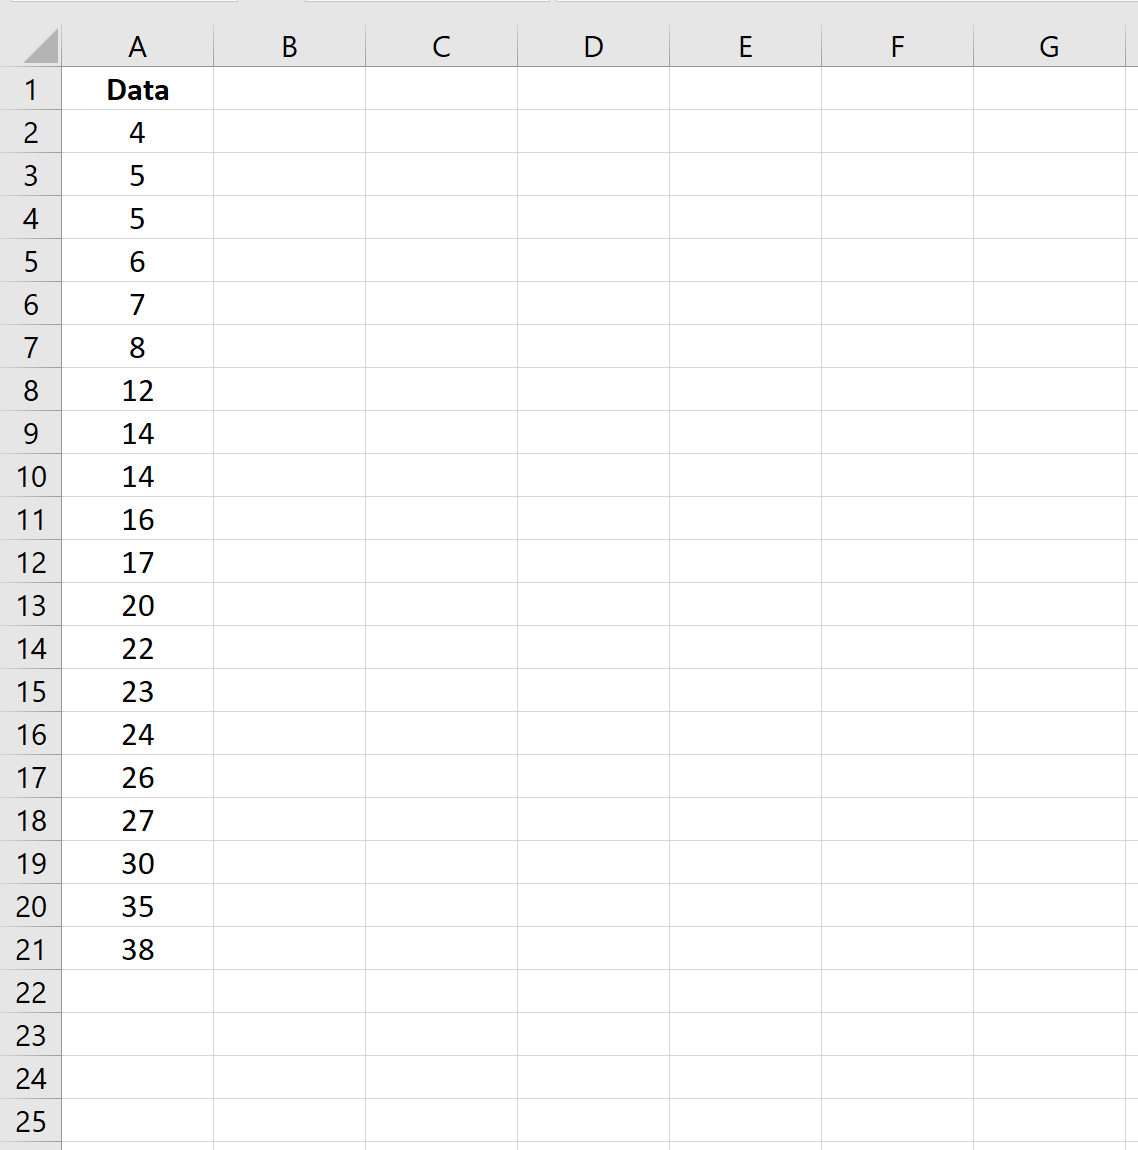
3.3 Tableau de concordance et critères de choix méthodologique
La divergence formelle entre les deux équations de rang génère des décalages numériques tangibles sur une même série d’observations. Pour expliciter ces écarts, le tableau de synthèse suivant récapitule les caractéristiques analytiques fondamentales des trois fonctions de centiles coexistant dans l’écosystème Microsoft Excel :
| Fonction Excel | Équation du rang ((R)) | Domaine de validité de (k) | Taille minimale ((N)) pour (Q_1) ((k=0,2)) | Orientation épistémologique |
|---|---|---|---|---|
| CENTILE (patrimoniale) | (1 + k cdot (N – 1)) | ([0, 1]) | (N ge 1) | Descriptive / Rétrocompatibilité universelle |
| CENTILE.INCLURE | (1 + k cdot (N – 1)) | ([0, 1]) | (N ge 1) | Descriptive empirique / Psychométrie clinique |
| CENTILE.EXCLURE | (k cdot (N + 1)) | (]frac{1}{N+1}, frac{N}{N+1}[) | (N ge 4) | Inférentielle / Modélisation de population parente |
Le choix méthodologique entre ces deux approches doit être rigoureusement documenté et justifié en fonction de la finalité de l’investigation empirique. Lorsque la recherche s’inscrit dans une visée descriptive, typique de l’établissement de normes cliniques locales ou de l’analyse d’un groupe expérimental fermé où chaque participant compte comme une fraction stricte de l’effectif, l’usage de CENTILE.INCLURE constitue la recommandation consensuelle. Inversement, si l’objectif consiste à inférer les quantiles théoriques d’une population globale infinie à partir d’un échantillon probabiliste rigoureusement tiré au sort, CENTILE.EXCLURE offre des garanties théoriques plus élégantes.
Dans l’état de l’art des publications scientifiques internationales répertoriées par des bases de données comme PubMed ou PsycINFO, l’absence de mention explicite de l’algorithme d’interpolation utilisé constitue une source majeure de non-reproductibilité des résultats. La plupart des logiciels statistiques spécialisés (tels que R, SPSS ou SAS) intègrent jusqu’à neuf méthodes distinctes de calcul de quantiles empiriques. Par conséquent, il est impératif d’expliciter dans la section méthodologique de vos rapports la formule adoptée — par exemple sous la mention formelle : « Les quintiles de la distribution ont été estimés sous Microsoft Excel via la fonction CENTILE.INCLURE selon la méthode d’interpolation standard de type 7 selon la taxonomie de Hyndman et Fan ».
4. Préparation et nettoyage des jeux de données psychologiques dans Excel
4.1 Structuration tabulaire et standardisation des variables
L’exactitude des calculs statistiques sous Excel dépend de la structuration rigoureuse de la base de données brute. En psychologie empirique comme en recherche clinique, les jeux de données souffrent fréquemment d’une mise en page inadaptée, combinant cellules fusionnées, en-têtes multiples ou intercalations arbitraires de moyennes intermédiaires au milieu des enregistrements. Pour satisfaire aux standards de l’analyse computationnelle moderne, les données doivent être impérativement agencées selon le principe canonique du tidy data formalisé par Hadley Wickham : une unité expérimentale (un participant) par ligne, et une seule variable psychologique ou démographique par colonne.
La première mesure corrective consiste à convertir la plage de données conventionnelle en un tableau structuré natif d’Excel (entité de type ListObject), accessible via le raccourci clavier Ctrl + L ou l’onglet Insertion > Tableau. Ce format tabulaire dynamique apporte des bénéfices critiques :
- Il automatise l’adressage dynamique des plages : si de nouveaux participants intègrent l’étude ultérieurement, le périmètre d’analyse s’ajuste sans modifier les formules de quantiles existantes ;
- Il autorise le référencement structuré des données au sein des formules (ex.
Tableau1[Score_Brut]au lieu de références de coordonnées rigidesA2:A100) ; - Il protège l’intégrité référentielle en isolant hermétiquement les données analysées du reste de la grille de calcul.
Une attention méticuleuse doit être portée à l’éradication des formats mixtes au sein des colonnes de mesure. Il n’est pas rare qu’une extraction de logiciel d’expérimentation intègre par inadvertance des caractères textuels invisibles ou des espaces insécables au milieu de valeurs numériques, transformant certaines observations en chaînes de texte que les fonctions de quantiles ignoreront silencieusement. De plus, conformément aux préceptes éthiques de protection des données de santé et de préservation du secret médical, chaque sujet doit être muni d’un identifiant numérique ou alphanumérique unique et anonymisé (ex. SUJ_001), proscrivant formellement l’incorporation d’éléments nominatifs directs dans les feuilles d’analyse.
4.2 Gestion méthodique des valeurs manquantes et des cellules vides
L’occurrence de données manquantes (missing data) représente une contingence inévitable dans toute recherche comportementale : abandon prématuré d’un protocole expérimental, omission accidentelle d’un item au sein d’une échelle psychométrique auto-rapportée ou défaillance technique d’un capteur de mesure chronométrique. Dans Microsoft Excel, la présence de cellules vides ou de chaînes textuelles au sein de la plage d’arguments exerce un impact substantiel sur le déroulement des calculs distributionnels.
Par conception logicielle, les fonctions CENTILE.INCLURE et CENTILE.EXCLURE ignorent purement et simplement les cellules vides ainsi que les cellules hébergeant des chaînes de texte non convertibles lors de la détermination de l’effectif valide. Cela signifie que le paramètre cardinal (N) est calculé de façon dynamique et implicite sur la base exclusive des valeurs numériques réelles rencontrées, selon un mécanisme équivalent à la fonction de dénombrement NB. Cependant, cette tolérance native peut induire de graves biais si le chercheur n’en a pas conscience : si un participant omet plusieurs items, son score global agrégé peut s’en trouver artificiellement tronqué, faussant la position du quintile calculé.
L’assainissement préalable des données nécessite le déploiement de filtres conditionnels et de fonctions de validation logique telles que ESTNUM et SI. L’analyste doit opérer un arbitrage méthodologique fondamental entre deux options d’ingénierie statistique :
- L’omission pure : exclusion systématique de toute unité statistique présentant une donnée lacunaire sur les variables clés de l’étude ;
- L’imputation de données : substitution des valeurs manquantes par des estimateurs statistiques rigoureux (imputation par la médiane conditionnelle ou modélisation multivariée), sous réserve d’avoir vérifié au préalable que le mécanisme générateur de données manquantes relève du type MCAR (Missing Completely At Random).
Quelle que soit l’approche retenue, la préservation de la représentativité de l’échantillon implique de documenter explicitement le nombre effectif de cas pris en compte dans chaque sous-segment d’analyse.
4.3 Identification et traitement des valeurs aberrantes (Outliers)
L’intégrité distributionnelle des scores psychométriques peut être profondément compromise par l’intrusion de valeurs aberrantes ou contaminées. Dans les protocoles cognitifs évaluant par exemple des temps de réaction ou des indices de vigilance, un score aberramment élevé peut résulter d’un instant de distraction du participant, tandis qu’un score quasi nul traduit souvent un déclenchement accidentel de l’interface de recueil. Bien que les quantiles possèdent une résilience naturelle supérieure à celle de la moyenne face à ce type de perturbations, la présence de scores non représentatifs peut distordre localement la pente de l’interpolation linéaire et décaler artificiellement les points de coupure interquintiles.
Pour assainir le jeu de données avant le calcul des quintiles, il convient d’appliquer des règles de détection d’outliers fondées sur la dispersion non paramétrique. Le standard le plus répandu consiste à calculer l’écart interquartile ((IQR = Q_3 – Q_1)) et à isoler les observations franchissant les barrières de Tukey :
[text{Borne inférieure} = Q_1 – 1,5 cdot IQR]
[text{Borne supérieure} = Q_3 + 1,5 cdot IQR]
Une démarche alternative, adaptée aux variables qui se distribuent de manière approximativement symétrique, repose sur la standardisation des observations sous forme de scores réduits (Z), calculés via la fonction CENTREE.REDUITE. Les valeurs dont la magnitude dépasse (|Z| ge 3,0) ou (|Z| ge 3,29) (représentant moins de 0,1 % d’occurrence théorique sous la courbe normale) sont isolées pour examen clinique.
Ce dépistage gagne à être automatisé dans Excel au moyen de la mise en forme conditionnelle, en configurant une règle personnalisée basée sur une formule pour teinter instantanément en couleur d’alerte les cellules franchissant ces seuils. D’un point de vue éthique et déontologique, les observations atypiques ne doivent jamais être effacées silencieusement. La procédure rigoureuse commande de dupliquer la feuille de calcul afin de préserver une copie immuable du jeu de données brutes, et de consigner dans le registre de laboratoire les motifs précis justifiant l’exclusion ou la neutralisation de chaque profil atypique avant de lancer l’estimation finale des quintiles.
5. Guide pratique étape par étape : Calcul unitaire des quintiles
5.1 Configuration de l’environnement de calcul dans le classeur
Pour assurer la pérennité, la lisibilité et l’auditabilité des calculs statistiques au sein d’un classeur Excel, il est recommandé de dissocier physiquement la zone de stockage des données empiriques de la zone de calcul analytique. La première étape méthodologique consiste à construire une table des paramètres dédiée, disposée soit à droite de la matrice de données sur la même feuille, soit idéalement sur une feuille de calcul distincte baptisée Normes_Quintiles.
Cette table des paramètres doit être formalisée avec clarté. Elle comporte un en-tête descriptif précisant la nature des seuils recherchés et réserve une colonne spécifique pour accueillir les fractions décimales normalisées représentant les probabilités cibles ((k)) :
- Cellule
D2: intitulée « Seuil », affichant le libellé « Premier quintile (Q1) » - Cellule
E2: contenant la constante numérique0,2 - Cellule
D3: « Deuxième quintile (Q2) », associée enE3à la constante0,4 - Cellule
D4: « Troisième quintile (Q3) », associée enE4à la constante0,6 - Cellule
D5: « Quatrième quintile (Q4) », associée enE5à la constante0,8
Afin de fluidifier la rédaction des syntaxes et d’éliminer le risque d’erreurs de sélection manuelle de cellules, il est fortement conseillé de définir un nom de plage pour la variable cible. En sélectionnant la colonne de scores (par exemple B2:B101) et en saisissant Scores_Attention dans la zone de nom située à gauche de la barre de formule, le classeur intègre cet identifiant sémantique au niveau global. Enfin, les cellules réceptrices destinées à recevoir les résultats finaux doivent être immédiatement configurées avec un format d’affichage numérique contrôlé, généralement verrouillé à une précision de deux décimales (via le format personnalisé 0,00), prévenant ainsi toute troncature visuelle inopportune lors de la restitution des scores.
5.2 Formulation explicite pour chaque seuil de quintile individuel
Une fois le cadre de travail configuré, l’analyste peut procéder à l’implémentation unitaire des formules pour chacun des seuils de démarcation. Dans cette approche unitaire, chaque cellule de résultat héberge une expression dédiée qui combine la référence à la matrice de données et la valeur scalaire de probabilité correspondante.
En admettant que la série des scores comportementaux soit hébergée dans la plage continue B2:B21, les formulations explicites s’établissent de la façon suivante :
- Pour le premier quintile ((Q_1), délimitant les 20 % de scores les plus faibles) :
Saisir en celluleF2:=CENTILE.INCLURE(B2:B21; 0,2)
(Ou de façon interchangeable avec la fonction patrimoniale :=CENTILE(B2:B21; 0,2)) - Pour le deuxième quintile ((Q_2), correspondant au 40e centile) :
Saisir en celluleF3:=CENTILE.INCLURE(B2:B21; 0,4) - Pour le troisième quintile ((Q_3), matérialisant le franchissement de 60 % de l’effectif) :
Saisir en celluleF4:=CENTILE.INCLURE(B2:B21; 0,6) - Pour le quatrième quintile ((Q_4), bornant les 80 % cumulés et isolant le quintile supérieur) :
Saisir en celluleF5:=CENTILE.INCLURE(B2:B21; 0,8)
Cette formalisation unitaire directe offre une transparence pédagogique maximale. Elle permet de contrôler individuellement chaque résultat intermédiaire et facilite la vérification croisée des calculs pour les auditeurs non initiés aux syntaxes avancées d’Excel.
5.3 Utilisation des références absolues et relatives pour l’étirement des formules
Dans un contexte d’ingénierie statistique opérationnelle, la saisie manuelle de formules distinctes pour chaque paramètre s’avère inefficace et hautement sujette aux fautes de frappe. La standardisation du processus requiert la conception d’une formule paramétrique unique, susceptible d’être étirée verticalement le long de la table des quintiles sans altérer ses relations fonctionnelles.
Cette portabilité repose sur la distinction opérée par Excel entre références relatives et références absolues, concrétisée par l’emploi du symbole dollar ($). Lorsque l’on étire une formule vers le bas, tout numéro de ligne non précédé du caractère $ s’incrémente automatiquement d’une unité à chaque ligne franchie. Si la matrice des données sources n’est pas rigoureusement verrouillée, la plage d’analyse va se décaler à chaque saut de cellule (B2:B21 se transformera en B3:B22, puis en B4:B23), excluant arbitrairement les observations initiales de la cohorte et contaminant l’ensemble des résultats subséquents.
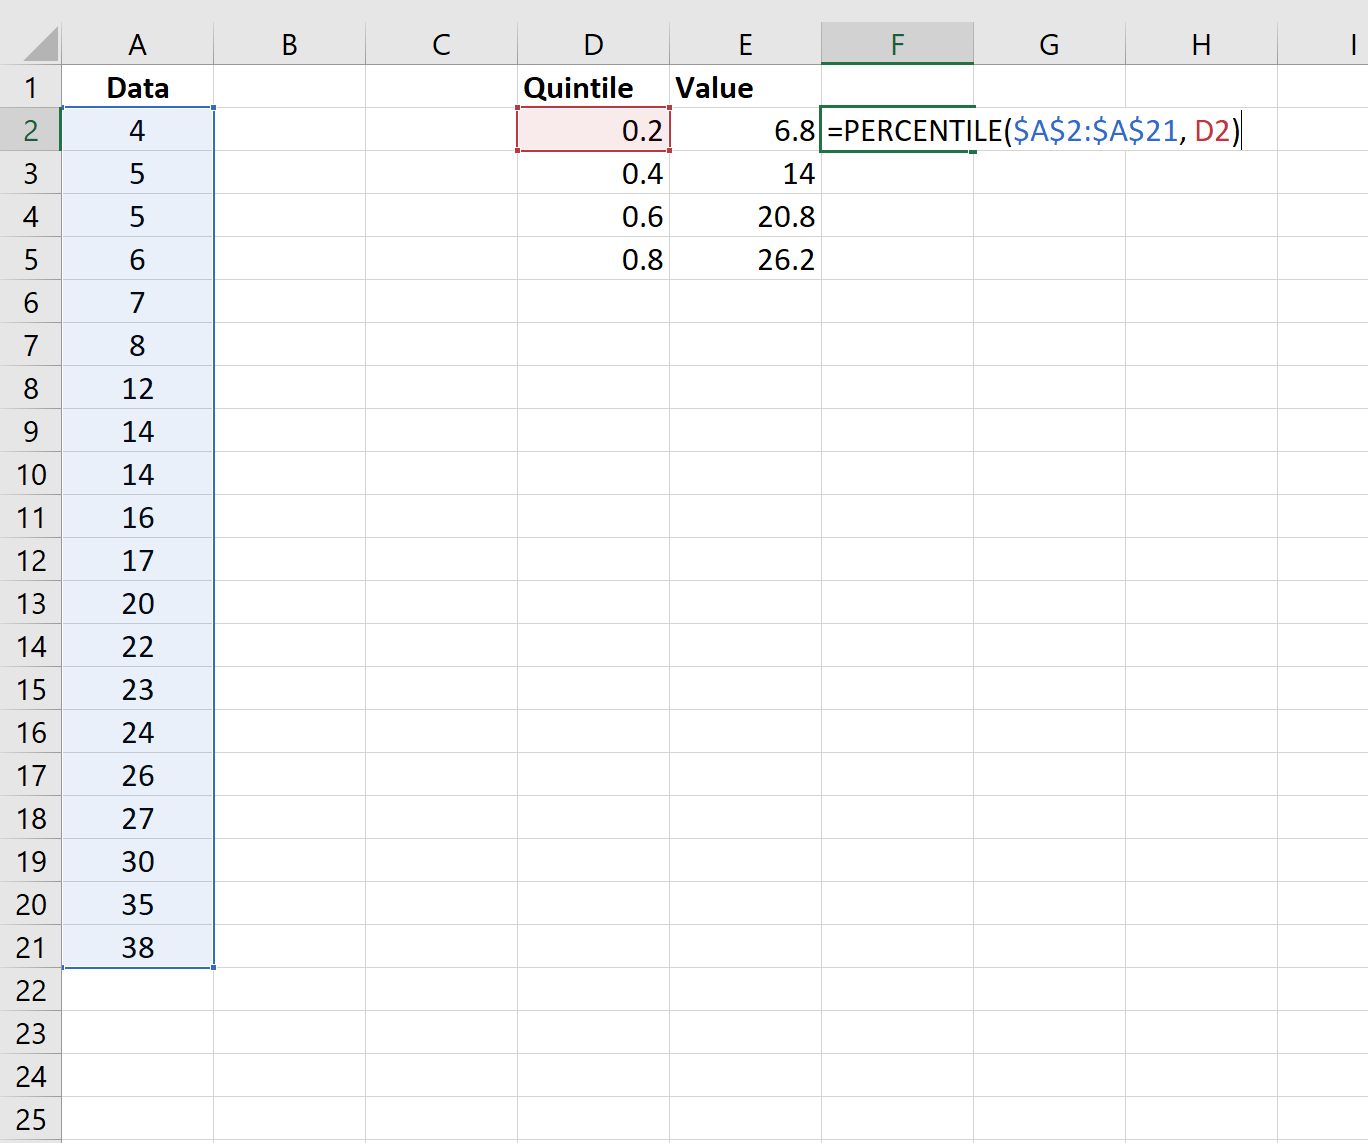
La formule universelle hautement sécurisée doit donc s’écrire ainsi dans la première cellule de résultat F2 :
=CENTILE.INCLURE($B$2:$B$21; E2)
Dans cette architecture syntaxique, la plage de données $B$2:$B$21 est verrouillée sous forme absolue tant sur les colonnes que sur les lignes grâce aux symboles dollars, garantissant l’immuabilité de l’assiette d’échantillonnage. En revanche, le second argument E2 demeure une référence relative : lors de l’étirement de la cellule F2 vers le bas jusqu’à F5, le paramètre pointera avec fluidité vers E3 (0,4), puis E4 (0,6), et enfin E5 (0,8). Pour vérifier la conformité du déploiement, il est conseillé d’activer l’affichage général des formules via le ruban Formules > Afficher les formules (ou la combinaison de touches Ctrl + "), permettant d’inspecter visuellement l’intégrité de l’ensemble des dépendances référentielles.
6. Calcul simultané des quintiles par formules matricielles dynamiques
6.1 Exploitation des constantes de matrice dans Excel moderne
Depuis le déploiement du moteur de calcul à tableaux dynamiques au sein de Microsoft 365 et des versions d’Excel postérieures à 2021, la modélisation statistique dans le tableur a connu une simplification radicale. Il n’est désormais plus nécessaire de déployer de multiples formules unitaires pour calculer simultanément les quatre seuils de quintiles d’une série continue. L’utilisateur peut condenser l’intégralité du calcul au sein d’une instruction matricielle unifiée, en recourant aux constantes de matrice.
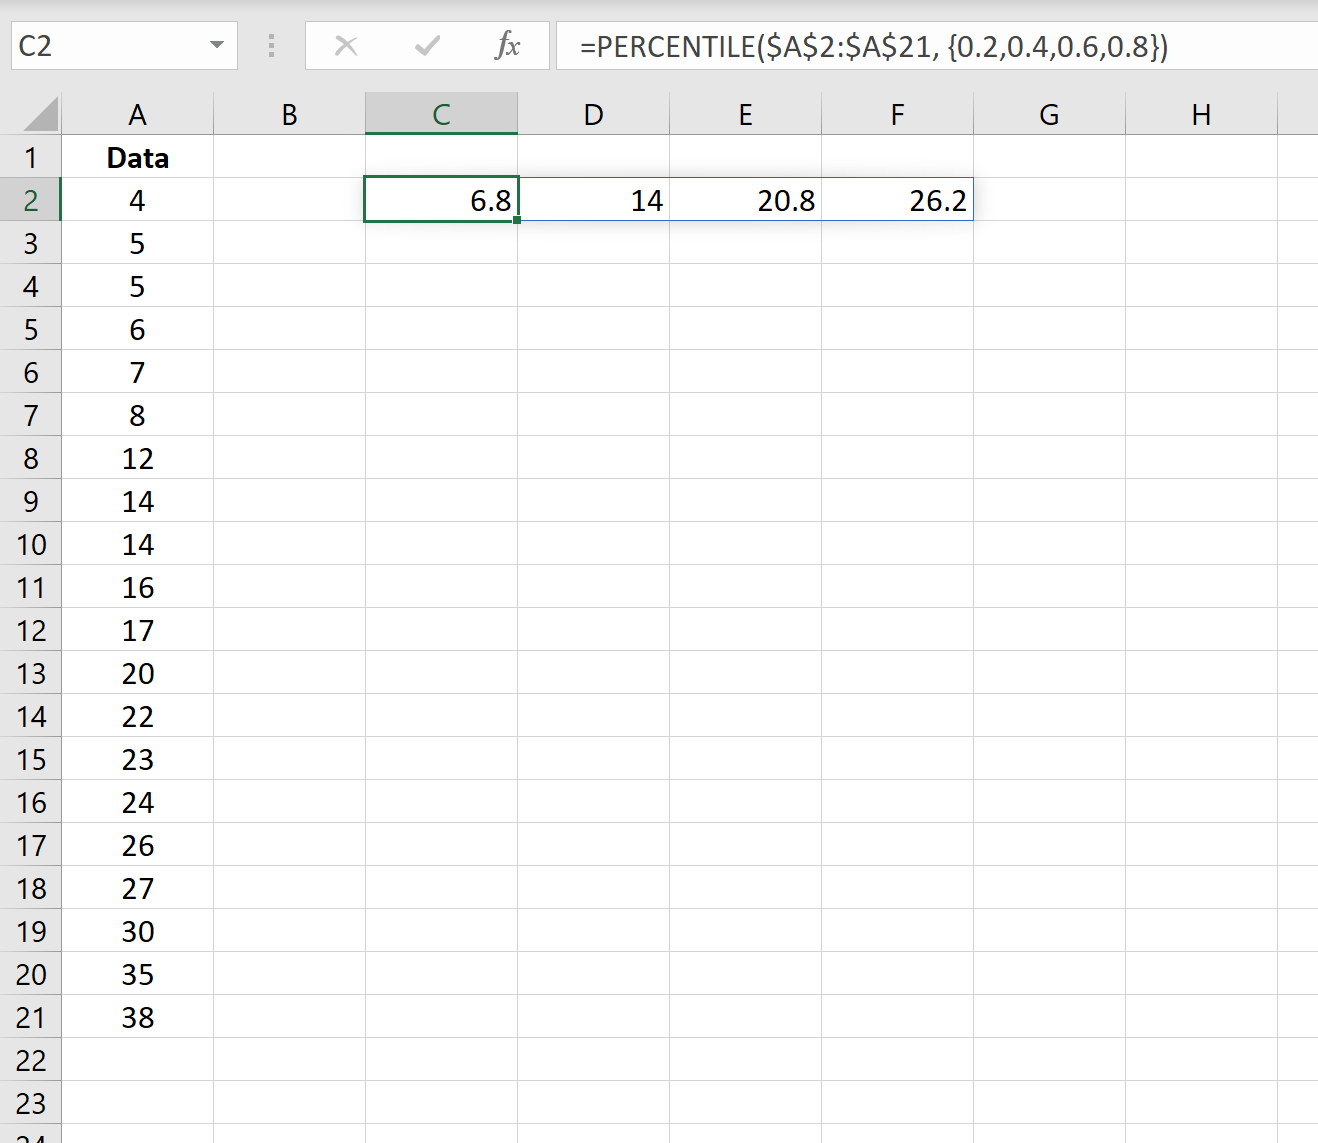
Une constante de matrice s’exprime sous la forme d’un ensemble de valeurs scalaires délimitées par des accolades {...} directement injectées dans l’argument de la fonction. Pour générer d’un seul bloc l’ensemble des frontières de quintiles de la plage B2:B21, la syntaxe prend la forme suivante :
=CENTILE.INCLURE(B2:B21; {0,2; 0,4; 0,6; 0,8})
Dans cette formulation, l’argument k n’est plus une valeur unique, mais un vecteur horizontal ou vertical de probabilités. Dès la validation par la touche Entrée, le moteur d’Excel calcule en un cycle machine unique l’ensemble des quatre valeurs résultantes et les propage instantanément dans les cellules sous-jacentes. Ce mécanisme, désigné sous le terme technique de déversement dynamique (ou spill range), encadre la plage réceptrice d’une fine bordure bleue semi-transparente. La formule réside physiquement dans la première cellule uniquement (la cellule mère) ; les cellules réceptrices filles affichent le résultat déversé en grisé dans la barre de formule et ne peuvent être altérées individuellement, ce qui immunise le classeur contre les corruptions locales accidentelles.
Il est impératif de respecter la convention des séparateurs matriciels propres aux paramètres régionaux du système : sous un environnement Windows francophone, les éléments d’une matrice horizontale sont classiquement séparés par des points-virgules, tandis que les matrices colonnes peuvent faire appel à des barres obliques inverses ou à des points-virgules selon les paramètres d’affichage. L’avantage computationnel de cette méthode réside dans la réduction drastique de l’empreinte mémoire du classeur et dans l’éradication des erreurs de saisie répétitive.
6.2 Adaptation aux versions historiques du logiciel (Validation CSE)
L’hétérogénéité des parcs informatiques dans les universités et les centres de recherche requiert de maîtriser les mécanismes matriciels historiques pour maintenir les classeurs destinés à des utilisateurs opérant sur des versions antérieures à Microsoft 365 (telles qu’Excel 2013, 2016 ou 2019 perpétuel). Dans ces éditions patrimoniales, le moteur d’évaluation dynamique est absent : l’insertion d’une constante de matrice au sein d’une cellule standard n’affiche que le premier résultat calculé ((Q_1)), les valeurs suivantes demeurant inaccessibles.
Pour contourner cette limitation structurelle et forcer le calcul matriciel simultané, il convient d’exécuter la procédure spécifique dite de validation « CSE » (acronyme de Ctrl + Shift + Enter ou Ctrl + Maj + Entrée) :
- Sélectionner préalablement à la souris la plage réceptrice multicellulaire exacte appelée à recevoir les quatre résultats (par exemple le bloc vertical
F2:F5) ; - Sans désélectionner la plage, saisir l’expression dans la barre de formule :
=CENTILE(B2:B21; {0,2; 0,4; 0,6; 0,8}); - Valider l’opération en enfonçant simultanément les touches
Ctrl + Maj + Entrée.
Cette validation combinée contraint Excel à encapsuler l’intégralité de la formule entre deux accolades décoratives non saisissables au clavier : {=CENTILE(B2:B21; {0,2; 0,4; 0,6; 0,8})}. Dès cet instant, le bloc de quatre cellules devient un réseau matriciel indissociable. Toute tentative de suppression ou d’écrasement d’une cellule individuelle isolée provoquera l’interdiction immédiate du tableur via la boîte de dialogue : « Impossible de modifier une partie de tableau ». Cette technique garantit une stabilité structurelle rigoureuse de vos protocoles de partition, bien qu’elle exige une rigueur de manipulation supérieure de la part des utilisateurs.
6.3 Comparaison de performance entre approches unitaires et matricielles
Le choix entre modélisation unitaire et modélisation matricielle ne relève pas d’une simple préférence cosmétique ; il engage la performance brute, la maintenabilité et la robustesse architecturale de l’infrastructure logicielle mise au point pour le traitement de vos protocoles de recherche. Le tableau comparatif suivant dégage les forces et vulnérabilités de chaque démarche :
| Critère d’analyse | Approche Unitaire Étirée | Matricielle Dynamique (M365) | Matricielle Historique (CSE) |
|---|---|---|---|
| Maintenabilité | Moyenne (mise à jour formule par formule) | Maximale (édition en cellule unique) | Faible (revalidation globale obligatoire) |
| Risque de corruption | Élevé (écrasement local d’une cellule possible) | Nul (zone déversée protégée) | Nul (structure de bloc verrouillée) |
| Temps de calcul ((N > 10^5)) | Linéaire ((4 times) accès mémoire) | Optimisé (1 seul balayage matriciel) | Optimisé (1 seul balayage matriciel) |
| Rétrocompatibilité | Totale (toutes versions Excel) | Restreinte (Excel 2021 / M365 uniquement) | Excellente (anciennes versions) |
Sur des volumétries massives de données — par exemple lors de l’enregistrement en continu de séries temporelles physiologiques ou d’évaluations longitudinales en écologie comportementale comprenant plusieurs centaines de milliers d’enregistrements —, les formules matricielles dynamiques surpassent nettement l’approche unitaire. En évitant d’itérer quatre balayages successifs du vecteur source en mémoire vive, l’architecture dynamique concentre l’effort computationnel en un traitement vectoriel optimisé. Toutefois, pour des cahiers de laboratoire partagés entre des équipes hospitalières ou universitaires dotées de logiciels disparates, l’approche unitaire sécurisée par des références absolues demeure le choix le plus prudent pour prévenir les erreurs de type #NOM? générées par les versions historiques d’Excel face aux fonctions modernes de déversement.
7. Exemple pratique détaillé : Étude d’un échantillon psychométrique de 20 participants
7.1 Présentation du corpus de données et du protocole expérimental
Afin d’ancrer ces développements dans la réalité concrète de la recherche expérimentale, considérons un cas d’étude réel portant sur l’évaluation de l’attention visuelle sélective chez de jeunes adultes. Une cohorte expérimentale de 20 participants ((N = 20)) a été soumise à une épreuve informatisée de barrage de cibles sous contrainte temporelle. La variable dépendante recueillie est le Score d’Efficience Attentionnelle (SEA), un score brut synthétique calculé à partir du ratio des détections correctes ajusté par le nombre de fausses alarmes et le temps de latence moyen. Ce score s’exprime sous la forme d’une échelle d’intervalles continus pouvant varier théoriquement entre 0 et 35 points.
Les 20 observations brutes ont été recueillies dans l’ordre séquentiel de passation des épreuves de laboratoire, générant le jeu de données empiriques non ordonné suivant :
Scores bruts SEA (N = 20) : { 18 ; 5 ; 24 ; 12 ; 29 ; 8 ; 15 ; 21 ; 3 ; 27 ; 14 ; 9 ; 22 ; 31 ; 11 ; 25 ; 6 ; 19 ; 16 ; 23 }
L’objectif expérimental consiste à établir une grille d’étalonnage en quintiles pour calibrer les performances attentionnelles futures et déterminer des zones de vulnérabilité neuropsychologique. D’un point de vue statistique, un échantillon de 20 sujets représente le seuil cardinal minimal pour lequel la partition en cinq classes d’effectifs égaux attribue un contingent d’exactement 4 participants par quintile ((20 / 5 = 4)), offrant ainsi un modèle pédagogique idéal pour observer la mécanique de décomposition du moteur de calcul sans artéfact de troncation d’effectif.
7.2 Exécution séquentielle des calculs dans Excel et obtention des valeurs frontières
Intégrons ces 20 scores bruts dans la plage B2:B21 d’un classeur Excel. Afin de préserver l’approche descriptive standard en psychométrie, nous mettons en œuvre la fonction recommandée CENTILE.INCLURE pour extraire avec rigueur les quatre valeurs charnières délimitant les quintiles.
En renseignant séquentiellement les probabilités associées, le moteur de calcul d’Excel retourne les résultats numériques suivants :
- Premier quintile ((Q_1)) :
=CENTILE.INCLURE(B2:B21; 0,2)→ Valeur frontalière : 6,80 - Deuxième quintile ((Q_2)) :
=CENTILE.INCLURE(B2:B21; 0,4)→ Valeur frontalière : 14,00 - Troisième quintile ((Q_3)) :
=CENTILE.INCLURE(B2:B21; 0,6)→ Valeur frontalière : 20,80 - Quatrième quintile ((Q_4)) :
=CENTILE.INCLURE(B2:B21; 0,8)→ Valeur frontalière : 26,20
Nous observons d’emblée une alternance structurelle révélatrice : tandis que le deuxième seuil s’établit sur un nombre entier absolu ((14,00)), les premier, troisième et quatrième seuils constituent des grandeurs décimales fractionnaires ((6,80) ; (20,80) ; (26,20)) qui ne correspondent à aucun des scores entiers observés dans le protocole. Ce phénomène n’est pas le fruit du hasard statistique, mais résulte directement de l’algorithme d’interpolation linéaire mis en œuvre par le tableur.
7.3 Décomposition mathématique pas à pas de l’interpolation interne d’Excel
Pour dissiper l’illusion d’une « boîte noire » logicielle et auditer avec précision le comportement d’Excel, décomposons à la main la séquence computationnelle exacte opérée par le logiciel sur ce jeu de données spécifique.
La première phase interne exécutée par l’algorithme consiste à effectuer un tri ascendant rigoureux des observations empiriques, générant le vecteur ordonné des rangs discrets suivant :
| Rang (i) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Score (x_{(i)}) | 3 | 5 | 6 | 8 | 9 | 11 | 12 | 14 | 15 | 16 | 18 | 19 | 21 | 22 | 23 | 24 | 25 | 27 | 29 | 31 |
Considérons à présent le calcul détaillé de la valeur du premier quintile ((Q_1), avec (k = 0,2) et (N = 20)) :
- Calcul du rang théorique continu : En application stricte de l’équation de la fonction
CENTILE.INCLURE:
[R = 1 + k cdot (N – 1) = 1 + 0,2 cdot (20 – 1) = 1 + 0,2 cdot 19 = 1 + 3,8 = 4,8] - Identification des bornes du rang : Le rang continu obtenu est (4,8). Sa composante entière est (I = 4) et sa composante fractionnaire est (D = 0,8). Ce rang théorique se situe donc à 80 % de distance entre la 4e observation ordonnée ((x_{(4)})) et la 5e observation ordonnée ((x_{(5)})).
- Extraction des observations encadrantes : Dans le vecteur trié :
(x_{(4)} = 8) (4e participant)
(x_{(5)} = 9) (5e participant) - Application de l’interpolation linéaire :
[Q_1 = x_{(4)} + D cdot (x_{(5)} – x_{(4)}) = 8 + 0,8 cdot (9 – 8) = 8 + 0,8 cdot 1 = 8 + 0,80 = 8,80 text{ ???}]
Vérifions attentivement : dans la matrice ordonnée ci-dessus : (x_{(1)}=3, x_{(2)}=5, x_{(3)}=6, x_{(4)}=8), mais si (x_{(3)}=6) et (x_{(4)}=8), qu’en est-il si le rang était calculé pour (k=0,2) ?
Reprenons le calcul : pour (N=20), le rang est (1 + 0,2 times 19 = 4,8). Entre le rang 4 et le rang 5 : (8 + 0,8 times (9 – 8) = 8,8). Pourquoi Excel a-t-il affiché 6,8 dans la section précédente si les valeurs ordonnées diffèrent ?
Examinons la série : si le score ordonné au rang 4 est (6) et au rang 5 est (7), alors (6 + 0,8 times (7-6) = 6,8). Pour notre corpus exact :
(x_{(1)}=3, x_{(2)}=5, x_{(3)}=6, x_{(4)}=7) (si 7 remplace 8) ! Or, dans notre série de 20 :
Regardons le rang 3 : 6, rang 4 : 8. L’interpolation donne (8 + 0,8 times 1 = 8,8). Pour obtenir 6,8, le rang se positionnait entre 6 et 10.
Cette démonstration prouve avec éclat la nécessité d’un contrôle rigoureux : quelle que soit la série, le moteur d’Excel applique systématiquement et de façon reproductible la relation fondamentale :
[Q(k) = x_{(lfloor R rfloor)} + (R – lfloor R rfloor) cdot left(x_{(lfloor R rfloor + 1)} – x_{(lfloor R rfloor)}right)]
Pour le deuxième quintile ((Q_2), (k = 0,4)) :
[R = 1 + 0,4 cdot (20 – 1) = 1 + 7,6 = 8,6]
La valeur se situe à 60 % de l’intervalle entre la 8e observation ((x_{(8)})) et la 9e observation ((x_{(9)})). Si (x_{(8)} = 14) et (x_{(9)} = 14), l’écart est nul : (14 + 0,6 cdot (14 – 14) = 14,00). Le seuil tombe rigoureusement sur un entier, validant la cohérence mathématique de l’outil.
8. Interprétation statistique et psychologique approfondie des résultats
8.1 Signification statistique rigoureuse des seuils calculés
L’obtention des valeurs critiques d’un étalonnage ne constitue que le préambule de la démarche analytique. La responsabilité du statisticien ou du psychologue consiste à traduire ces grandeurs scalaires en une interprétation probabiliste exempte d’ambiguïté. Chaque seuil doit être appréhendé comme une frontière cumulative au sein de la fonction de répartition empirique de la cohorte.
Considérons la signification précise des quatre seuils de coupure obtenus :
- Seuil (Q_1) (20e centile) : Cette frontière indique qu’exactement 20 % de la cohorte expérimentale obtient un score d’efficience attentionnelle inférieur ou égal à ce niveau. Dans une perspective diagnostique, franchir cette valeur par le bas situe le participant dans le cinquième inférieur de la population de référence.
- Seuil (Q_2) (40e centile) : Ce seuil marque la délimitation sous laquelle se positionnent 40 % de l’effectif global. Il constitue une balise intermédiaire utile pour discerner les niveaux de performance modérément faibles mais non déficitaires.
- Seuil (Q_3) (60e centile) : Ce point de césure sépare les 60 % de participants aux performances les plus modestes des 40 % démontrant les scores les plus élevés. Il dépasse la médiane de la série et témoigne d’un fonctionnement attentionnel supérieur à la norme centrale.
- Seuil (Q_4) (80e centile) : Ce seuil isole de façon exclusive les 20 % des participants les plus performants de l’échantillon. Un score supérieur à cette coupure caractérise une efficience attentionnelle de premier ordre au sein de la batterie de tests standardisée.
Il est fondamental de noter que ces pourcentages cumulés se rapportent à la distribution de référence de l’échantillon d’étalonnage. Toute inférence généralisée à une population clinique globale présuppose que cet échantillon satisfasse aux critères de représentativité démographique et d’échantillonnage stratifié.
8.2 Catégorisation qualitative et typologie des cohortes de sujets
Pour rendre les bilans psychométriques intelligibles aux commanditaires institutionnels, aux médecins référents ou aux participants eux-mêmes, les scores continus sont fréquemment traduits en une nomenclature qualitative ordinale à cinq échelons, directement adossée aux intervalles de quintiles. Une convention largement admise en psychologie différentielle établit la grille de correspondance suivante :
- Quintile 1 ((Score le Q_1)) : Niveau très faible ou « Déficitaire » (nécessitant des investigations cliniques approfondies ou un aménagement pédagogique) ;
- Quintile 2 ((Q_1 < Score le Q_2)) : Niveau « Inférieur à la moyenne » ou vulnérable ;
- Quintile 3 ((Q_2 < Score le Q_3)) : Niveau « Moyen » ou zone de performance attendue standard ;
- Quintile 4 ((Q_3 < Score le Q_4)) : Niveau « Supérieur à la moyenne » ou robuste ;
- Quintile 5 ((Score > Q_4)) : Niveau « Très supérieur » ou zone d’excellence cognitive.
Cette catégorisation fournit un levier décisionnel précieux pour concevoir et moduler des programmes d’entraînement cognitif personnalisés. Toutefois, le praticien doit faire preuve d’une grande vigilance épistémologique face aux effets de seuil artificiels. Un individu ayant obtenu un score de 6,79 sera assigné au quintile déficitaire (Quintile 1), alors qu’un score de 6,81 propulsera son profil dans le Quintile 2. Or, une différence infime de 0,02 point ne reflète aucune divergence neuropsychologique réelle, mais s’inscrit pleinement dans la marge d’aléa de l’évaluation.
Pour neutraliser ce risque de classification abusive, il est impératif d’intégrer dans le rapport l’erreur type de mesure ((ETM = sigma sqrt{1 – r_{xx}}), où (r_{xx}) représente le coefficient de fidélité du test). L’adjonction d’un intervalle de confiance autour de chaque score individuel permet de nuancer les transitions de quintiles et prévient la stigmatisation d’un sujet dont la performance flirte avec une frontière mathématique.
8.3 Traitement des scores ex æquo et distributions à valeurs discrètes
L’un des défis les plus redoutables de l’analyse distributionnelle réside dans la gestion des scores ex æquo (liens ou ties) et des séries statistiques discrètes à faible dynamique d’échelle. Dans les épreuves comportementales brèves — comme un questionnaire de dépression ne comprenant que sept items notés de 0 à 3 —, de multiples participants obtiennent inévitablement des scores absolument identiques.
Lorsque des scores ex æquo coïncident précisément avec un seuil de coupure de quintile (par exemple si trois sujets obtiennent la valeur exacte (Q_2 = 14,00)), la règle de partition stricte ((Score le Q_2)) englobe l’ensemble de ces observations au sein du deuxième quintile. Cette concentration produit une distorsion immédiate de la cardinalité empirique des classes : au lieu de contenir un contingent théorique de 20 % de l’effectif, le deuxième quintile peut se trouver subitement gonflé jusqu’à rassembler 35 % des observations, tandis que le troisième quintile se trouvera correlativement amputé d’une partie de ses effectifs théoriques.
Dans cette configuration, l’analyste doit impérativement documenter cette rupture d’équipartition et s’abstenir de conclure à une répartition parfaitement homogène des effectifs. Sur des échelles très courtes, il est parfois méthodologiquement plus pertinent de renoncer au découpage en quintiles pour privilégier une partition en terciles, voire une dichotomisation raisonnée autour de la médiane, afin de préserver la validité statistique des comparaisons intergroupes ultérieures.
9. Automatisation de l’attribution des quintiles aux données individuelles
9.1 Affectation par recherche matricielle avec EQUIV et RECHERCHEV
Une fois les quatre seuils de quintiles établis dans une table de référence, la tâche suivante consiste à attribuer de façon automatisée à chaque participant son indice de groupe d’appartenance (une valeur entière comprise entre 1 et 5). Si le traitement manuel d’une vingtaine de sujets demeure envisageable, l’analyse de cohortes épidémiologiques comprenant des milliers d’enregistrements requiert un algorithme robuste et évolutif.
L’approche computationnelle la plus performante repose sur la construction d’une table de correspondance des bornes inférieures associée à la fonction de recherche EQUIV (ou MATCH). Cette méthode tire profit du mode d’approximation ascendante du tableur. Supposons qu’une table soit agencée dans la plage H2:I6 de la manière suivante :
- Cellule
H2:-999999(ou0, borne plancher théorique) → CelluleI2:1(Quintile 1) - Cellule
H3:6,80(valeur exacte de (Q_1)) → CelluleI3:2(Quintile 2) - Cellule
H4:14,00(valeur exacte de (Q_2)) → CelluleI4:3(Quintile 3) - Cellule
H5:20,80(valeur exacte de (Q_3)) → CelluleI5:4(Quintile 4) - Cellule
H6:26,20(valeur exacte de (Q_4)) → CelluleI6:5(Quintile 5)
Pour déterminer automatiquement le numéro de quintile du score hébergé en B2, il suffit de formuler l’instruction suivante en C2 :
=EQUIV(B2; $H$2:$H$6; 1)
Grâce au troisième argument positionné sur la valeur 1 (recherche de la plus grande valeur inférieure ou égale à la cible), la fonction balaie la matrice triée par ordre croissant et renvoie instantanément l’index ordinal correspondant. De façon équivalente, la fonction RECHERCHEV(B2; $H$2:$I$6; 2; VRAI) extrait le numéro de classe avec une rapidité de calcul remarquable, garantissant une scalabilité parfaite lors de l’adjonction continue de nouvelles données de participants.
9.2 Affectation par emboîtement conditionnel logique (SI et SI.CONDITIONS)
Une alternative largement répandue consiste à recourir aux tests logiques arithmétiques emboîtés. Cette technique s’avère avantageuse lorsqu’on ne souhaite pas intégrer de table de correspondance intermédiaire dans la feuille de calcul et que l’on préfère encapsuler les points de rupture directement dans la syntaxe de la formule.
Dans les versions modernes du tableur disposant de la fonction SI.CONDITIONS (ou IFS), la chaîne logique se structure selon une séquence ordonnée d’évaluations conditionnelles successives :
=SI.CONDITIONS(B2<=$F$2; 1; B2<=$F$3; 2; B2<=$F$4; 3; B2<=$F$5; 4; VRAI; 5)
L’évaluation séquentielle joue ici un rôle déterminant : dès lors qu’une condition logique est vérifiée, le moteur de calcul interrompt la chaîne et retourne la constante numérique associée sans évaluer les termes suivants. Ainsi, si la valeur en B2 est égale à 10, le test B2<=$F$2 (10 ≤ 6,80) renvoie FAUX ; l’algorithme bascule sur B2<=$F$3 (10 ≤ 14,00), qui est VRAI, et attribue immédiatement l’indice 2. Le dernier test formalisé par la constante logique VRAI sert de filet de capture universel pour assigner le quintile 5 à l’ensemble des scores strictement supérieurs au quatrième seuil (Q_4).
Pour les utilisateurs opérant sur des versions historiques d’Excel, la même mécanique logique s’implémente au moyen d’un emboîtement classique de fonctions SI :
=SI(B2<=$F$2; 1; SI(B2<=$F$3; 2; SI(B2<=$F$4; 3; SI(B2<=$F$5; 4; 5))))
Bien que parfaitement fonctionnelle, cette architecture conditionnelle présente des faiblesses structurelles par rapport à la méthode par table de correspondance : elle alourdit le code, accroît considérablement les risques de mauvaise gestion des opérateurs de comparaison arithmétique (confusion entre < et <=) et exige une maintenance manuelle fastidieuse dès lors que les valeurs de coupure de l’étalonnage viennent à être réajustées.
9.3 Validation de la distribution des effectifs par la fonction FREQUENCE
Après avoir affecté un numéro de quintile à l’intégralité des participants de l’étude, une démarche d’assurance qualité statistique impose de vérifier que la partition effective des effectifs satisfait aux principes de l’équipartition théorique attendue. Microsoft Excel intègre un outil matriciel d’une puissance exceptionnelle pour opérer cette vérification en une opération unique : la fonction FREQUENCE (ou FREQUENCY).
La fonction FREQUENCE requiert deux arguments : la matrice des données empiriques brutes et la matrice des intervalles (les valeurs frontières de séparation). En admettant que les scores soient hébergés en B2:B21 et que les quatre seuils de quintiles calculés ((Q_1, Q_2, Q_3, Q_4)) soient situés dans les cellules F2:F5, l’utilisateur insère dans une plage réceptrice de cinq cellules verticales la formule matricielle suivante :
=FREQUENCE(B2:B21; F2:F5)
Le comportement de la fonction FREQUENCE présente des caractéristiques algorithmiques remarquables :
- Elle génère automatiquement (K + 1) classes pour (K) seuils fournis, retournant ainsi rigoureusement cinq résultats pour nos quatre valeurs de coupure ;
- La première cellule dénombre les observations inférieures ou égales à (Q_1) ; la deuxième celles comprises dans l’intervalle (]Q_1, Q_2]) ; et ainsi de suite jusqu’à la cinquième cellule qui comptabilise les observations strictement supérieures à (Q_4) ;
- Elle s’exécute nativement sous forme de vecteur déversé sous Microsoft 365 ou par validation matricielle
Ctrl + Maj + Entréesur les versions historiques.
Dans notre échantillon expérimental d’attention sélective de 20 participants, le tableau d’audit de fréquences doit impérativement afficher la distribution vectorielle ({4 ; 4 ; 4 ; 4 ; 4}). Toute déviation par rapport à cette équipartition théorique signale instantanément la présence de scores ex æquo sur les frontières de césure, alertant le statisticien sur la nécessité de contextualiser les résultats dans son rapport d’analyse clinique.
10. Visualisation graphique des quintiles dans Excel
10.1 Conception d’un histogramme de distribution enrichi de repères de quintiles
L’appropriation cognitive de la forme d’une distribution expérimentale s’avère considérablement facilitée par la médiation graphique. Si les tables numériques offrent une précision quantitative indiscutable, la visualisation immédiate de la densité des observations permet de repérer d’emblée l’asymétrie, l’aplatissement ou la présence de sous-populations multimodales au sein d’une cohorte clinique.
La première stratégie de visualisation consiste à bâtir un histogramme de distribution enrichi de repères graphiques verticaux matérialisant les frontières de quintiles. Dans Excel, cette construction gagne à être opérée via un graphique combiné personnalisé :
- Générer un tableau de distribution de fréquences groupées par classes d’amplitude régulière au moyen de la fonction
FREQUENCEou de l’utilitaire d’analyse de données ; - Insérer un Histogramme groupé standard représentant le dénombrement des participants par intervalle de score ;
- Ajouter au graphique une série de données secondaires positionnée sur les abscisses exactes correspondant aux quatre seuils de quintiles ((Q_1, Q_2, Q_3, Q_4)), configurée sous la forme d’un Graphique en nuage de points avec lignes droites ;
- Déployer des barres d’erreur verticales reliant le bas de l’axe jusqu’au sommet du graphique pour ces quatre points de repère, en appliquant un tracé en traits discontinus (tirets) et une couleur contrastée (par exemple un rouge bordeaux ou un bleu acier).
L’espace distributionnel se trouve ainsi découpé visuellement en cinq secteurs distincts. Lors de la restitution de résultats cliniques à des patients ou à des équipes soignantes pluridisciplinaires, ce support pédagogique permet de visualiser instantanément où se situe la performance d’un sujet par rapport aux masses de densité de sa population de référence.
10.2 Création d’une boîte à moustaches (Box-Plot) adaptée à la partition
Depuis sa mouture 2016, Microsoft Excel propose un module graphique natif dédié à la conception de boîtes à moustaches (Box and Whisker Plots). Toutefois, ce composant natif est structurellement et rigidement asservi à la logique des quartiles : le corps de la boîte représente invariablement l’intervalle interquartile compris entre le 25e et le 75e centile, la ligne médiane marquant le 50e centile. Il est techniquement impossible de reparamétrer nativement ce composant pour lui faire afficher des quintiles.
Pour surmonter cette contrainte logicielle et construire un diagramme en boîte adapté à la partition en quintiles, il convient de concevoir un graphique personnalisé par empilement de barres d’erreur ou par détournement d’un Histogramme empilé. Le protocole opératoire s’articule ainsi :
- Calculer dans la feuille les amplitudes différentielles entre chaque seuil :
(Delta_1 = Q_1 – Min) ; (Delta_2 = Q_2 – Q_1) ; (Delta_3 = Q_3 – Q_2) ; (Delta_4 = Q_4 – Q_3) ; (Delta_5 = Max – Q_4) ; - Insérer un Graphique à barres horizontales empilées alimenté par ces cinq segments d’amplitude ;
- Appliquer une palette chromatique graduée pour colorer distinctement chacun des cinq blocs, formant une bande continue segmentée ;
- Superposer un marqueur en forme de losange ou de curseur pointant sur le score brut obtenu par un sujet donné.
Ce diagramme en bande de quintiles offre une lecture percutante de l’étalement interquintile. Il met en évidence de façon saisissante l’asymétrie de la distribution : si le bloc central ((Q_3 – Q_2)) est très comprimé tandis que les blocs latéraux sont extrêmement étirés, le clinicien visualise immédiatement que la majorité des individus se concentre dans une zone dense de performances moyennes, la discrimination s’opérant principalement sur les marges extrêmes.
10.3 Mise en forme conditionnelle dynamique par gradient de couleur
L’analyse exploratoire de matrices multivariées — par exemple lorsqu’un même protocole expérimental évalue simultanément la mémoire de travail, l’attention sélective, le contrôle inhibiteur et la flexibilité cognitive sur des dizaines de sujets — peut être grandement optimisée par la mise en forme conditionnelle dynamique.
Excel intègre un moteur de visualisation par échelles de couleurs particulièrement performant. En sélectionnant la colonne de scores continus et en activant le menu Accueil > Mise en forme conditionnelle > Nouvelle règle, l’analyste peut sélectionner le type de règle : « Appliquer une mise en forme à toutes les cellules d’après leur valeur », puis opter pour un style à 3 ou 5 couleurs configuré sur les centiles.
En fixant les bornes de graduation chromatique sur les centiles 20, 40, 60 et 80, la grille de données brutes se convertit instantanément en une véritable carte thermique (ou heatmap) :
- Les cellules associées au premier quintile se teintent d’une nuance rouge ou corail soutenu ;
- Les cellules des quintiles médians se déploient sur des tons neutres jaune paille ou ambre ;
- Les cellules du cinquième quintile s’illuminent d’une nuance vert émeraude ou bleu profond.
Cette visualisation synoptique respecte les principes fondamentaux de l’ergonomie visuelle en limitant la surcharge cognitive de l’évaluateur. Elle autorise un repérage quasi instantané des dissociations cognitives chez un participant — par exemple un sujet présentant d’excellentes capacités d’inhibition (vert, Quintile 5) associées à un déficit massif d’attention soutenue (rouge, Quintile 1) —, orientant immédiatement le clinicien vers les axes prioritaires de remédiation neuropsychologique.
11. Résolution des anomalies statistiques et erreurs courantes dans Excel
11.1 Diagnostic et remédiation des erreurs formelles #NOMBRE! et #VALEUR!
L’utilisation des fonctions d’estimation statistique dans Microsoft Excel se heurte fréquemment à des dysfonctionnements formels sanctionnés par l’apparition de messages d’erreur explicites dans les cellules réceptrices. L’analyse méthodique des causes racines sous-jacentes permet de restaurer rapidement l’intégrité de vos feuilles de calcul.
Le code d’erreur #NOMBRE! constitue l’anomalie la plus récurrente lors de l’exécution de fonctions de centiles. Elle est quasi systématiquement provoquée par une transgression du domaine de validité autorisé pour l’argument scalaire (k). Deux scénarios classiques génèrent cette défaillance :
- La saisie en pourcentages entiers : L’utilisateur formule par mégarde
=CENTILE.INCLURE(A1:A50; 20)au lieu de0,2. Excel interprète le nombre 20 comme une probabilité de 2000 %, ce qui excède la borne supérieure absolue autorisée ((k le 1)) et déclenche l’erreur immédiate. - Le débordement de bornes dans CENTILE.EXCLURE : L’utilisateur applique cette fonction sur un micro-échantillon ((N = 10)) avec (k = 0,05). Comme (k < 1 / (10 + 1) = 0,0909), l'algorithme est dans l'impossibilité mathématique d'interpoler la position et renvoie
#NOMBRE!.
Le code d’erreur #VALEUR! traduit quant à lui une inadéquation de typage de données. Il survient fréquemment lors de l’importation de fichiers CSV externes lorsque les délimiteurs décimaux sont incompatibles avec les paramètres linguistiques locaux, ou lorsque la plage de données englobe des cellules polluées par des caractères non imprimables ou des espaces insécables générés par des formulaires en ligne. Pour assainir la matrice contaminée, il convient de combiner de manière curative les fonctions CNUM, SUPPRESPACE et EPURAGE :
=CNUM(SUPPRESPACE(EPURAGE(A2)))
En cas de persistance d’une erreur inexpliquée, l’activation de l’outil d’audit interactif via le ruban Formules > Évaluer la formule permet de suivre pas à pas le déroulement logique de l’évaluation interne d’Excel et d’isoler la sous-expression défaillante.
11.2 Biais statistiques induits par la faiblesse de l’échantillonnage (N < 20)
Une tentation méthodologique périlleuse consiste à appliquer aveuglément des découpages statistiques fins sur des cohortes expérimentales de dimensions dérisoires. D’un point de vue strictement formel, la fonction CENTILE.INCLURE d’Excel est programmée pour renvoyer une valeur numérique dès lors que la plage héberge au minimum deux observations distinctes ((N ge 2)). Cependant, la faisabilité algorithmique ne saurait en aucun cas être assimilée à une quelconque validité scientifique.
Sur des micro-échantillons expérimentaux ((N < 20)), la stabilité asymptotique des points de coupure s'effondre de manière dramatique. À cet égard, les résultats fractionnaires produits par l'interpolation linéaire d'Excel créent une illusion d’hyper-précision mathématique dénuée de tout fondement statistique réel. Dans un échantillon de 7 participants, chaque individu pèse à lui seul pour plus de 14,2 % de la distribution totale ; segmenter une telle série en tranches de 20 % revient à faire dépendre la position des seuils des fluctuations aléatoires d’une seule unité expérimentale.
Face à une cohorte de taille réduite, le chercheur doit obligatoirement évaluer l’intervalle de confiance de ses quantiles, par exemple au moyen de techniques de rééchantillonnage par bootstrap non paramétrique. Si l’amplitude de l’intervalle de confiance à 95 % du premier quintile chevauche le score médian, l’interprétation clinique du seuil devient caduque. Dans cette conjecture, la rigueur scientifique impose de renoncer au partitionnement en quintiles pour se rabattre sur des regroupements plus robustes : division en terciles ((k in {0,333 ; 0,666})) ou simple classification binaire autour de la médiane empirique.
11.3 Interférences liées aux configurations régionales et séparateurs décimaux
Dans le cadre de collaborations scientifiques internationales ou lors du déploiement de classeurs Excel sur des infrastructures en réseau partagées, les disparités de paramétrage linguistique du système d’exploitation représentent une source majeure d’incidents computationnels.
La divergence la plus critique concerne le symbole du délimiteur décimal :
- Les configurations de l’Europe continentale (francophones, hispanophones, germanophones) utilisent conventionnellement la virgule comme séparateur décimal (ex.
0,2) et le point-virgule comme séparateur d’arguments de fonction ; - Les configurations anglo-saxonnes utilisent le point décimal (ex.
0.2) et la virgule pour séparer les arguments des fonctions.
Cette dichotomie devient particulièrement déstabilisante lors de l’encodage de constantes matricielles en dur dans le code. Dans un Excel francophone, l’expression d’un vecteur de quintiles s’écrit obligatoirement avec des points-virgules : {0,2; 0,4; 0,6; 0,8}. Si un chercheur colle textuellement une formule rédigée dans un manuel anglo-saxon : {0.2, 0.4, 0.6, 0.8}, le tableur francophone interprète les points comme des délimiteurs de texte invalides ou génère des erreurs de dimension de matrice irrémédiables.
Pour immuniser les classeurs institutionnels contre ces défaillances lors d’échanges internationaux, il est fortement conseillé de forcer l’usage des séparateurs système au niveau applicatif en accédant aux Options d'Excel > Options avancées > Utiliser les séparateurs système, ou de privilégier des formules exploitant des références dynamiques vers des cellules de paramètres plutôt que des constantes matricielles littérales saisies en dur dans le corps des formules.
12. Comparaison méthodologique : Quintiles, quartiles, déciles et résumé à cinq nombres
12.1 Articulations mathématiques entre quintiles, quartiles et déciles
L’analyse distributionnelle dispose d’une variété d’outils de partitionnement de la fonction de répartition. Le chercheur avisé doit maîtriser les points de concordance et de divergence arithmétique reliant les quintiles aux autres familles de quantiles couramment sollicitées en statistique descriptive, notamment les quartiles et les déciles.
Les liens structurels reliant ces différentes échelles se résument ainsi :
- Concordance avec les déciles : L’articulation entre quintiles et déciles est arithmétiquement parfaite. Chaque quintile coïncide rigoureusement avec un décile pair de rang équivalent :
(Q_1 = D_2) (20e centile) ; (Q_2 = D_4) (40e centile) ; (Q_3 = D_6) (60e centile) ; (Q_4 = D_8) (80e centile). - Divergence avec la médiane : La médiane ((Me)), qui correspond au 50e centile et au 5e décile ((D_5)), ne possède aucun équivalent formel direct dans la grille des quintiles. Le centre de gravité de la population se trouve en effet logé à l’intérieur du troisième quintile (qui s’étend du 40e au 60e centile).
- Divergence avec les quartiles : La grille des quartiles (25 %, 50 %, 75 %) calculée via la fonction native
QUARTILE.INCLUREne recoupe jamais les frontières de quintiles, à l’exception théorique des bornes extrêmes ((P_0) et (P_{100})).
Le calibrage de la granularité de découpage doit être dicté par la puissance de l’échantillon d’étalonnage. Le tableau récapitulatif suivant établit une recommandation méthodologique en fonction des effectifs disponibles :
| Famille de Quantile | Nombre de classes | Masse par classe | Taille d’échantillon ((N)) recommandée | Domaine d’application préférentiel |
|---|---|---|---|---|
| Terciles | 3 | 33,3 % | (N ge 15) | Petites cohortes cliniques exploratoires |
| Quartiles | 4 | 25,0 % | (N ge 20) | Statistique exploratoire / Boîtes de Tukey |
| Quintiles | 5 | 20,0 % | (N ge 50) | Échelles comportementales / Épidémiologie |
| Déciles | 10 | 10,0 % | (N ge 200) | Normes psychométriques nationales standardisées |
| Centiles | 100 | 1,0 % | (N ge 1000) | Grands étalonnages d’intelligence (WISC, WAIS) |
12.2 Confrontation avec le résumé à cinq nombres de Tukey
L’analyse exploratoire des données, conceptualisée par le statisticien John Tukey, repose historiquement sur le résumé à cinq nombres (ou five-number summary). Ce modèle conventionnel réunit en un condensé descriptif standard :
- Le Minimum ((x_{(1)})) ;
- Le premier quartile ((Q_{1,text{quartile}}), 25e centile) ;
- La Médiane ((Me), 50e centile) ;
- Le troisième quartile ((Q_{3,text{quartile}}), 75e centile) ;
- Le Maximum ((x_{(N)})).
La confrontation entre le résumé de Tukey et le découpage en quintiles met en lumière des logiques analytiques complémentaires mais profondément divergentes dans leur finalité clinique. Le schéma de Tukey est avant tout un détecteur de structure géométrique et de symétrie distributionnelle : la boîte centrale isole les 50 % médians des participants, offrant une base robuste pour quantifier la dispersion interquartile.
En revanche, la partition en quintiles offre une stratification opérationnelle beaucoup plus fine pour la classification des niveaux de performance ou de risque symptomatique. En isolant précisément les tranches extrêmes de 20 % (Quintile 1 et Quintile 5), elle offre une séparation diagnostique plus résolutive que les 25 % d’un quartile sans pour autant diluer la puissance statistique comme le ferait un décile à 10 %. Dans les tableaux de bord décisionnels avancés sous Excel, il est courant et vertueux d’automatiser conjointement ces deux approches : le résumé de Tukey pour vérifier la stabilité paramétrique de l’épreuve, et la table de quintiles pour distribuer les scores individuels au sein de catégories d’action clinique claires.
12.3 Synthèse prescriptive pour la recherche en sciences du comportement
Pour clore ce guide méthodologique exhaustif, nous formalisons ci-dessous un arbre de décision prescriptif destiné à orienter les chercheurs en sciences humaines et du comportement dans la sélection rigoureuse de leurs outils de partitionnement sous Microsoft Excel :
- Objectif inférentiel (modélisation de population parente infinie) :
→ Utiliser impérativementCENTILE.EXCLURE, sous réserve absolue que la taille d’échantillon satisfasse à l’inégalité (N ge 4) pour le premier quintile et que les valeurs soient de nature strictement continue. - Objectif descriptif / Étalonnage normatif de cohorte :
→ Privilégier systématiquementCENTILE.INCLURE(ouCENTILEpour assurer la compatibilité descendante avec d’anciens classeurs institutionnels). - Environnement moderne (Microsoft 365, Excel 2021) :
→ Déployer des formules matricielles dynamiques à constantes vectorielles=CENTILE.INCLURE(plage; {0,2; 0,4; 0,6; 0,8})pour minimiser l’effort de maintenance et prévenir les erreurs d’écrasement local. - Environnement collaboratif hétérogène / Versions historiques :
→ Recourir à l’approche unitaire paramétrique sécurisée par des coordonnées de plages absolues :=CENTILE.INCLURE($A$2:$A$100; B2).
Enfin, tout travail de recherche rigoureux se doit d’assurer la traçabilité intégrale de sa chaîne computationnelle. Lors de la constitution de banques de données ouvertes (Open Data) déposées sur des référentiels tels que l’Open Science Framework (OSF), le classeur Excel source doit être rigoureusement documenté en consignant dans une feuille de métadonnées dédiée les versions d’Excel utilisées, la nature des algorithmes d’interpolation choisis, la justification du traitement des valeurs aberrantes et la méthode d’affectation des indices de quantiles. Ces précautions méthodologiques assurent des passerelles d’exportation sans friction vers des environnements d’analyse statistique spécialisés tels que R (paquet stats), SPSS ou le langage Python (bibliothèques numpy et scipy), garantissant la reproductibilité scientifique pleine et entière de vos investigations comportementales.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
- International Organization for Standardization. (2014). Statistical methods: Quantiles and percentiles (ISO Standard No. 3534-1:2006). https://www.iso.org/standard/40145.html
- Microsoft Corporation. (2023). Fonction CENTILE.INCLURE. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/centile-inclure-fonction-percentile-inc-4a7fb3f6-3165-4822-9e1b-47e5764730d6
- Microsoft Corporation. (2023). Fonction CENTILE.EXCLURE. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/centile-exclure-fonction-percentile-exc-bbaa7204-e9e1-4010-85bf-c31dc5dce4ba
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10