
Dans le domaine des sciences humaines, de la psychologie différentielle, du comportement organisationnel et des études de marché, la quantification rigoureuse d’attributs intangibles constitue un défi méthodologique fondamental. Les chercheurs et analystes de données sont continuellement confrontés à la nécessité d’opérationnaliser des construits latents complexes tels que l’anxiété, la satisfaction au travail, l’engagement organisationnel ou la résilience psychologique. Pour y parvenir, les instruments de mesure standardisés font majoritairement appel à des batteries d’énoncés ordonnés selon des échelles de type Likert. Toutefois, la simple agrégation arithmétique des réponses directes fournies par les participants conduit presque invariablement à des distorsions analytiques sévères lorsque l’instrument intègre, par dessein expérimental, des items dont la polarité linguistique s’oppose à la direction générale du construit mesuré.
Cette problématique introduit l’obligation impérative de procéder à un codage inversé (communément désigné sous l’anglicisme de reverse coding ou de recodage d’items). Cette opération mathématique et conceptuelle consiste à transmuter les valeurs ordinales attribuées à des items formulés de manière antagoniste, afin de rétablir une parfaite cohérence directionnelle avant toute estimation de fidélité, toute analyse factorielle ou tout calcul de score composite. Bien que des progiciels statistiques spécialisés tels que SPSS, R, SAS ou Stata intègrent des routines programmées pour exécuter cette tâche, une part considérable du traitement préparatoire des données de recherche continue de s’effectuer au sein du tableur Microsoft Excel. L’accessibilité universelle de cet outil, couplée à sa flexibilité visuelle, en fait la passerelle privilégiée pour la compilation primaire des données d’enquête.
Néanmoins, la manipulation de matrices psychométriques dans un environnement de tableur exige une rigueur absolue. Une mécompréhension des propriétés arithmétiques des échelles de mesure finies, un glissement d’indice de cellule ou l’absence d’anticipation des cellules vides peuvent compromettre irrémédiablement l’intégrité d’une cohorte entière. Ce manuel de référence exhaustif a pour vocation d’exposer en profondeur les fondements théoriques, les justifications psychométriques et les protocoles algorithmiques permettant d’exécuter un codage inversé parfait dans Microsoft Excel. À travers l’examen détaillé d’un cas empirique documenté, des formulations mathématiques sous-jacentes et de multiples méthodes de traitement adaptées à des architectures logicielles allant des versions historiques d’Excel jusqu’aux moteurs de calcul dynamique les plus contemporains, cet article constitue un guide définitif pour les praticiens exigeants.
1. Fondements théoriques du codage inversé en psychométrie
1.1 Définition et rôle du codage inversé dans les questionnaires psychologiques
Dans l’architecture d’un protocole d’évaluation psychométrique, l’introduction délibérée d’items formulés négativement ou de manière antinomique constitue une stratégie standard d’élaboration d’échelles. Un item inversé est un énoncé dont l’approbation logique par le sujet indique un niveau inférieur du trait latent que l’instrument cherche formellement à capturer. Par exemple, si une échelle est conçue pour quantifier le bien-être au travail, une assertion telle que « Je me sens dynamisé par mes missions quotidiennes » présente une valence sémantique positive directe. À l’inverse, l’énoncé « Je ressens un épuisement émotionnel intense dès le début de ma journée » possède une valence sémantique inverse par rapport au trait d’intérêt. Si ces deux questions utilisent une échelle de Likert allant de 1 (« Pas du tout d’accord ») à 5 (« Tout à fait d’accord »), un score élevé sur la première traduit un bien-être supérieur, tandis qu’un score élevé sur la seconde traduit une détresse accrue.
Le rôle fondamental du codage inversé réside dans le réalignement de la polarité statistique avec la valence théorique du construit étudié. Sans cette standardisation préalable, les variables associées aux items négatifs mesurent l’antithèse du phénomène observé. La distinction entre valence linguistique et valence statistique devient alors cardinale : la langue utilise la négation pour nuancer le propos, mais l’analyse quantitative requiert que chaque vecteur de données partage une covariance positive avec la variable latente sous-jacente. L’omission de cette étape de réalignement engendre des conséquences destructrices sur les propriétés mathématiques de la matrice de données. Plus particulièrement, dans les matrices de variance-covariance et de corrélations inter-items, les items non inversés présenteront des coefficients de corrélation négatifs avec les items alignés, invalidant immédiatement tout calcul de score total sommatif ou moyen.
Sur le plan de la théorie classique des tests (TCT), le score observé sur chaque item est censé être une fonction linéaire croissante du score vrai du participant sur le trait latent. L’absence d’inversion des items antagonistes viole directement ce postulat d’unidimensionnalité et de monotonie positive. Les variances des items s’additionnent alors de manière aberrante dans le calcul de la variance totale du test, annihilant la structure d’échelle et conduisant à des interprétations diagnostiques diamétralement opposées à la réalité clinique ou organisationnelle de l’échantillon évalué.
1.2 Atténuation des biais de réponse et validation d’échelle
L’implantation d’énoncés inversés ne répond pas uniquement à un caprice stylistique de rédaction, mais constitue un mécanisme de contrôle expérimental conçu pour neutraliser les styles de réponse systématiques. Le principal artefact méthodologique combattu par ce dispositif est le biais d’acquiescement (également désigné sous le terme de tendance à l’assentiment). Ce biais cognitif décrit la propension inconsciente de nombreux répondants à marquer leur accord avec les affirmations proposées, indépendamment de leur contenu sémantique réel, souvent en raison d’une déférence envers l’autorité scientifique perçue de l’expérimentateur ou par économie d’effort cognitif.
Lorsque tous les items d’une échelle pointent dans la même direction sémantique, un participant souffrant d’un biais d’acquiescement sévère obtiendra un score composite artificiellement saturé à l’extrémité positive du spectre, sans que cela ne reflète une adhésion authentique au construit. En intercalant des énoncés inversés, le concepteur du test force le participant à rompre l’automatisme de lecture. Pour maintenir la cohérence de son auto-évaluation, le sujet doit activement sélectionner des scores faibles sur les items négatifs s’il a précédemment sélectionné des scores élevés sur les items positifs. Ce mécanisme favorise un engagement cognitif accru lors du traitement de l’information textuelle.
De surcroît, les items inversés servent d’indicateurs de vigilance pour détecter les réponses inattentives, le remplissage aléatoire ou les patrons de réponse rectilignes (phénomène où un répondant coche la même colonne d’un bout à l’autre de l’instrument). Dans le cadre de la validation psychométrique, le maintien de ces items permet de préserver la validité de construit et la fidélité de l’échelle. Lors des phases subséquentes d’analyse factorielle confirmatoire (AFC), un ensemble d’items correctement inversés doit idéalement converger vers un facteur unique. Toutefois, les psychométriciens doivent garder à l’esprit que les items inversés peuvent parfois générer un « effet de méthode », créant un facteur résiduel artificiel lié à la formulation négative, ce qui rend leur manipulation analytique d’autant plus délicate et impérative.
1.3 Typologie des échelles de mesure sujettes au recodage
Toutes les variables collectées au cours d’une recherche ne requièrent pas les mêmes modalités d’inversion. Il convient de classifier avec précision la nature structurelle des échelles ordinales manipulées. Les plus omniprésentes en psychologie sont les échelles de Likert classiques à polarité symétrique, déclinées en formats d’évaluation de l’accord, de la fréquence (de « Jamais » à « Toujours ») ou de l’intensité émotionnelle (de « Pas du tout » à « Extrêmement »). Ces échelles reposent sur un continuum psychologique sous-jacent que l’on discrétise en un nombre déterminé d’ancres sémantiques ordonnées.
La distinction structurelle fondamentale s’opère entre les formats impairs et les formats pairs. Les échelles impaires (notamment les formats en 5 et 7 points) intègrent un point neutre médian explicite (tel que « Ni en désaccord, ni d’accord » ou « Modérément »). Ce point neutre agit comme un centre de gravité sémantique et arithmétique. Lorsqu’un codage inversé est appliqué sur une échelle impaire, ce point central possède la propriété géométrique unique de demeurer invariant après transformation. Par exemple, sur une échelle de 1 à 5, l’ancre centrale 3 demeure un 3 après inversion, traduisant le fait que la neutralité envers une proposition négative équivaut conceptuellement à la neutralité envers son pendant positif.
À l’opposé, les échelles paires (souvent employées en formats à 4 ou 6 points) sont intentionnellement conçues pour forcer le choix du sujet en éliminant tout refuge central. Dans ce type d’architecture, l’absence de valeur médiane implique que chaque modalité bascule obligatoirement d’un hémisphère psychologique à l’autre lors du recodage. Il est également nécessaire de discriminer les échelles selon leur borne d’origine : la grande majorité des inventaires psychologiques débute à l’unité (ancrage 1 à k), mais certaines disciplines comme la neuropsychologie, la psychophysique ou les neurosciences computationnelles ont massivement recours à des échelles dont l’origine mathématique est fixée à zéro (ancrage 0 à k). Cette distinction d’ancrage modifie radicalement les paramètres de l’équation de transformation linéaire qui doit être implémentée sous Excel.
2. Formulation mathématique de l’inversion de score
2.1 Équation standard pour échelles linéaires finies
Bien que le codage inversé soit fréquemment perçu par les analystes débutants comme une opération logique de substitution qualitative (remplacer les 1 par des 5, les 2 par des 4, etc.), il s’agit sur le plan analytique d’une transformation arithmétique linéaire purement déterministe. Pour toute échelle discrète finie bornée par une valeur minimale théorique et une valeur maximale théorique, l’inversion de score s’appuie sur le principe de symétrie centrale autour de la moyenne géométrique des bornes de l’intervalle de mesure.
L’équation fondamentale universelle s’exprime sous la forme suivante :
Score_inversé = (Valeur_Max + Valeur_Min) – Valeur_Brute
Cette formulation est rigoureusement exacte quelle que soit l’origine de l’échelle, pourvu que les intervalles entre les échelons successifs soient supposés équidistants. Lorsque l’instrument utilise la convention psychométrique standard où la borne inférieure est fixée à l’unité (Valeur_Min = 1), l’équation fondamentale se simplifie dans la littérature sous une expression extrêmement célèbre :
Score_inversé = (Valeur_Max + 1) – Valeur_Brute
Le terme (Valeur_Max + 1) constitue la constante additive du système de transformation. Pour une échelle de Likert classique en 5 points bornée de 1 à 5, la constante prend la valeur arithmétique 6 (soit 5 + 1). Pour une échelle en 7 points, la constante prend la valeur 8 (soit 7 + 1). Sur le plan algébrique, cette opération réalise une réflexion de l’espace vectoriel des réponses par rapport à l’axe de symétrie défini par la moyenne des extrêmes de l’échelle. L’intervalle géométrique et métrique séparant deux modalités consécutives est préservé de manière absolument invariante : la distance séparant un score brut de 1 et un score brut de 2 demeure rigoureusement identique à la distance séparant leurs scores inversés respectifs de 5 et de 4.
2.2 Comportement des points médians et extrêmes
L’application rigoureuse de cette fonction linéaire engendre des propriétés algébriques remarquables qui garantissent la conservation des paramètres de distribution théorique de la variable, à l’exception de l’inversion de son signe d’asymétrie (skewness). Examinons analytiquement la permutation des ancres sur une échelle en 5 points régie par l’équation Score_inversé = 6 – Score_Brut :
- Un score brut de 1 (l’ancrage minimal) devient : 6 – 1 = 5 (l’ancrage maximal).
- Un score brut de 2 (l’ancrage sub-minimal) devient : 6 – 2 = 4 (l’ancrage sub-maximal).
- Un score brut de 3 (l’ancrage médian théorique) devient : 6 – 3 = 3 (l’ancrage médian théorique).
- Un score brut de 4 (l’ancrage sub-maximal) devient : 6 – 4 = 2 (l’ancrage sub-minimal).
- Un score brut de 5 (l’ancrage maximal) devient : 6 – 5 = 1 (l’ancrage minimal).
L’invariance du point médian est mathématiquement vérifiée dès lors que le nombre total d’ancres est impair. En effet, sur un intervalle [1, k] où k est impair, la médiane théorique est exactement définie par (k + 1) / 2. Si l’on applique la formule d’inversion à cette médiane théorique, on obtient : (k + 1) – [(k + 1) / 2] = (k + 1) / 2. L’identité mathématique est démontrée. Cette stabilité du point neutre préserve l’interprétabilité psychologique : un répondant qui n’a pas souhaité pencher vers l’accord ou le désaccord sur une formulation négative ne voit pas sa position glisser arbitrairement vers un pôle d’opinion post-transformation.
Une propriété algébrique complémentaire cruciale est la stricte réversibilité (ou involution) de la formule. Si l’on applique l’opération d’inversion au résultat d’une inversion préalable, on retrouve avec une exactitude tautologique la valeur brute initiale : (k + 1) – [(k + 1) – Score_Brut] = Score_Brut. Cette propriété garantit que la transformation n’introduit aucune perte d’entropie ni aucune distorsion non linéaire au sein de l’espace de mesure original.
2.3 Adaptation aux échelles Likert débutant à zéro
Une source fréquente d’erreurs méthodologiques graves au sein des mémoires universitaires et des rapports d’études réside dans l’application aveugle de la constante (k + 1) à des instruments dont la graduation primaire intègre la valeur zéro comme premier échelon de réponse. C’est couramment le cas dans les inventaires cliniques évaluant la fréquence des symptômes dépressifs ou anxieux (comme l’échelle de dépression du CES-D ou certaines déclinaisons du PHQ-9), où les modalités sont échelonnées de 0 (« Jamais / Rarement ») à 3 ou 4 (« La plupart du temps »).
Si un protocole applique la constante issue d’une base unitaire à une échelle allant de 0 à 4, la tentative d’inversion par la formule (4 + 1) – Score_Brut = 5 – Score_Brut conduirait à ce qu’une valeur brute de 0 soit transmutée en un score de 5. Or, la valeur 5 n’appartient pas au domaine de définition de l’échelle d’origine. La variance de la variable se trouverait artificiellement dilatée et l’ensemble de la métrique faussé. En se référant à la formule fondamentale universelle exposée au paragraphe 2.1 :
Score_inversé = (Valeur_Max + Valeur_Min) – Valeur_Brute
Sachant que dans le cadre d’un ancrage à zéro, Valeur_Min = 0, l’équation s’ajuste immédiatement pour devenir :
Score_inversé = Valeur_Max – Valeur_Brute
Ainsi, pour une échelle graduée de 0 à 4, l’inversion d’un score s’opère par la simple soustraction Score_inversé = 4 – Score_Brut. Le tableau de correspondance algébrique s’établit alors comme suit : le score 0 devient 4, le score 1 devient 3, le score 2 demeure invariant (dans la mesure où 2 est le centre exact de [0, 4]), le score 3 devient 1, et le score 4 devient 0. La validation scrupuleuse des bornes réelles d’inclusion d’une échelle constitue ainsi la condition technique préalable à toute implémentation de formule de transformation sous Excel.
3. Configuration et structuration des données psychométriques dans Excel
3.1 Organisation tabulaire conforme aux normes de recherche
La viabilité d’un traitement quantitatif dépend intimement de l’architecture structurelle de la feuille de calcul initiale. Dans le strict respect des protocoles de recherche en psychométrie et des standards de modélisation de données (tels que les principes du Tidy Data), un tableur Excel ne doit jamais être conçu comme un support de mise en page visuelle arbitraire, mais comme une matrice relationnelle orthogonale rigide. La règle d’or implique qu’une ligne unique représente une unité d’observation individuelle (le participant ou répondant identifié par un code alphanumérique anonymisé, tel que « SUJ_001 »), et qu’une colonne distincte soit dédiée à chaque variable observée ou item mesuré.
L’introduction d’espaces vides accidentels, de fusions de cellules dans la zone de saisie des données ou de sauts de ligne décoratifs doit être rigoureusement proscrite. La première ligne de la feuille doit être exclusivement réservée aux en-têtes de colonnes standardisées (ex. Identifiant, Age, Genre, Q1, Q2, Q3, etc.). Les données quantitatives brutes doivent débuter uniformément dès la deuxième ligne. Parallèlement, il est méthodologiquement recommandé d’adjoindre au fichier un onglet distinct faisant office de livre de codes (Codebook).
Ce livre de codes répertorie pour chaque variable le texte intégral de l’item présenté au sujet, son échelle théorique d’ancrage, le construit psychologique ciblé, et surtout son statut directionnel (item direct versus item inversé). Enfin, la zone allouée aux données brutes primaires (issues de la saisie ou de l’export d’une plateforme d’enquête en ligne) doit impérativement être sanctuarisée et séparée des zones réservées aux transformations algorithmiques et aux calculs dérivés, afin de prévenir tout écrasement destructif irréversible des enregistrements initiaux.
3.2 Typologie et validation des formats de données
Une source sous-estimée d’anomalies de calcul dans Excel provient d’une mauvaise attribution des formats de cellules par le moteur interne du logiciel. Les données psychométriques issues de questionnaires sont des variables numériques discrètes (à niveau d’échelle au minimum ordinal). Dès lors, l’ensemble des plages matricielles contenant les réponses brutes et recodées doit être explicitement configuré au format « Nombre » avec zéro décimale, évitant ainsi le format « Standard » qui peut parfois interpréter subrepticeusement certains chiffres comme des chaînes de texte, notamment lors de l’importation de fichiers CSV délimités par des virgules ou des tabulations.
Pour immuniser la base de données contre les erreurs humaines de frappe ou d’encodage lors d’une saisie manuelle, le chercheur avisé déploiera des règles strictes de validation des données. En sélectionnant la matrice des réponses et en accédant au ruban Données > Validation des données, il est aisé d’imposer un critère d’admissibilité restreint aux nombres entiers compris rigoureusement entre la borne inférieure (ex. 1) et la borne supérieure (ex. 5) du protocole d’évaluation.
L’implémentation de la mise en forme conditionnelle constitue une ligne de défense supplémentaire particulièrement performante. En appliquant une règle de surbrillance automatique (par exemple, un remplissage rouge clair avec texte rouge foncé) à toute cellule dont la valeur est strictement inférieure à 1 ou strictement supérieure à 5, ou dont le type n’est pas numérique, le statisticien s’assure d’une traçabilité visuelle immédiate des aberrations typographiques. La protection structurelle de la feuille de calcul primaire via le menu Révision > Protéger la feuille permet ensuite de figer les cellules de données brutes contre toute modification intempestive lors de la manipulation des formules dans les colonnes adjacentes.
3.3 Identification systématique des items inversés du protocole
Avant d’engager la moindre frappe d’instruction dans la barre de formule d’Excel, un protocole strict d’audit sémantique du matériel d’évaluation doit être mené. L’analyste doit relire chaque énoncé du questionnaire à la lumière de la définition théorique opératoire du construit latent. Une attention méticuleuse doit être portée aux tournures syntaxiques subtiles : l’usage de doubles négations, d’adverbes restrictifs (tels que « rarement », « difficilement », « à peine ») ou de termes à forte charge émotionnelle antagoniste peut obscurcir la polarité réelle de l’item.
Une fois les items inversés formellement confirmés, cette caractéristique doit être explicitement codifiée dans les en-têtes de colonnes de la feuille d’analyse. La nomenclature standard en psychométrie consiste à apposer le suffixe _INV ou _R (pour reversed) au libellé originel de la question (par exemple : la colonne Q2 deviendra Q2_INV ou Q2_r dans la table transformée). Cette standardisation lexicale élimine toute ambiguïté lors de la phase de calcul des scores agrégés ultérieurs.
Dans les contextes de recherche académique ou d’évaluation clinique standardisée, cette étape ne doit idéalement pas reposer sur l’appréciation isolée d’un unique opérateur. Un processus d’évaluation inter-juges — impliquant la confrontation croisée d’au moins deux experts indépendants qui statuent sur la polarité perçue de chaque item — permet de consolider l’accord inter-juges (mesuré par un coefficient Kappa de Cohen) et d’écarter définitivement les ambiguïtés sémantiques qui risqueraient de vicier la fidélité globale de l’instrument psychométrique.
4. Présentation du cas pratique : Enquête psychologique sur 10 sujets
4.1 Description du protocole et du questionnaire de l’exemple
Afin de rendre limpide l’exécution technique des différentes procédures d’inversion au sein d’Excel, nous allons déployer un cas empirique représentatif des situations de diagnostic psychosocial. Imaginons une étude menée au sein d’un laboratoire de psychologie du travail, dont l’objectif est d’évaluer le niveau d’« Énergie et Dynamisme Psychologique au Travail » (EDPT) auprès d’un échantillon didactique restreint de 10 participants adultes (identifiés formellement de S01 à S10).
L’instrument de mesure mobilisé comprend 5 énoncés soigneusement calibrés, évalués à travers une échelle de Likert classique symétrique en 5 points. Le protocole attribue explicitement les ancrages numériques et sémantiques suivants :
- 1 : Pas du tout d’accord (adhésion minimale)
- 2 : Plutôt pas d’accord
- 3 : Neutre / Ni en désaccord ni d’accord (médiane d’équilibre)
- 4 : Plutôt d’accord
- 5 : Tout à fait d’accord (adhésion maximale)
Les énoncés administrés aux 10 sujets sont formulés comme suit :
- Item 1 (Q1) : « Je ressens une motivation profonde lorsque j’entame mes projets professionnels. » (Item direct)
- Item 2 (Q2) : « Je me sens mentalement vidé et découragé par mes tâches quotidiennes. » (Item inversé)
- Item 3 (Q3) : « J’aborde les imprévus professionnels avec enthousiasme et sérénité. » (Item direct)
- Item 4 (Q4) : « J’ai le sentiment d’accomplir des réalisations hautement significatives. » (Item direct)
- Item 5 (Q5) : « La fatigue intellectuelle m’empêche de fonctionner efficacement. » (Item inversé)
4.2 Matrice des données initiales avant recodage
L’administration du questionnaire auprès de nos 10 répondants a généré la matrice d’enregistrements bruts présentée dans le tableau ci-dessous. Au sein de cette feuille de calcul préliminaire, les colonnes A à F correspondent respectivement aux identifiants des participants et à leurs réponses directes brutes pour les questions Q1 à Q5, sans aucune modification préalable.
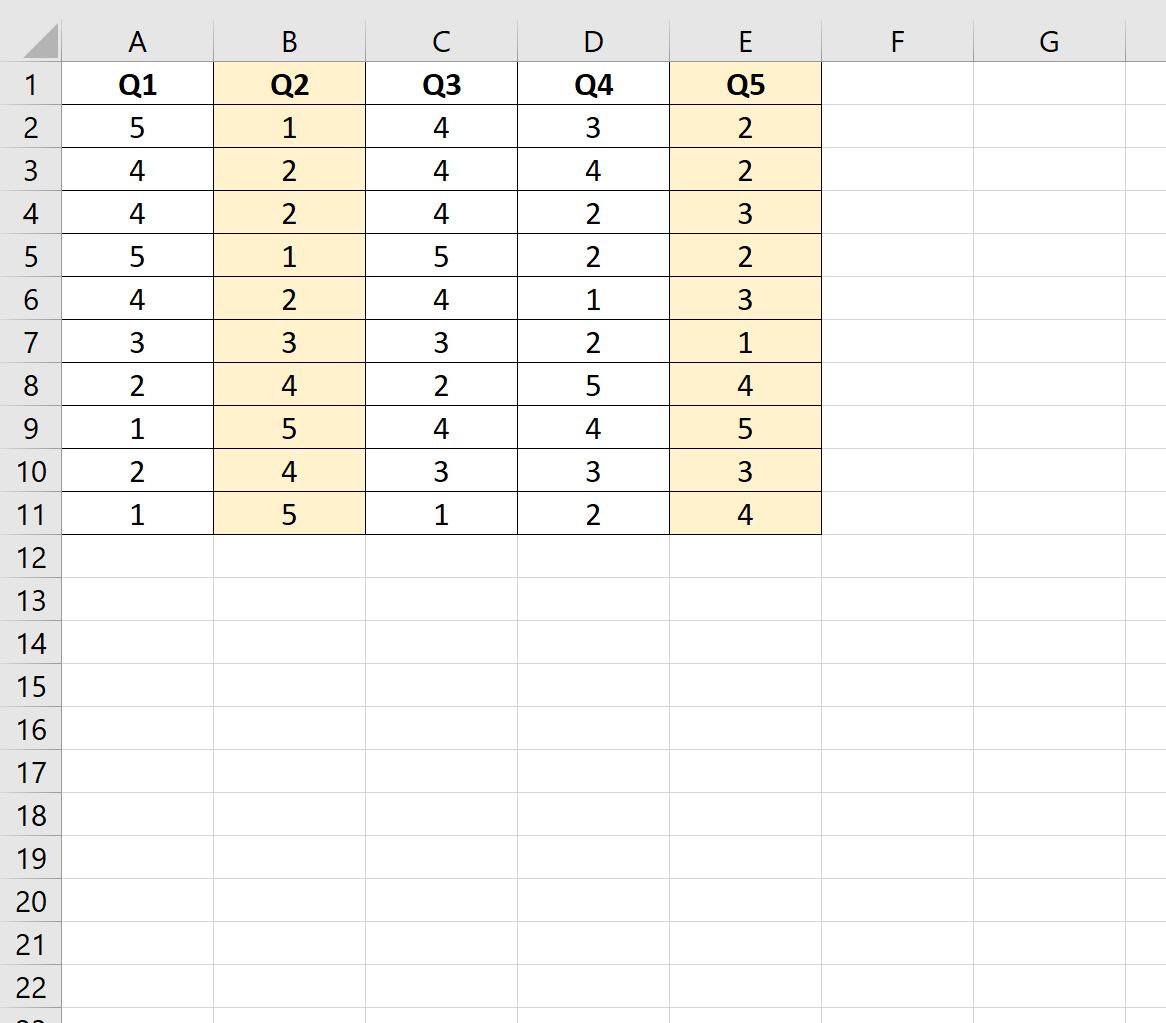
Examinons la distribution chiffrée issue de cette collecte :
- Sujet S01 : Q1 = 5 ; Q2 = 1 ; Q3 = 4 ; Q4 = 5 ; Q5 = 2
- Sujet S02 : Q1 = 4 ; Q2 = 2 ; Q3 = 4 ; Q4 = 4 ; Q5 = 1
- Sujet S03 : Q1 = 3 ; Q2 = 3 ; Q3 = 3 ; Q4 = 3 ; Q5 = 3
- Sujet S04 : Q1 = 2 ; Q2 = 4 ; Q3 = 2 ; Q4 = 2 ; Q5 = 4
- Sujet S05 : Q1 = 1 ; Q2 = 5 ; Q3 = 1 ; Q4 = 2 ; Q5 = 5
- Sujet S06 : Q1 = 4 ; Q2 = 1 ; Q3 = 5 ; Q4 = 4 ; Q5 = 2
- Sujet S07 : Q1 = 2 ; Q2 = 5 ; Q3 = 2 ; Q4 = 1 ; Q5 = 4
- Sujet S08 : Q1 = 5 ; Q2 = 2 ; Q3 = 4 ; Q4 = 5 ; Q5 = 1
- Sujet S09 : Q1 = 3 ; Q2 = 4 ; Q3 = 3 ; Q4 = 2 ; Q5 = 3
- Sujet S10 : Q1 = 4 ; Q2 = 2 ; Q3 = 3 ; Q4 = 4 ; Q5 = 2
Si un analyste inexpérimenté procédait immédiatement à la sommation brute de ces items pour calculer un score d’énergie psychologique pour chaque sujet (par exemple en posant la formule =SOMME(B2:F2) pour le sujet S01), le résultat obtenu serait dénué de tout sens méthodologique. Pour le sujet S01, qui présente une motivation éclatante (Q1 = 5) et un découragement quasi inexistant (Q2 = 1), le fait d’additionner ce « 1 » pénaliserait son score global, alors que ce score de 1 sur Q2 atteste en réalité d’un niveau d’énergie maximal. Le score composite brut est donc gravement faussé et sous-estimé pour les individus hautement résilients, et artificiellement gonflé pour les individus en souffrance psychologique.
4.3 Objectifs chiffrés de la transformation pour Q2 et Q5
L’opération de recodage a pour vocation de rétablir une parfaite équivalence de polarité vectorielle. Les items Q2 (« découragé ») et Q5 (« fatigue paralysante ») doivent être métamorphosés de telle sorte qu’un niveau d’accord élevé avec l’épuisement devienne numériquement minimal sur notre axe d’énergie psychologique, et inversement qu’un désaccord absolu avec ces états négatifs soit valorisé par le score d’énergie le plus élevé possible.
Puisque notre échelle est strictement bornée sur l’intervalle d’entiers [1, 5], la cible théorique de transmutation chiffrée s’énonce comme suit :
- Chaque occurrence du chiffre 1 dans les colonnes Q2 et Q5 doit être impérativement remplacée par la valeur 5.
- Chaque occurrence du chiffre 2 doit être transformée en 4.
- La modalité centrale 3 doit être conservée strictement à 3.
- Chaque occurrence du chiffre 4 doit devenir 2.
- Chaque occurrence du chiffre 5 doit être rétrogradée à 1.
Une fois cette transmutation appliquée à nos 10 sujets, le sujet S01 verra sa réponse Q2 (valeur brute = 1) transformée en 5, et sa réponse Q5 (valeur brute = 2) transformée en 4. Dès cet instant, les 5 dimensions mesurées convergeront harmonieusement vers l’expression d’un niveau supérieur de l’attribut latent « Énergie et Dynamisme Psychologique au Travail ». La matrice sera alors mathématiquement et psychométriquement prête pour l’agrégation statistique.
5. Méthode arithmétique directe dans Excel : La constante soustractive
5.1 Implémentation pas à pas de la formule standard
La technique la plus directe, la plus robuste sur le plan calculatoire et la moins gourmande en ressources mémoire pour implémenter un codage inversé dans Microsoft Excel repose sur l’application de la constante soustractive dérivée de l’équation standard étudiée à la section 2. Dans le cas de notre échelle de Likert à 5 points (allant de 1 à 5), la constante d’inversion s’établit à 5 + 1 = 6. L’instruction mathématique consiste simplement à soustraire la valeur brute observée de ce nombre pivot 6.
Pour exécuter cette transformation avec une netteté organisationnelle irréprochable, l’analyste crée deux nouvelles colonnes dédiées à côté des colonnes de données brutes, nommées respectivement Q2_INV en colonne G et Q5_INV en colonne H. Pour traiter la réponse du premier participant (sujet S01), dont la modalité brute pour la question Q2 est stockée dans la cellule C2, il suffit de saisir dans la cellule G2 la formule suivante :
=6-C2
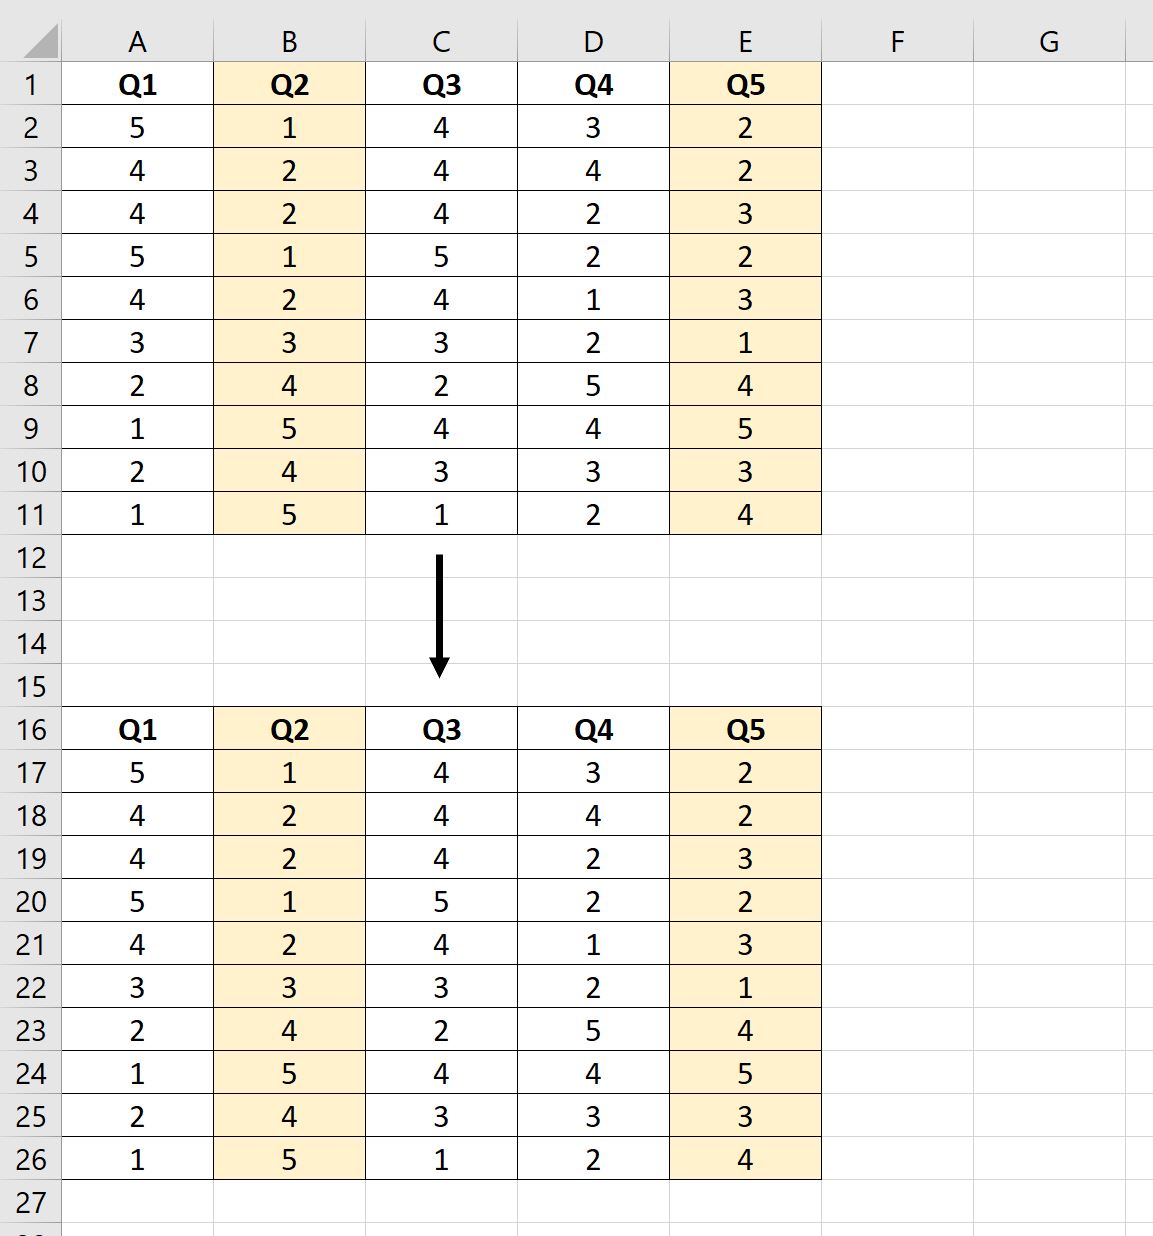
En validant par la touche Entrée, la cellule G2 renvoie instantanément la valeur 5 (puisque 6 – 1 = 5), ce qui correspond à la valeur inversée attendue. Pour propager cette transformation à l’ensemble des 10 participants, il suffit de cliquer sur la poignée de recopie (le petit carré noir situé à l’angle inférieur droit du cadre de sélection de la cellule G2) et de l’étirer vers le bas jusqu’à la cellule G11, ou plus rapidement d’effectuer un double-clic sur cette poignée pour déclencher la descente automatique de la formule sur toute la hauteur adjacente non vide du tableau.
La même logique opératoire s’applique immédiatement à l’item Q5. La réponse brute du premier sujet sur la question Q5 étant domiciliée en cellule F2, l’analyste se positionne dans la cellule H2 et saisit l’instruction :
=6-F2
Après extension de la formule vers le bas jusqu’à la ligne 11, l’ensemble des réponses à la question Q5 se retrouve parfaitement recodé. Cette méthode arithmétique se distingue par une vitesse d’exécution inégalée et une absence totale de complexité syntaxique.
5.2 Utilisation des références absolues pour rendre la formule dynamique
Bien que l’écriture « en dur » de la constante 6 dans la formule (=6-C2) soit très courante, elle présente une rigidité structurelle intrinsèque qui peut s’avérer problématique lors de protocoles de recherche itératifs ou d’études pilotes susceptibles d’évoluer vers des formats de réponse différents (par exemple le passage ultérieur d’une échelle à 5 points vers une échelle à 7 points). Pour hisser la feuille de calcul vers les meilleurs standards de modélisation paramétrique, il est vivement recommandé d’externaliser la valeur maximale de l’échelle au sein d’une cellule de configuration dédiée.
Désignons par exemple la cellule $J$1 comme le réceptacle du paramètre indiquant l’amplitude de l’échelle. L’analyste y inscrit manuellement la valeur 5. Dès lors, la constante arithmétique n’est plus figée arbitrairement dans le code, mais calculée dynamiquement par le logiciel en ajoutant 1 à la référence de cette cellule. Afin que cette référence ne dérive pas lors de la recopie incrémentale vers le bas de la colonne, l’emploi de l’opérateur de dollar ($) est impératif pour figer le positionnement matriciel en mode de référence absolue.
La formule paramétrique à insérer en cellule G2 prend alors la syntaxe suivante :
=($J$1+1)-C2
Grâce à cette architecture dynamique, si l’équipe de recherche décide de rééchelonner le test sur une échelle en 7 points et met à jour la cellule J1 en y saisissant le nombre 7, l’intégralité des milliers de calculs de codage inversé de la feuille se recalculera instantanément et sans risque d’erreur humaine en adoptant le nouveau pivot soustractif (7 + 1 = 8). Cette approche garantit une adaptabilité maximale et élimine tout risque d’omission lors de recalibrages expérimentaux.
5.3 Audit et validation des valeurs générées
Tout traitement automatisé de données doit faire l’objet d’un audit de conformité avant d’être validé pour l’analyse statistique inférentielle. Dans le cadre de l’inversion de score sous Excel, la première étape d’inspection consiste à opérer un contrôle visuel ponctuel sur des cas typiques remarquables au sein de notre cohorte de 10 participants :
- Vérification du score minimal brut : Le participant S01 présentait un score de 1 en Q2 ; la cellule G2 affiche bien 5. Le participant S06 présentait également 1 en Q2 ; G7 affiche bien 5.
- Vérification du score maximal brut : Le participant S05 présentait un score de 5 en Q2 et en Q5 ; les cellules G6 et H6 affichent rigoureusement la valeur 1.
- Vérification de la neutralité médiane : Le participant S03 présentait une attitude médiane neutre sur l’ensemble du questionnaire avec un score de 3 en Q2 et Q5 ; les cellules transformées G4 et H4 conservent scrupuleusement la valeur 3.
Pour auditer l’intégrité globale de l’implémentation sur de vastes volumes de données, l’analyste peut recourir au raccourci clavier universel Ctrl + " (sur les versions francophones, ou Ctrl + ` sur les claviers internationaux), qui bascule l’interface du tableur en mode Afficher les formules. Ce mode permet d’inspecter visuellement l’alignement absolu des indices de cellules d’une ligne à l’autre et de s’assurer qu’aucun décrochage d’adresse relative n’est venu corrompre la descente de la formule mathématique.
Enfin, une technique de vérification arithmétique élégante consiste à insérer temporairement une colonne de contrôle dont la formule additionne la colonne brute et la colonne inversée (=C2+G2). Si le codage inversé est exempt de tout défaut, la colonne de contrôle doit renvoyer sans la moindre déviation le chiffre constant 6 sur l’intégralité des lignes de la cohorte.
6. Méthode conditionnelle et logique : Utilisation des fonctions SI et CHOISIR
6.1 Recodage par imbrication de conditions logiques avec la fonction SI
Bien que l’élégance de la soustraction arithmétique directe soit indéniable pour les échelles régulières, certains praticiens formés aux algorithmes booléens préfèrent utiliser des structures conditionnelles explicites. Cette approche présente l’avantage d’exprimer textuellement chaque permutation, ce qui facilite la lecture par des non-statisticiens qui souhaitent visualiser la logique sous forme de règles « SI … ALORS … SINON ».
Dans Microsoft Excel, l’implémentation conditionnelle classique pour une échelle de Likert en 5 points s’effectue par l’imbrication successive de plusieurs fonctions SI. Pour recoder la cellule C2 (item Q2 du premier participant) au sein de la colonne G2, la syntaxe intégrale s’écrit :
=SI(C2=1; 5; SI(C2=2; 4; SI(C2=3; 3; SI(C2=4; 2; SI(C2=5; 1; "")))))
Le déroulement algorithmique de cette instruction est séquentiel. Le moteur d’évaluation d’Excel examine d’abord si la cellule C2 contient la valeur 1 ; si l’assertion est vérifiée, il lui assigne immédiatement le chiffre 5 et interrompt le calcul. Dans le cas contraire, il bascule vers le bloc conditionnel alternatif suivant, testant la présence du chiffre 2, et ainsi de suite jusqu’au chiffre 5. Le dernier argument (les guillemets vides "") offre une sécurité précieuse : si la cellule testée ne contient aucun des chiffres admissibles (par exemple en cas de cellule vide ou de saisie aberrante d’une lettre), le système renvoie un champ vide plutôt qu’un chiffre erroné.
Néanmoins, cette méthode d’imbrication présente des désavantages majeurs. D’une part, elle est hautement verbeuse et propice aux erreurs de syntaxe lors de la saisie manuelle des multiples parenthèses terminales. D’autre part, sur des échelles étendues (comme des échelles d’évaluation de la douleur graduées de 0 à 10), la complexité visuelle devient rédhibitoire et accroît substantiellement la charge cognitive requise lors de la relecture de la formule.
6.2 Alternative élégante via la fonction CHOISIR
Pour contourner la lourdeur des fonctions logiques imbriquées tout en conservant une approche d’attribution discrète non arithmétique, la fonction native CHOISIR (connue sous l’appellation CHOOSE dans les versions anglophones d’Excel) représente une alternative d’une remarquable simplicité conceptuelle. La fonction CHOISIR utilise le premier argument qu’on lui fournit comme un index positionnel entier (1, 2, 3, etc.) pour aller extraire l’élément correspondant dans la liste ordonnée des arguments suivants.
La structure syntaxique pour recoder l’item C2 sur notre échelle de Likert à 5 points prend la forme épurée suivante :
=CHOISIR(C2; 5; 4; 3; 2; 1)
Le fonctionnement mécanique est d’une clarté totale :
- Si le contenu de la cellule C2 est égal à 1, la fonction sélectionne le 1er argument de sa liste, qui est le nombre 5.
- Si C2 est égal à 2, elle extrait le 2e argument, soit le nombre 4.
- Si C2 est égal à 3, elle extrait le 3e argument, soit le nombre 3.
- Si C2 est égal à 4, elle extrait le 4e argument, soit le nombre 2.
- Si C2 est égal à 5, elle extrait le 5e argument, soit le nombre 1.
Cette syntaxe supprime l’arborescence touffue des conditions logiques tout en exécutant rigoureusement la même tâche. De plus, sur le plan computationnel, la fonction CHOISIR est exécutée plus rapidement par le processeur d’Excel que cinq niveaux successifs d’arbres de décision logiques. En revanche, elle impose une contrainte rigide absolue : la variable source doit impérativement être composée d’entiers consécutifs strictement positifs débutant obligatoirement à 1. Si la cellule contient un 0 ou un chiffre supérieur au nombre d’arguments fournis, la fonction générera irrémédiablement l’erreur #VALEUR!.
6.3 Comparatif d’efficacité entre approche arithmétique et approche logique
Face à la multiplicité des solutions techniques offertes par Excel, le chercheur doit opérer un arbitrage éclairé entre vitesse de traitement, tolérance aux modifications de structure et lisibilité opérationnelle par des pairs non spécialistes. La confrontation méthodique de l’approche arithmétique (=6-C2) et des approches logiques (SI ou CHOISIR) révèle des disparités fonctionnelles notables.
L’approche arithmétique se distingue par une supériorité absolue en termes d’efficience mathématique. Elle requiert une écriture minimale, s’adapte sans effort aux très grands volumes de données (plusieurs dizaines de milliers de lignes) sans alourdir le fichier, et peut être aisément paramétrée via des références absolues de cellules comme démontré précédemment. En outre, elle accepte naturellement des calculs sur des échelles continues ou quasi-continues sans nécessiter la redéfinition exhaustive de chaque palier numérique.
En contrepartie, les approches logiques offrent une meilleure traçabilité pour les évaluateurs externes qui ne maîtrisent pas la mécanique soustractive de la constante. La fonction CHOISIR, tout particulièrement, constitue une passerelle pédagogique rassurante car elle matérialise l’inversion sous la forme d’un tableau de valeurs ordonné directement visible au sein de la formule. Cependant, en cas de recalibrage de l’échelle (par exemple l’extension vers un format en 7 points), l’approche logique impose de réécrire manuellement l’ensemble des arguments de chaque cellule, là où l’approche arithmétique paramétrique ne sollicite que la modification instantanée d’une unique cellule pivot. L’approche arithmétique demeure donc la méthode de référence préconisée dans le cadre d’une pratique de recherche professionnelle.
7. Méthode par table de correspondance : Fonctions RECHERCHEV et RECHERCHEX
7.1 Création d’une table de transcodage dédiée
Lorsque les protocoles de recherche intègrent des codages hétérogènes, des libellés textuels ou des modalités qualitatives qui ne se prêtent pas immédiatement à une manipulation arithmétique (par exemple des exports de données brutes contenant textuellement « Pas d’accord », « Neutre », etc.), la méthode la plus pérenne réside dans l’édification d’une table de transcodage externe. Cette architecture sépare formellement les règles de conversion de la matrice des données opérationnelles.
Pour concevoir cette table de transcodage, l’analyste insère un nouvel onglet dans son classeur Excel, qu’il nomme judicieusement Paramètres ou Lookup_Tables. Au sein de cet onglet, une matrice compacte de deux colonnes est structurée :
- La première colonne (par exemple en A1:A5), intitulée Score_Original, répertorie les modalités brutes admissibles : 1, 2, 3, 4, 5.
- La seconde colonne (en B1:B5), intitulée Score_Recodé, aligne en vis-à-vis la valeur cible inversée correspondante : 5, 4, 3, 2, 1.
Afin de fluidifier la rédaction des futures formules et d’éliminer toute manipulation fastidieuse de coordonnées de cellules avec dollars, il est particulièrement élégant de nommer cette plage matricielle dans le Gestionnaire de noms d’Excel (accessible via le ruban Formules > Définir un nom). En attribuant le nom explicite Table_Inversion à la plage Paramètres!$A$2:$B$6, le chercheur dispose d’une constante de référence globale accessible depuis n’importe quelle cellule du classeur.
7.2 Mise en œuvre technique avec RECHERCHEV
La fonction RECHERCHEV (ou VLOOKUP en version anglophone) représente l’outil historique de transcodage le plus universellement utilisé sur Excel depuis des décennies. Son mécanisme consiste à rechercher verticalement une valeur cible dans la première colonne d’une table de référence, puis à extraire la donnée située sur la même ligne dans une colonne spécifiée.
Pour recoder la cellule C2 (item Q2 de notre premier sujet) au sein de la colonne de recodage en utilisant notre table nommée, la syntaxe exacte s’exprime comme suit :
=RECHERCHEV(C2; Table_Inversion; 2; FAUX)
L’analyse détaillée des paramètres constitutifs de cette fonction met en lumière sa rigueur :
- C2 : Désigne la valeur cherchée (le score brut de l’item à recoder).
- Table_Inversion : Indique la matrice de transcodage de référence (ou la plage absolue Paramètres!$A$2:$B$6).
- 2 : Précise le numéro d’index de la colonne d’où doit être extraite la nouvelle valeur (ici, la deuxième colonne de notre table, contenant les scores inversés).
- FAUX : Représente le paramètre déterminant de correspondance exacte. Cette instruction interdit absolument à Excel d’interpoler une valeur approximative si le chiffre cherché ne figure pas rigoureusement dans la table.
L’omission de ce quatrième paramètre (qui prend la valeur VRAI par défaut dans Excel) constituerait une erreur méthodologique fatale : si la table de référence n’était pas scrupuleusement triée par ordre croissant, le tableur pourrait renvoyer des valeurs aberrantes sans émettre le moindre message d’alerte, corrompant insidieusement les analyses psychométriques ultérieures.
7.3 Mise en œuvre moderne avec la fonction RECHERCHEX
Pour les utilisateurs équipés des versions contemporaines de la suite logicielle (Microsoft 365, Office 2021 et versions ultérieures), la fonction classique RECHERCHEV est désormais avantageusement supplantée par la fonction RECHERCHEX (ou XLOOKUP). Cette innovation architecturale élimine les vulnérabilités structurelles de son ancêtre en dissociant le vecteur de recherche du vecteur de restitution, et en intégrant nativement la gestion des erreurs de correspondance.
En exploitant notre table de correspondance domiciliée sur l’onglet Paramètres dans les colonnes distinctes Paramètres!$A$2:$A$6 (plage de recherche) et Paramètres!$B$2:$B$6 (plage de renvoi), l’instruction pour recoder la cellule C2 devient :
=RECHERCHEX(C2; Paramètres!$A$2:$A$6; Paramètres!$B$2:$B$6; "Invalide"; 0)
Cette formulation moderne confère une solidité incomparable au traitement des données :
- Le mode de correspondance exacte (matérialisé par le dernier argument 0) est désormais activé par défaut par le moteur de calcul, ce qui immunise le chercheur contre les erreurs de tri de table inhérentes à RECHERCHEV.
- L’argument textuel "Invalide" inséré en quatrième position intercepte instantanément les anomalies de saisie (comme un score accidentellement saisi à 6 ou 9) sans bloquer la feuille de calcul avec une erreur technique brute de type #N/A.
- L’insertion ultérieure de colonnes décoratives ou explicatives au sein de la table de paramètres ne brise pas l’intégrité de la formule, car les plages de cellules sources et cibles sont référencées de manière totalement découplée.
8. Automatisation matricielle dynamique : Fonctions LAMBDA, MAP et LET
8.1 Lisibilité et optimisation des calculs avec la fonction LET
Les versions récentes de Microsoft Excel ont profondément modernisé le paradigme de calcul sur tableur en intégrant des fonctionnalités inspirées des langages de programmation fonctionnelle. Au cœur de cette évolution figure la fonction LET, qui autorise la déclaration de variables locales intermédiaires au sein même d’une formule de cellule. Cette possibilité décuple la lisibilité des calculs psychométriques complexes tout en réduisant considérablement la charge computationnelle du processeur sur les volumineuses bases de données d’enquêtes nationales.
Dans un contexte d’inversion d’item Likert, l’emploi de LET permet d’expliciter chaque composante du calcul sous un nom évocateur avant d’ordonner la résolution mathématique finale. Pour recoder la cellule C2, la structure s’énonce comme suit :
=LET(max_echelle; 5; score_brut; C2; (max_echelle + 1) – score_brut)
L’évaluation s’exécute selon une clarté limpide : le système affecte la valeur 5 à la variable interne temporaire max_echelle, extrait le contenu de C2 pour le stocker dans score_brut, puis résout l’opération algébrique finale en injectant ces identifiants clairs. Cette méthode élimine les équations opaques composées de coordonnées de cellules cryptiques et permet à tout auditeur scientifique externe de comprendre immédiatement l’intention théorique de l’analyste sans nécessiter de notice explicative annexe.
8.2 Transformation dynamique d’une colonne entière via MAP et LAMBDA
L’une des limitations chroniques des approches traditionnelles sur tableur réside dans l’obligation de propager physiquement les formules ligne par ligne vers le bas au moyen de la poignée de recopie. Cette pratique génère une redondance massive de formules identiques et expose le chercheur à un risque majeur de désynchronisation structurelle si une formule est accidentellement altérée ou supprimée sur une seule ligne au sein d’une série de plusieurs centaines d’enregistrements.
Grâce à la combinaison révolutionnaire des fonctions MAP et LAMBDA introduite dans les moteurs de calcul dynamique d’Excel (Dynamic Spill Arrays), il est désormais possible de transformer l’intégralité d’un vecteur de données d’une colonne entière à travers une unique formule matricielle inscrite exclusivement dans la cellule supérieure.
Pour recoder d’un seul bloc l’ensemble des réponses brutes de nos 10 sujets pour l’item Q2 (cellules C2:C11), il suffit de sélectionner la cellule unique G2 et de saisir l’instruction matricielle suivante :
=MAP(C2:C11; LAMBDA(valeur_brute; 6 – valeur_brute))
En validant cette formule par une simple pression sur la touche Entrée, le phénomène de « déversement matriciel » (spill) s’enclenche instantanément : les résultats calculés se propagent d’eux-mêmes de la cellule G2 jusqu’à la cellule G11, encadrés par une bordure fine bleue dynamique. Les cellules sous-jacentes (G3 à G11) ne contiennent aucune formule modifiable, ce qui neutralise tout risque d’écrasement partiel accidentel. Si l’on ajoute ultérieurement des répondants en étendant la plage source, la plage de déversement s’ajuste en temps réel sans la moindre intervention manuelle de recopie.
8.3 Création d’une fonction personnalisée RECODER_LIKERT
Le summum de l’automatisation et de l’élégance logicielle dans Microsoft Excel contemporain réside dans la capacité à forger ses propres fonctions de calcul psychométrique sans recourir à la moindre ligne de programmation Visual Basic (VBA). Grâce à l’association du constructeur LAMBDA et du Gestionnaire de noms, tout chercheur peut modéliser une fonction personnalisée réutilisable dans l’ensemble de son environnement de travail.
Pour concevoir cette fonction native dédiée, la procédure se décompose ainsi :
- Accéder au ruban supérieur : Formules > Définir un nom.
- Dans le champ Nom, saisir l’identifiant opératoire : RECODER_LIKERT.
- Dans le champ Fait référence à, saisir rigoureusement la définition fonctionnelle suivante :
=LAMBDA(reponse; borne_max; (borne_max + 1) – reponse) - Valider en cliquant sur OK.
Dès cet instant, Excel reconnaît formellement RECODER_LIKERT comme une fonction de calcul native du classeur. Pour recoder la cellule C2 dont l’échelle est plafonnée à 5, l’analyste écrit simplement dans sa feuille de calcul :
=RECODER_LIKERT(C2; 5)
Cette approche modulaire standardise les protocoles d’analyse au sein d’un laboratoire de recherche ou d’un cabinet d’évaluation psychologique. Elle encapsule l’intelligence mathématique de l’inversion de score au sein d’une routine inviolable, éliminant les confusions récurrentes liées aux constantes additives et garantissant une reproductibilité sans faille de l’ensemble des transmutations d’échelles au fil des études successives.
9. Traitement des valeurs manquantes et gestion des anomalies
9.1 Préservation de l’intégrité face aux cellules vides
Dans la pratique réelle de la collecte de données psychométriques — que ce soit lors d’enquêtes de terrain sur formulaire papier ou via des protocoles informatisés autorisant l’omission volontaire —, l’apparition de valeurs manquantes (cellules vides dans la feuille de calcul) est un phénomène inévitable. L’application aveugle et non protégée d’une formule arithmétique de codage inversé à une cellule vide constitue l’un des pièges les plus dévastateurs pour l’intégrité d’une étude.
En effet, par convention de conception mathématique fondamentale, Microsoft Excel évalue une cellule vide comme étant équivalente au chiffre arithmétique zéro (0) dès lors qu’elle est sollicitée au sein d’une opération soustractive ou additive. Par conséquent, si un participant omet de répondre à l’item Q2 et que la cellule C2 demeure vierge, l’exécution mécanique de la formule standard =6-C2 ne générera aucun message d’erreur d’alerte, mais renverra silencieusement l’opération 6 – 0 = 6.
Ce dysfonctionnement insidieux attribue automatiquement au sujet omis un score de 6, qui non seulement excède la borne maximale autorisée de l’échelle (1 à 5), mais constitue de surcroît une imputation frauduleuse majeure : un individu qui n’a fourni aucun avis se retrouve subitement crédité du score de vitalité le plus spectaculaire du groupe d’étude. Pour juguler ce risque, il est impératif d’encapsuler la formule arithmétique au sein d’un test logique préalable au moyen de la fonction ESTVIDE :
=SI(ESTVIDE(C2); ""; 6 – C2)
Grâce à ce garde-fou algorithmique, si la cellule source est vide, Excel restitue une chaîne vide (""), préservant ainsi la nature manquante de l’enregistrement. L’intégrité de la variance de la cohorte est totalement protégée, évitant tout biais artificiel d’inflation des moyennes de groupe.
9.2 Gestion des codes numériques réservés aux valeurs manquantes
De nombreux logiciels de recueil de données et plateformes d’enquêtes psychologiques n’exportent pas les omissions de réponse sous forme de cellules vides, mais recourent à des conventions d’encodage numériques réservées établies par les standards méthodologiques internationaux, telles que les codes 9, 99, ou -9 (désignant généralement le « Refus de répondre », « Ne sait pas » ou la « Perte de signal »).
Si la cellule C2 contient le code de non-réponse 9 et qu’une formule d’inversion directe =6-C2 lui est appliquée, Excel effectuera l’opération arithmétique 6 – 9 = -3. Cette valeur négative aberrante dénaturera instantanément toute tentative d’estimation ultérieure de la fidélité de l’échelle. Pour neutraliser ce problème structurel, la formule de transformation doit intégrer un filtre de détection multidimensionnel capable d’isoler à la fois les cellules vides et les codes conventionnels spécifiques :
=SI(OU(ESTVIDE(C2); C2=9; C2=99; C2=-9); C2; 6 – C2)
En vertu de cette structure conditionnelle enrichie, si la cellule C2 contient l’une des étiquettes réservées aux données manquantes, cette étiquette est conservée intacte telle quelle sans subir la moindre altération mathématique. Les phases ultérieures de nettoyage de données et de filtrage statistique pourront ainsi identifier et ségréger sans ambiguïté les participants non engagés avant de procéder à l’estimation des modèles de mesure.
9.3 Détection automatique des valeurs hors bornes
L’assurance qualité des calculs psychométriques exige une surveillance stricte du domaine de validité numérique des entrées. Des erreurs de saisie manuelle (par exemple appuyer par mégarde sur deux touches adjacentes, saisissant un 54 au lieu d’un 5) ou des corruptions partielles de fichiers peuvent introduire des valeurs aberrantes qui, si elles sont inversées aveuglément, détruiront la fiabilité des analyses statistiques.
Une formulation de sécurité avancée consiste à imposer un contrôle de bornes strict avant toute opération de soustraction arithmétique. La fonction logique ET permet de vérifier simultanément que la valeur brute observée appartient sans conteste à l’intervalle théorique [1, 5] :
=SI(ESTVIDE(C2); ""; SI(ET(C2>=1; C2<=5); 6 – C2; "ERREUR_VALEUR"))
Le fonctionnement de cette barrière logicielle est complet :
- Si la cellule est vide, elle demeure vide.
- Si la valeur est comprise entre 1 et 5 inclusivement, le codage inversé arithmétique standard s’applique parfaitement.
- Si la valeur est strictement inférieure à 1 ou strictement supérieure à 5, la cellule affiche distinctement le message d’alerte textuel "ERREUR_VALEUR".
L’analyste peut ensuite mobiliser un simple filtre automatique ou une mise en forme conditionnelle sur cette mention d’erreur pour localiser et corriger manuellement les anomalies d’encodage au sein des questionnaires physiques primaires avant de lancer les calculs définitifs.
10. Calcul des scores composites post-inversion et analyses psychométriques
10.1 Agrégation du score total global et calcul des moyennes
Dès lors que l’ensemble des colonnes d’items antagonistes a fait l’objet d’un codage inversé validé, les données ont recouvré leur stricte unidimensionnalité et leur cohérence directionnelle. Il devient désormais méthodologiquement légitime de procéder à l’agrégation des scores pour chaque participant afin de quantifier le niveau global de l’attribut latent mesuré (« Énergie et Dynamisme Psychologique au Travail »).
Le calcul du Score Total composite pour chaque sujet s’opère en sommant l’ensemble des items alignés. Il convient de porter une attention extrême à la sélection rigoureuse des colonnes : les items directs d’origine (Q1, Q3, Q4) doivent être sommés avec les colonnes d’items inversés recodés (Q2_INV, Q5_INV), en évitant absolument d’inclure par inadvertance les colonnes d’items bruts négatifs d’origine. Pour notre premier participant (sujet S01), dont les données sont domiciliées sur la ligne 2, la formule d’agrégation sommatrice à inscrire dans la colonne Score_Total (colonne I) s’écrit :
=B2 + G2 + D2 + E2 + H2
Ou, de manière équivalente via la fonction native SOMME :
=SOMME(B2; G2; D2:E2; H2)
Parallèlement, dans la plupart des publications scientifiques, le Score Moyen individuel est préféré au score total brut sommatif, car il conserve l’interprétabilité directe de l’échelle d’ancrage d’origine (1 à 5). L’analyste insère dans la colonne Score_Moyen (colonne J) l’instruction suivante :
=MOYENNE(B2; G2; D2:E2; H2)
Examinons l’impact spectaculaire de cette rigueur de calcul sur nos participants extrêmes de l’échantillon didactique. Pour le participant S01, le score total s’élève désormais à : 5 (Q1) + 5 (Q2_INV) + 4 (Q3) + 5 (Q4) + 4 (Q5_INV) = 23 sur 25, correspondant à une moyenne individuelle éclatante de 4,60 sur 5. Si l’inversion avait été omise, son score total n’aurait été que de 17, reléguant injustement ce profil hautement dynamique dans une fausse moyenne médiane.
À l’autre extrémité de la cohorte, le participant S05 (souffrant d’épuisement massif) enregistre désormais : 1 (Q1) + 1 (Q2_INV) + 1 (Q3) + 2 (Q4) + 1 (Q5_INV) = 6 sur 25, soit une moyenne de 1,20 sur 5. L’échelle reflète enfin avec une acuité clinique parfaite les disparités psychologiques de l’échantillon.
10.2 Évaluation de la consistance interne de l’échelle dans Excel
La validation fondamentale de l’exécution d’un codage inversé en psychométrie s’illustre de façon éclatante lors de l’estimation de la consistance interne de l’instrument à travers le calcul du célèbre coefficient Alpha de Cronbach (noté α). Ce coefficient quantifie le degré auquel l’ensemble des items d’une échelle mesure le même construit latent unidimensionnel.
L’équation mathématique du coefficient Alpha s’exprime comme suit :
α = (k / (k – 1)) * [1 – (Σ(s²_i) / s²_total)]
Où :
- k représente le nombre total d’items composant l’échelle (ici, k = 5).
- s²_i représente la variance observée pour chaque item individuel i.
- Σ(s²_i) représente la somme arithmétique des variances de chacun des 5 items.
- s²_total représente la variance globale du score total agrégé de l’échelle.
Dans Microsoft Excel, ce calcul s’exécute avec une remarquable transparence sans nécessiter de macro VBA :
- Sous chaque colonne d’items alignés (Q1 en B, Q2_INV en G, Q3 en D, Q4 en E, Q5_INV en H), calculer la variance d’échantillon à l’aide de la fonction native VAR.S appliquée aux lignes 2 à 11 (ex. en cellule B13 : =VAR.S(B2:B11)).
- Additionner ces 5 variances d’items dans une cellule dédiée pour obtenir le terme Σ(s²_i) : =SOMME(B13; G13; D13:E13; H13).
- Calculer la variance de la colonne du Score Total (colonne I) : =VAR.S(I2:I11) pour obtenir le terme s²_total.
- Calculer enfin l’Alpha de Cronbach dans une cellule finale en saisissant la formule globale :
=(5 / (5 – 1)) * (1 – (Cellule_Somme_Variances / Cellule_Variance_Totale))
Si l’analyste exécute ce calcul sur les données correctement recodées de notre cas pratique, l’Alpha de Cronbach atteint une valeur hautement satisfaisante (supérieure à 0,85), attestant d’une excellente consistance interne de l’échelle d’énergie psychologique. En revanche, si ce même calcul est reconduit par mégarde sur les données brutes non inversées (en incluant Q2 et Q5 bruts), la variance totale du test se retrouve drastiquement compressée en raison de l’annulation mutuelle des covariances opposées. Le coefficient Alpha plonge alors de manière spectaculaire pour s’effondrer vers des valeurs négatives ou très proches de zéro (ex. α < 0,15). Cette chute brutale de l’Alpha de Cronbach constitue le témoin statistique irréfutable de l’absence impardonnable de codage inversé au sein du modèle de mesure.
10.3 Analyse des corrélations inter-items
L’inspection analytique approfondie d’une échelle d’évaluation nécessite la modélisation de sa matrice de corrélation de Pearson inter-items. Cette matrice cartographie l’ensemble des coefficients d’association linéaire unitaire liant chaque question à toutes les autres au sein du protocole d’évaluation.
Pour générer cette matrice au sein de Microsoft Excel :
- Activer, si ce n’est déjà fait, le complément statistique officiel en accédant à : Fichier > Options > Compléments > Gérer : Compléments Excel > Atteindre, puis cocher Utilitaire d’analyse.
- Se rendre sur le ruban supérieur : Données > Analyse de données.
- Sélectionner la commande statistique Corrélation.
- Dans la boîte de dialogue, renseigner la plage d’entrée regroupant les colonnes alignées (Q1, Q2_INV, Q3, Q4, Q5_INV), spécifier le groupement par colonnes et cocher la case Intitulés en première ligne.
Après validation, Excel génère un tableau matriciel carré. Lorsque le codage inversé a été fidèlement exécuté, un constat fondamental saute aux yeux du statisticien : l’intégralité des coefficients de corrélation hors-diagonale présente un signe strictement positif. Les items Q2_INV et Q5_INV corrèlent positivement avec Q1, Q3 et Q4, confirmant que tous les énoncés tirent de concert dans la même direction psychométrique.
Si un analyste observe au sein de sa matrice finale une colonne exhibant une série de corrélations systématiquement négatives avec la totalité des autres variables du construit, cette observation constitue un signal d’alarme diagnostique sans équivoque : un item formulé négativement a été malencontreusement oublié lors du processus de recodage, ou a subi une double inversion accidentelle. La matrice de corrélation constitue ainsi l’outil d’audit de second niveau le plus fiable en psychométrie empirique.
11. Bonnes pratiques, traçabilité et erreurs courantes lors du codage inversé
11.1 Préservation inviolable de la base de données brute
La règle d’or fondamentale de toute pratique de recherche quantitative et de science des données énonce qu’une base de données brute primaire (Raw Data) doit demeurer rigoureusement sacralisée, immuable et protégée contre toute altération directe. Il est méthodologiquement inacceptable d’utiliser la fonctionnalité « Rechercher et remplacer » d’Excel pour écraser les chiffres d’origine directement au sein des colonnes initiales de saisie.
L’écrasement destructif des données brutes prive définitivement l’investigateur de la possibilité d’auditer la chaîne de traitement en cas de doute ultérieur, rend impossible toute vérification par des pairs scientifiques lors de la soumission d’articles dans des revues à comité de lecture, et détruit l’accès aux réponses originelles des participants. La démarche scientifique impose une stricte séparation des couches fonctionnelles :
- La couche des données brutes (conservée dans un onglet dédié ou exportée dans un fichier source en lecture seule).
- La couche des données transformées et recodées (située dans de nouvelles colonnes ou sur une feuille de calcul intermédiaire explicitement étiquetée).
- La couche d’analyse statistique et de synthèse (regroupant les formules matricielles, calculs d’Alphas, moyennes et représentations graphiques).
En outre, l’analyste chevronné veillera à consigner de manière exhaustive chaque transformation au sein d’un onglet de documentation méthodologique (souvent intitulé README ou Journal_Modifications). Ce fichier de traçabilité détaille avec précision la date du traitement, l’identité de l’opérateur, les identifiants précis des colonnes inversées, la formule mathématique spécifique employée et la justification théorique associée, garantissant une reproductibilité computationnelle intégrale.
11.2 Inventaire des erreurs fréquentes rencontrées dans la pratique
L’expérience accumulée auprès de générations d’étudiants en recherche et de consultants d’études met en lumière la récurrence de pièges méthodologiques classiques lors de l’exécution de codages inversés sous tableur. L’inventaire suivant répertorie les défaillances les plus communes afin de s’en prémunir activement :
L’erreur d’offset arithmétique constante (Soustraction sans le +1) : C’est sans conteste la méprise la plus dévastatrice. Elle consiste à soustraire la valeur brute directement de la valeur maximale de l’échelle au lieu de (Valeur_Max + 1). Par exemple, sur une échelle de 1 à 5, poser la formule =5-C2. Cette équation tronquée transmute un 5 en 0, et un 1 en 4. Non seulement l’échelle est décalée d’une unité, mais elle engendre des zéros qui sont exclus de l’univers de définition de l’échelle d’origine.
La double inversion cyclique : Cette anomalie survient fréquemment lorsque plusieurs membres d’une équipe de recherche se partagent un même classeur d’analyse sans protocole de versionnement strict. Un second analyste, constatant la présence d’une colonne d’item négatif non documentée explicitement, réapplique un script de recodage sur une colonne qui avait déjà été inversée par son collègue. En vertu de la propriété involutive des fonctions d’inversion, la variable se retrouve instantanément rétablie dans sa polarité négative fautive d’origine.
L’inversion d’items syntaxiquement ambigus sans base théorique : L’erreur d’appréciation sémantique consiste à recoder des questions qui ne partagent pas d’opposition polaire réelle avec le construit, mais qui introduisent simplement une nuance ou une dimension connexe. Ce biais altère la validité de contenu du test.
La confusion des formats textuels et numériques : Importer des données d’enquêtes où les réponses sont enregistrées sous forme de caractères textuels (« 1 », « 2 » avec espace insécable ou apostrophe initiale masquée). Dans cette configuration, la soustraction arithmétique peut générer l’erreur #VALEUR! ou forcer des conversions implicites imprévisibles selon les versions linguistiques du système d’exploitation.
11.3 Procédures d’audit et de contrôle qualité des calculs
Pour certifier la robustesse absolue d’une matrice psychométrique avant de diffuser des résultats cliniques ou de soumettre des conclusions empiriques à publication, la mise en place d’une routine de contrôle qualité standardisée est indispensable. Trois procédures de vérification systématique doivent être rigoureusement appliquées au sein d’Excel :
La première procédure repose sur la colonne de somme de contrôle invariante. Pour toute colonne d’item inversé (ex. G2 pour Q2_INV), l’analyste crée temporairement une colonne de contrôle adjacente appliquant la formule =C2+G2. L’observateur applique ensuite la fonction MIN et MAX sur l’intégralité de cette colonne de somme de contrôle. Si le minimum est strictement égal à 6 et que le maximum est strictement égal à 6, l’invariance mathématique est certifiée à 100 % sur l’ensemble de la série d’enregistrements. Toute fluctuation numérique trahit immédiatement une anomalie locale.
La deuxième procédure exploite le filtrage automatique sélectif. En activant le filtre automatique (Ctrl + Maj + L) sur la ligne d’en-tête, le chercheur déploie le menu déroulant situé au sommet de chaque colonne recodée. L’inspection visuelle immédiate des valeurs uniques présentes dans la liste permet de s’assurer qu’aucun chiffre hors bornes (comme des 0, des 6 ou des codes négatifs résiduels) n’est présent dans le jeu de données.
La troisième procédure consiste en une revue par les pairs croisée indépendante (Code & Data Review). Un second statisticien ou collaborateur du laboratoire réexamine la chaîne de calculs à partir du livre de codes, en recalculant les scores composites de façon indépendante sur une copie vierge du fichier brut. La concordance parfaite des résultats finaux scelle la validation définitive de l’audit méthodologique.
12. Transition méthodologique : D’Excel aux progiciels statistiques avancés
12.1 Limites intrinsèques d’Excel pour la psychométrie lourde
Bien que Microsoft Excel demeure un instrument pédagogique et opérationnel remarquable pour appréhender la mécanique intime des transformations linéaires sur des cohortes réduites (telle que notre échantillon didactique de 10 participants), ses limites architecturales deviennent particulièrement pénalisantes dès lors que la recherche psychométrique s’étend à des dimensions industrielles ou académiques de grande envergure.
La première vulnérabilité réside dans la manipulation d’échantillons massifs de standardisation psychologique comprenant des dizaines de milliers de répondants et des centaines d’items. Sur de tels volumes, la multiplication de formules complexes de cellules étirées dégrade significativement la réactivité du moteur de calcul et dilate de façon disproportionnée le poids du fichier sur le disque dur. De surcroît, le risque de fausse manœuvre humaine — telle qu’un glisser-déposer involontaire décalant d’une seule ligne une plage de calcul — demeure une menace latente permanente dans un tableur dépourvu d’étanchéité stricte entre code et données.
Enfin, sur le plan des fonctionnalités psychométriques pures, Excel ne dispose d’aucune commande native pour modéliser des analyses factorielles exploratoires (AFE), des analyses factorielles confirmatoires (AFC), des modèles d’équations structurelles (SEM) ou des calibrations selon la théorie de la réponse aux items (TRI / Rasch). Dès lors que la recherche requiert des tests de validité multidimensionnelle ou le traitement d’effets de méthode liés aux items inversés, la migration méthodologique vers des environnements de programmation statistique dédiés devient une nécessité absolue.
12.2 Équivalences syntaxiques dans les logiciels spécialisés
La transition d’une maquette de calcul conçue sous Excel vers des progiciels statistiques de renommée internationale s’appuie sur une stricte équivalence conceptuelle. Il est extrêmement enrichissant pour l’analyste de maîtriser la traduction syntaxique directe de son codage inversé au sein des écosystèmes logiciels majeurs de la recherche en sciences humaines :
Environnement SPSS Statistics : Dans l’environnement classique d’IBM SPSS, le codage inversé s’exécute traditionnellement via la syntaxe formelle de recodage créant de nouvelles variables cibles afin de préserver les vecteurs d’origine :
RECODE Q2 Q5 (1=5) (2=4) (3=3) (4=2) (5=1) INTO Q2_r Q5_r.
EXECUTE.
Ou de façon arithmétique directe via l’instruction :
COMPUTE Q2_r = 6 – Q2.
COMPUTE Q5_r = 6 – Q5.
EXECUTE.
Langage R (Écosystèmes tidyverse et package psych) : En langage R, l’approche arithmétique s’intègre avec une fluidité exceptionnelle au sein d’un pipeline de manipulation de données dplyr, ou s’automatise à l’aide de fonctions spécialisées de psychométrie :
Via la syntaxe arithmétique tidyverse :
donnees <- donnees %>% mutate(Q2_r = 6 – Q2, Q5_r = 6 – Q5)
Via la fonction dédiée du package psychométrique psych :
donnees_recodes <- psych::reverse.code(keys = c(1, -1, 1, 1, -1), items = donnees[, c("Q1","Q2","Q3","Q4","Q5")])
Langage Python (Bibliothèque Pandas) : Dans les architectures contemporaines de modélisation en science des données sous Python, l’application d’une constante soustractive vectorielle sur un DataFrame Pandas s’effectue de manière instantanée et hautement optimisée en mémoire :
df[‘Q2_r’] = 6 – df[‘Q2’]
df[‘Q5_r’] = 6 – df[‘Q5’]
L’assimilation approfondie de la logique sous-jacente développée dans Excel permet d’aborder ces environnements de programmation avancés avec une assurance méthodologique absolue, la syntaxe changeant mais l’essence mathématique du recodage demeurant rigoureusement identique.
12.3 Synthèse et recommandations pour les chercheurs en sciences humaines
Au terme de cette exploration exhaustive des protocoles de codage inversé sous Microsoft Excel, il apparaît manifeste que la manipulation des instruments d’évaluation psychologique ne saurait souffrir d’approximations techniques. Bien que l’opération arithmétique fondamentale d’inversion s’appuie sur une équation linéaire d’une simplicité mathématique désarmante — (Valeur_Max + 1) – Score_Brut —, sa mise en œuvre pratique dans un environnement de données réelles mobilise l’ensemble des compétences de l’analyste rigoureux.
Le tableur Excel, lorsqu’il est employé dans le strict respect des canons de la modélisation relationnelle, de la protection des données primaires et des formules matricielles dynamiques modernes, constitue un instrument d’apprentissage et de diagnostic préliminaire incomparable. Il permet de matérialiser visuellement la trajectoire de chaque point de mesure, de comprendre intuitivement l’invariance des points neutres médians et de constater de visu la restauration de la consistance interne de l’échelle d’évaluation.
Pour sceller les bonnes pratiques au sein de votre routine d’analyse, il est vivement recommandé d’exécuter systématiquement la check-list opérationnelle suivante avant toute interprétation définitive d’un score psychométrique :
- Vérifier scrupuleusement la borne inférieure de votre échelle (1 versus 0) afin d’ajuster impérativement la constante additive de la formule.
- Sanctuariser les données brutes originelles dans une feuille de calcul protégée et verrouillée en écriture.
- Gérer systématiquement les cellules vides à l’aide de la condition ESTVIDE pour bannir l’apparition masquée de scores maximaux illégitimes.
- Attribuer des suffixes clairs et standardisés (_INV) aux en-têtes de colonnes recodées pour éliminer tout risque d’équivoque lors du calcul des moyennes composites.
- Contrôler la positivité générale de la matrice de corrélation inter-items et vérifier le redressement spectaculaire du coefficient Alpha de Cronbach.
- Documenter l’ensemble de la démarche algorithmique au sein d’un onglet de livre de codes dédié garantissant la stricte reproductibilité de votre démarche scientifique.
Références
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- DeVellis, R. F., & Thorpe, C. T. (2021). Scale development: Theory and applications (5th ed.). SAGE Publications.
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 5–55.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Paulhus, D. L. (1991). Measurement and control of response bias. In J. P. Robinson, P. R. Shaver, & L. S. Wrightsman (Eds.), Measures of personality and social psychological attitudes (pp. 17–59). Academic Press. https://doi.org/10.1016/B978-0-12-590241-0.50006-X
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Revelle, W. (2024). psych: Procedures for psychological, psychometric, and personality research (R package version 2.4.3). Northwestern University. https://CRAN.R-project.org/package=psych
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10