
Dans le champ de l’analyse quantitative, du contrôle de gestion et de la modélisation financière, la mesure de l’évolution des grandeurs numériques constitue une exigence heuristique fondamentale. Face à des séries temporelles complexes et hétérogènes, l’observateur ne peut se contenter d’une simple appréciation brute des fluctuations : il doit impérativement recourir à des instruments statistiques capables d’isoler l’intensité intrinsèque des variations observées. Le pourcentage de variation s’affirme précisément comme la métrique privilégiée permettant de transcender les effets d’échelle et d’uniformiser la lecture des dynamiques structurelles ou conjoncturelles. Au sein des environnements infonuagiques contemporains, l’application Google Sheets s’est imposée comme un outil omniprésent pour l’ingénierie et l’analyse de données, alliant puissance algorithmique, réactivité collaborative et accessibilité matricielle.
Toutefois, la transposition de concepts mathématiques élémentaires au sein d’un tableur distribué soulève des problématiques méthodologiques non négligeables. L’élaboration d’un modèle d’analyse pérenne requiert une maîtrise approfondie des mécanismes sous-jacents : typage des données, gestion rigoureuse des décalages d’indices, anticipation des asymptotes et indéterminations arithmétiques, ou encore préservation de la cohérence dimensionnelle face à des flux asynchrones. Trop souvent, une utilisation naïve des formules de calcul engendre des biais interprétatifs majeurs, des erreurs d’exécution systémiques telles que la redoutée division par zéro, ou des confusions analytiques préjudiciables aux prises de décision stratégiques au sein des organisations.
Le présent traité propose une déconstruction exhaustive, tant théorique que pratique, du calcul du pourcentage de variation dans l’environnement Google Sheets. En articulant formalisation algébrique, architecture des données, syntaxe avancée des fonctions natives et optimisation cognitive des restitutions visuelles, cette étude constitue un guide méthodologique de référence destiné aux analystes de données, auditeurs financiers et gestionnaires de systèmes d’information soucieux d’élever leurs modèles tabulaires vers les plus hauts standards de rigueur scientifique et d’efficience opérationnelle.
1. Fondements théoriques et définition mathématique du pourcentage de variation
1.1 Définition épistémologique du taux de variation relatif
D’un point de vue épistémologique, le taux de variation relatif s’appréhende comme une métrique scalaire adimensionnelle conçue pour caractériser le taux d’évolution d’une grandeur temporelle ou factorielle entre deux états discrets d’un système. Contrairement aux grandeurs brutes observées, tributaires de leurs unités physiques ou monétaires respectives (qu’il s’agisse de tonnes, d’euros, de mégawatts ou de volumes de transactions), la variation relative procède à une réduction normalisante. Elle extrait la pure dynamique d’accroissement ou de contraction, autorisant une comparaison symétrique entre des phénomènes dont les ordres de grandeur divergent de manière substantielle.
Cette distinction entre l’observation brute et l’intensité proportionnelle d’un phénomène est primordiale pour l’analyste. Si une multinationale voit son excédent brut d’exploitation progresser de cent millions d’euros tandis qu’une jeune entreprise innovante voit le sien augmenter de cent mille euros, la perspective absolue isole le volume financier alors que la perspective relative réoriente le diagnostic vers l’efficacité marginale du capital investi. Le pourcentage de variation constitue l’opérateur sémiotique qui transforme un différentiel volumique en un indicateur d’accélération systémique, garantissant la neutralité des échelles de mesure.
Sur le plan de l’interprétation sérielle, la variation relative informe sur la trajectoire cinétique des grandeurs économiques et physiques. Elle permet d’inférer si un système est en phase de croissance sous-linéaire, exponentielle, ou s’il s’approche d’un point d’inflexion critique. Dès lors, sa portée épistémique ne se résume pas à un simple artifice calculatoire, mais s’inscrit au cœur des théories de l’analyse cinématique des séries chronologiques.
1.2 Distinction conceptuelle entre variation absolue et variation relative
La variation absolue est formellement définie comme la simple différence arithmétique entre un état subséquent et un état initial, s’exprimant dans la même unité dimensionnelle que les variables sous-jacentes. Si l’on note $V_i$ la valeur initiale observée à la période $t$ et $V_f$ la valeur finale enregistrée à la période $t+n$, la variation absolue s’écrit $\Delta V = V_f – V_i$. Bien qu’indispensable pour quantifier des flux concrets d’énergie, de matière ou de liquidités, cette mesure souffre d’une dépendance ontologique stricte vis-à-vis de son unité de mesure, interdisant toute agrégation ou comparaison hétérogène directe.
À l’inverse, la variation relative transcende cette limitation physique en divisant la variation absolue par la valeur initiale servant de référentiel d’ancrage. En opérant cette normalisation, elle neutralise intégralement l’effet de taille inhérent aux systèmes macroscopiques comparés à des entités microscopiques. Par cette opération, une hausse de 10 euros sur une base de 100 euros équivaut rigoureusement, en intensité relative, à une hausse de 100 000 euros sur une base de 1 000 000 d’euros, les deux trajectoires affichant une progression relative normalisée de 0,10, soit 10 %.
L’analyse comparative de scénarios d’investissement met régulièrement en relief cette divergence fondamentale. Dans le cadre de l’arbitrage de portefeuille, un actif générant une variation absolue spectaculaire peut masquer un rendement relatif médiocre si le capital mobilisé est colossal. Inversement, une rentabilité relative fulgurante peut ne produire qu’un gain absolu dérisoire si l’assise financière initiale s’avère marginale. La maîtrise conceptuelle de cette dualité s’avère indispensable pour quiconque souhaite modéliser des analyses prédictives ou comparatives dans un tableur informatisé.
1.3 Formule mathématique universelle et décomposition algébrique
La formulation canonique de la variation relative se structure autour du rapport normalisé entre l’écart absolu et la base de référence temporelle. Elle s’énonce selon la relation suivante :
$$\tau = \frac{V_f – V_i}{V_i}$$
Dans cette équation formelle, $tau$ représente le taux de variation relatif exprimé sous forme décimale. Par convention et afin de faciliter l’appropriation cognitive des résultats dans les représentations humaines, ce ratio est fréquemment multiplié par un facteur scalaire cent afin de le projeter dans l’espace des pourcentages, sans que cette opération n’altère sa nature intrinsèque de nombre adimensionnel :
$$\tau_{%} = \left( \frac{V_f – V_i}{V_i} \right) \times 100$$
Une décomposition algébrique élémentaire permet de réécrire cette expression sous une forme simplifiée, particulièrement économe en cycles de calcul au sein des processeurs des moteurs de calcul tabulaire :
$$\tau = \frac{V_f}{V_i} – \frac{V_i}{V_i} = \frac{V_f}{V_i} – 1$$
Cette formulation alternative, strictement équivalente sur le plan analytique pour toute valeur initiale strictement non nulle ($V_i \neq 0$), démontre que le pourcentage de variation n’est rien d’autre que l’écart unitaire à l’indice d’évolution de base 1. Comprendre cette stricte équivalence algébrique permet au concepteur de modèles de fluidifier ses formules sous Google Sheets, en évitant la redondance d’appels aux coordonnées cellulaires de la valeur initiale dans l’arborescence syntaxique.
2. Préparation de l’environnement de travail dans Google Sheets
2.1 Structuration rigoureuse des colonnes et des séries temporelles
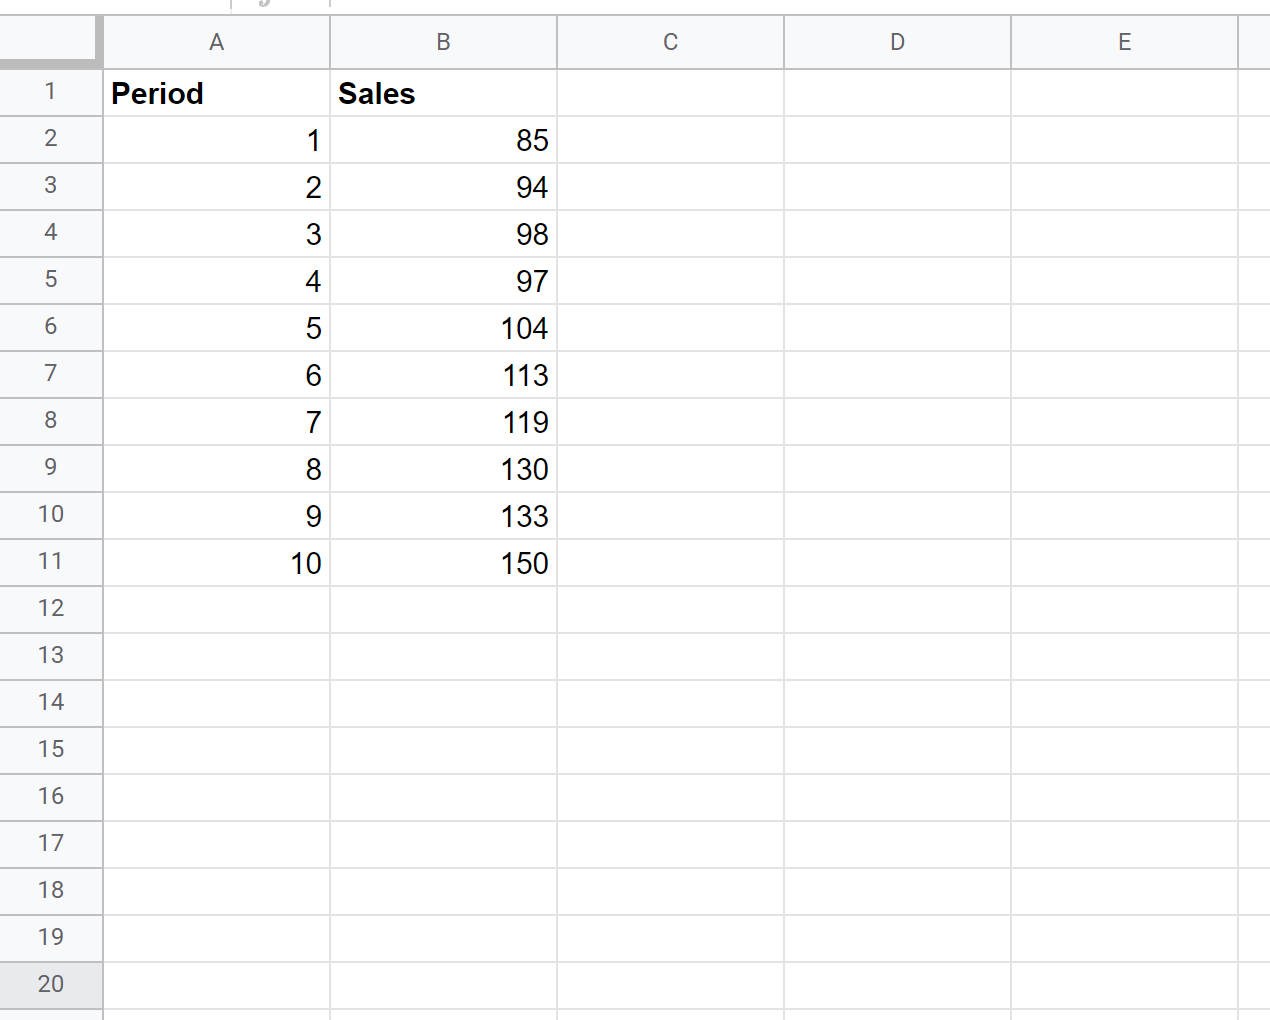
L’intégrité d’un modèle analytique repose avant tout sur l’hygiène structurelle des données sources. Dans l’écosystème Google Sheets, une série temporelle destinée à faire l’objet de calculs de variation relative doit être agencée selon les normes du modèle relationnel en colonnes. Les observations doivent être distribuées le long d’un axe vertical continu, chaque ligne représentant une période chronologique strictement ordonnée de manière ascendante (du passé vers le présent). Cet agencement séquentiel garantit que les décalages d’indices cellulaires s’opèrent avec une prédictibilité algorithmique absolue.
Les en-têtes de colonnes doivent être standardisés, explicites et dégagés de toute surcharge visuelle superflue. Il convient de bannir impérativement la fusion de cellules au sein des zones de données et des en-têtes fonctionnels, car cette pratique compromet l’adressage direct des cellules et brise l’exécution des formules vectorielles ou matricielles. De plus, la régularité temporelle doit être vérifiée : l’analyste doit s’assurer que le pas de discrétisation (mensuel, trimestriel, annuel) demeure constant sur l’ensemble de la plage d’étude afin de ne pas fausser la comparabilité des taux calculés.
Enfin, la présence de ruptures de séquence ou de cellules vides constitue un facteur critique de dégradation des calculs. Une cellule vide au sein d’une série numérique peut être interprétée de manière ambiguë par le moteur de Google Sheets, soit comme un zéro arithmétique, soit comme une absence d’observation. Cette indécision engendre des distorsions majeures ou des erreurs critiques d’exécution lors de la tentative de résolution de formules de variation temporelle contiguë.
2.2 Typage des données et vérification de l’intégrité numérique
Une cause prépondérante d’échec dans l’évaluation des formules réside dans la confusion pernicieuse entre les types de données. Dans Google Sheets, une chaîne de caractères textuelle ayant l’apparence visuelle d’un chiffre ne possède pas les propriétés algébriques d’un nombre flottant natif. L’analyste doit impérativement certifier que les cellules sous-jacentes contiennent des valeurs numériques réelles et non du texte résiduel issu d’extractions de bases de données ou de copié-collé non assainis.
Les symboles monétaires saisis manuellement (comme le signe « € » ou « $ »), les séparateurs de milliers sous forme d’espaces insécables (code Unicode 160) ou l’usage inadéquat d’apostrophes initiales constituent des obstacles majeurs. Pour assainir un jeu de données douteux, il est fortement recommandé d’utiliser la fonction ESTNUM (ou ISNUMBER) sur les plages de contrôle afin de valider systématiquement l’intégrité du typage de chaque enregistrement :
=ESTNUM(B2)
En présence de représentations textuelles de nombres, l’application de la fonction VALEUR (ou VALUE) ou l’exécution de règles de validation de données permet de contraindre les entrées et de forcer la coercition des chaînes vers des formats scalaires directement exploitables par les opérateurs arithmétiques.
2.3 Paramétrage des préférences régionales et des séparateurs décimaux
L’internationalisation logicielle de la plateforme Google Sheets implique une variabilité syntaxique conditionnée par les paramètres régionaux du classeur. Dans les configurations francophones standards (France, Belgique, Canada francophone), la convention typographique impose la virgule comme séparateur décimal officiel et le point-virgule comme délimiteur d’arguments au sein des fonctions. En revanche, dans la configuration anglo-saxonne (États-Unis, Royaume-Uni), le point fait office de séparateur décimal et la virgule sert de délimiteur d’arguments.
Une discordance entre la convention régionale configurée dans les paramètres de la feuille de calcul (accessibles via Fichier > Paramètres > Paramètres régionaux) et le format des données importées produit immédiatement des erreurs d’interprétation critiques. Si un utilisateur importe des données formatées avec des points décimaux dans une feuille paramétrée en environnement linguistique français, Google Sheets interprétera souvent ces entrées comme des chaînes de texte, voire comme des dates arbitraires, neutralisant ainsi toute tentative de calcul arithmétique ultérieur.
Il est donc essentiel d’aligner la localisation linguistique de l’environnement dès l’initialisation du projet. Cette précaution structurelle évite les anomalies de parsing lors de la saisie de formules complexes et assure une interopérabilité sans faille lors de la collaboration transnationale sur des classeurs partagés.
3. La formule fondamentale du pourcentage de variation dans Google Sheets
3.1 Traduction de la formule standard en syntaxe tableur
La transcription opérationnelle de la formule de variation relative dans la grammaire de Google Sheets requiert une rigueur absolue quant à l’ordonnancement des opérateurs et au respect des priorités algébriques. Supposons une observation initiale consignée dans la cellule B2 et une observation finale positionnée dans la cellule B3. La traduction littérale de la formule canonique prend la forme syntaxique suivante :
=(B3-B2)/B2
Dans cette formulation, l’emploi des parenthèses est strictement impératif. En vertu des règles universelles de priorité opératoire, l’omission des parenthèses, aboutissant à l’expression erronée =B3-B2/B2, conduirait le moteur de calcul à évaluer prioritairement la division B2/B2 (produisant le scalaire 1), puis à soustraire cette unité de B3, aboutissant à un résultat totalement aberrant. L’encapsulation de la différence (B3-B2) garantit que la variation absolue est intégralement résolue avant d’être soumise à la division par le référentiel initial.
Alternativement, la formule condensée issue de la simplification algébrique s’exprime ainsi :
=(B3/B2)-1
Bien que cette seconde écriture soit fonctionnellement identique et légèrement plus économe en références cellulaires, elle requiert la même vigilance lors de son évaluation interne par le compilateur d’expressions du tableur.
3.2 Référencement des cellules relatives et absolues
La robustesse d’un modèle tabulaire tient à la maîtrise différentielle des modes de référencement cellulaire. Lorsque l’objectif analytique consiste à calculer une variation continue d’une période sur la suivante (analyse séquentielle), l’usage exclusif de références relatives s’impose :
=(B3-B2)/B2
Lors de la propagation verticale de cette formule vers le bas, Google Sheets incrémente automatiquement les coordonnées de ligne (devenant =(B4-B3)/B3, puis =(B5-B4)/B4), préservant ainsi la nature glissante de la mesure temporelle.
En revanche, lorsque l’analyste désire évaluer l’évolution de chaque période par rapport à une période de référence historique invariante (calcul d’évolution sur base fixe ou base 100), le dénominateur ainsi que le terme soustractif doivent être verrouillés au moyen du marqueur d’ancrage absolu $. Si la période de base réside en B2, la formule déployée en C3 et étirée vers le bas s’écrira :
=(B3-$B$2)/$B$2
L’omission accidentelle de cet ancrage absolu lors d’une comparaison sur période de référence immuable provoque un décalage d’index progressif, altérant irrémédiablement l’architecture de calcul et corrompant l’ensemble des conclusions décisionnelles du modèle.
3.3 Application du formatage de pourcentage standard
Un principe fondamental de l’architecture logicielle de Google Sheets réside dans la dissociation stricte entre la valeur sous-jacente stockée en virgule flottante au sein de la mémoire vive et le masque d’affichage graphique restitué à l’écran. L’évaluation de l’expression =(110-100)/100 produit le nombre réel 0,10. Bien que mathématiquement exact, cet affichage décimal est souvent jugé peu intuitif pour des restitutions exécutives destinées à des décideurs habitués à la convention centésimale.
Pour convertir ce résultat brut en représentation visuelle de pourcentage sans en modifier la précision arithmétique interne, l’utilisateur doit appliquer le format de pourcentage. Cette opération s’effectue via l’interface utilisateur en cliquant sur le pictogramme « % » situé dans la barre d’outils supérieure, ou en utilisant la combinaison de touches standardisée Ctrl + Maj + 5 (sur Windows/Linux) ou Cmd + Maj + 5 (sur macOS). Le tableur applique alors une multiplication optique par 100 assortie du suffixe textuel adéquat, tout en conservant scrupuleusement la valeur 0,10 dans le registre numérique sous-jacent.
Il convient de calibrer avec précision le nombre de décimales affichées à l’aide des commandes d’augmentation ou de réduction de la précision décimale. Pour la majorité des analyses de gestion, une résolution fixée à une ou deux décimales (par exemple 10,00 %) offre le compromis optimal entre clarté visuelle et rigueur métrologique.
4. Utilisation experte de la fonction native TO_PERCENT
4.1 Rôle sémantique et comportement technique de TO_PERCENT()
Google Sheets propose une palette étendue de fonctions natives destinées à régir le typage et le formatage algorithmique des cellules. Parmi celles-ci, la fonction TO_PERCENT (ou EN_POURCENTAGE dans les interfaces francophones unifiées) opère un mécanisme de coercition de type explicite en convertissant un argument numérique donné en une valeur formatée en pourcentage. La syntaxe canonique s’articule ainsi :
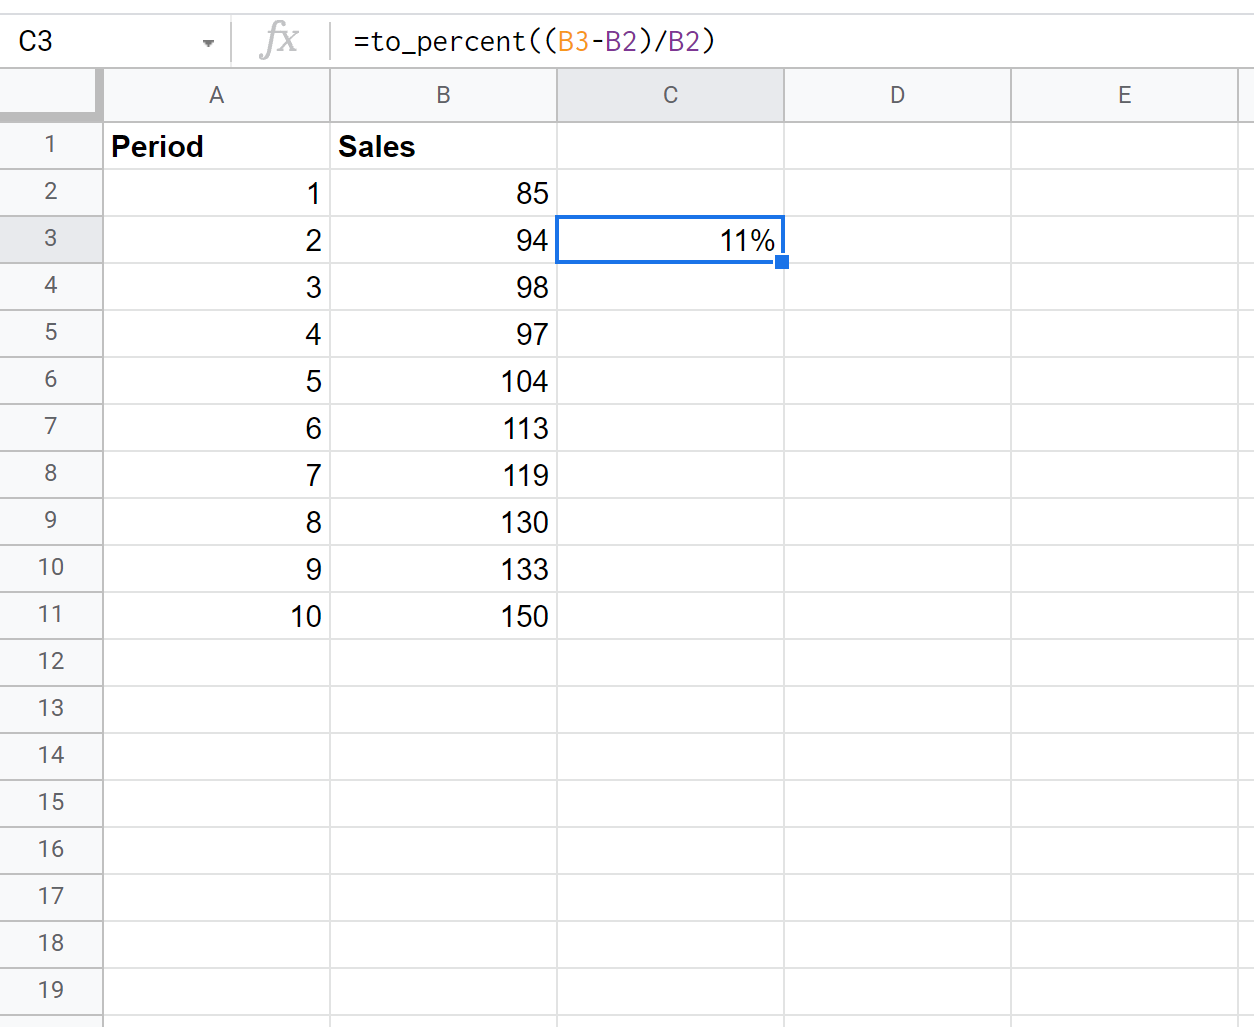
=TO_PERCENT((B3-B2)/B2)
Sur le plan de l’architecture logicielle interne, TO_PERCENT intercepte le scalaire issu du ratio arithmétique et lui adjoint un métatag de formatage spécifique au niveau du descripteur de cellule. Contrairement à une simple modification manuelle via l’interface graphique, l’encapsulation de l’opération dans une fonction explicite confère au classeur une dimension déclarative hautement documentée. Les développeurs de feuilles de calcul automatisées privilégient souvent cette approche afin de sanctuariser la nature visuelle du résultat, empêchant qu’un effacement accidentel des formats de cellule ne vienne rétrograder l’affichage à sa forme décimale brute.
Il est à noter que la valeur traitée par TO_PERCENT conserve rigoureusement son statut numérique. Les fonctions dépendantes en aval, telles que les moyennes, les sommes ou les fonctions conditionnelles statistiques, continuent de lire la grandeur réelle sans aucune rupture de compatibilité calculatoire.
4.2 Comparaison entre TO_PERCENT() et le formatage de cellule natif
L’arbitrage entre l’emploi de la fonction TO_PERCENT et l’application du formatage de surface via la barre d’outils relève d’un compromis technique entre charge de calcul et stabilité de transport des données. Le formatage de surface modifie uniquement les métadonnées de rendu visuel de la couche de présentation. Il s’avère particulièrement économe en ressources système lors du recalcul de feuilles imposantes contenant des dizaines de milliers de lignes.
Néanmoins, le formatage graphique présente une vulnérabilité : il s’efface facilement lors des opérations de collage spécial en valeurs seules, ou lorsque des flux de données externes réécrivent des plages entières via l’API Google Sheets. À l’opposé, la fonction TO_PERCENT s’inscrit au cœur même de la formule de calcul, garantissant que même après une réinitialisation des styles visuels ou lors d’une exportation vers certains environnements tiers, la volonté de formater l’expression en pourcentage demeure inscrite dans l’arbre d’exécution arithmétique.
Cependant, lors de l’exportation vers des formats textuels bruts de type Comma-Separated Values (CSV), TO_PERCENT peut entraîner l’exportation directe du symbole textuel « % », ce qui contraint les pipelines d’ingestion de bases de données (comme Google BigQuery ou Snowflake) à exécuter une étape supplémentaire de désérialisation pour recouvrer le flottant d’origine. L’analyste doit donc arbitrer en fonction de la destination finale de ses données.
4.3 Intégration de TO_PERCENT dans les chaînes d’évaluation complexes
La puissance de la fonction TO_PERCENT se révèle pleinement lorsqu’elle est combinée au sein d’expressions logiques imbriquées ou de générateurs de chaînes narratives dynamiques. Par exemple, au sein d’un tableau de bord de direction automatisé, il est fréquent de vouloir insérer une phrase de synthèse dynamique articulant texte informatif et indicateurs de performance quantitative. Dans ce contexte, l’utilisation brute d’un ratio au sein d’une concaténation engendre une dégradation de l’affichage, affichant un résultat sous forme décimale brute dénuée d’arrondi intelligible :
="La variation trimestrielle s'établit à " & ((B3-B2)/B2)
Cette syntaxe rudimentaire produira une chaîne inélégante telle que « La variation trimestrielle s’établit à 0.142857142857 ». L’intégration de la fonction de formatage explicite combinée à la fonction TEXTE (ou TEXT) permet de verrouiller rigoureusement l’expression :
="La variation trimestrielle s'établit à " & TEXTE((B3-B2)/B2; "0,0%")
Toutefois, si l’évaluation doit se faire dans des structures matricielles où les données restent numériques, TO_PERCENT permet de préserver l’interopérabilité mathématique du flux tout en imposant la syntaxe d’échelle, éliminant ainsi les confusions au sein des agrégations ultérieures de type SOMMEPROD ou filtres pondérés.
5. Cas pratique pas à pas : Analyse de ventes sur dix périodes consécutives
5.1 Présentation de la matrice empirique d’échantillonnage
Afin d’ancrer ces considérations théoriques dans une réalité tangible, formalisons un cas pratique portant sur l’analyse séquentielle du chiffre d’affaires d’une entreprise opérant dans le secteur du commerce électronique sur une trajectoire de dix trimestres consécutifs. La matrice expérimentale est agencée dans une feuille de calcul débutant à la cellule A1 selon le schéma dimensionnel suivant :
- Colonne A : Index temporel (Trimestres T1 à T10, de
A2àA11). - Colonne B : Chiffre d’affaires brut réalisé en milliers d’euros (de
B2àB11). - Colonne C : Pourcentage de variation séquentielle période à période (de
C3àC11).
Les observations quantitatives empiriques s’établissent comme suit : B2 (T1) = 120 ; B3 (T2) = 135 ; B4 (T3) = 128 ; B5 (T4) = 150 ; B6 (T5) = 145 ; B7 (T6) = 160 ; B8 (T7) = 175 ; B9 (T8) = 170 ; B10 (T9) = 195 ; B11 (T10) = 210. La disposition des colonnes garantit une lecture séquentielle sans rupture et prépare un espace d’évaluation contigu.
5.2 Implémentation séquentielle de la formule dans la première cellule
Le point d’ancrage logique du calcul de variation ne peut pas se situer sur la première ligne d’observation (C2), car la période initiale T1 ne possède aucun antécédent temporel mesuré au sein du système. Toute tentative d’implémentation sur la ligne inaugurale violerait les conditions d’antériorité requises par la cinématique différentielle. L’implémentation doit donc impérativement débuter en cellule C3, en regard de la période T2.
L’opérateur saisit dans la cellule C3 la formule paramétrée suivante :
=(B3-B2)/B2
L’évaluation interne de cette expression s’articule ainsi : $(135 – 120) / 120 = 15 / 120 = 0,125$. Dès validation de la formule, l’utilisateur sollicite la fonction de mise en forme en pourcentage en appliquant le style standardisé à deux décimales. La valeur affichée à l’écran transmute instantanément vers 12,50 %, témoignant d’une expansion conjoncturelle robuste des revenus entre le premier et le deuxième trimestre. Ce calcul étalon sert de balise de validation pour la propagation de l’analyse.
5.3 Propagation automatique par la poignée de recopie et formules matricielles
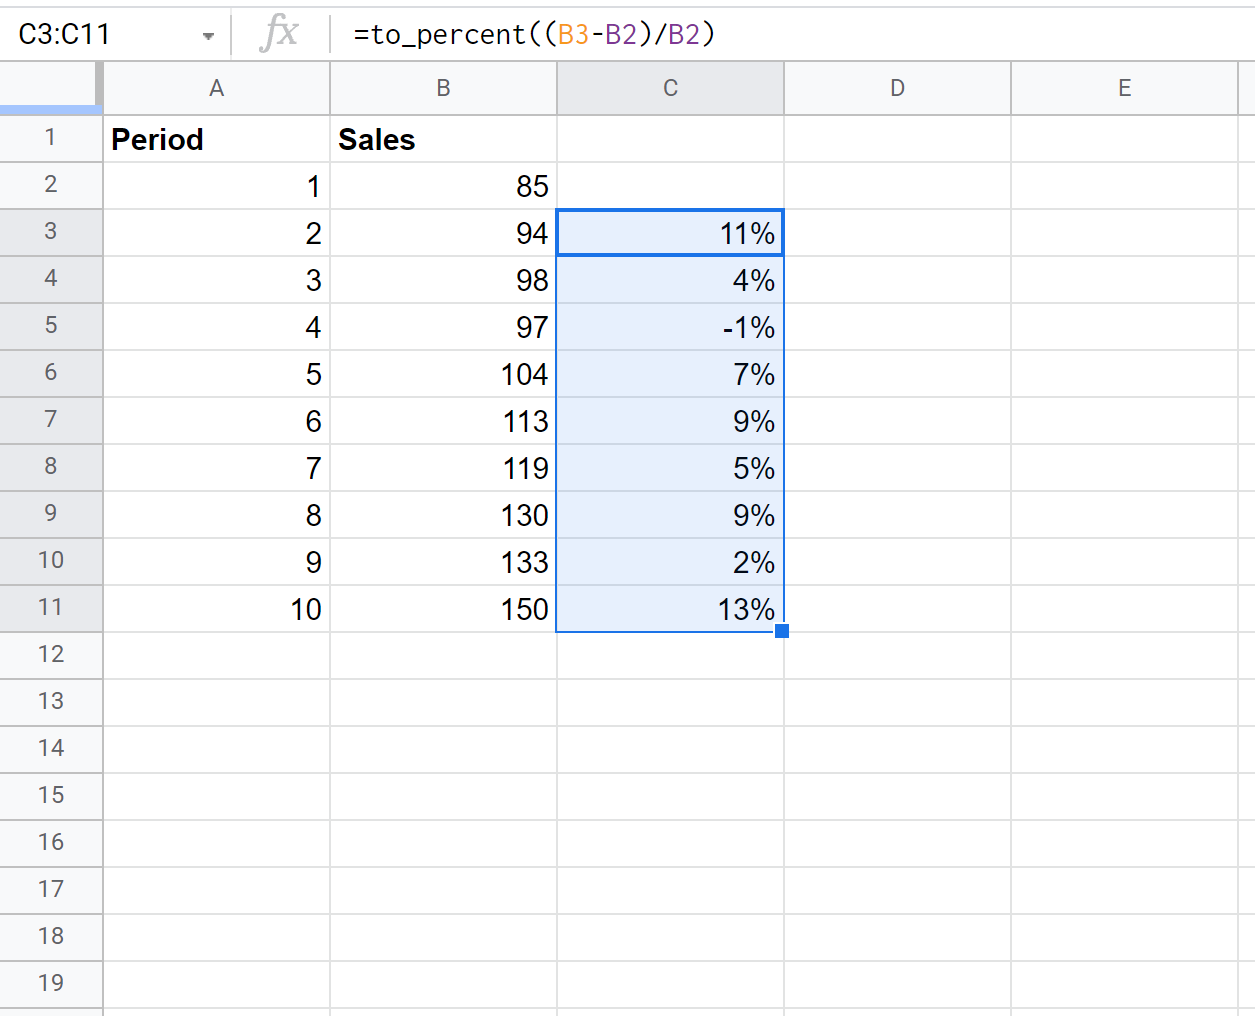
Une fois la validité arithmétique de la formule vérifiée sur la cellule C3, l’analyste procède à sa généralisation sur l’ensemble de la série temporelle. Cette extension s’effectue en positionnant le curseur de la souris sur le coin inférieur droit de la cellule C3, sur le carré bleu dénommé poignée de recopie. Un double-clic vigoureux ou une opération de glisser-déposer vers le bas jusqu’à la cellule C11 déclenche la propagation instantanée de l’algorithme.
En vertu du mécanisme de référencement relatif décrit précédemment, Google Sheets procède à l’incrémentation dynamique et synchronisée de l’ensemble des coordonnées cellulaires :
- En C4 :
=(B4-B3)/B3donne $(128 – 135) / 135 = -5,19 %$ - En C5 :
=(B5-B4)/B4donne $(150 – 128) / 128 = +17,19 %$ - En C6 :
=(B6-B5)/B5donne $(145 – 150) / 150 = -3,33 %$
L’analyste dispose ainsi d’un panorama exhaustif des accélérations et décélérations rythmant l’activité de l’entreprise sur l’ensemble de la période d’observation, tout en s’assurant que la formule s’interrompt strictement en C11 sans déborder sur les lignes vierges adjacentes.
6. Traitement des cas critiques et gestion des anomalies numériques
6.1 Problématique de la division par zéro (#DIV/0!) et neutralisation
L’écueil arithmétique le plus célèbre et le plus dévastateur dans l’automatisation des feuilles de calcul réside dans l’opération de division par zéro. D’un point de vue mathématique rigoureux, l’évaluation de l’expression $f(x) = \frac{x}{y}$ lorsque $y to 0$ est indéfinie au sein du corps des nombres réels. Lorsque la valeur de la cellule de départ ($V_i$) est égale à zéro, Google Sheets suspend immédiatement le calcul conventionnel et renvoie l’erreur standardisée #DIV/0!.
Cette rupture d’évaluation n’est pas seulement disgracieuse sur le plan visuel : elle propage un poison algorithmique au sein de toutes les cellules dépendantes qui s’alimentent de cette cellule cible. Pour assainir durablement le classeur, il est impératif d’encapsuler la formule de variation dans une structure de contrôle d’erreurs au moyen de la fonction SIERREUR (ou IFERROR) :
=SIERREUR((B3-B2)/B2; "N/A")
Une alternative encore plus rigoureuse sur le plan logique consiste à tester proactivement la nullité du dénominateur via la fonction conditionnelle SI (ou IF), distinguant ainsi explicitement l’absence de base d’un potentiel problème technique interne :
=SI(B2=0; "Base nulle"; (B3-B2)/B2)
Grâce à cette précaution défensive, le classeur gagne en stabilité et préserve son intégrité structurelle même en présence de valeurs de départ nulles.
6.2 Gestion des valeurs initiales nulles et limites théoriques du calcul
Au-delà de la sanction logicielle matérialisée par l’erreur #DIV/0!, la survenue d’une valeur initiale nulle soulève une limite épistémologique inhérente au pourcentage de variation lui-même. Que signifie, au sens strict, passer d’un niveau d’activité nul (zéro euro de chiffre d’affaires) à un niveau d’activité mesuré (par exemple, dix mille euros générés) ? Sur le plan du formalisme continu, la croissance depuis le néant est infinie, ce qui la prive de toute pertinence pour le pilotage opérationnel.
Dans les faits, les analystes sont divisés quant à la posture méthodologique à adopter face à ce phénomène. Certains préconisent l’exclusion pure et simple de l’observation relative, la qualifiant d’indéterminée et consignant l’information sous la mention de novo ou création initiale. D’autres recourent à des méthodes d’ajustement consistant à imputer une valeur plancher infinitésimale (par exemple 0,01 ou 1) pour forcer l’évaluation, mais cette pratique engendre des pourcentages astronomiques dénués de toute signification concrète (croissance artificielle de plusieurs millions de pour cent).
La règle de modélisation la plus prudente consiste à inhiber le calcul du pourcentage de variation en présence d’une valeur de départ nulle et à compléter l’analyse par la restitution de la variation absolue, seule à même de fournir une mesure objective de la performance sans distorsion d’échelle.
6.3 Impact des valeurs manquantes ou textuelles et assainissement
Un autre vecteur fréquent de dysfonctionnement réside dans la présence impromptue de chaînes textuelles au sein des cellules supposées abriter les opérandes de l’équation. Si la cellule initiale B2 contient la chaîne « En attente » ou une faute de frappe, la tentative d’évaluation arithmétique =(B3-B2)/B2 provoquera inéluctablement l’affichage de l’erreur d’incompatibilité de type #VALEUR! (ou #VALUE!).
La mise en place d’un protocole d’assainissement préventif repose sur la validation en amont du caractère numérique des deux termes de la division. L’équation gagne à être encapsulée dans une double vérification conditionnelle articulée autour de la fonction logique ET et du prédicat ESTNUM :
=SI(ET(ESTNUM(B2); ESTNUM(B3); B2<>0); (B3-B2)/B2; "Données invalides")
Cette écriture hautement résiliente garantit que le processeur de Google Sheets n’exécute l’opération différentielle que si et seulement si les deux entrées constituent des scalaires mathématiques exploitables et que le dénominateur est strictement distinct de zéro. Le modèle se trouve ainsi immunisé contre toute défaillance de saisie humaine ou corruption de flux de données amont.
7. Gestion rigoureuse des valeurs négatives dans les variations relatives
7.1 Paradoxes mathématiques lors du passage de valeurs négatives à positives
L’application brute de la formule standard de variation relative à des grandeurs pouvant adopter des valeurs négatives engendre un paradoxe mathématique et cognitif déroutant. Ce phénomène se produit fréquemment dans le domaine comptable et financier lors de l’analyse du résultat net, de l’excédent brut d’exploitation ou du flux de trésorerie disponible, qui oscillent structurellement entre profits et déficits.
Considérons la situation d’une entreprise dont le résultat d’exploitation s’élevait à $-100$ milliers d’euros à la période $t$ (déficit prononcé) et qui parvient à redresser sa situation pour afficher $+50$ milliers d’euros à la période $t+1$. L’application aveugle de la formule canonique donne :
$$\tau = \frac{50 – (-100)}{-100} = \frac{150}{-100} = -1,5 = -150%$$
Le résultat indique une décroissance spectaculaire de $-150,%$, alors même que la performance opérationnelle de l’organisation s’est considérablement améliorée, le résultat ayant bondi de 150 000 euros dans le sens positif. Cette aberration provient du dénominateur négatif qui inverse arbitrairement le signe de l’ensemble de la fraction, produisant un non-sens économique absolu.
7.2 Utilisation de la fonction ABS pour corriger le dénominateur
Pour restaurer la cohérence directionnelle du calcul et s’assurer qu’une amélioration financière se traduise systématiquement par un taux de croissance positif, il est indispensable de corriger la formule en neutralisant le signe négatif du dénominateur. La formulation mathématique rectifiée fait intervenir l’opérateur de la valeur absolue :
$$\tau_{\text{corrigé}} = \frac{V_f – V_i}{|V_i|}$$
Dans l’environnement syntaxique de Google Sheets, cette correction s’opère par l’intermédiaire de la fonction ABS, qui renvoie la valeur absolue d’un nombre donné sans considérer son signe algébrique :
=(B3-B2)/ABS(B2)
Si l’on réévalue l’exemple précédent au moyen de cette syntaxe ajustée :
=(50 - (-100)) / ABS(-100) = 150 / 100 = +150%
Le résultat restitue enfin fidèlement la réalité sous-jacente de l’évolution : la performance opérationnelle a progressé de manière remarquable, affichant une amélioration de $+150,%$. Cette formulation doit être systématiquement adoptée dès lors que les séries modélisées sont susceptibles d’évoluer en zone négative.
7.3 Interprétation empirique et biais d’évaluation des séries déficitaires
Bien que la neutralisation par la valeur absolue restaure le signe logique de la progression, elle ne résout pas l’intégralité des apories conceptuelles liées aux grandeurs négatives. Considérons le cas d’une aggravation d’un déficit, l’entreprise passant d’une perte de $-10$ milliers d’euros à une perte de $-30$ milliers d’euros. La formule avec valeur absolue produit :
$$\tau = \frac{-30 – (-10)}{|-10|} = \frac{-20}{10} = -200%$$
Bien que le signe négatif traduise correctement la détérioration, la magnitude du pourcentage s’avère souvent trompeuse et particulièrement difficile à appréhender intuitivement lors de présentations financières destinées à des comités d’audit ou à des investisseurs externes.
Dans de nombreuses circonstances touchant à des agrégats déficitaires, la communauté des analystes préconise d’omettre délibérément le pourcentage de variation relatif pour privilégier l’indication sans équivoque du différentiel absolu exprimé en unités monétaires brutes. Une autre approche conventionnelle consiste à mentionner la mention qualitative « Non Significatif » (NS) pour éviter que des artefacts de calcul n’orientent de façon erronée les conclusions stratégiques.
8. Automatisation avancée avec ARRAYFORMULA et formules dynamiques
8.1 Déploiement du calcul sur des colonnes entières sans recopie manuelle
L’un des traits distinctifs et des atouts majeurs de Google Sheets réside dans son moteur de calcul vectorisé natif, incarné par la puissante fonction ARRAYFORMULA. Dans un modèle de données traditionnel, l’analyste doit étirer manuellement ses formules vers le bas au fur et à mesure que de nouvelles observations s’ajoutent. Cette méthode manuelle engendre des risques chroniques d’oubli, de décalage ou de corruption involontaire des formules lors de l’insertion de lignes intermédiaires.
En mobilisant ARRAYFORMULA, une unique formule positionnée au sommet de la colonne de calcul suffit pour évaluer l’intégralité de la série de façon continue et instantanée. En supposant que nos données s’étendent de la ligne 2 à la ligne 11, la formule matricielle globale s’exprime ainsi :
=ARRAYFORMULA((B3:B11 - B2:B10) / B2:B10)
Le fonctionnement interne d’ARRAYFORMULA repose sur une translation vectorielle : le tableur soustrait terme à terme le vecteur décalé d’une unité B2:B10 au vecteur contemporain B3:B11, puis divise le vecteur résultant par ce même dénominateur B2:B10. Le résultat se déploie instantanément sous forme d’une plage expansive verticale sans qu’aucune duplication de formule ne soit requise.
8.2 Combinaison d’ARRAYFORMULA avec des filtres logiques et conditions IF
Dans un contexte de production industrielle, les jeux de données reçoivent des flux d’enregistrements continus, interdisant le figeage strict de la borne inférieure de la plage (par exemple B11). L’analyste cherche alors à utiliser des plages ouvertes s’étendant théoriquement jusqu’à l’infini (comme B3:B). Cependant, une telle référence matricielle ouverte évalue également l’ensemble des lignes vierges situées au bas de la feuille, générant une profusion d’erreurs #DIV/0! ou de zéros parasites.
Pour immuniser la matrice tout en préservant son dynamisme d’expansion, il est impératif d’intégrer une clause conditionnelle de filtrage logique au sein même de l’expression matricielle :
=ARRAYFORMULA(SI((B3:B="") + (B2:B=""); ; (B3:B - B2:B) / B2:B))
Dans cette formulation sophistiquée, l’expression booléenne sous forme de somme (B3:B="") + (B2:B="") vérifie si la cellule active ou sa devancière est dépourvue de contenu. Si tel est le cas, la fonction SI retourne une valeur vide (signalée par la succession immédiate des deux délimiteurs ; ;), bloquant le calcul sur les zones vierges. Dès qu’un utilisateur ou un connecteur de données insère un nouvel enregistrement à la suite du tableau, la plage matricielle s’étend dynamiquement et calcule instantanément le nouveau pourcentage de variation correspondant.
8.3 Optimisation de la performance de calcul pour les volumétries massives
Si la vectorisation matricielle confère une élégance architecturale indéniable aux feuilles de calcul, elle requiert une gestion rigoureuse des ressources computationnelles allouées par les serveurs distants de Google. L’application d’un ARRAYFORMULA sur une plage totalement ouverte (de type B2:B) au sein d’une feuille comportant plusieurs centaines de milliers de lignes force le moteur JavaScript sous-jacent à instancier un tableau mémoire disproportionné, ce qui peut dégrader significativement les temps de réponse du document.
Pour optimiser les performances de calcul sur des volumétries massives, plusieurs bonnes pratiques s’imposent :
- Supprimer systématiquement toutes les lignes et colonnes vides superflues au-delà des besoins opérationnels stricts du tableau.
- Délimiter dynamiquement la plage de calcul en utilisant des fonctions d’indexation indirecte ou des plages nommées adaptatives.
- Éviter la redondance de fonctions volatiles ou chronophages au sein de l’arborescence matricielle (telles que
INDIRECT,DECALERouAUJOURDHUI).
En observant ces principes de sobriété algorithmique, le concepteur s’assure que ses modèles de variation relative conservent une fluidité d’exécution optimale, même en présence d’architectures de données denses et multi-utilisateurs.
9. Visualisation cognitive et mise en forme conditionnelle des résultats
9.1 Perception cognitive des variations : cartographie thermique et contrastes
La transmission efficace d’un flux d’informations quantitatives ne dépend pas uniquement de l’exactitude de ses métriques fondamentales, mais également de la vitesse de son appropriation cognitive par le cerveau humain. La simple juxtaposition de chiffres décimaux ou de pourcentages au sein d’une grille uniforme impose une charge mentale non négligeable pour extraire les signaux faibles, les ruptures de tendance ou les anomalies de performance.
La mise en place d’une cartographie thermique (ou heat map) discrète repose sur l’exploitation d’échelles chromatiques divergentes calibrées sur l’amplitude des variations. Dans les conventions occidentales des affaires, les teintes vertes traduisent généralement la croissance et les teintes rouges soulignent la contraction ou l’alerte opérationnelle. Toutefois, une modélisation rigoureuse impose de modérer la saturation de ces pigments afin d’éviter la surcharge visuelle et la fatigue oculaire de l’utilisateur.
Il est par ailleurs impératif d’intégrer les exigences d’accessibilité universelle, en s’assurant notamment que le différentiel de contraste demeure parfaitement intelligible pour les personnes atteintes de déficiences de la vision chromatique (comme le daltonisme ou la deutéranopie). Le recours à des palettes alternatives, telles que le gradient bleu-orange, offre une robustesse de lecture bien supérieure.
9.2 Configuration des règles de mise en forme conditionnelle à nuances
L’implémentation d’une règle de mise en forme conditionnelle sur les colonnes de pourcentage de variation dans Google Sheets s’effectue via le menu Format > Randonnée / Règles conditionnelles. Pour éviter les erreurs d’interprétation, la méthode recommandée consiste à appliquer une échelle de couleurs à trois points d’ancrage :
- Le point minimum : configuré pour s’aligner sur le percentile le plus bas ou une valeur plancher négative déterminée (par exemple $-20,%$, teinté d’un rouge pastel doux).
- Le point médian : impérativement fixé sur le nombre absolu
0(associé à un blanc neutre ou un gris très clair), servant d’axe de symétrie visuelle absolu. - Le point maximum : configuré sur le percentile le plus haut ou un plafond de performance cible (par exemple $+20,%$, teinté d’un vert pastel doux).
L’erreur la plus commune consiste à laisser Google Sheets déterminer automatiquement le point médian par interpolation arithmétique entre le minimum et le maximum observés. Si une série oscille exclusivement entre $+10,%$ et $+50,%$, un paramétrage automatique positionnera le point neutre à $+30,%$, colorant fallacieusement les progressions s’élevant à $+15,%$ en rouge alarmant, alors même qu’elles traduisent une trajectoire expansionniste positive. L’ancrage rigide du point neutre sur la valeur zéro neutralise intégralement ce biais perceptif.
9.3 Ajout d’indicateurs visuels et flèches de tendance vectorielles
Au-delà de la coloration des fonds cellulaires, l’enrichissement graphique le plus élégant réside dans l’intégration directe de glyphes directionnels Unicode (flèches vers le haut ou vers le bas) au sein du format de nombre personnalisé. Cette technique permet d’adjoindre un indicateur vectoriel immédiat sans altérer la nature numérique sous-jacente de la valeur, préservant ainsi l’exploitabilité intégrale de la cellule pour des calculs d’agrégation subséquents.
Pour appliquer ce raffinement, sélectionnez la plage des variations relatives, accédez au menu Format > Nombre > Format de nombre personnalisé, et insérez la chaîne de description syntaxique suivante :
[Vert]+0,0% ▲;[Rouge]-0,0% ▼;0,0% ▬
La structure tripartite de ce masque de formatage segmente l’affichage de manière algorithmique :
- Le premier segment régit les grandeurs strictement positives en leur attribuant une coloration verte, un préfixe d’explicitation de signe « + », une décimale de précision et le glyphe ▲.
- Le deuxième segment intercepte les grandeurs strictement négatives en leur affectant une coloration rouge, un signe moins unitaire et le glyphe ▼.
- Le troisième segment s’applique exclusivement à la valeur nulle stricte, lui assignant un tiret d’invariance horizontal ▬.
Cette approche d’ingénierie visuelle confère aux tableaux de bord de gestion un niveau de lisibilité synthétique optimal, particulièrement apprécié des comités exécutifs.
10. Comparaisons multidimensionnelles et analyses temporelles
10.1 Calcul des variations d’une période à l’autre (Month-over-Month)
L’analyse séquentielle continue, fréquemment désignée sous l’anglicisme Month-over-Month (MoM) dans le cadre de relevés mensuels, mesure l’accélération marginale immédiate d’un indicateur. Elle s’exprime par le calcul de la variation d’un mois $M$ par rapport au mois antécédent direct $M-1$ :
$$\tau_{\text{MoM}} = \frac{V_t – V_{t-1}}{V_{t-1}}$$
Cette métrique s’avère particulièrement précieuse pour appréhender les réactions à court terme d’un écosystème commercial face à une décision tactique récente, telle que le lancement d’une campagne publicitaire, une refonte tarifaire ou un incident sur une chaîne logistique. Elle constitue l’instrument privilégié du monitoring opérationnel agile.
Néanmoins, la métrique MoM souffre d’une forte vulnérabilité face aux irrégularités calendaires. Un mois comportant 31 jours calendaires et 22 jours ouvrés disposera mécaniquement d’un potentiel de génération de flux supérieur à un mois de février comptant 28 jours. Par ailleurs, elle présente une très forte sensibilité aux effets de volatilité aléatoire et aux chocs exogènes passagers, rendant périlleuse toute extrapolation linéaire à long terme sur sa seule base.
10.2 Mesure des variations en glissement annuel (Year-over-Year)
Pour neutraliser les imperfections inhérentes aux comparaisons séquentielles de court terme, l’analyse macroéconomique et financière recourt prioritairement à la mesure en glissement annuel, dite Year-over-Year (YoY). Cette technique consiste à confronter la valeur d’une période donnée à celle observée au cours de la même période lors de l’année précédente (par exemple, comparer le mois de décembre de l’année $N$ au mois de décembre de l’année $N-1$) :
$$\tau_{\text{YoY}} = \frac{V_t – V_{t-12}}{V_{t-12}}$$
Au sein d’une feuille Google Sheets organisée en données mensuelles chronologiques, l’implémentation de cette mesure s’obtient simplement en décalant l’indexation de douze lignes vers le haut :
=(B14-B2)/B2
L’immense vertu analytique du glissement annuel réside dans sa capacité à neutraliser quasi intégralement l’impact des cycles de saisonnalité intrinsèques à l’activité de l’entreprise (comme les pics de ventes des fêtes de fin d’année ou les ralentissements estivaux). Elle offre ainsi une vision épurée de la trajectoire structurelle de fond et constitue la référence institutionnelle pour les rapports annuels audités et la communication financière.
10.3 Mesure du taux de croissance composé (TCAM / CAGR) dans Google Sheets
Lorsque l’observation s’étend sur une pluralité d’exercices annuels, l’analyste ne peut se contenter d’effectuer une simple moyenne arithmétique des pourcentages de variation annuelle constatés. En raison des mécanismes de composition des rendements dans le temps, la moyenne arithmétique surestime systématiquement la vitesse de progression réelle du phénomène étudié. Il devient alors indispensable de recourir au Taux de Croissance Annuel Composé (TCAM), universellement désigné sous le sigle anglophone CAGR (Compound Annual Growth Rate).
Le TCAM représente le taux de variation géométrique constant qui aurait permis à une grandeur d’évoluer d’un niveau initial $V_i$ à un niveau final $V_f$ sur un intervalle de $n$ périodes. Sa formulation mathématique canonique s’énonce :
$$\text{TCAM} = \left( \frac{V_f}{V_i} \right)^{\frac{1}{n}} – 1$$
Dans Google Sheets, ce calcul sophistiqué s’implémente au moyen de l’opérateur d’exponentiation ^ ou de la fonction PUISSANCE (ou POWER). Supposons que le capital initial réside en cellule B2 et que la valeur finale observée au terme de 5 exercices consécutifs réside en cellule B7 ($n = 5$). La formule s’articulera ainsi :
=(B7/B2)^(1/5) - 1
Pour conférer une dimension totalement adaptative à l’équation face à des séries dynamiques, il est conseillé de substituer au dénominateur fixe une expression de comptage automatique des périodes :
=(INDEX(B2:B; NB(B2:B)) / B2)^(1 / (NB(B2:B) - 1)) - 1
Cette écriture avancée extrait dynamiquement la dernière observation saisie et calcule le taux actuariel rigoureux, offrant une lecture épurée de la vitesse de croisière structurelle du phénomène sous observation.
11. Erreurs fréquentes d’interprétation et biais statistiques
11.1 Confusion sémantique entre points de pourcentage et pourcentage de variation
L’une des fautes professionnelles les plus récurrentes dans les synthèses managériales réside dans l’assimilation fallacieuse entre une variation exprimée en points de pourcentage et un pourcentage de variation relatif. Cette méprise survient spécifiquement dès lors que la variable fondamentale étudiée est elle-même un ratio préexistant (tel qu’un taux de marge brute, une part de marché ou un taux de conversion numérique).
Illustrons cette dichotomie : si le taux de conversion d’une plateforme transactionnelle passe de $10,%$ au trimestre $T1$ à $15,%$ au trimestre $T2$, il convient de distinguer impérativement deux réalités métrologiques distinctes :
- La variation absolue s’élève à : $15 – 10 = +5$ points de pourcentage.
- La variation relative s’établit à : $(15 – 10) / 10 = 5 / 10 = +50,%$ de variation.
Déclarer que le taux de conversion a progressé de « 5 % » constitue une erreur de communication majeure : cela laisserait entendre que le taux final s’établit à $10 \times 1,05 = 10,5,%$, ce qui sous-estimerait drastiquement l’ampleur réelle du bond opérationnel réalisé. L’analyste doit faire preuve d’une rigueur typographique et sémantique intraitable dans ses classeurs et rapports en distinguant scrupuleusement les mentions « pts » et « % ».
11.2 L’effet de base : asymétrie fondamentale entre hausses et baisses
Une caractéristique mathématique intrinsèque du pourcentage de variation réside dans son asymétrie fondamentale induite par l’effet de base. En raison du glissement continuel du dénominateur, les hausses et les baisses ne sont aucunement réversibles de manière arithmétique. Une baisse d’un pourcentage donné requiert impérativement une hausse proportionnellement bien plus substantielle pour rétablir le niveau initial.
Démontrons formellement cette asymétrie cinétique :
- Un portefeuille d’actifs valorisé à 100 subit une contraction de $-50,%$. Sa valeur chute à 50.
- Pour retrouver son niveau initial de 100, la valeur doit progresser de 50 unités sur une base désormais réduite à 50.
- L’augmentation relative requise s’élève donc à : $(100 – 50) / 50 = 50 / 50 = +100,%$.
Une contraction de $-50,%$ n’est pas compensée par une expansion de $+50,%$, mais exige un doublement intégral ($+100,%$). De manière analogue, une chute de $-80,%$ impose une envolée spectaculaire de $+400,%$ pour recouvrer l’équilibre. L’omission de cette réalité mathématique induit des biais cognitifs majeurs lors de l’évaluation de performances financières cycliques : des décideurs non avertis ont tendance à imaginer qu’une succession de pourcentages inverses de même module neutralise les variations, ce qui est mathématiquement infondé.
11.3 Biais de perception psychologique des pourcentages extrêmes
L’utilisation non contextualisée des taux de variation relatifs engendre un biais cognitif notoire lors du traitement de grandeurs portant sur des volumes initiaux dérisoires. Ce phénomène, qualifié de paradoxe des micro-volumes, génère des pourcentages d’évolution disproportionnés qui ne reflètent aucune matérialité économique significative.
Supposons qu’une division commerciale périphérique réalise une unique vente au cours du premier trimestre ($V_i = 1$) et parvienne à enregistrer quatre transactions au cours du second trimestre ($V_f = 4$). La formule de calcul restitue une croissance phénoménale de :
$$\tau = \frac{4 – 1}{1} = +300%$$
Parallèlement, une division centrale mature générant 100 000 transactions voit son volume progresser vers 120 000 unités, soit une croissance affichée de $+20,%$. Une lecture superficielle des taux placerait la première entité comme un pôle de dynamisme exceptionnel, occultant le fait que l’apport volumique marginal de la seconde entité (20 000 transactions supplémentaires) dépasse de plusieurs ordres de grandeur les trois transactions glanées par la première.
Pour prémunir les organisations contre ce piège de modélisation, il est impératif d’assortir systématiquement les pourcentages de variation de leurs volumétries absolues correspondantes, ou d’instaurer des seuils d’activation minimaux au sein des formules pour filtrer les micro-volumes non significatifs.
12. Synthèse méthodologique et bonnes pratiques de modélisation
12.1 Protocole de vérification et d’audit des formules dans Google Sheets
La validation de la robustesse d’un classeur d’analyse statistique requiert l’exécution d’un protocole d’audit systématique avant toute restitution officielle. La première étape de ce protocole consiste à basculer la feuille de calcul en mode d’inspection des formules en sollicitant le raccourci clavier universel Ctrl + ` (accent grave) ou via le menu Affichage > Afficher > Formules. Cette vue globale désactive les masques d’affichage et dévoile l’intégralité des syntaxes sous-jacentes, permettant de repérer instantanément d’éventuelles incohérences d’adressage ou des ruptures de structure matricielle au sein des colonnes.
La deuxième étape consiste à éprouver la sensibilité algorithmique du modèle par le biais de tests aux limites. L’auditeur doit délibérément insérer des valeurs extrêmes au sein de la colonne de référence afin d’observer le comportement du classeur :
- Insertion d’une valeur nulle (0) pour vérifier la bonne neutralisation de l’erreur
#DIV/0!. - Insertion de chaînes textuelles pour valider l’interception de l’erreur
#VALEUR!. - Insertion de grandeurs négatives pour contrôler l’implémentation de la fonction
ABSau dénominateur.
Cette approche d’assurance qualité logicielle garantit que le modèle ne s’effondrera pas sous l’effet d’anomalies de saisie futures.
12.2 Documentation interne des métriques au sein du tableur
L’un des écueils majeurs des feuilles de calcul d’entreprise réside dans leur perte d’intelligibilité au fil des transferts d’utilisateurs, phénomène connu sous le nom de dette documentaire. Un modèle de données pérenne doit être auto-porteur et documenter de façon transparente les conventions méthodologiques retenues.
Cette documentation s’articule sur plusieurs niveaux :
- L’insertion systématique de commentaires ou de notes explicatives (via le raccourci
Maj + F2) sur les cellules d’en-tête de colonnes, explicitant la formule de calcul, l’indice temporel retenu et la source de données amont. - La création d’un onglet de gouvernance des données dédié (intitulé par exemple « Dictionnaire des Données » ou « Métadonnées »), recensant la totalité des variables, leurs unités de mesure, leurs règles de validation et la conduite à tenir face aux cas particuliers (valeurs négatives, ruptures d’activité).
- L’adoption d’un standard de nommage rigoureux pour les plages de cellules nommées, substituant à des coordonnées abstraites (comme
Feuille1!B2:B50) des identifiants sémantiques clairs (tels queChiffreAffaires_2023).
Cette rigueur de formalisation transforme une simple feuille de calcul en un outil d’ingénierie d’analyse réutilisable et auditable par des tiers.
12.3 Check-list finale pour des calculs reproductibles et rigoureux
Avant d’archiver, de publier ou de déployer un tableau de calcul de pourcentage de variation au sein de Google Sheets, l’analyste se doit de renseigner la grille de conformité suivante afin de certifier la reproductibilité totale de ses travaux :
- Intégrité du typage : L’ensemble des cellules sous-jacentes contient-il des scalaires numériques réels exempts d’espaces insécables ou de formatages de texte résiduels ?
- Priorité algébrique : La formule canonique respecte-t-elle le parenthésage absolu du numérateur
=(Vf - Vi) / Viou adopte-t-elle la forme condensée=(Vf / Vi) - 1? - Traitement des dénominateurs négatifs : La fonction
ABS()a-t-elle été scrupuleusement adjointe au dénominateur pour conjurer le paradoxe d’inversion de signe ? - Neutralisation des asymptotes : Une fonction défensive telle que
SIERREUR()ou une conditionSI()préalable neutralise-t-elle les risques de division par zéro ? - Cohérence de l’affichage : Le masque de pourcentage applique-t-il un nombre de décimales suffisant sans fausser l’interprétation par une troncature excessive ?
- Ergonomie visuelle : Les règles de mise en forme conditionnelle ont-elles été rigidement ancrées sur un zéro médian neutre pour écarter toute perception erronée ?
- Scalabilité logicielle : Le déploiement s’appuie-t-il sur des formules matricielles (
ARRAYFORMULA) capables d’absorber l’adjonction future de nouveaux enregistrements sans intervention humaine ?
Le respect exhaustif de ces critères confère aux analyses produites une autorité méthodologique incontestable, fondant les délibérations stratégiques sur des données quantitatives d’une rigueur scientifique irréprochable.
Références
- Anderson, D. R., Sweeney, D. J., Williams, T. A., Camm, J. D., & Cochran, J. J. (2020). Statistics for Business & Economics (14th ed.). Cengage Learning.
- Berk, J., & DeMarzo, P. (2020). Corporate Finance (5th ed.). Pearson.
- Google. (s. d.). TO_PERCENT : Convertit un nombre fourni en pourcentage. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3094284
- Google. (s. d.). ARRAYFORMULA : Permet de générer des valeurs renvoyées par une formule matricielle sur plusieurs lignes ou colonnes. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3093275
- Google. (s. d.). SIERREUR : Renvoie le premier argument s’il ne s’agit pas d’une valeur d’erreur. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3093304
- Institut National de la Statistique et des Études Économiques (INSEE). (2021). Taux de variation : Définition méthodologique. Insee Définitions. Consulté le 24 mai 2024, à l’adresse https://www.insee.fr/fr/metadonnees/definition/c1509
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Winston, W. L. (2016). Microsoft Excel Data Analysis and Business Modeling (5th ed.). Microsoft Press.