
L’analyse des distributions de données constitue le socle fondamental de toute investigation empirique, qu’elle s’inscrive dans le cadre des sciences comportementales, de l’évaluation psychométrique ou du pilotage de la performance organisationnelle. Au sein de cet édifice méthodologique, la quantification de l’accumulation progressive des fréquences relatives représente une démarche charnière. Elle permet d’appréhender non pas simplement l’occurrence ponctuelle d’un événement au sein d’une classe de valeurs, mais la proportion consolidée d’observations se situant en deçà ou au niveau d’un seuil critique donné. Cette transition de la vision granulaire à la perspective globale s’avère indispensable pour conférer un sens opérationnel et prédictif aux masses d’informations collectées sur le terrain.
L’avènement des technologies infonuagiques de traitement de données, incarné avec force par l’application Google Sheets, a profondément transformé l’ingénierie du calcul statistique appliqué. Jadis réservées à des environnements logiciels spécialisés ou contraintes par des classeurs de calcul statiques et isolés, les opérations de sommation itérative et d’étalonnage dynamique s’exécutent désormais au sein d’espaces collaboratifs accessibles en temps réel. Cette fluidification du traitement quantitatif implique néanmoins une maîtrise rigoureuse de la syntaxe algorithmique propre aux tableurs modernes. Une méconnaissance des mécanismes de référencement spatial ou des principes d’évaluation matricielle expose l’analyste à des distorsions mathématiques majeures, invalidant la prise de décision stratégique ou diagnostique.
Le présent traité propose une déconstruction exhaustive, théorique et opérationnelle, du calcul du pourcentage cumulé dans l’environnement Google Sheets. En partant des fondements mathématiques de la théorie des probabilités jusqu’aux fonctions fonctionnelles de dernière génération telles que les expressions anonymes et les itérateurs vectoriels, ce document offre un guide d’ingénierie logicielle et statistique. L’objectif est d’armer l’analyste de données, le chercheur ou le gestionnaire d’une méthodologie exempte de failles pour structurer, formaliser, automatiser et interpréter les distributions cumulatives avec une rigueur académique sans concession.
1. Introduction théorique et méthodologique au pourcentage cumulé
1.1 Définition statistique et fondements mathématiques
Sur le plan de l’analyse distributionnelle, le pourcentage cumulé matérialise l’expression normalisée de la fonction de répartition empirique appliquée à un échantillon discret. Si l’on considère une variable aléatoire ordonnée observant un ensemble d’occurrences réparties dans des catégories mutuellement exclusives, la fréquence relative marginale quantifie le poids proportionnel d’une modalité spécifique par rapport à la cardinalité globale de l’échantillon. À l’inverse, l’agrégation cumulative procède à la sommation continue de ces proportions marginales depuis l’origine de l’espace distributionnel jusqu’à la modalité considérée. Mathématiquement, pour un ensemble ordonné d’observations dont la somme des effectifs bruts équivaut à un total défini, le pourcentage cumulé associé à un rang donné traduit la proportion des effectifs dont la valeur est inférieure ou égale à ce point focal.
Cette distinction s’avère primordiale dans l’évaluation des propriétés structurales d’un corpus quantitatif. Tandis que les fréquences simples révèlent des densités locales, susceptibles d’être parasitées par des fluctuations d’échantillonnage ou des artefacts de mesure, la fonction cumulative lisse ces disparités en mettant en exergue la trajectoire ascensionnelle de la masse de données. Elle permet d’établir une équivalence rigoureuse avec les concepts de fractiles, de quartiles et de déciles. Dans le cadre psychométrique, cette approche offre la possibilité d’étalonner une performance individuelle non plus par rapport à une moyenne abstraite, mais selon un seuil d’intégration relative dans une population normative, validant ainsi la comparabilité interindividuelle des scores composites obtenus lors des protocoles standardisés.
1.2 Pertinence dans l’analyse de données empiriques et comportementales
Dans l’observation empirique des conduites humaines ou des dynamiques organisationnelles, le déploiement du pourcentage cumulé autorise l’identification de patterns non linéaires qui échappent aux indicateurs de tendance centrale traditionnels. L’analyse temporelle des temps de réaction, de la latence d’apprentissage ou de l’accumulation de réponses face à un stimulus expérimental requiert impérativement cette approche d’intégration progressive. Elle permet d’identifier l’instant critique où une majorité qualifiée de sujets atteint un palier adaptatif ou comportemental préétabli, offrant ainsi des indices empiriques fiables pour la modélisation de courbes d’apprentissage ou de résistance à l’épuisement cognitif.
Parallèlement, la quantification cumulative s’inscrit au cœur des démarches d’audit opérationnel et de gestion des priorités via le célèbre principe formalisé par Vilfredo Pareto. Dans ce paradigme, le calcul du pourcentage cumulé des occurrences d’un dysfonctionnement ou de l’impact financier de certaines variables permet d’objectiver la règle empirique selon laquelle un segment restreint de causes génère une proportion disproportionnée des effets observés. La détermination des seuils charnières, classiquement situés à quatre-vingts pour cent de la masse cumulée, conditionne l’arbitrage dans l’allocation des ressources techniques et humaines, transformant une série brute de relevés en une feuille de route hiérarchisée selon des critères de rendement analytique optimal.
1.3 Architecture du tableur Google Sheets pour le traitement cumulatif
L’implémentation de calculs séquentiels cumulés dans un environnement infonuagique comme Google Sheets impose une compréhension fine des interactions entre le moteur d’évaluation des dépendances et le modèle de mémoire sous-jacent. Contrairement aux moteurs compilés bas niveau, le tableur en ligne gère un graphe acyclique dirigé des formules inscrites dans les cellules de la grille. Chaque calcul qui sollicite l’état de la ligne précédente ou une portion dynamique d’une colonne déclenche un parcours d’arbre d’exécution qui doit concilier réactivité de l’interface graphique et exactitude arithmétique. Cette mécanique repose fondamentalement sur le couplage d’adresses absolues et relatives au sein des références de plages expansives.
En outre, l’infrastructure de Google Sheets intègre un moteur de calcul JavaScript exécuté côté client couplé à des synchronisations périodiques vers les grappes de serveurs distants. Cette spécificité architecturale implique que face à des flux continus de données, tels que des réponses consolidées issues de formulaires ou des connexions directes à des bases transactionnelles via des connecteurs d’interface, la fonction cumulative doit être capable de se recalculer de manière dynamique sans engendrer de goulots d’étranglement computational. L’interopérabilité native entre les opérateurs arithmétiques standards et les constructions matricielles complexes offre la souplesse nécessaire pour passer d’un modèle itératif classique à une vectorisation avancée des flux cumulatifs.
2. Structuration optimale du jeu de données dans Google Sheets
2.1 Organisation spatiale et typologie des variables
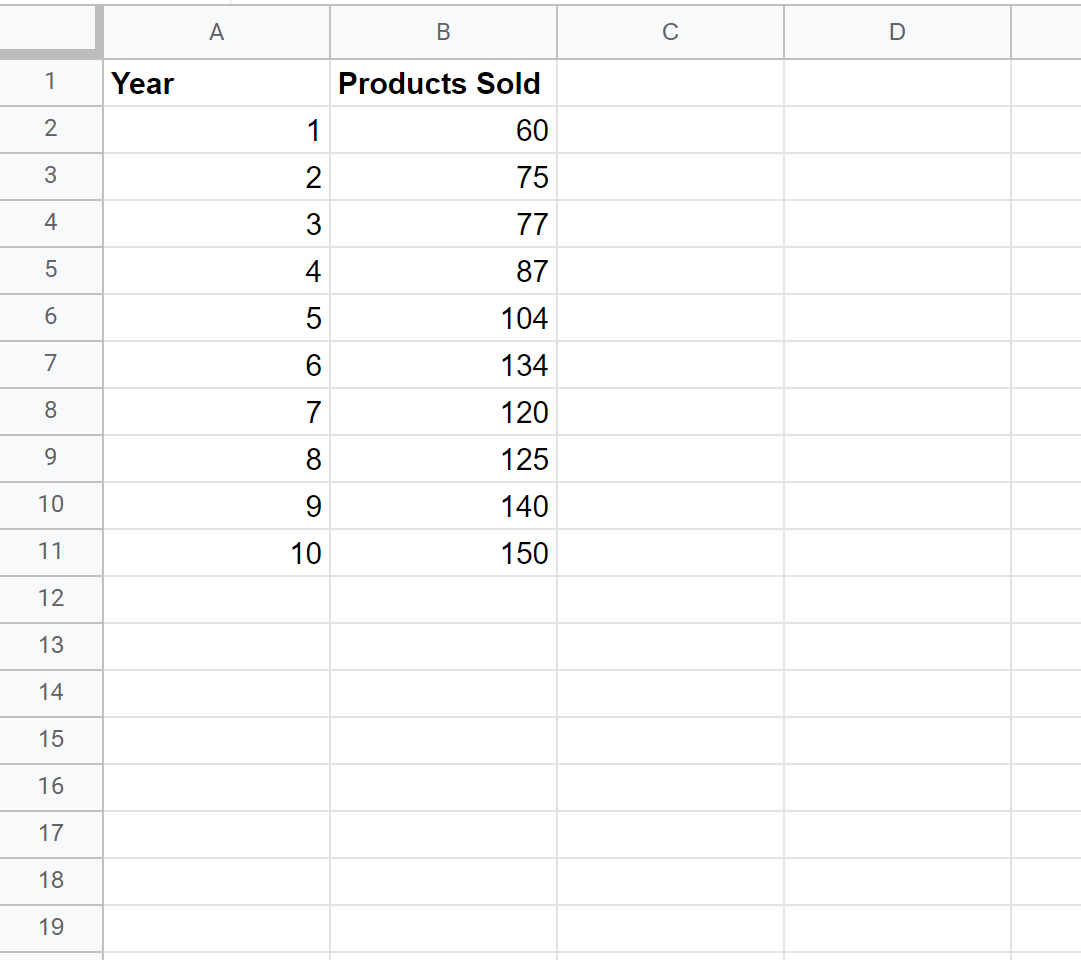
La pérennité d’un système de calcul cumulé dépend d’une stricte orthodoxie dans l’ordonnancement de la feuille de calcul. L’organisation en colonnes unidimensionnelles orthogonales représente la norme méthodologique absolue. La première colonne doit impérativement être réservée à l’identifiant univoque de l’observation ou au libellé ordonné de la classe de valeurs. La colonne contiguë doit accueillir la variable métrique d’intérêt, typiquement la fréquence brute observée, le volume transactionnel ou le décompte d’occurrences. Tout mélange spatial consistant à juxtaposer des tableaux intermédiaires de façon anarchique sur un même plan horizontal compromet la délimitation des plages d’analyse et multiplie les risques de collisions de références.
La typologie des variables introduites exige une classification rigoureuse en amont de toute saisie algorithmique. Qu’il s’agisse de variables quantitatives discrètes, de données continues réparties en intervalles de classes ou d’échelles ordinales psychométriques, la nature de la variable dicte la pertinence de l’accumulation. Avant d’engager la moindre opération mathématique, l’analyste doit valider l’homogénéité stricte des types de données au sein de la colonne source. L’injection inopinée d’un format monétaire mal converti ou d’une notation textuelle au sein d’un vecteur supposé contenir des entiers naturels est susceptible de fausser l’évaluation silencieuse du tableur, conduisant à des agrégats erronés sans génération explicite de message d’erreur.
2.2 Prétraitement et nettoyage des données initiales
L’intégrité de la distribution cumulative requiert un assainissement préalable méticuleux des séries numériques. L’analyste doit opérer une détection systématique des valeurs aberrantes ou des chaînes de caractères corrompues introduites lors des phases d’importation de fichiers externes ou de saisies manuelles non contraintes. Une cellule contenant une espace insécable invisible ou une valeur négative au sein d’une distribution de fréquences absolues détruit la validité axiomatique du pourcentage cumulé, lequel postule une somme strictement positive et une croissance continue de l’agrégat. L’utilisation d’outils d’audit intégrés ou de filtres d’inspection permet d’isoler ces anomalies structurelles.
Le traitement des observations nulles et des cellules vides constitue un autre jalon décisif du prétraitement. Dans un tableur, une cellule vide n’équivaut pas systématiquement à la valeur zéro sur le plan sémantique, particulièrement lorsqu’elle traduit une absence d’information plutôt qu’un comptage nul. L’analyste doit arbitrer entre l’imputation explicite d’un zéro logique ou l’exclusion de l’enregistrement de l’assiette d’analyse. La vérification de l’intégrité référentielle s’avère indispensable pour s’assurer qu’aucun décalage de rang ne survienne lors de l’application consécutive des formules d’indexation, garantissant que chaque fréquence brute corresponde sans ambiguïté à son intervalle modal spécifique.
2.3 Ordonnancement logique des observations
La validité interprétative de toute série cumulative dépend de l’ordre séquentiel dans lequel les données sont présentées au moteur de calcul. Si l’on cherche à formaliser une fonction de répartition ou un diagramme de Pareto, l’ordonnancement ne saurait être aléatoire. Dans une perspective de répartition théorique ou d’analyse par seuils de scores, les observations doivent être rigoureusement disposées selon un ordre croissant de la variable d’intensité. Inversement, lorsqu’il s’agit d’isoler les composantes hautement contributives selon la logique de Pareto, les données brutes doivent être triées de manière strictement décroissante sur la base de leur fréquence d’occurrence avant le déclenchement de la sommation cumulative.
Pour prévenir toute distorsion humaine dans cette opération critique, l’emploi de fonctions dynamiques telles que la commande de tri intégrée au langage du tableur s’impose comme une solution robuste. La fonction suivante permet de générer une table dérivée impeccablement ordonnée à partir d’une matrice source sans altérer l’enregistrement primaire :
=TRIER(A2:B100; 2; FAUX)
Cette syntaxe extrait la plage de données et assure une redistribution automatique basée sur la deuxième colonne selon un ordre décroissant. Toute modification subséquente du jeu de données primaires se répercute instantanément sur la série triée, maintenant l’exactitude de la chaîne de calculs cumulés sans exiger de réintervention manuelle sur les filtres de la feuille de calcul.
3. Calcul de la fréquence cumulée : L’étape préparatoire essentielle
3.1 Mécanisme des références mixtes avec la fonction SOMME
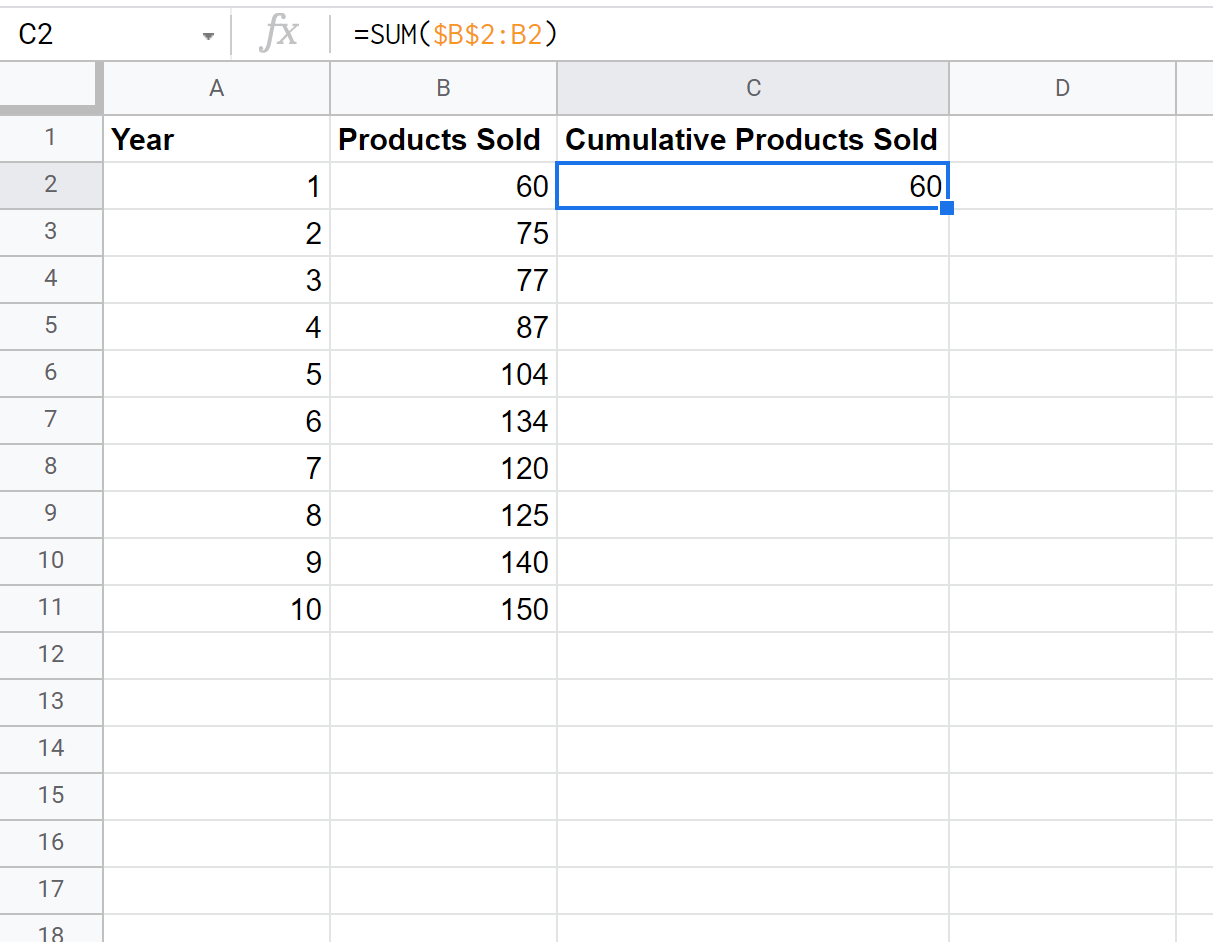
Le calcul de la fréquence cumulée brute constitue le pivot intermédiaire indispensable avant l’expression du résultat sous forme de ratio ou de pourcentage. La technique classique la plus élégante repose sur l’exploitation judicieuse du système d’adressage du tableur au moyen des références mixtes au sein de la fonction d’agrégation arithmétique. En ancrant rigidement l’origine du vecteur d’accumulation tout en laissant son extrémité supérieure libre d’évoluer, on crée ce que la littérature informatique qualifie de plage expansive ou glissante. L’opérateur dollar remplit ici la fonction de verrou topographique absolu.
Considérons une colonne de fréquences brutes débutant à la cellule B2. La formulation canonique inscrite dans la cellule contiguë de la première ligne d’analyse prend la forme suivante :
=SOMME($B$2:B2)
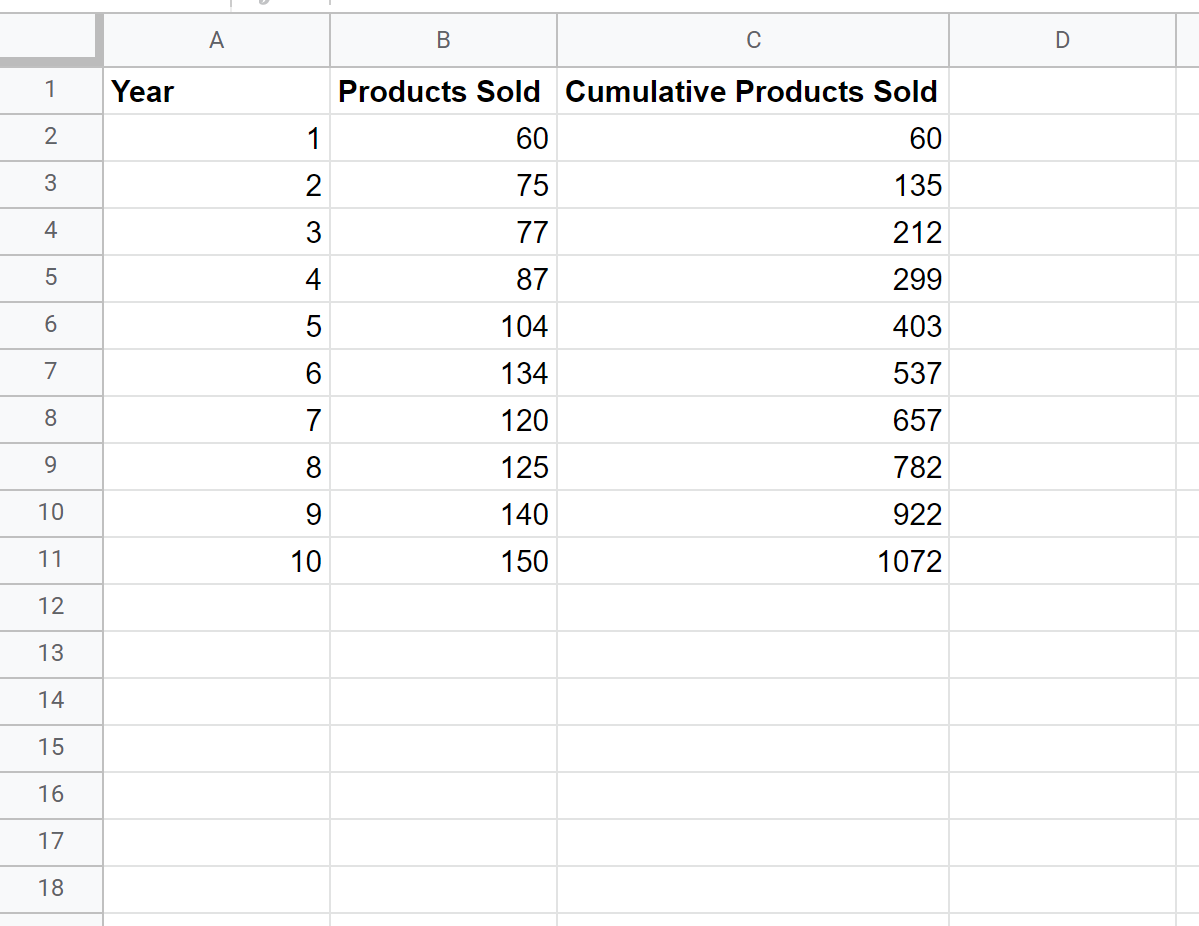
Lorsque cette formule est incrémentée verticalement vers le bas le long de la colonne, le premier argument $B$2 demeure immuable, garantissant que la sommation débute invariablement à la première modalité de la série statistique. En revanche, le second argument B2, dépourvu de tout marqueur de fixation, se transmute dynamiquement en B3, B4, puis Bn au fil de la descente. Il en résulte une sommation dynamique de l’ensemble des cellules comprises entre la racine de la distribution et l’indice de la ligne courante, matérialisant avec une économie conceptuelle remarquable la progression de l’effectif cumulé.
3.2 Méthode alternative par addition récursive
Une approche conceptuellement distincte, fréquemment observée chez les praticiens de la modélisation financière, consiste à formaliser l’accumulation sous la forme d’une équation de récurrence discrète. Dans ce schéma, la fréquence cumulée de la première ligne est directement assignée à la valeur brute correspondante. Dès la deuxième ligne, la cellule active est définie comme la somme de la fréquence brute de la ligne en cours et de la fréquence cumulée calculée sur la ligne immédiatement supérieure. L’expression algorithmique prend ainsi l’allure d’une liaison séquentielle continue reliant chaque cellule à son antécédent direct.
Bien que cette technique présente l’avantage d’une charge computationnelle théoriquement minime lors de chaque calcul élémentaire, chaque itération n’exécutant qu’une simple addition binaire plutôt qu’une sommation sur une plage grandissante, elle introduit une vulnérabilité systémique au sein du classeur. Toute suppression physique d’une ligne intermédiaire brise irrémédiablement la chaîne de dépendances, générant une cascade d’erreurs de référence non résolues. De surcroît, l’insertion accidentelle d’une nouvelle observation au cœur de la table sans réajustement des formules récursives compromet l’intégrité de l’ensemble des résultats situés en aval, rendant cette méthodologie peu recommandable au sein d’environnements de travail hautement collaboratifs.
3.3 Validation de l’intégrité de la série cumulée
Avant d’engager le calcul du pourcentage proprement dit, une phase de vérification logique de la série cumulée s’avère impérative pour attester de la validité mathématique du processus. Le premier point de contrôle consiste à valider la stricte concordance arithmétique entre la valeur affichée dans la dernière cellule de la colonne des fréquences cumulées et la somme globale de l’échantillon calculée indépendamment sur l’intégralité de la colonne source. Tout écart, même infinitésimal, trahit l’omission d’une cellule dans la plage expansive ou la présence d’une valeur textuelle non sommée au sein du vecteur d’origine.
Le second contrôle porte sur la vérification de la monotonie de la série. Par définition, une distribution de fréquences cumulées calculée sur des effectifs réels strictement positifs doit présenter une monotonie croissante continue. Pour formaliser ce contrôle au sein du tableur, l’analyste peut implémenter une colonne d’audit temporaire exploitant un test booléen conditionnel :
=SI(C3 >= C2; « VALIDE »; « RUPTURE DE MONOTONIE »)
Ce type de formule défensive permet de repérer instantanément toute anomalie arithmétique imputable à la présence d’un delta négatif imprévu ou à un décalage accidentel d’adressage de cellule, sécurisant ainsi l’édifice analytique avant l’étape de normalisation fractionnaire.
4. Formulation standard du pourcentage cumulé dans Google Sheets
4.1 Intégration du total général dans l’équation
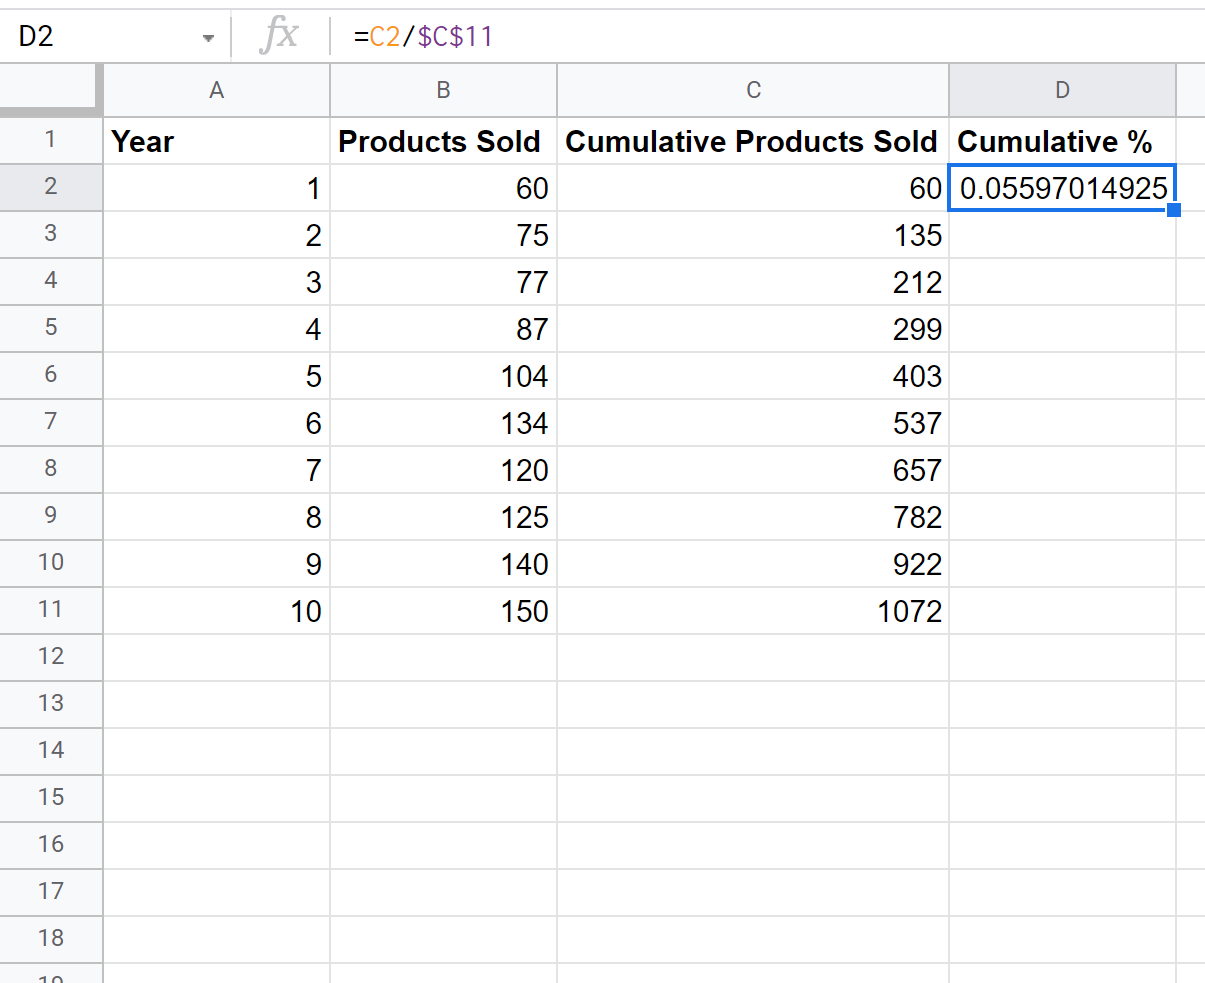
L’expression du pourcentage cumulé exige le rapport direct entre l’agrégat local obtenu à l’étape précédente et la masse globale représentée par la totalité des observations de l’échantillon. Pour formaliser ce calcul au sein d’une expression unifiée sans passer par une colonne de fréquence cumulée intermédiaire, l’analyste doit synthétiser deux opérations au sein de la même cellule : la sommation progressive au numérateur et la sommation exhaustive au dénominateur. La précision de l’opération repose sur la juxtaposition d’une plage expansive et d’une plage totalement figée.
La construction mathématique s’exprime alors selon la syntaxe suivante, déployée par exemple dans la cellule C2 d’une table débutant à la ligne 2 et s’étendant jusqu’à la ligne 100 :
=SOMME($B$2:B2) / SOMME($B$2:$B$100)
Dans cette formulation, le numérateur assure le calcul glissant de la fréquence cumulée jusqu’au rang courant, tandis que le dénominateur verrouille sans équivoque la totalité du champ expérimental au moyen du double adressage absolu $B$2:$B$100. Quelle que soit la progression de la recopie vers le bas, la constante d’échelle demeure invariante. Ce mécanisme garantit la stricte comparabilité des ratios calculés d’une ligne à l’autre en les rapportant continuellement au même référentiel unitaire.
4.2 Déploiement pas à pas de la formule de base
L’implémentation pratique de la formule standard obéit à un protocole opératoire précis au sein de l’interface graphique de Google Sheets. Dans un premier temps, l’analyste sélectionne la cellule initiale de la colonne destinée à accueillir les pourcentages cumulés, généralement située au même niveau horizontal que le premier enregistrement de données. La saisie de l’équation arithmétique doit être effectuée avec une vigilance extrême quant au placement des parenthèses et des symboles de fixation monétaire, sous peine de convertir accidentellement la référence en adresse relative lors de la validation.
Une fois l’instruction validée par la touche Entrée, l’extension de l’opération arithmétique s’opère par l’activation de la poignée de recopie, matérialisée par le petit carré bleu situé à l’angle inférieur droit du cadre de sélection cellulaire. Un double-clic rapide sur cette poignée déclenche une auto-complétion descendante qui s’interrompt automatiquement au niveau du dernier enregistrement contigu de la colonne adjacente. L’étape conclusive de ce déploiement consiste à examiner visuellement la dernière ligne du tableau : celle-ci doit obligatoirement restituer la valeur numérique un avant toute mise en forme, témoignant de l’exactitude de la couverture distributionnelle.
4.3 Optimisation via une cellule dédiée au total général
Lorsque le volume d’enregistrements traités croît de manière substantielle, atteignant des dizaines de milliers de lignes, l’évaluation répétée de la fonction de sommation au dénominateur au sein de chaque formule individuelle engendre une dégradation mesurable des performances de calcul du classeur. Dans une table de dix mille lignes, la formule standard contraint le processeur à recalculer dix mille fois la somme intégrale de la colonne, induisant une redondance computationnelle de complexité asymptotique quadratique évitable.
L’optimisation architecturale préconisée réside dans la dissociation du calcul global au moyen de l’affectation d’une cellule isolée dédiée à l’hébergement du total général de la distribution. En calculant préalablement cette somme dans une cellule désignée, par exemple B101, la formulation du pourcentage cumulé pour chaque ligne individuelle se simplifie de manière spectaculaire :
=SOMME($B$2:B2) / $B$101
Cette approche substitue un appel de fonction complexe par une simple lecture de mémoire statique à chaque ligne d’exécution. La réactivité du classeur s’en trouve décuplée, et la lisibilité du code s’accroît, facilitant les opérations d’audit ultérieures par des tiers ou la maintenance du modèle statistique par des collaborateurs distants.
5. Formatage typographique et configuration des pourcentages
5.1 Application des styles de mise en forme numérique
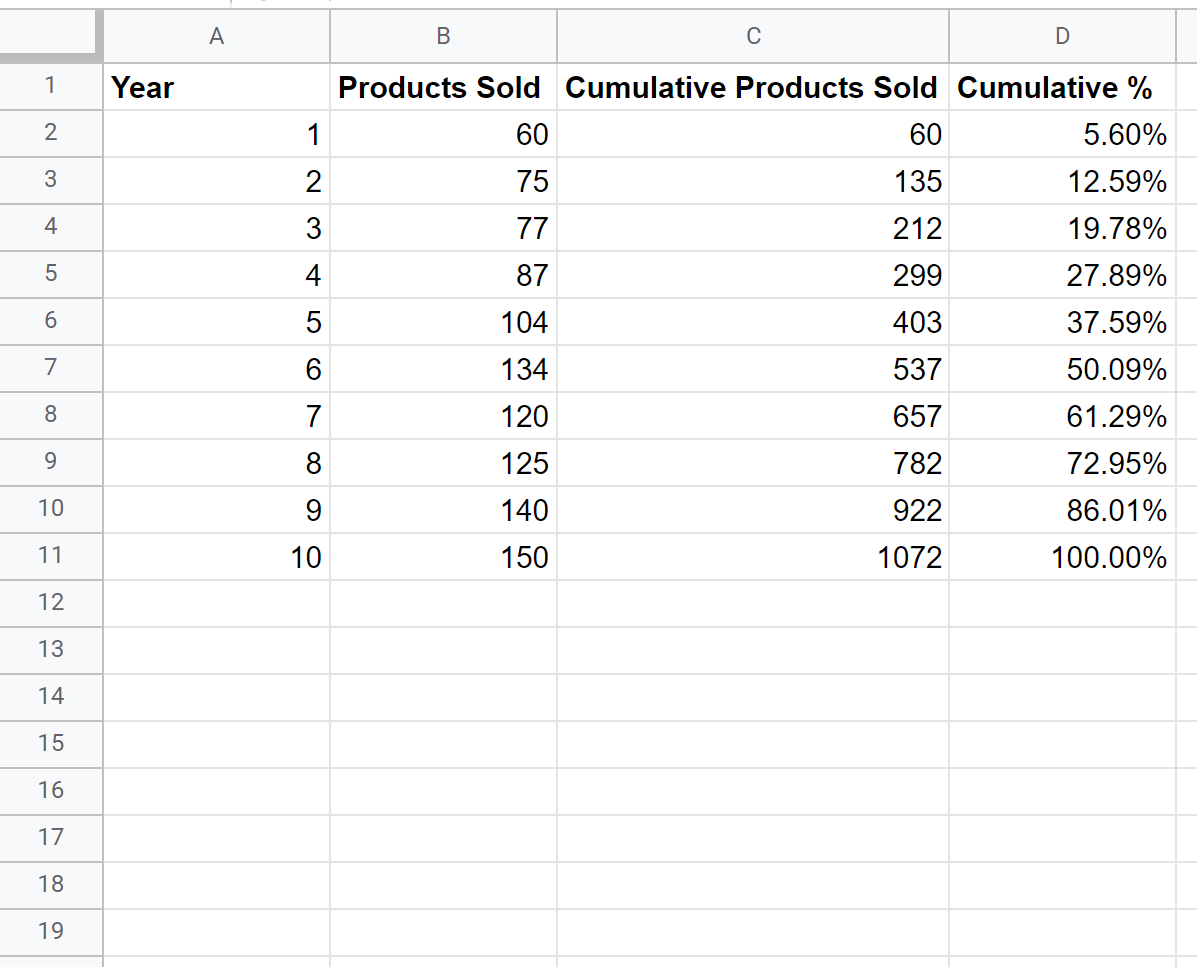
L’aboutissement du calcul arithmétique génère intrinsèquement un nombre décimal à virgule flottante compris dans l’intervalle fermé allant de zéro à un. Pour transformer cette grandeur abstraite en une représentation communicationnelle intelligible conforme aux standards de l’édition scientifique et financière, l’analyste doit lui appliquer une couche de présentation typographique dédiée. Le formatage en pourcentage au sein de Google Sheets ne modifie en rien la valeur sous-jacente stockée en mémoire par le moteur d’exécution ; il se borne à multiplier visuellement le nombre par cent tout en lui adjoignant le symbole typographique universel.
Cette conversion stylistique s’opère aisément au travers des menus natifs de l’interface utilisateur en empruntant le cheminement hiérarchique suivant : Format, puis Nombre, et enfin sélection du paramètre Pourcentage. Pour les opérateurs privilégiant une ergonomie orientée vers la productivité au clavier, l’application immédiate de cette mise en forme peut être invoquée par l’exécution de la combinaison de touches standardisée Ctrl + Shift + 5 sur les environnements Windows ou son équivalent Cmd + Shift + 5 sur l’écosystème macOS. Cette manipulation garantit l’alignement typographique instantané de la sélection active.
5.2 Précision décimale et rigueur académique
Le paramétrage du nombre de décimales affichées ne relève pas d’une simple préférence esthétique, mais d’une décision méthodologique engageant la crédibilité de l’analyse scientifique. Dans la majorité des protocoles de recherche en psychométrie ou en sciences sociales, l’affichage de deux décimales constitue la convention d’usage stipulée par les normes de l’American Psychological Association. Ce niveau de granularité permet de discriminer avec finesse des variations de distribution sur des échantillons restreints sans submerger le lecteur d’une profusion de chiffres parasites dépourvus de signification métrologique.
Il importe de maintenir une vigilance théorique constante face aux pièges cognitifs induits par les arrondis d’affichage. Deux cellules calculées affichant visuellement le même pourcentage arrondi, par exemple 79,6 %, peuvent recouvrir des fractions réelles divergentes telles que 0,7956 et 0,7964. Si ces valeurs conditionnent des règles d’exclusion de sujets au sein d’un protocole clinique, l’analyste doit s’assurer que les seuils décisionnels sont programmés sur les valeurs réelles calculées et non sur les valeurs textuelles arrondies générées par la couche de présentation du tableur.
5.3 Mise en forme conditionnelle appliquée aux seuils cumulatifs
La mise en forme conditionnelle constitue un instrument visuel d’une redoutable efficacité pour déceler immédiatement les paliers structuraux au sein de la distribution cumulative. En programmant des règles d’accentuation chromatique basées sur des opérateurs logiques, l’analyste transforme une austère colonne de chiffres en une cartographie thermique de la densité distributionnelle. Les seuils de cinquante pour cent (la médiane empirique), de quatre-vingts pour cent (le seuil de Pareto) et de quatre-vingt-quinze pour cent (la limite d’exclusion bilatérale classique) constituent les repères canoniques à mettre en exergue.
Google Sheets autorise la définition de gradients de couleurs bichromatiques ou trichromatiques personnalisés au sein du panneau latéral dédié. L’application d’une échelle allant d’un ton neutre pour les faibles pourcentages à une teinte soutenue au fur et à mesure de l’approche de la valeur unitaire permet de visualiser instantanément la cinétique d’accumulation de la variable. Cette stylisation accélère la détection visuelle des zones de forte concentration de données et facilite la restitution des conclusions analytiques auprès de publics décisionnels non spécialistes de la statistique mathématique.
6. Automatisation moderne sans étirement de formule via ARRAYFORMULA
6.1 Principes des formules matricielles dans Google Sheets
L’étirement manuel ou semi-automatique de formules individuelles au moyen de la poignée de recopie, bien que largement répandu, incarne une approche désuète et structurellement fragile de l’ingénierie des feuilles de calcul. Cette méthode fragmente le code logique sur des centaines de cellules indépendantes, ouvrant la voie à des écrasements involontaires lors de saisies concurrentes ou à des désynchronisations lorsque des lignes intercalaires sont insérées ultérieurement. L’architecture moderne de Google Sheets remédie à cette vulnérabilité au travers de son moteur d’évaluation matricielle, encapsulé dans la fonction directive ARRAYFORMULA.
Le paradigme matriciel permet d’écrire une expression algorithmique unique, cantonnée à la cellule d’en-tête ou à la première ligne de données, dont le résultat se déverse de manière dynamique sur une plage verticale de dimensions arbitraires. Le calcul s’exécute alors comme une opération vectorielle globale. L’ensemble des cellules sous-jacentes devient un réceptacle de projection logique qu’il est impossible de corrompre individuellement sans supprimer la directive d’origine, garantissant une intégrité structurelle absolue au modèle quantitatif.
6.2 Construction d’une formule matricielle cumulative classique
La transcription du concept d’accumulation itérative au sein du modèle matriciel classique exige une reformulation ingénieuse de l’opération de sommation, car la fonction standard SOMME tend par nature à condenser l’intégralité d’une matrice en une valeur scalaire unique. Pour obtenir une série cumulative au travers d’une formule matricielle traditionnelle, il convient de conjuguer la puissance d’ARRAYFORMULA avec la fonction SOMME.SI ou SOMME.SI.ENS en exploitant les indices positionnels des lignes comme prédicats logiques.
L’expression canonique se structure de la manière suivante dans la première cellule utile d’une distribution occupant la colonne B à partir de la ligne 2 :
=ARRAYFORMULA(SI(ESTVIDE(B2:B); « »; SOMME.SI(LIGNE(B2:B); « <= » & LIGNE(B2:B); B2:B) / SOMME(B2:B)))
Cette construction réalise une comparaison matricielle entre le vecteur des indices de lignes et sa propre projection transposée. Pour chaque observation, la fonction SOMME.SI évalue la somme de tous les éléments de la colonne B dont le numéro de ligne est inférieur ou égal à l’élément courant, matérialisant parfaitement l’accumulation requise. La division par la somme totale matricielle normalise immédiatement le vecteur résultant. La conditionnelle initiale garantit quant à elle qu’aucune valeur fantôme n’est générée au-delà du dernier enregistrement effectif du tableau.
6.3 Évaluation comparative : Formule standard contre approche matricielle
Le choix entre l’approche itérative classique par recopie et l’approche matricielle vectorisée doit résulter d’un arbitrage technique éclairé. Sur le plan de la sécurité des données et de l’élégance architecturale, la formule matricielle surclasse indiscutablement la méthode conventionnelle : elle supprime toute maintenance manuelle lors de l’adjonction de nouvelles lignes de données et prévient toute corruption accidentelle du code par des utilisateurs tiers non qualifiés.
Toutefois, sur le plan strictement computationnel, l’usage de la fonction SOMME.SI matricielle couplée à la comparaison vectorielle de numéros de lignes introduit une complexité algorithmique quadratique de l’ordre de O(N²). Sur des jeux de données excédant plusieurs dizaines de milliers d’enregistrements, cette méthode peut provoquer des ralentissements perceptibles du moteur de calcul du navigateur Web. L’analyste doit donc soupeser la taille du jeu de données face au besoin de modularité fonctionnelle avant d’arrêter son choix d’ingénierie, ou envisager les structures fonctionnelles modernes plus performantes.
7. Calcul dynamique avancé à l’aide des fonctions SCAN et LAMBDA
7.1 Introduction aux fonctions fonctionnelles modernes de Google Sheets
L’introduction récente dans le moteur de calcul de Google Sheets des fonctions de haut niveau empruntées au paradigme de la programmation fonctionnelle a révolutionné le traitement des séries cumulatives. Parmi ces ajouts majeurs, les fonctions LAMBDA et SCAN constituent désormais le standard d’excellence pour l’ingénierie de données sur tableur. La fonction LAMBDA offre la capacité de définir des fonctions personnalisées anonymes directement au sein de la cellule, sans recourir à l’éditeur de scripts externe Apps Script, rendant les opérations mathématiques intrinsèquement modulaires et réutilisables.
La fonction SCAN, quant à elle, a été spécifiquement conçue pour résoudre les problématiques d’accumulation séquentielle sans subir les dégradations de performance inhérentes aux anciennes astuces matricielles. Elle applique une fonction d’accumulation définie par un opérateur lambda sur chaque élément d’un tableau source, tout en conservant et en restituant l’historique de chaque état intermédiaire sous la forme d’un tableau dynamique étendu. Elle opère avec une complexité linéaire de O(N), constituant une rupture technologique majeure pour le calcul statistique en ligne.
7.2 Implémentation de SCAN pour la fréquence et le pourcentage cumulés
La mise en œuvre de la fonction SCAN pour le calcul d’un pourcentage cumulé représente l’expression algorithmique la plus pure, la plus lisible et la plus économe en ressources machine disponible sur Google Sheets. Sa syntaxe s’articule autour de trois composants essentiels : une valeur d’initialisation scalaire, un vecteur de données d’entrée, et l’expression logique lambda gouvernant la transition d’un état à l’autre.
Pour calculer la trajectoire du pourcentage cumulé sur une plage définie de B2 à B20, l’analyste peut inscrire la formule unifiée suivante dans la cellule de tête :
=LET(plage; B2:B20; total; SOMME(plage); SCAN(0; plage; LAMBDA(accumulateur; valeur; accumulateur + valeur)) / total)
Dans cette architecture optimisée au moyen de l’opérateur d’assignation LET, la plage et son total général ne sont évalués qu’une unique fois en mémoire vive. La fonction SCAN démarre son état avec un accumulateur initialisé à zéro. À chaque itération le long du vecteur source, elle incrémente l’accumulateur de la valeur de la cellule courante et propage le résultat intermédiaire. La division vectorielle par le scalaire total génère instantanément la colonne complète des pourcentages cumulés avec une efficience d’exécution inégalée.
7.3 Traitement élégant des lignes dynamiques futures
Dans les contextes opérationnels contemporains, les jeux de données ne sont que rarement figés : ils s’enrichissent en continu par l’afflux régulier de nouveaux enregistrements provenant d’outils de collecte automatique, à l’image des formulaires Google Forms ou de flux API connectés. L’architecture de calcul doit par conséquent s’adapter automatiquement aux extensions dimensionnelles sans intervention manuelle et sans générer de résidus de calcul inesthétiques sur les lignes vierges.
Cette adaptabilité dynamique s’obtient en combinant la puissance de l’accumulateur SCAN avec la fonction de purge structurelle FILTRE. L’instruction suivante garantit que seules les cellules effectivement pourvues d’un contenu numérique exploitable sont intégrées dans le pipeline d’accumulation :
=LET(donnees; FILTRE(B2:B; ESTNUM(B2:B)); tot; SOMME(donnees); SCAN(0; donnees; LAMBDA(acc; val; acc + val)) / tot)
Cette formulation exclut avec une étanchéité parfaite l’ensemble des cellules vides de la colonne B jusqu’aux confins de la feuille de calcul. Au fur et à mesure que de nouveaux enregistrements sont injectés dans les lignes subéquentes, la plage analysée s’ajuste dynamiquement, recalculant instantanément les ratios cumulés sur l’ensemble de la série sans qu’aucun artefact ou message d’anomalie ne vienne perturber l’aval du tableau de bord.
8. Gestion des valeurs aberrantes, cellules vides et cas particuliers
8.1 Neutralisation des cellules vides et des enregistrements incomplets
La survenue d’espaces vierges au sein d’un vecteur de données quantitatives constitue une source fréquente de perturbations algorithmiques dans les tableurs. Lorsqu’une formule itérative standard rencontre une cellule vide au sein d’une série de fréquences, le comportement par défaut de l’interpréteur consiste à assimiler cette absence à la valeur zéro. Si cette neutralisation arithmétique n’altère pas la somme brute, elle introduit une répétition artificielle de la valeur cumulée précédente, faussant la perception de la progression continue de la distribution.
Pour prévenir l’apparition de pourcentages résiduels erronés sur les lignes non encore renseignées d’une table extensible, l’analyste doit encapsuler ses opérations dans des garde-fous logiques rigoureux. L’emploi imbriqué de la fonction SI adossée à ESTVIDE ou à la vérification de la longueur de chaîne permet de neutraliser l’évaluation tant qu’une condition de saisie valide n’est pas satisfaite :
=SI(OU(ESTVIDE(B2); B2= » »); « »; SOMME($B$2:B2)/SOMME($B$2:$B$100))
Cette discipline préventive garantit que la zone de reporting demeure rigoureusement immaculée au-delà du front d’enregistrement réel des données, assurant une parfaite compatibilité en cas d’exportation automatisée vers des formats tabulaires intermédiaires tels que le CSV pour traitement subséquent sous R ou Python.
8.2 Prise en compte des fréquences nulles ou des valeurs négatives
D’un point de vue théorique strict, une distribution de fréquences statistiques se compose exclusivement de réels positifs ou nuls. Cependant, dans les contextes appliqués d’analyses longitudinales ou de suivis de différentiels comportementaux, l’analyste peut être confronté à des variations nettes intégrant des deltas négatifs, représentant par exemple des taux d’attrition ou des désinscriptions. L’introduction d’une valeur négative au sein d’un calcul cumulé détruit l’axiome fondamental de monotonie croissante, la courbe cumulative accusant alors des régressions locales.
L’analyste doit impérativement définir si cette non-monotonie traduit une réalité phénoménologique valide ou une corruption de données brutes. Si la série est censée mesurer une probabilité cumulée classique, toute valeur négative doit être proscrite et rejetée en amont. Pour sécuriser l’évaluation, des mécanismes de validation de données doivent interdire la saisie de réels inférieurs à zéro dans la colonne source. D’autre part, la présence de fréquences nulles, bien que mathématiquement indolore sur la somme, génère des paliers horizontaux dans la courbe de pourcentage cumulé. Ces plateaux doivent être conservés s’ils traduisent une absence réelle d’occurrence au sein d’une classe d’intervalles ordonnée.
8.3 Correction des erreurs courantes (#DIV/0!, #REF!, #VALEUR!)
L’exploitation opérationnelle de feuilles de calcul complexes confronte inévitablement l’utilisateur à l’émergence d’anomalies d’exécution signalées par les codes d’erreur conventionnels du tableur. L’anomalie #DIV/0! survient typiquement lorsque la somme globale servant de dénominateur est nulle, ce qui se produit fréquemment lorsque le tableau de données vient d’être initialisé sans aucun enregistrement numérique. L’encapsulation de la formule au moyen de la fonction SIERREUR permet de substituer à ce message disgracieux une sortie neutre ou un tiret d’attente :
=SIERREUR(SOMME($B$2:B2)/SOMME($B$2:$B$100); 0)
L’erreur #REF! signale quant à elle une rupture critique d’intégrité référentielle, consécutive par exemple à la suppression physique de cellules ou de colonnes incluses dans le champ de sommation originel, ou à la génération d’une référence circulaire non autorisée où une formule tenterait d’intégrer son propre résultat dans sa boucle d’évaluation. Enfin, l’anomalie #VALEUR! trahit systématiquement une incompatibilité de type, le moteur arithmétique butant sur un caractère textuel inséré dans une opération de division ou d’addition matricielle. Un contrôle méthodique des formats et des paramètres régionaux de la feuille (notamment l’usage de la virgule décimale contre le point anglo-saxon) permet de résoudre ces désynchronisations structurelles.
9. Visualisation graphique des pourcentages cumulés
9.1 Création d’un diagramme de Pareto complet
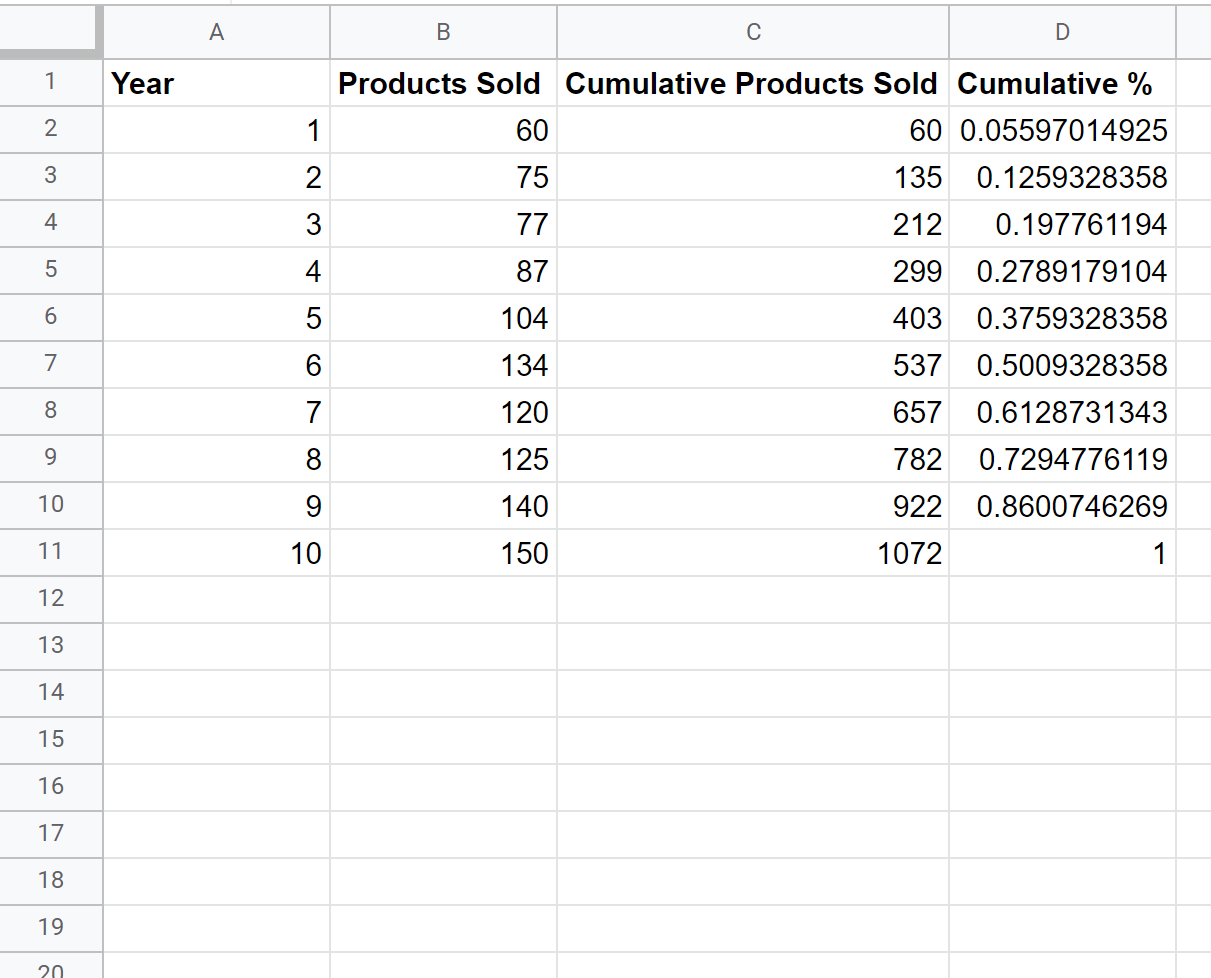
La formalisation visuelle du pourcentage cumulé atteint son expression la plus aboutie au sein du diagramme de Pareto, un artefact graphique hybride combinant une représentation par barres des fréquences absolues et une courbe continue retraçant l’accumulation proportionnelle. Pour élaborer cette visualisation dans Google Sheets, l’analyste sélectionne simultanément le vecteur des catégories, la colonne des fréquences brutes préalablement triées par ordre décroissant, et la colonne calculée des pourcentages cumulés, avant d’invoquer l’insertion d’un nouveau graphique.
Au sein du configurateur visuel, il convient de sélectionner le modèle dénommé Graphique combiné. Les fréquences brutes sont assignées au type Colonnes et ancrées sur l’axe vertical principal situé à gauche. La variable de pourcentage cumulé est quant à elle configurée sous la forme d’une Ligne continue et assignée sans équivoque à l’axe vertical secondaire disposé à droite de la zone de traçage.
Une étape de paramétrage technique impérative consiste à verrouiller l’échelle de cet axe vertical secondaire : le minimum doit être rigidement fixé à zéro et le maximum impérativement calibré sur un (soit cent pour cent). Sans ce verrouillage explicite, l’algorithme d’auto-ajustement de Google Sheets est susceptible d’étendre artificiellement l’axe au-delà de 100 %, altérant l’alignement visuel entre les colonnes de données et le seuil critique de parachèvement de la distribution.
9.2 Représentation sous forme d’ogive de Galton (courbe cumulative)
Dans le domaine de l’évaluation psychométrique et de l’analyse biostatistique, la représentation privilégiée de la fonction de répartition empirique s’incarne dans l’ogive de Galton. Ce graphique trace l’élévation sigmoïde classique du pourcentage cumulé en fonction des limites supérieures des classes de scores ordonnées le long de l’abscisse. L’ogive constitue l’instrument d’excellence pour procéder à des interpolations graphiques directes sans exiger de recalculs algébriques complexes.
La construction d’une ogive sous Google Sheets requiert un graphique linéaire épuré où l’axe horizontal représente la variable continue subdivisée en intervalles réguliers. La courbe cumulative y décrit une trajectoire ascendante caractéristique dont l’inflexion centrale coïncide avec la médiane théorique lorsque la distribution est gaussienne. La personnalisation soignée des repères de quadrillage, calés par exemple sur des incréments de dix pour cent le long de l’axe vertical, autorise une lecture visuelle immédiate des rangs centiles. Un examinateur peut ainsi déterminer d’un simple coup d’œil le score métrique précis en deçà duquel s’établit exactement une proportion donnée de la cohorte évaluée.
9.3 Interprétation visuelle des ruptures de pente
L’examen sémiologique de la courbe du pourcentage cumulé offre des enseignements qualitatifs profonds sur la structure de la population analysée. Le comportement de la dérivée graphique, matérialisé par l’inclinaison locale de la pente, trahit les variations de densité au sein de la distribution. Une section de courbe accusant une ascension quasi verticale révèle une concentration massive d’observations au sein d’une bande de valeurs extrêmement étroite. Inversement, l’apparition d’un aplatissement progressif ou d’un plateau horizontal prolongé témoigne d’un tarissement des effectifs et d’une raréfaction des occurrences sur ce segment de l’échelle métrique.
Dans un contexte d’optimisation des processus industriels ou de gestion de la qualité, l’identification du point d’inflexion où la courbe commence à fléchir permet de matérialiser le rendement marginal décroissant des interventions correctives. Dès lors que la courbe cumulative a franchi le palier des 80 %, les segments subséquents n’agrègent plus que des micro-catégories à faible incidence globale. Cette lecture topologique guide l’analyste stratégique dans la prise de décision, lui permettant d’interrompre le déploiement d’efforts coûteux là où le gain marginal en couverture distributionnelle devient négligeable au regard des coûts engagés.
10. Interprétation analytique et psychométrique des données cumulées
10.1 Assimilation du pourcentage cumulé à la fonction de répartition
Sur le plan de l’épistémologie statistique, le calcul du pourcentage cumulé ne constitue pas une simple manipulation d’affichage comptable, mais l’estimation non paramétrique directe de la fonction de distribution cumulative théorique régissant la population parente. Dans cette perspective, la valeur du pourcentage cumulé associée à une modalité spécifique représente la probabilité empirique formelle qu’une observation extraite au hasard présente une valeur strictement inférieure ou égale à cette borne critique. Cette assimilation conceptuelle ancre l’analyse de données de classeur dans le champ de la théorie des probabilités appliquées.
En psychométrie, cette correspondance mathématique constitue le socle de l’étalonnage des instruments psychologiques et éducatifs par la méthode des rangs centiles. Rapporter qu’un individu se situe au quatre-vingt-cinquième centile sur une échelle standardisée d’anxiété clinique ou d’efficience cognitive revient exactement à attester que son score brut se positionne au niveau de la modalité dont le pourcentage cumulé dans l’échantillon d’étalonnage équivaut à quatre-vingt-cinq pour cent. Cette standardisation élimine les biais d’arbitraire liés à la métrique brute de l’instrument d’évaluation, autorisant des comparaisons interindividuelles d’une rigueur absolue indépendantes de la dispersion initiale des scores.
10.2 Identification des seuils critiques et analyse de conformité
L’exploitation des pourcentages cumulés conditionne l’identification formelle des repères de centralité et de dispersion non paramétriques. Le seuil cumulé de cinquante pour cent isole par définition la valeur médiane de la distribution, offrant un indicateur de tendance centrale robuste et totalement insensible à la présence de valeurs extrêmes ou asymétriques susceptibles de dévaster la représentativité d’une moyenne arithmétique conventionnelle. De même, les seuils de vingt-cinq et soixante-quinze pour cent délimitent l’écart interquartile, encapsulant la cinquantaine centrale des sujets observés.
Au-delà de la description interne, l’analyste peut recourir à la série des pourcentages cumulés pour évaluer la conformité d’une distribution empirique vis-à-vis d’un modèle théorique prédéterminé, à l’instar de la loi normale ou de la loi logistique. Des procédures non paramétriques célèbres, telles que le test d’ajustement de Kolmogorov-Smirnov, reposent précisément sur la mesure de la distance maximale absolue observée entre la courbe de pourcentage cumulé empirique et la trajectoire cumulative de la distribution théorique sous-jacente. Cette confrontation formelle permet d’attester scientifiquement si les données observées peuvent être tenues pour représentatives d’une modélisation stochastique standard.
10.3 Limites interprétatives et précautions méthodologiques
En dépit de sa puissance synthétique, l’usage analytique du pourcentage cumulé requiert une vigilance méthodologique proportionnée pour éviter des conclusions fallacieuses. La principale vulnérabilité interprétative procède de la sensibilité extrême de la trajectoire cumulative à la taille de l’échantillon de référence. Sur un échantillon restreint comportant moins de trente observations, chaque cas individuel introduit un saut discret de plus de trois pour cent dans la fonction cumulative, conférant à la courbe un aspect en escalier rugueux rendant toute tentative d’inférence de population hautement hasardeuse.
Une seconde précaution réside dans l’impact majeur du choix de découpage en classes pour les variables continues. La modification arbitraire de la largeur des intervalles ou de leurs bornes extrêmes peut lisser artificiellement des irrégularités bimodales majeures ou, inversement, créer des artefacts de saturation trompeurs. Enfin, l’analyste ne doit jamais commettre la dérive téléologique consistant à confondre une corrélation d’accumulation temporelle avec une causalité séquentielle : le fait qu’un seuil cumulé atteigne quatre-vingt-dix pour cent à un moment précis du temps ne signifie nullement que les observations tardives sont régies par des mécanismes étiologiques différents des observations initiales.
11. Dépannage, audit et optimisation des performances du classeur
11.1 Audit des formules et traçage des dépendances
La pérennité d’une feuille de calcul statistique repose sur la capacité de son concepteur à procéder à des audits d’intégrité réguliers. Au sein de Google Sheets, l’un des réflexes méthodologiques fondamentaux consiste à basculer temporairement l’interface en mode d’inspection syntaxique au moyen de la commande Afficher les formules accessible dans le menu Affichage ou via la combinaison de touches Ctrl + ` (accent grave). Cette manipulation substitue aux valeurs numériques évaluées la structure textuelle explicite des équations sous-jacentes, révélant instantanément les décalages de références ou les cellules orphelines.
L’audit doit porter en priorité sur la régularité des plages glissantes d’accumulation. Un glissement accidentel provoqué par un copier-coller inconsidéré peut transmuer une référence d’origine $B$2:B10 en $B$3:B10, excluant silencieusement le premier décile de l’analyse. De surcroît, l’analyste doit vérifier méthodiquement l’impact de l’insertion de lignes physiques supplémentaires au sein de la table de données : une telle manipulation peut scinder les plages de référence de manière asymétrique si les bornes n’ont pas été ancrées au moyen de fonctions d’indexation dynamique étanches.
11.2 Optimisation computationnelle des feuilles de grande taille
Lorsque les classeurs Google Sheets atteignent des dimensions massives, comprenant des dizaines de milliers de lignes et des calculs transversaux multiples, l’expérience utilisateur peut être dégradée par des latences de recalcul persistantes. Cette lourdeur computationnelle résulte quasi systématiquement de la multiplication d’appels redondants à des fonctions d’agrégation globale au sein de boucles itératives réparties sur l’ensemble des lignes du document.
Pour restaurer une fluidité d’exécution optimale, il convient de substituer les formules itératives classiques par l’architecture moderne combinant SCAN et LAMBDA, laquelle minimise l’empreinte mémoire et rationalise l’utilisation du thread d’exécution JavaScript du navigateur. Par ailleurs, il est fortement recommandé d’éviter l’emploi de fonctions volatiles comme INDIRECT ou DECALER au sein des formules de cumul, car ces instructions forcent l’invalidation du cache de calcul et contraignent le processeur à réévaluer l’intégralité du classeur lors de la moindre modification cellulaire, même si celle-ci intervient sur une plage périphérique totalement indépendante.
11.3 Sécurisation et verrouillage des plages de calcul
Dans un contexte organisationnel où le tableur est partagé entre plusieurs intervenants aux compétences hétérogènes, la sécurisation structurelle de l’outil d’analyse constitue un impératif d’assurance qualité. Pour prévenir l’altération involontaire de la mécanique algorithmique par un utilisateur écrasant une formule complexe avec une valeur textuelle ou un nombre brut, l’analyste doit instaurer des protections d’accès périmétriques sur les colonnes de calculs cumulatifs.
Cette protection s’applique en accédant aux options de données via le menu contextuel et en sélectionnant Protéger les feuilles et les plages. L’administrateur du modèle peut ainsi verrouiller intégralement la colonne hébergeant les pourcentages cumulés tout en maintenant les cellules de saisie primaire ouvertes aux modifications des collaborateurs. En complément, l’adjonction de commentaires de métadonnées documentant explicitement la formule, ses conditions limites d’application et son cadre d’interprétation statistique parachève l’industrialisation de la feuille de calcul, garantissant sa gouvernance sur le long terme.
12. Étude de cas pratique : Analyse quantitative pas à pas
12.1 Présentation du jeu de données expérimental
Afin de concrétiser l’ensemble des préceptes théoriques et des prescriptions techniques exposés précédemment, nous allons déployer une étude de cas intégrale centrée sur l’analyse distributionnelle d’un instrument d’évaluation psychométrique. Considérons une cohorte clinique standardisée de cinq cents sujets (N = 500) ayant complété une échelle de sévérité symptomatique graduée en scores entiers discrets échelonnés de 1 à 7, où le score 1 traduit une absence de symptomatologie et le score 7 une désorganisation clinique sévère.
Le jeu de données brutes consolidé dans la feuille de calcul présente l’ordonnancement structurel suivant : la colonne A répertorie la classe de scores cliniques ordonnée de façon strictement croissante (de A2 à A8), tandis que la colonne B recense la fréquence absolue des patients se situant dans chaque classe respective (de B2 à B8). Les décomptes empiriques observés s’établissent comme suit :
- Classe 1 (Score 1) : 45 sujets
- Classe 2 (Score 2) : 85 sujets
- Classe 3 (Score 3) : 120 sujets
- Classe 4 (Score 4) : 110 sujets
- Classe 5 (Score 5) : 75 sujets
- Classe 6 (Score 6) : 45 sujets
- Classe 7 (Score 7) : 20 sujets
L’objectif de cette démarche analytique est de formaliser la colonne des effectifs cumulés en colonne C, de déterminer la série des pourcentages cumulés normalisés en colonne D, et d’isoler avec une rigueur absolue le seuil clinique correspondant au fractile des 80 % afin de définir la frontière d’orientation vers un protocole de prise en charge spécialisée.
12.2 Exécution séquentielle des formules et contrôle intermédiaire
La première phase opératoire consiste à implémenter le calcul de la fréquence cumulée en colonne C. Dans la cellule C2, l’analyste inscrit la formule à plage expansive classique :
=SOMME($B$2:B2)
Par recopie verticale jusqu’à la cellule C8, la série numérique générée restitue successivement les valeurs intermédiaires suivantes : 45 pour la classe 1, 130 pour la classe 2 (45+85), 250 pour la classe 3 (130+120), 360 pour la classe 4 (250+110), 435 pour la classe 5 (360+75), 480 pour la classe 6 (435+45), et finalement 500 pour la classe 7 (480+20). Le contrôle d’intégrité préliminaire s’avère parfaitement validé : la dernière valeur calculée en C8 coïncide rigoureusement avec la somme globale attendue de la cohorte expérimentale.
Dans un second temps, le calcul du pourcentage cumulé est instancié au sein de la colonne D. En exploitant l’architecture optimisée isolant le dénominateur, l’analyste déploie dans la cellule D2 l’expression fractionnaire suivante :
=C2 / $C$8
L’application du formatage de pourcentage à deux décimales via la séquence de commandes appropriée produit la distribution relative finale suivante le long des cellules D2 à D8 :
- Classe 1 : 9,00 %
- Classe 2 : 26,00 %
- Classe 3 : 50,00 %
- Classe 4 : 72,00 %
- Classe 5 : 87,00 %
- Classe 6 : 96,00 %
- Classe 7 : 100,00 %
L’inspection analytique de cette distribution cumulée permet de constater que la médiane empirique de la distribution correspond précisément à la classe de score 3, celle-ci accumulant exactement 50,00 % des effectifs. En outre, la détermination du seuil cible des 80 % met en lumière un basculement structurel : les quatre premières classes ne couvrent que 72,00 % de l’échantillon, tandis que l’intégration de la classe 5 propulse le cumul à 87,00 %. En vertu des principes de précaution diagnostique, le seuil d’admissibilité clinique au programme spécialisé est par conséquent rigoureusement calibré à partir d’un score supérieur ou égal à 5, isolant ainsi les 28 % de patients les plus sévèrement atteints de la cohorte.
12.3 Synthèse des bonnes pratiques et protocole de réutilisation
Pour pérenniser les acquis méthodologiques de cette étude de cas au sein d’une structure de recherche ou d’un service d’audit, il convient de codifier un gabarit réutilisable affranchi de toute maintenance manuelle. Si l’on souhaite condenser l’ensemble du processus en une directive matricielle moderne capable de gérer automatiquement les variations d’effectifs futures de ce protocole clinique, l’analyste remplacera les formules locales des colonnes C et D par une unique formule dynamique insérée en cellule D2 :
=LET(brut; FILTRE(B2:B; ESTNUM(B2:B)); somme_totale; SOMME(brut); SCAN(0; brut; LAMBDA(cumul; element; cumul + element)) / somme_totale)
Ce patron algorithmique résout simultanément l’accumulation, la normalisation à l’échelle unitaire, et l’immunisation contre les cellules vides en aval. Dans le cadre de l’archivage et du respect des exigences de reproductibilité scientifique, la feuille de calcul ainsi finalisée doit faire l’objet d’un verrouillage d’édition sur les cellules programmées et d’un export au format standardisé pour garantir que les analyses statistiques secondaires menées par d’autres équipes de recherche s’exécutent sur un corpus numérique vérifié, robuste et formellement documenté.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Google. (2023). Utiliser la fonction SCAN dans Google Sheets. Centre d’aide Google Docs. https://support.google.com/docs/answer/13168541
- Google. (2023). Utiliser la fonction ARRAYFORMULA dans Google Sheets. Centre d’aide Google Docs. https://support.google.com/docs/answer/3093275
- Juran, J. M. (1995). A history of managing for quality: The evolution, trends, and future directions of managing for quality. Quality Press.
- Pareto, V. (1896). Cours d’économie politique. Université de Lausanne, F. Rouge Éditeur.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.