
Dans le domaine de l’analyse quantitative des données comportementales, sociales et biomédicales, l’inférence statistique constitue la passerelle indispensable permettant de transcender l’observation d’un échantillon fini pour formuler des conclusions valides sur une population globale. Au cœur de cette démarche réside un concept souvent mal compris ou abstraitement appréhendé : la distribution d’échantillonnage. Alors que le chercheur n’observe, dans la pratique empirique, qu’une réalisation unique d’un protocole expérimental, la validité de ses conclusions repose entièrement sur la compréhension du comportement théorique qu’aurait manifesté sa statistique si l’expérience avait été répétée une infinité de fois sous des conditions strictement identiques. L’environnement statistique R offre une plateforme computationnelle d’une puissance exceptionnelle pour matérialiser, simuler et disséquer ces dynamiques stochastiques à travers l’expérimentation numérique.
Le calcul et la modélisation des distributions d’échantillonnage dans R permettent de combler le fossé entre la formalisation mathématique abstraite et l’application pratique en laboratoire de recherche. Grâce à des outils de simulation de Monte-Carlo, de vectorisation avancée et de rééchantillonnage non paramétrique, les chercheurs et analystes de données peuvent explorer concrètement la variabilité intrinsèque des estimateurs, appréhender la portée réelle du théorème central limite et quantifier l’incertitude inhérente aux mesures psychométriques. Cette approche computationnelle démystifie les propriétés asymptotiques des estimateurs statistiques en transformant des équations de convergence en distributions de fréquences empiriques directement observables et quantifiables.
Ce guide exhaustif a pour vocation d’exposer de manière rigoureuse la théorie, l’implémentation algorithmique et l’interprétation des distributions d’échantillonnage à l’aide du langage R. À travers une démarche progressive articulée autour de fondements théoriques solides, d’exemples d’implémentation itératifs et vectorisés, d’explorations graphiques de haute précision et d’études de cas portant sur des métriques psychométriques variées, ce document constitue un manuel de référence pour quiconque souhaite maîtriser l’inférence statistique moderne par la modélisation informatique.
1. Introduction aux distributions d’échantillonnage et fondements conceptuels
1.1 Définition formelle de la distribution d’échantillonnage
Pour appréhender avec exactitude la logique de l’inférence statistique, il est impératif d’établir une distinction formelle et irrévocable entre trois entités ontologiques distinctes : la population parente, l’échantillon observé et la distribution d’échantillonnage. La population parente représente l’ensemble exhaustif des unités d’observation sur lesquelles porte l’interrogation scientifique, caractérisée par des paramètres constants mais généralement inconnus, notés conventionnellement par des lettres grecques telles que l’espérance mathématique mu ou la variance sigma au carré. L’échantillon unique, quant à lui, n’est qu’un sous-ensemble fini d’observations prélevé au sein de cette population selon un plan de sondage déterminé, fournissant des données brutes à partir desquelles sont calculées des estimations ponctuelles.
La distribution d’échantillonnage ne se confond ni avec la variabilité des individus au sein de la population, ni avec la dispersion des mesures au sein de l’échantillon unique. Elle représente la distribution de probabilité théorique de toutes les valeurs possibles que peut adopter une statistique d’échantillon donnée — qu’il s’agisse d’une moyenne, d’une médiane, d’un coefficient de corrélation ou d’un rapport de cotes — calculée sur une infinité d’échantillons aléatoires indépendants de taille fixe N, tous issus de la même population parente. Dès lors, toute statistique d’échantillon doit être conceptualisée mathématiquement non pas comme une constante numérique fixe, mais comme une véritable variable aléatoire dotée de sa propre espérance, de sa propre variance et de sa propre fonction de densité de probabilité.
Cette distinction conceptuelle s’avère particulièrement cruciale dans l’analyse des mesures psychométriques et des scores comportementaux standardisés. Lorsque des chercheurs mesurent, par exemple, le niveau d’anxiété état chez un groupe de cent participants au moyen de l’inventaire de Spielberger, le score moyen obtenu au sein de ce groupe spécifique ne représente qu’une seule réalisation empirique parmi un continuum infini d’autres moyennes d’échantillons observables. L’inférence scientifique rigoureuse ne consiste pas à tenir ce score observé pour une vérité absolue, mais à évaluer où se situe cette réalisation particulière au sein de la distribution d’échantillonnage globale, conditionnant ainsi l’ensemble du processus de prise de décision statistique.
1.2 Différence entre écart-type de l’échantillon et erreur type
L’une des ambiguïtés les plus répandues dans la littérature empirique réside dans la confusion récurrente entre l’écart-type d’un échantillon et l’erreur type de l’estimateur. L’écart-type, usuellement désigné par la lettre s ou l’abréviation SD, quantifie la dispersion des observations individuelles autour de la moyenne de l’échantillon. Il s’agit d’une mesure descriptive de la variabilité intra-échantillon, reflétant l’hétérogénéité biologique, psychologique ou environnementale existant entre les individus participant à l’étude. Si l’on administre un test de quotient intellectuel à un échantillon représentatif, l’écart-type quantifie l’ampleur moyenne avec laquelle les performances cognitives des individus s’écartent de la moyenne du groupe.
À l’inverse, l’erreur type, notée SE pour standard error, mesure la dispersion inter-échantillons. Elle correspond précisément à l’écart-type de la distribution d’échantillonnage de la statistique considérée. Dans le cas précis de la moyenne d’un échantillon, l’erreur type s’exprime analytiquement par le ratio entre l’écart-type de la population parente sigma et la racine carrée de la taille d’échantillon N. Lorsque le paramètre sigma de la population est inconnu, ce qui constitue la norme dans les contextes empiriques, l’erreur type est estimée en substituant l’écart-type corrigé de l’échantillon s à sigma, fournissant l’estimateur empirique de l’erreur type.
Cette formulation analytique met en exergue le rôle prépondérant de la taille d’échantillon N dans l’amenuisement de l’incertitude. La présence du radical au dénominateur implique une relation d’efficacité non linéaire : pour diviser par deux l’erreur type d’une estimation et ainsi doubler la précision de la moyenne, il est indispensable de quadrupler l’effectif des participants. En psychologie quantitative et dans les sciences cognitives, cette réalité mathématique conditionne directement la largeur des intervalles de confiance calculés autour des paramètres estimés. Un intervalle de confiance à quatre-vingt-quinze pour cent se déploie proportionnellement à cette erreur type ; par conséquent, méconnaître la distinction entre dispersion des individus et variabilité de l’estimateur expose l’analyste à des conclusions erronées sur la précision réelle de ses protocoles de mesure.
1.3 Rôle de la distribution d’échantillonnage dans les tests d’hypothèses
L’appareil conceptuel des tests de signification statistique élaboré par Ronald Fisher, Jerzy Neyman et Egon Pearson repose intégralement sur l’exploitation des distributions d’échantillonnage conditionnelles. Lorsqu’un chercheur formule une hypothèse nulle, postulant classiquement l’absence d’effet d’une intervention psychologique ou l’égalité parfaite des performances entre deux conditions expérimentales, il postule en réalité une distribution d’échantillonnage spécifique : la distribution nulle. Cette distribution définit précisément l’éventail des variations d’échantillonnage attendues sous la stricte loi du hasard.
La dérivation de la p-valeur découle immédiatement de cette construction. La p-valeur n’exprime nullement la probabilité que l’hypothèse nulle soit vraie, ni la probabilité que l’hypothèse alternative soit exacte, mais représente la probabilité conditionnelle d’observer une statistique d’échantillon au moins aussi extrême que celle effectivement recueillie, dans l’hypothèse où la distribution d’échantillonnage nulle régirait le processus générateur de données. Dès lors, la quantification précise du risque d’erreur de première espèce alpha, c’est-à-dire le rejet injustifié d’une hypothèse nulle véridique, correspond à l’intégration de l’aire située sous les queues extrêmes de cette distribution d’échantillonnage théorique.
Symétriquement, le risque d’erreur de deuxième espèce bêta, consistant à omettre de rejeter une hypothèse nulle matériellement fausse, requiert l’élaboration d’une distribution d’échantillonnage alternative décentrée, centrée sur la magnitude réelle de l’effet existant dans la population. L’évaluation de ces distributions concurrentes met en lumière la fragilité des seuils d’inférence arbitraires fréquemment employés en psychologie expérimentale. La dichotomisation rigide des résultats sur la base exclusive d’un seuil p inférieur à zéro virgule zéro cinq fait abstraction de la continuité stochastique sous-jacente à la distribution d’échantillonnage, masquant souvent des variations aléatoires triviales derrière des déclarations de découverte scientifique non réplicables.
2. Cadre mathématique : Théorème central limite et loi des grands nombres
2.1 Le théorème central limite appliqué aux données psychologiques
Le théorème central limite constitue le pilier fondamental sur lequel s’édifie la majeure partie de la statistique inférentielle paramétrique. Formulé dans sa forme classique par Lindberg et Lévy, ce théorème stipule que si une suite de variables aléatoires indépendantes et identiquement distribuées présente une espérance mathématique finie mu et une variance finie sigma au carré, alors la distribution d’échantillonnage de la moyenne standardisée de ces variables converge asymptotiquement vers une loi normale standard de moyenne nulle et de variance unitaire à mesure que la taille N de l’échantillon tend vers l’infini. L’aspect le plus remarquable de ce résultat mathématique réside dans le fait que cette convergence s’opère quelle que soit la forme fonctionnelle de la distribution parente originelle.
Dans l’étude empirique des phénomènes psychologiques, cette propriété mathématique s’avère providentielle. Les variables mesurées en laboratoire s’écartent fréquemment du modèle gaussien idéal : les temps de réaction manifestent une asymétrie positive marquée avec une longue queue vers les latences prolongées, les échelles d’évaluation d’attitudes présentent des distributions plurimodales ou fortement asymétriques en raison d’effets de plafond ou de plancher, et les indicateurs cliniques exhibent souvent une surreprésentation des valeurs nulles. En vertu du théorème central limite, la moyenne d’échantillon de ces métriques non normales adopte une distribution d’échantillonnage rigoureusement gaussienne dès lors que la taille de l’échantillon atteint un volume suffisant.
Il importe toutefois de souligner les limites axiomatiques de ce théorème. La convergence asymptotique requiert impérativement que la variance de la population parente soit finie. Dans l’éventualité où les données seraient issues de lois à queues particulièrement épaisses ne possédant pas de second moment fini, telles que la distribution de Cauchy ou certaines distributions de Pareto à faible indice de forme, le théorème central limite classique cesse d’opérer. De surcroît, la vitesse de convergence dépend drastiquement du degré d’asymétrie initiale : si un effectif de trente participants s’avère généralement adéquat pour des populations mères modérément symétriques, des asymétries sévères exigent des échantillons considérablement plus vastes pour garantir la normalité de la distribution d’échantillonnage.
2.2 La loi des grands nombres et la convergence de la moyenne
Complémentaire mais conceptuellement distincte du théorème central limite, la loi des grands nombres décrit le comportement déterministe qui émerge progressivement de la répétition d’expériences aléatoires. Il convient de différencier rigoureusement la loi faible de la loi forte des grands nombres. La loi faible, théorisée initialement par Khintchine, énonce une convergence en probabilité : pour tout écart strictement positif, la probabilité que la valeur absolue de la différence entre la moyenne empirique de l’échantillon et l’espérance mathématique de la population excède cet écart tend vers zéro lorsque N progresse indéfiniment.
La loi forte des grands nombres, formulée par Kolmogorov, établit un degré d’adhérence stochastique supérieur en démontrant la convergence presque sûre de la moyenne d’échantillon vers l’espérance mathématique de la population parente. Dans le contexte de la recherche clinique et de l’évaluation psychologique, cette propriété offre la garantie formelle que la multiplication des observations au sein d’un échantillon stabilise mécaniquement l’estimation ponctuelle, immunisant progressivement l’analyste contre les fluctuations d’échantillonnage aléatoires qui polluent les échantillons de faible taille.
La portée méthodologique de ces lois de convergence pour la reproductibilité expérimentale est fondamentale. Alors que la loi des grands nombres garantit que la moyenne d’un très grand échantillon s’alignera avec une précision arbitrairement haute sur la réalité du paramètre de population, elle ne dispense pas le chercheur de s’assurer de la représentativité de son plan de sondage. La convergence n’opère en effet que vers l’espérance de la loi sous-jacente à l’échantillonnage ; si ce dernier souffre d’un biais systématique de sélection, la loi des grands nombres ne fera qu’accentuer la précision d’une estimation intrinsèquement biaisée.
2.3 Conséquences sur la puissance statistique et la taille d’échantillon
L’interaction entre les paramètres de la distribution d’échantillonnage et les propriétés asymptotiques du théorème central limite détermine directement la puissance statistique des protocoles de recherche, c’est-à-dire la probabilité de rejeter formellement l’hypothèse nulle lorsqu’un effet réel existe effectivement dans la population générale. Puisque la dispersion de la distribution d’échantillonnage se contracte proportionnellement à l’inverse de la racine de N, l’accroissement de la taille d’échantillon comprime le recouvrement probabiliste entre la distribution nulle et la distribution alternative décentrée.
Cette compression de la variance de l’estimateur accroît mathématiquement la fraction de la distribution alternative située au-delà de la valeur critique d’exclusion définie par le seuil alpha. Dès lors, la planification a priori de la taille d’échantillon optimale ne consiste pas en une application aveugle de formules empiriques standardisées, mais en une calibration minutieuse visant à façonner la géométrie de la distribution d’échantillonnage pour restreindre l’erreur type au niveau requis par la taille d’effet minimale scientifiquement pertinente.
Dans les plans expérimentaux factoriels complexes usuels en psychologie cognitive et neurosciences, la robustesse des tests paramétriques usuels tels que le test t de Student ou l’analyse de variance face aux violations du postulat de normalité des résidus s’explique précisément par cette dynamique de la distribution d’échantillonnage. Même en présence de déviations sensibles de la normalité intra-groupe, la validité des statistiques de test demeure préservée si les effectifs par cellule permettent à la distribution d’échantillonnage des moyennes d’approcher sa forme normale asymptotique, garantissant ainsi le respect nominal des taux d’erreur alpha et bêta.
3. Configuration de l’environnement R et reproductibilité numérique
3.1 Gestion des graines aléatoires avec set.seed()
La modélisation stochastique sur un système informatique nécessite de convertir des équations théoriques en flux de nombres pseudo-aléatoires. Dans le moteur d’exécution de R, ces flux sont générés par des algorithmes déterministes hautement sophistiqués, le mécanisme par défaut étant l’algorithme de Mersenne-Twister développé par Matsumoto et Nishimura. Bien que ces suites numériques présentent toutes les propriétés statistiques d’un bruit blanc aléatoire parfait, leur trajectoire séquentielle est entièrement déterminée par l’état initial fourni au générateur.
Pour garantir la reproductibilité absolue des calculs scientifiques, il est impératif d’initialiser ce générateur au moyen de la fonction native set.seed() avant d’exécuter la moindre simulation. L’attribution d’un entier spécifique comme argument de cette commande fige la trajectoire pseudo-aléatoire, assurant qu’un collaborateur, un réviseur scientifique ou un algorithme d’intégration continue reproduira à l’identique, au bit près, les estimations numériques et les graphiques résultants de la simulation. La documentation explicite de cette graine aléatoire dans l’en-tête des scripts d’analyse constitue désormais un standard inaliénable de l’intégrité scientifique ouverte.
Il convient néanmoins de manipuler la graine avec précaution dans les environnements de calcul haute performance et de simulation distribuée. Lors de l’exécution de simulations massives réparties sur plusieurs cœurs de processeur ou threads d’exécution, l’utilisation de graines identiques sur l’ensemble des nœuds provoquerait une duplication stochastique parfaite des échantillons simulés, anéantissant l’indépendance statistique des itérations. Dans de telles configurations, il devient indispensable d’adopter des générateurs dédiés aux flux parallèles, tels que l’algorithme L’Ecuyer-CMRG disponible nativement dans les bibliothèques de calcul parallèle de R.
3.2 Paramétrage des structures d’objets pour les simulations
L’efficacité computationnelle d’une simulation sous R dépend intrinsèquement de la manière dont la mémoire vive de l’ordinateur est allouée pour recueillir les statistiques générées au fil des itérations. Une erreur de débutant récurrente consiste à faire croître dynamiquement un vecteur à l’intérieur d’une boucle à l’aide de la fonction de concaténation c(). À chaque itération, cette approche contraint le ramasse-miettes et le gestionnaire de mémoire de R à réallouer un bloc contigu de mémoire supérieur, à copier l’intégralité des données préexistantes, puis à libérer l’ancien espace mémoire, induisant une dégradation quadratique des temps de calcul.
La bonne pratique algorithmique exige une pré-allocation stricte de la structure d’accueil. Lors de la planification d’une simulation visant à extraire dix mille moyennes d’échantillons, il convient d’initialiser un vecteur numérique de longueur adéquate rempli de valeurs manquantes en mobilisant l’expression rep(NA_real_, n_sim). Cette instruction réserve en amont l’espace mémoire nécessaire au stockage contigu des doubles précisions, réduisant l’affectation indicée ultérieure à une opération élémentaire à coût constant en temps d’accès.
De surcroît, la structuration formelle des paramètres directeurs de la simulation — la taille d’échantillon unitaire désignée conventionnellement par la constante n, le volume d’itérations répliquées n_sim, ainsi que les paramètres de la loi parente comme la moyenne de population mu et l’écart-type sigma — au sein d’une structure de données transparente, telle qu’une liste paramétrique ou un tibble du méta-package tidyverse, améliore grandement la maintenabilité du code et sa portabilité vers des conceptions d’expériences factorielles automatisées.
4. Génération pas à pas d’une distribution d’échantillonnage avec une boucle for
4.1 Décomposition algorithmique du processus d’échantillonnage
Afin de décomposer analytiquement la genèse d’une distribution d’échantillonnage, la mise en œuvre séquentielle d’une boucle for explicite constitue l’approche pédagogique la plus transparente. L’algorithme se structure autour d’un schéma d’itération invariable : à chaque pas de la boucle, l’environnement tire un échantillon aléatoire d’observations issues d’un modèle distributionnel prédéfini, calcule la statistique d’intérêt sur cette réalisation particulière, et stocke le résultat dans le vecteur pré-alloué.
Considérons l’application de ce protocole à la modélisation d’une mesure psychométrique standardisée, telle que l’évaluation des capacités de mémoire de travail dont les scores dans la population générale sont paramétrés par une espérance théorique de cent et un écart-type de quinze. Pour chaque itération indexée de un à dix mille, la fonction rnorm(n = 30, mean = 100, sd = 15) génère trente observations gaussiennes indépendantes simulant le recrutement d’un groupe d’étude expérimental. La fonction mean() est ensuite appliquée à cet échantillon transitoire, et la valeur résultante est immédiatement assignée à l’élément indexé du vecteur de résultats.
L’inspection analytique des premières valeurs enregistrées à l’aide de la commande head() confirme la dispersion stochastique inhérente au processus : bien que tous les échantillons proviennent rigoureusement de la même population parente centrée sur cent, les moyennes observées oscillent autour de cette valeur cible, adoptant par exemple des grandeurs telles que quatre-vingt-dix-sept virgule quatre, cent un virgule deux ou quatre-vingt-dix-neuf virgule huit. Ce vecteur agrégé ne reflète plus des scores d’individus, mais concrétise l’échantillon empirique de la distribution d’échantillonnage théorique.
4.2 Analyse de la performance computationnelle de l’approche itérative
L’évaluation rigoureuse de la boucle itérative exige de quantifier son profil d’exécution temporelle à l’aide de la fonction native system.time(). Dans les environnements interprétés tels que le noyau standard de R, l’exécution séquentielle d’une boucle for entraîne une surcharge temporelle non négligeable liée à l’interprétation syntaxique répétée de chaque ligne de code à chaque passage dans la structure de contrôle. Si cette latence demeure parfaitement négligeable pour dix mille itérations, elle s’accroît sensiblement dès lors que l’on ambitionne d’atteindre plusieurs millions de répétitions pour cartographier avec une fidélité extrême les queues de distributions asymptotiques.
Cette analyse de performance met en évidence le compromis fondamental qui s’impose au statisticien programmeur. Sur le plan purement pédagogique et conceptuel, la boucle séquentielle offre une traçabilité intégrale de l’opération d’échantillonnage : chaque étape stochastique d’instanciation de l’échantillon, de réduction matricielle par la moyenne et d’affectation vectorielle est articulée de manière explicite et vérifiable par l’opérateur. Elle facilite également l’intégration de mécanismes de débogage pas à pas ou l’insertion de barres de progression dynamiques pour les simulations chronophages.
Cependant, face à des exigences industrielles de traitement ou lors de la réalisation d’études de puissance par simulation factorielle croisant des centaines de conditions de variance et de distribution, la rigidité de la boucle explicite devient un goulot d’étranglement computationnel. C’est précisément pour dépasser ces limites temporelles que l’architecture interne de R a été conçue pour privilégier des mécanismes de vectorisation avancés, capables de déléguer les cycles itératifs directement aux bibliothèques précompilées sous-jacentes écrites en langage C ou Fortran.
5. Méthodes vectorisées pour le calcul efficace des distributions
5.1 Utilisation de replicate() pour une syntaxe concise
La fonction replicate() représente la première passerelle fonctionnelle permettant d’épurer l’écriture des simulations stochastiques sous R sans sacrifier la lisibilité logique du code. Conçue comme un habillage spécialisé de la famille des fonctions sapply(), replicate() prend pour premier argument le nombre de répétitions désiré et pour second argument l’expression non évaluée qu’il convient de répéter à chaque occurrence.
L’élimination des variables d’indexation temporaires assainit l’environnement global de travail. L’instruction concise replicate(10000, mean(rnorm(30, 100, 15))) accomplit en une ligne syntaxiquement transparente ce qui nécessitait auparavant l’initialisation préalable d’un conteneur, l’ouverture d’une boucle et la gestion explicite des indices de tableau. Cette concision linguistique favorise la lisibilité pour les pairs et minimise drastiquement les risques d’erreurs de syntaxe liées aux bornes de boucles ou aux collisions d’identifiants au sein du script.
Il demeure essentiel de veiller au type d’objet retourné par replicate(). Par défaut, la fonction tente de simplifier la structure du résultat final via l’argument simplify = TRUE. Si l’expression évaluée génère un scalaire unique, la fonction produit un vecteur atomique numérique homogène ; si elle génère un vecteur de longueur fixe, elle produira une matrice à deux dimensions. Cette prévisibilité structurelle garantit une transition sans heurt vers les modules de calcul statistique ou de visualisation graphique sans nécessiter de coercition explicite de type.
5.2 Vectorisation matricielle avec matrix() et colMeans()
Lorsque la vitesse d’exécution pure devient le critère prédominant, la vectorisation matricielle représente la stratégie algorithmique optimale au sein de l’interpréteur R. Cette approche s’abstrait totalement du paradigme de la répétition séquentielle pour concevoir la simulation comme une opération algébrique massive et unifiée. Elle tire parti de la disposition contiguë des éléments en mémoire dans les structures matricielles de R.
La méthode consiste à générer l’ensemble des observations requises pour l’intégralité de la simulation en un unique appel probabiliste. Si l’on requiert dix mille échantillons de trente observations chacun, l’instruction matrix(rnorm(10000 * 30, 100, 15), nrow = 30, ncol = 10000) génère instantanément les trois cent mille réalisations aléatoires et les agence au sein d’une grille dimensionnelle où chaque colonne correspond rigoureusement à un échantillon expérimental complet de taille N. Il suffit dès lors d’appliquer la fonction hautement optimisée colMeans() sur cette matrice pour calculer simultanément les dix mille moyennes d’échantillons en une infime fraction de seconde.
Les gains de performance mesurés par rapport à une boucle for ou à l’utilisation de replicate() atteignent fréquemment un facteur d’accélération de dix à vingt fois. La fonction colMeans() est directement implémentée au niveau du code C sous-jacent, exploitant les instructions vectorielles du processeur sans aucune surcharge d’interprétation. Le seul compromis inhérent à cette technique réside dans son empreinte sur la mémoire vive : stocker simultanément plusieurs dizaines ou centaines de millions d’observations au sein d’une matrice dense peut rapidement saturer la mémoire disponible sur une station de travail standard, imposant une gestion par blocs partitionnés pour les simulations ultra-massives.
5.3 Approches fonctionnelles avec purrr::map_dbl
Au sein de l’écosystème moderne du Tidyverse, la programmation fonctionnelle offre une structure formelle alliant rigueur structurelle, sécurité typologique et intégration transparente aux flux de travail analytiques. Le package purrr fournit à cet égard une alternative élégante aux mécanismes traditionnels grâce à sa collection de fonctions d’itération spécialisées, au premier rang desquelles figure map_dbl().
Contrairement aux fonctions de base qui peuvent occasionnellement modifier le type de données retourné en présence d’anomalies ou de valeurs nulles, map_dbl() applique un contrat strict : elle garantit formellement que l’objet résultant sera un vecteur de nombres décimaux en double précision, interrompant immédiatement l’exécution si une quelconque incohérence de typage survient. L’association de cette fonction avec un vecteur d’indices et l’opérateur de tuyauterie natif permet une formulation déclarative du processus de simulation.
Cette formulation facilite l’incorporation de la simulation au sein de structures complexes de type données imbriquées. Il devient trivial de paramétrer une série continue de tailles d’échantillons distinctes, d’imbriquer les simulations au sein d’une colonne de données et d’extraire les résumés statistiques via une syntaxe unifiée. Ce formalisme favorise l’auditabilité du code, réduit la dette technique des scripts analytiques volumineux et simplifie la maintenance évolutive des protocoles de simulation pour la publication académique.
6. Visualisation graphique rigoureuse de la distribution d’échantillonnage
6.1 Représentations graphiques avec R de base
L’exploration visuelle constitue la première étape incontournable pour valider l’intégrité empirique d’une distribution d’échantillonnage simulée. Le sous-système graphique natif de R permet de générer rapidement des représentations diagnostiques sans recourir à des dépendances externes. L’histogramme de fréquences, instancié via la fonction standard hist(), offre une vue immédiate de la morphologie générale des statistiques d’échantillons collectées.
Pour confronter rigoureusement cette distribution observée aux attentes mathématiques, il est impératif de paramétrer l’histogramme sur l’échelle des densités de probabilité en déclarant freq = FALSE ou probability = TRUE. Ce basculement dimensionnel autorise la superposition directe d’une estimation non paramétrique de la fonction de densité via l’appel coordonné de lines(density(sample_means)). Cette courbe empirique lissée permet d’identifier visuellement d’éventuelles asymétries locales ou irrégularités d’aplatissement qui échapperaient à une lecture brute des barres discrètes de l’histogramme.
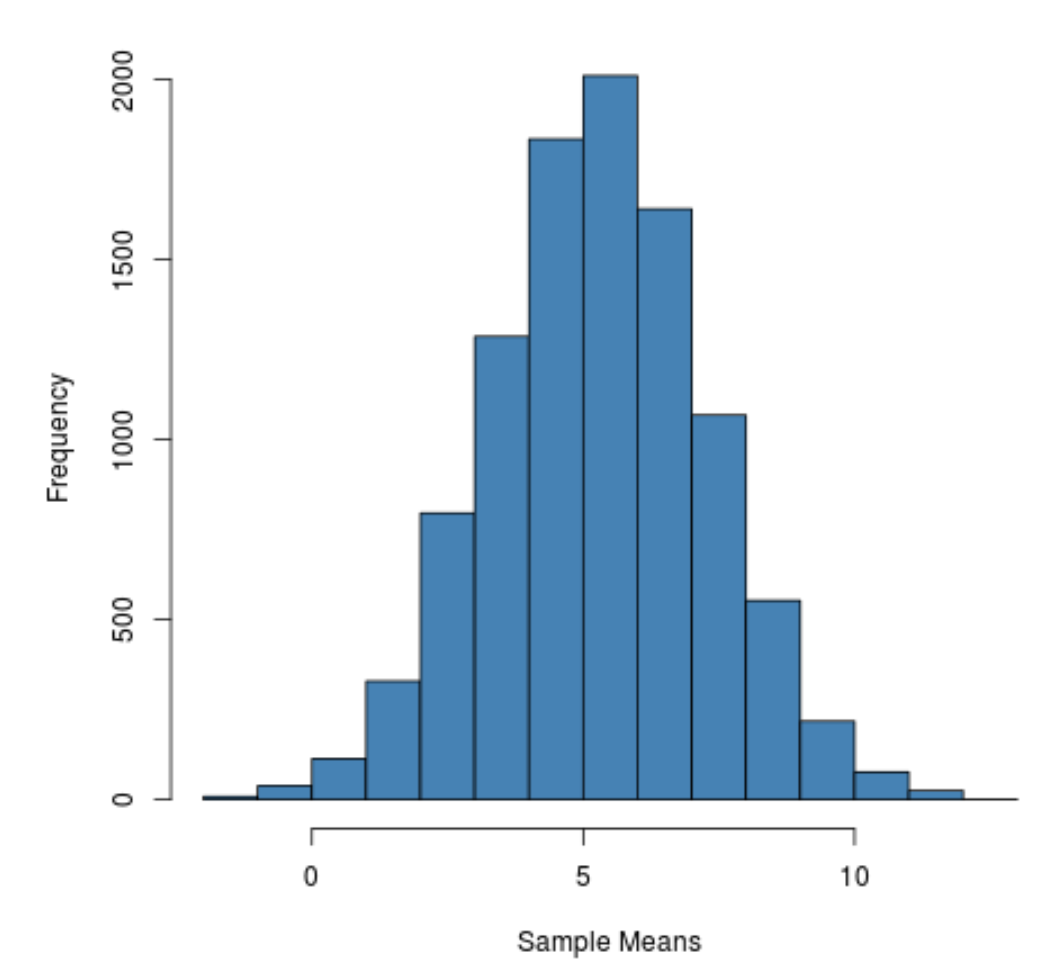
L’étape de validation ultime sous R de base consiste à superposer analytiquement la courbe de densité théorique issue du théorème central limite. En utilisant la fonction curve() conjointement avec l’ordonnée gaussienne dnorm(x, mean = mu, sd = sigma / sqrt(n)) et l’argument d’addition graphique add = TRUE, le statisticien peut procéder à un étalonnage visuel immédiat. Tout écart systématique entre le profil de l’histogramme simulé et la trajectoire théorique idéale révèle instantanément un volume d’itérations insuffisant, une taille d’échantillon N trop faible pour neutraliser une non-normalité parente, ou une anomalie dans la formalisation du code générateur.
6.2 Graphiques de niveau publication avec ggplot2
Pour répondre aux exigences éditoriales des revues scientifiques internationales, le recours à la grammaire des graphiques structurée par le package ggplot2 s’impose comme le standard méthodologique. En isolant explicitement les données, les correspondances esthétiques et les couches géométriques superposées, ggplot2 confère un contrôle microscopique sur chaque élément d’information visuelle.
La construction graphique s’articule autour de couches progressives : les moyennes d’échantillons converties en tableau de données alimentent l’esthétique générale, sur laquelle s’appose geom_histogram() calibré avec une largeur de compartiment statistiquement pertinente, complété par geom_density() adoptant une teinte semi-transparente pour dévoiler la topographie sous-jacente. L’intégration de la prédiction théorique s’opère élégamment via la fonction stat_function(fun = dnorm, args = list(mean = mu, sd = se_theorique)), dessinant un tracé continu d’une netteté mathématique irréprochable.
L’enrichissement sémantique du graphique s’accomplit par l’adjonction de repères verticaux précis générés par geom_vline(), signalant l’espérance de la population ainsi que les bornes délimitant l’intervalle critique bilatéral à quatre-vingt-quinze pour cent. L’application d’un thème épuré tel que theme_minimal() ou theme_classic(), associée à la vectorisation des libellés typographiques, garantit une lisibilité maximale pour les figures scientifiques destinées aux monographies imprimées ou aux supports numériques haute définition.
6.3 Évaluation de la normalité par les graphiques Quantile-Quantile (Q-Q plots)
Bien que l’histogramme et la courbe de densité fournissent une première impression qualitative sur la morphologie de la distribution d’échantillonnage, ils s’avèrent structurellement inaptes à détecter des déviations modérées mais statistiquement critiques localisées dans les extrémités asymptotiques. Le graphique Quantile-Quantile, communément désigné sous le vocable de Q-Q plot, constitue l’outil diagnostique de référence pour pallier cette défaillance perceptuelle.
Le principe mathématique sous-jacent repose sur la mise en relation bivariée ordonnée des quantiles empiriques extraits des données simulées avec les quantiles théoriques issus de la fonction de répartition inverse de la loi normale idéale. Dans l’écosystème graphique de R de base, les fonctions qqnorm() et qqline() tracent instantanément cette correspondance ainsi que la droite de référence passant par les premier et troisième quartiles. Sous ggplot2, ce diagnostic s’obtient au moyen des géométries stat_qq() et stat_qq_line().
L’interprétation clinique de ces graphiques renseigne immédiatement sur la conformité de la distribution d’échantillonnage aux postulats paramétriques. Si les points simulés s’alignent rigoureusement sur la droite diagonale sur l’intégralité de l’axe, la normalité de la statistique d’échantillon est empiriquement certifiée. En revanche, une courbure en forme de S traduit un kurtosis inadapté signalant des queues plus lourdes ou plus légères que celles de la loi normale, tandis qu’une incurvation unidirectionnelle trahit une asymétrie résiduelle persistante indiquant que la taille d’échantillon N n’a pas encore atteint le seuil requis pour saturer le théorème central limite.
7. Calcul des paramètres statistiques et validation théorique
7.1 Moyenne empirique versus espérance théorique
L’évaluation quantitative d’une simulation stochastique exige une confrontation formelle entre les métriques observées sur la distribution générée et les grandeurs exactes prédites par la théorie analytique. Le premier moment centré à l’origine, correspondant à l’espérance mathématique, s’estime directement sur le vecteur des moyennes d’échantillons à l’aide de la commande mean(sample_means).
Cette comparaison empirique illustre la propriété d’un estimateur sans biais. Un estimateur statistique est formellement qualifié de non biaisé si l’espérance mathématique de sa distribution d’échantillonnage égale la valeur exacte du paramètre de population sous-jacent qu’il vise à mesurer. Lorsque la simulation est menée sur un échantillon de taille N issu d’une population de moyenne mu, la moyenne arithmétique de la distribution d’échantillonnage converge de manière inexorable vers ce paramètre cible au fur et à mesure que le nombre d’itérations tend vers l’infini.
Pour quantifier avec précision la validité de cette convergence, il est préconisé de calculer systématiquement l’erreur absolue d’estimation, définie par la valeur absolue de la différence entre la moyenne simulée et l’espérance théorique, ainsi que l’erreur relative exprimée en pourcentage du paramètre réel. L’observation systématique d’une décroissance de cette erreur relative lors du passage de mille à dix mille, puis à cent mille itérations de simulation constitue la validation numérique concrète de la conformité du code aux principes de la loi des grands nombres.
7.2 Écart-type empirique versus erreur type théorique
Le second moment centré caractérisant la distribution d’échantillonnage mesure l’ampleur de sa dispersion stochastique. L’évaluation empirique de ce paramètre s’opère en calculant l’écart-type de l’ensemble des moyennes simulées via la fonction sd(sample_means). Cette grandeur représente numériquement l’erreur type empirique du protocole expérimental modélisé.
Cette métrique calculée sur les réalisations de Monte-Carlo doit être immédiatement confrontée à la valeur dérivée de la formulation analytique du théorème central limite, à savoir l’écart-type de la population sigma divisé par la racine carrée de l’effectif unitaire N. La divergence observée entre la statistique d’échantillonnage empirique et la prédiction théorique est désignée sous le terme de résidu stochastique ou erreur de Monte-Carlo, dont la magnitude est elle-même inversement proportionnelle à la racine carrée du nombre global d’itérations répliquées.
Cette confrontation revêt une portée conceptuelle déterminante. Elle démontre matériellement que l’erreur type n’est pas un artifice abstrait découlant d’une convention algébrique, mais constitue bel et bien l’écart-type observable et mesurable d’une population de moyennes d’échantillons générées par la répétition d’expériences. L’analyste valide ainsi concrètement le fait que l’incertitude pesant sur l’estimation d’un paramètre psychologique diminue strictement au rythme déterminé par le dénominateur de la formule théorique.
7.3 Indices de forme : Skewness et Kurtosis de la distribution générée
Pour attester formellement que la distribution d’échantillonnage simulée a atteint une conformité gaussienne intégrale, la seule correspondance des deux premiers moments d’espérance et de variance s’avère insuffisante. Il est indispensable d’évaluer les moments d’ordre supérieur, spécifiquement le troisième moment mesurant l’asymétrie ou skewness, et le quatrième moment mesurant l’aplatissement ou kurtosis.
Ces coefficients ne faisant pas l’objet de fonctions dédiées dans l’installation de base de R, il convient de mobiliser des packages spécialisés tels que e1071 ou moments. Le coefficient d’asymétrie d’une distribution parfaitement normale est rigoureusement nul. Toute valeur positive traduit un étirement de la queue droite de la distribution d’échantillonnage, tandis qu’une valeur négative dénote une asymétrie résiduelle vers les basses valeurs. Un coefficient d’asymétrie empirique dont la valeur absolue n’excède pas zéro virgule un atteste généralement d’une symétrie fonctionnelle suffisante pour les applications inférentielles usuelles.
L’analyse du kurtosis requiert une clarification conventionnelle relative au kurtosis d’excès, qui retranche la valeur trois issue de la loi normale idéale pour caler le zéro mathématique sur l’état mésokurtique standard. Une distribution d’échantillonnage présentant un kurtosis d’excès substantiellement supérieur à zéro est qualifiée de leptokurtique, caractérisée par une concentration centrale aiguë et des queues épaisses susceptibles d’engendrer un taux de faux positifs plus élevé que nominal. À l’inverse, une configuration platykurtique révèle un sommet aplati et des queues écourtées. La convergence de ces deux indices vers un voisinage strict de zéro atteste de la conformité asymptotique de la simulation.
8. Calcul de probabilités et d’intervalles critiques à partir de la distribution
8.1 Calcul empirique des fréquences relatives et probabilités associées
L’un des avantages majeurs conférés par la détention d’une distribution d’échantillonnage simulée réside dans la capacité d’estimer des probabilités complexes sans devoir recourir à l’intégration numérique de fonctions de densité analytiques intraitables. Cette approche repose sur le principe de l’intégration de Monte-Carlo, convertissant le calcul d’une probabilité théorique en une proportion empirique discrète d’événements observés.
Pour déterminer, par exemple, la probabilité d’obtenir une moyenne d’échantillon strictement supérieure à un seuil critique d’intervention psychologique fixé à cent cinq lorsque l’hypothèse nulle prévaut, il suffit d’appliquer un opérateur relationnel logique sur le vecteur des simulations. L’instruction vectorisée sample_means > 105 génère un vecteur booléen contenant les indicateurs logiques TRUE et FALSE. Dans le langage R, les valeurs booléennes adoptent implicitement les valeurs numériques un et zéro lors de l’application de fonctions mathématiques arithmétiques ; par conséquent, l’instruction mean(sample_means > 105) retourne directement la proportion relative des simulations satisfaisant la condition critique.
Cette proportion empirique peut être directement mise en regard de la probabilité théorique calculée via la fonction de répartition cumulative pnorm(q = 105, mean = mu, sd = se_theorique, lower.tail = FALSE). La quasi-identité des résultats numériques confirme l’adéquation opérationnelle de la simulation stochastique, validant son emploi pour quantifier le risque alpha dans des situations complexes où les dérivations mathématiques analytiques directes sont inexistantes ou compromises par des violations de postulats.
8.2 Standardisation et dérivation des scores Z
Pour transposer l’analyse de la distribution d’échantillonnage dans un cadre métrique universel indépendant de l’échelle d’origine des instruments de mesure, il est usuel de procéder à la standardisation algébrique de l’ensemble des moyennes simulées. Cette transformation consiste à retrancher l’espérance théorique de la population à chaque réalisation d’échantillon, puis à diviser cette différence par l’erreur type théorique, formalisant le passage au score Z classique.
Dans l’environnement de calcul R, cette opération vectorisée s’exprime par z_scores <- (sample_means - mu) / (sigma / sqrt(n)). La distribution d’échantillonnage standardisée résultante doit manifester une convergence étroite vers la loi normale standard caractérisée par une moyenne de zéro et une variance de un. Cette convergence permet de valider le comportement de l’estimateur face aux lois de probabilité standardisées répertoriées dans les tables statistiques usuelles.
L’exploitation conjointe de la fonction quantile() sur ces scores Z simulés autorise l’identification directe des seuils de démarcation percentile empiriques. Le repérage des coupures associées aux deux virgule cinq centièmes et quatre-vingt-dix-sept virgule cinq centièmes percentiles permet d’observer concrètement l’émergence empirique des célèbres bornes critiques à plus ou moins un virgule quatre-vingt-seize, ancrant l’abstraction des valeurs critiques dans la matérialité de données simulées.
8.3 Construction d’intervalles de confiance empiriques
L’extraction d’intervalles de confiance empiriques bilatéraux découle directement du partitionnement ordonné de la distribution d’échantillonnage générée. En invoquant la commande quantile(sample_means, probs = c(0.025, 0.975)), l’analyste délimite les bornes numériques précises entre lesquelles oscillent quatre-vingt-quinze pour cent des moyennes d’échantillons prélevées sous les paramètres spécifiés.
Cette méthode empirique offre une opportunité pédagogique de clarifier l’interprétation philosophique et méthodologique de l’intervalle de confiance. Dans le cadre de l’inférence fréquentiste stricte, l’intervalle de confiance dérivé d’un échantillon singulier observé ne signifie nullement qu’il existe une probabilité de quatre-vingt-quinze pour cent que le paramètre fixe inconnu de la population soit englobé entre ses bornes. Il stipule rigoureusement que si le protocole d’échantillonnage était répété indéfiniment et qu’un intervalle était calculé sur chaque réalisation selon cette méthode, quatre-vingt-quinze pour cent de ces intervalles engloberaient effectivement le paramètre réel.
En matérialisant visuellement la distribution d’échantillonnage et en y marquant les zones critiques d’exclusion, le statisticien visualise avec une limpidité parfaite la mécanique du rejet d’hypothèse. Un échantillon empirique dont l’intervalle de confiance exclut la valeur postulée par l’hypothèse nulle se positionne automatiquement dans la région de rejet définie par les quantiles extrêmes, réconciliant ainsi l’estimation par intervalle et le test d’hypothèse ponctuel au sein d’un même cadre conceptuel fondé sur la distribution d’échantillonnage.
9. Simulation avec des populations non normales et robustesse statistique
9.1 Échantillonnage à partir d’une distribution exponentielle
L’expérimentation stochastique sous R prend toute son envergure lorsqu’il s’agit de démontrer la robustesse du théorème central limite face à des violations massives du postulat de normalité des populations parentes. La loi exponentielle, caractérisée par une asymétrie positive drastique où la masse de probabilité est concentrée au voisinage de zéro avec une longue traîne décroissante vers les valeurs positives, constitue le modèle standard pour simuler des temps de réaction ou des latences de traitement de l’information cognitive.
En employant la fonction de génération aléatoire rexp(n, rate = lambda) pour concevoir la population d’origine, l’analyste peut générer des distributions d’échantillonnage pour des tailles d’échantillons progressives, par exemple pour N égal à deux, cinq, quinze, trente et cent participants. L’agrégation et la comparaison visuelle des distributions de moyennes obtenues révèlent de manière spectaculaire la métamorphose distributionnelle : pour N égal à deux ou cinq, la distribution d’échantillonnage conserve une asymétrie résiduelle notable héritée de la loi parente exponentielle.
Dès lors que la taille d’échantillon franchit le seuil de trente ou cinquante observations, la distribution d’échantillonnage des moyennes se métamorphose sous l’action du théorème central limite pour adopter une cloche symétrique indiscernable d’une loi normale pure. Cette expérience computationnelle enseigne une leçon méthodologique cruciale : l’analyste n’a point besoin que ses mesures brutes de temps de réaction soient normalement distribuées au sein de son échantillon pour appliquer des procédures inférentielles paramétriques sur la moyenne, à la condition expresse que la taille d’échantillon suffise à opérer cette régularisation asymptotique.
9.2 Échantillonnage à partir d’une distribution uniforme ou bimodale
Une autre configuration non normale hautement pertinente dans les sciences comportementales correspond aux structures distributionnelles uniformes ou bimodales. Une loi uniforme simule par exemple des échelles de choix forcés ou des distributions de scores rectangulaires où chaque catégorie de réponse possède une probabilité d’occurrence rigoureusement identique, ce que l’on produit sous R via runif(n, min = 0, max = 100).
Pour modéliser des populations polarisées ou des échantillons cliniques fragmentés en deux sous-groupes étanches — tels qu’un mélange de participants sains et de patients manifestant une pathologie psychiatrique sévère —, il est possible de générer un mélange gaussien bimodal en alternant stochastiquement des tirages issus de deux lois normales disjointes au moyen de ifelse(rbinom(n, 1, 0.5) == 1, rnorm(n, mean = 40, sd = 5), rnorm(n, mean = 80, sd = 5)). La population mère résultante présente deux pics nettement individualisés séparés par une vallée centrale quasi déserte.
En appliquant les algorithmes de simulation d’échantillonnage sur ce mélange bimodal, un résultat apparemment contre-intuitif émerge pour l’observateur profane : la distribution d’échantillonnage des moyennes issues de cette population bimodale ne présente aucunement une double cloche, mais se condense rapidement autour d’un pic univarié centré sur la moyenne arithmétique globale du mélange. Cette observation démystifie l’amalgame récurrent entre forme distributionnelle des données individuelles et forme distributionnelle de l’estimateur agrégé, rassurant le chercheur sur l’applicabilité des statistiques de tendance centrale sur des populations hétérogènes.
9.3 Impact des valeurs extrêmes et contaminations distributionnelles
Si le théorème central limite s’avère remarquable de résilience, il n’est pas omnipotent. L’évaluation de ses défaillances potentielles s’effectue sous R en introduisant délibérément des contaminations distributionnelles à queues lourdes au moyen de la loi de Cauchy, accessible via la fonction rcauchy(). La distribution de Cauchy présente la singularité mathématique de posséder des queues si massives que ses intégrales de moment divergent : elle ne possède ni moyenne théorique définie, ni variance mathématique finie.
L’exécution d’une simulation d’échantillonnage prélevant des moyennes sur une distribution de Cauchy produit un effondrement spectaculaire de la loi des grands nombres et du théorème central limite. Quelle que soit la grandeur de la taille d’échantillon N — fût-elle de dix, de cent ou de dix mille participants —, la distribution d’échantillonnage des moyennes d’échantillons ne converge jamais vers une loi normale étroite, mais conserve rigoureusement la même dispersion et la même imprévisibilité intrinsèque que la distribution unitaire initiale. La moyenne empirique ne se stabilise pas, polluée par des réalisations aberrantes disproportionnées apparaissant sporadiquement.
Cette mise en échec computationnelle sensibilise le praticien à la fragilité de la moyenne arithmétique ordinaire face aux contaminations extrêmes dans les échantillons réels. Dans les corpus de données psychométriques caractérisés par la présence de répondants inattentifs ou d’artefacts techniques violents générant des valeurs aberrantes massives, l’estimateur de la moyenne classique perd son efficience statistique. Cette démonstration légitime l’adoption d’estimateurs de substitution plus robustes, tels que les moyennes tronquées à dix ou vingt pour cent ou les estimateurs M de Huber, dont les distributions d’échantillonnage demeurent stables en dépit des anomalies observationnelles.
10. Distributions d’échantillonnage d’autres métriques psychométriques
10.1 Distribution d’échantillonnage de la médiane
L’inférence statistique ne se limite pas à l’estimation de l’espérance arithmétique. La médiane d’un échantillon constitue une statistique d’ordre centrale, fréquemment préférée à la moyenne lorsque les distributions individuelles manifestent une forte asymétrie ou que l’analyste désire prémunir son étude contre l’influence de points aberrants. Il est possible de cartographier la distribution d’échantillonnage de la médiane sous R par la simple substitution de la fonction median() dans le protocole de réplication vectorisé.
La comparaison stochastique directe entre la distribution d’échantillonnage de la moyenne et celle de la médiane pour des données parentes normalement distribuées met en relief le concept d’efficacité relative asymptotique. En observant l’écart-type de ces deux distributions d’échantillonnage respectives sur dix mille réplications, l’analyste constate empiriquement que l’erreur type de la médiane est approximativement vingt-cinq pour cent plus vaste que celle de la moyenne, obéissant au ratio asymptotique théorique équivalent à la racine carrée de pi divisé par deux, soit approximativement un virgule vingt-cinq.
En présence d’une distribution normale, la médiane s’avère donc un estimateur moins efficace que la moyenne, nécessitant un échantillon proportionnellement plus important pour atteindre une précision d’estimation similaire. Toutefois, si l’on altère la population parente en lui insufflant des queues épaisses de type loi log-normale ou distribution de Laplace, la dynamique s’inverse formellement : l’erreur type de la médiane devient substantiellement inférieure à celle de la moyenne arithmétique, illustrant expérimentalement l’arbitrage méthodologique entre efficacité paramétrique maximale et robustesse non paramétrique.
10.2 Distribution d’échantillonnage de la variance et loi du Chi-deux
L’estimation de la variabilité d’une population constitue un autre enjeu névralgique de la modélisation psychométrique, notamment pour la calibration des scores de dispersion d’un test standardisé. Lorsque l’on extrait de manière répétée la variance d’échantillons gaussiens au moyen de la fonction var(), la distribution d’échantillonnage résultante présente une morphologie asymétrique positive prononcée pour les faibles valeurs de taille d’échantillon N.
Cette topographie distributionnelle découle de son alignement mathématique sur la loi théorique du Chi-deux. Plus formellement, la variable transformée définie par le produit de N moins un par la variance d’échantillon, divisé par la variance de la population sigma au carré, suit exactement une distribution du Chi-deux à N moins un degrés de liberté. La simulation sous R permet de vérifier cette identité analytique en traçant l’histogramme des variances mises à l’échelle et en y superposant la densité dchisq(x, df = n - 1).
Cette simulation offre également l’opportunité de mettre en évidence le bien-fondé de la correction de Bessel, qui substitue le diviseur N moins un au diviseur N conventionnel dans le calcul de la variance d’échantillon. Si l’on recalcule artificiellement la variance non corrigée en multipliant par N moins un puis en divisant par N, la moyenne de la distribution d’échantillonnage sous-estime systématiquement la variance réelle de la population. Cette minoration démontre empiriquement le biais négatif structurel de l’estimateur de variance naïf et justifie l’amputation d’un degré de liberté pour restaurer un estimateur rigoureusement sans biais.
10.3 Distribution d’échantillonnage du coefficient de corrélation de Pearson
Dans l’évaluation des liens relationnels entre deux échelles d’évaluation comportementale, le coefficient de corrélation linéaire r de Pearson est omniprésent. Pour explorer la distribution d’échantillonnage de cette statistique bivariée sous R, il convient de mobiliser le générateur de variables aléatoires multivariées mvrnorm() proposé par le package MASS, en spécifiant une matrice de covariance régie par un coefficient de corrélation de population rho donné.
Lorsque la corrélation théorique de population rho est nulle, la distribution d’échantillonnage de r est parfaitement symétrique et centrée sur zéro, convergeant asymptotiquement vers une loi normale pour des échantillons de taille modérée. En revanche, dès lors que le paramètre de population rho s’écarte substantiellement de zéro pour atteindre des valeurs fortes telles que zéro virgule soixante-dix ou zéro virgule quatre-vingt-dix, la distribution d’échantillonnage subit une compression asymétrique sévère. La borne supérieure d’un coefficient de corrélation étant mathématiquement fixée à un, les fluctuations d’échantillonnage ne peuvent s’étendre symétriquement vers le haut, écrasant la variabilité à droite et étirant une queue traînante vers les valeurs plus basses.
Cette asymétrie prononcée interdit l’application directe des tests d’hypothèse gaussiens classiques fondés sur l’erreur type standard. La simulation permet alors de tester empiriquement la solution algorithmique élaborée par Ronald Fisher : la transformation z de Fisher, exprimée par le calcul de l’arc-tangente hyperbolique via atanh(r). En appliquant cette fonction au vecteur des corrélations d’échantillons simulées, l’analyste observe la restauration quasi parfaite de la symétrie normale de la distribution d’échantillonnage, stabilisant la variance à une valeur constante égale à un divisé par N moins trois, quel que soit le niveau réel de correlation dans la population d’origine.
11. L’approche non paramétrique : Le bootstrap empirique sous R
11.1 Principes fondamentaux du rééchantillonnage bootstrap
Dans de nombreuses situations de recherche empirique, les postulats théoriques adossés au théorème central limite s’avèrent inopérants : la taille d’échantillon est trop réduite pour effacer des distributions complexes, la nature de la statistique d’intérêt ne dispose d’aucune formule analytique connue pour son erreur type, ou la distribution parente sous-jacente s’avère indéterminable. Face à cette impasse, Bradley Efron a conçu à la fin des années 1970 une méthode de rééchantillonnage informatique révolutionnaire : le bootstrap non paramétrique.
Le postulat philosophique et mathématique du bootstrap est d’une remarquable simplicité conceptuelle : à défaut de connaître la population parente globale, l’échantillon unique recueilli sur le terrain — à la condition expresse qu’il ait été prélevé de façon rigoureusement aléatoire — constitue la meilleure approximation empirique disponible de cette population d’origine. Dès lors, le chercheur s’autorise à émuler le processus d’échantillonnage de la population en procédant à des tirages successifs répétés au sein même de son échantillon d’observations, à la condition sine qua non que ce rééchantillonnage s’effectue avec remise.
L’exigence du tirage avec remise, formalisée par l’instruction replace = TRUE, est fondamentale : elle permet à chaque observation individuelle d’être sélectionnée zéro, une, deux ou plusieurs fois au sein d’un rééchantillon bootstrap donné, introduisant la variation stochastique indispensable à la simulation de l’incertitude. L’ensemble des statistiques calculées sur ces milliers de rééchantillons engendre la distribution d’échantillonnage bootstrap, qui émule fidèlement la morphologie, la dispersion et l’asymétrie de la véritable distribution d’échantillonnage théorique sans jamais postuler d’hypothèse paramétrique contraignante.
11.2 Mise en œuvre manuelle du bootstrap dans R
L’implémentation algorithmique d’un protocole de rééchantillonnage bootstrap ne requiert que l’agencement de fonctions élémentaires du langage R de base. Considérons un vecteur de scores d’évaluation neuropsychologique de taille réduite, par exemple vingt patients souffrant d’amnésie post-traumatique, dont la distribution des scores s’avère hautement erratique et asymétrique, rendant toute hypothèse paramétrique hasardeuse.
La génération de dix mille répliques bootstrap de la moyenne ou de la médiane s’exécute avec une extrême clarté via l’imbrication de sample() dans replicate() : boot_means <- replicate(10000, mean(sample(donnees_observees, size = length(donnees_observees), replace = TRUE))). Chaque itération reconstruit un échantillon artificiel de même taille que le jeu de données initial, garantissant que l’ampleur de la variance d’échantillonnage modélisée respecte rigoureusement l’échelle stochastique induite par l’effectif N d’origine.
L’erreur type bootstrap s’obtient instantanément en calculant l’écart-type de cette distribution simulée via sd(boot_means). Pour dériver un intervalle de confiance empirique à quatre-vingt-quinze pour cent affranchi de tout postulat de symétrie, il suffit d’extraire les percentiles pertinents à l’aide de quantile(boot_means, probs = c(0.025, 0.975)). Cette procédure engendre un intervalle de confiance percentile robuste, capable d’épouser les asymétries réelles de la distribution sans imposer le centrage artificiel propre aux approches basées sur le score Z théorique de un virgule quatre-vingt-seize.
11.3 Utilisation du package boot pour une inférence robuste
Pour les analyses statistiques à haute exigence méthodologique, l’écriture manuelle du bootstrap présente des limites dès lors que l’on désire calculer des intervalles de confiance perfectionnés. Le package standardisé boot, conçu par Angelo Canty et Brian Ripley d’après les travaux de Davison et Hinkley, constitue la référence logicielle incontournable pour exécuter des procédures de rééchantillonnage avancées.
L’emploi de la fonction boot() requiert la définition préalable d’une fonction de statistique d’intérêt acceptant deux arguments formels : le jeu de données d’origine et un vecteur d’indices généré par le moteur de tirage. Cette fonction retourne la métrique cible calculée sur les observations indicées. L’objet structuré résultant de l’appel à boot(data = donnees, statistic = fonction_cible, R = 10000) consigne non seulement l’ensemble des répliques générées, mais évalue précisément le biais d’estimation empirique ainsi que l’erreur type globale.
Le point fort du package boot réside dans sa fonction dédiée boot.ci(), qui permet de dériver simultanément plusieurs catégories d’intervalles de confiance hautement sophistiqués. Outre l’intervalle percentile classique, le praticien a accès à l’intervalle studentisé, à l’intervalle de base, et tout particulièrement à l’intervalle BCa, pour biais-corrigé et accéléré. Ce dernier procède à des ajustements correctifs tenant compte à la fois de l’asymétrie locale de la distribution d’échantillonnage et du taux de variation de l’erreur type en fonction de la magnitude du paramètre, fournissant l’inférence non paramétrique la plus rigoureuse possible pour les petits échantillons expérimentaux.
12. Optimisation computationnelle, pièges courants et bonnes pratiques
12.1 Erreurs fréquentes d’interprétation et de codage
La pratique assidue de la simulation stochastique sous R met en lumière des récurrences d’erreurs méthodologiques et de bogues de programmation qu’il est indispensable d’identifier pour prémunir les recherches contre des conclusions erronées. La faute conceptuelle la plus insidieuse consiste à confondre visuellement et mathématiquement la distribution empirique de l’échantillon et la distribution d’échantillonnage de la statistique. Un chercheur débutant modélisant des données observe fréquemment l’histogramme de ses trente participants et déplore son asymétrie en jugeant ses tests paramétriques invalides, ignorant que l’objet déterminant pour l’inférence est la distribution des moyennes de tels échantillons, laquelle est infiniment plus resserrée et symétrique.
Sur le versant purement algorithmique, une erreur d’omission dévastatrice dans l’implémentation manuelle du bootstrap consiste à oublier l’argument replace = TRUE au sein de l’appel à la fonction sample(). Sans tirage avec remise, chaque rééchantillon n’est qu’une permutation ordonnée des mêmes vingt ou cinquante observations d’origine. Puisque la moyenne et la médiane sont invariantes à la permutation de l’ordre d’un vecteur, la distribution d’échantillonnage résultante présentera une variance strictement égale à zéro, fournissant une estimation absurdement illusoire d’une précision infinie.
Une autre inadvertance classique concerne la taille des itérations de simulation désignée par n_sim. Conclure à la déviation d’une distribution d’échantillonnage par rapport à la normalité théorique sur la base de seulement deux cents ou cinq cents répétitions de Monte-Carlo constitue une faute méthodologique caractérisée. À ce niveau de réplication, la variabilité d’échantillonnage de la simulation elle-même perturbe l’observation des quantiles extrêmes, mimant faussement des déformations morphologiques qui se dissipent intégralement dès lors que le protocole intègre dix mille ou cinquante mille réplications.
12.2 Accélération des simulations avec la parallélisation
Face à des protocoles de simulation intensifs — tels que le calibrage simultané de tests de puissance croisant plusieurs dizaines de facteurs de variance, de tailles d’échantillons et de taux de contamination sur des centaines de milliers d’itérations —, le traitement séquentiel sur un fil d’exécution unique s’avère prohibitif. Les microprocesseurs contemporains disposant d’architectures multicœurs massives, l’exploitation du calcul parallèle constitue la clé de voûte de l’optimisation moderne sous R.
Les packages standards parallel et foreach permettent de distribuer aisément la charge de calcul sur l’ensemble des cœurs physiques de la station de recherche. Le paradigme consiste à initialiser un cluster de calcul local via makeCluster(), à exporter les fonctions et variables requises sur chaque nœud satellite, puis à fragmenter la matrice d’itérations au moyen de parLapply() ou de l’opérateur combinatoire %dopar%. La simulation s’exécute ainsi de manière concurrente, divisant le temps de traitement global par un facteur quasi proportionnel au nombre de processeurs mobilisés.
Il est impératif, dans ce contexte distribué, d’adopter une stratégie de génération aléatoire adaptée sous peine de corrompre l’indépendance statistique des résultats. L’intégration de la commande clusterSetRNGStream() permet de configurer le générateur de flux parallèles L’Ecuyer-CMRG, assurant que chaque cœur de calcul opère sur des sous-séquences de nombres pseudo-aléatoires disjointes et statistiquement orthogonales. Cette précaution garantit à la fois l’indépendance irréprochable des tirages parallèles et la reproductibilité déterministe intégrale de la simulation globale.
12.3 Recommandations pour la recherche reproductible en psychologie ouverte
L’intégration de la modélisation des distributions d’échantillonnage au sein des flux de recherche contemporains exige une adhésion inconditionnelle aux standards de la science ouverte et aux principes directeurs FAIR, stipulant que les données et codes sources doivent être faciles à trouver, accessibles, interopérables et réutilisables. Un script de simulation ne doit jamais consister en une suite désordonnée d’instructions interactives exécutées au terminal, mais doit se concevoir comme une archive d’audit scientifique pérenne.
La modularisation du code constitue la première règle de bonne conduite : les fonctions de génération probabiliste, les calculateurs d’estimateurs statistiques et les routines d’assemblage graphique doivent être formellement isolés au sein de fonctions documentées, accompagnées de tests unitaires vérifiant leur intégrité face à des entrées anormales. Pour les simulations volumineuses dont le temps d’exécution excède plusieurs dizaines de minutes, il est fortement déconseillé de réexécuter l’intégralité du calcul à chaque compilation de document : la sauvegarde sérialisée des résultats intermédiaires au format compressé natif .rds via saveRDS() permet de figer les sorties numériques pour une réutilisation immédiate.
Enfin, l’inscription de ces architectures de calcul au sein de documents computationnels dynamiques via les environnements Quarto ou R Markdown matérialise l’idéal de la recherche reproductible. En fusionnant dans un fichier texte unique le discours théorique, le code exécutable, les graines d’initialisation, les tableaux paramétriques et les figures vectorielles haute résolution, le chercheur offre à la communauté scientifique les moyens d’auditer, de reproduire et d’étendre ses analyses sans la moindre friction technique, érigeant la simulation numérique sous R au rang d’instrument d’investigation épistémologique irréfutable.
Références
- Canty, A., & Ripley, B. D. (2021). boot: Bootstrap R (S-Plus) Functions (R package version 1.3-28). CRAN. https://cran.r-project.org/package=boot
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.r-project.org/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org/
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686