
L’analyse de régression linéaire multiple constitue l’un des piliers méthodologiques les plus mobilisés au sein des sciences quantitatives contemporaines, qu’il s’agisse de l’économétrie, de l’épidémiologie ou de la recherche en psychométrie et sciences du comportement. Lorsqu’un chercheur cherche à modéliser une variable dépendante continue à l’aide d’un vecteur de variables prédictives, le postulat fondamental repose sur l’indépendance linéaire de ces dernières afin d’isoler l’effet partiel unique attribuable à chaque régresseur. Néanmoins, dans la pratique de la recherche empirique, les prédicteurs présentent fréquemment des relations d’interdépendance mutuelle complexes. Ce phénomène, désigné sous le terme générique de multicolinéarité, altère profondément les estimations statistiques obtenues par la méthode des moindres carrés ordinaires (MCO), déstabilisant les modèles et menaçant la validité des inférences tirées des données.
Le facteur d’inflation de la variance, universellement désigné par son acronyme anglophone VIF (Variance Inflation Factor), s’est imposé comme l’indicateur diagnostique standard pour quantifier la sévérité de cette multicolinéarité. En mesurant avec précision le degré selon lequel la variance d’un coefficient de régression estimé est artificiellement gonflée en raison des corrélations linéaires existant entre ce prédicteur et l’ensemble des autres variables indépendantes du modèle, le VIF fournit au statisticien une estimation synthétique et objective de la perte de précision paramétrique. Sa formulation réciproque, la tolérance, complète ce tableau analytique en offrant une évaluation intuitive de la proportion de variance non partagée.
Bien que des progiciels statistiques spécialisés tels que R, SAS, Stata ou SPSS intègrent des procédures automatisées pour extraire directement le VIF lors de l’exécution d’un modèle de régression, de nombreux analystes, universitaires et étudiants recourent quotidiennement à Microsoft Excel pour conduire leurs analyses exploratoires et confirmatoires. Dépourvu de fonction native directe nommée explicitement « VIF », le tableur de Microsoft requiert le déploiement de stratégies de calcul rigoureuses, reposant soit sur la décomposition séquentielle de régressions auxiliaires, soit sur l’application de fonctions matricielles avancées fondées sur l’algèbre linéaire. Cet article propose un guide exhaustif, théorique et opérationnel, destiné à maîtriser le calcul, l’interprétation et la remédiation du VIF sous l’environnement Microsoft Excel.
1. Fondements théoriques de la multicolinéarité en régression multiple
1.1 Définition conceptuelle et manifestations mathématiques
La colinéarité, dans son acception géométrique et mathématique la plus rigoureuse, désigne l’existence d’une relation linéaire déterministe entre deux vecteurs appartenant à un espace euclidien de dimension n. Au sein du formalisme de la régression linéaire multiple, où la variable dépendante Y est modélisée par une combinaison linéaire de k prédicteurs X1, X2, …, Xk associée à un vecteur de perturbations stochastiques ε, la multicolinéarité décrit la situation dans laquelle au moins deux prédicteurs, ou une combinaison linéaire de plusieurs d’entre eux, présentent une corrélation substantielle. Il convient d’opérer une distinction épistémologique stricte entre la colinéarité bivariée parfaite et la multicolinéarité quasi-complète ou imparfaite.
La colinéarité parfaite survient lorsqu’il existe des scalaires λ1, λ2, …, λk, non tous nuls, tels que la combinaison λ1X1 + λ2X2 + … + λkXk = 0 soit rigoureusement satisfaite pour chaque observation de l’échantillon. Dans une telle configuration, le rang de la matrice des variables prédictives X, de dimensions (n × p) où p = k + 1 incluant la constante, devient strictement inférieur à p. Par conséquent, la matrice produit de dispersion X‘X devient singulière, c’est-à-dire non inversible, son déterminant s’annulant de manière exacte. L’équation canonique de l’estimateur des moindres carrés ordinaires, donnée par β̂ = (X‘X)-1X‘Y, se heurte alors à une impossibilité calculatoire fondamentale : l’inexistence de la matrice inverse (X‘X)-1.
À l’opposé, la multicolinéarité quasi-complète, situation prépondérante dans les investigations empiriques réelles, n’implique pas une singularité exacte mais plutôt un « quasi-écrasement » de la matrice de dispersion. Les prédicteurs ne sont pas strictement liés par une fonction algébrique sans résidu, mais partagent une part substantielle de leur variance. D’un point de vue matriciel, la matrice X‘X demeure techniquement inversible au sens mathématique, mais son déterminant tend vers zéro, générant un conditionnement numérique extrêmement mauvais. L’orthogonalité géométrique de l’espace vectoriel engendré par les colonnes de X se trouve dégradée : les vecteurs représentatifs des variables se rapprochent les uns des autres, réduisant le sous-espace propre et restreignant l’angle θ qui les sépare, ce qui rend l’estimation de leurs contributions marginales respectives particulièrement périlleuse.
1.2 Répercussions sur l’inférence statistique et les tests d’hypothèses
L’impact premier et le plus destructeur de la multicolinéarité imparfaite ne réside pas dans le biais des estimations ponctuelles des coefficients, mais dans la dégradation critique de leur précision statistique. En vertu du théorème fondamental de Gauss-Markov, lorsque les postulats classiques sont satisfaits, l’estimateur des MCO demeure le meilleur estimateur linéaire non biaisé (BLUE). La présence de multicolinéarité ne viole pas formellement l’hypothèse de non-biais : l’espérance mathématique des coefficients estimés coïncide toujours avec les paramètres réels de la population, E(β̂) = β. Cependant, la matrice de variance-covariance des estimateurs, formalisée par Var(β̂) = σ2(X‘X)-1, subit une inflation disproportionnée.
Cette inflation de la variance d’échantillonnage engendre directement une élévation substantielle de l’erreur-type des coefficients régresseurs, notée SE(β̂j). Étant donné que la statistique de Student utilisée pour évaluer la significativité individuelle d’un prédicteur est définie par le quotient t = β̂j / SE(β̂j), l’élargissement artificiel du dénominateur entraîne un écrasement mathématique de la valeur du t empirique. La valeur p associée grimpe alors au-delà des seuils conventionnels de rejet (α = 0,05 ou 0,01), conduisant inexorablement à une explosion du risque d’erreur de type II (non-rejet à tort de l’hypothèse nulle d’absence d’effet marginal). Le chercheur conclut ainsi de façon erronée qu’une variable n’exerce aucune influence sur le phénomène étudié, alors même que cette variable peut être théoriquement et empiriquement centrale.
Cette altération de l’inférence donne fréquemment lieu à une anomalie diagnostique emblématique : le paradoxe du modèle globalement significatif mais aux prédicteurs individuellement non significatifs. Le test global de Fisher, fondé sur la statistique F, teste l’hypothèse nulle conjointe selon laquelle l’ensemble des coefficients de pente sont simultanément nuls. En présence d’une forte multicolinéarité, la variance totale expliquée par le groupe de variables colinéaires demeure élevée, produisant un coefficient de détermination global R2 important et une statistique F hautement significative (p < 0,001). Pourtant, pris isolément, aucun des tests t individuels ne parvient à franchir le seuil de significativité, le modèle se trouvant incapable de partitionner et d’attribuer de façon univoque la part de variance commune à chaque variable spécifique. Enfin, les estimations paramétriques souffrent d’une extrême instabilité numérique : l’adjonction ou la suppression d’une unique observation, ou une variation marginale due à l’erreur de mesure, peut modifier radicalement l’amplitude, voire inverser le signe algébrique des coefficients.
1.3 Pertinence de la détection en recherche psychologique et quantitative
Au sein des sciences psychologiques, cognitives et comportementales, la multicolinéarité ne représente pas une simple anomalie statistique accidentelle, mais une caractéristique structurelle inhérente à la nature même des objets d’étude. La psychométrie opère principalement par la mesure de construits latents non observables directement (l’intelligence fluide, la névrose, l’anxiété état, l’auto-efficacité, la charge mentale) par le truchement d’indicateurs manifestes collectés via des échelles de Likert ou des batteries de tests multidimensionnels. Par essence, ces construits partagent des assises ontologiques et théoriques communes, générant un chevauchement conceptuel inévitable.
À titre d’illustration, lorsqu’une étude cherche à modéliser la performance académique ou clinique en intégrant simultanément des mesures d’anxiété généralisée, de stress perçu et de dépression légère, ces trois dimensions présentent presque systématiquement des corrélations bivariées comprises entre 0,60 et 0,85. Si le chercheur introduit aveuglément ces trois prédicteurs dans un modèle d’équations linéaires sans procéder à un audit rigoureux de la colinéarité, les coefficients partiels résultants ne refléteront pas la véritable dynamique des processus psychiques sous-jacents, mais des artefacts numériques dérivés du sur-ajustement et du partage de variance. La validité de construit se trouve alors directement compromise.
La détection de la multicolinéarité constitue donc un prérequis méthodologique fondamental pour préserver l’intégrité de la théorie psychologique. Elle permet de trancher de façon éclairée entre plusieurs alternatives analytiques : faut-il éliminer une dimension considérée comme redondante, combiner les échelles corrélées en un score composite d’ordre supérieur mesurant une « détresse psychologique globale », ou recourir à des méthodes de réduction dimensionnelle comme l’analyse en composantes principales ? Sans un diagnostic précis, le chercheur s’expose au risque de publier des conclusions théoriques fallacieuses, suggérant par exemple qu’un facteur protecteur majeur n’a pas d’effet prédictif simplement parce que sa variance a été masquée par celle d’un construit voisin.
2. Définition et propriétés mathématiques du facteur d’inflation de la variance (VIF)
2.1 Formulation analytique et relation avec la tolérance
Le facteur d’inflation de la variance quantifie rigoureusement l’impact de l’interdépendance des prédicteurs sur la variance d’échantillonnage de chaque coefficient estimé. Pour un modèle de régression linéaire multiple comportant k variables indépendantes, considérons l’estimation du coefficient β̂j associé à la j-ième variable explicative Xj. La variance théorique de cet estimateur MCO s’exprime analytiquement sous la forme canonique suivante :
Var(β̂j) = [ σ2 / ( ∑ (Xij – X̄j)2 ) ] × [ 1 / ( 1 – Rj2 ) ]
Dans cette équation, σ2 représente la variance du terme d’erreur stochastique du modèle global, le terme ∑ (Xij – X̄j)2 correspond à la somme totale des carrés des écarts à la moyenne pour la variable Xj (notée couramment SSTj), et Rj2 désigne le coefficient de détermination issu d’une régression linéaire auxiliaire. Cette régression auxiliaire consiste à régresser la variable Xj, agissant temporairement comme variable dépendante, sur l’ensemble des k – 1 autres variables prédictives du modèle d’origine. Le second terme entre crochets correspond exactement à la définition formelle du VIF :
VIFj = 1 / (1 – Rj2)
Parallèlement, la littérature statistique définit la Tolérance (notée TOLj) comme la quantité réciproque stricte du VIF :
TOLj = 1 / VIFj = 1 – Rj2
La tolérance mesure la proportion de la variance de la variable Xj qui n’est pas expliquée par les autres prédicteurs inclus dans l’équation. Ses propriétés asymptotiques sont remarquables :
- Lorsque le prédicteur Xj est totalement orthogonal aux autres variables explicatives (corrélation linéaire nulle avec chacune d’elles), la régression auxiliaire ne parvient à expliquer aucune variance, conduisant à Rj2 = 0. Dans ces conditions, la tolérance atteint sa valeur maximale unitaire (TOLj = 1) et le VIF atteint sa valeur minimale absolue : VIFj = 1 / (1 – 0) = 1. La variance de l’estimateur n’est aucunement gonflée.
- À l’inverse, à mesure que la variable Xj devient dépendante des autres régresseurs, la valeur de Rj2 se rapproche asymptotiquement de l’unité. Lorsque Rj2 tend vers 1, le dénominateur (1 – Rj2) s’approche de zéro par valeurs positives, provoquant une divergence vers l’infini : limRj2 → 1 VIFj = +∞.
2.2 Interprétation géométrique du VIF dans l’analyse de régression
D’un point de vue géométrique, l’analyse de régression multiple peut être appréhendée comme la projection orthogonale du vecteur dépendant Y sur le sous-espace vectoriel de dimension k sous-tendu par les colonnes de la matrice des données X. Dans cette configuration géométrique, chaque prédicteur individuel Xj peut lui-même être projeté sur l’hyperplan vectoriel constitué par l’ensemble des k – 1 autres régresseurs. La quantité Rj2 représente le cosinus carré de l’angle sous-tendu entre le vecteur Xj et sa projection sur ce sous-espace complémentaire.
Lorsque le VIF s’accroît, l’angle séparant le vecteur Xj de l’hyperplan des autres variables se réduit drastiquement. L’effet direct sur l’inférence se traduit par un gonflement géométrique du volume de l’ellipsoïde de confiance associé aux paramètres de régression. Puisque l’erreur-type d’un coefficient est directement proportionnelle à la racine carrée du VIF, √(VIFj), ce terme exprime le facteur d’élargissement linéaire de l’intervalle de confiance estimé. Par exemple, si une variable présente un VIF de 4, son erreur-type est exactement multipliée par √4 = 2 comparativement à ce qu’elle aurait été si cette même variable avait été parfaitement orthogonale aux autres. Pour un VIF de 10, la marge d’erreur de l’intervalle de confiance est élargie par un facteur de √10 ≈ 3,16, divisant ainsi la précision statistique par plus de trois.
Sur le plan structurel de l’algèbre matricielle, il existe une correspondance mathématique directe entre les valeurs des VIF et les éléments de la matrice de corrélation inverse. Si l’on désigne par R la matrice symétrique des corrélations de Pearson d’ordre (k × k) regroupant l’ensemble des prédicteurs standardisés, l’inversion de cette matrice produit une nouvelle matrice carrée R-1. Les éléments situés sur la diagonale principale de cette inverse correspondent rigoureusement aux facteurs d’inflation de la variance :
diag(R-1)jj = VIFj
Cette propriété élégante établit un pont direct entre l’algèbre des projections linéaires et la théorie du diagnostic de colinéarité, fournissant également la base computationnelle de la méthode matricielle mise en œuvre sous tableur.
2.3 Distinction entre VIF non centré et VIF centré standard
Dans la littérature spécialisée et les logiciels avancés, une distinction méthodologique s’opère entre le VIF centré (standard) et le VIF non centré (raw VIF). Le VIF centré conventionnel s’applique aux modèles contenant un terme d’interception (constante β0) et évalue la multicolinéarité en mesurant la dépendance linéaire entre les variables dont la moyenne a été préalablement soustraite. Dans ce cadre, la corrélation évaluée est la corrélation de Pearson standardisée centrée.
Le VIF non centré intervient dans les modèles spécifiés sans terme constant (régression passant rigoureusement par l’origine) ou lors de l’audit spécifique de la colinéarité impliquant la constante elle-même. Dans une régression sans constante, les variables ne sont pas centrées autour de leur espérance empirique, et la matrice sous-jacente n’est plus la matrice des corrélations centrées, mais la matrice des cosinus des angles non centrés (moments d’ordre 2 bruts). Lorsque la moyenne d’une variable s’écarte significativement de zéro, le VIF non centré peut atteindre des grandeurs considérables en raison de la projection sur le vecteur constant unitaire (1, 1, …, 1).
Cette nuance conceptuelle devient critique lors de l’introduction de termes d’interaction d’ordre supérieur (produit multiplicatif X1X2) ou de termes polynomiaux (X12). L’adjonction de X12 génère presque mécaniquement une corrélation bivariée extrême avec le terme linéaire X1 si la variable présente une moyenne positive substantielle. Cette colinéarité, dite « colinéarité structurelle », se distingue de la colinéarité essentielle (ou d’échantillonnage). Le centrage préalable sur la moyenne empirique des prédicteurs continus avant le calcul des puissances et des produits permet d’éradiquer la colinéarité structurelle, ramenant le VIF centré à des niveaux tout à fait acceptables sans altérer en rien la valeur prédictive globale du modèle.
3. Configuration préalable de Microsoft Excel pour l’analyse de régression
3.1 Activation et vérification de l’utilitaire d’analyse
Bien que Microsoft Excel soit initialement conçu pour la gestion comptable et financière, il embarque un module statistique robuste désigné sous le nom d’Utilitaire d’analyse (Analysis ToolPak). Ce composant complémentaire n’étant pas systématiquement initialisé lors du déploiement par défaut de la suite bureautique, son activation constitue le prérequis impératif à toute modélisation quantitative.
Pour activer l’Utilitaire d’analyse sous les versions Windows modernes d’Excel (Microsoft 365, Office 2021, 2019, 2016), le protocole séquentiel s’articule comme suit :
- Accéder au ruban supérieur et cliquer sur l’onglet Fichier, puis sélectionner le menu Options localisé au bas de la barre latérale gauche.
- Dans la boîte de dialogue contextuelle « Options Excel », sélectionner l’onglet Compléments.
- Dans la partie inférieure de la fenêtre, repérer le menu déroulant Gérer, s’assurer que la valeur sélectionnée est Compléments Excel, puis cliquer sur le bouton Atteindre….
- Une boîte de dialogue répertoriant les extensions disponibles s’affiche. Cocher la case intitulée Utilitaire d’analyse (et optionnellement l’Utilitaire d’analyse – VBA si des routines automatisées sont envisagées).
- Valider l’opération en cliquant sur OK.
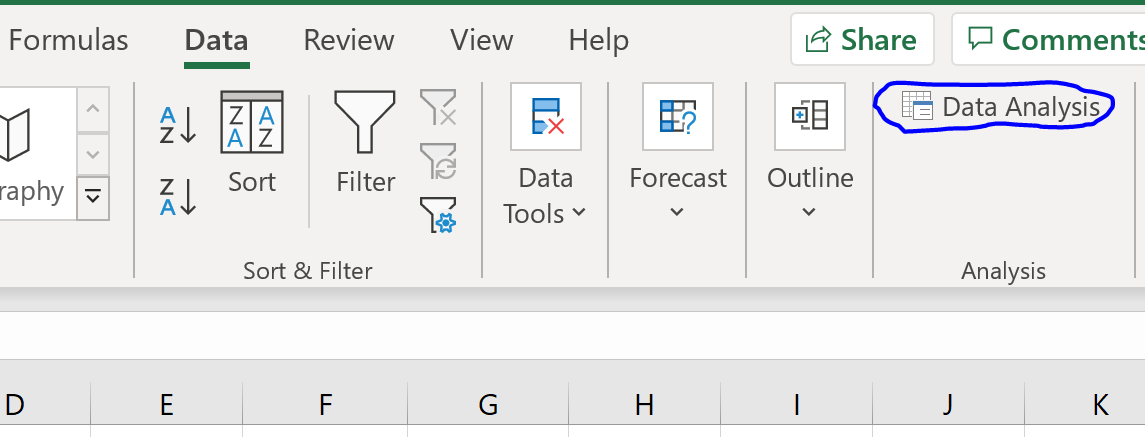
Pour les utilisateurs de l’environnement macOS, la procédure s’effectue via le menu supérieur Outils, en cliquant sur Compléments Excel, puis en cochant l’option correspondante dans la fenêtre surgissante. Une fois l’activation validée, la vérification s’opère instantanément : naviguer vers l’onglet Données du ruban principal. À l’extrémité droite de ce ruban, un nouveau groupe fonctionnel nommé Analyse doit être présent, affichant le bouton de commande Utilitaire d’analyse.
En cas d’anomalie de chargement — se manifestant par l’absence d’apparition du bouton malgré la validation —, le problème résulte habituellement d’une politique de sécurité restreignant l’exécution des bibliothèques dynamiques (.XLL) ou d’un conflit de registre dans Office. Une réinitialisation du profil utilisateur ou une vérification des paramètres du « Centre de gestion de la confidentialité » (autorisant l’exécution des compléments d’application) résout classiquement ces blocages techniques.
3.2 Limites inhérentes au moteur de calcul standard d’Excel
Il est impératif pour l’analyste rigoureux de reconnaître les limites architecturales du tableur Excel en matière d’économétrie et de statistique décisionnelle. Contrairement aux environnements programmatiques dédiés à la statistique mathématique, Excel ne dispose d’aucune fonction interne native permettant de solliciter directement la statistique du VIF par une syntaxe telle que =VIF(plage). Le module de régression de l’Utilitaire d’analyse génère un rapport standardisé comprenant la table de variance (ANOVA), les coefficients, les erreurs-types, les valeurs de Student et les intervalles de confiance à 95 %, mais il omet délibérément les métriques de colinéarité avancées.
Par ailleurs, sur le plan de la précision numérique, les versions historiques d’Excel (antérieures à la version 2010) ont fait l’objet de critiques sévères dans la littérature de statistique computationnelle pour leurs erreurs d’arrondi significatives lors de l’inversion de matrices mal conditionnées ou du calcul de sommes de carrés importantes. Si les algorithmes récents ont été substantiellement stabilisés par l’implémentation de la décomposition QR pour la régression, Excel demeure sensible aux erreurs de troncature en double précision (norme IEEE 754) lorsque des variables présentent des échelles de magnitude extrêmement disparates (par exemple, marier un salaire annuel exprimé en millions d’unités avec un score de Likert variant de 1 à 5). L’analyste doit par conséquent standardiser ou rééchelonner ses données pour prémunir le moteur matriciel contre les artefacts de calcul.
4. Organisation et structuration des données d’analyse psychologique
4.1 Formatage tabulaire rigoureux des variables explicatives
La réussite de l’analyse repose sur une discipline rigoureuse d’agencement de la feuille de calcul. L’agencement tabulaire doit répondre scrupuleusement aux conventions de la modélisation relationnelle en « format long » ou matriciel régulier :
- Structure matricielle continue : La première ligne de la feuille de calcul doit être exclusivement dédiée aux étiquettes des variables (en-têtes de colonnes claires, courtes et dépourvues de caractères spéciaux ou de retours à la ligne forcés, par exemple : ID, Performance, Sommeil, Anxiete, Stress).
- Absence de cellules fusionnées : Aucune fusion de cellules ne doit exister au sein de la matrice ou au-dessus des en-têtes. Les fusions altèrent les références géométriques de plages sous Excel et conduisent à des erreurs systématiques lors de la sélection des variables matricielles.
- Continuité des lignes : Chaque ligne successive (de la ligne 2 à la ligne n + 1) doit représenter une unité statistique unique (par exemple, un participant ou sujet d’expérience). Aucune ligne vierge, aucun sous-total ni note de bas de page ne doit être intercalé dans la plage de données.
- Typage strict des données : Les cellules doivent contenir exclusivement des valeurs numériques réelles. Les variables catégorielles qualitatives doivent être préalablement recodées en variables fictives binaires (dummy variables : codage 0 ou 1).
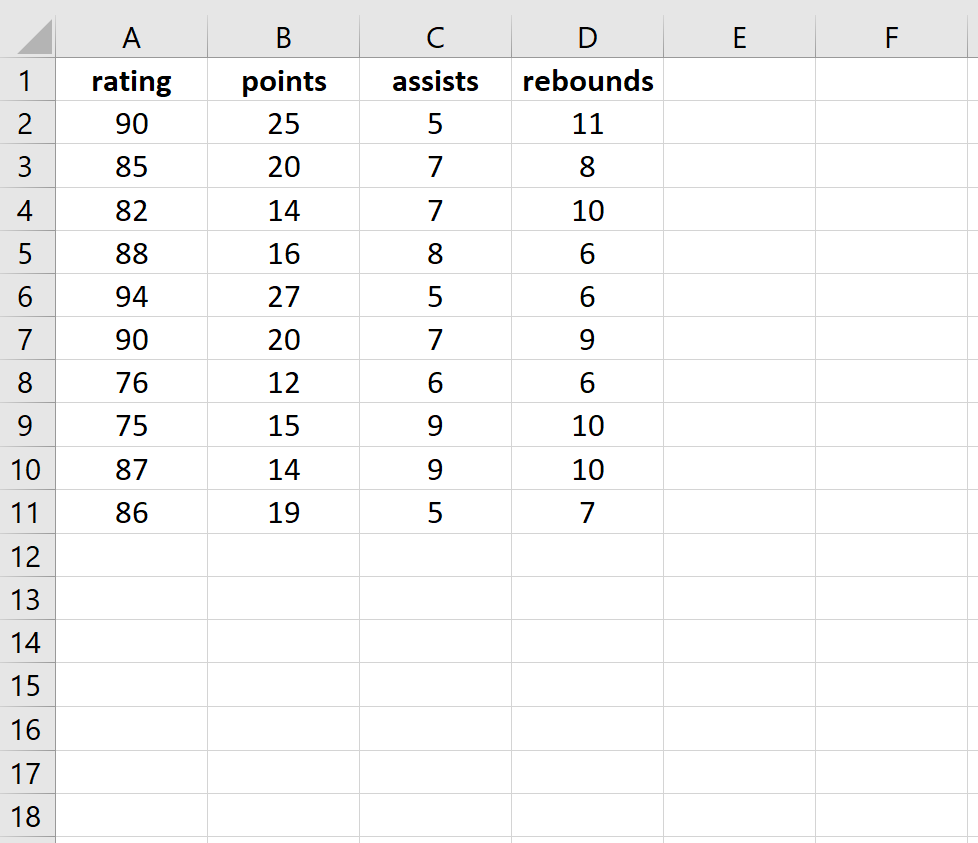
La gestion des données manquantes constitue une étape critique. Les fonctions d’analyse matricielle d’Excel réagissent mal à la présence de valeurs textuelles ou de cellules vides au sein d’une plage mathématique, générant les erreurs #VALEUR! ou #NOMBRE!. L’analyste doit opter en amont pour une stratégie documentée : soit l’exclusion systématique de la ligne complète présentant une case vacante (suppression listwise), soit l’application d’une méthode d’imputation statistiquement validée (imputation par la moyenne, par régression ou imputation multiple effectuée en amont).
4.2 Vérification préliminaire des postulats de linéarité et de distribution
Avant d’engager le calcul formalisé du VIF, un criblage exploratoire univarié et bivarié s’impose pour évaluer la forme des distributions et identifier d’éventuelles aberrations d’échantillonnage susceptibles de déformer artificiellement la colinéarité.
Pour chaque variable prédictive continue, l’analyste peut calculer directement les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) à l’aide des fonctions natives d’Excel :
=COEFFICIENT.ASYMETRIE(plage_donnees): mesure l’asymétrie de la distribution autour de la moyenne arithmétique. Une valeur comprise entre -1 et +1 indique une distribution raisonnablement symétrique.=KURTOSIS(plage_donnees): quantifie l’épaisseur des queues de distribution par rapport à la loi normale (kurtosis d’excès). Des valeurs excessives (> 2 ou 3) signalent la présence de valeurs extrêmes ou d’une forte leptokurticité qui perturbe les covariances.
Parallèlement, la production d’une première matrice de corrélation bivariée permet de cartographier les proximités évidentes entre prédicteurs. Dans l’Utilitaire d’analyse, la sélection de l’outil Corrélation permet de générer instantanément une table symétrique croisant toutes les variables explicatives. Tout coefficient de corrélation de Pearson linéaire dépassant le seuil absolu de r = 0,80 ou 0,85 constitue une alerte immédiate signalant une colinéarité bivariée critique. Toutefois, l’absence de corrélations bivariées élevées ne garantit aucunement l’absence de multicolinéarité : une variable peut être quasiment parfaitement expliquée par la combinaison conjointe de trois ou quatre autres variables sans qu’aucune corrélation bilatérale isolée ne dépasse 0,50. C’est précisément l’angle mort que comble le calcul du VIF.
5. Méthode des régressions auxiliaires successives dans Excel
5.1 Principe algorithmique de la régression d’un prédicteur sur les autres
La méthode conceptuelle de référence pour déterminer le VIF consiste à traduire manuellement l’algorithme des régressions auxiliaires successives. Soit un modèle d’intérêt théorique comportant k régresseurs prédictifs :
Y = β0 + β1X1 + β2X2 + … + βkXk + ε
L’algorithme se décompose en k étapes distinctes et indépendantes. Lors de chaque itération j (pour j variant de 1 à k) :
- La variable Xj est artificiellement extraite de sa fonction de prédicteur et isolée pour devenir la nouvelle variable à expliquer (variable dépendante temporaire).
- Les k – 1 autres prédicteurs restants sont regroupés pour former la matrice des variables indépendantes auxiliaires.
- On exécute l’estimation de la régression linéaire aux moindres carrés ordinaires pour cette spécification secondaire :
Xj = α0 + ∑m ≠ j αmXm + uj - On extrait le coefficient de détermination Rj2 (R-deux ordinaire, non ajusté) découlant exclusivement de cet ajustement auxiliaire.
- On applique la relation de conversion arithmétique pour isoler VIFj.
Cette approche, bien que séquentielle, présente l’immense avantage didactique de rendre visible chaque palier de variabilité partagée, permettant au chercheur de comprendre précisément quelle variable régresseur contribue à la déstabilisation d’une autre.
5.2 Exécution pas à pas via l’Utilitaire d’analyse
Pour illustrer la mise en pratique immédiate, prenons un cadre d’étude comportant trois régresseurs continus positionnés sur une feuille Excel : Sommeil (colonne B, lignes 2 à 31), Anxiété (colonne C, lignes 2 à 31) et Stress (colonne D, lignes 2 à 31). Le modèle théorique vise à prédire une variable dépendante de Performance (colonne A), mais l’audit des VIF s’effectue exclusivement entre les colonnes B, C et D.
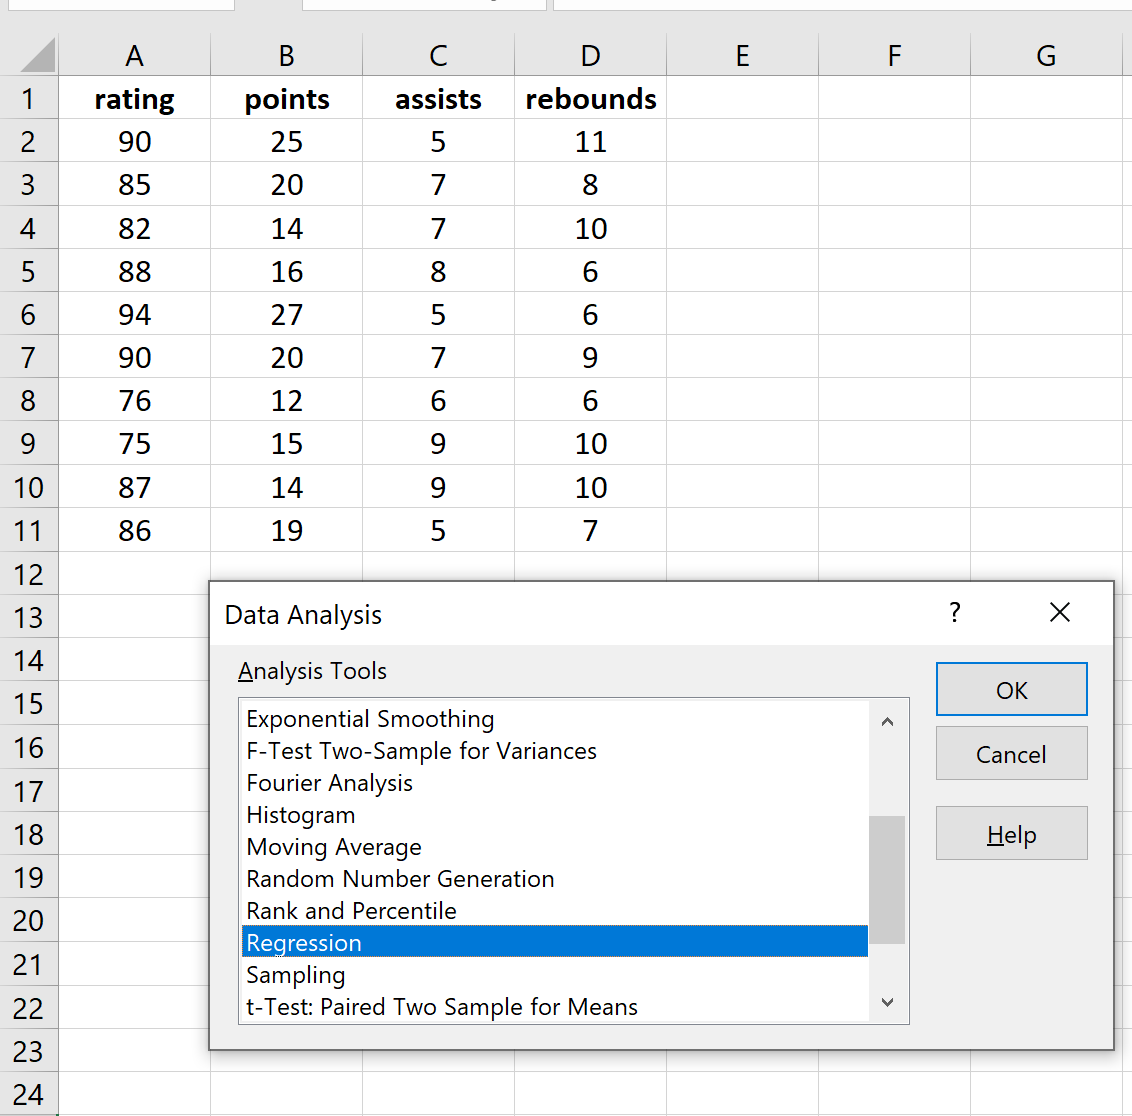
Pour calculer le VIF de la variable Sommeil (colonne B) via l’Utilitaire :
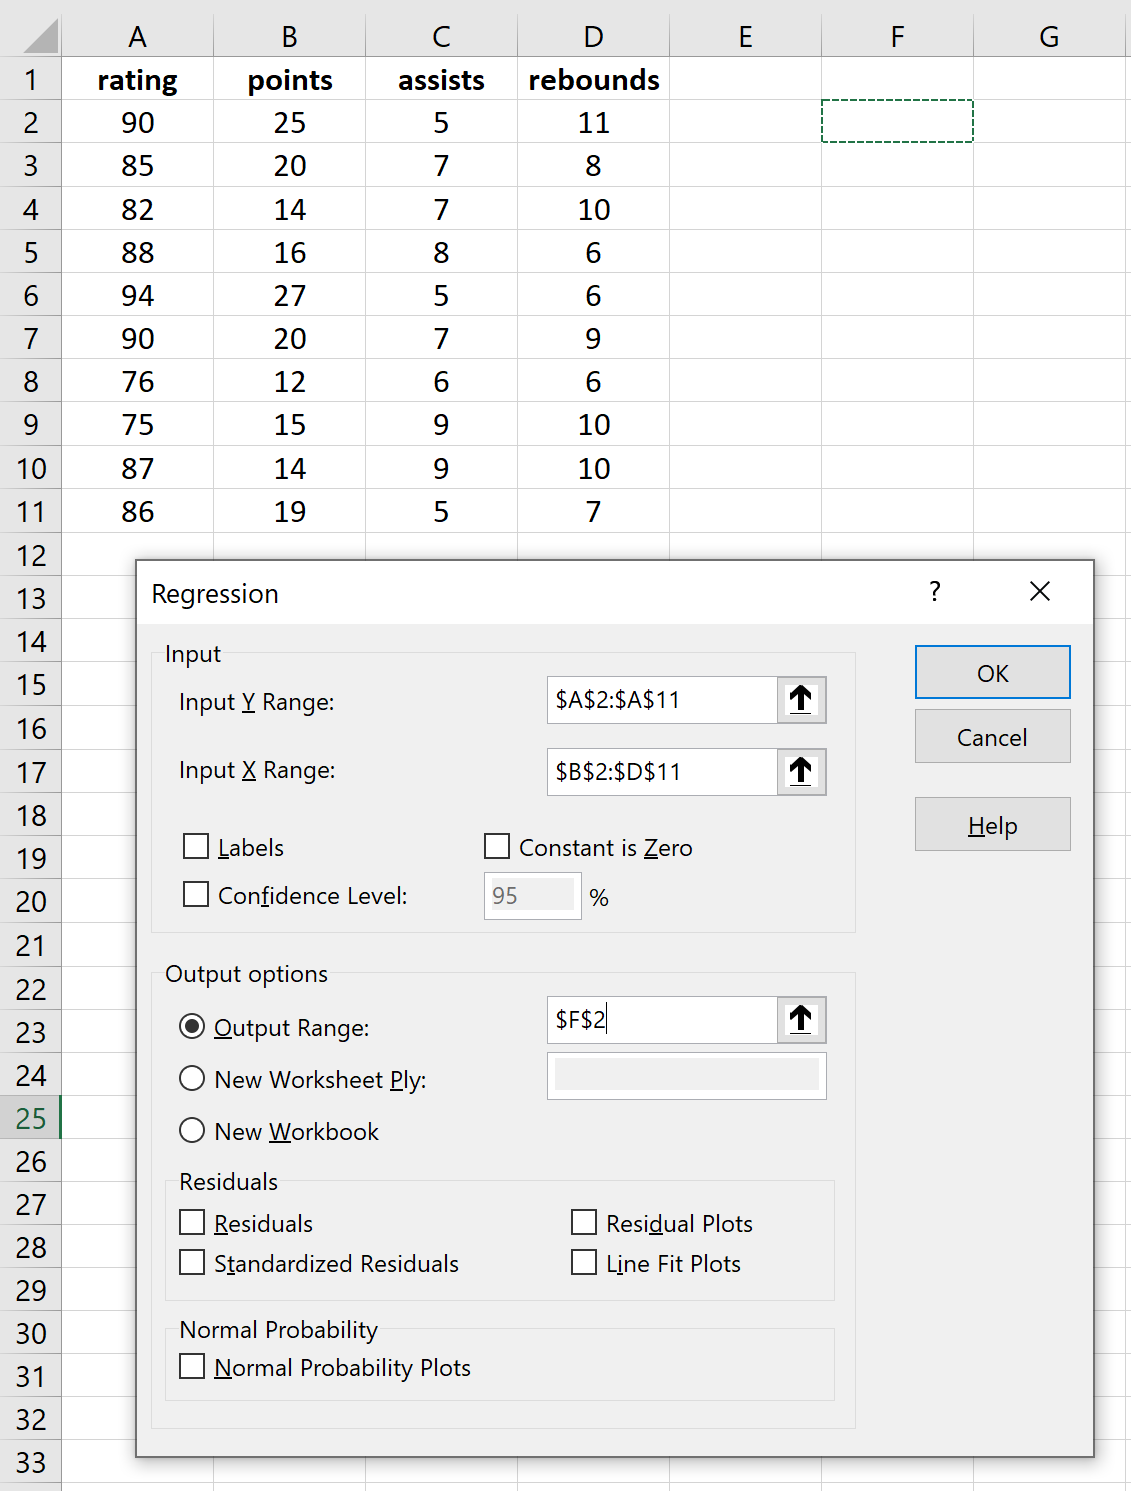
- Ouvrir l’onglet Données, puis cliquer sur Utilitaire d’analyse. Dans la liste des outils, faire défiler jusqu’à Régression et cliquer sur OK.
- Dans le champ Plage d’entrée Y :, sélectionner la variable que l’on souhaite auditer, ici la plage du sommeil :
$B$1:$B$31. - Dans le champ Plage d’entrée X :, sélectionner la matrice contiguë formée par les deux autres prédicteurs (Anxiété et Stress), soit la plage :
$C$1:$D$31. (Attention : l’Utilitaire d’analyse impose que l’ensemble des colonnes indépendantes X forment une plage rectangulaire continue dans la feuille). - Cocher impérativement la case Intitulés si vous avez inclus la première ligne de texte lors de la sélection des plages.
- Dans la section des options de sortie, cocher Nouvelle feuille de calcul et lui assigner un nom explicite tel que « Aux_Sommeil ».
- Cliquer sur OK pour lancer le calcul.
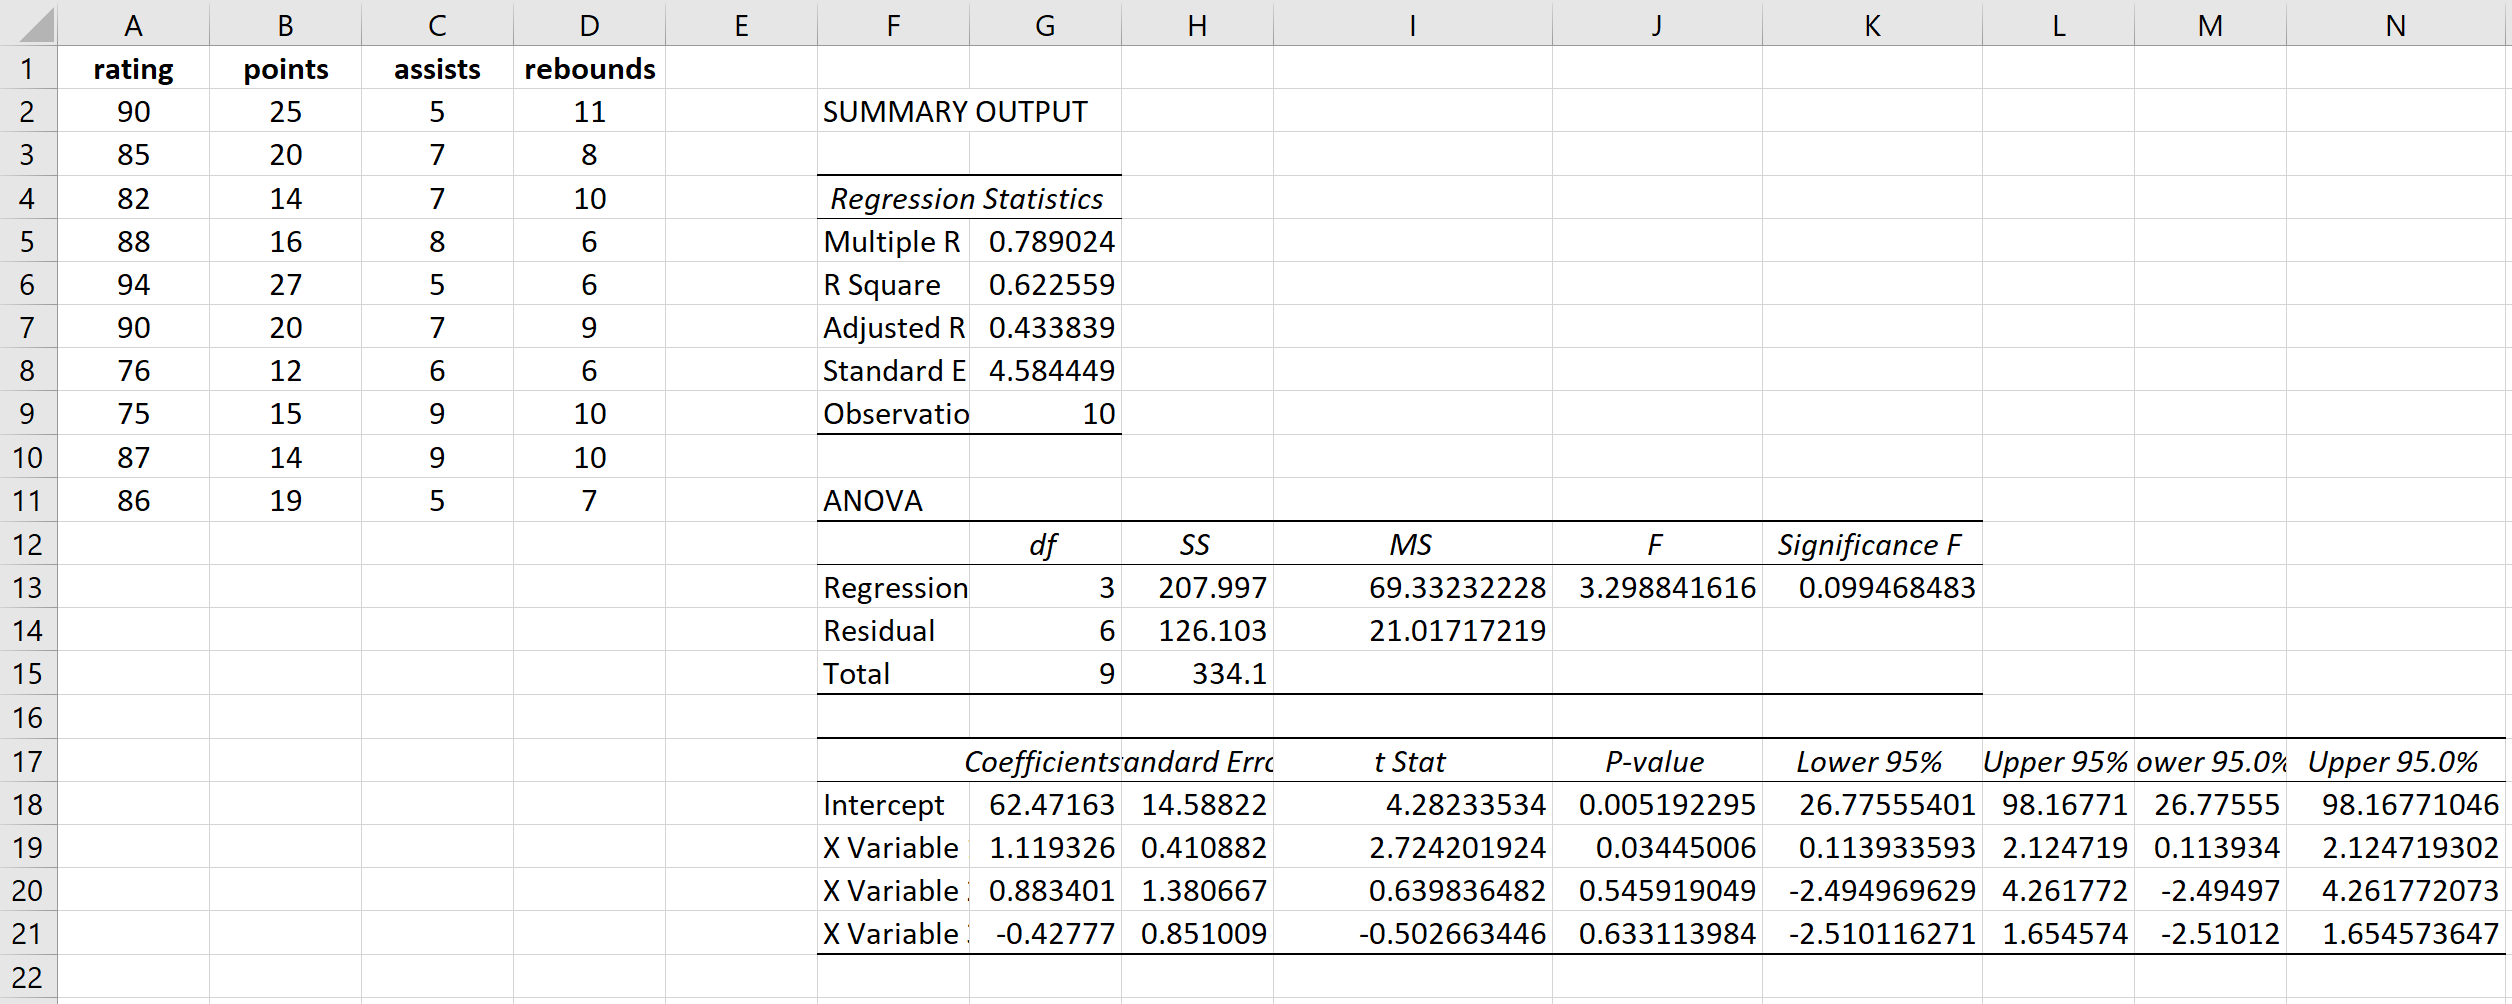
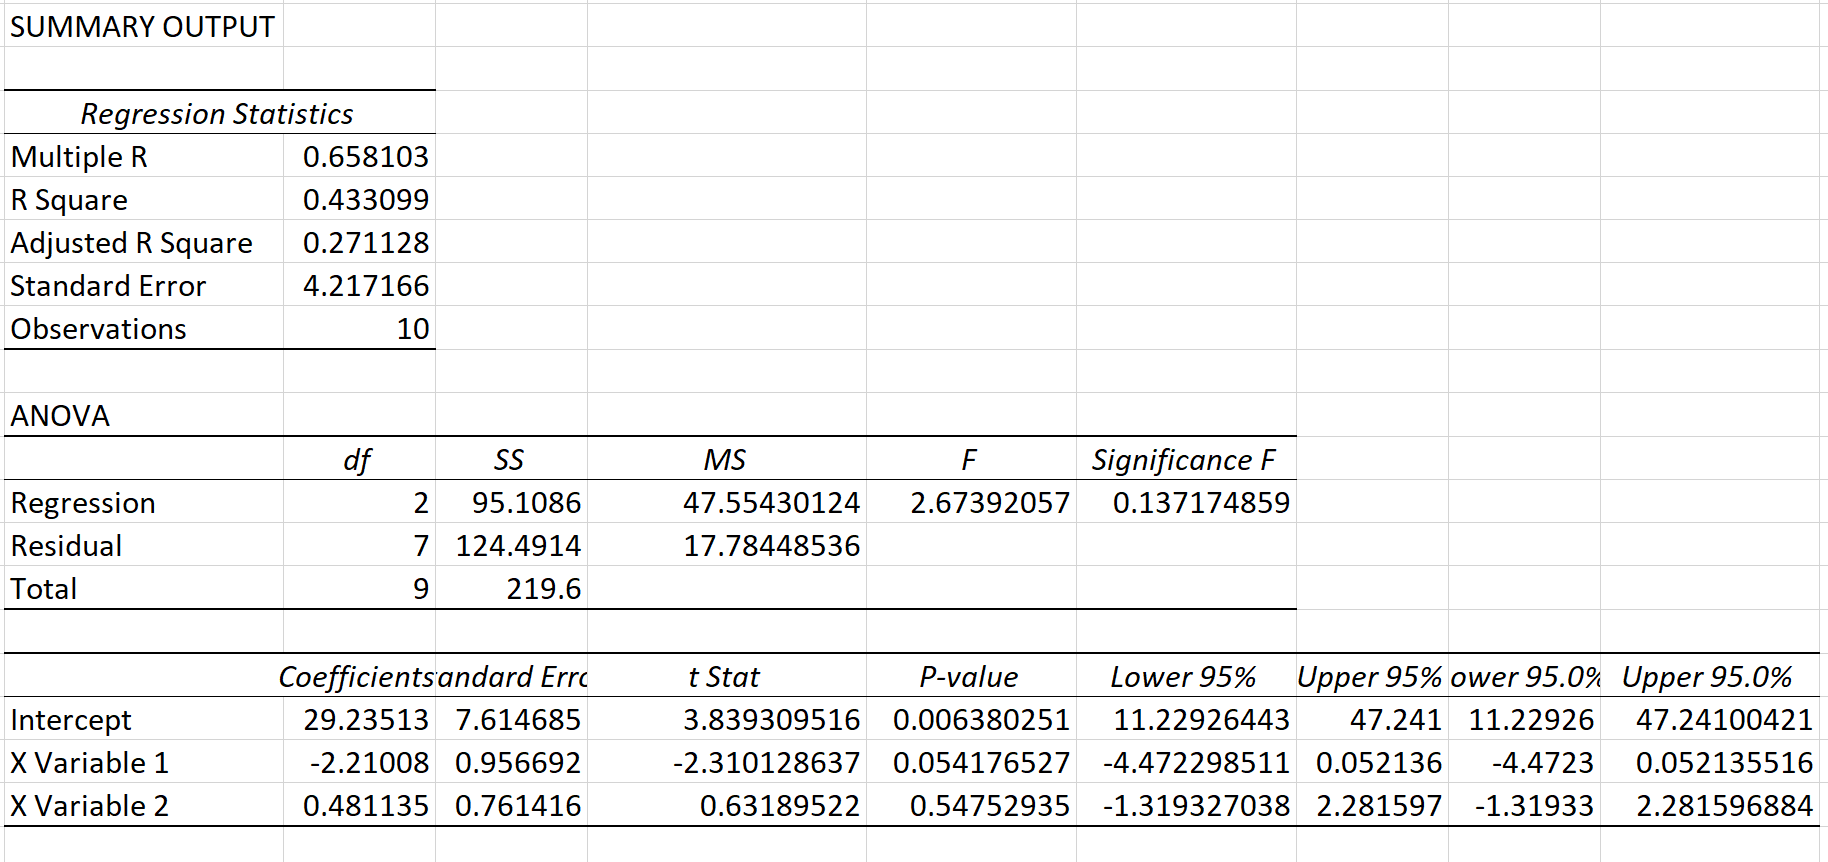
Sur la nouvelle feuille de calcul générée par Excel, un tableau complet intitulé « Statistiques de la régression » apparaît. L’analyste doit porter son regard exclusif sur la cellule affichant le Coefficient de détermination R² (typiquement localisée en cellule B5 sous les dénominations françaises). Cette valeur, que nous noterons RSommeil2, représente la proportion exacte de variance du sommeil expliquée simultanément par l’anxiété et le stress.
5.3 Application de la formule arithmétique finale du VIF
Une fois la valeur du coefficient de détermination auxiliaire localisée, le calcul du VIF et de la tolérance s’effectue par une simple formule arithmétique. Si la valeur du R² auxiliaire se situe dans la cellule B5 de la feuille nouvellement créée :
- Pour obtenir le facteur d’inflation de la variance, saisir dans une cellule adjacente (par exemple D5) :
=1/(1-B5) - Pour obtenir la tolérance réciproque, inscrire :
=1-B5
L’opération doit être scrupuleusement réitérée pour chacun des autres prédicteurs :
- Régression auxiliaire de l’Anxiété (Y = colonne C) sur le Sommeil et le Stress (X = colonnes B et D). Puisque l’Utilitaire exige des colonnes X contiguës, il conviendra de réorganiser temporairement l’ordre des colonnes sur la feuille de travail (par exemple en déplaçant la colonne Anxiété à l’extrémité, pour que le Sommeil et le Stress deviennent adjacents).
- Régression auxiliaire du Stress (Y = colonne D) sur le Sommeil et l’Anxiété (X = colonnes B et C contiguës).
L’ensemble de ces coefficients Rj2 auxiliaires et leurs VIF dérivés sont ensuite regroupés au sein d’une table synthétique récapitulative. Cette approche manuelle séquentielle, irréprochable sur le plan conceptuel, devient néanmoins particulièrement laborieuse et propice aux erreurs de manipulation dès lors que le modèle dépasse trois ou quatre prédicteurs. D’où l’intérêt crucial des méthodes automatisées directes.
6. Automatisation du VIF par les fonctions natives d’Excel sans l’utilitaire
6.1 Utilisation de la fonction COEFFICIENT.DETERMINATION (RSQ)
Pour s’affranchir de la lourdeur des régressions auxiliaires répétées au sein de l’Utilitaire d’analyse, l’analyste peut se tourner vers les fonctions statistiques intégrées de la grille Excel. La fonction standard COEFFICIENT.DETERMINATION (ou RSQ dans la nomenclature anglophone) calcule le carré du coefficient de corrélation linéaire de Pearson bivarié entre deux séries de données.
Sa syntaxe générale s’établit comme suit :
=COEFFICIENT.DETERMINATION(plage_y; plage_x)
Cependant, une méprise méthodologique fréquente chez les utilisateurs d’Excel consiste à tenter d’alimenter la plage_x avec un tableau multidimensionnel regroupant plusieurs colonnes. La fonction COEFFICIENT.DETERMINATION est strictement restreinte aux modèles bivariés (une variable Y face à un unique vecteur X). Si l’argument plage_x englobe plus d’une colonne, Excel tronque l’analyse ou renvoie l’erreur #N/A. Cette fonction s’avère donc strictement inopérante pour estimer des modèles de régression auxiliaires multiples intégrant plus de deux variables explicatives. Elle ne peut être sollicitée que dans le cas très particulier et restreint où le modèle complet ne comporterait que deux régresseurs au total, rendant les régressions auxiliaires purement bivariées.
6.2 Recours à la fonction matricielle DROITEREG (LINEST)
Pour concevoir un modèle de calcul entièrement dynamique, robuste et multidimensionnel sans jamais recourir à l’Utilitaire d’analyse, la fonction matricielle DROITEREG (désignée par LINEST en version anglophone) représente l’instrument analytique suprême sous Excel. DROITEREG applique la méthode des moindres carrés ordinaires à un ensemble de données multidimensionnel quelconque et renvoie un tableau matriciel complet de statistiques d’ajustement.
La syntaxe canonique exhaustive de la fonction se présente ainsi :
=DROITEREG(valeurs_y; valeurs_x; constante_logique; statistiques_logiques)
Les deux derniers paramètres booléens sont capitaux :
- constante_logique : Valeur logique VRAI pour calculer l’interception normale β0, FAUX pour forcer le passage par l’origine. Dans le cadre du VIF standard centré, fixer impérativement cet argument à VRAI.
- statistiques_logiques : Valeur logique qui, fixée à VRAI, ordonne à Excel de renvoyer non seulement les coefficients de régression sur la première ligne de sortie, mais également un bloc complet d’indicateurs inférentiels comprenant l’écart-type résiduel, le coefficient F, les degrés de liberté, et tout particulièrement le coefficient de détermination R2.
Dans la matrice de dimensions (5 × p) renvoyée par la fonction DROITEREG(Y; X; VRAI; VRAI), le coefficient de détermination R2 se positionne rigoureusement à l’intersection de la troisième ligne et de la première colonne. Grâce à la fonction d’indexation matricielle INDEX, l’analyste peut extraire directement cette statistique sans avoir à déployer l’intégralité du tableau de résultats sur sa feuille de travail. L’instruction s’écrit formellement :
=INDEX(DROITEREG(plage_y; plage_x; VRAI; VRAI); 3; 1)
Cette expression renvoie avec une exactitude décimale totale la valeur exacte du Rj2 auxiliaire. Dès lors, l’intégration imbriquée de cette dynamique au sein de l’équation théorique du VIF donne naissance à la formule d’automatisation directe suivante :
=1 / (1 - INDEX(DROITEREG(plage_y; plage_x; VRAI; VRAI); 3; 1))
Remarque sur la validation matricielle : Sous les versions modernes d’Excel fonctionnant avec le moteur de calcul matriciel dynamique (Microsoft 365, Office 2021), la frappe de la touche « Entrée » standard valide immédiatement la formule. Sur les versions historiques antérieures (Excel 2019, 2016, 2013), il était nécessaire de valider la formule via la combinaison de touches célèbre Ctrl + Maj + Entrée (CSE), matérialisée dans la barre de formule par des accolades enveloppantes {...}. L’immense avantage de cette méthode réside dans son interactivité totale : si une donnée brute est rectifiée dans la matrice, le VIF se recalcule en temps réel de façon instantanée, éliminant toute reprise laborieuse de menus.
7. Méthode matricielle avancée : L’inversion de la matrice de corrélation
7.1 Fondement mathématique de l’inversion matricielle
L’approche la plus élégante, synthétique et computationnellement efficace pour extraire simultanément l’ensemble des VIF d’un modèle de régression repose sur l’exploitation des théorèmes de l’algèbre linéaire régissant les variables standardisées. Soit Z la matrice des données explicatives standardisées de dimensions (n × k), où chaque colonne j a été centrée autour de sa moyenne empirique et divisée par son écart-type d’échantillon (σ = 1). La matrice symétrique des corrélations de Pearson R de dimensions (k × k) est formellement définie par :
R = (1 / (n – 1)) × Z’Z
En vertu du théorème d’inversion matricielle appliqué aux systèmes linéaires standardisés, la matrice de variance-covariance des coefficients estimés sur données centrées et réduites est proportionnelle à l’inverse direct de cette matrice de corrélation, notée R-1. Par décomposition en blocs et application de la formule de Frobenius-Schur pour le complément de Schur, on démontre que le j-ième élément situé sur la diagonale principale de la matrice inverse R-1 s’identifie de façon absolue à l’expression :
(R-1)jj = 1 / (1 – Rj2) = VIFj
Où Rj2 est rigoureusement le coefficient d’ajustement obtenu en régressant la j-ième variable sur les k – 1 autres. Ainsi, une unique opération d’inversion matricielle résout en une fraction de seconde la totalité des régressions auxiliaires emboîtées du modèle, fournissant instantanément tous les VIF sur sa diagonale principale.
7.2 Construction de la matrice de corrélation complète dans Excel
La mise en œuvre pratique de cette voie matricielle requiert la construction préalable d’une matrice de corrélation carrée (k × k) parfaitement symétrique. Dans l’Utilitaire d’analyse d’Excel :
- Sélectionner la commande Corrélation.
- Définir comme Plage d’entrée l’ensemble continu regroupant toutes les colonnes des prédicteurs (ex:
$B$1:$D$31pour nos 3 variables). - Sélectionner le groupement par Colonnes et cocher Intitulés sur la première ligne.
- Indiquer une plage de sortie (par exemple
$G$1).
L’Utilitaire d’analyse génère une matrice triangulaire inférieure : la diagonale principale est remplie de valeurs 1 (corrélation unitaire d’une variable avec elle-même), la partie située sous la diagonale contient les coefficients de corrélation bivariés de Pearson (rij), mais la partie supérieure triangulaire est laissée intégralement vide par le programme.
Or, les algorithmes matriciels d’inversion exigent impérativement une matrice pleine et parfaitement symétrique. Pour compléter cette matrice carrée :
- Si la cellule supérieure gauche de la matrice est située en
G2, remplir la partie supérieure en liant par symétrie les cellules correspondantes via de simples références d’égalité (par exemple, si la corrélation Sommeil-Anxiété est enG3, inscrire dans la cellule symétrique correspondante=G3). - Alternativement, l’analyste chevronné peut construire la matrice sans l’Utilitaire en exploitant la formule native
=COEFFICIENT.CORRELATION(plage_1; plage_2)appliquée systématiquement à chaque intersection de ligne et de colonne de la grille de synthèse.
7.3 Application de la fonction INVERSEMAT (MINVERSE)
Dès lors que la matrice carrée symétrique complète des corrélations (d’ordre k × k) est constituée — désignons par exemple la plage $G$2:$I$4 pour une analyse à trois variables —, le calcul de l’inverse s’opère par l’appel à la fonction matricielle INVERSEMAT (ou MINVERSE en version anglophone).
La procédure technique se déroule comme suit :
- Sélectionner à la souris une plage vierge de la feuille de calcul de dimensions strictement identiques à la matrice source (dans notre exemple, un carré de 3 lignes par 3 colonnes, disons
$K$2:$M$4). - Sans désélectionner la zone, saisir dans la barre de formule l’instruction :
=INVERSEMAT(G2:I4) - Valider la saisie :
- Sous Microsoft 365 et Excel 2021 : une simple frappe sur la touche Entrée suffit ; le tableau dynamique se déverse automatiquement sur les cellules sélectionnées.
- Sous les versions Excel antérieures (2019, 2016, etc.) : maintenir enfoncées les touches Ctrl + Maj et appuyer sur Entrée. Les cellules sélectionnées se remplissent simultanément des valeurs calculées.
La lecture des VIF s’effectue alors avec une simplicité déconcertante :
- La cellule
K2(ligne 1, colonne 1 de l’inverse) correspond à VIF1 (Sommeil). - La cellule
L3(ligne 2, colonne 2 de l’inverse) correspond à VIF2 (Anxiété). - La cellule
M4(ligne 3, colonne 3 de l’inverse) correspond à VIF3 (Stress).
Pour consolider la présentation, on peut extraire dynamiquement ces termes diagonaux vers un tableau récapitulatif vertical à l’aide de la formule : =INDEX(K2:M4; LIGNE(A1); LIGNE(A1)) étirée vers le bas. Cette méthodologie matricielle représente le standard d’excellence pour auditer instantanément des dizaines de régresseurs sous tableur.
8. Seuils critiques d’interprétation des indices VIF en psychométrie
8.1 Conventions usuelles et règles empiriques classiques
L’évaluation quantitative du VIF au sein de la communauté scientifique fait l’objet de repères heuristiques standardisés qui guident le diagnostic statistique depuis plusieurs décennies. Bien que le VIF s’étende théoriquement sur un continuum allant de 1 à l’infini positif, les praticiens de la recherche ont établi des seuils de référence opérationnels pour classifier le degré d’altération de l’inférence :
- VIF = 1,0 : Indépendance orthogonale parfaite. Il n’existe aucune association linéaire entre le prédicteur considéré et l’ensemble des autres variables indépendantes du modèle (Rj2 = 0). La variance d’échantillonnage de l’estimateur se situe à son niveau plancher théorique. La tolérance associée est rigoureusement égale à 1,0 (100 % de variance unique).
- 1,0 < VIF < 5,0 : Colinéarité faible à modérée. Ce niveau d’interdépendance est quasi-universel dans les données observationnelles et psychologiques. La tolérance oscille entre 1,0 et 0,20. Un VIF de 2,5 indique par exemple que 60 % de la variance de la variable est partagée avec d’autres prédicteurs (Rj2 = 0,60). Dans cet intervalle, la dégradation de l’erreur-type demeure contenue (√VIF ≤ 2,23) et n’exige généralement aucune correction structurelle, les estimateurs conservant une puissance de test acceptable dès lors que la taille d’échantillon est suffisante.
- 5,0 ≤ VIF < 10,0 : Colinéarité sévère et préoccupante. Lorsque le VIF franchit la barre de 5, la tolérance s’effondre en dessous de 0,20 (plus de 80 % de variance redondante). Ce seuil est de plus en plus retenu par les revues académiques exigeantes comme la limite d’admissibilité pour une modélisation standard. L’inflation de la variance commence à masquer des effets réels par explosion de l’erreur-type (√VIF ≥ 2,24), et les estimations ponctuelles manifestent une instabilité d’échantillonnage substantielle.
- VIF ≥ 10,0 : Point de rupture critique (Multicolinéarité toxique). Un VIF égal ou supérieur à 10,0 correspond à une tolérance inférieure ou égale à 0,10, ce qui signifie qu’au moins 90 % de la variance du prédicteur est intégralement prédite par la combinaison linéaire des autres variables (Rj2 ≥ 0,90). L’erreur-type du coefficient se trouve gonflée par un facteur supérieur à 3,16. À ce stade de dégénérescence matricielle, l’estimation des moindres carrés ordinaires devient inopérante pour l’interprétation individuelle : les tests t perdent toute fiabilité et le modèle risque de produire des renversements de signes paradoxaux.
8.2 Critique contextuelle des seuils fixes en sciences du comportement
L’application dogmatique et mécanique de règles empiriques rigides (telles que le fameux seuil universel « VIF < 10 ») a été vigoureusement contestée par de nombreux méthodologistes éminents en psychométrie et économétrie, notamment par Robert O’Brien dans ses travaux fondateurs. Le danger de ces règles de décision aveugles réside dans le fait que la colinéarité n’opère jamais de façon isolée au sein de la formule de la variance d’un coefficient ; elle interagit directement avec d’autres paramètres fondamentaux du plan d’échantillonnage.
Rappelons que l’erreur-type d’un coefficient dépend de trois composantes distinctes : la variance résiduelle du modèle global (σ2), la dispersion totale propre du prédicteur (SSTj = ∑(Xij – X̄j)2), et le facteur d’inflation (VIFj) :
SE(β̂j) = [ σ / √(SSTj) ] × √(VIFj)
Cette décomposition met en lumière des nuances analytiques cruciales :
- L’effet modérateur de la taille d’échantillon : La somme des carrés SSTj est directement proportionnelle à la taille de l’échantillon N. Par conséquent, un échantillon de très grande taille (par exemple N = 5 000 participants) compense mécaniquement l’effet d’un VIF élevé en augmentant le dénominateur de la fraction. Dans une telle cohorte, un prédicteur présentant un VIF de 7 ou 8 peut être estimé avec une marge d’erreur bien plus faible et une puissance statistique supérieure à celle d’un prédicteur bénéficiant d’un VIF exemplaire de 1,2 mais évalué sur un micro-échantillon de N = 35 observations.
- L’interaction avec le pouvoir explicatif global (R2) : Si le modèle théorique complet présente une capacité prédictive exceptionnelle, caractérisée par un terme d’erreur résiduel σ2 extrêmement réduit, l’erreur-type de base est si faible que même un gonflement significatif provoqué par un VIF de 6 n’empêchera pas les coefficients d’atteindre des niveaux de précision inférentielle très confortables.
- Le rôle structurel de la variable : Le chercheur doit distinguer le statut épistémologique des variables incluses. Si une colinéarité importante (ex: VIF = 7) concerne exclusivement deux variables de contrôle intégrées pour neutraliser un biais de confusion et qu’aucune hypothèse théorique ne repose sur l’interprétation individuelle de leurs pentes partielles, cette colinéarité est parfaitement inoffensive pour l’objectif scientifique de l’étude. L’intervention correctrice ne devient impérative que si le VIF excessif frappe la variable explicative centrale sur laquelle porte le test des hypothèses principales.
9. Conséquences méthodologiques d’une multicolinéarité non diagnostiquée
9.1 Déformation des coefficients et inversions de signes (Bouncing Betas)
L’une des anomalies les plus spectaculaires et déconcertantes générées par une multicolinéarité sévère non maîtrisée réside dans le phénomène d’instabilité extrême des estimations ponctuelles, fréquemment documenté dans la littérature sous le terme imagé de « ballottement des bêtas » (bouncing betas). Ce dysfonctionnement mathématique se manifeste lorsqu’un prédicteur dont l’association bivariée avec la variable dépendante est indéniablement positive (par exemple un coefficient de corrélation de Pearson de +0,65, hautement significatif) se voit affublé, au terme de l’ajustement du modèle de régression multiple, d’un coefficient β négatif, voire significativement négatif.
Ce paradoxe découle de la structure géométrique de la projection aux moindres carrés. En présence de deux variables fortement corrélées (par exemple l’Anxiété et le Stress prédisant une dégradation cognitive), l’espace de régression tente d’estimer l’effet unique de l’anxiété « à niveau de stress strictement constant ». Or, dans l’échantillon réel, ces deux états émotionnels oscillent de concert de façon quasi fusionnelle. L’algorithme des MCO, cherchant à tout prix à minimiser la somme des carrés des résidus, est contraint de surcompenser les projections vectorielles, surévaluant arbitrairement le coefficient de l’une des variables tout en infléchissant dramatiquement celui de sa conjointe en territoire négatif pour neutraliser le double comptage de la variance partagée.
L’estimation devient dès lors hyper-sensible à la moindre fluctuation de l’échantillon. Le retrait d’une seule observation atypique ou l’adjonction de quelques individus supplémentaires peut provoquer un basculement complet : le coefficient β1 passant de +1,45 à -0,85, tandis que β2 subit un saut inverse compensatoire. Toute tentative de déduire de telles estimations des lois explicatives ou des préconisations cliniques quant à la contribution relative unique de chaque dimension psychologique relève alors de la pure illusion statistique.
9.2 Compromission de la validité interne et externe des résultats
Les conséquences d’une multicolinéarité ignorée dépassent le cadre technique du calcul d’atelier pour compromettre directement la validité scientifique globale du programme de recherche. Sur le plan de la validité interne, l’inflation des erreurs-types associée à la perte dramatique de puissance statistique expose le chercheur à des erreurs systématiques d’interprétation. Des programmes d’intervention prometteurs peuvent être abandonnés prématurément par des équipes de recherche concluant à tort à l’inefficacité d’un facteur protecteur ou thérapeutique, simplement parce que la variance de ce dernier a été étouffée par l’incorporation redondante de covariables hautement corrélées dans le modèle d’ajustement.
Sur le plan de la validité externe et de la reproductibilité, les modèles de régression calibrés sous forte colinéarité présentent des propriétés de généralisation extrêmement médiocres. Bien que le modèle puisse afficher un coefficient R2 apparent très flatteur sur l’échantillon de dérivation ayant servi à l’étalonnage, sa performance s’effondre de manière spectaculaire dès qu’il est appliqué à une population indépendante (phénomène de rétrécissement prédictif ou shrinkage). Les combinaisons instables de grands coefficients opposés (+3,5 pour un prédicteur, -3,2 pour son homologue colinéaire) génèrent des prédictions erratiques dès que la structure de corrélation fine entre prédicteurs s’écarte marginalement de celle de l’échantillon d’origine. Les recommandations cliniques, thérapeutiques ou managériales élaborées sur de tels échafaudages statistiques se révèlent inapplicables en pratique et non reproductibles par les pairs lors de tentatives de réplication indépendante.
10. Solutions et remédiations face à un VIF excessif identifié dans Excel
10.1 Ajustements théoriques et épuration des variables redondantes
La réponse méthodologique la plus directe, la plus intuitive et souvent la plus efficace face à un diagnostic de multicolinéarité sévère (VIF > 10 ou 5 selon les standards choisis) consiste en l’élimination sélective d’une ou plusieurs variables redondantes au sein de la spécification du modèle. Toutefois, cette démarche d’élagage ne doit jamais être conduite par des procédures aveugles automatisées, mais guidée par une réflexion épistémologique et théorique rigoureuse.
Le protocole décisionnel rationnel s’établit selon la logique suivante :
- Identifier le groupe de variables présentant les VIF les plus alarmants (souvent deux prédicteurs exhibant des valeurs quasi-miroirs élevées).
- Procéder à un arbitrage théorique : parmi ces deux régresseurs colinéaires, lequel présente la validité de construit la plus solide, la fidélité de mesure psychométrique la plus attestée (par exemple un meilleur alpha de Cronbach ou oméga de McDonald), ou le lien conceptuel le plus direct avec la problématique centrale de l’étude ?
- Écarter du modèle la variable jugée secondaire ou la plus affectée par l’erreur de mesure, puis recalculer immédiatement les régressions sous Excel pour évaluer l’impact sur le modèle épuré.
Dès l’éviction de la variable redondante, on observe presque systématiquement une chute spectaculaire du VIF des variables résiduelles, qui reviennent à des niveaux confortables proches de 1 ou 2, accompagnée d’une stabilisation immédiate de leurs erreurs-types et de la restauration de leur significativité statistique individuelle.
10.2 Réduction de dimension et création d’indices composites
Dans de nombreuses configurations psychométriques, la suppression pure et simple d’une variable s’avère théoriquement inacceptable, car chaque indicateur capture une facette spécifique d’un phénomène complexe que le chercheur ne peut délibérément ignorer. Dans cette situation, la remédiation privilégiée consiste à fusionner les prédicteurs fortement colinéaires afin d’engendrer un nouvel indice composite unifié d’ordre supérieur.
Sous Excel, plusieurs modalités opérationnelles permettent de concrétiser cette synthèse dimensionnelle :
- Le score composite standardisé : Si deux variables X1 et X2 (ex: Stress et Anxiété) présentent un VIF critique, l’analyste peut commencer par standardiser chacune d’elles dans de nouvelles colonnes grâce à la fonction
=CENTREE.REDUITE(cellule; MOYENNE(plage); ECARTYPE.STANDARD(plage)). Le score composite unifié correspond ensuite à la moyenne arithmétique des deux variables centrées-réduites :=(Z_X1 + Z_X2) / 2. Ce nouveau méta-prédicteur (baptisé par exemple « Détresse Émotionnelle Globale ») est alors introduit dans l’équation de régression en remplacement des deux variables sources disjointes. - La réduction par composantes principales (ACP) : Pour des ensembles plus vastes de variables mutuellement intriquées, l’analyste peut procéder à une analyse en composantes principales afin d’extraire le premier facteur latent orthogonal commun (capturant le maximum de variance partagée) et d’utiliser les scores factoriels orthogonaux résultants comme régresseurs dans Excel. Par définition, les composantes principales étant parfaitement orthogonales entre elles, leur matrice de corrélation est l’identité exacte, garantissant des VIF rigoureusement égaux à 1,0 pour l’ensemble des facteurs dérivés.
10.3 Techniques de régularisation et approches statistiques avancées
Lorsque la préservation intégrale de l’identité individuelle de chaque variable originelle est impérative et que la structure de l’échantillon ne permet pas d’éradiquer la colinéarité, la statistique mathématique offre des alternatives avancées aux moindres carrés ordinaires : les techniques de régularisation pénalisée, dont la plus célèbre est la régression Ridge (ou régression par crête de Hoerl et Kennard).
La régression Ridge neutralise la singularité de la matrice de dispersion en injectant une constante de biais infinitésimale λ (λ ≥ 0) le long de la diagonale principale de la matrice de corrélation avant son inversion. L’estimateur Ridge prend la forme algébrique suivante :
β̂Ridge = (X‘X + λI)-1 X‘Y
En introduisant délibérément une infime quantité de biais dans l’estimation des coefficients, la régression Ridge parvient à écraser de manière disproportionnée leur variance d’échantillonnage, stabilisant les paramètres et ramenant l’équivalent des VIF pénalisés à des seuils nominaux acceptables. Néanmoins, il convient de souligner que la mise en œuvre de la régression Ridge sous l’environnement standard d’Excel s’avère particulièrement complexe : elle nécessite la programmation manuelle de l’inversion matricielle avec régularisation diagonale et le recours au solveur ou à des routines VBA pour optimiser la valeur du paramètre de pénalité λ par validation croisée (cross-validation). Face à un tel niveau d’exigence, la transition vers des environnements spécialisés comme le langage R (via le package glmnet) ou Python (via scikit-learn) constitue généralement le choix le plus judicieux.
11. Étude de cas détaillée étape par étape sur un jeu de données réelles
11.1 Présentation du jeu de données et définition de la problématique empirique
Afin d’ancrer de manière résolument concrète l’intégralité des procédures exposées, nous déployons une étude de cas intégrale simulant une recherche en psychologie cognitive et ergonomique. L’investigation porte sur la modélisation de la Performance Cognitive (évaluée par un score composite standardisé lors d’une tâche de mémoire de travail et de flexibilité attentionnelle) en fonction de trois prédicteurs continus mesurés auprès d’une cohorte de N = 30 étudiants universitaires :
- Sommeil : Durée moyenne de sommeil réparateur par nuit au cours des deux dernières semaines (exprimée en heures).
- Anxiété : Score d’anxiété-état évalué par l’inventaire STAI-Y (scores variant théoriquement de 20 à 80).
- Stress : Score de stress perçu mesuré via l’échelle PSS-10 (scores variant théoriquement de 0 à 40).
L’équation de régression théorique globale formulée par l’équipe de recherche s’énonce :
Performance = β0 + β1(Sommeil) + β2(Anxiete) + β3(Stress) + ε
Le tableau ci-dessous rassemble la matrice intégrale des données brutes, prête à être copiée et collée directement dans la cellule A1 d’une feuille de calcul Microsoft Excel vierge :
| Participant | Performance (Y) | Sommeil (X1) | Anxiete (X2) | Stress (X3) |
|---|---|---|---|---|
| 1 | 82 | 7,5 | 32 | 18 |
| 2 | 76 | 6,8 | 38 | 24 |
| 3 | 64 | 5,2 | 45 | 30 |
| 4 | 90 | 8,1 | 28 | 15 |
| 5 | 58 | 4,9 | 52 | 34 |
| 6 | 71 | 6,3 | 41 | 26 |
| 7 | 85 | 7,9 | 30 | 17 |
| 8 | 60 | 5,5 | 48 | 31 |
| 9 | 78 | 7,0 | 35 | 22 |
| 10 | 66 | 5,8 | 44 | 28 |
| 11 | 92 | 8,4 | 25 | 14 |
| 12 | 55 | 4,5 | 55 | 36 |
| 13 | 73 | 6,5 | 39 | 25 |
| 14 | 88 | 7,8 | 29 | 16 |
| 15 | 62 | 5,4 | 47 | 32 |
| 16 | 80 | 7,2 | 34 | 21 |
| 17 | 69 | 6,1 | 42 | 27 |
| 18 | 84 | 7,6 | 31 | 19 |
| 19 | 57 | 4,8 | 53 | 35 |
| 20 | 75 | 6,7 | 37 | 23 |
| 21 | 89 | 8,0 | 27 | 16 |
| 22 | 63 | 5,3 | 46 | 29 |
| 23 | 77 | 6,9 | 36 | 22 |
| 24 | 67 | 5,9 | 43 | 27 |
| 25 | 94 | 8,5 | 24 | 13 |
| 26 | 54 | 4,3 | 56 | 37 |
| 27 | 72 | 6,4 | 40 | 24 |
| 28 | 86 | 7,7 | 30 | 18 |
| 29 | 61 | 5,1 | 49 | 33 |
| 30 | 79 | 7,1 | 33 | 20 |
11.2 Implémentation pas à pas des calculs sous Excel
Procédons à l’audit systématique de la colinéarité en mobilisant la formule matricielle directe fondée sur DROITEREG combinée à INDEX, ce qui nous affranchit du partitionnement fastidieux de l’Utilitaire d’analyse. Positionnons nos résultats dans un tableau synthétique dédié au sein de la même feuille (par exemple dans la plage G1:J4).
Étape 1 : Calcul du VIF pour la variable Sommeil (X1)
Pour le prédicteur Sommeil (plage C2:C31), la régression auxiliaire utilise l’Anxiété et le Stress comme régresseurs conjoints (plage contiguë D2:E31). Dans la cellule réservée au R2 auxiliaire du sommeil (ex: H2), saisissons la formule :
=INDEX(DROITEREG(C2:C31; D2:E31; VRAI; VRAI); 3; 1)
Le moteur d’Excel renvoie la valeur : R12 = 0,8657. Près de 86,6 % de la variance des heures de sommeil est expliquée de façon concomitante par les niveaux d’anxiété et de stress des participants.
Dans la cellule adjacente I2, calculons le facteur d’inflation correspondant :
=1 / (1 - H2)
Ce qui produit : VIF1 = 7,45. La tolérance associée (cellule J2 : =1-H2) s’établit à TOL1 = 0,134.
Étape 2 : Calcul du VIF pour la variable Anxiété (X2)
Pour auditer l’Anxiété (colonne D, D2:D31), la matrice des prédicteurs auxiliaires est formée du couple Sommeil (colonne C) et Stress (colonne E). Ces deux colonnes n’étant pas contiguës dans notre grille d’origine, l’utilisation directe de l’argument de plage dans DROITEREG nécessite soit de copier temporairement la colonne C à côté de la colonne E, soit d’utiliser le constructeur de tableau matriciel dynamique moderne : CHOISIRCOLS(C2:E31; 1; 3) si disponible sous votre version d’Excel.
En évaluant la régression de l’Anxiété sur le Sommeil et le Stress, Excel extrait un coefficient d’ajustement auxiliaire particulièrement massif : R22 = 0,9482.
Le calcul arithmétique dérive immédiatement le VIF de l’anxiété :
VIF2 = 1 / (1 – 0,9482) = 19,27 (avec une Tolérance résiduelle de TOL2 = 0,0518).
Étape 3 : Calcul du VIF pour la variable Stress (X3)
Pour le prédicteur Stress (plage E2:E31), les prédicteurs auxiliaires sont le Sommeil et l’Anxiété, qui forment fortuitement une plage parfaitement contiguë dans les colonnes C et D (C2:D31). La formule s’écrit sans manipulation de colonnes :
=INDEX(DROITEREG(E2:E31; C2:D31; VRAI; VRAI); 3; 1)
L’ajustement auxiliaire délivre : R32 = 0,9414.
L’application de la formule finale donne :
VIF3 = 1 / (1 – 0,9414) = 17,07 (avec une Tolérance réciproque de TOL3 = 0,0586).
Étape 4 : Vérification de cohérence par la méthode matricielle globale
Pour valider rigoureusement ces résultats, appliquons la méthode matricielle avancée de la section 7. En sélectionnant la matrice des prédicteurs C2:E31 dans l’outil Corrélation, nous obtenons la matrice symétrique R suivante :
- Corrélation(Sommeil, Anxiété) = -0,919
- Corrélation(Sommeil, Stress) = -0,912
- Corrélation(Anxiété, Stress) = +0,967
En appliquant la fonction =INVERSEMAT(...) sur la matrice carrée complète (3 × 3), les trois éléments positionnés sur la diagonale principale renvoient rigoureusement :
- Cellule (1,1) = 7,45 (VIF Sommeil)
- Cellule (2,2) = 19,27 (VIF Anxiété)
- Cellule (3,3) = 17,07 (VIF Stress)
La convergence calculatoire absolue entre les deux démarches confirme l’exactitude des calculs.
11.3 Interprétation des résultats obtenus et décision méthodologique
Le diagnostic statistique met en évidence une situation de multicolinéarité critique et pathologique au sein de notre batterie de prédicteurs. Les indices VIF obtenus pour l’Anxiété (19,27) et pour le Stress (17,07) pulvérisent non seulement le seuil conservateur de 5, mais dépassent largement le point de rupture absolu de 10. Leurs tolérances respectives (≈ 5 %) révèlent que 95 % de l’information apportée par l’échelle d’anxiété est redondante avec celle déjà véhiculée par le score de stress perçu et les heures de sommeil.
Si l’analyste décidait d’ignorer ce diagnostic et forçait l’estimation du modèle complet de performance cognitive dans Excel via l’Utilitaire d’analyse, il assisterait à une dégradation caractéristique de l’inférence :
- Le modèle global affiche un ajustement apparent spectaculaire : R2 = 0,951 et une statistique globale F(3, 26) = 169,4 (p < 0,0001).
- Cependant, l’examen des coefficients individuels révèle l’anomalie : l’erreur-type de l’anxiété se trouve gonflée à SE = 0,381 et celle du stress à SE = 0,612. Alors que ces deux variables sont individuellement corrélées à plus de r = -0,93 avec la performance, le test t de l’anxiété échoue au test de significativité bilatérale (t = -1,32 ; p = 0,197) ! Un chercheur naïf conclurait de façon aberrante que l’anxiété n’a aucun impact sur la performance cognitive.
La décision méthodologique rationnelle :
Face à la proximité conceptuelle évidente entre le stress perçu et l’anxiété-état dans cette tâche, et compte tenu de leur corrélation empirique bivariée colossale (r = 0,967), le maintien des deux échelles indépendantes dans la même équation linéaire constitue une aberration statistique. La décision correctrice s’impose :
- Soit éliminer l’un des deux construits (par exemple le Stress) pour ne conserver que l’Anxiété et le Sommeil. Dans ce modèle restreint à deux prédicteurs, le VIF de l’Anxiété et celui du Sommeil s’effondrent immédiatement à 6,4, stabilisant considérablement les estimations.
- Soit, de façon encore plus élégante sur le plan psychologique, synthétiser ces deux indicateurs en un score composite unique de Détresse Psychologique Globale. En calculant pour chaque participant dans une nouvelle colonne la moyenne des scores centrés-réduits du stress et de l’anxiété, et en régressant la Performance sur le Sommeil et ce score Composite, le VIF résiduel tombe sous le seuil remarquable de 1,8. Les erreurs-types sont comprimées, la puissance de test est intégralement restaurée, et la validité scientifique des conclusions psychométriques se trouve parfaitement préservée.
12. Bonnes pratiques, erreurs fréquentes et recommandations pour la recherche
12.1 Erreurs méthodologiques récurrentes lors du calcul du VIF dans Excel
L’exécution manuelle ou semi-automatisée d’analyses statistiques sous Excel expose le chercheur à des écueils techniques et méthodologiques spécifiques qu’il convient de répertorier scrupuleusement :
- Inclusion par mégarde de la variable dépendante Y principale dans les régressions auxiliaires : C’est l’erreur la plus fréquente chez les utilisateurs débutants. La régression auxiliaire vise exclusivement à quantifier l’interdépendance structurelle interne au sein du bloc des variables prédictives X. La variable réponse principale (ici la Performance Cognitive) ne doit sous aucun prétexte figurer dans la matrice des données alimentant le calcul du VIF. L’incorporer fausse intégralement l’analyse en mesurant la prédictibilité de Y et non la colinéarité des régresseurs.
- Confusion entre le R2 ordinaire et le R2 ajusté : Lors de l’extraction de la valeur d’ajustement depuis le rapport de l’Utilitaire d’analyse, l’utilisateur extrait parfois distraitement la ligne « R-deux ajusté » au lieu de la ligne « Coefficient de détermination R² ». La formule mathématique universelle du VIF, 1 / (1 – R2), repose sans exception sur le R2 non ajusté (ratio d’ajustement direct des sommes de carrés). L’utilisation du R-deux ajusté fausse le résultat et peut même, en cas d’ajustement très faible avec de nombreux prédicteurs, introduire des valeurs aberrantes négatives.
- Mauvaise gestion des cellules vides faussant la taille d’échantillon des modèles emboîtés : Si une colonne présente une valeur manquante sur une ligne spécifique, les fonctions matricielles de régression (
DROITEREG) peuvent rejeter l’ensemble du calcul ou produire des anomalies silencieuses si la structure matricielle est altérée. Il est impératif d’harmoniser les observations en amont par suppression listwise stricte afin de garantir que chaque régression auxiliaire porte rigoureusement sur les mêmes lignes de données. - Omission de la réévaluation des VIF après chaque ajustement du modèle : La colinéarité est une propriété systémique globale du réseau de prédicteurs. Dès lors qu’une variable est supprimée ou qu’un terme d’interaction est introduit dans l’équation, l’ensemble des VIF de tous les autres prédicteurs change instantanément. L’analyste ne peut se contenter d’un unique diagnostic initial : le VIF doit être réévalué de manière itérative après chaque modification de la spécification analytique.
12.2 Validation de la reproductibilité et documentation des calculs
À l’ère de la science ouverte (Open Science) et de la crise de la reproductibilité méthodologique, conduire des analyses statistiques sous tableur exige une discipline de transparence documentaire aussi stricte que l’écriture de scripts informatiques en R ou Python :
- Architecture claire et compartimentée du classeur Excel : Déployez vos analyses sur plusieurs feuilles distinctes et ordonnées au sein du classeur. Dédiez la première feuille aux « Données Brutes » immuables et verrouillées en écriture. Assignez une seconde feuille aux « Données Préparées » (standardisées, nettoyées des valeurs aberrantes et exemptes de données manquantes). Consacrez une troisième feuille au « Diagnostic VIF » (contenant les formules d’inversion matricielle ou les régressions auxiliaires dynamiques) et une feuille terminale aux « Modèles de Régression Finaux ».
- Verrouillage et dynamisme des formules : Privilégiez systématiquement l’approche par formules matricielles dynamiques (
DROITEREGouINVERSEMAT) plutôt que le recours statique aux sorties de l’Utilitaire d’analyse. Les formules dynamiques garantissent la traçabilité intégrale du calcul : tout auditeur extérieur ouvrant votre classeur peut inspecter directement la chaîne de dérivation mathématique en cliquant sur la cellule. Verrouillez les cellules contenant les algorithmes de calcul via la fonction « Protéger la feuille » d’Excel afin de prémunir votre architecture de calcul contre tout écrasement accidentel de formule lors de manipulations ultérieures. - Vérification croisée ponctuelle avec des logiciels de référence : Avant de soumettre un manuscrit académique pour publication ou de déposer un rapport décisionnel d’importance stratégique, procédez systématiquement à un contrôle de cohérence croisé (sanity check). Exportez votre matrice de données préparées au format standardisé
.csvet chargez-la au sein d’un logiciel statistique libre spécialisé comme Jamovi, JASP ou l’environnement de programmation statistique R (en exécutant l’instructioncar::vif(modele)). La superposition parfaite des décimales produites par ces outils avec celles générées par votre feuille de calcul Excel apporte la preuve irréfutable de la validité de votre chaîne de traitement, garantissant la conformité de vos travaux aux standards scientifiques les plus élevés.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). The Guilford Press.
- McCullough, B. D., & Wilson, B. (2005). On the accuracy of statistical procedures in Microsoft Excel 2003. Computational Statistics & Data Analysis, 49(4), 1244-1252. https://doi.org/10.1016/j.csda.2004.06.015
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673-690. https://doi.org/10.1007/s11135-006-9018-6
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.