
L’inférence statistique moderne repose sur une tension fondamentale entre l’observation empirique finie et l’aspiration à modéliser des régularités universelles. Dans les sciences sociales, les sciences biomédicales, l’économétrie et l’analyse décisionnelle contemporaine, la simple estimation ponctuelle — telle que la moyenne d’un échantillon — s’avère structurellement insuffisante pour caractériser un phénomène. En effet, tout agrégat numérique issu d’un sous-ensemble d’une population sous-jacente demeure tributaire des fluctuations d’échantillonnage. Pour transcender cette limite sans verser dans des conjectures dogmatiques, l’estimation par intervalle constitue l’outil méthodologique par excellence. L’intervalle de confiance offre un encadrement probabiliste rigoureux qui quantifie explicitement l’incertitude inhérente à toute mesure empirique, fournissant aux chercheurs et aux analystes une marge de manœuvre analytique indispensable pour valider ou réfuter des hypothèses scientifiques.
Dans le paysage des logiciels d’analyse quantitative, les tableurs occupent une position prépondérante en raison de leur accessibilité, de leur flexibilité architecturale et de leur intégration native dans les flux de travail collaboratifs. Google Sheets s’est progressivement mué en un environnement informatique robuste, capable d’exécuter des algorithmes inférentiels sophistiqués jadis réservés à des environnements de programmation statistique dédiés tels que R, SAS ou SPSS. La plateforme intègre aujourd’hui un arsenal complet de distributions probabilistes continues, de fonctions de calcul matriciel et de routines analytiques permettant de calculer avec une précision numérique absolue les marges d’erreur, les valeurs critiques et les bornes d’intervalles associées à des designs expérimentaux simples ou complexes.
Le présent traité méthodologique a pour dessein d’explorer de manière exhaustive, théorique et opérationnelle, les protocoles de calcul des intervalles de confiance au sein de Google Sheets. Conçu selon les normes les plus exigeantes de la recherche académique, ce guide déploie une trajectoire didactique complète : depuis les fondements épistémologiques du paradigme fréquentiste de Neyman jusqu’à l’implémentation algorithmique de fonctions avancées pour échantillons indépendants, appariés ou binomiaux. À travers une formalisation mathématique systématique doublée d’instructions pas-à-pas transposées dans la syntaxe francophone du tableur, ce document constitue le manuel de référence définitif pour tout praticien soucieux de concilier rigueur mathématique et efficience bureautique.
1. Fondements théoriques de l’intervalle de confiance en analyse quantitative
1.1 Définition et postulats de l’estimation par intervalle
L’édifice de la statistique inférentielle repose sur une distinction épistémologique stricte entre le paramètre populationnel, entité immuable mais fondamentalement inconnue (conventionnellement désignée par la lettre grecque mu pour la moyenne ou pi pour la proportion), et l’estimateur ponctuel, variable aléatoire calculée à partir des unités composant l’échantillon observé (noté x-barre ou p). L’erreur fondamentale commise dans de nombreuses exploitations profanes de données consiste à assimiler la réalisation numérique de l’estimateur à la vérité intrinsèque de la population cible. Or, en vertu de la variabilité d’échantillonnage, la sélection d’un échantillon distinct engendre inéluctablement une valeur d’estimation divergente. L’estimation par intervalle, formalisée dans les années 1930 par le mathématicien Jerzy Neyman, abandonne l’illusion d’une exactitude ponctuelle au profit d’un segment probabiliste dont l’amplitude reflète précisément le degré d’indétermination statistique.
Le comportement théorique de ces estimations est gouverné par la distribution d’échantillonnage de la statistique d’intérêt. Si l’on procédait à l’extraction d’une infinité d’échantillons aléatoires indépendants de même taille au sein d’une même population, l’ensemble des moyennes empiriques collectées décrirait une distribution théorique prévisible. L’intervalle de confiance représente ainsi une procédure opérationnelle qui, appliquée de façon répétée à ces multiples réalisations expérimentales, capture le paramètre populationnel inconnu avec une fréquence relative prédéterminée, notée 1 moins alpha, où alpha symbolise le risque d’erreur consenti par l’analyste.
Il convient de dissiper immédiatement un contresens récurrent propre à l’école fréquentiste : affirmer qu’un intervalle de confiance calculé à 95 % possède 95 % de chances de contenir la vraie moyenne de la population est une aberration conceptuelle. Une fois l’échantillon recueilli et les bornes numériques calculées, l’intervalle obtenu contient ou ne contient pas le paramètre fixe ; il n’y a plus d’aléa. Le niveau de confiance 1 moins alpha qualifie la procédure mathématique elle-même et son taux de succès asymptotique, et non la probabilité rétrospective d’un événement déterminé. C’est l’armature globale de l’échantillonnage qui est probabiliste, et non le paramètre sous-jacent, postulée fixe dans l’approche fréquentiste classique.
1.2 Formule mathématique générale de l’intervalle pour une moyenne
L’expression analytique standard encadrant une moyenne populationnelle inconnue se structure invariablement autour de trois éléments consubstantiels : l’estimateur d’échantillon agissant comme centre de symétrie, un coefficient d’échelle issu de la loi théorique régissant les données, et l’erreur type de l’estimateur. Algébriquement, cet encadrement se formalise selon la double inégalité suivante : la borne inférieure est égale à la moyenne empirique moins le produit du quantile critique et de l’erreur type, tandis que la borne supérieure équivaut à la moyenne empirique plus ce même produit. La quantité soustraite et ajoutée au centre de gravité de l’échantillon constitue la marge d’erreur, souvent désignée par le symbole E.
Le facteur critique multiplicatif dépend de deux composantes primordiales : le risque alpha bilatéral choisi (généralement 0,05 pour un degré de certitude de 95 %) et la loi de probabilité théorique appropriée (la loi normale standard z ou la loi t de Student). Ce quantile formalise le nombre d’erreurs types dont il faut s’éloigner du centre de la distribution pour englober la proportion 1 moins alpha de la masse de probabilité totale. Plus l’exigence de certitude est élevée (par exemple 99 % avec alpha égal à 0,01), plus le coefficient critique s’élargit, dilatant mécaniquement l’amplitude de l’intervalle et réduisant la précision descriptive de l’analyse.
L’erreur type de la moyenne, quant à elle, mesure la dispersion théorique de la moyenne d’échantillon autour de la moyenne populationnelle. Elle correspond au rapport entre l’écart-type de la population (ou son estimation empirique sans biais s) et la racine carrée de la taille n de l’échantillon. Cette dépendance inverse vis-à-vis de la racine carrée de n implique une loi de rendement décroissant : pour réduire de moitié la marge d’erreur sans modifier le niveau de confiance, le chercheur doit obligatoirement quadrupler l’effectif de son échantillonnage. Cette réalité mathématique sous-tend l’ensemble des contraintes budgétaires et logistiques de l’expérimentation empirique.
1.3 Pertinence méthodologique dans la recherche empirique
Au-delà de sa fonction descriptive, l’intervalle de confiance joue un rôle épistémologique capital dans l’assainissement des pratiques scientifiques contemporaines. Durant plusieurs décennies, la recherche quantitative a souffert d’une dépendance excessive à l’égard des tests d’hypothèses nulles et de la sacro-sainte valeur p (p-value). Or, une valeur p inférieure au seuil conventionnel de 0,05 atteste uniquement qu’un effet observé a peu de chances d’être attribuable au simple bruit d’échantillonnage sous l’hypothèse nulle ; elle n’informe aucunement sur la magnitude réelle du phénomène ni sur la précision avec laquelle il a été quantifié. Un effet infinitésimal et dénué de pertinence clinique ou managériale peut devenir hautement significatif si la taille de l’échantillon est démesurée.
L’intervalle de confiance comble cette lacune majeure en combinant simultanément une information sur la taille d’effet et sur la précision expérimentale. L’amplitude des bornes renseigne instantanément sur l’incertitude résiduelle : un intervalle étroit témoigne d’une grande précision métrologique, tandis qu’un intervalle excessivement large signale un manque critique de puissance statistique, incitant à la prudence interprétative nonobstant la significativité formelle du test statistique associé. Cette propriété est fondamentale en psychométrie, en pharmacologie ou en macroéconomie, où la prise de décision requiert une délimitation stricte des scénarios du pire et du meilleur.
De surcroît, les intervalles de confiance constituent la matière première fondamentale de la méta-analyse et de l’effort collectif de réplicabilité scientifique. En synthétisant des études hétérogènes mesurant un même construit, les modèles d’intégration méta-analytique pondèrent chaque investigation par l’inverse de la variance de son estimateur, une quantité directement dérivée de l’erreur type et des intervalles de confiance rapportés. L’omission des intervalles au profit des seules valeurs p entrave l’accumulation cumulative du savoir, confinant les données isolées dans une opacité méthodologique que l’utilisation rigoureuse de Google Sheets permet d’éliminer.
2. Préparation et structuration des données dans Google Sheets
2.1 Organisation tabulaire des séries statistiques
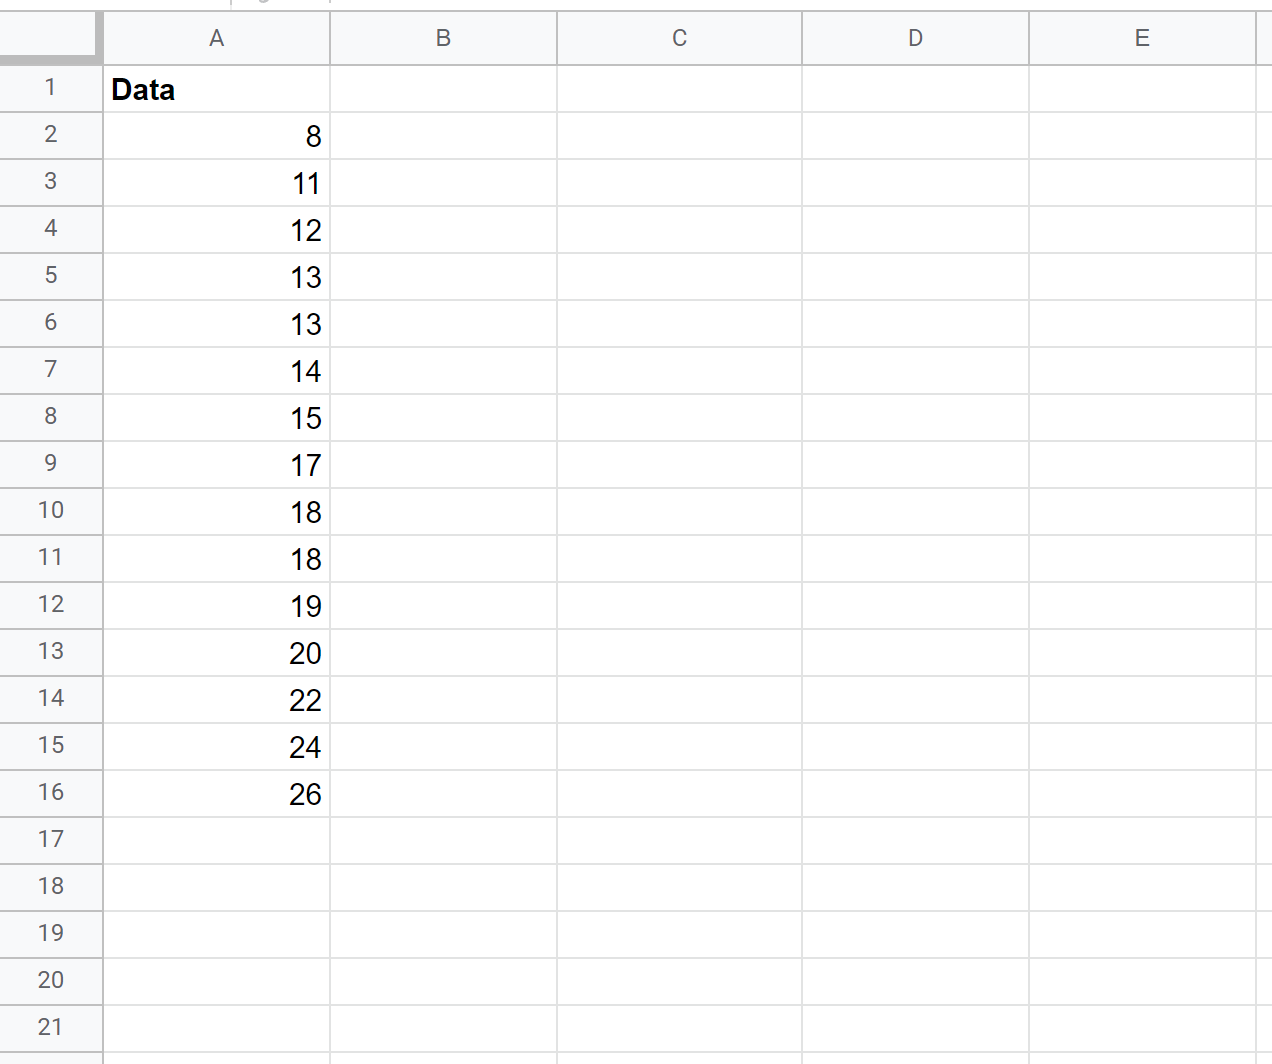
L’intégrité de toute inférence statistique sous Google Sheets est tributaire de la rigueur architecturale de la feuille de calcul matricielle. La disposition optimale des données obéit au paradigme des données ordonnées (communément qualifiées de tidy data dans la littérature scientifique internationale) : chaque variable quantitative ou qualitative doit être assignée à une colonne unique pourvue d’un en-tête univoque en première ligne, tandis que chaque observation individuelle ou unité expérimentale doit occuper une ligne distincte et exclusive. Toute imbrication de tableaux hétérogènes au sein de la même plage spatiale entraîne des risques majeurs d’altération des vecteurs de calcul lors de l’exécution des fonctions d’inférence.
Le nettoyage des séries statistiques implique une inspection minutieuse des valeurs aberrantes ou extrêmes (outliers). Si certaines déviations résultent d’erreurs de saisie évidentes — qu’il convient de corriger ou de supprimer sans délai —, d’autres reflètent l’hétérogénéité intrinsèque du système étudié. L’utilisation conjointe des fonctions logiques et de filtrage conditionnel, telles que TRI ou FILTER, permet d’isoler les points de données situés au-delà de trois écarts-types de la moyenne empirique. L’élimination injustifiée de points extrêmes sans justification théorique préalable constitue une faute déontologique, susceptible de rétrécir artificiellement l’amplitude des intervalles de confiance calculés subséquemment.
La gestion des données manquantes exige une attention tout aussi pointue. Google Sheets traite nativement les cellules vides en les ignorant dans la plupart des fonctions d’agrégation numérique, mais la présence de caractères invisibles, d’espaces typographiques résiduels ou de codes d’erreur de transmission de type texte peut corrompre irrémédiablement le typage de la variable. L’emploi préventif de fonctions d’assainissement telles que SUPPRESPACE et EPURAGE, combiné à la fonction ESTNUM pour s’assurer de la nature arithmétique de chaque cellule, garantit que les algorithmes inférentiels opèrent sur des plages homogènes et exemptes de biais computationnels induits.
2.2 Calculs descriptifs préliminaires dans le tableur
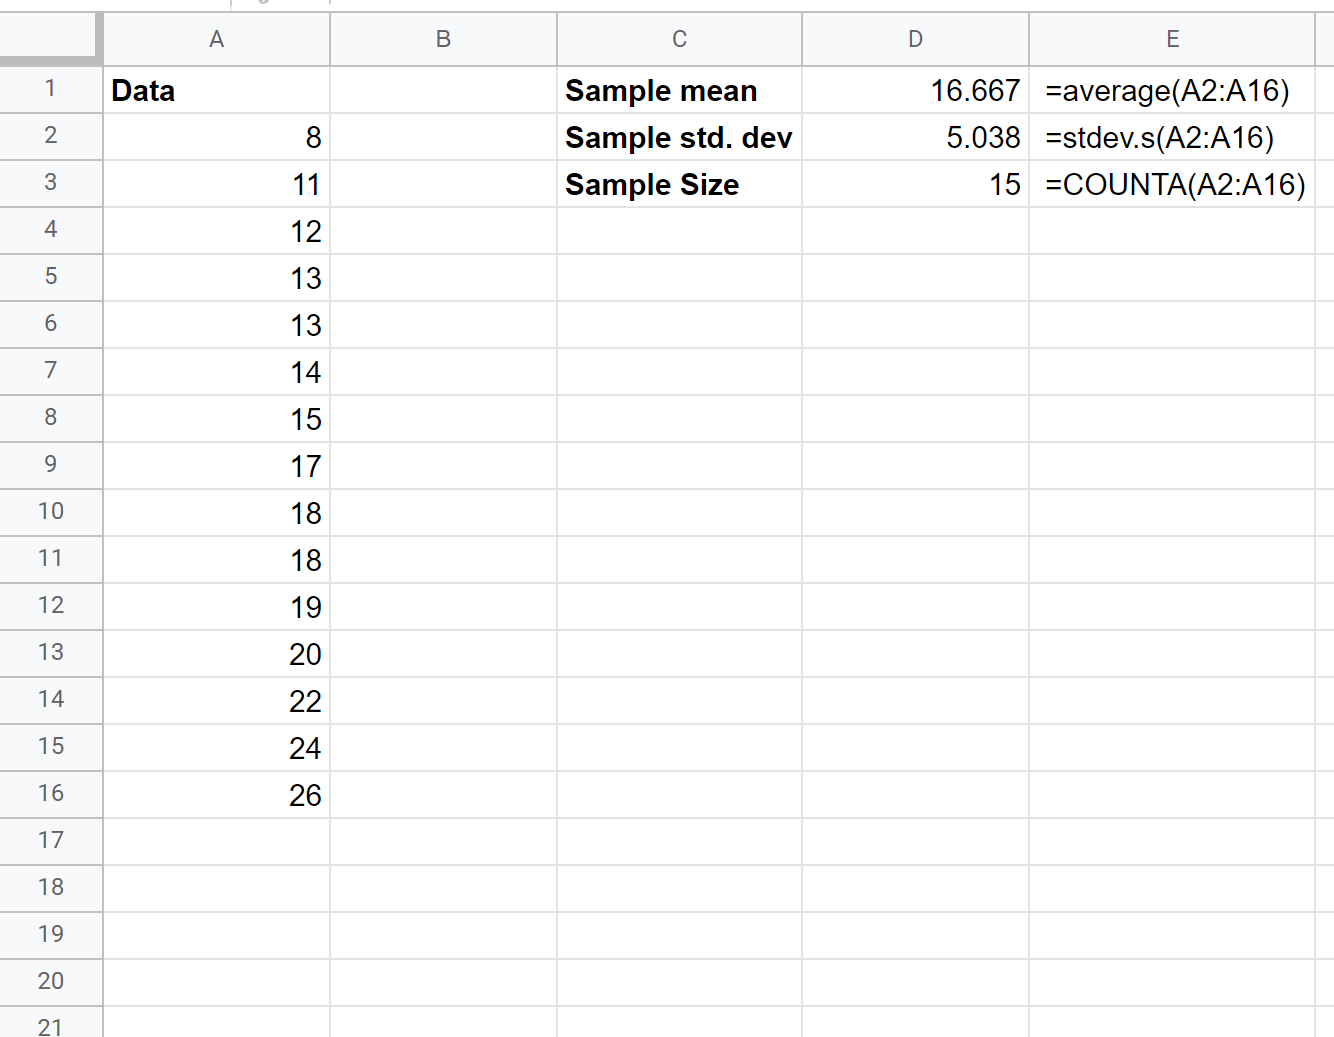
Préalablement à toute élaboration d’un intervalle de confiance, l’analyste doit extraire la triade descriptive élémentaire régissant son échantillon : la taille effective de la cohorte, la tendance centrale observée et la dispersion empirique. Dans Google Sheets, la quantification du volume d’observations valides s’opère par le truchement de la fonction NB, appliquée à la plage vectorielle étudiée (par exemple NB(A2:A150)). Contrairement à la fonction NBVAL qui comptabilise l’ensemble des cellules non vides y compris les chaînes textuelles erronées, NB restreint son décompte aux seules valeurs numériques effectives, prévenant ainsi toute surestimation dramatique de l’effectif réel.
La détermination de la moyenne d’échantillon est confiée à la fonction MOYENNE(A2:A150). Cette commande calcule la somme arithmétique des observations divisée par le cardinal des cellules numériques valides. Il est vivement préconisé d’attribuer à cette valeur une cellule dédiée, clairement nommée et isolée du corps principal de la matrice, afin qu’elle serve de nœud de liaison stable pour les formulations différentielles ultérieures. Toute altération dans le choix de la fonction de centralité dénaturerait le point d’ancrage fondamental de l’intervalle.
Enfin, l’évaluation de la dispersion exige une vigilance méthodologique aiguë quant au choix de la fonction d’écart-type. Google Sheets propose deux fonctions distinctes dont la confusion est source d’erreurs récurrentes : ECARTYPE.STANDARD (ou son équivalent direct STDEV) et ECARTYPE.POPULATION (ou STDEVP). Pour estimer la variance d’une population à partir d’un échantillon, il est mathématiquement impératif d’utiliser ECARTYPE.STANDARD. Cette fonction incorpore la correction de Bessel au dénominateur, divisant la somme des carrés des écarts par n moins 1 et non par n, éliminant ainsi le biais systématique de sous-estimation inhérent aux petits et moyens échantillons.
2.3 Vérification des hypothèses de distribution des données
L’application légitime des modèles d’inférence paramétrique repose sur des postulats distributionnels précis, au premier rang desquels figure la normalité de la variable au sein de la population parente. Dans Google Sheets, l’analyste peut sonder les propriétés morphologiques de sa distribution par le calcul de deux indices formels : le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). La fonction COEFFICIENT.ASYMETRIE(A2:A150) calcule le moment centré d’ordre trois standardisé. Une distribution parfaitement symétrique affiche une valeur de zéro ; une asymétrie substantielle (valeur absolue supérieure à 1) signale une dérive qui peut fausser le centrage des intervalles de Student sur de faibles effectifs.
De manière complémentaire, la fonction KURTOSIS(A2:A150) évalue le poids relatif des queues de distribution par rapport à la distribution normale de référence. Un kurtosis largement positif (distribution leptokurtique) indique une propension accrue aux événements extrêmes et une concentration centrale aiguë, tandis qu’un kurtosis négatif (distribution platykurtique) traduit un profil aplati. Ces déviations morphologiques influencent directement la précision du calibrage des quantiles théoriques, justifiant une éventuelle transformation mathématique préalable des variables (telle qu’une transformation logarithmique ou racine carrée) avant d’engager le protocole d’estimation.
Au-delà des métriques descriptives, l’inspection visuelle demeure une exigence de salubrité analytique. Google Sheets permet d’insérer instantanément des histogrammes de fréquences dynamiques via son moteur de rendu graphique. En configurant adéquatement la taille des classes de valeurs (buckets) dans l’éditeur de graphiques, l’utilisateur peut déceler d’un coup d’œil une bimodalité latente, une troncature des données ou la persistance d’amas de valeurs isolées qui trahiraient une violation rédhibitoire des hypothèses distributionnelles classiques sous-tendant la modélisation statistique paramétrique.
3. Calcul de l’intervalle de confiance avec la loi de Student pour petits échantillons (n < 30)
3.1 Justification théorique du modèle de Student
Lorsque la taille d’un échantillon statistique est modeste — conventionnellement inférieure à une trentaine d’unités d’observation — et que l’écart-type réel de la population générale demeure inconnu, l’analyste se trouve contraint d’estimer simultanément deux paramètres inconnus à partir de la même série de données : la moyenne mu et l’écart-type sigma. Cette double estimation introduit une source d’incertitude stochastique supplémentaire. L’écart-type d’échantillon s n’étant qu’une approximation fluctuante de sigma, le ratio standardisé reliant la différence des moyennes à l’erreur type ne suit plus une loi normale classique, mais une loi de Student, théorisée en 1908 par William Sealy Gosset sous le pseudonyme de Student.
La distribution t de Student présente une silhouette en cloche analogue à celle de la loi de Gauss, mais elle se singularise par des queues de distribution notablement plus épaisses et un sommet plus aplati. Cette morphologie spécifique traduit mathématiquement une probabilité supérieure d’observer des déviations importantes par rapport au centre, compensant ainsi la fragilité métrologique inhérente aux petits effectifs. Plus l’échantillon se restreint, plus l’incertitude quant à la véritable dispersion s’accroît, et plus les queues du modèle s’épaississent pour maintenir le niveau de couverture nominal de l’intervalle.
Cette distribution est rigoureusement paramétrée par un entier positif fondamental : le nombre de degrés de liberté (nu). Dans le contexte de l’estimation d’une moyenne unique, les degrés de liberté correspondent au cardinal de l’échantillon diminué d’une unité, soit n moins 1. Cette déduction découle directement de la contrainte algébrique imposée par le calcul préalable de la moyenne empirique : dès lors que la moyenne est fixée, seules n moins 1 observations demeurent libres de varier arbitrairement. Lorsque les degrés de liberté tendent vers l’infini, la distribution de Student converge asymptotiquement vers la loi normale standard, rendant la transition mathématique continue et cohérente.
3.2 Détermination du score critique t dans Google Sheets
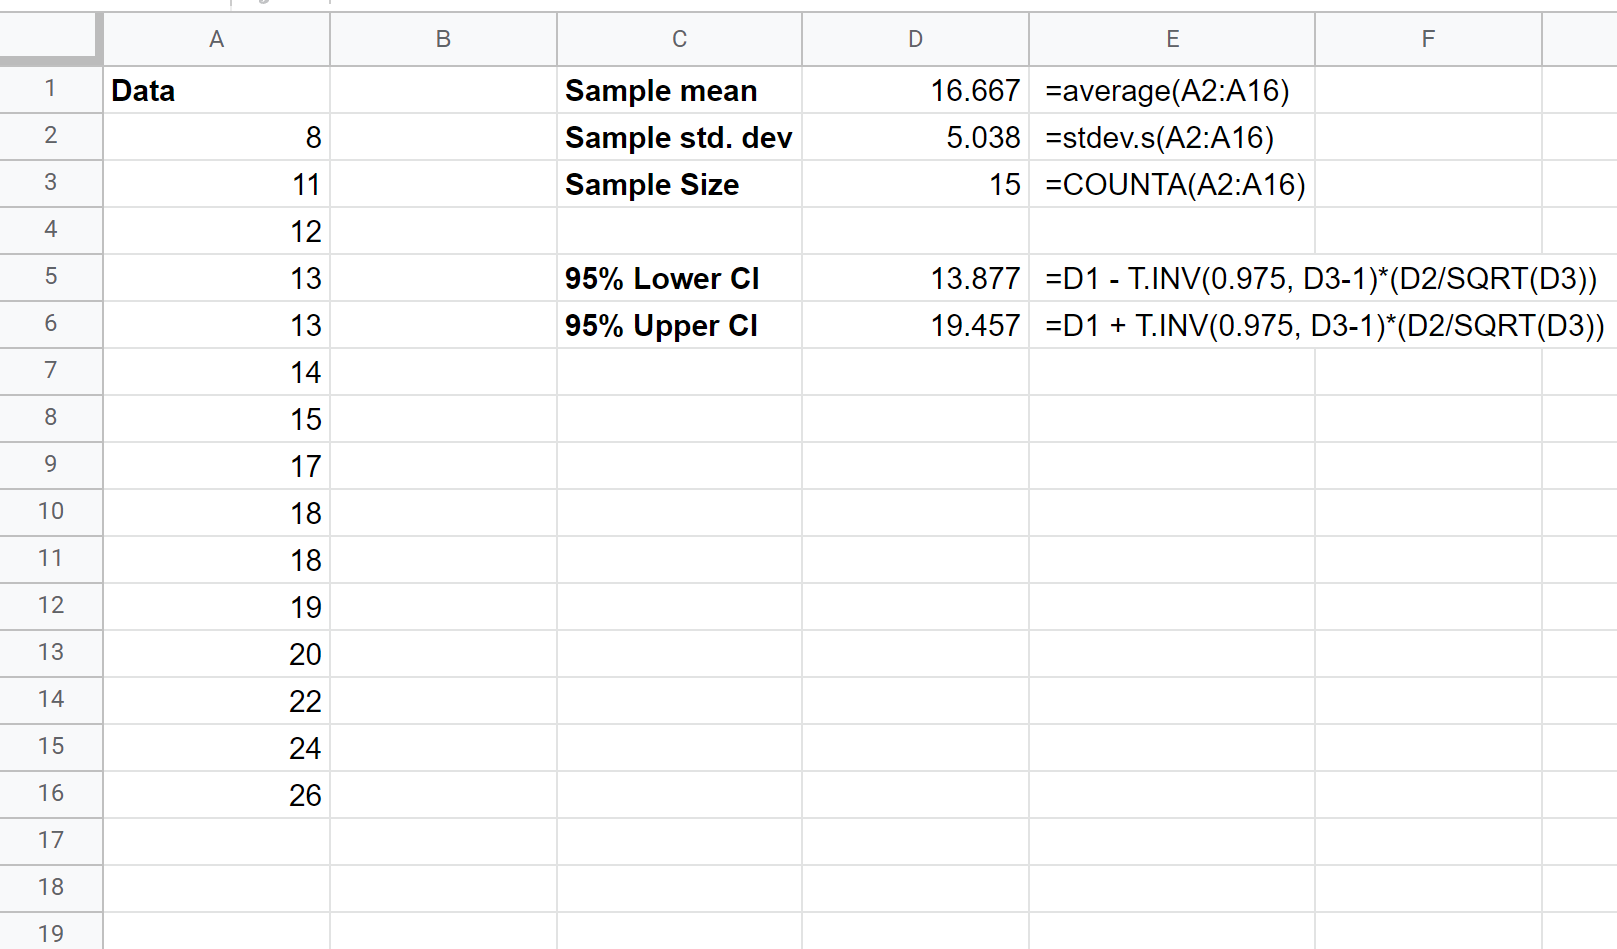
L’obtention du multiplicateur t précis associé au risque d’erreur consenti s’effectue dans Google Sheets au moyen d’une fonction spécialisée : LOI.STUDENT.INVERSE.BILATERALE. Cette fonction requiert rigoureusement deux arguments d’entrée : la probabilité bilatérale globale d’exclusion alpha, et le nombre de degrés de liberté associé au design expérimental. Par exemple, pour un niveau de confiance conventionnel de 95 %, le risque d’erreur bilatéral alpha est fixé à 0,05 (soit 1 moins 0,95). Si la série sous examen comprend 18 observations effectives, le nombre de degrés de liberté s’établit strictement à 17.
La transcription syntaxique exacte au sein d’une cellule dédiée s’énonce comme suit : =LOI.STUDENT.INVERSE.BILATERALE(0,05; 17). Le logiciel renvoie alors avec une très haute précision numérique la valeur 2,1098. Il est instructif de constater que cette valeur est substantiellement supérieure au score z classique de 1,96 issu de la loi normale standard. Cette majoration de plus de 7,6 % illustre la pénalisation protectrice induite par la loi de Student : pour garantir que 95 % des intervalles générés aléatoirement englobent le paramètre cible malgré un effectif restreint, il est impératif d’élargir le facteur critique.
Pour conférer à la feuille de calcul une totale dynamicité, il est vivement recommandé de substituer aux constantes numériques des liaisons directes vers les cellules de paramètres préalablement établies. Ainsi, si la taille de l’échantillon n réside en cellule B3 et que le niveau de confiance souhaité (exprimé sous la forme 0,95) se situe en cellule B4, la formule du score critique s’écrira : =LOI.STUDENT.INVERSE.BILATERALE(1 – B4; B3 – 1). Tout rafraîchissement ou incrémentation de la série expérimentale mettra instantanément à jour le quantile sans intervention manuelle de l’opérateur.
3.3 Calcul séquentiel des bornes inférieure et supérieure
Disposant de l’ensemble des composantes analytiques primaires, le déploiement opérationnel du calcul s’articule autour de la formalisation de l’erreur type de la moyenne. Dans une cellule réservée à cet effet (par exemple B7), l’analyste formule l’estimation de l’erreur type en divisant l’écart-type d’échantillon par la racine carrée de l’effectif, matérialisée par la syntaxe suivante : =B5 / RACINE(B3), où B5 héberge le résultat de la fonction ECARTYPE.STANDARD et B3 la fonction NB. Cette cellule quantifie l’incertitude unitaire de la mesure expérimentale.
La marge d’erreur E, qui constitue le demi-intervalle, est ensuite obtenue en multipliant le score critique t obtenu précédemment par l’erreur type qui vient d’être déterminée. Si le score t réside en B6 et l’erreur type en B7, la cellule B8 recevra la formule élémentaire : =B6 * B7. Cette décomposition pédagogique en étapes successives permet un contrôle qualité visuel immédiat, facilitant l’identification d’éventuelles anomalies numériques avant la fixation terminale des limites de l’intervalle.
L’aboutissement du protocole consiste à délimiter formellement le segment d’estimation. Dans la cellule dévolue à la borne inférieure, l’utilisateur implémente la soustraction de la marge d’erreur à la moyenne empirique : =B2 – B8, la cellule B2 hébergeant la valeur calculée par MOYENNE. Réciproquement, la cellule dévolue à la borne supérieure reçoit la formulation additive symétrique : =B2 + B8. Dès cet instant, le système d’équations est totalement articulé, offrant une fenêtre analytique indestructible garantissant une couverture de 95 % sous les hypothèses de normalité de la distribution parente.
4. Calcul de l’intervalle de confiance avec la loi normale pour grands échantillons (n ≥ 30)
4.1 Application du théorème central limite
L’affranchissement des contraintes de distribution des variables individuelles constitue l’une des percées théoriques les plus retentissantes de l’histoire des probabilités, matérialisée par le théorème central limite (TCL). Selon cette loi fondamentale, quelle que soit la nature de la distribution d’origine d’une variable aléatoire — qu’elle soit asymétrique, uniforme, bimodale ou discrète —, la somme et la moyenne d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées convergent asymptotiquement vers une loi normale lorsque la taille de l’échantillon n croît indéfiniment.
En pratique expérimentale, la convention méthodologique dominante considère que dès lors que le nombre d’observations franchit le seuil de 30 (n supérieur ou égal à 30), la distribution d’échantillonnage de la moyenne se rapproche suffisamment d’une courbe de Gauss pour autoriser l’utilisation de la loi normale standard z sans altération pernicieuse du taux de couverture nominal. À cette échelle d’observation, l’écart-type d’échantillon s devient un estimateur remarquablement convergent et stable de l’écart-type populationnel sigma, limitant drastiquement la variabilité stochastique du dénominateur de l’erreur type.
Néanmoins, l’analyste rigoureux doit garder à l’esprit que ce seuil conventionnel de 30 n’est pas une frontière magique étanche. Si la variable étudiée présente une dissymétrie extrême ou des distributions à queues particulièrement lourdes (comme dans les distributions de revenus de Pareto ou les cours boursiers), un échantillon de 50 voire de 100 observations peut s’avérer nécessaire avant que l’approximation normale n’atteigne une fidélité acceptable. À l’inverse, si la population sous-jacente est déjà parfaitement gaussienne, l’approximation normale est recevable quel que soit l’effectif, bien que l’usage de la loi de Student demeure systématiquement plus rigoureux mathématiquement.
4.2 Obtention de la valeur critique z dans le tableur
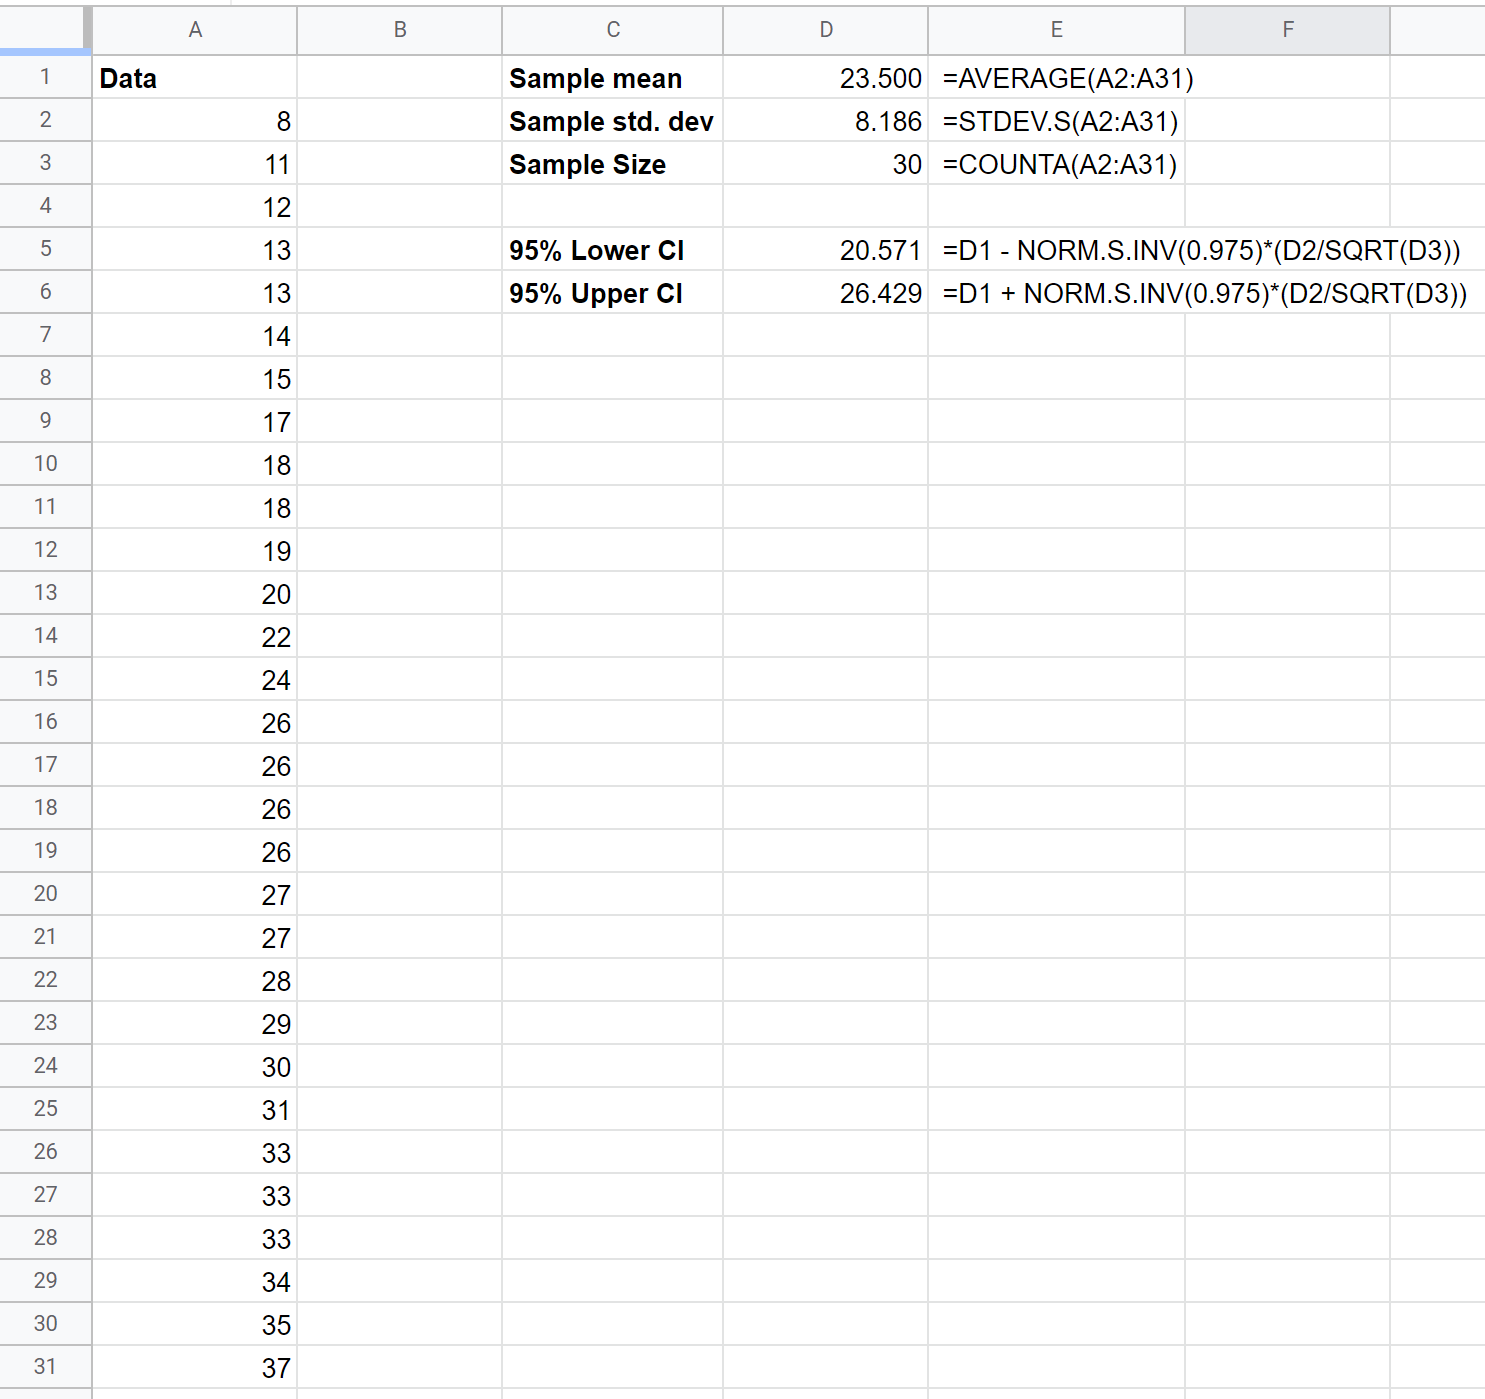
Pour mobiliser la loi normale standard dans Google Sheets, la fonction de référence incontournable est LOI.NORMALE.STANDARD.INVERSE (ou son pendant anglophone NORM.S.INV). Contrairement aux fonctions bilatérales spécifiques de Student, cette routine calcule le quantile de la fonction de répartition cumulative unilatérale d’une loi normale centrée réduite d’espérance nulle et de variance unitaire. Elle exige en unique argument d’entrée une probabilité cumulée orientée de la queue gauche jusqu’au point de coupure recherché.
Pour paramétrer adéquatement un intervalle bilatéral symétrique avec un risque global alpha, l’aire de rejet se scinde équitablement en deux moitiés distinctes de valeur alpha divisé par 2, réparties aux deux extrémités de la cloche gaussienne. En conséquence, la probabilité cumulée correspondant à la borne supérieure s’élève à 1 moins (alpha divisé par 2). Pour un niveau de confiance universel de 95 %, où alpha vaut 0,05, la probabilité cumulée à intégrer est 1 – (0,05 / 2) = 0,975. L’expression à transcrire dans le tableur prend ainsi la tournure suivante : =LOI.NORMALE.STANDARD.INVERSE(0,975).
L’exécution de cette formule délivre le célèbre score z théorique de 1,95996 (arrondi usuellement à 1,96). Les quantiles standards les plus récurrents en science empirique s’articulent ainsi :
- Niveau de confiance à 90 % (alpha = 0,10) : probabilité d’entrée 0,95, quantile z = 1,64485
- Niveau de confiance à 95 % (alpha = 0,05) : probabilité d’entrée 0,975, quantile z = 1,95996
- Niveau de confiance à 99 % (alpha = 0,01) : probabilité d’entrée 0,995, quantile z = 2,57583
En encapsulant cette syntaxe de façon paramétrique sous la forme =LOI.NORMALE.STANDARD.INVERSE(1 – (1 – B4)/2), la cellule calcule automatiquement le coefficient z rigoureux pour n’importe quel taux de confiance exprimé dans la cellule de contrôle B4.
4.3 Implémentation complète des formules asymptotiques
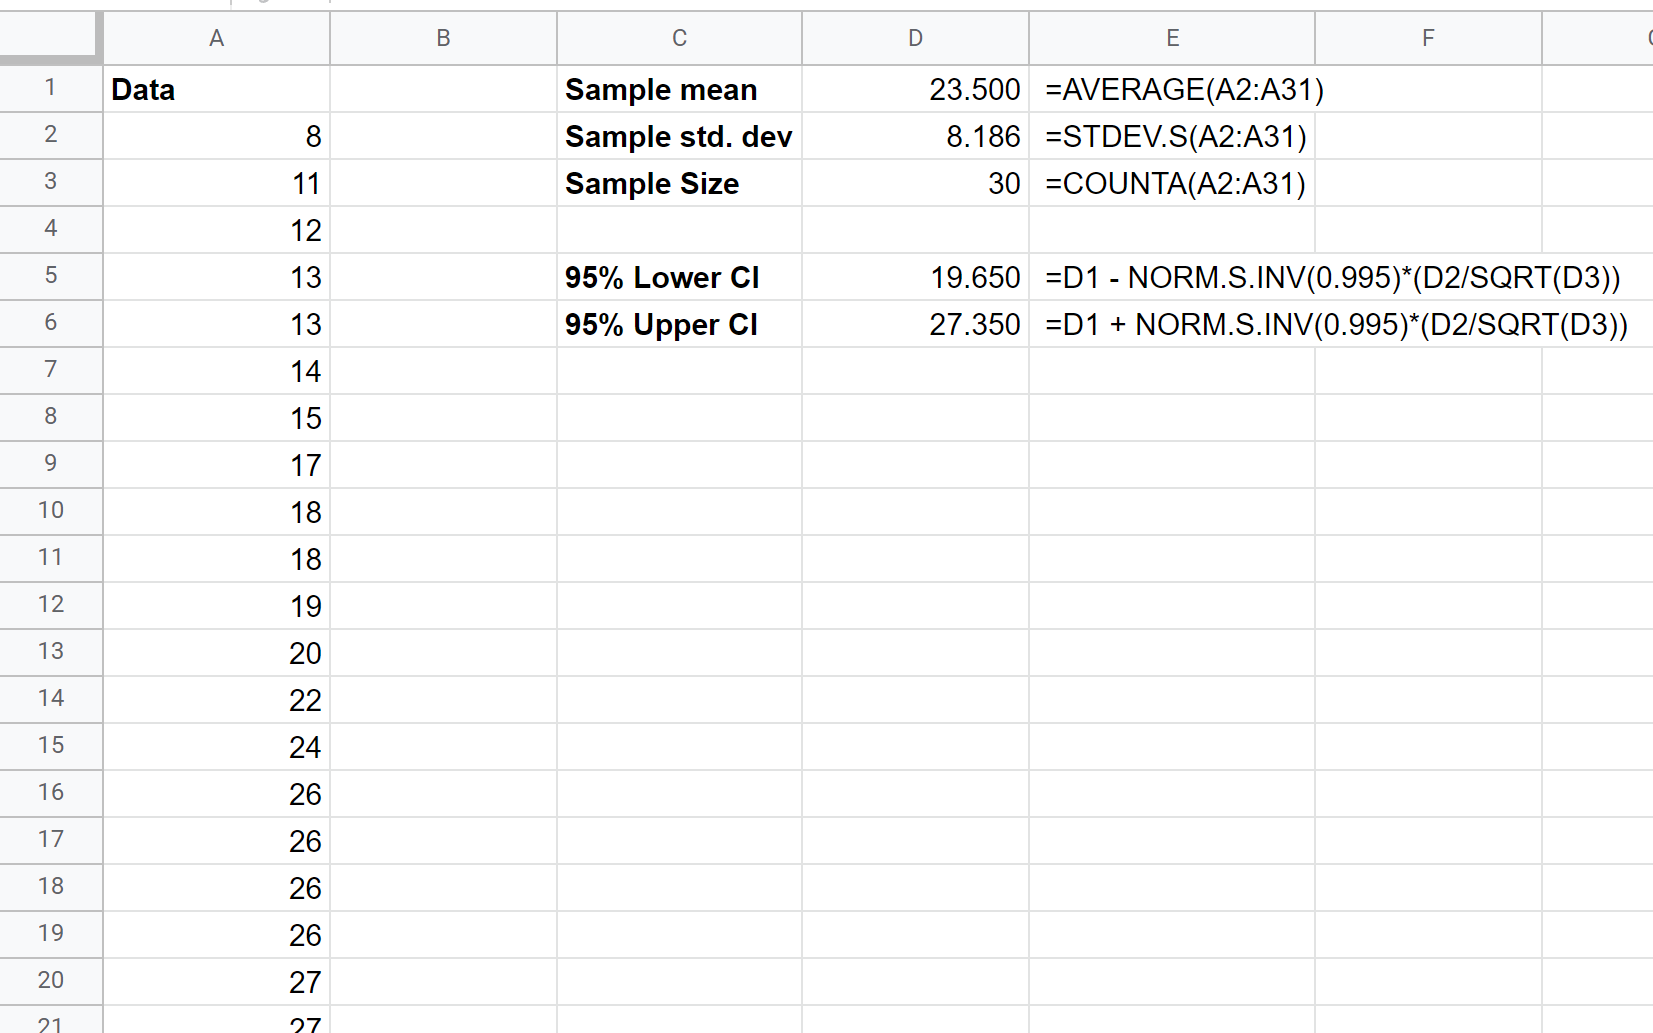
L’intégration structurelle de l’intervalle asymptotique sous Google Sheets peut s’exécuter soit de manière analytique segmentée, soit par une synthèse directe concentrée au sein des cellules de bornage. En optant pour une formulation intégrée, la borne inférieure de l’intervalle de confiance pour une série continue de grand effectif positionnée dans la colonne A (de A2 à A200) et un risque alpha de 5 % se résume par l’équation algorithmique unique suivante :
=MOYENNE(A2:A200) – LOI.NORMALE.STANDARD.INVERSE(0,975) * (ECARTYPE.STANDARD(A2:A200) / RACINE(NB(A2:A200)))
Symétriquement, la borne supérieure s’obtient par l’inversion de l’opérateur arithmétique de liaison :
=MOYENNE(A2:A200) + LOI.NORMALE.STANDARD.INVERSE(0,975) * (ECARTYPE.STANDARD(A2:A200) / RACINE(NB(A2:A200)))
Cette approche synthétique présente l’avantage d’une concision exemplaire sans dépendance envers des cellules périphériques. Elle recalcule en temps réel les bornes asymptotiques au fur et à mesure que de nouvelles observations sont saisies dans le bas du tableau. La comparaison numérique directe entre ces bornes z et celles dérivées du modèle de Student de la section précédente démontre que pour n égal à 200, l’écart entre les quantiles t et z n’apparaît qu’à la troisième décimale (1,972 contre 1,960), attestant l’exactitude pratique de l’équivalence asymptotique stipulée par le théorème central limite.
5. Utilisation des fonctions natives dédiées dans Google Sheets
5.1 La fonction INTERVALLE.CONFIANCE.NORM
Conscients de la récurrence de ces protocoles au sein des entreprises et des laboratoires, les concepteurs de Google Sheets ont intégré des fonctions prédéfinies destinées à accélérer le calcul direct de la marge d’erreur sans requérir l’articulation manuelle des quantiles et des fractions de dispersion. La première de ces fonctions dédiées est INTERVALLE.CONFIANCE.NORM (équivalente à CONFIDENCE.NORM dans les environnements anglophones). Cette routine automatise l’évaluation de la marge d’erreur asymptotique basée sur la loi normale.
La fonction réclame rigoureusement trois paramètres positionnels ordonnés :
- alpha : le niveau de risque bilatéral consenti (par exemple 0,05 pour un intervalle à 95 %) ;
- ecart_type : la valeur numérique de l’écart-type de référence (qu’il soit issu de la population connue ou calculé préalablement par ECARTYPE.STANDARD) ;
- taille : la taille d’échantillon effective n.
Sa syntaxe générale s’exécute ainsi : =INTERVALLE.CONFIANCE.NORM(alpha; ecart_type; taille). Il est impératif de souligner que cette fonction ne renvoie pas l’intervalle complet sous forme de couple de bornes, mais uniquement la marge d’erreur scalaire E. L’analyste doit impérativement ajouter et soustraire cette valeur à la moyenne d’échantillon pour matérialiser les bornes supérieure et inférieure de son estimation.
5.2 La fonction INTERVALLE.CONFIANCE.STUDENT
Dans les contextes où l’effectif restreint ou l’absence d’écart-type populationnel a priori impose la prudence de la modélisation de Gosset, Google Sheets propose la fonction native symétrique : INTERVALLE.CONFIANCE.STUDENT (ou CONFIDENCE.T). Cette fonction élimine l’étape d’extraction manuelle des degrés de liberté et de sélection du quantile t, intégrant ces calculs probabilistes au cœur de son moteur d’exécution binaire.
La structure syntaxique de cette fonction est rigoureusement superposable à sa contrepartie gaussienne : =INTERVALLE.CONFIANCE.STUDENT(alpha; ecart_type; taille). Bien que les paramètres soient formellement identiques, le mécanisme sous-jacent est fondamentalement distinct : la fonction déduit en arrière-plan le degré de liberté en soustrayant 1 de l’argument de taille fourni, consulte la table interne de Student bilatérale au seuil alpha, et procède au produit avec l’erreur type estimée.
La concordance entre le résultat délivré par cette fonction native et le calcul séquentiel détaillé dans la Section 3 est mathématiquement absolue, au millionième d’unité près. Si la cellule B2 stocke la moyenne, B3 la taille de l’échantillon, B4 le niveau de confiance (0,95) et B5 l’écart-type standard, la borne inférieure s’écrit avec une élégance structurelle irréprochable :
=B2 – INTERVALLE.CONFIANCE.STUDENT(1 – B4; B5; B3)
Cette condensation fonctionnelle réduit drastiquement le risque d’erreurs de syntaxe manuelle au sein des feuilles de calcul de grande envergure.
5.3 Automatisation des calculs d’intervalles groupés
Lorsque le dispositif expérimental comporte non pas une variable isolée mais une multitude de descripteurs suivis en parallèle (par exemple des mesures physiologiques multiples ou des métriques de performance commerciale segmentées par région), la duplication répétitive de formules scalaires devient contre-productive. L’association de formules matricielles avancées au moyen de ARRAYFORMULA ou de la fonction MAP permet d’automatiser le déploiement instantané d’intervalles de confiance sur l’ensemble d’un tableau synthétique.
Imaginons un tableau récapitulatif où les colonnes E, F et G contiennent respectivement les effectifs, les moyennes et les écarts-types de vingt groupes expérimentaux différents (disposés des lignes 2 à 21). Il est possible de générer d’un seul jet vectoriel l’ensemble des marges d’erreur de Student à 95 % dans la colonne H en insérant en H2 la formule dynamique :
=BYROW(E2:G21; LAMBDA(ligne; INTERVALLE.CONFIANCE.STUDENT(0,05; INDEX(ligne; 1; 3); INDEX(ligne; 1; 1))))
Cette formulation contemporaine exploite le moteur de calcul fonctionnel Lambda de Google Sheets pour itérer sur chaque ligne du tableau sans aucun glisser-déposer de formule. Elle protège l’intégrité de la structure contre les suppressions accidentelles de formules au sein des cellules intermédiaires et garantit que tout ajout d’un nouveau groupe expérimental dans la plage source recalculera instantanément l’ensemble des bornes associées avec une réactivité et une efficience computationnelle optimales.
6. Calcul d’intervalles de confiance pour des proportions et pourcentages
6.1 Spécificités de l’échantillonnage binaire et dichotomique
Les investigations scientifiques et les sondages d’opinion ne reposent pas systématiquement sur des variables quantitatives continues. Très fréquemment, le phénomène d’intérêt est dichotomique ou qualitatif binaire : succès ou échec, adhésion ou rejet, présence ou absence d’une pathologie. Dans ce cadre paradigmatique, la variable aléatoire sous-jacente suit une loi binomiale de paramètres n (le nombre de tirages) et p (la probabilité de succès inconnue). L’estimateur ponctuel de la proportion dans la population est la fréquence empirique observée, notée p-chapeau, obtenue en divisant le nombre de succès observés k par le nombre total d’essais n.
Contrairement au cas de la moyenne de variables continues où l’écart-type est un paramètre libre indépendant de l’espérance mathématique, la variance d’une variable de Bernoulli est entièrement déterminée par la proportion elle-même : elle est rigoureusement égale à p multiplié par (1 moins p). Par voie de conséquence, l’erreur type d’une proportion d’échantillon s’exprime analytiquement comme la racine carrée du produit de p-chapeau par (1 moins p-chapeau), le tout divisé par la taille n de l’échantillon.
L’inférence paramétrique classique sur des proportions fait intervenir l’approximation normale de la loi binomiale, autorisée en vertu du théorème de De Moivre-Laplace. Cependant, cette approximation n’est valide que sous des critères stricts de représentativité : la taille d’échantillon doit être suffisante et la proportion observée ne doit pas être excessivement périphérique. Les règles méthodologiques standards stipulent que le produit n fois p-chapeau ainsi que le produit n fois (1 moins p-chapeau) doivent impérativement être tous deux supérieurs ou égaux à 5 (ou 10 selon les canons méthodologiques les plus conservateurs), sous peine de biais d’estimation sévères.
6.2 Méthode de Wald standard dans la feuille de calcul
L’approche conventionnelle la plus répandue pour estimer un intervalle de proportion est l’intervalle de Wald. Fondé sur l’approximation normale standard, il calque sa structure sur l’intervalle pour une moyenne en appliquant le score critique z à l’erreur type binomiale estimée. Bien que critiqué pour ses faiblesses statistiques sur certains segments de distribution, il demeure largement enseigné et fréquemment requis dans les rapports d’analyse préliminaire.
Pour mettre en œuvre la méthode de Wald dans Google Sheets, supposons que la cellule B2 héberge le nombre d’occurrences favorables k (ex. 65) et que la cellule B3 contienne le total d’observations n (ex. 100). La proportion empirique s’obtient en B4 par la division =B2 / B3, affichant 0,65. L’erreur type binomiale s’implémente dans une cellule dédiée (par exemple B5) via l’expression suivante :
=RACINE((B4 * (1 – B4)) / B3)
La marge d’erreur pour un niveau de confiance à 95 % s’établit en B6 en multipliant cette erreur type par le quantile normal : =LOI.NORMALE.STANDARD.INVERSE(0,975) * B5. Les bornes inférieure et supérieure s’articulent alors respectivement par =B4 – B6 et =B4 + B6. Il convient toutefois de souligner une restriction fondamentale de l’intervalle de Wald : lorsque la proportion observée est très proche de 0 ou de 1, ou que l’effectif est restreint, les bornes calculées peuvent aberrer mathématiquement en franchissant les limites logiques de l’espace probabiliste, générant des bornes inférieures négatives ou des bornes supérieures excédant 100 %, ce qui impose le recours à des algorithmes alternatifs plus robustes.
6.3 Méthodes ajustées pour faibles effectifs ou proportions extrêmes
Pour pallier les tares congénitales de l’intervalle de Wald, la littérature statistique computationnelle préconise universellement deux alternatives supérieures : l’intervalle du score de Wilson et l’intervalle corrigé d’Agresti-Coull. Cette dernière méthode, d’une simplicité désarmante mais d’une robustesse mathématique remarquable, est souvent qualifiée d’ajustement à quatre pseudo-observations pour un niveau de confiance à 95 %. Elle consiste à ajouter artificiellement deux succès et deux échecs à l’échantillon empirique réel avant d’exécuter la formule classique de Wald.
Dans Google Sheets, l’ajustement d’Agresti-Coull pour alpha = 0,05 se modélise avec une fluidité totale. On définit une taille d’échantillon corrigée n-tilde égale à n + 4, et une proportion corrigée p-tilde égale à (k + 2) / (n + 4). En réinjectant ces valeurs dans le calcul de l’erreur type, les bornes d’estimation obtenues conservent un taux de couverture réel remarquablement stable, même avec des effectifs minuscules de 10 ou 15 sujets, et ne violent jamais les frontières naturelles [0 ; 1].
Pour une modélisation exacte de l’intervalle du score de Wilson — qui représente l’état de l’art académique —, l’utilisateur peut inscrire directement dans Google Sheets l’équation inversée de la parabole du score. Pour une proportion empirique p en B4, un effectif n en B3 et un score z en B5, la borne inférieure de Wilson se traduit par la formule suivante :
=(B4 + (B5^2)/(2*B3) – B5 * RACINE((B4*(1-B4)/B3) + (B5^2)/(4*(B3^2)))) / (1 + (B5^2)/B3)
Cette expression, certes complexe mais intégralement résoluble par le moteur de Google Sheets, garantit une inférence exempte de tout biais d’asymétrie, assurant une conformité totale avec les plus strictes exigences des revues médicales et épidémiologiques internationales.
7. Calcul de l’intervalle de confiance pour la différence entre deux moyennes indépendantes
7.1 Cadre théorique des plans inter-sujets
L’expérimentation scientifique classique confronte généralement deux populations mutuellement exclusives : un groupe exposé à un traitement ou une intervention novatrice (groupe expérimental) et un groupe servant de point de comparaison passif ou standard (groupe témoin ou contrôle). Le paramètre populationnel visé n’est plus une moyenne isolée, mais la différence entre deux moyennes théoriques : mu1 moins mu2. L’estimateur sans biais correspondant est la différence arithmétique observée entre les deux moyennes d’échantillon respectives : x-barre1 moins x-barre2.
La dérivation de l’intervalle de confiance encadrant cette différence requiert la détermination de la variance d’échantillonnage de la statistique différentielle. En vertu des propriétés fondamentales de l’addition des variables aléatoires indépendantes, la variance d’une différence de variables décorrélées équivaut strictement à la somme de leurs variances individuelles respectives. Par conséquent, l’erreur type de la différence de moyennes correspond à la racine carrée de la somme des variances d’échantillonnage individuelles (sigma1 carré sur n1 plus sigma2 carré sur n2).
Une bifurcation théorique critique intervient alors au regard de l’homogénéité des variances populationnelles. Si les deux populations mères partagent un niveau de dispersion théorique rigoureusement identique (hypothèse d’homoscédasticité), les données des deux cohortes peuvent être fusionnées pour calculer un estimateur unique plus puissant : la variance combinée (pooled variance). Si, au contraire, les variances sous-jacentes sont inégales (hétéroscédasticité), le cadre standard de Student s’effondre et doit être impérativement remplacé par la correction d’approximation de Welch-Satterthwaite pour les degrés de liberté.
7.2 Calcul de la variance combinée dans Google Sheets
Sous l’hypothèse d’homogénéité des variances — vérifiable préalablement par un test de Fisher ou l’observation d’un ratio de variances empiriques inférieur à un facteur 2 —, l’analyste combine les dispersions des deux séries. Supposons deux groupes indépendants A et B dont les statistiques descriptives sont préalablement renseignées dans la feuille : n1 en B3, s1 en B4, n2 en C3, et s2 en C4. Les degrés de liberté totaux sont la somme des degrés de liberté respectifs : (n1 – 1) + (n2 – 1), soit n1 + n2 – 2.
La variance combinée Sp carré se calcule sous Google Sheets par une moyenne pondérée des sommes des carrés d’écarts, formalisée dans une cellule dédiée par l’expression mathématique suivante :
=(((B3 – 1) * (B4^2)) + ((C3 – 1) * (C4^2))) / (B3 + C3 – 2)
Cette étape consolide la précision globale de l’estimation de dispersion en conférant un poids proportionnel à chaque échantillon en fonction de sa taille relative.
Dans l’éventualité beaucoup plus fréquente en sciences naturelles où l’égalité des variances ne peut être sereinement postulée, la modélisation de Welch préserve la neutralité méthodologique de l’inférence. L’erreur type de la différence se passe de variance combinée et se calcule directement par =RACINE((B4^2 / B3) + (C4^2 / C3)). Les degrés de liberté ajustés de Welch-Satterthwaite, souvent fractionnaires, s’obtiennent par une formule intégrant le rapport des erreurs types partielles, protégeant l’analyste contre toute inflation pernicieuse de l’erreur de première espèce (taux de faux positifs).
7.3 Détermination des bornes de la différence
La formalisation terminale de l’intervalle pour échantillons indépendants s’exécute en orchestrant les briques statistiques élaborées. La différence ponctuelle entre les moyennes s’implémente simplement : =B2 – C2, où B2 et C2 hébergent respectivement les moyennes empiriques du groupe expérimental et du groupe témoin. Cette différence constitue le centre de l’intervalle comparatif.
La marge d’erreur globale s’obtient ensuite par le produit du quantile t approprié et de l’erreur type combinée. En utilisant la fonction de Student bilatérale, la marge d’erreur s’écrit :
=LOI.STUDENT.INVERSE.BILATERALE(0,05; B3 + C3 – 2) * RACINE((((B3-1)*(B4^2) + (C3-1)*(C4^2))/(B3+C3-2)) * (1/B3 + 1/C3))
Les bornes inférieure et supérieure sont immédiatement obtenues en retranchant puis en additionnant cette marge d’erreur à la différence des moyennes initialement calculée.
L’analyse sémantique du résultat délivré par ces bornes est au cœur de l’interprétation scientifique moderne. La question primordiale que doit poser l’analyste est la suivante : la valeur zéro est-elle incluse ou exclue de l’intervalle de confiance calculé ? Si l’intervalle de la différence à 95 % englobe la valeur zéro (par exemple [-1,42 ; +4,85]), il est rigoureusement impossible de rejeter l’hypothèse nulle d’équivalence des deux groupes au seuil de signification de 5 %. À l’inverse, si l’intervalle exclut strictement zéro (par exemple [+0,35 ; +2,80]), l’effet comparatif est qualifié de statistiquement significatif au niveau consenti, et l’amplitude des bornes informe précisément sur la magnitude minimale et maximale plausible du gain induit par l’intervention.
8. Calcul d’intervalles de confiance pour échantillons appariés ou mesures répétées
8.1 Structure méthodologique des protocoles intra-sujets
Dans un nombre considérable de devis expérimentaux, les observations ne proviennent pas de sujets indépendants distribués dans deux bras d’étude séparés, mais d’une cohorte unique évaluée à plusieurs moments consécutifs (schéma pré-test / post-test) ou soumise successivement à deux conditions expérimentales distinctes (plan croisé ou mesures répétées). Dans cette configuration méthodologique, chaque observation de la première série entretient un lien de dépendance stochastique fondamental avec l’observation correspondante de la seconde série, puisque les deux mesures émanent de la même structure biologique, psychologique ou matérielle.
Traiter de telles données au moyen des formules pour échantillons indépendants exposées à la section précédente constituerait une faute méthodologique rédhibitoire. Ce procédé ignorerait totalement la covariance positive inter-mesures et gonflerait démesurément l’erreur type de l’analyse, masquant des effets expérimentaux bien réels. Le protocole intra-sujet vise précisément à contrôler la variabilité inter-individuelle en utilisant chaque sujet comme son propre témoin, ce qui décuple la sensibilité et la puissance statistique du dispositif de recherche.
La résolution analytique de ce problème repose sur une transformation vectorielle élémentaire mais déterminante : plutôt que de travailler sur deux colonnes de données dépendantes, l’analyste synthétise l’information sous la forme d’un vecteur différentiel unique. Pour chaque individu i, on calcule la différence individuelle Di = X_post,i – X_pre,i. Dès lors, le problème inférentiel à deux dimensions se ramène intégralement à l’estimation de la moyenne mu_D d’une population unique de scores de différence, s’inscrivant formellement dans le paradigme standard exposé à la Section 3.
8.2 Estimation statistique sur la série des différences
Au sein de Google Sheets, l’implémentation opérationnelle débute par la création d’une troisième colonne dédiée, systématiquement alignée en regard des séries sources. Supposons que les scores pré-test d’une cohorte de 25 patients soient disposés dans la plage A2:A26 et les scores post-test correspondants dans la plage B2:B26. Dans la cellule C2, l’analyste inscrit la formule différentielle =B2 – A2, qu’il propage par étirement vertical jusqu’à la ligne 26. La colonne C constitue désormais la variable aléatoire univariée des gains individuels.
Les paramètres descriptifs fondamentaux sont ensuite extraits exclusivement à partir de ce vecteur de variations relatives :
- Taille effective des paires (N) : déterminée en cellule E2 par la syntaxe =NB(C2:C26) ;
- Moyenne de l’effet d’intervention (D-barre) : calculée en E3 par la fonction =MOYENNE(C2:C26) ;
- Écart-type des différences individuelles (s_D) : obtenu en E4 par l’incontournable fonction =ECARTYPE.STANDARD(C2:C26).
L’erreur type de la série différentielle, qui mesure la fluctuation d’échantillonnage de l’effet moyen observé, s’obtient dans la cellule E5 par la formulation usuelle : =E4 / RACINE(E2). Cette grandeur synthétise à la fois la variabilité intrinsèque de la réaction des individus au protocole et la précision métrologique globale du système d’observation.
8.3 Calcul effectif de l’intervalle de l’effet moyen
L’aboutissement de l’analyse appariée s’aligne rigoureusement sur le formalisme de Student pour échantillon unique. Puisque l’estimation porte sur N paires de données couplées, le nombre de degrés de liberté associé au quantile critique correspond impérativement au nombre de paires diminué d’une unité, soit N – 1 (et non 2N – 2 comme ce serait le cas si les séries étaient indépendantes). Pour un échantillon de 25 participants, les degrés de liberté s’élèvent exactement à 24.
La marge d’erreur spécifique de l’effet moyen s’articule en cellule E6 par la formule suivante :
=LOI.STUDENT.INVERSE.BILATERALE(0,05; E2 – 1) * E5
Cette marge d’erreur reflète fidèlement la précision avec laquelle l’impact moyen de l’intervention est circonscrit au sein de la cohorte étudiée.
Enfin, les limites de l’intervalle de confiance à 95 % de l’effet moyen d’intervention se déduisent dans les cellules d’encadrement par =E3 – E6 pour la borne inférieure et =E3 + E6 pour la borne supérieure. Si, par exemple, le gain moyen calculé s’élève à +5,2 points et que l’intervalle de confiance résultant s’étend de +2,1 à +8,3 points, le chercheur peut conclure avec une assurance de 95 % que l’intervention produit un effet positif systématique dans la population parente, l’amplitude de l’effet moyen étant délimitée au sein de cette fourchette empirique hautement informative.
9. Visualisation graphique des intervalles de confiance dans Google Sheets
9.1 Configuration des diagrammes en barres avec marges d’erreur
La restitution visuelle des résultats constitue le couronnement de toute analyse quantitative, offrant une appréhension cognitive immédiate des grandeurs et des incertitudes associées. Dans Google Sheets, le diagramme en barres (ou à colonnes verticales) enrichi de barres d’erreur constitue le standard visuel prédominant dans les rapports d’activité et les publications techniques. Pour mettre en place ce visuel, l’utilisateur doit disposer d’un tableau récapitulatif condensé listant en colonne A le libellé des conditions expérimentales, en colonne B la moyenne observée de chaque condition, et en colonne C la marge d’erreur respective calculée selon les protocoles établis.
Après avoir sélectionné la plage des catégories et des moyennes (A1:B3), l’analyste sollicite l’assistant de création graphique (Insertion > Graphique) et assigne le type Graphique à colonnes. Dans le volet de personnalisation latérale, l’accès au sous-menu Séries dévoile l’option dédiée Barres d’erreur. Google Sheets permet d’activer des barres basées sur un pourcentage fixe ou un écart constant, mais pour garantir une conformité méthodologique absolue, il est impératif de sélectionner l’option Personnalisée ou Constante selon l’uniformité des marges calculées.
Lorsque les marges d’erreur diffèrent entre les groupes (ce qui est la norme empirique en raison des variations de dispersion ou d’effectif), la configuration personnalisée nécessite d’indiquer la plage spécifique contenant les demi-intervalles calculés. Google Sheets applique alors des barres de dispersion verticales parfaitement symétriques de part et d’autre du sommet de chaque barre, matérialisant avec une élégance professionnelle l’enveloppe de certitude probabiliste attachée à chaque mesure empirique.
9.2 Représentation sous forme de graphiques de dispersion avec intervalles
Bien que répandus, les diagrammes en barres essuient des critiques récurrentes au sein de la communauté académique, car ils dissimulent la densité réelle des données et consomment une surface d’encre disproportionnée pour représenter un point unique (le sommet de la barre). Le diagramme de dispersion catégoriel (souvent qualifié d’interval plot ou point plot) s’affirme comme une alternative visuelle bien supérieure selon les standards modernes de communication des données.
Pour implémenter cette représentation sous Google Sheets, on recourt à un Graphique en nuage de points où l’axe des abscisses répertorie les indices numériques des conditions ou des groupes, et l’axe des ordonnées affiche la valeur des moyennes ponctuelles. L’activation des barres d’erreur verticales sur ces points d’ancrage génère une série de segments verticaux épurés, suspendus dans l’espace graphique, dont le centre est marqué par le marqueur ponctuel de la moyenne.
Cette scénarisation visuelle permet une comparaison instantanée de plusieurs conditions expérimentales. L’œil de l’observateur évalue d’un regard le recouvrement vertical des barres d’intervalles : deux conditions dont les intervalles de confiance à 95 % ne se chevauchent pas attestent généralement d’une divergence statistiquement significative au seuil alpha classique. Inversement, un chevauchement substantiel des barres d’erreur modère instantanément l’interprétation d’une différence de moyennes qui pourrait n’être qu’un artéfact du bruit d’échantillonnage.
9.3 Bonnes pratiques graphiques selon les standards académiques
L’éthique de la visualisation de données impose le respect de canons graphiques rigoureux afin de prohiber toute manipulation perceptive délibérée ou involontaire. La règle cardinale la plus fréquemment enfreinte concerne la troncature arbitraire de l’axe des ordonnées. L’omission du zéro sur l’axe des y d’un graphique en barres exagère de façon disproportionnée des variations mineures, conférant à des fluctuations banales l’illusion d’écarts spectaculaires. Dans Google Sheets, il convient de verrouiller explicitement la borne minimale de l’axe vertical sur la valeur 0 dans les options de configuration de l’axe.
La transparence sémiotique exige par ailleurs un étiquetage textuel exhaustif et non équivoque de chaque composante graphique. Le titre du graphique et les légendes des axes ne doivent pas simplement mentionner les noms des variables, mais préciser explicitement la métrique représentée ainsi que la nature exacte des barres d’erreur déployées. Une mention textuelle standardisée telle que : Les barres d’erreur représentent l’intervalle de confiance bilatéral à 95 % fondé sur la loi de Student doit obligatoirement figurer en sous-titre ou en note de bas de graphique.
Enfin, l’analyste évitera tout encombrement visuel inutile : suppression des grilles de lecture d’arrière-plan redondantes, renonciation formelle aux effets tridimensionnels déformants (3D charts) totalement proscrits par les sciences de l’information graphique, et sélection d’une palette chromatique sobre et accessible aux personnes souffrant de déficiences de la vision des couleurs (daltonisme), assurant une lisibilité universelle et pérenne dans les publications institutionnelles.
10. Automatisation et création d’une feuille de calcul dynamique réutilisable
10.1 Modularité par la sélection dynamique du niveau de confiance
Pour transfigurer une feuille de calcul statique en un véritable outil d’aide à la décision institutionnel réutilisable indéfiniment, la modularité des paramètres d’entrée constitue un facteur déterminant. Le niveau de confiance requis par l’analyste n’est pas immuable : un audit exploratoire préliminaire peut tolérer un niveau de 90 %, une étude marketing standard réclamera 95 %, tandis qu’un essai de sécurité toxicologique ou aéronautique imposera un seuil de sévérité de 99 % ou 99,9 %.
Dans Google Sheets, cette flexibilité s’orchestre remarquablement en insérant un menu déroulant de validation de données dans la cellule de paramétrage de la confiance (par exemple la cellule C1). En accédant au menu Données > Validation des règles > Ajouter une règle, on sélectionne le critère Menu déroulant et l’on saisit les valeurs d’affichage standardisées : 90 %, 95 %, 99 %. Dans la cellule adjacente de traitement (C2), le risque alpha correspondant se déduit instantanément par une formule arithmétique transparente :
=(100 – CNUM(SUBSTITUE(C1; « % »; « »))) / 100
Grâce à cette articulation dynamique, toute modification opérée sur le menu déroulant de surface recalcule à la vitesse de l’éclair l’intégralité de l’arborescence analytique de la feuille : les quantiles z ou t s’ajustent instantanément, les marges d’erreur se dilatent ou se contractent en temps réel, et les bornes d’intervalles associées aux différents tableaux et représentations visuelles se repositionnent sur-le-champ sans la moindre réécriture d’équations.
10.2 Utilisation des plages nommées et des références absolues
L’une des vulnérabilités majeures des feuilles de calcul étendues réside dans l’opacité cryptique des coordonnées matricielles brutes. Une formule faisant référence à =B2-LOI.STUDENT.INVERSE.BILATERALE($C$2;$A$1-1)*($D$2/RACINE($A$1)) s’avère cognitivement fastidieuse à auditer et hautement propice aux erreurs de frappe lors des opérations de maintenance. Pour pallier ce travers structurel, Google Sheets propose le mécanisme des Plages nommées (accessible via Données > Plages nommées).
En assignant des identifiants sémantiques clairs aux cellules fondamentales du tableau — en nommant par exemple Moyenne_Ech la cellule de moyenne empirique, Ecart_Type_Ech la cellule de dispersion, Taille_N l’effectif valide et Alpha_Risque le niveau d’erreur —, la formule de calcul de la marge d’erreur gagne une lisibilité conceptuelle absolue, s’énonçant simplement ainsi :
=INTERVALLE.CONFIANCE.STUDENT(Alpha_Risque; Ecart_Type_Ech; Taille_N)
Parallèlement, la maîtrise des références absolues (matérialisées par le symbole dollar $) demeure indispensable lorsque des formules scalaires doivent être dupliquées par étirement sans subir de translations d’adresses non désirées. L’adressage strict garantit que pendant que la référence relative de la ligne d’observation se décale vers le bas, les pointeurs d’ancrage vers le seuil de confiance et les paramètres critiques demeurent inaltérablement immobiles.
10.3 Gestion des exceptions et contrôle de la qualité des données
Un gabarit analytique de niveau professionnel doit présenter une résilience irréprochable face aux données incomplètes, aux valeurs invalides ou aux scénarios aux limites susceptibles de générer des messages d’erreur système disgracieux (tels que #DIV/0!, #VALEUR! ou #NOMBRE!). L’inclusion préventive de structures de contrôle logique protège la fluidité visuelle et la sécurité opérationnelle du classeur.
La première ligne de défense réside dans la fonction SIERREUR, qui intercepte toute exception logicielle pour restituer une valeur de repli neutre ou un message d’orientation explicite. Ainsi, le calcul de l’erreur type s’encapsulera judicieusement dans la structure protectrice suivante :
=SIERREUR(ECARTYPE.STANDARD(Donnees_Brutes) / RACINE(NB(Donnees_Brutes)); « Effectif insuffisant »)
Par ailleurs, des conditions de garde substantielles doivent être dressées pour vérifier que les présupposés mathématiques minimaux sont satisfaits. Si l’effectif n est inférieur à 2, le calcul de l’écart-type d’échantillon est algébriquement impossible puisque les degrés de liberté s’annulent. De surcroît, si la dispersion est nulle (toutes les observations affichant une valeur strictement identique), la marge d’erreur s’effondre à zéro, ce qui dénote généralement une anomalie dans le recueil des données. L’implémentation de la fonction SI couplée à des règles de mise en forme conditionnelle alertant visuellement l’opérateur (fond de cellule écarlate en cas de taille n inférieure au seuil critique) confère à la feuille de calcul une robustesse applicative digne des logiciels d’audit les plus exigeants.
11. Interprétation académique et pièges fréquents dans Google Sheets
11.1 Erreurs techniques et fonctionnelles récurrentes dans le logiciel
L’ergonomie apparente des tableurs dissimule des pièges statistiques sournois dans lesquels trébuchent fréquemment même des analystes confirmés. L’écueil technique le plus universel au sein de Google Sheets réside dans la confusion funeste entre la fonction ECARTYPE.STANDARD et la fonction ECARTYPE.POPULATION. Lorsque l’analyste manipule un échantillon d’observations, l’usage de ECARTYPE.POPULATION sous-estime systématiquement la véritable dispersion en divisant par n au lieu de n – 1. Cette sous-évaluation de l’écart-type se répercute en cascade sur l’erreur type, comprimant artificiellement la marge d’erreur et délivrant un intervalle trompeusement étroit qui enfreint la rigueur méthodologique la plus élémentaire.
Un deuxième écueil majeur procède d’une mauvaise appréhension des paramètres d’orientation des lois de probabilité. Les fonctions de Google Sheets oscillent historiquement entre des formulations unilatérales (queue unique) et bilatérales (deux queues). L’affectation par inadvertance du risque alpha total dans une fonction unilatérale sans le diviser par 2 a pour conséquence désastreuse de modéliser un intervalle asymétrique ou correspondant en réalité à un niveau de confiance distinct de celui affiché. Une telle distorsion compromet gravement la validité des conclusions scientifiques publiées.
Enfin, une négligence algorithmique récurrente consiste à utiliser l’écart-type brut s au lieu de l’erreur type dans le produit de marge d’erreur, omettant purement et simplement la division par la racine carrée de l’effectif n. L’amplitude de l’intervalle se trouve alors multipliée par un facteur racine de n, générant un segment d’une largeur aberrante qui englobe la quasi-totalité de l’espace des données, confondant grossièrement la variabilité des individus avec l’incertitude pesant sur l’estimateur de la moyenne.
11.2 Mésinterprétations conceptuelles de l’intervalle de confiance
L’exactitude des formules matricielles au sein du tableur ne garantit nullement l’absence d’aberrations épistémologiques dans l’exégèse des résultats. La fallacie probabiliste la plus incrustée consiste à formuler l’assertion suivante : Il y a 95 % de chances que la moyenne de la population se situe entre la borne A et la borne B. Pour un statisticien fréquentiste, cette phrase est dénuée de sens : la moyenne de la population est un paramètre déterministe fixe, il ne possède aucune distribution de probabilité a posteriori. Seul l’intervalle est stochastique. L’interprétation rigoureuse impose d’énoncer : Si cette procédure d’échantillonnage était répétée indéfiniment, 95 % des intervalles de confiance ainsi construits recouvriraient la véritable moyenne de la population.
Une seconde confusion d’une gravité méthodologique extrême assimile l’intervalle de confiance à un intervalle de prédiction ou de tolérance. L’intervalle de confiance circonscrit l’emplacement de l’estimateur de position collective (la moyenne mu) ; il n’est aucunement conçu pour circonscrire les valeurs futures d’observations individuelles. L’intervalle de prédiction — qui quantifie l’incertitude entourant le résultat d’un sujet singulier extrait de la population — est considérablement plus étendu, car il doit additionner la variance d’échantillonnage de la moyenne et la variabilité individuelle intrinsèque de chaque sujet.
De même, l’absence de chevauchement entre deux intervalles de confiance indépendants constitue une condition suffisante mais nullement nécessaire pour attester d’une différence statistiquement significative. Deux estimations ponctuelles peuvent tout à fait afficher des intervalles de confiance à 95 % qui se recouvrent modérément, tout en présentant un test t de Student de comparaison de moyennes significatif au seuil p inférieur à 0,05. L’inférence comparative rigoureuse exige impérativement le calcul explicite de l’intervalle de la différence (détaillé à la Section 7) plutôt que la simple juxtaposition oculaire de deux intervalles marginaux isolés.
11.3 Normes de rédaction et communication scientifique des résultats
La communication des résultats quantitatifs au sein de la littérature scientifique arbitrée par les pairs est soumise à des normes de standardisation typographique strictes, au premier rang desquelles figurent les prescriptions de l’American Psychological Association (APA, 7e édition). Selon ces standards, tout rapport statistique d’une tendance centrale doit être indéfectiblement accompagné de son intervalle de confiance, formulé selon une typographie normalisée précisant la métrique, le niveau nominal et les bornes exactes entre crochets.
L’articulation rédactionnelle d’un résultat empirique conforme aux normes académiques s’illustre par le modèle de formulation suivant : Le score moyen de performance cognitive observé sous la condition expérimentale est substantiellement plus élevé (M = 114,35, ET = 12,40) que sous la condition de contrôle (M = 102,10, ET = 11,85), t(58) = 3,91, p < ,001, 95 % IC [6,98 ; 17,52]. L’inclusion explicite de l’intervalle encadrant la différence d’effets apporte la démonstration probante de la robustesse de l’expérimentation, contextualisant le gain moyen dans un corridor d’incertitude parfaitement balisé.
Dans les textes francophones, l’analyste veillera scrupuleusement au respect des règles typographiques nationales : l’utilisation exclusive de la virgule comme séparateur décimal (contrairement au point anglo-saxon) et l’insertion d’espaces insécables avant les signes de pourcentage ou à l’intérieur des crochets délimitant les bornes d’estimation. Enfin, la plus grande transparence méthodologique est requise dans le corps du texte quant au modèle mathématique employé sous Google Sheets, en spécifiant si l’intervalle procède de la loi de Student univariée, d’une approximation normale asymptotique ou d’une correction spécifique de type Agresti-Coull pour les proportions.
12. Étude de cas pratique intégrale : de la saisie brute à la conclusion empirique
12.1 Présentation du protocole et saisie des données brutes
Afin de synthétiser l’ensemble des concepts théoriques et opérationnels déployés tout au long de ce guide, considérons une investigation expérimentale concrète menée dans un laboratoire de neuroergonomie cognitive. L’étude se propose d’évaluer l’impact d’une interface homme-machine innovante à guidage prédictif sur le temps de réaction d’opérateurs de vol soumis à un environnement saturé en stimuli critiques. Un groupe expérimental composé de 20 pilotes sélectionnés aléatoirement est soumis au protocole chronométrique, les données étant consignées en millisecondes.
Au sein d’un nouveau classeur Google Sheets, l’opérateur structure sa matrice de travail en intitulant la cellule A1 Temps_Reaction_ms. Les vingt observations individuelles consécutives sont rigoureusement répertoriées dans les cellules A2 à A21 : 245, 268, 252, 280, 265, 272, 259, 291, 248, 263, 277, 285, 254, 269, 273, 261, 288, 256, 270 et 264. L’inspection visuelle préliminaire ne révèle aucune valeur négative ou manifestement aberrante (toutes les mesures s’inscrivent dans un corridor plausible entre 240 et 300 millisecondes).
Dans la zone périphérique du classeur dévolue aux paramètres de configuration méthodologique, l’analyste assigne la cellule D1 au libellé Niveau de Confiance et fixe sa valeur numérique à 0,95 (formaté en pourcentage 95 %). En cellule D2, il transcrit le calcul du risque alpha sous-jacent : =1 – D1, affichant instantanément le seuil d’exclusion bilatéral de 0,05. Le protocole est désormais opérationnel pour l’extraction computationnelle des propriétés de la série d’observations.
12.2 Mise en œuvre pas-à-pas des formules d’estimation
L’analyste déploie l’architecture des calculs statistiques descriptifs et inférentiels dans une colonne dédiée (colonne E), étiquetée de façon univoque :
- Taille d’échantillon effectif (Cellule E4) : =NB(A2:A21) délivre la valeur n = 20 ;
- Degrés de liberté (Cellule E5) : =E4 – 1 délivre nu = 19 ;
- Moyenne d’échantillon (Cellule E6) : =MOYENNE(A2:A21) délivre x-barre = 267,00 ms ;
- Écart-type échantillonnal non biaisé (Cellule E7) : =ECARTYPE.STANDARD(A2:A21) délivre s = 12,6985 ms ;
- Erreur type de la moyenne (Cellule E8) : =E7 / RACINE(E4) délivre SE = 2,8395 ms.
L’estimation inférentielle de la marge d’erreur s’opère ensuite en mobilisant simultanément les deux méthodologies complémentaires développées dans cet ouvrage à des fins d’audit croisé et de validation numérique :
Première méthode (décomposition analytique de Student en cellule E9) :
=LOI.STUDENT.INVERSE.BILATERALE(D2; E5) * E8
Le quantile critique t s’établissant à 2,0930 pour 19 degrés de liberté, la marge d’erreur calculée est rigoureusement égale à 5,943 ms.
Seconde méthode (fonction d’encadrement native en cellule E10) :
=INTERVALLE.CONFIANCE.STUDENT(D2; E7; E4)
Le logiciel renvoie sans la moindre déviation la valeur identique de 5,943 ms, confirmant l’exactitude de l’implémentation algorithmique.
Les bornes terminales de l’intervalle de confiance sont fixées dans les cellules ultimes de synthèse :
- Borne inférieure (Cellule E11) : =E6 – E9 renvoie 261,06 ms ;
- Borne supérieure (Cellule E12) : =E6 + E9 renvoie 272,94 ms.
12.3 Audit des résultats et formalisation du rapport académique
L’analyse métrologique de l’intervalle obtenu atteste d’une grande compacité : la marge d’erreur globale n’excède pas 2,23 % de la valeur moyenne de la métrique temporelle, confirmant la haute stabilité instrumentale du dispositif de mesure. Les vérifications de forme (évaluation du coefficient d’asymétrie égal à +0,22 via COEFFICIENT.ASYMETRIE(A2:A21) et du kurtosis égal à -0,61 via KURTOSIS(A2:A21)) corroborent l’adéquation distributionnelle de la loi de Student, aucun écart rédhibitoire à la normalité n’étant constaté sur cette cohorte de 20 pilotes.
L’analyste formalise ensuite le rapport de communication académique terminal, destiné à être intégré sans modification au sein du manuscrit scientifique soumis à publication :
L’analyse chronométrique des vingt pilotes opérant sous l’interface prédictive met en évidence un temps de réaction moyen de 267,00 ms (ET = 12,70 ms). L’intervalle de confiance bilatéral à 95 % calculé selon le modèle exact de Student pour 19 degrés de liberté délimite l’espérance mathématique de la population parente entre 261,06 ms et 272,94 ms (SE = 2,84 ms). Ces résultats empiriques apportent la confirmation probante que le temps moyen d’activation cognitive dans cette population de référence demeure, sous un niveau de confiance de 95 %, strictement circonscrit en deçà du seuil opérationnel critique standard de 275 millisecondes fixé par les autorités de sécurité aérienne.
Enfin, le classeur Google Sheets est verrouillé et documenté conformément aux principes fondamentaux de la science ouverte (Open Science) : les cellules de formules sont protégées contre les modifications accidentelles via Données > Feuilles et plages protégées, et l’historique des versions est archivé pour assurer une traçabilité totale et une reproductibilité expérimentale absolue par l’ensemble de la communauté scientifique internationale.
Références
- Agresti, A., & Coull, B. A. (1998). Approximate is better than « exact » for interval estimation of binomial proportions. The American Statistician, 52(2), 119-126. https://doi.org/10.1080/00031305.1998.10480550
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cumming, G. (2012). Understanding the new statistics: Effect sizes, confidence intervals, and meta-analysis. Routledge.
- Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Google. (2024). Aide Éditeurs Google Docs : Liste des fonctions de Google Sheets. Google Support. https://support.google.com/docs/table/25219
- Hogg, R. V., McKean, J., & Craig, A. T. (2018). Introduction to mathematical statistics (8th ed.). Pearson.
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333-380. https://doi.org/10.1098/rsta.1937.0005
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28-35. https://doi.org/10.1093/biomet/34.1-2.28
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209-212. https://doi.org/10.1080/01621459.1927.10502953