
Dans le champ contemporain de la recherche biomédicale, épidémiologique et comportementale, la quantification de l’efficacité d’une intervention ou de l’impact d’une exposition environnementale constitue le socle de la démarche translationnelle. Les chercheurs ne peuvent se satisfaire de simples constats descriptifs ou d’intuitions qualitatives ; ils doivent modéliser avec précision la probabilité d’apparition d’un événement clinique ou psychologique donné au sein de sous-populations distinctes. Le risque relatif (RR) s’impose historiquement comme l’une des métriques les plus intuitives, élégantes et puissantes pour saisir cette dynamique comparative. En rapportant l’incidence d’un phénomène observé dans un groupe exposé à celle mesurée au sein d’un groupe témoin, il fournit une mesure d’association directe qui résonne immédiatement auprès des cliniciens, des praticiens de la santé publique et des décideurs politiques.
Cependant, l’estimation ponctuelle du risque relatif issue d’un échantillon empirique ne reflète jamais qu’une réalisation singulière d’un processus stochastique sous-jacent. En raison des fluctuations inhérentes à l’échantillonnage aléatoire, toute valeur calculée comporte une part irréductible d’incertitude qui interdit toute généralisation naïve à la population cible. Dans les sciences empiriques, considérer un estimateur sans son indice de variabilité équivaut à ignorer la vulnérabilité intrinsèque des données face au hasard. C’est précisément à ce niveau d’exigence épistémologique qu’intervient la construction de l’intervalle de confiance (généralement fixé à 95 %), instrument indispensable de l’inférence fréquentiste qui délimite la zone de plausibilité du paramètre populationnel réel au regard des observations recueillies.
Le calcul rigoureux d’un intervalle de confiance pour le risque relatif présente toutefois une complexité mathématique singulière : la distribution d’échantillonnage du ratio de deux proportions empiriques est intrinsèquement asymétrique, bornée inférieurement par zéro et potentiellement infinie vers le haut. Cette distorsion géométrique rend l’application directe des lois normales standards totalement caduque sur l’échelle naturelle. Pour contourner cette limite théorique, les statisticiens recourent à une manœuvre élégante fondée sur la transformation logarithmique népérienne et la méthode Delta, permettant de normaliser la variance asymptotique avant d’opérer une rétro-transformation exponentielle. Le présent article propose une exploration intégrale, méthodique et exhaustive des fondements théoriques, des déductions mathématiques et des applications pratiques de cette procédure fondamentale dans l’analyse des données d’essais contrôlés et d’études de cohortes.
1. Fondements conceptuels du risque relatif dans la recherche psychologique et clinique
1.1 Définition et signification théorique du risque relatif (RR)
Le risque relatif, désigné conventionnellement par l’acronyme RR, est une mesure épidémiologique et biostatistique fondamentale définie comme le rapport entre deux probabilités conditionnelles cumulées. Dans le cadre d’un protocole d’observation prospectif ou d’un essai expérimental, il exprime le rapport de la probabilité d’apparition d’un critère de jugement spécifique (survenue d’une pathologie, rémission clinique, rechute comportementale ou succès thérapeutique) chez les individus soumis à une condition ou exposition particulière, comparativement à la probabilité de survenue de ce même événement chez des individus non exposés ou soumis à une condition témoin. D’un point de vue purement probabiliste, si l’on note E l’état d’exposition et M la survenue de l’événement d’intérêt, le risque relatif s’énonce formellement comme le ratio de la probabilité conditionnelle P(M|E) sur la probabilité conditionnelle P(M|non-E). Cette formulation met en lumière la nature multiplicative de l’indicateur, qui synthétise le changement proportionnel du risque attribué au facteur étudié.
Il est crucial de maintenir une distinction épistémologique limpide entre le risque relatif, le risque absolu et la réduction du risque absolu (RRA). Le risque absolu représente la probabilité brute, intrinsèque, qu’un événement survienne au sein d’un sous-groupe donné sur un intervalle temporel défini, sans mise en relation comparative avec un groupe témoin. À l’inverse, la réduction absolue du risque correspond à la différence arithmétique simple entre le risque mesuré dans le groupe exposé et celui relevé dans le groupe témoin. Alors que la différence de risque informe directement sur l’impact net en termes de nombre de cas évités ou générés au sein de la population générale, le risque relatif quantifie la force biologique ou psychologique sous-jacente de l’association. Dans les études évaluant l’efficacité d’interventions psychothérapeutiques, comportementales ou neuropsychologiques, le risque relatif offre une lecture standardisée et invariante d’échelle, permettant de juger de la magnitude de l’effet produit indépendamment de la prévalence basale de l’événement au sein de la communauté générale.
Sur le plan méthodologique, la validité conceptuelle et mathématique du calcul du risque relatif est strictement tributaire du schéma d’échantillonnage employé par les chercheurs. Le risque relatif n’est calculable de manière non biaisée que lorsque le plan d’étude permet de déterminer directement l’incidence de l’événement, c’est-à-dire le nombre de nouveaux cas survenus au sein d’une population initialement indemne suivie au fil du temps. Par conséquent, les devis de recherche éligibles sont exclusivement les études de cohortes prospectives (ou rétrospectives rigoureusement constituées à partir de registres complets) et les essais cliniques randomisés (ECR). Dans ces contextes longitudinaux, le dénominateur de chaque groupe correspond à l’effectif total des sujets engagés au départ sous une condition précise, ce qui autorise le calcul direct de la proportion cumulative de survenue du critère évalué. En revanche, dans les études cas-témoins où les sujets sont sélectionnés rétrospectivement sur la base de leur statut pathologique avéré, le dénominateur de la population sous-jacente reste inconnu, interdisant le recours direct à cette mesure.
1.2 Rôle des mesures d’association dans les sciences du comportement
Dans l’écosystème des sciences du comportement et de la psychiatrie expérimentale, la modélisation des dynamiques humaines requiert des indicateurs capables d’isoler l’influence de variables indépendantes sur des trajectoires cliniques complexes. Les mesures d’association, au premier rang desquelles figure le risque relatif, permettent d’opérationnaliser et de quantifier la force du lien reliant des variables d’exposition psychosociales (comme l’exposition à un traumatisme infantile, le niveau de précarité socio-économique ou l’observance d’un programme de méditation de pleine conscience) et un critère de jugement clinique binaire. Ce critère peut être négatif, à l’instar de la rechute dépressive majeure, de l’abandon thérapeutique ou de la décompensation anxieuse, ou positif, tel que la rémission symptomatique stabilisée, l’insertion professionnelle durable ou la réussite à un protocole de réhabilitation cognitive.
L’utilisation du risque relatif en psychologie clinique permet d’abandonner le paradigme purement descriptif fondé sur de simples pourcentages intra-groupes pour accéder à une évaluation formelle de l’efficacité comparative. Prenons le cas emblématique de l’adhésion à une thérapie cognitivo-comportementale (TCC) digitalisée comparée à une thérapie conventionnelle en cabinet : la mise en évidence d’un risque relatif d’abandon de 0,65 indique que le groupe exposé au format digital présente une réduction de 35 % du risque d’interrompre prématurément sa prise en charge par rapport au groupe témoin. Une telle quantification ne se contente pas de documenter une variation ; elle fournit une métrique standardisée permettant de comparer des protocoles cliniques concurrents, d’alimenter les méta-analyses contemporaines et d’appuyer les décisions d’allocation de ressources fondées sur des preuves factuelles au sein des institutions de santé mentale.
En outre, l’intégration du risque relatif dans la recherche translationnelle en psychologie assure un pont conceptuel entre les modèles étiopathogéniques fondamentaux et les politiques publiques de prévention. En évaluant comment des facteurs de stress environnementaux modifient le risque d’émergence de troubles psychopathologiques sévères, les chercheurs peuvent identifier des leviers d’action prioritaires. Par exemple, l’estimation d’un risque relatif élevé de dépendance aux substances chez les adolescents exposés à des violences intrafamiliales permet de modéliser avec précision l’impact potentiel de programmes préventifs ciblés. La modélisation de ces rapports de risque permet ainsi de dépasser le cadre strict de l’observation pour concevoir des interventions empiriques dont l’efficacité préventive peut être validée de manière tangible et reproductible.
2. Structure et formalisation mathématique de la table de contingence 2×2
2.1 Anatomie de la table de contingence standardisée
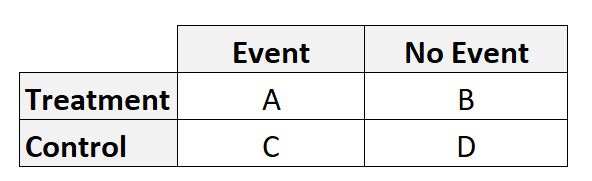
L’analyse empirique du risque relatif s’appuie universellement sur la structure matricielle de la table de contingence 2×2, dispositif algébrique fondamental croisant deux variables qualitatives dichotomiques : le statut d’exposition ou d’intervention (généralement disposé en lignes) et le statut de l’événement ou critère de jugement clinique (disposé en colonnes). Cette disposition standardisée permet d’agréger la totalité des données d’un essai ou d’une cohorte en quatre cellules cardinales mutuellement exclusives, garantissant une lisibilité optimale et servant de substrat numérique à l’ensemble des dérivations probabilistes ultérieures.
La formalisation conventionnelle affecte des lettres majuscules latines aux effectifs absolus dénombrés dans chacune des cellules :
- Cellule A : Sujets exposés au facteur d’intérêt (ou inclus dans le groupe expérimental) chez lesquels l’événement clinique considéré s’est produit au cours de la période d’observation (exposés / événement).
- Cellule B : Sujets exposés au facteur d’intérêt chez lesquels l’événement clinique ne s’est pas produit durant l’intervalle d’étude (exposés / non-événement).
- Cellule C : Sujets non exposés (ou affectés au groupe témoin / contrôle) chez lesquels l’événement d’intérêt a été constaté (non-exposés / événement).
- Cellule D : Sujets non exposés chez lesquels l’événement d’intérêt ne s’est pas manifesté (non-exposés / non-événement).
À partir de cette configuration quadripartite, les totaux marginaux de lignes et de colonnes s’établissent avec rigueur. La somme marginale de la première ligne, notée (A + B), correspond au sous-total de l’ensemble des individus soumis à l’exposition d’intérêt, constituant la taille de l’échantillon du groupe expérimental. De même, la somme marginale de la seconde ligne, (C + D), quantifie la taille de la cohorte témoin. Les totaux marginaux de colonnes agrègent quant à eux la distribution globale de l’événement : (A + C) représente le nombre total d’événements enregistrés dans l’ensemble de l’essai, tandis que (B + D) synthétise le nombre total d’individus indemnes de l’événement. La somme de l’ensemble des cellules, égale à (A + B + C + D), définit l’effectif global N de l’étude.
2.2 Formulation des probabilités conditionnelles d’incidence
La conversion des décomptes bruts de la table de contingence en mesures épidémiologiques repose sur la modélisation des probabilités conditionnelles d’incidence cumulée au sein de chacun des bras d’étude. Chez les sujets appartenant à la strate exposée, le risque empirique de survenue de l’événement, formellement désigné par la proportion p1 (ou parfois R1), s’obtient en divisant le nombre de cas incidents observés dans ce groupe par l’effectif total exposé initialement suivi. Algébriquement, cette proportion s’énonce sous la forme : p1 = A / (A + B). Cette grandeur constitue l’estimateur de la probabilité conditionnelle théorique P(M = 1 | E = 1).
De manière parfaitement symétrique, le risque empirique mesuré chez les sujets non exposés ou témoins, noté p0 (ou R0), correspond au rapport entre le nombre de cas incidents apparus dans le groupe contrôle et l’effectif marginal total de ce groupe. Son expression formelle est donnée par le ratio : p0 = C / (C + D). Cette quantité représente l’estimateur sans biais de la probabilité conditionnelle théorique P(M = 1 | E = 0). L’ensemble de l’édifice mathématique du risque relatif repose donc exclusivement sur le ratio de ces deux ratios marginaux d’incidence.
D’un point de vue inférentiel, ces deux proportions empiriques sont modélisées comme des réalisations de variables aléatoires suivant chacune une loi binomiale indépendante. Sous l’hypothèse d’indépendance mutuelle des observations individuelles et pour une probabilité d’événement constante au sein de chaque groupe, le nombre d’événements A suit une distribution binomiale B(A + B, pi1), et le nombre d’événements C suit une distribution binomiale B(C + D, pi0), où pi1 et pi0 représentent les paramètres d’incidence vrais de la population parente. Cette nature binomiale sous-jacente est essentielle, car elle conditionne la forme de la variance d’échantillonnage de chaque proportion et dicte la structure mathématique des erreurs types requises pour les intervalles de confiance.
3. Dérivation mathématique de l’estimateur ponctuel du risque relatif
3.1 Équation standard du risque relatif
L’estimateur ponctuel du risque relatif, souvent noté chapeau RR ou simplement RR dans les publications empiriques, s’obtient par la mise en rapport direct des deux proportions d’incidence cumulée précédemment dérivées. En combinant leurs expressions algébriques respectives, l’équation universelle du risque relatif dans une table 2×2 se structure ainsi : RR = p1 / p0 = [A / (A + B)] / [C / (C + D)]. Cette formulation montre sans ambiguïté que le risque relatif est le quotient de deux fractions, ce qui lui confère une propriété adimensionnelle : les unités de mesure temporelles ou d’échelle disparaissent au profit d’un coefficient multiplicatif pur.
L’interprétation de la valeur numérique générée par cet estimateur s’articule autour de trois paliers phénoménologiques clairs :
- La valeur nulle (RR = 1,0) : Indique une stricte équivalence d’incidence entre les deux groupes (p1 = p0). L’exposition étudiée n’exerce aucune influence discernable sur la survenue de l’événement ; il y a indépendance stochastique totale entre l’exposition et le critère de jugement.
- L’effet délétère ou favorisant (RR > 1,0) : L’incidence est quantitativement supérieure dans le groupe exposé par rapport au groupe témoin (p1 > p0). L’exposition majore le risque d’apparition du phénomène clinique. Par exemple, un RR de 1,80 signifie que les sujets exposés présentent un risque accru de 80 % par rapport aux non-exposés.
- L’effet protecteur ou préventif (RR < 1,0) : L’incidence est plus faible chez les exposés que chez les témoins (p1 < p0). L’intervention ou l’exposition réduit la probabilité de survenue de l’événement. Par exemple, un RR de 0,40 dénote une baisse relative de 60 % du risque d’apparition du critère par rapport au groupe contrôle.
Bien que cette valeur ponctuelle fournisse un condensé informatif immédiat, elle demeure extrêmement vulnérable aux fluctuations d’échantillonnage. Dans des études de taille modeste, le déplacement d’un unique événement d’une cellule vers une autre (par exemple, un événement clinique passant de B à A) peut modifier substantiellement la magnitude du ratio calculé. Cette instabilité structurelle démontre l’inanité d’une interprétation clinique exclusive de la valeur ponctuelle sans prise en compte rigoureuse de la marge d’erreur environnante.
3.2 Propriétés asymptotiques et asymétrie de distribution
L’étude mathématique approfondie du comportement d’échantillonnage de l’estimateur ponctuel RR révèle une contrainte théorique fondamentale : sa distribution d’échantillonnage est profondément asymétrique, non linéaire et hautement hétéroscédastique sur son échelle d’origine. Cette distorsion découle du fait que le risque relatif est restreint par une borne inférieure absolue stricte fixée à 0 (l’incidence ne pouvant être négative), tandis qu’il est potentiellement infini vers la droite. Par conséquent, l’espace représentant les effets protecteurs est artificiellement compressé dans un intervalle fermé restreint compris entre 0 et 1, alors que l’espace décrivant les effets délétères s’étend de manière ouverte et exponentielle de 1 à l’infini positif.
Cette asymétrie structurelle a pour conséquence qu’un doublement du risque (RR = 2,0) et une division par deux du risque (RR = 0,5) représentent des modifications biologiques d’amplitude équivalente mais de sens opposé. Or, sur l’échelle arithmétique linéaire, la distance séparant 1,0 de 2,0 (écart arithmétique de +1,0) est doublement supérieure à la distance séparant 0,5 de 1,0 (écart arithmétique de -0,5). Si l’on tentait de modéliser directement la distribution d’échantillonnage de l’estimateur RR brut sous l’égide d’une loi normale gaussienne, l’étalement de la queue de distribution droite violerait grossièrement les postulats de symétrie, générant des bornes d’intervalles inférieures absurdes, fréquemment négatives, ce qui est mathématiquement et biologiquement impossible.
Cette non-linéarité fondamentale empêche toute application valide du théorème central limite directement sur le ratio p1 / p0 pour les échantillons de taille finie. L’estimateur brut ne possède pas une variance d’échantillonnage stable ; sa variance est fonction directe de la magnitude même du paramètre, explosant lorsque le risque du groupe témoin tend vers zéro. Cette propriété interdit l’usage des techniques classiques d’intervalles symétriques de Wald de la forme [RR ± z * SE(RR)]. Il devient donc impératif de recourir à des transformations mathématiques adaptées pour stabiliser la variance et redresser la distribution d’échantillonnage afin de rétablir les conditions nécessaires à l’inférence asymptotique robuste.
4. Nécessité de l’intervalle de confiance pour l’inférence statistique
4.1 Limites inhérentes à l’estimation ponctuelle unique
Dans la démarche scientifique contemporaine régie par l’épistémologie de Karl Popper et la statistique inférentielle, présenter une estimation ponctuelle sans documenter son niveau de précision constitue une défaillance méthodologique majeure. L’estimateur ponctuel calculé à partir d’un échantillon fini n’est jamais qu’une approximation ponctuelle du paramètre inconnu de la population globale. Cette estimation est inévitablement parasitée par l’erreur d’échantillonnage aléatoire, les fluctuations stochastiques et la sensibilité aux biais de sélection non décelés. Deux études conduites sous des protocoles identiques sur deux échantillons distincts de même taille issus de la même population globale fourniront inéluctablement deux valeurs de risque relatif différentes.
Se fier aveuglément à une estimation ponctuelle isole le chercheur dans ce que les méthodologistes nomment l’illusion de précision. Par exemple, observer un risque relatif de 1,50 dans un essai portant sur 20 sujets n’a absolument pas la même portée empirique ni la même fiabilité qu’observer exactement ce même risque relatif de 1,50 au sein d’une cohorte prospective regroupant 20 000 participants. Dans le premier cas, la variabilité d’échantillonnage est colossale, et un rééchantillonnage aléatoire pourrait aisément produire un risque inférieur à 1,0 ; dans le second cas, l’immense taille de la cohorte confère à la mesure une stabilité et une fidélité statistiques remarquables.
De surcroît, la crise de la reproductibilité qui a traversé la psychologie expérimentale et les neurosciences comportementales au cours des deux dernières décennies a démontré les dangers inhérents aux conclusions hâtives tirées de simples estimations ponctuelles associées à des seuils de p-valeur arbitraires. La focalisation excessive sur l’estimation ponctuelle favorise les faux positifs et l’amplification artificielle de la taille de l’effet dans les études sous-puissantes. La quantification de l’incertitude via un intervalle devient le garant d’une posture scientifique prudente, permettant d’exposer en toute transparence la zone de compatibilité entre les données empiriques recueillies et la réalité populationnelle sous-jacente.
4.2 Apport conceptuel de l’intervalle de confiance à 95 %
L’intervalle de confiance à 95 %, conceptualisé originellement par Jerzy Neyman en 1937, propose un cadre inférentiel fréquentiste élégant pour surmonter l’impasse de l’estimation ponctuelle. Sa définition formelle est rigoureuse : si l’on répétait une expérience ou un protocole d’échantillonnage une infinité de fois dans des conditions méthodologiques rigoureusement identiques, et que l’on calculait pour chaque échantillon extrait un intervalle de confiance à 95 % selon la même règle mathématique, exactement 95 % de ces intervalles construits recouvriraient la valeur vraie et immuable du paramètre populationnel inconnu, tandis que 5 % échoueraient à l’englober. L’intervalle obtenu sur un échantillon donné ne garantit pas une probabilité bayésienne de 95 % que le paramètre s’y trouve, mais atteste que la procédure ayant mené à sa dérivation est fiable dans 95 % des situations d’échantillonnage possibles.
Il existe un lien théorique et algébrique direct entre l’intervalle de confiance bilatéral à 95 % et le test d’hypothèse statistique bilatéral paramétré au seuil de signification alpha de 0,05. L’intervalle de confiance regroupe l’ensemble des valeurs d’hypothèses nulles qui ne seraient pas rejetées au seuil alpha de 5 %. Cette correspondance offre une règle de décision immédiate pour les praticiens :
- Exclusion de la valeur nulle (1,0) : Si l’intervalle de confiance à 95 % ne contient pas la valeur 1,0 (par exemple, IC95 % [1,15 ; 2,51] ou IC95 % [0,45 ; 0,82]), le chercheur peut rejeter l’hypothèse nulle d’indépendance avec un niveau de confiance de 95 %. L’association observée est statistiquement significative au seuil alpha de 0,05 (p < 0,05).
- Inclusion de la valeur nulle (1,0) : Si l’intervalle de confiance à 95 % englobe la valeur 1,0 (par exemple, IC95 % [0,85 ; 1,65]), l’hypothèse nulle ne peut être rejetée au seuil conventionnel de 5 %. Les données empiriques sont statistiquement compatibles avec l’absence totale d’effet ou de différence d’incidence entre les groupes étudiés (p > 0,05).
L’avantage cardinal de l’intervalle de confiance sur le simple affichage d’une valeur p réside dans sa dimension informative bidimensionnelle : il informe simultanément sur la direction et la force plausible de l’effet clinique tout en quantifiant la précision métrique de l’estimation. Un intervalle très étroit reflète une puissance statistique optimale et une incertitude minime, permettant des décisions cliniques péremptoires. À l’inverse, un intervalle excessivement large, quand bien même il rejetterait la valeur nulle, révèle une imprécision méthodologique appelant à la réserve et à la réplication sur des cohortes plus massives.
5. La transformation logarithmique et la normalisation d’échantillonnage
5.1 Fondement théorique de la transformation log(RR)
Face à l’impossibilité de modéliser directement la variabilité du risque relatif sur son échelle arithmétique d’origine en raison de son asymétrie structurelle, les mathématiciens exploitent la transformation logarithmique naturelle (ou logarithme népérien, noté ln). Cette opération analytique constitue la pierre angulaire de l’inférence moderne sur les ratios. En appliquant la fonction continue strictement croissante ln(x) aux valeurs du risque relatif, on projette l’espace de définition initial ]0, +infini[ sur l’axe des nombres réels ]-infini, +infini[, supprimant la contrainte artificielle de la borne inférieure à zéro.
Cette projection mathématique redresse l’asymétrie de manière spectaculaire :
- La valeur nulle du risque relatif d’origine (RR = 1,0) correspond désormais au point zéro exact : ln(1,0) = 0.
- Les effets protecteurs, initialement comprimés entre 0 et 1, s’étalent harmonieusement sur toute la demi-droite des nombres réels négatifs : si RR = 0,5, alors ln(0,5) ≈ -0,693 ; si RR = 0,1, alors ln(0,1) ≈ -2,302.
- Les effets délétères s’étendent symétriquement sur la demi-droite des nombres réels positifs : si RR = 2,0, alors ln(2,0) ≈ +0,693 ; si RR = 10, alors ln(10) ≈ +2,302.
Grâce à cette linéarisation bijective, un doublement du risque (RR = 2) et une diminution de moitié du risque (RR = 0,5) se retrouvent exactement à égale distance de part et d’autre de la valeur nulle d’absence d’effet : ils valent respectivement +0,693 et -0,693 unités log. La distribution d’échantillonnage de la variable transformée ln(RR) devient quasi parfaitement symétrique et gaussienne pour des échantillons de taille modérée à grande. Cette normalisation rétablit l’applicabilité formelle du théorème central limite, ouvrant la voie à l’utilisation des fractiles standards de la loi normale centrée réduite.
5.2 Application de la méthode Delta
L’estimation théorique de la variance de la variable aléatoire transformée ln(RR) fait intervenir l’un des fleurons de la statistique mathématique : la méthode Delta. Il s’agit d’une technique d’approximation asymptotique s’appuyant sur le développement en série de Taylor au premier ordre, spécifiquement conçue pour estimer la variance d’une fonction non linéaire de variables aléatoires dont la moyenne et la variance sont préalablement connues ou estimables.
Rappelons que le risque relatif s’écrit comme le ratio p1 / p0. En appliquant les propriétés algébriques élémentaires du logarithme, le logarithme du risque relatif se scinde en une différence linéaire directe de deux logarithmes de proportions binomiales indépendantes : ln(RR) = ln(p1 / p0) = ln(p1) – ln(p0). Puisque les échantillons composant le groupe exposé et le groupe témoin sont constitués de manière indépendante, les variables aléatoires p1 et p0 sont stochastiquement indépendantes. Dès lors, la covariance entre p1 et p0 est strictement nulle. La variance de la différence est égale à la somme algébrique des variances respectives : Var(ln(RR)) = Var(ln(p1) – ln(p0)) = Var(ln(p1)) + Var(ln(p0)).
Il reste à calculer la variance de la fonction g(p) = ln(p), où p est une proportion binomiale de paramètres n (taille de l’échantillon) et pi (proportion théorique). La formule générale de la méthode Delta au premier ordre pour une fonction unidimensionnelle g(X) stipule que : Var(g(X)) ≈ [g'(E[X])]² * Var(X). La dérivée première de la fonction logarithme népérien est g'(p) = d(ln(p))/dp = 1 / p. Sachant que la variance d’une proportion binomiale empirique p est donnée par Var(p) = p * (1 – p) / n, nous pouvons injecter ces termes dans le développement de Taylor :
Var(ln(p)) ≈ [1 / p]² * [p * (1 – p) / n] = [1 / p²] * [p * (1 – p) / n] = (1 – p) / (n * p).
En remplaçant p par son estimation empirique basée sur les cellules de la table de contingence pour le groupe exposé (p1 = A / n1, où n1 = A + B) :
(1 – p1) / (n1 * p1) = [1 – A / (A + B)] / [ (A + B) * (A / (A + B)) ] = [ B / (A + B) ] / A = B / [A * (A + B)].
En observant que B = (A + B) – A, cette expression se réécrit élégamment :
B / [A * (A + B)] = [(A + B) – A] / [A * (A + B)] = (A + B) / [A * (A + B)] – A / [A * (A + B)] = 1 / A – 1 / (A + B).
Ce résultat théorique remarquable prouve de façon déductive que la variance du logarithme de chaque proportion s’exprime très simplement par l’inverse du nombre d’événements moins l’inverse de la taille totale du groupe.
6. Formule et calcul de l’erreur type du logarithme du risque relatif
6.1 Équation fondamentale de l’erreur type (SE)
En agrégeant les variances asymptotiques des deux sous-groupes indépendants dérivées via la méthode Delta, nous établissons la formule maîtresse de la variance du logarithme du risque relatif : Var(ln(RR)) = [1 / A – 1 / (A + B)] + [1 / C – 1 / (C + D)]. L’erreur type, désignée internationalement par le sigle SE (pour Standard Error), correspond à la racine carrée de cette variance d’échantillonnage globale. L’équation formelle universellement consacrée s’énonce donc :
SE(ln(RR)) = Racine_Carrée [ 1/A – 1/(A + B) + 1/C – 1/(C + D) ]
Une formulation algébrique alternative et strictement équivalente est fréquemment rapportée dans les manuels de biostatistique computationnelle :
SE(ln(RR)) = Racine_Carrée [ B / (A * (A + B)) + D / (C * (C + D)) ]
Les deux expressions mathématiques sont totalement interchangeables sur le plan arithmétique. La première présente l’avantage pédagogique de dissocier nettement la contribution des événements cliniques (les termes positifs 1/A et 1/C) de la correction liée à l’effectif global des cohortes (les termes soustractifs -1/(A + B) et -1/(C + D)).
L’examen minutieux de cette formule révèle immédiatement la relation inverse existant entre la magnitude des effectifs observés dans les cellules et l’amplitude de l’erreur type résultante. Plus le nombre d’événements observés A et C est substantiel, plus les termes 1/A et 1/C sont faibles, ce qui comprime la variance totale vers zéro et affine l’estimation. À l’inverse, si un essai clinique ne documente que très peu d’événements (par exemple A = 2 et C = 1), les inverses 1/2 = 0,5 et 1/1 = 1,0 généreront une variance d’échantillonnage massive, débouchant sur une erreur type volumineuse qui étirera démesurément l’intervalle de confiance final.
6.2 Sensibilité analytique aux effectifs marginaux
La stabilité et la validité de l’approximation normale sous-tendant la formule de l’erreur type dépendent intimement de la configuration des effectifs marginaux. Lorsque les cohortes expérimentales s’accroissent de concert (A + B et C + D tendant vers de grands nombres), les fractions 1/(A + B) et 1/(C + D) deviennent infinitésimales. Dans ce contexte asymptotique, l’erreur type est dominée quasi exclusivement par le décompte brut des événements cliniques 1/A et 1/C. Cela met en exergue un principe bien connu des épidémiologistes : dans une étude de suivi de cohorte, la puissance statistique et la précision de l’intervalle dépendent bien plus du nombre total d’événements survenus que de la taille brute de la population indemne incluse.
Cependant, une vulnérabilité mathématique critique apparaît dès lors qu’une cellule de la table de contingence présente un effectif très faible, ou pire, un effectif nul. Si la cellule A ou la cellule C est égale à zéro (aucun événement survenu dans l’un des bras), le calcul de l’erreur type s’effondre immédiatement en raison de l’impossibilité arithmétique de la division par zéro (1/0 n’étant pas défini dans le corps des réels). De même, lorsque le nombre d’événements est inférieur à 5 dans l’une des cellules, les conditions de convergence de l’approximation par le développement de Taylor de la méthode Delta ne sont plus rigoureusement satisfaites, induisant une sous-estimation systématique de la variance réelle dans les queues de distribution.
Avant d’engager le calcul standard de l’intervalle de confiance asymptotique de Wald pour le risque relatif, un diagnostic statistique préalable de la matrice 2×2 est indispensable. Les méthodologistes préconisent généralement que les effectifs attendus sous l’hypothèse d’indépendance soient au minimum de 5 dans chacune des cellules de la table. Si cette condition minimale n’est pas remplie, le recours à la méthode asymptotique classique doit être impérativement écarté au profit de techniques exactes fondées sur le score ou de procédures de régularisation que nous aborderons dans les sections méthodologiques avancées de cet exposé.
7. Procédure étape par étape pour le calcul manuel de l’intervalle de confiance à 95 %
7.1 Étape 1 : Calcul de l’estimateur ponctuel et de son logarithme
La mise en œuvre pratique de l’inférence sur le risque relatif obéit à une séquence algorithmique rigoureuse découpée en trois phases cardinales. La première phase consiste à extraire les paramètres empiriques de base à partir de la table 2×2. Le statisticien calcule dans un premier temps les deux proportions d’incidence en divisant l’effectif des événements observés par le total marginal correspondant de la rangée d’exposition : p1 = A / (A + B) pour le groupe expérimental, et p0 = C / (C + D) pour le groupe contrôle. Le ratio de ces deux grandeurs livre immédiatement l’estimateur ponctuel : RR = p1 / p0.
Dès que le risque relatif ponctuel est déterminé avec une précision décimale suffisante (au moins quatre à six décimales intermédiaires afin de prévenir les erreurs d’arrondi propagées), on procède à sa projection logarithmique en appliquant la fonction mathématique de base logarithme népérien. On calcule ainsi : ln(RR) = ln(p1 / p0). Il s’agit d’une étape de vérification conceptuelle élémentaire :
- Si la valeur de RR calculée est strictement inférieure à 1,0 (effet protecteur), le résultat de ln(RR) doit impérativement être un nombre négatif.
- Si la valeur de RR est strictement supérieure à 1,0 (effet aggravant ou favorisant), la valeur de ln(RR) doit obligatoirement être un nombre positif.
- Si le RR est exactement égal à 1,0, ln(RR) est identiquement nul.
Cette validation des signes assure au calculateur que la direction de l’effet a été correctement préservée avant d’introduire l’erreur type.
7.2 Étape 2 : Évaluation de la marge d’erreur logarithmique
La deuxième phase de l’algorithme consiste à opérer entièrement sur l’échelle continue linéarisée des logarithmes. L’objectif est d’y construire un intervalle de confiance classique parfaitement symétrique de type Wald. Pour ce faire, on calcule tout d’abord l’erreur type de l’estimateur transformé au moyen de la formule développée précédemment : SE(ln(RR)) = Racine_Carrée[1/A – 1/(A + B) + 1/C – 1/(C + D)].
On sélectionne ensuite la valeur critique, désignée par le score quantile z, issue de la table de distribution de la loi normale standardisée N(0, 1). Ce quantile est directement indexé sur le niveau de confiance bilatéral souhaité, défini par l’expression (1 – alpha) :
- Pour un intervalle de confiance bilatéral conventionnel fixé à 95 % (correspondant à alpha = 0,05), le quantile critique normé bilatéral vaut z = 1,95996, conventionnellement arrondi à 1,96.
- Pour un niveau de confiance plus conservateur à 99 % (alpha = 0,01), la valeur critique s’élève à 2,576.
- Pour un niveau de confiance modéré à 90 % (alpha = 0,10), la valeur critique correspondante est de 1,645.
La marge d’erreur logarithmique, notée ME_log, s’obtient par le produit direct de la valeur critique z par l’erreur type calculée : ME_log = z * SE(ln(RR)). Dans le cadre standard à 95 %, cette marge d’erreur s’établit à 1,96 * SE(ln(RR)). L’intervalle de confiance symétrique sur l’échelle logarithmique est alors défini par l’étendue encadrant l’estimateur ponctuel transformé :
Borne_Inférieure_log = ln(RR) – 1,96 * SE(ln(RR))
Borne_Supérieure_log = ln(RR) + 1,96 * SE(ln(RR))
À ce stade, l’intervalle est totalement symétrique autour de ln(RR), mais ses unités n’ont aucune signification clinique immédiate pour les praticiens.
7.3 Étape 3 : Rétro-transformation exponentielle vers l’échelle naturelle
La troisième et ultime étape opérationnelle réalise le retour obligatoire vers l’échelle de mesure originale du risque relatif, seule compréhensible intuitivement par la communauté médicale et scientifique. La fonction inverse absolue du logarithme népérien étant la fonction exponentielle mathématique exp(x) ou e^x, on applique cette fonction non linéaire aux deux bornes logarithmiques précédemment obtenues.
La dérivation formelle des limites finales sur l’échelle multiplicative naturelle s’exécute ainsi :
- Limite Inférieure finale (IC_bas) : exp[ Borne_Inférieure_log ] = exp[ ln(RR) – 1,96 * SE(ln(RR)) ]
- Limite Supérieure finale (IC_haut) : exp[ Borne_Supérieure_log ] = exp[ ln(RR) + 1,96 * SE(ln(RR)) ]
En vertu des propriétés analytiques fondamentales des fonctions d’exponentiation, exp(A – B) équivaut à exp(A) / exp(B) et exp(A + B) équivaut à exp(A) * exp(B). Sachant que exp(ln(RR)) = RR par définition, les bornes finales peuvent également s’écrire de manière factorisée :
IC_bas = RR / exp[ 1,96 * SE(ln(RR)) ]
IC_haut = RR * exp[ 1,96 * SE(ln(RR)) ]
Le facteur exp[ 1,96 * SE(ln(RR)) ] agit comme un facteur multiplicatif d’incertitude (ou ratio d’erreur). Cette propriété mathématique élégante garantit que l’intervalle de confiance final sur l’échelle brute est asymétrique autour de la valeur ponctuelle de RR, tout en demeurant strictement positif : la borne inférieure tendra asymptotiquement vers zéro en cas de grande imprécision mais ne pourra jamais franchir le seuil d’impossibilité négatif. L’intervalle de confiance final pour le risque relatif au niveau 95 % est formalisé selon la syntaxe universelle : RR [IC_bas ; IC_haut].
8. Exemple empirique détaillé : Application à un protocole d’entraînement psychologique
8.1 Présentation des données expérimentales
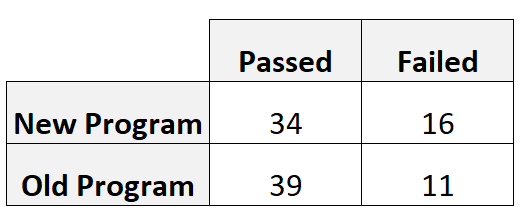
Pour illustrer avec une précision pédagogique absolue l’ensemble des théorèmes et développements algébriques formalisés ci-dessus, déployons un cas d’étude clinique contrôlé. Imaginons une équipe de recherche en psychologie clinique et cognitive évaluant l’efficacité d’un nouveau protocole d’entraînement attentionnel assisté par biofeedback, baptisé « P-BioBoost », destiné à réduire l’échec lors d’examens universitaires hautement stressants chez des étudiants souffrant de trouble d’anxiété de performance avéré.
Un essai contrôlé randomisé prospectif est exécuté auprès d’une cohorte totale de 100 étudiants présentant un niveau d’anxiété invalidant diagnostiqué. Ces participants sont répartis aléatoirement en deux groupes parallèles équilibrés de 50 sujets chacun :
- Groupe Expérimental (Exposition) : 50 étudiants suivent le programme intensif informatisé de huit semaines « P-BioBoost ».
- Groupe Témoin (Contrôle) : 50 étudiants suivent le protocole de relaxation standard conventionnellement délivré par le service de santé universitaire.
Le critère de jugement binaire retenu est le « succès académique », défini objectivement par l’obtention des examens terminaux avec une note supérieure ou égale au seuil de validation standard sans crise de panique documentée durant l’évaluation. Au terme de la période de suivi, l’observation des résultats livre les décomptes bruts suivants :
- Dans le groupe P-BioBoost (n1 = 50), 34 étudiants ont validé avec succès leurs épreuves, tandis que 16 ont échoué.
- Dans le groupe témoin (n0 = 50), 20 étudiants ont validé avec succès leurs épreuves, tandis que 30 ont échoué.
La transposition scrupuleuse de ces constats expérimentaux dans la matrice de contingence 2×2 standardisée s’établit comme suit :
- Cellule A (Exposé / Succès) = 34
- Cellule B (Exposé / Échec) = 16
- Cellule C (Témoin / Succès) = 20
- Cellule D (Témoin / Échec) = 30
- Total expérimental (A + B) = 34 + 16 = 50
- Total témoin (C + D) = 20 + 30 = 50
- Total des succès (A + C) = 34 + 20 = 54
- Total des échecs (B + D) = 16 + 30 = 46
- Effectif total N = 100
8.2 Résolution numérique pas à pas
Procédons désormais à la résolution computationnelle complète en explicitant chaque étape arithmétique intermédiaire avec une rigueur mathématique totale.
Sous-étape A : Détermination des risques absolus de succès
Calculons le risque absolu (ou taux d’incidence du succès) au sein de chacun des deux groupes d’intervention :
Proportion dans le groupe expérimental : p1 = A / (A + B) = 34 / 50 = 0,68 (soit un taux de réussite brute de 68,0 %).
Proportion dans le groupe témoin : p0 = C / (C + D) = 20 / 50 = 0,40 (soit un taux de réussite brute de 40,0 %).
Sous-étape B : Calcul de l’estimateur ponctuel du risque relatif
Le risque relatif ponctuel de succès associé au suivi du programme innovant se dérive par le quotient :
RR = p1 / p0 = 0,68 / 0,40 = 1,7000.
L’estimation ponctuelle suggère que les étudiants ayant bénéficié du protocole innovant présentent une probabilité de réussite 1,70 fois supérieure (soit une augmentation relative de 70 %) par rapport aux sujets assignés au protocole classique.
Sous-étape C : Transformation logarithmique de l’estimateur
Appliquons la fonction logarithme népérien au ratio obtenu :
ln(RR) = ln(1,70) ≈ 0,530628.
Sous-étape D : Évaluation computationnelle de l’erreur type
Reprenons la formule analytique de l’erreur type dérivée par la méthode Delta :
SE(ln(RR)) = Racine_Carrée [ 1/A – 1/(A + B) + 1/C – 1/(C + D) ].
Injectons les valeurs réelles issues de notre table de contingence :
1/A = 1 / 34 ≈ 0,029412
1/(A + B) = 1 / 50 = 0,020000
1/C = 1 / 20 = 0,050000
1/(C + D) = 1 / 50 = 0,020000
Combinons algébriquement ces quatre termes scalaires :
Variance(ln(RR)) = 0,029412 – 0,020000 + 0,050000 – 0,020000
Variance(ln(RR)) = 0,009412 + 0,030000 = 0,039412.
Calculons la racine carrée de cette variance d’échantillonnage :
SE(ln(RR)) = Racine_Carrée(0,039412) ≈ 0,198524.
À titre de contre-épreuve méthodologique, vérifions la formule alternative :
SE(ln(RR)) = Racine_Carrée [ B / (A*(A+B)) + D / (C*(C+D)) ]
B / (A*(A+B)) = 16 / (34 * 50) = 16 / 1700 ≈ 0,009412
D / (C*(C+D)) = 30 / (20 * 50) = 30 / 1000 = 0,030000
Somme = 0,009412 + 0,030000 = 0,039412.
Racine_Carrée(0,039412) ≈ 0,198524. L’équivalence arithmétique est vérifiée au cent-millième près.
8.3 Dérivation et formalisation des bornes finales
Nous pouvons désormais achever le processus d’estimation inférentielle en calculant les bornes de confiance au seuil standard de 95 % (z = 1,96).
Calcul de la marge d’erreur sur l’échelle logarithmique :
Marge_log = z * SE(ln(RR)) = 1,959964 * 0,198524 ≈ 0,389100 (arrondi usuel : 1,96 * 0,198524 = 0,389107).
Construction des bornes logarithmiques symétriques :
Borne_Inférieure_log = ln(RR) – Marge_log = 0,530628 – 0,389107 = 0,141521.
Borne_Supérieure_log = ln(RR) + Marge_log = 0,530628 + 0,389107 = 0,919735.
Rétro-transformation par la fonction exponentielle :
Pour convertir ces bornes abstraites en grandeurs concrètes de risque relatif, nous appliquons l’exponentiation :
Limite Inférieure finale (IC_bas) = exp(0,141521) = e^(0,141521) ≈ 1,15201 (arrondi à 1,15).
Limite Supérieure finale (IC_haut) = exp(0,919735) = e^(0,919735) ≈ 2,50860 (arrondi à 2,51).
Vérifions via l’approche par le facteur multiplicatif d’erreur :
Facteur d’erreur = exp(0,389107) ≈ 1,47566.
IC_bas = 1,70 / 1,47566 ≈ 1,15202.
IC_haut = 1,70 * 1,47566 ≈ 2,50862.
Le résultat académique finalisé selon les normes internationales se synthétise sous la forme péremptoire :
Risque Relatif (RR) = 1,70 ; Intervalle de Confiance à 95 % [1,15 ; 2,51].
9. Interprétation statistique et clinique des bornes de l’intervalle
9.1 Analyse de la signification statistique via l’intervalle
L’interprétation statistique primaire des résultats obtenus s’opère par l’examen de la position relative de l’intervalle de confiance par rapport à la valeur nulle d’équiprobabilité (RR = 1,0). Dans notre exemple d’entraînement attentionnel, l’intervalle de confiance dérive des bornes allant de 1,15 à 2,51. Nous constatons que la borne inférieure de cet intervalle (1,15) est strictement supérieure à 1,0. Par conséquent, la valeur d’indépendance 1,0 est entièrement exclue du spectre des valeurs plausibles défini par le niveau de confiance à 95 %.
En vertu de la dualité épistémologique unissant les intervalles de Neyman et les tests de Wald, cette exclusion de la valeur nulle garantit de manière catégorique que la différence d’incidence observée entre les deux groupes est statistiquement significative au seuil alpha bilatéral de 0,05 (ce qui équivaut rigoureusement à affirmer que p < 0,05). Si nous avions exécuté un test formel du Chi-carré d’indépendance de Pearson sur cette même table 2×2, nous aurions obtenu une statistique Chi-deux à un degré de liberté de 7,86, associée à une p-valeur asymptotique d’environ 0,0051. L’intervalle de confiance livre exactement la même conclusion d’inférence en rejetant l’hypothèse nulle, mais il apporte une information structurelle infiniment plus féconde qu’une simple p-valeur : il circonscrit la magnitude possible du phénomène dans la population générale.
Il est capital d’opérer ici une distinction clinique cardinale : la significativité statistique n’est pas synonyme de pertinence ou d’importance clinique. Une étude menée sur un échantillon colossal de 200 000 sujets pourrait identifier un risque relatif de 1,02 avec un intervalle de confiance microscopique [1,01 ; 1,03]. Bien que ce résultat soit hautement significatif sur le plan purement statistique (p < 0,001), une hausse du risque de 2 % ne possède dans la grande majorité des contextes cliniques qu’un intérêt pratique négligeable. L’analyse conjointe de la valeur ponctuelle et des deux bornes extrêmes de l’intervalle de confiance protège le chercheur contre les mirages de la p-valeur en replaçant la magnitude de l’effet au centre de l’évaluation médicale.
9.2 Évaluation de la pertinence clinique et décisionnelle
Pour fonder des choix cliniques, programmatiques ou politiques sur des bases scientifiques inattaquables, les praticiens doivent analyser les deux scénarios extrêmes délimités par les bornes de l’intervalle. L’intervalle de confiance à 95 % [1,15 ; 2,51] délimite la plage au sein de laquelle se situe, avec un haut niveau de confiance méthodologique, l’impact réel de l’entraînement P-BioBoost.
L’analyse pragmatique s’articule autour de la confrontation du « scénario minimaliste » et du « scénario optimal » :
- Le pire scénario compatible avec les données (Borne inférieure = 1,15) : Dans l’éventualité la plus pessimiste compatible avec les données recueillies, le programme P-BioBoost augmente tout de même la probabilité de succès aux examens de 15 % par rapport au suivi universitaire standard (RR = 1,15). Pour une direction de faculté ou un service de santé étudiante, une augmentation minimale garantie de 15 % de la validation académique chez des étudiants sévèrement anxieux peut déjà représenter un bénéfice éducatif et sociétal substantiel justifiant le coût d’acquisition des licences logicielles.
- Le scénario optimal compatible avec les données (Borne supérieure = 2,51) : Dans la conjecture la plus favorable autorisée par les observations, le protocole expérimental multiplie par un facteur de 2,51 la probabilité de succès (soit une augmentation impressionnante de 151 % du taux de réussite). Si le paramètre réel approche cette borne supérieure, le protocole représente une révolution thérapeutique majeure pour la prise en charge de l’anxiété de performance.
En complément, la largeur totale de l’intervalle renseigne sur la précision de l’essai. Ici, l’intervalle s’étend de 1,15 à 2,51, ce qui traduit une dispersion d’une unité et demie de risque relatif. Cette amplitude reflète un échantillon de taille intermédiaire (N = 100). Si la politique de santé universitaire envisageait un investissement financier massif de plusieurs millions d’euros pour équiper des dizaines de campus, les décideurs pourraient légitimement exiger la conduite d’un essai multicentrique de phase III incluant 500 à 1 000 participants afin de resserrer cet intervalle, par exemple entre 1,50 et 1,90, avant d’engager des financements structurels. L’intervalle de confiance constitue ainsi le pont opératoire indispensable reliant l’arithmétique stochastique à la gouvernance clinique factuelle.
10. Comparaison méthodologique : Risque relatif versus Odds Ratio
10.1 Distinction mathématique et conceptuelle fondamentale
Dans la littérature scientifique internationale, et plus particulièrement au sein des revues de psychiatrie, d’épidémiologie et de sciences sociales, une confusion conceptuelle pernicieuse et tenace persiste entre le risque relatif et l’Odds Ratio (OR), également désigné sous le terme de rapport des cotes. Bien que ces deux indices quantifient tous deux la force d’une association binaire à partir d’une même table 2×2, ils reposent sur des soubassements probabilistes profondément divergents et ne sont aucunement équivalents sur le plan arithmétique.
Tandis que le risque relatif rapporte directement des probabilités cumulées (succès sur total), l’Odds Ratio s’élabore à partir du concept anglo-saxon de « cote » (odds). La cote d’un événement correspond au ratio de la probabilité que cet événement survienne sur la probabilité complémentaire qu’il ne survienne pas : cote = p / (1 – p). Par conséquent, l’Odds Ratio se définit formellement comme le ratio de deux cotes : la cote de l’événement chez les exposés divisée par la cote de l’événement chez les non-exposés. Sur la base des décomptes d’une table 2×2, la formule classique s’établit par le produit croisé célèbre : OR = (A / B) / (C / D) = (A * D) / (B * C).
La relation comparée entre l’Odds Ratio et le risque relatif est gouvernée par le niveau d’incidence basale de l’événement au sein de la population étudiée :
- Sous l’hypothèse d’événement rare (prévalence ou incidence < 10 %) : Lorsque la survenue de l’événement clinique est rare dans les deux groupes, les valeurs de B et D deviennent extrêmement proches de (A + B) et (C + D). Dans cette configuration épidémiologique spécifique, les dénominateurs des probabilités et des cotes se confondent pratiquement, et l’Odds Ratio converge asymptotiquement vers une valeur presque identique à celle du risque relatif (OR ≈ RR).
- En cas d’événement fréquent (incidence > 10 % ou 20 %) : Dès lors que le critère de jugement est commun, l’Odds Ratio diverge mathématiquement de manière majeure par rapport au risque relatif. L’Odds Ratio s’éloigne systématiquement de la valeur nulle 1,0 beaucoup plus vite et plus violemment que le risque relatif. Si le phénomène est favorable (effet > 1), l’OR sera substantiellement supérieur au RR. Si l’effet est protecteur (effet < 1), l’OR sera substantiellement plus bas que le RR. L’Odds Ratio amplifie artificiellement la perception de la magnitude de l’effet.
Dans notre étude empirique sur l’anxiété de performance où le succès est un événement très fréquent (68 % et 40 %), le calcul de l’Odds Ratio livre : OR = (34 * 30) / (16 * 20) = 1020 / 320 = 3,1875. Alors que le risque relatif réel n’est que de 1,70, l’Odds Ratio affiche 3,19 ! Présenter imprudemment cet OR comme un « risque multiplié par 3 » auprès du public ou des médecins constituerait une distorsion scientifique majeure et une exagération trompeuse de l’effet thérapeutique réel.
10.2 Comparaison des formules d’intervalles de confiance respectives
Cette distinction probabiliste fondamentale se répercute directement sur les équations utilisées pour dériver les erreurs types et les intervalles de confiance respectifs. L’intervalle de confiance pour l’Odds Ratio repose sur la formule de variance asymptotique universelle établie historiquement par Barnet Woolf en 1955. La variance du logarithme de l’Odds Ratio s’exprime par la somme pure des inverses des quatre cellules de contingence :
Var(ln(OR)) = 1/A + 1/B + 1/C + 1/D
SE(ln(OR)) = Racine_Carrée [ 1/A + 1/B + 1/C + 1/D ]
Comparons structurellement cette équation à celle précédemment démontrée pour le logarithme du risque relatif :
Var(ln(RR)) = 1/A – 1/(A + B) + 1/C – 1/(C + D).
Il apparaît immédiatement que la formule de Woolf pour l’Odds Ratio additionne quatre termes positifs strictement déterminés par les effectifs internes des cellules, sans faire intervenir les marges globales sous forme négative. En raison de cette configuration mathématique, la variance de ln(OR) est structurellement supérieure à la variance de ln(RR) pour un même jeu de données. L’intervalle de confiance généré pour un Odds Ratio est donc intrinsèquement plus large que celui dérivé pour un risque relatif.
Le choix méthodologique entre l’usage du risque relatif ou de l’Odds Ratio n’est pas une question de préférence subjective, mais découle strictement du plan d’échantillonnage de la recherche :
- Dans les études cas-témoins, le nombre total d’individus à risque dans la population d’origine demeure inconnu car les marges (A + B) et (C + D) sont fixées arbitrairement par le protocole de sélection du chercheur. Le calcul du risque relatif y est logiquement impossible. L’Odds Ratio et son intervalle de Woolf s’imposent alors comme la seule mesure d’association valide.
- Dans les études de cohortes et les essais randomisés prospectifs, où l’incidence absolue cumulée est directement mesurable, le risque relatif doit être systématiquement privilégié en raison de son interprétabilité clinique naturelle, éliminant tout risque d’exagération artificielle de la taille de l’effet.
11. Calcul automatisé et implémentation computationnelle
11.1 Implémentation sous R (environnement de calcul statistique)
Dans l’écosystème open-source R, environnement de référence mondial pour le traitement de données biostatistiques, le calcul automatisé du risque relatif et de son intervalle de confiance s’exécute avec une remarquable fluidité algorithmique. Les chercheurs utilisent préférentiellement la bibliothèque spécialisée epitools, qui intègre des fonctions dédiées à l’inférence épidémiologique rigoureuse.
La fonction maîtresse s’intitule riskratio(). Pour traiter nos données expérimentales, le statisticien structure les données sous la forme d’une matrice matricielle deux par deux inversée ou configurée selon l’ordre d’exposition, ou fait appel à l’argument method = « wald » pour obtenir précisément l’intervalle de confiance asymptotique dérivé de la méthode Delta que nous avons résolu manuellement. La commande standardisée s’articule en déclarant le tableau sous forme d’objet matriciel orienté par colonnes avec la fonction matrix(), en fournissant les arguments de comptage A, B, C, D, puis en soumettant cette matrice à la routine riskratio.wald().
R ne se limite pas à la mise en œuvre de la méthode de Wald standard ; la fonction riskratio.small() ou les algorithmes fondés sur le package exact2x2 permettent d’extraire des intervalles de confiance exacts basés sur le score ou sur l’inversion du test exact de Fisher conditionnel. Cette flexibilité computationnelle permet aux biostatisticiens de comparer en quelques millisecondes la robustesse des bornes asymptotiques face aux limites de distribution pour petits effectifs sans dépendre d’outils propriétaires fermés.
11.2 Calcul sous Python (écosystème SciPy et Statsmodels)
Dans le paysage du calcul scientifique et de la science des données sous Python, les librairies canoniques SciPy et Statsmodels ont standardisé les procédures d’inférence pour les tables de contingence médicales. Le module hautement spécialisé statsmodels.stats.contingency_tables met à disposition la classe orientée objet Table2x2, conçue pour encapsuler l’ensemble des métriques d’association épidémiologiques.
Pour exécuter l’analyse de nos données sous Python, le chercheur instancie la classe Table2x2 en lui passant une matrice bidimensionnelle contenant les décomptes bruts de la table de contingence ordonnée adéquatement : la première ligne regroupant les effectifs exposés [A, B] et la seconde ligne les effectifs témoins [C, D]. Une fois l’objet de contingence instancié dans l’interpréteur, l’extraction de l’estimateur ponctuel s’opère instantanément via l’appel de l’attribut riskratio, tandis que la dérivation rigoureuse des bornes de l’intervalle de confiance à 95 % s’obtient au moyen de la méthode intégrée riskratio_confint(alpha=0.05, method=’log’).
L’implémentation algorithmique de Statsmodels applique rigoureusement sous le capot la méthode Delta avec transformation logarithmique symétrisée et inversion exponentielle, renvoyant exactement les valeurs 1,152 et 2,509 obtenues dans nos calculs manuels. L’intégration native de ces méthodes dans les structures de données DataFrame de la bibliothèque Pandas autorise le déploiement automatisé de ces calculs inférentiels sur des pipelines de traitement massif de dossiers patients informatisés.
11.3 Traitement dans SPSS et interprétation des sorties
Le logiciel commercial IBM SPSS Statistics demeure largement implanté dans les laboratoires universitaires de psychologie et les structures hospitalières. Bien que son interface graphique conviviale facilite l’analyse, l’extraction du risque relatif y requiert une vigilance méthodologique extrême en raison d’une idiosyncrasie historique d’affichage qui induit fréquemment en erreur les chercheurs juniors.
La procédure s’amorce par le menu déroulant : Analyser, puis Statistiques descriptives, puis Tableaux croisés (Crosstabs). L’utilisateur assigne la variable binaire d’exposition dans le champ des Lignes et la variable binaire du critère d’évaluation clinique dans le champ des Colonnes. Dans la boîte de dialogue secondaire accessible via le bouton Statistiques, il est impératif de cocher la case intitulée Risque (Risk). Dès validation, SPSS compile et édite une table de sortie spécifique intitulée « Estimation du risque » (Risk Estimate).
C’est à cette étape précise que réside le piège majeur d’interprétation sous SPSS :
- La première ligne de la table d’estimation du risque de SPSS s’intitule universellement « Odds Ratio pour [Variable Exposition] ». Beaucoup d’auteurs publient par inadvertance la valeur de cette première ligne en croyant rapporter le risque relatif !
- Le véritable risque relatif se situe obligatoirement sur les lignes subséquentes, identifiées textuellement sous les libellés « Cohorte pour [Nom de l’événement = Succès] » et « Cohorte pour [Nom de l’événement = Échec] ».
Pour documenter fidèlement l’effet recherché, le chercheur doit sélectionner la ligne de cohorte correspondant à la modalité clinique ciblée et y relever la valeur de l’estimateur ponctuel ainsi que les colonnes « Inférieure » et « Supérieure » de l’intervalle de confiance de Wald à 95 %. Tout amalgame entre la ligne de l’Odds Ratio et celle du risque relatif de cohorte invaliderait irrémédiablement le rapport scientifique déposé auprès des comités de lecture.
12. Pièges méthodologiques, limites d’échantillons et ajustements statistiques avancés
12.1 Gestion des cellules vides et des effectifs réduits
L’écueil mathématique le plus immédiat dans l’estimation de l’intervalle de confiance du risque relatif réside dans le problème de la cellule vide (décompte nul dans l’une des quatre cases de la table 2×2). Si A = 0, l’estimateur ponctuel RR devient nul et le calcul de ln(0) est indéfini ; si C = 0, le dénominateur de l’estimateur s’annule, rendant le calcul du RR arithmétiquement impossible en générant une division par zéro. De surcroît, comme nous l’avons souligné, l’équation de l’erreur type s’effondre face à l’inversion d’une valeur nulle.
Pour résoudre cette discontinuité computationnelle, la correction de continuité classique de Haldane-Anscombe s’est imposée comme la régularisation standard dans les logiciels biostatistiques. Cette technique consiste à ajouter une constante arbitraire standardisée de 0,5 à chacune des quatre cellules de la matrice de contingence (remplaçant A par A + 0,5, B par B + 0,5, etc.) dès lors qu’un zéro est détecté. Bien que cette correction permette de débloquer le calcul algébrique et de fournir une approximation de compromis, elle tend à biaiser l’estimateur vers la valeur 1,0 et peut s’avérer trop libérale lorsque la taille globale de l’échantillon est restreinte.
Dans des configurations où les effectifs sont substantiellement réduits (cellules < 5), les statisticiens contemporains préconisent d’abandonner l’approximation de Wald au profit d’intervalles basés sur le score de vraisemblance, tels que la méthode exacte de Koopman (1984) ou l’approche hautement optimisée de Miettinen et Nurminen (1985). Ces méthodes construisent l’intervalle par inversion directe du test de score du rapport de vraisemblance sur la distribution binomiale bivariée sans postuler de normalité logarithmique symétrique préalable. Les bornes ainsi dérivées offrent une couverture empirique rigoureusement égale ou supérieure au niveau nominal de 95 %, écartant tout risque de faux sentiment de certitude induit par les approximations linéaires standards.
12.2 Biais de confusion et modélisation multivariée
Une limitation méthodologique structurelle de la table de contingence 2×2 brute réside dans son incapacité foncière à neutraliser les variables de confusion. Dans la recherche comportementale et clinique en conditions réelles, l’association observée entre une exposition et un critère de santé peut être totalement ou partiellement parasitée par un tiers facteur associé à la fois à l’exposition et à l’événement clinique (par exemple : la sévérité initiale du trouble, le sexe, le niveau d’éducation ou l’âge des participants). Calculer un risque relatif brut sur un tableau 2×2 sans contrôle de confusion expose le chercheur au tristement célèbre paradoxe de Simpson, où la force voire la direction de l’effet peut s’inverser après stratification.
Pour contourner cet écueil dans les plans observationnels stratifiés simples, l’épidémiologie s’appuie sur la technique de stratification de Mantel-Haenszel. Cette méthode permet d’estimer un risque relatif ajusté combiné (RR_MH) et son intervalle de confiance associé à travers une série de sous-tables de contingence homogènes relatives aux strates du facteur de confusion. En pondérant l’impact de chaque strate par son effectif propre, la technique de Mantel-Haenszel épure l’estimation brute de la distorsion induite par la variable tierce.
Cependant, lorsque de multiples covariables continues et catégorielles doivent être neutralisées simultanément, la stratification tabulaire devient inapplicable en raison de la dispersion excessive des effectifs. Les chercheurs se tournent alors vers la modélisation statistique multivariée. Alors que la régression logistique classique produit nativement des Odds Ratios ajustés et non des risques relatifs, deux approches de modélisation linéaire généralisée prévalent aujourd’hui pour estimer directement des risques relatifs ajustés avec leurs intervalles de confiance :
- La régression log-binomiale : Ce modèle utilise directement une fonction de lien logarithmique appliquée à une distribution d’erreur binomiale. Ses coefficients exponentiés livrent directement les risques relatifs ajustés. Son principal écueil réside dans de fréquents problèmes de non-convergence algorithmique sur des données empiriques complexes.
- La régression de Poisson avec variance robuste (estimateur sandwich de Huber-White) : Popularisée par Zou en 2004, cette méthode adapte la distribution de Poisson aux variables binaires pour modéliser le risque relatif tout en appliquant une correction de variance sandwich pour compenser la violation de l’hypothèse d’équidispersion de Poisson. Elle s’impose aujourd’hui comme le standard méthodologique dominant pour calculer des risques relatifs multivariés stables assortis d’intervalles de confiance rigoureux.
12.3 Recommandations de rédaction selon les normes académiques (APA)
La publication de résultats quantitatifs dans les revues à comité de lecture affiliées à l’American Psychological Association (APA Style, 7e édition) ou au réseau international d’éditeurs médicaux ICMJE obéit à des normes typographiques et rédactionnelles formelles. L’Association Américaine de Psychologie prescrit expressément d’associer systématiquement toute estimation de taille d’effet ponctuelle à son intervalle de confiance délimité.
Les directives stylistiques officielles pour le rapportage du risque relatif imposent les standards suivants :
- L’estimateur ponctuel doit être désigné textuellement par l’acronyme stylisé en italique : RR.
- L’intervalle de confiance est noté IC (ou CI dans les manuscrits anglophones), suivi immédiatement de l’indication de son niveau de certitude numérique sans espacement : IC à 95 % ou 95% CI.
- Les bornes inférieure et supérieure doivent être isolées au sein de crochets typographiques fermés, séparées par un point-virgule et une espace insécable afin d’éviter toute ambiguïté avec les séparateurs décimaux : [1,15 ; 2,51].
- Les valeurs numériques décimales doivent faire l’objet d’un arrondi homogène, conventionnellement standardisé à deux ou trois décimales au maximum selon la précision clinique pertinente.
Un modèle de rédaction académique standardisé s’énonce ainsi : « L’analyse de l’incidence d’achèvement des études met en évidence une association positive et statistiquement significative en faveur du protocole informatisé innovant, RR = 1,70, IC à 95 % [1,15 ; 2,51], p = ,005. Les participants soumis au programme expérimental présentent une augmentation estimée de 70 % de la probabilité de succès comparativement aux sujets assignés au protocole standard. » Cette formulation combine en une phrase condensée et rigoureuse l’estimation ponctuelle, la précision stochastique, la significativité décisionnelle et la portée phénoménologique concrète de l’intervention empirique.
Références
- Altman, D. G. (1991). Practical statistics for medical research. Chapman and Hall/CRC.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Koopman, P. A. (1984). Confidence intervals for the ratio of two binomial proportions. Biometrics, 40(2), 513–517. https://doi.org/10.2307/2531397
- Miettinen, O., & Nurminen, M. (1985). Comparative analysis of two rates. Statistics in Medicine, 4(2), 213–226. https://doi.org/10.1002/sim.4780040211
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern epidemiology (3rd ed.). Lippincott Williams & Wilkins.
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x
- Zou, G. (2004). A modified poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090