
L’inférence statistique appliquée aux processus de comptage constitue l’un des piliers méthodologiques les plus cruciaux dans les sciences contemporaines, qu’il s’agisse de l’épidémiologie, de la recherche clinique, de la psychologie comportementale ou de l’ingénierie de la fiabilité. Lorsqu’un phénomène se manifeste sous la forme d’occurrences discrètes réparties au sein d’un continuum temporel, spatial ou volumique, la simple observation d’un dénombrement ponctuel s’avère fondamentalement insuffisante pour caractériser l’intensité du mécanisme sous-jacent. L’estimation ponctuelle, bien qu’intuitive, ignore la variabilité intrinsèque issue de l’échantillonnage stochastique et masque le degré d’incertitude inséparable de toute mesure empirique finie.
Pour dépasser les limites de cette estimation brute, l’établissement d’un intervalle de confiance s’impose comme une exigence épistémologique et analytique incontournable. Dans le cadre théorique défini par la loi de Poisson, cette démarche acquiert une spécificité mathématique singulière liée à la nature discrète de la variable et à l’asymétrie marquée des distributions de comptage, particulièrement marquée lorsque le nombre d’événements enregistrés demeure restreint. La détermination rigoureuse des bornes encadrant le paramètre d’intensité exige ainsi le recours à des méthodes probabilistes exactes, au premier rang desquelles figure la construction historique formulée par Frank Garwood en 1936, reliant avec élégance la loi de Poisson aux quantiles de la distribution du Chi-carré.
Le présent guide a pour vocation de décomposer, avec une exhaustivité mathématique et méthodologique absolue, l’intégralité du protocole permettant de calculer un intervalle de confiance exact pour un paramètre de Poisson. En explorant successivement les fondations théoriques du processus, les conditions strictes de validité empirique, le développement pas à pas des équations analytiques, ainsi que les alternatives asymptotiques et leurs implémentations logicielles, cette contribution offre aux chercheurs, biostatisticiens et analystes un cadre de référence complet pour quantifier l’incertitude avec la plus haute rigueur scientifique.
1. Introduction aux processus de Poisson et aux intervalles d’estimation
La modélisation probabiliste des phénomènes stochastiques requiert une distinction fondamentale entre les grandeurs continues et les variables discrètes issues de processus de dénombrement. La quantification rigoureuse des incertitudes entourant ces grandeurs repose sur une compréhension approfondie de la genèse des événements au sein de leur fenêtre d’observation.
1.1 Définition fondamentale de la distribution de Poisson
La distribution de Poisson, formalisée par le mathématicien français Siméon Denis Poisson dans son traité de 1837 sur la probabilité des jugements, constitue le cadre théorique par excellence pour modéliser le nombre d’occurrences d’un événement discret survenant dans un intervalle continu fixe. Cet intervalle d’exposition peut être de nature temporelle, à l’instar d’une durée de suivi exprimée en heures ou en années-patients, mais il peut également se matérialiser sous une forme spatiale, surfacique ou volumétrique. Le caractère fondamental de ce modèle réside dans sa capacité à décrire des processus où les événements se produisent de manière ponctuelle le long de ce continuum, chaque réalisation étant infinitésimale par rapport à la dimension globale du domaine d’observation.
Sur le plan distributionnel, la loi de Poisson est gouvernée par un paramètre d’intensité unique, conventionnellement noté par la lettre grecque lambda. Ce paramètre formalise simultanément l’espérance mathématique et la variance de la variable aléatoire sous-jacente, établissant ainsi une propriété remarquable et restrictive désignée sous le terme d’équidispersion stricte. Cette égalité théorique parfaite entre la tendance centrale et la dispersion de la distribution implique que toute élévation de l’espérance mathématique du dénombrement entraîne une augmentation proportionnelle et rigoureusement identique de la variabilité des observations autour de cette moyenne. Cette caractéristique structurelle distingue radicalement le processus de Poisson des distributions binomiales ou multinomiales classiques.
Dans la pratique de la recherche empirique, il est absolument capital de maintenir une distinction formelle entre le taux théorique sous-jacent, entité abstraite et invariable régissant le phénomène dans la population générale, et la fréquence observée au sein d’un échantillon expérimental donné. Le chercheur ne dispose jamais d’un accès direct à la valeur authentique de l’intensité stochastique ; il ne recueille qu’une réalisation empirique singulière, sujette au bruit d’échantillonnage. Confondre l’observation brute avec la vérité paramétrique constitue une erreur méthodologique majeure qui oblitère la nécessité d’une quantification formelle des marges d’erreur associées au protocole de mesure.
1.2 Nécessité de l’intervalle de confiance face à l’estimation ponctuelle
L’estimation ponctuelle, qui consiste à attribuer la valeur directement observée comme valeur estimée du paramètre d’intensité, présente des faiblesses intrinsèques qui compromettent la robustesse des conclusions scientifiques. En vertu des fluctuations stochastiques inhérentes à tout protocole expérimental, la probabilité exacte qu’un dénombrement empirique corresponde rigoureusement au paramètre théorique sous-jacent est particulièrement faible, voire nulle dans certaines configurations continues. Présenter une valeur isolée sans documenter la dispersion probable des valeurs compatibles avec les données observées conduit à une surévaluation illusoire de la précision de la mesure et expose l’analyste à des interprétations erronées.
L’intervalle de confiance répond précisément à cette limite en opérant une quantification formelle de l’incertitude liée à l’échantillonnage et à la finitude de la fenêtre d’exposition. En construisant une région paramétrique au sein de laquelle la véritable valeur sous-jacente a une probabilité définie d’être capturée dans le cadre d’expérimentations répétées, le chercheur explicite les limites de son observation. L’étendue de cette zone d’incertitude dépend directement du volume des données recueillies : une fenêtre d’exposition réduite engendre une grande imprécision qui se traduit mécaniquement par un écartement substantiel des bornes calculées, signalant une faible fiabilité métrologique.
Dans l’architecture de l’inférence statistique et de la validation des hypothèses empiriques, les bornes de l’intervalle jouent un rôle décisionnel déterminant. Elles permettent non seulement de vérifier si une valeur théorique de référence ou un seuil critique d’alerte peut être exclu avec un niveau de certitude prédéterminé, mais elles établissent également la plausibilité des variations observées. L’inférence moderne exige désormais systématiquement cette transition de la simple mesure descriptive vers la délimitation rigoureuse de l’espace des paramètres compatibles, condition sine qua non de la reproductibilité des résultats scientifiques.
1.3 Applications empiriques dans l’étude des comportements et événements rares
La pertinence empirique de la distribution de Poisson se manifeste avec une acuité particulière lors de l’investigation d’événements rares ou de comportements sporadiques au sein des disciplines biomédicales et humaines. En psychologie clinique et en psychiatrie expérimentale, la quantification de conduites cibles hautement spécifiques, telles que des crises d’agressivité soudaines, des épisodes compulsifs ou des comportements d’automutilation, s’accommode parfaitement de ce formalisme. Ces manifestations se déploient sur des périodes de suivi prolongées sans qu’il soit possible de segmenter le temps en une série d’essais indépendants discrets, conférant au modèle poissonnien une adéquation écologique et théorique incomparable.
Dans le domaine de la santé publique et du management hospitalier, l’analyse des flux d’admissions en service de réanimation ou le suivi longitudinal des appels dirigés vers les centres d’urgence sanitaire reposent intégralement sur l’hypothèse de processus de Poisson. Les gestionnaires et épidémiologistes doivent évaluer si les fluctuations observées au sein d’une semaine relèvent de variations purement aléatoires ou si elles traduisent une modification structurelle de la dynamique de transmission épidémique. L’intervalle de confiance calculé sur les dénombrements quotidiens ou hebdomadaires fournit le standard métrologique nécessaire pour calibrer la capacité d’accueil et activer des protocoles de crise sans céder aux fausses alertes générées par le bruit statistique.
Enfin, l’évaluation de l’efficacité d’interventions thérapeutiques ou comportementales innovantes requiert l’estimation précise de taux d’occurrence avant et après traitement. Qu’il s’agisse de mesurer la réduction du nombre d’accidents du travail consécutive à une politique de sécurité industrielle, ou d’évaluer l’impact d’une molécule pharmacologique sur la fréquence de crises épileptiques réfractaires, la comparaison des intervalles de confiance de Poisson garantit que l’effet attribué à l’intervention ne relève pas d’une régression vers la moyenne ou d’un simple artefact stochastique induit par un effectif d’événements modeste.
2. Fondements théoriques de la loi de Poisson en analyse quantitative
Avant d’aborder la construction algorithmique des intervalles d’estimation, il est indispensable de maîtriser la structure probabiliste régissant l’émergence des processus poissonniers et d’analyser rigoureusement la sensibilité de cette distribution aux écarts par rapport aux postulats initiaux.
2.1 Hypothèses sous-jacentes du modèle de Poisson
La validité théorique de l’application de la distribution de Poisson repose sur un ensemble d’axiomes stochastiques stricts régissant la survenue des événements au sein de l’espace d’observation continu. Le premier postulat fondamental concerne l’indépendance stochastique des occurrences : la manifestation d’un événement à un instant temporel ou à une coordonnée spatiale spécifique ne doit en aucun cas modifier, positivement ou négativement, la probabilité d’apparition d’un événement ultérieur. Toute forme de rétroaction, d’apprentissage comportemental, de contagion biologique ou de mémoire du système invalide immédiatement ce cadre d’analyse en créant des corrélations sérielles au sein de la série de données.
Le deuxième postulat impose l’homogénéité stationnaire du processus, signifiant que le taux moyen d’occurrence, désigné comme l’intensité stochastique du phénomène, demeure rigoureusement constant tout au long de la période de recueil des données. Ce taux d’incidence intrinsèque ne doit subir ni fluctuations saisonnières, ni dérives tendancielles, ni altérations induites par des facteurs exogènes non contrôlés durant le protocole expérimental. La stationnarité temporelle garantit que deux sous-intervalles de même durée possèdent une distribution de probabilité rigoureusement identique quant au nombre potentiel d’occurrences qu’ils sont susceptibles de contenir.
Le troisième axiome énonce l’ordre du processus et l’impossibilité de simultanéité stricte : la probabilité que deux événements ou davantage surviennent exactement au même instant infinitésimal tend vers zéro lorsque la largeur de l’intervalle temporel considéré approche de zéro. En termes d’analyse mathématique, la probabilité d’enregistrer une unique occurrence dans un intervalle différentiel de longueur delta t est proportionnelle à la constante d’intensité multipliée par delta t, tandis que la probabilité d’enregistrer deux occurrences ou plus relève d’un infiniment petit d’ordre supérieur. Cette condition garantit le caractère strictement ponctuel et distinct de chaque réalisation empirique.
2.2 Formalisation mathématique de la fonction de masse
La fonction de masse de probabilité régissant une variable aléatoire discrète X suivant une loi de Poisson de paramètre d’intensité lambda définit la probabilité exacte d’observer rigoureusement k occurrences au cours d’une unité d’exposition standardisée. Cette distribution se formalise par l’expression mathématique suivante :
P(X = k) = (lambda^k * exp(-lambda)) / k!
Dans cette formulation analytique, le terme k représente un entier naturel appartenant à l’ensemble des entiers positifs ou nuls, la constante e désigne la base du logarithme népérien, et le dénominateur k! correspond à la factorielle de l’entier considéré. L’introduction du facteur factoriel garantit la convergence stricte de la série infinie des probabilités vers l’unité, confirmant ainsi le statut rigoureux de mesure de probabilité sur l’espace des entiers naturels.
Lorsque le phénomène étudié est documenté sur un horizon temporel ou une surface d’exposition de dimension variable notée T, le paramètre lambda est avantageusement décomposé sous la forme du produit du taux d’occurrence par unité de temps, noté mu, et de la durée d’exposition totale T. La fonction de masse s’exprime alors en substituant le produit (mu * T) au paramètre global, ce qui autorise une standardisation rigoureuse des mesures obtenues à partir d’échantillons ayant bénéficié de durées d’observation hétérogènes. Cette paramétrisation sous-tend l’ensemble des analyses biostatistiques portant sur les taux d’incidence en épidémiologie analytique.
Sur le plan du comportement asymptotique, lorsque la valeur du paramètre lambda s’accroît et dépasse des valeurs substantielles, la distribution de Poisson subit une déformation structurelle progressive. Bien qu’intrinsèquement asymétrique et étirée vers la droite pour les faibles intensités, sa fonction de masse se symétrise sous l’effet du théorème central limite. Dès que lambda franchit le seuil conventionnel de vingt ou trente unités, la distribution converge de manière continue vers une loi normale de moyenne lambda et de variance identique, justifiant historiquement le recours à des approximations continues lorsque les outils de calcul automatisés faisaient défaut.
2.3 Sensibilité du modèle aux violations d’indépendance
Dans les contextes de recherche empirique, la parfaite conformité des données aux postulats théoriques de Poisson demeure l’exception plutôt que la règle. La violation la plus récurrente réside dans le phénomène de surdispersion statistique, configuration dans laquelle la variance empirique de l’échantillon excède de manière significative l’espérance mathématique observée. Ce décalage structurel est fréquemment engendré par une hétérogénéité non observée au sein de la population étudiée, où chaque sous-groupe d’individus présente un taux de base sous-jacent distinct, transformant le processus global en un mélange continu de lois de Poisson, formellement modélisable par une loi binomiale négative.
L’agrégation ou le regroupement temporel constitue une seconde cause majeure d’invalidation du modèle classique. Si la survenue d’un premier événement déclenche une cascade d’occurrences secondaires — dynamique fréquemment observée dans l’étude des répliques sismiques, de la propagation virale ou des épidémies comportementales —, l’axiome d’indépendance stochastique est irrémédiablement transgressé. Une telle dépendance sérielle provoque une concentration artificielle des dénombrements, gonflant démesurément la variance et faussant l’évaluation du risque d’erreur de première espèce si un intervalle de confiance classique de Poisson est appliqué sans ajustement préalable.
Avant d’engager tout calcul formel d’intervalle d’estimation fondé sur les lois de Poisson, l’analyste se doit d’évaluer la validité empirique de ces postulats au moyen de tests statistiques dédiés. Le calcul de l’indice de dispersion, rapport simple entre la variance empirique et la moyenne de l’échantillon, couplé au test du Chi-carré de conformité d’ajustement, permet de vérifier rigoureusement l’hypothèse d’équidispersion. En présence d’une surdispersion avérée, le recours à des modèles quasi-Poisson ou à des distributions binomiales négatives s’impose afin de ne pas générer des intervalles de confiance artificiellement étroits qui surestimeraient dramatiquement la précision réelle de l’expérience.
3. Fondements de la méthode exacte de Garwood
Pour s’affranchir des biais inhérents aux approximations asymptotiques, le calcul des bornes de confiance requiert une approche mathématique rigoureuse capable de préserver les propriétés nominales de couverture quel que soit le volume des événements enregistrés.
3.1 Lien mathématique entre les lois de Poisson et du Chi-carré
L’élaboration d’intervalles de confiance exacts pour la distribution de Poisson repose sur une passerelle mathématique élégante unissant les probabilités cumulées d’un dénombrement discret aux fonctions de répartition de distributions continues. Dès les années 1930, les statisticiens ont mis en lumière la relation analytique exacte reliant la somme partielle d’une série de Poisson à l’intégrale de la distribution Gamma. Plus précisément, la probabilité d’observer au plus k événements selon un paramètre d’intensité lambda équivaut strictement à la probabilité qu’une variable aléatoire continue suivant une loi Gamma de paramètres de forme et d’échelle adaptés excède une valeur seuil déterminée par ce même paramètre lambda.
Par un changement de variable analytique standard en théorie des probabilités, toute distribution Gamma dont le paramètre de forme est un demi-entier ou un entier peut être réexprimée sous la forme d’une distribution du Chi-carré. Cette propriété de transformation permet de convertir un problème d’inversion portant sur une somme discrète complexe en une simple recherche de quantiles sur la distribution continue du Chi-carré, dont les propriétés géométriques et les tabulations sont parfaitement maîtrisées. L’équivalence formelle s’établit par l’intermédiaire de la fonction gamma incomplète, reliant ainsi directement l’espace probabiliste discret de l’observation empirique à l’espace continu de l’inférence théorique.
Cette connexion analytique confère à la méthode un avantage décisif : la propriété de couverture exacte garantie. Alors que les techniques d’approximation fondées sur la loi normale ne valent que pour des limites asymptotiques théoriques tendant vers l’infini, la dualité Poisson-Chi-carré opère avec une rigueur absolue pour toute taille d’échantillon. Qu’un chercheur observe trois occurrences ou trois mille, le mécanisme d’inversion conserve son intégrité formelle, garantissant que la probabilité réelle de contenir le paramètre inconnu soit au moins égale au niveau nominal choisi, éliminant tout risque de sous-couverture aléatoire.
3.2 Présentation formelle de l’équation exacte de Garwood
Publiée par l’analyste britannique Frank Garwood dans la revue Biometrika en 1936, l’équation exacte déterminant les bornes de l’intervalle de confiance bilatéral pour le paramètre d’intensité constitue le canon méthodologique de la discipline. Pour un nombre total d’événements observés noté N, et pour un seuil de signification global fixé à alpha, la borne inférieure de l’intervalle d’estimation, désignée par lambda_L, est définie par l’expression formelle suivante :
lambda_L = (1 / 2) * Chi2(2 * N ; alpha / 2)
Dans cette formulation, Chi2(2 * N ; alpha / 2) représente le quantile critique d’ordre alpha divisé par deux issu de la fonction de répartition de la loi du Chi-carré comportant exactement deux fois N degrés de liberté. Cette borne délimite le seuil en deçà duquel la probabilité d’observer par hasard un nombre d’événements supérieur ou égal à la valeur empirique N devient strictement inférieure à la moitié du risque d’erreur global toléré par le protocole.
Réciproquement, la borne supérieure de l’intervalle de confiance, désignée formellement par lambda_U, intègre un ajustement conservateur indispensable lié au caractère discret de la variable en mobilisant deux degrés de liberté supplémentaires :
lambda_U = (1 / 2) * Chi2(2 * (N + 1) ; 1 – (alpha / 2))
Le terme Chi2(2 * (N + 1) ; 1 – (alpha / 2)) désigne le quantile d’ordre un moins alpha sur deux de la distribution du Chi-carré paramétrée avec deux fois la quantité N plus un degrés de liberté. L’adjonction systématique de cette unité dans le calcul des degrés de liberté supérieurs assure un ajustement de continuité exact, compensant le fait que la distribution sous-jacente procède par sauts discrets sur l’ensemble des entiers naturels, évitant ainsi toute sous-estimation structurelle de l’incertitude haute.
3.3 Avantages comparatifs par rapport aux approximations standard
L’atout prééminent de la formulation exacte de Garwood réside dans son respect indéfectible du taux nominal d’erreur fixé par le chercheur. Dans le cadre des approximations classiques, telles que l’intervalle de Wald fondé sur la normalité asymptotique, le taux d’erreur réel s’écarte fréquemment, et de manière substantielle, du seuil nominal déclaré. Pour des dénombrements faibles ou modérés, un prétendu intervalle de confiance à 95 % calculé par approximation normale peut présenter une couverture réelle inférieure à 88 %, exposant l’expérimentateur à un risque d’erreur de première espèce incontrôlé lors de ses prises de décision scientifique.
Ce phénomène d’instabilité est particulièrement criant lors du recueil de très faibles dénombrements empiriques, situations courantes dans l’étude des maladies orphelines, de la pharmacovigilance ou de la détection de défaillances industrielles rarissimes. Là où les formules asymptotiques génèrent fréquemment des aberrations arithmétiques — telles que des bornes inférieures strictement négatives pour un phénomène qui ne peut structurellement pas descendre sous zéro —, la méthode exacte de Garwood produit des limites strictement bornées dans le domaine des réels positifs, reflétant fidèlement l’asymétrie fondamentale de la distribution de probabilité d’origine.
En raison de ces attributs mathématiques impeccables, la méthode de Garwood bénéficie d’une reconnaissance institutionnelle unanime et constitue l’étalon de référence préconisé par les grandes agences internationales de réglementation, telles que la Food and Drug Administration (FDA) américaine et l’Agence européenne des médicaments (EMA). Elle est implémentée par défaut dans les bibliothèques d’analyses statistiques de pointe pour le traitement des comptages univariés, garantissant aux publications académiques qui l’emploient un standard de validité universellement incontestable.
4. Étape 1 : Mesure et validation du dénombrement des événements (N)
La mise en œuvre concrète de l’algorithme d’estimation s’ouvre impérativement par une phase de fiabilisation métrologique destinée à quantifier l’agrégat empirique N et à s’assurer de l’intégrité globale du système d’observation déployé.
4.1 Protocole de collecte et définition de la fenêtre temporelle
La première opération méthodologique consiste en une délimitation spatio-temporelle rigide de la fenêtre d’observation au cours de laquelle les occurrences seront répertoriées. Cette période d’exposition standardisée doit être définie de manière univoque en amont de la phase de recueil afin d’éviter tout biais de confirmation qui consisterait à interrompre l’expérience au moment opportun où le nombre d’événements observés correspond aux attentes théoriques de l’équipe de recherche. L’unité de mesure — qu’il s’agisse de minutes d’enregistrement comportemental continu, de journées d’hospitalisation ou d’années-sujets — doit demeurer invariable tout au long du protocole.
La maîtrise de la stabilité environnementale durant cette phase d’acquisition s’avère tout aussi déterminante pour satisfaire au critère d’homogénéité stationnaire du processus. Les conditions d’observation, les instruments de mesure, les observateurs humains ou les capteurs automatisés doivent opérer avec une régularité absolue. Toute modification du seuil de sensibilité d’un appareil ou tout changement de personnel soignant au cours du suivi est susceptible d’induire une fluctuation artificielle du taux de détection, corrompant la représentativité du paramètre global N.
Au terme de cette phase de recueil standardisée, le chercheur procède à l’agrégation arithmétique de l’ensemble des réalisations constatées, ce qui aboutit à la fixation de la valeur entière N. Ce dénombrement doit impérativement être un nombre entier absolu. Il représente la quantité brute d’occurrences indépendantes validées au cours de la période d’exposition totale, et servira d’unique paramètre empirique d’entrée dans la machinerie mathématique des degrés de liberté de la distribution du Chi-carré.
4.2 Traitement particulier du cas où aucun événement n’est observé
Une problématique analytique fréquente et délicate survient lorsqu’aucun événement n’est enregistré au cours de la fenêtre d’observation, aboutissant à un résultat empirique où N est rigoureusement égal à zéro. Face à un tel dénombrement nul, l’estimation ponctuelle naïve conclurait à un taux d’incidence de zéro, suggérant de manière fallacieuse l’impossibilité totale d’occurrence du phénomène étudié. Cette conclusion est naturellement invalide sur le plan stochastique, car l’absence de preuve n’équivaut nullement à la preuve de l’absence, particulièrement lorsque la fenêtre de mesure est de dimension modeste.
Dans le formalisme exact de Garwood, le cas d’un effectif nul est géré de manière analytiquement remarquable. Pour la limite basse de l’intervalle, la formule impose deux fois N degrés de liberté, soit zéro degré de liberté pour la distribution du Chi-carré. La théorie probabiliste contraint alors naturellement la borne inférieure lambda_L à s’annuler parfaitement, établissant le seuil bas à zéro. Il est en effet logique qu’en l’absence de tout événement constaté, le taux d’incidence minimal compatible avec les données empiriques puisse être nul.
En revanche, la détermination de la borne supérieure lambda_U revêt une importance stratégique fondamentale pour quantifier le risque latent ou l’incidence maximale plausible. En appliquant la formule exacte pour N égal à zéro, le nombre de degrés de liberté devient égal à deux fois la quantité zéro plus un, soit exactement deux degrés de liberté. Or, la distribution du Chi-carré à deux degrés de liberté correspond rigoureusement à une loi exponentielle standard, ce qui simplifie son inversion analytique : la borne supérieure équivaut alors précisément au logarithme népérien négatif du seuil de signification unilatéral, formalisé par moins le logarithme népérien de alpha sur deux. Cette propriété permet de borner supérieurement un risque sanitaire ou comportemental même lorsque celui-ci ne s’est jamais manifesté au cours de l’échantillon.
4.3 Vérification de l’absence de biais de détection
L’exactitude mathématique de l’intervalle de Garwood ne saurait compenser les défauts qualitatifs introduits par des biais métrologiques lors de l’enregistrement des données. L’exhaustivité de la détection constitue un réquisit absolu : chaque événement survenu au sein de la fenêtre d’exposition définie doit posséder une probabilité de capture égale à l’unité. Dans les protocoles cliniques ou les observations naturalistes, le phénomène de sous-détection — causé par la fatigue de l’observateur, la saturation momentanée des capteurs ou des dysfonctionnements matériels — conduit à une sous-estimation systématique de N, qui déplace l’intégralité de l’intervalle vers des valeurs anormalement basses.
De surcroît, le traitement des pertes de suivi et de la censure d’observation doit être rigoureusement documenté. Si des sujets d’expérience quittent la cohorte d’étude de manière prématurée, l’exposition temporelle globale ne peut être considérée comme homogène pour l’ensemble du groupe. Le calcul doit alors intégrer le cumul précis des temps de suivi individuels effectifs afin d’éviter d’attribuer un dénombrement restreint à une exposition temporelle nominale faussement étendue, ce qui diluerait artificiellement le taux de survenue calculé.
Enfin, la documentation transparente des conditions de laboratoire ou de terrain constitue le garant ultime de la validité scientifique de l’étude. L’ensemble des critères d’inclusion et d’exclusion des événements suspects, les procédures d’arbitrage en double aveugle pour les cas ambigus et les protocoles d’étalonnage des instruments doivent figurer explicitement dans le rapport méthodologique. Cette traçabilité garantit que le dénombrement N introduit dans l’algorithme représente fidèlement la réalité phénoménologique sous observation.
5. Étape 2 : Définition du seuil de signification et du niveau de confiance
Une fois le dénombrement N consolidé, la deuxième phase opératoire requiert la fixation concertée du niveau de confiance statistique encadrant l’estimation, démarche impliquant des arbitrages épistémologiques précis entre conservatisme décisionnel et précision paramétrique.
5.1 Sélection du coefficient de confiance
Le coefficient de confiance, conventionnellement exprimé sous la forme un moins alpha ou sous un format de pourcentage un moins alpha multiplié par cent, formalise la probabilité de couverture théorique garantie par la procédure d’inférence. Dans la vaste majorité des recherches en sciences biomédicales et humaines, le standard consensuel est historiquement fixé à 95 %, ce qui correspond à un seuil d’erreur alpha de 0,05 ou cinq centièmes. Ce seuil signifie que si le protocole expérimental devait être reproduit à l’identique un nombre infini de fois, 95 % des intervalles ainsi générés recouvriraient la valeur authentique du paramètre lambda.
Toutefois, la rigidité du standard à 95 % doit s’effacer au profit d’exigences renforcées dès lors que la décision statistique s’inscrit dans un contexte à haute criticité. En toxicologie réglementaire, dans l’industrie aérospatiale ou lors du suivi d’effets indésirables létaux d’un agent pharmacologique novateur, le seuil de signification alpha est fréquemment abaissé à 0,01, établissant ainsi un niveau de confiance à 99 %. Ce choix méthodologique draconien vise à minimiser drastiquement le risque d’exclure par erreur une valeur d’intensité alarmante, garantissant ainsi un principe de précaution opérationnel maximal.
Il existe une relation mathématique inverse et inéluctable unissant le seuil alpha et la largeur de l’intervalle de confiance résultant. La réduction de la marge d’erreur tolérée de cinq centièmes à un centième exige mécaniquement une expansion géométrique de la distance séparant la borne inférieure de la borne supérieure. Le chercheur doit donc avoir conscience que la quête d’une certitude statistique quasi absolue s’accompagne d’une perte d’information quant à la localisation précise du paramètre, l’intervalle s’élargissant pour capter les fluctuations d’échantillonnage les plus extrêmes.
5.2 Gestion de la bilatéralité de l’intervalle
Dans la configuration la plus générale de l’investigation scientifique, l’hypothèse de recherche ne préjuge pas de la direction des variations du paramètre d’intérêt. La construction de l’intervalle de confiance doit en conséquence adopter une approche bilatérale, destinée à borner simultanément les déviations potentielles par le bas et par le haut. Ce schéma requiert une distribution équitable et symétrique du risque d’erreur total alpha entre les deux queues de la distribution statistique de référence.
Cette scission du risque attribue formellement une probabilité d’erreur de alpha divisé par deux à la région de rejet inférieure. Lors de la détermination de la borne inférieure lambda_L, le calcul cherche le quantile en deçà duquel ne subsiste qu’une surface probabiliste égale à alpha sur deux, soit typiquement 0,025 pour un niveau de confiance standard de 95 %. Cette convention assure que le risque de sous-estimer la valeur minimale plausible du paramètre soit rigoureusement plafonné à 2,5 %.
Symétriquement, la région de rejet supérieure se voit assigner le seuil probabiliste complémentaire, positionné exactement à un moins alpha divisé par deux, équivalant à 0,975 dans une perspective bilatérale à 95 %. Ce quantile de queue supérieure garantit qu’il n’existe qu’une probabilité résiduelle de 2,5 % que la véritable intensité du processus soit supérieure à la borne haute lambda_U calculée. L’asymétrie naturelle de la distribution de Poisson n’altère en rien cette répartition orthogonale des risques d’erreur sur l’échelle des probabilités cumulées.
5.3 Arbitrage entre puissance statistique et précision de l’estimation
L’arbitrage entre la certitude accordée à l’inférence et le degré de précision de l’estimation constitue un défi central de l’analyse quantitative. Un intervalle excessivement large, bien que mathématiquement irréprochable au regard de sa probabilité de couverture théorique, s’avère dépourvu de valeur pragmatique pour guider la décision clinique ou organisationnelle. Déclarer avec une certitude de 99,9 % qu’un taux d’incidence horaire se situe entre une occurrence et plusieurs centaines ne procure aucune information opérationnelle exploitable aux décideurs.
Les conséquences d’un conservatisme statistique démesuré se traduisent directement par une chute de la puissance statistique des comparaisons ultérieures. Lorsque les intervalles de confiance d’estimation associés à deux conditions expérimentales distinctes présentent un chevauchement substantiel causé par un élargissement artificiel de leurs bornes, l’expérimentateur s’interdit de conclure à l’existence d’une différence cliniquement significative, commettant de facto une erreur de deuxième espèce par excès de prudence.
L’harmonisation des pratiques analytiques avec les standards éditoriaux internationaux en vigueur dans les revues à comité de lecture permet d’encadrer cet arbitrage. Sauf justification théorique exceptionnelle relative à des impératifs vitaux de sécurité, le maintien du niveau de confiance à 95 % demeure la norme académique préconisée. Cette standardisation facilite la comparabilité directe des résultats d’une cohorte à l’autre et favorise l’intégration ultérieure des données au sein de méta-analyses quantitatives systématiques sans nécessiter de transformations d’échelles complexes.
6. Étape 3 : Calcul des degrés de liberté associés au Chi-carré
Le pivot algorithmique de la méthode exacte de Garwood réside dans la conversion du nombre d’événements discrets N en dimensions dimensionnelles continues, formalisées par les degrés de liberté de la distribution du Chi-carré.
6.1 Détermination des degrés de liberté pour la borne inférieure
La dérivation de la limite basse de l’intervalle d’estimation repose sur une transformation algébrique directe du comptage empirique. La formule exacte prescrit d’assigner à la loi du Chi-carré un nombre de degrés de liberté strictement égal au doublement du nombre total d’événements observés, conventionnellement formalisé par l’expression deux fois N :
ddl_L = 2 * N
Le fondement probabiliste de cette relation provient de l’intégration par parties des lois d’attente d’un processus de renouvellement continu. Chaque événement observé est conceptuellement délimité par des intervalles de temps inter-occurrences qui suivent chacun une loi exponentielle standard. Étant donné que la somme de N variables exponentielles indépendantes engendre une loi Gamma d’indice N, et que cette dernière se transforme analytiquement en une distribution du Chi-carré par une homothétie d’un facteur deux, les degrés de liberté résultants correspondent rigoureusement au double du cardinal de l’échantillon d’événements validés.
Cette formulation met en lumière le cas singulier évoqué précédemment lors du recueil d’un effectif strictement nul. Lorsque le dénombrement N s’établit à zéro, l’évaluation arithmétique conduit à zéro degré de liberté pour la borne inférieure. En théorie des distributions, la loi du Chi-carré dégénère alors en une masse de Dirac positionnée à l’origine, confirmant mathématiquement que la limite inférieure ne peut être qu’absolument nulle. Dès lors que N est supérieur ou égal à un, la borne inférieure prend une valeur strictement positive.
6.2 Détermination des degrés de liberté pour la borne supérieure
Contrairement à la symétrie apparente des lois continues usuelles, le calcul de la borne supérieure exige une altération délibérée des degrés de liberté afin de prendre en compte la nature discontinue du domaine paramétrique de Poisson. La formule de Garwood stipule que le nombre de degrés de liberté mobilisé pour la limite haute doit être égal à deux fois la somme du dénombrement empirique et d’une constante unitaire entière :
ddl_U = 2 * (N + 1)
Ce décalage arithmétique d’une unité entière avant multiplication scalaire équivaut à octroyer deux degrés de liberté supplémentaires à la distribution du Chi-carré sous-jacente. Ce mécanisme compense l’asymétrie de couverture induite par l’évaluation des probabilités discrètes cumulées P(X <= N). Pour intégrer l’intégralité de la région critique supérieure compatible avec l’hypothèse nulle sans enfreindre le taux d’erreur prédéfini, l’inversion analytique requiert de basculer sur l’événement discret immédiatement consécutif, imposant cette incrémentation formelle.
L’impact de ce décalage unitaire est particulièrement protecteur sur le plan statistique. En augmentant la dimensionnalité de la distribution du Chi-carré supérieure, l’algorithme repousse mécaniquement le quantile critique vers des valeurs plus élevées de l’axe réel. Cette propriété garantit l’asymétrie protectrice caractéristique des intervalles de Garwood : la distance séparant l’estimation ponctuelle de la borne supérieure est structurellement supérieure à la distance la séparant de la borne inférieure, reflétant la traîne asymétrique à droite inhérente aux processus de Poisson de faible magnitude.
6.3 Lecture des tables statistiques et fonctions d’inversion
Historiquement, l’extraction des valeurs critiques associées à ces degrés de liberté reposait exclusivement sur l’interrogation manuelle de tables statistiques imprimées. L’analyste devait localiser la ligne correspondant exactement au nombre de degrés de liberté calculé — soit deux fois N d’une part, et deux fois la quantité N plus un d’autre part — puis identifier la colonne correspondant au niveau de risque unilatéral désiré. Cette manipulation physique était fréquemment entachée d’erreurs matérielles, notamment lorsque les tables omettaient les degrés de liberté pairs élevés ou fournissaient des arrondis grossiers limités à deux décimales.
Une confusion méthodologique classique réside dans la mauvaise interprétation de la convention typographique adoptée par l’auteur de la table statistique consultée. Alors que certains ouvrages documentent la probabilité cumulée à gauche de la distribution, formellement P(Chi2 <= seuil), d’autres fournissent la probabilité de queue unilatérale droite, définie par P(Chi2 > seuil). Sélectionner le quantile de queue droite en lieu et place du quantile de queue gauche inverse instantanément la signification des bornes et génère des résultats arithmétiquement incohérents, aboutissant parfois à des bornes inférieures supérieures aux bornes hautes.
À l’ère du calcul scientifique automatisé, ces tables imprimées sont avantageusement supplantées par des algorithmes numériques d’inversion directe, basés sur des développements en fractions continues de la fonction gamma incomplète régularisée. Ces fonctions mathématiques de quantile, implémentées dans les logiciels modernes, restituent les valeurs critiques instantanément avec une précision dépassant dix décimales, supprimant tout risque d’erreur d’interpolation manuelle et autorisant le traitement automatisé de flux massifs de données épidémiologiques.
7. Étape 4 : Extraction des quantiles critiques de la loi du Chi-carré
L’attribution des degrés de liberté étant rigoureusement établie pour chaque versant de l’intervalle, l’étape subséquente réside dans l’extraction numérique précise des quantiles d’intérêt au sein de la fonction de distribution cumulative inverse du Chi-carré.
7.1 Extraction du quantile pour la borne inférieure
L’identification de la valeur critique servant d’assise à la borne inférieure procède de l’évaluation de la fonction quantile du Chi-carré évaluée au niveau de probabilité alpha sur deux, sous une paramétrisation à deux fois N degrés de liberté. Ce point critique, que l’on note symboliquement q_inf, représente le seuil géométrique sous lequel se concentre exactement la proportion d’aire sous la courbe définie par le risque d’erreur inférieur choisi, soit typiquement deux centièmes et demi :
q_inf = Quantile_Chi2(alpha / 2 ; 2 * N)
Dans la conduite concrète de cette extraction, il convient de contrôler scrupuleusement la cohérence mathématique de la valeur recueillie. Par construction, pour tout dénombrement N strictement positif, le quantile critique inférieur doit impérativement être un réel strictement positif. À mesure que la valeur du dénombrement empirique N progresse, ce quantile croît de manière monotone, traduisant le déplacement vers la droite de la masse probabiliste de la distribution.
Si l’analyste utilise des fonctions logicielles codées selon la probabilité cumulée à gauche, l’argument de probabilité introduit doit correspondre exactement à alpha divisé par deux, soit 0,025 pour un intervalle à 95 %. En revanche, si la routine logicielle ou la table physique est paramétrée selon la probabilité unilatérale droite de dépassement, l’argument à rechercher correspondra alors rigoureusement à son complémentaire algébrique, soit un moins alpha sur deux, équivalant à 0,975. Cette vigilance sur la convention d’inversion évite toute inversion fâcheuse des points cardinaux de l’estimation.
7.2 Extraction du quantile pour la borne supérieure
La détermination du quantile régissant l’amplitude de la limite supérieure suit une logique symétrique sur le plan de la probabilité de queue, mais asymétrique quant à sa géométrie spatiale. La valeur critique supérieure, notée conventionnellement q_sup, correspond au quantile associé à la probabilité cumulée un moins alpha divisé par deux, calculé pour une distribution du Chi-carré dotée de deux fois la quantité N plus un degrés de liberté :
q_sup = Quantile_Chi2(1 – (alpha / 2) ; 2 * (N + 1))
L’examen comparatif de ce quantile supérieur avec le quantile inférieur extrait précédemment met en lumière l’asymétrie structurelle profonde de la méthode exacte. Même dans l’hypothèse où le dénombrement N est relativement substantiel, l’écart absolu séparant q_sup de la valeur médiane de la distribution est systématiquement plus prononcé que l’écart séparant q_inf de cette même valeur médiane. Ce profil reflète l’étalement de la loi du Chi-carré vers les valeurs positives infinies, caractéristique essentielle des lois de comptage asymétriques.
Ce point d’évaluation probabiliste capture l’extrême limite de l’intensité stochastique compatible avec l’observation expérimentale. Au-delà de ce seuil critique, la probabilité d’enregistrer fortuitement un nombre d’occurrences aussi faible que N deviendrait inférieure au seuil alpha sur deux, justifiant ainsi le rejet formel de valeurs paramétriques plus élevées au titre de la région de confiance convenue.
7.3 Validation numérique des quantiles obtenus
Avant d’engager la phase arithmétique finale, un contrôle de conformité numérique des deux quantiles extraits constitue une précaution méthodologique indispensable. La première vérification élémentaire repose sur le principe d’ordre strict : pour toute valeur de N supérieure ou égale à zéro, le quantile critique supérieur q_sup doit impérativement surpasser de manière stricte le quantile critique inférieur q_inf. Toute violation de cette relation d’ordre trahit une inversion manifeste des arguments de probabilité lors de l’interrogation de la distribution.
Dans l’éventualité où le calcul doit être conduit en environnement dégradé, privé d’accès immédiat à des outils de calcul formel ou à des tables statistiques exhaustives pour des degrés de liberté non conventionnels, l’approximation analytique de Wilson-Hilferty peut être exploitée pour valider l’ordre de grandeur des quantiles. Cette approximation transforme une variable Chi-carré à d degrés de liberté en une variable quasi normale au moyen d’une transformation à la puissance un tiers :
Quantile_Chi2(p ; d) approx= d * [1 – (2 / (9 * d)) + z_p * sqrt(2 / (9 * d))]^3
Dans cette formulation approximative auxiliaire, le terme z_p désigne le quantile standard correspondant de la loi normale centrée réduite. Bien que cette relation ne doive pas se substituer à la méthode exacte lorsque la rigueur absolue est exigée, elle fournit un mécanisme d’audit indépendant exceptionnel pour s’assurer que les valeurs critiques recueillies lors de l’étape d’extraction ne sont entachées d’aucune dérive algorithmique ou typographique majeure.
8. Étape 5 : Calcul arithmétique des bornes inférieure et supérieure
La dernière étape du protocole méthodologique synthétise les composantes d’analyse probabiliste précédemment développées en opérant les transformations arithmétiques finales nécessaires pour établir l’intervalle de confiance opérationnel.
8.1 Multiplication par le facteur scalaire d’ajustement
L’obtention des bornes définitives d’intensité cumulée exige l’application rigoureuse du coefficient multiplicateur scalaire prescrit par la dérivation analytique de Garwood. Chacun des deux quantiles critiques extraits de la loi du Chi-carré doit être pondéré par un facteur invariable d’un demi, soit une division arithmétique par deux de la valeur recueillie :
lambda_L = (1 / 2) * q_inf
lambda_U = (1 / 2) * q_sup
Ce facteur scalaire d’un demi découle intrinsèquement de la transformation différentielle ayant permis d’exprimer la fonction de masse de Poisson sous la forme intégrale d’une distribution du Chi-carré. La distribution standard du Chi-carré étant paramétrée avec un facteur d’échelle égal à deux dans sa formulation Gamma canonique, la restitution du paramètre authentique lambda nécessite cette division d’homothétie pour neutraliser le doublement dimensionnel introduit lors du calcul des degrés de liberté.
L’omission de cette étape de mise à l’échelle scalaire constitue l’une des erreurs arithmétiques les plus fréquentes chez les praticiens non spécialistes, conduisant à une surestimation globale d’un facteur deux de l’ensemble des limites de l’intervalle d’estimation. L’analyste veillera donc à exécuter cette opération élémentaire de manière systématique sur les deux composantes critiques avant toute interprétation subséquente.
8.2 Ajustement selon la durée de l’exposition temporelle
Dans une vaste proportion d’investigations empiriques, la finalité scientifique ne réside pas dans l’évaluation du nombre absolu d’événements cumulés sur l’ensemble de l’étude, mais bien dans l’estimation d’un taux d’incidence structurel rapporté à une unité d’exposition standardisée, couramment désigné par mu. Si la période d’observation globale équivaut à un volume temporel, spatial ou démographique noté T, les bornes de l’intervalle d’intensité lambda doivent impérativement être divisées par ce dénominateur d’exposition :
Taux_L = lambda_L / T = (1 / (2 * T)) * q_inf
Taux_U = lambda_U / T = (1 / (2 * T)) * q_sup
Cette division assure la standardisation dimensionnelle des résultats, permettant par exemple d’exprimer les limites de confiance sous la forme d’un nombre de manifestations par heure d’observation clinique, de cas par cent mille personnes-années, ou d’anomalies par kilomètre carré analysé. La cohérence dimensionnelle entre le numérateur d’événements et le dénominateur d’exposition temporelle se trouve ainsi préservée avec une totale rigueur métrologique.
Il est fondamental de souligner que cette normalisation temporelle n’affecte en aucune manière la couverture probabiliste nominale de l’intervalle. L’exposition globale T étant une grandeur déterministe fixée par le protocole expérimental et non une variable aléatoire stochastique, la division par ce scalaire invariant constitue une transformation affine stricte qui ne modifie nullement le niveau de confiance garanti par les propriétés mathématiques fondamentales de la méthode de Garwood.
8.3 Structuration formelle de l’intervalle de confiance final
L’intervalle de confiance parvient à son achèvement par sa structuration typographique et formelle définitive. Conformément aux canons de la notation mathématique, le résultat s’exprime sous la forme d’un ensemble continu délimité par des crochets ou des parenthèses, intégrant explicitement le niveau de confiance retenu :
IC_95% = [ lambda_L ; lambda_U ] ou IC_95% = [ Taux_L ; Taux_U ]
À ce stade, l’expérimentateur doit vérifier que l’estimation ponctuelle brute — qu’il s’agisse du dénombrement brut N ou du taux d’incidence observé N divisé par T — se trouve impérativement incluse à l’intérieur du domaine circonscrit par les bornes calculées. Une incohérence dans laquelle la valeur observée se situerait à l’extérieur des bornes trahirait une corruption immédiate des opérations de calcul sous-jacentes.
L’analyste constatera systématiquement l’asymétrie protectrice de cet intervalle définitif autour de l’estimation ponctuelle. La distance mathématique séparant la borne haute de la moyenne empirique (lambda_U – N) excédera invariablement la distance séparant cette même moyenne de la borne basse (N – lambda_L). Cette caractéristique géométrique, particulièrement spectaculaire lorsque N est restreint, constitue la signature visuelle et analytique indubitable de la méthode exacte de Garwood, attestant de son parfait ajustement à l’asymétrie de la distribution de probabilité d’origine.
9. Exemple numérique guidé : Résolution complète pas à pas
Afin d’ancrer de manière irréversible la compréhension de l’ensemble de ces concepts mathématiques, nous déployons à présent une démonstration numérique exhaustive, résolvant manuellement chaque étape sur un cas d’étude clinique concret.
9.1 Énoncé du cas clinique d’étude et paramètres initiaux
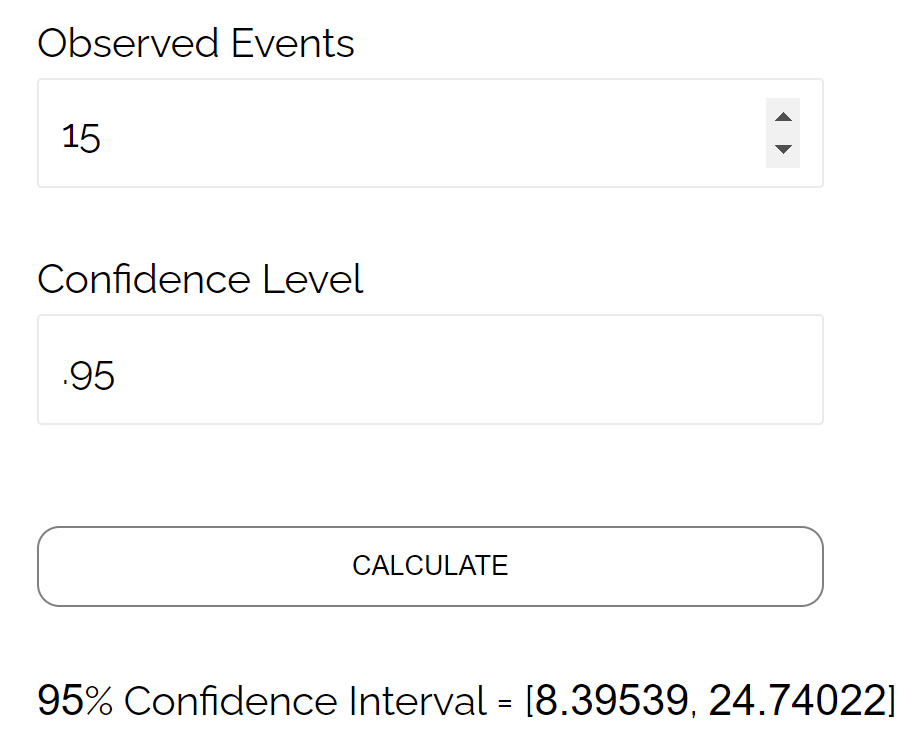
Imaginons un protocole expérimental conduit au sein d’une unité de neuropsychologie clinique visant à mesurer la fréquence d’apparition d’un comportement d’auto-agression stéréotypé chez un patient admis pour bilan diagnostique approfondi. L’équipe médicale met en place un suivi vidéo continu et standardisé d’une durée ininterrompue de vingt-quatre heures. Durant cette fenêtre d’exposition rigoureusement contrôlée, l’analyse exhaustive des enregistrements permet de valider le dénombrement précis de quinze manifestations comportementales indépendantes de ce type.
L’objectif scientifique fixé par le protocole réside dans l’estimation de l’intensité moyenne intrinsèque de survenue de ce comportement, assortie d’un intervalle de confiance bilatéral exact au niveau de confiance conventionnel de 95 %. L’analyste se trouve ainsi en présence des paramètres formels d’entrée suivants :
- Nombre total d’événements observés : N = 15
- Durée globale de l’exposition temporelle standardisée : T = 24 heures
- Niveau de confiance statistique requis : 1 – alpha = 0,95
- Seuil de signification global d’erreur toléré : alpha = 0,05
- Scission bilatérale du risque d’erreur : alpha / 2 = 0,025 et 1 – (alpha / 2) = 0,975
L’ensemble des conditions préalables d’indépendance et de stabilité environnementale ayant été contrôlées et validées par l’équipe soignante, la mise en œuvre de l’algorithme de Garwood peut être engagée sans réserve.
9.2 Détermination pas à pas des paramètres du Chi-carré
Conformément aux préceptes théoriques établis à l’étape 3, l’analyste procède en premier lieu au calcul des degrés de liberté respectifs nécessaires à l’interrogation de la distribution de probabilité continue du Chi-carré pour chacune des deux limites de confiance :
Pour la borne inférieure, le calcul applique le doublement arithmétique de l’effectif observé :
ddl_L = 2 * N = 2 * 15 = 30
Pour la borne supérieure, l’algorithme intègre le décalage unitaire conservateur :
ddl_U = 2 * (N + 1) = 2 * (15 + 1) = 2 * 16 = 32
L’analyste interroge désormais les fonctions de distribution du Chi-carré pour extraire les quantiles critiques associés à ces dimensions géométriques :
- Quantile critique inférieur pour 30 degrés de liberté au seuil de probabilité de 0,025 :
q_inf = Chi2(30 ; 0,025) approx= 16,7908 - Quantile critique supérieur pour 32 degrés de liberté au seuil de probabilité de 0,975 :
q_sup = Chi2(32 ; 0,975) approx= 49,4804
Le contrôle de cohérence préalable confirme la stricte positivité des valeurs obtenues et valide la relation d’ordre fondamentale, la valeur q_sup surpassant largement q_inf.
9.3 Résolution numérique finale et formalisation du résultat
L’étape de résolution finale consiste à appliquer le facteur d’échelle scalaire d’un demi sur chacun des quantiles préalablement extraits afin d’obtenir les bornes absolues du paramètre lambda pour la période globale de 24 heures :
lambda_L = (1 / 2) * 16,7908 = 8,3954
lambda_U = (1 / 2) * 49,4804 = 24,7402
L’intervalle de confiance exact à 95 % pour le nombre total d’occurrences sur vingt-quatre heures s’établit donc rigoureusement entre 8,40 et 24,74 événements (valeurs arrondies au centième supérieur). Nous constatons avec netteté l’asymétrie du résultat : l’amplitude basse (15 – 8,40 = 6,60) est sensiblement plus faible que l’amplitude haute (24,74 – 15 = 9,74).
Pour convertir ce résultat en un taux d’incidence horaire standardisé mu, les deux bornes absolues sont désormais divisées par le volume total d’exposition, à savoir T = 24 heures :
Taux_L = 8,3954 / 24 = 0,3498 événement par heure
Taux_U = 24,7402 / 24 = 1,0308 événement par heure
L’équipe médicale peut formaliser ses conclusions statistiques de la manière suivante : sur la base des quinze manifestations comportementales enregistrées durant le protocole de 24 heures, le taux d’incidence horaire sous-jacent est estimé ponctuellement à 0,63 manifestation par heure, avec un intervalle de confiance exact à 95 % compris entre 0,35 et 1,03 événement par heure. L’incertitude d’échantillonnage est ainsi parfaitement maîtrisée et documentée selon les standards internationaux les plus rigoureux.
10. Méthodes d’approximation asymptotique pour les grands échantillons
Bien que la méthode exacte de Garwood demeure l’étalon de référence incontournable, l’histoire et la pratique de l’analyse quantitative mobilisent également des formulations asymptotiques alternatives dont la maîtrise théorique permet d’en appréhender les avantages opérationnels et les périls analytiques.
10.1 L’approximation normale standard basée sur le test de Wald
L’approche d’approximation la plus intuitive et la plus anciennement diffusée repose sur l’inversion directe du test de Wald sous l’hypothèse de normalité asymptotique conférée par le théorème central limite. Puisque l’espérance et la variance d’une distribution de Poisson coïncident avec le paramètre lambda, l’erreur type de l’estimateur ponctuel N s’exprime naturellement par la racine carrée de N. L’intervalle de Wald bilatéral standard se structure selon la formulation canonique suivante :
IC_Wald = N +/- z_(1 – (alpha / 2)) * sqrt(N)
Dans cette équation, le terme z désigne le quantile d’ordre correspondant de la distribution normale centrée réduite, prenant la valeur universelle de 1,96 pour un niveau de confiance fixé à 95 %. Cette méthode séduit par son extrême simplicité calculatoire, ne requérant aucune extraction de quantiles de distributions asymétriques ni recours à des tables spécialisées.
Cependant, cette élégance arithmétique cache des déficiences méthodologiques majeures. L’intervalle de Wald impose une symétrie artificielle stricte autour du point d’observation empirique N. Lorsque le nombre d’événements observés est restreint (N inférieur à dix ou quinze), cette symétrie factice engendre fréquemment des bornes inférieures strictement négatives, absurdité biologique et mathématique totale pour un processus de comptage fondamentalement non négatif. De surcroît, le taux de couverture effectif de l’intervalle de Wald chute de manière imprévisible, oscillant fréquemment sous le seuil nominal déclaré, ce qui disqualifie son usage pour les effectifs restreints.
10.2 L’approximation par la méthode du score de Wilson modifiée
Pour pallier les tares rédhibitoires de la formulation de Wald sans pour autant implémenter l’intégralité de l’appareil mathématique de Garwood, plusieurs biostatisticiens ont développé une adaptation de la méthode du score de Rao-Wilson appliquée aux processus de Poisson. L’intervalle de score procède par inversion du test d’hypothèse portant sur le paramètre théorique au dénominateur de la statistique de test, stabilisant ainsi la relation d’interdépendance liant l’espérance à la variance de l’estimateur.
La formulation analytique résultant de cette inversion de score s’exprime par la relation quadratique suivante :
IC_Score = N + (z^2 / 2) +/- z * sqrt(N + (z^2 / 4))
L’examen structurel de cette équation révèle que le centre de l’intervalle d’estimation n’est plus positionné sur la valeur observée N, mais subit une translation positive d’une magnitude égale à la moitié du carré du quantile normal z (soit environ 1,92 unité pour un intervalle à 95 %). Cette translation asymétrique compense élégamment la dissymétrie intrinsèque de la distribution de Poisson sous-jacente.
Sur le plan des performances métrologiques, l’intervalle de score surpasse radicalement l’approximation de Wald. Sa couverture probabiliste réelle demeure remarquablement proche du seuil nominal de 95 %, y compris pour des comptages empiriques extrêmement modestes. De plus, il garantit formellement la stricte positivité de la borne inférieure pour toute valeur non nulle de N, éliminant ainsi le scandale méthodologique des taux d’occurrence négatifs propres aux formules de Wald non corrigées.
10.3 Transformation stabilisatrice de variance par la racine carrée
Une troisième voie asymptotique remarquable exploite la théorie de la méthode delta appliquée aux transformations stabilisatrices de variance. En vertu du lemme fondamental de la théorie asymptotique, l’application d’une fonction racine carrée à une variable aléatoire suivant une loi de Poisson a pour conséquence de découpler l’espérance mathématique de la variance asymptotique, cette dernière devenant constante et égale à la valeur invariable d’un quart (0,25), quelle que soit l’intensité lambda du processus sous-jacent.
En exploitant cette propriété de stabilisation homoscédastique, il devient possible d’ériger un intervalle de confiance symétrique classique sur l’échelle transformée de la racine carrée, avant d’opérer une rétro-transformation par élévation au carré pour restituer les bornes d’estimation sur l’échelle naturelle du comptage empirique. L’équation régissant cette méthode prend la forme analytique suivante :
IC_Racine = [ sqrt(N) +/- (z / 2) ]^2
Lorsque cette expression est développée algébriquement, la borne inférieure s’établit à [sqrt(N) – (z / 2)]^2, sous réserve que le terme entre crochets soit strictement positif, tandis que la borne supérieure atteint [sqrt(N) + (z / 2)]^2. Cette élévation quadratique réintroduit tout naturellement une asymétrie bénéfique au sein de l’intervalle final, l’écartement supérieur surpassant l’écartement inférieur sur l’échelle d’origine des entiers naturels.
Les études de simulation statistique comparative démontrent que l’approximation par stabilisation de variance offre un compromis analytique robuste entre la simplicité opérationnelle et la fidélité de couverture pour des échantillons moyens (N compris entre vingt et cinquante). Toutefois, dès lors que les effectifs tombent sous le seuil critique de dix événements, aucune approximation asymptotique ne parvient à égaler l’impeccable régularité de couverture protectrice garantie par la formulation exacte de Garwood.
11. Implémentation informatique du calcul sous R, Python et tableurs
La mise en application quotidienne de ces concepts d’inférence exige une maîtrise opérationnelle de leur traduction algorithmique au sein des principaux écosystèmes informatiques déployés dans les laboratoires de recherche et les directions statistiques.
11.1 Exécution automatisée sous l’environnement R
Le langage de programmation et environnement d’analyse R, plateforme dominante en biostatistique internationale, intègre nativement l’intégralité de la machinerie analytique exacte de Garwood au sein de sa distribution de base, sans qu’il soit nécessaire d’installer de packages externes tiers. La fonction de référence dédiée à cette estimation est la commande poisson.test.
L’utilisation de cette routine logicielle s’opère par le passage des arguments empiriques préalablement validés, en stipulant le nombre d’événements enregistrés, la dimension de la fenêtre d’exposition globale, ainsi que le niveau de confiance souhaité. Le script analytique classique prend la forme descriptive suivante :
resultat <- poisson.test(x = 15, T = 24, conf.level = 0.95)
L’objet structuré renvoyé par cette commande contient une collection exhaustive de descripteurs métrologiques. Pour extraire spécifiquement le vecteur numérique délimitant l’intervalle de confiance exact pour le taux standardisé, le statisticien sollicite l’attribut conf.int de la structure résultante au moyen de l’expression : resultat$conf.int. Le logiciel exécute sous le capot les calculs d’inversion du Chi-carré selon les équations exactes de Garwood avec une précision en virgule flottante double, restituant instantanément les bornes exactes calculées manuellement dans notre démonstration guidée précédente.
11.2 Programmation du calcul avec Python et SciPy
Dans l’écosystème de programmation Python, pilier de la science des données contemporaine, le calcul exact de l’intervalle de confiance de Poisson s’appuie sur la bibliothèque scientifique SciPy, et plus particulièrement sur son sous-module d’analyse probabiliste scipy.stats. Ce module met à disposition des chercheurs la classe chi2, qui encapsule l’intégralité des fonctions de masse, de densité et surtout de quantile (méthode de la fonction point percentile, notée ppf).
La structuration d’une fonction réutilisable pour calculer les intervalles exacts de Garwood sous Python s’écrit de la manière descriptive suivante :
L’analyste définit une fonction acceptant en paramètres d’entrée le nombre d’événements observés N, la base d’exposition globale T et le risque d’erreur alpha. Dans le corps de cette fonction, le cas particulier N égal à zéro fait l’objet d’un embranchement conditionnel assignant zéro à la borne inférieure, tandis que la borne supérieure s’évalue au moyen de chi2.ppf(1 – alpha, 2) divisé par deux. Lorsque N est strictement supérieur à zéro, l’algorithme évalue la borne basse par chi2.ppf(alpha / 2, 2 * N) / (2 * T) et la borne haute par chi2.ppf(1 – alpha / 2, 2 * (N + 1)) / (2 * T).
L’exécution de cette routine sur un interpréteur Python standard reproduit à l’identique les estimations biomédicales théoriques avec une vitesse de traitement autorisant son encapsulation au sein de pipelines de traitement massif de mégadonnées cliniques, confirmant la convergence algorithmique totale entre le formalisme théorique de 1936 et le calcul scientifique contemporain.
11.3 Calcul de l’intervalle au sein d’un tableur standard
Pour de nombreux analystes cliniques et gestionnaires opérationnels, le tableur de bureau — qu’il s’agisse de Microsoft Excel, LibreOffice Calc ou Google Sheets — demeure l’interface de calcul la plus accessible. L’implémentation de la méthode exacte de Garwood au sein d’une feuille de calcul dynamique s’avère parfaitement réalisable grâce à l’existence de formules natives d’inversion de la distribution du Chi-carré.
La syntaxe moderne de référence repose sur la fonction LOI.KHIDEUX.INVERSE (ou CHISQ.INV dans les versions anglophones), qui renvoie la valeur critique d’une distribution du Chi-carré en fonction d’une probabilité cumulée unilatérale gauche et d’un nombre de degrés de liberté déterminé. Pour une cellule A1 hébergeant le dénombrement N (égal à 15) et une cellule B1 hébergeant l’exposition temporelle T (égale à 24), les formules de bornes se configurent ainsi :
- Formule de la borne inférieure (au taux horaire) :
=SI(A1=0 ; 0 ; (1 / (2 * B1)) * LOI.KHIDEUX.INVERSE(0,025 ; 2 * A1)) - Formule de la borne supérieure (au taux horaire) :
=(1 / (2 * B1)) * LOI.KHIDEUX.INVERSE(0,975 ; 2 * (A1 + 1))
Il est capital d’avertir l’utilisateur contre l’usage des anciennes fonctions obsolètes, telles que LOI.KHIDEUX.INVERSE.DROITE (CHISQ.INV.RT), dont la convention d’évaluation s’appuie sur la probabilité unilatérale droite. Toute confusion entre ces deux formulations entraînerait une inversion des quantiles extraits et corromprait l’intégrité de l’intervalle d’estimation résultant sur la feuille de calcul dynamique.
12. Interprétation scientifique, communication des données et écueils
Le calcul numérique des bornes ne représente que la composante technique de l’inférence quantitative. La dimension épistémologique la plus délicate réside dans l’interprétation méthodologique adéquate de ces limites et dans leur restitution transparente au sein de la littérature scientifique.
12.1 Règles d’interprétation méthodologique des bornes obtenues
L’interprétation orthodoxe d’un intervalle de confiance s’ancre exclusivement dans l’approche fréquentiste de la théorie des probabilités. Déclarer qu’un intervalle de confiance à 95 % compris entre 0,35 et 1,03 signifie qu’il y a 95 % de chances que la véritable intensité sous-jacente appartienne à cet intervalle spécifique constitue une entorse conceptuelle majeure, bien que courante. Dans le paradigme fréquentiste, le paramètre théorique lambda n’est pas une variable aléatoire, mais une constante fixe inconnue : il se situe ou ne se situe pas dans l’intervalle calculé.
La définition épistémologique authentique stipule que le coefficient de confiance de 95 % s’applique à la procédure mathématique de calcul elle-même, et non au résultat empirique isolé issu d’un échantillon unique. Cela signifie que si un investigateur reproduisait ce protocole d’observation de 24 heures un nombre infini de fois dans des conditions parfaitement homogènes, 95 % des intervalles de confiance exacts ainsi matérialisés captureraient avec succès la véritable valeur de l’intensité stochastique, tandis que 5 % échoueraient à l’englober par le jeu des aléas d’échantillonnage.
Sur le plan pragmatique de la décision clinique ou industrielle, les bornes de l’intervalle délimitent l’espace des intensités phénoménologiques restant hautement plausibles à la lumière des données collectées. La borne inférieure formalise le scénario le plus optimiste (ou le niveau d’activité minimal crédible), tandis que la borne supérieure chiffre la pire dégradation envisageable du phénomène. Cette amplitude guide les arbitrages sécuritaires bien plus efficacement qu’un simple indicateur ponctuel central.
12.2 Erreurs méthodologiques courantes à éviter rigoureusement
Parmi les errements analytiques les plus dévastateurs figure l’application aveugle des approximations normales de Wald lors du traitement de dénombrements faibles. Persister à déployer des formules asymptotiques classiques pour des effectifs d’occurrences inférieurs à vingt ou trente relève d’une négligence méthodologique avérée, particulièrement lorsque les logiciels contemporains exécutent les algorithmes exacts de Garwood en une fraction de milliseconde sans le moindre surcoût computationnel.
Un deuxième écueil épistémologique préjudiciable réside dans la confusion conceptuelle fréquente entre l’intervalle de confiance encadrant le paramètre moyen lambda et un intervalle de prédiction empirique. L’intervalle de confiance de Poisson a pour vocation exclusive de borner la valeur de l’intensité stochastique moyenne du processus sur le long terme. Il ne prétend en aucun cas circonscrire la dispersion des réalisations concrètes futures d’une observation unique subséquente. La variabilité d’une observation future intègre non seulement l’incertitude sur la valeur de lambda, mais également la variance stochastique intrinsèque de la loi de Poisson elle-même, exigeant des formules de prédiction dédiées nettement plus étendues.
Enfin, l’omission de l’ajustement du dénominateur d’exposition lors de comparaisons de cohortes hétérogènes constitue un facteur récurrent de fausses conclusions épidémiologiques. Comparer brutalement les bornes absolues N issues de deux protocoles sans les rapporter rigoureusement à leur volumétrie de suivi respective (heures-machines, années-patients) revient à amalgamer un dénombrement avec un taux d’incidence, introduisant un biais systématique insurmontable dès lors que les durées de surveillance diffèrent.
12.3 Présentation standardisée des résultats dans les publications
La communication scientifique des résultats d’inférence quantitative doit satisfaire aux exigences de reproductibilité et de clarté édictées par les comités éditoriaux internationaux, à l’instar des recommandations de l’International Committee of Medical Journal Editors (ICMJE) ou des guides de publication APA (American Psychological Association). La présentation d’un dénombrement d’événements ne doit jamais se limiter à l’affichage isolé d’un taux moyen, mais doit obligatoirement expliciter la taille brute de l’échantillon, la durée d’exposition cumulée, l’estimation ponctuelle standardisée et les limites de l’intervalle d’estimation exact.
La formulation conventionnelle au sein du corps du texte académique adopte une structure rigoureuse telle que : « Le taux d’incidence moyen a été observé à 0,63 événement par heure (N = 15 manifestations en 24 heures d’observation continue ; Intervalle de Confiance exact de Garwood à 95 % : [0,35 ; 1,03]). » La mention explicite de la méthode de Garwood rassure immédiatement les évaluateurs et pairs relecteurs quant à l’absence de distorsion asymptotique dans le traitement de l’incertitude.
Cette rigueur de communication statistique permet une articulation fluide des résultats empiriques avec les impératifs de la méta-analyse contemporaine. En publiant des intervalles exacts non biaisés, les auteurs fournissent les métriques fondamentales requises pour consolider quantitativement les preuves scientifiques au sein de synthèses systématiques mondiales, garantissant que la contribution empirique individuelle participe pleinement à l’édification d’un corpus de connaissances reproductible et pérenne.
Références
- Barker, L. (2002). A comparison of nine confidence intervals for a Poisson parameter when the expected number of events is ≤ 5. The American Statistician, 56(2), 85–89. https://doi.org/10.1198/000313002317572739
- Garwood, F. (1936). Fiducial limits for the Poisson distribution. Biometrika, 28(3/4), 437–442. https://doi.org/10.2307/2333956
- Patil, V. V., & Kulkarni, H. V. (2012). Comparison of confidence intervals for the Poisson mean: Some new aspects. REVSTAT-Statistical Journal, 10(2), 211–227.
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier. Paris. https://gallica.bnf.fr/ark:/12148/bpt6k295033
- Ulm, K. (1990). A simple method to calculate the confidence interval of a standardized mortality ratio (SMR). American Journal of Epidemiology, 131(2), 373–375. https://doi.org/10.1093/oxfordjournals.aje.a115507
- Wilson, E. B., & Hilferty, M. M. (1931). The distribution of chi-square. Proceedings of the National Academy of Sciences of the United States of America, 17(12), 684–688. https://doi.org/10.1073/pnas.17.12.684