
Dans le champ de l’analyse multivariée, de la psychométrie appliquée et de l’évaluation quantitative des comportements, la quantification rigoureuse des écarts entre individus constitue une préoccupation méthodologique cardinale. Qu’il s’agisse de comparer des inventaires de personnalité, d’évaluer la concordance diagnostique entre plusieurs observateurs ou d’analyser la proximité comportementale au sein d’un échantillon expérimental, le choix de la métrique d’éloignement détermine directement la validité des inférences statistiques ultérieures. Parmi l’éventail des fonctions mathématiques de dissimilarité, la distance de Manhattan — également désignée sous les termes de métrique L1, distance géodésique sur grille ou géométrie du taxi — occupe une position singulière en raison de sa robustesse intrinsèque face aux valeurs extrêmes et de son interprétabilité géométrique directe sur des variables ordinales ou quantitatives discrètes.
Si des environnements de programmation statistique tels que R ou Python sont fréquemment mobilisés pour traiter de volumineux jeux de données, le tableur Microsoft Excel demeure l’outil privilégié de modélisation, d’audit préliminaire et d’analyse exploratoire pour une multitude de chercheurs, cliniciens et praticiens des ressources humaines. Sa transparence structurelle, la visibilité immédiate des matrices de calcul et son accessibilité universelle en font un laboratoire d’analyse particulièrement formateur et fonctionnel. Néanmoins, l’implémentation rigoureuse d’une métrique non euclidienne au sein d’un environnement tabulaire nécessite une maîtrise approfondie des fonctions matricielles, de la manipulation des vecteurs et de l’optimisation des algorithmes de calcul afin de prévenir les erreurs de dimensionnement ou les dégradations de performances.
Ce guide exhaustif a pour vocation d’exposer l’intégralité du cycle de vie du calcul de la distance de Manhattan dans Microsoft Excel, depuis ses fondements axiomatiques jusqu’à son automatisation à l’aide de Visual Basic pour Applications (VBA) et de Power Query. En articulant rigueur mathématique, contextualisation psychométrique et ingénierie de la feuille de calcul, cet article détaille les démarches opérationnelles indispensables pour concevoir des matrices de dissimilarité reproductibles, robustes face aux données manquantes et exploitables sur le plan diagnostique et classificatoire.
1. Fondements théoriques et mathématiques de la distance de Manhattan
1.1 Origine géométrique et métrique L1
La distance de Manhattan tire sa dénomination métaphorique de l’agencement orthogonal caractéristique des rues et avenues de l’arrondissement new-yorkais de Manhattan. Contrairement à l’espace géométrique standard modélisé par la géométrie euclidienne, au sein duquel la distance entre deux points correspond à la longueur du segment rectiligne qui les relie — le vol d’oiseau —, la géométrie du taxi (ou taxicab geometry, introduite formellement par le mathématicien Hermann Minkowski au tournant du XXe siècle) postule que le déplacement s’effectue exclusivement le long d’axes strictement perpendiculaires. Dans un réseau carroyé multidimensionnel, la trajectoire minimale entre deux coordonnées n’est donc pas une ligne oblique continue, mais une succession d’étapes discrètes accomplies parallèlement aux dimensions du référentiel.
Sur le plan de l’analyse mathématique, cette métrique dérive directement de la norme L1 (ou norme de la somme absolue). Pour qu’une fonction de dissimilarité puisse être formellement qualifiée de métrique au sens topologique, elle doit impérativement satisfaire quatre axiomes fondamentaux :
- La non-négativité : la distance entre deux vecteurs est toujours positive ou nulle.
- L’identité des indiscernables : la distance est strictement nulle si et seulement si les deux vecteurs sont rigoureusement identiques.
- La symétrie : la distance séparant un sujet A d’un sujet B équivaut parfaitement à celle séparant le sujet B du sujet A.
- L’inégalité triangulaire : le détour par un troisième profil intermédiaire C ne peut en aucun cas raccourcir la distance globale entre A et B.
Cette structure axiomatique confère à la distance de Manhattan une pertinence conceptuelle remarquable lorsqu’il s’agit de quantifier des écarts sur des échelles discrètes. Contrairement aux espaces continus isotropes où chaque direction spatiale est équivalente, les dimensions psychologiques ou comportementales mesurées par des inventaires psychométriques constituent des axes distincts et souvent non interchangeables. L’éloignement entre deux profils s’interprète alors comme la somme arithmétique cumulée des désaccords dimension par dimension, sans qu’un raccourci diagonal artificiel ne vienne masquer la réalité des écarts segmentaires.
1.2 Formulation mathématique formelle
D’un point de vue algébrique formel, considérons deux profils individuels représentés par des vecteurs de dimension n, notés respectivement A = (a₁, a₂, …, aₙ) et B = (b₁, b₂, …, bₙ), où chaque composante indicée correspond à la mesure quantitative d’une variable ou d’un trait psychologique particulier. La distance de Manhattan, communément notée d₁(A, B), s’exprime comme la somme arithmétique des valeurs absolues des différences dimensionnelles terme à terme :
d₁(A, B) = ∑ᵢ₌₁ⁿ |aᵢ – bᵢ|
Cette expression met en lumière la nature purement linéaire de l’opérateur de sommation. Dans le cadre plus large de la famille des distances de Minkowski d’ordre p, définie par la formule générale Dₚ(A, B) = (∑ |aᵢ – bᵢ|ᵖ)^(1/p), la distance de Manhattan correspond rigoureusement au cas particulier où le paramètre d’ordre p est fixé à 1. En comparaison, la distance euclidienne canonique correspond au paramètre p = 2, impliquant une élévation quadratique préalable de chaque écart individuel suivie d’une extraction finale de la racine carrée.
Cette divergence algébrique entre p = 1 et p = 2 engendre des conséquences méthodologiques profondes en matière de sensibilité aux distributions de données. En n’élevant pas les différences au carré, la métrique L1 préserve une proportionnalité constante face aux écarts marginaux. Un écart de 4 points sur une échelle d’extraversion pèse exactement le double d’un écart de 2 points. À l’inverse, dans un espace euclidien, un écart de 4 unités génère une contribution quadratique de 16, soit quatre fois plus d’impact qu’un écart de 2 unités (dont le carré vaut 4). La distance de Manhattan se distingue donc par une robustesse asymptotique nettement supérieure face aux valeurs atypiques isolées, évitant qu’une divergence marquée sur un seul trait psychologique ne sature artificiellement la mesure globale de dissimilarité.
1.3 Pertinence méthodologique en psychométrie et sciences du comportement
Dans l’écosystème de la psychométrie moderne, l’évaluation des inventaires de personnalité à large spectre — à l’instar du modèle des Big Five opérationnalisé par le NEO-PI-R ou le BFI, mesurant l’Ouverture, la Conscienciosité, l’Extraversion, l’Agréabilité et le Névrosisme — confronte fréquemment les praticiens au défi de la comparaison globale de profils. Les données issues de ces instruments sont traditionnellement recueillies via des échelles de Likert graduées en points discrets (couramment de 1 à 5 ou de 1 à 7). Dans un tel cadre, les postulats de continuité et de différentiabilité inhérents aux espaces géométriques continus sont contestables sur le plan épistémologique.
La distance de Manhattan s’impose comme une métrique naturelle pour les échelles ordinales ou pseudo-intervallaires. Lorsqu’un psychologue différentiel cherche à déterminer dans quelle mesure le profil d’un candidat à un poste se rapproche du profil de compétences cible défini par l’organisation, chaque degré d’éloignement sur un trait comportemental représente un coût d’adaptation ou un besoin de développement spécifique. L’accumulation linéaire de ces coûts individuels, permise par la métrique L1, offre une interprétabilité clinique et managériale immédiate : le score de dissimilarité total reflète le volume absolu de divergences cumulées sur l’ensemble du profil.
De surcroît, lors de diagnostics typologiques ou d’analyses de partitionnement (clustering) portant sur des sous-populations cliniques, l’accentuation non linéaire des écarts produite par les métriques quadratiques tend à scinder artificiellement des cohortes homogènes dès lors qu’un individu manifeste un score extrême isolé sur une dimension spécifique (par exemple, une réactivité émotionnelle particulièrement aiguë due à un stress transitoire). En neutralisant cette distorsion géométrique, la métrique de Manhattan stabilise l’analyse des profils comportementaux et favorise une classification reposant sur la globalité de la gestalt psychologique plutôt que sur la prédominance mathématique d’une variance locale excessive.
2. Structuration et préparation des données psychométriques dans Excel
2.1 Organisation tabulaire des vecteurs de données
L’implémentation sans faille du calcul vectoriel sous Excel requiert une discipline d’ingénierie des données particulièrement stricte. La disposition tabulaire standard prescrite par les principes du Tidy Data stipule que chaque ligne du tableau principal doit correspondre à une observation unitaire — en l’occurrence, un participant, un patient ou un collaborateur évalué — tandis que chaque colonne doit être dédiée à une variable psychométrique univoque. Cette structure vectorielle horizontale garantit que l’empreinte psychologique de chaque individu est encapsulée au sein d’une plage contiguë de cellules, simplifiant considérablement l’écriture des formules de calcul de distance.
Pour assurer la traçabilité intégrale et l’intégrité déontologique des analyses, il est impératif d’assigner à chaque participant un identifiant alphanumérique unique et invariable, positionné dans la première colonne de la feuille de calcul (colonne A, par exemple : « ID_Sujet »). Cet identifiant anonymisé prévient tout risque de confusion nominative et permet de lier dynamiquement les résultats des calculs de distance à d’éventuelles métadonnées sociodémographiques (âge, genre, groupe expérimental, ancienneté professionnelle).
L’alignement dimensionnel doit faire l’objet d’une vigilance absolue : l’ordre séquentiel des variables en colonnes doit demeurer rigoureusement constant d’une observation à l’autre. Si la colonne B recueille les scores d’Extraversion et la colonne C ceux de Névrosisme, cette assignation dimensionnelle doit s’appliquer sans exception à l’ensemble des rangées du tableau. Toute inversion de colonnes ou permutation accidentelle introduirait une erreur de calcul silencieuse mais dévastatrice, où des traits comportementaux orthogonaux se retrouveraient soustraits de manière erronée.
2.2 Nettoyage et harmonisation des échelles de mesure
Avant d’engager le moindre calcul différentiel, une étape préalable de contrôle de la cohérence métrique est obligatoire. Lorsque des instruments d’évaluation composite sont mobilisés, il arrive fréquemment que différentes sous-échelles emploient des amplitudes numériques divergentes : par exemple, un questionnaire d’intérêts professionnels mesuré sur une échelle de Likert en 5 points combiné à un inventaire d’anxiété gradué de 0 à 100 points. L’application directe de la formule de Manhattan sur de telles données brutes conduirait à une hypertrophie artificielle de l’influence de l’échelle d’anxiété sur la distance globale, la métrique L1 accordant un poids mathématique directement proportionnel à l’amplitude numérique des variables.
Pour remédier à ces distorsions de variance différentielle, deux stratégies d’harmonisation peuvent être aisément exécutées sous Excel :
- La standardisation par score Z (centrage-réduction) : cette méthode transforme chaque valeur brute x selon la formule z = (x – μ) / σ. Dans Excel, cette opération s’effectue au moyen des fonctions
MOYENNEetECARTYPE.STANDARD, ou directement via la fonction dédiéeCENTREE.REDUITE(cellule; moyenne; ecart_type). Les variables standardisées présentent alors toutes une moyenne nulle et un écart-type égal à 1, éliminant tout biais de dispersion d’échelle. - La normalisation min-max (mise à l’échelle unitaire) : cette technique projette linéairement les données brutes sur un intervalle borné compris entre 0 et 1, au moyen de la formulation x_norm = (x – min) / (max – min). Elle s’implémente dans Excel par l’expression mathématique
=(cellule - MIN(plage)) / (MAX(plage) - MIN(plage)). Cette approche est particulièrement intuitive lorsqu’on désire préserver les bornes absolues des instruments psychométriques tout en égalisant strictement les amplitudes potentielles de désaccord.
2.3 Configuration de la feuille de calcul pour l’analyse vectorielle
Une bonne pratique de modélisation tabulaire consiste à segmenter physiquement la feuille de travail en trois zones fonctionnelles distinctes afin d’éviter la contamination accidentelle des formules par des saisies manuelles intempestives. La première zone, idéalement située à gauche ou sur un premier onglet dédié, accueille la table des données sources nettoyées et harmonisées. La seconde zone est réservée aux paramètres globaux du modèle (poids éventuels des dimensions, seuils diagnostiques, critères de normalisation). La troisième zone héberge les moteurs de calcul différentiel et les matrices de restitution analytique.
La rigueur typographique et la configuration des métadonnées cellulaires jouent un rôle préventif fondamental. Il convient de vérifier systématiquement que l’ensemble des plages contenant des scores psychométriques soit formellement typé en « Nombre » au sein de la boîte de dialogue de format de cellule d’Excel, et non en format « Standard » ou « Texte ». Les valeurs accidentellement stockées sous forme textuelle représentent l’une des causes les plus insidieuses d’échec dans les formules matricielles, générant soit des erreurs de calcul (#VALEUR!), soit des résultats faussés dus à l’ignorance arithmétique silencieuse des chaînes textuelles par certaines fonctions de sommation.
Enfin, la création de plages nommées (via l’onglet Formules > Gestionnaire de noms) représente une convention d’excellence pour structurer les jeux de données d’envergure. En attribuant des libellés mnémoniques tels que Profil_Candidat_A à la plage B2:F2 et Profil_Reference à la plage B10:F10, l’analyste fiabilise l’écriture de ses syntaxes de calcul, améliore l’auditabilité par des tiers et neutralise les risques d’erreurs de décalage de références lors des opérations de copier-coller complexes.
3. Calcul élémentaire pas à pas : Méthode décomposée avec ABS et SOMME
3.1 Étape 1 : Calcul des écarts absolus élémentaires avec la fonction ABS
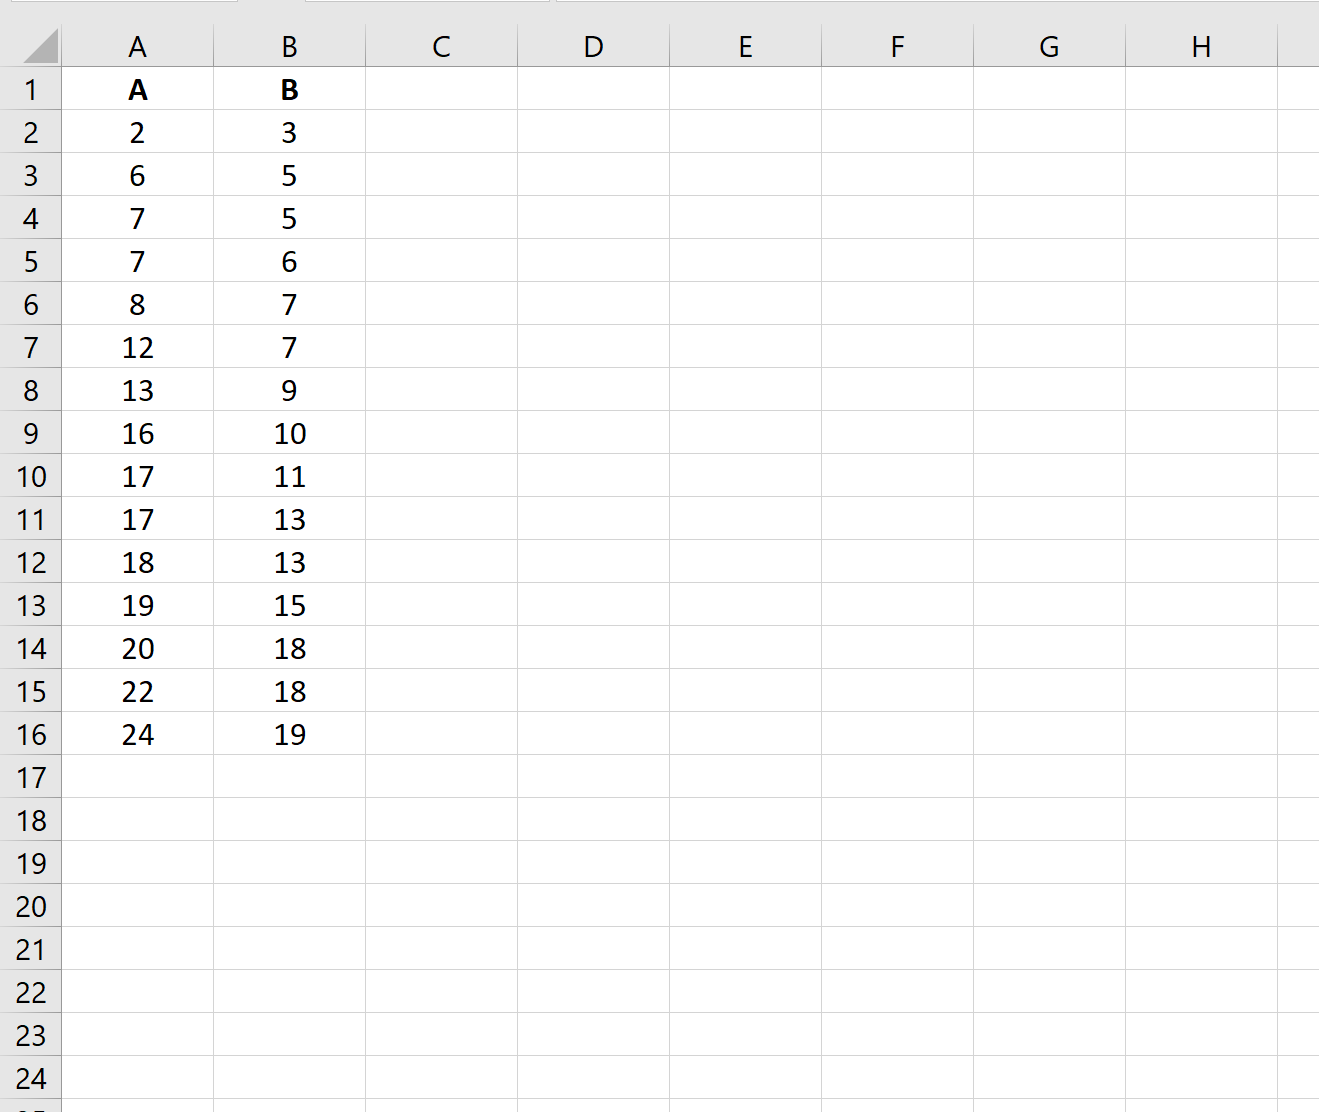
Pour appréhender le mécanisme opératoire de la métrique L1 et s’assurer d’une traçabilité absolue au stade du contrôle qualité, la décomposition du calcul en une séquence de colonnes intermédiaires représente l’approche didactique et méthodologique la plus robuste. Cette démarche permet d’isoler explicitement chaque composante vectorielle avant d’en effectuer l’agrégation finale. La première opération élémentaire consiste à soustraire le score du second individu de celui du premier pour une dimension donnée, puis à appliquer la fonction de valeur absolue.
Sous Excel, la fonction ABS renvoie la valeur absolue d’un nombre réel fourni en argument, c’est-à-dire sa grandeur arithmétique dépouillée de son signe algébrique positif ou négatif. Si l’on souhaite comparer le profil du sujet 1 (localisé dans la cellule B2 pour la première variable) à celui du sujet 2 (localisé dans la cellule B3), la syntaxe élémentaire s’écrit :
=ABS(B2 - B3)
Sur le plan mathématique, l’usage impératif de la fonction ABS évite l’écueil critique de la neutralisation par compensation. En l’absence de valeur absolue, une divergence positive de +3 sur le trait d’Extraversion se trouverait arithmétiquement annulée par une divergence négative de -3 sur le trait de Névrosisme lors de la sommation ultérieure (+3 + (-3) = 0), produisant la conclusion aberrante d’une identité parfaite entre deux profils pourtant radicalement opposés. La fonction ABS garantit que chaque écart contribue positivement et strictement à la distance globale.
En étendant horizontalement cette formule le long de la ligne intermédiaire de calcul (par exemple de la colonne B à la colonne F pour un inventaire à cinq facteurs), chaque cellule intermédiaire isole l’ampleur exacte du désaccord manifesté sur la dimension correspondante. Cette décomposition analytique offre une lecture diagnostique immédiate : le praticien identifie instantanément quelle variable spécifique est responsable de la rupture de similitude entre les deux sujets.
3.2 Étape 2 : Agrégation finale de la distance par la fonction SOMME
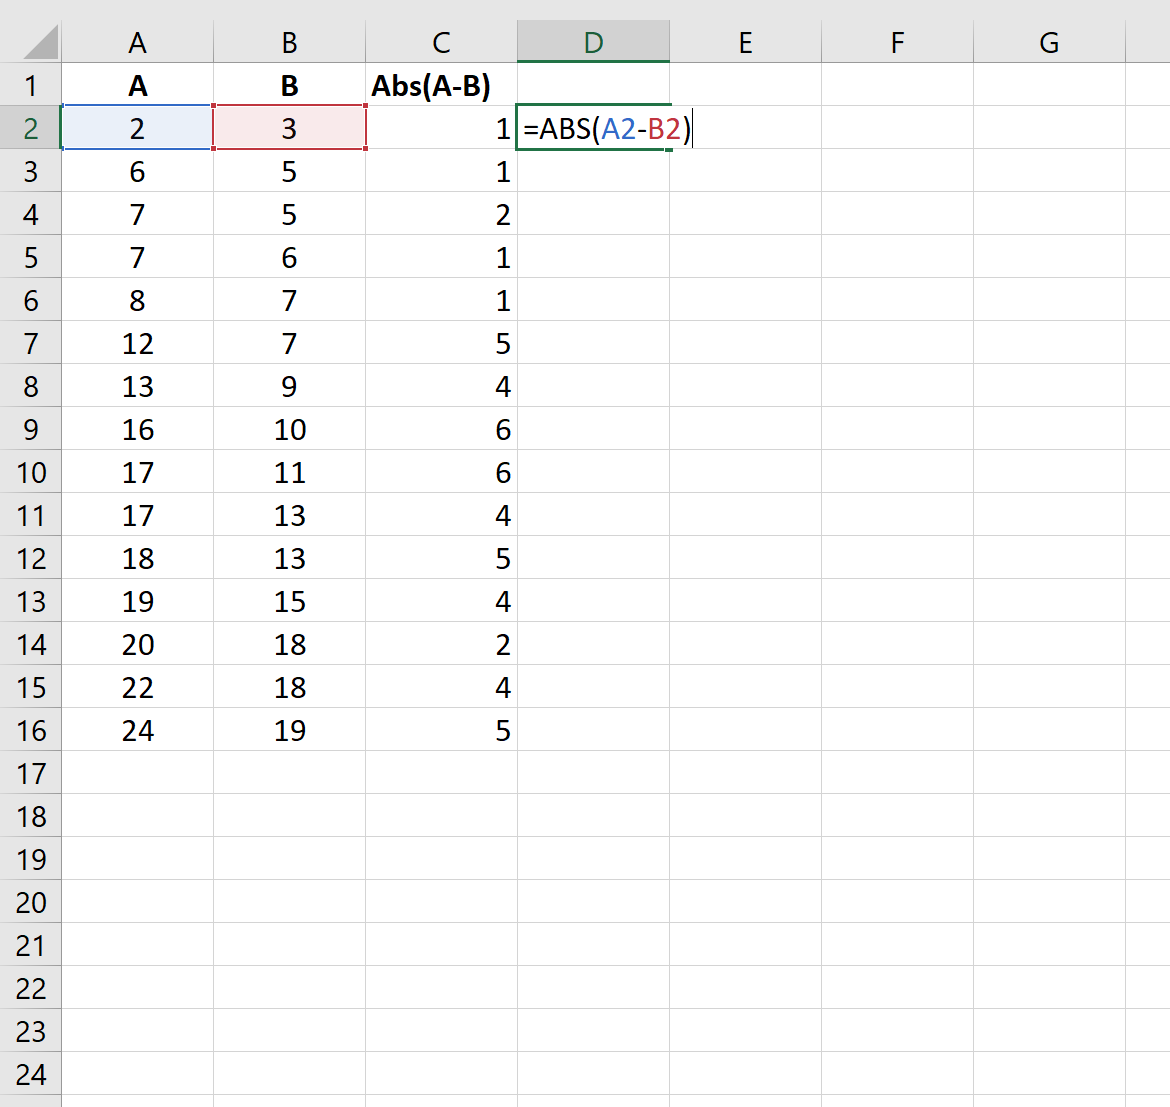
Une fois la série des écarts absolus élémentaires générée le long du vecteur dimensionnel, l’étape conclusive réside dans l’agrégation de ces contributions scalaires individuelles en un indice synthétique d’éloignement global. Cette opération d’intégration linéaire est assurée par la fonction canonique SOMME d’Excel.
En désignant par la plage H2:L2 l’ensemble des écarts absolus calculés à l’étape précédente pour nos cinq variables psychologiques, la formule de clôture s’articule de la manière suivante :
=SOMME(H2:L2)
Le résultat renvoyé par cette cellule représente la distance de Manhattan exacte séparant les deux profils. Considérons un cas d’application concret portant sur l’évaluation de deux profils psychométriques cotés de 1 à 7 sur le modèle des Big Five :
| Dimension Psychologique | Sujet A (Plage B2:F2) | Sujet B (Plage B3:F3) | Différence (A – B) | Écart Absolu =ABS(…) |
|---|---|---|---|---|
| Ouverture (O) | 6 | 4 | +2 | 2 |
| Conscienciosité (C) | 5 | 7 | -2 | 2 |
| Extraversion (E) | 3 | 2 | +1 | 1 |
| Agréabilité (A) | 7 | 6 | +1 | 1 |
| Névrosisme (N) | 2 | 5 | -3 | 3 |
| Distance de Manhattan Totale =SOMME(…) | 9 | |||
Le score global obtenu de 9 points traduit un éloignement métrique direct. Ce chiffre indique que pour aligner intégralement le profil du Sujet A sur celui du Sujet B, il est nécessaire de combler un déficit ou un excédent cumulé de 9 unités d’intensité comportementale réparties sur l’ensemble du spectre dimensionnel.
3.3 Audit et validation visuelle des résultats intermédiaires
L’avantage cardinal de cette méthode en deux temps réside dans son adéquation totale avec les procédures d’audit interne sous Excel. L’analyste peut solliciter le ruban Formules et actionner l’outil Évaluer la formule pour suivre pas à pas l’évaluation séquentielle des calculs et s’assurer de l’absence de glissements d’adresses cellulaires. Cet environnement visuel permet de vérifier la conformité des résultats face aux bornes théoriques minimales (la distance doit impérativement être supérieure ou égale à zéro) et maximales (sur une échelle en 7 points à 5 composantes, la distance théorique maximale ne saurait excéder 5 × (7 – 1) = 30 points).
Par ailleurs, cette décomposition facilite l’insertion de commentaires explicatifs au sein des cellules intermédiaires. En documentant directement les motifs d’écarts majeurs — par exemple, un différentiel de 3 points sur le Névrosisme traduisant une divergence majeure de gestion du stress en milieu organisationnel —, le classeur Excel dépasse le statut de simple outil arithmétique pour devenir un support d’aide à la décision clinique et psychologique transparente.
4. Formulation condensée monocellulaire via formules matricielles
4.1 La formule SOMMEPROD combinée avec ABS
Bien que la décomposition élémentaire soit irremplaçable pour des fins pédagogiques ou d’audit de cas isolés, elle s’avère rapidement intenable lorsqu’il s’agit d’analyser de vastes cohortes de participants. La prolifération de colonnes d’écarts intermédiaires alourdit considérablement l’architecture des feuilles de calcul et majore les risques de corruption de formules. Pour résoudre cette contrainte d’encombrement tabulaire, l’utilisation de la fonction SOMMEPROD combinée avec ABS permet de concentrer l’intégralité du calcul différentiel et de l’agrégation au sein d’une unique cellule de calcul.
La formulation syntaxique condensée standard s’énonce comme suit, en supposant que le vecteur du sujet 1 soit logé en B2:F2 et celui du sujet 2 en B3:F3 :
=SOMMEPROD(ABS(B2:F2 - B3:F3))
Le fonctionnement arithmétique sous-jacent de cette syntaxe repose sur le moteur d’évaluation matricielle interne de SOMMEPROD. Bien qu’elle soit originellement conçue pour multiplier des plages de cellules homologues puis en sommer les produits, SOMMEPROD traite nativement les opérations matricielles passées dans ses arguments sans exiger les anciennes validations complexes par combinaison de touches Ctrl + Maj + Entrée. Dans cette configuration, l’expression B2:F2 - B3:F3 génère un vecteur virtuel éphémère contenant les différences dimensionnelles relatives. La fonction ABS encapsulante convertit instantanément chaque élément de ce vecteur en sa valeur absolue correspondante. Enfin, SOMMEPROD réalise l’agrégation linéaire de ce vecteur abstrait, renvoyant la valeur scalaire définitive de la distance de Manhattan.
Cette approche présente l’avantage exceptionnel d’une parfaite rétrocompatibilité. Que le classeur soit ouvert sous des environnements patrimoniaux tels qu’Excel 2010, 2013 ou 2016, ou exécuté sur des infrastructures modernes, la formule s’évalue avec une stabilité et une fidélité absolues, éliminant tout aléa de portabilité logicielle au sein des équipes de recherche.
4.2 Formules dynamiques modernes dans Microsoft 365
Pour les utilisateurs opérant sur des versions contemporaines d’Excel intégrant le moteur de calcul à tableaux dynamiques (présent dans Microsoft 365, Office 2021 et versions ultérieures), la syntaxe analytique gagne encore en fluidité et en élégance syntaxique. L’émancipation vis-à-vis des contraintes matricielles traditionnelles permet désormais à la fonction canonique SOMME de gérer spontanément des opérations vectorielles complexes sans recourir systématiquement à l’artifice de SOMMEPROD.
La formulation monocellulaire sous Microsoft 365 s’écrit de manière épurée :
=SOMME(ABS(B2:F2 - B3:F3))
Dans ce modèle moderne, le moteur calcule l’écart terme à terme entre les plages de cellules vectorielles sous forme d’un tableau projeté virtuel en mémoire vive, applique la transformation absolue, puis exécute la sommation directe en validant la formule par un simple appui sur la touche Entrée. Cette lisibilité syntaxique accrue simplifie la maintenance du classeur par des utilisateurs moins familiers des subtilités algorithmiques avancées.
Il convient toutefois de souligner une précaution technique d’importance : l’alignement dimensionnel des plages passées en argument doit être irréprochable. Si les vecteurs comparés ne présentent pas exactement le même nombre de colonnes ou si leurs bornes sont accidentellement décalées (par exemple, B2:F2 confronté à B3:G3), le moteur d’Excel lèvera immédiatement une erreur d’incompatibilité de dimensions #VALEUR!. La vérification de la parfaite homothétie des plages constitue donc une condition sine qua non de validité opérationnelle.
4.3 Optimisation des performances de calcul pour les cohortes étendues
L’évaluation itérative de formules matricielles complexes monocellulaires, lorsqu’elle est répliquée sur des dizaines de milliers de lignes dans le cadre de vastes cohortes épidémiologiques ou organisationnelles, peut engendrer une sollicitation intensive des ressources du processeur et de la mémoire vive. Le moteur d’évaluation d’Excel recalcule par défaut l’intégralité des dépendances matricielles dès lors qu’une modification intervient au sein d’une cellule quelconque de la feuille de calcul active.
Afin de préserver la réactivité de l’application lors du déploiement massif de calculs de distance de Manhattan, plusieurs arbitrages d’optimisation technique doivent être instaurés :
- Passage en mode de calcul manuel : au sein du ruban Formules > Options de calcul, la sélection du mode Manuel permet de suspendre la réévaluation continue des matrices de dissimilarité durant la phase d’encodage ou de modification des profils sources. L’actualisation globale des calculs est alors déclenchée à l’initiative du chercheur par une pression sur la touche
F9. - Proscription absolue des références de colonnes entières : l’usage de syntaxes paresseuses telles que
=SOMMEPROD(ABS(A:A - B:B))force le tableur à analyser plus d’un million de lignes virtuelles en arrière-plan, provoquant des gels applicatifs sévères. Les plages doivent toujours être strictement bornées aux coordonnées réelles des données (ex.B2:B500). - Exploitation raisonnée des tableaux structurés Excel : en convertissant le jeu de données en Tableau officiel (via le raccourci
Ctrl + L), le tableur optimise la gestion dynamique de la mémoire et ajuste automatiquement les étendues de calcul sans surconsommation de mémoire tampon.
5. Construction d’une matrice de dissimilarité complète pour un groupe
5.1 Disposition structurelle de la matrice symétrique carrée
L’analyse typologique de groupe, la détection de profils marginaux et les techniques de regroupement exploratoire exigent la comparaison simultanée de tous les participants d’un échantillon les uns par rapport aux autres. Cette configuration se formalise mathématiquement et graphiquement sous la forme d’une matrice de distance carrée symétrique d’ordre N × N, où N désigne l’effectif total des individus observés.
La structure tabulaire s’organise selon un repère croisé rigoureux : les identifiants uniques des sujets sont disposés de manière strictement identique le long de l’axe vertical (les en-têtes de lignes, par exemple de A15 à A24 pour une cohorte de 10 individus) et le long de l’axe horizontal (les en-têtes de colonnes, de B14 à K14). L’intersection de la ligne i et de la colonne j héberge la valeur scalaire de la distance de Manhattan séparant l’individu i de l’individu j.
Cette matrice possède des propriétés géométriques et mathématiques fondamentales qu’il convient de garder à l’esprit lors de sa conception :
- La diagonale principale nulle : chaque cellule positionnée sur la diagonale reliant l’angle supérieur gauche à l’angle inférieur droit représente la distance d’un sujet avec lui-même (d₁(i, i)). En vertu de l’axiome d’identité des indiscernables, ces cellules contiennent impérativement une valeur rigoureusement égale à zéro.
- La symétrie bilatérale parfaite : la distance séparant le sujet i du sujet j étant rigoureusement identique à celle séparant j de i, la matrice est parfaitement symétrique par rapport à sa diagonale principale (D(i, j) = D(j, i)). Le triangle supérieur de la matrice est le miroir exact du triangle inférieur.
5.2 Formulation avec adressage absolu et relatif rigoureux
Le défi majeur dans la construction d’une matrice carrée sous Excel réside dans l’élaboration d’une formule unique et universelle capable d’être collée ou étirée sur l’intégralité de la grille N × N sans nécessiter de retouches manuelles cellule par cellule. Ce résultat s’obtient par la combinaison de la fonction SOMMEPROD avec les fonctions d’indexation dynamique d’Excel, conjuguée à une utilisation millimétrée des opérateurs de verrouillage dollar ($).
Supposons que nos données psychométriques brutes soient consignées dans le tableau $B$2:$F$11, où chaque ligne de 2 à 11 correspond respectivement aux sujets indexés de 1 à 10. La matrice de dissimilarité débute en cellule B15 (croisement entre le sujet 1 en ligne 15 et le sujet 1 en colonne B). Pour extraire dynamiquement les vecteurs correspondants en fonction des en-têtes de lignes et de colonnes, nous pouvons imbriquer la fonction INDEX :
=SOMMEPROD(ABS(INDEX($B$2:$F$11; LIGNE(A1); 0) - INDEX($B$2:$F$11; COLONNE(A1); 0)))
Analysons la mécanique de cette construction de référence :
- L’expression
INDEX($B$2:$F$11; LIGNE(A1); 0)extrait le vecteur complet de la ligne psychométrique désignée parLIGNE(A1)(soit la ligne 1 lors du positionnement initial). Le chiffre 0 passé en argument de colonne intime l’ordre à la fonctionINDEXde renvoyer la rangée vectorielle horizontale complète. - Symétriquement,
INDEX($B$2:$F$11; COLONNE(A1); 0)extrait le profil vectoriel correspondant à la colonne d’en-tête transversale. - Lorsque cette formule est recopiée vers la droite ou vers le bas, les coordonnées relatives
A1s’incrémentent dynamiquement, parcourant avec une précision absolue les rangées cibles de la table source sans rupture d’adressage.
Une alternative élégante consiste à utiliser des fonctions de recherche associées à l’identifiant nominatif :
=SOMMEPROD(ABS(INDEX($B$2:$F$11; EQUIV($A15;$A$2:$A$11; 0); 0) - INDEX($B$2:$F$11; EQUIV(B$14; $A$2:$A$11; 0); 0)))
Dans cette écriture robuste, le verrouillage de colonne sur $A15 et de ligne sur B$14 garantit que l’algorithme lit en permanence le bon couple d’identifiants, rendant la matrice totalement insensible aux tris ou aux réorganisations éventuelles des lignes du tableau source.
5.3 Extraction automatisée des paires les plus proches et les plus distantes
Au-delà de la visualisation brute de la grille, l’analyste a pour mission d’extraire rapidement les observations remarquables : quel binôme de sujets présente la proximité comportementale la plus fusionnelle ? Quel couple manifeste la plus forte polarisation psychologique ? Pour répondre à ces interrogations sans procéder à un examen visuel fastidieux et sujet à caution, l’emploi concerté des fonctions statistiques PETITE.VALEUR et GRANDE.VALEUR offre une solution automatisée redoutable.
L’extraction de la distance maximale (le couple le plus divergent) s’opère sans complexité particulière au moyen de la formule :
=GRANDE.VALEUR(B15:K24; 1)
Cette expression renvoie immédiatement le score d’éloignement L1 le plus élevé de la matrice entière.
En revanche, la détection de la paire la plus similaire requiert une précaution algorithmique essentielle : l’exclusion impérative de la diagonale principale. La valeur minimale absolue d’une matrice symétrique est par essence égale à 0 (chaque sujet comparé à lui-même). Si l’on applique naïvement la fonction MIN(B15:K24) ou PETITE.VALEUR(B15:K24; 1), le tableur renverra inévitablement la valeur 0, annihilant toute utilité analytique. Il convient dès lors de filtrer conditionnellement les valeurs strictement supérieures à zéro au moyen d’une formule dynamique moderne :
=PETITE.VALEUR(SI(B15:K24 > 0; B15:K24); 1)
Cette syntaxe matricielle ignore délibérément l’auto-comparaison diagonale et identifie la dissimilarité minimale effective entre deux individus réels distincts au sein du groupe.
6. Calcul de la distance de Manhattan pondérée dans Excel
6.1 Fondements de la pondération différentielle des variables
Dans de nombreuses situations expérimentales ou d’évaluation psychologique appliquée, le postulat d’équipotence dimensionnelle s’avère théoriquement intenable. En pratique, toutes les dimensions composant un profil psychologique ne possèdent pas la même validité incrémentielle ni la même importance diagnostique face à un objectif prédictif donné. Dans le cadre de la sélection professionnelle pour des postes à haute responsabilité managériale, par exemple, la stabilité émotionnelle (bas Névrosisme) et la Conscienciosité peuvent être jugées deux fois plus déterminantes que le niveau d’Ouverture à la créativité artistique.
Pour intégrer formellement ces hiérarchies théoriques, la formulation mathématique de la distance de Manhattan pondérée associe à chaque dimension i un coefficient multiplicateur positif wᵢ (le poids), modulant son impact sur la somme finale :
d₁_pondérée(A, B) = ∑ᵢ₌₁ⁿ wᵢ × |aᵢ – bᵢ|
D’un point de vue métrique et épistémologique, l’intégration de pondérations altère l’espace géométrique des observations. Les axes dimensionnels subissent une dilatation proportionnelle à leur poids : une divergence sur une variable lourdement pondérée produit un éloignement géométrique démultiplié, tandis qu’une divergence équivalente sur une variable marginale n’engendre qu’un effet négligeable. Pour préserver l’interprétabilité métrique et assurer la comparabilité entre cohortes, il est impératif d’astreindre le vecteur de pondération à une condition stricte de normalisation statistique, stipulant que la somme cumulée de l’ensemble des poids wᵢ doit impérativement être égale à 1 (soit 100 % de la masse de variance accordée au profil) :
∑ᵢ₌₁ⁿ wᵢ = 1
6.2 Mise en œuvre dans Excel avec SOMMEPROD
L’opérationnalisation d’une distance de Manhattan pondérée au sein du tableur Excel se prête magnifiquement à l’architecture computationnelle de la fonction SOMMEPROD. Grâce à sa capacité à gérer simultanément plusieurs arguments matriciels de dimensions homologues, la fonction peut multiplier le vecteur des poids par le vecteur des écarts absolus avant d’en effectuer la sommation unitaire.
Considérons que le vecteur des coefficients de pondération soit consigné dans la plage horizontale $B$1:$F$1, surplombant les colonnes de données psychométriques correspondantes. La formule monocellulaire calculant la distance pondérée entre le sujet 1 (plage B2:F2) et le sujet 2 (plage B3:F3) s’écrit avec une remarquable sobriété :
=SOMMEPROD($B$1:$F$1; ABS(B2:F2 - B3:F3))
Le déroulement de cette formule s’articule selon un processus en trois phases exécuté en mémoire :
- Excel calcule d’abord le vecteur des différences absolues non pondérées :
ABS(B2:F2 - B3:F3), générant une matrice temporaire 1 × 5 d’écarts bruts. - La fonction
SOMMEPRODeffectue la multiplication scalaire terme à terme entre chaque cellule du vecteur de pondération fixe$B$1:$F$1et l’écart absolu correspondant calculé à l’étape précédente. - Enfin, la somme arithmétique de ces produits élémentaires est calculée, renvoyant l’indice global de dissimilarité pondérée.
Il est indispensable de vérifier que les plages matricielles spécifiées dans SOMMEPROD partagent rigoureusement la même orientation géométrique et le même nombre de composantes. Si le vecteur des poids est agencé verticalement (ex. A1:A5) alors que les profils de sujets sont disposés horizontalement (ex. B2:F2), Excel lèvera inévitablement une erreur d’incompatibilité #VALEUR!. Le cas échéant, l’imbrication de la fonction TRANSPOSE($A$1:$A$5) permettra de redresser dynamiquement le vecteur dans l’orientation requise.
6.3 Scénarios d’application en évaluation psychologique
L’introduction d’un modèle pondéré offre une flexibilité décisionnelle considérable lors de simulations organisationnelles ou cliniques. En éditant dynamiquement les cellules du vecteur de poids $B$1:$F$1, le psychologue ou l’analyste peut procéder à des analyses de sensibilité poussées afin de déterminer dans quelle mesure le classement des candidats ou des profils types varie en fonction des présupposés théoriques adoptés.
Un autre cas d’application méthodologique majeur concerne la compensation des déséquilibres structurels dans les inventaires psychométriques composites. Lorsqu’une sous-échelle diagnostique regroupe accidentellement un nombre disproportionné d’items par rapport aux autres facettes du modèle (par exemple, 15 items évaluant l’Agréabilité contre 5 items seulement pour l’Extraversion), l’utilisation d’une pondération inversement proportionnelle au nombre d’items permet de restaurer l’équité dimensionnelle et de prévenir la captation de la dissimilarité globale par la sous-échelle la plus longue.
7. Gestion des données manquantes et valeurs atypiques dans le calcul
7.1 Impact délétère des cellules vides sur la distance de Manhattan
L’un des écueils méthodologiques les plus fréquents et insidieux rencontrés lors du traitement de questionnaires psychologiques réside dans la gestion des données manquantes (non-réponses partielles, omissions volontaires de questions délicates ou pannes de saisie logicielle). Dans l’environnement de calcul d’Excel, l’interaction entre les cellules vides et les fonctions arithmétiques standards peut induire des distorsions diagnostiques sévères si elle n’est pas rigoureusement encadrée.
Par défaut, lorsqu’une cellule vide intervient dans une opération arithmétique directe de soustraction (telle que B2 - B3), le moteur d’Excel convertit silencieusement la cellule vide en la valeur numérique 0. Supposons qu’un sujet n’ait pas renseigné l’item d’Extraversion (cellule vide en B2) tandis que son comparse affiche un score de 6 (cellule B3). La formule ABS(B2 - B3) évaluera l’écart à |0 – 6| = 6 points ! Une non-réponse se retrouve ainsi assimilée à un désaccord massif, gonflant artificiellement la distance de Manhattan globale. Inversement, si les deux sujets ont tous deux omis de répondre à la question, la différence évaluera |0 – 0| = 0, assimilant frauduleusement une ignorance bilatérale de données à une convergence psychologique absolue.
Ces biais de traitement altèrent profondément la validité des comparaisons interindividuelles : les sujets ayant omis plusieurs items verront leurs scores de dissimilarité systématiquement faussés, ce qui fausse l’ensemble de la cartographie relationnelle du groupe.
7.2 Formules d’exclusion conditionnelle des valeurs absentes
Pour neutraliser rigoureusement ce phénomène sans fausser la métrique, il est nécessaire de n’évaluer la distance de Manhattan que sur l’intersection des items effectivement renseignés par les deux individus comparés, tout en procédant à un ajustement d’échelle proportionnel pour maintenir la comparabilité avec les profils complets. Cette opération repose sur le filtrage conditionnel permis par la fonction ESTNUM.
La formule matricielle moderne d’exclusion des omissions bilatérales s’articule ainsi (validée pour Microsoft 365 ou avec SOMMEPROD) :
=SOMME(SI(ESTNUM(B2:F2) * ESTNUM(B3:F3); ABS(B2:F2 - B3:F3); 0)) / SOMME(SI(ESTNUM(B2:F2) * ESTNUM(B3:F3); 1; 0)) * NBVAL(B2:F2)
Décortiquons la logique séquentielle de cette construction :
- L’expression logique
ESTNUM(B2:F2) * ESTNUM(B3:F3)agit comme un filtre booléen binaire (masque d’inclusion). Elle renvoie 1 si et seulement si les cellules correspondantes des deux sujets contiennent toutes deux un nombre valide. Si l’un des deux sujets présente une cellule vide ou textuelle, le produit logique s’annule (0). - Le numérateur additionne exclusivement les écarts absolus valides, ignorant totalement les dimensions incomplètes.
- Le dénominateur compte le nombre exact de dimensions communes exploitables au sein de la paire évaluée.
- La division du numérateur par le dénominateur établit la distance de Manhattan moyenne par item valide.
- Enfin, la multiplication par le nombre théorique total d’items (
NBVAL(B2:F2)) réextrapole cette distance moyenne sur l’échelle globale, permettant de comparer équitablement le score de dissimilarité de cette paire incomplète avec celui de paires n’ayant manifesté aucune omission.
7.3 Méthodes simples d’imputation dans l’environnement Excel
Lorsque la structure du projet exige de conserver une matrice de données source exempte de toute cellule vide pour nourrir des algorithmes en aval ne tolérant aucune rupture dimensionnelle, le recours aux techniques d’imputation univariée directement dans le tableur constitue une solution pragmatique et reconnue en psychométrie appliquée.
Deux protocoles d’imputation centrale peuvent être facilement automatisés sous Excel :
- L’imputation par la moyenne de la variable : elle consiste à substituer à la valeur manquante la valeur moyenne observée sur l’ensemble de la cohorte pour cette dimension spécifique. Elle se formalise par l’expression conditionnelle :
=SI(ESTVIDE(B2); MOYENNE(B$2:B$100); B2). - L’imputation par la médiane de la variable : préférable en présence de distributions asymétriques ou fortement discrètes pour préserver les caractéristiques ordinales du construit :
=SI(ESTVIDE(B2); MEDIANE(B$2:B$100); B2).
Il importe toutefois de souligner une mise en garde méthodologique fondamentale : si l’imputation de valeurs centrales permet de stabiliser les calculs matriciels, elle induit mécaniquement une atténuation artificielle de la variance de la variable concernée et tend à sous-estimer légèrement les distances réelles entre individus. Toute démarche d’imputation doit impérativement être signalée dans le rapport méthodologique d’analyse pour garantir la probité scientifique des résultats.
8. Automatisation avancée par Visual Basic pour Applications (VBA)
8.1 Création d’une fonction personnalisée (UDF) ManhattanDistance
Bien que les formules matricielles natives d’Excel couvrent la grande majorité des cas d’usage, l’implémentation d’une fonction personnalisée (UDF ou User-Defined Function) codée en Visual Basic pour Applications apporte un confort ergonomique exceptionnel, une élégance syntaxique incomparable au sein des feuilles de calcul et une sécurité renforcée face aux manipulations accidentelles de formules imbriquées.
Pour concevoir cette fonction, l’utilisateur accède à l’éditeur VBA via le raccourci Alt + F11, insère un module standard (Insertion > Module) et implémente l’architecture procédurale suivante :
Function ManhattanDistance(VecteurA As Range, VecteurB As Range) As Variant

    Dim i As Long

    Dim NbElements As Long

    Dim EcartCumule As Double

    Dim ValA As Double, ValB As Double
If VecteurA.Count <> VecteurB.Count Then
ManhattanDistance = CVErr(xlErrValue)
Exit Function
End If
NbElements = VecteurA.Count
EcartCumule = 0
For i = 1 To NbElements
If IsNumeric(VecteurA.Cells(i).Value) And IsNumeric(VecteurB.Cells(i).Value) Then
ValA = CDbl(VecteurA.Cells(i).Value)
ValB = CDbl(VecteurB.Cells(i).Value)
EcartCumule = EcartCumule + Abs(ValA - ValB)
Else
ManhattanDistance = CVErr(xlErrNum)
Exit Function
End If
Next i
ManhattanDistance = EcartCumule
End Function
Dès sa compilation, cette fonction s’intègre naturellement au catalogue de calcul du classeur. L’utilisateur peut dès lors saisir directement dans n’importe quelle cellule de sa feuille :
=ManhattanDistance(B2:F2; B3:F3)
Le code intègre des gardes-fous algorithmiques rigoureux : il vérifie la parfaite correspondance du nombre de cellules entre les deux vecteurs soumis et intercepte les éventuelles entrées non numériques en renvoyant des codes d’erreur standards (#VALEUR! ou #NOMBRE!), garantissant une intégrité computationnelle totale.
8.2 Procédure Sub pour générer instantanément une matrice N x N
Lorsque la cohorte atteint plusieurs centaines d’individus (par exemple un échantillon normatif de 500 sujets), le calcul dynamique d’une matrice carrée de 250 000 cellules via des formules de feuille de calcul peut saturer la réactivité d’Excel. L’exécution d’une procédure autonome Sub programmée pour calculer l’intégralité de la matrice en mémoire vive avant de la transférer en un bloc unique vers la feuille de destination permet des gains de vélocité spectaculaires.
L’algorithme VBA repose sur le chargement des données brutes au sein d’un tableau de variables (Variant Array), le traitement par double boucle itérative emboîtée, et le déversement direct de la matrice résultante :
Sub GenererMatriceManhattan()

    Dim PlageSource As Range

    Dim Donnees As Variant, MatriceDist() As Double

    Dim N As Long, P As Long

    Dim i As Long, j As Long, k As Long

    Dim Dist As Double
Set PlageSource = ThisWorkbook.Sheets("Donnees").Range("B2:F101")
Donnees = PlageSource.Value
N = UBound(Donnees, 1)
P = UBound(Donnees, 2)
ReDim MatriceDist(1 To N, 1 To N)
For i = 1 To N
For j = i To N
If i = j Then
Dist = 0
Else
Dist = 0
For k = 1 To P
Dist = Dist + Abs(Donnees(i, k) - Donnees(j, k))
Next k
End If
MatriceDist(i, j) = Dist
MatriceDist(j, i) = Dist
Next j
Next i
ThisWorkbook.Sheets("Matrice").Range("B2").Resize(N, N).Value = MatriceDist
End Sub
Cette implémentation exploite intelligemment la propriété de symétrie de la métrique L1 : la boucle interne ne calcule que le triangle supérieur (de j = i à N), réduisant de moitié le nombre total d’opérations d’écarts absolus nécessaires, avant de dupliquer la valeur calculée dans la position symétrique homologue. Pour une cohorte de 500 sujets, le temps d’exécution passe ainsi de plusieurs dizaines de secondes par formules cellulaires à quelques fractions de seconde via la mémoire VBA.
8.3 Documentation, sécurité et distribution des macros
L’intégration de code procédural VBA au sein de classeurs destinés à la recherche collective ou à l’exploitation organisationnelle impose des règles strictes de gouvernance numérique. En premier lieu, le classeur doit obligatoirement être enregistré sous l’extension spécifique .xlsm (classeur prenant en charge les macros) ou packagé sous forme de complément autonome .xlam (Excel Add-In), ce qui permet de déployer la fonction ManhattanDistance sur l’ensemble des postes informatiques d’une équipe de recherche sans altérer les classeurs de données natifs.
La sécurité des macros représente un enjeu critique : les politiques de cybersécurité institutionnelles désactivent fréquemment l’exécution de code Visual Basic par défaut. Il est dès lors primordial d’accompagner le fichier d’une documentation explicitant le fonctionnement du code et d’apposer une signature numérique de confiance sur le projet VBA lorsque les protocoles de sécurité réseau l’exigent.
Enfin, sur le plan de l’interopérabilité, il convient de souligner que si les UDF et procédures VBA s’exécutent de manière transparente sous l’environnement Microsoft Excel pour Windows, des variations de performance ou des restrictions de permissions système peuvent survenir sous macOS. Les scripts doivent par conséquent faire l’objet de tests de portabilité préalables si l’écosystème de travail est hétérogène.
9. Utilisation de Power Query pour le calcul de dissimilarité par lots
9.1 Importation et transformation relationnelle des profils
Pour les analystes de données confrontés à des flux continus de passations psychométriques en ligne ou manipulant des bases de données volumineuses excédant les capacités interactives ordinaires des feuilles de calcul, l’outil ETL intégré Power Query constitue un environnement de choix. Power Query permet de bâtir un pipeline de transformation reproductible, entièrement automatisé et réactualisable d’un simple clic.
La première phase opérationnelle consiste à importer la table des données psychométriques dans l’éditeur Power Query (onglet Données > À partir d’un tableau/d’une plage). Une fois le jeu de données chargé, l’étape clé de modélisation relationnelle réside dans le dépivotement des colonnes de dimensions (l’opération Unpivot). En sélectionnant la colonne des identifiants (ID_Sujet) puis en actionnant la commande Dépivoter les autres colonnes, le modèle transforme la structure tabulaire large en une structure haute et étroite comprenant trois colonnes normalisées : ID_Sujet, Dimension (le nom du trait psychologique) et Valeur (le score obtenu).
Cette disposition relationnelle est essentielle pour s’affranchir des contraintes d’indexation vectorielle horizontale et appliquer des jointures relationnelles directes d’une fluidité parfaite.
9.2 Jointure croisée et calcul vectoriel de l’écart L1
Pour générer l’ensemble des comparaisons possibles entre tous les individus au sein de Power Query, l’étape suivante consiste à opérer une auto-jointure cartésienne (un produit cartésien complet de la table avec elle-même). Cette démarche permet de rapprocher chaque profil de tous les autres profils disponibles dans la cohorte.
Le pipeline de requêtes s’articule méthodologiquement comme suit :
- Dupliquer la requête source dépivotée pour disposer de deux entités distinctes :
Profils_AetProfils_B. - Créer une fusion de requêtes (Merge Queries) en reliant
Profils_AetProfils_Bsur le champ communDimension. Cette jointure garantit que chaque score du sujet A est strictement aligné avec le score du sujet B pour le même trait psychologique mesuré. - Développer la table jointe pour exposer les champs
ID_Sujet_BetValeur_B. - Ajouter une colonne personnalisée exécutant l’opération arithmétique de valeur absolue en langage M :
Number.Abs([Valeur] - [Valeur_B]), intituléeEcart_Absolu. - Appliquer une opération de regroupement (Group By) en sélectionnant simultanément les colonnes
ID_Sujet(du profil A) etID_Sujet_B, et en définissant comme opération d’agrégation la Somme appliquée sur la colonneEcart_Absolu.
Le tableau résultant de cette séquence de transformations livre immédiatement la liste exhaustive de l’ensemble des paires possibles associées à leur distance de Manhattan exacte.
9.3 Restitution tabulaire et actualisation automatique du modèle
Pour transformer cette liste relationnelle brute en une matrice carrée visuelle conventionnelle au sein d’Excel, l’utilisateur actionne l’opération inverse de pivotement au sein de Power Query : sélectionner la colonne ID_Sujet_B, cliquer sur Pivoter la colonne, et désigner la colonne agrégée de distance comme valeur de métrique.
Le jeu de données épuré est ensuite déversé directement dans une nouvelle feuille de calcul via la commande Fermer et charger dans. L’atout déterminant de cette ingénierie réside dans sa totale réactivité : dès lors qu’un nouveau lot de questionnaires ou de candidats est encodé dans le tableau source principal, un simple clic droit sur la table finale suivi de l’option Actualiser réexécute l’intégralité du pipeline d’ingestion, d’alignement, d’auto-jointure, de calcul L1 et de pivotement sans nécessiter la moindre retouche manuelle.
10. Analyse comparative : Distance de Manhattan versus Euclidienne et Hamming
10.1 Comparaison structurelle avec la distance euclidienne (L2)
Pour fonder scientifiquement le choix de la métrique de Manhattan dans un protocole d’évaluation psychométrique ou comportementale, il est indispensable de la confronter méthodologiquement à son alternative la plus courante : la distance euclidienne (norme L2). Sous Excel, le calcul d’une distance euclidienne entre deux vecteurs B2:F2 et B3:F3 s’implémente par l’expression quadratique :
=RACINE(SOMMEPROD((B2:F2 - B3:F3)^2))
La divergence entre métrique L1 et L2 ne se résume pas à une nuance de calcul : elle relève d’une différenciation géométrique et épistémologique fondamentale. Sur le plan de la topologie spatiale, les courbes d’isodistance (les lieux géométriques des points situés à égale distance d’une origine commune) dessinent des cercles ou des hypersphères dans l’espace euclidien, alors qu’elles forment des losanges, des carrés tournés à 45 degrés ou des hyper-octaèdres dans l’espace de Manhattan.
L’élévation au carré inhérente à la norme euclidienne amplifie disproportionnellement les écarts d’amplitude élevée. Considérons deux profils psychologiques comparés à une cible : le premier sujet manifeste un écart mineur de 1 point sur cinq dimensions distinctes (somme L1 = 5 ; somme L2 = √(1+1+1+1+1) ≈ 2,24). Le second sujet est rigoureusement identique à la cible sur quatre dimensions, mais présente un écart sévère de 5 points sur la cinquième dimension (somme L1 = 5 ; somme L2 = √(0+0+0+0+25) = 5). Alors que la distance de Manhattan traite ces deux profils comme rigoureusement équivalents en volume global de désaccord (score de 5 dans les deux cas), la métrique euclidienne double la distance du second candidat par rapport au premier.
Dès lors, la métrique euclidienne doit être réservée aux cadres où un écart extrême isolé est jugé rédhibitoire ou invalidant. À l’inverse, dès que les dimensions mesurées représentent des traits graduels d’égale valeur théorique dont on souhaite évaluer le cumul linéaire des écarts, la métrique de Manhattan s’impose méthodologiquement.
10.2 Comparaison avec la distance de Hamming pour données catégorielles
Un autre repère comparatif cardinal est constitué par la métrique introduite par Richard Hamming, prévalant dans l’analyse de données binaires, nominales ou discrètes non ordonnées. Alors que la métrique de Manhattan évalue l’amplitude quantitative des écarts scalaires, la distance de Hamming quantifie exclusivement le nombre d’incohérences ou de discordances d’état entre deux vecteurs de même longueur, sans considération de magnitude.
Sous Excel, la distance de Hamming entre deux plages catégorielles se calcule avec une élégante compacité au moyen de l’opérateur de double négation unaire (--) convertissant les comparaisons booléennes en entiers arithmétiques :
=SOMMEPROD(--(B2:F2 B3:F3))
Cette métrique trouve son domaine de pertinence privilégié lors du traitement de questionnaires de type présence/absence de symptômes cliniques (codés 0 ou 1) ou de réponses à des choix fermés multimodaux (ex. typologies d’intérêts professionnels de Holland). Dans le cas spécifique où les données psychométriques sont strictement binaires (0 ou 1), la distance de Manhattan et la distance de Hamming coïncident parfaitement sur le plan arithmétique (|1 – 0| = 1 et 1 <> 0 = VRAI = 1). Toutefois, dès que les échelles comportent plus de deux degrés ordonnés, la distance de Manhattan enrichit considérablement l’analyse en préservant l’information relative à la gravité ou à l’intensité de l’éloignement, ce que la distance de Hamming est incapable de capturer.
10.3 Tableau récapitulatif des métriques de proximité dans Excel
Afin de guider l’analyste et le chercheur dans la sélection instrumentale de ses formules tabulaires, le tableau synthétique suivant récapitule les caractéristiques structurales des trois métriques majeures implémentables sous Excel :
| Métrique de Proximité | Formule Directe Excel | Nature des Données Idéale | Sensibilité aux Valeurs Atypiques | Interprétation Psychométrique |
|---|---|---|---|---|
| Distance de Manhattan (L1) | =SOMMEPROD(ABS(A-B)) |
Échelles ordinales, Likert, scores discrets continus | Modérée et linéaire ; haute robustesse | Coût cumulé de réalignement ou somme linéaire des désaccords dimensionnels. |
| Distance Euclidienne (L2) | =RACINE(SOMMEPROD((A-B)^2)) |
Grandeurs spatiales réelles, scores Z strictement continus | Très forte ; sensibilité quadratique aux extrêmes | Éloignement physique « à vol d’oiseau » ; pénalisation sévère des discordances isolées. |
| Distance de Hamming | =SOMMEPROD(--(AB)) |
Items binaires (vrai/faux), variables qualitatives nominales | Nulle ; traite chaque divergence de manière binaire (0 ou 1) | Nombre strict d’attributs divergents ou de discordances de réponses. |
11. Visualisation et exploitation diagnostique des matrices sous Excel
11.1 Cartographie thermique par mise en forme conditionnelle
L’exploitation diagnostique d’une matrice carrée de distance de Manhattan ne saurait se limiter à un tableau aride de valeurs numériques. Pour révéler instantanément les structures sous-jacentes de la cohorte et repérer des regroupements d’individus présentant des proximités manifestes, la conversion de la matrice en carte thermique (heatmap) via les fonctionnalités de mise en forme conditionnelle d’Excel représente un outil analytique d’une rare efficacité visuelle.
Le paramétrage d’une échelle de nuances s’articule méthodologiquement ainsi :
- Sélectionner l’ensemble de la plage de données numériques de la matrice (en excluant les en-têtes d’identifiants).
- Accéder au ruban Accueil > Mise en forme conditionnelle > Nuances de couleurs.
- Sélectionner le dégradé Vert – Jaune – Rouge inversé (où le vert matérialise les valeurs faibles et le rouge les valeurs fortes). Dans cette configuration visuelle, la proximité psychologique (distance faible) s’illumine en vert, les éloignements intermédiaires en nuances ambrées et les fortes dissimilarités en rouge.
Une précaution esthétique et statistique indispensable concerne la gestion de la diagonale principale. Les cellules diagonales contenant toutes la valeur 0, leur saturation en vert sombre intense peut fausser l’appréciation globale du dégradé chromatique. Il est judicieux d’instaurer une règle de mise en forme prioritaire spécifique ciblant les cellules rigoureusement égales à 0 (via Mise en forme conditionnelle > Règles de mise en surbrillance des cellules > Égal à… 0) et de leur attribuer un remplissage neutre (gris pâle ou hachuré), neutralisant visuellement l’auto-comparaison pour laisser ressortir les dynamiques relationnelles interpersonnelles.
11.2 Identification automatisée de profils types et d’atypicités
L’exploitation approfondie de la matrice de dissimilarité L1 permet d’objectiver deux statuts psychologiques et comportementaux majeurs au sein d’une population : les profils prototypiques (individus centraux très représentatifs du groupe) et les profils atypiques (ou outliers multidimensionnels).
Pour chaque individu i de la cohorte, il est possible de calculer son indice de distance moyenne au groupe en intégrant la formule suivante dans une colonne récapitulative jouxtant la matrice carrée :
=SOMME(B15:K15) / (NBVAL(B$14:K$14) - 1)
L’exclusion d’une unité au dénominateur permet d’écarter l’auto-comparaison diagonale. Cet indicateur synthétique livre des clés d’interprétation diagnostique majeures :
- Le profil central prototypique : l’individu qui présente la distance moyenne au groupe la plus faible constitue le barycentre comportemental de l’échantillon. Il partage le plus haut degré de ressemblance cumulée avec ses pairs et s’avère un candidat idéal pour des fonctions de médiation ou de représentation collective.
- Le profil isolé ou atypique : un participant dont la distance moyenne au groupe excède de plus de deux écarts-types la moyenne des distances de l’échantillon manifeste une configuration psychologique singulière. En milieu organisationnel ou clinique, cette détection précoce permet d’anticiper d’éventuelles difficultés d’intégration ou, au contraire, d’identifier des potentiels d’innovation cognitive exceptionnels détonnant face à la norme du groupe.
11.3 Préparation des données pour la classification ascendante hiérarchique
La matrice de Manhattan calculée sous Excel constitue le socle direct requis par les méthodes de clustering ou de classification ascendante hiérarchique (CAH). Si la classification finale requiert fréquemment l’usage d’algorithmes d’agrégation sophistiqués (liage de Ward, liage complet ou moyen), Excel peut servir de passerelle d’ingestion et d’audit intermédiaire avant exportation vers des environnements spécialisés tels que R, Python (via scipy.spatial.distance) ou SPSS.
Pour assurer une conformité totale avec les spécifications d’importation de ces progiciels statistiques, plusieurs contrôles d’intégrité doivent être appliqués depuis la feuille de calcul :
- Vérifier la stricte symétrie bilatérale de la matrice par une formule de contrôle logique globale insérée en zone d’audit :
=ET(B15:K24 = TRANSPOSE(B15:K24)), laquelle doit impérativement renvoyerVRAI. - S’assurer de l’absence totale de valeurs manquantes, d’infinis ou d’erreurs matricielles au sein de la grille.
- Procéder à l’exportation exclusive de la plage matricielle au format normalisé CSV (séparateur point-virgule ou tabulation) avec encodage UTF-8, garantissant une transition logicielle sans altération des libellés d’identifiants.
12. Bonnes pratiques de modélisation, audit et intégrité des calculs
12.1 Stratégies d’audit des formules et prévention des erreurs arithmétiques
La crédibilité scientifique et professionnelle des conclusions dérivées d’analyses psychométriques dépend intimement de la robustesse computationnelle du classeur Excel. Le déploiement de formules matricielles avancées accroît le risque d’erreurs de référence invisibles à l’œil nu. L’analyste doit dès lors instituer une routine systématique d’audit technique.
L’utilisation des outils graphiques d’audit du ruban Formules — en particulier Repérer les antécédents et Repérer les dépendants — permet de matérialiser instantanément sous la forme de flèches bleues les flux de données alimentant une cellule de distance de Manhattan. Cet examen visuel permet de vérifier que le vecteur d’un individu situé en ligne 15 ne pointe pas accidentellement vers la ligne de scores d’un autre participant en raison d’une mauvaise manipulation du curseur de recopie.
Parallèlement, la mise en place d’une cellule de test unitaire constitue une règle d’art méthodologique incontournable. Elle consiste à insérer dans le classeur deux vecteurs théoriques factices dont la distance de Manhattan exacte est connue d’avance (par exemple, le profil [1, 1, 1, 1, 1] confronté à [2, 3, 4, 5, 6], dont la distance absolue théorique est exactement égale à |1-2| + |1-3| + |1-4| + |1-5| + |1-6| = 1 + 2 + 3 + 4 + 5 = 15). En appliquant la formule matricielle globale sur ces vecteurs de contrôle, une fonction logique conditionnelle vérifie l’intégrité de l’algorithme : =SI(SOMMEPROD(ABS(TestA - TestB)) = 15; "ALGORITHME VALIDE"; "ERREUR CRITIQUE"). Toute altération accidentelle du moteur de calcul est ainsi immédiatement signalée.
12.2 Protection, verrouillage et gouvernance de la feuille de calcul
Dès lors que la structure computationnelle du modèle est validée, la sécurisation des formules face aux manipulations fortuites s’impose, particulièrement lorsque le classeur est destiné à être manipulé par des collaborateurs non spécialistes ou des évaluateurs sur le terrain. Excel propose des mécanismes éprouvés de compartimentation et de protection des droits d’édition.
Le protocole de verrouillage s’ordonne selon les étapes suivantes :
- Sélectionner l’intégralité des cellules de la feuille (
Ctrl + A), accéder à la boîte de dialogue de format de cellule (Ctrl + 1), onglet Protection, et s’assurer que la case Verrouillée est cochée par défaut. - Sélectionner exclusivement la zone de saisie des nouvelles données psychométriques (les cellules où les notes brutes doivent être renseignées), retourner dans l’onglet Protection, et décocher la case Verrouillée.
- Appliquer éventuellement la fonctionnalité de Validation des données (onglet Données) sur cette plage éditable pour restreindre formellement la saisie à des nombres entiers strictement compris entre les bornes de l’instrument (ex. nombres entiers entre 1 et 7). Toute saisie aberrante (score de 8 ou caractère alphabétique) sera automatiquement bloquée à la source.
- Actionner la protection globale de la feuille (onglet Révision > Protéger la feuille), en définissant un mot de passe d’administration robuste. L’utilisateur final ne pourra ainsi éditer que les zones de saisie autorisées, les cellules abritant les formules matricielles
SOMMEPRODet les matrices de distance demeurant inviolables.
12.3 Documentation académique et reproductibilité de l’analyse
L’exigence contemporaine de transparence et de reproductibilité qui traverse la recherche quantitative et la psychométrie appliquée prescrit que tout fichier de données soit intégralement auto-documenté. Un classeur d’analyse ne doit jamais se présenter comme une « boîte noire » dont seuls les initiés comprennent l’ordonnancement.
Il est impératif d’intégrer en première position du classeur un onglet dédié exclusivement au Dictionnaire de données (Codebook). Cet onglet doit répertorier de manière exhaustive le nom technique de chaque variable, son libellé théorique intégral, l’instrument psychométrique source dont elle est extraite, ses bornes de mesure théoriques (minimum et maximum), la métrique employée pour la comparaison vectorielle (en consignant explicitement la formule mathématique de la distance de Manhattan L1) ainsi que les éventuelles méthodes de normalisation ou d’imputation appliquées.
Enfin, l’instauration d’un protocole rigoureux de versionnage du classeur (ex. Etude_BigFive_Manhattan_v1.2_2025.xlsx) et l’archivage systématique des fichiers sources garantissent une auditabilité totale conforme aux standards internationaux de publication scientifique et aux exigences déontologiques de l’évaluation psychologique.
Références
- Costa, P. T., & McCrae, R. R. (1992). Revised NEO Personality Inventory (NEO-PI-R) and NEO Five-Factor Inventory (NEO-FFI) professional manual. Psychological Assessment Resources.
- Deza, M. M., & Deza, E. (2016). Encyclopedia of distances (4e éd.). Springer. https://doi.org/10.1007/978-3-662-52844-0
- Hamming, R. W. (1950). Error detecting and error correcting codes. Bell System Technical Journal, 29(2), 147–160. https://doi.org/10.1002/j.1538-7305.1950.tb00463.x
- Krause, E. F. (1986). Taxicab geometry: An adventure in non-Euclidean geometry. Dover Publications.
- Microsoft Corporation. (2024). Fonction SOMMEPROD. Support Microsoft. https://support.microsoft.com/fr-fr/office/sommeprod-fonction-sommeprod-174fac74-9838-4f3a-aaac-4e4778c065ac
- Minkowski, H. (1910). Geometrie der Zahlen. B. G. Teubner.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3e éd.). McGraw-Hill.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10