
Dans le champ de l’analyse quantitative des données comportementales, psychométriques et biométriques, la quantification précise de la divergence entre profils constitue un enjeu méthodologique de premier ordre. Qu’il s’agisse de comparer des séquences de réponses binaires à des inventaires de personnalité, des concordances diagnostiques entre cliniciens ou des séries temporelles d’états attentionnels, les chercheurs doivent mobiliser des métriques de dissimilarité mathématiquement rigoureuses. Parmi ces outils, la distance de Hamming s’impose comme une référence fondamentale pour évaluer le degré de discordance ponctuelle entre deux vecteurs discrets de dimension strictement équivalente.
Bien que des environnements de programmation statistique tels que le langage R ou Python disposent de bibliothèques dédiées au calcul vectoriel et à la manipulation matricielle, le recours au tableur Microsoft Excel demeure prépondérant au sein de nombreux laboratoires de psychologie, structures hospitalières et cabinets de conseil en ressources humaines. L’environnement tabulaire offre en effet une transparence visuelle immédiate, une traçabilité intuitive des données brutes et une accessibilité ergonomique pour les praticiens qui ne maîtrisent pas la syntaxe du code scripté. Toutefois, le calcul direct de la métrique de Hamming dans Excel requiert une maîtrise avancée de l’algèbre booléenne, de la coercition de types et des fonctions matricielles natives.
Le présent traité méthodologique propose une exploration exhaustive de l’implémentation, de l’optimisation et de l’interprétation de la distance de Hamming au sein de Microsoft Excel. De la décomposition analytique des formules classiques combinant les fonctions SOMMEPROD et NB jusqu’à l’exploitation des fonctionnalités matricielles dynamiques contemporaines (telles que LAMBDA et LET) et des modules d’automatisation ETL via Power Query, ce guide détaille chaque étape nécessaire au déploiement de protocoles d’analyse robustes, reproductibles et conformes aux exigences académiques les plus strictes.
1. Introduction théorique à la distance de Hamming et fondements mathématiques
1.1 Définition formelle et métrique de Hamming
La distance de Hamming puise ses origines conceptuelles dans les travaux pionniers de Richard Hamming, ingénieur et mathématicien aux laboratoires Bell, consignés dans sa publication séminale de 1950 consacrée à la théorie des codes et aux mécanismes de détection et de correction d’erreurs dans les télécommunications numériques naissantes. Confronté à la vulnérabilité des cartes perforées face aux perturbations physiques lors des cycles de calcul, Hamming a élaboré un formalisme géométrique permettant de quantifier l’altération subie par un message binaire lors de sa transmission à travers un canal bruité.
Sur le plan strictement mathématique, la distance de Hamming entre deux vecteurs (X) et (Y) de dimension finie (N), appartenant à un espace vectoriel discret défini sur un alphabet quelconque, est formellement définie comme la cardinalité de l’ensemble des indices pour lesquels les composantes respectives diffèrent. Si nous posons (X = (x_1, x_2, dots, x_N)) et (Y = (y_1, y_2, dots, y_N)), la métrique s’exprime par la sommation d’une fonction indicatrice :
d(X, Y) = Σ [x_i ≠ y_i] pour i variant de 1 à N, où l’expression entre crochets prend la valeur 1 lorsque la proposition logique est vérifiée et 0 dans le cas contraire.
Pour être qualifiée de métrique au sens topologique strict, cette fonction doit satisfaire impérativement quatre axiomes fondamentaux :
- La positivité : Pour tous vecteurs (X) et (Y), la distance est un entier naturel supérieur ou égal à zéro.
- La séparation (ou identité des indiscernables) : La distance entre (X) et (Y) est strictement nulle si et seulement si les deux vecteurs sont rigoureusement identiques composante par composante ((X = Y)).
- La symétrie : La divergence mesurée de (X) vers (Y) est invariante par permutation des arguments, soit (d(X, Y) = d(Y, X)).
- L’inégalité triangulaire : Pour tout triplet de vecteurs (X), (Y) et (Z), la distance directe entre (X) et (Z) est toujours inférieure ou égale à la somme des distances intermédiaires, soit (d(X, Z) le d(X, Y) + d(Y, Z)).
Une condition préalable et non négociable à l’application de la distance de Hamming réside dans l’égalité stricte de la longueur des séquences comparées. Tout désalignement dimensionnel ou omission d’élément invalide la comparaison terme à terme, interdisant le calcul direct sans alignement préalable.
1.2 Différenciation avec les autres métriques vectorielles
Il s’avère indispensable d’opérer une distinction rigoureuse entre la distance de Hamming et les autres métriques spatiales couramment mobilisées dans les analyses multidimensionnelles, au premier rang desquelles figure la distance de Levenshtein. Si la métrique de Hamming se restreint exclusivement à des opérations de substitution à positions fixes entre chaînes de longueur identique, la distance de Levenshtein — souvent qualifiée de distance d’édition globale — autorise les insertions et les délétions de caractères. Dès lors que deux séquences présentent des longueurs dissemblables ou qu’un déphasage spatial intervient suite à l’omission d’un élément unitaire, la distance de Levenshtein demeure calculable là où celle de Hamming échoue structurellement.
Par rapport aux métriques géométriques continues traditionnelles telles que la distance euclidienne (norme (L_2)) ou la distance de Manhattan (norme (L_1)), la métrique de Hamming se caractérise par son insensibilité totale à l’amplitude des écarts numériques. Dans le calcul d’une distance de Manhattan sur des variables discrètes ordinées, un écart entre une modalité 1 et une modalité 5 engendre une pénalité quantitative de 4 unités (|1 – 5| = 4). À l’inverse, au sein du paradigme de Hamming, cet écart est appréhendé sous un prisme strictement nominal : dès lors que deux éléments ne coïncident pas, le coût de dissimilarité attribué est invariablement égal à 1, sans égards pour la distance cardinale séparant ces valeurs.
Cette spécificité confère à la distance de Hamming une pertinence épistémologique majeure dans le traitement des attributs qualitatifs nominaux non ordonnés (par exemple des choix de filières académiques, des catégories nosologiques ou des marqueurs génétiques alléliques). Néanmoins, cette rigidité spatiale constitue également sa limite mathématique fondamentale : la métrique est incapable de détecter la similarité sous-jacente de deux motifs structurellement identiques qui auraient simplement subi une translation ou un décalage d’un cran le long du vecteur d’observation.
1.3 Intérêt de l’implémentation dans un tableur comme Excel
L’implémentation d’une métrique formelle dans l’environnement Microsoft Excel répond à des exigences d’accessibilité opérationnelle prégnantes au sein des sciences comportementales, de la neuropsychologie et de la recherche clinique. Si les architectures de calcul distribué ou les scripts compilés s’avèrent indispensables pour le traitement de mégadonnées issues du séquençage génomique à haut débit, les protocoles expérimentaux en psychologie recueillent généralement des cohortes comprenant quelques dizaines à quelques centaines de participants, évalués sur des batteries de tests standardisées. Pour ces volumétries, la lourdeur d’un environnement comme Python ou R peut constituer un frein à l’analyse rapide exploratoire.
Excel offre un atout déterminant qui fait souvent défaut aux terminaux de commande : la vérification visuelle immédiate des divergences observationnelles. En juxtaposant les vecteurs dans des colonnes adjacentes, le chercheur conserve un contact visuel direct avec ses données brutes. Les discordances peuvent être instantanément contextualisées, inspectées et reliées aux caractéristiques qualitatives des sujets évalués, limitant ainsi le risque d’interpréter des artéfacts informatiques comme des signaux comportementaux significatifs.
De surcroît, le moteur de calcul réactif d’Excel garantit une flexibilité dynamique exceptionnelle. Toute modification manuelle d’une saisie erronée, tout recalcul consécutif à l’exclusion d’un item non discriminant, ou toute actualisation d’une réponse clinique répercute instantanément ses effets sur les scores de distance calculés sans nécessiter de réexécution complète d’un pipeline logiciel. Enfin, la formalisation de ces calculs sous la forme de formules standardisées et de modèles téléchargeables assure une parfaite reproductibilité des protocoles d’analyse au sein des équipes pluridisciplinaires, indépendamment de la compétence en programmation de chaque intervenant.
2. Applications de la distance de Hamming en psychométrie et sciences comportementales
2.1 Comparaison de profils diagnostiques et critères nosologiques
Dans le domaine de la psychopathologie quantitative, la classification nosologique s’appuie fréquemment sur des systèmes diagnostiques polytétraédriques tels que le DSM-5 (Manuel diagnostique et statistique des troubles mentaux) ou la CIM-11 (Classification internationale des maladies). Au sein de ces référentiels, la reconnaissance d’un trouble repose sur l’identification d’une constellation symptomatique où chaque manifestation clinique est encodée sous une forme binaire : présence (1) ou absence (0). La distance de Hamming s’illustre ici comme un indice éminemment rigoureux pour quantifier le degré d’écart sémiologique entre la présentation clinique d’un patient et le prototype canonique d’une pathologie.
Considérons par exemple l’évaluation d’un épisode dépressif caractérisé, articulé autour de neuf critères symptomatiques cardinaux. Deux patients répondant tous deux au seuil diagnostique minimal de cinq critères peuvent présenter des tableaux cliniques dissemblables. En appliquant la métrique de Hamming entre leurs vecteurs sémiologiques respectifs, le clinicien évalue avec précision la divergence de leurs phénotypes symptomatiques. Un score élevé met en lumière une hétérogénéité syndromique qui invite à singulariser les approches psychopharmacologiques et psychothérapeutiques, là où une étiquette nosologique globale masquerait ces nuances individuelles.
Par ailleurs, la métrique trouve un champ d’application naturel dans l’évaluation de la concordance inter-juges. Lors d’expertises médico-légales ou d’évaluations psychiatriques en double aveugle, deux praticiens sont régulièrement amenés à coter la présence ou l’absence d’éléments cliniques observables (agitation psychomotrice, hallucinations, ralentissement cognitif). Le calcul direct de la distance de Hamming entre les grilles d’évaluation des deux évaluateurs permet de quantifier instantanément le volume absolu de désaccords, complétant utilement les indices de corrélation intraclasse ou le kappa de Cohen en offrant une mesure tangible et intuitive de la divergence d’observation.
2.2 Analyse typologique et profils de réponses aux questionnaires
Les protocoles psychométriques mobilisent abondamment les formats de réponse à choix forcé, que ce soit dans les inventaires de personnalité, les épreuves de motivation ou les bilans vocationnels. Dans un questionnaire ipsatif où le répondant doit systématiquement opérer un arbitrage binaire entre deux assertions comportementales, le vecteur global de réponses traduit la configuration structurale des priorités psychologiques du sujet. La distance de Hamming permet d’établir une cartographie comparative de ces configurations en calculant les distances mutuelles entre tous les participants d’une cohorte.
Cette approche permet d’identifier avec une grande finesse des sous-groupes comportementaux naturels, sans contraindre les données dans les postulats de distribution normale exigés par les méthodes de partitionnement traditionnelles comme les nuées dynamiques basées sur des distances euclidiennes. Dans le cadre de l’analyse typologique, deux individus affichant une distance de Hamming remarquablement faible sur un inventaire de 50 items présentent une organisation cognitive et axiologique quasi-isomorphe. L’analyse des regroupements par agglomération de proches voisins met ainsi en lumière des profils de personnalité récurrents au sein d’une organisation ou d’une population clinique.
En outre, la métrique se révèle précieuse pour le contrôle de validité des protocoles et la détection des profils atypiques. Dans les cohortes de grande envergure, il est classique de comparer le vecteur de réponses de chaque participant à un vecteur de référence (représentant par exemple le patron de réponses modal de l’échantillon ou un profil théorique attendu). Une distance de Hamming statistiquement aberrante — qu’elle soit exagérément élevée, traduisant un patron de réponses anarchique attribuable à un manque de coopération, ou inversement suspecte par son alignement artificiel sur un profil d’acquiescement systématique — constitue un signal d’alerte méthodologique conduisant à l’exclusion ciblée de l’enregistrement incriminé.
2.3 Étude des processus de décision et trajectoires temporelles
L’exploration expérimentale des processus cognitifs recourt fréquemment à des paradigmes de décision séquentielle en laboratoire, tels que la tâche de sélection de cartes d’Iowa (Iowa Gambling Task) ou les épreuves de temps de réaction à choix multiples. Au cours de ces épreuves, le sujet émet une succession temporelle d’arbitrages comportementaux (par exemple opter pour un choix risqué versus un choix prudent à chaque itération (t)). La formalisation de la trajectoire décisionnelle sous la forme d’un vecteur ordonné d’états discrets permet de confronter rigoureusement la dynamique d’apprentissage de différents groupes expérimentaux via la distance de Hamming.
En psychologie du développement et en éthologie humaine, l’enregistrement continu des comportements en milieu écologique génère des séries temporelles qualitatives. Les observateurs codent, à intervalles réguliers d’une seconde, l’état attentionnel ou l’état affectif d’un nourrisson en interaction avec sa figure d’attachement (les modalités discrètes pouvant comprendre : regard conjoint, détournement du regard, vocalisation positive, protestation motrice). En calculant la distance de Hamming entre les séquences comportementales synchronisées de la mère et de l’enfant, les chercheurs quantifient le désalignement dyadique au cours de phases spécifiques, notamment lors du paradigme du visage impassible (Still-Face).
Enfin, cette approche s’avère particulièrement féconde pour modéliser la transition entre patterns comportementaux chez l’enfant au cours de l’acquisition de stratégies de résolution de problèmes. En comparant les séries d’actions déployées pour résoudre des puzzles spatiaux ou des casse-têtes logiques (comme la Tour de Hanoï) à la trajectoire optimale formalisée par un modèle computationnel, la distance de Hamming mesure précisément l’écart procédural franchi par l’apprenant à chaque stade de son développement cognitif.
3. Préparation et structuration des données vectorielles dans Excel
3.1 Organisation spatiale des données : colonnes versus lignes
L’efficacité du calcul matriciel dans Excel et la maintenabilité des feuilles d’analyse dépendent intimement du choix architectural opéré quant à l’orientation spatiale des vecteurs de données. Traditionnellement, deux paradigmes d’organisation s’opposent : la disposition en colonnes contiguës (orientation verticale) et la structuration en lignes séquentielles (orientation horizontale). Le choix entre ces deux approches n’est pas anodin, car il conditionne directement la syntaxe des fonctions de référence, la lisibilité des plages nommées et les performances de recalcul de l’application.
Pour la comparaison paritaire ponctuelle de deux sujets ou de deux conditions expérimentales, l’alignement des données en deux colonnes adjacentes (par exemple la plage A2:A51 pour le sujet 1 et la plage B2:B51 pour le sujet 2) s’avère hautement préconisé. Cette disposition verticale tire parti du défilement naturel de l’interface utilisateur, facilite l’inspection visuelle item par item et s’harmonise parfaitement avec les fonctions de sommation conditionnelle vectorielle qui opèrent préférentiellement sur des blocs de colonnes continus au sein du processeur de calcul d’Excel.
À l’inverse, dès lors que l’objectif méthodologique réside dans le traitement d’une cohorte globale comportant des centaines d’individus mesurés sur une batterie d’items, l’orthodoxie des bases de données relationnelles impose de structurer les participants en lignes (chaque ligne incarnant une observation indépendante) et les items en colonnes successives. Cette architecture matricielle standardisée permet d’appliquer les fonctions d’interrogation dynamique sans risquer de heurter les limites d’affichage et simplifie considérablement les opérations d’importation et d’exportation vers des progiciels statistiques spécialisés.
3.2 Normalisation des types de données et encodage
Avant d’exécuter la moindre opération de comparaison logique au sein d’une formule Excel, il est indispensable de procéder à un audit rigoureux de l’homogénéité des formats de données au sein des plages sources. L’une des sources d’erreurs les plus pernicieuses réside dans la coexistence silencieuse de représentations numériques et de chaînes de caractères d’apparence identique. Une cellule stockant la valeur numérique 1 ne sera jamais reconnue comme équivalente à une cellule hébergeant le caractère textuel « 1 » (souvent précédé d’une apostrophe invisible ou importé de manière défectueuse depuis une extraction CSV), ce qui induit mécaniquement des faux désaccords dans le calcul de la distance de Hamming.
Les réponses issues de formulaires dématérialisés présentent fréquemment des encodages booléens explicites (VRAI / FAUX). Bien qu’Excel gère nativement le type booléen au niveau logique, la cohabitation de booléens natifs avec des valeurs numériques binaires (1 / 0) ou des transcriptions textuelles littérales (« VRAI » / « FAUX ») produit des discordances systématiques lors des tests d’égalité élémentaire. Il est dès lors impératif d’uniformiser l’ensemble de la matrice par une passe de conversion systématique. L’utilisation conjointe de la fonction CNUM ou de l’opérateur arithmétique neutre (en multipliant par 1 ou en ajoutant 0) permet de contraindre toute chaîne numérique sous sa forme quantitative native.
Pour les variables qualitatives nominales encodées sous forme de texte (codes alphabétiques, étiquettes symptomatiques), une étape de standardisation typographique s’impose. La présence d’espaces typographiques accidentels en début ou fin de chaîne (induits lors de la saisie manuelle) fausse irrémédiablement le test d’équivalence logique. L’application préalable de la fonction SUPPRESPACE, conjuguée à la normalisation de la casse via les fonctions MAJUSCULE ou MINUSCULE, garantit que seules les divergences lexicales substantielles soient prises en compte dans le calcul de la dissimilarité.
3.3 Validation de l’intégrité vectorielle
Le respect absolu de la condition d’équidimensionnalité imposée par la métrique de Hamming requiert la mise en place d’un protocole de vérification d’intégrité vectorielle préalablement à l’évaluation des formules de divergence. Deux vecteurs dont les étendues spatiales ne coïncident pas strictement ne peuvent en aucun cas faire l’objet d’une comparaison de Hamming valide. La vérification de la longueur effective des séries doit être instrumentalisée au sein de la feuille de calcul au moyen des fonctions NB (pour les séries numériques) ou NBVAL (pour les séries alphanumériques généralistes).
L’existence de cellules vides au sein d’une plage de données pose un défi méthodologique majeur. Si une cellule est laissée vierge suite à une omission de réponse d’un participant tandis que la cellule correspondante chez le sujet comparé contient une valeur valide, Excel peut, selon la syntaxe mobilisée, interpréter le vide comme un zéro arithmétique ou comme une chaîne vide, générant ainsi un artefact d’évaluation. Il convient donc de déployer une fonction de contrôle préventif calculant la quantité de paires complètes disponibles à l’aide de formules conditionnelles croisées.
Pour fiabiliser l’architecture de calcul et sécuriser les formules complexes contre les erreurs de sélection de plages lors de l’étirement des formules, la création de plages de cellules nommées représente une pratique d’excellence. En attribuant, via le Gestionnaire de noms d’Excel, des identifiants sémantiques clairs tels que Profil_Patient_A et Profil_Patient_B aux blocs de données concernés, l’analyste accroît considérablement l’intelligibilité de ses algorithmes et prévient tout décalage accidentel des bornes vectorielles lors de la maintenance du classeur.
4. Anatomie de la formule standard : Décomposition de NB et SOMMEPROD
4.1 Logique générale de la formule fondamentale
Dans les versions patrimoniales et contemporaines de Microsoft Excel, l’implémentation de référence pour calculer la distance de Hamming entre deux vecteurs numériques s’appuie historiquement sur une élégante formulation indirecte faisant intervenir les fonctions NB et SOMMEPROD. Cette formulation canonique se structure sous la syntaxe générale suivante :
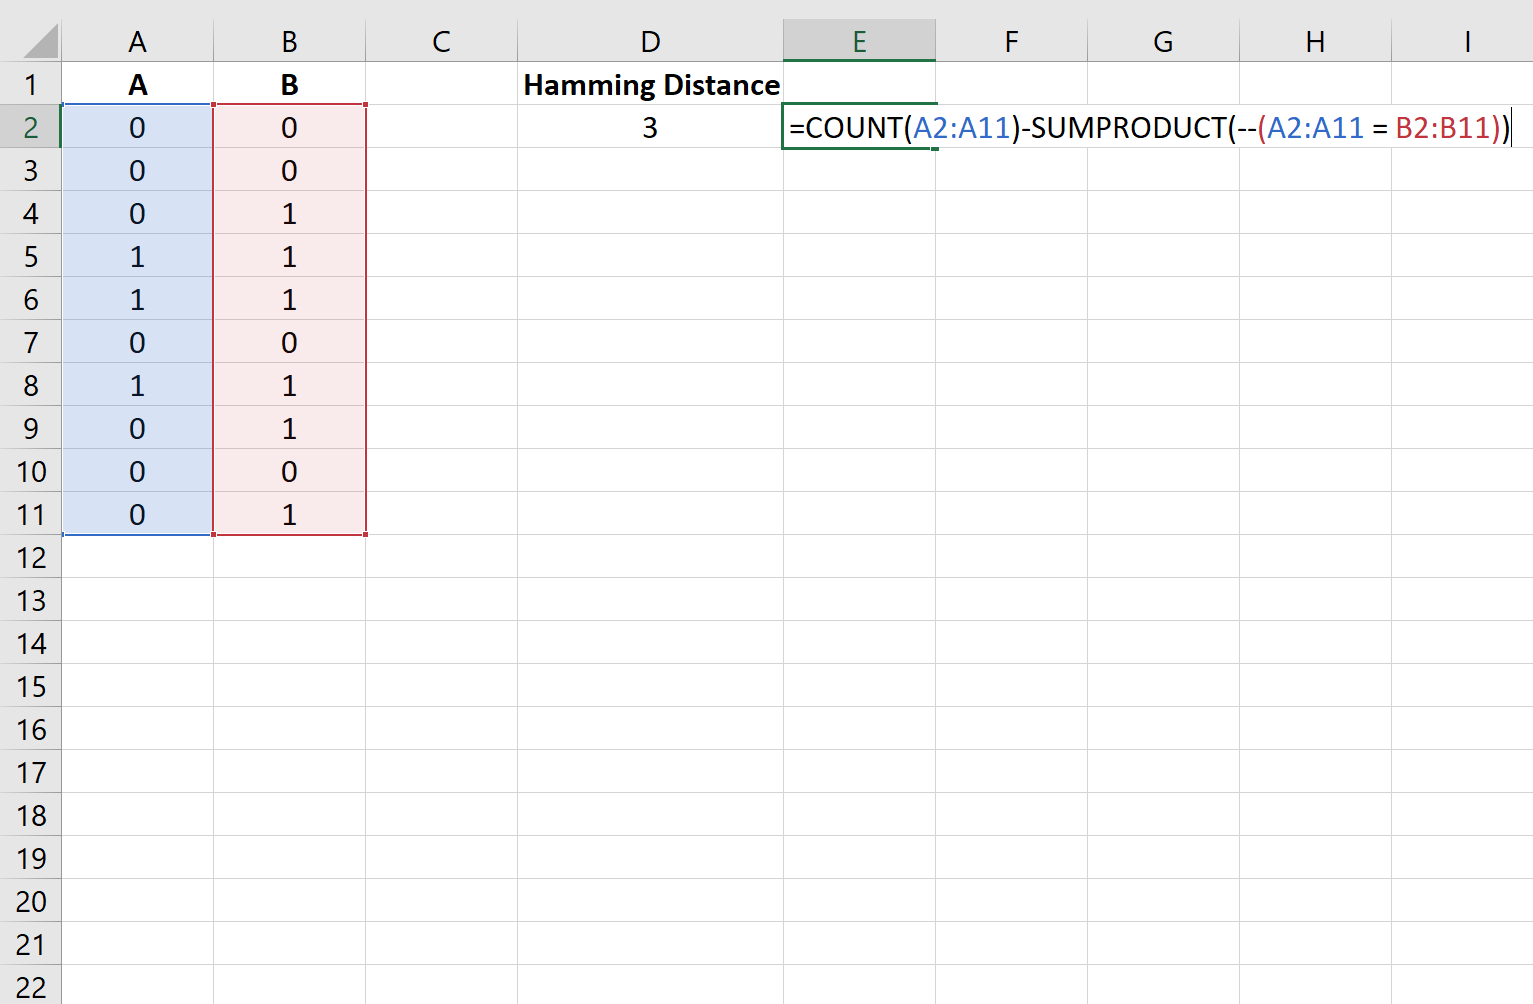
=NB(PLAGE1) – SOMMEPROD(–(PLAGE1 = PLAGE2))
La logique mathématique sous-jacente repose sur le principe ensembliste de complémentarité. Plutôt que de tenter d’isoler et de dénombrer directement les positions divergentes — ce qui pouvait s’avérer laborieux avec les moteurs de calcul matriciel antérieurs à l’introduction des tableaux dynamiques —, la formule procède par soustraction. Elle quantifie dans un premier temps le nombre total d’observations composant le vecteur par l’intermédiaire de NB(PLAGE1), puis en retranche la somme des concordances parfaites évaluée par le second terme de l’équation.
Cette méthodologie soustractive présente un avantage déterminant par rapport aux structures conditionnelles itératives basées sur des imbrications complexes de fonctions SI : elle s’exécute nativement au sein du moteur vectoriel sans requérir de colonnes de calcul intermédiaires pour chaque item, tout en maintenant une compatibilité ascendante et descendante parfaite avec l’intégralité des déclinaisons historiques d’Excel.
4.2 Le rôle du comparateur logique d’égalité (PLAGE1 = PLAGE2)
Le cœur opératoire de la composante de concordance réside dans l’instruction de comparaison logique paritaire (PLAGE1 = PLAGE2). Lorsque deux plages vectorielles de dimensions parfaitement isomorphes (par exemple deux colonnes de 20 cellules) sont soumises à cet opérateur relationnel, le moteur de calcul d’Excel ne renvoie pas une valeur scalaire unique, mais génère en mémoire tampon un tableau vectoriel constitué exclusivement de valeurs logiques booléennes : VRAI et FAUX.
Chaque élément (i) de ce tableau virtuel reflète le statut de la comparaison entre le (i)-ième élément de la première plage et le (i)-ième élément de la seconde plage. Si la cellule A2 contient la valeur 1 et que la cellule B2 héberge également la valeur 1, l’évaluation de cette première position renvoie le booléen VRAI. Si la cellule A3 contient la valeur 0 alors que la cellule B3 arbore la valeur 1, la seconde position de la table virtuelle prendra la valeur FAUX.
Il importe de souligner le comportement strict de cet opérateur face aux typologies de données : s’il gère avec une grande flexibilité la comparaison entre deux entiers ou deux réels, il échoue silencieusement à reconnaître l’équivalence entre une valeur numérique et son homologue encodé sous forme textuelle, renvoyant systématiquement FAUX même si la représentation optique semble identique à l’écran.
4.3 Le double opérateur unaire négatif (–) et son fonctionnement
L’insertion du double tiret — formellement désigné en informatique sous le terme de double opérateur unaire de négation — constitue l’un des mécanismes les plus ingénieux et fondamentaux du calcul matriciel sous Excel. Par conception, la fonction SOMMEPROD ignore superbement les valeurs logiques pures VRAI et FAUX lorsqu’elles lui sont directement transmises au sein d’un argument matriciel ; elle traite ces entrées comme de simples cellules vides ou des chaînes non numériques et renvoie un résultat nul (0).
Pour forcer le moteur de calcul à quantifier ces résultats logiques, il est nécessaire d’opérer une coercition de type (type casting), transformant les booléens abstraits en entiers arithmétiques exploitables, où VRAI devient 1 et FAUX devient 0. L’application du premier opérateur unaire de soustraction (–) convertit le booléen en son inverse arithmétique : -VRAI devient ainsi le nombre entier -1, tandis que -FAUX se transmute en 0. Le second opérateur unaire vient immédiatement inverser à nouveau le signe arithmétique : -(-1) restitue la valeur positive 1.
Bien que d’autres artifices arithmétiques permettent d’obtenir un résultat fonctionnel identique — tels que l’addition d’un zéro ((PLAGE1=PLAGE2)+0) ou la multiplication unitaire ((PLAGE1=PLAGE2)*1) —, le double unaire — est universellement privilégié par les experts en modélisation tabulaire en raison de sa supériorité avérée en matière de vitesse d’exécution dans les algorithmes massifs, le microprocesseur exécutant l’instruction de bas niveau de négation de bit beaucoup plus rapidement que les opérations de calcul arithmétique standard.
4.4 L’agrégation vectorielle par SOMMEPROD
La fonction SOMMEPROD accomplit la synthèse finale de cette chaîne algorithmique. À l’origine conçue pour réaliser le produit scalaire entre deux ou plusieurs vecteurs avant d’en additionner les résultats, sa propriété intrinsèque la plus précieuse réside dans sa capacité à traiter nativement des opérations matricielles sans exiger la validation par la combinaison triadique complexe de touches Ctrl + Maj + Entrée (traditionnellement requise pour les formules matricielles dans les éditions antérieures d’Excel).
En recevant comme paramètre la matrice coercée constituée d’une suite ordonnée de 1 et de 0 issue du traitement par double unaire, SOMMEPROD effectue une sommation arithmétique linéaire de l’ensemble des éléments de ce vecteur temporaire. Le total obtenu correspond très exactement au cardinal de l’ensemble des positions concordantes entre les deux profils examinés.
L’optimisation du moteur interne d’Excel alloue à la fonction SOMMEPROD des mécanismes de parallélisation de calcul particulièrement véloces sur les processeurs modernes multicœurs. Cette performance intrinsèque permet de manipuler des vecteurs comportementaux comprenant des dizaines de milliers de lignes sans provoquer le moindre gel perceptible de l’interface utilisateur, offrant une solution idéale pour le traitement intensif de données expérimentales.
5. Calcul de la distance de Hamming pour des vecteurs binaires dans Excel
5.1 Mise en œuvre sur des données de tests psychométriques (0/1)
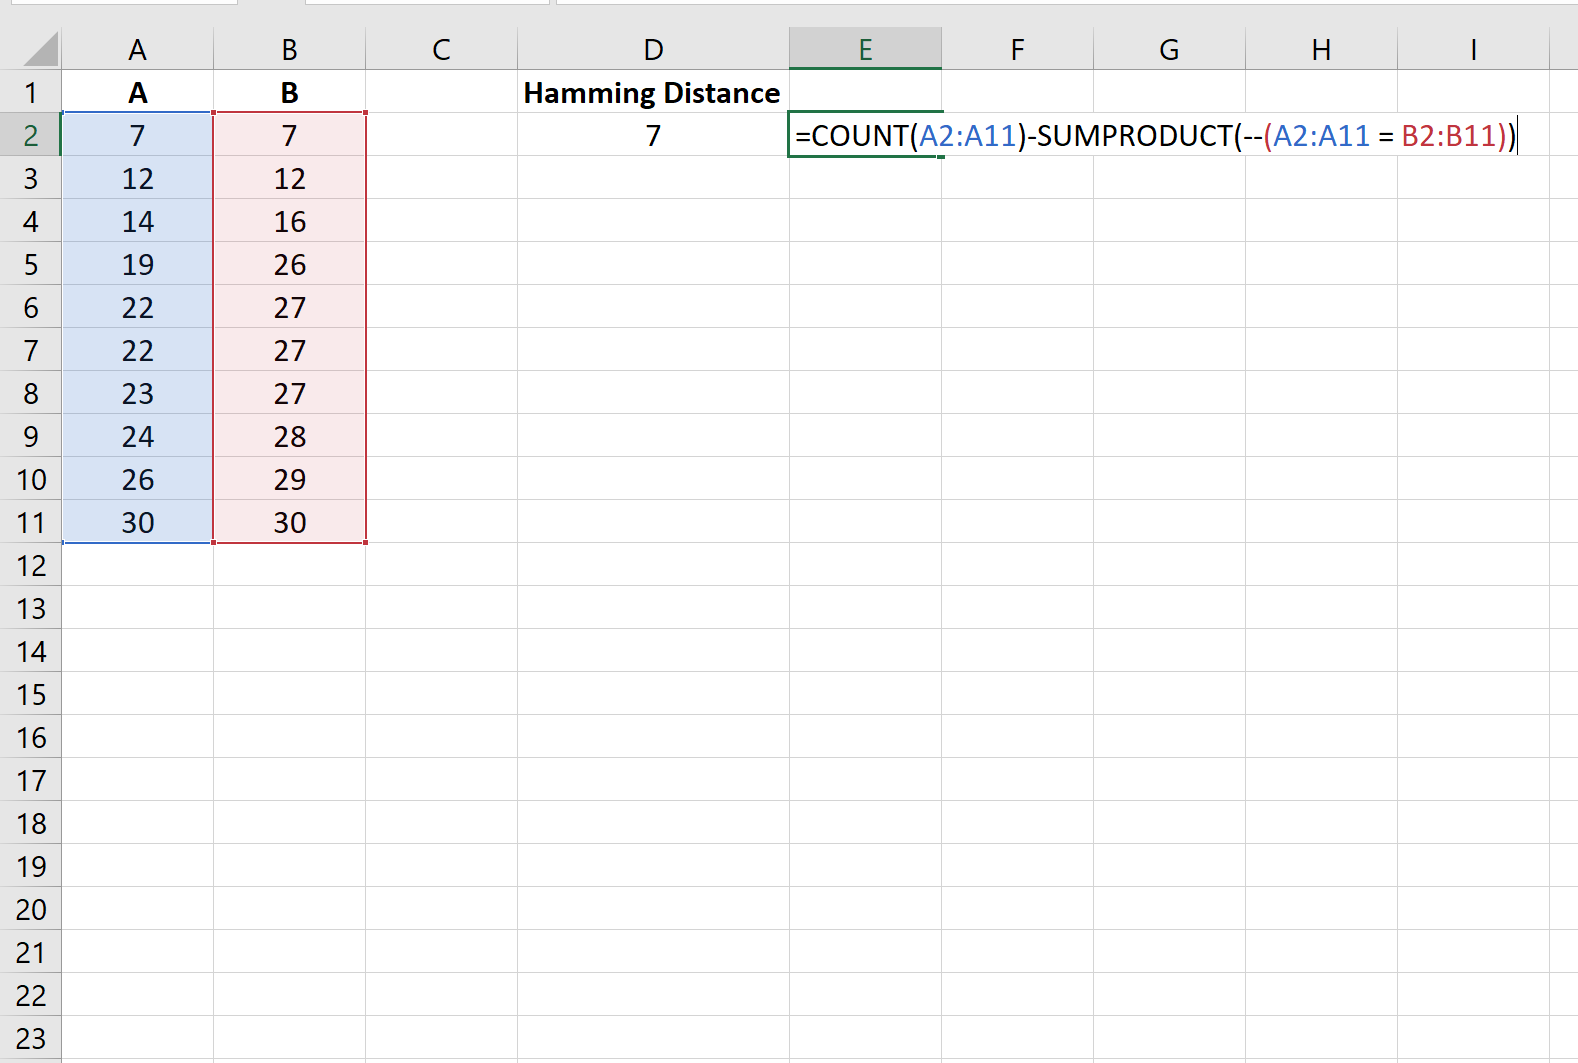
Afin d’illustrer concrètement le protocole d’implémentation opérationnelle, considérons une situation classique d’évaluation psychométrique où deux sujets ont été soumis à un inventaire d’auto-évaluation de la résilience émotionnelle constitué de 20 items dichotomiques. Les réponses affirmatives ont été préalablement encodées par la valeur 1 et les réfutations par la valeur 0. Les données du premier participant sont consignées dans les cellules A2 à A21, tandis que les réponses du second sujet occupent les cellules B2 à B21.
Pour déterminer la distance de Hamming séparant ces deux sujets au moyen de l’approche canonique indirecte, le praticien insère la formule suivante dans une cellule dédiée :
=NB(A2:A21) – SOMMEPROD(–(A2:A21 = B2:B21))
Le déroulement séquentiel du calcul s’opère selon les étapes suivantes :
- La fonction NB(A2:A21) analyse la première colonne et établit que le vecteur comprend rigoureusement 20 valeurs numériques.
- L’évaluation interne compare terme à terme les cellules A2:A21 et B2:B21, générant une matrice booléenne de dimension 20×1 (par exemple : {VRAI; VRAI; FAUX; VRAI; FAUX; …}).
- Le double opérateur — convertit cette matrice en un vecteur numérique d’entiers équivalents : {1; 1; 0; 1; 0; …}.
- La fonction SOMMEPROD totalise ces coefficients de concordance. Si les deux participants ont fourni une réponse rigoureusement identique sur 14 des 20 items, l’agrégation renvoie le chiffre 14.
- L’opération arithmétique finale soustrait ce sous-total du cardinal d’ensemble : 20 – 14 = 6.
L’interprétation clinique de ce résultat brut est limpide : la distance de Hamming entre le sujet A et le sujet B s’établit à 6, ce qui signifie que leurs profils psychologiques divergent sur exactement 6 items sur l’ensemble de la batterie administrée.
5.2 Variantes avec valeurs booléennes explicites (VRAI/FAUX)
Dans de nombreuses configurations expérimentales modernes, notamment lors de l’exportation brute depuis des plateformes d’administration de tests psychologiques en ligne (comme Qualtrics ou Google Forms), les données binaires ne sont pas pré-encodées sous forme d’entiers numériques 0 et 1, mais se présentent sous la forme explicite de valeurs de vérité booléennes natives VRAI et FAUX. L’application immédiate de la formule précédente sur ce type de données est susceptible de provoquer une anomalie de calcul majeure.
En effet, la fonction NB a pour mandat strict de ne comptabiliser exclusivement que les cellules contenant des valeurs de type numérique. Confrontée à une plage constituée de booléens natifs, elle renvoie invariablement la valeur zéro (0). Dès lors, l’évaluation de 0 – SOMMEPROD(…) aboutit à un score négatif absurde, contredisant directement l’axiome fondamental de positivité de la métrique de Hamming. Pour neutraliser cet écueil méthodologique, il est impératif de substituer la fonction NBVAL à la fonction NB :
=NBVAL(A2:A21) – SOMMEPROD(–(A2:A21 = B2:B21))
La fonction NBVAL opère le dénombrement sans distinction de type de toutes les cellules non vides, garantissant ainsi que l’effectif total d’items soit fidèlement répercuté au dénominateur ou dans le terme soustractif, que les données soient textuelles, logiques ou numériques. La transformation interne opérée par SOMMEPROD demeure parfaitement intègre, car la comparaison de deux booléens natifs identiques renvoie le booléen VRAI, lequel se voit assigner la valeur 1 par le double unaire avec une robustesse mathématique absolue.
5.3 Formule alternative directe basée sur l’opérateur de différence ()
Bien que la méthode soustractive décomposée précédemment offre une vertu pédagogique indéniable, il est mathématiquement plus élégant et informatiquement plus sobre de recourir à une formulation directe ciblant immédiatement les divergences vectorielles. En substituant l’opérateur d’inégalité stricte (différent de, noté <> dans la syntaxe d’Excel) au comparateur d’égalité, l’analyste fait l’économie de la fonction de dénombrement globale :
=SOMMEPROD(–(A2:A21 <> B2:B21))
L’architecture logique interne de cette expression est d’une grande limpidité conceptuelle. L’instruction relationnelle (A2:A21 <> B2:B21) génère un tableau booléen dans lequel la valeur VRAI n’est plus attribuée aux concordances, mais caractérise exclusivement les positions de discordance effective entre les deux séries. Le double opérateur d’inversion — transmute instantanément chaque discordance en un entier 1 et chaque concordance en un entier 0.
La fonction SOMMEPROD n’a plus qu’à agréger ces valeurs unitaires de désaccord pour obtenir, en une unique passe algorithmique, la distance de Hamming brute. Outre sa concision formelle remarquable, cette syntaxe alternative présente l’avantage métrologique d’être totalement indifférente au type sous-jacent des données comparées (entiers, réels, booléens ou chaînes textuelles), éliminant de facto tout risque d’erreur d’aiguillage entre les fonctions NB et NBVAL tout en allégeant le coût computationnel global.
6. Calcul de la distance de Hamming pour des vecteurs numériques et échelles de Likert
6.1 Application aux échelles d’évaluation ordonnées
L’administration d’instruments de mesure en sciences humaines repose majoritairement sur des échelles de Likert à 5 ou 7 points (graduées par exemple de « Pas du tout d’accord » à « Tout à fait d’accord »). L’application de la distance de Hamming à ces variables continues ou quasi-continues nécessite une réflexion épistémologique préalable quant à la nature de la métrique. Dans un espace euclidien, un participant ayant répondu 1 est considéré comme infiniment plus proche d’un individu ayant coté 2 que d’un sujet ayant sélectionné la modalité 5. La distance de Hamming neutralise délibérément cette gradation spatiale.
Pour la métrique de Hamming, toute différence de valeur — qu’elle s’exprime par une nuance marginale d’un point ou par une divergence polaire maximale — est rigoureusement assignée à une pénalité identique de 1 unité. Cette spécificité, qui pourrait de prime abord sembler être une perte d’information métrique, constitue au contraire un atout majeur dans certaines démarches de modélisation comportementale. Elle permet notamment d’évaluer la fidélité stricte d’alignement cognitif : deux individus ne sont considérés comme synchrones sur une assertion que s’ils partagent une adhésion rigoureusement isomorphe.
Cette approche est couramment mobilisée dans les protocoles d’analyse des profils de compétences ou d’évaluation de la culture d’entreprise, où l’on cherche à isoler les items qui suscitent un consensus parfait de ceux qui provoquent une dispersion, indépendamment de l’amplitude moyenne des réponses. La distance de Hamming agit ici comme un révélateur d’inflexion comportementale pure, imperméable aux biais d’ancrage métrique des échelles subjectives.
6.2 Calcul pas à pas sur un jeu de données expérimental
Considérons un protocole de recherche portant sur l’anxiété préopératoire, au sein duquel deux cohortes indépendantes de 49 patients ont été évaluées sur une batterie de 49 items psychométriques cotés de 1 à 5. Les profils moyens ou médians de ces deux groupes ont été agrégés et consignés respectivement dans les plages A2:A50 pour le Groupe Expérimental et B2:B50 pour le Groupe Témoin. L’objectif est de mesurer l’ampleur de la divergence globale des patrons de réponses entre ces deux entités cliniques.
L’application de la formule directe :
=SOMMEPROD(–(A2:A50 <> B2:B50))
permet de quantifier instantanément le nombre précis d’items pour lesquels les deux groupes présentent une divergence d’évaluation. Si le résultat renvoyé par le tableur affiche par exemple le score de 28, le statisticien sait immédiatement que les groupes divergent sur 28 des 49 dimensions explorées.
Pour approfondir l’analyse psychométrique et aller au-delà de ce score agrégé global, il est d’usage d’associer à cette formule principale une colonne d’inspection analytique adjacente. En inscrivant en C2 la formule simple =–(A2 <> B2) et en l’étirant jusqu’à la cellule C50, le chercheur génère un profil d’écart unitaire. Un simple tri ou un filtre automatique appliqué sur cette troisième colonne permet d’isoler en une fraction de seconde la nomenclature exhaustive des items hautement discriminants, guidant ainsi l’interprétation qualitative des mécanismes psychologiques sous-jacents aux écarts observés.
6.3 Normalisation de la distance de Hamming
Lorsque l’on est amené à comparer des protocoles expérimentaux ou des batteries d’instruments comprenant des nombres variables d’items (par exemple comparer la dissimilarité observée sur une échelle abrégée de 15 questions avec celle relevée sur une échelle intégrale de 60 items), le recours à la distance de Hamming brute s’avère méthodologiquement trompeur. Un score brut de 10 désaccords sur une échelle de 12 items traduit une divergence massive de plus de 83%, tandis que ce même score de 10 sur une épreuve comportant 100 items ne représente qu’une fluctuation marginale de 10%.
Il devient dès lors impératif de normaliser la distance de Hamming en la rapportant à la dimension totale (N) du vecteur d’observation, convertissant ainsi l’indice brut en un ratio scalaire adimensionnel compris strictement dans l’intervalle [0 ; 1], interprétable comme un taux de discordance relative. Au sein d’Excel, cette normalisation s’opère de manière dynamique et élégante en divisant l’agrégat de dissimilarité par le cardinal spatial de la plage, calculé au moyen de la fonction LIGNES :
=SOMMEPROD(–(A2:A50 <> B2:B50)) / LIGNES(A2:A50)
Grâce à cette formulation, toute modification future de la taille de l’échantillon ou de l’étendue des items pris en compte réajustera automatiquement le coefficient diviseur sans imposer de réécriture manuelle du dénominateur arithmétique. Si la cellule renvoie une valeur de 0,35, le chercheur peut formaliser que les deux profils analysés présentent un taux de dissemblance structurale de 35%, autorisant des comparaisons métriques rigoureuses et standardisées d’un protocole à un autre.
7. Traitement des chaînes de caractères et séquences textuelles dans Excel
7.1 Comparaison de vecteurs de symboles textuels en colonnes
Dans de nombreuses disciplines des sciences comportementales — telles que la linguistique computationnelle, l’analyse des styles d’attachement narratifs ou le codage d’observations comportementales naturalistes —, les données vectorielles ne sont pas encodées sous forme d’indices numériques, mais sont formalisées par des symboles alphanumériques discrets ou des étiquettes lexicales (par exemple les modalités de choix forcé : « OPTION_A », « OPTION_B », « OPTION_C »). Le calcul de la distance de Hamming entre deux séquences de ce type, agencées verticalement dans les plages A2:A30 et B2:B30, s’exécute à l’aide de la même syntaxe directe :
=SOMMEPROD(–(A2:A30 <> B2:B30))
Néanmoins, une attention méthodologique extrême doit être portée aux conventions d’interprétation internes du moteur de calcul d’Excel quant à la typographie textuelle. Par défaut, l’opérateur d’égalité standard (=) ainsi que l’opérateur de divergence (<>) d’Excel sont totalement insensibles à la casse (case-insensitive). Cela implique qu’une cellule contenant la chaîne « ALPHA » et sa vis-à-vis hébergeant la chaîne « alpha » seront considérées par cet algorithme comme parfaitement équivalentes et concorderont sans générer de pénalité de distance.
Dans la majorité des contextes d’analyse psychométrique standardisée, cette tolérance typographique constitue un avantage ergonomique indéniable, car elle permet d’absorber d’éventuelles hétérogénéités accidentelles de saisie sans compromettre l’évaluation sémantique. Toutefois, dans les protocoles nécessitant une discrimination fine de codes sensibles à la typographie (par exemple la différenciation entre allèles dominants notés en majuscules et récessifs en minuscules dans des études psycho-génétiques), cette insensibilité native constitue un biais d’analyse rédhibitoire.
7.2 Gestion de la sensibilité à la casse avec la fonction EXACT
Afin de restaurer une rigueur métrologique absolue face à des séquences textuelles où la casse porteuse de signification morphologique doit être impérativement discriminée, il est indispensable de convoquer la fonction EXACT. Contrairement aux opérateurs arithmético-logiques classiques, EXACT procède à une vérification binaire caractère par caractère en respectant scrupuleusement la table des codes ASCII/Unicode de chaque glyphe, distinguant sans ambiguïté une majuscule d’une minuscule.
Pour intégrer ce niveau de granularité au sein d’une formule globale de distance de Hamming calculant le volume d’incohérences typographiques entre les plages A2:A30 et B2:B30, la syntaxe doit être structurée comme suit :
=SOMMEPROD(–NON(EXACT(A2:A30; B2:B30)))
Le cheminement algorithmique de cette expression avancée se décompose avec une grande cohérence :
- La fonction EXACT(A2:A30; B2:B30) confronte les cellules paires par paires et génère une matrice vectorielle où la valeur VRAI est allouée exclusivement si les chaînes coïncident à la fois dans leur contenu alphabétique et dans leur conformation de casse.
- La fonction logique NON inverse immédiatement les résultats booléens générés : les identités parfaites deviennent FAUX et les divergences de casse ou de contenu deviennent VRAI.
- Le double opérateur unaire — convertit ces états de divergence en entiers numériques unitaires (1 pour une divergence, 0 pour une égalité stricte).
- La fonction SOMMEPROD agrège l’ensemble, délivrant une distance de Hamming sensible à la casse irréprochable.
7.3 Calcul de la distance de Hamming au sein d’une seule cellule pour deux chaînes
Il est fréquent, lors de l’extraction de données depuis des dispositifs d’enregistrement automatisés ou des fichiers de séquençage, que les vecteurs d’observation ne soient pas préalablement dispatchés dans des cellules indépendantes, mais se trouvent condensés sous la forme d’une chaîne de caractères unitaire continue au sein d’une cellule unique (par exemple la chaîne textuelle « ACTGCTTG » localisée en A1 et la séquence « ATTGCATG » située en B1).
Dans ce scénario, appliquer directement les formules précédentes est voué à l’échec, car Excel traiterait la chaîne entière comme un unique élément scalaire et renverrait une distance binaire de 1 si un seul caractère diffère, au lieu de quantifier le nombre précis de mutations ponctuelles. Il devient nécessaire de déconstruire dynamiquement la chaîne caractère par caractère en mémoire vive à l’aide d’une formule matricielle combinant STXT, LIGNE et INDIRECT :
=SOMMEPROD(–(STXT(A1; LIGNE(INDIRECT(« 1: » & NBCAR(A1))); 1) <> STXT(B1; LIGNE(INDIRECT(« 1: » & NBCAR(A1))); 1)))
Cette construction algorithmique déploie un mécanisme ingénieux :
- L’instruction NBCAR(A1) calcule la longueur intrinsèque (N) de la séquence textuelle.
- L’assemblage INDIRECT(« 1: » & NBCAR(A1)) génère une référence textuelle virtuelle matérialisant une plage allant de la ligne 1 à la ligne (N).
- La fonction LIGNE(…) convertit cette référence en un vecteur d’indices séquentiels entiers : {1; 2; 3; …; N}.
- La fonction STXT(A1; {1; 2; 3; …; N}; 1) extrait de manière isolée chaque caractère de la chaîne à sa position ordonnée respective, produisant un vecteur vertical composé des lettres individualisées.
- La comparaison relationnelle d’inégalité <> confronte ensuite terme à terme chaque lettre extraite de A1 avec son homologue positionnel issu de B1.
- Enfin, la sommation par SOMMEPROD totalise les divergences élémentaires constatées, délivrant la distance de Hamming exacte entre deux chaînes confinées dans des cellules isolées.
8. Gestion rigoureuse des valeurs manquantes et incohérences vectorielles
8.1 Impact des cellules vides sur le résultat de la formule
L’écueil le plus critique susceptible de compromettre la validité des calculs de dissimilarité réside dans l’intrusion non contrôlée de données manquantes (cellules vides) au sein des vecteurs de réponse. En psychologie clinique comme en sociologie empirique, il est exceptionnel qu’une passation de test ne souffre d’aucune omission de la part des participants. Or, les mécanismes de conversion implicite d’Excel adoptent un comportement par défaut qui introduit des biais mathématiques pernicieux.
Lorsqu’une cellule vierge est engagée dans une comparaison d’inégalité logique avec une cellule contenant une valeur numérique explicite, Excel n’interrompt pas le calcul en déclenchant un message d’erreur : il assimile silencieusement la cellule vide à la valeur numérique zéro (0). Si le vecteur d’observation utilise déjà la codification 0 pour désigner l’absence d’un symptôme ou un choix de réponse négatif, l’omission d’une réponse par un participant sera abusivement reconnue comme une réponse « 0 » valide. Cette confusion crée artificiellement des concordances illusoires si l’autre sujet a effectivement répondu 0, ou des discordances factices s’il a répondu 1, altérant substantiellement la fidélité de la distance de Hamming.
De surcroît, si les deux cellules comparées à une position donnée sont simultanément vides suite à une omission commune des deux participants, l’évaluation (CelluleVide = CelluleVide) sera évaluée comme VRAI, comptabilisant un accord psychologique authentique là où ne réside en réalité qu’un déficit bilatéral d’information. Dès lors, toute tentative d’analyser la proximité comportementale d’individus sans assainir préalablement les séries est vouée à l’invalidation méthodologique.
8.2 Stratégies d’exclusion des paires incomplètes (Pairwise Deletion)
Pour neutraliser rigoureusement le biais introduit par les omissions partielles, la stratégie métrologique de référence est l’exclusion par paire (pairwise deletion). Ce principe postule qu’une coordonnée vectorielle (i) ne doit être admise dans le calcul de la distance de Hamming que si et seulement si les deux sujets présentent simultanément une observation documentée et non vide à cette position.
Cette double condition de complétude peut être élégamment intégrée à l’intérieur même des arguments de la fonction SOMMEPROD en exploitant les propriétés de la multiplication booléenne, qui agit fonctionnellement comme un opérateur logique ET :
=SOMMEPROD((A2:A30 <> « ») * (B2:B30 <> « ») * (A2:A30 <> B2:B30))
Dans cette structure polyvalente, le premier terme (A2:A30 <> « ») s’assure que la cellule du premier sujet contient une donnée ; le second terme (B2:B30 <> « ») valide la présence effective d’une réponse chez le second sujet ; et le troisième terme (A2:A30 <> B2:B30) évalue la divergence de contenu. L’opérateur de multiplication arithmétique (*) contraint la résultante à zéro dès lors qu’au moins l’une des trois conditions n’est pas remplie, filtrant automatiquement les paires incomplètes sans nécessiter le double unaire — (la multiplication convertissant déjà intrinsèquement les booléens en entiers).
Dès lors que des données ont été ignorées via cette procédure, le dénominateur servant à normaliser la distance ne peut plus reposer sur la taille totale théorique de la batterie LIGNES(A2:A30). Il doit obligatoirement être recalculé dynamiquement pour refléter le nombre effectif de paires valides examinées :
=SOMMEPROD((A2:A30 <> « ») * (B2:B30 <> « ») * (A2:A30 <> B2:B30)) / SOMMEPROD((A2:A30 <> « ») * (B2:B30 <> « »))
8.3 Contrôle d’erreur dynamique avec SI et ESTVIDE
Dans une optique de déploiement de feuilles de calcul au sein d’équipes de recherche élargies, il est indispensable de border la saisie par des verrous algorithmiques préventifs. Une formule de distance ne devrait jamais s’exécuter si l’intégrité vectorielle minimale n’est pas garantie, au risque de propager des conclusions erronées au fil des analyses statistiques ultérieures.
L’implémentation d’un test logique d’intégrité via la fonction SI permet de conditionner le déclenchement du calcul à la stricte concordance dimensionnelle des séries. Par exemple, si l’on souhaite s’assurer qu’aucun vecteur ne soit totalement dépourvu d’observations valides avant de lancer l’analyse, on peut encapsuler la formule dans une structure de garde :
=SI(OU(NBVAL(A2:A30)=0; NBVAL(B2:B30)=0); « Erreur : Vecteur incomplet »; SOMMEPROD(–(A2:A30 <> B2:B30)))
Pour prémunir le tableau contre les propagations d’erreurs en cascade générées par d’éventuelles valeurs aberrantes en amont (telles que les erreurs de calcul division par zéro ou références brisées), l’encapsulation terminale par la fonction SIERREUR représente une règle de bonne pratique essentielle :
=SIERREUR(SOMMEPROD(–(A2:A30 <> B2:B30)); « Incohérence des plages »)
Cette démarche de sécurisation garantit que l’utilisateur final soit immédiatement alerté en présence d’un dysfonctionnement structurel dans les données d’entrée, assurant une parfaite traçabilité des anomalies conformément aux standards de qualité méthodologique préconisés en recherche académique.
9. Calculs avancés avec les fonctions dynamiques d’Excel 365 et Excel 2021
9.1 Utilisation de la fonction SOMME avec propagation matricielle dynamique
L’avènement du moteur de calcul matriciel dynamique — introduit initialement dans les versions de souscription de Microsoft 365 et pérennisé dans les déclinaisons autonomes depuis Excel 2021 — a profondément modernisé la gestion des opérations sur tableaux de données. La distinction historique entre formules standard et formules matricielles validées par Ctrl + Maj + Entrée s’est effacée au profit d’un environnement où toute formule manipulant des étendues vectorielles est nativement reconnue comme matricielle par le processeur d’évaluation.
Cette transformation majeure rend superflue l’utilisation quasi-dogmatique de la fonction SOMMEPROD pour les calculs paritaires simples. Désormais, la fonction basique SOMME assure avec une efficience algorithmique supérieure l’agrégation directe d’un tableau d’inégalités coercées par le double opérateur unaire :
=SOMME(–(A2:A20 <> B2:B20))
Le moteur moderne interprète spontanément l’argument interne –(A2:A20 <> B2:B20) comme un flux de données matricielles temporaire, exécute l’évaluation paritaire à l’échelle du processeur et transmet le vecteur d’entiers 0 et 1 directement à la fonction SOMME. Outre un allègement visuel substantiel de la syntaxe — ce qui renforce l’intelligibilité des classeurs pour les auditeurs et collaborateurs de recherche —, cette modernisation réduit marginalement l’empreinte mémoire requise lors des cycles de calcul itératifs volumineux.
9.2 Factorisation et lisibilité avec la fonction LET
L’une des innovations syntaxiques les plus marquantes apportées par les versions modernes d’Excel réside dans l’introduction de la fonction LET. Cette fonction offre la possibilité inédite d’assigner des noms de variables locaux à des expressions intermédiaires ou à des plages de données spécifiques directement à l’intérieur du corps de la formule, évitant la répétition fastidieuse des mêmes références de cellules au sein d’une équation complexe.
Dans le cadre du calcul d’une distance de Hamming normalisée et sécurisée contre les valeurs manquantes, la fonction LET permet de structurer le calcul comme un véritable mini-programme procédural d’une limpidité absolue :
=LET(
v1; A2:A20;
v2; B2:B20;
valides; (v1 <> « ») * (v2 <> « »);
divergences; valides * (v1 <> v2);
SI(SOMME(valides) = 0; 0; SOMME(divergences) / SOMME(valides))
)
L’optimisation procurée par cette approche est double : d’une part, l’analyste ne déclare les adresses des plages de données A2:A20 et B2:B20 qu’une unique fois au début de l’instruction, ce qui élimine quasi-totalement les erreurs humaines lors de la réaffectation des bornes spatiales ; d’autre part, le moteur de calcul mémorise le résultat des variables intermédiaires (telles que valides) et s’abstient de les réévaluer plusieurs fois, accélérant significativement la cadence d’exécution sur les modèles statistiques denses.
9.3 Création d’une fonction personnalisée et réutilisable avec LAMBDA
L’aboutissement ultime de la programmation fonctionnelle dans l’écosystème contemporain d’Excel s’incarne dans la fonction LAMBDA. Cette technologie permet aux chercheurs de concevoir leurs propres fonctions personnalisées, paramétrables et réutilisables à l’échelle de l’intégralité d’un classeur sans requérir une seule ligne de code VBA (Visual Basic for Applications) et sans imposer l’enregistrement du document sous le format risqué de macro (.xlsm).
Pour concevoir la fonction dédiée HAMMING_DIST, le modélisateur définit en premier lieu sa structure théorique à l’aide de l’opérateur LAMBDA :
=LAMBDA(vecteur_x; vecteur_y; SOMME(–(vecteur_x <> vecteur_y)))
L’implémentation opérationnelle de cette abstraction se déroule selon le protocole suivant :
- Accéder à l’onglet Formules du ruban Excel, puis cliquer sur l’icône Gestionnaire de noms.
- Créer un Nouveau nom, renseigner rigoureusement l’identifiant lexical HAMMING_DIST dans le champ de désignation.
- Dans le champ de référence Fait référence à, coller avec exactitude la formule LAMBDA préalablement rédigée :
=LAMBDA(vecteur_x; vecteur_y; SOMME(--(vecteur_x <> vecteur_y))). - Valider la configuration en cliquant sur OK et refermer le gestionnaire.
Dès cet instant, la fonction se comporte comme n’importe quelle commande native du logiciel. Il suffit désormais d’écrire dans n’importe quelle cellule du document :
=HAMMING_DIST(A2:A20; B2:B20)
pour obtenir instantanément la mesure de divergence. Cette abstraction logicielle garantit une étanchéité totale entre la logique formelle de l’algorithme et la topographie des données d’entrée, conférant aux classeurs d’analyse une élégance architecturale et une robustesse dignes des environnements professionnels d’ingénierie logicielle.
10. Génération d’une matrice complète de distances de Hamming inter-individus
10.1 Conception de l’architecture matricielle dans Excel
L’analyse typologique de cohortes comportementales requiert fréquemment l’évaluation exhaustive de l’ensemble des proximités paritaires au sein d’un groupe, formalisée sous la forme d’une matrice de dissimilarité carrée symétrique d’ordre (M times M), où (M) désigne le nombre total de participants évalués. Dans cette grille matricielle, chaque intersection d’une ligne (i) et d’une colonne (j) héberge la distance de Hamming séparant le participant (i) du participant (j).
Pour construire une telle architecture dans Excel, les données brutes doivent préalablement être organisées de manière rigoureuse dans une première feuille de calcul : les identifiants uniques des sujets sont consignés dans la première colonne, tandis que leurs vecteurs de réponses respectifs sont disposés horizontalement sur des lignes contiguës (par exemple de la colonne B à la colonne U pour 20 items psychométriques). Dans une seconde feuille d’analyse, l’analyste configure la grille matricielle en reportant les mêmes identifiants de participants à la fois sur l’en-tête vertical (axe des ordonnées) et sur l’en-tête horizontal (axe des abscisses).
La matrice résultante doit posséder des propriétés topologiques incontournables :
- La diagonale principale (les coordonnées où (i = j)) doit être uniformément constituée de zéros, traduisant la distance nulle séparant un individu de lui-même en vertu de l’axiome de séparation métrique.
- La symétrie bilatérale : la cellule située en ligne (i) et colonne (j) doit comporter une valeur rigoureusement identique à celle positionnée en ligne (j) et colonne (i), reflétant le caractère non orienté de la distance de Hamming classique.
Pour optimiser l’effort de calcul sur les grands échantillons, certains statisticiens choisissent de ne renseigner que la matrice triangulaire inférieure ou supérieure, masquant les cellules redondantes.
10.2 Formulation adaptée pour l’étirement bidirectionnel
Le défi majeur de l’implémentation matricielle réside dans la conception d’une formule maîtresse capable d’être déployée simultanément vers la droite et vers le bas sur des milliers de cellules sans exiger la moindre retouche manuelle de coordonnées. Pour relever ce défi, il est nécessaire d’articuler un ancrage spatial rigoureux au moyen du symbole dollar ($) conjugué à l’usage des fonctions d’indexation dynamique comme INDEX.
Supposons que notre table de données brutes se trouve sur la feuille Donnees, dans la plage B2:U51 (représentant les réponses de 50 participants à 20 items). Sur la feuille Matrice, l’analyste positionne les indices de ligne des participants (de 1 à 50) dans la colonne A (de A2 à A51) et les indices de colonne (de 1 à 50) sur la ligne 1 (de B1 à AY1). La formule matricielle universelle à inscrire dans la cellule B2 s’énonce ainsi :
=SOMMEPROD(–(INDEX(Donnees!$B$2:$U$51; $A2; 0) <> INDEX(Donnees!$B$2:$U$51; B$1; 0)))
L’efficacité de cette construction repose sur une propriété fondamentale de la fonction INDEX : lorsqu’on lui assigne une valeur d’argument de colonne égale à 0, elle ne renvoie pas une cellule scalaire isolée, mais extrait l’intégralité de la ligne spécifiée sous la forme d’un vecteur horizontal continu. Ainsi :
- Le segment INDEX(Donnees!$B$2:$U$51; $A2; 0) extrait le profil complet du sujet désigné par l’indice fixé en colonne A. L’ancrage mixte $A2 bloque la colonne lors de l’étirement vers la droite tout en libérant la ligne lors de l’étirement vers le bas.
- Le segment INDEX(Donnees!$B$2:$U$51; B$1; 0) extrait le profil du sujet référencé sur la ligne d’en-tête 1. L’ancrage mixte B$1 libère la colonne lors de l’étirement horizontal mais fige la référence à la ligne d’en-tête lors de la copie verticale.
En étirant cette cellule unique sur l’ensemble du quadrillage 50×50, la matrice de dissimilarité s’auto-génère intégralement en quelques fractions de seconde, avec des zéros parfaits sur la diagonale et une symétrie rigoureuse des scores de distance.
10.3 Automatisation de la matrice par Power Query
Lorsque la cohorte dépasse quelques centaines de participants, la prolifération de milliers de formules matricielles SOMMEPROD au sein de la grille de calcul est susceptible d’entraîner une dégradation sensible des performances de recalcul du classeur. Dans ce contexte de données volumineuses, l’exploitation du moteur ETL intégré Power Query constitue une alternative d’une grande puissance computationnelle.
Le protocole d’automatisation via Power Query s’articule autour des étapes suivantes :
- Charger le tableau des réponses des participants au sein de l’éditeur Power Query en le déclarant comme Table structurée.
- Générer une copie conforme de cette requête sous un second nom de table.
- Opérer une Fusion de requêtes croisée (produit cartésien complet) entre la table d’origine et sa réplique, associant chaque individu (i) à tous les individus (j) de la base sans exception.
- Développer les colonnes fusionnées pour mettre en regard les réponses respectives des paires de sujets sur chaque item.
- Ajouter une colonne personnalisée exécutant un code de calcul vectoriel en langage M, mesurant la quantité d’attributs non concordants entre les enregistrements appariés :
List.Sum(List.Transform(List.Zip({[Reponses_Sujet1], [Reponses_Sujet2]}), each if _{0} <> _{1} then 1 else 0)). - Appliquer une étape de Pivotement de colonnes en sélectionnant l’identifiant du second participant comme en-têtes et la valeur calculée de dissimilarité comme valeur d’agrégation.
Une fois la requête finalisée, le résultat est chargé dans la feuille de calcul sous la forme d’un tableau de données statique et optimisé. Cette méthode dissocie totalement l’effort computationnel lourd — relégué au moteur Power Query en arrière-plan — de la feuille de travail, restituant une réactivité instantanée au classeur tout en permettant une actualisation d’un simple clic lors de l’adjonction de nouvelles données expérimentales.
11. Visualisation et interprétation des résultats dans une optique psychométrique
11.1 Cartographie thermique via la mise en forme conditionnelle
La génération brute d’une matrice numérique de distances de Hamming d’ordre 50×50 confronte l’analyste à un ensemble dense de 2500 valeurs numériques, au sein duquel il est cognitivement ardu de discerner des régularités phénotypiques à l’œil nu. L’application d’une carte thermique (heatmap) via le moteur de Mise en forme conditionnelle d’Excel constitue un instrument visuel d’une efficacité redoutable pour révéler instantanément l’architecture structurale des données.
Pour implémenter cette cartographie sémiotique, il convient de sélectionner l’intégralité du corps numérique de la matrice de distance (en excluant les libellés d’en-têtes), puis d’accéder au menu Mise en forme conditionnelle > Nuances de couleurs. Une échelle tricolore continue de type Vert-Jaune-Rouge (ou idéalement un dégradé monochromatique perceptuellement uniforme allant du bleu profond au blanc cassé pour éviter les biais de discrimination chromatique) doit être appliquée :
- Les valeurs minimales (proches de 0, représentant une consonance presque parfaite des profils de réponses) sont assignées à une tonalité froide ou saturée (par exemple un vert sombre ou un bleu profond).
- Le point médian (correspondant à la divergence moyenne observée dans l’échantillon) adopte une nuance neutre atténuée (jaune pâle ou gris clair).
- Les valeurs maximales (matérialisant une opposition polaire des patrons décisionnels) sont teintées de rouge ou d’une nuance contrastée très claire.
Sous cette mise en scène chromatique, les grappes d’individus partageant des fonctionnements psychométriques homogènes apparaissent immédiatement sous la forme de blocs carrés denses et sombres le long de la diagonale principale (après réorganisation typologique des lignes). Inversement, les sujets isolés ou atypiques se distinguent par des traînées transversales lumineuses d’une netteté frappante, orientant immédiatement l’attention du chercheur vers les données méritant une inspection qualitative approfondie.
11.2 Interprétation quantitative : distances moyennes et indices de dispersion
Au-delà de l’inspection visuelle globale, l’exploitation statistique de la matrice de Hamming permet de dériver des indicateurs quantitatifs individuels fondamentaux pour la modélisation psychométrique. Le premier de ces métriques est la distance de Hamming moyenne d’un participant par rapport à l’ensemble de son groupe d’appartenance, calculée simplement en moyennant les cellules de sa ligne matricielle respective (à l’exclusion de l’auto-distance nulle de la diagonale) :
=(SOMME(B2:AY2) – 0) / (COLONNES(B2:AY2) – 1)
Cet indicateur quantifie rigoureusement ce que l’on nomme en psychométrie l’indice d’atypicité phénotypique ou de non-conformité structurelle. Un participant présentant une distance moyenne significativement plus faible que la moyenne générale du groupe incarne le profil archétypal ou le barycentre comportemental de la population étudiée. Ses réponses reflètent fidèlement le consensus normatif partagé par ses pairs.
À l’opposé, un individu dont la distance moyenne dépasse de plus de deux écarts-types la moyenne globale de la cohorte constitue une singularité clinique manifeste. Cette déviance quantitative peut trouver son origine dans une psychopathologie spécifique, une tentative de falsification de profil (faking good / faking bad) ou une incompréhension systématique des consignes de passation. L’agrégation globale des variances de ces distances individuelles permet par ailleurs de dériver un indice d’hétérogénéité sociométrique globale particulièrement précieux pour mesurer la cohésion ou la divergence d’attitudes au sein d’équipes de travail ou d’organisations.
11.3 Exportation des matrices pour analyses multivariées
Si Excel offre un cadre opérationnel incomparable pour la consolidation, le nettoyage, le calcul initial et l’inspection heuristique de la matrice de Hamming, certaines analyses multidimensionnelles avancées nécessitent l’appui de moteurs algorithmiques spécialisés. C’est tout particulièrement le cas du positionnement multidimensionnel non métrique (Multidimensional Scaling ou MDS) et de la classification ascendante hiérarchique (CAH), qui visent à projeter la matrice de dissimilarités dans un espace factoriel géométrique réduit à deux ou trois dimensions pour visualiser spatialement les proximités psychologiques.
Pour assurer une passerelle sans friction vers des environnements spécialisés tels que le package vegan ou cluster sous le logiciel R, ou le module scikit-learn sous Python, la matrice calculée dans Excel doit être conditionnée selon des standards typographiques rigoureux :
- Éliminer impérativement toute formule vivante en réalisant un Copier > Collage spécial par valeurs pour figer les résultats numériques et prévenir des recalculs accidentels lors du changement d’environnement.
- S’assurer que la matrice soit rigoureusement carrée ((M times M)) et que les en-têtes de colonnes coïncident strictement avec les en-têtes de lignes.
- Remplacer toute mention éventuelle de valeurs manquantes résiduelles ou de chaînes textuelles d’erreurs par des valeurs de remplissage conventionnelles compatibles (telles que
NAsous R). - Exporter la feuille matricielle sous un format texte délimité universel, préférentiellement un format CSV encodé en UTF-8 avec séparateur tabulation ou virgule standardisée.
Une fois importée dans ces environnements, la matrice de Hamming conçue dans Excel devient le substrat analytique d’arbres phylogénétiques comportementaux, de dendrogrammes de classification clinique ou de cartes factorielles spatiales, attestant de la complémentarité vertueuse entre le tableur pour la préparation analytique et les logiciels de script pour l’analyse multivariée poussée.
12. Erreurs courantes, diagnostic et optimisation des performances de calcul
12.1 Résolution des erreurs de syntaxe et de dimensions (#VALEUR!, #N/A)
Lors de l’élaboration de protocoles de calcul de dissimilarité dans Excel, l’apparition de messages d’erreurs logiques signale généralement des dysfonctionnements topologiques dans la déclaration des plages vectorielles. L’erreur la plus ubiquitaire en matière de calcul matriciel est l’écueil #VALEUR!. Dans 95% des situations d’analyse sous SOMMEPROD, cette anomalie est déclenchée par un désalignement dimensionnel entre les deux plages comparées.
Si l’analyste déclare la formule =SOMMEPROD(–(A2:A31 <> B2:B30)), la première plage comporte 30 coordonnées tandis que la seconde n’en compte que 29. Le moteur vectoriel d’Excel, incapable de trouver un homologue paritaire pour la cellule A31, se heurte à une impossibilité de diffusion matricielle et renvoie instantanément #VALEUR!. La résolution de ce problème exige un contrôle strict de la symétrie des plages via l’évaluation préventive LIGNES(PLAGE1) = LIGNES(PLAGE2).
Une seconde anomalie récurrente concerne l’incompatibilité des séparateurs d’arguments selon la configuration linguistique du système d’exploitation. Dans les environnements francophones (Canada excepté), le séparateur d’arguments officiel au sein des formules Excel est le point-virgule (;), la virgule étant dévolue à la séparation décimale arithmétique. L’utilisation accidentelle de virgules (issue de la transposition mécanique de snippets de code glanés dans des publications anglophones) provoque des erreurs de syntaxe immédiates bloquant la validation de la formule. Enfin, lors de l’assemblage de matrices de distance carrées, l’inclusion involontaire de la cellule d’évaluation elle-même au sein de la plage de référence génère des références circulaires destructrices, neutralisant le recalcul automatique du classeur.
12.2 Gestion des espaces invisibles et caractères non imprimables
Une pathologie insidieuse affectant fréquemment les données issues d’extractions web ou de formulaires de passation en ligne réside dans la présence de caractères invisibles parasitant les chaînes de texte. Le coupable le plus fréquemment identifié est l’espace insécable (espace non sécable, encodé sous le code ASCII décimal 160 ou en entité HTML ), couramment intercalé par les navigateurs internet pour des impératifs d’affichage typographique.
Confrontée à un espace insécable positionné à la fin d’une modalité de réponse (par exemple la chaîne "Accord " en cellule A2 comparée à la chaîne standard "Accord" en cellule B2), la fonction SUPPRESPACE standard d’Excel échoue totalement à corriger l’anomalie. Par conception historique, la fonction SUPPRESPACE est programmée pour ne cibler et ne purger exclusivement que l’espace typographique classique issu du code ASCII 32. Les deux chaînes continuent dès lors d’être déclarées discordantes par l’opérateur <>, générant des fausses distances de Hamming massives.
Pour immuniser définitivement le jeu de données contre cette altération cryptique, il est nécessaire d’appliquer une formule d’assainissement avancée combinant la fonction SUBSTITUE, la fonction CAR et la fonction EPURAGE (qui neutralise les codes de contrôle non imprimables de 0 à 31) :
=SUPPRESPACE(EPURAGE(SUBSTITUE(A2; CAR(160); » « )))
Cette expression opère la transmutation systématique de tous les espaces insécables 160 en espaces normaux 32, lesquels sont immédiatement éliminés par la fonction SUPPRESPACE englobante. L’exécution de ce protocole sur les colonnes de données sources garantit que seules des différences sémantiques réelles soient ultérieurement quantifiées par la métrique de Hamming.
12.3 Optimisation des performances sur des volumétries massives
Bien que le moteur de calcul d’Excel soit d’une vélocité remarquable, le déploiement de matrices de dissimilarité complètes sur des cohortes d’envergure expose l’application à des ralentissements exponentiels. Si l’on souhaite construire une matrice carrée pour un échantillon expérimental de 1 000 participants évalués sur 100 variables, le tableau requiert l’évaluation simultanée d’un million de cellules individuelles, chacune exécutant un produit vectoriel de dimension 100. Cette configuration impose 100 millions d’opérations élémentaires de comparaison à chaque cycle de recalcul.
Pour prévenir le gel de la station de travail, plusieurs mesures d’optimisation d’ingénierie tabulaire doivent être adoptées :
- Accéder aux options de calcul du tableur (Fichier > Options > Formules) et basculer temporairement le Mode de calcul en Manuel. Cette manipulation fondamentale empêche Excel de relancer l’évaluation intégrale de la matrice à chaque modification ponctuelle d’une cellule, le chercheur déclenchant le calcul délibérément via la touche F9 uniquement lorsque les saisies sont stabilisées.
- Supprimer toute fonction volatile (telle que INDIRECT, DECALER ou AUJOURDHUI) à l’intérieur des formules itératives, ces fonctions forçant la réévaluation de l’arbre de calcul complet même si les données sous-jacentes n’ont subi aucune modification.
Pour les scénarios extrêmes où la volumétrie dépasse les capacités d’évaluation dynamique des formules de cellules, l’externalisation du calcul au sein d’une procédure VBA (Visual Basic for Applications) opérant intégralement en mémoire vive via des tableaux virtuels (arrays) constitue la solution de performance ultime. L’exécution d’un script VBA optimisé transfère les données brutes dans la mémoire RAM, accomplit la double boucle séquentielle en code machine sans toucher aux cellules graphiques de la feuille, puis restitue la matrice complète en une unique écriture globale :
Dans un module standard, l’implémentation de la routine s’articule comme suit : la macro charge l’intégralité de la table de données d’entrée au sein d’une variable Variant mémoire (TableauData = Range("B2:U1001").Value), instancie une matrice bidimensionnelle de résultats de dimension 1000×1000 (ReDim MatriceDist(1 To 1000, 1 To 1000)), puis exécute deux boucles imbriquées For i = 1 To 1000 et For j = i + 1 To 1000 pour calculer les écarts paritaires et exploiter la symétrie MatriceDist(j, i) = MatriceDist(i, j). Enfin, la plage réceptrice est remplie instantanément par assignation directe (Range("B2").Resize(1000, 1000).Value = MatriceDist). Cette approche réduit le délai de traitement de plusieurs dizaines de minutes sous formules vivantes à moins de deux secondes d’exécution computationnelle pure, garantissant une efficacité industrielle au traitement des données comportementales les plus volumineuses.
Références
- Hamming, R. W. (1950). Error detecting and error correcting codes. Bell System Technical Journal, 29(2), 147–160. https://doi.org/10.1002/j.1538-7305.1950.tb00463.x
- Levenshtein, V. I. (1966). Binary codes capable of correcting deletions, insertions, and reversals. Soviet Physics Doklady, 10(8), 707–710.
- American Psychiatric Association. (2013). Diagnostic and statistical manual of mental disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
- Borg, I., & Groenen, P. J. F. (2005). Modern multidimensional scaling: Theory and applications (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28981-X
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.
- Kaufman, L., & Rousseeuw, P. J. (2009). Finding groups in data: An introduction to cluster analysis. John Wiley & Sons. https://doi.org/10.1002/9780470316801
- Legendre, P., & Legendre, L. (2012). Numerical ecology (3rd English ed.). Elsevier Science BV.
- Sneath, P. H. A., & Sokal, R. R. (1973). Numerical taxonomy: The principles and practice of numerical classification. W. H. Freeman.