
L’estimation des paramètres au sein des modèles linéaires par la méthode des moindres carrés ordinaires repose sur un ensemble d’hypothèses distributionnelles et structurelles fondamentales dont la violation compromet la validité des inférences statistiques. Parmi les menaces méthodologiques les plus insidieuses figure la présence d’observations singulières capables d’exercer une distorsion disproportionnée sur la trajectoire de l’hyperplan de régression. Dans les disciplines quantitatives contemporaines, qu’il s’agisse de l’économétrie, de la biostatistique ou de la psychométrie appliquée, l’analyste ne peut se contenter d’un examen superficiel des coefficients d’ajustement global. Il est impératif de procéder à un audit diagnostique granulaire visant à identifier les unités statistiques qui exercent un contrôle excessif sur les prédictions du modèle.
Parmi l’arsenal d’indicateurs développés au cours du second tiers du vingtième siècle pour sonder la robustesse locale des estimations, la statistique DFFITS, introduite initialement par David A. Belsley, Edwin Kuh et Roy E. Welsch dans leur ouvrage pionnier de 1980, s’impose comme une métrique de choix. En quantifiant directement la variation standardisée induite sur la valeur prédite d’un individu lorsque celui-ci est délibérément exclu du calibrage du modèle, le DFFITS fournit une mesure synthétique et élégante combinant l’écart résiduel de l’observation et sa position géométrique dans l’espace multidimensionnel des prédicteurs. Cette approche par suppression unitaire permet de démasquer des points qui, bien que ne paraissant pas nécessairement anormaux sur un diagramme de dispersion bivarié, altèrent substantiellement la structure prédictive globale.
Le présent article propose une exploration approfondie et exhaustive de la théorie, du calcul et de l’interprétation empirique de la statistique DFFITS au sein de l’environnement de programmation et d’analyse statistique R. À travers un protocole pas à pas alliant formulations mathématiques formelles, décompositions algorithmiques manuelles et utilisation des fonctions vectorisées natives de R, nous examinerons comment intégrer rigoureusement ce diagnostic dans les pipelines de recherche. Nous aborderons également les seuils critiques adaptés aux propriétés de l’échantillon, les stratégies de visualisation avancée, ainsi que les arbitrages méthodologiques et éthiques nécessaires face aux données aberrantes et influentes.
1. Introduction aux diagnostics de régression et à la métrique DFFITS
1.1 Notion d’influence et de levier en modélisation statistique
L’analyse rigoureuse des modèles de régression linéaire requiert une distinction conceptuelle fondamentale entre trois manifestations distinctes de l’atypicité des données : les valeurs aberrantes (outliers), les points de levier (leverage points) et les observations influentes (influential observations). Une valeur aberrante correspond classiquement à une observation dont la variable dépendante s’écarte substantiellement de la valeur attendue par le modèle conditionnel, générant ainsi un résidu de magnitude exceptionnelle. À l’inverse, un point de levier désigne une entité statistique occupant une position isolée ou extrême dans l’espace vectoriel formé par les variables prédictrices indépendantes, sans que sa réponse observée ne soit obligatoirement discordante par rapport à la droite de régression. L’effet de levier mesure donc un potentiel structurel d’altération du modèle, fonction exclusive des coordonnées dans l’espace des covariables.
L’observation influente, quant à elle, représente l’intersection opérationnelle ou la résultante dynamique de ces deux phénomènes. Une donnée n’est qualifiée d’influente que si son inclusion ou son omission modifie substantiellement les résultats statistiques fondamentaux du modèle, tels que la valeur des coefficients estimés, l’erreur standard résiduelle ou l’ensemble des valeurs ajustées. Dans le cadre de l’estimation par les moindres carrés ordinaires, le critère quadratique minimise la somme des carrés des résidus, conférant de facto un poids démesuré aux écarts importants. Par conséquent, un point combinant un levier élevé et un résidu non nul agit comme un point d’appui mécanique, attirant l’hyperplan vers lui et faussant la trajectoire générale de la relation modélisée.
Dans les sciences comportementales, sociales et psychométriques, la survenue de telles observations est fréquente en raison de l’hétérogénéité non observée, des comportements de réponse atypiques, de la fatigue expérimentale ou de simples bévues de saisie. Négliger la détection de ces cas singuliers menace directement l’intégrité des conclusions tirées des données d’échantillon. Un diagnostic post-estimation systématique n’est donc pas une simple formalité technique facultative, mais une étape indispensable garantissant la fiabilité des inférences, la reproductibilité des analyses et la validité interne des modèles empiriques déployés.
1.2 Origine conceptuelle et définition du DFFITS
La statistique DFFITS trouve son étymologie directe dans l’expression anglaise Difference in Fits, traduisible littéralement par la « différence d’ajustement ». Formalisée dans les travaux séminaux de David A. Belsley, Edwin Kuh et Roy E. Welsch consignés dans leur traité classique de 1980 intitulé Regression Diagnostics: Identifying Influential Data and Sources of Collinearity, cette mesure a été spécifiquement conçue pour évaluer l’impact marginal de la suppression d’une observation donnée sur sa propre prédiction. L’intuition théorique sous-jacente est d’une grande clarté : si le retrait d’un individu du jeu de données entraîne un déplacement substantiel de la valeur ajustée qui lui était assignée par le modèle, cet individu exerce alors une emprise déraisonnable sur le calibrage local de l’équation.
D’un point de vue fonctionnel, le DFFITS se définit formellement comme la différence standardisée entre la valeur ajustée pour l’observation i obtenue en utilisant l’intégralité de l’échantillon de taille n, et la valeur ajustée pour cette même observation issue d’un modèle réestimé sur l’échantillon réduit de taille n – 1 duquel la i-ème observation a été temporairement élaguée. L’opération de standardisation est opérée en divisant cet écart par une estimation rigoureuse de l’erreur type de la prédiction, calculée elle-même en omettant l’observation cible afin d’éviter toute contamination résiduelle de la variance d’erreur.
Contrairement à d’autres indicateurs qui fragmentent l’examen de l’influence en décomposant l’effet sur chaque coefficient individuel de régression, le DFFITS constitue un indicateur univarié synthétique de l’influence globale exercée sur la prédiction ponctuelle. Il offre ainsi à l’analyste un indice direct, condensé et élégant permettant de hiérarchiser immédiatement les observations selon la sévérité du trouble prédictif qu’elles injectent dans la structure globale du modèle linéaire paramétrique.
1.3 Pertinence du DFFITS dans la recherche empirique
L’utilité méthodologique du DFFITS dans la recherche empirique moderne s’étend bien au-delà de la simple vérification mathématique des conditions de régularité. Dans les protocoles cliniques ou les enquêtes probabilistes à grande échelle, cet indicateur agit comme un révélateur précieux de sous-populations non anticipées ou de cas cliniquement discordants. En repérant les sujets pour lesquels le modèle global échoue dramatiquement à fournir une prédiction stable en leur absence, le chercheur s’offre l’opportunité d’examiner en détail la plausibilité substantive des données recueillies et d’identifier de possibles biais d’échantillonnage ou des distorsions induites par des participants non représentatifs.
Sur le plan de l’inférence causale et prédictive, la présence d’individus présentant un DFFITS d’amplitude anormale a pour conséquence directe de gonfler artificiellement ou d’atténuer indûment les estimations des paramètres de régression, conduisant fréquemment à des erreurs de type I (faux positifs) ou de type II (faux négatifs). En stabilisant le modèle via l’examen rigoureux du DFFITS, on préserve la validité interne des estimations et on prévient la publication de relations fallacieuses qui échoueraient inéluctablement lors des tentatives ultérieures de réplication empirique sur des échantillons indépendants.
Enfin, dans le contexte actuel du déploiement d’algorithmes de prise de décision automatisés et d’architectures d’apprentissage statistique supervisé, où les modèles de type régression servent souvent de briques élémentaires ou de références interprétables, la robustesse aux données contaminées devient un enjeu opérationnel majeur. Le calcul systématique du DFFITS garantit que le modèle résultant ne reflète pas les particularités singulières d’une poignée d’individus excentriques, mais capture fidèlement les tendances structurelles sous-jacentes de la population cible.
2. Fondements théoriques et formulation mathématique du DFFITS
2.1 Décomposition mathématique de la formule
La formulation algébrique originelle du DFFITS pour une observation donnée indexée par la lettre i (avec i variant de 1 à n) repose sur la comparaison entre la prédiction complète, notée $\hat{y}_i$, issue de l’estimation sur la totalité de l’échantillon, et la prédiction avec omission, notée $\hat{y}_{(i)}$, calculée à partir des coefficients obtenus en excluant l’observation i. La formule brute s’exprime sous la forme du ratio suivant :
$$\text{DFFITS}_i = \frac{\hat{y}_i – \hat{y}_{(i)}}{\sqrt{s_{(i)}^2 h_{ii}}}$$
Dans cette formulation canonique, le dénominateur représente l’erreur type estimée de la valeur ajustée $\hat{y}_i$. Le terme $s_{(i)}^2$ désigne la variance résiduelle estimée (l’erreur quadratique moyenne) du modèle ajusté sans la $i$-ème observation, garantissant une estimation non contaminée de la dispersion du bruit de fond. La grandeur $h_{ii}$ correspond au $i$-ème élément diagonal de la matrice de projection orthogonale, communément dénommée matrice chapeau (hat matrix), définie par l’opérateur matriciel $H = X(X^T X)^{-1} X^T$, où $X$ représente la matrice de dessein des variables explicatives complétée par une colonne unitaire pour la constante.
Grâce aux identités fondamentales de l’algèbre linéaire appliquées à la régression, il n’est heureusement pas requis de réestimer formellement n régressions distinctes pour évaluer chaque prédiction avec suppression. Le DFFITS peut être factorisé et réécrit sous une forme computationnelle exacte combinant deux grandeurs analytiques fondamentales :
$$\text{DFFITS}_i = rstudent_i \times \sqrt{\frac{h_{ii}}{1 – h_{ii}}}$$
Dans cette équation élégante, le premier facteur, $rstudent_i$, représente le résidu studentisé externe (également appelé résidu jackknife ou résidu supprimé standardisé), défini par :
$$rstudent_i = \frac{e_i}{s_{(i)} \sqrt{1 – h_{ii}}}$$
où $e_i = y_i – \hat{y}_i$ est le résidu brut ordinaire des moindres carrés. Le second facteur, quant à lui, est une fonction strictement monotone de la valeur de levier $h_{ii}$. Cette factorisation met en lumière la nature profonde du DFFITS : il s’agit du produit direct entre une mesure de la non-conformité de la réponse (l’écart résiduel standardisé hors modèle) et une mesure de l’éloignement de l’observation par rapport au centre de gravité des prédicteurs dans l’espace euclidien.
2.2 Propriétés distributionnelles et comportement asymptotique
L’analyse distributionnelle du DFFITS découle directement des propriétés probabilistes du résidu studentisé externe et des caractéristiques de la matrice chapeau. Sous l’hypothèse nulle d’un modèle correctement spécifié avec des erreurs gaussiennes indépendantes et identiquement distribuées, le résidu studentisé $rstudent_i$ suit rigoureusement une distribution t de Student à $n – p – 1$ degrés de liberté, où $p$ représente le nombre total de paramètres estimés dans le modèle (incluant la constante). En revanche, le facteur de levier $\sqrt{h_{ii} / (1 – h_{ii})}$ est une constante déterministe conditionnellement à la matrice de dessein fixée $X$.
Lorsque la taille de l’échantillon $n$ tend vers l’infini pour un nombre de paramètres $p$ constant, la trace de la matrice chapeau restant égale à $p$ ($\sum_{i=1}^n h_{ii} = p$), la valeur moyenne du levier individuel $\bar{h} = p/n$ converge asymptotiquement vers zéro. Par conséquent, pour une observation typique, le terme $\sqrt{h_{ii} / (1 – h_{ii})}$ décroît selon un ordre de grandeur en $\mathcal{O}(n^{-1/2})$. Il s’ensuit que les valeurs de DFFITS ont naturellement tendance à se contracter vers zéro à mesure que le volume de données augmente, rendant les seuils critiques dépendants de la taille de l’échantillon.
À l’inverse, l’émergence d’une forte multicolinéarité au sein de la matrice de dessein perturbe sévèrement les propriétés de la matrice $(X^T X)^{-1}$, conduisant à une inflation substantielle de certains termes diagonaux $h_{ii}$. Dans une telle configuration, de légères variations dans les réponses peuvent engendrer des valeurs de DFFITS artificiellement explosives pour les observations situées le long des axes de colinéarité, amplifiant la sensibilité du modèle à des perturbations infinitésimales des données d’entraînement.
2.3 Comparaison théorique avec la distance de Cook
Dans la littérature statistique consacrée aux diagnostics d’influence, le DFFITS est très fréquemment mis en perspective avec la distance de Cook, formulée initialement par R. Dennis Cook en 1977. Bien que ces deux métriques partagent l’objectif fondamental d’identifier les observations déstabilisatrices, elles procèdent d’architectures théoriques distinctes et adoptent des échelles de mesure différenciées.
La distance de Cook évalue le décalage quadratique moyen subi par le vecteur complet des valeurs ajustées de l’ensemble des n observations sous l’effet de l’omission d’un point spécifique. Sa formulation canonique s’écrit :
$$D_i = \frac{(\hat{Y} – \hat{Y}_{(i)})^T (\hat{Y} – \hat{Y}_{(i)})}{p , s^2} = \frac{r_i^2}{p} \times \frac{h_{ii}}{1 – h_{ii}}$$
où $r_i$ désigne le résidu studentisé interne (calculé en utilisant l’estimateur de variance global $s^2$ incluant la $i$-ème observation). En comparant cette expression avec celle du DFFITS, on observe une relation structurelle directe. Si l’on substitue le résidu interne par le résidu externe (qui lui est fonctionnellement très proche pour des échantillons de taille modérée à grande), on obtient l’équivalence fonctionnelle remarquable suivante :
$$D_i \approx \frac{\text{DFFITS}_i^2}{p}$$
Cette relation met en évidence les divergences opérationnelles fondamentales entre les deux instruments :
- Le DFFITS est une quantité orientée, conservant le signe algébrique de l’écart prédictif, ce qui permet d’identifier si l’observation tire la prédiction vers le haut ou vers le bas, tandis que la distance de Cook est une métrique purement quadratique, toujours positive.
- Le DFFITS se focalise exclusivement sur la prédiction de la seule observation supprimée ($\hat{y}_i$), constituant ainsi une mesure d’influence locale, alors que la distance de Cook agrège la répercussion de cette suppression sur les prédictions des $n$ individus composant l’échantillon.
- L’échelle d’évaluation du DFFITS varie typiquement avec la racine carrée du rapport $p/n$, alors que la distance de Cook est calibrée par rapport aux quantiles d’une distribution de Fisher $F(p, n-p)$.
3. Préparation de l’environnement de travail et des données dans R
3.1 Configuration de la session R et chargement des packages
L’implémentation opérationnelle des diagnostics de régression dans R bénéficie d’une architecture native particulièrement robuste intégrée directement dans le package de base stats. Ce dernier met à disposition de l’utilisateur des fonctions hautement optimisées ne requérant aucune dépendance externe obligatoire pour les calculs algébriques élémentaires. Toutefois, pour garantir une manipulation fluide des structures tabulaires et concevoir des représentations visuelles de qualité publication, l’analyste a tout intérêt à enrichir son espace de travail avec l’écosystème moderne de la science des données.
Nous mobiliserons ainsi les bibliothèques du métapaquet tidyverse, en particulier dplyr pour les opérations de transformation matricielle et de filtrage logique, ainsi que ggplot2 pour la grammaire graphique. De surcroît, le package spécialisé car (Companion to Applied Regression), développé par John Fox et Sanford Weisberg, fournit une gamme étendue d’outils d’audit diagnostique de haut niveau, facilitant les contrôles de multicolinéarité et la comparaison croisée des métriques.
Afin de préserver la parfaite reproductibilité des calculs et des graphiques générés tout au long de cet article, il convient de figer l’environnement de travail, de réinitialiser la graine du générateur de nombres pseudo-aléatoires et de vérifier l’intégrité des versions logicielles déployées :
# Configuration de la session R
set.seed(42)
options(scipen = 999, digits = 5)
library(stats)
library(dplyr)
library(ggplot2)
library(car)
L’activation de l’option scipen = 999 empêche l’affichage par défaut en notation scientifique pour les petites valeurs décimales, favorisant une lecture directe et intuitive des métriques calculées lors des sorties tabulaires en console.
3.2 Sélection et exploration du jeu de données
Pour illustrer de façon didactique et immédiatement reproductible l’ensemble des concepts théoriques exposés, nous exploiterons le jeu de données classique mtcars, extrait des données de consommation automobile publiées par le magazine Motor Trend en 1974. Bien que compact avec ses 32 observations et 11 attributs, ce jeu de données présente des particularités morphologiques idéales pour l’étude des diagnostics d’influence : hétérogénéité des modèles de véhicules, présence simultanée de modèles de sport très performants et de berlines économiques, ainsi que des niveaux d’effet de levier diversifiés sur plusieurs dimensions mécaniques.
Une inspection préliminaire rigoureuse de la structure interne des données constitue un prérequis incontournable avant tout travail d’ajustement. L’exécution des fonctions str() et summary() permet de circonscrire l’amplitude des variables continues d’intérêt :
# Exploration structurelle du jeu de donnees mtcars
data(mtcars)
str(mtcars)
summary(mtcars[, c(« mpg », « disp », « hp », « wt »)])
Dans notre cadre expérimental, nous nous intéresserons spécifiquement à la modélisation de la consommation énergétique exprimée en miles par gallon (variable mpg, constituant la réponse continue $Y$), en fonction de trois prédicteurs technologiques continus : la cylindrée du moteur en pouces cubes (disp), la puissance brute développée en chevaux-vapeur (hp) et la masse totale du véhicule exprimée en milliers de livres (wt). Ce sous-ensemble de variables garantit une interprétabilité physique claire tout en induisant des tensions structurelles suffisantes pour générer des points de levier substantiels.
3.3 Validation des prérequis pour la régression linéaire multiple
Préalablement à l’extraction et à l’interprétation des valeurs de DFFITS, il est méthodologiquement impératif de s’assurer que les conditions fondamentales autorisant l’usage de la régression linéaire multiple sont raisonnablement satisfaites. L’existence d’une relation non linéaire flagrante ou d’une singularité matricielle sévère vicierait d’emblée la pertinence de tout diagnostic d’influence, dans la mesure où le résidu d’une observation ne refléterait alors pas son atypicité intrinsèque mais une mauvaise spécification fonctionnelle du modèle théorique.
L’examen des diagrammes de dispersion bivariés entre chaque variable explicative et la réponse mpg confirme l’existence d’associations négatives globalement monotones. Afin de vérifier l’absence d’une multicolinéarité dévastatrice qui pourrait déstabiliser artificiellement l’inversion de la matrice de dessein $X^T X$, nous pouvons examiner la matrice des corrélations entre prédicteurs à l’aide de la syntaxe suivante :
# Matrice de correlation des variables explicatives
cor_matrix <- cor(mtcars[, c(« disp », « hp », « wt »)])
round(cor_matrix, 3)
Bien que des corrélations substantielles soient observées entre la cylindrée, le poids et la puissance moteur (phénomène attendu dans la construction automobile mécanique traditionnelle), le déterminant de la matrice demeure strictement positif, excluant tout risque de singularité computationnelle directe. L’infrastructure méthodologique est ainsi validée, autorisant le calibrage formel du modèle linéaire multiple.
4. Ajustement du modèle de régression linéaire multiple
4.1 Construction du modèle à l’aide de la fonction lm()
L’estimation des coefficients de régression par les moindres carrés ordinaires s’effectue dans R via la fonction fondamentale lm(). La syntaxe repose sur l’opérateur tilde (~), séparant la variable endogène à expliquer à gauche du symbole, de la spécification additive des covariables explicatives à droite :
# Estimation du modele de regression lineaire multiple
modele_cars <- lm(mpg ~ disp + hp + wt, data = mtcars)
summary(modele_cars)
L’assignation du résultat à l’objet modele_cars crée une structure de classe "lm" qui encapsule une multiplicité d’attributs mathématiques cruciaux, tels que les coefficients estimés, les résidus ordinaires, les degrés de liberté résiduels, ainsi que les éléments de décomposition QR de la matrice des variables prédictrices.
L’examen des coefficients issus de l’instruction summary() révèle l’orientation et l’amplitude des effets marginaux. L’équation de prédiction empirique prend la forme suivante :
$$\hat{\text{mpg}} = \beta_0 + \beta_{\text{disp}} \cdot \text{disp} + \beta_{\text{hp}} \cdot \text{hp} + \beta_{\text{wt}} \cdot \text{wt}$$
La statistique $t$ associée à chaque régresseur permet d’évaluer la significativité statistique individuelle des contributions conditionnelles, chaque coefficient décrivant la variation attendue de la consommation pour chaque accroissement d’une unité de la variable correspondante, toutes les autres variables du modèle étant maintenues rigoureusement constantes.
4.2 Évaluation globale de la qualité de l’ajustement
L’évaluation globale de la performance du modèle s’appuie sur la trilogie canonique constituée par le coefficient de détermination $R^2$, le coefficient de détermination ajusté $R^2_{\text{adj}}$, et la statistique globale de Fisher ($F$-test). Au sein de l’objet résumé de notre modèle modele_cars, ces indicateurs synthétisent la proportion de variance de la consommation absorbée par le sous-espace vectoriel linéaire défini par les variables prédictrices.
Le coefficient de détermination multiple $R^2$ mesure le rapport de la somme des carrés expliquée à la somme des carrés totale :
$$R^2 = 1 – \frac{\sum_{i=1}^n (y_i – \hat{y}_i)^2}{\sum_{i=1}^n (y_i – \bar{y})^2}$$
Dans notre spécification, ce paramètre oscille aux alentours de 0.826, attestant qu’environ 82.6 % de la dispersion observée de l’efficacité énergétique des véhicules est prise en compte par le modèle. Le coefficient ajusté $R^2_{\text{adj}}$, pénalisant le nombre de régresseurs introduits pour prévenir le surajustement mécanique, corrobore cette solide assise prédictive.
Parallèlement, la statistique globale $F$ teste l’hypothèse nulle conjointe $H_0 : \beta_{\text{disp}} = \beta_{\text{hp}} = \beta_{\text{wt}} = 0$. La $p$-valeur associée, très largement inférieure au seuil critique conventionnel $\alpha = 0.001$, confirme le rejet catégorique de cette hypothèse nulle. Enfin, l’erreur standard résiduelle (Residual Standard Error, notée RSE), qui quantifie l’écart quadratique moyen des observations autour de l’hyperplan ajusté avec $n – p = 32 – 4 = 28$ degrés de liberté, s’établit à une valeur modérée d’environ 2.6 miles par gallon.
4.3 Extraction des éléments clés nécessaires aux diagnostics
Pour mener à bien un audit diagnostique rigoureux, il est essentiel de désassembler les composantes de l’objet modele_cars. Plusieurs fonctions d’extraction génériques intégrées dans le socle de base de R permettent d’accéder directement aux éléments mathématiques nécessaires à la construction des métriques d’influence.
Nous pouvons notamment isoler le vecteur des prédictions internes (les valeurs ajustées $\hat{y}_i$) au moyen de la fonction fitted(), et le vecteur des résidus ordinaires bruts $e_i$ via la fonction residuals(). De même, les paramètres scalaires relatifs à la dimensionnalité du modèle peuvent être programmés de manière totalement dynamique :
# Extraction des grandeurs structurales du modele
valeurs_ajustees <- fitted(modele_cars)
residus_bruts <- residuals(modele_cars)
n_obs <- nrow(mtcars)
p_params <- length(coef(modele_cars)) # inclut la constante bo
degres_liberte <- df.residual(modele_cars)
Ces éléments constituent le substrat informatique sur lequel les algorithmes d’influence vont opérer. En conservant l’indexation nominale des lignes du tableau originel (ici, les dénominations exactes des modèles de véhicules), R assure une traçabilité sans faille entre les coordonnées matricielles abstraites et les entités physiques observées.
5. Calcul pas à pas des valeurs de DFFITS avec la fonction dffits()
5.1 Utilisation de la fonction dffits() intégrée à R
L’extraction standardisée des valeurs de DFFITS dans l’environnement R ne requiert aucun calcul complexe préalable grâce à la présence de la fonction native dffits() appartenant au package stats. Cette fonction implémente directement les algorithmes d’actualisation rapide basés sur la décomposition QR, permettant un calcul instantané sans qu’aucune boucle itérative coûteuse ne soit exécutée sur la machine hôte.
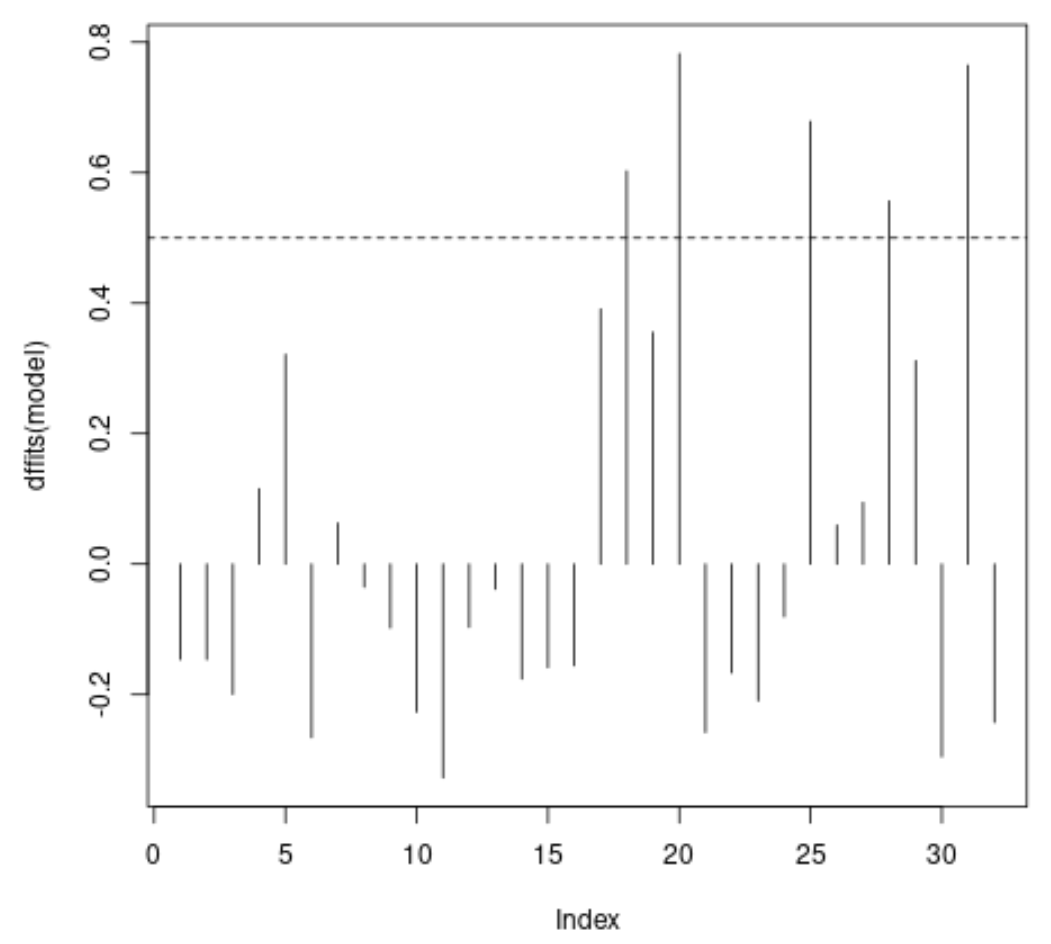
L’appel de la fonction s’effectue en lui transmettant simplement en argument l’objet de modélisation résultant de lm() :
# Calcul direct des valeurs de DFFITS
valeurs_dffits <- dffits(modele_cars)
head(valeurs_dffits, 10)
L’objet retourné est un vecteur numérique nommé à une dimension, dont la longueur correspond rigoureusement à la taille de l’échantillon $n$. Chaque élément vectoriel porte comme identifiant textuel le nom de l’observation correspondante, ce qui facilite les opérations de repérage et de manipulation ultérieure.
5.2 Structuration des résultats dans un tableau récapitulatif
Pour exploiter pleinement ces informations, la bonne pratique méthodologique consiste à agréger les grandeurs diagnostiques calculées au sein d’un tableau de données (data.frame ou tibble) regroupant les identifiants, les données empiriques réelles, les prédictions du modèle et les valeurs d’influence associées.
Le code suivant construit une structure tabulaire unifiée et trie les observations selon l’amplitude absolue de leur perturbation prédictive, permettant ainsi de faire émerger immédiatement les dix unités statistiques exerçant les tensions les plus prononcées :
# Structuration et hierarchisation tabulaire des resultats
diagnostic_df <- data.frame(
Vehicule = rownames(mtcars),
MPG_Reel = mtcars$mpg,
MPG_Predit = valeurs_ajustees,
Residu_Brut = residus_bruts,
DFFITS = valeurs_dffits,
Abs_DFFITS = abs(valeurs_dffits)
)
diagnostic_ordonne <- diagnostic_df %>%
arrange(desc(Abs_DFFITS))
# Visualisation des dix cas les plus singuliers
head(diagnostic_ordonne, 10)
Cette disposition tabulaire fournit un bilan de contrôle synthétique. Elle permet d’apprécier d’un simple coup d’œil si un véhicule particulier accumule un écart prédictif substantiel conjointement à une influence disproportionnée sur sa propre estimation.
5.3 Interprétation du signe algébrique du DFFITS
Contrairement aux mesures quadratiques globales d’influence, le DFFITS possède une orientation signée qui recèle une information diagnostique essentielle quant à la dynamique d’ajustement du point cible. Le signe du DFFITS découle directement du signe du résidu externe, lui-même aligné sur celui du résidu ordinaire $e_i = y_i – \hat{y}_i$.
Une valeur positive du DFFITS ($\text{DFFITS}_i > 0$) signifie que la valeur prédite complète $\hat{y}_i$ est supérieure à la prédiction avec suppression $\hat{y}_{(i)}$. En d’autres termes, la présence de l’observation i dans l’échantillon tire la surface de régression vers le haut au voisinage de ses coordonnées, de sorte que l’omission du point conduit à une prédiction amoindrie. La réponse réelle observée pour cet individu dépasse ce que la structure tendancielle des autres données prédisait, contraignant le modèle complet à ajuster ses estimations vers le haut pour tenter de réduire cet écart.
Réciproquement, une valeur négative du DFFITS ($\text{DFFITS}_i < 0$) atteste que la valeur prédite complète $\hat{y}_i$ est inférieure à la prédiction sans le point $\hat{y}_{(i)}$. L’observation exerce une attraction descendante sur l’hyperplan de régression. Si on retire ce point du calibrage, le modèle réestimé prédit une valeur plus élevée pour ce même ensemble de caractéristiques explicatives. L’analyste doit ainsi interpréter la magnitude absolue $|\text{DFFITS}_i|$ comme la force motrice de l’influence exercée, et le signe algébrique comme l’orientation vectorielle du déplacement imposé à la prédiction.
6. Calcul manuel et décomposition du DFFITS pour une validation théorique
6.1 Extraction des résidus studentisés externes
Afin de valider la compréhension théorique des mécanismes régissant le DFFITS et de s’émanciper d’une logique de boîte noire logicielle, il est hautement formateur de reconstituer manuellement cette métrique en programmant ses composants constitutifs élémentaires. La première étape consiste à extraire les résidus studentisés externes (résidus jackknife).
Dans R, la fonction dédiée rstudent() réalise cette opération en appliquant la formule de suppression unitaire de la variance résiduelle pour chaque observation :
# Extraction des residus studentises externes
residus_jackknife <- rstudent(modele_cars)
head(residus_jackknife, 5)
Sur le plan distributionnel, ces résidus permettent d’isoler la variance propre à l’observation examinée. Si un individu présente une valeur résiduelle extrêmement large, l’estimateur conventionnel de la variance résiduelle globale $s^2$ est artificiellement tiré vers le haut, ce qui tend à compresser indûment les résidus studentisés internes (phénomène de masquage statistique). En éliminant l’observation de l’estimation de l’erreur quadratique moyenne, le résidu externe $rstudent_i$ restaure une sensibilité optimale face aux anomalies singulières.
6.2 Calcul des valeurs de levier (hatvalues)
Le second pilier nécessaire à la reconstitution du DFFITS réside dans l’extraction des éléments diagonaux de la matrice de projection $H$, couramment dénommés poids de levier ou hat values ($h_{ii}$). Dans l’environnement R, ces valeurs s’obtiennent directement au moyen de la fonction vectorisée hatvalues() :
# Extraction des leviers diagonaux de la matrice chapeau
leviers_hii <- hatvalues(modele_cars)
head(leviers_hii, 5)
D’un point de vue géométrique, la grandeur $h_{ii}$ quantifie l’éloignement d’une observation par rapport au barycentre (le point moyen) du nuage de points formé par l’ensemble des prédicteurs dans l’espace $\mathbb{R}^p$. Elle est bornée par construction entre $1/n$ (dans un modèle avec constante) et 1. La somme totale des éléments diagonaux d’une matrice chapeau est invariablement égale au nombre de colonnes linéairement indépendantes de la matrice de dessein, soit la quantité exacte de coefficients $p$ :
$$\sum_{i=1}^n h_{ii} = \text{tr}(H) = p$$
Une valeur $h_{ii}$ particulièrement élevée signale une configuration morphologique rare ou excentrique des covariables, conférant mécaniquement à l’observation correspondante un levier géométrique considérable sur l’ajustement de la pente de régression.
6.3 Reconstitution algorithmique et vérification de la concordance
Disposant désormais du vecteur des résidus studentisés externes residus_jackknife et du vecteur des leviers leviers_hii, nous pouvons programmer l’équation de factorisation formelle et comparer les résultats obtenus à ceux renvoyés par la fonction standard dffits() :
# Reconstitution formelle de la formule mathematique
dffits_manuel <- residus_jackknife * sqrt(leviers_hii / (1 – leviers_hii))
# Comparaison analytique et controle de precision numerique
concordance <- all.equal(valeurs_dffits, dffits_manuel)
print(concordance)
L’exécution de la fonction all.equal() retourne la valeur booléenne TRUE, attestant que les écarts résiduels entre les deux approches se situent bien en deçà des limites de précision machine de la double précision virgule flottante (généralement inférieure à $10^{-15}$). Cet exercice apporte la preuve mathématique et computationnelle de l’équivalence stricte entre l’approche théorique par suppression séquentielle des lignes et la factorisation matricielle directe via les leviers et les résidus jackknife.
7. Établissement des seuils critiques d’influence
7.1 Seuils traditionnels recommandés par Belsley, Kuh et Welsch
L’évaluation quantitative du DFFITS nécessite une grille de décision objective permettant de distinguer les fluctuations statistiques naturelles des perturbations excessives exigeant une investigation méthodologique poussée. Dans leur publication fondatrice de 1980, David A. Belsley, Edwin Kuh et Roy E. Welsch ont proposé deux règles heuristiques distinctes selon la nature et l’envergure de l’échantillon analysé.
Pour les échantillons de taille modeste ou restreinte, les auteurs préconisent l’application d’un seuil empirique absolu fixe :
$$\text{Seuil}_{\text{petit}} = 1.0$$
Une valeur de $|\text{DFFITS}_i| > 1$ implique que le retrait de l’observation déplace sa propre valeur ajustée de plus d’un écart-type complet d’erreur prédictive, ce qui constitue une instabilité considérable pour un modèle linéaire paramétrique.
Néanmoins, pour les échantillons de taille moyenne à grande, l’accroissement continu du dénominateur d’échantillonnage $n$ a pour effet structurel de tasser mécaniquement les valeurs de levier $h_{ii}$. Dans ce cadre, un seuil fixe universel risquerait d’échouer à détecter des observations exerçant une influence relative très nette au sein de leur propre population. Les auteurs ont donc conçu un seuil dynamique dépendant de la dimensionnalité globale du modèle :
$$\text{Seuil}_{\text{grand}} = 2 \times \sqrt{\frac{p}{n}}$$
où $p$ désigne le nombre de coefficients estimés (y compris le terme constant) et $n$ le volume total d’observations. Ce seuil correspond approximativement au double de la valeur quadratique moyenne attendue sous l’hypothèse de dispersion homogène de l’influence parmi l’ensemble des données.
7.2 Calcul dynamique des seuils dans l’environnement R
L’automatisation du calcul du seuil dynamique constitue une excellente pratique algorithmique qui prévient les erreurs manuelles lors de modifications itératives de la structure des régresseurs ou de la taille de l’échantillon. Dans R, cette implémentation se programme en quelques lignes de syntaxe vectorisée :
# Calcul des parametres dimensionnels
n <- nrow(mtcars)
p <- length(coef(modele_cars))
# Determination des seuils critiques conventionnels
seuil_absolu <- 1.0
seuil_dynamique <- 2 * sqrt(p / n)
cat(« Taille de l’echantillon (n) : », n, « n »)
cat(« Nombre de parametres (p) : », p, « n »)
cat(« Seuil dynamique BKW (2*sqrt(p/n)) : », round(seuil_dynamique, 4), « n »)
Dans notre cas expérimental avec mtcars ($n = 32$, $p = 4$), la formule dynamique produit :
$$\text{Seuil}_{\text{dynamique}} = 2 \times \sqrt{\frac{4}{32}} = 2 \times \sqrt{0.125} \approx 0.7071$$
Nous pouvons alors procéder au filtrage programmatique des unités statistiques franchissant ce seuil critique :
# Identification des observations depassant le seuil dynamique
cas_influents <– diagnostic_df %>%
filter(Abs_DFFITS > seuil_dynamique) %>%
arrange(desc(Abs_DFFITS))
print(cas_influents[, c(« Vehicule », « DFFITS », « Abs_DFFITS »)])
L’application de ce critère dynamique permet d’isoler rigoureusement les individus qui dévient de façon disproportionnée par rapport au niveau d’influence moyen de l’échantillon étudié.
7.3 Nuances méthodologiques selon la taille de l’échantillon
Bien que la règle $2\sqrt{p/n}$ offre une assise théorique élégante, son application aveugle comporte des écueils méthodologiques bien documentés. Lorsque la taille d’échantillon devient exceptionnellement vaste (par exemple dans le cadre d’études génomiques, d’enquêtes de recensement ou de bases de données transactionnelles massives où $n$ se chiffre en dizaines ou centaines de milliers), le seuil dynamique converge vers des valeurs infinitésimales :
$$\lim_{n to \infty} 2 \times \sqrt{\frac{p}{n}} = 0$$
Dans ce contexte de mégadonnées (big data), un nombre considérable d’observations ordinaires franchiront mécaniquement le seuil critique, générant un phénomène massif de fausses alertes (sur-détection d’influence). Pour ces cohortes de grande dimension, l’analyste avisé privilégiera le seuil fixe de 1.0, voire un examen direct de la distribution empirique des valeurs de DFFITS via les quantiles extrêmes (par exemple, le 99e centile).
À l’inverse, dans les protocoles pilotes ou les expérimentations biomédicales restreintes où $n$ est particulièrement réduit par rapport au nombre de variables mesurées, le seuil dynamique peut devenir excessivement élevé, risquant de masquer des anomalies qui exercent pourtant une distorsion concrète sur les paramètres estimés (sous-détection). Il convient donc de traiter ces seuils numériques non pas comme des barrières absolues et dogmatiques, mais comme des indicateurs de tri heuristiques guidant l’attention de l’analyste vers les observations nécessitant une inspection clinique approfondie.
8. Visualisation graphique des valeurs de DFFITS
8.1 Représentation graphique élémentaire avec le moteur graphique de base
L’exploration visuelle constitue le complément indissociable de l’analyse tabulaire. L’environnement graphique natif de R permet d’ériger rapidement un diagramme d’indices (index plot) mettant en regard l’identifiant séquentiel de chaque ligne et sa valeur de DFFITS correspondante.
La syntaxe ci-après illustre la création d’un graphique d’indices annoté des seuils critiques :
# Graphique d’indices avec le moteur de base R
plot(valeurs_dffits,
type = « h »,
main = « Diagnostic d’influence : DFFITS par observation »,
xlab = « Index de l’observation »,
ylab = « Valeur du DFFITS »,
lwd = 2,
col = « steelblue »)
abline(h = 0, lty = 1, col = « grey60 »)
abline(h = c(-seuil_dynamique, seuil_dynamique), lty = 2, col = « firebrick », lwd = 1.5)
points(valeurs_dffits, pch = 19, col = « steelblue », cex = 0.8)
L’emploi du type "h" trace des barres verticales reliant chaque observation à l’axe d’ordonnée zéro, tandis que la fonction abline() matérialise les frontières d’alerte positives et négatives. Ce graphique offre un panorama visuel immédiat de la symétrie de la distribution et révèle sans ambiguïté les observations qui s’échappent des bandes de confiance centrales.
8.2 Conception d’une visualisation avancée avec ggplot2
Pour des présentations destinées à des revues académiques ou des rapports d’audit statistique formels, la grammaire graphique implémentée dans ggplot2 offre une flexibilité de mise en page et un rendu esthétique supérieurs. Le graphique en bâtons (lollipop plot) représente l’alternative visuelle la plus élégante pour ce type de diagnostic univarié signé.
Afin de prévenir tout chevauchement textuel lors de l’annotation des cas problématiques, nous pouvons adjoindre l’extension ggrepel, qui optimise algorithmiquement le placement des étiquettes :
# Construction d’un lollipop plot conditionnel avec ggplot2
library(ggrepel)
plot_df <- diagnostic_df %>%
mutate(
Index = row_number(),
Est_Influent = Abs_DFFITS > seuil_dynamique,
Label = if_else(Est_Influent, as.character(Vehicule), « »)
)
ggplot(plot_df, aes(x = Index, y = DFFITS)) +
geom_segment(aes(x = Index, xend = Index, y = 0, yend = DFFITS),
color = if_else(plot_df$Est_Influent, « firebrick », « grey70 »),
linewidth = 0.8) +
geom_point(aes(color = Est_Influent), size = 2.5) +
scale_color_manual(values = c(« FALSE » = « grey50 », « TRUE » = « firebrick »)) +
geom_hline(yintercept = 0, color = « black », linewidth = 0.4) +
geom_hline(yintercept = c(-seuil_dynamique, seuil_dynamique),
linetype = « dashed », color = « darkred », linewidth = 0.6) +
geom_text_repel(aes(label = Label), max.overlaps = 15, size = 3.2, box.padding = 0.5) +
labs(
title = « Audit d’influence : Diagnostic DFFITS par observation »,
subtitle = paste(« Seuil dynamique critique : +/-« , round(seuil_dynamique, 3)),
x = « Indice de l’observation »,
y = « Valeur DFFITS »
) +
theme_minimal() +
theme(legend.position = « none », plot.title = element_text(face = « bold »))
Cette visualisation permet d’identifier sans ambiguïté les observations franchissant le seuil critique grâce à un encodage chromatique conditionnel rouge, tandis que les étiquettes textuelles désignent nommément les entités responsables des tensions observées.
8.3 Intégration dans un tableau de bord diagnostique global
L’évaluation isolée du DFFITS ne saurait remplacer une analyse intégrée confrontant simultanément les différents faisceaux de preuves diagnostiques. Dans les protocoles de publication académique, il est recommandé de juxtaposer le DFFITS avec la distance de Cook et l’effet de levier diagonal $h_{ii}$.
Cette mise en regard conjointe permet de déterminer instantanément si l’influence exercée par une entité statistique découle prioritairement d’un résidu extrême sur la variable réponse ou d’une position singulière dans l’espace des covariables. Un tel tableau de bord graphique peut être facilement agencé à l’aide de bibliothèques de composition d’images telles que patchwork ou la fonction matricielle native layout() de R.
En observant la concordance entre ces multiples métriques, le praticien consolide son jugement statistique. Une observation isolée qui s’avère critique à la fois sous l’angle du DFFITS, de la distance de Cook et du levier de projection présente un niveau de certitude diagnostique maximal justifiant l’application d’un protocole d’inspection clinique et de sensibilité approfondi.
9. Analyse empirique et interprétation des observations influentes
9.1 Inspection clinique des individus statistiques identifiés
L’application de nos scripts aux données du jeu mtcars met en évidence plusieurs modèles automobiles franchissant le seuil critique dynamique $2\sqrt{p/n} \approx 0.7071$. Parmi ces véhicules figurent notamment la Chrysler Imperial, la Cadillac Fleetwood et la Lincoln Continental, aux côtés de modèles sportifs de faible cylindrée tels que la Toyota Corolla ou la Porsche 914-2.
L’analyste doit impérativement procéder à une inspection clinique détaillée de chaque cas signalé en extrayant leur profil multivarié complet :
# Extraction des profils complets des cas critiques
noms_critiques <- cas_influents$Vehicule
mtcars[noms_critiques, c(« mpg », « disp », « hp », « wt »)]
L’examen des données brutes de la Chrysler Imperial illustre parfaitement le mécanisme à l’œuvre. Ce véhicule affiche une consommation observée de 14.7 mpg, une cylindrée imposante de 440 pouces cubes, une puissance de 230 chevaux et une masse colossale de 5345 livres. Bien que ces caractéristiques soient extrêmes, elles demeurent parfaitement cohérentes avec les standards industriels des berlines américaines de luxe des années 1970. Il ne s’agit donc aucunement d’une erreur matérielle de saisie ou de codage numérique, mais d’une entité légitime représentant l’extrémité supérieure de l’espace morphologique de l’échantillon.
9.2 Effet de levier versus résidu élevé : dissection des mécanismes
La puissance diagnostique du DFFITS réside dans sa capacité à décomposer la source précise de l’influence en croisant l’effet de levier et l’écart résiduel studentisé :
$$\text{DFFITS}_i = \underbrace{rstudent_i}_{\text{Atypicité de la réponse } Y} \times \underbrace{\sqrt{\frac{h_{ii}}{1 – h_{ii}}}}_{\text{Isolement dans l’e\space } X}$$
Nous pouvons disséquer cette anatomie computationnelle pour les observations signalées au sein de notre modèle en extrayant conjointement ces deux composantes :
# Dissection des composantes de l’influence
dissection_df <- diagnostic_df %>%
mutate(
RStudent = residus_jackknife,
Levier = leviers_hii,
Facteur_Levier = sqrt(Levier / (1 – Levier))
) %>%
filter(Abs_DFFITS > seuil_dynamique) %>%
select(Vehicule, DFFITS, RStudent, Levier, Facteur_Levier) %>%
arrange(desc(abs(DFFITS)))
print(dissection_df)
L’analyse de ce tableau révèle deux typologies bien distinctes d’influence empirique :
- Les cas à fort effet de levier : Des véhicules tels que la Maserati Bora ou la Cadillac Fleetwood disposent d’un facteur de levier très prononcé en raison d’une puissance ou d’une masse atypiques. Même lorsque leur résidu studentisé demeure modéré, le multiplicateur géométrique propulse leur DFFITS au-delà de la ligne de démarcation critique.
- Les cas à fort résidu : À l’opposé, certains modèles affichent un levier modeste mais une discordance de consommation prononcée par rapport aux prévisions de la régression, ce qui suffit à engendrer un DFFITS élevé par la seule force de leur divergence résiduelle.
9.3 Impact direct sur les coefficients de régression
L’existence de valeurs de DFFITS prononcées implique directement qu’une rotation sensible est imposée au plan de régression par les points incriminés. Lorsqu’une observation combine un résidu négatif et un levier fort à l’extrémité supérieure d’un régresseur, elle tire vers le bas l’estimation de la pente associée à cette variable.
Cette distorsion a des conséquences méthodologiques directes sur la validité des conclusions substantives. Si une pente est artificiellement inclinée par le poids d’un ou deux individus isolés, le risque d’erreur de type I (conclure faussement à l’existence d’une relation générale statistiquement significative dans la population) ou d’erreur de type II (masquer une relation réelle qui s’appliquerait à 95 % des autres données) devient majeur. De plus, l’erreur quadratique moyenne de prédiction globale (RMSE) se trouve perturbée, dégradant les capacités de généralisation du modèle face à de nouvelles données indépendantes.
10. Comparaison approfondie : DFFITS, distance de Cook et DFBETAS
10.1 DFFITS versus distance de Cook
Le dialogue diagnostique entre le DFFITS et la distance de Cook constitue l’un des chapitres les plus élégants de la théorie de la régression linéaire. Si ces deux grandeurs mesurent l’influence globale exercée sur les valeurs ajustées, leurs comportements opérationnels diffèrent sous plusieurs aspects cruciaux récapitulés ci-après.
La distance de Cook repose sur une formulation quadratique invariablement positive, bornée dans $[0, +\infty[$, ce qui la rend insensible à la directionnalité de l’écart prédictif. À l’inverse, le DFFITS conserve le signe algébrique de l’écart, conférant une vision vectorielle orientée de la déstabilisation induite sur la prédiction locale de l’individu.
De plus, la sensibilité relative de ces métriques varie en fonction de la structure des données. Comme établi au point 2.3, l’approximation $D_i \approx \text{DFFITS}_i^2 / p$ montre que la distance de Cook comprime les écarts d’influence par la mise au carré et la division par le nombre de régresseurs $p$. Par conséquent, dans des modèles paramétriques larges comportant un grand nombre de variables indépendantes, la distance de Cook aura tendance à diluer visuellement l’impact des cas atypiques, tandis que le DFFITS conservera une sensibilité accrue à la variabilité de la prédiction spécifique.
10.2 DFFITS versus DFBETAS
Alors que le DFFITS fournit une mesure synthétique unidimensionnelle de l’altération globale de la prédiction ponctuelle, l’analyste a fréquemment besoin de comprendre quel coefficient spécifique de régression subit la plus forte contrainte. C’est précisément l’objet des statistiques DFBETAS (Difference in Betas).
Pour chaque observation i et chaque variable indépendante indexée par j ($j = 0, dots, p-1$), le DFBETAS quantifie la variation standardisée du coefficient $\beta_j$ résultant du retrait de la $i$-ème observation :
$$\text{DFBETAS}_{ij} = \frac{\hat{\beta}_j – \hat{\beta}_{j(i)}}{\text{SE}(\hat{\beta}_{j(i)})}$$
Dans R, cette métrique matricielle bidimensionnelle s’obtient via la fonction dfbetas() :
# Extraction des DFBETAS associes au modele
matrice_dfbetas <- dfbetas(modele_cars)
head(matrice_dfbetas, 5)
La complémentarité entre DFFITS et DFBETAS est évidente : le DFFITS sert d’alarme de premier niveau signalant qu’une observation perturbe la structure globale des ajustements, tandis que l’inspection subséquente des DFBETAS permet d’identifier avec précision le coefficient de régression spécifique qui se trouve déstabilisé par cette même observation.
10.3 Tableau comparatif des outils de diagnostic d’influence dans R
L’environnement R standardise l’accès à ces différents indicateurs diagnostiques par le biais d’un ensemble de fonctions vectorisées d’une grande cohérence syntaxique. De plus, la fonction intégrée influence.measures() agrège l’ensemble de ces mesures au sein d’une structure unique assortie de drapeaux booléens d’alerte :
# Synthese globale des diagnostics d’influence dans R
synthese_influence <- influence.measures(modele_cars)
summary(synthese_influence)
Le tableau comparatif suivant synthétise les propriétés mathématiques, les fonctions R dédiées et les seuils d’alerte associés à chaque famille de diagnostic :
- DFFITS : Fonction R
dffits(). Mesure la différence standardisée sur la prédiction de l’observation omise. Borne $[-\infty, +\infty]$. Seuil critique classique : $|\text{DFFITS}| > 1$ (échantillons réduits) ou $|\text{DFFITS}| > 2\sqrt{p/n}$ (échantillons modérés à larges). - Distance de Cook : Fonction R
cooks.distance(). Mesure le déplacement quadratique moyen de l’ensemble des prédictions vectorielles. Borne $[0, +\infty[$. Seuil critique classique : $D > 4/n$ ou comparaison avec le quantile $F(p, n-p)$ à 50 %. - DFBETAS : Fonction R
dfbetas(). Mesure la variation standardisée de chaque coefficient individuel de régression. Borne $[-\infty, +\infty]$. Seuil critique classique : $|\text{DFBETAS}| > 2/\sqrt{n}$. - Valeurs de levier ($h_{ii}$) : Fonction R
hatvalues(). Mesure l’éloignement structurel dans l’espace des covariables. Borne $[1/n, 1]$. Seuil critique classique : $h_{ii} > 2p/n$ ou $h_{ii} > 3p/n$. - Rapport de covariance (CovRatio) : Fonction R
covratio(). Mesure l’impact de l’observation sur la précision conjointe des estimations paramétriques. Borne $[0, +\infty[$. Seuil critique classique : $|\text{CovRatio} – 1| > 3p/n$.
11. Stratégies méthodologiques face aux observations influentes
11.1 La politique de rétention ou de suppression des données
La détection d’un DFFITS excédant les seuils critiques ne doit sous aucun prétexte déclencher l’élimination automatique de l’observation concernée. L’élagage mécanique des points influents sans justification théorique constitue une entorse grave à la déontologie scientifique, s’apparentant à une forme insidieuse de falsification de données connue sous le vocable de cherry-picking. Une telle pratique vicie les estimations d’erreur résiduelle, biaise artificiellement les distributions vers une normalité factice et conduit à une sous-estimation systématique de l’incertitude réelle régissant le phénomène étudié.
La suppression définitive d’une entité statistique ne peut être méthodologiquement légitimée que dans deux configurations circonscrites :
- Une contamination technique documentée et irréfutable, résultant d’une défaillance instrumentale avérée, d’une erreur de frappe non corrigible ou d’un non-respect flagrant des critères d’inclusion du protocole expérimental.
- Une observation démontrant que l’individu statistique n’appartient manifestement pas à la population cible couverte par la portée d’inférence du modèle (par exemple, un prototype de course engagé dans une enquête ciblant la consommation de berlines familiales de série).
En l’absence d’une telle preuve matérielle de non-validité, la singularité d’une observation reflète simplement la complexité intrinsèque et la variabilité naturelle du monde empirique. L’analyste a alors l’obligation scientifique de conserver la donnée tout en adaptant son appareil méthodologique pour traiter son impact sur les estimations.
11.2 Mise en œuvre d’analyses de sensibilité systématiques
Face à des points influents légitimes et valides, la meilleure pratique recommandée par les normes de publication méthodologiques (telles que les standards APA) consiste à conduire une analyse de sensibilité systématique. Cette démarche implique l’estimation et la présentation en vis-à-vis de deux spécifications parallèles du modèle : l’une calculée sur l’échantillon complet, l’autre calibrée après exclusion temporaire des observations à fort DFFITS.
Le script R ci-après documente la mise en œuvre de cette procédure comparative :
# Extraction des indices a conserver sans les cas influents
indices_a_garder <- which(abs(valeurs_dffits) <= seuil_dynamique)
# Ajustement du modele sans les cas influents
modele_sensibilite <- lm(mpg ~ disp + hp + wt, data = mtcars, subset = indices_a_garder)
# Confrontation des estimations de coefficients
comparaison_coefs <- cbind(
Complet = coef(modele_cars),
Purge = coef(modele_sensibilite),
Variation_Pct = round(((coef(modele_sensibilite) – coef(modele_cars)) / coef(modele_cars)) * 100, 2)
)
print(comparaison_coefs)
Si la comparaison atteste que les grandeurs estimées, leurs signes et leurs seuils de significativité statistique demeurent inchangés, l’analyste peut alors affirmer avec une grande robustesse que ses conclusions scientifiques ne sont pas tributaires d’un artéfact induit par une poignée d’individus atypiques. Si, à l’inverse, l’omission des points influents inverse le signe d’un coefficient clé ou détruit sa significativité, cette fragilité structurelle doit être rapportée en toute transparence dans le manuscrit final.
11.3 Alternatives d’estimation robuste dans R
Lorsque la présence d’observations à fort DFFITS déstabilise excessivement l’estimation ordinaire sans que leur suppression ne soit admissible, l’analyste doit abandonner les moindres carrés ordinaires au profit de méthodes d’estimation robuste. Ces approches ont pour objet d’attribuer un poids décroissant aux observations au fur et à mesure que leur atypicité résiduelle ou géométrique s’accroît.
Une première solution consiste à mobiliser les estimateurs M ou MM de la régression robuste implémentés dans la fonction rlm() du package MASS :
# Estimation par regression robuste (estimateurs MM de Huber / Tukey bisquare)
library(MASS)
modele_robuste <- rlm(mpg ~ disp + hp + wt, data = mtcars, method = « MM »)
summary(modele_robuste)
Une alternative non paramétrique consiste à recourir à la régression quantile (en particulier la régression médiane) via le package quantreg, qui minimise la somme des valeurs absolues des écarts plutôt que leur somme quadratique, offrant une immunité structurelle remarquable contre les valeurs aberrantes en $Y$.
Enfin, pour préserver la structure des estimateurs tout en corrigeant les inférences statistiques contre les distorsions d’échantillonnage, la méthode du rééchantillonnage par bootstrap permet de construire des intervalles de confiance robustes pour les paramètres sans requérir l’hypothèse de normalité gaussienne des erreurs.
12. Protocole complet, reproductibilité et bonnes pratiques dans R
12.1 Construction d’un pipeline de diagnostic entièrement automatisé
Afin d’intégrer de manière fluide le calcul du DFFITS dans des flux de traitement de données récurrents ou des architectures d’analyse industrielle, il est pertinent d’encapsuler l’ensemble de la démarche au sein d’une fonction R personnalisée, modulaire et documentée.
La fonction suivante accepte en entrée n’importe quel objet de classe "lm", applique les seuils théoriques adaptés, isole les observations singulières et retourne un compte rendu structuré sous la forme d’une liste exploitable :
# Fonction modulaire d’audit DFFITS automatise
auditer_dffits <- function(modele, seuil = c(« dynamique », « absolu »)) {
if (!inherits(modele, « lm »)) {
stop(« L’argument ‘modele’ doit etre un objet de classe ‘lm’. »)
}
seuil <- match.arg(seuil)
n <- nrow(model.matrix(modele))
p <- length(coef(modele))
val_dffits <- dffits(modele)
seuil_critique <- if (seuil == « dynamique ») 2 * sqrt(p / n) else 1.0
donnees_audit <- data.frame(
Observation = names(val_dffits),
DFFITS = val_dffits,
Abs_DFFITS = abs(val_dffits),
Depassement = abs(val_dffits) > seuil_critique
)
anomalies <- donnees_audit[donnees_audit$Depassement, ]
anomalies <- anomalies[order(-anomalies$Abs_DFFITS), ]
resultat <- list(
nombre_observations = n,
nombre_parametres = p,
seuil_choisi = seuil,
valeur_seuil = seuil_critique,
total_influents = nrow(anomalies),
cas_critiques = anomalies
)
return(resultat)
}
# Execution de la fonction personnalisee
audit_test <- auditer_dffits(modele_cars, seuil = « dynamique »)
print(audit_test)
Cette approche fonctionnelle s’insère naturellement dans des chaînes d’intégration continue de modélisation statistique, garantissant qu’aucune décision ne soit prise sur la base d’un modèle fragilisé par des données influentes non documentées.
12.2 Bonnes pratiques de publication et documentation scientifique
La publication de résultats issus de modèles linéaires multiples dans des périodiques scientifiques à comité de lecture exige une transparence totale quant à la gestion des observations influentes. Conformément aux directives du manuel de publication de l’American Psychological Association (APA 7th edition) et des standards de reproductibilité computationnelle, le chercheur doit expliciter :
- Les métriques diagnostiques utilisées pour sonder l’influence (mention expresse du DFFITS et de la distance de Cook).
- Le seuil de décision statistique formel retenu pour classifier les cas influents (en précisant systématiquement la formule mathématique, telle que $2\sqrt{p/n}$, et la valeur numérique exacte correspondante).
- Le nombre total d’observations identifiées et leur impact sur les paramètres du modèle, documenté via un tableau de sensibilité comparative.
- La justification théorique appuyant tout choix éventuel d’exclusion, de pondération ou de recours à des estimateurs alternatifs de type régression robuste.
De surcroît, la mise à disposition publique du code R sous licence ouverte sur des plateformes de partage académique (telles que Zenodo, OSF ou GitHub) constitue la clé de voûte de la science ouverte, permettant aux pairs d’auditer et de reproduire intégralement la chaîne de traitement diagnostique.
12.3 Synthèse et arbre de décision pour le praticien
Pour guider le praticien et le chercheur à travers les différentes étapes de l’évaluation diagnostique du DFFITS, il est utile de structurer la démarche sous la forme d’une séquence logique de décisions opérationnelles :
Étape 1 : Estimation initiale et extraction
Ajuster le modèle de régression linéaire par les moindres carrés ordinaires avec lm(), vérifier les conditions de linéarité et de non-multicolinéarité, puis extraire le vecteur des valeurs de DFFITS via la fonction native dffits().
Étape 2 : Établissement du seuil critique
Calculer le seuil dynamique théorique $2\sqrt{p/n}$. Si l’échantillon est restreint ($n < 50$), confronter ce seuil dynamique au seuil absolu unitaire de 1.0 afin de calibrer le niveau de vigilance approprié.
Étape 3 : Détection et dissection de l’influence
Isoler les observations dont la valeur absolue du DFFITS dépasse le seuil retenu. Extraire les résidus studentisés externes avec rstudent() et les leviers diagonaux avec hatvalues() pour déterminer si l’influence provient d’un résidu anormal sur la réponse ou d’une position excentrique dans l’espace des covariables explicatives.
Étape 4 : Audit clinique de validité substantielle
Inspecter individuellement les données brutes des cas identifiés à la recherche d’éventuelles erreurs de saisie, de défaillances de mesure ou d’incompatibilités avec la population cible du modèle.
Étape 5 : Choix de la stratégie méthodologique finale
Si une erreur matérielle irréfutable est avérée, corriger ou exclure l’observation avec justification documentaire dans le rapport d’analyse. Si les données sont réelles et légitimes, conduire une analyse de sensibilité comparative et/ou ajuster un modèle de régression robuste via rlm() du package MASS afin de consolider la portée des conclusions scientifiques.
Références
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
Maronna, R. A., Martin, R. D., Yohai, V. J., & Salibián-Barrera, M. (2019). Robust statistics: Theory and methods (with R) (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119214656
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858
Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686