
L’analyse des séries temporelles constitue un pilier méthodologique fondamental au sein des sciences quantitatives modernes, qu’il s’agisse de l’économétrie, de la biométrie, des neurosciences ou de la psychologie computationnelle. Dans de multiples contextes empiriques, l’hypothèse sous-jacente postulant que la relation liant deux grandeurs demeure invariable au cours du temps s’avère profondément erronée. Les systèmes dynamiques réels sont par nature soumis à des fluctuations environnementales, à des réorganisations internes et à des perturbations exogènes qui altèrent de manière continue l’intensité, la direction et la nature même des interdépendances bivariées. Dès lors, le recours à un indicateur statique unique pour résumer l’association globale sur l’intégralité d’un continuum temporel masque des dynamiques locales déterminantes, effaçant les phases critiques de synchronisation, de divergence ou de découplage fonctionnel.
Pour dépasser les limites inhérentes à l’approche statique conventionnelle, le calcul de la corrélation glissante, également désignée sous l’anglicisme de rolling correlation ou corrélation sur fenêtre mobile, s’impose comme une technique d’investigation incontournable. Cette approche consiste à estimer le coefficient de dépendance linéaire de manière séquentielle sur un sous-ensemble restreint d’observations consécutives, en déplaçant pas à pas cette fenêtre d’analyse le long de l’axe chronologique. L’opérateur obtient ainsi non plus un scalaire invariable, mais une nouvelle série chronologique traduisant fidèlement la trajectoire temporelle de l’association bivariée. Ce procédé offre une granularité analytique remarquable, révélant la labilité des interactions qui structurent les phénomènes observés.
Bien que les environnements de programmation statistique de pointe tels que le langage R ou Python disposent de fonctions hautement optimisées pour exécuter ce type de calcul, le tableur Microsoft Excel demeure un outil d’une prévalence absolue dans les laboratoires, les unités de recherche clinique et les départements d’analyse quantitative. Sa flexibilité, son moteur de calcul transparent et sa capacité d’inspection granulaire des données en font un vecteur privilégié pour la modélisation exploratoire. L’objectif de cette monographie exhaustive est de détailler, avec une rigueur statistique et opérationnelle absolue, les fondements théoriques, les postulats mathématiques et les protocoles pratiques permettant de calculer, d’automatiser et d’interpréter avec succès la corrélation glissante au sein de Microsoft Excel.
1. Cadre théorique et définition de la corrélation glissante
1.1 Définition conceptuelle de la corrélation dynamique
L’analyse bivariée classique repose traditionnellement sur le postulat d’homogénéité temporelle, stipulant que la structure de dépendance unissant deux variables aléatoires X et Y est stationnaire sur l’ensemble de la période d’échantillonnage. Dans ce cadre statique, le coefficient de corrélation linéaire de Bravais-Pearson est calculé de façon agrégée sur la totalité des N observations disponibles. Une telle agrégation globale comprime l’information temporelle en un scalaire unique, présumant implicitement que la variance conjointe observée au point initial t = 1 obéit aux mêmes lois de probabilité que celle enregistrée au point médian ou terminal. Or, dans les systèmes dynamiques complexes, cette invariance est régulièrement violée par l’émergence d’oscillations spontanées, de chocs structurels ou d’adaptations fonctionnelles.
La transition vers l’analyse temporelle dynamique s’opère par le concept de fenêtre temporelle mobile (rolling window). Le principe sous-jacent consiste à délimiter un intervalle d’observation d’une largeur prédéterminée, notée k, et à extraire la sous-matrice de données correspondant à ce sous-ensemble temporel borné entre t – k + 1 et t. Le calcul de la corrélation est alors exécuté exclusivement sur ce sous-échantillon local. À chaque itération séquentielle, la fenêtre glisse d’une unité temporelle vers l’avant : la plus ancienne observation est exclue du segment d’analyse tandis que la nouvelle mesure entrante y est incorporée, préservant ainsi une taille d’échantillon local constante tout au long de la translation.
Il convient de distinguer formellement la corrélation locale séquentielle ainsi obtenue de la corrélation globale cumulée (expanding correlation). Alors que cette dernière calcule une statistique sur un intervalle qui s’élargit continuellement depuis l’origine temporelle (de 1 à t), intégrant un volume d’information toujours plus grand et atténuant mécaniquement le poids des fluctuations récentes, la corrélation glissante maintient une mémoire finie. Cette propriété d’oubli progressif confère à la corrélation glissante une pertinence méthodologique inégalée pour capter l’instabilité structurelle des relations, mettre en évidence les ruptures de connectivité et documenter la nature transitoire des phénomènes d’interaction.
1.2 Utilité de la mesure en sciences comportementales et quantitatives
Dans le champ des sciences comportementales, de la psychologie cognitive et des neurosciences affectives, les processus étudiés ne s’inscrivent que rarement dans un régime d’équilibre stationnaire. L’identification des synchronisations de phase dans les processus cognitifs nécessite d’observer la manière dont les performances attentionnelles et les oscillations neurales se coordonnent temporairement lors de tâches d’effort mental soutenu. L’usage de fenêtres temporelles mobiles permet de capturer ces couplages éphémères qui, bien que déterminants dans la réussite d’une opération cognitive, s’estomperaient totalement au sein d’une moyenne bivariée globale.
De façon analogue, l’évaluation de la covariance émotionnelle et physiologique au fil du temps constitue un champ d’application privilégié. Lors de l’étude de la réactivité au stress, la relation entre l’élévation du rythme cardiaque (ou de la conductance cutanée) et l’intensité du ressenti affectif négatif fluctue selon les phases d’anticipation, de confrontation au stresseur et de récupération. La corrélation glissante met en exergue ces fenêtres de synchronie végétative ainsi que les moments critiques où les réponses physiologiques et psychologiques se découplent, traduisant par exemple la mise en œuvre de stratégies d’autorégulation émotionnelle ou d’inhibition cognitive.
Enfin, dans l’exploitation des données psychométriques longitudinales recueillies par des méthodologies d’évaluation écologique momentanée (Ecological Momentary Assessment ou EMA), l’analyse séquentielle locale permet la détection précoce des basculements de régime. Les transitions vers des états dépressifs majeurs ou des crises d’angoisse sont fréquemment précédées d’un phénomène de ralentissement critique (critical slowing down), qui se manifeste sur le plan relationnel par une corrélation mobile anormale et persistante entre des symptômes autrefois indépendants, signifiant une rigidification dysfonctionnelle du réseau psychologique de l’individu.
1.3 Formulation mathématique du coefficient de Pearson mobile
L’estimation rigoureuse de la corrélation linéaire locale au sein d’une fenêtre de taille k repose sur l’adaptation algébrique de la formulation standard du coefficient r de Bravais-Pearson. Soit deux séries temporelles univariées synchrones notées X = (x₁, x₂, …, x_N) et Y = (y₁, y₂, …, y_N). Pour chaque indice temporel t compris entre k et N, le sous-ensemble d’analyse est défini par les vecteurs locaux restreints aux k dernières observations :
X_(t,k) = (x_(t-k+1), x_(t-k+2), …, x_t)
Y_(t,k) = (y_(t-k+1), y_(t-k+2), …, y_t)
La moyenne empirique locale de chaque vecteur sur l’intervalle d’observation s’énonce comme :
x̄_(t,k) = (1 / k) * ∑_(i=0)^(k-1) x_(t-i)
ȳ_(t,k) = (1 / k) * ∑_(i=0)^(k-1) y_(t-i)
La covariance locale non biaisée ou normalisée sur ce sous-ensemble restreint de taille k correspond au produit croisé moyen des déviations par rapport aux moyennes locales respectives :
Cov_(t,k)(X, Y) = [1 / (k – 1)] * ∑_(i=0)^(k-1) [x_(t-i) – x̄_(t,k)] * [y_(t-i) – ȳ_(t,k)]
Concomitamment, les variances locales empiriques s’obtiennent par la somme des carrés des écarts locaux divisée par les degrés de liberté résiduels (k – 1), permettant de déduire les écarts-types locaux restreints à l’intervalle d’observation :
s_(x,t,k) = √[ (1 / (k – 1)) * ∑_(i=0)^(k-1) (x_(t-i) – x̄_(t,k))² ]
s_(y,t,k) = √[ (1 / (k – 1)) * ∑_(i=0)^(k-1) (y_(t-i) – ȳ_(t,k))² ]
Le coefficient de corrélation mobile instantané au temps t, noté r_(t,k), s’exprime alors comme le quotient de la covariance locale normalisée par le produit vectoriel des écarts-types locaux :
r_(t,k) = Cov_(t,k)(X, Y) / [ s_(x,t,k) * s_(y,t,k) ]
Ce quotient peut être reformulé sous une forme algébrique équivalente évitant la division intermédiaire par (k – 1) :
r_(t,k) = ∑_(i=0)^(k-1) [ (x_(t-i) – x̄_(t,k)) * (y_(t-i) – ȳ_(t,k)) ] / √[ ∑_(i=0)^(k-1) (x_(t-i) – x̄_(t,k))² * ∑_(i=0)^(k-1) (y_(t-i) – ȳ_(t,k))² ]
Il découle directement de cette expression que le coefficient r de Bravais-Pearson présente une sensibilité exacerbée aux fluctuations locales. Dans la mesure où les paramètres de centrage (x̄_(t,k)) et d’échelle (s_(x,t,k)) sont réévalués exclusivement sur le micro-échantillon k, toute instabilité brève, perturbation atypique ou synchronisation momentanée influencera de manière prépondérante le résultat, d’où la nécessité de maîtriser impérativement les fondements statistiques de son application.
2. Fondements statistiques et postulats préalables
2.1 Conditions d’application du coefficient de Pearson
L’estimation locale du coefficient de corrélation de Pearson n’est valide que si le jeu de données sous-jacent satisfait un ensemble d’hypothèses distributionnelles et relationnelles au sein de chaque fenêtre d’observation. En premier lieu, le modèle suppose la linéarité stricte de la relation liant X et Y. Si l’interaction bivariée suit une trajectoire curviligne, quadratique ou sigmoïdale sur l’intervalle k, le coefficient r sous-estimera dramatiquement l’intensité de la dépendance, pouvant afficher une valeur proche de zéro alors même qu’une association fonctionnelle déterministe parfaite opère entre les deux variables.
En second lieu, l’inférence statistique paramétrique associée au coefficient de Pearson postule la normalité bivariée des variables au sein de la fenêtre considérée. Dans les sous-échantillons restreints typiques des analyses glissantes (par exemple pour k < 30), la violation de cette condition par l’apparition d’asymétries distributionnelles (skewness) ou d’un aplatissement excessif (kurtosis) altère gravement l’estimateur. L’absence de normalité multidimensionnelle rend instable l’erreur standard locale et empêche tout calcul fiable de l’intervalle de confiance ou de la p-valeur ponctuelle.
Enfin, la présence de valeurs aberrantes (outliers) produit des conséquences néfastes décuplées sur les petits échantillons. Un point extrême isolé à l’intérieur d’une fenêtre de taille k = 10 peut artificiellement gonfler un coefficient de corrélation jusqu’à des valeurs proches de +1 ou -1 (corrélation fallacieuse locale), ou inversement masquer une corrélation systématique robuste par effet de levier sur la somme des carrés des écarts. Un audit distributionnel attentif s’avère donc impératif avant toute exploitation des séries mobiles.
2.2 Le problème de la non-stationnarité des séries temporelles
L’écueil méthodologique le plus redoutable dans le traitement des séries chronologiques réside dans la non-stationnarité des données. Une série temporelle est qualifiée de non-stationnaire lorsque ses propriétés statistiques fondamentales, telles que son espérance mathématique ou sa variance, varient en fonction du temps. On distingue principalement les tendances déterministes (dérive linéaire ou polynomiale systématique) et les tendances stochastiques (marches aléatoires avec ou sans dérive, intégration d’ordre I(1) ou supérieur). Lorsque deux séries indépendantes partagent une tendance d’évolution conjointe, l’application directe du coefficient de Pearson engendre presque inéluctablement une corrélation fallacieuse (spurious correlation), conceptualisée par Granger et Newbold (1974).
Ce phénomène se traduit par l’obtention de valeurs de corrélation mobile anormalement élevées, oscillant fréquemment au-delà de |r| > 0,80, accompagnées de tests de Student erronément significatifs, alors que les deux processus physiques ou psychologiques ne partagent aucun lien de causalité ni de covariance intrinsèque. La tendance sous-jacente capture mécaniquement la variance de l’échantillon, confondant l’évolution temporelle globale avec une relation de synchronie locale.
Pour immuniser l’analyse contre cet écueil, le recours à des techniques rigoureuses de stationnarisation préalable est requis. La méthode canonique consiste à appliquer une différenciation première aux séries brutes :
Δx_t = x_t – x_(t-1)
Le calcul de la corrélation glissante est ensuite opéré sur les séries différenciées ΔX et ΔY, isolant ainsi la co-variation des variations instantanées de celle des niveaux moyens. D’autres approches, telles que le filtrage passe-bande ou le filtre de Hodrick-Prescott, permettent d’extraire la composante cyclique stationnaire tout en neutralisant la dérive tendancielle de long terme.
2.3 Phénomène d’autocorrélation et ajustement des degrés de liberté
Les séries temporelles continues mesurées à haute fréquence manifestent quasi universellement une dépendance sérielle prononcée, désignée sous le terme d’autocorrélation. La valeur observée au temps t dépend étroitement de celle enregistrée à t – 1, violant frontalement le postulat fondamental d’indépendance et d’identique distribution (i.i.d.) des observations qui soutient la théorie asymptotique de Pearson. L’existence d’une mémoire sérielle positive au sein des séries a pour effet mathématique direct de réduire le contenu informatif intrinsèque de chaque nouvelle observation.
Il en résulte un biais systématique d’inflation de la significativité statistique. Bien que la taille nominale de la fenêtre glissante soit égale à k, le nombre d’observations indépendantes réelles est drastiquement inférieur. En conséquence, les erreurs types calculées de manière usuelle sont sous-estimées, conduisant l’analyste à rejeter à tort l’hypothèse nulle d’absence d’association (hausse drastique du risque de fausses découvertes ou erreur de Type I).
Pour remédier à cette distorsion, il convient d’appliquer la correction de Bartlett (1935) ou la formulation proposée par Moran (1948), qui redéfinit la taille effective d’échantillon (k_eff). En désignant par ρ_x(1) et ρ_y(1) les coefficients d’autocorrélation d’ordre 1 respectifs de X et Y au sein de la fenêtre locale, la taille effective approximative se modélise selon la relation :
k_eff ≈ k * [ (1 – ρ_x(1) * ρ_y(1)) / (1 + ρ_x(1) * ρ_y(1)) ]
Lorsque les séries présentent une forte inertie positive conjointe, k_eff chute substantiellement par rapport à k, imposant d’ajuster les degrés de liberté résiduels lors de l’évaluation de la robustesse inférentielle de chaque estimation locale.
3. Préparation et structuration rigoureuse des données sous Excel
3.1 Organisation tabulaire conforme aux normes analytiques
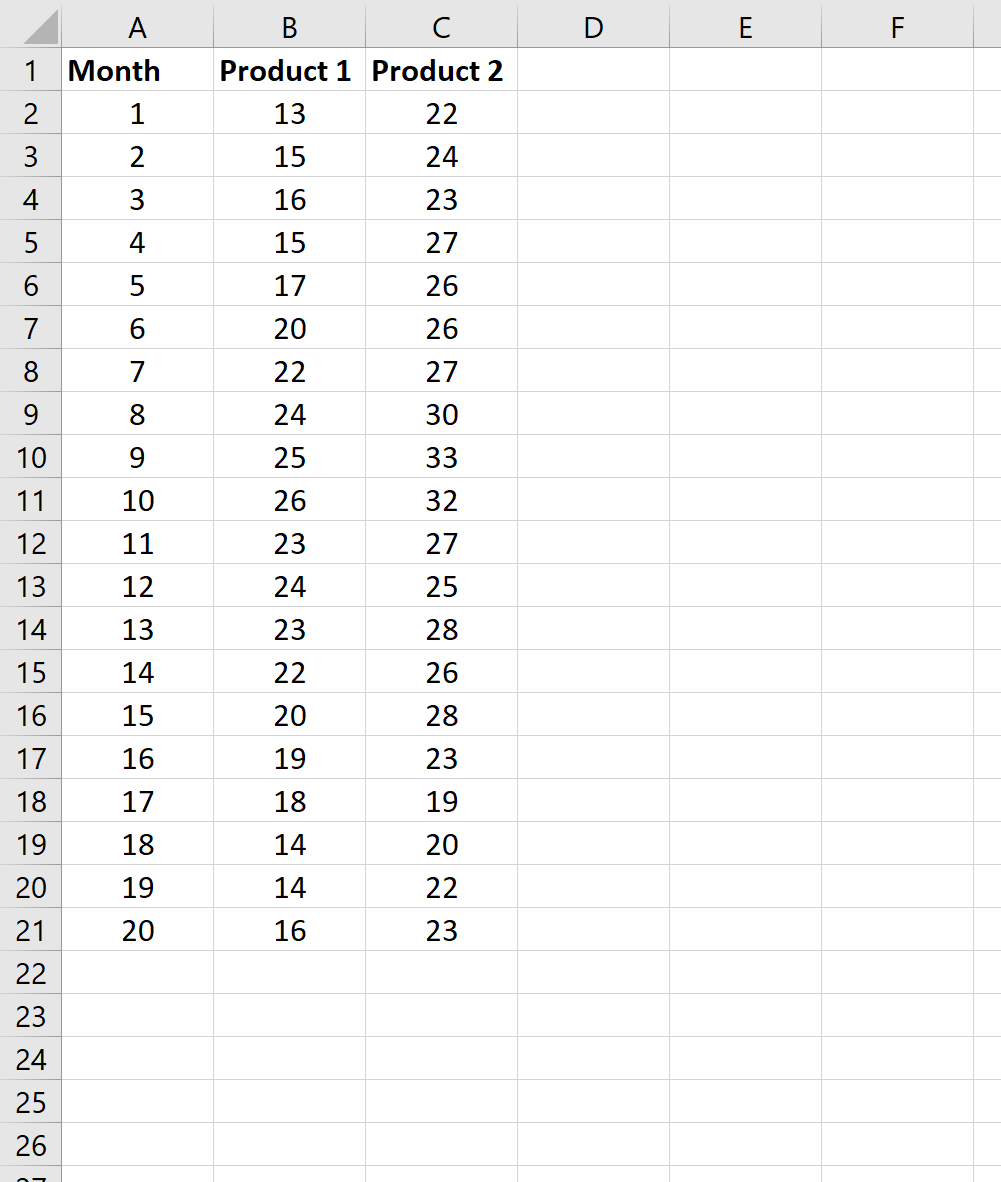
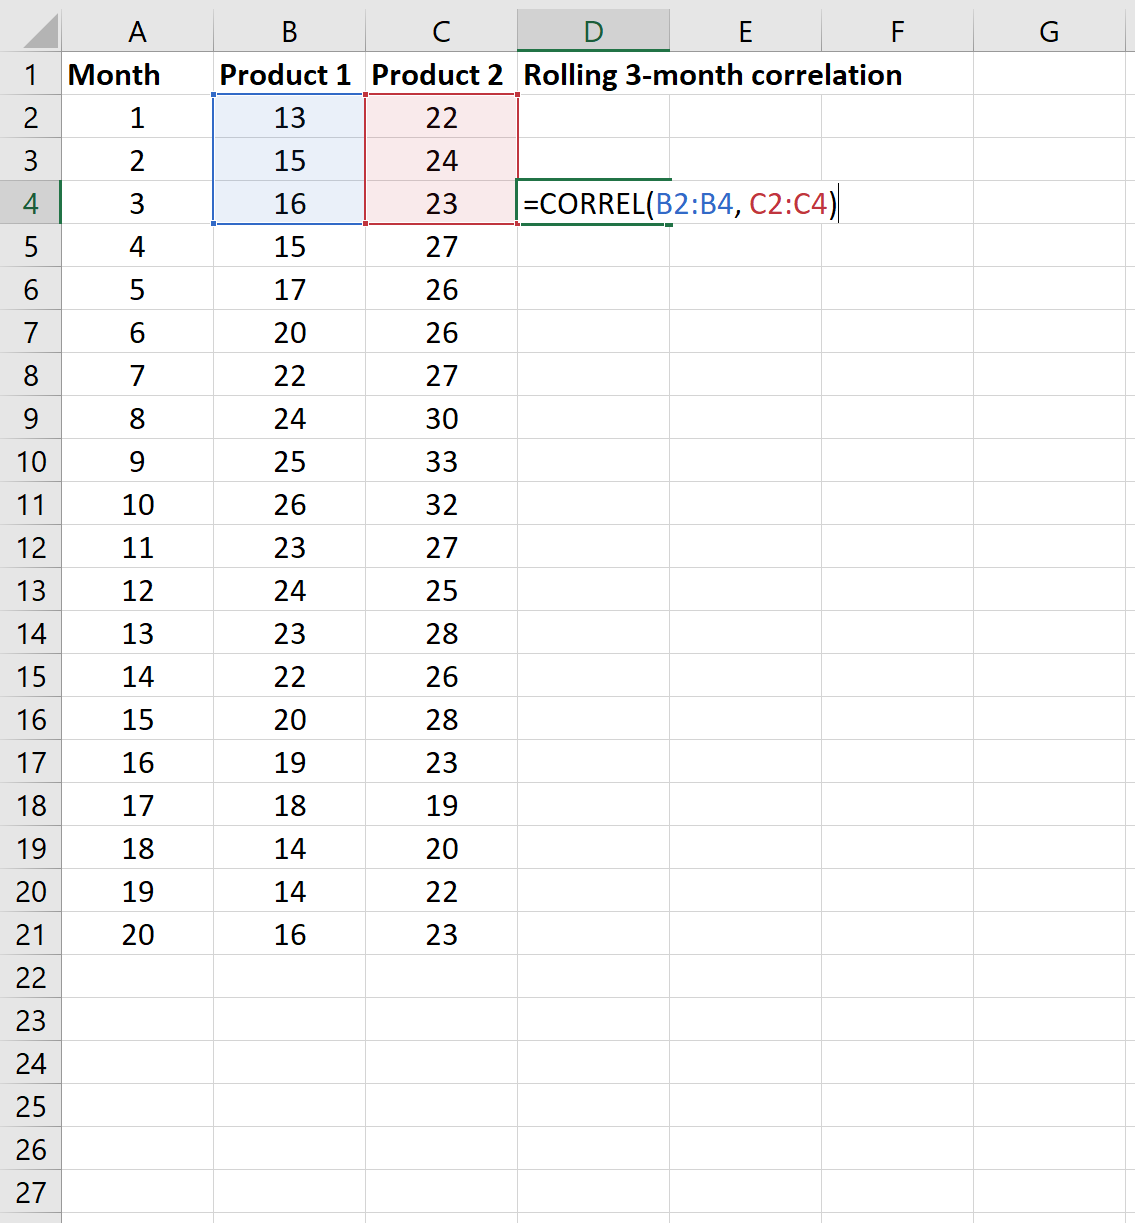
L’implémentation opérationnelle d’une corrélation mobile sous Microsoft Excel requiert une discipline architecturale stricte dès la phase d’agencement du classeur. Les séries doivent être impérativement structurées selon un schéma tabulaire normalisé (forme tidy data). Chaque variable doit occuper une colonne dédiée exclusive, tandis que chaque ligne doit correspondre à une observation temporelle unique, synchronisée et distincte. Le modèle typique d’ingénierie des données sur la feuille de calcul s’organise en allouant la colonne A au vecteur temporel (horodatage, index chronologique ou date), la colonne B à la première variable dépendante X, et la colonne C à la seconde variable Y.
Une attention méticuleuse doit être portée à l’uniformité des intervalles d’échantillonnage temporel. Si les observations sont espacées de manière hétérogène (par exemple des enregistrements séparés alternativement de 5 minutes, 15 minutes ou plusieurs heures), la fenêtre mobile perd sa signification physique, agrégeant sur certains segments des temps courts et sur d’autres des durées étendues. Une régularisation préalable de l’échelle temporelle par rééchantillonnage ou interpolation est requise pour assurer la comparabilité intra-série.
Il est vivement recommandé de convertir immédiatement la plage de cellules brutes en un Tableau Structuré Excel (via le raccourci clavier standard Ctrl + L ou Insertion > Tableau). Ce conteneur confère des propriétés dynamiques majeures : la propagation automatisée des formules calculées vers le bas, la mise à jour instantanée des plages lors de l’ajout ultérieur d’observations, et l’utilisation de références structurées lisibles qui limitent drastiquement les erreurs de pointage matriciel.
3.2 Audit et nettoyage des données manquantes
Les lacunes d’échantillonnage (cellules vides ou valeurs nulles artificielles) exercent un impact destructeur sur l’intégrité du calcul séquentiel mobile. Lorsqu’une formule glissante de longueur k rencontre une cellule vide au sein de sa plage d’évaluation, la fonction de corrélation native d’Excel exclut cette valeur de l’opération locale. Toutefois, cette élimination asymétrique produit un effet pervers : la taille réelle de l’échantillon local n’est plus égale à k, mais chute à k – m (où m représente le nombre de points manquants), sans que l’utilisateur n’en soit averti, induisant une hétérogénéité inattendue de la variance d’échantillonnage le long de la série calculée.
Deux stratégies d’imputation doivent être arbitrées en fonction de la nature des données :
- L’interpolation linéaire : si la variable évolue de manière continue et que la rupture n’excède pas une ou deux périodes, l’interpolation mathématique locale permet de reconstituer le point manquant sans altérer substantiellement la covariance.
- L’exclusion par segment : en présence de ruptures prolongées, l’imputation artificielle risque d’induire une fausse corrélation linéaire locale. Il devient alors indispensable de scinder l’analyse temporelle en sous-périodes indépendantes ou de renvoyer une valeur non définie (#N/A) sur l’ensemble de la fenêtre affectée par la discontinuité.
Toute intervention corrective appliquée sur la série brute doit être rigoureusement documentée dans le métadonnées du classeur afin de garantir la reproductibilité intégrale du protocole analytique.
3.3 Contrôle typologique et alignement chronologique
Une source récurrente de dysfonctionnement dans les classeurs complexes provient de corruptions typologiques imperceptibles. Les valeurs numériques importées depuis des systèmes d’enregistrement externes, des plateformes en ligne ou des fichiers CSV peuvent comporter des caractères parasites, des espaces insécables ou des séparateurs décimaux incompatibles avec les paramètres régionaux d’Excel (le point anglo-saxon au lieu de la virgule francophone). De tels enregistrements sont convertis de façon transparente par le logiciel sous la forme de chaînes de texte, ce qui conduit les formules de calcul statistique à ignorer purement et simplement les cellules en question sans lever systématiquement d’alerte explicite.
Le protocole de contrôle impose d’utiliser les fonctions logiques de vérification, telles que ESTNUM(), pour auditer l’intégralité des colonnes de données. L’application systématique de l’opérateur de conversion (par exemple multiplier la colonne par 1 ou utiliser la commande Convertir de l’onglet Données) garantit une conversion en format à virgule flottante double précision.
Enfin, l’intégrité de l’axe temporel commande d’exécuter un tri rigoureusement ascendant sur la colonne d’horodatage. Si les données présentent des inversions chronologiques sporadiques, la formule de corrélation glissante croiserait des valeurs issues d’époques hétérogènes, détruisant la validité conceptuelle de la fenêtre dynamique. L’adjonction d’une colonne d’index incrémental monotone (1, 2, …, N) matérialise le fil conducteur de la séquence et prévient les désalignements accidentels.
4. La fonction standard CORREL() sous Excel : Mécanismes et syntaxe
4.1 Architecture de la fonction native CORREL
Au cœur de l’arsenal statistique de Microsoft Excel se trouve la fonction native CORREL, dont la vocation algorithmique exclusive est d’évaluer le coefficient de corrélation linéaire de Pearson entre deux matrices de données univariées de même cardinalité. L’architecture syntaxique formelle de cette fonction s’énonce comme suit :
=CORREL(tableau1; tableau2)
Les arguments tableau1 et tableau2 doivent impérativement désigner des plages de cellules, des vecteurs de constantes ou des tableaux dynamiques contenant des valeurs quantitatives numériques. La contrainte opérationnelle fondamentale de cette fonction réside dans la symétrie dimensionnelle stricte : le nombre total de cellules composant le premier argument doit correspondre exactement au nombre de cellules formant le second. Toute incohérence de dimension (par exemple en comparant une plage de 10 cellules à une plage de 11 cellules) provoque l’interruption immédiate de l’évaluation et renvoie le code d’erreur matriciel #N/A.
En ce qui concerne son comportement interne vis-à-vis des données non numériques, la fonction CORREL opère un filtrage transparent : les cellules contenant du texte brut, des valeurs logiques booléennes (VRAI ou FAUX) ou demeurées strictement vides sont écartées du calcul. Néanmoins, si l’une des cellules cibles contient une valeur d’erreur déclarée (telle que #DIV/0!, #VALEUR! ou #NOM?), cette anomalie se propage immédiatement au résultat de la fonction, renvoyant l’erreur correspondante. Par ailleurs, si la variance de l’une des plages est strictement nulle (toutes les valeurs sont identiques au sein de la fenêtre), la fonction échoue dans sa normalisation par l’écart-type et produit l’erreur arithmétique #DIV/0!.
4.2 Délimitation relative et absolue des plages matricielles
Le passage d’un calcul statique invariant à un modèle de corrélation dynamique glissante repose entièrement sur l’orchestration précise des modes d’adressage sous Excel. Dans l’écosystème du tableur, l’utilisation des références absolues (matérialisées par le préfixe $ devant la coordonnée de colonne ou de ligne, comme $B$2:$B$11) fige irrémédiablement le pointeur matriciel lors de la duplication de la formule. Pour concevoir une fenêtre temporelle mobile, il est impératif d’adopter un adressage relatif vertical pour les bornes de la plage.
En inscrivant par exemple la syntaxe =CORREL(B2:B6; C2:C6) à la ligne 6, puis en étirant verticalement cette cellule vers le bas jusqu’à la ligne 7, le moteur d’évaluation d’Excel incrémente automatiquement d’une unité chaque indice de ligne : la formule devient dynamiquement =CORREL(B3:B7; C3:C7). Cette translation mécanique matérialise le glissement de la fenêtre le long du flux séquentiel, conservant rigoureusement la taille k = 5 tout en réactualisant les frontières locales de l’échantillon.
Dans les versions contemporaines équipées du moteur de calcul matriciel dynamique (Excel 365 et Excel 2021), la gestion interne des calculs a été profondément remaniée par l’introduction du déversement automatique (spill behavior). Cette évolution permet d’envisager non seulement la propagation manuelle de formules relatives, mais également l’instanciation de formules matricielles globales capables de renvoyer l’intégralité du vecteur des corrélations mobiles à partir d’une instruction unique, limitant ainsi la charge cognitive et éliminant tout risque de désynchronisation accidentelle des plages étirées à la main.
5. Mise en œuvre pas à pas du calcul sur une fenêtre déterminée
5.1 Configuration d’une fenêtre mobile de taille 3 (k = 3)
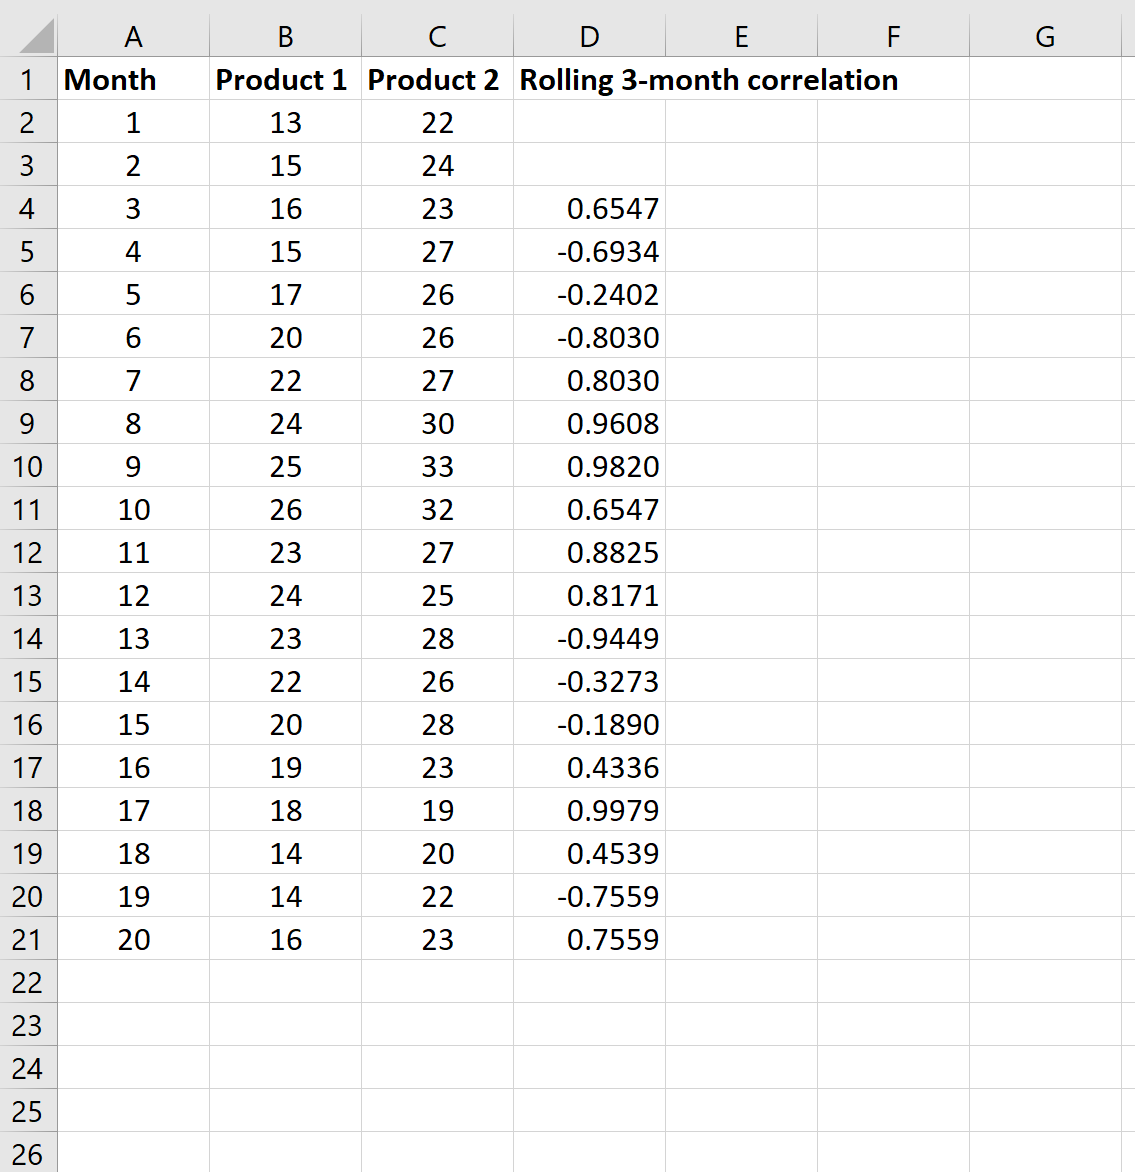
La configuration d’une fenêtre mobile ultra-courte de dimension k = 3 constitue le cas d’école optimal pour appréhender la mécanique computationnelle sans surcharge informationnelle. Supposons que nos données empiriques débutent à la ligne 2 de la feuille de calcul (les en-têtes de colonnes étant positionnés sur la ligne 1), la série X occupant la plage B2:B100 et la série Y la plage C2:C100. Une fenêtre de taille k = 3 exige la présence obligatoire d’au moins trois observations chronologiques consécutives pour pouvoir calculer mathématiquement une covariance et un écart-type non nuls.
Par conséquent, l’évaluation ne peut en aucun cas débuter aux lignes 2 ou 3, faute d’antériorité temporelle suffisante. La première estimation légitime doit être positionnée très précisément à la ligne 4 de la colonne d’analyse (admettons la colonne D). En se plaçant dans la cellule D4, l’opérateur formule la commande :
=CORREL(B2:B4; C2:C4)
L’évaluation locale porte ainsi sur le triplet d’enregistrements temporels {t₁, t₂, t₃}. Dès validation, la cellule affiche la valeur instantanée de la corrélation locale. L’opérateur propage ensuite cette formule vers le bas le long de la série temporelle en double-cliquant sur la poignée de recopie (le carré noir situé dans l’angle inférieur droit du curseur de sélection) ou par un glisser-déposer descendant le long de la colonne D. La ligne 5 contiendra automatiquement =CORREL(B3:B5; C3:C5), la ligne 6 évaluera =CORREL(B4:B6; C4:C6), et ainsi de suite jusqu’à l’ultime ligne de la série chronologique.
5.2 Élargissement à une fenêtre mobile intermédiaire (k = 6 ou k = 12)
Dans la plupart des recherches appliquées, une fenêtre de taille 3 s’avère trop sujette au bruit stochastique haute fréquence pour offrir une lecture stable. L’analyste se tourne alors fréquemment vers des amplitudes intermédiaires, par exemple k = 6 (correspondant par exemple à un cycle semestriel pour des mesures mensuelles) ou k = 12 (couvrant une année complète d’échantillonnage mensuel ou un cycle complet d’alternance).
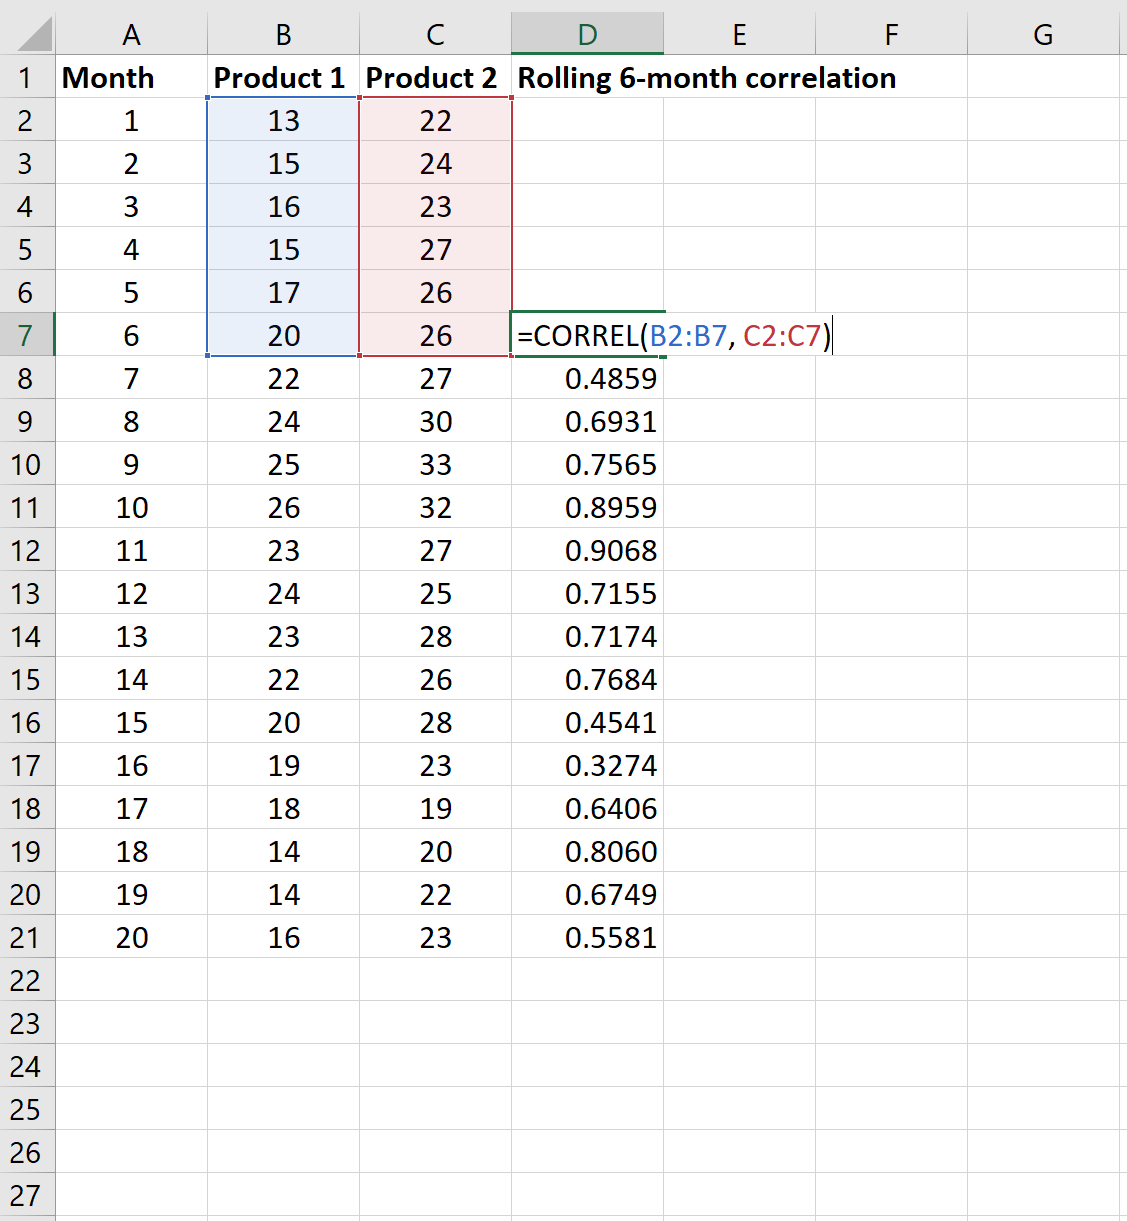
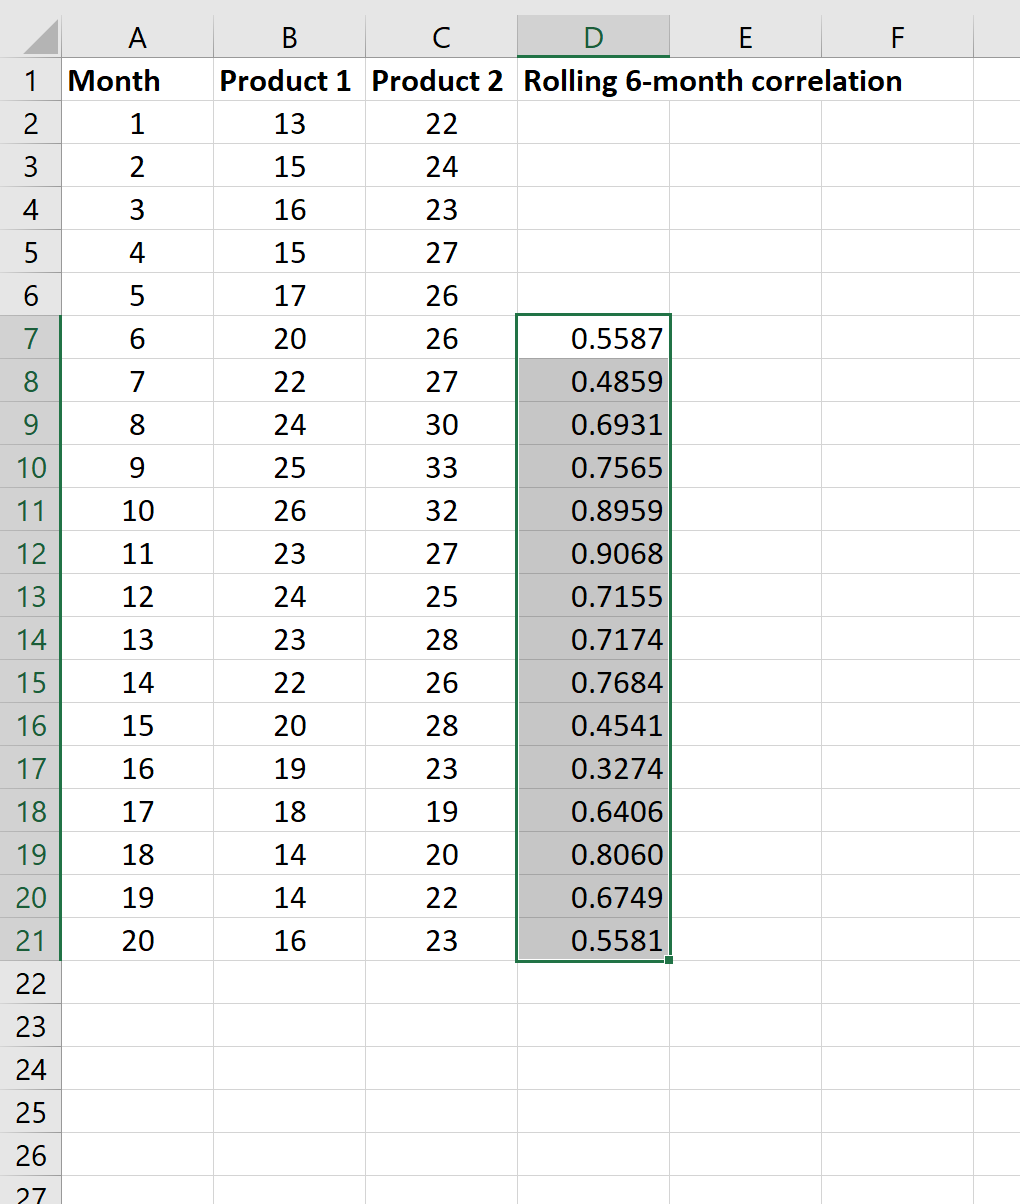
Pour implémenter rigoureusement une fenêtre de taille k = 6, le décalage initial doit être scrupuleusement ajusté : six enregistrements complets doivent précéder la clôture de la première fenêtre. Si les données débutent à la ligne 2, la première borne terminale se situe à la ligne 7 (soit les cellules 2, 3, 4, 5, 6 et 7). La formule doit donc être impérativement insérée dans la cellule D7 :
=CORREL(B2:B7; C2:C7)
Dans l’éventualité du déploiement d’une fenêtre de k = 12, la première ligne d’évaluation valide recule à la ligne 13 de la feuille de calcul, recevant la formule :
=CORREL(B2:B13; C2:C13)
Une vérification empirique attentive s’impose lors de cette phase : l’analyste doit contrôler que la dernière cellule du tableau (supposons D100) pointe fidèlement vers la plage B89:B100 et C89:C100. Une anomalie fréquente consiste à étirer par inadvertance la formule au-delà de la matrice de données, incorporant des cellules vides terminales qui fausseraient immédiatement la validité des dernières estimations de la série.
5.3 Gestion automatisée des premières lignes incomplètes
Lorsque la formule de corrélation glissante est saisie directement au palier k, les lignes antérieures (de la ligne 2 à la ligne k) demeurent visuellement vides ou sont exploitées pour d’autres usages. Cependant, cette hétérogénéité pose de sévères difficultés d’uniformisation lorsque l’on souhaite standardiser une colonne au sein d’un tableau de bord ou d’un Tableau Structuré Excel, car ce dernier applique systématiquement la même formule sur l’intégralité des cellules de la colonne sans discontinuité.
Pour surmonter cette contrainte structurelle et obtenir une présentation exempte d’artefacts d’affichage ou d’erreurs d’exécution, il convient d’encapsuler le calcul au sein d’une structure logique conditionnelle. La fonction LIGNE(), combinée à une instruction SI(), permet de neutraliser dynamiquement le calcul tant que l’indice séquentiel n’a pas atteint la maturité de la fenêtre requise :
=SI(LIGNE() - LIGNE($B$2) + 1 < 6; ""; CORREL(DECALER(B2; 0; 0; -6; 1); DECALER(C2; 0; 0; -6; 1)))
Ou, de façon plus simple dans une logique de références relatives directes débutant à la cellule D2 pour une fenêtre de taille 6 :
=SI(LIGNE() < 7; ""; CORREL(B2:B7; C2:C7)) (formule insérée en ligne 7, les cellules D2 à D6 recevant la constante textuelle vide "").
Pour blinder le système contre les erreurs arithmétiques générées par une variance locale ponctuellement nulle au cours du processus dynamique, l’encapsulation finale dans une fonction de traitement des exceptions assure une continuité esthétique et computationnelle sans faille :
=SI.ERREUR(CORREL(B2:B7; C2:C7); "")
Cette syntaxe prévient la prolifération disgracieuse des avertissements #DIV/0! sur les graphiques de restitution visuelle, transformant automatiquement les valeurs non évaluables en lacunes de tracé neutres.
6. Arbitrage et paramétrage de l’amplitude de la fenêtre mobile
6.1 Le dilemme biais-variance appliqué aux fenêtres temporelles
Le calibrage de la taille de la fenêtre mobile k constitue la décision méthodologique la plus stratégique de l’analyse, conditionnant directement la validité écologique et la précision statistique des inférences produites. Ce paramétrage incarne une manifestation éclatante du dilemme classique biais-variance propre à l’apprentissage statistique et à l’estimation non paramétrique.
D’une part, le choix d’une fenêtre étroite (faible valeur de k, par exemple k = 3 ou k = 5) offre une réactivité temporelle maximale face aux perturbations locales. L’indicateur réagit quasi instantanément aux mutations du couplage entre les variables. Néanmoins, cette hyper-réactivité s’opère au prix d’une variance d’échantillonnage dramatiquement élevée : le coefficient est dominé par le bruit stochastique résiduel et les erreurs de mesure locales, affichant des oscillations erratiques d’une amplitude excessive qui égarent l’analyste dans l’interprétation de micro-variations sans consistance fondamentale.
D’autre part, le recours à une fenêtre large (forte valeur de k, par exemple k = 30 ou k = 60) garantit un lissage robuste de la trajectoire d’association, neutralisant efficacement le bruit haute fréquence et resserrant les intervalles de confiance de l’estimateur. Toutefois, cette robustesse statistique engendre une inertie temporelle substantielle (biais de lissage). Les ruptures de corrélation authentiques ne sont détectées qu’avec un retard chronologique marqué, tandis que les événements de désynchronisation de courte durée sont entièrement absorbés et occultés par l’inertie de la mémoire d’échantillonnage.
6.2 Critères théoriques de sélection de la longueur k
La sélection de la constante k ne doit en aucun cas résulter d’un tâtonnement arbitraire guidé par la quête opportuniste de résultats visuellement attractifs. Elle doit reposer sur un ancrage théorique rigoureux, indexé sur les propriétés intrinsèques des phénomènes psycho-comportementaux ou physiologiques investigués. En premier lieu, la fenêtre d’analyse doit impérativement s’aligner sur la périodicité naturelle connue du système sous observation : les rythmes circadiens (fenêtres de 24 heures pour des pas horaires), les dynamiques hebdomadaires (fenêtres de 7 jours sur des journaux quotidiens) ou les cycles de travail et de repos constituent des repères écologiquement valides.
En second lieu, la sélection de k doit refléter la constante de temps estimée des mécanismes de régulation ou d’adaptation sous-jacents. Si une réaction émotionnelle s’estompe physiologiquement en l’espace de 10 minutes lors d’une induction expérimentale continue, paramétrer une fenêtre de 30 minutes détruira la signature dynamique du processus homéostatique en amalgamant la réaction aiguë et la phase basale post-stresseur.
Dans les situations exploratoires où la théorie ne dicte aucun paramètre catégorique a priori, il est méthodologiquement recommandé de procéder à une analyse de sensibilité multicritère. Cette technique consiste à calculer et superposer les trajectoires de corrélation pour plusieurs échelons scalaires étalonnés (par exemple k = 5, k = 15, k = 30) afin de discriminer avec certitude les singularités locales non reproductibles des macro-tendances de co-évolution structurelle.
7. Automatisation avancée avec les fonctions matricielles dynamiques
7.1 Formulation dynamique avec les fonctions DECALER et LIGNE
L’étirement manuel des formules relatives, bien qu’intuitif, présente des vulnérabilités patentes lors du traitement de séries volumineuses ou dans des tableaux soumis à des rafraîchissements périodiques de données. L’architecture logicielle d’Excel permet de concevoir une formule paramétrique hautement adaptable dont l’amplitude de fenêtre peut être dynamiquement pilotée depuis une unique cellule de contrôle (par exemple la cellule $F$1 dans laquelle l’opérateur saisit manuellement la valeur entière de k).
Pour opérationnaliser cette structure, la fonction DECALER s’impose comme un outil historique particulièrement flexible. Sa syntaxe combinée permet de construire dynamiquement un sous-vecteur mobile rétrograde à partir de la ligne active. Insérée en ligne d’évaluation et étirée le long de la série, la formule s’énonce :
=SI(LIGNE() - LIGNE($B$2) + 1 < $F$1; ""; CORREL(DECALER(B2; 0; 0; -$F$1; 1); DECALER(C2; 0; 0; -$F$1; 1)))
Dans cette expression, DECALER(B2; 0; 0; -$F$1; 1) commande au logiciel de générer une plage de hauteur égale à -$F$1 (c’est-à-dire orientée vers le haut depuis la ligne courante) et de largeur unitaire. Toute modification de la valeur présente en $F$1 recalcule instantanément l’intégralité du profil dynamique sans exiger la réécriture physique des coordonnées de cellule.
Il importe toutefois de souligner une contrainte d’ingénierie majeure : la fonction DECALER est intrinsèquement volatile. À chaque frappe clavier ou modification apportée dans le classeur, Excel est contraint de recalculer l’ensemble des occurrences de DECALER, même si les données sources sont demeurées immuables. Sur des jeux de données comportant plusieurs dizaines de milliers d’enregistrements temporels, ce recalcul perpétuel dégrade dramatiquement les performances computationnelles et induit des ralentissements perceptibles de l’interface.
7.2 Approche non-volatile via les fonctions INDEX et CHOISIRLIGNES
Afin de concilier flexibilité paramétrique et performance algorithmique optimale sans souffrir de la volatilité computationnelle, l’utilisation conjointe des fonctions INDEX ou des fonctions modernes telles que CHOISIRLIGNES s’impose comme le standard professionnel d’excellence. La fonction INDEX possède la propriété remarquable et sous-estimée de renvoyer une véritable référence de cellule (et non un simple scalaire) lorsqu’elle est combinée avec l’opérateur deux-points (:).
Ainsi, pour définir de façon non-volatile une fenêtre mobile de taille k (paramétrée en $F$1) se terminant à la ligne active i, il est possible d’articuler la formule suivante (en supposant que nos données débutent rigoureusement en B2:C1000) :
=CORREL(INDEX(B:B; LIGNE() - $F$1 + 1):INDEX(B:B; LIGNE()); INDEX(C:C; LIGNE() - $F$1 + 1):INDEX(C:C; LIGNE()))
Cette construction garantit que le moteur de calcul traite la plage exactement comme un intervalle fixe standard, sans inscrire la formule sur la liste d’arbre de dépendance volatile du classeur. Le calcul s’exécute quasi instantanément, autorisant le traitement fluide de séries massives de bio-signaux ou de traces numériques haute fréquence.
Dans l’environnement moderne d’Excel 365, la fonction matricielle CHOISIRLIGNES offre une alternative élégante lorsqu’elle est combinée avec SEQUENCE. En extrayant dynamiquement un bloc de lignes contiguës depuis un tableau structuré, on peut formuler des expressions compactes qui éliminent tout adressage absolu ou relatif conventionnel, sécurisant le modèle face aux suppressions ou insertions intempestives de colonnes intermédiaires.
7.3 Génération complète d’une colonne de corrélation par LAMBDA et MAP
L’introduction des fonctionnalités fonctionnelles de première classe (first-class functions) dans Microsoft Excel 365, incarnées par les fonctions LAMBDA, MAP et SCAN, marque une rupture paradigmatique dans la manipulation des séries chronologiques. Il est désormais possible de générer d’un seul bloc l’intégralité d’une colonne de corrélation mobile sans recourir à aucun étirement de formule vers le bas, éradiquant les risques d’omission ou d’altération de cellules individuelles.
Considérons que la série temporelle X est contenue dans la plage nommée PlageX (ex. B2:B500) et la série Y dans PlageY (ex. C2:C500), avec une amplitude de fenêtre stockée dans la cellule K_Val. Une formule matricielle dynamique globale peut être déployée au sommet de la colonne de restitution via la combinaison canonique des fonctions MAP et LAMBDA :
=MAP(SEQUENCE(LIGNES(PlageX)); LAMBDA(idx; SI(idx < K_Val; ""; CORREL(CHOISIRLIGNES(PlageX; SEQUENCE(K_Val; 1; idx - K_Val + 1)); CHOISIRLIGNES(PlageY; SEQUENCE(K_Val; 1; idx - K_Val + 1))))))
Cette architecture computationnelle opère selon une élégance mathématique stricte :
- La fonction
SEQUENCE(LIGNES(PlageX))génère un vecteur d’entiers allant de 1 jusqu’au nombre total d’observations. - La fonction itérative
MAPtransmet séquentiellement chaque indiceidxà l’abstractionLAMBDA. - Pour chaque valeur d’index inférieure à la fenêtre requise, l’expression renvoie immédiatement une chaîne vide, prévenant toute tentative d’évaluation sur des degrés de liberté incomplets.
- Dès que l’index atteint ou dépasse
K_Val, la fonctionCHOISIRLIGNESextrait vectoriellement la sous-matrice correspondant exactement aux k lignes précédant l’indice courant, en exploitantSEQUENCE(K_Val; 1; idx - K_Val + 1)pour générer la liste exacte des numéros de lignes locales à agréger. - La fonction
CORRELévalue ces deux sous-vecteurs matriciels en mémoire vive pure et déverse automatiquement le vecteur résultat sur la hauteur correspondante de la feuille.
Cette approche d’ingénierie déclarative supprime toute dépendance envers la géométrie de la feuille de calcul et confère au classeur une maintenabilité et une modularité proches des architectures logicielles professionnelles.
8. Visualisation graphique et sémiologie de la dynamique temporelle
8.1 Conception d’un graphique en lignes chronologique
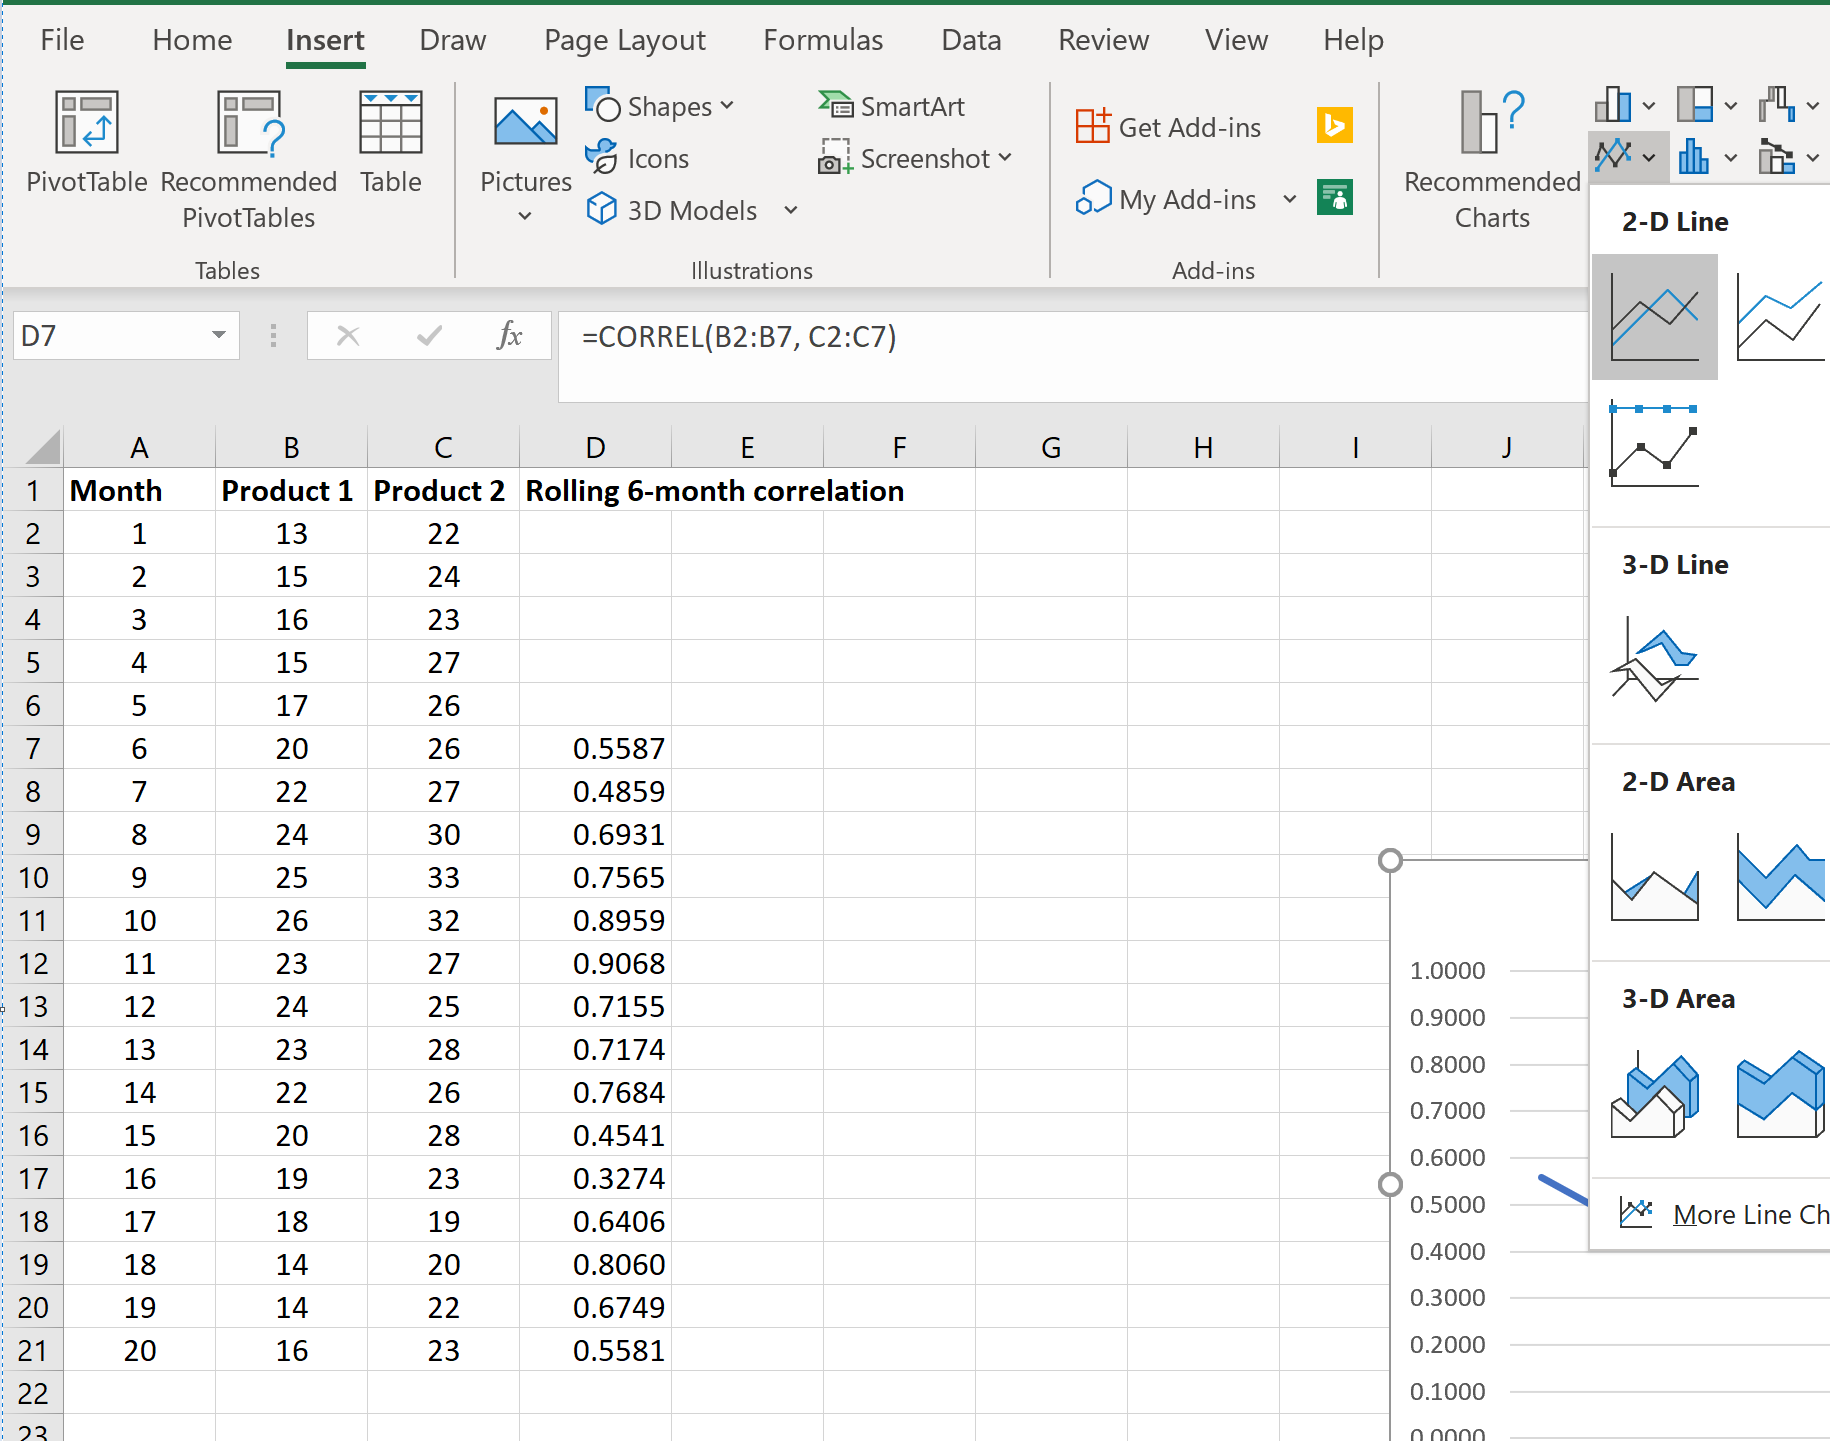
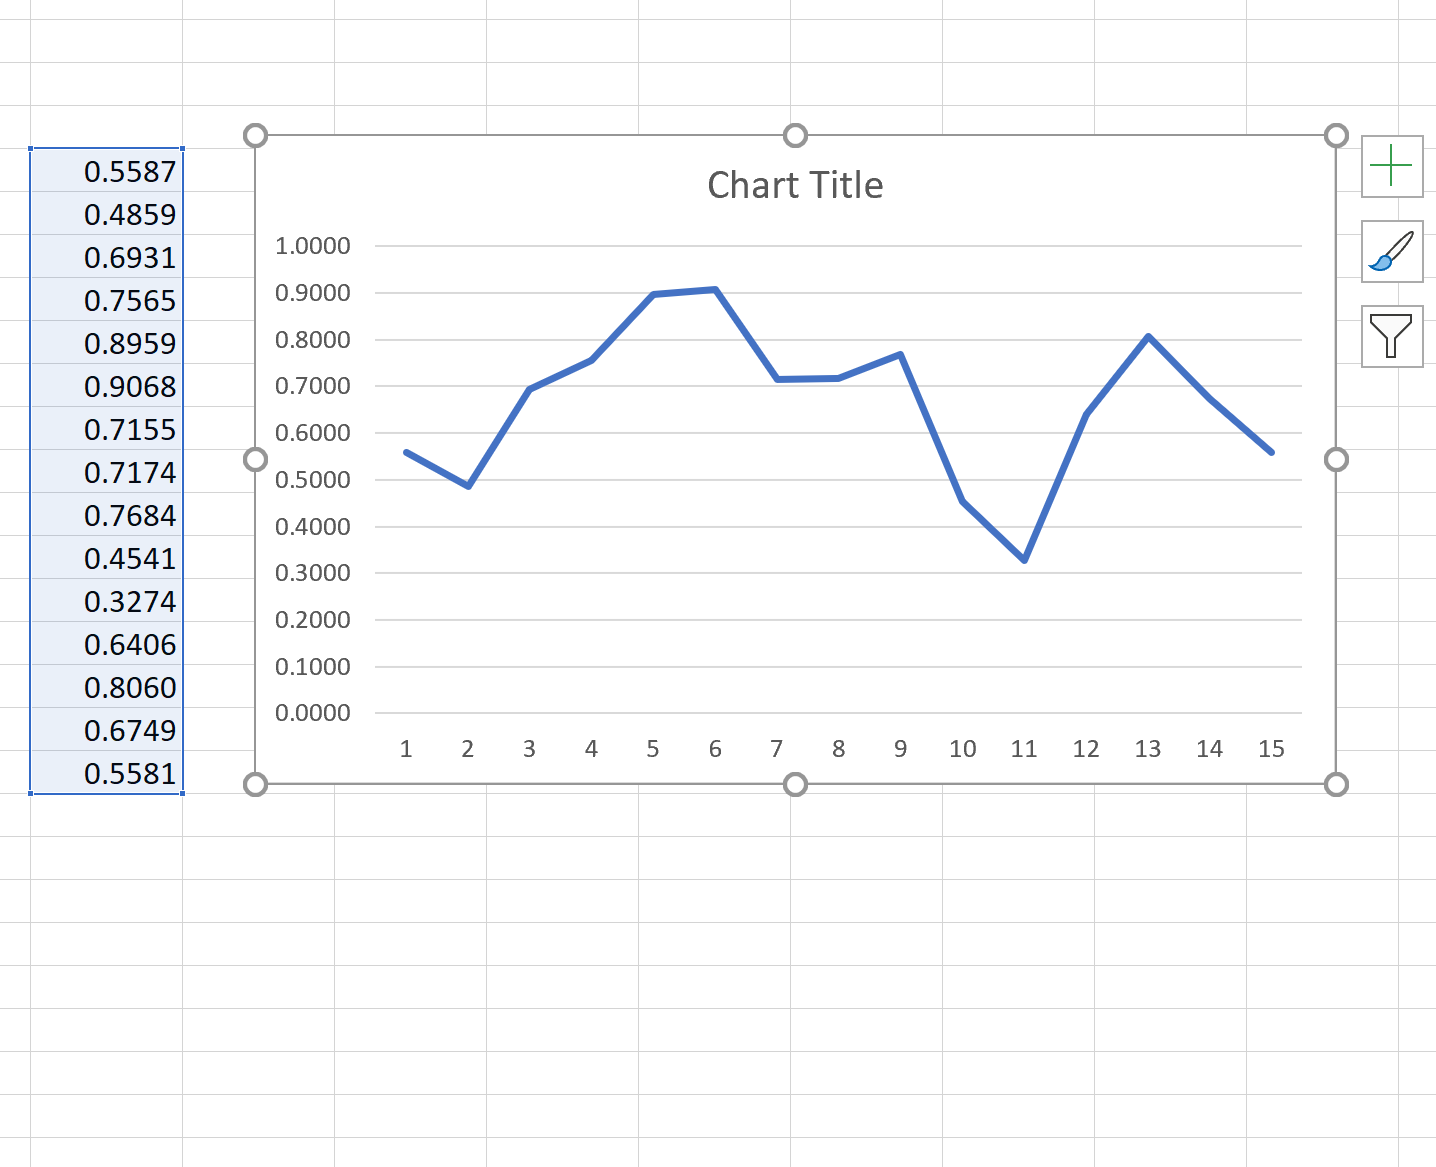
Le calcul numérique brut d’une corrélation mobile ne livre sa véritable substance analytique qu’à travers une sémiologie graphique parfaitement maîtrisée. L’esprit humain étant particulièrement performant dans la détection visuelle de formes et de ruptures continues, le tracé chronologique de la série calculée constitue la modalité de restitution par excellence. Sous Microsoft Excel, la conception de ce rendu impose de sélectionner simultanément la colonne de l’axe temporel (horodatage ou index chronologique) et le vecteur de corrélation mobile obtenu, puis d’insérer un graphique standard de type Lignes 2D ou Nuage de points avec lignes droites.
Le paramétrage sémiologique de l’axe vertical des ordonnées s’avère absolument crucial et non négociable. Par défaut, le moteur graphique d’Excel calibre automatiquement les bornes minimale et maximale en fonction des extremums présents dans l’échantillon empirique (par exemple en bornant l’axe entre +0,20 et +0,75). Ce calibrage opportuniste constitue une hérésie méthodologique majeure : il amplifie visuellement des micro-oscillations négligeables et empêche la comparaison visuelle inter-études. L’analyste doit impérativement forcer le format de l’axe des ordonnées pour fixer son minimum à -1,0 et son maximum à +1,0, respectant rigoureusement les frontières théoriques universelles du coefficient de Bravais-Pearson.
Concomitamment, il est indispensable de faire figurer une ligne de référence horizontale marquée à l’ordonnée zéro. Cette ligne médiane sert de frontière phénoménologique fondamentale, permettant à l’observateur d’identifier instantanément les phases d’inversion relationnelle, matérialisées par le passage d’un régime de synchronie positive (co-variation de même sens) à un régime d’opposition négative (relation inverse ou d’évitement).
8.2 Superposition comparative multifenêtres
Pour surmonter le dilemme biais-variance décrit précédemment et offrir une profondeur de lecture multiniveau, le traçage simultané de multiples fenêtres mobiles au sein d’un graphique unique constitue la meilleure pratique d’analyse de séries temporelles. Cette technique, inspirée du croisement des moyennes mobiles en analyse technique quantitative, consiste à superposer par exemple une courbe de réactivité immédiate (à court terme, ex. k = 5) et une courbe d’ancrage structurel (à plus long terme, ex. k = 20 ou k = 50).
La différentiation stylistique de ces deux vecteurs doit obéir à des conventions visuelles éprouvées :
- La dynamique rapide (court terme) sera tracée à l’aide d’un trait fin, éventuellement d’une tonalité semi-saturée, témoignant de sa sensibilité aux micro-variations locales.
- La dynamique lente (long terme) sera matérialisée par un trait plus épais, d’une couleur sombre ou contrastée, marquant sans ambiguïté le niveau moyen de connexion globale du système.
Cette mise en scène graphique met en exergue les points de convergence et de divergence relationnelle : lorsque la courbe court terme coupe vivement à la baisse la trajectoire long terme pour s’enfoncer sous la ligne zéro, elle documente une rupture brutale de synchronie que la lecture d’une seule série lissée n’aurait révélée qu’avec un temps de retard critique.
8.3 Mise en forme conditionnelle et zones d’ombre d’alerte
L’exploitation de la mise en forme conditionnelle sous Excel permet d’enrichir considérablement l’efficacité cognitive des tableaux et des visualisations associées. Dans la colonne des résultats chiffrés, l’application d’une échelle de nuances tricolores (dégradé de rouge pour les fortes corrélations négatives, jaune ou blanc pour l’absence d’association autour de 0, et vert ou bleu pour les fortes corrélations positives) offre une vue synoptique immédiate des basculements de phase sans nécessiter l’examen détaillé de chaque valeur numérique.
Pour sublimer la restitution graphique sur le plan académique, l’intégration de zones d’alerte semi-transparentes ou de bandes de seuils critiques de significativité est hautement recommandée. Bien que la significativité locale soit sujette aux biais d’autocorrélation évoqués au Chapitre 2, il est d’usage d’indiquer par un lignage discontinu horizontal les seuils critiques de Student théoriques pour une taille k donnée à α = 0,05, formulés selon la relation :
r_crit = ± t_(k-2; 0,05) / √[ t_(k-2; 0,05)² + k – 2 ]
Toute excursion de la courbe de corrélation mobile au-delà de ces bandes de tolérance matérialise visuellement un événement d’association statistiquement atypique à l’échelle de la fenêtre locale, guidant l’attention de l’analyste vers les périodes nécessitant une investigation clinique ou comportementale qualitative approfondie.
9. Gestion des anomalies, instabilité et ruptures structurelles
9.1 Le problème de la variance locale nulle
L’une des défaillances computationnelles les plus pénalisantes lors de l’automatisation d’une corrélation mobile le long d’une série continue réside dans le déclenchement de l’erreur d’interruption arithmétique #DIV/0!. L’architecture formelle de la corrélation de Pearson divise la covariance conjointe par le produit vectoriel des écarts-types individuels. Si, sur l’intervalle temporel restreint défini par la fenêtre de taille k, l’une des deux variables d’observation demeure strictement invariable (présentant un vecteur de valeurs constantes identique, comme {5, 5, 5}), la somme des carrés de ses écarts à la moyenne locale s’annule rigoureusement.
Par voie de conséquence, son écart-type local s’établit à 0, engendrant une division par zéro au dénominateur que le processeur d’Excel est dans l’impossibilité physique de résoudre. Cette situation survient très fréquemment dans les recherches comportementales : phases de sommeil prolongé dans les enregistrements actigraphiques, plafonnement des scores lors de tests psychométriques (effets de plafond ou de plancher constants) ou plateaux de calibrage technique d’un capteur biomédical.
La parade algorithmique sous Excel impose d’auditer en amont l’écart-type de chaque sous-fenêtre par une condition logique stricte préalablement au calcul :
=SI(OU(ECARTYPE.STANDARD(B2:B7) = 0; ECARTYPE.STANDARD(C2:C7) = 0); ""; CORREL(B2:B7; C2:C7))
Ce blindage computationnel court-circuite l’exécution de la fonction CORREL dès que l’un des vecteurs locaux dégénère en une constante invariante, inscrivant une cellule vide neutre qui préserve la continuité d’exécution de la chaîne de traitement et élimine tout plantage d’évaluation en cascade.
9.2 Effet d’entraînement des valeurs aberrantes (outlier shadowing)
Un phénomène sous-estimé propre au fonctionnement des fenêtres temporelles glissantes est l’effet d’entraînement des valeurs aberrantes, couramment désigné sous le concept d’effet d’ombre (outlier shadowing). Lorsqu’un événement exceptionnel, un artefact instrumental violent ou une erreur de saisie typographique produit un point de données aberramment éloigné de la distribution locale à l’instant t, ce point modifie instantanément l’estimation de la corrélation mobile au moment de son incorporation dans la fenêtre.
Toutefois, la pathologie algorithmique réside dans le fait que cette déformation artificielle de l’estimateur ne s’estompe pas à l’instant suivant : elle va persister avec une rigidité absolue pendant exactement k périodes consécutives, c’est-à-dire jusqu’à ce que la translation de la fenêtre mobile évacue enfin cette observation contaminée par sa borne arrière. L’analyste non averti est alors exposé à l’illusion optique d’observer une phase prolongée de corrélation anormale d’une durée égale à k, alors que le signal empirique n’a en réalité subi qu’une impulsion erratique unique à un instant discret isolé.
Pour diagnostiquer et neutraliser ce biais trompeur, deux démarches d’assainissement statistique peuvent être modélisées sous Excel :
- Le repérage préalable des sauts abrupts par le calcul des scores standardisés locaux (Z-scores glissants) et l’exclusion des valeurs excédant les seuils tolérés (ex. |Z| > 3).
- La winsorisation locale, qui consiste à écrêter automatiquement les valeurs extrêmes aux percentiles 5 et 95 locaux, réduisant leur levier artificiel sur le calcul de la somme des déviations croisées.
9.3 Impact des changements structurels de régime
L’existence de modifications structurelles fondamentales dans le système investigué soulève un défi d’interprétation critique pour la corrélation mobile. Lorsqu’un changement brutal de palier survient (par exemple, une élévation subite du niveau moyen d’une variable consécutive à l’administration d’un traitement pharmacologique ou à l’apparition d’une consigne expérimentale nouvelle), la fenêtre mobile absorbe ce décrochement de façon graduelle.
Pendant tout le temps où la frontière mobile traverse la zone de rupture, la fenêtre héberge conjointement des observations issues de l’ancien régime de moyenne et des observations issues du nouveau régime. Cette coexistence bimodale artificielle engendre une dispersion colossale de la somme des carrés des écarts locaux par rapport à la moyenne mobile x̄_(t,k), qui n’est représentative d’aucun des deux états stationnaires réels. La covariance locale se trouve ainsi polluée par le saut de niveau moyen, induisant une déformation spectaculaire du coefficient de corrélation qui peut bondir ou chuter sans qu’aucune modification de l’interaction fine bivariée n’ait eu lieu en réalité.
Pour prévenir cette confusion dommageable entre saut de moyenne et restructuration de covariance, l’analyste se doit de coupler systématiquement le tracé de la corrélation glissante avec les graphiques séquentiels des moyennes et des variances mobiles locales. L’observation conjointe d’une discontinuité des moyennes locales concomitante à l’inflexion du coefficient r constitue l’empreinte typique d’une rupture structurelle de palier, imposant de segmenter l’analyse en deux fenêtres indépendantes de part et d’autre de l’événement.
10. Applications aux séries temporelles psychologiques et comportementales
10.1 Couplage affectif et variabilité psychophysiologique
L’exploration des interactions somato-psychiques constitue un territoire d’élection pour le déploiement de la corrélation dynamique glissante. Dans les protocoles de monitoring psychophysiologique ambulatoire continu, les chercheurs enregistrent simultanément des marqueurs neurovégétatifs à haute résolution temporelle – tels que la variabilité du rythme cardiaque (VRC, notamment la puissance spectrale dans les hautes fréquences traduisant le tonus vagal) ou la conductance cutanée – et des auto-évaluations continues de la détresse affective ou de l’anxiété perçue recueillies sur des échelles analogiques numériques.
Sous une perspective statique globale, ces deux dimensions n’affichent fréquemment qu’une corrélation croisée négligeable ou marginalement significative, suggérant à tort une déconnexion entre le corps et l’esprit. L’implémentation d’une analyse par fenêtre mobile (avec une amplitude calibrée par exemple à k = 10 minutes de relevés) démontre au contraire l’existence d’une dynamique de couplage éminemment transitoire. Durant les phases d’exposition à un défi cognitif ou à une menace sociale, la corrélation entre la chute du tonus vagal et l’élévation de l’anxiété bondit à des amplitudes négatives intenses (r < -0,70), traduisant une synchronie végétative adaptative immédiate.
Inversement, lors des phases ultérieures de récupération ou chez des sujets présentant des traits d’alexithymie ou de stress post-traumatique, la courbe de corrélation mobile s’effondre vers zéro ou affiche des fluctuations déphasées. Ce phénomène documente une désynchronisation psychophysiologique pathologique, dans laquelle l’activation autonome persiste sans que le sujet n’en formule la conscience affective correspondante, ou vice-versa. L’évaluation continue de ce profil de couplage temporel enrichit remarquablement la précision diagnostique.
10.2 Dynamique longitudinale des thérapies et comportements de santé
L’avènement des méthodologies d’évaluation écologique momentanée (EMA) a profondément transformé le suivi longitudinal des protocoles de psychothérapie et des interventions sur les habitudes de santé. Les patients rapportent quotidiennement, via des terminaux mobiles, des mesures répétées portant sur l’observance thérapeutique, les ruminations dépressives, la qualité subjective du sommeil et la sévérité symptomatique sur des périodes s’étirant sur plusieurs mois.
L’évaluation par corrélation glissante journalière permet d’observer la restructuration progressive des relations inter-symptomatiques au fil de la trajectoire clinique. Par exemple, au début d’une prise en charge cognitivo-comportementale, la relation quotidienne entre l’apparition d’un stresseur relationnel et la consommation impulsive d’alcool peut afficher une corrélation mobile positive massive (r ≈ +0,80 sur des fenêtres de k = 14 jours), illustrant un pattern de régulation émotionnelle dysfonctionnelle prédominant.
À mesure que la thérapie déploie ses effets, la corrélation glissante met en exergue l’affaiblissement progressif de ce lien de covariation, qui dérive vers une zone d’orthogonalité (r ≈ 0), signalant la rupture du lien automatique stresseur-consommation et l’adoption de conduites d’ajustement plus flexibles. De surcroît, la réémergence inattendue d’une forte synchronie positive le long de la série temporelle constitue un signal d’alerte précoce d’un risque imminent de rechute clinique, offrant au thérapeute une opportunité d’intervention ciblée avant la matérialisation symptomatique complète de l’épisode aigu.
10.3 Analyse de la synchronie interindividuelle en psychologie sociale
L’analyse des interactions dyadiques – qu’il s’agisse de l’accordage émotionnel au sein d’un couple en conflit, de la syntonie non verbale entre un psychothérapeute et son patient, ou de la coordination motrice entre deux partenaires de négociation – repose sur la capture de flux temporels continus synchrones. Lors d’enregistrements vidéo ou de captations biométriques dyadiques, les mouvements posturaux, les prosodies vocales ou les expressions faciales faciales (par codage FACS dynamique) sont numérisés seconde par seconde pour chaque protagoniste.
L’application de la corrélation glissante le long de la ligne temporelle d’interaction isole les périodes précises de résonance affective et de syntonie empathique, matérialisées par des paliers prolongés de haute corrélation positive. Cependant, la complexité humaine réside dans le fait que la synchronie interpersonnelle est rarement purement simultanée : elle obéit à des mécanismes d’émission, de décodage et de rétroaction impliquant une latence comportementale inhérente.
Pour capturer cette dynamique d’influence réciproque sous Microsoft Excel, il est particulièrement pertinent de concevoir un modèle de corrélation glissante décalée (lagged rolling correlation). En insérant un décalage temporel fixe τ (par exemple en décalant la plage de l’interlocuteur B de 2 secondes en avant : CORREL(B4:B23; C2:C21)), l’analyste évalue si le comportement de l’un prédit de façon coordonnée la réaction de l’autre au sein de la fenêtre mobile. La comparaison des profils de corrélation glissante selon différents ordres de latence permet d’établir formellement la directivité temporelle et le leadership émotionnel régissant l’échange dyadique.
11. Comparaison méthodologique : Excel face aux environnements de script
11.1 Avantages opérationnels et accessibilité d’Excel
L’arbitrage entre l’usage d’un tableur tel que Microsoft Excel et le recours à des environnements statistiques entièrement scriptés (tels que R, Python ou Julia) fait l’objet de vifs débats méthodologiques. Il convient de reconnaître à l’environnement Excel des avantages ergonomiques et fonctionnels considérables qui justifient sa prévalence continue dans de nombreux secteurs professionnels et académiques. Le premier atout réside dans l’inspection visuelle directe et continue des matrices de calcul : l’analyste conserve un accès physique immédiat à chaque cellule individuelle, chaque sous-total et chaque formule intermédiaire.
Cette transparence prévient l’effet « boîte noire » fréquemment reproché aux pipelines de traitement algorithmiques automatisés dans lesquels des erreurs d’alignement d’index ou des conversions de type erronées peuvent s’exécuter silencieusement sans que l’opérateur n’en perçoive la trace tangible. Par ailleurs, l’absence absolue de barrière technique à l’entrée liée à l’apprentissage de la syntaxe d’un langage de code autorise un déploiement immédiat de la corrélation mobile par des cliniciens, des épidémiologistes de terrain ou des décideurs qui ne possèdent pas de compétences informatiques avancées.
Enfin, la facilité universelle de partage de rapports dynamiques sous la forme d’un unique fichier .xlsx standardisé simplifie considérablement la collaboration transdisciplinaire. N’importe quel collaborateur, membre d’un comité d’évaluation ou auditeur peut explorer l’architecture du calcul, modifier instantanément le paramètre de fenêtre k dans la cellule de pilotage et observer en temps réel la métamorphose adaptative des visualisations sans nécessiter l’installation d’interpréteurs, de compilateurs ou de packages spécifiques complexes.
11.2 Limites computationnelles et de reproductibilité
En contrepoint de son accessibilité séduisante, Microsoft Excel souffre de limitations intrinsèques pénalisantes dès lors que le protocole analytique franchit certains seuils de volume, de rigueur ou de complexité algorithmique. Sur le plan purement computationnel, les algorithmes de calcul matriciel du tableur sont fondamentalement optimisés pour des calculs interactifs ponctuels et non pour le traitement massivement parallélisé de flux de données continus. L’application de formules glissantes complexes exploitant des fonctions volatiles (telles que DECALER) sur des séries comportant plusieurs centaines de milliers de lignes génère une saturation de la mémoire vive et fige les performances du processeur.
Sur le plan de l’intégrité scientifique, le tableur expose l’analyste à un risque décuplé d’erreurs d’intervention humaine non traçables. Une fausse manipulation de poignée de recopie, l’omission accidentelle d’une ligne lors de l’étirement vertical d’une formule relative ou l’altération involontaire de la valeur d’une cellule isolée peuvent contaminer l’ensemble du profil dynamique sans qu’aucun historique d’exécution détaillé ni aucun journal d’audit (audit log) ne vienne documenter l’incident.
Enfin, la lacune la plus profonde réside dans l’incapacité pratique d’Excel à automatiser élégamment les tests de significativité statistique séquentiels et les corrections d’autocorrélation avancées. Alors qu’un script exécute en quelques millisecondes les redressements de degrés de liberté de Newey-West ou de Moran sur chaque pas de la fenêtre mobile, l’implémentation de ces protocoles au sein d’une grille de cellules Excel engendre des formules matricielles d’une lourdeur intolérable, augmentant considérablement la probabilité d’erreurs de syntaxe conceptuelle.
11.3 Correspondances fonctionnelles en Python et R
Pour le statisticien ou le chercheur amené à faire évoluer ses analyses vers des environnements de programmation scientifique à des fins de passage à l’échelle ou de standardisation reproductible, il est précieux d’établir les correspondances directes unissant les opérations de calcul mobile exécutées sous Excel avec leurs homologues syntaxiques sous Python et R.
Dans l’écosystème Python, la manipulation des séries temporelles s’appuie canoniquement sur la bibliothèque pandas. Le calcul séquentiel d’une corrélation mobile de fenêtre k = 10 entre deux colonnes d’un DataFrame s’exécute de manière vectorisée via la méthode native rolling :
rolling_corr = df['VariableX'].rolling(window=10).corr(df['VariableY'])
Cette instruction effectue en arrière-plan compilé C l’exact équivalent des formules Excel détaillées au Chapitre 5, attribuant automatiquement des valeurs NaN (l’homologue de #N/A) aux neuf premières observations incomplètes et traitant les variances nulles avec une stabilité numérique totale.
Dans l’environnement de programmation statistique R, le traitement des fenêtres mobiles s’appuie de façon préférentielle sur les fonctionnalités optimisées du package zoo et sa fonction universelle rollapply, ou plus spécifiquement sur le package roll :
rolling_corr <- zoo::rollapplyr(data[, c("VariableX", "VariableY")], width = 10, function(w) cor(w[,1], w[,2]), by.column = FALSE, fill = NA)
La compréhension intime de la mécanique matricielle acquise sur la feuille de calcul Excel constitue un tremplin pédagogique exceptionnel, facilitant l’appropriation de ces expressions déclaratives avancées au sein des scripts de recherche.
12. Recommandations méthodologiques, éthique et pièges interprétatifs
12.1 Le piège de la multiplicité des tests et du p-hacking temporel
La conduite d’une analyse de corrélation mobile confronte inévitablement le chercheur à un écueil inférentiel majeur : le problème des comparaisons multiples délocalisées dans le temps. Lorsqu’une formule glissante est évaluée le long d’une série temporelle de N = 1000 pas avec une fenêtre k = 20, l’analyste ne procède pas à un test d’hypothèse unique, mais calcule implicitement 981 coefficients de corrélation consécutifs. En appliquant naïvement le seuil nominal conventionnel de significativité α = 0,05 sur chaque estimation locale, la probabilité d’observer par pur hasard stochastique au moins une séquence affichant une significativité fallacieuse explose pour atteindre une quasi-certitude mathématique :
P(au moins une fausse alerte) = 1 – (1 – α)^m ≈ 1 (pour m élevé)
Cette réalité statistique expose l’analyste au risque insidieux de p-hacking temporel. Ce biais comportemental consiste à scruter visuellement la série calculée, à isoler a posteriori une fenêtre temporelle spécifique où la corrélation mobile atteint un pic spectaculaire et significatif, puis à échafauder un récit théorique rétrospectif (pratique dite du HARKing : Hypothesizing After the Results are Known) pour attribuer une importance phénoménologique décisive à cet intervalle.
Pour préserver l’éthique scientifique, il est indispensable d’interdire toute sélection opportuniste post-hoc. Les hypothèses relatives aux dynamiques de couplage temporel doivent être rigoureusement formulées a priori, en pré-spécifiant les segments temporels critiques d’intérêt (par exemple, exclusivement les phases précédant et suivant l’administration d’une intervention) et en appliquant des procédures strictes de contrôle du taux de fausses découvertes (procédure de Benjamini-Hochberg) ajustées sur le volume réel de tests corrélatifs indépendants exécutés.
12.2 Distinction formelle entre corrélation dynamique et causalité
L’observation d’une synchronisation mobile spectaculaire entre deux séries chronologiques ne confère aucune légitimité scientifique à la conclusion d’un lien causal sous-jacent. Si la mise en garde selon laquelle « corrélation ne vaut pas causalité » constitue le truisme méthodologique fondamental des sciences empiriques, elle acquiert une acuité encore plus impérieuse dans le cadre temporel dynamique. En effet, l’illusion de causalité est magnifiée par le caractère continu et spectaculaire des courbes de corrélation mobile, qui épousent fidèlement les contours des événements contextuels transversaux.
Le risque prépondérant réside dans l’omission d’une tierce variable confondante qui évolue de manière synchronisée avec le système analysé. Par exemple, au cours d’une journée de recueil psychologique ambulatoire, la corrélation glissante entre la consommation subjective de caféine et le niveau de productivité au travail peut afficher des montées synchrones régulières, suggérant une efficacité directe du stimulant sur le rendement professionnel. Toutefois, cette synchronisation locale peut être entièrement orchestrée par une troisième dynamique latente non modélisée : la charge d’exigence des échéances professionnelles imposées par l’environnement de travail, qui stimule simultanément la prise de stimulants et l’urgence de l’activité.
Les règles de restitution déontologique imposent de formuler les conclusions avec une stricte réserve épistémologique dans toutes les études observationnelles. L’analyse par corrélation mobile documente exclusivement la co-dépendance linéaire instantanée de signaux numériques observables ; la démonstration d’un mécanisme de directionnalité causale exige impérativement le recours à des plans d’expérimentation randomisés contrôlés ou à des modélisations autorégressives vectorielles instrumentées complétées par des analyses de causalité au sens de Granger.
12.3 Protocole type de rapport académique des résultats
Afin de garantir la transparence intégrale, l’auditabilité et la reproductibilité des analyses de corrélation mobile au sein des publications scientifiques évaluées par les pairs, les chercheurs doivent se conformer à un protocole de rapportage standardisé et exhaustif. L’omission des paramètres opérationnels du calcul prive la communauté scientifique des moyens indispensables pour vérifier ou répliquer les trajectoires temporelles publiées.
La section méthodologique d’un manuscrit académique ou d’un rapport de recherche doit impérativement expliciter les éléments suivants :
- La justification théorique et empirique de la taille de fenêtre k : spécifier formellement la valeur numérique de k (en unités temporelles et en nombre d’enregistrements effectifs) et expliciter les hypothèses physiques, physiologiques ou comportementales qui motivent ce paramétrage d’échelle.
- L’exposition détaillée des pré-traitements de séries : décrire exhaustivement les transformations appliquées pour satisfaire la condition de stationnarité (différenciation première, calcul des taux de variation, élimination des dérives tendancielles linéaires ou décomposition saisonnière).
- Le protocole de traitement des anomalies et données manquantes : divulguer avec exactitude les méthodes d’imputation mobilisées, les seuils d’exclusion des valeurs aberrantes ainsi que la stratégie d’encapsulation adoptée face aux séquences de variance locale nulle.
- Les modalités de restitution graphique : attester du respect de l’échelle canonique fixe des ordonnées ([-1; +1]) et préciser les corrections appliquées aux seuils d’inférence statistique face aux biais de dépendance sérielle.
- L’adhésion aux normes de la science ouverte (Open Science) : déposer au sein d’un entrepôt de données public sécurisé (tel que l’Open Science Framework ou Zenodo) le classeur Excel source complet, dûment nettoyé, commenté et anonymisé, permettant l’examen direct et sans ambiguïté des formules de calcul déployées.
L’application scrupuleuse de ces directives assure à l’analyse de corrélation glissante sous Microsoft Excel une validité scientifique indiscutable, réconciliant la flexibilité opérationnelle d’un outil grand public avec les standards de rigueur méthodologique les plus exigeants de la recherche contemporaine.
Références
Bartlett, M. S. (1935). Some aspects of the time-correlation problem in regard to tests of significance. Journal of the Royal Statistical Society, 98(3), 536-543. https://doi.org/10.2307/2980424
Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289-300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
Box, G. E., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5e éd.). John Wiley & Sons.
Granger, C. W., & Newbold, P. (1974). Spurious regressions in econometrics. Journal of Econometrics, 2(2), 111-120. https://doi.org/10.1016/0304-4076(74)90034-7
Hodrick, R. J., & Prescott, E. C. (1997). Postwar U.S. business cycles: An empirical investigation. Journal of Money, Credit, and Banking, 29(1), 1-16. https://doi.org/10.2307/2953682
Moran, P. A. (1948). Some experiments on the effective size of sample in time series. Biometrika, 35(1/2), 132-140. https://doi.org/10.2307/2332634
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Shrout, P. E., & Lane, S. P. (2012). Psychometrics. Dans M. R. Mehl & T. S. Eid (Éds.), Handbook of research methods for studying daily life (pp. 302-320). The Guilford Press.
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10