
L’analyse de l’interdépendance linéaire entre plusieurs grandeurs quantitatives constitue l’un des piliers méthodologiques les plus universellement employés dans les sciences contemporaines. Qu’il s’agisse de sonder la structure interne d’une batterie de tests psychométriques, de quantifier les dynamiques écologiques au sein d’écosystèmes complexes ou d’isoler des covariations physiologiques en épidémiologie, la question du calcul simultané des associations bivariées demeure au cœur du travail inférentiel. L’environnement statistique R s’impose aujourd’hui comme la plateforme de référence internationale pour exécuter ces protocoles matriciels, combinant une puissance computationnelle éprouvée, une conformité rigoureuse avec les axiomes de l’algèbre linéaire et une flexibilité algorithmique sans égale.
Toutefois, l’estimation d’une matrice de corrélation ne saurait être réduite à l’exécution mécanique d’une fonction de base. La transition d’un modèle bivarié simple à une approche multivariée intégrée engage des enjeux conceptuels et mathématiques profonds : la préservation de la semi-définition positive des matrices résultantes, la prise en compte des patrons d’attrition des données manquantes, le contrôle rigoureux du risque d’erreur de première espèce induit par la multiplicité des tests d’hypothèses, ainsi que la vérification scrupuleuse des postulats distributionnels. Une méconnaissance de ces principes expose l’analyste à des inférences erronées, à des artefacts d’échantillonnage ou à des conclusions fallacieuses dissimulant des associations fallacieuses sous le voile d’une significativité statistique factice.
Ce guide exhaustif a pour vocation de déconstruire, étape par étape et avec un niveau d’exigence académique maximal, l’ensemble de la chaîne de traitement permettant de calculer, d’ajuster, d’interpréter et de restituer des matrices de corrélation multivariées dans R. En abordant tour à tour les fondations algébriques du coefficient de Pearson, les extensions non paramétriques de Spearman et de Kendall, l’automatisation de l’inférence statistique via des packages spécialisés, le contrôle des variables confondantes par les corrélations partielles et la modélisation graphique avancée, ce document constitue un manuel de référence tant pour les chercheurs en sciences du comportement que pour les analystes de données confrontés aux défis de la recherche empirique.
1. Fondements théoriques du coefficient de corrélation et logique multivariée
1.1 Nature et propriétés mathématiques du r de Pearson
Le coefficient de corrélation produit-moment de Pearson, universellement désigné par la lettre r dans les cadres échantillonnaux et par la lettre grecque ρ au niveau populationnel, formalise le degré d’association linéaire entre deux variables aléatoires continues. Mathématiquement, ce coefficient s’obtient par la division de la covariance des deux distributions considérées par le produit de leurs écarts-types respectifs. Cette normalisation canonique affranchit la mesure de toute dépendance vis-à-vis des unités de mesure d’origine, conférant à cet indice une nature adimensionnelle particulièrement précieuse pour les comparaisons standardisées au sein de distributions hétérogènes.
L’intervalle théorique des valeurs admissibles pour le coefficient de Pearson est rigoureusement borné entre -1 et +1. Une valeur de +1 signale une relation linéaire positive parfaite, caractérisée par une concordance géométrique absolue des scores individuels le long d’une droite de régression ascendante, tandis qu’un coefficient de -1 traduit une relation linéaire négative parfaite où toute augmentation unitaire sur une dimension s’accompagne d’une diminution proportionnelle constante sur la seconde. La valeur zéro matérialise une absence intégrale d’association linéaire, indiquant que la variance partagée entre les deux entités mathématiques est nulle, bien que des configurations géométriques complexes ou des dépendances non monotones puissent néanmoins persister.
En psychométrie et en sciences sociales, le coefficient de Pearson requiert impérativement des échelles de mesure d’intervalles ou de rapports, garantissant que les distances arithmétiques séparant les échelons demeurent équivalentes sur l’ensemble du continuum considéré. La principale vulnérabilité structurelle du r de Pearson réside dans son incapacité ontologique à modéliser adéquatement les trajectoires relationnelles curvilignes, quadratiques ou exponentielles. Face à de telles distributions, le calcul d’un coefficient standard sous-estimera drastiquement l’intensité de la dépendance stochastique réelle, pouvant conclure de manière totalement erronée à l’indépendance de phénomènes pourtant étroitement connectés sur le plan fonctionnel.
1.2 Transition de l’analyse bivariée à l’analyse multivariée
L’investigation scientifique contemporaine peut rarement se contenter d’isoler des paires de variables au sein de systèmes complexes. En psychologie cognitive, en sociologie quantitative ou en neurobiologie comportementale, les construits étudiés sont fondamentalement multidimensionnels, nécessitant la prise en compte simultanée d’une pluralité d’indicateurs empiriques. L’abandon de l’analyse bivariée séquentielle au profit de la logique multivariée répond à l’impératif d’appréhender les réseaux d’interrelations globales qui caractérisent les systèmes réels, en transcendant la somme fragmentée des associations isolées pour capturer la cohérence structurelle de l’ensemble des dimensions observées.
D’un point de vue structural, cette démarche multivariée se matérialise par l’élaboration d’une matrice de variance-covariance, couramment notée Σ, au sein de laquelle les variances univariées occupent la diagonale principale tandis que les covariances bivariées s’organisent hors diagonale. En appliquant une transformation d’invariance d’échelle par la pré- et post-multiplication de cette matrice de covariance par l’inverse de la matrice diagonale des écarts-types, on obtient la matrice de corrélation R. Cette construction algébrique possède des propriétés formelles remarquables, au premier rang desquelles figurent sa symétrie parfaite par rapport à la diagonale et la présence exclusive de valeurs unitaires sur cette dernière.
La symétrie de la matrice découle directement de la commutativité inhérente à la covariance : l’association entre la variable X et la variable Y est strictement identique à celle reliant Y à X. Par ailleurs, la diagonale principale est systématiquement peuplée de 1, traduisant le fait qu’une variable présente invariablement une corrélation parfaite avec elle-même. Au-delà de ces évidences formelles, la matrice multivariée doit impérativement satisfaire à la condition de semi-définition positive, ce qui implique que l’ensemble de ses valeurs propres soit supérieur ou égal à zéro, condition indispensable pour que la structure spatiale sous-jacente corresponde à un espace vectoriel euclidien valide et autorise des calculs de décomposition factorielle ultérieurs.
1.3 Pertinence méthodologique en sciences du comportement
Dans le domaine des sciences du comportement, l’examen minutieux des matrices de corrélation multivariées remplit plusieurs missions méthodologiques indispensables à la robustesse des protocoles empiriques. En premier lieu, cet examen conditionne la vérification de la validité de construit dans le cadre du développement d’outils d’évaluation. En s’appuyant sur les préceptes de la matrice multitrait-multiméthode introduite par Campbell et Fiske, les chercheurs inspectent les patrons corrélationnels pour documenter la validité convergente (manifestée par des corrélations substantielles entre mesures distinctes d’un même construit latent) et la validité discriminante (attestée par des coefficients modestes entre construits théoriquement dissociables).
En second lieu, l’exploration d’une matrice de corrélation multivariée constitue une phase diagnostique incontournable préalablement à toute tentative de modélisation explicative ou prédictive, telle que la régression linéaire multiple ou les équations structurelles. Elle permet d’identifier précocement les manifestations de multicolinéarité, situation pathologique où plusieurs variables explicatives partagent des fractions de variance si massives que les estimateurs de moindres carrés ordinaires deviennent instables, entraînant une inflation exponentielle des erreurs-types des coefficients de régression et faussant l’évaluation de leur contribution respective.
Enfin, l’observation globale des coefficients croisés au sein d’une vaste batterie de questionnaires permet de formuler des hypothèses inductives sur l’organisation sous-jacente des comportements humains. En révélant des blocs de variables fortement associées entre elles mais faiblement reliées aux autres sous-ensembles matriciels, l’analyste identifie des profils de covariance qui orienteront la mise en œuvre d’analyses en composantes principales, d’analyses factorielles exploratoires ou de modélisations en réseaux psychométriques, assurant une passerelle méthodique entre l’observation brute des données et la théorisation psychologique de haut niveau.
2. Configuration de l’environnement R et instanciation du jeu de données
2.1 Initialisation du bloc de données empirique
Pour illustrer de manière transparente et rigoureusement reproductible l’ensemble des techniques computationnelles exposées dans ce traité, nous procéderons à l’instanciation directe d’un cadre de données synthétique, hébergeant quatre variables quantitatives continues désignées par les étiquettes alphabétiques a, b, c et d. Ce jeu de données fictif, représentatif des métriques observées dans les enquêtes d’évaluation psychologique (incluant par exemple des indices de temps de réaction, de régulation émotionnelle, d’attention soutenue et de mémoire de travail), servira de matrice expérimentale fil conducteur tout au long de nos développements algorithmiques.
L’élaboration programmatique de ce bloc de données s’opère au moyen de la primitive de base de création de tableaux, en combinant des distributions aléatoires multivariées ou des séquences vectorielles contrôlées permettant d’induire délibérément des intensités d’association contrastées. Dès que l’objet est instancié au sein de la mémoire vive de l’environnement R, il incombe à l’analyste de procéder à un examen méticuleux de sa structure interne en invoquant la fonction d’inspection structurelle str(). Cette commande dévoile immédiatement la classe de l’objet, le volume total d’enregistrements d’observations et la nature de chaque vecteur de données sous-jacent.
L’étape suivante consiste à valider la conformité dimensionnelle de la matrice empirique par l’entremise de la fonction dim(), qui restitue un vecteur d’entiers indiquant le nombre exact de lignes et de colonnes du tableau. Conjointement, l’affichage des premières rangées d’observations via la fonction head() permet de s’assurer visuellement de la cohérence des amplitudes numériques enregistrées, de l’absence de décalages accidentels lors de l’indexation des colonnes, et de l’intégrité générale du format tabulaire avant d’engager les opérations statistiques proprement dites.
2.2 Exploration descriptive univariée des distributions
Avant d’aborder les interdépendances multivariées, un examen rigoureux des propriétés distributionnelles individuelles de chaque variable s’impose impérativement. L’exécution de la commande descriptive générale summary() fournit un condensé immédiat des indicateurs fondamentaux de tendance centrale et de dispersion pour l’ensemble des colonnes numériques du tableau. Cette commande restitue la valeur minimale observée, le premier quartile, la médiane géométrique, la moyenne arithmétique, le troisième quartile et la valeur maximale enregistrée, offrant une cartographie univariée préliminaire de grande utilité.
Cette étape descriptive permet d’évaluer la symétrie apparente de chaque vecteur de données. Une divergence substantielle entre la moyenne arithmétique et la médiane signale d’emblée la présence d’une asymétrie distributionnelle prononcée, susceptible d’influencer la validité des futures estimations de Pearson. De même, l’observation des étendues de variation (la distance séparant le minimum du maximum) permet de repérer d’éventuelles anomalies d’enregistrement, des dépassements des bornes théoriques permises par les protocoles de mesure, ou des valeurs aberrantes univariées qui pourraient agir comme des leviers statistiques délétères lors des calculs d’association.
En parallèle, l’analyste doit certifier formellement que toutes les colonnes assignées à l’analyse corrélationnelle sont bel et bien encodées sous forme de vecteurs strictement numériques (types double ou integer). La présence involontaire d’une seule variable factorielle ou d’un vecteur de chaînes textuelles, même résultant d’une simple erreur typographique lors de l’importation d’un fichier source, suffirait à faire échouer l’ensemble des calculs matriciels ultérieurs en déclenchant des exceptions logicielles au niveau des routines d’algèbre linéaire sous-jacentes du noyau de R.
2.3 Environnement de travail et reproductibilité computationnelle
La conduite d’analyses quantitatives selon les standards de la science ouverte impose une vigilance absolue quant à la reproductibilité computationnelle des résultats produits. Dans le cadre de l’écosystème R, cette démarche implique une structuration rigoureuse de la session de travail. Lorsque des procédures de simulation, d’échantillonnage de Monte-Carlo ou de rééchantillonnage par réamorçage (bootstrapping) sont sollicitées, la fixation explicite de la graine du générateur de nombres pseudo-aléatoires au moyen de l’instruction set.seed() constitue une exigence technique incontournable pour garantir que des exécutions ultérieures reproduisent rigoureusement les mêmes métriques d’échantillonnage.
Il est vivement conseillé d’organiser le script d’analyse de manière modulaire et déclarative, en regroupant en tête de fichier l’ensemble des directives de chargement des bibliothèques logicielles tierces nécessaires. L’adoption d’un environnement hermétique ou la documentation scrupuleuse des versions des extensions employées (via des outils tels que renv ou la fonction de diagnostic sessionInfo()) protège le chercheur contre les dérives fonctionnelles potentielles consécutives aux mises à jour futures des packages mathématiques.
Les bibliothèques fondamentales pour mener à bien le protocole complet développé dans cet article englobent les outils canoniques de manipulation de données (dplyr), les utilitaires de calcul et de diagnostic psychométrique (psych, Hmisc, ppcor), ainsi que les moteurs graphiques spécialisés dans la cartographie des interrelations multivariées (corrplot, GGally, pheatmap). L’initialisation propre de cet écosystème garantit une exécution fluide, affranchie de conflits d’espaces de noms de fonctions et prête à supporter des calculs de haute dimensionnalité.
3. Calcul bivarié fondamental avec la fonction cor()
3.1 Syntaxe de base et extraction des vecteurs individuels
Le calcul le plus élémentaire pour sonder l’association reliant deux variables quantitatives s’opère dans le moteur de base de R au moyen de la primitive cor(). Pour isoler deux colonnes spécifiques au sein d’un cadre de données, la convention syntaxique canonique fait intervenir l’opérateur d’extraction vectorielle matérialisé par le symbole du dollar. Ainsi, l’interrogation de la relation linéaire associant la variable a et la variable b s’effectue en renseignant explicitement les deux vecteurs en tant qu’arguments positionnels dans l’appel fonctionnel : cor(df$a, df$b).
L’exécution de cette instruction renvoie immédiatement un nombre scalaire unique, compris dans les bornes canoniques de -1 à +1. Ce chiffre condense l’intensité et la direction de la covariation linéaire brute des deux indicateurs. Si, à titre d’illustration théorique, la commande retourne un coefficient de +0.68, ce résultat atteste d’une association positive d’une magnitude substantielle selon les référentiels usuels de la psychologie différentielle et de la psychométrie appliquée.
Sur le plan interprétatif, ce résultat indique que les participants ou unités d’observation manifestant des performances élevées sur l’indicateur a tendent systématiquement à exprimer des scores supérieurs à la moyenne sur l’indicateur b. En élevant ce coefficient au carré, l’analyste obtient immédiatement le coefficient de détermination linéaire (ici, 0.68 au carré équivaut à approximativement 0.46), ce qui autorise à déduire que près de 46 % de la variance observée au sein de la dimension b peut être expliquée mathématiquement par la variation linéaire de la dimension a, sous réserve de la validité des postulats du modèle.
3.2 Contraintes et arguments par défaut de la fonction de base
Bien que la fonction cor() brille par sa simplicité apparente, son fonctionnement repose sur des postulats algorithmiques stricts dont la méconnaissance peut engendrer des blocages ou des méprises analytiques. En premier lieu, la fonction exige que les deux vecteurs numériques passés en arguments possèdent des longueurs rigoureusement identiques. Toute tentative de mise en relation de deux séries quantitatives issues d’échantillons asynchrones ou de tailles inégales déclenche immédiatement une erreur d’incompatibilité dimensionnelle, le moteur R refusant d’appliquer le recyclage vectoriel à des opérations qui requièrent un appariement bivarié point à point.
Par défaut, l’argument désignant la méthode d’estimation est calibré sur la chaîne de caractères « pearson ». Par conséquent, en l’absence de spécification contraire de la part de l’utilisateur, l’algorithme assume implicitement que les distributions respectent les conditions de linéarité et de normalité bivariée. Une autre particularité cruciale de cor() réside dans son minimalisme strict : la fonction n’évalue aucun modèle probabiliste et s’abstient totalement de calculer les degrés de liberté, l’erreur-type d’échantillonnage, la valeur du test t associé ou la significativité statistique (la p-valeur).
Ce dépouillement fonctionnel a été délibérément conçu par les architectes du langage R afin de maximiser la vitesse computationnelle lors du traitement de volumes de données massifs ou lors de simulations itératives complexes. Toutefois, cette caractéristique impose à l’utilisateur averti de ne pas confondre le calcul descriptif de la magnitude de l’effet avec le processus d’inférence statistique formelle, lequel nécessitera l’emploi de primitives d’évaluation d’hypothèses distinctes que nous aborderons dans les sections subséquentes de ce manuel.
3.3 Comparaison croisée des paires de variables
Lorsque le cadre de données recèle plus de deux grandeurs observées, l’analyste peut être tenté, dans un premier élan exploratoire, d’exécuter une succession d’appels bivariés élémentaires pour cartographier manuellement les contrastes d’association. En sollicitant successivement des instructions telles que cor(df$a, df$c) puis cor(df$a, df$d), on commence à entrevoir la géométrie multidimensionnelle du phénomène mesuré en comparant les trajectoires de covariance spécifiques à chaque couple d’indicateurs.
Cette démarche comparatiste séquentielle met fréquemment en évidence des disparités notables dans l’orientation et la magnitude des relations. Il n’est nullement rare, au sein d’une batterie de tests psychologiques, de constater que la variable a entretient une association positive vigoureuse avec la variable b (par exemple, r = +0.68), tout en manifestant une indépendance quasi-totale vis-à-vis de la variable c (r = -0.04) et une corrélation inverse marquée avec l’indicateur d (r = -0.52). Cette configuration hétérogène illustre la complexité des compromis fonctionnels ou des oppositions cognitives au sein de l’architecture psychologique des sujets observés.
Cependant, procéder par comparaisons bivariées manuelles répétitives devient excessivement fastidieux et source d’erreurs dès que le nombre d’indicateurs excède trois ou quatre. Pour un ensemble de k variables distinctes, le nombre total de paires uniques d’associations bivariées s’élève à k multiplié par (k – 1) divisé par 2. Face à un inventaire de dix variables, l’opérateur devrait ainsi saisir quarante-cinq commandes isolées, soulignant l’urgente nécessité méthodologique d’abandonner l’extraction vectorielle fragmentée pour adopter le formalisme matriciel automatisé.
4. Extension matricielle : calcul simultané sur plusieurs variables
4.1 Sous-ensemble ciblé de variables via l’indexation matricielle
Pour dépasser les limites de l’approche bivariée isolée sans nécessairement saturer l’analyse avec la totalité des colonnes d’un jeu de données volumineux, le langage R autorise le calcul direct de matrices de corrélation sur des sous-ensembles arbitraires de variables au moyen de l’indexation matricielle standard. En exploitant la syntaxe d’extraction entre crochets, l’analyste peut sélectionner précisément les colonnes d’intérêt en leur passant un vecteur de chaînes de caractères correspondant à leurs étiquettes nominatives : cor(df[, c(« a », « b », « c »)]).
Cette instruction opère une extraction dynamique en mémoire et soumet directement le tableau résultant à l’algorithme de calcul matriciel de Pearson. Il est tout aussi envisageable d’opérer par sélection indiciaire ordinale, par exemple en spécifiant les positions des colonnes via cor(df[, 1:3]), bien que l’indexation par étiquettes textuelles doive être résolument privilégiée en pratique pour des motifs d’autodocumentation du code et d’immunité face aux éventuelles réorganisations de colonnes survenant en amont de la chaîne de traitement.
Le résultat généré par cette commande prend la forme d’une sous-matrice carrée d’ordre k par k (en l’occurrence, une matrice 3×3), dont chaque intersection ligne-colonne indique la corrélation produit-moment existant entre les deux variables correspondantes. Cette capacité à restreindre instantanément le périmètre d’estimation matricielle s’avère d’une efficacité redoutable dans les protocoles de validation d’échelles composites, où le chercheur souhaite isoler sélectivement les covariations existant au sein de sous-échelles théoriques spécifiques préalablement à l’évaluation de la cohérence interne globale de l’instrument.
4.2 Calcul de la matrice intégrale pour l’ensemble du jeu de données
Dès lors que l’ensemble des colonnes d’un tableau de données empirique satisfait aux réquisits de métricité numérique, l’analyste peut solliciter le calcul de la matrice de corrélation intégrale en transmettant directement l’objet tabulaire complet en paramètre unique de la fonction : cor(df). Cette syntaxe concise mobilise de façon optimale les primitives sous-jacentes compilées en Fortran et en langage C intégrées au moteur R, garantissant une rapidité d’exécution spectaculaire même face à des tableaux d’observations hébergeant des milliers de cas individuels.
La matrice résultante synthétise l’intégralité de l’espace relationnel du jeu de données. Sa structure formelle obéit scrupuleusement aux théorèmes fondamentaux de l’algèbre linéaire. La diagonale principale, orientée du coin supérieur gauche au coin inférieur droit, présente exclusivement la valeur unitaire 1.00, formalisant l’auto-corrélation triviale de chaque variable avec elle-même. De part et d’autre de cette diagonale centrale se déploie une structure strictement symétrique : la valeur positionnée à la ligne i et à la colonne j est rigoureusement identique à celle logée à la ligne j et à la colonne i.
La lecture méthodique de cette matrice s’opère en parcourant les intersections de manière systématique. Les cellules hors-diagonale dressent le profil corrélationnel exhaustif de chaque indicateur, révélant simultanément les polarités des trajectoires relationnelles (positives ou négatives) et leurs magnitudes relatives. Cette vue synoptique constitue le point d’ancrage standard de toute exploration multivariée, permettant de repérer d’un seul regard tant les grappes de variables agissant de concert que les axes factoriels d’opposition mutuelle au sein de l’échantillon analysé.
4.3 Précautions relatives aux types de données non numériques
L’exécution directe de la commande cor(df) sur un cadre de données brut se heurte fréquemment à un écueil computationnel récurrent : l’incompatibilité de type. Si le tableau héberge la moindre colonne de nature non numérique — qu’il s’agisse de variables catégorielles encodées sous forme de facteurs, d’identifiants de sujets transcrits en chaînes de caractères alphanumériques ou d’indicateurs temporels —, le moteur statistique interrompra instantanément le traitement en émettant une fin de non-recevoir logicielle signalant que ‘x’ doit être numérique.
Pour prévenir cette défaillance, l’analyste méthodique se doit d’assainir et de filtrer préventivement le flux de données. Dans le paradigme fonctionnel de base de R, cette sélection automatisée repose classiquement sur l’évaluation logique des classes de colonnes au moyen de la combinaison vectorielle sapply(df, is.numeric). Cette routine teste chaque vecteur unitaire et produit un masque booléen, lequel autorise le sous-échantillonnage immédiat des colonnes éligibles via l’instruction matricielle cor(df[, sapply(df, is.numeric)]).
Dans l’écosystème moderne de manipulation de données centré sur la syntaxe tidyverse, cette même précaution s’exprime de manière remarquablement élégante et lisible grâce à l’invocation des fonctions de projection conditionnelle : df %>% dplyr::select(where(is.numeric)) %>% cor(). Cette formulation explicite garantit une imperméabilité totale aux colonnes nominales parasites, préserve l’intégrité du pipeline de traitement de données et assure une maintenance optimale du code analytique dans les environnements de recherche collaborative.
5. Gestion méthodique des valeurs manquantes dans les matrices multivariées
5.1 Impact des données incomplètes sur l’estimation corrélationnelle
Dans les enquêtes empiriques, et tout particulièrement au sein des sciences humaines et biomédicales, la complétude absolue des recueils d’informations relève de l’exception plutôt que de la règle. Des abandons en cours d’étude longitudinale, des omissions accidentelles lors de la saisie d’auto-questionnaires ou des défaillances techniques de capteurs physiologiques génèrent inévitablement des cellules manquantes, formalisées dans l’environnement R par la constante logique réservée NA (Not Available).
Par défaut, l’algorithme interne de la fonction cor() adopte un comportement strictement conservateur dicté par le principe de propagation des valeurs indéterminées : si une seule valeur manquante survient au sein de l’une des variables impliquées dans le calcul, la cellule matricielle correspondante renverra inéluctablement la mention NA. Par conséquent, l’application naïve de cor(df) sur un jeu de données hébergeant des données incomplètes diffuses se soldera quasi-invariablement par une matrice stérile, intégralement ou largement peuplée de valeurs non définies.
Sur le plan épistémologique et méthodologique, la confrontation aux données manquantes contraint le chercheur à caractériser le mécanisme sous-jacent d’attrition, en se référant à la typologie canonique formulée par Donald Rubin : les manques complètement aléatoires (MCAR), les manques aléatoires conditionnels (MAR), ou les manques non aléatoires dépendants des variables non observées (MNAR). Le choix de la stratégie d’estimation matricielle sous R engage directement la validité des conclusions statistiques selon la conformité des données à ces schémas théoriques d’omission.
5.2 Suppression par liste complète : use = ‘complete.obs’
La première stratégie formalisée pour contourner l’oblitération des calculs par les valeurs manquantes réside dans la suppression par liste complète, également désignée sous l’appellation de suppression cas par cas (listwise deletion). Cette méthode s’active explicitement dans la fonction de calcul matriciel en configurant l’argument de gestion des lacunes sous la forme : cor(df, use = « complete.obs »).
Sous ce régime d’exécution, l’algorithme procède à une purge préalable draconienne : toute ligne d’observation présentant au minimum une valeur manquante, sur n’importe laquelle des colonnes sélectionnées pour l’analyse, est purement et simplement exclue avant le moindre calcul de covariance. Cette approche présente un atout algébrique majeur : l’ensemble des coefficients de la matrice finale est rigoureusement calculé sur la base d’un sous-échantillon d’observations strictement identique et homogène. La matrice résultante est ainsi mathématiquement garantie d’être semi-définie positive, ce qui préserve sa cohérence géométrique globale pour des utilisations avancées ultérieures.
Toutefois, le coût statistique de cette procédure peut s’avérer prohibitif. Si les données manquantes sont disséminées de façon diffuse à travers un grand nombre de variables distinctes, la suppression par liste complète peut résulter en une hécatombe d’enregistrements empiriques, réduisant la taille de l’échantillon effectif à une fraction marginale de la cohorte originelle. De surcroît, si le mécanisme de génération des données n’est pas rigoureusement MCAR (Missing Completely at Random), cette purge introduit un biais de sélection substantiel dans l’estimation des moyennes, des variances et des coefficients de corrélation de la population cible.
5.3 Suppression par paire : use = ‘pairwise.complete.obs’
Afin d’endiguer la déperdition massive de puissance statistique inhérente à la purge complète, les analystes recourent fréquemment à la suppression par paire (pairwise deletion), que l’on paramètre au sein de l’environnement R via l’instruction : cor(df, use = « pairwise.complete.obs »). Cette tactique computationnelle adopte une logique opportuniste et ciblée pour l’estimation de chaque coefficient individuel.
Dans ce cadre, lors de l’estimation de la corrélation unissant le vecteur a et le vecteur b, seules les observations présentant une valeur manquante spécifique sur a ou sur b sont temporairement neutralisées. Si un participant a omis de répondre à la question relative à la variable c mais dispose de données valides sur a et b, son observation demeure intégralement conservée pour l’estimation du coefficient unissant ces deux dernières grandeurs. Cette modalité permet de maximiser la quantité d’informations empiriques exploitées et préserve la puissance d’évaluation pour chaque association bivariée prise isolément.
Néanmoins, la suppression par paire introduit une anomalie mathématique non négligeable : les différentes cellules de la matrice finale de corrélation ne reposent plus sur le même échantillon d’observations ni sur des effectifs identiques (les tailles n variant d’une cellule à l’autre). Cette disparité sous-jacente brise les contraintes géométriques formelles de l’espace vectoriel euclidien standard, conférant occasionnellement à la matrice résultante la caractéristique pathologique de ne plus être semi-définie positive (l’apparition de valeurs propres négatives devenant possible). De surcroît, si le postulat MCAR est violé, les déformations d’estimation induites peuvent s’avérer asymétriques et particulièrement complexes à corriger lors de modélisations ultérieures.
6. Méthodes non paramétriques pour données ordinales et distributions asymétriques
6.1 Coefficient de corrélation des rangs de Spearman
L’application du coefficient produit-moment de Pearson présuppose que les données mesurées évoluent sur un continuum d’intervalles réguliers et respectent des postulats d’homogénéité distributionnelle souvent mis à mal dans la pratique de la recherche. Face à des mesures ordinales typiques des échelles d’attitudes psychologiques (telles que les échelles de type Likert à cinq ou sept points) ou en présence de distributions continues exhibant une asymétrie manifeste, le recours au coefficient non paramétrique de rangs de Charles Spearman, couramment désigné par la lettre grecque ρ (rho), constitue l’ajustement méthodologique de référence.
L’algorithme sous-jacent à la corrélation de Spearman repose sur un principe mathématique élégant : il consiste à opérer une substitution intégrale des valeurs numériques brutes d’origine par leurs rangs statistiques ordinaux respectifs au sein de chaque distribution vectorielle, puis à appliquer l’équation algébrique classique de Pearson sur ces séries de rangs transformées. Dans l’environnement R, cette méthodologie s’applique de manière universelle sur les matrices multivariées par la simple altération du paramètre méthodologique : cor(df, method = « spearman »).
Le coefficient de Spearman quantifie la monotonicité d’une relation plutôt que sa stricte linéarité. Dès lors qu’une variable augmente de manière systématique et concordante lorsque la seconde progresse, le coefficient de rangs atteindra une valeur parfaite de +1, même si la trajectoire géométrique réelle épouse une dynamique fortement exponentielle, logarithmique ou sigmoïdale. Cette insensibilité aux déformations d’échelles monotones en fait un instrument de modélisation particulièrement robuste face aux déviations de distribution fréquentes en psychométrie clinique.
6.2 Tau de Kendall pour petits échantillons et ex æquo
Une alternative non paramétrique de haute tenue scientifique au coefficient de Spearman est matérialisée par le tau de Maurice Kendall, identifié par la lettre grecque τ. Tandis que Spearman calque son calcul sur l’écart arithmétique quadratique des rangs assignés, Kendall fonde sa modélisation sur l’examen direct de la concordance et de la discordance ordinale relative caractérisant chaque paire possible d’observations tirée de l’échantillon empirique.
Une paire de sujets (i, j) est qualifiée de concordante si l’individu qui présente le score le plus élevé sur la variable X surpasse également son homologue sur la variable Y. Dans le cas contraire, la paire est réputée discordante. Si les deux sujets partagent un score identique sur l’une des dimensions, la paire est classifiée comme un ex æquo (ou rang lié). Le tau de Kendall évalue le différentiel net normalisé entre la proportion globale de paires concordantes et la proportion globale de paires discordantes. Au sein du moteur R, l’estimation matricielle multivariée du tau s’obtient par la configuration explicite : cor(df, method = « kendall »).
Le tau de Kendall est universellement reconnu par les théoriciens de la statistique pour sa robustesse analytique supérieure face aux échantillons de taille modeste. De surcroît, ses propriétés d’échantillonnage convergent de façon nettement plus stable et prévisible vers une distribution normale que celles du rho de Spearman, autorisant des inférences de significativité d’une précision mathématique irréprochable. Enfin, les corrections algorithmiques appliquées par le formalisme de Kendall face aux situations récurrentes de rangs liés (très fréquentes sur des échelles discrètes à faibles nombres de modalités) offrent des garanties d’impartialité d’estimation particulièrement solides.
6.3 Critères comparatifs de sélection de la méthode appropriée
Le choix raisonné entre les trois métriques canoniques (Pearson, Spearman et Kendall) engage la responsabilité épistémologique de l’analyste et conditionne la crédibilité de ses inférences de recherche. Le tableau suivant synthétise les postulats sous-jacents, les niveaux d’échelles requis et les vulnérabilités respectives de chaque estimateur multivarié afin d’orienter une sélection conforme aux normes internationales de publication scientifique :
- Coefficient de Pearson : Exige des échelles de mesure métriques continues (d’intervalles ou de rapports). Assume des postulats stricts de normalité bivariée ou multivariée et de linéarité des trajectoires. Démontre une vulnérabilité critique face aux observations aberrantes extrêmes (outliers), qui peuvent gonfler ou écraser artificiellement l’estimation de covariance.
- Coefficient de Spearman : Opère sur des échelles de mesure ordinales ou métriques continues affranchies des contraintes de normalité. Modélise les dépendances purement monotones (croissance ou décroissance continue non nécessairement rectiligne). Manifeste une résistance substantielle aux valeurs atypiques grâce à la conversion préalable en rangs.
- Tau de Kendall : Privilégié sur des échelles ordinales denses comportant de fréquents ex æquo ou sur des échantillons restreints en effectifs. Fondé sur la combinatoire des paires d’observations concordantes et discordantes. Présente les meilleures propriétés asymptotiques et des erreurs-types hautement fiables pour l’inférence statistique rigoureuse.
En pratique empirique, si les données satisfont aux inspections visuelles de linéarité et ne manifestent pas d’asymétries excessives (coefficients d’aplatissement et d’obliquité restant dans les tolérances standard de -1 à +1), le coefficient de Pearson demeure la métrique reine en vertu de sa comparabilité directe avec les algorithmes d’équations structurelles. Dès lors qu’une échelle discrète ordinale est employée sans conversion en score factoriel continu sous-jacent, le recours systématique aux métriques de Spearman ou de Kendall s’impose impérativement pour prévenir toute distorsion d’estimation liée à la discrétisation des mesures.
7. Inférence statistique et matrices de significativité multivariées
7.1 Limites de la fonction cor.test() face au multivarié
Si la fonction cor() permet d’édifier rapidement des structures matricielles exhaustives, nous avons souligné sa carence intrinsèque en matière de test d’hypothèses. Pour soumettre une association observée à un test d’inférence probabiliste et déterminer la plausibilité de l’hypothèse nulle d’absence de corrélation au sein de la population parente, l’environnement de base de R met à disposition la primitive spécialisée cor.test().
Cette commande exécute un test de Student paramétrique (pour Pearson) ou ses transpositions non paramétriques (pour Spearman et Kendall), restituant l’erreur-type de la mesure, la valeur de la statistique t de décision, les degrés de liberté exacts, la p-valeur de rejet de l’hypothèse nulle et, pour le coefficient de Pearson, l’intervalle de confiance à 95 % encadrant la taille d’effet estimée. Toutefois, cor.test() souffre d’une limitation structurelle majeure : elle a été programmée pour traiter exclusivement une paire unique de vecteurs bivariés, par exemple cor.test(df$a, df$b).
L’injection d’un cadre de données multivarié ou d’une matrice de plus de deux colonnes au sein de cor.test() provoque un échec logiciel immédiat. Pour combler cette lacune sans mobiliser de packages externes, l’utilisateur devrait concevoir des boucles itératives récursives fastidieuses ou des procédures vectorisées imbriquées de type apply() pour collecter les probabilités cellule par cellule. Face à cette lourdeur syntaxique, la communauté scientifique a développé des bibliothèques logicielles spécialisées capables de générer des matrices de significativité intégrales en une seule ligne de commande.
7.2 Exploitation de la fonction rcorr() du package Hmisc
Parmi les extensions les plus robustes pour surmonter l’indigence inférentielle du moteur de base figure le package Hmisc, conçu par le biostatisticien Frank Harrell. Au sein de cette bibliothèque, la fonction rcorr() s’impose comme un outil incontournable pour les analystes désireux d’obtenir simultanément les coefficients de corrélation et leurs p-valeurs associées sur des jeux de données multivariés.
Une précaution technique impérative gouverne l’utilisation de rcorr() : cette fonction n’accepte pas directement les cadres de données standards de type data.frame. Elle exige formellement une matrice numérique brute en entrée. L’analyste doit donc systématiquement convertir son tableau d’observations au moyen de la primitive de transtypage as.matrix(df) lors de l’invocation fonctionnelle : Hmisc::rcorr(as.matrix(df), type = « pearson »). La fonction supporte également l’argument type = « spearman » pour les évaluations ordinales.
L’objet composite retourné par rcorr() est une structure de type liste contenant trois matrices distinctes d’ordre identique : la matrice $r regroupant l’ensemble des coefficients de corrélation estimés, la matrice$n consignant les effectifs d’observations valides pris en compte pour chaque cellule bivariée (ce qui s’avère inestimable en présence de données incomplètes traitées par paires), et la matrice $P hébergeant les p-valeurs de significativité exactes associées à chaque croisement. Cette organisation tripartite facilite considérablement l’interrogation programmatique et l’extraction des seuils critiques requis pour la documentation des résultats.
7.3 Utilisation avancée du package psych avec corr.test()
Dans l’univers de la recherche en sciences du comportement et en psychométrie quantitative, le package psych, développé et maintenu par William Revelle, représente le sommet fonctionnel de l’analyse corrélationnelle. Sa fonction dédiée, corr.test(), surclasse notablement les alternatives existantes en combinant simplicité syntaxique, polyvalence distributionnelle et richesse des métriques d’inférence générées.
Contrairement à la fonction issue de Hmisc, psych::corr.test(df) ingère nativement les data frames sans imposer de conversion matricielle manuelle préalable. L’exécution de cette commande calcule non seulement les matrices complètes de coefficients et de p-valeurs, mais déploie également les matrices des statistiques de Student t, les erreurs-types d’estimation associées à chaque cellule (notées $se), ainsi que les degrés de liberté formels régissant chaque comparaison bivariée.
En outre, corr.test() calcule et structure automatiquement les intervalles de confiance à 95 % encadrant chaque coefficient de Pearson, tant sous leur forme matricielle que sous forme de tableaux récapitulatifs organisés par paires (accessibles via l’élément $ci). Cette fonctionnalité répond avec exactitude aux injonctions contemporaines des comités éditoriaux internationaux, lesquels exigent désormais des chercheurs qu’ils ne bornent plus leurs rapports statistiques à des valeurs p dichotomiques mais explicitent l’imprécision d’échantillonnage inhérente aux tailles d’effets via ces intervalles de confiance fiduciels.
8. Contrôle de l’inflation de l’erreur de type I lors de tests multiples
8.1 Problématique de la multiplicité des tests statistiques
Lorsqu’un chercheur calcule une matrice de corrélation englobant un volume substantiel de variables, il s’expose à un péril méthodologique redoutable bien que fréquemment sous-estimé : l’inflation de l’erreur de type I, couramment désignée sous l’appellation de problème de multiplicité des tests ou de multiplicité d’hypothèses. Lorsqu’un seuil conventionnel de significativité alpha de 0.05 est retenu pour tester une corrélation isolée, la probabilité d’accepter à tort une association fallacieuse (un faux positif) est contenue à 5 %.
Toutefois, dès lors que l’on évalue simultanément les interrelations au sein d’un réseau de k variables, le nombre total de comparaisons d’hypothèses indépendantes s’accroît de façon combinatoire. Pour un tableau hébergeant 20 variables indicatrices, l’analyste calcule conjointement 190 coefficients bivariés distincts. Si l’ensemble des variables était en réalité rigoureusement indépendant au sein de la population cible (l’hypothèse nulle globale étant intégralement vraie), la probabilité de constater au minimum une corrélation statistiquement significative par le simple jeu du hasard d’échantillonnage — le taux d’erreur par famille (Family-Wise Error Rate ou FWER) — s’élève selon la formule probabiliste canonique à 1 moins (1 – 0.05) élevé à la puissance 190, soit un risque vertigineux excédant 99.99 %.
Se dispenser de neutraliser ce phénomène transforme l’analyse exploratoire en une machine à générer des artefacts de recherche non reproductibles, l’expérimentateur célébrant comme des découvertes théoriques majeures ce qui ne relève que du bruit stochastique résiduel de son échantillon. Le contrôle de cette inflation constitue donc un devoir d’intégrité scientifique incontournable dans le traitement des matrices multivariées.
8.2 Procédures de correction conservatrices et modérées
Pour juguler l’inflation du taux d’erreur par famille et préserver le seuil alpha nominal global fixé par le protocole de recherche, plusieurs algorithmes correctifs peuvent être appliqués directement lors de l’estimation des probabilités matricielles. Le plus historiquement célèbre est l’ajustement de Bonferroni. Son mécanisme mathématique procède par une division arithmétique simple du seuil alpha nominal par le nombre total m de tests exécutés, ou symétriquement par la multiplication de chaque p-valeur brute par m.
Si la correction de Bonferroni garantit mathématiquement un contrôle irréprochable du risque de faux positifs, elle pèche par un conservatisme excessif. En présence de matrices volumineuses, elle dégrade de façon catastrophique la puissance statistique de l’analyse, augmentant démesurément le risque d’erreur de seconde espèce (erreur de type II) : le chercheur devient incapable de détecter des associations réelles de magnitude modeste en raison de la sévérité artificielle du seuil rectifié. Pour pallier cette rigidité, la procédure séquentielle de Sture Holm s’impose comme une alternative moderne de référence. En ordonnant les p-valeurs de manière croissante et en leur appliquant un diviseur séquentiellement ajusté, Holm offre une protection tout aussi infaillible du FWER que Bonferroni tout en démontrant une puissance statistique systématiquement supérieure.
Dans l’écosystème R, ces ajustements s’exécutent de façon transparente grâce à l’argument dédié adjust intégré au sein de la fonction du package psych. L’instruction psych::corr.test(df, adjust = « holm ») ou psych::corr.test(df, adjust = « bonferroni ») recalculera automatiquement la matrice $p retournée, appliquant la pénalité méthodologique requise sur chaque cellule pour neutraliser la multiplication des comparaisons simultanées.
8.3 Gestion du taux de fausses découvertes (FDR)
Dans les contextes de recherche exploratoire à haute dimensionnalité — tels que l’exploration de profils phénotypiques étendus, les batteries de dizaines d’échelles cliniques ou les données omiques et neuro-imageries —, la préservation intégrale du FWER via Bonferroni ou Holm paralyse toute capacité de découverte scientifique en étouffant les signaux statistiques réels sous un conservatisme disproportionné.
Face à cette impasse, les méthodologistes Yoav Benjamini et Yosef Hochberg ont proposé un changement de paradigme conceptuel fondamental en théorisant le contrôle du taux de fausses découvertes (False Discovery Rate ou FDR). Plutôt que de verrouiller à 5 % le risque de faire émerger ne serait-ce qu’un seul faux positif au sein de la famille entière de tests, la démarche de Benjamini-Hochberg (BH) garantit que, parmi l’ensemble des corrélations déclarées significatives par l’analyste, la proportion attendue de faux positifs ne dépassera pas un seuil tolérable fixé à l’avance (communément 5 %).
Cette approche équilibrée préserve une puissance statistique remarquable tout en assainissant les criblages empiriques massifs. Dans l’environnement R, l’analyste peut soit activer directement cet ajustement au sein de corr.test(df, adjust = « fdr »), soit extraire le vecteur non redondant des p-valeurs brutes de sa matrice pour lui appliquer la primitive canonique de correction vectorielle du système de base : p.adjust(vecteur_p, method = « BH »). Cette flexibilité computationnelle permet d’adapter avec précision la stratégie inférentielle aux visées, confirmatoires ou exploratoires, du programme de recherche.
9. Visualisation graphique des patrons de corrélation multivariés
9.1 Cartographie visuelle par le package corrplot
La lecture directe de matrices numériques hébergeant des dizaines de coefficients et de probabilités se révèle rapidement épuisante pour l’esprit humain et masque souvent la structure géométrique globale des associations. L’externalisation visuelle de ces métriques complexes au moyen de représentations graphiques dédiées s’avère indispensable pour appréhender instantanément l’architecture des données. Le package corrplot, maintenu par Taiyun Wei, constitue la référence académique pour concevoir des cartographies matricielles informatives et élégantes.
L’implémentation de base repose sur l’injection directe d’une matrice de corrélation préalablement calculée dans l’appel graphique : corrplot::corrplot(cor_matrix). Le package offre une vaste panoplie de déclinaisons visuelles via l’argument method, autorisant la substitution des chiffres par des cercles proportionnels, des carrés ombrés, des ellipses directionnelles orientées selon le signe de la pente, ou des aplats de couleurs lissés. La magnitude du coefficient dicte la saturation chromatique de la cellule, tandis que sa polarité oriente la tonalité générale (usuellement le bleu pour les valeurs positives et le rouge pour les dynamiques négatives).
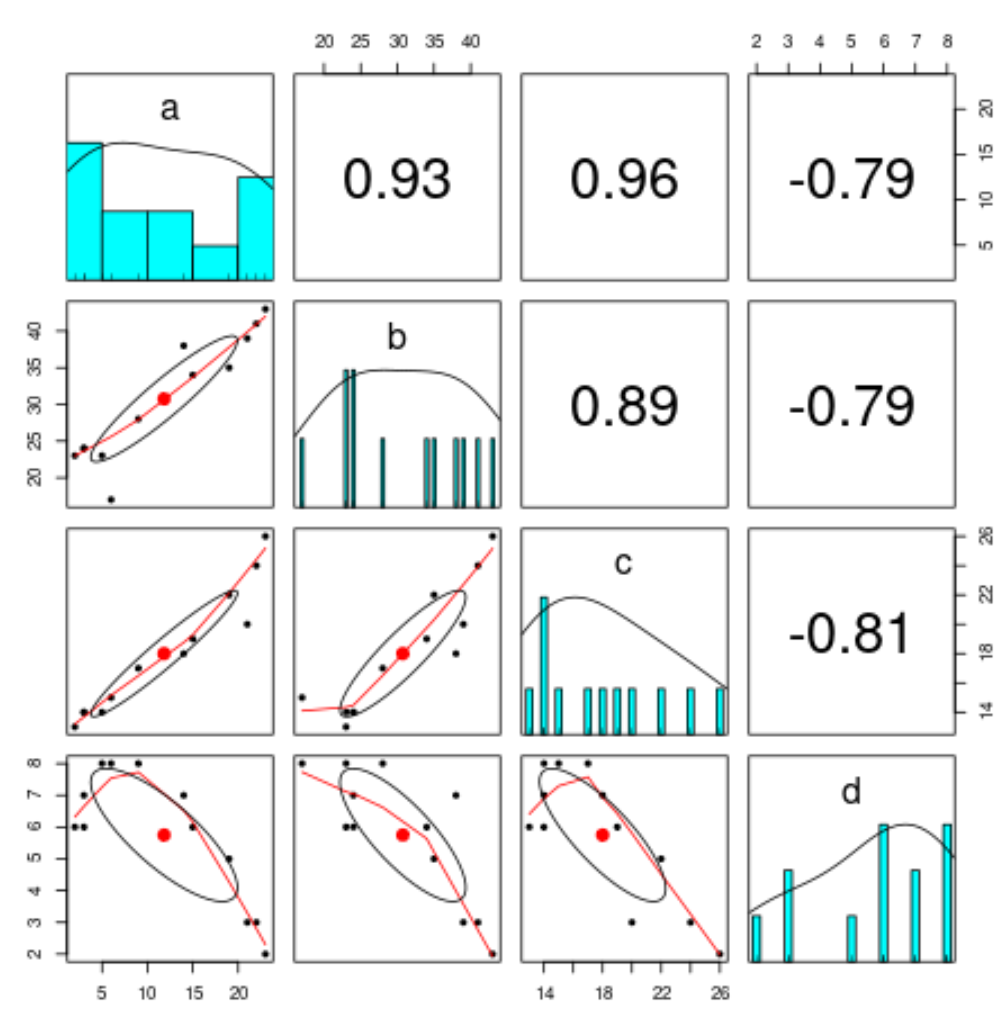
Une fonctionnalité analytique majeure de corrplot réside dans sa capacité à réorganiser dynamiquement l’ordre des lignes et des colonnes de la matrice selon des algorithmes de classification hiérarchique ascendante (argument order = « hclust »). En regroupant spatialement les indicateurs qui partagent des profils de corrélations mutuelles congruents, le graphique matérialise visuellement sous forme de blocs denses les dimensions latentes ou les regroupements de variables agissant en synergie, facilitant ainsi l’interprétation structurelle préliminaire des instruments psychométriques.
9.2 Matrices bivariées enrichies avec GGally::ggpairs()
Bien que les visualisations d’aplat matriciel soient remarquables pour résumer les forces d’association globales, elles sacrifient les détails fins des distributions univariées et la vérification visuelle de la linéarité. Pour combler cette perte d’information, le package GGally propose la fonction ggpairs(), laquelle déploie une matrice de dispersion interactive fondée sur le formalisme graphique universel de ggplot2.
L’instruction GGally::ggpairs(df) génère une matrice composite multifacette partitionnée en trois registres visuels complémentaires d’une formidable richesse diagnostique :
sur la diagonale principale s’affichent les courbes d’estimation de densité de probabilité univariées ou les histogrammes individuels de chaque variable, permettant d’évaluer d’un coup d’œil l’allure et la normalité de leurs distributions ;
au sein du panneau triangulaire inférieur se déploient l’ensemble des nuages de points bivariés (scatter plots), complétés par des courbes de régression polynomiale locale lissée (LOESS) qui trahissent instantanément toute rupture de linéarité ou la présence d’observations isolées influentes ;
dans le panneau triangulaire supérieur apparaissent les coefficients de corrélation numériques de Pearson, dont le dimensionnement typographique s’ajuste proportionnellement à l’intensité de la magnitude d’effet estimée.
Cette visualisation enrichie accepte également des arguments de partitionnement par groupes (via l’argument esthétique mapping = ggplot2::aes(color = groupe)). Cette possibilité permet d’observer simultanément si les trajectoires corrélationnelles s’avèrent invariantes à travers différentes sous-populations diagnostiques, ou si des phénomènes d’inversion locale de pente, caractéristiques du célèbre paradoxe de Simpson, se dissimulent sous l’agrégation globale des données.
9.3 Création de cartes thermiques (heatmaps) interactives et publiables
Pour les restitutions professionnelles exigeant une conformité rigoureuse avec les standards graphiques éditoriaux ou devant être intégrées au sein de tableaux de bord interactifs, le déploiement de cartes thermiques (heatmaps) spécialisées représente une voie d’excellence. Des extensions vectorielles sophistiquées comme pheatmap ou les primitives de carrelage coloré géométrique ggplot2::geom_tile() offrent une latitude totale dans le paramétrage typographique et colorimétrique de ces matrices.
La conception de ces cartes thermiques requiert une sélection rigoureuse de palettes chromatiques divergentes conformes aux principes universels d’accessibilité visuelle (notamment pour les lecteurs présentant des déficiences de perception des couleurs telles que le daltonisme). Les échelles perceptuellement uniformes et certifiées sans ambiguïté, telles que les palettes issues de ColorBrewer ou de l’environnement viridis (particulièrement les variantes cividis ou magma), doivent systématiquement supplanter les gradients bicolores désuets de type rouge-vert, ces derniers étant sources d’inintelligibilité graphique pour une fraction notable du lectorat scientifique.
En couplant ces moteurs de rendu thermique avec des algorithmes d’arbres de partitionnement dendrogrammique greffés sur les bordures supérieure et latérale de l’illustration, le chercheur offre une vision synthétique haut de gamme des proximités multivariées. Ces représentations vectorielles haute fidélité peuvent ensuite être directement exportées sous des formats d’encapsulation sans perte de résolution, tels que le PDF vectoriel ou le TIFF haute densité (à un minimum de 300 points par pouce), répondant scrupuleusement aux spécifications techniques les plus strictes des revues académiques internationales.
10. Corrélations partielles et contrôle des variables confondantes
10.1 Concept et utilité des corrélations partielles en psychologie
L’un des écueils majeurs de l’analyse corrélationnelle brute réside dans sa vulnérabilité face au phénomène des associations fallacieuses (spurious correlations). En psychologie, en épidémiologie et en sociologie, deux indicateurs empiriques peuvent manifester une covariance statistique extrêmement forte et statistiquement significative non pas en vertu d’une relation fonctionnelle directe, mais parce qu’ils sont tous deux sous l’influence conjointe d’une tierce variable régulatrice, fréquemment qualifiée de variable confondante ou de facteur de confusion exogène.
Considérons à titre d’exemple théorique l’association positive constatée entre le niveau d’anxiété d’évaluation d’un individu et son temps de réponse à une tâche d’inhibition cognitive. Cette association reflète-t-elle une altération directe de la vitesse de traitement induite par les pensées intrusives anxieuses, ou découle-t-elle simplement du fait que l’âge chronologique des participants influe simultanément sur l’augmentation de l’anxiété situationnelle et sur le ralentissement sensorimoteur général ? Si l’effet de l’âge n’est pas contrôlé, la corrélation brute entre anxiété et temps de réponse demeure méthodologiquement impossible à interpréter de façon valide.
La corrélation partielle offre une solution mathématique formelle à ce dilemme. Elle quantifie l’intensité de la relation linéaire reliant deux variables cibles une fois que l’influence mathématique linéaire d’une ou de plusieurs autres variables covariables a été rigoureusement réséquée des deux membres du couple observé. Sur le plan algorithmique, cela revient à ajuster deux modèles de régression linéaire prédisant respectivement la variable X par la covariable Z, puis la variable Y par cette même covariable Z, et à calculer ultérieurement le coefficient de Pearson standard reliant les résidus de ces deux régressions. La corrélation partielle s’impose ainsi comme un instrument analytique d’une puissance extraordinaire pour isoler les liaisons structurelles authentiques au sein de systèmes complexes.
10.2 Mise en œuvre algorithmique avec le package ppcor
L’arsenal computationnel de R dispose d’une extension spécialisée entièrement consacrée au déploiement des corrélations partielles et semi-partielles : le package ppcor, conçu par Seongho Kim. Cette bibliothèque permet d’opérer soit des calculs ciblés sur des triplets de variables, soit d’estimer l’intégralité de la matrice des corrélations partielles multivariées conditionnellement à l’ensemble des autres variables du modèle.
Pour soumettre un jeu de données complet à une analyse partielle intégrale, l’analyste invoque la fonction ppcor::pcor(df). L’algorithme procède instantanément à l’inversion de la matrice de variance-covariance empirique pour en déduire les coefficients partiels d’ordre supérieur, chaque corrélation entre deux colonnes quelconques étant mathématiquement contrôlée pour la variance partagée avec la totalité des autres colonnes hébergées dans le tableau. L’objet généré restitue trois éléments matriciels comparables à ceux observés dans les packages inférentiels : $estimate (les coefficients partiels),$p.value (les seuils de significativité associés) et $statistic (les valeurs des statistiques de Student de décision).
Si l’investigation méthodologique exige de neutraliser l’impact d’une covariable spécifique sans modifier le reste du système, la fonction ppcor::pcor.test(x = df$a, y = df$b, z = df$c) permet de calculer la corrélation partielle unissant a et b conditionnellement au contrôle unique de la variable c. La comparaison minutieuse de l’amplitude du coefficient brut (obtenu via cor()) et du coefficient partiel (obtenu via pcor.test()) apporte des éclairages cruciaux sur la dynamique sous-jacente : un effondrement substantiel de la magnitude signale un mécanisme de médiation ou une association fallacieuse largement médiée par la covariable, tandis que son maintien confirme la robustesse fonctionnelle de la liaison directe.
10.3 Corrélations semi-partielles (partielles séquentielles)
Une distinction statistique subtile mais primordiale sépare la corrélation partielle de la corrélation semi-partielle (parfois qualifiée de corrélation de partition séquentielle ou part correlation). Alors que la corrélation partielle retire l’influence de la covariable confondante à la fois de la variable prédictive et de la variable critère, la corrélation semi-partielle ne neutralise la variance associée à la tierce dimension que sur l’une seule des deux variables en jeu (usuellement la variable indépendante).
Cette démarche mathématique est indissociable de la logique de régression linéaire multiple hiérarchique. En élevant au carré un coefficient de corrélation semi-partielle, on obtient le pourcentage de variance totale de la variable dépendante qui est spécifiquement et exclusivement expliqué par cette variable prédictive particulière, au-delà et indépendamment de l’ensemble de la variance déjà absorbée par les autres facteurs prédictifs du modèle. Elle matérialise avec une rigueur absolue la contribution incrémentale propre d’un construit au sein d’un système explicatif concurrentiel.
Sous R, l’évaluation matricielle globale de ces contributions spécifiques s’opère par l’entremise de la fonction ppcor::spcor(df), ou au niveau unitaire par l’appel ppcor::spcor.test(x = df$a, y = df$b, z = df$c). L’exploitation de ces indices s’avère particulièrement éclairante en psychologie différentielle lorsqu’il s’agit de déterminer si une nouvelle dimension psychométrique (par exemple, l’intelligence émotionnelle) conserve une validité prédictive incrémentale propre face aux dimensions établies de longue date (telles que le quotient intellectuel général et les traits de personnalité du modèle en cinq facteurs).
11. Vérification des postulats statistiques et détection des observations atypiques
11.1 Évaluation de la normalité bivariée et multivariée
L’estimation non biaisée et l’inférence probabiliste associées au coefficient de Pearson reposent sur le postulat fondamental de la normalité des distributions, lequel stipule non seulement que chaque variable univariée suit une courbe de Gauss, mais que leur combinaison vectorielle conjointe respecte rigoureusement les lois de la distribution normale bivariée ou multivariée. L’absence de conformité à cette assise mathématique fragilise la fiabilité des tests d’hypothèses et vicie les intervalles de confiance paramétriques.
Au niveau univarié préliminaire, l’évaluation clinique des distributions combine l’inspection qualitative des diagrammes quantile-quantile (générés sous R via qqnorm() et qqline()) avec des tests formels d’ajustement comme le test de Shapiro-Wilk (shapiro.test()). Cependant, il est algébriquement démontré que la normalité de l’ensemble des composantes univariées prises isolément ne garantit en rien la normalité multivariée de leur distribution conjointe au sein de l’espace vectoriel multidimensionnel.
Pour certifier formellement la normalité multivariée d’un jeu de données complet, le recours aux coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) multivariés de Kanti Mardia s’avère indispensable. Le package MVN (Multivariate Normality) met à disposition la fonction mvn(df, mvnTest = « mardia »), laquelle évalue la forme globale de la distribution de l’échantillon. Si le test de Mardia conclut à un rejet significatif de l’hypothèse nulle de normalité conjointe, l’analyste doit impérativement abandonner les inférences paramétriques de Pearson pour s’orienter vers les estimateurs non paramétriques de Spearman/Kendall ou mettre en œuvre des procédures de rééchantillonnage par réamorçage (bootstrapping) pour estimer empiriquement les intervalles d’échantillonnage.
11.2 Inspection de la linéarité et de l’homoscédasticité
L’existence d’une relation de nature strictement linéaire entre chaque couple d’indicateurs constitue le deuxième grand postulat régissant l’estimation matricielle par les moindres carrés. Le coefficient produit-moment est intrinsèquement aveugle aux dynamiques non linéaires : une liaison fonctionnelle déterministe parfaite mais affectée d’une géométrie en cloche (quadratique inversée, comme celle illustrée par la loi de Yerkes-Dodson reliant le niveau d’éveil émotionnel à la performance cognitive) retournera un r de Pearson proche de zéro, dissimulant une dépendance stochastique majeure sous une apparence d’indépendance linéaire.
L’inspection méthodique des nuages de points multivariés, facilitée par les fonctionnalités de lissage non paramétrique offertes par les courbes LOESS (Local Polynomial Regression) au sein des sorties graphiques de GGally::ggpairs(), s’impose donc comme une démarche de salubrité analytique obligatoire. L’apparition d’une inflexion systématique, d’une cassure de pente ou d’une convexité marquée sur la courbe de tendance locale informe immédiatement le statisticien de l’inadéquation structurelle du modèle linéaire simple.
Conjointement, l’analyste doit vérifier l’homoscédasticité des relations bivariées, c’est-à-dire la constance de la variance résiduelle des points d’observation le long de l’ensemble du spectre des valeurs de la variable prédictive. L’hétéroscédasticité — qui se manifeste visuellement par un étalement en entonnoir des observations lorsque les valeurs progressent — viole les hypothèses d’équivariance, comprime artificiellement la précision des estimations de corrélation et altère sévèrement la représentativité de la métrique d’association synthétique calculée.
11.3 Détection d’observations aberrantes multivariées
La vulnérabilité du coefficient de corrélation classique face aux valeurs extrêmes est universellement documentée dans la littérature statistique. Cependant, l’investigation multivariée se heurte à une forme d’observation aberrante particulièrement pernicieuse : les valeurs atypiques multivariées. Un point d’observation individuel peut fort bien présenter des valeurs parfaitement banales et centrées sur chacune de ses dimensions univariées prises isolément, tout en constituant une anomalie géométrique absolue lorsqu’on examine la combinaison conjointe de ses scores au sein de l’espace vectoriel multidimensionnel.
L’instrument géométrique standard pour identifier ces configurations excentriques est la distance de Mahalanobis, notée mathématiquement D². Contrairement à la distance euclidienne naïve, la distance de Mahalanobis pondère les écarts spatiaux par la matrice de variance-covariance inverse du système, tenant rigoureusement compte des corrélations existantes entre les axes pour évaluer l’éloignement statistique d’une observation par rapport au centroïde multivarié de la distribution. Sous R, ce calcul s’opère au moyen de la fonction native : mahalanobis(df, center = colMeans(df), cov = cov(df)).
Les distances calculées suivent asymptotiquement une loi du khi-deux dont les degrés de liberté correspondent au nombre de variables intégrées dans l’analyse. La confrontation des scores de chaque sujet à la valeur critique du khi-deux (au seuil très conservateur de p < 0.001) permet d’isoler de manière automatisée les observations suspectes exerçant un bras de levier excessif. En présence de points d’appui influents avérés, l’analyste doit exécuter une analyse de sensibilité scrupuleuse, comparant les matrices estimées avec et sans ces individus atypiques afin de documenter la stabilité des conclusions scientifiques face aux fluctuations d’échantillonnage.
12. Mise en forme académique selon les normes de l’APA et rapportage des résultats
12.1 Structuration formelle du tableau matriciel de style APA 7
L’aboutissement logique d’une investigation corrélationnelle multivariée réside dans la communication publique de ses résultats au sein d’articles scientifiques ou de rapports institutionnels. Dans le champ des sciences comportementales et biomédicales, les normes édictées par l’American Psychological Association (septième édition du Manuel de publication de l’APA) fixent des règles typographiques et structurelles d’une rigueur absolue pour la composition des tableaux de corrélation.
La première règle formelle stipule la proscription totale de la redondance matricielle : le tableau ne doit jamais présenter une matrice carrée complète. L’analyste est tenu de formater ses données sous la forme d’une matrice triangulaire inférieure, en laissant l’ensemble des cellules de la moitié supérieure droite intégralement vides. La diagonale unitaire (peuplée de 1.00) est elle-même usuellement purgée ou substituée par les coefficients de fidélité et de cohérence interne des échelles de mesure correspondantes (tels que l’alpha de Cronbach ou l’oméga de McDonald), systématiquement encadrés par des tirets ou des parenthèses.
De surcroît, le style APA impose d’adosser à la matrice de corrélation les paramètres descriptifs univariés fondamentaux de chaque variable. Deux colonnes initiales doivent impérativement précéder le déploiement matriciel pour renseigner la moyenne arithmétique (M) et l’écart-type d’échantillonnage (SD) de chaque dimension. Enfin, l’indication de la significativité statistique est confiée à des astérisques normalisés (* p < .05, ** p < .01, *** p < .001), documentés dans une note tabulaire générale logée sous le corps du tableau, tandis que le zéro initial des coefficients de corrélation est conventionnellement omis en typographie anglophone (les valeurs s’écrivant par exemple .45 et non 0.45, le coefficient ne pouvant mathématiquement excéder l’unité).
12.2 Génération automatisée de tableaux prêts pour la publication
Composer manuellement des tableaux matriciels triangulaires intégrant moyennes, écarts-types et notes d’astérisques au sein d’un logiciel de traitement de texte représente une tâche laborieuse, hautement chronophage et particulièrement propice à l’introduction accidentelle d’erreurs de transcription numériques. L’environnement R propose heureusement des solutions logicielles permettant d’automatiser intégralement cette mise en forme avec un niveau de finition éditoriale impeccable.
L’extension spécialisée apaTables constitue un outil de choix pour les chercheurs publiant selon les normes internationales. L’exécution de la commande apaTables::apa.cor.table(df, filename = « Tableau_Correlations.doc ») analyse directement le bloc de données, extrait les distributions univariées descriptives, calcule les coefficients de Pearson ainsi que les intervalles de confiance à 95 %, applique le découpage matriciel triangulaire inférieur et exporte immédiatement un document formaté natif pour Microsoft Word, prêt pour l’insertion directe dans un manuscrit de soumission.
Dans un contexte de rédaction reproductible exploitant les environnements Quarto ou R Markdown, l’analyste privilégiera l’orchestration conjointe du package kableExtra et de knitr::kable(). En couplant ces outils avec des fonctions de transformation matricielle personnalisées, on programme la génération dynamique de tableaux en code vectoriel LaTeX haute définition ou en code HTML stylisé via des feuilles de styles typographiques adaptées, garantissant une passerelle computationnelle fluide et transparente entre le traitement analytique sous-jacent et le document éditorial final.
12.3 Rédaction textuelle standardisée des conclusions statistiques
L’insertion d’un tableau matriciel de haute tenue formelle n’exonère pas l’analyste de commenter et d’expliciter ses résultats au sein du corps du texte de son rapport de recherche. La formulation narrative d’une conclusion corrélationnelle doit satisfaire à des exigences d’exactitude statistique universellement codifiées, articulant l’amplitude de l’effet, la précision d’échantillonnage et le résultat du test d’hypothèse probabiliste.
Selon les conventions APA 7, la transcription textuelle standardisée d’un coefficient de Pearson s’énonce rigoureusement en consignant la lettre r en italique, suivie entre parenthèses des degrés de liberté exacts de l’analyse (calculés par la taille de l’échantillon valide diminuée de deux unités), de la valeur numérique du coefficient, de son intervalle de confiance à 95 % entre crochets, et de la p-valeur exacte : r(148) = .46, IC 95% [.32, .58], p < .001. Pour les métriques non paramétriques, la lettre grecque ou le symbole approprié se substitue à la notation standard, comme rs(148) = .42 pour un coefficient de rangs de Spearman.
Sur le plan herméneutique et déontologique, le chercheur se doit de maintenir une distinction conceptuelle infranchissable entre la significativité statistique d’un test et sa magnitude empirique pratique. Une corrélation d’une amplitude minuscule de r = .09 peut atteindre un seuil hautement significatif (p < .001) dès lors qu’elle est évaluée sur une cohorte épidémiologique colossale regroupant plusieurs dizaines de milliers d’enregistrements, sans pour autant détenir la moindre pertinence théorique ou clinique substantielle. Enfin, l’analyste doit systématiquement se conformer à l’impératif épistémologique absolu rappelant que corrélation n’équivaut jamais à causalité : l’existence d’une covariance linéaire multivariée, aussi vigoureuse soit-elle, ne suffit en aucun cas à établir une relation de cause à effet en l’absence d’un devis expérimental contrôlé et longitudinal.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202
- Harrell, F. E., Jr. (2023). Hmisc: Harrell Miscellaneous (R package version 5.1-1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=Hmisc
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.1093/biomet/30.1-2.81
- Kim, S. (2015). ppcor: An R package for a fast calculation to semi-partial and partial correlation coefficients for large data. Communications for Statistical Applications and Methods, 22(6), 665–674. https://doi.org/10.5351/CSAM.2015.22.6.665
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research (R package version 2.3.9). Comprehensive R Archive Network. https://CRAN.R-project.org/package=psych
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–590. https://doi.org/10.1093/biomet/63.3.581
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Wei, T., & Simko, V. (2021). R package ‘corrplot’: Visualization of a correlation matrix (Version 0.92). Comprehensive R Archive Network. https://CRAN.R-project.org/package=corrplot