
Dans le champ de l’analyse quantitative, de la psychométrie et des sciences comportementales, l’évaluation de la variabilité constitue un pilier fondamental pour appréhender la régularité et l’hétérogénéité des phénomènes observés. Si les paramètres de tendance centrale comme la moyenne arithmétique fournissent un point d’ancrage synthétique, ils demeurent insuffisants lorsqu’il s’agit de qualifier la stabilité intrinsèque d’un processus biologique, psychologique ou cognitif. Les mesures traditionnelles de dispersion absolue, au premier rang desquelles figurent la variance et l’écart-type, rendent compte de l’amplitude des écarts à la moyenne au sein d’un même jeu de données. Toutefois, leur sensibilité directe aux unités de mesure et à l’ordre de grandeur des moyennes observées restreint considérablement leur portée lorsqu’il convient d’établir des comparaisons inter-groupes, inter-individuelles ou inter-protocoles.
C’est précisément à cette aporie méthodologique que répond le coefficient de variation (CV), initialement formalisé par le statisticien Karl Pearson à la fin du dix-neuvième siècle. En exprimant la dispersion sous la forme d’un ratio sans dimension entre l’écart-type et la moyenne arithmétique, le coefficient de variation autorise une normalisation rigoureuse de la dispersion relative. Cet indicateur s’avère irremplaçable dans l’exploration de construits psychologiques complexes, tels que la variabilité intra-individuelle des temps de réponse lors d’épreuves de vigilance, l’instabilité motrice dans les pathologies neurodégénératives, ou encore l’homogénéité des cotations psychométriques issues de batteries de tests aux métriques hétérogènes. La quantification de cette instabilité relative apporte un éclairage substantiel sur les processus cognitifs sous-jacents, transcendant le simple constat de la vitesse moyenne de traitement de l’information.
Bien que les logiciels spécialisés d’analyse statistique comme R, SPSS ou SAS demeurent des références académiques, les plateformes collaboratives en nuage comme Google Sheets se sont imposées comme des environnements de travail incontournables pour les équipes de recherche contemporaines. La manipulation, l’apurement et le calcul d’indices statistiques au sein de Google Sheets permettent une traçabilité rigoureuse, une transparence méthodologique accrue et un partage fluide des matrices de données brutes. L’objet de ce guide exhaustif est de détailler, d’un point de vue conceptuel, mathématique et technique, l’ensemble des procédures requises pour calculer, automatiser, visualiser et interpréter le coefficient de variation dans Google Sheets, en accord avec les standards les plus exigeants de la recherche universitaire et de la pratique psychométrique.
1. Fondements théoriques et formulation mathématique du coefficient de variation
L’analyse de données exige une distinction conceptuelle claire entre les grandeurs absolues et relatives. Cette section explore les soubassements statistiques du coefficient de variation, ses formulations selon la nature de l’échantillonnage, et les contraintes mathématiques qui conditionnent son emploi légitime dans la recherche empirique.
1.1 Définition conceptuelle du coefficient de variation
Le coefficient de variation, souvent désigné par l’acronyme CV ou par l’expression de déviation standard relative (RSD), se définit formellement comme le rapport mathématique entre l’écart-type et la moyenne arithmétique d’une distribution. D’un point de vue analytique, cet indice réalise une opération de standardisation en rapportant l’amplitude des fluctuations observées autour du centre de gravité des données à l’amplitude même de ce centre. Contrairement aux statistiques descriptives de dispersion univariée traditionnelles, le coefficient de variation est une grandeur adimensionnelle. Cette caractéristique fondamentale implique que l’indice demeure invariant face aux transformations d’échelle linéaires strictes, ce qui élimine totalement l’impact de l’unité de mesure initiale, qu’il s’agisse de millisecondes, de points obtenus à une échelle de Likert, de microvolts ou de pourcentages d’erreurs.
Sur le plan de l’expression mathématique formelle, une distinction cardinale doit être opérée entre les paramètres théoriques d’une population parente exhaustive et les statistiques estimées à partir d’un échantillon probabiliste. Lorsque le chercheur a accès à l’intégralité de la population étudiée, le coefficient de variation de la population, noté classiquement par la lettre grecque gamma ou simplement par CV, s’énonce selon le ratio du paramètre d’écart-type de la population (sigma) sur la moyenne de la population (mu). Dans l’immense majorité des contextes expérimentaux en psychologie et en neurosciences, l’accès à la population parente s’avérant impossible, les chercheurs travaillent sur des échantillons représentatifs. Le coefficient de variation de l’échantillon, noté communément par l’abréviation latine cv ou CV, est défini par le rapport de l’écart-type corrigé de l’échantillon (noté s) sur la moyenne arithmétique de cet échantillon (notée x-barre).
Les propriétés statistiques fondamentales de la dispersion relative révèlent que le coefficient de variation constitue un estimateur direct du degré d’homogénéité interne d’une série de mesures. Plus la valeur numérique du CV est proche de zéro, plus la distribution des observations se concentre de manière étroite et homogène autour de la moyenne. Inversement, une valeur élevée dénote une hétérogénéité prononcée, traduisant une instabilité substantielle des réponses observées. En pratique biomédicale et psychométrique, le coefficient de variation est fréquemment multiplié par le scalaire 100 afin d’être exprimé sous forme de pourcentage, bien que sa forme décimale standard demeure la convention fondamentale pour les calculs algébriques ultérieurs.
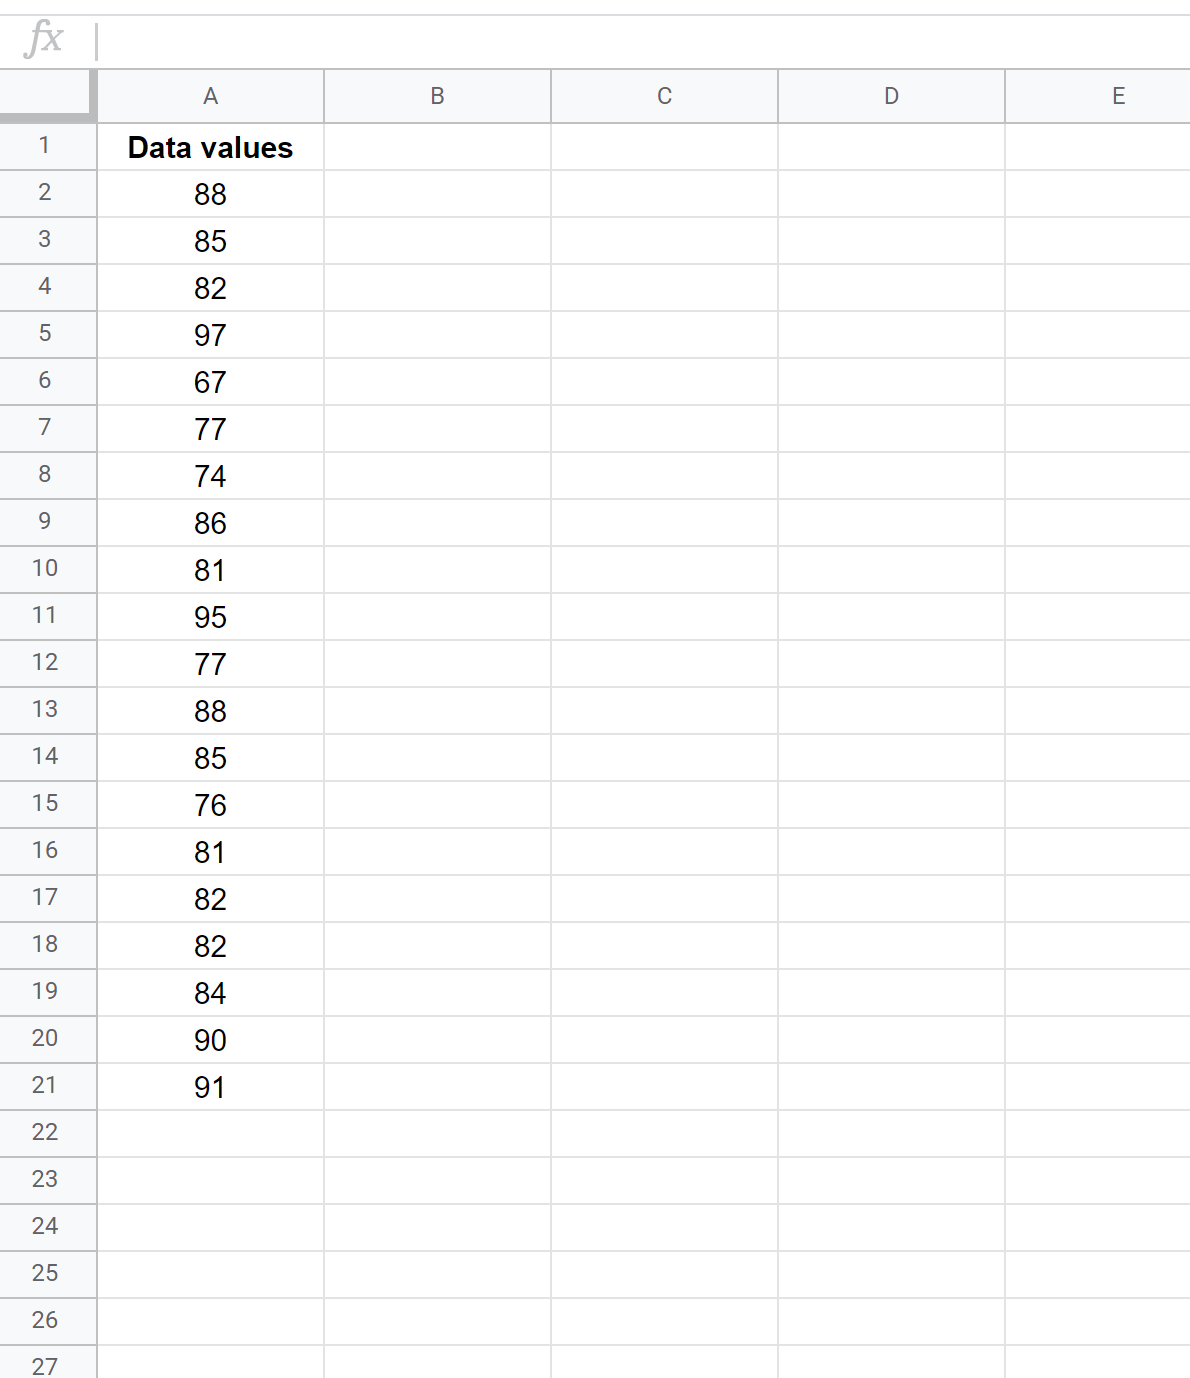
1.2 Distinction cruciale entre dispersion absolue et dispersion relative
La distinction entre dispersion absolue et dispersion relative repose sur un principe épistémologique majeur : la signification clinique ou expérimentale d’un écart donné ne peut être appréciée de manière isolée sans référence au niveau de base de la grandeur mesurée. Pour illustrer cette limite inhérente aux mesures absolues, considérons l’évaluation de deux protocoles cognitifs distincts. Dans une épreuve de temps de réaction simple, des participants adultes sains affichent un écart-type de 50 millisecondes autour d’une moyenne de 200 millisecondes. Dans une tâche complexe de raisonnement analogique, un autre groupe présente un écart-type rigoureusement identique de 50 millisecondes, mais autour d’une moyenne de 1 000 millisecondes. Si l’on s’en tenait à l’écart-type absolu, les deux conditions sembleraient présenter une instabilité strictement équivalente.
L’évaluation de la dispersion relative pulvérise cette fausse symétrie. Pour la première épreuve, le coefficient de variation s’établit à 0,25 (soit 25 %), tandis que pour la seconde, il n’atteint que 0,05 (soit 5 %). L’instabilité cognitive relative est ainsi cinq fois plus prononcée dans le premier protocole. L’écart-type brut, en ignorant la ligne de base, masquait la réalité de la dynamique attentionnelle sous-jacente. Ce phénomène, désigné sous le terme de paradoxe des moyennes divergentes à dispersion absolue constante, démontre l’incapacité de la variance et de l’écart-type à refléter fidèlement le comportement d’un phénomène lorsque les niveaux d’intensité varient.
L’adoption de la dispersion relative permet d’échapper aux biais d’interprétation lors de la comparaison de variables d’échelles disparates. Dans le cadre de l’évaluation neurocognitive, il est fréquent de confronter des grandeurs non commensurables, telles que le nombre d’erreurs commises à une épreuve de tri de cartes, la latence moyenne de focalisation oculaire et les scores d’anxiété auto-rapportés. Tenter de comparer les écarts-types de ces trois variables s’avérerait dénué de sens méthodologique, car les unités de mesure ne partagent aucune métrique commune. Le coefficient de variation, en dissolvant l’unité de mesure au dénominateur, offre une passerelle universelle de comparaison, rendant possible l’analyse intégrée de systèmes comportementaux multidimensionnels.
1.3 Conditions d’admissibilité statistique et échelles de mesure
L’application valide du coefficient de variation requiert le respect scrupuleux de conditions de mesure précises, souvent négligées dans la littérature empirique. La première condition sine qua non réside dans le niveau de mesure de la variable analysée. Selon la typologie des échelles établie par Stanley Smith Stevens, les variables quantitatives se subdivisent entre échelles d’intervalles et échelles de rapport (ou de ratio). Le coefficient de variation exige rigoureusement une échelle de rapport, c’est-à-dire une métrique dotée d’un zéro absolu représentant l’absence totale de la grandeur mesurée. Les variables temporelles (latence, durée), spatiales (distance, amplitude motrice) ou fréquentielles (comptage de réponses) répondent parfaitement à cette exigence méthodologique.
À l’inverse, l’application du coefficient de variation à des données mesurées sur une échelle d’intervalles, où le point zéro est conventionnel et arbitraire, constitue une aberration statistique. L’exemple classique de la température mesurée en degrés Celsius ou Fahrenheit illustre cette impossibilité : un décalage arbitraire de l’origine de l’échelle modifie la valeur de la moyenne sans impacter l’écart-type, ce qui entraîne une altération artificielle et non reproductible du coefficient de variation. Dans le domaine des sciences humaines, nombre de tests standardisés, tels que les scores de quotient intellectuel (QI) basés sur une distribution normale de moyenne 100 et d’écart-type 15, ou les scores T, constituent des échelles d’intervalles. Calculer un coefficient de variation sur de tels scores est méthodologiquement erroné, car la valeur obtenue découle de la convention de centrage de l’échelle et non des propriétés intrinsèques de l’échantillon.
Enfin, la validité de l’indice est fortement conditionnée par la forme de la distribution sous-jacente. Le coefficient de variation est un paramètre intimement lié à la théorie gaussienne, reposant sur l’hypothèse que la moyenne arithmétique constitue un indicateur valide de tendance centrale et que l’écart-type capture adéquatement la dispersion. En présence de distributions hautement asymétriques, plurimodales ou fortement tronquées, la moyenne arithmétique perd sa représentativité au profit de la médiane. Dans ces conditions statistiques défavorables, le CV standard devient instable et sensible aux fluctuations d’échantillonnage, ce qui impose d’envisager des alternatives robustes basées sur des quantiles pour éviter toute distorsion interprétative.
2. Pertinence du coefficient de variation dans l’analyse de données psychologiques
Les sciences du comportement et la neuropsychologie cognitive ont recours de manière croissante aux métriques de variabilité relative pour sonder l’architecture mentale humaine. Cette section analyse trois applications cliniques et expérimentales majeures où le coefficient de variation s’avère bien plus informatif que les scores moyens isolés.
2.1 Mesure de la variabilité intra-individuelle des temps de réaction
L’étude des chronométries mentales a historiquement privilégié la vitesse globale de traitement de l’information, matérialisée par la moyenne ou la médiane des temps de réaction (TR). Néanmoins, les paradigmes contemporains de psychologie expérimentale s’intéressent avec une acuité accrue à la variabilité intra-individuelle (IIV), c’est-à-dire à la fluctuation de la vitesse de réponse d’un participant d’un essai à l’autre au sein d’une même tâche continue. Le coefficient de variation intra-individuel (souvent abrégé en ICV ou $ISD/Mean$) constitue la métrique standard pour quantifier cette instabilité temporelle, en isolant le bruit cognitif des effets de ralentissement moteur global liés à l’âge ou à la fatigue.
Une performance caractérisée par un temps de réaction moyen lent combiné à un faible coefficient de variation reflète une vitesse de traitement modérée mais stable et prévisible. À l’opposé, un sujet affichant une moyenne équivalente mais un CV très élevé se caractérise par des survenues épisodiques de latences excessivement longues, désignées sous le nom de « lapses » attentionnels ou d’abandons de vigilance. Sur le plan neurophysiologique, cette inconstance de la réponse motrice traduit une fluctuation momentanée dans le recrutement des réseaux fronto-pariétaux responsables du maintien du contrôle exécutif.
Sur le versant clinique, l’analyse du CV des temps de réponse fournit des biomarqueurs comportementaux d’une remarquable sensibilité. Dans le diagnostic du trouble du déficit de l’attention avec ou sans hyperactivité (TDAH), les enfants et adultes atteints présentent de manière reproductible un coefficient de variation significativement supérieur à celui des témoins appariés lors d’épreuves de performance continue comme le test de Conners ou la tâche de vigilance psychomotrice (PVT). De manière similaire, en gérontologie et en neuro-épidémiologie, une augmentation prononcée de l’ICV constitue un indice précoce et prédictif du déclin cognitif léger (MCI) et de l’entrée dans des pathologies neurodégénératives comme la maladie d’Alzheimer, devançant fréquemment la détérioration de la vitesse moyenne de traitement.
2.2 Comparaison de protocoles psychométriques hétérogènes
Les bilans psychologiques exhaustifs reposent sur l’administration concomitante de multiples batteries d’épreuves mesurant des domaines cognitifs distincts : mémoire de travail, flexibilité mentale, fluence verbale, perception spatiale et praxies constructives. Chaque subtest dispose de son système propre de cotation : nombre de mots évoqués en 60 secondes, score brut sur une échelle de 0 à 30, durée d’exécution en secondes ou nombre d’essais nécessaires pour atteindre un critère d’apprentissage. Face à une telle hétérogénéité des métriques opérationnelles, il s’avère impossible pour le clinicien ou le chercheur de comparer directement les écarts-types afin de déterminer quel sous-système cognitif présente la plus grande fragilité ou dispersion au sein d’une cohorte.
Le coefficient de variation permet de résoudre cette complexité en mettant toutes les épreuves sur un pied d’égalité dimensionnel. En appliquant la formule du CV à chaque épreuve, le chercheur peut instantanément cartographier le degré d’homogénéité des compétences cognitives d’un échantillon. Par exemple, si une cohorte de patients cérébrolésés présente un CV de 12 % lors d’une tâche de dénomination orale mais un CV de 48 % dans une tâche de planification de la tour de Londres, cette disparité relative indique avec certitude que la fonction exécutive de planification constitue le domaine le plus hétérogène et discriminatif, indépendamment du fait que la première épreuve compte des points et la seconde des secondes d’inhibition.
Ce contrôle de la sensibilité discriminante d’un instrument psychologique s’avère précieux lors des phases de développement et d’étalonnage de nouvelles échelles. Un subtest affichant un coefficient de variation excessivement restreint au sein de la population générale risque de souffrir d’un effet de plafond ou d’un manque criant de pouvoir de différenciation inter-individuelle. À l’inverse, un CV anormalement élevé peut signaler une ambiguïté des consignes ou une sensibilité excessive à des facteurs parasites externes, altérant la validité de construit du test psychométrique.
2.3 Contrôle de la fidélité et stabilité des mesures comportementales
La reproductibilité des observations comportementales constitue le fondement de la démarche expérimentale. Dans le cadre de l’évaluation de la fidélité test-retest, les chercheurs doivent s’assurer que la dispersion des mesures obtenues lors de sessions répliquées ne reflète pas une instabilité inhérente au dispositif expérimental ou à l’instrument de mesure lui-même. Le coefficient de variation est utilisé dans ce contexte pour quantifier l’erreur relative de mesure intra-sujet, souvent conceptualisée sous le vocable de coefficient de variation analytique ou biologique. Cette démarche est particulièrement courante dans l’analyse des mouvements oculaires (eye-tracking), de l’électroencéphalographie quantitative (indices de puissance spectrale EEG) ou des mesures physiologiques de l’anxiété comme la conductance cutanée.
En outre, la caractérisation du coefficient de variation au sein de groupes stratifiés (selon le sexe, l’âge, le niveau socio-éducatif ou le génotype) permet de vérifier si l’hétérogénéité d’un comportement demeure constante à travers les sous-populations. Lors d’expérimentations pharmacologiques explorant l’effet d’une molécule nootropique ou anxiolytique, un traitement expérimental peut ne pas induire de modification statistiquement significative de la moyenne d’un comportement, mais en réduire considérablement le coefficient de variation. Cette baisse de l’hétérogénéité relative atteste que l’intervention homogénéise la réponse des sujets, un effet biologique capital qui échapperait à une analyse de variance classique focalisée uniquement sur les effets principaux des moyennes.
Enfin, le coefficient de variation intervient directement dans les analyses de puissance statistique a priori et le calibrage de la taille d’échantillon requise pour les protocoles expérimentaux longitudinaux. Les équations de modélisation de puissance intégrant le CV permettent aux investigateurs de déterminer avec rigueur le nombre minimal de participants à recruter pour détecter une modification de variabilité entre deux phases expérimentales. Un calibrage optimal évite le sur-recrutement de sujets, en accord avec les impératifs éthiques encadrant la recherche biomédicale et comportementale.
3. Organisation et assainissement des matrices de données dans Google Sheets
L’exécution rigoureuse de calculs statistiques avancés au sein d’un tableur nécessite une phase préalable de structuration et de nettoyage des données. L’absence d’une architecture tabulaire standardisée est la cause première des erreurs de calcul et des corruptions d’indices statistiques dans Google Sheets.
3.1 Structuration optimale des feuilles de calcul pour l’analyse
Pour garantir la pérennité et la réplicabilité des analyses statistiques dans Google Sheets, les matrices de données doivent impérativement être organisées selon les principes des « données ordonnées » (tidy data), théorisés par Hadley Wickham. Dans ce schéma canonique, chaque ligne représente de manière univoque une unité observationnelle (par exemple, un participant ou un essai temporel individuel), chaque colonne correspond à une variable spécifique (variable dépendante, facteur fixe, covariable ou identifiant unique), et chaque cellule contient une valeur scalaire unique. L’utilisation de cellules fusionnées, d’en-têtes hiérarchiques sur plusieurs lignes ou de tableaux disjoints sur une même feuille doit être formellement proscrite, car ces configurations perturbent les algorithmes d’analyse matricielle des formules de Google Sheets.
La première ligne de la feuille doit être strictement réservée aux noms des variables. Il convient d’adopter une nomenclature rigoureuse, en évitant les espaces, les caractères diacritiques ou les symboles spéciaux au profit de conventions d’écriture telles que le serpentin (ex. : temps_reaction_ms, identifiant_sujet) ou le chameau (ex. : scoreMemoire, groupeAge). Cette hygiène de nommage prend tout son sens lors de l’intégration de formules complexes exploitant des chaînes textuelles. Pour optimiser la lisibilité des syntaxes et prévenir les erreurs d’adressage lors de l’étirement des formules, il est vivement recommandé d’utiliser les plages nommées via le menu Données > Plages nommées de Google Sheets. Attribuer le nom explicite TR_Bruts à la plage $C$2:$C$150 rendra la formule du coefficient de variation immédiatement intelligible et immunisée contre les décalages accidentels de références.
Par ailleurs, une bonne pratique de recherche consiste à isoler structurellement les données primaires brutes des calculs dérivés. Il est conseillé de consacrer un onglet distinct, nommé Raw_Data, dans lequel aucune modification manuelle n’est opérée après l’importation initiale, et de déployer les tableaux d’analyse, d’agrégation et de calcul des coefficients de variation dans des onglets dédiés, dénommés Analyses_CV ou Synthese_Groupes. Cette compartimentation assure l’intégrité de la traçabilité scientifique et simplifie la validation croisée des calculs par des auditeurs externes.
3.2 Détection et traitement des valeurs aberrantes préalables
Le coefficient de variation reposant conjointement sur la moyenne arithmétique et l’écart-type, deux métriques notoirement sensibles aux observations extrêmes, la présence de valeurs aberrantes (outliers) constitue une menace critique pour sa validité. Une seule valeur aberrante provoquée par une déconnexion d’électrode, un mouvement parasite du sujet ou une seconde d’inattention au cours d’une tâche de temps de réaction peut gonfler de façon disproportionnée l’écart-type tout en modifiant artificiellement la moyenne, faussant l’évaluation du coefficient de variation global.
Avant toute tentative de calcul de dispersion relative, une procédure méthodique d’identification des artéfacts s’impose au sein de Google Sheets. Deux approches quantitatives sont couramment déployées. La première méthode repose sur le calcul des scores standardisés (scores z). En allouant une colonne dédiée au calcul des z-scores via la formule :
=(A2 – MOYENNE($A$2:$A$100)) / ECARTYPE.STANDARD($A$2:$A$100)
le chercheur peut identifier et filtrer automatiquement les observations dont la valeur absolue dépasse un seuil d’admissibilité fixé a priori, généralement 2,5 ou 3 écarts-types.
La seconde approche, plus robuste car non assujettie à la normalité de la distribution initiale, s’appuie sur l’intervalle interquartile (IQR). Dans Google Sheets, la règle de Tukey peut être implémentée en combinant les fonctions QUARTILE.EXCLURE ou QUARTILE.INCLURE. Les bornes d’exclusion inférieure et supérieure sont établies selon les expressions :
=QUARTILE.INCLURE(A2:A100; 1) – 1.5 * (QUARTILE.INCLURE(A2:A100; 3) – QUARTILE.INCLURE(A2:A100; 1))
et
=QUARTILE.INCLURE(A2:A100; 3) + 1.5 * (QUARTILE.INCLURE(A2:A100; 3) – QUARTILE.INCLURE(A2:A100; 1))
Toute valeur franchissant ces seuils critiques doit faire l’objet d’un examen qualitatif minutieux afin de décider de son exclusion légitime ou de son maintien justifié dans le protocole.
3.3 Gestion méthodique des cellules vides et des données censurées
L’un des écueils majeurs lors du traitement de données empiriques dans un tableur réside dans la confusion technique et sémantique entre une cellule vide et une cellule contenant le chiffre zéro. Dans Google Sheets, un zéro est traité comme une valeur numérique effective de magnitude nulle. À l’inverse, une cellule vide représente une omission ou une absence de mesure. Si un chercheur encode par inadvertance l’absence d’une réponse sous la forme d’un 0 dans une colonne de temps de réaction, la fonction MOYENNE intégrera ce zéro dans son dénominateur, abaissant drastiquement la moyenne et augmentant artificiellement l’écart-type. Il en résulte un coefficient de variation totalement biaisé vers le haut.
Les fonctions statistiques standards de Google Sheets telles que MOYENNE et ECARTYPE.STANDARD disposent d’un mécanisme d’omission automatique des cellules entièrement vides et des cellules contenant des chaînes de caractères textuels. Pour garantir l’intégrité du calcul du coefficient de variation, les données manquantes dues à des défections expérimentales (drop-out, pannes de capteurs, omissions de réponse) doivent être laissées soit strictement vides, soit encodées sous la forme d’une chaîne spécifique d’indisponibilité, comme NA ou #N/A, reconnue par les moteurs de calcul.
Dans les situations expérimentales de données censurées à droite ou à gauche (par exemple, un participant qui n’a pas répondu avant la fin du temps limite de 2 000 ms fixé par l’ordinateur), l’imputation directe de la valeur seuil (2 000 ms) altère la variance de manière artificielle. Le chercheur doit explicitement documenter si ces temps limites sont exclus des calculs de variabilité via des filtres dynamiques, ou s’ils font l’objet d’un modèle d’imputation statistique dédié avant l’exécution du rapport écart-type sur moyenne.
4. Fonctions statistiques fondamentales requises dans Google Sheets
Le calcul du coefficient de variation ne fait pas l’objet d’une fonction native unifiée (telle qu’une hypothétique formule « CV() ») dans le catalogue standard des formules de Google Sheets. Sa détermination repose sur l’assemblage modulaire de deux fonctions statistiques élémentaires : le calcul de la moyenne arithmétique et l’estimation de l’écart-type.
4.1 Calcul de la moyenne arithmétique avec la fonction MOYENNE
La fonction statistique centrale pour déterminer le centre de gravité d’une série de valeurs est la fonction MOYENNE (ou AVERAGE dans la version anglophone du moteur de calcul). Sa syntaxe générale s’exprime sous la forme =MOYENNE(valeur1; [valeur2; …]) ou, de façon plus fréquente et opérationnelle, par le passage d’une plage matricielle de cellules contiguës, par exemple =MOYENNE(B2:B150). Lorsque cette formule est exécutée, Google Sheets additionne arithmétiquement l’ensemble des valeurs numériques contenues dans la plage spécifiée et divise cette somme par le nombre cardinal précis de cellules contenant des valeurs numériques.
Une vigilance technique s’impose quant à l’usage alternatif de la fonction MOYENNEA (AVERAGEA). Contrairement à la fonction MOYENNE conventionnelle, qui ignore purement et simplement les cellules contenant des chaînes textuelles ou des expressions booléennes, MOYENNEA force la conversion des chaînes de texte et de la valeur logique FAUX en zéro numérique (0), tandis que la valeur logique VRAI est convertie en unité numérique (1). L’emploi involontaire de MOYENNEA au sein d’une matrice comportementale comportant des annotations qualitatives (telles que « erreur », « absent » ou « rejet ») intégrera une multiplicité de zéros factices, effondrant la moyenne observée et faussant gravement le calcul subséquent du coefficient de variation. Par conséquent, l’usage exclusif de la fonction standard MOYENNE doit être rigoureusement observé.
La fonction MOYENNE prend également en charge les plages discontinues séparées par des points-virgules, par exemple =MOYENNE(A2:A20; C2:C20; E2:E20), ce qui s’avère précieux lorsque les blocs expérimentaux ont été répartis sur différentes sections de la feuille de calcul. Néanmoins, pour des raisons de maintenabilité et de réduction des risques d’erreurs de pointage de cellules, le regroupement continu des données reste la règle architecturale d’or.
4.2 Divergence entre ECARTYPE.STANDARD et ECARTYPEP
L’étape la plus critique dans la construction de la formule du coefficient de variation réside dans la sélection de la fonction d’écart-type appropriée. Google Sheets propose principalement deux implémentations mathématiques distinctes : ECARTYPE.STANDARD (équivalent à STDEV.S dans la version anglaise) et ECARTYPEP (équivalent à STDEV.P). La divergence entre ces deux fonctions découle directement de la théorie de l’échantillonnage et de la correction de Bessel.
La fonction ECARTYPEP calcule l’écart-type d’une population totale. Son dénominateur mathématique repose sur la division par l’effectif total N :
$$\sigma = \sqrt{\frac{\sum (x_i – \mu)^2}{N}}$$
À l’opposé, la fonction ECARTYPE.STANDARD calcule une estimation sans biais de l’écart-type de la population à partir d’un échantillon fini de données. Pour corriger la tendance naturelle d’un échantillon à sous-estimer la dispersion de sa population parente d’origine, cette fonction applique la correction de Bessel au dénominateur, en divisant la somme des carrés des écarts par l’effectif moins un ($n – 1$) :
$$s = \sqrt{\frac{\sum (x_i – \bar{x})^2}{n – 1}}$$
Le tableau suivant synthétise les propriétés respectives de ces deux fonctions :
| Critère | ECARTYPE.STANDARD (STDEV.S) | ECARTYPEP (STDEV.P) |
|---|---|---|
| Dénominateur mathématique | Divisé par $n – 1$ (degrés de liberté) | Divisé par $N$ (taille absolue de la population) |
| Nature de l’estimateur | Estimateur non biaisé de la population | Valeur exacte de la population exhaustive |
| Champ d’application expérimental | Échantillons expérimentaux de sujets ou essais | Recensements exhaustifs, cohortes complètes fermées |
| Sensibilité à la taille de l’échantillon | Différence substantielle pour les petits échantillons ($n < 30$) | Sous-estime systématiquement la variance sur de petits $n$ |
| Recommandation académique | Obligatoire pour les publications scientifiques | À proscrire hors études exhaustives de bases de données globales |
Dans la quasi-totalité des recherches empiriques en psychologie, les cohortes de sujets et les séries temporelles de mesures constituent des échantillons d’une réalité biologique plus large. Dès lors, le recours à la fonction ECARTYPE.STANDARD est impératif. L’utilisation d’ECARTYPEP sur des échantillons restreints engendre une sous-estimation systématique de la variabilité réelle, entraînant un biais baissier artificiel sur le coefficient de variation.
4.3 Combinaison fonctionnelle pour le calcul sans étapes intermédiaires
La décomposition du calcul statistique en étapes intermédiaires distinctes — à savoir calculer l’écart-type dans une cellule, la moyenne dans une seconde, puis effectuer le quotient dans une troisième — présente une valeur pédagogique indéniable lors de la phase d’apprentissage. Toutefois, sur le plan de la gouvernance de données et de l’architecture d’un projet de recherche sous Google Sheets, cette pratique encombre inutilement la matrice et démultiplie les risques d’altération accidentelle des liaisons cellulaires lors des déplacements de colonnes.
L’imbrication directe des fonctions en une syntaxe unique constitue la pratique académique standard. En combinant la fonction d’écart-type de l’échantillon et la fonction de moyenne dans une même formule arithmétique, l’expression de base s’écrit :
=ECARTYPE.STANDARD(B2:B100) / MOYENNE(B2:B100)
Cette formulation compacte offre de multiples avantages techniques : elle limite l’utilisation de mémoire tampon au sein du moteur de calcul en évitant le stockage volatile de résultats intermédiaires, elle fluidifie la duplication du calcul sur plusieurs colonnes expérimentales, et elle garantit que la modification dynamique d’une valeur dans la plage source répercute instantanément l’ajustement du coefficient de variation sans dépendance externe.
La lisibilité et la maintenance des calculs au sein d’une équipe de recherche collaborative imposent de documenter adéquatement ces formules combinées. Google Sheets autorise l’ajout de métadonnées descriptives directement au sein des en-têtes de colonnes ou par le truchement de notes de cellules (accessibles via un clic droit puis Insérer une note), explicitant la formule exacte mobilisée, l’échantillonnage visé et les éventuels critères d’exclusion retenus.
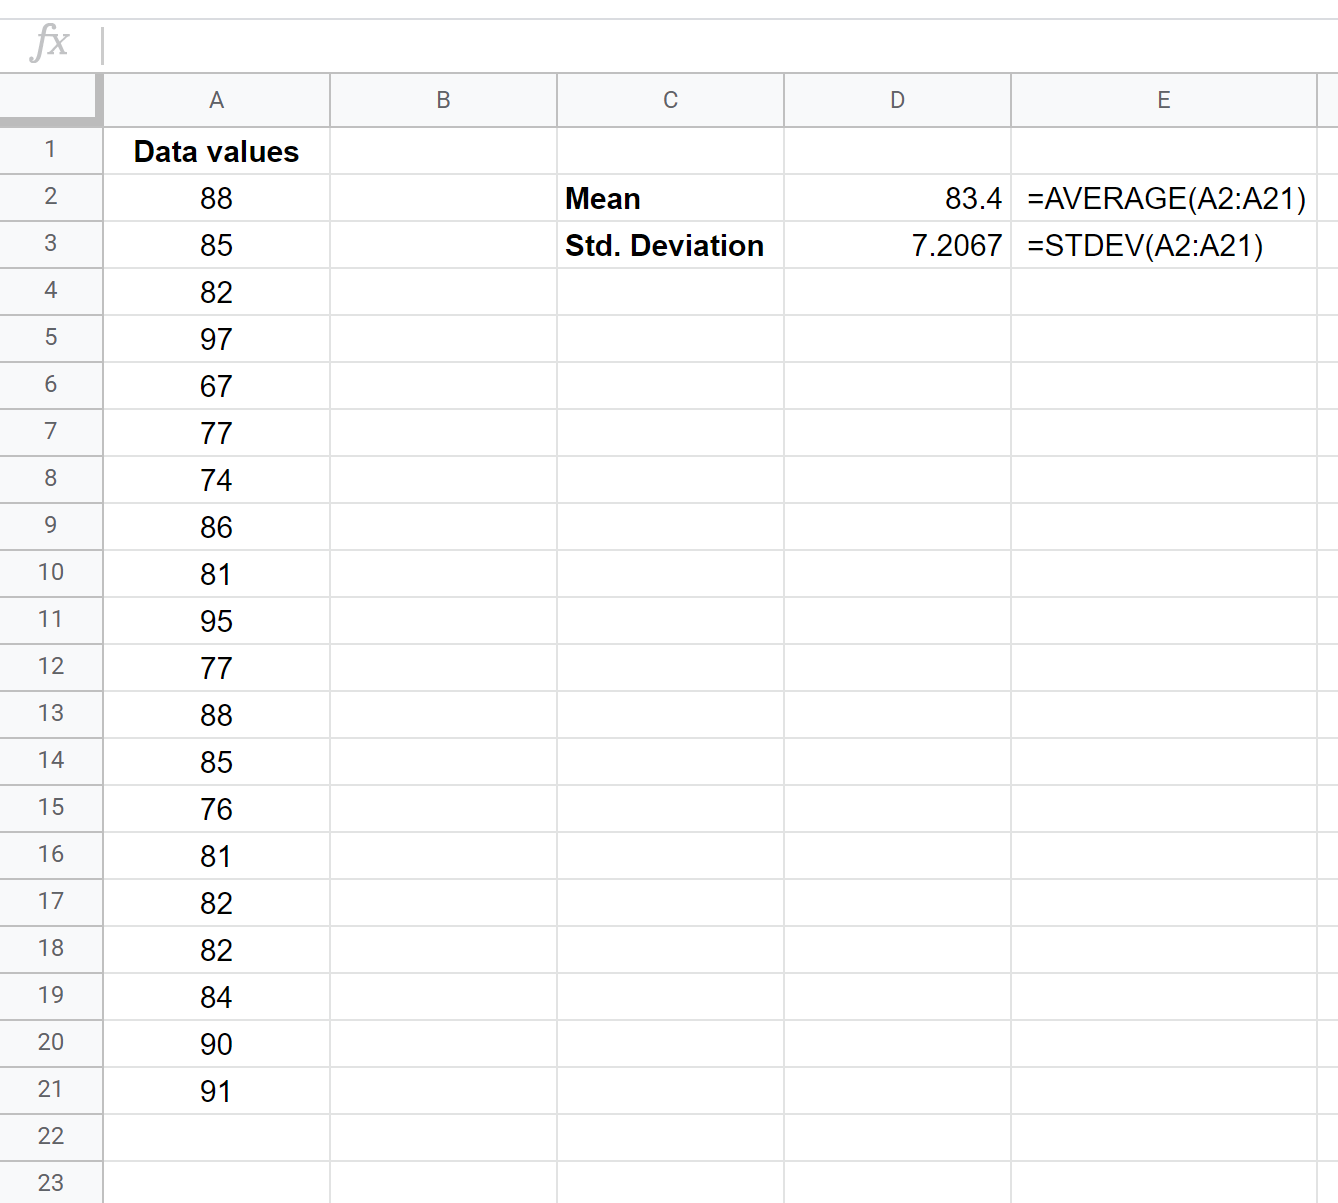
5. Procédure pas à pas pour calculer le coefficient de variation
L’implémentation opérationnelle de la formule du coefficient de variation au sein de l’interface de Google Sheets suit une chronologie rigoureuse garantissant l’exactitude des calculs, la cohérence des plages de données et la lisibilité formelle des livrables analytiques.
5.1 Implémentation de la formule standard pour données d’échantillon
Pour illustrer le déploiement opérationnel pas à pas, prenons pour référence une expérimentation psychologique où la colonne A répertorie l’identifiant des participants (Sujet_01 à Sujet_50) et la colonne B compile les temps de réaction moyens obtenus lors d’une épreuve informatisée (plage B2:B51).
Pour exécuter le calcul du coefficient de variation de cet échantillon :
1. Positionnez le curseur actif sur une cellule libre destinée à accueillir la statistique finale (par exemple la cellule D2).
2. Saisissez le signe égal (=) pour initialiser l’analyseur lexical de formules de Google Sheets.
3. Rédigez l’appel à la fonction d’écart-type d’échantillon en ouvrant la parenthèse : ECARTYPE.STANDARD(
4. Sélectionnez à la souris la plage de données empiriques ou renseignez-la manuellement au clavier en intégrant les références absolues à l’aide du symbole dollar afin de figer la matrice : $B$2:$B$51
5. Refermez la parenthèse de la première fonction statistique : )
6. Insérez l’opérateur arithmétique de division : /
7. Déclarez la fonction de tendance centrale : MOYENNE(
8. Spécifiez de manière symétrique la même plage de cellules avec le même niveau d’ancrage absolu : $B$2:$B$51)
9. Validez la formule en appuyant sur la touche Entrée du clavier.
L’expression définitive présente la forme suivante :
=$ECARTYPE.STANDARD($B$2:$B$51)/MOYENNE($B$2:$B$51)
Google Sheets retourne immédiatement un nombre décimal flottant (par exemple 0,1478234…). Cette valeur brute constitue le coefficient de variation unitaire de votre jeu de données. Pour éprouver l’intégrité de la formule saisie, il est judicieux d’effectuer une vérification préalable sur un sous-ensemble simple : une série numérique telle que {10 ; 20 ; 30} génère un écart-type d’échantillon de 10 et une moyenne de 20, retournant un coefficient de variation exact de 0,500 (soit 50 %).
5.2 Formatage typographique et conversion en pourcentage
L’expression brute d’un coefficient de variation sous forme de nombre décimal à multiples virgules flottantes complexifie la lecture rapide des rapports statistiques et ne répond pas aux canons de communication de la majorité des comités de lecture scientifiques. Deux méthodes distinctes permettent d’afficher cet indice sous la forme d’un pourcentage standardisé : la modification cosmétique de l’affichage typographique ou la multiplication scalaire au sein de la formule.
La méthode recommandée sur le plan de la rigueur statistique consiste à préserver la valeur décimale sous-jacente tout en modifiant exclusivement son formatage d’affichage dans la couche visuelle de Google Sheets. Pour ce faire, sélectionnez la cellule contenant le calcul, puis rendez-vous dans la barre d’outils supérieure et cliquez sur l’icône de pourcentage (%), ou suivez le chemin du menu : Format > Nombre > Pourcentage. Google Sheets multiplie visuellement la valeur par 100 et y adjoint le glyphe de pourcentage sans en altérer la précision décimale réelle en mémoire. À l’aide des icônes d’ajustement décimal situées dans la barre d’outils, ajustez l’affichage pour présenter rigoureusement deux décimales après la virgule, conformément aux standards éditoriaux de l’American Psychological Association (APA). Une valeur brute de 0,1478234 s’affichera ainsi comme 14,78 %.
L’alternative consiste à injecter directement une multiplication scalaire par 100 dans la formule mathématique :
=(ECARTYPE.STANDARD($B$2:$B$51)/MOYENNE($B$2:$B$51))*100
Bien que visuellement fonctionnelle, cette approche présente l’inconvénient technique majeur de modifier la valeur arithmétique intrinsèque de la cellule (qui passe de 0,1478 à 14,78). Si cette cellule doit être réutilisée subséquemment comme argument dans d’autres fonctions mathématiques, probabilistes ou modélisatrices, cette amplification par cent risque d’induire des erreurs d’ordre de grandeur désastreuses dans la chaîne de traitement statistique. La conversion typographique par le menu de formatage doit donc systématiquement prévaloir.
5.3 Vérification de l’intégrité et audit des formules
L’audit méthodologique d’une feuille de calcul scientifique constitue une étape incontournable garantissant l’absence d’erreurs de syntaxe, de glissements d’adresses ou de références croisées indésirables. Google Sheets met à disposition des chercheurs des outils d’inspection particulièrement adaptés au contrôle qualité des métriques de dispersion.
Le premier levier d’audit consiste à basculer la feuille de calcul en mode « Afficher les formules ». En utilisant le raccourci clavier universel Ctrl + ` (ou via le menu Affichage > Afficher > Formules), le tableur substitue l’ensemble des résultats numériques par leurs syntaxes textuelles sources d’origine. Cette vue synoptique permet de balayer d’un coup d’œil l’ensemble d’une colonne de calcul afin de vérifier que la plage de données d’écart-type et celle de moyenne sont rigoureusement superposables pour chaque individu ou condition, et qu’aucune cellule parasite n’a été insérée à la suite d’un copier-coller malencontreux.
Le second levier repose sur l’exploitation des outils graphiques de traçabilité des dépendances. En sélectionnant la cellule renfermant votre coefficient de variation et en naviguant dans Données > Traçabilité des formules, Google Sheets déploie des vecteurs colorés fléchés reliant la formule d’estimation aux cellules antécédentes qui alimentent le calcul. Cette visualisation confirme instantanément si la formule puise bien dans la plage valide des données du participant sans omettre de lignes en bas de tableau ni incorporer indûment l’en-tête de colonne textuel, garantissant une étanchéité computationnelle totale.
6. Automatisation et vectorisation des calculs sur grands volumes de données
Lors du traitement de cohortes massives regroupant des centaines de participants ou de données chronométriques denses, l’étirement manuel d’une formule sur des milliers de lignes devient une pratique inefficiente, propice aux erreurs de manipulation et dégradant la réactivité de l’application en ligne. Google Sheets dispose d’un moteur de calcul matriciel autorisant la vectorisation avancée des opérations statistiques.
6.1 Utilisation de la fonction ARRAYFORMULA pour le calcul dynamique
La fonction ARRAYFORMULA est traditionnellement utilisée dans Google Sheets pour étendre automatiquement le calcul d’une opération arithmétique ou d’une transformation linéaire à l’ensemble d’une colonne sans nécessiter de réplication manuelle de la formule dans chaque cellule. Néanmoins, l’application directe d’ARRAYFORMULA aux fonctions d’agrégation statistique classiques telles que MOYENNE et ECARTYPE.STANDARD se heurte à une limitation structurelle fondamentale de l’interpréteur de Google Sheets.
Ces fonctions statistiques sont par nature des fonctions « réductrices » d’agrégation : lorsqu’elles reçoivent une matrice de valeurs en entrée, leur algorithme interne compile l’ensemble des cellules fournies pour produire un résultat scalaire unique, plutôt que d’itérer ligne par ligne. Ainsi, une syntaxe naïve du type :
=ARRAYFORMULA(ECARTYPE.STANDARD(B2:E2)/MOYENNE(B2:E2))
ne parviendra pas à générer spontanément le coefficient de variation ligne par ligne si elle est déployée le long d’une colonne verticale sans ajustements complexes.
Pour contourner ce goulot d’étranglement historique, les utilisateurs de Google Sheets ont longtemps dû recourir à des formulations matricielles algébriques décomposées, utilisant des produits matriciels avec la fonction PRODUITMAT (MMULT) pour calculer les moyennes et les écarts-types ligne par ligne de manière vectorisée. Heureusement, l’introduction récente dans le moteur de calcul de Google Sheets des fonctions de première classe LAMBDA a rendu obsolètes ces contournements fastidieux, ouvrant la voie à une manipulation vectorielle d’une élégance et d’une puissance inédites.
6.2 Déploiement des fonctions LAMBDA et MAP modernes
L’intégration des fonctions d’ordre supérieur LAMBDA au sein de Google Sheets a révolutionné l’analyse matricielle. La fonction LAMBDA permet au chercheur de définir ses propres fonctions personnalisées directement dans une cellule, en associant des arguments à une formule de traitement spécifique. Combinée à la fonction itérative MAP, elle offre la possibilité d’appliquer un calcul statistique ligne par ligne le long d’un vaste vecteur de données de façon totalement dynamique et réactive.
Considérons une situation expérimentale où nous disposons de multiples mesures répétées pour chaque participant, réparties de la colonne B à la colonne F, de la ligne 2 à la ligne 1000. Pour calculer le coefficient de variation individuel de chaque sujet sans jamais tirer manuellement la moindre formule le long des mille lignes, la fonction MAP articulée avec LAMBDA s’exécute selon la syntaxe :
=MAP(B2:B1000; C2:C1000; D2:D1000; E2:E1000; F2:F1000; LAMBDA(v1; v2; v3; v4; v5; ECARTYPE.STANDARD({v1; v2; v3; v4; v5}) / MOYENNE({v1; v2; v3; v4; v5})))
Dans cette formulation, MAP parcourt séquentiellement les lignes de la matrice. À chaque itération, elle assigne les cellules individuelles de la ligne aux variables locales v1 à v5, assemble ces valeurs dans un tableau scalaire temporaire ({…}), puis calcule instantanément le coefficient de variation pour la ligne courante.
Cette approche apporte un gain substantiel de performance en termes de vitesse d’exécution de la feuille de calcul. Au lieu de forcer le tableur à instancier des centaines de formules redondantes et coûteuses en ressources, une seule formule résidant dans la première cellule génère l’ensemble du vecteur de dispersion relative, optimisant drastiquement le rafraîchissement des calculs sur des serveurs distants.
6.3 Calcul simultané multi-colonnes via BYCOL et BYROW
Pour les architectures tabulaires où les données sont regroupées en blocs matriciels compacts, Google Sheets propose les fonctions jumelles d’agrégation dimensionnelle BYCOL et BYROW. Ces fonctions spécialisées éliminent la complexité de l’énumération manuelle des arguments en scannant globalement des plages bidimensionnelles.
La fonction BYCOL s’avère particulièrement adaptée lorsque les différentes variables expérimentales (par exemple, divers tests cognitifs ou différentes sessions expérimentales T1, T2, T3) sont ordonnées en colonnes parallèles. Supposons une matrice s’étendant de B2 à K100, où chaque colonne correspond à une épreuve cognitive distincte. Pour obtenir d’un seul coup, sur une ligne récapitulative, le coefficient de variation respectif de chacune de ces dix colonnes, la formule s’écrit avec une remarquable simplicité conceptuelle :
=BYCOL(B2:K100; LAMBDA(colonne; ECARTYPE.STANDARD(colonne) / MOYENNE(colonne)))
Google Sheets extrait chaque vecteur vertical sous l’étiquette colonne, calcule le ratio dispersion/moyenne, et renvoie horizontalement l’ensemble des dix coefficients de variation sans étape intermédiaire.
À l’inverse, si la configuration de la feuille de recherche exige de calculer la variabilité intra-individuelle d’un participant le long de sa propre ligne de réponses (par exemple, dix essais chronométriques successifs ordonnés de B2 à K2), la fonction BYROW intervient avec une efficacité équivalente :
=BYROW(B2:K100; LAMBDA(ligne; ECARTYPE.STANDARD(ligne) / MOYENNE(ligne)))
Cette formule unique déploie verticalement, le long de la marge du tableau, la variabilité relative calculée spécifiquement pour chaque sujet sur sa série d’essais. Cette modularité matricielle constitue l’état de l’art pour la conception de tableaux de bord analytiques et de protocoles de recherche avancés sous Google Sheets.
7. Traitement rigoureux des anomalies et erreurs de calcul dans la feuille
Les données empiriques réelles ne s’ajustent pas toujours aux conditions idéales de la théorie statistique. Les défaillances instrumentales, les biais d’encodage et les particularités mathématiques de certaines distributions peuvent provoquer l’apparition de codes d’erreur sévères au sein de la matrice, bloquant la chaîne de traitement computationnelle.
7.1 Neutralisation de l’erreur de division par zéro (#DIV/0!)
L’erreur la plus emblématique et fréquente rencontrée lors du calcul du coefficient de variation est l’erreur d’indétermination arithmétique #DIV/0!. Par définition mathématique, le coefficient de variation exige une division par la moyenne de la série ($s / \bar{x}$). Dès lors, dès lors que la moyenne arithmétique de la plage ciblée est rigoureusement égale à zéro, l’opération devient mathématiquement indéterminée et l’interpréteur de Google Sheets interrompt le calcul en affichant l’alerte #DIV/0!. Cette situation se produit immanquablement si la plage de cellules ne contient que des zéros, mais également si des valeurs positives et négatives s’annulent parfaitement dans leur somme.
Pour assainir la matrice et préserver l’esthétique ainsi que la continuité opérationnelle des tableaux de bord statistiques, deux stratégies de neutralisation programmatique doivent être appliquées. La première approche, globale et curative, fait appel à l’encapsulation de la syntaxe au moyen de la fonction SIERREUR (IFERROR). Sa syntaxe générale s’énonce ainsi :
=SIERREUR(ECARTYPE.STANDARD(A2:A50) / MOYENNE(A2:A50); « »)
Dans ce cas, dès qu’une condition d’erreur survient (qu’il s’agisse d’une division par zéro, d’une plage totalement vide ou d’une indisponibilité technique), Google Sheets intercepte l’anomalie et retourne une cellule vide textuelle (« »), prévenant la propagation de codes d’erreur rouges dans le reste des analyses dépendantes.
La seconde approche, préventive et analytiquement supérieure, consiste à tester explicitement le dénominateur à l’aide de la fonction conditionnelle SI (IF). Cette méthode évite de masquer silencieusement d’autres anomalies critiques et force le système à vérifier si la moyenne est suffisamment éloignée de zéro avant d’enclencher le calcul :
=SI(MOYENNE(A2:A50) = 0; NA(); ECARTYPE.STANDARD(A2:A50) / MOYENNE(A2:A50))
En forçant le renvoi du marqueur statistique officiel NA() (non disponible) en cas de moyenne nulle, le chercheur signale de manière explicite et traçable l’impossibilité d’évaluer la variabilité relative sur cette variable, évitant toute confusion entre une absence de dispersion ($CV = 0$) et une impossibilité d’évaluation mathématique.
7.2 Gestion des moyennes négatives et risques d’interprétation
L’une des limites épistémologiques majeures du coefficient de variation concerne son comportement en présence de grandeurs négatives. D’un point de vue purement arithmétique, si la moyenne arithmétique d’une série de données s’avère négative tandis que l’écart-type demeure, par construction mathématique, strictement positif (racine carrée d’une variance positive), le quotient résultant arborera un signe négatif. Un coefficient de variation négatif est dénué de sens conceptuel en statistique descriptive : la dispersion relative ne peut pas être inférieure au néant.
Pour pallier ce problème arithmétique, certains praticiens ont recours à l’usage de la valeur absolue appliquée au dénominateur de la formule, formalisée dans Google Sheets par la fonction ABS :
=ECARTYPE.STANDARD(A2:A50) / ABS(MOYENNE(A2:A50))
Cette formulation neutralise le signe négatif et produit un résultat formellement positif. Cependant, sur le plan méthodologique, ce contournement technique soulève de lourdes réserves épistémologiques.
L’apparition d’une moyenne négative trahit quasi systématiquement le fait que la variable mesurée n’est pas établie sur une véritable échelle de rapport dotée d’un zéro absolu naturel, mais relève d’une échelle d’intervalles arbitraire (comme des scores de différence de potentiel émotionnel, des variations relatives de gain, ou des échelles bipolaires de -5 à +5). En outre, lorsque la moyenne s’approche dangereusement de zéro, qu’elle soit positive ou négative, le dénominateur devient infinitésimal, provoquant une explosion asymptotique de la valeur du CV qui tend alors vers l’infini sans que cela ne reflète une instabilité comportementale réelle. Par conséquent, en présence de distributions franchissant l’axe du zéro ou ancrées dans les valeurs négatives, le chercheur doit renoncer au coefficient de variation au profit d’autres indicateurs de dispersion absolue ou de rangs standardisés.
7.3 Filtrage robuste des données non numériques avec FILTER
Dans les bases de données comportementales de terrain, il est fréquent que les colonnes de recueil compilent de façon désordonnée des scores numériques, des chaînes de texte d’encodage (ex. : « Abandon », « Refus », « Erreur_Capteur ») ou des codes d’erreur accidentels (#N/A, #VALEUR!). Bien que la fonction MOYENNE native contourne la majorité des cellules purement textuelles, la présence d’espaces insécables résiduels ou de cellules corrompues issues d’imports de fichiers CSV peut bloquer l’évaluation d’ECARTYPE.STANDARD et renvoyer une erreur générale.
Pour conférer une robustesse absolue à la chaîne de calcul, il est conseillé d’intercaler la fonction d’épuration dynamique FILTER au sein de l’expression statistique. La fonction FILTER permet d’extraire sélectivement à la volée uniquement les éléments d’une plage qui valident des critères logiques précis. La combinaison avec la fonction ESTNUM (ISNUMBER), qui renvoie un booléen VRAI uniquement en présence de données scalaires numériques valides, offre un blindage algorithmique complet :
=ECARTYPE.STANDARD(FILTER(A2:A100; ESTNUM(A2:A100))) / MOYENNE(FILTER(A2:A100; ESTNUM(A2:A100)))
Dans cette configuration hautement sécurisée, Google Sheets extrait d’abord un sous-vecteur temporaire expurgé de toute cellule vide, de tout caractère typographique parasite et de tout texte résiduel avant d’appliquer les opérateurs de dispersion et de centralité.
Cette pratique d’assainissement in situ garantit que le calcul du coefficient de variation s’exécute avec une fluidité inaltérable, même sur des matrices de données imparfaites issues d’enquêtes en ligne décentralisées ou de capteurs connectés non étalonnés. Elle assure la reproductibilité et la stabilité des scripts de traitement au sein des équipes de recherche pluridisciplinaires.
8. Calcul conditionnel et stratifié du coefficient de variation
L’analyse scientifique se limite rarement à l’évaluation globale d’une cohorte univariée. Le cœur de la démarche expérimentale réside dans la comparaison de sous-groupes soumis à des conditions expérimentales distinctes ou caractérisés par des profils sociodémographiques stratifiés.
8.1 Segmentation par groupe expérimental avec la fonction FILTER
Dans un protocole expérimental factoriel classique en neurosciences comportementales, les participants sont assignés soit à un groupe contrôle recevant un placebo, soit à un groupe expérimental recevant un principe actif ou une stimulation cognitive active. Les données sont alors généralement agencées avec une colonne indiquant l’appartenance au groupe (colonne A, contenant les chaînes « Controle » ou « Experimental ») et une colonne regroupant la mesure dépendante du comportement (colonne B, latence de réponse).
Google Sheets ne possède pas de fonction combinée dédiée du type « ECARTYPE.SI.ENS », contrairement aux fonctions usuelles SOMME.SI.ENS ou MOYENNE.SI.ENS. Pour réaliser un calcul conditionnel de dispersion relative par strate expérimentale, la conjugaison de la fonction standard avec le prédicat logique FILTER s’impose comme la solution canonique la plus performante. Pour calculer le coefficient de variation spécifique au groupe expérimental, la formule s’articule comme suit :
=ECARTYPE.STANDARD(FILTER(B2:B100; A2:A100 = « Experimental »)) / MOYENNE(FILTER(B2:B100; A2:A100 = « Experimental »))
De manière symétrique, le coefficient de variation du groupe contrôle est déterminé en remplaçant la condition logique par A2:A100 = « Controle ».
Cette syntaxe offre une flexibilité totale. Elle permet d’intégrer des conjonctions de critères logiques multiples pour affiner la stratification empirique. Par exemple, si l’on souhaite restreindre le calcul du CV aux seuls participants du groupe expérimental âgés de plus de 60 ans (l’âge étant consigné en colonne C), il suffit d’adjoindre un second critère dans chaque fonction de filtrage :
=ECARTYPE.STANDARD(FILTER(B2:B100; (A2:A100 = « Experimental ») * (C2:C100 > 60))) / MOYENNE(FILTER(B2:B100; (A2:A100 = « Experimental ») * (C2:C100 > 60)))
Cette capacité de ciblage conditionnel sans restructuration préalable de la matrice brute fait de Google Sheets un instrument d’analyse particulièrement véloce pour l’exploration de données de recherche.
8.2 Agrégation dynamique multicritère via la fonction QUERY
Lorsque le schéma expérimental intègre un nombre élevé de strates croisées (croisant par exemple trois tranches d’âge, deux genres et quatre conditions de traitement), multiplier les formules FILTER unitaires devient fastidieux et expose à des incohérences de maintenance. La fonction QUERY, qui implémente le puissant moteur de requêtes Google Visualization API Query Language au sein de Google Sheets, permet de résoudre élégamment les problématiques d’agrégation multidimensionnelle.
Toutefois, une contrainte technique majeure doit être intégrée : le moteur de langage de QUERY supporte nativement des clauses d’agrégation pour la moyenne (avg), la somme (sum), le comptage (count), le minimum (min) et le maximum (max), mais ne propose pas de clause native d’écart-type d’échantillon (stddev n’étant pas disponible dans le dialecte QUERY de Google Sheets). Pour contourner cette limite et automatiser la création de tables récapitulatives de CV par strate, la méthode optimale consiste à combiner une requête QUERY préparatoire avec un traitement matriciel itératif.
Une table de contingence synthétique peut d’abord extraire la liste unique des groupes expérimentaux via la commande :
=UNIQUE(A2:A100)
Puis, en déployant une boucle BYROW sur cette liste de modalités uniques extraite, la formule associe dynamiquement pour chaque modalité identifiée le calcul du coefficient de variation stratifié au moyen d’un filtre conditionnel. Cette synergie entre l’extraction relationnelle de QUERY ou UNIQUE et la flexibilité calculatoire des fonctions matricielles récentes permet de générer des tableaux de bord statistiques synthétiques capables de s’actualiser en temps réel au fur et à mesure que de nouveaux participants sont inclus dans la feuille de collecte de données.
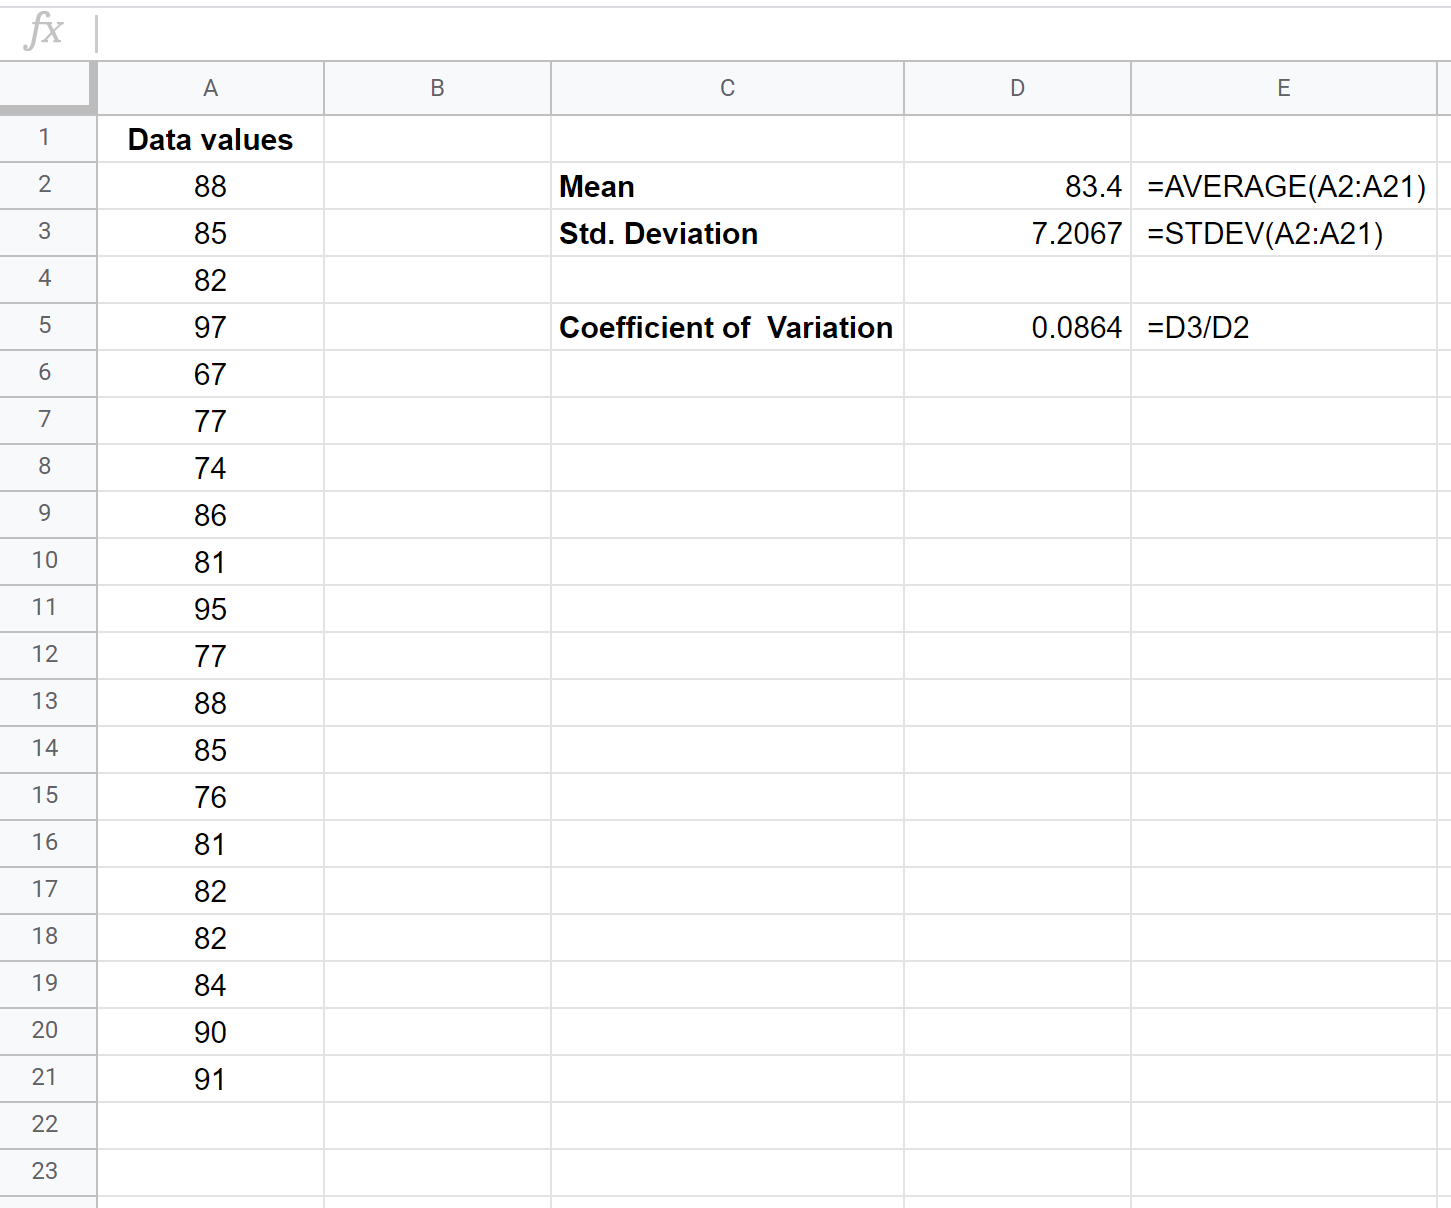
8.3 Calcul de CV pondéré pour échantillons représentatifs complexes
Dans les enquêtes épidémiologiques en santé mentale ou les sondages d’opinion à large échelle, l’échantillonnage ne repose pas sur un tirage aléatoire simple mais sur des plans de sondage stratifiés complexes à plusieurs degrés. Pour corriger les distorsions de représentativité induites par les taux de non-réponse différentiels ou le sur-échantillonnage délibéré de certaines minorités cliniques, chaque observation individuelle est assortie d’un coefficient de pondération statistique (poids d’échantillonnage w, consigné par exemple dans la colonne C). Dans ce contexte méthodologique, calculer un coefficient de variation classique non pondéré aboutirait à une estimation sévèrement biaisée des paramètres populationnels.
Le coefficient de variation pondéré ($CV_w$) requiert l’estimation rigoureuse de la moyenne pondérée ($\bar{x}_w$) et de l’écart-type pondéré sans biais ($s_w$). Dans Google Sheets, la moyenne pondérée s’obtient élégamment grâce à la fonction SOMMEPROD, qui réalise le produit scalaire des valeurs par leurs poids respectifs avant d’en effectuer la somme, divisée par la somme globale des poids :
$$\bar{x}_w = \frac{\text{SOMMEPROD}(B2:B100; C2:C100)}{\text{SOMME}(C2:C100)}$$
L’implémentation de la variance pondérée de l’échantillon exige d’intégrer le facteur correctif de normalisation des poids (correction de fiabilité pour données pondérées).
Dans la syntaxe matricielle de Google Sheets, l’expression complète menant à la dérivation de l’écart-type pondéré et à sa division par la moyenne pondérée s’exprime selon la formule avancée :
=RACINE( SOMMEPROD($C$2:$C$100; ($B$2:$B$100 – (SOMMEPROD($B$2:$B$100; $C$2:$C$100)/SOMME($C$2:$C$100)))^2) / (SOMME($C$2:$C$100) – (SOMMEPROD($C$2:$C$100^2)/SOMME($C$2:$C$100))) ) / (SOMMEPROD($B$2:$B$100; $C$2:$C$100)/SOMME($C$2:$C$100))
Bien que cette écriture présente un haut niveau de complexité algébrique, elle confère à Google Sheets la puissance analytique d’un logiciel biométrique professionnel, garantissant aux épidémiologistes une fidélité absolue dans l’estimation de l’instabilité relative des indicateurs de santé mentale au sein d’enquêtes populationnelles d’envergure nationale.
9. Représentation graphique et restitution visuelle des coefficients de variation
La compréhension des phénomènes statistiques ne saurait se cantonner à la contemplation de tableaux numériques austères. La restitution visuelle de la variabilité relative à travers des représentations graphiques optimisées et des dispositifs de mise en forme conditionnelle dynamise l’exploration des données et facilite la transmission des conclusions scientifiques auprès des pairs.
9.1 Création de graphiques de dispersion avec barres d’erreur normalisées
La visualisation la plus rigoureuse de l’instabilité comportementale repose sur le graphique de dispersion univarié ou le diagramme à barres affichant explicitement la tendance centrale flanquée de ses marges d’incertitude relative. Dans Google Sheets, l’éditeur de graphiques natif propose des options sophistiquées de barres d’erreur, mais leur paramétrage requiert une vigilance méthodologique particulière pour refléter fidèlement le coefficient de variation.
Pour concevoir une figure respectant les canons scientifiques :
1. Créez au préalable une table récapitulative listant en colonnes les noms des conditions expérimentales, les moyennes arithmétiques respectives et les coefficients de variation préalablement calculés sous forme décimale ou de pourcentage.
2. Sélectionnez la plage des conditions et des moyennes, puis ouvrez le module via Insertion > Graphique.
3. Dans l’onglet Configuration du panneau latéral, définissez le type de graphique sur Graphique à colonnes ou Graphique à nuage de points.
4. Basculez sur l’onglet Personnaliser, déployez la section Série, et cochez l’option Barres d’erreur.
5. Dans le menu déroulant Type des barres d’erreur, l’utilisateur a le choix entre Pourcentage ou Constante. Si vous sélectionnez Pourcentage, Google Sheets appliquera un intervalle proportionnel à la moyenne de la barre. En reportant rigoureusement la valeur de votre coefficient de variation dans le champ numérique attenant (par exemple en saisissant la valeur 15 pour un CV de 15 %), les barres d’erreur projetées autour de la moyenne matérialiseront visuellement l’amplitude exacte de la déviation standard relative de chaque condition.
Cette mise en scène graphique met immédiatement en relief l’hétérogénéité différentielle entre plusieurs cohortes cliniques : deux colonnes d’égale hauteur (moyennes identiques) afficheront des empattements de barres d’erreur d’amplitudes nettement asymétriques, illustrant instantanément aux yeux des évaluateurs la divergence d’instabilité comportementale sous-jacente.
9.2 Intégration de micro-graphiques SPARKLINE dans les tableaux récapitulatifs
La fonction SPARKLINE de Google Sheets constitue une innovation visuelle majeure permettant d’intégrer des graphiques miniatures haute définition directement à l’intérieur d’une cellule unique de la feuille de calcul. Cet outil s’avère précieux pour condenser l’information visuelle au sein de matrices de profils psychologiques individuels ou de tableaux synoptiques de grande taille.
Pour injecter une représentation visuelle directe de la magnitude du coefficient de variation à côté de sa valeur chiffrée, la fonction SPARKLINE peut être configurée sous la forme d’une micro-jauge horizontale linéaire de type barre. Supposons que le coefficient de variation décimal soit calculé dans la cellule D2 (affichant par exemple 0,28, soit 28 %). Dans la cellule adjacente E2, la fonction SPARKLINE s’implémente selon la syntaxe paramétrée suivante :
=SPARKLINE(D2; {« charttype » »bar »; « max »1; « color1″SI(D2>0.3; « crimson »; « seagreen »)})
Dans cette instruction, le graphique de type barre est calibré sur une échelle normalisée de 0 à 1 (représentant 0 % à 100 % de CV).
L’intégration d’une logique conditionnelle au paramètre de couleur transforme ce micro-graphique en une jauge d’alerte automatisée : si le coefficient de variation dépasse le seuil critique d’instabilité de 0,30 (30 %), la jauge s’illumine instantanément en rouge cramoisi (« crimson »), signalant sans équivoque une instabilité comportementale anormale chez le sujet. Dans le cas contraire, la barre adopte une teinte verte apaisée (« seagreen »). Cette intégration visuelle densifie la portée diagnostique des synthèses cognitives, permettant aux cliniciens de repérer d’un simple balayage oculaire les profils atypiques au sein d’une cohorte de patients.
9.3 Mise en forme conditionnelle appliquée aux valeurs de dispersion
La mise en forme conditionnelle enrichit l’analyse exploratoire en appliquant des styles graphiques dynamiques aux cellules en fonction des grandeurs scalaires qu’elles contiennent. Dans le cadre de l’exploitation de matrices multicancanal de coefficients de variation, l’application d’un nuancier thermique (heatmap) permet de visualiser les gradients de dispersion sans charger l’interface avec des diagrammes périphériques.
Pour instaurer un gradient chromatique rigoureux fondé sur la distribution empirique des coefficients de variation :
1. Sélectionnez la plage complète des cellules abritant vos estimations de CV (par exemple D2:D150).
2. Cliquez sur Format > Mise en forme conditionnelle dans le ruban supérieur.
3. Dans le panneau latéral de configuration, sélectionnez l’onglet Échelle de couleurs.
4. Paramétrez les points d’ancrage colorimétriques : assignez une couleur froide (par exemple un bleu profond ou un vert forêt) au point minimal représentant les distributions hautement régulières et stables, une teinte neutre médiane (blanc cassé ou jaune pâle) pour le cinquantième percentile (médiane de l’échantillon), et une teinte chaude accentuée (rouge corail ou pourpre) au point maximal marquant les plus fortes instabilités cognitives.
Au-delà des échelles continues en dégradé, l’établissement de règles explicites d’avertissement statistique s’avère hautement stratégique. En adjoignant une règle conditionnelle ciblant les cellules dont la valeur est supérieure à un point critique théorique (par exemple $CV > 0,50$), le gestionnaire de la base de données peut faire surligner automatiquement ces observations en aplat d’alerte vif. Ce mécanisme offre une double utilité : il accélère le repérage de défaillances de mesure potentielles lors de la phase d’apurement des données et met en exergue les sujets expérimentaux présentant des profils d’inconstance neuropsychologique extrême justifiant une investigation clinique qualitative approfondie.
10. Développement d’une fonction personnalisée avec Google Apps Script
Bien que les combinaisons de formules natives satisfassent la majorité des usages descriptifs, la répétition fréquente de syntaxes matricielles complexes peut alourdir la maintenance des grands classeurs collaboratifs. Google Sheets permet d’étendre son catalogue de formules par la programmation de fonctions personnalisées (User-Defined Functions) exécutées sur le moteur JavaScript côté serveur via Google Apps Script.
10.1 Programmation de la fonction COEFFICIENT_VARIATION en JavaScript
Pour créer une fonction personnalisée dédiée au calcul du coefficient de variation, l’utilisateur accède à l’environnement de développement intégré via le menu Extensions > Apps Script. Dans l’éditeur de code, un algorithme computationnel robuste en JavaScript pur peut être consigné afin de gérer aussi bien des arguments scalaires isolés que des plages matricielles à deux dimensions.
Le code source standard de la fonction s’établit selon la structure logicielle suivante :
function COEFFICIENT_VARIATION(plageDeDonnees, estEchantillon) {
if (estEchantillon === undefined) {
estEchantillon = true;
}
var tableauPlat = [];
if (Array.isArray(plageDeDonnees)) {
for (var i = 0; i < plageDeDonnees.length; i++) {
for (var j = 0; j < plageDeDonnees[i].length; j++) {
var valeur = plageDeDonnees[i][j];
if (typeof valeur === 'number' && !isNaN(valeur)) {
tableauPlat.push(valeur);
}
}
}
} else if (typeof plageDeDonnees === 'number' && !isNaN(plageDeDonnees)) {
tableauPlat.push(plageDeDonnees);
}
var n = tableauPlat.length;
if (n < 2) {
throw new Error("L'échantillon doit contenir au minimum deux valeurs numériques valides.");
}
var somme = 0;
for (var k = 0; k < n; k++) {
somme += tableauPlat[k];
}
var moyenne = somme / n;
if (moyenne === 0) {
throw new Error("La moyenne arithmétique est égale à zéro : division impossible.");
}
var sommeCarres = 0;
for (var m = 0; m < n; m++) {
sommeCarres += Math.pow(tableauPlat[m] – moyenne, 2);
}
var denominateurDegresLiberte = estEchantillon ? (n – 1) : n;
var ecartType = Math.sqrt(sommeCarres / denominateurDegresLiberte);
return ecartType / Math.abs(moyenne);
}
Après avoir cliqué sur l'icône de disquette pour enregistrer le script sous le projet Statistiques_Recherche, la fonction personnalisée devient immédiatement opérationnelle au sein de toutes les cellules de la feuille de calcul active, s'appelant simplement sous la syntaxe intuitive :
=COEFFICIENT_VARIATION(A2:A100)
10.2 Paramétrage d’options avancées dans le script personnalisé
L’intérêt majeur d’une fonction développée sous Apps Script réside dans sa plasticité algorithmique. Le script implémenté ci-dessus intègre nativement un second argument booléen optionnel, estEchantillon, qui octroie à l’utilisateur un contrôle méthodologique direct sur la correction de Bessel.
Par défaut, si le second argument est omis par le chercheur, la variable locale est initialisée sur la valeur booléenne true, appliquant une division par $n – 1$ conforme aux standards de l’estimation d’échantillon. Si l’analyste manipule les données d’un recensement démographique exhaustif ou d’une cohorte exhaustive totale, il lui suffit de renseigner explicitement la valeur logique FAUX (FALSE) comme second paramètre dans la cellule de Google Sheets :
=COEFFICIENT_VARIATION(A2:A100; FAUX)
L’algorithme bascule dynamiquement son dénominateur sur la division par n, reproduisant la statistique exacte de population ECARTYPEP.
De plus, l’architecture du code intègre un filtre de nettoyage dynamique : les boucles itératives plates parcourent la matrice fournie en testant le typage réel de chaque cellule au moyen de l’expression typeof valeur === ‘number’ && !isNaN(valeur). Ce mécanisme évacue de manière transparente les cellules textuelles, les valeurs nulles indéterminées et les cellules vides sans générer de rupture logicielle, assurant un niveau de robustesse d’exécution supérieur aux formules composites classiques.
10.3 Documentation, autocomplétion et déploiement de la fonction
Pour transformer ce script JavaScript en un composant logiciel intégré aux standards professionnels de Google Sheets, l’adjonction de métadonnées descriptives sous la convention JSDoc est nécessaire. Ces balises de documentation permettent à Google Sheets d’afficher une infobulle d’assistance interactive lorsque l’utilisateur commence à taper le nom de la fonction dans une cellule.
Pour activer cette assistance contextuelle, placez le bloc de commentaires suivant immédiatement au-dessus de la déclaration de la fonction dans l’éditeur Apps Script :
/**
* Calcule le coefficient de variation (dispersion relative) d’une série de données numériques.
*
* @param {A2:A100} plageDeDonnees Plage matricielle contenant les valeurs numériques observées.
* @param {TRUE} estEchantillon Optionnel : VRAI pour utiliser la correction d’échantillon (n-1), FAUX pour la population (n). VRAI par défaut.
* @return {number} Le ratio sans dimension entre l’écart-type et la moyenne arithmétique.
* @customfunction
*/
L’annotation @customfunction indique explicitement à l’interpréteur de Google Sheets d’indexer cette fonction dans son catalogue public d’autocomplétion. Dès lors qu’un utilisateur saisit =COEFF… dans une cellule de la feuille, une fenêtre modale d’aide contextuelle surgit à l’écran, détaillant la définition de la fonction, les prérequis attendus pour chaque paramètre et un exemple concret d’exécution, simplifiant son utilisation pour les membres non programmeurs de l’équipe de recherche.
Pour déployer cette fonction sur l’ensemble d’un laboratoire ou d’une organisation académique sans obliger chaque collaborateur à copier-coller manuellement le code source dans chaque nouveau classeur, Google Apps Script permet d’exporter le script sous forme de bibliothèque partagée ou de module complémentaire (Google Workspace Add-on) distribué via le Google Workspace Marketplace privé de l’institution universitaire.
11. Études de cas empiriques en psychologie et sciences du comportement
Afin de lier l’ensemble des concepts théoriques et des procédures techniques développés précédemment, cette section présente trois études de cas empiriques représentatives des champs de recherche contemporains en psychologie cognitive, psychométrie et psychiatrie translationnelle.
11.1 Cas pratique 1 : Analyse de la variabilité des temps de réaction sous privation de sommeil
Dans cette expérimentation de neuroergonomie, une cohorte de 20 pilotes de ligne est soumise à une tâche de vigilance psychomotrice (PVT) d’une durée continue de 10 minutes (environ 100 essais chronométriques par session), à deux moments distincts : en condition de repos nominal (session de base) puis après 24 heures d’éveil continu (condition de privation totale de sommeil). Les latences brutes en millisecondes sont consignées sur la feuille de calcul. La colonne A contient l’identifiant du sujet, la colonne B la condition (Repos vs Privation) et la colonne C le temps de réponse brut de chaque essai.
La mise en place analytique sous Google Sheets vise à déterminer si la privation de sommeil altère davantage la vitesse brute d’exécution ou la stabilité attentionnelle relative. À l’aide de la fonction FILTER imbriquée, nous créons un tableau récapitulatif synthétisant les moyennes et les coefficients de variation individuels pour chaque sujet dans les deux états de veille. Pour le participant 1 en condition de privation, la formule du CV intra-individuel s’écrit :
=ECARTYPE.STANDARD(FILTER(C$2:C; A$2:A = « Sujet_01 »; B$2:B = « Privation »)) / MOYENNE(FILTER(C$2:C; A$2:A = « Sujet_01 »; B$2:B = « Privation »))
L’analyse des résultats révèle que le temps de réaction moyen subit un ralentissement moyen modéré de 18 % sous privation de sommeil (passant de 220 ms à 260 ms). En revanche, le coefficient de variation intra-individuel subit une envolée spectaculaire, passant d’une moyenne de 12 % en condition de repos à plus de 38 % en état de privation de sommeil. L’interprétation neuropsychologique démontre que l’impact critique du manque de sommeil ne réside pas tant dans un ralentissement homogène et continu de l’ensemble du système nerveux, mais dans une incapacité oscillatoire à maintenir un contrôle attentionnel stable, se traduisant par des ruptures phasiques de traitement de l’information (défaillances attentionnelles ou microsommeils transitoires) capturées de façon élective par l’explosion du coefficient de variation.
11.2 Cas pratique 2 : Comparaison de la fidélité de sous-échelles d’un test de personnalité
Une équipe de psychométrie procède au développement d’un nouveau questionnaire évaluant l’intelligence émotionnelle perçue. L’instrument est administré à un échantillon normatif de 500 étudiants universitaires. L’échelle se compose de trois sous-dimensions théoriques distinctes : la régulation émotionnelle personnelle (Sous-échelle 1, notée sur 30 points), la perception des émotions d’autrui (Sous-échelle 2, notée sur 50 points) et l’expression verbale des affects (Sous-échelle 3, notée sur 20 points). Les scores bruts agrégés de ces trois domaines sont stockés respectivement dans les colonnes B, C et D du classeur.
En raison de la disparité du nombre d’items et des barèmes maximaux théoriques de chaque dimension, la simple inspection des écarts-types bruts s’avère trompeuse : l’écart-type de la Sous-échelle 2 est naturellement plus ample en valeur absolue simplement parce que son échelle culmine à 50. Pour évaluer la dispersion relative des réponses au sein de la population et sonder l’homogénéité de chaque construit, les chercheurs déploient la fonction BYCOL pour dériver simultanément les trois coefficients de variation :
=BYCOL(B2:D501; LAMBDA(echelle; ECARTYPE.STANDARD(echelle) / MOYENNE(echelle)))
Le calcul produit les coefficients de variation suivants : 14,2 % pour la Régulation émotionnelle, 15,1 % pour la Perception d’autrui, et 39,7 % pour l’Expression des affects. Cette mise en regard standardisée met en lumière une réalité psychométrique nette : alors que les deux premières dimensions présentent une dispersion relative comparable et resserrée autour du centre de la cohorte, la troisième sous-échelle manifeste une hétérogénéité relative presque trois fois plus marquée. Cette observation alerte les concepteurs du test sur la nécessité de réviser les items de la sous-échelle d’expression émotionnelle, suspectée de présenter une ambiguïté sémantique ou une trop forte sensibilité aux variations socioculturelles individuelles.
11.3 Cas pratique 3 : Analyse des fluctuations émotionnelles écologiques (méthode ESM)
L’évaluation écologique momentanée (Experience Sampling Method ou ESM) constitue un paradigme de pointe en psychiatrie clinique, consistant à solliciter les participants via leur smartphone plusieurs fois par jour durant deux semaines pour sonder l’intensité de leur affect négatif (tristesse, anxiété, irritabilité) sur une échelle numérique continue de 0 à 100. Cette approche génère une série chronologique intensive de mesures répétées en contexte de vie réelle, totalisant environ 70 points de mesure par patient. Le fichier de données collige l’ensemble de ces alertes journalières en colonne C, avec les identifiants patients en colonne A.
Dans l’analyse des troubles de l’humeur et du trouble de la personnalité borderline, la labilité émotionnelle — conceptualisée comme l’amplitude des oscillations affectives au fil des heures — constitue un marqueur diagnostique bien plus probant que l’intensité moyenne brute de l’affect négatif. Un patient peut présenter un niveau moyen d’affect négatif modéré mais vivre des bascules émotionnelles drastiques et violentes d’un moment à l’autre. Pour modéliser cette dynamique au sein de Google Sheets, la formule matricielle calcule pour chaque patient de la cohorte son coefficient de variation écologique de l’affect négatif :
=MAP(UNIQUE(A2:A); LAMBDA(id_patient; SI(ESTVIDE(id_patient); « »; ECARTYPE.STANDARD(FILTER(C2:C; A2:A = id_patient)) / MOYENNE(FILTER(C2:C; A2:A = id_patient)))))
Cette ligne de commande unique génère instantanément le vecteur complet des coefficients de variation longitudinaux pour chaque participant. Les analyses subséquentes confirment que les patients présentant un diagnostic de trouble de la personnalité borderline affichent un coefficient de variation d’affect négatif moyen de 62 %, contre 21 % chez les témoins sains, malgré des écarts de moyennes d’affects parfois restreints. La dérivation automatisée du CV sous Google Sheets s’affirme ainsi comme un vecteur direct de quantification de l’instabilité psychologique, ouvrant des perspectives tangibles pour l’évaluation personnalisée de l’efficacité de psychothérapies ciblées sur la régulation affective.
12. Bonnes pratiques académiques, limites méthodologiques et interprétation critique
L’utilisation d’outils informatiques puissants et accessibles tels que Google Sheets comporte le risque inhérent de découpler le calcul technique de la réflexion épistémologique et critique nécessaire. L’exploitation du coefficient de variation exige une compréhension lucide de ses bornes de validité et une conformité rigoureuse aux standards de publication scientifique internationale.
12.1 Interprétation contextualisée et seuils de référence
Une méprise courante parmi les jeunes chercheurs réside dans la quête d’un seuil universel absolu à partir duquel un coefficient de variation serait intrinsèquement qualifié de « bon », de « faible » ou d’« inacceptable ». Dans l’absolu, un coefficient de variation n’a aucun sens intrinsèque hors de son paradigme d’étalonnage. En biochimie et en pharmacologie clinique, un CV analytique supérieur à 5 % ou 10 % sur des dosages hormonaux est souvent considéré comme révélateur d’une défaillance méthodologique inacceptable du matériel de laboratoire. À l’inverse, en psychologie différentielle et en sociologie quantitative, des coefficients de variation oscillant entre 20 % et 40 % constituent la norme empirique attendue au vu de l’hétérogénéité intrinsèque des comportements humains et de la variabilité inter-individuelle naturelle.
Toute tentative de comparaison de coefficients de variation doit s’opérer exclusivement entre des conditions expérimentales rigoureusement identiques employant des dispositifs de mesure comparables. Affirmer qu’un groupe de participants est « plus variable » intellectuellement qu’un autre en comparant le CV d’une épreuve de temps de réaction au CV d’un inventaire de mémoire épisodique relève d’une erreur conceptuelle grossière, car chaque épreuve convoque des architectures cognitives distinctes dotées de ratios signal/bruit spécifiques.
Par ailleurs, il convient de souligner la vulnérabilité mathématique du coefficient de variation estimé sur des échantillons de taille restreinte ($n < 15$). Dans ces contextes d'échantillons ténus, la distribution d'échantillonnage du coefficient de variation s'avère asymétrique et biaisée positivement. Pour corriger ce biais d'échantillonnage sur les cohortes réduites, certains statisticiens recommandent d'appliquer la correction de Sokal et Rohlf au résultat obtenu dans Google Sheets :
$$CV_{corr} = CV \cdot \left(1 + \frac{1}{4n}\right)$$
Cette précaution analytique permet d'éviter de surestimer la dispersion relative réelle de la population lors d'études pilotes à effectifs marginaux.
12.2 Vulnérabilité du CV face aux distributions bimodales et asymétriques
Comme mentionné lors de l’examen des fondements théoriques, le coefficient de variation standard repose sur le couple paramétrique moyenne/écart-type. Cette architecture conceptuelle devient hautement fragile dès lors que la distribution empirique s’écarte substantiellement des postulats de normalité gaussienne. En présence d’une distribution bimodale (traduisant par exemple la présence de deux sous-populations distinctes non identifiées au sein de l’échantillon) ou d’une distribution fortement asymétrique (comme la loi log-normale décrivant classiquement les temps de réaction ou les temps de séjour hospitalier), la moyenne arithmétique ne coïncide plus avec le centre de gravité probabiliste de la population, et l’écart-type est tiré vers le haut par les longues traînes de distribution.
Dans ces conditions statistiques défavorables, le recours à un indicateur robuste de dispersion relative, non paramétrique et insensible aux valeurs extrêmes, constitue une alternative méthodologique indispensable. La métrique de référence la plus robuste est le coefficient de variation basé sur la médiane et l’écart absolu à la médiane (Median Absolute Deviation ou MAD). L’écart absolu médian se définit comme la médiane des écarts absolus par rapport à la médiane de l’échantillon :
$$\text{MAD} = \text{Médiane}(|x_i – \text{Médiane}(x)|)$$
Sous l’hypothèse de normalité asymptotique, la MAD est multipliée par le facteur d’échelle constant 1,4826 pour offrir une estimation non biaisée équivalente à l’écart-type.
L’indice alternatif robuste du coefficient de variation, désigné sous le terme de $CV_{robuste}$ ou $RSD_{médiane}$, s’exprime alors par le ratio de la MAD normalisée sur la médiane :
$$CV_{robuste} = \frac{1,4826 \cdot \text{MAD}}{\text{Médiane}}$$
Dans Google Sheets, cet indice robuste peut être calculé de façon directe sans macro, en combinant des fonctions de médiane imbriquées au sein d’une formule matricielle avancée appliquée à la plage A2:A100 :
=(1.4826 * MEDIANE(INDEX(ABS(A2:A100 – MEDIANE(A2:A100))))) / MEDIANE(A2:A100)
Le déploiement de cette métrique robuste au sein de vos feuilles de calcul permet de caractériser avec une précision mathématique inaltérable la dispersion relative des comportements, sans craindre les biais induits par les asymétries de distribution ou la présence d’observations extrêmes atypiques.
12.3 Normes de restitution des résultats dans les publications scientifiques
La valorisation des analyses menées sous Google Sheets dans des revues savantes exige une adhésion scrupuleuse aux standards de communication statistique régis par les normes de l’American Psychological Association (APA 7ème édition). Sur le plan de la transparence empirique, il est scientifiquement proscrit de ne publier que le seul coefficient de variation de manière déconnectée des paramètres absolus qui l’ont constitué.
Le rapportage scientifique rigoureux impose d’exposer conjointement, pour chaque condition ou groupe investigué : la taille effective de l’échantillon ($n$), la moyenne arithmétique ($M$), l’écart-type non biaisé ($SD$), et enfin le coefficient de variation ($CV$). Ce formalisme d’exposition permet aux évaluateurs pairs de reconstituer mentalement la structure globale des données et de contrôler la plausibilité des inférences conduites. Dans le corps textuel d’un manuscrit soumis à publication, la transcription textuelle standardisée adoptera une syntaxe du type :
« Les temps de réponse dans la condition de surcharge cognitive présentent une variabilité relative significativement plus marquée ($M = 452\text{ ms}$, $SD = 113\text{ ms}$, $CV = 25{,}00,%$) que ceux observés dans la condition de contrôle ($M = 310\text{ ms}$, $SD = 37\text{ ms}$, $CV = 11{,}94,%$). »
Enfin, dans l’esprit contemporain de la science ouverte (Open Science) et des principes d’intégrité FAIR (Facile à trouver, Accessible, Interopérable et Réutilisable), les chercheurs sont instamment encouragés à déposer le lien pérenne de leur feuille de calcul Google Sheets nettoyée et documentée au sein de dépôts institutionnels publics tels que l’Open Science Framework (OSF) ou Zenodo. En fournissant l’accès direct aux formules matricielles, aux scripts Google Apps Script et à la traçabilité intégrale du calcul du coefficient de variation, la recherche psychologique et comportementale garantit sa reproductibilité computationnelle, affermissant durablement la crédibilité des sciences humaines à l’ère numérique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bland, J. M., & Altman, D. G. (1996). Statistics notes: Measurement error. BMJ, 313(7059), 744. https://doi.org/10.1136/bmj.313.7059.744
Conners, C. K. (2014). Conners 3rd edition (Conners 3). Multi-Health Systems.
Dinges, D. F., & Powell, J. W. (1985). Microcomputer analyses of performance on a portable, simple visual RT task during sustained operations. Behavior Research Methods, Instruments, & Computers, 17(6), 652–655. https://doi.org/10.3758/BF03200977
Google Workspace Developers. (2023). Google Apps Script: Custom functions in Google Sheets. Google Developers. https://developers.google.com/apps-script/guides/sheets/functions
Hultsch, D. F., Strauss, E., Hunter, M. A., & MacDonald, S. W. (2008). Intraindividual variability, cognition, and aging. In F. I. M. Craik & T. A. Salthouse (Eds.), The handbook of aging and cognition (3rd ed., pp. 491–556). Psychology Press.
MacDonald, S. W. S., Nyberg, L., & Bäckman, L. (2006). Intra-individual variability in behavior: Links to brain structure, neurotransmission and neuronal activity. Trends in Neurosciences, 29(8), 474–480. https://doi.org/10.1016/j.tins.2006.06.011
Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
Sokal, R. R., & Rohlf, F. J. (2012). Biometry: The principles and practice of statistics in biological research (4th ed.). W. H. Freeman and Company.
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Trull, T. J., & Ebner-Priemer, U. W. (2013). Ambulatory assessment in psychopathology research: Current state, progress, and future directions. Psychological Assessment, 25(4), 1079–1082. https://doi.org/10.1037/a0034606
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.