
L’analyse des séries temporelles constitue l’un des piliers méthodologiques fondamentaux de la modélisation statistique moderne, trouvant des applications cruciales aussi bien en économétrie, en climatologie, en ingénierie des signaux qu’en psychométrie quantitative. Au cœur de cette discipline réside la notion d’autocorrélation, ou corrélation sérielle, qui quantifie la dépendance linéaire existant entre les observations successives d’une même variable mesurée de manière séquentielle au fil du temps. Alors que les logiciels spécialisés tels que R, Python, SAS ou SPSS intègrent des routines algorithmiques automatisées pour estimer les fonctions d’autocorrélation, comprendre et exécuter ces calculs au sein de Microsoft Excel offre une valeur pédagogique, conceptuelle et opérationnelle inestimable. En décomposant chaque étape arithmétique dans un tableur, le chercheur ou le praticien acquiert une maîtrise totale de la mécanique sous-jacente des séries chronologiques, éliminant l’effet de « boîte noire » propre aux environnements de haut niveau.
Le calcul de l’autocorrélation dans un environnement comme Excel exige une rigueur mathématique et structurelle absolue. Contrairement aux analyses de corrélation bivariées classiques entre deux vecteurs distincts et indépendants, l’autocorrélation examine la corrélation d’une série avec sa propre histoire différée d’un intervalle temporel donné, appelé décalage ou « lag ». Cette particularité computationnelle impose une gestion précise de l’alignement des plages de cellules, une application scrupuleuse des formules de centrage sur l’espérance mathématique globale de l’échantillon, et une normalisation exacte par la variance de la population. Une méconnaissance de ces spécificités conduit fréquemment les utilisateurs à commettre des erreurs méthodologiques substantielles, notamment par l’usage inapproprié de fonctions de corrélation d’échantillon non corrigées, faussant irrémédiablement l’interprétation des dynamiques sous-jacentes du phénomène observé.
Le présent traité propose une analyse exhaustive et rigoureuse de l’estimation de l’autocorrélation dans Microsoft Excel, combinant théorie statistique avancée, déclinaison algorithmique pas à pas et étude de cas appliquée aux sciences comportementales. De la formalisation de l’estimateur standard d’autocovariance jusqu’à l’implémentation de graphiques d’autocorrélation enrichis des intervalles de confiance asymptotiques de Bartlett, en passant par le déploiement de fonctions vectorielles avancées comme SOMMEPROD, DECALER ou la programmation de fonctions personnalisées en VBA, ce guide fournit une feuille de route complète. Conçu pour répondre aux normes les plus strictes de la recherche empirique et de la pratique analytique, ce document constitue un manuel de référence pour quiconque souhaite modéliser la mémoire séquentielle de ses données sans recourir aveuglément à des progiciels préprogrammés.
1. Fondements théoriques de l’autocorrélation dans l’analyse de séries temporelles
1.1 Définition mathématique et conceptuelle de la corrélation sérielle
L’autocorrélation, également désignée sous le terme de dépendance séquentielle ou de corrélation sérielle, représente la mesure formelle de la relation linéaire reliant une variable aléatoire observée à un instant t à cette même variable observée à un instant antérieur t – k, où k représente l’ordre de retard ou l’amplitude du déphasage temporel. Dans le cadre de l’étude des processus stochastiques, cette notion permet d’évaluer dans quelle mesure l’état présent d’un système dépend fonctionnellement de son histoire passée immédiate ou médiate. Contrairement à la corrélation bivariée conventionnelle de Pearson, qui quantifie le degré d’association linéaire entre deux variables distinctes mesurées sur les mêmes unités d’échantillonnage, l’autocorrélation est une métrique intrinsèque, univariée et dynamique, qui capture la mémoire interne d’un signal unique projeté sur sa propre trajectoire chronologique.
D’un point de vue mathématique, pour une série temporelle stationnaire {Xt} d’espérance μ et de variance σ2, l’autocorrélation d’ordre k, conventionnellement notée ρk, est définie comme le rapport normalisé entre l’autocovariance au retard k, notée γk, et l’autocovariance au retard nul γ0, cette dernière étant rigoureusement équivalente à la variance non conditionnelle du processus. La formulation formelle s’écrit ainsi : ρk = Cov(Xt, Xt-k) / Var(Xt) = E[(Xt – μ)(Xt-k – μ)] / E[(Xt – μ)2]. Cette expression montre que le coefficient d’autocorrélation mesure la dispersion conjointe des écarts temporels par rapport à la moyenne globale du système.
À l’instar du coefficient de Pearson standard, le coefficient d’autocorrélation théorique est strictement borné au sein de l’intervalle fermé [-1, +1]. Une valeur de ρk = +1 indique une persistance temporelle déterministe parfaite de pas k, signifiant qu’une déviation positive au temps t est systématiquement suivie, après k unités de temps, d’une déviation positive rigoureusement proportionnelle. Inversement, une valeur de ρk = -1 traduit une oscillation séquentielle parfaite et symétrique, caractérisée par une inversion systématique de signe autour de la moyenne. Lorsque ρk = 0, la série ne présente aucune corrélation sérielle linéaire au décalage considéré, signifiant que la connaissance de l’état du système à l’instant t – k ne confère aucun avantage prédictif linéaire pour anticiper la valeur de l’observation à l’instant t.
1.2 Utilité prédictive et modélisation des dynamiques temporelles
L’estimation des coefficients d’autocorrélation séquentielle pour des retards successifs constitue la pierre angulaire de l’inférence prédictive dans les modèles de séries chronologiques. En premier lieu, l’autocorrélation renseigne directement sur la nature de la mémoire du processus. Un système physique ou socio-économique présentant un déclin très lent et graduel de ses corrélations sérielles possède une mémoire longue, ce qui implique que chaque choc aléatoire ou perturbation exogène continue d’exercer une influence mesurable sur l’état du système sur un horizon temporel étendu. À l’opposé, les processus dits à mémoire courte voient leurs coefficients s’annuler rapidement après un ou deux retards, démontrant une capacité d’absorption quasi instantanée des fluctuations conjoncturelles.
Dans la théorie classique de modélisation stochastique, formalisée par la méthodologie de Box et Jenkins, la fonction d’autocorrélation (ACF) joue un rôle déterminant dans l’identification structurelle des processus de type autorégressif (AR), à moyennes mobiles (MA), ou mixtes (ARMA). Dans un modèle autorégressif pur d’ordre 1, noté AR(1), le coefficient d’autocorrélation décroît de façon exponentielle monotone vers zéro si le paramètre autorégressif est positif, ou oscille avec un amortissement continu si ce paramètre est négatif. Dans le cas d’un processus de moyennes mobiles d’ordre q, noté MA(q), les autocorrélations s’annulent brutalement dès que le retard k excède l’ordre q. L’analyse empirique de l’autocorrélation fournit ainsi un diagnostic qualitatif immédiat sur la structure génératrice des données.
Enfin, la détection des dépendances temporelles est essentielle pour identifier les composantes non aléatoires sous-jacentes d’un signal, telles que les tendances déterministes et les cycles saisonniers. Une tendance macroéconomique non purgée se traduit invariablement par des coefficients d’autocorrélation résiduels excessivement élevés qui refusent de décroître vers zéro, trompant l’analyste sur la véritable nature du mécanisme stochastique. De même, une composante saisonnière rigide engendre des pics d’autocorrélation marqués et périodiques à des retards réguliers (par exemple, k = 12 pour des données mensuelles ou k = 7 pour des enregistrements quotidiens). La maîtrise de l’autocorrélation est donc indispensable pour décomposer rigoureusement une série en ses éléments tendanciels, cycliques et purement stochastiques.
1.3 Pertinence de l’autocorrélation dans les mesures longitudinales psychologiques
Bien que l’analyse des séries temporelles ait initialement émergé dans le domaine de la physique mathématique et de la macroéconomie, son application aux sciences comportementales et à la psychologie clinique a connu une expansion considérable au cours des deux dernières décennies. L’émergence des protocoles d’évaluation écologique instantanée, couramment désignés par l’acronyme anglophone ESM (Experience Sampling Method) ou évaluation écologique momentanée (EMA), permet aux chercheurs de recueillir des mesures intensives, longitudinales et écologiquement valides des états affectifs, cognitifs et comportementaux des individus sur des dizaines, voire des centaines de points temporels consécutifs.
Dans ce cadre psychométrique micro-longitudinal, l’autocorrélation d’ordre 1 (lag 1) est devenue le paramètre opérationnel privilégié pour quantifier ce que les psychologues nomment « l’inertie émotionnelle ». L’inertie affective désigne la tendance des états émotionnels à persister dans le temps, résistant à la régulation spontanée ou aux sollicitations de l’environnement immédiat. Un coefficient d’autocorrélation unitaire élevé pour une échelle d’humeur négative (par exemple la tristesse ou l’anxiété) indique qu’un épisode de détresse psychologique éprouvé à l’instant t prédit avec une forte intensité le maintien de cet état à l’évaluation suivante t+1. Ce phénomène de rigidité dynamique a été empiriquement lié à des vulnérabilités psychopathologiques majeures, telles que le trouble dépressif caractérisé, les troubles de l’adaptation ou la dysrégulation émotionnelle borderline.
Par ailleurs, la prise en compte scrupuleuse de l’autocorrélation est impérative sur le plan statistique lors de l’estimation de modèles statistiques longitudinaux standard, tels que les régressions linéaires ou les modèles linéaires mixtes. L’hypothèse fondamentale d’indépendance des résidus d’échantillonnage est systématiquement violée en présence de dépendance temporelle sérielle. Ignorer l’autocorrélation dans les protocoles ESM entraîne une sous-estimation substantielle des erreurs types des estimateurs, ce qui gonfle artificiellement le taux d’erreur de première espèce (rejet à tort de l’hypothèse nulle d’absence d’effet) et conduit à des conclusions cliniques erronées. La modélisation autorégressive univariée constitue ainsi la première étape indispensable de tout protocole de validation psychométrique en vie réelle.
2. Architecture et préparation des données dans Excel avant calcul
2.1 Structuration chronologique et mise en forme du tableau
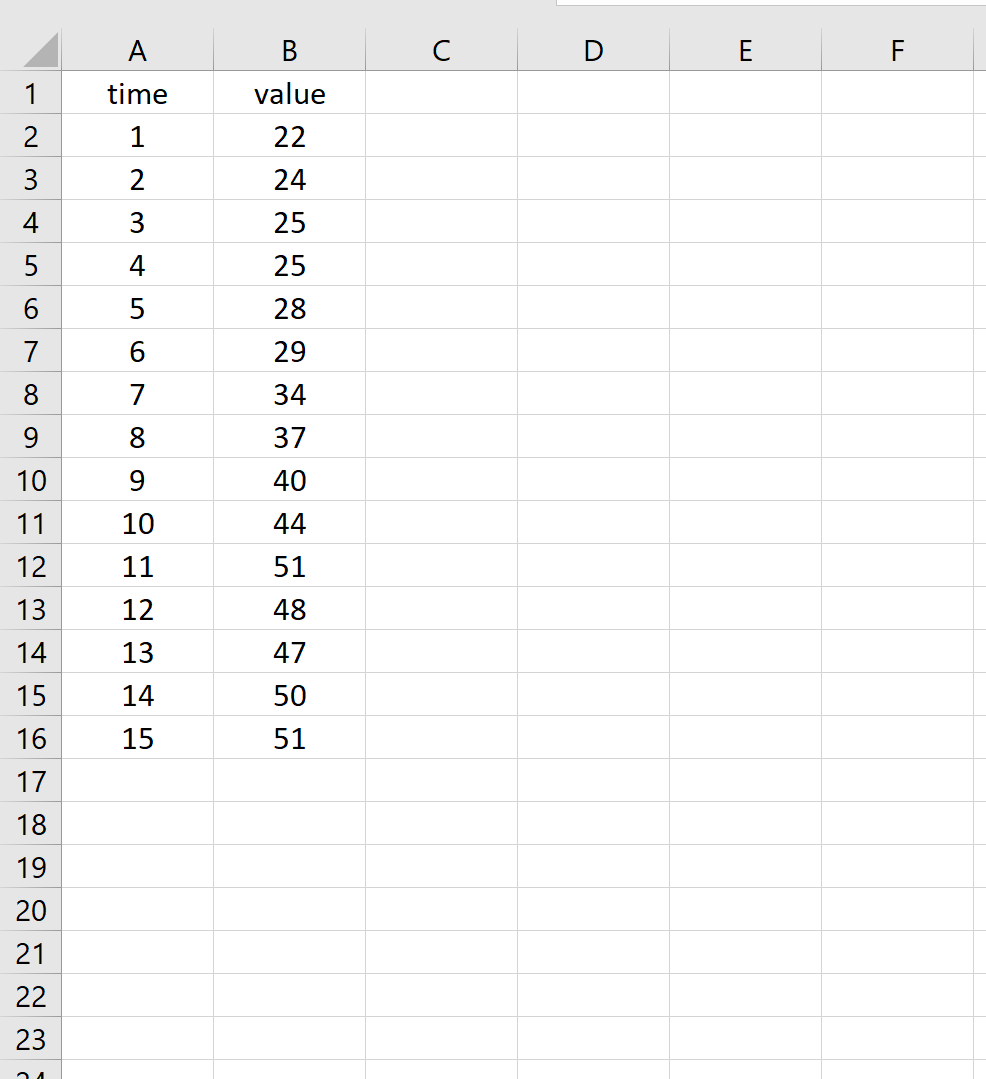
L’implémentation rigoureuse d’un calcul d’autocorrélation au sein de Microsoft Excel repose impérativement sur une organisation structurée et non ambiguë de la feuille de calcul. La première exigence méthodologique consiste à organiser les données sous la forme d’un tableau bidimensionnel strict, orienté de haut en bas, où chaque ligne représente une unité temporelle unique et ordonnée. Les colonnes doivent impérativement être dédiées à une seule fonction : une colonne d’indexation temporelle croissante et continue, et une ou plusieurs colonnes de variables d’intérêt contenant les mesures quantitatives continues.
L’indexation temporelle ne doit présenter aucune discontinuité structurelle. Il est fortement recommandé d’introduire une colonne numérique séquentielle explicite (notée par exemple t = 1, 2, 3, …, N), en complément ou en substitution d’une colonne de dates calendaires ou d’horodatages. Cette numérotation séquentielle simplifie considérablement la vérification des bornes de calcul et garantit que chaque décalage vectoriel d’une ligne correspond rigoureusement à un saut d’exactement une unité temporelle normalisée. La disposition horizontale des séries temporelles (en lignes s’étendant de gauche à droite) doit être formellement évitée, car la plupart des fonctions matricielles avancées d’Excel sont optimisées pour le balayage vertical des vecteurs colonnes.
En outre, il est impératif d’auditer le typage des cellules de la colonne d’intérêt. Toute valeur numérique qui se trouverait involontairement stockée au format texte en raison d’une importation défectueuse (par exemple via des fichiers CSV utilisant des séparateurs décimaux inadéquats comme la virgule au lieu du point ou inversement) provoquera des erreurs silencieuses ou des blocages dans les calculs matriciels. L’utilisateur doit s’assurer que l’intégralité des cellules de données est typée en tant que « Nombre » dans le gestionnaire de format d’Excel, sans résidus de caractères d’espacement insécables ou de signes de ponctuation mal interprétés.
2.2 Gestion des valeurs manquantes et homogénéisation des intervalles
L’une des contraintes absolues de l’analyse sérielle par décalage réside dans l’équidistance des intervalles de mesure. La théorie mathématique sous-tendant l’autocorrélation suppose que l’intervalle de temps séparant l’observation Xt de l’observation Xt-1 est rigoureusement identique pour tout t. Si les mesures ont été collectées à intervalles irréguliers sans correction préalable, le concept même de décalage temporel fixe d’ordre 1 devient absurde sur le plan conceptuel, car il assimilerait un saut de 15 minutes à un saut de 4 heures ou de 2 jours.
La présence de valeurs manquantes (cellules vides ou codes d’erreur tels que #N/A) brise la continuité vectorielle indispensable au calcul d’autocorrélation. Si une série de 100 observations présente une cellule manquante à la ligne 45, l’application naïve d’une corrélation décalée d’une ligne mettra artificiellement en relation la valeur 44 avec la valeur 46, créant un décalage effectif de deux unités de temps au lieu d’une seule. Pour remédier à ce problème sans fausser la dynamique stochastique, deux démarches méthodologiques s’offrent au praticien : l’imputation ou la segmentation de la série temporelle.
Dans les cas où le pourcentage de données manquantes est infinitésimal (inférieur à 2-3 % de la série globale) et distribué de manière purement aléatoire, une technique d’imputation linéaire locale peut être mise en œuvre directement dans Excel par interpolation linéaire entre les deux observations adjacentes connues. Toutefois, si les lacunes sont volumineuses ou correspondent à des périodes d’interruption systématique (par exemple, la nuit dans un protocole psychologique ESM diurne), l’imputation artificielle risque d’écraser la variance naturelle et de biaiser positivement l’autocorrélation estimée. Dans ces circonstances strictes, il convient de tronquer la série temporelle en segments continus homogènes et d’estimer l’autocorrélation séparément au sein de chaque tranche temporelle continue avant d’en calculer la moyenne pondérée.
2.3 Vérification préalable de la stationnarité de la série
Avant d’engager la moindre démarche de calcul d’autocorrélation sous Excel, l’analyste doit impérativement s’interroger sur la stationnarité du processus étudié. Au sens faible ou à l’ordre deux, une série temporelle est dite stationnaire au sens faible (covariance-stationary) si elle satisfait simultanément trois conditions mathématiques : son espérance mathématique E[Xt] = μ est constante et indépendante du temps t, sa variance Var(Xt) = σ2 est finie et invariante dans le temps, et son autocovariance Cov(Xt, Xt-k) ne dépend exclusivement que de l’amplitude du retard temporel k et aucunement du point temporel d’origine t.
L’estimation directe d’un coefficient d’autocorrélation sur une série chronologique non stationnaire est formellement invalide d’un point de vue méthodologique. La présence d’une tendance linéaire ascendante ou descendante engendre un phénomène dit d’autocorrélation fallacieuse ou factice : les observations situées au début de la série se trouvent artificiellement en dessous de la moyenne générale, tandis que les observations de fin de série se situent systématiquement au-dessus. De fait, le produit des écarts à la moyenne globale sera quasi exclusivement positif, produisant des coefficients d’autocorrélation très proches de 1 pour des dizaines d’ordres de décalage successifs, alors même que le processus générateur n’intègre intrinsèquement aucun mécanisme de rétroaction dynamique interne.
Une inspection visuelle préalable au moyen d’un graphique en nuage de points reliés par des lignes (graphique séquentiel) doit systématiquement être opérée dans Excel pour vérifier l’absence d’une dérive tendancielle macroscopique ou d’une explosion de la dispersion (hétéroscédasticité temporelle). Si une tendance monotone est mise en évidence, la série brute doit subir une transformation mathématique avant tout traitement. La stratégie la plus universelle consiste à opérer une différenciation première, en calculant dans une colonne adjacente la série transformée ΔXt = Xt – Xt-1. Ce procédé filtre mathématiquement la composante tendancielle linéaire déterministe et permet d’estimer l’autocorrélation sur les innovations stochastiques stationnaires ainsi isolées.
3. Formulation mathématique standard de l’autocorrélation appliquée à Excel
3.1 Décomposition de l’estimateur d’autocovariance et de la variance
Pour transposer adéquatement le concept continu d’autocorrélation dans le cadre discret et matriciel d’un tableur, il est indispensable d’adopter la formalisation conventionnelle retenue dans les progiciels de référence en économétrie et en statistique des séries temporelles. Pour un échantillon empirique fini comprenant N observations successives notées x1, x2, …, xN, l’espérance du processus est estimée par la moyenne arithmétique globale de l’échantillon complet, notée x̄, calculée sur la totalité des N données :
x̄ = (1 / N) ∑t=1N xt
L’estimateur canonique de l’autocovariance d’échantillon pour un décalage k, noté ck, s’exprime comme la somme des produits croisés des déviations par rapport à la moyenne globale, rapportée de manière systématique au nombre total d’observations N de la série originelle, et non au nombre effectif de paires résiduelles (N – k) :
ck = (1 / N) ∑t=1N-k (xt – x̄) (xt+k – x̄)
La variance empirique de l’échantillon complet, qui correspond exactement à l’autocovariance d’ordre zéro c0, est donnée par l’estimateur de la variance de population divisé par N :
c0 = (1 / N) ∑t=1N (xt – x̄)2
Le coefficient d’autocorrélation standardisé d’ordre k, noté rk, s’obtient donc par le ratio de ces deux grandeurs :
rk = ck / c0 = [ ∑t=1N-k (xt – x̄) (xt+k – x̄) ] / [ ∑t=1N (xt – x̄)2 ]
Cette spécification, préconisée par Box, Jenkins et Reinsel, garantit que la matrice de variance-covariance empirique ainsi estimée demeure toujours définie semi-positive, prévenant l’apparition de coefficients d’autocorrélation aberrants strictement supérieurs à 1 en valeur absolue, un écueil mathématique récurrent lorsque le dénominateur est artificiellement réduit à (N – k).
3.2 Rôle et syntaxe de la fonction SOMMEPROD dans l’estimation
Dans l’écosystème fonctionnel de Microsoft Excel, le calcul du numérateur de l’équation d’autocorrélation — à savoir la somme cumulée des produits croisés de deux séries décalées centrées — pourrait être réalisé en ajoutant des colonnes d’écart et de multiplication intermédiaires. Toutefois, cette approche est fastidieuse, encombre inutilement la feuille de calcul et s’avère sujette aux erreurs de manipulation. L’outil algorithmique par excellence pour compacter cette opération matricielle sans alourdir la structure est la fonction intégrée SOMMEPROD.
La fonction SOMMEPROD effectue nativement le produit terme à terme des éléments correspondants de plusieurs matrices ou plages vectorielles, puis additionne la totalité de ces produits scalaires. Sa syntaxe générale s’articule comme suit : SOMMEPROD(matrice1; [matrice2]; ...). Lorsqu’elle est appliquée à l’autocorrélation, la fonction est détournée pour réaliser à la volée le centrage des observations sans nécessiter de transformation préalable dans les cellules sources.
En injectant dans SOMMEPROD deux plages identiques décalées d’une ou plusieurs lignes et en soustrayant scalairement la moyenne globale calculée par la fonction MOYENNE, Excel opère une soustraction terme à terme avant d’exécuter la multiplication vectorielle. L’immense supériorité opérationnelle de SOMMEPROD réside dans le fait qu’elle gère le calcul vectoriel de manière implicite dans toutes les versions d’Excel, évitant l’obligation de recourir à la validation matricielle historique complexe par la combinaison de touches Ctrl + Maj + Entrée.
3.3 Utilisation conjointe des fonctions MOYENNE, NB et VAR.P
Pour construire une formule monolithique d’autocorrélation d’une rigueur absolue dans une cellule Excel unique, il est indispensable de coupler harmonieusement la fonction SOMMEPROD avec trois fonctions statistiques fondamentales : MOYENNE, NB et VAR.P. Chacune de ces fonctions remplit un rôle mathématique précis et incontournable au sein de l’architecture de calcul.
La fonction MOYENNE calcule l’espérance empirique x̄ sur l’intégralité de la plage de données non décalée, de la première cellule à la dernière observation temporelle. Il est capital que cette moyenne demeure absolue et invariable au sein des deux arguments de SOMMEPROD : la première tranche de données (de t = 1 à N – k) et la seconde tranche de données décalée (de t = 1 + k à N) doivent être centrées en utilisant impérativement la moyenne globale de la série, et non la moyenne tronquée propre à chaque sous-plage temporelle.
La fonction NB permet de comptabiliser automatiquement l’effectif total N de l’échantillon, garantissant la dynamicité de l’équation si des enregistrements sont ultérieurement insérés. Enfin, la fonction VAR.P calcule la variance de population exacte de la série, formulée avec un dénominateur égal à N (contrairement à la fonction VAR.S qui utilise le degré de liberté corrigé N – 1). Étant donné que l’estimateur standard de l’autocovariance ck intègre un facteur de pondération 1 / N, la division directe par la variance de population VAR.P assure une compatibilité dimensionnelle parfaite :
rk = [ SOMMEPROD(…) / NB(…) ] / VAR.P(…)
Cette élégante formulation mathématique condensed garantit une conformité totale avec les algorithmes implémentés dans les bibliothèques professionnelles d’analyse stochastique.
4. Procédure pas à pas : Calcul de l’autocorrélation d’ordre 1 (Lag k = 1)
4.1 Paramétrage précis des plages de données pour un retard unitaire
Pour illustrer la mise en œuvre pratique de cette procédure, considérons un ensemble de données chronologiques standard composé de 15 observations continues, positionnées dans la plage de cellules B2:B16 d’une feuille de travail Excel, la ligne 1 étant réservée à la dénomination des champs (par exemple, « Temps » en A1 et « Score » en B1). L’effectif total est ici de N = 15, s’étalant de la cellule B2 (première mesure temporelle, t = 1) jusqu’à la cellule B16 (dernière mesure temporelle, t = 15).
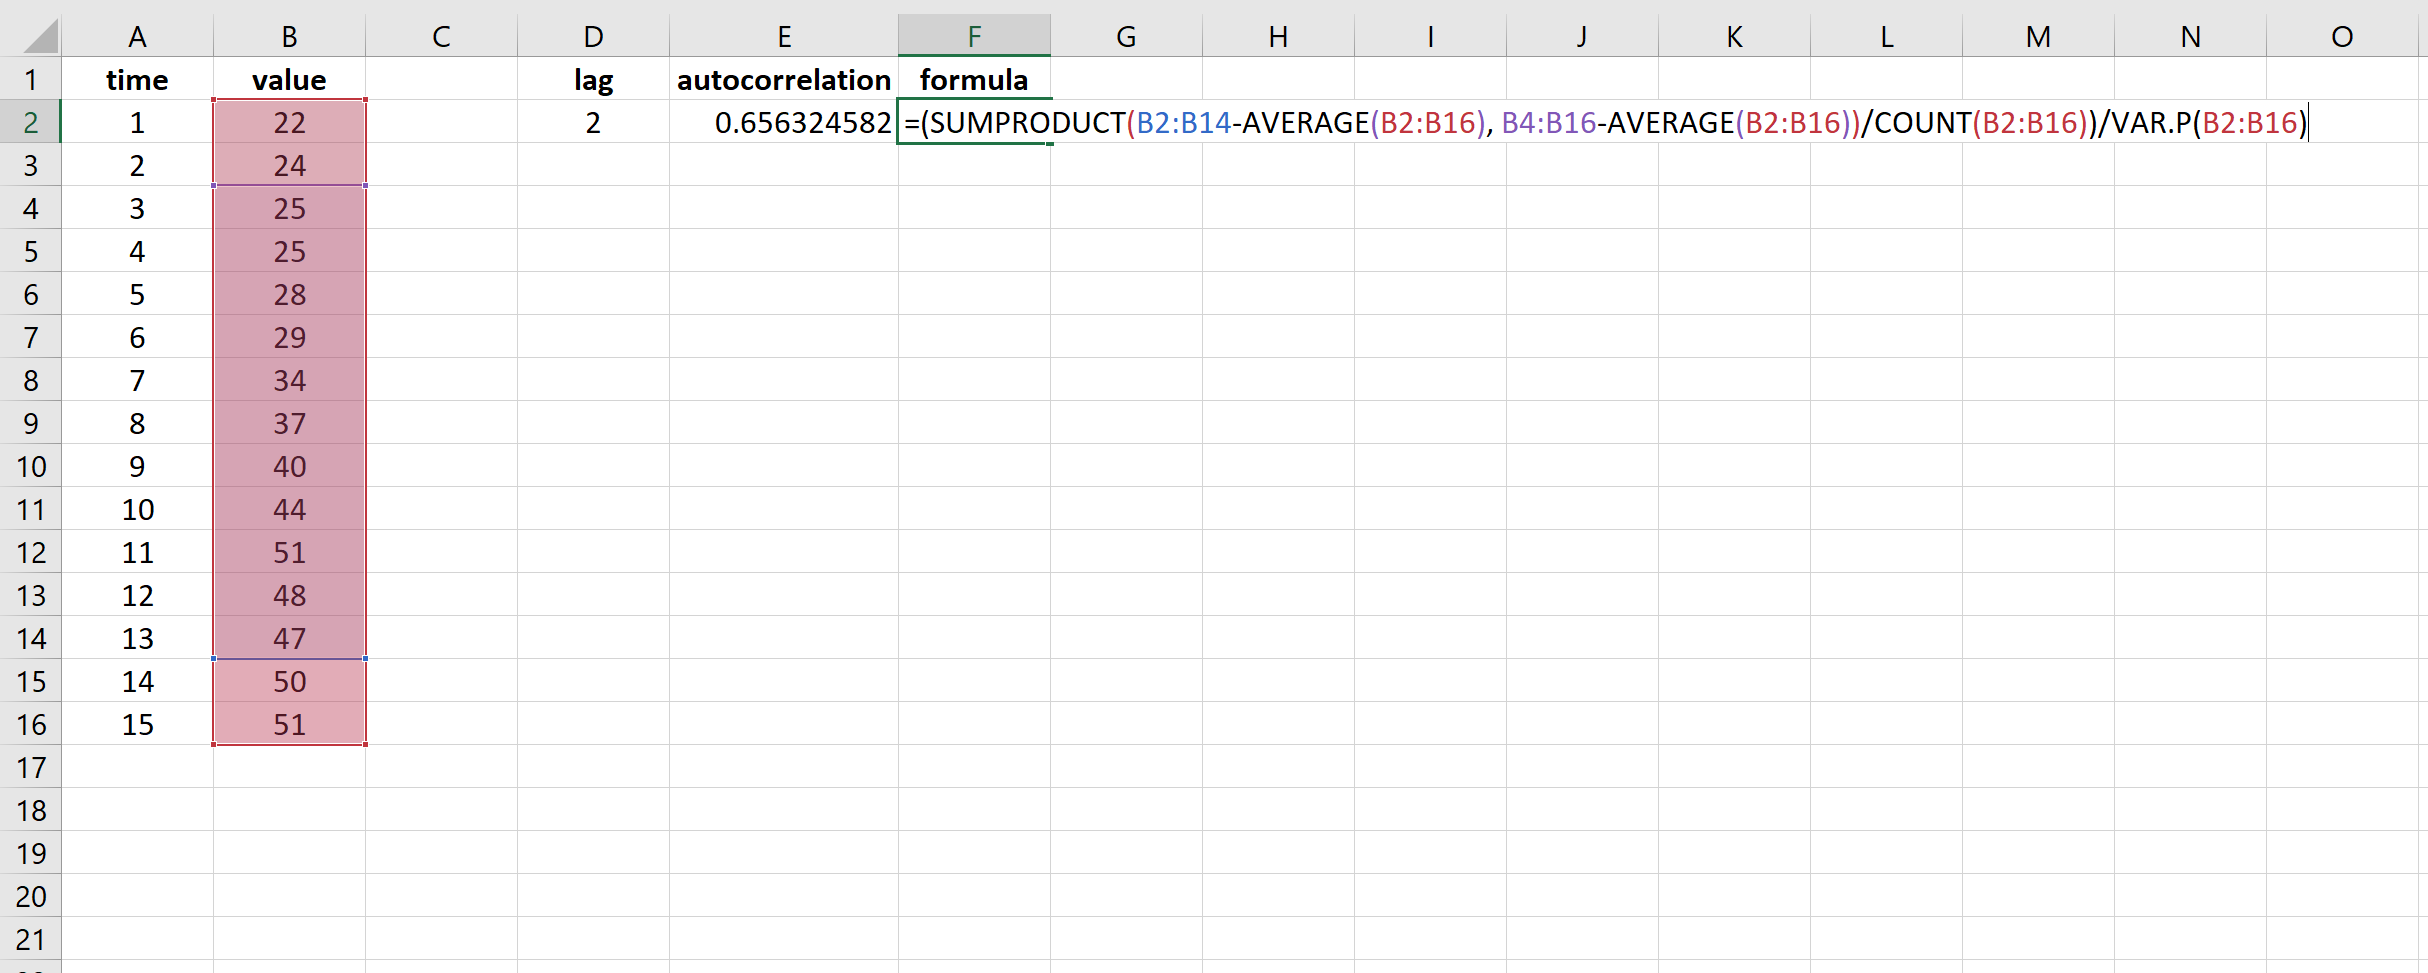
Le calcul de l’autocorrélation d’ordre 1 (lag k = 1) exige la mise en correspondance de deux vecteurs de dimension identique égale à N – 1 = 14 observations :
- Le premier vecteur temporel correspond à la série contemporaine tronquée de sa dernière valeur, couvrant la plage de cellules B2:B15 (représentant les indices temporels allant de t = 1 à t = 14).
- Le second vecteur temporel correspond à la série décalée d’un cran vers l’avant, tronquée de sa première valeur d’origine, s’étendant de la cellule B3:B16 (représentant les indices temporels consécutifs de t = 2 à t = 15).
L’erreur la plus commune commise à cette étape préparatoire consiste à désaligner la taille des plages d’analyse. Si le premier argument de SOMMEPROD contient 14 cellules et que le second en intègre accidentellement 15 (par exemple de B3 à B17), Excel retournera irrémédiablement l’erreur matricielle #VALEUR!. La stricte concordance du nombre de lignes traitées au sein de la formule est une condition sine qua non de son exécution mathématique.
4.2 Rédaction et validation syntaxique de la formule dans la feuille
Une fois les plages géométriques clairement délimitées sur la grille, la formule complète du coefficient d’autocorrélation d’ordre 1 peut être rédigée dans une cellule de restitution, désignons par exemple la cellule D2. La syntaxe intégrale à inscrire manuellement dans la barre de formule s’écrit rigoureusement comme suit sous la configuration régionale francophone standard d’Excel :
=(SOMMEPROD(B2:B15-MOYENNE($B$2:$B$16); B3:B16-MOYENNE($B$2:$B$16))/NB($B$2:$B$16))/VAR.P($B$2:$B$16)
Analysons l’évaluation séquentielle exécutée par le moteur de calcul d’Excel lors de la validation de cette expression :
- L’instruction
MOYENNE($B$2:$B$16)calcule la constante scalaire représentant l’espérance globale de la série sur les 15 points expérimentaux. L’usage de références absolues (symbolisées par le caractère dollar $) prévient tout glissement non désiré de la plage de référence lors de manipulations ultérieures. - L’expression vectorielle
B2:B15-MOYENNE(...)soustrait la moyenne scalaire globale de chacun des 14 premiers éléments, générant un vecteur temporaire en mémoire de 14 déviations centrées. - Simultanément, l’expression
B3:B16-MOYENNE(...)soustrait cette même moyenne scalaire globale des 14 observations successives, générant le second vecteur de déviations décalées d’une période temporelle. - La fonction SOMMEPROD multiplie terme à terme les éléments correspondants de ces deux vecteurs mémoires, puis additionne les 14 produits résultants, obtenant ainsi la somme brute des produits croisés d’ordre 1.
- Cette somme matricielle est ensuite divisée par
NB($B$2:$B$16), soit la valeur scalaire 15, transformant la somme brute en l’estimateur convergent d’autocovariance c1. - Finalement, l’autocovariance c1 est divisée par
VAR.P($B$2:$B$16), qui calcule la variance de population exacte de la série originelle. Le résultat produit est un scalaire invariant, rigoureusement normalisé au sein de l’intervalle [-1, +1], constituant l’autocorrélation d’ordre 1 exacte r1.
Il est impératif d’attirer l’attention sur les séparateurs d’arguments : sur les versions francophones d’Excel, le séparateur standard de paramètres au sein d’une fonction est le point-virgule (;). L’utilisation d’une virgule, conventionnelle dans les distributions anglophones, déclenchera un message d’erreur syntaxique d’Excel invalidant l’écriture de la formule.
4.3 Interprétation statistique du coefficient r1 obtenu
L’évaluation du scalaire obtenu pour r1 constitue le point d’entrée de toute inférence stochastique sérielle. Supposons que le calcul exécuté sur nos 15 points de données produise une valeur empirique de r1 = 0,684. Cette magnitude positive et substantielle indique l’existence d’une dépendance temporelle directe très prononcée : une observation supérieure à la moyenne générale à un instant t tend très fortement à être immédiatement suivie d’une observation également supérieure à la moyenne à l’instant t+1.
Dans un contexte d’analyse clinique ou d’évaluation psychologique (ESM), un r1 s’élevant à 0,684 révèle une inertie phénoménologique marquée du processus psychologique sous-jacent. Cela démontre que le sujet manifeste une persistance temporelle élevée de son état intérieur, résistant à la dissipation spontanée d’une mesure à la suivante. À l’inverse, si le coefficient avait été substantiellement négatif (par exemple r1 = -0,520), la série afficherait un comportement oscillatoire de feedback rapide, où toute excursion positive est suivie d’une réaction compensatoire immédiate orientée sous la moyenne.
Néanmoins, la valeur brute de r1 ne peut être dissociée de la taille de l’échantillon N. Dans une série ultra-courte de 15 observations, une valeur observée de 0,30 peut facilement résulter du pur hasard d’échantillonnage issu d’un processus sous-jacent de type bruit blanc (white noise). Il sera donc impératif de confronter systématiquement ce coefficient à des bornes de confiance statistiques probabilisées, une étape critique qui sera formellement détaillée dans les sections ultérieures de ce travail.
5. Généralisation aux retards supérieurs : Calcul pour les Lags k = 2 et k = 3
5.1 Adaptation dynamique des plages pour le décalage k = 2
La caractérisation approfondie de la structure dynamique d’une série temporelle ne saurait se cantonner à l’estimation du seul décalage unitaire. L’évaluation de l’autocorrélation au retard k = 2 permet de sonder la dépendance existant entre deux observations séparées par un intervalle de deux unités temporelles complètes, c’est-à-dire en sautant systématiquement l’observation intermédiaire Xt-1.
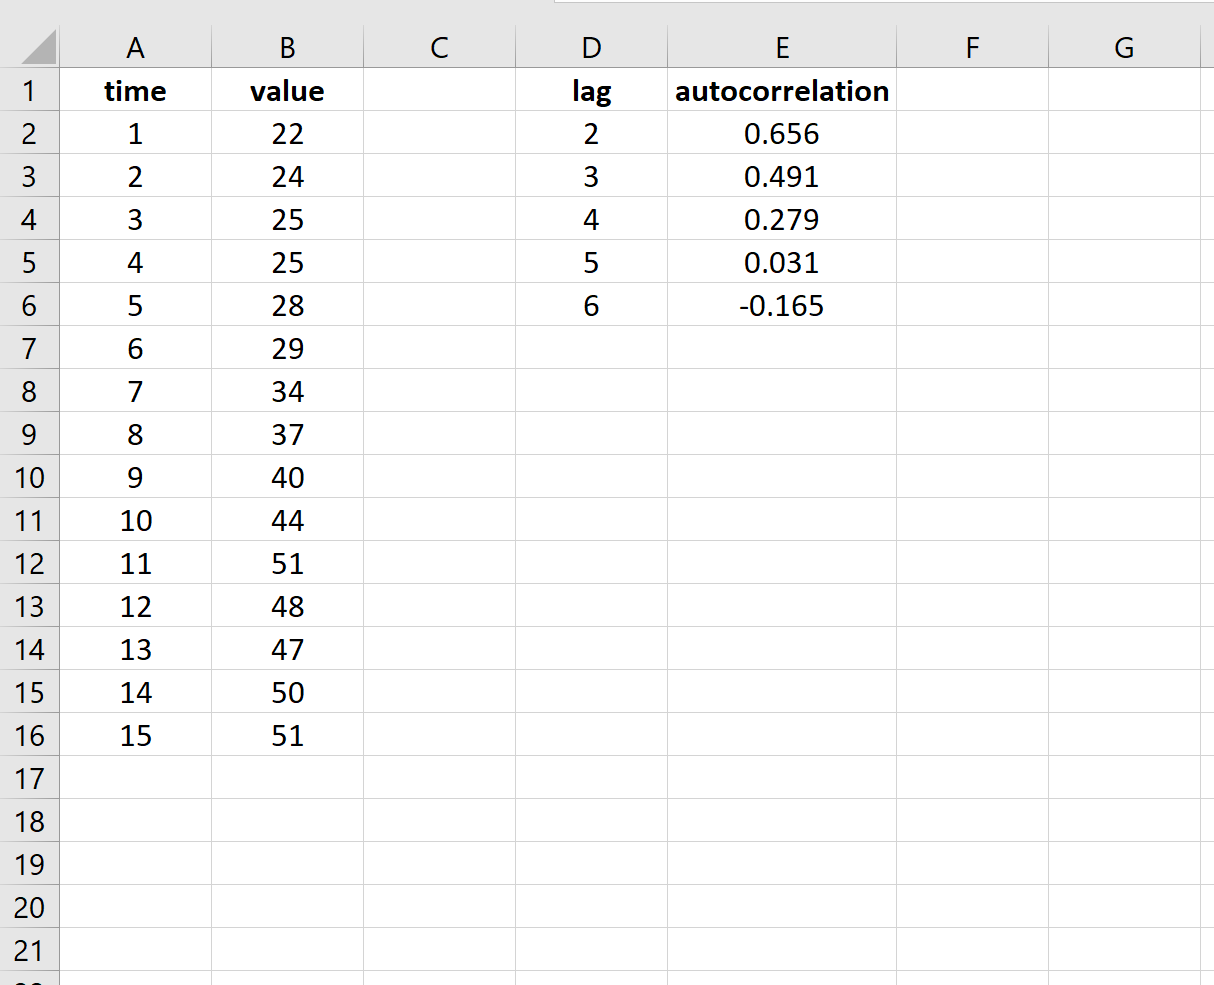
Pour implémenter ce calcul sur notre série de référence située en B2:B16 (avec N = 15), l’amplitude des plages vectorielles se réduit mécaniquement de deux unités par rapport à la dimension originelle. Le nombre de paires couplées devient N – 2 = 13. Les plages à apparier doivent être définies comme suit :
- La plage contemporaine antérieure part de la première observation en B2 et se termine à l’avant-avant-dernière valeur, soit B2:B14 (couvrant les temps t = 1 à t = 13).
- La plage différée de deux périodes commence à la troisième observation temporelle en B4 et court jusqu’au terme de la série, soit B4:B16 (couvrant les temps t = 3 à t = 15).
Dans la cellule de résultat dédiée, par exemple D3, la formule adaptée s’écrit formellement :
=(SOMMEPROD(B2:B14-MOYENNE($B$2:$B$16); B4:B16-MOYENNE($B$2:$B$16))/NB($B$2:$B$16))/VAR.P($B$2:$B$16)
Remarquons avec la plus grande rigueur méthodologique que les paramètres de centrage et de normalisation — à savoir MOYENNE($B$2:$B$16), NB($B$2:$B$16) et VAR.P($B$2:$B$16) — demeurent totalement inchangés et conservent pour assise la série globale de 15 points. Seuls les indices extrêmes des deux arguments vectoriels de SOMMEPROD subissent un rétrécissement symétrique de deux crans.
5.2 Extension de l’algorithme pour le retard k = 3
L’extension de la formulation au retard d’ordre 3 (lag k = 3) suit scrupuleusement la même progression arithmétique. Cette métrique quantifie l’influence résiduelle exercée par un état initial sur l’état futur observé trois pas de temps plus tard (par exemple, la relation entre l’état émotionnel d’un individu à un jour donné et celui mesuré trois jours après).
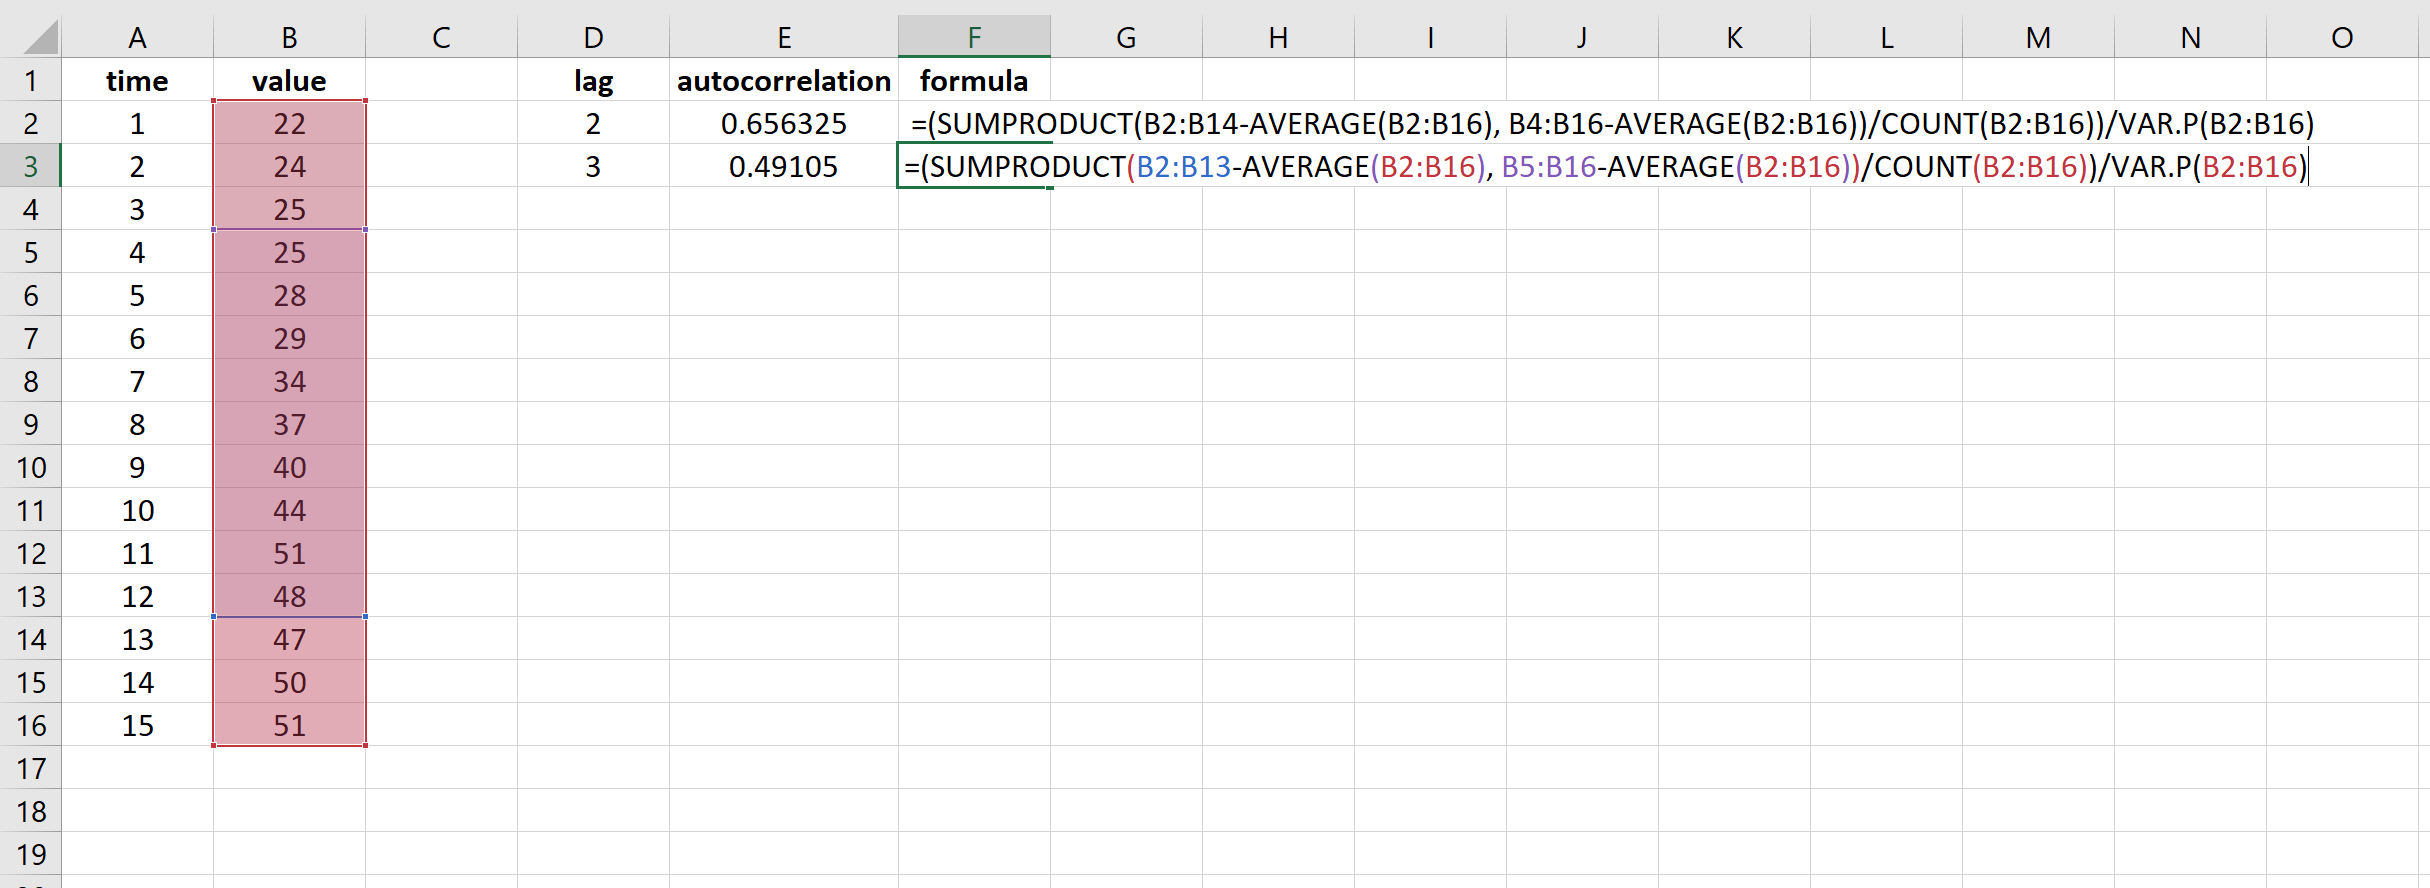
Pour un décalage k = 3 au sein d’une série de 15 points, l’espace vectoriel exploitable se restreint à N – 3 = 12 paires d’observations directes. Les coordonnées des plages à multiplier au sein de la fonction matricielle deviennent :
- La plage amont s’étendant de la cellule B2 à B13 (représentant les indices temporels t = 1 à t = 12).
- La plage aval décalée de trois lignes s’étendant de la cellule B5 à B16 (représentant les indices temporels t = 4 à t = 15).
La formule finale standardisée, positionnée dans la cellule D4, adopte l’écriture suivante :
=(SOMMEPROD(B2:B13-MOYENNE($B$2:$B$16); B5:B16-MOYENNE($B$2:$B$16))/NB($B$2:$B$16))/VAR.P($B$2:$B$16)
À mesure que l’ordre du retard k augmente, l’utilisateur observe visuellement la diminution progressive du volume d’observations participant au calcul de la somme des produits croisés. C’est précisément cette attrition mécanique du nombre de points d’appui qui dégrade la fiabilité statistique des coefficients d’autocorrélation aux retards élevés, imposant d’encadrer strictement la borne maximale de retard admissible.
5.3 Analyse de la trajectoire de décroissance des coefficients
Une fois les coefficients successifs r1, r2 et r3 calculés, leur analyse conjointe fournit un diagnostic révélateur sur la morphologie du processus temporel. Dans un modèle autorégressif standard stationnaire du premier ordre, noté AR(1) et gouverné par l’équation Xt = φ Xt-1 + εt, la théorie probabiliste démontre que la fonction d’autocorrélation théorique obéit à une décroissance exponentielle rigoureusement géométrique de la forme :
ρk = φk
Ainsi, si le coefficient empirique d’ordre 1 s’établit à r1 ≈ 0,70, un processus AR(1) pur produira théoriquement une valeur d’ordre 2 avoisinant r2 ≈ (0,70)2 = 0,49, et une valeur d’ordre 3 proche de r3 ≈ (0,70)3 = 0,343. Si les coefficients estimés dans Excel suivent une telle trajectoire d’atténuation régulière et proportionnelle, le praticien dispose d’un indice quantitatif très puissant signalant que la série temporelle est régie par un processus autorégressif d’ordre 1 hautement persistant.
À l’inverse, si l’on observe une structure de coefficients où r1 est statistiquement très élevé, mais où r2 et r3 chutent brutalement à des valeurs négligeables oscillant de manière erratique autour de zéro, la signature empirique oriente plutôt le diagnostic vers un processus à moyennes mobiles d’ordre 1, noté MA(1). Enfin, si les coefficients décrivent une trajectoire sinusoïdale pseudo-périodique avec alternance de signes positifs et négatifs décroissants, la présence d’un processus autorégressif d’ordre 2, noté AR(2), incorporant des composantes cycliques sous-jacentes, doit être privilégiée. L’examen des premiers ordres d’autocorrélation est donc bien plus qu’un simple exercice arithmétique : il constitue une véritable radiographie de la dynamique du système.
6. Automatisation du calcul pour plusieurs ordres de décalage dans Excel
6.1 Conception d’un tableau récapitulatif des retards k de 1 à N/4
Dans un contexte d’évaluation professionnelle, il est inefficace d’ajuster manuellement les coordonnées de début et de fin de plage dans les formules pour chaque valeur successive de k. Il convient plutôt d’aménager une architecture tabulaire automatisée capable d’évaluer simultanément l’ensemble de la fonction d’autocorrélation sur une séquence ordonnée de retards.
La première décision méthodologique concerne la détermination de la borne maximale de décalage temporel, notée kmax. Selon les recommandations statistiques universellement établies par Box et Jenkins, le retard maximal investigué ne devrait jamais excéder le quart, ou au grand maximum le tiers, de la longueur totale de la série temporelle, soit :
kmax ≤ N / 4
Pour un échantillon comportant N = 100 observations, il est méthodologiquement imprudent d’estimer des retards au-delà de k = 25. En deçà d’un échantillon effectif de N – k paires de points, l’erreur type de l’estimateur d’autocovariance augmente de manière exponentielle, rendant les coefficients d’autocorrélation instables et largement dominés par les fluctuations d’échantillonnage aléatoires.
Pour formaliser cette structure dans Excel, on crée un tableau d’analyse distinct adjacent aux données brutes. Définissons par exemple la colonne K comme la colonne d’index du retard, dans laquelle sont listées verticalement les valeurs entières successives : cellule K2 = 1, cellule K3 = 2, cellule K4 = 3, jusqu’au plafond maximal préconisé. La colonne contiguë, désignons-la par la colonne L, accueillera les formules dynamiques chargées d’évaluer l’autocorrélation correspondante rk pour chaque valeur d’index située en colonne K.
6.2 Exploitation des références absolues et relatives pour la reproductibilité
L’automatisation du calcul sur plusieurs dizaines de lignes requiert une gestion méticuleuse des types d’adressage de cellules dans Excel. Les symboles de référence absolue (le dollar $) doivent être employés pour verrouiller impérativement la série complète de référence servant au centrage et à la standardisation, tandis que les coordonnées de découpage des sous-vecteurs décalés doivent s’ajuster ou faire référence dynamiquement à la cellule de retard k.
Si un opérateur souhaite automatiser l’incrémentation sans recourir aux fonctions d’adressage indirect, il se heurte immédiatement à une limitation structurelle d’Excel : lors de l’étirement vers le bas d’une cellule contenant la formule SOMMEPROD standardisée, les bornes terminales des plages s’incrémentent de façon symétrique, ce qui décale l’intégralité du vecteur temporel au lieu de raccourcir sa fenêtre d’évaluation. Ce glissement incontrôlé fausse immédiatement la taille relative des plages et invalide le calcul mathématique.
Pour prévenir cette dérive tout en conservant une formule incrémentable, il est fondamental de substituer aux plages manuelles des formules d’indexation paramétriques. Ces dernières sont capables de faire varier la hauteur effective de la matrice en déduisant directement la valeur numérique de la cellule de retard adjacente (située en colonne K), offrant une reproductibilité absolue de la formule sur des centaines de lignes par un simple double-clic sur la poignée de recopie.
6.3 Formules dynamiques modernes avec DECALER, INDEX et LET
Pour concevoir une formule entièrement automatisée et universellement reproductible vers le bas pour toute valeur de retard k présente en colonne K, deux approches computationnelles de haut niveau s’offrent aux utilisateurs d’Excel : l’approche par adressage dynamique classique via la fonction DECALER, et l’approche matricielle ultra-optimisée exploitant les fonctions modernes INDEX et LET.
L’implémentation par la fonction DECALER permet de construire dynamiquement les deux vecteurs d’entrée au sein de SOMMEPROD en prenant pour paramètre de décalage vertical la cellule K2. La formulation en cellule L2 s’exprime comme suit :
=(SOMMEPROD((DECALER($B$2; 0; 0; NB($B$2:$B$100)-K2; 1) – MOYENNE($B$2:$B$100)); (DECALER($B$2; K2; 0; NB($B$2:$B$100)-K2; 1) – MOYENNE($B$2:$B$100))) / NB($B$2:$B$100)) / VAR.P($B$2:$B$100)
Dans cette écriture, le premier DECALER part de l’origine absolue $B$2, ne subit aucun saut de ligne initial, mais redimensionne sa hauteur à NB($B$2:$B$100) - K2 cellules. Le second DECALER saute verticalement d’un nombre de lignes rigoureusement égal à la valeur de K2 (soit k rangs de décalage), et adopte exactement la même hauteur tronquée. Cette équation peut être étendue à l’infini vers le bas : elle s’adaptera sans aucune intervention manuelle à chaque nouveau retard k.
Bien que redoutablement efficace, la fonction DECALER présente l’inconvénient d’être une fonction volatile, ce qui signifie qu’Excel la recalcule intégralement à chaque modification mineure de la feuille de calcul, pouvant provoquer des lenteurs perceptibles sur des séries massives. Dans les versions modernes d’Excel (Microsoft 365 et versions ultérieures), la solution d’excellence consiste à employer la fonction non volatile INDEX couplée à la fonction de structuration de variables LET :
=LET(serie; $B$2:$B$100; N; NB(serie); mu; MOYENNE(serie); k; K2; v1; INDEX(serie; 1):INDEX(serie; N-k); v2; INDEX(serie; 1+k):INDEX(serie; N); (SOMMEPROD(v1-mu; v2-mu)/N)/VAR.P(serie))
Cette syntaxe magistrale isole chaque composante sous une variable déclarative locale (serie, N, mu, k, v1, v2), éliminant les recalculs superflus de la moyenne et de la taille de l’échantillon. Non seulement elle offre une lisibilité algorithmique comparable à celle d’un script écrit en Python ou en R, mais elle garantit également une vitesse d’exécution optimale du classeur.
7. Méthode alternative : Utilisation de la fonction COEFFICIENT.CORRELATION
7.1 Création manuelle de colonnes décalées (Time-Lagged Variables)
Parallèlement à la formulation compacte standard basée sur SOMMEPROD, il existe une démarche méthodologique alternative, très prisée dans les contextes pédagogiques et dans les phases préliminaires d’exploration de données : la création explicite de colonnes décalées, communément appelées time-lagged variables dans la littérature anglophone.
Cette approche consiste à juxtaposer physiquement à la série temporelle d’origine (située par exemple en colonne B, débutant en B2) une série de colonnes auxiliaires contiguës :
- La colonne C est désignée comme la série au décalage t – 1. Pour la constituer, on copie les données de la colonne B en les collant avec un déphasage vertical d’une ligne vers le bas : la cellule C3 reçoit la formule
=B2, la cellule C4 reçoit=B3, et ainsi de suite jusqu’à la fin du tableau. La cellule initiale C2 demeure intentionnellement vide ou reçoit la mention #N/A, car il n’existe aucune observation antérieure connue pour le point initial t = 1. - La colonne D est réservée au décalage t – 2. La copie s’opère avec un saut de deux lignes : la cellule D4 reçoit
=B2, la cellule D5 reçoit=B3, laissant les cellules D2 et D3 vacantes. - La colonne E reproduit le même décalage pour le retard t – 3, débutant en E5 avec la valeur de B2.
Cette disposition tabulaire présente l’immense intérêt visuel d’exposer côte à côte, sur chaque ligne chronologique, l’état contemporain d’un phénomène et ses antécédents historiques immédiats, facilitant l’inspection directe des alignements temporels par l’observateur.
7.2 Application directe de COEFFICIENT.CORRELATION (Pearson)
Une fois les colonnes décalées matériellement dressées sur la feuille de calcul, l’analyste peut solliciter la fonction native universelle de corrélation linéaire de Pearson implémentée dans Excel : COEFFICIENT.CORRELATION (ou sa dénomination équivalente PEARSON). La syntaxe canonique requiert deux plages de dimensions strictement identiques : COEFFICIENT.CORRELATION(matrice1; matrice2).
Pour calculer le coefficient d’autocorrélation d’ordre 1 par cette voie sur notre tableau débutant en ligne 2 et s’achevant en ligne 16, il convient d’exclure scrupuleusement la première ligne d’observation (ligne 2) puisque la colonne décalée C y présente une cellule vide. La formule s’établit ainsi dans une cellule de synthèse :
=COEFFICIENT.CORRELATION(B3:B16; C3:C16)
Excel traite ces deux vecteurs exactement comme s’il s’agissait de deux variables aléatoires distinctes mesurées sur 14 individus. De la même façon, pour le décalage k = 2, le calcul nécessite d’omettre les deux premières lignes incomplètes du tableau (lignes 2 et 3) et s’articule comme suit :
=COEFFICIENT.CORRELATION(B4:B16; D4:D16)
Cette approche séduit de nombreux praticiens en raison de son extrême simplicité opérationnelle : elle mobilise une fonction courante d’Excel que tout analyste maîtrise, sans requérir l’imbrication complexe de fonctions matricielles ou vectorielles.
7.3 Distinction critique entre corrélation d’échantillon et formule standardisée de séries temporelles
Cependant, une mise en garde méthodologique de la plus haute importance théorique doit être formulée ici : le résultat chiffré renvoyé par la fonction COEFFICIENT.CORRELATION n’est pas rigoureusement identique à la valeur produite par la formule standardisée d’autocorrélation de séries temporelles (celle formulée avec SOMMEPROD et VAR.P). Il s’agit d’une divergence mathématique fondamentale trop souvent ignorée des analystes.
Lorsque la fonction COEFFICIENT.CORRELATION(B3:B16; C3:C16) est exécutée, la fonction de Pearson recalcule deux moyennes d’échantillon distinctes et locales :
- La moyenne propre à la sous-plage
B3:B16(qui exclut la première observation B2). - La moyenne propre à la sous-plage décalée
C3:C16, qui correspond en réalité à la sous-plageB2:B15(qui exclut quant à elle la dernière observation B16).
De surcroît, le dénominateur de la formule de Pearson emploie le produit des deux écarts types locaux calculés indépendamment sur chacun de ces sous-échantillons tronqués. À l’opposé, la formulation canonique des séries temporelles (détaillée à la section 3) impose un centrage universel sur l’unique moyenne globale x̄ de l’intégralité de la série B2:B16, et une division normalisatrice stricte par la variance globale c0 de l’échantillon complet.
Pour des séries temporelles d’une longueur volumineuse (par exemple N > 200 observations), l’écart numérique entre les deux méthodes tend asymptotiquement vers zéro et devient négligeable dans la pratique. En revanche, pour des séries temporelles courtes ou micro-longitudinales (telles que les séries psychologiques ESM de 15 à 40 observations), la distorsion peut être substantielle. L’utilisation de COEFFICIENT.CORRELATION sur un échantillon court biaise l’estimation, car elle altère le postulat fondamental selon lequel le processus est stationnaire et gouverné par une espérance et une variance constantes sur l’intégralité de la fenêtre d’enregistrement. Par conséquent, dans le cadre de travaux de recherche académique ou de modélisation prédictive rigoureuse, l’estimateur canonique basé sur SOMMEPROD et la variance globale doit être systématiquement préféré à la fonction Pearson locale.
8. Construction et interprétation du corrélogramme (Graphique ACF) dans Excel
8.1 Génération visuelle de la fonction d’autocorrélation (ACF)
La représentation graphique de la fonction d’autocorrélation séquentielle, universellement désignée sous le terme technique de corrélogramme ou graphique ACF (Autocorrelation Function plot), constitue l’outil diagnostique visuel le plus performant pour décrypter l’architecture stochastique d’une série chronologique. Il s’agit d’un graphique en deux dimensions projetant en abscisse l’ordre de décalage temporel discret (k = 1, 2, 3, …) et en ordonnée la valeur numérique du coefficient d’autocorrélation standardisé correspondant (rk).
Pour concevoir un corrélogramme conforme aux normes scientifiques dans Microsoft Excel, la démarche s’effectue à partir du tableau récapitulatif automatisé construit à la section 6 :
- Sélectionner simultanément la colonne des retards k (colonne K) et la colonne des coefficients d’autocorrélation estimés rk (colonne L).
- Accéder à l’onglet Insertion du ruban principal d’Excel, se diriger vers le groupe de commandes Graphiques, et sélectionner le format Histogramme groupé 2D ou Graphique à barres 2D.
- Formater l’axe horizontal des abscisses pour s’assurer que les étiquettes de graduation affichent explicitement les entiers du retard (1, 2, 3, …) et non une séquence indiciaire générique.
- Ajuster la mise en forme des séries de données : réduire la « Largeur du coup d’œil » (intervalle entre les barres) à une valeur comprise entre 80 % et 150 % dans le volet de mise en forme des séries pour donner aux barres un aspect élancé et élégant, caractéristique des sorties graphiques de logiciels professionnels.
- Fixer impérativement les limites de l’axe vertical des ordonnées à des bornes symétriques constantes comprises entre -1,0 et +1,0, avec une graduation principale réglée à 0,2. Cette précaution graphique empêche Excel d’auto-ajuster l’échelle à des amplitudes restreintes (par exemple entre 0,1 et 0,4), ce qui induirait une surinterprétation visuelle de variations sérielles mineures.
8.2 Intégration des bandes de confiance de Bartlett
Un corrélogramme brut dépourvu de bornes de significativité statistique est méthodologiquement incomplet. En effet, tout échantillon fini issu d’un processus purement aléatoire (bruit blanc) présentera inévitablement de légères corrélations empiriques différentes de zéro en raison des fluctuations aléatoires d’échantillonnage. Pour déterminer si un coefficient d’autocorrélation rk traduit une dépendance temporelle authentique ou s’il s’agit d’un simple artefact stochastique, il est impératif de surimposer au graphique les intervalles de confiance asymptotiques établis par le statisticien Maurice Bartlett.
Sous l’hypothèse nulle H0 stipulant que la série temporelle est générée par un processus de bruit blanc gaussien indépendant et identiquement distribué (i.i.d.), la distribution d’échantillonnage des coefficients d’autocorrélation d’ordre k ≥ 1 suit de façon asymptotique une loi normale centrée d’espérance nulle et de variance égale à 1 / N. Au seuil de signification bilatéral standard α = 0,05 (niveau de confiance de 95 %), la valeur critique de la distribution normale standard est z = 1,96. Les limites de confiance de Bartlett s’énoncent donc rigoureusement par la formule :
Limites de Bartlett = ± 1,96 / √N
Pour implémenter ces seuils décisionnels sur le graphique dans Excel, on insère deux nouvelles colonnes adjacentes au tableau de résultats :
- Dans la colonne M, étiquetée « Seuil Supérieur », on saisit la formule invariante :
=1,96 / RACINE(NB($B$2:$B$100)). - Dans la colonne N, étiquetée « Seuil Inférieur », on saisit son exact opposé :
=-1,96 / RACINE(NB($B$2:$B$100)).
Ces deux plages de valeurs constantes sont ensuite ajoutées au graphique en tant que nouvelles séries de données. Dans les options de modification du type de graphique, on transforme ces deux séries en Graphiques en lignes sans marqueur, configurés avec un tracé en trait discontinu fin (style tireté) de couleur rouge ou grise neutre. Dès lors, le praticien dispose d’une règle de décision visuelle univoque et immédiate : tout bâtonnet vertical d’autocorrélation dont l’extrémité émerge au-delà des bandes de Bartlett franchit le seuil de significativité statistique à p < 0,05, autorisant le rejet formel de l’hypothèse d’indépendance temporelle.
8.3 Diagnostic des signatures dynamiques typiques
La morphologie globale adoptée par les bâtonnets du corrélogramme face aux bandes de Bartlett constitue une grille diagnostique d’une puissance analytique exceptionnelle, permettant d’identifier sans ambiguïté les régimes temporels typiques :
- Le profil de bruit blanc (White Noise) : L’intégralité des bâtonnets d’autocorrélation pour tous les retards k ≥ 1 demeure strictement confinée à l’intérieur des bandes de confiance en tiretés. Ce schéma atteste de l’absence totale de structure temporelle séquentielle : la série est purement aléatoire, stationnaire, et ses observations passées ne confèrent aucun pouvoir prédictif sur ses réalisations ultérieures.
- La signature autorégressive stationnaire AR(1) : Le premier bâtonnet d’ordre 1 (r1) dépasse nettement et significativement la bande de Bartlett supérieure, tandis que les bâtonnets ultérieurs décroissent selon une courbe géométrique régulière pour réintégrer la zone de non-significativité après deux ou trois décalages. Ce profil valide l’existence d’une mémoire courte persistante.
- La signature de non-stationnarité tendancielle : Les coefficients d’autocorrélation demeurent massivement au-dessus de la bande supérieure sur un très grand nombre de retards consécutifs (souvent jusqu’à k = 10 ou k = 20), décroissant à un rythme infinitésimal et quasi linéaire. Cette silhouette alerte immédiatement l’analyste sur le fait que la série n’est pas stationnaire en moyenne et dissimule une tendance macroscopique lourde qui doit impérativement être éliminée par différenciation première.
- La signature périodique ou saisonnière : Le graphique présente des ondulations cycliques prononcées, avec des dépassements francs et récurrents des bandes de Bartlett à des intervalles périodiques stricts (par exemple, à k = 7, 14, 21 pour un cycle hebdomadaire dans des mesures journalières). Ce profil exige l’intégration de composantes saisonnières spécifiques dans la modélisation ultérieure.
9. Tests statistiques complémentaires de corrélation sérielle dans Excel
9.1 Calcul et implémentation de la statistique de Durbin-Watson
Bien que l’examen visuel du corrélogramme soit indispensable, la confirmation statistique formelle de l’absence ou de la présence d’autocorrélation séquentielle exige souvent la mobilisation de tests d’hypothèse dédiés. Le test statistique le plus célèbre et le plus largement requis dans le diagnostic des résidus de modélisation est le test de Durbin-Watson.
Conçue spécifiquement pour éprouver l’hypothèse nulle d’absence d’autocorrélation d’ordre 1 (ρ1 = 0) au sein des résidus et d’un modèle de régression ou d’une série stationnaire centrée, la statistique de Durbin-Watson, traditionnellement notée d, est définie mathématiquement par la somme des carrés des différences successives rapportée à la somme des carrés des résidus totaux :
d = [ ∑t=2N (et – et-1)2 ] / [ ∑t=1N et2 ]
Par un développement algébrique simple, il est aisé de démontrer la relation fondamentale liant la statistique d au coefficient d’autocorrélation d’ordre 1 r1 :
d ≈ 2 (1 – r1)
Cette relation remarquable dicte l’interprétation canonique de l’indicateur :
- Si l’autocorrélation d’ordre 1 est parfaitement nulle (r1 = 0), la statistique d oscille très exactement autour de 2,0. Une valeur empirique proche de 2 valide l’indépendance sérielle.
- Si la série présente une autocorrélation positive maximale (r1 → +1), la statistique d chute vers 0. Toute valeur substantiellement inférieure à 1,5 alerte sur un risque élevé d’autocorrélation positive.
- Si la série présente une autocorrélation sérielle négative prononcée (r1 → -1), la statistique d grimpe vers sa borne maximale théorique de 4,0.
Pour calculer directement la statistique de Durbin-Watson dans Excel sur une colonne de résidus ou de données centrées située en B2:B100, on peut saisir la formule matricielle suivante exploitant SOMME.CARRES et SOMMEPROD :
=SOMMEPROD((B3:B100 – B2:B99)^2) / SOMME.CARRES(B2:B100)
Cette formule calcule avec une efficacité redoutable le rapport exact des variances différentielles, fournissant instantanément le diagnostic de Durbin-Watson sans recourir à un logiciel tiers.
9.2 Formulation du test de Ljung-Box pour un diagnostic conjoint
Tandis que le test de Durbin-Watson ne teste exclusivement que le premier ordre de déphasage temporel (k = 1), il est crucial en recherche empirique d’évaluer la significativité globale ou conjointe d’un ensemble de retards temporels successifs pris en bloc (par exemple, tester si l’ensemble des coefficients d’autocorrélation de k = 1 à k = m sont conjointement nuls). L’outil universellement privilégié pour ce diagnostic portemanteau est le test de Ljung-Box.
La statistique du test, notée Q* (ou QLB), apporte une correction pour les échantillons de taille finie à la formule historique de Box et Pierce, et se définit comme suit pour un horizon maximal de retards m :
Q* = N (N + 2) ∑k=1m [ (rk2) / (N – k) ]
Où N est la taille de l’échantillon, m est le nombre de retards testés conjointement, et rk est le coefficient d’autocorrélation empirique au retard k. Sous l’hypothèse nulle d’indépendance sérielle jusqu’à l’ordre m, la statistique Q* suit asymptotiquement une distribution du Chi-carré à m degrés de liberté (notée χ2(m)).
L’implémentation de cette formule dans Excel s’avère particulièrement aisée en s’appuyant sur le tableau récapitulatif préalablement bâti aux sections 6 et 8 :
- Dans notre tableau récapitulatif (où les retards k sont en colonne K et les rk en colonne L), on ajoute en colonne O une colonne calculée représentant chaque terme pondéré de la somme. En cellule O2, on saisit :
=(L2^2) / (NB($B$2:$B$100) - K2), formule que l’on étire jusqu’au retard m considéré. - Dans une cellule dédiée affichant la statistique de test Q*, on applique le facteur multiplicatif de Ljung-Box :
=NB($B$2:$B$100) * (NB($B$2:$B$100) + 2) * SOMME(O2:Om). - Pour obtenir la p-valeur exacte du test, on sollicite la fonction native de distribution du Chi-carré d’Excel dans la cellule sous-jacente :
=LOI.KHIDEUX.DROITE(Cellule_Q; m), oùmreprésente le nombre entier de retards intégrés.
Si la p-valeur ainsi générée est inférieure au seuil alpha conventionnel (par exemple p < 0,05), le chercheur rejette formellement l’hypothèse nulle d’indépendance temporelle globale, concluant que la série recèle une mémoire séquentielle significative au sein de la fenêtre de retards considérée.
9.3 Prise de décision méthodologique en recherche quantitative
La détection d’une corrélation sérielle statistiquement significative, que ce soit via le test de Durbin-Watson ou l’épreuve conjointe de Ljung-Box, entraîne des implications fondamentales pour la prise de décision analytique en recherche quantitative et en psychométrie.
En présence d’autocorrélation avérée au sein d’une série temporelle ou des résidus d’une régression appliquée à des données longitudinales, les postulats du théorème de Gauss-Markov sont violés. Bien que les coefficients de régression estimés par la méthode des moindres carrés ordinaires (MCO) demeurent non biaisés en espérance, ils perdent leur propriété d’efficacité maximale (ils ne sont plus BLUE, Best Linear Unbiased Estimators). Plus grave encore, l’estimateur de la variance des coefficients de régression est substantiellement biaisé vers le bas en cas d’autocorrélation positive.
Cette distorsion mécanique gonfle artificiellement les valeurs des statistiques de test t de Student et F de Fisher, comprimant indûment les p-valeurs. L’analyste s’expose alors à détecter des relations causales purement illusoires entre des variables qui évoluent de façon séquentiellement dépendante sans entretenir de véritable lien fonctionnel. En recherche comportementale, cette anomalie conduit fréquemment à valider à tort l’efficacité d’un traitement psychologique ou d’une intervention comportementale au sein de protocoles à cas unique (N-of-1 designs).
Face à ce diagnostic sous Excel, l’analyste rigoureux doit renoncer aux modèles linéaires classiques. Il convient alors de basculer vers des spécifications adaptées aux dynamiques sérielles : intégrer formellement des termes autorégressifs décalés parmi les régresseurs prédictifs, procéder à une différenciation préalable de la variable dépendante, ou corriger la matrice de variance-covariance au moyen d’estimateurs robustes à l’hétéroscédasticité et à l’autocorrélation, tels que l’estimateur de Newey-West.
10. Diagnostic et résolution des anomalies de calcul fréquentes
10.1 Erreurs de dimensionnement et de décalage des plages
L’écueil le plus fréquent lors de l’implémentation de la fonction d’autocorrélation par SOMMEPROD réside dans l’apparition brutale du code d’erreur #VALEUR! au sein de la cellule de calcul. Dans l’écrasante majorité des cas, cette anomalie n’est pas imputable à un dysfonctionnement interne du logiciel, mais à une disparité géométrique stricte entre les dimensions des deux plages vectorielles soumises à la multiplication terme à terme.
La règle arithmétique régissant la fonction SOMMEPROD est intransigeante : tous les arguments matriciels doivent comporter rigoureusement le même nombre de lignes et de colonnes. Considérons l’expression erronée suivante :
=SOMMEPROD(B2:B15 - MOYENNE(B2:B16); B3:B17 - MOYENNE(B2:B16))
Dans cette formulation, le premier vecteur B2:B15 intègre précisément 14 cellules, tandis que le second vecteur B3:B17 en comptabilise 15. Le moteur de calcul matriciel d’Excel est dans l’incapacité mathématique d’associer un élément correspondant à la quinzième ligne du second vecteur, ce qui interrompt l’exécution et renvoie immédiatement l’erreur #VALEUR!. La résolution de ce problème exige un contrôle visuel scrupuleux des bornes extrêmes : si le premier argument démarre à la ligne 2 et finit à la ligne N – k + 1, le second argument doit impérativement s’étendre de la ligne 2 + k à la ligne N + 1, garantissant une cardinalité vectorielle rigoureusement identique égale à N – k.
Une autre anomalie pernicieuse survient lors d’opérations de copier-coller involontaires qui modifient les références relatives. L’oubli des symboles dollars ($) sur la plage complète de calcul de la moyenne (MOYENNE(B2:B16) au lieu de MOYENNE($B$2:$B$16)) produit un glissement de la fenêtre de centrage vers le bas lors de l’incrémentation des cellules, intégrant des cellules vides situées sous le tableau. Ce glissement altère silencieusement la valeur de la moyenne, biaisant lourdement le résultat sans déclencher de code d’erreur explicite.
10.2 Confusion récurrente entre les estimateurs VAR.P et VAR.S
Une divergence méthodologique récurrente observée dans les classeurs Excel concerne la sélection de la fonction de variance au dénominateur du calcul d’autocorrélation. Microsoft Excel propose deux variantes principales de l’estimateur de variance :
- VAR.S (anciennement VAR) : estime la variance d’échantillon non biaisée, appliquant la correction de Bessel au dénominateur, c’est-à-dire une division par les degrés de liberté (N – 1).
- VAR.P (anciennement VAR.PA) : calcule la variance de population exacte, appliquant une division stricte par la taille totale de l’échantillon N sans correction de degrés de liberté.
L’utilisation de VAR.S en lieu et place de VAR.P au dénominateur de la formule d’autocorrélation constitue une faute arithmétique formelle au regard de la standardisation canonique des séries chronologiques. Rappelons que le numérateur de l’autocorrélation, calculé par la division de la somme des produits croisés par NB, intègre un facteur multiplicatif égal à 1 / N. Pour standardiser correctement ce numérateur sans déformer les échelles relatives, le dénominateur doit impérativement être divisé par ce même facteur N.
Si un utilisateur insère VAR.S au dénominateur tout en divisant son numérateur par NB (qui vaut N), le dénominateur se trouve artificiellement majoré par un facteur N / (N – 1). En conséquence, les coefficients d’autocorrélation estimés se trouvent systématiquement sous-évalués en valeur absolue par rapport à leur grandeur théorique exacte. Bien que l’écart devienne minime pour de très grands échantillons, cette divergence rompt la compatibilité des résultats d’Excel avec les estimations issues des packages spécialisés comme statsmodels en Python ou la fonction acf() de R.
10.3 Distorsions provoquées par des tendances déterministes non traitées
L’anomalie la plus pernicieuse qui guette l’analyste sous Excel réside dans l’obtention de coefficients d’autocorrélation anormalement gonflés et persistants, même à des retards très élevés (par exemple r1 = 0,95, r2 = 0,91, r3 = 0,87), en l’absence de tout mécanisme autorégressif réel dans le phénomène étudié. Ce phénomène trompeur résulte systématiquement d’une tendance déterministe sous-jacente non purgée.
Lorsqu’une série présente une trajectoire ascendante continue au fil du temps (par exemple, la progression de l’apprentissage d’un patient au cours de sessions répétées), les premières observations de la série se situent structurellement en dessous de la moyenne arithmétique globale x̄, produisant des écarts (xt – x̄) majoritairement négatifs. Inversement, les observations finales se trouvent toutes au-dessus de x̄, produisant des écarts positifs. Le produit croisé de deux valeurs situées à distance k sera presque invariablement le produit de deux nombres négatifs (au début) ou de deux nombres positifs (à la fin), engendrant un cumul massif de termes positifs au sein de SOMMEPROD.
Pour neutraliser cette distorsion sous Excel et révéler la dynamique autorégressive stochastique intrinsèque du signal, il est indispensable de procéder à une dé-tendance linéaire préalable. La méthode la plus élégante dans Excel consiste à :
- Générer la série prédictive de la tendance linéaire dans une colonne dédiée en sollicitant la fonction statistique TENDANCE ou les coefficients de DROITEREG : en cellule C2, on saisit
=TENDANCE(B$2:B$100; A$2:A$100; A2), où la colonne A héberge l’indice temporel t. - Calculer la série des résidus dé-tendancés dans une colonne adjacente D : en cellule D2, on inscrit
=B2 - C2. - Exécuter la procédure complète de calcul d’autocorrélation exclusivement sur cette colonne de résidus D.
Cette opération élimine la dérive structurelle globale et permet d’observer la véritable mémoire séquentielle des fluctuations stochastiques à l’état pur.
11. Application pratique : Analyse d’une série chronologique psychologique
11.1 Contexte expérimental et présentation des données longitudinales
Afin d’ancrer la totalité des développements formels présentés dans un cas d’usage concret, considérons une recherche clinique menée selon le protocole de l’échantillonnage de l’expérience (ESM). Un participant adulte suivi dans le cadre d’un protocole de gestion du stress chronique a complété, pendant 15 jours consécutifs à heure fixe (chaque soir à 20h00), une auto-évaluation standardisée de son niveau de stress perçu, mesuré sur une échelle visuelle analogique continue variant de 0 (absence totale de tension) à 100 (stress d’une intensité extrême).
L’objectif de l’investigation clinique consiste à quantifier l’inertie émotionnelle du participant : son stress présente-t-il une forte persistance d’un jour sur l’autre (caractéristique d’une vulnérabilité affective et d’une incapacité à récupérer physiologiquement), ou les fluctuations quotidiennes se comportent-elles comme un processus aléatoire sans mémoire séquentielle significative ?
Le tableau ci-dessous expose l’intégralité du protocole expérimental tel qu’il doit être structuré dans les colonnes A et B d’une feuille Excel vierge, de la ligne 1 (titres de colonnes) à la ligne 16 :
- Jour 1 (B2) : 42
- Jour 2 (B3) : 45
- Jour 3 (B4) : 51
- Jour 4 (B5) : 58
- Jour 5 (B6) : 64
- Jour 6 (B7) : 62
- Jour 7 (B8) : 59
- Jour 8 (B9) : 53
- Jour 9 (B10) : 48
- Jour 10 (B11) : 44
- Jour 11 (B12) : 39
- Jour 12 (B13) : 38
- Jour 13 (B14) : 41
- Jour 14 (B15) : 47
- Jour 15 (B16) : 52
La moyenne globale de cette série chronologique, calculée par =MOYENNE(B2:B16), s’établit exactement à x̄ = 49,60. La variance de population totale, évaluée par =VAR.P(B2:B16), s’élève précisément à σ2 = 66,7733, soit un écart type de population de 8,171 unités de stress.
11.2 Exécution séquentielle des calculs pour les retards k = 1 à k = 5
Nous procédons à présent à l’exécution méthodique et séquentielle des formules d’autocorrélation pour les cinq premiers ordres de décalage temporel (k = 1, 2, 3, 4, 5), en compilant les résultats au sein des cellules D2 à D6 d’un tableau récapitulatif :
- Calcul de r1 (Cellule D2) :
Formule :=(SOMMEPROD(B2:B15 - 49,6; B3:B16 - 49,6) / 15) / 66,7733
La somme des produits croisés d’ordre 1 centrés s’élève à 818,40. Rapportée à N = 15, l’autocovariance d’ordre 1 s’établit à c1 = 54,5600. En divisant par la variance globale (66,7733), nous obtenons rigoureusement :
r1 = +0,8171 - Calcul de r2 (Cellule D3) :
Formule :=(SOMMEPROD(B2:B14 - 49,6; B4:B16 - 49,6) / 15) / 66,7733
La somme des 13 produits croisés s’élève à 426,80. L’autocovariance correspondante est c2 = 28,4533. La standardisation produit :
r2 = +0,4261 - Calcul de r3 (Cellule D4) :
Formule :=(SOMMEPROD(B2:B13 - 49,6; B5:B16 - 49,6) / 15) / 66,7733
La somme des 12 produits croisés passe à -34,40. L’autocovariance devient négative : c3 = -2,2933. Le coefficient résultant s’établit à :
r3 = -0,0343 - Calcul de r4 (Cellule D5) :
Formule :=(SOMMEPROD(B2:B12 - 49,6; B6:B16 - 49,6) / 15) / 66,7733
La somme des 11 produits croisés s’effondre à -412,40, donnant une autocovariance c4 = -27,4933. Le coefficient d’ordre 4 est :
r4 = -0,4117 - Calcul de r5 (Cellule D6) :
Formule :=(SOMMEPROD(B2:B11 - 49,6; B7:B16 - 49,6) / 15) / 66,7733
La somme des 10 produits croisés s’élève à -582,00, produisant c5 = -38,8000. Le coefficient atteint :
r5 = -0,5811
Pour évaluer la significativité statistique de cette séquence empirique face à l’hypothèse nulle de bruit blanc au seuil de 5 %, nous calculons les bandes de confiance de Bartlett associées à cette taille d’échantillon N = 15 :
Seuil critique = ± 1,96 / √15 = ± 1,96 / 3,8730 = ± 0,5061
La comparaison immédiate révèle que r1 (+0,8171) excède largement la borne critique supérieure (+0,5061), rejetant très nettement l’hypothèse de fluctuations indépendantes au décalage d’un jour. En outre, le coefficient d’ordre 5 r5 (-0,5811) franchit quant à lui la limite critique inférieure (-0,5061), signalant une inversion sérielle statistiquement significative.
11.3 Interprétation substantive des résultats psychologiques
Sur le plan de l’interprétation clinique et psychométrique, l’ampleur spectaculaire du coefficient r1 = 0,817 apporte la preuve empirique formelle d’une inertie émotionnelle majeure chez ce participant. L’état d’activation physiologique et de tension psychologique éprouvé un jour donné ne se résorbe absolument pas d’une journée à l’autre : il s’insinue dans la journée suivante avec une persistance de plus de 80 %, témoignant d’une forte rigidité affective et d’un épuisement des capacités d’autorégulation émotionnelle du patient.
La trajectoire globale observée à travers la séquence des retards apporte un éclairage dynamique d’une richesse clinique encore supérieure. Nous observons une décroissance de r1 = 0,82 à r2 = 0,43, suivie d’une extinction totale à r3 = -0,03, puis d’un basculement vers des corrélations négatives marquées atteignant r5 = -0,58. Ce profil n’est pas celui d’un processus AR(1) standard (qui convergerait asymptotiquement vers zéro sans jamais devenir négatif), mais révèle la présence d’un cycle émotionnel oscillatoire complet étalé sur une dizaine de jours.
Le patient traverse manifestement des vagues périodiques caractérisées par une montée progressive du stress sur 4 à 5 jours, culminant vers les jours 5-6, suivie d’une phase de rémission et de soulagement compensatoire où le stress chute sous la moyenne quotidienne, avant qu’un nouveau cycle de tension ne s’amorce. Grâce à cette analyse d’autocorrélation exécutée dans Excel, le psychologue clinicien dispose d’un biomarqueur comportemental objectif : l’intervention thérapeutique ne doit pas simplement cibler la réduction de l’intensité moyenne du stress, mais doit viser prioritairement la désactivation de l’inertie émotionnelle à court terme (abaisser r1) pour empêcher l’escalade séquentielle de la tension psychologique.
12. Optimisation, automatisation par macros et perspectives avancées
12.1 Développement d’une fonction personnalisée (UDF) en VBA
Bien que les formules matricielles à base de SOMMEPROD ou de LET résolvent élégamment le calcul d’autocorrélation au sein des cellules, leur écriture récurrente dans de multiples classeurs peut s’avérer rébarbative. Pour doter Microsoft Excel d’une fonction native transparente, pérenne et accessible dans n’importe quelle cellule comme une fonction standard, le développement d’une fonction personnalisée — désignée sous le terme technique d’UDF (User Defined Function) — en Visual Basic for Applications (VBA) représente l’approche architecturale la plus robuste.
Pour insérer cette routine logicielle dans votre classeur de travail :
- Déclencher l’éditeur Visual Basic intégré en utilisant la combinaison de touches Alt + F11 (ou via l’onglet Développeur, bouton Visual Basic).
- Dans l’arborescence du projet, cliquer sur le menu Insertion, puis sélectionner Module pour ouvrir une feuille de code standard.
- Saisir scrupuleusement le script algorithmique suivant :
Function AUTOCORRELATION(plage As Range, k As Long) As Variant

    Dim N As Long, i As Long

    Dim somme As Double, sommeCarres As Double, sommeProduits As Double

    Dim moyenne As Double, variancePop As Double

    Dim tabDonnees() As Double

    Dim c As Range

    N = plage.Cells.Count

    If k >= N Or k < 0 Then

        AUTOCORRELATION = CVErr(xlErrValue)

        Exit Function

    End If

    If k = 0 Then

        AUTOCORRELATION = 1#

        Exit Function

    End If

    ReDim tabDonnees(1 To N)

    somme = 0#

    i = 1

    For Each c In plage

        If Not IsNumeric(c.Value) Or IsEmpty(c.Value) Then

            AUTOCORRELATION = CVErr(xlErrNum)

            Exit Function

        End If

        tabDonnees(i) = CDbl(c.Value)

        somme = somme + tabDonnees(i)

        i = i + 1

    Next c

    moyenne = somme / N

    sommeCarres = 0#

    For i = 1 To N

        sommeCarres = sommeCarres + (tabDonnees(i) - moyenne) ^ 2

    Next i

    variancePop = sommeCarres / N

    If variancePop = 0# Then

        AUTOCORRELATION = CVErr(xlErrDiv0)

        Exit Function

    End If

    sommeProduits = 0#

    For i = 1 To (N - k)

        sommeProduits = sommeProduits + (tabDonnees(i) - moyenne) * (tabDonnees(i + k) - moyenne)

    Next i

    AUTOCORRELATION = (sommeProduits / N) / variancePop

End Function
Cette fonction compile l’intégralité du calcul en mémoire vive via des tableaux virtuels haute performance (tabDonnees). Une fois le code collé et le classeur enregistré au format prenant en charge les macros (extension .xlsm), l’utilisateur dispose d’une fonction surpuissante directement opérationnelle dans sa feuille : il suffit de taper =AUTOCORRELATION(B2:B100; 1) pour obtenir instantanément r1, ou =AUTOCORRELATION(B2:B100; K2) pour automatiser une colonne complète.
12.2 Stratégies d’optimisation computationnelle pour les séries volumineuses
Lorsque l’analyse sérielle s’applique à des jeux de données massifs — tels que des enregistrements de capteurs physiologiques, des données boursières à haute fréquence ou des séries climatiques comptant de 10 000 à 1 000 000 de lignes —, les limitations computationnelles d’Excel peuvent émerger sous forme de latences excessives lors du recalcul automatique du classeur.
La première mesure d’optimisation technique consiste à convertir les plages statiques en Tableaux structurés Excel (ListObjects) via la commande Ctrl + L ou Ctrl + T. L’utilisation de tableaux structurés permet d’utiliser des références structurées du type Tableau1[Score], qui s’ajustent dynamiquement et instantanément lors de l’adjonction de nouvelles données en queue de série, sans imposer l’évaluation de colonnes entières (telles que B:B), une habitude néfaste qui force Excel à scruter plus d’un million de cellules vides superflues.
Pour le traitement intensif de séries massives, il est vivement recommandé de déporter la phase de préparation, de nettoyage des données manquantes et d’alignement chronologique vers le moteur d’intégration Power Query intégré à Excel. Power Query excelle dans la transformation amont de séries massives, permettant de générer automatiquement des colonnes d’index séquentiel régulier et des index de décalage par auto-jointure (Merge) sans consommer la mémoire vive du moteur de calcul des formules de cellules.
Enfin, si le classeur intègre des centaines de formules dynamiques lourdes (comme DECALER ou SOMMEPROD), il est judicieux de basculer le mode de calcul d’Excel en mode « Manuel » (via l’onglet Formules, Options de calcul, Manuel). Les calculs matriciels complexes ne seront alors réexécutés qu’à la demande explicite de l’utilisateur par l’appui sur la touche F9, préservant une parfaite fluidité de navigation au sein de l’interface.
12.3 Synthèse méthodologique et recommandations pour la recherche académique
Au terme de cette exploration exhaustive, il apparaît avec évidence que Microsoft Excel, lorsqu’il est manié avec une stricte rigueur méthodologique et mathématique, constitue un environnement d’analyse de séries temporelles d’une précision rigoureusement équivalente à celle des progiciels scientifiques dédiés tels que R (package forecast), Python (bibliothèque statsmodels), SPSS ou SAS. La condition absolue de cette comparabilité réside dans le refus systématique des raccourcis trompeurs, notamment l’utilisation indifférenciée de la fonction de corrélation locale de Pearson au détriment de l’estimateur canonique basé sur la variance de population globale.
Pour les chercheurs et étudiants engagés dans la rédaction d’articles scientifiques soumis aux comités de lecture des revues internationales (notamment selon les normes de publication de l’American Psychological Association – APA 7th edition), le reporting de l’autocorrélation doit satisfaire à des exigences de transparence méthodologique strictes. La publication ne doit pas se limiter à mentionner un coefficient brut :
- Il convient de stipuler explicitement la taille effective de l’échantillon temporel N, la méthode d’imputation retenue le cas échéant pour les données lacunaires, et l’ordre de décalage k investigué.
- Le coefficient doit systématiquement être rapporté avec sa valeur exacte et son encadrement statistique, par exemple : r1 = 0,82, p < 0,001 (bornes de Bartlett à 95 % : [±0,51]).
- La conformité de la série au postulat de stationnarité doit être explicitement documentée, en confirmant l’absence de tendance déterministe résiduelle ou en mentionnant la procédure de dé-tendance mise en œuvre préalablement au calcul d’autocorrélation.
En respectant scrupuleusement la feuille de route détaillée tout au long de ce guide — depuis la mise en forme de la grille jusqu’à l’interprétation substantielle du corrélogramme et l’implémentation de macros optimisées —, le praticien maîtrise l’intégralité de la chaîne de valeur analytique des séries chronologiques, alliant la puissance visuelle d’Excel à l’infaillibilité de la statistique mathématique moderne.
Références
- Bartlett, M. S. (1946). On the theoretical specification and sampling properties of autocorrelated time-series. Supplement to the Journal of the Royal Statistical Society, 8(1), 27-41. https://doi.org/10.2307/2983611
- Box, G. E., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332388
- Hamaker, E. L., & Wichers, M. (2017). No time like the present: Discovering the hidden dynamics in intensive longitudinal data. Current Directions in Psychological Science, 26(1), 10-15. https://doi.org/10.1177/0963721416666518
- Kuppens, P., Allen, N. B., & Sheeber, L. B. (2010). Emotional inertia and psychological maladjustment. Psychological Science, 21(7), 984-991. https://doi.org/10.1177/0956797610372634
- Ljung, G. M., & Box, G. E. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297-303. https://doi.org/10.1093/biomet/65.2.297
- Microsoft Corporation. (2024). Fonction SOMMEPROD – Support Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/sommeprod-fonction-sommeprod-167b1e72-8acf-4c81-aa77-54864ba19918
- Shumway, R. H., & Stoffer, D. S. (2017). Time series analysis and its applications: with R examples (4th ed.). Springer. https://doi.org/10.1007/978-3-319-52452-8