
L’analyse des séries temporelles et des données longitudinales occupe une place prépondérante dans la modélisation quantitative contemporaine, traversant des disciplines aussi variées que l’économétrie, la psychologie quantitative, la climatologie, la biométrie et l’épidémiologie. Au cœur de ces investigations réside un phénomène fondamental nommé la dépendance sérielle, ou autocorrélation, qui traduit la propension des observations successives à maintenir une relation stochastique au fil du temps. Contrairement aux postulats classiques de l’échantillonnage aléatoire simple, où les entités observées sont supposées indépendantes et identiquement distribuées, les données séquentielles portent en elles une mémoire temporelle intrinsèque. Comprendre, mesurer et modéliser cette mémoire constitue un impératif méthodologique pour tout chercheur ou praticien de la donnée.
L’environnement statistique R s’est imposé comme l’écosystème computationnel de référence pour le traitement de ces structures dépendantes, offrant un ensemble d’outils analytiques allant des fonctions natives aux bibliothèques spécialisées les plus pointues. Néanmoins, le calcul de l’autocorrélation dans R ne saurait être réduit à l’exécution machinale d’une fonction isolée telle que acf(). Une utilisation rigoureuse exige une compréhension mathématique approfondie des concepts de décalage temporel, de stationnarité, de structures d’invariance et de distributions asymptotiques. Les praticiens doivent être capables de naviguer avec précision entre les corrélations totales et partielles, d’évaluer la significativité statistique à l’aide de tests omnibus adaptés, et de diagnostiquer les anomalies structurelles comme les tendances déterministes ou la non-stationnarité.
Ce guide exhaustif a pour vocation d’articuler l’ensemble des fondements théoriques, des considérations algorithmiques et des protocoles d’implémentation nécessaires pour quantifier et interpréter l’autocorrélation dans R. De la formalisation de la covariance sérielle à la modélisation avancée par moindres carrés généralisés, en passant par l’analyse des devis en mesures répétées et des protocoles d’échantillonnage écologique momentané, cet ouvrage fournit une feuille de route détaillée, robuste et directement exploitable pour mener des analyses temporelles de haut niveau académique.
1. Fondements théoriques de l’autocorrélation et pertinence en analyse quantitative
1.1 Définition mathématique et conceptuelle de la corrélation sérielle
L’autocorrélation, fréquemment désignée sous le terme de corrélation sérielle, mesure la dépendance linéaire existant entre les valeurs d’une même variable stochastique observée à différents instants temporels. D’un point de vue conceptuel, elle quantifie le degré d’association entre une observation présente et ses réalisations antérieures. Pour formaliser cette notion, considérons un processus stochastique discret indexé par le temps, noté X(t), où t appartient à l’ensemble des entiers relatifs. Si nous supposons que ce processus possède une espérance mathématique constante notée μ et une variance finie σ², l’autocovariance au décalage temporel k (fréquemment désigné par le terme anglophone lag k) se définit comme l’espérance du produit croisé des écarts à la moyenne : γ(k) = E[(X(t) – μ)(X(t + k) – μ)].
Le coefficient d’autocorrélation théorique au décalage k, universellement noté ρ(k), correspond à la normalisation de cette autocovariance par la variance globale du processus stochastique. Mathématiquement, il s’exprime par le ratio ρ(k) = γ(k) / γ(0), où γ(0) représente l’autocovariance à un décalage nul, c’est-à-dire la variance pure de la série temporelle. En vertu de l’inégalité de Cauchy-Schwarz, ce coefficient d’autocorrélation est strictement borné à l’intérieur de l’intervalle fermé [-1, +1]. Une valeur s’approchant de +1 dénote une persistance temporelle positive prononcée, caractérisée par une forte inertie du système où des valeurs élevées sont préférentiellement suivies de valeurs élevées. Inversement, une valeur tendant vers -1 reflète une alternance systématique et oscillatoire, tandis qu’une valeur nulle traduit une absence totale d’association linéaire sérielle au décalage considéré.
Il est crucial de distinguer cette dynamique selon la nature sous-jacente du processus stochastique. Un processus est qualifié de stationnaire au sens faible (ou stationnaire au second ordre) si son espérance mathématique est invariante par translation dans le temps et si son autocovariance γ(t, t + k) ne dépend exclusivement que de l’écart temporel k et non du repère temporel absolu t. Lorsque cette condition d’invariance temporelle fait défaut, le processus est qualifié de non-stationnaire. Dans ce cas, la covariance sérielle devient fonction de l’instant considéré, ce qui invalide l’estimation standard du coefficient unique d’autocorrélation et nécessite des transformations préalables de la série chronologique pour restaurer la stationnarité.
1.2 Notion de décalage temporel (lag) et fonction d’autocorrélation
Le mécanisme du décalage temporel, ou lag, constitue le principe opérationnel fondamental permettant de calculer la dépendance sérielle. Concrètement, décaler une série univariée d’un ordre k équivaut à aligner chaque observation X(t) avec sa valeur observée k unités de temps auparavant, soit X(t – k). En opérant ce glissement systématique, on génère des paires d’observations conjointes sur lesquelles s’appliquent les estimateurs classiques de covariance. Au décalage k = 1, nous évaluons la mémoire immédiate du processus, c’est-à-dire l’influence directe de l’instant précédent sur l’état courant. Au décalage k = 2, nous sondons l’influence résiduelle de l’instant séparé par deux pas d’échantillonnage, et ainsi de suite pour l’ensemble des décalages entiers positifs.
La séquence ordonnée de l’ensemble de ces coefficients d’autocorrélation pour les décalages successifs k = 0, 1, 2, …, K forme ce que la littérature statistique nomme la fonction d’autocorrélation, universellement abrégée par l’acronyme ACF (Autocorrelation Function). L’ACF constitue une véritable empreinte digitale probabiliste du processus stochastique. Elle décrit la manière dont l’information contenue dans le passé s’estompe, persiste ou se propage vers le futur. Pour un processus purement aléatoire sans mémoire, tel qu’un bruit blanc gaussien, l’ACF présente une valeur unitaire au décalage zéro (ρ(0) = 1) et s’annule rigoureusement pour tout décalage k ≥ 1.
L’analyse du comportement asymptotique de l’ACF permet d’opérer une distinction fondamentale entre les processus dits à mémoire courte et les processus à mémoire longue. Dans un processus à mémoire courte, typiquement illustré par les modèles autorégressifs et moyennes mobiles (ARMA), les coefficients d’autocorrélation décroissent de manière exponentielle ou géométrique vers zéro à mesure que le décalage k croît vers l’infini, garantissant que la somme absolue des coefficients demeure finie. À l’opposé, les processus stochastiques à mémoire longue, souvent modélisés par des processus fractionnairement intégrés (ARFIMA), présentent une décroissance hyperbolique extrêmement lente de leurs autocorrélations, entraînant la divergence de la somme des coefficients et traduisant la rémanence d’événements passés sur des horizons temporels considérables.
1.3 Enjeux méthodologiques de la dépendance sérielle dans les mesures longitudinales
Dans le domaine des analyses quantitatives et de la modélisation statistique, la présence d’autocorrélation non prise en compte viole directement l’un des postulats cardinaux du théorème de Gauss-Markov, à savoir l’indépendance mutuelle des termes d’erreur. Lorsque des modèles de régression linéaire par moindres carrés ordinaires (MCO) sont ajustés sur des séries chronologiques ou des données longitudinales dépendantes, les estimateurs des coefficients de régression demeurent mathématiquement sans biais, mais ils perdent leur propriété d’efficacité asymptotique. En d’autres termes, ils ne constituent plus les meilleurs estimateurs linéaires sans biais (BLUE).
La conséquence la plus délétère de cette violation concerne l’estimation de la matrice de variance-covariance des coefficients. En présence d’une autocorrélation positive des résidus, les moindres carrés ordinaires sous-estiment systématiquement les erreurs-types des estimateurs. Cette sous-estimation artificielle gonfle la statistique de test de Student et comprime indûment les p-valeurs associées, entraînant une inflation exponentielle du risque d’erreur de type I. Le chercheur est alors conduit à rejeter à tort l’hypothèse nulle d’absence d’effet et à identifier des relations prédictives totalement fallacieuses. Ce phénomène, documenté initialement dans les travaux pionniers de Yule (1926) relatifs aux corrélations illusoires, demeure l’un des écueils méthodologiques les plus destructeurs de l’inférence statistique observationnelle.
Au-delà de ces considérations purement inférentielles, l’autocorrélation constitue en elle-même une métrique substantielle d’un immense intérêt théorique, notamment en psychométrie, en sciences comportementales et en médecine personnalisée. Dans les paradigmes de dynamique psychologique, l’autocorrélation de premier ordre mesurée au sein d’une séquence temporelle d’états affectifs est interprétée comme un indicateur d’inertie émotionnelle. Une inertie élevée, quantifiée par une autocorrélation sérielle positive substantielle, reflète une rigidité régulatrice où l’individu peine à se détacher d’un état affectif négatif pour revenir à sa ligne de base. À l’inverse, une autocorrélation modérée témoigne d’une flexibilité adaptative saine face aux perturbations environnementales. L’estimation précise de cette dépendance sérielle est donc indispensable tant pour corriger les modèles statistiques que pour théoriser la dynamique temporelle des phénomènes observés.
2. Préparation de l’environnement R et manipulation des séries temporelles
2.1 Installation et chargement des bibliothèques nécessaires
Pour mener à bien une étude exhaustive de l’autocorrélation sous R, il convient de structurer un environnement computationnel robuste en mobilisant à la fois les modules natifs du système et les extensions spécialisées développées par la communauté statistique. L’environnement R de base dispose nativement du package stats, lequel fournit les fonctions élémentaires et historiques pour l’analyse spectrale et temporelle, notamment la routine acf(), la fonction pacf() et la routine d’ajustement arima(). Ces outils constituent le socle fondamental sur lequel reposent la plupart des développements ultérieurs.
Cependant, pour accéder à des procédures de diagnostic plus sophistiquées, notamment les tests formels de racine unitaire, les tests d’hétéroscédasticité et les outils de détection économétrique, l’installation de bibliothèques tierces s’avère indispensable. Le package tseries, développé sous l’égide du projet Rmetrics, offre des implémentations particulièrement robustes pour les tests de stationnarité tels que le test de Dickey-Fuller augmenté (ADF) et le test KPSS. Parallèlement, le package forecast fournit des routines de calcul et de visualisation très complètes, tandis que la bibliothèque lmtest s’avère indispensable pour mener des tests diagnostiques approfondis sur les résidus de modèles linéaires, à l’image du test de Durbin-Watson ou du test de Breusch-Godfrey.
L’initialisation de la session de travail doit idéalement intégrer le chargement ordonné de ces différentes bibliothèques logicielles. On veillera à exécuter les commandes d’installation via la fonction install.packages() pour les composants non présents dans le répertoire système local, suivies des appels à la fonction library(). Une gestion rigoureuse des dépendances évite les conflits de masquage de fonctions, particulièrement fréquents dans le domaine de la manipulation des séries temporelles où plusieurs packages peuvent proposer des méthodes homonymes pour la manipulation de décalages ou l’extraction de métriques sérielles.
2.2 Conversion et structuration des vecteurs en objets temporels
L’une des particularités du traitement des séries chronologiques dans R réside dans l’utilisation de structures de données formelles encapsulant explicitement la dimension temporelle. Bien qu’un vecteur numérique brut puisse faire l’objet de calculs d’autocorrélation séquentielle élémentaires, l’attribution d’une classe temporelle formelle permet de garantir l’intégrité de l’échantillonnage, la manipulation transparente des pas temporels et l’activation automatique des méthodes génériques adaptées.
La fonction ts() constitue la routine canonique du package stats pour convertir un vecteur numérique conventionnel en un objet de classe ts (time series). Cette fonction exige la spécification explicite de paramètres cardinaux, à savoir l’instant de départ via l’argument start (qui peut être un scalaire ou un vecteur de deux entiers désignant l’année et la sous-période), et la fréquence d’observation via l’argument frequency. Par exemple, une fréquence de 1 correspond à des relevés annuels réguliers, une fréquence de 4 caractérise des données trimestrielles, une fréquence de 12 s’applique aux séries mensuelles, et une fréquence de 365.25 permet d’encoder des mesures quotidiennes continues en tenant compte des années bissextiles.
La structuration correcte d’un objet ts confère à la série temporelle une grille temporelle équidistante stricte. R associe alors à l’objet des attributs spécifiques tels que tsp, qui encode le début, la fin et le pas d’échantillonnage de la trajectoire. Cette formalisation permet aux fonctions d’analyse subséquentes d’interpréter sans ambiguïté les décalages temporels, non pas simplement comme des indices de rangs vectoriels, mais comme des intervalles temporels concrets correspondant aux unités réelles du phénomène étudié (jours, mois, trimestres). Le contrôle de cette régularité d’échantillonnage est impératif, car l’application de calculs d’autocorrélation sur une séquence temporelle irrégulièrement espacée sans ajustement préalable introduit un biais systématique dans l’estimation de la vitesse de dissipation de la mémoire sérielle.
2.3 Gestion rigoureuse des valeurs manquantes préalablement au calcul
Dans les jeux de données empiriques longitudinaux, la présence de valeurs manquantes (notées NA sous R) constitue un défi méthodologique omniprésent. Les estimateurs standards de l’autocovariance reposent sur la somme de produits croisés entre des observations séparées par un décalage fixe. Dès lors qu’une seule valeur manque au temps t, le produit croisé impliquant cette valeur au décalage k, soit l’interaction entre X(t) et X(t – k), ainsi que l’interaction entre X(t + k) et X(t), devient indéterminé. L’omission de cette contrainte peut paralyser les routines de calcul ou produire des vecteurs entièrement contaminés par des indéterminations.
Le diagnostic préalable des cellules manquantes s’opère usuellement par l’application conjointe des fonctions is.na() et which(), ou via des résumés globaux permettant de localiser précisément les discontinuités dans la trajectoire temporelle. Face à des valeurs manquantes, la tentation primaire du praticien consiste souvent à supprimer purement et simplement les lignes déficientes. Cette approche par suppression de cas complets (ou listwise deletion) est formellement proscrite dans le cadre des séries chronologiques : elle détruit irrémédiablement l’équidistance des observations, crée des sauts artificiels dans le temps et altère de manière irréversible la structure de dépendance sérielle sous-jacente.
Il est donc impératif de recourir à des méthodes d’imputation adaptées aux propriétés dynamiques de la séquence étudiée. Pour des séries à tendance continue sans saisonnalité abrupte, l’interpolation linéaire ou spline, accessible via la fonction na.interp() du package forecast, permet de reconstituer les points manquants en préservant la trajectoire locale. Lorsque les données présentent une inertie forte et une variation discrète, la méthode du maintien de la dernière valeur observée (Last Observation Carried Forward), disponible via la fonction na.locf() du package zoo, peut être mobilisée avec précaution. Pour des cadres d’inférence statistique plus exigeants, l’utilisation de filtres de Kalman appliqués à des modèles d’espace d’états structuraux permet d’imputer les données manquantes de manière optimale en conditionnant les estimations sur l’ensemble de la structure stochastique observée.
3. Calcul programmatique de l’autocorrélation avec la fonction acf() de base
3.1 Syntaxe, arguments fondamentaux et exécution sans tracé
La fonction acf(), intégrée nativement dans le socle du package stats de R, constitue le point d’ancrage fondamental pour l’évaluation de la dépendance sérielle univariée et multivariée. Son implémentation computationnelle repose sur des algorithmes optimisés en langage C, garantissant une exécution rapide même sur des séquences comportant des dizaines de milliers d’observations. La signature formelle de cette fonction mobilise plusieurs arguments stratégiques qu’il est indispensable de maîtriser pour contrôler avec précision le flux de traitement numérique.
L’argument principal de la fonction est le vecteur ou la série temporelle univariée transmise en entrée. Par défaut, l’appel de la fonction génère automatiquement une fenêtre graphique affichant le corrélogramme de la série. Dans le cadre d’un pipeline de calcul scientifique automatisé ou d’une analyse statistique programmatique, ce comportement visuel par défaut s’avère fréquemment sous-optimal, voire perturbateur. L’assignation explicite de l’argument plot = FALSE permet de neutraliser cette sortie graphique et d’astreindre la fonction à retourner exclusivement un objet informatique structuré contenant les résultats numériques des estimations.
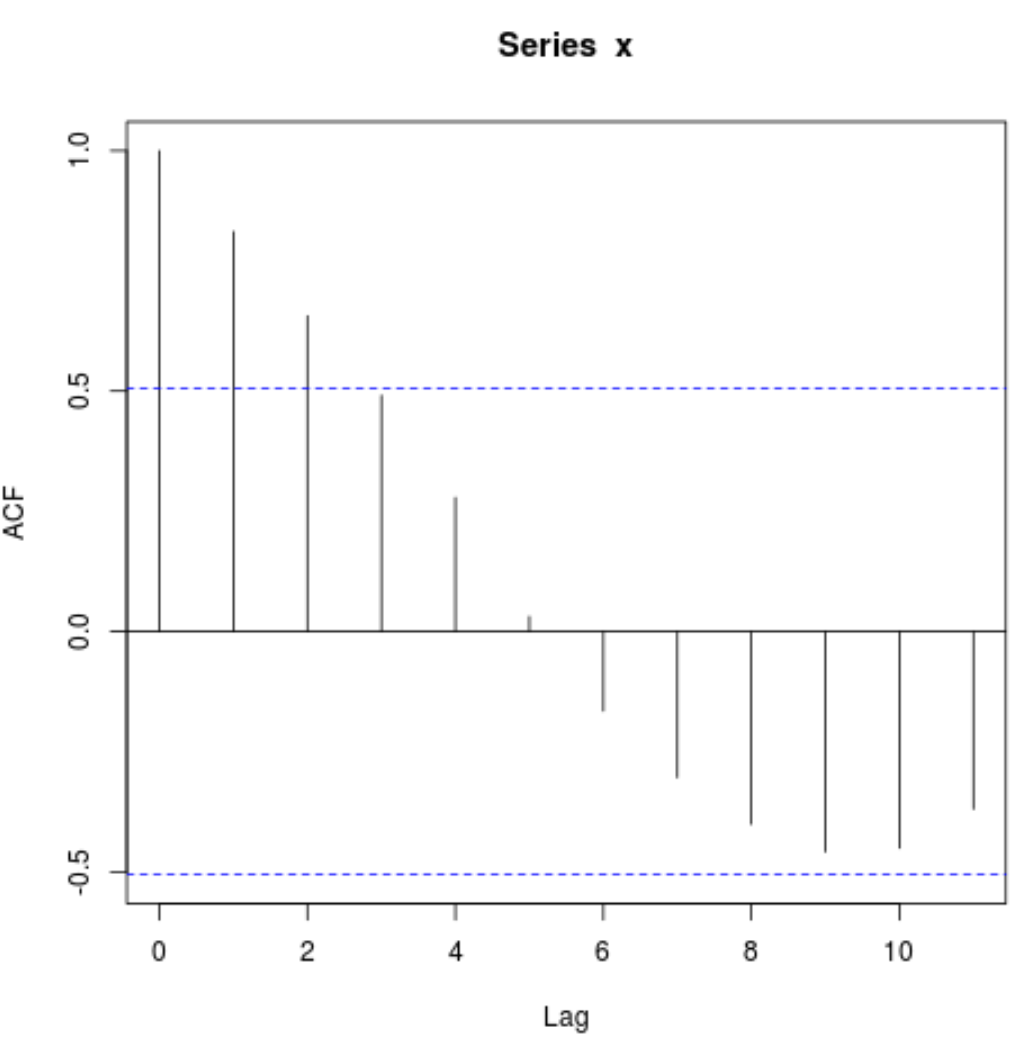
Un autre paramètre cardinal réside dans l’argument type, qui admet par défaut la valeur textuelle correlation. Cette configuration impose le calcul des coefficients d’autocorrélation normalisés bornés entre -1 et +1. Cependant, l’utilisateur peut également spécifier type = « covariance » pour extraire les autocovariances brutes γ(k), ou type = « partial » pour basculer vers le calcul des autocorrélations partielles. Par ailleurs, la fonction intègre un paramètre demean = TRUE, qui ordonne le centrage automatique de la série par soustraction de sa moyenne empirique préalable au calcul des sommes de produits croisés, une opération théoriquement requise pour assurer la validité de l’estimateur de covariance sous hypothèse de stationnarité.
3.2 Extraction et interprétation matricielle des coefficients d’autocorrélation
L’exécution de la fonction avec la désactivation du tracé graphique génère un objet complexe appartenant à la classe S3 acf. Cet objet est une liste nommée encapsulant plusieurs éléments essentiels : acf, type, n.used, lag et series. L’élément qui concentre l’attention computationnelle est la composante $acf, qui héberge la matrice tridimensionnelle des coefficients calculés. Pour une série univariée, cette structure se présente sous la forme d’un tableau de dimensions [K + 1, 1, 1], où K représente le nombre maximal de décalages calculés.
L’observation immédiate de la première valeur contenue dans cet objet, située à l’indice vectoriel 1 correspondant au décalage temporel zéro (lag 0), révèle un résultat systématiquement égal à 1. D’un point de vue statistique, cette égalité parfaite ρ(0) = 1 découle directement de la définition formelle de l’autocorrélation : elle traduit la corrélation d’une variable avec elle-même sans aucun décalage temporel, soit le ratio de la variance sur elle-même. Les coefficients informatifs pour le modélisateur débutent donc strictement à partir du décalage un (lag 1), situé à l’indice vectoriel 2 en indexation R standard.
L’extraction programmatique des coefficients s’opère par un sous-ensemble indiciel ciblé. Par exemple, pour isoler le vecteur linéaire des corrélations sérielles du décalage 0 au décalage maximal, on appliquera l’opérateur d’extraction mon_objet$acf[, 1, 1] ou la fonction de conversion as.numeric(mon_objet$acf). L’interprétation séquentielle de ces coefficients permet de cartographier la structure temporelle : un coefficient au décalage 1 de 0.75 indique une forte mémoire immédiate, tandis que des valeurs subséquentes au décalage 2 de 0.56 et au décalage 3 de 0.42 suggèrent une décroissance géométrique typique d’un processus autorégressif stable d’ordre un.
3.3 Paramétrage du décalage maximal via lag.max
Par défaut, lorsque l’utilisateur ne spécifie aucun décalage limite, la fonction acf() calcule les coefficients jusqu’à un horizon temporel maximal déterminé par une règle heuristique codée en dur dans les routines de R. Pour une série de taille N, ce décalage maximal par défaut est fixé à la valeur arrondie de 10 * log10(N / m), où m désigne le nombre de composantes de la série. Bien que cette heuristique offre un aperçu visuel rapide, elle peut s’avérer inadaptée aux objectifs spécifiques d’une étude empirique rigoureuse.
L’argument lag.max permet au praticien de reprendre le contrôle absolu sur la profondeur temporelle de l’analyse en fixant explicitement l’entier maximal des décalages à estimer. La détermination de cette borne obéit à un compromis statistique délicat entre richesse informationnelle et stabilité stochastique des estimateurs. À mesure que le décalage k augmente, le nombre effectif de paires d’observations disponibles pour calculer la covariance diminue mécaniquement : pour une série de longueur N, il n’existe que N – k observations conjointes pour évaluer γ(k).
En conséquence, l’estimation des autocorrélations à des décalages trop élevés souffre d’une variance d’échantillonnage considérable, rendant les coefficients hautement imprécis et erratiques. La recommandation méthodologique classique issue des travaux fondateurs de Box et Jenkins (1976) stipule que le décalage maximal exploré ne devrait jamais excéder le quart ou au maximum le tiers de la longueur totale de la série temporelle (soit lag.max ≤ N / 4), tout en veillant à conserver un seuil absolu minimal suffisant pour capturer les périodicités saisonnières ou institutionnelles sous-jacentes au phénomène modélisé.
4. Utilisation du package tseries et alternatives computationnelles
4.1 Calcul de l’autocorrélation avec les routines du package tseries
Le package tseries constitue l’une des extensions historiques les plus reconnues pour l’économétrie computationnelle sous R. Son intégration dans un workflow d’analyse sérielle ne vise pas simplement à substituer la fonction de calcul de base, mais à insérer cette évaluation dans un pipeline rigoureux d’inférence économétrique. Lors du chargement de tseries, l’environnement R bénéficie de passerelles transparentes entre les objets de séries chronologiques et des tests stochastiques de nouvelle génération.
L’interaction entre les fonctions de tseries et le calcul de dépendance sérielle se manifeste particulièrement lors de la modélisation de processus financiers ou volatils. Par exemple, la fonction garch() présente dans le package s’appuie directement sur l’évaluation des autocorrélations des résidus au carré pour diagnostiquer l’hétéroscédasticité conditionnelle autorégressive. Bien que tseries mobilise fréquemment en interne les primitives compilées de l’ACF native de R, il impose des contrôles de cohérence stricts sur la taille d’échantillon et offre des structures d’intégration directe avec des tests de stationnarité sophistiqués.
L’utilisation concertée de tseries permet également d’automatiser des séquences d’évaluation où le calcul d’autocorrélation intervient consécutivement à un test de racine unitaire. En articulant la fonction adf.test() avec l’extraction séquentielle des autocorrélations résiduelles, le modélisateur dispose d’un écosystème hautement cohérent pour valider si la dépendance mesurée est le produit d’un processus stationnaire autorégressif ou le symptôme d’une intégration d’ordre un nécessitant une différentiation structurelle.
4.2 Comparaison de performance entre base::acf() et packages spécialisés
Dans le traitement de données massives (Big Data), telles que les enregistrements de flux financiers à haute fréquence, les relevés de capteurs industriels connectés ou les données neurophysiologiques échantillonnées à la milliseconde, la performance computationnelle du calcul de l’ACF devient un facteur déterminant. L’algorithme standard implémenté dans base::acf() effectue le calcul des autocovariances dans le domaine temporel direct par sommation itérative des produits croisés, ce qui induit une complexité algorithmique de l’ordre de O(N * K), où N est le nombre total de points et K le nombre maximal de décalages.
Lorsque la taille N atteint des centaines de milliers de lignes et que K est également élevé, cette approche directe peut induire des temps de calcul prohibitifs. Pour contourner cette saturation, des bibliothèques algorithmiques spécialisées exploitent le théorème de Wiener-Khinchin. Ce théorème fondamental démontre que l’autocorrélation d’un signal correspond à la transformée de Fourier inverse de sa densité spectrale de puissance. En mobilisant l’algorithme de Transformée de Fourier Rapide (Fast Fourier Transform ou FFT), la complexité temporelle chute de manière spectaculaire à O(N * log(N)), indépendamment du nombre de décalages requis.
Des packages tels que stats (via sa routine interne optimisée pour de très grandes séries) ou des extensions de traitement du signal exploitent cette dualité spectrale. Cependant, les tests de robustesse démontrent une parfaite concordance mathématique entre les estimations obtenues par sommation directe et celles issues de la FFT, sous réserve d’une gestion adéquate du remplissage par des zéros (zero-padding) requis par les algorithmes de Fourier pour prévenir le phénomène d’autocorrélation circulaire périodique. Sur le plan de la résistance aux valeurs aberrantes extrêmes, les estimateurs gaussiens standards demeurent sensibles aux chocs ponctuels, ce qui justifie parfois le recours à des estimateurs d’autocorrélation robuste basés sur les rangs ou sur les médianes d’écarts bivariés.
4.3 Extraction programmée des métriques sous forme de data frame
L’intégration des résultats issus de la fonction acf() au sein de pipelines d’analyse modernes, notamment ceux affiliés à la philosophie du tidyverse, nécessite de transcender la structure S3 historique de l’objet natif. Par défaut, l’objet retourné par R encapsule ses métriques sous forme de matrices multidimensionnelles et d’attributs imbriqués, une conformation qui ne se prête pas nativement aux opérations de manipulation fluide avec des verbes tels que filter(), mutate() ou à l’exportation directe vers des bases de données relationnelles.
Pour convertir de manière reproductible un objet acf en un tableau de données rectangulaire standard (data frame ou tibble), il convient de concevoir une séquence de désassemblage explicite. Cette opération consiste à extraire simultanément le vecteur numérique aplati des décalages temporels et le vecteur correspondant des coefficients d’autocorrélation, puis à les encapsuler au sein d’une structure tabulaire bidimensionnelle. Cette démarche permet d’associer immédiatement chaque entier k à sa métrique sérielle ρ(k).
Ce formatage rectangulaire offre une souplesse analytique remarquable. Il autorise l’adjonction de colonnes dérivées calculées à la volée, telles que les bornes inférieures et supérieures des intervalles de confiance de Bartlett associées à chaque décalage spécifique, la p-valeur issue d’un test individuel de significativité, ou des drapeaux booléens signalant le dépassement des seuils de criticité statistique. Ce tableau tidy devient ainsi la source unique de vérité pour alimenter des synthèses tabulaires académiques, générer des visualisations graphiques avancées ou servir de matrice d’entrée pour des algorithmes d’apprentissage automatique supervisé exploitant la structure de mémoire temporelle comme variable explicative.
5. Représentation graphique et diagnostic visuel du corrélogramme sous R
5.1 Génération et personnalisation du corrélogramme avec plot.acf()
La représentation graphique de la fonction d’autocorrélation, universellement désignée sous le terme de corrélogramme, constitue l’outil diagnostique exploratoire le plus utilisé en analyse des séries temporelles. Lors de l’invocation de la fonction acf() avec son paramètre par défaut plot = TRUE, R dispatche automatiquement l’objet résultant vers la méthode graphique générique plot.acf(). Ce tracé synthétise de manière immédiate la structure de dépendance en matérialisant, pour chaque décalage temporel k en abscisse, une barre verticale dont la hauteur correspond à la magnitude du coefficient d’autocorrélation ρ(k) en ordonnée.
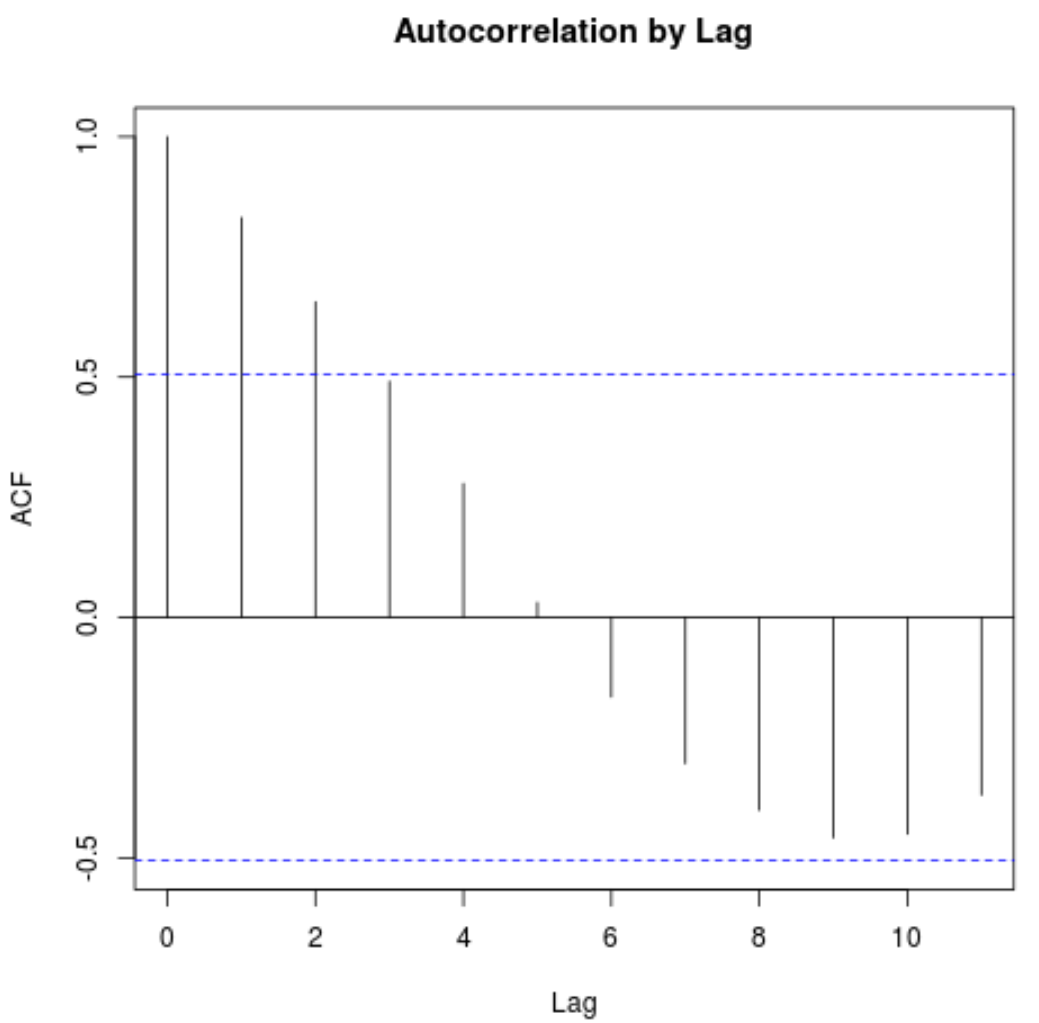
Le moteur graphique de base de R autorise une personnalisation poussée de cette figure via le passage d’arguments graphiques standards intégrés dans l’appel initial. L’utilisateur peut modifier l’épaisseur des segments verticaux à l’aide du paramètre lwd, altérer la couleur de la dynamique sérielle via col, ajuster les échelles des axes au moyen de ylim pour garantir une comparaison visuelle équitable entre plusieurs séries distinctes, et définir des titres informatifs par les arguments main, xlab et ylab.
Un enjeu ergonomique fréquent dans la visualisation du corrélogramme concerne la présence de la barre unitaire au décalage 0. Dans de nombreuses circonstances, cette barre d’amplitude 1 compresse artificiellement l’échelle visuelle de l’ordonnée, réduisant la lisibilité des fluctuations subtiles situées aux décalages supérieurs. Pour masquer intentionnellement ce décalage initial trivial, il est possible d’isoler manuellement les coefficients du décalage 1 à K et d’utiliser une fonction de tracé adaptée, ou d’invoquer des paramètres d’ajustement d’axes excluant l’abscisse 0, forçant ainsi le regard analytique à se concentrer exclusivement sur la mémoire empirique informative du processus.
5.2 Interprétation des bandes de confiance statistiques de Bartlett
L’un des apports majeurs du corrélogramme réside dans la présence de deux lignes horizontales discontinues, généralement tracées en bleu, symétriquement disposées de part et d’autre de l’axe horizontal d’ordonnée nulle. Ces lignes délimitent les bandes de confiance statistiques bilatérales au seuil de significativité conventionnel de 95 %. Elles permettent d’opérer un test visuel rapide de l’hypothèse nulle stipulant que la série chronologique est générée par un processus de bruit blanc pur, c’est-à-dire un processus purement aléatoire et dépourvu de la moindre corrélation sérielle.
Le fondement théorique sous-jacent à ces bornes de confiance repose sur la célèbre formule asymptotique établie par Maurice Bartlett (1946). Sous l’hypothèse nulle de bruit blanc gaussien d’espérance nulle et de variance constante pour une série comportant N observations indépendantes, les estimateurs des coefficients d’autocorrélation pour k ≥ 1 suivent asymptotiquement une loi normale centrée d’écart-type égal à 1 / √N. En appliquant le quantile standard de la loi normale centrée réduite correspondant à un niveau de confiance de 95 % (soit environ 1.96), les bandes de confiance sont rigoureusement fixées aux valeurs critiques ± 1.96 / √N.
La règle de décision heuristique s’énonce ainsi : tout coefficient dont le pic vertical franchit ces limites discontinues est considéré comme statistiquement significatif au seuil α = 0.05, signalant le rejet probable de l’hypothèse d’indépendance pour ce décalage particulier. Toutefois, une réserve théorique substantielle s’impose : ces bandes de Bartlett standard ne sont valables que sous l’hypothèse nulle stricte de bruit blanc. Si le processus sous-jacent présente déjà une forte autocorrélation au premier ordre, la variance des estimateurs aux ordres supérieurs est considérablement modifiée par l’effet d’entraînement sériel. Dans ce contexte, l’application de bandes statiques fondées sur le bruit blanc tend à surestimer la significativité des décalages éloignés, un phénomène nécessitant le recours à des bandes de Bartlett conditionnelles plus sophistiquées.
5.3 Visualisation moderne et reproductible avec ggplot2 et ggfortify
Bien que le système graphique natif de R offre une réactivité appréciable pour l’exploration rapide, la production de figures répondant aux standards esthétiques et typographiques des revues scientifiques internationales privilégie aujourd’hui l’écosystème ggplot2. L’intégration de la visualisation des séries temporelles dans cette grammaire graphique repose soit sur des extensions dédiées, soit sur une construction personnalisée à partir du tableau de données préalablement extrait.
L’approche la plus directe et automatisée mobilise le package ggfortify. En étendant la méthode générique autoplot() aux objets de classe acf, ggfortify permet de générer en une seule instruction un corrélogramme élégant, parfaitement stylisé selon les normes de ggplot2, intégrant nativement les bandes de confiance de Bartlett et la mise en forme vectorielle des segments. Cette solution combine la commodité d’utilisation des fonctions de base avec la puissance de personnalisation thématique de ggplot2.
Pour un contrôle éditorial total, le modélisateur peut construire manuellement le corrélogramme à partir du data frame propre élaboré précédemment. Cette approche exploite la géométrie geom_segment() pour tracer les bâtonnets verticaux reliant l’axe d’ordonnée zéro à la valeur exacte de chaque coefficient ρ(k), et la géométrie geom_hline() pour positionner avec une précision absolue les seuils critiques horizontalement calculés à ± 1.96 / √N. L’adjonction de thèmes épurés tels que theme_minimal() ou theme_classic(), combinée à une typographie vectorielle soignée et à une palette chromatique accessible, garantit une reproductibilité graphique parfaite et une intégration harmonieuse au sein de rapports Quarto ou de publications LaTeX professionnelles.
6. Calcul de l’autocorrélation partielle (PACF) dans l’environnement R
6.1 Fondements méthodologiques et distinction entre ACF et PACF
Si la fonction d’autocorrélation simple (ACF) mesure la dépendance globale entre X(t) et X(t – k), elle présente une limite analytique majeure : elle agrège l’ensemble des effets linéaires directs et indirects transmis à travers les pas temporels intermédiaires t – 1, t – 2, …, t – k + 1. Par exemple, dans un processus autorégressif d’ordre un classique où l’état présent dépend uniquement de l’état immédiatement antérieur, une corrélation substantielle sera mécaniquement observée au décalage 2, simplement parce que X(t) dépend de X(t – 1), qui lui-même dépend de X(t – 2). Cette corrélation indirecte brouille l’identification précise de la structure génératrice sous-jacente.
Pour isoler la dépendance linéaire pure existant entre deux observations séparées par k unités de temps en neutralisant formellement l’effet parasite de l’ensemble des décalages intermédiaires, la théorie statistique a introduit la notion de fonction d’autocorrélation partielle (ou PACF, pour Partial Autocorrelation Function). L’autocorrélation partielle au décalage k, généralement notée φ(k, k) ou α(k), correspond au coefficient de corrélation conditionnelle entre X(t) et X(t – k), sachant l’ensemble du vecteur des observations intermédiaires {X(t – 1), X(t – 2), …, X(t – k + 1)}.
D’un point de vue de modélisation linéaire, le coefficient φ(k, k) équivaut rigoureusement au dernier coefficient de régression estimé lorsque la variable X(t) est régressée par moindres carrés sur les k variables décalées X(t – 1), X(t – 2), …, X(t – k). Sur le plan computationnel, plutôt que d’ajuster une série de régressions linéaires successives particulièrement coûteuses en ressources mémoire, les algorithmes de calcul s’appuient sur la résolution matricielle des célèbres équations de Yule-Walker, mobilisant des schémas récursifs extrêmement rapides tels que l’algorithme de Durbin-Levinson. Cette formulation permet d’extraire la séquence complète des coefficients partiels avec une efficacité numérique optimale.
6.2 Implémentation de la fonction pacf() sous R
L’environnement R fournit une implémentation dédiée pour cette métrique via la fonction pacf(), également hébergée au sein du module natif stats. Sa syntaxe générale reflète étroitement celle de la fonction acf(), admettant en argument principal la série temporelle ou le vecteur numérique d’intérêt, ainsi que les paramètres lag.max pour fixer la portée temporelle maximale et plot = FALSE pour réprimer la génération du tracé graphique.
Une différence structurelle essentielle sépare néanmoins les sorties des deux fonctions. Alors que l’ACF présente systématiquement un coefficient au décalage 0 rigoureusement égal à l’unité, la fonction pacf() débute son estimation de manière universelle au décalage 1 (lag 1). D’un point de vue théorique, conditionner une observation par rapport à elle-même n’a aucun sens mathématique dans le cadre de la corrélation partielle ; le décalage 0 est donc conceptuellement indéfini et absent de la sortie informatique. Le premier coefficient retourné par pacf(), correspondant à l’indice vectoriel 1, coïncide d’ailleurs exactement avec le premier coefficient d’autocorrélation simple issu de acf(), puisqu’au décalage 1, aucun intermédiaire temporel n’existe pour exercer une médiation.
L’extraction programmatique des coefficients d’autocorrélation partielle suit une logique similaire à celle observée pour l’ACF. L’accès à l’élément $acf de l’objet de classe S3 retourné par pacf() renvoie une matrice de dimension [K, 1, 1]. En appliquant la conversion as.numeric(mon_objet_pacf$acf), le praticien dispose d’un vecteur continu de coefficients directement exploitables pour des analyses paramétriques, chaque élément i de ce vecteur correspondant sans le moindre décalage d’indice au décalage temporel effectif k = i.
6.3 Diagnostic conjoint ACF/PACF pour l’identification de modèles stochastiques
L’association conjointe de l’examen de l’ACF et de la PACF constitue la clé de voûte de la phase d’identification structurelle dans la célèbre méthodologie de Box-Jenkins dédiée aux processus de type ARMA (AutoRegressive Moving Average). L’observation des motifs graphiques et numériques de décroissance ou d’annulation brusque sur ces deux fonctions permet de déduire la nature et l’ordre des processus générateurs de données.
Pour un processus purement autorégressif d’ordre p, noté AR(p), les fondements stochastiques démontrent que la fonction d’autocorrélation simple (ACF) s’estompe progressivement vers zéro selon une décroissance géométrique exponentielle ou sous forme d’oscillations sinusoïdales amorties. En revanche, la fonction d’autocorrélation partielle (PACF) présente une rupture nette et catégorique : elle affiche des coefficients significativement non nuls jusqu’au décalage p, puis s’effondre brutalement à zéro pour tous les décalages strictement supérieurs à p (k > p). Ainsi, une PACF coupant net après le décalage 1 désigne de manière univoque un processus autorégressif d’ordre un AR(1).
Inversement, pour un processus moyenne mobile d’ordre q, noté MA(q), les propriétés dynamiques s’inversent rigoureusement par un principe de dualité mathématique. L’ACF présente une coupure franche et nette, s’annulant rigoureusement au-delà du décalage q (reflétant le fait que la mémoire des chocs ne subsiste que pendant q périodes), tandis que la PACF s’éteint graduellement de manière exponentielle ou oscillatoire sans jamais afficher d’annulation abrupte. Enfin, lorsqu’un processus combine à la fois des dynamiques autorégressives et moyennes mobiles au sein d’un modèle mixte ARMA(p, q), tant l’ACF que la PACF adoptent un schéma de décroissance amortie progressive sans coupure immédiate, signalant la nécessité de recourir à des critères d’information pénalisés, tels que l’AIC ou le BIC, pour déterminer les ordres parcimonieux de la modélisation.
7. Tests statistiques formels pour la significativité de l’autocorrélation
7.1 Le test d’indépendance globale de Ljung-Box via Box.test()
Bien que l’examen visuel du corrélogramme adossé aux bandes de Bartlett fournisse un premier diagnostic qualitatif, la rigueur académique impose de corroborer ces observations par des tests d’hypothèses formels. Évaluer la significativité décalage par décalage présente le risque d’induire des erreurs d’inférence statistique par multiplication des tests. Pour tester de manière conjointe si un ensemble complet de décalages sériels est simultanément différent de zéro, la statistique globale de Ljung-Box constitue l’étalon méthodologique de référence.
Le test de Ljung-Box repose sur l’hypothèse nulle (H0) stipulant que la série temporelle est générée par un processus indépendant, ce qui implique que l’ensemble des coefficients d’autocorrélation jusqu’au décalage m est rigoureusement nul : ρ(1) = ρ(2) = … = ρ(m) = 0. L’hypothèse alternative (H1) affirme qu’au moins l’un de ces coefficients est significativement différent de zéro, révélant une dépendance sérielle globale. La statistique de test, traditionnellement notée Q*, est calculée selon une pondération ajustée qui compense la réduction de taille d’échantillon effective aux décalages élevés :
Q* = N * (N + 2) * ∑ [ ρ̂(k)² / (N – k) ], où la sommation s’étend de k = 1 jusqu’à m. Sous l’hypothèse nulle, cette statistique Q* suit asymptotiquement une loi du chi-deux (χ²) à m degrés de liberté.
Sous R, l’exécution de ce test est prise en charge par la fonction native Box.test(). Pour calibrer correctement la routine, il est impératif de spécifier l’argument type = « Ljung-Box » (le paramètre par défaut exécutant le test de Box-Pierce) et de fixer le décalage agrégé au moyen de l’argument lag. Le choix de ce décalage m dépend de la dynamique de la série : pour des données non saisonnières, une valeur de m = 10 ou m = 14 est communément recommandée par Hyndman et Athanasopoulos (2021), tandis que pour des séries périodiques, un décalage équivalent au double de la période saisonnière (par exemple 24 pour des données mensuelles) assure une couverture adéquate. Une p-valeur inférieure au seuil critique conventionnel (α = 0.05) rejette catégoriquement l’hypothèse d’indépendance et confirme l’existence d’une mémoire sérielle significative au sein des données.
7.2 Le test de Box-Pierce et comparaison méthodologique
La statistique historique développée originellement par Box et Pierce (1970) constitue l’ancêtre direct de la procédure de Ljung-Box. Elle repose sur une formulation computationnelle plus rudimentaire de la statistique du portmanteau, définie par la sommation directe des carrés des coefficients d’autocorrélation estimés multipliée par la taille de l’échantillon : Q = N * ∑ ρ̂(k)² pour k = 1 à m. Cette forme simplifiée est invoquée sous R en exécutant la fonction Box.test() avec l’argument type = « Box-Pierce ».
Néanmoins, les recherches subséquentes en théorie asymptotique ont rapidement mis en lumière des défaillances structurelles de la statistique originelle de Box-Pierce. Pour des séries temporelles de taille petite à modérée (par exemple N < 200), la distribution d’échantillonnage de la statistique Q s’écarte substantiellement de la loi théorique du chi-deux à laquelle elle est comparée. Cette distorsion entraîne un aplatissement de la statistique réelle qui conduit à une sous-estimation systématique de la significativité statistique, conférant au test un caractère excessivement conservateur et augmentant dramatiquement le risque d’erreur de type II (ne pas rejeter l’indépendance alors que l’autocorrélation est bien réelle).
C’est précisément pour remédier à cette déficience que Ljung et Box ont introduit leur modification correctrice en 1978, incorporant le facteur d’échelle (N + 2) / (N – k) qui rééquilibre la variance des corrélations aux ordres élevés. En conséquence, la littérature méthodologique contemporaine s’accorde de manière unanime pour recommander la proscription quasi systématique du test de Box-Pierce en pratique appliquée au profit exclusif du test de Ljung-Box, qui garantit une maîtrise rigoureuse de l’erreur de type I et une puissance statistique optimale sur les échantillons finis.
7.3 Le test de Durbin-Watson pour les résidus de modèles linéaires
Dans le contexte spécifique de la modélisation économétrique par régression linéaire multiple via la fonction lm(), l’évaluation de la dépendance sérielle ne s’applique pas à la série observée brute, mais aux termes d’erreur non observables estimés par les résidus du modèle. Le test canonique consacré à cette vérification d’absence de corrélation sérielle de premier ordre est le test de Durbin-Watson, proposé initialement par James Durbin et Geoffrey Watson au début des années 1950.
Ce test évalue spécifiquement si les résidus e(t) obéissent à un schéma autorégressif d’ordre un du type e(t) = ρ * e(t – 1) + u(t), confrontant l’hypothèse nulle d’indépendance (ρ = 0) à l’hypothèse d’une autocorrélation résiduelle positive ou négative. La statistique de Durbin-Watson, traditionnellement notée d, est calculée par le rapport de la somme des carrés des différences successives de résidus sur la somme classique des carrés des résidus :
d = ∑ [e(t) – e(t – 1)]² / ∑ [e(t)]². Cette métrique évolue rigoureusement dans l’intervalle fermé [0, 4].
Une valeur de d strictement égale à 2 correspond à une absence totale d’autocorrélation de premier ordre (ρ = 0). Une valeur de d tendant vers 0 signale une autocorrélation sérielle positive prononcée, tandis qu’une valeur s’approchant de 4 indique une forte autocorrélation négative. Sous l’environnement R, le test de Durbin-Watson est implémenté avec une précision rigoureuse au sein du package lmtest via la fonction dwtest(). Cette fonction accepte directement un objet de modèle lm en entrée et calcule la p-valeur exacte par l’algorithme numérique de Pan ou par approximation de saddlepoint, offrant un diagnostic inférentiel décisif pour valider la non-violation des postulats de Gauss-Markov.
8. Calcul de l’autocorrélation sur des séries chronologiques non stationnaires
8.1 Effet d’une tendance déterministe ou stochastique sur le profil de l’ACF
L’interprétation statistique classique de la fonction d’autocorrélation repose de manière inconditionnelle sur l’hypothèse de stationnarité au second ordre du processus stochastique sous-jacent. Lorsqu’une série temporelle viole cette condition fondamentale, par exemple en raison de la présence d’une tendance déterministe (une dérive temporelle linéaire ou quadratique) ou d’une tendance stochastique (la présence d’une racine unitaire caractérisant une marche aléatoire), le comportement théorique de l’estimateur de l’ACF est profondément dénaturé.
En présence d’une tendance, les observations successives partagent une proximité numérique artificielle simplement parce qu’elles se situent sur une trajectoire d’évolution moyenne croissante ou décroissante, et non en raison d’une mémoire dynamique transitoire. Cette dérive induit un profil corrélogrammique symptomatique et universellement reconnaissable : les coefficients d’autocorrélation ρ(k) débutent à un niveau extrêmement élevé proche de 1, puis décroissent de manière pseudo-linéaire avec une lenteur extrême au fur et à mesure que le décalage k augmente, persistant largement au-delà des bandes de Bartlett même sur plusieurs dizaines de décalages.
Ce phénomène constitue le cœur du problème de l’autocorrélation fallacieuse (spurious autocorrelation). Conclure à une persistance de chocs stochastiques à long terme face à un tel profil constitue une faute d’interprétation majeure. Avant toute modélisation dynamique de l’ACF, il est donc impératif de procéder à un diagnostic formel de non-stationnarité. Ce contrôle s’effectue sous R en administrant des tests de racine unitaire, tels que le test de Dickey-Fuller augmenté via la fonction adf.test() du package tseries ou le test de Phillips-Perron via pp.test(), permettant d’objectiver mathématiquement la présence d’une composante non stationnaire intégrée d’ordre un.
8.2 Différenciation de la série temporelle avec diff() et recalcul de l’ACF
Dès lors que la présence d’une racine unitaire stochastique est diagnostiquée, le protocole méthodologique impose de transformer la série chronologique originelle afin d’éliminer la non-stationnarité et de restaurer l’invariance temporelle de la moyenne et de la variance. L’opérateur de transformation canonique pour les processus intégrés d’ordre un, notés I(1), est l’opérateur de différence première, mathématiquement défini par la transformation ΔX(t) = X(t) – X(t – 1).
Sous R, cette opération se programme avec une simplicité remarquable au moyen de la fonction native diff(). L’application de la commande diff(x, differences = 1) sur un objet temporel génère instantanément la série des accroissements successifs, dont la longueur vectorielle est exactement amputée d’une observation par rapport à la série initiale (N – 1). Une fois cette série différenciée constituée, le recalcul de la fonction d’autocorrélation via acf(diff(x), plot = FALSE) révèle la véritable mémoire stochastique transitoire du système.
Dans le cas typique d’une marche aléatoire pure, dont le corrélogramme initial affichait une décroissance pseudo-linéaire massive fallacieuse, l’ACF de la série différenciée se transforme instantanément en un profil de bruit blanc parfait, où l’intégralité des coefficients pour k ≥ 1 s’effondre à l’intérieur des bandes de confiance de Bartlett. Il convient néanmoins de manipuler cet opérateur avec discernement pour prévenir le piège de la sur-différenciation (overdifferencing). Appliquer une différenciation première sur une série qui était déjà stationnaire en tendance introduit artificiellement une racine unitaire moyenne mobile, matérialisée dans l’ACF recalculée par l’apparition aberrante d’une autocorrélation négative sévère au premier décalage (ρ(1) avoisinant -0.50), dégradant inutilement la variance du modèle.
8.3 Désaisonnalisation et filtrage avant estimation de la dépendance sérielle
Outre les tendances séculaires à long terme, la présence d’oscillations périodiques régulières, ou saisonnalité, constitue une seconde cause majeure de distorsion dans l’évaluation de l’autocorrélation. Dans les séries économiques, climatiques ou démographiques, des cycles annuels, mensuels ou hebdomadaires génèrent des pics d’autocorrélation massifs et récurrents aux décalages multiples de la période saisonnière fondamentale (par exemple aux décalages k = 12, 24, 36 pour des données mensuelles), masquant les dynamiques d’ajustement sériel plus diffuses.
Pour mesurer la dépendance sérielle intrinsèque indépendamment de ces variations calendaires mécaniques, une phase préalable de filtrage ou de désaisonnalisation s’impose. L’écosystème R offre des méthodes puissantes pour décomposer une série temporelle en ses composantes fondamentales : la tendance générale, le motif saisonnier fixe ou évolutif, et la composante résiduelle aléatoire. La fonction classique decompose() met en œuvre une décomposition par moyennes mobiles, tandis que la routine stl() (Seasonal and Trend decomposition using Loess) utilise des régressions pondérées locales pour extraire les composantes de manière hautement adaptative et non linéaire.
Une fois la décomposition stl calculée, le modélisateur peut extraire formellement la composante résiduelle non cyclique au moyen de l’instruction mon_stl$time.series[, « remainder »]. C’est sur ce vecteur spécifique d’irrégularités résiduelles que le calcul de l’autocorrélation pure doit être programmé via acf(). L’examen du corrélogramme de cette composante désaisonnalisée permet de sonder la mémoire dynamique réelle du phénomène sans que le diagnostic ne soit pollué par les récurrences cycliques imposées par l’astronomie ou les conventions organisationnelles humaines.
9. Calcul de l’autocorrélation dans la modélisation statistique avancée
9.1 Intégration d’une structure de corrélation sérielle avec nlme::gls()
Lorsque des données longitudinales ou des régressions temporelles présentent des erreurs autocorrélées, persister dans l’utilisation de la fonction lm() par moindres carrés ordinaires vicie profondément les tests d’inférence. La stratégie statistique optimale consiste à migrer vers la méthode des moindres carrés généralisés (Generalized Least Squares ou GLS), capable d’estimer simultanément les coefficients structurels de régression et les paramètres caractérisant la matrice de variance-covariance des erreurs sériellement dépendantes.
Le package nlme fournit l’infrastructure la plus complète pour cette approche à travers la fonction gls(). Contrairement aux modèles linéaires classiques, gls() autorise la spécification explicite d’une matrice de corrélation intra-groupe ou temporelle via son argument correlation. Pour modéliser une dépendance temporelle où l’erreur suit un processus autorégressif d’ordre un, on associe l’argument à la fonction de corrélation corAR1().
L’estimation est exécutée par maximisation de la vraisemblance restreinte (REML). L’extraction de l’objet ajusté permet d’isoler directement la valeur estimée du paramètre autorégressif interne, universellement désigné par la lettre grecque Φ (Phi), qui quantify l’autocorrélation conditionnelle résiduelle après contrôle de l’ensemble des covariables du modèle. L’inférence sur les coefficients fixes bénéficie alors d’erreurs-types rigoureusement redressées, éliminant le sur-risque d’erreur de type I induit par l’autocorrélation non modélisée.
9.2 Ajustement des modèles autorégressifs univariés avec arima() et ar()
Une autre perspective fondamentale pour quantifier et modéliser l’autocorrélation consiste à ajuster directement un modèle de séries temporelles paramétrique univarié sur la trajectoire observée. Les fonctions ar() et arima(), toutes deux disponibles dans le socle natif de R, constituent les instruments privilégiés pour accomplir cette tâche avec une rigueur statistique maximale.
La fonction arima(x, order = c(1, 0, 0)) ajuste un processus purement autorégressif d’ordre un sur la série stationnaire x. Le paramètre ar1 retourné par la procédure d’optimisation numérique par maximum de vraisemblance coïncide conceptuellement avec le coefficient d’autocorrélation de premier ordre de la série. Toutefois, l’ajustement fournit en complément précieux l’erreur-type exacte (standard error) de ce coefficient autorégressif, ce qui permet de construire des intervalles de confiance rigoureux autour de la métrique d’autocorrélation et de tester formellement sa significativité face à zéro via un test de Wald.
Pour parachever l’évaluation du modèle paramétrique ajusté, l’exécution de la fonction checkresiduals(), disponible dans le package forecast, offre un protocole diagnostique complet. Cette fonction extrait les résidus standardisés du modèle autorégressif, génère simultanément le corrélogramme résiduel de l’ACF, trace l’histogramme de densité comparativement à une loi normale théorique, et exécute automatiquement un test de Ljung-Box global calibré avec une correction rigoureuse des degrés de liberté soustrayant le nombre de paramètres estimés. La confirmation de l’absence totale d’autocorrélation résiduelle atteste que la mémoire sérielle a été intégralement capturée par le paramètre autorégressif modélisé.
9.3 Impact de la correction d’autocorrélation sur l’inférence statistique
Pour appréhender concrètement l’importance pratique du traitement de la corrélation sérielle, il est instructif de comparer les conclusions inférentielles tirées d’un modèle non corrigé face à un modèle intégrant une modélisation stochastique de la dépendance. Dans une régression temporelle standard non corrigée, un coefficient prédictif peut afficher une t-valeur hautement significative de 4.50 associée à une p-valeur de 0.0001, incitant le modélisateur à certifier l’existence d’un effet déterminant.
Dès lors que l’autocorrélation positive résiduelle (par exemple ρ = 0.60) est incorporée dans l’estimation via une structure corAR1 sous gls() ou corrigée par une matrice de variance-covariance hétéroscédastique et autocorrélée (HAC), l’erreur-type réelle de l’estimateur augmente substantiellement. La t-valeur recalculée peut alors chuter de manière drastique, passant par exemple de 4.50 à 1.65, repoussant instantanément la p-valeur au-dessus du seuil de 0.10. Les intervalles de confiance à 95 %, initialement étroits et faussement rassurants, s’élargissent considérablement pour refléter la véritable incertitude d’échantillonnage induite par la redondance informationnelle des mesures dépendantes.
Une alternative computationnelle très répandue en macroéconomie et en finance empirique consiste à maintenir l’estimation des coefficients par les moindres carrés ordinaires avec lm(), tout en substituant l’estimation de leur variance par l’estimateur sandwich de Newey et West (1987). Accessible sous R via la fonction NeweyWest() du package sandwich, cet estimateur non paramétrique recalibre la matrice de covariance en sommant les autocovariances croisées pondérées par un noyau de Bartlett jusqu’à un décalage prédéterminé, produisant des erreurs-types robustes à la corrélation sérielle sans imposer de forme paramétrique rigide aux résidus.
10. Calcul de l’autocorrélation dans les devis de mesures répétées et protocoles ESM
10.1 Défis spécifiques aux données écologiques momentanées (EMA/ESM)
L’essor considérable des méthodologies d’échantillonnage écologique momentané (Ecological Momentary Assessment ou EMA) et des protocoles de recueil d’expériences vécues (Experience Sampling Methodology ou ESM) en médecine comportementale et en psychologie clinique a profondément renouvelé l’application du calcul de l’autocorrélation. Dans ces dispositifs, les participants répondent à des micro-questionnaires sur leurs téléphones intelligents plusieurs fois par jour pendant des semaines, générant des séquences temporelles denses en milieu écologique naturel.
Néanmoins, ces données observationnelles soulèvent des défis computationnels majeurs qui interdisent l’application naïve des fonctions d’autocorrélation standard. Le premier écueil réside dans l’hétérogénéité des intervalles de mesure : les notifications sont généralement programmées selon des grilles semi-aléatoires pour éviter les effets d’anticipation, ce qui viole l’hypothèse d’équidistance temporelle requise par l’ACF discrète. Le second défi, encore plus structurel, concerne l’interruption nocturne du sommeil. Traiter le premier relevé du matin comme s’il succédait immédiatement au dernier relevé du soir sans discontinuité introduit une contiguïté temporelle artificielle qui biaise sévèrement l’estimation de l’inertie psychologique.
Pour neutraliser ces artefacts, une restructuration rigoureuse de la grille de données s’impose. La méthode méthodologiquement la plus saine consiste à insérer des rangées explicites remplies de valeurs manquantes (NA) pour combler artificiellement les périodes nocturnes et les créneaux d’évaluation non complétés. Cette opération rétablit une échelle temporelle discrète nominalement régulière et empêche les fonctions de décalage de calculer des produits croisés absurdes reliant la soirée d’une journée à l’aurore du lendemain, garantissant que l’autocorrélation de premier ordre n’évalue que la persistance intra-journalière en éveil.
10.2 Calcul de l’autocorrélation intra-individuelle pour panels multi-sujets
Dans un protocole ESM ou un devis en mesures répétées multi-sujets, la structure du jeu de données se présente sous une forme hiérarchique où chaque individu constitue une série temporelle spécifique imbriquée au sein d’un groupe expérimental. Calculer une autocorrélation globale en agrégeant l’ensemble des observations au sein d’un unique vecteur produit un résultat complètement corrompu par la variance interindividuelle moyenne, illustrant de manière paradigmatique le paradoxe de Simpson ou l’erreur écologique.
L’exigence analytique commande donc de calculer l’autocorrélation sérielle de manière strictement intra-individuelle (within-person). Pour implémenter cette démarche de manière fonctionnelle et élégante sous R, les outils du méta-package tidyverse, et en particulier les verbes de dplyr et les fonctions de cartographie du package purrr, se révèlent exceptionnellement puissants. En segmentant la table de données par le facteur identifiant chaque participant via l’instruction group_by(id_sujet), le modélisateur peut appliquer itérativement la fonction d’extraction d’autocorrélation au décalage un sur la trajectoire émotionnelle de chaque sujet.
Cette programmation s’exécute couramment par l’intermédiaire de la fonction summarise() combinée à une instruction d’extraction conditionnelle robuste gérant les cellules manquantes : acf(variable_affect, lag.max = 1, plot = FALSE, na.action = na.pass)$acf[2, 1, 1]. Le résultat obtenu est un tableau analytique assignant à chaque individu un coefficient d’autocorrélation univarié unique ρ₁, qui quantifie rigoureusement la dynamique d’inertie comportementale propre à chaque trajectoire psychologique observée.
10.3 Analyse de la distribution des coefficients d’autocorrélation au niveau du groupe
Une fois la distribution complète des coefficients d’autocorrélation intra-individuels extraite pour l’ensemble de la cohorte expérimentale, le modélisateur peut engager la phase d’analyse de second niveau. La première étape consiste à documenter les métriques de tendance centrale et de dispersion de cette dépendance sérielle au niveau populationnel. En raison des contraintes d’asymétrie fréquemment observées sur les métriques bornées entre -1 et +1, l’usage de la médiane et de l’intervalle interquartile s’avère souvent plus robuste que la simple moyenne arithmétique.
Par ailleurs, pour exploiter ces coefficients d’autocorrélation individuels comme prédicteurs ou variables dépendantes au sein de régressions linéaires ou de modèles multiniveaux, une normalisation préalable est vivement recommandée. L’application de la transformation de Fisher (Fisher’s z-transformation), définie par l’instruction z = 0.5 * log((1 + r) / (1 – r)) ou atanh(r), convertit la métrique bornée en une variable stochastique continue non bornée dont la distribution d’échantillonnage se rapproche étroitement d’une loi normale gaussienne standard, stabilisant ainsi la variance d’estimation.
L’exploration visuelle de l’hétérogénéité interindividuelle des profils d’ACF s’avère particulièrement éclairante. En représentant les corrélogrammes individuels superposés sous forme de diagrammes de spaghetti ou sous la forme de cartes thermiques (heatmaps), le chercheur visualise immédiatement l’éventail des dynamiques temporelles présentes au sein de l’échantillon, discernant les profils hautement réactifs caractérisés par une mémoire sérielle quasi nulle des profils cliniques marqués par une inertie psychologique rigide et persistante.
11. Automatisation et programmation fonctionnelle du calcul de corrélation sérielle
11.1 Développement d’une fonction R personnalisée d’extraction complète
Dans le cadre de projets de recherche reproductibles impliquant des batteries massives de signaux temporels, la réplication manuelle d’appels distincts pour l’ACF, la PACF et les tests formels d’indépendance représente une source potentielle d’erreurs et de redondances de code. L’écriture d’une fonction personnalisée robuste et modulaire permet de standardiser l’extraction analytique en encapsulant l’ensemble de ces étapes au sein d’un composant logiciel unifié.
Une telle fonction doit intégrer en amont des mécanismes de validation rigoureux des données transmises : vérification que l’objet en entrée constitue bien un vecteur numérique, contrôle de la longueur minimale d’échantillon requise pour garantir la convergence asymptotique, et décompte explicite du taux de valeurs manquantes. La fonction doit ensuite orchestrer les appels conjoints à acf(), pacf() et Box.test() avec l’argument plot = FALSE, isoler les composantes matricielles pertinentes, et assembler ces métriques au sein d’une structure rectangulaire standardisée.
Cette architecture programmatique sécurisée permet de retourner en une seule instruction un objet composite enrichi, structuré sous forme de liste nommée ou de tibble, documentant de manière exhaustive : les coefficients d’autocorrélation simple pour les décalages d’intérêt, les coefficients partiels correspondants, les bornes de Bartlett bilatérales, la statistique de test de Ljung-Box ainsi que sa p-valeur associée. Ce formalisme encapsulé fiabilise l’analyse statistique et garantit une portabilité logicielle totale à travers différents projets d’analyse.
11.2 Traitement moderne des séries temporelles avec tsibble et feasts
Pour les praticiens désireux de s’inscrire pleinement dans la révolution moderne de l’écosystème de traitement sériel conçu par Rob Hyndman et son équipe, la suite logicielle tidyverts constitue le standard contemporain le plus avancé. Ce framework repose sur la structure de données tsibble, qui modernise radicalement la classe ts historique en adaptant les principes du data frame rectangulaire aux séries temporelles, grâce à l’association explicite d’un index temporel obligatoire (index) et de variables clés d’identification de séries multiples (key).
Au sein de cet écosystème moderne, le package feasts (Feature Extraction and Statistics for Time Series) propose une réimplémentation complète des calculs d’autocorrélation respectant scrupuleusement la philosophie tidy. La fonction ACF() du package feasts ne se contente pas d’exécuter l’estimation des corrélations sérielles : elle retourne instantanément un tableau d’observations rectangulaire où chaque décalage temporel lag est apparié à son coefficient d’autocorrélation acf, s’intégrant sans la moindre friction computationnelle dans des chaînes d’instructions mobilisant les verbes de dplyr.
L’atout prépondérant de cette architecture moderne se révèle dans le traitement simultané de panels temporels complexes comportant des centaines de séries stratifiées. Grâce aux structures tsibble indexées par clés catégorielles, l’application d’une seule instruction ACF() calcule instantanément et en parallèle les fonctions d’autocorrélation distinctes pour chaque série temporelle du groupe. Ce flux unifié élimine le recours aux boucles de calcul complexes et permet d’enchaîner directement vers une restitution graphique via la fonction autoplot() de feasts, matérialisant des corrélogrammes en facettes d’une lisibilité et d’une rigueur scientifique exceptionnelles.
11.3 Exportation académique et mise en forme des tableaux de résultats
L’aboutissement de la démarche computationnelle consiste à transposer les métriques d’autocorrélation estimées sous la forme de tableaux récapitulatifs respectant scrupuleusement les canons formels des publications académiques internationales (notamment les normes éditoriales de l’American Psychological Association, ou normes APA). Les consoles de sortie brutes de R ne sauraient être directement insérées dans un manuscrit scientifique sans une phase de mise en forme typographique professionnelle.
Pour convertir le data frame contenant les estimations sérielles et les tests de significativité en une table typographique élégante, le package knitr fournit la fonction universelle kable(), laquelle peut être substantiellement magnifiée par les extensions de mise en page du package kableExtra. Cette chaîne d’outils permet de formater les en-têtes de colonnes en intégrant la notation mathématique appropriée (par exemple ρ̂, Q*, p), d’arrondir uniformément les coefficients à deux ou trois décimales conformément aux standards bibliographiques, et d’insérer des notes de bas de page précisant la formulation des bandes de Bartlett ou les hypothèses du test de Ljung-Box.
Par ailleurs, pour des cadres de publication multivariés plus complexes, des extensions spécialisées telles que modelsummary ou gt permettent d’exporter directement ces tableaux consolidés vers une multitude de formats finaux de publication sans rupture logicielle, incluant le code source LaTeX, les formats HTML interactifs et les documents Microsoft Word. Cette automatisation garantit la parfaite reproductibilité de l’article scientifique, éliminant tout risque de transcription manuelle erronée entre l’environnement de calcul R et le document textuel final.
12. Erreurs méthodologiques courantes, pièges statistiques et bonnes pratiques
12.1 Erreurs d’indexation et confusion récurrente autour du lag 0
Parmi les écueils computationnels les plus répandus lors de l’utilisation de la fonction acf() native sous R figure la confusion structurelle entre l’indice de position vectorielle dans le logiciel et l’ordre effectif du décalage temporel (lag). R adopte une convention d’indexation vectorielle débutant de manière universelle à l’entier 1, alors que la théorie de l’autocorrélation débute intrinsèquement son évaluation au décalage temporel nul k = 0.
En conséquence, l’élément situé au premier indice du vecteur de résultat, accessible par mon_acf$acf[1], correspond sans exception au décalage temporel 0, dont la valeur est mathématiquement verrouillée à 1. Le coefficient d’autocorrélation sérielle de premier ordre réel (lag 1), qui quantifie l’inertie effective d’un pas temporel à l’autre, se trouve physiquement localisé à l’indice vectoriel 2 (mon_acf$acf[2]). Omettre cette spécificité structurelle conduit fréquemment les praticiens néophytes à extraire par mégarde le coefficient unitaire du décalage 0 en lieu et place du coefficient d’autocorrélation de premier ordre recherché.
Cette bévue programmatique induit des distorsions analytiques dévastatrices lorsque ces coefficients sont ensuite intégrés dans des calculs dérivés, par exemple lors du calcul de la moyenne de persistance d’une cohorte ou au sein de modèles de régression multivariée. Pour prémunir son code de cette vulnérabilité, il est vivement préconisé d’utiliser systématiquement des fonctions d’extraction explicites qui filtrent l’objet par sa dimension temporelle nominale (en sélectionnant les décalages strictement supérieurs à zéro) ou d’encapsuler la séquence d’accès indiciel au sein d’une fonction d’extraction testée et documentée.
12.2 Surinterprétation des pics isolés et risque d’erreur de multiplicité
Un piège statistique particulièrement insidieux dans l’interprétation diagnostique du corrélogramme graphique concerne la surinterprétation systématique de tout dépassement isolé des bandes de confiance de Bartlett. Lorsque le modélisateur inspecte visuellement une fonction d’autocorrélation calculée sur une profondeur temporelle substantielle, par exemple lag.max = 40, il examine simultanément 40 hypothèses statistiques individuelles indépendantes.
En vertu de la définition formelle d’un seuil de significativité bilatéral fixé à α = 0.05, il existe une probabilité théorique incompressible de 5 % d’observer un dépassement aléatoire des bandes de confiance sous la stricte hypothèse nulle de bruit blanc. Sur une exploration sérielle de 40 décalages, il est mathématiquement attendu d’observer en moyenne deux décalages franchissant artificiellement les seuils critiques sous le seul effet des fluctuations d’échantillonnage stochastique, sans que le système physique ne recèle la moindre mémoire sérielle réelle.
Conclure immédiatement à l’existence d’une dépendance périodique complexe face à un pic solitaire situé à un décalage lointain et sans cohérence théorique (par exemple au décalage k = 23 pour des données non saisonnières) constitue une faute méthodologique majeure résultant du problème des tests multiples. Face à un dépassement marginal isolé, la posture scientifique rigoureuse consiste à examiner si ce décalage s’inscrit dans un motif théoriquement plausible, à vérifier si la statistique conjointe globale de Ljung-Box confirme ou non le rejet de l’indépendance, et le cas échéant à appliquer une procédure de correction pour multiplicité d’hypothèses telle que l’ajustement de Bonferroni ou la régulation du taux de fausse découverte (False Discovery Rate).
12.3 Check-list rigoureuse pour une analyse d’autocorrélation reproductible sous R
Afin de garantir un niveau d’intégrité analytique et de reproductibilité méthodologique optimal lors de l’estimation de l’autocorrélation dans R, il est vivement recommandé d’astreindre son protocole de traitement à une séquence de vérifications formelles pré-analytiques et post-analytiques. Cette check-list opérationnelle s’articule autour des points cardinaux suivants :
- Vérification formelle de la stationnarité : La trajectoire temporelle présente-t-elle une moyenne et une variance stables au cours du temps ? Un test formel de racine unitaire (tel que le test ADF via tseries::adf.test()) a-t-il été exécuté pour exclure formellement le piège de l’autocorrélation fallacieuse avant d’interpréter le profil de l’ACF ?
- Contrôle de l’équidistance temporelle : Les observations ont-elles été collectées selon un pas d’échantillonnage temporel strictement uniforme ? En cas d’interruptions systématiques (périodes nocturnes, week-ends calendaires), des rangées explicites de valeurs manquantes (NA) ont-elles été insérées pour éviter les jointures temporelles artificielles ?
- Traitement des valeurs manquantes : La stratégie d’imputation retenue (interpolation spline via na.interp(), filtrage de Kalman) est-elle documentée et transparente, sans recours interdit à la suppression de cas complets qui déstructurerait la grille temporelle ?
- Paramétrage du décalage maximal (lag.max) : Le nombre de décalages explorés respecte-t-il la contrainte méthodologique de ne pas excéder 25 % à 33 % de la taille totale de l’échantillon d’observations disponibles ?
- Diagnostic conjoint ACF et PACF : L’analyse articule-t-elle systématiquement l’examen de l’autocorrélation simple et de l’autocorrélation partielle pour distinguer rigoureusement les dynamiques de type autorégressif (AR) des composantes de moyenne mobile (MA) ?
- Validation statistique conjointe : La significativité globale a-t-elle été formellement validée par le test de Ljung-Box (Box.test(…, type = « Ljung-Box »)) avec un décalage agrégé adapté, plutôt que par l’inspection visuelle naïve de coefficients individuels isolés ?
- Reproductibilité computationnelle intégrale : La version de l’interpréteur R, l’ensemble des bibliothèques mobilisées ainsi que les éventuelles graines stochastiques aléatoires (set.seed()) sont-ils scrupuleusement enregistrés dans un environnement contrôlé pour permettre la réplication exacte des résultats ?
En observant scrupuleusement ces préceptes méthodologiques et computationnels, le chercheur ou l’analyste de données s’assure de déployer une modélisation de la dépendance sérielle d’une parfaite rigueur conceptuelle sous l’environnement R, transformant une simple fonction informatique en un instrument analytique de haute précision scientifique.
Références
- Bartlett, M. S. (1946). On the theoretical specification and sampling properties of autocorrelated time-series. Supplement to the Journal of the Royal Statistical Society, 8(1), 27-41. https://www.jstor.org/stable/2983638
- Box, G. E., & Jenkins, G. M. (1976). Time series analysis: Forecasting and control. Holden-Day. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Box, G. E., & Pierce, D. A. (1970). Distribution of residual autocorrelations in autoregressive-integrated moving average time series models. Journal of the American Statistical Association, 65(332), 1509-1526. https://www.jstor.org/stable/2284077
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332388
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression: II. Biometrika, 38(1/2), 159-177. https://doi.org/10.2307/2332325
- Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/
- Ljung, G. M., & Box, G. E. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297-303. https://doi.org/10.1093/biomet/65.2.297
- Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://www.jstor.org/stable/1913610
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Yule, G. U. (1926). Why do we sometimes get nonsense-correlations between time-series? A study in sampling and the nature of time-series. Journal of the Royal Statistical Society, 89(1), 1-63. https://www.jstor.org/stable/2984083