
Dans le vaste champ de la psychométrie, de l’économétrie et de l’évaluation quantitative des sciences comportementales, la mesure rigoureuse de construits inobservables constitue un défi méthodologique permanent. Qu’il s’agisse de mesurer la satisfaction d’un usager, l’anxiété clinique, l’engagement professionnel ou le climat organisationnel, le chercheur ne peut appréhender directement ces réalités latentes. Il doit recourir à des instruments de mesure multi-items, tels que des questionnaires, des inventaires psychologiques ou des échelles d’attitudes, conçus pour capturer les multiples facettes d’un même phénomène psychologique ou sociologique.
La question centrale qui émerge immédiatement est celle de la qualité métrologique de ces instruments. Un questionnaire ne peut fournir de conclusions valides s’il ne repose pas sur une mesure stable, précise et exempte d’erreurs aléatoires excessives. C’est dans ce cadre théorique que s’impose le concept de fidélité, et plus précisément celui de cohérence interne. Parmi l’ensemble des indicateurs développés par les statisticiens au cours du vingtième siècle, le coefficient alpha de Cronbach s’est établi comme le standard d’évaluation le plus universellement rapporté dans la littérature scientifique internationale, devenant un passage obligé pour quiconque souhaite valider une échelle de mesure.
La mise en œuvre de cette analyse statistique requiert des outils informatiques dotés d’une rigueur computationnelle absolue. L’environnement SAS (Statistical Analysis System), plébiscité par les industries biomédicales, les institutions académiques et les organismes d’évaluation publique, offre un ensemble de procédures hautement optimisées pour sonder la structure des données psychométriques. Ce guide propose une immersion exhaustive dans le calcul, l’interprétation et la valorisation académique de l’alpha de Cronbach sous SAS. De la théorie classique des tests jusqu’aux subtilités d’exécution de la procédure PROC CORR, chaque concept sera abordé avec une granularité théorique et opérationnelle maximale, appuyé par un cas pratique documenté pas à pas.
1. Introduction théorique à l’alpha de Cronbach en psychométrie
1.1 Définition et rôle de la cohérence interne
La fidélité d’un instrument de mesure, telle que formalisée au sein de la théorie classique des tests (Classical Test Theory ou TCT), renvoie au degré selon lequel un ensemble d’observations empiriques reflète le « score vrai » d’un sujet, plutôt que les fluctuations induites par des erreurs de mesure aléatoires. Selon le postulat fondamental de Spearman, tout score observé $X$ se décompose de manière additive en une composante vraie $T$ (True score) et une composante d’erreur résiduelle non systématique $E$ (Error score), selon l’équation canonique $X = T + E$. Dans cette perspective, la fidélité globale est définie comme la proportion de variance du score observé attribuable à la variance du score vrai. Plus cette proportion est proche de l’unité, plus l’instrument est immunisé contre les bruits de mesure.
Il convient de distinguer rigoureusement la cohérence interne d’autres modalités d’estimation de la fidélité, telles que la stabilité temporelle par test-retest ou la fidélité par formes parallèles. La méthode test-retest suppose de soumettre le même échantillon d’individus au même instrument à deux moments distincts dans le temps, ce qui expose l’analyse à des effets de mémoire, d’apprentissage ou à des évolutions intrinsèques du construit sous-jacent. La méthode des formes parallèles, quant à elle, requiert l’élaboration de deux versions équivalentes d’une même échelle, une démarche souvent coûteuse et complexe à opérationnaliser. La cohérence interne s’affranchit de ces contraintes logistiques en estimant la fidélité à partir d’une seule et unique administration du test. Elle évalue le degré auquel les différents items constitutifs d’une échelle convergent vers une cible conceptuelle commune.
L’évaluation de l’homogénéité fonctionnelle des items permet de vérifier si les différentes questions opèrent de concert pour quantifier le même phénomène. Si un chercheur agrège des items aux propriétés dissemblables, le score total produit devient ambigu, hybride et mathématiquement instable. Un déficit avéré de cohérence interne entraîne des conséquences délétères directes sur la validité de construit : si un instrument ne parvient pas à démontrer qu’il mesure une entité homogène de manière cohérente, il devient logiquement impossible d’affirmer qu’il mesure fidèlement le concept théorique précis qu’il prétend évaluer. La cohérence interne constitue donc une condition nécessaire, bien que non suffisante, à la validité scientifique d’une échelle.
1.2 Fondements historiques introduits par Lee Cronbach (1951)
L’origine de l’alpha de Cronbach trouve sa genèse dans les travaux fondateurs de G. Frederic Kuder et Marion Richardson, qui publièrent en 1937 leur célèbre formule KR-20. Bien que révolutionnaire pour l’époque, la formule KR-20 présentait une contrainte majeure : elle était exclusivement restreinte à des items à cotation dichotomique (succès/échec, oui/non, 0/1). Les psychologues et sociologues des décennies 1930 et 1940, sous l’impulsion notable des travaux de Rensis Likert, commencèrent néanmoins à multiplier les instruments fondés sur des échelles graduées continues ou polytomiques, pour lesquelles la formule KR-20 était mathématiquement inapplicable sous sa forme initiale.
C’est en 1951 que Lee Joseph Cronbach publia dans la revue Psychometrika son article princeps intitulé « Coefficient alpha and the internal structure of tests ». Cronbach y démontra que sa formulation représentait une généralisation algébrique directe de la KR-20, capable de traiter indifféremment des variables binaires, ordinales ou continues. Son apport ne s’est pas limité à cette extension computationnelle : Cronbach a fourni une assise épistémologique majeure en explicitant la signification mathématique de son coefficient, prouvant formellement qu’il correspondait à la moyenne exacte de tous les coefficients de fidélité que l’on obtiendrait en divisant un test selon toutes les combinaisons possibles de bissection (split-half reliabilities).
Depuis le début des années 2000, le coefficient alpha fait toutefois l’objet de vifs débats méthodologiques au sein de la communauté psychométrique. De nombreux statisticiens contemporains, à l’instar de Tenko Raykov ou Wayne Velicer, pointent du doigt son utilisation routinière et parfois aveugle, dénonçant le non-respect fréquent de ses postulats mathématiques sous-jacents. Bien que de nouvelles métriques fondées sur la modélisation en équations structurelles, telles que l’oméga de McDonald, gagnent du terrain, l’alpha de Cronbach conserve une prééminence historique et pratique incontournable, demeurant le standard de référence exigé par la majorité des comités de lecture des revues internationales.
1.3 Applications pratiques dans la validation de questionnaires
L’utilisation de l’alpha de Cronbach intervient à des étapes décisives de la vie d’un instrument psychométrique. L’un de ses champs d’application préférentiels réside dans la validation transculturelle et l’adaptation linguistique d’échelles de personnalité ou de santé mentale. Lorsqu’un inventaire d’évaluation de la dépression, développé initialement en langue anglaise, est traduit vers le français, les chercheurs doivent administrer la version traduite à une cohorte francophone et vérifier que la structure des inter-corrélations demeure comparable à l’original. Un effondrement de l’alpha signale d’emblée des ambiguïtés sémantiques, des contresens linguistiques ou des biais d’interprétation culturelle au niveau des items traduits.
En psychologie cognitive, sociale et clinique, l’alpha permet d’objectiver la précision de la mesure de construits latents complexes tels que la résilience, l’estime de soi, le sentiment d’efficacité personnelle ou le burn-out. Ces attributs ne se manifestent jamais de façon brute ; ils sont inférés par le prisme de réponses graduées. Dans les diagnostics organisationnels, les professionnels des ressources humaines et les psychologues du travail mobilisent l’alpha pour s’assurer que les baromètres d’engagement, les mesures de la charge mentale perçue ou les sondages de satisfaction client reposent sur des batteries de questions hautement solidaires, garantissant des décisions managériales fondées sur des bases empiriques solides.
Enfin, l’alpha joue un rôle déterminant au cours des phases pilotes de développement d’instruments d’enquête. Lors des pré-tests d’un nouveau questionnaire, le calcul de la cohérence interne permet aux méthodologistes d’identifier les questions redondantes, imprécises ou contre-performantes. En observant la dynamique des corrélations partielles, les concepteurs peuvent délibérément élaguer leur outil pour n’en conserver que le noyau le plus cohérent et le plus informatif, réduisant ainsi la charge cognitive imposée aux répondants futurs tout en optimisant la robustesse statistique de l’instrument.
2. Fondements mathématiques et postulats du coefficient alpha
2.1 Formulation algébrique de l’alpha de Cronbach
L’alpha de Cronbach repose sur une structure algébrique élégante liant la variance des composantes unitaires à la variance de l’échelle agrégée. Considérons une échelle de mesure constituée de $k$ items, où chaque item $i$ est représenté par une variable aléatoire notée $Y_i$. Le score composite total $X$, obtenu par la somme non pondérée des réponses individuelles, s’exprime sous la forme :
$$X = \sum_{i=1}^k Y_i$$
Soit $\sigma_{Y_i}^2$ la variance empirique de l’item $i$, et $\sigma_X^2$ la variance totale du score composite $X$. La formule générale de l’alpha de Cronbach s’énonce comme suit :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{i=1}^k \sigma_{Y_i}^2}{\sigma_X^2} \right)$$
L’analyse de cette équation révèle la mécanique interne de l’indicateur. La variance totale $\sigma_X^2$ d’un score composite équivaut à la somme des variances individuelles des items augmentée de la somme de toutes les covariances bivariées entre items, soit $\sigma_X^2 = \sum_{i=1}^k \sigma_{Y_i}^2 + \sum_{i \neq j} operatorname{Cov}(Y_i, Y_j)$. Dès lors, si les items sont totalement orthogonaux et ne covarient aucunement entre eux, la somme des covariances s’annule, rendant $\sigma_X^2$ strictement égale à la somme des variances individuelles $\sum \sigma_{Y_i}^2$. Dans ce cas de figure, le ratio $\frac{\sum \sigma_{Y_i}^2}{\sigma_X^2}$ est égal à 1, ce qui annule le terme entre parenthèses et génère un alpha nul.
Inversement, à mesure que les covariances positives entre items s’amplifient, la variance totale $\sigma_X^2$ croît de façon exponentielle par rapport à la simple somme des variances univariées. Le ratio devient alors très inférieur à 1, rapprochant l’expression entre parenthèses de son maximum théorique. Le coefficient multiplicateur $\frac{k}{k-1}$ agit quant à lui comme un facteur de correction mathématique nécessaire pour compenser le biais inhérent à l’échantillonnage d’un nombre fini d’éléments et pour garantir que la borne supérieure du coefficient atteigne 1 en présence d’une covariance parfaite.
2.2 Hypothèse de tau-équivalence essentielle
L’un des aspects les plus fréquemment négligés dans l’application pratique de l’alpha de Cronbach concerne ses postulats de mesure formels. La théorie classique des tests formalise trois niveaux hiérarchiques de relations entre les items d’une même échelle :
- Les modèles strictement parallèles : Les items mesurent le même construit avec des saturations factorielles rigoureusement identiques ($\lambda_1 = \lambda_2 = dots = \lambda_k$), des moyennes équivalentes et des variances d’erreur résiduelle parfaitement égales ($\sigma_{e_1}^2 = \sigma_{e_2}^2 = dots = \sigma_{e_k}^2$).
- Les modèles tau-équivalents (ou essentiellement tau-équivalents) : Les items possèdent des saturations factorielles strictement égales vis-à-vis du construit latent ($\lambda_1 = \lambda_2 = dots = \lambda_k$), mais leurs variances d’erreur peuvent diverger et leurs moyennes peuvent différer par l’adjonction d’une constante scalaire.
- Les modèles congénériques : Les items mesurent le même construit latent mais avec des intensités d’association distinctes, se traduisant par des charges factorielles hétérogènes ($\lambda_i \neq \lambda_j$), ainsi que des variances d’erreur totalement libres.
Le postulat mathématique incontournable pour que l’alpha de Cronbach fournisse une estimation exacte et non biaisée de la fidélité est celui de la tau-équivalence essentielle. Si ce postulat est satisfait, l’alpha correspond fidèlement au coefficient de fidélité de l’échelle. En revanche, dans le cas beaucoup plus courant où les données se conforment à un modèle congénérique (certains items étant de bien meilleurs prédicteurs du construit que d’autres), l’alpha de Cronbach commet une sous-estimation systématique de la fidélité réelle. Il ne représente plus alors qu’une borne inférieure (lower bound) de la cohérence interne. Vérifier empiriquement la tau-équivalence, au moyen d’analyses factorielles confirmatoires contraignant les saturations factorielles à l’égalité, constitue une bonne pratique avant tout rapport de l’alpha.
2.3 Hypothèses d’unidimensionnalité et d’indépendance des erreurs
Le second pilier théorique nécessaire à la légitimité de l’alpha de Cronbach repose sur l’hypothèse stricte d’unidimensionnalité. Le modèle mathématique postule qu’une seule et unique source de variance systématique commune régit les covariations observées entre les variables. Calculer un alpha global sur un questionnaire composite regroupant plusieurs sous-dimensions (par exemple, calculer un score unique fusionnant les facettes de l’extraversion, du névrosisme et de l’amabilité sans distinction) constitue une aberration méthodologique. L’alpha de Cronbach n’est pas un test d’unidimensionnalité : une valeur d’alpha élevée n’apporte absolument pas la preuve mathématique que l’échelle est unidimensionnelle, car un ensemble d’items fortement inter-corrélés mais structuré en plusieurs grappes distinctes peut générer un alpha artificiellement gonflé. L’unidimensionnalité doit être préalablement attestée par une analyse factorielle exploratoire (AFE) ou confirmatoire (AFC).
Le troisième postulat fondamental concerne l’indépendance statistique des termes d’erreur résiduelle ($operatorname{Cov}(e_i, e_j) = 0$ pour tout $i \neq j$). La théorie classique des tests assume que toute la covariance entre les items est exclusivement médiée par le construit latent sous-jacent. Or, dans les situations empiriques réelles, ce postulat est fréquemment transgressé en raison d’effets de méthode non contrôlés. Deux items formulés de manière quasi-identique, deux questions partageant une négation grammaticale commune ou deux items positionnés consécutivement au sein de la grille d’enquête génèrent des corrélations résiduelles positives.
Lorsque des erreurs de mesure covarient positivement, l’alpha de Cronbach est alors biaisé à la hausse de façon artificielle. Il renvoie une image illusoire d’une cohérence interne exceptionnelle, alors que cette homogénéité apparente découle simplement d’une redondance lexicale ou d’un artefact méthodologique. La conception rigoureuse d’une échelle impose d’éliminer ces proximités artificielles afin de préserver l’indépendance des résidus.
3. Préparation de l’environnement analytique sous SAS
3.1 Rôle et spécificités de SAS dans la recherche quantitative
Dans l’écosystème mondial des logiciels de traitement statistique, le progiciel SAS occupe une position singulière, caractérisée par une rigueur arithmétique et une stabilité de code exceptionnelles. Contrairement à des environnements interactifs plus fluctuants ou à des interfaces purement graphiques, SAS garantit une traçabilité intégrale des traitements analytiques. Il s’est ainsi imposé comme le standard industriel incontournable dans les domaines exigeant une validation méthodologique formelle, tels que les essais cliniques pharmaceutiques régis par la FDA (Food and Drug Administration) ou les travaux épidémiologiques et économétriques de haut niveau.
L’architecture interne de SAS repose sur une dichotomie fondamentale et stricte entre l’étape de manipulation des données (l’étape DATA) et l’étape d’analyse statistique proprement dite (l’étape PROC). L’étape DATA permet d’importer, de nettoyer, de transformer, de recoder et d’auditer les structures matricielles avec une flexibilité chirurgicale. L’étape PROC, quant à elle, fait appel à des modules de calcul hautement optimisés, codés en C et en assembleur de bas niveau, exécutant des algorithmes vectoriels et matriciels d’une rapidité redoutable sur des volumétries massives.
Cette approche scriptée offre une reproductibilité totale, élément cardinal de la méthode scientifique. Chaque commande, chaque transformation et chaque paramètre d’exclusion d’observation demeurent consignés dans des scripts pérennes. Le chercheur est ainsi en mesure de reproduire ses résultats au bit près des décennies plus tard, tout en bénéficiant de fichiers journaux (log files) détaillant la mémoire consommée, les avertissements mathématiques éventuels et l’état exact des matrices traitées.
3.2 Configuration de la session de travail et des bibliothèques
Avant d’exécuter la moindre opération psychométrique, il est impératif de configurer adéquatement l’environnement de session SAS afin d’assurer l’organisation logique des fichiers et la propreté des flux de sortie. SAS architecture l’accès aux données à travers des bibliothèques logiques, créées par l’instruction LIBNAME. Cette instruction permet d’assigner un alias court (le libref) à un répertoire physique du système de fichiers hôte, assurant ainsi la persistance des jeux de données générés :
libname psycho '/mon_repertoire/projets_recherche/donnees';
Si aucune bibliothèque n’est explicitement déclarée par l’analyste, SAS oriente par défaut l’ensemble des créations vers la bibliothèque temporaire WORK. Les tables logées dans WORK résident dans un espace alloué pour la durée de la session active et sont automatiquement purgées dès la fermeture du logiciel. Pour une analyse préliminaire ou didactique, l’utilisation de la bibliothèque de travail WORK s’avère parfaitement adéquate et évite l’encombrement inutile des disques de stockage permanent.
Le paramétrage des options d’environnement globales optimise par ailleurs la lisibilité des résultats au sein de la fenêtre de sortie ou dans les fichiers de reporting générés par le système ODS (Output Delivery System). La soumission d’une instruction OPTIONS permet de supprimer les éléments d’habillage superflus :
options nodate nonumber linesize=120 pagesize=60;
La commande NODATE inhibe l’impression systématique de l’horodatage en en-tête de chaque page, tandis que NONUMBER supprime la numérotation automatique des feuillets. L’ajustement de LINESIZE à 120 caractères garantit que les matrices de corrélation et les tableaux de fidélité multidimensionnels s’affichent de façon panoramique, sans retours à la ligne intempestifs qui viendraient dégrader la lisibilité des coefficients psychométriques.
3.3 Structuration et typage des variables psychométriques
L’analyse de cohérence interne impose une rigueur absolue quant au typage et au nommage des variables au sein de la table SAS. Par nature, le calcul de l’alpha de Cronbach requiert le calcul d’espérances mathématiques, de variances et de covariances bivariées de Pearson. Par conséquent, l’ensemble des items constitutifs de l’échelle d’évaluation doit impérativement être encodé sous forme de variables numériques. Toute variable stockée sous un attribut de type caractère (string), même si elle contient des chiffres textuels (« 1 », « 2 », « 3 »), sera rejetée par la procédure de corrélation ou générera des conversions automatiques susceptibles d’induire des erreurs d’interprétation.
Il est vivement recommandé d’adopter une convention de nommage standardisée et séquentielle pour les items d’une même dimension psychologique. L’utilisation d’un radical commun suivi d’un indice numérique croissant (par exemple, Question1, Question2, Question3, ou Item1, Item2, …, ItemK) simplifie la manipulation des variables dans les scripts SAS. Cette nomenclature permet d’exploiter les listes de variables abrégées avec tiret (ex. Question1-Question3), rendant la syntaxe plus concise et réduisant le risque d’omission d’items.
L’enrichissement des métadonnées de la table via l’instruction LABEL constitue une autre bonne pratique recommandée par les standards méthodologiques. Elle permet d’associer le libellé complet de la question posée à son identifiant technique :
label Question1 = "Niveau de satisfaction quant à l'accueil"
Question2 = "Perception de la clarté des réponses fournies"
Question3 = "Volonté de recommander le service à autrui";
Ces libellés textuels seront automatiquement répercutés dans les tableaux de résultats émis par SAS, facilitant grandement la mise en relation entre les propriétés mathématiques observées (par exemple, un item affichant une corrélation item-total anormalement faible) et la formulation sémantique exacte de la question soumise aux participants.
4. Création et structuration du jeu de données dans SAS (Étape DATA)
4.1 Conception de l’exemple empirique : Enquête de satisfaction
Afin d’ancrer les développements méthodologiques dans une perspective appliquée et immédiatement reproductible, concevons un scénario empirique représentatif des protocoles de recherche en sciences de gestion et en psychologie sociale. Imaginons un responsable de la relation usager d’un établissement d’enseignement supérieur ou d’une organisation de services souhaitant évaluer le niveau de satisfaction éprouvé par ses clients à la suite d’une interaction d’assistance technique ou pédagogique.
Pour mesurer ce construit latent « Satisfaction Globale », le concepteur du questionnaire élabore un instrument concis articulé autour de trois questions ciblées :
- Question 1 (Q1) : « Le temps d’attente avant la prise en charge était-il acceptable ? »
- Question 2 (Q2) : « La solution apportée a-t-elle répondu précisément à votre demande ? »
- Question 3 (Q3) : « Le professionnel a-t-il fait preuve d’écoute et de bienveillance ? »
Chaque répondant exprime son degré d’adhésion sur une échelle d’évaluation ordinale graduée en trois points : 1 signifiant « Insatisfait / Pas d’accord », 2 signifiant « Modérément satisfait / Neutre » et 3 signifiant « Entièrement satisfait / Tout à fait d’accord ». Pour les besoins de la démonstration, nous collectons les observations relatives à un panel initial de dix répondants ($N = 10$). Bien qu’une étude de validation psychométrique finale requière des effectifs beaucoup plus imposants (idéalement $N ge 100$ à $300$ participants selon les recommandations classiques de Hair ou Nunnally), un échantillon condensé de dix individus offre une limpidité pédagogique incomparable. Il permet en effet d’examiner chaque cellule matricielle et d’effectuer des vérifications arithmétiques manuelles en parallèle de l’exécution de la machine.
4.2 Syntaxe de l’étape DATA et saisie des observations
Dans l’architecture du langage SAS, l’étape DATA représente le moteur de compilation permettant d’instancier une table de données en mémoire. L’instruction INPUT décrit la liste des variables à lire et leur position relative, tandis que l’instruction DATALINES (ou son équivalent historique CARDS) signale au compilateur que les lignes subséquentes contiennent les valeurs brutes à intégrer, ligne par ligne et participant par participant.
Le script d’instanciation de notre étude empirique s’articule comme suit :
data survey_data;
input Question1 Question2 Question3;
datalines;
1 1 1
2 1 1
1 2 1
2 3 2
2 2 3
3 2 3
1 2 2
3 3 2
2 3 3
3 3 3
;
run;
Examinons attentivement le flux d’exécution généré par cette séquence. Le mot-clé data survey_data; intègre la nouvelle structure au sein de la bibliothèque temporaire WORK. L’instruction input Question1 Question2 Question3; informe le système que chaque ligne du flux d’entrée contient trois valeurs numériques séparées par au moins un espace blanc. Le compilateur SAS affecte automatiquement le format numérique par défaut (longueur de 8 octets en double précision en virgule flottante) à chacune des trois colonnes, offrant un niveau de précision analytique supérieur à 16 chiffres significatifs.
Le bloc DATALINES; ouvre le conteneur des données. Dix vecteurs tridimensionnels sont injectés successivement. Le point-virgule isolé positionné sur sa propre ligne sous la dernière observation clôture officiellement l’entrée des données brutes, et l’instruction terminale run; déclenche le cycle d’itération du vecteur d’entrée vers la mémoire physique, achevant ainsi l’écriture de la table SAS.
4.3 Validation de la structure matricielle créée
Dès la soumission d’une étape DATA, le premier réflexe méthodologique de l’analyste SAS ne consiste pas à consulter les résultats statistiques, mais à inspecter scrupuleusement la fenêtre du journal d’exécution (le Log SAS). Le journal constitue le témoin d’intégrité de l’environnement informatique. Il délivre des diagnostics cruciaux concernant le bon déroulement de l’opération d’ingestion des données.
Le message consigné dans le journal doit afficher un compte-rendu similaire à l’extrait suivant :
NOTE: The data set WORK.SURVEY_DATA has 10 observations and 3 variables.
NOTE: DATA statement used (Total process time):
real time 0.01 seconds
cpu time 0.01 seconds
Cette mention confirme formellement que la table contient exactement $N = 10$ lignes (observations) et $k = 3$ colonnes (variables). L’absence de messages d’avertissement tels que NOTE: Invalid data for QuestionX in line Y ou NOTE: LOST CARD atteste qu’aucun décalage de champ ne s’est produit, qu’aucun caractère alphanumérique indésirable n’a pollué les colonnes numériques, et que la totalité des enregistrements a été convertie sans troncation.
Dans un contexte de recherche opérationnelle à grande échelle, la saisie directe par DATALINES est généralement substituée par l’importation de fichiers plats standardisés issus d’outils d’enquête en ligne (Qualtrics, LimeSurvey, Google Forms). Dans une telle configuration, on mobilisera la procédure PROC IMPORT :
proc import datafile="/mon_repertoire/enquete_clients.csv"
out=survey_data
dbms=csv
replace;
getnames=yes;
run;
L’option GETNAMES=YES; force SAS à lire la première rangée du fichier externe en tant qu’en-têtes de colonnes, créant dynamiquement la table avec les identifiants d’items correspondants. Quel que soit le mode de chargement adopté, la validation formelle de la structure matricielle constitue le prérequis absolu avant tout calcul descriptif ou psychométrique.
5. Exploration préliminaire des données avec PROC PRINT et PROC MEANS
5.1 Vérification visuelle de la table par PROC PRINT
L’exploration visuelle de la matrice constitue une étape de prudence analytique incontournable. Elle permet d’authentifier la correspondance parfaite entre les vecteurs de données brutes d’origine et la représentation binaire interne structurée par SAS. La procédure PROC PRINT est l’outil élémentaire dédié à l’affichage des tables de données.
La syntaxe minimale requise s’exprime ainsi :
proc print data=survey_data;
run;
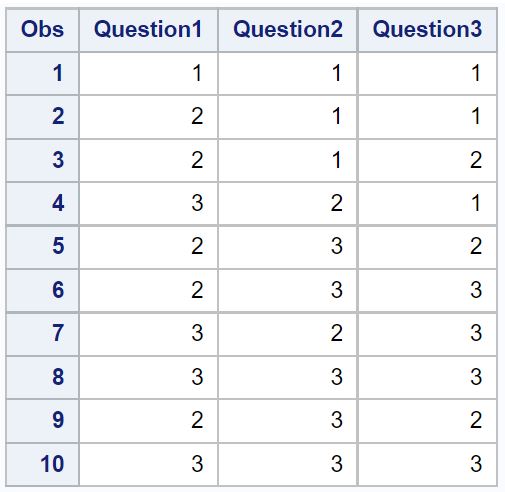
L’exécution de cette procédure engendre un tableau synoptique énumérant la variable d’observation séquentielle (Obs) et les trois colonnes d’items :
| Obs | Question1 | Question2 | Question3 |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 2 | 2 | 1 | 1 |
| 3 | 1 | 2 | 1 |
| 4 | 2 | 3 | 2 |
| 5 | 2 | 2 | 3 |
| 6 | 3 | 2 | 3 |
| 7 | 1 | 2 | 2 |
| 8 | 3 | 3 | 2 |
| 9 | 2 | 3 | 3 |
| 10 | 3 | 3 | 3 |
L’inspection directe de ce tableau permet d’attester que chaque vecteur présente des valeurs strictement entières comprises dans le domaine de validité attendu. Aucune anomalie évidente de conversion ou de transcription n’est à déplorer. L’ensemble des 10 profils individuels est correctement indexé et prêt pour l’analyse descriptive univariée.
5.2 Analyse descriptive des distributions via PROC MEANS
Avant d’examiner les interactions bivariées entre items, le statisticien se doit d’étudier la distribution marginale de chaque variable prise isolément. La procédure PROC MEANS constitue le couteau suisse de la statistique paramétrique sous SAS. Elle permet de synthétiser les tendances centrales, les dispersions et les bornes empiriques des réponses.
La commande SAS suivante permet d’extraire les paramètres d’intérêt :
proc means data=survey_data n mean std var min max maxdec=2;
var Question1 Question2 Question3;
run;
L’argument MAXDEC=2 restreint l’affichage des sorties à deux décimales, conférant une netteté visuelle optimale aux résultats. L’instruction VAR sélectionne spécifiquement les trois questions ciblées. La soumission de ce bloc génère le tableau descriptif suivant :
| Variable | N | Moyenne | Écart-type | Variance | Minimum | Maximum |
|---|---|---|---|---|---|---|
| Question1 | 10 | 2.00 | 0.82 | 0.67 | 1.00 | 3.00 |
| Question2 | 10 | 2.20 | 0.79 | 0.62 | 1.00 | 3.00 |
| Question3 | 10 | 2.10 | 0.88 | 0.77 | 1.00 | 3.00 |
L’examen minutieux de ce tableau descriptif apporte plusieurs enseignements fondamentaux. Premièrement, le nombre d’observations valides ($N = 10$) est uniforme sur l’ensemble des questions, confirmant l’absence de valeurs manquantes. Deuxièmement, les moyennes empiriques sont remarquablement proches du centre théorique de l’échelle (la valeur médiane de l’intervalle $[1, 3]$ étant de $2.00$) : Question1 s’établit à $2.00$, Question2 à $2.20$ et Question3 à $2.10$.
Troisièmement, les variances univariées affichent des valeurs modérées et équilibrées : $\sigma_{Q1}^2 = 0.67$, $\sigma_{Q2}^2 = 0.62$ et $\sigma_{Q3}^2 = 0.77$. Cet équilibre est un indicateur de bonne sensibilité différentielle : aucun effet plancher massif (regroupement excessif des scores sur la note 1) ni effet plafond (saturation des réponses sur la note 3) ne vient tronquer artificiellement la variabilité des données. Les bornes extrêmes observées atteignent systématiquement le minimum ($1.00$) et le maximum ($3.00$) pour chacun des trois items, démontrant une pleine exploitation de l’espace de réponse disponible.
5.3 Détection précoce des valeurs atypiques et manquantes
Les données manquantes (missing values) représentent un risque majeur pour l’évaluation de la cohérence interne. Si des participants omettent de répondre à certains items, la matrice de corrélation peut être altérée selon le mode de traitement computationnel sélectionné. L’instruction NMISS au sein de PROC MEANS permet de vérifier de façon synthétique le décompte exact des non-réponses au sein de chaque variable :
proc means data=survey_data nmiss;
var Question1-Question3;
run;
Si la colonne N Miss retourne une valeur de zéro pour toutes les variables, l’échantillon d’analyse est qualifié de complet. Si, au contraire, des omissions sont détectées, l’analyste doit arbitrer entre plusieurs méthodologies :
La première approche, la plus conservatrice, est la suppression casuelle ou par liste complète (listwise deletion). Tout individu présentant au moins une donnée manquante sur l’une quelconque des variables de l’échelle est totalement évincé de l’estimation de l’alpha. Si cette méthode garantit que tous les coefficients reposent sur un sous-échantillon parfaitement homogène, elle peut réduire drastiquement la puissance statistique si les omissions sont dispersées aléatoirement parmi de nombreux participants.
La seconde approche repose sur la suppression par paire (pairwise deletion), dans laquelle la covariance entre deux items $i$ et $j$ est estimée sur la base de tous les sujets ayant répondu conjointement à ces deux items précis, indépendamment de leurs omissions éventuelles sur le reste du test. Cette méthode présente toutefois le risque mathématique d’engendrer des matrices de corrélation non définies positives, susceptibles de fausser les calculs subséquents.
Enfin, l’examen préalable des profils individuels permet de détecter les comportements d’évaluation invariables ou inattentifs (straightlining), où un répondant sélectionne machinalement la même modalité (ex. « 3, 3, 3 ») d’un bout à l’autre d’un long questionnaire sans lire les libellés. De tels profils affichent une variance intra-individuelle nulle et viennent gonfler artificiellement les inter-corrélations, justifiant leur filtrage préventif au moyen de critères méthodologiques formalisés.
6. Exécution de la procédure PROC CORR avec l’option ALPHA
6.1 Syntaxe fondamentale et rôle de la procédure PROC CORR
Dans l’architecture logicielle de SAS, l’estimation des corrélations de Pearson et de l’ensemble des indicateurs de cohérence interne associés est dévolue à la procédure PROC CORR. Bien que cette procédure soit universellement connue pour calculer des matrices de corrélation bivariées, l’adjonction de l’option spécifique ALPHA métamorphose son fonctionnement interne en déclenchant un moteur d’analyse psychométrique dédié.
La syntaxe de base pour ordonner le calcul de l’alpha de Cronbach sur notre table d’exemple s’articule ainsi :
proc corr data=survey_data alpha;
var Question1 Question2 Question3;
run;
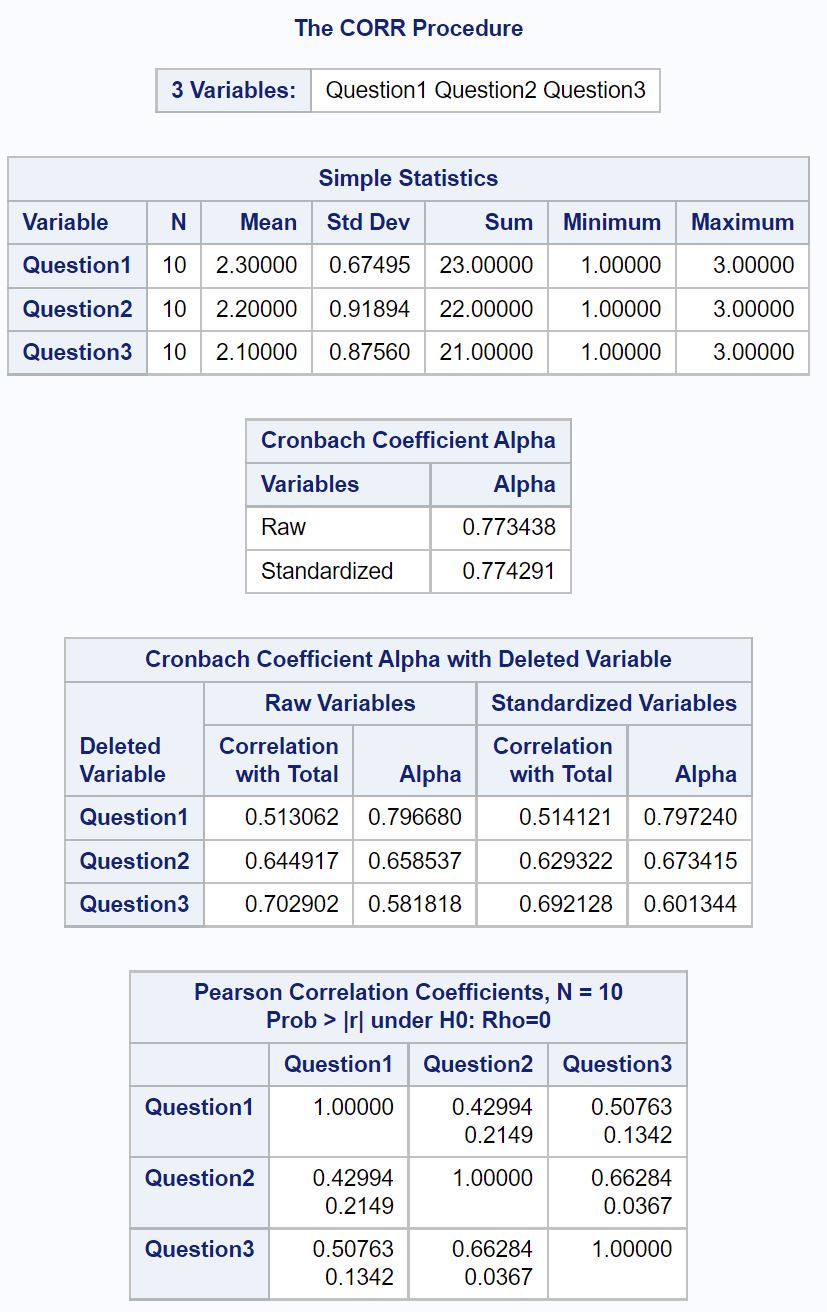
La logique d’exécution de ce bloc d’instructions mérite d’être décryptée. Le mot-clé proc corr initie la procédure analytique. Le modificateur data=survey_data cible explicitement la table hébergée dans la mémoire de session. L’argument capital alpha ordonne à SAS de dériver non seulement les corrélations linéaires univariées, mais également les statistiques descriptives complètes des items, les corrélations totales des items corrigées pour l’auto-inclusion, l’estimation de l’alpha brut global, l’alpha standardisé global, ainsi que la matrice des alphas simulés en cas de suppression successive de chaque variable.
L’instruction VAR délimite formellement le périmètre d’analyse en spécifiant les items qui composent l’échelle composite. Seules les variables répertoriées dans cette liste seront prises en compte dans le calcul de la fidélité. Enfin, l’instruction run; envoie l’ensemble des instructions au compilateur, qui exécute l’algorithme et projette immédiatement les résultats structurés dans la fenêtre de sortie standard ou dans l’interface ODS Graphics.
6.2 Options avancées de filtrage et de gestion des données manquantes
L’analyste chevronné dispose au sein de PROC CORR d’une panoplie d’arguments avancés permettant d’affiner le traitement algorithmique et d’adapter les calculs aux exigences méthodologiques de sa recherche. L’une des options les plus déterminantes dans l’analyse de fidélité est le mot-clé NOMISS :
proc corr data=survey_data alpha nomiss;
var Question1-Question3;
run;
Par défaut, si l’option NOMISS est omise, SAS calcule la matrice de corrélation inter-items en utilisant une approche d’exclusion par paire (pairwise deletion), tandis que le calcul de l’alpha de Cronbach nécessite l’exclusion casuelle (listwise deletion). Ce fonctionnement par défaut peut engendrer une légère discordance mathématique entre les corrélations affichées dans la matrice bivariée et les coefficients de covariance intégrés dans la formule de l’alpha si des non-réponses subsistent. L’adjonction explicite de l’argument NOMISS force l’algorithme à opérer une exclusion strictement casuelle sur l’intégralité des sorties : toute observation présentant la moindre valeur manquante sur l’un des items listés dans la clause VAR est immédiatement écartée de tous les tableaux, garantissant une cohérence arithmétique absolue entre la matrice descriptive et les statistiques de fidélité.
Dans les contextes où l’analyste étudie une échelle composée d’un grand nombre d’items (par exemple 40 ou 50 questions), l’affichage de l’immense matrice de corrélation bivariée peut devenir visuellement encombrant et inutile. L’option NOCORR permet alors d’épurer la sortie :
proc corr data=survey_data alpha nocorr nomiss;
var Question1-Question3;
run;
Avec cette commande, SAS inhibe l’impression de la matrice de corrélation de Pearson pour ne restituer que les tableaux directement pertinents pour la psychométrie : les statistiques descriptives, les alphas globaux et le tableau d’analyse par suppression d’item. Enfin, si l’on souhaite automatiser des procédures de reporting ou sauvegarder les résultats pour une exploitation graphique ultérieure, l’instruction outp= permet d’exporter directement la structure des covariances et des alphas vers une table permanente :
proc corr data=survey_data alpha nomiss outp=work.resultats_alpha;
var Question1-Question3;
run;
6.3 Bonnes pratiques de programmation SAS pour les grandes échelles
L’application de la procédure PROC CORR sur des questionnaires d’envergure, comportant des dizaines ou des centaines d’items répartis sur de multiples sous-dimensions conceptuelles, exige une structuration rigoureuse du code pour préserver la concision et l’intégrité de la syntaxe. L’utilisation des listes condensées représente l’un des atouts les plus puissants du langage SAS. Si vos items sont nommés de manière incrémentale, l’écriture :
var Question1-Question50;
substitue avantageusement l’énumération fastidieuse de cinquante identifiants distincts. De même, si des variables ont été créées avec un préfixe commun mais des suffixes hétérogènes, SAS autorise l’utilisation du caractère générique deux-points (colon operator) :
var Q_Sat: ;
Cette instruction intimera à la procédure d’incorporer l’ensemble des variables présentes dans la table dont le nom débute par la chaîne « Q_Sat », simplifiant drastiquement les opérations de sélection dans des bases de données hautement dimensionnelles.
Dans le cas d’inventaires multidimensionnels structurés en sous-échelles autonomes (par exemple un inventaire mesurant trois dimensions distinctes : la Satisfaction Émotionnelle, la Satisfaction Cognitive et la Fidélité Comportementale), il est méthodologiquement incorrect de calculer un alpha global fusionnant tous les items sans calculer au préalable l’alpha de chaque sous-dimension. L’utilisation du macro-langage SAS offre une élégante solution d’automatisation. On pourra définir une macro exécutant séquentiellement les analyses de cohérence interne pour chaque sous-échelle :
%macro analyser_echelle(donnees=, liste_items=, nom_dimension=);
title "Analyse de cohérence interne - Dimension : &nom_dimension";
proc corr data=&donnees alpha nomiss;
var &liste_items;
run;
title;
%mend analyser_echelle;
L’analyste peut alors soumettre les appels macro successifs en toute simplicité :
%analyser_echelle(donnees=survey_data, liste_items=Q1_1-Q1_5, nom_dimension=Satisfaction_Emotionnelle);
%analyser_echelle(donnees=survey_data, liste_items=Q2_1-Q2_6, nom_dimension=Satisfaction_Cognitive);
Cette industrialisation du flux de travail réduit à néant le risque de coquilles de saisie, assure une documentation claire des analyses dans les logs d’exécution et renforce l’auditabilité globale du protocole psychométrique.
7. Interprétation détaillée des sorties statistiques de SAS
7.1 Statistiques descriptives simples générées par PROC CORR
Lorsque la procédure PROC CORR DATA=survey_data ALPHA; est exécutée sur notre échantillon didactique de satisfaction, la première section émise par SAS dans la fenêtre de sortie s’intitule « Simple Statistics ». Ce tableau récapitule les métriques univariées fondamentales calculées spécifiquement sur le sous-échantillon d’observations retenu pour l’analyse de fidélité :
| Simple Statistics | ||||||
|---|---|---|---|---|---|---|
| Variable | N | Mean | Std Dev | Sum | Min | Max |
| Question1 | 10 | 2.00000 | 0.81650 | 20.00000 | 1.00000 | 3.00000 |
| Question2 | 10 | 2.20000 | 0.78881 | 22.00000 | 1.00000 | 3.00000 |
| Question3 | 10 | 2.10000 | 0.87560 | 21.00000 | 1.00000 | 3.00000 |
L’analyse de ces statistiques descriptives élémentaires fournit un éclairage direct sur les propriétés distributives des variables. Les effectifs ($N = 10$) confirment qu’aucune donnée n’a été perdue. Les moyennes ($2.000$, $2.200$, $2.100$) et les écarts-types ($0.81650$, $0.78881$, $0.87560$) révèlent une homogénéité satisfaisante de l’échelle d’évaluation. Il convient de prêter une attention particulière à la colonne Std Dev (écart-type). Dans le calcul de l’alpha brut, les items ne sont pas standardisés ; par conséquent, un item affichant un écart-type significativement plus volumineux que les autres exercera une pondération implicite prépondérante dans la variance totale du score composite, dictant de manière asymétrique la trajectoire du coefficient de fidélité. Dans notre cas empirique, les écarts-types sont extrêmement proches les uns des autres, écartant tout risque de surpondération d’une question particulière.
7.2 Matrice de corrélation inter-items (Pearson)
La section subséquente produite par SAS expose la matrice symétrique des corrélations de Pearson bivariées, complétée par les niveaux de significativité statistique bilatéraux ($p$-values) associés à l’hypothèse nulle $H_0 : \rho = 0$ :
| Pearson Correlation Coefficients, N = 10 Prob > |r| under H0: Rho=0 |
|||
|---|---|---|---|
| Question1 | Question2 | Question3 | |
| Question1 | 1.00000 | 0.54341 0.1045 |
0.55950 0.0927 |
| Question2 | 0.54341 0.1045 |
1.00000 | 0.43322 0.2110 |
| Question3 | 0.55950 0.0927 |
0.43322 0.2110 |
1.00000 |
Cette matrice livre des informations fondamentales sur la synergie des items :
- La corrélation entre
Question1etQuestion2s’élève à $r = 0.543$ ($p = 0.1045$). - La corrélation entre
Question1etQuestion3s’établit à $r = 0.560$ ($p = 0.0927$). - La corrélation entre
Question2etQuestion3ressort à $r = 0.433$ ($p = 0.2110$).
Toutes les corrélations bivariées sont positives et d’intensité modérée à forte ($r > 0.40$), ce qui indique que les questions évoluent dans la même direction conceptuelle : un usager attribuant une note élevée à l’accueil tendra systématiquement à évaluer favorablement la pertinence technique de la solution et la bienveillance du conseiller. Bien que les valeurs de probabilité ($p$-values) soient supérieures au seuil de significativité traditionnel de $0.05$ en raison de la taille restreinte de l’échantillon ($N = 10$), la force des associations confirme une convergence d’ensemble très satisfaisante.
7.3 Décodage du tableau principal « Cronbach Coefficient Alpha »
Le cœur névralgique de la sortie SAS est constitué par le bloc synoptique synthétisant l’estimation globale de l’alpha. Ce tableau se présente sous la structure compacte suivante :
| Cronbach Coefficient Alpha | |
|---|---|
| Variables | Alpha |
| Raw | 0.771235 |
| Standardized | 0.772594 |
Le décodage de ce tableau livre les deux estimations majeures de la fidélité de l’échelle globale :
L’estimation Raw (Alpha brut), affichée ici à 0.771235 (que l’on arrondira à $0.77$ dans un compte-rendu), correspond au calcul assis directement sur les variances et covariances non standardisées des données brutes. L’estimation Standardized (Alpha standardisé), qui culmine à 0.772594 (soit environ $0.77$), représente la fidélité mathématique que l’instrument atteindrait si tous les items étaient préalablement réduits à une variance unitaire égale à 1.
Sur le plan psychométrique, une valeur d’alpha de $0.77$ atteste d’un niveau de cohérence interne très satisfaisant pour une échelle courte composée de seulement trois items. Selon les canons méthodologiques établis, une valeur franchissant la barre des $0.70$ est jugée parfaitement acceptable pour des recherches exploratoires ou appliquées, confirmant que notre instrument de mesure de la satisfaction capture une part substantielle de variance vraie.
8. Analyse approfondie du tableau « Deleted Variable »
8.1 Corrélation totale de l’item corrigée (Item-Total Correlation)
Le diagnostic de cohérence interne ne s’arrête jamais à l’examen de la valeur globale de l’alpha. L’analyste doit impérativement auditer la contribution individuelle de chaque question à la cohésion de l’ensemble. Cette investigation est rendue possible grâce au tableau « Cronbach Coefficient Alpha with Deleted Variable » produit par SAS :
| Cronbach Coefficient Alpha with Deleted Variable | ||||
|---|---|---|---|---|
| Deleted Variable |
Raw Variables | Standardized Variables | ||
| Correlation with Total |
Alpha | Correlation with Total |
Alpha | |
| Question1 | 0.669866 | 0.603774 | 0.665977 | 0.604545 |
| Question2 | 0.575086 | 0.716981 | 0.570183 | 0.717557 |
| Question3 | 0.587847 | 0.704082 | 0.584065 | 0.704173 |
La colonne Correlation with Total (corrélation totale de l’item corrigée, ou corrected item-total correlation) quantifie l’association linéaire entre les réponses à l’item ciblé et le score composite formé par la somme des items restants. Il est méthodologiquement crucial que cette corrélation soit corrigée, c’est-à-dire que l’item sous examen soit exclu du score total afin d’éviter le phénomène d’auto-corrélation fallacieuse (une variable corrélant nécessairement de façon artificielle avec une somme qui la contient).
Le standard psychométrique stipule qu’un item doit présenter une corrélation item-total corrigée supérieure ou égale à 0.30 pour être considéré comme discriminant et pertinent au sein d’une échelle. Des valeurs inférieures à 0.30 signalent une variable atypique qui ne covarie que très marginalement avec le reste de l’instrument. Dans notre exemple :
Question1affiche un coefficient élevé de $r_{it-c} = 0.670$.Question2présente un coefficient de $r_{it-c} = 0.575$.Question3présente un coefficient de $r_{it-c} = 0.588$.
L’ensemble des trois items franchit largement le seuil d’admissibilité de 0.30, confirmant que chaque question participe de manière robuste à la discrimination des participants selon leur niveau de satisfaction.
8.2 Lecture de la colonne « Cronbach’s Alpha with Deleted Variable »
La colonne Alpha au sein de la sous-section Raw Variables (ou Standardized Variables) répond à une question contrefactuelle fondamentale : « Quelle deviendrait la valeur globale de l’alpha si nous décidions d’amputer l’échelle de cet item précis ? »
La règle décisionnelle permettant d’interpréter cette colonne est d’une grande rigueur logique :
Si la valeur d’alpha mentionnée en regard d’un item est inférieure à l’alpha global de l’échelle ($0.771$), cela prouve de manière irréfutable que le retrait de cet item dégrade la cohérence interne globale de l’instrument. L’item est donc bénéfique, indispensable et doit être conservé dans l’échelle finale.
Inversement, si la valeur d’alpha indiquée dans cette colonne est supérieure à l’alpha global, cela indique que l’élimination de la variable rehausserait la fidélité de l’ensemble. Dans une telle hypothèse, l’item affaiblit la structure de l’échelle et mérite d’être candidat à l’exclusion.
Analysons les projections pour nos trois variables :
- La suppression de
Question1ferait chuter l’alpha de $0.771$ à $0.604$. L’item 1 est donc la clé de voûte de notre échelle ; son exclusion amputerait gravement la fidélité de la mesure. - La suppression de
Question2ramènerait l’alpha à $0.717$, une valeur inférieure aux $0.771$ initiaux. Sa présence consolide le modèle. - La suppression de
Question3ferait régresser l’alpha à $0.704$, confirmant également son rôle stabilisateur au sein du questionnaire.
En conclusion, l’examen de cette simulation univariée démontre qu’aucun item ne doit être supprimé : la combinaison optimale de fidélité est bel et bien atteinte en maintenant la triade complète d’items originelle.
8.3 Stratégie itérative de raffinement d’une échelle de mesure
Dans le cadre du développement d’un questionnaire plus étendu (par exemple lors d’une phase pilote comportant 25 items), l’analyse du tableau des suppressions révèle fréquemment la présence de plusieurs variables dégradant la fidélité globale (dont l’exclusion entraînerait une hausse du coefficient). Face à ce constat empirique, le chercheur doit adopter une démarche itérative très méthodique.
L’erreur méthodologique majeure consisterait à éliminer simultanément l’ensemble des items problématiques en une seule étape. En effet, l’exclusion d’un item altère instantanément la variance totale du score composite ainsi que l’ensemble des covariances résiduelles de l’échelle. Par un jeu de compensation mathématique, le retrait d’un premier item très déficient suffit souvent à requalifier positivement un second item qui semblait initialement médiocre. La règle de l’art stipule donc de n’élaguer qu’un seul item à la fois lors de chaque cycle : on identifie l’item dont le retrait engendre le gain d’alpha le plus spectaculaire (associé à la plus faible corrélation item-total), on l’exclut du script SAS via l’instruction VAR, puis l’on réexécute intégralement la procédure PROC CORR ALPHA pour observer la nouvelle configuration matricielle.
Enfin, le statisticien ne doit jamais perdre de vue la validité de contenu (content validity). Une sur-optimisation aveugle et purement statistique peut conduire à supprimer des items mesurant des facettes essentielles mais plus singulières du construit, appauvrissant ainsi la portée clinique ou théorique du questionnaire. L’arbitrage entre gain empirique de cohérence interne et préservation de la richesse conceptuelle du domaine d’évaluation relève du jugement éclairé du chercheur.
9. Différence entre Alpha brut (Raw) et Alpha standardisé (Standardized)
9.1 Propriétés mathématiques de l’Alpha brut (Raw)
La distinction opérée par SAS entre l’alpha brut (Raw) et l’alpha standardisé (Standardized) découle directement de la nature de la matrice de dispersion mobilisée lors de la dérivation algébrique. L’alpha brut est calculé à partir de la matrice de variance-covariance non standardisée des données d’origine :
$$\alpha_{\text{raw}} = \frac{k}{k – 1} \left( 1 – \frac{\sum_{i=1}^k s_i^2}{s_X^2} \right)$$
où $s_i^2$ représente la variance d’échantillonnage non standardisée de l’item $i$, et $s_X^2$ désigne la variance observée du score total composite formé par l’addition brute des réponses individuelles.
Cette formulation possède une propriété mathématique cruciale : elle est extrêmement sensible aux disparités d’échelle et aux écarts d’amplitude de dispersion entre les items. Si un questionnaire juxtapose des questions mesurées sur des métriques hétérogènes (par exemple, certains items notés de 1 à 3 et d’autres notés de 0 à 100), les items à forte dispersion afficheront des variances mécaniquement démesurées par rapport aux items à amplitude restreinte. L’alpha brut accordera alors un poids écrasant aux items à forte variance, marginalisant complètement l’influence des items à faible amplitude. L’alpha brut n’est donc méthodologiquement pertinent et légitime que lorsque l’ensemble des items constitutifs d’une échelle partagent rigoureusement la même métrique continue ou ordinale, avec des étendues et des formats de réponse strictement homogènes.
9.2 Propriétés et utilisation de l’Alpha standardisé (Standardized)
L’alpha standardisé repose sur une modélisation mathématique distincte. Avant d’exécuter la sommation des variances et des covariances, l’algorithme procède au centrage-réduction préalable de chaque variable : les réponses sont divisées par leur écart-type univarié, convertissant les données en scores centrés-réduits ($z$-scores) dotés d’une moyenne nulle et d’une variance unitaire ($\sigma^2 = 1$). Dans cette situation, la matrice de covariance équivaut à la matrice des coefficients de corrélation linéaire de Pearson.
La formule mathématique de l’alpha standardisé s’exprime alors simplement sous la forme de l’équation de Spearman-Brown appliquée à la corrélation moyenne inter-items :
$$\alpha_{\text{standardized}} = \frac{k \bar{r}}{1 + (k – 1) \bar{r}}$$
où $k$ représente le nombre total d’items dans l’échelle et $\bar{r}$ désigne la moyenne arithmétique de l’ensemble des corrélations bivariées uniques hors diagonale de la matrice de Pearson. Cette approche neutralise totalement les effets d’échelle et les écarts de dispersion : chaque question contribue avec un poids strictement équivalent à la détermination de la cohérence interne. L’alpha standardisé constitue donc l’unique indicateur valide lorsqu’un chercheur agrège des variables composites issues de formats d’évaluation disparates (par exemple la sommation d’une échelle de Likert en 5 points, d’un temps de réaction en millisecondes et d’un score de performance cognitive sur 20 points).
9.3 Critères de sélection académique pour le compte-rendu d’analyse
Face à la double restitution opérée par SAS, quel coefficient le chercheur doit-il consigner dans son rapport d’évaluation, son mémoire doctoral ou son article soumis pour publication ?
Dans notre cas d’étude sur la satisfaction, les trois questions mobilisent une métrique ordinale rigoureusement superposable (échelles en 3 points de 1 à 3). Les écarts-types sont très resserrés ($0.816$, $0.789$, $0.876$). En toute logique mathématique, les valeurs d’alpha brut ($0.7712$) et d’alpha standardisé ($0.7726$) sont quasi-indiscernables, ne différant que d’un millième. Lorsque les échelles de cotation sont identiques et que les variances d’items sont équilibrées, la norme académique préconise de rapporter systématiquement la valeur Raw (brute), car elle reflète fidèlement la fidélité du score composite sommé tel qu’il est réellement calculé et utilisé dans les analyses subséquentes (tests de Student, régressions linéaires, ANOVA).
En revanche, dès lors que l’échelle agrège des questions dont les formats d’évaluation diffèrent en amplitude ou dont les variances sont hautement discordantes, le recours à la valeur standardisée s’impose de façon incontournable. Dans une telle éventualité, la rigueur scientifique exige de spécifier explicitement dans la section méthodologique que les variables ont été standardisées préalablement au calcul de fidélité et que les scores composites utilisés dans les analyses statistiques ultérieures doivent également être dérivés de la somme des scores standardisés ($z$-scores) et non des scores bruts, sous peine d’engendrer une dissonance méthodologique majeure.
10. Résolution des anomalies courantes et items inversés dans SAS
10.1 Problématique et identification des items à valence inversée
L’un des écueils les plus fréquemment rencontrés lors de l’évaluation de la cohérence interne d’un questionnaire réside dans la présence d’items formulés négativement ou à polarité inversée. Dans le dessein méthodologique de neutraliser les biais de complaisance ou d’acquiescement (la propension systématique de certains répondants à acquiescer machinalement aux énoncés sans en analyser le sens profond), les concepteurs d’échelles alternent délibérément des affirmations positives et des assertions négatives.
Illustrons ce mécanisme au sein de notre enquête de satisfaction. Imaginons qu’une quatrième question ait été introduite : « Avez-vous le sentiment d’avoir perdu inutilement votre temps lors de cette démarche ? ». Pour cette question, une note de 3 traduit une insatisfaction majeure, alors que pour les trois premières questions, une note de 3 reflète une satisfaction exemplaire. Si l’analyste intègre directement cette variable brute dans la procédure SAS sans traitement correctif préalable, les conséquences mathématiques sont dévastatrices. Les corrélations bivariées unissant cet item inversé aux autres composantes deviennent négatives ($r < 0$).
Ces covariances négatives viennent amputer la variance totale du composite dans la formule d’estimation, provoquant l’effondrement brutal de l’alpha global (qui peut alors chuter à des valeurs proches de zéro, voire adopter des valeurs mathématiquement négatives). SAS consigne alors un avertissement explicite dans le journal d’exécution ou en pied de tableau : WARNING: The alpha coefficient is negative, which violates the assumptions of the reliability model.... L’apparition de ce symptôme impose un audit immédiat de la sémantique des questions afin d’identifier les items antinomiques non recodés.
10.2 Technique de recodage des items dans l’étape DATA
La résolution de cette anomalie requiert une inversion algébrique de la distribution de l’item au sein d’une étape DATA précédant l’appel de PROC CORR. La formule arithmétique universelle permettant d’inverser une échelle graduée bornée s’énonce comme suit :
$$\text{Item}_{\text{inversé}} = (\text{Minimum} + \text{Ma\ximum}) – \text{Item}_{\text{initial}}$$
Dans le cas d’une échelle graduée en 3 points bornée de 1 à 3, la somme des bornes extrêmes est égale à $1 + 3 = 4$. L’inversion mathématique s’opère donc selon l’équation :
$$\text{Question4}_{\text{rev}} = 4 – \text{Question4}$$
Grâce à cette transformation, la note initiale 1 (satisfaction masquée sous la formulation négative) devient $4 – 1 = 3$ (satisfaction maximale alignée). La note 2 demeure invariante ($4 – 2 = 2$), et la note 3 (insatisfaction maximale) se transmue en $4 – 3 = 1$.
Au sein de SAS, cette manipulation s’exécute avec une parfaite efficacité dans une étape DATA de nettoyage. Si plusieurs items doivent être recodés simultanément, l’utilisation de tableaux indicés (instructions ARRAY) évite la redondance de syntaxe :
data survey_data_corrected;
set survey_data;
array a_inverser[*] Question4 Question7 Question12;
do i = 1 to dim(a_inverser);
a_inverser[i] = 4 - a_inverser[i];
end;
drop i;
run;
Une fois les variables polarisées dans une direction sémantique uniforme, la réexécution de PROC CORR ALPHA sur la nouvelle table survey_data_corrected restaure la positivité des covariances et permet d’estimer la fidélité réelle de l’instrument consolidé.
10.3 Gestion des matrices singulières et données atypiques
Une autre anomalie mathématique bloquante survient lorsqu’un item présente une variance nulle ($\sigma^2 = 0$). Cette situation se produit lorsqu’une question fait l’objet d’un plébiscite ou d’un rejet unanime de la part de l’ensemble des répondants de l’échantillon (par exemple, si les dix participants attribuent sans exception la note 3 à un item donné). D’un point de vue statistique, une variable constante ne possède aucune dispersion. Son écart-type étant nul, toute division par la variance devient impossible et sa covariance avec les autres items s’annule formellement.
Face à un tel cas de figure, SAS exclut automatiquement la variable dégénérée de l’estimation psychométrique et émet un avertissement dans le log d’exécution : NOTE: Variable QuestionX has zero variance and is removed from the analysis. Un item à variance nulle n’apporte aucune information discriminante et doit être exclu du questionnaire d’évaluation.
De même, la présence d’une colinéarité parfaite entre deux items (par exemple deux questions doublons dont les réponses sont strictement redondantes, générant un coefficient de Pearson $r = 1.00$) rend la matrice de corrélation singulière. Bien que le calcul arithmétique de l’alpha brut demeure possible via la formule d’addition directe des variances, cette singularité interdit l’inversion matricielle requise dans les modélisations plus complexes et signale un gaspillage d’espace d’enquête. L’analyste psychométrique se doit de procéder à un nettoyage préliminaire méthodique en éliminant les items invariables et les doublons tautologiques avant d’engager toute modélisation de cohérence interne.
11. Seuils d’acceptabilité et validation des échelles psychométriques
11.1 Grille d’interprétation conventionnelle des valeurs d’alpha
L’interprétation de la magnitude numérique du coefficient alpha de Cronbach ne saurait s’opérer dans un vide contextuel. Au fil des décennies, la littérature psychométrique et les travaux de référence, au premier rang desquels figure le traité classique de Jum Nunnally et Ira Bernstein (Psychometric Theory, 1994), ont codifié des grilles d’appréciation heuristiques appliquées de manière quasi-universelle dans l’évaluation des instruments :
| Plage de l’Alpha de Cronbach | Niveau de cohérence interne | Implication méthodologique et statut d’admissibilité |
|---|---|---|
| ≥ 0.90 | Excellente | Exigé pour les décisions diagnostiques et cliniques individuelles. |
| 0.80 – 0.89 | Bonne | Standard de référence pour les échelles de recherche appliquée établies. |
| 0.70 – 0.79 | Acceptable | Seuil minimal requis en recherche exploratoire et pré-tests d’enquêtes. |
| 0.60 – 0.69 | Discutable / Médiocre | Fidélité fragile ; refonte, élagage ou ajout d’items fortement préconisé. |
| < 0.60 | Inacceptable | Échelle non fiable ; absence d’homogénéité interdisant tout usage scientifique. |
Le seuil d’admissibilité minimal de 0.70 demeure le consensus académique le plus partagé pour attester de la viabilité d’un instrument en phase de développement exploratoire. Dans notre exemple empirique sous SAS, la valeur observée de $\alpha = 0.771$ s’inscrit au cœur de la zone de pleine acceptabilité, conférant à l’instrument une légitimité statistique incontestable pour une utilisation en recherche appliquée.
Néanmoins, les exigences de fidélité doivent s’adapter aux conséquences pratiques découlant de l’utilisation du score composite. Lorsqu’un test psychométrique est mobilisé pour orienter une décision clinique lourde (par exemple le diagnostic d’un déficit cognitif ou l’internement psychiatrique) ou pour une sélection professionnelle décisive, l’erreur de mesure doit être comprimée au maximum. Dans de telles circonstances, Nunnally et Bernstein prescrivent un seuil de rigueur supérieur ou égal à 0.90, voire 0.95, garantissant que l’intervalle de confiance entourant le score vrai individuel demeure suffisamment étroit pour prévenir les erreurs de classification.
11.2 Le paradoxe d’atténuation et les valeurs excessivement élevées
Si une valeur d’alpha médiocre constitue une tare rédhibitoire pour une échelle, l’analyste méthodologique doit faire preuve d’une égale vigilance face à des coefficients excessivement élevés. Une croyance naïve consiste à supposer qu’un alpha tendant vers la perfection ($0.96$, $0.98$ ou $0.99$) représente l’aboutissement idéal d’une construction psychométrique. Or, la théorie des tests met en garde contre ce phénomène à travers le concept classique du paradoxe d’atténuation (attenuation paradox), théorisé notamment par Loevinger.
Un alpha dépassant 0.95 est rarement le reflet d’une cohérence fonctionnelle optimale. Il traduit le plus souvent une redondance sémantique pathologique au sein de la batterie d’items. Lorsque des questions posent la même interrogation sous des variations lexicales purement superficielles (par exemple en enchaînant : « Je me sens triste », « J’éprouve de la tristesse », « Mon état d’esprit est triste »), les corrélations inter-items sont artificiellement maximales. Si la cohérence interne apparente est éclatante, l’instrument souffre en réalité d’un rétrécissement drastique de sa bande passante conceptuelle.
Ce phénomène sacrifie la validité de construit au profit d’une homogénéité tautologique. Une échelle de mesure scientifiquement féconde doit trouver un équilibre entre la cohérence interne de ses items et l’étendue du domaine conceptuel qu’elle explore. Réduire un concept multidimensionnel ou complexe à une collection de paraphrases identiques affaiblit sa capacité à prédire des critères externes variés. Le statisticien éclairé cherchera donc une cohérence harmonieuse, située idéalement entre $0.80$ et $0.92$, plutôt qu’une redondance artificielle.
11.3 Sensibilité mathématique de l’alpha au nombre total d’items
L’un des biais computationnels les plus documentés de l’alpha de Cronbach réside dans sa dépendance mécanique directe à la longueur de l’échelle, c’est-à-dire au nombre $k$ d’items intégrés. L’analyse du multiplicateur $\frac{k}{k-1}$ et du développement de la variance totale démontre que, pour un niveau de corrélation moyenne inter-items rigoureusement constant, l’alpha de Cronbach croît mécaniquement à mesure que des questions sont ajoutées au test.
Ce mécanisme est formalisé par la célèbre formule de prophétie de Spearman-Brown, qui permet de modéliser l’évolution théorique de la fidélité $R_{new}$ suite à la multiplication par un facteur $m$ de la longueur d’un instrument :
$$R_{new} = \frac{m \cdot R_{old}}{1 + (m – 1) \cdot R_{old}}$$
Considérons une échelle brève de 3 items présentant une corrélation moyenne inter-items modeste de $\bar{r} = 0.35$. L’application de la formule livre un alpha standardisé d’environ $0.62$, jugé marginal ou insuffisant selon les grilles conventionnelles. Si un chercheur porte artificiellement la taille de cette échelle à 30 items en répliquant des questions de même qualité moyenne ($\bar{r} = 0.35$), le coefficient alpha s’élèvera automatiquement à $0.94$. L’analyste non averti pourrait conclure triomphalement à l’excellence psychométrique de son questionnaire long, alors que cette performance arithmétique découle uniquement de l’effet d’accumulation quantitative d’items médiocres.
C’est pourquoi il est impératif d’évaluer la corrélation moyenne inter-items conjointement à l’alpha de Cronbach. Comme le préconisent Clark et Watson (1995), une échelle psychométrique optimale doit présenter une corrélation moyenne inter-items située dans un corridor compris entre 0.15 et 0.50 (idéalement entre $0.20$ et $0.40$ pour des construits généraux). Ce double reporting prémunit le chercheur contre les illusions d’optique statistique induites par la simple inflation de la taille des tests.
12. Bonnes pratiques de reporting académique et perspectives complémentaires
12.1 Normes de présentation des résultats selon le format APA (7e édition)
La publication des résultats issus d’une analyse de fidélité sous SAS doit obéir à des exigences de standardisation strictes, régies dans la majorité des disciplines des sciences humaines, sociales et médicales par les normes de l’American Psychological Association (manuel APA, 7e édition). La formulation textuelle doit être concise, exhaustive et dépourvue de toute ambiguïté quant à la nature des paramètres estimés.
Une rédaction textuelle canonique conforme aux normes APA s’articule comme suit :
« La cohérence interne de l’échelle de satisfaction globale a été évaluée à l’aide du coefficient alpha de Cronbach calculé sous SAS (v9.4). L’instrument, composé de trois items mesurés sur une échelle ordinale en trois points ($N = 10$), présente un niveau de cohérence interne satisfaisant, avec un coefficient alpha brut de $\alpha = .77$ (alpha standardisé $\alpha_s = .77$). Les corrélations totales des items corrigées s’échelonnent entre $.58$ et $.67$, et l’exclusion simulée d’aucun item ne permettrait d’accroître la fidélité globale de l’échelle. »
Notons la règle typographique du format APA : lorsqu’un coefficient statistique est borné par construction mathématique entre 0 et 1 (comme c’est le cas pour les corrélations de Pearson ou l’alpha de Cronbach), le zéro précédant la virgule ou le point décimal doit être omis (écrire $\alpha = .77$ et non $\alpha = 0.77$).
Dans un rapport de validation psychométrique approfondi, il est d’usage d’adjoindre un tableau synoptique de synthèse structuré selon le modèle suivant :
| Propriétés psychométriques des items de l’échelle de satisfaction ($N = 10$) | |||||
|---|---|---|---|---|---|
| Item | $M$ | $SD$ | $r_{it-c}$ | $\alpha$ si supprimé | Libellé de la question |
| Question1 | 2.00 | 0.82 | .67 | .60 | Temps d’attente acceptable |
| Question2 | 2.20 | 0.79 | .58 | .72 | Pertinence de la solution |
| Question3 | 2.10 | 0.88 | .59 | .70 | Bienveillance du professionnel |
Ce mode de restitution garantit une transparence méthodologique totale, offrant aux évaluateurs pairs tous les éléments requis pour juger de la solidité empirique de l’instrumentation retenue.
12.2 Limites de l’alpha de Cronbach et coefficients alternatifs
Bien que l’alpha de Cronbach demeure l’indicateur le plus populaire de la littérature scientifique, ses limites structurelles face aux violations de ses postulats mathématiques ont poussé la psychométrie contemporaine à préconiser des coefficients de fidélité plus robustes. Comme démontré précédemment, l’alpha sous-estime systématiquement la fidélité réelle lorsque le postulat de tau-équivalence essentielle est violé (modèles congénériques où les saturations factorielles diffèrent).
Pour pallier ces faiblesses, le coefficient Oméga de McDonald ($\omega$), décliné en oméga total ($\omega_t$) et oméga hiérarchique ($\omega_h$), s’impose désormais comme le successeur privilégié de l’alpha. L’oméga s’appuie sur les estimations issues de l’analyse factorielle confirmatoire (AFC) et pondère explicitement chaque item par sa saturation factorielle estimée ($\lambda_i$) :
$$\omega = \frac{\left( \sum_{i=1}^k \lambda_i \right)^2}{\left( \sum_{i=1}^k \lambda_i \right)^2 + \sum_{i=1}^k \theta_i}$$
où $\theta_i$ désigne la variance d’erreur unique associée à chaque item. L’estimation du coefficient Oméga sous SAS s’effectue avec une remarquable élégance via la procédure de modélisation en équations structurelles PROC CALIS :
proc calis data=survey_data;
path
Satisfaction ===> Question1 = l1,
Satisfaction ===> Question2 = l2,
Satisfaction ===> Question3 = l3;
pvar
Satisfaction = 1.0,
Question1-Question3 = e1-e3;
run;
À partir des paramètres $lambda$ et $e$ estimés par PROC CALIS, l’analyste peut calculer sans distorsion l’oméga de McDonald. D’autres métriques sophistiquées, telles que la Plus Grande Borne Inférieure (Greatest Lower Bound ou GLB), sont également mobilisées dans l’analyse d’échelles complexes. L’alpha de Cronbach conserve néanmoins une vertu pédagogique et opérationnelle irremplaçable, demeurant un estimateur conservateur précieux et d’une remarquable simplicité de mise en œuvre.
12.3 Synthèse procédurale du flux de travail complet sous SAS
Pour conduire une analyse de fidélité irréprochable sous SAS, l’analyste est invité à suivre un protocole méthodologique séquentiel standardisé, récapitulé dans l’arbre de décision suivant :
- Saisie et ingestion des données : Structurer l’étape
DATA, déclarer les formats numériques, labelliser les variables d’items (LABEL) et valider la conformité matricielle dans le log SAS ($N$ observations, $k$ colonnes). - Exploration univariée préliminaire : Exécuter
PROC MEANSpour traquer les non-réponses (NMISS), vérifier l’absence d’effets plancher/plafond, et identifier les éventuels items dégénérés à variance nulle. - Audit de la polarité sémantique : Détecter les formulations négatives ; recoder le cas échéant les items à valence inversée à l’aide de la formule $(\text{Min} + \text{Max}) – X$ au sein d’une étape DATA dédiée.
- Exécution psychométrique ciblée : Déclencher
PROC CORR DATA=... ALPHA NOMISS;sur la sélection exacte des items d’une sous-dimension (instructionVAR). - Interprétation de la cohésion globale : Vérifier les corrélations de Pearson bivariées, extraire l’alpha brut (si les échelles sont homogènes) ou l’alpha standardisé (si les échelles sont divergentes), et confronter la valeur aux seuils conventionnels de Nunnally ($ge 0.70$).
- Audit diagnostique des items individuels : Examiner la corrélation totale corrigée ($r_{it-c} ge 0.30$) et vérifier qu’aucune suppression d’item n’engendre une élévation de l’alpha global dans le tableau
Deleted Variable. - Raffinement itératif si nécessaire : Élaguer les items contre-performants un par un, en réexécutant la procédure SAS après chaque retrait afin de préserver l’équilibre de l’échelle.
- Reporting académique final : Restituer les résultats selon les canons du style APA (7e édition) en documentant la taille d’échantillon, la corrélation moyenne inter-items et les limites inhérentes à la tau-équivalence.
En respectant scrupuleusement ce cadre procédural, le praticien ou le chercheur confère à ses instruments d’évaluation une assise psychométrique inattaquable. Le progiciel SAS s’avère un vecteur d’excellence méthodologique, alliant précision numérique, puissance computationnelle et traçabilité intégrale au service d’une recherche quantitative rigoureuse, transparente et pérenne.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Clark, L. A., & Watson, D. (1995). Constructing validity: Basic issues in objective scale development. Psychological Assessment, 7(3), 309–319. https://doi.org/10.1037/1040-3590.7.3.309
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/BF02288391
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Raykov, T. (1997). Scale reliability, Cronbach’s coefficient alpha, and violations of essential tau-equivalence with fixed congeneric components. Multivariate Behavioral Research, 32(4), 329–344. https://doi.org/10.1207/s15327906mbr3204_2
- SAS Institute Inc. (2023). SAS/STAT 15.3 User’s Guide: The CORR Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
- Spearman, C. (1904). « General intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107