
L’analyse de variance (ANOVA) constitue l’un des piliers méthodologiques les plus largement mobilisés en psychologie, en sciences cognitives, en médecine computationnelle et dans l’ensemble des sciences du comportement. Développée originellement par Sir Ronald Fisher, cette technique inférentielle permet d’évaluer l’effet de facteurs catégoriels sur une variable dépendante continue en décomposant la variance totale observée en composantes attribuables au traitement et en composantes relevant de la variabilité non expliquée. Cependant, l’élégance formelle du test F de Fisher repose sur un ensemble d’hypothèses distributionnelles strictes qui gouvernent le comportement du terme d’erreur stochastique. Trop souvent reléguée au rang de formalité mécanique ou éludée au profit d’un examen direct et superficiel des données brutes, l’analyse diagnostique des résidus constitue pourtant la véritable clé de voûte de la validité statistique des conclusions expérimentales.
Dans la pratique contemporaine de la recherche, guidée par les standards méthodologiques croissants de l’American Psychological Association (APA) et le mouvement pour la science ouverte et reproductible, considérer le modèle linéaire sous sa seule forme paramétrique globale expose le chercheur à des risques majeurs de biais inférentiels. Des distorsions graves dans les taux d’erreur de première espèce (α) et de seconde espèce (β), ainsi que des surestimations ou sous-estimations substantielles de la taille d’effet, émergent fréquemment dès lors que les postulats théoriques sont transgressés. Le modèle ANOVA n’évalue pas directement la distribution globale de la variable réponse agrégée sur tous les groupes, mais plutôt les écarts individuels autour des moyennes conditionnelles associées à chaque modalité factorielle.
Ce guide exhaustif a pour ambition de fournir aux chercheurs, doctorants et analystes de données un cadre conceptuel rigoureux et une feuille de route opérationnelle pour inspecter, diagnostiquer et traiter les résidus d’un modèle ANOVA univarié, factoriel ou à mesures répétées. En explorant successivement les fondements mathématiques, les procédures de calcul, les approches graphiques et inférentielles de la normalité, de l’homoscédasticité et de l’indépendance, ainsi que les alternatives robustes et modernes face aux déviations observées, cet article propose une synthèse approfondie conjuguant rigueur épistémologique et pertinence appliquée.
1. Fondements théoriques des résidus dans le modèle ANOVA
1.1 Définition mathématique et conceptuelle du résidu
D’un point de vue formel, le modèle linéaire général appliqué à l’analyse de variance à un facteur s’exprime traditionnellement sous la forme de l’équation :
Yij = μ + αj + εij
où Yij représente le score individuel de l’observation i au sein de la condition expérimentale j, μ désigne la moyenne générale non pondérée de l’échantillon ou de la population, αj matérialise l’effet spécifique du niveau j du facteur expérimental (satisfaisant à la contrainte d’identifiabilité habituelle selon laquelle la somme des αj est nulle), et εij symbolise l’erreur aléatoire théorique non observable. Cette formulation peut être réécrite de façon équivalente sous la forme du modèle par moyennes de cellules, où μj = μ + αj incarne la moyenne conditionnelle de la modalité j.
Dans ce formalisme, le terme théorique d’erreur stochastique εij = Yij – μj est une variable latente supposée résumer la multitude des déterminants non contrôlés agissant sur la mesure. Le résidu empirique, désigné par eij, constitue l’estimateur par échantillonnage de cette perturbation latente. Il est calculé en soustrayant du score observé Yij l’estimation de la moyenne du groupe, notée ŷij = Ȳ.j. Le résidu représente par conséquent la composante de variance intra-groupe (erreur résiduelle) isolée de toute influence imputable aux variables indépendantes manipulées. C’est précisément sur cette grandeur que se cristallisent l’ensemble des postulats mathématiques autorisant la dérivation exacte de la distribution F de Fisher-Snedecor.
1.2 Rôle des résidus dans la validation des postulats du modèle linéaire
La validité des tests de signification statistiques construits sur la somme des carrés dépend intimement du théorème de Gauss-Markov et de la théorie de la normalité asymptotique. Les conclusions statistiques tirées d’une ANOVA reposent sur trois postulats capitaux : l’indépendance sérielle et spatiale des erreurs, l’homogénéité des variances conditionnelles (homoscédasticité) et la normalité de leur distribution. Lorsque ces conditions sont satisfaites, l’estimateur des moindres carrés ordinaires (MCO) est le meilleur estimateur linéaire non biaisé (BLUE), et les ratios de variance suivent exactement une distribution F sous l’hypothèse nulle.
Une confusion récurrente parmi les praticiens consiste à vérifier la normalité ou l’absence d’asymétrie sur la variable dépendante globale sans tenir compte de la structure factorielle. Si les moyennes de groupes sont très dissemblables, la variable dépendante globale présentera une distribution multimodale ou asymétrique, quand bien même les erreurs au sein de chaque groupe seraient parfaitement gaussiennes et homoscédastiques. L’analyse diagnostique moderne opère un décentrement méthodologique indispensable : elle quitte l’examen superficiel des variables marginales pour se focaliser exclusivement sur le comportement des erreurs de prédiction conditionnelles, c’est-à-dire les résidus. Ce n’est qu’en inspectant la structure fine des résidus que l’analyste peut s’assurer que le modèle ne souffre pas de sous-spécification ou de violations distributives invalidant la métrique inférentielle.
1.3 Spécificités des résidus en recherche psychologique et comportementale
Les données colligées dans le champ des sciences comportementales, cognitives et cliniques possèdent des propriétés particulières qui augmentent la probabilité d’irrégularités résiduelles. Les variables psychométriques (échelles d’anxiété, inventaires de personnalité, indices de dépression de Beck) sont souvent construites sur des échelles discrètes ou de type Likert, introduisant par nature une granularité et des effets de plancher ou de plafond susceptibles d’altérer la normalité des erreurs. De plus, les données chronométriques (temps de réaction en millisecondes dans les paradigmes d’inhibition cognitive ou d’amorçage sémantique) exhibent quasi-systématiquement des distributions fortement asymétriques positives, engendrant des résidus étirés vers les valeurs élevées.
Le bruit de mesure en recherche comportementale est également alimenté par la fluctuation attentionnelle des sujets, les erreurs de consigne, la fatigue expérimentale et une forte hétérogénéité interindividuelle constitutive de la complexité psychologique. Ces sources de variance non contrôlées s’agglomèrent directement au sein des résidus. Dès lors, analyser rigoureusement les résidus en psychologie expérimentale n’est pas uniquement un impératif d’ajustement mathématique : c’est un outil heuristique majeur. Un résidu anormalement élevé ne reflète pas simplement une défaillance de distribution, il peut signaler une stratégie cognitive atypique chez un participant, une incompréhension de la tâche ou la présence d’un sous-groupe psychopathologique méconnu au sein de l’échantillon.
2. Calcul et typologie des résidus en ANOVA
2.1 Procédure de calcul manuel des résidus bruts
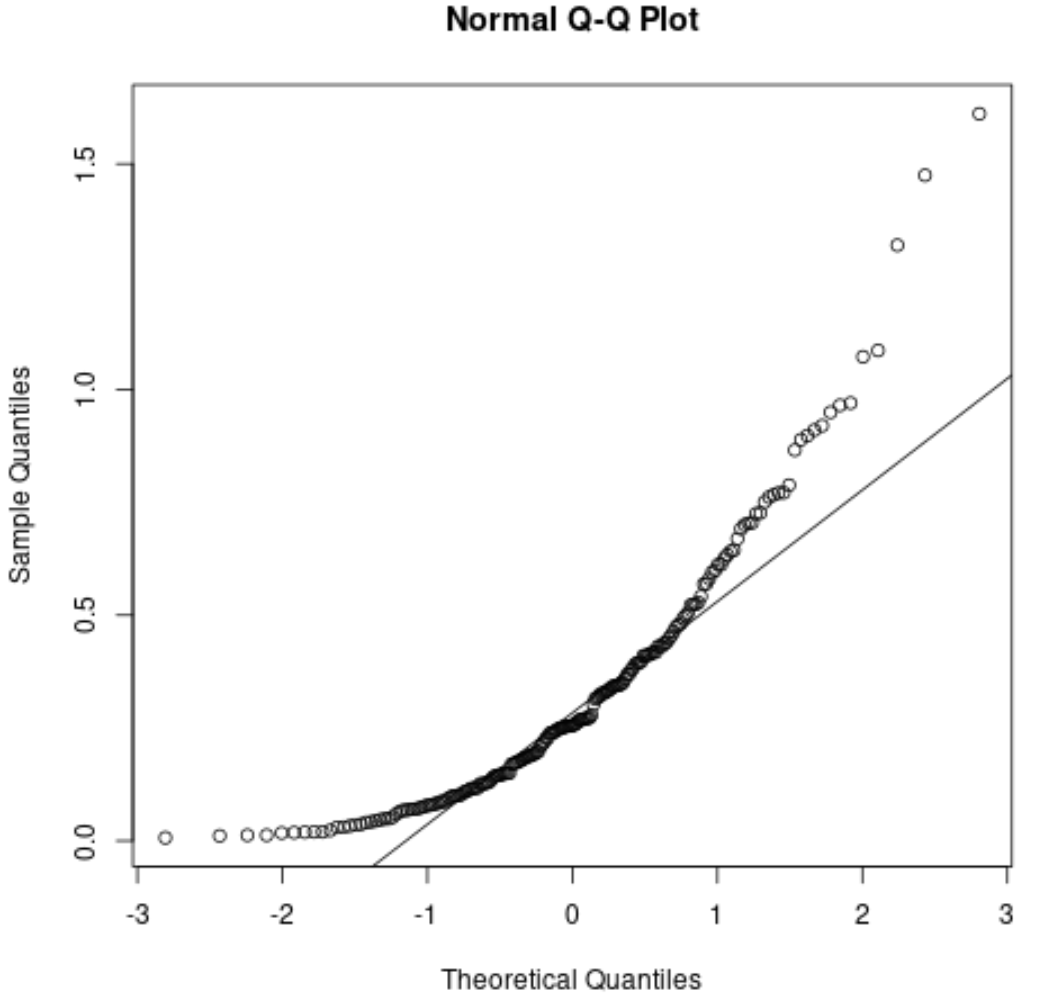
Le calcul des résidus bruts au sein d’une ANOVA à un facteur repose sur une arithmétique simple mais exigeante quant à sa cohérence conceptuelle. Considérons une expérience psychologique comportant trois conditions thérapeutiques distinctes (par exemple : Groupe Contrôle Liste d’attente, Groupe Thérapie Cognitivo-Comportementale, Groupe Méditation de Pleine Conscience) conçue pour moduler un score de détresse psychologique. Soit Yij le score obtenu par l’individu i appartenant au groupe j. La première étape consiste à déterminer avec précision la moyenne empirique de chaque cellule expérimentale :
Ȳ.j = (1 / nj) ∑i=1nj Yij
Une fois ces moyennes de sous-groupes obtenues, le résidu brut associé à chaque observation individuelle est généré par soustraction directe :
eij = Yij – Ȳ.j
Une propriété algébrique fondamentale de l’estimation par les moindres carrés ordinaires réside dans le fait que la somme algébrique des résidus au sein de chaque niveau de traitement est strictement égale à zéro :
∑i=1nj eij = ∑i=1nj (Yij – Ȳ.j) = ∑ Yij – nj Ȳ.j = 0
Par voie de conséquence, la somme totale des résidus sur l’ensemble de l’expérience est également nulle. Cette propriété démontre que le résidu brut est centré sur zéro au sein de chaque groupe. La variance de ces résidus bruts fournit l’estimateur de la variance d’erreur intra-groupe, couramment dénommée carré moyen résiduel (CMR ou MSerror), qui servira de dénominateur au test F.
2.2 Résidus standardisés et résidus studentisés
Bien que les résidus bruts fournissent une mesure directe de l’écart dans l’unité originale de la variable dépendante, ils présentent une limite méthodologique sévère : leur amplitude dépend intrinsèquement de l’échelle de mesure employée, ce qui interdit toute comparaison objective entre des instruments psychométriques différents ou entre des modèles distincts. Pour surmonter cet obstacle, la statistique inférentielle recourt à la standardisation et à la studentisation des erreurs.
Le résidu standardisé (ou résidu semi-étudiantisé) est obtenu en divisant le résidu brut par la racine carrée du carré moyen de l’erreur du modèle global :
zij = eij / √(CMR)
Cependant, cette standardisation élémentaire néglige le fait que les résidus n’ont pas tous la même variance théorique lorsque la matrice de projection orthogonale (la matrice chapeau ou hat matrix, H) est prise en compte. En ANOVA, l’élément diagonal de cette matrice pour l’individu i dans le groupe j est exactement hii = 1 / nj. Les résidus des observations issues de groupes de petite taille possèdent donc une variance d’échantillonnage intrinsèquement différente de ceux issus de groupes volumineux. Le résidu studentisé interne corrige cette disparité en divisant l’écart brut par son écart-type d’échantillonnage théorique exact :
rij = eij / [ √(CMR) × √(1 – hii) ] = eij / [ √(CMR) × √(1 – 1/nj) ]
Plus puissant encore pour l’identification des valeurs atypiques, le résidu studentisé externe (souvent qualifié de résidu supprimé ou jackknifed residual, noté tij) recalcule la variance d’erreur résiduelle en excluant expressément la i-ème observation du modèle. Si une valeur aberrante contamine le calcul global du CMR, le résidu studentisé externe élimine cette contamination et révèle l’ampleur véritable de l’anomalie. Ces résidus suivent rigoureusement une loi de Student à (N – k – 1) degrés de liberté, permettant l’établissement de seuils inférentiels précis pour la détection des déviations extrêmes.
2.3 Extraction programmatique des résidus via les logiciels statistiques
Dans l’environnement de calcul statistique R, l’extraction des résidus s’articule autour de l’ajustement préalable d’un objet linéaire généré par les fonctions de modélisation standard. Après avoir déclaré un modèle univarié par le biais de la syntaxe fondamentale reliant la variable dépendante au facteur catégoriel, l’analyste peut invoquer la fonction residuals() pour obtenir les résidus bruts, la fonction rstandard() pour isoler les résidus standardisés selon la matrice chapeau, et la fonction rstudent() pour dériver les résidus studentisés externes. L’extraction de ces vecteurs permet leur intégration immédiate au sein du jeu de données principal sous la forme de nouvelles colonnes dédiées à la validation visuelle et inférentielle.
Au sein de l’écosystème commercial IBM SPSS Statistics, l’accès à ces diagnostics s’opère majoritairement par le module du Modèle Linéaire Général Univarié ou par la procédure de régression linéaire. Dans la boîte de dialogue dédiée à l’enregistrement des variables diagnostiques, l’utilisateur a la faculté de cocher sélectivement la sauvegarde des résidus non standardisés, standardisés et studentisés, ainsi que des indices d’influence tels que la distance de Cook. SPSS génère alors automatiquement de nouvelles variables standardisées nommées par défaut avec des préfixes identifiables dans la vue des données, permettant la manipulation subséquente dans les menus de graphiques interactifs.
Dans l’univers Python, l’extraction repose principalement sur la bibliothèque spécialisée statsmodels conjointement avec scipy.stats. Suite à la déclaration de la formule d’ANOVA et à l’application de la méthode d’ajustement aux moindres carrés ordinaires, l’objet résultant expose des attributs directs renfermant les résidus bruts. L’instanciation de la classe consacrée à l’analyse de l’influence fournit quant à elle des méthodes vectorisées retournant les résidus studentisés externes et les résidus standardisés sous forme de séries exploitables par les bibliothèques graphiques de haut niveau.
3. Évaluation de l’hypothèse de normalité des résidus
3.1 Fondements de l’hypothèse de normalité distributionnelle
L’inférence classique de l’ANOVA s’enracine dans la dérivation du ratio de variance sous l’hypothèse nulle d’homogénéité des moyennes. Pour que le rapport entre le carré moyen inter-groupes (MSbetween) et le carré moyen intra-groupes (MSwithin) suive avec exactitude une distribution de probabilité F de Fisher-Snedecor, il est rigoureusement requis que les sommes de carrés constituantes soient distribuées selon des lois du Chi-deux indépendantes. Cette propriété mathématique découle directement du fait que les variables stochastiques individuelles sous-jacentes suivent une loi normale univariée.
Lorsque les résidus s’écartent substantiellement de la loi normale, particulièrement en présence de distributions bimodales, multimodales ou présentant une forte asymétrie combinée à des queues lourdes (leptocurticité), la distribution d’échantillonnage de la statistique empirique s’écarte de la loi théorique de référence. Si les erreurs sont symétriques mais aplaties (platycurtiques) ou au contraire très pointues, les probabilités associées aux valeurs critiques sont altérées. Il convient de réaffirmer avec force que le postulat ne requiert à aucun moment que la variable dépendante brute soit normalement distribuée dans sa globalité sans distinction de condition, mais stipule exclusivement que l’erreur aléatoire intra-condition εij partage une distribution gaussienne commune centrée sur zéro.
3.2 Méthodes diagnostiques visuelles de la normalité
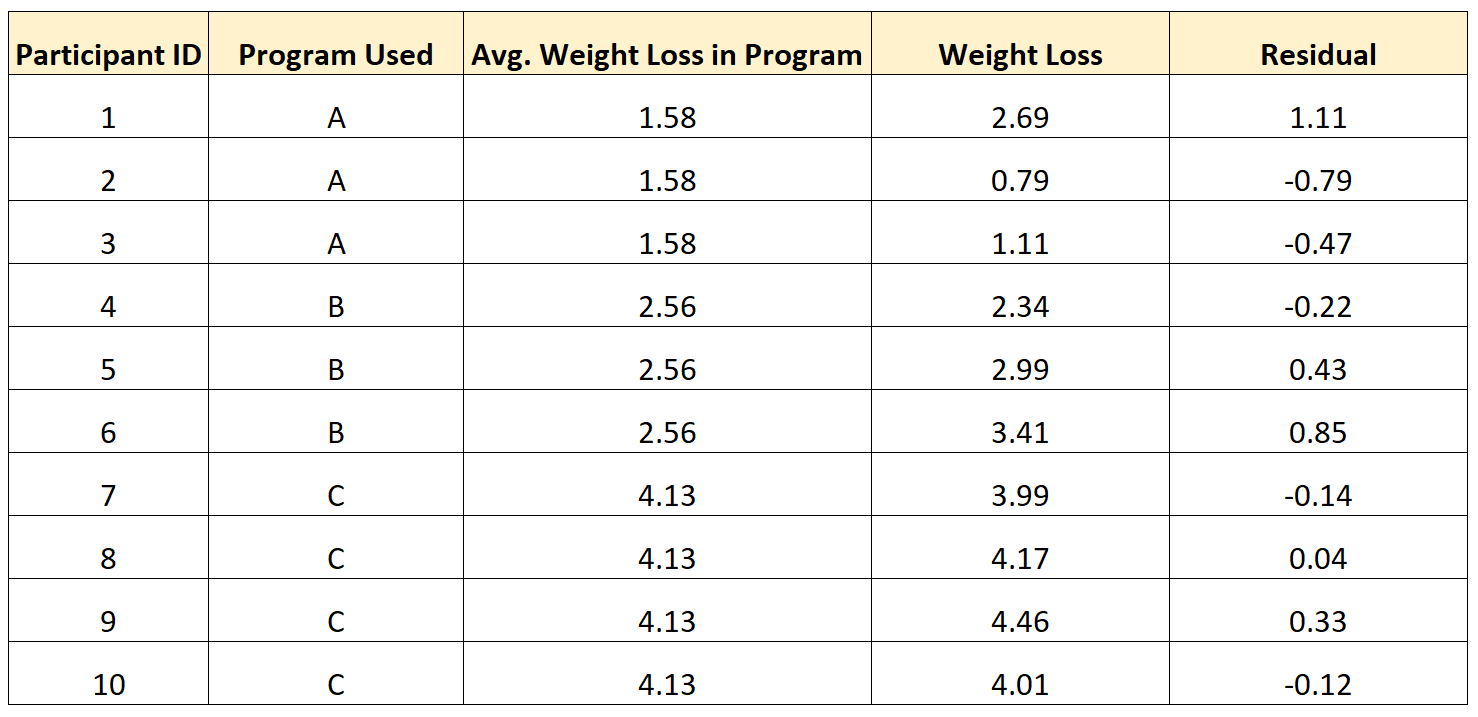
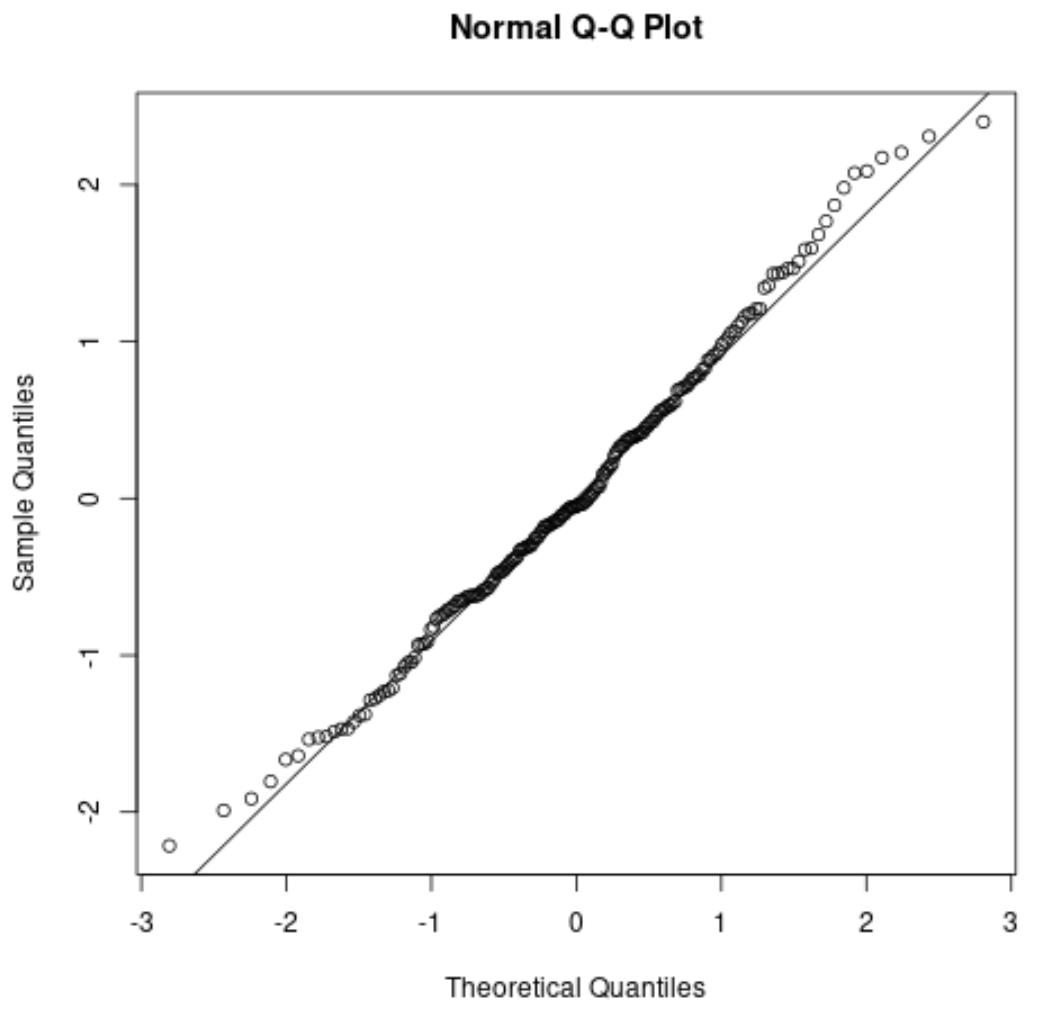
L’inspection graphique représente l’étape préalable incontournable et souvent la plus informative de l’analyse des résidus, surpassant fréquemment l’interprétation rigide des tests d’hypothèse formels dans l’appréciation pratique du profil distributionnel. L’outil diagnostique de référence universelle est le diagramme quantile-quantile normal, universellement désigné sous l’appellation de Q-Q plot. Ce graphique projette les quantiles empiriques des résidus standardisés ou studentisés sur l’axe des ordonnées contre les quantiles théoriques attendus sous une loi normale standard sur l’axe des abscisses.
Sous la condition idéale de normalité, les points se disposent de façon rectiligne le long de la diagonale de référence à 45 degrés. Les courbures systématiques révèlent instantanément la nature de l’écart : une forme en arc convexe ou concave dénote une asymétrie positive ou négative prononcée, tandis qu’une forme sigmoïde en « S » signale des queues de distribution anormalement lourdes ou légères par rapport aux prédictions gaussiennes. La superposition d’un histogramme des résidus studentisés avec le tracé continu d’une densité normale théorique ajustée permet d’apprécier la présence éventuelle de multimodalités masquées, reflétant l’action de covariables ignorées ou de stratifications sous-jacentes non modélisées au sein des groupes expérimentaux.
3.3 Tests statistiques formels d’adéquation à la loi normale
En complément des visualisations diagnostiques, la littérature méthodologique recourt fréquemment à des tests formels d’adéquation statistique. Le test de Shapiro-Wilk s’impose historiquement comme l’un des plus puissants et sensibles pour tester l’hypothèse nulle selon laquelle les résidus sont issus d’une population normalement distribuée. Fondé sur le rapport entre l’estimateur optimal de la variance basé sur les statistiques d’ordre et la variance d’échantillonnage habituelle, sa statistique W oscille entre 0 et 1, des valeurs proches de l’unité témoignant d’une concordance étroite avec la normalité. Une valeur de p inférieure au seuil critique alpha usuel conduit au rejet formel de l’hypothèse de normalité.
Le test de Kolmogorov-Smirnov, lorsqu’il intègre la correction de Lilliefors pour compenser le fait que la moyenne et la variance résiduelles sont estimées à partir des données elles-mêmes, offre une alternative basée sur la distance suprémum entre la fonction de répartition empirique et la fonction théorique cumulative. Cependant, une limite épistémologique majeure de ces épreuves inférentielles réside dans leur dépendance fonctionnelle directe à la taille de l’échantillon. Dans les petits échantillons (typiquement N < 30), où la normalité est cruciale en raison de l’inapplicabilité asymptotique, les tests manquent cruellement de puissance statistique et échouent régulièrement à détecter des déviations substantielles. Inversement, dans les échantillons massifs (typiquement N > 300), ces mêmes tests deviennent hypersensibles, rejetant l’hypothèse de normalité pour des écarts minimes, totalement dénués d’impact pratique sur l’intégrité du test F.
4. Diagnostic de l’homoscédasticité (homogénéité des variances)
4.1 Le postulat d’égalité des variances intra-groupes
L’homoscédasticité postule que la variance du terme d’erreur stochastique demeure rigoureusement constante à travers l’ensemble des conditions expérimentales définies par le ou les facteurs de l’ANOVA. En d’autres termes, l’amplitude de la dispersion aléatoire ne doit être ni amplifiée ni comprimée en fonction de la modalité particulière du traitement assigné au sujet :
Var(εij) = σ2 ∀ j ∈ {1, 2, …, k}
Cette condition autorise le calcul légitime d’une variance d’erreur commune, le carré moyen résiduel (CMR), en agrégeant l’information de variabilité issue de chaque cellule pour constituer le dénominateur commun des statistiques de test.
Lorsque cette hypothèse est violée, la situation d’hétéroscédasticité qui en résulte déstabilise gravement la machinerie inférentielle de l’ANOVA. Les conséquences sont particulièrement redoutables dans les plans d’expérience non équilibrés, où les effectifs par cellule nj diffèrent. Si les groupes possédant les plus faibles effectifs présentent les variances les plus importantes, la statistique F empirique est artificiellement gonflée, provoquant une explosion incontrôlée du risque de fausse découverte (erreur de type I). À l’inverse, si les groupes volumineux concentrent la plus forte dispersion, le test F devient hyper-conservateur, laminant la puissance statistique du dispositif expérimental et augmentant dramatiquement le risque de commettre une erreur de type II.
4.2 Analyses graphiques de dispersion des résidus
Le diagnostic visuel privilégié pour ausculter l’homoscédasticité consiste à construire le graphique bivarié confrontant les résidus standardisés ou studentisés (disposés sur l’axe vertical) aux valeurs prédites ou ajustées par le modèle (fitted values, placées sur l’axe horizontal). Dans le contexte d’une ANOVA, les valeurs prédites correspondent strictement aux moyennes de chaque condition expérimentale. Le graphique présente ainsi une suite d’alignements verticaux de points, chaque colonne représentant la distribution résiduelle d’un groupe expérimental donné.
L’analyste examine attentivement l’étalement vertical de ces colonnes de résidus. Sous l’hypothèse d’homoscédasticité, la dispersion des points doit paraître homogène d’une colonne à l’autre, formant une bande de dispersion horizontale régulière sans gradient perceptible. La détection d’une structure en entonnoir (funnel shape) ou en mégaphone, caractérisée par un accroissement ou un rétrécissement systématique de l’amplitude verticale le long de l’axe des valeurs prédites, signale une hétéroscédasticité monotone où la variance d’erreur dépend fonctionnellement du niveau de la réponse moyenne. La visualisation parallèle des résidus sous forme de boîtes à moustaches conditionnelles constitue également une méthode intuitive remarquable pour comparer visuellement les étendues interquartiles et les amplitudes totales entre cellules expérimentales.
4.3 Tests inférentiels d’homoscédasticité
Afin d’étayer le jugement graphique par une démarche probabiliste, plusieurs tests d’homogénéité des variances sont couramment mobilisés. Le test de Levene originel évalue la significativité des écarts absolus des observations individuelles par rapport à la moyenne de leur groupe respectif à l’aide d’une ANOVA unidirectionnelle. Cependant, en raison de sa sensibilité aux violations de normalité, les méthodologistes recommandent impérativement l’emploi de sa variante robuste, proposée par Brown et Forsythe, qui substitue la médiane de groupe à la moyenne arithmétique pour le calcul des déviations :
zij = | Yij – Mdj |
Le test de Brown-Forsythe préserve remarquablement son taux nominal d’erreur de première espèce même en présence d’asymétries distributionnelles marquées dans les données psychologiques.
À l’opposé, le test de Bartlett, fondé sur une statistique de rapport de vraisemblance, bénéficie d’une puissance statistique supérieure lorsque la stricte normalité des données est garantie sans réserve. Néanmoins, il est notoire pour son hypersensibilité dramatique aux déviations de normalité : un écart bénin à la courbe de Gauss conduit fréquemment le test de Bartlett à rejeter l’homogénéité des variances alors même que les variances réelles sont rigoureusement identiques. Par conséquent, l’usage du test de Bartlett doit être banni dans les contextes où la parfaite normalité des résidus ne peut être préalablement démontrée, au profit exclusif du test de Levene centré sur la médiane.
5. Diagnostic de l’indépendance des résidus
5.1 Fondement théorique de l’indépendance statistique des erreurs
De l’ensemble des postulats gouvernant la validité du modèle ANOVA, celui stipulant l’indépendance mutuelle des résidus est sans conteste le plus critique sur le plan inférentiel, tout en étant paradoxalement le plus complexe à corriger a posteriori :
Cov(εij, εi’j’) = 0 ∀ (i, j) ≠ (i’, j’)
L’hypothèse d’indépendance pose que la valeur prise par l’erreur associée à une unité d’observation donnée ne fournit rigoureusement aucune information prédictive sur la valeur que prendra l’erreur associée à n’importe quelle autre unité d’observation de l’échantillon.
La présence d’une corrélation résiduelle positive, même d’une intensité modeste (par exemple une corrélation intra-classe de l’ordre de 0,05 ou 0,10), exerce un effet dévastateur sur l’inférence. Elle conduit à une sous-estimation systématique et sévère de la véritable erreur-type des estimateurs, engendrant des statistiques F exagérément gonflées et des valeurs de p artificiellement infimes. Le chercheur s’expose alors à déclarer significatifs des effets purement illusoires. En psychologie et en recherche comportementale, les sources de dépendance sont légion : sujets testés au sein d’une même séance de groupe, élèves nichés dans des classes scolaires identiques, patients suivis par le même thérapeute clinicien, ou passations successives administrées par un même expérimentateur développant des biais inconscients au fil du protocole.
5.2 Évaluation de l’autocorrélation sérielle et des effets d’ordre
Lorsque le recueil des données expérimentales s’échelonne séquentiellement dans le temps ou dans l’espace, l’indépendance peut être rompue par des phénomènes dynamiques tels que la dérive d’étalonnage des appareils de laboratoire, les effets d’apprentissage progressif chez l’expérimentateur, ou encore la fatigue cumulative des participants dans les protocoles d’évaluation continue. Le diagnostic primaire de cette pathologie repose sur la représentation graphique des résidus en fonction de l’ordre temporel ou chronologique d’acquisition des données.
L’apparition de grappes de résidus successifs de même signe, visualisées par des oscillations lentes et sinueuses autour de l’axe zéro, trahit une autocorrélation positive du premier ordre. À l’inverse, une alternance rapide et hachée de signes positifs et négatifs consécutifs indique une autocorrélation négative. Sur le plan inférentiel formel, le coefficient d’autocorrélation de Durbin-Watson (noté d) permet de tester spécifiquement l’existence d’une dépendance autorégressive de premier ordre :
d = [ ∑t=2N (et – et-1)2 ] / [ ∑t=1N et2 ]
La statistique oscille théoriquement dans un intervalle fermé borné par 0 et 4. Une valeur proche de 2 atteste de l’absence totale d’autocorrélation résiduelle sérielle, tandis que des valeurs divergeant substantiellement en deçà de 1,5 ou au-delà de 2,5 alertent sur l’existence d’une structure d’interdépendance séquentielle nécessitant une restructuration analytique immédiate.
5.3 Implications pour les devis quasi-expérimentaux et longitudinaux
Dans les devis quasi-expérimentaux ou longitudinaux, l’indépendance des erreurs est structurellement remise en cause par l’architecture même du plan de recherche. Lorsque des mesures répétées sont recueillies sur les mêmes participants à travers plusieurs étapes temporelles ou plusieurs conditions de tâche cognitive, la proximité temporelle et l’identité biologique de l’individu induisent une corrélation substantielle entre les erreurs de mesure associées à ce sujet. Tenter d’analyser de telles données via une ANOVA univariée standard pour groupes indépendants constitue une erreur méthodologique gravissime, car le modèle ignore la partition intra-sujet de la variance.
Pour prévenir l’émergence de dépendances fallacieuses lors de la phase de recueil, les chercheurs doivent appliquer une randomisation rigoureuse de l’ordre d’assignation des traitements, des séquences de présentation des stimuli et des horaires de passation. Dès lors qu’une dépendance de regroupement (clustering) s’avère inhérente au protocole expérimental, le chercheur doit obligatoirement abandonner le cadre de l’ANOVA classique pour embrasser les modèles linéaires mixtes (MLM) ou les approches multiniveaux hiérarchiques. Ces formalismes avancés intègrent explicitement des effets aléatoires pour absorber et modéliser la covariance résiduelle intra-grappe, garantissant ainsi l’impartialité des tests inférentiels.
6. Identification et traitement des résidus atypiques et influents
6.1 Typologie des données atypiques en ANOVA
L’apparition d’observations divergentes constitue une réalité empirique universelle dans le traitement des protocoles expérimentaux comportementaux. Une distinction épistémologique et technique capitale doit impérativement être établie entre une donnée aberrante marginale (un score brut inhabituel au regard de la population entière) et un résidu conditionnel extrême. Une valeur observée peut sembler atypique à l’échelle globale de l’échantillon tout en possédant un résidu quasi nul si elle appartient à une condition expérimentale dont la moyenne est elle-même très élevée. Inversement, une observation située parfaitement au centre de la distribution marginale globale peut correspondre à un résidu colossal si elle dévie de façon aberrante par rapport à la moyenne spécifique de son groupe de traitement.
Ces résidus atypiques trouvent fréquemment leur source dans des dysfonctionnements méthodologiques : erreurs humaines de transcription numérique lors de la saisie, pannes momentanées d’un capteur psychophysiologique, non-respect manifeste des instructions par le participant (réponses aléatoires rapides pour achever l’épreuve sans effort attentionnel), ou appartenance involontaire du sujet à une population non ciblée (par exemple, un participant sous médication psychotrope dans une étude sur l’attention soutenue). Au-delà de ces explications d’ordre technique, le chercheur doit maintenir une vigilance clinique et théorique soutenue : une déviation extrême peut traduire une véritable singularité psychologique ou neuropsychologique qui mérite une investigation qualitative individualisée plutôt qu’une élimination mécanique non réfléchie.
6.2 Seuils statistiques de décision pour les résidus extrêmes
L’évaluation métrique de l’atypicité s’articule autour de critères quantitatifs normalisés. Une règle empirique largement reconnue stipule que les résidus standardisés ou studentisés doivent être examinés avec attention dès lors qu’ils excèdent en valeur absolue le seuil de 2, et qualifiés d’observations hautement atypiques lorsqu’ils franchissent le seuil critique absolu de 3. Sous l’hypothèse de normalité, la probabilité d’observer un résidu dépassant 3 écarts-types est inférieure à 0,27 %, ce qui en fait un événement stochastique particulièrement improbable sous le modèle spécifié.
Pour mesurer l’influence réelle exercée par une observation sur l’ensemble du modèle paramétrique, la métrique fondamentale demeure la distance de Cook (notée Di). Cette quantité synthétise simultanément l’amplitude du résidu studentisé et l’effet de levier (leverage, noté hii) exercé par le positionnement structurel de l’observation :
Di = [ eij2 / (k × CMR) ] × [ hii / (1 – hii)2 ]
Dans le cadre strict d’une ANOVA à un facteur, les effets de levier sont constants au sein de chaque cellule et valent 1 / nj. Par conséquent, la distance de Cook est principalement modulée par la taille du groupe et le carré du résidu. Bien que le seuil théorique classique de Di > 1 soit fréquemment cité, un critère plus sensible et rigoureux pour les données expérimentales contemporaines est fixé à 4 / N ou 4 / (N – k – 1), où N désigne la taille totale de l’échantillon et k le nombre de groupes. Toute observation excédant cette borne doit faire l’objet d’un examen approfondi.
6.3 Protocole décisionnel face aux données aberrantes
La découverte de résidus extrêmes place l’analyste face à un dilemme méthodologique qui ne doit jamais être tranché par une suppression aveugle dictée par la seule recherche de la significativité statistique. L’exclusion unilatérale d’observations uniquement parce qu’elles détériorent la qualité des postulats ou font échouer le test d’hypothèse constitue une fraude scientifique passive susceptible de gonfler dramatiquement le taux de faux positifs dans la littérature publiée.
Le protocole décisionnel optimal exige la conduite systématique d’une analyse de sensibilité transparente (parfois désignée sous le terme d’analyse de robustesse à deux volets). Le chercheur effectue et consigne rigoureusement l’analyse complète de son modèle sur l’échantillon intégral, puis réitère l’estimation après exclusion documentée des observations présentant des résidus démesurés ou une distance de Cook excessive. Si les conclusions scientifiques majeures (coefficients, direction des contrastes, significativité) demeurent convergentes entre les deux itérations, le chercheur dispose d’une preuve éclatante de la stabilité empirique de son modèle. Si des divergences critiques apparaissent, l’analyste est déontologiquement tenu de rendre compte des deux analyses dans son manuscrit, en discutant explicitement des raisons pour lesquelles certaines observations singulières altèrent la trajectoire des conclusions globales.
7. Conséquences de la violation des postulats résiduels
7.1 Robustesse intrinsèque de l’ANOVA face aux écarts de normalité
Dans la littérature statistique appliquée, l’ANOVA est traditionnellement réputée pour sa robustesse face aux déviations du postulat de normalité des erreurs. Cette résilience relative trouve sa justification théorique dans le théorème central limite, lequel stipule que la distribution d’échantillonnage de la moyenne empirique converge vers une loi normale à mesure que l’effectif s’accroît, indépendamment de la forme distributionnelle de la population d’origine, pourvu que cette dernière possède une variance finie.
Néanmoins, cette tolérance générale connaît des limites strictes que tout expérimentateur rigoureux doit maîtriser. La robustesse est effective principalement lorsque les distributions résiduelles sont symétriques, même si elles présentent un kurtosis modéré, et que les effectifs par groupe sont équilibrés et d’une taille suffisante (idéalement nj ≥ 25 à 30 participants par condition). En revanche, lorsque l’échantillon est restreint (par exemple nj ≤ 10 à 12, situation fréquente en neuropsychologie ou en imagerie cérébrale) et que les résidus affichent une asymétrie marquée (skewness sévère), la statistique F empirique perd son calibrage théorique. Dans ces conditions critiques, les probabilités nominales fournies par les tables de distribution s’écartent dangereusement de la réalité stochastique, conduisant à des inférences invalides.
7.2 Dangerosité de l’hétéroscédasticité en plans déséquilibrés
Si la violation de la normalité est souvent tolérable sous grand échantillon, l’inégalité des variances résiduelles (hétéroscédasticité) représente en revanche un péril analytique majeur pour l’intégrité de l’ANOVA, en particulier dans les plans d’expérience déséquilibrés (unbalanced designs). La vulnérabilité du test F face à ce phénomène dépend directement de la direction de la corrélation entre les effectifs des groupes nj et les variances intra-groupes σj2.
Deux configurations distinctes doivent être identifiées avec précision :
- L’association négative ou inverse : Les groupes associant un effectif restreint à une variance d’erreur très élevée, face à des groupes à large effectif présentant une variance étroite. Dans cette configuration, le carré moyen résiduel global (qui est une moyenne pondérée par les degrés de liberté) est largement dominé par les grands groupes et sous-estime tragiquement la variance réelle des petits groupes. Il en résulte une surélévation substantielle du ratio F, et le taux réel d’erreur de type I peut facilement atteindre 15 % à 25 % au lieu du seuil nominal de 5 %. L’analyste conclut alors à l’existence d’une différence expérimentale qui n’est qu’un artefact arithmétique.
- L’association positive ou directe : Les groupes associant un large effectif à une variance résiduelle très ample. Dans ce scénario, le CMR est artificiellement gonflé par les grands groupes, ce qui écrase la statistique F. Le test devient exagérément conservateur, laminant la puissance statistique et empêchant de détecter des effets expérimentaux pourtant réels et substantiels.
7.3 Biais d’estimation de la taille d’effet
Les conséquences d’une perturbation des résidus ne se cantonnent pas à la seule valeur p issue du test d’hypothèse nulle ; elles contaminent directement les estimateurs quantitatifs de la taille d’effet. L’indice le plus usité, l’Êta-carré partiel (η2p), exprime le rapport de la somme des carrés de l’effet sur la somme des carrés de l’effet additionnée à la somme des carrés résiduelle :
η2p = SCeffet / (SCeffet + SCrésiduelle)
Si les résidus hébergent des variances instables, des déviations extrêmes ou une asymétrie lourde, la somme des carrés résiduelle (SCrésiduelle) devient un estimateur biaisé et hautement instable de la variance inexpliquée réelle.
De surcroît, les estimateurs ajustés moins biaisés tels que l’Oméga-carré (ω2) ou l’Epsilon-carré (ε2), qui intègrent le carré moyen résiduel au sein de leur formule de correction pour éliminer le biais d’échantillonnage, subissent de plein fouet l’imprécision d’un CMR contaminé par l’hétéroscédasticité. Lorsque la variance résiduelle est déformée, l’évaluation de la magnitude clinique ou théorique de l’intervention est faussée. Cette distorsion méthodologique compromet gravement les futures synthèses de la littérature, les méta-analyses quantitatives et les calculs de puissance a priori réalisés par la communauté scientifique sur la base de ces indices publiés.
8. Stratégies correctives : transformation mathématique des données
8.1 Transformations classiques pour régulariser les résidus
Face à des résidus violant manifestement les postulats d’homoscédasticité et de normalité, la première ligne de défense méthodologique classique consiste à soumettre la variable dépendante brute à une transformation mathématique non linéaire monotone avant de réajuster le modèle linéaire. L’objectif premier est de stabiliser la variance à travers les groupes et de corriger l’asymétrie résiduelle sans modifier l’ordonnancement fondamental des scores des participants.
Les transformations conventionnelles les plus éprouvées comprennent :
- La transformation logarithmique (log(Y) ou log(Y + c)) : Éminemment efficace pour corriger une asymétrie positive marquée (étalement vers la droite) et stabiliser les résidus dont l’écart-type croît proportionnellement à la moyenne conditionnelle.
- La transformation racine carrée (√Y ou √(Y + 0,5)) : Particulièrement adaptée aux données discrètes issues de comptages de comportements (fréquence d’erreurs, nombre de persévérations motrices) dont la distribution théorique sous-jacente s’apparente à une loi de Poisson, où la variance est intrinsèquement liée à la moyenne.
- La transformation réciproque ou inverse (1 / Y) : Fréquemment appliquée aux données chronométriques (temps de réaction ou de latence). En transformant une latence en vitesse d’exécution (traitements par seconde), elle neutralise l’impact démesuré des temps de réponse extrêmement longs sur la queue droite des résidus.
8.2 Famille de transformations paramétriques de Box-Cox
Plutôt que de choisir arbitrairement une transformation arithmétique par tâtonnements successifs, le statisticien peut recourir à la méthode formalisée par George Box et David Cox. La famille de transformations de Box-Cox définit une classe continue de transformations de puissance régies par un unique paramètre réel continu, noté λ :
Y(λ) = (Yλ – 1) / λ (si λ ≠ 0)
Y(λ) = ln(Y) (si λ = 0)
Cette formulation élégante subsume les transformations conventionnelles : λ = 1 n’applique aucune modification de forme, λ = 0,5 correspond à la racine carrée, λ = 0 incarne le logarithme népérien, et λ = -1 équivaut à la transformation inverse.
La valeur optimale de λ est déterminée empiriquement par l’algorithme d’estimation par le maximum de vraisemblance, en construisant la courbe de log-vraisemblance du modèle ANOVA réestimé à travers une grille dense de valeurs potentielles de λ. La valeur maximisant cette fonction fournit l’ajustement mathématique garantissant des résidus les plus proches possible d’une distribution normale parfaitement homoscédastique. Il convient toutefois de souligner une contrainte opérationnelle stricte : la formulation standard de Box-Cox est exclusivement définie pour des valeurs de Y strictement positives (Y > 0). En présence de scores nuls ou négatifs, un terme de décalage constant c doit être obligatoirement additionné à la variable dépendante brute au préalable.
8.3 Limites épistémologiques et interprétatives des données transformées
Malgré leur élégance formelle et leur efficacité computationnelle incontestable pour réaligner les résidus avec les axiomes de Gauss-Markov, les transformations non linéaires soulèvent d’épineuses interrogations théoriques et pratiques que le chercheur ne doit jamais sous-estimer. Le principal écueil réside dans la dénaturation de l’échelle métrique d’origine. Si une échelle psychométrique a été validée pour mesurer des unités d’intervalle psychologique (par exemple des points d’anxiété clinique), raisonner et calculer sur le logarithme ou la racine carrée de ces scores transforme profondément la signification substantielle du construit mesuré.
De plus, l’interprétation des contrastes de moyennes devient considérablement plus opaque. Dans l’espace transformé, les effets additifs du modèle linéaire se muent fréquemment en effets multiplicatifs sur l’échelle naturelle d’origine. Lorsque l’on procède à la rétro-transformation mathématique des moyennes (par exemple en calculant l’exponentielle de la moyenne des scores transformés en log), on n’obtient plus la moyenne arithmétique de départ, mais la moyenne géométrique de la distribution. Cette altération complique l’intégration des résultats dans les revues systématiques et la restitution clinique auprès des praticiens. Face à ces entraves interprétatives, la communauté statistique contemporaine privilégie fréquemment les modélisations robustes ou généralisées directes, qui préservent l’échelle originelle de mesure sans forcer les données dans le carcan gaussien.
9. Alternatives analytiques robustes en présence de résidus non conformes
9.1 Ajustements paramétriques robustes à l’hétéroscédasticité
Lorsque le diagnostic des résidus démontre une hétéroscédasticité prononcée alors que la distribution conserve une symétrie acceptable, l’abandon des moindres carrés ordinaires au profit du test d’ANOVA de Welch (ou test F de Welch) s’impose comme le standard méthodologique absolu. Conçu spécifiquement pour contourner le postulat d’égalité des variances, le test de Welch n’utilise pas un carré moyen résiduel commun au dénominateur, mais pondère directement chaque moyenne de groupe par l’inverse de sa propre variance d’échantillonnage (wj = nj / sj2).
Parallèlement, la statistique de Welch procède à une correction analytique rigoureuse des degrés de liberté du dénominateur, réduisant ces derniers en fonction directe de l’intensité du différentiel des variances et de l’inégalité des effectifs. D’innombrables simulations de Monte-Carlo ont démontré de façon irréfutable que le test de Welch contrôle impeccablement le taux nominal d’erreur de première espèce (α = 0,05) sous les pires conditions d’hétéroscédasticité combinée à des plans asymétriques, tout en exhibant une puissance statistique pratiquement identique, voire supérieure, à celle de l’ANOVA classique lorsque les variances sont homogènes. Cette supériorité est telle que de nombreux statisticiens méthodologistes préconisent aujourd’hui l’adoption du test de Welch par défaut dans les rapports scientifiques, rendant caduque l’obligation de prouver préalablement l’homoscédasticité.
9.2 Approches non paramétriques et par rangs
Dans les contextes où l’analyse des résidus révèle simultanément une rupture drastique de la normalité (asymétrie sévère, queues excessivement lourdes, bimodalité) et une hétéroscédasticité incurable sur de petits échantillons, les méthodes paramétriques classiques doivent s’effacer devant les procédures non paramétriques basées sur les rangs. Pour une comparaison univariée à plusieurs groupes, le test de Kruskal-Wallis constitue l’alternative historique la plus fréquemment mobilisée.
Le test de Kruskal-Wallis substitue aux valeurs métriques brutes leur rang séquentiel calculé sur l’ensemble de l’échantillon combiné, évaluant ensuite la dispersion des sommes de rangs par rapport à la moyenne théorique attendue sous l’hypothèse nulle. Toutefois, une misconception répandue postule que le test de Kruskal-Wallis s’affranchit de toute exigence distributionnelle. En réalité, pour que ce test puisse être interprété comme un test rigoureux portant sur les médianes des populations, il requiert formellement que les formes des distributions au sein de chaque groupe soient rigoureusement identiques (partageant la même dispersion et la même asymétrie). Si les résidus indiquent des formes de distribution profondément disparates entre les conditions, le test de Kruskal-Wallis teste simplement une dominance stochastique globale et peut perdre son étalonnage sous forte hétérogénéité de dispersion.
9.3 Méthodes de rééchantillonnage et modélisation avancée
Les méthodes statistiques modernes computationnelles offrent des solutions infiniment plus puissantes et flexibles pour traiter les pathologies résiduelles sans sacrifier la puissance des données métriques d’origine. Parmi celles-ci, le rééchantillonnage par bootstrap résiduel (ou bootstrap semi-paramétrique) s’avère remarquable : après ajustement du modèle initial, les résidus centrés sont tirés au sort avec remise de façon répétée (typiquement 5 000 à 10 000 itérations) pour synthétiser de nouveaux jeux de données sous l’hypothèse nulle, permettant ainsi de construire une distribution d’échantillonnage empirique exacte pour la statistique F, totalement affranchie du postulat de normalité.
Pour les devis expérimentaux hautement contrôlés sur des échantillons réduits, les tests de permutation exacts constituent une référence inférentielle imparable : ils réassignent aléatoirement les scores observés aux différentes modalités de traitement afin d’énumérer toutes les permutations possibles et de calculer la probabilité exacte d’observer la dispersion des moyennes empiriques. Enfin, l’évolution analytique la plus structurelle consiste à migrer vers les Modèles Linéaires Généralisés (GLM) ou les modèles de régression robuste. En autorisant l’appariement direct de la variable réponse à des lois d’erreur non gaussiennes (distribution Gamma pour les temps de réaction, loi binomiale négative pour les comptages surdispersés) via une fonction de lien appropriée, les GLM éliminent à la racine le besoin d’assumer des résidus normaux et homoscédastiques.
10. Analyse des résidus dans les plans factoriels et à mesures répétées
10.1 Diagnostics spécifiques aux plans factoriels intersujets
Dans le cadre des plans factoriels croisés (par exemple un devis 2×2 ou 3×2 intersujets), l’analyse des résidus s’enrichit d’exigences diagnostiques spécifiques liées à l’interaction statistique entre les facteurs expérimentaux. L’examen des résidus ne doit pas être mené de manière globale pour chaque facteur pris isolément, mais doit être conduit rigoureusement au niveau de chaque cellule individuelle du plan (c’est-à-dire chaque croisement factoriel particulier). Les résidus bruts sont calculés en soustrayant à chaque observation la moyenne spécifique de la cellule factorielle à laquelle elle appartient :
eijk = Yijk – Ȳ.jk
L’omission d’un terme d’interaction dans l’écriture du modèle factoriel produit une pathologie résiduelle caractéristique hautement informative : les résidus conservent une structure systématique non modélisée. Lorsque l’on trace les résidus en fonction des niveaux des facteurs, des patrons de variation réguliers ou des déviations groupées émergent, révélant que la variance prétendument aléatoire intra-cellule héberge en vérité une interaction réelle masquée par la sous-spécification du modèle. De même, l’évaluation de l’homogénéité des variances requiert d’appliquer le test de Levene basé sur la médiane non pas sur les facteurs marginaux, mais sur la variable d’interaction globale croisant l’ensemble des cellules du protocole factoriel.
10.2 Résidus et postulat de sphéricité dans les devis intrasujets
Dans les plans d’ANOVA à mesures répétées (plans intrasujets), où chaque participant traverse successivement l’ensemble des modalités du traitement expérimental, la structure d’erreur devient intrinsèquement multidimensionnelle. L’analyste se trouve confronté au postulat de sphéricité, qui constitue l’extension directe du postulat d’homoscédasticité au cas des données appariées. La sphéricité postule que les variances de toutes les différences possibles calculées entre les paires de conditions répétées sont rigoureusement équivalentes dans la population d’origine :
Var(Yijk – Yijk’) = constante ∀ k ≠ k’
Cette hypothèse est intimement corrélée à la structure de la matrice de covariance résiduelle multivariée. La violation de ce postulat est universellement diagnostiquée par le test de sphéricité de Mauchly, dont l’hypothèse nulle stipule que la matrice de variance-covariance des contrastes orthogonaux normalisés est proportionnelle à une matrice identité. En cas de rejet de la sphéricité (p < 0,05), les degrés de liberté du test F pour l’effet intrasujet doivent impérativement être corrigés par le coefficient epsilon (ε) de Greenhouse-Geisser (si ε < 0,75) ou de Huynh-Feldt (si ε ≥ 0,75). Cette réduction pondératrice pénalise la statistique de test proportionnellement à l’intensité de la distorsion de la covariance des erreurs résiduelles.
10.3 Transition vers les modèles mixtes pour structures d’erreur complexes
Bien que les corrections traditionnelles de Greenhouse-Geisser et Huynh-Feldt permettent d’ajuster formellement l’ANOVA à mesures répétées face aux défaillances de la sphéricité, cette approche paramétrique univariée demeure fondamentalement rigide et incapable de composer avec les données manquantes ou les rythmes de passation irréguliers. La transition vers les Modèles Linéaires Mixtes (LMM ou Linear Mixed-Effects Models) incarne l’aboutissement méthodologique contemporain pour surmonter l’ensemble des contraintes résiduelles associées aux mesures répétées et aux protocoles hiérarchiques.
Les modèles mixtes transcendent l’obligation de sphéricité en offrant à l’expérimentateur la faculté de paramétrer explicitement l’architecture stochastique de la matrice de covariance résiduelle. Au lieu de postuler une homoscédasticité universelle et indépendante, le chercheur peut déclarer des structures matricielles adaptées à la réalité empirique de son devis :
- Une matrice autorégressive de premier ordre (AR1), capturant la décroissance graduelle de la corrélation résiduelle au fil du temps.
- Une matrice hétérogène (CSH ou UN), autorisant explicitement chaque modalité temporelle à posséder sa propre variance d’erreur tout en modélisant des covariances asymétriques.
En décomposant simultanément la variance résiduelle au niveau interindividuel (intercepts et pentes aléatoires) et au niveau intra-individuel (résidus conditionnels stochastiques), les modèles mixtes assainissent intégralement la mécanique inférentielle, conférant aux conclusions une robustesse inaccessible à l’ANOVA conventionnelle.
11. Protocole pas à pas d’analyse des résidus sur un cas empirique
11.1 Description du devis expérimental et ajustement du modèle initial
Afin de matérialiser la mise en application de ces principes méthodologiques, considérons un protocole de recherche clinique interventionnel conduit dans le domaine des troubles anxieux. L’expérimentateur souhaite évaluer l’efficacité différentielle de trois protocoles thérapeutiques brefs pour réduire la détresse psychologique évaluée par l’Inventaire d’Anxiété de Beck (BAI). Soixante-quinze participants souffrant de trouble anxieux généralisé sont randomisés au sein de trois conditions thérapeutiques indépendantes comportant chacune 25 sujets : Groupe 1 (Liste d’attente / Contrôle actif), Groupe 2 (Thérapie Cognitivo-Comportementale classique – TCC) et Groupe 3 (Thérapie d’Acceptation et d’Engagement basée sur la pleine conscience – ACT).
La première démarche opérationnelle consiste à ajuster le modèle ANOVA univarié initial reliant le score continu d’anxiété post-intervention (BAI) au facteur catégoriel à trois modalités. Dès l’ajustement complété via la méthode des moindres carrés, l’analyste procède à l’extraction et à l’enregistrement systématique au sein du jeu de données des résidus bruts, des moyennes conditionnelles prédites, des résidus standardisés, des résidus studentisés externes et des distances de Cook associées à chaque observation.
11.2 Exécution séquentielle de la batterie diagnostique
L’exécution de la batterie diagnostique débute par l’évaluation visuelle et inférentielle de la normalité distributionnelle. La construction du diagramme Q-Q plot des résidus studentisés révèle un alignement global satisfaisant le long de la diagonale de référence, à l’exception de deux points isolés dans l’extrémité supérieure droite, traduisant une légère élongation de la queue positive. L’application du test de Shapiro-Wilk sur l’ensemble des résidus retourne une statistique W = 0,974 avec une valeur de p = 0,132. L’hypothèse nulle de normalité ne pouvant être rejetée, la distribution des résidus est jugée compatible avec les exigences d’un modèle gaussien.
L’étape suivante consiste à examiner le graphique de dispersion des résidus studentisés en fonction des valeurs prédites (moyennes de groupes). La dispersion verticale au sein de la condition Contrôle (valeur prédite la plus haute) et de la condition TCC apparaît symétrique et modérée ; en revanche, le groupe ACT présente un étalement vertical nettement plus comprimé. L’application du test de Levene robuste fondé sur la médiane (test de Brown-Forsythe) confirme formellement cette disparité en retournant une statistique F(2, 72) = 4,89 assortie d’une valeur p = 0,010, actant ainsi l’existence d’une hétéroscédasticité statistiquement significative entre les trois cellules.
L’auscultation se poursuit par la vérification de l’absence de résidus extrêmes et de cas d’influence disproportionnée. L’inspection des résidus studentisés externes montre qu’une seule observation (le sujet numéro 14 au sein du groupe Contrôle) atteint une valeur de t14 = +2,92, frôlant le seuil d’alerte sans toutefois excéder la limite absolue de 3. Le calcul des distances de Cook met en lumière que la valeur la plus élevée culmine à D14 = 0,082, ce qui demeure très nettement en dessous du seuil critique conservateur fixé à 4 / (75 – 3 – 1) = 0,056. Ce résultat indique que bien que le participant 14 présente un niveau résiduel singulièrement élevé, il ne biaise pas l’estimation de la moyenne de sa cellule de façon inacceptable.
11.3 Arbre décisionnel et sélection de la trajectoire d’ajustement
Au terme de cette séquence diagnostique rigoureuse, l’état méthodologique des résidus peut être formalisé comme suit : l’hypothèse de normalité est respectée, aucun point n’exerce une influence toxique au sens de la distance de Cook, mais l’homogénéité des variances intra-groupes est indubitablement invalidée par le test de Levene. Bien que les effectifs soient formellement équilibrés (n1 = n2 = n3 = 25), ce qui confère une certaine résilience au test F classique, l’existence d’une hétéroscédasticité documentée impose par prudence scientifique l’abandon de l’ANOVA ordinaire au profit de l’ANOVA de Welch corrigée.
Le calcul de l’ANOVA classique aux moindres carrés ordinaires fournit une statistique F(2, 72) = 8,45, p < 0,001, η2p = 0,190. L’application de la correction robuste de Welch sur ces mêmes données produit un ratio F(2, 45,63) = 9,12, p < 0,001. La convergence parfaite des niveaux de signification inférentielle entre les deux approches démontre sans équivoque que la violation de l’homoscédasticité ne remet pas en cause l’effet thérapeutique global observé. En outre, la conduite des comparaisons multiples post-hoc doit obligatoirement abandonner le test de Tukey-HSD classique (qui présuppose une variance résiduelle commune) pour adopter la procédure de Games-Howell, conçue spécifiquement pour comparer des conditions aux variances inégales, garantissant ainsi l’intégrité intégrale de l’inférence scientifique.
12. Directives de publication et restitution des analyses selon les normes APA
12.1 Exigences du JARS-Quant de l’APA relatives aux postulats statistiques
L’American Psychological Association a profondément modernisé ses standards de rigueur méthodologique à travers la publication des directives du Journal Article Reporting Standards for Quantitative Research (JARS-Quant). Ces normes éditoriales formelles prescrivent que les auteurs ne peuvent plus se limiter à rapporter mécaniquement les valeurs F, les degrés de liberté et les seuils de probabilité sans détailler la conformité de leurs données aux postulats sous-jacents aux modèles employés.
Conformément au JARS-Quant, les sections Méthode et Résultats des manuscrits quantitatifs doivent expliciter avec clarté :
- La liste des postulats distributionnels et structurels préalablement vérifiés avant toute modélisation.
- L’indication précise des techniques diagnostiques mobilisées (tests formels avec justification des variantes robustes, analyses graphiques).
- La description exhaustive du traitement accordé aux observations extrêmes ou influentes, incluant la justification théorique ou technique de toute exclusion.
- La justification méthodologique du recours à des ajustements correctifs (tels que la correction de Welch ou les tests de robustesse par permutation) dès lors qu’une entorse aux postulats résiduels est mise au jour.
12.2 Modèles de rédaction académique pour les diagnostics résiduels
Afin de répondre aux standards éditoriaux internationaux les plus stricts, la restitution des analyses diagnostiques doit suivre des formules rhétoriques codifiées alliant concision et transparence.
Exemple de formulation en cas de respect des postulats résiduels :
« Préalablement à l’inférence statistique, les postulats distributionnels du modèle linéaire général ont été examinés sur les résidus du modèle ANOVA. L’évaluation de la normalité résiduelle par l’inspection du diagramme quantile-quantile normal (Q-Q plot) et le test de Shapiro-Wilk a confirmé l’adéquation distributionnelle (W = 0,987, p = 0,452). Le diagnostic de l’homoscédasticité via le test de Levene basé sur la médiane n’a révélé aucune déviation significative de l’égalité des variances à travers les conditions, F(2, 87) = 1,12, p = 0,331. De surcroît, le calcul des distances de Cook (Di max = 0,034) n’a signalé aucun cas d’influence disproportionnée. L’ANOVA unidirectionnelle classique aux moindres carrés a par conséquent été maintenue pour l’évaluation des hypothèses. »
Exemple de formulation en présence d’une hétéroscédasticité exigeant une correction robuste :
« L’auscultation diagnostique des erreurs conditionnelles a mis en évidence une violation de l’hypothèse d’homoscédasticité, le test de Levene centré sur la médiane indiquant une hétérogénéité significative des variances entre les groupes de traitement, F(3, 116) = 5,64, p = 0,001. La normalité résiduelle demeurant pleinement satisfaisante (Shapiro-Wilk W = 0,981, p = 0,094), nous avons eu recours à l’ajustement robuste de Welch avec correction des degrés de liberté afin de prémunir le test contre toute inflation de l’erreur de première espèce. L’effet omnibus du traitement s’est avéré statistiquement significatif, FWelch(3, 58,42) = 7,88, p < 0,001, ω2 = 0,14. Les contrastes a posteriori ont été réalisés au moyen de la procédure de Games-Howell afin d’accommoder les variances inégales. »
12.3 Conception graphique professionnelle pour manuscrits scientifiques
La transmission efficace de la qualité d’ajustement d’un modèle linéaire dans une revue académique de premier plan repose sur l’intégration harmonieuse de figures diagnostiques multipanels respectant la charte graphique APA (typographie sans empattement uniforme, contraste élevé en noir et blanc ou échelle de gris, absence de fioritures décoratives superflues). Un panneau diagnostique moderne et professionnel combine idéalement quatre visualisations standardisées :
- Le diagramme Q-Q plot des résidus studentisés externes avec bande de confiance pointwise à 95 %.
- Le graphique des résidus studentisés en regard des moyennes conditionnelles ajustées (fitted values), rehaussé d’une ligne de référence horizontale à zéro et d’une courbe de lissage non paramétrique de type LOESS pour tracer la dérive éventuelle de la moyenne conditionnelle.
- Le graphique Scale-Location (ou Spread-Location), représentant la racine carrée des résidus standardisés absolus en regard des valeurs prédites pour ausculter spécifiquement l’homoscédasticité sous une métrique stabilisée.
- Le diagramme de levier confrontant les résidus studentisés aux valeurs de levier avec contours d’iso-distance de Cook.
Dans l’esprit du mouvement contemporain pour la reproductibilité scientifique et les principes FAIR (Findable, Accessible, Interoperable, Reusable), les auteurs sont instamment encouragés à consigner l’intégralité de leurs scripts diagnostiques (R Markdown, scripts Python ou syntaxes SPSS commentées) ainsi que les matrices de résidus anonymisées sur des dépôts ouverts publics et pérennes tels que l’Open Science Framework (OSF) ou Zenodo. Cette transparence méthodologique intégrale garantit la vérifiabilité des choix analytiques, fortifie la crédibilité des publications et participe à l’élévation des standards de rigueur dans l’ensemble de la recherche expérimentale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409–428. https://doi.org/10.2307/2332388
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://hdl.handle.net/2440/15227
- Glass, G. V., Peckham, P. D., & Sanders, J. R. (1972). Consequences of failure to meet assumptions underlying the fixed effects analyses of variance and covariance. Review of Educational Research, 42(3), 237–288. https://doi.org/10.3102/00346543042003237
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02383-7