
Dans les domaines des sciences expérimentales, de l’économétrie, de la recherche biomédicale et de l’analyse opérationnelle contemporaine, la manipulation rigoureuse des données constitue le socle de toute inférence valide. L’ordonnancement initial des observations au sein d’une base de données brute n’est presque jamais neutre : il reflète la chronologie de collecte, un tri alphabétique conventionnel, une hiérarchisation institutionnelle ou des contingences géographiques. Laisser subsister de telles structures séquentielles lors de l’attribution de traitements, de l’échantillonnage de sous-populations ou de la présentation de stimuli cognitifs expose inévitablement l’analyste à des artéfacts méthodologiques dévastateurs. Dès lors, la maîtrise des techniques de réordonnancement stochastique s’impose non pas comme une commodité d’usage, mais comme un impératif épistémologique absolu.
L’avènement des suites bureautiques infonuagiques, et tout particulièrement de Google Sheets, a démocratisé l’accès à des capacités de calcul autrefois réservées à des environnements statistiques spécialisés comme R, SAS ou Python. Néanmoins, l’apparente simplicité d’un tableur collaboratif dissimule des mécanismes de calcul complexes, dont la méconnaissance peut introduire des biais systématiques ou corrompre l’intégrité de matrices relationnelles entières. La randomisation d’une liste — qu’elle concerne des identifiants de patients, des séries de réactifs chimiques, des lots industriels ou des items psychométriques — requiert une compréhension exacte des algorithmes sous-jacents, des modes d’évaluation des formules et des fonctionnalités natives proposées par l’interface utilisateur.
Ce traité méthodologique approfondi a pour vocation d’explorer l’ensemble des paradigmes d’aléisation au sein de Google Sheets. À travers un continuum allant de la commande manuelle directe aux architectures programmatiques automatisées sous Google Apps Script, en passant par les formulations matricielles dynamiques de dernière génération, nous détaillerons les protocoles opératoires, les fondements mathématiques et les garde-fous nécessaires à la préservation de la rigueur scientifique de vos jeux de données.
1. Introduction à l’aléisation de données dans Google Sheets et ses fondements méthodologiques
1.1 Définition et principes de l’échantillonnage probabiliste dans les tableurs
L’échantillonnage probabiliste au sein des architectures logicielles repose sur le postulat fondamental selon lequel chaque unité expérimentale d’une population cible possède une probabilité d’inclusion strictement définie, non nulle et calculable au préalable. Dans l’environnement opérationnel d’un tableur tel que Google Sheets, ce principe se traduit par la capacité à transformer une série ordonnée d’enregistrements en une suite permutée où chaque configuration possible de l’espace d’état jouit d’une équiprobabilité rigoureuse. Cette opération mathématique correspond formellement à une permutation aléatoire uniforme, issue du groupe symétrique d’ordre N, noté SN, où le nombre total de réarrangements équiprobables possibles pour N éléments est exactement égal à N! (factorielle de N).
Toutefois, les architectures informatiques déterministes sont incapables de produire un aléa pur sans interface avec des processus physiques stochastiques externes tels que le bruit thermique des semi-conducteurs ou la désintégration radioactive. Par conséquent, les tableurs déploient des générateurs de nombres pseudo-aléatoires (PRNG pour Pseudorandom Number Generators). Ces algorithmes mathématiques complexes génèrent des séquences déterministes de nombres qui émulent avec une précision remarquable les propriétés statistiques de la distribution uniforme standard sur l’intervalle [0, 1[. L’état de l’art dans Google Sheets s’appuie sur des implémentations robustes, historiquement dérivées d’architectures de type Mersenne Twister (notamment MT19937) ou d’algorithmes modernes de la famille Xorshift/Xoroshiro, intégrés au moteur d’exécution JavaScript V8 sous-jacent.
D’un point de vue épistémologique, il convient d’opérer une dissociation radicale entre le simple « désordre arbitraire » et une « distribution aléatoire contrôlée ». Un désordre arbitraire découle souvent d’une manipulation humaine subjective — telle qu’une saisie désordonnée ou un mélange intuitif d’enregistrements —, laquelle demeure irrémédiablement polluée par des biais cognitifs inconscients d’alternance et de regroupement. À l’inverse, l’aléisation algorithmique garantit une neutralité statistique totale en se conformant scrupuleusement aux lois probabilistes, autorisant l’émergence ponctuelle de regroupements (ou clusters) locaux parfaitement normaux selon la loi des grands nombres, tout en éliminant toute corrélation sérielle prédictive entre les entrées successives.
1.2 Importance de la randomisation en recherche expérimentale et sciences comportementales
Dans l’architecture de la recherche quantitative, théorisée notamment par Ronald A. Fisher et enrichie par le modèle causal de Neyman-Rubin, l’assignation aléatoire constitue la condition sine qua non de l’inférence causale valide. Dans tout protocole expérimental, qu’il s’agisse d’un essai clinique randomisé en double aveugle ou d’un protocole d’évaluation psychophysique, la variabilité observée entre les sujets peut être attribuée soit à la variable indépendante manipulée, soit à des variables confondantes non mesurées. L’attribution stochastique permet de neutraliser l’effet de ces dernières en dispersant uniformément les caractéristiques intrinsèques des participants (âge, statut socio-économique, polymorphisme génétique, traits de personnalité) entre les différents bras de l’étude.
En sciences du comportement et en neurosciences cognitives, la randomisation joue également un rôle capital dans l’atténuation des effets d’ordre et de report (carryover effects). Lorsqu’un même sujet est exposé à une batterie séquentielle de stimuli — par exemple, une série de visages exprimant des émotions distinctes ou des énoncés linguistiques complexes —, la présentation systématique des items dans une chronologie invariable induit des biais d’apprentissage, d’habituation, de sensibilisation ou de fatigue attentionnelle. La randomisation intra-sujet de la séquence de présentation brise ces corrélations temporelles néfastes et assure que la réponse différentielle mesurée reflète exclusivement la nature intrinsèque du stimulus plutôt que son positionnement relatif dans la tâche.
Enfin, sur le plan de la validité statistique interne, l’absence d’assignation probabiliste invalide d’emblée l’application des tests d’hypothèse paramétriques usuels (comme le test t de Student ou l’analyse de variance ANOVA). Ces derniers présupposent l’indépendance statistique des erreurs et l’absence d’autocorrélation résiduelle. En négligeant la randomisation rigoureuse de la constitution des cohortes ou des protocoles d’administration des traitements au sein de Google Sheets, le chercheur s’expose au risque de transformer des corrélations purement fortuites en pseudo-causalités statistiques fallacieuses, ruinant ainsi la reproductibilité de ses conclusions scientifiques.
1.3 Vue d’ensemble des capacités fonctionnelles de Google Sheets pour la randomisation
L’écosystème infonuagique de Google Sheets déploie un spectre méthodologique gradué pour répondre aux impératifs d’aléisation des données. À l’extrémité la plus accessible de ce continuum réside la fonctionnalité native intégrée « Aléatoriser la plage », accessible directement par le biais des menus contextuels. Conçue pour une exécution manuelle ponctuelle, cette commande effectue une permutation in situ des cellules préalablement sélectionnées. Si son accessibilité séduit par sa convivialité ergonomique, son usage requiert une vigilance absolue quant aux limites de sélection géométrique, sous peine de fracturer l’intégrité relationnelle des tables à colonnes interdépendantes.
À un niveau supérieur d’abstraction opérationnelle figurent les mécanismes dynamiques pilotés par les fonctions de calcul intégrées. L’introduction conjointe de la fonction matricielle SORT (ou TRIER dans sa nomenclature francophone) et du générateur de tableaux stochastiques RANDARRAY (ou TABLEAU.ALEA) a profondément modernisé le traitement des flux de données tabulaires. Ces formules permettent d’élaborer des vues randomisées complètement découplées de la matrice source originale, instaurant un paradigme non destructif où le corpus brut d’observations demeure strictement préservé pendant que la version stochastique est projetée vers une zone réceptrice distincte.
Néanmoins, la mise en œuvre de telles architectures dans un tableur partagé hébergé sur le cloud soulève la problématique cruciale de la volatilité algorithmique. Par nature, les fonctions de distribution pseudo-aléatoire réévaluent leur état à chaque modification du document ou à chaque actualisation de l’onglet du navigateur web. Pour l’expérimentateur, cette instabilité cinétique constitue un risque majeur de perte d’historique ou de divergence des conditions expérimentales en cours de manipulation. La maîtrise des flux stochastiques dans Google Sheets exige ainsi la mise en balance permanente des fonctions matricielles en direct, des procédures de figeage par copie sélective en valeurs et des procédures d’orchestration avancées au moyen du langage de script JavaScript Google Apps Script.
2. La méthode native : Utilisation de la commande « Aléatoriser la plage » pour une liste unique
2.1 Procédure opérationnelle pas à pas pour un vecteur univarié
La commande native d’aléisation constitue la modalité d’action la plus directe pour réorganiser un vecteur univarié — c’est-à-dire une sélection linéaire unidimensionnelle restreinte à une seule colonne de valeurs continues ou catégorielles. Cette fonctionnalité est implémentée au niveau du moteur applicatif central de Google Workspace et opère une permutation instantanée des valeurs sans exiger l’insertion préalable de formules arithmétiques secondaires ou de colonnes de tri auxiliaires.
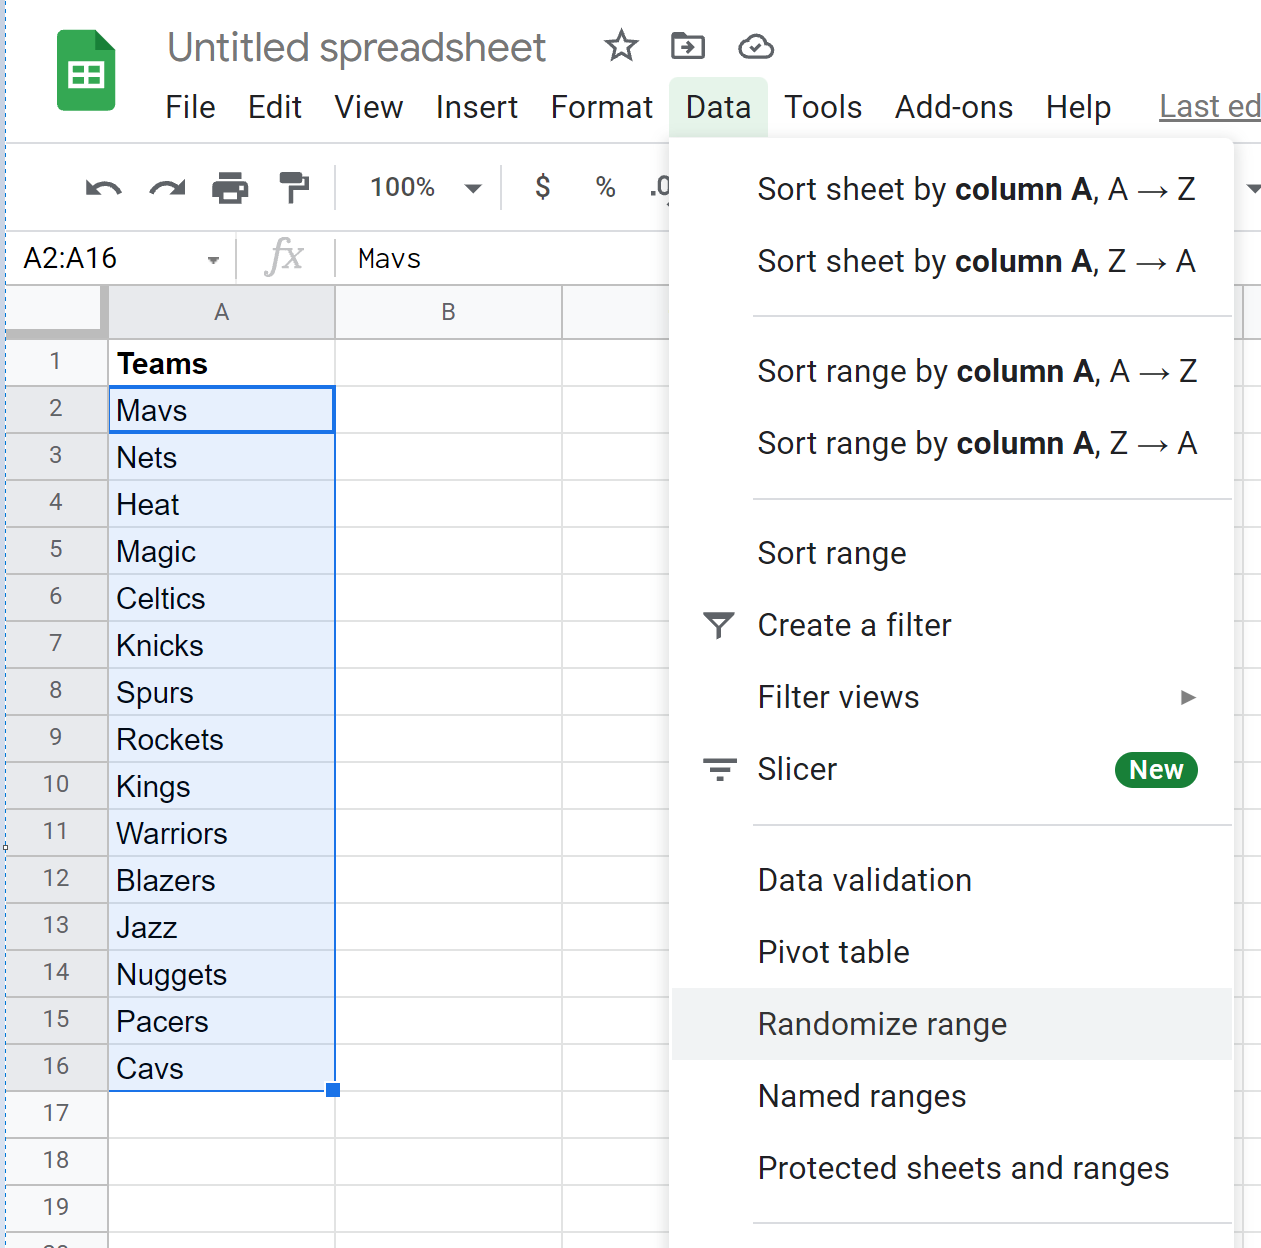
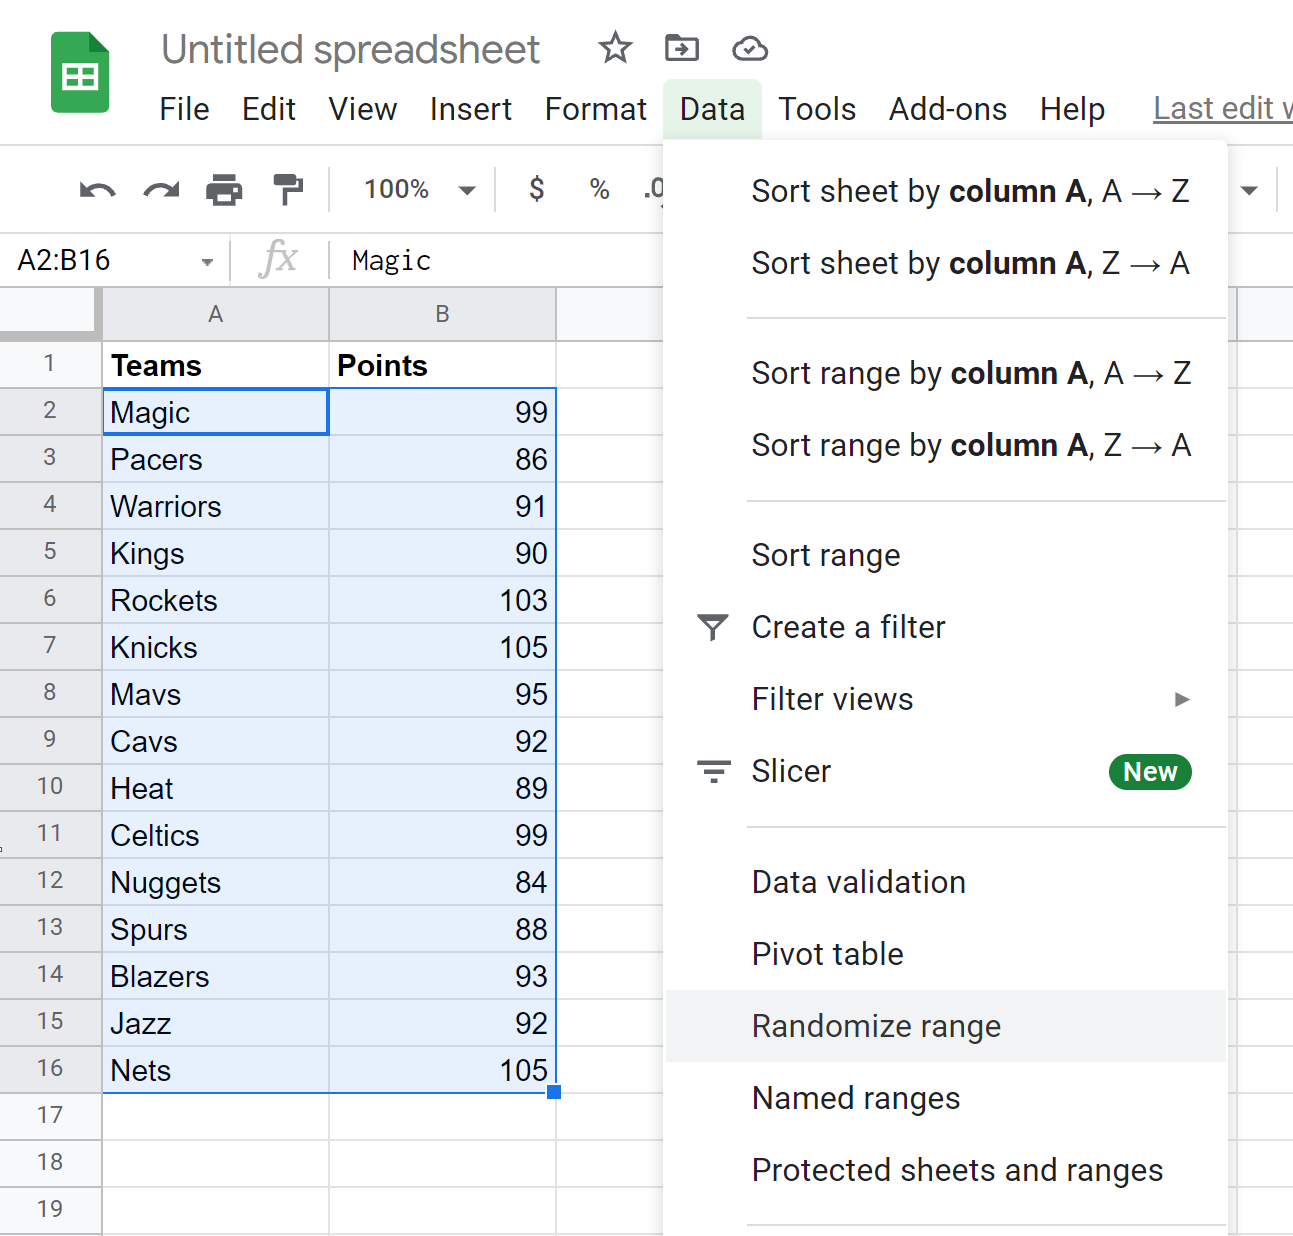
Pour orchestrer ce réarrangement stochastique avec une rigueur absolue, l’analyste doit d’abord délimiter le sous-espace géométrique précis des données à permuter. Il est indispensable d’exclure méticuleusement de cette sélection manuelle toute métadonnée périphérique, telle que l’intitulé de la colonne, les cellules de sous-totaux ou les marqueurs de section. Une fois la plage de cellules surlignée (par exemple de la cellule A2 à la cellule A50), l’opérateur doit accéder au ruban supérieur du tableur, cliquer sur le menu déroulant intitulé Données, puis sélectionner la commande spécifique Aléatoriser la plage.
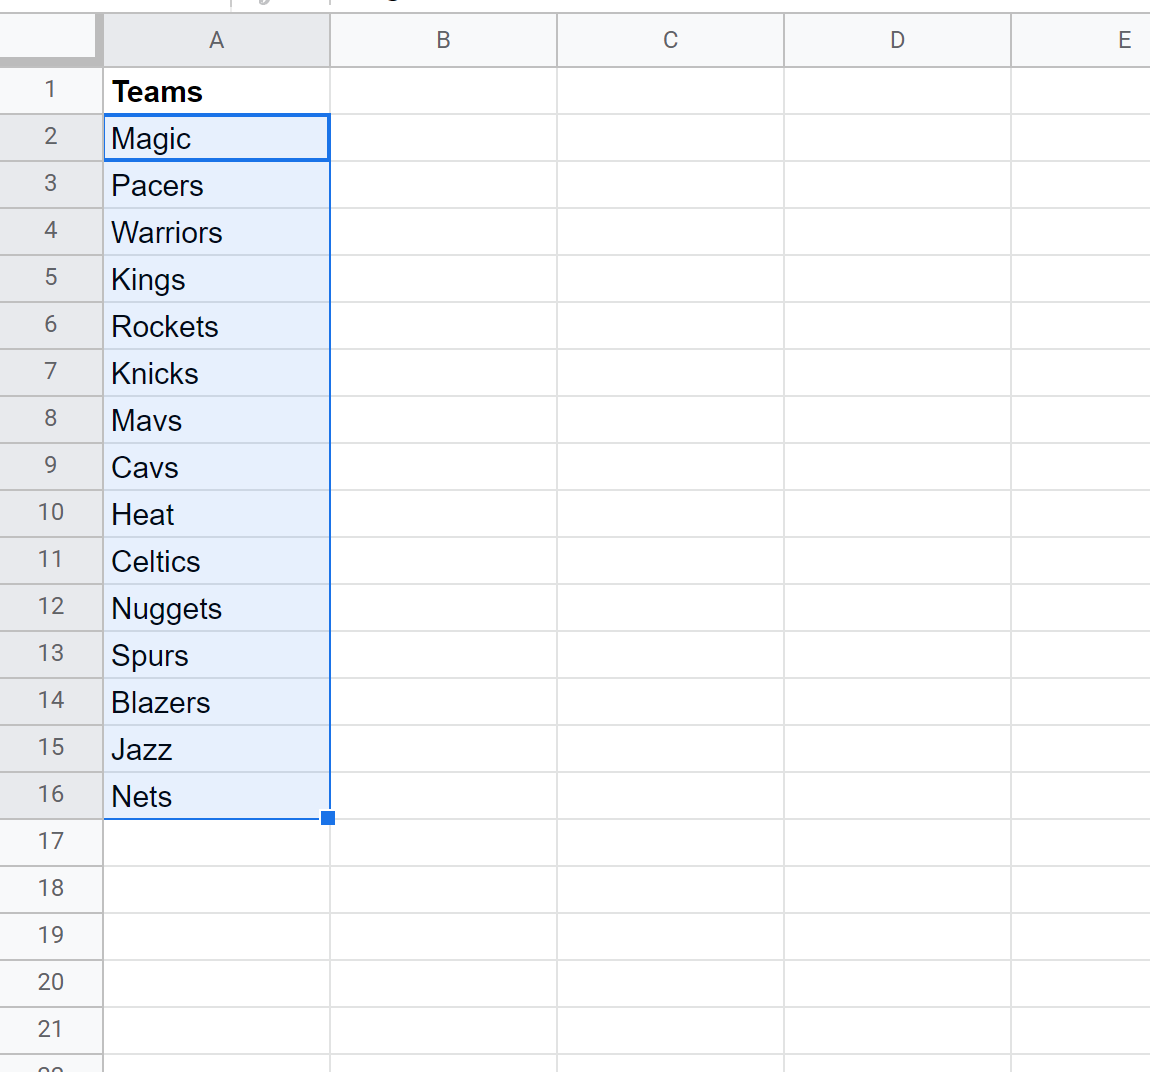
Dès l’envoi de cette instruction, l’algorithme sous-jacent exécute une permutation instantanée de l’ensemble des éléments contenus dans la plage délimitée. Visuellement, les chaînes textuelles ou les grandeurs numériques sont redistribuées de manière non prédictible le long de l’axe vertical sélectionné. Contrairement aux méthodes basées sur des fonctions volatiles, ce réarrangement est statique : il modifie directement l’état physique du document sans recalcul continu ultérieur, offrant une stabilité immédiate qui isole la liste permutée des modifications futures apportées aux cellules avoisinantes du classeur.
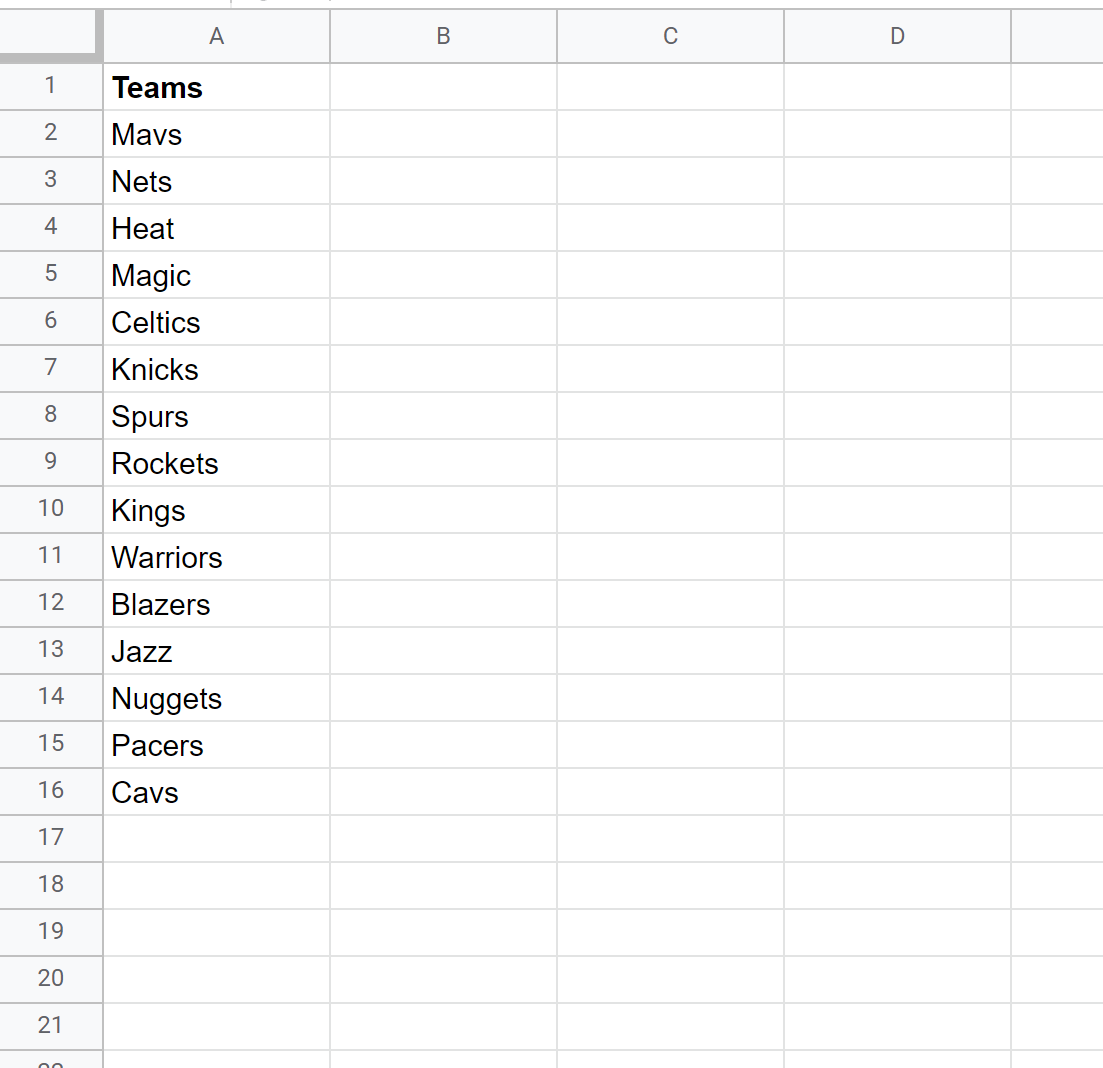
2.2 Exemple pratique 1 : Randomisation d’une cohorte de participants ou d’équipes
Considérons une mise en situation clinique au sein d’un laboratoire de psychologie cognitive, où l’expérimentateur dispose d’une liste de 30 participants enregistrés sous des identifiants alphanumériques anonymisés (par exemple de P01 à P30), disposés verticalement de la cellule A2 à la cellule A31. L’objectif expérimental consiste à déterminer l’ordre chronologique de passage de ces volontaires devant une tâche d’imagerie par résonance magnétique fonctionnelle (IRMf), afin de neutraliser les effets de dérive temporelle du signal instrumentalisé.
En surlignant la plage matricielle A2:A31 et en appliquant l’instruction Données > Aléatoriser la plage, les identifiants subissent une permutation exhaustive. L’expérimentateur observe alors un ordre nouveau, tel que P14, P03, P28, P01, etc. Pour attester de la fiabilité du protocole, deux vérifications méthodologiques doivent être conduites immédiatement : d’une part, le comptage absolu des entrées via la fonction NBVAL(A2:A31), qui doit impérativement retourner la valeur exacte de 30, confirmant l’absence de toute suppression involontaire de cellule lors du traitement informatique.
D’autre part, l’opérateur peut vérifier l’unicité stricte de chaque identifiant à l’aide de la formule matricielle NB(LIGNE(A2:A31)) = NBVAL(UNIQUE(A2:A31)). L’application réitérée de cette commande à plusieurs dizaines de reprises démontre empiriquement l’absence de biais de position : chaque participant présente une distribution fréquentielle uniforme quant à sa probabilité d’occuper la première position du vecteur ou toute autre position ordinale, illustrant le respect scrupuleux de l’équiprobabilité inhérente aux permutations univariées natives.
2.3 Précautions cruciales : La gestion des en-têtes et des métadonnées de colonnes
L’erreur la plus répandue et la plus délétère lors de l’exécution de la commande « Aléatoriser la plage » réside dans la sélection involontaire de la cellule d’en-tête située en première ligne de la feuille de calcul. Si l’opérateur sélectionne la colonne entière en cliquant sur la lettre d’identification sommitale (la colonne A entière, par exemple), le libellé descriptif (tel que « Identifiant_Sujet ») est assimilé par le logiciel à une donnée textuelle ordinaire du vecteur et se retrouve incorporé dans l’espace des permutations possibles.
Cette inadvertance engendre une corruption structurelle majeure du jeu de données : l’en-tête descriptif peut être relégué en plein milieu de la série d’observations, tandis qu’une valeur observationnelle aléatoire est propulsée au sommet du tableau en guise d’intitulé factice. Pour prévenir systématiquement cette défaillance, il est hautement préconisé d’utiliser la fonctionnalité de gel des volets structurels via le menu Afficher > Figer > 1 ligne. Bien que le gel n’interdise pas formellement à la commande native d’altérer la cellule figée si celle-ci est explicitement surlignée, il offre une délimitation visuelle nette et permet de sélectionner commodément la sous-plage utile à partir de la ligne 2 sans inclure l’étiquette sémantique.
Dans l’éventualité où une telle anomalie d’incorporation survient, l’expérimentateur doit immédiatement interrompre toute saisie additionnelle et déclencher la restauration d’état par le raccourci transactionnel Ctrl + Z (ou Cmd + Z sous macOS). Cette commande révoque la permutation et rétablit l’ordonnancement structurel initial. Si l’incident n’est découvert qu’ultérieurement, il sera indispensable de recourir à l’historique des versions de Google Drive pour récupérer l’intégrité relationnelle originale de la colonne corrompue.
3. Préservation de l’intégrité relationnelle : Aléatoriser plusieurs colonnes associées
3.1 Principe de contiguïté et maintien des liens entre attributs appariés
Dans toute base de données empirique structurée sous forme tabulaire rectangulaire, les colonnes ne constituent pas des vecteurs isolés, mais des dimensions complémentaires associées à une même entité d’observation fondamentale. Chaque ligne horizontale représente un n-uplet (ou tuple au sens de l’algèbre relationnelle de Codd), au sein duquel les attributs sont intrinsèquement appariés : l’identifiant du sujet, son âge, son groupe sanguin, sa mesure basale et son assignation clinique sont liés par une contrainte de cohérence absolue.
L’opération de randomisation sur des structures de données multidimensionnelles soulève le risque d’une déconnexion horizontale fatale, souvent désignée dans la littérature informatique sous le terme d’« asynchronisme d’alignement ». Si l’analyste sélectionne par mégarde une unique colonne au sein d’une matrice qui en compte cinq pour lui appliquer la commande d’aléisation univariée, les valeurs de cette colonne seront redistribuées stochastiquement, tandis que les quatre colonnes adjacentes demeureront parfaitement immobiles. Le résultat est désastreux : le patient A se voit subitement attribuer l’âge du patient K, la glycémie du patient Z et le score psychométrique du patient C.
Préserver l’intégrité relationnelle exige de concevoir la matrice de données comme un bloc indivisible de lignes solidaires. Lorsque l’ordre des observations doit être modifié aléatoirement pour masquer des tendances chronologiques ou contrer des effets de présentation de blocs, la permutation ne doit en aucun cas altérer les relations internes aux observations. Elle doit opérer une bijection pure entre l’ensemble ordonné des lignes et une nouvelle disposition spatiale, maintenant chaque vecteur ligne rigoureusement homomorphe à son état primitif.
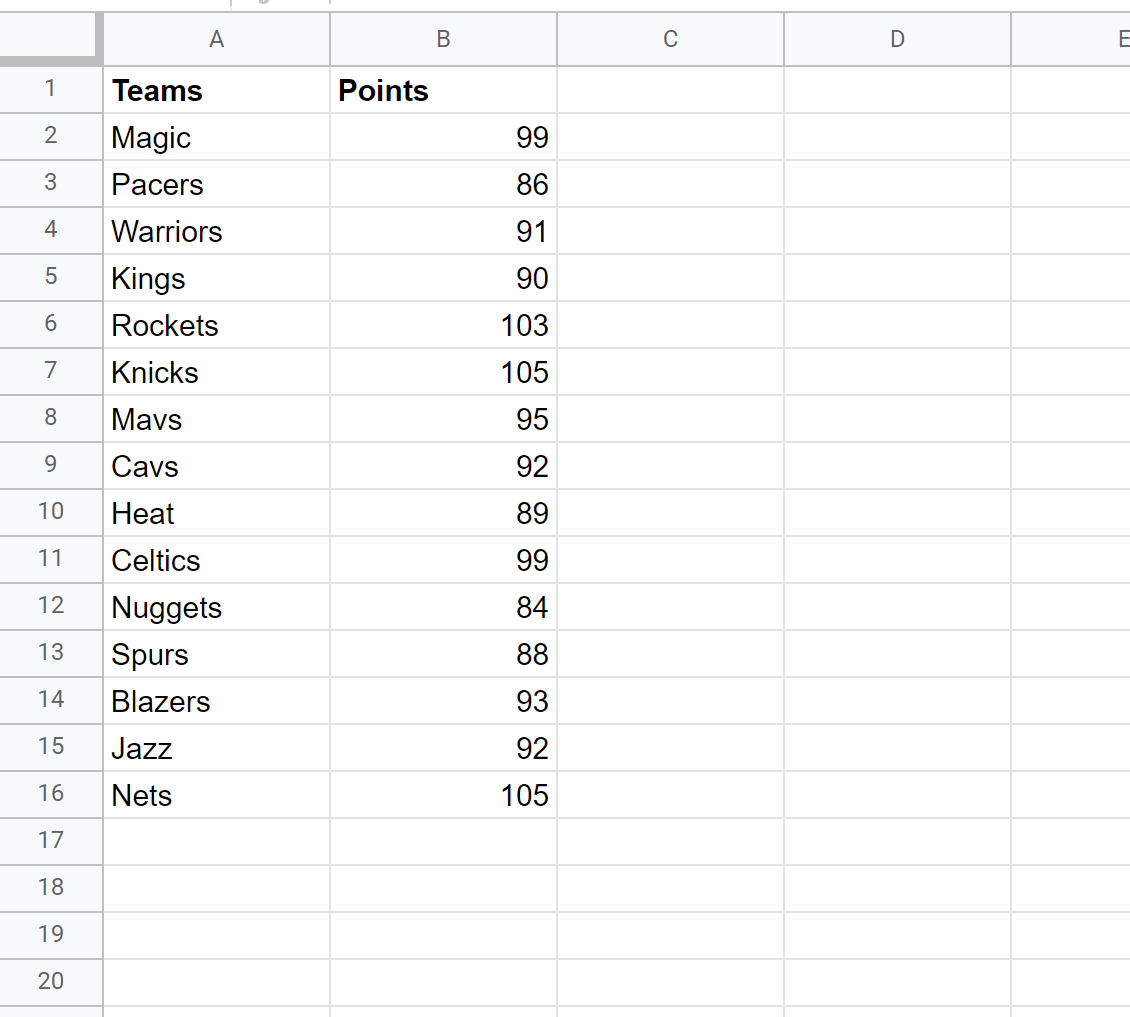
3.2 Exemple pratique 2 : Réordonnancement d’équipes et de leurs scores respectifs
Illustrons cette nécessité à l’aide d’un protocole d’analyse de performance sportive ou d’évaluation d’équipes de travail. Supposons une table bidimensionnelle s’étendant sur trois colonnes et seize lignes utiles (de la ligne 2 à la ligne 17). La colonne A consigne le nom de l’équipe (ex. « Équipe Alpha », « Équipe Bêta »), la colonne B enregistre l’identifiant de son entraîneur référent, et la colonne C contient le score de performance normalisé obtenu lors d’une session préliminaire de qualification.
Pour aléatoriser l’ordre de passage de ces collectifs tout en préservant scrupuleusement l’affectation des entraîneurs et des scores respectifs à chaque entité, la délimitation de la plage doit être exhaustivement bidimensionnelle. L’opérateur clique sur la cellule A2, maintient la touche de sélection enfoncée et étend le champ jusqu’à la cellule C17, délimitant la plage rectangulaire A2:C17. Ce n’est qu’après avoir verrouillé cette emprise multidimensionnelle que la commande Données > Aléatoriser la plage doit être invoquée.
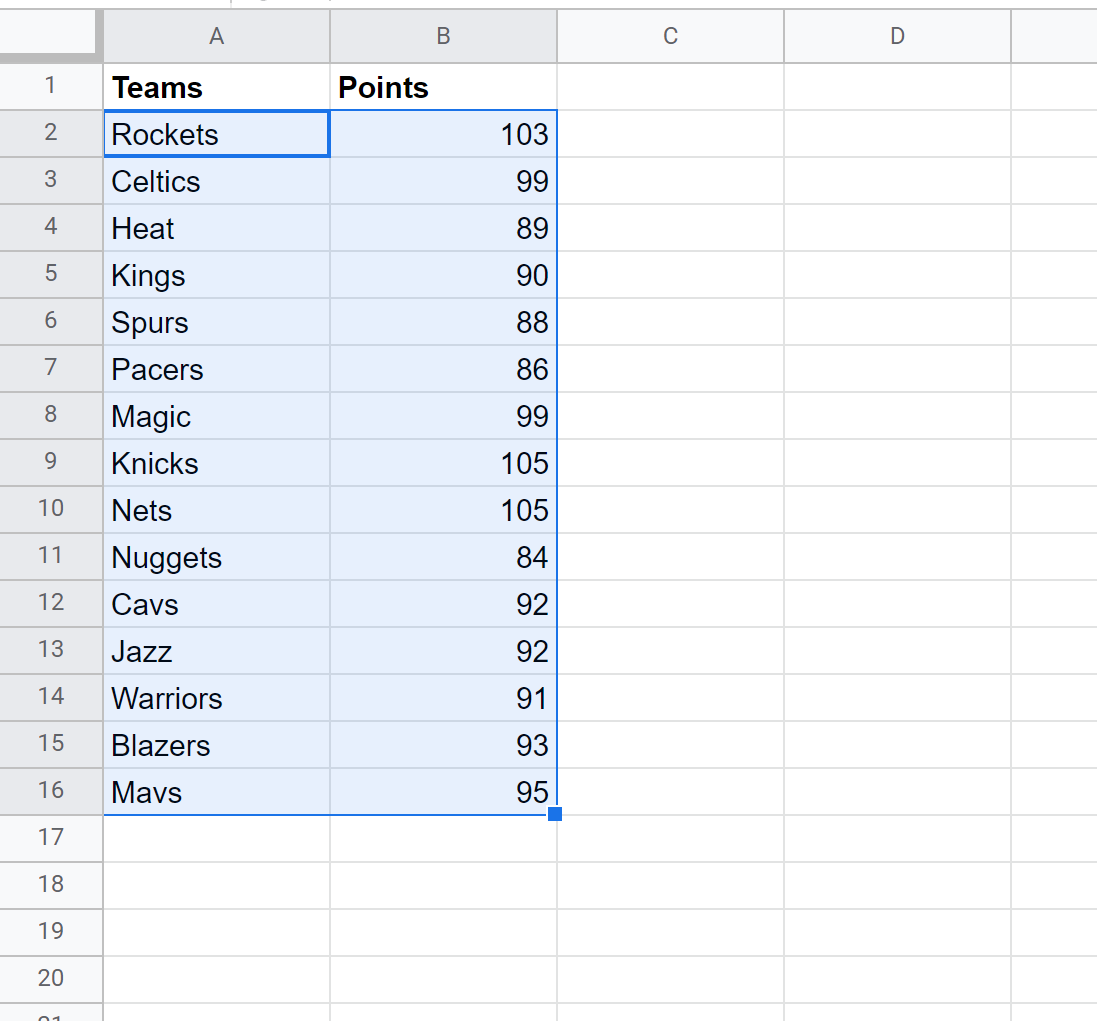
Lors du traitement, le moteur d’exécution de Google Sheets traite chaque ligne horizontale de la sélection comme un enregistrement indivisible. Si la ligne 8, qui associait originellement l’« Équipe Epsilon », l’entraîneur « Martin » et le score « 84.5 », est déplacée en position 2 du tableau résultant, l’intégralité de ce triplet migre de manière solidaire vers les cellules A2, B2 et C2. Les correspondances empiriques entre variables dépendantes et indépendantes demeurent inaltérées, écartant toute corruption des corrélations statistiques sous-jacentes au profit d’un simple changement d’indexation spatiale.
3.3 Diagnostic et vérification post-aléisation des relations inter-colonnes
Afin de certifier qu’aucune distorsion horizontale n’a affecté un jeu de données massives après une opération de réarrangement manuel, l’analyste rigoureux met en place un dispositif de diagnostic pré- et post-traitement. La méthodologie recommandée repose sur l’injection préliminaire d’une colonne d’audit technique exploitant des sommes de contrôle (checksums) ou des identifiants universels uniques (UUID).
Avant toute manipulation, l’analyste insère une colonne auxiliaire en fin de tableau hébergeant une formule d’empreinte numérique ou textuelle, associant par concaténation les différentes cellules de la ligne, par exemple : =A2 & "_" & B2 & "_" & C2. Parallèlement, une métrique globale d’intégrité peut être calculée en utilisant la fonction SOMMEPROD pour totaliser le produit croisé de certaines colonnes numériques sensibles, par exemple =SOMMEPROD(C2:C17; LIGNE(C2:C17)). Si une sélection asynchrone survient, les produits croisés vectoriels s’effondrent immédiatement et signalent mathématiquement la rupture des couplages.
Après l’exécution de la commande de randomisation, il suffit de vérifier que l’empreinte concaténée de chaque ligne coïncide fidèlement avec la recomposition des valeurs individuelles adjacentes. L’évaluation de la formule =EXACT(D2; A2 & "_" & B2 & "_" & C2) propagée sur l’ensemble de la colonne d’audit doit afficher uniformément la valeur booléenne VRAI. En cas d’apparition de la valeur FAUX, la rupture de liaison relationnelle est formellement démontrée, imposant un arrêt immédiat du protocole et la restauration de la matrice mère par les commandes d’annulation historique.
4. Méthodes dynamiques par formules : L’usage des fonctions ALEA et ALEA.ENTRE.BORNES
4.1 Mécanique théorique du générateur de nombres pseudo-aléatoires (ALEA)
Pour s’émanciper des manipulations manuelles et intégrer l’aléisation au sein de chaînes de traitement automatisées, Google Sheets met à disposition la fonction native fondamentale ALEA() (ou RAND() dans les environnements anglophones). Cette fonction statistique ne prend aucun argument en paramètre et génère, à chaque appel, un nombre réel pseudo-aléatoire issu d’une loi uniforme continue sur l’intervalle semi-ouvert [0, 1[. Cela implique que chaque valeur décimale comprise entre 0 (inclus) et 1 (exclu) possède une densité de probabilité identique de survenir lors du calcul.
Le comportement algorithmique de ALEA() répond aux règles de la volatilité informatique. Dans l’architecture de calcul d’un tableur, une fonction est qualifiée de « volatile » lorsqu’elle est systématiquement réévaluée à la moindre modification d’une quelconque cellule de la feuille, ou lors de tout événement de recalcul provoqué par l’ouverture du classeur, la modification des paramètres d’itération ou le rechargement de la page web. Sur le plan de la précision numérique, les valeurs produites exploitent le standard IEEE 754 pour l’arithmétique en virgule flottante en double précision, offrant approximativement 15 à 17 chiffres décimaux significatifs, ce qui réduit la probabilité théorique de collision exacte entre deux tirages indépendants à un seuil infinitésimal.
Cette volatilité continue constitue à la fois la puissance et la vulnérabilité intrinsèque de la fonction ALEA(). D’un côté, elle permet de dynamiser les modèles de simulation stochastique en recalculant instantanément des milliers de tirages par une simple validation de cellule vide. De l’autre côté, dans un protocole d’assignation expérimentale où chaque participant doit conserver le traitement attribué lors de sa première visite, cette instabilité cinétique impose d’isoler rapidement les résultats générés de leur dépendance algorithmique vive.
4.2 Technique de la colonne auxiliaire d’indexation stochastique
La technique classique la plus robuste pour trier aléatoirement des données à l’aide de formules consiste à adjoindre une colonne auxiliaire d’indexation stochastique le long de la plage d’intérêt. Cette méthodologie préserve l’ordonnancement de base jusqu’à l’application explicite d’un tri directionnel et offre une visibilité totale sur les clés de tri générées par le système.
La procédure opérationnelle se déploie selon un ordonnancement rigoureux en trois phases :
- Insertion et génération vectorielle : L’analyste insère une colonne temporaire adjacente à son jeu de données (par exemple, la colonne D si les observations occupent les colonnes A, B et C). Dans la cellule D2, il insère la formule scalaire
=ALEA(), qu’il étire verticalement jusqu’à la dernière observation active de la table, associant ainsi à chaque ligne un scalaire stochastique unique et continu. - Exécution du tri fondé sur l’index stochastique : En sélectionnant l’ensemble du bloc rectangulaire élargi (de A2 à D100), l’analyste fait appel à l’outil de tri avancé via le menu Données > Trier une plage > Options avancées de tri des plages. Il définit la colonne auxiliaire D comme clé de tri principale, avec un ordre de classement indifféremment croissant ou décroissant.
- Suppression ou neutralisation du vecteur temporaire : Les données matricielles des colonnes A à C ayant été réagencées selon la distribution des valeurs aléatoires continues, l’opérateur peut supprimer définitivement la colonne D ou en effacer le contenu pour rendre au tableau sa physionomie originelle sans altérer le nouvel ordre statique obtenu.
4.3 Génération d’intervalles discrets via la fonction ALEA.ENTRE.BORNES
Lorsque le besoin méthodologique ne réside pas dans le tri d’un continuum d’observations existantes, mais dans la discrétisation directe des observations vers des groupes finis, Google Sheets propose la fonction ALEA.ENTRE.BORNES(bas; haut) (ou RANDBETWEEN). Cette fonction génère un entier pseudo-aléatoire compris entre les bornes minimale et maximale spécifiées, selon une loi uniforme discrète où chaque entier possède une probabilité d’occurrence égale à 1 / (haut – bas + 1).
Si un protocole de recherche requiert de ventiler 100 participants vers quatre bras expérimentaux codifiés de 1 à 4, l’application de la formule =ALEA.ENTRE.BORNES(1; 4) sur chaque ligne permettra d’assigner instantanément chaque individu à une condition donnée. Néanmoins, l’analyste doit impérativement appréhender la problématique probabiliste des collisions et du tirage avec remise inhérente à cette approche discrète : contrairement à une permutation aléatoire continue issue de ALEA(), les tirages discrets génèrent naturellement de multiples doublons identiques.
Tenter de trier une liste d’observations en utilisant une colonne auxiliaire renseignée par ALEA.ENTRE.BORNES avec un intervalle restreint (par exemple de 1 à 10 pour trier 100 observations) constitue une aberration méthodologique sévère. En vertu du principe des tiroirs de Dirichlet, les ex-æquo massifs forcent l’algorithme de tri à s’appuyer sur l’ordre chronologique d’apparition initial pour départager les doublons, préservant ainsi une fraction substantielle de la structure non aléatoire d’origine. Pour garantir une permutation bijective dépourvue de toute ambiguïté de classement, l’utilisation exclusive d’un continuum à haute résolution via ALEA() ou TABLEAU.ALEA() demeure obligatoire.
5. Tri dynamique avancé : Combinaison des fonctions TRIER et ALEA (SORT et RANDARRAY)
5.1 Exploitation de la formule matricielle SORT combinée à RANDARRAY
L’introduction des fonctions matricielles dynamiques de nouvelle génération dans Google Sheets a totalement redéfini les standards d’élégance et d’efficacité computationnelle du logiciel. La fusion fonctionnelle entre les instructions TRIER (ou SORT) et TABLEAU.ALEA (ou RANDARRAY) permet d’effectuer des randomisations complètes, automatisées et non destructives à l’aide d’une syntaxe matricielle unifiée déployée dans une cellule maîtresse unique.
La formule d’excellence pour opérer une telle permutation matricielle s’articule comme suit :
=TRIER(A2:B20; TABLEAU.ALEA(LIGNES(A2:B20); 1); VRAI)
Dans cette formulation, l’expression LIGNES(A2:B20) calcule dynamiquement la hauteur cardinale de la matrice source, soit 19 enregistrements. L’instruction TABLEAU.ALEA(19; 1) génère instantanément en mémoire vive un vecteur colonnaire virtuel de 19 nombres réels pseudo-aléatoires compris entre 0 et 1. Enfin, la fonction englobante TRIER ordonne les lignes de la matrice source A2:B20 selon les grandeurs numériques générées par ce vecteur virtuel invisible, sans nécessiter la moindre colonne auxiliaire physique dans l’interface de la feuille.
Le résultat de cette opération matricielle se déploie sous la forme d’une plage dynamique propagée (spill range). Aucune écriture n’est requise dans les cellules adjacentes ou sous-jacentes : celles-ci sont automatiquement renseignées par le moteur de rendu de Google Sheets à partir de la formule initiale. Ce paradigme élimine radicalement les erreurs de manipulation humaine, car la modification accidentelle d’une cellule située dans la zone de débordement est physiquement bloquée ou génère une erreur explicite, sanctuarisant la distribution aléatoire obtenue contre les altérations involontaires.
5.2 Exemple pratique 3 : Randomisation non destructive d’un registre d’observations
Considérons un registre institutionnel de santé publique hébergeant des données de surveillance épidémiologique. La feuille maîtresse, nommée Donnees_Brutes, contient un registre de patients consigné dans la plage A2:C150, compilant le numéro d’anonymisation, le site hospitalier d’origine et la date d’inclusion. Pour des motifs éthiques et méthodologiques stricts, l’équipe d’analystes a l’interdiction de modifier l’ordre séquentiel de cette feuille de saisie originale.
Pour extraire une vue stochastique destinée aux statisticiens chargés des analyses préliminaires, l’analyste crée un second onglet de travail intitulé Analyse_Stochastique. Dans la cellule A2 de cet onglet vierge, il implémente la formule matricielle suivante :
=TRIER(Donnees_Brutes!A2:C150; TABLEAU.ALEA(NBVAL(Donnees_Brutes!A2:A150); 1); VRAI)
Immédiatement, les 149 enregistrements de patients sont extraits, réordonnés de manière aléatoire et projetés sur la nouvelle feuille de calcul.
Cette approche non destructive offre des bénéfices analytiques considérables. Si un opérateur ajoute de nouvelles entrées dans la feuille mère Donnees_Brutes, la fonction NBVAL réévalue dynamiquement la volumétrie globale, adapte la dimension du vecteur généré par TABLEAU.ALEA et met à jour instantanément la projection randomisée. Le registre primaire demeure inviolé dans son état d’archivage réglementaire, tandis que l’espace d’analyse bénéficie d’une permutation continue et sécurisée, totalement immunisée contre les manipulations accidentelles de l’opérateur.
5.3 Gestion des plages dynamiques ouvertes et filtrage des cellules vides
L’utilisation de plages ouvertes — telles que A2:B — constitue une pratique courante dans les flux de travail infonuagiques pour absorber continuellement de nouveaux flux d’enregistrements sans contraindre l’analyste à réajuster périodiquement les bornes de ses formules. Néanmoins, l’application directe d’un tri aléatoire sur une plage ouverte génère une anomalie géométrique majeure : les milliers de cellules vides situées au bas de la colonne sont intégrées au calcul stochastique, dispersant les données textuelles au milieu d’immenses espaces vides ou reléguant les observations utiles au fin fond du tableur.
Pour parer à ce dysfonctionnement, l’imbrication de la fonction FILTRE (ou FILTER) s’impose comme une nécessité absolue. Le schéma d’implémentation avancée s’articule comme suit :
=TRIER(FILTRE(A2:B; A2:A <> « »); TABLEAU.ALEA(LIGNES(FILTRE(A2:B; A2:A <> « »)); 1); VRAI)
Cette formulation isole d’abord rigoureusement les enregistrements non vides de la plage A2:B avant de calculer la dimension exacte du vecteur pseudo-aléatoire correspondant, interdisant à la moindre ligne vierge d’interférer avec le processus d’ordonnancement.
Il convient de souligner que cette structure matricielle avancée requiert une zone réceptrice exempte de tout obstacle spatial. Si une donnée textuelle, un commentaire ou un résidu de formule préexiste au sein de la plage où le résultat est censé se propager, Google Sheets interrompt le calcul et renvoie une erreur critique de type #REF! avec la mention explicite « Le résultat de l’expansion n’a pas pu être étendu, car il écraserait des données ». L’analyste doit impérativement garantir la vacuité intégrale de la colonne cible en aval de la cellule maîtresse pour permettre le déploiement normal du calcul vectoriel.
6. Aléatorisation sans remise versus avec remise : Protocoles mathématiques sous Google Sheets
6.1 Distinction formelle entre tirages bernoulliens et permutations exhaustives
Dans la théorie classique des probabilités, il est indispensable de formaliser la distinction fondamentale entre un processus d’échantillonnage sans remise et un processus d’échantillonnage avec remise. Cette distinction régit directement le comportement des estimateurs statistiques, la structure des variances d’échantillonnage et la conformité des protocoles de recherche expérimentale aux théorèmes asymptotiques fondamentaux.
Le tirage sans remise correspond à une permutation exhaustive des éléments préexistants d’une population finie ou à l’extraction d’un sous-ensemble strict d’entités sans duplication possible. Chaque unité statistique ne peut être sélectionnée qu’une seule et unique fois dans l’échantillon final. L’univers des tirages successifs est conditionné par les tirages antérieurs : la probabilité de sélection d’une unité passe de 1/N lors du premier tirage à 1/(N-1) lors du second, traduisant une dépendance séquentielle régie par la loi hypergéométrique. En pratique, l’aléa sans remise est le modèle requis pour l’attribution des traitements thérapeutiques ou la constitution de files d’attente randomisées.
À l’opposé, le tirage avec remise (ou tirage bernoullien indépendant) repose sur l’indépendance stochastique stricte de chaque tirage élémentaire. Dès qu’une observation est extraite de l’urne d’échantillonnage, elle y est immédiatement réintégrée avant le tirage subséquent. Dès lors, la probabilité d’extraction d’une unité demeure invariante et égale à 1/N à chaque étape, autorisant des redondances multiples de certains individus et l’omission totale d’autres. Cette modalité mathématique constitue le fondement opérationnel des algorithmes d’inférence non paramétrique par rééchantillonnage intensif, universellement connus sous l’appellation de Bootstrap.
6.2 Implémentation d’un tirage aléatoire avec remise (Bootstrap)
Pour orchestrer un protocole d’échantillonnage avec remise au sein de Google Sheets — afin d’estimer des intervalles de confiance empiriques ou de simuler des trajectoires stochastiques —, l’analyste combine astucieusement les fonctions INDEX, ALEA.ENTRE.BORNES et LIGNES. Cette triangulation algorithmique permet de simuler un tirage indépendant à probabilités uniformes.
Supposons une population source d’observations empiriques consignée dans la plage A2:A51 (représentant 50 données expérimentales). Pour extraire un échantillon rééchantillonné (pseudo-échantillon bootstrap) de taille identique ou inférieure, l’opérateur implémente dans une colonne distincte la formule suivante, qu’il étire sur la profondeur désirée :
=INDEX($A$2:$A$51; ALEA.ENTRE.BORNES(1; LIGNES($A$2:$A$51)))
Pour un déploiement matriciel automatisé évitant l’étirement manuel, la formulation exploitant MAP et SEQUENCE s’avère particulièrement puissante :
=MAP(SEQUENCE(50; 1); LAMBDA(_i; INDEX($A$2:$A$51; ALEA.ENTRE.BORNES(1; LIGNES($A$2:$A$51)))))
Dans cette configuration, l’instruction ALEA.ENTRE.BORNES(1; 50) sélectionne à chaque occurrence une ligne d’extraction de manière totalement indépendante de la précédente. L’analyste constatera fréquemment qu’une même valeur de la liste d’origine apparaît deux, trois, voire quatre fois au sein de l’échantillon extrait, tandis que certaines observations n’y figurent pas du tout. Cette distribution fréquentielle est parfaitement conforme à la théorie asymptotique : lorsqu’un échantillon de taille N est extrait avec remise d’une population de taille N, la probabilité qu’un élément spécifique ne soit jamais tiré converge vers 1/e ≈ 36,8 %, un résultat classique de la combinatoire probabiliste.
6.3 Simulation d’un tirage sans remise de taille k inférieure à la population N
Une nécessité courante dans les protocoles d’échantillonnage consiste à extraire un sous-échantillon strict de taille k (par exemple 10 sujets) à partir d’une cohorte mère de taille N (par exemple 100 candidats), en garantissant une équiprobabilité totale d’inclusion sans jamais tolérer de doublon. Cette opération équivaut mathématiquement à un tirage combinatoire sans remise gouverné par la loi hypergéométrique.
Les versions récentes de Google Sheets simplifient grandement cette tâche grâce à l’introduction des fonctions d’extraction géométrique de tranches matricielles, notamment CHOISIRLIGNES (ou CHOOSEROWS). La modélisation de cette extraction sans remise s’exécute par la formule imbriquée suivante :
=CHOISIRLIGNES(TRIER(A2:B101; TABLEAU.ALEA(LIGNES(A2:B101); 1); VRAI); SEQUENCE(10; 1))
Dans cette architecture, l’intégralité du tableau A2:B101 est d’abord soumise à une permutation complète non destructive via le couple TRIER / TABLEAU.ALEA, puis la fonction CHOISIRLIGNES intercepte exclusivement les 10 premières lignes ordonnées de ce tableau nouvellement permuté.
L’équiprobabilité de sélection de chaque individu est mathématiquement irréprochable : chaque sous-ensemble distinct de cardinal k parmi N possède rigoureusement une probabilité d’extraction égale à l’inverse du coefficient binomial :
P = 1 / (N! / (k! * (N – k)!))
Aucune duplication d’individu n’est possible, et chaque ligne extraite conserve son intégrité relationnelle native. Ce mécanisme est la référence absolue pour l’attribution aléatoire de quotas stricts dans les panels de sondage ou l’échantillonnage de contrôle qualité industriel au sein d’un tableur.
7. Automatisation et reproductibilité : Scripts Google Apps Script pour l’échantillonnage aléatoire
7.1 Introduction à l’environnement Apps Script pour le contrôle probabiliste
Bien que les formules matricielles dynamiques offrent une flexibilité analytique remarquable, elles atteignent leurs limites opérationnelles dès lors qu’un protocole expérimental requiert une auditabilité réglementaire inattaquable, un scellement définitif des états tirés et une reproductibilité paramétrable à l’identique. La volatilité inhérente aux fonctions de calcul automatique fait peser une menace permanente de modification intempestive du tirage au moindre clic involontaire d’un collaborateur.
Pour s’affranchir de cette fragilité cinétique, le recours à Google Apps Script constitue la voie royale de l’ingénierie des données sur Google Workspace. Apps Script est un environnement de développement intégré propulsé par le moteur JavaScript moderne V8, s’exécutant directement sur les serveurs d’infrastructure infonuagique de Google. Il accorde à l’analyste un contrôle programmatique exhaustif sur le modèle d’objet du document (DOM du tableur), permettant de lire des matrices de données brutes, d’exécuter des transformations algorithmiques complexes en mémoire vive et de réécrire les résultats sous forme de valeurs scalaires statiques définitives.
Le déploiement d’un script personnalisé permet de découpler totalement la logique de calcul de l’interface graphique de consultation. Les tirages sont déclenchés à la demande par des déclencheurs événementiels (boutons interactifs, menus sur mesure) et peuvent être couplés à des mécanismes de journalisation (logging) temporelle et cryptographique, garantissant que la séquence d’aléisation utilisée lors d’un essai scientifique est certifiée conforme et traçable dans le cadre de directives de bonnes pratiques de laboratoire (BPL).
7.2 Implémentation de l’algorithme de mélange de Fisher-Yates (Knuth Shuffle)
Lors de la programmation d’un tri aléatoire dans un environnement algorithmique impératif, de nombreux développeurs commettent l’erreur d’utiliser des approches naïves biaisées, telles que le passage d’une fonction de comparaison aléatoire du type array.sort(() => Math.random() - 0.5). Des études mathématiques approfondies ont prouvé que cette méthode naïve produit des biais de distribution considérables en raison du comportement déterministe des algorithmes de tri sous-jacents (comme Timsort ou Quicksort), certaines permutations bénéficiant d’une probabilité d’apparition significativement supérieure à d’autres.
Pour garantir une permutation parfaitement uniforme et non biaisée, l’état de l’art algorithmique impose la mise en œuvre de l’algorithme de mélange de Fisher-Yates (également théorisé par Donald Knuth). Cet algorithme présente une complexité algorithmique optimale en temps linéaire, notée O(n), et garantit que chaque permutation possible parmi les n! configurations concevables dispose d’une probabilité d’occurrence rigoureusement identique.
Le protocole opératoire sous Apps Script s’articule autour du script formel suivant :
L’expérimentateur ouvre l’éditeur via Extensions > Apps Script et intègre la routine de randomisation optimisée :
function randomiserPlageFisherYates() {
var feuille = SpreadsheetApp.getActiveSpreadsheet().getActiveSheet();
var plage = feuille.getRange(« A2:B20 »);
var valeurs = plage.getValues();
var n = valeurs.length;
for (var i = n – 1; i > 0; i–) {
var j = Math.floor(Math.random() * (i + 1));
var temp = valeurs[i];
valeurs[i] = valeurs[j];
valeurs[j] = temp;
}
plage.setValues(valeurs);
}
Dans ce segment de code, l’algorithme parcourt le tableau d’observations de la fin vers le début, sélectionnant à chaque itération un index stochastique équiprobable parmi les positions résiduelles et procédant à une permutation atomique des éléments. Les n-uplets de chaque ligne demeurent strictement solidaires, préservant l’intégrité relationnelle, et la fonction setValues() réinjecte la matrice permutée directement sur la feuille, figeant instantanément le résultat sous forme de données fixes non volatiles.
7.3 Exemple pratique 4 : Automatisation d’un bouton d’aléisation pour chercheurs
Afin de rendre ce dispositif algorithmique accessible à des équipes de terrain ou des techniciens de recherche non initiés à la manipulation de scripts ou de formules matricielles, il est recommandé d’encapsuler la routine au sein d’un déclencheur graphique interactif intégré directement à la feuille de calcul.
La mise en place de cette interface s’accomplit par les étapes séquentielles suivantes :
- Création du composant graphique : L’analyste accède au menu Insertion > Dessin. Dans l’atelier de modélisation vectorielle, il façonne un bouton à coins arrondis, lui applique un style visuel clair, y insère un libellé textuel explicite tel que « Exécuter la Randomisation » et enregistre le composant pour l’ancrer sur la feuille de calcul.
- Liaison scripturale : En cliquant sur les trois points verticaux de contrôle situés dans l’angle supérieur droit de la forme graphique nouvellement insérée, l’analyste sélectionne la commande Attribuer un script. Il saisit précisément dans le champ d’assignation le nom de la fonction JavaScript précédemment validée, à savoir
randomiserPlageFisherYates. - Vérification et journalisation de conformité : Pour consolider la traçabilité de l’essai, le script peut être enrichi d’une ligne consignant l’horodatage exact (timestamp ISO 8601) et l’identifiant du chercheur connecté dans un onglet dédié d’audit trail :
feuilleJournal.appendRow([new Date(), Session.getActiveUser().getEmail(), « Randomisation Cohorte Principale »]);
Désormais, une simple pression sur ce bouton exécute la permutation de Fisher-Yates de manière instantanée et sécurisée. L’expérimentateur n’a plus aucun contact direct avec le code ou les formules sensibles, éliminant les risques de mauvaise manipulation tout en garantissant un scellement immédiat du tirage stochastique au sein du registre d’observations.
8. Applications en recherche expérimentale et psychologique : Neutralisation des biais d’ordre
8.1 Contrebalancement et conception de plans expérimentaux intra-sujets
Dans la conception de protocoles expérimentaux intra-sujets (où chaque participant est soumis successivement à l’ensemble des conditions ou stimuli sous étude), la neutralisation des biais d’ordre représente un défi méthodologique majeur. Les effets d’ordre surviennent dès lors que la réponse d’un participant à une condition expérimentale donnée est influencée par les conditions qui l’ont précédée chronologiquement.
Ces perturbations se manifestent principalement sous trois formes : les effets de pratique ou d’apprentissage (amélioration progressive de la performance au fil des tâches, indépendamment de la difficulté propre de la tâche), les effets de fatigue ou d’épuisement attentionnel (dégradation linéaire du temps de réaction ou de la précision cognitive), et les effets de rémanence ou de report (le traitement d’un stimulus émotionnel négatif intense venant altérer la perception du stimulus neutre présenté immédiatement après). Pour prémunir l’expérimentateur contre ces artéfacts de mesure, la dispersion stochastique des séquences d’administration constitue le mécanisme de défense privilégié.
Sous Google Sheets, l’expérimentateur conçoit des plans de contrebalancement en générant des matrices stochastiques individualisées. Chaque participant se voit attribuer une ligne de traitement unique au sein d’une table d’ordonnancement construite par des formules matricielles réparties. Par exemple, si une tâche cognitive exige la passation séquentielle de quatre blocs de tâches (A, B, C, D), l’application de permutations aléatoires sans remise indépendantes pour chaque participant garantit que la probabilité globale qu’une condition précède ou succède à une autre est parfaitement uniformisée à l’échelle de l’échantillon global, neutralisant les effets de transition sur l’estimation de l’effet principal.
8.2 Assignation aléatoire double-aveugle aux conditions expérimentales
L’administration d’essais comparatifs randomisés obéit à la contrainte méthodologique stricte du double aveugle : ni le participant qui reçoit l’intervention, ni l’expérimentateur ou le clinicien qui l’administre et en mesure les effets ne doivent connaître l’assignation au groupe actif ou au groupe placebo. Dans Google Sheets, la modélisation de cette procédure requiert une architecture de données cloisonnée et chiffrée afin de prévenir tout levage prématuré ou involontaire de l’insu.
Le protocole technique repose sur la génération d’un registre de codage anonymisé. L’investigateur principal crée une première table maîtresse dans un onglet masqué ou protégé par des droits d’accès stricts. Dans cet onglet, les conditions d’intervention réelles (« Molécule Active XYZ » versus « Solution Saline Placebo ») sont associées aléatoirement à des codes alphanumériques hermétiques aléatoires (par exemple « ALFA-78 », « BETA-42 »), générés à l’aide de formules combinant ALEA.ENTRE.BORNES et des chaînes de caractères chiffrées.
Sur l’onglet opérationnel destiné aux cliniciens de terrain, seule la liste des participants appariée aux codes alphanumériques apparaît. Les exécutants administrent les fioles étiquetées selon ces codes sans jamais pouvoir identifier la nature pharmacologique du produit dispensé. L’alignement relationnel au sein de la feuille garantit que chaque patient est strictement rattaché à son identifiant unique de condition. Ce n’est qu’une fois la totalité de la collecte empirique verrouillée et archivée que l’investigateur principal déploie une fonction RECHERCHEV ou XLOOKUP vers la table de codage maîtresse pour procéder au démasquage statistique officiel de l’étude.
8.3 Établissement de carrés latins équilibrés assisté par tableur
Lorsque le nombre de conditions expérimentales augmente et que la taille de l’échantillon ne permet pas d’administrer l’ensemble des k! permutations possibles du groupe symétrique complet, le plan en carré latin s’impose comme un compromis d’une remarquable élégance mathématique. Un carré latin d’ordre k est une matrice carrée de dimension k × k contenant k symboles distincts disposés de telle sorte que chaque symbole apparaît exactement une fois sur chaque ligne et une fois sur chaque colonne.
L’apport spécifique de Google Sheets réside dans la génération assistée de carrés latins dits « équilibrés » (ou carrés de Williams), particulièrement prisés en recherche comportementale car chaque condition y précède chaque autre condition un nombre strictement égal de fois, contrôlant ainsi de façon optimale les effets de report au premier ordre. La construction tabulaire débute par la génération d’un carré latin standard de référence via des séquences arithmétiques modulaires implémentées avec la fonction MOD(dividende; diviseur).
Une fois la matrice structurale de base établie, l’analyste procède à une double aléisation stochastique : il applique d’abord une permutation aléatoire native sur les lignes du carré latin, puis une seconde permutation indépendante sur ses colonnes, tout en réassignant aléatoirement les lettres de traitement aux conditions réelles de l’expérience. Cette triple randomisation préserve rigoureusement la propriété formelle d’orthogonalité mathématique du carré latin tout en éliminant toute régularité prédictible, fournissant un plan expérimental hautement sophistiqué directement exportable vers les plateformes de recueil de données expérimentales.
9. Gestion des contraintes complexes : Stratification, blocs aléatoires et appariement
9.1 Aléatisation stratifiée au sein de sous-populations hétérogènes
Dans de nombreuses études cliniques ou sociologiques, la cohorte d’étude présente une hétérogénéité marquée selon des facteurs de confusion pronostiques majeurs, tels que le genre, la tranche d’âge ou le stade de sévérité d’une pathologie. Procéder à une randomisation globale simple sur une telle cohorte expose le chercheur au risque d’un déséquilibre stochastique fortuit : le groupe expérimental pourrait malencontreusement héberger une proportion significativement plus élevée de sujets âgés ou de cas sévères que le groupe témoin, altérant la comparabilité des bras.
L’aléisation stratifiée neutralise ce danger en segmentant initialement la population en sous-groupes homogènes (les strates), puis en exécutant une randomisation totalement indépendante au sein de chaque strate. Dans Google Sheets, cette architecture se matérialise de manière dynamique par l’orchestration conjointe des fonctions UNIQUE, FILTRE, et du moteur matriciel TRIER / TABLEAU.ALEA.
L’analyste utilise d’abord la formule =UNIQUE(Base_Sujets!C2:C) pour cartographier les différentes strates (par exemple « Femme_Plus_de_50ans », « Homme_Moins_de_50ans »). Ensuite, pour chaque strate identifiée, il déploie une formule matricielle dédiée qui extrait et permute exclusivement les individus appartenant à ce segment :
=TRIER(FILTRE(Base_Sujets!A2:B; Base_Sujets!C2:C = « Femme_Plus_de_50ans »); TABLEAU.ALEA(LIGNES(FILTRE(Base_Sujets!A2:B; Base_Sujets!C2:C = « Femme_Plus_de_50ans »)); 1); VRAI)
Cette approche garantit mathématiquement une parité de distribution optimale des covariables entre les bras d’étude, optimisant la puissance statistique des tests de comparaison ultérieurs sans compromettre le caractère stochastique fondamental de l’assignation.
9.2 Technique de randomisation par blocs permutés
Dans les essais thérapeutiques prospectifs où le recrutement des participants s’échelonne sur une temporalité étendue (souvent plusieurs mois ou années), la randomisation simple présente le risque critique d’engendrer des déséquilibres numériques majeurs entre les groupes à des points d’étape intermédiaires de l’étude. Si, au cours des trente premières inclusions, le hasard attribue 22 patients au groupe de traitement actif et seulement 8 au groupe contrôle, toute analyse de futilité intermédiaire ou tout arrêt précoce de l’essai pour toxicité sera sévèrement compromis.
La randomisation par blocs permutés (ou permuted-block randomization) résout cette vulnérabilité en imposant que l’assignation s’effectue par sous-ensembles fermés de taille prédéfinie, appelés blocs (par exemple des blocs de taille 4 ou 6), au sein desquels la proportion des traitements est obligatoirement équilibrée (dans un bloc de 4 pour deux traitements A et B, il y aura impérativement deux A et deux B). La randomisation ne porte plus sur les individus eux-mêmes, mais sur la permutation de l’ordre interne de chaque bloc ou sur le choix de blocs préconfigurés.
Dans Google Sheets, l’analyste modélise cette méthodologie en créant un dictionnaire matriciel de tous les arrangements possibles d’un bloc de taille donnée. Pour un bloc binaire de taille 4, il existe exactement 6 arrangements équiprobables : AABB, ABAB, ABBA, BAAB, BABA, BBAA. L’opérateur génère ensuite une série stochastique d’indices de blocs à l’aide de la formule =ALEA.ENTRE.BORNES(1; 6), puis concatène dynamiquement les vecteurs correspondants. Ainsi, à la fin de chaque bloc complété, le ratio d’allocation entre les groupes actif et placebo demeure strictement égal à 1:1, protégeant l’étude contre les biais de recrutement séquentiels et les dérives saisonnières des critères d’admissibilité clinique.
9.3 Traitement des échantillons appariés et équilibrage des covariables
Le plan expérimental apparié (ou par paires jumelées) est une stratégie d’échantillonnage de haute précision consistant à regrouper les unités expérimentales deux par deux en fonction de leur proximité sur une série de covariables multidimensionnelles continues (par exemple, apparier deux participants ayant le même indice de masse corporelle, le même âge au mois près et le même profil glycémique de base), souvent formalisée par le score de propension (propensity score).
Une fois les paires constituées horizontalement sur chaque ligne de la feuille de calcul (le sujet 1 occupant les colonnes A et B, le sujet 2 occupant les colonnes C et D), la randomisation consiste à déterminer lequel des deux membres de la dyade recevra l’intervention expérimentale, le second étant obligatoirement assigné à la condition contrôle. Cette modalité mathématique équivaut à un tirage à pile ou face indépendant pour chaque ligne.
L’implémentation opérationnelle s’exécute à l’aide de la fonction booléenne conditionnelle suivante insérée en colonne E :
=SI(ALEA() < 0,5; « Sujet 1 = Actif / Sujet 2 = Témoin »; « Sujet 1 = Témoin / Sujet 2 = Actif »)
Cette formulation applique un tirage bernoullien indépendant de paramètre p = 0,5 à chaque dyade. Elle élimine totalement la variance inter-sujets pour les variables de matching et garantit que les deux groupes constitués sont des images miroirs rigoureuses sur le plan des covariables régulées, conférant aux tests statistiques sur mesures appariées (comme le test t apparié ou le test de Wilcoxon) une puissance statistique maximale pour détecter des effets d’intervention minimes.
10. Erreurs méthodologiques courantes et pièges techniques lors de l’aléisation
10.1 Le piège de la volatilité incontrôlée : Écrasement des tirages par recalcul
Le piège le plus insidieux et dévastateur pour la réplication scientifique réside dans la sous-estimation de la volatilité dynamique des fonctions ALEA(), TABLEAU.ALEA() et ALEA.ENTRE.BORNES(). Un chercheur inexpérimenté peut concevoir une assignation clinique parfaite à l’aide de formules, débuter l’administration de ses protocoles en se basant sur les affichages de son écran, puis constater avec effroi le lendemain que la simple saisie d’une note dans une cellule marginale ou la réouverture du fichier partagé a déclenché un recalcul universel de la feuille.
Dans ce scénario critique, l’ensemble des tirages précédents est instantanément écrasé par un nouveau flux pseudo-aléatoire, modifiant rétrospectivement l’attribution des traitements de patients déjà recrutés. Cette instabilité dynamique brise l’intégrité de la traçabilité de l’essai et rend l’étude méthodologiquement caduque et inauditable auprès des instances de régulation éthique ou pharmacologique.
Le garde-fou technique fondamental contre cette catastrophe procédurale est le figeage immédiat des valeurs calculées. Dès que la randomisation dynamique a opéré sur la plage réceptrice, l’analyste doit impérativement exécuter une séquence de neutralisation : surligner l’ensemble du bloc calculé, exécuter la commande de copie (Ctrl + C), puis réappliquer immédiatement sur le même emplacement la commande Édition > Collage spécial > Valeurs uniquement (Ctrl + Maj + V). Cette action détruit définitivement la dépendance aux fonctions volatiles sous-jacentes et convertit les nombres générés en constantes scalaires immuables.
10.2 Biais de non-uniformité induit par les tris sur troncatures numériques
Une anomalie subtile de distribution statistique peut survenir lorsqu’un analyste procède à des réductions arbitraires de la précision numérique des clés de tri stochastiques. Soucieux de rendre les colonnes aléatoires plus lisibles à l’écran, certains utilisateurs appliquent prématurément des fonctions d’arrondi telles que ARRONDI(ALEA(); 2) ou tronquent l’affichage à deux décimales.
Cette mutilation de la précision continue engendre un effet pervers : elle restreint l’espace des valeurs possibles à seulement 100 états discrets (de 0,00 à 0,99). Dès que la liste à trier dépasse quelques dizaines d’éléments, le phénomène des collisions (illustré mathématiquement par le paradoxe des anniversaires) se produit inévitablement : plusieurs dizaines de lignes se retrouvent gratifiées d’une clé de tri rigoureusement identique. Or, face à des valeurs équivalentes, les algorithmes de tri des tableurs ne mélangent pas les doublons : ils maintiennent leur ordre de saisie initial.
La conséquence méthodologique est immédiate et sévère : le jeu de données conserve des grappes structurelles non aléatoires héritées du tri précédent, violant le principe fondamental d’équiprobabilité des permutations. Pour garantir une indépendance sérielle totale et une distribution asymptotiquement uniforme, l’analyste doit sanctuariser la pleine précision en virgule flottante double précision 64 bits native de la fonction ALEA(), laquelle fournit une résolution d’environ 10-16, rendant le risque de collision statistique mathématiquement négligeable sur les corpus d’études conventionnels.
10.3 Oubli de plages disjointes et ruptures structurelles de bases de données
L’ergonomie des interfaces graphiques modernes présente des risques inhérents liés à la manipulation spatiale du pointeur de souris. L’une des défaillances les plus fréquentes en matière d’intégrité de bases de données est l’omission de colonnes disjointes lors du paramétrage d’une opération de randomisation matricielle manuelle.
Ce cas de figure se produit typiquement lorsqu’une base de données comporte une colonne masquée (par exemple la colonne C hébergeant des numéros de téléphone confidentiels) ou lorsqu’une colonne vide a été insérée artificiellement pour des motifs de mise en page esthétique entre deux blocs d’attributs. Si l’opérateur surligne le tableau en utilisant des raccourcis claviers automatiques de contiguïté (comme Ctrl + Maj + Flèche Droite), la sélection s’interrompt prématurément à la frontière de la rupture visuelle, excluant le pan latéral de la base de données.
Si l’analyste déclenche la commande « Aléatoriser la plage » sur ce bloc tronqué, la moitié gauche du tableau subit une permutation complète tandis que la moitié droite demeure statique. L’intégrité relationnelle de l’entité est irrémédiablement brisée : les noms de famille ne correspondent plus aux adresses de courriel, les antécédents médicaux sont intervertis et l’analyse devient totalement erronée. Pour s’immuniser contre ce désastre silencieux, l’analyste doit recourir systématiquement à la formalisation de plages nommées (via Données > Plages nommées) englobant explicitement l’ensemble des coordonnées géométriques de la matrice et interdisant les sélections accidentelles partielles.
11. Comparaison critique des méthodes : Fonctionnalités natives vs Formules dynamiques vs Scripts
11.1 Critères d’ergonomie, d’accessibilité technique et de courbe d’apprentissage
Le choix d’une méthode de randomisation ne saurait se faire in abstracto ; il est intrinsèquement tributaire des compétences logicielles de l’équipe d’analystes, du degré d’interactivité requis et de la criticité méthodologique du projet. Les trois grandes approches déployées dans Google Sheets — la commande native de menu, les formules matricielles dynamiques et les scripts procéduraux — se positionnent sur un continuum d’accessibilité technique contrasté.
La commande native Données > Aléatoriser la plage présente une ergonomie d’une simplicité absolue. Elle ne requiert aucune connaissance en programmation ni aucune maîtrise de la syntaxe des formules de tableur. Sa courbe d’apprentissage est quasi-instantanée, ce qui en fait l’outil d’élection pour les opérations d’appoint, les dépouillements exploratoires informels ou la manipulation de listes uniques au sein d’environnements pédagogiques. Son défaut majeur réside dans son absence totale d’automatisation : chaque action exige une intervention humaine manuelle et répétitive.
Les formules matricielles avancées comme SORT(..., RANDARRAY(...)) requièrent quant à elles une maîtrise conceptuelle substantielle du paradigme de calcul vectoriel et de la propagation matricielle. Cette approche s’adresse à des analystes familiers de l’imbrication syntaxique et de la modélisation conditionnelle. Enfin, le déploiement de Google Apps Script représente le niveau d’exigence technique le plus élevé, imposant des notions solides en développement JavaScript, la gestion des contextes d’exécution infonuagiques et l’implémentation rigoureuse d’algorithmes combinatoires comme celui de Fisher-Yates.
11.2 Performance de calcul, évolutivité et tenue sur grands jeux de données
Sur le plan de l’évolutivité computationnelle (scalability), les différentes approches manifestent des profils de latence et de consommation de ressources hautement différenciés lorsque la volumétrie des données croît de façon exponentielle, franchissant les paliers de 1 000, 10 000 ou 50 000 enregistrements.
Les fonctions natives de tableur (tant la commande d’interface que les fonctions de calcul interne comme SORT) sont directement exécutées en code compilé natif (C++) au niveau des serveurs centraux de Google. Par conséquent, elles affichent une rapidité d’exécution remarquable : le tri matriciel stochastique d’un registre de 20 000 lignes s’exécute en une fraction de seconde, sans provoquer de gel sensible du navigateur web client.
En revanche, Google Apps Script s’exécute dans une machine virtuelle d’application soumise à des quotas stricts d’infrastructure. Les allers-retours répétés entre le moteur de script et l’interface de la feuille via des appels d’API fréquents (tels que des getValue() ou setValue() insérés à tort dans des boucles itératives) induisent une latence considérable. Une routine mal optimisée peut nécessiter plusieurs dizaines de secondes pour mélanger 10 000 lignes et finir par dépasser la limite temporelle stricte imposée par Google (6 minutes par exécution de script). L’analyste traitant des volumes massifs de données doit impérativement privilégier les opérations matricielles en mémoire tampon globale ou les fonctions vectorielles natives pour maintenir une réactivité opérationnelle acceptable.
11.3 Matrice décisionnelle multicritères pour le choix de l’outil optimal
Afin de guider l’analyste, le chercheur ou le gestionnaire de données dans l’arbitrage technologique le plus pertinent au regard de ses contraintes opérationnelles, le tableau synthétique ci-dessous propose une confrontation critique et multicritère des trois méthodologies analysées :
| Critères d’Évaluation | Commande Native (« Aléatoriser ») | Formules Dynamiques (SORT + RANDARRAY) | Scripts Avancés (Apps Script / Fisher-Yates) |
|---|---|---|---|
| Niveau de compétence requis | Débutant (utilisation immédiate de l’interface graphique) | Intermédiaire (manipulation de formules matricielles imbriquées) | Avancé (maîtrise du langage JavaScript V8 et des API) |
| Nature de la transformation | Destructive (modifie la matrice source in situ) | Non destructive (projette la distribution sur une zone dédiée) | Configurable (peut opérer in situ ou déporter l’écriture) |
| Stabilité cinétique du résultat | Statique (aucun recalcul après l’exécution) | Volatile (recalcul automatique à chaque modification) | Statique (résultat figé sous forme de valeurs scalaires) |
| Performance sur grands volumes | Optimale (moteur C++ natif du serveur de calcul) | Excellente (gestion vectorielle fluide en mémoire vive) | Moyenne à faible (latence liée à la machine virtuelle JavaScript) |
| Traçabilité et auditabilité éthique | Nulle (aucune journalisation automatique de l’action) | Faible (la source dynamique ne conserve aucun historique d’état) | Optimale (génération d’horodatages, logs et signatures d’audit) |
| Cas d’usage préférentiel | Tirages rapides, listes d’attente, pédagogie, arbitrages simples | Tableaux de bord d’analyse dynamique, cohortes évolutives | Essais cliniques randomisés, protocoles réglementés, protocoles en double aveugle |
12. Bonnes pratiques de documentation, traçabilité et validation des tirages aléatoires
12.1 Archivage et gel des états expérimentaux pour la réplication scientifique
L’exigence contemporaine de reproductibilité de la recherche scientifique — cristallisée par les principes FAIR (Findable, Accessible, Interoperable, Reusable) — interdit d’abandonner les protocoles de randomisation à des états logiciels éphémères. Un tirage aléatoire sur lequel repose la publication de résultats empiriques doit pouvoir être reconstitué, audité et validé par des pairs ou des organismes d’inspection plusieurs années après sa réalisation effective.
Le premier impératif méthodologique réside dans le protocole de scellement d’archive. Dès que l’assignation aléatoire a été exécutée et figée en valeurs, l’analyste doit exporter la feuille d’attribution dans un format textuel universel non propriétaire, au premier rang desquels figure le format CSV (Comma-Separated Values) encodé en UTF-8. Ce fichier texte brut doit faire l’objet d’une empreinte cryptographique de hachage — typiquement calculée selon l’algorithme SHA-256 — permettant de générer une signature numérique unique de 64 caractères hexadécimaux certifiant de manière inaltérable que le fichier n’a subi aucune altération postérieure à sa constitution.
Conjointement, l’analyste doit exploiter les fonctionnalités institutionnelles de Google Drive en nommant explicitement une version dans l’historique du classeur (via Fichier > Historique des versions > Attribuer un nom à la version actuelle). Cet étiquetage sémantique crée un point de restauration immuable dans l’infrastructure de Google, documentant précisément la date, l’heure à la seconde près et l’adresse de messagerie certifiée de l’opérateur ayant procédé à l’opération stochastique.
12.2 Tests d’adéquation statistique pour confirmer l’absence de biais
Avant d’engager des ressources expérimentales considérables sur la base d’une liste randomisée au sein de Google Sheets, l’analyste rigoureux soumet l’échantillon ou la séquence permutée à une batterie d’épreuves de validation d’hypothèse statistique afin de confirmer empiriquement l’équiprobabilité et l’absence d’autocorrélation sérielle résiduelle.
Le test statistique fondamental pour valider l’uniformité d’une distribution discrète est le test d’adéquation du Chi-deux de Pearson. Si 200 participants ont été ventilés entre quatre bras d’intervention par une procédure pseudo-aléatoire, l’effectif théorique attendu sous l’hypothèse nulle H0 d’équiprobabilité parfaite est exactement de 50 sujets par bras. L’analyste calcule les effectifs observés réels à l’aide de la fonction NB.SI, puis confronte les distributions en exécutant directement la formule intégrée de Google Sheets :
=TEST.CHIDEUX(plage_effectifs_observes; plage_effectifs_theoriques)
Si la p-valeur résultante est confortablement supérieure au seuil d’alpha conventionnel de 0,05, l’hypothèse nulle d’uniformité de la distribution ne peut être rejetée, attestant de la conformité du protocole d’assignation.
Pour des analyses séquentielles complexes où l’indépendance de l’ordre d’apparition est cruciale, l’analyste met en œuvre le test des séries de Wald-Wolfowitz (Runs test). Ce test non paramétrique évalue le nombre de séquences consécutives d’éléments identiques au sein du vecteur temporel pour vérifier si le mélange n’a pas produit de sur-représentation anormale de blocs alternés ou de persistances stationnaires. Le calcul peut être couplé à la génération d’un histogramme visuel de dispersion sous Google Sheets, apportant une validation graphique immédiate de la neutralité stochastique du modèle.
12.3 Rédaction du protocole méthodologique dans les rapports scientifiques
La crédibilité d’un rapport expérimental, d’une thèse universitaire ou d’une publication dans une revue internationale à comité de lecture repose sur la précision chirurgicale de sa section « Méthodologie ». Une formulation vague telle que « les participants ont été assignés de manière aléatoire via un tableur » est aujourd’hui universellement considérée comme insuffisante par les standards éditoriaux contemporains (tels que les directives CONSORT pour les essais cliniques randomisés ou les standards de l’American Psychological Association).
Le protocole méthodologique rédigé doit stipuler explicitement l’ensemble des coordonnées techniques ayant concouru à la génération des flux aléatoires. L’analyste décrira formellement la version de la plateforme logicielle mobilisée, la nomenclature exacte des algorithmes sous-jacents (par exemple l’algorithme de mélange de Fisher-Yates déployé sous environnement JavaScript Google Apps Script, ou l’usage de la fonction RANDARRAY basée sur le moteur V8), ainsi que les paramètres de dispersion retenus.
De surcroît, le rapport doit expliciter avec une transparence totale les modalités de scellement des données (recours au collage spécial en valeurs statiques à une date précise), les procédures de vérification de l’intégrité relationnelle mises en place, les éventuels critères de stratification ou de blocage appliqués pour équilibrer les covariables cliniques, ainsi que la méthode de masquage utilisée pour préserver le double aveugle. Cette standardisation de l’écriture protocolaire atteste de la conformité de la recherche aux plus hauts standards méthodologiques internationaux et assure à l’expérimentateur une défendabilité scientifique absolue lors des audits de comités d’éthique et d’évaluation par les pairs.
Références
- Cochran, W. G., & Cox, G. M. (1957). Experimental designs (2nd ed.). John Wiley & Sons.
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Google Workspace. (2024). Google Sheets function list: Math and array formulas. Google Support. https://support.google.com/docs/table/25273
- Google Workspace Developers. (2024). Apps Script documentation: Spreadsheet Service. Google Developers. https://developers.google.com/apps-script/reference/spreadsheet
- Knuth, D. E. (1997). The art of computer programming: Seminumerical algorithms (Vol. 2, 3rd ed.). Addison-Wesley.
- Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c869. https://doi.org/10.1136/bmj.c869
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350
- Schulz, K. F., & Grimes, D. A. (2002). Unequal group sizes in randomised trials: Guarding against guessing. The Lancet, 359(9310), 966–970. https://doi.org/10.1016/S0140-6736(02)08029-3
- Williams, E. J. (1949). Experimental designs balanced for the estimation of residual effects of treatments. Australian Journal of Scientific Research, Series A: Physical Sciences, 2(2), 149–168. https://doi.org/10.1071/CH9490149