
Dans le domaine de l’ingénierie des données et de l’analyse biostatistique, la manipulation rigoureuse des tables d’observations constitue le fondement de toute inférence scientifique valide. Le système SAS (Statistical Analysis System), reconnu mondialement pour sa robustesse dans le traitement des données massives et son omniprésence au sein des industries hautement régulées telles que la recherche clinique et l’économétrie financière, repose sur un paradigme de traitement séquentiel particulièrement optimisé. Cependant, contrairement aux systèmes de gestion de bases de données relationnelles traditionnels qui intègrent fréquemment des pseudo-colonnes automatiques ou des index physiques visibles, SAS ne génère pas de manière explicite et permanente une colonne dédiée à l’indexation séquentielle des lignes lors de la création d’une table de données standard.
Cette particularité architecturale impose aux analystes, statisticiens et ingénieurs de données la maîtrise complète des mécanismes internes régissant l’étape DATA. L’attribution d’un identifiant numérique unique ou d’un compteur séquentiel, qu’il soit global ou conditionné par des sous-groupes catégoriels, représente bien plus qu’une simple commodité cosmétique. Il s’agit d’un impératif méthodologique conditionnant la traçabilité des observations, la reproductibilité des analyses longitudinales, l’implémentation d’algorithmes d’échantillonnage stratifié et la mise en conformité avec les normes d’audit les plus strictes, notamment les directives des agences de régulation sanitaire et financière.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, les mécanismes computationnels sous-jacents et les implémentations pratiques permettant d’ajouter des numéros de ligne au sein de l’environnement SAS. De la variable automatique sous-jacente au vecteur de données de programme (PDV) jusqu’aux requêtes avancées sous la procédure SQL, en passant par la gestion subtile de l’instruction de somme implicite et le traitement par groupe, cet article explore l’ensemble du spectre méthodologique requis pour structurer et fiabiliser vos jeux de données de recherche.
1. 1. Introduction à l’indexation des observations sous l’environnement SAS
1.1 1.1 Importance méthodologique de la numérotation des lignes
Dans le cadre de la recherche quantitative moderne, l’auditabilité et la reproductibilité des chaînes de traitement statistique constituent des critères d’évaluation fondamentaux. L’adjonction d’un identifiant séquentiel au sein d’une table d’observations brutes permet de matérialiser une piste de vérification (audit trail) indispensable, notamment dans les contextes assujettis aux exigences de la réglementation FDA 21 CFR Part 11. Lorsqu’un jeu de données subit des transformations successives—telles que des transpositions, des sous-échantillonnages, des imputations de valeurs manquantes ou des jointures relationnelles—la présence d’une numérotation de ligne native garantit qu’il est toujours possible de remonter avec une précision absolue à l’enregistrement source initial. Cette traçabilité prévient la perte d’informations contextuelles et permet de détecter d’éventuelles anomalies d’appariement lors d’opérations de fusion complexes.
Dans les protocoles de recherche en psychométrie, en épidémiologie ou en sociologie quantitative, la modélisation des données requiert souvent une séparation stricte entre l’unité statistique d’observation et les attributs temporels ou environnementaux qui lui sont associés. L’introduction d’un index séquentiel sert de pivot pour identifier de manière univoque un participant, une session expérimentale ou une passation de questionnaire spécifique. En l’absence de clé primaire composite fiable fournie en amont, la génération d’un numéro de ligne unique devient la méthode de référence pour prévenir l’ambiguïté référentielle, stabiliser les procédures d’échantillonnage probabiliste (comme le tirage aléatoire systématique) et faciliter le partitionnement des données d’apprentissage et de validation dans les modélisations prédictives.
D’un point de vue conceptuel et théorique, il convient d’opérer une distinction rigoureuse entre l’ordre physique de stockage des données sur le support disque et l’ordre logique d’analyse déterminé par les instructions de programmation. Les architectures de stockage distribuées ou les formats de fichiers compressés peuvent modifier l’agencement physique des blocs d’octets sans modifier la hiérarchie logique des variables. L’attribution explicite d’une colonne de numérotation transforme une propriété d’ordre implicite, tributaire du système de fichiers et de la méthode de lecture séquentielle, en une variable de données persistante, immuable et manipulable par les opérateurs algébriques et relationnels du langage SAS.
1.2 1.2 Spécificités de l’architecture de données SAS
Pour appréhender la mécanique de numérotation sous le logiciel SAS Institute, il est indispensable de comprendre le fonctionnement fondamental de l’étape DATA (DATA step). Contrairement aux architectures de bases de données relationnelles (RDBMS) fondées sur la théorie des ensembles où les données sont appréhendées comme des tuples non ordonnés, le compilateur SAS traite l’information de manière fondamentalement séquentielle. L’étape DATA exécute une boucle implicite qui procède ligne par ligne, lisant une observation source, la chargeant dans une structure de mémoire tampon intermédiaire, exécutant les instructions de transformation séquentielle, puis écrivant l’enregistrement résultant dans la table cible avant de réinitialiser la mémoire pour l’itération suivante.
Au cœur de cette architecture se trouvent les mécanismes de gestion interne des pointeurs d’enregistrement. Lors de la lecture d’un jeu de données SAS standard (table de type .sas7bdat), le moteur de stockage interne gère un descripteur d’en-tête qui maintient l’état des métadonnées, incluant le nombre total d’observations, la longueur fixe de chaque enregistrement physique et la position courante du pointeur de lecture. Bien que le moteur sous-jacent sache en permanence quel enregistrement physique il est en train de traiter via son adresse relative ou son décalage (offset), cette information d’infrastructure demeure confinée aux couches basses du système et n’est pas exposée directement sous la forme d’une variable accessible dans l’espace de calcul utilisateur.
Cette absence par défaut d’une colonne d’indexation explicite dans les tables de sortie SAS surprend fréquemment les programmeurs formés à d’autres écosystèmes logiciels. Dans un fichier de données SAS finalisé, seules les colonnes déclarées ou créées explicitement figurent dans le dictionnaire des variables. Il n’existe pas d’équivalent persistant direct automatique aux concepts de clés primaires auto-incrémentées (telles que le champ AUTO_INCREMENT en MySQL ou IDENTITY en Microsoft SQL Server). Par conséquent, c’est au programmeur qu’incombe la responsabilité architecturale d’instancier, de valoriser et de documenter la colonne qui portera le numéro d’ordre de chaque observation.
2. 2. La variable automatique _N_ : fondements théoriques et cycle d’exécution
2.1 2.1 Définition et comportement du vecteur de données de programme (PDV)
Le Programme Data Vector (PDV), ou vecteur de données de programme, constitue la zone mémoire logique fondamentale créée par le compilateur SAS lors de la phase de préparation de l’étape DATA. Le PDV agit comme une structure tampon bidirectionnelle qui reçoit les variables lues depuis la table source ou instanciées par le code utilisateur, avant leur transfert définitif vers la table de destination. Lors de la compilation, SAS alloue dans le PDV des emplacements fixes pour chaque variable, accompagnés d’indicateurs de statut régissant leur comportement, notamment l’attribut d’initialisation (remise à blanc ou à valeur manquante à chaque tour de boucle) et l’indicateur de conservation (sauvegarde de la variable dans la table de sortie finale).
Au sein de cette mécanique interne, le système initialise automatiquement des variables système spéciales, dont la plus notable est la variable automatique _N_. Par nature, _N_ est une variable éphémère : elle réside exclusivement dans le PDV pendant le temps de calcul de l’étape DATA, mais elle possède intrinsèquement un indicateur d’exclusion permanent qui empêche son écriture automatique dans la table SAS résultante. Sa valeur numérique est automatiquement incrémentée d’une unité à chaque fois que l’étape DATA franchit le point d’entrée de son cycle d’exécution principal, agissant ainsi comme un compteur d’itérations de la boucle sous-jacente.
Une confusion méthodologique fréquente consiste à assimiler la variable _N_ au numéro physique de l’observation au sein de la table d’entrée. Il s’agit d’une approximation théorique erronée. La variable _N_ mesure strictement le nombre de fois où l’étape DATA a recommencé son cycle d’instructions. Dans le cas d’une lecture séquentielle simple d’un fichier source sans branchements conditionnels complexes, sans instruction OUTPUT explicite et sans boucle itérative interne de type DO, la valeur de _N_ coïncide parfaitement avec le numéro de la ligne en cours de lecture. Toutefois, dès lors que la topologie du code intègre des instructions de saut conditionnel, des boucles de lecture multiples par itération ou des filtrages en amont, la divergence entre le compteur d’itérations du PDV et l’identifiant physique de la ligne devient effective.
2.2 2.2 Impact de l’instruction SET sur la variable _N_
L’interaction entre l’instruction de lecture séquentielle SET et la variable automatique _N_ conditionne la justesse des métriques d’indexation. Dans un schéma d’exécution direct sans clause restrictive, à l’instant où l’instruction de compilation commence la première itération, _N_ prend la valeur 1. L’instruction SET déplace le pointeur d’enregistrement sur la première ligne de la table d’entrée et charge ses variables dans le PDV. Lorsque le flot d’instructions atteint la fin logique de l’étape DATA matérialisée par l’instruction RUN, une écriture implicite se produit, le PDV est réinitialisé selon les règles de persistance, le pointeur d’itération _N_ est incrémenté à 2, et le cycle se répète jusqu’à ce que l’instruction SET rencontre le marqueur de fin de fichier (End-Of-File ou EOF).
Les conséquences des mécanismes de filtrage sur la relation entre _N_ et les observations générées sont hautement critiques. Il est primordial de distinguer le filtrage pré-chargement opéré par la clause WHERE du filtrage post-chargement opéré par l’instruction conditionnelle IF. Lorsque l’on applique une clause WHERE sur l’instruction SET, le moteur de stockage SAS filtre les enregistrements avant même qu’ils ne soient transmis au PDV. Dans ce cas de figure, l’étape DATA ne commence une nouvelle itération que pour les observations qui satisfont la condition logique ; par conséquent, _N_ s’incrémente de manière continue sans rupture par rapport aux lignes filtrées retenues. À l’inverse, si l’on utilise une condition de sous-ensemble de type IF logique après le chargement par SET, chaque observation de la table source entraîne l’incrémentation de _N_. Si l’observation ne valide pas le critère du IF, l’exécution s’interrompt pour cette ligne et l’écriture dans la table de sortie est ignorée, créant ainsi des discontinuités majeures si l’on tente d’affecter _N_ directement comme index séquentiel.
Un autre piège classique dans la construction de l’étape DATA réside dans l’emplacement chronologique de l’affectation de la variable personnalisée par rapport à l’instruction SET. Considérons une écriture où l’affectation de la variable d’indexation précède l’instruction SET dans le bloc de code. Bien que le compilateur SAS assemble l’ensemble des instructions selon un ordre strict, placer l’assignation avant l’instruction SET implique que la valeur de _N_ est capturée dans le PDV avant que les variables de l’observation ne soient chargées et que la condition de fin de fichier ne soit évaluée. Si une interruption ou un branchement intervient au niveau du SET, la valeur de l’index peut se désynchroniser. La bonne pratique d’ingénierie logicielle SAS impose d’ordonner les instructions de manière à ce que la lecture des données sources stabilise d’abord le PDV avant toute affectation de métriques positionnelles dérivées.
3. 3. Méthode standard : attribution globale d’un identifiant séquentiel
3.1 3.1 Syntaxe fondamentale de la numérotation absolue
La technique la plus élémentaire, mais néanmoins la plus robuste pour attribuer un numéro séquentiel unique à l’ensemble des observations d’une table non subdivisée, repose sur la capture directe de la variable système _N_ dans une variable permanente nouvellement déclarée. La syntaxe canonique de cette opération s’articule de la manière suivante :
data table_cible;
set table_source;
numero_ligne = _N_;
run;
Dans cette structure, le compilateur SAS analyse les instructions, dimensionne le PDV pour accueillir l’ensemble des colonnes présentes dans la table source, et ajoute une case mémoire supplémentaire nommée numero_ligne. Au cours de la phase d’exécution, pour chaque passage au sein de la boucle de l’étape DATA, l’instruction SET transfère l’enregistrement courant de la table source dans le PDV. L’instruction d’affectation attribue ensuite la valeur courante de l’entier _N_ à la variable numero_ligne. Contrairement à _N_ qui reste masquée et éphémère, la variable numero_ligne ne possède aucun indicateur d’exclusion et sera donc physiquement écrite dans la table finale lors de la résolution de l’étape RUN.
Cette variable nouvellement générée est systématiquement typée par défaut comme un nombre flottant à double précision (format numérique SAS standard de 8 octets), garantissant une capacité de numérotation s’étendant sans perte de précision jusqu’à plusieurs millions d’enregistrements. L’ordre d’évaluation des instructions revêt ici une importance primordiale : en plaçant l’affectation immédiatement après la clause SET, l’analyste s’assure que seules les lignes effectivement lues et validées par les filtres amont héritent d’une estampille séquentielle strictement croissante, débutant obligatoirement à la valeur 1 pour la première observation traitée.
3.2 3.2 Exemple empirique appliqué sur un échantillon univarié
Afin de concrétiser ce paradigme fondamental, prenons l’exemple empirique d’un jeu de données issu de l’évaluation des performances sportives de franchises de basketball, répertoriant les équipes et leurs scores offensifs moyens. Considérons la création initiale d’une table d’expérimentation nommée resultats_equipes, compilée à partir du code ci-après :
data resultats_equipes;
input franchise $ score;
datalines;
Mavs 102
Rockets 98
Spurs 115
Warriors 120
Celtics 108
;
run;
Pour indexer de manière absolue ces cinq enregistrements, nous instancions une nouvelle table de données dans laquelle nous formalisons notre variable de numérotation séquentielle :
data resultats_indexe;
set resultats_equipes;
id_observation = _N_;
run;
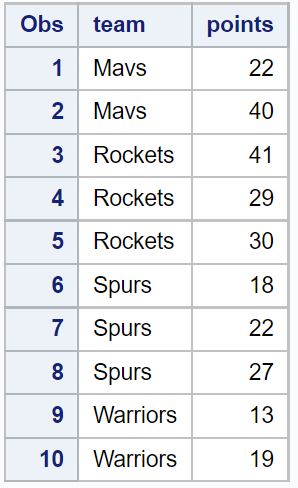
L’exécution de la procédure standard d’affichage documentaire, via l’appel proc print data=resultats_indexe; run;, permet de valider le comportement du moteur d’exécution. Dans la sortie SAS générée, chaque observation se voit attribuer un entier strictly monotone : la franchise Mavs est étiquetée avec la valeur 1, Rockets avec la valeur 2, Spurs avec la valeur 3, Warriors avec la valeur 4, et Celtics avec la valeur 5. L’intégrité séquentielle continue est ainsi confirmée : il n’existe aucune discontinuité d’indice, aucune troncature, et la variable générée se prête sans restriction à des tris postérieurs ou à des opérations d’appariement relationnel.
3.3 3.3 Gestion de l’ordre des colonnes dans la table finale
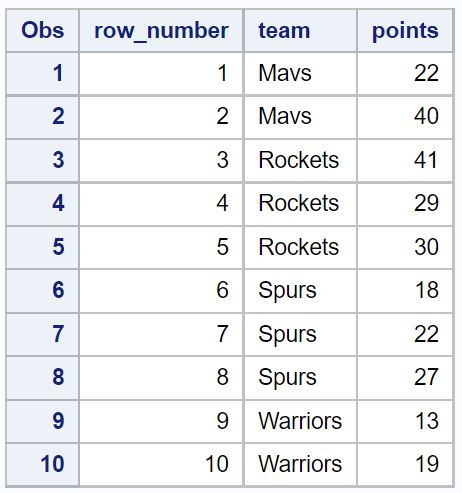
Bien que le code précédent ajoute fonctionnellement le numéro d’observation, il induit une disposition structurelle où la colonne id_observation est rejetée à l’extrémité droite de la table SAS. En effet, par conception, le compilateur SAS ordonne les colonnes au sein du descripteur de table selon leur ordre d’apparition textuel au cours de l’analyse du code source de l’étape DATA. Les variables importées via l’instruction SET étant résolues en premier, elles occupent les positions vectorielles initiales, reléguant toute variable calculée ultérieurement aux dernières positions de la table.
Dans une perspective d’ergonomie documentaire, de présentation de rapports statistiques ou d’exportation vers des revues scientifiques, il est généralement requis que la clé primaire ou l’index séquentiel figure en première colonne (position la plus à gauche). Pour contraindre l’ordonnancement structurel sans altérer la dynamique de lecture, il est nécessaire de déclarer la variable d’indexation avant l’instruction SET au moyen d’instructions déclaratives non exécutables telles que RETAIN ou LENGTH. Considérons l’implémentation suivante :
data resultats_indexe_ordonne;
retain id_observation;
set resultats_equipes;
id_observation = _N_;
run;
L’instruction RETAIN indique au compilateur d’allouer la première position du PDV à la variable id_observation avant même la détection des variables de la table source transmise par SET. De plus, pour respecter scrupuleusement les exigences de documentation des données préconisées par la communauté scientifique, il est hautement recommandé d’associer un libellé formel et un format d’affichage à cette variable, garantissant ainsi que les propriétés métrologiques du jeu de données sont intégralement documentées au niveau des dictionnaires SAS de type DICTIONARY.COLUMNS ou PROC CONTENTS.
4. 4. Prétraitement et ordonnancement des données avec PROC SORT
4.1 4.1 Nécessité du tri préalable pour le traitement groupé
Dès lors que l’objectif analytique dépasse la simple numérotation globale pour s’orienter vers une indexation stratifiée ou intra-groupe—par exemple, numéroter les patients au sein de chaque centre hospitalier ou numéroter les transactions au sein de chaque compte client—, la maîtrise de l’ordonnancement des données devient une condition sine qua non. Le compilateur SAS, fidèle à sa philosophie de traitement séquentiel par flux, ne dispose pas de mémoire associative native lui permettant d’effectuer des calculs d’agrégation ou de rupture sur des données dispersées aléatoirement sans un alignement séquentiel préalable.
L’utilisation de la clause BY au sein de l’étape DATA impose que les données d’entrée soient strictement organisées selon les valeurs de la variable de regroupement. Si l’interpréteur SAS rencontre une rupture de séquence au cours de la lecture d’une table non ordonnée associée à une instruction BY, l’exécution s’interrompt brutalement et génère une erreur critique dans le journal (SAS Log) : ERROR: Data set is not sorted in ascending order. Cette contrainte architecturale sévère garantit en contrepartie une vitesse d’exécution optimale et une consommation de mémoire vive constante, dans la mesure où le système n’a jamais besoin de conserver en mémoire plus d’une observation à la fois pour statuer sur les frontières de chaque groupe.
L’algorithme sous-jacent de la procédure standard PROC SORT assure une stabilité d’ordonnancement indispensable pour la reproductibilité scientifique. Lorsque des observations possèdent des valeurs identiques sur la clé de tri spécifiée, le respect de l’ordre d’origine ou l’application de clés de tri secondaires permet de lever toute indétermination mathématique. Ainsi, le passage systématique par une étape de tri contrôlée constitue le point de départ incontournable de tout pipeline de données SAS impliquant une logique d’indexation conditionnelle.
4.2 4.2 Mise en œuvre technique de PROC SORT
La syntaxe de base de la procédure d’ordonnancement PROC SORT s’exécute selon une structure d’une grande sobriété opérationnelle :
proc sort data=table_brute out=table_triee;
by variable_groupe;
run;
L’utilisation explicite du paramètre out= est une excellente pratique de programmation défensive. Elle permet d’éviter l’écrasement destructif de la table source originale, autorisant ainsi des comparaisons d’audit a posteriori. Lorsque l’analyse exige une numérotation des observations ordonnée selon une grandeur statistique interne au groupe—par exemple, numéroter les athlètes d’une franchise de basketball par ordre décroissant de performance individuelle—, la hiérarchisation des clés de tri multiples devient impérative :
proc sort data=resultats_equipes out=equipes_ordonnees;
by franchise descending score;
run;
Dans ce bloc d’instructions, le mot-clé descending s’applique exclusivement à la métrique de score qui lui succède immédiatement, garantissant que pour chaque franchise, le joueur ayant cumulé le plus grand nombre de points apparaîtra en tête de séquence dans la table ordonnée. Sur le plan de la performance informatique appliquée aux jeux de données massifs (plusieurs dizaines de gigaoctets), la procédure SORT peut être paramétrée à l’aide d’options de compilation avancées telles que TAGSORT. Cette option stocke uniquement les variables d’index et l’adresse physique des enregistrements dans les tables temporaires de tri, allégeant drastiquement les opérations d’entrées/sorties sur les disques durs. De même, l’option PRESORTED permet d’éviter un cycle complet de tri si le système de fichiers ou la base de données source atteste déjà de la conformité de l’ordre requis.
5. 5. Numérotation intra-groupe : logique des variables FIRST. et LAST.
5.1 5.1 Fonctionnement interne des variables temporaires générées par l’instruction BY
L’association de l’instruction BY à une étape DATA transforme radicalement l’environnement d’exécution du PDV. Pour chaque variable énumérée dans l’instruction BY, le superviseur d’exécution SAS génère automatiquement deux variables système temporaires : FIRST.variable et LAST.variable. À l’instar de la variable _N_, ces variables d’état sont strictement confinées à la mémoire vive volatile du PDV et ne sont jamais transférées dans la table de données finale, sauf si le programmeur décide explicitement de copier leur contenu dans une variable personnalisée permanente.
Ces variables temporaires fonctionnent comme des drapeaux logiques booléens, prenant exclusivement les valeurs entières 1 (vrai) ou 0 (faux). La variable FIRST.variable prend la valeur 1 lorsque l’observation courante constitue la toute première ligne associée à une nouvelle valeur de la variable de regroupement spécifiée, et elle prend la valeur 0 pour toutes les observations suivantes appartenant au même groupe. Réciproquement, LAST.variable prend la valeur 1 lorsque l’enregistrement en cours de traitement représente l’ultime observation de la modalité courante de cette même variable de groupe, et 0 dans tous les autres cas.
La détection de ces transitions repose sur un mécanisme de prélecture (look-ahead buffer) opéré par le moteur SAS. Dès le traitement de l’enregistrement courant, le moteur inspecte la valeur de la ligne suivante dans la table source afin de déterminer si une frontière de groupe est franchie. Cette prouesse algorithmique confère au langage SAS une puissance analytique remarquable pour l’évaluation séquentielle sans nécessiter la mise en cache de l’intégralité du groupe de données, garantissant un traitement en temps linéaire d’une complexité computationnelle théorique optimale d’ordre O(N).
5.2 5.2 Réinitialisation du compteur au changement de strate
L’attribution d’un numéro d’observation qui redémarre à 1 pour chaque nouvelle sous-population statistique (numérotation intra-groupe) s’appuie directement sur l’interception du marqueur FIRST.variable. Puisque la variable globale _N_ continue de croître de manière univoque sans égard pour les frontières catégorielles des sous-groupes, elle ne peut être employée directement pour cette tâche. Il est nécessaire de concevoir une variable de comptage dédiée, asservie aux signaux booléens générés par l’architecture BY-group.
La règle algorithmique fondamentale pour implémenter cette réinitialisation repose sur l’évaluation de la condition logique suivante :
if first.variable_groupe then compteur_groupe = 0;
Ce positionnement conditionnel permet de forcer la remise à zéro de la cellule mémoire du compteur dès que le moteur d’exécution détecte le passage vers une nouvelle modalité catégorielle. Toutefois, pour que ce compteur puisse progresser et incrémenter sa valeur au fil des enregistrements consécutifs d’une même strate, l’affectation simple ne suffit pas : elle doit être impérativement couplée soit à une instruction d’accumulation implicite, soit au mécanisme de rétention explicite. L’absence de ce couplage provoquerait la réinitialisation de la variable à une valeur manquante lors de chaque cycle de l’étape DATA, anéantissant toute possibilité de suivi cumulatif intra-strate.
6. 6. L’instruction d’addition implicite et le mécanisme de rétention
6.1 6.1 Décomposition syntaxique de l’instruction d’accumulation (row_number + 1)
Le langage SAS met à disposition des développeurs une syntaxe compacte et performante, formellement désignée sous le nom d’instruction de somme (Sum Statement) ou d’addition implicite. Cette construction syntaxique se matérialise par l’expression mathématique :
compteur + 1;
Sous cette formulation d’une grande sobriété textuelle se dissimule une double propriété architecturale fondamentale au fonctionnement du PDV. En premier lieu, l’instruction de somme impose automatiquement l’attribut de rétention (RETAIN) à la variable située à gauche de l’opérateur d’addition. Cela signifie que la valeur numérique stockée dans cette variable n’est pas réinitialisée à une valeur manquante (notée ‘.’) à la fin du cycle d’itération de l’étape DATA, mais demeure préservée en mémoire vive pour être accessible lors du cycle d’exécution suivant.
En second lieu, l’instruction de somme gère de manière autonome l’initialisation arithmétique. Si l’on utilisait l’instruction explicite concurrente :
retain compteur;
compteur = compteur + 1;
et que la variable compteur n’avait pas été préalablement valorisée, sa valeur initiale dans le PDV serait une valeur manquante numérique. En vertu des règles de l’algèbre SAS, toute addition appliquée à une valeur manquante produit irrémédiablement une valeur manquante (missing value propagation). En revanche, l’instruction d’accumulation implicite compteur + 1; initialise automatiquement la variable à zéro dès la compilation, transformant toute valeur manquante initiale en valeur arithmétique neutre pour l’addition. Cette gestion native simplifie l’écriture du code et élimine le risque d’échec de comptage consécutif à une initialisation omise.
6.2 6.2 Analyse étape par étape du flux d’exécution dans le PDV
Pour appréhender avec rigueur la synchronisation entre la réinitialisation de frontière et l’accumulation séquentielle, il est éclairant de décomposer la cinématique du PDV lors de la lecture de deux enregistrements consécutifs délimitant un changement de strate.
Lors de la lecture du premier enregistrement d’une nouvelle modalité (par exemple, la première observation de l’équipe Spurs après le traitement de l’équipe Rockets), l’instruction SET charge les données. Le compilateur évalue le contexte et positionne la variable temporaire FIRST.franchise à la valeur 1. Le flux d’instructions rencontre ensuite le test conditionnel : if first.franchise then rang_equipe = 0;. La condition étant validée, la mémoire du PDV pour rang_equipe est immédiatement écrasée avec la valeur 0. La ligne de code suivante exécute l’instruction de somme implicite : rang_equipe + 1;. Le système prend la valeur courante (0), lui ajoute l’incrément de 1, et stocke le résultat 1 dans le PDV. L’étape DATA atteint sa conclusion, écrit l’enregistrement dans la table cible avec la variable rang_equipe valant 1, et boucle vers l’itération suivante.
Au début de l’itération consacrée au second enregistrement des Spurs, l’instruction SET charge la nouvelle observation. Le mécanisme de surveillance BY constate que la franchise est toujours Spurs : par conséquent, FIRST.franchise bascule à 0. Lorsque le flux de contrôle évalue le test conditionnel if first.franchise then…, la condition est déclarée fausse, et l’instruction de réinitialisation à 0 est totalement ignorée. La mémoire du PDV conserve ainsi la valeur 1 héritée du cycle précédent grâce à la rétention implicite. L’instruction d’accumulation rang_equipe + 1; est ensuite évaluée : le système prend la valeur retenue 1, lui ajoute 1, et met à jour le PDV avec la valeur 2. L’observation est alors transcrite dans la table de destination. Ce mécanisme d’horlogerie interne se poursuit de manière déterministe jusqu’à l’ultime observation du jeu de données.
7. 7. Exemple pratique détaillé : segmentation par équipe et métriques associées
7.1 7.1 Modélisation de la table expérimentale d’athlètes
Afin d’illustrer la puissance opérationnelle de cette méthode dans un cadre expérimental contrôlé, nous construisons une table SAS de travail représentative, intégrant des séries de données asymétriques issues de quatre franchises sportives de la NBA (Mavs, Rockets, Spurs, Warriors). Le code d’instanciation de cet échantillon s’établit comme suit :
data cohortes_sportives;
input franchise $ points;
datalines;
Warriors 110
Warriors 105
Mavs 99
Mavs 104
Spurs 95
Spurs 98
Spurs 102
Rockets 112
;
run;
Ce jeu de données présente volontairement une structure non ordonnée selon les standards alphabétiques de la variable franchise, ainsi que des effectifs d’échantillonnage inégaux d’un groupe à l’autre : la modalité Warriors comprend 2 observations, Mavs comprend 2 observations, Spurs en compte 3, tandis que Rockets ne comporte qu’un unique enregistrement (n=1). Cette variabilité structurelle est idéale pour tester la robustesse des algorithmes de réinitialisation de compteurs séquentiels.
7.2 7.2 Application du script complet de numérotation groupée
Le traitement complet nécessite d’enchaîner deux étapes distinctes : la phase de tri formel via PROC SORT, suivie de l’étape DATA incorporant la logique BY-group et l’instruction de somme. Voici le script d’ingénierie de données correspondant :
proc sort data=cohortes_sportives out=cohortes_triees;
by franchise;
run;
data cohortes_indexees;
set cohortes_triees;
by franchise;
if first.franchise then numero_joueur = 0;
numero_joueur + 1;
run;
Dans ce bloc de programmation, la procédure SORT réarrange les enregistrements selon l’ordre alphabétique des équipes (Mavs, puis Rockets, puis Spurs, et enfin Warriors). L’étape DATA lit ensuite séquentiellement ce flux ordonné. À chaque changement de franchise, la variable numero_joueur est initialisée à 0 avant d’être immédiatement incrémentée à 1, garantissant une numérotation intra-groupe continue et exempte d’artefacts.
7.3 7.3 Interprétation académique des résultats obtenus
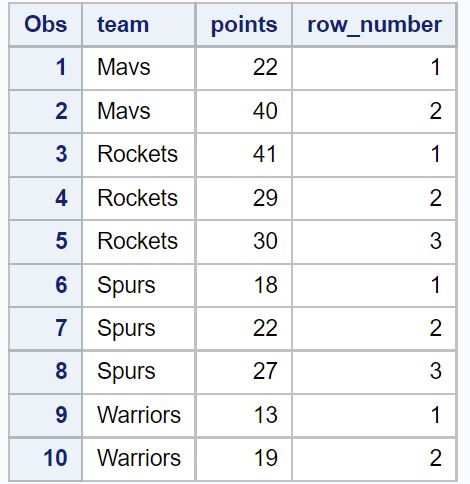
L’inspection des résultats via la procédure d’affichage proc print data=cohortes_indexees; run; confirme l’exactitude de l’attribution des index au sein de chaque groupe. Pour la franchise Mavs, les deux lignes se voient affecter les numéros 1 et 2. Pour les Rockets, l’observation unique reçoit la valeur 1. Pour les Spurs, les trois lignes génèrent la suite 1, 2 et 3. Enfin, pour les Warriors, les observations reçoivent les valeurs 1 et 2.
D’un point de vue méthodologique, cette indexation intra-groupe présente des applications analytiques majeures dans le domaine de l’échantillonnage statistique. Elle permet notamment d’extraire instantanément des sous-échantillons équilibrés, par exemple en sélectionnant les n premiers individus de chaque strate via une clause logique du type : if numero_joueur <= 2;. Elle constitue également le socle technique du calcul des statistiques de rang univariées et autorise des opérations de transposition horizontale ou verticale sans perte de traçabilité des identités individuelles au sein des blocs expérimentaux.
8. 8. Numérotations conditionnelles avancées et hiérarchies multiniveaux
8.1 8.1 Gestion des structures de données hiérarchiques à plusieurs facteurs
Dans les schémas de recherche épidémiologique ou économique, les jeux de données présentent fréquemment une structure imbriquée ou hiérarchique complexe, par exemple des patients regroupés au sein d’hôpitaux, eux-mêmes situés dans différentes régions géographiques. Le langage SAS permet d’étendre la logique des variables FIRST. et LAST. à des niveaux d’arborescence multiples via l’instruction BY multi-factorielle :
proc sort data=donnees_multiniveaux;
by region hopital patient;
run;
data hierarchie_indexee;
set donnees_multiniveaux;
by region hopital;
if first.region then index_region + 1;
if first.hopital then index_hopital_dans_region = 0;
index_hopital_dans_region + 1;
run;
Une règle architecturale critique régit l’évaluation hiérarchique des variables automatiques FIRST.variable dans SAS : si une variable de niveau supérieur dans l’instruction BY change de valeur (par exemple, transition vers une nouvelle region), la variable système FIRST. correspondante prend la valeur 1, mais toutes les variables FIRST. des niveaux subordonnés (ici first.hopital) prennent également et obligatoirement la valeur 1, même si la chaîne textuelle ou l’identifiant de l’hôpital venait fortuitement à coïncider d’une région à l’autre. Cette cascade logique interne garantit l’étanchéité des frontières hiérarchiques et prévient toute contamination des compteurs subordonnés à travers les strates mères.
8.2 8.2 Numérotation filtrée selon des critères statistiques
Il est parfois nécessaire de restreindre l’attribution d’un numéro d’observation à une sous-population vérifiant des contraintes quantitatives rigoureuses—comme un seuil de score minimal ou une compliance clinique—tout en conservant l’exhaustivité du jeu de données dans la table finale. Ce cas d’usage requiert une disjonction stricte entre le flux global d’écriture des enregistrements et l’évaluation conditionnelle du compteur :
data cohortes_filtrees;
set cohortes_triees;
if points >= 100 then do;
compteur_haute_performance + 1;
end;
else do;
compteur_haute_performance = .;
end;
run;
Dans ce scénario, seules les observations franchissant le seuil critique métrique de 100 points incrémentent la variable compteur_haute_performance. Pour les observations non conformes au critère statistique, le programme assigne explicitement une valeur manquante (.), sans altérer la progression du compteur pour les observations ultérieures satisfaisant le critère. Cette approche permet de construire des répertoires d’observations indexées conditionnellement sans déstructurer l’alignement matriciel initial de la base de données de recherche.
9. 9. Approche alternative via le langage SQL sous SAS (PROC SQL)
9.1 9.1 Utilisation de la fonction non documentée MONOTONIC()
Bien que l’étape DATA constitue l’outil historique et idiomatique par excellence de l’écosystème SAS, de nombreux ingénieurs de données habitués à la syntaxe SQL sollicitent régulièrement la procédure PROC SQL pour manipuler les tables. Au sein de cette procédure, il existe une fonction spécifique, connue sous le nom de monotonic(), qui permet de générer un entier séquentiel croissant sans avoir recours aux boucles de l’étape DATA :
proc sql;
create table donnees_sql_index as
select monotonic() as numero_ligne, *
from resultats_equipes;
quit;
Cette formulation séduit par sa concision textuelle et son élégance déclarative. Toutefois, d’un point de vue académique et réglementaire, il est capital de souligner que la fonction monotonic() n’est pas officiellement documentée ni formellement supportée par l’éditeur SAS Institute pour les environnements de production critique. Dans des requêtes complexes impliquant des clauses WHERE, des regroupements GROUP BY, des sous-requêtes imbriquées ou des jointures multiples, l’ordre d’évaluation interne de l’optimiseur de requêtes SQL peut conduire à des résultats imprévisibles, tels que des sauts de numérotation, des doublons d’index ou des réinitialisations inopinées du compteur en cours de traitement. Son emploi doit donc demeurer cantonné à l’exploration interactive rapide et proscrit des pipelines de validation clinique certifiés.
9.2 9.2 Simulation d’indexation groupée en SQL ANSI sous SAS
Pour implémenter une numérotation intra-groupe rigoureuse et entièrement conforme aux standards de l’ANSI SQL sans recourir à l’étape DATA ni aux fonctions non documentées, l’analyste doit mettre en œuvre une auto-jointure non équitable (non-equi self-join) couplée à une fonction d’agrégation COUNT. Considérons le cas d’application suivant sur notre table d’équipes sportives :
proc sql;
create table sql_rang_equipe as
select a.franchise, a.score,
count(b.score) as rang_intra_groupe
from cohortes_sportives a
inner join cohortes_sportives b
on a.franchise = b.franchise
and a.score <= b.score
group by a.franchise, a.score;
quit;
Cette formulation purement déclarative génère un rang d’observation en comptant le nombre d’éléments au sein de la même franchise possédant un score supérieur ou égal à l’enregistrement évalué. Bien que théoriquement robuste, cette méthodologie présente une complexité computationnelle quadratique d’ordre O(N^2) par groupe d’agrégation. Sur des tables contenant des centaines de milliers de lignes, cette approche génère une surcharge exponentielle de temps de calcul CPU et d’espace de mémoire temporaire, soulignant la supériorité architecturale incontestable de l’étape DATA native (en complexité linéaire O(N)) pour ce type d’ingénierie statistique.
10. 10. Analyse comparative des performances et optimisation des ressources
10.1 10.1 Efficacité computationnelle sur les jeux de données massifs
L’évaluation des performances sur des volumétries massives de données (Big Data) révèle des disparités majeures entre les différentes approches méthodologiques d’indexation sous SAS. Pour quantifier ces écarts, il convient d’analyser la consommation des ressources selon trois axes fondamentaux : l’utilisation du processeur (temps CPU), la durée d’horloge réelle (temps réel écoulé ou Elapsed Time) et les opérations d’entrées/sorties (I/O) sur les systèmes de stockage.
L’étape DATA utilisant l’instruction numero_ligne = _N_; ou le compteur à somme implicite compteur + 1; présente le coût computationnel le plus faible de l’ensemble de l’écosystème SAS. Sa consommation de mémoire vive demeure infinitésimale et constante, car la taille du PDV est fixée dès la phase de compilation. En revanche, les requêtes PROC SQL nécessitent l’instanciation de tables de tri temporaires dans l’espace SASWORK et mobilisent des algorithmes d’appariement en mémoire qui saturent rapidement les caches processeur lorsque la table dépasse plusieurs gigaoctets.
Pour optimiser le traitement lors de l’indexation de tables massives, il est crucial de restreindre le dimensionnement du PDV au strict minimum nécessaire en utilisant les options de filtrage de colonnes KEEP= ou DROP=. De plus, si la table d’entrée est déjà physiquement ordonnée sur le disque (par exemple en provenance d’un flux séquentiel chronologique), l’utilisation du mot-clé notsorted au sein de l’instruction BY permet d’exploiter les variables FIRST. et LAST. sans subir le coût computationnel prohibitif d’un passage préalable par la procédure PROC SORT :
data table_optimisee;
set table_chronologique;
by variable_groupe notsorted;
if first.variable_groupe then rang_groupe = 0;
rang_groupe + 1;
run;
10.2 10.2 Bonnes pratiques d’ingénierie de données en contexte de recherche
Dans un centre de recherche académique ou un département d’études biomédicales, la robustesse du code doit toujours s’accompagner d’une rigueur documentaire irréprochable. L’adjonction d’une colonne de numérotation séquentielle ne doit jamais être effectuée au détriment de l’intégrité des métadonnées du jeu de données hôte. Chaque variable d’index générée doit être explicitement qualifiée au moyen d’une instruction LABEL afin de documenter sa finalité au sein des outils de catalogage de données :
label numero_ligne = « Identifiant séquentiel unique d’auditabilité protocolaire »;
Par ailleurs, lors de la création de tables volumineuses indexées, l’activation de la compression binaire via l’option d’ensemble de données compress=yes ou compress=binary s’avère particulièrement judicieuse. L’introduction d’une variable numérique de type flottant double précision (8 octets par ligne) peut augmenter sensiblement le volume d’occupation sur disque d’un jeu de données contenant des dizaines de millions d’enregistrements. L’algorithme de compression SAS permet d’absorber l’empreinte physique de cette nouvelle variable sans dégrader la bande passante lors des opérations d’E/S ultérieures.
11. 11. Diagnostic des erreurs fréquentes et techniques de débogage
11.1 11.1 Erreurs de positionnement de l’instruction d’affectation
L’une des anomalies les plus pernicieuses observées dans le code produit par les analystes débutants concerne le conflit temporel entre l’attribution de la variable système _N_ et les instructions conditionnelles d’élimination d’enregistrements. Considérons le cas d’école problématique suivant :
data echantillon_biaise;
set donnees_initiales;
if statut = « Incomplet » then delete;
id_ligne = _N_;
run;
Dans ce scénario, le programmeur souhaite éliminer les observations incomplètes tout en attribuant un numéro de ligne continu aux observations retenues. Or, ce script produit une anomalie majeure : des ruptures de séquence et des sauts de numérotation au sein de la colonne id_ligne. En effet, la variable _N_ s’incrémente à chaque passage de la boucle principale de l’étape DATA, y compris pour les observations portant le statut « Incomplet ». Lorsque l’instruction DELETE s’exécute, l’écriture de la ligne est annulée, mais le compteur _N_ a déjà progressé. La prochaine observation conservée se voit donc affecter une valeur de _N_ qui saute par-dessus les itérations supprimées.
Pour résoudre rigoureusement cette anomalie et obtenir une séquence parfaitement continue d’entiers consécutifs sans saut, il est impératif de dissocier le comptage de la variable d’itération _N_ et de s’appuyer sur l’instruction de somme implicite post-filtrage :
data echantillon_corrige;
set donnees_initiales;
if statut ne « Incomplet »;
id_ligne + 1;
run;
Ici, le filtrage par l’instruction de sous-ensemble IF s’opère en amont absolu. Si la condition n’est pas validée, l’exécution s’interrompt immédiatement pour la ligne courante sans atteindre l’instruction d’addition. L’incrément de la variable id_ligne n’a lieu que pour les enregistrements effectivement validés et écrits dans la table finale, restaurant ainsi une séquentialité continue et exempte de discontinuités d’indice.
11.2 11.2 Mauvaise manipulation des données groupées et contournements
Dans le traitement des données groupées, l’omission la plus fréquente réside dans l’oubli de la réinitialisation du compteur lors de la première observation d’un groupe. Si l’analyste utilise l’instruction rang + 1; sous une clause BY sans insérer au préalable l’instruction if first.variable then rang = 0;, le système maintient la rétention de la variable d’un groupe à l’autre sans jamais la remettre à zéro. Il en résulte un compteur global cumulatif déguisé, ruinant l’objectif d’une numérotation intra-groupe étanche.
Pour diagnostiquer ces anomalies de comportement au sein du PDV lors de développements complexes, SAS met à disposition des instructions de traçabilité en temps réel via l’instruction PUT et le journal système (SAS Log). L’insertion de points de contrôle permet d’afficher l’état exact des variables internes à chaque itération :
put « DEBUG: Itération= » _N_ » Groupe= » franchise » FIRST= » first.franchise » Rang= » rang_joueur;
Pour les pipelines industriels hautement critiques, l’environnement SAS propose également le mode interactif de débogage de l’étape DATA, activable en insérant l’option / debug sur l’instruction DATA. Ce mode permet d’exécuter le code pas à pas, d’inspecter visuellement le contenu dynamique de chaque adresse mémoire du PDV et de détecter immédiatement les écrasements accidentels de compteurs ou les mauvais embranchements conditionnels.
12. 12. Synthèse pratique et recommandations pour une recherche reproductible
12.1 12.1 Matrice décisionnelle pour le choix de la méthode d’indexation
Le choix de la méthodologie appropriée pour ajouter des numéros de ligne dans l’environnement SAS doit résulter d’un arbitrage rigoureux entre la typologie des données, les objectifs de l’analyse statistique et les contraintes computationnelles de l’infrastructure d’hébergement. Le tableau ci-dessous synthétise les propriétés métrologiques et les conditions optimales de mise en œuvre de chaque approche explorée :
| Méthode SAS | Type d’indexation | Complexité algorithmique | Fiabilité en production | Cas d’usage privilégié |
|---|---|---|---|---|
| _N_ direct | Globale / Absolue | O(N) – Linéaire optimale | Maximale certifiée | Indexation séquentielle globale de tables brutes sans filtres conditionnels IF complexes. |
| Compteur implicite (Sum statement) | Globale filtrée ou Intra-groupe | O(N) – Linéaire optimale | Maximale certifiée | Numérotation après exclusions de données et indexation stratifiée via BY-groups. |
| PROC SQL : monotonic() | Globale | O(N) théorique | Non recommandée (Non documentée) | Requêtes SQL interactives rapides ad hoc hors environnements réglementés. |
| PROC SQL : Auto-jointure | Intra-groupe / Rangs | O(N^2) – Quadratique | Normée ANSI SQL | Environnements purement déclaratifs sur tables de dimensions restreintes. |
Pour les protocoles d’essais cliniques, les cohortes épidémiologiques longitudinales et les études de bioéquivalence, la combinaison de l’étape DATA native, de la clause BY et de l’instruction de somme implicite représente la référence méthodologique absolue (gold standard). Elle offre une reproductibilité mathématique totale, insensible aux variations matérielles ou aux versions ultérieures de l’interpréteur SAS.
12.2 12.2 Modèle de code standardisé réutilisable
Dans une optique d’industrialisation du code et de standardisation des pratiques d’ingénierie statistique, il est particulièrement efficace d’encapsuler la logique d’indexation au sein d’une macro-commande SAS paramétrable. Ce composant logiciel réutilisable automatise la détection des regroupements, le tri préalable et la sécurisation des compteurs :
%macro AjouterNumerotation(
table_entree=,
table_sortie=,
var_index=numero_ligne,
var_groupe=,
var_ordre=
);
%if %length(&var_groupe) > 0 %then %do;
proc sort data=&table_entree out=work._tmp_sorted;
by &var_groupe &var_ordre;
run;
data &table_sortie;
retain &var_index;
set work._tmp_sorted;
by &var_groupe;
if first.&var_groupe then &var_index = 0;
&var_index + 1;
label &var_index = « Numéro d’observation intra-groupe (&var_groupe) »;
run;
proc datasets library=work nolist;
delete _tmp_sorted;
quit;
%end;
%else %do;
data &table_sortie;
retain &var_index;
set &table_entree;
&var_index + 1;
label &var_index = « Numéro d’observation séquentiel absolu »;
run;
%end;
%mend AjouterNumerotation;
Cette architecture macro analytique évalue dynamiquement les paramètres fournis : en l’absence de variable de regroupement, elle génère une indexation globale continue à l’aide de l’instruction de somme implicite ; lorsqu’une variable de groupe est fournie, elle orchestre automatiquement l’ordonnancement via PROC SORT, déploie les balises conditionnelles de groupe, documente la colonne résultante et nettoie les tables temporaires générées dans la bibliothèque de travail WORK. L’adoption de tels patrons d’architecture logicielle garantit la maintenabilité à long terme de vos processus analytiques et hisse vos pratiques de traitement des données sous SAS aux plus hauts standards de rigueur scientifique et technique.
Références
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc. https://support.sas.com/en/books.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- Food and Drug Administration. (2003). Guidance for Industry: Part 11, Electronic Records; Electronic Signatures — Scope and Application. U.S. Department of Health and Human Services. https://www.fda.gov/regulatory-information/search-fda-guidance-documents/part-11-electronic-records-electronic-signatures-scope-and-application
- SAS Institute Inc. (2020). SAS(R) 9.4 Statements: Reference. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lestmtsref/titlepage.htm
- SAS Institute Inc. (2021). Base SAS(R) 9.4 Procedures Guide: Statistical Procedures (4th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/proc/titlepage.htm
- SAS Institute Inc. (2023). SAS SQL Procedure User’s Guide. SAS Institute Inc. https://support.sas.com/documentation/cdl/en/sqlproc/62234/HTML/default/viewer.htm#titlepage.htm
- Whitlock, I. (2007). Categorizing and Ordering Data with SAS BY-Group Processing. Proceedings of the SAS Global Forum 2007 Conference.