
La communication visuelle des résultats quantitatifs constitue l’un des piliers fondamentaux de la démarche scientifique contemporaine. Dans les disciplines empiriques telles que la biométrie, l’économétrie, la psychométrie ou la physique expérimentale, un graphique ne se résume pas à une simple illustration esthétique ; il incarne une démonstration formelle où chaque élément typographique véhicule une signification théorique précise. La transmission non ambiguë de concepts complexes repose sur le respect scrupuleux des normes de notation mathématique, au sein desquelles les indices et les exposants jouent un rôle sémantique déterminant. Une ambiguïté typographique, telle que la confusion entre une variable indicée désignant un sous-groupe d’échantillonnage et un exposant désignant une puissance algébrique ou un opérateur de dérivation, peut altérer la compréhension d’un modèle et affaiblir la portée des conclusions publiées.
Le langage R s’est imposé comme l’environnement de référence pour l’analyse statistique et la visualisation de données, en grande partie grâce à la flexibilité exceptionnelle de ses moteurs graphiques. Qu’il s’agisse du système graphique historique intégré dans le noyau du langage ou de l’écosystème moderne fondé sur la grammaire des graphiques, R intègre des mécanismes sophistiqués dédiés au rendu de formules mathématiques complexes. Toutefois, la maîtrise de ces fonctionnalités exige une compréhension approfondie des structures de données internes du langage, notamment la manipulation des objets d’expression et l’exploitation du sous-système typographique. De nombreux praticiens et chercheurs se heurtent à des écueils techniques récurrents : concaténation défectueuse de chaînes textuelles et de symboles dynamiques, débordement des glyphes au-delà des marges d’affichage, ou encore altération de l’espacement interligne lors de l’exportation vectorielle.
Ce traité exhaustif a pour ambition d’explorer de manière méthodique et rigoureuse l’ensemble des techniques permettant d’incorporer des exposants et des indices au sein des visualisations produites sous R. En abordant successivement les fondements théoriques de l’interpréteur de symboles, l’application concrète aux axes, titres, légendes et annotations directes, ainsi que l’interfaçage avec les extensions contemporaines, ce guide propose un cadre méthodologique complet. À travers une analyse comparative des paradigmes graphiques et une série d’études de cas appliquées aux sciences du comportement et à la modélisation statistique, le lecteur acquerra les compétences nécessaires pour produire des figures d’une qualité conforme aux exigences les plus strictes des revues scientifiques internationales avec comité de lecture.
1. Introduction à la notation mathématique dans les graphiques R
1.1 Importance de la rigueur typographique dans les visualisations scientifiques
Dans l’édition scientifique internationale, la typographie n’est pas un artifice décoratif, mais un instrument fondamental d’intelligibilité conceptuelle. Les normes internationales de communication scientifique, codifiées notamment par l’American Psychological Association dans son manuel de style ou par le Comité international des rédacteurs de revues médicales à travers les recommandations de Vancouver, imposent des distinctions typographiques strictes entre variables, constantes, vecteurs et opérateurs. Selon ces référentiels méthodologiques, une variable scalaire doit systématiquement figurer en italique, tandis que les chiffres, les opérateurs mathématiques et les abréviations textuelles d’indices doivent être composés en caractères droits (romains). L’omission ou la mauvaise gestion de ces règles au sein d’une figure détériore immédiatement la lisibilité du propos empirique et expose l’auteur à des critiques méthodologiques légitimes lors du processus d’évaluation par les pairs.
L’impact de la clarté visuelle des symboles statistiques sur l’interprétation empirique s’avère direct et mesurable. Lorsqu’un lecteur examine une courbe de régression ou une distribution de densité, le système cognitif traite simultanément les propriétés géométriques des tracés et les informations lexicales portées par les étiquettes d’axes. La moindre incertitude dans la différenciation entre une puissance mathématique, indiquant par exemple une transformation quadratique d’une variable indépendante, et un exposant textuel d’annotation peut conduire à des contresens analytiques majeurs. Par exemple, la notation formelle d’un coefficient de détermination linéaire impose un exposant strict, tandis que l’indication d’une condition expérimentale requiert un indice placé précisément sous la ligne de base. Les conventions typographiques normalisées, telles que celles édictées par l’ISO 80000-2 pour les grandeurs et unités mathématiques, visent précisément à prévenir ces ambiguïtés sémiotiques en imposant des règles de positionnement vertical et d’échelle de réduction des glyphes subordonnés.
Face à ces exigences impératives, les chaînes de caractères brutes s’avèrent structurellement insuffisantes. Le recours naïf à des caractères textuels standards, tels que l’usage de la lettre minuscule « x » pour mimer un signe de multiplication, l’utilisation de l’accent circonflexe standard pour désigner une puissance ou la juxtaposition maladroite de chiffres au même niveau que la variable pour simuler un indice, dégrade la crédibilité professionnelle du manuscrit. Bien que le standard moderne de codage Unicode offre certains caractères pré-composés pour quelques indices et exposants, cette solution de contournement présente de sévères limitations techniques : la couverture des glyphes demeure fragmentaire, l’alignement vertical s’avère souvent hétérogène selon les polices installées sur le système d’exploitation de l’utilisateur, et l’intégration de structures mathématiques imbriquées, combinant simultanément plusieurs niveaux de sous-indexation, y est rigoureusement impossible. Il devient donc indispensable de maîtriser les moteurs de composition mathématique internes au logiciel d’analyse statistique.
1.2 Objectifs du guide et conventions adoptées
Le présent ouvrage vise à fournir une couverture exhaustive des protocoles de composition mathématique dans l’environnement R, en analysant en profondeur les rouages algorithmiques et les syntaxes associées. Les fonctions centrales du langage R consacrées au rendu typographique spécialisé s’articulent autour d’un mécanisme d’évaluation symbolique différée. Plutôt que de traiter les chaînes d’étiquettes comme de simples flux d’octets textuels, l’interpréteur graphique de R est capable d’analyser des arbres syntaxiques abstraits pour transformer des instructions symboliques en instructions de dessin vectoriel de haute précision. Ce guide détaillera pas à pas la construction de ces commandes, depuis les expressions les plus élémentaires jusqu’aux formulations statistiques multi-composantes nécessitant des variables injectées dynamiquement au moment de l’exécution.
Une distinction fonctionnelle capitale traverse l’ensemble de cet ouvrage : la divergence d’implémentation entre le moteur graphique natif de base de R et le paradigme moderne développé dans le cadre du méta-paquet ggplot2. Le moteur historique de R repose sur un paradigme impératif direct, orchestré par les fonctions de bas niveau du paquet par défaut, où les paramètres d’environnement graphique globaux contrôlent directement l’agencement spatial des éléments graphiques. En revanche, le système fondé sur la grammaire des graphiques repose sur une architecture déclarative en couches, déléguant la gestion du rendu au sous-système vectoriel de grille. Les mécanismes de passage des expressions mathématiques, bien que partageant une grammaire commune dérivée du même moteur formel, présentent des subtilités de comportement, d’évaluation et de paramétrage de mise en page qu’il convient de délimiter rigoureusement pour éviter toute erreur de compilation graphique.
Afin d’assurer une démarche didactique et immédiatement transposable aux travaux de recherche empirique, ce guide s’appuie sur une structure méthodologique progressive. Chaque concept théorique sera systématiquement contextualisé par le biais de jeux de données d’exemple représentatifs des problématiques courantes en modélisation quantitative, incluant des séries temporelles biomédicales, des structures factorielles psychométriques et des plans expérimentaux factoriels. Toutes les conventions de nommage, les notations formelles et les représentations graphiques respecteront strictement les canons académiques internationaux. Les scripts conceptuels présentés décriront avec précision la séquence des arguments nécessaires pour configurer les marges, sélectionner les fontes adaptées et garantir un rendu vectoriel irréprochable sous les formats d’exportation professionnels tels que le PDF vectoriel et le PostScript encapsulé.
2. Fondements syntaxiques : la fonction expression() et le moteur plotmath
2.1 Mécanique sous-jacente de la fonction expression()
Pour comprendre comment R parvient à dessiner un indice ou un exposant sans recourir à un logiciel externe de mise en page, il est impératif de disséquer la nature de l’objet renvoyé par la commande d’expression. Dans l’architecture interne de R, un objet de type expression est une liste ordonnée contenant un ou plusieurs appels syntaxiques non évalués. Contrairement à une chaîne de caractères traditionnelle, qui se limite à une séquence de codes de caractères, ou à un calcul arithmétique standard, qui est immédiatement exécuté par la boucle de lecture et d’évaluation de l’interpréteur pour retourner une valeur numérique scalaire, l’expression préserve l’arbre de dérivation grammaticale sous une forme symbolique latente.
Cette différence fonctionnelle entre évaluation standard et analyse symbolique différée constitue la clé de voûte du système. Lorsque l’analyste écrit une commande statistique conventionnelle, R évalue immédiatement les symboles en fonction de l’environnement d’exécution pour en extraire les données associées. En revanche, lorsqu’une instruction est encapsulée au sein de la fonction d’expression, le parseur du langage génère une structure arborescente interne appelée arbre de syntaxe abstraite sans tenter de résoudre la valeur numérique des variables citées. Cet objet symbolique peut ensuite être transmis en tant qu’argument textuel à une fonction graphique. C’est à cet instant précis que le moteur graphique intercepte l’objet, désactive le traceur de texte brut standard et redirige le flux de commande vers son module typographique dédié, lequel traduira chaque nœud de l’arbre syntaxique en instructions géométriques de placement relatif de glyphes.
L’interaction entre le moteur graphique de R et la table des symboles mathématiques repose sur un protocole de liaison dynamique interne. Historiquement conçu par Paul Murrell et Ross Ihaka, ce sous-système fait le pont entre la représentation symbolique abstraite et les glyphes vectoriels disponibles dans la table de caractères de la police courante. Si un nœud de l’arbre syntaxique représente un opérateur d’élévation, le moteur n’effectue aucune opération arithmétique de puissance ; il calcule la hauteur d’encombrement du glyphe de base, détermine un facteur d’échelle réducteur proportionnel, applique une translation verticale ascendante au point de départ du traceur de coordonnées, puis restitue le glyphe subsidiaire avec une taille de point typographique réduite. Ce processus est entièrement vectoriel, assurant une netteté absolue quelle que soit l’échelle d’agrandissement de la figure finale.
2.2 Le module plotmath : grammaire et règles de base
Le module interne responsable de cette traduction typographique est documenté dans l’écosystème R sous l’appellation générique de plotmath. Accessible à tout moment au sein de la console interactive via la commande d’aide dédiée aux fonctionnalités mathématiques, cette documentation constitue la spécification officielle de la syntaxe acceptée par le moteur de rendu. La grammaire plotmath définit un langage dédié qui emprunte de nombreuses conventions à la syntaxe de composition mathématique TeX développée par Donald Knuth, tout en l’adaptant à la structure syntaxique native des expressions de R. Cette grammaire transforme des opérateurs arithmétiques courants en instructions de mise en page spatiale bi-dimensionnelle.
Au cœur de cette grammaire se trouvent les règles d’écriture des opérateurs d’élévation à la puissance et d’indexation. L’opérateur chapeau, représenté par l’accent circonflexe standard, est interprété par plotmath non pas comme un calcul de puissance, mais comme une commande de positionnement en exposant supérieur (superscript). À l’inverse, l’opérateur d’indexation, matérialisé par des crochets droits fermés, est traduit en une commande de positionnement en indice inférieur (subscript). La syntaxe plotmath impose que chaque opérateur lie un élément de base situé à sa gauche immédiate à un élément subordonné situé à sa droite ou entre ses délimiteurs. Le non-respect de cette polarité structurelle engendre des erreurs d’analyse syntaxique bloquantes qui empêchent l’affichage du graphique.
La gestion de la hiérarchie syntaxique et de l’imbrication des termes constitue l’un des aspects les plus rigoureux de plotmath. Tout comme dans une formule algébrique formelle, les opérations obéissent à des règles de précédence strictes. Si une expression nécessite d’associer plusieurs termes au sein d’un même exposant, ou d’appliquer un indice à une structure composite préexistante, l’usage des délimiteurs syntaxiques devient obligatoire. En plotmath, les parenthèses standard produisent des parenthèses visibles dans le rendu final, tandis que l’application de structures invisibles ou de regroupements atomiques impose une gestion minutieuse de l’imbrication d’arbres syntaxiques. Une maîtrise imparfaite de cette hiérarchie engendre fréquemment des déplacements non désirés de glyphes, un terme subsidiaire venant par exemple se positionner en indice de l’exposant plutôt qu’en indice direct de la variable principale.
3. Ajout d’exposants aux étiquettes d’axes avec le moteur graphique de base
3.1 Syntaxe générale de l’opérateur chapeau (^)
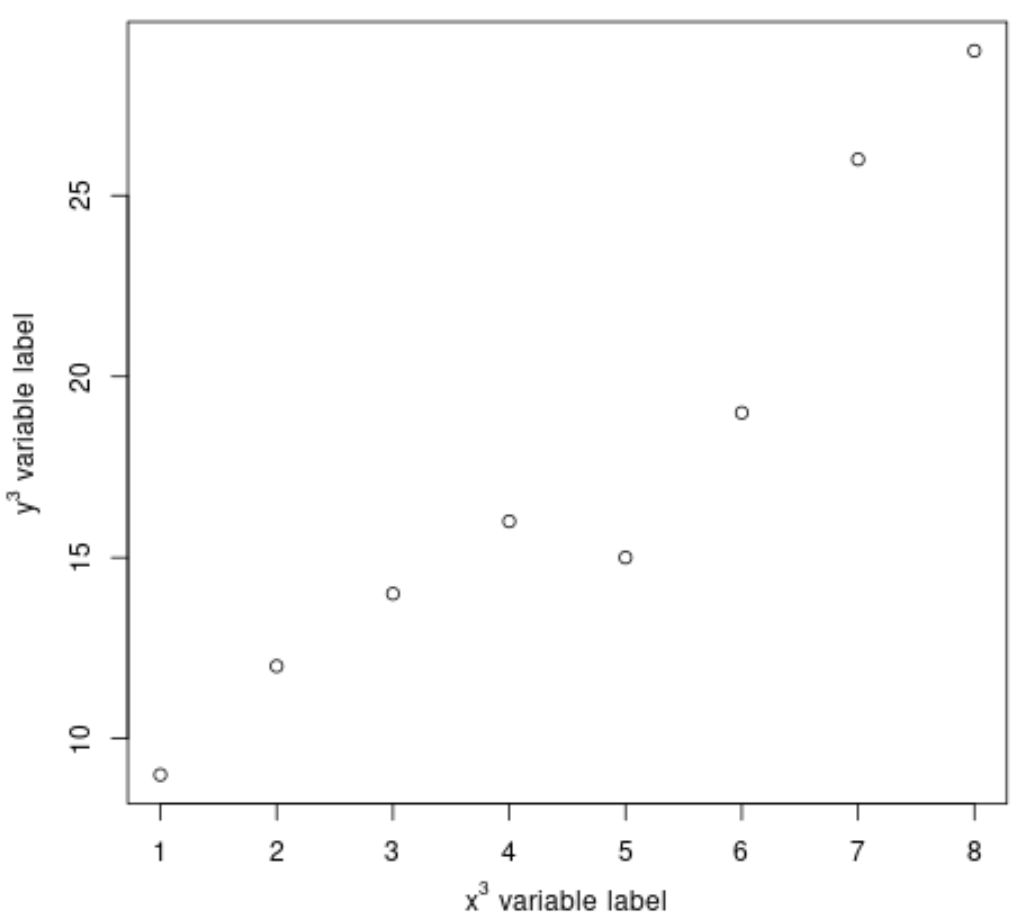
L’implémentation d’un exposant sur l’étiquette d’un axe cartésien constitue l’application la plus fréquente de la notation mathématique dans les graphiques scientifiques. Dans le système graphique de base de R, cette opération s’effectue en transmettant un objet d’expression à l’argument désignant l’étiquette de l’axe horizontal ou de l’axe vertical au sein de la fonction de tracé générique. La structure syntaxique formelle repose sur l’association directe de la variable cible, de l’opérateur circonflexe et du terme à élever. Lorsqu’il s’agit d’un exposant numérique simple, la commande se formalise en liant par exemple la lettre désignant une unité de surface à un entier, ce qui donne l’instruction structurelle liant la lettre aux mètres avec le chiffre deux pour composer des mètres carrés.
L’application d’exposants alphabétiques ou composés à une variable requiert une attention méthodologique particulière. Dès lors que l’exposant dépasse le cadre d’un chiffre unique ou d’un symbole scalaire isolé, l’interpréteur plotmath évalue la séquence selon ses règles de priorités internes. Si l’on souhaite inscrire une expression associant plusieurs lettres ou une formulation textuelle complète au niveau de l’exposant, la chaîne de caractères concernée doit être formellement délimitée. Si l’on omet cette précaution, seul le premier caractère suivant le circonflexe sera effectivement élevé au niveau supérieur, le reste de la chaîne étant immédiatement rétrogradé au niveau de la ligne de base principale du texte, produisant ainsi une rupture visuelle fautive.
Pour intégrer ces éléments dans les arguments des axes lors de l’appel d’une fonction de visualisation standard, l’analyste encapsule l’énoncé complet dans une directive d’expression formelle. Le moteur graphique intercepte ces paramètres avant le calcul des marges internes de la zone de traçage. Le calcul géométrique de la boîte englobante de l’étiquette intègre automatiquement la hauteur supplémentaire générée par l’exposant, évitant ainsi que le glyphe supérieur ne vienne empiéter sur les graduations numériques de l’axe. Cette intégration native assure une parfaite fluidité d’exécution, le dessin vectoriel s’adaptant instantanément aux dimensions dynamiques de la fenêtre de rendu graphique.
3.2 Exemple pratique : tracé de métriques de variance et coefficients de détermination
Considérons une situation d’analyse empirique où un modèle de régression linéaire est ajusté pour prédire des scores de performance en fonction de variables prédictives continues. Dans le cadre de la restitution graphique des résultats, il est d’usage d’indiquer sur l’axe des ordonnées le coefficient de détermination sous sa forme symbolique conventionnelle, à savoir la lettre R majuscule accompagnée d’un exposant numérique deux indiquant la variance expliquée. Pour rendre compte de la rigueur de la démarche, l’analyste génère un échantillon empirique simulé, calibre le modèle linéaire par la méthode des moindres carrés ordinaires, extrait le coefficient statistique associé, puis prépare la commande de visualisation.
La création de l’expression mathématique dédiée à l’axe des ordonnées se concrétise en assignant à l’argument d’étiquette verticale une expression contenant le symbole formel du coefficient au carré. La commande s’articule de telle sorte que le glyphe du chiffre deux soit positionné exactement dans le quart supérieur droit du glyphe de la lettre R, sans qu’aucun espace parasite ne vienne rompre la continuité typographique du descripteur statistique. La comparaison visuelle directe entre un graphique employant du texte brut sans mise en forme et un graphique exploitant la formulation vectorielle d’expression met immédiatement en lumière le gain qualitatif. Alors que le texte brut engendre un déséquilibre optique donnant l’impression trompeuse d’un facteur multiplicatif ordinaire, la version typographique formelle s’intègre harmonieusement dans les conventions d’édition internationales.
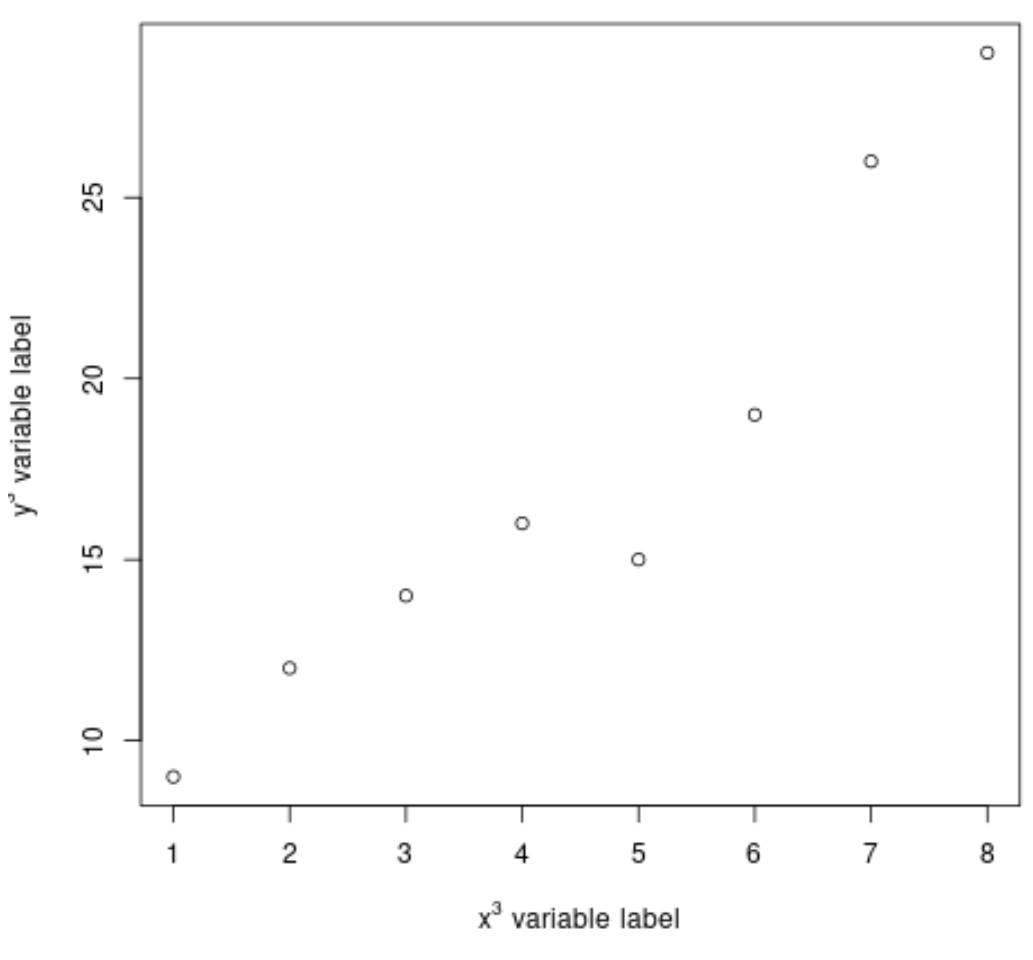
La vérification de l’alignement vertical du glyphe d’exposant constitue une étape cruciale du contrôle qualité de la figure. En fonction de la police de caractères active dans le périphérique graphique (généralement Helvetica, Arial ou Times New Roman selon le système d’exploitation et la configuration de R), le positionnement relatif de l’exposant peut subir de minimes variations de décalage vertical. Le moteur plotmath compense intrinsèquement ces variations en calculant la ligne médiane de la police active. L’exposant est ancré de manière à ce que son alignement inférieur repose au-dessus de la hauteur d’œil des minuscules de base, garantissant ainsi que l’équilibre visuel demeure constant, que la figure soit générée dans une fenêtre de travail interactive ou enregistrée sous forme de fichier vectoriel destiné à l’impression haute résolution.
4. Ajout d’indices aux étiquettes d’axes dans les visualisations de base
4.1 Syntaxe générale avec crochets droits ([])
L’indexation de variables constitue une nécessité formelle tout aussi prégnante dans la modélisation statistique. Dans la grammaire plotmath de R, la notation indicée n’est pas matérialisée par le caractère de soulignement comme c’est le cas dans la syntaxe LaTeX, mais par l’emploi strict de crochets droits fermés encadrant le terme subsidiaire. Cette décision conceptuelle prise lors de la conception du moteur graphique découle du fait que le caractère de soulignement était originellement réservé par le langage R à l’assignation dans les premières versions historiques dérivées du langage S, conduisant les concepteurs à privilégier la notation indiciaire vectorielle propre aux mathématiques computationnelles.
Il est fondamental de distinguer la sélection indiciaire opérée sur une structure de données en mémoire de l’évaluation visuelle opérée par plotmath. Dans le corps d’un script d’analyse classique, l’accolement de crochets à un objet vectoriel a pour effet d’en extraire un sous-ensemble d’éléments indexés par leur position. En revanche, au sein d’une fonction d’expression transmise à un argument graphique, le crochet ne déclenche aucune opération d’indiçage mémoire : il est intercepté par le parseur comme un opérateur de composition géométrique. Celui-ci commande la réduction typographique du contenu situé entre les crochets et sa translation sous la ligne de base du caractère qui le précède immédiatement, reproduisant ainsi l’apparence visuelle d’un indice scientifique conventionnel.
Cette syntaxe s’applique avec une égale rigueur aux indices numériques simples et aux chaînes d’indices multi-caractères. Si l’on souhaite attribuer à une variable une référence temporelle discrète, il suffit de placer l’entier entre les crochets attachés au symbole représentant la dimension observée. Dans le cas d’un indice textuel complexe, composé par exemple d’une abréviation latine ou d’une spécification catégorielle complète, l’analyste peut inscrire le libellé directement entre les crochets. Si le libellé contient des espaces ou des caractères non alphabétiques, l’encapsulation de la sous-chaîne entre des guillemets doubles à l’intérieur même des crochets garantit que l’interpréteur traitera l’ensemble du bloc comme une unité lexicale continue sans déclencher d’erreur d’analyse syntaxique.
4.2 Exemple pratique : représentation de séries temporelles ou de sous-groupes
Pour illustrer concrètement l’usage des indices au sein des graphiques de base, examinons la modélisation d’une série temporelle discrète représentative de mesures physiologiques recueillies à des intervalles réguliers. Dans de tels protocoles expérimentaux, les instants de mesure sont formellement référencés sous la forme d’un vecteur d’états d’échantillonnage discrets, le temps initial étant systématiquement désigné par un indice zéro apposé à la variable temporelle, tandis que les paliers ultérieurs d’observation adoptent des valeurs incrémentales successives.
Le paramétrage du modèle graphique nécessite d’affecter cette formulation indicée à l’axe des abscisses. Lors de la construction de l’appel graphique principal, l’analyste affecte à l’argument d’étiquette horizontale une expression définissant la lettre minuscule désignant le temps, suivie immédiatement de crochets enserrant l’indice d’échantillonnage souhaité. Cette configuration permet de stipuler avec clarté que les coordonnées du plan représentent une trajectoire dynamique démarrant à un état de référence formellement identifié, éliminant toute ambiguïté quant à la nature continue ou discrète de l’échelle d’observation retenue pour l’analyse empirique.
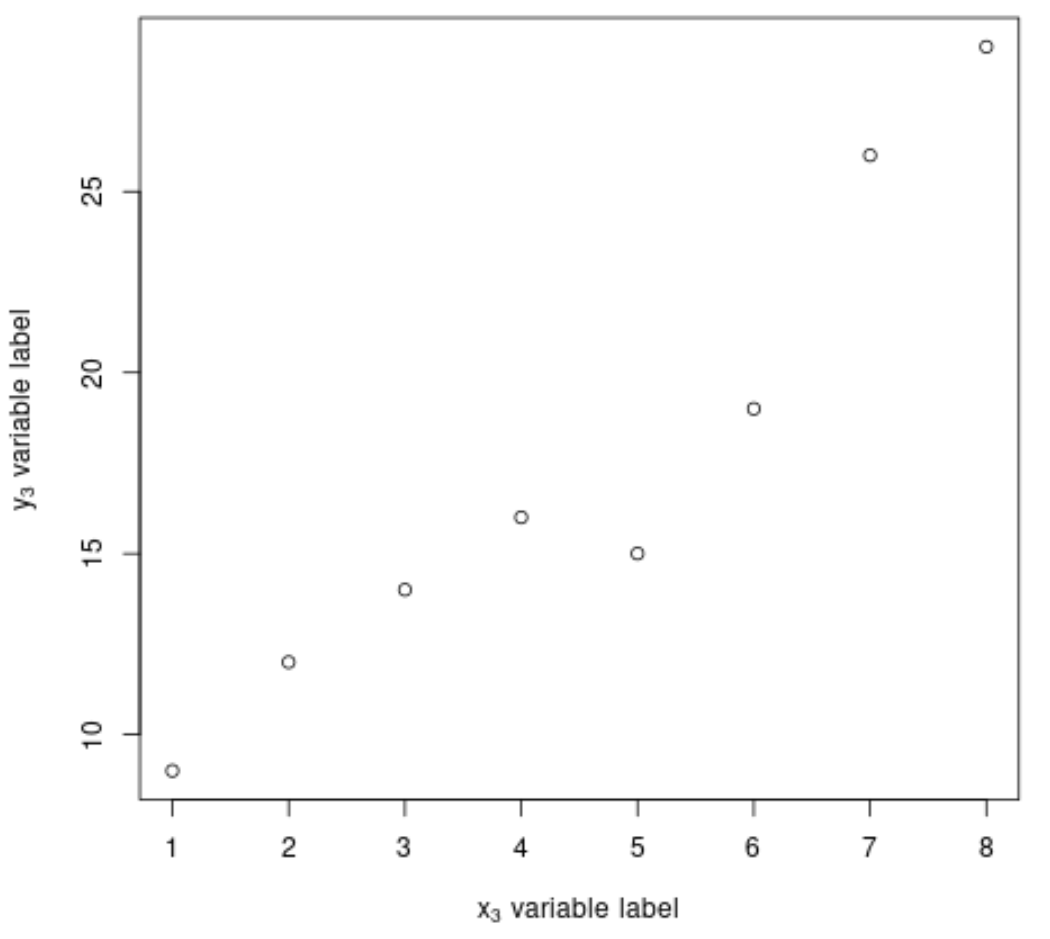
Le contrôle de la lisibilité de la taille de police de l’indice est une exigence technique essentielle, tout particulièrement lorsque la figure finale a vocation à être insérée sur une double colonne ou réduite au format d’une page de revue scientifique. Par défaut, le moteur plotmath applique un facteur de réduction géométrique proportionnel aux éléments situés en position d’indice. Cependant, si la police globale de l’axe est définie avec une taille trop restreinte, l’indice peut franchir un seuil critique d’illisibilité optique. Il appartient donc au chercheur de calibrer conjointement la taille relative des caractères d’annotation et l’épaisseur du tracé graphique à l’aide des paramètres de mise à l’échelle typographique disponibles dans l’environnement global, assurant ainsi que les indices multi-caractères conservent une netteté absolue à l’impression.
5. Combinaison simultanée d’indices et d’exposants dans une même expression
5.1 Règles d’imbrication pour les notations complexes
L’une des manifestations les plus exigeantes de la composition typographique scientifique réside dans la juxtaposition simultanée d’un indice et d’un exposant sur un symbole mathématique identique. Cette configuration est omniprésente dans la formalisation des modèles statistiques avancés, qu’il s’agisse de désigner le carré d’une observation spécifique au sein d’un échantillon ou de spécifier des estimateurs multivariés dont les composantes sont distribuées à la fois dans le temps et dans l’espace factoriel. La grammaire plotmath gère nativement ces configurations complexes, à la condition expresse de respecter les lois d’ordonnancement de ses opérateurs internes.
L’ordre séquentiel des opérateurs d’élévation et d’indexation détermine la structure de l’arbre syntaxique sous-jacent. Lorsqu’une variable doit être à la fois indicée et élevée à une puissance, deux syntaxes sont théoriquement envisageables : attacher l’indice puis l’exposant, ou attacher l’exposant puis l’indice. Dans la grammaire de plotmath, lier la variable à l’indice via les crochets, puis adjoindre immédiatement le circonflexe d’élévation produit une composition canonique où l’indice et l’exposant sont superposés verticalement de part et d’autre de la ligne de base du caractère principal. Les deux glyphes subsidiaires partagent le même alignement horizontal d’ancrage, ce qui respecte scrupuleusement les exigences des normes typographiques de l’édition scientifique.
La distinction conceptuelle entre une variable indicée dont la valeur est élevée à une puissance et une puissance affectant directement la variable dans sa globalité requiert une maîtrise des regroupements logiques et des parenthèses invisibles. Lorsque l’analyste écrit une syntaxe positionnant le circonflexe à l’intérieur des crochets de l’indice, le moteur interprète l’exposant comme une propriété subsidiaire de l’indice lui-même, créant ainsi un indice supérieur d’indice. Pour éviter cet écueil et garantir que la puissance s’applique à la variable complète, des structures de délimitation explicites doivent être employées. Dans les cas où les parenthèses de regroupement doivent demeurer invisibles à l’affichage tout en orientant l’ordre de priorité du parseur graphique, l’utilisation de fonctions de regroupement atomique s’avère indispensable pour neutraliser toute distorsion visuelle.
5.2 Exemple pratique : formulations statistiques avancées
Afin de mettre en pratique ces principes d’imbrication dans un contexte expérimental réaliste, étudions la représentation graphique de la distribution d’échantillonnage d’un test d’adéquation non paramétrique fondé sur le khi-deux de Pearson. Dans ce cadre inférentiel, le descripteur statistique ne se limite pas à la simple lettre grecque khi élevée au carré ; il requiert impérativement un indice textuel spécifiant qu’il s’agit de la valeur empirique observée sur les données d’échantillonnage, afin de la discriminer visuellement de la valeur critique théorique issue de la table de distribution théorique.
La formalisation graphique de cette grandeur statistique s’obtient en combinant le nom formel de la lettre grecque au sein de plotmath avec l’opérateur d’indexation accueillant le descripteur d’observation, l’ensemble étant immédiatement suivi de l’opérateur chapeau affectant la puissance quadratique. En exécutant cette instruction au sein de l’étiquette d’ordonnée d’un graphique illustrant la fonction de densité de probabilité, R dessine de manière vectorielle le glyphe de la lettre grecque, positionne l’abréviation de l’observation sous sa marge inférieure droite, et appose le chiffre deux exactement au-dessus de ladite abréviation, conférant à la figure un rendu mathématique de niveau éditorial irréprochable.
L’évaluation méticuleuse de la symétrie et de l’espacement visuel entre l’indice et l’exposant superposés révèle la précision du sous-système typographique de R. Contrairement aux approches artisanales fondées sur le collage approximatif d’éléments textuels disjoints, le moteur plotmath calibre dynamiquement le recouvrement horizontal pour éviter tout chevauchement vertical entre les glyphes de l’indice et de l’exposant, même lorsque ceux-ci possèdent des empattements marqués ou des largeurs de chasse contrastées. Cette compensation optique automatique garantit la préservation de la géométrie des symboles statistiques, autorisant une interprétation sans faille lors de la lecture des diagrammes d’inférence décisionnelle.
6. Gestion des espaces et concaténation textuelle avec les opérateurs plotmath
6.1 Rôle de l’opérateur tilde (~) pour l’insertion d’espaces
L’un des obstacles les plus déconcertants pour les utilisateurs non initiés à la grammaire plotmath réside dans le traitement particulier appliqué aux espaces blancs typographiques. Dans un script d’analyse ordinaire ou au sein d’une chaîne de caractères standard, l’insertion de la barre d’espacement du clavier permet d’espacer librement les mots. Au sein d’un objet d’expression interprété par plotmath, ce principe s’avère totalement inopérant : l’analyseur syntaxique ignore purement et simplement les espaces physiques introduits entre les opérateurs, les considérant comme de simples délimiteurs lexicaux neutres dans l’arbre de syntaxe abstraite.
Pour forcer l’insertion d’un espace typographique mesurable au sein d’une étiquette graphique composée, le module plotmath attribue un rôle sémantique précis à l’opérateur tilde. Lorsque deux termes au sein d’une expression mathématique sont séparés par un tilde unique, le moteur graphique insère entre eux un blanc d’espacement standard équivalent à l’espace normal d’un mot dans le texte courant. Cette commande permet de séparer visuellement une désignation textuelle en langage naturel du symbole formel qui lui est rattaché, sans risquer de rompre la cohésion interne de l’objet graphique ou de provoquer des collisions de glyphes à l’affichage.
Le sous-système typographique offre en outre une gradation précise de l’espacement par l’introduction du double tilde consécutif. Alors que le tilde simple correspond à une espace justifiée ordinaire, la répétition de deux tildes sans symbole intermédiaire ordonne au moteur de générer un espacement large, équivalent au cadratin typographique traditionnel. Cette granularité fine permet de régler avec une grande rigueur l’aération visuelle des étiquettes composites, évitant les erreurs fréquentes où des termes conceptuellement distincts, tels que l’intitulé d’une variable physique et son unité de mesure élevée à une puissance négative, se retrouvent agglomérés de manière illisible sur les axes du graphique.
6.2 Rôle de l’opérateur astérisque (*) pour la juxtaposition stricte
À l’opposé exact de l’opérateur d’espacement représenté par le tilde, la grammaire plotmath met à la disposition des modélisateurs l’opérateur astérisque, dont la finalité structurelle est d’opérer une juxtaposition stricte sans le moindre espace résiduel. Dans le contexte de l’interpréteur mathématique, l’astérisque ne remplit aucunement une fonction d’opérateur arithmétique de multiplication (laquelle est déléguée aux fonctions spécifiques de croix de produit ou de point centré), mais agit comme un ciment syntaxique soudant deux entités contiguës au sein de l’arbre graphique.
Cette distinction s’avère absolument indispensable dès lors qu’il s’agit d’associer un préfixe textuel descriptif, un symbole alphabétique grec et un ensemble d’indices ou d’exposants. Si un utilisateur utilise un tilde là où une contiguïté parfaite est requise, une rupture visuelle disgracieuse viendra fragmenter l’entité mathématique. En appliquant rigoureusement l’astérisque entre une chaîne littérale encadrée de guillemets et un identifiant formel indicé, le moteur positionne les glyphes consécutifs avec un crénage optimal, calculé d’après les tables de métriques de la police courante. Cela permet par exemple d’écrire des mentions complexes où une unité de mesure préfixée se soude immédiatement à sa dimension indicée.
Une erreur méthodologique d’une extrême fréquence consiste à tenter de combiner les fonctions de concaténation traditionnelles du langage de base, telles que la commande paste ou sa variante condensée paste0, à l’intérieur même d’un appel d’expression mathématique. Cette pratique découle d’une mauvaise compréhension de la chronologie d’évaluation de R : les fonctions de concaténation de chaînes renvoient des vecteurs textuels bruts qui perdent instantanément toute propriété de hiérarchie arborescente. Transmises à l’environnement graphique, ces chaînes sont traitées sans interprétation plotmath, affichant ainsi à l’écran les symboles syntaxiques bruts au lieu de tracer les indices et exposants attendus. Le recours exclusif aux opérateurs tilde et astérisque constitue la seule voie autorisée pour articuler texte descriptif et notation formelle au sein d’une expression graphique de base.
7. Résolution des problèmes de mise en page et de rognage via la fonction par()
7.1 Diagnostic du débordement des exposants sur l’axe des ordonnées
L’introduction d’exposants de taille élevée ou d’expressions mathématiques à plusieurs niveaux sur les étiquettes de coordonnées soulève des défis géométriques majeurs liés à la configuration spatiale des périphériques d’affichage. Dans le moteur graphique standard de R, la zone d’affichage globale d’une figure se divise strictement en deux compartiments géométriques distincts : la région interne de traçage, délimitée par le cadre rectangulaire des axes au sein duquel sont projetées les données numériques, et les marges périphériques externes, réservées à l’inscription des graduations chiffrées, des légendes et des intitulés d’axes.
Par défaut, les dimensions de ces marges sont calibrées pour accueillir des chaînes textuelles simples composées d’une ligne unique de hauteur d’œil standard. Dès lors qu’une étiquette d’axe vertical intègre un symbole mathématique surmonté d’un exposant élevé, ou pire, d’une fraction ou d’une puissance composée, la hauteur totale de la boîte englobante de l’expression s’accroît considérablement dans la dimension perpendiculaire à l’axe. Dans cette configuration, le barycentre typographique de l’étiquette est automatiquement centré par R sur la ligne de marge assignée par défaut. Cette translation mécanique a pour effet direct de projeter la partie sommitale de l’exposant au-delà du bord gauche absolu du périphérique graphique, provoquant un phénomène brutal de troncature ou de rognage visuel du glyphe supérieur.
Ce problème de dépassement est d’autant plus insidieux qu’il varie considérablement en fonction de la résolution d’exportation choisie et du ratio d’aspect imposé lors de la génération du fichier final. Une figure apparaissant parfaitement cadrée au sein de la fenêtre de prévisualisation graphique interactive d’un environnement de développement peut se révéler sévèrement tronquée une fois compilée sous la forme d’un fichier image matriciel haute résolution à trois cents points par pouce, ou lors de son inclusion dans un canevas vectoriel de publication. La cause fondamentale de cette divergence réside dans le calcul des unités de mesure physiques : les marges par défaut sont définies en nombre de lignes de texte élémentaires, dont l’épaisseur absolue ne s’ajuste pas toujours proportionnellement aux variations des métriques d’encombrement des polices vectorielles mathématiques complexes.
7.2 Ajustement précis des marges et des positions avec mar et mgp
La résolution pérenne de ces désordres structurels repose sur l’exploitation méthodique de la fonction de contrôle des paramètres graphiques globaux, et plus particulièrement sur l’ajustement coordonné des paramètres vectoriels désignant les marges extérieures et l’espacement des lignes de tracé. Le paramètre mar accepte un vecteur numérique à quatre dimensions stipulant l’épaisseur des marges dans l’ordre conventionnel inférieur, gauche, supérieur et droit, exprimé en unités de lignes de texte typographiques. Pour remédier à la troncature d’un exposant sur l’axe vertical, l’analyste doit impérativement augmenter la deuxième composante de ce vecteur avant d’exécuter la commande de dessin, élargissant ainsi la zone disponible pour l’ancrage des glyphes externes.
Toutefois, le simple élargissement de la marge globale s’avère souvent insuffisant si la distance relative entre l’axe physique et le libellé textuel demeure figée. C’est à ce niveau qu’intervient le paramètre mgp, dont le vecteur contrôle avec une précision millimétrique l’emplacement spatial des trois composantes fondamentales de l’axe : la première valeur gouverne l’ancrage de l’étiquette d’axe globale, la deuxième valeur détermine l’emplacement des étiquettes numériques de graduation, et la troisième valeur spécifie la position géométrique de la ligne de tracé de l’axe lui-même. En modifiant judicieusement ces coordonnées relatives, il devient possible de translater subtilement l’étiquette mathématique vers l’intérieur pour compenser la hauteur de son exposant, tout en maintenant les graduations chiffrées à une distance idéale évitant tout risque de chevauchement spatial.
L’application rigoureuse de ces réglages impose le respect d’une procédure standard de gestion des environnements graphiques dans R. Les modifications apportées par la fonction de paramétrage affectent durablement la session de travail active jusqu’à la fermeture du périphérique courant. Pour prévenir tout effet de bord indésirable sur les figures subséquentes, il est de bonne pratique méthodologique d’enregistrer l’état initial des paramètres système au sein d’un objet temporaire dédié avant toute manipulation, puis de restaurer intégralement ces constantes de configuration originelles dès la conclusion de la routine de visualisation, garantissant ainsi l’entière reproductibilité du pipeline d’analyse statistique.
8. Intégration d’exposants et d’indices dans les titres, sous-titres et légendes
8.1 Enrichissement des titres principaux (main) et secondaires (sub)
L’adjonction de notations formelles composées ne se cantonne pas aux seules bordures directionnelles des graphiques ; elle concerne au premier chef le titre principal et le sous-titre méthodologique situés au sommet de la figure. Ces éléments textuels ont pour mission d’énoncer sans ambiguïté la nature des grandeurs modélisées, ce qui impose fréquemment de stipuler la taille effective de l’échantillon d’analyse, l’ordre de dérivation d’un polynôme d’ajustement ou la valeur estimée d’un indice d’ajustement structurel enrichi de ses coefficients de puissance.
Dans le moteur de base de R, l’intégration s’opère de manière directe en affectant une fonction d’expression aux arguments dédiés aux titres principaux et secondaires au sein de l’instruction de traçage ou par l’intermédiaire de la fonction complémentaire de titrage. La syntaxe accepte l’intégralité du répertoire des commandes plotmath, autorisant l’auteur à construire des énoncés sophistiqués où des descripteurs textuels rédigés en caractères droits de taille prépondérante s’articulent harmonieusement avec des notations formelles indicées ou exponentiées. L’analyseur typographique assure la mise à l’échelle automatique de l’ensemble, calibrant la réduction de l’exposant en fonction de la taille nominale assignée au titre principal par les directives de style.
La gestion de l’alignement horizontal et vertical des titres enrichis exige une attention scrupuleuse pour préserver la symétrie globale du canevas. Par défaut, le moteur graphique applique un alignement horizontal centré sur le titre principal, prenant comme référence la largeur totale de la zone interne de dessin. Lorsqu’une expression mathématique asymétrique comportant de lourdes structures indiciaires est injectée dans le titre, le centre de masse optique peut subir un léger glissement perceptif. L’analyste peut corriger cette distorsion en manipulant les paramètres d’ajustement horizontal d’alignement au sein des directives de dessin textuel, positionnant par exemple le titre en alignement strict sur le bord gauche de la boîte de traçage pour répondre aux exigences éditoriales modernes des publications biomédicales et psychométriques.
8.2 Formatage des éléments de légendes avec la fonction legend()
La légende constitue un composant critique de l’architecture graphique, car elle assure le décodage sémiotique des éléments visuels différentiels tels que les palettes de couleurs, les motifs de tiretés et les formes de symboles ponctuels. Lorsque ces attributs correspondent à des séries expérimentales identifiées par des formulations mathématiques formelles, les entrées textuelles de la légende doivent impérativement refléter cette rigueur en intégrant les indices et exposants appropriés, sans se replier sur des simplifications typographiques dégradées.
L’implémentation de cette exigence s’effectue au moyen de la fonction de légende intégrée, dont l’argument assignant les descripteurs textuels accepte un vecteur structuré d’expressions mathématiques. Contrairement à une croyance répandue qui inciterait à utiliser une liste hétérogène, la transmission d’un appel d’expression contenant plusieurs arguments distincts permet à R de générer un vecteur d’arbres syntaxiques. Chaque composante de ce vecteur est évaluée séquentiellement par le moteur de rendu, qui dessine chaque entrée de légende avec son formatage complet, positionnant avec une exactitude mathématique les indices sous les symboles de séries et les puissances en élévation supérieure.
La coordination spatiale entre les symboles graphiques géométriques (tels que l’épaisseur de ligne, le type de tireté ou le type de point) et les étiquettes indicées requiert une vérification pointue de l’interligne vertical de la boîte englobante. L’adjonction d’indices profonds combinés à des exposants élevés accroît l’empreinte verticale de chaque ligne de texte au sein de la légende. Si l’écartement interligne par défaut est conservé, les glyphes inférieurs d’une entrée supérieure risquent d’entrer en collision avec les exposants de l’entrée immédiatement consécutive. Pour juguler ce phénomène, l’ajustement des paramètres d’espacement interligne de la légende et l’optimisation des dimensions de son cadre externe doivent être calibrés afin d’assurer une respiration visuelle idéale et une ségrégation perceptive sans ambiguïté.
9. Annotations textuelles directes à l’intérieur de la zone graphique
9.1 Positionnement exact avec la fonction text()
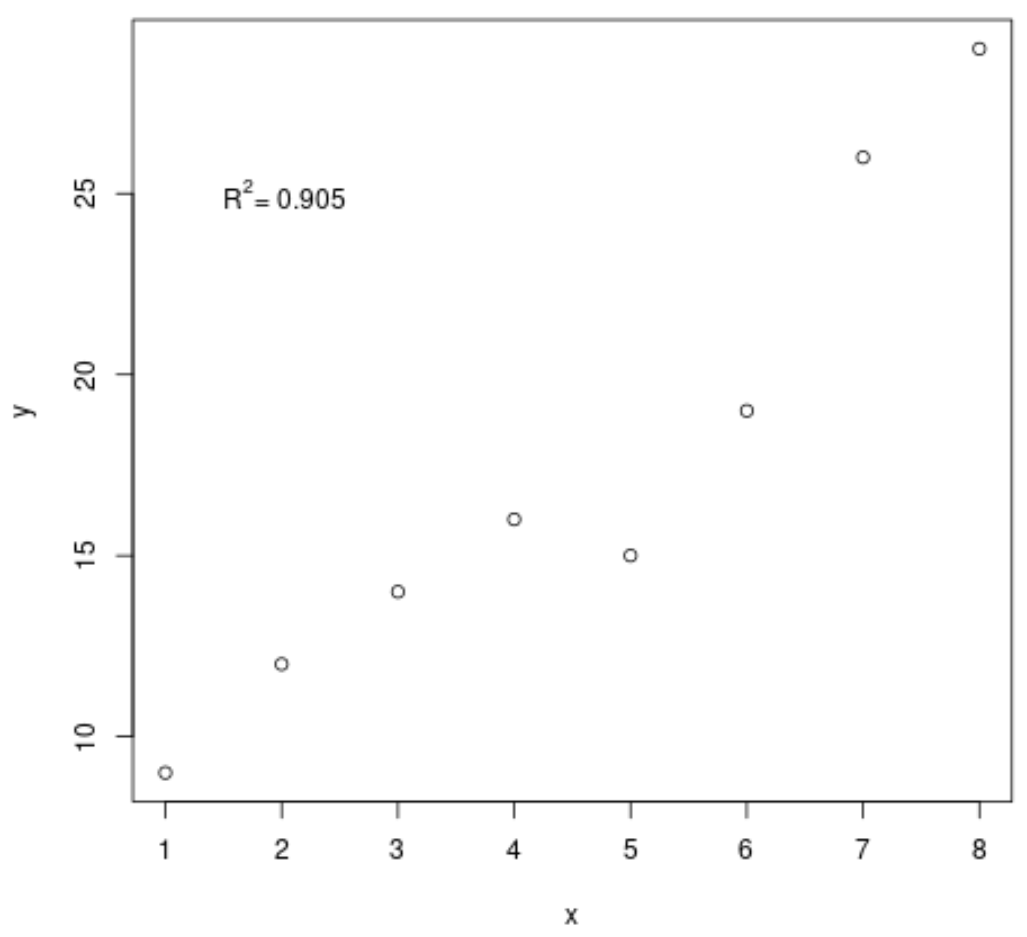
Au-delà de la périphérie délimitée par les axes et les marges extérieures, la formalisation de la preuve statistique impose fréquemment d’inscrire des annotations symboliques directement au cœur du nuage de points ou au voisinage immédiat des courbes de modélisation théorique. Qu’il s’agisse de documenter la position d’un point d’inflexion singulier, de spécifier localement une équation de régression multivariée ou d’afficher la valeur exacte d’un seuil de significativité inférentielle associé à un coefficient de variance partagée, l’insertion in-situ d’expressions mathématiques relève de la fonction d’annotation textuelle directe.
L’ancrage d’une expression mathématique via cette fonction repose sur la transmission de coordonnées cartésiennes absolues correspondant au repère géométrique des données actives. Le modélisateur transmet l’objet d’expression souhaité à l’argument textuel dédié, conjointement aux abscisses et ordonnées cibles. Le moteur graphique intercepte ces coordonnées pour y fixer le point de référence de la boîte englobante du symbole composite. L’affinement de cette position s’obtient par l’exploitation des paramètres de positionnement cardinal et des facteurs d’ajustement fractionnaire, lesquels permettent de décaler le texte vers l’un des quatre quadrants entourant les coordonnées d’ancrage sans altérer l’intégrité structurelle des indices ou exposants inclus dans l’expression.
Considérons l’application typique consistant à signaler ponctuellement un seuil de significativité inférentielle de haute précision couplé à l’affichage d’un coefficient de détermination ajusté au sommet d’une courbe de tendance. La commande construira une expression articulant la notification de la probabilité critique et la désignation formelle du coefficient indicé pour son ajustement et élevé au carré pour sa dimension métrique. L’utilisation minutieuse du décalage spatial garantit que cette formulation complexe vienne flotter précisément au-dessus de la zone de densité informative sans jamais recouvrir les données empiriques réelles, conférant à la démonstration une limpidité analytique optimale.
9.2 Annotations périphériques avec la fonction mtext()
Dans de nombreux cas d’usage académiques, l’intégration d’annotations formelles au sein de la région active de dessin est contre-indiquée en raison de la densité critique des points de données ou de la présence de courbes multiples saturant le repère cartésien. La solution méthodologique consiste alors à exploiter les marges périphériques externes pour y inscrire des mentions analytiques secondaires, des rappels de calibration instrumentale ou des renvois bibliographiques formulés en langage mathématique strict, tâche dévolue à la fonction d’annotation marginale.
La commande d’annotation marginale se distingue par son mode de repérage spatial : au lieu de s’ancrer sur des coordonnées de données internes, elle se réfère aux quatre côtés géométriques du graphique (numérotés de un à quatre pour désigner respectivement le bas, la gauche, le haut et la droite) et à un système de coordonnées exprimé en lignes de marge physiques. En transmettant une expression combinant indices et exposants à cette routine, l’analyste peut projeter avec une flexibilité totale une formule mathématique complète dans n’importe quel compartiment périphérique du canevas, indépendamment de l’échelle numérique portée par les axes de coordonnées cartésiennes.
Cette technique s’avère particulièrement précieuse pour intégrer des équations structurelles de référence en marge supérieure droite d’une figure, ou pour ajouter une annotation méthodologique le long de l’axe vertical droit afin de définir formellement une unité composite complexe sans surcharger l’intitulé de l’axe vertical principal. La maîtrise du paramètre contrôlant la ligne de décalage vertical combiné au paramètre de positionnement transversal le long de la bordure offre un contrôle typographique d’une rigueur absolue, garantissant que les expressions volumineuses ne viennent empiéter ni sur les graduations de bordure, ni sur les bordures périphériques du document lors de l’assemblage éditorial de la planche de figures.
10. Implémentation des indices et exposants dans ggplot2
10.1 Utilisation de expression() dans labs(), xlab() et ylab()
Le développement spectaculaire de l’écosystème tidyverse a profondément remodelé les standards de production visuelle dans la communauté scientifique internationale, conférant à la bibliothèque ggplot2 une position hégémonique. Reposant conceptuellement sur les axiomes théoriques de Leland Wilkinson, ce paradigme dissocie l’encodage des variables de leur représentation physique en couches. Fort heureusement, les concepteurs de cette extension ont veillé à assurer une compatibilité totale avec la grammaire plotmath intégrée dans le noyau historique du langage, permettant aux utilisateurs d’exploiter la fonction d’expression au sein des directives modernes d’étiquetage.
L’adjonction d’indices et d’exposants sur les axes d’un tracé élaboré sous cette grammaire s’effectue en transmettant l’objet d’expression aux arguments de nommage des fonctions d’étiquetage d’axes directes ou au sein du conteneur unifié de libellés. Le moteur sous-jacent de ggplot2, qui s’appuie sur le système vectoriel de bas niveau grid, convertit nativement l’arbre de syntaxe abstraite en un objet graphique typographique spécialisé. Ce dernier est ensuite évalué spatialement par les algorithmes de calcul de boîte d’encombrement dynamique du paquet, qui recalculent automatiquement la géométrie globale du tracé pour réserver l’espace nécessaire à l’élévation des exposants et à l’abaissement des indices, sans requérir l’ajustement manuel initial des marges qui caractérisait le moteur de base.
Néanmoins, des divergences comportementales notables subsistent quant à l’interaction entre les spécifications typographiques du thème global et le rendu mathématique vectoriel. Lorsque l’analyste altère les propriétés de la police dans la configuration du thème général (par exemple en imposant une police sans empattement spécifique, une taille d’élément particulière ou un angle d’orientation non nul pour les libellés de l’axe des ordonnées), le moteur graphique doit projeter l’expression en tenant compte de ces déformations affines. Si l’angle de rotation d’une étiquette verticale est fixé à quatre-vingt-dix degrés, le traceur vectoriel réoriente l’intégralité du système de coordonnées locales de l’expression mathématique, préservant l’orthogonalité exacte entre la ligne de base du symbole, la descente d’indice et la hauteur d’exposant, écartant ainsi tout risque de distorsion asymétrique du glyphe mathématique.
10.2 Formatage dynamique des facettes et des échelles
L’un des atouts les plus puissants de ggplot2 réside dans sa capacité à partitionner un ensemble de données complexe en sous-graphiques multiples au moyen de son architecture de facettage conditionnel. Cependant, l’intégration de notations mathématiques au sein des en-têtes de ces sous-graphiques ou le long des graduations numériques d’échelles discrètes et continues se heurte à une contrainte structurelle majeure : les variables de conditionnement sont généralement contenues dans des structures de données relationnelles sous la forme de facteurs qualitatifs ou de chaînes de caractères brutes, incompatibles par nature avec l’encapsulation directe au sein d’une directive d’expression statique unique.
Pour surmonter cette barrière technique et permettre la composition typographique dynamique des en-têtes de facettes, le système intègre une fonction d’étiquetage spécialisée connue sous l’identifiant de parseur d’étiquettes mathématiques. Cette routine algorithmique prend en entrée le flux de chaînes textuelles généré par les modalités du facteur de regroupement, applique à chacune de ces entrées un analyseur syntaxique convertissant la chaîne en un appel d’expression plotmath formel, puis délègue le rendu graphique à l’interpréteur de symboles. Pour que cette chaîne soit convertible sans erreur, l’analyste doit formater les données textuelles du tableau de manière à ce qu’elles respectent rigoureusement les conventions lexicales de plotmath, en utilisant par exemple les crochets pour délimiter les indices et le circonflexe pour les exposants au sein même du libellé de chaque modalité factorielle.
La mise en œuvre de cette stratégie au niveau des graduations dynamiques d’échelles continues s’avère tout aussi déterminante, tout particulièrement lors du tracé d’échelles de mesures transformées selon une fonction logarithmique ou exponentielle. En associant la commande de mise à l’échelle continue à la routine de dérivation syntaxique des étiquettes mathématiques, il devient possible de transformer automatiquement une suite de valeurs de puissances entières en une série élégante de bases décimales surmontées de leurs exposants vectoriels respectifs. Cette approche confère aux axes une clarté optique conforme aux meilleurs standards de la visualisation cartésienne contemporaine, supprimant la notation scientifique rudimentaire à base de lettres de séparation numérique exponentielle au profit d’une écriture mathématique formelle.
11. Cas d’application en psychométrie et sciences comportementales
11.1 Indices de fidélité et coefficients factoriels
Les disciplines relevant de la psychométrie, de la psychologie différentielle et de l’analyse comportementale mobilisent un corpus hautement formalisé d’indicateurs de consistance interne, de saturation factorielle et d’adéquation structurale. La publication d’une matrice de corrélation ou d’un diagramme de cheminement d’analyse factorielle confirmatoire impose une notation stricte des coefficients métriques pour éviter toute ambiguïté sur la nature du modèle de mesure déployé par les investigateurs.
Dans ce contexte, le coefficient de consistance interne le plus universellement rapporté, à savoir l’alpha de Cronbach, requiert une formulation graphique irréprochable associant le glyphe de la lettre grecque minuscule à un indice textuel romain explicitant son attribution méthodologique. La tentative de composer cette étiquette avec du texte brut engendre immanquablement un risque de confusion avec d’autres paramètres alpha d’erreurs de type I. En exploitant la grammaire de composition formelle de R, le modélisateur génère une expression liant le symbole grec au descripteur d’indice textuel sans espace parasite, assurant une lecture immédiate et sans équivoque sur les axes d’un graphique de saturation factorielle.
Cette rigueur de composition s’avère d’autant plus impérative lors de l’affichage des coefficients de fidélité structurelle modernes destinés à supplanter les métriques traditionnelles, tels que le coefficient oméga de McDonald décliné sous sa forme hiérarchique ou totale. De même, les indices d’ajustement global des modèles d’équations structurelles, à l’instar de l’erreur quadratique moyenne d’approximation ou de l’indice de concordance comparative, doivent fréquemment être affichés avec leurs composantes de bornes d’intervalles de confiance sous forme de valeurs exponentiées ou sous-indicées. La maîtrise combinée des indices et des puissances permet de compiler des planches graphiques multiparamétriques d’une remarquable élégance, facilitant la transmission d’informations analytiques denses lors de l’évaluation méthodologique par les comités de lecture.
11.2 Tailles d’effet et coefficients expérimentaux
L’évolution des exigences épistémologiques et éditoriales en sciences du comportement, accentuée par les lignes directrices sur la reproductibilité des inférences empiriques, accorde une primauté croissante au signalement visuel des tailles d’effet standardisées et de leurs incertitudes d’échantillonnage associées, au détriment de la seule mise en valeur binaire des probabilités de rejet de l’hypothèse nulle. Cette transition méthodologique implique une représentation rigoureuse d’indicateurs métriques tels que le d de Cohen, l’êta-carré d’analyse de variance ou les coefficients de régression directionnelle standardisés.
Lors de la composition graphique des résultats d’un plan factoriel d’analyse de variance à mesures répétées, la quantification de l’ampleur de l’effet exige couramment l’insertion du coefficient êta-carré partiel. Cette grandeur condense une complexité typographique exemplaire : elle impose d’adjoindre simultanément au glyphe de la lettre grecque êta un indice textuel désignant la nature partielle de la partition de variance, et un exposant numérique signifiant l’élévation au carré de la métrique d’association. La transcription vectorielle de cette combinaison structurelle via le module de composition de R garantit que l’indice de partialité et l’exposant quadratique s’alignent dans une parfaite cohérence optique le long des diagrammes d’interaction factorielle.
La même rigueur s’impose dans la restitution graphique des modèles de régression multiple ou de médiation comportementale modérée. L’identification univoque des coefficients de régression standardisés nécessite l’apposition d’un indice numérique ou vectoriel sous la lettre grecque bêta pour expliciter le rang prédictif de chaque régresseur au sein du système linéaire. En intégrant ces expressions mathématiques dynamiquement au sein des tracés de distribution de densités a posteriori ou des graphiques de modélisation de pente, l’expérimentateur s’assure d’une clarté de restitution absolue, éliminant tout doute sémantique quant à la chaîne de causalité théorique soumise à l’épreuve des données expérimentales.
12. Dépannage avancé, erreurs courantes et alternatives modernes
12.1 Diagnostic des erreurs de syntaxe courantes dans plotmath
En dépit de sa puissance intrinsèque, le moteur de composition typographique interne de R se caractérise par une sévérité syntaxique extrême, constituant une source permanente de frustration pour les analystes confrontés à des arrêts brutaux de compilation graphique. La catégorie d’erreur la plus répandue réside sans conteste dans l’omission des opérateurs de liaison requis entre les chaînes textuelles littérales et les identifiants mathématiques symboliques. Dans un langage de programmation tolérant, la juxtaposition d’une chaîne et d’un symbole peut faire l’objet d’une coercition implicite ; dans l’analyseur de plotmath, toute suite d’éléments non interconnectée par un opérateur formel d’espacement ou de soudure provoque une erreur irrécupérable de syntaxe inattendue qui bloque le rendu.
Une autre source fréquente de défaillance réside dans les conflits d’évaluation survenant lors de la tentative d’injection de valeurs numériques scalaires variables déterminées au moment de l’exécution du script d’analyse. Un utilisateur non averti cherchera couramment à insérer un objet numérique calculé directement au sein d’une déclaration d’expression statique, espérant que le moteur substituera la valeur courante de la variable au nom symbolique de l’objet. Ce mécanisme échoue systématiquement : la fonction d’expression capture les symboles sous une forme littérale non résolue, affichant à l’écran le nom textuel de l’objet computationnel plutôt que le résultat quantitatif escompté.
Pour déceler méthodiquement la source d’un dysfonctionnement au sein d’une expression complexe, il convient d’adopter une stratégie de débogage séquentiel par décomposition arborescente. L’isolement de l’expression problématique et son évaluation préalable au moyen de la fonction de parsing textuel autonome permet d’interroger directement l’analyseur grammatical du noyau sans subir les interférences du sous-système de tracé graphique. Si l’analyseur génère une erreur avant même l’appel de la fonction de dessin, le problème réside indiscutablement dans l’agencement des délimiteurs, l’équilibrage des parenthèses ou l’absence d’un opérateur de liaison au sein de la formule mathématique.
12.2 Injection de variables dynamiques avec bquote() et substitute()
La résolution élégante et pérenne de la limitation structurelle de la fonction d’expression face aux variables calculées dynamiquement passe par l’abandon de sa forme statique au profit des mécanismes d’interpolation par quasi-citation offerts par la fonction d’évaluation conditionnelle et la fonction de substitution formelle. Ces deux outils constituent le cœur de la métaprogrammation avancée appliquée au rendu graphique dans l’environnement R.
La commande bquote met en œuvre un paradigme d’évaluation différée sélective calqué sur le mécanisme de quasi-citation des langages fonctionnels dérivés de LISP. L’analyste écrit son expression mathématique selon la grammaire standard de plotmath, tout en encapsulant les objets dynamiques devant être immédiatement évalués au sein d’un opérateur d’échappement matérialisé par un point suivi de parenthèses. Lors de l’exécution, le moteur évalue uniquement le contenu de ces délimiteurs spécifiques, extrait les valeurs numériques ou les chaînes associées en mémoire, puis substitue ces grandeurs directement au sein de l’arbre syntaxique global avant de le transmettre au traceur graphique, préservant ainsi l’intégrité de tous les indices et exposants non échappés.
Pour les infrastructures de traitement automatisé à grande échelle, telles que la génération de rapports d’analyses répétées au sein de boucles itératives massives ou de pipelines de calcul distribué, l’approche fondée sur la commande substitute procure un contrôle computationnel absolu. En construisant une liste d’association associant explicitement des étiquettes symboliques temporaires aux valeurs réelles issues des modèles statistiques séquentiels, la fonction réécrit dynamiquement l’arbre de syntaxe abstraite à chaque passage de boucle. Cette technique offre une robustesse industrielle pour l’automatisation complète de graphiques hautement standardisés, garantissant que les étiquettes indicées et exponentiées intègrent avec une fidélité absolue les estimations statistiques propres à chaque strate d’échantillonnage analysée.
12.3 L’alternative moderne : le package latex2exp
Bien que la grammaire plotmath présente des fonctionnalités étendues, sa courbe d’apprentissage demeure abrupte et son utilisation requiert une gymnastique mentale constante pour les chercheurs déjà formés aux standards de composition typographique du système LaTeX. L’écart entre la syntaxe TeX conventionnelle et les idiosyncrasies lexicales de plotmath constitue un facteur récurrent de ralentissement dans la rédaction de documents académiques complexes. C’est précisément pour lever cet obstacle que le paquet moderne latex2exp a été développé et mis à la disposition de la communauté scientifique.
L’architecture de cette extension repose sur un principe d’une grande limpidité opérationnelle : elle fournit une fonction de conversion principale chargée de traduire à la volée une chaîne de caractères rédigée en syntaxe LaTeX standard en un objet d’arbre syntaxique rigoureusement interprétable par le moteur graphique de R. L’utilisateur peut ainsi composer ses indices au moyen du caractère de soulignement familier et ses exposants via l’accent circonflexe standard, en exploitant l’ensemble des commandes traditionnelles de mise en forme mathématique, sans avoir à mémoriser les règles de liaison par tildes ou astérisques propres à plotmath.
D’un point de vue méthodologique, l’arbitrage entre le recours à ce traducteur moderne et l’emploi exclusif des mécanismes natifs de plotmath dépend principalement des exigences de portabilité et de dépendance logicielle du projet d’analyse. L’utilisation du paquet tiers simplifie considérablement la rédaction des formules les plus denses et accélère la transition des scripts d’analyse vers les manuscrits finaux pour les modélisateurs familiers de l’écosystème TeX. Néanmoins, la maîtrise directe du moteur interne de R conserve un avantage déterminant en termes de vitesse d’exécution dans les environnements de calcul de haute performance et garantit une autonomie absolue vis-à-vis des extensions périphériques, assurant la parfaite pérennité des codes d’analyse statistique à long terme.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- International Organization for Standardization. (2019). Quantities and units — Part 2: Mathematics (ISO Standard No. 80000-2:2019). https://www.iso.org/standard/64973.html
- Knuth, D. E. (1984). The TeXbook. Addison-Wesley Professional.
- Meschiari, S. (2022). latex2exp: Use LaTeX expressions in plots (R package version 0.9.6). Comprehensive R Archive Network. https://cran.r-project.org/package=latex2exp
- Murrell, P. (2018). R graphics (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429490408
- Murrell, P., & Ihaka, R. (2000). An approach to providing mathematical labelling in plots. Journal of Computational and Graphical Statistics, 9(3), 582–599. https://doi.org/10.1080/10618600.2000.10474900
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0