
Dans le domaine de l’analyse exploratoire des données et de l’économétrie appliquée, la représentation graphique bivariée constitue une étape analytique fondamentale. Le nuage de points, formalisé historiquement dans le cadre de la théorie des corrélations par Sir Francis Galton et Karl Pearson, offre une projection spatiale cartésienne directe des associations entre deux variables continues. Toutefois, une projection purement géométrique cantonne souvent l’analyste à une perception macroscopique des structures de dépendance, des tendances stochastiques ou des concentrations d’observations. L’absence d’identification nominale des marqueurs graphiques engendre une rupture heuristique majeure : l’observateur perçoit une singularité statistique ou un point d’inflexion sans pouvoir immédiatement le rattacher à l’entité empirique qu’il incarne.
L’introduction d’annotations textuelles directement ancrées sur les coordonnées cartésiennes des observations permet de résoudre cette césure analytique. En conférant une lisibilité qualitative immédiate à des espaces géométriques abstraits, l’étiquetage transforme une simple cartographie de dispersion en un outil de diagnostic probabiliste et contextuel rigoureux. Dans les environnements corporatifs comme académiques, le tableur Microsoft Excel demeure la plateforme matricielle la plus universellement déployée pour traiter, modéliser et communiquer l’information quantitative. Néanmoins, l’annotation individualisée au sein de son moteur graphique natif a longtemps constitué un défi ergonomique notoire, conduisant fréquemment à des pratiques d’édition artisanales sources de désynchronisation critique des séries empiriques.
Ce guide exhaustif expose les fondements sémiotiques, les démarches opératoires, les extensions algorithmiques et les contraintes de publication gouvernant l’ajout et l’optimisation des étiquettes textuelles sur un nuage de points dans Excel. De la préparation d’une matrice ordonnée à l’automatisation par Visual Basic for Applications (VBA), en passant par les protocoles de résolution des occlusions textuelles et les exigences de la mise en page scientifique internationale, ce document offre une référence méthodologique complète pour convertir vos visualisations de dispersion en vecteurs de communication scientifique irréprochables.
1. Introduction à la visualisation par nuage de points et pertinence de l’étiquetage
1.1 Fondements méthodologiques du nuage de points en recherche empirique
Le nuage de points, ou diagramme de dispersion cartésien, repose sur l’inscription orthogonale de couples de mesures issues d’un même échantillon statistique au sein d’un plan défini par deux axes gradués. En statistique inférentielle, ce dispositif graphique fournit une évaluation empirique préliminaire indispensable à toute modélisation linéaire ou non linéaire. Il permet d’apprécier visuellement l’homoscédasticité, la présence de non-linéarités sous-jacentes, ainsi que l’intensité de la covariance empirique entre les variables explicatives et expliquées. L’œil humain y discerne spontanément des régularités vectorielles, des régimes de distribution distincts ou, au contraire, une dispersion entropique suggérant l’orthogonalité des grandeurs mesurées.
Au-delà de la mise en évidence des tendances centrales, le tracé de dispersion révèle immédiatement la structure typologique interne de l’échantillon, notamment les phénomènes d’agrégation spatiale (clusters) et l’existence d’observations discordantes, couramment qualifiées de valeurs atypiques ou aberrantes (outliers). Dans l’analyse d’un résidu de régression, l’observation visuelle d’un point isolé à forte distance de Cook permet de suspecter un levier excessif sur l’estimation des moindres carrés ordinaires. Cependant, lorsque les marqueurs géométriques sont dépourvus de désignation textuelle, la quantification de l’anomalie reste stérile : le chercheur doit constamment alterner entre l’espace graphique et la feuille matricielle pour identifier le cas d’étude concerné, induisant une déperdition d’attention préjudiciable à la rigueur diagnostique.
Les limites cognitives inhérentes à l’interprétation d’un nuage de points muet sont ainsi manifestes. Le système perceptif humain excelle dans la reconnaissance morphologique globale, mais s’avère incapable d’inférer une identité sémantique à partir d’une simple position euclidienne. Dès lors que l’échantillon comporte des entités individualisables telles que des pays, des entreprises cotées, des cohortes cliniques ou des espèces biologiques, l’absence de repères qualitatifs explicites réduit le graphique à une pure abstraction. Cette privation entrave le rapprochement entre la singularité géométrique d’un point et la connaissance de son arrière-plan théorique ou historique.
1.2 Fonction sémiotique des étiquettes textuelles dans l’analyse de données
D’un point de vue sémiotique, l’incorporation d’une étiquette textuelle modifie la nature même du signe graphique. Selon la sémiologie graphique développée par Jacques Bertin, l’image graphique traduit des rapports de ressemblance, d’ordre et de proportion par l’intermédiaire de variables visuelles fondamentales (position, taille, orientation, teinte). En superposant le code linguistique (l’étiquette nominale) au code spatial (la coordonnée X-Y), le diagramme passe du statut d’analogie continue à celui de système hybride d’identification univoque. Le point géométrique ne désigne plus seulement une grandeur quantitative double, mais incarne l’unité statistique singulière dans sa plénitude conceptuelle.
Cette transition de l’abstraction statistique à l’individualisation des cas joue un rôle déterminant dans l’allègement de la charge cognitive de l’analyste. Selon la théorie de la charge cognitive élaborée par John Sweller, la mémoire de travail humaine dispose d’une capacité de traitement restreinte. La dissociation entre le tracé graphique et la table de données textuelles impose une charge cognitive extrinsèque substantielle, issue de la recherche visuelle itérative et des allers-retours oculaires constants. L’étiquetage contextualisé résout le problème de l’attention partagée en unifiant, en un point spatial unique du champ visuel, la quantification et la qualification de l’observation empirique.
Dans le protocole de vérification des hypothèses descriptives, ces annotations textuelles exercent un rôle probant incontestable. Elles permettent de valider immédiatement des intuitions théoriques : la position excentrée d’une observation correspond-elle précisément à l’événement macroéconomique anticipé, à l’incident de laboratoire documenté ou à l’anomalie de fabrication suspectée ? L’annotation confère au nuage de points une force démonstrative immédiate lors de la soutenance de résultats empiriques, transformant la visualisation en un argument scientifique articulé, accessible sans ambiguïté tant aux pairs qu’aux décideurs.
1.3 Normes de clarté graphique et exigences de publication académique
L’intégration d’étiquettes au sein d’un document destiné aux revues à comité de lecture est assujettie aux critères rigoureux de la communication scientifique contemporaine. Les directives éditoriales d’instances telles que l’American Psychological Association (normes APA 7th edition), l’IEEE ou la maison d’édition Elsevier convergent vers un postulat fondamental : chaque figure doit constituer une unité d’information autonome (self-contained unit), compréhensible sans recours systématique au corps du texte. À ce titre, la précision de restitution des données implique que toute étiquette affichée renvoie formellement à une désignation établie sans équivoque dans le protocole expérimental.
Le principal défi réside dans l’arbitrage minutieux entre l’exhaustivité de l’information transmise et la lisibilité visuelle du document final. Une surcharge typographique engendre ce qu’Edward Tufte conceptualise sous le terme de « chartjunk » : une accumulation de signaux visuels parasites qui saturent l’espace graphique et occultent la distribution sous-jacente des données. L’étiquetage exhaustif d’un échantillon comportant plusieurs centaines d’observations produit invariablement une imbrication textuelle illisible, disqualifiant la figure lors de l’évaluation par les pairs. Il est donc indispensable de subordonner le choix et la densité des annotations à des critères de pertinence statistique stricts.
Enfin, la conformité avec les contraintes mécaniques d’impression des périodiques savants impose le respect de dimensions normalisées, s’inscrivant généralement sur une largeur de colonne simple (environ 80 à 90 mm) ou de double colonne (environ 170 à 180 mm). À ces échelles de réduction, les textes miniaturisés risquent de disparaître ou d’empiéter sur les tracés géométriques. La mise au point des étiquettes dans Excel exige donc une rigueur architecturale anticipant le format de publication final, garantissant la netteté typographique, la lisibilité chromatique en nuances de gris et la précision des distances vectorielles de repérage.
2. Structuration et préparation rigoureuse du jeu de données dans Excel
2.1 Organisation tabulaire conforme aux principes de données ordonnées
La réussite de l’automatisation et de la mise en page d’un nuage de points dans Excel découle de la structure logique de la feuille de calcul. Il est impératif de respecter les principes fondamentaux des « données ordonnées » (tidy data) tels que théorisés par Hadley Wickham : chaque variable doit correspondre à une colonne distincte, chaque observation doit constituer une ligne unique, et chaque type d’unité d’observation doit former une table dédiée. Dans le contexte d’une distribution bivariée étiquetée, la disposition canonique requiert une matrice de données composée au minimum de trois colonnes contiguës réparties selon un ordre strictement défini.
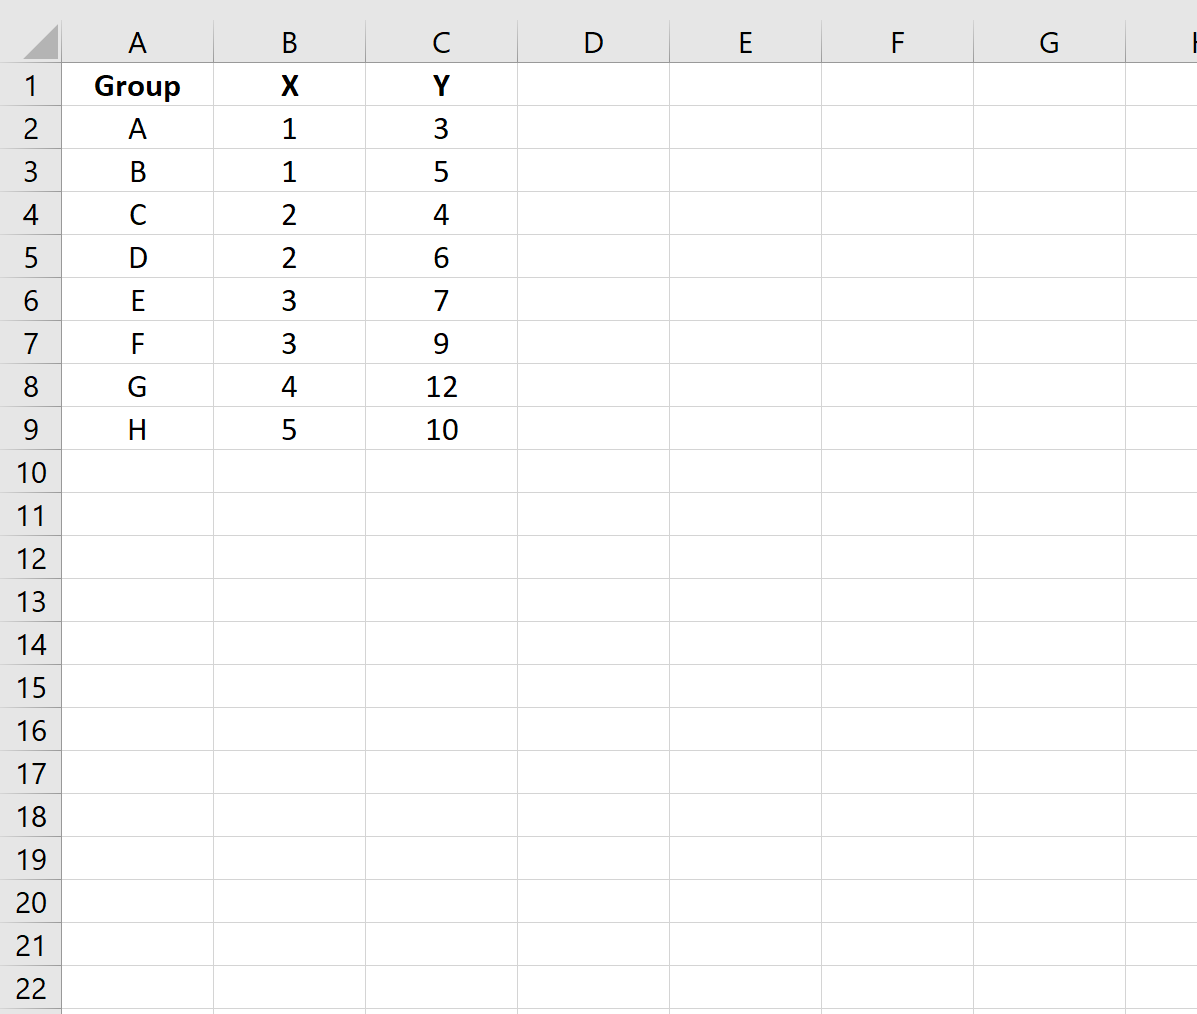
La première colonne doit héberger les identifiants textuels destinés à former les étiquettes (par exemple, le nom des entités, les codes de référence d’échantillons ou les acronymes institutionnels). Les deux colonnes adjacentes immédiates doivent contenir respectivement les coordonnées numériques de l’axe des abscisses (variable indépendante ou prédictive X) et de l’axe des ordonnées (variable dépendante ou réponse Y). Cette organisation linéaire prévient les erreurs de référence et garantit une interprétation transparente par les assistants graphiques du tableur. L’homogénéité absolue des formats de cellules est requise : les colonnes X et Y doivent être formellement déclarées en format numérique (standard, décimal ou scientifique) pour proscrire toute interprétation sous forme de chaîne de caractères par le moteur graphique, anomalie qui paralyserait l’échelle continue de l’axe cartésien.
Les en-têtes de colonnes doivent faire l’objet d’une standardisation rigoureuse. Une unique ligne d’en-tête, dépourvue de cellules fusionnées, de sauts de ligne intempestifs ou de symboles ambigus, doit surplomber les données. Ces libellés serviront ultérieurement à générer automatiquement les titres d’axes et les légendes des séries. Une défaillance dans l’uniformité structurelle de ces en-têtes perturbe la reconnaissance des plages dynamiques lors des réorganisations tabulaires et altère l’indexation absolue des cellules au sein des requêtes matricielles.
2.2 Nettoyage préalable et gestion des observations manquantes
L’intégrité de la projection graphique dépend de l’assainissement préalable de la matrice empirique. Les enregistrements incomplets constituent la cause première des décalages d’indices entre les valeurs coordonnées et leurs étiquettes d’identification. Dans Excel, si une cellule de coordonnées numériques demeure vide au sein d’une série continue, le moteur peut, selon la configuration des options d’affichage des cellules masquées et vides, soit interpoler linéairement la lacune, soit laisser un espace nul, soit tracer une coordonnée zéro arbitraire, altérant la géométrie intrinsèque du nuage.
Pour prévenir toute dislocation entre la série d’étiquettes et les paires ordonnées réelles, trois démarches préventives doivent être menées systématiquement :
- L’élimination définitive des lignes comportant des valeurs manquantes non imputables, en veillant à supprimer solidairement l’identifiant textuel et les valeurs X et Y correspondantes.
- Le recours explicite à la fonction d’imputation statistique ou l’assignation de la valeur d’erreur
#N/A(via la fonction=NA()), laquelle neutralise le traçage du marqueur géométrique et de son étiquette associée sans corrompre la continuité d’indexation de la plage de cellules. - L’épuration typographique des identifiants au moyen des fonctions
SUPPRESPACE()(TRIM) etEPURAGE()(CLEAN) pour éliminer les espaces insécables résiduels, les tabulations et les caractères de contrôle non imprimables fréquemment importés depuis des bases de données SQL ou des fichiers CSV non calibrés.
Une vigilance particulière doit être accordée au synchronisme des indices de lignes. Si une colonne de coordonnées numériques subit un filtrage autonome sans intégrer la colonne d’étiquettes, une désynchronisation fatale survient : l’étiquette de l’observation i se trouvera projetée sur les coordonnées de l’observation j, générant une falsification involontaire mais destructrice de l’analyse scientifique.
2.3 Standardisation des identifiants pour un rendu graphique optimal
L’optimisation spatiale d’une figure implique une maîtrise de l’emprise physique des libellés textuels. Des désignations exhaustives (par exemple, « République Démocratique du Congo » ou « Échantillon biologique de contrôle post-traitement n°4B ») occupent une surface excessive qui provoque des télescopages visuels inévitables. Il convient de concevoir une colonne intermédiaire dédiée aux identifiants normalisés d’affichage graphique, dissociée de la désignation descriptive complète conservée pour le tableau de données principal.
Cette standardisation repose fréquemment sur l’adoption de codes courts normalisés internationalement, tels que les codes ISO 3166-1 alpha-3 pour les entités géopolitiques (par exemple, FRA, DEU, USA), ou une nomenclature alphanumérique concise rigoureusement indexée pour les protocoles expérimentaux. Lorsque l’analyse implique des variables catégorielles ordinales conjointes, l’identifiant peut condenser deux dimensions d’information par une syntaxe codifiée (par exemple, « G1-T01 » pour le premier individu du groupe expérimental n°1). L’analyste doit néanmoins veiller scrupuleusement à l’unicité sémantique de chaque acronyme au sein de l’espace de représentation, afin d’interdire toute homonymie visuelle qui compromettrait l’identification descriptive des points d’intérêt.
3. Procédure standard de génération du graphique de dispersion sous Excel
3.1 Sélection ciblée des plages de coordonnées quantitatives
L’initialisation d’un nuage de points robuste sous Microsoft Excel exige une sélection précise des plages matricielles dès la première étape. Une erreur courante consiste à sélectionner l’intégralité du tableau de données, incluant d’emblée la colonne d’identifiants textuels. Face à une sélection de trois colonnes (Texte, Numérique, Numérique), l’assistant graphique d’Excel peut interpréter par erreur le jeu de données comme deux séries temporelles distinctes projetées sur un axe catégoriel ordinal, convertissant le graphique en diagramme en courbes ou en lignes brisées erronées.
La procédure d’excellence requiert d’isoler temporairement les composantes géométriques pures. L’analyste doit sélectionner exclusivement la plage bidimensionnelle formée par les colonnes de valeurs quantitatives X et Y, en incluant impérativement leur cellule d’en-tête respective. Par exemple, pour un jeu de données s’étendant de la ligne 1 à la ligne 101, la sélection couvrira la plage B1:C101, en laissant la colonne d’identifiants A1:A101 hors de la sélection initiale. Il convient de s’assurer par un examen visuel ou par le raccourci clavier de vérification des dimensions (Ctrl+Flèche Basse) que les deux colonnes numériques possèdent une cardinalité rigoureusement identique, garantissant l’isomorphisme structurel des deux séries de coordonnées.
3.2 Insertion du nuage de points via le ruban d’outils
Une fois les coordonnées quantitatives sélectionnées, l’insertion s’effectue en accédant au ruban principal d’Excel, onglet « Insertion ». Au sein du groupe d’outils « Graphiques », l’utilisateur clique sur l’icône dédiée « Insérer un graphique en nuage de points (X, Y) ou un graphique à bulles ». Une bibliothèque de déclinaisons morphologiques s’affiche alors, comprenant le nuage de points standard, le nuage de points avec lignes adoucies et marqueurs, le nuage de points avec lignes droites, ou encore les tracés sans marqueurs.
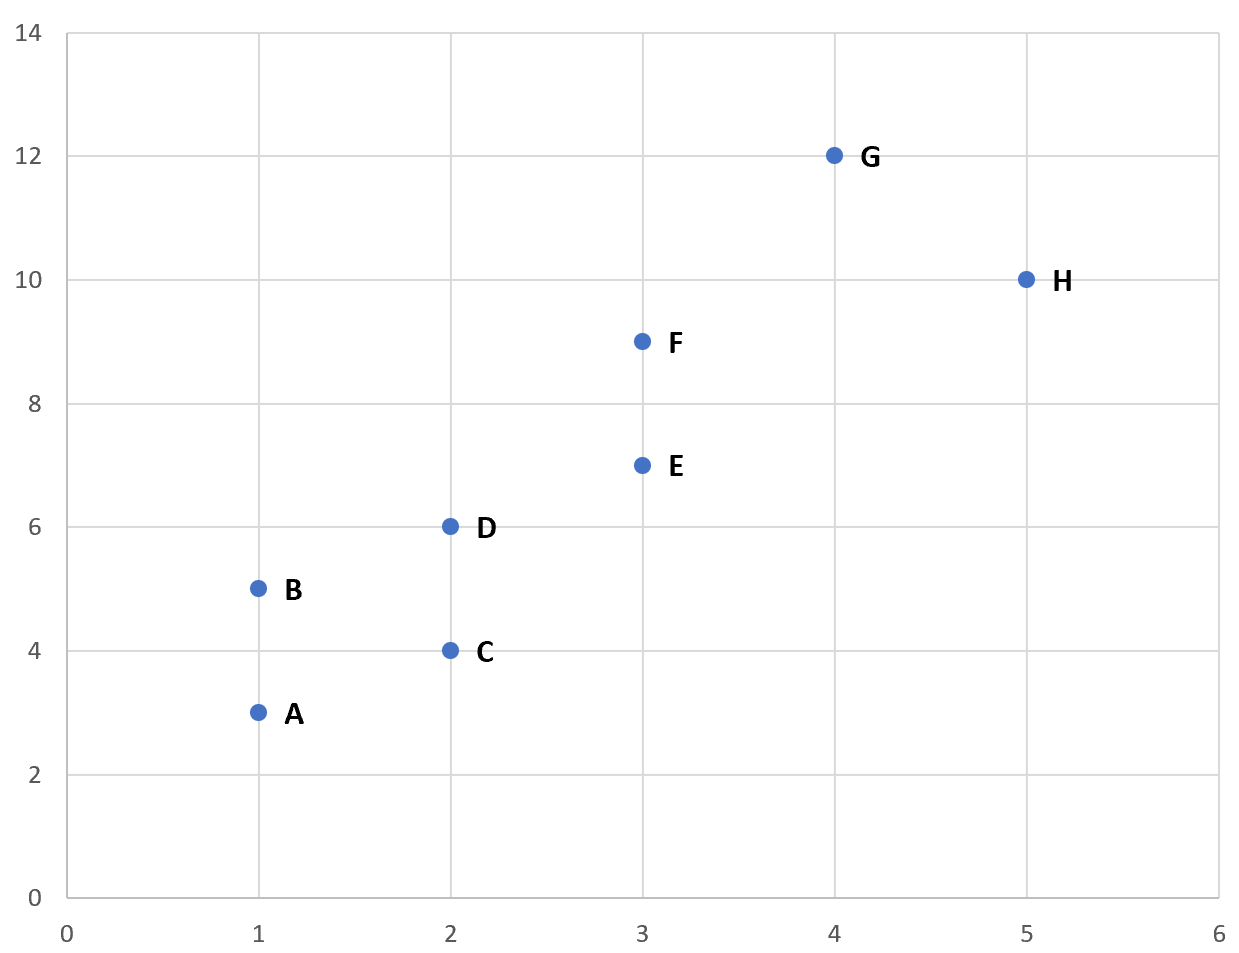
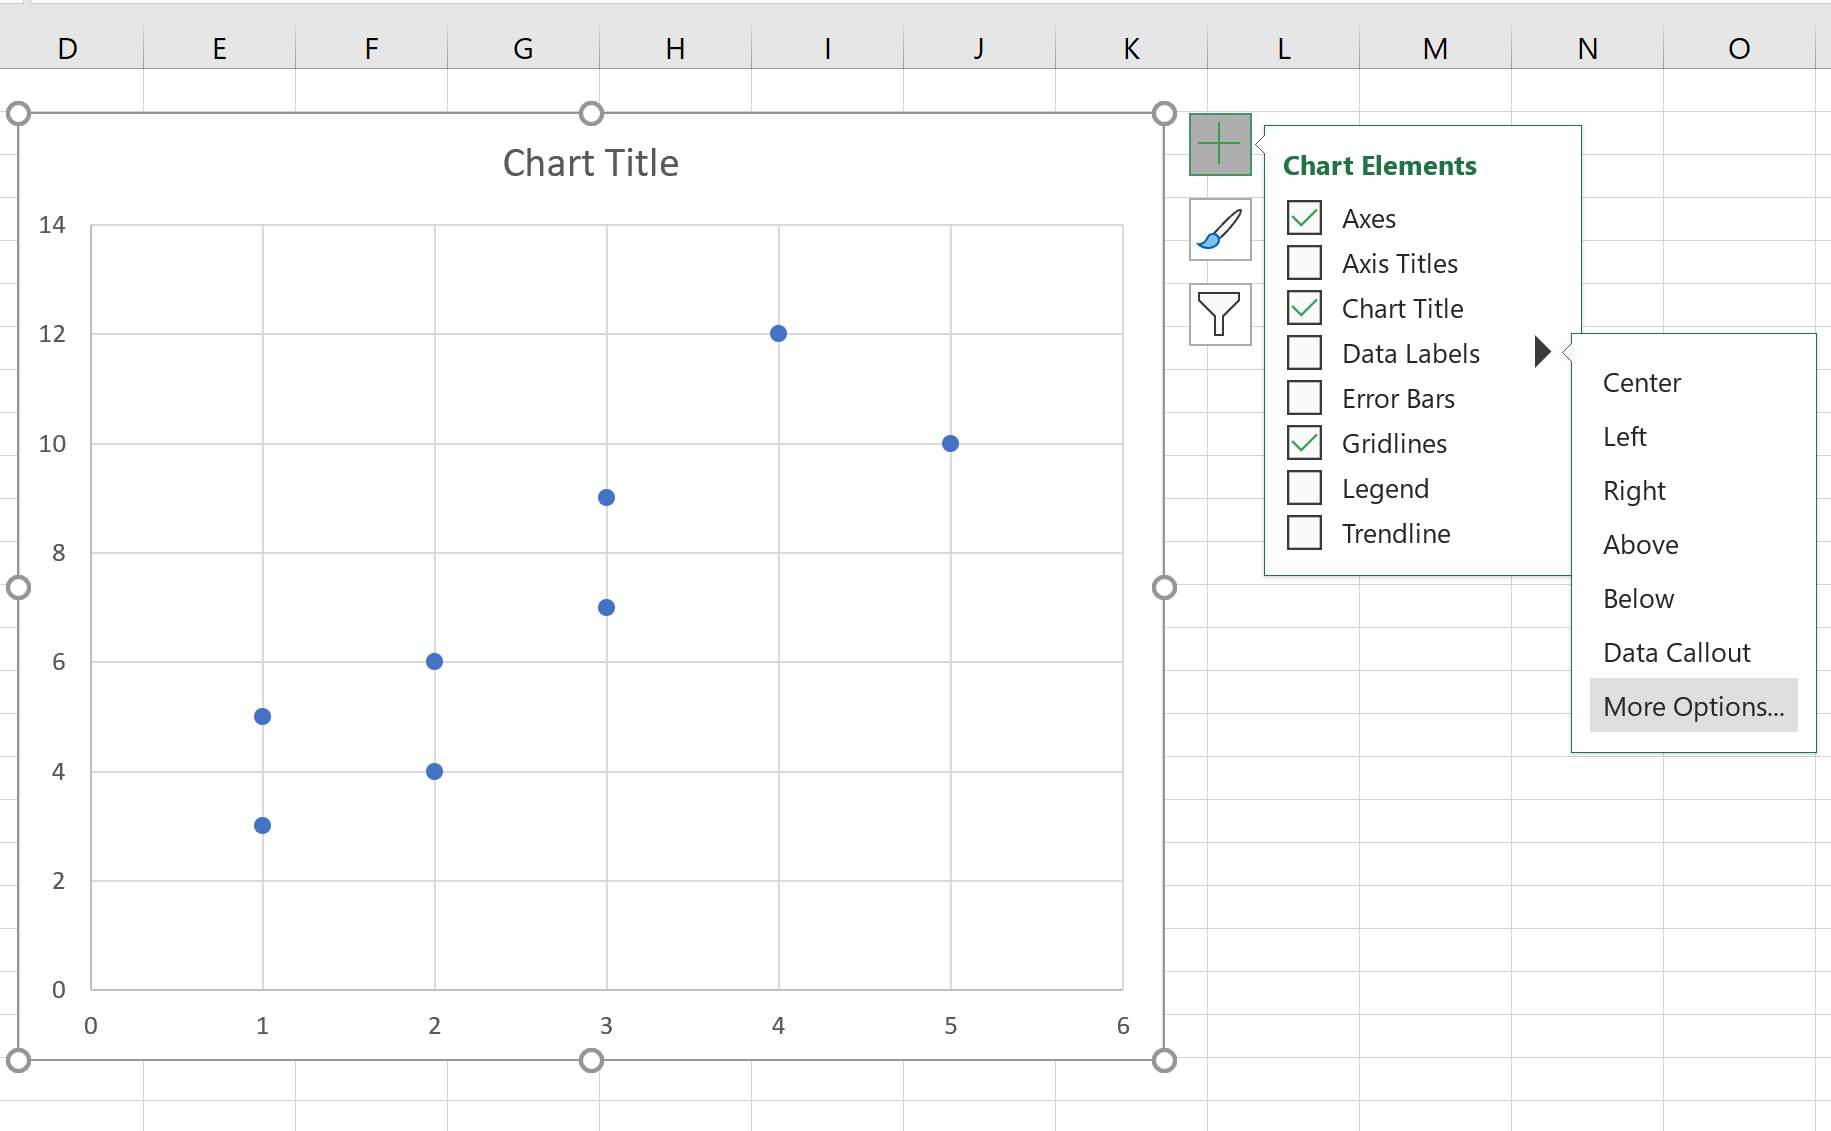
Dans le cadre d’une démarche scientifique d’analyse descriptive, le choix doit se porter impérativement sur le modèle élémentaire : Nuage de points standard, caractérisé par des marqueurs géométriques discrets dépourvus de tout segment d’interconnexion continu. L’adjonction de lignes de connexion relève d’une hypothèse de dépendance séquentielle ou chronologique stricte, hors de propos dans l’exploration d’une corrélation bivariée classique. Dès la génération du graphique sur la feuille active, l’utilisateur doit procéder à une validation critique immédiate : vérifier que la variable indépendante théorique est bien assignée à l’axe horizontal (abscisses) et la variable dépendante à l’axe vertical (ordonnées). En cas d’inversion opérée unilatéralement par le logiciel, la correction s’effectue via le menu contextuel « Sélectionner des données », en éditant la série concernée pour réassigner manuellement les plages d’abscisses de la série et d’ordonnées de la série.
3.3 Paramétrage fondamental de la zone de traçage initiale
Le gabarit graphique inséré par défaut par Excel présente une surcharge visuelle notable qu’il convient de neutraliser méthodiquement pour asseoir une base de travail rigoureuse. L’objectif est de maximiser le coefficient « encre-données » préconisé par la littérature spécialisée. La première opération consiste à supprimer le quadrillage secondaire superflu, voire à estomper le quadrillage principal en réduisant son épaisseur à 0,25 ou 0,5 point et en adoptant une teinte grise neutre (par exemple, RVB 220, 220, 220) pour éviter qu’il n’interfère avec la perception des coordonnées.
L’ajustement des bornes des axes constitue la deuxième intervention déterminante. Par défaut, Excel paramètre l’origine des axes à zéro avec un calcul automatique de la borne supérieure qui tend à tasser les données dans un quadrant marginal de la zone de traçage. Il est recommandé de cliquer avec le bouton droit sur chaque axe, d’ouvrir le volet « Format de l’axe », et de définir manuellement les limites minimale et maximale en se calquant au plus près de l’étendue réelle des observations empiriques (min-max), tout en ménageant une marge de sécurité visuelle d’environ 5 % à chaque extrémité. Cet étalement optimise la dispersion spatiale des marqueurs géométriques, réduisant mécaniquement les densités locales et préparant un espace dégagé pour l’incorporation ultérieure des libellés textuels sans risque excessif de chevauchement précoce.
4. Protocole pas à pas : Intégration native des étiquettes via la plage de cellules
4.1 Activation des étiquettes de données par l’interface contextuelle
L’activation des libellés de données s’opère par l’entremise de l’environnement graphique dynamique introduit dans les versions contemporaines d’Excel. La première manipulation impose de cibler la série de données : un clic gauche appliqué sur l’un quelconque des marqueurs géométriques sélectionne instantanément l’intégralité des points de la série, action confirmée visuellement par l’apparition de micro-poignées de dimensionnement circulaires sur l’ensemble des marqueurs cartésiens.
Dès la sélection établie, deux voies d’accès s’offrent à l’opérateur pour engager l’annotation :
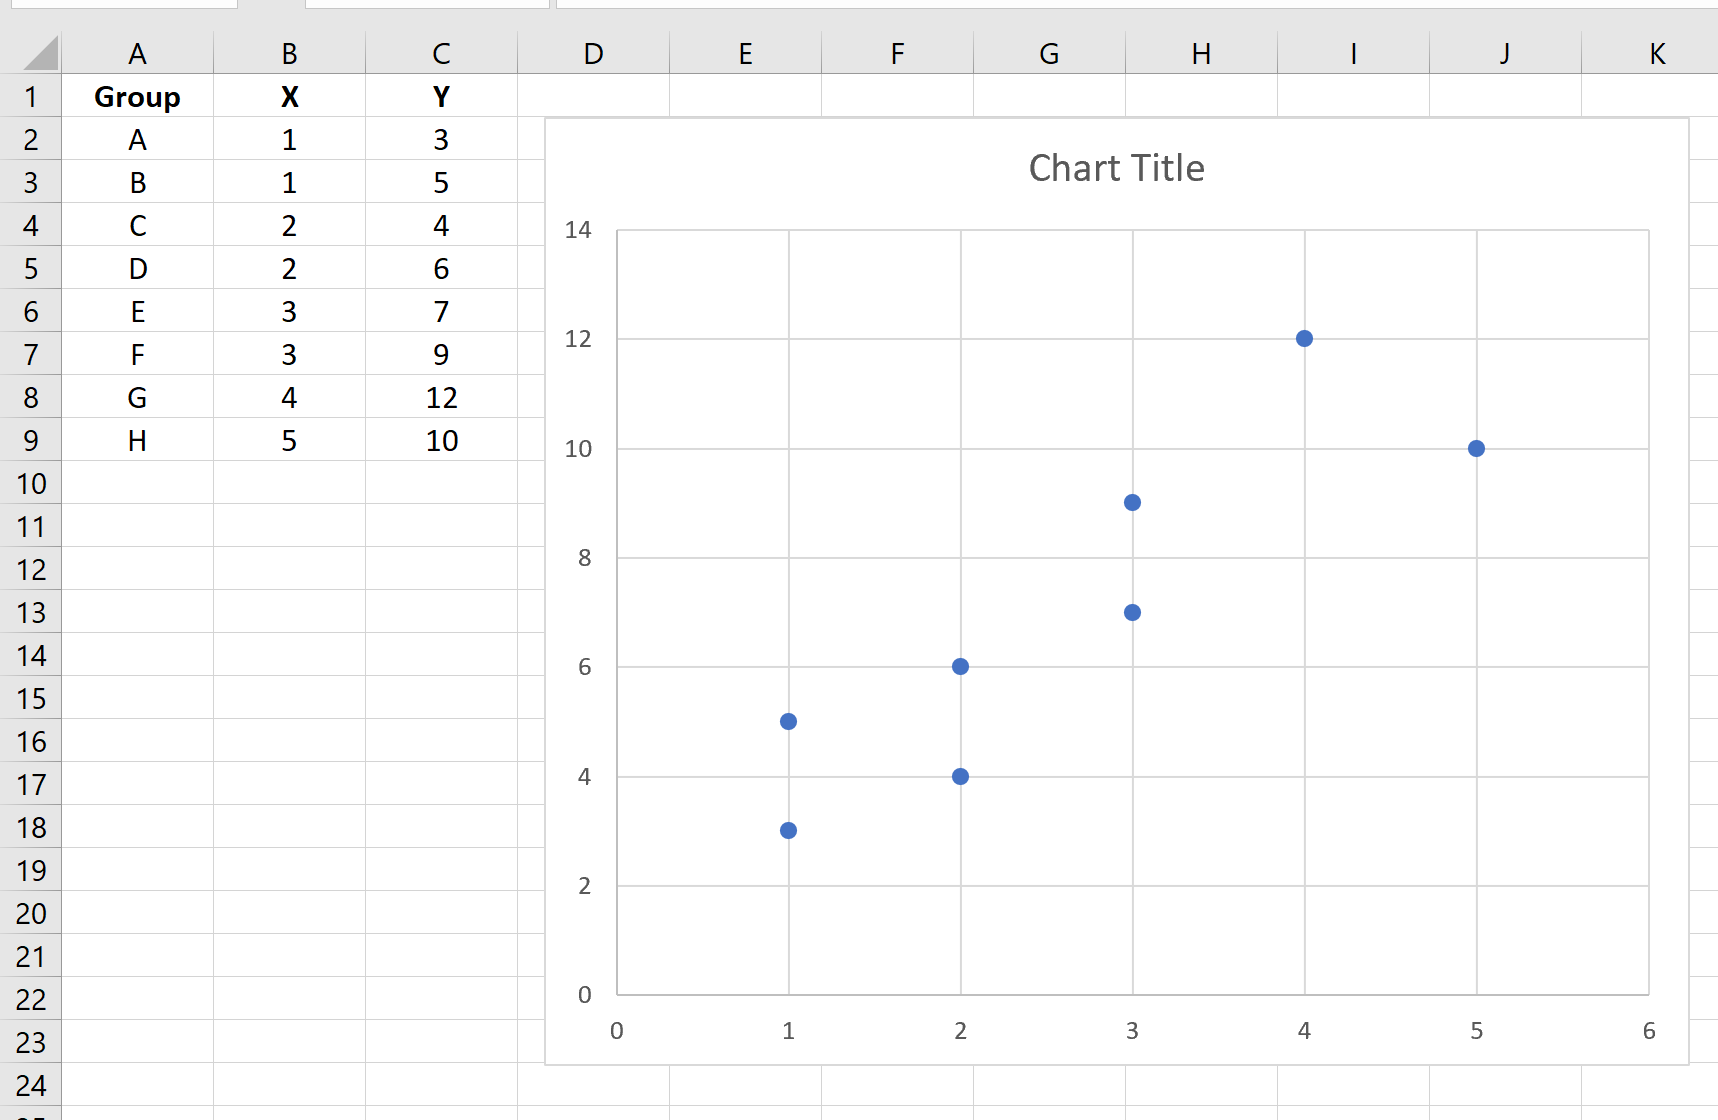
- L’usage du bouton contextuel en forme de croix verte (« Éléments de graphique »), situé à l’angle supérieur droit de la boîte de délimitation du graphique. En survolant l’option « Étiquettes de données », une flèche d’extension permet d’accéder aux options de déploiement et de sélectionner « Autres options… ».
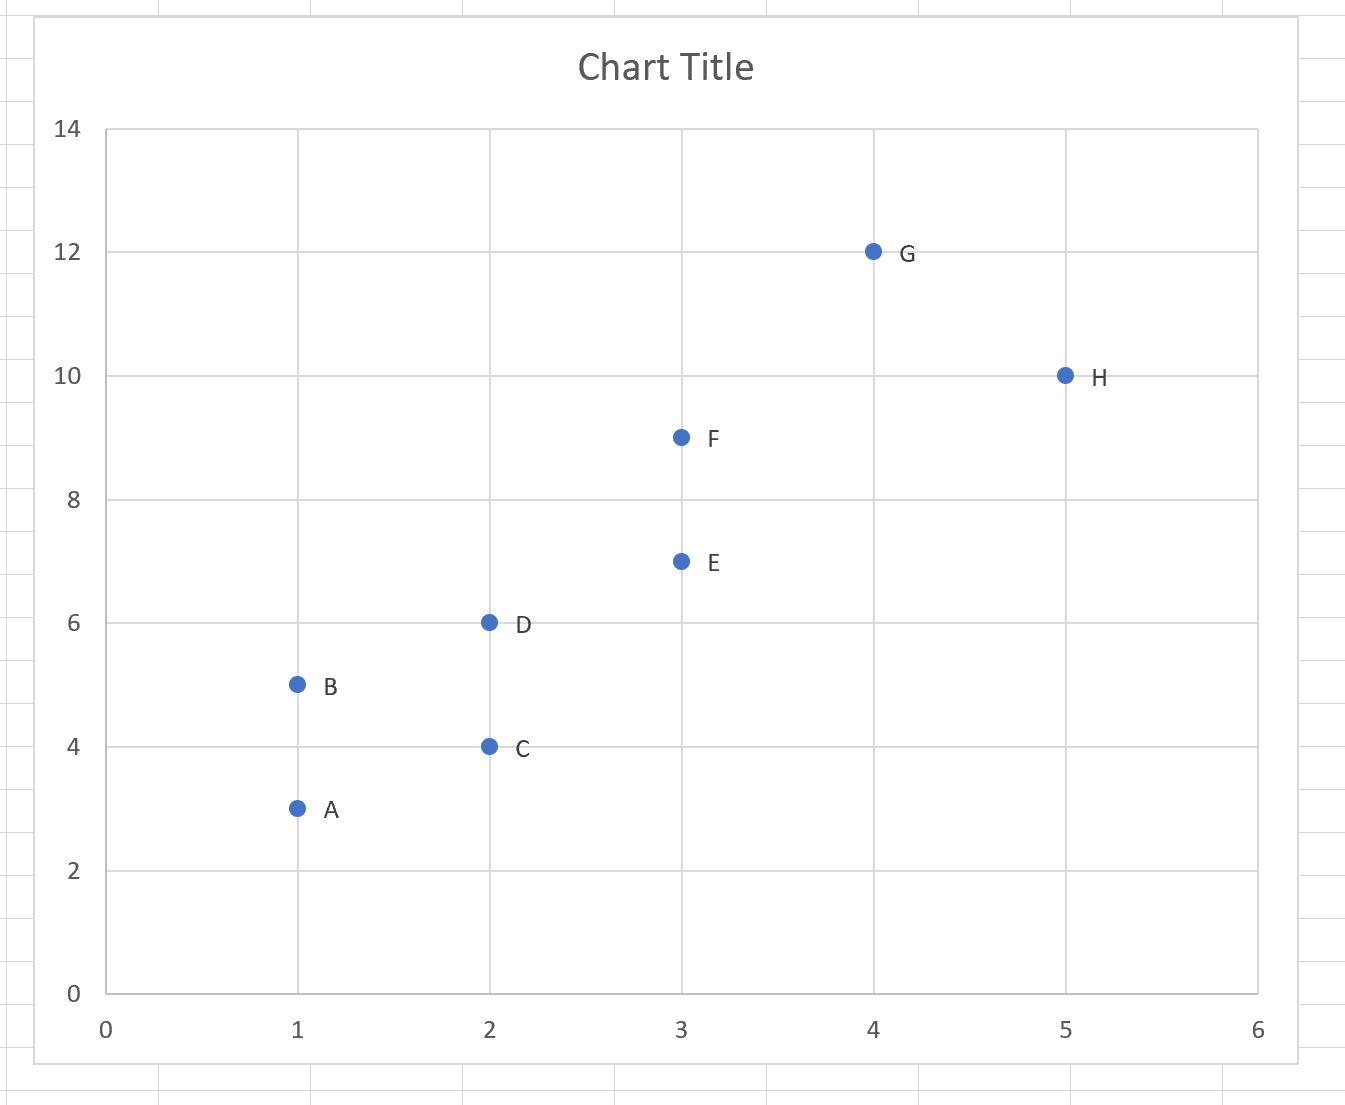
- Le recours au menu contextuel traditionnel, déclenché par un clic droit sur l’un des marqueurs sélectionnés, suivi du choix « Ajouter des étiquettes de données ». Dans sa configuration d’origine, cette commande plaque immédiatement à côté de chaque marqueur sa coordonnée numérique Y, disposition transitoire qu’il s’agit impérativement de modifier.
L’accès à l’ancrage « Autres options… » provoque l’ouverture latérale droite du volet modal indispensable : « Format des étiquettes de données », au sein duquel réside le moteur de paramétrage fin des liaisons textuelles matricielles.
4.2 Configuration du volet Options d’étiquette et attribution de la plage
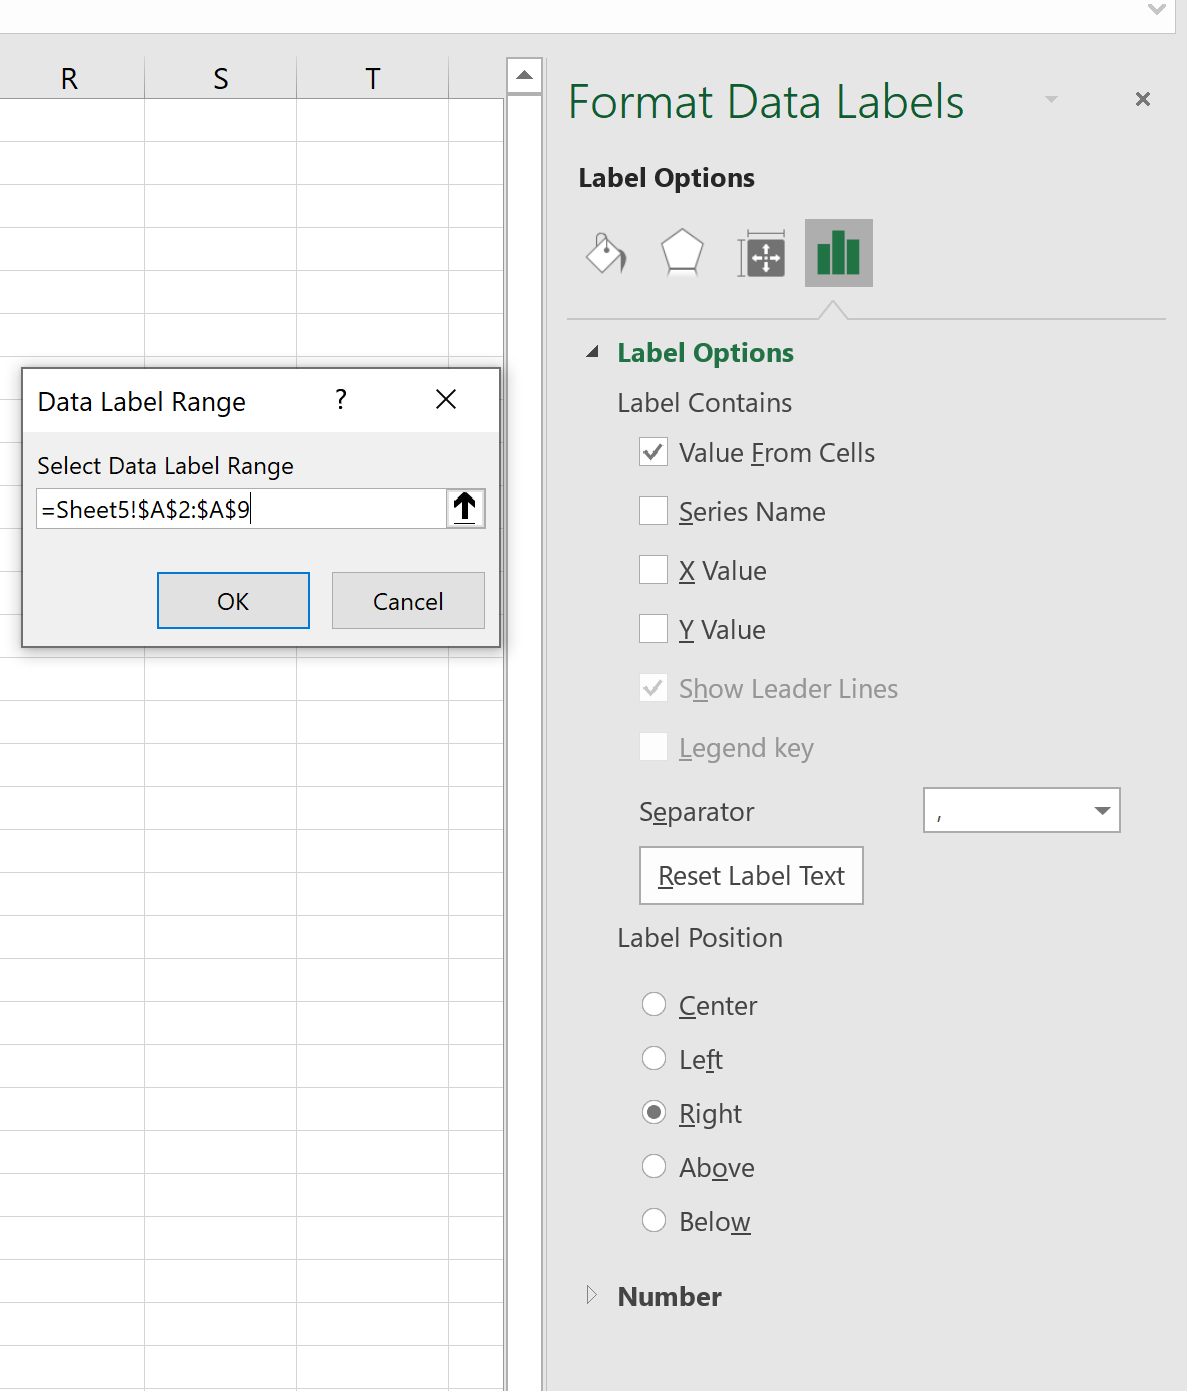
Au sein du volet « Format des étiquettes de données », l’analyste doit naviguer vers le sous-onglet figuré par une icône de graphique à barres, explicitement intitulé « Options d’étiquette ». Par défaut, Excel active la case à cocher « Valeur Y », ce qui explique la prolifération de chiffres redondants sur le graphique. La configuration méthodique s’articule autour d’une séquence de réglages précis.
Il convient de cocher la case prioritaire : Valeur à partir des cellules. Cette action déclenche l’apparition d’une boîte de dialogue modale flottante intitulée « Plage d’étiquettes de données ». À l’aide de l’outil de sélection de plage ou par saisie directe de la syntaxe de référence, l’utilisateur sélectionne la plage vectorielle contenant les identifiants textuels préparés au chapitre 2 (par exemple, Feuil1!$A$2:$A$101). Il est impératif que cette sélection présente une dimension stricte identique en nombre de lignes à la plage de coordonnées numériques X et Y exploitée par le tracé. Une fois la validation effectuée en cliquant sur « OK », le moteur graphique d’Excel injecte les chaînes de caractères sur chaque point correspondant.
L’étape subséquente impose de nettoyer immédiatement le contenu textuel des étiquettes afin de prévenir toute pollution d’affichage. Il est indispensable de décocher formellement la case « Valeur Y », ainsi que les cases « Valeur X » et « Afficher les lignes de repère » si celles-ci sont cochées par défaut. À ce stade, seul le texte nominal personnalisé extrait de la colonne source doit figurer à l’écran, restituant à chaque marqueur son identifiant univoque.
4.3 Validation du synchronisme et finalisation de la liaison dynamique
La finalisation de cette procédure native met en jeu un principe d’architecture logicielle : la dynamicité du lien d’objet OLE (Object Linking and Embedding) interne à Excel. La liaison établie via « Valeur à partir des cellules » n’est pas une copie statique mais un pont référentiel direct. L’analyste doit valider l’intégrité de ce synchronisme en opérant un test de modification sur la matrice source : la modification d’un libellé dans la colonne A doit répercuter son actualisation typographique de façon instantanée et asynchrone sur le marqueur graphique associé, sans nécessiter de rafraîchissement manuel du moteur de rendu.
Un contrôle de cohérence croisé s’impose alors sur les observations extrêmes. L’analyste vérifie que le point présentant la coordonnée X maximale ou la coordonnée Y minimale arbore scrupuleusement l’identifiant matriciel attendu. Cette précaution confirme l’absence de décalage d’index vectoriel lors de la phase de désignation de la plage. Si une discordance est observée, elle signale immanquablement un écart dimensionnel entre la plage d’étiquettes (incluant ou omettant indûment l’en-tête de colonne) et la plage de coordonnées numériques sous-jacente.
5. Positionnement spatial et ajustement géométrique des libellés
5.1 Modes d’ancrage relatifs aux marqueurs graphiques
Le positionnement relatif de l’étiquette par rapport au marqueur géométrique conditionne la rapidité d’assimilation cognitive de la figure et participe directement à la prévention des collisions graphiques primaires. Dans le volet « Format des étiquettes de données », sous la section « Position de l’étiquette », Excel propose cinq ancrages géométriques normalisés :
- Centré : Superpose le centre géométrique de la boîte de texte sur le centre du marqueur cartésien. Cette option est généralement proscrite dans un nuage de points standard, car le texte oblitère la lecture du point physique, sauf à utiliser des marqueurs évidés ou de très grande dimension dans des infographies non scientifiques.
- Gauche : Positionne l’étiquette à l’ouest du marqueur. Utile pour les points situés le long de la bordure droite de la zone de traçage.
- Droite : Position par défaut dans de nombreuses configurations, plaçant le libellé à l’est du point. Elle épouse le sens de lecture occidental dominant de gauche à droite, facilitant la transition oculaire du point vers son texte descriptif.
- Au-dessus : Ancrage au nord du marqueur, fortement recommandé lors de la présence d’une ligne de régression ou d’une courbe de tendance à forte pente positive pour éviter que les étiquettes ne coupent le segment linéaire.
- Au-dessous : Ancrage au sud du point, particulièrement adapté aux séries de données présentant une dispersion concentrée sous un plafond asymptotique.
Le choix d’un alignement uniforme doit répondre à la dynamique directionnelle de l’échantillon empirique. Cependant, une homogénéité stricte de l’ancrage sur l’ensemble de la série s’avère souvent intenable dans les zones à forte concentration d’observations, appelant une différenciation spatiale individualisée.
5.2 Gestion des marges internes et décalage directionnel
La compacité d’un libellé dépend non seulement de sa longueur textuelle et de sa taille de police, mais également de la géométrie de sa boîte de délimitation invisible (bounding box). Par défaut, les applications de la suite Microsoft Office attribuent aux conteneurs de texte des marges internes généreuses : typiquement 2,5 mm pour les marges gauche et droite, et 1,3 mm pour les marges haute et basse. Dans un graphique dense, ces marges gonflent artificiellement la zone d’encombrement de chaque étiquette, créant des recouvrements indésirables alors même que les caractères d’imprimerie ne se touchent pas matériellement.
Pour optimiser l’encombrement spatial, il convient d’accéder, au sein du volet de format, à l’onglet « Taille et propriétés » (figuré par une icône de boîte de mesure géométrique). Dans la rubrique « Alignement », l’analyste doit réduire systématiquement les marges intérieure gauche, droite, supérieure et inférieure à une valeur minimale comprise entre 0 et 0,5 mm. Cette opération resserre le périmètre de collision textuelle au plus près des glyphes typographiques, dégageant un espace interstitiel précieux au sein de la zone de traçage.
Parallèlement, le décalage directionnel manuel peut être exploité pour les observations critiques. En sélectionnant individuellement une étiquette unique par un second clic modérément espacé (single-click) appliqué sur le texte concerné, l’opérateur acquiert la faculté de transrater manuellement la boîte d’étiquette par un glisser-déposer contrôlé à la souris ou par l’usage précis des flèches directionnelles du clavier, modifiant ainsi son vecteur de translation par rapport aux coordonnées natives du marqueur.
5.3 Déploiement et mise en forme des lignes de repère directionnelles
Dès lors qu’une étiquette est substantiellement écartée de son marqueur géométrique d’origine pour échapper à un secteur de forte occlusion, la dissociation spatiale risque de générer une ambiguïté d’attribution : à quel point ce libellé flottant appartient-il ? Pour dissiper toute incertitude de rattachement, Excel intègre un mécanisme de lignes de repère (leader lines) automatiques.
L’activation de cette fonctionnalité s’effectue en cochant l’option « Afficher les lignes de repère » dans le volet des options d’étiquette. Dès qu’une boîte textuelle subit une translation manuelle au-delà d’un rayon de seuil critique par rapport au centre du marqueur, un segment vectoriel se déploie dynamiquement, reliant l’ancre du texte au centre du point cartésien. Pour préserver la rigueur esthétique de la figure et ne pas introduire un encombrement géométrique concurrent, ces lignes de repère doivent faire l’objet d’un calibrage typographique strict :
- Une épaisseur de trait ultra-fine, calibrée préférentiellement à 0,25 ou 0,5 point.
- Une nuance chromatique discrète, telle qu’un gris anthracite ou un ton moyen assorti à la couleur du marqueur, proscrivant les noirs saturés qui focalisent indûment le regard.
- Un style de ligne continu ou finement pointillé selon la densité générale du graphique.
Il convient de désactiver unilatéralement les lignes de repère lorsque les étiquettes demeurent dans le voisinage immédiat de leur point d’ancrage, leur présence s’avérant alors redondante et constitutive de bruit graphique inutile.
6. Résolution des conflits de chevauchement et encombrement visuel
6.1 Diagnostic des zones à forte densité d’observations
L’écueil récurrent de l’étiquetage d’un nuage de points réside dans la formation d’amas textuels illisibles, désignés dans la littérature d’ingénierie visuelle sous le terme de surtraçage (overplotting) ou d’occlusion mutuelle. Dès lors que deux observations partagent des coordonnées euclidiennes proches au regard de l’échelle d’affichage, leurs conteneurs textuels respectifs se chevauchent invariablement, détruisant l’accessibilité cognitive de l’information.
Ce phénomène ne constitue pas simplement un désagrément esthétique ; il induit un biais d’interprétation statistique majeur. Dans une zone d’occlusion sévère, l’observateur perçoit un magma typographique informe qui occulte la cardinalité exacte du sous-ensemble observé. De surcroît, lors de la reproduction imprimée ou de l’incorporation dans un fichier PDF haute résolution, les algorithmes de rastérisation peuvent fusionner les contours des glyphes typographiques en taches indéchiffrables. Il est donc indispensable d’opérer un diagnostic exhaustif de la zone de dispersion préalable à toute finalisation : identification des barycentres d’agrégation, calcul de la densité spatiale locale, et inventaire des observations masquées ou tronquées.
6.2 Stratégies d’espacement manuel et d’ajustement géométrique
Pour décongestionner les zones de densité moyenne, l’analyste peut déployer des stratégies d’optimisation spatiale manuelles précises au sein de l’environnement natif d’Excel. La méthode fondamentale repose sur l’intervention individualisée par double clic sélectif : un premier clic sélectionne la série d’étiquettes dans son ensemble, puis un second clic ciblé isole l’étiquette en conflit. Dès lors, cette dernière peut être manipulée de manière autonome sans altérer le positionnement des autres éléments de la série.
Une technique géométrique efficiente consiste à répartir radialement les étiquettes autour de l’amas de points selon une trajectoire en éventail. Si un groupe comporte quatre observations serrées, l’opérateur disposera manuellement une étiquette au nord-ouest, la seconde au nord-est, la troisième au sud-est et la quatrième au sud-ouest, en étirant légèrement les lignes de repère pour maintenir l’association sans collision de texte. Si cette marge de manœuvre demeure insuffisante, l’analyste peut procéder à une déformation contrôlée de la surface de traçage en modifiant le ratio d’aspect global du graphique (étirement horizontal ou vertical du cadre général) ou en ajustant les limites minimale et maximale des axes pour augmenter l’écartement linéaire physique entre les marqueurs sur l’écran.
6.3 Technique de dispersion contrôlée et d’étiquetage sélectif
Face à des jeux de données denses (comportant plusieurs dizaines ou centaines d’individus), l’étiquetage exhaustif devient une impossibilité géométrique absolue. L’orthodoxie méthodologique préconise alors l’étiquetage sélectif contrôlé (filtering annotation), consistant à n’annoter explicitement que les observations porteuses d’une valeur informative critique au regard de la problématique empirique (points extrêmes, cas aberrants théoriquement documentés, ou étalons de référence).
Pour mettre en œuvre cette sélectivité de manière dynamique dans Excel sans détruire la cohérence du tableau source, il convient d’adjoindre à la matrice de données une colonne calculée dédiée à l’étiquetage sélectif, utilisant une structure conditionnelle matricielle. Par exemple, pour n’étiqueter que les observations dont la valeur Y excède un seuil statistique ou dont l’identifiant appartient à un groupe d’intérêt, on appliquera une formule du type :
=SI(OU(C2>SEUIL_SUPERIEUR; C2<SEUIL_INFERIEUR); A2; "")
En assignant cette colonne conditionnelle comme plage source via l’option « Valeur à partir des cellules », le moteur d’Excel n’affiche de libellés textuels que pour les lignes satisfaisant au prédicat logique, les cellules renvoyant une chaîne vide "" demeurant rigoureusement invisibles sur la zone de traçage. Toute manipulation éditoriale de cette nature doit être scrupuleusement documentée dans la légende méthodologique ou les notes de bas de figure, stipulant explicitement la règle probabiliste ou déterministe ayant présidé à la sélection des étiquettes affichées.
7. Mise en forme esthétique et typographique conforme aux critères scientifiques
7.1 Sélection des familles de polices et calibrage du corps de texte
L’apparence typographique d’une figure conditionne son autorité épistémique. Dans le cadre d’une publication scientifique ou d’un rapport de haute technicité, le choix des polices de caractères doit obéir à des critères stricts de neutralité stylistique et d’efficience morphologique. Il convient de proscrire absolument les polices de fantaisie, les polices manuscrites, ainsi que les polices à empattements très contrastés qui supportent mal la réduction d’échelle.
Le consensus éditorial international accorde un privilège unanime aux polices linéaires sans-serif (sans empattements) de haute lisibilité : Arial, Helvetica, Calibri, ou les fontes libres équivalentes telles que Roboto ou Liberation Sans. Ces polices se distinguent par une hauteur d’x généreuse, une uniformité de graisse de trait et des contreformes ouvertes qui préviennent le bouchage optique des lettres à petit corps. Le calibrage du corps de texte doit être rigoureusement anticipé : au format d’impression final (après mise en page dans la revue), aucune étiquette ne doit présenter une taille inférieure à 6 points typographiques (la norme optimale se situant entre 7 et 9 points). Au sein d’Excel, travaillant généralement sur une surface graphique non réduite, il est recommandé de calibrer les étiquettes à une taille de 8 à 10 points, garantissant la netteté lors d’une réduction vectorielle subséquente.
Une règle architecturale majeure réside dans l’uniformisation typographique globale : la police employée pour les étiquettes de points doit correspondre formellement à celle assignée aux graduations numériques des axes, aux titres d’axes et, dans la mesure du possible, à la famille typographique dominante du manuscrit académique d’accueil.
7.2 Gestion des contrastes, bordures et arrière-plans
La perceptibilité d’un texte graphique repose directement sur le différentiel de luminance entre les caractères et leur arrière-plan immédiat, paramètre formalisé par le rapport de contraste selon les directives internationales d’accessibilité (WCAG 2.1). Lorsque les étiquettes franchissent des lignes de quadrillage, des bandes de confiance statistiques ou des zones d’ombrage de traçage, la lisibilité brute se détériore immédiatement.
Pour restaurer une isolation optique irréprochable sans altérer la clarté du nuage, l’opérateur peut intervenir sur le volet de remplissage de la boîte d’étiquette :
- L’application d’un remplissage d’arrière-plan uniforme blanc ou solidement désaturé, combiné à un indice de transparence maîtrisé (typiquement calibré entre 15 % et 25 %). Cette semi-transparence permet de lire le texte sans ambiguïté tout en conservant la visibilité résiduelle de tout marqueur géométrique sous-jacent.
- L’évitement systématique des bordures de boîtes d’étiquettes. L’application d’un filet noir ou de couleur autour de chaque étiquette segmente l’espace en une multitude de micro-rectangles inesthétiques qui saturent visuellement la zone de traçage. Le texte doit flotter librement sur la surface graphique, soutenu uniquement si nécessaire par son halo d’arrière-plan semi-transparent.
- La conformité absolue avec les contraintes d’accessibilité chromatique pour les lecteurs atteints de déficiences de la vision des couleurs (daltonisme, deutéranopie, protanopie). Il convient de valider que les étiquettes et les marqueurs conservent un ratio de contraste supérieur à 4,5:1 en conversion monochrome noir et blanc.
7.3 Différenciation graphique en fonction de variables catégorielles tierces
Dans de nombreuses recherches empiriques, les unités statistiques projetées appartiennent à des sous-populations distinctes régies par un facteur qualitatif orthogonal (par exemple, typologie sectorielle, région biogéographique, statut de traitement clinique). La mise en forme typographique des étiquettes peut alors être mobilisée comme une variable visuelle d’encodage tertiaire.
Cette différenciation s’opère par l’homologie chromatique entre la police du libellé et le marqueur géométrique correspondant. L’assignation d’une couleur d’accentuation spécifique (par exemple, bleu profond pour le groupe témoin et bordeaux sombre pour le groupe expérimental) unifie immédiatement l’étiquette et le point au sein d’une gestalt perceptive unitaire. L’emploi de la graisse typographique (semi-bold ou bold) doit quant à lui demeurer parcimonieux : il doit être exclusivement réservé à la désignation de points singuliers remarquables (par exemple, le centre de gravité de la distribution, une valeur cible réglementaire ou un échantillon témoin fondamental), offrant un point d’ancrage hiérarchique immédiat au regard du lecteur lors de la découverte de la figure.
8. Automatisation avancée de l’étiquetage par scripts VBA et macros
8.1 Limites de la méthode manuelle face aux jeux de données volumineux
L’environnement graphique interactif de Microsoft Excel, bien qu’abouti, manifeste des lacunes fonctionnelles substantielles dès lors que le volume d’échantillonnage s’étend à des centaines d’unités d’observation. L’ajustement manuel point par point devient une procédure chronophage, source d’erreurs humaines massives et dénuée de toute reproductibilité scientifique. La reproductibilité constitue pourtant le pilier épistémologique de la recherche contemporaine : un traitement graphique qui ne peut être réexécuté de manière algorithmique et déterministe lors de l’actualisation des données brutes affaiblit la robustesse du protocole expérimental.
De surcroît, lors de manipulations tabulaires ultérieures (opérations de tri multi-colonnes, adjonction de nouvelles cohortes de mesures, modifications de filtres structurels), les annotations manuelles subissent fréquemment des dégradations de liaison ou des anomalies de repositionnement spatial. La formalisation d’une routine programmée via l’interpréteur Visual Basic for Applications (VBA) représente la solution technique d’ingénierie logicielle garantissant une automatisation pérenne, scalable et rigoureusement standardisée de l’annotation graphique.
8.2 Architecture et logique d’une macro VBA d’annotation de nuage de points
L’automatisation du processus par script VBA repose sur l’instanciation hiérarchique du modèle objet d’Excel. La routine doit établir une référence pointée vers l’objet graphique incorporé (ChartObject), isoler la série de dispersion active (Series), puis exécuter une boucle itérative indexée associant séquentiellement chaque élément textuel de la plage de cellules d’entrée au point géométrique correspondant au sein de la collection Points.
La structure conceptuelle de cette routine d’annotation automatisée s’articule autour des instructions fondamentales du modèle objet graphique d’Excel :
L’initialisation requiert la déclaration explicite des variables typées afin d’optimiser l’exécution en mémoire : l’objet graphique Cht, la série de données Srs, la plage de libellés textuels LblRange et un compteur itératif i. Le script procède ensuite à la vérification impérative de l’isomorphisme dimensionnel : le nombre de cellules contenu dans la sélection de libellés doit être rigoureusement égal à la valeur renvoyée par la méthode Srs.Points.Count. En cas de disparité géométrique, la routine interrompt l’exécution via une boîte de message d’alerte, protégeant l’analyste contre toute désynchronisation accidentelle.
La boucle d’exécution active d’abord l’affichage des étiquettes de données par l’assignation de la propriété booléenne Srs.HasDataLabels = True. Ensuite, pour chaque indice itératif allant de 1 au nombre total d’observations, l’instruction maîtresse affecte le contenu textuel dynamique :
Srs.Points(i).DataLabel.Text = LblRange.Cells(i).Value
Ce protocole algorithmique s’affranchit de toute manipulation interactive de la souris. Il est exécutable instantanément sur n’importe quel classeur de données, conférant au chercheur l’assurance d’un étiquetage intégral, réplicable à l’infini en une fraction de seconde, quelle que soit la version logicielle de la plateforme d’exécution.
8.3 Algorithmes automatisés de prévention basique du chevauchement
Il est possible d’étendre la sophistication de la routine VBA en y intégrant un algorithme élémentaire de positionnement géométrique contextuel (heuristique d’évitement de collision). Cet algorithme calcule, pour chaque observation i, la pente locale par rapport à ses voisins immédiats ou par rapport au centroïde global du nuage, afin de déterminer dynamiquement le quadrant d’ancrage le plus dégagé.
La programmation peut évaluer la coordonnée relative d’un point par rapport à la moyenne générale des abscisses et ordonnées. Si un point se situe dans le quadrant supérieur droit (valeurs X et Y supérieures à la moyenne), le script configure automatiquement la propriété spatiale :
Srs.Points(i).DataLabel.Position = xlLabelPositionAbove ou xlLabelPositionRight
Pour les points périphériques situés à une distance de Mahalanobis ou euclidienne critique du centre, la routine peut accroître programmatiquement la valeur de translation du conteneur textuel et forcer la propriété d’affichage des traits de repère directeurs via Srs.Points(i).DataLabel.ShowLegendKey = False tout en validant la propriété Srs.DataLabels.ShowRange = True. Ces ajustements automatiques réduisent drastiquement le temps alloué à la retouche cosmétique manuelle des visualisations volumineuses.
9. Gestion des nuages de points multivariés et étiquetage par sous-groupes
9.1 Décomposition d’un nuage de points en séries distinctes
L’analyse descriptive contemporaine implique fréquemment d’examiner comment la relation bivariée entre X et Y est modélisée ou modulée par un facteur de stratification polytomique (par exemple, plusieurs classes d’âge, différentes zones géographiques ou cohortes pharmacologiques distinctes). L’erreur méthodologique standard consiste à générer un tracé global unique et à tenter de différentier visuellement les points a posteriori par des colorations individuelles disparates. Cette pratique paralyse la gestion automatisée des étiquettes d’Excel.
La méthodologie optimale réside dans la partition matricielle en sous-groupes expérimentaux autonomes. Au sein de la table de calcul, les observations sont triées et scindées en autant de colonnes X et Y secondaires qu’il existe de modalités factorielles. Lors de la construction graphique, chaque modalité est déclarée sous forme d’une série graphique distincte au sein de la même zone de traçage. Cette compartimentation confère une flexibilité opérationnelle totale :
- Chaque série bénéficie de son propre marqueur géométrique (disque plein, triangle, carré évidé) facilitant l’accessibilité en impression monochrome.
- Les étiquettes de données sont assignées, configurées et mises en forme de manière indépendante pour chaque sous-ensemble, autorisant des polices, des couleurs et des tailles typographiques adaptées aux contraintes de chaque groupe.
- La légende native d’Excel référence automatiquement et rigoureusement les différentes sous-populations, dispensant l’analyste de l’insertion manuelle d’annotations explicatives complexes dans le corps de la figure.
9.2 Création d’étiquettes combinées multidimensionnelles
L’étiquette de données ne doit pas nécessairement être restreinte au simple libellé nominal de l’observation. Dans un contexte de transmission dense d’information statistique, il s’avère particulièrement pertinent d’intégrer dans le corps même de l’étiquette des données quantitatives d’appoint issues d’autres dimensions analytiques (par exemple, la variance locale, le volume d’échantillon ou les coordonnées précises de mesure).
Cette richesse informative s’obtient par la constitution d’une colonne de concaténation syntaxique dans la feuille de calcul en amont du tracé graphique. Grâce à l’opérateur de concaténation & ou à la fonction native TEXTE.CONCAT(), l’analyste assemble dynamiquement le texte désignatif et les valeurs numériques associées préalablement formatées. L’insertion de la fonction de formatage TEXTE() s’avère ici indispensable pour maîtriser le nombre de décimales affichées et proscrire les expansions flottantes à dix chiffres qui pollueraient la zone de traçage. Par exemple, la formule suivante :
=A2 & " (" & TEXTE(B2; "0,0") & " ; " & TEXTE(C2; "0,00") & ")"
génère une étiquette structurée associant le nom du cas et ses coordonnées bivariées précises. Pour maintenir une emprise spatiale compacte et éviter l’étalement horizontal du texte, il est préconisé d’incorporer un saut de ligne directement dans la formule via la fonction CAR(10) (sur Windows) ou CAR(13) (sur macOS) :
=A2 & CAR(10) & "[" & TEXTE(D2; "+0,0%") & "]"
En assignant cette colonne calculée à l’option « Valeur à partir des cellules », l’étiquette se déploie verticalement en deux lignes denses, préservant la compacité de la zone de dispersion tout en fournissant une analyse multidimensionnelle immédiate.
9.3 Mise en évidence contextuelle des profils singuliers ou aberrants
L’attention heuristique d’une audience scientifique se focalise quasi systématiquement sur les profils statistiques atypiques : les points situés hors des enveloppes de confiance à 95 %, les résidus extrêmes d’un ajustement économétrique ou les déviations biologiques majeures. L’annotation textuelle doit alors opérer comme un projecteur cognitif sélectif.
Cette stratégie repose sur l’automatisation de la détection statistique par calcul des scores Z (écart normalisé) ou de l’intervalle interquartile (IQR). Dans la feuille de calcul, une colonne conditionnelle évalue la distance statistique de l’observation :
=SI(ABS((C2-MOYENNE($C$2:$C$101))/ECARTYPE.STANDARD($C$2:$C$101))>2,5; A2; "")
Dans ce modèle, seuls les individus excédant 2,5 écarts-types par rapport à la moyenne théorique reçoivent un identifiant textuel, tandis que l’ensemble des observations standardisées régulières demeurent sous forme de points neutres discrets. Cette sélectivité contextualisée désencombre totalement le cœur du nuage de points tout en offrant un diagnostic qualitatif exhaustif sur les marges du modèle expérimental.
10. Spécificités selon les versions d’Excel et solutions d’extension tierces
10.1 Évolution historique de la fonctionnalité de liaison de cellules
La compréhension des mécanismes d’étiquetage dans Excel requiert une mise en perspective rétrospective de l’évolution du moteur graphique de la suite bureautique de Microsoft. Dans les versions historiques d’Excel (Excel 2003, 2007 et 2010), l’incorporation d’étiquettes textuelles issues d’une plage matricielle tierce était tout simplement impossible de manière native. Les utilisateurs étaient contraints soit de se borner à l’affichage rigide des valeurs X ou Y numériques, soit d’éditer manuellement chaque étiquette une par une en cliquant dessus et en tapant manuellement la référence de cellule dans la barre de formule (par exemple, =Feuil1!$A$2), une astreinte insoutenable sur des jeux de données d’envergure.
La mise à disposition d’Excel 2013 a marqué une rupture décisive avec l’introduction de la fonctionnalité native « Valeur à partir des cellules », standardisant enfin l’indexation dynamique d’une plage textuelle sur une série cartésienne. Cette avancée a aligné le tableur sur les exigences fonctionnelles minimales de l’ingénierie visuelle contemporaine. Cependant, des disparités ergonomiques et fonctionnelles subsistent encore aujourd’hui entre la version Windows d’Excel et sa déclinaison sous macOS. Si les fonctionnalités fondamentales de liaison demeurent synchrones, la gestion de l’accélération matérielle graphique, l’agilité de manipulation des volets latéraux contextuels et la précision des raccourcis clavier de positionnement présentent des divergences structurelles que l’analyste multi-plateforme se doit d’anticiper rigoureusement.
10.2 Compléments logiciels et utilitaires historiques de référence
Face à la carence prolongée des versions antérieures d’Excel, la communauté internationale des praticiens et statisticiens a vu émerger des compléments logiciels tiers devenus emblématiques. Le plus célèbre d’entre eux, qui a constitué pendant plus de quinze ans la référence technique absolue dans les laboratoires de recherche, est l’utilitaire XY Chart Labeler développé par Rob Bovey (MVP Microsoft Excel). Cette macro complémentaire (add-in en format .xlam) injectait via l’API interne d’Excel une interface robuste permettant d’assigner une plage textuelle à n’importe quelle série de nuage de points en un clic unique, tout en autorisant des décalages directionnels multidirectionnels groupés.
Bien que la fonctionnalité soit désormais intégrée nativement depuis Excel 2013, le recours à de tels utilitaires spécialisés ou à des compléments contemporains (tels que l’add-in Peltier Tech Chart Utility) conserve une justification légitime dans des cas d’usage industriels spécifiques : traitement en masse de graphiques multiples synchronisés, recalibrage vectoriel automatique d’étiquettes après application de filtres complexes, ou contournement des restrictions de sécurité d’environnements corporatifs verrouillés. Toutefois, sur le plan de la pérennité et de l’interopérabilité des fichiers de travail, l’usage des fonctionnalités natives d’Excel doit être systématiquement privilégié lors de la diffusion d’un classeur destiné à des tiers, écartant tout risque de blocage à l’ouverture dû à l’absence du complément logiciel chez le destinataire.
10.3 Comportement sur Excel Online et environnements collaboratifs
L’essor contemporain des infrastructures de travail en nuage (cloud computing) via Microsoft 365 impose d’examiner scrupuleusement le comportement du nuage de points au sein d’Excel Online (interface web sur navigateur) et des espaces collaboratifs partagés (Microsoft Teams, SharePoint). Le moteur de rendu web d’Excel prend parfaitement en charge l’affichage des étiquettes personnalisées configurées via « Valeur à partir des cellules » et maintient le synchronisme dynamique des textes lors de la mise à jour des cellules matricielles de la feuille.
Néanmoins, les fonctionnalités d’édition avancée sur l’application web demeurent sensiblement restreintes au regard de l’application de bureau (desktop client). Les réglages fins tels que la modification millimétrique des marges internes du conteneur de texte, la translation manuelle individualisée d’une étiquette unique isolée par double clic ciblé, ou la configuration paramétrique fine des styles de traits de repère ne sont pas supportés au sein du navigateur. Le protocole méthodologique optimal consiste donc à concevoir, calibrer et figer la disposition géométrique de la figure sur le client lourd de bureau avant d’héberger et de partager le classeur final au sein de l’environnement collaboratif dématérialisé pour consultation ou révision analytique.
11. Erreurs méthodologiques fréquentes et protocoles de dépannage
11.1 Désynchronisation entre plages de données et étiquettes textuelles
Le risque méthodologique le plus dommageable lors de la manipulation d’un nuage de points réside dans la dissociation latente entre la colonne d’identifiants qualitatifs et les colonnes de coordonnées quantitatives. Ce dysfonctionnement survient de manière récurrente lorsqu’un opérateur exécute un tri ordinal sur une colonne spécifique (par exemple, un tri décroissant sur la variable Y) sans étendre expressément la sélection à l’intégralité du tableau de données, ou lorsqu’il insère manuellement des cellules individuelles par décalage partiel.
Dans un tel scénario, l’architecture du graphique n’affiche aucune erreur apparente : le nuage conserve sa géométrie globale et les étiquettes demeurent affichées. Pourtant, l’attribution est faussée de part en part : le marqueur i porte désormais le libellé i+k, faussant radicalement toute déduction analytique. Pour détecter et corriger une telle dislocation, l’analyste doit instaurer un protocole systématique de contrôle d’intégrité croisé :
- Inspecter la syntaxe des séries dans le menu « Sélectionner des données » : s’assurer que la plage déclarée dans « Valeur à partir des cellules » couvre très exactement la même étendue de lignes (par exemple,
$A$2:$A$100) que les plages des abscisses X ($B$2:$B$100) et des ordonnées Y ($C$2:$C$100). - Mettre en place une cellule de contrôle logique au sein de la feuille : une formule vérifiant la parité des fonctions
LIGNES()sur l’ensemble des plages sources concernées. - Verrouiller systématiquement l’adressage par la notation absolue (usage strict des dollars
$) pour interdire tout glissement de référence lors d’opérations de copie ou de déplacement de la zone graphique au sein du classeur.
11.2 Dysfonctionnements d’affichage liés aux filtres et lignes masquées
L’application d’un filtre automatique sur un jeu de données sources ou le masquage manuel de certaines lignes matricielles peut engendrer des altérations graphiques inattendues. Selon les options par défaut de Microsoft Excel, le masquage d’une ligne dans le tableau entraîne la disparition simultanée du marqueur géométrique et de son étiquette de données sur l’espace graphique.
Ce comportement peut s’avérer destructeur si l’analyste souhaite épurer son tableau sans pour autant déstabiliser la projection graphique d’ensemble. Pour maîtriser ce comportement, il convient d’accéder au menu contextuel « Sélectionner des données », puis de cliquer sur le bouton inférieur « Cellules masquées et cellules vides ». Une fenêtre de paramétrage dédiée offre alors l’option fondamentale : « Afficher les données des lignes et des colonnes masquées ». En cochant cette option, l’analyste sanctuarise le traçage complet du nuage de points et de ses étiquettes, autorisant l’usage flexible de filtres de tri ou d’analyses tabulaires intermédiaires sur la feuille de calcul sans altérer l’intégrité physique de la restitution visuelle de la figure.
11.3 Incohérences d’actualisation suite à l’extension du jeu de données
Lorsqu’un jeu de données s’enrichit régulièrement par l’incorporation de nouvelles cohortes de mesures, la déclaration traditionnelle des plages de cellules sous forme de coordonnées fixes (par exemple, $A$2:$C$50) montre immédiatement ses limites opérationnelles. L’ajout d’une nouvelle ligne 51 demeure ignoré par le moteur graphique, exigeant une réaffectation manuelle récurrente des plages de coordonnées X, Y et d’étiquettes.
La solution structurelle à cette limitation repose sur la conversion immédiate de la matrice de données brutes en un Tableau Excel structuré (via le raccourci Ctrl+L ou l’onglet « Accueil > Mettre sous forme de tableau »). Dans cet environnement orienté objet, les colonnes reçoivent des références structurées nommées (par exemple, Tableau1[Identifiant], Tableau1[VarX], Tableau1[VarY]). Dès qu’un nouvel enregistrement est annexé au bas de la table, le tableau structuré s’étend automatiquement vers le bas, et le moteur graphique absorbe instantanément les nouvelles coordonnées numériques tout en générant l’étiquette textuelle dynamique associée, sans nécessiter la moindre intervention manuelle sur les propriétés du graphique.
À défaut de tableau structuré, l’analyste avancé peut configurer des plages nommées dynamiques via la fonction DECALER() combinée à la fonction NBVAL() dans le Gestionnaire de noms :
=DECALER(Feuil1!$A$2; 0; 0; NBVAL(Feuil1!$A:$A)-1; 1)
Cette syntaxe garantit que l’emprise vectorielle de la plage d’étiquettes s’ajuste continuellement au volume réel des observations saisies.
12. Synthèse procédurale et recommandations pour l’édition scientifique
12.1 Liste de contrôle qualité avant soumission d’une figure
Avant d’extraire définitivement un graphique en vue de son intégration dans un manuscrit académique, une thèse de doctorat ou un rapport exécutif d’entreprise, il est impératif de soumettre la figure à une grille d’audit qualité méthodologique rigoureuse. Cette démarche garantit l’élimination des scories visuelles et valide la conformité aux standards internationaux.
La grille d’audit doit consigner explicitement les points de validation suivants :
- Exactitude et bijection : Chaque étiquette nominale affichée correspond-elle de manière biunivoque et certaine aux coordonnées du point auquel elle se rattache ? Aucun glissement d’indice n’est-il survenu ?
- Absence totale d’occlusion : Aucun glyphe typographique n’empiète-t-il sur un glyphe voisin, sur un marqueur physique ou sur les axes gradués ? Le tracé garantit-il une lisibilité intégrale sans effort de décryptage ?
- Clarté des vecteurs de repérage : Les lignes de repère directionnelles sont-elles clairement identifiables ? Pointent-elles avec précision vers le centre géométrique du marqueur sans masquer d’autres données ?
- Résolution typographique : La taille des caractères de l’étiquette respecte-t-elle le plancher minimal de lisibilité (au moins 7 points après mise aux dimensions réelles de la revue) ? La police employée est-elle strictement neutre et sans empattements ?
- Test d’invariance chromatique : La figure conserve-t-elle son intelligibilité intégrale après une conversion simulée en nuances de gris (black & white / grayscale check) ? L’information textuelle supplée-t-elle efficacement une éventuelle indiscernabilité des teintes de marqueurs ?
12.2 Exportation vectorielle et insertion dans les manuscrits académiques
Le mode d’extraction d’un graphique depuis Excel vers un logiciel de traitement de texte ou de mise en page professionnelle (Microsoft Word, LaTeX, Adobe InDesign) conditionne de manière irréversible le rendu typographique final. La pratique élémentaire consistant à réaliser une capture d’écran (screenshot) ou un simple copier-coller matriciel au format bitmap (JPEG, PNG basse résolution) est formellement proscrite dans le cadre d’un protocole scientifique sérieux : elle génère immanquablement une pixellisation destructive des contours typographiques et un flou sur les lignes de repère lors de l’impression professionnelle.
Deux voies d’exportation conformes à l’état de l’art doivent être privilégiées :
- L’exportation vectorielle native : Sous environnement Windows, copier le graphique dans Excel et utiliser la commande « Collage spécial » dans le logiciel d’accueil en sélectionnant le format « Image (métafichier amélioré) » (EMF) ou « Image vectorielle SVG ». Ce mode préserve la structure géométrique : les caractères typographiques demeurent des éléments vectoriels infiniment résolutifs, éditables et insensibles aux artéfacts d’agrandissement ou de rétrécissement.
- La conversion PDF haute définition : Sauvegarder la feuille Excel ou déplacer le graphique sur une feuille graphique isolée, puis imprimer au format PDF en paramétrant le moteur d’impression virtuel sur une résolution minimale de 300 voire 600 DPI (dots per inch). Ce fichier vectoriel peut ensuite être directement converti au format EPS (Encapsulated PostScript) pour une intégration native et sans bavure typographique dans un document rédigé sous LaTeX.
- Le format matriciel non destructif (si exigé par l’éditeur) : Si la revue scientifique exige impérativement un format image rastérisé, l’analyste doit exporter la figure exclusivement au format TIFF non compressé à 300 ou 600 DPI réels, en s’assurant que la largeur en millimètres corresponde rigoureusement à l’emprise sur la colonne d’impression finale pour interdire tout redimensionnement algorithmique destructeur lors du prépresse.
12.3 Réflexion éthique sur l’intégrité de la représentation graphique
L’acte d’étiqueter une distribution de points dépasse la simple technicité logicielle ; il engage la responsabilité éthique de l’analyste quant à la transmission fidèle de la preuve empirique. Dans une communication graphique, la mise en lumière d’une information constitue corrélativement une mise dans l’ombre d’une autre. La sélection délibérée des étiquettes affichées ne doit sous aucun prétexte servir à manipuler l’interprétation de l’audience en créant des distorsions sélectives d’attention.
Le chercheur doit veiller à proscrire formellement tout artifice tendant à minorer ou masquer visuellement des observations contredisant son hypothèse de travail de départ. Si des étiquettes sont omises pour préserver la lisibilité générale d’un groupe d’observations, cette omission doit répondre à une règle statistique objective, formulée en amont, appliquée symétriquement et documentée explicitement dans le protocole descriptif de l’étude. L’intégrité de la représentation repose sur cette transparence épistémologique : l’étiquette textuelle n’a pas vocation à biaiser le regard, mais à apporter l’éclairage qualitatif indispensable à la pleine compréhension des réalités complexes encodées dans les coordonnées mathématiques du nuage de dispersion.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars / Mouton. https://monoskop.org/images/8/89/Bertin_Jacques_Semiologie_graphique.pdf
- Bovey, R. (2012). XY Chart Labeler Add-In for Microsoft Excel. Application Automation Specialists. https://www.appspro.com/Utilities/ChartLabeler.htm
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press. https://www.stat.purdue.edu/~wsc/
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Microsoft Corporation. (2023). Ajouter ou supprimer des étiquettes de données dans un graphique. Support Microsoft. https://support.microsoft.com/fr-fr/office/ajouter-ou-supprimer-des-%C3%A9tiquettes-de-donn%C3%A9es-dans-un-graphique-884bf2f1-2e53-4549-8c6c-b44d0361252e
- Peltier, J. (2018). Labeling Scatter Plot Points in Excel. Peltier Tech Blog. https://peltiertech.com/label-scatter-plot-points-excel/
- Sweller, J. (2011). Cognitive load theory. In J. P. Mestre & B. H. Ross (Eds.), The Psychology of Learning and Motivation: Cognition in Education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387691-1.00002-8
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10