
Dans le paysage contemporain de la recherche quantitative en psychologie, en psychiatrie translationnelle et dans les sciences du comportement, l’évaluation rigoureuse de la taille d’effet constitue un impératif méthodologique incontournable. Si le coefficient de corrélation ou le d de Cohen règnent traditionnellement sur les variables quantitatives continues, les devis de recherche confrontés à des issues dichotomiques — présence ou absence d’un trouble psychopathologique, rémission clinique versus persistance symptomatique, réussite ou échec à un paradigme cognitif — requièrent des métriques spécifiques adaptées à la nature catégorielle des observations. C’est dans ce contexte que le rapport de cotes, universellement désigné sous le vocable anglo-saxon d’odds ratio (OR), s’est imposé comme l’un des indices statistiques les plus prééminents et polyvalents de l’inférence moderne.
Toutefois, la simple communication d’un rapport de cotes ponctuel s’avère fondamentalement insuffisante pour guider le jugement scientifique ou éclairer une décision thérapeutique éclairée. Un estimateur ponctuel, isolé de son contexte probabiliste, demeure aveugle à la variabilité inhérente à l’échantillonnage et aux fluctuations stochastiques propres aux petits effectifs ou aux cohortes cliniques hétérogènes. C’est ici qu’intervient la construction mathématique de l’intervalle de confiance, pierre angulaire de l’inférence fréquentiste qui permet de circonscrire, avec un degré de certitude prédéterminé, la région paramétrique au sein de laquelle réside la véritable valeur populationnelle de l’effet. L’estimation par intervalle ne se contente pas de pallier l’incomplétude du résultat ponctuel : elle redéfinit entièrement la lecture des données empiriques en articulant conjointement précision métrique et portée décisionnelle.
Le présent article propose une exploration exhaustive, théorique et appliquée, de la dérivation et du calcul de l’intervalle de confiance pour un rapport de cotes. En abordant successivement les soubassements probabilistes de la cote, la justification de la transformation logarithmique népérienne, la démonstration de l’erreur type selon la méthode historique de Woolf, le traitement des effectifs nuls, jusqu’aux extensions multivariées sous modèle de régression logistique, ce guide s’adresse aux chercheurs, psychologues statisticiens, épidémiologistes et étudiants avancés désireux de maîtriser les arcanes de cette modélisation tout en se conformant aux standards éditoriaux les plus stricts de la communauté scientifique internationale.
1. Fondements théoriques de l’odds ratio et son rôle en psychologie
1.1 Définition probabiliste de la cote comparativement à la probabilité
Pour appréhender avec exactitude la nature métrologique de l’odds ratio, il convient d’opérer une distinction sémantique et algébrique rigoureuse entre la probabilité classique et la cote. Dans le cadre de la théorie axiomatique des probabilités de Kolmogorov, la probabilité, conventionnellement notée p, mesure la plausibilité d’occurrence d’un événement donné sur une échelle continue strictement comprise dans l’intervalle fermé [0, 1]. Cette métrique exprime une proportion : le ratio du nombre d’événements favorables sur la totalité des événements possibles. Bien qu’intuitive, cette formulation présente une limitation structurelle dans les modélisations prédictives en raison de son confinement entre une borne inférieure nulle et un plafond unitaire, induisant des relations non linéaires dès lors que l’on tente d’extrapoler les effets d’un traitement ou d’une exposition environnementale.
La cote, désignée sous le terme d’odds en anglais, transpose cette probabilité sur une tout autre échelle fonctionnelle. Formellement définie par le ratio $\omega = \frac{p}{1-p}$, elle représente la fréquence relative d’occurrence de l’événement comparativement à sa non-occurrence. Lorsque la probabilité p tend vers zéro, la cote converge vers zéro ; en revanche, lorsque p approche l’unité, le dénominateur s’amenuise, projetant la valeur de la cote vers l’infini positif. L’espace mathématique de la cote s’étend ainsi sur le demi-axe réel positif $[0, +\infty[$. Cette transition géométrique d’un espace borné à un espace ouvert constitue un avantage considérable pour la modélisation mathématique des processus psychologiques dichotomiques, facilitant l’application de fonctions de lien logistiques ou linéaires généralisées.
En contexte clinique et expérimental, la cote bénéficie d’une interprétation directe qui résonne avec le raisonnement diagnostique. Considérons, à titre d’illustration, une cohorte de patients admis dans un service de psychiatrie d’urgence présentant un épisode dépressif majeur caractérisé par une résistance thérapeutique. Si la probabilité d’observer une rémission à six semaines sous un protocole expérimental de stimulation magnétique transcrânienne répétée est évaluée à $p = 0{,}80$, la cote associée s’établit à $\frac{0{,}80}{1 – 0{,}80} = \frac{0{,}80}{0{,}20} = 4{,}0$. Cette valeur indique qu’il est quatre fois plus probable d’observer une rémission clinique que de constater un échec thérapeutique. À l’inverse, une probabilité de rechute de $p = 0{,}25$ correspond à une cote de $\frac{0{,}25}{0{,}75} = \frac{1}{3} \approx 0{,}33$, signifiant qu’un événement favorable se produit pour trois événements défavorables.
1.2 Le concept de rapport de cotes dans les études comportementales
L’odds ratio (OR) découle logiquement de la comparaison relative de deux cotes distinctes calculées au sein de deux sous-populations distinctes ou exposées à des conditions expérimentales contrastées. En sciences du comportement, où les protocoles opposent fréquemment un groupe interventionnel bénéficiant d’une thérapie novatrice à un groupe contrôle recevant un placebo ou un traitement usuel, l’OR quantifie l’ampleur et la direction du changement dans les chances d’observer l’issue ciblée. Formellement, si l’on désigne par $\omega_1$ la cote du groupe exposé et par $\omega_0$ la cote du groupe de référence, le rapport de cotes se définit par l’équation $\text{OR} = \frac{\omega_1}{\omega_0} = \frac{p_1 / (1 – p_1)}{p_0 / (1 – p_0)}$.
L’une des vertus épistémologiques et statistiques majeures de l’odds ratio réside dans sa remarquable propriété d’invariance directionnelle. Contrairement au risque relatif (RR), dont l’estimation exige impérativement la connaissance de l’incidence cumulative dans une population suivie longitudinalement au sein d’une étude prospective ou d’un essai randomisé contrôlé, l’odds ratio possède la capacité mathématique unique de pouvoir être estimé indifféremment à travers des devis prospectifs, transversaux ou rétrospectifs de type cas-témoins. Démontrée originellement par Jerome Cornfield en 1951, cette propriété fondamentale stipule que l’odds ratio calculé en comparant la cote d’exposition chez les cas à celle des témoins est rigoureusement identique à l’odds ratio calculé en comparant la cote de survenue de la maladie chez les exposés à celle des non-exposés. Cette invariance fait de l’OR la métrique reine pour explorer les facteurs de risque psychopathologiques rares, tels que les conduites suicidaires avérées ou l’apparition d’un premier épisode psychotique.
Au-delà de cette flexibilité d’échantillonnage, le rapport de cotes joue un rôle structurant dans la quantification de la taille d’effet en méta-analyse et en évaluation des thérapeutiques cognitives et comportementales. Il fournit un indice standardisé et adimensionnel qui affranchit le chercheur des variations arbitraires d’échelles de mesure. Une valeur d’OR égale à $1{,}0$ consacre l’indépendance statistique la plus stricte, traduisant l’absence de toute association entre l’exposition et l’issue. Toute valeur supérieure à l’unité reflète une augmentation des cotes de l’événement chez les sujets exposés, tandis qu’une valeur comprise entre zéro et un signale un effet protecteur ou une réduction de l’occurrence du comportement étudié sous l’influence du prédicteur.
1.3 Structure matricielle d’une table de contingence 2×2
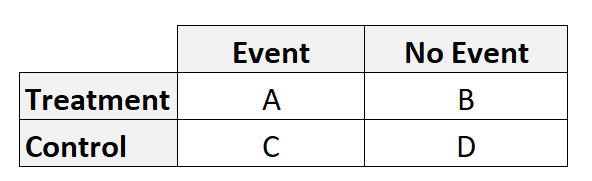
L’opérationnalisation empirique de l’odds ratio s’articule canoniquement autour de la formalisation matricielle d’une table de contingence $2 \times 2$, croisant une variable explicative dichotomique (souvent le facteur d’exposition ou l’assignation à un groupe thérapeutique) disposée en lignes, et une variable de réponse binaire (l’état clinique ou psychologique observé) disposée en colonnes. Cette organisation tabulaire permet de répertorier de manière exhaustive l’ensemble des fréquences absolues observées au sein de l’échantillon expérimental.
Par convention universelle dans la littérature statistique, la disposition des effectifs s’établit selon la typologie matricielle standardisée suivante : la cellule A dénombre les individus exposés présentant l’issue d’intérêt (les « vrais positifs » de l’exposition) ; la cellule B regroupe les individus exposés ne manifestant pas l’issue ; la cellule C comptabilise les individus non exposés (ou groupe témoin) manifestant l’issue ; enfin, la cellule D quantifie les individus non exposés exempts de l’issue d’intérêt. Les totaux marginaux en lignes s’expriment respectivement par $A + B$ pour l’ensemble des exposés et $C + D$ pour l’ensemble des non-exposés, tandis que les marges en colonnes correspondent à $A + C$ (total des événements observés) et $B + D$ (total des non-événements), le volume d’échantillonnage global étant noté $N = A + B + C + D$.
À partir de cette distribution cellulaire, la cote d’événement dans le groupe exposé s’écrit $\omega_1 = \frac{A / (A + B)}{B / (A + B)} = \frac{A}{B}$, tandis que la cote dans le groupe non exposé s’exprime par $\omega_0 = \frac{C / (C + D)}{D / (C + D)} = \frac{C}{D}$. En substituant ces expressions algébriques dans la formule princeps de l’odds ratio, les dénominateurs marginaux s’annulent élégamment pour donner lieu à la formule fondamentale dite du « rapport des produits croisés » :
$$\text{OR} = \frac{\frac{A}{B}}{\frac{C}{D}} = \frac{A \cdot D}{B \cdot C}$$
Cette simplification algébrique met en exergue le fait que la validité de l’estimation de l’OR repose sur les caractéristiques d’échantillonnage sous-jacentes. Selon que les marges du tableau sont considérées comme fixes à l’avance par le protocole expérimental (comme dans un essai randomisé où le chercheur fixe délibérément le nombre de sujets dans chaque groupe) ou qu’elles sont purement aléatoires et multinomiales (comme dans les enquêtes transversales en population générale), les hypothèses probabilistes conditionnant la dérivation de la variance asymptotique demeurent structurellement robustes, confirmant la suprématie opérationnelle de cette métrique.
2. Nécessité statistique de l’intervalle de confiance pour l’odds ratio
2.1 Insuffisance intrinsèque de l’estimation ponctuelle
L’estimation ponctuelle de l’odds ratio, obtenue par la simple résolution du produit croisé $\frac{A \cdot D}{B \cdot C}$, offre une photographie instantanée et séduisante de la relation observée au sein de l’échantillon à l’étude. Pourtant, considérer cette valeur comme l’expression définitive de la réalité populationnelle relève d’une illusion méthodologique périlleuse. En effet, tout échantillon empirique n’est qu’une réalisation singulière parmi une infinité d’échantillons potentiels susceptibles d’être extraits de la même population parente selon les lois du tirage aléatoire. Par conséquent, l’estimateur ponctuel est intrinsèquement assujetti à l’erreur d’échantillonnage, oscillant de manière imprévisible autour du paramètre populationnel inconnu, noté $\theta$.
Une valeur ponctuelle isolée ne fournit strictement aucun renseignement sur sa propre précision métrologique. Un chercheur observant un rapport de cotes de $2{,}50$ dans une étude exploratoire portant sur quarante participants pourrait être enclin à revendiquer un effet d’entraînement cognitif spectaculaire. Néanmoins, en l’absence d’information sur la dispersion de cet estimateur, il demeure rigoureusement impossible de déterminer si ce résultat reflète une relation stable ou s’il découle d’une simple fluctuation fortuite de l’échantillonnage. Dans les échantillons de taille restreinte, typiques de la neuropsychologie clinique ou de l’imagerie cérébrale fonctionnelle, la volatilité des effectifs cellulaires peut engendrer des surévaluations massives du paramètre d’intérêt, induisant des conclusions erronées si aucune démarche ensembliste ne vient contextualiser la mesure.
L’inférence statistique contemporaine, sous l’impulsion des réformes méthodologiques prônant l’abandon du réductionnisme décisionnel, exige impérativement que toute quantification d’un effet biologique ou comportemental soit assortie d’une mesure explicite de son incertitude. L’estimation par intervalle constitue l’incarnation opérationnelle de cette exigence. Elle substitue à l’illusion de certitude d’un nombre unique une plage continue de valeurs hautement plausibles, contraignant le clinicien et le chercheur à calibrer leur niveau d’adhésion aux conclusions tirées des données.
2.2 Quantification de l’incertitude liée à l’échantillonnage
L’intervalle de confiance pour un rapport de cotes matérialise l’ampleur de l’incertitude induite par le processus de recueil de données. Selon la définition fréquentiste standard formalisée par Jerzy Neyman, un intervalle de confiance à $95%$ signifie que si une même expérience psychologique était répliquée à l’infini selon un protocole expérimental strictement identique, et que pour chaque réplication un intervalle de confiance était calculé selon la même procédure algorithmique, exactement $95%$ de ces intervalles recouvriraient la véritable valeur du rapport de cotes populationnel $\theta$, tandis que $5%$ échoueraient à l’englober.
Il existe une relation mathématique inversement proportionnelle entre la taille globale de l’échantillon $N$ (ainsi que l’équilibre de sa répartition dans les cellules de contingence) et l’amplitude de l’intervalle de confiance. Plus la cohorte est volumineuse et les événements fréquents, plus l’erreur type s’amenuise, resserrant l’intervalle autour de l’estimateur ponctuel et garantissant une haute précision métrique. Inversement, face à des effectifs réduits ou des distributions très asymétriques — situations légion dans l’étude des pathologies mentales à faible prévalence —, l’intervalle s’évase considérablement. Cette dilatation visuelle met immédiatement en garde l’analyste contre le risque de surinterpréter un ratio numériquement élevé mais statistiquement volatil.
La prise en compte de la variabilité d’échantillonnage via l’intervalle de confiance préserve ainsi la communauté scientifique du travers du publication bias et des faux positifs. Elle permet de quantifier explicitement la marge d’aléa incompressible associée au protocole d’observation, fournissant une base probabiliste robuste pour juger de la reproductibilité ultérieure des découvertes neuropsychologiques.
2.3 Prise de décision clinique et rejet de l’hypothèse nulle
Au-delà de son rôle descriptif de la précision de la mesure, l’intervalle de confiance s’affirme comme un puissant instrument d’inférence hypothético-déductive. Dans le cadre du test de l’hypothèse nulle ($H_0$), le chercheur postule l’absence totale de divergence entre les cotes des deux groupes considérés, ce qui se traduit mathématiquement par l’égalité $\text{OR}_{H_0} = 1{,}0$. Dès lors, l’examen de l’inclusion ou de l’exclusion de cette valeur nulle unitaire au sein des limites de l’intervalle de confiance à $95%$ fournit un critère décisionnel univoque, directement homologue au test de significativité bilatéral au seuil $\alpha = 0{,}05$.
Si la valeur critique $1{,}0$ n’est pas contenue dans l’intervalle de confiance — par exemple, lorsque les bornes s’étendent de $1{,}35$ à $3{,}80$ —, l’analyste est fondé à rejeter l’hypothèse nulle au seuil de $5%$ et à conclure à l’existence d’une association statistiquement significative entre l’exposition et l’issue. En revanche, si l’intervalle chevauche la valeur unitaire — par exemple avec un intervalle s’étendant de $0{,}85$ à $2{,}40$ —, le maintien de l’hypothèse nulle s’impose, signifiant que les données observationnelles ne permettent pas d’écarter l’éventualité que l’effet observé découle du simple hasard d’échantillonnage.
Cependant, l’intervalle de confiance surpasse largement la simple valeur de $p$ (valeur p) en matière d’utilité clinique. Tandis que la valeur de p confond de manière inextricable la taille de l’effet et la taille de l’échantillon dans un indice de significativité binaire, l’intervalle de confiance préserve l’échelle substantive de la mesure. Il permet de distinguer immédiatement un résultat non significatif par manque cruel de puissance statistique (intervalle démesurément large, par exemple $[0{,}40 ; 8{,}50]$) d’un résultat confirmant avec précision l’absence d’effet cliniquement signifiant (intervalle extrêmement étroit centré sur l’unité, tel que $[0{,}96 ; 1{,}04]$). Cette dissociation fondamentale préserve le clinicien d’erreurs d’interprétation délétères pour la prise en charge des patients.
3. Propriétés distributionnelles et transformation logarithmique
3.1 Asymétrie prononcée de la distribution de l’odds ratio
L’obstacle mathématique prépondérant qui surgit lors de la modélisation de l’intervalle de confiance de l’odds ratio tient à la structure topologique et probabiliste hautement asymétrique de sa distribution d’échantillonnage sur l’échelle naturelle. Comme souligné précédemment, l’odds ratio est contraint par une borne inférieure absolue fixée à zéro, tandis que son plafond théorique s’étend vers l’infini positif ($[0, +\infty[$). La valeur nulle d’équivalence absolue se situe à $1{,}0$.
Cette configuration engendre une distorsion géométrique sévère : l’ensemble des effets réducteurs de risque ou protecteurs (où la cote est diminuée chez les exposés) se trouve comprimé dans un segment infinitésimal compris entre $0$ et $1$, tandis que l’ensemble des effets augmentant le risque ou facilitateurs (où la cote est accrue) s’éploie sans limite sur l’intervalle ouvert de $1$ à $+\infty$. Il en résulte que la distribution d’échantillonnage de l’odds ratio brut présente une asymétrie positive majeure (distribution étirée vers la droite avec une longue traîne), violant flagornerait les postulats de normalité requis pour l’application des méthodes paramétriques classiques basées sur la loi de Gauss.
Tenter de dériver un intervalle de confiance selon l’équation canonique de Wald appliquée sur l’échelle brute de l’odds ratio, à savoir $\text{OR} \pm z_{alpha/2} \cdot \text{SE}(\text{OR})$, conduirait à des aberrations théoriques et pratiques substantielles. Dans les configurations d’échantillons modestes, cette formulation linéaire symétrique peut fréquemment générer des bornes inférieures négatives, une impossibilité ontologique pour une métrique par nature strictement positive. En outre, le taux de couverture effectif d’un tel intervalle s’écarterait drastiquement du niveau nominal de $95%$, ruinant toute velléité d’inférence valide.
3.2 Normalité asymptotique du logarithme népérien du rapport de cotes
Pour s’affranchir de cette asymétrie handicapante, les statisticiens recourent à une transformation mathématique élégante : le passage à l’échelle logarithmique continue par le biais de la fonction logarithme népérien, donnant naissance au log odds ratio, noté $\ln(\text{OR})$ ou $\text{Logit}(\text{OR})$. L’effet régulateur de cette transformation est immédiat et profond : elle projette l’intervalle asymétrique $[0, +\infty[$ sur l’axe complet des réels $]-\infty, +\infty[$.
Sous cette transformation, la symétrie conceptuelle est intégralement restaurée. La valeur de référence d’absence d’effet $\text{OR} = 1{,}0$ devient $\ln(1{,}0) = 0$. Une réduction du risque divisant la cote par deux ($\text{OR} = 0{,}5$) donne une valeur logarithmique de $\ln(0{,}5) \approx -0{,}693$, tandis qu’une augmentation du risque doublant la cote ($\text{OR} = 2{,}0$) produit une valeur rigoureusement opposée et de magnitude identique, $\ln(2{,}0) \approx +0{,}693$. L’asymétrie structurelle entre effets protecteurs et multiplicateurs se dissipe totalement, chaque direction bénéficiant d’une pondération métrique équipollente de part et d’autre de zéro.
Sur le plan distributionnel, en vertu du théorème central limite conjugué aux propriétés de la méthode delta appliquée aux fonctions non linéaires d’estimateurs du maximum de vraisemblance, la variable aléatoire $\ln(\widehat{\text{OR}})$ converge très rapidement vers une loi normale asymptotique dès lors que les effectifs cellulaires atteignent des valeurs raisonnables :
$$\ln(\widehat{\text{OR}}) mathrel{\dot{\sim}} \mathcal{N}\left(\ln(\theta), , \sigma_{\ln(\text{OR})}^2\right)$$
Cette normalité asymptotique autorise désormais la construction d’un intervalle de confiance linéaire parfaitement symétrique sur l’échelle log-transformée, en s’appuyant sur les quantiles tabulés de la loi normale centrée réduite $\mathcal{N}(0, 1)$.
3.3 Principe de la transformation exponentielle inverse
Une fois l’intervalle de confiance calculé avec rigueur sur l’échelle logarithmique symétrique — sous la forme conventionnelle $[\ln(\text{OR})_{\text{\inf}} ; \ln(\text{OR})_{\text{\sup}}] = \ln(\widehat{\text{OR}}) \pm z \cdot \text{SE}(\ln(\widehat{\text{OR}}))$ —, ces valeurs demeurent difficilement interprétables pour le clinicien ou l’expérimentateur en raison de leur nature log-linéaire abstraite. Il est donc impératif de retranscrire ces bornes sur l’échelle naturelle de l’odds ratio afin de restituer la signification concrète de la taille d’effet.
Cette opération s’effectue par l’application de la fonction exponentielle inverse $e^x$ (ou $exp(x)$), qui constitue la bijection réciproque exacte du logarithme népérien. En appliquant l’exponentielle à chacune des deux extrémités logarithmiques, on obtient les bornes finales de l’intervalle de confiance du rapport de cotes :
$$\text{Borne}_{\text{Inf}} = \exp\left(\ln(\widehat{\text{OR}}) – z_{alpha/2} \cdot \text{SE}(\ln(\widehat{\text{OR}}))\right)$$
$$\text{Borne}_{\text{Sup}} = \exp\left(\ln(\widehat{\text{OR}}) + z_{alpha/2} \cdot \text{SE}(\ln(\widehat{\text{OR}}))\right)$$
En vertu de la stricte monotonie croissante de la fonction exponentielle, l’ordre des quantiles est rigoureusement préservé. Toutefois, le retour à l’échelle naturelle restitue l’asymétrie fondamentale de l’odds ratio : la distance séparant l’estimateur ponctuel $\widehat{\text{OR}}$ de sa borne supérieure est systématiquement plus grande que la distance qui le sépare de sa borne inférieure. Cet étalement asymétrique ne constitue en aucun cas un défaut de modélisation ; il représente l’expression mathématiquement exacte de l’incertitude sur une échelle multiplicative non linéaire bornée à zéro.
4. Formulation mathématique rigoureuse de l’intervalle de confiance
4.1 Erreur type asymptotique selon la méthode de Woolf
La formulation de l’erreur type asymptotique du logarithme du rapport de cotes a été formellement établie par le généticien et biostatisticien Barnet Woolf dans son article séminal publié en 1955. La méthode de Woolf, couramment désignée sous l’appellation d’approximation de Taylor ou méthode delta, permet d’extraire la variance asymptotique d’une fonction de variables aléatoires multinomiales ou poissoniennes.
Considérant que les effectifs de contingence $A$, $B$, $C$ et $D$ sont issus de processus stochastiques indépendants, et sachant que la variance de l’effectif d’un dénombrement est asymptotiquement égale à l’effectif lui-même, l’application d’un développement en série de Taylor du premier ordre à la fonction multivariée $g(A, B, C, D) = \ln\left(\frac{A \cdot D}{B \cdot C}\right) = \ln(A) + \ln(D) – \ln(B) – \ln(C)$ donne l’expression analytique suivante de la variance asymptotique :
$$\text{Var}(\ln(\widehat{\text{OR}})) \approx \left(\frac{\partial g}{\partial A}\right)^2 \text{Var}(A) + \left(\frac{\partial g}{\partial B}\right)^2 \text{Var}(B) + \left(\frac{\partial g}{\partial C}\right)^2 \text{Var}(C) + \left(\frac{\partial g}{\partial D}\right)^2 \text{Var}(D)$$
Puisque $\frac{\partial \ln(x)}{\partial x} = \frac{1}{x}$, et en substituant la variance d’échantillonnage de chaque cellule par sa propre fréquence observée, la formule se simplifie de manière spectaculaire :
$$\text{Var}(\ln(\widehat{\text{OR}})) \approx \left(\frac{1}{A}\right)^2 A + \left(-\frac{1}{B}\right)^2 B + \left(-\frac{1}{C}\right)^2 C + \left(\frac{1}{D}\right)^2 D = \frac{1}{A} + \frac{1}{B} + \frac{1}{C} + \frac{1}{D}$$
L’erreur type (Standard Error, SE) de Woolf pour le logarithme népérien du rapport de cotes est tout simplement la racine carrée de cette variance d’échantillonnage :
$$\text{SE}(\ln(\widehat{\text{OR}})) = \sqrt{\frac{1}{A} + \frac{1}{B} + \frac{1}{C} + \frac{1}{D}}$$
Cette équation révèle avec une éclatante clarté la dépendance directe de la précision de la mesure envers la taille de chaque cellule du tableau $2 \times 2$. L’erreur type est régie par la somme des inverses des effectifs : par conséquent, il suffit qu’une seule cellule contienne un effectif extrêmement faible pour que son inverse devienne démesuré, augmentant considérablement l’erreur type globale et élargissant drastiquement l’intervalle de confiance final.
4.2 Détermination du coefficient critique standardisé z
La largeur de l’intervalle de confiance sur l’échelle logarithmique dépend directement du niveau de confiance souhaité, conventionnellement formalisé par l’expression $100(1 – \alpha)%$, où $\alpha$ représente le risque d’erreur de première espèce (probabilité de rejeter à tort l’hypothèse nulle d’inclusion du paramètre). Dans la quasi-totalité des publications biomédicales et psychologiques, le seuil nominal est fixé à $\alpha = 0{,}05$, correspondant à un degré de confiance de $95%$.
La normalité asymptotique de $\ln(\widehat{\text{OR}})$ autorise l’extraction du coefficient d’élargissement critique, noté $z_{alpha/2}$ ou simplement $z$, directement à partir de la fonction de répartition de la loi normale standardisée $\mathcal{N}(0, 1)$. Ce coefficient correspond à la valeur d’abscisse qui délimite une surface bilatérale d’exclusion égale à $\alpha$ (soit une aire de $alpha/2 = 0{,}025$ sous chaque queue de distribution). Pour un intervalle de confiance à $95%$, l’évaluation numérique standard donne :
$$\Phi(z_{0{,}025}) = 1 – 0{,}025 = 0{,}975 implies z_{0{,}025} \approx 1{,}95996 \approx 1{,}96$$
Selon les exigences épistémiques de la recherche ou la nature exploratoire versus confirmatoire de l’étude, d’autres coefficients critiques peuvent être adoptés. Ainsi, pour un intervalle de confiance à $90%$ ($\alpha = 0{,}10$), plus permissif mais plus resserré, la valeur critique est fixée à $z = 1{,}645$. À l’opposé, pour un intervalle de confiance hautement conservateur à $99%$ ($\alpha = 0{,}01$), conçu pour circonscrire le risque de faux positifs dans les études génétiques d’association pan-génomique ou les essais cliniques de phase III, le quantile s’élève à $z = 2{,}576$.
4.3 Formules analytiques des bornes inférieure et supérieure
L’intégration formelle des composantes mathématiques développées ci-dessus permet d’établir les expressions analytiques définitives de l’intervalle de confiance pour l’odds ratio selon l’algorithme de Woolf. En intégrant simultanément la transformation logarithmique, la pondération par l’erreur type et le retour à l’échelle naturelle par exponentiation, la formulation ensembliste complète s’exprime comme suit :
$$\text{IC}_{1-\alpha}(\text{OR}) = \left[ , \exp\left( \ln\left(\frac{A \cdot D}{B \cdot C}\right) – z_{alpha/2} \sqrt{\frac{1}{A} + \frac{1}{B} + \frac{1}{C} + \frac{1}{D}} \right) ; ; ; \exp\left( \ln\left(\frac{A \cdot D}{B \cdot C}\right) + z_{alpha/2} \sqrt{\frac{1}{A} + \frac{1}{B} + \frac{1}{C} + \frac{1}{D}} \right) , \right]$$
Ces deux équations garantissent la génération de bornes strictement positives, éliminant tout risque d’incohérence métrologique. On observe avec intérêt que cette formulation peut être réécrite sous une forme multiplicative élégante :
$$\text{Facteur d’erreur (EF)} = \exp\left( z_{alpha/2} \cdot \text{SE}(\ln(\widehat{\text{OR}})) \right)$$
$$\text{Borne}_{\text{Inf}} = \frac{\widehat{\text{OR}}}{\text{EF}} \quad \text{et} \quad \text{Borne}_{\text{Sup}} = \widehat{\text{OR}} \cdot \text{EF}$$
Cette présentation factorielle confirme la structure géométrique et multiplicative de l’intervalle : sur l’échelle de l’odds ratio, la marge d’erreur ne s’additionne ni ne se soustrait pas à l’estimateur ponctuel, mais agit comme un coefficient multiplicateur et diviseur symétrique, matérialisant parfaitement la courbure de l’espace des cotes.
5. Protocole algorithmique étape par étape pour le calcul manuel
5.1 Étape 1 : Structuration des données dans la table de contingence
La première phase de la séquence calculatoire consiste à préparer rigoureusement les données brutes afin de prévenir toute inversion catégorielle susceptible de dénaturer le sens du rapport de cotes. Le chercheur doit clairement identifier la variable d’exposition (variable indépendante) et la variable de réponse (variable dépendante ou issue clinique).
Il est impératif d’assigner les observations selon une logique binaire irréprochable :
- Cellule A : Sujets exposés au facteur de risque ou recevant le traitement expérimental ET manifestant l’événement clinique ciblé (succès ou trouble présent).
- Cellule B : Sujets exposés au facteur de risque ou recevant le traitement expérimental MAIS ne manifestant pas l’événement (absence du trouble).
- Cellule C : Sujets non exposés (groupe témoin ou traitement standard) ET manifestant l’événement clinique ciblé.
- Cellule D : Sujets non exposés (groupe témoin ou traitement standard) MAIS ne manifestant pas l’événement.
Un contrôle systématique des sommes marginales doit être exécuté : $A + B$ doit correspondre rigoureusement à l’effectif total du groupe exposé, $C + D$ au total du groupe de contrôle, et la somme globale $A + B + C + D$ doit égaler l’échantillon nominal de l’étude. Tout double comptage ou exclusion inexpliquée invalide d’emblée la procédure d’inférence.
5.2 Étape 2 : Calcul de l’OR ponctuel et transformation logarithmique
Une fois les effectifs distribués sans ambiguïté au sein de la matrice, l’estimateur ponctuel de l’odds ratio est obtenu en appliquant la formule des produits croisés. Il convient de calculer le produit du numérateur $(A \cdot D)$ et le produit du dénominateur $(B \cdot C)$, puis de procéder à leur division arithmétique :
$$\widehat{\text{OR}} = \frac{A \cdot D}{B \cdot C}$$
Dès l’obtention de cette valeur décimale, l’analyste applique la fonction logarithme népérien (notée $ln$ sur les calculateurs scientifiques ou $log$ dans la plupart des bibliothèques algorithmiques). Il est hautement recommandé à cette étape de conserver une précision numérique d’au moins quatre à six décimales significatives. Un arrondi prématuré de la valeur de $\ln(\widehat{\text{OR}})$ introduirait une erreur d’approximation non négligeable lors de la phase finale d’exponentiation, biaisant substantiellement l’emplacement exact des bornes sur l’échelle naturelle.
5.3 Étape 3 : Calcul de l’erreur type et des marges logarithmiques
La troisième étape requiert le calcul séquentiel de la variance asymptotique selon le théorème de Woolf. Le calcul manuel s’opère par la décomposition arithmétique suivante :
- Calculer l’inverse de l’effectif de chaque cellule : $\frac{1}{A}$, $\frac{1}{B}$, $\frac{1}{C}$, et $\frac{1}{D}$.
- Sommer ces quatre fractions décimales pour dériver la variance : $\text{Var}(\ln(\widehat{\text{OR}})) = \frac{1}{A} + \frac{1}{B} + \frac{1}{C} + \frac{1}{D}$.
- Extraire la racine carrée de cette somme pour obtenir l’erreur type : $\text{SE}(\ln(\widehat{\text{OR}})) = \sqrt{\text{Var}(\ln(\widehat{\text{OR}}))}$.
Une fois l’erreur type isolée, la marge d’erreur logarithmique ($M$) est calculée en multipliant l’erreur type par la constante critique $z$ sélectionnée (soit $1{,}96$ pour un intervalle à $95%$) : $M = 1{,}96 \cdot \text{SE}(\ln(\widehat{\text{OR}}))$. Ensuite, cette marge est successivement soustraite et ajoutée au logarithme de l’odds ratio pour définir les limites de l’intervalle sur l’axe log-linéaire :
$$\text{Limite Log Inférieure} = \ln(\widehat{\text{OR}}) – M$$
$$\text{Limite Log Supérieure} = \ln(\widehat{\text{OR}}) + M$$
5.4 Étape 4 : Exponentiation finale des bornes
La dernière étape algorithmique consiste à reconvertir l’intervalle logarithmique dans l’échelle d’origine de la mesure. Pour cela, la base naturelle $e \approx 2{,}71828$ est élevée à la puissance de chacune des deux bornes log-linéaires calculées précédemment :
$$\text{Borne}_{\text{Inf}} = e^{\text{Limite Log Inférieure}}$$
$$\text{Borne}_{\text{Sup}} = e^{\text{Limite Log Supérieure}}$$
Le résultat final doit impérativement être consigné selon la convention académique universelle, en arrondissant les valeurs finales à deux ou trois décimales : $\text{OR} = X{,}XX , [IC , 95% : Y{,}YY ; Z{,}ZZ]$. La borne inférieure doit obligatoirement être inférieure à l’estimateur ponctuel, et ce dernier strictement inférieur à la borne supérieure, respectant la relation d’ordre $0 < \text{Borne}_{\text{Inf}} le \widehat{\text{OR}} le \text{Borne}_{\text{Sup}}$.
6. Application empirique détaillée dans un cadre psychologique
6.1 Contexte de l’étude : Évaluation d’un programme d’entraînement cognitif
Afin d’illustrer la mise en œuvre empirique de ce protocole, considérons une étude quasi-expérimentale menée en neuropsychologie du vieillissement. Une équipe de chercheurs évalue l’impact d’un programme novateur d’entraînement informatisé de la mémoire de travail (désigné « Programme Cible ») comparativement à un entraînement cognitif non spécifique traditionnel (désigné « Programme Standard ») chez des personnes âgées de 65 à 80 ans présentant un trouble neurocognitif léger.
L’issue de l’étude est dichotomique : la réussite ou l’échec à un test psychométrique standardisé de transfert d’apprentissage (une épreuve de raisonnement fluide) administré à l’issue de huit semaines de prise en charge. Cent participants ont été randomisés de manière équilibrée : cinquante sujets dans le groupe expérimental (« Programme Cible ») et cinquante sujets dans le groupe témoin actif (« Programme Standard »). La variable d’exposition correspond au type de programme suivi, et la variable réponse est la performance finale classée en « Réussite » ou « Échec » au test seuil.
6.2 Extraction des fréquences et calculs intermédiaires complets
Le recueil des données à l’issue du protocole expérimental permet de renseigner la table de contingence $2 \times 2$ avec les effectifs cellulaires observés suivants :
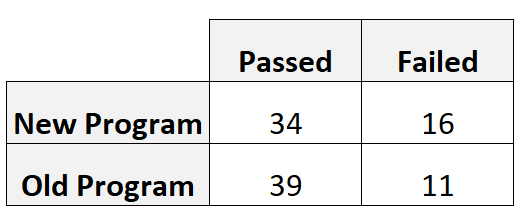
- Groupe Nouveau Programme : 34 succès (Cellule A = 34), 16 échecs (Cellule B = 16) sur un total de 50 sujets.
- Groupe Ancien Programme : 39 succès (Cellule C = 39), 11 échecs (Cellule D = 11) sur un total de 50 sujets.
Procédons scrupuleusement au déroulement séquentiel des calculs algébriques :
Calcul de l’odds ratio ponctuel par le rapport des produits croisés :
$$\widehat{\text{OR}} = \frac{A \cdot D}{B \cdot C} = \frac{34 \cdot 11}{16 \cdot 39} = \frac{374}{624} \approx 0{,}59935897$$
Ce résultat ponctuel indique que la cote de succès chez les participants soumis au nouveau programme est environ $40%$ inférieure à celle observée chez les participants ayant suivi le programme standard ($1 – 0{,}5994 = 0{,}4006$).
Transformation logarithmique de l’estimateur ponctuel :
$$\ln(\widehat{\text{OR}}) = \ln(0{,}59935897) \approx -0{,}5118944$$
Calcul de la variance asymptotique de Woolf par la sommation des inverses des cellules :
$$\frac{1}{A} = \frac{1}{34} \approx 0{,}02941176$$
$$\frac{1}{B} = \frac{1}{16} = 0{,}06250000$$
$$\frac{1}{C} = \frac{1}{39} \approx 0{,}02564103$$
$$\frac{1}{D} = \frac{1}{11} \approx 0{,}09090909$$
$$\text{Var}(\ln(\widehat{\text{OR}})) = 0{,}02941176 + 0{,}06250000 + 0{,}02564103 + 0{,}09090909 = 0{,}20846188$$
6.3 Résolution des bornes et déduction de l’intervalle
L’extraction de la racine carrée de la variance d’échantillonnage permet d’isoler l’erreur type de l’estimateur transformé :
$$\text{SE}(\ln(\widehat{\text{OR}})) = \sqrt{0{,}20846188} \approx 0{,}45657626$$
Pour un degré de confiance à $95%$, la constante critique de la loi normale est $z = 1{,}96$. La marge d’erreur logarithmique $M$ s’établit ainsi à :
$$M = 1{,}96 \cdot 0{,}45657626 \approx 0{,}89488947$$
Détermination des bornes sur l’axe log-linéaire :
$$\text{Limite Log Inférieure} = -0{,}5118944 – 0{,}89488947 = -1{,}40678387$$
$$\text{Limite Log Supérieure} = -0{,}5118944 + 0{,}89488947 = +0{,}38299507$$
Reconversion finale sur l’échelle naturelle des rapports de cotes par exponentiation :
$$\text{Borne}_{\text{Inf}} = \exp(-1{,}40678387) \approx 0{,}244929 \approx 0{,}245$$
$$\text{Borne}_{\text{Sup}} = \exp(0{,}38299507) \approx 1{,}466671 \approx 1{,}467$$
L’estimation par intervalle s’énonce donc rigoureusement ainsi : $\text{OR} = 0{,}60$ avec un $\text{IC } 95% ; [0{,}25 ; 1{,}47]$.
6.4 Analyse critique des résultats de l’exemple
L’examen approfondi des résultats obtenus apporte des éclairages méthodologiques cruciaux pour les chercheurs en neurosciences comportementales. Si l’on s’était borné à une lecture naïve de l’estimateur ponctuel ($\text{OR} \approx 0{,}60$), on aurait pu conclure hâtivement à la nette infériorité du programme cognitif expérimental par rapport au programme usuel.
Néanmoins, l’intervalle de confiance calculé englobe sans ambiguïté la valeur critique d’équivalence $1{,}0$ (son empan s’étendant de $0{,}25$ à $1{,}47$). Cette constatation entraîne une conséquence statistique majeure : l’effet mesuré n’est pas statistiquement significatif au seuil bilatéral de $5%$ ($p > 0{,}05$). L’équipe de recherche est donc dans l’incapacité formelle de rejeter l’hypothèse nulle d’égalité des performances cognitives entre les deux conditions d’entraînement.
De surcroît, l’amplitude remarquable de l’intervalle — la borne supérieure ($1{,}47$) étant près de six fois supérieure à la borne inférieure ($0{,}25$) — témoigne d’un manque manifeste de précision métrologique. Les données expérimentales recueillies s’avèrent compatibles à la fois avec une réduction drastique de $75%$ des cotes de succès sous le nouveau programme et avec une potentielle augmentation de $47%$ de ces mêmes cotes. Cette grande incertitude statistique démontre sans équivoque que la cohorte initiale ($N = 100$) possédait une puissance statistique insuffisante pour statuer définitivement sur l’efficacité comparée des protocoles, incitant à la reconduction de l’essai sur un échantillon plus vaste.
7. Interprétation substantive des bornes de l’intervalle de confiance
7.1 La position de la valeur nulle 1.0 comme repère critique
L’interprétation clinique et comportementale des bornes d’un intervalle de confiance s’articule autour de la position relative de l’intervalle par rapport au seuil critique $\text{OR} = 1{,}0$. Ce chiffre représente la ligne de démarcation absolue entre l’effet protecteur, l’invariance et l’effet délétère (ou facilitateur selon la polarité de l’événement codé).
Trois configurations topologiques exhaustives se présentent au statisticien :
- L’intervalle est strictement supérieur à 1,0 ($\text{Borne}_{\text{Inf}} > 1{,}0$) : L’association statistique est positive et significative au seuil $\alpha$ choisi. Dans une étude portant sur les facteurs de vulnérabilité, l’exposition majore incontestablement les chances de développer le trouble psychopathologique considéré.
- L’intervalle est strictement inférieur à 1,0 ($\text{Borne}_{\text{Sup}} < 1{,}0$) : L’association statistique est négative et significative. L’exposition diminue de façon statistiquement fiable la survenue de l’événement ; il s’agit typiquement de l’effet protecteur conféré par une intervention psychothérapeutique ou un traitement pharmacologique.
- L’intervalle chevauche la valeur 1,0 ($\text{Borne}_{\text{Inf}} le 1{,}0 le \text{Borne}_{\text{Sup}}$) : L’hypothèse nulle d’indépendance statistique ne peut être écartée. Les observations empiriques ne permettent pas d’affirmer que le statut d’exposition modifie d’une quelconque manière la survenue de l’issue clinique.
7.2 Évaluation de la précision métrique par la largeur de l’intervalle
La simple significativité statistique (l’exclusion du chiffre $1{,}0$) ne renseigne en rien sur la valeur informative de la mesure. Pour apprécier la qualité métrologique d’un résultat, le chercheur doit examiner avec acuité la largeur de l’intervalle de confiance. Sur l’échelle multiplicative du rapport de cotes, la dispersion relative d’un intervalle ne s’évalue pas par la simple soustraction arithmétique des bornes, mais par le ratio d’amplitude géométrique :
$$\text{Ratio d’Amplitude} = \frac{\text{Borne}_{\text{Sup}}}{\text{Borne}_{\text{Inf}}}$$
Un ratio d’amplitude proche de l’unité traduit une remarquable stabilité de l’estimation. À l’inverse, un ratio substantiellement élevé (par exemple supérieur à $4$ ou $5$) dénonce un flou statistique majeur, révélateur d’un échantillon exigu ou d’un déséquilibre quantitatif marqué au sein des cellules de la table de contingence. Dans ce cadre, il convient de réaffirmer un précepte fondamental de l’épistémologie des sciences comportementales : « l’absence de preuve ne constitue pas la preuve de l’absence ». Un intervalle s’étendant de $0{,}92$ à $4{,}80$ ne démontre aucunement l’inutilité d’une thérapie, mais illustre uniquement l’incapacité méthodologique de l’étude à trancher en raison de sa sous-puissance d’échantillonnage.
7.3 Traduction pratique des bornes inférieure et supérieure
L’un des apports majeurs de l’approche par intervalle de confiance réside dans sa propension à faciliter la communication des résultats de la recherche médicale et psychologique auprès des décideurs de santé publique et des praticiens cliniciens. Au lieu de focaliser le discours sur l’estimation ponctuelle — qui a une probabilité asymptotique nulle d’être exactement égale au véritable paramètre populationnel —, les bornes de l’intervalle permettent de délimiter le scénario le plus pessimiste et le scénario le plus optimiste compatibles avec les données collectées.
Considérons une méta-analyse démontrant qu’une thérapie cognitivo-comportementale informatisée réduit les rechutes dépressives avec un $\text{OR} = 0{,}65$ et un $\text{IC } 95% ; [0{,}45 ; 0{,}94]$. L’interprétation clinique ne doit pas se cantonner à énoncer une diminution moyenne de $35%$ des cotes de rechute. Le praticien éclairé traduira ce résultat en expliquant que, compte tenu des incertitudes d’échantillonnage, le bénéfice thérapeutique réel peut aller, dans l’hypothèse la plus favorable étayée par la littérature, jusqu’à une division par plus de deux de la cote de rechute ($\text{OR} = 0{,}45$, soit une réduction de $55%$), tout en garantissant, dans le scénario le plus modeste compatible avec les données d’évaluation, une réduction minimale d’au moins $6%$ ($\text{OR} = 0{,}94$). Cette formulation contextualisée ancre la pratique clinique dans une gestion réaliste du risque et de l’incertitude.
8. Traitement des cellules à effectif nul : La correction de Haldane-Anscombe
8.1 Le problème de la singularité mathématique et division par zéro
Une pathologie calculatoire récurrente surgit dans l’analyse de tableaux de contingence $2 \times 2$ lorsqu’au moins l’une des quatre cellules matricielles présente un effectif d’observation nul ($n_{ij} = 0$). Cette configuration n’a rien d’exceptionnelle en psychopathologie expérimentale ou en épidémiologie psychiatrique, où l’on étudie fréquemment des manifestations comportementales à prévalence extrêmement basse (telles que le passage à l’acte homicide chez des adolescents ou les suicides complétés dans des cohortes fermées sous psychotropes).
L’occurrence d’un zéro cellulaire déclenche une singularité mathématique dévastatrice pour les algorithmes classiques de Woolf :
- Si la cellule $B$ ou la cellule $C$ est nulle, le dénominateur de l’odds ratio $(B \cdot C)$ s’annule, projetant la valeur ponctuelle $\widehat{\text{OR}}$ vers un infini mathématique inexploitable.
- Si la cellule $A$ ou la cellule $D$ est nulle, le numérateur $(A \cdot D)$ s’annule, aboutissant à un $\widehat{\text{OR}} = 0$, suggérant de façon fallacieuse une protection absolue ou l’extinction totale de la cote.
- Sur le plan de l’inférence, la formule de Woolf pour la variance asymptotique s’effondre irrémédiablement en tentant d’exécuter une division par zéro lors du calcul du terme $\frac{1}{0}$, rendant l’erreur type $\text{SE}(\ln(\widehat{\text{OR}}))$ strictement indéfinie.
8.2 Mécanisme formel de la correction de Haldane-Anscombe
Pour surmonter cette rupture algorithmique sans recourir à l’éviction préjudiciable des variables concernées, les biostatisticiens J.B.S. Haldane (1956) et Francis Anscombe (1956) ont développé une technique de lissage bayésien devenue canonique : la correction de Haldane-Anscombe. Cette méthode consiste à incorporer une constante de pseudocomptage égale à $0{,}5$ à chacune des quatre cellules du tableau de contingence préalablement au calcul de l’odds ratio et de son erreur type.
Les effectifs cellulaires corrigés sont alors redéfinis formellement par :
$$A’ = A + 0{,}5, \quad B’ = B + 0{,}5, \quad C’ = C + 0{,}5, \quad D’ = D + 0{,}5$$
L’odds ratio corrigé s’exprime dès lors par l’équation régularisée :
$$\widehat{\text{OR}}_{\text{HA}} = \frac{(A + 0{,}5)(D + 0{,}5)}{(B + 0{,}5)(C + 0{,}5)}$$
L’erreur type du logarithme de cet odds ratio corrigé s’obtient en transposant la formule de Woolf aux nouvelles valeurs incrémentées :
$$\text{SE}(\ln(\widehat{\text{OR}}_{\text{HA}})) = \sqrt{\frac{1}{A + 0{,}5} + \frac{1}{B + 0{,}5} + \frac{1}{C + 0{,}5} + \frac{1}{D + 0{,}5}}$$
L’apport d’Anscombe a été de démontrer mathématiquement que l’adjonction de la valeur fixe de $0{,}5$ ne constitue pas un artifice numérique arbitraire, mais minimise le biais d’échantillonnage d’ordre $O(N^{-1})$ inhérent à l’estimation logarithmique, rapprochant de façon optimale l’espérance de $\ln(\widehat{\text{OR}}_{\text{HA}})$ de la véritable valeur populationnelle $\ln(\theta)$.
8.3 Conséquences sur l’estimation ponctuelle et l’intervalle
La correction de Haldane-Anscombe rétablit immédiatement la calculabilité de l’intervalle de confiance, dissipant l’indétermination liée aux zéros divisionnaires. Toutefois, son application n’est pas sans impact sur la morphologie des résultats et requiert une interprétation prudente de la part du chercheur.
L’ajout systématique de $0{,}5$ exerce un effet de régularisation conservatrice (effet de shrinkage) : il atténue l’ampleur absolue des effets extrêmes, ramenant légèrement l’odds ratio estimé vers la valeur d’indifférence $1{,}0$. De plus, comme l’une des cellules incrémentées possède un effectif virtuel de $0{,}5$, l’évaluation de son inverse produit un terme massif $\frac{1}{0{,}5} = 2{,}0$, qui vient gonfler considérablement la variance globale. Il en résulte un élargissement marqué de l’intervalle de confiance final, traduisant fidèlement l’extrême incertitude induite par la présence d’un effectif nul.
Il est capital de souligner que la correction de Haldane-Anscombe est optimale lorsque le zéro cellulaire résulte de la rareté de l’événement dans un échantillon de taille globale modérée à grande. Lorsque l’ensemble du tableau souffre d’un sous-échantillonnage drastique (par exemple $N < 20$), cette correction asymptotique perd de sa fiabilité et doit céder le pas aux méthodes exactes basées sur des distributions discrètes.
9. Méthodes alternatives pour petits échantillons et distributions asymétriques
9.1 L’intervalle de confiance exact basé sur la distribution hypergéométrique
Lorsque les effectifs cellulaires observés s’avèrent particulièrement modestes — violant la règle empirique exigeant que chaque cellule d’une table $2 \times 2$ compte au moins cinq individus pour valider l’approximation normale de Woolf —, le recours aux méthodes asymptotiques induit un taux d’erreur de première espèce non contrôlé. Dans cette situation, la référence méthodologique absolue repose sur l’intervalle de confiance exact, formalisé par Ronald Fisher dans le cadre de son test exact d’indépendance.
La théorie de l’inférence exacte repose sur le conditionnement par les marges observées du tableau de contingence : les totaux marginaux $A+B$, $C+D$, $A+C$ et $B+D$ sont considérés comme des constantes fixées d’avance. Sous cette hypothèse conditionnelle, la distribution d’échantillonnage de l’effectif de la cellule $A$ suit rigoureusement une loi hypergéométrique non centrale dépendante du seul paramètre de rapport de cotes $\theta$. La dérivation de l’intervalle de confiance exact (méthode de Baptista-Pike ou de Thomas-Gart) consiste à inverser mathématiquement le test exact de Fisher :
$$\sum_{k=A}^{\min(A+B, A+C)} P(X = k mid \theta_{\text{\inf}}) = \frac{\alpha}{2} \quad \text{et} \quad \sum_{k=0}^{A} P(X = k mid \theta_{\text{\sup}}) = \frac{\alpha}{2}$$
L’intervalle de confiance exact garantit de façon inconditionnelle un taux de couverture au moins égal au niveau nominal spécifié (par exemple $ge 95%$), éliminant toute distorsion d’approximation. En contrepartie, en raison de la nature discrète de la distribution hypergéométrique, cet intervalle présente un caractère intrinsèquement conservateur : sa couverture effective est fréquemment de $96%$ ou $97%$, générant des bornes plus larges que ce qui serait strictement requis sous continuité.
9.2 L’intervalle basé sur le profil de vraisemblance
Une alternative paramétrique particulièrement robuste entre l’approximation fruste de Wald-Woolf et le conservatisme de l’intervalle de Fisher réside dans la construction de l’intervalle de confiance basé sur le profil de vraisemblance (Profile Likelihood Confidence Interval). Cette démarche découle directement de la théorie du rapport de vraisemblance (Likelihood Ratio Test) développée en modélisation statistique avancée.
Au lieu de postuler arbitrairement la courbure parabolique et symétrique de la log-vraisemblance au sommet de l’estimateur — postulat implicite sous-tendant la méthode de Woolf —, l’approche par profil de vraisemblance cartographie la véritable forme de la fonction de log-vraisemblance $L(\theta)$ en faisant varier le paramètre d’intérêt tout en maximisant les paramètres de nuisance. Les bornes de l’intervalle à $95%$ correspondent aux valeurs extrêmes du paramètre $\theta$ pour lesquelles la déviance par rapport au maximum absolu ne dépasse pas le quantile critique d’un khi-deux à un degré de liberté :
$$2 \cdot \left[ \ln L(\widehat{\theta}) – \ln L(\theta) \right] le \chi_{1 ; 1-\alpha}^2 = (1{,}96)^2 \approx 3{,}841$$
Bien que son calcul exige une résolution algorithmique par itérations numériques successives (telle que l’optimisation de Newton-Raphson), l’intervalle par profil de vraisemblance affiche des propriétés d’invariance remarquables sous reparamétrisation et surclasse très nettement la méthode de Woolf en termes de précision lorsque les effectifs marginaux sont fortement déséquilibrés.
9.3 Approches non paramétriques par rééchantillonnage Bootstrap
Lorsque les données empiriques proviennent d’échantillonnages complexes impliquant des pondérations d’enquête, une stratification non standard ou des distributions fortement altérées par des valeurs atypiques, les approches computationnelles de rééchantillonnage Bootstrap constituent une solution d’une remarquable puissance.
Le principe fondamental du bootstrap repose sur la génération d’un grand nombre (généralement $B ge 2,000$ à $10,000$) de pseudo-échantillons tirés de manière aléatoire avec remise à partir de la matrice d’observations initiale. Pour chaque pseudo-échantillon généré, un rapport de cotes est recalculé, créant une distribution empirique de plusieurs milliers de réalisations stochastiques du paramètre. La dérivation de l’intervalle de confiance peut alors s’effectuer selon deux modalités principales :
- La méthode des percentiles bootstrap : Les bornes inférieure et supérieure correspondent directement aux quantiles empiriques $(alpha/2)$ et $(1 – alpha/2)$ de la distribution rééchantillonnée (soit le $2{,}5^{\text{e}}$ centile et le $97{,}5^{\text{e}}$ centile pour un IC à $95%$).
- La méthode BCa (Bias-Corrected and Accelerated) : Variante sophistiquée qui ajuste mathématiquement les centiles sélectionnés pour corriger à la fois le biais médian de l’estimateur et le coefficient d’asymétrie de la distribution d’échantillonnage, fournissant un intervalle d’une très haute précision asymptotique d’ordre $O(N^{-1})$.
10. Calcul computationnel de l’intervalle de confiance via les logiciels statistiques
10.1 Implémentation sous le langage R
L’environnement statistique de programmation open-source R s’impose comme la référence méthodologique internationale pour le traitement automatisé des tables de contingence et l’estimation des intervalles de confiance de l’odds ratio. Plusieurs packages dédiés permettent d’exécuter ces procédures avec une flexibilité totale.
Le package spécialisé epitools intègre la fonction canonique oddsratio(), capable de calculer nativement les intervalles selon la méthode de Woolf, la correction de Haldane ou la méthode exacte de Fisher. La syntaxe opérationnelle s’organise ainsi :
install.packages("epitools")

library(epitools)

matrice <- matrix(c(34, 16, 39, 11), nrow = 2, byrow = TRUE)

oddsratio(matrice, method = "wald") # Calcul selon Woolf

oddsratio(matrice, method = "fisher") # Calcul exact conditionnel
Par ailleurs, dans le cadre fondamental de la modélisation log-linéaire généralisée, l’extraction de l’odds ratio s’opère via la fonction native glm() en spécifiant une famille binomiale avec fonction de lien logit. L’interrogation de l’objet de régression à l’aide de la commande confint() génère directement les intervalles de confiance basés sur le profil de vraisemblance, que l’on convertit sur l’échelle naturelle par simple exponentiation :
modele <- glm(issue ~ groupe, family = binomial(link = "logit"), data = donnees)

exp(cbind(OR = coef(modele), confint(modele)))
10.2 Procédure dans le logiciel SPSS
Au sein des laboratoires de psychologie clinique et des institutions hospitalières, le logiciel IBM SPSS Statistics demeure largement exploité. L’obtention d’un intervalle de confiance pour un rapport de cotes s’y effectue via la procédure des Tableaux croisés de contingence.
Le protocole de navigation logicielle requiert la séquence suivante :
- Accéder au menu supérieur déroulant : Analyser > Statistiques descriptives > Tableaux croisés…
- Assigner la variable indépendante (exposition ou groupe thérapeutique) dans le champ Lignes, et la variable dépendante (issue clinique binaire) dans le champ Colonnes.
- Cliquer sur l’onglet latéral Statistiques, cocher impérativement la case Risque, puis valider en cliquant sur Poursuivre et OK.
Dans la fenêtre d’affichage des résultats, SPSS génère un tableau intitulé « Estimation du risque » (Risk Estimate). L’odds ratio se lit sur la première ligne, intitulée « Rapport de cotes pour [Variable] (1 / 2) ». Les colonnes adjacentes affichent immédiatement les bornes inférieure et supérieure de l’intervalle de confiance à $95%$. Il est toutefois impératif de contrôler minutieusement l’ordre de codage des modalités au sein des variables : SPSS modélise par défaut la probabilité de la modalité la plus élevée, ce qui peut inverser l’orientation substantielle du rapport si les catégories n’ont pas été préalablement calibrées.
10.3 Automatisation avec Python (scipy et statsmodels)
L’essor de la science des données et de l’intelligence artificielle appliquée à la psychiatrie a positionné le langage de programmation Python au premier plan de l’analyse biomédicale. Les bibliothèques scientifiques scipy et statsmodels proposent des modules d’une haute précision algorithmique.
Le sous-module scipy.stats.contingency propose la fonction odds_ratio, qui prend en argument une matrice matricielle $2 \times 2$ et permet d’extraire instantanément tant l’estimation ponctuelle que les bornes exactes ou asymptotiques :
import numpy as np

from scipy.stats.contingency import odds_ratio

table = np.array([[34, 16], [39, 11]])

res = odds_ratio(table)

ic = res.confidence_interval(confidence_level=0.95)

print(f"OR: {res.statistic:.4f}, IC 95%: [{ic.low:.4f}, {ic.high:.4f}]")
Pour des architectures d’analyse plus complexes intégrant des variables d’ajustement, l’API de modélisation statsmodels.formula.api permet d’exécuter une régression logistique via logit(). L’exponentiation des coefficients estimés et de leur matrice de variance-covariance permet de restituer avec élégance l’ensemble des rapports de cotes ajustés et leurs intervalles associés au sein d’un pipeline d’analyse reproductible.
11. Extension multivariée : Intervalles de confiance pour l’odds ratio ajusté
11.1 Transition du tableau bivarié à la régression logistique multivariée
Bien que l’analyse des tables de contingence $2 \times 2$ offre une clarté didactique indéniable, la recherche contemporaine en sciences psychologiques peut rarement se cantonner à une approche bivariée naïve. Les comportements humains et les pathologies mentales sont intrinsèquement polyfactoriels, façonnés par une myriade d’influences intriquées : âge, sexe biologique, statut socio-économique, comorbidités psychiatriques ou traits de personnalité sous-jacents.
Dès lors qu’une variable tierce entretient une association simultanée avec le facteur d’exposition et l’issue observée, elle constitue un facteur de confusion susceptible de biaiser l’estimation brute du rapport de cotes, allant parfois jusqu’à induire un paradoxe de Simpson où le sens de l’effet s’inverse. La neutralisation de ces biais exige la transition du tableau de contingence simple vers le modèle multivarié de régression logistique binaire, outil d’ajustement prééminent de l’épidémiologie moderne.
Dans un modèle de régression logistique multivarié, la relation mathématique liant la probabilité conditionnelle de survenue de l’événement $P(Y=1 mid X)$ aux multiples prédicteurs s’exprime par l’équation du lien logit :
$$\text{logit}(P) = \ln\left(\frac{P}{1 – P}\right) = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + dots + \beta_k X_k$$
Sous cette formulation log-linéaire, le coefficient partiel de régression $\beta_j$ associé à une variable dichotomique $X_j$ correspond rigoureusement au logarithme de l’odds ratio ajusté, toutes les autres variables du modèle étant maintenues strictement constantes. Par conséquent, l’odds ratio ajusté (noté $\text{aOR}$) s’obtient par l’exponentiation directe de son coefficient partiel : $\text{aOR}_j = \exp(\beta_j)$.
11.2 Calcul de l’intervalle de confiance du paramètre bêta
L’estimation des paramètres $\beta$ d’une régression logistique ne relève pas de la méthode des moindres carrés ordinaires, mais s’effectue par maximisation de la fonction de log-vraisemblance par le biais d’algorithmes itératifs d’optimisation numérique (tels que la méthode de Newton-Raphson ou l’algorithme de score de Fisher). La précision asymptotique de ces coefficients est dictée par la matrice d’information de Fisher observée, dont l’inversion fournit la matrice de variance-covariance des estimateurs.
L’erreur type du coefficient, notée $\text{SE}(\beta_j)$, s’extrait directement de l’élément diagonal correspondant au prédicteur $X_j$ au sein de cette matrice inversée. En vertu de la théorie du grand échantillon du maximum de vraisemblance, l’estimateur $\widehat{\beta}_j$ suit asymptotiquement une loi normale centrée sur le véritable paramètre populationnel $\beta_j$.
La construction de l’intervalle de confiance symétrique de Wald à $95%$ sur l’échelle du paramètre de régression $\beta$ s’établit dès lors selon l’équation classique :
$$\text{IC}_{95%}(\beta_j) = \left[ , \widehat{\beta}_j – 1{,}96 \cdot \text{SE}(\widehat{\beta}_j) ; ; ; \widehat{\beta}_j + 1{,}96 \cdot \text{SE}(\widehat{\beta}_j) , \right]$$
Pour transposer cet intervalle de régression sur l’échelle naturelle de l’odds ratio ajusté, il suffit, tout comme dans la méthode de Woolf, d’appliquer la transformation exponentielle inverse aux deux bornes linéaires calculées :
$$\text{Borne}_{\text{Inf}}(\text{aOR}_j) = \exp\left( \widehat{\beta}_j – 1{,}96 \cdot \text{SE}(\widehat{\beta}_j) \right)$$
$$\text{Borne}_{\text{Sup}}(\text{aOR}_j) = \exp\left( \widehat{\beta}_j + 1{,}96 \cdot \text{SE}(\widehat{\beta}_j) \right)$$
11.3 Interprétation de l’intervalle de confiance ajusté
L’intervalle de confiance d’un odds ratio ajusté délivre une information étiologique supérieure à celle issue d’une table bivariée brute. Il circonscrit la magnitude plausible de l’effet net ou indépendant de l’intervention psychologique ou du facteur environnemental, une fois purgé de l’influence parasite des covariables introduites dans l’équation de régression.
La confrontation analytique de l’intervalle brut et de l’intervalle ajusté constitue un puissant outil de diagnostic méthodologique. Si l’introduction d’un ajustement déplace substantiellement la position de l’intervalle vers l’unité, le clinicien conclut à l’existence d’un biais de confusion majeur dans l’association initiale. De surcroît, le statisticien doit surveiller avec rigueur l’impact de la multicolinéarité : si les prédicteurs introduits dans le modèle logistique présentent de fortes intercorrélations mutuelles, la variance gonfle (Variance Inflation Factor), induisant une explosion artificielle de l’erreur type $\text{SE}(\beta_j)$ et une dilatation aberrante de l’intervalle de confiance ajusté.
12. Bonnes pratiques de publication scientifique et erreurs méthodologiques fréquentes
12.1 Conformité aux normes de reporting APA et ICMJE
La restitution académique des intervalles de confiance dans les revues internationales à comité de lecture est assujettie à des normes de standardisation typographique et méthodologique strictes, formulées notamment par l’American Psychological Association (manuel de publication de l’APA, 7e édition) et le Comité international des éditeurs de revues médicales (ICMJE).
Le manuel de l’APA proscrit formellement la publication isolée d’un odds ratio non assorti de son intervalle d’incertitude. Le formatage textuel standardisé doit obéir à une stylisation rigoureuse : l’abréviation de la statistique s’inscrit en italique, suivie de la valeur arrondie à deux décimales, de la spécification explicite du niveau de couverture nominal, puis de l’énumération des bornes délimitées par des crochets :
Exemple de formulation APA 7 : « L’analyse multivariée démontre une majoration statistiquement significative des cotes de rémission sous thérapie intégrative, OR = 2,42, IC 95 % [1,28 ; 4,58], p = ,007. »
L’APA insiste lourdement sur la complémentarité impérative entre la valeur de p et l’intervalle de confiance. L’intervalle de confiance ne doit pas être perçu comme un simple substitut au test de rejet de $H_0$, mais bien comme le véhicule primordial de la communication de la taille d’effet et de son exactitude métrique.
12.2 Confusion récurrente entre rapport de cotes et risque relatif
L’une des dérives interprétatives les plus pernicieuses et les plus répandues dans la littérature comportementale et médicale consiste à assimiler de façon abusive l’odds ratio à un risque relatif (RR). Trop souvent, des auteurs concluent qu’un $\text{OR} = 3{,}0$ signifie que les sujets exposés ont « trois fois plus de risques » de développer le trouble psychique, ce qui constitue une distorsion conceptuelle majeure.
L’odds ratio n’approxime convenablement le risque relatif que sous l’égide de l’hypothèse de la maladie rare (Rare Disease Assumption), formulée initialement par Cornfield. Cette approximation n’est valide que lorsque la prévalence de l’événement au sein de la population cible est inférieure à $10%$ (idéalement $p < 0{,}05$). Dès lors que l’issue clinique devient fréquente (par exemple un taux d’amélioration cognitive s’élevant à $40%$ ou $50%$), l’odds ratio s’éloigne drastiquement du risque relatif :
- Lorsque l’effet est facilitateur ($\text{OR} > 1$), l’odds ratio surestime considérablement l’ampleur du risque relatif, exagérant visuellement l’efficacité apparente d’un traitement.
- Lorsque l’effet est protecteur ($\text{OR} < 1$), l’odds ratio sous-estime la proportion résiduelle, exagérant symétriquement la puissance de protection.
Pour convertir de façon rigoureuse un odds ratio en risque relatif au sein d’une étude prospective où l’incidence initiale $P_0$ dans le groupe de référence est connue, il convient d’appliquer la correction de Zhang et Yu (1998) :
$$\text{RR} = \frac{\text{OR}}{(1 – P_0) + (P_0 \cdot \text{OR})}$$
Cette correction permet de recalculer des bornes d’intervalle transposées, garantissant une communication exempte de toute surévaluation sensationnaliste de l’impact thérapeutique auprès des professionnels de santé.
12.3 Erreurs techniques d’asymétrie et arrondis précoces
Sur le plan du calcul technique, plusieurs bévues méthodologiques continuent de polluer les manuscrits soumis aux revues de psychologie. La première faute, d’une gravité théorique absolue, réside dans la tentative d’appliquer la marge d’erreur de manière additive et symétrique directement sur l’échelle de l’odds ratio brut ($\text{OR} \pm 1{,}96 \cdot \text{SE}$). Cette erreur anéantit le postulat de distribution log-normale et conduit inéluctablement à des bornes dénuées de sens probabiliste.
Une seconde erreur, plus insidieuse mais particulièrement délétère, concerne l’introduction d’arrondis numériques prématurés au cours des phases de calcul intermédiaire. Arrondir le logarithme népérien de l’odds ratio à une ou deux décimales seulement (par exemple écrire $-0{,}51$ au lieu de $-0{,}511894$) introduit un glissement qui, une fois soumis à la fonction exponentielle exponentiellement amplificatrice, modifie substantiellement la troisième ou la deuxième décimale des bornes finales. La rigueur académique exige d’exécuter l’intégralité de la chaîne algorithmique en double précision flottante au sein des scripts, en ne réservant le formatage à deux décimales qu’à l’ultime étape d’édition textuelle.
Enfin, les erreurs de transposition au sein de la matrice $2 \times 2$ — intervertir par inadvertance les lignes ou les colonnes — transforment un effet protecteur majeur ($\text{OR} = 0{,}20$) en son inverse algébrique ($\text{OR} = 5{,}00$). Le chercheur doit impérativement instaurer des procédures de double saisie et vérifier la cohérence directionnelle de ses calculs préalablement à toute dissémination scientifique.
12.4 Checklist d’assurance qualité avant soumission d’un article de recherche
Afin de prémunir les auteurs contre les écueils de révision par les pairs et d’élever les standards de reproductibilité des découvertes scientifiques, le protocole suivant formalise une grille d’audit qualité à renseigner avant toute soumission éditoriale :
- Vérification matricielle exhaustive : L’orientation des lignes (exposition) et des colonnes (issues) est-elle explicitement définie dans le corps du manuscrit ou dans les notes de tableau ? Les totaux marginaux correspondent-ils scrupuleusement au flux d’échantillonnage de l’étude ?
- Diagnostic des zéros cellulaires : Existe-t-il au moins une cellule de contingence affichant un effectif nul ? Si oui, la correction de Haldane-Anscombe ($+0{,}5$) ou un calcul d’intervalle exact (test de Fisher / méthode du profil de vraisemblance) a-t-il été rigoureusement mobilisé et explicité dans la section méthodologique ?
- Contrôle de conformité de l’asymétrie : La borne inférieure de l’intervalle de confiance calculé est-elle strictement positive ($> 0$) ? La relation d’ordre $\text{Borne}_{\text{Inf}} < \widehat{\text{OR}} < \text{Borne}_{\text{Sup}}$ est-elle scrupuleusement respectée ? La distance de l’OR à la borne supérieure est-elle bien supérieure à la distance le séparant de la borne inférieure ?
- Plausibilité épidémiologique et sémantique : Si l’événement étudié affiche une prévalence observée excédant $10%$, les auteurs ont-ils proscrit l’usage abusif des termes « risque », « fois plus de risques » ou « probabilité accrue » lors de la discussion des bornes de l’odds ratio ?
- Intégrité du reporting APA : Chaque rapport de cotes ponctuel est-il systématiquement accompagné de son intervalle de confiance à $95%$ et de sa valeur de p exacte (à trois décimales, sans mention réductrice de type $p < \text{NS}$) ? Les effectifs bruts ayant servi au calcul sont-ils fournis pour garantir une méta-analyse ultérieure ?
En observant scrupuleusement ces directives méthodologiques, les chercheurs et praticiens en sciences du comportement consolident la rigueur épistémique de leurs inférences, participent activement à la résolution de la crise de reproductibilité des résultats expérimentaux et fournissent à la communauté clinique des données métrologiques d’une solidité irréprochable.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1956). On estimating binomial response relations. Biometrika, 43(3/4), 461–464. https://doi.org/10.2307/2332926
- Cornfield, J. (1951). A method of estimating comparative rates from clinical data; applications to cancer of the lung, breast, and cervix. Journal of the National Cancer Institute, 11(6), 1269–1275. https://pubmed.ncbi.nlm.nih.gov/14861651/
- Fisher, R. A. (1935). The logic of inductive inference. Journal of the Royal Statistical Society, 98(1), 39–82. https://doi.org/10.2307/2342435
- Haldane, J. B. S. (1956). The estimation and significance of the logarithm of a ratio of frequencies. Annals of Human Genetics, 20(4), 309–311. https://doi.org/10.1111/j.1469-1809.1955.tb01285.x
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern epidemiology (3rd ed.). Lippincott Williams & Wilkins.
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x
- Zhang, J., & Yu, K. F. (1998). What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA, 280(19), 1690–1691. https://doi.org/10.1001/jama.280.19.1690