
Au sein des sciences quantitatives contemporaines, et plus particulièrement en psychologie empirique, le choix d’un dispositif analytique ne constitue jamais un acte purement mécanique ou neutre. L’analyse de variance (ANOVA) et la régression linéaire multiple représentent sans conteste les deux piliers historiques sur lesquels repose l’inférence statistique comportementale. Bien que ces deux méthodologies partagent une structure algébrique identique au sein du Modèle Linéaire Général (GLM), les traditions de recherche les ont longtemps maintenues dans des silos conceptuels distincts, érigeant une frontière artificielle entre la démarche expérimentale pure et l’approche corrélationnelle ou observationnelle.
Cette polarisation historique a forgé des représentations épistémologiques profondément ancrées chez les chercheurs et praticiens : d’un côté, une analyse de variance perçue comme la méthode par excellence pour établir des causalités au sein d’essais randomisés en laboratoire ; de l’autre, des modèles de régression mobilisés pour quantifier des associations multivariées, pondérer des gradients prédictifs ou traiter des séries écologiques complexes. Or, les erreurs d’aiguillage méthodologique demeurent fréquentes : dichotomisation arbitraire de variables continues pour se conformer aux réquisits apparents d’un plan factoriel, interprétation erronée des coefficients d’ajustement ou incompréhension des décompositions de sommes de carrés face à des plans non orthogonaux.
Cet article propose une déconstruction exhaustive, comparative et rigoureuse de l’ANOVA et de la régression linéaire. À travers une trajectoire articulée autour de leurs racines historiques, de leur convergence mathématique fondamentale, du traitement des variables prédictives et dépendantes, ainsi que des écueils méthodologiques majeurs observés dans la littérature psychométrique, nous clarifierons les conditions exactes de leur déploiement opérationnel. L’objectif ultime est d’offrir une boussole analytique unifiée, permettant d’optimiser la puissance statistique des protocoles de recherche tout en garantissant une fidélité d’interprétation irréprochable face aux exigences de reproductibilité scientifique.
1. Introduction conceptuelle et historique : ANOVA et régression en psychologie
1.1 Évolution historique des approches expérimentales et corrélationnelles
L’histoire de la psychologie scientifique et des méthodes quantitatives est intimement liée à deux figures emblématiques de la statistique moderne dont les travaux ont cristallisé deux épistémologies distinctes. D’une part, Sir Ronald Aylmer Fisher formalise, au début des années 1920 dans le cadre de la station agronomique de Rothamsted, les bases théoriques de l’analyse de variance. Fisher cherchait alors à déterminer avec précision si des variations systématiques appliquées à des parcelles agricoles (engrais, irrigation) provoquaient des différences de rendement supérieures aux fluctuations aléatoires inhérentes au sol. Cette logique d’intervention active, de manipulation factorielle contrôlée et de randomisation stricte a été immédiatement adoptée par la psychologie expérimentale naissante, trouvant un écho direct dans les travaux béhavioristes puis cognitivistes visant à isoler l’effet causal de stimuli sur le comportement humain.
D’autre part, Sir Francis Galton, à la fin du XIXe siècle, cherchait à comprendre les mécanismes de l’hérédité des traits biologiques et psychologiques humains. Constatant que la descendance d’individus exceptionnellement grands ou petits tendait à se rapprocher de la moyenne de la population, il théorise la « régression vers la médiocrité », concept qui sera ultérieurement formalisé mathématiquement par Karl Pearson sous la forme du coefficient de corrélation produit-moment et de la régression linéaire. Cette tradition s’ancra dans la psychologie différentielle, soucieuse de mesurer la covariation naturelle entre aptitudes intellectuelles, traits de personnalité et performances scolaires sans intervention manipulatoire préalable.
Cette dichotomie donna lieu à ce que Lee Cronbach a célèbrement désigné en 1957 comme « les deux disciplines de la psychologie scientifique » : l’expérimentale et la corrélationnelle. Les expérimentalistes s’appropriaient l’ANOVA pour rejeter l’hypothèse nulle d’égalité des moyennes de traitement, reléguant la variance interindividuelle au rang de simple « bruit d’erreur ». Les corrélationnistes, à l’inverse, utilisaient la régression pour modéliser précisément cette variance interindividuelle comme leur objet premier d’investigation. Ce n’est qu’à partir du dernier quart du XXe siècle, sous l’impulsion de méthodologistes comme Jacob Cohen, que la psychologie a progressivement amorcé une réunification de ces approches, reconnaissant que cette scission reposait moins sur une incompatibilité mathématique que sur des habitudes coutumières de laboratoire.
1.2 Définitions fondamentales et objectifs analytiques distincts
D’un point de vue conceptuel élémentaire, l’ANOVA est une procédure de décision statistique conçue pour tester l’égalité simultanée de moyennes de deux ou plusieurs populations indépendantes ou appariées. Sa question centrale s’énonce ainsi : les écarts observés entre les moyennes d’échantillons classés selon un ou plusieurs facteurs discrets sont-ils attribuables à l’effet réel de ces facteurs ou à de simples fluctuations d’échantillonnage ? La statistique de décision, le rapport $F$ de Fisher, compare la variabilité systématique intergroupes à la variabilité aléatoire intragroupe. L’ANOVA se structure donc prioritairement comme un test d’hypothèse globale (omnibus), souvent suivi de tests post-hoc ou de contrastes planifiés afin d’identifier les paires ou configurations de moyennes statistiquement divergentes.
À l’opposé, la régression linéaire multiple s’articule autour d’une logique fonctionnelle et prédictive. Son objectif analytique n’est pas simplement de déterminer si des groupes diffèrent, mais d’estimer les paramètres d’une équation linéaire reliant une variable dépendante continue à un ensemble de prédicteurs (qu’ils soient continus, binaires ou polynomiaux). La régression cherche à quantifier le taux de variation marginal du critère pour chaque unité incrémentale d’un prédicteur donné, tout en maintenant constants les autres prédicteurs du modèle. Elle offre une décomposition explicite de la droite (ou de l’hyperplan) de régression par le biais de l’ordonnée à l’origine (constante ou intercept) et de coefficients de pente directionnels.
Il en résulte une divergence fondamentale dans les questions de recherche adressées : l’expérimentateur recourant à l’ANOVA interroge l’existence de ruptures de seuil ou de différences qualitatives provoquées par des conditions distinctes (« Le traitement cognitivo-comportemental produit-il une baisse moyenne d’anxiété supérieure au traitement pharmacologique et au placebo ? »). Le chercheur employant la régression s’intéresse à la continuité dynamique des processus (« Dans quelle mesure l’intensité de l’alliance thérapeutique et le nombre d’heures d’exposition prédisent-ils continûment la réduction du score d’anxiété ? »). La causalité, loin d’être inhérente à l’algorithme de calcul, découle exclusivement de la présence ou de l’absence de manipulation expérimentale et de randomisation.
1.3 Pertinence contemporaine dans la recherche psychologique
Dans l’écosystème contemporain des sciences du comportement, l’emploi de l’ANOVA demeure prédominant au sein des essais cliniques randomisés (ECR), des protocoles en neurosciences cognitives (tels que les paradigmes d’IRM fonctionnelle et d’électroencéphalographie impliquant des conditions de stimulation factorielles) et de la psychologie sociale expérimentale. La force d’attraction de l’ANOVA dans ces domaines réside dans sa lisibilité immédiate : les résultats se communiquent aisément sous la forme de graphiques en barres ou de profils de moyennes, immédiatement interprétables pour évaluer l’efficacité différentielle d’un protocole clinique ou d’une manipulation comportementale.
Inversement, l’explosion des études longitudinales, des collectes de données par évaluation écologique momentanée (EMA via smartphone), de la génétique comportementale et des grandes bases de données épidémiologiques a fait de la régression linéaire — et de ses extensions multiniveaux — l’outil privilégié de la psychologie moderne. Lorsque les participants ne peuvent être assignés au hasard à des conditions expérimentales (comme dans l’étude des traumatismes infantiles, du vieillissement neurocognitif ou du statut socioéconomique), la régression permet d’isoler statistiquement des effets propres en intégrant une multiplicité de facteurs de confusion potentiels sans recourir à des découpages arbitraires d’échantillons.
Face à la crise de la reproductibilité scientifique qui a profondément ébranlé la psychologie, la rigueur dans le choix et l’exécution de ces méthodes est devenue un enjeu épistémologique de premier plan. L’arbitrage aveugle entre ANOVA et régression, dicté par la seule conformité aux usages de sous-disciplines plutôt que par la structure réelle des données psychométriques, constitue l’un des vecteurs identifiés de distorsions méthodologiques. Comprendre l’architecture intime de ces deux outils s’avère indispensable pour tout chercheur soucieux d’extraire des inférences valides, réplicables et cliniquement signifiantes.
2. Fondements mathématiques communs : Le Modèle Linéaire Général (GLM)
2.1 Équivalence algébrique sous-jacente
L’un des apports majeurs de la statistique computationnelle au cours des cinq dernières décennies a été de démontrer de manière irréfutable que l’ANOVA ne constitue pas une entité mathématique autonome, mais bien un cas particulier, strictement restreint, de la régression linéaire multiple. Cette synthèse conceptuelle s’opère au sein du cadre unifié du Modèle Linéaire Général (GLM). Sous sa formulation matricielle standard, le modèle s’exprime par l’équation canonique :
$$Y = X\beta + \varepsilon$$
Dans cette expression fondamentale, $Y$ représente le vecteur colonne de dimension $(n \times 1)$ des observations de la variable dépendante quantitative continue ; $X$ est la matrice de dessein (ou design matrix) de dimensions $(n \times p)$, contenant les valeurs des prédicteurs continus ou les vecteurs d’indicatrices catégorielles associées aux différents groupes expérimentaux ; $\beta$ est le vecteur de dimension $(p \times 1)$ des paramètres inconnus de population (l’ordonnée à l’origine et les coefficients de régression ou contrastes) ; et $varepsilon$ désigne le vecteur $(n \times 1)$ des erreurs résiduelles aléatoires, supposées indépendantes et identiquement distribuées selon une loi normale centrée d’écart-type constant $\sigma$.
Quelle que soit l’appellation attribuée au logiciel statistique utilisé, la décomposition de la dispersion observée repose sur la partition invariante de la somme totale des carrés des écarts ($SS_{Total}$) en deux composantes mutuellement exclusives et exhaustives :
$$SS_{Total} = SS_{Modgrave{e}le} + SS_{Racute{e}sidus}$$
Dans l’ANOVA factorielle traditionnelle, ces quantités sont qualifiées de somme des carrés intergroupes ($SS_{Inter}$) et somme des carrés intragroupes ou erreur ($SS_{Intra}$). Dans la régression, elles sont respectivement nommées somme des carrés de la régression ($SS_{Reg}$) et somme des carrés résiduelle ($SS_{Res}$). L’équivalence formelle entre la statistique omnibus $F$ de l’ANOVA et le coefficient de détermination multivarié $R^2$ de la régression multiple se vérifie algébriquement par l’identité mathématique stricte :
$$F = \frac{\frac{R^2}{k}}{\frac{1 – R^2}{N – k – 1}} = \frac{\frac{SS_{Modgrave{e}le}}{df_{Modgrave{e}le}}}{\frac{SS_{Racute{e}sidus}}{df_{Racute{e}sidus}}}$$
où $k$ représente le nombre de paramètres de prédiction (ou le nombre de groupes moins un dans une ANOVA à un facteur) et $N$ l’effectif d’échantillon total. L’ANOVA teste donc rigoureusement l’hypothèse nulle selon laquelle le $R^2$ de la matrice de dessein catégorielle est nul dans la population parente.
2.2 Paramétrisation et estimation des moindres carrés
L’estimation des paramètres du GLM repose universellement sur la méthode des moindres carrés ordinaires (OLS – Ordinary Least Squares), dont le principe mathématique consiste à trouver le vecteur d’estimation $\hat{\beta}$ qui minimise la somme des carrés des écarts entre les valeurs observées $Y$ et les valeurs ajustées par le modèle $\hat{Y} = X\hat{\beta}$. La solution analytique directe s’obtient par l’équation normale bien connue :
$$\hat{\beta} = (X^T X)^{-1} X^T Y$$
La divergence d’apparence entre l’ANOVA et la régression provient exclusivement de la configuration interne de la matrice de dessein $X$. Dans l’approche classique de l’ANOVA, dite modèle des moyennes de cellules, l’équation s’écrit traditionnellement :
$$Y_{ij} = \mu_i + \varepsilon_{ij}$$
ou, sous la forme d’un modèle avec grand-moyenne :
$$Y_{ij} = \mu + \alpha_i + \varepsilon_{ij}$$
où $\mu$ représente la moyenne générale non pondérée et $\alpha_i$ l’effet spécifique du niveau expérimental $i$, avec la contrainte d’identification habituelle $\sum \alpha_i = 0$. Dans la régression linéaire, la paramétrisation intègre formellement une colonne de uns pour modéliser la constante (l’intercept), suivie de colonnes encodant les variables sous forme métrique ou par indicatrices binaires.
Les degrés de liberté alloués au numérateur et au dénominateur du test $F$ sont rigoureusement identiques dans les deux approches : le numérateur consomme autant de degrés de liberté qu’il y a de colonnes indépendantes ajoutées à la matrice pour représenter l’effet ($k – 1$ pour un facteur à $k$ modalités), tandis que le dénominateur dispose de $N – p$ degrés de liberté pour estimer la variance résiduelle $\sigma^2$. En outre, la sensibilité mathématique aux observations atypiques s’avère absolument équivalente. Une observation extrême au sein d’une cellule d’une ANOVA exerce un levier mathématique (leverage) et un résidu standardisé dont l’impact géométrique sur l’estimation de la moyenne de cellule est formellement indistinguable de la distance de Cook ou de l’indice DFBETAS calculés sur un prédicteur dichotomique en régression.
2.3 Implications pratiques de l’unification GLM
La reconnaissance de cette identité algébrique profonde détient des conséquences opératoires fondamentales pour la recherche en psychologie. En premier lieu, elle garantit qu’un même jeu de données analysé via une routine d’ANOVA factorielle ou via une procédure de régression multiple paramétrée adéquatement produira des valeurs de $F$, des degrés de liberté, des sommes de carrés, des valeurs $p$ et des résidus rigoureusement identiques au dix-millième près. L’opposition stylistique entre les deux méthodes n’est donc pas d’ordre calculatoire, mais procède d’un découpage ergonomique hérité de l’ère pré-informatique.
En second lieu, les logiciels de pointe contemporains (tels que R avec les fonctions lm() et aov(), ou la commande PROC GLM de SAS) exécutent ces calculs via exactement les mêmes algorithmes d’inversion matricielle (généralement basés sur la décomposition QR ou la décomposition en valeurs singulières SVD). La dualité logicielle s’efface ainsi au profit d’une interface utilisateur différenciée. Les sorties de régression privilégient la restitution des paramètres de pente individuels ($b_i$, erreurs-types associées et tests $t$ univariés), tandis que les tables d’ANOVA concentrent l’affichage sur les blocs factoriels globaux (tests $F$ omnibus multivariés).
Enfin, cette unification conceptuelle constitue le prérequis méthodologique indispensable pour appréhender les extensions analytiques supérieures. Comprendre que l’ANOVA est une régression permet au chercheur de s’affranchir des limitations rigides des plans factoriels standards et d’évoluer sans heurts vers les modèles linéaires mixtes (LMM), la modélisation hiérarchique (HLM) ou la régression régularisée (Lasso, Ridge), où prédicteurs continus et catégoriels s’articulent harmonieusement sans heurter les postulats du modèle mathématique sous-jacent.
3. La nature des variables prédictives : Discrètes vs Continues
3.1 Variables catégorielles et classification dans l’ANOVA
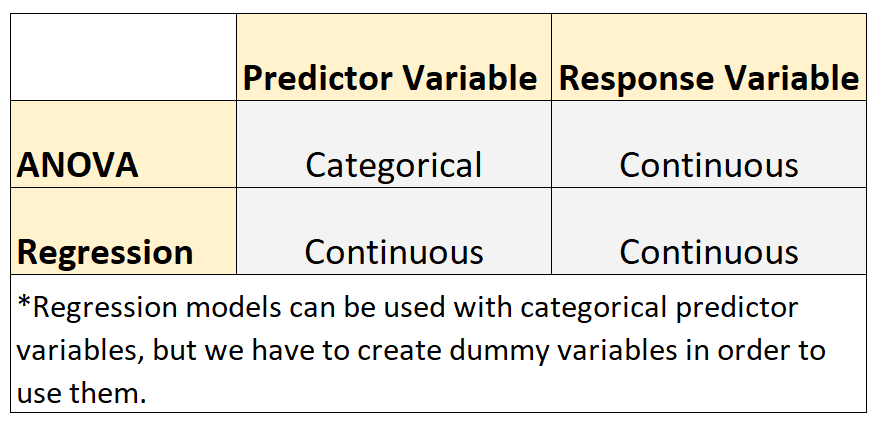
L’analyse de variance impose, par sa constitution opératoire même, que l’ensemble des variables prédictives indépendantes (facteurs) soient de nature strictement catégorielle, mesurées sur des échelles nominales ou ordinales à effectifs finis. Dans les plans expérimentaux de psychologie, ces variables correspondent classiquement à des modalités de traitement manipulées (par exemple : thérapie d’acceptation et d’engagement vs thérapie cognitive basée sur la pleine conscience vs liste d’attente), à des statuts diagnostiques établis selon des critères nosographiques fermés (schizophrénie, trouble bipolaire, témoins neurotypiques), ou à des caractéristiques sociodémographiques structurellement discrètes (secteur d’habitation, branche professionnelle, cohortes scolaires fixes).
Cette obligation structurelle de manipuler des catégories discrètes génère une contrainte méthodologique majeure : elle exige que le chercheur conçoive la réalité psychologique sous la forme de compartiments étanches. L’hypothèse sous-jacente d’une ANOVA à un facteur est que l’ensemble des participants assignés à une même cellule expérimentale partagent la même espérance mathématique pour le critère dépendant, la variance intra-groupe n’étant considérée que comme un résidu stochastique homogène. Lorsque le phénomène étudié présente effectivement une nature taxinomique ou catégorielle authentique (comme l’administration d’une molécule pharmacologique active versus un placebo inerte), ce cadre s’ajuste parfaitement aux prémisses théoriques.
Néanmoins, l’application rigide de ce formalisme à des construits psychologiques intrinsèquement fluides pose de sérieux problèmes d’adéquation conceptuelle. Dès lors qu’un chercheur stratifie artificiellement une population en groupes disjoints pour pouvoir appliquer une ANOVA (par exemple, segmenter un échantillon clinique en trois niveaux d’anxiété : faible, modérée, sévère à partir d’un inventaire auto-rapporté), il introduit une partition qui masque l’hétérogénéité interne de chaque segment tout en exagérant la discontinuité existant entre les individus situés de part et d’autre de la frontière de coupure arbitraire.
3.2 Variables prédictives continues dans la régression
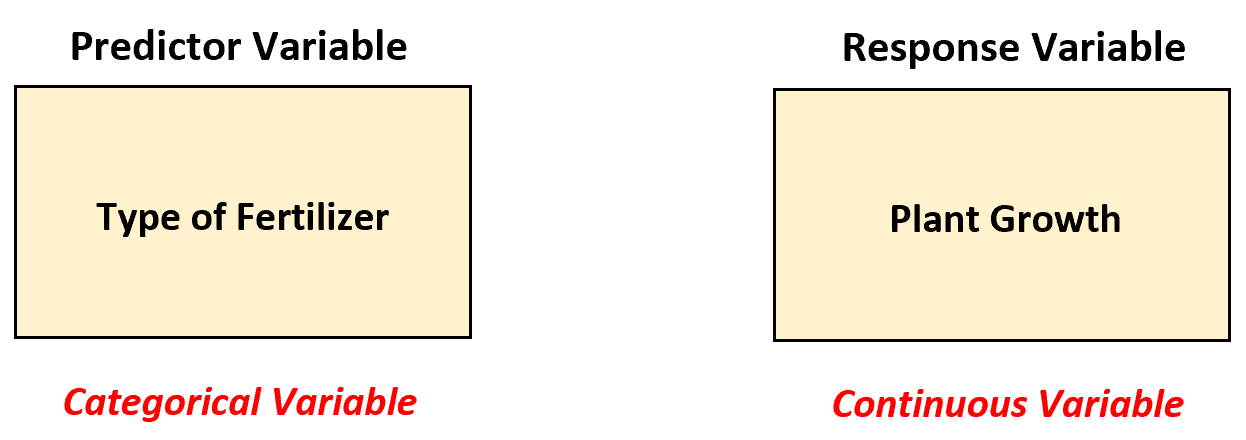
À l’opposé de la segmentation propre à l’ANOVA, la régression linéaire multiple brille par sa capacité intrinsèque à manipuler des variables prédictives métriques continues, mesurées sur des échelles d’intervalles ou de rapports. Dans la pratique psychométrique, cela recouvre un spectre immense de construits : scores composites issus de batteries psychologiques standardisées (comme le QI mesuré par l’échelle de Wechsler, les scores de dépression du BDI-II, les dimensions du Big Five), mesures psychophysiologiques (temps de réaction en millisecondes, conductance cutanée, puissance spectrale électroencéphalographique) ou encore variables sociologiques continues (âge chronologique précis, revenu annuel net, nombre d’années de scolarisation formelle).
Le recours à des prédicteurs continus au sein de la régression préserve la granularité originale de l’information et respecte la distribution empirique naturelle du construit. Plutôt que de postuler des sauts qualitatifs discrets, le modèle estime un taux de variation fonctionnel : le coefficient de régression linéaire non standardisé ($b_1$) exprime la modification quantitative moyenne observée sur la variable critère lorsque le prédicteur s’accroît d’une unité métrique, l’ensemble des autres termes étant maintenus constants. Cela autorise la capture fine de gradients de vulnérabilité, de cinétiques de réponse symptomatique ou de trajectoires d’apprentissage progressives.
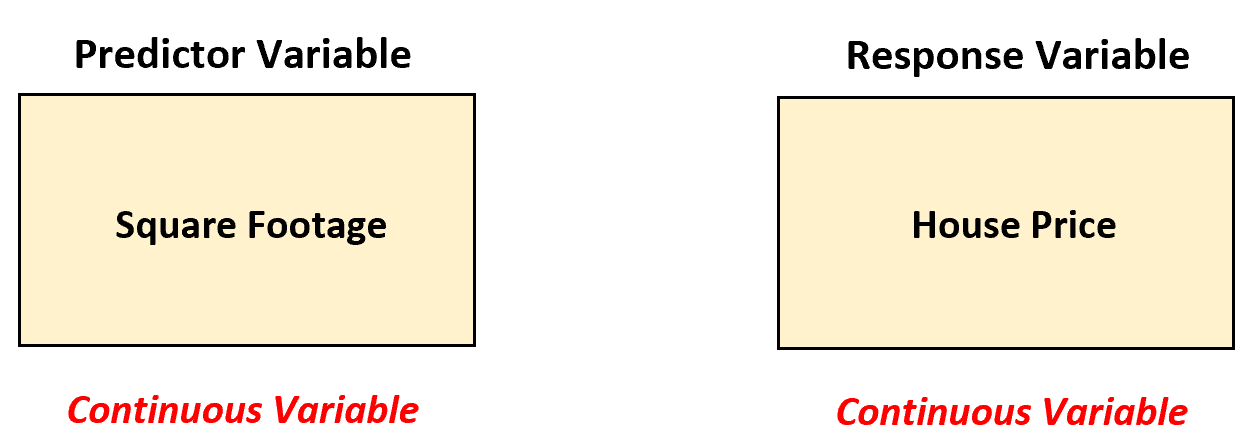
Qui plus est, la régression ne s’enferme nullement dans l’alternative stérile « tout continu » ou « tout catégoriel ». L’une de ses forces les plus éclatantes réside dans sa flexibilité analytique totale : il est parfaitement trivial d’introduire simultanément, au sein d’une même équation de régression, trois prédicteurs continus (âge, score de neuroticisme, niveau de cortisol basal) et deux prédicteurs catégoriels (statut vaccinal codé 0/1, type de protocole psychothérapeutique codé via des indicatrices). Cette intégration conjointe, qui dépasse le clivage traditionnel des disciplines, permet d’ajuster chaque variable pour les autres avec un niveau de précision inaccessible aux plans de découpage factoriel classiques.
3.3 Le problème de la dichotomisation des variables continues
L’un des égarements méthodologiques les plus documentés — et pourtant persistant dans les revues internationales de psychologie — réside dans la pratique de la dichotomisation artificielle de variables continues, dont l’exemple paradigmatique est la césure par la médiane (median split). Cette procédure consiste à mesurer une dimension psychologique continue chez les participants (par exemple, le score d’estime de soi de Rosenberg), puis à scinder l’échantillon en deux groupes artificiels (« haute estime de soi » versus « basse estime de soi ») dans le seul but de soumettre les données à une ANOVA factorielle à deux niveaux, perçue à tort par certains chercheurs comme plus simple à exécuter ou plus noble à présenter qu’une régression linéaire.
Les démonstrations statistiques formelles, notamment celles publiées par MacCallum, Zhang, Preacher et Rucker (2002) ainsi que par Maxwell et Delaney (1993), ont mis en évidence la toxicité analytique de cette pratique. En premier lieu, la discrétisation par la médiane provoque une hémorragie de puissance statistique : transformer une échelle continue en variable binaire équivaut à détruire délibérément entre un tiers et la moitié de l’information variance-covariance contenue dans le jeu de données d’origine. Cette perte d’information réduit drastiquement la probabilité de détecter des effets réels de petite ou moyenne amplitude dans la population.
En second lieu, et de façon plus pernicieuse, la dichotomisation de deux prédicteurs continus initialement corrélés entraîne une distorsion sévère du taux d’erreur de première espèce ($\alpha$). Les calculs démontrent qu’en présence de covariation naturelle entre deux variables, leur partition artificielle en sous-groupes par la médiane engendre des corrélations spurieuses entre les termes factoriels résultants, conduisant à des taux de faux positifs pouvant s’élever jusqu’à 20 % ou 30 % pour tester un effet principal ou une interaction inexistante. Enfin, cette pratique aplatit la variance intragroupe : deux participants situés immédiatement au-dessus et immédiatement en dessous de la médiane sont traités comme radicalement dissemblables, tandis qu’un individu situé sur la médiane est amalgamé avec un sujet se trouvant à trois écarts-types au-dessus de celle-ci. Le consensus de la communauté méthodologique est catégorique : toute variable psychométrique continue doit être impérativement conservée dans son échelle métrique originelle et traitée au moyen de modèles de régression adéquats.
4. La variable dépendante : Exigences de métrique et distribution
4.1 Exigence de continuité pour le critère (Y)
Alors que la nature des variables explicatives ($X$) constitue l’axe de divergence opérationnelle entre ANOVA et régression, il est impératif de souligner que, vis-à-vis de la variable dépendante ou critère ($Y$), les deux méthodes partagent rigoureusement les mêmes contraintes fondamentales : l’invariance métrique impose que la variable réponse soit de nature quantitative continue, mesurée au minimum sur une échelle d’intervalles au sens de Stevens. Cette exigence découle directement du calcul des résidus sous l’estimateur des moindres carrés, lequel présuppose que les distances géométriques entre scores réels et scores modélisés possèdent une signification métrique constante tout au long de l’espace de mesure.
Dans la recherche psychologique appliquée, ce postulat se heurte fréquemment à l’utilisation ubiquitaire des échelles d’évaluation de type Likert (par exemple, réponses échelonnées de 1 « Pas du tout d’accord » à 5 « Tout à fait d’accord »). La question de savoir si un item isolé de Likert peut être légitimement introduit comme variable dépendante dans une ANOVA ou une régression a suscité des débats intenses. L’orthodoxie méthodologique stipule qu’un item unique est ordinal : les intervalles subjectifs séparant les échelons ne sont en aucun cas démontrés comme arithmétiquement égaux. L’application d’un modèle linéaire général à un item ordinal à cinq points s’avère fragile, particulièrement lorsque la distribution empirique est asymétrique ou concentrée sur les extrêmes.
En revanche, la pratique psychométrique courante consistant à agréger une multiplicité d’items de Likert (dix à trente items mesurant un construit unidimensionnel cohérent) sous la forme d’un score total ou d’une moyenne de score composite bénéficie d’une tolérance mathématique robuste. Les sommes d’items ordonnés tendent, en vertu des propriétés de la loi des grands nombres et de l’adjonction de variables discrètes, à approximer un continuum métrique sous-jacent avec une fidélité suffisante pour autoriser l’usage du GLM. Néanmoins, lorsque la variable dépendante souffre d’effets de plancher sévères (la majorité des participants affichent un score de zéro, comme dans les échelles mesurant les comportements délinquants ou les idéations suicidaires aiguës) ou d’effets de plafond (scores maximaux saturés), l’hypothèse de continuité linéaire s’effondre, rendant l’ANOVA comme la régression standard OLS intrinsèquement biaisiées.
4.2 Gestion des distributions asymétriques et non normales
L’inférence paramétrique classique déployée dans l’ANOVA et la régression OLS repose sur la théorie des distributions d’échantillonnage gaussiennes. Dès lors que la variable dépendante affiche une asymétrie positive marquée (telle qu’observée systématiquement sur les distributions des temps de réaction chronométriques, des coûts de santé mentale ou des durées de rétablissement clinique), les estimations ponctuelles et les tests statistiques associés subissent une perte de validité potentielle. Une confusion récurrente consiste à scruter la distribution marginale brute de $Y$ plutôt que sa distribution conditionnelle. Ni l’ANOVA ni la régression n’exigent que la variable $Y$ brute soit normalement distribuée ; elles requièrent impérativement que les erreurs conditionnelles (les résidus du modèle global) se conforment à la normalité.
Face à une déviation sévère de la normalité des résidus, trois voies méthodologiques s’offrent historiquement aux analystes. La première relève de l’ingénierie des données via les transformations mathématiques univariées : transformation logarithmique ($ln(Y)$ ou $\log_{10}(Y)$) pour résorber l’asymétrie positive, transformation racine carrée ($\sqrt{Y}$) pour stabiliser la variance de variables de comptage, ou encore algorithmes paramétriques d’optimisation comme la transformation de Box-Cox (1964), qui identifie la puissance optimale $lambda$ minimisant la somme des résidus non gaussiens. Si ces transformations restaurent la validité des calculs de $p$-values, elles compliquent substantiellement l’interprétabilité clinique directe des coefficients, contraignant l’analyste à des opérations de conversion inverse (back-transformation) pour rapporter les résultats dans la métrique originale du phénomène.
La seconde alternative, aujourd’hui considérée comme la norme de référence dans les standards psychométriques avancés, consiste à s’extirper du Modèle Linéaire Général au profit des Modèles Linéaires Généralisés (GLM, formalisés par Nelder et Wedderburn en 1972). Dans ce cadre probabiliste supérieur, l’hypothèse de normalité de la variable réponse est abandonnée au profit de lois de distribution issues de la famille exponentielle naturelle : régression gamma pour les temps de réaction continus hautement asymétriques, régression de Poisson ou binomiale négative pour les variables de comptage psychologique, régression logistique binaire pour les choix dichotomiques, ou modèle de probit ordinal pour les items de Likert stricts. Ce dépassement méthodologique démontre une fois encore l’hégémonie conceptuelle de la pensée régressive, les modèles généralisés intégrant indifféremment des facteurs de groupe (assimilables à l’ANOVA) ou des régresseurs métriques.
4.3 Sensibilité à l’erreur de mesure sur la variable réponse
Un principe fondamental de la psychométrie classique — incarné par la théorie classique des tests (TCT) développée par Lord et Novick — stipule que tout score observé sur une variable psychologique ($Y$) se décompose en un score vrai ($T$) et une erreur de mesure aléatoire ($e$) : $Y = T + e$. L’incidence de cette erreur de mesure non corrélée sur l’analyse de données diverge profondément selon qu’elle affecte la variable dépendante ($Y$) ou les variables indépendantes ($X$). Lorsqu’elle se situe sur la variable dépendante continue, l’erreur de mesure agit de manière parfaitement symétrique au sein de l’ANOVA et de la régression linéaire.
En présence d’un instrument de mesure présentant une fidélité médiocre (par exemple, un coefficient alpha de Cronbach ou un oméga de McDonald inférieur à 0,70 pour une échelle composite d’anxiété), la variance résiduelle aléatoire ($SS_{Racute{e}sidus}$ ou $SS_{Intra}$) se trouve mécaniquement gonflée par la variance propre du bruit de mesure ($s_e^2$). Les coefficients de régression non standardisés ($b$) ou les écarts bruts entre moyennes de cellules de l’ANOVA demeurent des estimateurs non biaisés de l’effet moyen dans la population sous-jacente. En revanche, le dénominateur des tests statistiques s’accroît, ce qui entraîne une dégradation drastique de la statistique de test ($F$ ou $t$), un élargissement proportionnel des intervalles de confiance à 95 % et un effondrement substantiel de la puissance statistique des protocoles de recherche.
En outre, l’erreur de mesure sur $Y$ comprime mécaniquement les indices standardisés d’intensité de relation : le coefficient de détermination multivarié ($R^2$) de la régression ainsi que l’êta-carré partiel ($\eta_p^2$) de l’ANOVA sont systématiquement atténués par rapport à l’effet réel qui prévaudrait sur le plan des variables latentes parfaites. Dans les contextes cliniques ou appliqués où les seuils de significativité guident des décisions diagnostiques ou thérapeutiques majeures, l’illusion d’une robustesse mathématique du GLM ne saurait masquer la nécessité impérieuse de maximiser la cohérence interne et la stabilité test-retest des instruments de recueil psychologique préalablement à toute tentative de modélisation comparative.
5. Postulats statistiques comparés : Normalité, homoscédasticité et indépendance
5.1 Indépendance des observations
Parmi les postulats axiomatiques conditionnant la validité des modèles d’inférence linéaire, l’indépendance conditionnelle des observations constitue la clause technique la plus critique, tout en étant la plus fréquemment violée dans les recherches en sciences comportementales. Ce postulat exige formellement que l’erreur résiduelle associée à l’observation $i$ soit rigoureusement non corrélée avec l’erreur résiduelle associée à l’observation $j$, soit matérialisé par $\text{Cov}(\varepsilon_i, \varepsilon_j) = 0$ pour tout $i \neq j$. Contrairement aux hypothèses distributionnelles de normalité ou de variance homogène, pour lesquelles des mécanismes de correction algorithmique existent, la violation du postulat d’indépendance ruine le fondement même du calcul des erreurs-types standards asymptotiques.
Dans la recherche psychologique, la dépendance des résidus surgit principalement sous deux formes géométriques : le regroupement hiérarchique naturel (clustering) et la répétition temporelle sérielle (longitudinal design). Le regroupement spatial ou social se manifeste typiquement lorsque des élèves sont échantillonnés au sein de classes scolaires distinctes, des patients pris en charge par un même thérapeute, ou des sujets testés au sein d’unités de travail d’entreprise partagées. Dans de telles configurations, les individus partagent un micro-environnement commun, des influences contextuelles non modélisées et des dynamiques interactives qui induisent une ressemblance mutuelle systématique (mesurée par le coefficient de corrélation intraclasse, ICC).
Ignorer cette dépendance groupée en traitant les participants comme des unités d’échantillonnage totalement indépendantes au sein d’une ANOVA inter-sujets ou d’une régression multiple classique conduit à une sous-estimation dramatique des erreurs-types standards des estimateurs. Les tests de signification ($t$ et $F$) deviennent artificiellement gonflés, provoquant une explosion catastrophique du taux de faux positifs (l’erreur de type I réelle peut allègrement atteindre 40 % à 50 % au lieu du seuil nominal de 5 %). Face à une telle structure, l’ANOVA traditionnelle s’avère totalement inopérante. Le chercheur doit impérativement migrer vers des méthodologies adaptées : l’ANOVA à mesures répétées lorsque l’appariement est simple et rigide, ou de manière immensément plus flexible et robuste, les modèles de régression multiniveaux à effets mixtes (HLM/LMM), capables de modéliser explicitement la covariance résiduelle complexe au sein des unités d’échantillonnage.
5.2 Homogénéité de la variance (Homoscédasticité)
Le second postulat cardinal du Modèle Linéaire Général impose que la variance des termes d’erreur résiduelle demeure absolument constante à travers l’ensemble des valeurs ou des combinaisons de valeurs des variables explicatives : $\text{Var}(\varepsilon | X) = \sigma^2$. Dans la tradition lexicale de l’ANOVA, cette condition prend le nom d’homogénéité des variances ou homoscédasticité intergroupes. Dans la tradition de la régression linéaire, elle est désignée sous le terme d’homoscédasticité des résidus le long de la droite d’ajustement ou de l’axe des valeurs prédites ($\hat{Y}$).
Pour évaluer l’homoscédasticité dans le cadre d’une ANOVA, la littérature préconise le test d’homogénéité des variances de Levene, ou sa variante plus robuste aux déviations de normalité développée par Brown et Forsythe (qui substitue la médiane de cellule à la moyenne arithmétique). Si ces tests atteignent le seuil de signification conventionnel ($p < 0,05$), l'hypothèse nulle d'égalité des variances est rejetée, attestant la présence d'une hétéroscédasticité empirique. Dans la régression linéaire, l'évaluation s'opère de manière privilégiée par l'inspection visuelle du graphique de dispersion opposant les résidus standardisés aux valeurs prédites (qui ne doit révéler aucune forme en entonnoir, en éventail ou en pavillon de trompette), doublée de tests formels tels que le test de Breusch-Pagan ou le test de White.
L’hétéroscédasticité n’affecte pas l’espérance mathématique des coefficients de régression ni des moyennes de cellule : les estimateurs des moindres carrés demeurent non biaisés. En revanche, elle rend les estimateurs des erreurs-types inefficients et mathématiquement faux. Si les groupes possédant les plus faibles effectifs présentent les variances les plus massives (hétéroscédasticité hétérogène négative), le test $F$ standard de l’ANOVA devient excessivement libéral, multipliant les détections de faux positifs. À l’inverse, si les groupes aux effectifs volumineux portent les plus fortes variances, le test devient ultra-conservateur, paralysant la puissance de détection. Les remèdes analytiques contemporains privilégient l’abandon du modèle d’homoscédasticité parajusté au profit de l’ANOVA de Welch pour les plans factoriels, ou de l’intégration d’estimateurs de variance-covariance robustes à l’hétéroscédasticité (matrices sandwich de Huber-White, de type HC3 ou HC4) au sein des régressions linéaires.
5.3 Normalité des résidus et théorème central limite
Le troisième postulat fondamental concerne la forme de la distribution probabiliste des termes d’erreur résiduelle, postulée comme conforme à une loi normale continue : $\varepsilon \sim \mathcal{N}(0, \sigma^2)$. Une incompréhension tenace parmi les apprentis chercheurs consiste à exiger que la variable dépendante composite brute affiche une distribution gaussienne parfaite avant toute modélisation. Cette exigence est théoriquement absurde : la distribution globale de $Y$ représente un mélange composite de multiples sous-populations ; si les différents groupes d’une étude expérimentale possèdent des moyennes réelles distinctes, l’histogramme de la variable $Y$ agrégée sera nécessairement bimodal ou plurimodal sans que cela ne constitue en rien une violation du postulat du modèle.
La normalité s’évalue exclusivement sur les résidus d’échantillonnage conditionnels ($e_i = Y_i – \hat{Y}_i$). Les outils diagnostiques de référence comprennent les tracés graphiques quantile-quantile (Q-Q plots de probabilité normale), sur lesquels les résidus standardisés doivent idéalement s’aligner sur la bissectrice d’ajustement sans décrochage curviligne aux extrémités, ainsi que les épreuves d’ajustement formelles comme le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov corrigé par Lilliefors. Toutefois, dans les échantillons de taille substantielle, ces tests formels pèchent par un excès de sensibilité statistique, conduisant à rejeter la normalité pour des écarts infinitésimaux et méthodologiquement insignifiants.
C’est ici qu’intervient la puissance protectrice du Théorème Central Limite (TCL). Selon ce principe fondamental de la statistique probabiliste, dès lors que la taille totale de l’échantillon devient modérément vaste (typiquement lorsque les effectifs de cellule d’une ANOVA excèdent 30 à 50 observations par condition, ou que le ratio sujets/prédicteurs d’une régression multiple est généreux), la distribution d’échantillonnage de la moyenne empirique et des coefficients de régression converge asymptotiquement vers une loi normale parfaite, quelle que soit la forme de la distribution parente sous-jacente des données (à l’exclusion des lois présentant des moments infinis). Par conséquent, l’ANOVA et la régression linéaire sous OLS s’avèrent hautement robustes aux déviations modérées de la normalité des résidus. Lorsque les déviations s’avèrent extrêmes (asymétries écrasantes, distributions multimodales irréductibles) ou que les échantillons sont de dimension très réduite (par exemple, en neuropsychologie clinique avec $N < 15$), les méthodologies non paramétriques de rééchantillonnage par rééchantillonnage bootstrap avec correction de biais et accélération (BCa), ou l'application d'estimateurs robustes de type M-estimateurs de Huber, s'imposent pour préserver l'intégrité de l'inférence.
6. Le codage des variables qualitatives dans la régression
6.1 Mécanismes du codage fictif (Dummy Coding)
L’intégration mathématique de facteurs de classification catégoriels au sein de l’architecture d’une régression linéaire s’opère par le truchement de matrices de codage binaire. Le codage fictif (plus communément désigné sous le terme anglo-saxon de dummy coding ou codage par variables indicatrices) représente la modalité de paramétrisation par défaut de la quasi-totalité des logiciels d’analyse statistique contemporains (tels que le traitement par défaut de lm() en langage R). Pour modéliser une variable qualitative $k$ niveaux factoriels, le système génère impérativement un sous-espace vectoriel composé de $k – 1$ variables binaires artificielles, affectées chacune de valeurs 0 ou 1.
Le principe fondamental exige la désignation préalable d’un groupe de référence théorique (souvent le groupe témoin, la condition placebo ou la modalité sociodémographique de base). Ce groupe de référence se voit attribuer la valeur 0 sur l’ensemble des $k – 1$ variables créées. À titre d’illustration, considérons une étude psychothérapeutique évaluant trois conditions : Groupe Témoin Liste d’Attente ($k_1$), Groupe Thérapie Cognitive Classique ($k_2$), et Groupe Thérapie d’Exposition Virtuelle ($k_3$). Si le Groupe Témoin ($k_1$) est désigné comme référence, deux indicatrices ($D_1$ et $D_2$) sont générées. Pour un individu appartenant à $k_1$, le vecteur est $(D_1 = 0, D_2 = 0)$. Pour un sujet appartenant à $k_2$, le vecteur devient $(D_1 = 1, D_2 = 0)$, et pour un sujet de $k_3$, il s’établit à $(D_1 = 0, D_2 = 1)$.
Cette paramétrisation confère une signification arithmétique rigoureuse et univoque à chaque terme de l’équation de régression $Y = b_0 + b_1 D_1 + b_2 D_2 + \varepsilon$ :
- L’ordonnée à l’origine (la constante $b_0$ ou intercept) n’est plus une grande moyenne globale, mais correspond exactement à la moyenne arithmétique de la variable dépendante au sein du seul groupe de référence : $b_0 = \bar{Y}_{Tacute{e}moin}$.
- Le coefficient de pente $b_1$ reflète le contraste univarié simple mesurant l’écart moyen exact entre le groupe $k_2$ et le groupe témoin : $b_1 = \bar{Y}_{k_2} – \bar{Y}_{Tacute{e}moin}$.
- Le coefficient de pente $b_2$ capture similairement l’écart moyen entre le groupe $k_3$ et le groupe témoin : $b_2 = \bar{Y}_{k_3} – \bar{Y}_{Tacute{e}moin}$.
Les tests de Student ($t$) associés à chaque pente évaluent donc si chaque modalité spécifique se démarque significativement de la modalité de contrôle. Cependant, le test $F$ omnibus du modèle de régression, qui éprouve l’hypothèse conjointe $H_0 : b_1 = b_2 = 0$, s’avère absolument et rigoureusement identique au test $F$ omnibus issu de l’ANOVA factorielle à un facteur appliquée à ces trois mêmes groupes.
6.2 Codage par effet (Unweighted Effects Coding)
Bien que le codage fictif s’avère extrêmement intuitif pour confronter des conditions actives à un témoin, il ne permet pas de reproduire directement dans les coefficients de pente les effets principaux traditionnellement restitués par les tables d’ANOVA factorielle classique. Pour reproduire la paramétrisation standard de l’ANOVA au sein de l’espace de régression, l’analyste doit recourir au codage par effet (unweighted effects coding ou codage par déviation). Ce système applique une contrainte mathématique structurelle imposant que la somme des coefficients associés aux différents niveaux du facteur soit égale à zéro : $\sum \alpha_i = 0$.
Sous ce système, une variable catégorielle à $k$ modalités requiert toujours la création de $k – 1$ variables d’indicatrices. Pour une condition donnée arbitrairement sélectionnée pour absorber la contrainte (souvent la dernière modalité), les scores sur toutes les indicatrices ne sont plus fixés à 0, mais systématiquement assignés à la valeur $-1$. En reprenant l’exemple précédent à trois groupes, si la condition 3 reçoit le codage $-1$, la matrice se cấufigure comme suit : Groupe 1 ($E_1 = 1, E_2 = 0$), Groupe 2 ($E_1 = 0, E_2 = 1$), et Groupe 3 ($E_1 = -1, E_2 = -1$).
Les conséquences algébriques de ce codage sur l’interprétation des paramètres modélisés au sein de l’équation $Y = b_0 + b_1 E_1 + b_2 E_2 + \varepsilon$ modifient radicalement les conclusions individuelles :
- L’ordonnée à l’origine ($b_0$) devient l’estimation non biaisée de la grande moyenne non pondérée de l’ensemble des cellules de l’expérience : $b_0 = \mu = \frac{\bar{Y}_1 + \bar{Y}_2 + \bar{Y}_3}{3}$.
- Le coefficient de pente $b_1$ capture la déviation arithmétique de la moyenne du premier groupe par rapport à cette grande moyenne non pondérée : $b_1 = \bar{Y}_1 – \mu$.
- Le coefficient $b_2$ exprime similairement la déviation de la moyenne du second groupe par rapport à la grande moyenne : $b_2 = \bar{Y}_2 – \mu$.
- L’effet associé au groupe omis (le groupe 3) n’a pas disparu : il s’obtient instantanément par la déduction algébrique contrainte : $b_3 = -(b_1 + b_2) = \bar{Y}_3 – \mu$.
Cette paramétrisation s’avère cruciale dans les plans factoriels équilibrés ou déséquilibrés, car elle assure l’alignement le plus direct avec les calculs traditionnels des sommes de carrés de Type III de l’ANOVA, rendant ainsi le modèle linéaire multiple entièrement transparent pour l’expérimentateur habitué au paradigme fisherien.
6.3 Contrastes planifiés et contrastes orthogonaux
Dans de multiples paradigmes psychologiques élaborés, le recours au test $F$ omnibus de l’ANOVA — qui pose comme hypothèse alternative générique « au moins une des moyennes diffère des autres » — apparaît d’une pauvreté épistémologique criante. L’expérimentateur formule rarement des hypothèses informes ou diffuses ; il anticipe au contraire des hiérarchies précises dictées par ses postulats théoriques (par exemple, anticiper que deux variantes d’une même thérapie feront jeu égal mais surpasseront conjointement une condition témoin). Le codage par contrastes permet de transcrire directement ces hypothèses ciblées sous forme de coefficients pondérés.
Un contraste représente une combinaison linéaire formelle des moyennes des populations, définie par l’équation générale $L = \sum c_j \mu_j$, soumise à la condition impérative que la somme des coefficients de pondération soit strictement nulle : $\sum c_j = 0$. Deux contrastes distincts $L_1 = \sum c_{1j} \mu_j$ et $L_2 = \sum c_{2j} \mu_j$ sont qualifiés d’orthogonaux si et seulement si la somme des produits de leurs pondérations respectives s’annule : $\sum c_{1j} c_{2j} = 0$. L’orthogonalité garantit une indépendance informationnelle absolue : chaque contraste extrait une portion de variance unique, non redondante avec les autres composantes de l’analyse.
Pour un facteur comprenant $k$ modalités, il existe rigoureusement un ensemble maximal de $k – 1$ contrastes orthogonaux mutuellement indépendants. La somme des sommes des carrés associée à cet ensemble de contrastes reproduit très exactement la somme des carrés intergroupes globale ($SS_{Inter}$) de l’ANOVA. En transposant ces poids au sein de la matrice de régression, les variables résultantes sont mathématiquement non corrélées ($r = 0$), immunisant ainsi l’analyste contre tout phénomène de colinéarité. Cette démarche confère deux avantages méthodologiques décisifs :
- Elle maximise la puissance statistique en condensant l’énergie analytique sur des tests à 1 degré de liberté correspondant fidèlement aux hypothèses directes du chercheur.
- Elle protège l’analyse contre la prolifération incontrôlée de l’erreur de type I globale (familywise error rate), éliminant le besoin de pénalisations post-hoc hyper-conservatrices telles que la correction de Bonferroni.
7. Analyse des plans factoriels complexes : ANOVA factorielle vs Régression multiple
7.1 Gestion des plans déséquilibrés et sommes de carrés
Dans un plan factoriel parfaitement équilibré (où chaque croisement de facteurs comporte exactement le même nombre de participants, par exemple $n = 30$ par cellule dans un plan $2 \times 2$), les facteurs sont mathématiquement orthogonaux. Dans cette situation idyllique, la décomposition de la variance s’opère sans la moindre ambiguïté : la somme des carrés du modèle se scinde parfaitement en la somme des carrés de l’effet principal A, la somme des carrés de l’effet principal B et la somme des carrés de leur interaction $A \times B$. Néanmoins, dans la pratique empirique des sciences psychologiques, les plans équilibrés constituent l’exception plutôt que la norme, en raison des abandons d’études (attrition), des données manquantes, de la rareté de certains profils cliniques ou de quotas démographiques asymétriques.
Dès lors que les effectifs de cellules deviennent inégaux (plans non orthogonaux), les facteurs se retrouvent corrélés les uns aux autres : une portion de la variance expliquée par le modèle devient partagée entre les prédicteurs. Ce chevauchement engendre un conflit méthodologique capital quant à l’ordre et à la méthode de décomposition de la variance, conflictualité formalisée par la distinction entre les sommes de carrés de Type I, Type II et Type III :
- Sommes de carrés de Type I (Séquentielles) : Les facteurs sont introduits successivement selon un ordre imposé par l’analyste. Le premier facteur s’attribue toute la variance possible, le second facteur n’hérite que de la variance incrémentale non captée par le premier, et l’interaction ne reçoit que les résidus ultimes. Cette méthode est extrêmement sensible à l’ordre d’entrée des variables dans la syntaxe et s’avère inappropriée pour la validation standard de plans factoriels croisés en psychologie.
- Sommes de carrés de Type II (Hiérarchiques) : Chaque effet principal est ajusté pour les autres effets de même ordre ou d’ordre inférieur (l’effet A est ajusté pour B, et B pour A), mais sans être ajusté pour l’interaction d’ordre supérieur ($A \times B$). Ce type optimise la puissance statistique sous l’hypothèse stricte que l’interaction d’ordre supérieur est théoriquement nulle.
- Sommes de carrés de Type III (Marginales ou Simultanées) : Chaque terme du modèle — chaque effet principal comme l’interaction — est évalué en étant simultanément ajusté pour l’ensemble des autres termes présents dans l’équation. L’effet A est ajusté pour B et pour $A \times B$ ; l’interaction est ajustée pour A et pour B.
Dans la littérature psychologique, et conformément aux prescriptions des manuels canoniques de l’American Psychological Association, le Type III constitue la norme analytique par défaut lors du déploiement d’une ANOVA factorielle déséquilibrée. Cette convention garantit que les tests des effets principaux reflètent les déviations des moyennes non pondérées (conformément à la logique du codage par effet en régression) sans être pollués par les disparités d’échantillonnage de chaque cellule. Les routines de régression linéaire paramétrées avec un codage par effet orthogonal reproduisent scrupuleusement les résultats de l’ANOVA de Type III, alors qu’une paramétrisation naïve par codage fictif dans une régression simple conduirait à estimer des effets conditionnels dépendants de la cellule de référence, source récurrente d’incompréhension pour l’analyste inexpérimenté.
7.2 Plans à mesures répétées et structures hiérarchiques
L’évaluation des processus psychologiques requiert très fréquemment le suivi intra-individuel des mêmes sujets au fil d’intervalles chronologiques successifs (par exemple, dans les études de mémoire de travail à plusieurs essais, les évaluations longitudinales d’un protocole antidépresseur à l’inclusion, à 6 semaines, 12 semaines et 6 mois, ou les protocoles de réhabilitation cognitive). Historiquement, la psychologie a abordé ces paradigmes sous l’angle exclusif de l’ANOVA à mesures répétées (rm-ANOVA) ou des plans mixtes inter-intra (split-plot designs).
Toutefois, la rm-ANOVA s’accompagne de contraintes de postulats particulièrement tyranniques, au premier rang desquelles trône la sphéricité (homogénéité de la variance des différences entre toutes les paires possibles de conditions répétées). Dès lors que la sphéricité est violée — situation quasi-systématique dès que les niveaux temporels dépassent trois mesures —, l’analyste est contraint d’appliquer des corrections de degrés de liberté pénalisantes (Greenhouse-Geisser ou Huynh-Feldt) ou de basculer vers des formulations d’analyse multivariée de la variance (MANOVA). Plus handicapant encore, la rm-ANOVA repose sur la suppression pure et simple de toute l’observation longitudinale d’un individu dès lors qu’une seule mesure temporelle fait défaut (listwise deletion), entraînant un biais d’attrition dévastateur et une chute sévère de puissance statistique.
La supériorité de la pensée régressive s’est ici manifestée avec éclat par la transition massive de la communauté scientifique vers les modèles linéaires mixtes (LMM), parfois désignés sous le terme de régression multiniveau (HLM). En conceptualisant les mesures répétées comme des observations de Niveau 1 nichées (nested) à l’intérieur d’individus autonomes de Niveau 2, la régression mixte traite sans la moindre difficulté les déséquilibres d’observations : les données manquantes aléatoires (MAR) n’imposent plus l’éviction du participant. De plus, la régression multiniveau permet de modéliser le temps comme un continuum arithmétique fluide (jours, mois, années réels de passation) plutôt que comme des blocs discrets uniformes, et d’estimer des trajectoires d’évolution spécifiques à chaque participant via la décomposition de pentes aléatoires (random slopes) et d’ordonnées à l’origine aléatoires (random intercepts), ouvrant la voie à une compréhension infiniment plus fine des processus de changement psychologique.
7.3 L’ANCOVA comme pont direct entre ANOVA et régression
L’Analyse de Covariance (ANCOVA) matérialise historiquement l’hybridation la plus limpide et la plus illustrative entre les traditions de l’ANOVA et de la régression linéaire. Conçue initialement par Ronald Fisher, l’ANCOVA poursuit un double dessein expérimental : d’une part, réduire la variance d’erreur résiduelle non expliquée en extrayant des résidus la variance imputable à une covariable quantitative continue ; d’autre part, ajuster statistiquement les moyennes de groupes observées sur la variable dépendante en neutralisant les disparités initiales existant sur cette covariable.
D’un point de vue opératoire, l’ANCOVA ajuste l’équation classique de l’ANOVA en lui intégrant une composante de pente régressive directe :
$$Y_{ij} = \mu + \alpha_i + \beta(X_{ij} – \bar{X}_{..}) + \varepsilon_{ij}$$
où $X_{ij}$ représente la mesure continue de la covariable pour le participant $j$ dans le groupe $i$, $\bar{X}_{..}$ est la grande moyenne observée sur la covariable, et $\beta$ incarne le coefficient de régression linéaire liant la covariable au critère $Y$. L’extraction de ce terme régressif a pour effet direct de comprimer la somme des carrés de l’erreur ($SS_{Racute{e}sidus}$), ce qui augmente mécaniquement la valeur du rapport de test $F$ pour les facteurs catégoriels $\alpha_i$, conférant ainsi un gain substantiel de puissance statistique.
Cependant, la légitimité de ce pont analytique repose sur un postulat mathématique formel et incontournable : l’homogénéité des pentes de régression à travers les groupes expérimentaux (homogeneity of regression slopes). Ce postulat exige que la force et la direction de l’association linéaire liant la covariable au critère soient rigoureusement parallèles et identiques au sein de chaque sous-groupe : $\beta_1 = \beta_2 = dots = \beta_k$. Si cette condition est violée — signifiant qu’il existe une interaction statistique entre la covariable continue et le facteur catégoriel —, l’ANCOVA standard s’effondre conceptuellement : on ne peut légitimement ajuster les moyennes marginales sur une pente moyenne qui n’est représentative d’aucun groupe. L’analyste se voit alors contraint d’abandonner l’ANCOVA conventionnelle pour revenir à une formulation de régression multiple intégrant pleinement l’interaction continue-catégorielle, démontrant une fois encore que la régression constitue le cadre mathématique englobant dont l’ANCOVA n’est qu’une déclinaison bornée.
8. Modélisation des interactions et modération : Deux lectures d’un même phénomène
8.1 L’interaction factorielle dans l’ANOVA
Dans l’architecture conceptuelle de l’analyse de variance factorielle, une interaction survient dès lors que l’amplitude ou la direction de l’effet d’un premier facteur expérimental sur la variable dépendante se modifie en fonction des niveaux spécifiques occupés par un second facteur expérimental. En termes algébriques formels, l’effet conjoint de deux variables combinées ne se résume pas à l’addition pure et simple de leurs effets principaux isolés :
$$\mu_{ij} \neq \mu + \alpha_i + \beta_j$$
La présence d’un terme résiduel d’interaction $(\alpha\beta)_{ij} = \mu_{ij} – (\mu + \alpha_i + \beta_j)$ quantifie l’ampleur de cette non-additivité.
Sur le plan heuristique et sémiologique, l’interaction en ANOVA s’illustre traditionnellement par des graphiques de profil de moyennes : dès lors que les segments linéaires reliant les moyennes des cellules dévient du strict parallélisme, une interaction potentielle se profile. L’interaction est qualifiée d’ordinale lorsque l’écart entre les niveaux d’un facteur s’accentue ou se resserre à travers les niveaux de l’autre sans inversion de polarité, et de croisée ou disjonctive (crossover interaction) lorsque la hiérarchie des performances s’inverse radicalement d’une modalité à l’autre.
La survenue d’une interaction statistiquement significative modifie radicalement la conduite de l’analyse : elle interdit le plus souvent toute interprétation globale et univoque des effets principaux. En présence d’une interaction croisée substantielle, affirmer qu’un effet principal A est « significatif » n’a aucun sens psychologique, car cet effet peut être massivement positif sous la condition B1 et massivement négatif sous la condition B2. L’analyste doit alors décomposer cette interaction omnibus en analysant les effets simples (simple effects), c’est-à-dire en testant l’effet du facteur A isolément à l’intérieur de chacun des niveaux du facteur B, opération systématiquement assortie d’ajustements correctifs pour protéger l’erreur alpha globale (comme les procédures de Tukey HSD ou de Bonferroni).
8.2 L’effet modérateur dans la régression linéaire
Ce que la tradition de l’expérimentation factorielle nomme « interaction », la tradition de la modélisation corrélationnelle et psychométrique le formalise sous le concept d’effet modérateur (ou modération). Une variable agit en tant que modérateur ($M$) dès lors qu’elle modifie la force, la forme ou la direction de la relation fonctionnelle liant une variable prédictive indépendante ($X$) à une variable critère dépendante ($Y$). La modélisation de cette dynamique s’opère par l’introduction d’un terme de produit multiplicatif au sein de l’équation de régression linéaire multiple :
$$Y = b_0 + b_1 X + b_2 M + b_3 (X \times M) + \varepsilon$$
Dans ce modèle, le coefficient $b_3$ associé au terme d’interaction produit $(X \times M)$ teste directement l’existence et l’amplitude de l’effet de modération. Si $b_3$ s’avère statistiquement distinct de zéro, l’effet de $X$ sur $Y$ n’est pas fixe, mais devient une fonction mathématique linéaire dépendante de la valeur prise par le modérateur $M$ :
$$\frac{\partial Y}{\partial X} = b_1 + b_3 M$$
Pour assurer la stabilité numérique de l’estimation et garantir une interprétabilité clinique immédiate des paramètres constitutifs, il est impératif d’opérer un centrage préalable des variables continues ($X$ et $M$) autour de leur moyenne respective ($X – \bar{X}$, $M – \bar{M}$) avant de calculer leur produit multiplicatif. Ce centrage élimine la multicolinéarité non essentielle entre les termes constitutifs simples et leur produit, et permet d’interpréter $b_1$ comme l’effet simple de $X$ lorsque le modérateur $M$ est fixé exactement à sa moyenne d’échantillon, plutôt qu’à une valeur arithmétique de zéro qui s’avère souvent dénuée de sens biologique ou psychométrique (comme un score de QI nul ou un âge de zéro an).
La décomposition analytique d’une modération en régression s’effectue historiquement via l’analyse des pentes simples (simple slopes analysis, popularisée par Aiken et West en 1991), consistant à tester la significativité de la régression de $Y$ sur $X$ à des valeurs conditionnelles arbitraires de $M$ (habituellement à la moyenne, à $+1$ écart-type, et à $-1$ écart-type). Cependant, l’approche la plus rigoureuse et élégante repose désormais sur la technique de Johnson-Neyman (1936). Plutôt que de choisir des valeurs de coupe discrétionnaires, cette procédure résout analytiquement l’équation pour identifier la région de signification continue exacte : elle détermine la plage de valeurs mathématiques précises du modérateur $M$ à l’intérieur de laquelle l’effet conditionnel de $X$ sur $Y$ est statistiquement significatif au seuil désigné, et les zones au-delà desquelles il s’éteint ou change de polarité.
8.3 Comparaison épistémologique de l’interprétation des interactions
L’affrontement entre l’interaction factorielle issue de l’ANOVA et la modération par régression linéaire met en exergue des conceptions épistémologiques profondément différentes de la modélisation du comportement. L’ANOVA factorielle contraint l’interaction dans un cadre rigide de catégories mutuellement exclusives. Même lorsqu’un phénomène psychologique interagit selon un gradient continu, l’ANOVA pousse l’esprit du chercheur à penser en termes de « basculements de tiroirs » ou d’effets de seuil étanches. Ce mode de pensée est particulièrement flagrant dans les modélisations traditionnelles du stress : l’individu est artificiellement classé dans un statut binaire (« vulnérabilité génétique présente vs absente » croisé avec « environnement familial hostile vs bienveillant »).
À l’opposé, la régression par terme d’interaction produit traite le psychisme comme un champ de forces continues où les gradients de réactivité s’ajustent de manière infinitesimale le long d’un continuum. Si nous considérons l’interaction biopsychosociale classique entre le niveau de stress perçu (variable continue) et l’ampleur perçue du réseau de soutien social (variable continue) sur l’expression d’une symptomatologie dépressive continue, la régression modélise une nappe de surface bidimensionnelle incurvée (ou paraboloïde hyperbolique). Cette modélisation reflète fidèlement la réalité phénoménologique : le pouvoir tampon du soutien social s’accroît de façon progressive et proportionnelle à l’intensification de l’adversité.
Forcer un tel phénomène continu au sein d’une grille factorielle ANOVA (par le biais d’un découpage en sous-groupes de type « Haut Stress / Bas Stress » croisé avec « Haut Soutien / Bas Soutien ») constitue un anachronisme méthodologique majeur. Ce découpage entraîne non seulement une dégradation massive de puissance analytique, mais expose le chercheur à des artéfacts d’interprétation sévères, masquant la forme réelle de la surface de réponse et créant de fausses ruptures d’homogénéité là où opérait en réalité une modulation continue fluide.
9. Critères de décision empirique : Choisir entre ANOVA et régression en recherche psychologique
9.1 Arbre décisionnel guidé par le devis expérimental
Face à un protocole de recherche empirique en psychologie, le choix stratégique entre l’application d’une ANOVA ou le déploiement d’une régression multiple ne saurait être abandonné à la subjectivité ou à la simple maîtrise technique d’un logiciel. Ce choix doit résulter d’un arbitrage rationnel guidé par trois piliers : la nature du devis expérimental, la structure métrique des variables et les objectifs d’inférence. Le schéma décisionnel opérationnel se synthétise selon des axes directeurs rigoureux :
- Conditions propices à l’ANOVA : L’ANOVA factorielle s’impose comme le véhicule le plus parsimonieux et le plus universellement compréhensible dès lors que l’étude constitue un véritable protocole expérimental randomisé en laboratoire, caractérisé par la manipulation délibérée d’une ou plusieurs variables indépendantes qualitatives pures (conditions de traitement, dosages discrets, consignes cognitives distinctes), réparties de manière quasi-équilibrée au sein d’un échantillon modéré, sans nécessité d’incorporer de variables métriques continues comme prédicteurs explicatifs majeurs. Dans ce cadre, la lisibilité des tables de décomposition $F$ et la publication de profils de moyennes standardisées se conforment directement aux attentes des pairs évaluateurs et aux standards de communication scientifique.
- Conditions d’hégémonie de la régression linéaire : La régression linéaire multiple devient impérative dès lors que le devis est observationnel, corrélationnel ou quasi-expérimental, et que les prédicteurs centraux comportent des dimensions continues (scores de questionnaires, indicateurs physiologiques, variables sociologiques). Elle s’impose également de façon absolue dès lors que le plan expérimental présente un déséquilibre structurel important dans les effectifs de cellules, qu’un ou plusieurs prédicteurs continus doivent être ajustés simultanément, ou que l’investigation théorique s’articule autour de questions de modération continue sans points de rupture nosographiques avérés.
9.2 Contrôle des variables confondantes et prédicteurs multiples
Dans la recherche psychologique non interventionnelle — telle que l’épidémiologie psychiatrique, la psychologie du développement ou l’étude du bien-être au travail —, les facteurs d’exposition et les trajectoires comportementales sont inextricablement enchevêtrés dans un écheveau complexe de variables de confusion (âge, niveau socio-éducatif, morbidités somatiques, traits de personnalité de base). L’incapacité de l’ANOVA factorielle à gérer efficacement cette multidimensionnalité constitue l’une de ses plus grandes limites pratiques.
Dès lors qu’un chercheur souhaite neutraliser l’effet de cinq ou six variables confondantes au sein d’une ANOVA, la complexité géométrique explose : créer un plan factoriel croisant l’ensemble de ces variables exigerait des milliers de cellules et un échantillon de plusieurs dizaines de milliers d’individus pour éviter que la majorité des croisements ne se retrouvent désespérément vides d’observations. L’alternative boiteuse de l’ANCOVA multiple montre rapidement ses limites face aux risques d’hétérogénéité des pentes et à l’inflation des interactions d’ordre supérieur indéchiffrables.
La régression multiple résout ce défi avec une élégance et une parcimonie mathématique inégalées. Par l’estimation d’équations multivariées, elle permet d’intégrer simultanément un nombre considérable de covariables continues et catégorielles, tout en isolant l’effet propre (unique variance) de chaque prédicteur via les coefficients d’ajustement partiel ($b_i$). Elle permet en outre un diagnostic quantitatif rigoureux de la redondance entre variables via l’indice de tolérance et le facteur d’inflation de la variance (VIF – Variance Inflation Factor). Enfin, la régression offre la possibilité de structurer l’analyse selon des blocs hiérarchiques séquentiels : l’analyste peut ainsi démontrer formellement que l’adjonction de variables psychologiques cognitives innovantes apporte un incrément d’explication de variance ($\Delta R^2$) statistiquement significatif au-delà du contrôle strict exercé préalablement par un bloc de variables sociodémographiques lourdes.
9.3 Objectif de recherche : Détection de différences ou inférence prédictive
L’arbitrage ultime entre les deux paradigmes s’ancre dans la finalité téléologique de la question scientifique formulée par l’investigateur. S’agit-il d’un objectif de corroboration différentielle ou d’un projet d’inférence fonctionnelle et prédictive ?
Si la finalité théorique de l’étude est strictement bornée à la décision confirmatoire locale — c’est-à-dire établir formellement s’il existe une ligne de fracture statistique entre les performances moyennes de populations distinctes soumises à des conditions environnementales contrôlées —, le cadre conceptuel de l’ANOVA est parfaitement configuré pour apporter cette réponse binaire : le test omnibus signale la présence de la divergence, et les contrastes planifiés précisent la topographie des écarts. Ce format est particulièrement valorisé dans les phases initiales de validation de protocoles de recherche fondamentale.
Si l’ambition scientifique se tourne vers la modélisation pronostique, la prédiction personnalisée ou la psychométrie translationnelle, la régression s’impose comme le seul instrument conceptuellement adapté. L’équation de régression obtenue ne se contente pas de trancher un test d’hypothèse nulle ; elle met à disposition de la communauté un modèle fonctionnel paramétré ($Y = b_0 + b_1 X_1 + dots + b_k X_k$) directement exploitable pour estimer le devenir symptomatique futur d’un patient individuel sur la base de son profil psychométrique spécifique. Ce passage d’une logique confirmatoire collective à une logique d’estimation structurelle individuelle marque la transition de la recherche de laboratoire vers les applications cliniques et prédictives des sciences comportementales.
10. Comparaison de la puissance statistique, taille d’effet et interprétabilité
10.1 Métriques de taille d’effet : Eta-carré versus R-carré et coefficients standardisés
Sous les exigences méthodologiques contemporaines édictées par les comités de rédaction des revues scientifiques de premier rang, la simple publication d’une valeur de probabilité empirique ($p$-value) est jugée obsolète et insuffisante. Les analystes se doivent de documenter avec une précision chirurgicale l’amplitude quantitative des phénomènes observés au moyen de métriques de taille d’effet standardisées et corrigées de leur biais d’échantillonnage.
Dans la tradition de l’ANOVA, les indices emblématiques de taille d’effet s’articulent autour de la proportion de variance expliquée par chaque terme factoriel :
- Êta-carré classique ($\eta^2$) : Représente le rapport brut entre la somme des carrés de l’effet factoriel et la somme totale des carrés de l’expérience : $\eta^2 = \frac{SS_{Effet}}{SS_{Total}}$. Cet indice a l’inconvénient d’être strictement descriptif et d’augmenter artificiellement dès que des variables non pertinentes sont retirées du plan.
- Êta-carré partiel ($\eta_p^2$) : Isole la variance propre de l’effet en ne la rapportant qu’à la somme de la variance de l’effet et de la variance de l’erreur pure : $\eta_p^2 = \frac{SS_{Effet}}{SS_{Effet} + SS_{Racute{e}sidus}}$. Bien qu’extrêmement répandu dans les sorties de logiciels comme SPSS, cet indice souffre d’un défaut conceptuel : la somme des $\eta_p^2$ d’un modèle factoriel peut largement excéder 1,00 (100 %), ce qui interdit toute comparaison directe rigoureuse d’une étude à l’autre.
- Oméga-carré ($\omega^2$) et Oméga-carré partiel ($\omega_p^2$) : Développés pour corriger la surestimation positive systématique inhérente aux échantillons empiriques, ils soustraient de la variance expliquée le terme de variance résiduelle pondéré par les degrés de liberté, fournissant ainsi une estimation non biaisée de l’effet dans la population parente :
$$\omega_p^2 = \frac{df_{Effet}(MS_{Effet} – MS_{Racute{e}sidus})}{df_{Effet} MS_{Effet} + (N – df_{Effet})MS_{Racute{e}sidus}}$$
Dans la tradition de la régression, l’amplitude globale s’exprime par le coefficient de détermination multivarié $R^2$, ainsi que par le $R^2$ ajusté de Wherry ou d’Ezekiel, qui intègre une pénalité formelle pour chaque prédicteur additionnel afin de neutraliser le surajustement d’échantillonnage. Au niveau des paramètres univariés individuels, la régression se distingue de l’ANOVA en offrant deux lectures complémentaires :
- Les coefficients non standardisés ($B$ ou $b$), exprimés dans les unités physiques ou psychométriques réelles des instruments, indispensables pour juger de la portée clinique et concrète d’une intervention.
- Les coefficients standardisés ($\beta$), qui convertissent toutes les métriques sur une échelle d’écarts-types communs, autorisant la comparaison directe de la puissance prédictive relative de facteurs d’exposition hétérogènes (par exemple, comparer l’impact relatif des années d’études vs du score d’anxiété sur les facultés mnésiques).
Pour les besoins des méta-analyses intégrant des corpus mixtes, des passerelles algébriques universelles permettent de convertir ces métriques (comme le passage du $d$ de Cohen au $r$ de Pearson, ou la conversion d’un $\eta_p^2$ en indice de taille d’effet multivarié $f^2$ de Cohen selon la formule $f^2 = \frac{\eta_p^2}{1 – \eta_p^2}$), réaffirmant la permutabilité totale des résultats à travers les frontières méthodologiques formelles.
10.2 Puissance statistique et optimisation de l’échantillon
La puissance statistique ($1 – \beta$) mesure la probabilité conditionnelle qu’un protocole d’investigation statistique rejette formellement l’hypothèse nulle lorsque cette dernière est effectivement fausse dans la population avec une intensité donnée d’effet. La détermination a priori de la taille d’échantillon nécessaire à l’aide d’outils algorithmiques standardisés (tels que le logiciel G*Power de l’Université de Düsseldorf) requiert une compréhension fine de la consommation des degrés de liberté inhérente à chaque dispositif.
L’un des pièges récurrents de l’ANOVA factorielle mal conçue réside dans l’hémorragie involontaire de degrés de liberté causée par la prolifération de modalités catégorielles non nécessaires. Lorsqu’un chercheur déploie une ANOVA factorielle $3 \times 4 \times 2$, le modèle consomme 23 degrés de liberté rien que pour estimer l’ensemble des termes d’effets principaux et d’interactions croisées. Si certaines cellules ne disposent que de faibles effectifs d’observations, la variance d’erreur résiduelle demeure vaste, le dénominateur du test $F$ reste peu puissant, et l’investigation échoue à détecter des effets statistiquement réels par simple étalement stérile de la variabilité.
Inversement, le maintien des prédicteurs dans leur métrique continue naturelle au sein d’une équation de régression multiple optimise mécaniquement la puissance statistique disponible. En économisant les degrés de liberté — un prédicteur continu ne consommant qu’un unique degré de liberté au numérateur pour modéliser une relation linéaire là où un facteur à quatre modalités en mobilise trois —, la régression concentre la recherche de covariance sur un vecteur unidirectionnel précis. Les calculs de puissance d’échantillonnage révèlent ainsi de façon constante qu’à amplitude d’effet sous-jacente identique, une stratégie analytique préservant la continuité des prédicteurs dans une régression requiert typiquement entre 25 % et 40 % d’individus en moins pour atteindre le seuil conventionnel de puissance de 0,80 qu’un protocole ayant forcé la discrétisation catégorielle pour satisfaire aux contraintes apparentes d’une ANOVA.
10.3 Interprétabilité clinique et communication scientifique
Au-delà de la stricte puissance numérique, l’acceptabilité d’un modèle statistique dépend étroitement de la clarté sémiotique avec laquelle ses résultats peuvent être appréhendés par des cliniciens de terrain, des décideurs de santé publique ou des praticiens non rompus à la technicité du calcul matriciel. Sur ce plan d’analyse, l’ANOVA bénéficie historiquement d’une supériorité intuitive indéniable : comparer les moyennes arithmétiques directes de trois groupes de patients traités et constater visuellement que l’écart entre le groupe $A$ et le groupe $B$ s’établit à $12$ points sur l’inventaire clinique parle immédiatement au sens commun du praticien.
La régression multiple souffre parfois d’une perception de plus grande complexité mathématique, particulièrement lorsque les modèles intègrent des standardisations de variables, des termes d’interactions multiplicatives continues et des transformations non linéaires. L’interprétation du coefficient partiel $b$ comme « l’effet théorique moyen d’une variable lorsque l’ensemble des autres variables du système sont fixées à leur valeur arithmétique de zéro » peut rapidement désarçonner les lecteurs cliniciens non statisticiens, singulièrement lorsque le zéro ne correspond à aucun état empirique observable.
Toutefois, la régression offre une plus-value translationnelle inestimable : la pente fonctionnelle fournit un barème direct pour l’ajustement des interventions de santé. Là où l’ANOVA se borne à énoncer que le groupe traité affiche une supériorité moyenne sur le groupe contrôle, l’équation de régression précise qu’à chaque séance thérapeutique supplémentaire suivie par un patient, une réduction prévisible de 1,8 point sur l’échelle de détresse psychologique est attendue. Il appartient donc au chercheur de respecter scrupuleusement les prescriptions des normes éditoriales de l’APA (Publication Manual, 7e édition), en combinant systématiquement l’affichage des coefficients de régression bruts (pour la contextualisation clinique concrète) et des métriques standardisées avec leurs intervalles de confiance à 95 % respectifs pour assurer l’interopérabilité des résultats au sein de la communauté scientifique internationale.
11. Erreurs méthodologiques courantes et pièges d’interprétation
11.1 Le p-hacking et la dichotomisation opportuniste
L’avènement du mouvement pour la science ouverte (Open Science) a mis en lumière l’ampleur dévastatrice des degrés de liberté de l’expérimentateur (researcher degrees of freedom) et des pratiques de questionnement opportuniste des données (familièrement regroupées sous le terme de p-hacking). Dans cette zone grise méthodologique, l’arbitrage artificiel entre ANOVA et régression a trop souvent servi d’instrument pour faire basculer artificiellement une analyse sous le seuil fatidique de $p < 0,05$.
La dichotomisation opportuniste post-hoc constitue l’un des archétypes les plus pervers de cette dérive : un chercheur ayant colligé des scores continus constate avec amertume que sa régression linéaire produit une pente non significative à $p = 0,08$. Plutôt que d’accepter ce résultat nul instructif, il procède en coulisses à des fractionnements arbitraires de son échantillon (par la médiane, les tertiles ou les quartiles) jusqu’à identifier empiriquement un découpage catégoriel produisant une ANOVA affichant un $p = 0,042$. Il rédige ensuite son manuscrit scientifique comme si ce partitionnement de sous-groupes avait constitué son hypothèse théorique formulée a priori.
Ce type de manipulations génère une prolifération de faux positifs toxiques au sein de la littérature psychologique, contribuant directement aux échecs répétés de réplication empirique. Pour éradiquer ces dérives déontologiques, la communauté psychologique exige désormais de façon croissante le pré-enregistrement formel des protocoles et des plans d’analyses sur des plateformes ouvertes certifiées (telles que le Centre for Open Science / OSF). Le pré-enregistrement contraint l’investigateur à spécifier rigoureusement en amont de toute collecte la nature exacte de ses variables, ses algorithmes de codage et le modèle analytique matriciel retenu, fermant ainsi la porte aux réorientations opportunistes d’après-coup.
11.2 Confusion entre causalité statistique et causalité méthodologique
L’une des distorsions épistémologiques les plus profondément incrustées dans l’inconscient académique consiste à attribuer à l’analyse de variance une vertu magique de démonstration causale intrinsèque, tout en reléguant la régression au statut subalterne de simple constatation descriptive et associative. Cette croyance, entretenue par une pédagogie manichéenne introductive des statistiques, procède d’une confusion fatale entre la mécanique algorithmique de l’outil et l’architecture méthodologique du recueil d’observation.
L’équation de l’ANOVA ne « prouve » rigoureusement aucune causalité : elle calcule uniquement des rapports de variances numériques. La légitimité d’une inférence causale dépend exclusivement et entièrement du devis méthodologique déployé en amont : randomisation stricte des participants au sein de conditions mutuellement indépendantes, manipulation contrôlée active de la variable indépendante par l’expérimentateur, standardisation absolue de l’environnement de passation et double aveugle destiné à neutraliser les attentes expérimentales et les effets placebo. Si un chercheur applique une ANOVA factorielle à des groupes préconstitués de sujets (par exemple, des patients diagnostiqués dépressifs versus anxieux versus contrôles), cette analyse, bien que formulée sous l’étiquette classique d’une « ANOVA », demeure d’une nature strictement observationnelle et corrélationnelle : il est scientifiquement invalide d’en tirer la moindre conclusion de causalité unidirectionnelle, en raison de l’impossibilité d’exclure les variables tierces omises ou les causalités inverses.
À l’inverse, dès lors qu’un essai pharmacologique ou expérimental randomisé applique une manipulation factorielle quantitative continue (par exemple, assigner aléatoirement des participants à ingérer 0 mg, 10 mg, 20 mg, 40 mg ou 80 mg d’un agent thérapeutique psychotrope actif), l’équation de régression linéaire ajustant la réponse symptomatique sur ces dosages arithmétiques bénéficie d’une validité d’inférence causale parfaite et absolue. La causalité est la fille de la méthode expérimentale, non du modèle linéaire retenu pour son traitement mathématique.
11.3 Ignorance de la multicolinéarité et de la non-linéarité
Le recours à la modélisation statistique s’accompagne d’angles morts techniques spécifiques à chaque procédure qui, lorsqu’ils sont ignorés par le chercheur, induisent des contresens interprétatifs monumentaux. Dans la sphère de la régression linéaire multiple, la multicolinéarité excessive constitue une menace invisible récurrente. Lorsque deux ou plusieurs variables prédictives s’avèrent excessivement corrélées entre elles au sein d’une batterie d’inventaires psychométriques ($r > 0,80$), la matrice $(X^T X)$ frôle la singularité arithmétique. Les erreurs-types standards des coefficients de pente explosent, rendant les estimations univariées extrêmement instables : un coefficient peut changer brusquement de signe mathématique ou perdre toute significativité sous l’effet de l’adjonction ou du retrait d’une seule observation.
De surcroît, le déploiement naïf d’une régression linéaire simple ou d’une ANOVA standard repose sur le postulat d’une monotonie des relations. Or, la psychologie et la physiologie regorgent d’interactions fonctionnelles non linéaires complexes, dont l’exemple emblématique est la célèbre loi de Yerkes-Dodson (1908) illustrant la relation en « U inversé » entre le niveau d’éveil physiologique (l’anxiété) et l’efficience cognitive. Appliquer aveuglément une régression linéaire standard ou une ANOVA binaire à une distribution en U inversé conduira inexorablement à une pente moyenne quasi-nulle et à un test omnibus insignifiant : le modèle linéaire échoue lamentablement à capturer l’inflexion curviligne, conduisant le chercheur candide à rejeter l’existence d’une relation qui s’avérait pourtant massive.
L’antidote impératif à ce piège méthodologique réside dans l’examen visuel préalable scrupuleux de l’intégralité des nuages de points de dispersion (scatterplots) et des matrices de corrélation non paramétriques avant tout calcul automatisé. Face à des trajectoires non linéaires flagrantes, la régression dévoile à nouveau sa suprématie méthodologique sur l’ANOVA catégorielle par son aptitude directe à modéliser mathématiquement ces dynamiques d’ordre supérieur via l’intégration contrôlée de termes polynomiaux quadratiques ($X^2$) ou cubiques ($X^3$), ou par l’application de régressions non paramétriques par splines et de modèles additifs généralisés (GAM).
12. Synthèse méthodologique et recommandations pour la pratique psychométrique
12.1 Tableau récapitulatif des divergences opérationnelles
Afin de clore cette déconstruction technique et de fournir un repère décisionnel synthétique pour l’analyste de données en sciences du comportement, le tableau comparatif ci-dessous formalise l’alignement conceptuel, terminologique et structurel unifiant et distinguant l’analyse de variance et la régression linéaire multiple au sein du Modèle Linéaire Général :
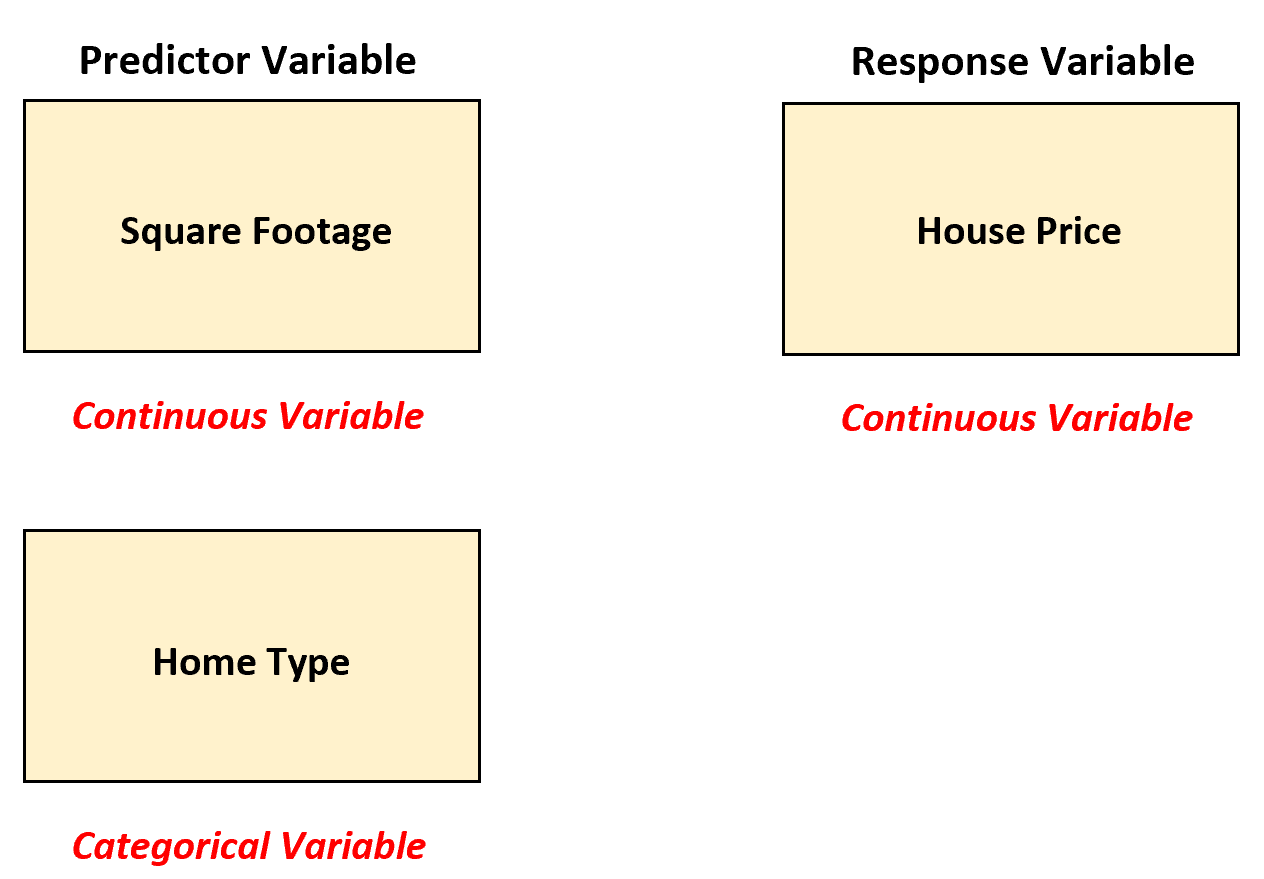
| Axe de Comparaison | Analyse de Variance (ANOVA) | Régression Linéaire Multiple |
|---|---|---|
| Nature des Prédicteurs ($X$) | Strictement catégoriels (variables discrètes, nominales, ordinales finies, groupes étanches). | Mixtes : continus (intervalles/rapports), discrets ou codés sous forme d’indicatrices binaires. |
| Nature du Critère ($Y$) | Quantitative continue (échelle d’intervalles métrique, résidus normaux postulés). | Quantitative continue (échelle d’intervalles métrique, résidus normaux postulés). |
| Paramétrisation du Modèle | Modèle de moyennes de cellules ou de déviation : $Y_{ij} = \mu + \alpha_i + \varepsilon_{ij}$. | Modèle fonctionnel de pente : $Y_i = \beta_0 + \beta_1 X_{1i} + dots + \beta_k X_{ki} + \varepsilon_i$. |
| Codage des Groupes | Implicite au sein de la matrice de dessein (décompositions de contrastes internes). | Explicite : codage fictif (dummy), codage par effet, contrastes orthogonaux formalisés. |
| Objectif Analytique Premier | Test d’hypothèse globale omnibus sur l’égalité arithmétique de moyennes de populations. | Estimation paramétrique, modélisation de trajectoires fonctionnelles et prédiction quantitative. |
| Sensibilité aux Plans Déséquilibrés | Requiert impérativement l’arbitrage entre Sommes de Carrés de Type I, II ou III. | Gérée nativement par l’inversion matricielle des moindres carrés ajustée simultanément. |
| Métriques d’Effet Standard | Êta-carré ($\eta^2$), Êta-carré partiel ($\eta_p^2$), Oméga-carré non biaisé ($\omega^2$). | Coefficient de détermination $R^2$, $R^2$ ajusté, pentes brutes ($B$) et standardisées ($\beta$). |
| Gestion des Prédicteurs Multiples | Limitation rapide due à la saturation du nombre de cellules dans les plans croisés. | Excellente capacité à intégrer et contrôler de multiples covariables continues simultanées. |
| Détection des Non-linéarités | Incapable de saisir la continuité non linéaire fluide (découpe les effets en paliers). | Remarquable via l’intégration directe de termes polynomiaux ($X^2$) ou de fonctions splines. |
| Statut Épistémologique Réel | Cas particulier restreint du Modèle Linéaire Général appliqué à des indicatrices. | Formulation universelle et matriciellement englobante du Modèle Linéaire Général. |
12.2 Vers des cadres d’analyse plus avancés : Modèles mixtes et SEM
L’évolution de la psychométrie et de la modélisation des données comportementales au XXIe siècle rend le clivage binaire séculaire entre ANOVA et régression linéaire de plus en plus désuet. Les méthodologies modernes ont transcendé cette dialectique par le déploiement d’architectures analytiques supérieures qui assimilent, intègrent et dépassent les fonctionnalités de ces deux approches historiques.
Le premier saut évolutif a été matérialisé par les Modèles Linéaires Mixtes (LMM – Linear Mixed Models). En permettant la modélisation conjointe d’effets fixes (assimilables aux facteurs systématiques de l’ANOVA ou aux pentes de régression conventionnelles) et d’effets aléatoires (capturant la variabilité spécifique des individus ou des contextes d’échantillonnage), les modèles mixtes s’affranchissent totalement des limitations de la sphéricité, des exigences d’équilibre de cellules et des rigidités temporelles. Ils unifient au sein d’un même formalisme le traitement des prédicteurs continus et catégoriels sur des structures de données hiérarchiques et répétées.
Le second saut méthodologique majeur réside dans la Modélisation par Équations Structurelles (SEM – Structural Equation Modeling). Bien que le Modèle Linéaire Général unifié sous-tendant l’ANOVA et la régression constitue une avancée algébrique magistrale, il demeure asservi à une faiblesse ontologique majeure de la statistique classique : il postule implicitement que l’ensemble des prédicteurs observés ($X$) sont mesurés sans la moindre erreur de mesure ($\sigma_e^2 = 0$). Or, en psychologie, cette clause est systématiquement violée. En intégrant la théorie des variables latentes issues de l’analyse factorielle confirmatoire à des systèmes de régression multivariés simultanés, le SEM permet de modéliser des réseaux d’influence causale, des médiations sérielles et des analyses factorielles confirmatoires multi-groupes tout en purifiant analytiquement les construits de leur bruit de mesure psychométrique. C’est l’accomplissement historique ultime de la fusion entre les disciplines expérimentale et corrélationnelle prophétisée par Cronbach.
12.3 Bonnes pratiques éditoriales et standards de publication
Pour assurer la pérennité de l’édifice scientifique et répondre avec rigueur aux exigences des protocoles d’évaluation par les pairs au sein des revues affiliées à l’APA ou à l’Association for Psychological Science (APS), tout chercheur manipulant l’ANOVA ou la régression doit s’astreindre à une discipline éditoriale irréprochable. Cette rigueur méthodologique s’articule autour de principes opératoires impératifs :
- Rapporter systématiquement les tailles d’effet non biaisées : Ne jamais borner la communication des résultats à la seule formulation des valeurs $p$. Accompagner obligatoirement tout test d’une métrique d’amplitude non biaisée appropriée ($\omega_p^2$ pour l’ANOVA, $R^2$ ajusté et coefficients de régression non standardisés assortis de leurs intervalles de confiance à 95 % pour la régression).
- Justifier a priori la puissance statistique : Documenter explicitement dans la section Méthode le calcul prévisionnel de taille d’échantillon effectué en amont de la récolte de données (via G*Power ou simulations Monte Carlo), en spécifiant la taille minimale d’effet clinique ou théorique jugée significative.
- Transparence absolue sur la vérification des postulats : Fournir les éléments concrets attestant de la vérification diagnostique des prémisses statistiques (distribution des résidus, homoscédasticité, détection de colinéarité par le VIF), et justifier méthodologiquement le recours à des estimateurs robustes (Welch, matrices sandwich HC4, bootstrap) en cas d’infraction avérée.
- Refus absolu de la dichotomisation opportuniste : Préserver impérativement l’intégrité continue des échelles de mesure et rejeter toute découpe artificielle en sous-groupes discrets non adossée à une rationalité nosographique objective validée en amont.
- Ouverture des données et scripts d’analyse (Open Science) : Déposer sur des registres publics institutionnels (Open Science Framework, Zenodo, GitHub) les matrices de données brutes anonymisées ainsi que les syntaxes computationnelles complètes et commentées (fichiers de code R, syntaxe SPSS, scripts Python). Cette traçabilité totale constitue le seul rempart authentique garantissant la reproductibilité empirique, l’invariance analytique et la probité des conclusions théoriques dégagées au sein de la psychologie scientifique moderne.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cohen, J. (1968). Multiple regression as a general data-analytic system. Psychological Bulletin, 70(6), 426-443. https://doi.org/10.1037/h0026714
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cronbach, L. J. (1957). The two disciplines of scientific psychology. American Psychologist, 12(11), 671-684. https://doi.org/10.1037/h0043943
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246-263. https://doi.org/10.2307/2841583
- Johnson, P. O., & Neyman, J. (1936). Tests of certain linear hypotheses and their application to some educational problems. Statistical Research Memoirs, 1, 57-93.
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19-40. https://doi.org/10.1037/1082-989X.7.1.19
- Maxwell, S. E., & Delaney, H. D. (1993). Bivariate median splits and pathologic categorization. Psychological Bulletin, 113(1), 181-190. https://doi.org/10.1037/0033-2909.113.1.181
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, 187, 253-318. https://doi.org/10.1098/rsta.1896.0007
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330-336. https://doi.org/10.1093/biomet/38.3-4.330
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459-482. https://doi.org/10.1002/cne.920180503