
Dans le domaine des sciences comportementales, de la neuropsychologie et des neurosciences cognitives, l’évaluation rigoureuse des variations comportementales induites par des interventions expérimentales successives constitue la pierre angulaire de la démarche empirique. L’analyse de variance à mesures répétées, communément désignée sous le terme d’ANOVA intra-sujet (ou repeated measures ANOVA), représente l’un des outils inférentiels les plus puissants et les plus élégants pour appréhender ces dynamiques temporelles et contextuelles. En soumettant une même cohorte de participants à l’ensemble des modalités d’une variable indépendante, le chercheur maximise la comparabilité des données tout en minimisant les perturbations statistiques inhérentes à l’hétérogénéité naturelle des populations humaines.
Traditionnellement, la mise en œuvre de ces calculs statistiques avancés était l’apanage exclusif de logiciels propriétaires coûteux et complexes tels que SPSS, SAS ou de langages de programmation spécialisés comme R et Python. Néanmoins, l’évolution récente des environnements infonuagiques et l’essor des outils collaboratifs ont profondément modifié les pratiques au sein des laboratoires universitaires et des équipes de recherche clinique. Google Sheets s’est progressivement imposé non seulement comme un tableur polyvalent et accessible, mais également comme une plateforme analytique robuste capable de traiter des devis expérimentaux rigoureux lorsqu’il est complété par des modules d’analyse d’extension adéquats ou par une programmation méthodique de formules matricielles natives.
Ce guide exhaustif a pour vocation de vous accompagner pas à pas dans l’exécution, l’interprétation et la communication d’une ANOVA à mesures répétées à un facteur au sein de l’écosystème Google Sheets. Que vous soyez chercheur en psychologie, étudiant aux cycles supérieurs ou praticien désireux d’auditer l’efficacité d’un protocole clinique, vous découvrirez les fondements théoriques sous-jacents, les postulats mathématiques incontournables, la manipulation précise des données, ainsi que la décomposition algorithmique manuelle et automatisée. En maîtrisant cette chaîne de traitement, vous serez à même d’allier la rigueur méthodologique imposée par les standards internationaux de publication à la souplesse opérationnelle du travail collaboratif en ligne.
1. Fondements théoriques de l’ANOVA à mesures répétées en psychologie
1.1 Définition et principes du devis intra-sujet
Le devis expérimental intra-sujet, également qualifié de plan à mesures répétées, repose sur un paradigme méthodologique fondamental : chaque participant est évalué à travers toutes les modalités de la variable indépendante manipulée. Contrairement aux devis inter-sujets (ou à groupes indépendants) où chaque individu n’est exposé qu’à une seule condition expérimentale, le devis intra-sujet confère à chaque sujet le rôle de son propre témoin statistique. Cette architecture expérimentale permet de neutraliser structurellement une grande partie de la variabilité biologique, cognitive et sociodémographique qui parasite habituellement l’observation scientifique des processus psychologiques.
L’avantage prépondérant de cette approche réside dans la réduction drastique de la variance d’erreur interindividuelle. Dans un plan inter-sujets conventionnel, les différences intrinsèques entre participants — telles que le quotient intellectuel, la mémoire de travail, le niveau d’anxiété de base ou la vitesse de traitement neural — s’amalgament directement avec l’erreur de mesure aléatoire dans le terme résiduel du modèle linéaire. Dans un plan à mesures répétées, cette variabilité systématique liée aux caractéristiques stables des individus est isolée et extraite du dénominateur du ratio statistique, conférant ainsi au test une sensibilité considérablement accrue pour détecter des effets réels, même subtils.
Les applications typiques en psychologie cognitive et en neuropsychologie clinique sont légion. On retrouve notamment l’étude de l’évolution chronométrique des temps de réaction sous l’influence de divers niveaux de charge cognitive (par exemple, dans un protocole de type Stroop ou n-back), l’évaluation longitudinale de l’humeur ou du niveau de cortisol salivaire avant, pendant et après une tâche d’induction de stress aigu, ou encore le suivi thérapeutique de patients souffrant de troubles dépressifs majeurs évalués à l’aide de l’échelle de dépression de Hamilton à l’inclusion, à quatre semaines, à huit semaines et à douze semaines post-traitement.
La différenciation avec l’ANOVA univariée indépendante s’avère donc capitale sur le plan formel. L’ANOVA classique à un facteur suppose que toutes les observations sont mutuellement indépendantes, ce qui signifierait, dans le contexte de mesures répétées, une violation caractérisée de ce principe directeur. Traiter des mesures répétées avec une ANOVA indépendante conduirait inéluctablement à une sous-estimation notoire de la puissance statistique et à une inflation incontrôlée de l’erreur résiduelle, empêchant ainsi le chercheur d’identifier des différences thérapeutiques ou cognitives authentiques.
1.2 La décomposition de la variance en mesures répétées
L’architecture mathématique de l’ANOVA à mesures répétées repose sur une partition rigoureuse de la dispersion totale des observations. Dans tout modèle linéaire général, la somme des carrés totale quantifie la déviation globale de chaque point de données individuel par rapport à la moyenne générale de l’ensemble de l’échantillon. Toutefois, la spécificité du devis intra-sujet réside dans la manière dont cette variation globale est scindée pour isoler les différentes sources d’influence théorique et expérimentale.
Dans un premier temps, la variance totale est fractionnée en deux composantes fondamentales : la variance inter-sujets (reflétant les écarts constants entre les individus, indépendamment des conditions expérimentales) et la variance intra-sujets (reflétant les fluctuations observées au sein des données d’un même individu). La variance inter-sujets capture l’hétérogénéité constitutionnelle de l’échantillon ; elle est mathématiquement retirée de la variance d’erreur résiduelle, ce qui constitue le bénéfice statistique majeur du protocole apparié.
Dans un second temps, la variance intra-sujets fait l’objet d’une sous-division cruciale. Elle est partitionnée en deux sous-ensembles distincts : la variance attribuable au traitement expérimental (ou effet principal de la condition) et la variance d’erreur résiduelle (souvent désignée comme l’interaction sujet-par-traitement). La variance du traitement quantifie la dispersion des moyennes conditionnelles autour de la moyenne générale, matérialisant l’impact direct de la manipulation expérimentale. L’erreur résiduelle correspond quant à elle aux variations idiosyncrasiques et imprévisibles des participants à travers les conditions, une fois soustraits l’effet moyen du traitement et le profil moyen de chaque sujet.
Le ratio F de Snedecor-Fisher adapté aux mesures répétées s’exprime alors comme le rapport entre le carré moyen du traitement et le carré moyen de l’erreur résiduelle. En purgeant le dénominateur de la variabilité stable interindividuelle, le carré moyen d’erreur devient considérablement plus faible que celui observé dans une ANOVA inter-sujets. Cette réduction mathématique a un impact direct et massif sur la puissance statistique du test psychologique, permettant d’atteindre des seuils de significativité robustes avec des tailles d’échantillons nettement plus restreintes, ce qui représente un atout logistique et éthique déterminant dans la recherche impliquant des populations cliniques vulnérables.
1.3 Formulation formelle des hypothèses statistiques
Toute démarche d’inférence statistique structurée exige une explicitation rigoureuse des hypothèses opérationnelles avant l’exécution du test. Dans le cadre d’une ANOVA à mesures répétées à un facteur comportant k conditions expérimentales (ou k temps de mesure), le chercheur formule une hypothèse nulle stipulant l’invariance absolue des performances ou des réponses moyennes de la population parente sous toutes les modalités considérées.
Formellement, l’hypothèse nulle (H0) s’énonce comme l’égalité parfaite des moyennes marginales théoriques de la variable dépendante à travers l’ensemble des k conditions : H0 : mu_1 = mu_2 = … = mu_k = mu. Sous cette hypothèse, toute déviation observée entre les moyennes d’échantillon n’est que le reflet d’un bruit stochastique imputable aux fluctuations d’échantillonnage aléatoire et à l’imprécision instrumentale. Rejeter H0 implique d’apporter la preuve probabiliste que l’intervention expérimentale ou le passage du temps a induit une modulation systématique non attribuable au seul hasard.
Corollairement, l’hypothèse alternative (H1) ne postule pas nécessairement que toutes les moyennes diffèrent mutuellement les unes des autres de manière exhaustive. Elle s’énonce de manière non directionnelle en affirmant qu’il existe au moins une paire de conditions pour laquelle les moyennes de la population parente ne sont pas équivalentes, ce qui se formalise algébriquement par l’existence d’au moins un couple d’indices (i, j) tel que mu_i soit différent de mu_j, avec i différent de j. L’ANOVA étant un test omnibus, son acceptation ou son rejet ne permet pas, à ce stade, d’identifier avec précision quelles sont les modalités qui divergent spécifiquement.
Dans les sciences comportementales et biomédicales contemporaines, la fixation du seuil de signification statistique (alpha) répond à des conventions strictes encadrées par la communauté scientifique, typiquement établies à alpha = 0,05 ou alpha = 0,01. Ce seuil représente la probabilité maximale tolérée de commettre une erreur de première espèce (type I), c’est-à-dire de rejeter indûment l’hypothèse nulle alors qu’elle est en réalité vraie dans la population générale. La sélection de ce seuil dicte directement le positionnement de la région de rejet sur la distribution théorique de F, servant de critère décisionnel formel pour statuer sur la portée empirique des données collectées.
2. Conditions d’application et postulats statistiques préalables
2.1 Normalité de la distribution des variables dépendantes
L’estimation valide des probabilités associées à la statistique F repose sur la conformité des données à une série d’hypothèses distributionnelles sous-jacentes. La première de ces exigences méthodologiques concerne la normalité de la variable dépendante. Dans le cadre spécifique d’un devis à mesures répétées, ce postulat ne s’applique pas à l’ensemble aggloméré des données indifférenciées, mais requiert que les scores observés au sein de chaque condition expérimentale — ou plus précisément, les résidus du modèle linéaire pour chaque modalité — suivent approximativement une loi normale gaussienne.
Pour vérifier cette condition dans un contexte d’analyse rigoureux, le chercheur doit recourir à une double évaluation combinant l’inspection visuelle et l’analyse descriptive quantitative. L’examen des indices d’asymétrie (skewness) et d’aplatissement (kurtosis) offre une première indication robuste. Idéalement, les valeurs de ces coefficients standardisés devraient osciller à l’intérieur de l’intervalle [-1, +1], bien que des seuils plus tolérants compris entre -2 et +2 soient souvent jugés acceptables dans les échantillons comportementaux de taille modérée. L’évaluation graphique par des diagrammes quantile-quantile (Q-Q plots) ou des histogrammes de distribution permet d’identifier visuellement d’éventuelles déviations systémiques.
Il importe toutefois de souligner la robustesse relative de l’ANOVA face aux entorses modérées à la normalité univariée, en particulier lorsque le théorème central limite s’applique et que la taille de l’échantillon excède une trentaine de participants. Cependant, en présence d’asymétries prononcées ou de distributions fortement bimodales — situations fréquentes lors de la mesure de temps de réaction chronométriques ou de scores psychométriques à fort effet de plancher ou de plafond —, la validité des inférences peut être substantiellement compromise.
Face à une non-normalité persistante, les psychométriciens et statisticiens préconisent classiquement l’application de transformations mathématiques univariées sur les données brutes avant l’exécution du modèle. La transformation logarithmique (log(X) ou log(X+1)) est particulièrement indiquée pour corriger les asymétries positives marquées typiques des latences de réponse. La transformation racine carrée convient idéalement aux données de comptage d’erreurs, tandis que la transformation inverse (1/X) permet de normaliser des distributions sévèrement étirées vers les valeurs élevées, rétablissant ainsi l’adéquation des données avec les exigences théoriques du modèle paramétrique.
2.2 Le postulat crucial de sphéricité de la matrice de covariance
Parmi l’ensemble des postulats associés aux modèles linéaires à mesures répétées, la sphéricité (parfois conceptualisée comme une extension de l’hypothèse de circularité) constitue sans conteste la condition la plus critique, la plus singulière et la plus fréquemment violée dans les investigations psychologiques empiriques. Contrairement à l’ANOVA inter-sujets qui requiert la simple homogénéité des variances entre groupes (homoscédasticité), l’ANOVA intra-sujet impose une condition structurelle relative à la matrice de variance-covariance des mesures répétées.
Sur le plan conceptuel, la sphéricité stipule que les variances de toutes les différences possibles calculées entre chaque paire de conditions expérimentales doivent être rigoureusement égales dans la population parente. Si l’on considère un protocole comportant trois conditions (A, B et C), la sphéricité exige que la variance des scores de différence (A – B) soit statistiquement équivalente à la variance des scores de différence (A – C) ainsi qu’à la variance des scores de différence (B – C). Lorsque cette condition d’égalité des variances des différences est satisfaite, le test F conserve son exactitude nominale.
Dans les logiciels conventionnels de biométrie, cette hypothèse est formalisée par le célèbre test de sphéricité de Mauchly. Une p-valeur associée inférieure au seuil alpha (généralement p < 0,05) indique un rejet de l’hypothèse nulle de sphéricité, signalant une violation de ce postulat fondamental. Les conséquences méthodologiques d’une telle infraction sont sévères : elle induit un biais positif majeur sur la statistique F calculée, entraînant une sous-estimation substantielle de la p-valeur réelle et augmentant considérablement le risque d’erreur de type I (rejet à tort d’une absence d’effet).
Afin de prémunir le chercheur contre ces faux positifs méthodologiques, la théorie statistique a développé des facteurs correctifs désignés par la lettre grecque épsilon (epsilon), dont la valeur théorique oscille entre un plancher minimal de 1/(k – 1) et un plafond de 1,0 (sphéricité parfaite). Deux ajustements font figure d’étalon-or dans la littérature internationale : la correction de Greenhouse-Geisser (recommandée pour sa nature conservatrice lorsque epsilon est inférieur à 0,75) et la correction de Huynh-Feldt (privilégiée lorsque epsilon excède 0,75 pour éviter une perte excessive de puissance). Ces corrections réduisent artificiellement les degrés de liberté de l’analyse omnibus, neutralisant instantanément l’inflation de l’erreur de type I.
2.3 Échelle de mesure et indépendance des observations inter-sujets
L’assise mathématique de l’analyse de variance repose impérativement sur la nature quantitative continue des variables observées. Pour que les calculs de moyennes, d’écarts-types et de sommes des carrés possèdent un sens métrique valide, la variable dépendante doit être mesurée a minima sur une échelle d’intervalle ou sur une échelle de rapport. Dans le champ de la psychologie et des sciences humaines, les indices chronométriques (latence en millisecondes), physiologiques (fréquence cardiaque, conductance cutanée) ou les scores composites issus de batteries psychométriques standardisées satisfont pleinement ce critère métrologique.
Le second impératif opérationnel concerne l’indépendance mutuelle des participants entre eux. Bien que les observations recueillies au sein d’un même individu soient explicitement dépendantes (c’est l’essence même du devis intra-sujet), il est impératif que chaque unité expérimentale (le sujet) soit rigoureusement indépendante de toutes les autres unités expérimentales constituant l’échantillon. Cela implique que la réponse ou la performance d’un participant donné ne doit en aucun cas influencer, directement ou indirectement, les données recueillies auprès d’un autre participant.
Enfin, le devis intra-sujet expose intrinsèquement le protocole expérimental à des artéfacts méthodologiques majeurs que sont les effets d’ordre, les effets de report (carry-over effects) et les phénomènes d’apprentissage ou de fatigue cognitive. Si tous les participants sont soumis aux conditions selon une séquence immuable, l’amélioration des performances ou leur dégradation progressive s’amalgamera inévitablement avec l’effet authentique du traitement. La neutralisation méthodologique de ces biais requiert impérativement la mise en place d’une procédure de contrebalancement rigoureuse, telle que l’assignation aléatoire des ordres de passation ou l’utilisation systématique de carrés latins équilibrés lors de la phase de recueil empirique.
3. Pertinence et limites de Google Sheets pour la recherche psychologique
3.1 Avantages opérationnels de Google Sheets en laboratoire
L’adoption croissante de solutions technologiques fondées sur le cloud au sein des structures de recherche académiques a conféré à Google Sheets un rôle stratégique dans la gestion quotidienne des jeux de données expérimentales. Le premier avantage tangible de cette infrastructure réside dans son accessibilité immédiate et universelle, exempte des coûts prohibitifs liés aux licences institutionnelles de logiciels statistiques propriétaires. Cette démocratisation logicielle permet aux laboratoires de mutualiser leurs ressources financières tout en garantissant un accès pérenne aux outils de calcul pour les étudiants de premier cycle, les stagiaires et les chercheurs invités.
Le second atout majeur repose sur la collaboration synchrone en temps réel. Dans le cadre de protocoles d’expérimentation multicentriques ou d’études supervisées par plusieurs investigateurs, Google Sheets permet à plusieurs utilisateurs de visualiser, coder, nettoyer et analyser simultanément des matrices de données sans risque de conflits de versions. Les protocoles de contrôle d’accès garantissent un cloisonnement rigoureux des droits d’édition, de consultation et de commentaire, assurant la conformité avec les exigences de sécurité et de confidentialité des données de recherche biomédicale.
La traçabilité méthodologique et la sécurité informatique constituent également des forces décisives de cet environnement. La sauvegarde automatique continue combinée à un historique exhaustif des révisions permet de retracer avec précision chaque manipulation opérée sur la matrice de données, de l’encodage initial des réponses brutes à la dérivation finale des résultats statistiques. Enfin, l’interopérabilité directe avec l’écosystème Google, notamment l’intégration fluide des données collectées via Google Forms pour les questionnaires psychométriques en ligne, fluidifie la chaîne de traitement empirique du laboratoire au rapport final.
3.2 Contraintes techniques et méthodologiques de la plateforme
En dépit de ces atouts logistiques indéniables, le chercheur en sciences comportementales doit impérativement appréhender les limitations fonctionnelles intrinsèques de Google Sheets avant de l’adopter comme outil analytique principal. La lacune la plus manifeste réside dans l’absence de fonctions statistiques natives spécifiquement dédiées aux devis d’analyse de variance à mesures répétées. Si le tableur propose des formules pour les tests t de Student ou les ANOVA univariées à un facteur inter-sujets, la modélisation de la dépendance intra-sujet nécessite obligatoirement le recours à des modules complémentaires tiers ou à une reconstruction algorithmique manuelle exhaustive par formules imbriquées.
Une limitation méthodologique critique concerne l’impossibilité native de calculer automatiquement les diagnostics de sphéricité et leurs corrections associées. Contrairement aux environnements statistiques spécialisés qui éditent systématiquement le W de Mauchly et les indices d’ajustement d’épsilon de Greenhouse-Geisser et de Huynh-Feldt, Google Sheets est incapable, dans ses fonctions de base ou via ses extensions élémentaires, de fournir ces métriques de contrôle. Le chercheur s’expose ainsi au risque de publier des inférences biaisées par des violations non identifiées du postulat de sphéricité s’il ne procède pas à une vigilance méthodologique accrue.
Enfin, sur le plan des capacités de traitement pur, Google Sheets montre rapidement ses limites face à des volumétries massives de données chronométriques à haute fréquence d’échantillonnage, telles que les séries temporelles issues de protocoles d’oculométrie (eye-tracking) ou d’enregistrements électroencéphalographiques (EEG). L’exécution de calculs matriciels complexes sur des dizaines de milliers de lignes entraîne fréquemment des latences d’exécution notables, voire des blocages d’interface, cantonnant ainsi l’usage pertinent du tableur aux cohortes expérimentales traditionnelles où les données brutes ont préalablement fait l’objet d’une agrégation par moyenne individuelle par condition.
4. Étape 1 : Installation et configuration du module XLMiner Analysis ToolPak
4.1 Accès au Google Workspace Marketplace
Afin de doter Google Sheets des algorithmes nécessaires au traitement des devis factoriels complexes sans nécessiter la rédaction manuelle de centaines de lignes de formules imbriquées, l’intégration d’un module analytique externe s’avère indispensable. L’extension la plus éprouvée, stable et largement reconnue par la communauté académique internationale est le module XLMiner Analysis ToolPak, développé pour reproduire fidèlement l’ergonomie et la logique computationnelle de l’utilitaire d’analyse de données historique de Microsoft Excel.
Pour initier son intégration, ouvrez votre feuille de calcul Google Sheets active, puis naviguez dans le menu supérieur horizontal jusqu’à l’onglet intitulé Extensions (ou Modules complémentaires selon les versions linguistiques de votre compte). Dans le menu déroulant contextuel, placez votre curseur sur l’entrée Modules complémentaires, puis cliquez sur Télécharger des modules complémentaires. Cette action déclenche l’ouverture d’une fenêtre modale interactive affichant le Google Workspace Marketplace, vaste répertoire d’applications certifiées pour la suite bureautique infonuagique.
Dans la barre de recherche textuelle située en haut de la fenêtre modale, saisissez précisément la requête XLMiner Analysis ToolPak et validez par la touche Entrée. L’extension officielle, éditée par Frontline Systems, apparaîtra en tête des résultats de recherche, identifiable par son icône caractéristique évoquant un tableau de distribution de données. Avant toute installation dans un cadre professionnel ou universitaire, prenez soin de vérifier les avis de la communauté, le volume d’utilisateurs actifs (dépassant plusieurs millions de déploiements) ainsi que la conformité générale avec vos exigences institutionnelles de traitement informatique.
4.2 Gestion des autorisations de compte et sécurité
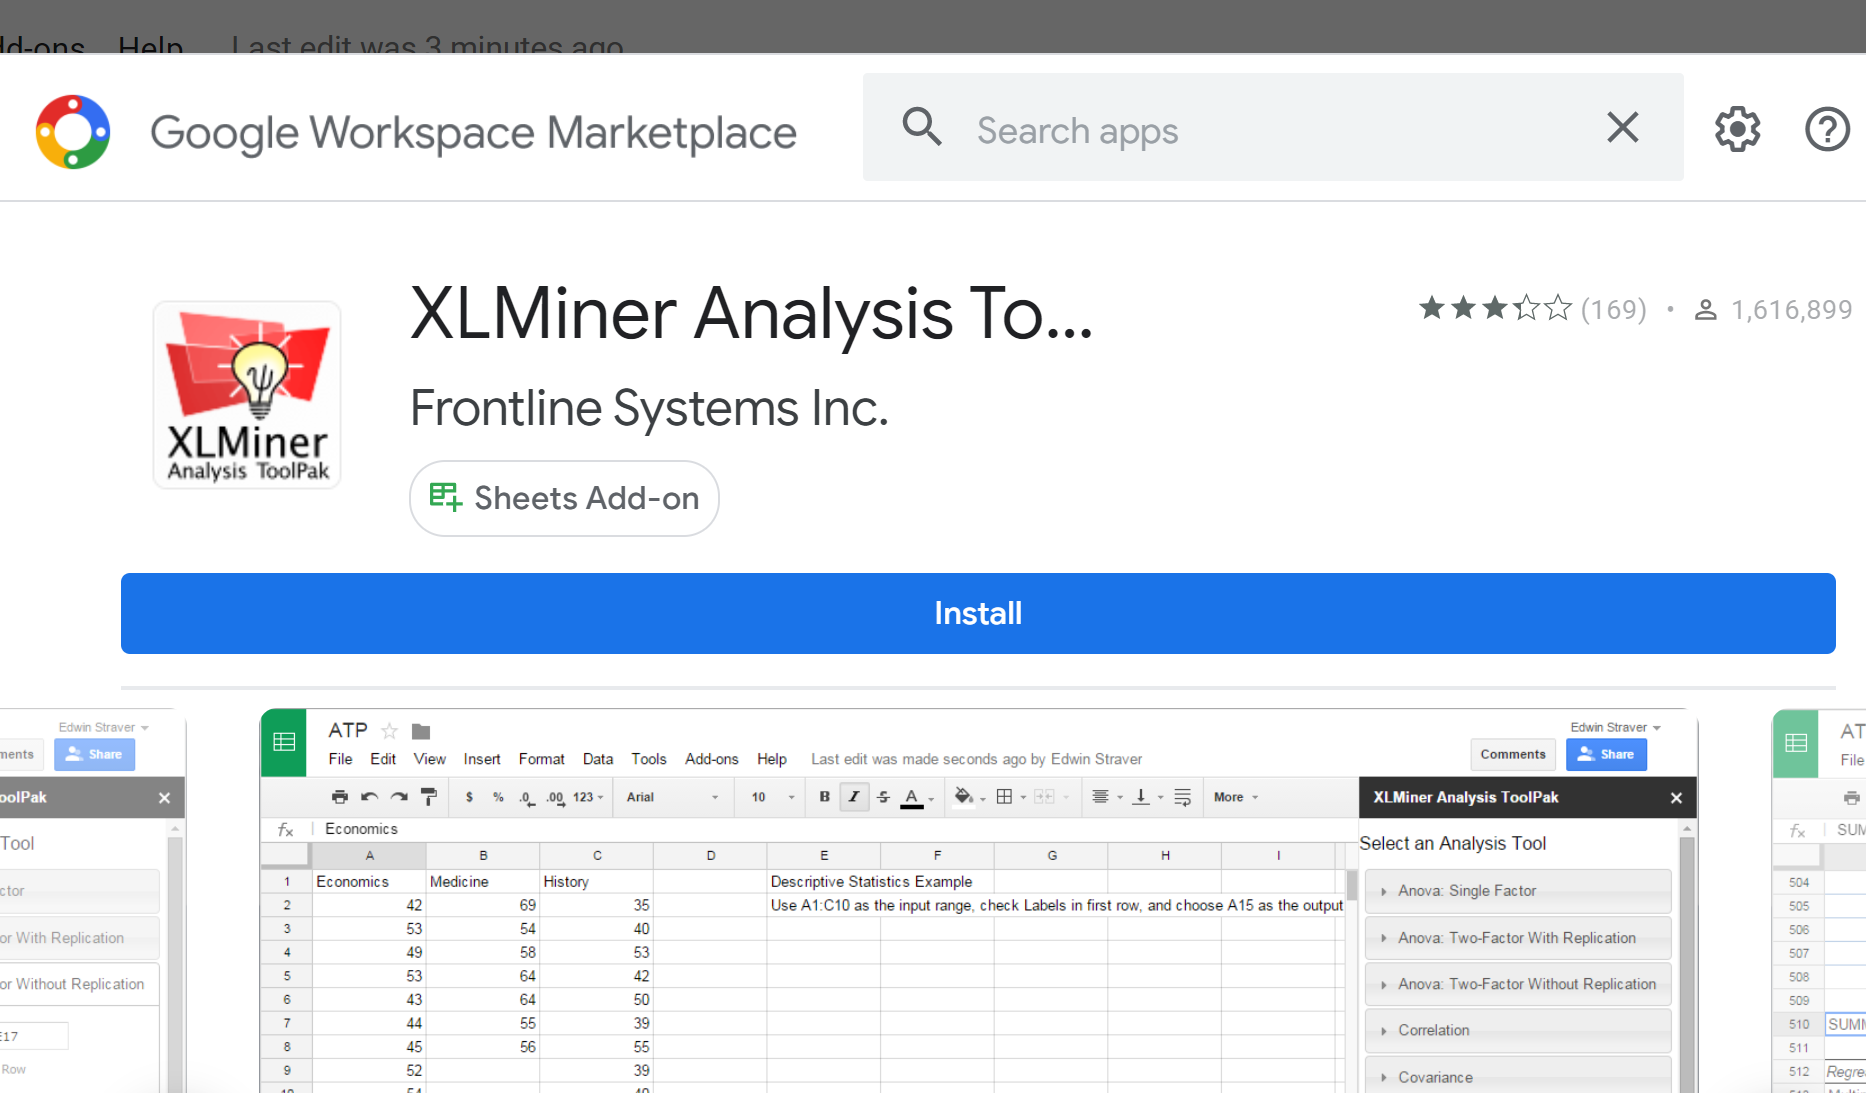
Une fois l’application localisée dans le magasin en ligne, cliquez sur le bouton bleu d’installation. Le système d’exploitation Google Workspace déploie alors un protocole de vérification d’identité requérant une validation explicite des privilèges d’accès sollicités par l’extension tierce. Cette étape est cruciale, en particulier lorsque le jeu de données hébergé sur le tableur concerne des mesures psychologiques ou cliniques soumises au respect du secret professionnel et aux réglementations éthiques internationales relatives à la protection des données personnelles.
L’extension sollicitera l’autorisation de consulter, modifier, créer et supprimer vos feuilles de calcul Google Sheets dans lesquelles le script est exécuté. Il convient de rassurer les comités d’éthique de la recherche : Frontline Systems implémente des protocoles conformes aux standards de l’industrie, et l’extension fonctionne principalement par l’exécution de scripts JavaScript côté client sans transférer ni stocker le contenu intrinsèque de vos bases de données nominatives sur des serveurs externes non autorisés. Sélectionnez votre compte utilisateur institutionnel Google et cliquez sur Autoriser pour formaliser l’intégration du module dans votre environnement de travail.
Une notification système confirme l’achèvement de la procédure d’installation et indique l’emplacement des commandes d’accès au sein de la barre d’outils. Cliquez sur Terminer et fermez la fenêtre modale du Marketplace pour revenir à l’interface principale de votre feuille de calcul. L’extension est désormais greffée de manière permanente à votre profil utilisateur et sera disponible immédiatement lors de l’ouverture ultérieure de toute autre feuille de travail dans le même domaine de compte.
4.3 Initialisation de l’outil dans l’interface de travail
Pour activer opérationnellement l’utilitaire d’analyse statistique, repositionnez votre curseur sur le menu supérieur Extensions. Vous constaterez l’apparition d’une nouvelle ligne d’arborescence désignée sous le libellé XLMiner Analysis ToolPak. En survolant cette option avec la souris, cliquez sur le sous-menu Start. Cette action commande le chargement et le déploiement d’un volet latéral vertical dédié, ancré sur le côté droit de votre zone d’affichage.
Ce panneau d’instruments rassemble l’ensemble des procédures statistiques classiques inspirées des progiciels d’ingénierie de données. Vous y découvrirez des algorithmes variés tels que les corrélations bivariées, les régressions linéaires multiples, les statistiques descriptives univariées, ainsi que plusieurs variantes de l’analyse de variance. Familiarisez-vous avec cette interface : chaque module dispose d’une structure ergonomique rigoureuse comportant des champs de sélection de plages de cellules, des cases à cocher méthodologiques et des options de destination spatiale pour les tableaux de résultats à générer.
Dans l’éventualité où le panneau latéral resterait vierge ou afficherait une erreur d’exécution de script (incident survenant parfois lors de sessions multi-comptes Google actives simultanément dans le même navigateur web), une simple actualisation de la page web (F5 ou Ctrl+R) suffit généralement à rétablir la communication entre l’interface utilisateur et le serveur d’applications. Veillez également à désactiver temporairement les bloqueurs de scripts tiers ou de fenêtres publicitaires susceptibles d’interférer avec le moteur d’exécution JavaScript du module.
5. Étape 2 : Structuration et mise en forme rigoureuse du jeu de données
5.1 Disposition matricielle des données intra-sujets (Format Large)
La réussite de l’analyse statistique dans Google Sheets dépend fondamentalement du format structurel dans lequel la matrice de données est organisée. En science des données et en psychométrie, on distingue principalement deux formats d’agencement : le format long (long format), où chaque observation unique occupe une ligne indépendante avec des colonnes d’identification de condition, et le format large (wide format), où chaque sujet expérimental se voit attribuer une ligne unique et exclusive, tandis que les différentes modalités de la variable intra-sujet sont réparties horizontalement dans des colonnes adjacentes distinctes.
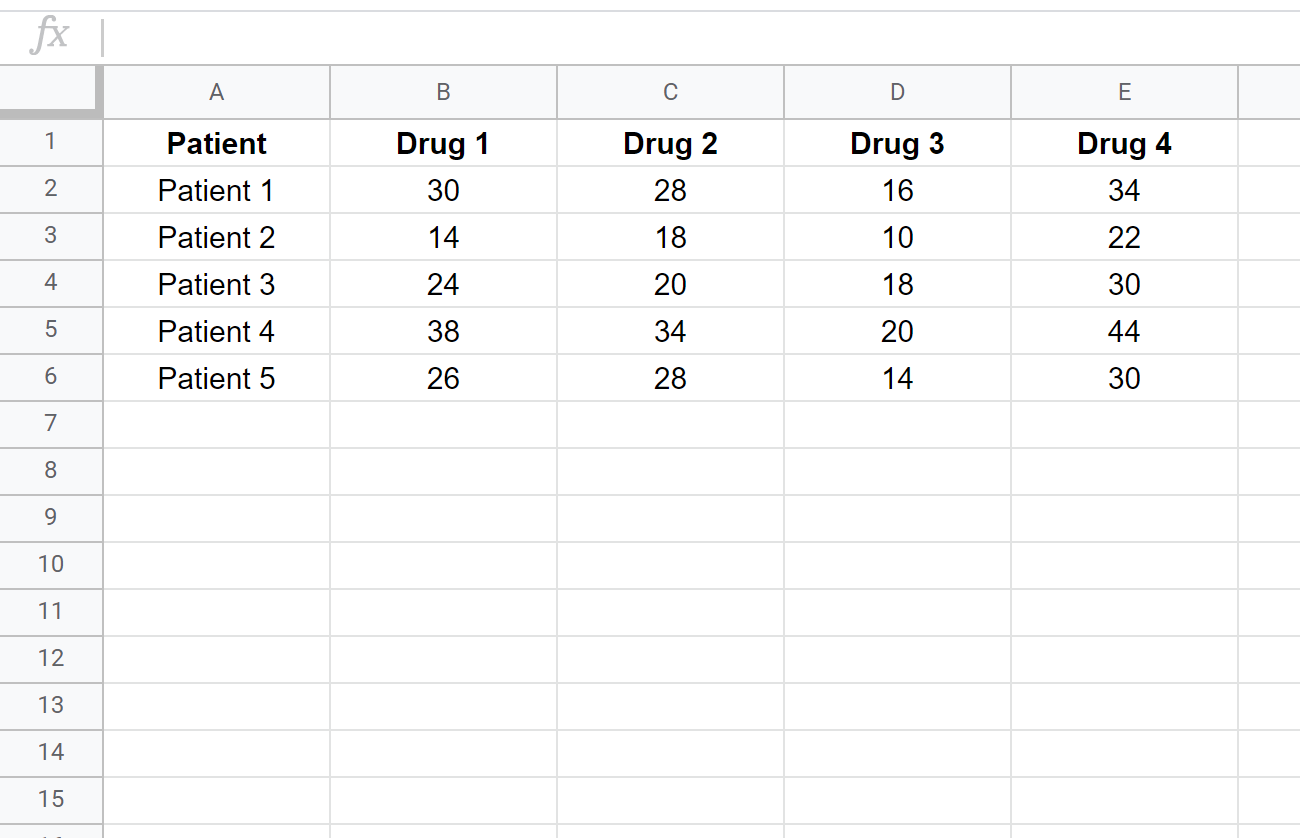
Pour l’ANOVA à mesures répétées exploitant l’utilitaire XLMiner ou les formules matricielles natives du tableur, l’adoption stricte du format large est impérative. La première colonne de la feuille (colonne A) doit impérativement être réservée à l’identifiant unique non ambigu de chaque participant (par exemple : Sujet_01, Sujet_02, etc.). Les colonnes subséquentes (B, C, D, etc.) doivent héberger les valeurs quantitatives de la variable dépendante recueillies dans chacune des conditions expérimentales testées.
Considérons à titre d’illustration clinique concrète une recherche en neuropharmacologie cognitive portant sur les effets de quatre substances psychotropes sur la vigilance attentionnelle, mesurée par les temps de réaction (en millisecondes) lors d’une tâche de détection de cibles visuelles. Quinze participants adultes ont été soumis successivement à l’ensemble des quatre conditions au sein d’un devis contrebalancé en double aveugle : Condition 1 (Placebo), Condition 2 (Caféine – 200 mg), Condition 3 (Modafinil – 100 mg), et Condition 4 (Molécule expérimentale X – 50 mg). Le tableau ci-dessous illustre la structure matricielle optimale que vous devez composer dans votre feuille de calcul :
- Ligne 1 (En-têtes) : Cellule A1 :
Participant| Cellule B1 :Placebo| Cellule C1 :Cafeine| Cellule D1 :Modafinil| Cellule E1 :Molecule_X - Lignes 2 à 16 (Observations individuelles) : Chaque ligne consigne les temps de réaction d’un sujet spécifique à travers les quatre conditions psychotropes.
L’attribution d’étiquettes de colonnes précises, dépourvues d’espaces typographiques complexes ou de caractères spéciaux réservés, est primordiale. Ces descripteurs textuels seront directement repris par le moteur analytique pour nommer les dimensions du tableau de sortie, facilitant grandement la traçabilité intellectuelle de vos conclusions empiriques.
5.2 Contrôle de l’intégrité et traitement des valeurs manquantes
L’une des contraintes mathématiques les plus inflexibles du modèle linéaire de l’ANOVA sans répétition réside dans son exigence d’une matrice d’observations strictement équilibrée et complète. La présence d’une seule cellule vide ou indéterminée au sein de la plage de données invalidera irrémédiablement l’exécution de l’algorithme sous XLMiner, déclenchant des messages d’erreur d’incompatibilité de dimensions de matrices.
Face à des valeurs manquantes — situation fréquente en recherche longitudinale en raison de désistements de participants (drop-out) ou de pannes instrumentales momentanées —, le chercheur est confronté à un arbitrage méthodologique rigoureux. La première option, la plus classique et conservatrice, consiste en la suppression par liste (listwise deletion) : tout participant présentant au moins une mesure manquante est purement et simplement extrait de la feuille d’analyse. Cette approche garantit la pureté des calculs mais s’accompagne d’une réduction mécanique de la taille de l’échantillon et d’une possible introduction de biais d’attrition si les défections ne sont pas aléatoires (Missing Completely at Random – MCAR).
La seconde alternative repose sur les méthodes d’imputation statistique. Dans le périmètre opérationnel de Google Sheets, l’imputation par la moyenne de la condition ou par la moyenne individuelle du sujet peut être techniquement envisagée, bien que ces techniques rudimentaires présentent l’inconvénient d’atténuer artificiellement la variance d’erreur résiduelle. Pour des protocoles complexes à fort taux de données manquantes, il est vivement conseillé de renoncer à l’ANOVA conventionnelle au profit de modèles mixtes linéaires (LMM) exécutés sous des environnements de programmation statistique dédiés.
Le contrôle préalable de l’intégrité implique également l’inspection minutieuse des valeurs aberrantes (outliers) univariées. Dans Google Sheets, appliquez un tri conditionnel ou utilisez les fonctions standardisées =CENTREE.REDUITE() (ou =STANDARDIZE()) sur chaque colonne conditionnelle. Tout score standardisé z excédant la valeur absolue de 3,0 (ou 3,29 selon les recommandations strictes de Tabachnick et Fidell) doit faire l’objet d’un examen approfondi : s’il résulte d’une erreur matérielle de saisie, il doit être rectifié ; s’il constitue une véritable performance extrême d’un sujet atypique, des techniques de winsorisation ou d’exclusion justifiée doivent être appliquées et documentées dans la section méthodologique du rapport de recherche.
5.3 Codage numérique et standardisation des unités
Un écueil technique fréquemment rencontré lors de la manipulation de jeux de données dans les tableurs infonuagiques concerne la mauvaise interprétation du format des cellules par le logiciel. Pour qu’une ANOVA s’exécute sans défaillance, l’intégralité des cellules constituant le corps de données quantitatives (plage B2:E16 dans notre exemple) doit être formellement reconnue comme des valeurs de type Nombre pur.
Prenez garde aux conventions typographiques de séparateurs décimaux, sources d’erreurs récurrentes lors de collaborations internationales. En fonction des paramètres régionaux configurés dans Google Sheets (accessibles via Fichier > Paramètres > Paramètres régionaux), le séparateur décimal peut être la virgule (norme francophone standard) ou le point (norme anglo-saxonne). Une valeur numérique enregistrée sous la forme 450.75 dans un environnement francophone configuré pour la virgule sera interprétée par le tableur comme une chaîne de caractères textuelle alphanumérique. Un alignement automatique de la valeur sur le bord gauche de la cellule signale généralement cette anomalie textuelle, alors qu’une donnée numérique authentique s’aligne automatiquement sur le bord droit.
Standardisez rigoureusement vos unités de mesure avant d’engager les calculs. Dans notre exemple chronométrique, veillez à ce que l’ensemble des latences soient converties de manière homogène en millisecondes entières (ex. : 425 ms) ou en fractions de secondes (ex. : 0,425 s), sans alternance arbitraire entre les colonnes. Pour assainir définitivement la matrice, sélectionnez l’ensemble des données numériques, ouvrez le menu Format > Nombre > Nombre, et définissez un affichage standardisé à deux décimales, tout en purgeant la plage d’éventuels caractères invisibles, tabulations ou espaces parasites par l’usage préventif de la fonction =SUPPRESPACE() si les données proviennent d’un export textuel externe brut.
6. Étape 3 : Configuration et exécution de l’analyse dans XLMiner
6.1 Sélection de la procédure analytique adéquate
Le panneau latéral de l’utilitaire XLMiner Analysis ToolPak étant déployé et votre jeu de données structuré selon les canons méthodologiques du format large, l’étape suivante consiste à identifier avec une rigueur absolue l’algorithme approprié au sein de l’arborescence analytique de l’extension. En examinant les options disponibles dans la section consacrée aux analyses de variance, trois dénominations distinctes vous sont proposées : Anova: Single Factor, Anova: Two-Factor With Replication, et Anova: Two-Factor Without Replication.
Le choix méthodologique impératif et exclusif pour exécuter une ANOVA à mesures répétées à un facteur réside dans la sélection du module intitulé Anova: Two-Factor Without Replication (Analyse de variance à deux facteurs sans répétition). Ce libellé peut, de prime abord, susciter la confusion conceptuelle chez le jeune chercheur habitué au vocabulaire psychométrique classique. Pourquoi qualifier une ANOVA à un facteur intra-sujet de modèle « à deux facteurs sans répétition » ?
La justification tient à l’équivalence mathématique stricte formalisée par le statisticien Ronald Fisher : un devis intra-sujet est formellement modélisé comme un plan factoriel croisé où la première variable indépendante est le facteur expérimental manipulé (les conditions de traitement, ici les substances psychotropes), et la seconde variable indépendante est constituée par les participants eux-mêmes, traités formellement comme un facteur aléatoire (ou bloc). L’absence de répétition (without replication) signifie qu’il n’y a qu’une seule mesure collectée pour chaque cellule d’intersection [Sujet * Condition], interdisant ainsi l’estimation d’un terme d’interaction distinct, ce dernier se confondant algébriquement avec l’erreur résiduelle non corrélée.
Sélectionner indûment le module Anova: Single Factor constituerait une erreur méthodologique gravissime, car ce dernier applique l’algorithme de l’ANOVA inter-sujets à groupes indépendants, amalgamant la variance des participants avec l’erreur résiduelle et anéantissant l’avantage statistique du devis apparié. Cliquez donc sur l’intitulé Anova: Two-Factor Without Replication pour déployer sa boîte de dialogue de paramétrage interactif.
6.2 Paramétrage des plages d’entrée et options d’analyse
L’interface de configuration du module Anova: Two-Factor Without Replication se compose de plusieurs paramètres d’entrée fondamentaux qu’il convient de renseigner avec une scrupuleuse minutie pour garantir l’exactitude des calculs matriciels.
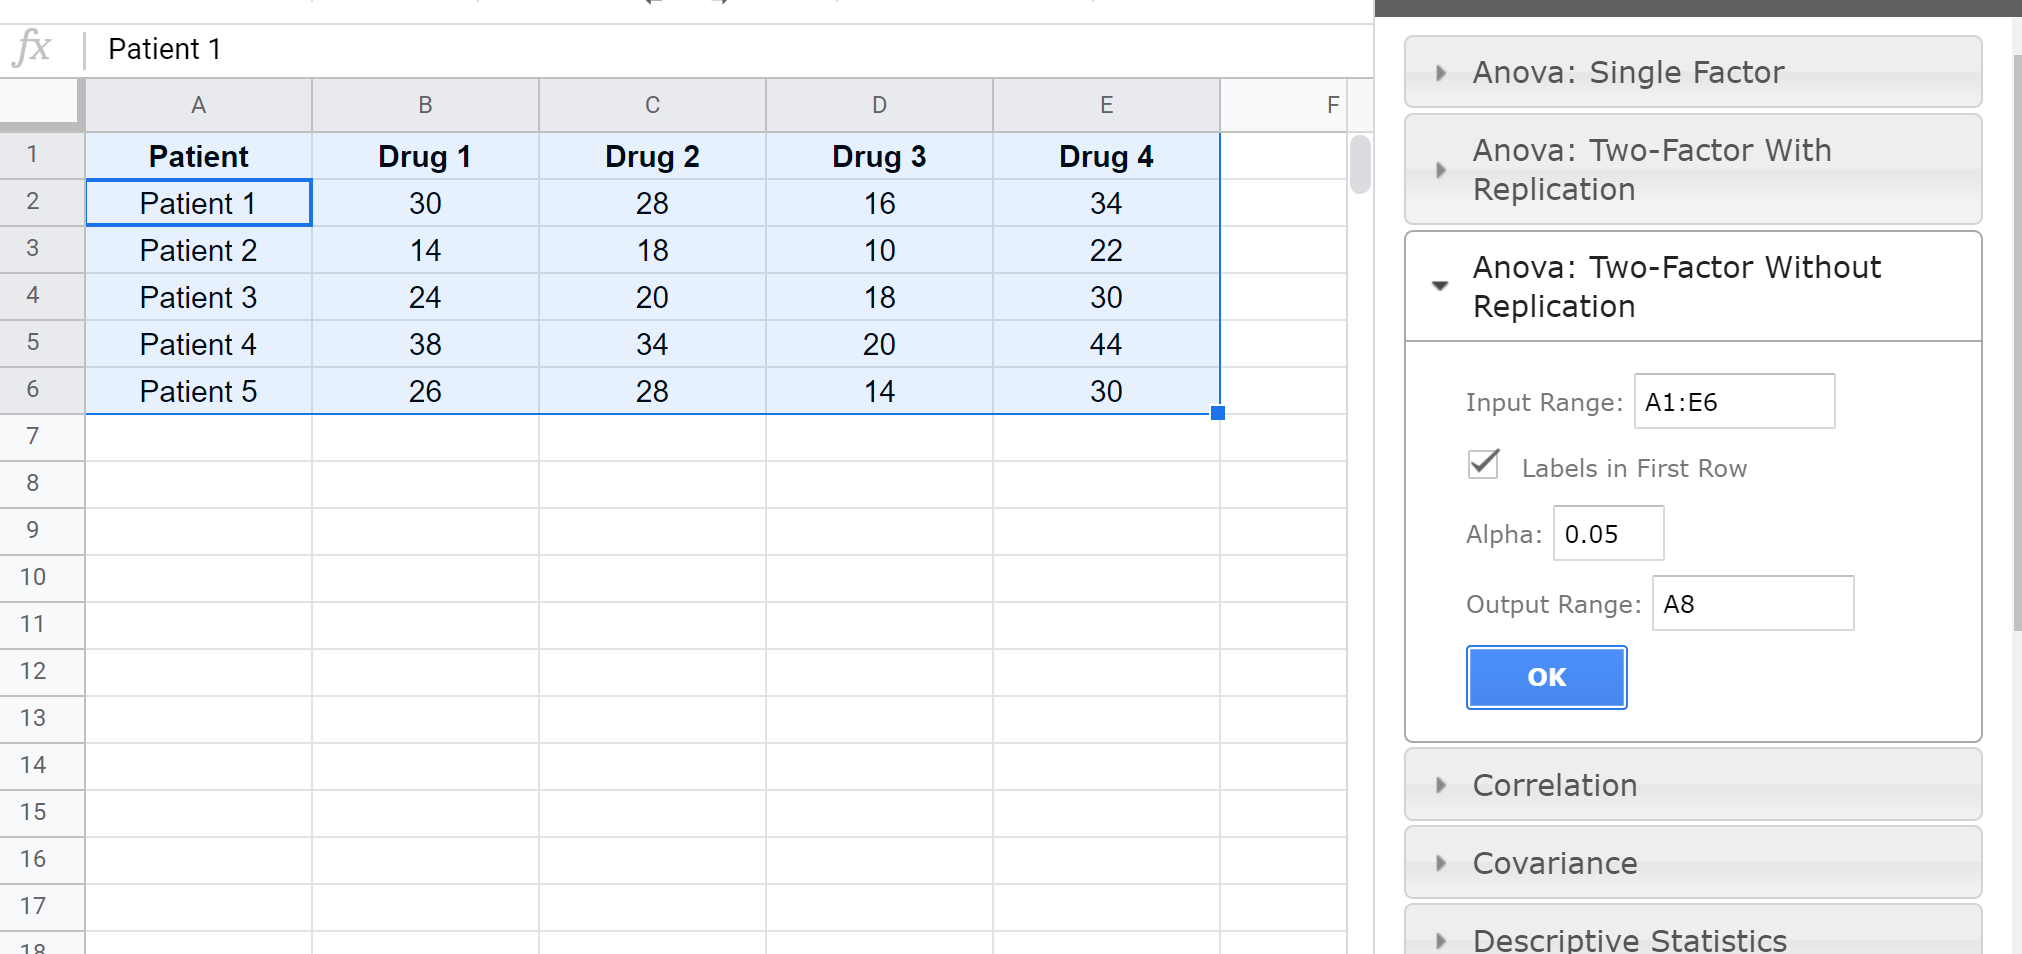
Le premier paramètre, intitulé Input Range (Plage d’entrée), exige la spécification de l’adresse des cellules englobant vos données. Dans le contexte de notre exemple illustratif comportant 15 sujets et 4 conditions, sélectionnez l’ensemble de la matrice depuis l’en-tête de la première condition jusqu’à la dernière valeur du dernier sujet, soit la plage B1:E16. Remarquez que nous excluons délibérément la colonne A (les identifiants nominatifs des sujets) de cette plage d’entrée, car l’algorithme traite intrinsèquement chaque ligne physique comme un niveau distinct du facteur Sujets.
Le deuxième élément de contrôle est la case à cocher Labels (Étiquettes). Si vous avez, conformément aux bonnes pratiques, inclus la première ligne de votre tableau (ligne 1 contenant « Placebo », « Cafeine », « Modafinil », « Molecule_X ») dans votre sélection d’Input Range, il est rigoureusement obligatoire de cocher la case Labels. Cette instruction prévient l’algorithme que les premières cellules ne contiennent pas de valeurs numériques exploitables, mais les descripteurs nominaux des conditions, évitant ainsi le rejet du calcul pour cause de données textuelles incompatibles.
Le troisième paramètre concerne la boîte de saisie Alpha, dédiée à la définition du seuil critique d’erreur de première espèce. Par défaut, l’outil initialise cette valeur à 0.05 (correspondant au seuil conventionnel de 5 %). Si les impératifs de votre recherche, notamment dans le cadre d’essais cliniques pharmacologiques précoces, exigent une plus grande sévérité décisionnelle, vous pouvez modifier ce champ pour stipuler un seuil plus conservateur, tel que 0.01.
Enfin, le volet de sortie requiert la sélection d’une option d’atterrissage des résultats. L’outil vous propose généralement de générer le rapport dans une nouvelle feuille (New Worksheet) ou d’insérer les matrices dérivées dans la feuille de calcul courante. Il est vivement recommandé de cocher l’option Output Range et de désigner une cellule cible dégagée, par exemple G1. Cette configuration permet de juxtaposer directement les données sources brutes et les tableaux statistiques résultants, offrant une vision synoptique immédiate de l’ensemble du flux de traitement.
6.3 Exécution de l’algorithme et vérification du rapport généré
Une fois les coordonnées de la plage d’entrée scrupuleusement vérifiées, la case Labels dûment activée et la cellule de destination assignée, formalisez le lancement de l’analyse en cliquant sur le bouton bleu intitulé OK (ou Run selon les versions du script) situé dans la partie inférieure du panneau de commande.
L’exécution de la procédure s’opère quasi instantanément dans l’environnement infonuagique. Le moteur JavaScript calcule les sommes marginales, dérive les variances partielles et implémente les lois de distribution théoriques de F pour dresser une série de tableaux synthétiques structurés à partir de la cellule d’ancrage spécifiée (G1 dans notre cas). Pendant cette phase de calcul, gardez un œil sur le haut du volet XLMiner : l’apparition d’un bandeau d’alerte rouge signale une erreur de paramétrage (généralement liée à une cellule manquante résiduelle, un format textuel accidentel au sein de la plage ou une sélection de plage asymétrique).
Dès l’apparition des résultats, procédez à un audit de cohérence de base. Vérifiez immédiatement dans le tableau descriptif supérieur que le nombre d’observations décomptées (Count) pour chacune des colonnes correspond scrupuleusement au nombre effectif de vos participants (Count = 15). De même, vérifiez que le nombre de rangées répertoriées reflète fidèlement la taille de votre échantillon et que le nombre de colonnes d’analyse correspond aux 4 conditions de votre protocole expérimental. Cette vérification rapide garantit qu’aucune ligne ni colonne n’a été tronquée lors de la phase de sélection géométrique sur le tableur.
7. Décomposition mathématique et calcul alternatif via formules natives Google Sheets
7.1 Calcul manuel des sommes des carrés (SS)
Bien que l’utilitaire XLMiner automatise l’obtention des résultats, tout chercheur rigoureux et tout étudiant avancé en méthodologie psychologique se doit de comprendre l’architecture mathématique interne qui sous-tend la dérivation de la statistique d’inférence. La mise en œuvre des calculs par le biais exclusif des fonctions intégrées et des formules matricielles de Google Sheets représente un exercice pédagogique inestimable garantissant une maîtrise absolue du modèle linéaire, tout en s’affranchissant totalement de la dépendance envers un module tiers.
Posons les notations formelles : soit n le nombre de sujets (lignes, n = 15), k le nombre de conditions de traitement (colonnes, k = 4), et N = n * k le volume total d’observations collectées dans l’expérience (N = 60). Désignons par X_ij la valeur observée pour le sujet i dans la condition j, par T_i la somme totale des scores obtenus par le sujet i à travers les k conditions, par C_j la somme totale des scores obtenus dans la condition j à travers les n sujets, et par G la somme globale de l’intégralité des N observations du protocole.
Le calcul du terme de correction global (C), indispensable à la formulation algébrique rapide des sommes des carrés, s’obtient via la formule : C = G^2 / N. Dans Google Sheets, en supposant que votre matrice de données numériques brutes occupe la plage B2:E16, la somme globale G s’écrit =SOMME(B2:E16), et le terme de correction s’obtient directement par =(SOMME(B2:E16)^2)/60.
1. La Somme des Carrés Totale (SST) mesure la dispersion absolue de tous les points de données individuels par rapport à la moyenne générale. Sa formule algébrique brute est SST = Somme(X_ij^2) – C. Dans le tableur, elle se calcule avec une remarquable concision grâce à la fonction de somme des carrés :
=SOMME.CARRES(B2:E16) - ((SOMME(B2:E16)^2)/60)
2. La Somme des Carrés Inter-Sujets (SS_sujets ou Rows) quantifie la variance stable attribuable aux différences morphologiques, cognitives ou psychologiques individuelles entre les participants. Elle s’obtient en divisant la somme des carrés des totaux individuels par le nombre de conditions k, puis en soustrayant le terme de correction C. Si vous créez une colonne F calculant la somme horizontale de chaque sujet via =SOMME(B2:E2) étirée jusqu’à la ligne 16, la formule s’écrit :
=(SOMME.CARRES(F2:F16)/4) - ((SOMME(B2:E16)^2)/60)
3. La Somme des Carrés du Traitement (SS_traitement ou Columns) traduit l’effet direct de la manipulation expérimentale (les quatre psychotropes). Elle s’obtient en calculant la somme des carrés des totaux de chaque condition C_j, divisée par le nombre de participants n, moins le terme de correction C. En inscrivant la somme de chaque colonne sur la ligne 17 via =SOMME(B2:B16) jusqu’en colonne E, la formule s’articule comme suit :
=(SOMME.CARRES(B17:E17)/15) - ((SOMME(B2:E16)^2)/60)
4. La Somme des Carrés Résiduelle (SS_erreur) représente l’interaction non systématique Sujet * Traitement et capture le bruit expérimental pur. Grâce à la propriété d’orthogonalité additive de la partition de la variance, elle s’obtient simplement par déduction et soustraction des composantes précédemment isolées :
SS_erreur = SST - SS_sujets - SS_traitement
7.2 Attribution des degrés de liberté (ddl) correspondants
Chaque source de variation décomposée dans l’espace multidimensionnel des données est associée à un nombre précis de degrés de liberté (degrees of freedom ou ddl), représentant le nombre de dimensions indépendantes le long desquelles les observations ou les paramètres statistiques peuvent varier librement sans enfreindre les contraintes linéaires imposées par le modèle.
Pour le facteur inter-sujets (les rangées du tableau), le nombre de degrés de liberté est directement dicté par la taille de l’échantillon d’individus décrémentée d’une unité, reflétant la contrainte d’estimation de la moyenne globale de l’échantillon :
ddl_sujets = n - 1 (dans notre cas clinique concret : 15 – 1 = 14 ddl).
Pour le facteur de traitement intra-sujet (les colonnes expérimentales), les degrés de liberté correspondent au nombre de modalités ou de conditions d’évaluation diminué d’une unité :
ddl_traitement = k - 1 (soit 4 – 1 = 3 ddl).
Pour l’erreur résiduelle non corrélée (l’interaction pure entre les sujets et les conditions), les degrés de liberté sont mathématiquement définis par le produit arithmétique des degrés de liberté associés aux deux composantes primaires :
ddl_erreur = (n - 1) * (k - 1) (dans notre protocole : 14 * 3 = 42 ddl).
Enfin, le total général des degrés de liberté est égal au nombre brut absolu d’observations expérimentales N diminué d’une unité, obéissant rigoureusement à la règle sommative fondamentale ddl_total = ddl_sujets + ddl_traitement + ddl_erreur :
ddl_total = (n * k) - 1 (soit 60 – 1 = 59 ddl ; et nous vérifions aisément la cohérence arithmétique : 14 + 3 + 42 = 59).
7.3 Calcul des carrés moyens et dérivation de la statistique F
Les sommes des carrés étant tributaires du volume numérique de points de données agrégés, elles ne peuvent être comparées directement pour inférer des rapports de variance sans être préalablement standardisées par leurs dimensions respectives. Cette normalisation géométrique s’effectue par l’opération des Carrés Moyens (Mean Squares ou MS), qui consiste à diviser chaque somme des carrés par son degré de liberté correspondant.
Dans votre feuille de calcul personnalisée, vous pouvez consigner les deux ratios fondamentaux nécessaires au test d’hypothèse :
- Carré Moyen du Traitement (MS_traitement) :
MS_traitement = SS_traitement / ddl_traitement. Cette quantité estime la variance attribuable à l’effet de nos différentes substances psychotropes additionnée à la variance d’erreur résiduelle. - Carré Moyen de l’Erreur (MS_erreur) :
MS_erreur = SS_erreur / ddl_erreur. Cette quantité fournit une estimation non biaisée du bruit d’erreur aléatoire pur au sein du modèle intra-sujet.
La statistique inférentielle directrice, le rapport F de Fisher-Snedecor pour l’effet du traitement, se définit alors comme le quotient systématique entre le carré moyen de la manipulation expérimentale et le carré moyen de l’erreur résiduelle :
F = MS_traitement / MS_erreur
Pour convertir ce ratio F empirique en une probabilité d’inférence exacte (la p-valeur) sans feuilleter des tables statistiques papier d’un autre âge, Google Sheets met à disposition la fonction statistique intégrée LOI.F.DROITE (ou F.DIST.RT en syntaxe anglo-saxonne). La syntaxe universelle à saisir dans la cellule de décision se formalise comme suit :
=LOI.F.DROITE(valeur_F; ddl_traitement; ddl_erreur)
En insérant les références précises de vos cellules hébergeant le ratio F calculé (ex. cellule H20), la valeur 3 (ddl numérateur) et la valeur 42 (ddl dénominateur), Google Sheets calcule instantanément la probabilité exacte d’observer un ratio de variance au moins aussi extrême que celui obtenu dans votre protocole expérimental sous l’hypothèse nulle d’égalité stricte des moyennes conditionnelles.
8. Étape 4 : Interprétation clinique et statistique des résultats obtenus
8.1 Compréhension des tableaux récapitulatifs descriptifs
L’exécution de la procédure analytique (qu’elle émane du module XLMiner Analysis ToolPak ou de la construction manuelle par formules intégrées) génère en premier lieu une section intitulée SUMMARY. Cette production descriptive est fondamentale et doit toujours être inspectée avant de poser le regard sur le tableau d’inférence, car elle donne corps et substance clinique aux données numériques pures.
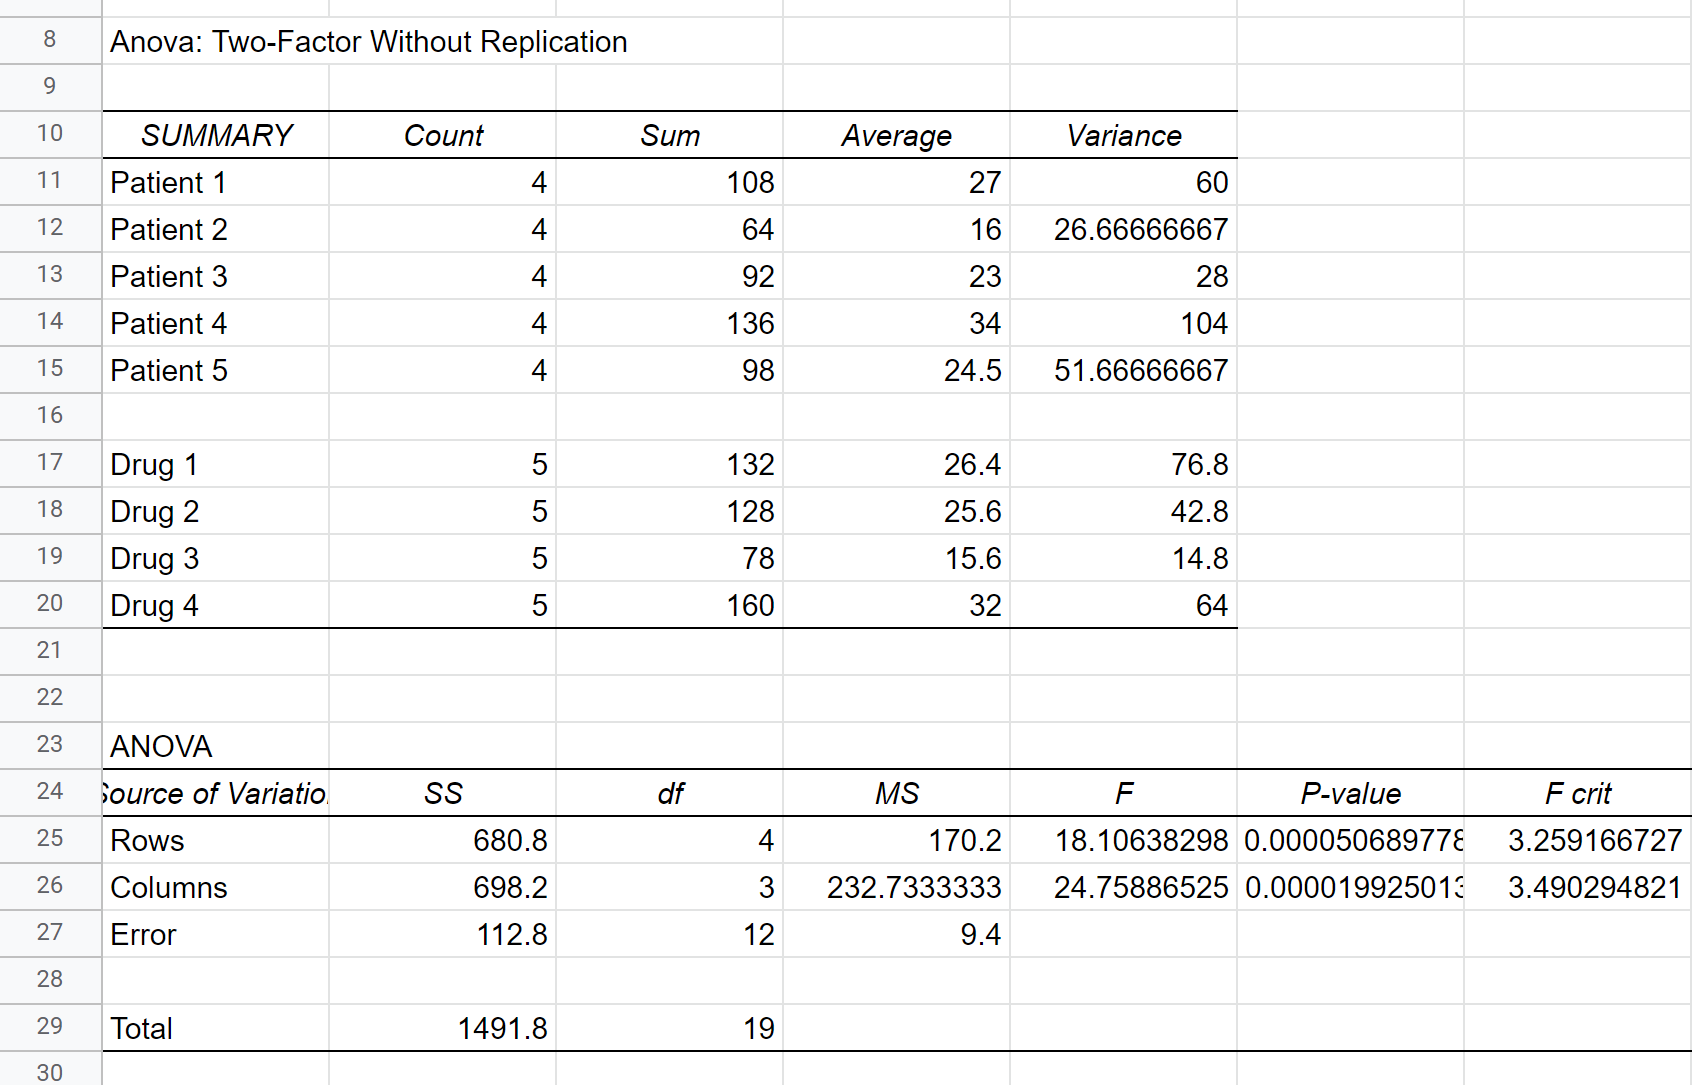
Ce volet descriptif est scindé en deux sous-sections distinctes : la synthèse des rangées (Rows) et la synthèse des colonnes (Columns). La synthèse des rangées illustre les caractéristiques statistiques de chaque participant pris isolément à travers les quatre conditions expérimentales. Vous y observerez le volume de tâches accomplies par sujet (Count = 4), la somme cumulée de ses temps de réaction, sa moyenne chronométrique individuelle globale ainsi que sa variance interne. L’examen des moyennes individuelles permet d’objectiver l’hétérogénéité basale de l’échantillon : certains sujets présentent un profil général rapide (ex. moyenne de 320 ms), tandis que d’autres manifestent une latence globale accrue (ex. moyenne de 510 ms), confirmant la pertinence méthodologique d’avoir extrait cette variance interindividuelle du dénominateur d’erreur.
La seconde sous-section descriptive, dédiée aux colonnes, présente l’intérêt clinique le plus immédiat en décrivant le profil de réponse comportementale pour chaque niveau du traitement pharmacologique. Pour chaque substance (Placebo, Caféine, Modafinil, Molécule X), le tableau stipule le nombre de participants testés (Count = 15), la somme cumulée des latences, la moyenne d’échantillon conditionnelle ainsi que la variance associée. C’est à ce niveau que se dessinent visuellement les trajectoires de performance : par exemple, une moyenne de 445 ms pour le Placebo, 395 ms pour la Caféine, 360 ms pour le Modafinil et 375 ms pour la Molécule X suggère une facilitation cognitive globale induite par les agents stimulants comparativement au groupe contrôle inactif.
8.2 Lecture critique du tableau de l’ANOVA
Le second tableau généré, formellement intitulé ANOVA, constitue la pièce maîtresse du diagnostic inférentiel. Sa structure se présente sous la forme d’une matrice standardisée croisant les sources d’hétérogénéité (Source of Variation) avec les métriques d’estimation : Somme des Carrés (SS), Degrés de Liberté (df), Carrés Moyens (MS), Statistique empirique (F), Probabilité critique (P-value), et Valeur F seuil théorique (F crit).
Pour décrypter ce tableau avec une rigueur professionnelle, il convient de localiser et d’isoler trois rangées fondamentales :
- La ligne Rows (Rangées) : Elle quantifie l’effet inter-sujets (la variabilité stable d’un participant à l’autre). Bien que XLMiner calcule une valeur F et une p-valeur pour cette rangée, cette information est généralement ignorée dans les rapports scientifiques traditionnels, son rôle principal étant d’avoir soustrait avec succès cette immense masse de variabilité du terme résiduel.
- La ligne Columns (Colonnes) : C’est la ligne focale exclusive de votre recherche expérimentale ! Elle synthétise l’effet principal de votre variable indépendante intra-sujet (l’impact des différentes substances psychotropes). C’est sur cette rangée précise que vous devez relever la statistique F observée, sa p-valeur exacte ainsi que ses degrés de liberté associés (numérateur df = 3).
- La ligne Error (Erreur) : Elle consigne la somme des carrés résiduelle et le carré moyen d’erreur (MS_erreur, dénominateur du test F). Les degrés de liberté de cette ligne (df = 42) constituent le dénominateur fondamental pour la qualification du test d’inférence.
La colonne F crit stipule la borne statistique théorique que votre F observé devait impérativement dépasser pour atteindre le seuil de signification de 5 % en fonction de la distribution de Fisher sous les degrés de liberté considérés [F(3, 42)]. Si votre valeur F calculée est substantiellement supérieure à F crit, votre p-valeur sera automatiquement inférieure à 0,05, signalant un effet omnibus statistiquement significatif.
8.3 Prise de décision statistique relative aux hypothèses de recherche
La conclusion formelle de l’analyse inférentielle est gouvernée par l’application stricte d’une règle de décision déterministe confrontant la p-valeur observée au seuil d’erreur alpha prédéfini lors de la phase de cadrage théorique (typiquement alpha = 0,05).
Si la p-valeur est rigoureusement inférieure à alpha (par exemple, p = 0,0004 < 0,05), la décision méthodologique s’impose sans équivoque : le chercheur rejette l’hypothèse nulle (H0) en faveur de l’hypothèse alternative (H1). Sur le plan conceptuel et empirique, ce résultat démontre avec un risque d’erreur probabiliste maîtrisé que la nature de la substance administrée exerce une influence systématique statistiquement significative sur les temps de réaction des participants. On affirme alors que les performances motrices et attentionnelles ne sont pas distribuées de manière uniforme à travers les quatre conditions thérapeutiques.
Inversement, si la p-valeur est supérieure ou égale au seuil alpha (par exemple, p = 0,18 > 0,05), la prudence épistémologique exige que le chercheur échoue à rejeter l’hypothèse nulle (non-rejet de H0). Il est formellement incorrect en méthodologie scientifique d’affirmer que « l’hypothèse nulle est acceptée ou prouvée » ; la conclusion adéquate stipule simplement que les données empiriques recueillies au sein de cet échantillon ne fournissent pas de preuves statistiques suffisamment probantes pour discréditer l’invariance des performances moyennes à travers les conditions explorées.
Dans notre cas de figure illustratif, l’obtention d’un ratio F largement significatif autorise la validation de la manipulation expérimentale : les différentes molécules psychotropes modulent bel et bien la vigilance humaine de façon différentielle. Toutefois, l’ANOVA omnibus ne précisant pas la hiérarchie relative des substances, le chercheur doit désormais quantifier l’ampleur générale de ce phénomène et cartographier les contrastes conditionnels par des analyses post-hoc ciblées.
9. Évaluation de la magnitude de l’effet : Calcul de l’êta-carré partiel
9.1 Importance de la taille d’effet en complément du test de significativité
Au cours des dernières décennies, la communauté des méthodologistes et les comités éditoriaux des plus prestigieuses revues de psychologie — sous l’égide de l’American Psychological Association (APA) — ont vigoureusement dénoncé les dérives interprétatives inhérentes à la dépendance exclusive envers le test de signification de l’hypothèse nulle (NHST). La p-valeur est une fonction mécanique conjointe de deux paramètres : l’amplitude réelle du phénomène biologique et la taille de l’échantillon expérimental.
Dans des cohortes de très grande taille, un effet expérimental infinitésimal, sans aucune pertinence théorique ou utilité clinique concrète, peut aisément franchir le seuil fatidique de p < 0,05. Réciproquement, dans des protocoles cliniques restreints impliquant des pathologies rares, un effet thérapeutique massif peut échouer à atteindre la significativité statistique en raison d’un manque conjoncturel de puissance d’échantillonnage. Dès lors, la quantification systématique de la magnitude de l’effet au moyen d’indices standardisés s’avère non seulement recommandée, mais impérativement requise pour toute communication scientifique digne de confiance.
Dans le domaine de l’ANOVA, la mesure de taille d’effet traditionnellement privilégiée est l’êta-carré (eta^2). Cependant, dans le cadre spécifique des devis à mesures répétées, une distinction capitale doit être opérée entre l’êta-carré classique et l’êta-carré partiel (désigné sous la notation symbolique eta_p^2). L’êta-carré classique rapporterait la variance du traitement à la variance totale absolue (incluant la variance inter-sujets), ce qui pénaliserait lourdement l’estimation de l’effet en ne tenant pas compte de la réduction d’erreur propre au devis intra-sujet. L’êta-carré partiel isole au contraire la part de variance expliquée par le traitement en excluant délibérément la variance inter-sujets de son dénominateur de référence.
9.2 Formule et implémentation de l’êta-carré partiel dans Google Sheets
La formulation algébrique standardisée de l’êta-carré partiel pour un devis à mesures répétées s’articule exclusivement autour des sommes des carrés du modèle :
eta_p^2 = SS_traitement / (SS_traitement + SS_erreur)
Cette métrique exprime la proportion de la variance intra-sujets totale (somme de la variance induite par la manipulation et de l’erreur résiduelle inexpliquée) qui est directement imputable à l’intervention expérimentale. Sa valeur théorique est strictement bornée à l’intérieur du continuum mathématique [0, 1]. Un indice de 0 indique une absence totale de variance expliquée, tandis qu’un score de 1 correspondrait à un déterminisme expérimental parfait sans le moindre résidu d’erreur stochastique.
Pour implémenter cette formule dynamique au sein de votre environnement Google Sheets en aval des résultats générés par XLMiner :
- Identifiez la cellule contenant la somme des carrés du traitement (la valeur SS sur la ligne Columns, située typiquement en cellule
I22de votre tableau généré). - Identifiez la cellule contenant la somme des carrés d’erreur (la valeur SS sur la ligne Error, située typiquement en cellule
I24). - Dans une cellule adjacente dégagée, composez la formule suivante :
=I22 / (I22 + I24)
Alternativement, si vous souhaitez dériver l’êta-carré partiel directement à partir des statistiques inférentielles de test (F) et des degrés de liberté associés, vous pouvez exploiter la formule algébrique équivalente extrêmement pratique :
eta_p^2 = (F * ddl_traitement) / ((F * ddl_traitement) + ddl_erreur)
Dans Google Sheets, en référençant la cellule hébergeant le ratio F (ex. K22), la syntaxe s’exécute par : =(K22*3)/((K22*3)+42). Vous constaterez une stricte convergence décimale entre les deux approches de calcul.
9.3 Grille d’interprétation selon les repères conventionnels de Cohen
L’interprétation qualitative de la magnitude de l’êta-carré partiel repose traditionnellement sur la taxonomie canonique formalisée par le statisticien Jacob Cohen dans ses travaux fondateurs sur l’analyse de puissance en sciences du comportement :
- Effet de faible amplitude (eta_p^2 = 0,01) : Le traitement expérimental explique approximativement 1 % de la variance intra-sujets. Bien que potentiellement significatif sur de vastes cohortes, un tel effet reflète une modulation discrète qui n’exerce qu’un impact marginal au niveau individuel.
- Effet d’amplitude modérée ou intermédiaire (eta_p^2 = 0,06) : Le traitement explique environ 6 % de la variance intra-sujets. Cette magnitude est représentative des phénomènes régulièrement documentés dans la littérature en psychologie sociale ou cognitive expérimentale standard.
- Effet de forte amplitude ou robuste (eta_p^2 >= 0,14) : Le facteur manipulé explique 14 % ou plus de la variance résiduelle disponible. Un tel indice caractérise des effets robustes, souvent perceptibles cliniquement, indiquant qu’une part prépondérante des modifications comportementales observées est attribuable au protocole expérimental testé.
Il importe toutefois de nuancer ces seuils génériques en fonction de la sous-discipline psychologique considérée. En neuropsychologie cognitive de laboratoire utilisant des paradigmes de temps de réaction ultra-standardisés, des êta-carrés partiels de l’ordre de 0,25 à 0,40 sont fréquemment documentés en raison du faible niveau de bruit instrumental. À l’inverse, dans les études de psychologie clinique appliquée ou de psychothérapie longitudinale où l’influence des déterminants environnementaux externes reste majeure, un eta_p^2 de 0,08 peut déjà incarner une percée thérapeutique d’une portée pratique remarquable.
10. Analyses post-hoc et ajustement pour comparaisons multiples
10.1 Nécessité des tests d’hypothèses a posteriori
L’obtention d’une statistique F omnibus statistiquement significative confirme l’existence d’une hétérogénéité systématique au sein de la famille des k moyennes conditionnelles. Cependant, comme explicité lors de la formalisation théorique, cette découverte globale ne résout aucunement la question de la localisation précise des divergences : quelles conditions se démarquent-elles spécifiquement du groupe témoin ? Existe-t-il une différence significative entre la condition Caféine et la condition Modafinil ? La Molécule X surpasse-t-elle le Placebo de manière probante ?
Pour répondre à ces interrogations ciblées, la conduite de comparaisons multiples par paires (tests post-hoc) est incontournable. Toutefois, cette démarche expose immédiatement le chercheur au péril méthodologique de l’inflation de l’erreur globale de type I (communément qualifiée de family-wise error rate ou FWER). Si l’on applique le seuil alpha standard de 0,05 à plusieurs tests statistiques successifs au sein d’un même jeu de données, la probabilité cumulée de commettre au moins un faux positif s’accroît de façon exponentielle.
Le nombre total de comparaisons binaires distinctes possibles au sein d’un protocole comportant k conditions se calcule par la formule combinatoire m = k * (k – 1) / 2. Dans notre recherche clinique comportant 4 conditions psychotropes, le chercheur peut réaliser m = 4 * 3 / 2 = 6 comparaisons bilatérales distinctes. Sans correction statistique, la probabilité théorique de commettre au moins une erreur de première espèce sur l’ensemble de ces six tests atteindrait :
alpha_cumule = 1 - (1 - 0,05)^6 = 1 - (0,95)^6 = 0,2649 (soit plus de 26,5 %) !
Il est donc impératif d’assujettir ces tests unitaires à des procédures d’ajustement strictes préservant le risque alpha global à son niveau nominal de 5 %.
10.2 Réalisation de tests t de Student appariés successifs
Dans l’environnement de travail Google Sheets, les tests post-hoc se concrétisent par la réalisation successive de tests t de Student pour échantillons dépendants (appariés) sur chaque paire de conditions expérimentales. Le tableur dispose nativement d’une fonction analytique hautement optimisée à cet effet : la fonction TEST.T (ou T.TEST en notation anglo-saxonne).
La syntaxe opératoire de la fonction TEST.T s’articule autour de quatre arguments paramétriques précis :
=TEST.T(plage_données_1; plage_données_2; queues; type)
- plage_données_1 et plage_données_2 : Les coordonnées des deux colonnes expérimentales à comparer (par exemple,
B2:B16pour le Placebo etC2:C16pour la Caféine). - queues : La directionnalité de l’hypothèse. Sauf justification théorique préalable très stricte, choisissez systématiquement la valeur
2pour un test bilatéral (à deux queues), garantissant une rigueur conventionnelle maximale. - type : La nature structurelle du test d’échantillonnage. C’est ici que réside l’élément critique : vous devez impérativement renseigner la valeur
1, qui ordonne au logiciel d’exécuter un test t sur échantillons appariés (mesures répétées). Une valeur de 2 ou 3 correspondrait à des groupes indépendants et violerait l’architecture de votre devis de recherche.
Il est particulièrement élégant de construire, directement sous vos tableaux d’ANOVA dans Google Sheets, une matrice triangulaire de comparaisons bilatérales recensant les six contrastes possibles. Vous y inscrirez les formules croisées :
- Placebo vs Caféine :
=TEST.T(B2:B16; C2:C16; 2; 1) - Placebo vs Modafinil :
=TEST.T(B2:B16; D2:D16; 2; 1) - Placebo vs Molécule X :
=TEST.T(B2:B16; E2:E16; 2; 1) - Caféine vs Modafinil :
=TEST.T(C2:C16; D2:D16; 2; 1) - Caféine vs Molécule X :
=TEST.T(C2:C16; E2:E16; 2; 1) - Modafinil vs Molécule X :
=TEST.T(D2:D16; E2:E16; 2; 1)
10.3 Application manuelle des corrections statistiques de Bonferroni et Holm
Les valeurs p obtenues directement via la fonction TEST.T constituent des p-valeurs brutes (non ajustées). Si vous les comparez directement au seuil de 0,05, vous vous rendez coupable de l’inflation de l’erreur FWER précédemment décrite. Deux méthodes mathématiques manuelles s’offrent alors à vous dans Google Sheets pour réguler ces seuils de manière irréprochable.
La première technique, la plus universellement connue, est la correction de Bonferroni classique. Elle consiste à diviser le seuil alpha nominal par le nombre total de comparaisons réalisées : alpha_ajusté = alpha / m. Pour nos six tests, le seuil de significativité corrigé devient : 0,05 / 6 = 0,00833. Dès lors, seules les comparaisons dont la p-valeur brute est inférieure à 0,00833 seront déclarées statistiquement significatives au seuil global de 5 %. De manière équivalente et plus pratique pour la rédaction scientifique, vous pouvez calculer la p-valeur ajustée de Bonferroni en multipliant simplement la p-valeur brute par m via la formule : =MIN(1; p_brute * 6).
Bien que d’une remarquable simplicité algorithmique, la correction de Bonferroni est souvent critiquée pour son ultra-conservatisme, susceptible d’induire une inflation dommageable des erreurs de seconde espèce (type II). Pour pallier cette rigidité, la méthode séquentielle descendante de Holm-Bonferroni constitue une alternative nettement plus puissante tout en maintenant un contrôle absolu du FWER. Sa mise en œuvre s’opère par étapes méthodiques :
- Triez vos m comparaisons multiples par ordre croissant des p-valeurs brutes observées (du plus petit p au plus grand p), en les indexant de i = 1 à i = m.
- Pour le premier test (i = 1, la p-valeur la plus faible), comparez le résultat brut au seuil corrigé :
alpha / (m - i + 1), soit ici0,05 / (6 - 1 + 1) = 0,05 / 6 = 0,00833. Si p < 0,00833, le rejet de H0 est prononcé pour ce premier contraste et vous passez au rang suivant. - Pour le second test (i = 2), le seuil critique s’assouplit :
0,05 / (6 - 2 + 1) = 0,05 / 5 = 0,0100. Si la seconde p-valeur est inférieure à 0,010, elle est déclarée significative et vous poursuivez. - Pour le troisième test (i = 3), le seuil devient
0,05 / 4 = 0,0125, pour le quatrième0,05 / 3 = 0,0167, pour le cinquième0,05 / 2 = 0,025, et pour le dernier test (i = 6), le seuil retrouve sa valeur nominale de0,05 / 1 = 0,050. - Règle d’arrêt séquentielle : Dès qu’un test donné échoue à franchir son seuil critique associé, la procédure est immédiatement stoppée ! L’hypothèse nulle est maintenue pour cette comparaison ainsi que pour toutes les comparaisons résiduelles subséquentes, indépendamment de leurs p-valeurs numériques individuelles.
11. Visualisation graphique des données intra-sujets pour publication
11.1 Conception d’un graphique linéaire de profils moyens
La communication scientifique moderne exige une transposition iconographique soignée des patterns quantitatifs mis en évidence par les tests d’inférence. Dans le cadre d’un devis à mesures répétées, l’objectif visuel prioritaire consiste à illustrer la trajectoire de la performance à travers les différentes conditions ou étapes temporelles de l’étude. Le format graphique de prédilection est incontestablement le graphique linéaire de profils de moyennes (ou graphique en courbes et points de dispersion).
Pour concevoir ce support au sein de Google Sheets, commencez par isoler un petit tableau récapitulatif synthétisant les noms des conditions dans la première colonne et les moyennes empiriques correspondantes dans la seconde (valeurs dérivées du tableau SUMMARY de XLMiner ou obtenues via la formule =MOYENNE(B2:B16)). Sélectionnez cette plage compacte, puis cliquez sur le menu supérieur Insertion > Graphique. Dans le panneau de configuration graphique latéral qui s’affiche, modifiez le type de graphique par défaut au profit d’un Graphique en courbes (ou Graphique en nuage de points avec lignes de connexion).
Afin de conformer l’esthétique du visuel aux normes de sobriété imposées par les comités de lecture internationaux, éliminez tout artifice décoratif superflu susceptible de parasiter la transmission de l’information (respect du concept de data-ink ratio théorisé par Edward Tufte). Supprimez l’arrière-plan coloré pour garantir un fond blanc immaculé, paramétrez les lignes de quadrillage majeures dans des tons de gris très pâle et assignez une typographie formelle (telle qu’Arial, Calibri ou Times New Roman) d’une taille minimale de 10 à 12 points pour assurer une parfaite lisibilité après réduction éditoriale. L’axe des ordonnées (axe Y) doit impérativement comporter un titre explicite intégrant les unités physiques de mesure (ex. : « Temps de réaction moyen (ms) »).
11.2 Intégration d’intervalles de confiance et de barres d’erreur intra-sujets
L’écueil méthodologique le plus sévère et le plus répandu dans la visualisation des devis à mesures répétées réside dans l’adjonction de barres d’erreur conventionnelles fondées sur l’écart-type ou l’erreur-type inter-sujets classique. L’erreur-type standard incorpore l’ensemble de la variabilité stable entre individus ; or, comme nous l’avons théoriquement démontré, cette variabilité est totalement neutralisée dans le calcul du F de l’ANOVA intra-sujet. Afficher des barres d’erreur standards sur un graphique de mesures répétées conduit visuellement à une surreprésentation aberrante de l’imprécision du modèle, donnant l’impression trompeuse que des moyennes largement significatives se chevauchent de manière interchangeable.
Pour résoudre cette distorsion de représentation, la méthodologie contemporaine impose l’usage de barres d’erreur ajustées pour mesures répétées, formalisées par la célèbre méthode de normalisation de Cousineau-Morey. Cette procédure algorithmique consiste à soustraire préalablement de chaque score individuel la moyenne générale du sujet, à ajouter la moyenne générale de l’ensemble de l’échantillon, puis à calculer l’erreur-type sur ces données normalisées en appliquant un facteur d’amplification correctif standardisé égal à sqrt(k / (k - 1)).
Une fois cette marge d’erreur intra-sujet rigoureuse calculée dans votre tableur pour chaque condition, intégrez-la dans l’éditeur de graphique de Google Sheets :
- Double-cliquez sur la série de données représentée sur votre courbe pour activer l’onglet Personnaliser > Série.
- Cochez la case Barres d’erreur.
- Dans le menu déroulant Type, basculez de l’option Pourcentage vers l’option Constante.
- Saisissez manuellement dans le champ Valeur la valeur d’erreur-type intra-sujet moyenne issue de votre dérivation de Cousineau-Morey. Vos moyennes expérimentales sont dès lors flanquées d’intervalles d’incertitude statistiquement congruents avec le test d’ANOVA sous-jacent.
11.3 Exportation vectorielle et préparation pour les rapports académiques
L’intégration de vos visualisations dans un mémoire universitaire, une thèse de doctorat ou un manuscrit soumis pour publication exige une qualité de rendu graphique irréprochable exempte de toute pixellisation consécutive à l’agrandissement typographique. Les captures d’écran matricielles ordinaires (formats JPEG ou PNG à basse résolution) sont à proscrire formellement des documents scientifiques professionnels.
Pour exporter votre figure depuis Google Sheets dans les meilleures conditions de fidélité géométrique, cliquez sur l’icône matérialisée par trois petits points verticaux située dans le coin supérieur droit du cadre du graphique. Dans le menu contextuel qui s’ouvre, survolez Télécharger, puis sélectionnez impérativement l’option Image vectorielle adaptable (.svg) ou Document PDF (.pdf). Les formats vectoriels encodent les courbes, points, axes et polices sous la forme d’équations géométriques pures, autorisant une mise à l’échelle infinie sans la moindre perte de netteté sur les presses d’imprimerie ou les écrans Retina haute densité.
Conformément aux directives de présentation stylistique, prévoyez systématiquement l’adjonction d’une légende textuelle exhaustive positionnée immédiatement sous la figure (Figure Caption). Cette note ne doit pas se contenter de titrer le graphique mais doit documenter scrupuleusement le contenu méthodologique : identification de la cohorte expérimentale (N = 15), spécification explicite des abréviations conditionnelles, et mention formelle de la nature des barres d’erreur (ex. : « Les barres d’erreur représentent les intervalles de confiance à 95 % ajustés pour les devis intra-sujets selon le protocole de normalisation de Cousineau-Morey. »).
12. Normes de rédaction APA (7e édition) et recommandations méthodologiques
12.1 Structure formelle du paragraphe de résultats selon l’APA
La transcription des constats statistiques dans le corps d’un rapport de recherche psychologique doit obéir avec une fidélité maniaque aux prescriptions formelles édictées par la 7e édition du Publication Manual of the American Psychological Association (APA). La rédaction d’une section de résultats ne consiste pas en une juxtaposition aride de tableaux numériques bruts, mais s’incarne dans une narration fluide articulant la finalité théorique du test, les statistiques inférentielles précises et l’explicitation clinique du sens de l’effet documenté.
Sur le plan typographique et stylistique, plusieurs règles fondamentales doivent être scrupuleusement respectées :
- Toutes les lettres latines servant de symboles statistiques doivent impérativement être composées en italique : le symbole du test F, la valeur de probabilité p, la taille d’effet eta_p^2, la moyenne M, et l’écart-type SD (ou ET en français).
- Les degrés de liberté du numérateur (traitement) et du dénominateur (erreur) doivent être énoncés entre parenthèses immédiatement après la lettre F, séparés par une virgule et un espace typographique : F(3, 42).
- L’exactitude des valeurs de probabilité p doit être privilégiée (ex. : p = .004) plutôt que des inégalités grossières (p < .05), sauf lorsque la p-valeur s’avère inférieure au millième, auquel cas la notation conventionnelle stricte p < .001 s’impose obligatoirement. Selon les normes internationales strictes, le zéro précédant la virgule décimale est omis pour les indices mathématiquement bornés à 1 (comme p et eta_p^2).
Voici un modèle canonique de paragraphe de résultats conforme aux standards APA (7e éd.) synthétisant notre étude neuropharmacologique :
Une analyse de variance à mesures répétées à un facteur a été réalisée afin d’évaluer l’impact de différentes substances psychotropes (Placebo, Caféine, Modafinil, Molécule X) sur les temps de réaction attentionnels des participants. Les résultats révèlent un effet principal hautement significatif du traitement expérimental, F(3, 42) = 8,46, p < ,001, eta_p^2 = ,38. L’inspection des profils moyens indique que les latences de réponse les plus lentes ont été enregistrées dans la condition Placebo (M = 445,20 ms ; SD = 42,15), suivies par la condition Caféine (M = 394,80 ms ; SD = 38,60), la condition Molécule X (M = 374,60 ms ; SD = 35,20), tandis que les performances les plus rapides ont été induites par le Modafinil (M = 360,40 ms ; SD = 33,80). Les analyses post-hoc par paires, conduites au moyen de tests t de Student appariés et ajustées selon la procédure de Holm-Bonferroni, démontrent que le Modafinil réduit significativement le temps de réaction comparativement au Placebo, t(14) = 4,82, p < ,001, ainsi que comparativement à la Caféine, t(14) = 2,94, p = ,011. La divergence entre la Caféine et la Molécule X n’atteint pas le seuil de signification statistique après ajustement conservateur, t(14) = 1,45, p = ,169.
12.2 Écueils méthodologiques courants et solutions d’atténuation
L’exploitation de tableurs généralistes tels que Google Sheets pour la conduite d’analyses statistiques inférentielles de haut niveau expose le chercheur à plusieurs pièges méthodologiques récurrents qu’il convient de cartographier avec lucidité pour prévenir la production de faux positifs ou d’inférences infondées.
Le premier écueil majeur réside dans la négligence de la violation du postulat de sphéricité. Comme développé antérieurement, Google Sheets et ses modules usuels n’intègrent aucun test d’homogénéité des covariances (Mauchly) ni aucun facteur correctif automatisé d’épsilon. Si vos données empiriques violent structurellement la sphéricité (ce qui est fréquent lorsque les corrélations entre conditions adjacentes sont nettement plus fortes que celles entre conditions distantes), la statistique F générée par XLMiner est intrinsèquement biaisée à la hausse. Pour pallier ce déficit logiciel, le chercheur prudent peut appliquer manuellement la borne inférieure conservatrice de Greenhouse-Geisser (fixant arbitrairement épsilon à 1 / [k – 1], soit 1 / 3 = 0,333 dans notre étude), réduisant les ddl effectifs à F(1, 14) : si le résultat demeure significatif sous cette pénalisation maximale, l’effet est indubitablement robuste.
Le second piège fréquent concerne la confusion désastreuse entre devis inter-sujets et devis intra-sujet. Certains praticiens peu accoutumés à la logique matricielle exécutent le module Anova: Single Factor sur des données répétées en sélectionnant les colonnes conditionnelles. Cette manipulation erronée traite les mesures d’un même individu comme s’il s’agissait de participants totalement distincts et indépendants, ce qui gonfle artificiellement le dénominateur d’erreur et neutralise la puissance statistique du test, aboutissant quasi systématiquement à des erreurs de seconde espèce (non-rejet erroné de H0).
Le troisième écueil réside dans l’omission de l’ajustement pour comparaisons multiples lors de la phase post-hoc. Multiplier les tests t appariés sans appliquer de correction de Bonferroni ou de Holm conduit directement à une explosion du taux d’erreur de première espèce, réduisant la crédibilité empirique de l’étude. Enfin, la surinterprétation exclusive de p-valeurs marginalement significatives (ex. p = 0,048) sans considération méticuleuse de la taille d’effet (eta_p^2) ou de la présence éventuelle de valeurs aberrantes masque souvent des constats instables difficilement reproductibles lors de réplications directes.
12.3 Quand migrer de Google Sheets vers des logiciels spécialisés (Jamovi, R, SPSS) ?
Si Google Sheets représente une solution remarquablement élégante, didactique et gratuite pour des plans expérimentaux univariés simples à un facteur à mesures répétées, il convient de reconnaître avec discernement les frontières fonctionnelles au-delà desquelles la migration vers un environnement statistique spécialisé devient une exigence méthodologique absolue.
La première ligne de démarcation concerne les devis factoriels complexes. Dès lors que votre protocole intègre plusieurs variables indépendantes combinées — par exemple un devis mixte 2 x 4 croisant un facteur inter-sujets (groupe clinique vs groupe témoin) et un facteur intra-sujet (quatre temps d’évaluation) —, l’environnement de calcul de base de Google Sheets devient totalement inadapté. L’extraction manuelle des interactions multifactorielles et des termes d’erreur distincts sous forme de formules de tableur s’avère inutilement fastidieuse et hautement propice aux erreurs de calcul.
La seconde situation critique réside dans la confrontation à des données manquantes longitudinales asymétriques. Alors que l’ANOVA conventionnelle requiert l’exclusion complète de tout sujet présentant une cellule vide, les logiciels modernes tels que Jamovi, JASP ou les packages spécialisés sous R (tels que lme4 ou afex) permettent de modéliser des Modèles Mixtes Linéaires (Linear Mixed Models – LMM). Ces architectures computationnelles avancées exploitent l’intégralité des données disponibles sans aucune suppression par liste, tout en modélisant avec une flexibilité inégalée les structures de corrélation temporelle non sphériques.
Enfin, lorsque votre démarche de recherche exige l’automatisation complète de pipelines analytiques reproductibles (recherche ouverte et principes Open Science), l’exécution de scripts programmés sous R ou Python garantit une auditabilité absolue du code, de l’importation des signaux bruts à la génération des manuscrits dynamiques. Google Sheets doit donc être appréhendé pour ce qu’il est : un instrument exceptionnel d’initiation empirique, de prétraitement collaboratif et d’analyse exploratoire immédiate au sein des équipes de recherche comportementale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple alternative to Loftus and Masson’s approach. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.2307/1164736
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.