
La communication scientifique contemporaine repose sur un postulat fondamental : une mesure sans indication de son incertitude est dénuée de valeur opérationnelle et épistémique. Dans le cadre de la recherche quantitative, qu’il s’agisse de la psychologie cognitive, de la biomédecine, des sciences agronomiques ou de l’économétrie, la présentation des données agrégées ne saurait être dissociée de la variabilité sous-jacente qui caractérise les échantillons observés. L’environnement statistique R, couplé à des bibliothèques d’analyse visuelle sophistiquées telles que ggplot2, s’est imposé comme la référence internationale pour l’ingénierie graphique et la modélisation statistique reproductible. Toutefois, la maîtrise technique de ces outils exige une compréhension approfondie des mécanismes computationnels et mathématiques qui régissent la construction des représentations visuelles de l’erreur.
Trop souvent réduites à une simple convention cosmétique, les barres d’erreur constituent en réalité des interfaces critiques entre l’observation descriptive et la déduction inférentielle. Une barre mal configurée, un choix erroné entre l’écart-type et l’intervalle de confiance, ou une mauvaise synchronisation des positions spatiales lors du croisement de plusieurs facteurs expérimentaux peuvent induire les lecteurs en erreur, dénaturer les conclusions d’une étude et compromettre la reproductibilité des résultats. À l’inverse, une visualisation rigoureuse, respectant scrupuleusement la grammaire des graphiques et les normes éditoriales académiques internationales, offre une transparence analytique totale qui renforce la portée des démonstrations empiriques.
Ce guide exhaustif a pour ambition d’accompagner les chercheurs, data scientists, analystes et étudiants avancés dans la maîtrise intégrale de la représentation de l’incertitude dans l’écosystème R. En parcourant les fondements statistiques essentiels, la préparation des structures de données avec le méta-paquet Tidyverse, l’implémentation fine de la fonction génératrice des barres d’erreur et la résolution des problématiques méthodologiques complexes telles que les mesures répétées intra-sujets, ce document fournit une référence méthodologique et pratique définitive pour produire des visualisations de qualité publiable au sein des revues scientifiques les plus exigeantes.
1. Introduction à la représentation de l’incertitude expérimentale dans R
1.1 Rôle épistémique des barres d’erreur dans la recherche empirique
L’estimation ponctuelle, qu’elle prenne la forme d’une moyenne arithmétique, d’une médiane ou d’un coefficient de régression, ne constitue qu’une réduction synthétique d’une réalité empirique éminemment variable. Dans tout protocole d’acquisition de données, les observations recueillies résultent de la conjonction d’un signal théorique d’intérêt et d’un bruit stochastique composé d’erreurs de mesure, de fluctuations instrumentales et d’une variabilité biologique ou comportementale interindividuelle inhérente à l’échantillon. Contextualiser l’estimation centrale par une mesure graphique de l’incertitude n’est donc pas une simple précaution stylistique, mais une exigence logique incontournable. L’absence de quantification visible de l’erreur condamne le lecteur à l’illusion de la certitude absolue, favorisant des interprétations téléologiques non fondées.
Dans le domaine des sciences expérimentales et des sciences du comportement en particulier, la crise de la reproductibilité mise en lumière durant la dernière décennie a révélé à quel point l’omission ou la distorsion de la variabilité expérimentale pouvait biaiser l’appréciation des effets substantiels. L’affichage systématique et rigoureux de l’incertitude permet à la communauté des pairs d’évaluer immédiatement la robustesse des données présentées, de discerner un effet robuste d’un artefact causé par quelques valeurs extrêmes, et d’intégrer visuellement la plausibilité des hypothèses concurrentes. La transparence graphique agit comme un puissant garde-fou contre les conclusions prématurées issues de la seule lecture des seuils de significativité binaire.
En réponse à ces enjeux de crédibilité scientifique, les comités de rédaction des plus grandes revues internationales, à l’instar de Nature, Science, ou des périodiques édités par l’American Psychological Association, ont profondément durci leurs exigences méthodologiques. Il est désormais impératif de stipuler explicitement dans chaque légende graphique la nature statistique exacte des barres représentées, la taille de l’échantillon effectif pour chaque niveau de comparaison, ainsi que les méthodes d’ajustement employées en présence de mesures appariées. Les simples graphiques en barres pleines dépourvus d’indications de variabilité, péjorativement qualifiés de diagrammes en dynamite dans la littérature méthodologique, font l’objet d’un rejet quasi unanime au profit de représentations multidimensionnelles intégrant pleinement la structure probabiliste des données.
1.2 L’écosystème graphique de R : Du moteur de base à l’environnement ggplot2
Historiquement, le langage R s’est développé autour d’un moteur graphique natif performant mais intrinsèquement procédural, articulé autour de fonctions élémentaires telles que la commande générique dédiée aux tracés en barres et l’opérateur d’ajout de segments vectoriels fléchés pour dessiner les bornes d’incertitude. Bien que cette approche historique permette de concevoir des graphiques rapides lors des phases exploratoires préliminaires, elle présente d’importantes limites computationnelles dès que la structure de l’expérience gagne en complexité. L’alignement manuel des segments sur les coordonnées matricielles des barres esquivées exige des calculs trigonométriques et géométriques fastidieux, sources fréquentes d’erreurs d’implantation spatiale et de décalages visuels non reproductibles.
Pour dépasser ces limitations algorithmiques, le statisticien Leland Wilkinson a formalisé dans son œuvre séminale la grammaire des graphiques, une théorie structuraliste proposant de décomposer toute représentation visuelle de données en un ensemble cohérent de couches géométriques, d’échelles de transformation, de systèmes de coordonnées et d’assignations esthétiques formelles. Cette philosophie a trouvé son incarnation computationnelle définitive dans l’environnement R grâce au travail pionnier de Hadley Wickham et à la conception du paquet d’analyse visuelle moderne, désormais incontournable dans le milieu de la recherche.
Dans ce cadre déclaratif, l’utilisateur ne décrit plus la séquence mécanique de dessin d’un trait à l’écran, mais déclare les relations fonctionnelles liant les variables de la base de données aux propriétés géométriques de la scène graphique. L’incorporation d’une barre d’erreur cesse d’être une manipulation géométrique externe pour devenir une couche analytique autonome qui hérite de la structure factorielle, des filtres et des mécanismes de partitionnement du graphique global. Cette cohérence modulaire garantit une standardisation totale des visualisations, une interopérabilité sans faille avec les pipelines de modélisation statistique et une adaptabilité immédiate aux évolutions des protocoles expérimentaux les plus élaborés.
1.3 Objectifs pédagogiques et structure générale du guide
L’objectif de ce manuel didactique est de doter le praticien des compétences analytiques et programmatiques indispensables pour maîtriser avec une précision chirurgicale l’ensemble du spectre de la visualisation de l’incertitude. Nous explorerons en profondeur l’utilisation de l’opérateur géométrique central dédié aux barres d’erreur ainsi que l’ensemble de ses déclinaisons alternatives, afin d’adapter la finesse du tracé aux objectifs communicatifs spécifiques de chaque étude. Cette maîtrise instrumentale sera constamment sous-tendue par une réflexion statistique rigoureuse sur la nature de l’erreur à afficher, garantissant que chaque trait dessiné corresponde scrupuleusement à l’architecture formelle du plan expérimental sous-jacent.
La trajectoire pédagogique s’organise selon un continuum méthodologique allant de la conceptualisation mathématique à l’exportation typographique. Le lecteur apprendra d’abord à formaliser mathématiquement le choix entre dispersion et inférence avant de manipuler les structures tabulaires adaptées à l’ingestion par les algorithmes de rendu graphique. Nous progresserons ensuite de l’implémentation de modèles unifactoriels simples vers la résolution d’architectures factorielles croisées complexes, l’automatisation dynamique des calculs à la volée, la neutralisation des biais inhérents aux mesures répétées intra-sujets, pour clore notre étude sur l’adhésion aux normes éditoriales de publication et l’analyse critique des biais cognitifs associés à la lecture des graphiques scientifiques.
2. Fondements statistiques : Sélection rigoureuse de la métrique d’erreur
2.1 Écart-type (SD) : Quantifier la dispersion intra-échantillon
L’écart-type constitue la mesure fondamentale de la dispersion des observations individuelles autour de la moyenne arithmétique d’un échantillon. Algébriquement défini comme la racine carrée de la variance empirique non biaisée, il s’exprime dans la même unité de mesure physique ou psychométrique que la variable d’intérêt initiale. En postulant une distribution normale des données sous-jacentes, l’écart-type offre une description géométrique prévisible de la distribution : approximativement soixante-huit pour cent des observations individuelles sont contenues dans l’intervalle délimité par une valeur d’écart-type de part et d’autre de la moyenne, tandis que deux valeurs d’écart-type en englobent près de quatre-vingt-quinze pour cent.
L’usage de l’écart-type est impératif lorsque l’objectif de la communication scientifique réside dans la description fidèle de la variabilité naturelle et biologique propre aux entités observées. Par exemple, lors de la caractérisation d’un groupe de participants sains sur des indices de temps de réaction, de masse corporelle ou de seuils de discrimination sensorielle, l’écart-type renseigne précisément sur l’amplitude des variations interindividuelles réelles. Masquer cette dispersion brute derrière des indices d’incertitude inférentielle artificielle restreindrait la compréhension clinique ou écologique de la population étudiée.
Toutefois, une confusion méthodologique majeure surgit fréquemment lorsque des auteurs mobilisent l’écart-type pour tenter d’étayer une démonstration inférentielle relative à l’existence d’une différence significative entre deux traitements. L’écart-type est un paramètre descriptif de l’échantillon qui ne diminue pas asymptotiquement vers zéro lorsque la taille de l’échantillon tend vers l’infini ; il converge au contraire de manière stable vers l’écart-type de la population cible. Employer un écart-type comme une marge d’incertitude sur l’exactitude de la moyenne constitue une grave erreur conceptuelle susceptible d’amener le lecteur à sous-estimer la robustesse d’un résultat appuyé sur un échantillon de très grande taille.
2.2 Erreur type de la moyenne (SEM) : Précision de l’estimateur
À la différence fondamentale de l’écart-type, l’erreur type de la moyenne ne quantifie aucunement la variabilité des données individuelles brutes, mais estime la dispersion théorique de la distribution d’échantillonnage de la moyenne elle-même. En vertu des principes cardinaux du théorème central limite, si l’on procédait à une infinité de tirages d’échantillons aléatoires indépendants de même taille au sein d’une population globale, la moyenne de chacun de ces sous-ensembles fluctuerait autour de la véritable moyenne populationnelle selon une loi normale dont la variance est inversement proportionnelle à la taille de l’échantillon examiné.
Mathématiquement, l’erreur type de la moyenne s’obtient par le ratio de l’écart-type empirique sur la racine carrée de l’effectif total du groupe considéré. Cette relation algébrique met en lumière un comportement dynamique décisif : à mesure que le nombre de sujets s’accroît, la valeur de l’erreur type décroît de manière déterministe en suivant une courbe en racine carrée. Cette métrique informe donc exclusivement sur la précision métrologique avec laquelle la moyenne empirique de l’échantillon permet d’approximer la position du paramètre moyen théorique de la population générale dont il est issu.
L’erreur type de la moyenne est particulièrement plébiscitée dans les domaines des sciences de la vie et des neurosciences fondamentales pour évaluer la stabilité d’une estimation ponctuelle issue d’un protocole expérimental standardisé. Néanmoins, sa popularité dans la littérature scientifique masque parfois un usage cosmétique critiquable : dans la mesure où l’erreur type est systématiquement plus étroite que l’écart-type dès lors que la taille d’échantillon dépasse l’unité, de nombreux auteurs cèdent à la tentation inconsciente de recourir à cette métrique pour conférer à leurs graphiques un aspect de netteté et de précision trompeur, alors même que les exigences inférentielles commanderaient l’emploi d’intervalles plus formels.
2.3 Intervalles de confiance (IC à 95 %) : Inférence et tests d’hypothèses
L’intervalle de confiance, calculé conventionnellement au seuil bilatéral de quatre-vingt-quinze pour cent, constitue l’outil par excellence de la statistique inférentielle fréquentiste pour expliciter l’incertitude entourant un paramètre estimé. Dans la théorie orthodoxe développée par Jerzy Neyman, l’intervalle de confiance ne stipule pas qu’il existe quatre-vingt-quinze pour cent de chances que la véritable moyenne se trouve enfermée dans l’intervalle spécifique obtenu ; il garantit que si le protocole d’échantillonnage et de calcul était répété indéfiniment selon des conditions rigoureusement identiques, quatre-vingt-quinze pour cent des intervalles ainsi calculés contiendraient le paramètre populationnel inconnu mais fixe.
Pour un échantillon de taille finie suivant une distribution de nature normale, la borne supérieure et la borne inférieure de cet intervalle se construisent en ajoutant et en retranchant à la moyenne empirique le produit de l’erreur type de la moyenne par la valeur critique théorique issue de la distribution t de Student. Ce seuil critique dépend des degrés de liberté associés à l’estimation de la variance résiduelle. Lorsque les effectifs sont restreints, l’emploi de la distribution de Student pénalise adéquatement l’imprécision sur l’estimation de l’écart-type en élargissant substantiellement les bornes de l’intervalle, évitant ainsi un excès d’optimisme statistique.
L’inspection visuelle des intervalles de confiance est un outil d’aide à la décision heuristique d’une remarquable puissance, mais elle impose une prudence épistémologique absolue. Contrairement à une intuition très répandue chez de nombreux praticiens, l’absence de chevauchement entre deux intervalles de confiance à quatre-vingt-quinze pour cent relatifs à deux groupes indépendants n’est pas le critère minimal requis pour rejeter l’hypothèse nulle au seuil de cinq pour cent. Des travaux classiques d’optométrie statistique ont rigoureusement démontré que deux moyennes indépendantes peuvent différer de manière statistiquement significative au seuil alpha de zéro virgule zéro cinq même si leurs intervalles de confiance à quatre-vingt-quinze pour cent se recouvrent légèrement, pourvu que ce chevauchement n’excède pas environ la moitié d’un bras de l’intervalle lorsque les variances sont comparables.
3. Préparation et manipulation des données avec le Tidyverse
3.1 Structuration au format long (Tidy Data) pour ggplot2
Avant d’initier la moindre commande de rendu graphique au sein du moteur d’analyse visuelle de R, la structuration formelle des données brutes en amont constitue le facteur déterminant de la réussite du processus analytique. Le paradigme des données bien ordonnées, théorisé et formalisé dans la suite d’outils du Tidyverse, repose sur trois axiomes canoniques : chaque variable expérimentale doit être représentée par une colonne unique et sans ambiguïté, chaque observation singulière doit correspondre à une ligne transversale distincte, et chaque type d’unité d’observation doit être encapsulé au sein d’une table relationnelle individualisée.
Dans la pratique courante des laboratoires, les jeux de données expérimentales sont fréquemment encodés au format large au sein de tableurs bureautiques traditionnels, où les différentes conditions d’une même expérience ou les mesures répétées dans le temps sont distribuées sur plusieurs colonnes contiguës pour faciliter la saisie manuelle. Ce format large est totalement inopérant pour alimenter les mécanismes déclaratifs de ggplot2, qui requièrent que les attributs distincts soient factorisés sous forme d’une variable d’étiquetage catégorielle et d’une variable de score numérique continue. L’application rigoureuse de la fonction de pivotement vers le bas fournie par la bibliothèque spécialisée de réorganisation matricielle permet de transformer instantanément une matrice large en un tableau long strictement conforme.
Cette conversion structurelle fondamentale offre un avantage algorithmique majeur : elle autorise l’assignation directe des colonnes d’intérêt aux canaux perceptifs graphiques tels que la position horizontale, la modulation chromatique ou le partitionnement spatial. Sans cette normalisation préalable, l’analyste serait contraint de multiplier artificiellement les calques géométriques indépendants pour chaque colonne de son tableau d’origine, détruisant la nature modulaire et expressive de la grammaire des graphiques et compromettant la maintenabilité de son code source.
3.2 Agrégation descriptive systématique avec dplyr
Bien que certaines fonctions de rendu avancées soient capables d’effectuer des calculs d’agrégation directement à la volée à partir des observations brutes, la démarche analytique la plus robuste et la plus transparente sur le plan computationnel consiste à générer explicitement un tableau de synthèse paramétrique en mobilisant les verbes de transformation du paquet de manipulation de données. Ce processus séquentiel débute par la spécification des facteurs de classification au moyen de l’opérateur de regroupement catégoriel, suivi immédiatement par la directive de réduction statistique globale.
Au sein de cette phase d’agrégation descriptive, le statisticien est en mesure d’extraire simultanément l’ensemble des métriques de tendance centrale et de dispersion requises par son protocole d’analyse. La formulation d’instructions explicites permet de calculer la moyenne arithmétique de chaque sous-groupe, l’écart-type empirique corrigé, la taille de l’échantillon effectif via le compteur d’occurrences, ainsi que l’erreur type de la moyenne dérivée directement de ces deux grandeurs. Pour les intervalles de confiance formels, l’adjonction d’un calcul basé sur la fonction quantile de la loi de Student permet d’établir les marges d’erreur spécifiques avec une exactitude mathématique parfaite.
Le stockage de ces métriques agrégées dans un nouvel objet tabulaire dédié offre une lisibilité exemplaire et facilite les contrôles de cohérence internes. L’analyste conserve la possibilité d’inspecter visuellement et numériquement le résultat de ses réductions statistiques avant de les soumettre au moteur de rendu, s’assurant ainsi qu’aucune dérive de calcul n’intervienne en arrière-plan. Ce tableau condensé servira de matrice primaire pour l’alimentation des calques géométriques principaux et de leurs barres d’erreur associées.
3.3 Traitement rigoureux des valeurs manquantes et des valeurs aberrantes
L’existence d’observations manquantes au sein des protocoles expérimentaux réels représente un défi statistique majeur qui influe directement sur l’exactitude des calculs de dispersion. Par défaut dans le langage R, toute fonction mathématique de réduction statistique recevant un vecteur contenant une valeur non renseignée renvoie immédiatement une valeur indéterminée afin d’alerter l’utilisateur sur l’incomplétude du jeu de données. L’activation délibérée du paramètre d’exclusion des valeurs absentes au sein des opérations d’agrégation est indispensable pour permettre l’aboutissement des calculs numériques.
Toutefois, l’emploi systématique et machinal de ce paramètre sans vérification attentive du volume d’observations effectivement soustraites peut vicier gravement l’analyse visuelle. En éliminant silencieusement des lignes, l’analyste modifie la taille effective du sous-échantillon concerné. Si la formule de l’erreur type ou de l’intervalle de confiance est calculée en supposant un effectif théorique constant alors que de multiples points ont été omis, les barres d’erreur affichées apparaîtront artificiellement resserrées, simulant un niveau de précision métrologique totalement infondé empiriquement.
Il est donc impératif d’adopter de strictes pratiques de contrôle de qualité en extrayant explicitement le nombre d’observations valides réellement retenues après exclusion des données manquantes pour chaque combinaison factorielle. De même, la détection et le traitement des observations aberrantes fondés sur des critères statistiques objectifs (tels que la distance de Cook ou l’écart interquartile) doivent être documentés avec une transparence absolue. Toute décision d’imputation ou de suppression de valeurs extrêmes modifie drastiquement l’estimation de la variance résiduelle et se répercute instantanément sur l’envergure graphique des barres d’erreur, engageant la responsabilité méthodologique de l’auteur.
4. Syntaxe fondamentale de geom_errorbar() dans ggplot2
4.1 Anatomie de la commande et assignation des esthétiques obligatoires
Au sein de la bibliothèque de visualisation moderne de R, l’incorporation visuelle de l’incertitude statistique est principalement confiée à la géométrie spécialisée dédiée au tracé des barres d’erreur. D’un point de vue structural, cette fonction trace un segment linéaire vertical muni conventionnellement de deux petits segments horizontaux à ses extrémités, souvent qualifiés de chapeaux ou de terminaisons. Contrairement aux primitives géométriques élémentaires telles que les points ou les barres qui ne réclament qu’une position horizontale et une position verticale pour être positionnées, cette géométrie d’erreur requiert impérativement la déclaration mathématique explicite de deux bornes verticales distinctes.
Ces deux propriétés géométriques indispensables sont la borne inférieure et la borne supérieure de l’intervalle. L’assignation de ces coordonnées s’effectue dynamiquement au sein de la fonction de mappage esthétique, en reliant les bornes aux colonnes préalablement calculées dans le tableau de données condensé. Typiquement, la borne inférieure correspondra à la soustraction de la métrique d’erreur choisie (écart-type, erreur type ou marge critique d’intervalle de confiance) à la valeur de la moyenne, tandis que la borne supérieure sera définie par l’addition de cette même grandeur à la moyenne arithmétique.
L’interaction fonctionnelle entre le calque principal de données et le calque de barres d’erreur est régie par le principe d’héritage universel de la grammaire des graphiques. Si l’initialisation du canevas principal déclare une correspondance générale entre une variable de classification sur l’axe des abscisses et la moyenne sur l’axe des ordonnées, la géométrie des barres d’erreur réutilise automatiquement ces positions pour s’ancrer avec une exactitude absolue au-dessus des niveaux catégoriels désignés, assurant une parfaite cohésion architecturale à l’ensemble du graphique.
4.2 Contrôle de l’envergure géométrique avec l’argument width
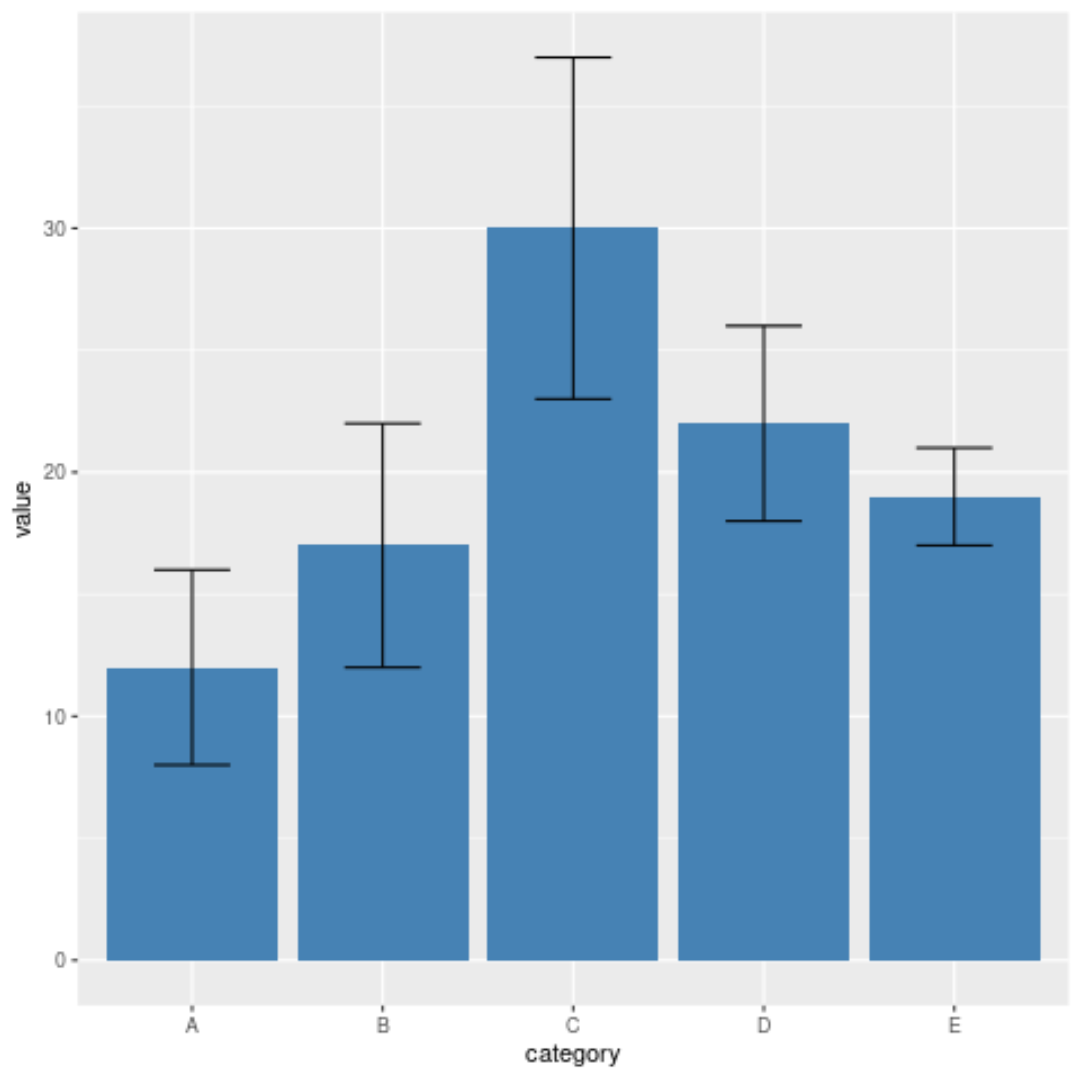
L’un des écueils visuels les plus manifestes rencontrés lors de l’apprentissage de la fonction de tracé d’erreur réside dans le calibrage par défaut de son envergure transversale. En l’absence de spécification explicite, le logiciel applique un ratio géométrique unitaire qui étend les terminaisons horizontales des barres d’erreur sur l’intégralité de la largeur allouée à chaque catégorie expérimentale le long de l’axe des abscisses. Cette configuration native produit un rendu graphique saturé et visuellement disgracieux, où les barres adjacentes entrent fréquemment en collision spatiale.
Le contrôle de cette dimension horizontale est gouverné par un argument de calibrage dédié, dont la valeur numérique doit être ajustée de manière empirique et proportionnée. Sur une échelle catégorielle standardisée où la distance séparant deux niveaux consécutifs est arbitrairement normalisée à l’unité, une valeur de calibrage comprise entre zéro virgule un et zéro virgule trois permet généralement d’obtenir des chapeaux de terminaison fins, élégants et immédiatement discernables sans encombrer la scène perceptuelle.
Il importe toutefois de souligner que le comportement de ce paramètre d’envergure diffère profondément selon la nature mathématique de l’axe horizontal. Lorsque les barres d’erreur sont projetées sur un axe continu (par exemple une série temporelle continue ou une échelle de doses pharmacologiques), la valeur de largeur n’est plus évaluée en fraction relative de la catégorie discrète, mais s’exprime dans les unités physiques réelles de la variable d’abscisse. Un paramétrage inadéquat pourrait alors rendre les terminaisons microscopiques ou au contraire démesurément gigantesques, exigeant une vigilance particulière de la part du programmeur.
4.3 Gestion de l’ordre d’empilement des couches graphiques
Dans la philosophie algorithmique de la grammaire des graphiques, le rendu visuel final procède de l’empilement successif et ordonné de calques translucides, chaque nouvelle directive géométrique venant se superposer au sommet des éléments précédemment générés selon la logique du peintre. Cet ordonnancement temporel au sein du script de programmation exerce un impact direct et décisif sur la lisibilité des barres d’erreur lorsque celles-ci interagissent avec des géométries volumétriques pleines, telles que des diagrammes en barres ou des surfaces colorées.
Si la géométrie d’erreur est déclarée chronologiquement avant l’élément principal dans le pipeline d’instructions graphiques, le corps opaque de la barre de données viendra recouvrir le segment vertical de l’erreur dans toute sa moitié inférieure. La barre d’incertitude se trouvera alors partiellement masquée, n’apparaissant plus que comme une antenne asymétrique pointant au-dessus du tracé plein. Pour garantir l’intégrité de la représentation et rendre visible la symétrie de la distribution d’erreur, il est donc impératif de déclarer la couche de barres d’erreur postérieurement à la géométrie de remplissage, assurant ainsi qu’elle trône au premier plan de la scène.
Dans les configurations denses où les tracés se croisent ou lorsque l’esthétique générale requiert d’éviter toute rupture brutale des lignes géométriques, l’emploi judicieux du paramètre de translucidité optique offre une alternative technique remarquable. En atténuant subtilement la saturation des tracés d’erreur ou en conférant une transparence partielle aux corps des barres sous-jacentes, l’analyste préserve la visibilité globale de chaque couche sans générer de confusion visuelle ni masquer les intersections critiques.
5. Diagrammes en barres avec barres d’erreur à partir de données résumées
5.1 Implémentation pas à pas de l’exemple standard unifactoriel
Pour illustrer la mise en œuvre pratique de ces préceptes au moyen d’un protocole reproductible, considérons un plan d’expérience unifactoriel visant à comparer l’efficacité de trois conditions de traitement pharmacologique distinctes sur une réponse physiologique continue. La démarche débute systématiquement par la création ou l’importation du tableau de données synthétique contenant les identifiants catégoriels des traitements, les moyennes observées pour chacun d’entre eux, et l’écart-type associé décrivant la dispersion biologique des sujets analysés.
L’initialisation de la commande graphique requiert de stipuler au sein du canevas principal l’assignation de la variable de traitement sur l’axe des abscisses et de la moyenne sur l’axe des ordonnées. L’intégration de la géométrie de barre pleine nécessite ensuite l’adjonction de l’argument de neutralisation statistique stipulant formellement que les données fournies correspondent directement aux hauteurs géométriques finales et ne doivent pas subir de comptage automatique de fréquences par le moteur sous-jacent. Une fois la géométrie de barre déclarée, l’adjonction de la couche d’erreur s’opère en spécifiant les formules dynamiques liant les bornes supérieure et inférieure à la soustraction et à l’addition de l’écart-type sur la moyenne.
En harmonisant les attributs cosmétiques tels que la coloration sobre des bordures de barres, la réduction mesurée de l’envergure horizontale des chapeaux et l’élévation de l’épaisseur du trait pour en assurer la netteté, l’opérateur obtient un diagramme canonique rigoureux. Chaque condition de traitement expose immédiatement sa tendance centrale tout en exhibant clairement l’amplitude de sa variabilité intra-groupe, fournissant une synthèse descriptive unifactorielle parfaitement proportionnée.
5.2 Gestion des limites physiologiques ou théoriques (barres asymétriques)
L’une des défaillances méthodologiques les plus communes dans la littérature biomédicale et psychométrique réside dans l’affichage insouciant de barres d’erreur parfaitement symétriques franchissant allègrement des frontières mathématiques ou physiologiques infranchissables. Lorsqu’une variable mesurée correspond à un pourcentage strictement borné entre zéro et cent, à un score de toxicité non négatif ou à un taux de survie cellulaire, l’application aveugle de la formule standard soustrayant une valeur fixe de dispersion peut projeter la borne inférieure de la barre dans des zones de valeurs négatives totalement dépourvues de sens empirique.
Ce phénomène d’effraction des limites théoriques signale quasi systématiquement que la distribution sous-jacente des données n’est pas gaussienne, mais présente au contraire une asymétrie positive marquée, fréquente en présence d’effets de plancher ou de distributions log-normales. Pour résoudre cette contradiction graphique sans dissimuler l’asymétrie réelle des scores, le chercheur doit programmer des conditions d’ajustement explicites au sein de son pipeline de préparation tabulaire. En recourant à des fonctions de plafonnement ou de plancher (telles que les opérateurs vectoriels extrayant la valeur maximale entre le calcul brut de la borne et le zéro absolu), la barre d’erreur est artificiellement mais rigoureusement contrainte à s’interrompre à la frontière admissible.
Il demeure cependant indispensable d’assortir ce type de manipulation graphique d’une justification explicite et transparente au sein de la légende du graphique ou du corps du manuscrit. L’auteur doit y préciser sans ambiguïté que la variabilité de la variable présente une asymétrie structurelle imposant le recours à des barres d’erreur tronquées ou asymétriques, évitant ainsi que la modification géométrique ne soit interprétée par les évaluateurs comme une tentative de dissimulation de données ou une erreur d’implémentation logicielle.
5.3 Exportation vectorielle et matricielle pour publication
L’aboutissement du processus de visualisation de l’incertitude ne s’arrête pas à la génération satisfaisante de la scène graphique dans la fenêtre de prévisualisation de l’environnement de développement ; il culmine dans l’exportation physique du fichier destiné à l’imprimeur ou à la plateforme de soumission éditoriale. Cette phase finale est critique : une barre d’erreur subtilement calibrée sur un écran haute définition peut perdre toute lisibilité si la pixellisation lors de la compression matricielle vient dégrader le tracé ou si l’épaisseur du trait est trop ténue pour franchir l’épreuve de l’impression sur papier couché.
Pour garantir une netteté absolue et pérenne, la fonction d’exportation standardisée de l’écosystème graphique de R offre des leviers de contrôle exhaustifs. Pour les publications imprimées et les manuscrits soumis aux revues de premier rang, le recours aux formats vectoriels universels tels que le format PDF ou le langage PostScript encapsulé est vivement préconisé. Contrairement aux images matricielles, les formats vectoriels encodent les éléments sous forme d’équations géométriques pures, autorisant un agrandissement ou une réduction arbitraire sans la moindre perte de définition ni flou des lignes de délimitation.
Dans les contextes techniques où les exigences éditoriales imposent formellement le dépôt de fichiers d’images matricielles au format TIFF, il est impératif de configurer la résolution spatiale à un seuil minimal absolu de trois cents points par pouce pour les figures en demi-teinte, et de six cents à douze cents points par pouce pour les tracés au trait pur contenant du texte et des barres fines. La maîtrise stricte des dimensions physiques réelles (en centimètres ou en pouces) assignées lors de la commande d’exportation garantit que les polices de caractères et l’épaisseur des barres d’erreur conservent leur parfaite proportionnalité lors de leur insertion dans la maquette finale de l’article scientifique.
6. Calcul dynamique et direct de l’incertitude à partir de données brutes
6.1 Automatisation statistique sans dataframe résumé via stat_summary()
Bien que la construction préalable d’un tableau synthétique d’agrégation descriptive offre une transparence indéniable, le moteur d’ingénierie visuelle de R dispose d’un mécanisme computationnel particulièrement puissant permettant de court-circuiter l’étape intermédiaire de calcul manuel : la couche de synthèse statistique directe. Cet opérateur permet d’ingérer directement un jeu de données massives composé de milliers d’observations individuelles brutes et de déléguer l’ensemble du processus de réduction mathématique aux algorithmes internes du moteur graphique lors de la compilation du tracé.
Le fonctionnement interne de cette géométrie computationnelle repose sur la décomposition fonctionnelle des calculs. L’utilisateur spécifie d’une part la fonction scalaire dédiée à l’estimation de la tendance centrale (typiquement la moyenne arithmétique transmise via l’argument désignant l’opérateur central), et d’autre part une fonction vectorielle complexe capable de renvoyer simultanément la position centrale et les deux bornes d’incertitude. L’argument spécialisé dédié aux fonctions de dispersion accepte des fonctions préprogrammées reconnues nativement par le moteur, telles que l’opérateur d’écart-type symétrique ou l’opérateur d’erreur type standard.
Cette approche par synthèse dynamique à la volée fluidifie considérablement les phases de recherche exploratoire. L’analyste peut tester en temps réel différentes spécifications d’erreur sans devoir modifier, régénérer ou maintenir de multiples tableaux descriptifs dérivés. Le code source du graphique demeure extrêmement concis, et toute modification apportée aux filtres de données ou à la structure du jeu de données source se répercute instantanément et automatiquement sur le dessin des barres d’erreur sans la moindre intervention manuelle.
6.2 Exploitation de la bibliothèque Hmisc pour les intervalles paramétriques
Pour transcender les simples approximations descriptives de l’écart-type et de l’erreur type et déployer des calculs inférentiels plus sophistiqués au sein de la synthèse dynamique, le moteur graphique de R s’interface de manière native avec des bibliothèques statistiques avancées, tout particulièrement le paquet spécialisé de biostatistique développé par Frank Harrell. Cette interopérabilité offre un accès immédiat à des estimateurs paramétriques et non paramétriques d’une remarquable rigueur mathématique sans requérir la moindre ligne de code supplémentaire.
Parmi ces outils, la fonction d’intervalle de confiance paramétrique classique permet de calculer dynamiquement pour chaque sous-groupe les bornes exactes de l’intervalle de confiance à quatre-vingt-quinze pour cent en se fondant sur la distribution théorique de Student ajustée aux degrés de liberté réels. Plus précieux encore, pour les distributions empiriques asymétriques ou dérogeant sévèrement au postulat de normalité gaussienne, la bibliothèque propose un estimateur non paramétrique basé sur la méthode du rééchantillonnage avec remise. Cette fonction génère des milliers de pseudo-échantillons par bootstrap afin d’extraire les quantiles empiriques réels de la distribution d’échantillonnage, fournissant ainsi des intervalles de confiance non symétriques d’une robustesse exceptionnelle.
L’exploitation de ces fonctions avancées requiert toutefois que les dépendances sous-jacentes soient correctement installées et chargées dans l’espace de travail R. De surcroît, le calcul d’intervalles par rééchantillonnage dynamique sur de très vastes bases de données regroupant des millions de lignes peut induire une charge computationnelle non négligeable lors de la régénération du graphique, nécessitant parfois d’arbitrer entre la commodité de l’automatisation à la volée et la performance d’un précalcul statique en amont.
6.3 Analyse comparative : calcul préalable versus synthèse à la volée
Le choix entre l’agrégation préalable explicite via les verbes de manipulation tabulaire et le calcul dynamique implicite via la synthèse statistique dépend d’un équilibre subtil entre exigences d’auditabilité, contraintes de scalabilité algorithmique et vélocité de développement. L’agrégation préalable constitue le standard absolu de la recherche confirmatoire reproductible. En dissociant formellement l’étape du calcul statistique de l’étape de rendu visuel, elle permet d’exporter les valeurs chiffrées exactes sous forme de tableaux annexes intégrables dans les rapports scientifiques, offre un point de contrôle d’intégrité aisé lors de la relecture par les pairs, et garantit un rendu graphique quasi instantané puisque le moteur n’a pas à répéter de calculs matriciels complexes.
À l’opposé, la synthèse graphique à la volée brille lors des phases itératives d’exploration analytique. Lorsqu’un chercheur manipule un tableau complexe comportant de nombreuses strates factorielles et souhaite examiner en quelques secondes l’impact visuel de différentes métriques d’erreur sur plusieurs sous-groupes, la compacité syntaxique de la synthèse dynamique permet d’éviter l’écriture de fastidieuses chaînes d’opérations d’agrégation. Elle garantit également une cohérence absolue en cas d’application de facettes multiples, les calculs s’opérant dynamiquement au niveau de chaque sous-panneau sans intervention de la part de l’utilisateur.
Toutefois, face à des jeux de données d’une volumétrie substantielle, telle qu’on en rencontre fréquemment dans le traitement de données de séquençage génétique ou de flux transactionnels, la synthèse à la volée peut devenir un goulet d’étranglement informatique majeur. Recommencer l’ensemble des procédures d’agrégation et de rééchantillonnage à chaque micro-ajustement de la typographie ou des légendes du graphique entraîne une perte de productivité considérable. Dans de telles circonstances, la doctrine préconise systématiquement de procéder à une réduction tabulaire préliminaire optimisée avant toute injection dans les calques géométriques.
7. Personnalisation esthétique avancée des barres d’erreur
7.1 Modulation des paramètres de style : couleur, épaisseur et transparence
Une fois la structure mathématique de l’erreur rigoureusement établie, l’optimisation esthétique et perceptive du tracé devient l’enjeu prépondérant. Dans les versions modernes de la bibliothèque de visualisation de R, la gestion de l’épaisseur des éléments filaires a bénéficié d’une clarification bienvenue : alors que les versions historiques utilisaient un paramètre générique de taille pour contrôler indifféremment le rayon des points et l’épaisseur des traits, les normes récentes ont scindé ces contrôles en introduisant un paramètre spécifiquement dédié à la largeur physique de la ligne géométrique.
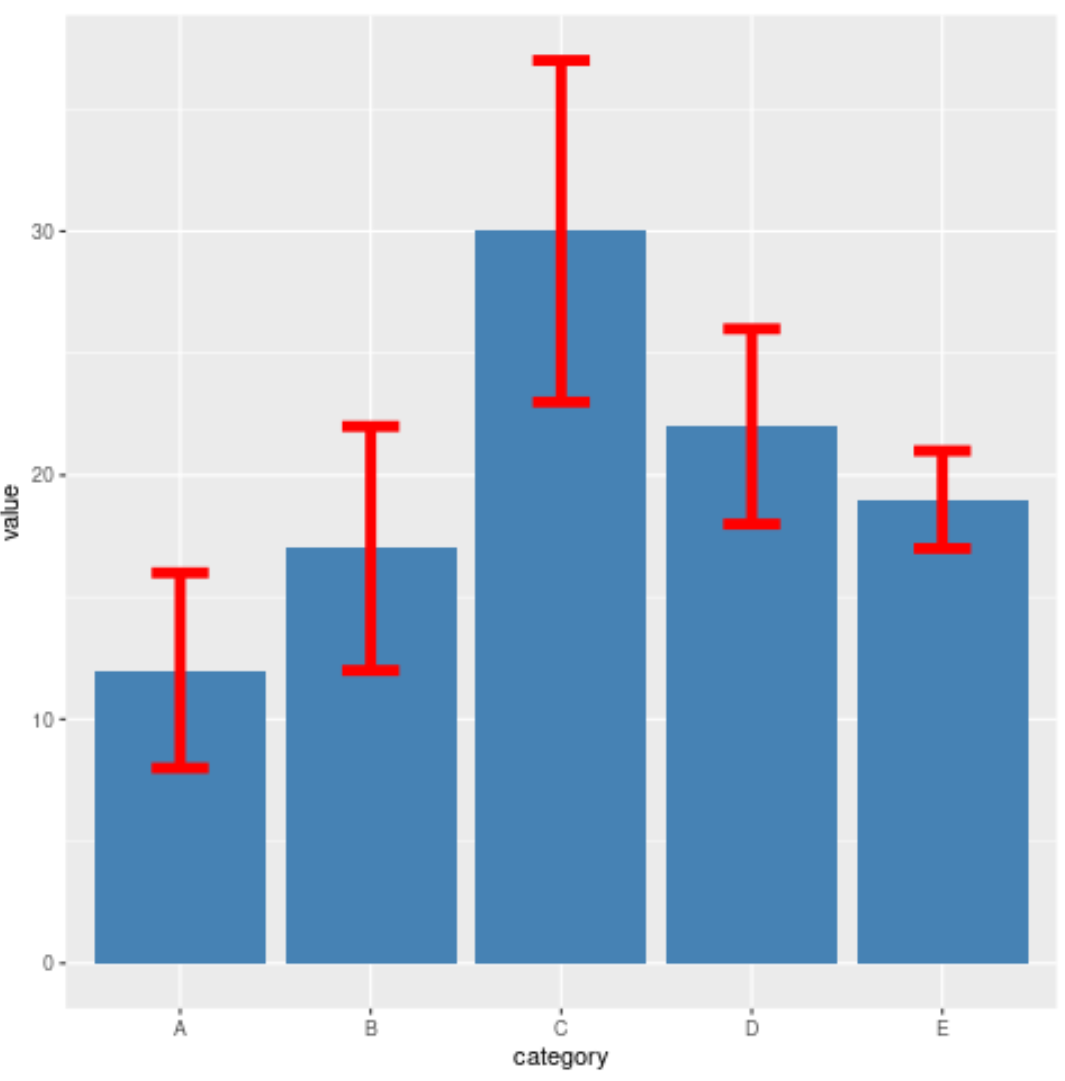
Le calibrage de la largeur de ligne des barres d’erreur doit faire l’objet d’un ajustement proportionné au gabarit du graphique. Une ligne trop fine risque de disparaître lors de la réduction d’échelle imposée par la mise en page d’un article imprimé sur deux colonnes, tandis qu’une ligne démesurément épaisse surcharge le dessin et nuit à l’appréciation exacte des frontières extrêmes de l’intervalle. De façon standard, une épaisseur oscillant entre zéro virgule cinq et zéro virgule huit millimètre assure une lisibilité idéale pour la plupart des publications scientifiques.
Le contrôle chromatique offre également un levier narratif considérable. Par défaut, la teinte de la barre d’erreur est calquée sur une valeur sombre neutre. L’analyste peut cependant assigner une couleur distincte pour faire ressortir l’intervalle du fond ou, à l’inverse, lier dynamiquement la coloration de l’erreur à la variable expérimentale de groupe pour créer une continuité chromatique harmonieuse avec le corps des géométries principales. L’utilisation conjointe de la translucidité par le canal alpha permet d’adoucir la présence visuelle des barres d’erreur denses en réduisant l’encombrement graphique global de la scène.
7.2 Alignement spatial et évitement des chevauchements avec position_dodge()
L’écueil géométrique le plus fréquemment rencontré lors de la confection de graphiques multifactoriels combinant plusieurs variables de croisement réside dans la superposition chaotique des éléments. Lorsque deux ou plusieurs barres doivent être dessinées côte à côte pour chaque niveau de l’axe principal afin de représenter un plan factoriel croisé, le moteur graphique applique un déplacement latéral connu sous le terme d’esquive spatiale. Si les barres d’erreur ne reçoivent pas une instruction d’esquive rigoureusement identique, elles demeurent figées au centre de l’abscisse et viennent s’empiler les unes sur les autres de manière confuse.
Pour conjurer cette dysharmonie, il est indispensable de mobiliser la fonction de positionnement esquivé et d’en synchroniser scrupuleusement le paramètre d’amplitude d’esquive entre la géométrie de données (qu’il s’agisse de barres pleines ou de points d’estimation) et la géométrie des barres d’erreur. Si la largeur d’esquive est fixée par exemple à une magnitude de zéro virgule neuf sur le calque principal, l’opérateur doit déclarer exactement la même valeur au sein de la fonction d’esquive assignée aux barres d’erreur. Cette identité mathématique force le moteur à calculer des décalages latéraux symétriques, positionnant chaque barre d’erreur au centre parfait de la barre de données à laquelle elle se rapporte.
Un piège récurrent survient lorsque l’assignation esthétique du groupe de remplissage n’est pas déclarée explicitement dans le bloc esthétique global, mais uniquement de manière isolée au sein de la géométrie de données. Dans un tel scénario, le calque des barres d’erreur ignore la subdivision factorielle sous-jacente et s’avère incapable de calculer le décalage géométrique requis. La déclaration globale du facteur de groupement au niveau racine de l’instruction graphique prévient systématiquement ce dysfonctionnement en propageant l’information de compartimentage à l’ensemble des couches descendantes.
7.3 Création de thèmes éditoriaux épurés conformes aux standards académiques
L’affichage par défaut des représentations visuelles issues de l’environnement R se caractérise par une trame de fond grise quadrillée de lignes blanches. Bien que cette signature stylistique ait été initialement pensée pour maximiser la comparaison cartésienne selon les préceptes de William Cleveland, elle est unanimement proscrite par les normes éditoriales des presses universitaires et des périodiques à comité de lecture, qui exigent des surfaces d’affichage vierges de tout bruit visuel parasite non porteur d’information statistique.
L’application immédiate de thèmes préétablis épurés, à l’image du thème classique ou du thème minimaliste disponibles nativement, permet d’évacuer d’emblée la grille grise superflue et d’instaurer un fond blanc virginal. Pour autant, l’obtention d’une figure de standing professionnel impose d’aller au-delà de ces configurations automatiques en raffinant individuellement les composants de l’interface graphique via la fonction de paramétrage thématique global. Cette étape permet d’ajuster avec précision le tracé des axes cartésiens, de calibrer l’orientation et la dimension des graduations numériques, ainsi que de normaliser la taille et la graisse de la typographie des titres et des légendes.
Dans un contexte institutionnel ou au sein d’une équipe de recherche publiant régulièrement, la pratique d’excellence consiste à encapsuler l’ensemble de ces spécifications thématiques au sein d’une fonction personnalisée réutilisable. Cette fonction de style institutionnel peut alors être appelée à la fin de chaque pipeline de rendu au sein de l’ensemble des scripts du laboratoire, garantissant une harmonie esthétique et visuelle absolue à travers toutes les publications issues des différents projets de recherche sans nécessiter de redondances de programmation.
8. Graphiques linéaires et séries temporelles avec barres et bandes d’erreur
8.1 Construction de profils expérimentaux combinant points, lignes et barres
Dans le cadre de protocoles longitudinaux, de cinétiques biochimiques ou d’études d’apprentissage temporel, le recours aux diagrammes en barres pleines s’avère conceptuellement inadapté, car il suggère une discontinuité artificielle entre les mesures tout en dissimulant la trajectoire dynamique sous-jacente. Dans ces configurations temporelles, la convention scientifique privilégie l’usage de profils expérimentaux associant sur un même tracé des points représentant les estimations ponctuelles discrètes, des segments de liaison visualisant la cinétique et des barres d’erreur matérialisant l’incertitude à chaque étape temporelle.
La réussite architecturale d’un tel graphique repose sur une coordination méticuleuse de trois couches géométriques superposées : le calque filaire unissant les coordonnées temporelles, le calque ponctuel marquant les moyennes empiriques, et le calque des barres d’erreur. Lorsque plusieurs groupes expérimentaux sont comparés sur le même axe temporel, l’application d’un léger décalage latéral au moyen de la fonction d’esquive devient indispensable pour éviter que les barres d’erreur et les points centraux de conditions concurrentes ne se chevauchent de manière illisible. Cette esquive doit cependant être appliquée simultanément au calque linéaire et au calque des points sous peine de briser la continuité géométrique du profil.
Il importe de veiller à ce que les segments de liaison ne masquent pas les détails des points d’estimation. À cet effet, l’ordre d’appel des fonctions au sein du script revêt une importance capitale : déclarer d’abord la ligne, puis la barre d’erreur, et enfin le point central permet d’assurer que ce dernier trône au sommet de la pile visuelle. En appliquant éventuellement un fond plein opaque au point central, l’opérateur masque l’intersection du segment linéaire sous-jacent, créant une figure d’une netteté professionnelle irréprochable.
8.2 Alternative continue : Déploiement de rubans d’incertitude avec geom_ribbon()
Lorsque la densité temporelle des mesures recueillies devient particulièrement élevée, comme c’est le cas lors de l’enregistrement de signaux électrophysiologiques continus, de cinétiques enzymatiques à haute résolution ou de trajectoires biomécaniques échantillonnées à haute fréquence, l’emploi de barres d’erreur verticales discrètes engendre une congestion visuelle majeure. Les barres d’erreur individuelles se touchent et fusionnent en un bloc noir opaque indéchiffrable qui détruit toute possibilité de lecture analytique du signal.
Pour surmonter cette saturation géométrique, la bibliothèque graphique de R met à disposition une géométrie d’enveloppe surfacique continue conçue pour tracer des bandes ou rubans d’incertitude. Tout comme les barres d’erreur classiques, cette fonction requiert l’assignation impérative des esthétiques de borne inférieure et de borne supérieure le long d’une échelle continue. Au lieu de dessiner des segments isolés pour chaque point, l’algorithme génère un polygone continu épousant fidèlement les courbures de la dispersion statistique tout au long de la dynamique temporelle.
La manipulation de la translucidité optique constitue le cœur stylistique de cette approche. En conférant à la surface du ruban un coefficient de transparence marqué (typiquement compris entre zéro virgule deux et zéro virgule quatre), l’analyste permet à la courbe centrale de tendance moyenne de demeurer parfaitement visible et nette, tout en laissant percevoir en arrière-plan la zone d’incertitude statistique. Lorsque plusieurs conditions temporelles sont comparées, les rubans semi-transparents autorisent une lecture fluide des zones de recouvrement et de divergence des distributions sans occlusion destructrice.
8.3 Comparaison fonctionnelle entre barres verticales et bandes d’erreur
La décision méthodologique d’opter pour des barres d’erreur verticales ou des bandes continues d’incertitude ne relève pas d’une simple préférence esthétique, mais procède d’une analyse rigoureuse de la nature des variables et de la charge cognitive imposée au lecteur. Les barres d’erreur verticales constituent le choix canonique par excellence lorsque la variable disposée en abscisse présente une discontinuité formelle, qu’il s’agisse de catégories qualitatives pures ou de moments expérimentaux discrets très espacés dans le temps (par exemple un pré-test, un post-test immédiat et une mesure de suivi à trois mois). Elles soulignent le caractère ponctuel et découplé des étapes d’évaluation.
À l’inverse, dès lors que l’axe horizontal véhicule un processus continu sous-jacent et que l’acquisition des données a été réalisée avec un pas d’échantillonnage temporel dense, la bande d’incertitude s’impose comme la seule représentation scientifiquement et perceptivement défendable. Elle permet à l’œil humain de percevoir immédiatement la dynamique globale du système, d’identifier les phases d’asymptote d’apprentissage, et de repérer avec précision les fenêtres temporelles critiques où les intervalles de confiance cessent temporairement de se chevaucher, signant l’émergence d’un effet différentiel statistiquement significatif.
Le tableau ci-dessous synthétise les critères de décision technique gouvernant l’arbitrage entre ces deux modes d’expression graphique de l’incertitude :
- Densité d’échantillonnage : Utiliser les barres verticales discrètes pour les faibles densités (moins de six points temporels) ; privilégier les rubans continus pour les densités élevées ou les signaux continus.
- Continuité phénoménologique : Réserver les barres verticales aux catégories qualitatives ou aux étapes discrètes ; réserver les rubans aux processus dynamiques et fluides (cinétiques, chronobiologie, croissance).
- Charge cognitive : Les barres verticales multiples esquivées deviennent rapidement illisibles au-delà de trois conditions croisées ; les rubans continus semi-transparents tolèrent le chevauchement avec une bien meilleure résilience visuelle.
- Clarté des points de données : Les barres verticales permettent d’identifier immédiatement chaque moyenne spécifique ; les rubans d’incertitude favorisent l’appréhension de la forme générale et des dérivées de la fonction plutôt que des valeurs scalaires ponctuelles.
9. Visualisation de plans factoriels complexes et données multifactorielles
9.1 Plans factoriels 2×2 et interactions statistiques
Dans la recherche expérimentale contemporaine, la majorité des protocoles dépasse le cadre unifactoriel élémentaire pour explorer l’interaction complexe entre au moins deux facteurs indépendants, comme dans le modèle canonique du plan factoriel deux par deux. Visualiser adéquatement une interaction statistique requiert de représenter avec une transparence absolue la convergence ou la divergence des effets d’un facteur selon les modalités du second facteur, tout en explicitant l’incertitude propre à chaque cellule expérimentale de la matrice.
La mise en scène graphique d’un tel plan s’opère typiquement en assignant le premier facteur à l’axe des abscisses et en différenciant les niveaux du second facteur au moyen du canal de coloration de surface ou de contour. Les barres d’erreur doivent impérativement être assujetties à la même structure de croisement, en appliquant un déplacement d’esquive latérale parfaitement calibré. L’alignement visuel des barres permet d’apprécier d’un coup d’œil si la différence observée entre deux conditions sous une modalité se maintient, s’annule ou s’inverse sous l’autre modalité.
Pour enrichir la portée analytique de la figure, il est fréquent d’incorporer des annotations géométriques directes signalant les contrastes significatifs décelés par les tests d’effets simples post-hoc. L’adjonction de segments de comparaison horizontaux surplombant les barres d’erreur et surmontés de symboles conventionnels (astérisques de significativité) doit être réalisée avec une rigueur géométrique méticuleuse : ces segments doivent toujours être positionnés légèrement au-dessus de la barre d’erreur la plus haute de la zone de comparaison pour éviter toute collision graphique et préserver l’équilibre visuel du diagramme.
9.2 Segmentation par facettes avec facet_wrap() et facet_grid()
Lorsque la structure expérimentale intègre un troisième ou un quatrième facteur de croisement, tenter de tout condenser au sein d’un panneau graphique unique au moyen de multiples teintes et d’esquives latérales successives aboutit inéluctablement à une saturation visuelle désastreuse. L’esprit humain ne parvenant plus à démêler l’imbrication des barres d’erreur et des corps de données, le chercheur doit recourir à la technique de partitionnement spatial en panneaux multiples, connue sous le nom de facettage.
L’écosystème graphique de R offre à cet effet deux fonctions complémentaires d’une élégance algorithmique remarquable. La première génère une séquence linéaire de panneaux qui s’enroulent automatiquement sur plusieurs lignes ou colonnes en fonction d’un facteur unique, tandis que la seconde construit une matrice cartésienne bidimensionnelle rigide croisant un facteur distribué en lignes horizontales avec un facteur distribué en colonnes verticales. L’application de ces directives redistribue instantanément les données en sous-graphiques autonomes partageant des échelles coordonnées.
Dans ce cadre facetté, la gestion du calibrage des axes cartésiens constitue un impératif méthodologique de premier ordre. Par défaut, le moteur maintient des échelles strictement fixes et communes à l’ensemble des panneaux. Cette contrainte d’invariance d’échelle est cruciale : autoriser une liberté d’échelle entre les différents panneaux risquerait de fausser totalement l’appréciation visuelle des barres d’erreur, une barre d’amplitude identique semblant visuellement deux fois plus grande sur un sous-panneau comprimé, trompant ainsi gravement le lecteur lors de la comparaison inter-facettes.
9.3 Harmonisation des palettes de couleurs accessibles et inclusives
La sélection de la charte chromatique habillant les corps de données et les barres d’erreur n’est pas un simple caprice d’esthète ; elle soulève des questions fondamentales d’éthique scientifique et d’accessibilité universelle. Une proportion non négligeable de la communauté des chercheurs et des lecteurs souffre de déficiences de la vision des couleurs, tout particulièrement de daltonisme sous ses formes deutéranope ou protanope. L’emploi historique de palettes combinant des teintes rouge et vert saturées rend les graphiques totalement indéchiffrables pour ces lecteurs, les contrastes s’effondrant en une masse indifférenciée de gris et de bruns.
Pour assurer une conformité totale avec les critères d’accessibilité internationaux et les exigences actuelles des éditeurs scientifiques majeurs, l’analyste doit intégrer des palettes de couleurs perceptuellement uniformes et universellement lisibles. La bibliothèque de nuances Viridis s’est imposée à cet égard comme la référence absolue dans l’écosystème R. Conçues initialement pour la visualisation cartographique et biomédicale, ces échelles de couleurs présentent la remarquable propriété mathématique de conserver une progressivité de contraste monotone parfaite, qu’elles soient visualisées par un œil normatif, perçues par un individu daltonien, ou même imprimées en noir et blanc pur sur un support papier monochrome.
De plus, il importe de maintenir un contraste lumineux adéquat entre les barres d’erreur et le fond coloré des géométries qu’elles chevauchent. Lorsque des barres de données sont remplies de teintes très denses ou sombres, des barres d’erreur noires peuvent s’avérer difficiles à discerner. Dans de telles circonstances, l’analyste peut opter soit pour des contours de barres d’erreur colorés d’une teinte contrastée, soit pour une légère désaturation des teintes de remplissage intérieur, assurant ainsi une démarcation graphique sans faille de l’envergure de l’incertitude.
10. Barres d’erreur pour mesures répétées et plans intra-sujets
10.1 Le biais d’estimation des barres d’erreur inter-sujets standard
L’un des paradoxes méthodologiques les plus insidieux et les plus répandus dans l’analyse de données expérimentales concerne l’application aveugle des formules standards de calcul d’erreur à des dispositifs expérimentaux reposant sur des mesures répétées ou des plans d’échantillonnage intra-sujets. Dans un plan de recherche indépendant (inter-sujets), chaque individu n’est exposé qu’à une condition unique ; la variance totale de l’échantillon intègre donc légitimement la forte variabilité interindividuelle globale (les différences de niveau de base entre les personnes).
En revanche, dans un plan intra-sujets où chaque participant traverse successivement l’ensemble des conditions expérimentales (comme dans un protocole d’imagerie cérébrale ou une tâche psychophysique mesurant des réponses consécutives), cette variabilité interindividuelle globale est rigoureusement contrôlée et éliminée du terme d’erreur par le calcul statistique d’une analyse de variance à mesures répétées ou d’un modèle mixte. Le facteur d’intérêt réside exclusivement dans la cohérence des variations intra-individuelles d’une condition à l’autre, indépendamment du fait que certains sujets soient globalement plus rapides ou plus lents sur l’ensemble de la batterie d’évaluation.
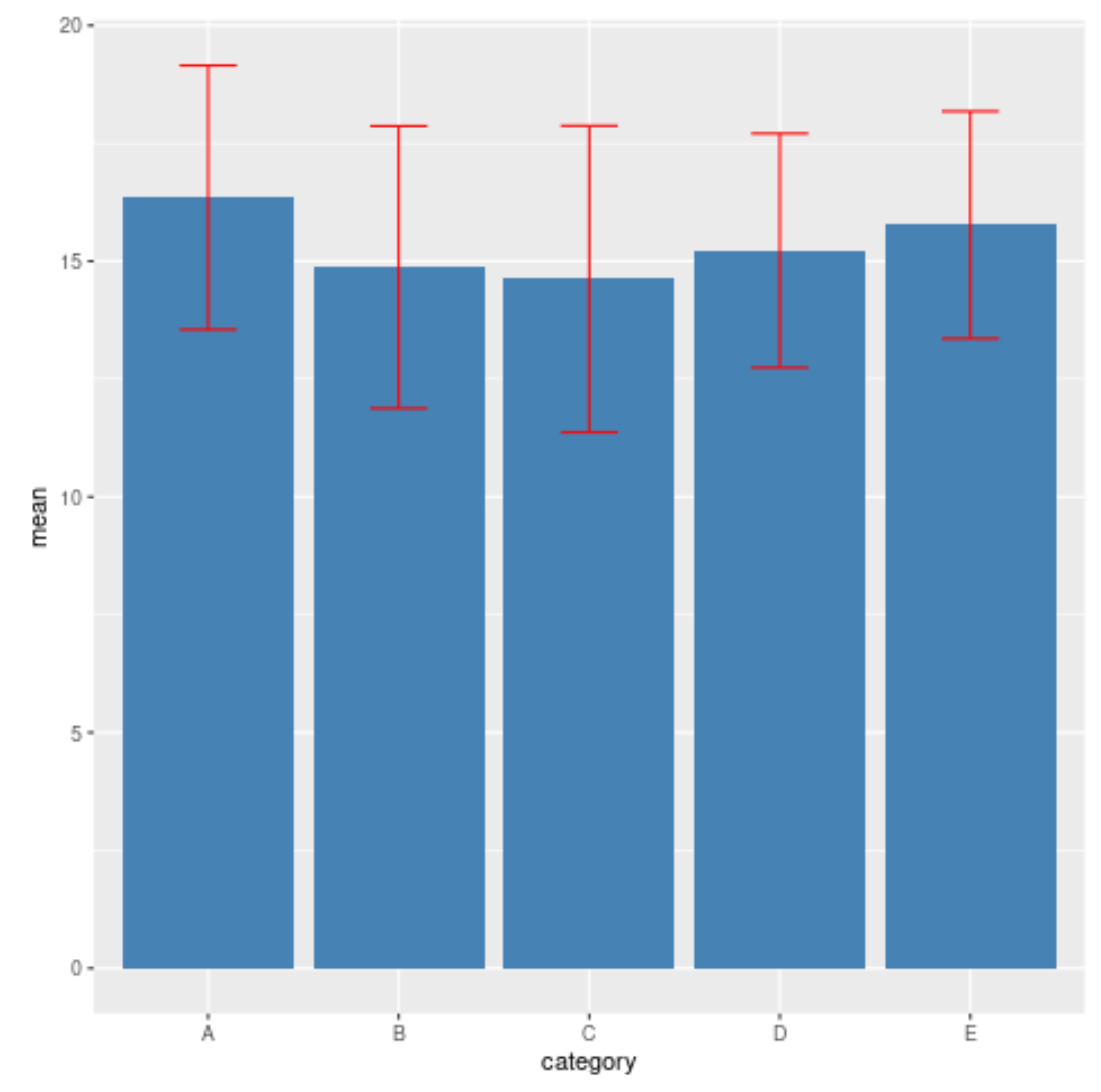
Si l’analyste se contente de calculer des barres d’erreur classiques (qu’il s’agisse d’écarts-types ou d’intervalles de confiance conventionnels) en traitant les données de chaque condition comme si elles provenaient de groupes distincts et indépendants, les barres d’erreur résultantes intègreront l’intégralité de la variance interindividuelle globale. Elles apparaîtront démesurément larges et se chevaucheront massivement, donnant visuellement l’illusion trompeuse d’une absence d’effet statistique, alors même qu’un test apparié formel démontrerait une différence hautement significative avec un p-value infinitésimal. Cette incohérence flagrante entre l’inspection graphique et le test statistique formel ruine la crédibilité communicative de la figure.
10.2 Méthode de normalisation de Cousineau-Morey
Pour restaurer l’adéquation conceptuelle et perceptive indispensable entre les barres d’erreur et les tests statistiques appariés, des statisticiens méthodologues ont formalisé une procédure de correction mathématique élégante, connue dans la littérature sous l’appellation de méthode de normalisation de Cousineau, perfectionnée par la correction analytique de Richard Morey. Cette technique permet de soustraire visuellement la variabilité interindividuelle non pertinente pour ne conserver que la variance résiduelle spécifique à l’interaction intra-sujet.
Le premier temps algorithmique de cette approche, développé par Denis Cousineau, consiste à centrer les scores de chaque participant en calculant la moyenne individuelle de chaque sujet sur l’ensemble des conditions expérimentales qu’il a traversées. Cette moyenne individuelle est ensuite soustraite de chaque observation brute du sujet, avant d’y réinjecter la moyenne générale globale de l’échantillon afin de préserver l’échelle de mesure originelle. Cette translation géométrique annule instantanément les écarts de niveau de base interindividuels : tous les participants présentent désormais un profil normalisé gravitant autour de la même moyenne d’ensemble.
Néanmoins, comme l’a rigoureusement démontré Richard Morey en 2008, cette manipulation de centrage réduit artificiellement les degrés de liberté réels de la matrice de données, introduisant un biais mathématique qui tend à sous-estimer la variance résiduelle de façon systématique. Pour compenser ce resserrement excessif, la correction de Morey applique un facteur multiplicatif analytique proportionnel à la racine carrée du ratio entre le nombre de conditions expérimentales évaluées et ce même nombre diminué d’une unité. En appliquant ce coefficient correcteur d’expansion à l’erreur type calculée sur les données centrées, on obtient des barres d’erreur ajustées dont le chevauchement ou la divergence reflète enfin fidèlement le résultat du test d’hypothèse apparié correspondant.
10.3 Implémentation automatisée dans R avec le package Rmisc ou des scripts sur mesure
L’implémentation opérationnelle de la normalisation de Cousineau-Morey au sein de l’environnement R peut s’effectuer par deux voies complémentaires : l’utilisation d’une bibliothèque dédiée d’automatisation ou la décomposition algorithmique explicite à l’aide des verbes de manipulation tabulaire. Historiquement, le paquet utilitaire Rmisc a largement popularisé cette méthode auprès des chercheurs grâce à sa fonction clé en main dédiée aux mesures répétées intra-sujets. Cette fonction accepte directement la spécification de la variable dépendante, des facteurs intra-sujets et de l’identifiant unique du participant, produisant en sortie un tableau récapitulatif contenant les moyennes réelles et les intervalles de confiance rigoureusement corrigés.
Toutefois, pour les analystes désireux d’éviter la multiplication de dépendances logicielles externes et de conserver une maîtrise absolue de chaque transformation algébrique au sein d’un pipeline d’ingénierie de données moderne, la reconstitution manuelle du protocole de Cousineau-Morey au moyen des fonctions de groupement et de mutation tabulaire s’avère hautement formatrice et transparente. Ce processus séquentiel comprend :
- Le calcul préalable de la moyenne globale de l’échantillon et de la moyenne propre à chaque participant à travers toutes ses conditions au moyen d’un groupement par identifiant de sujet.
- La génération d’une nouvelle colonne de scores ajustés où la moyenne individuelle du sujet est soustraite de sa mesure brute avant d’y additionner la moyenne générale d’ensemble.
- Le calcul de la variance et de l’erreur type sur ces scores centrés pour chaque niveau du facteur expérimental.
- La multiplication de cette erreur type par le facteur de correction analytique de Morey, défini par la racine carrée du nombre de conditions divisé par le nombre de conditions moins un.
- L’application de ce produit corrigé pour borner les intervalles de confiance finaux qui seront projetés dans les calques géométriques de visualisation.
Quelle que soit l’option technique retenue, il est une obligation méthodologique et déontologique impérative : la légende du graphique final doit expressément mentionner la nature ajustée des barres d’erreur affichées. L’auteur doit stipuler en toutes lettres que les intervalles ont été calculés selon la méthode de normalisation intra-sujets de Cousineau-Morey, garantissant aux évaluateurs et aux lecteurs une interprétation visuelle éclairée et conforme aux postulats de l’analyse inférentielle sous-jacente.
11. Variantes géométriques alternatives à geom_errorbar()
11.1 Représentations épurées : geom_pointrange() et geom_linerange()
Bien que la géométrie traditionnelle des barres d’erreur à chapeaux horizontaux demeure solidement ancrée dans les habitudes de publication, elle fait l’objet de critiques stylistiques récurrentes de la part des théoriciens du design d’information, au premier rang desquels figure Edward Tufte. Selon les préceptes de l’optimisation du ratio d’encre utile, tout élément graphique qui ne transmet pas une information statistique substantielle doit être impitoyablement élagué. Dans cette optique, les chapeaux horizontaux n’apportent aucun surcroît d’information sur la distribution, tout en introduisant un encombrement géométrique susceptible de nuire à la perception des micro-différences spatiales.
Pour répondre à cette exigence d’épuration graphique, l’écosystème de rendu de R propose des variantes fonctionnelles plus légères. La première, dédiée aux plages linéaires pures, supprime intégralement les terminaisons horizontales pour ne conserver qu’un segment vertical épuré délimitant l’intervalle entre les bornes inférieure et supérieure. La seconde, encore plus polyvalente et élégante, intègre directement au sein d’une couche unique le tracé du segment d’incertitude vertical et le dessin du point central d’estimation ponctuelle, garantissant un alignement spatial parfait sans risque de déphasage entre deux calques distincts.
Ces géométries minimalistes sont particulièrement préconisées dans les contextes de modélisation statistique avancée, tels que l’affichage des coefficients de régression logistique ou linéaire, les méta-analyses et les graphiques de forêt d’estimations de cotes (forest plots). En éliminant le bruit visuel des barres larges et des chapeaux parasites, elles permettent de juxtaposer plusieurs dizaines de paramètres estimés sur une échelle verticale unique tout en préservant une lisibilité et une précision cartésienne incomparables.
11.2 Intervalles en blocs avec geom_crossbar()
À l’opposé stylistique de l’épuration filaire, la bibliothèque graphique intègre une fonction permettant de matérialiser les marges d’incertitude sous la forme d’un bloc rectangulaire évidé ou coloré, traversé en son centre par un trait horizontal marquant la position de la tendance moyenne. Cette géométrie transforme l’intervalle d’incertitude en une boîte géométrique volumétrique délimitée par les bornes inférieure et supérieure déclarées dans l’assignation esthétique.
Cette approche trouve son utilité préférentielle dans des contextes métrologiques spécifiques où l’incertitude n’est pas simplement perçue comme un gradient probabiliste diffus, mais délimite une zone franche de tolérance industrielle, une enveloppe d’équivalence biomédicale ou un intervalle de spécification réglementaire. Le remplissage de la boîte par des teintes différenciées ou des motifs de transparence permet de marquer physiquement l’espace des valeurs acceptables ou prédites par un modèle théorique.
Il convient néanmoins de manier cette géométrie avec précaution dans les publications académiques courantes. Sa morphologie rectangulaire rappelle fortement la boîte de dispersion des diagrammes de Tukey, ce qui peut engendrer une confusion cognitive chez le lecteur non averti, qui risquerait d’interpréter le rectangle comme un écart interquartile bordé par des médianes plutôt que comme un intervalle de confiance classique entourant une moyenne arithmétique. Une explicitation minutieuse de la nature du tracé dans la légende de la figure est donc obligatoire.
11.3 Superposition de barres d’erreur sur des nuages de points réels (Jittering)
L’une des avancées les plus remarquables de la visualisation de données scientifiques de ces dernières années réside dans le rejet croissant de la réduction aveugle des distributions complexes à de simples indices agrégés. Les distributions bimodales, les grappes de sous-groupes ou la présence de fortes valeurs aberrantes peuvent produire des moyennes et des erreurs types strictement indiscernables de celles issues d’une distribution gaussienne uniforme parfaite, dissimulant des réalités biologiques ou psychologiques radicalement divergentes.
Pour pallier cette occultation de l’information brute, la méthodologie moderne plébiscite la superposition conjointe des observations individuelles réelles et des estimateurs d’incertitude synthétiques. En mobilisant une couche de dispersion stochastique contrôlée (connue sous le terme de jittering), l’analyste projette l’ensemble des points de données brutes sur la scène graphique en leur appliquant un micro-déplacement aléatoire sur l’axe transversal, évitant ainsi que des observations identiques ne se masquent mutuellement par surimpression exacte.
Sur ce nuage de points individuels translucides déployé en arrière-plan, l’incorporation au premier plan d’une barre d’erreur stylisée ou d’une plage d’estimation centrée offre une synthèse visuelle d’une puissance absolue. Le lecteur a un accès direct et simultané à deux niveaux de réalité : il observe la distribution empirique non déformée de chaque participant tout en percevant instantanément l’estimation inférentielle et son incertitude associée, incarnant ainsi l’idéal contemporain de transparence intégrale dans l’analyse de données empiriques.
12. Bonnes pratiques éditoriales, pièges fréquents et conformité APA
12.1 Directives de présentation selon le manuel de publication de l’APA (7e édition)
L’élaboration de figures destinées à franchir l’épreuve de l’évaluation par les pairs au sein des revues affiliées à l’American Psychological Association ou adoptant ses directives requiert une conformité formelle rigide avec les prescriptions de la septième édition de son manuel de publication. L’exigence cardinale énoncée par ces normes impose que chaque figure scientifique soit conçue comme une entité communicative autonome, capable d’être interprétée intégralement sans que le lecteur ne soit contraint de naviguer à travers le corps du texte pour en déchiffrer les composantes de base.
Cette autonomie repose avant tout sur la rédaction exhaustive de la légende et des notes de bas de figure. Pour toute présence de barres d’erreur, l’auteur a l’obligation formelle de déclarer avec une exactitude statistique millimétrique la nature exacte de la métrique employée (par exemple en mentionnant explicitement que les barres représentent un écart-type, une erreur type de la moyenne ou un intervalle de confiance à quatre-vingt-quinze pour cent). Lorsque des intervalles de confiance sont affichés, il convient de préciser si les calculs ont fait l’objet d’un ajustement pour mesures répétées selon la correction de Cousineau-Morey, et d’indiquer sans ambiguïté les degrés de liberté théoriques ou la méthode de rééchantillonnage mise en œuvre.
Les normes APA imposent également une discipline typographique stricte : l’emploi de polices de caractères sans empattement universellement répandues (telles qu’Arial, Calibri ou Helvetica) avec une échelle de corps homogène oscillant entre huit et quatorze points pour l’ensemble des inscriptions graphiques. De surcroît, le volume effectif de chaque groupe expérimental doit être systématiquement rapporté, soit par une inscription directe au sein des étiquettes des axes gradués, soit sous forme de note synthétique stipulant la taille d’échantillon pour chaque modalité factorielle examinée.
12.2 Pièges cognitifs et erreurs d’interprétation visuelle récurrentes
L’utilisation des représentations graphiques d’incertitude est parasitée par de nombreux biais cognitifs et heuristiques perceptuelles fallacieuses solidement documentés par la psychologie de la perception visuelle. Le piège le plus universel est incontestablement l’illusion du chevauchement. De nombreux praticiens, conditionnés par une interprétation binaire des seuils statistiques, déduisent erronément que dès lors que les barres d’erreur de deux groupes indépendants se touchent ou se recouvrent partiellement, la différence entre les deux conditions est nécessairement non significative au seuil classique de cinq pour cent.
Cette déduction intuitive est mathématiquement fausse lorsque les barres représentent des intervalles de confiance à quatre-vingt-quinze pour cent ou des erreurs types de la moyenne. Deux intervalles de confiance à quatre-vingt-quinze pour cent indépendants peuvent se recouvrir sur près de vingt-cinq pour cent de leur envergure totale tout en correspondant à un test de comparaison de moyennes statistiquement significatif au seuil standard de p inférieur à zéro virgule zéro cinq. De même, l’absence de chevauchement de barres d’erreur types ne garantit en rien une significativité statistique, le seuil d’espacement requis pour rejeter l’hypothèse nulle étant considérablement plus grand qu’une simple séparation visuelle tangentielle.
Un autre biais majeur découle de la troncature artificielle des axes de coordonnées sur les diagrammes en barres pleines. Si un chercheur restreint l’origine de l’axe des ordonnées pour débuter arbitrairement à une valeur proche des moyennes observées plutôt qu’à l’origine du zéro absolu, la hauteur visuelle des barres d’erreur s’en trouve démesurément amplifiée par rapport à la masse de la colonne sous-jacente. Cette déformation cartésienne induit chez l’observateur une perception hypertrophiée de l’instabilité des données ou, inversement, amplifie artificiellement des variations infinitésimales. Il est donc fondamental de réserver les axes tronqués aux seuls graphiques à points et profils filaires, en maintenant impérativement le zéro naturel pour toute géométrie volumétrique pleine.
12.3 Liste de contrôle méthodologique pour des graphiques irréprochables
Afin de prémunir le chercheur contre les bévues méthodologiques et d’optimiser le parcours éditorial de ses manuscrits, l’application systématique d’une grille d’audit de qualité avant toute soumission finale s’avère hautement profitable. Cette liste de contrôle méthodologique articule les points d’ancrage critiques garantissant la rigueur mathématique, la clarté perceptuelle et la reproductibilité computationnelle intégrale des visualisations d’incertitude générées sous R :
- Vérification de la cohérence métrique : L’entité statistique tracée (SD, SEM ou IC) est-elle rigoureusement alignée sur les objectifs communicatifs de l’étude (description de la variance versus inférence sur la moyenne) et fidèlement reflétée dans la formulation de la légende ?
- Contrôle mathématique des frontières : Les barres d’erreur franchissent-elles des limites naturelles ou théoriques de l’échelle mesurée (scores négatifs impossibles, pourcentages excédant cent pour cent) ? Si oui, une troncature ou une méthode asymétrique appropriée a-t-elle été mobilisée et documentée ?
- Synchronisation des décalages d’esquive : Les valeurs de déplacement spatial (dodge) sont-elles scrupuleusement identiques entre la géométrie de tendance centrale et la géométrie des barres d’erreur sur l’ensemble des facteurs croisés ?
- Correction pour mesures répétées : Dans le cas de protocoles appariés ou intra-sujets, la normalisation de Cousineau-Morey a-t-elle été appliquée pour neutraliser l’effet d’amplification de la variance interindividuelle globale ?
- Conformité de résolution graphique : Le fichier exporté présente-t-il les attributs de format requis par la revue (tracé vectoriel sans dégradation, ou matrice avec une densité minimale certifiée de 300 à 600 DPI) ?
- Archivage du script reproductible : L’ensemble de la chaîne de code, depuis la lecture du tableau brut jusqu’à l’exportation finale via l’instruction dédiée, s’exécute-t-il de manière autonome sans déclencher d’avertissement d’incohérence statistique ou d’occlusion de calque ?
L’observation rigoureuse de ces canons méthodologiques hisse la production graphique au rang d’instrument d’investigation et de démonstration scientifique irréprochable. En maîtrisant les subtilités du langage R et en articulant la puissance déclarative de ggplot2 aux postulats de la statistique théorique, l’analyste s’assure que chaque barre d’erreur tracée contribue avec fidélité, élégance et exactitude à l’avancement intelligible du savoir empirique.
Références
- Cleveland, W. S. (1994). The Elements of Graphing Data (2nd ed.). Hobart Press.
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. The Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200702082
- Harrell, F. E. (2023). Hmisc: Harrell Miscellaneous (R package version 5.1-1). Comprehensive R Archive Network. https://cran.r-project.org/package=Hmisc
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0