
Dans l’immense édifice de la statistique inférentielle moderne, rares sont les outils qui ont exercé une influence aussi profonde et durable sur les sciences empiriques que le test du khi-deux développé par Karl Pearson à l’aube du XXe siècle. Conçu à une époque charnière où la recherche scientifique s’émancipait des modèles déterministes stricts pour embrasser la variabilité probabiliste du monde naturel et social, ce test a révolutionné l’analyse des données observationnelles. En offrant aux chercheurs un cadre formel pour évaluer si les écarts entre des fréquences observées sur le terrain et des fréquences théoriques attendues résultent de simples fluctuations d’échantillonnage aléatoires ou d’une véritable dynamique sous-jacente, le test du khi-deux s’est imposé comme un pilier méthodologique incontournable.
Le développement spectaculaire des sciences comportementales, de la psychologie clinique, de la sociologie et de l’épidémiologie au cours des dernières décennies a mis en lumière la prédominance des variables qualitatives et catégorielles. Contrairement aux grandeurs physiques continues qui se prêtent naturellement aux distributions gaussiennes et aux tests paramétriques classiques, les phénomènes humains et sociaux s’expriment fréquemment à travers des typologies, des choix discrets, des classifications diagnostiques ou des préférences subjectives. Face à ces données nominales et ordinales, le test du khi-deux fournit un moyen rigoureux d’échapper à l’arbitraire de l’intuition brute, transformant de simples dénombrements en inférences statistiques hautement informatives.
Pourtant, en dépit de son omniprésence dans les manuels et les logiciels d’analyse de données, l’application du test du khi-deux dans des contextes réels soulève d’importantes questions méthodologiques et épistémologiques. Entre les tests d’adéquation destinés à confronter une distribution empirique à une norme théorique, et les tests d’indépendance cherchant à déceler des associations structurelles entre deux attributs distincts, la pratique scientifique requiert une maîtrise rigoureuse des postulats sous-jacents, de la taille des échantillons, des résidus standardisés et des mesures de taille d’effet. Cet article propose une exploration approfondie de cette méthode à travers son ancrage théorique, ses fondements algébriques et quatre études de cas détaillées issues de la vie réelle et des sciences du comportement.
1. Introduction aux tests non paramétriques et fondements du test du khi-deux
1.1 Genèse historique et épistémologique du test de Karl Pearson
L’émergence de la statistique moderne à la fin du XIXe siècle est indissociable des travaux pionniers de Karl Pearson, mathématicien et polymathe britannique dont les contributions ont redéfini la philosophie des sciences. Confronté aux données biologiques et sociologiques recueillies par Francis Galton et d’autres chercheurs de son époque, Pearson s’est rapidement heurté à une impasse épistémologique majeure : les méthodes statistiques existantes reposaient quasi exclusivement sur l’hypothèse d’une distribution normale des variables, héritée des travaux de Gauss et de Laplace sur les erreurs de mesure astronomiques. Or, les phénomènes biologiques et humains refusaient obstinément de se conformer à cette symétrie parfaite, affichant des asymétries prononcées, des formes multimodales et des discontinuités structurelles.
La nécessité de modéliser des variables qualitatives et catégorielles dans les sciences humaines et sociales est devenue impérieuse au tournant des années 1900. Dans un article fondateur publié en 1900 dans le Philosophical Magazine, Pearson introduit la statistique du khi-deux comme un critère permettant de vérifier si un ensemble donné d’observations déviant d’une loi théorique pouvait être raisonnablement attribué au simple hasard de l’échantillonnage. Cette publication a marqué une rupture fondamentale avec les postulats de normalité imposés par les tests paramétriques gaussiens. Pour la première fois, les chercheurs disposaient d’un instrument capable de traiter des grandeurs purement fréquentielles et discontinues sans exiger la continuité métrique des mesures.
Cette percée a profondément transformé l’évolution de l’inférence statistique appliquée aux sciences psychologiques et comportementales. En permettant d’analyser des distributions de fréquences empiriques sans préjuger de la nature sous-jacente de l’échelle de mesure, le test de Pearson a légitimé l’étude quantitative des traits de personnalité, des attitudes sociales, des symptômes psychiatriques et des comportements de choix. Il a ouvert la voie à ce que l’on qualifiera plus tard de statistique non paramétrique, une branche dont l’objectif premier est de fournir des outils décisionnels robustes lorsque les hypothèses distributionnelles restrictives des modèles linéaires classiques ne peuvent être satisfaites par les données réelles.
1.2 Définition théorique et vocation inférentielle
Au cœur de l’architecture conceptuelle du test du khi-deux réside le principe fondamental de la comparaison systématique entre des fréquences observées sur un échantillon empirique et des fréquences théoriques attendues selon un modèle probabiliste spécifié a priori. Ce paradigme repose sur une question heuristique simple : si l’hypothèse de recherche formulée par l’analyste – qu’il s’agisse de l’équiprobabilité des événements ou de l’indépendance de deux facteurs – était rigoureusement exacte dans la population parente, quelle distribution des effectifs devrait-on observer, et à quel point l’observation empirique s’écarte-t-elle de cette attente mathématique ?
Pour quantifier cette divergence, le test utilise une modélisation de l’écart quadratique réduit standardisé. En élevant au carré la différence entre chaque effectif observé et son homologue théorique, l’analyste neutralise l’annulation mutuelle des déviations positives et négatives tout en conférant un poids proportionnellement plus élevé aux écarts majeurs. En divisant ensuite ce carré par l’effectif attendu correspondant, on réalise une normalisation locale qui pondère la déviation par l’ordre de grandeur attendu, empêchant ainsi les cellules à fort volume de dominer artificiellement la statistique globale au détriment des cellules plus modestes.
Cette approche confère au test du khi-deux un rôle clé dans la validation ou le rejet de l’hypothèse nulle (notée H0), qu’elle prenne la forme d’une absence de biais de sélection, d’une conformité à une loi génétique mendélienne, ou d’une parfaite indépendance stochastique entre deux variables psychologiques. En sciences cognitives et en psychologie clinique, cette pertinence heuristique est inestimable : elle permet d’évaluer si la distribution des réponses des participants à une tâche de jugement perceptif ou à un inventaire clinique s’écarte d’un profil de réponse purement aléatoire, apportant ainsi la preuve formelle de l’existence d’un processus psychologique structuré sous-jacent.
1.3 Positionnement du khi-deux dans l’arsenal méthodologique des sciences comportementales
Pour mobiliser judicieusement le test du khi-deux, il convient de le situer avec précision au sein de l’arsenal méthodologique des sciences empiriques, ce qui exige d’abord une distinction stricte entre données métriques continues et données nominales discontinues. Les variables métriques, issues d’échelles d’intervalles ou de rapports (telles que le temps de réaction en millisecondes, le taux de cortisol plasmatique ou le score brut à une échelle standardisée de quotient intellectuel), autorisent le calcul de moyennes arithmétiques, de variances et l’application de tests paramétriques comme le test t de Student. En revanche, les données nominales ne renvoient qu’à des étiquettes ou des catégories d’appartenance mutuellement exclusives (par exemple, le profil nosographique, l’orientation professionnelle ou la modalité de réponse binaire oui/non), interdisant toute opération de centrage ou de réduction arithmétique classique.
Dans ce cadre, le test du khi-deux s’avère hautement complémentaire avec d’autres méthodes multivariées, en particulier l’analyse de variance (ANOVA) et la régression logistique binaire ou polytomique. Alors que l’ANOVA requiert une variable dépendante continue et des facteurs explicatifs catégoriels sous contrainte d’homoscédasticité, le khi-deux permet d’analyser les relations entre deux facteurs nominaux sans postuler de relation directionnelle ou causale stricte a priori. De même, le khi-deux d’indépendance constitue fréquemment l’étape exploratoire indispensable précédant une modélisation par régression logistique, permettant d’identifier les variables catégorielles affichant une association brute significative avant de contrôler d’éventuels facteurs de confusion.
Cette flexibilité fait du khi-deux un instrument de prédilection en recherche observationnelle, en épidémiologie sociale et dans les protocoles de recherche quasi-expérimentaux. Lorsqu’un protocole expérimental avec assignation aléatoire et manipulation d’une variable indépendante continue s’avère éthiquement impossible ou matériellement impraticable – comme dans l’étude des traumatismes psychologiques ou des troubles de la personnalité –, l’analyse des tableaux de contingence par le test du khi-deux demeure l’une des voies les plus directes et fiables pour tester des hypothèses de covariation dans des populations naturelles.
2. Cadre mathématique et postulats d’application
2.1 Formulation algébrique et distribution sous l’hypothèse nulle
L’échafaudage mathématique du test du khi-deux repose sur une formulation algébrique élégante, caractérisée par la somme pondérée des résidus au carré. Pour un ensemble de k cellules ou catégories d’observations, la statistique de Pearson, conventionnellement désignée par la lettre grecque chi au carré (χ²), est formellement définie par l’expression canonique suivante :
χ² = Σ [ (O_i – E_i)² / E_i ]
Dans cette équation fondamentale, O_i représente la fréquence empirique observée dans la i-ème cellule, tandis que E_i désigne la fréquence théorique attendue (souvent notée Expected en littérature anglo-saxonne) sous la condition de validité stricte de l’hypothèse nulle. La sommation s’étend sur l’ensemble des k classes d’un vecteur univarié ou sur l’ensemble des cellules issues du produit des lignes et des colonnes (r × c) d’une matrice de contingence bivariée. Les résidus bruts (O_i – E_i) capturent la déviation locale du modèle théorique, leur élévation à la puissance deux assure une valeur globale strictement positive ou nulle, et la division par E_i attribue une variance théorique locale sous l’hypothèse d’une loi de distribution de Poisson pour chaque cellule indépendante.
Le comportement probabiliste de cette statistique dépend directement de la détermination des degrés de liberté (notés ddl ou ν). Dans le cas d’un modèle d’adéquation univarié comportant k classes sans estimation de paramètres supplémentaires, le nombre de degrés de liberté est égal à k – 1, traduisant la contrainte unique selon laquelle la somme des fréquences attendues doit coïncider avec la taille totale de l’échantillon N. Dans le cadre d’un tableau de contingence croisant r rangées et c colonnes pour un test d’indépendance, les degrés de liberté sont dictés par la formule (r – 1)(c – 1), correspondant au nombre de cellules libres d’évoluer une fois que les marges horizontales et verticales sont fixées.
D’un point de vue asymptotique, lorsque la taille totale de l’échantillon N tend vers l’infini, la distribution d’échantillonnage de cette somme discrète converge en loi vers la distribution continue du khi-deux à ν degrés de liberté. La règle de décision statistique s’applique dès lors de façon unilatérale à droite : l’analyste compare la statistique empirique χ² observée à une valeur critique seuil, dérivée de la fonction de répartition de la loi du khi-deux pour un niveau de risque d’erreur de première espèce alpha (généralement 0,05 ou 0,01). Si la statistique observée excède la valeur critique, ou de façon équivalente si la p-valeur associée est inférieure au seuil alpha, l’hypothèse nulle est rejetée en faveur de l’hypothèse alternative.
2.2 Conditions de validité et critères de robustesse de Cochran
La validité des déductions inférentielles issues du test du khi-deux repose sur le strict respect de postulats méthodologiques fondamentaux. Le premier et le plus incontournable de ces postulats concerne l’exigence absolue d’indépendance des observations. Chaque unité statistique (patient, consommateur, apprenant) doit impérativement être assignée à une et une seule classe de la matrice, et chaque événement consigné doit être statistiquement indépendant des autres. Cela exclut de facto l’analyse directe de mesures répétées, d’évaluations longitudinales ou de questionnaires autorisant des réponses multiples au moyen du khi-deux classique, sous peine de biaiser dramatiquement l’estimation de la variance et de produire des résultats fallacieux.
Le second ensemble de conditions concerne la taille des effectifs théoriques attendus (E_i), théorisé de manière magistrale par le statisticien William Cochran dans les années 1950. Étant donné que la distribution continue du khi-deux n’est qu’une approximation asymptotique de la loi multinomiale discrète sous-jacente, cette approximation devient médiocre lorsque les fréquences attendues s’avèrent trop faibles. Selon la règle empirique de Cochran, le test du khi-deux demeure valide et robuste sous deux conditions simultanées : aucune cellule du tableau de contingence ne doit comporter une fréquence attendue strictement inférieure à 1, et au moins 80 % des cellules du tableau doivent présenter un effectif théorique supérieur ou égal à 5.
L’inobservation de ces seuils théoriques entraîne des conséquences délétères sur le plan de la décision statistique, provoquant une distorsion majeure du taux d’erreur de type I (rejet erroné d’une hypothèse nulle pourtant vraie). Face à des tableaux présentant des effectifs clairsemés, deux stratégies d’ajustement classiques sont envisageables : la fusion de modalités catégorielles adjacentes ou conceptuellement homogènes afin d’augmenter artificiellement la taille des effectifs par compartiment, ou l’application de la correction de continuité de Frank Yates pour les tables de contingence deux par deux, bien que cette dernière soit parfois critiquée pour son caractère excessivement conservateur réduisant la puissance statistique globale.
2.3 Traitement des violations des hypothèses sous-jacentes
Lorsque les données recueillies enfreignent de manière irréductible les conditions de validité asymptotique, en particulier en présence d’échantillons cliniques de petite taille ou de distributions hautement asymétriques où la fusion de catégories s’avère scientifiquement insensée, le statisticien doit abandonner l’approximation continue de Pearson au profit d’approches exactes. L’alternative reine pour les tables de contingence de format deux par deux réside dans le test exact de Fisher, fondé sur la loi hypergéométrique. En conditionnant le calcul par les totaux marginaux observés, cette méthode calcule la probabilité combinatoire exacte d’obtenir la configuration matricielle constatée ou une configuration plus extrême, éliminant tout recours à une convergence asymptotique.
Toutefois, la manipulation de matrices de contingence de dimensions plus vastes (trois par trois, quatre par quatre ou tableaux rectangulaires r × c) disqualifie la version standard du test de Fisher en raison de la complexité combinatoire exponentielle liée au calcul exhaustif de toutes les permutations matricielles envisageables. Dans ce scénario méthodologique complexe, les chercheurs ont recours à des techniques modernes de rééchantillonnage assisté par ordinateur, notamment le bootstrap non paramétrique et les procédures de permutations exactes de Monte-Carlo.
La simulation de Monte-Carlo génère aléatoirement un nombre massif (couramment 100 000 ou 1 000 000) de tables de contingence virtuelles présentant scrupuleusement les mêmes distributions marginales que le tableau empirique sous l’hypothèse nulle d’indépendance. En calculant la statistique du khi-deux de Pearson sur chaque réplicat simulé, on construit une distribution empirique de référence exempte de tout biais d’approximation continue. La p-valeur exacte correspond alors simplement au ratio entre le nombre de réplicats virtuels dont la statistique égale ou surpasse la valeur observée sur les données réelles et le nombre total d’itérations simulées, offrant une fiabilité décisionnelle irréprochable même en contexte de forte parcimonie d’échantillonnage.
3. Typologie différentielle : adéquation versus indépendance
3.1 Le test d’adéquation (Goodness of Fit) : principe et architecture
La vaste famille des tests du khi-deux se scinde principalement en deux grands schémas expérimentaux aux finalités analytiques contrastées : le test d’adéquation (souvent désigné par la terminologie anglaise Goodness of Fit) et le test d’indépendance. Le test d’adéquation intervient lorsqu’un chercheur souhaite confronter la distribution empirique observée d’une seule variable catégorielle univariée à k modalités face à une distribution théorique établie a priori, déduite d’un modèle probabiliste canonique, d’une loi scientifique universelle ou de données épidémiologiques de référence tirées de la littérature spécialisée.
La formalisation probabiliste d’un test d’adéquation structure rigoureusement les hypothèses d’étude. L’hypothèse nulle stipule que les proportions observées dans chaque modalité k sont rigoureusement identiques aux probabilités théoriques spécifiées (H0: p1 = π1, p2 = π2, …, pk = πk, où la somme des π_i est égale à 1). L’hypothèse alternative H1 énonce qu’au moins une proportion empirique diffère significativement de la prédiction théorique associée. Les effectifs attendus sont alors déterminés très simplement en multipliant la taille totale de la cohorte par chaque probabilité postulée :
E_i = N × π_i
Dans cette architecture univariée, le calcul des degrés de liberté obéit à la règle ν = k – 1 – m, où k représente le nombre de classes de la variable et m le nombre de paramètres théoriques de la loi parente qui ont dû être directement estimés à partir de l’échantillon lui-même (comme la moyenne ou la variance dans le cadre de l’adéquation à une loi discrète). Lorsque les probabilités théoriques sont entièrement postulées a priori sans aucune estimation empirique dérivée des données (ce qui est le cas classique lors d’un test d’équiprobabilité où chaque π_i = 1/k), la valeur m est nulle, et la formule se simplifie en k – 1.
3.2 Le test d’indépendance : structure matricielle et covariation
À l’opposé du schéma univarié d’adéquation, le test du khi-deux d’indépendance vise à évaluer la covariation stochastique ou l’absence de corrélation entre deux variables qualitatives catégorielles distinctes mesurées conjointement sur un même échantillon représentatif d’individus. Sa mise en œuvre requiert la construction systématique d’un tableau de contingence croisant les r modalités de la première variable en lignes et les c modalités de la seconde variable en colonnes, produisant ainsi une matrice bidimensionnelle de r × c compartiments.
Sous l’hypothèse nulle d’indépendance probabiliste (selon laquelle la probabilité conjointe d’un événement correspond au produit strict de leurs probabilités marginales respectives : P(A ∩ B) = P(A) × P(B)), les effectifs théoriques attendus au sein de chaque compartiment situé à l’intersection de la i-ème ligne et de la j-ème colonne sont mathématiquement dérivés des produits des marges empiriques rapportés à l’effectif total d’observations :
E_ij = (R_i × C_j) / N
Dans cette formalisation, R_i symbolise l’effectif marginal total de la ligne i, C_j représente l’effectif marginal total de la colonne j, et N correspond à la somme cumulative des observations de la table entière. L’identification des déviations majeures entre les effectifs observés O_ij et attendus E_ij permet de localiser des attractions ou des répulsions comportementales entre sous-groupes populationnels spécifiques. Le nombre de degrés de liberté associé à cette table matricielle s’établit à (r – 1)(c – 1), reflétant les contraintes linéaires imposées par la préservation des totaux marginaux horizontaux et verticaux.
3.3 Critères discriminants pour sélectionner le test approprié
Bien que les formulations algébriques finales du khi-deux d’adéquation et d’indépendance partagent un socle computationnel identique reposant sur la somme des carrés des déviations pondérées, la confusion entre ces deux protocoles constitue une anomalie récurrente dans les travaux de recherche universitaires et les mémoires de psychologie clinique. Pour sélectionner le test approprié, le chercheur doit d’abord analyser le protocole expérimental et le schéma de collecte des données : l’étude repose-t-elle sur le recueil d’un unique attribut qualitatif sur un échantillon univarié que l’on compare à un standard extérieur, ou procède-t-elle à la mesure simultanée de deux caractéristiques intrinsèques sur chaque individu ?
Le second critère discriminant réside dans la nature même de la question de recherche postulée par l’investigateur. Si la problématique interroge la conformité d’une structure observée à une norme prédéterminée, à une répartition égale des choix (équiprobabilité) ou à un équilibre historique documenté, le test d’adéquation est souverain. En revanche, si l’interrogation scientifique porte sur l’existence d’une relation d’association, d’une dépendance mutuelle ou d’une interaction phénoménologique entre deux dimensions qualitatives, le tableau de contingence croisé et le test d’indépendance s’imposent impérativement.
Une troisième variante conceptuelle mérite d’être soulignée pour dissiper toute ambiguïté théorique : le test du khi-deux d’homogénéité. Bien que mathématiquement indiscernable du test d’indépendance dans son exécution matricielle, le test d’homogénéité se distingue par son plan d’échantillonnage. Dans le test d’indépendance, un seul groupe global est échantillonné puis ventilé a posteriori selon deux axes catégoriels. Dans le test d’homogénéité, l’expérimentateur constitue a priori plusieurs sous-populations distinctes d’effectifs fixes (par exemple 100 dépressifs, 100 anxieux et 100 témoins sains) et vérifie si la distribution d’une variable réponse polytomique unique s’avère similaire ou hétérogène à travers ces sous-groupes prédéterminés.
4. Exemple 1 : Répartition des flux de fréquentation dans le commerce et comportement d’achat
4.1 Contexte de l’étude et formulation de la problématique commerciale
Pour illustrer de manière concrète l’application pratique du test d’adéquation du khi-deux dans le monde réel, examinons la problématique d’un gestionnaire de point de vente spécialisé confronté à des décisions d’organisation logistique et de planification du personnel. Dans le secteur de la distribution, une croyance managériale courante postule une affluence parfaitement homogène tout au long des jours ouvrés de la semaine, du lundi au vendredi. Selon cette intuition, la clientèle se répartirait de manière uniforme, chaque journée concentrant une fraction équivalente d’exactement 20 % du volume hebdomadaire global d’achats.
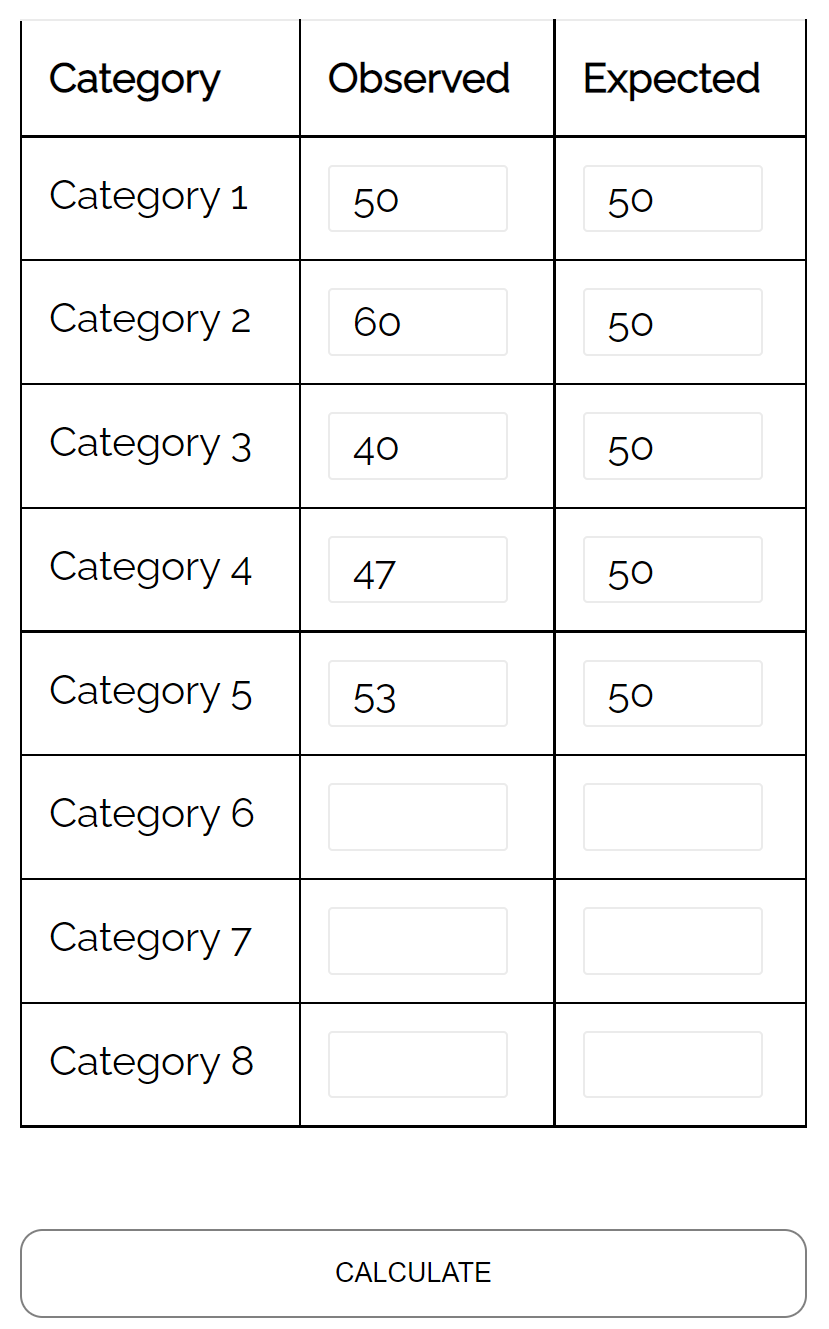
Afin d’éprouver scientifiquement ce postulat d’équiprobabilité temporelle, le responsable d’exploitation met en place un recueil méticuleux des flux de transactions enregistrées sur une semaine ouvrée représentative, totalisant N = 250 passages en caisse distincts. Les données brutes observées se ventilent de la manière suivante :
- Lundi : 50 clients
- Mardi : 60 clients
- Mercredi : 40 clients
- Jeudi : 47 clients
- Vendredi : 53 clients
Cette question empirique dépasse la simple curiosité statistique : elle comporte des implications managériales directes en psychologie du travail et en ergonomie des services. Si l’affluence présente des irrégularités statistiquement étayées, le maintien d’une présence égale du personnel sur tous les créneaux engendre une surcharge de travail le mardi, source d’épuisement professionnel et d’altération de la qualité d’accueil, couplée à un sous-emploi le mercredi. Sur le plan formel, la croyance du commerçant se traduit par une hypothèse nulle stipulant que p_lundi = p_mardi = p_mercredi = p_jeudi = p_vendredi = 0,20.
4.2 Exécution intégrale du test d’adéquation du khi-deux
L’exécution de la procédure inférentielle débute par le calcul de l’effectif moyen théorique attendu (E_i) sous condition de validité de l’hypothèse nulle. Pour un échantillon global de 250 transactions distribuées sur cinq journées ouvrées équivalentes, le calcul arithmétique donne :
E_i = 250 × 0,20 = 50 clients par jour
Chacun des cinq jours de la semaine se voit donc attribuer une attente théorique stricte de 50 clients. Nous pouvons dès lors expliciter le calcul cellule par cellule de l’écart quadratique réduit en appliquant la formule standard de Pearson :
- Lundi : O = 50, E = 50 → (50 – 50)² / 50 = 0 / 50 = 0,000
- Mardi : O = 60, E = 50 → (60 – 50)² / 50 = (10)² / 50 = 100 / 50 = 2,000
- Mercredi : O = 40, E = 50 → (40 – 50)² / 50 = (-10)² / 50 = 100 / 50 = 2,000
- Jeudi : O = 47, E = 50 → (47 – 50)² / 50 = (-3)² / 50 = 9 / 50 = 0,180
- Vendredi : O = 53, E = 50 → (53 – 50)² / 50 = (3)² / 50 = 9 / 50 = 0,180
La sommation linéaire de ces composantes individuelles fournit la statistique globale du test d’adéquation :
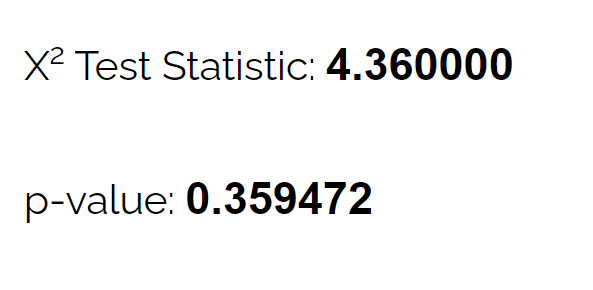
χ² = 0,000 + 2,000 + 2,000 + 0,180 + 0,180 = 4,360
Le nombre de degrés de liberté est déterminé par le nombre de classes moins un, soit ν = 5 – 1 = 4 ddl. En consultant la table de distribution cumulative de la loi du khi-deux à 4 degrés de liberté pour un seuil conventionnel alpha fixé à 0,05, on constate que la valeur critique théorique requise pour rejeter l’hypothèse nulle est de 9,488. Par ailleurs, le calcul analytique de l’intégrale de probabilité associe à cette statistique empirique χ² = 4,36 une p-valeur très exactement égale à p = 0,359.
4.3 Interprétation psychologique et décisionnelle des résultats
L’analyse inférentielle aboutit à une décision sans ambiguïté : la p-valeur calculée (0,359) s’avérant très nettement supérieure au seuil d’erreur alpha de 0,05, et la statistique observée (4,360) demeurant très en deçà du seuil critique (9,488), il est mathématiquement impossible de rejeter l’hypothèse nulle d’équiprobabilité. Faute de preuves empiriques tangibles, le gestionnaire ne peut affirmer qu’il existe une variabilité journalière structurelle au sein de la fréquentation de son commerce.
Sur le plan de la psychologie de la décision managériale, ce résultat offre une leçon d’une portée considérable. L’observateur humain est cognitivement enclin à détecter des motifs ou des régularités causales là où n’opère que le pur aléa, un biais bien documenté en psychologie cognitive sous le nom d’apophénie. En voyant 60 clients franchir le pas de la porte le mardi et seulement 40 le mercredi, l’intuition du commerçant est immédiatement tentée d’échafauder des théories explicatives spécieuses reliant cette baisse perçue au calendrier scolaire ou à la météo locale.
Le verdict du khi-deux d’adéquation démontre que ces fluctuations apparentes (±10 individus par rapport à la moyenne) sont parfaitement compatibles avec les variations aléatoires inhérentes à tout échantillonnage de taille modérée issu d’une population sous-jacente homogène. Par conséquent, sur le plan organisationnel et pratique, il serait prématuré et potentiellement préjudiciable de restructurer les plannings du personnel ou de redéployer les équipes de vente sur la base d’une variabilité journalière qui n’a pas atteint le statut de régularité statistique avérée.
5. Exemple 2 : Styles d’attachement affectif et stratégies de régulation émotionnelle
5.1 Fondements théoriques en psychologie clinique et du développement
Le deuxième exemple illustre la puissance du test du khi-deux d’indépendance au sein d’une recherche fondamentale en psychologie clinique et développementale. La théorie de l’attachement, initialement conceptualisée par John Bowlby et opérationnalisée empiriquement par Mary Ainsworth, postule que les interactions précoces entre le nourrisson et sa figure de soins primaire forgent des modèles internes opérants durables. Chez l’adulte, ces schémas relationnels s’articulent classiquement autour de trois grands styles prototypiques : le style sécurisant (caractérisé par une perception positive de soi et d’autrui, ainsi qu’une aisance dans la proximité affective), le style insécurisant-évitant (marqué par une surévaluation de l’autonomie et une désactivation des besoins relationnels) et le style insécurisant anxieux-ambivalent (défini par une peur constante de l’abandon et une hyperactivation émotionnelle).
Parallèlement, les théories modernes de la régulation émotionnelle distinguent plusieurs stratégies cognitives et comportementales majeures déployées par les individus face à l’adversité : la réévaluation cognitive (processus adaptatif visant à modifier la signification d’un événement stressant), la suppression expressive (inhibition délibérée de la manifestation extérieure des émotions) et la rumination mentale (focalisation répétitive et passive sur les symptômes de détresse sans résolution de problème). L’hypothèse théorique sous-tendant cette recherche postule l’existence d’une dépendance structurelle significative entre le style d’attachement adulte d’un sujet et sa stratégie dominante de régulation émotionnelle.
Pour soumettre cette hypothèse à l’épreuve des faits, une cohorte clinique de 300 adultes consultant dans des centres de prise en charge psychologique a été soumise à une passation combinant un inventaire psychométrique d’attachement reconnu et le questionnaire de régulation émotionnelle. Chaque participant a été classé de manière exclusive dans l’une des trois modalités d’attachement et dans l’une des trois stratégies dominantes de régulation, fournissant une matrice de données catégorielles trois par trois idéale pour un test d’indépendance.
5.2 Tableau de contingence et calcul matriciel du test d’indépendance
Les 300 participants se ventilent dans une table de contingence 3 × 3 croisant le Style d’Attachement (Lignes : Sécurisant, Évitant, Anxieux) et la Régulation Émotionnelle (Colonnes : Réévaluation, Suppression, Rumination). Les fréquences empiriques observées (O_ij) sont réparties ainsi :
- Sécurisant : 70 en Réévaluation, 15 en Suppression, 15 en Rumination (Total ligne R1 = 100)
- Évitant : 20 en Réévaluation, 65 en Suppression, 15 en Rumination (Total ligne R2 = 100)
- Anxieux : 10 en Réévaluation, 20 en Suppression, 70 en Rumination (Total ligne R3 = 100)
- Totaux marginaux colonnes : Réévaluation C1 = 100, Suppression C2 = 100, Rumination C3 = 100 (Total N = 300)
Dans ce protocole équilibré, le calcul matriciel des effectifs théoriques attendus (E_ij = [R_i × C_j] / N) aboutit à une distribution uniformément répartie au sein de chaque cellule :
E_ij = (100 × 100) / 300 = 33,33 individus par cellule
Nous procédons alors au calcul de la déviation quadratique réduite (O_ij – E_ij)² / E_ij pour chacune des 9 cellules du tableau croisé :
- Cellule Sécurisant / Réévaluation : (70 – 33,33)² / 33,33 = (36,67)² / 33,33 = 1344,44 / 33,33 = 40,33
- Cellule Sécurisant / Suppression : (15 – 33,33)² / 33,33 = (-18,33)² / 33,33 = 336,11 / 33,33 = 10,08
- Cellule Sécurisant / Rumination : (15 – 33,33)² / 33,33 = (-18,33)² / 33,33 = 336,11 / 33,33 = 10,08
- Cellule Évitant / Réévaluation : (20 – 33,33)² / 33,33 = (-13,33)² / 33,33 = 177,78 / 33,33 = 5,33
- Cellule Évitant / Suppression : (65 – 33,33)² / 33,33 = (31,67)² / 33,33 = 1002,78 / 33,33 = 30,08
- Cellule Évitant / Rumination : (15 – 33,33)² / 33,33 = (-18,33)² / 33,33 = 336,11 / 33,33 = 10,08
- Cellule Anxieux / Réévaluation : (10 – 33,33)² / 33,33 = (-23,33)² / 33,33 = 544,44 / 33,33 = 16,33
- Cellule Anxieux / Suppression : (20 – 33,33)² / 33,33 = (-13,33)² / 33,33 = 177,78 / 33,33 = 5,33
- Cellule Anxieux / Rumination : (70 – 33,33)² / 33,33 = (36,67)² / 33,33 = 1344,44 / 33,33 = 40,33
En agrégeant l’ensemble de ces contributions partielles, on obtient la statistique globale du khi-deux d’indépendance :
χ² = 40,33 + 10,08 + 10,08 + 5,33 + 30,08 + 10,08 + 16,33 + 5,33 + 40,33 = 158,07
Le nombre de degrés de liberté associé à cette matrice est ν = (3 – 1) × (3 – 1) = 2 × 2 = 4 ddl. Pour 4 degrés de liberté et un niveau de significativité alpha de 0,001, la valeur critique théorique tabulée est de 18,467. La statistique observée (158,07) écrasant littéralement ce seuil critique, la p-valeur asymptotique associée est infinitésimale (p < 0,000001). L’hypothèse nulle d’indépendance stochastique est rejetée sans la moindre réserve.
5.3 Analyse des résidus standardisés et implications psychopathologiques
Le simple rejet de l’hypothèse nulle atteste qu’une relation d’association globale unit l’attachement affectif et la régulation émotionnelle, mais il ne renseigne pas sur les composantes spécifiques du tableau qui portent cette significativité massive. C’est ici qu’intervient l’examen des résidus standardisés ajustés d’Haberman. Dans une telle décomposition, toute cellule affichant un résidu standardisé supérieur à +1,96 indique une attraction statistiquement significative au seuil de 5 %, tandis qu’un résidu inférieur à -1,96 traduit une répulsion marquée.
L’analyse résiduelle détaillée met en exergue des patterns hautement différenciés :
- Chez les individus sécurisants, on note une surreprésentation massive de la réévaluation cognitive (résidu ajusté z = +7,35) et un évitement très net de la suppression expressive (z = -3,67) et de la rumination (z = -3,67).
- Le profil évitant est caractérisé par une attraction univoque et spectaculaire vers la suppression expressive (z = +6,35), accompagnée d’un déficit marqué de réévaluation cognitive (z = -2,67) et de rumination (z = -3,67).
- Le groupe anxieux-ambivalent manifeste un ancrage pathognomonique dans la rumination mentale intrusive (z = +7,35), parallèlement à une répulsion sévère envers la réévaluation cognitive (z = -4,67) et la suppression (z = -2,67).
Sur le plan de la pratique psychothérapeutique, ces déductions statistiques fournissent des repères cliniques précieux. Les patients au profil évitant utilisent préférentiellement la suppression émotionnelle comme une défense adaptative visant à masquer leur vulnérabilité, ce qui suggère qu’un travail thérapeutique axé d’emblée sur l’expression directe de la détresse suscitera une forte résistance défensive. Inversement, les patients anxieux sont submergés par un cercle vicieux de rumination cognitive amplifiant l’affect négatif, nécessitant une prise en charge ciblée sur le désengagement attentionnel et la restructuration cognitive. Le khi-deux démontre ici qu’une typologie développementale s’ancre dans des mécanismes fonctionnels distincts de gestion du stress.
6. Exemple 3 : Efficacité comparée d’interventions thérapeutiques selon le tableau clinique
6.1 Problématique en psychiatrie et psychologie clinique intégrative
Le troisième cas d’étude ancre l’utilisation du test du khi-deux au cœur des débats contemporains de la médecine fondée sur les preuves (Evidence-Based Practice) et de la psychiatrie personnalisée. Depuis plusieurs décennies, le champ de la santé mentale cherche à dépasser le modèle générique du traitement unique pour déterminer précisément quelle modalité psychothérapeutique offre le taux d’efficacité le plus élevé en fonction de la spécificité sémiologique du patient. L’objectif n’est plus seulement de savoir si une thérapie fonctionne globalement, mais pour quel tableau clinique précis elle déploie son potentiel thérapeutique maximal.
Dans ce cadre intégratif, un essai clinique multicentrique a été conduit pour évaluer la réponse clinique obtenue après douze semaines de protocole standardisé en croisant trois approches thérapeutiques d’orientation distincte face à trois entités nosographiques majeures relevant des troubles de l’humeur et de l’anxiété :
- Les modalités thérapeutiques examinées incluent la thérapie cognitivo-comportementale classique (TCC), axée sur l’exposition et la restructuration cognitive ; la thérapie cognitive basée sur la pleine conscience (MBCT, Mindfulness-Based Cognitive Therapy) ; et la thérapie de soutien non directive d’inspiration rogérienne.
- Les trois catégories diagnostiques recrutées sont l’épisode dépressif majeur récurrent (EDM), le trouble panique avec agoraphobie (TP), et le trouble de l’anxiété généralisée (TAG).
Le critère d’évaluation clinique retenu est la rémission complète du trouble, définie objectivement par une réduction standardisée d’au moins 50 % des scores sur les échelles d’évaluation diagnostiques internationales. La question de recherche statistique se formule ainsi : le taux d’accès à la rémission complète est-il stochastiquement indépendant de l’association croisée entre la modalité thérapeutique appliquée et la catégorie diagnostique du consultant ?
6.2 Modélisation du test d’indépendance pour l’évaluation des soins
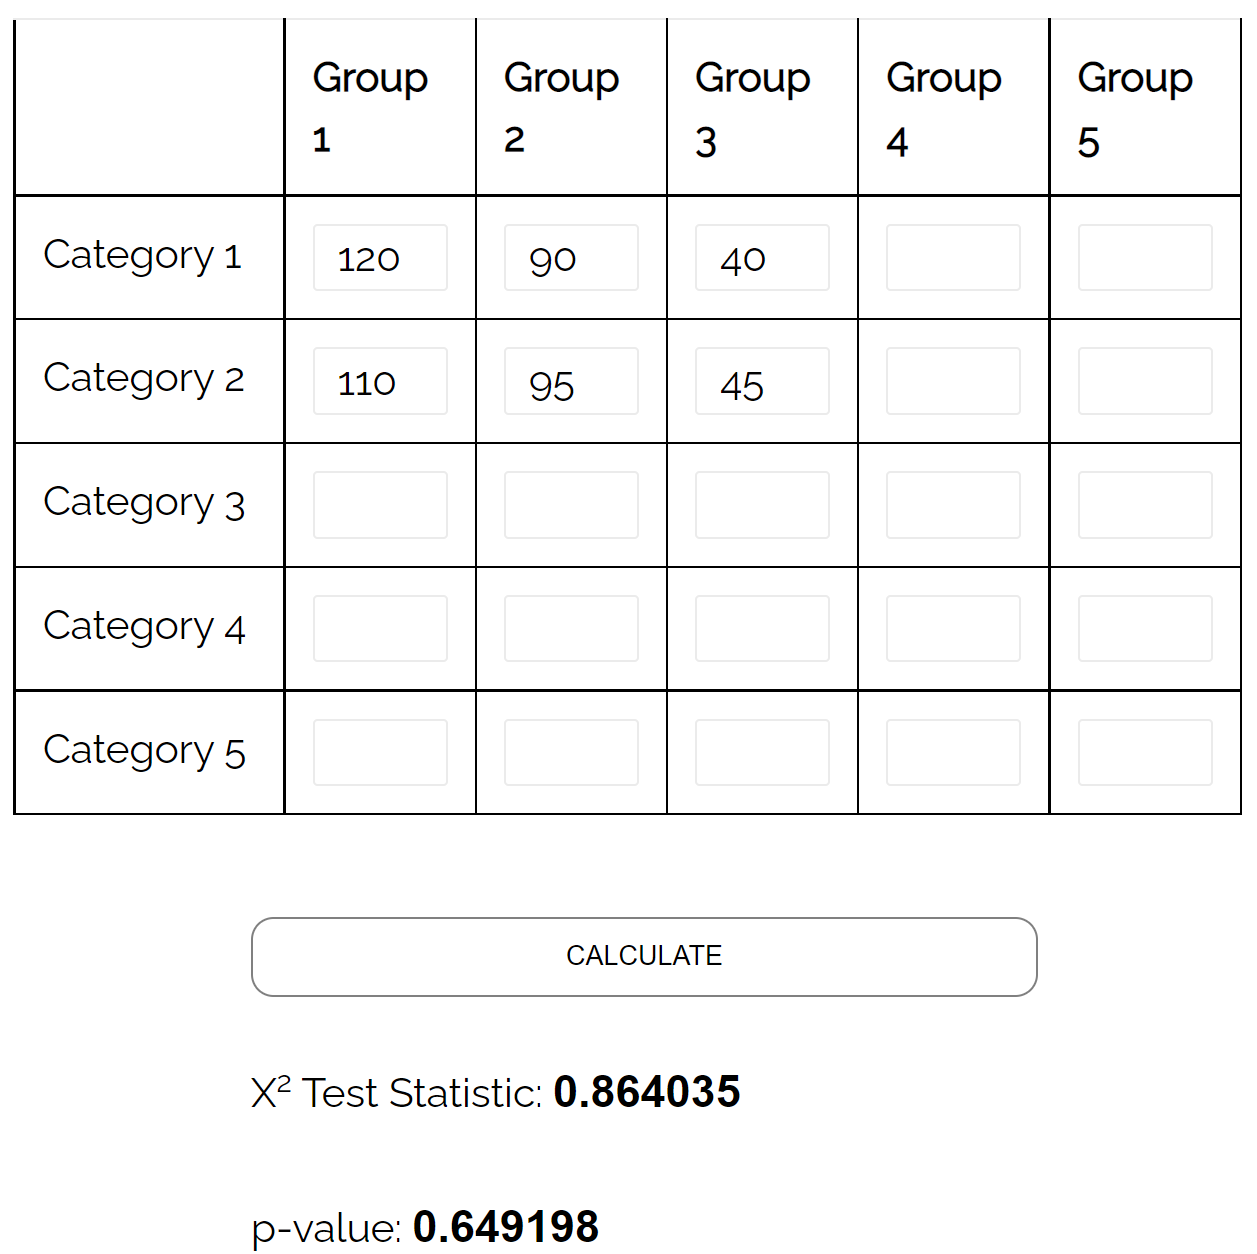
L’étude a rassemblé un échantillon clinique de 450 patients ayant atteint le terme du suivi thérapeutique, chaque sous-groupe diagnostique comprenant exactement 150 patients équitablement répartis entre les trois approches. Nous examinons ici la distribution des succès thérapeutiques (patients parvenus à la rémission clinique complète, totalisant 270 rémissions au sein de l’échantillon global). La matrice croise la Catégorie Diagnostique en lignes (EDM, TP, TAG) et l’Approche Thérapeutique en colonnes (TCC, MBCT, Soutien). Les effectifs de patients en rémission observés (O_ij) s’établissent ainsi :
- Épisode Dépressif Majeur (EDM) : 25 rémissions sous TCC, 45 sous MBCT, 20 sous Soutien (Total rémissions EDM R1 = 90)
- Trouble Panique (TP) : 55 rémissions sous TCC, 15 sous MBCT, 20 sous Soutien (Total rémissions TP R2 = 90)
- Anxiété Généralisée (TAG) : 30 rémissions sous TCC, 35 sous MBCT, 25 sous Soutien (Total rémissions TAG R3 = 90)
- Totaux marginaux colonnes : TCC C1 = 110, MBCT C2 = 95, Soutien C3 = 65 (Total rémissions N = 270)
Vérifions en premier lieu les conditions d’application de Cochran. Chaque cellule présente des effectifs très confortables (tous supérieurs à 15), excluant tout risque de biais asymptotique. Calculons les effectifs théoriques attendus sous l’hypothèse nulle stipulant que la répartition des rémissions entre les trois thérapies est totalement homogène quel que soit le diagnostic sous-jacent :
- Pour la colonne TCC (C1 = 110) : E_1j = (90 × 110) / 270 = 36,67 pour chaque groupe diagnostique
- Pour la colonne MBCT (C2 = 95) : E_2j = (90 × 95) / 270 = 31,67 pour chaque groupe diagnostique
- Pour la colonne Soutien (C3 = 65) : E_3j = (90 × 65) / 270 = 21,67 pour chaque groupe diagnostique
Le calcul de la statistique de Pearson donne :
- Ligne EDM :
- TCC : (25 – 36,67)² / 36,67 = (-11,67)² / 36,67 = 136,19 / 36,67 = 3,71
- MBCT : (45 – 31,67)² / 31,67 = (13,33)² / 31,67 = 177,69 / 31,67 = 5,61
- Soutien : (20 – 21,67)² / 21,67 = (-1,67)² / 21,67 = 2,79 / 21,67 = 0,13
- Ligne Trouble Panique :
- TCC : (55 – 36,67)² / 36,67 = (18,33)² / 36,67 = 335,99 / 36,67 = 9,16
- MBCT : (15 – 31,67)² / 31,67 = (-16,67)² / 31,67 = 277,89 / 31,67 = 8,77
- Soutien : (20 – 21,67)² / 21,67 = (-1,67)² / 21,67 = 2,79 / 21,67 = 0,13
- Ligne TAG :
- TCC : (30 – 36,67)² / 36,67 = (-6,67)² / 36,67 = 44,49 / 36,67 = 1,21
- MBCT : (35 – 31,67)² / 31,67 = (3,33)² / 31,67 = 11,09 / 31,67 = 0,35
- Soutien : (25 – 21,67)² / 21,67 = (3,33)² / 21,67 = 11,09 / 21,67 = 0,51
En effectuant la sommation de ces neuf termes, nous aboutissons à :
χ² = 3,71 + 5,61 + 0,13 + 9,16 + 8,77 + 0,13 + 1,21 + 0,35 + 0,51 = 29,58
Avec ν = (3 – 1)(3 – 1) = 4 degrés de liberté, la valeur critique tabulée pour alpha = 0,001 est de 18,467. La valeur empirique χ² = 29,58 est largement supérieure au seuil critique, avec une p-valeur associée de p = 0,0000057. Ce résultat impose le rejet formel de l’hypothèse nulle d’indépendance.
6.3 Retombées thérapeutiques et personnalisation des soins de santé mentale
La décomposition par partitionnement du khi-deux et l’inspection des résidus standardisés apportent un éclairage clinique d’une haute précision opérationnelle sur la structuration des soins. L’interaction dominante du tableau provient sans conteste de la cellule croisant le Trouble Panique et la Thérapie Cognitivo-Comportementale (O = 55 contre E = 36,67, résidu ajusté z = +4,12). Ce résultat corrobore de manière éclatante la littérature psychiatrique internationale : le trouble panique réagit de manière spectaculaire aux protocoles d’exposition intéroceptive et de désamorçage de la peur de la peur propres à la TCC, surpassant significativement les approches méditatives dans la phase aiguë de ce trouble.
À l’opposé, la thérapie cognitive basée sur la pleine conscience (MBCT) démontre une supériorité marquée dans la prise en charge de l’épisode dépressif majeur récurrent (O = 45 contre E = 31,67, z = +3,28), alors qu’elle s’avère nettement sous-optimale pour le trouble panique (O = 15 contre E = 31,67, z = -3,85). Ce constat s’explique psychologiquement par le fait que la décentration méditative enseignée par la MBCT cible directement la réactivité cognitive et les ruminations dépressogènes, empêchant la rechute dépressive, tandis que le patient paniqueux en crise requiert des techniques actives et comportementales de restructuration physiologique.
Quant au trouble de l’anxiété généralisée (TAG), ses résidus standardisés ne s’écartent pas significativement du seuil de ±1,96, traduisant une réponse plus diffuse et équilibrée entre les différentes modalités psychothérapeutiques. Il convient toutefois de souligner les limites inhérentes à ces inférences catégorielles : l’analyse exclut par définition les profils comorbides complexes (par exemple les patients cumulant dépression majeure et addiction), qui constituent pourtant une part substantielle de la patientèle hospitalière réelle, invitant à la prudence avant d’ériger ces associations en dogmes cliniques intangibles.
7. Exemple 4 : Préférences d’apprentissage et typologies cognitives en sciences de l’éducation
7.1 Croyances pédagogiques et styles d’apprentissage en milieu universitaire
Le quatrième exemple d’application du test du khi-deux aborde une question sensible aux confins de la psychologie cognitive, des neurosciences et des sciences de l’éducation : la question des prétendus styles d’apprentissage. Depuis plusieurs décennies, le modèle commercial et pédagogique VAK (Visuel, Auditif, Kinesthésique) soutient que chaque apprenant possède une modalité sensorielle privilégiée pour l’encodage et l’assimilation des connaissances conceptuelles. Selon ce dogme largement répandu dans le milieu éducatif, les étudiants en sciences exactes présenteraient majoritairement un profil visuel et analytique, tandis que les filières artistiques ou littéraires concentreraient respectivement des profils kinesthésiques ou auditifs.
Cependant, la communauté scientifique internationale a largement dénoncé cette catégorisation rigide comme un neuromythe dépourvu de base empirique solide. L’hypothèse selon laquelle adapter la modalité pédagogique au profil prétendu de l’étudiant améliorerait la rétention mnésique a été réfutée par de multiples méta-analyses. Il demeure néanmoins instructif d’évaluer statistiquement si la préférence déclarée par les apprenants eux-mêmes covarie effectivement avec leur domaine d’inscription universitaire, ou si la distribution de ces préférences reflète une simple dispersion aléatoire indépendante du cursus poursuivi.
Pour explorer cette dynamique, un questionnaire standardisé d’auto-évaluation a été administré auprès d’une cohorte transversale de 600 étudiants de première année d’université, répartis rigoureusement en trois filières académiques majeures : Sciences Fondamentales et Ingénierie (n = 200), Sciences Humaines et Lettres (n = 200), et Arts et Design (n = 200). Chaque étudiant devait désigner sa modalité préférentielle spontanée parmi les trois pôles classiques (Visuel, Auditif, Kinesthésique).
7.2 Application méthodologique conjointe d’adéquation et d’association
Dans un protocole expérimental complet, il est particulièrement élégant de combiner séquentiellement un test d’adéquation univarié et un test d’indépendance bivarié. Dans un premier temps, examinons la distribution globale des préférences déclarées par les 600 étudiants, tous cursus confondus : 230 se déclarent Visuels, 185 Auditifs et 185 Kinesthésiques. Formulons l’hypothèse nulle d’adéquation stipulant une stricte équiprobabilité des trois modalités sensorielles au sein de la population estudiantine générale (p_visuel = p_auditif = p_kinesthésique = 1/3, soit une attente théorique de E = 200 pour chaque catégorie).
Le calcul du test d’adéquation préliminaire fournit :
χ² = [ (230 – 200)² / 200 ] + [ (185 – 200)² / 200 ] + [ (185 – 200)² / 200 ] = [ 900 / 200 ] + [ 225 / 200 ] + [ 225 / 200 ] = 4,50 + 1,125 + 1,125 = 6,75
Pour ν = 3 – 1 = 2 degrés de liberté, la valeur critique théorique à alpha = 0,05 est de 5,991. La valeur observée χ² = 6,75 étant supérieure à cette limite critique (p = 0,034), nous rejetons l’hypothèse nulle d’équiprobabilité globale : il existe un léger biais d’auto-déclaration en faveur de la modalité visuelle au sein de la population générale.
Abordons à présent le test d’indépendance croisant la Filière Académique (Sciences, Lettres, Arts) et la Préférence Déclarée (Visuel, Auditif, Kinesthésique) au sein de notre matrice 3 × 3 :
- Filière Sciences (Total R1 = 200) : 85 Visuels, 60 Auditifs, 55 Kinesthésiques
- Filière Lettres (Total R2 = 200) : 70 Visuels, 75 Auditifs, 55 Kinesthésiques
- Filière Arts (Total R3 = 200) : 75 Visuels, 50 Auditifs, 75 Kinesthésiques
- Totaux colonnes : Visuel C1 = 230, Auditif C2 = 185, Kinesthésique C3 = 185 (Total N = 600)
Calculons les effectifs attendus E_ij sous l’hypothèse nulle d’indépendance :
- Pour la colonne Visuel : E_1j = (200 × 230) / 600 = 76,67 pour chaque filière
- Pour la colonne Auditif : E_2j = (200 × 185) / 600 = 61,67 pour chaque filière
- Pour la colonne Kinesthésique : E_3j = (200 × 185) / 600 = 61,67 pour chaque filière
Calculons les écarts quadratiques pour chaque compartiment matriciel :
- Sciences :
- Visuel : (85 – 76,67)² / 76,67 = (8,33)² / 76,67 = 69,39 / 76,67 = 0,91
- Auditif : (60 – 61,67)² / 61,67 = (-1,67)² / 61,67 = 2,79 / 61,67 = 0,05
- Kinesthésique : (55 – 61,67)² / 61,67 = (-6,67)² / 61,67 = 44,49 / 61,67 = 0,72
- Lettres :
- Visuel : (70 – 76,67)² / 76,67 = (-6,67)² / 76,67 = 44,49 / 76,67 = 0,58
- Auditif : (75 – 61,67)² / 61,67 = (13,33)² / 61,67 = 177,69 / 61,67 = 2,88
- Kinesthésique : (55 – 61,67)² / 61,67 = (-6,67)² / 61,67 = 44,49 / 61,67 = 0,72
- Arts :
- Visuel : (75 – 76,67)² / 76,67 = (-1,67)² / 76,67 = 2,79 / 76,67 = 0,04
- Auditif : (50 – 61,67)² / 61,67 = (-11,67)² / 61,67 = 136,19 / 61,67 = 2,21
- Kinesthésique : (75 – 61,67)² / 61,67 = (13,33)² / 61,67 = 177,69 / 61,67 = 2,88
La sommation des neuf résidus quadratiques donne la statistique globale :
χ² = 0,91 + 0,05 + 0,72 + 0,58 + 2,88 + 0,72 + 0,04 + 2,21 + 2,88 = 10,99
Le nombre de degrés de liberté est ν = (3 – 1)(3 – 1) = 4 ddl. La valeur critique tabulée pour alpha = 0,05 à 4 degrés de liberté est de 9,488. Notre statistique empirique χ² = 10,99 étant légèrement supérieure à cette valeur seuil, le calcul de la p-valeur fournit p = 0,0267. L’indépendance statistique est rejetée au seuil nominal de 5 %.
7.3 Conséquences pédagogiques et conception des dispositifs d’enseignement
Bien que le test du khi-deux se révèle formellement significatif au seuil standard de 5 % (p = 0,0267), une lecture scientifique lucide impose une interprétation mesurée. La significativité statistique est ici facilitée par un échantillon relativement large (N = 600 participants). L’examen cellule par cellule montre que les déviations empiriques demeurent modestes : les étudiants littéraires déclarent un peu plus souvent une préférence auditive (75 observés pour 61,67 attendus), et les étudiants d’art une préférence kinesthésique (75 observés pour 61,67 attendus).
En sciences de l’éducation, ces légères surreprésentations ne valident en rien l’existence de canaux d’apprentissage étanches ou génétiquement prédéterminés. Elles reflètent bien davantage des effets d’auto-sélection culturelle et d’imprégnation contextuelle : un étudiant inscrit en arts plastiques manipule quotidiennement des matériaux et valorise spontanément l’action corporelle, ce qui oriente ses réponses déclaratives sans prouver qu’il soit incapable d’apprendre par d’autres voies.
L’apport majeur de l’analyse inférentielle est de déconstruire le mythe selon lequel les étudiants en sciences posséderaient un profil visuel exclusif : l’écart à l’effectif attendu dans cette case n’est que de 8,33 étudiants (résidu non significatif). Les formateurs universitaires doivent donc rejeter les cloisonnements pédagogiques rigides. L’enseignement doit demeurer multimodal, exploitant simultanément les représentations graphiques, l’argumentation discursive et la mise en pratique contextuelle, car c’est la redondance codée de l’information qui favorise la consolidation mnésique chez l’ensemble des apprenants.
8. Méthodologie de calcul pas à pas et tests post-hoc
8.1 Protocole systématique de calcul manuel d’une table de contingence
Pour tout praticien ou étudiant désireux de maîtriser l’architecture d’un tableau croisé, l’exécution manuelle du test d’indépendance constitue une étape pédagogique fondamentale. Le protocole opérationnel se déroule invariablement selon une séquence chronologique en quatre phases distinctes :
- Étape 1 : Construction des marges. Disposer les données brutes dans une grille matricielle à r lignes et c colonnes, puis calculer la somme arithmétique de chaque ligne (R_i), la somme de chaque colonne (C_j), et vérifier que la double sommation des lignes et des colonnes converge vers un effectif global total identique (N).
- Étape 2 : Évaluation matricielle des fréquences théoriques attendues. Pour chaque intersection de cellule (i, j), multiplier l’effectif marginal de sa ligne par celui de sa colonne, puis diviser le produit obtenu par la taille totale de l’échantillon : E_ij = (R_i × C_j) / N. S’assurer impérativement que les conditions de Cochran sont satisfaites avant de poursuivre.
- Étape 3 : Calcul des écarts standardisés au carré. Pour chaque compartiment individuel, soustraire l’effectif théorique attendu de la valeur empirique observée (O_ij – E_ij), élever cette différence à la puissance deux pour obtenir l’écart quadratique brut, puis diviser ce résultat par l’effectif théorique de la cellule.
- Étape 4 : Sommation et identification de la zone de rejet. Réaliser la somme de toutes les contributions individuelles calculées à l’étape 3 pour obtenir la valeur finale du khi-deux de Pearson (χ²). Calculer ensuite les degrés de liberté ν = (r – 1)(c – 1), puis comparer la valeur empirique au seuil critique figurant dans les tables de distribution probabiliste pour le risque alpha préalablement choisi.
8.2 Analyse approfondie des résidus standardisés ajustés
L’obtention d’une statistique globale du khi-deux hautement significative indique l’existence d’une dépendance statistique globale entre les variables, mais présente une limite intrinsèque majeure : elle ne permet pas d’identifier avec précision quelles cellules spécifiques créent cette association. Pour combler cette lacune descriptive, la méthode de référence développée par le statisticien Shelby Haberman repose sur le calcul des résidus standardisés ajustés (Adjusted Standardized Residuals, ou résidus d’Haberman).
Le résidu standardisé brut de Pearson, formulé sous la forme (O_ij – E_ij) / √E_ij, pèche par le fait que sa variance sous-jacente est systématiquement inférieure à l’unité. La formule d’Haberman intègre une correction prenant en compte les proportions marginales du tableau afin d’obtenir un score z rigoureusement distribué selon une loi normale centrée réduite N(0, 1) :
z_ij = (O_ij – E_ij) / √[ E_ij × (1 – R_i / N) × (1 – C_j / N) ]
Dans cette formulation élaborée, le terme R_i / N représente la proportion marginale de la i-ème ligne et C_j / N la proportion marginale de la j-ème colonne. L’utilisation pratique de ces scores standardisés s’avère particulièrement aisée :
- Un résidu ajusté z_ij excédant la valeur seuil critique de +1,96 indique une attraction statistiquement significative au seuil alpha bilatéral de 5 % : la modalité observée est significativement surreprésentée par rapport à l’indépendance théorique.
- Inversement, un résidu inférieur à -1,96 dénote une répulsion statistiquement significative, signalant un déficit structurel d’observations dans cette catégorie.
- Pour des seuils de confiance plus exigeants, les limites conventionnelles s’établissent à ±2,58 pour un risque d’erreur alpha de 1 %, et à ±3,29 pour un seuil d’erreur de 0,1 %.
La cartographie de ces résidus standardisés au sein de la matrice permet au chercheur de dresser une véritable carte des polarités positives et négatives du jeu de données, évitant ainsi les surinterprétations erronées relatives aux cellules ne présentant que de faibles fluctuations stochastiques non significatives.
8.3 Tests de comparaisons multiples et ajustement de l’erreur globale
Lorsque le statisticien décompose un tableau de contingence de grande dimension (par exemple une matrice 3 × 3 ou 4 × 4) en sous-tables élémentaires de format deux par deux ou effectue de multiples comparaisons par paires pour isoler les contrastes explicatifs, il s’expose au phénomène classique d’inflation de l’erreur de type I (Family-Wise Error Rate). Si l’on réalise une série de m tests statistiques distincts, chacun au seuil de risque individuel alpha = 0,05, la probabilité cumulée de rejeter à tort au moins une hypothèse nulle vraie s’élève mathématiquement à 1 – (1 – 0,05)^m. Pour un ensemble de 6 sous-tests croisés, ce risque d’erreur global atteint plus de 26 %.
Pour neutraliser cette dérive probabiliste, plusieurs stratégies d’ajustement s’offrent au chercheur :
- La correction classique de Bonferroni : Approche la plus simple et la plus conservatrice, elle consiste à diviser le seuil de significativité nominal alpha par le nombre total m de comparaisons effectuées (alpha’ = alpha / m). Une comparaison n’est alors déclarée significative que si sa p-valeur empirique se situe en dessous de ce seuil ajusté très strict.
- La procédure séquentielle de Holm-Bonferroni : Nettement plus puissante tout en maintenant un contrôle strict du risque global de type I, elle ordonne les p-valeurs calculées par ordre croissant (p_(1) ≤ p_(2) ≤ … ≤ p_(m)) et compare chaque p_(i) au seuil séquentiel alpha / (m – i + 1), interrompant le processus de test dès lors qu’un résultat échoue à franchir le seuil correspondant.
- Le contrôle du taux de fausses découvertes (False Discovery Rate – FDR) : Développée par Benjamini et Hochberg, cette procédure est particulièrement adaptée aux tableaux de contingence complexes ou aux analyses catégorielles exploratoires à grande échelle. Plutôt que de contrôler l’occurrence d’au moins une erreur de type I, le FDR vise à borner la proportion attendue de faux rejets parmi l’ensemble des résultats déclarés significatifs.
9. Mesures de la taille d’effet associées au test du khi-deux
9.1 Limitation inhérente de la p-valeur face à la puissance d’échantillonnage
Une dérive méthodologique majeure en statistique appliquée consiste à confondre la significativité statistique (attestée par une faible p-valeur) avec l’importance clinique, comportementale ou pratique d’un phénomène. La formule canonique de la statistique du khi-deux révèle une sensibilité mécanique absolue à la taille de l’échantillon N : à structure de proportions parfaitement constante, la valeur de χ² augmente de manière strictement proportionnelle avec N. Il suffit de multiplier les effectifs de chaque cellule d’un tableau par un facteur 10 pour que la statistique résultante soit elle-même multipliée par 10, divisant la p-valeur de façon spectaculaire.
Cette sensibilité mathématique engendre deux risques symétriques pour l’analyste :
- Sur des cohortes observationnelles massives (portant sur des dizaines ou des centaines de milliers d’individus, fréquentes dans les bases de données médico-administratives ou le traitement des mégadonnées), le test du khi-deux rejettera l’hypothèse nulle pour des divergences dérisoires, statistiquement indéniables mais dépourvues de toute pertinence concrète sur le plan décisionnel.
- Inversement, sur des échantillons restreints caractéristiques des études cliniques rares, un effet relationnel d’une grande intensité psychologique pourra échouer à franchir le seuil critique de 5 % faute d’une puissance d’échantillonnage suffisante, conduisant à une erreur de type II.
Face à cet état de fait, les normes méthodologiques contemporaines imposent l’obligation déontologique de rapporter systématiquement une mesure standardisée de la taille d’effet (Effect Size) aux côtés de la p-valeur. La taille d’effet quantifie l’intensité intrinsèque de l’association statistique entre les variables indépendamment de la taille globale de l’échantillon analysé.
9.2 Le coefficient Phi et le V de Cramer
Pour mesurer la force de dépendance au sein d’une table de contingence, les statisticiens disposent de métriques d’association standardisées adaptées aux dimensions du tableau. Dans le cas spécifique des tables dichotomiques de format deux par deux (r = 2, c = 2), la métrique fondamentale est le coefficient Phi (noté φ), défini algébriquement par la racine carrée du quotient de la statistique du khi-deux par la taille totale de l’échantillon :
φ = √(χ² / N)
Le coefficient Phi partage des propriétés formelles directes avec le coefficient de corrélation linéaire r de Pearson calculé sur des variables binaires codées 0 et 1. Il évolue dans un intervalle compris entre 0 (indépendance totale) et 1 (dépendance fonctionnelle absolue lorsque l’association est orientée positivement). Toutefois, dès que la matrice croise plus de deux lignes ou plus de deux colonnes, le coefficient Phi peut excéder l’unité, perdant ainsi sa normalisation et son interprétabilité géométrique.
Pour les matrices rectangulaires ou carrées de dimensions arbitraires (r × c), la mesure de référence universelle est le coefficient V de Harald Cramér (Cramér’s V). Ce coefficient standardisé résout le problème dimensionnel en divisant la statistique du khi-deux par le produit de l’effectif N et de la dimension minimale du tableau diminuée de un :
V = √[ χ² / (N × min(r – 1, c – 1)) ]
Le V de Cramer est rigoureusement borné entre 0 et 1, quelle que soit la structure de la table de contingence. Son interprétation quantitative s’appuie sur les repères conventionnels établis par le statisticien Jacob Cohen, ajustés en fonction du nombre de degrés de liberté minimaux du tableau k_min = min(r, c) :
- Pour un tableau à 4 degrés de liberté totaux issu d’une matrice 3 × 3 (où k_min – 1 = 2) :
- Une valeur de V d’environ 0,07 traduit une taille d’effet négligeable à faible.
- Une valeur de V avoisinant 0,21 signale un effet d’ampleur moyenne.
- Une valeur de V atteignant ou dépassant 0,35 reflète une association statistique forte.
Illustrons cette métrique sur les exemples présentés précédemment :
- Dans notre Exemple 2 (Attachement et Régulation émotionnelle, N = 300, χ² = 158,07, matrice 3 × 3) :
V = √[ 158,07 / (300 × 2) ] = √[ 158,07 / 600 ] = √0,2634 = 0,513
Un V de Cramer de 0,513 atteste d’un effet d’une ampleur exceptionnelle, soulignant un couplage fonctionnel majeur entre styles relationnels précoces et mécanismes défensifs.
- Dans notre Exemple 4 (Filières académiques et Styles d’apprentissage, N = 600, χ² = 10,99, matrice 3 × 3) :
V = √[ 10,99 / (600 × 2) ] = √[ 10,99 / 1200 ] = √0,00916 = 0,096
Bien que formellement significative (p = 0,0267), l’association présente un V de Cramer inférieur à 0,10. L’effet est statistiquement trivial et sans grande portée pratique, confirmant le danger d’une surinterprétation des croyances pédagogiques isolées.
9.3 Rapports de cotes (Odds Ratios) et risques relatifs en tables deux par deux
Lorsque l’analyse porte sur une table de contingence 2 × 2 croisant par exemple une exposition à un facteur de risque (Exposé / Non-exposé) et la survenue d’un événement clinique (Malade / Sain), l’indice préférentiel d’évaluation d’effet est le rapport de cotes, internationalement désigné sous le vocable d’Odds Ratio (OR). En épidémiologie clinique, la cote (odds) d’un événement est le ratio entre la probabilité que l’événement se réalise et la probabilité qu’il ne se produise pas (p / [1 – p]).
Dans un tableau 2 × 2 où les cases sont désignées par les lettres a (Exposé et Malade), b (Exposé et Sain), c (Non-exposé et Malade) et d (Non-exposé et Sain), le rapport des cotes de maladie entre le groupe exposé et le groupe témoin se réduit à la formule simple dite du produit croisé :
OR = (a × d) / (b × c)
L’interprétation de l’Odds Ratio s’avère particulièrement parlante pour les praticiens :
- Un OR égal à 1,0 indique une absence stricte d’association : la cote de pathologie est strictement identique dans les deux groupes.
- Un OR supérieur à 1,0 signifie que l’exposition augmente la cote de développer le trouble. Par exemple, un OR = 2,5 indique que les sujets exposés ont une cote de développer la pathologie 2,5 fois plus élevée que les non-exposés.
- Un OR inférieur à 1,0 caractérise un facteur d’exposition protecteur.
Pour assortir l’Odds Ratio d’une estimation de sa précision d’échantillonnage, on calcule systématiquement son intervalle de confiance à 95 % (IC 95 %). Ce calcul transite par l’erreur-type logarithmique standard (SE_ln(OR)) :
SE_ln(OR) = √[ (1/a) + (1/b) + (1/c) + (1/d) ]
Les bornes de confiance logarithmiques sont données par ln(OR) ± 1,96 × SE_ln(OR), dont on prend ensuite l’exponentielle. Si l’intervalle de confiance à 95 % n’englobe pas la valeur 1,0, le praticien peut conclure à une association statistiquement significative au seuil de 5 %, convertissant de simples effectifs catégoriels en indicateurs clairs de pronostic médical.
10. Limites méthodologiques et alternatives statistiques
10.1 Écueils fréquents liés à la violation d’indépendance
L’une des fautes méthodologiques les plus destructrices lors de l’application du test du khi-deux consiste à méconnaître le postulat strict d’indépendance mutuelle des observations. Ce biais, qualifié de pseudo-réplication, survient dès lors qu’une même unité statistique génère plusieurs données intégrées dans la même analyse. L’exemple typique réside dans l’administration d’un protocole expérimental à mesures répétées longitudinales (avant et après une intervention clinique) ou dans le recueil de réponses à des items où les participants sont autorisés à cocher plusieurs choix catégoriels simultanés.
Lorsque cette contrainte est transgressée, la statistique du khi-deux classique ne suit plus sa loi asymptotique de référence : le nombre effectif de degrés de liberté est surestimé et la variance résiduelle est artificiellement comprimée, conduisant à une explosion incontrôlée du risque d’erreur de type I. Face à des données catégorielles binaires appariées issues de protocoles avant/après, le chercheur doit obligatoirement abandonner le test de Pearson au profit du test de McNemar.
Le test de McNemar concentre son analyse exclusivement sur les cellules discordantes du tableau (les participants passés de non-répondeur à répondeur, et inversement), en évaluant si la dissymétrie des changements observés s’écarte d’une distribution binomiale équilibrée. De manière analogue, si le protocole longitudinal ou intra-sujets comporte plus de deux temps de mesure successifs sur des variables dichotomiques (par exemple l’évaluation de la présence d’un symptôme à l’admission, à la sortie et à 6 mois), l’extension non paramétrique requise est le test Q de Cochran, capable d’évaluer la trajectoire temporelle globale des proportions sans jamais enfreindre les postulats de dépendance sérielle.
10.2 Le paradoxe de Simpson et les variables modératrices cachées
Un piège épistémologique redoutable menaçant l’interprétation des tableaux de contingence bivariés simples est le paradoxe de Simpson. Ce phénomène survient lorsqu’une association statistique apparente constatée entre deux variables catégoriques se trouve totalement inversée, annulée ou amplifiée dès lors que les données sont ventilées en tenant compte d’une troisième variable de confusion non intégrée dans le tableau initial.
Ce mécanisme pervers s’explique par la présence d’une variable confondante sous-jacente qui entretient des liens de dépendance asymétriques à la fois avec la variable prédictive et avec la variable réponse. Si un chercheur examine par exemple l’association brute entre un traitement psychothérapeutique innovant et le taux de guérison sans contrôler la gravité clinique initiale des patients, il peut observer une efficacité apparente moindre du nouveau traitement simplement parce que les cliniciens ont eu tendance à assigner préférentiellement les patients les plus sévèrement atteints à ce nouveau protocole.
Pour prévenir les déductions fallacieuses engendrées par ces facteurs confondants cachés, la statistique inférentielle offre deux grandes alternatives multivariées :
- La modélisation log-linéaire : Cette méthode constitue une généralisation multidimensionnelle du test d’indépendance du khi-deux. Elle permet de décomposer le logarithme népérien des effectifs attendus d’une table de contingence à trois dimensions ou plus en effets principaux et en termes d’interactions d’ordre supérieur, isolant ainsi l’association nette de deux facteurs après neutralisation des interactions marginales.
- La régression logistique binaire ou multinomiale : En plaçant la modalité d’intérêt en variable dépendante et en intégrant l’ensemble des facteurs catégoriels et continus comme prédicteurs simultanés, la régression logistique permet de calculer des Odds Ratios ajustés exempts du paradoxe de Simpson.
10.3 Gestion des cellules vides et des effectifs clairsemés
Une difficulté pratique courante dans l’analyse de tableaux de contingence réels concerne la survenue de cellules à fréquence théorique nulle ou clairsemée. L’apparition d’un effectif théorique attendu inférieur à un dans ne serait-ce qu’un seul compartiment matriciel invalide théoriquement la distribution continue du khi-deux, provoquant une division par une valeur proche de zéro qui fait diverger artificiellement la statistique de test.
Face à un tableau creux, l’analyste doit arbitrer entre plusieurs démarches méthodologiques raisonnées :
- Le regroupement raisonné de modalités : Lorsque le cadre théorique l’autorise, il est possible d’agréger deux catégories conceptuellement proches (par exemple fusionner les modalités anxiété modérée et anxiété sévère en une classe unique) afin de regonfler les effectifs attendus au-dessus des seuils de Cochran. Cette opération doit toutefois impérativement faire l’objet d’une justification scientifique a priori et ne jamais être dictée par une recherche opportuniste de significativité.
- L’algorithme de Freeman-Halton : Pour les matrices rectangulaires ou carrées de format r × c comportant des effectifs théoriques faibles ne permettant pas la fusion de classes, le statisticien délaisse l’approximation du khi-deux pour recourir à l’extension du test exact de Fisher aux tables de contingence arbitraires, dite extension de Freeman-Halton. Cet algorithme calcule la somme des probabilités hypergéométriques exactes de toutes les matrices possibles partageant rigoureusement les mêmes marges observées.
- Les approximations de Monte-Carlo : Lorsque la combinatoire matricielle excède les capacités de calcul des ordinateurs pour une résolution exacte, le recours aux simulations de permutations de Monte-Carlo permet d’obtenir une estimation empirique non biaisée de la p-valeur avec un intervalle de confiance maîtrisé.
11. Implémentation pratique sous R, Python et SPSS
11.1 Calculs statistiques sous le langage R
Le langage de programmation statistique R constitue l’environnement de référence pour l’analyse des données catégorielles dans le monde académique. L’exécution d’un test du khi-deux repose principalement sur la fonction native chisq.test, dont la flexibilité permet de traiter aussi bien des vecteurs univariés d’adéquation que des matrices bivariées de contingence.
Pour illustrer son implémentation, considérons le code conceptuel permettant d’analyser un tableau croisé. L’utilisateur construit d’abord la matrice empirique via la fonction matrix en renseignant les effectifs par case et les dimensions appropriées. L’appel de l’objet résultant dans chisq.test exécute immédiatement le test de Pearson, affichant la statistique du khi-deux, les degrés de liberté et la p-valeur asymptotique. En appliquant l’argument correct = FALSE, l’analyste désactive la correction de continuité de Yates pour obtenir la statistique de Pearson pure.
L’intérêt majeur de l’environnement R réside dans l’extraction directe des objets internes générés par le modèle statistique :
- La commande $expected extrait la matrice complète des effectifs théoriques attendus, permettant une vérification immédiate des critères de Cochran.
- La commande $residuals renvoie les résidus standardisés bruts de Pearson.
- La commande $stdres génère la matrice exacte des résidus standardisés ajustés d’Haberman, indispensables pour identifier les cellules statistiquement déviantes par rapport aux bornes critiques ±1,96.
Pour aller plus loin dans la restitution graphique et la mesure de taille d’effet, les bibliothèques spécialisées vcd et rcompanion offrent des fonctionnalités avancées. La fonction CramerV permet un calcul automatisé du V de Cramer accompagné de son intervalle de confiance par bootstrap, tandis que la fonction mosaic du package vcd produit des graphiques en mosaïque (Mosaic Plots) visuellement informatifs, où les cellules sont dimensionnées proportionnellement à leurs effectifs et colorées selon l’amplitude de leurs résidus d’Haberman.
11.2 Traitement des données catégorielles sous Python
Dans l’écosystème de la science des données et du machine learning sous Python, l’analyse inférentielle des tableaux de contingence s’articule principalement autour des modules scipy.stats et pandas. La manipulation des jeux de données volumineux débute généralement par la création d’un tableau croisé dynamique à partir d’un DataFrame au moyen de la fonction pandas.crosstab, qui agrège instantanément les occurrences des deux variables qualitatives étudiées.
L’inférence statistique proprement dite mobilise ensuite les fonctions spécialisées du module scipy.stats :
- Pour un test d’adéquation univarié, on fait appel à la fonction scipy.stats.chisquare en lui fournissant la liste des effectifs observés ainsi que la liste optionnelle des fréquences attendues si le modèle théorique ne stipule pas l’équiprobabilité par défaut.
- Pour un test d’indépendance bivarié sur une matrice de contingence, on utilise la fonction scipy.stats.contingency.chi2_contingency. Cette fonction calcule et renvoie simultanément quatre éléments mathématiques : la statistique empirique du khi-deux de Pearson, la p-valeur associée, les degrés de liberté du tableau, et un tableau numpy contenant l’ensemble des effectifs théoriques attendus.
Afin de visualiser élégamment les interactions sous-jacentes, les bibliothèques matplotlib et seaborn sont fréquemment sollicitées. La fonction seaborn.heatmap permet de concevoir des cartographies de chaleur matricielles particulièrement expressives, mettant en contraste les effectifs observés et attendus ou représentant la distribution des résidus d’association. De surcroît, le calcul d’intervalles de confiance empiriques pour le V de Cramer peut être programmé au moyen de boucles de rééchantillonnage bootstrap avec numpy.
11.3 Procédures guidées sous l’environnement SPSS
Le logiciel propriétaire IBM SPSS Statistics demeure extrêmement répandu dans les laboratoires de recherche hospitaliers et les départements universitaires de psychologie en raison de son interface graphique conviviale et standardisée. La réalisation d’un test du khi-deux d’indépendance y suit une démarche séquentielle standardisée via le menu principal :
- Accéder au menu Analyse, naviguer dans la section Statistiques descriptives, puis sélectionner le sous-menu Tableaux croisés (Crosstabs).
- Affecter la première variable catégorielle dans le champ des Lignes et la seconde dans le champ des Colonnes.
- Ouvrir l’onglet Statistiques : cocher obligatoirement la case Khi-deux pour obtenir la statistique de Pearson et le test exact de Fisher, et cocher la case Phi et V de Cramer pour activer l’estimation de la taille d’effet.
- Ouvrir l’onglet Cellules (Cells) : cet onglet est crucial. Dans la rubrique Effectifs, s’assurer que les options Observés et Attendus sont activées. Dans la rubrique Résidus, cocher impérativement l’option Ajustés standardisés pour obtenir les scores z d’Haberman.
Dans la fenêtre de sortie générée par SPSS, l’analyste examine en priorité le tableau Récapitulatif des tests du khi-deux. La première ligne, intitulée Khi-deux de Pearson, fournit la statistique de test, les degrés de liberté et la p-valeur sous la colonne Signification asymptotique (bilatérale). Une note située au bas de ce tableau indique expressément le nombre et le pourcentage de cellules affichant un effectif théorique inférieur à 5, permettant de contrôler en un coup d’œil le respect de la règle de Cochran.
12. Normes de rédaction scientifique et recommandations académiques
12.1 Conformité stricte avec les normes de style de l’APA (7e édition)
La publication de résultats statistiques dans les revues académiques internationales de psychologie et de sciences comportementales exige le respect scrupuleux des directives typographiques et formelles énoncées par l’American Psychological Association (APA, 7e édition). La transcription d’un test du khi-deux ne saurait se résumer à la simple affirmation d’un résultat significatif : elle doit comporter l’intégralité des paramètres inférentiels requis pour permettre au lecteur d’évaluer la rigueur de l’analyse.
Le formatage textuel standard impose de rapporter la lettre grecque χ² (en italique ou conventionnellement rédigée chi2), suivie entre parenthèses des degrés de liberté du modèle, de la taille globale de l’échantillon analysé sans espacement intérieur, de la valeur numérique de la statistique de test arrondie à deux décimales, de la p-valeur exacte et de la mesure de taille d’effet (V de Cramer ou Phi) :
- Modèle de rédaction pour un test d’adéquation (Exemple 1) : « Un test du khi-deux d’adéquation a révélé que la fréquentation journalière du commerce ne s’écarte pas significativement d’une répartition homogène sur l’ensemble de la semaine ouvrée, χ²(4, N = 250) = 4,36, p = ,359. »
- Modèle de rédaction pour un test d’indépendance hautement significatif (Exemple 2) : « Un test du khi-deux d’indépendance a démontré une relation statistiquement significative et de forte magnitude entre le style d’attachement affectif et la stratégie de régulation émotionnelle privilégiée, χ²(4, N = 300) = 158,07, p < ,001, V = ,51. L’examen des résidus standardisés ajustés indique que les participants sécurisants recourent significativement plus à la réévaluation cognitive (z = 7,35), tandis que les participants évitants surinvestissent la suppression expressive (z = 6,35). »
Les règles de mise en forme typographique de l’APA proscrivent l’insertion d’un zéro avant la virgule pour les grandeurs probabilistes qui ne peuvent mathématiquement jamais excéder l’unité, telles que la p-valeur, le coefficient Phi ou le V de Cramer (écrire p = ,026 et non p = 0,026). Lorsque la p-valeur calculée par un logiciel est extrêmement faible et affichée sous la forme .000, elle doit être obligatoirement retranscrite sous la forme p < ,001 afin d’éviter l’erreur épistémologique affirmant une probabilité strictement nulle.
12.2 Bonnes pratiques méthodologiques pour la recherche comportementale
Au-delà de la conformité formelle d’écriture, l’intégrité de la recherche en sciences comportementales requiert l’adoption de bonnes pratiques méthodologiques tout au long de la chaîne de traitement des données catégorielles. La première de ces exigences réside dans la planification a priori de la puissance statistique. Avant même d’entamer le recueil de données, le chercheur doit calculer la taille d’échantillon nécessaire au moyen d’outils dédiés tels que le logiciel G*Power, en précisant le risque d’erreur alpha consenti, la puissance statistique minimale désirée (généralement 0,80 ou 0,90) et l’ordre de grandeur de la taille d’effet (V de Cramer) escompté selon la littérature.
La transparence méthodologique constitue le second impératif fondamental. Dans la section Méthode des manuscrits scientifiques, les chercheurs doivent consigner de manière exhaustive :
- Les éventuelles exclusions d’observations et les justifications associées.
- Toute décision de regroupement a posteriori de modalités catégorielles pour satisfaire aux critères de Cochran, en démontrant que cette fusion préserve la cohérence théorique des construits psychologiques.
- Le respect systématique du principe de pré-enregistrement des hypothèses (Preregistration) sur des plateformes ouvertes comme l’Open Science Framework (OSF), garantissant que le test du khi-deux exécuté répond bien à une démarche confirmatoire a priori et non à une exploration fortuite des données (p-hacking).
Enfin, il est impératif d’éviter l’écueil intellectuel de l’illusion causale. La mise en évidence d’une indépendance rejetée au moyen d’un test du khi-deux atteste formellement d’une covariation stochastique entre deux dimensions qualitatives, mais ne prouve en aucun cas l’existence d’une relation causale directe. Seule la triangulation méthodologique, articulant rigueur expérimentale, contrôle rigoureux des facteurs de confusion et réplication empirique sur des échantillons diversifiés, permet d’ériger les inférences du khi-deux en véritables piliers de la compréhension scientifique des conduites humaines.
Références
Ainsworth, M. D. S., Blehar, M. C., Waters, E., & Wall, S. (1978). Patterns of attachment: A psychological study of the strange situation. Lawrence Erlbaum Associates.
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bowlby, J. (1982). Attachment and loss: Vol. 1. Attachment (2nd ed.). Basic Books.
Cochran, W. G. (1952). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
Gross, J. J. (2002). Emotion regulation: Affective, cognitive, and social consequences. Psychophysiology, 39(3), 281–291. https://doi.org/10.1017/s0048577201393198
Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
Pashler, H., McDaniel, M., Rohrer, D., & Bjork, R. (2008). Learning styles: Concepts and evidence. Psychological Science in the Public Interest, 9(3), 105–119. https://doi.org/10.1111/j.1539-6053.2009.01038.x
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604