
Dans l’architecture de la méthode scientifique moderne, la modélisation des relations entre phénomènes observables constitue le socle fondamental sur lequel repose toute tentative d’explication, de prédiction et de généralisation. Dès lors qu’un chercheur s’attache à comprendre la dynamique d’un système complexe — qu’il s’agisse des processus cognitifs humains, des dynamiques sociales ou des mécanismes neurobiologiques —, il se trouve confronté à l’impérieuse nécessité de segmenter la réalité empirique en entités mesurables et interdépendantes. C’est au cœur de cette démarche de réductionnisme méthodologique raisonné que s’articule la distinction cardinale entre la variable explicative et la variable de réponse. Cette dichotomie opératoire ne constitue pas un simple artifice de nomenclature statistique, mais incarne le principe directeur de l’inférence causale et descriptive dans les sciences contemporaines.
Trop souvent réduites à des synonymes interchangeables au sein de manuels d’initiation — sous les vocables de variables indépendantes et dépendantes —, les notions de variable explicative et de variable de réponse recèlent en réalité une profondeur épistémologique et technique considérable. Leur conceptualisation adéquate dicte l’ensemble du protocole empirique : du choix du plan d’échantillonnage à la sélection rigoureuse des modèles mathématiques sous-jacents, en passant par le contrôle des biais d’attribution. Une confusion dans l’assignation de ces rôles au sein d’un devis de recherche compromet irrémédiablement la validité interne et externe des conclusions, ouvrant la voie à des interprétations fallacieuses sur le plan de la causalité.
Le présent article propose une analyse exhaustive et rigoureuse de ces deux concepts fondateurs, articulée autour de leurs soubassements théoriques, de leurs propriétés métrologiques et de leurs applications empiriques concrètes au sein des sciences humaines, cognitives et biomédicales. À travers un examen méthodique des paradigmes expérimentaux, quasi-expérimentaux et observationnels, nous explorerons comment l’identification précise de la variable explicative et de la variable de réponse permet de transcender la simple corrélation pour approcher la mécanique intime des relations fonctionnelles régissant nos objets d’étude.
1. Fondements conceptuels des variables explicatives et des variables de réponse
1.1 Origine épistémologique de la distinction bivariée
L’émergence historique de la modélisation statistique dans les sciences du comportement et de la vie trouve ses racines dans le passage progressif d’une science purement descriptive et taxonomique à une science explicative et prédictive. Au cours du XIXe siècle, sous l’impulsion de pionniers tels qu’Adolphe Quetelet et Sir Francis Galton, les savants ont commencé à percevoir que la variabilité inhérente aux phénomènes humains ne constituait pas un simple bruit indésirable, mais un objet d’étude légitime susceptible d’être formalisé mathématiquement. Toutefois, pour dépasser le stade de la simple constatation des variations concomitantes, il est apparu impératif de structurer l’espace expérimental de manière asymétrique, en isolant les conditions d’émergence des phénomènes observés de leurs manifestations concrètes.
Cette nécessité méthodologique de segmenter les phénomènes en entrées (inputs) et en sorties (outputs) mesurables s’est cristallisée avec l’avènement de la psychologie physiologique et des travaux fondateurs de Wilhelm Wundt et d’Hermann von Helmholtz. Pour ces précurseurs, comprendre la perception ou la vitesse de transmission de l’influx nerveux exigeait d’introduire une différenciation fondamentale entre l’observation passive de la nature et sa manipulation active. Alors que l’observation naturaliste enregistre des variations spontanées sans pouvoir démêler l’écheveau des influences mutuelles, l’expérimentation impose une partition délibérée du réel où certains facteurs sont tenus pour directeurs et d’autres pour subordonnés.
C’est précisément ici que l’inférence statistique moderne, formalisée ultérieurement par Karl Pearson et Sir Ronald Fisher, a conféré à cette distinction bivariée toute sa rigueur analytique. Fisher a démontré que l’attribution d’un lien fonctionnel entre deux entités ne peut s’effectuer que si le chercheur impose une structure directionnelle claire à son modèle d’analyse. Dans cette perspective, la distinction bivariée n’est pas une propriété intrinsèque de la nature elle-même, mais une construction épistémologique indispensable permettant au scientifique d’extraire de la régularité à partir du chaos des variations phénoménales et de tester empiriquement des théories formalisées.
1.2 Définition axiomatique de la relation fonctionnelle
D’un point de vue axiomatique et mathématique, la relation entre une variable explicative et une variable de réponse s’exprime fondamentalement sous la forme d’une fonction liant un ensemble de départ à un ensemble d’arrivée. Dans le cadre de la modélisation statistique univariée, cette abstraction se formalise par l’équation canonique générale :
Y = f(X) + ε
Dans cette formulation, Y représente la variable de réponse, X désigne la variable explicative (ou le vecteur des variables explicatives dans le cas multivarié), f incarne la fonction de liaison structurale qui mappe les valeurs de X sur celles de Y, et ε symbolise le terme d’erreur stochastique résiduelle. Cette écriture consacre le statut de Y en tant qu’image de X modulée par une incertitude intrinsèque.
Cette présence systématique du terme d’erreur met en lumière la nature stochastique, et non déterministe, des relations étudiées dans les sciences empiriques, et tout particulièrement en psychologie expérimentale et en neurosciences. Contrairement aux systèmes de la mécanique classique où, dans des conditions idéales, une valeur précise de la variable d’entrée détermine sans équivoque une valeur unique de sortie, les sciences du comportement sont confrontées à une variabilité interindividuelle et intra-individuelle irréductible. Le terme ε agrège l’ensemble des influences non mesurées, les fluctuations physiologiques transitoires, les erreurs de mesure instrumentales ainsi que les composantes proprement probabilistes du fonctionnement neuropsychologique.
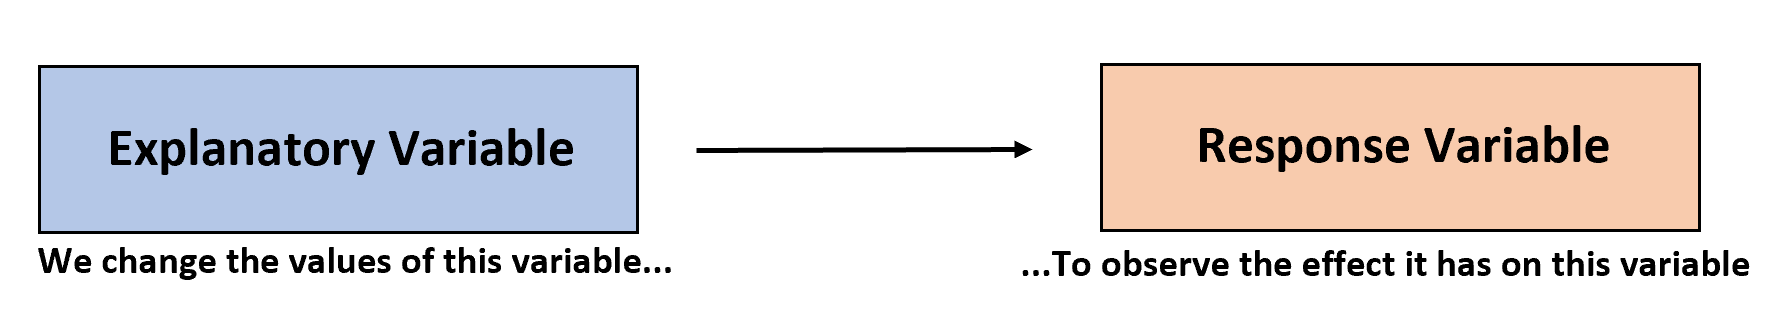
Les implications épistémologiques de cette modélisation stochastique sont majeures pour la réplicabilité des résultats empiriques. Elles impliquent que la relation démontrée entre la variable explicative et la variable de réponse ne s’exprime jamais sous la forme d’une certitude absolue pour une observation unique, mais sous la forme d’une espérance conditionnelle formalisée par E(Y|X). La validité d’une telle relation fonctionnelle repose donc sur la constance de la distribution de probabilité des résidus et sur la capacité du modèle à minimiser la variance de cette composante non expliquée, garantissant ainsi que l’effet documenté ne constitue pas un artefact lié aux fluctuations de l’échantillonnage.
1.3 Importance dans la démarche hypothético-déductive
L’opérationnalisation rigoureuse de la distinction entre variable explicative et variable de réponse constitue la clé de voûte de la méthode hypothético-déductive. Cette démarche intellectuelle, qui va du cadre théorique abstrait vers la confrontation aux données empiriques, exige la formulation d’hypothèses opérationnelles orientées selon un vecteur directionnel strict. Une hypothèse scientifique ne saurait se contenter d’énoncer une vague corrélation entre deux concepts ; elle doit préciser sans équivoque quelle entité est postulée comme l’antécédent ou le moteur du changement, et quelle entité constitue la manifestation ou la conséquence mesurable de cette dynamique.
Cette clarification préalable dicte de manière univoque la conception des protocoles empiriques rigoureux. En désignant précisément la variable explicative dès la phase de conceptualisation, l’expérimentateur détermine quelles conditions doivent être artificiellement créées, isolées ou soigneusement sélectionnées, tandis que la désignation de la variable de réponse fixe les instruments métrologiques qui seront mobilisés pour enregistrer la réaction du système. Cette architecture protocolaire prévient les dérives post-hoc et l’illusion cognitive consistant à rationaliser rétrospectivement des corrélations fortuites observées après la collecte des données.
Par conséquent, fixer les rôles respectifs de ces variables permet de cristalliser les attentes théoriques du chercheur en prédictions quantitatives réfutables au sens de Karl Popper. Si la théorie postule que la charge cognitive altère la rétention d’informations à court terme, la formulation doit désigner le niveau de charge comme variable explicative et la fidélité de restitution comme variable de réponse. Toute inversion ou ambiguïté dans ce couplage théorico-opérationnel vide la démarche déductive de sa substance et prive le chercheur de la possibilité d’invalider de manière concluante son modèle conceptuel face aux données du réel.
2. Définition rigoureuse et caractéristiques de la variable explicative
2.1 Nature et attributs fonctionnels de la variable explicative
La variable explicative, souvent désignée par le symbole conventionnel X, se définit conceptuellement comme l’entité postulée, manipulée ou observée dont les variations systématiques sont censées rendre compte, éclairer ou prédire les fluctuations observées au sein d’un phénomène cible. Sa propriété cardinale réside dans son antériorité temporelle, qu’elle soit empiriquement démontrée ou conceptuellement postulée. Dans la dynamique séquentielle du monde physique et psychologique, un événement explicatif doit nécessairement précéder chronologiquement la réponse qu’il engendre, interdisant formellement toute causalité rétroactive au sein de la modélisation.
Sur le plan fonctionnel, la variable explicative se distingue par sa capacité intrinsèque à réduire l’incertitude quant à l’état de la variable cible. En termes d’analyse de l’information, la connaissance de l’état ou de la modalité prise par la variable explicative apporte une quantité d’information non nulle sur la distribution conditionnelle de la variable dépendante associée. Cette capacité prédictive découle du fait que la variable explicative porte en elle-même soit l’impulsion motrice d’un mécanisme biologique ou psychologique, soit un indicateur robuste d’un faisceau de facteurs sous-jacents qui influencent directement le phénomène observé.
Selon le paradigme de recherche mobilisé, la variable explicative possède le potentiel d’être directement et activement manipulée par l’expérimentateur dans un environnement contrôlé — comme l’intensité d’un stimulus sonore ou l’administration d’une molécule pharmacologique. Toutefois, dans une vaste proportion d’études observationnelles ou épidémiologiques, cette variable conserve son statut explicatif sans pour autant faire l’objet d’une quelconque manipulation délibérée. C’est le cas lorsque le chercheur s’intéresse à des facteurs démographiques, génétiques, ou à des événements historiques préexistants dont la survenue échappe totalement à son emprise expérimentale mais dont l’effet présumé demeure l’objet central de la modélisation.
2.2 Typologie des échelles de mesure pour la variable explicative
Le statut mathématique et statistique d’une variable explicative est intimement tributaire de son échelle de mesure, conformément à la typologie fondamentale formalisée par Stanley Smith Stevens. La première catégorie regroupe les variables explicatives qualitatives nominales, qui se caractérisent par des modalités mutuellement exclusives et non hiérarchisées. Dans les protocoles de psychologie clinique ou d’évaluation thérapeutique, ces variables prennent couramment la forme de groupes d’appartenance : groupe recevant une thérapie comportementale, groupe sous placebo, groupe sous traitement pharmacologique de référence, ou encore catégorisations nosographiques distinctes (patients diagnostiqués avec un trouble anxieux généralisé versus témoins sains).
La deuxième catégorie concerne les variables explicatives qualitatives ordinales, dont les modalités entretiennent un rapport d’ordre hiérarchique sans que les intervalles entre les niveaux ne soient rigoureusement égaux ou quantifiables. On y retrouve fréquemment des variables telles que des niveaux d’anxiété graduelle évalués par des bornes discrètes (faible, modérée, sévère), des paliers de statut socio-économique ou des classes d’intensité de stress perçu. Bien que ces variables permettent de postuler une progression monotone de l’effet sur la variable de réponse, elles interdisent l’usage direct d’opérations arithmétiques linéaires sans un traitement statistique approprié tel que le codage contrasté ou l’usage de modèles à seuils.
Enfin, les variables explicatives quantitatives regroupent les mesures discrètes et continues, dotées d’échelles d’intervalles ou de rapports. Les variables discrètes procèdent par comptage d’unités indivisibles (nombre de tentatives préalables, nombre de séances thérapeutiques complétées), tandis que les variables continues peuvent théoriquement prendre une infinité de valeurs au sein d’un continuum donné (l’âge chronologique des participants, le temps d’exposition à un stimulus visuel en millisecondes, ou le dosage d’une substance psychoactive exprimé en milligrammes). Le niveau de mesure de la variable explicative détermine de manière intransigeante l’architecture du modèle statistique sous-jacent, conditionnant l’orientation vers des analyses de variance, des régressions linéaires multiples ou des modèles logistiques non linéaires.
2.3 Degré de contrôle expérimental et classification
Une distinction épistémologique essentielle réside dans le degré d’ingérence et de contrôle exercé par le chercheur sur la variable explicative, ce qui conduit à séparer formellement les variables provoquées des variables invoquées. Une variable explicative provoquée, ou manipulée activement, correspond à une situation où l’expérimentateur décide unilatéralement du niveau, de la modalité et du moment exact d’application du traitement à chaque unité expérimentale. Par le biais d’un appareillage calibré ou d’instructions standardisées, le chercheur crée de toutes pièces les variations de X, éliminant par principe toute corrélation préexistante entre la variable explicative et les caractéristiques intrinsèques des participants.
À l’opposé, les variables explicatives invoquées, également qualifiées de variables attributives, de statut ou d’organismes, représentent des caractéristiques propres aux sujets de l’étude que l’expérimentateur ne peut que constater sans pouvoir les attribuer arbitrairement. Cette classe de variables englobe la structure de la personnalité (telle que mesurée par les traits du modèle des Big Five), le genre biologique, les antécédents médicaux, les profils génétiques ou le niveau d’instruction. Bien que le chercheur puisse stratifier son échantillon ou comparer des cohortes constituées sur la base de ces attributs, il ne détient aucun pouvoir de manipulation directe sur leur distribution.
Cette dichotomie entre variable provoquée et invoquée impose des limites infranchissables quant à l’inférence causale valide. Lorsqu’une variable explicative est purement invoquée, l’existence d’une relation fonctionnelle solide avec la variable de réponse ne permet jamais d’affirmer que X cause Y de façon directe. Les individus différant sur une variable attributive diffèrent également, par nature, sur une multitude d’autres dimensions biologiques, culturelles et psychologiques non contrôlées. Dès lors, le statut invoqué de la variable explicative exige une humilité méthodologique accrue, imposant de qualifier les conclusions d’associations descriptives ou prédictives plutôt que d’assignations strictement mécanistiques.
3. Définition rigoureuse et caractéristiques de la variable de réponse
3.1 Propriétés théoriques de la variable de réponse
La variable de réponse, traditionnellement notée Y, constitue le réceptacle opérationnel au sein duquel s’inscrivent les effets, les répercussions ou les manifestations du phénomène étudié. Elle adopte un comportement fondamentalement passif ou réactif au regard des sollicitations, des manipulations ou des états décrits par la variable explicative. Dans l’économie conceptuelle d’une recherche, la variable de réponse incarne l’indicateur terminal de l’effet produit, l’aboutissement du processus cognitif, comportemental ou physiologique dont on cherche à percer la logique structurale.
Pour prétendre à ce statut critique, la variable de réponse doit impérativement faire preuve d’une fidélité métrologique et d’une sensibilité discriminative exceptionnelles. La sensibilité désigne l’aptitude de l’instrument de mesure à enregistrer des variations subtiles de l’état du sujet en réponse à des modulations minimes de la variable explicative. Une variable de réponse grossière, incapable de détecter des gradients fins d’intensité ou de performance, condamne l’expérimentateur à commettre des erreurs de type II, en concluant de manière erronée à l’absence d’effet du facteur prédictif.
Par ailleurs, la sélection de la variable de réponse nécessite une définition opérationnelle exempte de toute ambiguïté conceptuelle. Elle doit matérialiser sans équivoque le construit théorique sous-jacent que le chercheur entend sonder. Si l’objet d’étude est l’inhibition cognitive, la variable de réponse ne peut être simplement un « comportement d’attente », mais doit être opérationnalisée par une mesure chronométrique standardisée ou un taux de fausses alarmes dans une tâche de type Go/No-Go. L’opérationnalisation constitue le pont théorico-pratique garantissant que les variations quantitatives observées traduisent fidèlement les fluctuations du concept psychologique abstrait ciblé par la recherche.
3.2 Modalités d’évaluation quantitative et qualitative
Le spectre des variables de réponse mobilisées dans la recherche contemporaine se déploie selon une vaste palette de modalités méthodologiques, au premier rang desquelles figurent les mesures comportementales directes. Dans la tradition de la psychologie expérimentale chronométrique, le temps de réaction — exprimé en millisecondes avec une précision d’enregistrement de haute résolution — constitue la métrique reine pour sonder l’architecture du traitement de l’information. À ces données de latence s’adjoignent les mesures d’exactitude, les taux d’erreurs d’omission ou de commission, ainsi que la fréquence d’apparition ou la durée de comportements spécifiques enregistrés selon des grilles d’observation standardisées.
À un second niveau se déploient les mesures psychométriques standardisées, omniprésentes en psychologie clinique, différentielle et sociale. Ces variables de réponse prennent la forme de scores composites agrégés, obtenus par le biais d’échelles d’auto-évaluation de type Likert, d’inventaires de symptômes psychopathologiques (tels que le BDI-II pour la dépression ou l’échelle STAI pour l’anxiété) ou de batteries d’évaluation cognitive validées. La robustesse de ces variables dépend intégralement de la structure factorielle sous-jacente des instruments et de leur consistance interne démontrée, souvent estimée par des coefficients d’alpha de Cronbach ou d’oméga de McDonald élevés.
Enfin, l’essor des neurosciences intégratives a popularisé l’usage d’indicateurs physiologiques et neurophysiologiques en tant que variables de réponse objectives. Ceux-ci englobent des paramètres du système nerveux autonome — tels que la réponse électrodermale ou la variabilité de la fréquence cardiaque —, des marqueurs endocriniens salivaires ou sériques, ainsi que des indices d’imagerie fonctionnelle comme l’amplitude des potentiels évoqués en électroencéphalographie (EEG) ou le signal BOLD (Blood-Oxygen-Level-Dependent) en IRM fonctionnelle. Ces variables posent des défis métrologiques particuliers, notamment les artéfacts de mouvement et les problèmes de recalage spatial et temporel.
Quelle que soit la modalité retenue, la collecte des données de réponse doit impérativement esquiver les écueils redoutables de l’effet de plafond et de l’effet de plancher. Un effet de plafond survient lorsque la tâche ou l’instrument s’avère excessivement facile ou sous-calibré, confinant la quasi-totalité des participants au score maximal théorique quel que soit le niveau de la variable explicative. Inversement, l’effet de plancher survient lors d’une tâche d’une complexité insurmontable où l’ensemble des mesures s’écrase au niveau le plus bas ou au niveau du hasard. Dans les deux cas, la variance de la variable de réponse est artificiellement tronquée, anéantissant toute possibilité statistique de mettre en évidence la relation fonctionnelle recherchée.
3.3 Stabilité temporelle et réactivité des mesures
La variable de réponse se situe perpétuellement à la croisée de deux exigences contradictoires : elle doit faire preuve d’une réactivité aiguë aux influences immédiates de la variable explicative tout en manifestant une stabilité suffisante face aux bruits de fond environnementaux et individuels non pertinents. Cette tension soulève la question fondamentale de la sensibilité transitoire de la mesure. Dans les protocoles évaluant les états affectifs ou les charges exécutives, le chercheur espère que sa variable de réponse capturera les fluctuations d’état (state) sans être totalement masquée par les prédispositions stables de traits (trait) propres à chaque individu.
Le principal obstacle à cette clarté réside dans la présence incompressible de fluctuations intra-individuelles spontanées et d’erreurs de mesure instrumentales. À tout instant, l’attention d’un sujet oscille sous l’effet de micro-distractions, de cycles de fatigue neuronale ou de pensées intrusives non liées à la tâche expérimentale. Si la variable de réponse repose sur une mesure instantanée unique (par exemple, le temps de réponse à un seul essai critique), ce bruit aléatoire risque de submerger complètement le signal produit par la manipulation expérimentale de la variable explicative.
Pour parer à cette dégradation du rapport signal-sur-bruit, les chercheurs recourent systématiquement à des stratégies d’agrégation temporelle et de réplication d’essais. En moyennant la variable de réponse sur des dizaines, voire des centaines d’itérations au sein d’une même condition expérimentale, les composantes aléatoires du bruit s’annulent mutuellement selon les postulats de la loi des grands nombres. Ce processus de stabilisation temporelle permet d’extraire un score composite robuste, reflétant avec une fidélité accrue l’espérance mathématique de la réponse du sujet et autorisant une modélisation statistique sereine et reproductible.
4. Clarification terminologique et équivalences conceptuelles
4.1 Variable explicative, indépendante et prédictive
La multiplicité des terminologies désignant l’élément « entrée » du modèle statistique engendre fréquemment des confusions méthodologiques préjudiciables. L’expression variable indépendante puise son origine directe dans l’héritage de l’expérimentation agronomique et biologique formalisé par Sir Ronald Fisher dans les années 1920. Au sens strict du terme expérimental, cette variable est dite « indépendante » parce que sa distribution et ses valeurs sont déterminées par l’opérateur en toute indépendance par rapport aux caractéristiques individuelles des unités expérimentales et des conditions environnementales adventices. Son allocation est entièrement autonome au regard du système observé.
À l’inverse, l’usage contemporain préfère le vocable de variable prédictive dans le cadre de la modélisation statistique observationnelle et des analyses de régression. Dans ces contextes non interventionnistes, l’appellation d’indépendance perd sa pertinence factuelle, puisque le facteur étudié est souvent profondément imbriqué dans un réseau de corrélations avec d’autres variables subjectives ou contextuelles. La désigner comme variable prédictive indique sobrement son statut mathématique : elle constitue un prédicteur dans l’équation de prédiction linéaire ou probabiliste, sans présupposer une manipulation active ni une indépendance causale absolue.
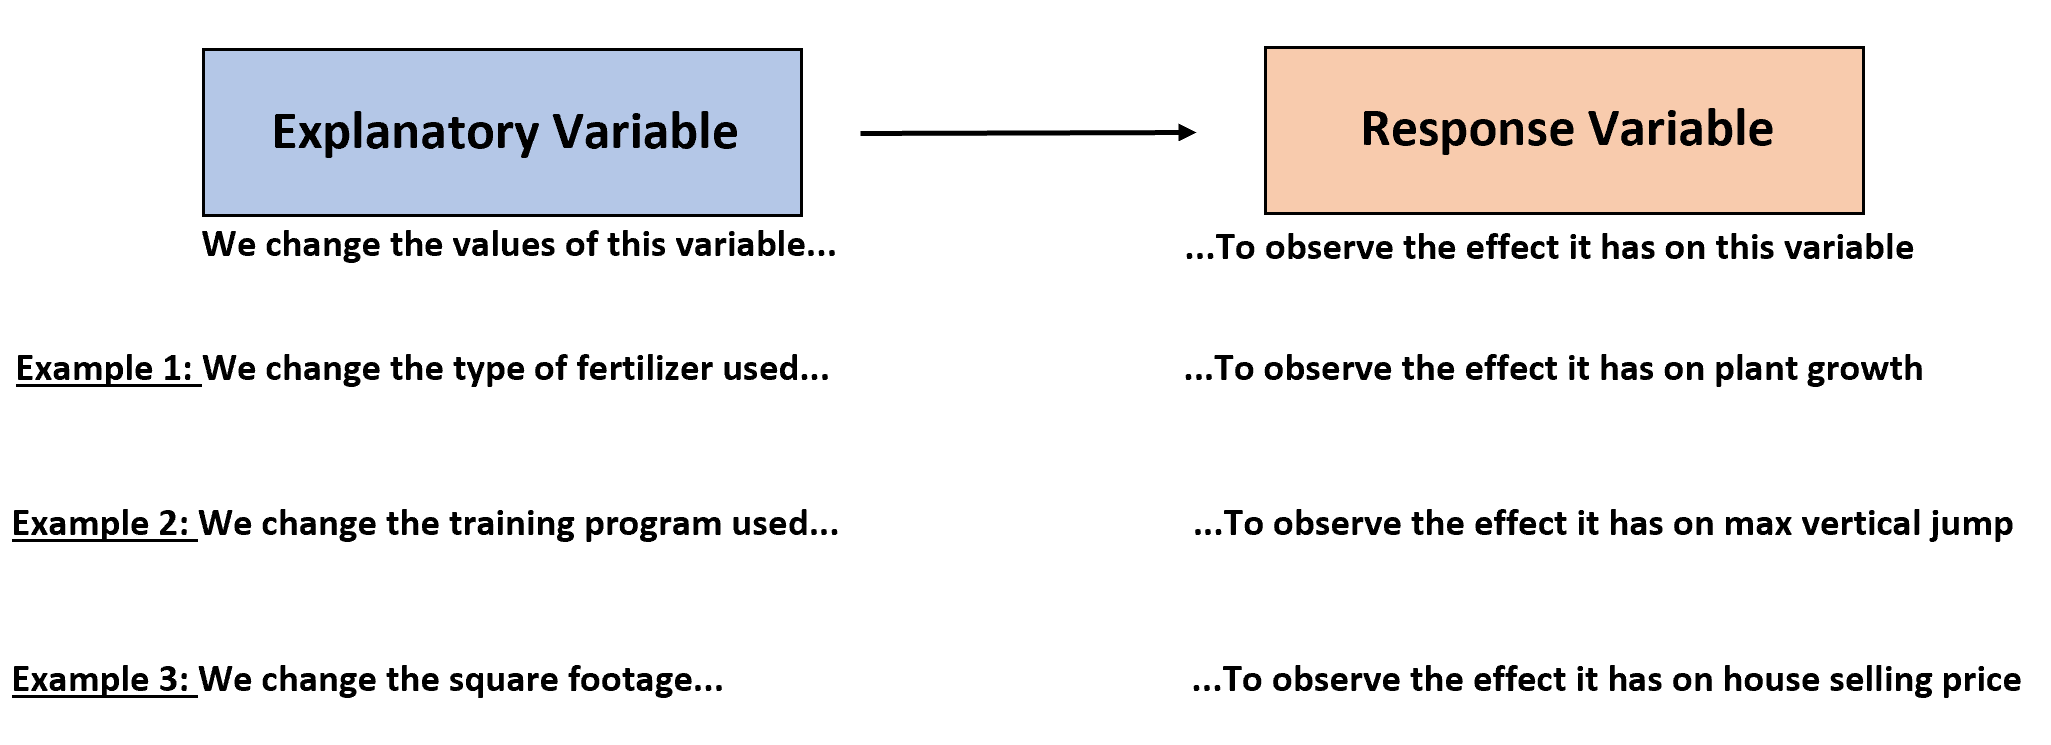
Face à ces nuances sémantiques, le syntagme variable explicative s’impose aujourd’hui dans l’épistémologie de la modélisation statistique comme un concept unificateur et rigoureux. Il présente l’avantage décisif d’englober tant les variables indépendantes manipulées que les variables prédictives observées, tout en décrivant fidèlement l’ambition de l’analyste : rendre compte d’une part de la dispersion de l’indicateur d’intérêt. Il convient toutefois de maintenir une vigilance sémantique sans faille : réserver l’expression « variable indépendante » aux seuls protocoles véritablement expérimentaux permet d’éviter l’illusion consistant à octroyer un statut causal à un simple régresseur observationnel.
4.2 Variable de réponse, dépendante et critère
De façon symétrique, la formalisation de la variable de sortie a traversé diverses évolutions doctrinales au cours du développement des sciences empiriques. L’expression historique variable dépendante a été forgée pour marquer la dépendance causale et probabiliste directe de cette mesure à l’égard de la variable indépendante manipulée. Elle postule que les variations quantitatives observées ne sont pas autonomes, mais tributaires des changements imprimés en amont sur le système. Bien qu’ancrée dans les habitudes rédactionnelles des psychologues depuis plus d’un siècle, cette dénomination véhicule parfois une promesse causale que les devis corrélationnels ne peuvent pas honorer.
Dans l’univers de la psychométrie appliquée, de la psychologie du travail et de la docimologie de sélection, c’est le terme variable critère qui a historiquement prévalu. Dans ce cadre pratique, la variable critère incarne la cible comportementale ultime que l’on cherche à anticiper ou à classer à partir de batteries d’évaluation psychologique (par exemple, le succès académique ultérieur, le rendement au travail ou la persistance dans un programme de soins). L’accent y est mis sur l’efficacité prédictive brute de la corrélation plutôt que sur la validation d’une chaîne mécanistique étiologique.
Le consensus statistique moderne penche résolument vers la locution unificatrice variable de réponse (ou parfois variable cible dans le domaine de l’apprentissage statistique). Ce terme présente l’immense mérite de la neutralité épistémologique : il décrit fonctionnellement le fait que la métrique réagit, correspond ou fait écho aux fluctuations du modèle explicatif, sans forcer la conclusion quant à la nature ontologique de ce lien. L’interchangeabilité laxiste de ces vocables au sein d’un manuscrit scientifique est proscrite, car elle brouille la frontière essentielle séparant les ambitions de prédiction statistique brute et les revendications de confirmation causale formelle.
4.3 Facteurs, covariables et régresseurs : précisions supplémentaires
Au-delà de cette dyade principale, l’arsenal d’analyse statistique mobilise une terminologie spécialisée selon le cadre mathématique déployé pour relier explications et réponses. Dans le champ de l’analyse de variance (ANOVA) et des plans d’expériences factoriels, une variable explicative nominale est universellement dénommée un facteur. Les différentes catégories ou modalités constitutives de ce facteur sont quant à elles désignées comme les niveaux du facteur. Un plan factoriel 2×3 implique ainsi deux facteurs explicatifs catégoriels, le premier présentant deux niveaux et le second trois.
Lorsque le chercheur introduit dans son modèle d’analyse de variance une variable explicative continue non pas comme facteur primaire d’intérêt, mais pour ajuster et réduire la variance d’erreur résiduelle, celle-ci accède au rang de covariable dans une analyse de covariance (ANCOVA). La covariable a pour rôle d’épurer statistiquement la variable de réponse de l’influence de facteurs confondants préexistants (par exemple, neutraliser le niveau initial de QI des sujets lors de l’évaluation de l’efficacité de deux méthodes pédagogiques concurrentes), augmentant de facto la précision de l’estimation de l’effet du facteur principal.
Sur le plan de l’algèbre matricielle sous-tendant les modèles linéaires généraux et généralisés, chaque variable explicative — qu’elle provienne de la décomposition en variables indicatrices (dummy coding) d’un facteur qualitatif ou de mesures scalaires continues — prend la désignation générique et mathématiquement univoque de régresseur. Dans la formulation matricielle classique Y = Xβ + ε, la matrice X est désignée sous le terme de matrice d’expérience (design matrix), et chaque colonne de cette matrice représente un régresseur distinct associé à un paramètre d’estimation β au sein de l’espace vectoriel modélisé.
5. Causalité versus corrélation : la frontière méthodologique
5.1 Les critères stricts de la causalité selon la méthode scientifique
L’un des écueils épistémologiques les plus redoutables dans la manipulation des concepts de variables explicatives et de réponse réside dans la tentation quasi instinctive d’attribuer une nature causale à toute relation prédictive statistiquement significative. Or, l’inférence causale valide obéit à des réquisitions méthodologiques rigoureuses qui dépassent infiniment la simple observation d’une covariation entre deux séries de données. Pour qu’une variable explicative puisse prétendre au statut de cause avérée au sein d’un mécanisme produisant une variable de réponse, trois critères fondamentaux issus de la philosophie empiriste doivent impérativement être satisfaits de façon simultanée.
Le premier critère incontournable est l’antériorité chronologique irréfutable de la cause sur l’effet présumé. La modification de la variable explicative doit précéder sans aucune équivoque l’émergence des variations constatées sur la variable de réponse dans la ligne temporelle. Le second critère réside dans l’existence d’une covariation systématique, robuste et statistiquement reproductible : les changements de valeurs de la variable explicative doivent s’accompagner de glissements prévisibles et concordants des valeurs de la variable de réponse, au-delà de ce que les fluctuations fortuites d’échantillonnage pourraient justifier.
Le troisième critère, de loin le plus exigeant sur le plan opératoire, consiste en l’élimination exhaustive de toutes les explications alternatives plausibles. Pour affirmer que X est la cause directe des variations de Y, il faut apporter la démonstration probante qu’aucune autre force, variable cachée ou dynamique environnementale non mesurée n’est intervenue de façon concomitante pour induire ce résultat. Cette exigence s’inscrit dans la continuité des célèbres critères de causalité de Sir Austin Bradford Hill en épidémiologie, transposables à la psychologie expérimentale : cohérence théorique, relation dose-réponse biologique ou comportementale, plausibilité du mécanisme d’action et réversibilité de l’effet lors du retrait de l’exposition.
5.2 L’illusion causale dans les études corrélationnelles
L’omission de ces garde-fous épistémologiques engendre ce que la littérature nomme l’illusion causale, un biais cognitif et méthodologique récurrent dans l’interprétation des devis purement corrélationnels. La faille structurelle majeure de ces approches réside dans le piège de la troisième variable, couramment formalisée sous le concept de cause commune latente ou de variable de confusion. Lorsque deux variables X et Y présentent une corrélation substantielle, cette association peut n’être que purement spéculaire, l’ensemble de leur covariation étant orchestré en sous-main par une troisième entité Z non prise en compte dans le protocole de recueil des données.
Un autre défi indissociable des études transversales observationnelles réside dans le problème de la causalité inverse. En l’absence d’une borne temporelle explicitement contrôlée par le devis de recherche, il s’avère fréquemment impossible de déterminer si c’est la variable initialement étiquetée comme « explicative » qui génère la « réponse », ou si le vecteur d’influence s’exécute en réalité dans le sens diamétralement opposé. Dans les recherches sur l’estime de soi et les performances scolaires, la corrélation positive observée a longtemps nourri l’hypothèse qu’accroître l’estime de soi propulserait la réussite, avant que des analyses longitudinales plus rigoureuses ne démontrent que c’est bien souvent la réussite académique continue qui vient nourrir rétrospectivement le sentiment d’auto-évaluation positive.
L’histoire des sciences humaines regorge d’interprétations hâtives fondées sur une sacralisation excessive des coefficients de détermination (R²). Il convient de répéter avec force qu’un coefficient de détermination élevé atteste uniquement de la précision avec laquelle un modèle linéaire projette une variable sur une autre, sans porter la moindre garantie intrinsèque quant à la véracité du lien causal supposé. Deux variables chronologiques présentant des tendances séculaires synchrones — comme la consommation annuelle de certains aliments et les taux d’accidents de la route sur une décennie donnée — peuvent exhiber un R² frôlant l’unité sous l’effet de corrélations fallacieuses (spurious correlations), sans qu’aucun canal causal n’unisse ces deux univers de mesure.
5.3 Le rôle charnière du plan expérimental avec randomisation
Face aux fragilités structurelles de l’observation passive, le plan expérimental avec randomisation s’affirme comme le modèle de référence méthodologique pour asseoir la causalité. Le coup de génie théorique de Sir Ronald Fisher a consisté à concevoir l’assignation aléatoire des sujets aux modalités de la variable explicative comme un procédé algorithmique destiné à pulvériser systématiquement les corrélations entre la variable explicative et la totalité des caractéristiques préexistantes des participants, qu’elles soient connues ou totalement inconnues de l’investigateur.
Grâce à la randomisation, la distribution des variables parasites potentielles (âge, quotient intellectuel, prédispositions génétiques, historique de vie, motivation intrinsèque) tend vers une parfaite équivalence probabiliste entre les différents groupes expérimentaux au sein d’échantillons de taille suffisante. En conséquence, l’indépendance statistique entre X et l’ensemble de la constellation des attributs non mesurés se trouve expérimentalement garantie. Si une divergence statistiquement significative émerge ultérieurement sur la variable de réponse entre les groupes, cette divergence ne peut plus être imputée à une variable de confusion préexistante, mais découle logiquement et univoquement de la manipulation délibérée de la variable explicative.
Cette supériorité de la démarche expérimentale est consolidée par l’adjonction de groupes de contrôle appropriés et le recours aux protocoles en double aveugle, neutralisant les effets d’attente du sujet (effet placebo) et les biais d’observation de l’expérimentateur (effet Pygmalion). L’expérimentation randomisée réalise ainsi le saut qualitatif décisif : elle émancipe l’analyste de la simple conjecture descriptive pour autoriser l’imputation causale formelle, scellant solidement le statut de la variable explicative en tant que moteur déclencheur des variations observées sur la variable de réponse.
6. Exemples appliqués en psychologie cognitive et neuropsychologie
6.1 Impact de la charge mentale sur le rappel mnésique
Le champ de la psychologie cognitive offre une illustration remarquable de l’articulation entre variables explicatives et de réponse à travers l’étude de l’architecture de la mémoire de travail humaine, initialement modélisée par Alan Baddeley et Graham Hitch. Dans un protocole expérimental classique évaluant les limitations de capacité de l’administrateur central, un chercheur peut concevoir un devis où la variable explicative est constituée par la complexité d’une tâche concurrente de charge cognitive administrée pendant la phase de rétention. Cette variable explicative peut être opérationnalisée de manière ordinale selon trois niveaux distincts : absence de tâche concurrente (charge nulle), répétition continue d’une syllabe simple (charge articulatoire faible), et génération aléatoire de chiffres à intervalles réguliers d’une seconde (charge exécutive élevée).
Dans ce dispositif, la variable de réponse est quantifiée par le pourcentage de mots correctement restitués lors d’une tâche de rappel libre différé portant sur une liste de vingt items lexicaux préalablement encodés. Cette variable continue capture la fidélité de l’accès aux traces mnésiques stabilisées. L’opérationnalisation permet de tester l’hypothèse déductive selon laquelle l’accroissement de la charge de travail concurrente induit une déplétion des ressources attentionnelles nécessaires au maintien actif de l’information en mémoire immédiate.
Les données typiques générées par un tel plan mettent en évidence un écroulement statistiquement significatif de la variable de réponse au fur et à mesure que la variable explicative progresse vers son niveau le plus exigeant. Ce patron empirique permet de trancher entre différentes modélisations théoriques de l’interférence proactive et rétroactive. L’expérimentateur peut affirmer que la charge exécutive est le facteur responsable de la dégradation de la performance, car l’assignation aléatoire des participants aux conditions d’interférence et la standardisation millimétrée de la vitesse de présentation des mots écartent toute explication concurrente fondée sur des différences interindividuelles d’aptitude mnésique basale.
6.2 Effet de la privation de sommeil sur l’attention soutenue
Dans le domaine de la neuropsychologie humaine et de la physiologie du travail, l’exploration des effets de l’éveil prolongé sur la vigilance fournit un modèle d’analyse exemplaire mobilisant des variables explicatives quantitatives continues. Dans ce type de paradigme, la variable explicative est mesurée par la durée continue de privation totale de sommeil, quantifiée en heures ininterrompues d’éveil au sein d’un laboratoire de chronobiologie contrôlé (par exemple, un enregistrement échelonné de 0 à 48 heures sans repos nocturne).
La variable de réponse privilégiée pour sonder cette dégradation cognitive est le temps de réaction moyen mesuré au cours du test d’attention soutenue psychomotrice, universellement désigné sous le sigle de tâche PVT (Psychomotor Vigilance Task). Au cours de ce test standardisé d’une durée de dix minutes, le participant doit réagir le plus promptement possible à l’apparition imprévisible d’un compte à rebours numérique sur un écran en pressant un bouton dédié. Les temps de latence, recueillis en millisecondes, permettent de quantifier avec une résolution extrême la cinétique de traitement du système nerveux central.
En parallèle de ce temps de réaction continu, les chercheurs extraient fréquemment une variable de réponse discrète dérivée : le nombre de « laps attentionnels », opérationnellement définis par des temps de réponse excédant 500 millisecondes. L’analyse statistique révèle généralement une fonction non linéaire de la dégradation de la réponse, caractérisée par une détérioration abrupte franchissant des seuils critiques au-delà de 24 heures d’éveil consécutif. La modélisation de cette variable de réponse en fonction de la variable explicative chronologique permet d’identifier l’interaction intime entre la pression homéostatique de sommeil (processus S) et les oscillations du rythme circadien endogène (processus C).
6.3 Neurostimulation et vitesse de traitement perceptif
L’essor des techniques de neurostimulation non invasive, particulièrement la stimulation magnétique transcrânienne (TMS), illustre avec une clarté sans précédent la manipulation active de variables explicatives biologiques pour observer des réponses comportementales directes. Dans un paradigme neuropsychologique explorant le rôle du cortex visuel primaire (V1) dans la conscience perceptive, la variable explicative est opérationnalisée par le délai temporel exact (l’intervalle inter-stimulus) séparant la présentation d’un flash lumineux sur un écran de l’administration d’une impulsion de TMS focale délivrée au-dessus du pôle occipital du participant.
Cette variable explicative temporelle, manipulée à des échelons de quelques millisecondes (par exemple, impulsions délivrées de 20 à 140 ms après le stimulus par paliers de 20 ms), permet de cartographier la fenêtre temporelle critique au sein de laquelle l’activité de V1 est indispensable à la prise de conscience perceptive. La variable de réponse quantifiée est le seuil de détection visuelle, mesuré par le taux de détection correcte de l’orientation d’un réseau de Gabor présenté brièvement à la limite du contraste perceptible.
Les résultats empiriques révèlent un profil diphasique hautement reproductible : lorsque la variable explicative se situe aux alentours de 80 à 100 millisecondes post-stimulus, la variable de réponse s’effondre drastiquement, les sujets rapportant ne plus rien percevoir consciemment alors même que leur rétine a été stimulée de manière identique. Ce protocole établit de façon univoque le statut explicatif de l’inhibition corticale occipitale induite par la TMS sur la suppression de la réponse visuelle, confirmant l’existence d’une boucle de réentrée corticale nécessaire à la synthèse phénoménale.
7. Exemples appliqués en psychologie clinique et psychopathologie
7.1 Efficacité différentielle des protocoles psychothérapeutiques
L’évaluation rigoureuse des thérapeutiques non médicamenteuses en psychologie clinique et en psychiatrie repose sur des devis d’essais cliniques randomisés (ECR) qui structurent méticuleusement les variables en jeu. Dans le cadre d’un essai évaluant le traitement de l’épisode dépressif caractérisé, la variable explicative principale est représentée par le type d’intervention thérapeutique structurée administrée aux patients. Il s’agit d’une variable nominale à plusieurs modalités indépendantes : thérapie cognitive et comportementale (TCC) standardisée, thérapie basée sur la pleine conscience (MBCT), et condition contrôle active de soutien non directif ou de liste d’attente standard.
La variable de réponse canonique employée pour quantifier l’effet clinique produit est l’ampleur de la réduction du score global obtenu à un inventaire psychométrique validé, à l’instar de l’Inventaire de Dépression de Beck (BDI-II) ou de l’échelle d’évaluation de la dépression de Hamilton (HAM-D). Cette mesure quantitative continue est recueillie à plusieurs jalons temporels préétablis : avant l’initiation des soins (ligne de base), à la fin du cycle thérapeutique de 12 semaines, et lors de suivis longitudinaux programmés à 6 et 12 mois pour attester du maintien des gains cliniques.
L’un des défis méthodologiques cruciaux dans ce type d’architecture expérimentale réside dans le traitement statistique de l’attrition des participants, c’est-à-dire les abandons en cours d’intervention. Si les sujets qui quittent prématurément le protocole sont simplement exclus des calculs, cela introduit un biais d’attrition dévastateur sur la variable de réponse, surestimant artificiellement l’efficacité du traitement. Les statisticiens recourent donc à des analyses en intention de traiter (ITT) couplées à des modèles mixtes linéaires pour modéliser la trajectoire de la variable de réponse sur l’ensemble de la cohorte initialement randomisée, garantissant ainsi l’impartialité de la comparaison entre les modalités de la variable explicative.
7.2 Exposition au stress aigu et réactivité neuroendocrinienne
L’investigation de la vulnérabilité au stress et de l’axe hypothalamo-hypophyso-surrénalien (HHS) illustre l’interaction entre une variable explicative psychosociale provoquée et des variables de réponse neuroendocriniennes dynamiques. Le protocole de référence mondialement mobilisé est le test de stress social de Trier (Trier Social Stress Test – TSST). Au sein de ce paradigme, la variable explicative consiste en l’exposition délibérée à une situation de stress psychosocial aigu combinant la menace du soi social (prise de parole en public devant un comité d’experts stoïques et neutres) et l’impossibilité de contrôle (épreuve de calcul mental rapide avec interruption systématique en cas d’erreur), comparativement à une tâche contrôle non menaçante.
La variable de réponse primaire est incarnée par la cinétique de libération du cortisol salivaire, prélevé à intervalles standardisés de manière répétée (par exemple, à -10, 0, +15, +30, +60 et +90 minutes par rapport à la fin de l’induction du stress). Plutôt que d’analyser chaque point temporel de façon fragmentée, les chercheurs synthétisent la dynamique globale de la variable de réponse par le calcul de l’aire sous la courbe (Area Under the Curve – AUC), déclinée sous deux indices cardinaux : l’aire sous la courbe par rapport au sol (AUCg), qui reflète la production totale de cortisol, et l’aire sous la courbe par rapport à l’augmentation (AUCi), qui isole précisément la magnitude réactive du pic sécrétoire provoqué par le TSST.
Cette approche permet d’observer comment la variable de réponse neuroendocrinienne est modulée de manière hétérogène selon des covariables individuelles majeures. Des antécédents de traumatismes dans l’enfance ou l’appartenance à un chronotype particulier agissent comme des variables modératrices modifiant l’intensité de la réponse surrénalienne, illustrant la nécessité de modéliser des systèmes d’explication complexes où la réaction biologique ne se limite pas à un réflexe stéréotypé mais intègre l’histoire biologique et psychologique du sujet.
7.3 Pharmacothérapie et réduction des comportements compulsifs
L’exploration clinique des troubles obsessionnels compulsifs (TOC) fournit un exemple classique de modélisation pharmacologique où la variable explicative quantitative continue s’articule à une variable de réponse clinique dans le cadre d’une relation dose-réponse. Dans une étude d’optimisation thérapeutique, la variable explicative est fixée par la posologie quotidienne administrée d’un inhibiteur sélectif de la recapture de la sérotonine (ISRS), tel que la sertraline, échelonnée méthodiquement par paliers fixes (50 mg, 100 mg, 150 mg, 200 mg par jour).
La variable de réponse standardisée est le score total à l’échelle d’obsession-compulsion de Yale-Brown (Y-BOCS), administrée par des cliniciens évaluateurs maintenus dans l’ignorance stricte de la posologie prescrite aux participants. Cette échelle psychométrique explore la fréquence, l’interférence, la détresse, la résistance et le degré de contrôle associés tant aux obsessions cognitives qu’aux rituels comportementaux, convertissant la sévérité sémiologique en une valeur numérique continue comprise entre 0 et 40 points.
L’analyse de cette relation fonctionnelle permet de tracer des courbes dose-réponse caractéristiques et d’identifier mathématiquement des paliers d’efficacité thérapeutique au-delà desquels l’accroissement de la dose de la variable explicative n’entraîne plus de diminution cliniquement significative du score de la variable de réponse, tout en majorant de manière disproportionnée le risque d’effets indésirables. Cette formalisation objective fonde les recommandations de bonne pratique clinique en définissant les fenêtres thérapeutiques optimales pour les praticiens.
8. Exemples appliqués en psychologie sociale et du travail
8.1 Influence de la pression sociale sur le conformisme individuel
Les dynamiques de groupe et l’influence sociale constituent un terrain d’élection historique pour la mise en scène de variables explicatives et de réponse hautement standardisées. Le protocole matriciel conçu par Solomon Asch sur le conformisme visuel en offre une illustration paradigmatique. Dans ce cadre, la variable explicative principale est représentée par la taille de la majorité unanime des compères complices de l’expérimentateur émettant un jugement perceptif manifestement erroné lors de la comparaison de longueurs de lignes géométriques. Cette variable discrète est délibérément manipulée pour adopter des valeurs entières successives : 1, 2, 3, 4, jusqu’à 15 compères unanimes.
La variable de réponse est quantifiée par la proportion ou la probabilité empirique que le sujet naïf abandonne son jugement visuel évident pour se conformer à la réponse incorrecte proférée par le groupe complice. Cette réponse est binaire lors de chaque essai individuel (conformisme versus indépendance) et se convertit en une variable quantitative continue lorsqu’elle est agrégée sous la forme du taux global d’erreurs de conformité manifestées par le participant tout au long de la session de test.
Les déclinaisons contemporaines de ce paradigme au sein des plateformes numériques et des réseaux sociaux transposent fidèlement cette architecture : la variable explicative devient le nombre d’approbations numériques préalables (« likes » ou votes approbateurs forgés de toutes pièces par un script d’expérimentation) affichées sous une assertion factuellement fausse, tandis que la variable de réponse est le consentement du participant à relayer ou approuver à son tour l’information. La modélisation de ces données révèle une relation logistique typique où la pression de la variable explicative atteint un plateau d’impact maximal dès que la majorité factice atteint trois à quatre individus unanimes, l’adjonction de compères surnuméraires n’accroissant plus substantiellement le taux de conformisme.
8.2 Style de leadership managérial et épuisement professionnel
Le champ de la psychologie des organisations et de la santé au travail exploite massivement l’analyse corrélationnelle multivariée pour décrypter les antécédents du bien-être au travail. Dans une étude explorant l’émergence du syndrome de burnout, la variable explicative conceptuelle est le style de leadership perçu déployé par l’encadrement supérieur. Cette variable est opérationnalisée par des scores continus recueillis via des inventaires validés, opposant par exemple le leadership transformationnel (stimulant et soutenant) au leadership abusif ou toxique (caractérisé par des humiliations publiques et une gestion par la peur).
La variable de réponse centrale est le score d’épuisement émotionnel des salariés, mesuré par la sous-échelle dédiée du Maslach Burnout Inventory (MBI). Cette dimension constitue le cœur d’ancrage de la souffrance psychologique liée au travail, traduisant le sentiment de vidage complet des ressources énergétiques individuelles. Ce type de recherche requiert une vigilance méthodologique particulière en raison de la nature hiérarchique ou nichée des données recueillies : plusieurs collaborateurs partagent souvent le même supérieur direct au sein d’une unité de travail.
L’ignorance de cette interdépendance des observations violerait le postulat d’indépendance résiduelle indispensable aux régressions classiques. Les chercheurs modélisent donc la variable de réponse par le truchement de régressions multiniveaux, partitionnant explicitement la variance du score d’épuisement émotionnel entre la variance attribuable aux caractéristiques subjectives propres à chaque employé (niveau 1) et celle imputable au climat managérial partagé par l’ensemble de l’équipe (niveau 2). Cela permet de quantifier avec exactitude la contribution de la variable explicative collective sur la santé psychique individuelle.
8.3 Aménagement ergonomique et performance cognitive en open space
L’ergonomie cognitive et environnementale se penche avec une grande précision sur l’impact des ambiances physiques de travail sur les processus d’attention sélective. Dans un contexte expérimental reproduisant les conditions d’un espace de travail partagé (open space), la variable explicative est fréquemment isolée sous la forme du niveau et de la nature de la pression acoustique ambiante. Cette variable peut être déclinée de manière quantitative par le niveau de décibels pondérés A (dB(A)), ou de manière qualitative par la typologie du bruitage diffusé : bruit blanc continu, conversations intelligibles dans la langue maternelle, ou conversations en langue étrangère inintelligible, toutes étalonnées à une intensité sonore strictement égale (par exemple, 65 dB(A)).
La variable de réponse est quantifiée par l’efficacité du traitement de l’information au cours d’une tâche de détection de signaux textuels exigeant la correction d’épreuves typographiques complexes. Les indicateurs opérationnels retenus sont le temps nécessaire à la complétion de la relecture et le taux d’erreurs non détectées. Ces variables de réponse mesurent avec sensibilité le détournement automatique des ressources cognitives allouées à la lecture vers le traitement non désiré du canal auditif concurrent.
Les résultats attestent systématiquement d’une puissante interaction statistique : la dégradation de la variable de réponse n’est pas simplement fonction de la puissance acoustique brute de la variable explicative, mais de son contenu sémantique. Les conversations intelligibles provoquent un effondrement bien plus marqué des performances cognitives qu’un bruit continu de niveau énergétique équivalent, en raison de l’accès irrépressible de la parole articulée aux boucles phonologiques de la mémoire de travail de l’opérateur, illustrant comment l’ergonomie opérationnalise des variables de réponse comportementales pour guider l’aménagement architectural des environnements tertiaires.
9. Variables parasites, modératrices et médiatrices : complexification du modèle
9.1 La variable de confusion et le biais d’attribution
La relation bivariée directe entre une variable explicative et une variable de réponse ne constitue que très rarement un système hermétique et autosuffisant dans le monde réel. L’intrusion d’une variable de confusion — ou facteur confondant — représente la menace méthodologique la plus insidieuse pesant sur la validité interne d’une conclusion empirique. Une variable tierce Z est formellement qualifiée de confondante si et seulement si elle satisfait deux conditions simultanées : elle est statistiquement associée à la variable explicative X, et elle constitue un prédicteur direct et causal de la variable de réponse Y, sans pour autant figurer sur la trajectoire causale intermédiaire liant X à Y.
Lorsqu’un modèle omet une telle variable de confusion, l’effet apparent de la variable explicative sur la réponse se trouve irrémédiablement contaminé, conduisant à un biais d’attribution sévère. Ce phénomène est couramment illustré en épidémiologie psychiatrique : une corrélation robuste peut être mise en évidence entre la consommation quotidienne de caféine (variable explicative présumée) et le risque de développer un trouble anxieux (variable de réponse). Toutefois, si la consommation de tabac (variable de confusion Z) est massivement corrélée à celle du café tout en constituant un anxiogène pharmacologique direct puissant, l’effet initialement imputé à la caféine peut n’être qu’un pur artefact résultant de l’oubli méthodologique du facteur tabagique.
Pour neutraliser l’action pernicieuse des variables de confusion, la méthodologie scientifique met en œuvre deux grandes familles de parades. En amont de la collecte, lors de l’élaboration du protocole, les chercheurs recourent à l’appariement minutieux des participants (matching) ou à l’assignation par blocs randomisés, garantissant une répartition rigoureusement uniforme des facteurs de confusion potentiels au sein de chaque strate expérimentale. En aval, lors de la phase de traitement des données, le recours aux analyses de régression multivariée, aux techniques de stratification ou au calcul de scores de propension permet de contrôler mathématiquement l’influence de la variable tierce, isolant ainsi l’effet net propre de la variable explicative sur la variable de réponse.
9.2 La variable modératrice : altération de la force ou du sens du lien
Tandis que la variable de confusion constitue une nuisance méthodologique à éliminer, la variable modératrice incarne un enrichissement théorique capital permettant d’affiner le degré de généralité d’une relation fonctionnelle. Sur le plan conceptuel, une variable modératrice, traditionnellement désignée par la lettre M ou W, altère la force statistique, la magnitude ou la direction du lien unissant la variable explicative X à la variable de réponse Y. Poser une question de modération revient méthodologiquement à se demander : « Pour qui ? » ou « Dans quelles circonstances spécifiques l’effet de la variable explicative sur la réponse se manifeste-t-il ? ».
Sur le plan de la modélisation mathématique linéaire, la modération se formalise par l’introduction d’un terme d’interaction multiplicatif au sein de l’équation de régression :
Y = β₀ + β₁X + β₂W + β₃(X × W) + ε
Dans cette formulation, le coefficient β₃ quantifie précisément l’effet modérateur. Si ce paramètre atteint le seuil de signification statistique, cela atteste que la pente de régression de la variable explicative sur la réponse n’est pas constante, mais fluctue linéairement en fonction de la valeur adoptée par le modérateur.
Un exemple topique en psychopathologie clinique réside dans l’interaction entre l’exposition à des événements de vie stressants (variable explicative X) et le risque de déclenchement d’un épisode dépressif majeur (variable de réponse Y), sous la modération du niveau de névrosisme ou de neuroticisme prémorbide du sujet (variable modératrice W). Chez les individus caractérisés par un très faible score de névrosisme, la survenue de stresseurs majeurs n’entraîne qu’une élévation modérée de la réponse dépressive (pente simple faible). En revanche, chez les sujets dotés d’un haut niveau de névrosisme, le coefficient de régression s’accentue dramatiquement, la même quantité de stress induisant un effondrement clinique sévère. Les techniques de visualisation des pentes simples (simple slopes analysis) et les tests de régions de signification de Johnson-Neyman permettent alors de délimiter avec précision les seuils du modérateur pour lesquels l’action de la variable explicative s’active de manière critique.
9.3 La variable médiatrice : élucidation du mécanisme psychologique
À la différence fondamentale de la modération qui s’intéresse aux conditions d’émergence d’un effet, la médiation se consacre à l’élucidation de la machinerie interne du phénomène, répondant à la question : « Comment ? » ou « Par quel mécanisme intermédiaire la variable explicative parvient-elle à impacter la variable de réponse ? ». Une variable médiatrice, notée M, s’insère explicitement dans la chaîne séquentielle causale : la variable explicative X transmet son impulsion au médiateur M, qui à son tour engendre la modification observable sur la variable de réponse finale Y.
Le modèle canonique de médiation, initialement popularisé par Reuben Baron et David Kenny puis considérablement affiné par Andrew Hayes, décompose la dynamique globale en plusieurs sous-trajets mathématiques :
- Le trajet a, qui estime l’impact direct de la variable explicative sur le médiateur (X → M).
- Le trajet b, qui évalue l’effet du médiateur sur la variable de réponse tout en contrôlant la présence de la variable explicative (M → Y).
- Le trajet c’, qualifié d’effet direct, qui représente la part d’influence résiduelle que X conserve sur Y indépendamment de l’action du médiateur.
- Le produit des coefficients (a × b), qui cristallise l’effet indirect, c’est-à-dire la quantité d’influence canalisée et véhiculée à travers le médiateur.
Considérons l’expérimentation pédagogique où l’on cherche à analyser l’impact d’un programme d’entraînement aux techniques d’autorégulation de l’apprentissage (variable explicative X) sur la performance académique finale des étudiants lors des examens universitaires (variable de réponse Y). On peut formuler l’hypothèse théorique que cet entraînement n’améliore pas directement les notes de façon magique, mais que son action est médiée par le sentiment d’auto-efficacité des étudiants (variable médiatrice M). L’entraînement accroît la confiance des étudiants dans leur capacité d’organisation (trajet a), ce qui mobilise une persévérance accrue dans les révisions et propulse subséquemment les notes d’examens (trajet b).
Dans l’arsenal statistique contemporain, la vérification de la signification de l’effet indirect (a × b) s’émancipe désormais du test obsolète de Sobel — réputé manquer de puissance en raison de l’asymétrie de la distribution d’un produit mathématique — pour s’appuyer quasi exclusivement sur des méthodes non paramétriques de rééchantillonnage avec remplacement (bootstrapping). En générant des milliers de pseudo-échantillons à partir des données sources, le chercheur calcule un intervalle de confiance robuste à 95 % pour l’effet indirect ; si cet intervalle exclut le zéro absolu, la démonstration statistique du rôle transmetteur du médiateur est établie avec une validité formelle sans faille.
10. Rôle des variables dans les devis expérimentaux et quasi-expérimentaux
10.1 Devis entièrement randomisés à groupes indépendants
Le devis entièrement randomisé à groupes indépendants, traditionnellement qualifié de plan inter-sujets (between-subjects design), incarne la quintessence du paradigme expérimental classique. Dans cette architecture méthodologique, la variable explicative est opérationnalisée sous la forme d’un ensemble de conditions ou de traitements mutuellement exclusifs, chaque participant recruté n’étant exposé qu’à une seule et unique modalité du facteur. La partition de l’échantillon global en sous-groupes indépendants est entièrement scellée par l’algorithme d’assignation aléatoire.
L’objectif fondamental de ce plan est de maximiser la variance inter-groupes — qui reflète directement l’empreinte de la variable explicative sur la variable de réponse — tout en minimisant autant que possible la variance intra-groupe, ou variance d’erreur, qui agrège les bruits de mesure et les différences individuelles d’origine génétique, développementale ou psychologique. Pour garantir la détection d’un effet statistiquement significatif sur la variable de réponse sans multiplier inconsidérément les inclusions, le chercheur doit impérativement réaliser un calcul de puissance statistique a priori (estimant la taille d’effet escomptée, la puissance souhaitée typiquement fixée à 1 – β = 0,80, et le risque d’erreur alpha à α = 0,05).
Le mérite absolu du plan inter-sujets réside dans son immunité totale face aux effets de transfert inter-conditions : aucun participant ne risquant d’être contaminé par le souvenir, l’entraînement ou la fatigue générés par une modalité préalable, la mesure de la variable de réponse conserve une pureté phénoménale absolue pour la modalité assignée. En contrepartie, son inconvénient structurel majeur réside dans sa moindre sensibilité statistique brute comparée aux devis appariés, exigeant des cohortes d’échantillonnage volumineuses pour surmonter l’hétérogénéité naturelle présente d’un individu à un autre au sein de chaque groupe.
10.2 Devis à mesures répétées et plans intra-sujets
Pour juguler l’impact préjudiciable de la variance interindividuelle sur la précision de la modélisation, le devis à mesures répétées — ou plan intra-sujets (within-subjects design) — adopte une stratégie d’une efficacité redoutable. Dans cette configuration expérimentale, chaque participant est lui-même son propre témoin et se trouve exposé de manière successive à l’intégralité des modalités de la variable explicative. La variable de réponse fait ainsi l’objet d’évaluations itératives pour chaque condition chez chaque sujet formant la cohorte.
Ce protocole confère un gain de puissance statistique spectaculaire. Dans la mesure où les caractéristiques structurales fondamentales des participants demeurent rigoureusement identiques d’une condition à l’autre, la part de variance attribuable aux idiosyncrasies personnelles est mathématiquement retranchée de la variance d’erreur résiduelle, décuplant la capacité du modèle à isoler les fluctuations fines de la variable de réponse imputables à la variable explicative. De surcroît, ces devis s’avèrent infiniment plus économiques sur le plan de la taille globale de l’échantillon requis.
Toutefois, cette architecture expose le chercheur à des menaces méthodologiques internes redoutables : les effets de report, d’apprentissage progressif, d’habituation ou d’épuisement attentionnel induits par la répétition des mesures de la réponse. La parade méthodologique absolue repose sur le contrebalancement systématique de l’ordre de présentation des modalités de la variable explicative, typiquement agencé selon les matrices équilibrées de carrés latins. Sur le plan statistique formel, l’analyse de ces devis exige la vérification stricte du postulat de sphéricité de la matrice de variance-covariance des différences de réponses (estimée par le test de sphéricité de Mauchly) ; en cas de violation de ce postulat, des corrections drastiques des degrés de liberté — à l’instar des ajustements conservateurs de Greenhouse-Geisser ou de Huynh-Feldt — doivent être appliquées pour éviter une inflation pernicieuse de l’erreur de type I.
10.3 Devis quasi-expérimentaux et séries temporelles interrompues
Dans de multiples situations relevant de la psychologie clinique, de la psychiatrie institutionnelle ou des politiques de santé publique, des barrières éthiques ou logistiques insurmontables interdisent formellement l’assignation aléatoire des unités d’observation aux modalités de la variable explicative. Le chercheur ne saurait en effet assigner aléatoirement des citoyens à subir un traumatisme psychologique, un licenciement économique ou à être hébergés dans des prisons de régimes différents. Face à ces contraintes, la démarche empirique investit les devis quasi-expérimentaux.
Dans ces dispositifs d’évaluation, le chercheur étudie l’impact de la variable explicative en composant avec des groupes préexistants ou non équivalents. Pour pallier l’absence de randomisation et limiter les biais de sélection massifs, les analystes recourent à des techniques sophistiquées telles que l’appariement par score de propension (propensity score matching), qui recrée a posteriori des sous-cohortes de participants présentant des probabilités équivalentes d’avoir été exposés au traitement au regard d’un vaste vecteur de covariables démographiques et cliniques.
Une modalité particulièrement puissante du devis quasi-expérimental est le devis à séries temporelles interrompues. Dans cette approche, la variable de réponse est enregistrée de façon continue et séquentielle à de multiples points d’ancrage temporels avant l’introduction de l’événement ou de la politique d’intérêt (phase pré-intervention), puis mesurée selon une fréquence identique après cette introduction (phase post-intervention). Cette trajectoire permet d’estimer si la variable explicative temporelle produit un changement abrupt de niveau ou une modification graduelle de la pente d’évolution de la variable de réponse, tout en contrôlant les tendances séculaires sous-jacentes. Les menaces pesant sur la validité interne demeurent néanmoins prégnantes, au premier rang desquelles figurent les événements historiques co-occurrents contemporains de l’intervention étudiée.
11. Modélisation statistique : de la régression aux équations structurelles
11.1 Modèles linéaires univariés : régression simple et multiple
Le modèle de régression linéaire univarié et multivarié constitue l’échafaudage mathématique de base permettant d’estimer avec une rigueur paramétrique la relation reliant une variable de réponse continue à une ou plusieurs variables explicatives. Dans sa formalisation générale, la régression multiple projette la variable dépendante Y sur un hyperplan défini par une combinaison linéaire de prédicteurs :
Y = β₀ + β₁X₁ + β₂X₂ + … + βₖXₖ + ε
L’estimation des coefficients de régression partiels βₖ s’opère usuellement par la méthode des moindres carrés ordinaires (MCO), minimisant la somme quadratique des écarts entre les valeurs observées et les projections du modèle.
L’interprétation de ces coefficients requiert une distinction méthodologique entre les coefficients bruts non standardisés (notés couramment B) et les coefficients standardisés (notés β). Les premiers expriment le changement concret anticipé en unités métriques de la variable de réponse lorsqu’une variable explicative donnée augmente d’une unité propre, toutes les autres variables étant maintenues rigoureusement constantes. Les coefficients standardisés, purgés des unités de mesure d’origine, permettent d’évaluer la puissance relative d’impact comparée des différents régresseurs au sein du modèle. La proportion globale de variance de la variable de réponse capturée conjointement par l’ensemble des prédicteurs est résumée par le coefficient de détermination R², qui doit être corrigé en R² ajusté pour pénaliser l’inclusion artificielle de variables explicatives superflues.
La validité statistique de ces inférences repose intégralement sur le respect scrupuleux de postulats stochastiques fondamentaux : la normalité de la distribution des résidus, l’homoscédasticité (constance de la variance résiduelle sur toute l’étendue des prédictions), et la stricte indépendance des erreurs (absence d’autocorrélation, vérifiable par des métriques comme la statistique de Durbin-Watson). De surcroît, le statisticien doit impérativement conduire un diagnostic d’absence de multicolinéarité excessive entre les variables explicatives via le calcul des facteurs d’inflation de la variance (VIF). Un VIF excédant des seuils critiques révèle une redondance massive entre régresseurs, déstabilisant les erreurs-types des coefficients et invalidant les tests de significativité associés.
11.2 Modèles linéaires généralisés pour réponses non gaussiennes
L’hypothèse selon laquelle la variable de réponse est nécessairement continue et distribuée selon une courbe normale de Gauss se heurte violemment à la réalité empirique de la recherche en sciences du comportement et en médecine. De nombreuses variables de réponse se présentent sous la forme de données binaires (succès ou échec, rechute clinique ou maintien de la rémission), de données ordinales (stades d’une maladie), ou de variables de comptage discrètes (nombre de consultations médicales, fréquence de survenue d’un tic moteur par heure). Tenter d’appliquer les moindres carrés ordinaires à ces formats produit des prédictions mathématiquement absurdes (telles que des probabilités négatives ou excédant 100 %) et viole systématiquement l’homoscédasticité.
Pour surmonter ces impasses, la statistique contemporaine s’appuie sur le cadre unificateur des Modèles Linéaires Généralisés (Generalized Linear Models – GLM), théorisés par John Nelder et Robert Wedderburn. Un modèle linéaire généralisé s’émancipe du postulat gaussien en postulant que la variable de réponse Y appartient à la vaste famille des distributions exponentielles (binomiale, de Poisson, binomiale négative, gamma) et se lie au prédicteur linéaire par l’entremise d’une fonction de lien mathématique spécifique g(.), telle que :
g(E(Y)) = Xβ
Dans le cas d’une variable de réponse bichlorotique (binaire), la régression logistique mobilise la fonction de lien logit, modélisant le logarithme népérien du rapport des cotes (log-odds). Les coefficients estimés s’interprètent alors sous la forme intuitive de rapports de cotes (Odds Ratios – OR), quantifiant l’augmentation ou la diminution de probabilité que l’événement survienne pour chaque incrément unitaire de la variable explicative. Pour des données de comptage manifestant une asymétrie positive marquée, la régression de Poisson (utilisant un lien logarithmique) ou les modèles négatifs binomiaux (en présence de surdispersion de variance) fournissent le cadre rigoureux requis pour lier les explications aux réponses sans distorsion métrologique.
11.3 Modèles multiniveaux et modélisation par équations structurelles
L’exploration contemporaine des systèmes psychologiques et sociologiques aborde des architectures de données d’une complexité qui surpasse largement les capacités des modèles linéaires traditionnels à un seul niveau de régression. D’une part, les données de terrain présentent fréquemment une structuration hiérarchique imbriquée : des élèves nichés au sein de classes scolaires, elles-mêmes nichées dans des établissements distincts ; ou des mesures répétées recueillies au sein d’un même individu au fil du temps. Les modèles linéaires hiérarchiques ou multiniveaux permettent d’assigner formellement des variables explicatives de niveau 1 (attributs individuels de l’élève) et des variables explicatives de niveau 2 (politique pédagogique de la classe) pour rendre compte de la variable de réponse finale, en autorisant tant l’ordonnée à l’origine que les pentes de régression à varier aléatoirement d’un groupe à un autre.
D’autre part, la modélisation par équations structurelles (Structural Equation Modeling – SEM) accomplit la synthèse méthodologique la plus achevée entre la psychométrie factorielle et la modélisation économétrique des trajectoires causales. Contrairement aux régressions classiques qui s’exécutent sur des variables manifestes supposées mesurées sans la moindre erreur, la SEM permet de formaliser tant les variables explicatives que les variables de réponse sous la forme de variables latentes non observables directement, estimées à partir de multiples indicateurs empiriques observables dans le cadre d’un modèle de mesure confirmatoire.
Cette distinction transcende les modélisations fragmentées en permettant d’estimer simultanément un réseau complet de relations d’interdépendance directionnelle où une même variable peut simultanément jouer le rôle de variable de réponse pour un sous-système de prédicteurs et de variable explicative pour une autre dimension du réseau théorique (modèles d’analyses de trajectoires ou path analysis). L’adéquation du modèle conceptuel aux données empiriques n’est pas jugée sur un simple test univarié, mais sur une constellation d’indices d’ajustement global hautement exigeants (Comparative Fit Index [CFI], Tucker-Lewis Index [TLI], Root Mean Square Error of Approximation [RMSEA]), consacrant l’alignement formel entre la structure postulée par la théorie et la matrice empirique de variance-covariance.
12. Erreurs méthodologiques fréquentes et recommandations pratiques
12.1 Erreurs de spécification et d’attribution du statut de variable
L’histoire de la recherche quantitative est jalonnée d’erreurs méthodologiques récurrentes trouvant leur source dans une mauvaise spécification des statuts alloués aux variables du modèle. L’une des anomalies les plus dévastatrices sur le plan inférentiel est le conditionnement accidentel sur une variable de collision (collider bias), un concept magistralement formalisé par le logicien Judea Pearl dans le cadre des graphes causaux orientés acycliques (DAG). Une variable de collision est une variable commune causée simultanément par deux entités distinctes :
X → C ← Y
Si l’analyste commet l’erreur d’introduire cette variable C comme covariable de contrôle ou de stratifier son échantillon selon ses modalités, il crée mécaniquement une association statistique totalement fallacieuse et inexistante dans la population entre la variable explicative X et la variable de réponse Y, faussant irrémédiablement l’interprétation des résultats.
Une autre bévue classique réside dans l’inversion non concertée des rôles de variable explicative et de réponse lors d’analyses secondaires de bases de données volumineuses. Face à l’absence de significativité dans le sens prescrit par le modèle théorique initial, certains chercheurs inversent purement et simplement le sens de leur équation de régression pour dénicher un coefficient statistique publiable. Cette dérive épistémologique — consistant à ajuster la théorie aux caprices de distributions stochastiques opportunistes — détruit l’intégrité de la démarche hypothético-déductive en substituant l’exploration inductive post-hoc à la vérification d’hypothèses étayées.
Enfin, le biais par omission de variable explicative majeure (omitted variable bias) guette toute analyse qui néglige des régresseurs fondamentaux documentés par la littérature scientifique. L’omission d’un prédicteur capital a pour conséquence directe de forcer le terme d’erreur ε du modèle à absorber cette influence exclue. Dès lors que cette composante manquante est corrélée aux variables explicatives retenues, l’hypothèse d’indépendance entre les résidus et les régresseurs est violée de plein fouet, conduisant à des estimations dramatiquement biaisées et inconsistantes des coefficients β, ce qui vide les tests de significativité de toute valeur probante.
12.2 Mauvaises pratiques d’échantillonnage et de mesure
Les fragilités d’un modèle reliant variables explicatives et de réponse ne résident pas uniquement dans l’algèbre des modèles statistiques, mais s’enracinent très fréquemment en amont, dans des défaillances opératoires lors du recueil empirique des données. Au premier rang de ces écueils figure le sous-dimensionnement chronique des échantillons de recherche. Conduire une étude avec une puissance statistique sous-calibrée (par exemple 1 – β = 0,40 au lieu des 0,80 minimaux prescrits par les standards de la communauté) empêche non seulement de détecter des effets réels sur la variable de réponse, mais expose également au piège des résultats faussement positifs dont la taille d’effet se trouve massivement surestimée (effet de la malédiction du vainqueur).
Une mauvaise pratique particulièrement néfaste, pourtant historiquement répandue dans certaines branches des sciences comportementales, est la dichotomisation artificielle de variables explicatives continues par la technique dite du « partage médian » (median split). Sous prétexte de simplifier le traitement analytique en recourant à des analyses de variance bivariées, transformer une variable continue riche et nuancée (comme l’âge, l’anxiété ou le QI) en deux catégories discrètes (« haut » versus « bas ») constitue un contresens méthodologique majeur. Cette mutilation des données détruit irréversiblement une part considérable de l’information métrologique, affaiblit drastiquement la puissance statistique des tests, réduit la variance expliquée sur la variable de réponse et peut même créer des artefacts statistiques en altérant la distribution des résidus.
Enfin, l’emploi d’instruments de mesure de la variable de réponse n’ayant fait l’objet d’aucune validation psychométrique formelle ou souffrant d’une absence d’invariance de mesure à travers les sous-groupes démographiques vicie la validité de construit de l’ensemble de la recherche. Si l’instrument métrologique retenu ne présente pas une invariance configurale, métrique et scalaire démontrée, les divergences constatées sur la variable de réponse entre les groupes expérimentaux ne refléteront pas une variation authentique du construit psychologique d’intérêt, mais de simples fluctuations idiosyncrasiques dans la manière dont les différents groupes interprètent et répondent aux items de l’outil d’évaluation.
12.3 Recommandations déontologiques et méthodologiques pour la recherche
Face à la crise de la réplicabilité qui a secoué l’ensemble des sciences contemporaines au cours de la dernière décennie, la communauté scientifique a forgé une série de standards déontologiques et opérationnels d’une rigueur renouvelée. La recommandation cardinale réside dans le pré-enregistrement systématique (preregistration) des protocoles empiriques sur des plateformes publiques sécurisées telles que l’Open Science Framework (OSF). Ce pré-enregistrement impose à l’équipe de recherche de verrouiller formellement, avant toute collecte du moindre point de donnée, la désignation univoque de la variable explicative principale, de la variable de réponse terminale, des covariables sélectionnées, de la taille de l’échantillon calculée par analyse de puissance, ainsi que du script précis des analyses statistiques qui seront exécutées.
Cette transparence préalable constitue le rempart ultime contre les pratiques contestables de recherche (Questionable Research Practices – QRPs), particulièrement le dragage de données (p-hacking) et l’infâme pratique consistant à formuler les hypothèses une fois les résultats connus (HARKing : Hypothesizing After the Results are Known). La désignation explicite et immuable des statuts respectifs des variables prévient toute manipulation opportune de modèles multivariés ou toute sélection a posteriori de sous-échelles de réponse qui flatteraient artificiellement le seuil fatidique de significativité fixé à p < 0,05.
Dans cette même perspective de science ouverte et reproductible, les revues d’excellence exigent désormais la mise à disposition publique des données brutes anonymisées (open data) accompagnées des codes computationnels reproductibles d’analyse (scripts R, syntaxe Python, scripts SPSS). De surcroît, la culture de la recherche doit s’émanciper impérativement du biais de publication qui a trop longtemps confiné les résultats nuls dans les tiroirs des laboratoires. Publier avec fierté et rigueur l’absence d’effet statistiquement démontrable d’une variable explicative sur une variable de réponse constitue une avancée scientifique tout aussi primordiale pour la connaissance humaine que l’affirmation d’une relation fonctionnelle, préservant ainsi l’édifice scientifique de la perpétuation de dogmes non vérifiés.
Références
- Asch, S. E. (1951). Effects of group pressure upon the modification and distortion of judgments. In H. Guetzkow (Ed.), Groups, leadership, and men (pp. 177-190). Carnegie Press.
- Baddeley, A. D., & Hitch, G. (1974). Working memory. In G. H. Bower (Ed.), The psychology of learning and motivation: Advances in research and theory (Vol. 8, pp. 47-89). Academic Press. https://doi.org/10.1016/S0079-7421(08)60452-1
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173-1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). Guilford Press.
- Hill, A. B. (1965). The environment and disease: Association or causation? Proceedings of the Royal Society of Medicine, 58(5), 295-300. https://doi.org/10.1177/003591576505800503
- Kirschbaum, C., Pirke, K. M., & Hellhammer, D. H. (1993). The ‘Trier Social Stress Test’–a tool for investigating psychobiological stress responses in a laboratory setting. Neuropsychobiology, 28(1-2), 76-81. https://doi.org/10.1159/000119004
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677