
Dans le domaine des sciences comportementales, de la psychologie cognitive, de la neuropsychologie et de la recherche clinique, la modélisation statistique des données expérimentales constitue la clé de voûte de la découverte empirique. Lorsqu’un protocole expérimental implique la comparaison de plusieurs groupes d’individus ou conditions expérimentales soumis à des interventions distinctes, l’analyse de variance (ANOVA) à un facteur s’impose historiquement comme l’outil d’inférence de premier ordre. Cependant, l’obtention d’une valeur de p statistiquement significative associée au test F de Fisher ne résout qu’une partie infime de l’énigme scientifique posée par le chercheur : elle affirme simplement que les moyennes observées ne proviennent pas toutes d’une même population théorique, sans jamais préciser lesquelles diffèrent significativement les unes des autres.
Cette insuffisance fondamentale du test omnibus contraint le chercheur à déployer des procédures d’investigation secondaires dénommées comparaisons multiples ou tests post-hoc. C’est précisément à cette étape de l’analyse que surgit un arbitrage méthodologique délicat, porteur d’enjeux scientifiques considérables. Face à la multitude d’approches mathématiques disponibles dans les progiciels d’analyse statistique modernes, trois figures canoniques dominent la littérature et divisent les praticiens : le test de la différence honnêtement significative de Tukey (Tukey’s HSD), la correction universelle de Bonferroni et la méthode globale des contrastes de Scheffé. Chacun de ces outils repose sur des hypothèses distributionnelles particulières, propose un équilibre singulier entre la protection contre les faux positifs et la puissance statistique, et répond à des objectifs de recherche distincts.
Choisir l’une de ces méthodes par simple habitude logicielle ou par mimétisme éditorial constitue un risque méthodologique majeur pouvant compromettre la reproductibilité des conclusions scientifiques. Une procédure excessivement conservatrice condamne le chercheur à l’erreur de type II, masquant des effets thérapeutiques ou comportementaux pourtant bien réels ; à l’inverse, une procédure trop libérale gonfle artificiellement le taux de faux positifs, alimentant la crise de la réplication qui frappe la psychologie contemporaine. Cet article fournit une analyse théorique, mathématique et pratique exhaustive du triumvirat composé par Tukey, Bonferroni et Scheffé, afin d’offrir aux chercheurs, analystes de données et étudiants avancés une boussole décisionnelle rigoureuse et pérenne.
1. Fondements de l’analyse post-hoc après une ANOVA en psychologie
1.1 Limites intrinsèques de l’ANOVA unidirectionnelle
L’analyse de variance unidirectionnelle repose sur la décomposition de la variance totale des données en deux composantes fondamentales : la variance factorielle (ou inter-groupes), attribuable aux manipulations expérimentales, et la variance résiduelle (ou intra-groupes), qui capture les variations individuelles et les erreurs de mesure aléatoires. Le rapport de ces deux variances génère le ratio de Snedecor-Fisher ($F$). Lorsque ce ratio dépasse la valeur critique associée au seuil de signification choisi (typiquement $\alpha = 0{,}05$), le chercheur rejette formellement l’hypothèse nulle globale ($H_0 : \mu_1 = \mu_2 = dots = \mu_k$). Ce rejet autorise à conclure qu’au moins une des moyennes de population diffère d’au moins une autre. Néanmoins, le test F est par essence un test omnibus : il possède une structure non directionnelle et non différentielle qui agrège l’ensemble des écarts sans pouvoir localiser l’origine exacte du signal statistique.
Dans la pratique de la recherche psychologique, où un plan expérimental peut intégrer quatre, cinq ou six conditions différentes — par exemple, l’effet de plusieurs molécules psychotropes comparativement à un placebo et à une thérapie cognitive standard —, le test global laisse le chercheur dans une cécité inférentielle complète. Savoir que le système des moyennes n’est pas homogène n’indique en rien si le traitement A surpasse le traitement B, si la thérapie standard fait mieux que le placebo, ou si la combinaison des approches présente une synergie. L’incapacité de l’ANOVA à cartographier les paires de moyennes divergentes rend impérative une analyse consécutive approfondie.
L’erreur méthodologique la plus grave consisterait à sur-interpréter la significativité du test F global pour légitimer de simples constats visuels à partir des graphiques de moyennes. Déclarer qu’une condition expérimentale est supérieure à une autre uniquement parce que sa moyenne empirique est plus haute et que l’ANOVA globale est significative constitue un biais de confirmation flagrant. L’inférence statistique exige que chaque comparaison spécifique fasse l’objet d’un contrôle rigoureux de son erreur d’échantillonnage, sous peine de transformer de simples fluctuations aléatoires en découvertes théoriques factices.
1.2 La transition des tests omnibus vers les comparaisons multiples
Pour dépasser l’impasse du test omnibus, le statisticien dispose de deux voies épistémologiques distinctes : les contrastes planifiés a priori et les tests de comparaisons multiples a posteriori, universellement appelés tests post-hoc. Les contrastes a priori sont déduits directement des hypothèses théoriques formulées avant la collecte des données. Ils ciblent un nombre restreint de questions de recherche précises et bénéficient d’un cadre inférentiel particulièrement puissant. Cependant, l’investigation empirique ne permet pas toujours d’anticiper la totalité des dynamiques comportementales, notamment dans les contextes exploratoires ou lors de l’évaluation de protocoles d’intervention novateurs.
C’est ici qu’interviennent les tests post-hoc. Contrairement aux démarches confirmatoires strictes, les tests post-hoc permettent d’explorer l’ensemble des différences possibles entre groupes une fois les données recueillies et l’ANOVA omnibus validée. Ils permettent de « sonder » la matrice des résultats sans formuler d’interdits méthodologiques préliminaires. En psychologie expérimentale et en neurosciences, cette distinction entre recherche confirmatoire et recherche exploratoire est primordiale : les tests post-hoc constituent le garde-fou mathématique indispensable qui autorise l’exploration sans sombrer dans l’anarchie statistique.
Au cœur de cet arsenal figure le grand triumvirat analytique : Tukey, Bonferroni et Scheffé. Bien qu’ils partagent le même objectif fondamental — garantir la validité des conclusions multiples —, ils abordent le compromis entre rigueur probabiliste et sensibilité de manière radicalement différente. Tukey a conçu une technique spécialisée dans la comparaison exhaustive par paires de moyennes ; Bonferroni propose une correction universelle dérivée de la théorie des probabilités pures, applicable à tout ensemble de tests d’hypothèses ; Scheffé, quant à lui, a bâti un cadre géométrique généralisant le test F à n’importe quel contraste linéaire, qu’il soit simple ou complexe.
1.3 Objectifs scientifiques de la régulation statistique
La régulation statistique des comparaisons multiples répond à une obligation éthique et scientifique : garantir l’intégrité inférentielle des protocoles expérimentaux. Lorsque les chercheurs multiplient les analyses sur un même jeu de données, ils augmentent artificiellement la probabilité de découvrir un résultat qualifié de « statistiquement significatif » qui ne reflète en réalité que le bruit de mesure. Dans des protocoles comportementaux complexes comprenant des tâches cognitives multiples, des scores psychométriques multidimensionnels et des groupes d’âge variés, la multiplication anarchique des tests d’hypothèses ruine la valeur probante des inférences.
Un autre objectif fondamental de ces méthodes de régulation réside dans l’élimination systématique du cherry-picking (le tri opportuniste des données). Sans un cadre post-hoc standardisé et contraignant, un chercheur peu scrupuleux ou inconscient des pièges stochastiques pourrait être tenté de n’extraire et de ne commenter que la paire de conditions expérimentales affichant une valeur de p brute inférieure à 0,05, en passant sous silence les dizaines d’autres comparaisons non concluantes menées en coulisses. Les corrections post-hoc imposent une pénalité mathématique proportionnelle à la liberté d’exploration prise par l’analyste.
Enfin, le maintien d’une régulation stricte est la condition sine qua non de la reproductibilité scientifique. La psychologie contemporaine a été profondément ébranlée par la prise de conscience que de nombreux effets classiques publiés dans des revues prestigieuses étaient impossibles à répliquer. L’usage indiscriminé de tests statistiques mal contrôlés, couplé à une inflation du taux de faux positifs, a été identifié comme l’une des causes majeures de cette crise. Comprendre et appliquer avec rigueur les méthodes de Tukey, Bonferroni et Scheffé représente ainsi un acte d’assainissement méthodologique indispensable pour quiconque souhaite produire une science pérenne.
2. Le problème de la multiplicité et le taux d’erreur par famille (FWER)
2.1 Mécanisme mathématique de l’inflation de l’erreur de type I
Pour appréhender la nécessité vitale des tests post-hoc, il convient d’analyser la dynamique stochastique qui sous-tend la répétition d’épreuves statistiques indépendantes ou partiellement dépendantes. Lorsque l’on effectue un test d’hypothèse unique, tel qu’un test t de Student pour deux échantillons indépendants, le niveau de risque de première espèce (erreur de type I) est traditionnellement fixé à $\alpha = 0{,}05$. Cela signifie que si l’hypothèse nulle est strictement vraie dans la population, il demeure une probabilité de $5,%$ de la rejeter à tort, attribuant au hasard une différence inexistante. La probabilité de ne pas commettre d’erreur sur ce test isolé est donc le complémentaire, soit $1 – \alpha = 0{,}95$.
Considérons à présent une expérience impliquant $k$ groupes indépendants. Le nombre total de comparaisons par paires deux à deux possibles est donné par la formule combinatoire :
$m = \frac{k(k – 1)}{2}$
Si un chercheur commettait l’hérésie méthodologique d’appliquer $m$ tests t de Student indépendants pour explorer ces paires sans aucun ajustement, la probabilité conjointe de ne commettre aucune erreur de type I sur l’ensemble des $m$ tests (en supposant l’indépendance statistique des comparaisons) chuterait à $(1 – \alpha)^m$. Dès lors, la probabilité d’observer au moins une décision faussement positive parmi l’ensemble des tests — ce que l’on appelle le taux d’erreur global ou par famille — s’élève mathématiquement à :
$\alpha_{\text{global}} = 1 – (1 – \alpha)^m$
Cette relation met en lumière une croissance quasi exponentielle du risque d’erreur au fur et à mesure que le nombre de groupes s’accroît. Prenons l’exemple concret d’une recherche clinique évaluant cinq conditions thérapeutiques ($k = 5$). Le nombre de comparaisons deux à deux s’établit à :
$m = \frac{5 \times 4}{2} = 10\text{ paires}$
En conservant un seuil nominal de $\alpha = 0{,}05$ pour chaque test individuel, le taux d’erreur global s’élève à :
$\alpha_{\text{global}} = 1 – (1 – 0{,}05)^{10} = 1 – (0{,}95)^{10} \approx 1 – 0{,}5987 = 0{,}4013$
Autrement dit, le chercheur a plus de $40,%$ de risque de déclarer à tort au moins une différence significative dans son étude, alors même que l’hypothèse nulle globale serait parfaitement vérifiée. L’accumulation de tests t de Student conventionnels après une ANOVA est une stratégie analytique suicidaire sur le plan inférentiel.
2.2 Définition formelle du Family-Wise Error Rate (FWER)
Pour endiguer ce phénomène d’inflation stochastique, la théorie statistique moderne a formalisé le concept de Family-Wise Error Rate (FWER), ou taux d’erreur par famille de comparaisons. Le FWER se définit comme la probabilité d’affirmer à tort au moins une découverte statistique (commettre au moins une erreur de type I) au sein d’un ensemble prédéfini — une « famille » — de tests d’hypothèses formulés sur le même ensemble de données. Le FWER s’oppose conceptuellement au Per-Comparison Error Rate (PCER), qui correspond simplement au risque d’erreur consenti sur un test pris isolément, indépendamment de tous les autres.
Dans l’évaluation des propriétés d’une procédure statistique, on distingue deux niveaux d’exigence de contrôle du FWER : le contrôle au sens faible (weak control) et le contrôle au sens fort (strong control). Le contrôle au sens faible garantit que le taux d’erreur par famille ne dépasse pas le niveau nominal $\alpha$ uniquement sous l’hypothèse nulle globale absolue, c’est-à-dire dans la configuration où toutes les moyennes de population sans exception sont parfaitement égales. Cependant, ce critère s’avère insuffisant dans la recherche empirique réelle, car il est fréquent qu’une partie des groupes diffère réellement tandis qu’un sous-ensemble demeure invariant.
Le contrôle au sens fort exige que le FWER soit maintenu inférieur ou égal à $\alpha$ quelle que soit la configuration des moyennes sous-jacentes, qu’elles soient toutes égales ou que seules certaines d’entre elles le soient (hypothèses nulles partielles). Les méthodes post-hoc validées par la communauté statistique — au premier rang desquelles figurent Tukey, Bonferroni et Scheffé — assurent toutes un contrôle au sens fort du FWER. Cette garantie mathématique constitue la pierre angulaire de la crédibilité des publications scientifiques, attestant que le dispositif méthodologique ne produit pas d’artefacts statistiques par simple jeu combinatoire.
2.3 Conséquences épistémologiques pour la recherche clinique et cognitive
L’omission de la régulation du FWER engendre des ravages épistémologiques majeurs, en particulier dans les disciplines appliquées telles que la psychologie clinique, la psychiatrie biologique et la neuropsychologie. Dans un essai thérapeutique explorant différents dosages ou variantes d’une psychothérapie face à des groupes témoins, déclarer un effet différentiel significatif sur la base d’un test non ajusté peut conduire à l’homologation ou à la promotion de prises en charge cliniques sans réelle valeur ajoutée. L’impact se mesure ici en termes de coûts financiers pour la santé publique et d’opportunités de soins perdues pour les patients.
Sur le plan fondamental, l’histoire récente des neurosciences cognitives et de la génétique comportementale offre un cas d’école des dangers de la multiplicité non contrôlée. Durant les années 2000, la prolifération d’études d’imagerie par résonance magnétique fonctionnelle (IRMf) identifiant des « activations cérébrales » corrélées à des états mentaux a été violemment remise en question lorsqu’il est apparu que des milliers de voxels étaient testés sans contrôle rigoureux du FWER. L’illustration célèbre du saumon mort placé dans un scanner IRMf, dont les données ont révélé des activations neurales statistiquement significatives lorsqu’aucun correctif n’était appliqué, demeure un avertissement méthodologique durable sur la capacité du hasard à mimer le sens biologique.
Face à ce constat, les comités de lecture des revues internationales de premier rang, telles que le Journal of Personality and Social Psychology, Psychological Science ou NeuroImage, imposent désormais une rigueur éditoriale intransigeante. La soumission de manuscrits rapportant des dizaines de tests t sans procédure explicite de contrôle du taux d’erreur par famille expose désormais les auteurs à un rejet immédiat. La maîtrise des mécanismes de correction n’est plus un raffinement technique optionnel, mais une condition d’éligibilité à la publication scientifique internationale.
3. Le test HSD de Tukey : théorie, principes et cadre d’utilisation
3.1 Fondements mathématiques et loi de l’étendue Studentisée
Conçu par le grand statisticien américain John Tukey au début des années 1950, le test de la différence honnêtement significative (HSD pour Honestly Significant Difference) a été spécifiquement élaboré pour résoudre le problème des comparaisons par paires exhaustives. Tukey a identifié que l’accumulation d’erreurs de type I lors de la comparaison de plusieurs moyennes provenait de la variabilité inhérente à l’écart maximal observé dans un échantillon de moyennes ordonnées. Pour neutraliser ce phénomène, il ne s’est pas appuyé sur la distribution standard du t de Student, mais a fondé sa procédure sur la loi de l’étendue Studentisée (dénommée statistique $q$).
La statistique de l’étendue Studentisée est définie comme le quotient de la différence maximale entre la plus grande et la plus petite moyenne d’un échantillon de $k$ groupes, divisée par l’estimation de l’erreur-type de la moyenne :
$q = \frac{\bar{X}_{\max} – \bar{X}_{\min}}{\sqrt{\frac{MS_{\text{résiduel}}}{n}}}$
où $MS_{\text{résiduel}}$ représente la variance moyenne résiduelle intra-groupes tirée de la table de l’ANOVA (le carré moyen des erreurs), et $n$ la taille des échantillons (supposés ici égaux). La distribution théorique de $q$ dépend non seulement des degrés de liberté de l’erreur ($df_e = N – k$), mais également du nombre total de groupes en compétition ($k$).
À partir de cette distribution, Tukey a établi une formule permettant de calculer un seuil d’écart critique unique, universellement applicable à toutes les différences de paires observées dans l’expérience :
$HSD = q_{\alpha, k, df_e} \times \sqrt{\frac{MS_{\text{résiduel}}}{n}}$
Dans cette formulation, $q_{\alpha, k, df_e}$ représente la valeur critique tabulée de l’étendue Studentisée pour le niveau de risque $\alpha$ choisi. Toute paire de moyennes dont la différence absolue $|\bar{X}_i – \bar{X}_j|$ est strictement supérieure à la valeur critique $HSD$ est déclarée statistiquement significative au niveau global de protection $\alpha$. Le génie de cette méthode réside dans le fait qu’elle module automatiquement l’exigence critique en fonction du nombre total de moyennes dans la famille, garantissant un contrôle rigoureux du FWER pour l’ensemble des comparaisons possibles.
3.2 Conditions d’application et postulats fondamentaux
L’élégance et la précision statistique du test HSD de Tukey reposent sur des postulats paramétriques stricts que l’expérimentateur ne doit pas négliger. La première condition d’application concerne la distribution des résidus : la variable dépendante doit suivre une loi normale au sein de chacune des populations correspondant aux $k$ conditions expérimentales. Si de légères déviations de la normalité sont généralement tolérées lorsque les effectifs sont substantiels grâce au théorème central limite, des asymétries prononcées ou des kurtosis extrêmes peuvent biaiser le calcul de la statistique $q$.
La deuxième condition, absolument fondamentale pour la validité du test de Tukey original, est l’homogénéité des variances ou homoscédasticité ($\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2$). Le calcul de l’erreur-type s’appuie directement sur la mise en commun de la variance résiduelle issue de l’ensemble du dispositif expérimental ($MS_{\text{résiduel}}$). Si cette hypothèse d’homogénéité est violée de manière importante — ce que révèlent des tests préalables comme le test de Levene ou de Brown-Forsythe —, le test HSD standard peut devenir excessivement libéral (taux d’erreur de première espèce incontrôlé) ou artificiellement conservateur, selon la répartition des tailles d’échantillons au sein des variances hétérogènes.
Enfin, le modèle postule l’indépendance stricte des observations et des erreurs de mesure. Les sujets doivent être affectés aux groupes de manière totalement aléatoire et non appariée, sans corrélations spatiales, temporelles ou hiérarchiques non modélisées. Dans sa version originale, le test de Tukey exigeait impérativement des effectifs d’échantillons strictement égaux ($n_1 = n_2 = dots = n_k$). Cette contrainte d’équilibrage a longtemps constitué son principal frein dans les recherches en psychologie de terrain, où les pertes de participants en cours d’expérimentation (attrition) sont courantes.
3.3 Adaptation aux groupes déséquilibrés : le test de Tukey-Kramer
Face à l’omniprésence des plans de recherche comportant des effectifs inégaux en sciences sociales et en psychologie clinique, Clyde Kramer a proposé en 1956 une généralisation mathématique élégante du test de Tukey, désignée sous le nom de procédure de Tukey-Kramer. Cette avancée méthodologique permet d’appliquer la logique de l’étendue Studentisée à des groupes possédant des effectifs distincts ($n_i \neq n_j$), tout en maintenant un contrôle robuste du FWER.
L’adaptation repose sur la substitution de la taille fixe d’échantillon $n$ par la moyenne harmonique des effectifs respectifs des deux groupes comparés. La formulation de l’erreur-type associée à la différence entre les moyennes $i$ et $j$ prend alors la forme suivante :
$SE_{ij} = \sqrt{\frac{MS_{\text{résiduel}}}{2} \left(\frac{1}{n_i} + \frac{1}{n_j}\right)}$
L’écart critique de Tukey-Kramer devient ainsi spécifique à chaque paire de groupes évaluée :
$HSD_{ij} = q_{\alpha, k, df_e} \times \sqrt{\frac{MS_{\text{résiduel}}}{2} \left(\frac{1}{n_i} + \frac{1}{n_j}\right)}$
Des démonstrations analytiques exhaustives, consolidées par Hayter en 1984, ont prouvé que la procédure de Tukey-Kramer est non seulement mathématiquement exacte lorsque les variances sont homogènes, mais qu’elle présente un profil légèrement conservateur lorsque les tailles d’échantillons diffèrent. Cela signifie que le FWER réel demeure toujours inférieur ou égal au seuil nominal $\alpha$. En conséquence, dans les progiciels statistiques contemporains (R, SPSS, JASP), la sélection de l’option « Tukey » déclenche automatiquement l’algorithme de Tukey-Kramer dès que le jeu de données présente un déséquilibre numérique d’échantillonnage, assurant une transition transparente et rigoureuse pour l’utilisateur.
4. La méthode de Bonferroni : rigueur, simplicité et compromis statistique
4.1 Principe de l’inégalité de Boole-Bonferroni
Parmi l’ensemble des méthodes correctives existantes, la procédure de Bonferroni est sans conteste la plus intuitive, la plus célèbre et la plus largement diffusée dans les sciences biomédicales et comportementales. Son fondement ne dérive pas d’une distribution statistique particulière ou de la géométrie de la décomposition de variance, mais d’un axiome élémentaire de la théorie mathématique des probabilités : l’inégalité de Boole-Bonferroni. Cette inégalité postule que pour toute réunion finie d’événements stochastiques aléatoires, la probabilité que l’un d’entre eux se produise est toujours inférieure ou égale à la somme arithmétique de leurs probabilités individuelles :
$P\left(\big\cup_{i=1}^{m} A_i\right) le \sum_{i=1}^{m} P(A_i)$
Transposée au domaine du test d’hypothèses, si nous réalisons une famille de $m$ comparaisons distinctes et que nous attribuons à chaque test un niveau d’erreur individuel noté $\alpha_{\text{PCER}}$, la probabilité de commettre au moins une erreur de type I sur l’ensemble de la famille ($FWER$) ne peut jamais excéder la somme des risques individuels :
$FWER le \sum_{i=1}^{m} \alpha_{\text{PCER}} = m \times \alpha_{\text{PCER}}$
Dès lors, pour garantir de manière absolue que le FWER ne franchisse jamais le seuil global cible $\alpha_{\text{FWER}}$ (par exemple 0,05), il suffit d’imposer à chaque comparaison individuelle un seuil de décision ajusté, extrêmement sévère :
$\alpha_{\text{ajusté}} = \frac{\alpha_{\text{FWER}}}{m}$
Dans la pratique moderne, plutôt que de fractionner le seuil alpha nominal, les analystes préfèrent multiplier directement la valeur de p brute observée par le nombre total de comparaisons effectuées ($p_{\text{ajusté}} = p_{\text{brute}} \times m$), en bornant mathématiquement le résultat obtenu à 1,0. L’attrait fondamental de la méthode de Bonferroni réside dans son universalité totale : elle s’applique à des tests t, des régressions, des corrélations de Pearson, des tests non paramétriques de Wilcoxon ou des tables de contingence de Wilcoxon, sans requérir aucune hypothèse sur la nature du plan expérimental sous-jacent.
4.2 Le coût méthodologique : l’effondrement de la puissance statistique
Cette universalité conceptuelle et cette élégante simplicité arithmétique se paient toutefois au prix fort : un effondrement dramatique de la puissance statistique ($1 – \beta$). L’inégalité de Boole constitue une borne supérieure pessimiste. En considérant le pire des scénarios probabilistes, Bonferroni traite les différents tests comme s’ils étaient entièrement disjoints ou mutuellement exclusifs, ce qui est rarement le cas dans la réalité expérimentale. Dans un plan expérimental à mesures multiples, les données sont hautement corrélées entre elles ; les comparaisons partagent des groupes et des variances communes.
Cette sur-correction systématique entraîne une inflation monumentale de l’erreur de type II ($\beta$) : la probabilité d’échouer à rejeter une hypothèse nulle pourtant fausse augmente de manière exponentielle. Dès que le nombre de comparaisons $m$ devient modérément élevé, le seuil critique chute à des niveaux infinitésimaux. Par exemple, dans une étude clinique à six groupes explorant l’ensemble des 15 paires possibles, le seuil de décision passe de $\alpha = 0{,}05$ à :
$\alpha_{\text{ajusté}} = \frac{0{,}05}{15} \approx 0{,}00333$
À ce niveau de sévérité, des effets thérapeutiques d’amplitude modérée mais cliniquement significatifs sont systématiquement rejetés comme « non significatifs », condamnant des recherches de grande valeur au néant éditorial.
En psychologie expérimentale et cognitive, où la taille des effets réels est souvent petite à moyenne (estimée fréquemment entre $d = 0{,}3$ et $d = 0{,}6$ selon les conventions de Jacob Cohen), la pénalité de Bonferroni est fréquemment léthale pour la détection empirique. L’utilisation indiscriminée de cette méthode pour des analyses exploratoires étendues dénature l’esprit de la recherche scientifique, transformant la prudence légitime en un aveuglement méthodologique.
4.3 Variantes modernes et améliorations séquentielles
Conscients de l’extrême conservatisme de l’ajustement standard de Bonferroni, les théoriciens de la statistique ont développé des procédures séquentielles capables d’optimiser le gain de puissance tout en conservant un contrôle rigoureux du FWER au sens fort. La plus célèbre et la plus efficiente de ces innovations est sans conteste la procédure de Holm-Bonferroni (proposée par Sture Holm en 1979), qui repose sur un algorithme descendant (step-down).
La procédure de Holm fonctionne selon une logique de hiérarchisation progressive :
- Les $m$ valeurs de p brutes obtenues sont ordonnées par ordre croissant : $p_{(1)} le p_{(2)} le dots le p_{(m)}$.
- Chaque valeur de p est comparée séquentiellement à un seuil critique adaptatif : $\frac{\alpha}{m – i + 1}$, où $i$ représente le rang de la comparaison.
- La plus petite valeur de p ($p_{(1)}$) est testée contre $\frac{\alpha}{m}$, exactement comme dans la méthode de Bonferroni classique.
- Si le test est significatif, le processus se poursuit : $p_{(2)}$ est évaluée face à un seuil légèrement plus permissif : $\frac{\alpha}{m – 1}$.
- L’algorithme progresse de manière dynamique jusqu’à ce qu’une valeur de p échoue à franchir le seuil critique correspondant, interrompant instantanément la séquence et déclarant non significatives toutes les comparaisons restantes.
Une autre variante reconnue est la procédure de Hochberg (1988), qui adopte un mécanisme ascendant (step-up). Cette approche évalue les valeurs de p en partant de la plus grande ($p_{(m)}$) pour descendre vers la plus petite. Bien qu’elle requière des conditions d’indépendance ou de corrélation positive plus contraignantes (connues sous le nom de condition PRDS pour Positive Regression Dependency on Subsets), elle surpasse la procédure de Holm en matière de puissance statistique. Ces améliorations séquentielles rendent l’usage de la formule brute de Bonferroni techniquement obsolète dans les analyses complexes, bien qu’elle demeure un étalon de référence pédagogique.
5. La méthode de Scheffé : polyvalence et analyse des contrastes complexes
5.1 Fondement théorique basé sur la distribution F
Élaborée par Henry Scheffé en 1953, la méthode de Scheffé occupe une place unique et prestigieuse dans le paysage de l’inférence statistique. Contrairement aux approches de Tukey et de Bonferroni qui ont été pensées principalement pour un ensemble dénombrable et fermé de comparaisons deux à deux, Scheffé s’est fixé un objectif théorique plus ambitieux : fournir une procédure d’intervalle de confiance simultané capable de contrôler le taux d’erreur de première espèce pour une infinité potentielle de contrastes linéaires possibles au sein d’un modèle d’ANOVA.
Le fondement mathématique de Scheffé découle directement de la distribution $F$ de Fisher-Snedecor. Scheffé a démontré que la borne d’erreur globale d’un ensemble de contrastes est géométriquement isomorphe à l’ellipsoïde de confiance entourant le vecteur complet des moyennes de population dans un espace vectoriel à $k$ dimensions. En conséquence, la valeur critique d’un contraste de Scheffé ne fait appel ni à la statistique $q$ ni à une division arithmétique arbitraire de $\alpha$, mais à une transformation directe du seuil critique omnibus du test $F$ :
$S = \sqrt{(k – 1) \times F_{\alpha, k-1, df_e}}$
Pour évaluer si un contraste empirique $\hat{L}$ est statistiquement significatif, la statistique calculée — qui peut être exprimée sous forme d’un ratio F de contraste ($F_{\text{contraste}} = \frac{MS_{\text{contraste}}}{MS_{\text{résiduel}}}$) ou d’une statistique $t$ de contraste — est confrontée à cette limite critique élargie.
La conséquence mathématique de cette dérivation est d’une portée théorique considérable : la méthode de Scheffé garantit que le risque de commettre au moins une erreur de type I ne dépassera jamais $\alpha$, même si le chercheur formulait des centaines de contrastes différents après avoir scruté ses données sous tous les angles. Cette universalité absolue a une contrepartie inévitable : le test de Scheffé est la procédure la plus conservatrice de toute la statistique paramétrique post-hoc.
5.2 Exploration des contrastes linéaires simples et complexes
Pour comprendre la suprématie technique de Scheffé dans certains contextes de recherche, il est nécessaire de formaliser le concept de contraste linéaire. Un contraste $L$ sur un ensemble de $k$ moyennes de populations est une combinaison linéaire définie par l’équation :
$L = \sum_{i=1}^{k} c_i \mu_i$
avec la contrainte mathématique absolue que la somme des coefficients de pondération soit rigoureusement nulle :
$\sum_{i=1}^{k} c_i = 0$
On distingue deux grandes familles de contrastes :
- Les contrastes simples (ou par paires) : Ils ne comparent que deux moyennes isolées, en attribuant les coefficients $c_1 = 1$, $c_2 = -1$ et $c_i = 0$ pour tous les autres groupes.
- Les contrastes complexes : Ils opposent des sous-ensembles combinés ou des moyennes pondérées de plusieurs groupes. Par exemple, comparer la moyenne combinée de deux nouvelles molécules psychopharmacologiques ($c_1 = +0{,}5$, $c_2 = +0{,}5$) face à un groupe témoin recevant un traitement de référence ($c_3 = -1{,}0$).
Les tests de Tukey et de Bonferroni sont intrinsèquement limités face à cette richesse analytique. Tukey est strictement structuré pour évaluer des contrastes simples du type $\mu_i – \mu_j$. Quant à Bonferroni, s’il peut évaluer un contraste complexe, il exige que ce contraste ait été formulé avant l’analyse et consomme une part précieuse du quota d’erreurs. Scheffé, en revanche, offre une liberté absolue : le chercheur peut explorer n’importe quelle moyenne composite imaginée a posteriori, tout en restant protégé par la garantie mathématique que le seuil critique $S$ ne sera jamais transgressé par une fluctuation aléatoire.
5.3 Robustesse intrinsèque aux violations méthodologiques
Au-delà de son universalité géométrique, la méthode de Scheffé brille par une robustesse statistique exceptionnelle, largement documentée dans la littérature spécialisée. Alors que la loi de l’étendue Studentisée de Tukey repose sur l’hypothèse de l’homoscédasticité et nécessite des correctifs en cas d’effectifs inégaux, la méthode de Scheffé intègre nativement les déséquilibres d’échantillonnage les plus extrêmes sans que ses propriétés fondamentales ne soient dénaturées.
La formulation de la variance d’un contraste empirique chez Scheffé s’adapte directement aux effectifs réels de chaque condition :
$\hat{\sigma}^2_{\hat{L}} = MS_{\text{résiduel}} \times \sum_{i=1}^{k} \frac{c_i^2}{n_i}$
Cette propriété rend Scheffé insensible aux asymétries numériques qui surviennent inévitablement dans les études épidémiologiques, les recherches cliniques multicentriques ou les collectes de données sur populations rares.
De surcroît, la méthode fait preuve d’une tolérance remarquable aux violations modérées de l’hypothèse d’homogénéité des variances, en particulier lorsque les plans ne sont que modérément déséquilibrés. Cette résilience provient de son ancrage direct dans le cadre du modèle linéaire généralisé et de la théorie des formes quadratiques associées au test F. Dans des conditions où les postulats d’application de Tukey deviennent intenables, Scheffé constitue une forteresse méthodologique, offrant une sécurité inférentielle inégalée pour tout résultat franchissant son exigeante barrière de signification.
6. Comparaison directe : Tukey versus Bonferroni
6.1 Performances lors de comparaisons par paires exhaustives
L’affrontement méthodologique le plus classique en analyse de données oppose le test HSD de Tukey à la procédure de correction de Bonferroni lorsqu’il s’agit d’évaluer l’ensemble exhaustif des comparaisons deux à deux issues d’une ANOVA unidirectionnelle. Bien que les deux approches contrôlent le FWER au sens fort, leurs performances analytiques et leur puissance statistique se séparent nettement au profit de Tukey.
Le test de Tukey est optimal par conception pour la matrice intégrale des paires. Parce qu’il modélise la corrélation interne inhérente aux différences de moyennes ordonnées par l’intermédiaire de l’étendue Studentisée, il extrait l’intégralité de l’information structurelle disponible. À l’inverse, l’ajustement de Bonferroni applique une réduction linéaire aveugle ($\alpha / m$) qui ignore délibérément les interdépendances entre les paires. Dès lors que le nombre de groupes $k$ dépasse la valeur charnière de trois, l’écart de puissance s’accentue drastiquement :
- À $k = 3$ ($m = 3$ paires), les seuils de rejet de Tukey et de Bonferroni sont quasiment identiques, Bonferroni étant parfois très légèrement plus conservateur.
- À $k = 4$ ($m = 6$ paires), Tukey surpasse Bonferroni de façon systématique, affichant des intervalles de confiance plus étroits.
- À $k ge 5$ ($m ge 10$ paires), Bonferroni plonge dans une sur-correction marquée. Les intervalles de confiance calculés par Bonferroni deviennent sensiblement plus larges que ceux générés par Tukey, induisant une perte massive de sensibilité statistique.
Pour tout chercheur en psychologie expérimentale manipulant un plan factoriel équilibré ou modérément déséquilibré avec un nombre substantiel de conditions, le test de Tukey constitue incontestablement le choix par excellence pour examiner l’ensemble des paires de moyennes. Choisir Bonferroni dans ce contexte précis relève d’une erreur d’appréciation méthodologique qui pénalise injustement la recherche en dissimulant de véritables effets réels.
6.2 Scénarios où Bonferroni conserve un avantage décisif
Ce tableau comparatif ne signifie nullement que la méthode de Bonferroni doive être écartée du champ expérimental. Son architecture probabiliste lui confère un avantage concurrentiel décisif dans des scénarios méthodologiques où le test de Tukey s’avère totalement inadapté ou sous-performant. Le domaine d’élection de Bonferroni est celui des sous-ensembles restreints de comparaisons pré-spécifiées.
Considérons une étude clinique évaluant huit dosages différents d’un anxiolytique face à une condition placebo unique ($k = 9$ groupes). Si le protocole n’a aucun intérêt théorique à comparer les dosages entre eux (ce qui représenterait 28 comparaisons inutiles), mais s’intéresse uniquement à la comparaison de chaque dose contre le placebo, le nombre de comparaisons effectives se réduit à $m = 8$. Dans ce scénario précis :
- Le test de Tukey calibrerait son étendue critique sur la totalité des $\frac{9 \times 8}{2} = 36$ comparaisons potentielles, infligeant une pénalité disproportionnée.
- Bonferroni, quant à lui, ajustera son niveau de décision uniquement sur les $m = 8$ tests réellement exécutés ($\alpha / 8 = 0{,}00625$), ignorant souverainement les 28 comparaisons non réalisées.
Dans ce cadre analytique, la puissance de Bonferroni dépasse largement celle de Tukey. De surcroît, Bonferroni bénéficie d’une simplicité de mise en œuvre et d’une clarté de communication universelle. Tout lecteur d’une revue scientifique, même néophyte en modélisation avancée, comprend instantanément qu’une valeur de $p$ brute de $0{,}004$ multipliée par 8 tests donne une valeur ajustée de $0{,}032$, validant formellement l’effet sous le seuil canonique de $0{,}05$.
6.3 Étude de cas simulée : protocole de mémorisation à quatre conditions
Pour illustrer de manière transparente les divergences opérationnelles entre Tukey et Bonferroni, examinons une étude empirique fictive en psychologie de la mémoire humaine. Un chercheur évalue le rappel libre d’une liste de 30 mots sous quatre conditions d’encodage distinctes, avec $n = 20$ participants par groupe ($N = 80$) :
- Groupe 1 : Contrôle (lecture passive)
- Groupe 2 : Répétition subvocalique
- Groupe 3 : Imagerie mentale visuelle
- Groupe 4 : Encodage sémantique approfondi
L’ANOVA à un facteur produit un carré moyen résiduel de $MS_{\text{résiduel}} = 16{,}0$ avec $df_e = 76$. Les moyennes obtenues sont respectivement de : $\bar{X}_1 = 12{,}0$, $\bar{X}_2 = 14{,}5$, $\bar{X}_3 = 17{,}8$, et $\bar{X}_4 = 19{,}2$. L’erreur-type standard de la différence entre deux moyennes s’établit à :
$SE = \sqrt{16{,}0 \times \left(\frac{1}{20} + \frac{1}{20}\right)} = \sqrt{1{,}6} \approx 1{,}265$
Analysons la comparaison critique entre le Groupe 2 (Répétition, $\bar{X}_2 = 14{,}5$) et le Groupe 3 (Imagerie, $\bar{X}_3 = 17{,}8$), dont la différence observée est de $\Delta = 3{,}30$ mots. Le ratio de Student empirique s’élève à :
$t = \frac{3{,}30}{1{,}265} \approx 2{,}609$
La valeur de p bilatérale brute non ajustée associée à ce résultat (avec 76 degrés de liberté) est d’environ $p_{\text{brute}} = 0{,}0109$.
Appliquons désormais les deux protocoles de correction sur la totalité des $m = 6$ comparaisons par paires du plan :
- Ajustement de Bonferroni : La valeur de p ajustée s’obtient par : $p_{\text{Bonferroni}} = 0{,}0109 \times 6 = 0{,}0654$. La valeur de $p$ dépassant $0{,}05$, l’expérimentateur est contraint de déclarer la différence non statistiquement significative. Il doit conclure à l’incapacité de démontrer la supériorité de l’imagerie mentale sur la répétition simple.
- Test HSD de Tukey : La statistique d’étendue Studentisée observée est calculée par : $q = t \times \sqrt{2} = 2{,}609 \times 1{,}4142 \approx 3{,}69$. Pour $k = 4$ et $df_e = 76$, la valeur critique au seuil $\alpha = 0{,}05$ est approximativement de $q_{\text{crit}} = 3{,}70$. Une estimation polynomiale plus exacte de la distribution de Tukey produit une valeur de $p$ ajustée de $p_{\text{Tukey}} = 0{,}0462$.
La différence est flagrante : là où l’extrême sévérité de Bonferroni rejette le résultat dans le domaine du non-significatif ($p = 0{,}065$), le test HSD de Tukey permet au chercheur de franchir légitimement le seuil de décision ($p = 0{,}046$) et de conclure à la supériorité de la stratégie d’imagerie. Cet exemple démontre concrètement l’impact direct du choix statistique sur la découverte empirique.
7. Comparaison directe : Tukey versus Scheffé
7.1 Le dilemme des comparaisons de paires simples
Lorsque le protocole d’analyse est dédié aux comparaisons simples par paires de moyennes, confronter le test HSD de Tukey à la méthode de Scheffé tourne invariablement à l’avantage du premier. Il s’agit d’une règle d’or de la méthodologie statistique : il ne faut jamais employer la méthode de Scheffé pour tester de simples comparaisons par paires.
La raison de cette supériorité structurelle de Tukey tient à l’asymétrie de leurs ambitions probabilistes respectives. Le test de Tukey a été conçu et étalonné pour protéger l’analyste contre l’erreur de première espèce au sein du périmètre circonscrit des paires de moyennes. En revanche, le multiplicateur de Scheffé ($S = \sqrt{(k-1)F}$) a été conçu pour couvrir un espace infini de combinaisons multidimensionnelles. En appliquant Scheffé à une simple paire de moyennes, l’analyste fait supporter à sa comparaison élémentaire le coût probabiliste de milliers de contrastes complexes potentiels qu’il ne réalisera pourtant jamais.
Le résultat pratique est une perte colossale de puissance statistique. Les intervalles de confiance générés par la procédure de Scheffé sur les paires de moyennes sont remarquablement plus larges que ceux produits par Tukey. Dans des configurations à cinq, six ou huit conditions, il est très fréquent que des différences par paires hautement significatives sous Tukey ($p < 0{,}01$) deviennent marginales voire non significatives avec Scheffé. Recourir à Scheffé pour des paires simples sous prétexte de « prudence » ne relève pas de la bonne science, mais d'une pénalisation excessive de l'échantillon.
7.2 Gestion des hypothèses complexes et analyses exploratoires
La hiérarchie des performances s’inverse totalement dès lors que l’analyste s’émancipe de la simple opposition de deux moyennes pour aborder le domaine des contrastes complexes non planifiés. Dans cette arène spécifique, le test HSD de Tukey devient méthodologiquement inopérant. Par construction géométrique, Tukey ne sait évaluer que des différences d’amplitudes uniques entre deux éléments scalaires individuels. Tenter de tester des moyennes composites ou des contrastes d’interaction avec la statistique $q$ de Tukey constitue une erreur théorique majeure.
C’est ici que la méthode de Scheffé démontre sa suprématie. Elle s’impose comme l’unique outil de la statistique inférentielle classique autorisant le « minage de données post-hoc » (post-hoc data mining) sur les contrastes sans encourir l’accusation de manipulation statistique. Imaginons un chercheur en psychologie du travail observant, après clôture de la collecte des données, que les deux groupes soumis à des horaires flexibles combinés à du télétravail semblent présenter des niveaux d’épuisement professionnel radicalement plus bas que la moyenne conjointe des trois groupes en présentiel rigide.
Cette observation n’ayant fait l’objet d’aucune hypothèse a priori, la formuler et la tester rétrospectivement à l’aide d’un test t ordinaire constituerait un biais méthodologique sévère (HARKing : Hypothesizing After the Results are Known). En appliquant la procédure de Scheffé, le chercheur neutralise instantanément ce biais : le modèle est précisément calibré pour tolérer la formulation opportuniste d’hypothèses complexes suggérées par l’inspection visuelle des données, garantissant aux pairs et à la communauté scientifique une étanchéité méthodologique absolue.
7.3 Conséquences pratiques pour les plans de recherche en neurosciences
Dans les plans expérimentaux de neurosciences cognitives, d’électrophysiologie (EEG) et de neuropsychologie clinique, la confrontation entre Tukey et Scheffé est quotidienne. Les chercheurs travaillent régulièrement avec des paradigmes factoriels complexes combinant plusieurs états de vigilance, types de stimulations sensorielles et groupes de patients lésionnels ou témoins. L’arbitrage entre flexibilité d’analyse et sensibilité de détection y est particulièrement prégnant.
Dans un protocole étudiant les potentiels évoqués cognitifs (comme l’onde P300), le chercheur peut souhaiter évaluer si l’amplitude moyenne de l’onde chez les sujets sains diffère de celle de trois groupes cliniques distincts (par exemple : schizophrénie, trouble bipolaire et dépression majeure). Si l’investigateur cherche à savoir si le sous-ensemble « schizophrénie + bipolaire » diffère du groupe « dépression », il manipule un contraste complexe :
$L = (+0{,}5) \mu_{\text{schizo}} + (+0{,}5) \mu_{\text{bipol}} – (1{,}0) \mu_{\text{dépression}} + (0) \mu_{\text{témoin}}$
Pour cette démarche analytique, Scheffé s’impose comme le cadre normatif incontournable. En revanche, si le projet de recherche vise exclusivement à comparer de manière unitaire les performances des patients lésionnels frontaux, temporaux et pariétaux face à un groupe témoin sur une tâche de mémoire de travail, le test HSD de Tukey (ou Tukey-Kramer) reste la méthode de référence, assurant la préservation de la puissance de détection indispensable face aux effectifs cliniques réduits.
8. Comparaison directe : Bonferroni versus Scheffé
8.1 Le seuil critique de bascule du nombre de comparaisons
L’arbitrage entre la procédure de Bonferroni et la méthode de Scheffé repose sur une propriété mathématique objective et élégante : le croisement des seuils critiques en fonction du volume de contrastes formulés. Parce que Bonferroni applique une pénalité linéaire directement indexée sur le nombre de tests $m$ ($\alpha / m$), son niveau de sévérité augmente sans aucune limite structurelle. En revanche, le seuil critique de Scheffé ($S$) est invariant : il est définitivement fixé par le nombre de groupes $k$ et les degrés de liberté résiduels, indépendamment du nombre de contrastes exécutés.
Il existe par conséquent un seuil de bascule mathématique précis :
- Lorsque le nombre de contrastes envisagés ($m$) est inférieur ou égal au nombre de degrés de liberté factoriels ($k – 1$), la méthode de Bonferroni est systématiquement plus puissante et moins conservatrice que la méthode de Scheffé.
- Lorsque le nombre de contrastes commence à excéder $k – 1$ et s’accroît modérément, Bonferroni demeure généralement supérieur pour les petits nombres d’analyses.
- Dès que le nombre de contrastes devient très grand ($m gg k$), la pénalité linéaire de Bonferroni devient prohibitive. La courbe de puissance de Bonferroni s’effondre alors sous celle de Scheffé. À ce point de bascule, Scheffé devient plus puissant et plus libéral que Bonferroni.
Cette dynamique stochastique fournit une directive claire à l’expérimentateur : si l’analyse post-hoc porte sur un sous-ensemble étroit de contrastes sélectionnés, la correction de Bonferroni (ou sa version optimisée de Holm) surpasse méthodologiquement la méthode de Scheffé. À l’inverse, dès lors qu’un protocole exploratoire engage une avalanche de contrastes combinés, Scheffé reprend l’ascendant statistique.
8.2 Flexibilité des contrastes : hypothèses préétablies vs découverte fortuite
Au-delà de la pure arithmétique des seuils, la ligne de partage entre Bonferroni et Scheffé est d’ordre épistémologique : elle réside dans la chronologie intellectuelle reliant la conceptualisation des hypothèses à l’observation des données empiriques. L’ajustement de Bonferroni est intrinsèquement dépendant d’un dénombrement strict et exhaustif des tests menés. Pour que la garantie mathématique du FWER soit valide sous Bonferroni, la liste des $m$ comparaisons doit impérativement être fixée avant de scruter la table des moyennes.
Si un analyste consulte ses résultats, repère une configuration inattendue de moyennes, puis décide de calculer un ajustement de Bonferroni en affirmant qu’il ne réalise qu’« une seule comparaison » ($m = 1$), son raisonnement est biaisé. Il ignore en effet que son cerveau a silencieusement scanné toutes les autres combinaisons pour ne retenir que la plus saillante. L’inégalité de Boole est alors violée, car le véritable $m$ correspond à l’ensemble des régularités possibles que l’œil humain aurait pu repérer.
La méthode de Scheffé résout définitivement cette ambiguïté éthique et méthodologique. En calibrant son seuil de protection sur le supremum de l’ensemble des contrastes de l’espace vectoriel, Scheffé confère à l’investigateur une immunité inférentielle totale face à la sérendipité. Découvrir une anomalie distributionnelle stupéfiante au fin fond d’un jeu de données complexe, formuler le contraste ad hoc correspondant et démontrer qu’il franchit le seuil $S$ de Scheffé apporte une preuve empirique inattaquable par les pairs.
8.3 Synthèse tabulaire des propriétés mathématiques
Afin de structurer la comparaison des trois procédures post-hoc fondamentales, le tableau analytique ci-dessous synthétise leurs spécifications structurelles, leurs distributions de référence, leurs champs d’application préférentiels et leurs compromis opérationnels :
| Propriété / Paramètre | Tukey (HSD / Tukey-Kramer) | Bonferroni (standard) | Scheffé |
|---|---|---|---|
| Statistique de base | Étendue Studentisée ($q$) | Student ($t$) ou Fisher ($F$) standard | Rapport de Fisher-Snedecor ($F$) |
| Seuil ou ajustement critique | Valeur critique tabulée $q_{\alpha, k, df_e}$ | Multiplication de la valeur p : $p \times m$ | $S = \sqrt{(k – 1) \times F_{\alpha, k-1, df_e}}$ |
| Type d’hypothèses cibles | Comparaisons simples deux à deux | Toutes comparaisons (paires ou complexes) | Contrastes simples et complexes infinis |
| Chronologie d’analyse | Post-hoc exploratoire exhaustif | Préétablie / nombre fermé $m$ | Exploratoire complet ou data mining |
| Niveau de conservatisme | Parfaitement équilibré pour les paires | Très sévère dès que $m$ est élevé | Le plus conservateur de tous les tests |
| Sensibilité aux violations | Vulnérable à l’hétéroscédasticité | Dépend du test de base sous-jacent | Exceptionnellement robuste |
| Performance optimale | Matrice complète des paires | Nombre très restreint de tests ($m le 4$) | Contrastes complexes multi-groupes |
9. Gestion des violations d’hypothèses et robustesse pratique
9.1 Conséquences de l’hétéroscédasticité sur les trois tests
L’analyse statistique appliquée se déroule rarement dans les conditions idéales prescrites par la théorie des manuels scolaires. L’une des menaces les plus fréquentes qui pèse sur la validité des tests post-hoc réside dans la violation de l’hypothèse d’homogénéité des variances intra-groupes (l’hétéroscédasticité). Lorsque les variances des populations sources ($\sigma_i^2$) présentent des écarts marqués — situation récurrente en psychopathologie, où un groupe clinique présente presque systématiquement une variabilité comportementale accrue comparativement à des sujets contrôles homogènes —, les propriétés de contrôle du FWER sont compromises.
Le test HSD de Tukey standard se révèle particulièrement vulnérable face à cette violation. Dès lors que l’hétéroscédasticité est couplée à un déséquilibre d’effectifs, deux dérives inférentielles majeures peuvent survenir :
- Si les plus petits échantillons sont associés aux plus fortes variances, le test de Tukey devient dramatiquement libéral, voyant son FWER réel grimper à 15 ou $20,%$, générant de faux positifs à la chaîne.
- À l’inverse, si les grands échantillons abritent les plus grandes variances, le test s’enferme dans un conservatisme excessif, annihilant sa puissance.
La correction standard de Bonferroni partage rigoureusement la même vulnérabilité si elle est appliquée sur des tests t classiques supposant l’égalité des variances. Cependant, Bonferroni offre une souplesse que Tukey ne possède pas nativement : le chercheur peut appliquer l’ajustement de Bonferroni sur une série de tests t de Welch (qui n’assument pas l’homogénéité des variances). Enfin, la méthode de Scheffé manifeste la plus grande résistance relative parmi les procédures classiques, même si une hétéroscédasticité sévère finit également par en altérer le calibrage asymptotique.
Lorsque le test de Levene rejette sans équivoque l’égalité des variances, le praticien rigoureux doit délaisser les procédures traditionnelles pour se tourner vers des alternatives robustes dédiées, au premier rang desquelles figure le test de Games-Howell. Cette procédure combine la logique de l’étendue Studentisée de Tukey avec l’approximation des degrés de liberté de Welch-Satterthwaite et le calcul séparé des variances d’échantillons, fournissant une protection adéquate sans exiger l’homoscédasticité.
9.2 Impact des tailles d’échantillons très déséquilibrées
Le déséquilibre des tailles d’échantillons constitue la seconde grande source de distorsion empirique en psychologie et sciences de la santé. Ce déséquilibre résulte le plus souvent de contraintes de recrutement de patients, de l’attrition longitudinale ou de plans d’échantillonnage stratifiés non proportionnels. La statistique d’étendue Studentisée de Tukey d’origine, ayant été déduite sous l’hypothèse d’un effectif d’échantillon unique $n$, s’effondre en cas d’asymétrie numérique notable.
Bien que l’adaptation de Tukey-Kramer résolve remarquablement cette contrainte pour des déséquilibres modérés (par exemple, un rapport de 1 à 1,5 entre le plus petit et le plus grand groupe), son comportement aux limites peut susciter des réserves méthodologiques lorsque les disparités deviennent massives (par exemple, $n_1 = 150$ versus $n_2 = 15$). Dans de telles configurations, l’erreur-type calculée par la moyenne harmonique est disproportionnellement tirée vers le bas par l’échantillon le plus restreint, augmentant le risque d’estimations instables.
La procédure de Scheffé gère nativement et sans aucune approximation les déséquilibres d’effectifs, car la pondération analytique de chaque variance individuelle $\frac{c_i^2}{n_i}$ est directement intégrée dans la projection du contraste. L’estimation linéaire conserve ainsi ses propriétés de BLUE (Best Linear Unbiased Estimator), garantissant une sécurité analytique optimale. Quant à Bonferroni, son comportement dépend de la formule de variance employée dans le test t sous-jacent : si le chercheur utilise la formulation adéquate pour échantillons inégaux, l’inégalité de Boole conserve son intégrité formelle.
9.3 Non-normalité et distribution des scores psychométriques
Les données psychométriques issues de questionnaires, d’échelles de Likert, de temps de réaction en millisecondes ou de mesures d’erreurs commises présentent souvent des déviations notables par rapport à la distribution normale théorique (asymétrie positive prononcée, effets de plancher ou de plafond, distributions bimodales). La résilience des tests post-hoc face à ces déviations constitue un enjeu pratique majeur.
En vertu du théorème central limite (TCL), dès que les effectifs atteignent des tailles raisonnables ($n_i ge 25$ à 30 individus par groupe), la distribution d’échantillonnage des moyennes converge de manière satisfaisante vers la normalité, conférant aux tests de Tukey, Bonferroni et Scheffé une tolérance opérationnelle satisfaisante. Toutefois, en présence d’échantillons restreints ($n < 15$) affichant de fortes asymétries, les valeurs de p rapportées peuvent être profondément biaisées.
Face à des données réfractaires à toute transformation mathématique conventionnelle (logarithmique, racine carrée, Box-Cox), l’analyste moderne se tournera avantageusement vers les méthodes de rééchantillonnage par bootstrapping. En générant empiriquement des milliers de sous-échantillons avec remise à partir du jeu de données expérimental, le bootstrap permet d’estimer des intervalles de confiance ajustés pour les différences de Tukey, de Bonferroni ou de Scheffé sans formuler aucun postulat sur la loi distributionnelle parente. Cette stratégie d’analyse robuste s’impose de plus en plus comme le standard d’excellence dans la littérature psychologique contemporaine.
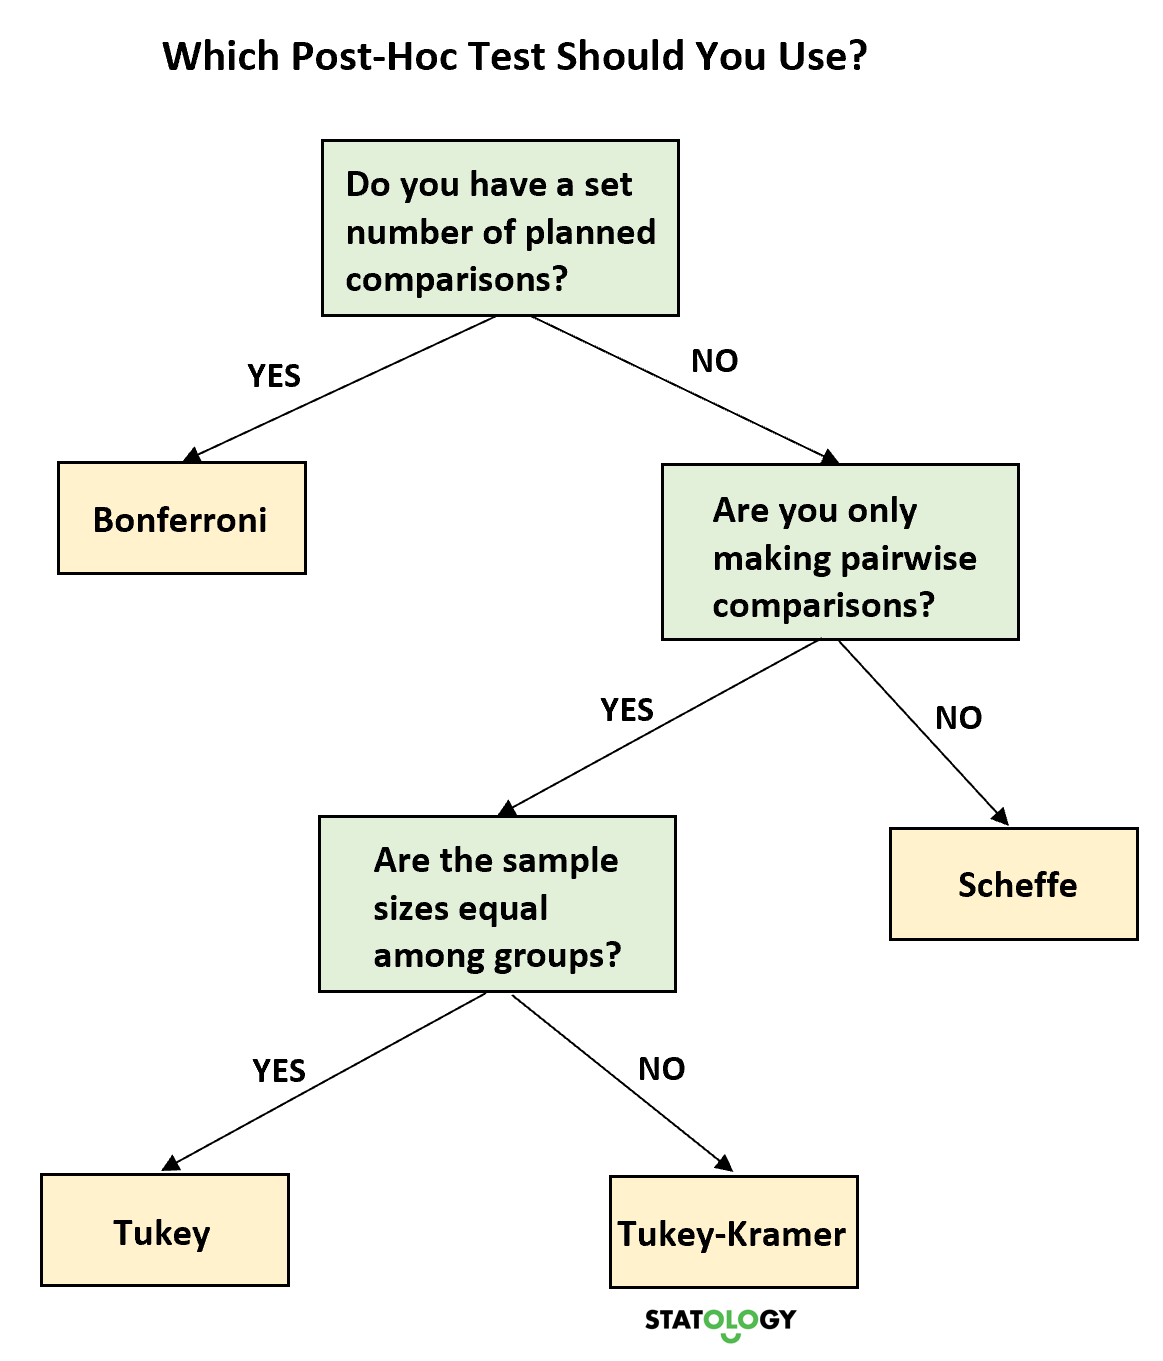
10. Arbre décisionnel : critères de sélection selon le protocole
10.1 Critère 1 : Nature des comparaisons (paires simples vs contrastes complexes)
Pour guider le chercheur à travers le dédale des choix méthodologiques, l’élaboration d’un arbre décisionnel s’impose. Le premier filtre analytique, éliminatoire et structurel, concerne la nature géométrique et conceptuelle des comparaisons que l’on envisage de mener sur le jeu de données.
La question liminaire que doit se poser tout analyste est la suivante : mon plan de recherche implique-t-il exclusivement l’évaluation de paires de moyennes individuelles ($\mu_i$ versus $\mu_j$), ou requiert-il d’évaluer des regroupements factoriels et des combinaisons linéaires complexes ($\frac{\mu_1 + \mu_2}{2}$ versus $\mu_3$) ?
- Si l’investigation intègre ne serait-ce qu’un seul contraste complexe linéaire a posteriori, le test de Tukey est strictement disqualifié. L’analyste se trouve alors orienté de manière quasi exclusive vers la méthode de Scheffé, ou vers Bonferroni si le contraste complexe était planifié a priori.
- Si le protocole est strictement borné à la comparaison unitaire de paires simples de moyennes, les trois méthodes demeurent en lice, et le choix sera arbitré par le volume de comparaisons et la structure des variances.
10.2 Critère 2 : Nombre de comparaisons envisagées
Le deuxième filtre décisionnel se concentre sur l’exhaustivité des comparaisons au sein du protocole d’analyse. Deux orientations fondamentales se dessinent :
- Le chercheur souhaite explorer la matrice intégrale des paires deux à deux : Toutes les combinaisons de groupes doivent être passées au crible empirique de manière exploratoire ou exhaustive. Dans cette configuration, le test HSD de Tukey (ou Tukey-Kramer) s’impose comme le choix méthodologique optimal. Il surpasse sans équivoque Bonferroni en matière de puissance statistique et préserve l’analyste du conservatisme excessif de Scheffé.
- Le chercheur cible un sous-ensemble étroit et restreint de comparaisons : L’intérêt expérimental se limite à confronter quelques groupes cibles à un contrôle, ou à évaluer uniquement 2 ou 3 paires cliniquement pertinentes parmi les 10 ou 15 possibles. Dans ce cadre précis, la méthode de Bonferroni (idéalement déployée sous sa forme séquentielle de Holm) devient largement supérieure à Tukey et à Scheffé, sa pénalité ciblée restant dérisoire face à la pénalisation globale des autres méthodes.
10.3 Critère 3 : Caractéristiques de l’échantillonnage et structure des données
Le troisième et dernier niveau d’arbitrage intègre les contraintes concrètes pesant sur la structure distributionnelle des données : homogénéité des variances et équilibrage des tailles d’échantillons.
- Variances homogènes et groupes équilibrés ou modérément déséquilibrés : L’application du test HSD de Tukey (avec l’ajustement natif de Tukey-Kramer) s’exécute en toute sécurité et constitue la norme de référence dans les revues internationales.
- Variances hétérogènes (hétéroscédasticité avérée au test de Levene) : Les formulations standard de Tukey, Bonferroni et Scheffé doivent être proscrites. L’orientation méthodologique s’effectue préférentiellement vers la procédure de Games-Howell, ou vers un test t de Welch couplé à une correction séquentielle de Holm-Bonferroni.
- Exploration non planifiée libre et opportuniste (data mining) : Si le chercheur explore un ensemble vaste et imprévisible de configurations de moyennes après avoir visualisé les résultats, seule la méthode de Scheffé offre le blindage inférentiel requis pour garantir la validité des conclusions publiées.
11. Mise en pratique logicielle : R, SPSS et JASP
11.1 Exécution et interprétation sous le logiciel R
Le logiciel d’analyse statistique R représente l’environnement de prédilection de la recherche contemporaine en raison de sa puissance algorithmique et de sa transparence reproductible. L’exécution des procédures de Tukey, Bonferroni et Scheffé y est standardisée au moyen de fonctions dédiées issues de l’environnement de base ou de bibliothèques spécialisées.
Pour exécuter le test HSD de Tukey (intégrant l’ajustement de Tukey-Kramer), la procédure standard s’applique sur un objet de modélisation linéaire créé par la fonction aov(). L’appel de la fonction native TukeyHSD() extrait instantanément les écarts de moyennes, les intervalles de confiance simultanés à $95,%$ et les valeurs de p ajustées :
Dans l’écosystème R, la démarche se formalise par :
- Modélisation de l’ANOVA :
modele <- aov(Score ~ Groupe, data = donnees) - Application de Tukey :
TukeyHSD(modele, conf.level = 0.95)
Pour la procédure de Bonferroni (ou son optimisation de Holm), la fonction la plus directe est pairwise.t.test(), qui autorise la spécification explicite de la méthode d’ajustement des probabilités au moyen de l’argument p.adjust.method = "bonferroni" ou "holm". Cette fonction offre l’avantage exceptionnel de pouvoir commuter sur un calcul d’erreur-type sans assomption de variance égale via l’argument pool.sd = FALSE, basculant l’algorithme vers une correction de Bonferroni sur base de Welch.
Enfin, pour mettre en œuvre la méthode de Scheffé, le recours au paquet spécialisé DescTools (avec la fonction ScheffeTest()) ou au puissant paquet agricolae (avec scheffe.test()) permet d’obtenir immédiatement l’ensemble des contrastes simples et des sous-ensembles homogènes étalonnés selon le seuil critique de Scheffé.
11.2 Procédure standard dans IBM SPSS Statistics
Dans l’environnement graphique d’IBM SPSS Statistics, l’accès à ces trois tests est directement implémenté dans la routine de l’analyse de variance à un facteur. La navigation s’effectue via le menu déroulant standard : Analyser > Comparer les moyennes > ANOVA à 1 facteur.
En cliquant sur le bouton d’options Post Hoc..., le praticien fait apparaître une boîte de dialogue structurée en deux sections majeures :
- Variances égales supposées : Cette section regroupe les options
Tukey(qui active en réalité automatiquement l’algorithme de Tukey-Kramer dès que les effectifs sont inégaux),Bonferroni, etScheffé. L’analyste peut cocher conjointement ces tests pour comparer leurs seuils de sévérité sur son jeu de données. - Variances égales non supposées : Cette seconde section propose les alternatives robustes indispensables en cas d’hétéroscédasticité, dont le fameux test de
Games-Howell.
L’interprétation des sorties SPSS requiert une attention particulière aux deux tableaux générés :
- Le tableau des Comparaisons multiples rapporte pour chaque paire la différence de moyennes, son erreur-type, la valeur de p ajustée exacte et l’intervalle de confiance à $95,%$. Une astérisque (*) signale automatiquement les différences franchissant le seuil critique.
- Le tableau des Sous-ensembles homogènes (pour Tukey et Scheffé) regroupe les conditions dont les moyennes ne diffèrent pas significativement au sein de colonnes communes. Ce tableau fournit une lecture visuelle immédiate des regroupements empiriques.
11.3 Approche pédagogique moderne avec JASP
Développé par l’Université d’Amsterdam, le logiciel open-source JASP s’est imposé comme l’alternative contemporaine de choix face à SPSS, combinant une interface graphique intuitive, une rigueur méthodologique sans compromis et une adhérence native aux principes de la science ouverte (Open Science).
Dans JASP, après avoir sélectionné ANOVA > ANOVA et assigné la variable dépendante ainsi que le facteur d’intérêt, le déploiement des analyses post-hoc s’opère dans le panneau déroulant Post Hoc Tests :
- Le chercheur glisse le facteur dans la boîte d’analyse active.
- Dans la section Type, des cases à cocher permettent de sélectionner de façon modulaire
Standard(Tukey/Tukey-Kramer),Bonferroni,Holm, ouScheffé. - Une fonctionnalité majeure de JASP réside dans la génération automatique et instantanée des graphiques de différences de moyennes assortis de leurs intervalles de confiance ajustés à $95,%$. Ce retour visuel dynamique permet de constater immédiatement l’effet de la méthode choisie sur la largeur de l’intervalle : les barres d’erreur de Scheffé apparaissent visiblement plus étendues que celles de Tukey.
De surcroît, JASP offre l’avantage éditorial inestimable d’exporter les tableaux de résultats directement préformatés selon les normes typographiques strictes de l’American Psychological Association (APA 7), supprimant les erreurs manuelles de transcription lors de la rédaction finale du manuscrit.
12. Recommandations rédactionnelles et normes APA en psychologie
12.1 Rapporter rigoureusement les tests post-hoc selon le manuel APA 7
La restitution écrite des analyses statistiques dans les revues affiliées à l’APA doit répondre à des normes de précision, d’exhaustivité et de transparence d’une grande rigueur. La 7e édition du manuel de publication de l’American Psychological Association interdit toute formulation floue et impose de rapporter systématiquement la statistique de test, les degrés de liberté, la valeur de p ajustée exacte ainsi que la taille d’effet et son intervalle de confiance.
Voici un modèle rédactionnel canonique conforme aux exigences éditoriales pour rapporter les résultats d’un test post-hoc de Tukey :
« L’analyse de variance à un facteur a révélé un effet principal significatif de la modalité d’apprentissage sur le score de rappel mnésique, F(3, 76) = 8,42, p < ,001, $\eta_p^2 = 0{,}25$. Les comparaisons multiples post-hoc conduites à l’aide de la procédure HSD de Tukey (avec correction de Tukey-Kramer pour échantillons inégaux) ont mis en évidence que les participants ayant bénéficié d’un encodage sémantique (M = 19,20 ; SD = 3,85) rappelaient significativement plus de mots que les participants du groupe témoin (M = 12,00 ; SD = 4,10), $\Delta M = 7{,}20$, IC 95 % [4,15, 10,25], p < ,001, d = 1,81. En revanche, la différence observée entre le groupe répétition (M = 14,50 ; SD = 3,92) et le groupe témoin ne franchissait pas le seuil de signification conventionnel, $\Delta M = 2{,}50$, IC 95 % [-0,55, 5,55], p = ,142, d = 0,62. »
Si la correction de Bonferroni avait été mobilisée, il conviendrait de mentionner explicitement le multiplicateur appliqué ou le seuil critique corrigé : « Les valeurs de p ont été ajustées selon la méthode de Bonferroni pour une famille de six comparaisons ($p_{\text{ajustée}} = p_{\text{brute}} \times 6$). » Pour Scheffé, la formule critique associée au contraste complexe doit être précisée en note méthodologique.
12.2 Au-delà de la significativité : tailles d’effet et puissance a posteriori
Une dérive courante dénoncée avec constance par les comités éditoriaux consiste à réduire l’analyse post-hoc à une lecture binaire et mécaniste des valeurs de p. Franchir le seuil fatidique de 0,05 ne garantit en rien qu’un effet expérimental possède une magnitude théorique substantielle ou une pertinence clinique tangible. La présentation systématique des tailles d’effet standardisées — principalement le d de Cohen pour les comparaisons de paires ou l’êta-carré partiel ($\eta_p^2$) — est désormais une exigence absolue de l’APA.
Le calcul du d de Cohen pour une comparaison par paires après une ANOVA s’appuie idéalement sur la variance résiduelle mise en commun du modèle global (racine carrée du $MS_{\text{résiduel}}$), plutôt que sur les écarts-types isolés des deux seuls groupes comparés :
$d = \frac{\bar{X}_i – \bar{X}_j}{\sqrt{MS_{\text{résiduel}}}}$
Cette approche standardise l’estimation de l’amplitude de l’effet en tirant parti de la puissance informationnelle de l’ensemble de l’expérience.
Par ailleurs, les chercheurs doivent se garder de l’erreur classique consistant à interpréter une valeur de p post-hoc non significative comme une preuve formelle de l’équivalence des moyennes (« absence de preuve n’est pas preuve d’absence »). Une comparaison non significative sous Bonferroni ou Scheffé peut résulter d’un manque criant de puissance statistique (échantillons trop faibles pour surmonter la pénalité corrective). Pour attester de l’absence réelle d’effet, le recours à des procédures de tests d’équivalence (TOST : Two One-Sided Tests) est méthodologiquement requis.
12.3 Transparence scientifique, préenregistrement et Open Science
Dans le contexte actuel de refondation méthodologique initié par le mouvement de la science ouverte, le choix entre Tukey, Bonferroni et Scheffé ne peut plus être opéré dans l’opacité du laboratoire. La pratique délétère du p-hacking — qui consiste à tester tour à tour Tukey, Bonferroni, Scheffé, Newman-Keuls et Fisher LSD jusqu’à ce que l’une des procédures produise miraculeusement une valeur de p inférieure à 0,05 — constitue une fraude scientifique caractérisée aux conséquences lourdes pour la reproductibilité.
La communauté internationale encourage désormais vigoureusement le préenregistrement formel des plans d’analyse sur des plateformes certifiées telles que l’Open Science Framework (OSF) ou AsPredicted.org. Le chercheur y spécifie préalablement à la collecte des données :
- Si les comparaisons consécutives à l’ANOVA seront de nature confirmatoire (contrastes a priori) ou exploratoire (post-hoc).
- La procédure d’ajustement exacte retenue (ex. test HSD de Tukey pour les paires exhaustives, ou Holm-Bonferroni pour les sous-ensembles ciblés).
- Les critères de décision face aux violations potentielles d’hypothèses (recours systématique au test de Games-Howell en cas de test de Levene significatif).
En accompagnant le manuscrit publié de ses scripts de traitement des données (en code R ou syntaxe SPSS/JASP) déposés dans des archives ouvertes pérennes, l’investigateur démontre une intégrité scientifique exemplaire. Cette transparence totale assure aux pairs que le choix du test post-hoc n’a pas été dicté par la quête opportuniste de la significativité, mais par une rigueur théorique garantissant l’authenticité de la découverte empirique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal n’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Hayter, A. J. (1984). A proof of the conjecture that the Tukey-Kramer multiple comparisons procedure is conservative. The Annals of Statistics, 12(1), 61–75. https://doi.org/10.1214/aos/1176346392
- Hochberg, Y. (1988). A sharper Bonferroni procedure for multiple tests of significance. Biometrika, 75(4), 800–802. https://doi.org/10.1093/biomet/75.4.800
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001466
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Scheffé, H. (1953). A method for judging all contrasts in the analysis of variance. Biometrika, 40(1–2), 87–110. https://doi.org/10.1093/biomet/40.1-2.87
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Tukey, J. W. (1953). The problem of multiple comparisons (Unpublished manuscript). Princeton University.