
Dans le paysage des sciences quantitatives, de l’économétrie contemporaine et de la psychométrie expérimentale, peu de principes mathématiques possèdent une force unificatrice comparable à celle du théorème central limite. Souvent qualifié de véritable clef de voûte de l’inférence statistique moderne, ce résultat probabiliste fondamental résout un paradoxe apparent qui a longtemps intrigué les chercheurs : comment extraire des conclusions fiables, générales et rigoureusement paramétrées sur une population globale lorsque les mesures individuelles brutes qui la composent se révèlent chaotiques, asymétriques, discrètes ou totalement inconnues ? En apportant une réponse formelle à cette interrogation épistémologique, le théorème établit les conditions sous lesquelles la somme et la moyenne d’un ensemble de variables aléatoires indépendantes convergent vers une morphologie mathématique singulière et universelle : la distribution normale de Gauss-Laplace.
Loin d’être une simple curiosité abstraite confinée aux traités de calcul stochastique, le théorème central limite constitue la justification méthodologique indispensable qui permet aux biostatisticiens, cliniciens, ingénieurs et chercheurs en sciences du comportement de déployer des techniques paramétriques éprouvées — telles que le test t de Student, l’analyse de variance ou les modélisations de régression linéaire — sur des données empiriques dont la distribution d’origine s’écarte pourtant radicalement de la courbe en cloche idéale. Sans ce théorème, toute tentative d’estimer avec précision la marge d’erreur d’un sondage, de quantifier l’efficacité clinique d’un nouveau composé pharmacologique à partir d’échantillons finis ou de valider la métrologie d’un inventaire psychologique s’effondrerait sous le poids des incertitudes distributionnelles.
Le présent article propose une analyse exhaustive, rigoureuse et multidimensionnelle du théorème central limite. En articulant formalisation mathématique de haut niveau, profondeur historique, déconstructions analytiques des postulats sous-jacents et modélisations empiriques concrètes, cette monographie dresse un inventaire complet des dynamiques de convergence à l’œuvre dans l’échantillonnage aléatoire. À travers des études de cas méthodologiques détaillées — allant des distributions continues uniformes et exponentielles aux processus discrets de Bernoulli et aux distributions asymétriques observées dans les cohortes cliniques —, nous mettrons en lumière les mécanismes précis qui président à la métamorphose des données brutes en distributions d’échantillonnage régulières, tout en délimitant rigoureusement les frontières et les écueils interprétatifs qui jalonnent son application dans la pratique scientifique contemporaine.
1. Introduction fondamentale et énoncé formel du théorème central limite
1.1 Définition rigoureuse et intuition probabiliste
Sur le plan mathématique formel, le théorème central limite (couramment abrégé en TCL) décrit le comportement asymptotique de la somme normalisée d’une suite de variables aléatoires réelles. Soit une suite $X_1, X_2, dots, X_n$ de variables aléatoires définies sur un même espace de probabilité probabilisé $(\Omega, \mathcal{F}, \mathbb{P})$, mutuellement indépendantes et identiquement distribuées selon une loi commune quelconque, possédant une espérance mathématique finie $\mathbb{E}[X_i] = \mu$ et une variance strictement positive et finie $\mathrm{Var}(X_i) = \sigma^2 in ]0, +\infty[$. Si l’on note $\overline{X}_n = \frac{1}{n} \sum_{i=1}^n X_i$ la moyenne arithmétique empirique calculée sur cet échantillon de taille $n$, et $S_n = \sum_{i=1}^n X_i$ la somme correspondante, le théorème stipule formellement que la variable aléatoire standardisée :
$$Z_n = \frac{\overline{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}} = \frac{S_n – n\mu}{\sigma \sqrt{n}}$$
converge en loi (ou distributionnellement, noté $Z_n x\rightarrow{\mathcal{L}} \mathcal{N}(0, 1)$) vers la distribution normale standard lorsque $n$ tend vers l’infini. Cela signifie de manière analytique que pour tout nombre réel continu $z in \mathbb{R}$, la fonction de répartition empirique de la variable centrée et réduite satisfait l’égalité asymptotique fondamentale :
$$\lim_{n to \infty} \mathbb{P}(Z_n le z) = \Phi(z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-\frac{t^2}{2}} , \mathrm{d}t$$
L’intuition probabiliste qui soutient cette formulation est d’une profondeur conceptuelle remarquable. Elle implique qu’en agrégeant un nombre suffisant de réalisations indépendantes issues d’un phénomène aléatoire, la variabilité propre aux structures intrinsèques de la loi parente — qu’elle soit continue, discrète, multimodale, tronquée ou caractérisée par une sévère asymétrie — s’efface progressivement au profit d’une structure d’agencement universelle gouvernée uniquement par deux paramètres d’échelle : l’espérance $\mu$ et la variance $\sigma^2$. Il s’opère ainsi une distinction épistémologique capitale entre la distribution de la population d’origine, qui demeure strictement inchangée et fidèle à ses spécificités morphologiques, et la distribution de probabilité de la statistique agrégée (la somme ou la moyenne), qui s’organise spontanément selon la symétrie canonique de la cloche gaussienne.
1.2 Contexte historique : De Moivre, Laplace et Lindeberg
L’édification théorique du théorème central limite s’étend sur près de deux siècles de maturation analytique au sein de l’école européenne des probabilités. La genèse de ce concept remonte aux travaux pionniers du mathématicien français émigré à Londres, Abraham de Moivre. Dans la seconde édition de son ouvrage fondamental The Doctrine of Chances publiée en 1738, puis dans son mémoire latin Miscellanea Analytica, de Moivre s’attelle à simplifier le calcul prohibitif des probabilités binomiales associées au jeu de pile ou face équilibré pour un très grand nombre d’épreuves. En utilisant des approximations géométriques et en introduisant pour la première fois une forme préliminaire de l’intégrale exponentielle quadratique, il démontre que le terme central de la loi binomiale symétrique peut être approché par une courbe continue exponentielle négative, posant ainsi la première pierre de ce qui deviendra le théorème de De Moivre-Laplace.
Il faut néanmoins attendre le début du XIXe siècle pour que cette intuition appliquée aux processus binaires soit étendue à une dimension véritablement universelle grâce au génie analytique de Pierre-Simon de Laplace. Dans sa monumentale Théorie analytique des probabilités parue en 1812, Laplace dépasse le cadre restreint des épreuves de Bernoulli pour considérer des variables aléatoires possédant des fonctions de densité continues arbitraires. Grâce au développement de la méthode des fonctions génératrices et à l’usage systématique des intégrales eulériennes, Laplace formalise la première preuve générale de la convergence de la somme des erreurs d’observation vers la loi normale, établissant le principe selon lequel toute erreur globale résultant de l’addition d’une myriade de micro-perturbations indépendantes et infinitésimales adopte inévitablement un profil gaussien.
Au cours de la première moitié du XXe siècle, la formalisation de la théorie moderne de la mesure et de l’intégration au sens de Lebesgue impose une révision rigoureuse des conditions de validité de ce résultat. Des mathématiciens russes illustres, à l’instar de Pafnouti Tchebychev, Andreï Markov et Alexandre Liapounov, apportent des contributions substantielles en introduisant l’usage des fonctions caractéristiques (transformées de Fourier des distributions de probabilité). Enfin, le mathématicien finlandais Jarl Waldemar Lindeberg en 1920, puis William Feller, établissent la célèbre condition de Lindeberg-Feller. Cette condition nécessaire et suffisante relâche l’obligation d’avoir des variables identiquement distribuées : pourvu qu’aucune variable individuelle ne domine démesurément la variance globale de la somme totale, la normalité asymptotique émerge avec une rigueur absolue dans les systèmes aléatoires hétérogènes.
1.3 Importance cardinale en méthodologie quantitative et psychométrie
En méthodologie quantitative contemporaine, le théorème central limite constitue le fondement épistémologique qui légitime la transition de l’échantillon descriptif contingent vers l’inférence populationnelle probabiliste. Dans la quasi-totalité des dispositifs de recherche empirique, qu’il s’agisse des protocoles expérimentaux randomisés en médecine ou des enquêtes sociologiques par sondage, le chercheur ne possède qu’un fragment fini de la réalité objective. Le théorème central limite garantit que, dès lors que la procédure d’échantillonnage probabiliste respecte les critères fondamentaux d’indépendance, la moyenne de l’échantillon constitue non seulement une estimation sans biais du paramètre populationnel inconnu, mais que son comportement stochastique est prévisible, quantifiable et assujetti aux lois universelles de la géométrie gaussienne.
Cette garantie prend une dimension encore plus cruciale dans le champ de la psychométrie et des sciences de l’évaluation comportementale. Les construits psychologiques latents — tels que le névrosisme, les fonctions exécutives, l’intelligence fluide ou le sentiment de compétence parentale — sont traditionnellement opérationnalisés par des échelles ordinales d’auto-évaluation de type Likert ou des inventaires de symptômes dichotomiques. Les distributions brutes de ces mesures manifestes violent presque systématiquement le postulat de normalité univariée : les échelles d’anxiété présentent fréquemment une asymétrie positive prononcée en population générale, tandis que les tests de performance cognitive affichent souvent des effets de plafond massifs.
Le théorème central limite apporte ici une justification théorique déterminante : en sommant ou en moyennant les scores élémentaires pour composer des scores totaux ou en comparant des cohortes d’individus, la distribution des statistiques d’intérêt converge vers une loi normale. Cette propriété préserve l’intégrité et la validité inférentielle des modèles statistiques linéaires les plus exigeants, permettant d’appliquer des régressions multivariées, des analyses factorielles confirmatoires et des tests paramétriques d’équivalence sans exiger une normalité intrinsèque des attributs psychologiques sous-jacents.
2. Propriétés mathématiques et postulats statistiques sous-jacents
2.1 L’égalité des espérances mathématiques
La première propriété structurelle fondamentale qui régit la mécanique du théorème central limite réside dans la préservation rigoureuse de la tendance centrale lors du passage de la distribution populationnelle à la distribution d’échantillonnage de la moyenne. Considérons un échantillon aléatoire simple de taille $n$ composé de variables indépendantes et identiquement distribuées $X_1, X_2, dots, X_n$, chacune admettant pour espérance le paramètre théorique $\mathbb{E}[X_i] = \mu$. En vertu de la propriété linéaire fondamentale de l’opérateur d’espérance mathématique, l’espérance de la statistique moyenne empirique $\overline{X}_n$ se développe analytiquement de la façon suivante :
$$\mathbb{E}[\overline{X}_n] = \mathbb{E}\left[ \frac{1}{n} \sum_{i=1}^n X_i \right] = \frac{1}{n} \sum_{i=1}^n \mathbb{E}[X_i] = \frac{1}{n} \sum_{i=1}^n \mu = \frac{1}{n} (n\mu) = \mu$$
Cette égalité stricte, valide pour toute taille d’échantillon $n ge 1$ et ne nécessitant aucunement l’intervention d’une convergence asymptotique infinie, confère à la moyenne empirique la propriété statistique d’estimateur non biaisé (ou sans distorsion systématique) de la moyenne populationnelle. Quelle que soit l’irrégularité morphologique, l’asymétrie ou la discontinuité de la loi sous-jacente, le centre de gravité de la distribution d’échantillonnage demeure invariablement ancré sur la véritable valeur paramétrique $\mu$. En répétant indéfiniment l’extraction d’échantillons aléatoires de même taille dans une population cible, l’agrégation de leurs moyennes respectives convergera infailliblement vers le barycentre exact du système probabiliste étudié.
2.2 La variance de l’échantillonnage et l’erreur type
Tandis que la tendance centrale reste parfaitement fixe, la dispersion stochastique des moyennes d’échantillon subit une contraction mathématique prévisible et inversement proportionnelle au volume de données collectées. En mobilisant l’opérateur de variance et en exploitant le postulat d’indépendance mutuelle entre les observations individuelles — qui assure l’annulation rigoureuse de tous les termes de covariance croisée —, la variance de la moyenne d’échantillon s’exprime selon le développement analytique suivant :
$$\mathrm{Var}(\overline{X}_n) = \mathrm{Var}\left( \frac{1}{n} \sum_{i=1}^n X_i \right) = \frac{1}{n^2} \sum_{i=1}^n \mathrm{Var}(X_i) = \frac{1}{n^2} \sum_{i=1}^n \sigma^2 = \frac{1}{n^2} (n\sigma^2) = \frac{\sigma^2}{n}$$
La racine carrée positive de cette variance d’échantillonnage définit une entité métrologique cardinale en méthodologie statistique : l’erreur type de la moyenne (notée $\sigma_{\overline{X}}$ ou $SE$). Sa formulation universelle s’écrit :
$$\sigma_{\overline{X}} = \frac{\sigma}{\sqrt{n}}$$
Cette relation analytique formalise la fameuse règle de la décroissance de l’erreur d’échantillonnage en proportion de la racine carrée de la taille d’échantillon ($1/\sqrt{n}$). Elle démontre qu’afin de doubler la précision d’une estimation paramétrique (c’est-à-dire réduire l’erreur type de moitié), il ne suffit pas de doubler le nombre d’observations, mais il est rigoureusement impératif de quadrupler l’effectif d’échantillonnage ($n \times 4$). Cette contrainte d’échelle impose un compromis pragmatique constant dans le design expérimental, dictant le calcul de la puissance statistique face aux coûts logistiques inhérents à l’accroissement des cohortes.
2.3 Conditions de régularité : Indépendance et variance finie
Bien que le théorème central limite jouisse d’une robustesse exceptionnelle, il ne saurait être appréhendé comme une vérité mathématique absolue dénuée de prérequis techniques. Son applicabilité repose sur le respect impératif de deux conditions de régularité fondamentales : l’indépendance stochastique des unités d’observation et l’existence d’un second moment centré fini ($\sigma^2 < +\infty$). L'indépendance statistique postule que la réalisation ou la mesure d'une variable $X_i$ n'exerce aucune influence directe ou conditionnelle sur la distribution de probabilité d'une autre variable $X_j$ (pour tout $i \neq j$). Lorsque cette hypothèse est violée — par exemple dans les séries chronologiques présentant une autocorrélation sérielle ou dans les structures de données hiérarchiques regroupées en grappes sans ajustement pour l'effet de groupe —, la formule de variance susmentionnée devient invalide et les garanties asymptotiques s'effondrent en créant des variances empiriques artificiellement réduites.
Le second postulat indispensable concerne l’existence d’une variance finie au sein de la population génératrice. Si ce postulat est satisfait pour l’écrasante majorité des lois d’usage courant en sciences naturelles et sociales (lois normale, uniforme, binomiale, exponentielle, de Poisson, gamma), il exclut explicitement les distributions dites à queues lourdes ou lois de puissance sans moments d’ordre deux. Le cas d’école le plus célèbre de violation de cette exigence est représenté par la loi de Cauchy standard, dont la fonction de densité de probabilité est donnée par :
$$f(x) = \frac{1}{\pi (1 + x^2)}, \quad x in \mathbb{R}$$
Pour une variable aléatoire suivant une loi de Cauchy, les intégrales définissant l’espérance mathématique et la variance divergent vers l’infini au sens de l’analyse réelle. Par conséquent, la moyenne arithmétique $\overline{X}_n$ d’un échantillon de $n$ variables de Cauchy indépendantes ne se concentre nullement autour d’une valeur fixe et n’adopte aucunement une forme gaussienne : elle suit rigoureusement, pour toute valeur arbitraire de $n$, la même loi de Cauchy que les observations isolées. L’augmentation de la taille de l’échantillon ne réduit en aucune manière l’incertitude ni la dispersion de l’estimateur, illustrant avec éclat qu’en l’absence de variance finie, le théorème central limite est strictement inopérant.
3. La distribution d’échantillonnage de la moyenne : Mécanismes et comportement
3.1 Distinction entre distribution de la population et distribution d’échantillonnage
Pour maîtriser pleinement l’épistémologie de l’inférence quantitative, il est primordial d’établir une ligne de démarcation conceptuelle infranchissable entre deux univers probabilistes distincts mais intimement liés : la distribution de la population parente et la distribution d’échantillonnage d’une statistique. La distribution de la population modélise la fréquence relative, la dispersion et la variabilité intrinsèque des entités unitaires qui constituent l’ensemble d’intérêt. Par exemple, si l’on s’intéresse au temps de séjour en milieu hospitalier mesuré en jours ou au niveau de revenu brut des ménages au sein d’une métropole, la distribution de la population est incarnée par l’ensemble exhaustif des individus réels. Elle est invariante et ses paramètres fondamentaux — la moyenne populationnelle $\mu$, l’écart-type populationnel $\sigma$, son asymétrie et son aplatissement — sont des constantes descriptives fixes du monde matériel.
À l’opposé, la distribution d’échantillonnage de la moyenne ne contient aucune mesure individuelle brute. Elle se définit rigoureusement comme la distribution de probabilité théorique générée par l’ensemble infini de toutes les moyennes d’échantillons possibles de taille fixe $n$ pouvant être extraits par tirage aléatoire simple de cette même population. L’une des confusions pédagogiques les plus récurrentes consiste à confondre l’histogramme empirique d’un échantillon concret recueilli sur le terrain avec cette distribution d’échantillonnage sous-jacente. Alors que la distribution empirique d’un échantillon singulier aura tendance, par le théorème fondamental de la statistique (théorème de Glivenko-Cantelli), à calquer fidèlement le profil morphologique chaotique ou asymétrique de la population parente à mesure que $n$ croît, la distribution d’échantillonnage, elle, se métamorphose activement vers la symétrie gaussienne la plus parfaite.
3.2 Émergence spontanée de la forme en cloche gaussienne
Comment s’opère sur le plan fonctionnel cette transmutation morphologique qui engendre une courbe en cloche symétrique à partir de distributions primaires asymétriques ou uniformes ? La réponse réside dans la combinatoire inhérente au processus d’agrégation arithmétique. Lorsqu’un chercheur calcule la moyenne $\overline{X}_n = \frac{1}{n} \sum_{i=1}^n X_i$, chaque observation individuelle apporte sa propre déviation stochastique par rapport au barycentre théorique $\mu$. Pour que la moyenne de l’échantillon prenne une valeur extrêmement déviante vers la droite ou vers la gauche, il faudrait que le hasard sélectionne quasi exclusivement des valeurs situées aux confins extrêmes de la distribution d’origine au cours du même tirage.
Or, les lois de la combinatoire et de l’indépendance probabiliste rendent cette configuration hautement improbable : dans l’immense majorité des tirages aléatoires indépendants, les valeurs extrêmes positives sont neutralisées par la présence concomitante de valeurs modérées ou négatives. Cette compensation arithmétique spontanée concentre massivement les réalisations de la moyenne autour de l’espérance $\mu$. Sur le plan des moments d’ordre supérieur, l’agrégation exerce un effet d’amortissement systématique sur l’asymétrie (skewness) et l’aplatissement (kurtosis). On démontre analytiquement que le coefficient d’asymétrie de la moyenne d’échantillon $\gamma_1(\overline{X}_n)$ et son coefficient d’excès d’aplatissement $\gamma_2(\overline{X}_n)$ obéissent aux lois de décroissance suivantes :
$$\gamma_1(\overline{X}_n) = \frac{\gamma_{1,\text{pop}}}{\sqrt{n}} \quad \text{et} \quad \gamma_2(\overline{X}_n) = \frac{\gamma_{2,\text{pop}}}{n}$$
où $\gamma_{1,\text{pop}}$ et $\gamma_{2,\text{pop}}$ représentent respectivement les coefficients d’asymétrie et d’excès de la loi parente. Ces formulations démontrent sans ambiguïté que l’asymétrie s’éteint à une cadence d’ordre $O(n^{-1/2})$, tandis que l’excès d’aplatissement disparaît encore plus rapidement à une vitesse d’ordre $O(n^{-1})$. Ainsi, la loi normale agit comme un véritable attracteur universel dans l’espace fonctionnel des densités de probabilité soumises à la convolution itérée.
3.3 Standardisation et score Z de la moyenne d’échantillon
L’aboutissement opérationnel de cette convergence gaussienne se concrétise à travers la transformation linéaire de standardisation. Puisque la moyenne d’échantillon $\overline{X}_n$ converge distributionnellement vers une loi normale paramétrée par son espérance $\mu$ et son écart-type d’échantillonnage $\frac{\sigma}{\sqrt{n}}$, nous pouvons définir le score de déviation standardisé ou score $Z$ d’échantillonnage :
$$Z = \frac{\overline{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}}$$
Cette équation fondamentale projette l’estimateur empirique dans l’espace de la loi normale centrée réduite $\mathcal{N}(0, 1)$, caractérisée par une moyenne nulle et une variance unitaire. Dès lors que cette transformation est opérée, le chercheur s’affranchit totalement des unités métriques initiales du protocole de mesure pour accéder directement aux tables probabilistes universelles de la loi normale standardisée ou aux fonctions de répartition numériques des environnements de calcul statistique moderne.
Ce formalisme constitue la pierre angulaire analytique nécessaire à la détermination rigoureuse de la valeur $p$ (ou degré de significativité) dans les tests de conformité à une norme théorique ou les tests d’hypothèses univariés. Si une hypothèse nulle $H_0$ postule que la moyenne d’une population soumise à une intervention thérapeutique est égale à une constante historique $\mu_0$, la mesure de l’écart standardisé $Z_{\text{obs}} = \frac{\overline{x} – \mu_0}{\sigma / \sqrt{n}}$ permet de calculer instantanément la probabilité critique bidirectionnelle :
$$p = 2 \cdot \big(1 – \Phi(|Z_{\text{obs}}|)\big)$$
Si la valeur $p$ ainsi obtenue se révèle inférieure au seuil de risque nominal de première espèce $\alpha$ arbitrairement fixé (habituellement $0{,}05$ ou $0{,}01$), l’analyste peut rejeter formellement l’hypothèse nulle avec une assurance méthodologique étayée par la régularité du théorème central limite.
4. La condition de la taille de l’échantillon et ses nuances empiriques
4.1 La règle heuristique classique des trente observations
Dans l’enseignement classique des méthodes quantitatives et dans une abondante littérature de vulgarisation statistique, il est fréquemment énoncé comme un dogme absolu que le théorème central limite s’applique avec une précision suffisante dès lors que la taille de l’échantillon atteint ou excède le seuil arbitraire de trente observations ($n ge 30$). L’origine historique de cette heuristique pratique remonte aux premières tables numériques de la loi de Student établies au début du XXe siècle par William Sealy Gosset. Vers $n = 30$ (soit 29 degrés de liberté), la distribution de la statistique $t$ de Student commence à se confondre étroitement avec les ordonnées de la loi normale standard $\mathcal{N}(0, 1)$, l’écart entre les quantiles critiques correspondants devenant minime à un niveau de précision décimale modeste (par exemple, le quantile $0{,}975$ passe de $2{,}045$ pour $df=29$ à $1{,}960$ pour la normale).
Toutefois, ériger le seuil $n = 30$ en règle de validité universelle relève d’une simplification méthodologique excessive susceptible d’induire en erreur le praticien de la recherche empirique. La valeur $n = 30$ n’est ni un point de transition discontinu dans la nature physique des nombres, ni une garantie absolue de normalité opérationnelle. L’exactitude de l’approximation normale dépend en réalité de façon symbiotique et critique de la géométrie de la distribution de la population d’origine, et plus particulièrement de l’ampleur de ses moments d’ordre trois (asymétrie) et d’ordre quatre (kurtosis).
4.2 Impact de la forme initiale sur la vitesse de convergence
La vitesse à laquelle la distribution d’échantillonnage de la moyenne se conforme aux prédictions de la loi normale varie de manière spectaculaire en fonction des caractéristiques morphologiques de la loi génératrice d’origine :
- Populations symétriques et unimodales : Lorsque la population sous-jacente présente déjà une structure parfaitement symétrique (telle qu’une distribution uniforme continue ou une loi triangulaire), la convergence est quasi instantanée. Des échantillons d’une taille aussi réduite que $n = 5$ ou $n = 10$ suffisent amplement pour obtenir une distribution d’échantillonnage dont les déviations par rapport à la courbe de Gauss sont méthodologiquement imperceptibles.
- Populations asymétriques régulières : Pour des lois continues présentant une asymétrie unilatérale modérée (par exemple une loi exponentielle de paramètre $lambda$ ou une distribution gamma modérément étirée), le seuil conventionnel de $n = 30$ à $n = 50$ s’avère généralement adéquat pour autoriser une inférence paramétrique raisonnablement robuste.
- Populations hautement asymétriques ou bimodales : En présence de distributions lourdement asymétriques (comme la distribution de Pareto, la distribution log-normale à forte variance ou les distributions bimodales segmentant deux sous-populations polarisées), la vitesse de convergence est considérablement freinée. Dans de telles configurations, un échantillon de $n = 100$, $n = 500$, voire $n = 1000$ unités peut s’avérer strictement requis pour dissiper l’asymétrie résiduelle et stabiliser les quantiles extrêmes de la distribution de la moyenne.
Ce phénomène d’inertie distributionnelle est rigoureusement quantifié par le célèbre théorème de Berry-Esseen. Établi indépendamment par Andrew Berry en 1941 et Carl-Gustav Esseen en 1942, ce résultat fondamental borne précisément la distance suprémale (ou distance de Kolmogorov-Smirnov) entre la fonction de répartition de la variable normalisée $F_n(z) = \mathbb{P}(Z_n le z)$ et la fonction de répartition normale théorique $Phi(z)$ :
$$\sup_{z in \mathbb{R}} |F_n(z) – \Phi(z)| le \frac{C \cdot \rho}{\sigma^3 \sqrt{n}}$$
où $\rho = \mathbb{E}[|X – mu|^3] < +\infty$ représente le troisième moment absolu centré de la variable d'origine, $\sigma^3$ l'écart-type élevé au cube, et $C$ une constante universelle dont la meilleure borne supérieure actuelle est strictement inférieure à $0{,}47$. Cette inégalité analytique met directement en lumière le rôle prépondérant du ratio d'asymétrie $\frac{\rho}{\sigma^3}$ : plus la population initiale possède un troisième moment lourd traduisant un étirement de sa queue de distribution, plus l'erreur d'approximation reste élevée, exigeant un dénominateur $\sqrt{n}$ substantiellement plus important pour neutraliser cette divergence.
4.3 Conséquences pour les petits effectifs en recherche clinique
Ces nuances théoriques prennent une résonance concrète d’une gravité capitale dans le domaine des essais cliniques précoces, de la recherche translationnelle sur modèles animaux ou de l’investigation des maladies orphelines, où les impératifs de recrutement restreignent inéluctablement les tailles d’échantillons à des cohortes de petite taille ($n < 20$, voire $n < 10$). Dans ce régime de faible effectif, présumer aveuglément que le théorème central limite « normalisera » magiquement la distribution de la moyenne relève d'une faute méthodologique majeure.
L’application non critique de tests $t$ de Student ou de modèles d’analyse de variance à des micro-échantillons prélevés au sein de populations non gaussiennes entraîne une distorsion insidieuse du taux d’erreur de première espèce nominal ($\alpha = 0{,}05$). L’analyste s’expose à un risque sévère de faux positifs ou, inversement, à un effondrement dramatique de la puissance statistique du test si les queues de distribution sont hypertrophiées. Face à de tels contextes de recherche restreints, l’adoption de stratégies analytiques alternatives devient méthodologiquement incontournable : recours systématique aux tests de permutation exacts de Fisher-Pitman, utilisation d’approches non paramétriques fondées sur les rangs (test de Wilcoxon-Mann-Whitney) ou déploiement de techniques de rééchantillonnage par bootstrap non paramétrique afin d’évaluer la variabilité d’échantillonnage sans postuler d’approximation gaussienne prématurée.
5. Exemple 1 : Application à la loi uniforme continue
5.1 Modélisation théorique d’une variable uniforme
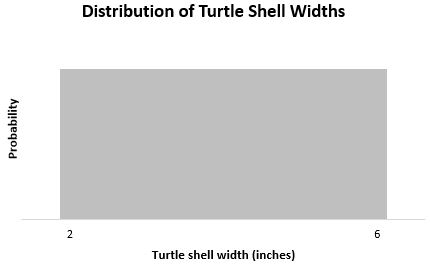
Pour illustrer de manière limpide la mécanique du théorème central limite, considérons en premier lieu l’un des archétypes les plus purs de distribution non gaussienne : la loi uniforme continue sur l’intervalle réel $[a, b]$, notée $\mathcal{U}(a, b)$. Une variable aléatoire continue $X \sim \mathcal{U}(a, b)$ possède une fonction de densité de probabilité constante définie formellement par :
$$f(x) = \begin{\cases} \frac{1}{b – a} &a\mp; \text{si } x in [a, b] 0 &a\mp; \text{sinon} \end{\cases}$$
Cette distribution se caractérise par une morphologie strictement rectangulaire, dénuée du moindre point culminant, d’aucun mode distinct et exempte de toute forme de convexité en cloche. Toutes les valeurs au sein du support bénéficient d’une probabilité de réalisation infinitésimale parfaitement équiprobable. Son espérance mathématique $\mu$, identifiable par symétrie au centre géométrique du domaine de définition, et sa variance théorique $\sigma^2$ s’obtiennent par dérivation intégrale directe :
$$\mu = \int_{a}^{b} x \frac{1}{b – a} , \mathrm{d}x = \frac{a + b}{2}$$
$$\sigma^2 = \int_{a}^{b} \left(x – \frac{a+b}{2}\right)^2 \frac{1}{b – a} , \mathrm{d}x = \frac{(b – a)^2}{12}$$
À titre d’exemple numérique canonique, considérons une loi uniforme standard définie sur l’intervalle réel compact $[0, 10]$. Dans ce cadre paramétrique, nous obtenons une espérance théorique $\mu = \frac{0 + 10}{2} = 5$ et une variance analytique $\sigma^2 = \frac{(10 – 0)^2}{12} = \frac{100}{12} \approx 8{,}333$, ce qui correspond à un écart-type de population $\sigma \approx 2{,}887$.
5.2 Évolution de la distribution selon la taille n
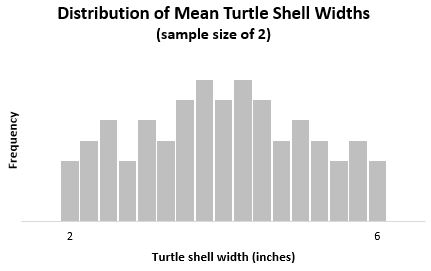
Examinons à présent ce qui advient lorsque l’on extrait des échantillons aléatoires de taille croissante de cette distribution rectangulaire et que l’on calcule leur moyenne empirique $\overline{X}_n$. Pour $n = 2$, la distribution d’échantillonnage de la statistique $S_2 = X_1 + X_2$ s’obtient analytiquement par le produit de convolution de la densité uniforme par elle-même :
$$f_{S_2}(s) = (f * f)(s) = \int_{-\infty}^{+\infty} f(t)f(s – t) , \mathrm{d}t$$
Le résultat de cette intégration engendre une distribution triangulaire exacte (distribution de Bates pour la moyenne, ou distribution d’Irwin-Hall pour la somme). Bien que cette morphologie présente des angles vifs discontinus au niveau de ses dérivées premières à la base et à son apex, la métamorphose vers la centralité est déjà frappante : l’équiprobabilité a totalement disparu au profit d’une concentration modale marquée autour de la valeur médiane 5.
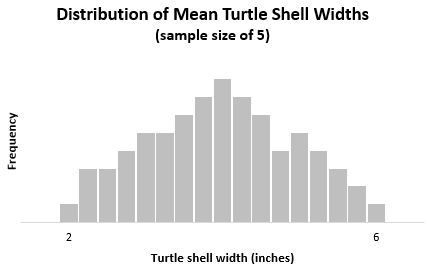
Dès que la taille de l’échantillon progresse vers $n = 5$, le lissage mathématique opéré par la convolution répétée est spectaculaire. Les arêtes vives du profil triangulaire s’estompent entièrement, laissant place à une courbe continue aux inflexions douces, visuellement indiscernable d’une cloche classique. À ce stade, la probabilité d’observer une moyenne d’échantillon proche des bornes extrêmes 0 ou 10 devient infinitésimale.
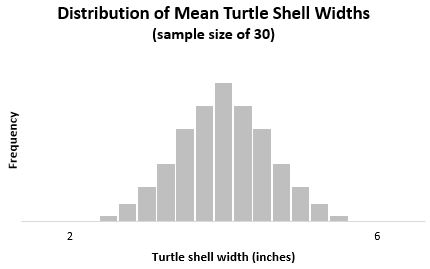
Lorsque la taille d’échantillon atteint $n = 30$, la distribution d’échantillonnage de la moyenne $\overline{X}_{30}$ présente une adéquation quasi parfaite avec le profil analytique de la loi normale théorique. L’aplatissement caractéristique du rectangle initial a été complètement absorbé par la dynamique combinatoire de la sommation stochastique.
5.3 Vérification des propriétés de la moyenne et de la variance
Pour quantifier avec précision le respect des principes théoriques, nous pouvons confronter les paramètres d’échantillonnage prédits aux calculs analytiques pour un échantillon de taille $n = 30$ issu de notre loi uniforme $\mathcal{U}(0, 10)$. L’espérance mathématique de la distribution d’échantillonnage vérifie impeccablement l’invariant fondamental :
$$\mathbb{E}[\overline{X}_{30}] = \mu = 5$$
En parallèle, l’erreur type théorique régissant la dispersion des moyennes s’établit avec une stricte précision quantitative :
$$\sigma_{\overline{X}} = \frac{\sigma}{\sqrt{n}} = \frac{\sqrt{8{,}333}}{\sqrt{30}} = \frac{2{,}887}{5{,}477} \approx 0{,}527$$
La variance d’échantillonnage $\mathrm{Var}(\overline{X}_{30}) = \frac{8{,}333}{30} \approx 0{,}278$ est ainsi trente fois plus petite que la variance de la population d’origine. Si l’on trace un diagramme quantile-quantile normal (Q-Q plot) confrontant les quantiles empiriques de ces moyennes d’échantillons aux quantiles théoriques de la loi normale standard $\mathcal{N}(0, 1)$, on observe un alignement linéaire rigoureusement rectiligne sur la quasi-totalité du spectre distributionnel, confirmant empiriquement que l’approximation gaussienne est d’une fidélité chirurgicale dès $n = 30$ lorsque la loi mère jouit d’une symétrie initiale.
6. Exemple 2 : Application à la loi exponentielle et aux temps de réaction
6.1 Caractéristiques de la distribution exponentielle des latences
Dans les sciences de la cognition, la neuropsychologie et l’ergonomie expérimentale, la modélisation mathématique des latences temporelles et des temps de réaction (TR) à des stimuli visuels ou auditifs mobilise fréquemment des distributions asymétriques continues, parmi lesquelles la loi exponentielle joue un rôle théorique de premier plan. Soit une variable aléatoire continue $T$, mesurant la latence d’une réponse motrice en millisecondes, gouvernée par une fonction de densité de probabilité exponentielle de paramètre de taux d’occurrence $lambda > 0$ :
$$f(t) = \begin{\cases} \lambda e^{-\lambda t} &a\mp; \text{si } t ge 0 0 &a\mp; \text{si } t < 0 \end{\cases}$$
Cette loi probabiliste se distingue par deux particularités analytiques fondamentales : une asymétrie positive massive et continue orientée vers la droite (queue de distribution étirée vers les temps longs), ainsi qu’une égalité formelle constante entre son espérance mathématique et son écart-type :
$$\mu = \frac{1}{\lambda} \quad \text{et} \quad \sigma = \frac{1}{\lambda} implies \sigma^2 = \frac{1}{\lambda^2}$$
De surcroît, le coefficient d’asymétrie de toute loi exponentielle est invariant et égal à $\gamma_1 = 2$, ce qui dénote une déviation substantielle par rapport à la symétrie nulle d’une courbe de Gauss ($\gamma_1 = 0$), tandis que son excès d’aplatissement s’élève à $\gamma_2 = 6$. Prenons pour modèle expérimental une tâche de détection perceptive élémentaire où les temps de réponse présentent une moyenne théorique $\mu = 200 \text{ ms}$, correspondant à un paramètre de taux $\lambda = \frac{1}{200} = 0{,}005 \text{ ms}^{-1}$. Dans ce modèle, l’écart-type de la population est également de $\sigma = 200 \text{ ms}$.
6.2 Démonstration de la normalisation progressive des moyennes temporelles
Analysons la dynamique d’agrégation lorsque l’on recueille des blocs de temps de réaction de tailles graduelles. Contrairement au cas uniforme précédent, l’asymétrie intrinsèque de la loi exponentielle exerce une résistance manifeste contre le processus de normalisation :
- Pour des micro-blocs ($n = 5$) : La distribution de la somme des temps de réponse suit exactement une loi d’Erlang (loi gamma spécialisée). Pour $n = 5$, le coefficient d’asymétrie de la moyenne d’échantillon s’élève à $\gamma_1(\overline{T}_5) = \frac{2}{\sqrt{5}} \approx 0{,}894$. Bien que ce coefficient ait diminué de plus de moitié par rapport au score initial de 2, l’histogramme de distribution des moyennes affiche toujours une traîne asymétrique résiduelle flagrante vers les valeurs temporelles lentes.
- Pour des échantillons intermédiaires ($n = 15$) : L’asymétrie régresse à $\gamma_1(\overline{T}_{15}) = \frac{2}{\sqrt{15}} \approx 0{,}516$. La morphologie globale s’arrondit nettement, mais les queues de distribution demeurent inégales, la queue droite étant perceptiblement plus épaisse que la queue gauche comprimée par la borne inférieure zéro.
- Pour des échantillons larges ($n ge 50$ ou $n = 100$) : L’asymétrie résiduelle s’abaisse respectivement à $0{,}283$ puis à $0{,}200$. À ces niveaux de volume d’échantillonnage, la distribution de la moyenne temporelle s’est pratiquement affranchie de sa dissymétrie originelle pour se superposer de façon très étroite à une courbe normale théorique dont les paramètres sont $\mu_{\overline{T}} = 200 \text{ ms}$ et $\sigma_{\overline{T}} = \frac{200}{\sqrt{100}} = 20 \text{ ms}$.
6.3 Recommandations d’usage pour les protocoles expérimentaux
Cette démonstration empirique éclaire d’une lumière théorique limpide une pratique méthodologique extrêmement répandue en psychologie cognitive et en neurosciences comportementales : l’agrégation des temps de réaction par condition expérimentale. Les chercheurs procèdent quasi systématiquement au calcul du temps de réaction moyen d’un participant en réalisant la moyenne arithmétique de ses latences sur un bloc comprenant typiquement de 40 à 100 essais répétés par modalité de tâche.
Le théorème central limite fournit l’exacte justification formelle de cette approche : même si les temps de réaction individuels instantanés violent massivement le postulat de normalité gaussienne en raison de leur asymétrie positive prononcée, la moyenne intra-individuelle calculée sur un bloc d’essais suffisamment conséquent constitue une variable d’échantillonnage dont le comportement probabiliste est hautement normalisé. Les analystes peuvent ainsi légitimement injecter ces moyennes individuelles agrégées dans des tests paramétriques à mesures répétées (tels que les modèles ANOVA factoriels ou les modèles linéaires mixtes) avec une garantie de robustesse inférentielle optimale, contournant le besoin systématique d’une transformation logarithmique préalable ($log(TR)$) souvent complexe à réinterpréter dans le domaine des grandeurs physiques directes.
7. Exemple 3 : Application à la distribution binomiale et aux choix forcés
7.1 Le théorème de De Moivre-Laplace comme fondement analytique
L’application du théorème central limite au domaine des variables discrètes constitue l’un des chapitres les plus élégants de l’histoire mathématique, scellé par le théorème d’approximation de De Moivre-Laplace. Considérons une suite de $n$ épreuves de Bernoulli indépendantes, caractérisées par un événement binaire n’admettant que deux issues exclusives : le succès codé conventionnellement 1 (avec une probabilité théorique de survenue $p in ]0, 1[$) et l’échec codé 0 (avec une probabilité $q = 1 – p$). La variable aléatoire globale $X$, représentant le décompte total des succès obtenus sur les $n$ épreuves, suit par définition une loi binomiale $\mathcal{B}(n, p)$.
L’espérance mathématique du décompte de succès s’établit à $\mathbb{E}[X] = np$, et sa variance analytique à $\mathrm{Var}(X) = np(1-p)$. Puisque la loi binomiale n’est rien d’autre que la somme de $n$ variables de Bernoulli indépendantes et identiquement distribuées, le théorème central limite s’y applique de plein droit. Dès lors que le produit d’échantillonnage satisfait les critères empiriques traditionnels de sécurité :
$$np ge 10 \quad \text{et} \quad n(1 – p) ge 10$$
la distribution de probabilité discrète du décompte $X$ converge de façon remarquable vers une loi normale continue :
$$X mathrel{\dot{\sim}} \mathcal{N}\big(np, np(1 – p)\big)$$
Simultanément, la proportion empirique d’échantillon $\widehat{P}_n = \frac{X}{n}$, qui n’est autre que la moyenne arithmétique directe des variables de Bernoulli sous-jacentes, converge vers une distribution normale de paramètres :
$$\widehat{P}_n mathrel{\dot{\sim}} \mathcal{N}\left(p, \frac{p(1 – p)}{n}\right)$$
7.2 Cas concret : Tâche comportementale à choix forcé binaire
Pour matérialiser cette convergence dans le champ expérimental, concevons un paradigme de psychophysique sensorielle reposant sur une tâche de détection de signaux faibles à choix forcé binaire (2-AFC). Un participant est confronté à $n = 100$ stimulations visuelles subliminales successives et doit identifier la présence ou l’absence d’une modulation lumineuse en choisissant obligatoirement entre deux réponses prédéfinies. Sous l’hypothèse nulle d’une absence totale de perception consciente (l’individu répondant au pur hasard stochastique), la probabilité élémentaire de succès théorique est rigoureusement de $p = 0{,}50$.
Calculons les paramètres directeurs du système probabiliste associé à ce protocole :
- Espérance mathématique du décompte : $\mu_X = np = 100 \times 0{,}50 = 50 \text{ succès}$.
- Variance du décompte : $\sigma_X^2 = np(1 – p) = 100 \times 0{,}50 \times 0{,}50 = 25$.
- Écart-type du décompte : $\sigma_X = \sqrt{25} = 5 \text{ succès}$.
- Erreur type de la proportion empirique : $\sigma_{\widehat{P}} = \sqrt{\frac{0{,}50 \times 0{,}50}{100}} = \frac{0{,}50}{10} = 0{,}05$ (soit $5,%$).
Si le participant enregistre empiriquement un score expérimental de $62$ détections correctes sur les $100$ essais présentés, la proportion d’échantillon observée est de $\widehat{p} = 0{,}62$. En exploitant la standardisation autorisée par le théorème central limite, le score $Z$ correspondant se calcule selon :
$$Z = \frac{\widehat{p} – p}{\sigma_{\widehat{P}}} = \frac{0{,}62 – 0{,}50}{0{,}05} = \frac{0{,}12}{0{,}05} = 2{,}40$$
En interrogeant la fonction de répartition de la loi normale standardisée $Phi(z)$, la probabilité critique unilatérale de surpasser une telle performance par le simple fait du hasard s’établit à $1 – \Phi(2{,}40) \approx 0{,}0082$ (et une valeur $p$ bilatérale de $0{,}0164$). L’analyste conclut avec un degré de certitude robuste au rejet de l’hypothèse nulle d’indétectabilité, validant l’existence d’un traitement perceptif subliminal significatif chez ce sujet.
7.3 Correction de continuité et ajustements de calcul
L’utilisation de la distribution normale continue pour modéliser une variable fondamentalement discrète (ne pouvant prendre que des valeurs entières positives) introduit une approximation d’échelle géométrique qui peut être affinée par l’application de la correction de continuité de Yates. Sur le plan structural, une probabilité discrète isolée comme $\mathbb{P}(X = k)$ correspondrait, dans une intégration continue pure, à l’intégrale d’une surface d’une largeur géométrique infiniment nulle, soit zéro. Pour pallier cet écart méthodologique, la masse de probabilité discrète associée à l’entier $k$ est conventionnellement étendue sur le segment réel unitaire délimité par l’intervalle $[k – 0{,}5 ,;, k + 0{,}5]$.
Par voie de conséquence, si l’on souhaite calculer avec une rigueur accrue la probabilité cumulée d’obtenir au moins 62 succès dans notre tâche comportementale précédente, le calcul asymptotique corrigé s’exprime selon :
$$\mathbb{P}(X ge 62) \approx 1 – \Phi\left(\frac{(62 – 0{,}5) – 50}{5}\right) = 1 – \Phi\left(\frac{61{,}5 – 50}{5}\right) = 1 – \Phi(2{,}30) \approx 0{,}0107$$
L’omission de cette correction d’un demi-point génère un léger biais d’optimisme statistique (ici $Z = 2{,}40$ contre $Z = 2{,}30$). Il convient toutefois de souligner que lorsque le volume des essais devient massif — par exemple dans des études de choix forcé regroupant plusieurs milliers d’observations issues de cohortes en ligne —, le terme correctif de $0{,}5 / \sigma$ devient infinitésimal face à l’ampleur du produit $np(1-p)$, rendant la correction de continuité pratiquement superflue dans les environnements expérimentaux à haute intensité de données.
8. Exemple 4 : Application aux scores psychométriques et inventaires cliniques
8.1 Asymétrie structurelle des scores dans les populations non cliniques
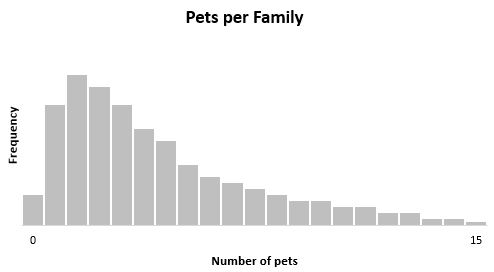
L’un des défis les plus récurrents auxquels sont confrontés les chercheurs en psychiatrie quantitative, en épidémiologie et en psychologie de la santé réside dans le traitement analytique des inventaires d’auto-évaluation symptomatique appliqués à des cohortes issues de la population générale. Considérons des instruments standardisés universellement documentés tels que l’inventaire de dépression de Beck (BDI-II), le questionnaire sur la santé du patient (PHQ-9) ou l’échelle d’anxiété généralisée (GAD-7). Dans un échantillon non clinique représentatif, l’immense majorité des participants déclare une absence totale ou quasi totale de manifestations anxiodépressives au cours des semaines précédant la passation.
Ce profil comportemental génère un phénomène psychométrique bien connu : un effet de plancher massif (floor effect). La distribution brute des scores sommatifs individuels est caractérisée par une concentration extrême d’observations amassées sur les scores planchers (0, 1 ou 2 points), suivie d’une décroissance exponentielle rapide vers les scores sévères. La distribution brute d’un tel échantillon est donc caractérisée par une asymétrie positive vertigineuse, une variance hétérogène et une violation patente du postulat d’homoscédasticité et de normalité imposé par les manuels de statistique élémentaire.
8.2 Normalisation de la moyenne des scores sommatifs de groupe
Face à une distribution brute aussi éloignée de la courbe de Gauss, le jeune chercheur pourrait être tenté de disqualifier d’emblée toute comparaison de moyennes paramétriques par crainte d’invalider ses conclusions inférentielles. C’est précisément à cet endroit que le théorème central limite déploie toute son utilité théorique. Même si le score brut d’un individu isolé $X_i$ au questionnaire de santé est distribué selon une loi discrète lourdement asymétrique, la moyenne arithmétique globale $\overline{X}_n$ calculée sur un groupe de $n = 150$ participants constitue une entité probabiliste entièrement différente.
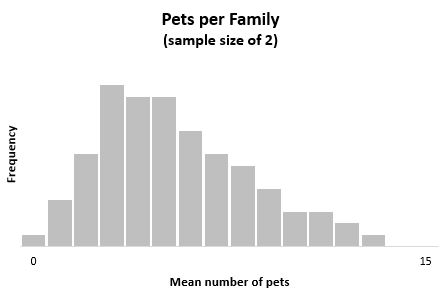
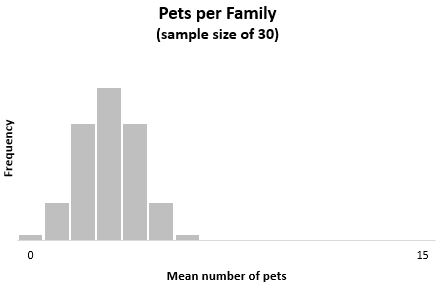
En vertu du théorème central limite, la distribution d’échantillonnage de cette moyenne de groupe converge vers une loi normale symétrique avec une erreur type rigoureusement bornée par $\sigma / \sqrt{n}$. L’effet de plancher qui déformait les observations individuelles disparaît entièrement au niveau de la moyenne de cohorte : les déviations idiosyncrasiques s’annulent mutuellement, et la variabilité inter-échantillons des moyennes s’aligne fidèlement sur une densité gaussienne.
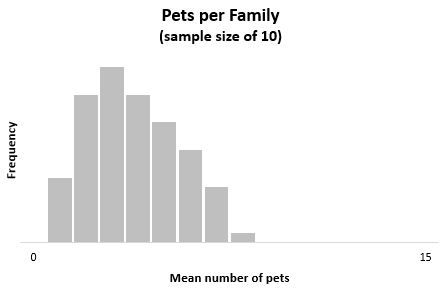
Dès lors, comparer l’efficacité de deux prises en charge d’intervention psychologique ou communautaire (par exemple, méditation de pleine conscience versus contrôle actif) en appliquant un test $t$ de Student pour échantillons indépendants sur les moyennes de scores finaux est une procédure parfaitement légitime et robuste au regard de la théorie des probabilités, pourvu que les effectifs de chaque bras d’étude soient d’une taille suffisante (idéalement $n ge 50$ par groupe pour compenser la forte asymétrie de plancher initiale).
8.3 Distinction cruciale entre inférence de groupe et diagnostic individuel
Il existe néanmoins un danger déontologique et méthodologique absolu contre lequel tout clinicien et psychométricien doit se prémunir : la confusion fatale entre inférence de groupe et bilan psychologique individuel. Le théorème central limite est un théorème d’agrégation d’échantillons ; il s’applique de manière exclusive aux statistiques composites résultant d’une sommation (moyennes de groupes, proportions collectives, coefficients de régression agrégés). Il n’a aucunement le pouvoir — et n’a jamais eu la prétention mathématique — de normaliser la distribution des scores individuels bruts au sein de la population.
Par conséquent, lorsqu’un praticien examine le score isolé d’un unique patient dans le cadre d’un bilan d’évaluation clinique, postuler arbitrairement que ce score brut appartient à une distribution normale et convertir sa performance en une note $Z$ classique (en soustrayant la moyenne et en divisant par l’écart-type de l’échantillon normatif pour en inférer un rang percentile par la table de Laplace-Gauss) constitue une erreur méthodologique sévère si l’instrument souffre d’un effet de plancher. Dans une telle configuration asymétrique, un score $Z$ ne correspond absolument pas aux pourcentages théoriques de la loi normale (les fameux $68,%$ entre $\pm 1 \sigma$ ou $95,%$ entre $\pm 1{,}96 \sigma$). Pour le diagnostic et la restitution individuelle, l’analyste doit impérativement renoncer à l’approximation gaussienne et s’appuyer strictement sur des méthodes d’étalonnage non paramétriques empiriques, fondées sur les rangs percentiles directs observés au sein de la cohorte d’étalonnage standardisée.
9. Rôle du théorème central limite dans l’inférence statistique et les tests d’hypothèses
9.1 Fondement théorique de la construction des intervalles de confiance
L’un des piliers opérationnels de la démarche scientifique moderne repose sur l’estimation par intervalle de confiance, permettant de cerner un paramètre populationnel inconnu au sein d’une fourchette métrique assortie d’un indice de certitude probabiliste contrôlé. La dérivation mathématique universelle de l’intervalle de confiance pour la moyenne d’une population repose très précisément sur la convergence normale garantie par le théorème central limite.
Puisque la quantité standardisée $Z = \frac{\overline{X}_n – \mu}{\sigma / \sqrt{n}}$ converge en loi vers la distribution normale standard $\mathcal{N}(0, 1)$, nous pouvons affirmer que pour tout niveau de confiance nominal $(1 – \alpha)$, il existe un quantile critique bilatéral $z_{1 – alpha/2}$ satisfaisant la relation probabiliste :
$$\mathbb{P}\left(-z_{1 – alpha/2} le \frac{\overline{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}} le z_{1 – alpha/2}\right) x\rightarrow{n to \infty} 1 – \alpha$$
En isolant algébriquement le paramètre cible $\mu$ au centre de cette double inégalité, nous obtenons la structure de l’intervalle de confiance asymptotique à $(1 – \alpha)%$ :
$$\mathrm{IC}_{1-\alpha}(\mu) = \left[ \overline{X}_n – z_{1 – alpha/2} \frac{\sigma}{\sqrt{n}} ;,; \overline{X}_n + z_{1 – alpha/2} \frac{\sigma}{\sqrt{n}} \right]$$
Pour le seuil de confiance classique de 95 % ($\alpha = 0{,}05$), le quantile critique de la loi normale standard est de $z_{0{,}975} \approx 1{,}960$. L’interprétation méthodologique rigoureuse de cette formulation stipule que si l’on répétait indéfiniment la procédure d’extraction d’échantillons de même taille $n$ dans la même population cible, 95 % des intervalles ainsi construits recouvriraient la véritable moyenne inconnue $\mu$. La largeur totale de cet intervalle de précision (sa marge d’erreur) est régie par la dynamique combinée de la variabilité inhérente du phénomène $\sigma$ et de la taille d’échantillon collectée $\sqrt{n}$, démontrant formellement la rentabilité décroissante de l’effort expérimental lors de l’accroissement des cohortes.
9.2 Justification de la robustesse des tests de Student et de l’ANOVA
Dans la pratique de l’expérimentation biologique, médicale et humaine, les chercheurs mettent en œuvre de façon quasi systématique des tests de comparaison inférentielle paramétriques, au premier rang desquels figurent le test $t$ de Student (pour la comparaison de deux moyennes) et l’analyse de variance ou ANOVA (pour l’évaluation factorielle simultanée de trois groupes ou plus). Les manuels d’instruction formulent invariablement parmi les postulats de base de ces tests l’obligation que la variable dépendante d’intérêt soit « distribuée normalement » au sein de chaque groupe étudié.
Pourtant, dans la réalité matérielle des laboratoires, cette condition de normalité parfaite des scores individuels bruts n’est presque jamais rigoureusement satisfaite. Comment expliquer dès lors que la communauté scientifique continue d’exploiter avec une fiabilité remarquable ces modèles linéaires classiques sans voir ses conclusions systématiquement biaisées ? La réponse repose directement sur le théorème central limite. La statistique $t$ de Student ou la statistique $F$ de Fisher-Snedecor mobilisent au numérateur des différences de moyennes d’échantillons. Dès lors que les effectifs de chaque groupe sous revue atteignent des niveaux suffisants (généralement $n ge 30$ à $50$ par cellule de traitement), la normalisation des distributions d’échantillonnage de ces moyennes neutralise efficacement l’impact des déviations non gaussiennes des scores bruts sous-jacents.
Les tests paramétriques d’inférence sur les moyennes sont réputés statistiquement « robustes » à la violation de la normalité : le taux d’erreur de type I réel demeure remarquablement fidèle au seuil théorique nominal $\alpha = 0{,}05$. Il existe néanmoins une réserve méthodologique d’une importance capitale : cette robustesse est pleinement préservée tant que les groupes sont de tailles équilibrées ($n_1 \approx n_2$) et que le postulat d’homogénéité des variances (homoscédasticité) est rigoureusement respecté. En revanche, si une asymétrie distributionnelle prononcée coexiste avec un déséquilibre numérique sévère des effectifs et des variances résiduelles hautement disparates, les garanties asymptotiques peuvent être corrompues, exigeant alors le recours à des ajustements correctifs tels que la correction de Welch-Satterthwaite.
9.3 Planification de la puissance statistique et dimensionnement d’échantillon
Le théorème central limite constitue également le socle mathématique fondamental gouvernant l’analyse de puissance a priori et le calcul du dimensionnement d’échantillon lors de la conception d’un devis de recherche expérimental. La puissance statistique d’une étude ($1 – \beta$) désigne la probabilité méthodologique d’observer un résultat empirique statistiquement significatif au seuil $\alpha$ lorsqu’il existe bel et bien un effet réel d’une amplitude déterminée (taille d’effet) dans la population sous-jacente.
Considérons le cas d’une comparaison de deux moyennes indépendantes présentant une différence minimale clinique attendue $\Delta = |\mu_1 – \mu_2|$ sous une hypothèse alternative bilatérale $H_1$, avec un écart-type commun présumé $\sigma$. En mobilisant les propriétés asymptotiques gaussiennes des distributions d’échantillonnage des deux groupes, l’erreur type de la différence de moyennes s’exprime selon $\sigma_{\Delta} = \sigma \sqrt{\frac{2}{n}}$ (pour des tailles d’échantillons égales $n$). Le calibrage analytique du nombre d’unités $n$ requis par cellule pour garantir simultanément un risque de première espèce $\alpha$ et une puissance fixée $1 – \beta$ se déduit directement de l’équation de chevauchement gaussien :
$$n = \frac{2 \cdot (z_{1 – alpha/2} + z_{1 – \beta})^2 \cdot \sigma^2}{\Delta^2} = \frac{2 \cdot (z_{1 – alpha/2} + z_{1 – \beta})^2}{d^2}$$
où $d = \frac{\Delta}{\sigma}$ représente le célèbre d de Cohen (taille d’effet standardisée), et $z_{1 – \beta}$ le quantile de la loi normale standard associé au niveau de puissance désiré (par exemple $z_{0{,}80} \approx 0{,}84$ pour une puissance conventionnelle de 80 %). Cette formulation démontre avec éclat que toute la structure décisionnelle de l’optimisation des ressources en recherche quantitative est une conséquence déductive directe du resserrement stochastique garanti par le théorème central limite.
10. Erreurs d’interprétation courantes et limites méthodologiques
10.1 La confusion entre données individuelles et moyennes d’échantillons
En dépit de son omniprésence dans les cursus universitaires, le théorème central limite demeure l’un des concepts les plus fréquemment travestis et mal interprétés au sein de la communauté scientifique appliquée. L’erreur conceptuelle la plus répandue consiste à proclamer : « Si mon échantillon contient plus de trente sujets, alors mes données sont normales ». Cette proposition est une aberration théorique manifeste qui témoigne d’une confusion épistémologique profonde entre les propriétés d’un échantillon individuel et celles d’une distribution d’échantillonnage abstraite.
L’accroissement de la taille de l’échantillon n’a absolument aucun pouvoir de modifier la morphologie distributionnelle intrinsèque du phénomène mesuré dans le monde réel. Si vous mesurez le nombre d’enfants par foyer fiscal, le volume de transactions financières boursières quotidiennes ou le temps de survie cellulaire après exposition à un rayonnement ionisant, la distribution sous-jacente est et restera indéfiniment asymétrique ou discontinue. Recueillir un échantillon colossal de $n = 50,000$ observations ne transformera en aucune manière l’histogramme de ces données en une courbe normale ; au contraire, en vertu de la loi forte des grands nombres et du théorème de Glivenko-Cantelli, cet échantillon massif révélera avec une netteté empirique de plus en plus chirurgicale la véritable asymétrie non gaussienne de la population mère. Ce qui converge vers une loi normale avec l’élévation de $n$, c’est exclusivement la distribution de la moyenne calculée sur de multiples tirages, et non le nuage des données élémentaires brutes.
10.2 Sensibilité aux valeurs extrêmes et contamination distributionnelle
Une seconde limite méthodologique majeure du théorème central limite tient à la vulnérabilité intrinsèque de la moyenne arithmétique face aux observations extrêmes aberrantes (outliers) et aux contaminations de distribution. La moyenne empirique $\overline{X}_n$ possède un point de rupture statistique égal à $1/n$ : il suffit théoriquement d’une seule observation erratique ou d’une erreur d’encodage décimale monumentale pour déplacer arbitrairement la moyenne vers des valeurs absurdes, perturbant instantanément l’estimation du barycentre.
Sur le plan du théorème central limite, la présence d’une proportion même infime de valeurs extrêmes au sein d’une population — ce que les statisticiens modélisent sous forme de distributions contaminées par un mélange d’échelles — a pour conséquence d’hypertrophier artificiellement le troisième et le quatrième moment de la loi mère ($rho$ et $\sigma^4$). Comme nous l’avons souligné à travers le théorème de Berry-Esseen, un troisième moment disproportionné ralentit considérablement la vitesse de convergence de la distribution d’échantillonnage vers la loi normale. Dans de telles circonstances, croire que l’approximation gaussienne opère convenablement à $n = 30$ est une illusion dangereuse : la distribution de la moyenne peut conserver des queues épaisses et une instabilité structurelle importante jusqu’à des effectifs de plusieurs centaines d’unités. Pour surmonter cette fragilité, il est souvent préférable de recourir à des estimateurs d’emplacement robustes, tels que les moyennes tronquées (trimmed means) ou les moyennes winsorisées, dont les distributions d’échantillonnage bénéficient également d’une normalité asymptotique mais avec une stabilité empirique bien supérieure face aux contaminations accidentelles.
10.3 Violation de l’hypothèse d’indépendance des observations
Le troisième piège méthodologique fondamental réside dans la transgression silencieuse mais dévastatrice du postulat d’indépendance stochastique des données. Le théorème central limite standard postule sans équivoque que chaque unité statistique apporte une information totalement découplée des unités adjacentes. Or, dans les protocoles de recherche contemporains, les données présentent fréquemment des architectures de dépendance intrinsèques qui violent cette hypothèse :
- Structures hiérarchiques et regroupées (clustered data) : Des élèves évalués au sein de mêmes classes scolaires, des patients soignés par un même thérapeute ou des mesures collectées dans des centres hospitaliers distincts partagent des facteurs environnementaux communs non observés, induisant une corrélation intra-classe (ICC) strictement positive.
- Dépendances longitudinales et séries temporelles : Les protocoles d’évaluation écologique momentanée (EMA) ou les suivis par capteurs connectés génèrent des mesures intrapersonnelles hautement autocorrélées au fil du temps (processus autorégressifs AR(1)).
Lorsque des données non indépendantes sont traitées par la machinerie standard du théorème central limite sans modélisation correctrice, la formule conventionnelle de l’erreur type $\frac{\sigma}{\sqrt{n}}$ sous-estime drastiquement la véritable variance de l’échantillonnage. En présence d’une corrélation intra-classe positive, la variance réelle de la moyenne est multipliée par un coefficient de déflation de variance (design effect) approximé par :
$$\mathrm{Deff} = 1 + (m – 1) \cdot \rho_{\text{ICC}}$$
où $m$ est la taille moyenne des grappes et $\rho_{\text{ICC}}$ le coefficient de corrélation intra-groupe. L’ignorer aboutit à des intervalles de confiance excessivement étroits, des scores $Z$ artificiellement gonflés et une explosion dramatique du taux de faux positifs bien au-delà du seuil nominal des 5 %. Pour restaurer la validité des théorèmes limites dans ces configurations complexes, les chercheurs doivent obligatoirement recourir aux théorèmes asymptotiques spécifiques de la modélisation multiniveau ou déployer des estimateurs de variance robustes par grappes (Huber-White cluster sandwich estimators).
11. Simulations numériques et visualisations empiriques de la convergence
11.1 Architecture d’une simulation de Monte Carlo pour observer la convergence
L’avènement de la puissance computationnelle moderne permet aujourd’hui d’observer la dynamique fonctionnelle du théorème central limite non plus seulement par des abstractions déductives, mais par la puissance visuelle et quantitative des simulations de Monte-Carlo. L’architecture algorithmique d’une telle expérience numérique est élégante et universelle. Elle se décompose selon le protocole séquentiel suivant :
- Définition de la population mère génératrice : On sélectionne délibérément une loi de probabilité réputée hautement non normale, caractérisée par une forte asymétrie ou une discontinuité prononcée (par exemple une distribution log-normale de paramètres $\mu = 0$ et $\sigma = 1$, ou une loi chi-carré à un degré de liberté $\chi^2(1)$ dont l’asymétrie théorique est extrême avec $\gamma_1 = \sqrt{8} \approx 2{,}83$).
- Génération itérative d’échantillons indépendants : Pour une taille d’échantillon fixée $n$ (par exemple $n in {2, 5, 15, 30, 100}$), on simule par calcul informatique $K = 10,000$ tirages pseudo-aléatoires indépendants et exhaustifs de taille $n$.
- Extraction de la statistique d’intérêt : Pour chaque réplication $k in {1, dots, K}$, on calcule la moyenne empirique de l’échantillon $\overline{x}_k = \frac{1}{n} \sum_{i=1}^n x_{i,k}$, que l’on enregistre dans un vecteur de résultats de dimension $K$.
- Analyse de la distribution d’échantillonnage résultante : On examine la forme de l’histogramme empirique constitué par les $10,000$ moyennes recueillies, on superpose la densité théorique normale attendue, et l’on évalue quantitativement le rapprochement des moments empiriques d’ordre trois et quatre vers leurs cibles gaussiennes idéales (0 et 3).
11.2 Analyse comparative visuelle : Histogrammes, densités et diagrammes quantile-quantile
Le suivi de cette simulation à travers des représentations graphiques synchronisées offre une démonstration empirique spectaculaire de la validité du théorème central limite. Lorsque la taille d’échantillon est unitaire ($n = 1$), l’histogramme des $10,000$ tirages reproduit fidèlement la distribution de la population mère : une falaise abrupte écrasée contre l’origine zéro et une longue traînée de valeurs rares s’étirant vers la droite.
À mesure que la taille de l’échantillon augmente pour passer par $n = 5$, puis $n = 15$, la métamorphose visuelle s’accélère. L’histogramme se décolle de l’axe vertical d’origine, le pic de densité se déplace vers le centre de gravité théorique, et la dissymétrie s’efface progressivement sous l’effet de l’annulation combinatoire des écarts stochastiques. À $n = 30$, et de manière encore plus éclatante à $n = 100$, l’histogramme de ces moyennes simulées s’ajuste parfaitement à la cloche de Gauss continue théorique calculée avec une espérance $\mu$ et un écart-type $\sigma / \sqrt{n}$.
L’outil diagnostique le plus rigoureux pour scruter cette adéquation reste le diagramme quantile-quantile (Q-Q plot). Ce graphique projette les quantiles empiriques de la distribution des moyennes simulées en ordonnée contre les quantiles théoriques d’une distribution normale standard en abscisse. Pour des petits échantillons ($n = 2$ ou $5$), le tracé Q-Q affiche une courbure parabolique prononcée traduisant l’asymétrie résiduelle tenace. En revanche, dès que $n$ atteint 30 ou 50, les points expérimentaux se fondent sur la première bissectrice rectiligne idéale. Les écarts marginaux résiduels ne subsistent qu’aux extrémités les plus lointaines des quantiles extrêmes (au-delà de trois écarts-types, $|Z| > 3$), confirmant que le cœur de la distribution d’échantillonnage s’est impeccablement normalisé.
11.3 Tests de normalité appliqués aux distributions d’échantillonnage
Face à ces séries de moyennes simulées, il est méthodologiquement instructif d’administrer des tests statistiques formels d’adéquation à la normalité, à l’image du test de Shapiro-Wilk, du test de D’Agostino-Pearson ou du test d’Anderson-Darling. L’application de ces tests à des simulations de Monte-Carlo recèle toutefois un paradoxe statistique captivant qui requiert une solide maturité interprétative : la question de la sur-puissance d’échantillonnage.
Les tests d’hypothèse de normalité évaluent l’hypothèse nulle $H_0$ selon laquelle l’échantillon est issu d’une population strictement gaussienne. Comme pour tout test statistique, la puissance du test croît proportionnellement à la taille de la cohorte analysée. Si nous administrons le test de Shapiro-Wilk à notre vecteur de moyennes de Monte-Carlo de taille $K = 10,000$ pour un échantillon modéré de $n = 30$, le test retournera fréquemment une valeur $p < 0{,}001$, rejetant formellement l'hypothèse de normalité parfaite !
Ce résultat n’invalide en rien le théorème central limite : il souligne simplement que la convergence garantie par le théorème est une propriété mathématique asymptotique ($n to \infty$). Pour une taille finie comme $n = 30$, il subsiste inévitablement une infime déviation résiduelle par rapport à la perfection gaussienne. Parce que notre simulation contient 10 000 réplications, le test possède une puissance gigantesque capable de détecter cette microscopique divergence infinitésimale, qui est pourtant totalement dénuée de la moindre conséquence pratique sur l’inférence clinique ou économique. Ce phénomène met en garde le chercheur contre la dépendance aveugle aux valeurs $p$ des tests de normalité purs sur de grands échantillons, rappelant que l’évaluation méthodologique opérationnelle de la normalité doit toujours privilégier l’examen visuel des quantiles et le calcul des indices d’asymétrie ($le |1|$) et d’excès d’aplatissement ($le |2|$) plutôt que le simple rejet mécanique d’une hypothèse nulle stricte.
12. Synthèse conceptuelle et perspectives méthodologiques en recherche expérimentale
12.1 Tableau synoptique des formules et principes directeurs
Afin de consolider les équations directrices et les propriétés probabilistes décortiquées tout au long de cette étude, le tableau synoptique suivant récapitule l’architecture mathématique de l’échantillonnage aléatoire simple sous l’égide du théorème central limite :
| Paramètre ou Statistique | Formulation Mathématique | Signification Méthodologique |
|---|---|---|
| Espérance de la moyenne | $$\mathbb{E}[\overline{X}_n] = \mu$$ | Propriété de non-biais absolu ; la moyenne d’échantillon gravite exactement autour du barycentre de la population quelle que soit la taille $n$. |
| Variance d’échantillonnage | $$\mathrm{Var}(\overline{X}_n) = \frac{\sigma^2}{n}$$ | Contraction stochastique inversement proportionnelle à la taille de l’échantillon sous postulat d’indépendance des observations. |
| Erreur type de la moyenne | $$\sigma_{\overline{X}} = \frac{\sigma}{\sqrt{n}}$$ | Écart-type de la distribution d’échantillonnage ; mesure fondamentale de la précision métrologique de l’estimation empirique. |
| Score Z standardisé | $$Z_n = \frac{\overline{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}} x\rightarrow{\mathcal{L}} \mathcal{N}(0, 1)$$ | Transformation linéaire universelle permettant le calcul des valeurs $p$ et l’inférence probabiliste sans égard aux unités de départ. |
| Atténuation d’asymétrie | $$\gamma_1(\overline{X}_n) = \frac{\gamma_{1,\text{pop}}}{\sqrt{n}}$$ | Vitesse de symétrisation de la distribution d’échantillonnage au fur et à mesure de l’élévation du nombre d’unités d’observation. |
| Borne d’erreur d’approximation | $$\sup_{z} |F_n(z) – \Phi(z)| le \frac{C \cdot \rho}{\sigma^3 \sqrt{n}}$$ | Théorème de Berry-Esseen fixant la vitesse de convergence maximale vers la fonction de répartition normale standard. |
12.2 Arbre décisionnel pour le choix des tests statistiques
La mobilisation opérationnelle du théorème central limite au sein des laboratoires de recherche implique une démarche raisonnée évitant aussi bien l’immobilisme frileux que l’optimisme téméraire. L’arbre décisionnel suivant schématise le protocole méthodologique optimal pour guider le choix entre statistiques paramétriques conventionnelles et approches alternatives :
- Étape 1 : Diagnostic des effectifs d’échantillonnage ($n$) :
- Si $n$ est très grand ($n ge 100$ par groupe) : Le théorème central limite opère avec une puissance robuste. Même en présence d’asymétrie marquée ou de variables discrètes ordinales, les statistiques paramétriques (tests $t$, ANOVA, régressions linéaires) sont pleinement autorisées et conservent leur robustesse nominale.
- Si $n$ est modéré ($30 le n < 100$) : Examiner la forme de la distribution empirique. Si l’asymétrie est modérée sans valeurs extrêmes catastrophiques, les tests paramétriques demeurent hautement valides. En présence d’une distribution lourdement bimodale ou à effet plancher extrême, privilégier des analyses de robustesse complémentaires (bootstrap).
- Si $n$ est petit ($n < 30$) : Le théorème central limite ne peut pas être invoqué pour garantir automatiquement la normalité. Passer impérativement à l’étape 2.
- Étape 2 : Évaluation des petits échantillons ($n < 30$) :
- Vérifier rigoureusement l’adéquation distributionnelle par un diagramme Q-Q plot et les connaissances théoriques du domaine de mesure.
- Si les données proviennent d’un phénomène physiologiquement normalisé (par exemple la taille d’adultes sains) : L’application du test $t$ de Student reste appropriée.
- Si les données sont asymétriques, discrètes ou d’allure incertaine : Rejeter les tests paramétriques standards. Orienter le protocole vers les tests de rangs non paramétriques (Mann-Whitney, Wilcoxon, Kruskal-Wallis) ou les tests de permutation exacts.
- Étape 3 : Contrôle transversal incontournable de l’indépendance :
- Quelle que soit la valeur de $n$, vérifier si les observations sont indépendantes. En cas de données appariées, longitudinales ou groupées par grappes, abandonner les modèles univariés simples au profit des modèles linéaires à effets mixtes (LMM) ou des équations d’estimation généralisées (GEE).
12.3 Recommandations de rédaction selon les standards académiques
Pour assurer la transparence, la reproductibilité scientifique et la conformité aux exigences des revues académiques internationales de premier plan (notamment les recommandations de l’American Psychological Association – APA 7e édition, et du consortium CONSORT pour les essais cliniques), les chercheurs sont tenus de documenter rigoureusement le traitement de leurs distributions d’échantillonnage :
- Déclaration explicite des postulats méthodologiques : Il est impératif d’énoncer clairement comment les postulats d’application des tests ont été investigués. Bannir les formules vagues telles que « les données étaient normales » et préciser explicitement : « En vertu du théorème central limite et compte tenu de la taille de nos effectifs ($n = 65$ par groupe), la distribution d’échantillonnage des moyennes a été considérée comme asymptotiquement normale, autorisant l’usage de tests paramétriques malgré l’asymétrie modérée observée sur les scores bruts ».
- Transparence sur les indices de dispersion : Ne jamais confondre l’écart-type ($SD$) et l’erreur type de la moyenne ($SE$). L’écart-type décrit la variabilité intrinsèque des observations individuelles brutes ; l’erreur type quantifie l’incertitude de l’estimation de la moyenne. Rapporter systématiquement les deux indices ou associer la moyenne empirique à son intervalle de confiance à 95 % explicitement formalisé : « $M = 24{,}35 \text{ ms}$, $SD = 8{,}12$, $95,% \text{ IC } [22{,}34 ,;, 26{,}36]$ ».
- Justification des procédures de validation croisée : Lorsque les effectifs sont limités ou que les distributions présentent des formes complexes, mentionner systématiquement les méthodes de sensibilité déployées : « En raison d’un effectif réduit ($n = 18$ par cellule), les résultats du test $t$ ont été confirmés par une procédure de bootstrap non paramétrique à $10,000$ rééchantillonnages avec correction de biais et accélération ($BC_a$) ».
En embrassant cette rigueur épistémologique et en articulant avec discernement les certitudes analytiques offertes par le théorème central limite avec la vigilance empirique requise face aux données réelles, le chercheur moderne s’assure que ses inférences statistiques ne constituent pas de simples artefacts calculatoires, mais d’authentiques découvertes scientifiques robustes, reproductibles et universellement interprétables.
Références
- Berry, A. C. (1941). The accuracy of the Gaussian approximation to the sum of independent variates. Transactions of the American Mathematical Society, 49(1), 122–136. https://doi.org/10.1090/S0002-9947-1941-0003498-3
- de Moivre, A. (1738). The Doctrine of Chances: Or, A Method of Calculating the Probability of Events in Play (2nd ed.). H. Woodfall.
- Esseen, C.-G. (1942). On the Liapunoff limit of error in the theory of probability. Arkiv för Matematik, Astronomi och Fysik, A28(9), 1–19.
- Feller, W. (1968). An Introduction to Probability Theory and Its Applications (3rd ed., Vol. 1). John Wiley & Sons.
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
- Lindeberg, J. W. (1920). Eine neue Herleitung des Exponentialgesetzes in der Wahrscheinlichkeitsrechnung. Mathematische Zeitschrift, 15(1), 211–225. https://doi.org/10.1007/BF01494395
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Pek, J., Wong, O., & Wong, A. C. (2018). How to address non-normality: A taxonomy of approaches, reviewed, and illustrated. Frontiers in Psychology, 9, 2104. https://doi.org/10.3389/fpsyg.2018.02104
- Student [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Wilcox, R. R. (2017). Introduction to Robust Estimation and Hypothesis Testing (4th ed.). Academic Press.