
Au cœur de l’épistémologie contemporaine et des sciences du comportement réside une exigence impérieuse de rigueur méthodologique, condition sine qua non de la découverte de vérités scientifiques robustes et réplicables. La psychologie scientifique, la psychiatrie translationnelle et l’épidémiologie clinique se confrontent perpétuellement à la complexité intrinsèque de l’appareil psychique et à l’extrême variabilité des populations humaines. Dans cet univers saturé de bruits de mesure, de confusions conceptuelles et de déterminants polyfactoriels, la maîtrise de l’aléa mathématique constitue l’un des piliers méthodologiques les plus puissants jamais conceptualisés par l’esprit humain. Pourtant, deux opérations fondamentales mobilisant le principe de stochasticité continuent de susciter des amalgames théoriques et pratiques regrettables, y compris chez des chercheurs chevronnés : la sélection aléatoire (ou échantillonnage probabiliste) et l’assignation aléatoire (ou randomisation expérimentale).
Cette confusion n’est nullement une simple querelle sémantique réservée aux puristes de l’analyse statistique ou aux épistémologues de salon. Elle touche directement à la nature même des conclusions qu’une investigation empirique est en droit d’énoncer. Confondre le mécanisme par lequel les participants sont extraits d’une population parente avec le protocole selon lequel ces mêmes participants sont répartis au sein de conditions expérimentales concurrentes revient à confondre la transférabilité d’un constat avec la démonstration formelle de son étiologie causale. Alors que la communauté scientifique internationale traverse une crise de la reproductibilité sans précédent, marquée par l’échec de réplication de paradigmes classiques en neurosciences cognitives et en psychologie sociale, une clarification sans concession de ces deux piliers s’avère indispensable.
Le présent traité méthodologique propose une exploration exhaustive, critique et formalisée de la ligne de partage séparant la sélection aléatoire de l’assignation aléatoire. En articulant les fondements de la statistique inférentielle, les théories contrefactuelles de la causalité et les impératifs concrets de la recherche de laboratoire et de terrain, cet article dissèque les mécanismes opérationnels, les retombées théoriques sur la validité interne et externe, les matrices de devis de recherche qui en découlent, ainsi que les écueils statistiques et éthiques inhérents à leur implémentation. L’objectif ultime est d’offrir aux étudiants, aux chercheurs et aux cliniciens une cartographie conceptuelle sans faille, permettant de concevoir, d’analyser et d’évaluer la littérature scientifique avec la plus haute exigence d’intégrité intellectuelle.
1. Introduction conceptuelle et distinction fondamentale
1.1 Définition globale de la sélection et de l’assignation aléatoires
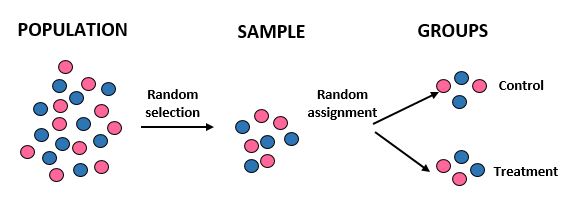
La différenciation structurelle entre l’obtention de l’échantillon d’étude et la répartition ultérieure des participants constitue le socle fondamental sur lequel repose l’architecture de la recherche quantitative. La sélection aléatoire, relevant de la théorie de l’échantillonnage statistique initiée par des pionniers tels que Jerzy Neyman, désigne le processus stochastique par lequel un sous-ensemble d’unités d’observation est extrait d’une population globale définie. Dans ce cadre, chaque élément de la population parente dispose d’une probabilité d’inclusion mathématiquement formalisable et strictement supérieure à zéro. Il s’agit d’un mécanisme d’importation : l’objectif est d’extraire du macrocosme de la population un microcosme expérimental dont les propriétés distributionnelles reflètent fidèlement celles de l’ensemble d’origine.
À l’inverse, l’assignation aléatoire — théorisée magistralement par Ronald Aylmer Fisher dans le cadre des devis expérimentaux agricoles avant d’être transplantée dans les sciences biomédicales et psychologiques — n’intervient qu’une fois les participants effectivement recrutés au sein du protocole. Elle régit la distribution interne de ces individus au sein des différents bras d’une manipulation expérimentale (par exemple, un groupe recevant une psychothérapie comportementale versus un groupe placé sur liste d’attente ou recevant un placebo). L’assignation aléatoire est donc une opération de structuration distributive, qui ne s’intéresse aucunement à la provenance des sujets, mais assure l’indépendance statistique entre les caractéristiques intrinsèques des participants et leur appartenance à un groupe de traitement spécifique.
L’origine épistémologique de ce paradigme probabiliste dans les sciences comportementales marque le passage historique d’une psychologie purement descriptive ou spéculative à une science expérimentale rigoureuse. La clarification sémantique entre échantillonnage probabiliste et randomisation expérimentale n’est donc pas une coquetterie technique, mais l’expression de deux nécessités distinctes : répondre avec rigueur à la question « De qui parle-t-on ? » (sélection) tout en garantissant une réponse irréfutable à la question « Qu’est-ce qui cause quoi ? » (assignation). Ce double ancrage probabiliste confère aux démarches empiriques une autorité méthodologique indispensable pour asseoir la validité scientifique des modèles psychologiques.
1.2 La métaphore canonique : ‘Recruter’ versus ‘Organiser’
Pour dissiper les ambiguïtés persistantes, la métaphore didactique articulant l’action de « Recruter » à celle d’« Organiser » demeure la plus éclairante. La sélection aléatoire opère à la frontière extérieure de l’investigation empirique : elle constitue le filtre d’admission à travers lequel des citoyens ordinaires, des patients diagnostiqués ou des étudiants sont extraits de leur milieu naturel pour franchir le seuil du laboratoire ou de la cohorte d’enquête. C’est l’acte de constitution de la matière première de la recherche. Si ce recrutement repose sur un tirage au sort probabiliste, le chercheur s’assure que la diversité sociodémographique, les profils cognitifs sous-jacents et les idiosyncrasies de la population générale pénètrent équitablement dans l’espace de la recherche.
L’assignation aléatoire intervient dans un second temps logique et chronologique, au cœur du laboratoire ou de la clinique : elle consiste à « organiser » ce matériel humain préalablement constitué. Une fois que la cohorte de participants a franchi les portes de l’étude et signé le formulaire de consentement éclairé, la question n’est plus de savoir s’ils représentent la société dans son ensemble, mais comment les répartir au sein des conditions expérimentales de manière à ce qu’aucun biais humain — qu’il émane des préférences de l’expérimentateur ou des désirs conscients ou inconscients du sujet — ne dicte l’attribution d’un protocole particulier. C’est un mécanisme de tri aveugle, une redistribution stochastique garantissant que les groupes d’intervention soient des copies conformes les uns des autres avant même l’administration de la moindre variable indépendante.
Les conséquences directes d’une mauvaise interprétation opérationnelle de cette chronologie sont délétères pour le chercheur. Prendre un groupe d’étudiants volontaires en première année de psychologie (échantillon de stricte convenance, non sélectionné aléatoirement) et les répartir au sort entre deux tâches cognitives permet d’isoler l’effet causal de la tâche, mais n’autorise en rien à affirmer que cet effet se manifestera à l’identique chez des adultes âgés ou des ouvriers d’usine. Inversement, tirer au sort un échantillon parfaitement représentatif de 5 000 Français issus du recensement national pour ensuite administrer un nouveau traitement aux seuls citadins et l’ancien traitement aux ruraux anéantit toute possibilité d’inférence causale, en dépit d’une représentativité de départ exemplaire.
1.3 Importance de la distinction pour la reproductibilité en psychologie
Depuis le début des années 2010, les sciences du comportement sont traversées par une crise systémique de la reproductibilité, documentée par des consortiums internationaux tels que l’Open Science Collaboration. Une proportion alarmante d’effets publiés dans les revues les plus prestigieuses s’est avérée incapable de franchir l’épreuve de la réplication indépendante. Si les pratiques de falsification délibérée demeurent exceptionnelles, l’analyse des défaillances méthodologiques a révélé que la mauvaise compréhension des biais d’échantillonnage et des faiblesses d’assignation constitue le terreau fertile de cette instabilité empirique. Lorsqu’une étude revendique un effet universel sur la mémoire de travail sur la base d’un échantillon restreint et hautement sélectionné, elle expose l’ensemble de l’édifice théorique à l’effondrement lors de tentatives de généralisation ultérieures.
Chaque concept neutralise en effet un ensemble distinct de menaces méthodologiques. L’échantillonnage non probabiliste introduit des biais de sélection qui distordent la distribution des variables et créent des modérateurs cachés : un effet psychologique réel peut n’exister que sous l’action conjuguée de traits de personnalité surreprésentés chez les volontaires rémunérés des plateformes en ligne, comme Amazon Mechanical Turk ou Prolific. À l’opposé, les manquements à l’assignation aléatoire ouvrent la voie à des confusions d’effets majeures, où des variables parasites non contrôlées (motivation intrinsèque, niveau socio-éducatif des répondants, sévérité initiale de la pathologie) se trouvent corrélées avec la condition expérimentale, générant des faux positifs statistiques (erreurs de type I).
Face à ces dérives, les normes de publication académique, notamment les directives de l’American Psychological Association (APA) et les standards internationaux d’intégrité de la recherche, exigent désormais une précision terminologique absolue. Les auteurs ne peuvent plus employer le vocable générique de « randomisation » sans spécifier s’il se rapporte au mécanisme d’inclusion dans l’échantillon ou à l’attribution des conditions expérimentales. La rigueur rédactionnelle devient ainsi le rempart direct contre les extrapolations abusives et l’illusion de causalité, consolidant la robustesse cumulative des connaissances en psychologie.
2. La sélection aléatoire : Mécanismes, définition et finalité méthodologique
2.1 Principes directeurs du tirage au sort dans la population
La sélection aléatoire s’enracine dans la théorie axiomatique des probabilités appliquées aux ensembles finis. Son principe fondamental réside dans l’équiprobabilité d’inclusion : chaque unité statistique appartenant à la population cible préalablement circonscrite doit posséder une probabilité strictement égale et connue d’être extraite lors du tirage. Ce postulat mathématique s’exprime par le ratio $P(E_i) = \frac{1}{N}$, où $N$ représente la taille exhaustive de la population parente et $E_i$ l’événement caractérisant l’inclusion du $i$-ème individu dans l’échantillon de taille $n$. Pour opérationnaliser ce principe, le chercheur doit obligatoirement disposer d’un cadre d’échantillonnage (ou base de sondage), constitué de la liste exhaustive, sans doublon ni omission, de tous les membres composant la population cible.
Dans la pratique de la recherche psychologique et épidémiologique, l’accès à une base de sondage parfaite s’avère extrêmement rare et complexe. Les listes électorales, les registres nationaux d’assurance maladie ou les annuaires d’établissements scolaires souffrent structurellement d’erreurs de couverture. Ces erreurs se scindent en omissions (sous-couverture d’individus marginalisés, sans domicile ou institutionnalisés) et en inclusions indues (sur-couverture d’individus ayant déménagé ou décédés). Dès lors que le cadre d’échantillonnage est imparfait, le principe d’équiprobabilité se trouve mathématiquement compromis, introduisant une asymétrie originelle dans la modélisation probabiliste du recrutement de sujets humains.
La modélisation mathématique du hasard ne saurait être confondue avec un geste d’improvisation informelle ou de cueillette au hasard d’une rue passante. Elle requiert des algorithmes générateurs de nombres pseudo-aléatoires cryptographiquement sûrs, exécutés sur des serveurs dédiés, ou des procédures combinatoires physiques inviolables. L’aléa méthodologique est un protocole de rigueur arithmétique absolue destiné à dépouiller l’expérimentateur de toute influence décisionnelle, garantissant que les caprices subjectifs du chercheur ne président jamais à l’incorporation d’un sujet dans la cohorte d’analyse.
2.2 Objectif central : L’optimisation de la représentativité
L’ambition centrale de la sélection aléatoire est l’atteinte d’un isomorphisme structurel entre l’échantillon extrait et la population parente. En vertu de la loi des grands nombres théorisée par Jacques Bernoulli, à mesure que la taille de l’échantillon $n$ croît, la distribution empirique de n’importe quelle variable observée au sein de cet échantillon converge stochastiquement vers la distribution réelle de cette même variable dans la population mère $N$. Cet équilibre ne concerne pas uniquement les variables sociodémographiques manifestes — telles que la répartition par tranche d’âge, le sexe biologique, le niveau de revenu ou la catégorie socioprofessionnelle —, mais s’étend aux variables latentes et aux traits psychologiques non observés directement par le chercheur.
L’apport le plus décisif de la sélection probabiliste réside dans sa capacité unique à neutraliser le biais du volontariat et les distorsions inhérentes à l’auto-sélection. Il est empiriquement documenté que les individus qui décident spontanément de participer à une investigation scientifique présentent des profils psychologiques atypiques : ils affichent en moyenne des niveaux plus élevés d’ouverture à l’expérience (selon le modèle du Big Five), un statut socio-économique plus favorisé, une compliance institutionnelle supérieure et des motivations altruistes ou pécuniaires marquées par rapport aux non-répondants. En soumettant l’inclusion à un mécanisme de tirage au sort probabiliste couplé à des efforts proactifs de relance, le chercheur minimise la surreprésentation de ces profils psychologiques particuliers.
Grâce à cette homogénéisation indirecte des caractéristiques observables et inobservables, l’échantillon aléatoire devient un miroir statistique fidèle. L’estimation ponctuelle d’un paramètre psychométrique — par exemple, le score moyen d’anxiété générale mesuré via le questionnaire GAD-7 — peut alors être calculée sans distorsion systématique. Les traits psychologiques intrinsèques de la population cible se trouvent représentés selon leurs proportions naturelles, permettant aux modèles quantitatifs d’appréhender la réalité humaine dans sa complexité écologique véritable.
2.3 Portée théorique : L’ancrage de la validité externe
Dans l’édifice épistémologique conceptualisé par Donald T. Campbell et Julian Stanley dans leur ouvrage fondateur de 1963, la validité externe désigne le degré auquel les relations causales observées au sein d’un dispositif empirique spécifique peuvent être légitimement étendues et appliquées à travers différentes populations d’individus, différents contextes spatiaux, différents moments temporels et différents modes de mesure opérationnelle. La sélection aléatoire constitue l’artisan exclusif de la dimension populationnelle de cette validité externe. Sans tirage au sort rigoureux, l’extrapolation des résultats observés au-delà du cercle restreint des individus composant l’échantillon relève de la conjecture non vérifiée sur le plan statistique.
Dans les sciences cognitives et le comportement humain, la validité externe se double de l’exigence de validité écologique : la certitude que les processus mentaux décrits en laboratoire reflètent le fonctionnement adaptatif réel des individus dans leur vie quotidienne. L’échantillonnage aléatoire garantit que les observations ne sont pas l’artefact d’un segment d’individus aux facultés exécutives exceptionnellement préservées ou aux fragilités émotionnelles idiosyncrasiques. Il confère au chercheur le droit formel de procéder à l’inférence statistique inductive : déduire les propriétés d’un tout inaccessible à partir de l’analyse scrupuleuse de sa fraction représentative.
Néanmoins, la portée théorique de la sélection aléatoire se heurte à des limites pragmatiques incontournables. Même lorsque le cadre d’échantillonnage de départ est parfait et le tirage au sort mathématiquement irréprochable, le taux d’attrition au recrutement (taux de refus de consentir à l’étude) altère irrémédiablement l’équiprobabilité finale. Si 60 % des personnes tirées au sort refusent de participer, l’échantillon terminal n’est plus un échantillon aléatoire pur, mais un échantillon d’individus tirés au sort qui ont accepté de répondre. Cette résistance comportementale au recrutement réintroduit sournoisement les biais d’auto-sélection que le hasard était précisément censé anéantir.
3. L’assignation aléatoire : Principes fondamentaux et contrôle expérimental
3.1 Le mécanisme de randomisation entre groupes expérimentaux
L’assignation aléatoire, ou randomisation expérimentale, s’applique à un collectif d’individus déjà constitués pour l’étude et se définit comme une procédure d’allocation stochastique garantissant que chaque sujet dispose d’une probabilité précisément déterminée — généralement égale, soit $P = 0,5$ dans un devis bilatéral — d’être affecté au groupe expérimental ou au groupe témoin. Le mécanisme repose sur le principe cardinal de l’indépendance statistique des affectations successives : le sort réservé au $k$-ème participant ne dépend en aucune manière du profil sociodémographique de ce participant, de la décision prise pour le $(k-1)$-ème sujet, ni de l’intuition clinique du chercheur en charge de l’expérimentation.
Ce protocole constitue la manifestation opérationnelle la plus pure de l’isolation scientifique. En confiant le tri des sujets à un algorithme mathématique totalement indépendant de l’objet d’étude, l’assignation aléatoire opère une rupture radicale avec les déterminismes psychosociaux habituels. Dans la vie courante, les individus choisissent leurs traitements en fonction de la sévérité de leurs symptômes, de leur affinité envers un praticien ou de leurs moyens économiques ; de même, les thérapeutes ont tendance à orienter préférentiellement les patients les plus fragiles vers les thérapies qu’ils jugent les plus douces ou les plus prometteuses. La randomisation détruit délibérément ces corrélations naturelles en imposant une affectation aveugle et mécanique.
Il en résulte une neutralisation a priori de l’ensemble des facteurs individuels préexistants. Qu’il s’agisse de variables psychologiques manifestes (le degré de détresse psychique, le quotient intellectuel, l’optimisme dispositionnel) ou de variables biologiques complexes (le polymorphisme génétique, l’activité neuro-endocrinienne, le microbiote intestinal), le hasard assure qu’aucune de ces variables ne dictera l’appartenance d’un individu à un groupe particulier. L’assignation aléatoire transforme ainsi des êtres humains intrinsèquement hétérogènes en agrégats statistiques initiaux parfaitement comparables.
3.2 Objectif central : L’équivalence initiale des groupes
La finalité méthodologique primordiale de l’assignation aléatoire est la genèse d’une équivalence initiale absolue — sur le plan probabiliste — entre les différents bras du protocole de recherche. Avant toute administration de la variable indépendante (qu’il s’agisse d’une molécule pharmacologique, d’une intervention psychothérapeutique ou d’un paradigme de privation sensorielle), les groupes doivent être rigoureusement indiscernables dans leurs profils agrégés. Cela signifie que la moyenne, la variance et les moments statistiques supérieurs de n’importe quelle caractéristique individuelle doivent être statistiquement équivalents entre le groupe test et le groupe témoin.
La puissance conceptuelle de la randomisation réside dans le fait qu’elle équilibre non seulement les covariables que le chercheur a eu la perspicacité de mesurer, mais également et surtout l’infinité des variables latentes, insoupçonnées ou techniquement impossibles à quantifier. Alors que les techniques de contrôle par appariement a posteriori ne peuvent égaliser les groupes que sur un nombre fini et restreint de variables identifiées à l’avance (comme l’âge ou le sexe), l’assignation aléatoire disperse uniformément les particularités individuelles méconnues dans l’ensemble des conditions. Elle dissout l’hétérogénéité individuelle au sein du grand nombre statistique.
En éliminant toute confusion systématique entre l’impact de la manipulation expérimentale et les disparités individuelles sous-jacentes, le chercheur éradique le phénomène de confusion statistique (confounding). Si, au terme de six mois d’intervention, le groupe expérimental manifeste une rémission symptomatique statistiquement supérieure à celle du groupe témoin, cette différence ne saurait être imputée à une plus grande résilience de départ, à un niveau d’éducation plus favorable ou à une meilleure observance supposée, puisque ces paramètres ont été préalablement distribués de façon équivalente entre les conditions par la grâce de l’aléa.
3.3 Portée théorique : La garantie de la validité interne
Dans la taxonomie épistémologique de Campbell et Stanley, la validité interne représente le critère d’évaluation le plus impitoyable de la démarche expérimentale : elle interroge la validité de la conclusion selon laquelle une relation de cause à effet non équivoque existe bel et bien entre deux variables mesurées. L’assignation aléatoire constitue la condition préalable irremplaçable permettant d’établir formellement une telle inférence causale. Sans assignation aléatoire, l’expérimentateur ne peut observer qu’une covariation ou une corrélation, prisonnière de l’aporie épistémologique classique : la simultanéité temporelle ne prouve nullement l’antécédence causale.
L’élimination impérative des hypothèses rivales constitue le mécanisme par lequel la validité interne se trouve garantie. Dans une étude non randomisée comparant les effets d’une thérapie cognitive à un suivi médical usuel, si les patients du groupe thérapie guérissent plus vite, une multitude d’hypothèses alternatives surgissent immédiatement : ces patients étaient-ils plus motivés ? Disposaient-ils de plus de temps libre ? Leurs cliniciens étaient-ils plus chaleureux ? L’assignation aléatoire neutralise structurellement ces hypothèses concurrentes en amont, les réduisant à de simples bruits de fond stochastiques distribués symétriquement entre les groupes.
Dès lors, dans le cadre d’un plan expérimental pur (true experimental design), l’assignation aléatoire permet d’isoler l’action de la variable indépendante ($X$) sur la variable dépendante ($Y$). Elle offre la justification théorique formelle permettant de poser l’équation contrefactuelle fondamentale : la différence d’issue observée entre les groupes est attribuable, au risque alpha d’erreur près, à la seule intervention manipulée par le chercheur. La randomisation est ainsi le moteur méthodologique exclusif de l’affirmation de causalité scientifique.
4. Validité externe versus validité interne : La ligne de partage théorique
4.1 La dualité de Campbell et Stanley appliquée aux deux concepts
L’analyse comparée de la sélection aléatoire et de l’assignation aléatoire s’articule impeccablement autour de la dialectique conceptuelle formulée par Campbell et Stanley, opposant validité interne et validité externe. Cette dualité matérialise une tension philosophique permanente au sein de la pratique scientifique : la validité interne s’érige en prérequis absolu à l’interprétabilité des tests d’hypothèses, tandis que la validité externe commande l’applicabilité pratique, clinique et sociétale des conclusions empiriques obtenues. Une étude dénuée de validité interne est conceptuellement nulle et non avenue : si l’on ne peut affirmer avec certitude que le traitement est responsable du résultat, l’expérimentation n’a produit que de l’illusion cognitive.
Cependant, la quête d’une validité interne irréprochable se fait historiquement au détriment de la validité externe, et vice-versa, esquissant ce que la littérature nomme le « dilemme du chercheur ». Pour maximiser le contrôle expérimental et s’assurer de l’effet causal d’une variable cognitive, le psychologue tend à resserrer drastiquement ses critères d’inclusion, sélectionnant un échantillon ultra-homogène de jeunes adultes indemnes de toute comorbidité psychiatrique, qu’il assigne aléatoirement à des tâches hautement décontextualisées sur écran d’ordinateur. Le lien de causalité interne est alors d’une netteté cristalline, mais la transposabilité des constats à un patient gériatrique polymédiqué dans son quotidien devient hautement suspecte.
Le tableau ci-dessous synthétise la dissociation théorique et fonctionnelle entre ces deux opérations méthodologiques majeures, illustrant la manière dont elles se complètent tout en répondant à des finalités épistémologiques divergentes :
- Sélection aléatoire : Opère au niveau de la population pour constituer l’échantillon. Elle garantit l’isomorphisme populationnel et gouverne la validité externe (généralisabilité des résultats de l’échantillon vers la population cible).
- Assignation aléatoire : Opère au sein de l’échantillon déjà constitué pour composer les groupes de comparaison. Elle neutralise les facteurs de confusion initiaux et gouverne la validité interne (démonstration formelle de la causalité de l’intervention).
4.2 Menaces méthodologiques spécifiques neutralisées par la sélection aléatoire
Lorsqu’un chercheur renonce à la sélection aléatoire au profit d’échantillons de convenance opportunistes, il expose son édifice expérimental à des menaces de validité externe dévastatrices. La première d’entre elles réside dans le biais de sélection initiale et la sous-représentation critique de sous-groupes cliniques ou sociologiques déterminants. Dans les recherches en psychologie de la santé, par exemple, les populations marginalisées, les minorités ethnoculturelles et les strates sociales défavorisées sont structurellement absentes des cohortes de volontaires, empêchant toute modélisation des disparités de santé à l’échelle d’un territoire national.
Une menace corollaire concerne le biais de survie et la distorsion d’attrition lors du recrutement. Si les participants qui répondent à un appel d’offres expérimental sont uniquement ceux qui possèdent la disponibilité temporelle, les ressources logistiques et la stabilité psychologique nécessaires pour se déplacer dans un laboratoire universitaire, l’échantillon obtenu présente une résilience atypique. L’évaluation de l’efficacité d’un programme d’accompagnement psychosocial sur un tel groupe surestimera systématiquement son impact positif par rapport à ce qui serait observé dans une population plus vulnérable et instable.
Enfin, la psychologie contemporaine est aujourd’hui confrontée aux limites du modèle dit WEIRD (Western, Educated, Industrialized, Rich, and Democratic), popularisé par Joseph Henrich et ses collègues. En s’appuyant à plus de 80 % sur des étudiants de premier cycle universitaire occidental non sélectionnés aléatoirement, la discipline a érigé des théories dites « universelles » du développement moral, de la perception visuelle ou de la mémoire qui s’avèrent n’être que des artefacts culturels hautement situés. Seule une sélection probabiliste à l’échelle transnationale permettrait d’extirper les sciences comportementales de cette myopie contextuelle.
4.3 Menaces méthodologiques spécifiques neutralisées par l’assignation aléatoire
En l’absence d’assignation aléatoire des conditions, la validité interne d’une recherche est immédiatement pilonnée par des menaces méthodologiques de premier ordre. Le biais d’attribution, conditionné par les préférences conscientes ou inconscientes des participants et des évaluateurs, constitue la première brèche. Si un patient souffrant d’anxiété sociale sévère a la liberté de choisir entre un groupe de thérapie d’exposition collective et un groupe de relaxation individuelle, les individus les plus phobiques fuiront l’exposition. Toute comparaison ultérieure de l’efficacité relative des deux thérapies sera totalement corrompue par l’asymétrie de la sévérité initiale du trouble.
L’introduction pernicieuse de variables parasites confondantes (confounding factors) représente le deuxième risque fatal. Dans une entreprise voulant évaluer l’impact d’une formation à la méditation de pleine conscience sur le bien-être au travail, proposer la formation sur la base du volontariat crée un groupe expérimental intrinsèquement plus motivé, plus soucieux d’hygiène de vie et potentiellement moins accablé par des urgences professionnelles que le groupe témoin composé des employés restés à leur poste. Le prétendu effet de la méditation n’est alors rien d’autre que la mesure de la motivation préalable ou du niveau de charge mentale différentiel entre les cohortes.
Enfin, l’assignation aléatoire neutralise de manière éclatante l’effet trompeur de la régression vers la moyenne (regression toward the mean). En psychologie clinique, les patients intègrent fréquemment les protocoles au moment précis où leur souffrance atteint un paroxysme aigu. Naturellement, en vertu des fluctuations stochastiques d’un trouble de l’humeur, ces scores symptomatiques ont tendance à décroître spontanément au fil des semaines. Si les groupes ne sont pas constitués par randomisation, la régression vers la moyenne peut s’exercer de manière asymétrique entre un groupe test composé de cas extrêmes et un groupe témoin plus modéré, mimant un prétendu effet thérapeutique qui n’est qu’un artefact mathématique de retour à la normale biologique.
5. Typologie matricielle des plans de recherche empirique
5.1 Sélection aléatoire combinée à l’assignation aléatoire (Le standard d’or)
Le croisement logique des deux opérations probabilistes engendre une matrice méthodologique à quatre quadrants, dont le sommet d’excellence scientifique est incontestablement constitué par l’association simultanée de la sélection aléatoire et de l’assignation aléatoire. Ce plan expérimental idéal — souvent qualifié de standard d’or absolu (gold standard) — réunit les conditions optimales de l’inférence causale et de la transférabilité populationnelle. Le protocole débute par l’extraction d’un échantillon représentatif d’une population cible par tirage au sort probabiliste dans un registre exhaustif, immédiatement suivie de la randomisation stricte de ces participants au sein des différentes conditions expérimentales sous contrôle aveugle.
L’archétype paradigmatique de ce devis d’exception s’observe dans les essais d’intervention communautaire à l’échelle nationale ou les grands programmes de santé publique pilotés par des organismes d’État. Considérons, par exemple, une étude mandatée par un ministère de l’Éducation nationale visant à évaluer l’efficacité causale d’un programme d’entraînement neurocognitif sur les compétences en littératie : des élèves sont tirés au sort aléatoirement au sein du fichier national exhaustif de l’ensemble des écoliers du pays, puis ces élèves recrutés sont randomisés individuellement entre le nouveau programme et le curriculum standard. Les conclusions issues d’un tel dispositif bénéficient d’une force de frappe scientifique totale : l’effet est indéniablement causal (validité interne) et sa magnitude est directement transposable à l’ensemble des enfants du pays (validité externe).
Toutefois, la concrétisation de ce standard d’or demeure d’une rareté notoire dans la littérature psychologique contemporaine. Les contraintes logistiques colossales, la nécessité d’infrastructures décentralisées réparties sur des territoires étendus et les coûts financiers faramineux (souvent chiffrés en millions d’euros) cantonnent généralement ce type de devis à des consortiums épidémiologiques majeurs ou à des programmes de recherche pharmacologique transnationaux soutenus par des agences multilatérales.
5.2 Assignation aléatoire sans sélection aléatoire (Le paradigme majoritaire en laboratoire)
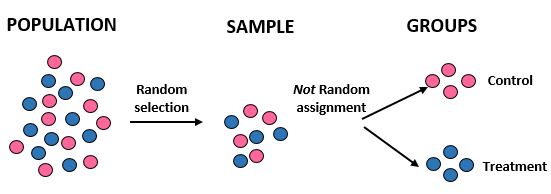
Le deuxième quadrant de la matrice méthodologique représente, de loin, la configuration empirique la plus omniprésente dans la recherche académique mondiale, particulièrement au sein des laboratoires universitaires de psychologie cognitive, de psychologie sociale et de neurosciences computationnelles. Dans ce schéma, les participants sont recrutés par des méthodes d’échantillonnage non probabilistes de convenance : annonces affichées sur les campus universitaires, crédits de cours alloués aux étudiants inscrits en première année, ou panels numériques rémunérés via des plateformes spécialisées. Une fois ce contingent de volontaires présent dans les locaux ou connecté à l’interface logicielle, ils sont immédiatement assignés aléatoirement aux diverses conditions de manipulation expérimentale.
Ce paradigme se caractérise par une asymétrie épistémologique revendiquée : une très haute validité interne couplée à une validité externe circonscrite et théoriquement conditionnée. Sur le plan de la démonstration causale, l’assignation aléatoire fonctionne avec une efficacité mathématique totale : si les étudiants assignés à une condition de privation partielle de sommeil obtiennent des performances de mémorisation significativement inférieures à ceux assignés au sommeil normal, l’expérimentateur a parfaitement le droit de conclure que le manque de sommeil dégrade la rétention mnésique dans son échantillon. Le lien causal n’est pas contaminé par des confusions d’effets locales.
Néanmoins, la transférabilité de cet effet à d’autres strates de la population humaine — par exemple, à des travailleurs de nuit chevronnés de 50 ans dont le système circadien présente une adaptation chronique — ne saurait être déduite des données de l’étude. Pour pallier ce déficit de représentativité sans sacrifier le lien causal, les chercheurs recourent à des réplications conceptuelles systématiques, réitérant le protocole auprès de sous-groupes démographiques différenciés afin de cartographier progressivement les limites et les modérateurs potentiels du phénomène psychologique isolé.
5.3 Sélection aléatoire sans assignation aléatoire (L’approche corrélationnelle et épidémiologique)
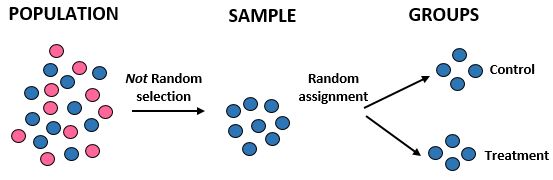
Le troisième quadrant méthodologique inverse rigoureusement la logique précédente en mobilisant une sélection aléatoire rigoureuse de la population mais en s’abstenant délibérément de toute assignation aléatoire à des conditions expérimentales. Ce cadre est l’apanage historique de la sociologie quantitative, de la psychologie différentielle, des sciences politiques et de la psychiatrie épidémiologique. Les enquêtes en population générale, à l’image des sondages probabilistes d’envergure nationale ou des grandes cohortes prospectives longitudinales (telles que les études de suivi de naissance ou les enquêtes de santé publique de l’Organisation Mondiale de la Santé), incarnent parfaitement cette posture.
Dans ce modèle, les chercheurs déploient des techniques d’échantillonnage probabiliste hautement sophistiquées (stratification, tirage par grappes à plusieurs degrés) pour garantir que les milliers d’individus sondés représentent fidèlement la structure socio-démographique de la population parente. Les mesures recueillies permettent de documenter avec une précision clinique remarquable la prévalence de la dépression, l’évolution du stress perçu au fil du vieillissement ou la distribution des traits de personnalité selon les professions. La représentativité et la généralisation descriptive sont ici maximales : les intervalles de confiance calculés reflètent la réalité épidémiologique de la nation étudiée.
Cependant, l’absence formelle d’assignation aléatoire condamne ces investigations à une impuissance structurelle lorsqu’il s’agit d’attester de relations de cause à effet. Constater, sur un échantillon parfaitement aléatoire de 20 000 individus, que l’utilisation intensive des réseaux sociaux est fortement corrélée à une baisse de l’estime de soi ne permet absolument pas de déduire que les réseaux sociaux provoquent cette détérioration psychologique. L’hypothèse de causalité inverse (les individus souffrant déjà d’une faible estime de soi se réfugient massivement sur les réseaux sociaux) ou l’action d’une tierce variable non mesurée (l’isolement relationnel réel sous-jacent) demeurent des explications rivales mathématiquement impossibles à éliminer sans randomisation expérimentale.
5.4 Ni sélection ni assignation aléatoires (Les devis quasi-expérimentaux et qualitatifs)
Le dernier quadrant de la matrice rassemble les devis de recherche qui n’intègrent ni tirage au sort des participants dans une population parente, ni randomisation expérimentale entre les conditions observées. Ce domaine méthodologique englobe une vaste palette d’investigations, allant des plans quasi-expérimentaux sur groupes naturels intacts jusqu’aux démarches phénoménologiques et cliniques qualitatives. Les recherches menées en contexte écologique contraint — par exemple, comparer les performances scolaires d’une classe d’école pilote adoptant une nouvelle méthode pédagogique avec celles d’une classe témoin située dans un autre établissement — illustrent typiquement cette situation de double non-aléa.
Ces protocoles se caractérisent par une vulnérabilité épistémologique maximale : ils sont simultanément menacés par des biais de représentativité drastiques (les deux classes observées ne représentent nullement l’ensemble des écoliers du pays) et par des biais de confusion interne majeurs (les élèves de la classe pilote bénéficiaient peut-être d’un environnement socioculturel plus stimulant, ou leur enseignant était naturellement plus dynamique et motivé). Toute inférence causale directe est ici méthodologiquement proscrite. Pour extraire un signal scientifique valide de ces terrains complexes, les chercheurs sont contraints de recourir à des armatures statistiques compensatoires sophistiquées, telles que l’analyse des scores de propension, les modèles à effets fixes ou les devis à séries temporelles interrompues.
Pour autant, disqualifier ces travaux serait une erreur épistémologique lourde. Dans une multitude de situations cliniques d’urgence, de rares psychopathologies ou d’innovations institutionnelles locales, le recours au hasard pur est logistiquement impraticable ou éthiquement impensable. Ces recherches exploratoires et naturalistes constituent le terreau irremplaçable de la découverte empirique : elles observent les phénomènes humains dans leur sève écologique originelle, documentent des dynamiques qualitatives subtiles et génèrent les hypothèses novatrices qui feront, ultérieurement, l’objet de tests expérimentaux stricts au sein de laboratoires contrôlés.
6. Méthodes et protocoles d’implémentation de la sélection aléatoire en psychologie
6.1 Échantillonnage aléatoire simple et échantillonnage systématique
L’échantillonnage aléatoire simple (EAS) représente la formalisation mathématique la plus dépouillée et canonique du recrutement probabiliste. Sa mise en œuvre exige que le chercheur attribue un identifiant numérique unique compris entre 1 et $N$ à chaque membre répertorié dans la base de sondage intégrale. Ensuite, à l’aide d’un générateur certifié de nombres pseudo-aléatoires conforme aux standards cryptographiques modernes (évitant les biais périodiques des générateurs informatiques élémentaires), $n$ numéros distincts sont tirés sans remise. Ce processus confère à chaque sous-ensemble possible d’individus de taille $n$ une chance rigoureusement identique d’être constitué, assurant l’indépendance mathématique la plus absolue entre les inclusions d’unités statistiques.
En pratique de terrain, les chercheurs ont souvent recours à une alternative procéduralement plus accessible : l’échantillonnage systématique. Le protocole s’articule autour d’un intervalle d’échantillonnage régulier, noté $k$, calculé mathématiquement par la formule arithmétique :
$k = \frac{N}{n}$
Le chercheur effectue un tirage aléatoire unique d’un point de départ entier, $r$, compris entre 1 et $k$. L’échantillon final est alors constitué par la séquence mécanique des individus occupant les positions $r, r+k, r+2k, r+3k$, et ainsi de suite jusqu’à épuisement de la population. Cette méthode garantit une dispersion homogène le long de la liste sans nécessiter la génération de milliers de nombres aléatoires individuels.
Néanmoins, l’échantillonnage systématique dissimule une faille méthodologique pernicieuse : le risque de périodicité cachée (ou cyclicité non décelée). Si la liste administrative servant de cadre d’échantillonnage est involontairement structurée selon un motif récurrent qui coïncide avec le pas $k$ — par exemple, une liste de dossiers de patients psychiatriques classés par semaine d’admission où chaque 7-ème dossier correspond systématiquement aux admissions critiques du samedi soir —, le mécanisme de tirage systématique introduira un biais de sélection massif et invisible, détruisant l’équiprobabilité initiale et distordant profondément la représentativité clinique de la cohorte recueillie.
6.2 Échantillonnage aléatoire stratifié
L’échantillonnage aléatoire stratifié s’impose dès lors que le chercheur dispose d’informations préalables sur des variables clés susceptibles d’exercer une influence majeure sur le construit psychologique évalué (telles que le genre, l’âge, l’appartenance socio-économique ou le niveau de gravité symptomatique). La démarche consiste à fragmenter préalablement la base de sondage globale en sous-ensembles mutuellement exclusifs et collectivement exhaustifs, nommés « strates ». Une fois cette segmentation effectuée, le chercheur procède à un échantillonnage aléatoire simple de manière totalement autonome à l’intérieur de chacune des strates identifiées, recomposant l’échantillon global par l’agrégation de ces sous-échantillons probabilistes indépendants.
Deux politiques d’allocation prévalent dans ce schéma : l’allocation proportionnelle et l’allocation non proportionnelle. Dans l’allocation proportionnelle, la taille de l’échantillon tiré dans chaque strate reflète scrupuleusement le poids démographique réel de cette strate dans la population générale : si une catégorie professionnelle représente 12 % de la nation, elle occupera rigoureusement 12 % de l’échantillon final. À l’inverse, l’allocation non proportionnelle est délibérément mise en œuvre lorsque le chercheur souhaite analyser des sous-groupes minoritaires (par exemple, des individus porteurs d’un trouble bipolaire de type I dans une enquête générale de santé mentale). Pour garantir une puissance statistique adéquate à ces strates marginales, le protocole les suréchantillonne artificiellement lors du tirage, réajustant ensuite mathématiquement les calculs inférentiels au moyen de coefficients de pondération statistique.
L’immense avantage méthodologique de l’échantillonnage stratifié réside dans la réduction drastique de la variance d’échantillonnage. En contrôlant directement la composition des strates, le chercheur élimine la variabilité stochastique inter-strates pour ne laisser s’exprimer que l’hétérogénéité intra-strate. Pour les constructs psychologiques complexes et fortement différenciés selon les milieux de vie, cette méthode garantit une fidélité d’estimation et une précision des intervalles de confiance bien supérieures à celles offertes par un échantillonnage aléatoire simple à effectif équivalent.
6.3 Échantillonnage par grappes et à plusieurs degrés
Lorsque la constitution d’une base de sondage listant chaque individu d’une vaste population est logistiquement impossible ou financièrement inaccessible, l’échantillonnage par grappes (cluster sampling) s’impose comme la solution de référence. Contrairement aux méthodes précédentes, l’unité primaire d’échantillonnage n’est plus l’individu isolé, mais un regroupement collectif préexistant et naturellement constitué dans l’environnement social ou institutionnel : des écoles entières, des services d’hospitalisation psychiatrique, des centres pénitentiaires ou des circonscriptions administratives. Le chercheur procède alors au tirage au sort probabiliste d’un certain nombre de ces grappes, puis intègre l’intégralité des individus présents dans les grappes sélectionnées au sein de l’étude.
L’échantillonnage à plusieurs degrés (multistage sampling) affine cette démarche en emboîtant successivement plusieurs phases de tirage au sort hiérarchique. Par exemple, pour mener une étude représentative sur le bien-être psychologique des adolescents scolarisés, le chercheur tire d’abord au sort 30 districts scolaires à l’échelle nationale (premier degré) ; au sein de chacun de ces districts, il tire au sort 4 établissements secondaires (deuxième degré) ; dans chaque établissement, il sélectionne au sort 2 classes de troisième (troisième degré) ; et enfin, au sein des classes retenues, il tire aléatoirement 10 élèves (quatrième degré). Cette cascade probabiliste permet de constituer une cohorte d’envergure sans jamais avoir eu à concevoir le fichier national nominatif de tous les collégiens du territoire.
Néanmoins, ces stratégies collectives introduisent une altération statistique majeure qu’il convient impérativement de corriger : l’effet de grappe (design effect). En raison du principe sociologique d’homophilie et de l’exposition partagée à un même environnement physique et humain, les individus appartenant à une même grappe (par exemple, les élèves d’une même classe) tendent à se ressembler davantage entre eux qu’avec les individus des autres grappes. Cette corrélation intra-classe (mesurée par le coefficient $rho$) réduit la quantité d’information statistique indépendante apportée par chaque participant additionnel. Dès lors, le chercheur en psychométrie est contraint d’augmenter substantiellement la taille brute de son échantillon global et d’appliquer des modélisations multiniveaux complexes afin de ne pas surestimer artificiellement la significativité de ses tests d’hypothèses.
7. Techniques et procédures opérationnelles d’assignation aléatoire en laboratoire et en clinique
7.1 Assignation complètement aléatoire et randomisation simple
L’assignation complètement aléatoire, communément dénommée randomisation simple, constitue la déclinaison la plus directe de l’aléa en contexte expérimental. Dans ce protocole, chaque participant qui se présente au laboratoire ou dans la salle de consultation clinique est affecté à l’un des bras de l’étude par un processus stochastique indépendant, équivalent sur le plan formel au lancer successif d’une pièce de monnaie équilibrée ($P = 0,5$ pour le groupe A, $P = 0,5$ pour le groupe B). Dans la pratique contemporaine, les expérimentateurs mobilisent des suites de nombres pseudo-aléatoires préprogrammées ou des modules logiciels d’allocation automatisée intégrés aux plateformes de recueil de données expérimentales (telles que PsychoPy, OpenSesame ou Qualtrics).
Si la randomisation simple brille par son élégance conceptuelle et son absence totale de contraintes algorithmiques préalables, elle recèle un piège méthodologique redoutable lorsque les échantillons sont de taille modeste ($n < 100$). En vertu des simples lois combinatoires de la distribution binomiale, le tirage au sort indépendant non contraint engendre fréquemment des déséquilibres substantiels dans les effectifs finaux des groupes. Il n'est nullement exceptionnel, dans une étude clinique planifiée sur 40 patients, d'aboutir stochastiquement à une répartition de 26 individus dans le groupe témoin et de seulement 14 dans le groupe de traitement innovant.
Cette disproportion numérique n’est pas sans conséquence scientifique : elle ampute sévèrement la puissance statistique du devis de recherche. La capacité d’un test paramétrique (comme le test $t$ de Student ou l’analyse de variance univariée) à rejeter une hypothèse nulle fausse dépend directement de la taille harmonique des sous-groupes comparés. Une asymétrie d’effectif réduit l’efficience statistique globale du test, augmentant le risque d’erreur de type II ($\beta$) : le chercheur échoue alors à détecter un effet thérapeutique bien réel, victime exclusive de la fluctuation d’échantillonnage induite par une randomisation non maîtrisée.
7.2 Randomisation par blocs (Block Randomization)
Pour juguler les risques d’asymétrie numérique inhérents à la randomisation simple, les méthodologistes préconisent le recours systématique à la randomisation par blocs (ou randomisation par blocs permutés). Ce protocole technique consiste à scinder le flux continu des inclusions de participants en petits sous-ensembles structurés de taille fixe ou variable, désignés sous le terme de blocs. À l’intérieur de chaque bloc, le nombre de places dévolues à chaque condition expérimentale est rigoureusement prédéterminé afin de maintenir un ratio d’allocation constant et équilibré tout au long de l’expérimentation.
Illustrons ce mécanisme par un plan bivarié (Groupe A vs Groupe B) utilisant des blocs de taille 4. Le chercheur génère l’ensemble des permutations combinatoires possibles contenant deux affectations A et deux affectations B, soit six arrangements théoriques : AABB, ABAB, ABBA, BAAB, BABA, BBAA. Au fur et à mesure de l’admission des participants, un bloc est sélectionné aléatoirement parmi ces six configurations, dictant l’ordre exact d’attribution pour les quatre sujets suivants. Ce processus garantit qu’au terme de chaque bloc de quatre sujets, l’égalité numérique parfaite entre les conditions est mathématiquement verrouillée, neutralisant les disparités d’effectifs et prévenant les déséquilibres temporels majeurs liés aux variations saisonnières ou aux dérives de profil dans le recrutement au long cours.
Cependant, en milieu hospitalier ou lors d’essais cliniques en double aveugle, l’utilisation de blocs de taille fixe expose le protocole à une rupture de confidentialité redoutable : le décodage de l’allocation (allocation prediction). Si un investigateur clinique identifie les conditions des trois premiers patients d’un bloc de quatre (par exemple A, B, puis A), il sait avec une certitude absolue que le quatrième et dernier patient du bloc sera inévitablement affecté au groupe B. Pour conjurer cette menace qui réintroduirait le biais humain dans l’admission des cas, les standards de la recherche translationnelle imposent d’adopter des blocs de taille aléatoirement variable (alternant de manière imprévisible des blocs de taille 4, 6 ou 8), rendant mathématiquement indéchiffrable l’attribution du sujet suivant.
7.3 Randomisation stratifiée et techniques d’appariement préalable
Lorsque la taille globale de l’échantillon demeure restreinte mais que le chercheur a identifié en amont des covariables pronostiques dont l’impact sur la variable dépendante est scientifiquement avéré (par exemple, le statut ménopausique dans une étude sur la dépression hormonale, ou le niveau initial de détérioration cognitive dans un protocole sur la maladie d’Alzheimer), la randomisation simple risque de laisser subsister un déséquilibre accidentel entre les groupes sur ces variables critiques. La randomisation stratifiée offre une réponse technique hautement sophistiquée à cette vulnérabilité.
Le protocole débute par la classification de chaque participant recruté au sein d’une strate pronostique définie par le croisement des covariables majeures (par exemple : Strate 1 = Femme / Moins de 40 ans ; Strate 2 = Femme / 40 ans et plus ; Strate 3 = Homme / Moins de 40 ans ; Strate 4 = Homme / 40 ans et plus). Au sein de chacune de ces strates fermées, une liste d’assignation par blocs indépendante est exécutée. Ainsi, le mécanisme garantit non seulement l’équivalence numérique globale de l’essai, mais scelle l’équivalence de composition démographique et clinique bras par bras pour chaque caractéristique pronostique majeure isolée.
Une modalité historique connexe est la technique des paires appariées suivie de randomisation intra-paire (matched-pairs randomized design). Dans cette approche rigoureuse, les sujets sont classés deux par deux sur la base de leur similitude quasi-parfaite sur une variable psychométrique continue (par exemple, deux patients ayant le même score précis d’anxiété pré-test). Une fois la paire hermétiquement constituée, le sort intervient au moyen d’un tirage aléatoire binaire : l’un des deux jumeaux méthodologiques est versé au groupe expérimental, contraignant mécaniquement le second à rejoindre le groupe témoin. Cette approche élimine d’emblée la variance parasite liée au facteur d’appariement, maximisant l’acuité statistique de l’expérimentation.
7.4 Procédures adaptatives et minimisation dynamique
Aux frontières de la recherche biomédicale contemporaine et des neurosciences comportementales d’avant-garde, les protocoles d’assignation adaptative — et plus singulièrement l’algorithme de minimisation dynamique théorique initié par Taves et perfectionné par Pocock et Simon — représentent l’incarnation la plus avancée du contrôle expérimental. Contrairement aux méthodes d’assignation statiques où les listes de randomisation sont figées dans le marbre informatique avant même l’inclusion du premier sujet, la minimisation ajuste dynamiquement les probabilités d’affectation en temps réel au fil des admissions successives de participants.
Le fonctionnement algorithmique de la minimisation s’enclenche à chaque nouvelle entrée d’un patient. Le système analyse les caractéristiques pronostiques multifactorielles de ce nouvel arrivant (par exemple : son âge, son sexe, son génotype, son niveau de sévérité clinique). Il simule ensuite informatiquement l’impact de son affectation au groupe A, puis au groupe B, calculant la somme des déséquilibres marginaux totaux induits sur l’ensemble des covariables d’intérêt. L’algorithme privilégie alors automatiquement l’attribution vers le bras d’expérimentation qui réduit le plus l’asymétrie globale de l’essai, en lui conférant une probabilité d’affectation prépondérante (par exemple $P = 0,85$), tout en maintenant une composante stochastique irréductible ($P = 0,15$) afin de préserver l’essence probabiliste du processus.
Ces méthodologies computationnelles s’avèrent particulièrement salvatrices dans les essais cliniques portant sur des thérapies cognitives ciblées ou des protocoles de stimulation cérébrale profonde, où le recrutement de patients est extrêmement limité, lent et onéreux. La minimisation dynamique garantit un équilibre pronostique multi-dimensionnel d’une perfection qu’aucune randomisation simple ne pourrait atteindre avec de si faibles cohortes, offrant un niveau de comparabilité basale incomparable sans violer les fondements théoriques de l’inférence causale moderne.
8. Erreurs méthodologiques fréquentes et confusions conceptuelles dans la littérature
8.1 Confusion terminologique dans les publications scientifiques
La littérature académique internationale, y compris au sein des revues indexées à fort facteur d’impact, est fréquemment entachée d’un usage abusif et polysémique de l’adjectif « aléatoire ». Nombre d’auteurs déploient des formulations nébuleuses telles que « notre échantillon a été recueilli de manière aléatoire sur les réseaux sociaux », alors qu’une lecture scrupuleuse de la section méthodologique dévoile un protocole d’auto-sélection passive sur internet : un lien d’enquête partagé en ligne, sans base de sondage nominative, sans contrôle des probabilités d’inclusion et sans gestion active des non-répondants. Qualifier d’aléatoire ce qui relève d’une cueillette opportuniste constitue une imposture scientifique flagrante qui travestit la nature des données colligées.
Une confusion sémantique encore plus dommageable consiste à affirmer l’universalité d’un résultat expérimental sous le prétexte fallacieux que l’assignation des sujets aux conditions était randomisée. On observe fréquemment des manuscrits affirmant doctement : « L’assignation aléatoire des participants à nos trois conditions expérimentales garantit la représentativité de nos conclusions pour l’ensemble des adolescents ». Cette phrase trahit une méconnaissance épistémologique fondamentale : la randomisation interne n’a jamais conféré la moindre valeur de représentativité externe. Elle garantit l’équivalence des groupes comparés, rien de plus, rien de moins.
L’analyse textuelle critique d’articles rétractés ou corrigés ces dernières années démontre que ces confusions lexicales ne sont pas de simples lapsus de plume : elles sous-tendent une surinterprétation généralisée des données empiriques. Les relecteurs pairs et les comités éditoriaux portent une responsabilité lourde dans la perpétuation de ces dérives, en tolérant des raccourcis de langage qui masquent les faiblesses originelles des plans d’échantillonnage derrière la respectabilité méthodologique conférée par le vocabulaire de la randomisation.
8.2 Le biais de sélection insidieux post-assignation
Une expérimentation rigoureusement conçue sur le papier, ayant mis en place une assignation aléatoire irréprochable au temps $t_0$, n’est jamais à l’abri d’une contamination méthodologique destructrice survenant au cours de son déroulement temporel : l’attrition différentielle sélective. Dans le cadre d’un essai comparant une psychothérapie d’exposition cognitive hautement anxiogène à un protocole témoin basé sur des exercices de relaxation bienveillante, il est fréquent que les patients les plus sévèrement phobiques abandonnent massivement le groupe d’exposition (incapables de tolérer la détresse émotionnelle induite), tandis que le groupe de relaxation affiche une assiduité sans faille.
Au terme des trois mois de suivi, l’expérimentateur qui analyserait naïvement les seuls participants ayant achevé le protocole (analyse par protocole ou per-protocol) comparerait en réalité des pommes et des oranges. L’équivalence initiale forgée par la randomisation au départ est anéantie : le groupe d’exposition ne comprend plus que les individus les plus robustes psychologiquement, tandis que le groupe témoin conserve l’ensemble de son spectre de gravité clinique. Dès lors, si le groupe d’exposition obtient de meilleurs scores de récupération, cette issue positive ne peut en aucun cas être attribuée avec certitude à la supériorité de la technique thérapeutique : elle reflète un biais d’attrition dévastateur, l’intervention ayant agi comme un filtre sélectif éliminant les patients les plus résistants.
Pour prévenir cette résurgence post-assignation du biais de sélection, la communauté méthodologique internationale a formalisé le standard de l’analyse en intention de traiter (ITT, pour Intention-to-Treat). Ce paradigme analytique impératif prescrit que l’ensemble des participants randomisés doivent être inclus dans l’évaluation statistique terminale au sein du groupe auquel le sort les avait initialement assignés, indépendamment des ruptures de protocole, des abandons prématurés ou des défaillances d’observance thérapeutique. En mobilisant des techniques d’imputation multiple des données manquantes, l’analyse ITT préserve l’intégrité de la randomisation originelle et offre l’estimation la plus honnête et prudente de l’efficacité d’un traitement en conditions réelles.
8.3 Croire que le hasard garantit toujours l’équivalence parfaite
Un sophisme méthodologique particulièrement répandu chez les jeunes chercheurs réside dans la croyance quasi-magique que l’assignation aléatoire élimine infailliblement toute disparité entre les groupes expérimentaux dès la minute où elle est exécutée. Cette vision déterministe oublie que le hasard statistique n’est pas un agent réparateur d’équilibre, mais un processus stochastique générateur de fluctuations probabilistes. Dans les études à faible effectif ($n < 30$ par bras), la probabilité mathématique que des déséquilibres substantiels apparaissent spontanément sur des covariables majeures par simple caprice stochastique est extraordinairement élevée.
Face à ce danger, la pratique traditionnelle imposait aux chercheurs de documenter un tableau comparatif d’équivalence initiale (baseline table) et d’y adjoindre des tests de signification statistique (des tests $t$ ou du chi-carré comparant les moyennes pré-test des groupes). Cependant, cette coutume a été sévèrement réprouvée par les plus éminents méthodologistes internationaux. Réaliser un test d’hypothèse pour vérifier si une différence observée à la baseline entre deux groupes randomisés est due au hasard relève de l’absurdité logique la plus totale : puisque l’assignation a été aléatoire par décret expérimental, la valeur $p$ ne teste rien d’autre qu’une hypothèse que l’expérimentateur sait déjà être vraie à 100 % (la différence est nécessairement née du hasard).
La posture scientifique moderne consiste à abandonner les tests de signification à l’inclusion pour se concentrer sur l’estimation pragmatique de la magnitude clinique des déséquilibres basaux (au moyen des tailles d’effet standardisées, comme le $d$ de Cohen). Si une variable pronostique majeure (l’anxiété basale ou l’âge) manifeste un écart substantiel non négligeable entre les bras en dépit de la randomisation, la réponse méthodologique rigoureuse ne réside pas dans le déni ou l’abandon de l’étude, mais dans l’intégration a priori de cette variable comme covariable d’ajustement dans un modèle d’analyse de la covariance (ANCOVA) ou de régression linéaire hiérarchique, afin de purger mathématiquement l’effet du traitement de cette asymétrie résiduelle stochastique.
9. Considérations éthiques, pratiques et contraintes de terrain dans la recherche psychologique
9.1 Obstacles éthiques à l’assignation aléatoire en psychologie clinique
Si la randomisation expérimentale s’impose comme le parangon de la causalité sur le plan méthodologique formel, sa mise en œuvre dans les sciences du comportement et la psychiatrie clinique se heurte fréquemment à des dilemmes déontologiques insolubles. Il est éthiquement et juridiquement inconcevable de concevoir un protocole expérimental qui assignerait aléatoirement des êtres humains à des conditions délétères, traumatisantes ou nocives pour leur santé mentale. On ne saurait randomiser des participants entre une condition « maltraitance infantile » et une condition « parentalité bienveillante » pour évaluer les impacts neurocognitifs des stress précoces ; l’investigation de ces phénomènes demeure tributaire de devis d’observation rétrospectifs ou corrélationnels.
De surcroît, la privation délibérée d’une intervention thérapeutique validée au profit d’un groupe témoin inactif soulève une interrogation éthique brûlante. Dans les pathologies psychiatriques sévères marquées par un risque suicidaire prégnant (dépression majeure résistante, trouble de la personnalité borderline), maintenir des patients vulnérables sous placebo ou sur liste d’attente prolongée sans leur délivrer le traitement actif ou la thérapie usuelle constitue une violation directe du principe de bienfaisance et de non-malfaisance inscrit dans la Déclaration d’Helsinki de l’Association Médicale Mondiale.
Pour contourner ces impasses sans renoncer à la puissance de la randomisation, les méthodologistes ont élaboré des architectures de compromis éthique. Le devis avec liste d’attente (waitlist control design) garantit que les patients témoins recevront l’intégralité du protocole innovant dès la fin de l’évaluation comparative du groupe expérimental. Plus sophistiquée encore, la randomisation par étapes échelonnées (stepped-wedge cluster design) permet à l’ensemble des grappes ou des services hospitaliers de recevoir à terme l’intervention novatrice, le hasard déterminant exclusivement le moment chronologique précis où chaque unité de soin bascule de l’état de contrôle vers l’état de traitement actif.
9.2 Barrières logistiques et économiques à la sélection aléatoire
La matérialisation d’une sélection aléatoire authentique à l’échelle d’une population nationale représente un défi logistique et financier titanesque, souvent insurmontable pour les budgets ordinaires des laboratoires de recherche académique. La constitution et l’accès à une base d’échantillonnage exhaustive se heurtent à des barrières administratives drastiques liées à la protection des données personnelles (telles que le RGPD en Europe ou les législations HIPAA aux États-Unis). Obtenir les autorisations régaliennes pour tirer au sort des citoyens dans les fichiers de la sécurité sociale requiert des années de procédures juridiques hautement complexes.
À ces obstacles structurels s’ajoute l’écueil économique de l’attrition et de la non-réponse. Dans les enquêtes probabilistes contemporaines, le taux de refus initial atteint régulièrement 70 à 80 % lors du premier contact par courrier ou téléphone. Pour obtenir un échantillon représentatif final de 1 000 individus, l’équipe de recherche doit contacter, solliciter et relancer jusqu’à 5 000 ménages, mobilisant des enquêteurs de terrain rémunérés, des plateformes téléphoniques professionnelles et des incitations financières conséquentes. Le coût unitaire par participant recruté de manière aléatoire peut ainsi dépasser plusieurs centaines d’euros, là où un protocole universitaire classique ne dépense presque rien.
Face à cette réalité économique asphyxiante, la recherche comportementale contemporaine s’est massivement rabattue sur l’usage des panels en ligne rémunérés. Cependant, ces cohortes commerciales sont structurellement gangrenées par des biais psychométriques majeurs : « professionnalisation » des répondants qui enchaînent des dizaines de questionnaires quotidiens, usage croissant d’outils d’automatisation ou de fermes de serveurs délocalisées pour valider les gains, et surreprésentation d’individus présentant des profils d’anxiété sociale ou d’inactivité professionnelle. Ce compromis financier fragilise insidieusement la robustesse écologique des découvertes empiriques contemporaines.
9.3 Gestion de la déontologie face aux populations vulnérables
L’application des mécanismes probabilistes requiert une vigilance déontologique décuplée dès lors que les recherches s’adressent à des populations catégorisées comme vulnérables : enfants en milieu scolaire, personnes placées sous tutelle ou curatelle, patients admis en soins psychiatriques sans consentement, ou détenus au sein d’institutions pénitentiaires. Dans ces contextes asymétriques d’autorité institutionnelle, la sélection aléatoire d’un individu peut être perçue par lui non comme un tirage probabiliste neutre, mais comme une injonction administrative à laquelle il lui est impossible de se soustraire, menaçant la liberté de son consentement.
L’évaluation rigoureuse du rapport bénéfice/risque individuel constitue la pierre angulaire de l’analyse menée par les Comités d’Éthique de la Recherche (CER) et les Comités de Protection des Personnes (CPP). Ces instances d’arbitrage éthique scrutent désormais avec une minutie obsessionnelle l’utilité méthodologique exacte du hasard. Soumettre un détenu ou un enfant à un protocole de randomisation contraignant ne saurait être légitimé par la simple « élégance » du devis ; les chercheurs doivent attester que les questions scientifiques posées ne peuvent en aucun cas trouver de réponse via des méthodes d’observation non invasives, et que le protocole aléatoire ne lui impose aucun préjudice psychologique disproportionné.
La transparence informationnelle devient alors l’impératif éthique cardinal. Les formulaires de consentement doivent expliciter sans ambiguïté les notions abstraites d’équiprobabilité et de randomisation, dans un langage dénué de tout jargon mathématique intimidant. Le participant vulnérable — ou son représentant légal — doit appréhender parfaitement que son affectation à tel ou tel protocole de prise en charge relève d’une procédure stochastique aveugle et que son refus de participer ne modifiera en rien la qualité de l’attention institutionnelle et médicale qui lui est due au quotidien.
10. Analyse statistique et implications modélisatrices des deux processus
10.1 Théorie de l’inférence statistique et sélection aléatoire
L’assise mathématique de l’inférence statistique inductive repose directement sur les théorèmes asymptotiques de la théorie des probabilités, au premier rang desquels figure le théorème central limite formulé par Pierre-Simon de Laplace et Carl Friedrich Gauss. Lorsqu’un échantillon de taille $n$ est sélectionné aléatoirement au sein d’une population globale de moyenne inconnue $\mu$ et d’écart-type fini $\sigma$, la distribution de la moyenne d’échantillonnage $\bar{X}$ converge vers une loi normale $\mathcal{N}\left(\mu, \frac{\sigma}{\sqrt{n}}\right)$, à mesure que $n$ grandit. L’erreur type de la moyenne ($SE$), formalisée par l’équation canonique ci-dessous, matérialise l’incertitude d’échantillonnage inhérente au tirage stochastique :
$SE = \frac{s}{\sqrt{n}} \cdot \sqrt{\frac{N – n}{N – 1}}$
Le second terme de l’expression représente le facteur de correction pour population finie, rendu caduc lorsque la population parente $N$ est infiniment supérieure à l’échantillon extrait $n$. Cette architecture probabiliste offre le fondement rigoureux permettant de délimiter des intervalles de confiance à 95 % formellement valides : la probabilité mathématique que l’intervalle calculé recouvre le véritable paramètre inconnu de la population globale dépend ontologiquement de la stricte équiprobabilité du tirage initial.
Dès lors que le protocole de sélection aléatoire s’écarte de l’échantillonnage simple pour adopter des structures stratifiées ou en grappes, l’inférence statistique standard devient caduque si elle n’est pas modélisée par des pondérations compensatoires. Les données d’enquête complexes exigent le calcul de poids de sondage (correspondant à l’inverse de la probabilité d’inclusion $w_i = \frac{1}{\pi_i}$), ajustés pour pallier les distorsions de non-réponse par calage sur marges (techniques de raking ratio). Sans cette réarticulation mathématique rigoureuse de la sélection probabiliste dans la modélisation statistique finale, les erreurs types sont sous-estimées, produisant des faux positifs désastreux pour l’épidémiologie comportementale.
10.2 Théorie contrefactuelle et assignation aléatoire
La portée causale de l’assignation aléatoire trouve sa théorisation moderne la plus puissante au sein du modèle causal de Rubin (dit modèle de Neyman-Rubin des issues potentielles, ou Potential Outcomes Framework). Dans cette ontologie statistique formalisée par Donald Rubin, chaque individu $i$ de l’étude possède deux issues potentielles théoriques : $Y_i(1)$, qui matérialise son comportement ou score clinique s’il est exposé au traitement, et $Y_i(0)$, qui matérialise son score s’il n’est pas exposé. L’effet causal individuel correspond rigoureusement à la différence algébrique entre ces deux grandeurs :
$\tau_i = Y_i(1) – Y_i(0)$
Or, le « problème fondamental de l’inférence causale » stipule qu’il est ontologiquement impossible d’observer simultanément $Y_i(1)$ et $Y_i(0)$ pour un même être humain au même instant chronologique : l’une des deux issues constitue obligatoirement un état contrefactuel (ce qui se serait produit si l’individu avait vécu l’histoire alternative).
C’est ici qu’intervient le prodige mathématique de l’assignation aléatoire. En rendant le mécanisme d’attribution du traitement $W_i in {0, 1}$ totalement indépendant de l’état potentiel des issues $(Y_i(0), Y_i(1)) perp!!!perp W_i$, la randomisation autorise l’estimation sans biais de l’effet moyen du traitement (Average Treatment Effect, ATE) au niveau populationnel :
$ATE = E[Y_i(1) – Y_i(0)] = E[Y_i | W_i = 1] – E[Y_i | W_i = 0]$
L’assignation aléatoire transforme ainsi un dilemme contrefactuel individuel insoluble en une simple opération de soustraction arithmétique de moyennes observables au niveau du groupe. Elle garantit que le groupe témoin observé constitue un clone parfait du contrefactuel inobservable du groupe expérimental, décapitant d’un geste mathématique la totalité du biais de sélection latent non observé.
10.3 Techniques correctives en cas de défaillance des protocoles
Lorsque des contraintes éthiques ou logistiques interdisent le déploiement pur de l’assignation ou de la sélection aléatoires, l’économétrie et la biostatistique modernes ont forgé un arsenal de techniques mathématiques palliatives conçues pour « simuler » a posteriori les vertus du hasard au sein de bases observationnelles imparfaites. Au premier rang de ces innovations trône l’appariement par score de propension (Propensity Score Matching, formulé par Rosenbaum et Rubin en 1983). Le score de propension quantifie la probabilité conditionnelle qu’un individu $i$ reçoive le traitement expérimental en fonction d’un vecteur exhaustif de covariables observables préexistantes :
$e(X_i) = P(W_i = 1 | X_i)$
En appariant un participant traité avec un participant non-traité partageant un score de propension strictement identique, le statisticien récrée artificiellement l’équilibre des covariables mesurées caractéristique d’une randomisation expérimentale.
Toutefois, le score de propension demeure aveugle aux variables de confusion non mesurées. Pour surmonter cette vulnérabilité intrinsèque, les chercheurs mobilisent la méthode des variables instrumentales (VI), empruntée à l’économétrie pure. Une variable instrumentale $Z$ doit agir comme un tirage aléatoire « naturel » de la vie réelle : elle influe sur l’exposition au traitement $W$, mais n’exerce aucun impact direct sur l’issue dépendante $Y$, si ce n’est à travers le traitement lui-même. Lorsque ces hypothèses restrictives sont satisfaites, la régression par double moindre carré permet d’extraire la variance exogène du traitement et de restaurer une inférence causale valide, même en présence de facteurs de confusion inobservés majeurs.
Enfin, la régression sur discontinuité (Regression Discontinuity Design, RDD) exploite les seuils arbitraires d’éligibilité institutionnels (par exemple, allouer un soutien psychiatrique spécifique uniquement aux adolescents dont le score d’évaluation dépasse le cut-off de 50 points). Les sujets situés immédiatement sous la barre (49,5) et ceux situés immédiatement au-dessus (50,5) sont présumés indiscernables sur l’ensemble de leurs caractéristiques basales, leur bascule d’un côté ou de l’autre de la frontière relevant d’un quasi-tirage au sort stochastique naturel, autorisant l’isolement d’un effet causal robuste au point de coupure.
11. Études de cas appliquées en psychologie : Comparaison contextuelle des deux processus
11.1 Cas 1 : Essai randomisé contrôlé en psychothérapie cognitive et comportementale (TCC)
Pour appréhender l’impact différencié des deux concepts probabilistes dans la clinique appliquée, analysons l’architecture d’un essai randomisé contrôlé (ERC) classique évaluant une nouvelle thérapie cognitive et comportementale (TCC) ciblant le trouble obsessionnel-compulsif (TOC). Les chercheurs mènent un recrutement opportuniste au sein d’une clinique psychiatrique tertiaire hyperspécialisée : les patients inclus sont des volontaires adressés par des confrères, présentant des formes cliniques particulièrement chroniques, ayant un haut niveau d’éducation et exempts de troubles concomitants de l’usage de substances. L’échantillon final de 80 sujets est donc tout sauf aléatoire ; il s’agit d’un échantillon hautement filtré, non représentatif de la mosaïque des patients TOC suivis en médecine générale.
Toutefois, une fois ce recrutement achevé, les investigateurs déploient une randomisation stratifiée par blocs hautement rigoureuse, allouant 40 patients à la TCC innovante et 40 patients à une thérapie de soutien non directive sous double aveugle pour les évaluateurs indépendants. Au terme du protocole, les patients du bras TCC affichent une régression de 45 % de leur score sur l’échelle Y-BOCS, contre seulement 12 % dans le groupe témoin, avec une valeur $p < 0,001$. Grâce à l'assignation aléatoire, la validité causale interne de cette découverte est inattaquable : la TCC spécifique a formellement provoqué la réduction des compulsions au sein de ce groupe de 80 patients.
Mais quelle est la validité externe d’un tel constat ? C’est ici que l’absence de sélection aléatoire initiale pèse de tout son poids méthodologique. Les psychiatres de secteur travaillant en centres médico-psychologiques (CMP) avec des populations précaires, souffrant de comorbidités addictives massives et affichant des niveaux de compliance fluctuants, ne peuvent présumer que la nouvelle TCC produira une telle magnitude d’efficacité dans leur patientèle quotidienne. L’effet causal est validé en laboratoire spécialisé, mais son extrapolation pragmatique demeure suspendue à des études d’effectivité ultérieures.
11.2 Cas 2 : Enquête épidémiologique nationale sur la prévalence des troubles dépressifs
Envisageons à présent le scénario méthodologique inverse : une vaste enquête épidémiologique nationale commanditée par l’Institut National de la Santé pour cartographier la prévalence réelle et les déterminants sociologiques des épisodes dépressifs majeurs dans la population générale. Les chercheurs mobilisent un échantillonnage aléatoire stratifié à plusieurs degrés : tirage probabiliste de 500 communes à travers le pays, suivi du tirage au sort nominatif de ménages dans les registres du recensement, aboutissant à un panel final de 15 000 participants représentatifs de la population nationale en termes de genre, d’âge, de précarité et de ruralité.
Les instruments psychométriques validés (tels que le PHQ-9) révèlent avec une très haute acuité statistique une prévalence dépressive de 9,8 % à l’échelle du territoire. L’analyse corrélationnelle met en lumière un lien statistique puissant : les personnes habitant des zones urbaines à haute densité présentent un risque relatif de dépression majoré de 35 % par rapport aux résidents ruraux, même après ajustement démographique. Grâce à la sélection aléatoire initiale irréprochable, la validité externe de ces constats descriptifs est absolue : les pouvoirs publics peuvent planifier les budgets de santé mentale sur la base de ces chiffres, qui reflètent incontestablement la réalité épidémiologique de la nation.
Cependant, en l’absence formelle de toute manipulation expérimentale et d’assignation aléatoire, l’affirmation selon laquelle « la densité urbaine cause l’augmentation de la dépression » est scientifiquement invalide. L’hypothèse contrefactuelle inverse de la dérive sociale (les individus génétiquement ou psychologiquement prédisposés à la dépression ont tendance à migrer préférentiellement vers les métropoles après des ruptures de vie) ne peut être réfutée par les données observationnelles. L’enquête nationale a une validité externe magistrale, mais sa validité interne relative à la causalité étiologique est structurellement nulle.
11.3 Cas 3 : Expérimentation en psychologie sociale sur les stéréotypes implicites
Le troisième cas paradigmatique prend racine dans les laboratoires de psychologie sociale expérimentale étudiant les biais implicites et la cognition automatisée. Une équipe universitaire recrute 120 étudiants de licence de psychologie inscrits à un cours d’introduction, via un système de gestion des participants en ligne offrant des crédits de formation obligatoires. Cet échantillon présente une homogénéité démographique caricaturale : 85 % de jeunes femmes de 19 à 22 ans, issues de classes moyennes à supérieures, urbaines et occidentales. Aucun tirage au sort probabiliste dans la société civile n’a présidé à leur recrutement.
Les participants sont accueillis dans des cabines d’expérimentation isolées acoustiquement et assignés aléatoirement par le logiciel expérimental à l’une des deux conditions d’amorçage : la condition expérimentale est exposée subliminalement pendant 17 millisecondes à des stimuli visuels d’appartenance à un groupe minoritaire stigmatisé, tandis que la condition témoin reçoit des stimuli neutres de forme géométrique. Immédiatement après, tous les participants accomplissent une tâche informatisée d’identification d’objets perçus comme des armes versus des outils. Les résultats démontrent avec une précision temporelle de l’ordre de la milliseconde que l’amorçage stochastique modifie significativement le seuil d’identification de l’objet.
L’assignation aléatoire permet d’isoler avec une rigueur absolue l’effet causal neurocognitif de l’amorçage sur la réactivité cérébrale au sein de ces étudiants dans l’espace hermétique du laboratoire. Cependant, la controverse épistémologique historique entourant ces recherches réside dans le saut qualitatif audacieux accompli par certains auteurs prétendant déduire de cette tâche sur écran informatisé les causes profondes des discriminations systémiques à l’embauche dans le monde entrepreneurial réel. L’absence conjointe de sélection aléatoire des sujets et de validité écologique de la tâche interdit formellement d’ériger cette démonstration de causalité en laboratoire en explication univoque des disparités structurelles au sein de la société globale.
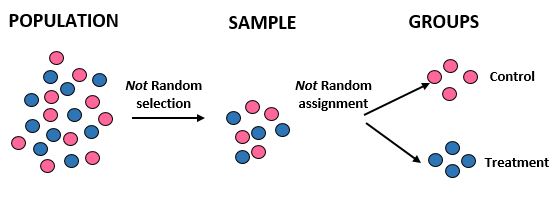
12. Synthèse critique, recommandations pour chercheurs et perspectives méthodologiques
12.1 Grille de décision pour la conception de protocoles de recherche
Pour clarifier la prise de décision opérationnelle lors de la conception d’un programme d’investigation en psychologie ou en épidémiologie comportementale, le chercheur doit articuler scrupuleusement ses choix méthodologiques à la nature précise de sa question théorique dominante. Si l’objectif principal de la recherche est l’estimation sans distorsion d’un paramètre populationnel, d’une prévalence clinique ou d’un réseau de covariations naturelles (visée descriptive ou exploratoire externe), les ressources financières et logistiques doivent être allouées prioritairement à la sélection aléatoire : construction rigoureuse de la base de sondage, stratification sociodémographique et politiques intensives de relance pour vaincre la non-réponse.
Si, à l’inverse, l’ambition centrale est l’isolation sans ambiguïté d’une relation de cause à effet, la démonstration de l’efficacité intrinsèque d’une molécule ou la validation d’un modèle contrefactuel de neuro-imagerie (visée explicative causale interne), l’assignation aléatoire devient le sanctuaire méthodologique absolu. Dans cette configuration, le chercheur peut tolérer un échantillon de convenance initialement circonscrit, à condition d’investir ses efforts dans l’étanchéité absolue de la procédure d’allocation : randomisation masquée (allocation concealment), préservation du double aveugle, minimisation des sorties d’essai et modélisation en intention de traiter.
L’arbre de décision méthodologique suivant résume la trajectoire conceptuelle que doivent emprunter les directeurs de recherche, les doctorants et les relecteurs pairs pour aligner légitimement leurs prétentions scientifiques avec le plan déployé :
- Question : Déterminer la prévalence ou décrire fidèlement un état de population ?
Exigence méthodologique : Priorité absolue à la Sélection aléatoire. L’assignation aléatoire est sans objet. Les conclusions sont formulées en termes d’estimations représentatives et de corrélations descriptives. - Question : Prouver formellement qu’un traitement X guérit ou transforme un comportement Y ?
Exigence méthodologique : Priorité absolue à l’Assignation aléatoire. Si la sélection aléatoire est impossible, assumer l’utilisation d’un échantillon non probabiliste et circonscrire les extrapolations à ce domaine écologique précis. - Question : Évaluer l’efficacité clinique à grande échelle d’une politique de santé mentale publique ?
Exigence méthodologique : Combinaison impérative de la Sélection aléatoire et de l’Assignation aléatoire (Essai communautaire pragmatique en grappes).
12.2 Recommandations pour la rédaction scientifique et la transparence des données
L’assainissement de la littérature scientifique en sciences du comportement exige une adhésion inconditionnelle aux lignes directrices internationales de transparence méthodologique. Pour la rédaction de tout essai randomisé, les chercheurs sont tenus d’appliquer rigoureusement la grille standardisée des déclarations CONSORT (Consolidated Standards of Reporting Trials). La section méthode doit décrire avec une clarté désarmante le type précis de randomisation mobilisé (simple, par blocs, stratifiée ou adaptative), la méthode concrète de génération de la séquence stochastique, ainsi que les mesures techniques empêchant les investigateurs cliniques d’anticiper l’attribution des sujets (systèmes d’allocation vocale ou serveurs web sécurisés distants).
Symétriquement, les investigations basées sur des cohortes observationnelles ou des enquêtes probabilistes de terrain doivent se conformer aux standards de la grille STROBE (Strengthening the Reporting of Observational Studies in Epidemiology). Les auteurs doivent détailler exhaustivement la structure de leur base d’échantillonnage, expliciter les taux d’abandon et les motifs précis des non-réponses à chaque étape du tirage, et publier en annexe les coefficients de pondération statistique déployés pour rectifier les asymétries de représentativité démographique.
Enfin, la lutte contre les biais de publication et les « degrés de liberté de l’expérimentateur » (p-hacking, sélection opportuniste des critères d’évaluation basaux) passe impérativement par la généralisation du pré-enregistrement (preregistration) systématique des protocoles sur des plateformes institutionnelles ouvertes telles que l’Open Science Framework (OSF) ou ClinicalTrials.gov. En figeant publiquement le plan d’échantillonnage et l’algorithme d’assignation avant l’inclusion du tout premier sujet humain, les chercheurs apportent la preuve formelle que les résultats empiriques observés ne procèdent pas d’une manipulation post-hoc des données, restaurant la confiance collective dans l’intégrité de la méthode scientifique.
12.3 Évolution méthodologique : Big Data, intelligence artificielle et nouveaux défis
L’avènement de l’ère du Big Data, des données massives comportementales issues des plateformes numériques et des modèles prédictifs d’intelligence artificielle a suscité l’illusion chez certains technologues que la taille astronomique des ensembles de données rendrait désormais obsolète la théorie probabiliste classique de l’échantillonnage et de la causalité. Cette croyance naïveté relève d’un mythe épistémologique absolu. Un milliard de données numériques recueillies via des comportements de navigation sur internet ou des interactions sur les réseaux sociaux ne constituent en rien un échantillon représentatif de l’humanité : elles agrègent des biais d’auto-sélection incommensurables, surreprésentant les utilisateurs actifs, les classes ultra-connectées et les algorithmes générateurs de flux artificiels (bots).
Comme l’a formellement démontré le statisticien Xiao-Li Meng dans ses analyses de la « loi des grands volumes sans représentativité », lorsque des données souffrent d’un biais de sélection même infinitésimal au départ, l’augmentation exponentielle de la taille de l’échantillon $N$ ne réduit pas l’erreur : elle l’amplifie paradoxalement en écrasant artificiellement la variance d’erreur, conférant des intervalles de confiance d’une étroitesse infime autour d’une estimation totalement fausse. Un échantillon aléatoire pur de seulement 1 000 individus offre une prédiction sociologique infiniment plus fiable et valide qu’une base de données non probabiliste de 50 millions d’utilisateurs captés sur des téléphones intelligents.
Dans le même temps, le secteur technologique numérique a paradoxalement redécouvert la puissance absolue de l’assignation aléatoire à travers le déploiement généralisé des tests A/B en ligne. En randomisant des millions d’utilisateurs entre deux interfaces cognitives ou algorithmes de recommandation, les géants du web exécutent sans cesse le paradigme de Fisher à une échelle planétaire. Aujourd’hui, la frontière la plus prometteuse réside dans la convergence computationnelle entre l’expérimentation randomisée pure et l’inférence causale par apprentissage automatique (causal machine learning, popularisé par Susan Athey et Judea Pearl). Ces nouveaux modèles apprennent à identifier automatiquement des sous-groupes hétérogènes d’efficacité au sein d’essais randomisés massifs, unissant le pouvoir souverain de la randomisation expérimentale aux capacités prédictives de l’intelligence artificielle pour fonder la psychologie de précision de demain.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Athey, S., & Imbens, G. W. (2017). The state of applied econometrics: Causality and policy evaluation. Journal of Economic Perspectives, 31(2), 3–32. https://doi.org/10.1257/jep.31.2.3
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally & Company.
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, family cars, and presidential elections. Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-AOAS1161SF
- Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: updated guidelines for reporting parallel group randomised trials. BMJ, 340, c869. https://doi.org/10.1136/bmj.c869
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pocock, S. J., & Simon, R. (1975). Sequential treatment assignment with balancing for prognostic factors in the controlled clinical trial. Biometrics, 31(1), 103–115. https://doi.org/10.2307/2529712
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. Lancet, 370(9596), 1453–1457. https://doi.org/10.1016/S0140-6736(07)61602-X